모터는 멈춘 뒤에야 고장을 알면 늦다. 생산 중단과 부품 손상이 이미 발생했기 때문이다. PHM(Prognostics and Health Management)은 온도·전류·진동처럼 설비가 내는 신호를 읽어 현재 상태를 진단하고, 이상이 커지는 추세를 감시하며, 가능하면 남은 수명까지 추정하는 일이다.
이 글은 2024년 학부 연구생으로 연구실 석사과정 연구원의 논문 작업을 지원하며 다룬 모터 진동 데이터와 당시 Python 코드를, 2026년 기준으로 다시 감사한 기록이다. 발표자료는 당시 전처리 실습을 복원하는 직접 자료로 사용했고, 「고장 진단에 대한 연구」 PDF는 PHM과 로봇 감속기 고장 진단의 배경을 이해하기 위한 참고자료로만 검토했다. 다만 원 데이터는 비공개이므로 수치와 그림을 공개 벤치마크 성능처럼 일반화하지 않는다.
먼저 결론: 당시 파이프라인은 대용량 CSV를 읽고 IQR 처리, 스케일링, PCA, t-SNE까지 수행한 유의미한 탐색이었다. 하지만 예쁜 2차원 군집만으로 고장 진단에 성공했다고 말할 수는 없다. 운전 조건과 측정 세션을 먼저 분리하고, 라벨 누수 없이 새 세션에서 성능을 확인해야 비로소 진단 모델이 된다.
#PHM을 처음 보는 사람을 위한 설명
회전 장치의 베어링이나 기어에 손상이 생기면 마찰과 충격의 양상이 달라진다. 센서는 이 변화를 시간에 따른 진동값으로 기록한다. 우리가 해야 할 일은 큰 숫자를 찾는 것이 아니라, 운전 속도와 하중이 바뀌어도 반복되는 고장 특유의 패턴을 찾는 것이다.
설비와 운전 조건
  ↓
센서 수집 ── 시간 파형 ── RMS·Peak·Crest factor
  │                         └─ 진동의 크기와 충격성
  └──────── FFT/주파수 특징 ── 회전·기어·베어링 성분
                              ↓
                    상태 진단 / 이상 감지 / 수명 예측
PHM은 세 문제를 포함한다.
| 질문 | 과업 | 이 실험에서의 위치 |
|---|---|---|
| 지금 정상인가? | 이상 감지 | PCA와 t-SNE로 구조를 먼저 탐색 |
| 무엇이 고장 났는가? | 고장 분류·진단 | 별도의 라벨과 검증 모델이 필요 |
| 언제까지 쓸 수 있는가? | 예지·잔여수명 추정 | 열화 시간축이 없어 아직 수행하지 않음 |
따라서 이 글의 결과는 엄밀히 말해 고장 예지 전체를 완성한 결과가 아니라, 진동 데이터 진단을 준비한 탐색과 전처리 연구다.
#실험 자료에서 복원한 데이터 구조
발표자료에는 SVS 40 진동 센서 한 행이 다음 특징으로 구성됐다고 기록돼 있다.
| 특징 묶음 | 개수 | 쉽게 말하면 |
|---|---|---|
| Time Peak | 1 | 관측 구간에서 가장 큰 진폭 |
| Time RMS | 1 | 진동 에너지의 대표 크기 |
| Crest Factor | 1 | Peak / RMS, 순간 충격이 얼마나 뾰족한지 표현 |
| Time Data | 2,048 | 시간 순서대로 측정한 원 파형 |
| FFT Data | 1,024 | 파형을 주파수별 성분으로 바꾼 값 |
| 합계 | 3,075 | 설정·라벨 열을 제외한 센서 특징 |
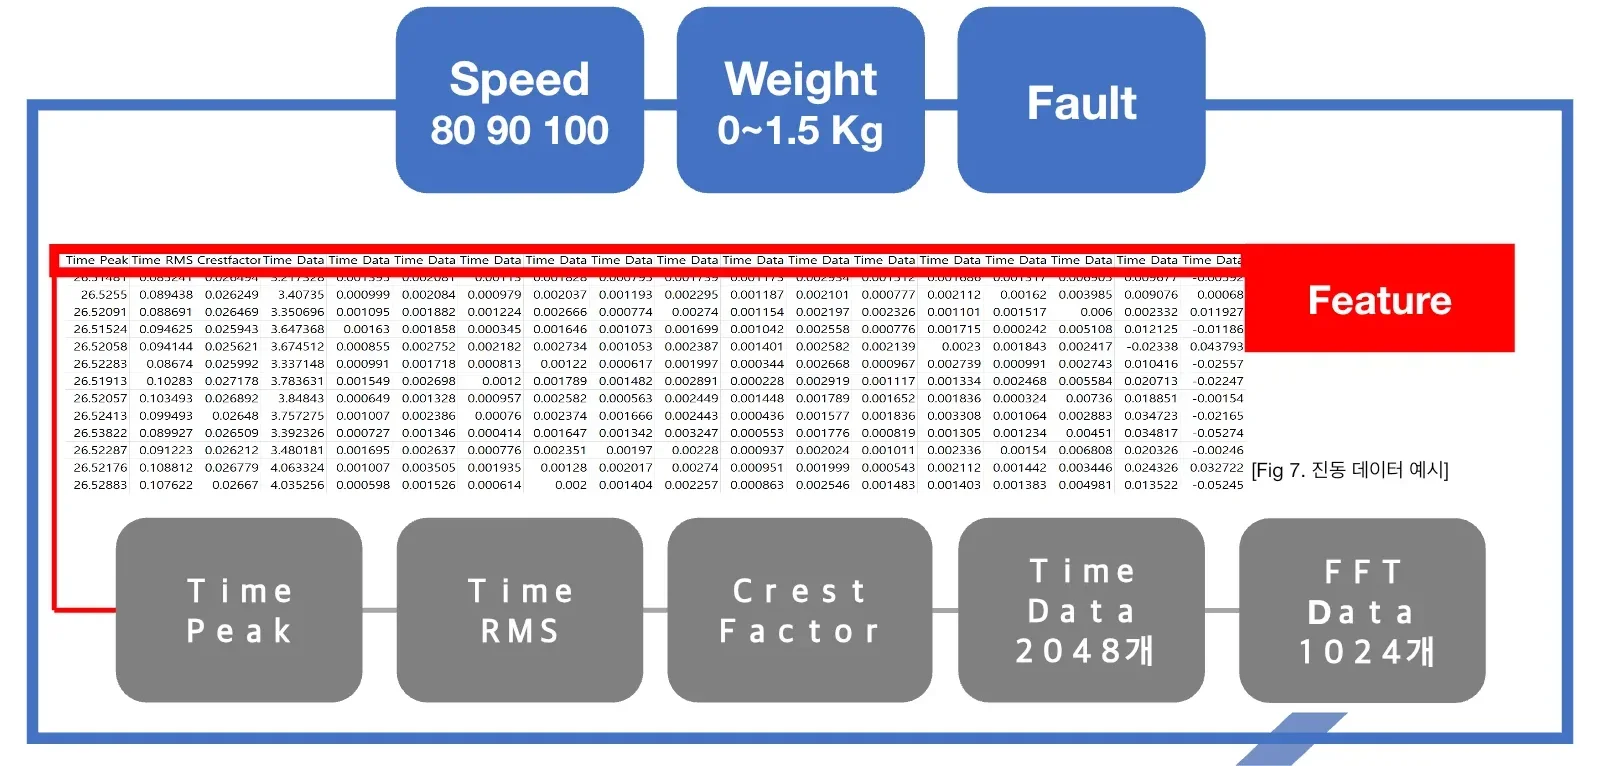
그림: 2024년 2월 6일 AML 연구실 발표자료 10쪽을 웹용으로 변환했다. 속도 80·90·100, 하중 0~1.5 kg, 고장 조건과 3,075개 특징의 관계를 보여 준다.
여기서 속도와 하중은 단순한 부가 정보가 아니다. 정상 모터도 속도가 빨라지거나 하중이 커지면 진동 분포가 바뀐다. 모델이 고장이 아니라 속도 100을 외워도 훈련 데이터에서는 잘 맞을 수 있다. 그러므로 최소한 다음 축을 따로 기록해야 한다.
- 센서 위치와 센서 ID
- 회전 속도와 하중
- 정상·고장 상태와 가능한 고장 종류
- 측정 날짜, run 또는 session ID
- sampling rate, window 길이와 overlap
- 장비 교체·재장착·gain 변경 여부
#참고 논문은 이 실험의 원문이 아니다
아니다. 「고장 진단에 대한 연구」는 당시 연구실 석사과정 연구원의 논문 작업과 관련된 참고 문서다. 사용자는 학부 연구생으로 그 연구를 지원했지만, 이 PDF의 연구 전체를 본인의 단독 연구 성과로 제시하지 않는다. 문서는 산업용 로봇의 하모닉 드라이브를 대상으로 정상, 플렉스 스플라인 결함, 백래시 조건을 다루고 진동 센서와 3축 가속도 센서를 비교한다.
반면 이 글의 Python 파일과 발표자료는 H, B, F 같은 센서 그룹과 속도·하중을 파일명에서 읽는 별도 전처리 실습의 직접 자료다. 따라서 PDF는 PHM 실험 설계를 이해하기 위한 참고자료, 발표자료와 코드는 사용자가 당시 지원하며 수행한 전처리·탐색 작업의 직접 증거로 구분했다. 두 자료의 실험 조건과 라벨도 하나의 데이터셋처럼 합치지 않았다.
#진동 특징을 물리적으로 읽는 법
#RMS: 전체적인 진동 에너지
길이가 N인 파형 x의 RMS는 다음과 같다.
RMS = sqrt((x₁² + x₂² + ... + xₙ²) / N)RMS가 커지면 진동 에너지가 증가했다고 볼 수 있지만, 곧바로 고장이라고 결론 내릴 수는 없다. 속도와 하중 증가도 RMS를 올릴 수 있기 때문이다. 정상 상태의 운전 조건별 기준선과 비교해야 한다.
#Peak와 Crest Factor: 순간 충격 찾기
Peak는 구간 안의 최대 절댓값이고 Crest Factor는 Peak / RMS다. 반복적인 충격이 생기는 결함은 RMS가 크게 변하기 전에 Crest Factor가 먼저 민감해질 수 있다. 반대로 센서가 책상에 부딪히거나 케이블 접촉이 나빠도 한 번의 큰 Peak가 생긴다. 큰 값의 원인이 설비인지 측정 오류인지 시간 파형에서 확인해야 한다.
#FFT: 어디에서 반복되는가
FFT는 시간 파형을 주파수별 진폭으로 바꾼다. 회전 주파수, 기어 맞물림 주파수, 베어링 결함 주파수와 그 배수 성분을 비교할 수 있다. 그러나 FFT bin 1,024개를 그대로 넣기 전에 sampling rate와 window 길이를 알아야 각 bin을 실제 Hz로 환산할 수 있다. 이 메타데이터가 없으면 그래프는 그릴 수 있어도 물리적인 해석은 제한된다.
#당시 Python 코드가 실제로 한 일
| 단계 | 확인한 구현 | 잘한 점 | 다시 고칠 점 |
|---|---|---|---|
| 입력 점검 | read_csv(..., chunksize=1000)으로 행 수와 메모리 누적 | 16GB급 파일을 한 번에 읽는 위험을 인식 | 청크를 다시 전부 결합하면 peak memory가 커짐 |
| 스키마 부여 | 별도 Excel의 열 이름을 CSV에 적용 | 이름 없는 센서 열에 의미 부여 | 열 개수·dtype·단위 검증이 없음 |
| 메타데이터 | 파일명에서 sensor·speed·weight 파싱 | 운전 조건을 자동 연결 | 잘못된 파일명을 조용히 허용할 수 있음 |
| 특징 조합 | 전체, FFT만, FFT+Peak/RMS/Crest Factor 비교 | 특징 묶음별 영향 비교를 시도 | 조건별 결과표와 selection 기준이 남아 있지 않음 |
| 이상치 | 행별 Time/FFT 구간에 1.5×IQR clipping | 극단값 영향 비교 | 실제 고장 impulse도 잘라낼 수 있음 |
| 스케일링 | MinMaxScaler, StandardScaler, 미적용 비교 | 전처리 선택을 실험 변수로 둠 | 전체 데이터에 먼저 fit하면 test 누수 |
| 차원 축소 | PCA 99% 또는 12개 component, t-SNE 2D | 고차원 구조를 탐색 | label 혼입 가능성, seed·표본화 기록 부족 |
발표자료의 결론은 “데이터 종류에 따라 scaling과 이상치 제거가 오히려 특징을 저하시킬 수 있다”였다. 이 판단은 중요한 출발점이다. 전처리는 무조건 많이 적용한다고 좋아지는 것이 아니라, raw / clipped / standardized / normalized를 동일한 데이터 분할에서 비교해 선택해야 한다.
원본과 정리된 코드는 아래에서 확인할 수 있다. 원본은 당시 절대경로와 실험 흔적을 보존한 archive이며, 바로 실행되는 package로 오해하면 안 된다.
#세 결과 그림을 다시 판독하기
#라벨 누수를 의심해야 하는 PCA
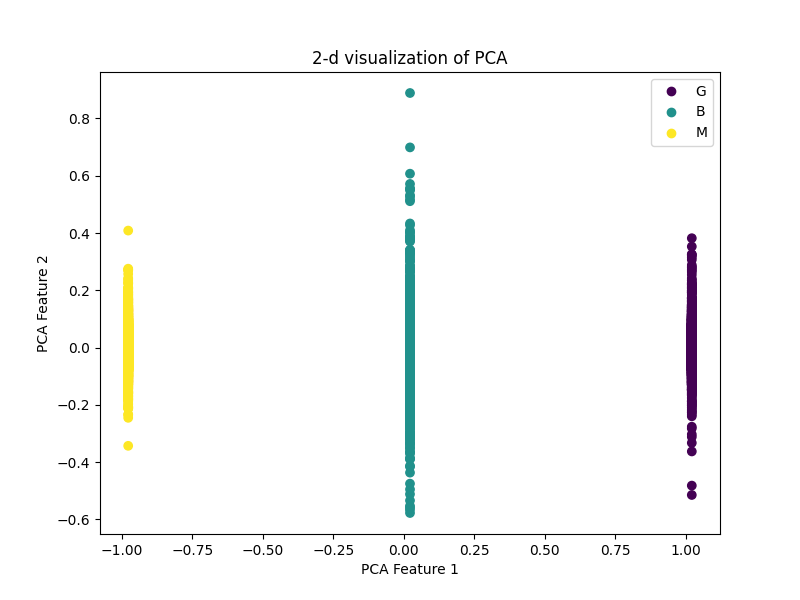
G/B/M 세 그룹이 첫 축의 -1, 0, 1 부근에 정확히 놓인다. 자연스러운 진동 특징이 이렇게 세 수직선을 만들었다고 보기 어렵다. 범주형 라벨을 숫자로 바꾼 열이나 라벨을 직접 반영한 열이 PCA 입력에 남았을 가능성이 크다.
이 그림은 좋은 분류 결과가 아니라 target leakage를 알려 주는 실패 증거다. PCA에 넣는 행렬은 센서 특징만 포함하고, label·sensor·speed·weight는 색상과 검증 그룹을 지정하는 메타데이터로만 사용해야 한다.
#센서 특징을 사용한 PCA
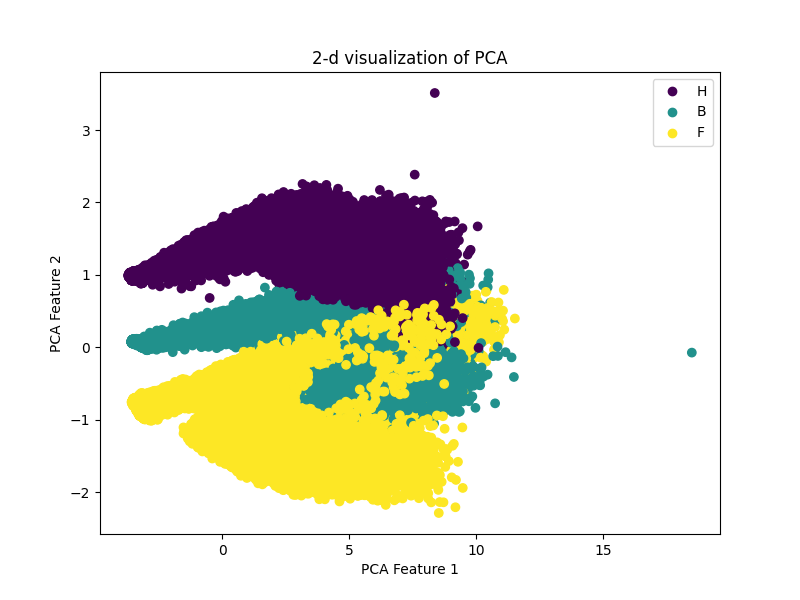
H, B, F가 서로 다른 곡선 영역을 만들지만 경계에서는 겹친다. PCA는 클래스를 분리하는 알고리즘이 아니라 전체 분산이 큰 직교 방향을 찾는다. 이 분리가 센서 장착 위치, gain, 속도·하중 또는 실제 고장 패턴 중 무엇에서 왔는지는 그림 하나로 알 수 없다.
다음 두 대조 그림이 필요하다.
- 같은 속도·하중 안에서 센서 또는 상태를 비교한다.
- 같은 센서·상태 안에서 속도와 하중을 비교한다.
첫 번째 주성분의 설명 분산 비율이 약 0.7861이었다는 기록도 “고장을 78.61% 설명했다”는 뜻이 아니다. 입력 변수 전체의 표본 분산 중 78.61%가 그 선형축에 놓였다는 뜻이다. 고장에 중요한 작은 충격 신호는 저분산 방향에 남을 수도 있다.
#t-SNE는 지도이지 성적표가 아니다
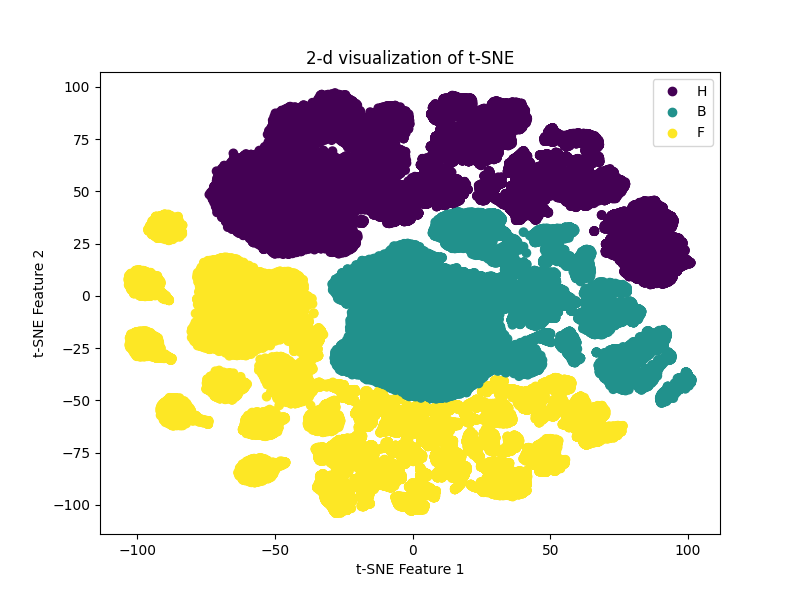
t-SNE에서는 세 그룹이 여러 섬처럼 갈라진다. t-SNE는 가까운 이웃을 2차원에서도 가깝게 보이도록 최적화하므로, 멀리 떨어진 섬 사이의 거리나 축의 숫자를 물리량처럼 읽으면 안 된다. perplexity, seed, learning rate와 표본 선택이 바뀌면 모양도 달라질 수 있다.
따라서 이 그림이 말할 수 있는 범위는 “일부 국소 이웃 구조가 다를 가능성이 있다”까지다. 새 측정 세션을 분리한 분류 성능이나 이상 탐지 성능을 대신하지 않는다.
#가장 위험한 함정: 행 단위 무작위 분할
진동 데이터는 한 번의 연속 측정을 짧은 window 여러 개로 나누는 경우가 많다. 바로 옆 window는 거의 같은 운전 상태와 노이즈를 공유한다. 이를 행 단위로 무작위 분할하면 같은 측정의 쌍둥이 조각이 train과 test에 동시에 들어간다.
잘못된 분할
session A: [window 1 → train] [window 2 → test] [window 3 → train]

권장 분할
train: session A, B, C
valid: session D
test : session E  ← 전처리 선택과 튜닝이 끝날 때까지 봉인
같은 모터를 반복 측정했다면 GroupKFold의 group을 session 또는 run으로 둔다. 실제 배포에서 다른 모터에도 적용할 목적이라면 더 강하게 motor ID 단위로 분리해야 한다.
#IQR 이상치 처리를 다시 설계한다면
IQR 범위는 Q1 - 1.5×IQR부터 Q3 + 1.5×IQR까지다. 발표자료와 코드는 이 범위를 벗어난 값을 경계값으로 바꾸는 capping을 사용했다. 일반 표 데이터에서는 합리적인 기준이지만 진동에서는 극단값 자체가 결함 충격일 수 있다.
- 센서의 측정 한계와 saturation을 먼저 확인한다.
- spike가 한 번뿐인지, 회전마다 주기적으로 반복되는지 본다.
- FFT, envelope spectrum 또는 order spectrum에서 대응 성분을 찾는다.
- raw, IQR-capped, robust-scaled 조건을 같은 split에서 비교한다.
- test 결과를 본 뒤 처리 규칙을 바꾸지 않는다.
즉 “box plot 밖에 있다”는 통계적 사실과 “센서 노이즈다”라는 공학적 판단은 서로 다르다.
#재현 가능한 파이프라인으로 바꾸기
from pathlib import Path
import pandas as pd
from sklearn.decomposition import IncrementalPCA
from sklearn.preprocessing import StandardScaler

META = ["sensor", "speed", "weight", "session_id", "condition"]

def iter_chunks(paths: list[Path], schema: list[str], chunksize: int = 10_000):
    for path in paths:
        labels = parse_and_validate_filename(path.name)
        for chunk in pd.read_csv(path, header=None, names=schema, chunksize=chunksize):
            if len(chunk.columns) != len(schema):
                raise ValueError(f"schema mismatch: {path.name}")
            yield chunk.assign(**labels)

# 1. 행이 아니라 측정 session을 먼저 나눈다.
train_files, valid_files, test_files = split_by_session(all_files)

# 2. scaler와 PCA는 train으로만 학습한다.
scaler = StandardScaler()
ipca = IncrementalPCA(n_components=12, batch_size=10_000)

# 3. valid에서 전처리와 모델을 선택한 뒤 test는 한 번만 평가한다.
대용량 처리의 핵심은 chunksize라는 옵션 자체가 아니다. 각 청크를 읽고 다시 거대한 DataFrame으로 합치면 메모리 절감 효과가 사라진다. 통계량은 스트리밍으로 누적하고, IncrementalPCA는 청크별 partial_fit, 결과는 Parquet 같은 열 지향 형식으로 나눠 저장해야 한다.
#다음 실험에서 만들어야 할 그림
| 그림 | 무엇을 확인하는가 | 오해 방지 장치 |
|---|---|---|
| raw waveform + 확대 구간 | 충격의 크기와 반복성 | 동일 y축, 속도·하중 표기 |
| FFT 또는 PSD | 반복 성분의 주파수 | sampling rate와 Hz 축 명시 |
| RMS·Crest Factor 분포 | 조건별 에너지·충격성 | session별 점을 함께 표시 |
| PCA score + loading | 분산 구조와 기여 특징 | label 열 제외, 설명 분산 병기 |
| t-SNE/UMAP | 국소 이웃 탐색 | seed·표본 수·파라미터 기록 |
| confusion matrix | 어떤 고장을 혼동하는가 | 완전히 분리한 test session 사용 |
| 시간별 경보 그래프 | 현장 false alarm과 탐지 지연 | threshold 결정 구간 분리 |
정확도 하나만 보고하지 않는다. 고장 샘플이 적다면 PR-AUC와 class별 recall을 함께 보고, 현장 적용을 생각한다면 시간당 오경보 수와 고장 전 탐지 지연도 측정해야 한다.
#재실험 체크리스트
- 열 이름, 단위, sampling rate를 데이터 사전에 고정
- sensor·motor·run·session ID를 파일 내용과 함께 저장
- 정상·고장·속도·하중 조합별 표본 수 확인
- 결측값, 무한값, 상수열, 중복 window 감사
- train/valid/test를 session 또는 motor 단위로 먼저 분리
- scaler·PCA·특징 선택을 train에만 fit
- 속도·하중만으로 예측하는 confounder baseline 측정
- raw와 IQR 처리 조건을 같은 split에서 비교
- PCA loading과 주파수의 물리적 의미 확인
- t-SNE seed·perplexity·표본 선택 기록
- accuracy 외 class별 precision·recall·F1·PR-AUC 보고
- 라이브러리 버전, seed, 실행 명령과 결과표 보존
#이 작업에서 확인한 것과 아직 모르는 것
확인한 것은 SVS 40 기반 3,075개 특징 구조, 속도·하중 조건, IQR·scaling·feature set 비교 계획, PCA·t-SNE 코드와 과거 산출물이다. 아직 모르는 것은 정확한 sampling rate, 각 숫자 라벨의 물리적 단위, H/B/F 센서 위치의 공식 정의, session 경계, 최종 고장 클래스 매핑이다.
이 정보가 복원되기 전에는 “모터 고장을 정확히 분류했다”는 표현을 사용하지 않는다. 지금 단계의 올바른 결론은 데이터 구조를 복원했고, 기존 시각화의 누수 가능성과 검증 공백을 찾았으며, 재실험 가능한 절차를 정의했다는 것이다.
#자료와 참고 원문
- 내부 자료: 「인공지능 데이터 전처리」, 한국공학대학교 AML 연구실 세미나 발표자료, 2024-02-06.
- 참고자료: 연구실 석사과정 연구원의 논문 작업 관련 문서, 「고장 진단에 대한 연구」, 69쪽. 사용자는 당시 학부 연구생으로 연구를 지원했으며, 이 글에서는 하모닉 드라이브 고장 유형과 센서·검증 설계를 이해하는 참고자료로만 사용했다.
- scikit-learn PCA
- scikit-learn IncrementalPCA
- scikit-learn common pitfalls: inconsistent preprocessing and data leakage
- Case Western Reserve University Bearing Data Center
- Paderborn University Bearing Data Center
공개 데이터로 같은 파이프라인을 재실행할 때는 원 데이터 라이선스와 정확한 인용 정보를 별도 기록하고, 이 비공개 실험의 결과와 직접 점수 비교하지 않는다.