#1. 오늘의 레이더: ‘더 자유롭게 채우기’가 항상 더 좋은 추론은 아니다
문장을 왼쪽에서 오른쪽으로 한 단어씩 쓰는 언어 모델은 익숙하다. 그런데 확산 언어 모델(diffusion language model, dLLM)은 문장 곳곳의 빈칸을 함께 보고, 자신 있는 빈칸부터 메우는 방식도 쓸 수 있다. 겉으로 보면 더 자유롭고 더 빠를 법하다. 2026년 ICML Outstanding Paper로 선정된 JustGRPO 연구는 바로 이 직관을 시험했다.[1]
결과는 의외다. 수학과 코드 문제처럼 답안의 논리 전개가 중요한 과제에서는, 빈칸을 아무 순서로 채우게 한 학습보다 왼쪽에서 오른쪽으로 답안을 완성하게 한 학습이 더 다양한 풀이를 남기고 높은 성과를 냈다고 연구진은 보고한다.[2] 논문의 요지는 “확산 LLM이 틀렸다”가 아니다. 모델이 답을 만드는 순서와, 그 순서에서 보상을 주는 방식이 추론의 폭을 바꿀 수 있다는 것이다.
이 글은 상을 받았다는 사실을 성능의 보증서로 읽지 않는다. ICML 공식 발표는 이 논문을 Outstanding Paper로 명시한다.[1] 하지만 그 상이 모든 언어 과제에서 왼쪽부터 쓰기가 우월하다고 증명하는 것은 아니다. 저자들의 공개 실험은 세 dLLM 계열과 네 수학·코드 벤치마크를 중심으로 한다.[2] 사람의 사고 과정, 창작 글쓰기, 실제 제품의 비용과 안전성까지 검증한 결과는 아니다.
먼저 남겨 둘 한 문장은 이렇다. JustGRPO는 AI가 스스로 진화했다는 이야기가 아니라, 이미 있는 확산 언어 모델을 보상으로 훈련할 때 ‘어떤 순서로 답안을 만들게 할지’를 단순하게 바꿔 본 연구다. 그 단순한 변경이 왜 중요한지, 언어 모델을 처음 접하는 독자도 따라갈 수 있게 차례로 풀어 보자.
#2. 언어 모델은 문장을 어떻게 ‘만드는가’
언어 모델은 문장을 통째로 떠올리는 기계라기보다, 글을 잘게 나눈 조각인 토큰(token)의 다음 선택을 예측하는 모델이다. 토큰은 꼭 한 단어와 같지 않다. 한글 어절의 일부, 영어 단어의 일부, 기호가 될 수도 있다. 여기서는 이해를 위해 토큰을 단어 조각이라고 생각해도 충분하다.
가장 익숙한 방식은 자기회귀(autoregressive, AR)다. “비가 오므로 우산을 ___”이라는 문장을 만들 때 앞에서 쓴 내용 뒤에 올 토큰 하나를 고르고, 그 선택을 문맥으로 삼아 다음 토큰을 고른다. 말하자면 왼쪽 끝에서 오른쪽 끝으로 한 칸씩 쓰는 방식이다. 앞부분의 선택이 뒤의 선택을 제한하므로, 과정이 자연스럽게 한 줄로 이어진다.
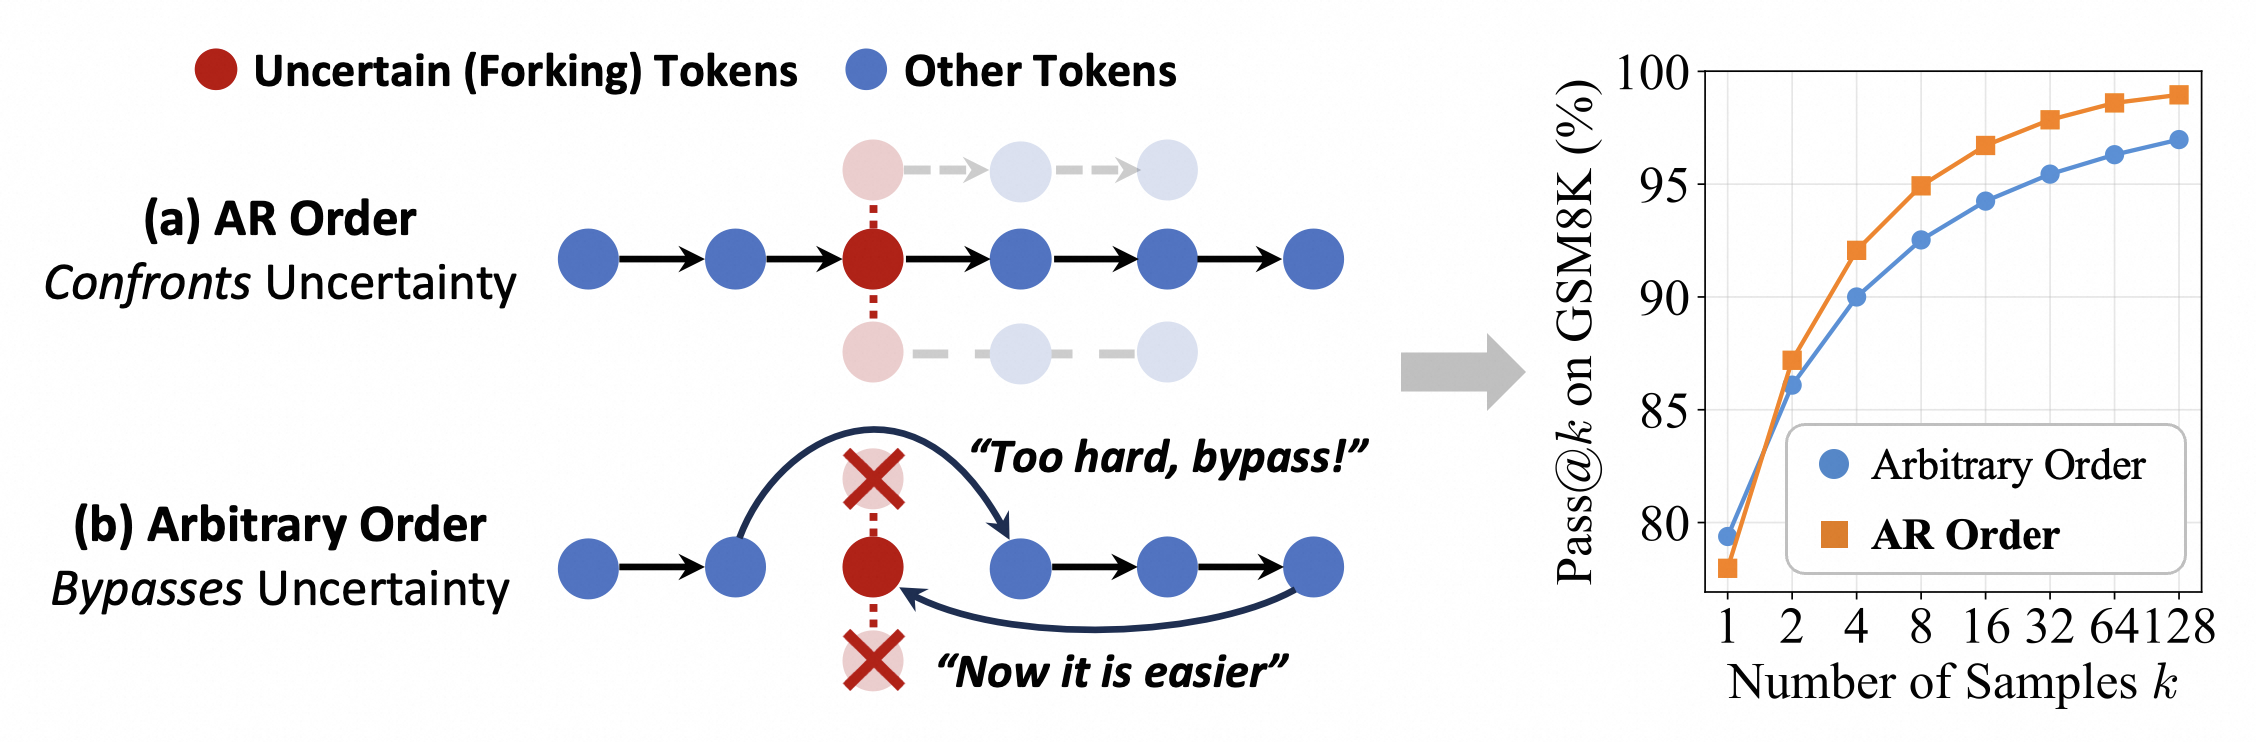
확산 언어 모델은 출발점이 다르다. 문장의 여러 위치를 가린 상태에서 시작해 가려진 위치를 반복해서 복원할 수 있다. 예를 들어 “비가 ___ 우산을 챙겼다”에서 온다를 먼저 채울 수도 있고, 뒤쪽 표현을 먼저 확정한 다음 중간을 메울 수도 있다. 여러 칸을 병렬로 다룰 수 있다는 점은 긴 문장을 빠르게 복원할 수 있는 가능성을 준다. 이 글에서 말하는 임의 순서(arbitrary order, AO)는 이런 복원 위치를 매 단계 자유롭게 고르는 경우를 가리킨다.[2]
여기서 흔한 오해가 하나 있다. AR은 ‘생각을 잘하는 모델’, dLLM은 ‘생각을 못하는 모델’이라는 구분이 아니다. 둘은 문장을 생성하는 경로의 차이다. dLLM도 특정한 순서를 강제해 AR처럼 토큰을 하나씩 만들 수 있고, AR 모델도 여러 답안을 뽑아 비교할 수 있다. JustGRPO의 질문도 “어느 모델이 더 똑똑한가”가 아니라, 같은 dLLM에서 훈련 중 생성 순서를 달리하면 무엇이 달라지는가다.
처음 보는 용어는 여기서 잠깐
- 생성(generation): 모델이 빈칸을 채워 답안을 만드는 과정이다.
- 추론(reasoning): 이 글에서는 정답으로 가는 중간 선택과 논리 전개를 넓게 뜻한다. 사람이 실제로 머릿속에서 하는 사고를 완전히 측정했다는 뜻은 아니다.
- 확률: 모델은 다음 토큰 후보마다 ‘그럴 법함’을 수치로 낸다. 높은 확률은 사실 판정이나 진실 보증이 아니라, 학습한 데이터와 문맥에서 더 자주 맞았던 선택이라는 뜻이다.
- 마스크(mask): 아직 채우지 않은 토큰 자리를 가리는 표시다. 확산 모델은 마스크를 반복적으로 줄이며 문장을 완성한다.
#3. 왜 ‘아무 순서’가 오히려 길을 좁힐 수 있나
수학 풀이를 적는 상황을 생각해 보자. “식에 x=3을 넣으면 12가 된다. ___ 따라서 답은 12다.”라는 문장에서 따라서, 그러므로, 왜냐하면 같은 연결어는 짧지만 중요하다. 앞뒤의 논리 관계를 정한다. 이 자리에 무엇을 놓느냐에 따라 이후의 설명이 자연스럽게 이어질 수도, 억지로 이어 붙일 수도 있다.
저자들은 임의 순서 복원이 이런 불확실하지만 논리적으로 갈라지는 토큰을 뒤로 미루기 쉽다고 본다. 확신이 높은 숫자나 자주 쓰는 표현부터 먼저 채우면, 나중에 남은 연결어는 이미 정해진 문장의 틀에 끼워 맞춰야 한다. 연구진은 Therefore, Thus, Since 같은 예를 들며, 이런 조기 우회가 해법의 다양성을 줄일 수 있다고 설명한다.[2][3]
중요한 것은 “연결어가 어려우니 항상 먼저 써야 한다”가 아니다. 이 연구의 주장과 관찰은 현재의 dLLM 샘플링·보상 학습 조건에서 그렇다는 것이다. 문장 중간부터 써도 더 잘 맞는 작업은 얼마든지 있을 수 있다. 빈칸 채우기, 편집, 병렬 초안 생성처럼 뒤쪽 문맥이 앞쪽 선택을 도와주는 작업이 그렇다. 이번 결과를 모든 언어 생성 방식의 규칙으로 일반화하면 안 된다.
그렇다면 연구진은 ‘다양성’을 어떻게 보았을까. 핵심 지표가 Pass@k다. 같은 문제에 답안 하나만 뽑아 맞으면 Pass@1이다. 답안 k개를 독립적으로 뽑았을 때 그중 하나라도 맞으면 Pass@k다. 수학이나 코드에서는 하나의 답이 틀렸더라도 다른 시도가 맞을 수 있으므로, Pass@k는 모델이 서로 다른 유효 경로를 얼마나 남기는지 살피는 한 방법이 된다.
예를 들어 코드 문제에 대해 모델이 네 개의 서로 비슷한 답만 계속 만든다면, 네 번의 기회가 있어도 같은 실수를 반복할 수 있다. 반대로 서로 다른 접근을 네 개 만들면 한 접근이 테스트를 통과할 가능성이 생긴다. Pass@k가 높다고 답안 한 개의 품질이나 안전성이 자동으로 좋아지는 것은 아니다. 그러나 여러 시도를 허용하는 사용 환경에서 해법 공간이 얼마나 빨리 좁아지는지는 보여 줄 수 있다.
프로젝트 페이지가 소개한 HumanEval 실험에서는 AR 순서로만 생성한 경우 Pass@1024가 21.3%, AO 순서로만 생성한 경우 0.6%였다.[2] 이 수치는 1,024번 뽑아 하나라도 통과한 문제의 비율이라는 특정 조건의 결과다. 일상 대화의 정답률도 아니고, 한 번 생성할 때의 성공률도 아니다. 숫자를 크게 보이게 하는 장식으로 읽기보다, 생성 순서가 해법의 폭을 크게 바꿀 수 있다는 관찰으로 읽는 편이 정확하다.
#4. 실험은 무엇을 같은 조건에서 비교했나
이 논문은 LLaDA-Instruct, Dream-Instruct, LLaDA 1.5라는 세 dLLM 계열을 대상으로, 수학 두 종류와 코드 두 종류의 과제를 비교했다고 설명한다.[2] GSM8K는 문장으로 된 학교 수준 수학 문제, MATH-500은 더 어려운 수학 문제 집합이다. HumanEval과 MBPP는 프로그램을 작성하고 테스트로 맞는지 평가하는 코드 벤치마크다. 네 이름을 외울 필요는 없다. 앞의 둘은 계산과 풀이 전개, 뒤의 둘은 실행 가능한 코드라는 차이를 기억하면 된다.
연구의 중심 비교는 간단하다. 하나의 dLLM을 보상 학습할 때, 답안의 마스크를 AR 순서로 풀게 하는가, 아니면 AO 순서로 풀게 하는가다. 이때 AO가 고정된 무작위 순서만을 뜻하는 것은 아니다. 확산 모델이 각 빈칸을 얼마나 자신 있게 채울 수 있는지 보고 다음 위치를 택하는 방식이 포함될 수 있다. 그래서 이 논문은 단순히 ‘왼쪽부터 쓴 문장’과 ‘순서를 섞은 문장’만 비교한 것이 아니라, 보상 학습 과정에서 어떤 경로를 모델이 더 자주 경험하는가를 비교한다.
이 구분은 실험을 읽을 때 특히 중요하다. 한 논문의 표에서 어떤 방법이 높다고 해서, 그 방법의 이름만 바꾸면 모든 모델에서 같은 효과가 난다는 뜻은 아니다. 기반 모델, 학습 데이터, 보상 판정, 생성 길이, 샘플 수, 계산 예산이 함께 결과를 만든다. 저자 저장소도 결과 표와 함께 학습·평가 코드, 모델 체크포인트를 공개한다.[3] 이 점은 결과를 독립적으로 재현·검토할 출발점이 있다는 장점이다. 반대로 공개 코드가 있다는 사실만으로 다른 장비와 다른 데이터에서 재현됐다고 결론 내릴 수는 없다.
#5. JustGRPO가 바꾼 한 가지: 학습 중에는 한 줄로 답안을 만든다
이름이 어렵지만 변화는 비교적 작다. GRPO(Group Relative Policy Optimization)는 같은 질문에 대해 여러 답안을 만든 뒤, 그 답안들을 서로 비교해 상대적으로 좋은 답을 더 자주 만들도록 모델의 확률을 조정하는 보상 학습 계열이다. 수학 문제라면 최종 답이 맞는지, 코드라면 테스트를 통과하는지 같은 판정이 보상이 될 수 있다. 누군가 답안을 직접 한 문장씩 채점해 주는 방식만을 뜻하지는 않는다.
JustGRPO는 이 학습에서 dLLM에게 “빈칸을 아무 순서로 복원하라”고 맡기지 않고, 답안 토큰을 왼쪽에서 오른쪽으로 하나씩 생성하라고 정한다. 그러면 표준 AR 모델에 쓰는 GRPO의 계산을 더 직접적으로 적용할 수 있다. 저자들은 이 선택이 임의 순서 경로의 조합적 복잡도, 근사 우도 계산, 학습할 때의 샘플러와 평가할 때의 모델 불일치 문제를 피한다고 설명한다.[3]
수식 자체는 겁낼 필요가 없다. 같은 질문 x에 대해 K개의 답 y₁, …, yᴋ를 만들고 각각 보상 rᵢ를 받았다고 하자. 답들의 평균 보상에서 얼마나 위·아래인지 나타내는 아주 단순한 표준화 값은 다음처럼 쓸 수 있다.
Aᵢ는 i번째 답이 같은 질문에서 뽑힌 답들보다 얼마나 좋았는지 나타내는 상대 점수다. r̄는 그 묶음의 평균 보상, sᵣ는 보상들의 퍼짐, ε은 0으로 나누는 일을 막는 아주 작은 수다. 여기서 모델은 Aᵢ가 큰 답안의 선택을 더 자주 하도록 바뀐다. 이 식은 GRPO의 직관을 위한 설명식이며, 실제 구현은 이전 정책과의 비율·클리핑 등 추가 안전장치를 둔다. 논문·코드의 정확한 목적함수와 동일한 한 줄 구현이라고 주장하는 식은 아니다.[3]
AR 순서에서는 답 전체의 확률을 각 위치의 조건부 확률을 곱해 다룰 수 있다.
yₜ는 t번째 토큰, T는 답안 길이, θ는 모델의 조정 가능한 값이다. 앞 토큰 y₁부터 yₜ₋₁까지가 주어진 뒤 다음 토큰을 평가하므로, “이 답안을 이 순서로 만들 확률”을 명확히 계산할 수 있다. 반면 여러 빈칸을 임의 순서로 복원하는 경로는 가능한 순서가 많다. 어떤 경로를 학습 대상으로 삼고 무엇을 근사할지 복잡해진다. JustGRPO는 이 복잡한 경로를 새 수학으로 모두 해결했다기보다, 학습 단계에서는 그 경로를 선택하지 않는 방법을 택했다.
여기서 다시 한 번 구별해야 한다. 저자들은 학습 때만 AR 순서를 사용하며, 추론 단계에서는 dLLM의 병렬 복원 방식을 유지할 수 있다고 말한다.[2][3] 따라서 “확산 LLM을 보통 AR LLM으로 교체했다”는 설명은 부정확하다. 더 정확한 표현은 “dLLM을 보상으로 훈련하는 경로를 AR로 고정해 표준 GRPO를 적용했다”이다.
#6. 결과 표를 읽는 법: 숫자보다 비교 조건부터
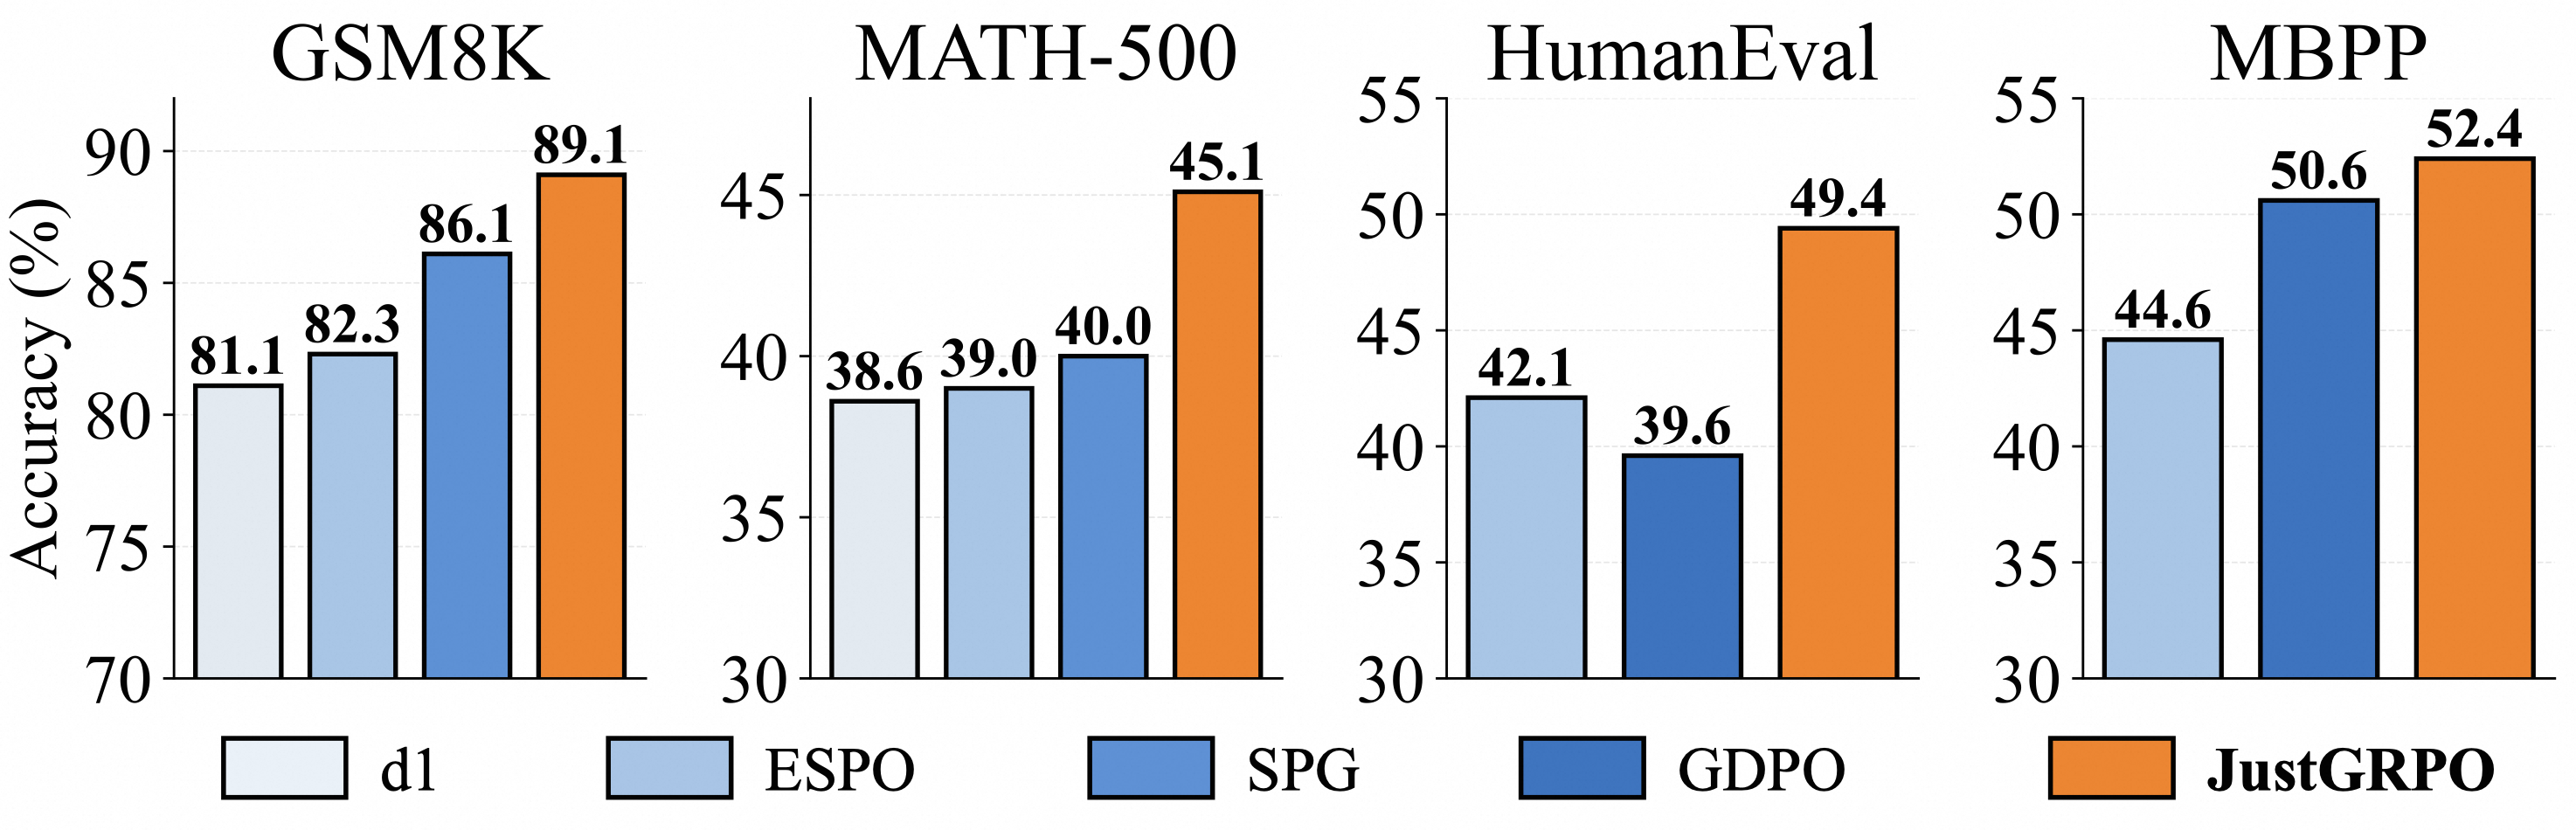
저자 공개 저장소의 full fine-tuning 표에서 generation length 256 조건의 수치는 GSM8K 89.1, MATH-500 45.1, HumanEval 49.4, MBPP 52.4다.[3] 아래는 같은 저장소에 실린 generation length별 결과를 다시 옮긴 것이다. 각 행은 서로 다른 과제이므로, 89.1이 49.4보다 ‘두 배 더 좋다’는 뜻이 아니다. 각 벤치마크의 채점 방식과 난도가 다르다.
| 과제 | 길이 128 | 길이 256 | 길이 512 | 무엇을 확인하나 |
|---|---|---|---|---|
| GSM8K | 83.8 | 89.1 | 89.8 | 문장형 수학 문제 |
| MATH-500 | 39.0 | 45.1 | 45.2 | 더 어려운 수학 풀이 |
| HumanEval | 37.8 | 49.4 | 48.7 | 함수 구현과 실행 테스트 |
| MBPP | 50.6 | 52.4 | 49.0 | 기초 프로그램 작성 |
길이를 128에서 256으로 늘렸을 때 네 과제 모두 이 표에서는 높아졌지만, 512에서 계속 증가하지는 않는다. 이것만으로 “답을 길게 쓰면 추론력이 계속 올라간다”고 말할 수 없다. 토큰 예산이 늘면 더 자세히 풀이할 기회가 생기는 한편, 잘못된 방향으로 길게 전개할 기회도 늘어난다. 평가 방식과 샘플링 설정까지 함께 봐야 한다.
원본 비교 그림에는 JustGRPO 외에도 여러 확산 모델용 보상 학습 방법이 등장한다. 표를 볼 때 특히 조심할 점은 모든 막대가 같은 기반 모델·같은 학습 예산·같은 생성 길이로 훈련됐다고 자동 가정하면 안 된다는 것이다. 프로젝트 페이지는 자기들의 표에서 비교 조건을 설명하지만, 다른 연구의 수치를 한 장에 놓는 일에는 언제나 구현·예산 차이가 섞일 수 있다.[2] 이번 글이 가장 강하게 말할 수 있는 부분은 “저자들의 공개 설정에서 AR 학습 경로가 강한 결과를 보였다”까지다.
그럼에도 이 결과가 연구자에게 흥미로운 이유는 방법이 화려해서가 아니라 반대다. dLLM의 고유한 ‘임의 순서’를 살리기 위해 별도 보상 공식이 필요하다고 여겨진 문제에서, 기존 AR용 GRPO로 돌아가는 선택이 나왔기 때문이다. 좋은 방법은 언제나 더 많은 구성요소를 더하는 방식이 아니다. 어떤 자유도가 학습 신호를 흐리게 만든다면, 그 자유도를 잠시 제한하는 편이 낫다는 사례가 될 수 있다.
#7. 그렇다면 이 AI는 스스로 좋아지는가
어느 의미에서는 그렇다. 모델은 여러 답을 내고, 보상 판정이 더 좋다고 한 답의 패턴을 다음 업데이트에서 더 자주 선택한다. 이 폐루프는 답안 생성 → 채점 또는 테스트 → 상대 보상 → 확률 업데이트로 이어진다. 학습 전과 후의 모델이 달라지므로, 좁은 의미의 성능 개선은 실제로 일어난다.
하지만 이것을 ‘AI가 스스로 연구 방향을 정하고 자기 목적함수까지 고쳐 가며 진화한다’고 부르면 과장이다. 누가 문제 집합을 고를지, 어떤 답을 맞다고 판정할지, 얼마나 긴 답을 허용할지, 어느 시점에 학습을 멈출지는 여전히 사람이 정한 실험 설계다. 수학 문제의 최종 답 또는 코드 테스트처럼 비교적 명확한 보상이 있는 영역에서 특히 잘 작동할 여지가 있다. 정답이 하나로 고정되지 않은 정책 결정, 창작, 안전이 중요한 대화에서는 보상 자체를 정의하는 일이 더 어렵다.
또한 보상은 정답의 일부만 볼 수 있다. 코드가 공개 테스트를 통과해도 숨은 조건을 놓칠 수 있고, 수학 답의 마지막 숫자가 맞아도 풀이가 일반적으로 타당한지는 별도 검증이 필요할 수 있다. JustGRPO는 보상 학습을 없앤 것이 아니라, 보상에 도달하는 답안 생성 순서를 단순화했다. 따라서 보상 판정이 불완전하면 학습 결과도 그 한계를 가진다.
#8. 이 연구가 아직 말하지 못하는 것
첫째, 네 벤치마크의 개선이 모든 종류의 추론으로 이어진다고 검증된 것은 아니다. 과학 실험 설계, 장기 계획, 다국어 대화, 창작 글쓰기에서 같은 현상이 나타나는지는 별도 실험이 필요하다. 둘째, Pass@k는 여러 답 중 하나를 고를 수 있을 때의 가능성을 보는 지표다. 실제 서비스가 한 번만 답하고 사용자가 검증할 여유가 없다면 Pass@1, 오류의 종류, 비용과 지연 시간이 더 중요할 수 있다.
셋째, 이 연구는 모델을 새로 사전학습한 기록이 아니라 공개된 dLLM을 과제별로 보상 학습한 비교다. 그래서 ‘확산 모델 전체의 근본 한계’보다 ‘현재의 post-training 설계에서 얻은 강한 실험적 교훈’으로 읽어야 한다. 넷째, ICML Outstanding Paper는 심사위원회가 기여를 높게 평가했다는 공식 신호이지만, 독립 팀의 재현과 실제 제품 환경의 검증을 대신하지 않는다.[1]
마지막으로 공개 코드는 큰 장점과 남은 과제를 함께 준다. 학습 스크립트, 평가 스크립트, 체크포인트가 공개되어 있어 누구나 주장과 결과 사이를 추적할 출발점이 있다.[3] 그러나 실행 명령이 있다고 해서 누구나 같은 계산 자원·데이터 전처리·무작위성 조건에서 같은 숫자를 얻는다는 보장은 없다. 재현은 저장소를 내려받는 데서 끝나지 않고, 환경과 평가 규칙을 맞추고 결과 차이를 해석하는 과정까지 포함한다.
#9. 다음 dLLM 뉴스를 읽을 때 물어볼 네 가지
새 모델이 “병렬 생성”, “더 많은 추론 경로”, “보상 학습 개선”을 말할 때는 이름보다 다음 질문이 유용하다.
- 무엇을 바꿨나? 모델 구조, 생성 순서, 보상 함수, 샘플 수, 평가 절차 중 어디가 달라졌는가?
- 무엇을 재는가? 한 번의 정답률인지, 여러 번 시도한 Pass@k인지, 코드 테스트인지, 사람이 평가한 품질인지 구분하는가?
- 무엇과 같은 조건에서 비교했나? 기반 모델, 학습 데이터, 생성 길이, 계산 예산이 맞춰졌는가?
- 누가 다시 확인할 수 있나? 논문뿐 아니라 코드·체크포인트·평가 규칙이 공개됐는가, 다른 팀의 결과가 나왔는가?
JustGRPO는 이 네 질문을 연습하기 좋은 사례다. ‘임의 순서 생성’이라는 멋진 기능을 무조건 살리지 않고, 수학·코드 보상 학습에서는 그 기능을 학습 중 잠시 접었을 때 어떤 일이 생기는지 보여 줬다. 앞으로 더 강한 dLLM이 나온다면, 자유도가 얼마나 많은지가 아니라 그 자유도가 어떤 측정 가능한 문제를 실제로 해결했는지를 물어야 한다.
#10. 출처와 원본 그림
[1] ICML 2026 Awards — Outstanding Paper 공식 발표. 수상 사실 확인.
[2] 저자 공식 프로젝트 페이지 — The Flexibility Trap. 연구의 문제 설정, AR·AO 비교, Pass@k 설명, 방법과 결과 표. 열람: 2026-09-14.
[3] LeapLabTHU/JustGRPO 공개 저장소. 학습·평가 코드, 체크포인트, 결과 표, 원본 그림 두 장. 저장소 라이선스는 MIT이며, 이 글의 원본 그림은 파일을 변경하지 않고 저작자·출처·라이선스와 함께 사용했다. 열람: 2026-09-14.
[4] arXiv:2601.15165 — Why Arbitrary Order Limits Reasoning Potential in Diffusion Language Models. 저자 원고와 버전 이력.
원본 그림은 위 저자 저장소의 mechanism_to_passk.png, acc_compare.png를 그대로 보존한 파일이다. 이 글의 두 초록색·갈색 설명 그림은 수치나 실측 데이터를 추가하지 않은 JJo 자체 제작 교육용 도식이며, 원 논문 그림을 다시 그린 것이 아니다.