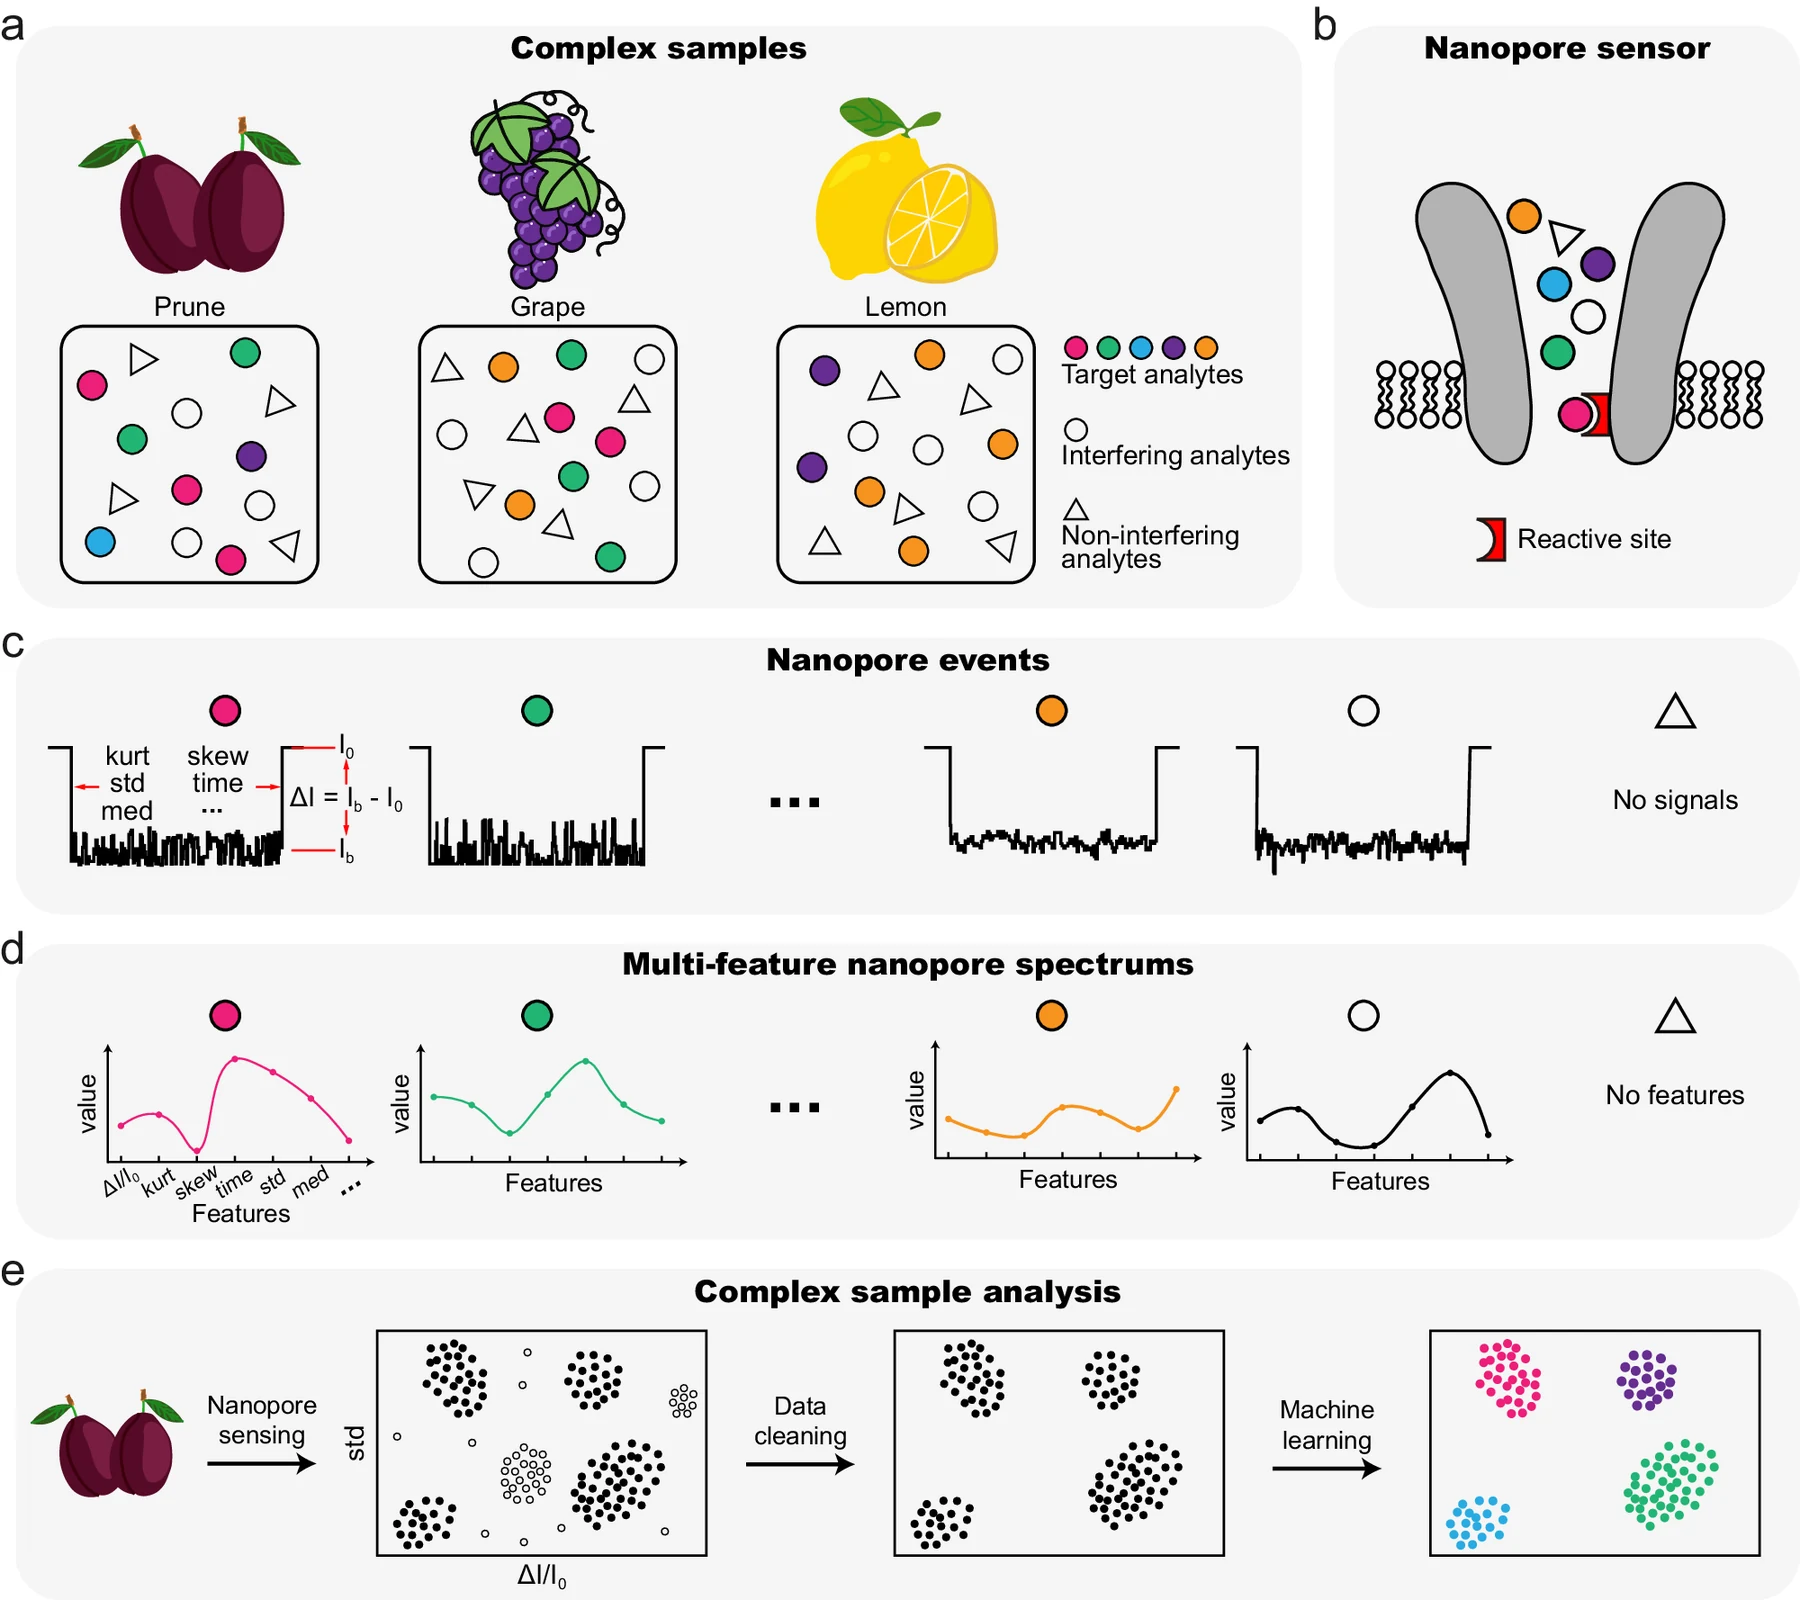
2026.09.15 Top 1 · 생체분자 센서. 위 그림은 같은 MspA 계열 센서의 원리를 보여주는 2024년 관련 연구의 원본 그림이다. 이번 FPBA 센서의 사진이나 40종 분류 결과는 아니다. 이번 연구의 공개 그림과 보충자료는 마지막 출처에서 직접 열 수 있다.
#1. 작은 구멍 하나가 분자의 이름을 알아맞힌다고?
보이지 않을 만큼 작은 구멍을 통과하는 전류를 보고 분자의 종류를 짐작한다. 처음 들으면 낯설지만, 좁은 통로에서 사람이 잠시 멈추면 뒤쪽 통행량이 달라지는 모습을 떠올리면 이해하기 쉽다. 센서는 분자를 카메라로 찍는 대신, 분자와 구멍이 상호작용하는 동안 전류가 얼마나 줄고, 얼마나 오래 머물며, 얼마나 흔들리는지를 읽는다. 나노미터 크기의 구멍을 이용하므로 이런 센서를 나노포어라고 부른다.
9월 14일 Nature Biotechnology에 게재된 연구는 MspA라는 단백질 구멍에 FPBA 어댑터를 붙였다. 연구진은 이 한 종류의 센서로 아미노산, 뉴클레오타이드, 당, 짧은 펩타이드에 해당하는 40개 분석 대상의 신호를 구별했다. 다양한 화학 계열을 같은 감지 구조로 다뤘다는 점이 오늘의 핵심이다. 이것을 곧바로 단백질·RNA·당의 전체 서열을 읽는 만능 장비라고 부르면 안 된다.[1]
일상적인 비유로는 여러 언어의 글자를 인식하는 스캐너에 가깝다. 글자 종류를 잘 구분하는 능력과, 처음 보는 책을 처음부터 끝까지 오류 없이 복원하는 능력은 다르다. 이번 결과에서 앞쪽 능력은 인상적이지만, 뒤쪽 능력이 완성됐다고 말할 근거는 없다. 이 차이를 기억하면 뒤에 나오는 98.7%라는 숫자도 훨씬 정확하게 읽을 수 있다.
#2. 아미노산·뉴클레오타이드·당은 서로 무엇이 다를까
단백질을 길게 연결된 목걸이에 비유하면 아미노산은 그 목걸이의 구성 구슬이다. 몇 개의 아미노산이 이어진 짧은 사슬은 펩타이드라고 부른다. 같은 구슬이 들어 있어도 연결 순서가 다르면 다른 사슬이 될 수 있다. 따라서 구성 성분을 알아내는 것만으로 원래 단백질의 이름이나 전체 배열이 자동으로 정해지지는 않는다.
뉴클레오타이드는 핵산을 이루는 단위와 관계된 분자다. 이번 논문에서 다룬 것은 긴 RNA 사슬 자체가 아니라 뉴클레오사이드 일인산, 줄여서 NMP라는 작은 분자군이다. 단당류는 당의 가장 기본적인 단위다. 당이 여러 개 연결되면 연결 위치와 가지 구조까지 문제가 되므로, 작은 당 몇 종을 구분하는 것과 복잡한 당사슬의 구조를 밝히는 것도 별개의 과제가 된다.
이 분자들은 크기만 다른 것이 아니다. 전하, 표면의 화학적 성질, 반응할 수 있는 부분도 다르다. 분석 장비가 특정 분자와 잘 상호작용하도록 만들어졌다면 다른 분자에서는 눈에 띄는 신호를 얻지 못할 수 있다. 지폐 판별기에 동전을 넣어도 같은 방식으로 금액이 읽히지 않는 것과 비슷하다. 하나의 장치를 여러 분자군에 쓰려면 장치가 받아들이는 화학적 신호의 종류부터 넓혀야 한다.
여기서 ‘멀티오믹스’라는 말이 등장한다. 단백질, RNA, 당처럼 생명현상의 서로 다른 층을 함께 분석하려는 접근이다. 하지만 같은 센서에 여러 분자군의 신호가 잡힌다고 해서 그 층 전체를 빠짐없이 측정하는 것은 아니다. 어느 분자를 어떤 전처리로 얼마만큼 측정했는지, 서로 다른 측정 결과를 어떻게 연결했는지가 추가로 필요하다. 이번 연구는 그런 통합을 향한 센서 전단의 가능성을 보여준다.[1,2]
#3. 새로워진 것은 AI보다 구멍 안의 화학적 접점이다
MspA는 단백질이 이루는 통로이고, constriction은 그 통로가 가장 좁아지는 부분을 뜻한다. 연구진은 이 위치에 maleimido-C2-FPBA라는 어댑터를 고정했다. 긴 화학명 자체를 외울 필요는 없다. 분자가 잠시 상호작용할 수 있는 감지 접점을 구멍 안에 마련했다는 점이 중요하다. 측정 신호가 충분히 구별되어야 뒤의 머신러닝도 일을 할 수 있다.[1]
어댑터를 여러 물건을 잠깐 붙잡아 보는 손잡이에 비유할 수 있다. 아무 손잡이나 모든 물건에 잘 맞지는 않는다. 잡히지 않고 지나가거나, 붙잡히더라도 다른 물건과 거의 같은 흔적을 남기면 구분이 어렵다. 새로운 어댑터는 서로 다른 화학 계열을 같은 감지 위치에서 다룰 수 있도록 설계됐다는 점에서 의미가 있다. 단순히 기존 데이터에 더 큰 AI 모델을 붙였다는 이야기가 아니다.
공개 Extended Data의 비교 실험은 기존 MspA-PBA와 MspA-NTA-Ni가 특정 조합에서 원하는 이벤트를 만들지 못한 사례를 제시한다. 다만 이 결과를 기존 센서가 모든 상황에서 무용하다는 뜻으로 확대해서는 안 된다. 무엇을 넣었고 어떤 조건으로 측정했는지가 붙어 있는 비교다. 실제로 2024년 관련 연구에서는 PBA를 단 MspA가 과일 속 여러 cis-diol 분자를 구분하는 데 사용됐다.[1,3]
앞에 실은 배경 그림을 볼 때도 구멍의 모양, 막의 양쪽, 전류가 흐르는 경로를 먼저 보면 된다. 그림 안의 분자 이름을 모두 외우기보다 ‘특정 화학적 접점이 전류 변화를 만들어 낸다’는 연결을 읽는 편이 낫다. 2024년 PBA 결과와 2026년 FPBA 결과는 다른 실험이며, 이 글에서는 앞선 연구의 그림을 새로운 연구의 증거로 대체하지 않는다.
#4. 전류의 흔적을 아홉 개 특징으로 바꾸는 과정
센서가 기록한 전류는 시간에 따라 이어지는 선이다. 분자가 감지 위치와 상호작용하면 이 선에 짧은 변화가 나타나는데, 논문은 이를 이벤트라고 부른다. 연구진은 이벤트 하나를 단순히 ‘전류가 많이 줄었다’라는 한 문장으로 표현하지 않고 아홉 가지 특징으로 바꿨다. 이 특징 목록은 보충자료의 Supplementary Table 7에서 확인할 수 있다.[2]
| 특징 묶음 | 포함되는 값 | 처음 읽을 때의 의미 |
|---|---|---|
| 전류 변화의 크기 | ΔI, 최솟값, 최댓값, 범위 | 신호가 어디까지 움직였는가 |
| 신호의 흔들림 | SD, LocalSD Ratio | 머무르는 동안 얼마나, 어떤 식으로 흔들렸는가 |
| 시간 | t_off | 이벤트가 얼마나 오래 이어졌는가 |
| 분포의 모양 | skew, kurtosis | 값의 분포가 비대칭인지, 극단값이 어떤지 |
이렇게 얻은 아홉 개 숫자는 이벤트의 지문과 같다. 키가 같은 두 사람도 걸음 속도와 목소리가 다르면 구별하기 쉬운 것처럼, 전류 감소량이 비슷한 두 분자도 머무른 시간이나 잡음 패턴이 다르면 분류의 단서가 늘어난다. 물론 특징을 많이 쓴다는 사실만으로 정확도가 보장되는 것은 아니다. 측정이 흔들리거나 특징끼리 사실상 같은 정보라면 도움이 적을 수 있다.
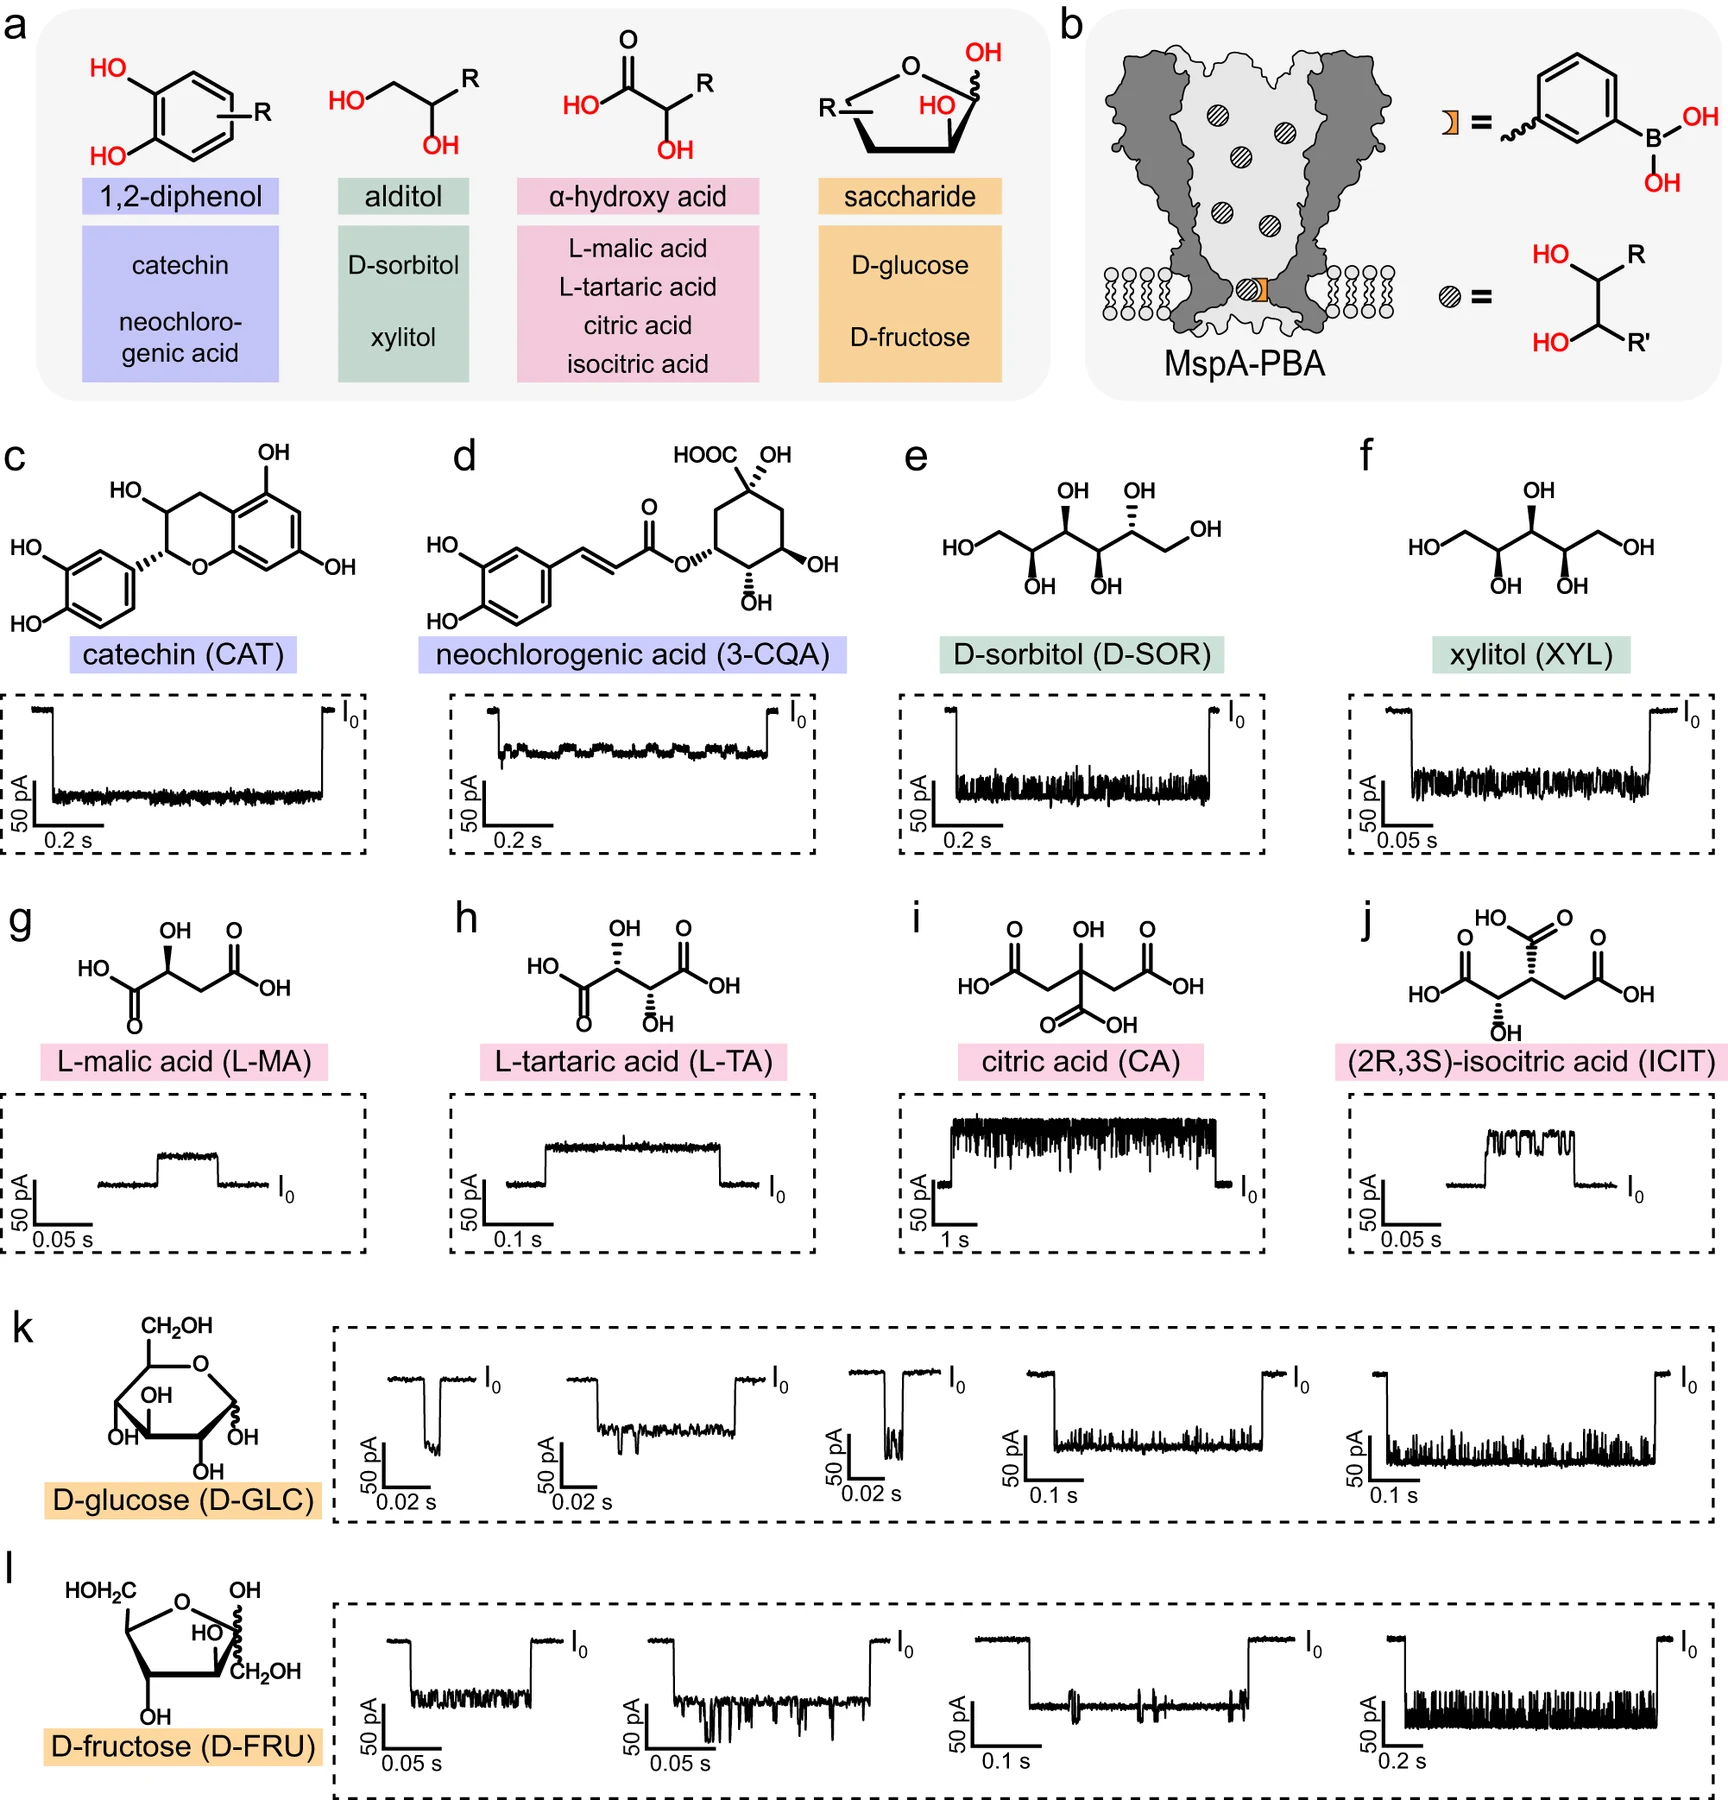
위 그림 역시 2024년 관련 연구에서 얻은 원본이다. 전류 기록과 분자군별 신호를 어떻게 연결해 읽는지 보는 배경 자료이며, 아래에 설명하는 2026년의 40개 클래스 성능표는 아니다. 이번 논문의 정확도는 별도로 연결한 Supplementary Table 7을 기준으로 읽어야 한다.[2,3]
머신러닝의 역할은 이 지문들을 보고 미리 정의한 이름표 중 어느 쪽에 가까운지 판단하는 것이다. 여기서 사용된 Bagged Trees는 여러 결정나무의 판단을 묶는 방식이다. ‘이벤트가 길고 전류 감소가 크면 어느 그룹에 가깝다’와 같은 구분을 여러 나무가 나눠 맡는다고 생각하면 된다. 매우 큰 생성형 AI가 문장을 이해하는 과정과는 목적도 입력도 다르다. 이번 일에서 먼저 중요한 것은 센서 신호가 분자를 구분할 정보를 가지고 있느냐다.
#5. 40종과 98.7%를 정확히 읽는 법
논문이 구성한 분류 대상은 단백질 구성 아미노산 21개, 번역 후 변형 아미노산 3개, 기본 NMP 4개와 변형 NMP 3개, 단당류 4개, 펩타이드 5개다. 합하면 40개 클래스다. 여기서 21이라는 수는 논문의 대상 분류를 그대로 옮긴 것이며, 교과서에서 흔히 배우는 아미노산 목록을 임의로 바꿔 센 숫자가 아니다.[1,2]
더 주의할 점은 ‘40종 데이터로 분류했다’와 ‘40종이 모두 섞인 임의 시료를 한 번에 정량했다’가 같은 문장이 아니라는 것이다. 분류기 학습 데이터의 대상 수, 혼합 실험에서 실제로 함께 넣은 성분 수, 실제 시료에서 이름을 붙일 수 있었던 분자 수는 각각 확인해야 한다. 클래스 수가 넓어졌다는 사실은 중요한 진전이지만, 그것만으로 모든 혼합물의 구성과 농도를 복원했다고 말할 수는 없다.
보충자료는 데이터를 학습용 80%와 시험용 20%로 나눴다고 설명한다. 학습 쪽에서는 열 묶음을 번갈아 검증에 사용하는 10-fold 교차검증을 했고, 여러 모델을 비교했다. Bagged Trees의 검증 정확도는 98.7%, 별도 시험 세트 정확도는 96.7%였다. 이 글에서는 두 수치를 섞지 않는다. 98.7%만 떼어 제목에 놓으면 독자가 실제 새 시료에서 얻은 성능으로 오해할 수 있기 때문이다.[2]
시험 세트를 따로 둔 것은 중요하다. 문제집을 익힌 뒤 문제집 안의 문제를 다시 푸는 것과, 따로 남겨 둔 문제를 푸는 것은 다르다. 그렇지만 별도 시험 세트가 곧 다른 연구실의 외부 검증을 뜻하지는 않는다. 다른 구멍, 다른 측정일, 다른 시료 제조 배치까지 완전히 분리됐는지는 그 단위에 맞는 검증을 따로 봐야 한다. 공개 성능표의 분할 비율만으로 그런 독립성 전부를 확인했다고 할 수 없다.
정확도와 검출한계도 구별해야 한다. 정확도는 들어온 이벤트에 이름표를 얼마나 잘 붙였는지에 가깝다. 검출한계는 아주 적게 존재하는 분자도 배경과 구별할 수 있는지의 문제다. 전화가 연결된 뒤 상대의 목소리를 잘 알아듣는 것과, 너무 약한 신호 속에서 전화가 왔다는 사실 자체를 알아차리는 것은 다른 능력이다. 높은 분류 정확도 하나로 임상 시료에서의 미량 검출 능력을 대신 설명할 수 없다.
#6. 효모 추출물 실험이 더 흥미로운 이유와 남은 거리
연구진은 표준 분자 용액만 측정하지 않고 효모 세포 추출물의 여과액에도 센서를 적용했다. 공개 설명에 따르면 few-shot learning으로 이벤트를 아미노산·NMP·당·펩타이드 계열로 분류한 뒤, 학습된 Bagged Trees로 일부 아미노산과 NMP를 추가 식별했다. 또 당이 붙은 짧은 펩타이드를 효소로 절단하면서 방출되는 아미노산과 당화 부위가 포함된 조각의 신호를 살폈다.[1,2]
이것은 ‘교과서에 나온 순수 물질에서만 작동하는가’라는 질문에서 한 걸음 나아간 실험이다. 실제 생물에서 나온 시료에는 여러 성분이 있으므로, 분석 신호가 복잡해져도 일정한 단서를 읽을 수 있다는 시범의 가치가 있다. 다만 효모 추출물은 사람의 혈액도 아니고, 모든 성분의 정답이 완전히 알려진 무작위 평가 세트도 아니다. 일부 분자를 알아본 결과를 세포 전체의 단백질·RNA·당을 전부 복원한 결과로 바꾸면 증거의 범위를 넘는다.
효소 절단 실험도 같은 구분이 필요하다. 목걸이를 구슬 몇 개와 짧은 조각으로 잘라 센서로 읽었다면, 센서는 절단 과정이 내놓는 물질을 본 것이다. 절단이 어디서 멈추는지, 어떤 조각이 남는지, 한 분자의 생성물들이 시간적으로 어떻게 대응하는지에 따라 원래 구조를 되짚는 난도가 달라진다. 아무 단백질이나 넣으면 전체 서열이 출력되는 장비라면 이런 연결을 훨씬 넓게 입증해야 한다.
실험 조건도 결과의 일부다. 첨부 편집안과 공개 자료에는 높은 염 농도와 정해진 전압·분자 농도를 사용하는 조건이 제시돼 있다. 이를 곧바로 일상적 혈액검사 환경에 대입할 수는 없다. 다만 통제된 조건을 썼다는 이유만으로 연구의 가치가 없어지는 것도 아니다. 새로운 감지 원리가 가능한지 보여주는 단계와, 전처리 없이 누구나 쓰는 장비를 만드는 단계가 다르다는 뜻이다.
#7. 이 기술이 장비가 되려면 무엇을 더 봐야 할까
다음 검증은 정확도를 소수점 아래에서 조금 올리는 일만이 아니다. 가장 먼저 보고 싶은 것은 처음 보는 분자가 들어왔을 때 모른다고 말할 수 있는가다. 40개 이름표 중 하나만 반드시 고르게 만든 분류기는 목록 밖 분자를 만났을 때 그럴듯한 오답을 낼 수 있다. 실제 시료에서는 ‘아는 것의 분류’와 ‘모르는 것의 거절’을 함께 평가하는 편이 실용적이다. 이는 이번 논문이 이미 해결했다고 주장하는 내용이 아니라, 후속 장비를 평가할 때 필요한 질문이다.
그다음은 센서 사이의 차이다. 한 구멍에서 잘 구분한 지문이 다른 구멍에서도 같은 좌표에 놓이는지, 측정일이 바뀌어도 같은 전류 기준을 쓰는지 확인해야 한다. 기계마다 눈금이 조금 다른 체중계를 생각해 보자. 한 기계에서 학습한 분류 규칙이 다른 기계로 옮겨 갈 때 보정이 필요할 수 있다. 여러 센서에서 독립적으로 모은 데이터로 평가하면 이런 이동 가능성을 더 직접적으로 볼 수 있다.
농도 차이와 방해 성분도 중요한 질문이다. 어떤 분자가 매우 많고 다른 분자가 드물 때 드문 분자의 이벤트를 놓치지 않는지, 비슷한 분자가 함께 들어왔을 때 이름표가 얼마나 바뀌는지 봐야 한다. 분자를 맞히는 비율뿐 아니라 검출되지 않은 분자, 잘못 검출됐다고 판단한 분자, 판단을 보류한 이벤트의 비율도 함께 보고 싶다. 이런 지표가 있어야 실제 분석에서 어떤 오류가 생기는지 이해할 수 있다.
마지막은 장시간 운용과 공개 재현이다. 코드와 학습 자료가 제공된다는 것은 유용한 출발점이지만, 제3자가 내려받아 같은 결과를 얻었다는 뜻은 아니다. 이 글에서도 공개 여부는 확인했으나 소프트웨어를 실행해 성능을 재현하지 않았다. 별도 연구실의 재현 결과, 눈가림 혼합 시료, 센서 교체 후 성능 같은 자료가 추가된다면 지금보다 강한 결론을 내릴 수 있다.
#8. 오늘의 후보들과 비교하면 무엇이 보이나
오늘 Top 1을 이 연구로 고른 이유는 ‘98.7%라서 가장 우수하다’가 아니다. 생체분자 종류가 달라질 때마다 갈라지던 감지 접점을 한 구조로 넓혔다는 질문이 선명하고, 실제로 무엇을 측정했는지 공개 보충자료에서 따라갈 수 있기 때문이다. 나노포어의 범용성을 향한 의미 있는 개념검증이지만 범용 서열분석기, 임상 진단기, 상용 제품의 완성은 아니다.
| 편집 위치 | 함께 올린 글 | 읽을 때 가장 중요한 경계 |
|---|---|---|
| Top 1 · 96점 | 이 글의 MspA-FPBA | 알려진 분자의 이벤트 분류와 전체 서열분석은 다르다 |
| 후보 2 · 94점 | APOE에 따라 다시 읽은 알츠하이머 유전지도 | 연관성을 찾은 연구이지 개인의 발병이나 치료 반응을 확정한 검사가 아니다 |
| 후보 3 · 92점 | 필요한 정보만 먼저 고르는 MoS₂ 신경망 반도체 | 소자 측정과 소자 보정 시뮬레이션을 완성 칩의 실측 전력으로 혼동하지 않는다 |
96·94·92점은 이번 편집안의 상대적 선정 점수이며 학술지의 공식 평가, 수상, 의학적 권고 점수가 아니다. 분야가 다른 논문을 보편적인 한 줄 순위로 재단할 수는 없다. 실제 치료의 중요도를 더 중시하면 후보의 우선순위가 달라질 수 있다.
보류 후보도 남긴다. FDA의 Isembyld(apitegromab-mstn) 승인 소식은 9월 11일 사건이어서 오늘의 72시간 우선 후보에서는 뒤로 뒀다. FDA 공지의 대상은 기존 SMN2 표적 치료를 받는 2세 이상 소아와 성인의 척수성 근위축증이다. 기존 치료를 대신하는 만능 치료가 아니라 근육 손실을 직접 겨냥하는 치료라는 점이 핵심이다. 골절 위험과 태아·생식 관련 안전성 경고도 있어 승인 사실만으로 안전성을 단정해서는 안 된다. 승인일과 적응증은 공식 자료로 확인해야 하며 개인의 치료 변경 근거로 이 글을 사용해서는 안 된다.[4,5]
나노포어 연구에도 이해관계가 있다. Shuo Huang과 Lang Yao는 FPBA 어댑터를 포함한 MspA 제작과 응용 관련 특허 출원을 밝혔다. 특허가 결과를 무효로 만드는 것은 아니지만, 독자는 기술의 잠재력과 개발 당사자의 이해관계를 함께 알 필요가 있다. 앞으로 주목할 것은 강한 홍보 문구보다, 더 낯선 시료와 독립된 센서에서도 같은 구분이 유지되는지다.[1]
#9. 출처와 확인 범위
[1] Yao et al., An engineered nanopore identifies saccharides, amino acids, peptides and ribonucleotides, Nature Biotechnology, 2026-09-14. 초록, 공개 그림 설명, Extended Data 1·6·7, 데이터·코드 제공 안내, 이해관계 정보를 확인했다. 구독 제한 본문 전체를 읽었다고 주장하지 않는다.
[2] 같은 논문의 Supplementary Information, 77쪽. 정확도는 PDF 11쪽의 Supplementary Table 7을 표 이미지와 추출 텍스트로 대조했다. 전체 코드 실행과 독립 재현은 하지 않았다.
[3] Fan et al., Nanopore analysis of cis-diols in fruits, Nature Communications 15, 1969, 2024. 두 배경 그림의 원출처. CC BY 4.0에 따라 출처를 표시하고 비율을 유지한 크기 조정과 WebP 변환만 했다. 이번 2026년 FPBA 실험과 별개다.
[4] FDA, 2026년 신규 의약품 승인 목록. 2026-09-15 검색 수록본의 Isembyld 항목에서 9월 11일 승인과 적응증을 확인했다. 이 목록은 접속 가능한 FDA 공식 확인 경로이며, 열람 환경에 따라 갱신 시점이 다른 캐시가 보일 수 있다.
[5] FDA, “FDA Approves First Therapy to Target Muscle Loss in Spinal Muscular Atrophy”, 2026-09-11. 안전성 문구는 FDA 공식 공지의 검색 수록 본문에서 확인했다. 공지 직접 수집은 차단 안내로 이동한 뒤 404를 반환했고 직접 열람도 확인하지 못했으므로, 정상 접속을 확인한 링크처럼 제시하지 않는다. 승인 확인에는 위 FDA 목록을 사용한다.