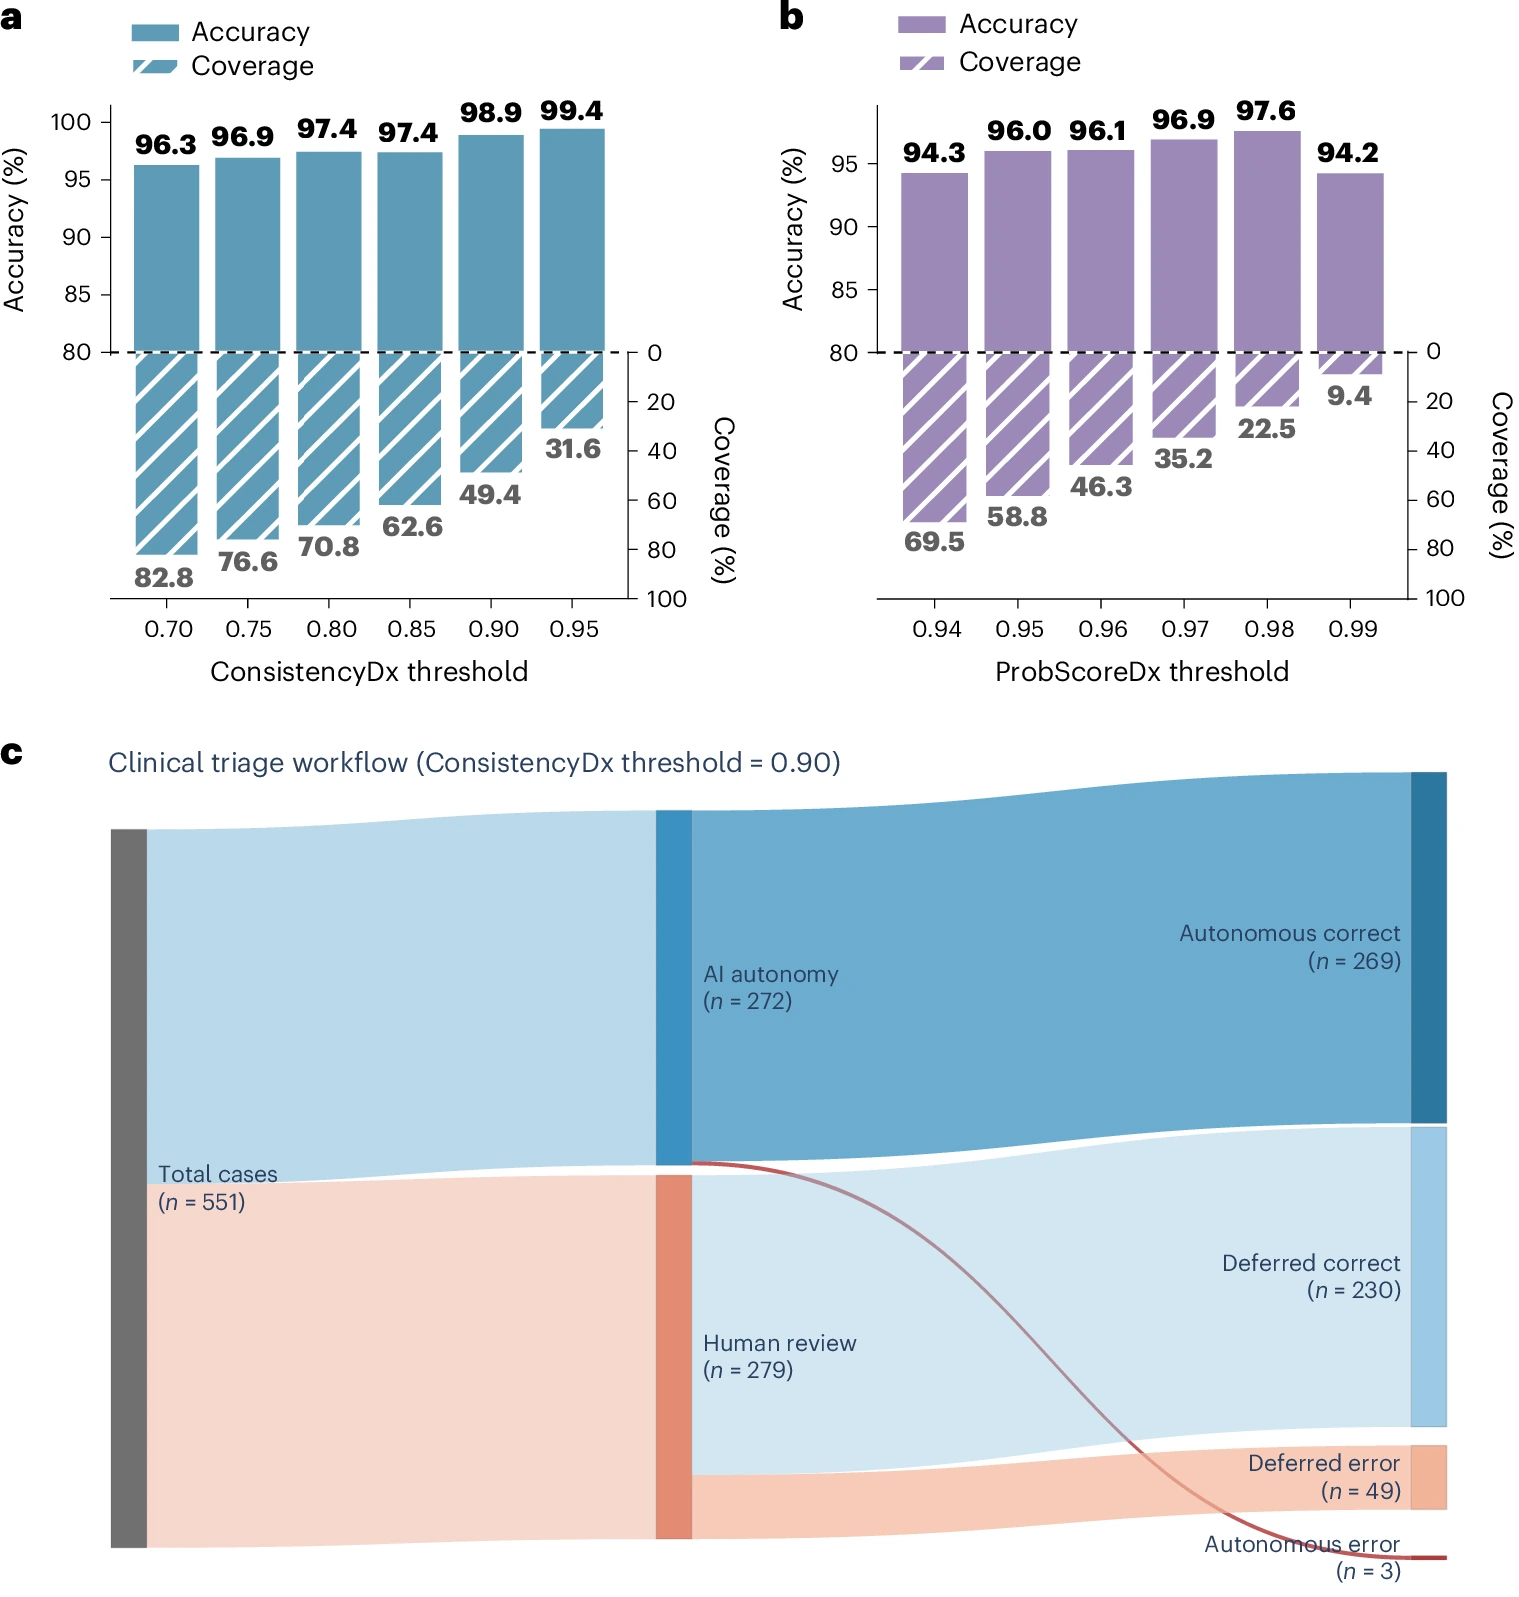
연구 단계: 과거 의료기록과 증례를 바탕으로 만든 텍스트 시뮬레이션 평가다. 실제 환자를 전향적으로 진료한 임상시험이 아니다. 앞 그림은 이번 Nature Medicine 논문의 Figure 6 원본으로, 자동 처리를 허용하는 비율과 그 집단의 정확도를 함께 보여준다.[1]
#1. 한 문장 결론
의료 AI를 믿을 것인지 한 번에 결정하기보다, 어느 사례는 맡기고 어느 사례는 사람에게 넘길지 나누자는 연구다. 같은 사례를 여러 번 풀었을 때 진단이 얼마나 일관적인지를 이용하면, 시험 데이터에서 비교적 오류가 적은 부분집합을 골라낼 수 있었다. 그러나 남겨 둔 사례에서도 오류는 사라지지 않았고 실제 진료의 안전성이 입증된 것은 아니다.[1]
이 글은 9월 16일 편집안의 두 번째 후보를 설명한다. 94점이라는 편집 점수보다 중요한 것은 무엇을 측정했는지다. 전체 정확도, 일관성 점수, 자동 처리 비율, 선별한 집단의 정확도는 모두 다른 숫자다. 이 네 가지를 구분하는 것이 논문을 이해하는 출발점이다.
#2. 왜 이 문제가 어려운가
#틀리는 AI보다 더 어려운 것은, 틀릴 때도 자신 있어 보이는 AI다
의료 질문에 길고 유창하게 답한다고 옳은 판단인 것은 아니다. 사용자는 설명이 자세하거나 전문용어가 많으면 근거가 탄탄하다고 느끼기 쉽다. 하지만 문장을 만드는 능력과 해당 환자의 질환을 올바르게 구분하는 능력은 다르다. 이 연구는 그 차이를 ‘결정을 신뢰할 수 있는가’라는 문제로 다룬다.[1]
진단(diagnosis)은 관찰한 증상과 검사 등의 정보를 바탕으로 질환을 판단하는 일이다. 비슷한 증상이 여러 질환에서 나타날 수 있고, 필요한 정보가 처음부터 모두 주어지지 않을 수 있다. 따라서 첫 질문에 바로 병명을 답하는 것과, 추가 질문을 하고 검사 정보를 모은 뒤 판단하는 과정은 평가해야 할 능력도 다르다.
논문의 에이전트(agent)는 단순 채팅창의 다른 이름이 아니다. 질문과 검사 요청 같은 행동을 선택하고, 돌아온 정보를 참고해 다음 행동을 이어가는 소프트웨어다. 다만 이 실험에서 검사를 요청했다는 것은 실제 환자에게 검사를 시행했다는 뜻이 아니다. 준비된 기록을 바탕으로 시뮬레이션 환경이 정보를 제공한다.[1]
#데이터를 병원 밖으로 보내지 않는 것과 진단이 맞는 것은 별개다
온프레미스(on-premise)는 기관이 관리하는 내부 환경에 모델을 두고 실행하는 방식이다. 외부 회사의 서버를 호출하는 클라우드 API와 대비되는 개념이다. 기관은 모델 버전과 접근 권한, 기록 보관 등을 더 직접 관리할 수 있다. 논문은 이런 운영 통제와 의사결정의 신뢰를 나누어 설명한다.[1]
내부 서버에 둔다고 개인정보 보호가 자동으로 끝나지는 않는다. 누가 기록에 접근하는지, 로그에 무엇이 남는지, 모델과 장치의 보안 패치를 어떻게 관리하는지 여전히 확인해야 한다. 반대로 외부 전송을 막았다는 이유만으로 진단 정확도가 높아지는 것도 아니다. 장소의 문제와 판단의 문제를 섞으면 도입 조건을 잘못 정하게 된다.
이 구별은 산업 현장의 AI에도 적용할 수 있다. 로봇 옆 컴퓨터에서 모델을 실행하면 네트워크 지연을 줄일 수 있지만, 그 사실이 위험 행동을 모두 막았다는 뜻은 아니다. 의료에서도 데이터가 어디에서 처리되는가와 그 결과로 무엇을 하도록 허용하는가는 서로 다른 평가 항목이다.
#3. 기존 방식은 무엇이 부족했나
#평균 정확도 하나로 모든 사례를 맡길 수는 없다
가상의 시험에서 100개 중 90개를 맞혔다면 정확도는 90%다. 그러나 실제 사용자는 자신이 묻는 한 사례가 맞은 90개와 비슷한지, 틀린 10개와 비슷한지 알고 싶다. 전체 평균만으로는 그 질문에 답할 수 없다. 특히 오류의 영향이 큰 업무에서는 자동 처리하지 않을 대상을 구분하는 일이 중요해진다.
이를 선택적 예측(selective prediction)이라고 부를 수 있다. 모든 입력에 반드시 답하도록 강제하는 대신, 조건을 만족하는 입력에서만 답을 채택하고 나머지는 보류한다. 논문은 이를 에이전트의 선택적 자율성(selective autonomy)과 연결한다. 여기서 자율성은 법적·임상적 독립 진료 권한을 얻었다는 말이 아니라 평가에서 제안한 처리 규칙이다.[1]
#말투와 단어 확률은 정답 확률이 아니다
언어모델은 다음에 어떤 토큰을 낼지 확률을 계산한다. 토큰(token)은 모델이 텍스트를 처리하는 작은 단위다. 자주 나타나는 진단 표현을 높은 확률로 생성했다고 해서 실제 질환일 확률이 그만큼 높다는 뜻은 아니다. ‘문장으로 자연스러운가’와 ‘상황에 맞는가’가 다르기 때문이다.
연구진은 내부 생성 확률뿐 아니라 ‘아마도’ 같은 표현, 임상 개념의 밀도, 반복 실행에서의 일관성을 각각 측정했다. 한 가지 자신감 신호를 그대로 믿지 않고 여러 신호가 실제 정오를 얼마나 잘 구분하는지 비교한 것이다. 전문용어가 많다는 사실을 임상적 정확성의 대용 지표로 쓰지 않는다는 점이 중요하다.[1]
사람 검토자를 하나 더 흉내 낸 에이전트를 붙이면 항상 좋아질까? 논문의 비판자 에이전트 비교에서는 전체 진단 정확도가 추가했을 때 87.1%, 추가하지 않았을 때 88.4%였다. 특정 질환의 예외가 있었지만 전체 성능은 개선되지 않았다. 따라서 후속 신뢰도 분석은 기본 단일 에이전트 구성으로 진행했다. ‘여러 AI가 토론하면 더 안전하다’는 일반화를 경계하게 하는 결과다.[1]
#4. 새 방법을 3단계로 설명
#첫째, 같은 진료 시뮬레이션 안에서 모델을 비교한다
의사 역할의 에이전트는 환자 역할의 에이전트와 대화하고, 검사 결과를 요청하며, 마지막에 진단과 이유를 제시한다. 환자 역할 역시 실제 사람이 아니다. 과거 기록에서 구성한 사례를 바탕으로 응답하는 시뮬레이션이다. 혈액검사나 영상의학 정보를 요청하더라도 모델이 실제 장비를 작동하거나 원본 의료영상 자체를 판독한 것으로 확대하지 않는다.[1]
서로 다른 언어모델을 비교할 때는 에이전트 구조와 평가 절차를 같게 두었다. 모델만 바꿔야 관찰한 차이가 무엇과 관련되는지 읽기 쉽기 때문이다. 그렇더라도 모델의 크기와 서버 구성, 처리 속도가 모두 동일하다는 뜻은 아니다. 정확도 비교와 운영비 비교는 다른 자료를 필요로 한다.
#둘째, 같은 사례를 다섯 번 풀게 한다
모델은 같은 정보를 받아도 확률적 생성 때문에 조금씩 다른 답을 낼 수 있다. 연구진은 기본적으로 사례마다 독립적인 확률적 실행을 다섯 번 수행했다. 그 뒤 최종 진단과 설명을 각각 임베딩(embedding)이라는 수치 벡터로 바꿨다. 벡터는 문장의 의미를 비교하기 위해 사용하는 표현이지 환자의 생물학적 상태 그 자체는 아니다.[1]
두 문장의 벡터 방향이 얼마나 비슷한지는 코사인 유사도(cosine similarity)로 비교한다. 문구가 완전히 같지 않아도 의미가 비슷하면 가까운 값이 나오도록 하는 접근이다. 다섯 번의 답을 서로 짝지으면 열 쌍이다. 논문은 이 모든 쌍의 유사도를 평균 낸다.[1]
N은 실행 횟수, eᵢ는 i번째 출력의 임베딩이다. 앞의 계수는 쌍별 유사도 합을 평균으로 바꾸기 위한 것이다. 이어 평균을 0과 1 사이로 제한해 일관성 점수 Scon을 만든다. 이 식은 논문의 방법을 설명한 것이며 새로 고안한 안전성 공식이 아니다.
여기서 0.90은 ‘다섯 번 중 90%가 같은 병명을 말했다’가 아니다. 다섯 번 실행으로 그런 투표 비율을 직접 만들 수도 없다. 문장을 벡터로 바꾼 뒤 계산한 연속적인 유사도 점수다. 따라서 0.90을 환자가 해당 질병을 가질 확률 90%로 해석해서도 안 된다.
#셋째, 일관성 기준을 넘는 사례만 남긴다
실행 결과의 진단이 충분히 일관적이면 자동 처리 후보로 남기고, 그렇지 않으면 사람 검토 대상으로 보낸다. 연구진은 기준을 바꾸면서 얼마나 많이 남길 수 있는지와 남긴 집단이 얼마나 정확한지를 함께 그렸다. 앞의 양을 커버리지(coverage), 뒤의 오류 수준을 선택적 위험으로 이해할 수 있다.[1]
문제를 적게 풀면 평균 점수가 높아지는 것과 비슷하지만, 쉬운 문제를 정답지를 보고 골라서는 의미가 없다. 실제 운영 때 사용할 수 있는 신호로 선택해야 한다. 이번 접근은 정답을 직접 보지 않는 반복 일관성을 이용한다. 다만 기준의 성능을 평가한 시험 집단과 미래에 들어오는 환자 집단이 다르면 관계가 달라질 수 있다.
#5. 핵심 실험과 수치
#최고 진단 모델과 일관성 분석 모델은 같지 않다
주요 진단 비교에서 MIRA-v2는 551개 사례와 7개 질환, CDM은 2,400개 사례와 4개 복부 질환을 사용했다. 두 평가 모두 MIMIC-IV 계열의 단일 기관 의료기록을 바탕으로 한다. 이 사례 수는 논문을 위해 새로 모집한 임상시험 환자 수가 아니다.[1]
공개 결과에서 Qwen3.5의 정확도는 MIRA-v2 약 90.0%, CDM 83.8%였다. 동일한 에이전트 구조의 클라우드 GPT-5.2 비교는 MIRA-v2 90.7%였다. 그런데 주요 신뢰도·선별 분석에서는 구조를 고정한 GLM-4.5-Air 기본 구성을 사용했다. Qwen의 최고 정확도와 뒤의 선별 성적을 한 모델의 한 번 실행 결과처럼 이어 붙이지 않는다.[1]
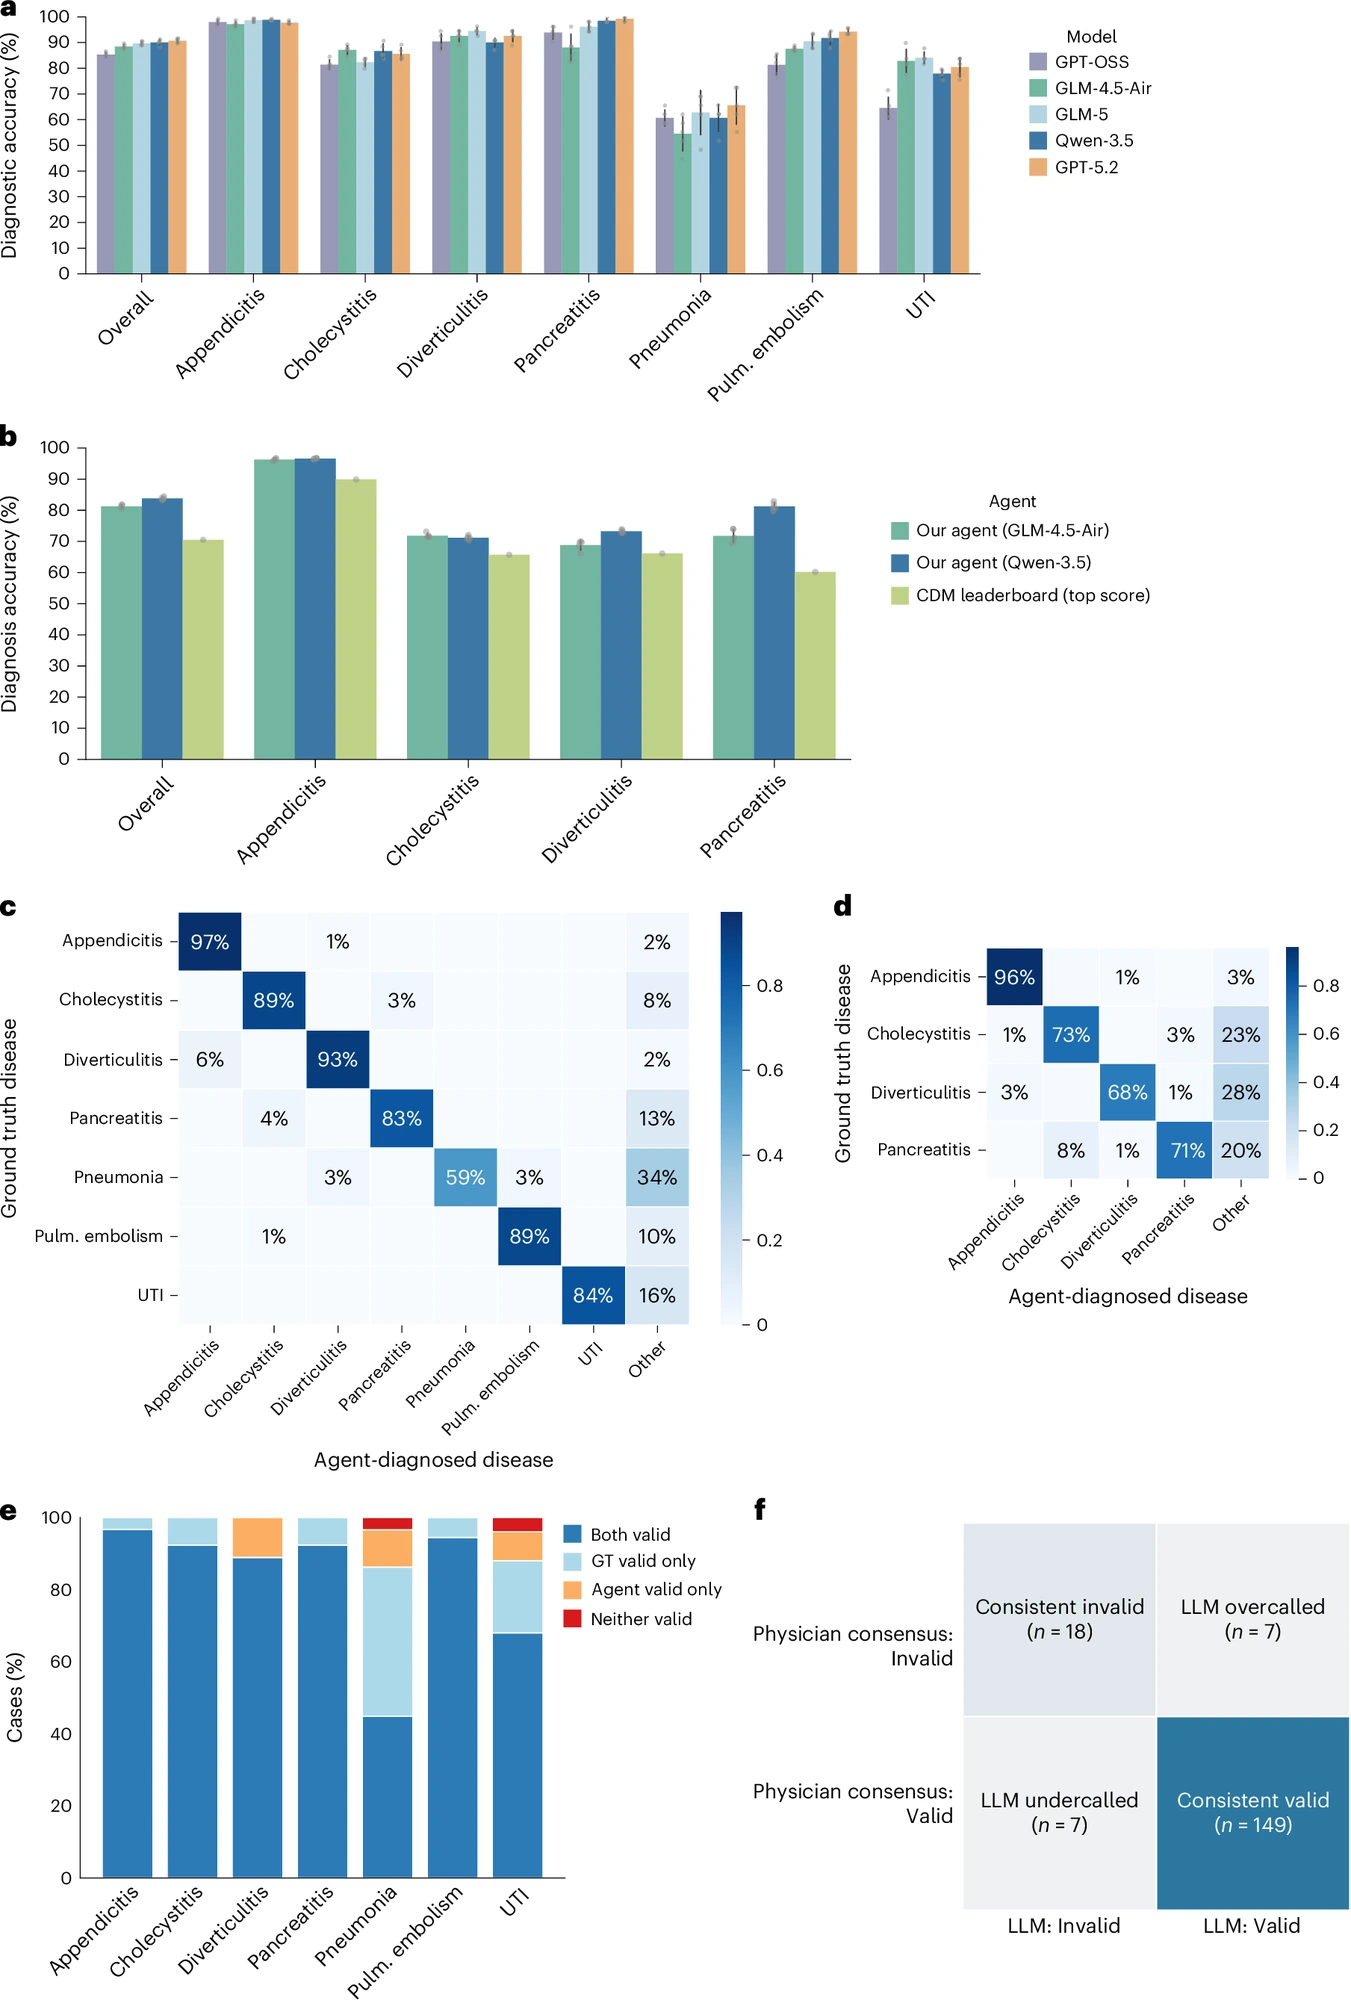
이번 논문의 Figure 2는 모델별·질환별 평가와 실행 변동을 함께 보여준다. 막대 하나의 높이만 보는 대신 비교 조건과 질환별 차이를 확인해야 한다. 일부 질환의 성적이 좋아도 다른 질환의 오류가 사라지는 것은 아니다. 숫자를 한 줄로 압축할수록 이런 분포가 보이지 않게 된다.[1]
#49.4%를 남겼을 때 98.9%라는 말의 분모
일관성 기준을 0.90으로 두면 MIRA-v2의 551개 중 272개가 남았다. 남긴 272개 중 269개는 맞고 3개는 틀렸다. 따라서 커버리지는 약 49.4%, 그 집단의 진단 정확도는 약 98.9%다. 전체 551개를 98.9%로 진단했다는 결과가 아니다.[1]
| 선별 결과 | 사례 수 | 해석 |
|---|---|---|
| 원래 평가 대상 | 551 | 주요 신뢰도 평가의 전체 집단 |
| 자동 처리 후보로 남김 | 272 | 전체의 49.4% |
| 남긴 집단에서 정답 | 269 | 272개를 분모로 계산 |
| 남긴 집단에서 오류 | 3 | 높은 일관성에서도 오류가 남음 |
| 사람 검토로 보냄 | 279 | 정답이던 230개와 오답이던 49개 포함 |
마지막 행도 중요하다. 사람에게 넘긴 사례가 모두 틀린 사례는 아니다. 이미 모델이 맞힌 230개도 함께 넘어간다. 사람 검토가 그 279개를 모두 정확히 해결했는지, 검토 시간은 얼마나 걸렸는지, AI 없이 진료할 때보다 결과가 좋아졌는지는 이 표만으로 알 수 없다. 이를 ‘의사 업무가 절반으로 줄었다’고 바꾸지 않는다.
#외부 평가가 없었던 것은 아니다
논문에는 주요 두 평가 외에 VivaBench 990개 증례, 10개 전문 분야 평가도 있다. 이는 의사들이 정리한 PubMed 증례 기반의 외부 벤치마크다. 따라서 두 주요 평가가 MIMIC-IV에서 왔다는 사실을 ‘외부 자료를 전혀 쓰지 않았다’고 확대하면 부정확하다.[1]
다만 외부 벤치마크는 다른 병원에 실제로 배포해 환자를 진료한 시험과 다르다. VivaBench에서 Qwen3.5는 72.22% 수준의 정확도를 보였고, 선택적 처리 분석의 한 지점은 기준 0.85에서 32.0%를 남겨 89.9% 정확도를 기록했다. 데이터가 바뀌면 전체 성능과 선별 기준의 결과도 달라진다는 점을 보여준다. MIRA의 0.90·98.9%와 섞지 않는다.[1]
#6. 논문의 한계와 반대 증거
#같은 답을 반복해서 틀릴 수도 있다
일관성은 유용한 신호지만 정답의 증명은 아니다. 모델이 같은 편향이나 누락된 정보를 공유하면 다섯 번 모두 비슷한 오답을 낼 수 있다. 실제로 선별 집단에도 세 오류가 남았다. 검사 결과의 정확성을 외부 기준과 대조하는 일과, 모델 출력끼리 서로 비슷한지 비교하는 일은 근본적으로 다르다.
논문은 진단 일관성이 정오를 구분하는 성능을 ROC 곡선의 면적인 AUC로도 평가했다. 주요 조건의 0.860과 스트레스 조건의 0.875는 오류를 구분하는 점수의 판별력을 나타낸다. ‘환자의 질환을 86.0%로 진단했다’는 별도의 정확도 수치가 아니다. 한 연구에서 서로 다른 지표가 0과 1 사이로 표시된다고 같은 의미는 아니다.[1]
일관성은 임베딩 모델, 생성 온도, 반복 횟수에도 영향을 받는다. 온도(temperature)는 여기서 체온이 아니라 생성의 무작위성을 조절하는 설정이다. 논문은 이런 구현 조건의 민감도도 분석한다. 실제 운영 모델을 업데이트하면서 기준 0.90만 그대로 복사해도 안전성이 유지된다고 가정할 수 없다.[1]
#다섯 번 물으면 계산도 더 필요하다
이 방법의 신뢰도 신호는 무료가 아니다. 독립 실행 다섯 번이면 단일 실행보다 더 많은 토큰과 연산이 필요하다. 직렬로 실행하면 대기시간이 늘 수 있고 병렬 실행은 서버 자원을 더 요구한다. 내부 서버가 있다는 사실만으로 이런 반복 평가가 필요한 속도와 비용에 맞는지는 알 수 없다.
의료 판단에는 시간을 지체할 수 없는 경우도 있다. 따라서 높은 선별 정확도뿐 아니라 판단까지의 시간, 사람에게 넘긴 뒤 처리 흐름, 시스템 장애 시 대안까지 평가해야 한다. 이 문단은 실제 도입을 위한 후속 질문이며, 논문이 이런 운영 전체를 이미 구현했다고 주장하는 설명이 아니다.
#기록으로 만든 대화는 실제 환자와 다르다
과거 기록에는 최종적으로 수집된 정보가 정리돼 있지만 실제 환자는 증상을 불완전하게 설명하거나 질문을 오해할 수 있다. 검사 선택에 따른 시간·위험·비용도 현실에서 발생한다. 시뮬레이션의 환자 에이전트가 그 모든 차이를 대변하지는 못한다. 실제 의료정보 시스템과의 표준 연동 역시 별도 검증이 필요하다.[1]
전향적 연구는 미리 계획한 절차로 앞으로 들어오는 사례에서 결과를 관찰하는 방식이다. 이번 후향적 벤치마크 연구는 그런 단계로 나아갈 질문을 제공하지만 대신하지는 않는다. 사람의 평가를 받은 일부 사례가 있다는 사실도 실제 환자를 대상으로 자율 진료의 위해를 평가한 임상시험으로 바뀌지 않는다.
#공개 코드와 이해관계도 함께 읽는다
연구진은 코드와 재현 자료를 공식 저장소 및 Zenodo에 공개했다. 그러나 공개 경로가 있다는 사실과 이 글이 전체 실험을 재실행했다는 것은 다르다. 여기서는 공개 논문과 방법·결과·코드 제공 안내를 대조했으며 독립적인 임상 성능 재현을 수행하지 않았다.[1][2]
저자 일부는 의료 AI·제약 관련 회사의 자문, 지분 또는 고용 관계를 밝혔다. 예를 들어 교신저자는 AstraZeneca·Bioptimus 자문과 여러 AI 기업 지분을, 다른 저자는 Synagen의 지분·고용 관계를 공개했다. 이는 결과가 틀렸다는 증거는 아니지만 기술 도입의 주장을 평가할 때 독립 검증이 필요한 배경이다.[1]
#7. 실제로 무엇이 달라질 수 있나
가까운 변화는 의료 AI를 평가하는 질문의 확장이다. ‘정확도가 몇 퍼센트인가’에서 멈추지 않고 ‘어떤 경우에 사용을 허용할 것인가’, ‘어떤 신호가 나오면 사람에게 넘길 것인가’를 명시할 수 있다. 모델 자체를 개선하는 일과 모델에 부여할 권한을 설계하는 일이 함께 필요해지는 것이다.
이는 에이전트 운영의 일반적인 원칙과도 연결된다. 계산 결과를 내는 단계, 근거를 검토하는 단계, 실제 행동을 승인하는 단계를 구분하면 실패의 위치를 더 잘 추적할 수 있다. 다만 의료 현장에 적용할 구체적인 승인 기준은 이 해설이 처방할 수 있는 값이 아니며 해당 업무의 위해와 실제 검증 자료를 바탕으로 정해야 한다.
기관 내부 모델은 버전을 고정하고 결과를 감사하는 체계를 구성하는 데 도움이 될 가능성이 있다. 그러나 운영 통제가 가능하다는 이유만으로 의료진을 대체할 준비가 끝났다고 결론 내리면 안 된다. 이 연구에서 배울 것은 무조건 자율성을 늘리는 방법보다, 자율성을 제한하는 기준을 측정하려는 접근이다.
#8. 다음에 확인할 트리거
다음으로는 실제 여러 병원에서 수집한 사례, 전향적 의료진 보조 평가, 사람에게 넘긴 뒤의 정확도와 처리 시간을 확인해야 한다. 특히 최종 시스템이 틀린 답을 채택한 비율과 검토 부담을 함께 보여줘야 한다. 특정 커버리지에서 높은 성적 하나만으로 비용·안전성·효용이 모두 해결된 것은 아니다.
같은 모델의 다른 버전이나 다른 언어, 다른 전문 분야에서도 일관성 기준이 유지되는지도 중요하다. 정답을 모르는데 자신 있어 보이는 시스템보다, 모르는 경우를 찾아내려는 시스템이 나은 방향일 수 있다. 하지만 ‘모름을 감지하는 능력’ 역시 독립적으로 검증해야 한다는 점은 변하지 않는다.
오늘 Top 1인 수소·담수 공동생산 시스템과 다른 후보 OECT 팽윤 측정도 같은 태도로 읽을 수 있다. 좋은 평균 성능뿐 아니라 어떤 운전 조건에서 실패할 수 있는지 드러낼 때, 연구가 실제 적용에 필요한 다음 질문을 제공한다.
#9. 출처
[1] Zhang et al., On-premise medical AI agents for reliable clinical decision-making, Nature Medicine, 2026-09-15. DOI: 10.1038/s41591-026-04609-x. 공개 본문·Methods·Results·Discussion·Figure 2·6·이해관계 및 보충자료를 대조했다. CC BY 4.0인 Figure 2·6의 전체 패널을 출처와 함께 사용했다. Flaticon 별도 권리가 있는 Figure 1은 재게시하지 않았다.
[2] 저자 공식 코드 저장소와 Zenodo 재현 자료. 논문의 Code availability에서 연결된 경로다. 코드 공개 사실을 재현 성공으로 소개하지 않는다.