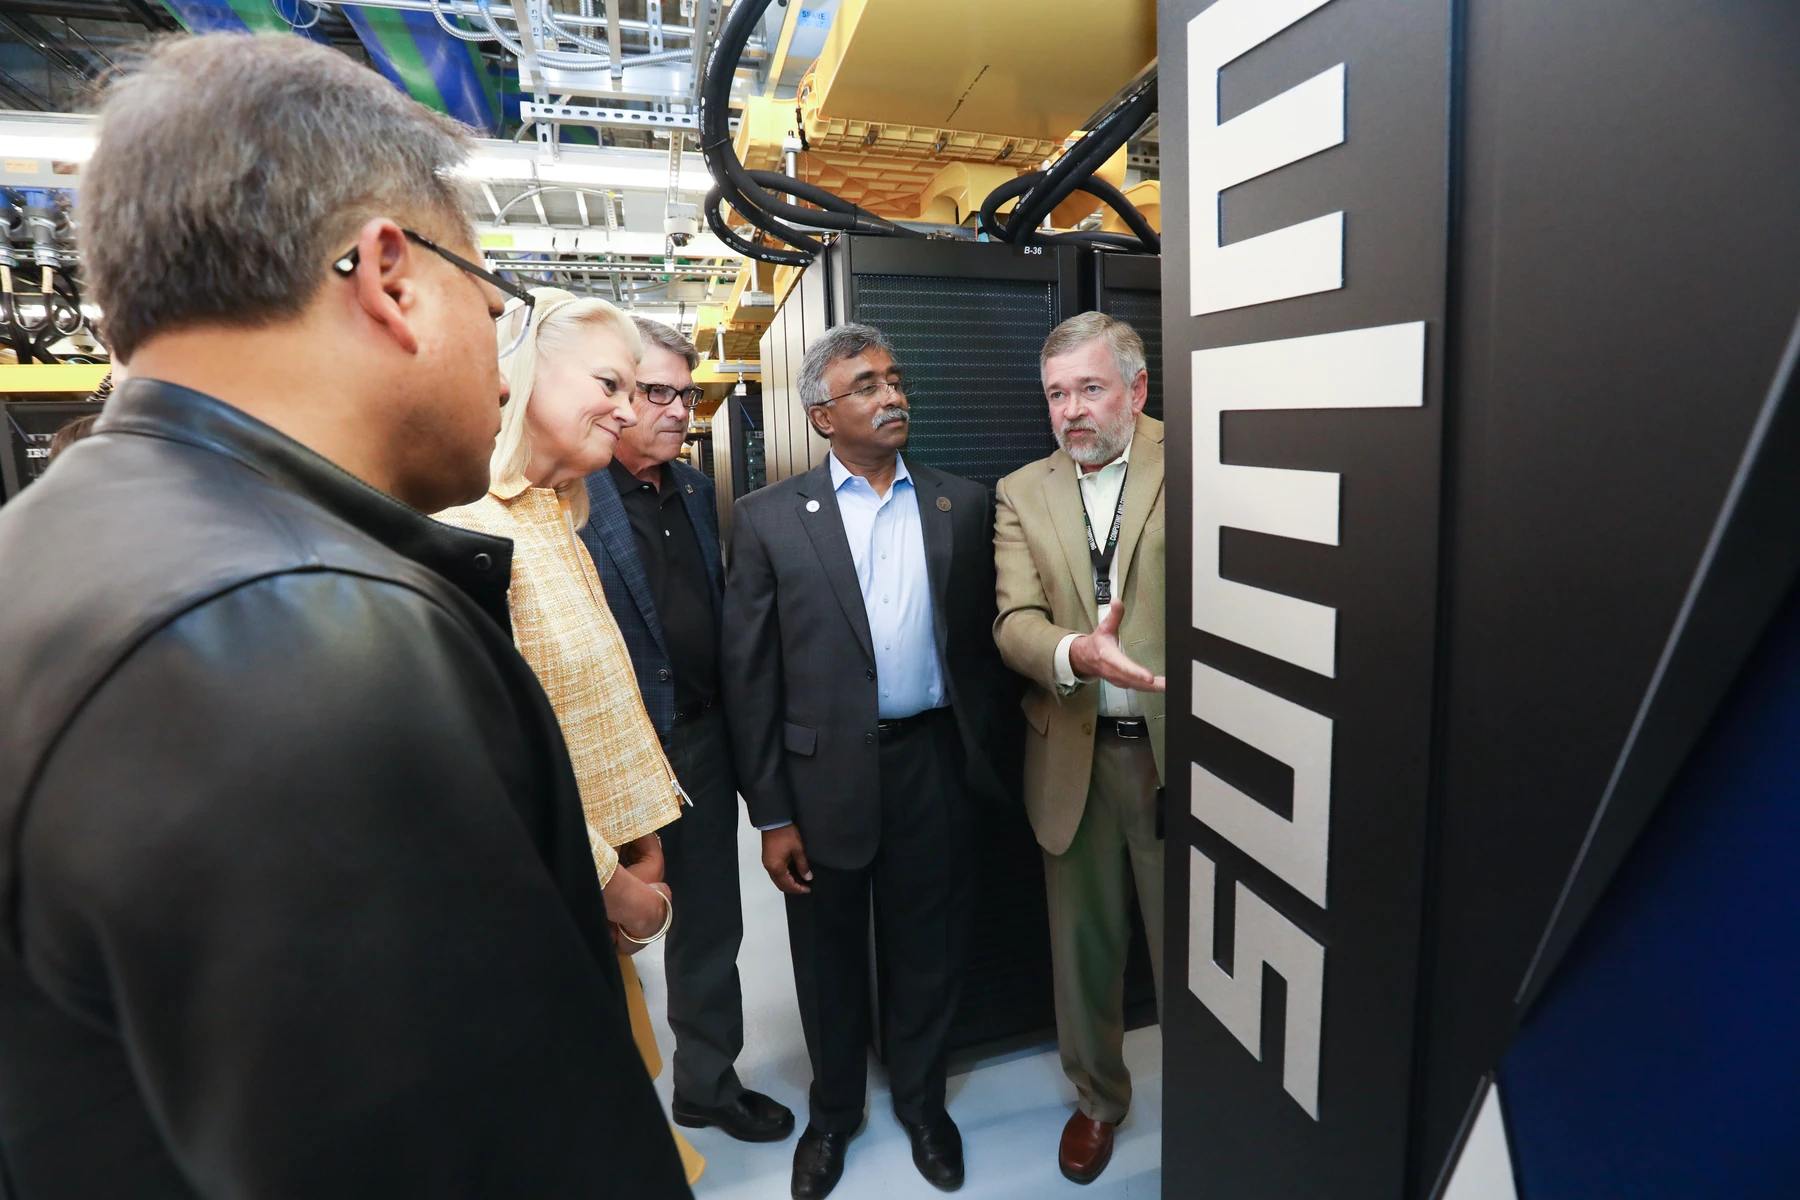
자료 기준: 2026년 9월 16일 발표, 9월 17일 원자료 대조. 증거 등급: INDUSTRY_TRIGGER. MLPerf 규칙에 따른 기업 제출 결과이며 학술지 동료평가 논문이나 제3자가 Rubin 장비를 독립 재실험했다는 뜻은 아니다. 대표 사진은 2018년 Summit 슈퍼컴퓨터의 랙으로, Rubin 실물이나 이번 시험 장비 사진이 아니다. 이번 플랫폼의 모습과 회사 원본 도표는 NVIDIA 공식 발표에서 확인할 수 있다.
#1. 한 문장 결론
Vera Rubin NVL72의 MLPerf 데뷔는 ‘새 GPU가 몇 배 빨라졌다’보다, 같은 품질·응답 조건에서 랙 전체가 얼마나 많은 요청을 처리하는지 비교할 자료가 생겼다는 사건이다. NVIDIA는 Qwen3-VL에서 GB300 NVL72 대비 최대 3.7배, DeepSeek-R1에서 최대 2.5배의 처리량을 발표했다. 하지만 모든 시나리오가 그만큼 빨라진 것은 아니며, 해당 Rubin 제출은 Preview로 분류돼 있다.[1][2]
여기서 토큰(token)은 모델이 문장을 다룰 때 사용하는 조각이다. 한 토큰이 항상 한 단어나 한 글자는 아니다. 처리량(throughput)은 일정 시간에 처리한 일의 양이고, 지연시간(latency)은 개별 사용자가 기다린 시간이다. 하루에 손님을 많이 받는 식당도 내 음식은 늦게 나올 수 있듯, 두 숫자는 같은 뜻이 아니다. 이 차이부터 알아야 ‘3.7배’가 내 서비스에 어떤 의미인지 판단할 수 있다.
MLCommons는 표준 시험의 규칙과 결과를 공개하는 조직이다. NVIDIA는 그 규칙에 맞춰 자기 하드웨어와 소프트웨어의 결과를 제출한다. 따라서 회사 자체 시연만 있는 경우보다 비교의 공통 바탕은 강해지지만, 이해관계가 사라지는 것은 아니다. 이 글은 회사가 설명한 원인, 공식 집계표에서 확인한 값, 설명을 위해 계산한 예시를 따로 표시한다.[1][3]
#2. 왜 이 문제가 어려운가
#GPU가 빠른데도 답변은 늦을 수 있다
GPU는 같은 종류의 수많은 계산을 병렬로 수행하는 장치다. CPU는 운영체제, 작업 배치, 데이터 준비 등 전체 작업을 조정한다. GPU 옆 고대역폭 메모리(HBM)는 모델의 숫자와 중간 상태를 보관한다. 여러 GPU가 하나의 모델을 나누어 처리하면 장치 사이를 연결하는 통신망도 계산의 일부처럼 중요해진다. 어느 한 부분이 기다리면 다른 부분의 최대 계산 능력은 온전히 쓰이지 않는다.
FLOPS는 초당 부동소수점 연산 횟수다. 계산기의 최대 계산 속도에 가까운 지표이지, 사용자의 질문 하나가 끝나는 시간을 직접 말해 주는 지표는 아니다. 같은 GPU라도 모델 크기, 입력 길이, 출력 길이, 동시에 들어오는 요청 수가 달라지면 병목이 바뀐다. 아주 큰 행렬을 한꺼번에 곱할 때와 작은 작업을 순서대로 반복할 때는 좋은 설계의 기준부터 다르다.
언어 모델의 추론(inference)은 크게 두 단계로 나눠 생각할 수 있다. 프리필(prefill)은 사용자가 넣은 질문과 문서를 읽어 내부 상태를 준비하는 단계다. 디코드(decode)는 그 상태를 바탕으로 다음 토큰을 차례로 생성하는 단계다. 프리필은 긴 입력을 묶어서 처리할 여지가 크고, 디코드는 앞서 생성한 결과를 기다리며 반복한다. 둘을 같은 작업으로 취급하면 어느 자원에 힘을 줘야 할지 잘못 판단하기 쉽다.
KV 캐시(KV cache)는 이미 읽은 문맥의 일부 계산 결과를 저장해 다음 단계에서 다시 쓰는 공간이다. 매번 책을 처음부터 재독하지 않도록 꽂아 두는 색인에 비유할 수 있다. 입력이 길거나 대화가 많아지면 이 저장 공간도 커진다. 모델 가중치만 메모리에 들어간다고 서비스가 원활하게 돌아가는 것은 아닌 이유다. 동시에 처리할 대화 수를 늘리다가 메모리가 먼저 부족해질 수 있다.
#모델을 나누면 통신이라는 새 숙제가 생긴다
전문가 혼합 모델(Mixture-of-Experts, MoE)은 입력마다 여러 하위 네트워크 중 일부를 골라 쓴다. 전문가(expert)는 사람이 아니라 모델의 계산 블록이다. 전문가 병렬화(expert parallelism)는 이 블록들을 여러 가속기에 나누어 놓는 방식이다. 계산을 덜 하도록 전문가를 선택했더라도, 해당 전문가가 다른 GPU에 있다면 입력과 결과가 장치를 오가야 한다.
이때 중요한 것은 통신망의 큰 숫자 하나만이 아니다. 얼마나 많은 데이터를 보낼 수 있는지뿐 아니라 작은 메시지가 얼마나 빨리 도착하는지, 특정 장치로 요청이 몰리지 않는지, 통신과 계산을 얼마나 겹쳐 수행하는지도 중요하다. 따라서 GPU의 계산량 증가만 보고 MoE 서비스의 응답 속도를 예측하면 통신 대기와 자원 불균형을 빠뜨릴 수 있다.
랙(rack)은 서버와 통신 장치를 쌓아 넣는 물리적 프레임이다. 그러나 NVL72 같은 설계에서 랙은 단순 선반을 넘어 여러 가속기가 협력하는 시스템 단위가 된다. 이번 비교에서 확인할 단위도 단일 GPU가 아니라 같은 수의 가속기를 포함한 시스템이다. 공식 CSV에서 시스템 이름에 ‘72’가 있다고 끝내지 않고 실제 total_accelerators가 72인 행을 골랐다. 같은 GB300 이름 아래 288개 가속기 결과도 함께 있기 때문이다.[3]
#3. 기존 방식은 무엇이 부족했나
#최고 연산량과 서비스 성능은 다른 시험이다
제품 소개의 최대 FLOPS는 하드웨어가 특정 숫자 형식과 계산에서 낼 수 있는 잠재력을 보여 준다. 반면 서비스는 모델의 답변 품질과 사용자의 기다림까지 관리해야 한다. 계산을 과감하게 줄여 빠르게 만들었지만 답이 틀리거나, 요청을 오래 모아 큰 묶음으로 처리하느라 사용자가 기다린다면 서비스 목표를 만족했다고 할 수 없다.
MLPerf의 Closed 부문은 이러한 비교를 위해 기준 모델과 품질 조건 등의 규칙을 둔다. 그렇다고 모든 회사가 같은 실행 코드를 쓰거나 모든 숫자를 같은 정밀도로 저장한다는 뜻은 아니다. 모델을 어떤 커널로 실행하고, 어떤 허용된 최적화를 적용하고, 요청을 어떻게 배치하는가는 여전히 경쟁의 대상이다. 따라서 Closed는 ‘하드웨어만 바꾼 완벽한 통제 실험’보다 ‘정해진 과제를 정해진 품질 조건으로 수행하는 시스템 비교’라고 이해하는 편이 정확하다.[4]
시나리오도 구분해야 한다. Offline은 미리 준비한 일을 충분히 제공했을 때 얼마나 많이 처리하는지에 초점을 둔다. Server는 요청이 도착하는 상황에서 정해진 지연 조건을 지키는 처리 능력이 중요하다. Interactive는 상호작용에 필요한 더 엄격한 응답 특성을 다룬다. 정확한 지연 제한과 품질 기준은 모델과 해당 버전의 규칙을 함께 봐야 하며, 이름만으로 임의의 시간 제한을 붙여서는 안 된다.[4][6]
예를 들어 야간 일괄 문서 분석 서비스는 대량 처리량을 우선할 수 있다. 반대로 사용자가 화면 앞에서 대화하는 서비스는 첫 답이 나오는 시간과 이후 토큰이 이어지는 속도가 중요하다. 한 시스템의 Interactive 개선 폭을 다른 서비스의 Offline 개선 폭으로 그대로 옮기는 것은 서로 다른 종목의 기록을 섞는 일이다.
#단일 벤치마크 우승은 모든 작업의 우승이 아니다
이미지를 읽는 시각·언어 모델(Vision-Language Model, VLM)에는 이미지 처리와 텍스트 생성이 함께 들어간다. 추론형 언어 모델은 긴 출력과 여러 단계의 사고를 요구할 수 있다. 그래서 같은 장치의 결과도 모델별로 달라진다. NVIDIA가 이번에 제출한 Qwen3-VL과 DeepSeek-R1은 의미 있는 대형 과제이지만, 모든 기업의 사내 모델과 모든 입력 길이를 대표하지는 않는다.[2]
이 글에서 새로운 기술의 원인을 세 단계로 설명하는 것은 이해를 돕기 위한 구조다. 세 단계를 각각 켰다 끄며 기여도를 측정한 독립 절제 실험(ablation)을 확인한 것은 아니다. 최종 성능 차이를 GPU, 정밀도, 통신망의 몫으로 몇 퍼센트씩 나누어 말하지 않는다.
#4. 새 방법을 3단계로 설명
#첫째, 계산해야 할 숫자와 옮겨야 할 숫자를 함께 줄인다
NVIDIA는 Rubin의 Tensor Core와 Transformer Engine, 그리고 NVFP4 활용을 주요 요소로 설명한다. Tensor Core는 행렬 계산을 빠르게 수행하는 연산 장치이고, Transformer Engine은 모델 계산에 적절한 숫자 형식을 사용하는 소프트웨어·하드웨어 지원을 포함한다. 정밀도(precision)는 숫자를 얼마나 자세하게 표현하느냐를 말한다.[2]
큰 숫자 형식을 작은 형식으로 바꾸면 저장 공간과 데이터 이동량을 줄일 기회가 생긴다. 그러나 자릿수를 줄이면 반올림과 표현 범위의 문제도 생긴다. 노트에 소수점 아래 열 자리까지 적던 값을 두 자리만 남겨 적는 비유를 떠올릴 수 있다. 실제 NVFP4는 단순히 모든 값을 같은 네 비트 정수로 바꾸는 방식은 아니지만, 정밀도와 비용 사이의 교환 관계를 이해하는 데는 이 비유가 유용하다.
회사 설명은 가중치뿐 아니라 attention과 KV 캐시까지 낮은 정밀도의 활용 범위를 넓혔다고 말한다. 다만 CSV의 weight_data_types 한 열을 곧바로 모든 연산·캐시의 정밀도로 읽으면 안 된다. 확인한 VLM 행의 그 열에는 bf16이, DeepSeek-R1 행에는 fp4가 기록되어 있다. 이 메타데이터와 회사의 전체 스택 설명은 범위가 다르다. ‘모든 계산이 NVFP4’라고 하나의 문장으로 합치지 않는다.[2][3]
#둘째, 질문을 읽는 팀과 답을 쓰는 팀을 분리한다
분리형 서빙(disaggregated serving)은 프리필과 디코드를 서로 다른 자원에 배치하는 접근이다. 식당으로 비유하면 주문 전처리를 하는 팀과 완성된 음식을 내보내는 팀을 각 작업에 맞게 구성하는 셈이다. 길이가 긴 문서를 읽는 요청이 짧은 답변을 이어 쓰는 요청을 계속 밀어내지 않도록 자원 배치를 조절할 수 있다.[2]
분리는 공짜가 아니다. 프리필에서 만든 상태를 디코드 쪽으로 전달해야 하고, 두 팀 중 하나만 바빠지면 나머지 자원이 놀 수 있다. 입력 길이와 출력 길이가 바뀌면 최적 비율도 달라진다. 그러므로 ‘분리하면 무조건 빨라진다’보다, 전송 비용과 자원 분배를 관리할 수 있는 시스템에서 유리해질 수 있다고 이해해야 한다.
NVIDIA는 Qwen3-VL에 vLLM과 Dynamo, DeepSeek-R1에 TensorRT-LLM을 사용했다고 밝혔다. vLLM과 TensorRT-LLM은 모델을 실제로 실행하고 요청을 처리하는 추론 소프트웨어이며, Dynamo는 분산된 추론 자원을 조정하는 역할을 맡는다. 서로 다른 소프트웨어 이름을 새로운 칩 이름으로 혼동하지 않는 것이 중요하다.[2]
#셋째, 여러 GPU 사이의 이동을 랙 안에서 조율한다
NVLink와 NVLink Switch는 여러 GPU 사이의 데이터를 교환하는 연결 기반이다. 회사는 여섯 번째 세대 NVLink와 대규모 전문가 병렬화를 이번 스택의 핵심으로 제시한다. CPU가 작업을 준비하고, GPU가 계산하고, HBM이 상태를 보관하며, 연결망이 분산된 전문가를 묶는 전체 흐름을 동시에 설계한다는 뜻이다.[2]
이런 공동 설계(co-design)의 장점은 장치 하나의 약점을 다른 계층의 선택으로 줄일 수 있다는 것이다. 반면 실제 이용자는 하드웨어뿐 아니라 특정 실행 소프트웨어와 운영 방법의 성숙도에도 영향을 받는다. 벤치마크의 모델·설정을 그대로 쓸 때와 자체 모델을 포팅할 때의 비용이 다를 수 있다는 점도 시스템 평가에 포함해야 한다.
#5. 핵심 결과와 수치: ‘최대’ 뒤의 조건을 읽자
NVIDIA 발표의 ‘최대 3.7배’는 Qwen3-VL 세 시나리오 모두가 3.7배라는 말이 아니다. 9월 17일 확보한 MLCommons summary.csv에서 NVIDIA의 72가속기 GB300·VR200 행을 같은 모델·시나리오끼리 대응해 나눈 값은 다음과 같다. VR200은 해당 집계표에 적힌 시스템 명칭이며, 발표문은 Vera Rubin NVL72라는 제품명을 쓴다.[2][3]
| 과제 | 시나리오 | GB300 결과 | VR200 결과 | 같은 행끼리 나눈 비율 |
|---|---|---|---|---|
| Qwen3-VL | Offline | 1,304.99 samples/s | 2,392.70 samples/s | 약 1.83배 |
| Qwen3-VL | Server | 1,210.49 queries/s | 2,323.27 queries/s | 약 1.92배 |
| Qwen3-VL | Interactive | 349.29 queries/s | 1,306.61 queries/s | 약 3.74배 |
| DeepSeek-R1 | Offline | 679,740 tokens/s | 1,183,326.85 tokens/s | 약 1.74배 |
| DeepSeek-R1 | Server | 596,944 tokens/s | 1,175,890.22 tokens/s | 약 1.97배 |
| DeepSeek-R1 | Interactive | 253,506 tokens/s | 652,750.14 tokens/s | 약 2.57배 |
표의 수치는 원자료의 소수점을 반올림한 값이며, 배율은 원래 정밀도로 계산했다. Qwen3-VL의 queries/s와 DeepSeek-R1의 tokens/s는 단위가 다르므로 서로 직접 나누어 모델 간 우열을 만들지 않는다. 이 표는 원자료 대응 계산이지 실제 장비를 다시 실행한 결과가 아니다.[3]
회사 발표는 DeepSeek-R1을 최대 2.5배라고 표현하지만, 확보한 CSV의 Interactive 행끼리 나누면 약 2.57배다. 이 차이를 조용히 같은 숫자로 덮지 않는다. 회사 발표의 표현은 2.5배로 인용하고, 시점이 명시된 집계표 계산은 약 2.57배로 따로 남긴다. 공식 제출 사이트의 ID와 CSV의 플랫폼·경로 식별자도 같은 열이 아니므로, 발표에 적힌 제출 ID가 CSV에 그대로 들어 있다고 주장하지 않는다.
공식 CSV에는 Rubin 행의 inferred가 1로 표시된다. 이 집계 표지만으로 전체 랙의 모든 시나리오가 각각 독립 실측됐다고 해석해서는 안 된다. 표지의 정확한 산출 의미와 개별 제출 로그까지 추가 대조하기 전에는 직접 측정 범위를 확대하지 않는다. 반대로 이 표지만 보고 결과 전체가 무효라고 단정할 근거도 없다. 독자는 공개 결과, 측정 로그, 제출 규칙을 함께 확인해야 한다.[3]
MLCommons 발표의 2.99배와 5.7배는 또 다른 비교다. 전자는 VLM의 최고 가속기당 Server 결과를 이전 v6.0과 비교한 값이고, 후자는 DeepSeek-R1 최고 결과의 v5.1 대비 변화다. 라운드 사이 최고 기록의 변화이지 동일 Rubin–GB300 행의 비율이 아니다. 이 두 종류의 배수를 한 그래프에서 같은 기준처럼 섞으면 결론이 달라진다.[1]
#6. 한계와 반대 증거
#Preview는 무엇을 말하고 무엇을 말하지 않는가
Available은 MLPerf가 정한 기준에 따라 구매하거나 클라우드에서 이용 가능한 제출 구성이고, Preview는 아직 그 구분에 해당하지 않는 제출이다. 이것은 매우 중요한 제한이다. 다만 벤치마크의 제출 구성 분류와 제품 전체의 제조 상태는 별개의 사실이다.[4]
NVIDIA는 이미 2026년 5월 31일 Vera Rubin 플랫폼의 본격 생산 확대를 회사 발표로 알렸다. 따라서 이번 Preview 결과를 소개하면서 ‘Rubin은 아직 전혀 생산되지 않았다’거나 ‘모든 Rubin 제품을 어디에서도 살 수 없다’고 쓰는 것은 확인 범위를 넘는다. 정확한 표현은 ‘이번에 비교한 Rubin 제출 구성은 MLPerf에서 Preview로 분류됐다’이다. 생산 시작, 개별 서버 구성의 주문 가능 여부, 고객 현장의 안정적 서비스는 서로 다른 단계다.[5]
MLCommons가 성능 결과를 검토한다고 해서 의학·공학 학술지의 논문 심사와 같은 절차를 거쳤다는 뜻도 아니다. 특히 공식 규칙의 Available 제출에 대한 감사 조건을 Preview에 그대로 적용해 제3자의 재측정이 끝났다고 말해서는 안 된다. 이번 자료의 강점은 규칙과 비교 결과가 공개됐다는 점이며, 독립 실험실의 재현을 대신하지 않는다.[6]
#전력과 가격이 없으면 비용 승자는 아직 정해지지 않는다
확인한 비교 행의 has_power는 False다. 메타데이터의 GPU 설계 전력 표기는 해당 시험에서 실제 랙 전체의 소비 전력을 시간에 따라 측정한 값과 다르다. 따라서 그 표기에 GPU 개수만 곱해 실제 전력 효율을 계산하거나, 여기에 3.7배를 적용해 전기요금 절감을 확정하지 않는다.[3]
총소유비용(Total Cost of Ownership, TCO)은 장비 구매비뿐 아니라 전력, 냉각, 네트워크, 공간, 정비, 운영 인력을 포함한다. 처리량이 늘어도 장비 비용이 더 크게 늘거나 실제 가동률이 낮으면 토큰당 비용은 기대만큼 줄지 않을 수 있다. 다음 식은 이 관계를 보여 주는 설명용 회계식이지 Rubin의 실제 원가 계산 결과가 아니다.
여기서 T는 초당 처리 가능한 토큰 수이고, u는 그 능력을 실제 유효 요청에 사용한 비율이다. 예를 들어 시간당 비용이 같고 가동률도 같을 때 처리량이 두 배가 되면 토큰당 비용은 절반이 된다. 반대로 비용도 두 배라면 그 효과는 사라진다. 이 예시는 조건의 중요성을 보여 줄 뿐, 이번 장비의 가격이나 가동률을 가정한 예측이 아니다.
#7. 실제로 무엇이 달라질 수 있나
이번 발표의 산업적 의미는 구매 담당자가 물어야 할 질문을 바꾼다는 데 있다. ‘어느 GPU가 가장 큰 FLOPS를 갖는가’에 더해 ‘우리 입력 길이와 출력 길이에서, 필요한 응답 시간을 지키며, 한 랙이 얼마만큼의 유효 작업을 처리하는가’를 물어야 한다. 회사의 최고 기록은 후보를 좁히는 출발점이지 서비스 계약의 보증 수치가 아니다.
실무에서는 먼저 자신의 작업을 정의해야 한다. 이미지가 섞이는지, 긴 문서를 읽는지, 답변이 길게 이어지는지, 갑자기 요청이 몰리는지에 따라 필요한 시험이 달라진다. 다음으로 같은 모델 품질 조건과 비슷한 입력·출력 분포에서 비교해야 한다. 마지막으로 최대 처리량 외에도 첫 토큰 시간, 지속 생성 속도, 요청 실패, 실제 전력과 유효 이용률을 함께 기록해야 한다.
이 관점은 대형 데이터센터만의 문제가 아니다. 작은 연구실이 제한된 GPU에서 비전·언어 모델을 실행할 때도 메모리 용량, KV 캐시, 동시 요청과 런타임 선택의 영향을 받는다. 다만 72개 가속기의 랙에서 얻은 배수를 노트북 한 대의 성능 향상으로 옮겨서는 안 된다. 같은 병목 원리가 존재한다는 것과 개선 폭이 같다는 것은 다른 주장이다.
이 글의 Top 1 선택은 제공된 편집안의 95점 판단을 출발점으로 삼았다. 학회 수상이나 MLCommons의 공식 종합 점수가 아니다. 중요도를 판단한 핵심은 신제품 발표에 공개 비교 자료가 붙었다는 점이고, 검증 후 보완한 핵심은 시나리오별 차이·단위·생산 상태·미확인 메타데이터를 드러냈다는 점이다. 새로운 수치가 나온다고 이전에 소개한 수소 공정 연구의 과학적 가치가 사라지는 것은 아니다.
#8. 다음에 확인할 트리거
가장 먼저 볼 것은 같은 제출 구성이 Available로 전환되는지와 그때 소프트웨어·장비 구성이 어떻게 달라지는지다. 이름이 같다는 이유만으로 Preview와 후속 Available 결과를 같은 시스템의 연속 기록이라고 가정하지 않는다. 변경된 모델 버전이나 실행 설정이 있다면 별도 비교가 필요하다.
두 번째는 실제 전력 측정이다. 토큰당 에너지(tokens/J의 역수)를 말하려면 시험 동안 소비한 에너지와 처리한 유효 작업을 함께 알아야 한다. 냉각이나 네트워크를 어디까지 포함했는지도 밝혀야 한다. 측정 경계가 다른 수치를 같은 전력 효율 순위에 넣으면 하드웨어 선택을 오도할 수 있다.
세 번째는 이 글에서 분리해 둔 메타데이터와 원시 로그다. inferred 표지의 구체적 의미, 제출 사이트 ID와 저장소 경로의 대응, 회사 발표 2.5배와 확보된 집계표 계산의 차이를 추적할 수 있어야 한다. 공개 집계표도 수정될 수 있으므로 검토 시점과 파일 해시를 남기는 것이 중요하다.
네 번째는 실제 고객의 다양한 모델과 장기간 운영 결과다. 여러 사용자가 자원을 공유하는 환경에서는 최대 처리량보다 꼬리 지연시간과 장애 복구가 먼저 문제가 될 수 있다. 특정 벤치마크에서 성공한 분리형 서빙이 긴 입력·짧은 출력, 짧은 입력·긴 출력 모두에서 유리한지 확인해야 한다.
함께 검토한 생명과학 후보는 MS 재발 전 EBV 신호와 청소년 혈우병 B 유전자 치료다. 전자는 관찰연구의 인과 추론, 후자는 초기 인간 임상의 안전성 해석이 핵심이다. 세 글 모두 큰 숫자를 소개하는 데서 멈추지 않고, 그 숫자의 분모와 측정 조건부터 확인한다.
#9. 출처
[1] MLCommons, MLPerf Inference v6.1 공식 결과 발표, 2026-09-16. 라운드 전체의 최고 성능 변화와 새 시험 소개.
[2] Zhihan Jiang / NVIDIA, Vera Rubin NVL72의 MLPerf 데뷔 기술 설명, 2026-09-16. 최대 배율과 소프트웨어·하드웨어 설명은 기업 자체 발표로 인용했다.
[3] MLCommons, inference_results_v6.1 / summary.csv. 2026-09-17 취득본의 NVIDIA·72가속기·동일 모델·동일 시나리오 행을 대조했다. 결과 표는 재실행이 아니라 해당 행의 비율 계산이다. 취득 해시와 원행은 저장소의 검토 기록에 보존했다.
[4] MLCommons, MLPerf Inference: Datacenter. Closed/Open, Available/Preview와 결과표 해석 안내. 2026-09-17 확인.
[5] NVIDIA, Vera Rubin full-production ramp 발표, 2026-05-31. 회사의 생산 발표와 벤치마크 제출 구성의 Preview 분류를 구분하기 위한 반대 근거.
[6] MLCommons, Inference Rules. 모델·품질·시나리오 및 제출 감사 규칙. 최신 저장소 문서는 이후 수정될 수 있으며, 이번 해설은 2026-09-17 확인 범위에 한정한다.