#1. 혈액검사의 성능을 읽는 첫 질문
췌장암을 혈액으로 더 이른 시기에 찾으려면 두 가지를 동시에 해결해야 한다. 암이 있는 사람의 신호를 충분히 포착하고, 암이 없는 사람에게 불필요한 추가 검사를 너무 많이 유발하지 않아야 한다. PANXEON은 10종 microRNA 신호와 CA19-9를 결합해 초기 췌관선암을 구별하는 복합 생체표지자 검사다. 2026년 9월 16일 Nature Medicine에 발표된 연구는 네 나라 1,785명이 참여한 다기관 전향적 관찰 연구에서 그 가능성을 평가했다.[1]
검증해야 할 핵심은 “혈액만으로 암을 알 수 있다”라는 문장보다 구체적이다. 어떤 사람들을 비교했으며, 몇 병기의 암을 얼마나 발견했고, 비교군에서는 얼마나 자주 양성이 나왔는가? 이 질문에 따라 같은 86.8%라는 숫자의 의미가 달라진다. 특히 저위험 대조군과 고위험 대조군의 결과를 따로 읽어야 한다.
이 글은 연구 결과를 해설한다. 개인의 증상이나 검사 결과를 해석하거나 검사 여부를 결정하는 안내는 아니다. 연구팀의 공식 발표에서도 PANXEON을 연구용 검사로 소개하며, 추가 평가가 필요한 고위험 사람을 찾는 보완 도구로 설명한다.[2]
#2. 하나의 표지자로 구별하기 어려운 문제
검사의 입력은 혈액 속 분자 정보이고, 검사자가 알고 싶은 것은 췌관선암의 존재다. 이 둘 사이에는 여러 단계가 있다. 분자가 혈액에 얼마나 나타나는지, 채혈과 보관 뒤 얼마나 안정적으로 측정되는지, 암 이외의 상태에서도 비슷한 신호가 나타나는지, 여러 신호를 합친 점수가 어떤 기준에서 양성이 되는지 확인해야 한다.
PANXEON의 발상은 하나의 표지자에 모든 역할을 맡기기보다 서로 다른 정보의 조합으로 분별력을 높이는 것이다. 논문은 microRNA signature와 CA19-9를 결합한다. 연구기관의 설명에서는 순환 microRNA, 엑소좀 관련 microRNA, CA19-9의 정보를 하나의 점수로 통합하는 접근을 소개한다.[1][2]
microRNA는 여기에서 읽어야 할 분자 신호다. 엑소좀은 신호가 관측되는 생물학적 맥락을 설명하고, CA19-9는 결합에 사용하는 별도의 표지자다. 측정하는 표지자와 최종 예측 점수는 서로 다른 층위다. 표지자 하나의 값이 높다는 것, 여러 표지자를 입력한 점수가 높다는 것, 최종 기준을 넘어 양성이라는 것은 차례대로 구분해서 읽어야 한다.
이 차이는 머신러닝 모델을 보는 사람에게도 중요하다. 입력 특징이 늘어났다고 항상 일반화가 좋아지는 것은 아니다. 새로운 조합을 학습 자료에서 고른 뒤에는, 그 선택에 쓰지 않은 자료에서 성능을 확인해야 한다. 검사의 값이 실제로 유용한지는 학습 정확도보다 독립적인 평가 조건에서 드러난다.
#3. 10종 microRNA와 CA19-9를 어떻게 해석할까
논문의 microRNA 목록은 hsa-miR-142-3p, hsa-miR-30c-5p, hsa-miR-335-5p, hsa-miR-340-5p, hsa-miR-200b-3p, hsa-miR-1260b, hsa-miR-145-3p, hsa-miR-145-5p, hsa-miR-429, hsa-miR-200a-3p다. 이 목록은 검사가 읽는 생물학적 입력을 구체화한다. 논문은 분석·시각화 코드도 별도의 보관소에 공개했다고 명시한다.[1][3]
여러 측정값을 점수로 바꾸는 과정은 다음과 같이 읽을 수 있다. 먼저 각 표지자의 값을 정해진 분석법으로 얻는다. 다음으로 학습된 조합이 표지자들의 관계를 이용해 하나의 점수를 계산한다. 마지막으로 미리 정한 기준값과 비교해 양성·음성을 판단한다. 이 설명은 일반적인 분류 검사의 계산 구조이며, PANXEON의 공개되지 않은 계수나 임의의 가중합을 만들어 낸 것은 아니다.
특히 모델 점수를 곧바로 “이 사람에게 암이 있을 확률”로 읽으려면 추가 조건이 필요하다. 점수가 순서를 잘 매기는지와 실제 발생 비율에 맞게 보정돼 있는지는 다른 성질이다. 높은 점수의 사람들이 낮은 점수보다 더 자주 암인 경우에도, 0.8이라는 출력이 실제로 80%의 암 확률을 뜻하는지 확인하려면 별도의 보정 평가가 있어야 한다.
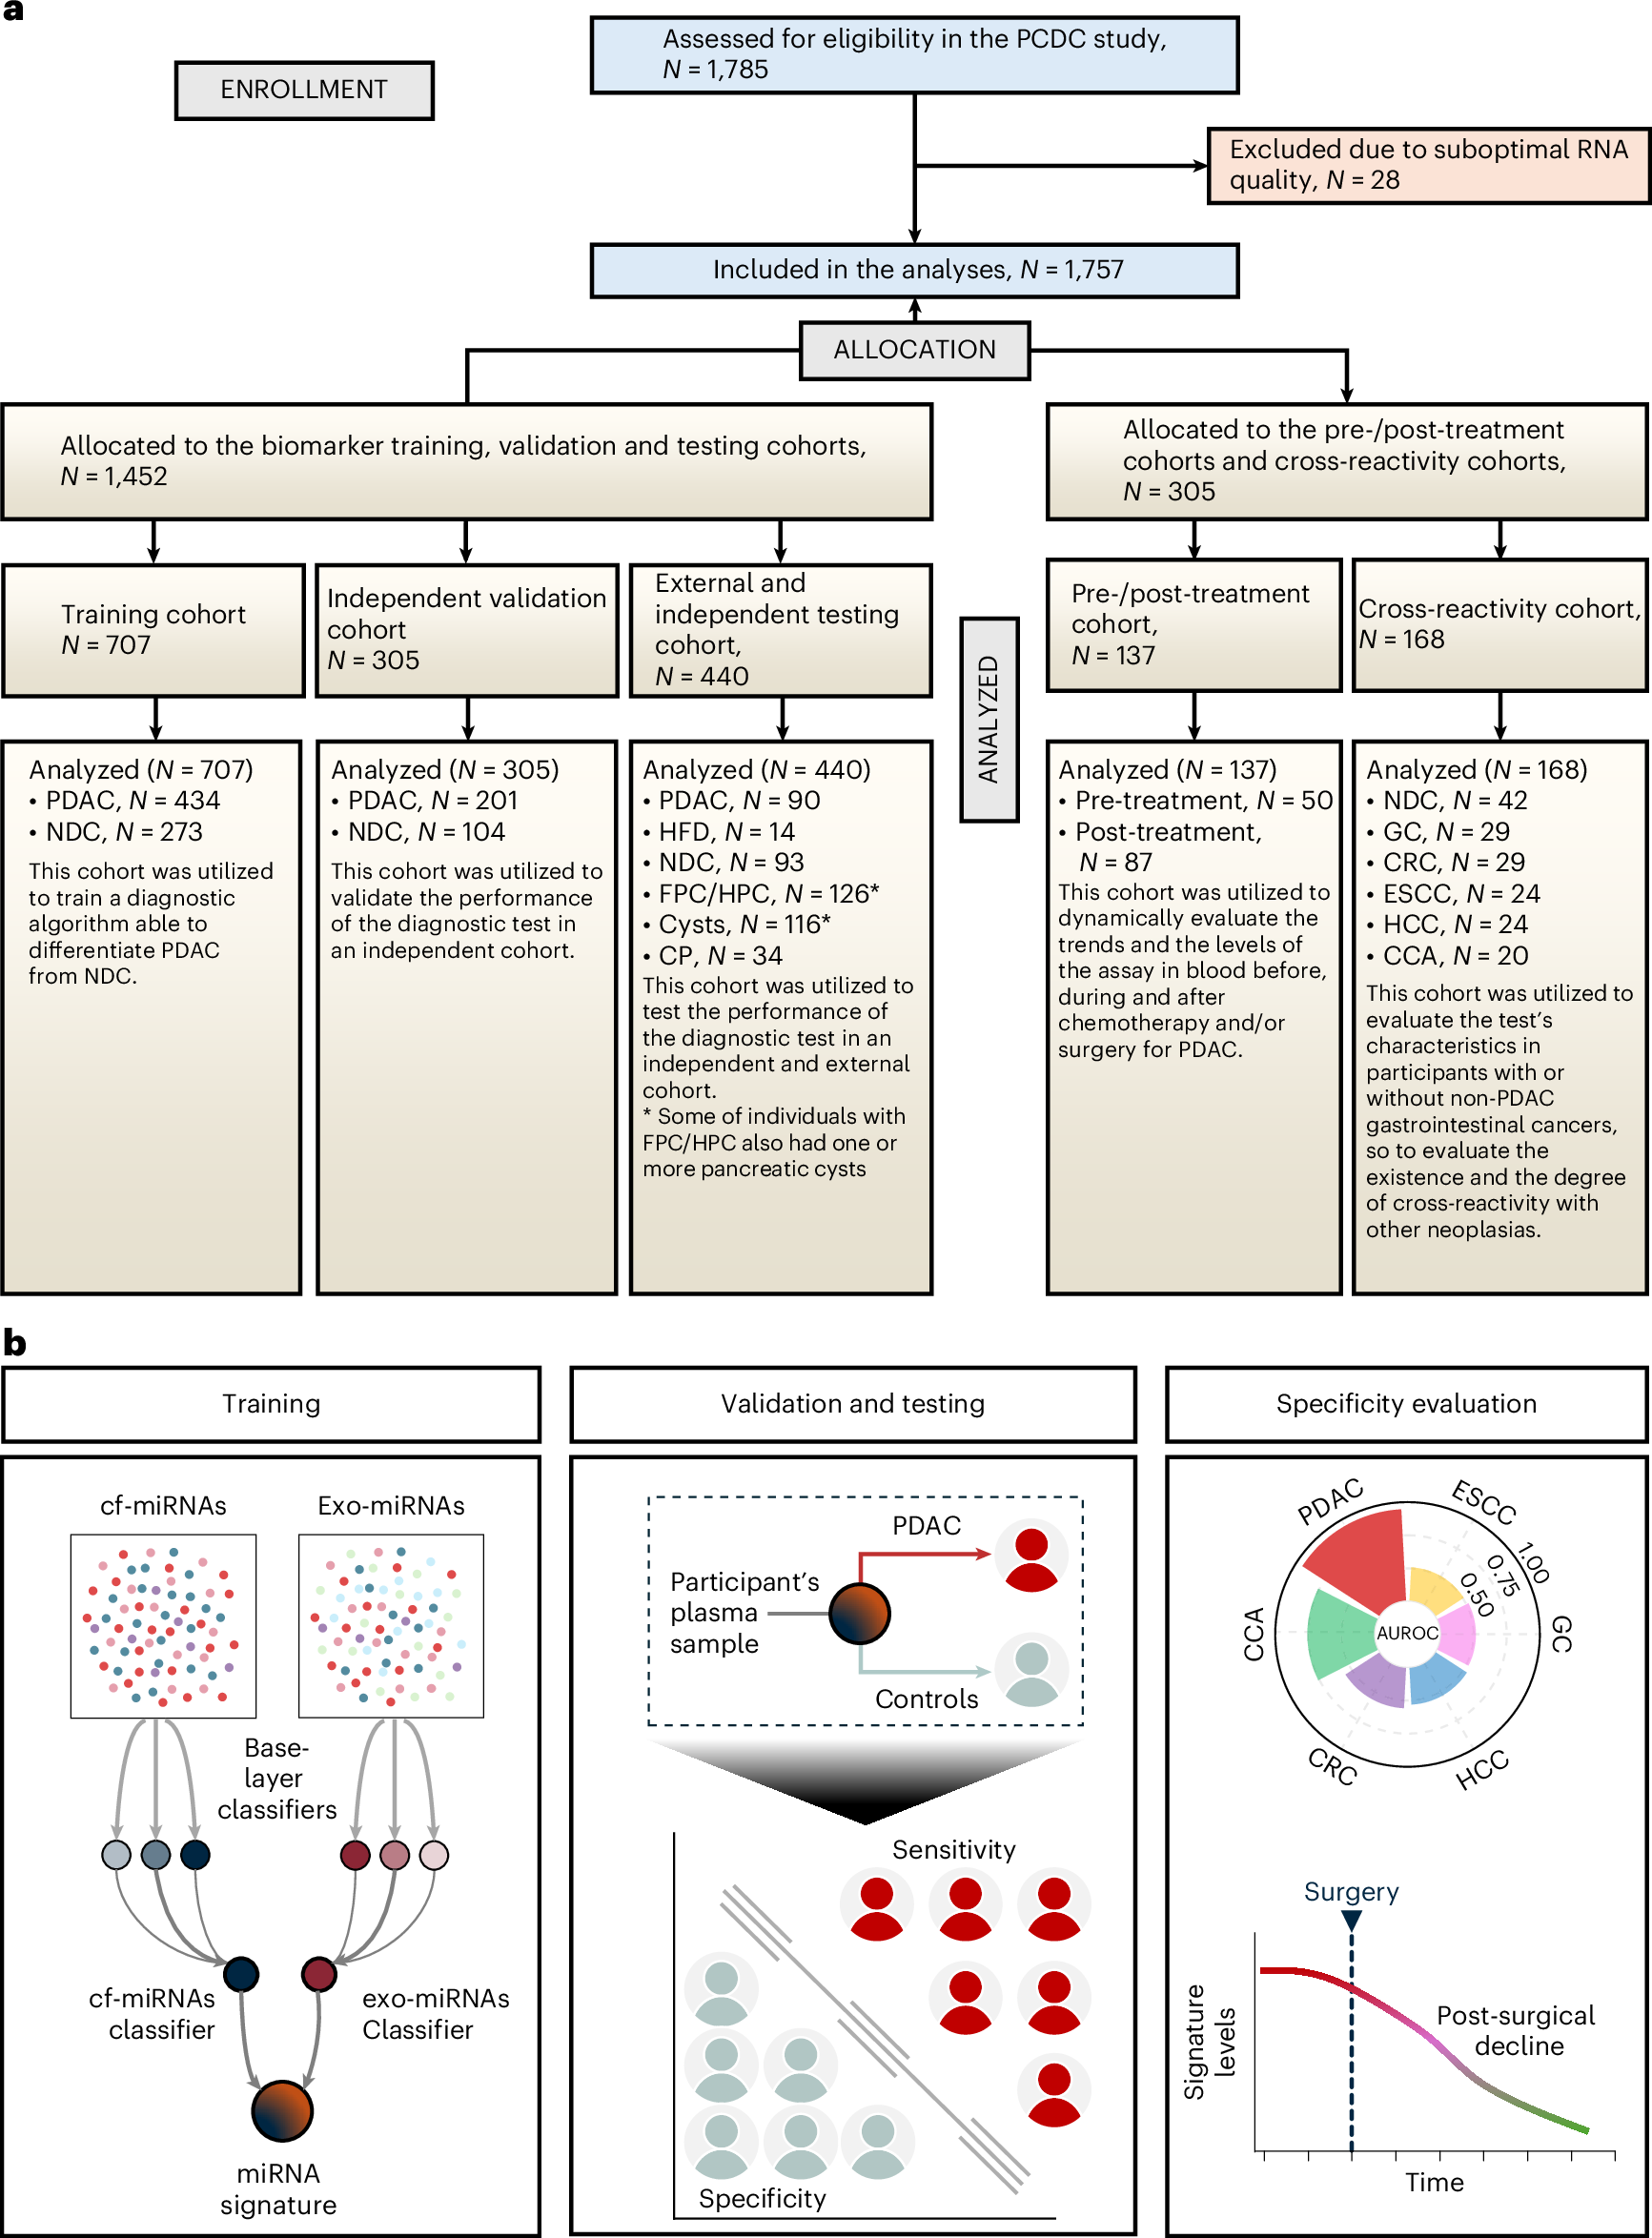
따라서 복합 검사의 그림을 읽을 때도 순서를 지켜야 한다. 연구의 흐름도에서는 대상자와 표본이 어떤 집합에 들어갔는지 확인하고, 성능 그림에서는 그 집합에서 어느 기준값을 적용했는지 확인한다. 복잡한 모델 그림보다 누구에게서 배웠고 누구에게서 시험했는지가 먼저다.
#4. 민감도·위양성률·AUC는 다른 질문의 답이다
민감도는 암이 있는 사람 중 양성으로 잡아낸 비율이다. 위양성률은 암이 없는 비교군 중 양성으로 나온 비율이다. 각각의 분모가 다르므로 두 숫자를 같은 사람 집합의 비율처럼 읽을 수 없다.
86.8%의 분모에는 누가 들어가는가? 기호·연산·계산 과정 펼치기
는 암이 있고 검사도 양성인 참양성, 은 암이 있지만 음성인 위음성이다. 그래서 민감도의 분모 에는 암이 있는 사람이 들어간다. 는 암이 없는데 양성인 위양성, 은 암이 없고 음성인 참음성이다. 위양성률의 분모 에는 암이 없는 비교군이 들어간다.
분자에서 관심 있는 결과를 세고, 해당 결과가 생길 수 있는 전체 집합으로 나눈다. 특이도는 암이 없는 사람을 음성으로 분류한 비율이므로 다. 위양성률 3.2%는 같은 집합에서 특이도 96.8%에 대응한다.
“양성 결과를 받은 사람 중 암인 비율”은 여기의 민감도와 다르다. 그 질문의 분모는 이며, 뒤에서 양성예측도로 계산한다. 검사 용어를 한 번씩 암기하기보다 지금 분모가 어느 사람들인지 먼저 확인하면 혼동이 줄어든다.
ROC 곡선은 양성 기준값을 바꾸면서 민감도와 위양성률의 관계를 보여 준다. AUC는 이 곡선 아래 면적으로, 하나의 기준값에서 얻은 민감도나 정확도와 다르다. 논문이 miRNA signature의 testing cohort AUC를 88.6%로 보고했다는 것은, 전체 연구 참가자의 88.6%를 올바르게 진단했다는 뜻으로 바로 바꿀 수 없다.[1]
기준을 낮추면 더 많은 사람을 양성으로 포착할 수 있지만 비교군에서도 양성이 늘 수 있다. 기준을 높이면 추가 검사가 줄어드는 대신 놓치는 암이 늘 수 있다. 검사의 좋은 성능이란 단지 곡선 하나의 수치가 높은 것에서 끝나지 않고, 사용할 사람 집합에서 수용 가능한 추가 검사와 놓침의 균형에 연결돼야 한다.
#5. 연구가 실제로 보고한 결과
| 대상 또는 지표 | 논문에 보고된 값 | 함께 보아야 하는 조건 |
|---|---|---|
| 등록과 분석 규모 | 등록 1,785명 → 분석 1,757명 | RNA 품질로 28명을 제외했다. 각 성능 지표의 분모는 해당 평가 집합이다. |
| miRNA signature의 testing AUC | 88.6% | 복합 PANXEON의 초기암 민감도와 구분한다. |
| miRNA signature의 초기 PDAC 민감도 | 83.8% | miRNA signature에 대한 보고다. |
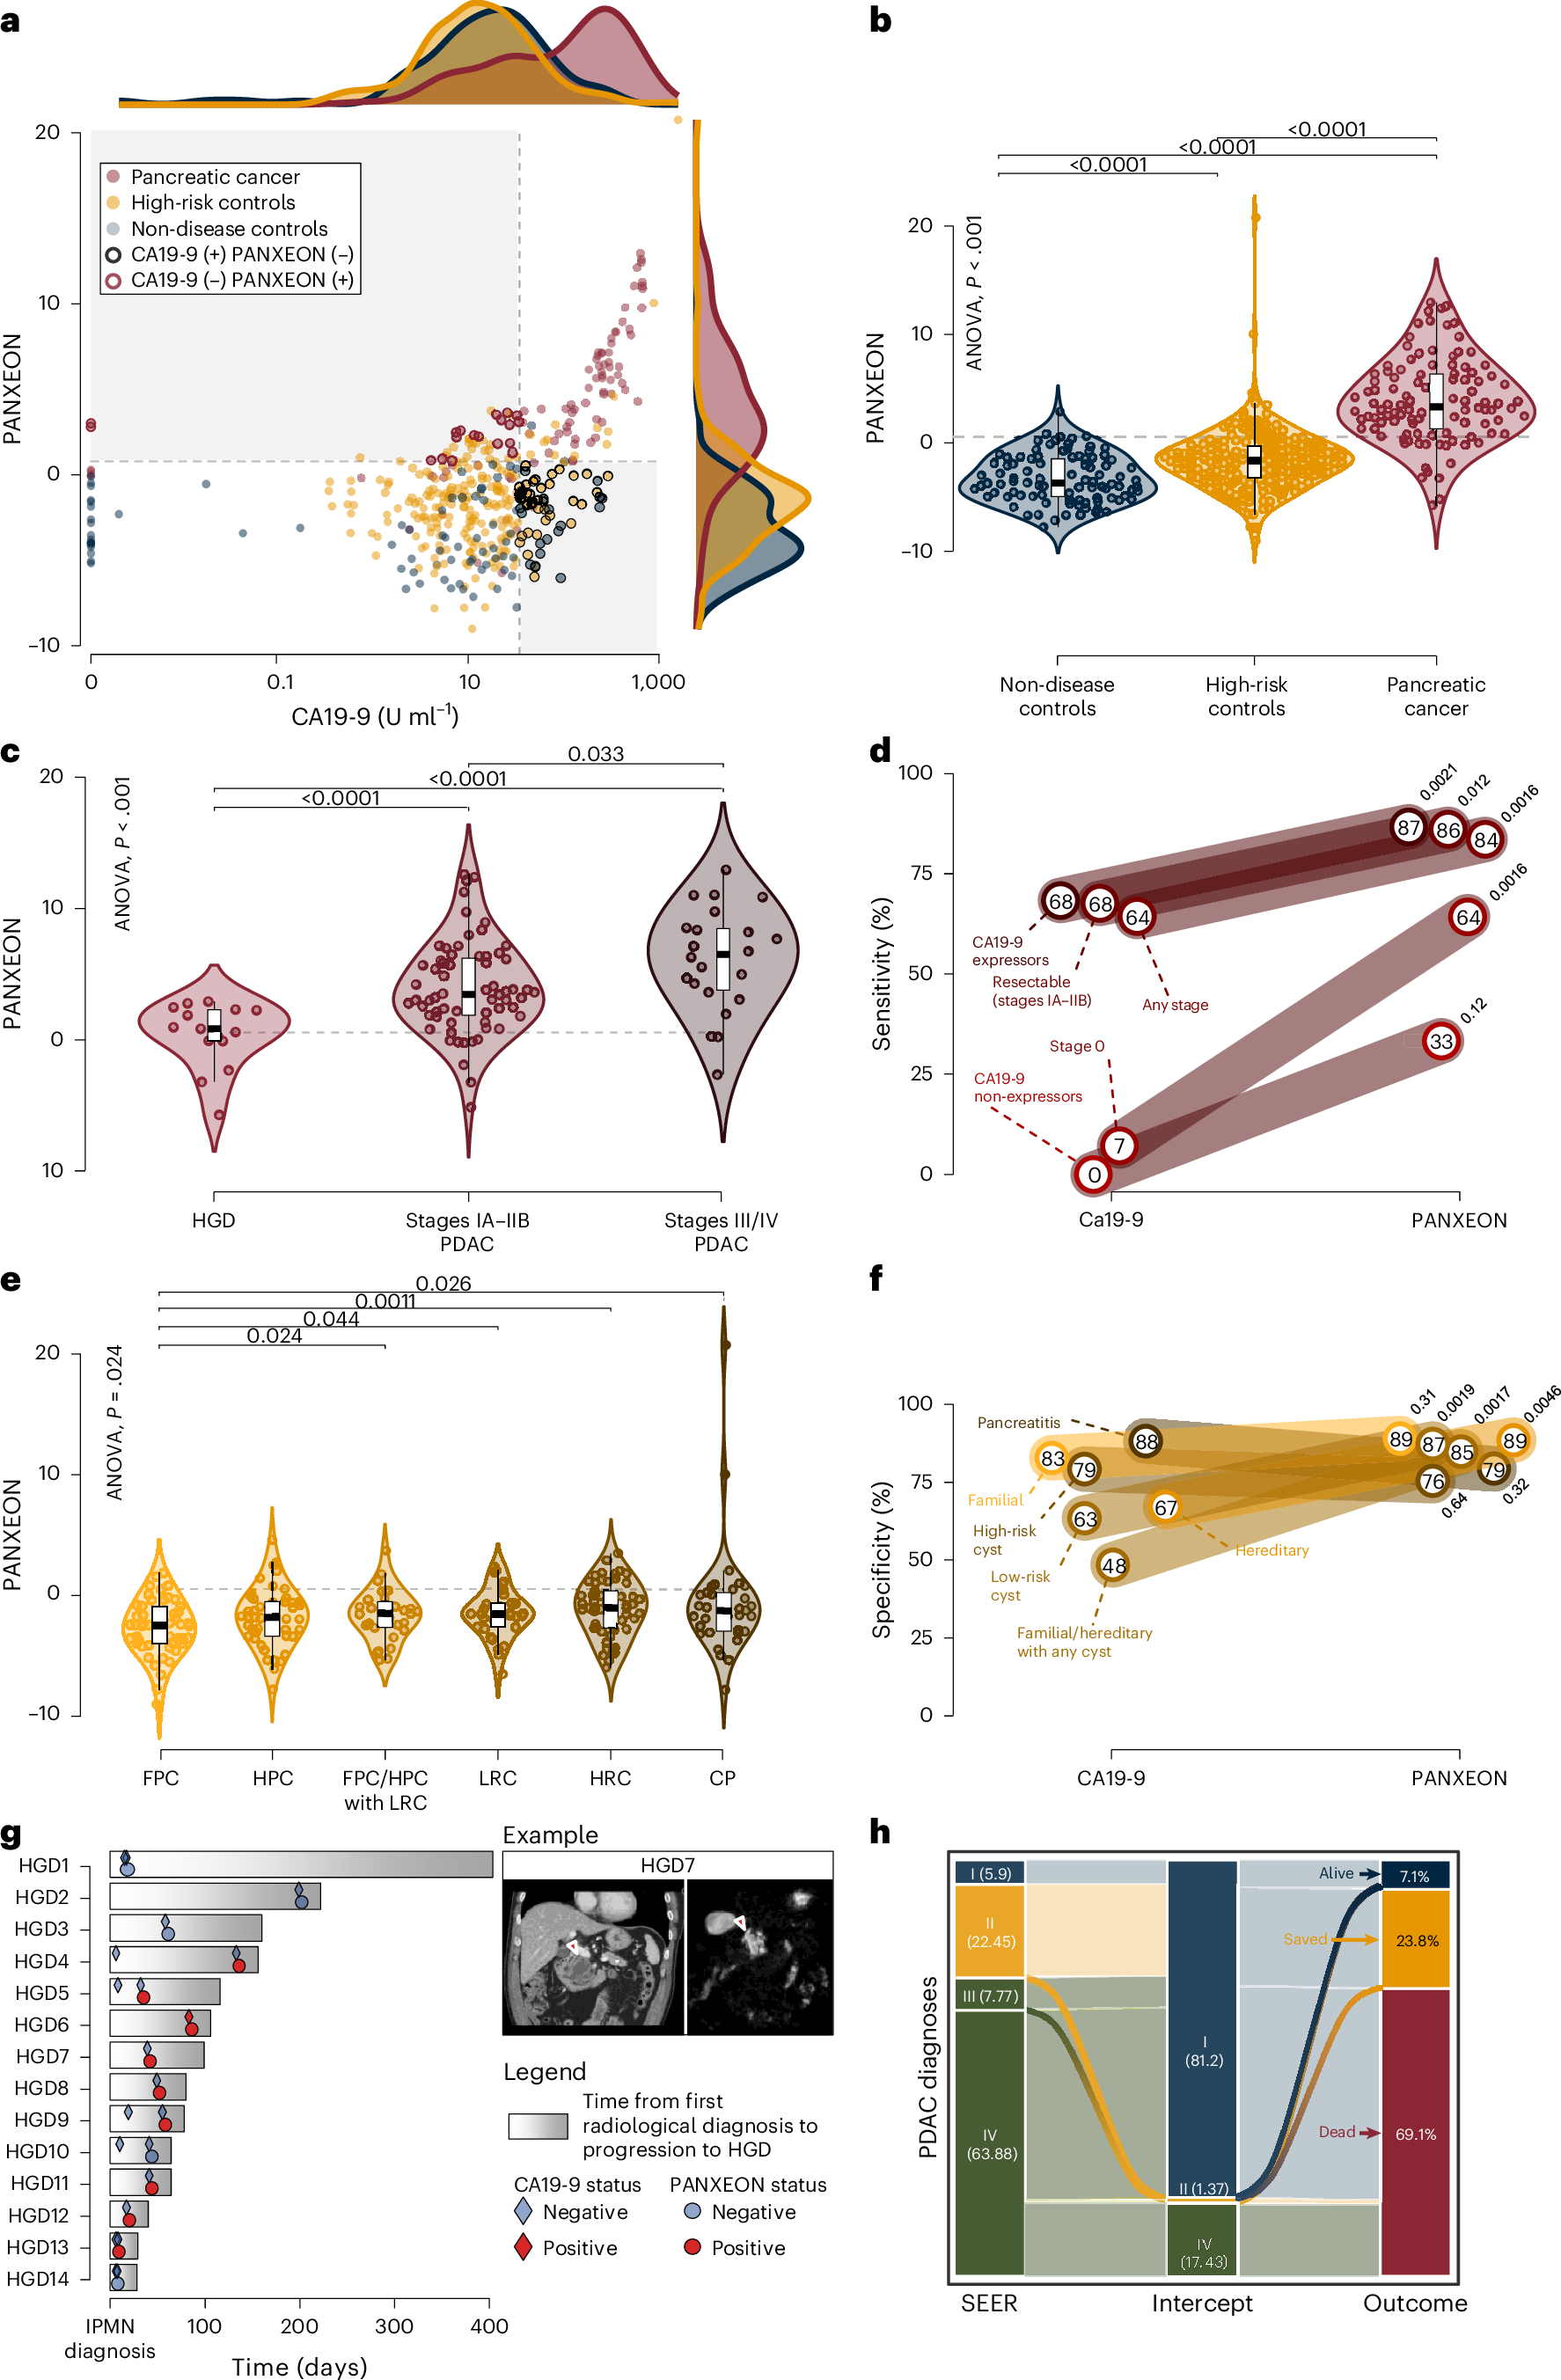
| PANXEON의 I–II기 민감도 | 86.8% | miRNA와 CA19-9를 결합한 검사 결과다. |
| 저위험 대조군 위양성률 | 3.2% | 이 대조군에서의 특이도는 96.8%다. |
| 고위험 대조군 위양성률 | 15.6% | 이 대조군에서의 특이도는 84.4%다. |
| 고위험 췌장 낭종의 고도이형성 검출 | 64.3% | 침윤성 PDAC의 민감도와 다른 대상이다. |
표는 논문의 공개 초록과 Figure 1·4의 설명을 바탕으로 구성했다. Figure 1은 학습 707명, 독립 검증 305명, 외부·독립 시험 440명을 제시한다. 별도의 치료 전후 평가 137명과 교차반응 평가 168명도 표시되며, 이들을 모두 하나의 정확도 계산에 섞지 않는다.[1]
연구에는 19명의 치료 전후 추적도 포함된다. microRNA signature가 항암치료·수술 과정에서 감소하고 재발 전에 증가하는 양상이 보고됐다. 이는 시간에 따른 표지자의 변화를 관찰한 결과다. 건강한 사람을 지속적으로 검사해 재발 또는 암 발생을 얼마나 일찍 찾아내는지 평가하는 별도의 대규모 선별 연구와는 질문이 다르다.[1]
또 하나의 중요한 구분은 전향적 자료 수집과 무작위 선별검사 시험이다. 전향적 관찰 설계는 중요한 증거이지만, 검사를 시행한 집단과 시행하지 않은 집단을 비교해 췌장암 사망률이 감소했는지까지 자동으로 증명하지는 않는다. 이 연구가 다음 단계의 임상 검증을 뒷받침하는 이유와, 이미 모든 검증을 끝낸 검사를 구분하는 이유가 여기에 있다.
#6. 드문 질환에서는 위양성의 수가 커질 수 있다
검사의 정확한 임상적 해석에는 검사 대상 집합에서 질환이 얼마나 흔한지도 들어간다. 같은 민감도와 위양성률이어도 암이 거의 없는 집합을 검사하면, 양성 결과 가운데 비교적 많은 부분이 위양성일 수 있다. 이것은 특정 검사를 비판하기 위한 예외가 아니라, 분모의 구성에서 나오는 기본적인 계산이다.
양성인 사람 중 실제 암인 비율은 어떻게 계산하는가? 기호·연산·계산 과정 펼치기
는 민감도, 은 위양성률, 는 검사 대상 집합의 유병 비율이다. 분자의 는 전체 사람 중 질환이 있고 양성인 비율이다. 분모의 두 번째 항 는 질환이 없는데 양성인 비율이다. 두 종류의 양성을 더한 뒤 그중 참양성의 몫을 구한다.
설명용으로 10,000명 중 질환 비율이 0.1%, 민감도가 86.8%, 위양성률이 3.2%라고 가정하자. 질환자는 기대값으로 10명이고 참양성은 8.68명이다. 질환이 없는 9,990명 중 위양성은 319.68명이다. 따라서 양성예측도는 다.
이 0.1%는 이해를 위한 가상 유병 비율이며 연구가 관측한 일반 인구 발생률이 아니다. 소수점으로 나온 인원은 반복 집단에서의 기대값이다. 특정 개인의 위험이나 PANXEON의 실제 일반인 선별 성능으로 사용하지 않는다.
고위험 집합에서는 질환 비율이 높아질 수 있지만 검사 결과의 분포도 달라질 수 있다. 실제 연구가 고위험 대조군에서 보고한 위양성률은 15.6%였다. 그러므로 저위험 집합의 낮은 위양성률을 그대로 가져와 고위험 선별의 이익을 계산하면 평가 조건을 섞게 된다.[1]
가령 이번에는 질환 비율을 가정상 1%, 민감도를 86.8%, 위양성률을 15.6%로 두자. 10,000명에서 참양성의 기대값은 86.8명, 위양성은 1,544.4명이며 양성예측도는 약 5.32%다. 두 예제는 실제 두 집단의 우열을 비교하려는 것이 아니라, 유병 비율과 비교군 특이도를 함께 알아야 한다는 점을 보여 준다. 두 가정의 인구 구성을 임상 수치로 둔갑시키지 않는 것이 중요하다.
#7. 좋은 구별 성능이 곧 선별검사 효과가 되는 것은 아니다
혈액검사가 위험 신호를 내면 다음에는 영상검사와 진료 등 추가 확인 과정이 이어진다. 이 과정을 생각하면 평가해야 할 결과가 넓어진다. 검사가 찾은 초기 병변에 실제로 유익한 처치가 가능했는지, 추가 검사에서 어떤 부담이 생겼는지, 음성인 사람을 언제 다시 검사하는지, 발견 시점이 바뀐 것이 건강 결과 개선으로 이어졌는지를 구분해야 한다.
논문은 인구 수준과 비용효과를 다루는 모의 분석도 공개 그림 설명에 포함한다. 여기서 가상의 집단을 입력으로 한 시뮬레이션과 실제로 관찰한 사망 감소를 구분해야 한다. 어떤 전이 확률과 검사 성능을 가정하느냐에 따라 모의 결과가 달라질 수 있다. 시뮬레이션은 후속 시험을 설계하는 데 도움을 주지만, 그 그림의 막대가 모두 현장에서 관측한 사건 수는 아니다.[1]
고도이형성에 대한 결과도 같은 원칙으로 읽는다. 고위험 낭종에서 그 신호를 찾는 것은 중요한 별도 과제다. 그러나 해당 하위집단의 검출률을 모든 건강한 사람의 암 전단계 검출률로 확대할 수는 없다. 어떤 병변을 기준으로 삼았는지, 정답은 어떻게 확인했는지, 음성 대상자는 얼마나 추적했는지를 함께 확인해야 한다.
이 글에서 제안하는 다음 평가는 모델 하나의 최고 점수보다 검사를 포함한 전체 진료 흐름의 평가다. 데이터 수집 단계의 기관 차이, 검체 처리와 보관, 검사 반복의 재현성, 후속 검사 이행, 발견된 병변의 결과를 사전에 정한 지표로 묶어야 한다. 이 문단은 연구 결과의 복제가 아니라, 그 결과를 실무로 옮길 때의 분석적 제안이다.
#모델 선택과 최종 평가를 분리하는 작은 예
분류 모델의 연구를 읽을 때 “시험했다”는 표현만으로 데이터의 역할을 알 수는 없다. 설명용으로 점수 기준을 0.3, 0.5, 0.7 중에서 고르는 상황을 생각하자. 동일한 자료에서 세 기준을 모두 비교한 뒤 가장 좋아 보이는 값을 선택하면, 그 자료는 기준 선택에 쓰인 것이다. 선택한 기준의 성능을 같은 자료에서만 발표하면 새로운 대상자를 만났을 때의 성능과 차이가 생길 수 있다.
여러 나라가 참여했다는 사실도 이 구분을 대신하지 않는다. 국가가 다양해도 각 기관의 표본이 어떤 단계에서 사용됐는지 따져야 한다. 반대로 한 단계에서 정한 검사와 알고리즘을 고정하고 다른 기관·시기의 자료에 적용했다면, 그 독립성이 평가의 중요한 조건이 된다. 이 예는 PANXEON이 실제로 특정 누출을 일으켰다는 주장이 아니라, 개발·검증·시험의 역할을 읽는 기준이다.
또한 비율에는 표본 수의 불확실성이 붙는다. 같은 90%라도 10명 중 9명과 1,000명 중 900명은 추정의 정밀도가 다르다. 따라서 병기별 실제 분모와 신뢰구간을 함께 읽어야 한다. Figure 4의 독립 시험군은 PDAC 90명, 고도이형성 14명, 비질환 비교군 93명, 여러 고위험 비교군 243명을 명시한다. Figure 1의 고위험 세부 항목에는 가족력·유전성과 낭종이 겹치는 사람이 있으므로 항목별 숫자를 무조건 더하면 중복이 생긴다.
고도이형성 64.3%의 분모는 공개 Figure 4 설명에서 확인한 14명이다. 이 하위집단은 수술로 고도이형성이 확인된 고위험 낭종 사례다. 이는 같은 비율을 전체 1,785명에 곱하는 계산과 다른 질문이다. 그림 (h)의 23.8% Saved 역시 후속 사망 감소를 직접 관찰한 수치가 아니라, SEER 기반 단계 이동을 가정한 모형 추정으로 표시되어 있다.
#두 종류의 오류가 다음 검사에 미치는 영향
거짓음성은 평가 대상에 포함된 질환을 검사에서 놓친 경우이고, 거짓양성은 그 평가 기준에서 질환이 없는 사람을 양성으로 분류한 경우다. 같은 총 오류 수라도 이 두 오류가 만드는 후속 경로는 다르다. 양성 뒤에 영상검사나 추가 평가를 연결하는 설계에서는 거짓양성 수가 후속 평가의 규모에 영향을 주고, 음성 뒤의 추적 간격을 정하는 설계에서는 놓친 사례의 특성이 중요해진다. 어떤 후속 경로가 실제로 이득을 주는지는 그 경로를 포함한 연구에서 확인해야 한다.
따라서 임계값 하나를 고르기 전에 “양성인 사람에게 무엇을 할 것인가”와 “음성인 사람은 어떻게 추적할 것인가”를 함께 정의해야 한다. 이것은 개인의 검사 선택에 대한 권고가 아니라, 진단 성능의 숫자를 실제 연구 설계로 연결하는 질문이다. PANXEON의 후속 근거도 혈액검사 하나의 정확도뿐 아니라 이 전체 경로에서 얻은 결과를 통해 평가할 수 있다.
#8. 이 연구가 만든 다음 질문
첫째, 앞으로 사용할 검사 기준과 알고리즘을 고정한 상태에서 독립적인 대상자를 계속 모집해 성능을 확인할 수 있는가다. 이미 관측한 결과에 맞춰 기준을 다시 조정하면, 새 집단에서의 성능이 어떻게 달라지는지 별도로 시험해야 한다. 기준을 선택한 자료와 성능을 보고한 자료의 경계가 독자가 가장 먼저 확인할 항목이다.
둘째, 고위험 집합에서 15.6%의 위양성이 어떤 추가 검사량으로 이어지는지다. 필요 없는 검사를 줄이는 방향과 놓침을 줄이는 방향은 함께 최적화해야 한다. 연구기관이 PANXEON을 기존 영상검사를 보완할 가능성으로 소개한 것도, 이 점수 뒤에 확인 과정이 이어진다는 맥락에서 읽을 수 있다.[2]
셋째, 공개 데이터와 코드로 분석 절차를 점검할 수 있는가다. 논문은 익명화 자료의 OSF 보관과 XGBoost 분석·시각화 코드의 Zenodo 공개를 명시한다. 공개 위치가 있다는 사실과 여기서 원자료 분석을 재실행했다는 사실은 다르다. 이번 원고에서는 접근 가능한 초록·그림 설명·공개 안내를 대조했으며, 제공되지 않은 모형 계수나 하위집단 분모를 추정해 채우지 않았다.[1][3][4]
저자의 이해관계도 출처에 함께 공개되어 있다. 일부 저자의 기업 자문, 연구비 및 관련 특허가 신고됐으며, 이를 “모든 저자 이해관계 없음”으로 단순화하지 않았다.[1]
PANXEON의 가치는 암의 초기 신호를 서로 다른 표지자의 조합으로 더 잘 구별할 가능성을 다기관 자료로 제시한 것이다. 이 성과를 제대로 평가하려면 민감도, 비교군별 위양성률, 양성예측도, 실제 건강 결과를 한 줄의 정확도에서 분리해야 한다. 그 구분이 다음 시험의 목적도 선명하게 만든다.
#9. 출처와 자료 범위
[1] Xu, C., Mannucci, A., Han, H. et al. Liquid biopsy for early detection of pancreatic ductal adenocarcinoma. Nature Medicine, 2026-09-16.
[2] City of Hope 연구기관 발표: New Study: Blood Test Shows Promise for Detecting Pancreatic Cancer at Its Earliest Stages.
[3] 논문이 지정한 분석·시각화 코드 보관소.
[4] 논문이 지정한 익명화 데이터 보관소. 자료 기준: 2026-09-18. 공개 초록·확장 그림 설명·데이터와 코드 공개 안내, 연구기관 발표를 대조했다. 구독 본문 전체 열람이나 원자료 재분석을 완료한 것은 아니다. 유병 비율 0.1%·1%의 계산은 교육용 가정이다. 원본 도판의 전체 패널과 공개 캡션을 대조해 연결했다.