#1. 한 문장 결론
Paper2Agent는 논문의 코드와 데이터를 실행 도구로 정리하고, 그 도구가 기준 결과를 재현하는지 시험한 뒤 자연어로 호출하게 만드는 시스템이다. 독자는 논문에 적힌 방법을 이해하는 데서 한 걸음 더 나아가, 자신의 데이터에 그 방법을 적용하고 실행 결과를 확인할 수 있다. 2026년 9월 16일 Nature에 게재된 연구는 이러한 변환을 여러 논문으로 확장했을 때의 성공률과 실패 원인, 실제 질문에 답하는 성능을 함께 보고했다.[1]
이 변화의 중심에는 역할 분담이 있다. 언어모델은 사용자의 요구를 해석하고 필요한 분석을 선택한다. 실제 계산은 미리 정리하고 시험한 함수가 맡는다. 따라서 매 질문마다 분석 프로그램 전체를 다시 쓰는 부담을 줄이고, 어떤 논문의 어떤 기능을 사용했는지 추적할 출발점을 만든다. 논문을 읽는 인터페이스와 방법을 실행하는 인터페이스가 연결되는 것이다.
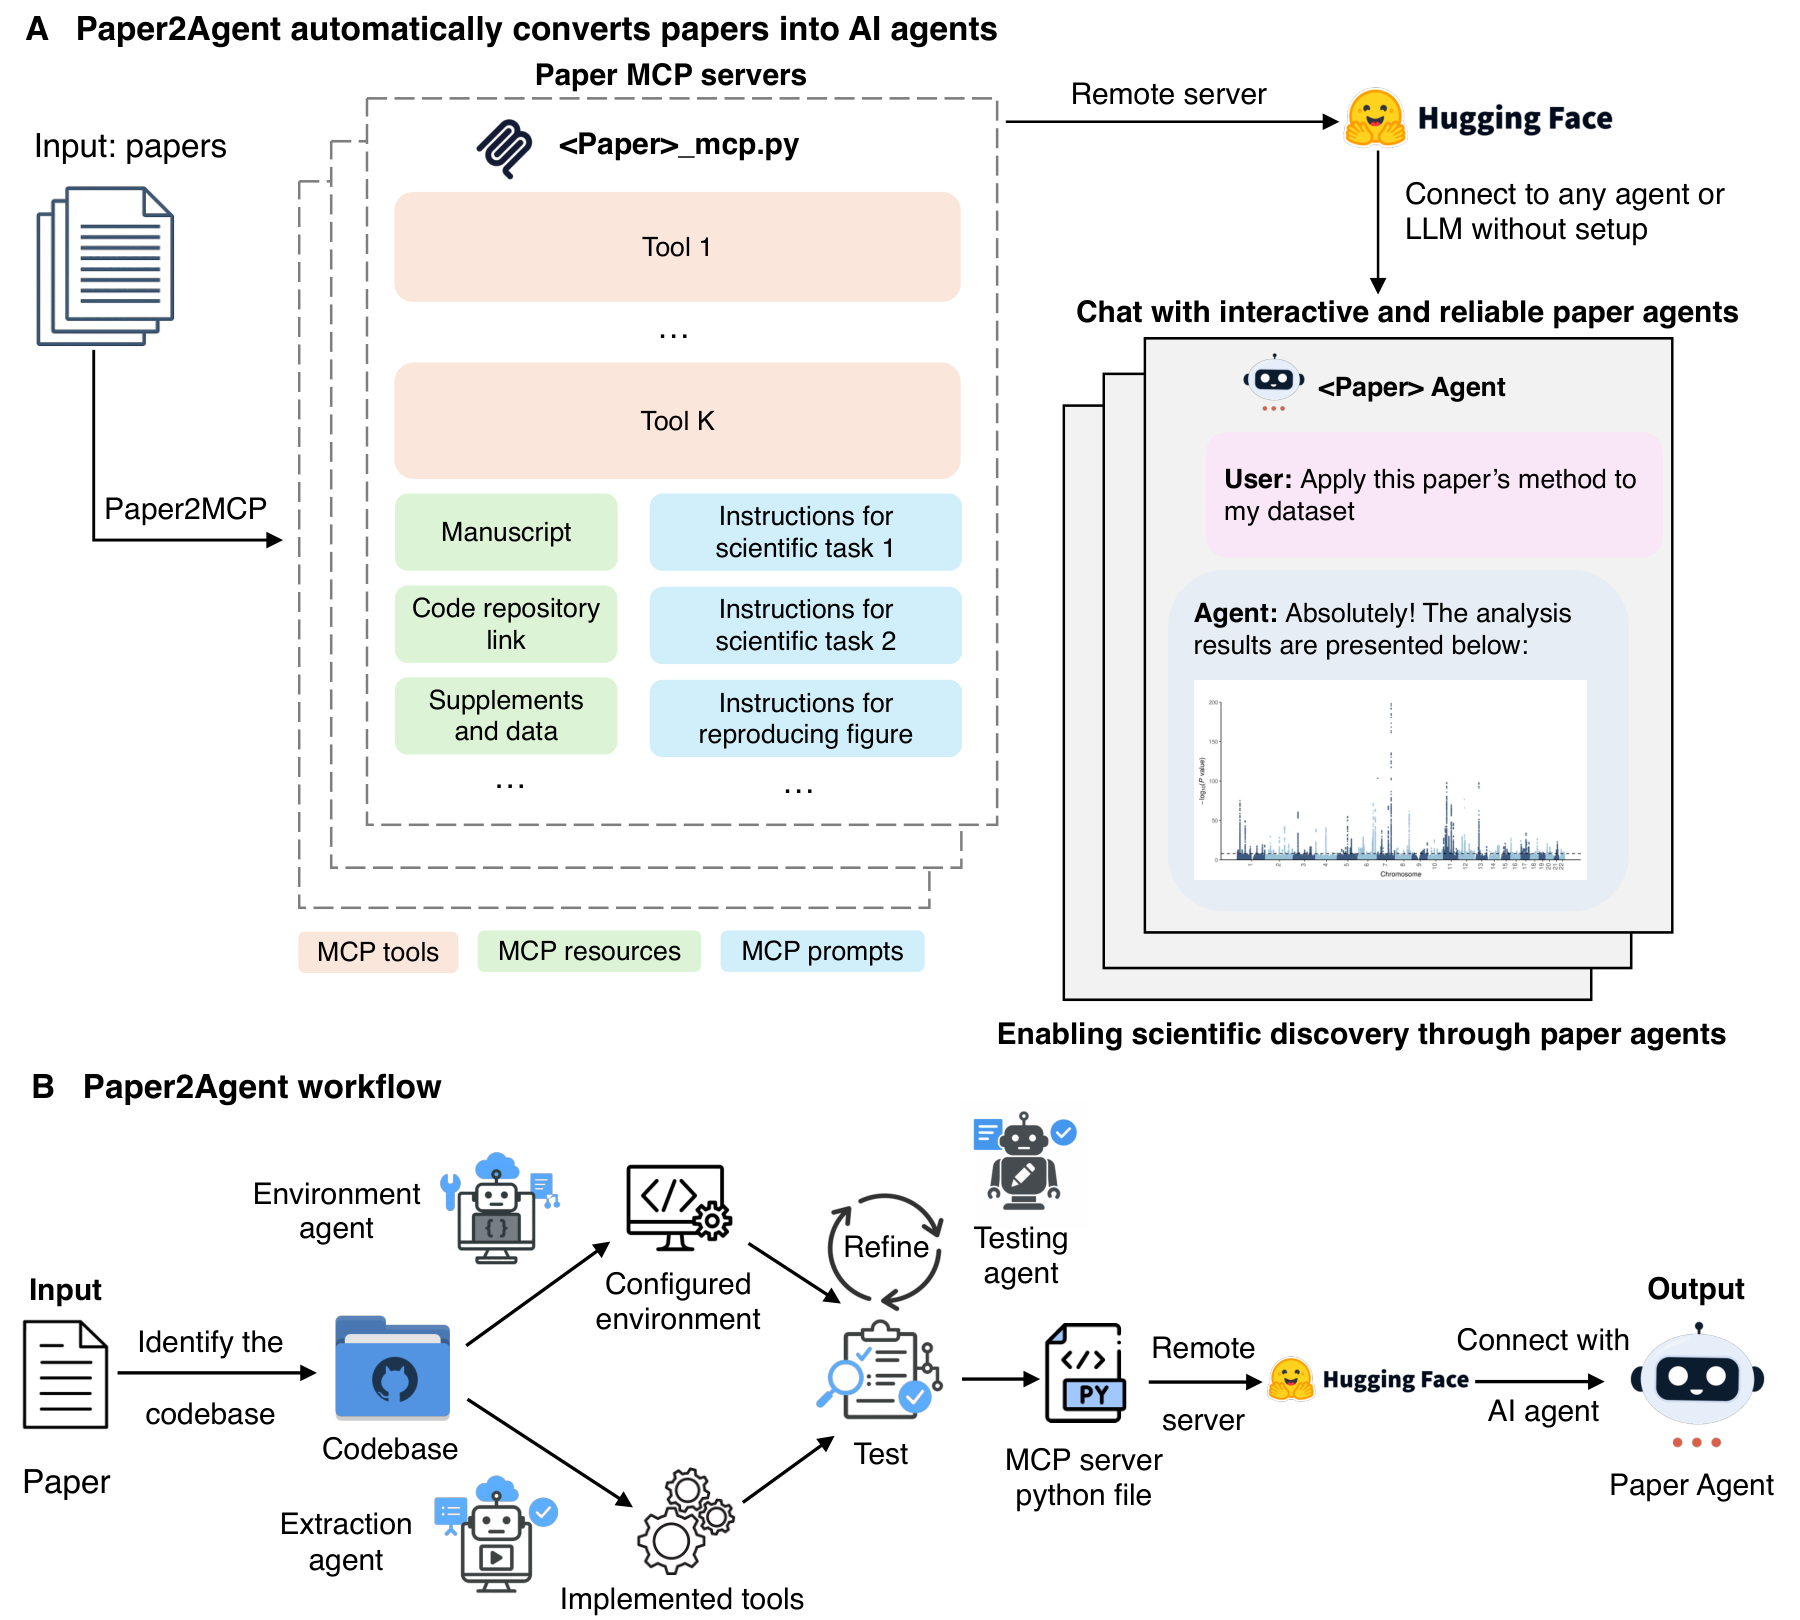
먼저 위 그림의 A를 왼쪽에서 오른쪽으로 읽어 보자. 논문에서 출발한 정보는 가운데 Paper MCP server로 모인다. 주황색 상자는 실행할 도구, 녹색 상자는 원고·보충자료·데이터, 파란색 상자는 분석 순서를 안내하는 지침이다. 오른쪽의 대화형 에이전트가 이 세 종류를 이용해 사용자의 요청을 처리한다. 아래 B는 그 서버를 준비하는 과정을 보여 준다. 환경 구성과 도구 추출이 테스트로 모이고, 수정과 재시험을 거쳐 배포 가능한 서버 파일이 만들어진다.[2]
자료 주석: 본문의 규모 평가 수치는 2026년 Nature 정식 출판본을 기준으로 한다. 원본 도판은 CC BY 4.0으로 공개된 2025년 10월 16일 arXiv v2의 Figure 1·4를 사용했다. 첫 공개일은 2025년 9월 8일이다. 버전별 그림 번호와 평가 범위는 해당 출처에서 확인할 수 있다.[1][2]#2. 왜 이 문제가 어려운가
#논문을 이해한 다음에도 남는 실행의 간격
새로운 분석법을 발견했다고 가정하자. 초록에는 목적과 성능이, 방법 절에는 알고리즘이, GitHub에는 코드가 있다. 그런데 실제로 사용하려면 어느 스크립트에서 시작할지 정하고, 라이브러리 버전을 맞추고, 필요한 모델 파일과 입력 데이터를 준비해야 한다. 코드가 실행되어도 결과 파일의 의미와 비교 기준을 알아야 한다. 논문에 대한 이해와 소프트웨어를 재사용하는 능력은 이처럼 여러 단계로 이어진다.
그중 입력의 의미가 특히 중요하다. 같은 표 형태라도 행이 표본인지 유전자인지, 값이 원시 측정량인지 정규화된 수치인지에 따라 실행해야 할 함수와 순서가 달라진다. 파일을 읽을 수 있다는 사실만으로 분석 전제가 충족되는 것은 아니다. 프로그램 입장에서 올바른 형식과 연구자 입장에서 올바른 해석이 함께 맞아야 한다. 자동화가 담당할 일도 단순히 오류 메시지를 없애는 것보다 넓어진다.
Paper2Agent 논문은 AlphaGenome을 구체적인 사례로 든다. 유전체 변이의 영향을 분석하려면 API 키를 설정하고, 변이 객체와 입력 구간을 구성하고, 출력할 생물학적 신호를 선택해야 한다. 생물학적 질문을 가진 사용자가 소프트웨어 API의 구조까지 익혀야 하는 구간이다. 연구팀은 이 설정과 호출 절차를 도구로 정리해, 사용자가 원하는 분석을 자연어로 표현할 수 있도록 했다.[1]
#코드를 매번 생성하면 기준도 계속 움직인다
언어모델에게 논문과 저장소를 보여 주고 분석 코드를 작성하게 하면 이러한 간격을 줄일 수 있다. 다만 새 코드가 만들어질 때마다 입력 처리, 기본값, 필터링, 저장 방식 등을 다시 확인해야 한다. 같은 요청을 반복했는데 실행 경로가 달라지면 결과를 비교할 근거도 흔들린다. 여기서 필요한 것은 유창한 설명과 함께 반복해서 호출할 수 있는 명확한 실행 단위다.
Paper2Agent는 준비 비용을 앞쪽으로 옮긴다. 논문을 처음 도구화할 때 코드와 환경을 조사하고, 기준 출력과 비교하는 시험을 수행한다. 그 뒤의 질의 단계에서는 통과한 도구를 재사용한다. 원고를 읽는 단계, 분석 기능을 만드는 단계, 실제 질의에 사용하는 단계가 구분되므로 어느 지점에서 문제가 생겼는지 점검하기도 쉬워진다.[1]
이제 다음 질문은 자연스럽다. 실행할 함수를 준비했다면 언어모델이 그것을 어떻게 찾고, 어떤 입력을 보내며, 결과를 어떻게 받아야 할까? 이 접점을 정리하는 규약이 Model Context Protocol, 줄여서 MCP다.
#3. 기존 방식에서 실행 인터페이스로
#문장·실행 기능·작업 지침을 구분해 전달하기
MCP는 에이전트와 외부 시스템이 도구 및 정보를 주고받는 방식을 정리한 프로토콜이다. Paper2Agent에서는 논문 한 편의 연구 산출물을 tools, resources, prompts로 나누어 제공한다. 이 세 구분을 알면 앞선 그림의 색상과 실제 동작이 연결된다.[1][4]
| 구성 | 담는 것 | 사용자가 요청했을 때의 역할 |
|---|---|---|
| 도구(Tools) | 입력과 출력이 정의된 실행 함수 | 데이터를 읽고, 분석하고, 결과 파일이나 수치를 만든다. |
| 자료(Resources) | 원고, 데이터 설명, 보충자료와 관련 정보 | 분석의 전제·데이터의 의미·방법의 해석에 필요한 문맥을 제공한다. |
| 지침(Prompts) | 여러 도구를 사용하는 작업 안내 | 어떤 순서로 실행하고 어떤 결과를 확인할지 연결한다. |
검색 증강 생성(RAG)은 찾아낸 자료를 답변의 문맥으로 사용하는 방식이다. 예를 들어 “이 논문의 정규화 방법은 무엇인가?”라는 질문에는 관련 문장을 찾아 설명하는 접근이 잘 맞는다. “그 정규화를 내 데이터에 적용하고 결과를 저장해 달라”는 요청에는 실제 실행 함수와 입력 계약이 추가로 필요하다. 두 접근은 역할이 다르므로 함께 사용할 수 있다. Paper2Agent의 기여는 논문의 설명과 실행을 하나의 인터페이스로 묶는 데 있다.[1]
Binder나 CodeOcean처럼 실행 환경을 제공하는 방식도 이 과정의 중요한 기반이다. 환경이 준비돼 있으면 사용자는 설치 문제를 덜 겪는다. Paper2Agent는 여기에 자연어 요청을 실행 기능으로 연결하는 계층을 더한다. 무엇이 설치되어 있는가, 무엇을 호출할 수 있는가, 어떤 요청에 그 호출이 적합한가를 각각 다루는 셈이다. 에이전트가 사용하는 실행 계층이 분명할수록 사람도 그 결정을 검토할 수 있다.[1]
#도구 하나가 작을수록 항상 좋은 것은 아니다
도구 경계를 정할 때에는 논문의 작업 흐름을 고려해야 한다. 함수 하나를 노출할지, 여러 함수를 묶어 하나의 분석 단계로 만들지에 따라 사용자가 관리할 인자와 중간 파일이 달라진다. 너무 넓은 도구는 어느 단계에서 결과가 바뀌었는지 확인하기 어렵고, 너무 작은 도구는 올바른 호출 순서를 조합하는 부담을 남긴다. 이 문단은 구조를 읽기 위한 설계 관점이다. 구체적인 경계는 해당 논문의 튜토리얼과 입출력에 따라 검토해야 한다.
예를 들어 “파일을 열기”와 “군집 결과를 저장하기” 사이에는 품질 관리, 정규화, 차원 축소 등 여러 단계가 있을 수 있다. 좋은 도구 설명은 함수 이름뿐 아니라 필요한 입력, 만들어지는 결과, 선행 조건을 알려 준다. 도구화된 논문의 재사용성을 평가하려면 함수 개수만 세기보다 사용자가 실제 분석 경로를 끝까지 수행할 수 있는지 봐야 한다.
#4. 새 방법을 세 단계로 따라가기
#첫째, 논문과 코드에서 실행 경로를 찾는다
Paper2Agent는 여러 역할의 에이전트를 조정해 원고와 저장소, 튜토리얼, 데이터 의존성을 조사한다. 환경 담당은 실행에 필요한 패키지와 설정을 준비하고, 추출 담당은 주요 분석을 호출 가능한 기능으로 구성한다. 튜토리얼은 논문의 방법이 실제 코드에서 어떤 순서로 사용되는지 보여 주는 출발점이 된다. 위 Figure 1의 B에서 두 경로가 테스트 지점으로 합쳐지는 이유가 여기에 있다.[1][2]
이 단계의 결과는 연구 방법을 대신하는 새로운 모델이라기보다, 기존 방법에 접근할 수 있는 실행 단위다. 따라서 원 저장소의 품질이 중요하다. 필요한 파일이 존재하고, 실행법이 문서화되어 있으며, 입력을 바꿔도 사용할 수 있는 구조여야 자동 변환이 수월하다. 논문 PDF가 준비되어 있어도 학습 가중치나 분석 데이터가 빠져 있다면 그 지점은 별도로 해결해야 한다.
#둘째, 도구의 출력을 기준 결과와 비교한다
생성한 함수를 곧바로 사용자에게 노출하는 대신, 테스트 담당이 기준 결과와 비교한다. Nature 방법 절은 파일·수치·그림을 서로 다른 방식으로 검사하는 절차를 설명한다. 부동소수점 결과에는 3% 허용오차를 두고, 그림은 지각 해시(perceptual hash)를 비교한다. 문제가 발생하면 원인을 진단하고 수정한 뒤 다시 시험한다. 반복 실패한 기능은 사용 가능한 MCP 도구에서 제외한다.[1]
지각 해시는 이미지를 작은 특징값으로 요약해 유사성을 비교하는 방법이다. 그림의 모양이 기준에 가까운지 검사하는 데 쓰이지만, 생물학적 해석의 타당성을 직접 판단하는 수단은 아니다. 수치 허용오차도 같은 맥락에서 읽어야 한다. 여기서 3%는 해당 구현 검사의 설정이며 모든 과학 분야의 결과에 공통으로 적용할 정답 기준을 뜻하지 않는다. 실제 도입에서는 출력의 단위, 허용되는 오차, 확률적 실행의 변동을 함께 검토해야 한다.
중요한 것은 시험의 대상이 분명하다는 점이다. 이 도구가 원래 분석 경로를 충실하게 실행하는가를 먼저 확인하고, 그 결과를 새로운 데이터에 어떻게 해석할지는 연구 질문과 전제에 맞춰 검토한다. 실행의 검증과 과학적 판단을 구분하면 자동화가 맡은 영역과 사람이 확인할 영역을 구체적으로 정할 수 있다.
#셋째, 통과한 도구를 실제 질문에 연결한다
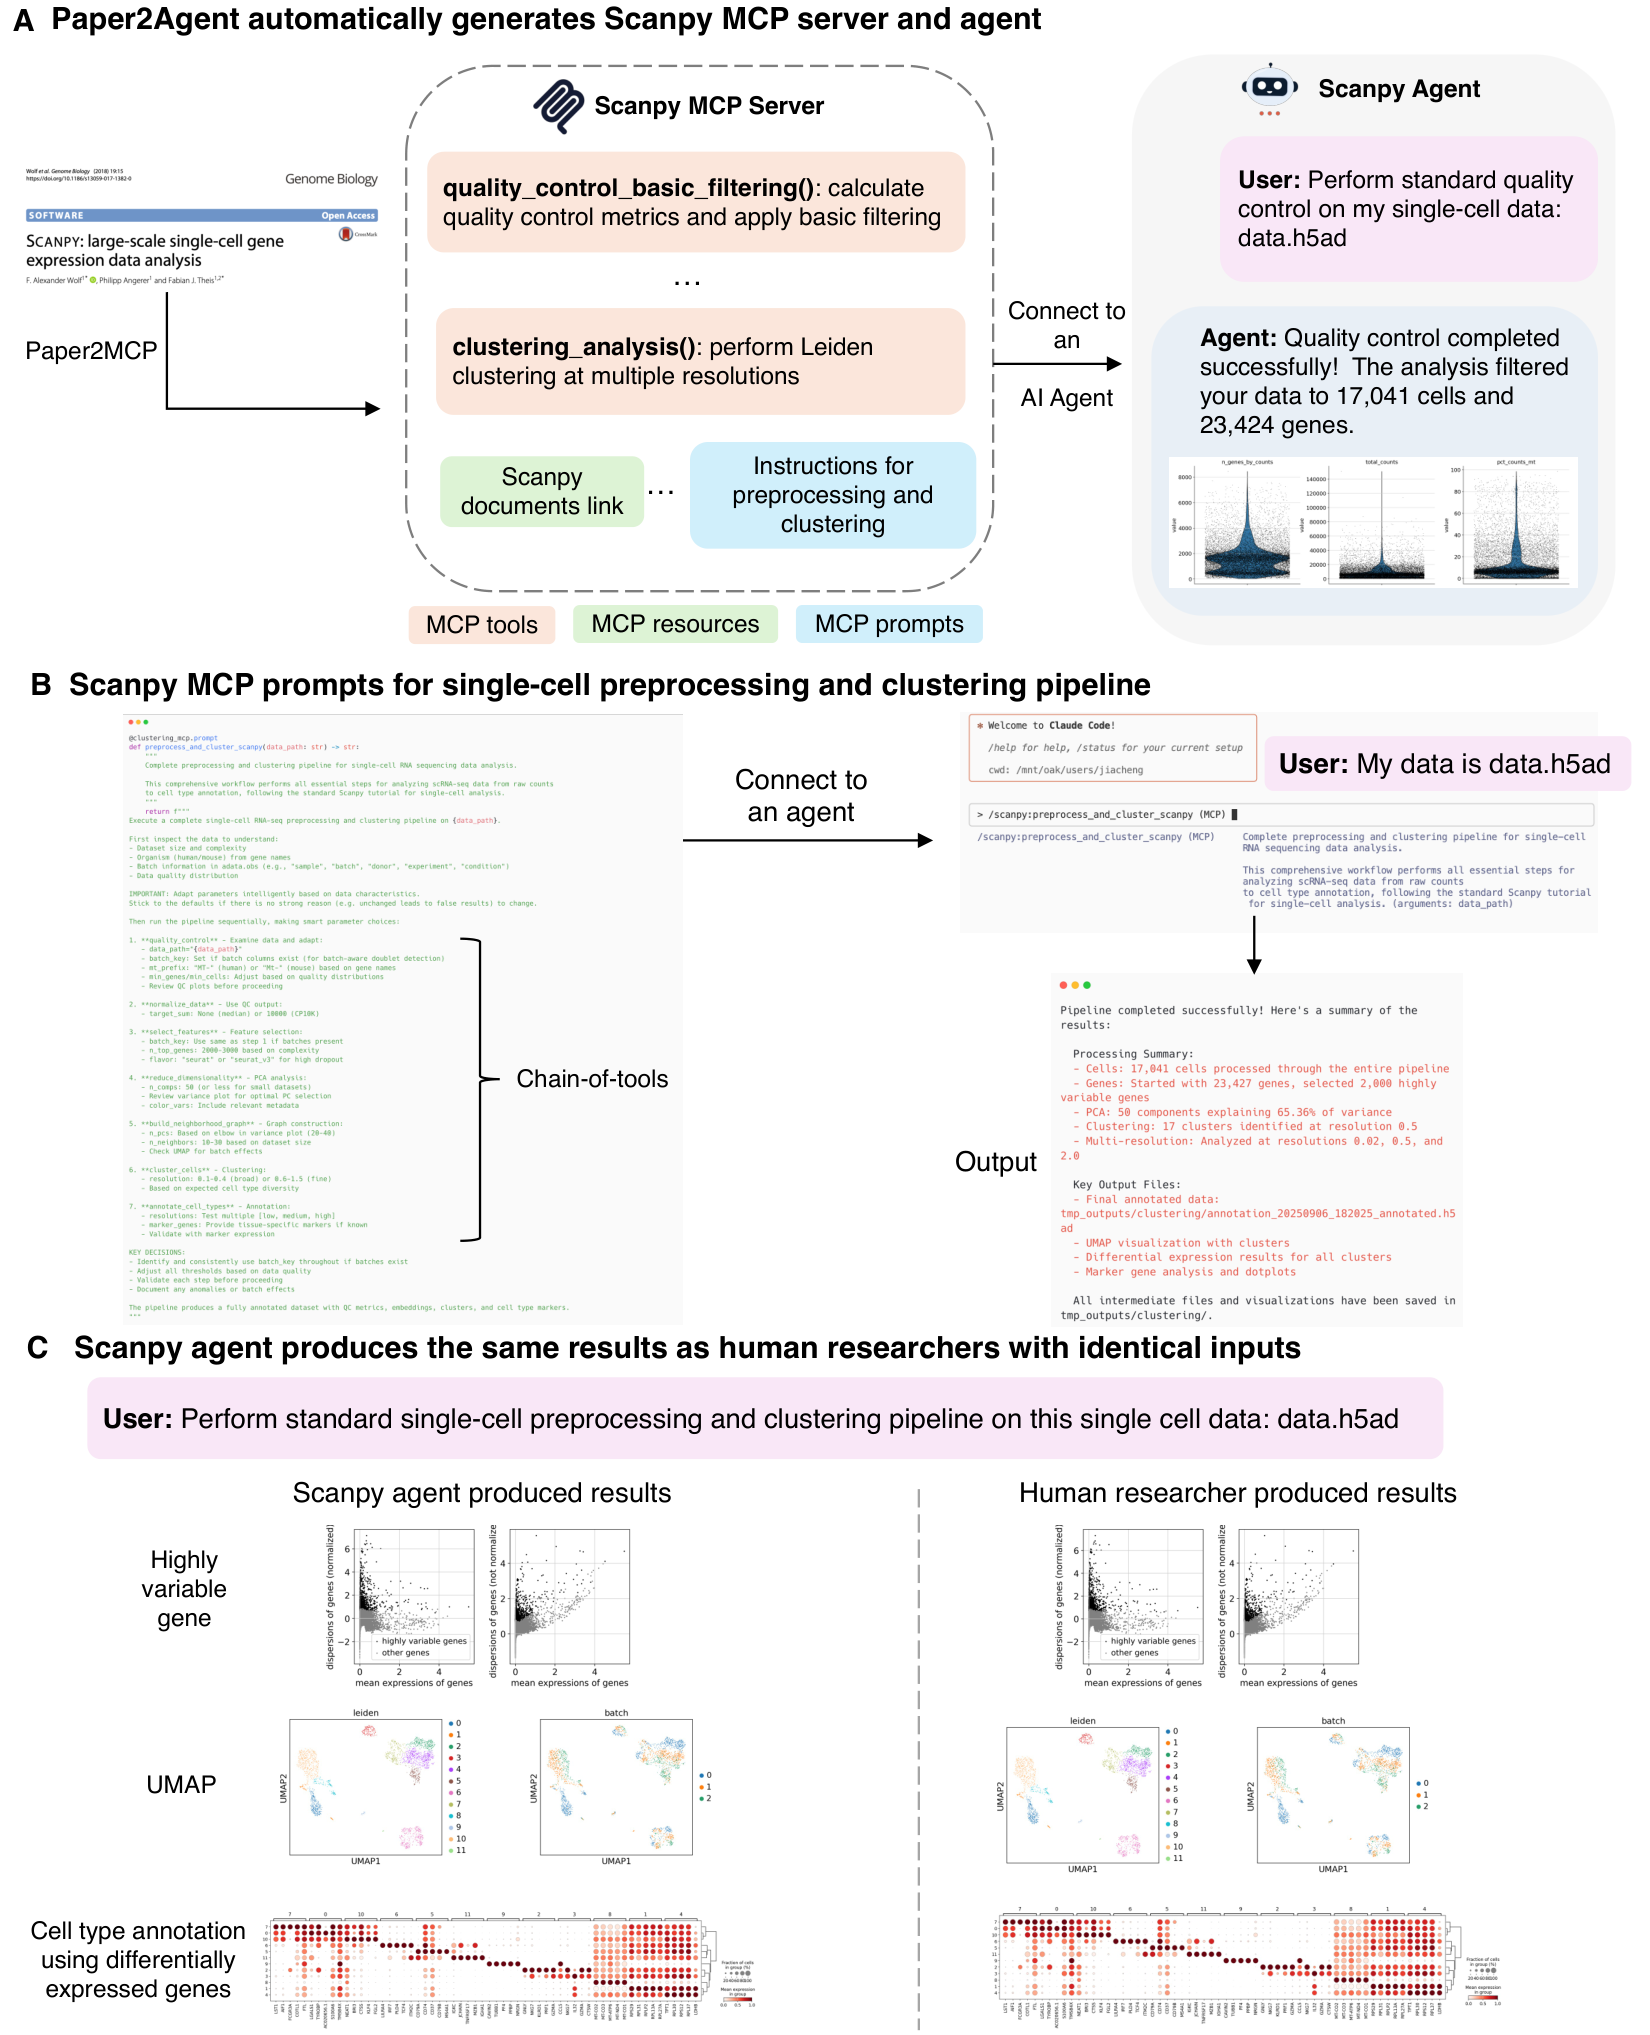
위 Scanpy 예제의 A에서는 단일세포 데이터의 품질 관리와 군집화 같은 기능이 주황색 도구로 묶인다. 사용자가 데이터 파일과 요청을 주면 에이전트가 해당 기능을 호출해 결과를 돌려준다. B는 여러 도구를 이어 사용하는 지침과 실행 결과를 보여 준다. C의 왼쪽은 에이전트 결과, 오른쪽은 사람이 같은 입력으로 수행한 결과다. 변동성이 높은 유전자, UMAP 좌표에 표현한 세포 분포, 유전자 발현을 이용한 세포 유형 해석을 나란히 비교한다.[2]
이 그림에서 UMAP은 고차원 데이터를 낮은 차원에 배치해 구조를 살펴보는 시각화이고, 색상과 점은 선택한 군집이나 표본 정보를 표현한다. 같은 입력에서 대응하는 결과를 얻었다는 것은 분석 경로가 재현되는지 살펴볼 근거다. 새로운 실험이나 다른 조직의 데이터에 적용할 때에는 품질 기준과 군집 해석을 다시 확인해야 한다. 자동 실행이 절약하는 시간은 이러한 해석과 비교에 사용할 수 있다.
공식 저장소의 현재 안내는 Paper2Agent skill에 논문·관련 파일·선택적 코드 저장소와 출력 디렉터리를 전달하는 방식이다. 생성된 서버를 연결할 때에는 결과물의 USAGE.md에서 시험한 환경, 실행 진입점과 필요한 환경변수를 확인하게 되어 있다. 따라서 프로젝트 소개 그림의 간편한 대화 경험 뒤에는 준비된 실행 환경과 도구 계약이 존재한다. API 키와 민감 데이터의 처리는 실행 환경에서 별도로 관리해야 한다.[3]
#5. 핵심 실험: 숫자마다 분모가 다르다
#논문 변환, 도구 검사, 질문 응답을 나누어 보기
규모 평가에서는 computational biology 논문 100편 중 74편을 실행 가능한 에이전트로 변환했다. 그 과정에서 제안한 도구 599개 중 593개가 자동 검증을 통과했다. 변환에 성공한 74편에서 구성한 튜토리얼 기반 질문 300개를 대상으로 실제 응답 성능도 평가했다. 같은 시스템을 다루지만 세 숫자가 묻는 질문은 다르다.[1]
| 평가 단위 | 논문 보고값 | 무엇을 확인하는가 |
|---|---|---|
| 논문 변환 | 100편 중 74편 성공 | 출발 논문에서 실행 에이전트까지 만들 수 있는 범위 |
| 제안된 도구 검증 | 599개 중 593개 통과 | 만들어진 개별 도구가 기준 출력을 재현하는 정도 |
| 300개 질문, Paper2Agent + Sonnet 4 | 91.2±1.6% | 검증된 도구를 이용한 질문 처리 성능 |
| 같은 질문, Sonnet 4 직접 저장소 사용 | 80.3±2.3% | 같은 모델이 논문과 저장소를 직접 활용하는 기준선 |
| 같은 질문, Sonnet 4.6 직접 저장소 사용 | 86.3±1.1% | 더 새로운 모델로 바꾼 직접 사용 기준선 |
도구 검증률 약 99%의 분모는 599개 도구이고, 논문 변환률 74%의 분모는 100편 논문이다. 성공적으로 준비된 도구의 품질이 높다는 결과와 모든 논문을 변환할 수 있다는 주장은 별개다. 또한 300개 질문은 변환에 성공한 논문들을 대상으로 한다. 이 구분을 유지해야 방법의 도달 범위와 준비된 도구의 효용을 동시에 읽을 수 있다.
아래 세 수식을 누르면 분자·분모와 계산 과정이 펼쳐진다. 첫 두 식은 성공 비율을, 세 번째 식은 동일 모델 비교에서의 성능 차이를 계산한다. 표의 ± 값은 논문에 보고된 표기를 유지했으며 여기서 별도의 신뢰구간으로 재해석하지 않았다.
논문 변환률 — 100편에서 몇 편을 사용할 수 있었나? 수식을 눌러 분자·분모와 계산 과정 보기
비교 단위는 논문 한 편이다
는 전체 출발 논문 가운데 실행 에이전트로 변환된 논문의 비율이다. 분자 74는 변환 성공 수, 분모 100은 시도한 논문 전체 수다. 먼저 74를 100으로 나누어 0.74를 얻고, 백분율로 표시하기 위해 100%를 곱한다.
나머지 편은 이 실행 변환에 성공하지 못했다. 여기서 빼기는 출발 집합을 성공과 실패로 나누는 계산이다. 별도 자료 기반 평가에 사용한 26편은 다른 표본 집합이다.
도구 검증률 — 제안된 함수 중 몇 개가 기준을 통과했나? 수식을 눌러 분자·분모와 계산 과정 보기
이번에는 논문이 아니라 개별 도구를 센다
의 분자 593은 자동 검증을 통과한 도구 수, 분모 599는 제안된 도구 전체 수다. 한 논문에서 여러 도구를 만들 수 있으므로 앞의 100편과 단위가 다르다. 593을 599로 나누면 약 0.989983이고, 백분율은 약 98.9983%다. 소수 첫째 자리에서 99.0%로 표시했다.
차이 6은 제안된 도구 가운데 이 검사를 통과하지 못한 수다. 높은 도구 검증률은 준비된 함수의 실행 품질을 설명하고, 앞의 논문 변환률은 그 함수를 준비할 수 있는 범위를 설명한다. 두 값을 함께 보면 성공한 부분의 품질과 전체 적용 범위를 구분할 수 있다.
응답 성능 차이 — 같은 Sonnet 4에서 얼마나 달라졌나? 수식을 눌러 뺄셈과 퍼센트포인트의 의미 보기
비율 두 개를 빼면 퍼센트포인트 차이가 된다
는 질문 응답 성능의 차이다. 첫 값 91.2%는 Paper2Agent와 Sonnet 4, 둘째 값 80.3%는 같은 모델로 저장소를 직접 사용하는 방식의 보고된 평균이다. 같은 단위의 두 값을 빼서 10.9퍼센트포인트(pp)를 얻는다.
상대 증가율을 별도로 묻는다면 차이 10.9를 기준 성능 80.3으로 나누어 약 13.6%를 얻는다. 위 10.9pp는 절대 차이, 이 13.6%는 기준선 대비 상대 차이다. 둘은 같은 보고값을 다른 질문으로 계산한 결과다. 300개 질문의 반복 평가 평균을 사용했으므로 이 계산으로 정답 개수를 정수 하나로 확정하지 않는다.
같은 Sonnet 4를 사용한 비교는 특히 중요하다. 모델 자체를 바꾸지 않은 상태에서, 검증된 도구를 제공하는 방식이 직접 저장소를 사용하는 방식과 어떤 차이를 보였는지 볼 수 있기 때문이다. Sonnet 4.6 기준선은 더 새로운 모델에서도 직접 저장소 접근의 성능을 추가로 확인한 것이다. 이 평가 범위 밖의 모든 모델·모든 연구 과제로 차이를 일반화하려면 별도의 검증이 필요하다.
#응답 비용과 도구를 만드는 비용을 분리하기
질의당 평균 비용과 시간은 Paper2Agent가 0.20달러·1.6분, Sonnet 4 직접 저장소 사용이 0.38달러·4.3분으로 보고됐다. 보고된 평균을 단순 계산하면 비용 차이는 0.18달러, 시간 차이는 2.7분이다. 반복 질의에서 준비된 함수를 재사용하는 구조가 어떤 이점을 줄 수 있는지 보여 주는 값이다.[1]
전체 도입 비용을 판단할 때에는 최초 서버 구축 비용을 별도로 더해야 한다. 설명용으로 구축에 필요한 추가 비용을 , 반복 질의 수를 라고 두면, 위 질의당 평균 차이에 따른 절감액은 달러다. 비교 방식의 다른 준비 비용을 생략한 단순 모형에서는 이 절감액이 구축비를 넘어서는 시점이 중요해진다. 이 계산은 논문 전체 실험의 투자수익률이 아니라 비용 구조를 읽기 위한 예다.
따라서 한 번만 사용할 연구 방법과 여러 사람이 수백 번 호출할 방법은 도구화의 가치가 다를 수 있다. 재사용 횟수뿐 아니라 기준 데이터의 유지, 패키지 업데이트와 추가 검수에 드는 시간도 고려해야 한다. 빠른 개별 질의가 장기간의 유지관리까지 자동으로 해결해 주는 것은 아니므로 두 종류의 비용을 분리해 기록하는 편이 판단에 도움이 된다.
#서로 다른 세 논문 집합을 구분하기
연구팀은 생물정보학 밖의 AI·통계·계량경제·게임이론·천체물리 분야에서도 10편 논문의 42개 실행 과제를 평가했다. 다섯 번 반복한 결과는 98.1±0.8%였다. 다른 분야에도 실행 인터페이스를 구성할 가능성을 보여 주지만, 표본 규모와 과제 구성은 앞선 생물정보학 평가와 다르다.[1]
또 다른 평가는 별도로 선정한 데이터·발견 중심 논문 26편을 대상으로 한다. bioRxiv 13편과 Nature 13편에서 구성한 자료를 resources 계층으로 정리하고, 정보 종합 질문 100개에 답하도록 했다. 결과는 89.0±3.1%, browser-use 기준선은 82.0±3.8%였다. 이 26편은 앞선 100편 중 변환에 실패한 26편과 다른 집합이다. 자료 기반 질의와 실행 도구 기반 질의가 각각 어디에 유용한지 보는 별도의 시험이다.[1]
자료 평가의 비용 34배 감소·속도 15배 향상도 그 시험의 조건에 해당한다. 이를 앞의 실행 질의당 0.20달러·1.6분과 하나의 비율로 섞으면 비교 대상이 달라진다. 실험표를 읽을 때에는 논문 집합, 질문 수, 수행할 작업, 사용하는 모델과 기준선을 한 줄에 함께 놓는 것이 가장 안전하다.
#6. 논문의 한계와 반대 증거
#실패한 26편이 알려 주는 연구 소프트웨어의 상태
100편 중 26편은 완전한 실행 에이전트로 변환되지 않았다. 실행 코드가 없거나 데이터·모델 산출물이 빠져 있는 경우, 의존성을 구성하기 어려운 경우, 기존 스크립트를 새로운 입력에 재사용하기 어려운 경우 등이 원인으로 보고됐다. 자동 변환의 성공 범위를 이해하려면 높은 응답 점수뿐 아니라 이 실패를 같이 봐야 한다.[1]
이 결과는 논문을 쓰는 쪽에도 구체적인 질문을 준다. 실행에 필요한 파일을 공개했는가, 입력과 출력의 단위를 설명했는가, 튜토리얼과 최소 예제를 남겼는가, 결과를 비교할 기준 산출물이 있는가? 이런 준비는 사람이 재현할 때에도 유용하고 자동 도구화에도 기반이 된다. 논문을 에이전트로 만드는 과정은 연구 소프트웨어의 재사용 준비 상태를 점검하는 과정이기도 하다.
#실행의 충실성과 분석의 타당성은 각자 확인한다
기준 출력과 일치했다면 우선 확인한 것은 해당 분석 경로를 충실하게 실행했다는 사실이다. 데이터 선택이 편향되어 있거나 모델의 전제가 새 표본에 맞지 않는 경우까지 그 검사 하나로 판단할 수는 없다. 원 논문의 오류도 동일하게 재현될 수 있다. 저자들은 열린 과학적 분석에 여러 타당한 답이 존재할 수 있으며, 하나의 기준 답과의 일치가 분석의 전체 타당성을 대표하지 않는다고 설명한다.[1]
실용적인 검토는 두 층으로 진행할 수 있다. 먼저 파일·수치·그림이 기대한 형식과 값으로 나오는지 확인한다. 다음으로 연구 질문에 맞는 데이터, 통계적 가정, 검정과 해석을 사용했는지 검토한다. 앞 층의 자동화가 충분할수록 뒤 층에 더 많은 주의를 배분할 수 있다. 에이전트의 출력을 받는 사람에게도 이 두 질문을 나누어 보여 주는 보고서가 필요하다.
연구팀은 잘못된 경로·의존성·오타·사용 중단 API를 넣은 저장소 변형으로 복구 절차를 평가했고, 범위 밖 질문에 대한 거절도 시험했다. 보고된 100% 거절은 해당 질문·논문을 바꾸어 연결한 시험에서의 결과다. 실제 연구소의 임의 입력 전체에 대한 보증으로 확장하기보다, 어떤 오류와 요청을 시험했는지 목록으로 확인하는 것이 유용하다.[1]
평가가 주로 저자들이 구성한 과제와 Claude 계열 에이전트에 기반한다는 점도 남는다. 독립 연구진이 다른 저장소, 다른 모델과 다른 운영 환경에서 같은 기준을 적용할 때 결과가 얼마나 유지되는지가 후속 검증의 핵심이다. 원격 도구를 연결하는 환경에서는 데이터 접근 권한, 외부 전송, 파일 쓰기와 비밀값 관리도 별도의 운영 문제로 다뤄야 한다.
#7. 실제로 무엇이 달라질 수 있나
#한 논문의 실행 기능을 다른 논문의 데이터에 연결하기
논문별 에이전트가 생기면 한 연구의 예측을 다른 연구의 실험 데이터로 검토하는 흐름을 구성할 수 있다. Nature 연구의 건선 사례에서는 AlphaGenome, scCRISPRi, Perturb-seq에 기반한 에이전트를 연결했다. 변이의 영향을 예측하는 방법과 유전자·조절 요소를 교란했을 때의 발현 자료를 연결해, 관련 위치에서 어떤 유전자가 중요한지 검토한 것이다.[1]
구체적으로 AlphaGenome 에이전트가 rs887314 위치에서 GPR137을 유력 후보로 제시했다. 이후 시스템이 검토 전략 열 가지를 제안했고, 사람 연구자가 발현 변화 서명 간 상관분석을 선택했다. 선택한 전략에 따라 조절 요소를 교란한 결과와 각 후보 유전자를 억제한 결과를 비교했다. 이 과정에서 분석 전략을 선택한 사람의 역할과 자료를 찾아 계산한 에이전트의 역할을 함께 볼 수 있다.[1]
자극을 준 조건의 GPR137 비교에서 보고된 Spearman 상관계수는 8시간 조건 0.613, 48시간 조건 0.630이었다. 기존 실험 데이터와 계산 예측을 연결해 후보를 지지하는 근거를 얻은 사례다. 새 생체 실험을 수행한 결과와는 구분하며, 자극 상태에 따른 해석도 함께 남겨야 한다. 이런 사례의 가치는 최종 유전자 이름뿐 아니라 서로 다른 자료를 어떤 비교로 연결했는지에 있다.
#논문 산출물에 실행 계약을 더하기
연구 산출물을 공유할 때 원고와 코드 외에 시험한 도구의 입력·출력, 기준 데이터, 환경 기록을 함께 전달하면 후속 사용자가 출발하기 쉬워진다. 논문의 방법을 직접 재구현할지, 제공된 도구로 먼저 결과를 확인할지 선택할 수 있기 때문이다. Paper2Agent는 이 실행 계약을 자연어 에이전트와 연결하는 구체적인 사례를 보여 준다.
이 관점을 다른 분야에 적용하는 것은 향후 설계의 문제다. 예를 들어 영상 연구에서 전처리, 추론, 평가 지표 계산을 각각 도구로 제공한다고 가정하면, 사용자는 데이터 형식을 확인한 뒤 같은 평가 경로를 호출할 수 있다. 이때 센서 조건과 데이터 분할이 달라지면 해석도 달라진다. 이 예는 블로그의 이해를 돕는 확장 시나리오이며, 해당 영상 과제에서 Paper2Agent의 성능을 측정했다는 뜻은 아니다.
#8. 다음에 확인할 트리거
첫째는 독립적인 재현과 실패 목록의 공개다. 논문 수를 늘렸을 때 전체 변환률이 유지되는지, 성공한 논문만으로 구성한 질의 성능과 전체 출발 집합에 대한 접근 가능성이 어떻게 달라지는지 함께 보고해야 한다. 코드 품질별 실패 유형을 나누면 시스템 개선과 연구 산출물 개선 중 어디에 투자해야 할지도 판단할 수 있다.
둘째는 시간이 지난 뒤의 재현성이다. 공개 저장소와 외부 API는 바뀔 수 있으므로 논문 버전, 코드 커밋, 패키지 환경, 사용 모델과 기준 데이터의 연결을 남길 필요가 있다. 이러한 기록을 유지하고 다시 시험하는 절차가 있다면, 오늘 성공한 실행이 나중에 왜 달라졌는지 추적할 수 있다. 여기서 버전 고정과 변경 기록은 도입을 검토할 때 요구할 조건이며, 모든 생성 서버가 이미 장기 재현을 보장한다는 선언은 아니다.
셋째는 사람이 검토할 수 있는 실행 보고서다. 어떤 자료를 읽었고, 어떤 도구에 어떤 입력을 보냈으며, 어떤 결과가 생겼는지 확인할 수 있어야 한다. 오류가 발생했을 때는 실패한 단계와 아직 수행하지 않은 단계를 분리해 보여 주는 것이 중요하다. 성공한 기준 테스트와 새로운 데이터에서의 미검증 결과가 같은 표시로 묶이면 사용자는 신뢰의 범위를 판단하기 어렵다.
넷째는 출판·배포 관행의 변화다. DOI에 연결된 실행 산출물, 도구의 유지 주체, 코드와 데이터 권리, 원격 호출의 접근 통제 등을 출판물과 어떻게 함께 관리할지에 대한 논의가 필요하다. 특정 출판사가 이미 이런 제출 형식을 공식 채택했다고 단정하기보다, 실제 정책과 운영 사례가 나오는지 확인할 항목으로 남긴다.
Paper2Agent가 보여 준 방향은 연구자의 판단을 건너뛰는 자동화보다, 논문의 방법을 반복해서 호출하고 그 실행을 검토할 수 있게 만드는 자동화다. 읽을 수 있는 연구가 사용할 수 있는 연구로 이어지려면, 설명·코드·데이터·검증 기록이 함께 움직여야 한다. 이번 논문의 성공 사례와 실패 사례는 그 연결을 어디까지 만들었는지 살펴볼 구체적인 출발점이다.
#9. 출처
[1] Miao, J. 외, Reimagining research papers as interactive and reliable AI agents, Nature, 2026-09-16. DOI: 10.1038/s41586-026-11044-y. 규모 평가·Methods의 세 논문 집합·검증 절차·발견 사례·한계의 기준 출처.
[2] Miao, J. 외, Paper2Agent: Reimagining Research Papers As Interactive and Reliable AI Agents, arXiv:2509.06917v2, 2025-10-16. Figure 1·4의 원본 출처. 버전 이력 · CC BY 4.0.
[3] Paper2Agent 공식 공개 저장소, README와 LICENSE, 2026-09-18 확인. 현재의 skill·생성 서버 사용 안내와 MIT 코드 라이선스. 사용 방법은 저장소의 해당 버전 및 생성 결과물의 USAGE.md를 함께 확인한다.
[4] Model Context Protocol 공식 문서, Understanding MCP servers, 2026-07-28 문서 버전. Tools·Resources·Prompts의 역할.
편집 주석: 원고 선정안의 96/100은 블로그의 편집 점수다. 본문은 원자료의 결과와 별도 계산·설계 시나리오를 구분했다. 출판사 원문은 공개 검색으로 제공된 본문·Methods 구절과 첨부 원고를 대조했으며, 자동 다운로드의 HTTP 200 응답은 자바스크립트 확인 페이지여서 원문 취득으로 처리하지 않았다. 원 논문의 학습·실험을 별도로 재실행한 것은 아니다. 대표 도판의 저작자와 변환 기록은 그림 아래에 표시했다.