#1. 한 문장 결론
Anthropic의 자체 생물학 실험실은 AI가 제안한 일을 실제 장비로 수행하고, 측정 결과를 다음 판단에 반영하는 연구 체계를 회사 안에 구축하려는 움직임이다. 2026년 9월 18일 Reuters는 Anthropic 생명과학 책임자 Eric Kauderer-Abrams의 인터뷰를 통해 샌프란시스코 베이 지역의 wet lab 존재를 보도했다. 회사는 이미 컴퓨터 안의 분석을 넘어 물리적 생물학 실험을 수행하고 있다고 설명했다. 다만 해당 시설이 신약 발견만을 위한 실험실은 아니며, 현재 임상시험을 수행할 계획도 없다고 밝혔다.[1]
Wet lab은 시료와 시약, 실험 장비를 직접 다루는 공간이다. 이 공간을 갖는다는 것은 예측 모델의 출력 다음에 오는 일을 다룬다는 뜻이다. 가설을 시험할 시료를 준비하고, 장비를 움직이고, 실제로 얻은 측정이 믿을 만한지 판단해야 한다. 결과가 예상과 다르면 가설, 실험 조건, 장비 상태 중 무엇을 다시 확인할지도 결정해야 한다.
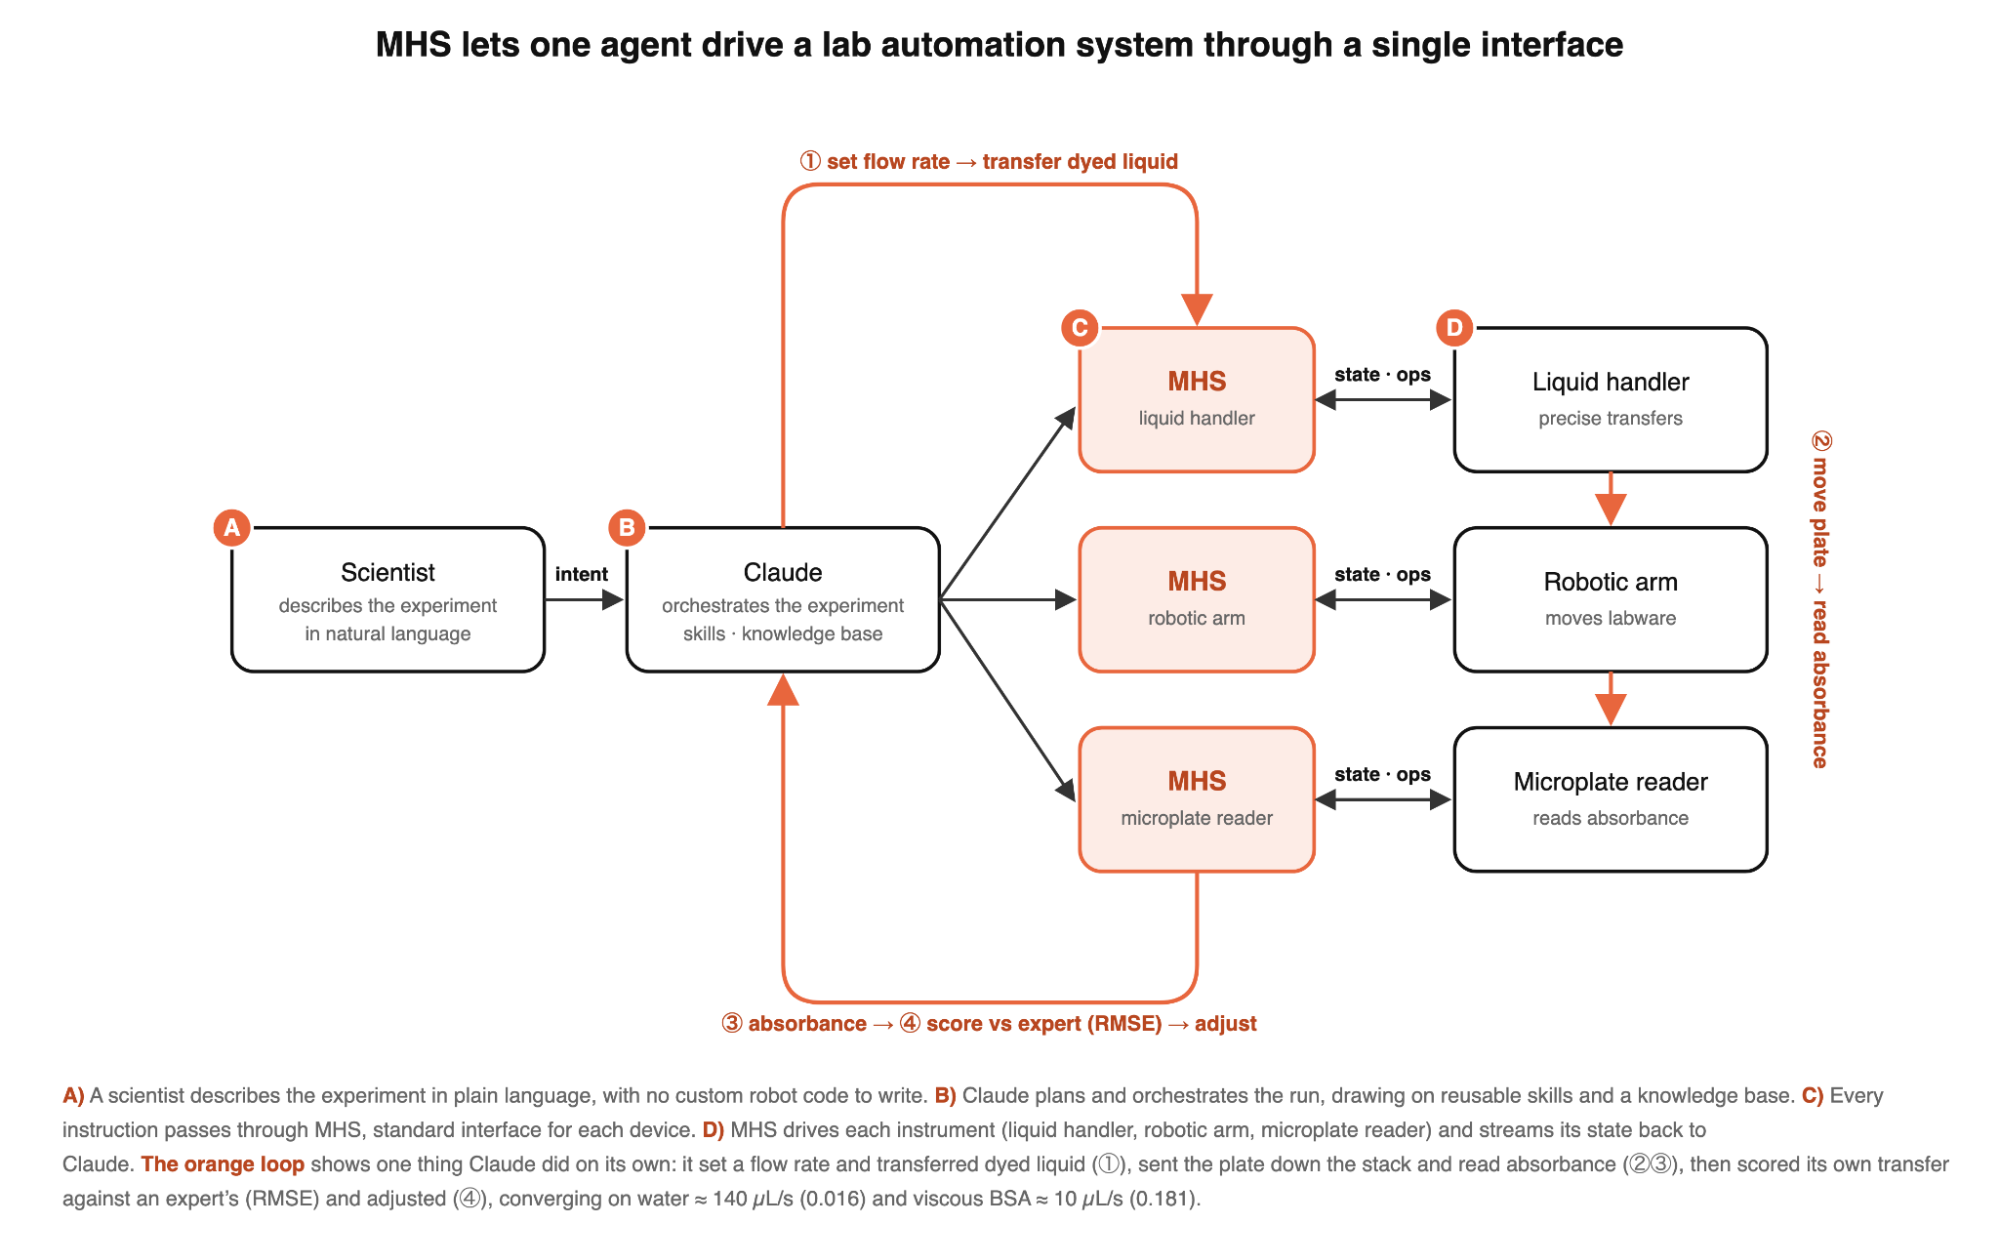
이번 소식은 시설의 존재를 확인한 사건이다. 그 시설의 자율 실험 성공률이나 발견 성과까지 보여 준 발표는 아직 확인되지 않았다. 반면 8월 27일 공개된 Model Hardware Standard(MHS)의 협력사 사례에는 장비를 연결하고 매개변수를 조정한 과정이 제시돼 있다. 따라서 자체 실험실의 소식과, Genentech에서 이미 수행한 장비 자동화 실험을 두 개의 근거로 나누어 읽어야 한다. 위 원본 그림은 후자인 Genentech의 실험 흐름을 보여 준다.[1][2]
기준일: 2026-09-19 · INDUSTRY_TRIGGER. 시설 확인은 Reuters의 9월 18일 인터뷰 보도, 장비 구조와 Genentech 사례는 Anthropic의 8월 27일 MHS 연구 사전공개 자료를 기준으로 한다. 회사·협력사의 공개 설명과 이 글의 구조적 해석을 구분해 읽는다.#2. 왜 이 문제가 어려운가
#계산 결과가 실험 결과가 되기까지
생물학적 질문을 분석 프로그램으로 옮기는 일과, 그 프로그램의 제안을 실제 시료에서 확인하는 일은 서로 이어져 있지만 요구하는 정보가 다르다. 계산에서는 입력 파일, 모델, 실행 환경을 지정할 수 있다. 실험에서는 같은 명령을 보내더라도 시료의 점도, 용기의 위치, 장비의 보정 상태와 이전 작업이 남긴 변화가 결과에 영향을 준다. 실험 자동화가 다루는 대상에는 코드와 함께 물리적 상태가 포함된다.
예를 들어 “이 액체를 옮겨라”라는 요청을 생각해 보자. 로봇이 목적 위치에 도착했다는 기록만으로 액체가 의도한 양만큼 이동했다고 판단할 수 있을까? 어느 팁과 용기를 사용했고, 액체에 거품이 있었으며, 센서가 무엇을 읽었는지까지 연결해야 한다. 명령의 완료, 액체 이동의 성공, 최종 분석에 사용할 수 있는 데이터의 확보는 각각 확인할 지점이다. 이 구분이 있어야 장비가 오류 없이 끝났는데도 결과가 틀리는 상황을 설명할 수 있다.
공개된 Genentech 사례는 이 차이를 액체 취급에서 보여 준다. 연구진은 물과 점성이 있고 거품이 생기기 쉬운 BSA 용액을 다뤘다. 처음에 Claude가 서로 다른 액체에 같은 유량을 적용하자 점성 시료에서 거품과 부정확한 이동이 발생했다. BSA는 소 혈청 알부민(bovine serum albumin)이라는 단백질이며, 이 실험에서는 알려진 농도의 표준 시료로 사용됐다. 문제의 출발점은 피펫이라는 도구의 이름보다 그 안에서 이동하는 액체의 성질이었다.[2]
#장비끼리의 연결과 실험의 의미를 함께 맞춰야 한다
또 다른 간격은 인터페이스다. 액체 처리 장치, 로봇 팔, 측정기가 각각 다른 방식으로 명령을 받고 결과를 반환하면, 한 단계의 완료를 다음 장비가 어떻게 알아야 할지부터 정해야 한다. 장비 한 대를 움직이는 프로그램이 있다고 해서 여러 장비를 잇는 실험이 곧바로 만들어지는 것은 아니다. 데이터가 어느 시료와 어느 실행에서 나왔는지도 연결돼야 한다.
가령 측정값이 낮게 나왔을 때, 시료에 단백질이 적어서인지 액체가 덜 옮겨져서인지 구별하지 못하면 다음 판단이 달라진다. 전자라면 생물학적 결과를 해석해야 하고, 후자라면 실험의 수행 과정을 점검해야 한다. 데이터 분석과 로봇 실행을 한 화면에 모으는 것보다 중요한 것은, 이처럼 측정값과 그것이 만들어진 조건을 함께 다루는 것이다.
MHS가 겨냥하는 지점도 여러 제조사의 장비를 발견하고 공통 형식으로 읽고 제어하는 연결 문제다. 공식 설명은 맞춤형 연동 작업의 부담을 줄이는 데 초점을 둔다. 장비의 작동 원리와 시료의 물성이 모두 같아지는 것은 아니므로, 공통 인터페이스 위에서도 각 장비와 실험에 맞는 정보가 필요하다.[2]
#3. 기존 방식은 무엇이 부족했나
#자동 실행과 측정 기반 조정을 구분하기
정해진 순서를 반복하는 자동화는 미리 정한 조건을 안정적으로 수행하는 데 적합하다. 그러나 측정 결과를 보고 다음 조건을 바꾸려면 판단과 실행을 다시 연결해야 한다. 이를 폐루프(closed loop)라고 부른다. 여기서 루프가 닫힌다는 말은 결과가 다음 행동을 고르는 입력으로 돌아온다는 뜻이다. 사람이 매번 조건을 고르는지, 프로그램이 고르는지, AI 에이전트가 허용된 범위 안에서 고르는지를 따로 보면 자율성의 범위도 더 명확해진다.
예를 들어 처음부터 유량 다섯 개를 정해 놓고 차례로 시험하는 방식과, 앞선 측정의 오차를 평가해 다음 유량을 고르는 방식은 실행 목록이 만들어지는 시점부터 다르다. 두 방식 모두 자동화할 수 있지만, 후자는 관측 결과를 의사결정에 넣는다. 그렇다고 후자가 항상 더 좋은 결과를 내는 것은 아니다. 오차의 정의가 잘못됐거나 관측이 오염돼 있으면 잘못된 목표를 향해 조건을 바꿀 수도 있다.
AI와 로봇을 연결하는 연구 방향에는 선행 사례도 있다. 2023년 Nature의 Coscientist 연구는 언어모델에 문서 검색, 코드 실행과 실험 자동화 도구를 연결해 실험 계획·실행·최적화를 다뤘다. 이번 소식의 의미는 자율 실험이라는 개념의 최초 등장보다, 대형 AI 회사의 과학 소프트웨어·장비 연결 전략과 자체 시설 보유가 함께 드러났다는 데서 찾을 수 있다.[6]
#Claude Science, MCP, MHS, wet lab은 각각 무엇을 맡나
이름을 한 묶음으로 부르면 중요한 구분이 사라진다. Claude Science는 연구자가 문헌과 데이터, 분석 코드와 계산 자원을 다루는 작업 환경이다. MHS는 장비의 기능과 상태를 공통 방식으로 노출하는 연결 계층이다. MCP는 에이전트가 그 기능을 호출하는 데 사용할 수 있는 통신 방식 중 하나다. Wet lab은 이러한 명령이 실제 시료와 장비의 변화로 이어지는 장소다.[2][3]
| 구성 | 받아들이는 것 | 담당하는 일 |
|---|---|---|
| Claude Science | 연구 질문, 문헌, 데이터, 분석 자원 | 분석 작업을 조정하고 코드·그림·결과의 이력을 다룬다. |
| MCP 등 호출 경로 | 에이전트가 선택한 도구와 입력 | 에이전트와 외부 기능 사이에서 요청과 결과를 주고받는다. |
| MHS와 장비별 드라이버 | 읽기·쓰기·장비 기능 호출 | 제조사별 인터페이스를 연결하고 상태·조정 가능 항목을 노출한다. |
| Wet lab의 장비와 시료 | 허용된 물리 작업 | 시료의 상태를 바꾸고 센서와 측정기로 결과를 만든다. |
이 표는 공개된 구성요소를 역할별로 정리한 것이다. Anthropic 자체 시설에서 이 네 요소가 어떤 배치로 통합됐는지 확인한 내부 시스템 구성도는 아니다. 다만 어디에 새로운 능력이 필요한지 판단하는 데 도움이 된다. 언어모델의 추론을 개선할 것인지, 장비 드라이버를 보완할 것인지, 측정의 품질을 높일 것인지는 서로 다른 개발 과제다.
#4. 새 구조를 세 단계로 따라가기
#첫째, 연구자의 의도를 실행 가능한 작업으로 구체화한다
Genentech 원본 그림의 A는 연구자, B는 Claude다. 연구자가 자연어로 실험의 의도를 전달하면 Claude가 재사용 가능한 기술과 지식 기반을 참조해 실행을 조정한다. 이때 연구자가 정한 과제와 기준은 출발점으로 남는다. 공개된 유량 최적화에서는 전문가가 탐색할 유량 범위를 정했고, 같은 플레이트에 전문가가 수행한 기준 이동 결과도 제공했다.[2]
따라서 여기서 모델이 선택한 것은 허용된 실험 안의 실행 조건이다. 어떤 생물학적 문제가 중요한지부터 모든 평가 기준을 스스로 정한 실험으로 읽기보다는, 연구자가 설정한 목표를 장비 호출과 측정에 연결한 사례로 읽는 것이 정확하다. 이 구조에서는 “어떤 목표를 주었는가”와 “주어진 목표를 얼마나 잘 수행했는가”가 서로 다른 평가 질문이 된다.
#둘째, 장비의 기능과 상태를 같은 방식으로 연결한다
그림의 C는 장비별 MHS 인터페이스, D는 실제 장비다. 액체 처리 장치에는 정밀한 액체 이동을, 로봇 팔에는 실험 용기의 이동을, 마이크로플레이트 리더에는 흡광도 측정을 맡긴다. MHS와 장비 사이의 양방향 연결은 명령을 보내는 경로와 상태를 받는 경로를 함께 나타낸다. 하나의 모델이 세 장비의 역할을 조정하더라도 각 장비가 수행하는 물리 작업은 구별된다.[2]
MHS의 read와 write는 이 연결을 이해할 출발점이다. 예를 들어 현재 온도를 읽는 일과 목표 온도를 바꾸는 일은 서로 다른 동작이다. 드라이버는 이런 공통 표현을 장비가 제공하는 실제 인터페이스에 연결한다. 공식 설명은 자연어 태그를 통해 장비 특성, 측정할 수 있는 값, 조정 가능한 항목과 적용될 안전 한계에 관한 참조 정보를 제공하는 방식도 소개한다.[2]
장비 설명이 있다는 것과 모든 상황에서 안전한 동작이 보장된다는 것은 별도로 검증해야 한다. 설명 문서는 모델이 작업을 이해하도록 돕고, 실행 권한과 인터록은 허용되지 않은 동작을 막는 역할을 맡는다. 이 글에서 두 역할을 나누는 이유는 장비 설명의 품질과 실제 차단 기능을 같은 시험으로 평가할 수 없기 때문이다.
#셋째, 측정 결과를 다음 실행 조건으로 돌려보낸다
그림의 주황색 ①–④ 경로를 따라가면 폐루프가 보인다. 유량을 정하고 액체를 옮긴 다음, 플레이트를 리더로 보내 흡광도를 측정한다. Claude는 얻은 데이터를 전문가의 기준 결과와 비교해 오차를 계산하고 다음 유량을 조정한다. 주황색 고리는 바로 이 조건 선택 → 실행 → 측정 → 평가 → 조건 변경의 반복을 표시한다.[2]
이 연결에서 AI가 모든 모터의 짧은 시간 간격 제어를 직접 계산할 필요는 없다. Anthropic의 MHS 설명은 모델의 온라인 추론보다 빠르게 수행해야 하거나 오래 이어지는 작업을 여러 드라이버 명령을 연결한 코드로 실행하는 방식도 소개한다. 높은 수준의 판단과 장비 가까이에서 반복하는 실행을 나눠 보면, 에이전트가 하는 일과 결정적 스크립트가 하는 일이 구체적으로 드러난다.[2]
앞서 게시한 Paper2Agent 해설은 논문의 코드와 데이터를 재사용 가능한 실행 도구로 만드는 과정을 다뤘다. 이번 글에서는 그 실행의 대상에 물리 장비와 시료가 추가된다. 호출 가능한 도구가 준비된 다음에도 실제 상태를 읽고, 측정의 품질을 판단하고, 실패 뒤에 무엇이 달라졌는지 확인할 층이 필요한 것이다.
#5. 핵심 실험과 수치
#BCA와 BSA부터 구분해서 읽기
Genentech가 자동화를 시험한 대상은 BCA 단백질 정량 분석이다. BCA는 시료의 총단백질 농도를 측정하는 분석법의 이름이고, BSA는 이 사례에 표준 시료로 사용한 단백질의 이름이다. 액체 처리 장치가 시료를 옮기고, 로봇 팔이 용기를 이동시키며, 리더가 광학적 흡광도를 읽는 작업이 연결된다. 유량 조정은 이 과정에서 액체를 얼마나 안정적으로 취급하는지 개선하기 위한 과제였다.[2]
여기서 유량은 팁을 통과하는 액체의 부피를 시간으로 나눈 값이다. 단위 는 초당 마이크로리터를 뜻한다. 유량을 정하는 것과 최종적으로 옮길 총부피를 정하는 것은 다르다. 이 차이를 알아야 아래 표의 140과 10을 시료의 농도나 한 번에 옮긴 부피로 읽지 않게 된다.
| Genentech에서 시험한 액체 | 사례에서 선택한 유량 | 보고된 RMSE |
|---|---|---|
| 물 | 약 140 μL/s | 0.016 |
| 점성이 높은 BSA 시료 | 10 μL/s | 0.181 |
공식 자료는 자동화 전문가들이 이 설정에서 합리적인 매개변수라고 확인했다고 설명한다. 이 표가 보여 주는 것은 서로 다른 액체에 같은 기본 유량을 적용하는 대신, 실제 측정과 기준 결과를 이용해 조건을 조정했다는 점이다. 표의 수치는 Genentech proof-of-concept의 결과이며 Anthropic 자체 wet lab의 성능표가 아니다. 다른 팁, 용기, 시료 농도와 장비에서도 그대로 사용할 공통 설정값으로 제시된 것도 아니다.[2]
#RMSE는 무엇을 비교하는 숫자인가
평균제곱근오차(root mean square error, RMSE)는 대응하는 두 측정값의 차이를 제곱해 평균 낸 뒤 제곱근을 취한다. 이 사례에서 기준은 전문가가 수행한 액체 이동이다. 공개 설명은 플레이트 리더의 측정 데이터를 이용했다고 밝히지만, 보고된 0.016과 0.181을 곧바로 마이크로리터나 백분율로 환산하는 데 필요한 단위와 정규화 조건까지 이 수치만으로 확인할 수는 없다. 따라서 원자료의 RMSE로 표시하고 해석 범위를 유지한다.[2]
아래 식은 지표의 계산을 설명하기 위한 일반식이다. 새로운 모델 학습식을 소개하는 부분이 아니라, 위 결과표를 읽기 위한 보조 설명이다.
차이를 왜 제곱하고, 평균 낸 뒤 제곱근을 취할까? 기호·연산·계산 과정 펼치기
는 i번째 시험의 측정값, 는 그에 대응하는 기준값, 은 비교한 쌍의 수다. 두 값은 같은 의미와 단위를 가져야 한다. 측정 조건이 다른 값을 아무 기준 없이 한 쌍으로 묶으면 계산은 가능해도 비교의 의미가 달라진다.
먼저 로 기준보다 얼마나 크거나 작은지 구한다. 차이를 그대로 더하면 양의 오차와 음의 오차가 상쇄될 수 있으므로 제곱한다. 제곱된 차이들을 합한 뒤 분모 n으로 나누면 비교 쌍 하나당 평균적인 제곱오차가 된다. 마지막 제곱근은 제곱하며 바뀐 차원을 원래 측정값의 차원으로 되돌린다. 큰 오차가 평균에 더 강하게 반영되는 특성도 남는다.
계산만 확인하기 위해 같은 임의 단위의 오차 세 개를 0.02, −0.01, 0.01로 가정하자. 제곱하면 0.0004, 0.0001, 0.0001이고, 합은 0.0006이다. 세 쌍으로 나눈 0.0002에 제곱근을 취하면 약 0.0141을 얻는다.
이 세 값은 설명을 위해 정한 숫자이며 Genentech의 원시 측정 데이터가 아니다. 실제 성능을 비교하려면 측정량의 단위, 기준값을 얻은 방법, 비교 쌍의 수와 반복 측정의 변동을 함께 확인해야 한다. RMSE가 작다는 한 사실만으로 전체 실험의 성공률이나 새로운 생물학적 발견의 타당성을 알 수는 없다.
이 결과에서 바로 “물의 실험이 BSA보다 몇 배 더 잘됐다”는 순위를 만들기보다, 각 액체 안에서 어떤 기준을 향해 조정했는지 보는 편이 적절하다. 두 액체의 측정 범위와 정규화가 동일한지 확인하지 않고 오차의 비율만 계산하면 다른 조건을 하나의 숫자로 합치게 된다. 원시 데이터와 반복별 추이가 공개되면 초기 설정 대비 개선, 수렴의 안정성, 사람의 개입 시점을 함께 검토할 수 있다.
#6. 한계와 반대 증거
#거품이 생긴 뒤에는 같은 명령도 다른 실험이 된다
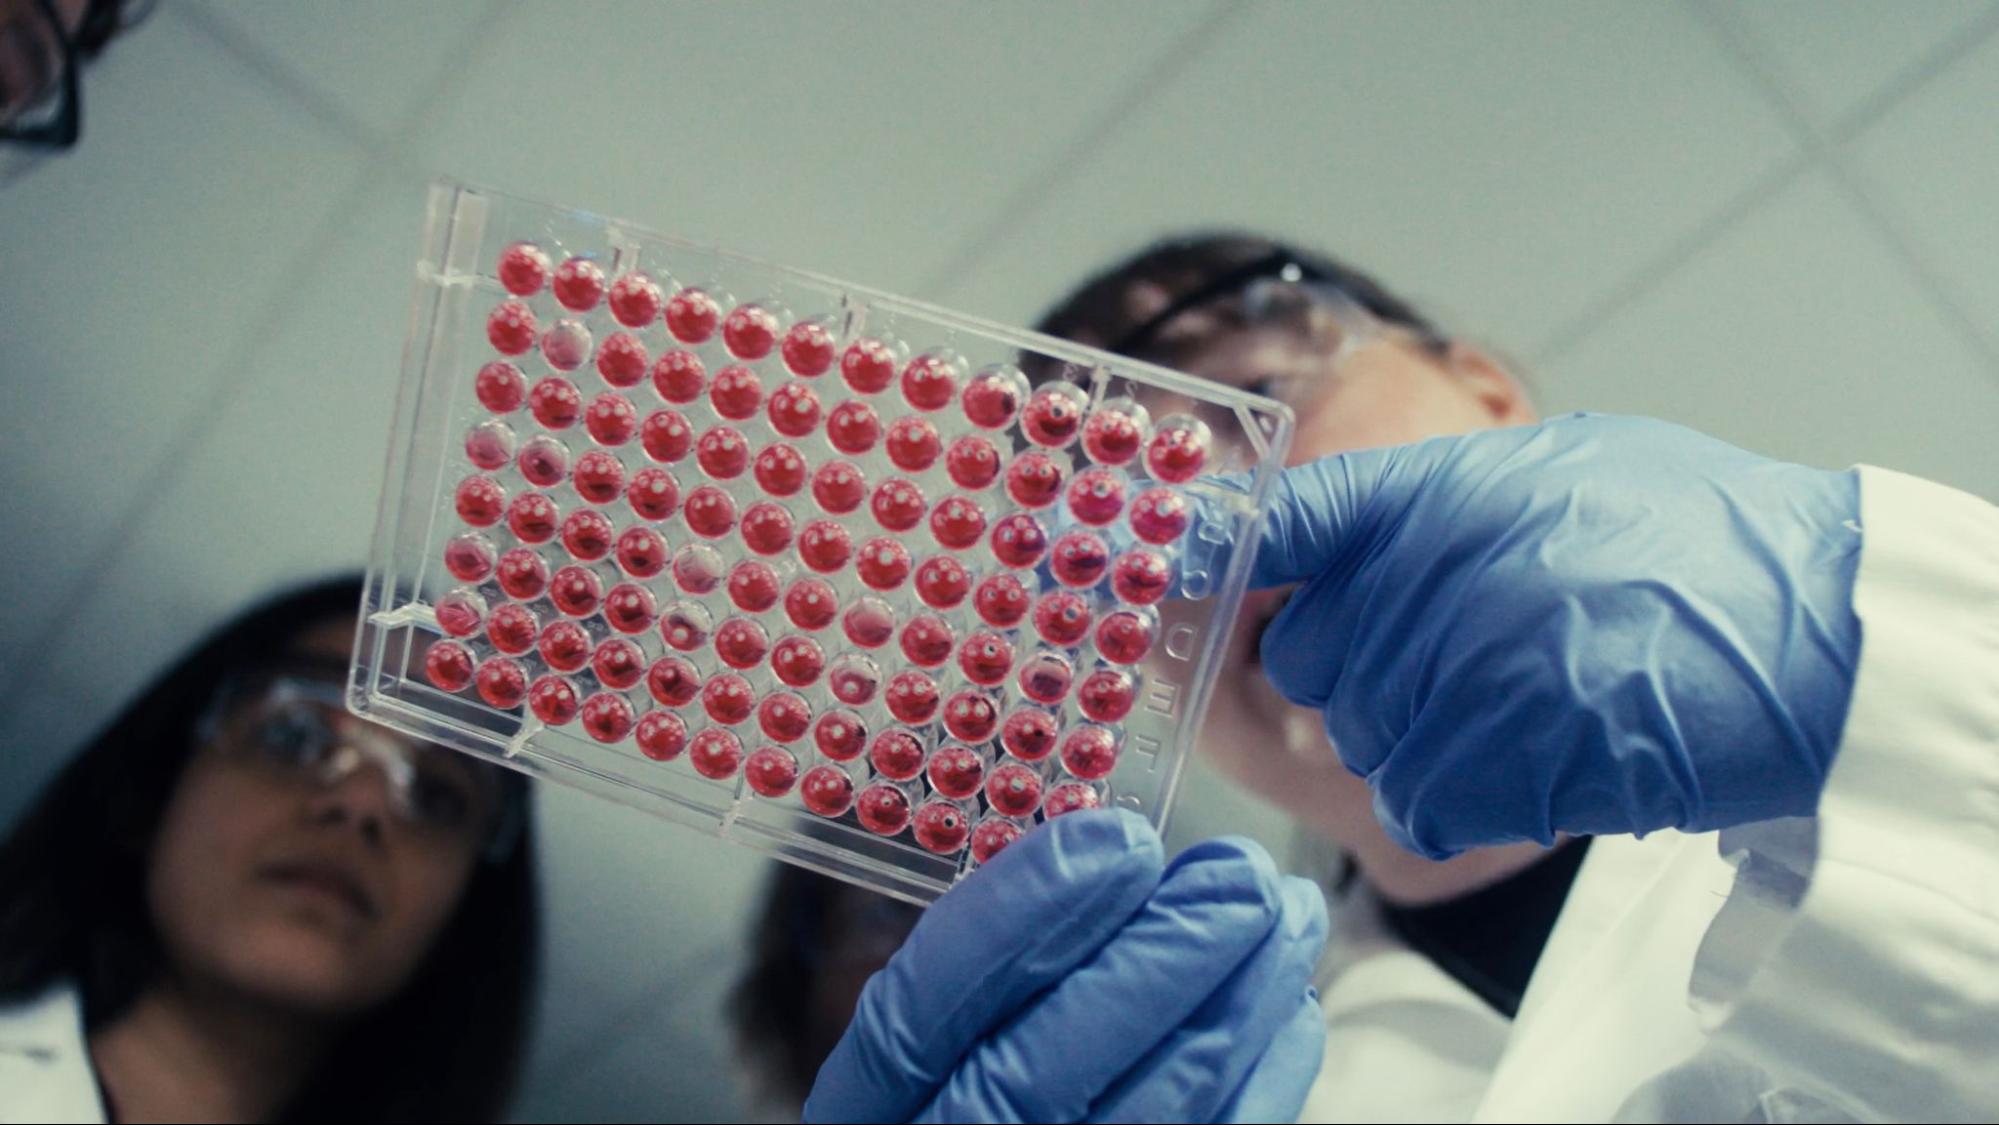
사진은 Genentech 연구자들이 플레이트의 거품을 확인하는 장면이다. 각 웰에 들어 있는 시료의 상태를 살펴보는 일은 로그에 기록된 명령만으로 충분히 표현되지 않는 정보를 제공한다. 원문은 거품이 실제 이동한 액체의 양, 액면 감지, 최종 광학 측정에 영향을 줄 수 있다고 설명한다. 하나의 물리적 변화가 실행 단계와 측정 단계 양쪽에 문제를 만들 수 있는 것이다.[2]
공개 사례에서 Claude는 혼합 중 거품으로 생긴 실행 오류를 만났을 때, 같은 웰에서 매개변수를 바꾸어 재시도했다. 그 동작은 액체를 더 자극해 거품을 늘렸다. 연구자가 오류의 물리적 원인을 알려 주고 깨끗한 웰 사용과 혼합 횟수 감소를 안내한 뒤, Claude는 그 문맥을 나머지 실행에 유지했다. 연구진은 이후 이러한 내용을 재사용 가능한 액체 취급 기술로 정리했다.[2]
이 실패에서 중요한 것은 재시도가 시작 상태를 자동으로 복구하지 않는다는 점이다. 파일을 다시 읽는 것과 이미 섞인 액체를 다시 다루는 것은 다르다. 앞선 행동이 거품을 만들었다면 다음 시도는 이미 바뀐 시료에서 출발한다. 같은 웰이라는 위치 정보는 같아도, 내부의 물리적 상태는 달라진다. 따라서 매개변수만 바꾸어 반복할지, 상태를 다시 관측할지, 새로운 시료나 용기가 필요한지를 판단해야 한다.
이 사례 하나로 모든 언어모델의 물리 추론 능력을 평가할 수는 없다. 구체적으로 확인된 것은 해당 실험에서 모델이 거품의 원인과 올바른 복구 방법을 처음부터 선택하지 못했고 전문가의 설명을 필요로 했다는 사실이다. 반대로 전문가가 제공한 지식을 이후 실행의 지침으로 보존한 과정은 개선 경로를 보여 준다. 실패를 없었던 것으로 처리하는 대신, 어떤 상태에서 어떤 개입이 유효했는지 기록할 수 있기 때문이다.[2]
#장비를 연결하는 규격과 안전 검증은 서로 다른 일이다
MHS는 모델에 장비 정보를 제공하고 호출 경로를 통일하는 데 초점을 둔다. 8월 발표는 연구 사전공개 단계이며, 협력사들과 물리적 안전 평가와 보호 장치를 더 개발한 뒤 오픈소스화하겠다는 계획을 설명한다. 그래서 이 글에서는 MHS를 이미 검증이 끝난 범용 로봇 안전 규격으로 소개하지 않는다.[2]
안전성을 검토하는 관점에서는 모델이 내린 판단과 실행을 허용하는 조건을 분리해 볼 필요가 있다. 예를 들어 로봇이 옮길 용기가 맞는지, 다른 장비가 작업 중인지, 측정 데이터가 최신인지 등을 확인하는 역할과, 연구 목적에 맞는 다음 조건을 제안하는 역할은 다르다. 이것은 이 글의 시스템 설계 관점이며, Anthropic 자체 실험실에 특정 인터록이나 승인 정책이 구현돼 있음을 확인한 목록은 아니다.
또한 자체 시설의 처리량, 재현성, 실패율과 실제 발견 성과는 별도의 공개 근거가 필요하다. 시설을 갖고 있다는 확인과 협력사의 시연을 이어 붙여 이미 완성된 무인 신약 연구소의 성과로 읽으면, 확인한 사실보다 더 큰 결론을 만들게 된다. 현재의 평가 단위는 공개된 사례와 그 사례에 남아 있는 사람의 역할이다.[1][2]
#7. 실제로 무엇이 달라질 수 있나
#실패의 원인까지 다음 실행에 전달할 기회
과학적 피드백 루프의 가치는 결과값 하나가 늘어난다는 데서 끝나지 않는다. 어떤 조건을 골랐고, 장비가 무엇을 수행했으며, 시료와 센서가 어떻게 반응했는지를 함께 얻을 수 있다. 이 기록이 있으면 모델의 판단 오류, 장비 실행 오류, 실험의 변동을 구분해 개선할 출발점이 생긴다. 이 부분은 자체 실험실 보유의 잠재적 의미에 대한 해석이다.
Genentech에서 확인된 직접적인 연결은 전문가가 설명한 거품 처리 지식을 재사용 가능한 기술로 정리했다는 점이다. 지침을 갱신하는 일과 기반 모델의 가중치를 다시 학습하는 일은 구분해야 한다. 전자는 다음 실행에 전달할 문맥과 절차를 바꾸는 방법이고, 후자는 별도의 학습·평가를 거쳐 모델 자체를 바꾸는 방법이다. 자체 wet lab의 모든 실험이 곧바로 Claude의 학습에 반영되는 자동 경로는 이번 공개 자료로 확인되지 않았다.[2]
이를 평가 가능한 구조로 만들려면 성공한 실행만 모으는 것보다 실패를 포함한 이력이 중요하다. 거품이 발생한 상태, 실패를 감지한 신호, 사람이 알려 준 내용, 이후 결과를 함께 기록해야 복구 방법의 효과를 판단할 수 있다. 마지막에 좋은 플레이트를 얻었다는 결과와 처음부터 개입 없이 성공했다는 결과는 다른 경험을 나타낸다.
#최근 발표들은 같은 방향을 보여 주지만 서로 다른 근거다
| 날짜 | 발표 또는 보도 | 확인할 수 있는 변화 |
|---|---|---|
| 2026-06-30 | Claude Science 공개 | 과학 도구와 계산 자원, 결과 이력을 한 작업 환경에서 다루는 방향 |
| 2026-08-27 | MHS 연구 사전공개 | 장비 연결 방식과 협력사 자동화 사례 |
| 2026-09-16 | Novo Nordisk–Anthropic 협력 발표 | 특정 R&D 작업에 Claude Science 등을 시험할 협력 계획 |
| 2026-09-17 | Life Sciences Verification Program 공개 | 검증된 생명과학 연구팀을 위한 모델 접근 프로그램 |
| 2026-09-18 | Reuters의 wet lab 보도 | Anthropic 자체 물리 실험시설의 존재 확인 |
Claude Science의 6월 발표는 문헌·데이터·계산을 다루고 결과의 생성 이력을 추적하는 작업 환경을 설명한다. Novo Nordisk의 9월 발표는 과학자들이 식별한 문제와 특정 R&D 작업에 이를 시험하는 협력이다. 두 발표는 연구 실행 기반을 넓히는 움직임으로 읽을 수 있지만, 특정 치료제의 유효성을 확인한 임상 결과와는 증거의 종류가 다르다.[3][5]
Life Sciences Verification Program은 연구 자격과 보안, 윤리적 감독을 확인한 팀에 생명과학 작업에 맞는 모델 접근을 제공하는 제도다. 어떤 사용자가 어떤 연구 범위에서 모델을 이용하는지 다루는 접근 정책과, 실제 로봇이 움직일 때 적용할 장비 안전 조건은 구분해서 관리해야 한다. 프로그램 가입을 물리 실험의 포괄적인 실행 승인으로 읽어서는 안 된다.[4]
이 흐름이 확장되면 AI-for-Science의 경쟁 기준에 실험의 회전 속도와 데이터 품질이 더해질 수 있다. 다만 빨리 반복하는 것만으로 충분하지 않다. 잘못된 측정을 빨리 많이 모으면 잘못된 결정을 강화할 수 있기 때문이다. 의미 있는 경쟁력은 신뢰할 수 있는 실험 결과를 얼마나 빨리 얻고, 그 근거로 다음 판단을 얼마나 잘 바꾸는가에 가깝다.
#8. 다음에 확인할 트리거
다음 발표에서는 장비 수나 시연 영상보다 실험의 경계와 분모를 먼저 확인할 필요가 있다. 어디까지 사람이 준비했고, 어느 시점부터 모델이 판단했으며, 실패한 실행을 결과에서 어떻게 처리했는지가 있어야 서로 다른 시스템을 비교할 수 있다. 다음 표는 이번 공개 자료에 보고된 새 성능 수치가 아니라, 후속 결과를 읽기 위한 검토 기준이다.
| 확인할 항목 | 공개돼야 의미가 명확해지는 정보 |
|---|---|
| 자율 수행 범위 | 사람의 사전 준비, 허용된 행동, 실행 중 개입과 최종 승인 역할 |
| 성공률과 복구 능력 | 전체 시도 수, 실패·중단 포함 규칙, 사람 개입 횟수, 복구 후 데이터 품질 |
| 실험 처리량 | 단위 시간당 실행 수와 실제 분석에 사용할 수 있는 결과 수, 장비 대기와 준비 시간 |
| 재현성 | 같은 조건의 반복 변동, 다른 날·장비·독립 연구실에서의 반복 결과 |
| 새로운 과학적 결과 | 기존 기준의 재현과 새 가설의 검증을 구분한 데이터, 독립적인 후속 확인 |
예를 들어 시도한 실험 중 일부를 다시 수행했다면 최종적으로 얻은 성공 결과 수만 알려 주는 것으로는 충분하지 않다. 재시도와 사람의 도움까지 포함해야 필요한 자원과 자율 수행의 범위를 알 수 있다. 처리량도 장비가 명령을 완료한 횟수와 신뢰할 수 있는 데이터를 만든 횟수를 함께 봐야 한다. 이런 분모가 공개되면 시연의 인상보다 실행의 실제 특성을 비교할 수 있다.
MHS에서는 연구 사전공개 이후의 규격·드라이버·안전 평가 공개가 중요한 다음 단계다. 장비를 추가했을 때 어떤 정보를 작성해야 하는지, 실패 상태를 어떻게 전달하는지, 허용하지 않는 동작을 어디서 차단하는지가 구체화될수록 다른 연구실에서 검증하기 쉬워진다. 8월 발표는 추가 평가를 거친 뒤 오픈소스화하겠다는 계획을 제시한 상태다.[2]
Anthropic 자체 wet lab에서는 그 시설에서 수행한 과제와 반복별 성능 자료가 우선이다. 그다음은 가설 설정부터 시료 준비, 실행, 측정과 해석이 어느 범위까지 이어졌는지 확인하는 일이다. 새로운 생물학적 결론이 제시된다면 독립 연구실의 재현 결과가 더 강한 근거가 된다. 현재 공개된 시설의 존재와 Genentech 사례는 그 검증을 기다릴 구체적인 출발점을 제공한다.[1][2]
이번 사건은 AI 회사가 실험으로부터 피드백을 얻을 기반을 소유하기 시작했다는 산업적 신호다. Genentech의 원본 그림에서는 이미 특정 유량 조정의 루프를 읽을 수 있고, 거품 사례에서는 그 루프에 전문가 지식이 필요한 지점을 볼 수 있다. 앞으로 중요한 것은 이 두 장면을 함께 개선하는 것이다. 더 많은 작업을 연결하면서도, 어떤 상태에서 실패했고 어떻게 복구했는지를 설명하고 재현할 수 있어야 한다.
#9. 출처
[1] Jeffrey Dastin·Michael Erman, “Anthropic quietly sets up biology lab as it ramps AI drug program,” Reuters, 2026-09-18. 자체 wet lab과 회사 설명에 관한 인터뷰 보도.
[2] Anthropic, “Previewing the Model Hardware Standard,” 2026-08-27. How MHS works 및 Genentech의 BCA 분석·유량 조정·거품 관련 오류 복구 사례. 기업·협력사가 공개한 연구 사전공개 자료.
[3] Anthropic, “Claude Science, an AI workbench for scientists, is now available,” 2026-06-30. 과학 작업 환경의 기능과 결과 이력.
[4] Anthropic, “Introducing the Life Sciences Verification Program,” 2026-09-17. 연구팀의 검증과 접근 유형에 관한 공식 발표.
[5] Novo Nordisk A/S, “Novo and Anthropic will collaborate to advance drug discovery with Claude,” 2026-09-16. 회사가 GlobeNewswire를 통해 배포한 협력 발표.
[6] Boiko, D. A. et al., “Autonomous chemical research with large language models,” Nature 624, 570–578, 2023-12-20. DOI: 10.1038/s41586-023-06792-0. 검색·코드·실험 자동화를 연결한 Coscientist 선행 연구.