단백질 구조 모델이 새로운 분자를 더 잘 이해하게 만드는 길만 있는 것은 아니다. 이미 학습된 모델의 같은 계산을 더 짧은 시간과 적은 메모리로 수행하는 길도 있다. Anthropic은 Claude를 이용해 30개 이상의 공개 생체분자·유전체 모델의 실행 코드를 최적화했다고 발표했다. 새 생물학 모델의 발견보다, 연구자가 모델을 실행할 때 기다리는 시간과 하드웨어 장벽을 줄이는 과학 소프트웨어 공학의 사례다.[1]
2026년 9월 17일 공개한 회사 기술 보고와 공식 코드의 9월 20일 상태를 기준으로 한다. 동료평가 논문과 같은 증거 등급으로 다루지 않으며, 독립 재현이 필요한 EARLY_SIGNAL이다. 원본 성능 그림과 실패 사례를 함께 배치했다.#1. 같은 예측을 더 싸게 실행하는 문제가 중요해진 이유
단백질 설계 과정에서는 후보 구조를 한 번 계산하고 끝내기보다, 많은 후보를 만들고 구조를 예측하고 점수를 계산하는 과정을 반복한다. 한 모델의 실행이 느리거나 큰 입력을 메모리에 담지 못하면 탐색할 수 있는 후보 수가 줄어든다. 계산을 빠르게 하는 일은 생물학적 정답을 보장하지 않지만, 같은 예산으로 평가할 수 있는 가설과 후보의 범위를 바꾼다.[1]
이번 작업에서 Claude가 수정한 것은 여러 모델의 추론 경로(inference path)다. 낮은 수준의 GPU 커널을 만들고, 반복 계산을 저장해 재사용하며, 개별 모델에 불필요한 분기나 메모리 이동을 정리했다. 회사는 생체분자 모델링 경험은 있지만 커널 최적화 경험은 없던 기술 인력 두 명이 감독했고, 4주가 채 걸리지 않았다고 설명한다. 이 시간과 인력은 회사의 수행 기록이며 외부 팀이 같은 기간을 재현했다는 결과는 아니다.[1]
공개 저장소에는 36개의 최적화 kit가 있다. kit는 고정된 upstream 프로그램 버전에 대응하는 실행 패키지이므로, 이를 곧바로 서로 다른 36개 과학 모델을 새로 학습했다는 뜻으로 세면 안 된다. 구조 예측, 단백질 설계, 단백질·유전체 언어모델 등 서로 다른 작업이 포함된다. 각 도구마다 지원 모드와 환경, 정밀도 선택이 다르다는 점이 실제 사용의 출발점이다.[3]
이 발표의 큰 질문은 세 가지다. 왜 계산이 느렸는가, 어떤 수준에서 얼마나 빨라졌는가, 빨라진 결과가 원래의 과학적 판단을 유지하는가. 메모리 최적화가 열어 준 매우 큰 입력은 네 번째 질문이다. 계산을 끝내는 능력과 올바른 구조를 예측하는 능력을 마지막까지 구분해야 한다.
#2. 삼각형 계산은 왜 커지기 쉬운가
구조 모델은 개별 잔기만 보지 않고 잔기 쌍과 세 위치 사이의 관계를 갱신한다. Pairformer 계열에서 triangle attention과 triangle multiplication은 세 토큰의 관계를 통해 분자 기하 정보를 처리하는 핵심 연산이다. 이때 토큰은 일반 문장 토큰과 다르게 아미노산, 핵산의 뉴클레오타이드, 작은 분자·이온의 원자 등에 대응한다. 같은 ‘1만 토큰’이라도 텍스트 창과 같은 데이터를 세는 것이 아니다.[1][2]
세 인덱스를 모두 따라야 하는 계산을 단순하게 생각하면 입력 길이의 세제곱에 따라 연산이 커질 수 있다. 길이가 두 배이면 단순 연산량은 여덟 배, 세 배이면 스물일곱 배가 된다. 다만 실제 메모리는 어느 중간 텐서를 한꺼번에 저장하는지에 따라 달라진다. 모든 구현이 항상 동일한 세제곱 크기의 메모리를 필요로 하는 것은 아니며, 중간 계산을 타일로 나누고 재사용하는 것이 바로 최적화의 대상이다.
GPU 커널은 이 연산을 장치에서 수행하는 실행 코드다. 수학적 목표가 같더라도 어떤 데이터를 어느 메모리에 두고 몇 번 읽는지, 작은 작업을 합칠지, 중간 결과를 얼마나 오래 보관할지에 따라 시간이 달라진다. 모델 가중치를 더 작게 학습시키는 일과, 같은 모델을 계산하는 경로를 바꾸는 일을 구분하면 이번 결과의 위치가 명확해진다.
Anthropic은 FlashPairformer라는 커널 묶음을 개발했다고 보고했다. 회사가 정한 비교 구성에서 triangle attention은 평균 2.7–2.9배, triangle multiplication은 1.7–3.2배의 가속을 제시한다. 이 숫자는 특정 연산의 커널 비교다. 모델 전체의 실행시간, 입력 전처리와 결과 해석까지 포함한 워크플로 시간은 별도로 측정해야 한다.[1][2]
#3. 커널이 네 배 빨라도 전체 작업은 다르게 변한다
부품의 가속이 전체 가속과 같지 않은 이유를 작은 계산으로 확인할 수 있다. 아래는 발표 수치를 재현한 식이 아니라, 최적화 범위를 해석하기 위한 Amdahl 형태의 설명용 모델이다. 한 번의 원래 실행시간을 1로 놓고 특정 연산이 차지하는 비율만 개선한다고 가정한다.
실행시간의 일부만 네 배 빨라지면 전체는 얼마나 빨라질까? 기호·연산·계산 과정 펼치기
는 원래 전체 시간 중 개선할 부분의 비율, 는 그 부분의 가속 배수, 는 전체 가속 배수다. 개선하지 못한 시간은 로 남는다. 개선한 부분은 같은 일을 배 빠르게 하므로 걸리는 시간이 로 줄어든다. 두 시간이 순서대로 필요하다고 가정해 더한 것이 분모다.
전체 시간의 80%가 해당 연산이고 그 부분이 4배 빨라졌다고 가정하면 다. 새 시간은 , 전체 가속은 배다. 100초였던 작업은 이 가정에서 40초가 된다. 커널 4배와 전체 2.5배는 서로 모순되지 않는다.
개선 대상이 전체의 20%뿐이면 새 시간은 이고 가속은 약 1.18배다. 병렬 겹침, 통신 변화와 추가 오버헤드를 생략한 계산이지만, 어떤 구간을 재었는지 모르는 배수끼리 비교하면 안 되는 이유를 보여준다.
이번 작업도 공통 커널에서 끝나지 않았다. 동일한 값을 반복해서 계산하는 부분을 캐시하고, 실제 실행에서 상수 결과가 되는 분기를 정리하는 모델별 변경을 더했다. 이를 통해 공통 연산 최적화와 프로그램 전체의 실행 경로 최적화를 함께 적용했다는 것이 회사의 설명이다. 각 변경이 어떤 출력을 보존하는지는 공개 kit의 CHANGES와 고정 upstream 기록에서 확인하도록 구성돼 있다.[1][3]
#4. 원본 가속 그래프: exact·fast·big을 나눠 읽기
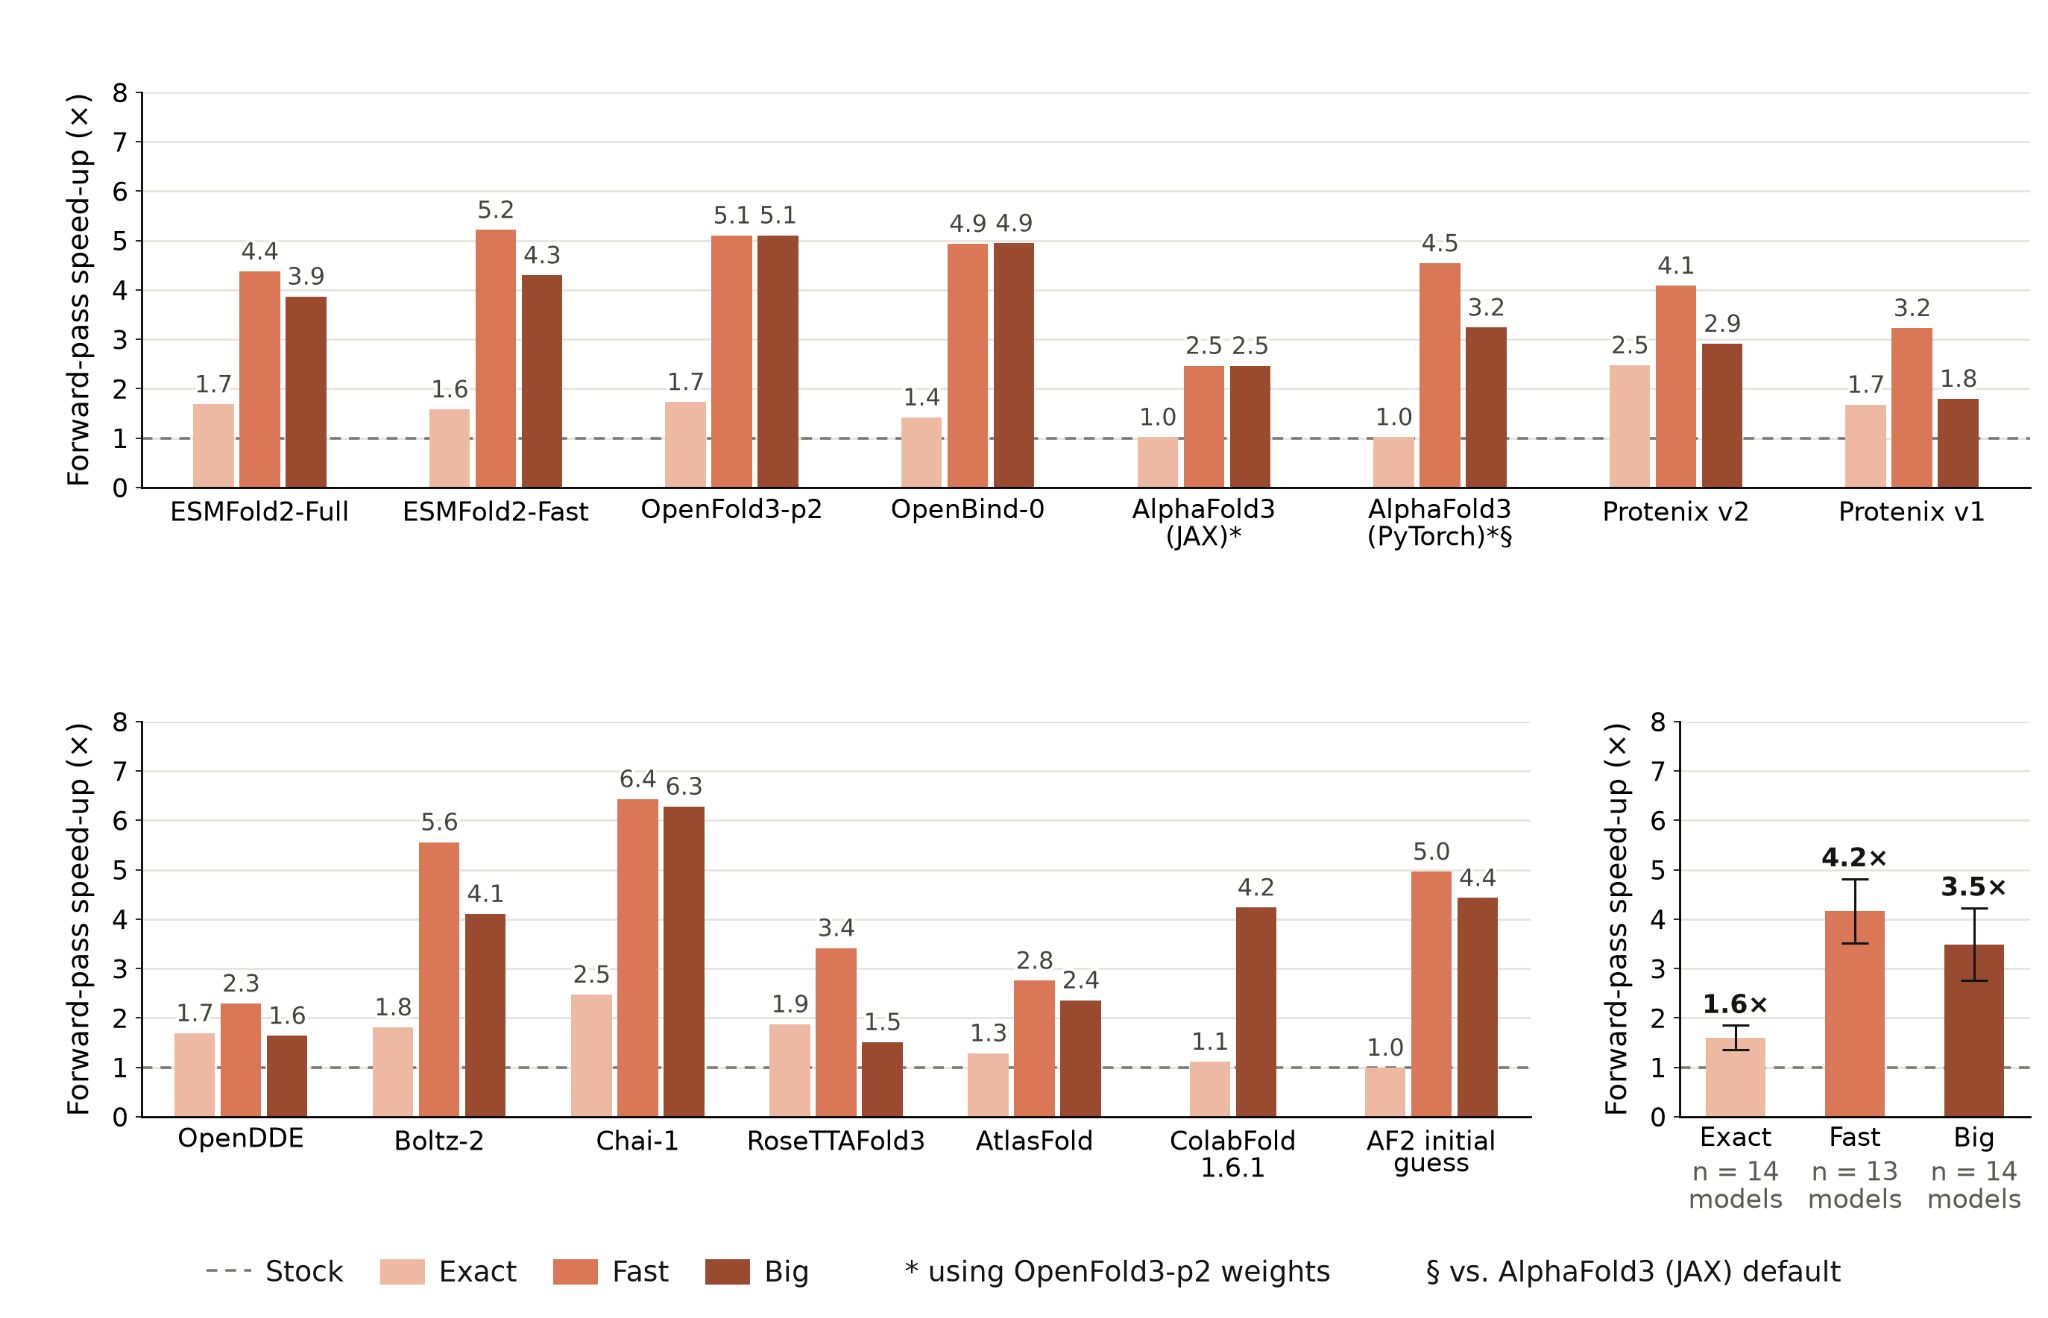
첫 그림의 가로축은 모델·실행 구현, 세로축은 기준 대비 순전파(forward pass) 가속이다. 점선 1배가 기준이고 세 가지 색 막대가 exact·fast·big을 구분한다. 오른쪽 요약은 exact 1.6배, fast 4.2배, big 3.5배다. 각 평균에 들어간 구성은 각각 14개·13개·14개로 다르므로, 완전히 같은 집합에서 정밀도 하나만 바꾼 세 숫자로 보아서는 안 된다.[1][2]
회사 발표의 도입부는 전체 작업을 대략 4배, 동일 출력의 경우 거의 2배라고 요약한다. 구조 예측 그래프의 1.6배는 그 안의 특정 구성 집합을 요약한 값이다. 발표 전체의 표현, 그래프별 평균, 한 모델의 최고 가속을 같은 수치처럼 합치지 않고 어느 모집단에서 측정했는지 붙여 읽는다.
| 모드 | 선택의 목표 | 공개 자료에서 확인할 내용 |
|---|---|---|
| off | 고정한 upstream 기준 실행 | 버전·가중치·환경과 기준 결과 |
| exact | 출력을 동일하게 유지하는 가속 | 지원하는 구성에서 동일성 검사 |
| fast | 작은 수치 차이를 허용하는 가속 | 도구별 허용 차이와 후속 정확도 |
| big | 최대 입력을 위한 메모리 절약 | GPU 수·최대 메모리·입력 길이·정확도 |
공식 README는 모든 kit가 네 모드를 모두 지원하는 것은 아니라고 명시한다. 가능한 모드를 kit별로 확인해야 하며, 적용할 수 없는 장치에서는 이유를 출력하고 종료하도록 설계했다. 실행됐다고 생각했는데 최적화가 조용히 꺼진 기준 프로그램으로 돌아가는 경우를 구분하려는 장치다. 기본 모드도 다르므로 비교 결과에는 실제 활성화된 모드를 남겨야 한다.[3]
첫 그림의 별표도 중요하다. 일부 AlphaFold3로 표시된 구현은 OpenFold3-p2 가중치를 사용했고, 특정 PyTorch 비교의 기준은 JAX 기본 설정이라고 표시돼 있다. 이름만 보고 공식 AlphaFold3의 동일 가중치·동일 실행 환경을 그대로 비교했다고 추정하지 않는다. 또한 동시 공개된 ColabFold 1.6.3의 선택적 빠른 커널은 그 그래프에서 아직 평가하지 않았다고 명시했다. 이런 조건을 생략하면 ‘모든 최신 구현보다 몇 배 빠르다’는 과장으로 바뀐다.[1][2]
#5. 정확도를 지켰다는 근거는 무엇인가
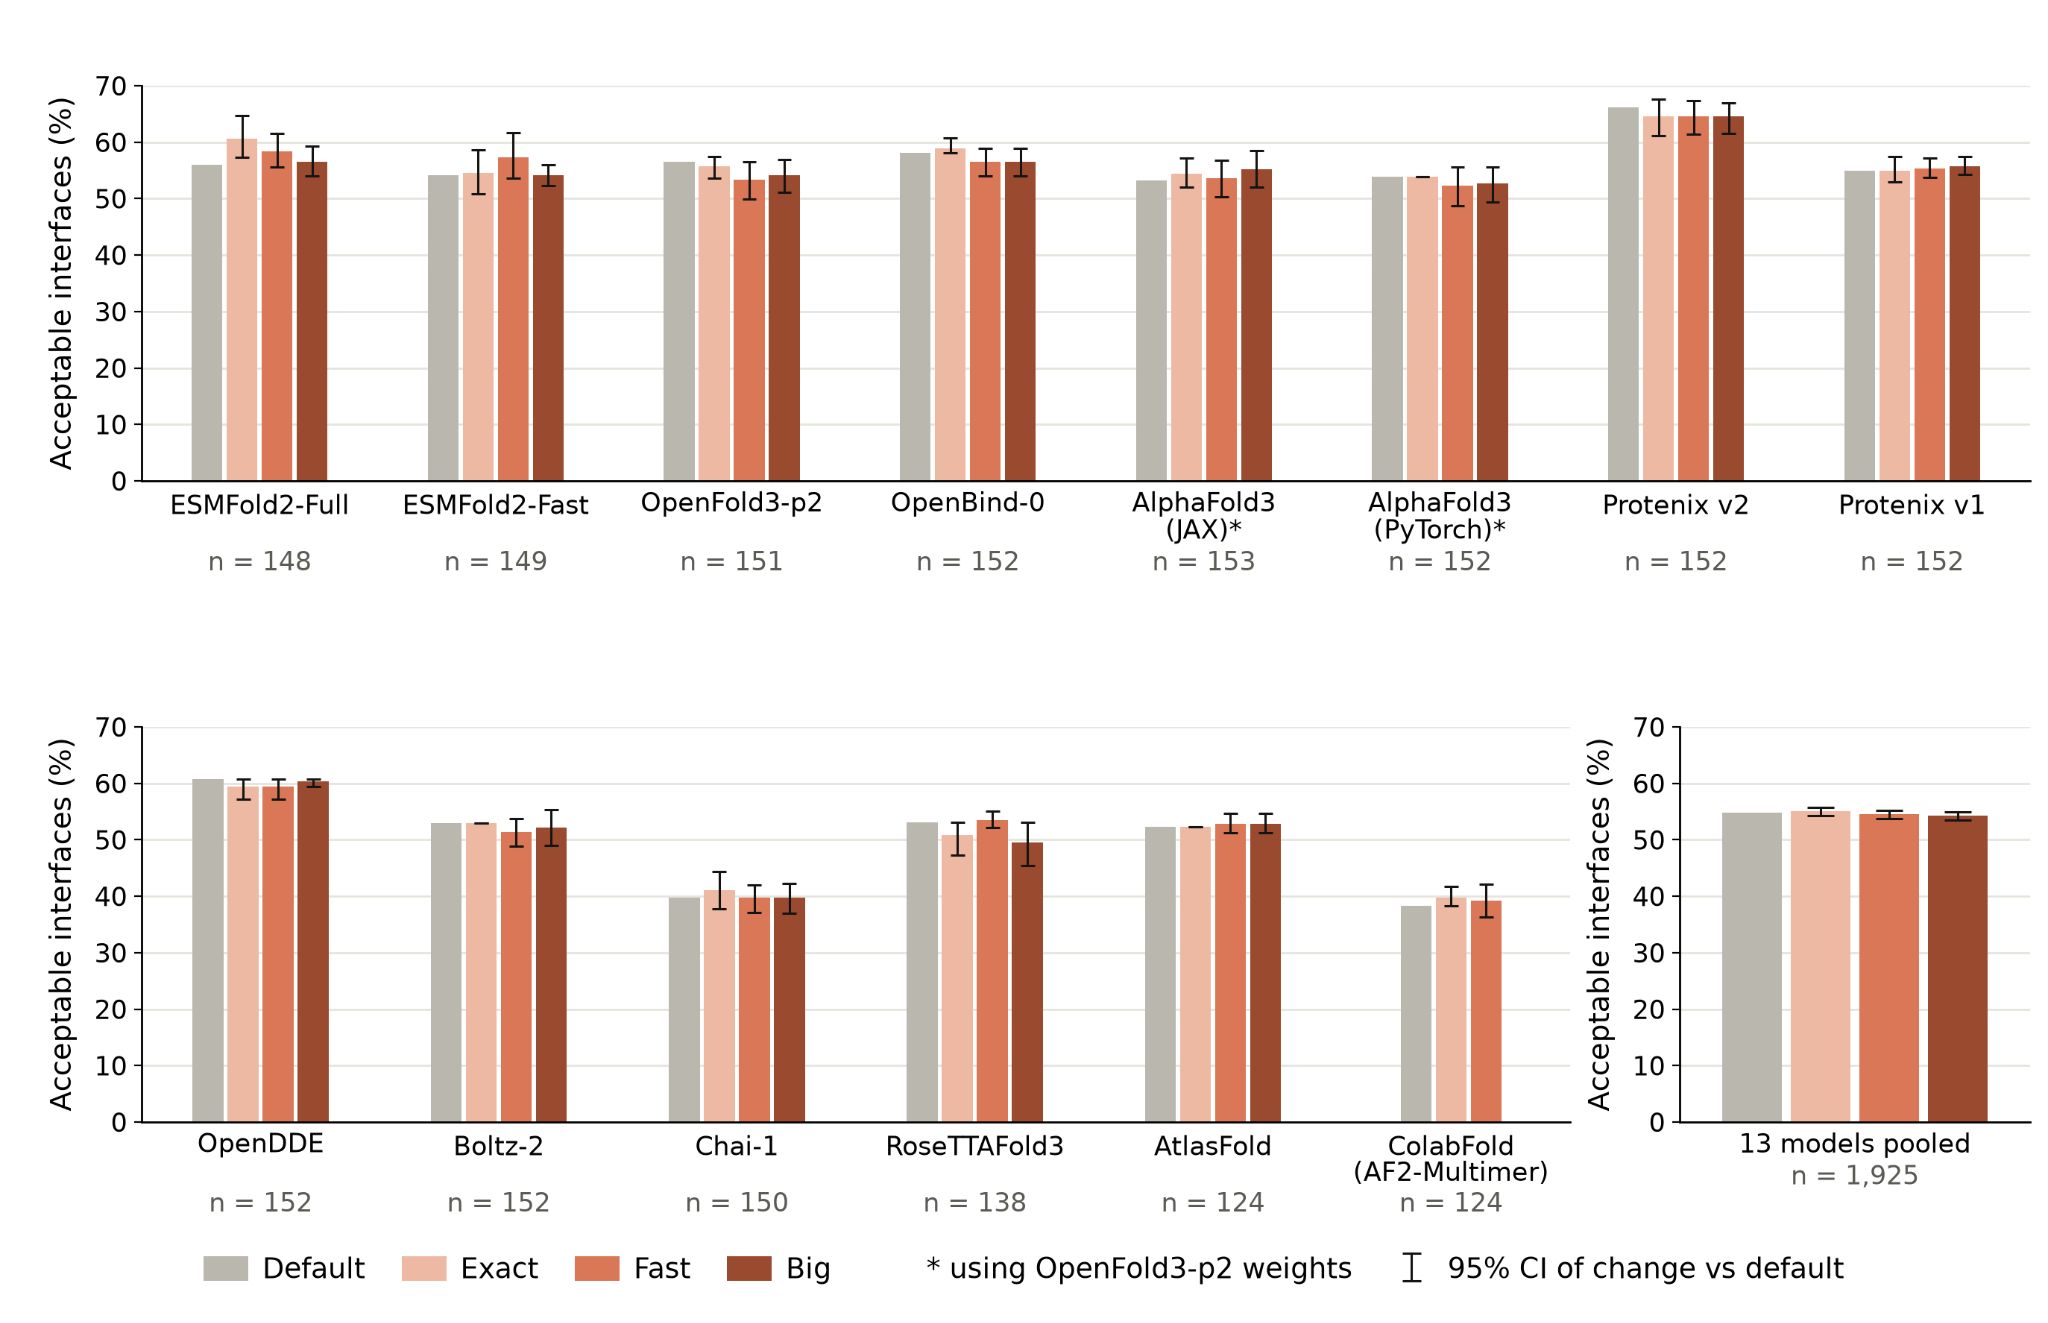
두 번째 그림은 시간 그래프가 아니라 구조 예측의 평가 결과다. 세로축은 DockQ 기준을 만족한 분자 접촉면(interface)의 비율이다. 여러 모델에서 기본 모드와 최적화 모드의 막대를 비교하고, 아래에 각 구성의 접촉면 수를 적었다. 오른쪽에는 13개 모델에서 합친 1,925개의 접촉면을 묶은 결과가 있다. 여기의 1,925는 독립 연구실 수나 신약 후보 수가 아니다.[1][2]
그림의 검은 오차막대는 범례에 따라 기본 모드 대비 변화의 95% 신뢰구간으로 읽는다. 단순히 막대가 비슷하게 보인다는 이유만으로 모든 개별 입력에서 동일 결과가 나온다고 결론내리지 않는다. 회사는 합친 평가 집합에서 fast와 기본 설정의 성능이 통계적으로 구별되지 않았다고 보고한다. 이 주장은 측정한 접촉면 지표와 평가 집합에 관한 것이며, 학습 범위를 크게 벗어난 입력에도 그대로 적용되는 보증은 아니다.[1]
수치적 동일성과 과학적 정확도도 별개의 질문이다. exact는 기준 프로그램과 결과가 같도록 설계한 실행 모드지만, 기준 프로그램 자체가 어떤 입력에서 틀린 구조를 예측하면 같은 오류를 빠르게 낼 수 있다. fast는 값이 조금 달라도 선택한 과학 지표가 유지되는지를 본다. 실험적으로 알려진 구조와의 비교가 있어야 실행 일치와 실제 정답에 대한 일치를 구분할 수 있다.
검증을 더 강하게 하려면 평균 외에 모델별·입력 크기별·분자 종류별 결과가 필요하다. 특정 모델의 작은 악화가 다른 모델의 개선으로 가려질 수 있기 때문이다. 입력 시드, 반복 실행과 신뢰구간도 중요하다. 이것은 회사 보고를 무조건 부정하는 기준이 아니라, 공개 코드가 독립 재현의 출발점이 되기 위해 필요한 비교 조건이다.
#6. 1만 토큰의 정확한 구조와 7만 토큰의 붕괴
메모리 절약의 성과는 더 큰 분자계를 실행할 수 있게 만든 데 있다. 회사는 Big 모드에서 인간 미토콘드리아 complex I, TRiC, proteasome, 세균 ribosome 같은 큰 시스템을 계산했고, 일부 1만 토큰 이상 사례가 알려진 실험 구조와 잘 맞았다고 보고했다. 이 결과는 큰 입력에서 의미 있는 일반화가 가능한 사례를 제시한다.[1][2]
그러나 ‘한 노드’는 ‘GPU 한 장’과 같은 말이 아니다. 하나의 서버 노드에 여러 GPU를 장착할 수 있고, 공식 kit는 Big 예측 하나를 그 노드 안의 여러 GPU로 분산하는 경로를 제공한다. 특히 3.1만–7만 토큰 규모의 극단 입력은 B300 GPU 8개가 들어 있는 한 노드에서 계산한 사례다. 단일 GPU로 같은 실행이 가능했다고 서술하면 하드웨어 조건이 바뀐다.[1][3]
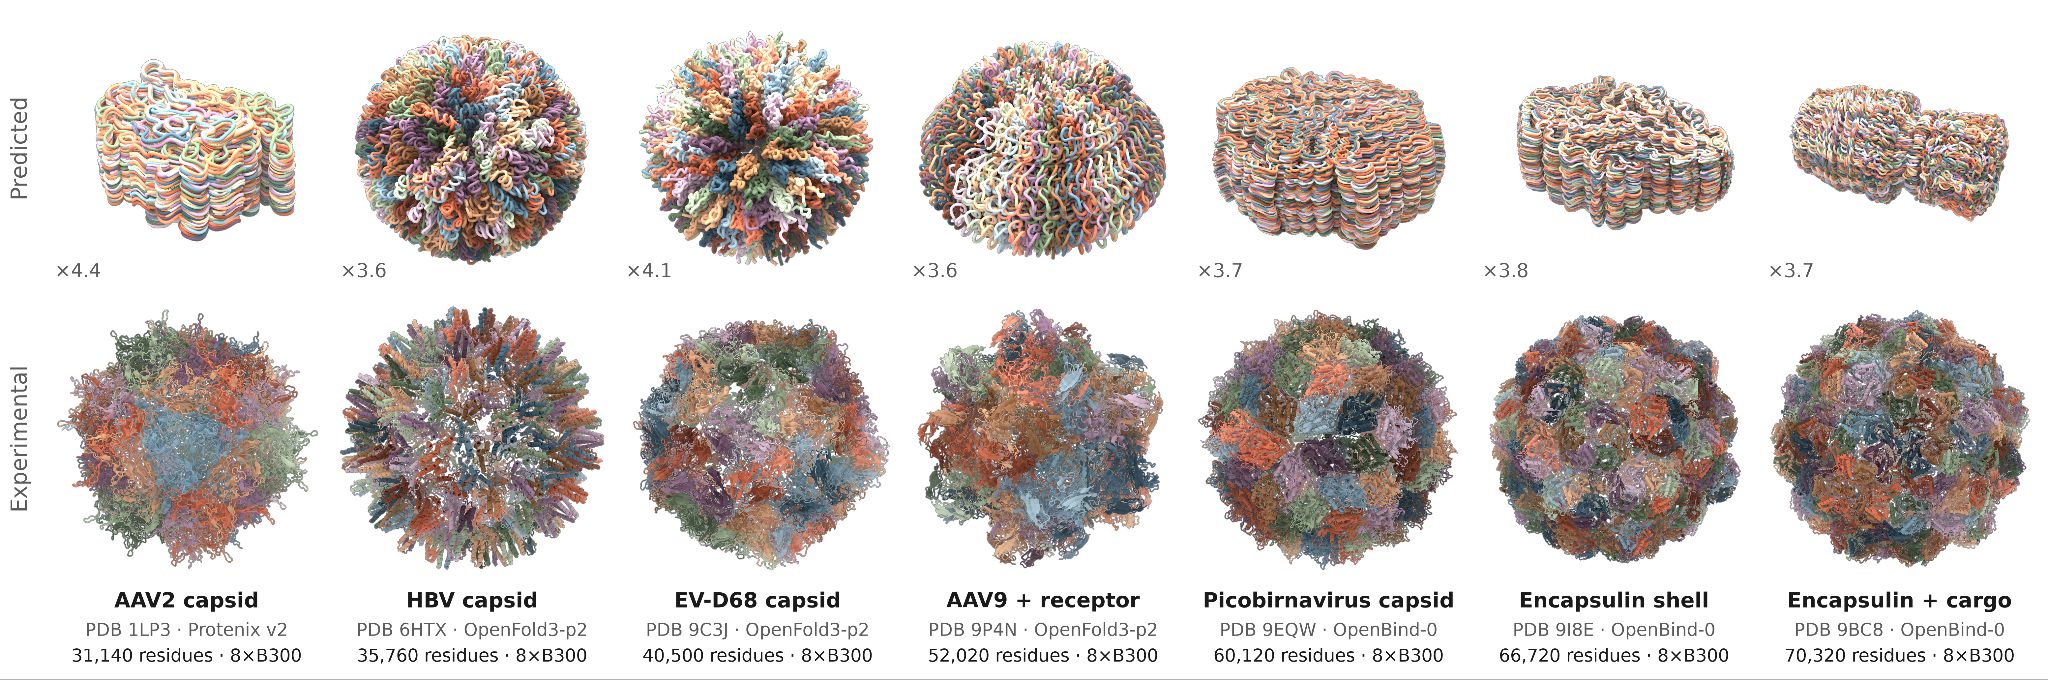
실패 그림은 위쪽 예측 구조와 아래쪽 실험 구조를 같은 열에 배치한다. 고리나 껍질의 넓은 구조가 예측에서는 안으로 뭉개진 모습을 볼 수 있다. 각각의 입력 크기와 8×B300 조건도 아래에 붙어 있다. 구조 사이에 표시한 배율은 이미지 크기 비교의 문맥에서 읽어야 하며, 앞의 순전파 가속 그래프의 배수로 옮겨서는 안 된다.[1][2]
이 극단 입력 실험은 한 번의 trunk pass와 재순환 없음(no recycles)이라는 제한된 실행 구성으로 제시됐다. 계산이 끝나 결과 파일을 만들었다는 성공과, 생체분자 구조를 정확히 예측했다는 성공이 갈라진다. 최적화는 계산 가능한 영역을 넓혔지만 모델이 그 크기의 구조를 이해하도록 훈련한 것은 아니다. 회사도 이 사례를 잘못 예측한 구조로 공개했다.
| 결과의 층위 | 공개한 근거 | 후속 확인 |
|---|---|---|
| 실행 가속 | 기준 대비 순전파 시간 | 입력·모드·GPU·예열 조건 동일성 |
| 정확도 보존 | DockQ 접촉면 평가 | 개별 사례·집합 구성·신뢰구간 |
| 큰 구조의 정확한 예측 | 일부 1만 토큰 이상 실험 구조와 비교 | 모델과 분자계별 일반화 범위 |
| 극단 입력 실행 | 8×B300, 약 3.1만–7만 토큰 | 결과는 구조 붕괴; 실행 범위와 정확도 분리 |
이 구분은 다른 AI 가속 연구에도 적용된다. 메모리 부족이 사라지면 모델의 기존 일반화 한계를 드러내는 새로운 시험을 할 수 있다. 실패가 보인 것은 계산 최적화가 무의미해서가 아니라, 다음 병목이 하드웨어에서 모델 능력으로 옮겨갔음을 보여주는 경우일 수 있다. 다만 그 해석도 실제 정확도 평가와 함께 남겨야 한다.
#7. 연구 비용에서 어떤 변화가 보고됐나
회사는 이전 단백질 결합체 설계 실험과 비교해 더 간소한 에이전트 구성을 시험했다. 한 Claude에 H200 한 장과 24시간을 주고, 16개 표적에서 설계를 수행했다. 이전의 복잡한 하위 에이전트 구성보다 약 두 자릿수 규모로 적은 GPU 시간을 사용하면서 비슷한 계산상 ipSAE 점수를 얻었다고 보고한다. 평균과 최대 점수를 보여주는 곡선도 in silico 평가다.[1]
이전 실험의 상한 예산, 다른 GPU 종류, 프롬프트 길이와 에이전트 구성, 도구 속도가 함께 달라졌다. 따라서 결과를 커널 하나가 실제 실험 비용을 정확히 100분의 1로 만들었다는 통제 비교로 바꾸면 안 된다. 발표는 가속된 도구와 단순해진 실행 체계를 합친 캠페인의 계산 효율을 보여준다. 실제로 결합하는 단백질의 비율이나 치료 효능은 별도 wet-lab 측정이 필요하다.
시간과 자원 비용은 분모를 맞추면 더 명확해진다. 한 장을 24시간 쓰면 24 GPU·hour, 여덟 장을 24시간 쓰면 192 GPU·hour다. 벽시계 시간은 같아도 총 자원량은 다르다. GPU 세대와 장치 가격도 다르면 GPU·hour만으로 금액이 같다고 판단할 수 없다. 모델 가속을 예산으로 환산할 때는 이런 조건을 함께 고정해야 한다.
공개 저장소를 사용하는 연구자는 kit가 적용한 버전 고정, 변경 내역, 가중치와 환경을 확인할 수 있다. 동시에 README는 이 공개본을 지속 유지보수하지 않으며 pull request를 받지 않는 참고 릴리스라고 명시한다. 공개 코드가 있다는 점은 검증에 유리하지만 장기 지원되는 제품이라는 뜻은 아니다. upstream 코드와 모델 가중치의 라이선스도 kit의 원저작 코드 라이선스와 따로 확인해야 한다.[3]
#8. 다음 검증은 빠른 숫자보다 같은 실험 조건에서 시작한다
첫 후속 과제는 독립적인 재실행이다. 같은 입력·가중치·버전·GPU에서 off와 각 모드를 비교하고, 컴파일·예열을 포함했는지, 순전파만 재었는지, 전체 파일 처리까지 포함했는지 밝혀야 한다. 메모리 역시 최고 사용량과 지속 사용량을 구분해 기록해야 큰 입력의 실용성을 판단할 수 있다.
두 번째는 정확도의 세분화다. 전체 평균이 비슷한 것과 생물학적으로 중요한 드문 복합체에서 결과가 유지되는 것은 다른 조건이다. 접촉면, 전체 구조, 작은 리간드 위치처럼 과제에 맞는 지표를 나누면 어떤 최적화가 어느 판단을 보존하는지 더 명확해진다. 수치 차이의 허용 범위와 과학적 판단의 허용 범위도 같은 것으로 가정하지 않는다.
세 번째는 계산 범위 확장 뒤의 일반화다. 1만 토큰에서 성공한 모델이 7만 토큰에도 성공하리라는 보장은 없다. 실제 실패 구조를 함께 공개하면 새로운 학습이나 추론 전략이 무엇을 개선해야 하는지 알 수 있다. 단순히 더 큰 값을 메모리에 올렸다는 기록보다, 어느 크기·구성에서 어떤 구조적 오류가 생기는지가 후속 연구에 더 유용할 수 있다.
이번 발표는 AI가 생물학 질문에 답하는 도구에 머무르지 않고, 그 질문을 계산하는 소프트웨어 자체를 개선하는 역할로 확장됐다는 신호다. 그러나 주장 수준은 공개된 증거에 맞춘다. 가속 배수는 실행 범위를, 정확도 평가는 과학적 성능을, 큰 입력의 붕괴는 남은 일반화 한계를 설명한다. 이 세 결과를 함께 보는 것이 회사 발표를 연구 관점에서 읽는 방법이다.
#9. 원문과 데이터
[1] Anthropic. How Claude is uplifting biomolecular modeling. 2026-09-17. 공식 설명과 원본 그래프·실패 구조.
[2] 동일 발표의 기술 보고서. 모델별 커널·추론 최적화, 실행 구성과 평가.
[3] 공식 inference optimization kits. README, STOCK, CHANGES, 모드·환경·유지보수 상태. 2026-09-20 확인.