처음 읽는 분 처음 읽는다면: 어려운 최적화 문제를 자석의 줄서기로 바꾼다 그림으로 보기
칩을 설계할 때는 수많은 블록을 선으로 연결해야 한다. 선이 너무 길거나 서로 부딪히면 칩이 커지고 느려진다. 가능한 배치와 경로를 하나씩 모두 시험하면 경우의 수가 폭발한다. 이 연구는 답 후보를 0과 1, 또는 위·아래를 가리키는 작은 자석 상태로 바꾸고, 서로 연결된 자석들이 에너지가 낮은 배열을 찾아가도록 만들었다.
- Ising spin: 원래 자성체를 설명하는 위·아래 두 상태 변수. 계산에서는 인 선택 하나로 쓴다.
- Hamiltonian: 각 답 후보가 얼마나 좋은지 매기는 에너지 함수. 가장 낮은 상태가 원하는 해에 대응하도록 문제를 번역한다.
- MRAM: 자화 방향에 따라 저항이 달라지는 비휘발성 메모리.
- VCMA: voltage-controlled magnetic anisotropy. 짧은 전압 펄스로 자석이 방향을 바꿀 장벽을 조절한다.
- EDA: electronic design automation. 칩의 배치·배선·검증을 돕는 설계 자동화.
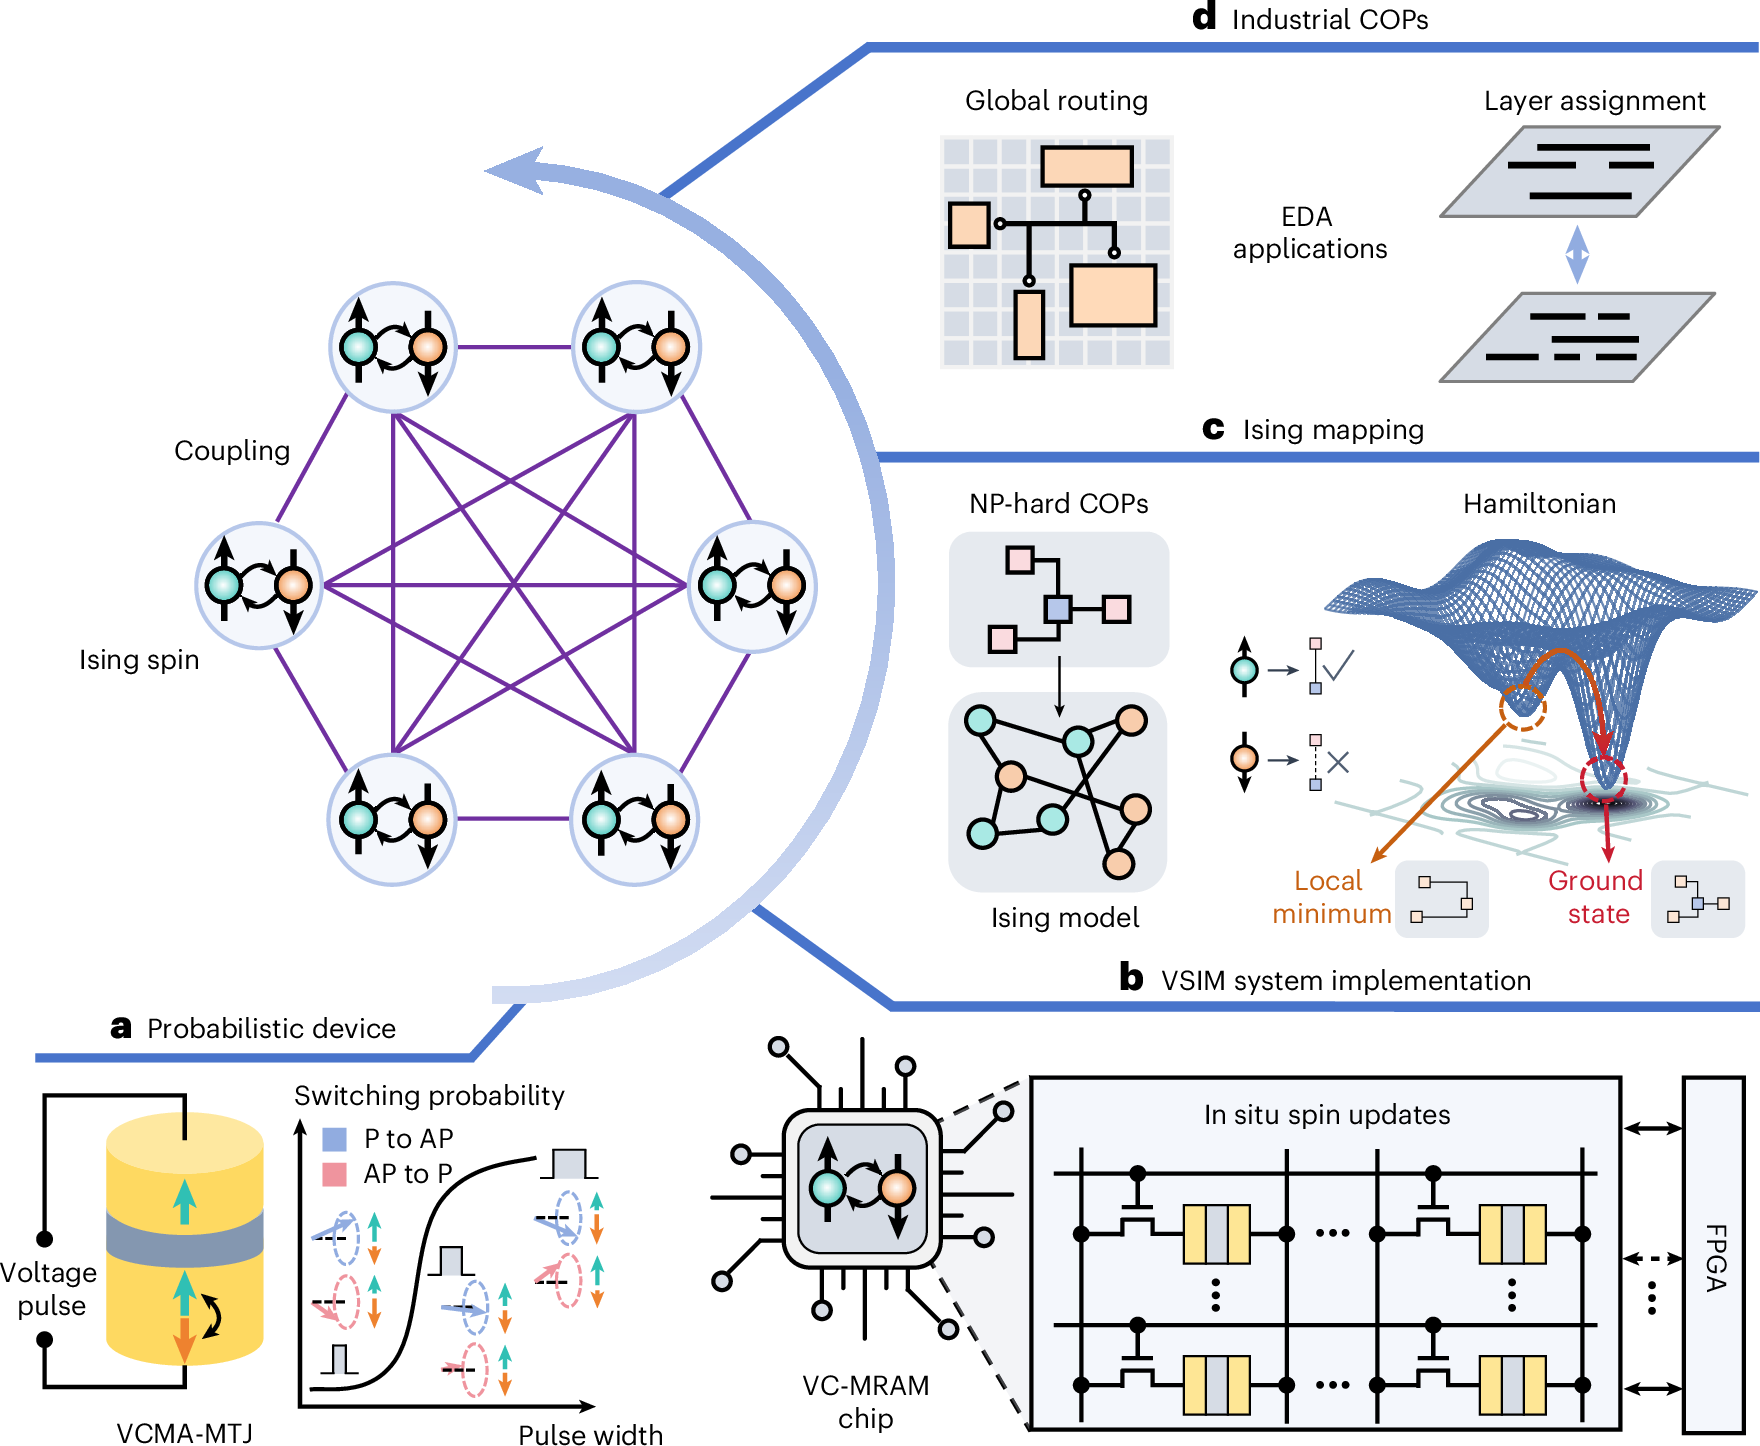
원문 Figure 1은 전체 지도다. (a)는 펄스 폭으로 자석의 반전 확률을 조절하는 소자, (b)는 VC-MRAM 칩과 FPGA 제어부, (c)는 실제 최적화 문제를 Ising 에너지로 옮기는 과정, (d)는 global routing과 layer assignment라는 반도체 설계 문제다. 이 Figure가 말하는 핵심은 “자석이 스스로 정답을 안다”가 아니라
문제를 에너지 함수로 정확히 번역하고, 확률적인 하드웨어가 낮은 에너지 후보를 빠르게 반복 탐색한다
는 것이다.
#1. 30초 결론: 메모리의 흔들림을 계산 자원으로 썼다
2026년 9월 22일 Nature Electronics에 공개된 연구는 96,000개의 voltage-controlled magnetic anisotropy magnetic tunnel junction(VCMA-MTJ)을 담은 VC-MRAM 칩을 기반으로 spintronic Ising machine을 구현했다. 펄스 폭을 바꾸면 한 비트가 뒤집힐 확률을 0에서 거의 1까지 조절할 수 있고, 이 확률적 업데이트를 조합 최적화 탐색에 사용했다.[1]
실증 문제는 장난감 숫자 퍼즐만이 아니었다. 칩 설계의 global routing과 layer assignment를 Ising Hamiltonian으로 바꾸고, 하드웨어에서 해 후보가 개선되는 과정을 보였다. 별도의 dense Max-cut 평가에서 현재 측정 시스템은 60-node 문제에 대해 약 45 ns의 iteration과 40 mW를 사용했고, time-to-solution 130.5 μs를 바탕으로 solutions/s/W를 계산했다.[2]
그러나 제목의 0.3–1 ns와 40 fJ를 시스템 전체 숫자로 읽으면 안 된다. 0.3–1 ns는 소자에 인가되는 짧은 쓰기 펄스와 spin update의 목표 시간 범위이고, 40 fJ/spin은 2 V·100 kΩ·1 ns를 둔 소자 수준의 추정이다. 현재 실증 시스템의 한 iteration은 45 ns, 전력은 40 mW다. 1 ns iteration과
solutions/s/W는 향후 ASIC 통합을 가정한 전망이다. 논문이 보여 준 진전은 크지만, 실측과 projection을 분리해야 정확하다.
증거 상태: 동료심사를 거친 논문과 공개 Supplementary Information, 연구진의 공개 코드·데이터 저장소를 확인했다. 원문 Figures 1–4는 패널을 자르거나 색을 바꾸지 않고 해설 목적으로 인용했다. 논문 본문은 구독 접근이 필요한 구간이 있어, 공개 abstract·Figures·보충자료에서 직접 확인되는 범위만 단정한다.
#2. 왜 컴퓨터 배선이 자석 문제로 바뀔까
global routing은 칩의 여러 단자를 격자 위에서 연결하되 전체 선 길이와 혼잡을 줄이는 문제다. 두 점만 잇는 최단 경로라면 쉽지만, 단자가 여러 개이고 장애물·직각 배선·공유 경로·충돌 금지 조건이 붙으면 후보 수가 빠르게 늘어난다. layer assignment는 정해진 배선 조각을 여러 금속층에 나누어 배치하면서 via와 충돌을 줄이는 문제다. 어느 한 선택이 주변 선택의 비용을 바꾸므로 각 결정을 독립적으로 고르기 어렵다.
일반 CPU나 GPU도 이런 문제를 푼다. simulated annealing, integer programming, heuristic search, specialized accelerator가 각각 다른 방식으로 후보를 줄인다. Ising machine의 차이는 0/1 결정을 spin으로 표현하고, 목적함수와 제약을 하나의 에너지로 묶은 뒤 많은 spin의 확률적 갱신으로 낮은 에너지를 찾는 데 있다. 문제 번역이 잘못되면 낮은 에너지가 곧 올바른 배선이라는 보장이 사라진다. 따라서 하드웨어 속도보다 먼저 목적함수와 penalty가 무엇을 뜻하는지 확인해야 한다.
어떻게 좋은 답을 낮은 에너지로 바꿀까? 기호·연산·계산 과정 펼치기
는 i번째 선택을 나타내는 spin으로 +1 또는 -1이다. 는 i와 j가 같은 방향 또는 반대 방향일 때 얼마의 보상·벌점을 줄지 정하는 결합, 는 한 spin 자체에 주는 bias다. spin은 단위가 없는 이산 변수이고, Hamiltonian의 절대 단위는 문제를 매핑할 때 정한 계수의 단위를 따른다. 최적화에서는 절대 에너지보다 후보 사이의 상대 순서가 중요하다.
예를 들어 두 spin이 같은 값을 가져야 좋은 문제에서 로 두면
는 둘이 같을 때 -J, 다를 때 +J가 된다. 낮은 에너지를 찾으면 같은 상태가 선택된다. 반대로 서로 달라야 좋은 Max-cut 관계라면 부호를 바꿀 수 있다. 실제 routing에는 “필수 단자를 연결하라”, “cycle을 만들지 마라”, “직각 경로를 사용하라” 같은 제약이 더해지고, 보충자료는 목적항과 네 개의 제약 Hamiltonian에 penalty 계수를 곱해 합친다.
[2]
이 논문이 방정식의 닫힌 해를 구했다는 뜻은 아니다. 조합 문제를 quadratic Ising form으로 구성하고, 확률적 하드웨어가 낮은 에너지 후보를 반복 탐색하게 한 근사 최적화다. penalty가 너무 작으면 짧지만 연결 규칙을 어긴 답이 나오고, 너무 크면 목적함수 차이가 묻힐 수 있다. Supplementary Note 5가 penalty에 따른 solution probability를 따로 보는 이유다.
#3. 원문 Figure 2: 자석은 왜 일부러 확률적으로 뒤집힐까
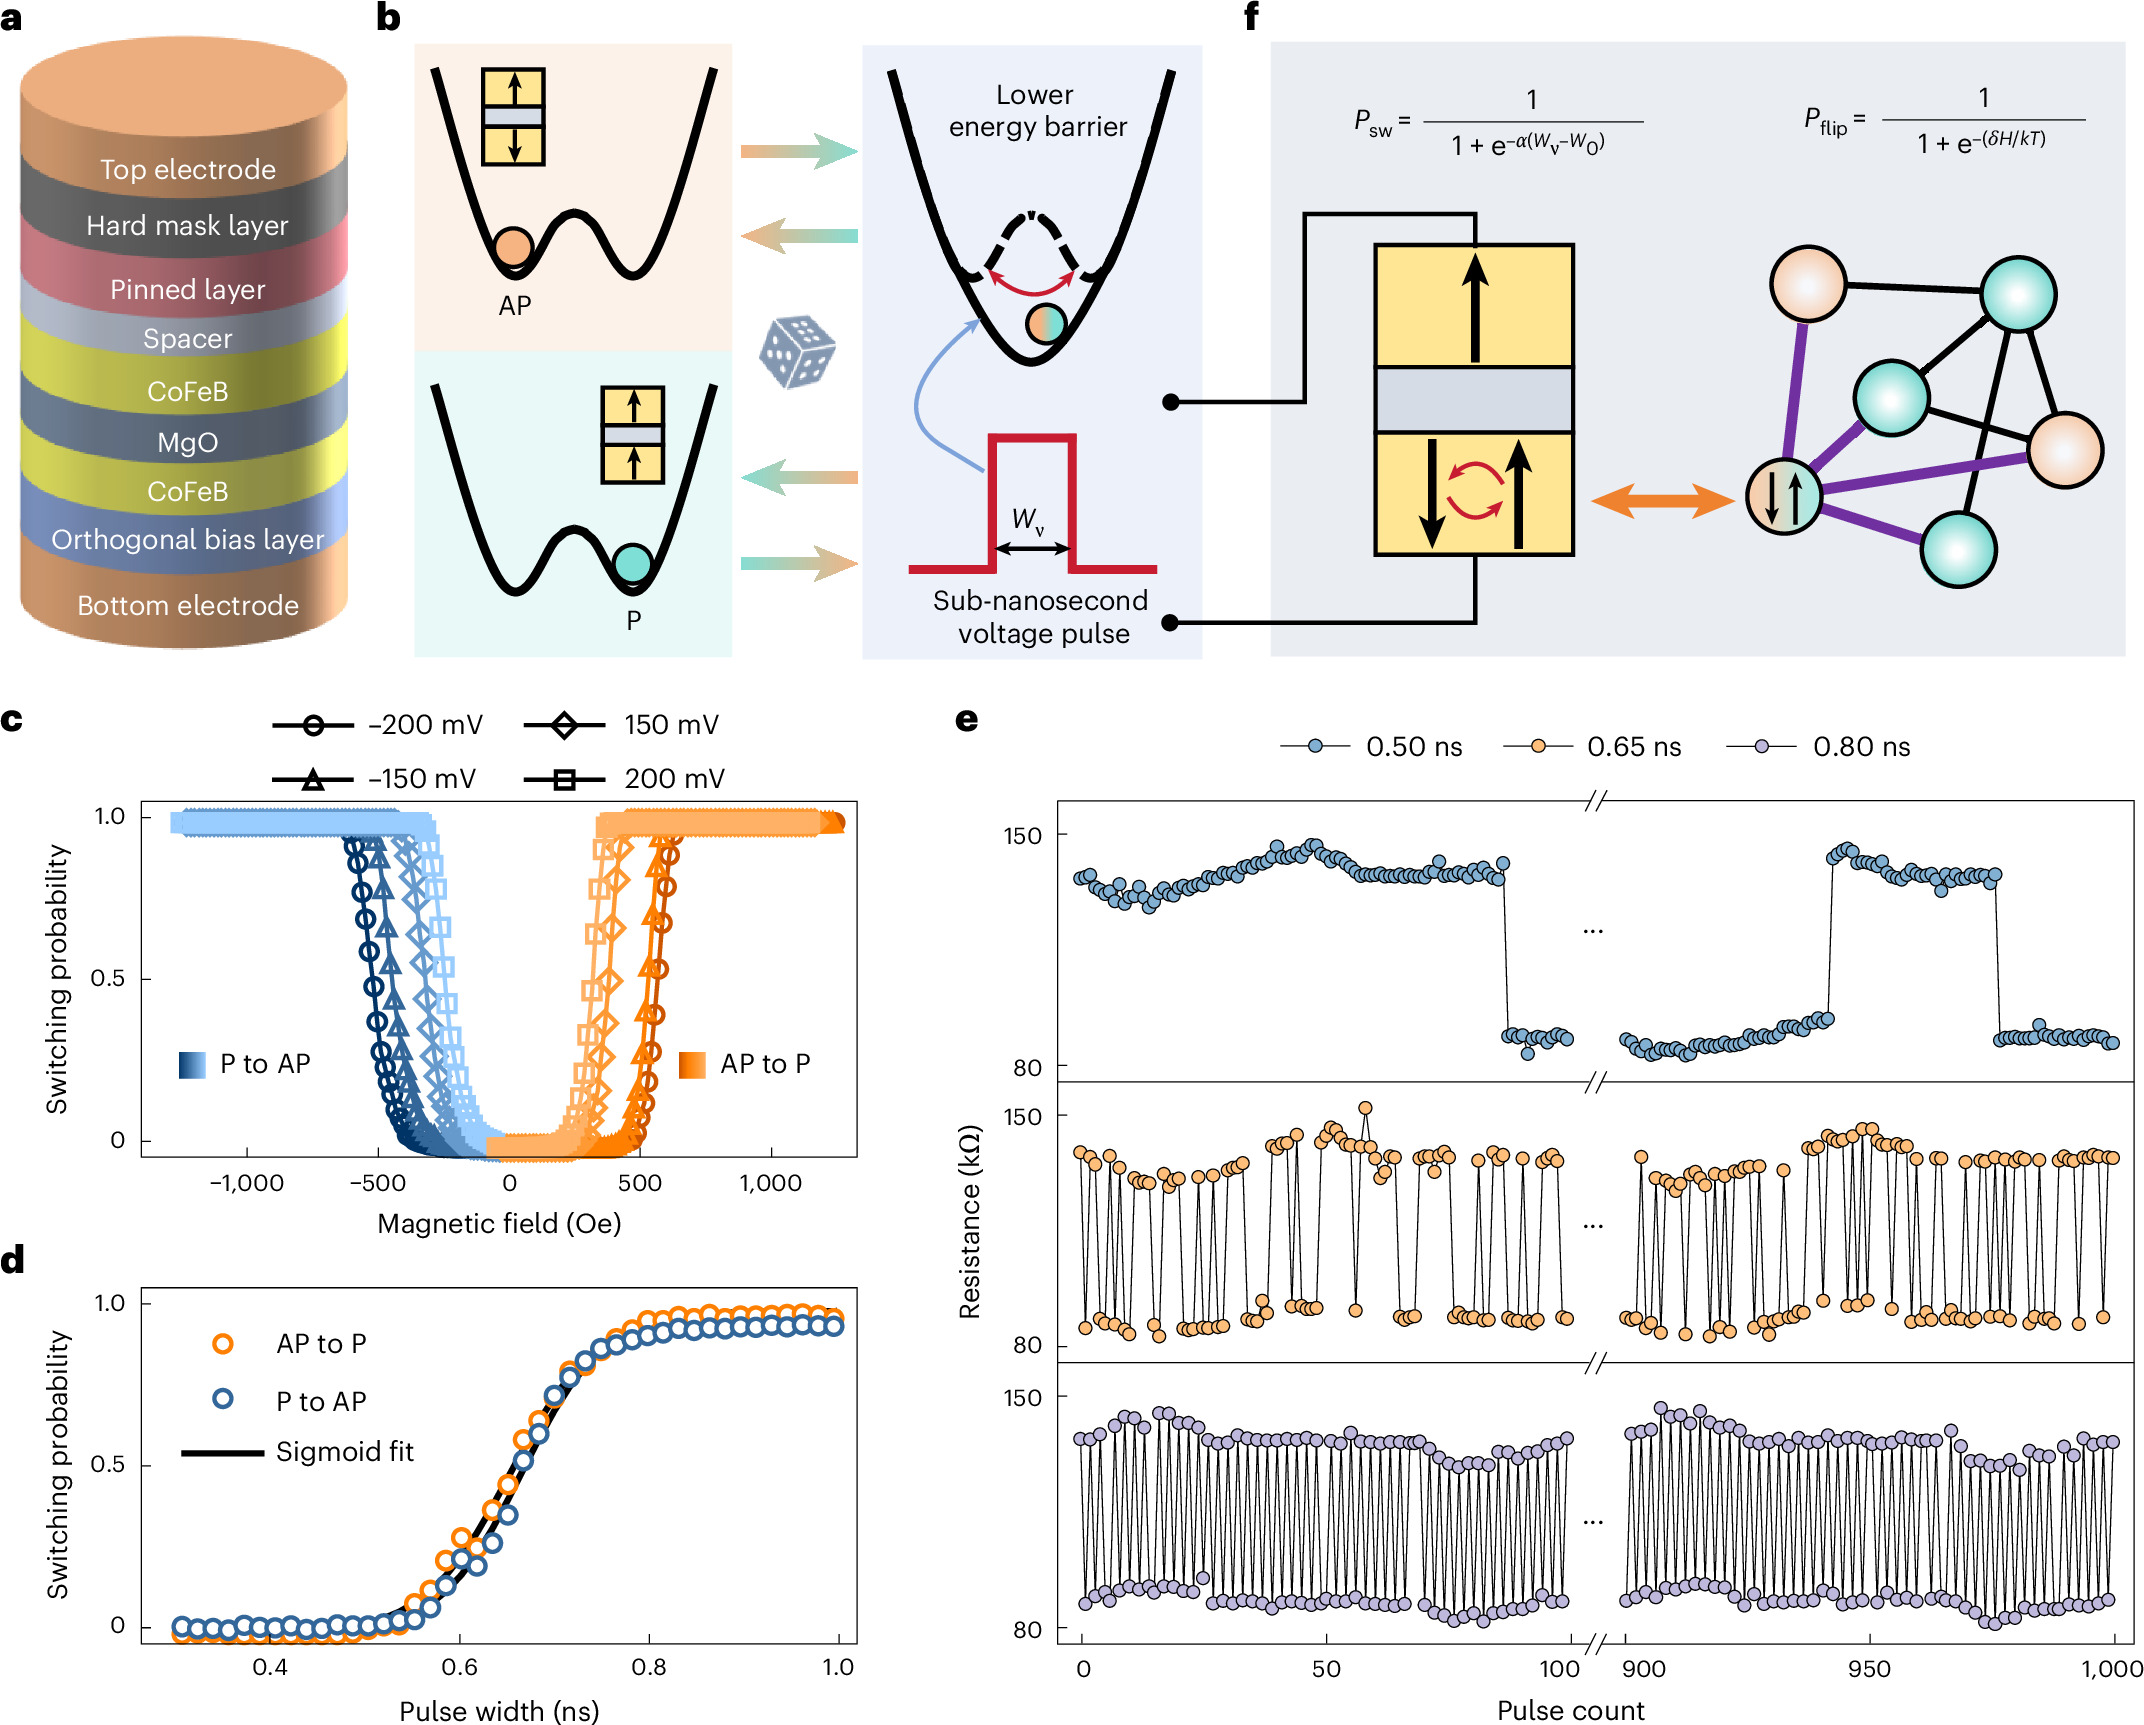
Figure 2a는 VCMA-MTJ의 층 구조다. 가운데 MgO 장벽을 사이에 둔 자성층의 상대 방향이 평행(P)이면 저항이 낮고, 반평행(AP)이면 높아져 0과 1을 읽을 수 있다. (b)는 전압 펄스가 자기 에너지 장벽을 잠시 낮추는 직관도다. 장벽을 완전히 없애 항상 뒤집는 대신, 펄스 폭과 조건으로 뒤집힐 확률을 조절한다.
(c)는 외부 자기장에 따른 switching probability, (d)는 펄스 폭에 따른 P→AP와 AP→P 확률이다. 약 0.4 ns 부근에서는 거의 안 뒤집고, 0.6~0.7 ns 부근에서는 중간 확률, 더 긴 펄스에서는 거의 항상 뒤집힌다. (e)는 서로 다른 펄스 폭에서 저항 상태를 반복 읽은 결과다. 0.50 ns에서는 한 상태가 오래 유지되고, 0.65 ns에서는 불규칙하게 바뀌며, 0.80 ns에서는 거의 매번 바뀌는 패턴이 보인다. (f)는 이 소자 확률과 Ising spin의 flip probability를 연결한다.
펄스 폭을 확률 눈금으로 바꾸는 sigmoid는 무엇을 뜻할까? 기호·연산·계산 과정 펼치기
는 한 번의 펄스 뒤 자화가 바뀔 확률, 는 펄스 폭, 는 전환 확률이 1/2가 되는 중심 폭, 는 곡선이 얼마나 가파른지 나타내는 계수다. 지수 안은 단위가 없어야 하므로 W가 시간 단위라면 α는 1/시간 단위다. 이 식은 Figure 2d의 S자 곡선을 표현하는 경험적 calibration 모델이다.
예를 들어 이면 지수가 0이고 분모는 2이므로 확률은 0.5다. 펄스가 중심보다 충분히 짧으면 0에, 길면 1에 가까워진다. 이 중간 확률은 잡음 때문에 생긴 실패로만 취급되지 않는다. 높은 에너지 상태에서도 가끔 반대 방향으로 움직일 수 있게 해 local minimum을 탈출하는 탐색 자원으로 쓴다.
다만 소자마다 W₀와 α가 조금씩 다르면 같은 펄스가 다른 확률을 만든다. 연구진은 calibration과 pulse-width generation을 사용했고, Supplementary Information은 variation과 true-randomness 검사를 별도로 다룬다. “확률적”이라는 말이 보정 없이도 항상 정확한 Boltzmann 분포를 만든다는 뜻은 아니다.
#4. 원문 Figure 3: 9만 6천 spin 전부가 한 번에 최적화를 했나
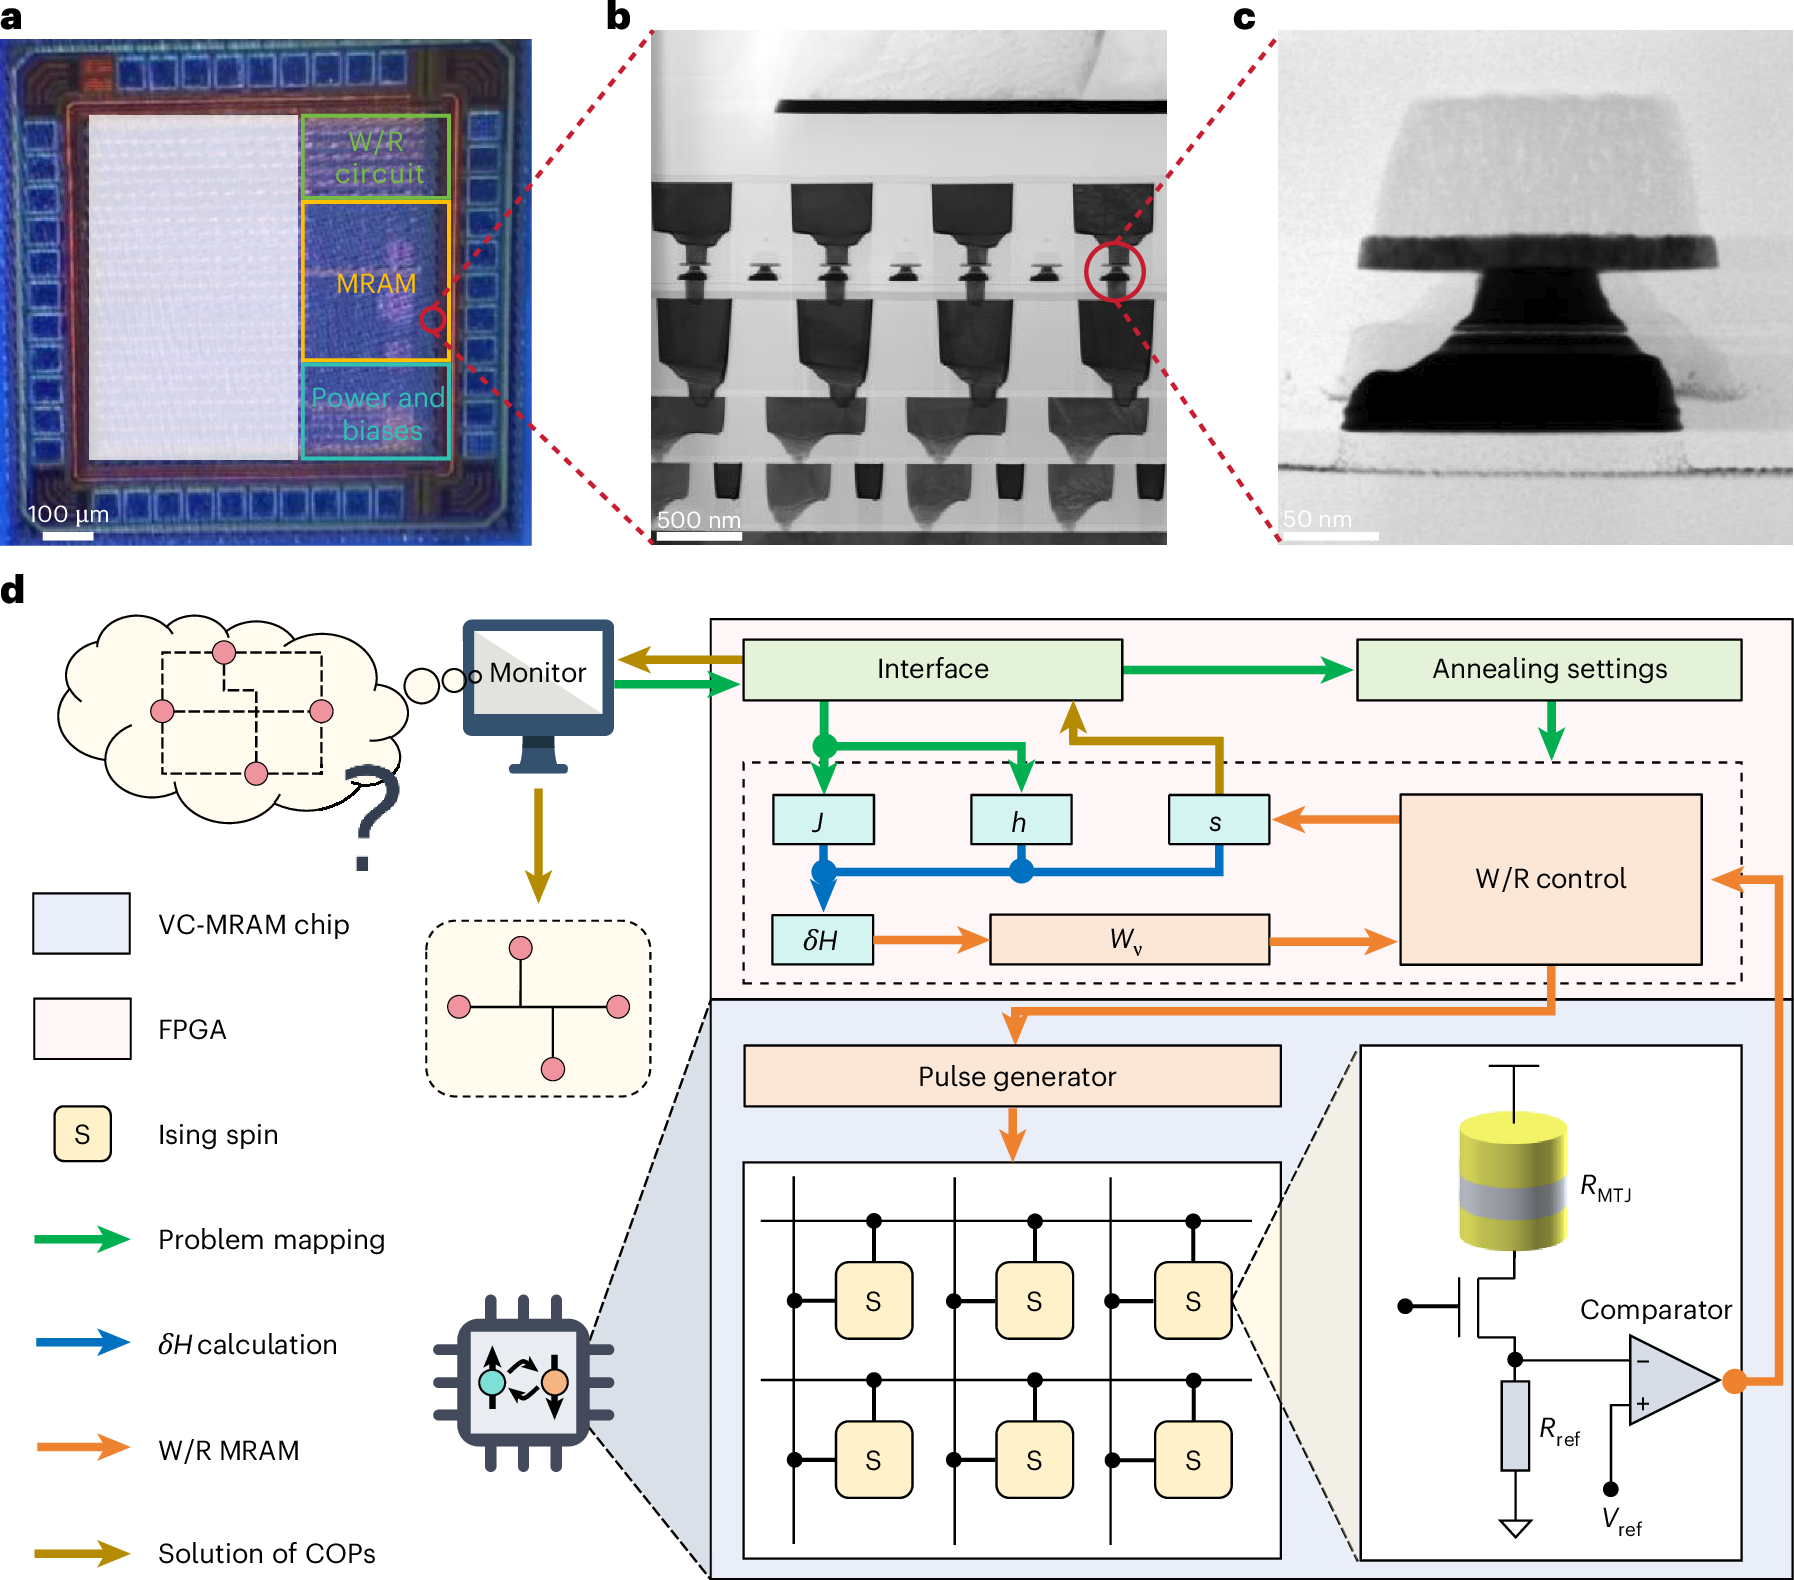
Figure 3a는 실제 VC-MRAM chip photograph다. W/R circuit, MRAM array, power·bias block이 구분돼 있다. (b)와 (c)는 memory cell 단면으로, 이 연구가 단순 software simulation만은 아님을 보여 준다. (d)는 전체 system block diagram이다. 사용자가 문제의 J와 h를 넣으면 FPGA가 local energy change를 계산하고, 그 결과를 pulse width로 바꾸어 VC-MRAM의 spin을 읽고 쓴다.
여기서 중요한 표현은 hybrid system이다. 96,000개의 물리 spin이 칩에 존재하지만, 현 실증의 모든 결합 계산과 제어가 MRAM array 안에서만 끝나는 완전 단일칩 계산기는 아니다. Figure 3의 분홍색 FPGA 영역이 이를 명확히 보여 준다. 따라서 96,000 spin capacity와 한 문제에서 동시 사용한 변수 수, 소자 pulse와 system iteration을 각각 구분해야 한다.
연구의 강점은 실제 메모리 공정과 빠른 확률적 update를 EDA mapping에 연결했다는 것이다. 동시에 다음 병목은 spin 사이 결합 계산, 데이터 이동, pulse generation을 얼마나 가까이 통합하느냐에 있다. 보충자료의 projected ASIC 수치는 바로 이 제어 경로가 짧아진 미래 구성을 가정한다. 현재 Figure 3의 측정 시스템 성능과 같은 열에 놓되 동일한 실측이라고 부르면 안 된다.
#5. 원문 Figure 4: 배선 답이 만들어지는 과정을 어떻게 읽나
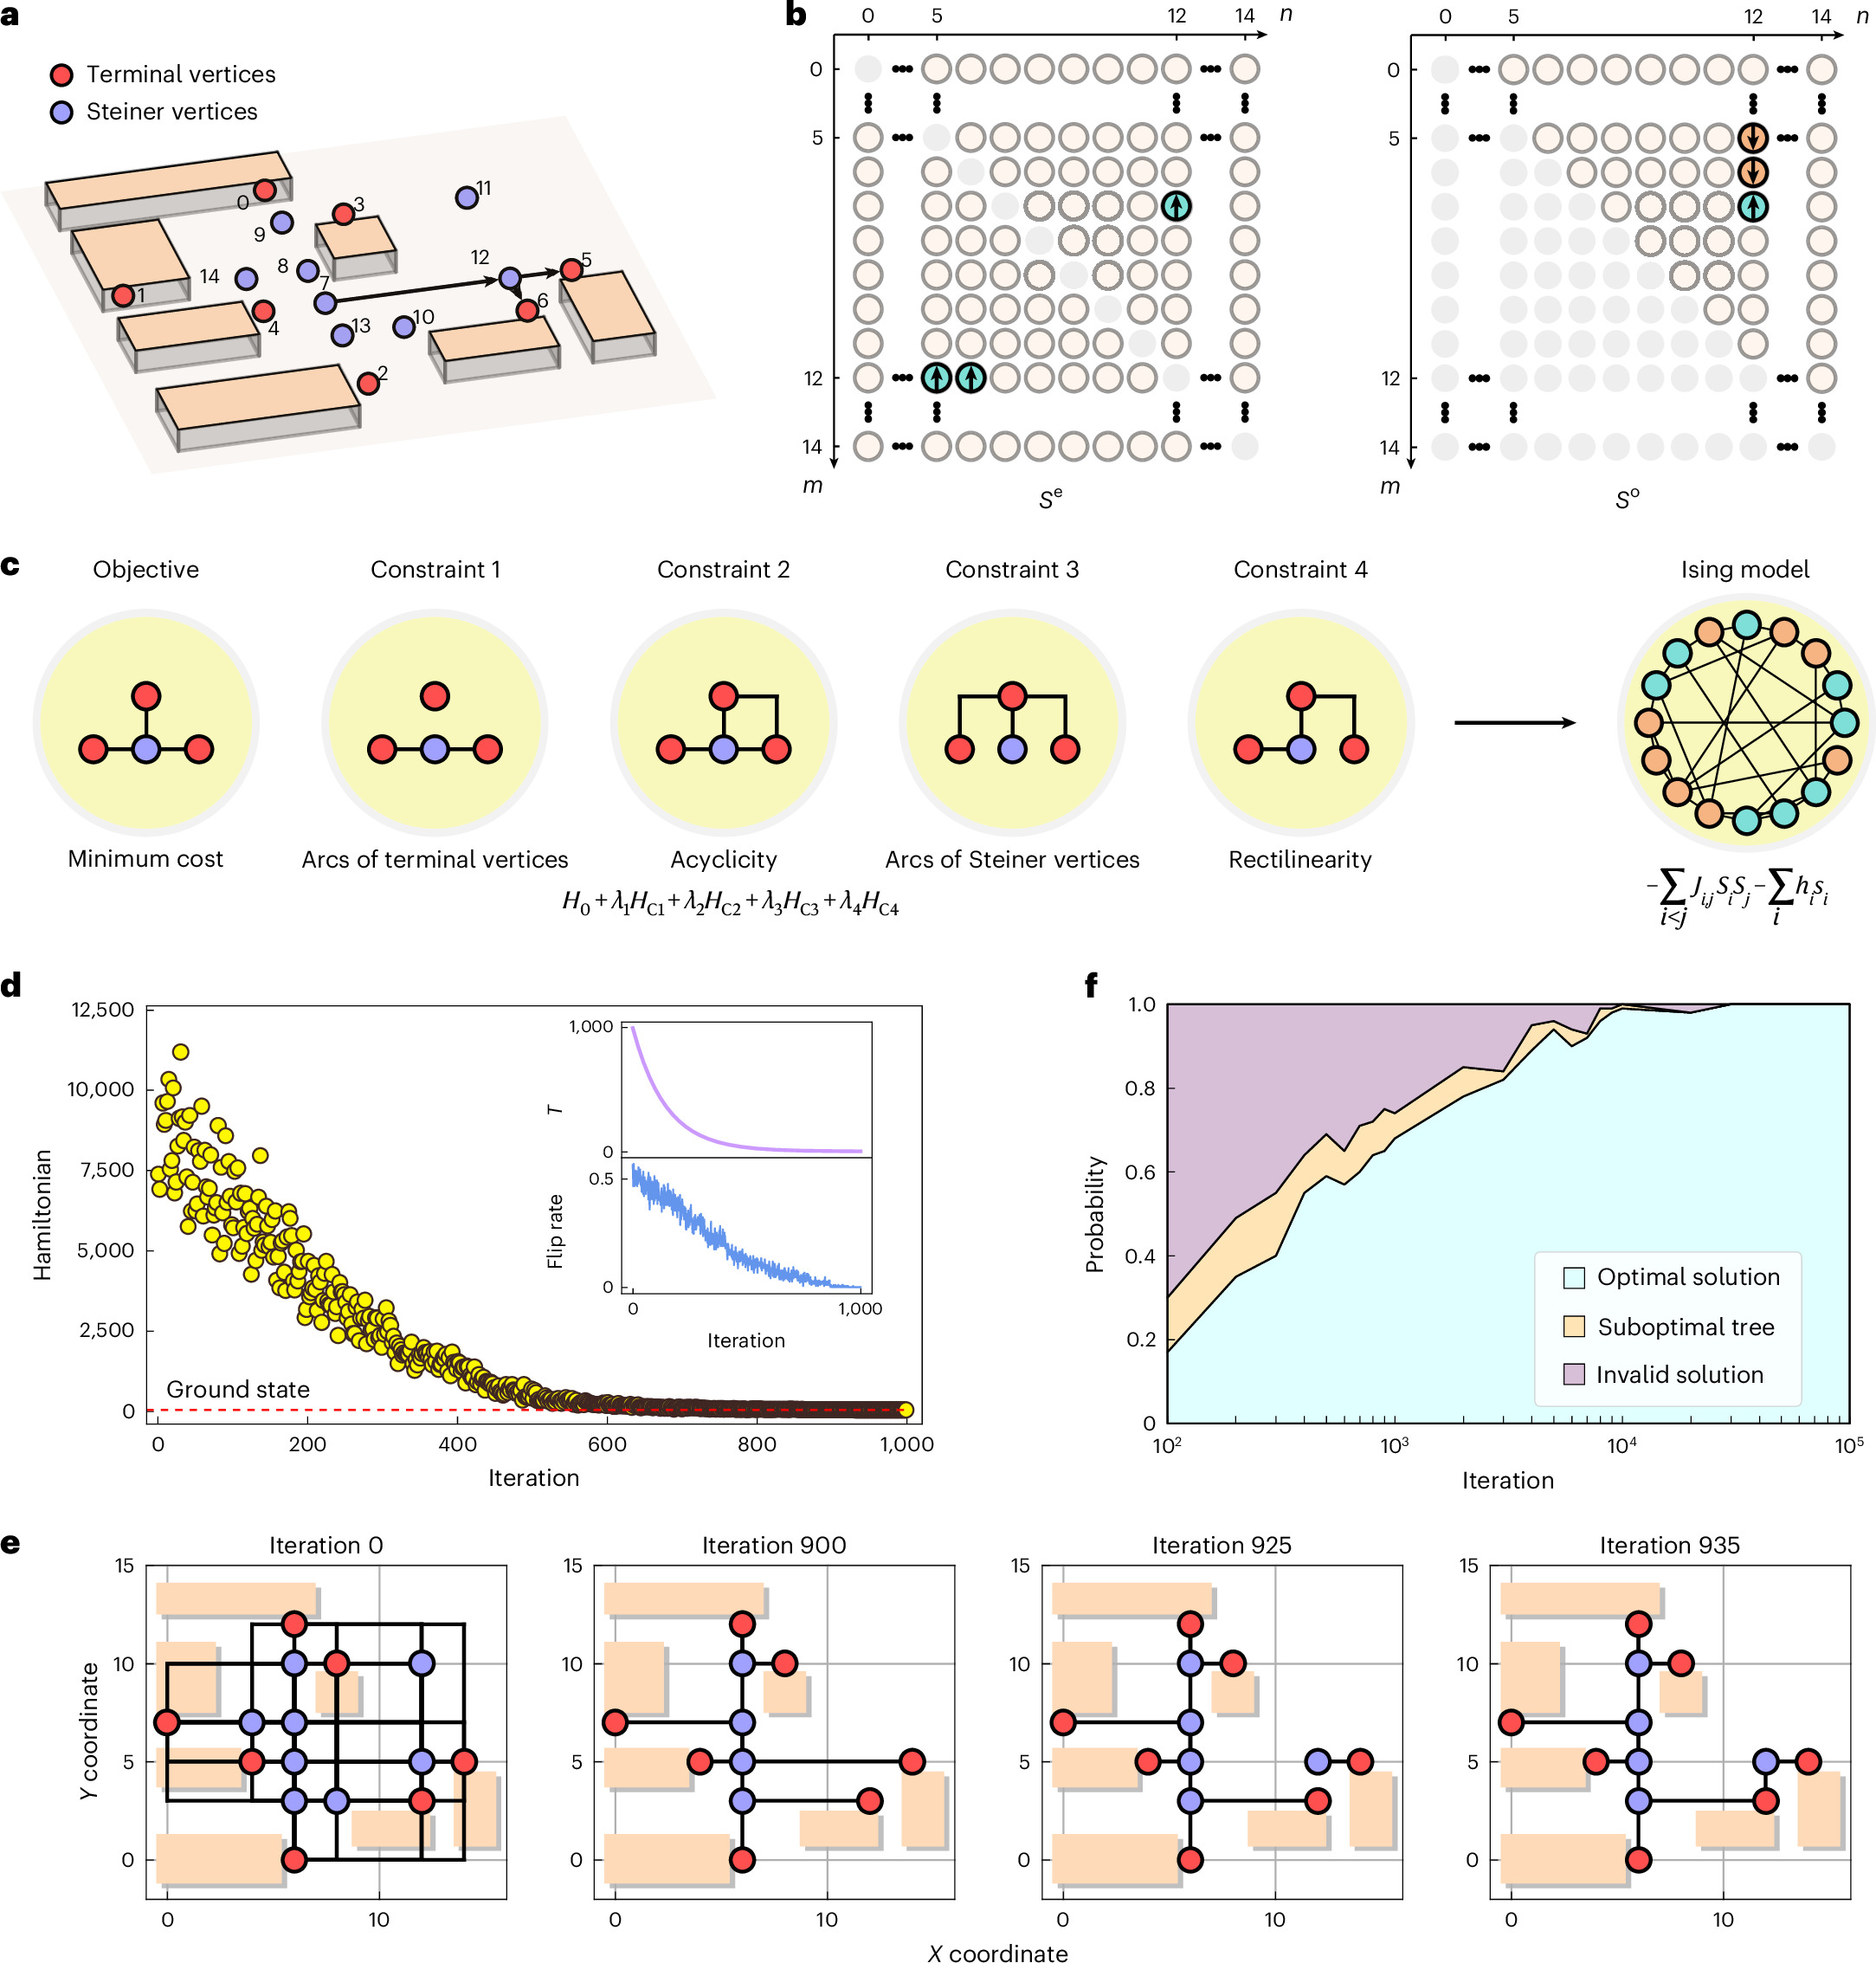
Figure 4a의 빨간 점은 반드시 연결해야 하는 terminal, 보라색 점은 경로를 합치기 위해 추가할 수 있는 Steiner vertex다. (b)는 가로·세로 방향 edge를 spin 변수로 배치한 모습이다. (c)는 최소 비용이라는 목표와 terminal 연결, acyclicity, Steiner vertex 사용, rectilinearity라는 제약을 각각 Hamiltonian으로 만든 뒤 합치는 흐름이다.
(d)의 세로축 Hamiltonian은 iteration이 진행되면서 낮아진다. 빨간 점선 ground state에 가까워지는 것은 정답 후보의 비용이 좋아진다는 뜻이다. (e)는 0, 900, 925, 935 iteration에서 실제 경로가 어떻게 정돈되는지 보여 준다. 처음에는 불필요한 선과 규칙 위반이 많고, 마지막에는 terminal을 연결하는 짧은 직각 tree가 남는다. (f)는 iteration 수가 늘수록 invalid solution 비율이 줄고 optimal solution 비율이 커지는 여러 실행의 통계다.
이 그림을 “항상 935번이면 정답”으로 읽으면 안 된다. stochastic search이므로 instance, 초기 상태, penalty, annealing schedule에 따라 성공 확률과 필요한 iteration이 달라진다. 그래서 속도 비교에는 한 번의 실행 시간만 아니라 원하는 성공 확률에 도달하는 time-to-solution이 필요하다.
1.92×10⁵ solutions/s/W는 어떻게 나온 수치인가? 기호·연산·계산 과정 펼치기
는 시스템 전력(W), 은 목표 성공 확률에 도달하는 time-to-solution(s)이다. 분모의 단위는 W·s이므로 결과는 solutions/s/W로 읽는다. 논문 보충자료가 보고한 현재 시스템 값 와 를 넣으면
다.
이 계산의 T는 60-node, 50% connectivity dense Max-cut에서 80% 성공 기준으로 정한 값이다. global routing의 모든 크기에 그대로 적용되는 상수가 아니다. 또한 40 fJ/spin은 에 2 V, 100 kΩ, 1 ns를 둔 소자 update 에너지 추정이고, 40 mW는 FPGA와 현재 system operation의 전력이다. 서로 다른 경계의 숫자를 섞어 “96,000 spins 전체가 40 fJ로 문제를 풀었다”고 표현할 수 없다.
향후 ASIC 통합 전망은 1 ns iteration과 더 높은 효율을 가정한다. 연구 방향을 보여 주는 유용한 수치지만, 제작된 ASIC에서 측정한 결과는 아니다. 다음 논문에서는 같은 문제·성공률·전력 계측 경계로 현재와 projection을 연결해야 한다.
#6. 기존 방법과 정확히 무엇이 달라졌나
| 접근 | 답 후보를 움직이는 방식 | 강점 | 이번 연구가 남긴 비교 경계 |
|---|---|---|---|
| CPU/GPU simulated annealing | 난수와 수치 계산으로 spin을 갱신 | 유연하고 큰 문제를 쉽게 바꿈 | 소프트웨어·메모리 이동 비용과 같은 조건 비교 필요 |
| FPGA 기반 Ising machine | 디지털 논리로 local field와 flip을 계산 | 제어가 명확하고 재구성 가능 | 물리 난수 소자의 에너지 이점과 시스템 통합을 분리해야 함 |
| oscillator·annealer 계열 | 발진 위상이나 전용 물리 상태가 결합 | 병렬 탐색 가능 | 문제 embedding과 결합 밀도에 따른 비용 비교 필요 |
| 기존 STT/SOT MRAM 기반 | 전류로 자화를 바꾸는 stochastic bit | 비휘발성, 메모리 공정 활용 | 쓰기 에너지·시간·주변 회로가 다름 |
| 이번 VCMA-MTJ | 펄스 폭으로 반전 확률을 조절 | sub-ns pulse와 작은 소자 에너지 잠재력 | 현재는 FPGA 결합 45 ns iteration, ASIC 값은 전망 |
새로움은 Ising 식 자체가 아니다. Max-cut이나 routing을 Ising model로 바꾸는 연구도, 확률적 bit로 annealing을 하는 연구도 이미 있다. 이번 연구의 핵심은 CMOS-integrated VC-MRAM array에서 pulse-width-controlled probability를 보여 주고, 96,000-spin 규모의 physical memory와 system controller를 연결해 산업 EDA 문제를 실행했다는 조합에 있다.[1]
반대로 “NP-hard 문제를 해결했다”는 표현도 조심해야 한다. 특정 instance에서 좋은 해를 빨리 찾는 heuristic machine을 구현한 것이며, 모든 크기의 NP-hard 문제를 polynomial time에 정확히 푼다는 증명은 아니다. 해의 품질, 성공 확률, mapping overhead와 controller energy를 함께 비교해야 한다.
#7. 해결된 부분과 아직 해결되지 않은 부분
해결된 첫 부분은 소자의 stochasticity를 제어 가능한 계산 요소로 만든 것이다. Figure 2는 pulse width와 switching probability의 연속 관계와 반복 switching trace를 보여 준다. 둘째는 array와 controller를 실제로 연결한 것이다. Figure 3은 chip photograph와 단면, system path를 동시에 제공한다. 셋째는 EDA problem을 형식적으로 mapping하고 결과 경로가 개선되는 과정을 시각화했다.
남은 첫 문제는 end-to-end integration이다. 현재 45 ns iteration에는 FPGA 기반 local-field calculation과 control path가 포함된다. projected 1 ns가 현실이 되려면 memory, local field, schedule, read/write가 ASIC 안에서 안정적으로 연결돼야 한다. 둘째는 dense coupling이다. 모든 spin이 모든 spin과 직접 물리 결합하는 것이 아니므로 J matrix를 계산·전달하는 비용이 문제 크기에 따라 커질 수 있다.
셋째는 variability와 endurance다. 확률 분포의 차이를 calibration으로 보정할 수 있어도 온도·시간·소자 열화에 따라 W₀가 이동하면 다시 보정해야 한다. 짧은 펄스 한 번의 에너지가 작아도 답 하나를 얻기 위해 필요한 총 iteration과 재시도 수가 많으면 시스템 에너지는 달라진다. 넷째는 benchmark fairness다. solution quality와 target probability, host preprocessing, mapping time, controller power를 동일하게 포함한 비교가 필요하다.
#8. 다음에 확인할 트리거
첫째, 논문이 전망한 fully integrated ASIC이 실제 silicon으로 제작돼 1 ns iteration을 측정하는지 보자. 둘째, 60-node Max-cut뿐 아니라 규모가 커지는 routing·layer assignment에서 solution quality와 TTS가 어떻게 변하는지 확인해야 한다. 셋째, chip array의 몇 개 spin을 실제 문제에서 동시에 사용했고 defect·variation을 어떻게 우회했는지 더 상세한 mapping 자료가 필요하다. 넷째, wall-plug power와 host·I/O를 포함한 system boundary를 공개해야 한다.
독자가 기억할 문장은 하나다. 이 연구는 9만 6천 자석이 정답을 마법처럼 계산했다는 보고가 아니라, 조절 가능한 확률적 MRAM 소자를 실제 최적화 시스템의 spin으로 연결한 하드웨어 실증이다. 현재 측정된 45 ns·40 mW·1.92×10⁵ solutions/s/W와 향후 1 ns·3.45×10⁸ 전망을 나누어 읽으면, 성과와 남은 공학 문제가 동시에 보인다.
#9. 출처
[1] A CMOS-integrated spintronic Ising machine with 96,000 spins. Nature Electronics, 2026-09-22. Abstract, Figures 1–5, Methods·rights 안내.
[2] 같은 논문의 Supplementary Information. Ising mapping, penalty, device calibration, random tests, system latency·power, actual/projected benchmark.
[3] SpinX-Lab, Voltage-controlled Spintronic Ising Machine 공개 저장소. 논문 관련 code·data와 재현 자료.