먼저 쉬운 답부터. 학교 지도를 볼 때 학생 수만 세는 것과 누가 누구 옆에 있는지 보는 것은 다르다. 암 조직도 세포의 종류·양뿐 아니라 배치에 정보가 있다. SpaCEy는 세포 지도를 읽어 예후를 예측한 뒤, 예측에 중요했던 이웃 묶음을 표시하는 AI다. 비유는 공간 배열의 중요성만 설명하며 세포가 학생처럼 행동한다는 뜻은 아니다. 예측에 중요하다는 것과 병의 원인이라는 것도 다르다.
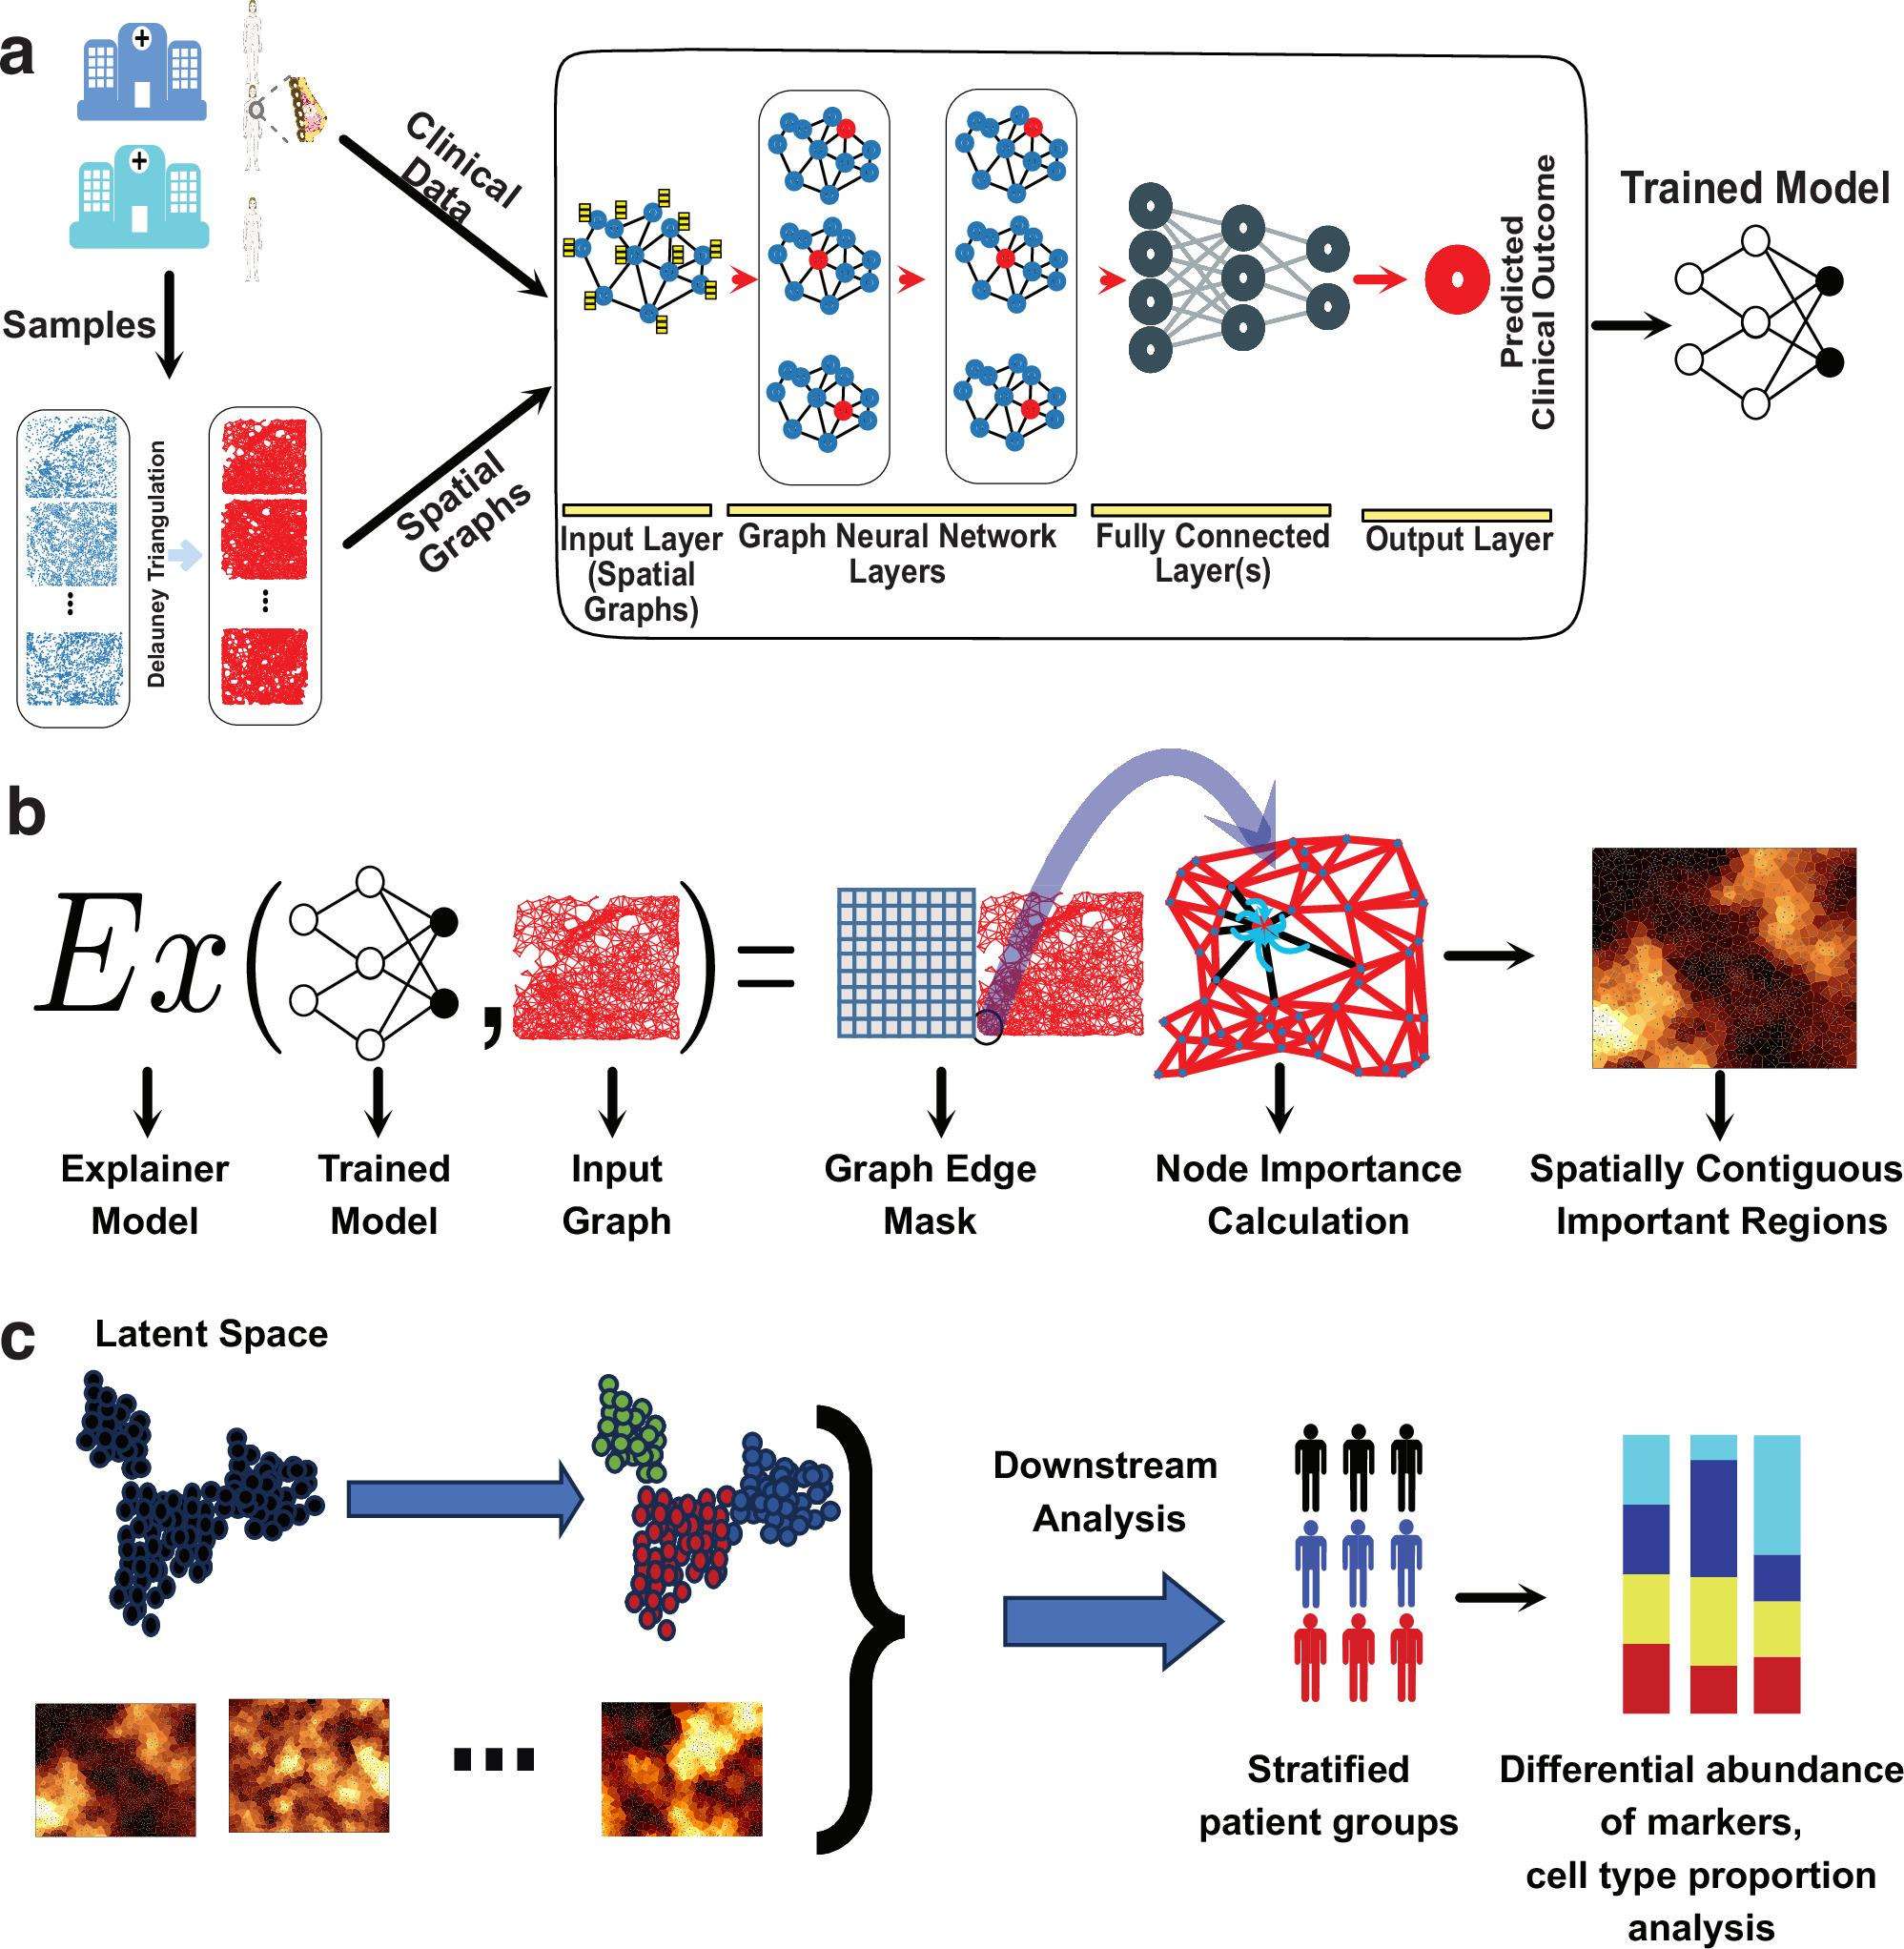
#원본 Figure 1 읽기: 세 줄을 각각 입력·예측·설명으로 읽자
a는 자료가 모델로 들어가는 길이다. 세포마다 단백질 표지자 값을 측정하고 가까운 세포를 선으로 연결해 그래프를 만든다. 점은 세포, 선은 공간 이웃이지 혈관이나 인과관계가 아니다. GNN은 이 지도를 이용해 예후 점수를 만든다. 조직 사진·세포 분할은 이미 준비된 입력이므로 일반 사진 한 장을 넣으면 진단이 끝나는 시스템은 아니다.
b는 AI가 무엇을 봤는지 되묻는 길이다. 예측 모델을 고정한 뒤 선들을 선택적으로 약화·유지한다. 원래 예측에 중요한 연결을 찾아 작은 이웃 묶음으로 정리한다. ‘설명’은 새로운 정답표를 만드는 것이 아니라 이 모델의 예측을 보존하는 부분이 어디인가를 찾는 단계다. c는 그 묶음을 생물학적으로 비교하는 길이다. 그림을 다 외우기보다 a에서 점수를 만들고 b에서 근거로 쓴 공간을 찾는다는 분리를 기억하면 된다.[1]
이 도판은 논문의 원본이다. 본문 CC BY 4.0과 별도로 원본 캡션에 명시된 여성 아이콘(Servier Medical Art, CC BY 4.0)·유방 아이콘(Bioicons, CC BY 3.0)의 출처와 조건도 아래에 표시했다. 그림을 누르면 전체 해상도로 볼 수 있다.
아이콘 출처: Servier Medical Art · Bioicons · CC BY 3.0. 원본 변경 없음.
처음 읽는 분 spatial omics·graph·GNN이 낯설다면: 세포 지도를 먼저 보기 그림으로 보기
① 조직 사진을 graph로 바꾼다
Delaunay triangulation으로 가까운 세포를 연결한다. 입력에는 미리 붙인 cell type·해부학 영역 label을 넣지 않는다.
② GNN과 explainer의 역할을 분리한다
먼저 GNN이 예후를 예측한다. 그 가중치를 고정한 뒤 explainer가 예측을 유지하는 작은 연결 subgraph를 찾는다.
중요: 선택된 motif는 예측에 유용한 pattern이지 질병 원인이라는 증명은 아니다.
③ 숫자는 ‘비교 우위’와 ‘절대 성능’을 함께 읽는다
서로 다른 task와 split에서 나온 값이므로 세 숫자를 직접 순위처럼 비교하지 않는다. 같은 dataset·평가조건 안에서 baseline과 비교한다.
spatial proteomics는 조직 속 단백질 marker를 측정하면서 각 세포의 위치도 보존한다. 일반 표처럼 세포별 수치만 남기는 것이 아니라 “어떤 세포 옆에 어떤 세포가 있었는가”를 함께 볼 수 있다.
- node: graph에서 한 세포를 나타내는 점
- edge: 공간적으로 이웃한 두 세포를 잇는 선
- node feature: 그 세포에서 측정한 protein-marker abundance
- GNN: 이웃 node의 정보를 주고받으며 graph 전체를 분류하거나 score를 예측하는 neural network
- explainer: 이미 학습된 예측을 많이 보존하는 node·edge 부분집합을 찾는 별도 단계
- motif: 반복적으로 발견되는 연결된 작은 spatial pattern
SpaCEy의 입력에 pathologist가 붙인 cell type이나 anatomical region label이 없다는 말은 marker도 없는 raw image를 바로 읽는다는 뜻이 아니다. single-cell protein abundance와 cell position으로 만든 graph는 사용한다. cell-type annotation은 설명 결과를 해석하는 post-hoc 단계에 쓰인다.
#1. 한 문장 결론: 성능표 뒤에 ‘어디를 봤는가’를 붙였다
2026년 9월 26일 Nature Communications에 발표된 SpaCEy는 spatial proteomics sample을 cell graph로 만들고, graph neural network(GNN)로 cancer progression·survival을 예측한 뒤, 그 예측에 중요한 연결된 subgraph를 추출한다. 연구진은 cell type이나 anatomical region label을 모델 입력으로 요구하지 않고 protein expression과 공간 이웃 관계에서 prognostic motif를 찾았다고 보고했다.[1]
가장 강한 결과는 단지 GNN이 baseline보다 높았다는 데 있지 않다. prediction model의 weights를 고정한 뒤 explainer가 edge mask를 학습하고, patient outcome과 연결된 compact·connected tissue pattern을 보여 준다. 즉 black-box score 하나에서 “어떤 세포 배치가 예측을 밀었는가”로 분석 단위를 옮겼다.[1][2]
하지만 설명 가능한 AI라는 이름이 임상 원인 규명이나 개인 치료결정을 보장하지는 않는다. LUAD progression task의 mean AUC는 0.62로 baseline보다 높지만 절대 성능은 modest하다. explainer가 찾은 motif는 predictive feature이지 causal determinant가 아니다. 이 경계를 논문 결과와 함께 읽는 것이 핵심이다.[1]
#2. 표로 세포 수를 세는 것과 공간을 보는 것은 다르다
기존의 단순한 접근은 sample마다 immune cell, tumor cell, stromal cell의 비율을 계산해 outcome과 연결하는 것이다. 이 방식은 이해하기 쉽지만 공간 배열을 잃는다. tumor cell 30%, T cell 20%인 두 조직도 T cell이 tumor 안으로 침투했는지, 가장자리에서 막혔는지에 따라 biological state가 다를 수 있다.
spatial proteomics는 이웃 관계를 남긴다. SpaCEy는 cell centroid를 기준으로 Delaunay triangulation을 적용해 graph를 만든다. 각 node에는 protein-marker measurements가 들어가고, edge는 가까운 세포의 공간적 연결을 나타낸다. GNN은 node 자체의 특징과 이웃에서 모인 정보를 여러 layer에 걸쳐 결합한다.[1][2]
여기서 “label-free”라고 부를 때 조심해야 한다. outcome label은 supervised prediction을 위해 필요하고, segmented cell과 marker data도 이미 전처리된 입력이다. 모델이 사용하지 않는 것은 사전에 정의한 cell-type·region label이다. 생물학자의 annotation이 완전히 사라진 end-to-end raw pathology system은 아니다.
이 차이는 재현성에도 중요하다. segmentation error, panel에 포함된 marker, tissue sampling과 batch effect가 graph의 node feature와 edge를 바꿀 수 있다. 모델이 anatomical label에 덜 의존한다는 장점과, upstream measurement에 의존한다는 사실을 함께 기록해야 한다.
#3. SpaCEy는 두 단계로 동작한다
첫 단계는 예측이다. sample마다 만든 spatial graph를 GNN에 넣어 LUAD progression 같은 binary outcome 또는 survival risk score를 학습한다. patient의 여러 image·region이 train과 test에 흩어져 들어가면 leakage가 생길 수 있으므로 split은 patient 단위로 관리해야 한다. 논문은 survival 평가에서 고정된 patient-separated split을 사용했다.[1][2]
두 번째 단계는 설명이다. 이미 학습한 GNN weights를 freeze하고, 각 edge가 prediction에 얼마나 필요했는지를 나타내는 mask를 최적화한다. 많은 edge를 남기면 prediction은 보존하기 쉽지만 설명이 너무 커진다. 너무 적게 남기면 간단하지만 원래 score를 재현하지 못한다. 그래서 fidelity와 sparsity·connectivity 사이를 조절한다.[1]
연결된 subgraph를 요구하는 이유는 생물학적 해석 가능성이다. 조직 양 끝의 무관한 cell 몇 개를 모은 집합보다 실제로 맞닿아 있는 neighborhood가 cell–cell interaction 가설로 이어지기 쉽다. 그러나 보기 좋은 connected pattern을 만든다는 제약 자체가 결과의 형태에 영향을 준다. explainer hyperparameter에 따라 선택되는 범위가 얼마나 안정적인지도 확인해야 한다.
설명은 model과 분리돼 있지만 model error에서 자유롭지 않다. predictor가 spurious batch signal을 배웠다면 explainer는 그 잘못된 예측을 충실하게 설명할 수 있다. explainability는 accuracy·external validity를 대신하지 않는다.
#4. AUC 0.62를 어떻게 읽어야 하나
AUC는 임의로 뽑은 positive sample이 임의의 negative sample보다 높은 risk score를 받을 확률로 해석할 수 있다. 0.5는 random ranking, 1.0은 완벽한 ranking이다. threshold 하나의 sensitivity·specificity가 아니라 모든 threshold의 ranking을 요약한다.
LUAD dataset은 416 patients였고 그중 progression information이 있는 404명을 이용한 평가가 보고됐다. 5-fold cross-validation에서 SpaCEy의 mean accuracy는 0.68, F1은 0.68, AUC는 0.62였다. 비교 baseline의 AUC는 0.57과 0.52였다.[1]
0.62는 baseline 대비 개선이지만 환자 개인에게 단독으로 의사결정을 내릴 임상 수준이라고 부르기 어렵다. class balance, confidence interval, calibration, external cohort에서의 재현이 더 필요하다. 특히 accuracy 0.68만 보고 좋은 모델이라고 판단하면 majority-class baseline의 영향을 놓칠 수 있어 AUC·F1을 함께 봐야 한다.
반대로 AUC 0.62라는 이유만으로 연구가 무의미한 것도 아니다. high-dimensional tissue graph에서 사전 cell-type label 없이 outcome-associated spatial signal을 추출할 수 있다는 방법론적 증거다. 이 연구의 1차 가치는 diagnostic product보다 discovery tool에 가깝다.
#5. survival C-index는 작은 순위 시험이다
survival task에서는 모든 환자의 정확한 사망·재발 시간이 관측되지 않는다. study 종료 때까지 event가 없는 censored case가 있기 때문이다. C-index는 비교 가능한 patient pair에서 더 빨리 event가 발생한 사람에게 모델이 더 높은 risk를 줬는지 센다.
세 환자의 risk ranking이 맞았는지 어떻게 세나? 기호·연산·계산 과정 펼치기
은 실제 event order를 비교할 수 있는 patient pair 수다. 는 먼저 event가 난 환자에게 더 높은 predicted risk가 간 pair, tied는 risk가 같은 pair다.
예를 들어 A·B·C 세 환자의 비교 가능한 pair가 3개이고 모델이 2개 순서를 맞히고 1개를 틀렸다면 이다. 세 pair를 모두 맞히면 1.0, 장기적으로 무작위 ranking이면 약 0.5에 가깝다.
이는 계산 원리를 보여 주는 가상 예다. censoring 처리와 실제 구현의 comparable-pair 규칙은 evaluation library와 연구 protocol을 따라야 한다.
JacksonFischer breast-cancer cohort의 720 samples, 357 patients 평가에서 SpaCEy의 C-index는 0.720±0.061이었다. best baseline은 cell-type composition과 Gradient Boosting을 결합한 0.617±0.092, Cox proportional hazards baseline은 0.600±0.095였다. METABRIC의 460 images, 405 patients에서는 SpaCEy 0.688±0.038, best baseline 0.570±0.071, CoxPH 0.562±0.048가 보고됐다.[1][2]
± 값이 있다는 것은 split에 따라 변동한다는 뜻이다. 서로 다른 dataset의 0.720과 0.688을 직접 우열처럼 비교하지 않고, 같은 split·dataset의 baseline과 비교해야 한다.
#6. explainer의 node importance는 인과효과가 아니다
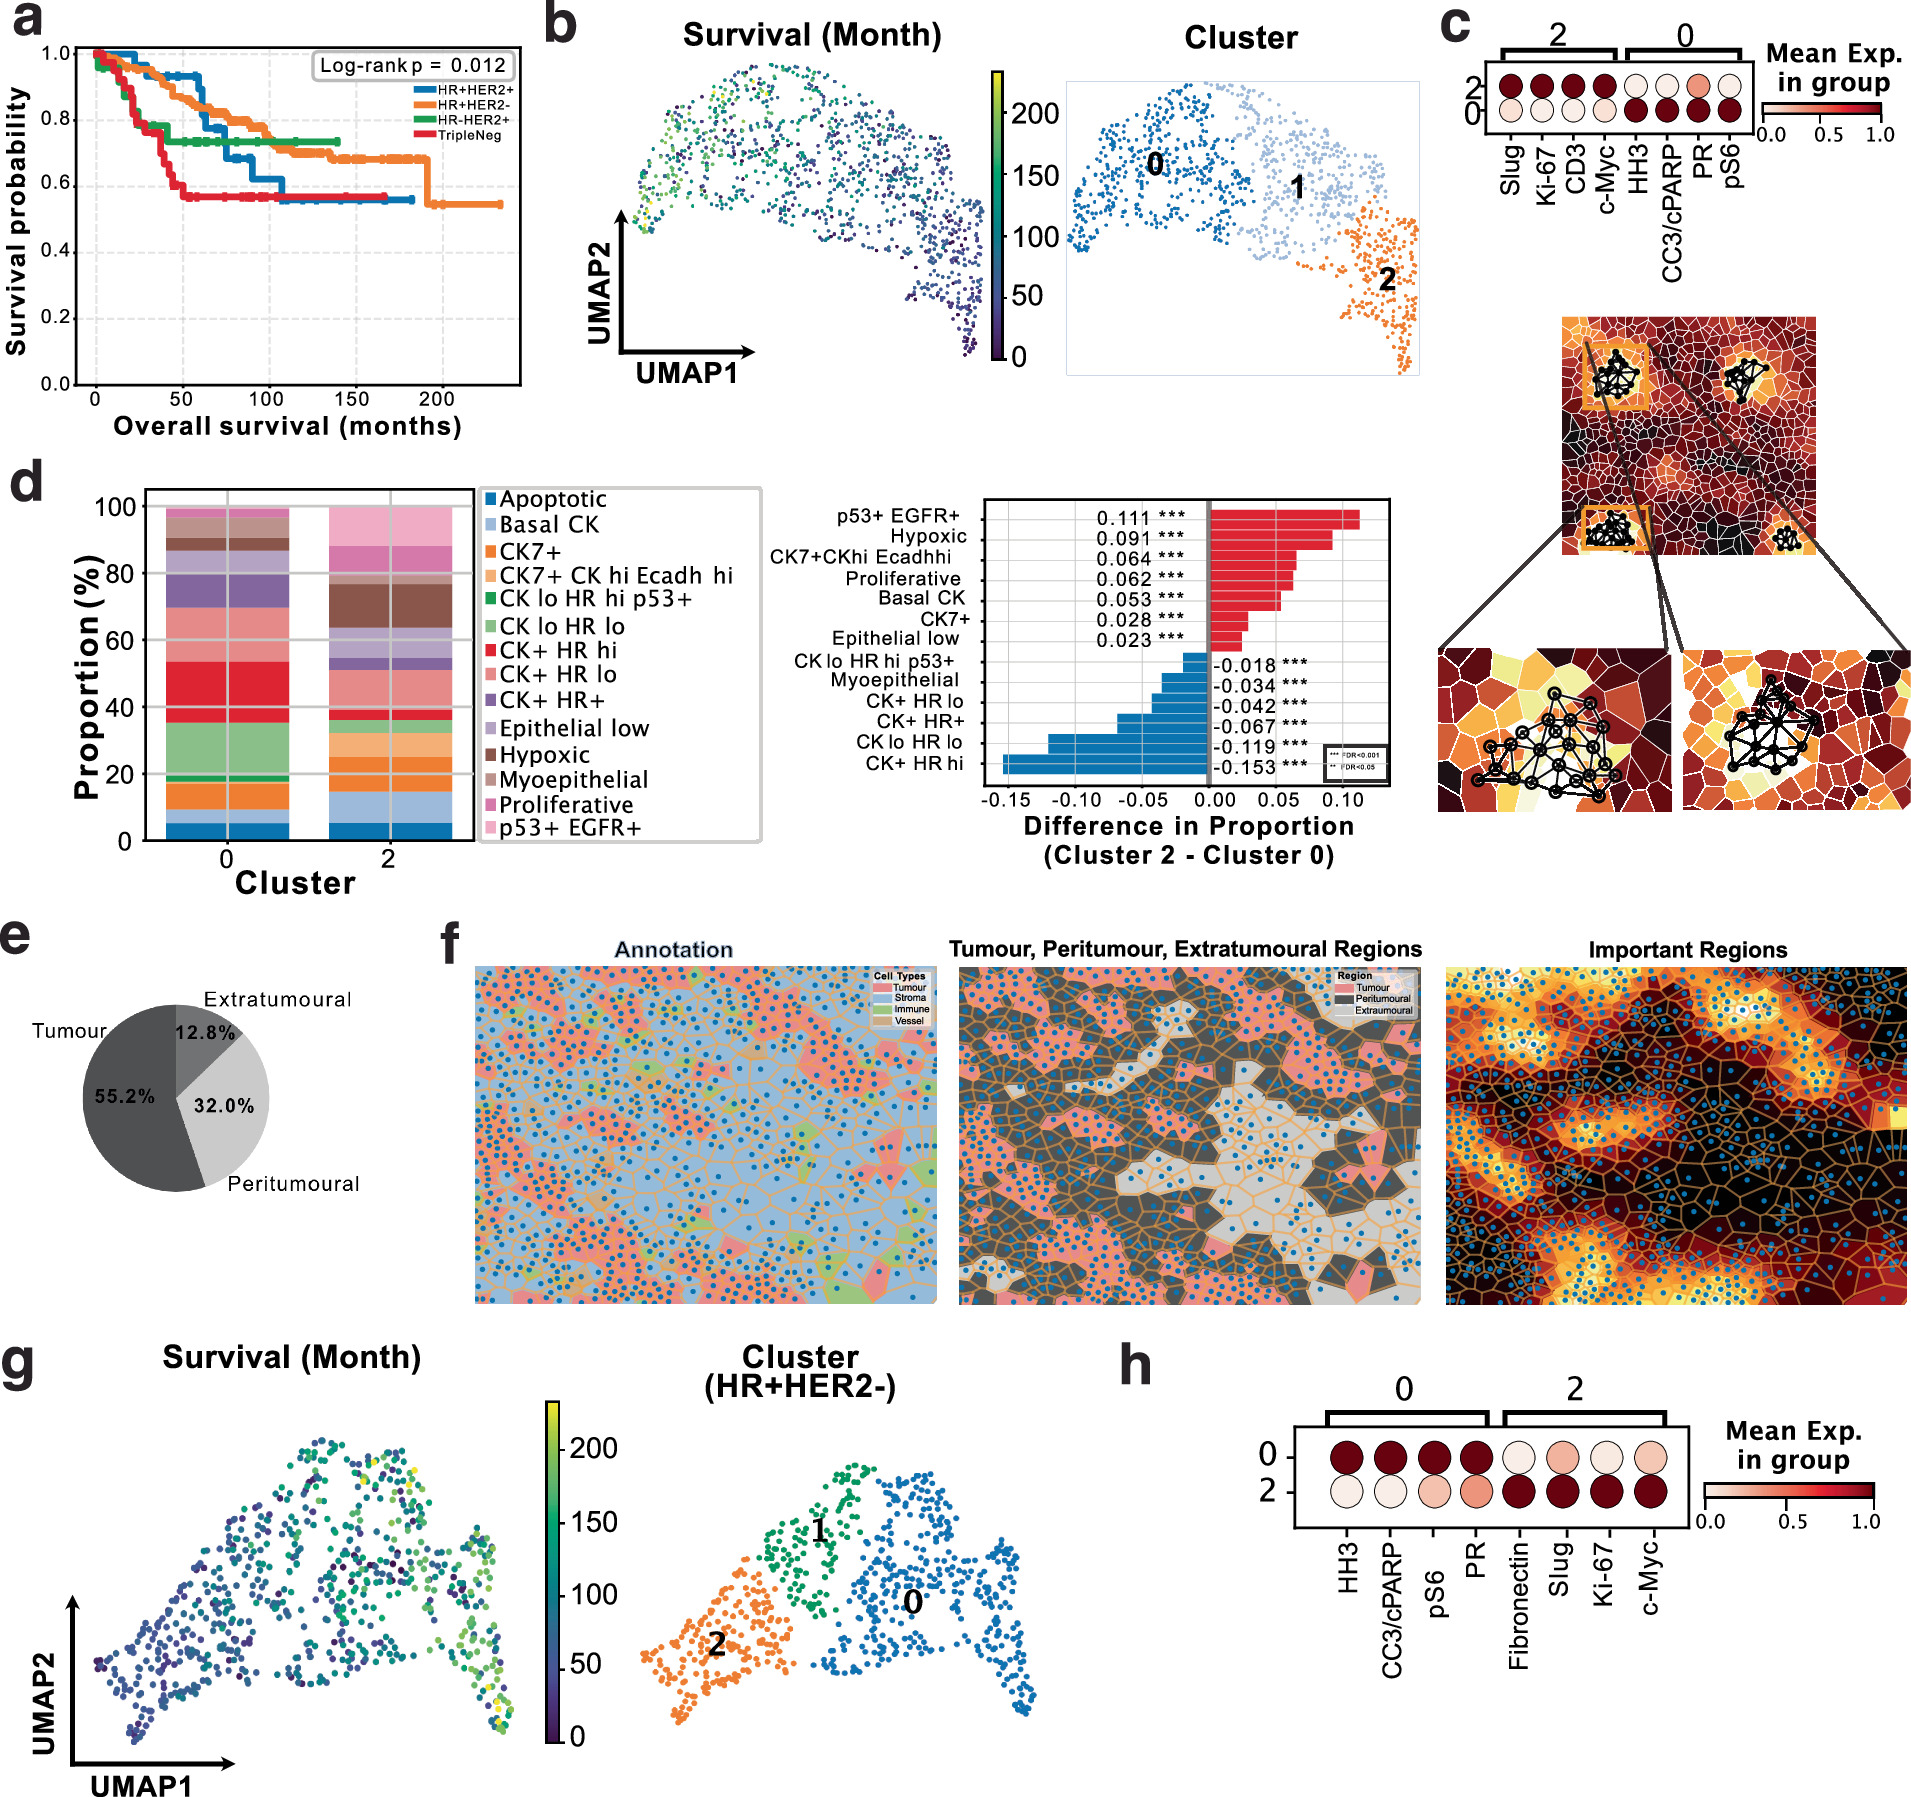
#원본 Figure 3 읽기: 색칠된 공간은 ‘암의 원인 지도’가 아니다
입문자는 f부터 본다. 같은 조직을 세포·구역 표시와 모델 중요도로 나란히 본다. “중요한 영역”은 해당 예측 모델이 활용한 위치라는 뜻이다. 어두운 표시를 죽은 세포, 전이 경로, 원인 세포로 번역하면 안 된다. e의 55.2%·32.0%·12.8%는 선택한 중요 구역의 종양 안·종양 주변·바깥 분포이지 환자 진단 정확도가 아니다.[1]
a의 생존 곡선은 별개의 임상 배경이다. 가로축은 개월, 세로축은 생존 비율, 색은 호르몬 수용체·HER2에 따른 그룹이다. 특정 시점의 곡선 높이는 C-index와 다른 값이다. b의 UMAP 가로·세로 좌표는 특징을 축약한 표현이며 몸의 실제 위치도, 시간축도 아니다. 가까이 모인 점들이 어떤 조직·임상 특성을 공유하는지 확인하는 보조 그림이다.
연구자는 c·d·g·h에서 표지자·그룹별 패턴과 빈도를 확인하되, 모델이 고른 묶음의 생물학적 일관성과 임상 인과성을 분리해서 판단한다. 같은 모델·측정 데이터 안에서 설명이 그럴듯하다는 것만으로 새 병원이나 새 환자에게 치료 결정을 맡길 수는 없다.
edge mask가 만들어지면 한 node 주변에 남은 edge weight를 모아 node importance로 요약할 수 있다. 논문은 k-hop neighborhood의 masked edge weights를 이용해 cell importance를 구성하고, 이후 cell phenotype과 spatial motif를 해석한다.[1][2]
한 세포의 중요도는 주변 edge weight로 어떻게 요약하나? 기호·연산·계산 과정 펼치기
는 관심 cell node, 는 그 node의 k-hop neighborhood에 있는 edge 집합, 는 explainer가 edge에 준 mask weight다. 평균이 높으면 해당 세포 주변 연결이 모델 예측을 보존하는 데 많이 선택됐다는 뜻이다.
예를 들어 주변 edge weight가 0.9, 0.7, 0.2라면 평균 importance는 이다. 이는 가상 계산이며 논문 patient의 실제 cell score가 아니다.
높은 는 그 cell을 제거하면 질병이 치료된다는 causal effect가 아니다. model의 입력·가중치·mask objective 아래 prediction에 중요했다는 algorithmic attribution이다.
연구진은 selected subgraph를 post-hoc cell annotation과 대조해 어떤 phenotype과 neighborhood가 enrich되는지 분석했다. 이 과정은 model이 새 hypothesis를 만드는 데 유용하다. 다음 실험에서는 다른 cohort의 imaging, perturbation 또는 spatial transcriptomics로 motif가 반복되는지 검증해야 한다.
#7. 성능과 해석의 증거 경계를 한 표에 둔다
| 확인한 대상 | 논문이 직접 보고한 것 | 이 결과만으로 말할 수 없는 것 |
|---|---|---|
| graph input | cell 위치, protein-marker feature, Delaunay edge | raw whole-slide image의 완전 자동 진단 |
| LUAD progression | 416 patients, mean AUC 0.62; baseline 0.57·0.52 | 개인 환자 치료결정에 충분한 임상 성능 |
| breast survival | JacksonFischer 0.720, METABRIC 0.688 C-index | 모든 암종·병원·marker panel에서 같은 성능 |
| explainer | prediction을 보존하는 compact connected subgraph | motif가 암의 원인이라는 인과 증명 |
| 공개성 | GitHub code, archived code와 preprocessed data | 원시 조직 전처리부터 완전 자동 재현 |
두 breast-cancer cohort에서 baseline보다 높은 C-index가 반복된 점은 장점이다. 반면 LUAD AUC 0.62는 모델의 절대 discrimination이 제한적임을 보여 준다. 좋은 편집은 높은 상대 개선과 낮지 않은 불확실성을 같은 문단에 둔다.[1]
dataset 규모도 sample과 patient를 섞지 않아야 한다. 한 patient에서 여러 image나 region이 나올 수 있기 때문에 720 samples가 720명의 독립 환자를 뜻하지 않는다. patient-separated split이 필요한 이유도 여기에 있다.[2]
#8. 기존 논문 결과와 일반 AI 설명을 구분한다
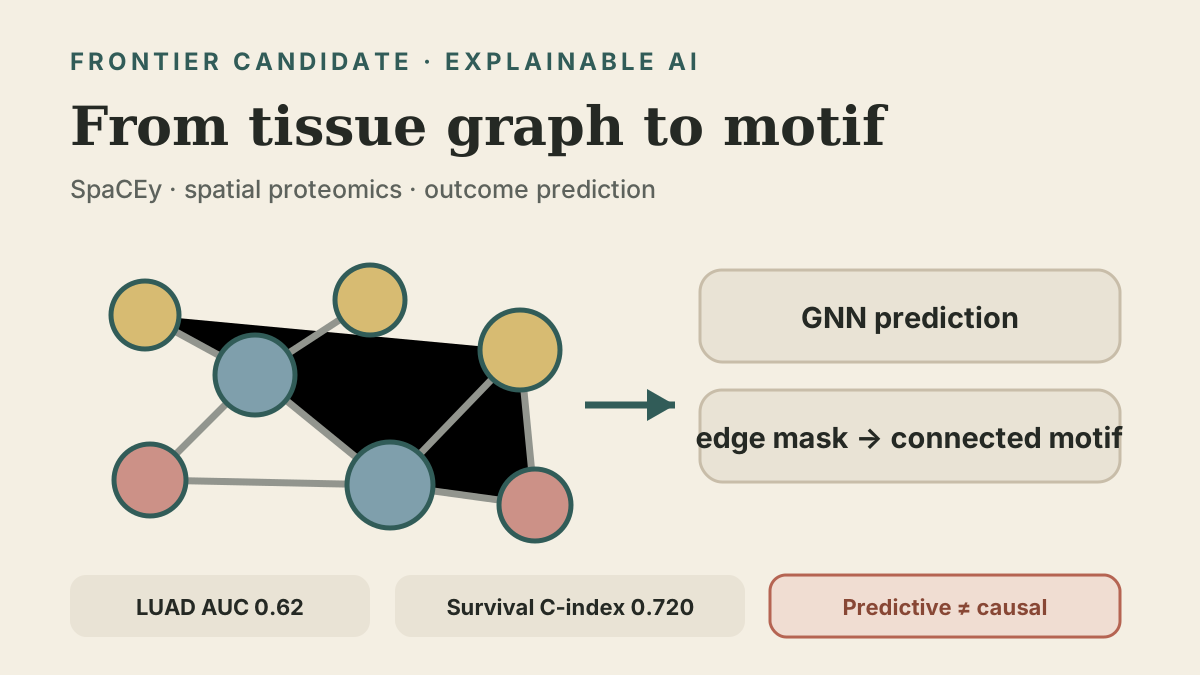
위 자체 개념도는 논문의 실제 조직 영상이 아니라 입력 → 예측 → 설명의 순서를 다시 정리한 교육 그림이다. 첫 화면과 6절의 원본 Figure 1·3은 연구진의 도판, 이 그림은 JJo 설명용이라는 역할을 분리했다. 원본은 축·패널·색·표시를 바꾸지 않고 출처와 라이선스를 붙였다.
node·edge·message passing, AUC와 C-index 설명은 일반적인 graph machine learning·survival evaluation의 교육 내용이다. Delaunay graph, frozen-predictor edge-mask explainer, 세 cohort의 성능과 identified motif는 SpaCEy 논문의 구체적 결과다.[1]
공개 범위도 구체적으로 적을 수 있다. 연구진은 SpaCEy code를 GitHub에 제공하고, publication snapshot을 Zenodo에 archive했으며, preprocessed data도 별도 Zenodo record로 연결했다.[3][4] 이는 재실행 가능성을 높이지만 raw imaging acquisition, segmentation, institutional preprocessing 차이를 없애지는 않는다.
이해관계는 ‘없음’으로 단순화하면 안 된다. 논문은 J.S.R.의 제약사 funding·fees 관련 disclosure를 적고 다른 저자들은 competing interests가 없다고 밝혔다.[1] disclosure가 결과 오류를 뜻하지는 않지만 독자가 평가할 수 있도록 연구 결과와 함께 기록해야 한다.
또한 논문이 찾은 motif의 biological naming은 post-hoc annotation과 기존 지식에 기대어 해석된다. “사전 cell-type label 없이 발견”과 “사람의 생물학적 해석 없이 의미가 자동 확정”은 다른 주장이다.
#9. 다음 기록: 설명이 안정적인지부터 확인한다
첫 번째 후속 질문은 external validation이다. 다른 병원, 다른 imaging platform, 다른 marker panel에서도 outcome ranking과 spatial motif가 유지돼야 한다. 두 번째는 explainer stability다. seed·split·mask sparsity를 바꿔도 같은 neighborhood가 반복되는지 정량화할 필요가 있다.
세 번째는 whole-slide coverage와 scale이다. 제한된 region of interest가 tumor heterogeneity 전체를 대표하는지, 수백만 cell graph에서 memory·runtime을 감당하는지 봐야 한다. 네 번째는 multimodal extension이다. spatial transcriptomics, morphology와 clinical covariate를 결합했을 때 단순한 더 큰 model이 아니라 검증 가능한 insight가 늘어나는지 확인해야 한다.
마지막은 causal follow-up이다. SpaCEy가 찾은 cell neighborhood를 독립 cohort와 실험 perturbation에서 재현해야 한다. 그때 predictive motif가 mechanism hypothesis로 발전한다. 지금 단계에서 가장 정확한 결론은 조직의 공간 구조를 outcome prediction과 해석 가능한 subgraph로 연결한 공개 분석 도구이지, AI가 암의 원인을 알아냈다는 선언이 아니다.
#출처와 열람 범위
[1] Ahmet Sureyya Rifaioglu et al., “SpaCEy links spatial tissue patterns to clinical outcomes using explainable graph neural networks,” Nature Communications, Version of Record 2026-09-26, DOI 10.1038/s41467-026-77924-z. Methods, results, data·code availability와 competing interests
[2] 동일 논문 Supplementary Information. Cohort 구성, split, model·explainer 설정과 추가 결과
[3] saezlab/SpaCEy GitHub repository. 설치·실행 코드와 사용 예시. 열람일 2026-09-28
[4] SpaCEy archived code, Zenodo DOI 10.5281/zenodo.22073069. Preprocessed data record: DOI 10.5281/zenodo.17710588