먼저 쉬운 답부터. 이 연구의 AI는 새로운 백신 항원을 상상한 챗봇이 아니다. 이미 만든 mRNA를 지질 입자에 담은 뒤, 어떤 보존제 조합으로 말려야 다시 물에 풀었을 때 기능이 잘 남는지 다음 실험을 추천했다. 좋은 조합이 있을 법한 곳과 아직 잘 모르는 곳의 가치를 함께 계산하면서 조성을 좁혔다. 정해진 차례대로 두 종류의 실험을 번갈아 했다는 뜻은 아니다. 오늘의 핵심 질문은 “냉장고를 없앴나?”보다 “무엇을 보존했고, 무엇은 아직 증명하지 못했나?”다.
실험 단계: 세포 시험 + 설치류·비인간 영장류 전임상. 인간 임상시험이나 사람의 감염 예방률을 검증한 연구는 아니다. 의료·접종 방법을 안내하는 글이 아니다.
읽기 전에 필요한 세 단어. mRNA는 세포가 단백질을 만들 때 읽는 정보이고, LNP는 그 정보를 보호·전달하는 지질 나노입자다. 보존제 조합은 건조한 뒤 다시 물에 풀었을 때 이 전달 기능이 남도록 돕는 구성요소다. 아래의 접힌 그림은 이 기초 설명을 더 자세히 보고 싶은 독자를 위한 것이다.
읽고 나면 할 수 있는 일: Figure 1의 발광과 Figure 5의 항체 반응이 다른 측정임을 구분하고, 한 회의 탐색과 한 시료를 구분하며, 모델이 추천한 후보도 실제 실험으로 확인해야 하는 이유를 설명한다. 먼저 현상만 알고 싶다면 §1→§2→§6→§7, 모델을 따라 계산하려면 §4의 목표·GP 카드와 §5의 측정식 카드, 원문 대응을 검토하려면 카드의 가정과 마지막 출처 목록 순서로 읽어도 된다. 선택 규칙은 원문 Methods의 EI 표기와 정확한 구현 대응이 미확인인 경계까지 설명한다.
처음 읽는 분 mRNA·LNP·보존제가 낯설다면: 설계도와 포장을 나눠 보기 그림으로 보기
① 설계도와 운반 포장을 함께 지켜야 한다
비유로는 종이 설계도와 택배 포장이다. 종이만 멀쩡해도 포장이 세포 안으로 전달하지 못하면 단백질을 충분히 만들 수 없다.
② AI는 답을 선언하지 않고 다음 실험을 고른다
- 보존제 조합을 시험하고 발광을 측정
- 성능 예측과 불확실성을 함께 갱신
- 좋아질 가능성이 큰 다음 조합을 추천
추천 → 제조 → 측정 → 모델 갱신을 반복한다. 사람과 실제 실험을 생략하는 챗봇이 아니다.
③ 같은 100%라도 무엇의 비율인지 확인한다
발광 신호 유지 → mRNA가 단백질을 만들도록 전달하는 기능의 지표.
동물의 항체 반응 → 별도로 측정한 면역반응. 사람의 감염 예방률과 같지 않다.
사람에게 쓸 수 있는 제품 → 임상·제조·보관 조건의 추가 검증이 필요한 다음 단계.
mRNA(messenger RNA, 전령 RNA)는 세포가 어떤 단백질을 만들지 읽는 정보다. LNP(lipid nanoparticle, 지질 나노입자)는 이를 보호하고 세포에 전달하는 작은 포장이다. excipient(첨가제·부형제)는 여기서 유효성분을 새로 만드는 물질이 아니라 건조·보관·재용해 과정의 상태를 돕는 구성요소다. 다만 익숙한 첨가제라는 이유만으로 새 용도와 농도의 안전성까지 승인된 것은 아니다.
설계도와 택배 포장이라는 비유는 정보와 운반 역할을 구분하려는 것이다. LNP가 단순한 빈 상자라거나 mRNA가 종이처럼 움직인다는 뜻은 아니다. 실제 지질의 배열과 수분·전하·세포막과의 상호작용은 훨씬 복잡하다.
#뒤의 항체 그래프를 읽기 전에: RBD·ACE2·IgG는 무엇인가
항원(antigen)은 면역계가 알아보는 대상이다. 여기서 백신용 mRNA는 코로나바이러스 표면 단백질의 일부인 RBD(receptor-binding domain, 수용체 결합 부위)를 만들도록 하는 정보를 담는다. RBD는 바이러스가 세포 표면의 ACE2(angiotensin-converting enzyme 2)에 붙는 부분이다. 문과 손잡이라는 비유로 기억할 수 있지만, ACE2는 문 자체가 아니라 실제 기능을 가진 단백질이며 감염 과정도 이 결합 하나로 끝나지 않는다.
항체(antibody)는 특정 대상을 알아보고 붙는 면역 단백질이다. IgG(immunoglobulin G, 면역글로불린 G)는 항체의 한 종류다. 뒤에서 볼 ‘RBD 특이 IgG’는 RBD를 알아보는 IgG를 측정했다는 뜻이다. 많이 붙는가와 바이러스의 작동을 막는가는 다른 질문이다. 항체가 RBD와 ACE2의 결합을 얼마나 방해하는지 별도 시험하는 이유가 여기에 있다. 이 기초 관계는 앞선 항체 연구에서도 다뤄졌다.[6]
정리하면 mRNA는 만들 정보, RBD는 면역계가 익힐 대상, IgG는 반응의 한 지표, RBD–ACE2 결합 억제는 기능을 살피는 별도 시험이다. 어느 하나의 숫자도 바로 사람의 감염 예방률이 되지는 않는다.
저자 공개 원고 v1의 Figure 1 전체 보기 (PDF p.13) — 이 글은 Figure 1 이미지를 싣지 않고, 아래에서 b→e→a 패널을 글로 읽는다.
#원본 Figure 1 읽기: 보존제보다 먼저 ‘무엇을 시험했나’를 보자
처음에는 b 패널만 보자. 지질 나노입자에 보존제를 섞고, 진공에서 물을 제거한 다음, 다시 물에 풀어 세포에 넣는다. 마지막에 빛을 얼마나 내는지 측정한다. 그림 속 불빛은 효율 좋은 전구를 개발했다는 뜻이 아니라, 전달된 mRNA가 단백질을 만들 수 있었는지 읽는 표지다.
그다음 e 패널의 바둑판을 읽는다. 가로는 보존제 종류·농도, 세로는 서로 다른 LNP 조성과 완충액이다. 색은 용액 대조군에 비해 남은 발광의 비율이다. 같은 보존제도 어떤 포장과 완충액을 쓰느냐에 따라 성능이 다르다. “설탕을 넣으면 모든 mRNA가 안정해진다”는 결론을 내릴 수 없는 이유가 이 칸들의 차이다. a 패널의 별은 이번 방법의 결과를 기존 보고와 비교하지만, 각 연구의 조건이 모두 같다는 뜻은 아니다. 같은 조건의 알고리즘 비교는 뒤의 Figure 2f에서 따로 읽는다.[2]
출처 버전은 구분해 읽어야 한다. 2026년 9월 18일 공개된 bioRxiv v1은 저자 공개 원고이고, 9월 28일 Nature Biotechnology 논문은 이후의 출판본이다. Figure 1·2·5는 bioRxiv v1 원문 링크와 패널별 설명으로 안내한다. 아래 Figure 3 이미지는 bioRxiv v1 PDF p.15의 도판 영역을 통째로 래스터화한 것으로, 페이지 머리글과 인쇄 캡션은 제외하고 크기만 조정했다. 열두 패널과 도표 정보는 그대로 보존했으며 Nature 출판본 도판과는 다른 버전이다.
#1. 한 문장 결론: AI가 바꾼 것은 ‘다음 실험을 고르는 규칙’이다
Jinbi Tian, Khanh T. M. Tran 등 연구진의 AGENT는 고처리량 실험과 베이지안 최적화(Bayesian optimization)를 연결한 제형 탐색 체계다. 정식 논문은 2026년 9월 28일 공개됐다. 논문 초록은 6회 반복·약 한 달의 탐색으로 얻은 고체 제형이 37°C에서 두 달 넘게 보관된 뒤에도 bioactivity를 유지했다고 보고한다. bioactivity 유지 100%는 사람의 감염 예방률 100%가 아니다. 서로 다른 측정을 같은 숫자처럼 쓰지 않는 것이 이 논문의 첫 번째 읽기 규칙이다.[1]
모델의 역할은 화학 법칙을 모두 풀어 최적 조성을 증명하는 것이 아니다. 실제로 측정한 조합에서 미측정 조합의 성능과 불확실성을 추정하고, 실험 예산 안에서 다음 후보를 고르는 것이다. “방정식을 해결했다”보다 비용이 큰 실험의 선택을 개선했다가 정확하다. 표본이 적은 영역에 큰 신경망을 그대로 적용하는 접근과도 다르다.
원고에서 직접 확인한 탐색 과정은 LNP A에서 6회·48개 조합, LNP B에서 3회·12개 조합이다. 한 회에 여러 조합을 병렬로 시험했으므로 “여섯 번만 실험했다”가 아니다. A와 B는 각각 SM-102와 ALC-0315를 사용하는, 임상적으로 관련 있는 지질 조성을 대표한다. 새 연구 제형을 시판 Moderna·Pfizer 완제품과 동일시해서는 안 된다. 같은 계열의 포장이라는 사실과 허가된 제품이라는 사실은 다르다.[2]
#2. 왜 말리는 것만으로는 충분하지 않을까
소금이나 분유를 생각하면 물을 줄여 보관하는 원리가 낯설지 않다. 그러나 mRNA-LNP에서는 건조가 장점과 스트레스를 동시에 만든다. 물이 줄면 어떤 분해 경로와 분자 이동은 줄어들 수 있지만, 건조 중 성분이 농축되고 입자 사이 거리가 바뀌며, 다시 물에 풀 때 포장의 상태가 달라질 수 있다. 잘 보관되는 고체와 다시 썼을 때 잘 작동하는 전달체는 같은 조건이 아니다.
예를 들어 mRNA 사슬의 길이가 보존돼도 LNP가 크게 뭉치거나 세포 안 전달이 약해지면 단백질 발현은 떨어질 수 있다. 반대로 발광이 잘 나온다고 모든 입자의 구조가 처음과 같다는 뜻도 아니다. 따라서 기능 시험과 입자 크기, 포집률, RNA 무결성, 형태 관찰을 따로 봐야 한다. 이것은 한 장의 예쁜 현미경 사진이 전체 품질 검증을 대체할 수 없는 이유이기도 하다.
공개 원고의 사전 탐색은 완충액만 넣어 말리는 경우나 단일 첨가제만 넣는 경우가 충분하지 않았음을 보여 준다. LNP 조성에 따라 결과가 달라져 다성분 조합을 찾을 필요가 있었다. Figure 1e의 옅고 짙은 칸을 “색이 예쁘다”가 아니라 재료와 환경의 상호작용이 있다는 신호로 읽으면, 왜 다음 단계에 다변수 탐색이 필요한지 이해된다.[2]
여기서 상호작용은 두 성분을 따로 시험한 효과를 단순히 더할 수 없다는 뜻이다. 비유로 빵을 구울 때 물과 밀가루를 각각 늘렸을 때의 효과가 두 재료를 동시에 늘린 효과와 같지 않은 것에 가깝다. 이는 이해를 위한 비유이며 백신 제조법이 아니다. 조합과 건조·재용해 조건의 영향을 따로 고정하지 않으면 알고리즘이 학습할 대상 자체가 흔들린다.
#100이라는 숫자의 분모부터 정하자
발광 100%는 무엇과 비교한 100%인가? 식이 길면 좌우로 이동해 읽으세요. 키보드는 수식에 초점을 둔 뒤 방향키를 사용합니다. 기호·연산·계산 과정 펼치기
이 식은 Figure 1e·3a·3g의 정규화 발광(normalized luminescence)을 읽기 위한 정의식이다. 원고에 새로 증명된 정리가 아니라 캡션의 비교 방식을 독자용 기호로 표현했다. 원문 위치는 공개 원고 p.13 Figure 1 캡션, p.15–16 Figure 3 캡션이다.[2]
- R: 비교군 대비 발광 비율. 퍼센트로 표현하지만 차원은 없다.
- L dry: 건조한 뒤 다시 물에 푼 시료의 발광 측정값.
- L solution: 대응하는 용액 상태 대조군의 측정값. 동일한 첨가제 조건을 포함한다.
- 두 L은 같은 장비·처리 방식의 단위여야 한다. 세포 시험의 발광 단위와 동물 IVIS의 photon/second를 임의로 섞으면 안 된다.
함께 푸는 가상 예제: 같은 세포 시험에서 용액 대조군의 발광이 1,000, 건조 시료가 950이라고 하자. 두 값은 같은 발광 단위다. 먼저 950÷1,000=0.95를 구하고, 100을 곱해 R=95%로 표시한다. Figure 1e의 색을 읽을 때도 ‘어떤 시료를 어떤 용액 대조군으로 나눴는가’를 먼저 확인한다. 여기서 95%는 상대 발현 지표이지 100명 중 95명이 감염을 막는다는 뜻이 아니다.
조건을 바꿔 확인: 건조 시료는 950 그대로인데 대응 대조군이 1,250이면 R은 얼마일까? 답: 950÷1,250×100=76%다. 분모가 바뀌어 비율이 낮아졌으므로 이것만으로 건조 시료 자체가 더 손상됐다고 결론 낼 수 없다. 서로 다른 배치·용량·측정 시점의 대조군을 섞지 않아야 한다. 두 계산 모두 교육용 가상값이며 논문의 측정값이 아니다.
가정과 경계: 비교에 쓰인 용량, 세포, 측정 시점, 정규화 방식이 대응해야 한다. 이 연구는 발광을 탐색 목표로 사용했고, 항체·중화 관련 반응은 이후 다른 실험으로 확인했다. 기존 단일 첨가제 탐색과 AGENT가 같은 지표를 개선하더라도 제품의 모든 안정성 문제가 해결된 것은 아니다.
#3. 기존 해결 방식에서 무엇이 부족했나
첫 번째 선행 전략은 저온 보관이다. 제품별 검증된 조건 안에서 분해를 늦추는 운영 해법이다. 냉장고를 사용하는 것 자체가 실패한 기술은 아니다. 문제는 운송·보관 인프라의 부담이며, 새 제형이 그 부담을 줄일 수 있는가다. 이 글은 현재 허가된 백신의 보관 지침을 변경하지 않는다.
두 번째는 동결건조와 보호 첨가제다. 액체를 고체 상태로 만드는 방향은 이미 연구돼 왔다. 이번 연구가 처음 발견한 물리 원리가 아니다. 공개 원고는 기존 동결건조 연구와 진공건조 연구를 구분하고, 임상적으로 관련 있는 LNP 조성의 회복 성능을 더 넓은 조합 탐색으로 개선하려 했다. 진공건조가 모든 제형에서 동결건조보다 우수하다는 전면 비교 실험으로 읽지 않는다.[2]
세 번째는 한 번에 한 변수만 바꾸는 방법(one-variable-at-a-time)이다. 예를 들어 다른 성분을 고정하고 설탕 농도만 바꾼다. 원인 해석은 쉬워지지만, 성분끼리 조합돼 나타나는 효과를 놓칠 수 있다. 다섯 변수를 각각 다섯 수준만 고르게 시험해도 모든 조합은 5의 5제곱, 즉 3,125개다. 이는 논문의 실제 후보 개수가 아니라 조합 폭증을 설명하는 편집자 가상 계산이다.
네 번째는 무작위 탐색(random search)이다. 모델 가정을 최소화하고 고르게 새로운 점을 시험한다는 장점이 있다. 그러나 이전 실험의 결과를 다음 조합 선택에 반영하지 않으면, 실험 횟수가 제한된 문제에서 정보를 덜 활용할 수 있다. Figure 2f는 동일한 표본 수를 시험한 AGENT와 무작위 탐색의 결과를 제시한다. 그래프 한 장으로 모든 문제에서 베이지안 최적화가 이긴다고 일반화하지 말자.[2]
마지막은 베이지안 최적화 자체의 계보다. 이것 역시 이번 논문이 발명한 알고리즘은 아니다. 가우시안 과정(Gaussian process, GP)으로 미측정 성능의 분포를 추정하고, 획득 함수(acquisition function)로 다음 실험을 고르는 방식은 이미 실험 설계 도구에 구현돼 있다. 이번 변화는 이 규칙을 진공건조 mRNA-LNP의 조성 탐색에 연결하고, 실제 세포·동물 시험으로 끝까지 검증했다는 데 있다.[4]
#4. AGENT를 세 단계로 읽기
 그림의 글자가 작다면 원본 크게 보기 · 새 탭
#Figure 2 읽기: 왼쪽은 문제 정의, 가운데는 반복, 오른쪽은 검증
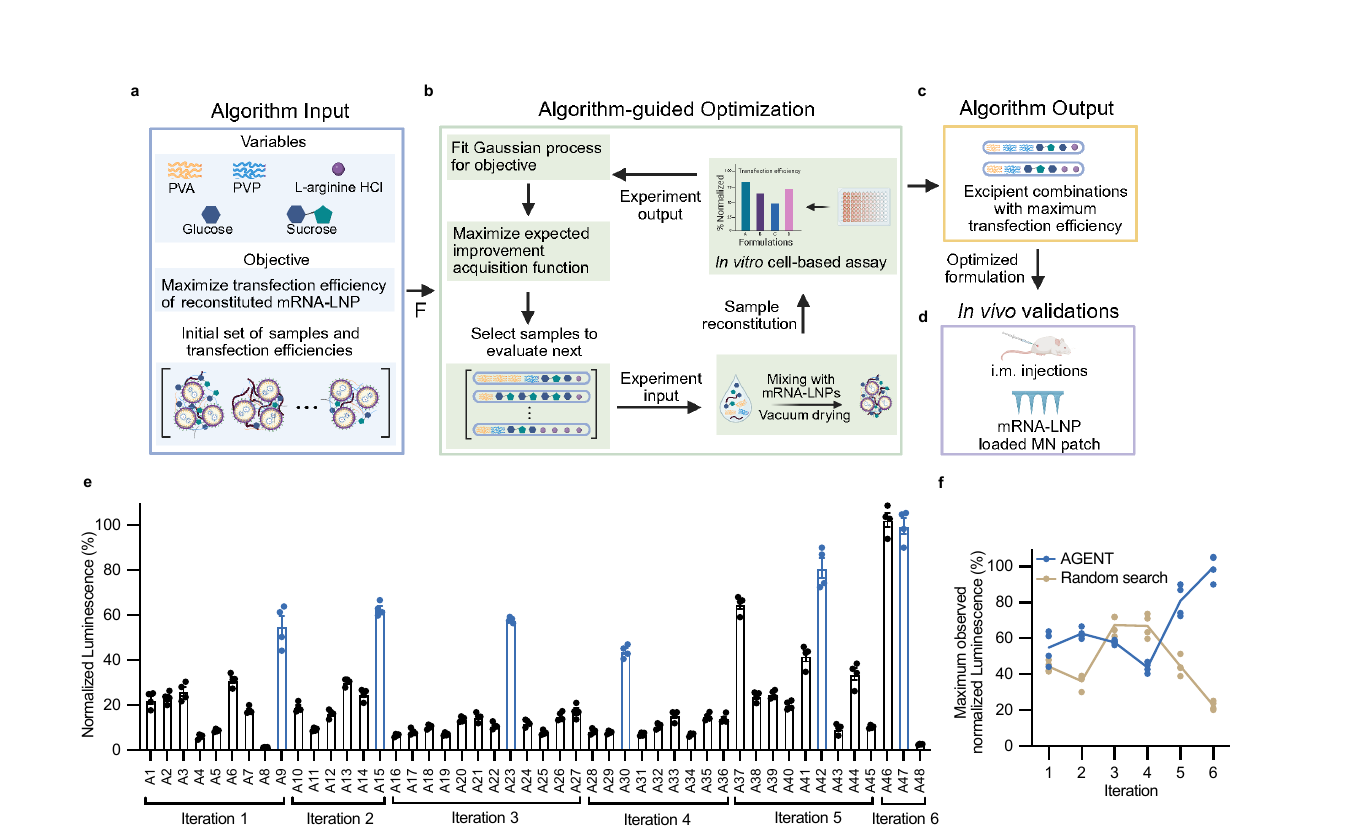
a 패널에는 재료의 후보, 허용 범위, 목표, 초기 실험이 있다. 연구자는 먼저 무엇을 조절할 수 있고 어떤 측정을 높일지 정한다. 알고리즘이 재료 목록이나 모든 안전 제약을 저절로 발명하지 않는다. 공개 원고 p.5–6의 다섯 입력은 PVA, PVP, sucrose(자당), glucose(포도당), L-arginine 계열 첨가제의 농도다. PVP·자당·포도당·L-arginine은 각각 0–10% (w/v), PVA는 0–5% (w/v) 범위의 연속 변수로 제한했다. w/v는 질량을 용액 부피에 대응시킨 농도 표시이며, 예를 들어 1% (w/v)는 최종 용액 100 mL당 성분 1 g이라는 뜻이다. 이는 단위 설명이지 백신 제조 처방이 아니다. Figure 2a에는 L-arginine HCl이라고 표시돼 있으므로 그림의 재료명과 본문 약칭도 구분해 읽는다.
왜 PVA만 상한이 낮을까? 사전 단일 첨가제 시험에서 5%가 10%보다 나았다는 관찰을 바탕으로 연구자가 탐색 범위를 정했기 때문이다. Tris 완충액도 고정해 탐색 차원을 다섯 개로 줄였다. 이 범위는 연구자가 정한 탐색 제약이지 임상 안전 한계나 모든 가능한 조합의 범위가 아니다. 보충자료의 최종 조성 비율과도 분모가 같다고 단정하지 않는다.[2]
출판본 Methods는 초기 GP에 무작위9개와 수동 선택4개, 총13개 조합을 사용했다고 명시한다. 초기 학습 집합과 최종 시험 조합48개를 혼동하지 않는다.[1]
b 패널의 화살표가 핵심이다. 먼저 측정한 결과를 GP에 넣고, 기대 개선량(expected improvement, EI)을 계산해 다음 조합을 고른다. 그 조합을 실제로 만들고 말리고 다시 풀어 세포 시험을 한다. 결과는 다시 모델로 돌아간다. 가운데 그림은 모델이 실험을 추천하고 실험이 모델을 수정하는 폐루프다. 컴퓨터의 예측만 수천 개 만든다고 실제 측정이 수천 개 생기는 것은 아니다.
c 패널은 알고리즘이 찾은 고성능 조합이라는 출력이고, 그 아래 d 패널이 동물 전달 시험이다. 세포에서 잘 되는 것과 동물에서 잘 되는 것은 별개의 문제이므로 마지막 검증 화살표를 생략할 수 없다. e 패널의 한 막대는 한 조합의 시험 결과이며, 파란 막대는 각 회차에서 가장 잘 나온 조합이다. 한 iteration(회차) 안에 여러 막대가 들어가므로 여섯 반복과 여섯 시료를 혼동하지 않는다.
f 패널은 각 회차에 시험한 후보 중 최댓값을 비교한 곡선으로 읽는다. 이전 회차의 최고값을 계속 보존하는 ‘누적 최고 기록’ 곡선과 다르다. 따라서 다음 회차의 점이 낮아질 수 있으며, 그림에서도 AGENT의 일부 회차와 무작위 탐색 곡선은 내려간다. 후보 조합이 달라지고 측정에도 변동이 있다는 점을 생각하면 이상한 모양이 아니다. 양쪽 방법은 회차별 같은 수의 시료를 시험했다는 캡션 조건 아래 비교해야 한다. 이 비교가 EI 단독의 효과나 모든 초기 조건에서의 우위를 증명하는 것은 아니다.[2]
중학생 수준에서는 이를 “틀릴 수 있는 지도를 계속 고쳐 가며 다음 장소를 고르는 일”로 이해해도 된다. 지도가 어느 장소를 좋다고 예측하더라도 실제로 가서 확인해야 한다. 대학 수준에서는 이 지도에 평균과 불확실성이 함께 있다는 것이 중요하다. 대학원 수준에서는 커널, 관측 노이즈, 실험 배치, 탐색 영역과 선택 편향이 다음 후보를 얼마나 바꾸는지 질문해야 한다.
그림에서 기호로 넘어가는 연결. Figure 2b에서 실험 결과가 모델로 돌아오는 화살표는 GP가 사용할 관찰값 y에 대응한다. 다음에 시험할 조합은 x, 그 조합의 예상 점수와 불확실성은 μ와 s, 다음 실험을 고르는 규칙은 EI다. 이는 독자를 위한 표현 연결이지 그림에서 μ·s의 실제 수치를 읽어 냈다는 뜻은 아니다. Figure 2e·f는 실제 탐색 결과를 비교하지만 EI만 바꾼 단독 제거 실험은 아니므로, 곡선의 차이를 EI 식의 한 항이 만든 효과로 분해할 수 없다.
#목표·관찰·유사성부터 정의하자
목적함수와 커널: 실험 선택을 위한 모형 식이 길면 좌우로 이동해 읽으세요. 키보드는 수식에 초점을 둔 뒤 방향키를 사용합니다. 기호·연산·계산 과정 펼치기
Methods #Sec23의 명시적 목적함수·관찰식·공분산식(PAPER_EXPLICIT)을 한 단위로 묶었다. X는 허용 농도 영역, f는 세포 시험의 목표 성능, x 별은 이상적인 최대점, f 별은 그 최대 성능이다. arg max는 값이 아닌 입력을 고르는 연산이다. 목표를 적었다는 것이 전역 최적점을 찾아냈다는 증명은 아니다. y는 실제 관찰이며 ε는 측정오차다.[1]
d=5, i는 농도 좌표 번호, l i는 좌표별 길이척도, σ f²는 신호의 공분산 스케일이다. x와 l은 같은 좌표 단위, |x i−x′ i|/l i와 지수는 무차원, K와 σ f²는 성능 단위의 제곱이다. 입력을 정규화하면 길이척도도 정규화된 좌표로 읽어야 한다. l i>0과 유효한 공분산이 필요하다.
가상 예제: 한 좌표의 차이를 길이척도로 나눈 값이1이고 나머지가0이면 K≈0.368σ f²다. 같은 차이에서 길이척도를 두 배로 하면 K≈0.607σ f²다. 더 넓은 차이를 비슷하게 보는 모형이 된다는 뜻이다.
확인 질문: 길이척도가 커지면 실제 제형이 같아지는가? 답: 아니다. 모형의 유사성 가정이 달라진다. Figure 2b의 예측 층에 연결되는 설명이지 Figure 3의 입자 구조를 측정하는 물리 방정식이 아니다.
원문은 이 커널을 Matérn1/2라고 부르지만 인쇄식은 좌표별 절대 차이의 합이다. 임의로 유클리드 거리로 바꾸지 않았다. 사전 분포 p(f)=GP(f;μ,K)와 함수·관찰의 결합 공분산은 바로 다음 갱신식의 근거다. 결합 블록의 μ·m은 각각 함수·관찰 평균, K·C는 각각의 공분산, κ는 교차공분산이다. 이 보조 표기는 원문 같은 절에서 추적할 수 있다. 정확한 실행 코드와의 일치는 별도 검토 대상이다.
#모델은 한 개의 예상 점수 대신 분포를 만든다
논문에 명시된 GP 갱신식은 무엇을 계산할까? 식이 길면 좌우로 이동해 읽으세요. 키보드는 수식에 초점을 둔 뒤 방향키를 사용합니다. 기호·연산·계산 과정 펼치기
출판본 Methods ‘Bayesian optimization algorithm’(#Sec23)에 실제 명시된 추정식(PAPER_EXPLICIT)이다. 이전 초안의 교재식으로 원문을 대신하지 않았다. 원문 식 번호는 없다.[1]
쉬운 질문: 이미 시험한 조합의 결과를 알고 나면, 아직 시험하지 않은 조합의 예상 성능과 불확실성은 어떻게 바뀔까? 벡터는 숫자 목록, 행렬은 숫자 표, 공분산은 두 값의 변동이 함께 움직이는 정도다. ‘함께 움직임’은 통계적 관계이지 같은 분자라는 뜻이 아니다.
- x·x′: 다섯 농도 좌표. 연구자의 허용 영역 안에서 비교한다.
- y: n개 관찰의 성능 벡터. m: 그 관찰들의 사전 평균 벡터.
- μ(x)·μ D(x): 관찰 전·후 함수의 평균. 둘 다 목표 성능 단위다.
- C: 관찰값들의 n×n 공분산 행렬. κ(x): 새 점과 n개 관찰 사이의 공분산 벡터.
- K·K D: 함수값의 관찰 전·후 공분산. C·κ·K의 단위는 성능 단위의 제곱이다.
- T는 전치, C⁻¹는 역행렬, D는 데이터다. x′=x이면 K D(x,x)가 잠재 함수의 분산이고 그 제곱근이 표준편차 s다. 관측잡음과 함수의 불확실성은 다르다.
첫 줄은 사전 평균에 ‘관찰이 예상에서 얼마나 벗어났는가’를 가중해 더한다. 둘째 줄은 기존 데이터가 설명하는 부분을 사전 공분산에서 뺀다. Figure 2b의 실험 결과가 모델로 돌아오는 화살표가 y에, 아직 시험하지 않은 후보가 x에 대응한다. 도판에서 C·κ의 실제 값을 읽어 냈다는 뜻이 아니라 설명자의 표현 연결이다.
함께 푸는 가상 예제: 관찰 하나, μ=m=0, y=80, C=125, κ=50, K(x,x)=100이라 하자. 평균은50×80/125=32, 분산은100−50²/125=80이다. κ가100이면 평균64, 분산20이 된다. 같은 사전분산 아래 관찰과 더 밀접한 점이 더 많은 정보를 얻는다. 이는 교육용 가상 공분산·성능이며 실제 연구값이 아니다.
확인 질문: 분산80이20으로 줄면 백신 효과가 네 배 좋아지는가? 답: 아니다. 줄어든 것은 모형의 불확실성이다. 실제 기능·안전성은 별도 실험으로 확인한다.
가정·경계: 유효한 공분산과 계산 가능한 C가 필요하다. 실제 수치 계산에는 역행렬을 직접 만드는 대신 선형계를 풀 수 있다. C를 K+σ n²I로 바꾸려면 독립·등분산 잡음 등 추가 가정이 필요하며, 그 치환을 이 논문의 인쇄식이라고 소개하지 않는다. 보충자료 Table 2는 길이척도 등 모형 설정값의 초기값과 최적화 범위를 제시한다. 이 표에서 최종 학습값을 확인할 수는 없다. 정확한 실행 커밋·전처리·관측잡음 구현은 재현하지 않았다. 무작위 탐색 대비 결과는 전체 폐루프의 비교이지 이 두 식만 바꾼 제거 실험이 아니다.
#평균이 가장 높은 조합만 고르면 안 되는 이유
출판본 Methods의 “Bayesian optimization algorithm”(#Sec23)은 후보 선택 규칙을 expected improvement (EI)라고 부른다. 그러나 현재 확인한 원문 표시에는 적분 변수의 측도와 최대화 변수·영역이 계산을 그대로 복원할 만큼 분명히 적혀 있지 않다. 이 글에서는 빠진 표기를 보충해 완결식으로 바꾸거나 실제 연구의 점수를 계산했다고 주장하지 않는다. Nature Biotechnology 출판본의 Methods §23에서 연구진의 표기를 직접 확인할 수 있다.
말로만 설명할 수 있는 범위: 연구진은 이 규칙을 새 관찰을 이용해 다음 실험 후보를 고르는 방법으로 설명한다. Figure 2f의 비교는 전체 탐색 절차의 결과이지 EI 하나만 바꾼 제거 실험은 아니다. 공개 코드·일반 저장소가 있다고 해서 해당 논문의 정확한 실행 설정과 표기 대응까지 확인된 것은 아니다. 독자용 설명에 코드 재현은 필수 조건이 아니지만, 이 문단도 정확한 실행을 재현했다고 말하지 않는다.
확인 질문: 선택 점수가 높으면 실제 성능도 가장 좋은가? 답: 보장되지 않는다. 후보는 실제로 만들고 측정해야 하며, 이 연구의 표시식과 코드 사이의 정확한 대응은 미확인이다.
#5. Figure 3은 성능·포장·원인을 서로 나눠 보자
원본: Tian, Tran 등, bioRxiv v1 Figure 3 · 공개 원고 · CC BY 4.0. 도판 영역을 이미지로 변환·크기 조정했으며 패널과 데이터는 유지했다. 출판본 도판과 구분한다.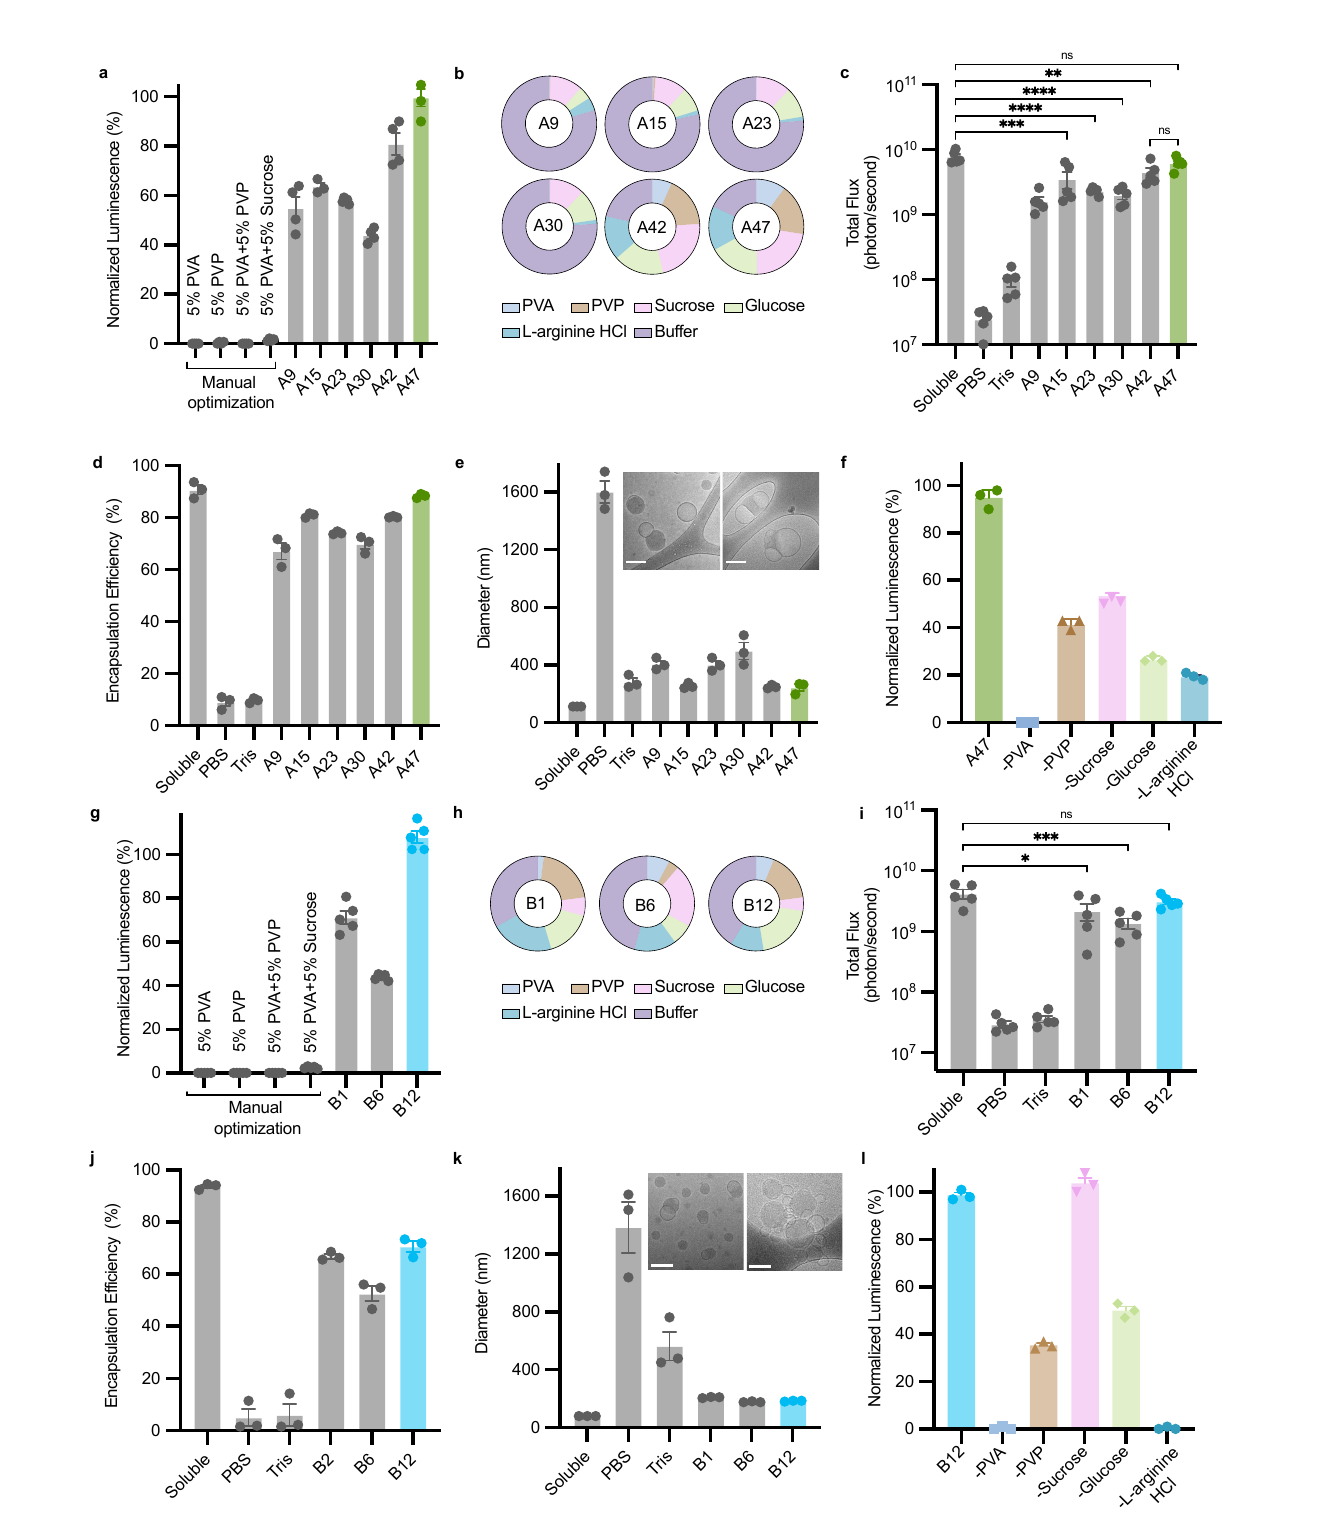 그림의 글자가 작다면 원본 크게 보기 · 새 탭
열두 패널을 한꺼번에 이해하려 하면 어렵다. 윗부분 a–f는 LNP A, 아랫부분 g–l은 LNP B라는 두 줄로 먼저 나눈다. 같은 열이 대체로 같은 질문을 담당한다. 왼쪽 a·g는 세포의 발광, 가운데 c·i는 동물의 주사 부위 발광이다. 세포 결과를 동물 결과라고 읽거나 그 반대로 읽지 않는다.[2]
a·g의 마지막 색 막대는 선택된 최종 조합이다. 회색 막대는 다른 후보와 비교 조건이다. 막대 높이뿐 아니라 점의 수와 퍼짐을 같이 본다. 시료 ID A47·B12는 포뮬러의 마법 이름이 아니라 탐색한 조합을 구분하는 번호다. 논문에서 두 지질 시스템 모두 개선이 있었지만, 조성별 필요한 반복 횟수가 달랐다는 점이 중요하다.
b·h의 도넛 그림은 첨가제와 완충액 조합을 시각화한다. 색이 많다고 서로 다른 항원을 합쳤다는 뜻이 아니다. 원고의 탐색 농도와 보충자료 표의 제형 비율은 표시 기준이 다를 수 있으므로, 그림 조각의 각도만 보고 실제 제조 처방을 추정하지 않았다. 연구용 조성을 개인이 백신에 적용하라는 안내도 아니다.
d·j는 포집률(encapsulation efficiency), e·k는 입자 직경과 cryo-TEM 형태다. 포집률은 전체 RNA 중 입자에 포집된 분율과 관련된 측정이며, “사람의 세포 안에 들어간 비율”은 아니다. 직경은 nm 단위의 입자 크기다. e·k 안의 회색 영상은 실제 현미경 자료이고 눈으로만 구조가 동일하다고 판정하면 안 된다. 원본 캡션은 현미경 삽입 사진의 왼쪽을 용액 시료, 오른쪽을 고체를 다시 물에 푼 시료로 구분한다. 공개 원고의 캡션에는 눈금 길이가 100 nm로 적혀 있다. 입자 크기를 사진에서 비교하려면 해당 패널의 눈금과 시료 조건을 먼저 확인해야 한다. 캡션의 눈금 길이와 DLS로 측정한 평균 입자 직경은 서로 다른 값이다. 같은 사진 안의 대조군과 처리군을 먼저 확인하자. 공개 원고는 재용해 뒤 bleb-like 형태를 관찰했다고 설명한다.[2]
#포집률의 분자와 분모는 무엇인가
전체 RNA 중 입자에 담긴 비율 읽기 식이 길면 좌우로 이동해 읽으세요. 키보드는 수식에 초점을 둔 뒤 방향키를 사용합니다. 기호·연산·계산 과정 펼치기
출판본 Methods ‘mRNA–LNP characterization’(#Sec12)은 (TX−TE)/TX×100%를 명시한다. 여기서는 형광 신호임을 나타내는 F와 결과 이름 E encap을 붙였다. 원문 명시식의 기호 재명명이지 새로운 추정법이 아니다.[1]
RiboGreen은 접근 가능한 RNA의 형광을 읽는 시약이다. TE는 Tris–EDTA 완충액 조건, TX는 Triton X-100으로 입자를 풀어 전체 RNA 신호를 읽는 조건이다. F TX는 전체 신호, F TE는 포집되지 않아 접근 가능한 신호로 해석한다. 같은 형광 단위·배경 보정·검출 조건과 F TX>0이 필요하다. 검출의 선형성이나 입자를 충분히 푸는 조건이 어긋나면 이 해석도 흔들린다.
가상 풀이: F TX=1,000, F TE=200이면 (1,000−200)/1,000×100=80%다. F TE가400이면60%다. Figure 3d/j의 이 비율과 Figure 3a/g의 발광은 다른 측정이다. 80%는 사람 세포에 전달된 비율이 아니다.
확인 질문: 포집률이 유지되면 크기와 발현 기능도 같은가? 답: 아니다. DLS·형태 관찰·발광으로 각각 확인한다. 이 비율은 같은 형광 시험의 분자·분모를 설명하는 표준 분석식이다. 높은 포집률만으로 입자 형태·발현·면역반응을 대신 판정할 수 없으므로 서로 다른 패널의 지표를 따로 확인한다.
f·l는 성분 하나를 빼 보는 실험이다. 한 성분을 제거한 조합의 발광이 떨어지면 그 성분이 최종 조합에서 기능에 기여한다는 단서가 된다. 그러나 이 실험 하나로 정확한 분자 수준 작용기작을 증명한 것은 아니다. 성분을 뺄 때 다른 물성이 함께 변할 수 있고, 기여는 나머지 조합에 의존하기 때문이다. LNP B에서 sucrose를 뺀 조건이 다른 제거 조건과 다르게 보인다는 점도 “모든 첨가제가 같은 중요도”라는 설명을 막는다.
연구자 관점에서는 여기서 세 질문이 이어진다. 최종 후보가 특정 세포 배치에만 유리했는가, 재용해 뒤 입자 구조 변화가 기능과 어떻게 연결되는가, 독립 배치에서도 제거 실험의 방향이 재현되는가. 최적화가 원인 규명과 같지는 않지만, 다음 메커니즘 실험의 후보를 줄이는 데는 도움이 될 수 있다. 이것은 이 글의 해석이며 논문이 독립 재현까지 마쳤다는 주장과 구분한다.
#6. 더운 곳 두 달과 실온 일 년은 같은 시험이 아니다
| 질문 | 확인한 측정 | 여기까지 말할 수 있다 | 확대하면 안 되는 결론 |
|---|---|---|---|
| 세포에서 회복됐나 | 재용해 후 A549 세포 발광 | 해당 시험의 상대 발현 기능 | 인간 감염 예방률 |
| 37°C 저장 후에도 작동하나 | RBD 제형 약 두 달 저장 후 동물 항체 반응 | 그 제형·기간의 전임상 안정성 근거 | 모든 기후의 무기한 상온 보관 |
| 실온 일 년은 무엇인가 | 보충 Figure 4c의 FLuc reporter, LNP B | 그 reporter의 동물 발광 유지 | 동일 백신의 일 년 임상 예방 효과 |
| 패치가 가능한가 | 쥐·비인간 영장류의 전달·면역반응 | 전임상 전달 가능성 | 자가접종 승인·인간 안전성 완성 |
저장 시험의 시간과 면역 측정의 시간도 구분하자. 공개 원고 Figure 4d·e의 ‘두 달’은 투여 전에 제형을 보관한 기간이고, 항체 측정은 접종 후5주차다. 저장 두 달과 면역 관찰 두 달을 같은 일정으로 읽지 않는다. 이 Figure의 비교군은5마리 단위이고, Figure 4b의 일부 단일 첨가제군은3마리다. 같은 패널 안에서도 표본 수가 모두 같다고 가정하면 안 된다.
같은 Figure라도 비교 질문에 따라 검정이 다르다. 공개 원고 Figure 4b·d·e는 일원 분산분석(one-way ANOVA) 뒤 Tukey 다중비교, 4c·g는 양측 비대응 t 검정(two-tailed unpaired t test)을 지정한다. 앞의 방법은 여러 조건의 평균을 비교하고, 뒤의 방법은 두 독립 집단의 평균 차이를 비교한다. 그래프의 점은 생물학적으로 독립적인 쥐인지, 같은 시료의 반복 측정인지도 캡션과 함께 확인해야 한다. 어느 검정도 그 자체로 사람의 감염 예방 효과나 두 제형의 동등성을 증명하지 않는다. ns는 이 검정에서 유의한 차이를 찾지 못했다는 뜻이며, 차이가 없다는 증명과 다르다.[2]
표의 세 번째 행은 특히 중요하다. 출판본 Supplementary Figure 4c에서 일 년 시험은 FLuc reporter를 담은 LNP B, 동물 주사 부위의 발광 평가다. FLuc는 반딧불이 발광 효소를 만드는 표지용 mRNA다. 감염 예방률이나 같은 RBD 백신의 장기 임상 효과가 아니다. 이를 “백신이 실온에서 일 년 동안 사람에게 효과 있었다”로 바꾸면 측정 대상이 바뀐다.[3]
#보충 Figure 7·8은 같은 항체 시험일까?
출판본 보충자료의 PDF p.8, 인쇄면 p.7에서 두 그림을 함께 보면, 위쪽 Figure 7은 RBD 항원, 아래쪽 Figure 8은 OVA라는 다른 시험용 항원의 항체 지표다. 같은 ‘IgG’라는 이름이 붙어도 무엇에 반응하는 항체인지부터 확인해야 한다. 권리 확인이 끝나지 않은 보충 그림은 본문에 복제하지 않고 원문을 연결했다.[3]
Figure 7은 LNP A 조성에서 새 용액 시료, 최적화한 고체 시료, 실온 또는 37°C에 한 달 저장한 고체 시료를 비교한다. 캡션의 항체 측정 시점은 접종 후 5주차, 군당 생물학적으로 독립적인 쥐 5마리다. ‘저장 한 달’과 ‘면역 측정 5주차’는 다른 시계다. 공개 원고 Figure 4의 두 달 저장 시험과 이 보충 그림을 하나의 기간으로 합치지 않는다. 세 비교선 위의 ns는 일원 분산분석(ANOVA)과 Tukey 검정에서 유의한 차이를 찾지 못했다는 표시이지, 저장 조건들의 동등성을 입증했다는 뜻은 아니다.
Figure 8a·b는 각각 LNP A·B 조성의 OVA 시험이다. 캡션에는 BL/6 쥐에 근육 주사로 mRNA 3 μg을 투여하고 2주 뒤 추가 접종, 3주차에 항체 측정, 군당 5마리라고 적혀 있다. 이 두 패널의 검정은 양측 비대응 t 검정이다. Figure 7과 항원·일정·검정이 다르며, 더 앞의 미세바늘 RBD 시험과도 같은 조건이 아니다. y축은 둘 다 log₁₀ 역가지만 높이를 그대로 비교해 어느 항원이 더 효과적인지 정할 수 없다. 해당 페이지의 캡션만으로는 오차막대가 표준편차인지 표준오차인지 확인하지 못했으므로, 이를 특정 신뢰구간으로 읽지도 않았다.
그림을 연결해 확인: 보충 Figure 7에서 ‘한 달’은 항체를 관찰한 기간일까, 접종 전에 시료를 저장한 기간일까? 답: 접종 전 저장 기간이다. 항체는 접종 후 5주차에 측정했다. 이 순서를 분리하면 저장 안정성의 근거와 면역반응의 근거가 어떻게 이어지는지 보인다. 어느 쪽도 사람의 감염 예방률을 직접 측정한 것은 아니다.
한편 공개 원고 Figure 4의 저장 후 RBD 제형 시험은 면역 관련 지표를 측정한다. 발광 탐색에서 찾은 조합을 실제 항원으로 옮기는 다리인 셈이다. 탐색용 대리지표(surrogate assay)가 최종 관심 지표와 언제 연결되는지 확인하는 단계다. 대리지표가 높다고 항상 모든 임상 목적에 유리하지는 않으므로 이 다리를 직접 놓았다는 점은 가치가 있다.[2]
연구가 보여 준 좋은 결과와 제품으로 해결해야 할 목록을 구분하자. 습도, 용기 밀봉, 재용해 후 사용 시간, 용량 균일성, 운송 중 흔들림, 독립 제조 배치의 품질은 서로 다른 조건이다. 이 글은 그 모든 항목에서 실패했다고 말하는 것도 아니다. 이번에 확인한 근거로 모든 유통 조건까지 통과했다고 결론 낼 수 없다는 뜻이다. 제품 단계에서는 관련 조건을 직접 정하고 시험해야 한다.
#7. 원본 패치 사진과 동물의 항체 그래프를 읽는 법
 그림의 글자가 작다면 원본 크게 보기 · 새 탭
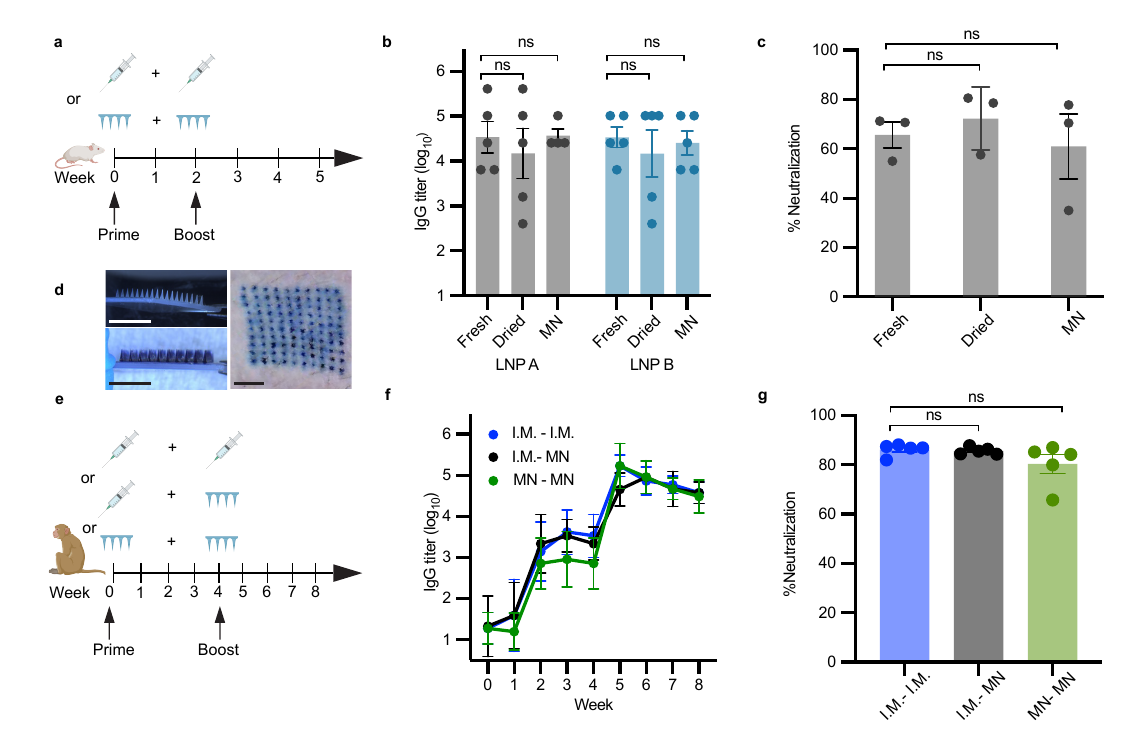
d 패널은 이번 연구의 실제 사진이다. 왼쪽은 제작한 미세바늘(microneedle, MN) 패치와 염색용 패치, 오른쪽은 비인간 영장류 피부의 염색 흔적이다. 피부 관통 가능성을 확인한 이미지이지 사람에게 투여한 사진이 아니다. 사진이 있다고 통증 감소나 자가접종 편의까지 인간에서 검증됐다고 읽지 않는다.[2]
a·b·c는 쥐 시험이다. a에서 일정과 전달 방식을 확인한 뒤 b의 항체 역가, c의 결합 억제 관련 중화 지표를 본다. 막대 위의 ns는 사용한 통계 검정에서 유의한 차이를 찾지 못했다는 표시다. ns가 통계적 동등성이나 비열등성의 엄밀한 증명인 것은 아니다. 정식 비열등성 결론에는 사전 한계값, 표본 설계와 신뢰구간 같은 근거가 추가로 필요하다. 이 글은 초록의 non-inferior 표현을 따옴표 없는 “완전히 같다”로 확대하지 않는다.
e·f·g는 비인간 영장류 시험이다. e의 첫 접종과 추가 접종 일정, f의 시간에 따른 IgG, g의 8주차 결합 억제 관련 측정을 나눠 읽는다. I.M.은 근육 주사, MN은 미세바늘 패치다. 조합 이름에는 첫 접종과 추가 접종의 경로가 함께 들어 있다. 공개 원고의 NHP 일정은 0주와 4주 투여, 8주까지 면역반응을 관찰하는 구성이며, 임상 환자 수를 나타내는 그래프가 아니다.[2]
항체 역가(titer)는 정해진 검사 기준에서 항체 반응이 어느 희석 수준까지 검출되는지를 나타내는 값이다. 출판본 Methods ‘Anti-OVA and SARS-CoV-2 anti-RBD titer quantification’(#Sec20)은 접종 전 혈청 배경 신호의 세 배 이상을 내는 가장 높은 혈청 희석 수준으로 endpoint를 정의한다. 혈액 속 항체의 무게나 예방률과 같은 값은 아니다.[1]
IgG 역가의 log₁₀ 축도 조심해야 한다. 축에서 4와 5의 차이는 선형 값이 1만큼 늘었다는 뜻이 아니라 해당 정의 아래 10배 차이에 해당한다. 실제 역가는 희석·검출 기준과 함께 정의되므로 로그 높이만 다른 그래프에서 떼어 와 비교하면 안 된다. 중화 관련 그래프도 원고 캡션상 RBD–ACE2 binding assay와 정해진 혈청 희석 조건의 결과다. 임상 감염 발생이나 실제 바이러스 공격 시험의 보호율과 구분한다.
그림을 읽고 확인: 같은 역가 정의의 log₁₀ 축에서 값이 4에서 5로 높아졌다면 선형 값은 얼마나 다른가? 답: 10의 4제곱에서 10의 5제곱으로, 열 배다. 이는 축을 읽기 위한 가상 예제이며 항체가 열 배이면 감염 예방률도 열 배라는 뜻이 아니다. Figure 5b·f의 항체 지표와 c·g의 결합 억제는 서로 다른 시험이므로 각각의 축·용량·희석·시점을 확인한다.
#수치와 실험 조건을 한 번 더 붙여 읽기
Figure 5 캡션에서 쥐 접종군과 b 패널의 항체 역가는 군당 5마리, 한 번에 mRNA 0.3 μg 조건이다. 0주와 2주에 투여하고 4주차 혈청을 평가한다. 다만 출판본 c 패널의 RBD–ACE2 결합 억제 시험은 n=3이다. 접종군 수를 모든 후속 검사에 그대로 적용하면 안 된다. μg(마이크로그램)은 백만 분의 1그램이다. 비인간 영장류 시험은 한 번에 30 μg, 첫 투여 뒤 28일에 추가 투여하고 8주차 결합 억제를 측정한다. 쥐와 영장류는 종·용량·일정이 모두 달라 두 그래프의 높이를 그대로 이어 비교하지 않는다.[1] [2]
c·g의 RBD–ACE2 결합 시험에는 혈청 1:50 희석 조건이 적혀 있다. 혈청은 혈액에서 분리한 액체 성분이며, 1:50은 원래 혈청이 최종 혼합물의 50분의 1을 차지하도록 묽혔다는 뜻이다. 농도가 달라지면 같은 항체도 결합 억제 값이 달라질 수 있으므로 희석 조건이 빠진 퍼센트 비교는 불완전하다. c는 4주차 쥐의 LNP A, g는 8주차 영장류 혈청이다. 출판본 Methods ‘Macaque vaccination’과 Figure 5f·g 캡션에서 영장류는 총15마리, 세 군에 각각5마리임을 확인했다. 두 번 근육 주사, 근육 주사 뒤 패치, 두 번 패치의 세 경로를 비교한다. 산점도의 점 수로 n을 추정한 것이 아니라 원문 군 배정을 사용했다.
b·f는 ELISA(enzyme-linked immunosorbent assay)로 측정한 항체 지표다. 대상에 붙은 항체를 효소의 신호로 읽는 시험이라고 생각하면 된다. 그 신호·역가와 c·g의 결합 억제, 실제 감염 예방은 각각 다른 측정이다. 이 캡션이 지정한 ANOVA와 Tukey 다중비교도 차이 검정이지 사람의 임상 효과나 엄밀한 비열등성 시험 설계를 대신하지 않는다.
이 그림에서 읽을 만한 메시지는 “패치가 주사를 대체했다”는 선언보다 좁고 탄탄하다. 건조 상태를 견디도록 최적화한 조성을 다른 전달 방식에 연결해 동물 면역반응을 확인했다. 전달 가능성, 저장 안정성, 면역반응이라는 세 조건을 하나씩 확인한 것이다. 사람에게 적용하려면 안전성과 용량·피부 상태·반복 사용 같은 조건이 더 필요하다.
#8. 연구자가 다음에 확인할 것은 기록이 아니라 경계다
#표본 수와 눈가림까지 봐야 결과의 강도가 보인다
저자들의 연구 보고서(Reporting Summary, p.2)는 사전 검정력 분석을 하지 않았다고 밝힌다. 검정력 분석은 예상 효과를 놓치지 않으려면 표본이 얼마나 필요한지 계획하는 과정이다. 탐색 시험은 최소 n=3으로 진행했고 각 그림의 표본 수를 따로 제시했다. 따라서 그래프의 ns를 ‘두 제형이 동등하다’는 증명으로 읽으면 안 된다.
같은 보고서는 비인간 영장류 연구를 한 번 수행했으며, 쥐는 무작위로 군에 배정하고 영장류는 나이·성별을 고려해 군을 균형 있게 배정했다고 설명한다. 세포 시험의 측정에서는 시료 정체를 쉽게 알지 못하도록 배치했지만, 투여 경로가 다른 동물실험에는 눈가림을 적용하지 않았다. 눈가림은 측정자가 어느 처리군인지 모르게 해 기대가 평가에 영향을 줄 가능성을 줄이는 장치다. 이 조건들이 결과를 자동으로 무효화하지는 않는다. 다만 군당 개체 수, 연구 반복 횟수, 눈가림은 서로 다른 근거이므로, 독립 반복과 사전에 설계한 비교가 다음 확인 지표가 된다.[8]
AI 논문으로 읽으면 같은 실험 예산의 반복 비교가 중요하다. 모델 없이 무작위로 고르는 경우, 단순한 회귀 모델로 고르는 경우, EI와 다른 획득 함수로 고르는 경우를 여러 초기 조건에서 비교하면 개선의 안정성을 더 잘 볼 수 있다. Figure 2f는 이번 비교의 근거지만 모든 seed와 모든 LNP에 대한 보편적 우위를 증명하는 정리는 아니다. 이는 후속 검증 제안이다.
제형 논문으로 읽으면 어떤 성분이 무엇을 보호하는가가 중요하다. 단백질 발현을 높인 조합의 물리적 원인을 밝히려면 수분과 입자 구조, 지질 산화, RNA 상태, 재용해 특성을 연결해야 한다. 논문이 보고한 bleb-like 구조를 “새 구조가 반드시 안정성의 원인”이라고 단정하지 않았다. 구조 관찰, 제거 실험, 기능 유지가 함께 제시돼도 상관과 원인은 구분해야 한다.
제품 개발로 읽으면 포장과 제조를 포함한 전체 경계가 중요하다. 이미 알려진 첨가제를 사용했다는 사실은 장점일 수 있지만, 새 농도·경로·조합·공정으로 만든 제품의 허가를 대신하지 않는다. 연구실에서 48개 조합을 고르는 최적화 문제와 생산 배치의 품질을 일정하게 유지하는 공정 문제도 다르다. 배치 편차가 커지면 GP가 학습한 지도와 실제 생산 지도가 달라질 수 있다.
출판본의 자료 공개 범위도 구분하자. 연구에서 생성·분석한 데이터는 Zenodo에 있다고 안내하지만, 추가 데이터는 교신저자에게 합리적인 요청을 해야 받을 수 있다고 적었다. 코드 안내는 AutODEx 플랫폼·구현 설명·AutoOED 저장소의 경로다. 이 링크들만으로 이 논문의 정확한 실행 버전과 설정까지 공개·복원됐다고 판단하지 않는다. 이번 글은 공개 원고·보충자료에 더해 2026-10-06에는 기존 브라우저 이용 권한으로 출판본 Main·Results·Discussion·Methods를 읽어 대조했다. AutoOED 일반 코드와 실제 실험 버전은 구분한다. 실험을 직접 재현하거나 당시 실행 코드의 정확한 커밋·모든 하이퍼파라미터를 복원하지 않았다. 논문을 읽는 것과 수치 재현을 완료하는 것은 별도 단계다.[1] [3] [4] [5]
이해관계도 숨기지 않는다. 보존된 공개 원고의 Funding·Competing interests(p.21–22)는 Gates Foundation 지원과 일부 저자의 이해관계를 공개한다. 2026-10-01 출판사 공개 페이지의 이해관계 항목도 다시 읽었지만 연결된 외부 기업 목록 전체를 검토한 것은 아니다. Ana Jaklenec의 공개 내역에는 Moderna를 포함한 기업과의 라이선스·투자·자문·연구 관계가 있고, Robert Langer의 내역은 별도 링크로 안내된다. 이런 관계가 결과를 자동으로 무효화하지는 않지만, 임상 확대 해석을 할 때 독립 검증이 중요한 이유 중 하나다.[2]
2026년 9월 29일의 연구 후보에는 큰 RNA 화물의 지질 입자 전달을 다룬 LC-1과 실리콘 전고체전지 연구도 있었다. 대표 연구와 후보 연구를 같은 글 안에 섞어 이번 AGENT의 성능 근거처럼 쓰지 않았다. 후보의 별도 원고는 추가 원문·권리·조건 검증이 필요하며 이번 글과 함께 자동 발행하지 않는다. 특히 전고체전지 원문은 현재 CC BY-NC-ND 4.0 조건이어서 광고가 있는 블로그의 원본 도판 재사용을 자동 승인하지 않았다.
#9. 한 번 더 요약하고, 더 깊게 읽는 순서
중고등학생 독자는 설계도와 포장을 함께 지켜야 한다는 점을 가져가면 된다. AI는 실험을 대신한 것이 아니라 다음 실험을 효율적으로 고르는 데 쓰였다. 발광, 항체, 예방률은 서로 다른 단계의 질문이다. 처음 볼 때는 Figure 1b의 공정, Figure 2b의 반복, Figure 5d의 실제 패치 사진 순서로 다시 보면 흐름이 잡힌다.
공대 학부생은 입력·모델·선택·검증을 구분해 보자. 입력은 조합의 농도, 측정은 발광, GP는 평균·분산, EI는 다음 점을 고르는 규칙, 동물 시험은 다른 수준의 검증이다. 수식 카드의 단위를 점검하면 숫자를 퍼센트포인트와 비율로 섞거나, 모델 불확실성을 임상 신뢰도로 오해하는 실수를 줄일 수 있다.
대학원생과 연구자는 바뀐 항과 바뀌지 않은 문제를 구분해 보자. GP와 EI에 새로운 물리 법칙을 넣어 완전한 제형 역설계 해를 구한 연구가 아니다. 실험 선택 규칙을 제형 탐색에 연결한 시스템 성과다. 커널 가정, 초기 배치, 반복 실험의 노이즈, 탐색 밖 제형으로의 일반화, 최종 품질 기준이 남아 있다. 이 경계를 유지하면 다음 실험이나 재현 과제를 구체적으로 정할 수 있다.
관련 글로는 SpaCEy의 예측과 인과 구분을 읽으면 AI 성능과 생물학적 결론을 분리하는 연습을 할 수 있다. 움직임에 강한 임플란트 무선 전력은 전임상 시스템의 수치가 어디까지를 측정하는지 다른 사례로 보여 준다. NEWS 목록에서는 날짜별 대표 연구와 후보를 다시 찾아볼 수 있다.
출처·도판 권리·열람 범위 (8)
#원문·그림·수식의 출처
-
Tian, J., Tran, K. T. M. et al. Accelerated discovery of thermostable mRNA–lipid nanoparticle vaccines using data-efficient AI. Nature Biotechnology, 2026-09-28. DOI: 10.1038/s41587-026-03331-w.
2026-10-06 기존 브라우저 이용 권한으로 Abstract·Main·Results·Discussion·Methods와 도판 캡션을 읽고 Methods #Sec23의 표시 수식을 화면에서도 확인했다. 2026-10-07 KST에는 출판본 Figure 1–5의 실제 패널과 캡션을 추가 대조했다. 최신 정정 전수 확인·정확한 실행 코드 재현은 미완료다. 읽기 권한은 사진 재게시 허가가 아니다.
-
동일 저자의 공개 원고, Accelerated discovery of thermostable vaccines using data-efficient AI. bioRxiv v1, 2026-09-18, DOI: 10.64898/2026.09.17.752370.
Results(결과) p.4–9, Discussion(논의) p.10–12, Figure 1–5 p.13–18, 이해관계 p.22 확인. 이 v1에는 별도의 Methods(방법)·Data availability·Code availability 절이 없다. 방법·공개 데이터·코드 설명은 출판본·보충자료·별도 저장소를 구분해 인용했다. Figure 1은 원문 링크로 안내하고 Figure 2·3·5는 bioRxiv v1의 원본 도판을 사용한다. Figure 2·3·5는 각각 PDF p.14·15·18의 도판 영역을 이미지로 변환했다. PDF p.1의 CC BY 4.0 고지와 Figure 3 캡션 pp.15–16의 개별 크레딧 여부를 함께 표시했다. 이는 이후 Nature 출판본 도판의 권리나 다른 그림의 사용 범위로 확대되지 않는다. 공개 원고 자체의 preprint 상태와 이후 동료평가 출판을 구분한다.
-
Nature Biotechnology 출판본 Supplementary Information.
Table 2, Figure 4c, Figure 5–9와 캡션 확인. PDF 쪽수와 문서 내부 쪽수는 표지 때문에 한 쪽 차이 난다. 이 보충 PDF의 이미지는 재게시하지 않았다.
-
AutoOED 공식 저장소.
autooed/mobo/acquisition/ei.py의ExpectedImprovement._evaluate,surrogate_model/gp.py의GaussianProcess._evaluate확인. 실제 AGENT 실행 버전의 완전 재현과 구분한다. -
저자 공개 데이터: Datasets for accelerated discovery of thermostable vaccines using data-efficient AI.
최적화·NHP ELISA·저장 ELISA 파일의 등록 확인. 모든 데이터의 독립 재분석을 완료했다고 주장하지 않는다.
-
Premkumar et al., The receptor binding domain of the viral spike protein is an immunodominant and highly specific target of antibodies in SARS-CoV-2 patients (2020). RBD–ACE2 관계와 항체 측정의 기초 설명에만 사용했다. 이번 AGENT 제형의 성능 근거가 아니다. 현재 PMC 직접 열기는 보안 확인 화면이었고, 검색으로 제공된 원문 Results의 해당 구간을 확인했다. 선행 연구 전체 정독 또는 동일 조건의 AGENT baseline 검증으로 취급하지 않는다.
-
Rasmussen, C. E. & Williams, C. K. I., Gaussian Processes for Machine Learning (MIT Press, 2006), Chapter 2. §2.2, 인쇄본 p.16–17(이 장 PDF의 10–11번째 쪽), 식 (2.20)–(2.26)을 앞선 검토에서 읽었다. 독립 노이즈와 잠재 함수 분산을 복습하는 별도 배경 자료이며, 현재 GP 카드의 직접 출처는 AGENT 출판본 Methods다. AGENT의 실제 커널·전처리·실행 설정을 이 교재에서 확인했다는 뜻은 아니다. 새 관측값의 분산과 잠재 함수 분산 구분은 같은 장 p.19를 참조한다. 교재 전체·그림 검수는 아니다.
-
Nature Portfolio Reporting Summary: AGENT 논문의 연구 설계·소프트웨어·동물실험 보고. p.2의 Sample size·Replication·Randomization·Blinding을 확인했다. 2026-10-07 KST 공식 PDF를 다시 받아 기존 사본과 SHA-256이 같음을 확인하고, 네 쪽의 실제 화면을 읽었다. 저자의 설계 보고를 독립 실험 검증으로 취급하지 않는다.
#코드와 수식의 경계 확인
출판본 Code availability는 AutODEx와 AutoOED를 안내한다. 공개 일반 도구의 지원 기능과 이번 실험의 정확한 실행 버전은 다르다. Methods에 표시된 좌표별 절대 거리 커널과 획득 함수의 표기를 일반 코드로 조용히 대체하지 않았다. 실제 실행 설정과 원문 참고문헌의 대응을 확인해야 재현 범위를 넓힐 수 있다. 읽기 가능한 본문이 확보된 것과 이 대응 문제가 해결된 것은 구분한다.
원본 도판의 출처·변환·재사용 조건
Jinbi Tian, Khanh T. M. Tran 등, bioRxiv v1(2026-09-18), DOI 10.64898/2026.09.17.752370의 Figure 2·3·5를 사용했다. 공개 원고 PDF p.1의 저자·지원기관 저작권 및 CC BY 4.0 고지, Figure 2(p.14)·Figure 3(pp.15–16)·Figure 5(p.18)의 도판과 캡션을 확인했다. 확인한 범위에서 별도 제3자 크레딧이나 재사용 제외 표시는 찾지 못했다. 이 근거는 해당 v1에 한정하며 이후 Nature Biotechnology 출판본의 도판 권리로 확대하지 않는다.
PDF의 도판 영역을 래스터 이미지로 변환하고 표시 크기를 조정했다. Figure 2의 a–f, Figure 3의 a–l, Figure 5의 a–g 패널과 축·점·현미경 및 패치 사진은 유지했다. 주변 본문·페이지 머리글·인쇄 캡션은 이미지 밖에 두고, 원문으로 연결했다. Figure 1은 이미지를 싣지 않고 원문 링크로 안내한다. 원본 데이터 재분석이나 출판본과의 완전한 동등성을 확인했다는 뜻은 아니다.