먼저 쉬운 답부터. 체스에서는 상대 말의 종류와 위치가 모두 보인다. Stratego는 상대 말의 위치는 보여도 종류는 숨겨진다. Ataraxos는 보이지 않는 말을 하나로 단정하지 않고 여러 가능성을 추정한 뒤 수를 고르는 AI다. Nature 논문은 인간 최상위권 선수와 20판에서 15승·1패·4무, 무승부를 반 승으로 계산한 유효 승률 85%를 보고했다. 특정 게임에서 강하다는 관찰과, 현실의 불확실한 결정을 잘한다는 일반화는 별개다.[1]
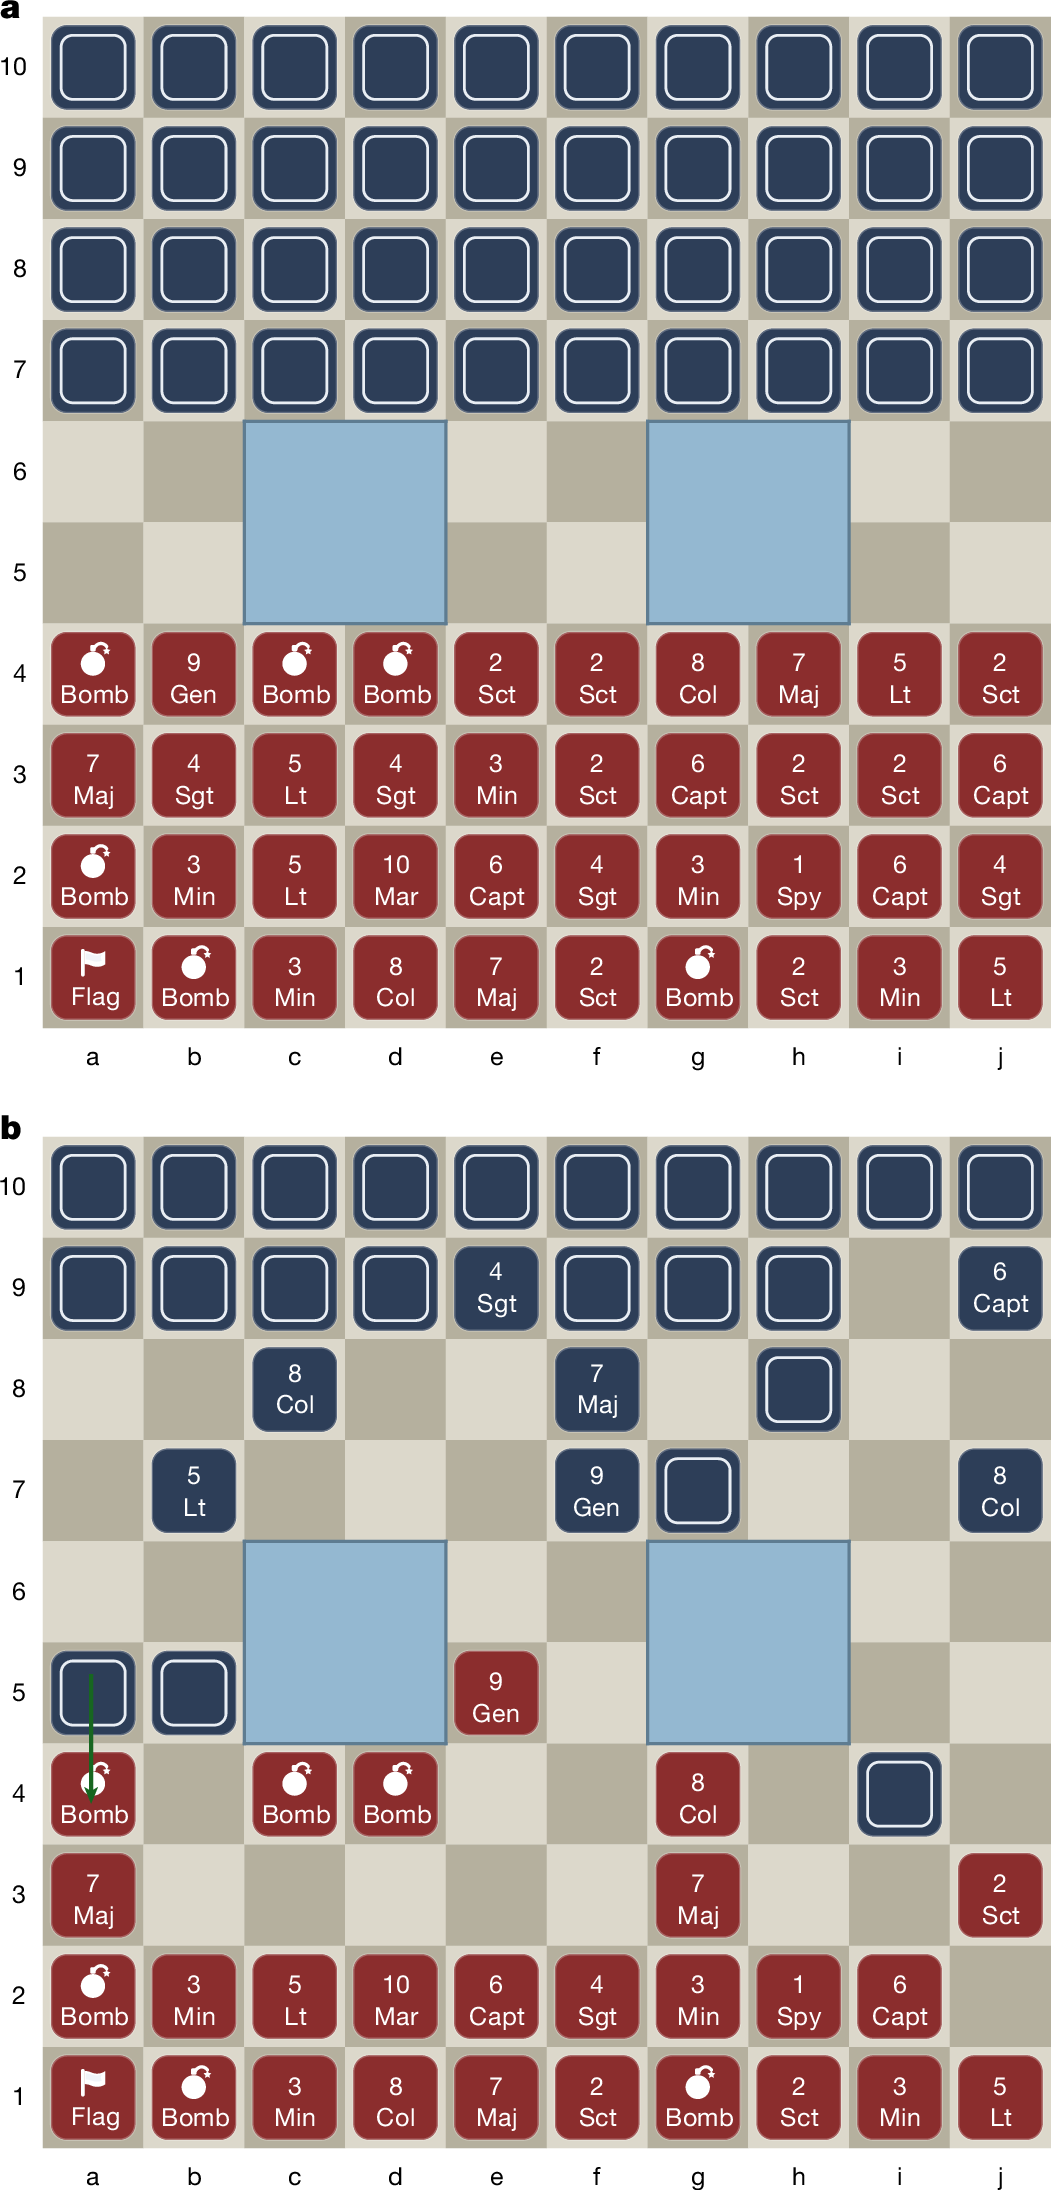
#원본 Figure 2 읽기: 파란 말을 모른다는 것이 핵심이다
a는 빨간 편에서 보는 시작 판이다. 아래 빨간 말에는 종류가 쓰여 있지만, 위 파란 말은 뒷면만 보인다. 플레이어는 상대의 위치는 알아도 그 말이 약한 정찰병인지 강한 장군인지 알 수 없다. 가운데 물색 칸은 이동할 수 없는 호수다. b에서는 파란 말이 빨간 말 쪽으로 이동해 전투가 일어나는 장면이다. 전투 때 말의 종류가 드러나고 결과가 정해진다. 이 그림은 실제 20판 중 한 대국의 현장 사진이 아니라 게임 규칙을 설명하는 논문 원본 일러스트다.[1]
처음 읽는 분 '숨은 정보'를 처음 듣는다면: 카드와 체스를 비교해 보기 그림으로 보기
체스처럼 판 위의 상태를 양쪽이 똑같이 볼 수 있으면 완전정보 게임이라고 한다. 상대 패가 보이지 않는 카드게임이나 Stratego는 불완전정보 게임이다. 운만 작용하는 것이 아니다. 상대가 지금까지 어떤 행동을 했는지 보면 숨겨진 상태에 관한 단서가 생긴다.
belief(믿음 분포)는 그 단서를 반영한 가능성의 목록이다. 예를 들어 상대 말 하나가 정찰병일 확률 60%, 장군일 확률 40%라고 생각하는 것이다. 이 숫자는 설명용 가상 예시이며 논문의 실제 배치를 복원한 값이 아니다. 어느 한 경우가 확실하다고 꾸미는 대신, 가능한 상태들에서 한 수의 위험과 이득을 함께 본다.
self-play(자기 대국)는 AI가 자기 자신과 반복해서 경기하며 경험을 만드는 학습 방식이다. test-time search는 훈련 후 실제 한 수를 둘 때 가능한 미래를 더 계산하는 과정이다. 훈련 시간과 한 수당 계산 시간을 혼동하지 않아야 한다.
#왜 체스에서 통하던 탐색이 그대로 안 되나
체스에서는 “이 수를 두면 공개된 판이 어떻게 바뀌는가?”를 계산할 수 있다. Stratego에서는 같은 수라도 상대 말이 무엇인지에 따라 결과가 뒤집힌다. 논문은 시작 배치의 숨은 경우가 10³³개보다 많다고 설명한다. 모든 상태를 하나씩 펼쳐 보는 방법은 현실적인 탐색 시간이 감당하기 어렵다. 게다가 상대도 내 행동을 보고 생각을 바꾼다. 지금 가능한 상태의 비율은 과거에 각자가 어떤 전략을 택했는지에 영향받는다.[1]
Ataraxos는 이를 세 부분으로 나눴다. 정책·가치 네트워크가 후보 수와 결과 전망을 제시하고, belief 네트워크가 상대의 숨은 말 배치를 추정하며, 대국 중 탐색이 여러 추정 배치에서 후보 수를 시험한다. 논문은 출발 배치를 고르는 네트워크와 이동을 고르는 네트워크도 별개로 학습시켜 서로의 결과를 다시 반영했다. 사람이 붙여 준 개별 Stratego 정답 수를 외우는 구조가 아니라 자기 대국에서 자료를 만든다.[1]
학습이 흔들리는 것을 줄인 dynamic damping도 중요하다. 불완전정보 게임에서는 새 전략에 너무 빠르게 달려들면 상대가 거기에 대응하고 다시 방향을 바꾸는 순환이 생길 수 있다. 연구진은 학습 초기에 더 강한 정규화와 큰 정책 업데이트를, 나중에는 둘 다 약하게 적용해 안정적으로 개선하려 했다. 여기서 damping은 판에 가짜 정보를 더하는 장치가 아니라 학습 변화의 크기를 조절하는 방법이다. 논문은 학습 비용이 수천 달러 수준이었다고 보고하지만, 사용한 시뮬레이터·하드웨어·가격 조건과 별도로 모든 후속 배포 비용을 보증한 숫자는 아니다.[1]
#실제 20판 성적은 무엇을 뜻하나
연구진은 세계대회 우승 경력이 있는 Pim Niemeijer와 3주에 걸쳐 20판을 평가했다. 사람은 여러 대국 동안 AI의 습관을 관찰할 수 있었고 AI는 그 사람에게 맞춰 모델을 재훈련하지 않았다. 이 설정은 강한 상대와 반복해서 붙은 기록이라는 장점이 있다. 동시에 대국 상대는 한 명이고, 게임들은 동일한 조건에서 독립적으로 동전을 던진 20회 같은 표본이 아니다. 상대의 적응, 시작 배치, 경기 흐름이 서로 영향을 줄 수 있다.[1]
15승·1패·4무가 왜 85%인가? 기호·연산·계산 과정 펼치기
이는 논문의 새로운 AI 수식이 아니라 대국 성적을 요약하는 일반적인 계산이다. 승리 1점, 무승부 0.5점, 패배 0점을 주면 15점+2점=17점이고, 20판으로 나누면 0.85, 즉 85%다. 단순 승리 비율은 15/20=75%이므로 같은 표현이 아니다. 작은 평가 표본의 불확실성이나 다른 사람을 상대로 한 성적을 이 85% 하나가 모두 말해 주지도 않는다.[1]
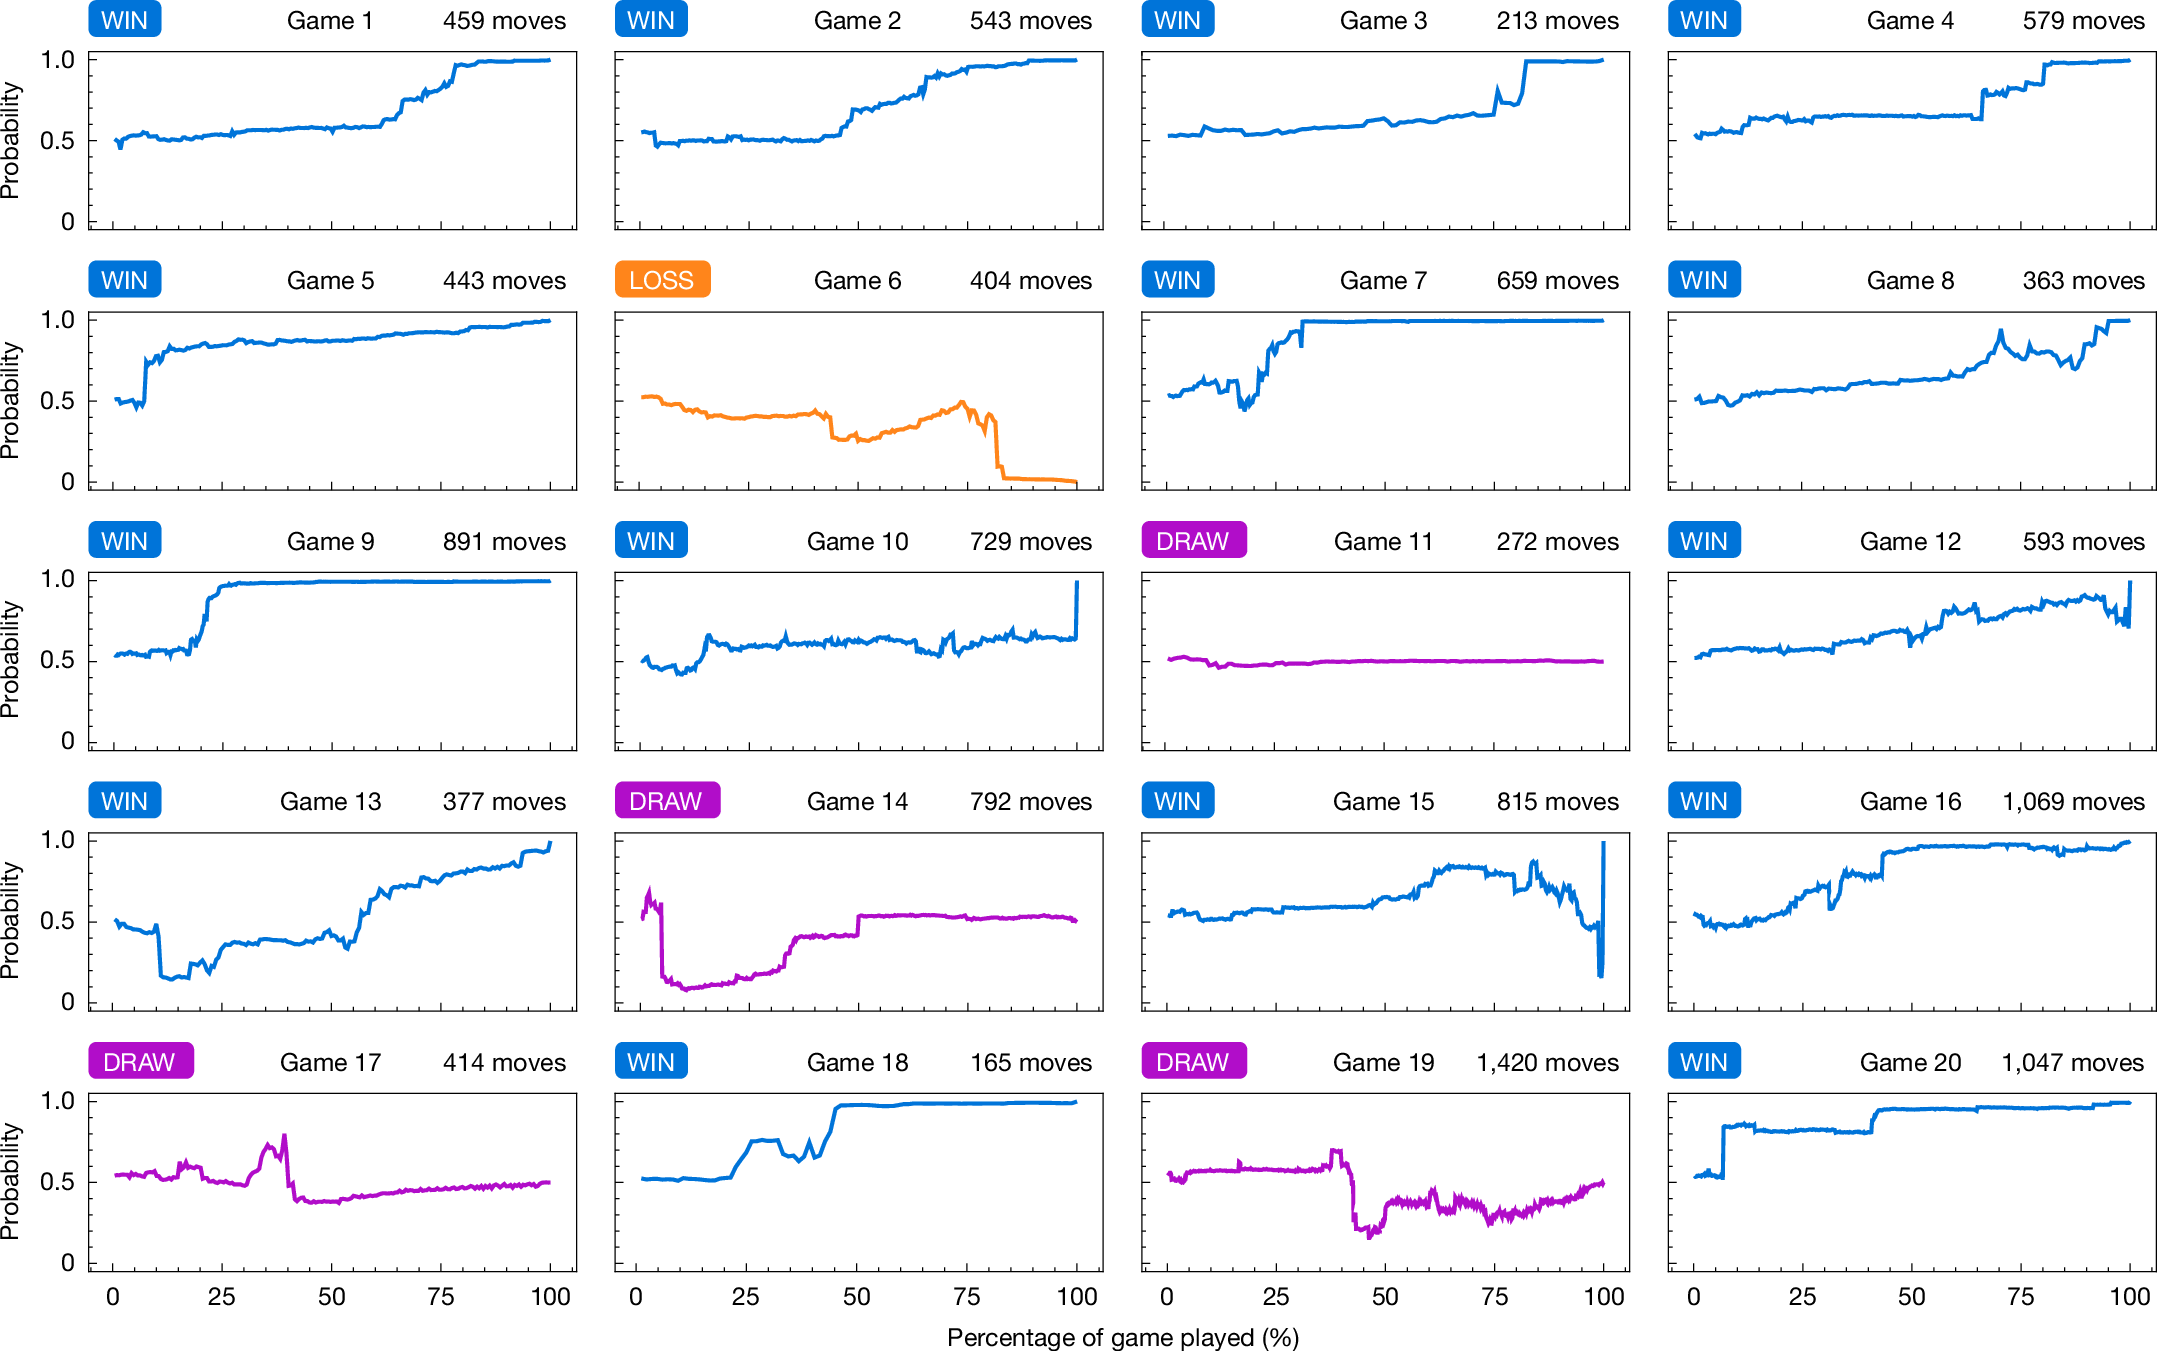
#원본 Figure 3 읽기: 파란 선은 실제 승률이 아니다
각 칸은 한 대국이다. 위쪽 WIN·LOSS·DRAW는 최종 결과이고, 선은 그 대국이 진행되며 Ataraxos의 가치 네트워크가 전망한 유효 승리 확률이다. 가로축은 해당 대국이 몇 퍼센트 진행됐는지, 세로축은 모델의 전망값이다. 파란 선이 0.8이라고 그 시점에 20판 중 16판을 이미 이겼다는 뜻이 아니다. 손실한 6번 대국의 주황 선, 무승부 11·14·17·19번의 보라 선도 함께 보자. 한 대국 도중 전망이 오르내리는 것은 숨은 말이 드러나고 수가 바뀌기 때문이다. 그래프의 후반 상승은 전체 모델의 실제 확률 보정(calibration)을 증명하지 않는다.[1]
20판 외에 연구진은 2025년 대회 현장에서 참가자들과 40판을 시연해 38승·2패를 보고했다. 이 역시 강한 추가 신호지만, 대회 참가자의 선발 방식·대국 환경이 20판 평가와 달라 두 수치를 한 표본으로 합쳐 새로운 승률을 만들지는 않는다. 논문은 Barrage Stratego, 협력 게임 Hanabi, 세 사람이 두 편으로 나뉘는 dou dizhu에서도 경쟁력 있는 결과를 보고했다. 게임마다 상대와 평가 기준이 달라 “모든 게임에서 세계 챔피언 85% 승리”라고 묶을 수 없다.[1]
| 질문 | 연구에서 직접 확인한 것 | 아직 확인하지 않은 것 |
|---|---|---|
| 인간 강자 대국 | Pim Niemeijer 상대 20판 15승·1패·4무 | 모든 상위권 인간 상대의 보편적 승률 |
| 다른 게임 | Barrage Stratego·Hanabi·dou dizhu의 각기 다른 기준 성적 | 규칙이 불명확한 현실 협상·전략 과제의 성능 |
| 비용 | 보고된 Stratego 훈련 계산비와 빠른 시뮬레이터 | 모든 환경의 개발·운영·전력 총비용 |
| 코드·기록 | 공식 코드와 20판 대국 기록 공개 | 독립 연구자가 모든 결과를 재현했다는 사실 |
#게임 바깥으로 옮길 때 가장 큰 조건
자기 대국은 규칙과 점수를 분명히 정의하고, 빠르게 복제 가능한 시뮬레이터가 있을 때 강하다. 현실의 투자·외교·의료·로봇 협업에서는 숨겨진 상태뿐 아니라 규칙 자체가 바뀌고, 잘못된 행동의 대가를 수백만 번 시험할 수 없다. 상대도 고정된 프로그램이 아니며, 성과 지표를 잘못 정하면 엉뚱한 전략을 학습할 수 있다. 따라서 Ataraxos가 보여 준 것은 “숨은 정보가 큰 게임에서도 자기 대국과 탐색이 작동할 수 있다”는 설계 가능성이지, 현장의 모든 불확실성을 해결한 범용 의사결정 엔진이 아니다.[1]
독자는 세 가지를 기억하면 된다. Figure 2는 무엇이 숨겨져 있는지, Figure 3은 그 불확실성 아래 한 판에서 전망이 어떻게 바뀌는지, 15·1·4 기록은 정해진 평가에서 실제로 얻은 결과가 무엇인지를 보여 준다. 방법의 새로움과 결과의 범위를 나누면 “슈퍼휴먼 AI”라는 큰 제목도 정확하게 읽을 수 있다.
#출처·그림 권리
[1] Samuel Sokota et al., “Scalable decision-making for games of imperfect information,” Nature 658, 55–59, 2026-09-30, DOI 10.1038/s41586-026-11036-y. 원문 Overview·Evaluation·Figures 2·3·Methods와 CC BY 4.0 권리 확인: 2026-10-01.[2] Ataraxos 연구팀 공식 프로젝트 사이트. 20판 기록의 원자료 연결 지점이다. 구현 코드는 논문 Code availability의 공식 GitHub 조직을 참고한다.
그림 2장은 논문의 원본 Figure 2·3을 패널·축·색 변경 없이 사용했다. 논문은 CC BY 4.0이며 해당 그림 캡션에 별도 제3자 권리 표시가 없음을 확인했다. 각 그림 아래 저자·논문·라이선스·변경 여부를 명시했다.