먼저 쉬운 답부터. 사진 파일의 구석에 이름을 적는 대신, AI가 만든 단백질 자체에 나중에 검사할 수 있는 출처 신호를 남기는 연구다. 다만 여기에는 서로 다른 두 물건이 있다. 서열 워터마크는 실제 합성할 수 있는 아미노산 배열에 들어가고, 구조 워터마크는 AlphaFold 3가 예측한 디지털 3차원 좌표에 들어간다. 연구진은 첫 번째가 일부 결합 단백질의 실험실 기능을 해치지 않았고, 두 번째가 예측 정확도를 크게 낮추지 않았다고 보고했다. 모든 AI 단백질을 알아보는 범용 감별기가 만들어졌다는 뜻은 아니다.[1]
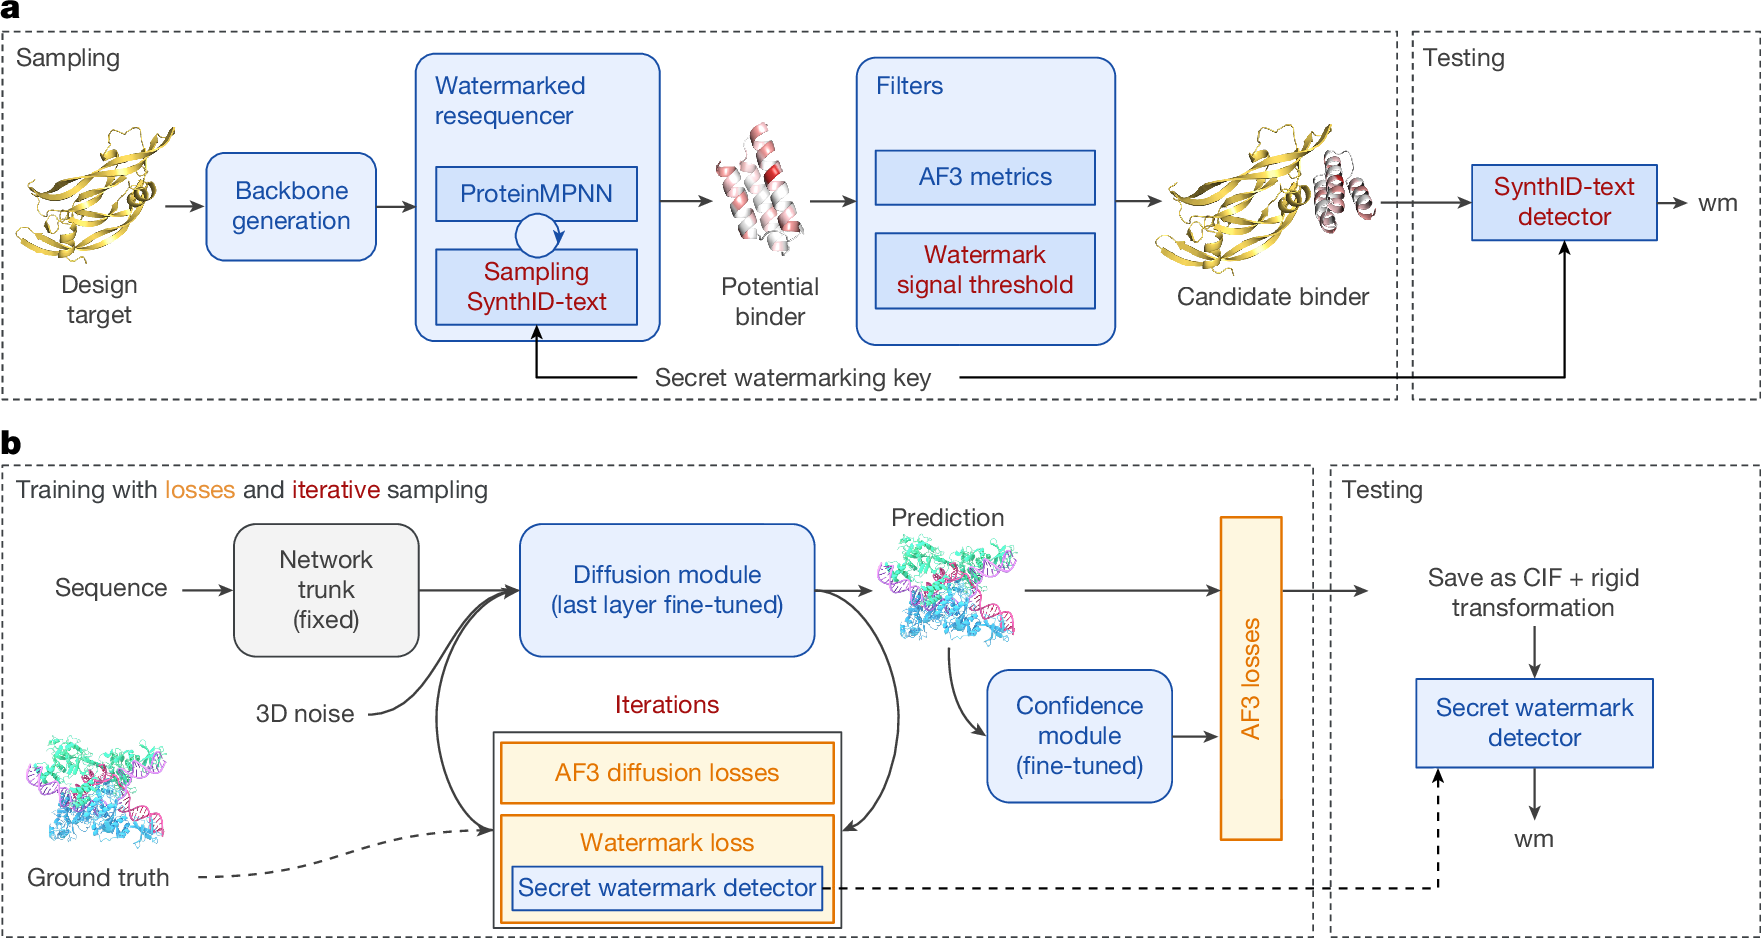
#원본 Figure 1 읽기: 위와 아래는 같은 워터마크가 아니다
위쪽 a에서 왼쪽의 단백질 뼈대(backbone)는 출발 모양이다. ProteinMPNN이 그 위에 놓일 아미노산 순서를 고를 때 비밀 키를 사용해 선택 경향에 작은 신호를 섞는다. 생성된 후보는 AlphaFold 3의 예측 지표와 워터마크 검출 임계값을 모두 통과해야 오른쪽의 결합 후보로 남는다. 이 그림은 단백질 합성까지 전부 자동으로 검증했다는 사진이 아니라 설계·선별 절차다.[1]
아래 b는 별도 연구다. 구조 예측 모델의 diffusion 부분을 다시 학습시켜, 출력되는 원자 좌표에 검출 가능한 흔적을 남긴다. 오른쪽의 CIF 파일은 예측 결과를 저장하는 파일 형식이다. 구조 워터마크가 담긴 것은 예측 좌표이지 실험실에서 만든 단백질 분자에 새 원자가 붙은 것이 아니다. 두 접근의 장점과 깨지는 방식도 다르다.[1]
처음 읽는 분 단백질과 워터마크를 처음 본다면 그림으로 보기
단백질은 여러 종류의 아미노산이 순서대로 연결된 긴 사슬이다. 글자의 순서처럼 배열을 적은 것이 서열(sequence)이고, 그 사슬이 접혀 실제로 공간에서 차지하는 모양이 구조(structure)다. 같은 서열의 구조는 환경과 측정법에 따라 다르게 관찰될 수 있으며, 계산 모델의 구조는 어디까지나 예측이다.
binder(결합 단백질)는 특정 표적에 달라붙도록 설계·선별된 단백질이다. 이 논문은 VEGF-A, PD-L1, SARS-CoV-2의 receptor-binding domain(RBD)이라는 세 표적의 binder를 시험했다. 이름을 외울 필요는 없다. 서로 다른 세 표적에서 “표시를 넣은 뒤에도 붙는가?”를 본 실험이라고 읽으면 된다.[1]
워터마크는 사람 눈에 보이는 로고가 아니다. 생성 과정에만 아는 비밀 키나 학습된 검출기로 통계적 흔적을 확인한다. 양성 결과는 “이 방식으로 생성됐을 가능성이 높다”는 판정이지, 그 단백질의 제작자·목적·안전성을 증명하는 신분증은 아니다.
#왜 출처 표시가 필요한가
AI가 단백질 서열과 구조를 점점 더 쉽게 만든다. 디지털 파일이라면 누가 만들었는지 메타데이터를 붙일 수 있지만, 복사하거나 파일 형식을 바꾸면 그 꼬리표가 떨어질 수 있다. 생물학에서는 문제를 두 층으로 나눠야 한다. 실제 합성된 단백질의 서열은 제작 이력을 파일 밖에서도 추적하고 싶은 대상이고, 공유되는 예측 구조 파일은 사람의 실험값으로 잘못 취급되지 않도록 출처가 중요하다. 워터마크는 이 둘을 위한 보조 신호다. 기존의 서명·기록·검증을 대체하는 단독 안전장치가 아니다.[1][2]
이번 Nature 논문은 서열을 생성하는 단계의 SynthIDBio-sequence와 구조를 예측하는 단계의 SynthIDBio-structure를 함께 제시했다. 두 기법을 묶어 부르는 이름이 SynthID Bio다. 서열 쪽은 ProteinMPNN을 이용한 기존 단백질 설계 흐름에 워터마크를 얹었고, 구조 쪽은 AlphaFold 3의 일부 모델 가중치를 미세 조정했다. 저자들은 이를 기술적 개념 증명(proof of concept)으로 표현한다. 출처 확인 서비스가 산업 전반에 배포됐거나 악의적 변형을 모두 막았다는 결과는 아니다.[1]
#실험실에서 무엇을 직접 확인했나
서열이 조금 바뀌어도 결합 단백질이 표적을 붙잡는 힘이 유지되는지가 핵심이다. 연구진은 이전 AlphaProteo 연구에서 이미 결합력이 확인된 뼈대들을 출발점으로 삼고, 각 뼈대를 표시 없는 방식과 표시 있는 방식으로 다시 서열화했다. 이는 아무 출발 정보 없이 모든 단백질을 처음부터 만든 시험이 아니다. 세 표적에 대해 합성한 후보의 결합 친화도와 일정 기준을 넘긴 hit rate를 비교했다.[1]
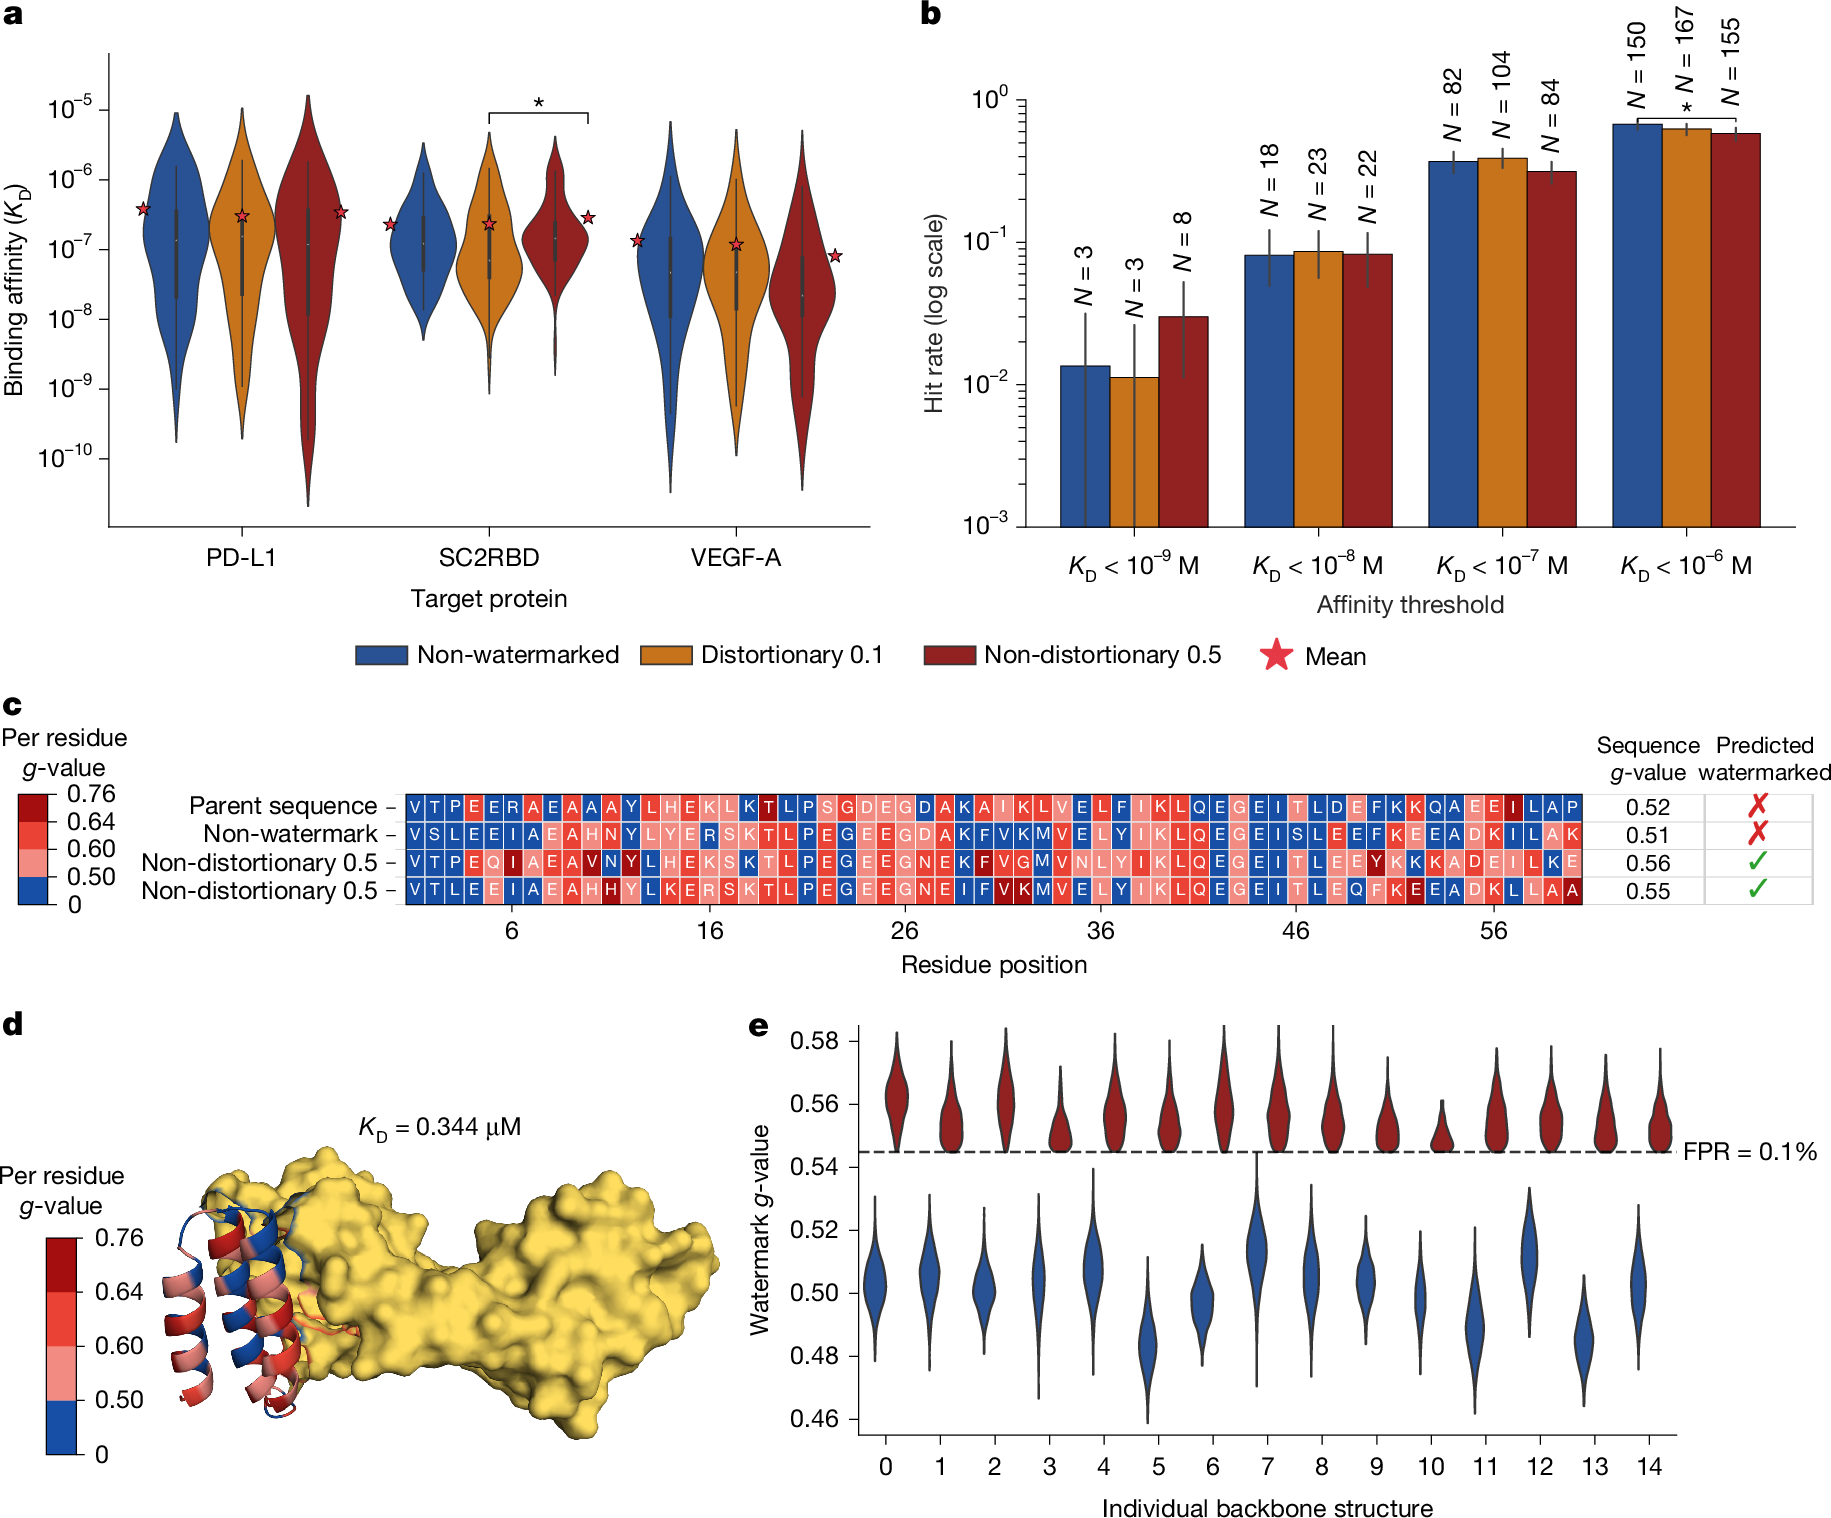
#원본 Figure 2 읽기: a의 세로축부터 보자
a의 세로축은 결합의 해리상수 KD이고 로그 눈금이다. 일반적으로 값이 작을수록 더 강하게 결합한다. 파랑은 표시하지 않은 후보, 주황·진빨강은 서로 다른 워터마크 설정이다. 세 표적의 분포가 크게 겹친다는 것이 핵심이다. 그러나 SC2RBD에서 두 워터마크 설정 사이 유의한 차이가 있고, b의 10⁻⁶ M 기준에서는 일부 hit rate 차이도 있다. 따라서 “모든 조건에서 완전히 동일했다”는 요약은 논문의 세부 결과를 지운다.[1]
b의 가로축은 “얼마나 강하게 붙어야 성공으로 셀까”의 기준이다. 10⁻⁹ M는 10⁻⁶ M보다 훨씬 엄격하다. 각 막대 위의 N은 그 기준에서 세어진 사례 수이며 전체 설계 후보 수와 같지 않다. c·d는 색으로 표시 신호가 한 글자나 단백질 표면의 한 점에만 몰리지 않음을 보여 준다. e는 출발 뼈대마다 신호 세기가 달라, 추가 임계값을 통과한 후보만 남겼다는 이유를 보여 준다. 그림 d의 3D 모양은 예측 구조 시각화이지 실제 분자의 현미경 사진이 아니다.[1]
Kᵈ가 10배 작으면 무엇이 달라질까? 기호·연산·계산 과정 펼치기
이 식은 이번 연구가 새로 발견한 법칙이 아니라 결합 평형을 이해하기 위한 일반식이다. [P]는 혼자 있는 결합 단백질, [L]은 표적, [PL]은 붙은 복합체의 농도다. 농도의 단위를 몰농도(M)로 맞추면 KD도 M다. 아주 단순한 1:1 평형에서는 10⁻⁸ M(10 nM)이 10⁻⁷ M(100 nM)보다 강한 결합을 뜻한다. 실제 센서의 측정 곡선·오차·결합 형태를 확인해야 하며, Figure 2의 분포를 이 두 숫자로 바꿔 계산한 것은 아니다.[1]
#검출률 100%의 분모는 ‘선별된 후보’다
워터마크 성능에는 거짓 양성률(FPR)과 참 양성률(TPR)이 있다. FPR은 표시 없는 것을 표시 있다고 잘못 말하는 비율, TPR은 표시 있는 것을 제대로 찾는 비율이다. 논문은 FPR 0.1%가 되도록 기준을 정하고, 그 기준보다 워터마크 점수가 높은 후보만 통과시키는 필터를 썼다. 그래서 실험 대상으로 선별된 디자인에서는 TPR 100%가 되도록 했다. 필터를 걸기 전 만들어진 모든 서열의 검출률이 100%라는 뜻이 아니다. Figure 3은 필터를 강화할수록 통과율이 줄어 더 많은 후보를 만들어야 한다는 교환관계를 보여 준다.[1]
가상의 숫자로 보자. 표시 없는 10,000개를 검사할 때 FPR 0.1%라면 평균적으로 약 10개가 잘못 양성으로 나올 수 있다. 단, 실제 결과의 개수는 검사 집단과 독립성·임계값 보정에 따라 달라진다. 표시 양성 = AI가 만들었다는 확정 판결로 사용해서는 안 된다. 더구나 이 검출기는 특정 생성·표시 체계를 알아보는 것이지, 세상의 모든 AI 설계 단백질을 찾아내는 검사기가 아니다.
구조 워터마크의 다른 수치도 분모를 붙여야 한다. AlphaFold 3 평가 집합에서 FPR 0.1%로 맞췄을 때 세 구조 모델의 TPR은 99.8%를 넘었다. 가장 약한 변형 설정인 s=0.001에서는 LDDT와 template modelling score가 기준 모델보다 낮아지지 않았다고 보고했다. 이 지표는 예측 구조의 정확도를 평가하며 실제 단백질의 치료 효과를 뜻하지 않는다. 반대로 구조 파일을 분자 역학적으로 완화(relaxation)하면 표지가 잘 유지되지 않는 한계도 저자들이 명시했다.[1]
| 질문 | 논문이 보여 준 것 | 아직 입증하지 않은 것 |
|---|---|---|
| 실제 분자 기능 | 출발 뼈대가 알려진 세 표적 binder의 실험실 결합 시험 | 모든 종류의 단백질·생체 기능·임상 효능 |
| 서열 검출 | 설정된 FPR와 검출 필터를 통과한 설계 후보 | 재서열화에도 사라지지 않는 영구 추적 |
| 구조 검출 | AlphaFold 3 평가 집합의 디지털 좌표와 정확도 지표 | 합성 단백질의 물리적 3D 구조에 직접 새기는 표지 |
| 정보량 | 표지의 존재를 판정하는 zero-bit 방식 | 제작자별 식별·사용 이력·목적 추적 |
#보안·출처 추적에서 남는 빈칸
저자들은 ProteinMPNN으로 다시 서열을 만들면 서열 워터마크가 제거될 수 있다고 직접 시험했다. 그 과정이 binder의 예상 성공률을 낮출 수 있다는 평가도 제시하지만, 제거가 불가능하다고 말하지 않는다. 구조 쪽은 회전·약한 잡음 등에는 견디지만 relaxation에는 약하다. 표지가 한 종류인지 여부를 알려 주는 zero-bit 형식이라 서로 다른 실험실이나 사용자 이름을 넣을 수도 없다. 연구진은 생물학적 안전과 연구 무결성에 쓸 가능성을 제시하면서도, 실제 운영에는 기술 개선과 업계 협력이 필요하다고 적었다.[1]
이 논문의 직접 관찰은 특정 설계 파이프라인·평가 집합·세 표적의 결합 실험이다. “워터마크가 있으면 안전하다”, “표지가 없으면 사람이 만든 단백질이다”, “AI 단백질은 앞으로 모두 추적된다”는 문장은 이 데이터로 성립하지 않는다. 이번 결과의 뉴스 가치는 기능을 유지하면서 출처 신호를 넣을 수 있다는 가능성을 실험실 시험까지 연결했다는 데 있다.
재현을 위한 공개 범위도 구분한다. 논문은 서열 워터마크 코드와 in-vitro 검증 자료를 공개했고, 권장 설정인 s=0.001의 구조 모델 가중치 접근 안내도 같은 저장소에 있다고 적었다. 이것이 비밀 검출기나 모든 배포용 서비스를 무제한 공개했다는 뜻은 아니다. 또한 연구는 Alphabet의 지원을 받았고, 저자 전원이 Alphabet 직원이며 주식을 보유할 수 있다고 이해관계를 공개했다. 공개 코드·동료평가·이해관계 표시는 함께 읽을 정보이며, 독립 실험실의 재현은 다음 단계다.[1][3]
#출처·그림 권리
[1] David Stutz et al., “Function-preserving watermarking of AI-generated proteins,” Nature, 2026-09-30, DOI 10.1038/s41586-026-10965-y. 원문 Results·Methods·Figures 1–4와 Rights and permissions 확인: 2026-10-01. [2] Google DeepMind, “Introducing SynthID Bio,” 2026-09-30. 연구팀의 공식 설명이다. 수치의 기준은 학술 논문 [1]로 두었다. [3] Google DeepMind, SynthID Bio 공식 코드·검증 자료 저장소. 공개 범위는 논문 [1]의 Data/Code availability를 기준으로 설명했다.그림 2장은 논문 Figure 1·2의 원본 PNG를 패널·축·색을 바꾸지 않고 사용했다. 논문 본문은 CC BY 4.0이며 해당 두 그림 캡션에서 별도 제3자 권리 표시를 확인하지 못했다. 그림의 저작자·논문·라이선스 링크와 변경 여부는 각 그림 아래에 명시했다.