후보 상태:
BACKLOG_CANDIDATE· 2026-10-06 Top 3
#한 문장 결론
포유류 세포에 새로운 대사 기능을 넣으려면 유전자 하나만 고르는 것으로 끝나지 않는다. 어떤 유전자를 얼마나 만들고 세포 안 어디에서 일하게 할지가 함께 맞아야 한다. 샷건 유전공학(Shotgun Genetic Engineering, SGE)은 완성된 긴 설계도를 하나씩 시험하는 대신, 식별표를 붙인 작은 유전자 단위를 조합해 많은 세포에서 병렬 선별한다. 이번 결과는 세포주에서 경로를 찾은 개념증명이지 환자 치료나 산업 생산 공정의 완성이 아니다.
#기존 방식과 무엇이 다른가
대사공학(metabolic engineering)은 세포가 물질을 만들고 바꾸는 반응 경로를 설계하는 일이다. 반응은 여러 효소가 이어서 맡는다. 앞단 효소만 많고 뒷단이 부족하면 중간 물질이 쌓일 수 있고, 필요한 효소가 서로 다른 세포 구획에 있으면 같은 유전자 목록으로도 결과가 달라질 수 있다. 그래서 유전자의 종류, 발현을 조절하는 프로모터, 세포에 들어간 사본 수, 효소 사이 상대량, 세포 안 위치가 함께 설계 변수다.
논문에서 전사 단위(transcription unit, TU)는 단백질을 만드는 유전자와 그 발현·위치를 조절하는 요소를 묶은 작은 설계 단위다. 바코드는 그 단위를 나중에 식별하기 위한 짧은 DNA 표지다. 여러 단위를 섞은 라이브러리를 사용하면 세포마다 서로 다른 조합을 갖게 된다. 연구진은 원하는 기능을 보인 세포를 선별한 뒤 바코드를 읽어 어떤 조합이 있었는지 거슬러 올라간다. 한 세포에 여러 단위가 들어가도록 한다는 설계 원리와, 모든 세포에 같은 수·같은 조합이 들어간다는 주장은 다르다.
#선행 연구의 실제 사진으로 비교 기준 이해하기
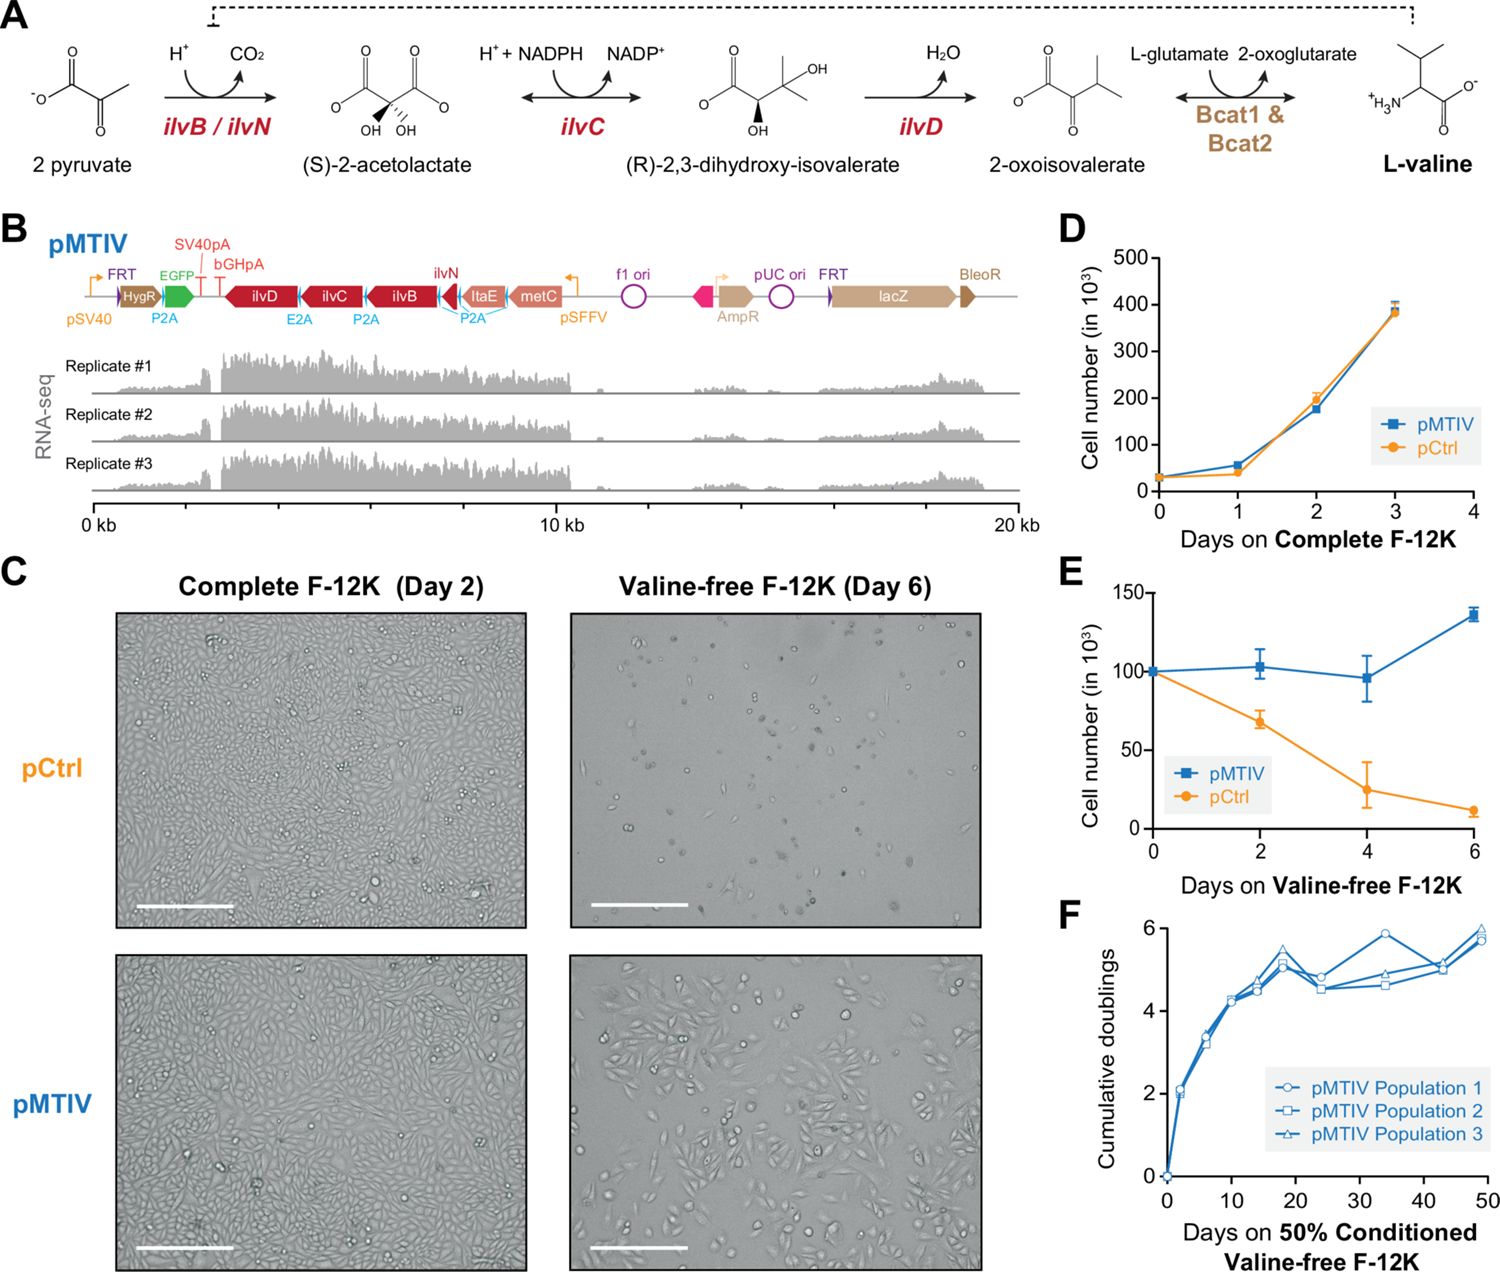
2022년 선행 연구는 미리 설계한 경로를 넣은 CHO-K1 세포가 발린이 없는 조건에서도 기능하는지 확인했다. 아래는 그 선행 연구의 원본 Figure 2다. 이번 2026년 SGE 실험의 사진이나 결과는 아니다.
 그림의 글자가 작다면 원본 크게 보기 · 새 탭
먼저 C의 두 열을 읽는다. 왼쪽은 영양분을 갖춘 배지의 2일째, 오른쪽은 발린 없는 배지의 6일째 사진이다. 위쪽 pCtrl은 대조군, 아래쪽 pMTIV는 연구진이 설계한 경로를 가진 세포다. 촬영 날짜가 다르므로 왼쪽과 오른쪽의 세포 수만 바로 빼서 성장 속도를 계산하면 안 된다. 같은 열 안에서 대조군과 경로 도입군을 비교하고, 시간에 따른 세포 수는 D·E의 성장 곡선으로 확인한다.
이 그림이 답하는 질문은 ‘도입한 경로가 기능하는가’다. SGE는 여기서 더 나아가, 어떤 유전자 구성·양·세포 안 위치의 조합을 시험할지 넓은 조합 공간을 탐색한다. 두 연구가 사용하는 세포·배지·분석 조건까지 같다고 가정해서는 안 된다.
#가장 강한 증거
- 많은 세포에서 조합을 병렬 탐색했고, CHO의 서로 다른 조합 수는 모의 계산에서 약 156만 개로 추정됐다. 모든 조합을 개별 측정한 수가 아니다.
- 선별한 CHO 두 클론의 발린 없는 조건에서 세포 수가 두 배가 되는 시간은 1.14일·1.05일이었다. 선행 합리적 설계 pMTIV의 3.77일과 비교한 값이며, 이후 한 구성물로 재조립한 설계의 1.25일과도 구분한다.
- CHO 세포에서 여섯 유전자로 이소류신을 외부 공급 없이 만드는 기능을 찾음
- 사람 T세포 유래 Jurkat 세포주에서 발린 없는 조건의 성장 시연
- 기능을 보인 설계에 23–52 kb 규모의 삽입 합성 DNA가 포함됨. kb는 DNA 길이를 나타내는 킬로베이스 단위다.
- 기능 경로에서 효소가 세포 안 미토콘드리아에 위치하는 구성이 반복적으로 선택됨
#조합의 수와 실제로 확인한 해법의 수
설계 선택지가 늘면 가능한 조합도 빠르게 늘어난다. 하지만 세포에 전달되는 단위의 분포가 균등하지 않거나 같은 단위가 반복해 들어가면 이론적으로 가능한 조합과 실제 세포에 만들어진 조합은 달라진다. 논문은 측정한 라이브러리 분포를 사용한 몬테카를로 시뮬레이션으로 이 범위를 추정한다. 몬테카를로는 정해진 확률 규칙에 따라 가상의 전달을 여러 번 뽑아 결과의 분포를 계산하는 방법이다.
이 모델은 세포별 삽입 수에 포아송 분포를 가정한다. 한 번 정한 평균 주변에서 실제 세포의 삽입 수가 달라질 수 있음을 나타내는 모형이다. 따라서 ‘수백만 조합’은 모든 세포의 모든 삽입을 직접 읽어 빠짐없이 확인했다는 뜻이 아니다. 관측한 분포, 확률 모형, 선별해 실제로 읽은 클론의 결과를 구분해야 한다. 모델의 가정이 전달 과정과 다르면 조합 공간의 추정도 달라질 수 있다.
#기능 점수는 무엇을 나눈 값인가
발린은 단백질을 만드는 아미노산 중 하나다. 이 연구의 질문은 세포가 외부에서 받던 발린을 스스로 만드는 경로를 가질 수 있느냐는 것이다. ‘발린 없이도 기능한다’는 평가를 위해 저자들은 같은 클론의 발린 없는 배지와 발린이 있는 배지에서 대사 활성 신호를 비교했다. 발린 점수(Val score)는 앞 조건의 신호를 뒤 조건의 신호로 나눈 상대값이다. 서로 다른 클론의 일반적인 성장 속도나 초기 세포 수 차이를 줄여 읽으려는 비교다.
이 신호는 살아 있는 세포의 환원 활성에 반응하는 검사에서 나온다. 세포 수, 실제 증식 속도, 발린 합성량 그 자체와 동일한 물리량은 아니다. 따라서 ‘점수가 두 배이니 발린을 두 배 만든다’고 바꿔 쓰면 안 된다. 분모의 신호가 너무 작으면 비율 해석도 불안정해지므로 대조 조건과 반복 측정을 함께 봐야 한다.
또 선택 기준은 목적에 따라 다르다. 원문의 표현형 선별 기준, 강한 기능군을 나누는 기준, 기계학습의 이진 정답을 만드는 기준을 하나로 합치지 않는다. 아래 분류기에서는 Val score가 0.23을 넘는지를 정답 표지로 사용했다. 이 경계는 사람 치료에 적용하는 임상 기준이 아니다.
#바코드는 세포 안의 무엇을 알려 주나
바코드는 어느 유전자 단위가 들어갔는지 추적하는 짧은 식별표다. 바코드 읽기 비율이 높다고 효소가 그 비율만큼 많이 만들어지거나, 대사 반응 속도가 그만큼 높다는 뜻은 아니다. 논문은 읽기 자료의 모호한 대응과 바코드 바뀜 가능성을 별도로 다룬다. 따라서 유전자 조합을 추적한 결과와 실제 기능 측정을 구분해야 한다.
보충자료는 선택한 CHO 클론 네 개를 긴 DNA 읽기로 점검했다. 예상한 조절부·단백질 암호화 부분의 바코드에 대응한 읽기는 각각 95.1%, 93.7%였다. 이 값의 분모는 분석한 DNA 읽기이며, 전체 세포에서 유전자가 정확히 들어간 성공률이나 기능 성공률이 아니다. 선택한 네 클론의 점검을 라이브러리 전체에 대한 오류 없음으로 확대하지 않는 것이 중요하다. [보충자료 Note 3, PDF 4쪽]
실제 RNA 양을 읽는 시험에도 별도의 측정 한계가 있다. 이 연구의 RNA-seq은 poly(A) 꼬리가 있는 RNA를 주로 모으지만, 도입한 SGE 유전자의 전사체는 그 꼬리가 없도록 설계됐다. 따라서 도입 유전자의 읽기 수가 적어도 곧바로 발현이 없다고 단정할 수 없다. 바코드는 들어간 설계의 흔적을, RNA 검사는 만들어진 전사체의 일부를, 성장 시험은 최종 기능을 본다. 세 측정이 서로를 그대로 대신하지 않는다. [원문 Methods, RNA-seq]
또 살아남은 여러 세포 집단이 모두 독립적인 설계에서 출발했다고 볼 수 없다. 같은 조상 세포에서 갈라진 집단이면 비슷한 조합이 반복될 수 있다. 저자들은 바코드 양상이 매우 비슷한 집단을 연결망으로 묶어 이런 형제 클론을 점검했다. 수백만 조합을 탐색했다는 표현도 모든 이론적 조합을 빠짐없이 시험했다는 의미는 아니다.
#기계학습은 미래 계획만이 아니다
연구진은 클론 119개에서 전사 단위 40종의 상대 읽기 비율을 입력으로 사용했다. 각 단위의 읽기 수를 같은 클론의 전체 바코드 읽기 수로 나누므로, 읽기 수가 많은 시료와 적은 시료를 총량 그대로 비교하는 것은 아니다. 정답 표지는 Val score 0.23 초과 여부이며, 여러 결정나무의 판단을 합치는 랜덤 포레스트 분류기로 이를 예측했다. 네 묶음으로 나누어 일부를 남겨 검증하는 교차검증에서 119개 중 112개를 맞혔다고 보고한다. 비슷한 형제 클론의 중복을 제거한 분석에서는 59개 중 53개를 맞혔다. 두 분석은 분모가 다르므로 같은 결과로 섞지 않는다.
이 결과는 관측한 조합과 기능 사이의 관계를 분류할 수 있다는 증거다. 아직 만들어 보지 않은 최적 설계를 생성하거나, 환자에게 쓸 세포의 안전성과 효과를 예측하는 검증은 아니다.
#확인 질문
비슷한 바코드 조합을 가진 클론이 여러 개 발견되면 서로 다른 해법을 많이 찾았다고 바로 셀 수 있을까? 아니다. 같은 조상에서 나온 집단의 반복일 수 있다. 설계 다양성과 표본 독립성을 따로 확인해야 한다.
#유사한 클론을 어떻게 묶었나
저자들은 바코드 양상의 피어슨 상관계수가 0.9 이상인 두 클론을 연결했다. 극도로 드문 신호 때문에 우연한 일치를 크게 읽지 않도록 각 시료에 0이 아닌 바코드 특징이 적어도 두 개 있는 경우만 비교에 남겼다. 이렇게 만든 무방향 연결망에서 서로 연결된 집단을 형제 클론 후보로 묶었다.
연결망에서 A와 B가 이어지고 B와 C가 이어지면 세 클론이 한 집단에 들어갈 수 있다. 이것은 모든 쌍의 직접 상관이 기준을 넘었다는 뜻과 다르다. 또한 바코드 유사성으로 추정한 계보이지 모든 세포의 분열 이력을 직접 촬영해 확인한 결과는 아니다. 중복 제거 뒤의 59개 분석을 원래의 119개 분석과 따로 읽어야 하는 이유가 여기에 있다.
#같은 세포주에서도 성공한 기능과 얻지 못한 기능이 있다
Jurkat은 사람 T세포에서 유래한 세포주이지 환자에게서 채취한 일차 T세포가 아니다. 발린을 적게 제공한 조건에서 선별한 클론 119개 가운데 85개가 연구의 Val score 기준을 넘었다. 이는 선별 뒤 따로 분리한 클론 중 비율이며, 처음 실험에 들어간 모든 세포의 성공률은 아니다. 더 자세히 관찰한 두 클론은 발린 없는 조건에서 각각 약 2.02일·1.87일에 세포 수가 두 배가 됐다. [원문 Engineering valine prototrophic human T cells; Fig. 5]
반면 이소류신이 적은 조건에서는 32일간 관찰해도 실험 집단이 대조 집단보다 우세해지지 않았다. 연구진은 이번 Jurkat 선별에서 이소류신 자급 표현형을 얻지 못했다고 보고한다. CHO에서 여섯 유전자 경로를 찾았다는 결과를 Jurkat에도 그대로 옮길 수 없는 이유다. 다만 이는 시험한 범위에서의 음성 결과이지 모든 설계에서 영원히 불가능하다는 증명은 아니다. [원문 같은 절; Extended Data Fig. 8c]
#가장 큰 한계
현재 증거는 CHO와 Jurkat 세포주에서의 개념증명이다. 유전자 단위를 많이 삽입한 뒤 기능이 좋은 세포를 찾았다는 사실과, 치료용 세포를 안전하고 일정하게 제조할 수 있다는 주장은 다르다. 사본 수를 얼마나 잘 제어하는지, 삽입 위치가 세포에 위해를 주는지, 특정 계보의 세포만 과도하게 늘어나는지, 장기간 기능이 유지되는지를 별도로 검증해야 한다.
또 성장 여부처럼 뚜렷하게 드러나는 표현형에는 선별이 유리할 수 있다. 표현형은 세포에서 실제로 관찰하는 성질이다. 그러나 미세한 분비량 차이·복잡한 기능·안전성처럼 살아남았는지만으로 판단하기 어려운 성질에서도 같은 규모의 탐색이 효과적인지는 확인되지 않았다.
저자들은 관련 특허 출원과 여러 바이오기업의 창업자·자문 관계를 공개했다.
#왜 보존할 가치가 있나
SGE의 의미는 포유류 세포의 대사 설계를 소수의 사전 설계만으로 탐색하는 대신, 다양한 조합을 만들고 실제 기능에 따라 선별한 자료로 넓힐 가능성에 있다. 환자에게서 얻은 일차세포, 삽입 위치·사본 수의 제어, 치료와 관련된 기능에서도 재현돼야 활용 범위를 판단할 수 있다. 조합 자료가 많다는 사실만으로 미래 세포 설계를 정확히 예측하는 AI가 완성된 것은 아니다.
#재검토 트리거
- 사람 일차세포에서의 독립 검증
- 삽입 위치·사본 수를 더 잘 제어하는 방식에서도 기능 유지
- 치료와 관련된 세포 기능과 안전성의 검증
- 더 작은 유전 구성으로 다시 설계한 뒤에도 기능 유지
- 이미 관찰한 자료를 맞히는 것을 넘어 새로운 조합을 예측하는 모형의 검증
#출처
- Trolle, J. et al., “Highly multiplexed mammalian metabolic engineering with a shotgun approach,” Nature Biotechnology, 6 October 2026. DOI: 10.1038/s41587-026-03318-7.
원문·그림·열람 범위
공개 본문의 도입부와 분류기 결과, 바코드 분석·형제 클론 분석 Methods, 데이터·코드 공개 범위 및 권리 조항을 확인한 비공개 교정본이다. 나머지 본문·보충자료·코드는 전수 검토하지 않았다. 2026년 논문의 Figure 1에는 BioRender 크레딧이 있고 라이선스는 CC BY-NC-ND 4.0이라 복제하지 않았다. 삽입한 그림은 별도의 2022년 선행 논문 Figure 2이며, 해당 논문의 CC BY 4.0과 크레딧을 확인한 원본이다. 원본 JPG를 자르거나 다시 그리지 않았다.