BACKLOG_CANDIDATE · 기준일 2026-10-16 KST · Rank 3 · 91/100 · PEER_REVIEWED_FRONTIER. 이번 검토는 arXiv v2의 기준궤적·평가 지표·선별 결과와 Table 3을 대조했다. 전체 HTML·도판·데이터·SDK 실행 검수가 끝난 것은 아니다.
콘텐츠 식별·선정 기록
rank: 3contentId:frontier-2026-10-16-03-fomostatus:BACKLOG_CANDIDATEtitle: FoMo: A Multi-Season Dataset for Robot Navigation in Forêt MontmorencynormalizedTitle:fomo a multi season dataset for robot navigation in foret montmorencydate:2026-10-14venue: The International Journal of Robotics ResearchDOI:10.1177/02783649261491481arxivId:2603.08433officialUrl:https://fomo.norlab.ulaval.ca/evidenceGrade:PEER_REVIEWED_FRONTIERscore:91 = 17+13+24+18+10+9
#한 문장 결론
FoMo는 같은 숲길을 사계절 반복 주행한 10TB 초과 다중센서 자료로, 좋은 날의 SLAM 정확도보다 계절이 바뀐 뒤 다시 위치를 찾는 능력을 시험하게 한다.
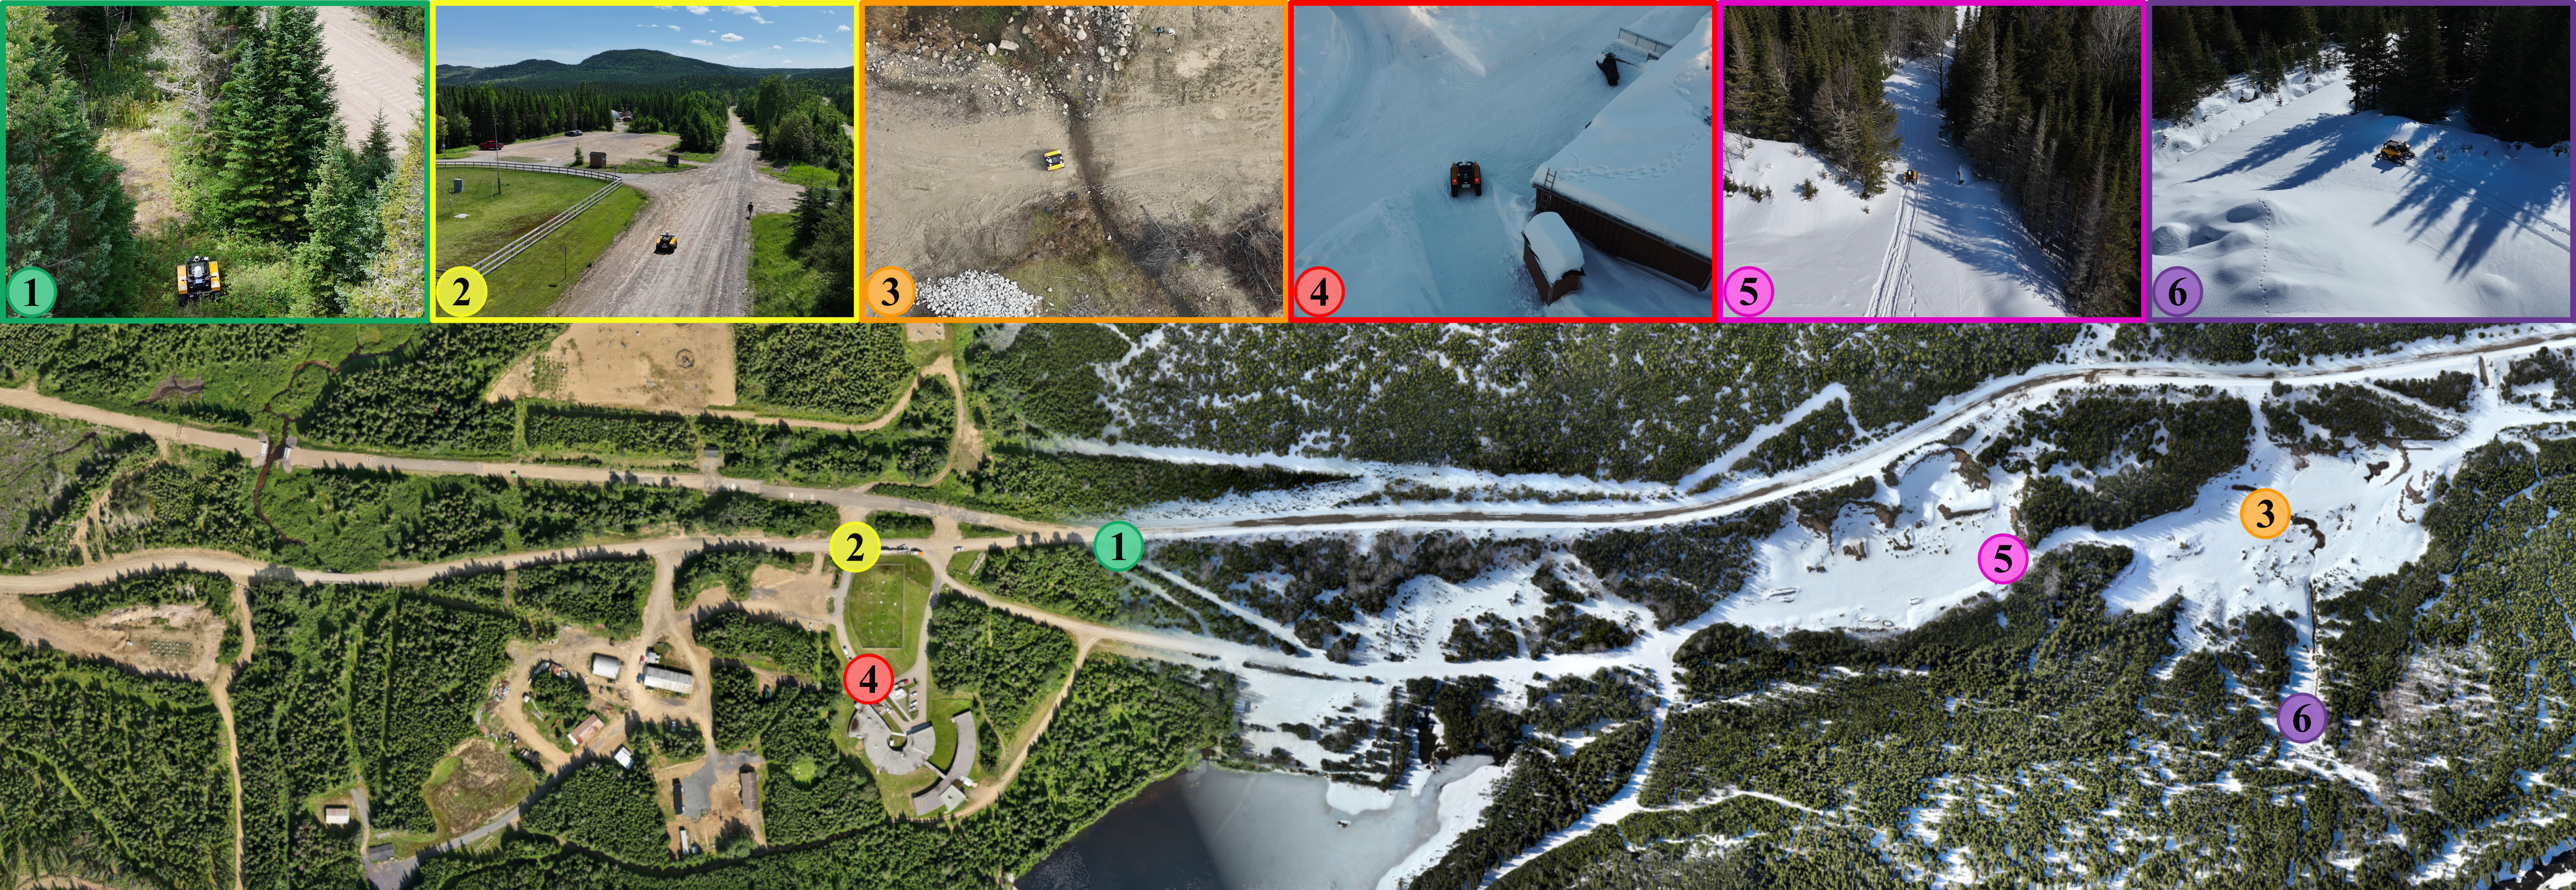 그림의 글자가 작다면 원본 크게 보기 · 새 탭
#지도 없이 움직임을 잇는 것과 옛 지도에서 위치를 찾는 것
오도메트리(odometry)는 센서의 연속 관측으로 ‘직전 위치에서 얼마나 움직였는가’를 누적한다. 조금씩 틀리면 오차도 쌓인다. 재위치추정(re-localization)은 예전에 만든 지도에서 지금 있는 곳을 다시 찾는 일이다. SLAM은 위치 추정과 지도 작성을 함께 수행하는 접근이다. 같은 숲이라도 눈과 잎이 바뀌면 이전에 기억한 특징을 찾기 어려워진다.
루프 폐쇄(loop closure)는 이미 지난 장소를 다시 알아보고 누적된 궤적을 고치는 과정이다. 따라서 최종 오차가 작아도 매 순간의 추정이 처음부터 정확했다고 단정할 수 없다. 이 데이터셋은 무엇을 입력으로 주었는지뿐 아니라 이런 수정 기능과 반환 궤적의 범위를 함께 비교하게 한다.
#중요성과 차이
도시 자율주행 데이터는 크지만 포장도로와 안정된 구조물이 많다. FoMo는 캐나다 침엽수림의 포장·비포장·무경로 구간, 1m가 넘는 적설, 성장한 식생, 급경사와 진동을 같은 여섯 경로에서 반복 기록했다. 두 lidar, FMCW radar, stereo·mono camera, 두 IMU와 세 GNSS 수신기의 기준궤적을 함께 제공한다.
#수치·비교조건
자료는 1년, 12회 deployment, 6개 경로, 총 64km 이상이며 10TB를 넘는다. 1월 29일 지도를 기준으로 다른 계절을 찾는 비교에서 lidar-inertial translation drift는 10월 14일에 46.5%였고, stereo-inertial SLAM은 같은 비교에서 0.9%였지만 9개 deployment 중 3개에서 완전한 궤적을 내지 못했다. radar-gyro 방식은 2D radar와 급회전 때문에 평균적으로 큰 오차를 보였다. 서로 다른 센서·실패율을 한 숫자로 합치면 안 된다.
이 이동 드리프트는 100·200·…·800m 길이의 여러 궤적 구간에서 상대 오차를 구해 평균한 지표다. 0.9%를 전체 주행 끝점의 오차나 모든 계절의 평균으로 해석하면 안 된다. Table 3의 별표는 기준궤적 시간의 90% 미만만 반환한 경우, N/A는 궤적이 너무 짧아 지표를 계산할 수 없는 경우다. stereo-inertial의 세 건은 부분 궤적 두 건과 N/A 한 건으로, 모두 같은 종류의 완전 실패였다는 뜻은 아니다. 숫자가 작아도 반환 범위가 짧다면 완주한 방법보다 안정적이라고 단정할 수 없다.
원문 부록은 10월 14일 열의 작은 시각 SLAM 오차에 반복된 루프 폐쇄가 기여했다고 설명한다. 반면 재위치추정에 실패한 뒤에는 오도메트리로 이어 가는 방식도 있다. 따라서 드리프트 표의 한 칸을 순수한 ‘계절을 넘어 옛 장소를 알아본 능력’의 점수로 읽으면 안 된다. 같은 수치 안에도 재위치추정과 누적 이동 추정의 기여가 섞일 수 있다.
#같은 시각의 관측인지도 확인해야 한다
여러 센서의 시계를 맞추는 일과, 실제 노출·측정 순간에 올바른 시각을 붙이는 일은 다르다. §5는 카메라 드라이버가 붙인 시각의 지연을 별도로 추정한다. 로봇이 움직이는 동안 서로 다른 순간의 관측을 묶으면 공간적으로도 어긋날 수 있다.
원문 식 (1)은 지연 추정식이다.
원문 식 (1): 드라이버 시각은 얼마나 늦는가? 식이 길면 좌우로 이동해 읽으세요. 키보드는 수식에 초점을 둔 뒤 방향키를 사용합니다. 기호·연산·계산 과정 펼치기
여기서 모든 시간은 같은 초 단위로 맞춘다. t_ROS는 드라이버 시각, t_QR는 촬영한 코드에 담긴 절대 시각, t_gen은 코드 생성에 걸린 시간이다. t_delay는 그 차이로 추정한 지연이다. 즉 생성 시간을 포함한 기준 시각을 드라이버 시각에서 뺀다. 이것은 지연을 측정하는 방법이지 모든 센서를 지연 없이 만든다는 보장이 아니다.
논문은 15분 측정에서 평균 51.48ms, 표준편차 8.78ms를 보고한다. 평균 보정값 하나가 매 프레임의 정확한 지연과 같지는 않다. 관성측정장치(IMU)는 각속도와 가속도를 측정한다. 이 장치도 USB로 받은 값을 해석할 때 시각을 붙이므로 카메라와는 별도로 지연을 추정한다.
원문 식 (2): 카메라를 기준으로 IMU 지연 추정하기 식이 길면 좌우로 이동해 읽으세요. 키보드는 수식에 초점을 둔 뒤 방향키를 사용합니다. 기호·연산·계산 과정 펼치기
세 기호 모두 시간이다. t_imu는 추정한 IMU 지연, 위에 막대가 있는 t_delay는 앞서 구한 카메라의 평균 지연, t_shift는 Kalibr 보정 도구로 추정한 상대 시간차다. 서로 같은 단위로 바꾼 뒤 뺀다. 원문 §5의 결과는 Vectornav 56.09ms, Xsens 60.23ms다. 이 식만 보고 데이터 파일의 시각에 무조건 같은 값을 더하거나 빼면 안 된다. 실제 적용에는 보정 파일의 상대 시간차 부호 규약도 확인해야 한다.
Kalibr의 공식 YAML 문서는 timeshift_cam_imu를 초 단위로 정의하고, 카메라 시각에 shift를 더해 IMU 시각으로 옮긴다고 설명한다. 이 문서의 IMU 시각은 관측에 붙은 타임스탬프인 반면, 위 FoMo 식의 t_imu는 추정 지연이다. 같은 이름처럼 보여도 물리적 의미가 다르다. 이 규약 확인만으로 FoMo의 모든 파일에 보정이 이미 적용됐는지, SDK가 어느 방향으로 보정하는지까지 검증한 것은 아니다. 실제 파일·처리 코드의 적용 여부는 별도로 대조해야 한다.
확인 질문: 컴퓨터 시계를 동기화했으니 카메라 측정 시각도 완벽할까? 아니다. 드라이버가 언제 시각을 붙이는지와 지연 변동까지 확인해야 한다.
#한계·반대 증거
#비교 기준인 ‘정답 궤적’은 어떻게 만들었나
기준궤적은 로봇에 고정한 GNSS 안테나 세 개의 위치를 후처리해 합친 결과다. 원문 §7의 식 (3)~(5)는 먼저 안테나들의 알려진 배치와 측정 위치를 맞추고, 다음으로 위치별 불확실성을 고려해 변환을 추정한다. 공분산은 오차가 어느 방향으로 얼마나 퍼질지를 나타내는 행렬이다. 모든 방향을 같은 신뢰도로 취급하는 단순 거리와 구분해야 한다.
다만 제공된 기준값도 별도 검증 대상이다. 작은 공분산이 실제 정확도를 보장하지는 않는다. 아래의 오차·방향 제한은 이 계산 결과를 해석할 때도 그대로 적용된다.
원문 식 (3): 방향별 불확실성을 고려하는 목적함수 식이 길면 좌우로 이동해 읽으세요. 키보드는 수식에 초점을 둔 뒤 방향키를 사용합니다. 기호·연산·계산 과정 펼치기
이 식은 위치를 바로 출력하는 공식이 아니라, 어떤 회전·이동이 관측과 더 잘 맞는지 비교하는 목적함수다. k는 안테나 세 개를 센다. 잔차 e는 관측 위치와 변환한 안테나 위치의 차이로 단위는 m, W는 그 위치의 공분산 행렬로 단위는 m²다. 따라서 역행렬 W⁻¹의 단위는 m⁻²이고 각 항과 합 J는 무차원이다. 이 형태로 계산하려면 W의 역행렬이 존재해야 한다.
같은 거리 차이도 측정이 더 정밀하다고 보는 방향에서는 더 큰 벌점을 받는다. 가상 1차원 예시로 잔차가 0.1m일 때 표준편차를 0.1m로 두면 항은 1, 0.2m로 두면 0.25다. 이는 단위와 가중치의 뜻을 보이는 계산이지 이 데이터셋의 실측 오차가 아니다. 추정 공분산 자체가 부정확하면 가중치도 실제 신뢰도와 달라질 수 있다.
원문 식 (4)는 먼저 가중하지 않은 점 사이 거리로 초기 변환을 찾고, 식 (5)는 공분산을 고려한 변환 추정을 기술한다. 논문은 점-평면 방식의 작은 회전 근사를 위해 초기 정렬이 필요하다고 설명한다. 다만 식 (5)에 적힌 고정된 초기 잔차와 최적화 변수의 관계는 구현까지 대조하지 않았으므로, 이 글에서 완성된 실행 알고리즘으로 재구성하지 않는다.
기준궤적은 GNSS에 의존해 넓은 길을 선호했고, 숲 canopy 아래 실제 오차는 수십 cm까지 갈 수 있다. 논문은 GNSS 후처리가 출력한 공분산이 실제 불확실성을 과소평가한다고도 설명한다. 공분산은 위치 추정의 불확실성을 나타내는 수치이므로, 파일의 작은 값만 믿고 기준궤적이 항상 mm 단위로 정확하다고 결론 내리면 안 된다. 제공 파일의 방향 칸에는 신뢰할 수 있는 방향 추정 대신 항등 쿼터니언(identity quaternion)을 넣는다. 파일에 값이 있다고 해서 로봇이 실제로 회전하지 않았거나 그 값이 자세의 정답이라는 뜻은 아니다. 일부 경로는 폭설·배터리·접근 제한 때문에 빠졌고 후방 카메라 노출 실패도 있었다. preliminary benchmark는 Yellow 경로 중심이며 모든 센서·경로를 포괄한 리더보드는 아직 계획 단계다.
#읽고 확인하기
오차가 더 작은 방법이 항상 좋은 방법일까? 아니다. 같은 기준 지도·평가 주행·궤적 범위를 맞추고 실패도 함께 봐야 한다. 실패한 구간을 임의의 큰 오차값으로 만들어 평균에 넣는 것도 정당하지 않다. 이 데이터셋이 제공하는 것은 계절 변화에 따른 위치 추정 평가이지, 모든 조건의 충돌 없는 자율주행 보장은 아니다.
#Code/Data·이해관계
codeAvailable: 예 — Python/Rust SDK, Docker 기반 평가 예시dataAvailable: 예 — 선택 다운로드, human-readable·ROS2 MCAP, calibration·GT·RINEXconflictsOfInterest: 저자들은 잠재적 이해상충 없음 선언strongestEvidence: 계절간 지도 재사용에서 0.9~46.5% drift와 완전 궤적 실패를 함께 공개limitations: 한 지역·여섯 경로, GNSS 기준의 방향 부재, 10TB 접근비용, 불완전 반복
SDK 저장소는 공개돼 있지만 README 자체가 작업 중이라고 표시한다. 공개 접근 가능성과 사용 허가·재현 완료는 별개다. 데이터·SDK·논문 그림의 사용 조건을 하나로 묶지 않고 각각 확인해야 하며, 이번에는 코드 실행이나 데이터 재배포를 하지 않았다.
#출처·식별자
- arXiv v2 전체 원문 — 2026-10-05 수정, IJRR 게재 확정 문구와 DOI 포함.
- FoMo 공식 데이터셋 — 데이터·SDK·선택 다운로드.
- DOI
10.1177/02783649261491481, arXiv2603.08433.
#재검토 트리거
공식 리더보드 개장, 독립 팀의 baseline 재현, GNSS 방향·공분산 개선, 전 경로/전 계절 결과, 더 작은 배포 패키지가 나오면 재평가한다.