#한 문장 결론
영상에 행동의 시점과 결과를 기록하는 일을 주석 달기라고 한다. GPU는 영상 처리에 필요한 계산을 병렬로 수행하는 장치다. API는 외부 모델에 영상 분석을 요청하고 결과를 받는 연결 방식이다.
Flora는 로봇 영상을 시간 구간별 설명과 성공·실패 보상으로 바꾸는 세 공개 모델을 묶어 대규모 데이터 엔진으로 제시했지만, 최고 처리량은 자체 인프라 수치이고 API 비교는 실측이 아니라 모델링이다.
근거 상태: 이 글은 저자들이 공개한 arXiv v1 논문 원고에 근거하며, 표의 값은 저자 보고 평가 결과다. 동료심사 여부는 이 검토에서 확인하지 못했다.
#중요성과 차이
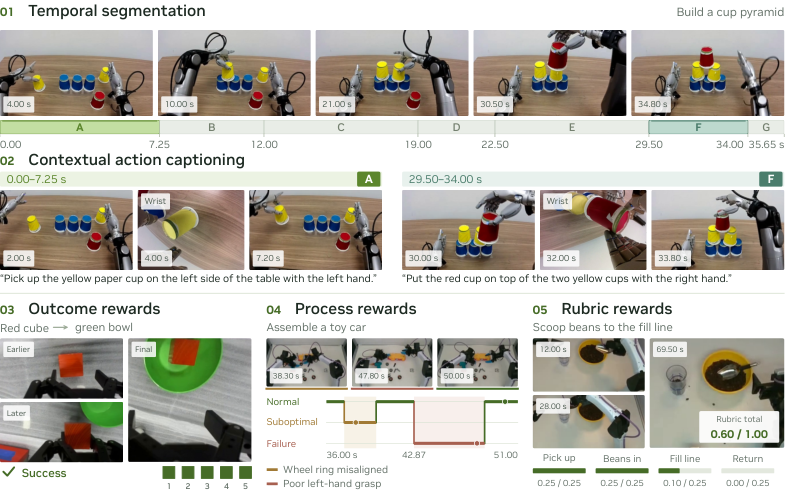
로봇 학습의 병목은 영상이 없어서가 아니라 “언제 어떤 행동을 했고 얼마나 잘했는지”를 일관되게 붙이는 비용이다. Flora는 TempSeg 9B가 사건 경계를 찾고, Captioner 27B가 구간을 설명하며, Rewarder 27B가 전체 결과·과정·사용자가 정한 평가 기준에 따른 보상을 낸다. Flora는 영상에서 사건의 경계를 찾는 작업과 각 구간을 설명하는 작업을 서로 다른 모델에 맡긴다. 이 분리가 비용에 얼마나 기여했는지는 논문의 전체 비용 비교로 분리해 확인할 수 없다. 원문 §1
 그림의 글자가 작다면 원본 크게 보기 · 새 탭
그림을 볼 때 영상 한 편에서 무엇이 나오는지부터 따라가 보자. 컵을 집는 영상이라면 구간 분할은 집기 시작과 끝의 시점을 찾고, 구간 설명은 그 사이에 일어난 행동을 문장으로 붙인다. 보상은 컵을 안정적으로 잡았는지처럼 정해진 기준에 따라 결과나 과정을 평가한다. 이 컵 예시는 세 작업의 차이를 보여주기 위한 것이다. 뒤의 식 (9)는 영상 처리에 드는 비용을 원본 영상 길이로 나눈다. 각 모델의 비용 기여분을 알려면 모델별로 사용한 GPU 시간이 따로 필요하다.
#수치와 비교 조건
NVIDIA는 GB300 GPU 512개를 사용한 작업에서 하루에 최대 영상 20만 시간 분량을 주석 처리했다고 보고했다. 영상의 재생 시간으로 잰 처리량이며, 로봇이 실제로 가동된 시간이나 한 영상의 처리 지연을 뜻하지 않는다.
NVIDIA 공개 표에서 구간과 설명을 함께 평가한 joint point F1@0.5(%) 점수는 Human100에서 Flora 37.4, GPT-6 Astra 29.7이었다. Robot200에서는 Flora 51.0, GPT-6 Astra 57.9로 순서가 바뀌었다. 두 수치는 같은 지표의 서로 다른 평가 집합에서 나온 결과다. 로봇 트랙에서는 새 설명 생성이 빠진 영상 5개와 oracle·joint 평가의 미완료 심판 작업 98건이 남았다. 저자들은 고정 분모를 유지하면서 확인되지 않은 기여분에는 점수를 주지 않았다. 따라서 Robot200 순위를 모든 결과가 완전히 관측된 비교로 읽을 수 없다. 부록 B.4
#점수는 시간 구간과 설명을 함께 본다
구간을 나누는 시각이 맞아도 행동 설명이 틀리면 좋은 주석이 되기 어렵다. 논문 부록 B.3 식 (8)은 예측 구간과 정답 구간을 하나씩 짝지으며, 시간 겹침 비율(tIoU)이 0.5 이상인 짝에서 설명의 품질 q를 합산한다.
F_joint = 2 × (일대일 짝짓기에서 얻은 q의 최대 합)
/ (예측 구간 수 + 정답 구간 수)
q는 단위가 없는 설명 품질 점수다. 원문 식 (7)은 q = 2M/(R+M+F)로 정의한다. R은 확인 가능한 정답 요구사항의 가중치 합, M은 설명이 충족한 요구사항의 가중치 합, F는 입증된 사실 오류에 부여한 가중 패널티다. 모든 기호는 단위 없는 가중 점수이며, 평가 가능한 요구사항이 없는 짝은 점수를 확인할 수 없는 상태로 처리한다. 구간 수 역시 개수이므로 결과에는 물리 단위가 없다. 빈 설명을 내놓아도 예측 구간은 분모에 남는다. 예측 구간만 많이 만들어 점수를 높이기 어려운 이유다. 설명 품질은 정답 요구사항과 판단 모델에 의존하므로 점수의 해석에도 그 평가 절차가 필요하다. 원문은 고정된 GPT-6 Astra를 심판으로 사용해 정답 요구사항과 표본 영상 근거로 설명을 평가한다. Astra 자체도 비교 대상이므로 생성 모델과 심판이 같을 때의 자기 선호 가능성이 한계로 남는다. 원문 부록 B.3, 식 (6)–(8)
#비용 비교는 어떤 조건에서 나왔나
비용과 품질을 함께 비교한 표본은 사람 영상 20개, 평행 그리퍼 영상 15개, 다관절 로봇 손 영상 15개다. Flora와 API 비교군은 평가 기준으로 쓰인 정답 주석의 판본이 완전히 같지 않았다. 따라서 비용 차이를 근거로 같은 품질을 보장한다고 해석하기는 어렵다.
GPU 한 대를 한 시간 쓰면 1 GPU·시간이다. 에피소드 한 개는 이 비교에서 로봇 과제 한 번을 기록한 영상 단위다.
저자본 부록 D.2 식 (9)의 비용 추정식은 다음과 같다.
C_Flora = p × g × N / (3600 × H × S)
여기서 p는 GPU·시간당 달러, g는 GPU 수, N은 에피소드 수, H는 원본 영상의 합계 재생 시간(시간), S는 GPU 8개를 사용하는 구성 전체가 초당 처리하는 에피소드 수다. N/S로 얻은 처리 시간(초)을 3600으로 나누면 시간으로 바뀐다. GPU 수와 단가를 곱하면 달러가 되고, H로 나누면 원본 영상 1시간당 비용이 된다.
저자본 부록 D.2의 식 (9)는 GPU 시간당 가정 가격에 GPU 수와 처리 시간을 곱하고, 원본 영상의 재생 시간으로 나눈다. 에피소드 50개를 초당 약 1.235개 처리하면 약 40.5초가 걸린다. GPU 8개가 그 시간 동안 동작하면 약 0.090 GPU·시간이므로 가정한 단가에서 전체 처리 비용은 약 0.90달러다. 이를 에피소드 50개의 재생 시간 합계인 약 1.245시간으로 나누면 영상 1시간당 비용이 나온다. 저자들은 GB300 8개, GPU당 시간당 10달러, 초당 약 1.235개 에피소드 처리라는 가정 아래 영상 1시간당 약 0.72달러를 추산했다. 비교 대상인 GPT-6 Astra 최대 추론 설정의 추산값은 약 88.49달러였다. 논문의 약 125배 차이는 이 비교에서 나왔다. 저장 비용과 배포 운영비는 제외했고, Flora의 실제 운영 GPU 사용 시간은 검증되지 않았다. 처리율을 산정할 때 참고한 작업량은 이전 배포 연구의 영상 구간 660개와 캡션 890개다. 이번 비교에서 모델 호출 횟수나 실제 처리율을 측정해 얻은 값과는 구분해야 한다. 부록의 영상 1시간당 $0.5102~$1.2600 범위는 운영 가정을 바꿔 계산한 시나리오 값이다. 원문 부록 D.2
#한계·반대 증거
처리량 그래프의 외부 API 지점은 quota와 토큰 수로 계산한 조건부 상한이며 실제 wall-clock 측정이 아니다. 부록 D.3의 처리량 비교는 예산을 지점별로 맞춘 실험이 아니다. DenseRewardBench에서 Flora-Rewarder는 정상 step의 약 11%를 실패로 표시했다. 완전 실패·완전 성공 사례에서는 GPT-6 Astra가 적어도 동등하게 정확했고, Flora의 장점은 부분 완료 상태에 집중됐다. 데이터셋과 judge 설계가 자체 모델에 유리할 가능성도 남는다.
#code/data·이해관계
공식 Hugging Face 컬렉션에는 Captioner·TempSeg·Rewarder 모델이 등록돼 있다. 모델 카드에는 NVIDIA OneWay Noncommercial License(2022년 3월 22일)가 명시돼 있다. 학습 데이터 전체와 512-GPU 운영 스택의 완전한 재현 가능성은 확인하지 못했다. 이번 비교는 저자들이 자체 모델을 평가한 결과이며 독립 재현 결과는 추가로 확인해야 한다.
#비교 점수는 어떻게 만들었나
비용 비교의 영상 50개는 사람 손 20개, 평행 그리퍼 15개, 다관절 로봇 손 15개로 구성됐다. 저자들은 각 그룹에서 구간 검출, 정답 구간의 설명, 구간과 설명을 함께 맞히는 성능을 같은 비중으로 합쳤다. 세 그룹의 점수도 같은 비중으로 합쳤다. Flora와 API 모델은 서로 다른 버전의 정답 주석을 사용했다. API 비용에는 구간 검출과 예측 구간의 설명에 대해 사용량을 확인한 요청만 집계했다. 전체 요청 7,062회 중 106회는 사용량이 보고되지 않았다. 해당 API 비용은 확인 가능한 사용량의 소계다. 따라서 비용과 품질의 차이는 이 표본과 집계 조건 안에서 해석해야 한다. 부록 D.1
실패 탐지 비교에서는 모든 모델이 같은 508개 영상 구간을 평가했다. 저자들은 학습에서 제외한 영상 40편의 4,861개 시점에 걸쳐 예측을 정답과 비교했다. 정상 시점의 약 11%를 실패로 표시했다는 수치는 이 평가에서 나온 오탐 비율이다. 부록 C의 DenseRewardBench 평가와 부록 E
 그림의 글자가 작다면 원본 크게 보기 · 새 탭
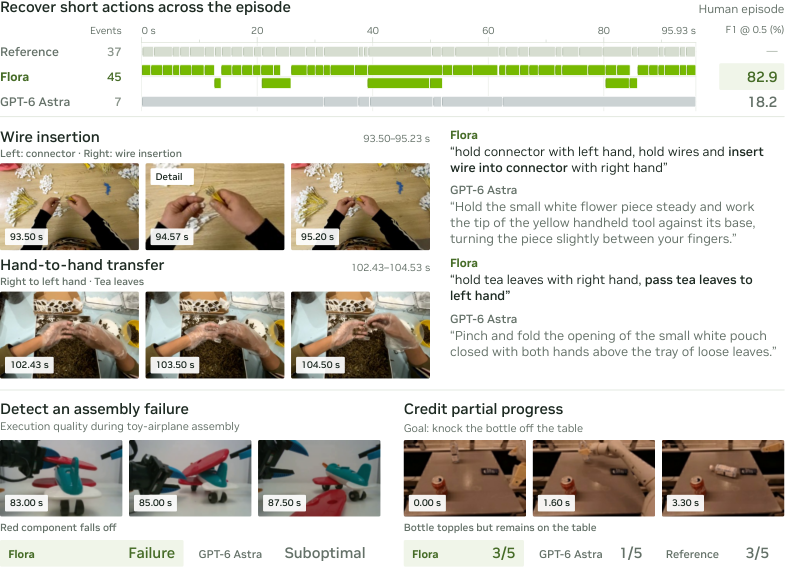
이 도판은 패널마다 다른 일을 보여준다. 위 패널의 F1@0.5는 선택된 사람 영상 한 편에서 행동 구간을 맞춘 점수(Flora 82.9, GPT-6 Astra 18.2)다. 식 (8)의 joint F1은 구간이 시간 기준을 넘겨 겹친 짝에서 캡션 품질 q까지 함께 평가하므로, 위 패널의 구간 점수와 같은 지표가 아니다. 가운데는 전선 삽입과 찻잎 전달 행동 설명을 비교한다. 아래 왼쪽은 조립 부품이 떨어진 사례의 실패 판정이고, 오른쪽의 3/5와 1/5는 병을 넘어뜨린 뒤 남은 부분 진행을 매긴 순서형 점수다. 이 점수는 퍼센트가 아니며, 그림의 사례도 전체 벤치마크 평균을 뜻하지 않는다. 원문 Figure 5 · joint F1 정의, 식 (8)
#이해 확인
영상에서 컵을 집기 시작한 시점을 찾는 일과 컵을 안정적으로 잡았는지 평가하는 일은 어느 모델이 맡을까? 전자는 구간을 찾는 TempSeg, 후자는 기준에 따라 평가하는 Rewarder가 맡는다.
같은 영상 묶음을 같은 GPU 수와 단가로 처리할 때 초당 처리량만 두 배가 되면 영상 1시간당 비용은 어떻게 바뀔까? 식 (9)에서 S만 두 배가 되므로 추정 비용은 절반이다. GPU 수나 단가까지 바뀌는 배포에서는 그 값도 함께 넣어 계산해야 한다.
빈 설명을 낸 예측 구간은 joint point F1의 분모에서 제외될까? 아니다. 식 (8)의 분모는 예측 구간 수와 정답 구간 수를 더하므로, 설명이 비어도 예측 구간은 계속 센다.
원문 열람 범위와 확인하지 않은 항목
이번 글의 주된 근거는 arXiv v1 HTML의 초록, 본문, Methods, Appendix A–H와 참고문헌이다. 그림과 표는 캡션·범례 기준으로 목록화했으며, 글에 넣지 않은 Figure 2–14의 픽셀은 확인하지 않았다. 이 글은 저자 보고 평가를 요약하며 독립 재현을 뜻하지 않는다. 인용된 다른 연구의 원문, 코드, 전체 학습 데이터와 512-GPU 배포 스택은 확인하지 못했다.