로봇이 컵을 집는 영상을 보면 무엇을 배웠는지 알 수 있을까? 로봇이 보는 정보, 선택하는 행동, 학습에 쓰는 신호를 따라가며 로봇 학습의 기본 개념을 살펴보자.
강의 영상 · Oier Mees, ETH Zurich 2026 · 공식 강의 · 슬라이드 PDF
로봇 학습(Robot Learning)은 로봇 문제에 학습을 적용하는 넓은 분야이고, 강화학습(Reinforcement Learning, RL)은 행동의 결과와 보상을 이용해 의사결정을 개선하는 방법이다. 로봇에 인공지능 모델이 들어갔다고 해서 모두 강화학습으로 만든 로봇인 것은 아니다.
컵을 옮기는 로봇을 생각해 보자. 영상에서 컵의 위치를 찾는 모델, 힘을 가했을 때 컵이 얼마나 움직일지 예측하는 모델, 집게를 어느 방향으로 움직일지 정하는 정책은 서로 다른 역할을 한다.
| 질문 | 배우거나 설계할 대상 | 역할 |
|---|---|---|
| 컵은 어디에 있는가? | 인식·표현 모델 | 영상에서 행동에 필요한 정보를 얻는다. |
| 밀면 어떻게 움직이는가? | 동역학 모델 | 행동 이후의 변화를 예측한다. |
| 지금 무엇을 해야 하는가? | 정책 | 관측과 목표를 바탕으로 행동을 선택한다. |
정책은 사람의 시연을 따라 배울 수도 있고, 보상을 이용해 개선할 수도 있다. 이 장에서는 로봇의 입력, 행동, 학습에 쓰는 신호를 나누어 보면서 로봇 학습의 전체 지도를 그린다.
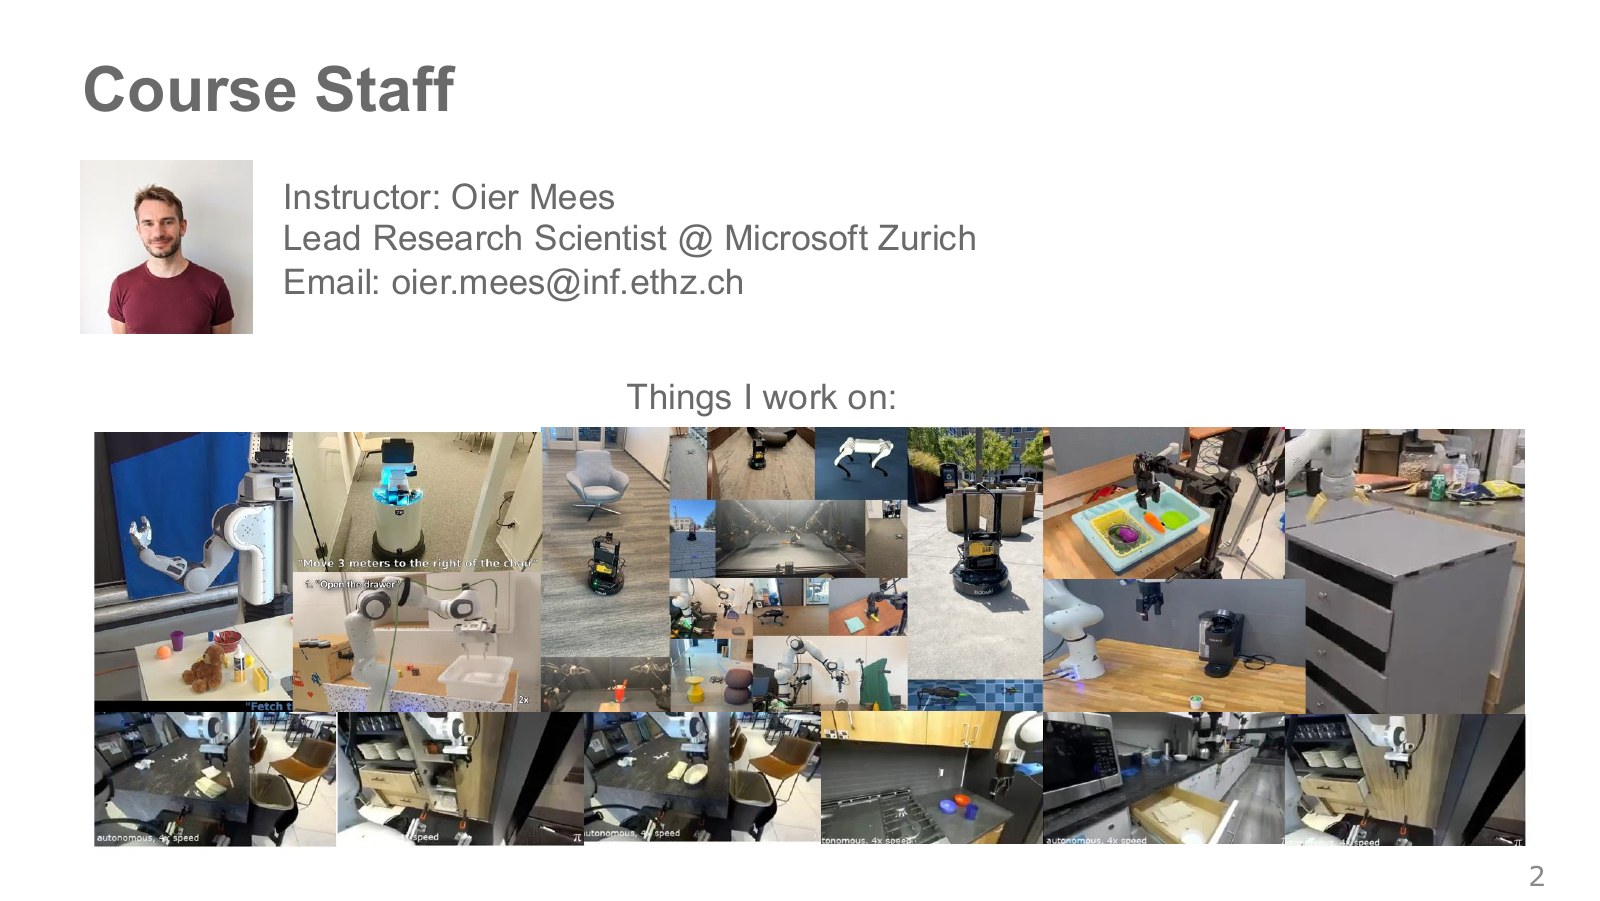
강의를 맡은 Oier Mees는 프라이부르크에서 박사 학위를 받고, UC Berkeley에서 Sergey Levine과 연구한 뒤 취리히로 옮겼다. 슬라이드의 연구 콜라주에는 로봇 팔의 물체 조작, 이동 로봇의 내비게이션, 사족보행과 드론 등 다양한 형태의 로봇이 등장한다. 강의에서는 이 작업들을 잇는 모방학습·강화학습의 공통 원리를 다룬다.
강의 당시에는 Microsoft Zurich의 Lead Research Scientist였으며, 현재 연구와 소속은 Oier Mees 개인 홈페이지에서 볼 수 있다. 개인 페이지에는 2026년 8월 Project Prometheus로 옮긴 이력도 안내되어 있다.
- 강사: Oier Mees · 강의 자료의 연락처: oier.mees@inf.ethz.ch
- ETH 연구실: Computer Vision and Geometry Group
- 강의 멘토: Marc Pollefeys · marc.pollefeys@inf.ethz.ch
- 강의에서 소개한 Microsoft 연구실: Spatial AI Lab, Zurich
- 관련 연구실: Berkeley Robot Learning Lab
각 연구자의 논문과 프로젝트를 함께 보면, 같은 정책 학습 아이디어가 서로 다른 하드웨어와 작업에서 어떻게 쓰이는지 이어서 살펴볼 수 있다.
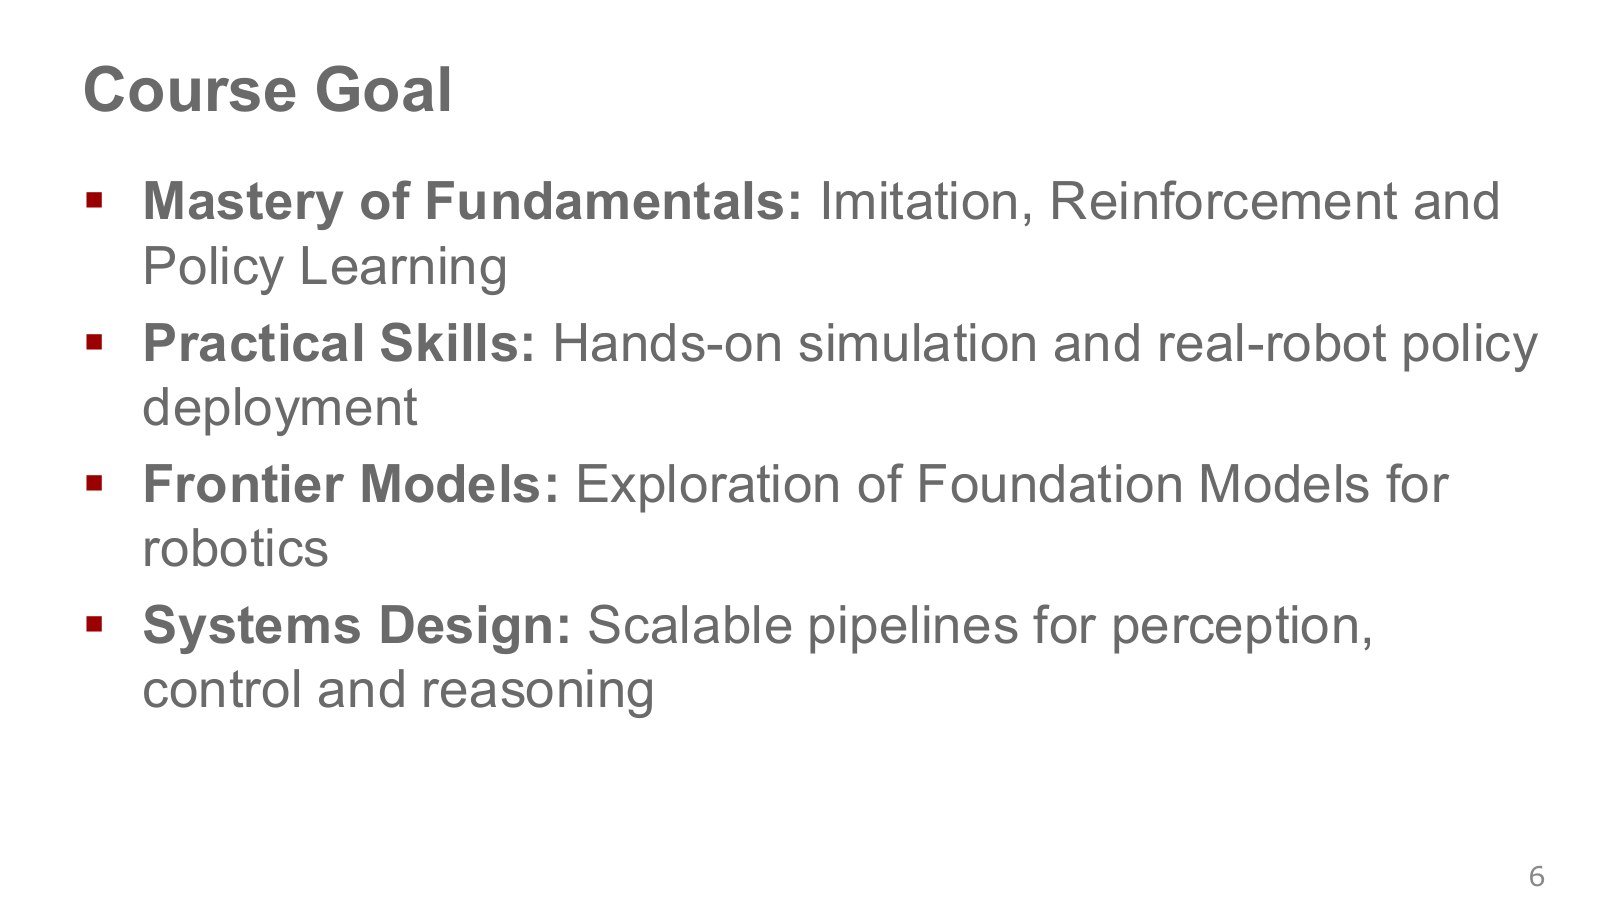
로봇 학습은 큰 신경망 하나를 훈련하는 일에서 끝나지 않는다. 기초 알고리즘을 이해하고, 시뮬레이션에서 구현하고, 실제 로봇에 연결한 뒤, 인식·제어·추론이 함께 작동하도록 만들어야 한다.
정책(Policy)은 주어진 정보에서 행동을 선택하는 규칙이다. 카메라 영상과 관절 위치, 작업 지시를 받아 다음 명령을 고른다. action = policy(observation, goal)처럼 생각하면 된다. 정책을 실행하는 것은 이 규칙으로 행동을 계산하는 일이고, 정책을 학습하는 것은 데이터와 목적에 따라 규칙을 바꾸는 일이다.
| 강의의 네 목표 | 공부할 때 붙잡을 질문 |
|---|---|
| 모방학습·강화학습·정책 학습의 기초 | 무엇을 신호로 행동을 개선하는가? |
| 시뮬레이션과 실제 로봇 실습 | 관측과 행동을 코드에 어떻게 연결하는가? |
| 로봇 파운데이션 모델 | 여러 작업에서 배운 지식을 어떻게 공유하는가? |
| 인식·제어·추론을 잇는 시스템 | 모델의 출력이 실제 움직임으로 어떻게 이어지는가? |
모델이 올바른 이동 방향을 골라도 좌표계, 단위, 명령 주기가 맞지 않으면 로봇은 엉뚱하게 움직일 수 있다. 모델과 실행 시스템을 함께 공부해야 하는 이유다.
DeepMind/UCL 1강 33:59–36:21은 정책, 가치 함수, 환경 모델을 나누어 설명한다. 정책은 행동을 고르고, 가치 함수는 앞으로 얻을 보상의 합을 예상하며, 환경 모델은 행동 뒤의 변화를 예상한다. 가령 컵을 오른쪽으로 밀지 결정하는 것이 정책, 그 선택이 최종 정리에 얼마나 도움이 될지 평가하는 것이 가치, 컵이 어디로 이동할지 예측하는 것이 모델이다. 에이전트가 반드시 세 가지를 모두 학습해야 하는 것은 아니다. 무작위로 행동하는 규칙도 정책이며, 가치 함수나 학습된 환경 모델 없이 동작하는 정책도 있다.
NTU 기초 강의 5:00–6:28에서 부르는 Actor도 관측을 받아 행동을 내는 함수라는 출발점에서 이해할 수 있다. 서로 다른 강의의 용어를 만났을 때 이름보다 입출력을 먼저 대응시키면 된다. 여기서 배우려는 대상은 정답 문장 하나가 아니라, 환경과 반복해서 상호작용하는 행동 규칙이다.
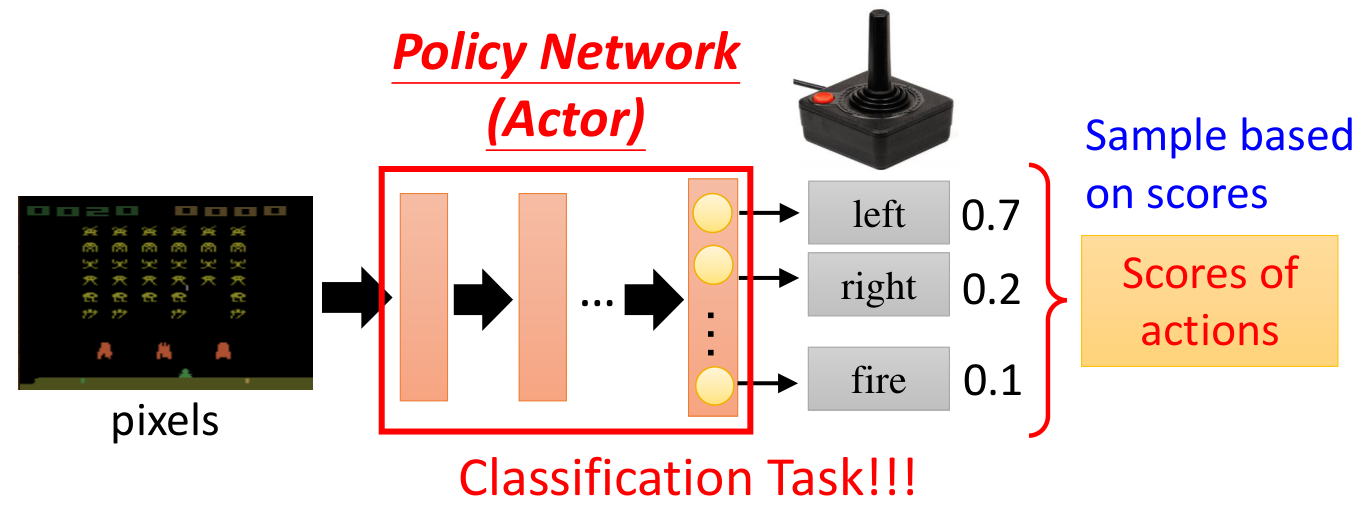
그림을 왼쪽부터 읽으면 화면의 픽셀, 학습할 신경망, 가능한 행동과 확률이 이어진다. 여기서 0.7은 ‘왼쪽으로 가면 보상 0.7점을 받는다’는 뜻이 아니다. 현재 화면에서 왼쪽 행동을 선택할 확률로 읽는다. NTU 영상 13:27–15:24도 분류 신경망과 비슷한 입출력 구조에서 출발한다. 하지만 분류에서 고양이라는 정답을 주는 것과, 행동의 장기 결과로 정책을 개선하는 것은 학습 신호가 다르다.
이 확률적 선택을 관측 중심의 표기로 쓰면 다음과 같다. 아래 식은 그림을 설명하기 위한 표기이며, 원본의 화면 입력을 관측 o로 적었다.
t는 행동을 고르는 시점, o_t는 그때의 관측, a_t는 선택한 행동, θ는 신경망의 학습 가능한 파라미터다. ∼는 분포에서 뽑는다는 뜻이다. 같은 화면에서 100번 뽑는다고 정확히 70번 왼쪽이 나오는 것은 아니지만, 많은 반복에서는 0.7의 비율에 가까워진다. 항상 가장 큰 값의 행동만 고르는 실행 방식도 가능하며, 확률에서 뽑는 방식과는 구분한다. 연속적인 로봇 팔 명령에서는 세 버튼 대신 이동량이나 관절 목표의 분포를 다룰 수 있다.
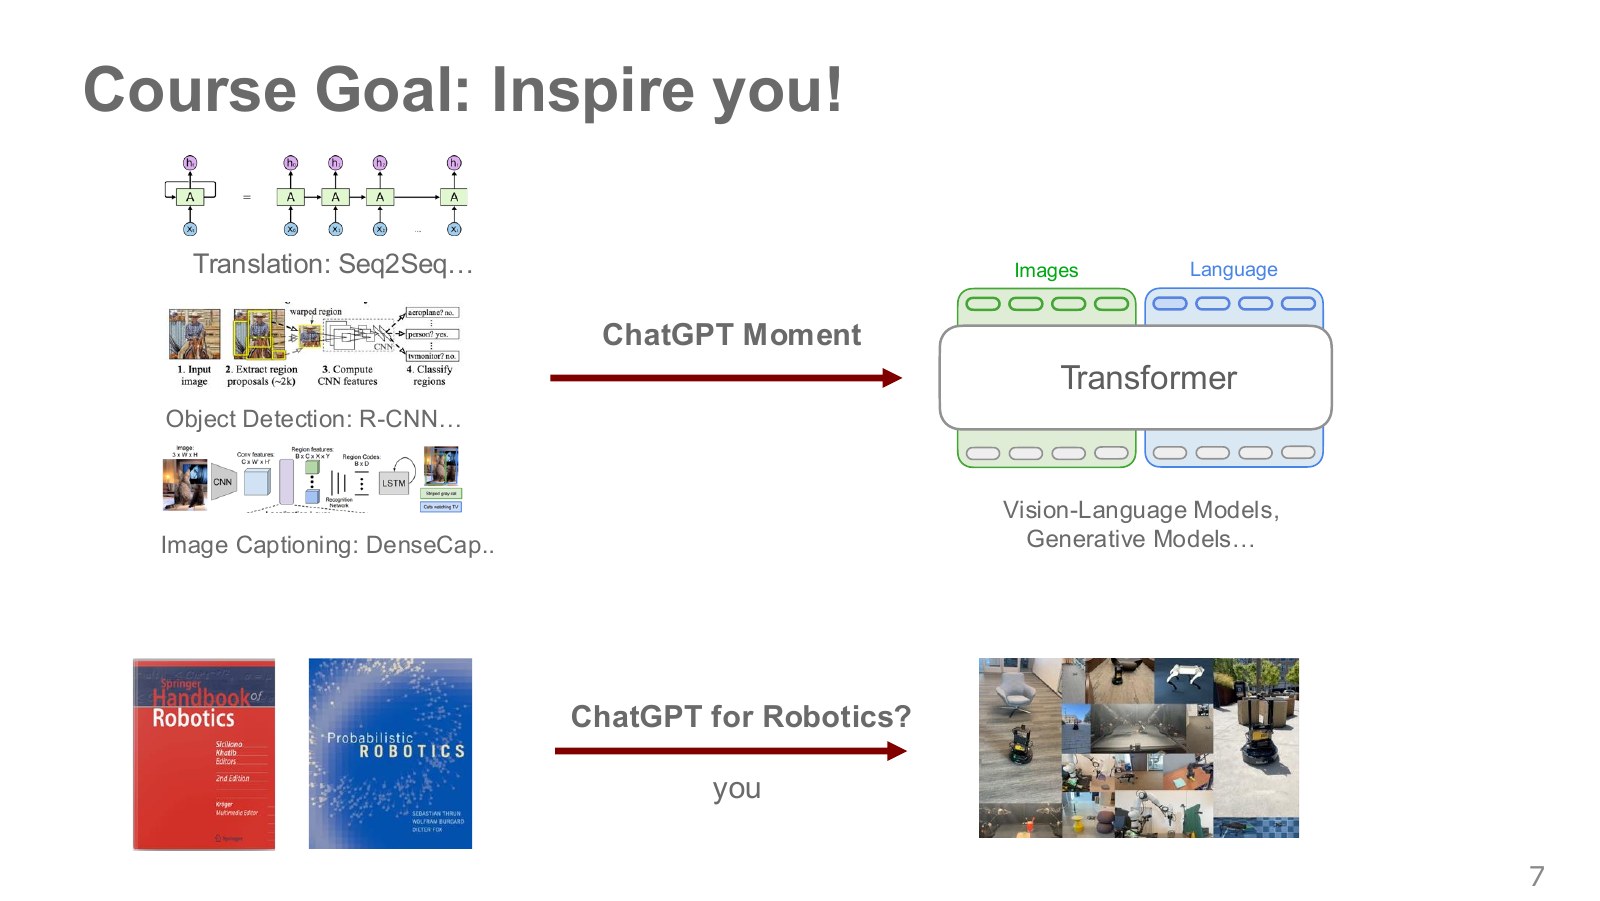
과거에는 번역, 객체 검출, 영상 설명에 각각 다른 모델을 만들었다. Transformer와 대규모 사전학습의 발전은 여러 작업이 표현과 지식을 공유하는 방향으로 흐름을 바꾸었다. 슬라이드는 로봇 공학에서도 비슷한 변화가 가능할지를 묻는다.
언어·영상 모델의 지식을 로봇 행동에 연결하려는 연구가 시각·언어·행동 모델(Vision-Language-Action model, VLA)이다. 예를 들어 RT-2는 로봇 행동을 토큰으로 표현하고, 로봇 궤적과 시각·언어 데이터를 함께 사용해 모델을 미세조정한다. 실행할 때는 출력 토큰을 다시 로봇 행동으로 바꾼다.
여기서 Transformer는 모델 구조이고, VLA는 입출력의 구분이며, 강화학습은 학습 방법이다. 같은 Transformer 구조라도 시연을 따라 학습할 수 있고 보상으로 개선할 수도 있다. 따라서 모델 이름을 읽을 때 무슨 정보를 받고, 무엇을 출력하며, 어떤 신호로 배웠는가를 따로 확인하면 혼동이 줄어든다.
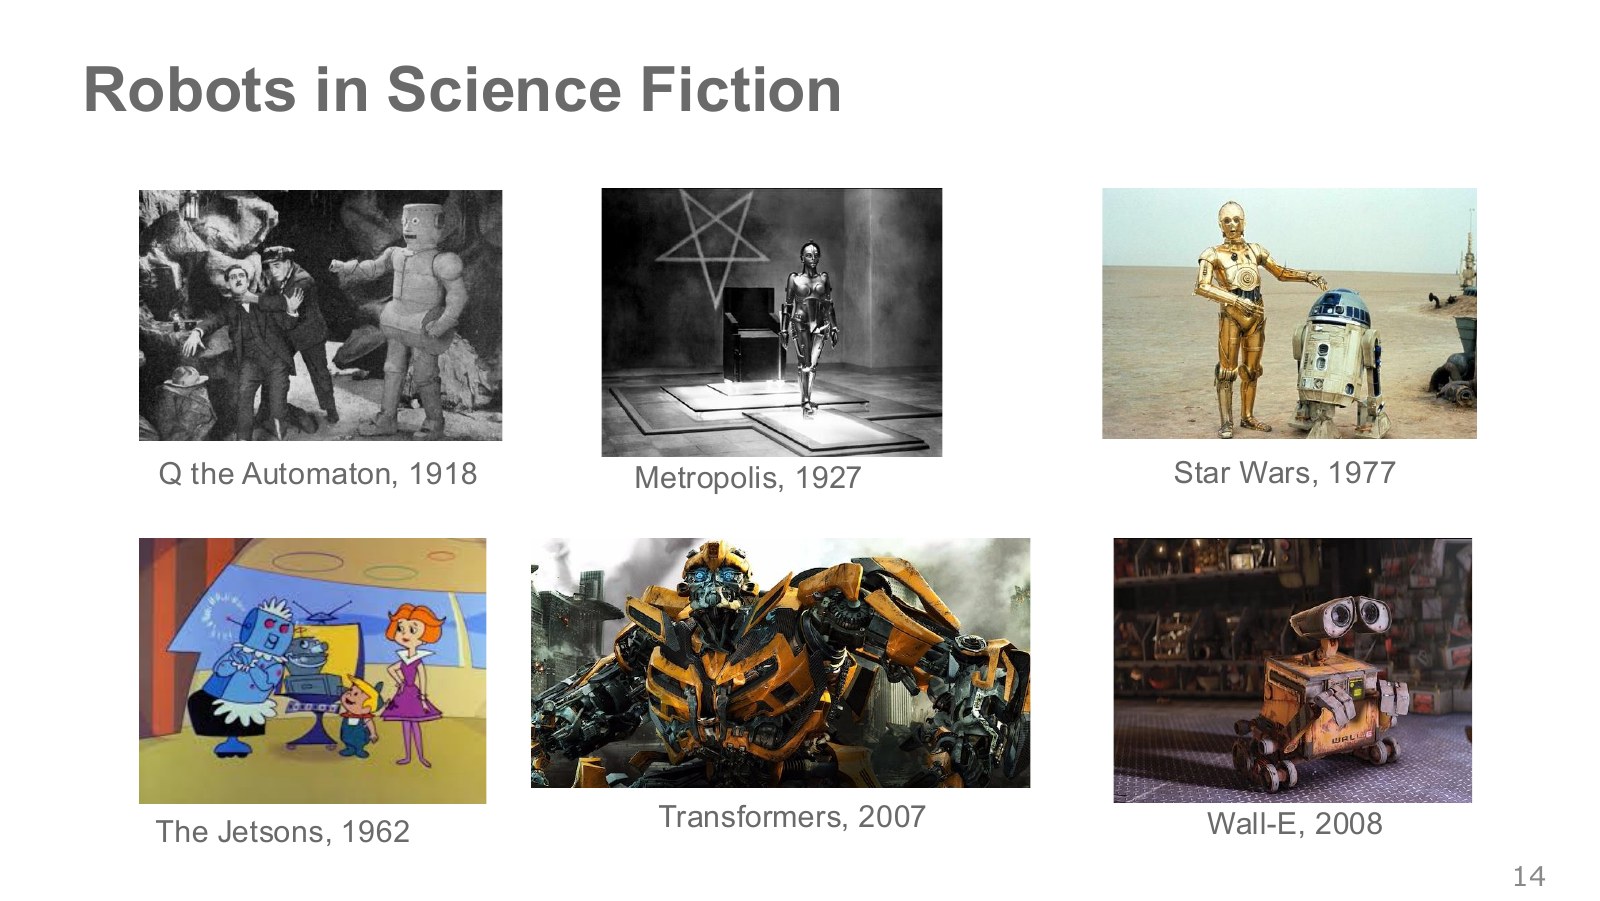
영화와 애니메이션은 오랫동안 로봇에 대한 기대를 만들어 왔다. 공장 일을 대신하는 기계에서 집안일을 돕는 서비스 로봇으로, 다시 사람과 관계를 맺는 등장인물로 상상력이 넓어졌다. 슬라이드는 《Metropolis》, 《The Jetsons》, 《Star Wars》, 《Transformers》, 《WALL·E》 등의 사례를 나란히 놓는다.
이 기대를 연구 문제로 바꾸려면 ‘사람처럼 일한다’를 더 작은 행동으로 풀어야 한다. 컵을 찾고, 손을 뻗고, 미끄러지지 않게 잡고, 장애물을 피해 옮기고, 목표 위치에 놓는 과정마다 다른 문제가 있다. 하나의 자연스러운 행동도 로봇에게는 인식·계획·접촉·제어를 연결하는 과제다.
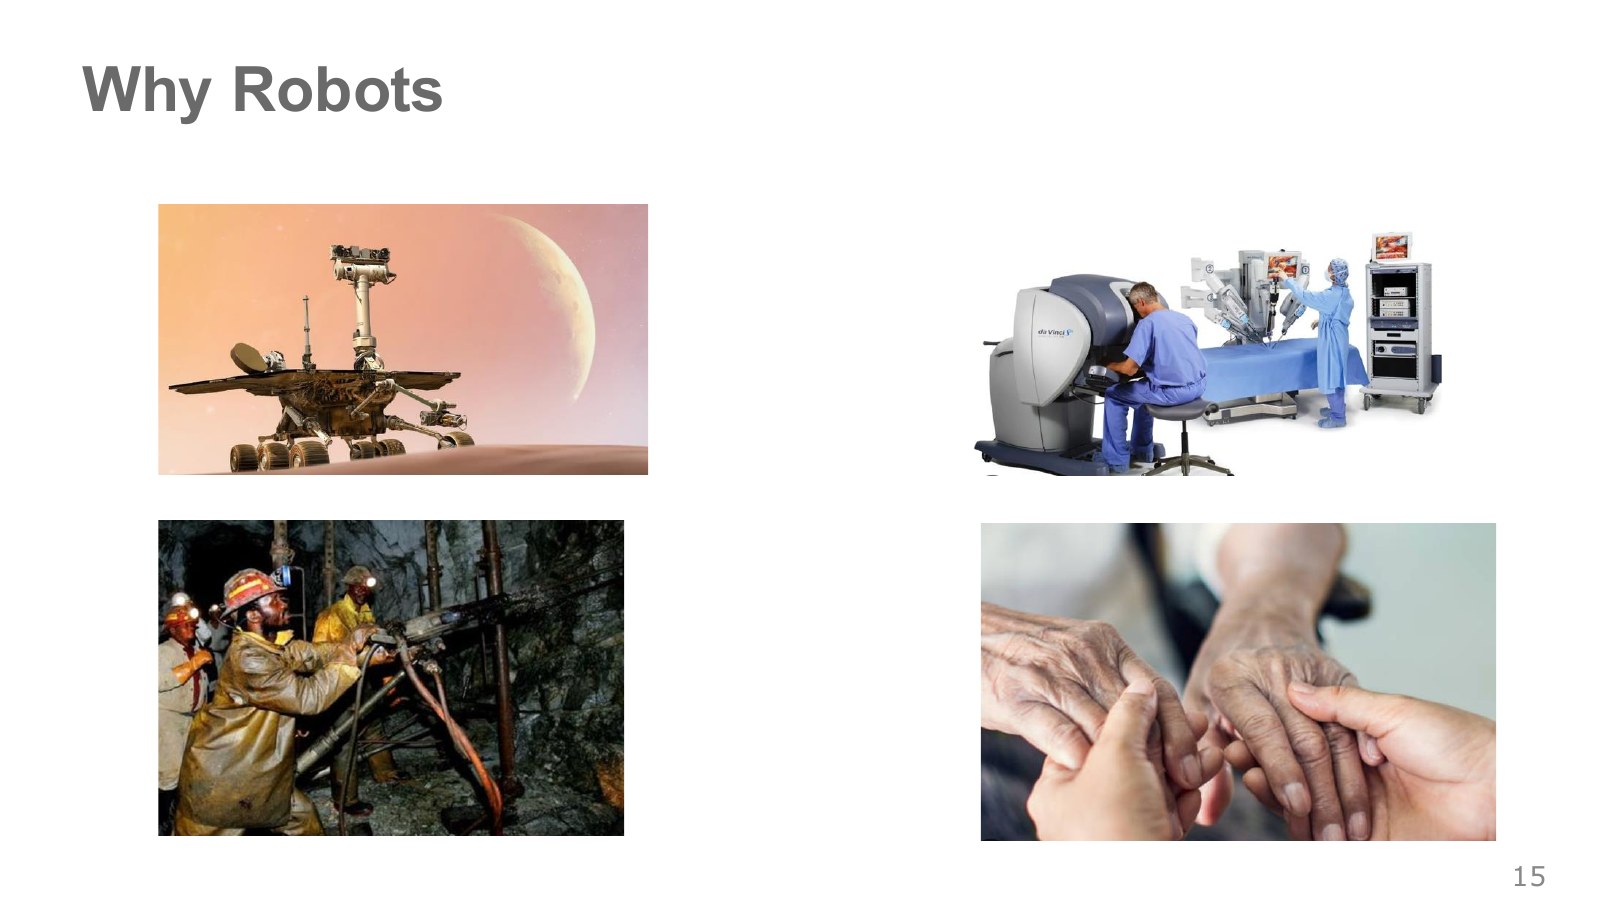
로봇이 필요한 이유는 사람이 직접 하기 위험하거나, 멀리 떨어져 있거나, 반복적으로 부담이 큰 일을 맡길 수 있기 때문이다. 행성 탐사와 재난 구조, 광산 작업처럼 사람을 위험에 노출시키는 일뿐 아니라 수술 보조와 일상 돌봄에도 연결된다.
이 작업들은 같은 지능을 요구하지 않는다. 탐사 로봇은 통신 지연 속에서 판단해야 하고, 수술 시스템은 정밀한 움직임과 사람의 지시를 결합해야 하며, 가정용 로봇은 매일 바뀌는 물건 배치에 적응해야 한다. 로봇 학습의 목표는 이런 환경 변화에 대응할 수 있는 행동 능력을 데이터와 경험에서 얻는 것이다.
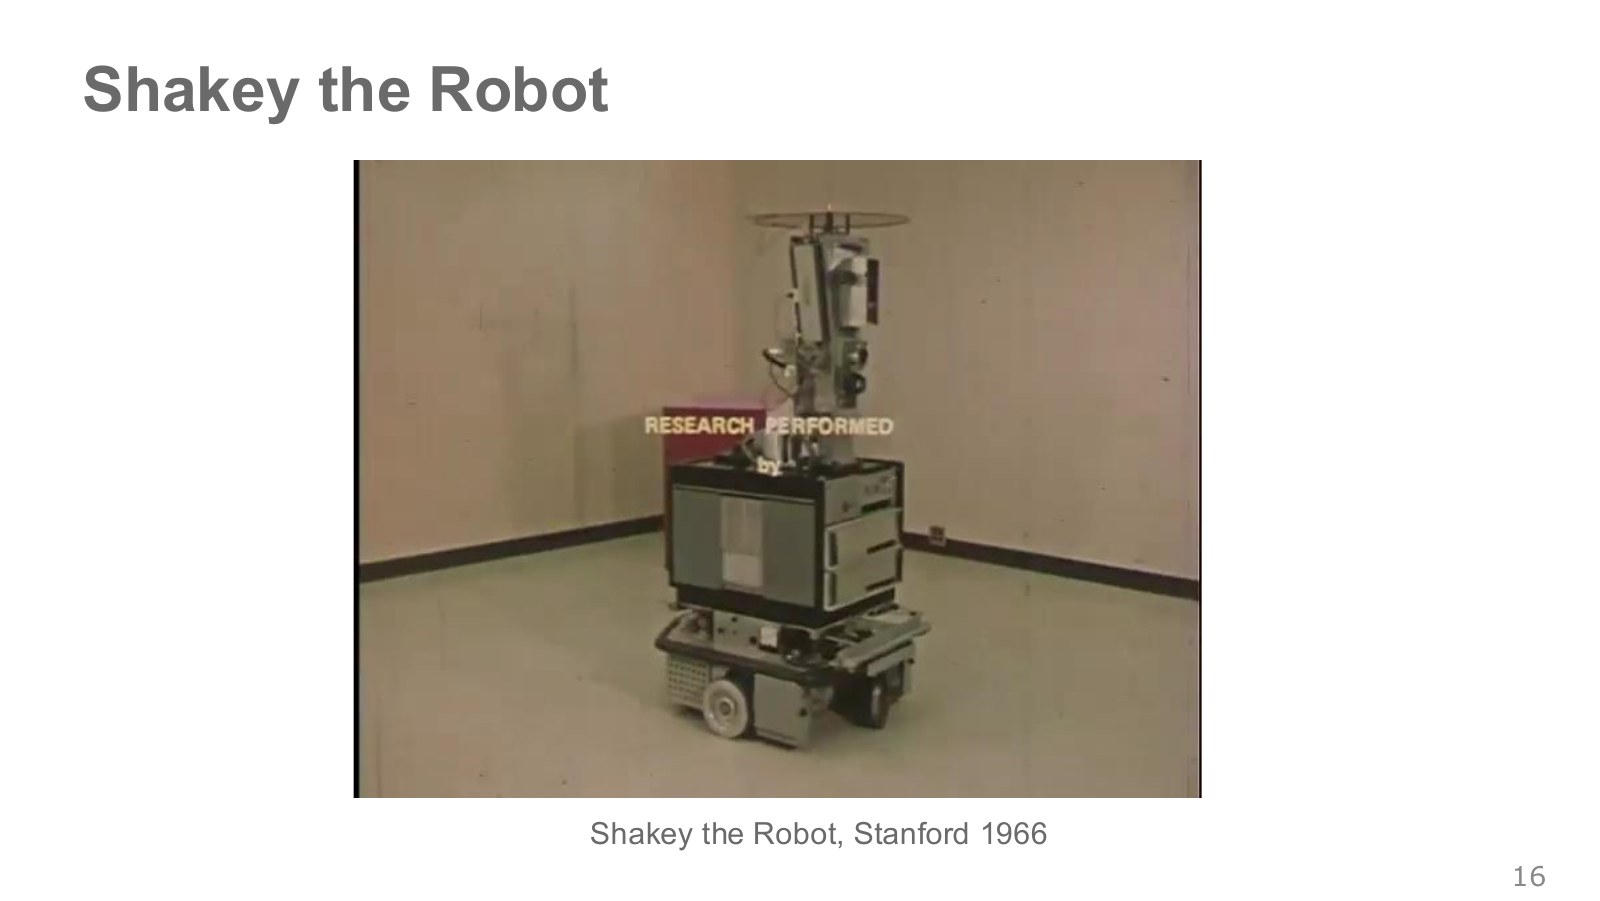
Shakey는 카메라와 센서를 사용해 주변을 파악하고, 이동 경로와 물체를 옮기는 순서를 계획하던 초기 이동 로봇이다. 핵심은 미리 정한 동작을 재생하는 데서 나아가, 관찰한 환경을 바탕으로 행동 순서를 결정했다는 점이다.
SRI의 역사 자료는 Shakey 연구를 1966–1972년 SRI 인공지능 연구로 설명한다. 슬라이드의 ‘Stanford’는 당시 기관의 이름인 Stanford Research Institute라는 맥락에서 읽으면 된다. 이를 오늘날의 Stanford University 연구실과 그대로 동일시하면 기관의 역사를 혼동하기 쉽다.
이 사례에서 이어지는 기본 흐름이 인지–계획–행동(Sense–Plan–Act)이다. 센서로 환경을 읽고, 목표까지의 행동을 계획한 다음, 구동기를 움직인다.
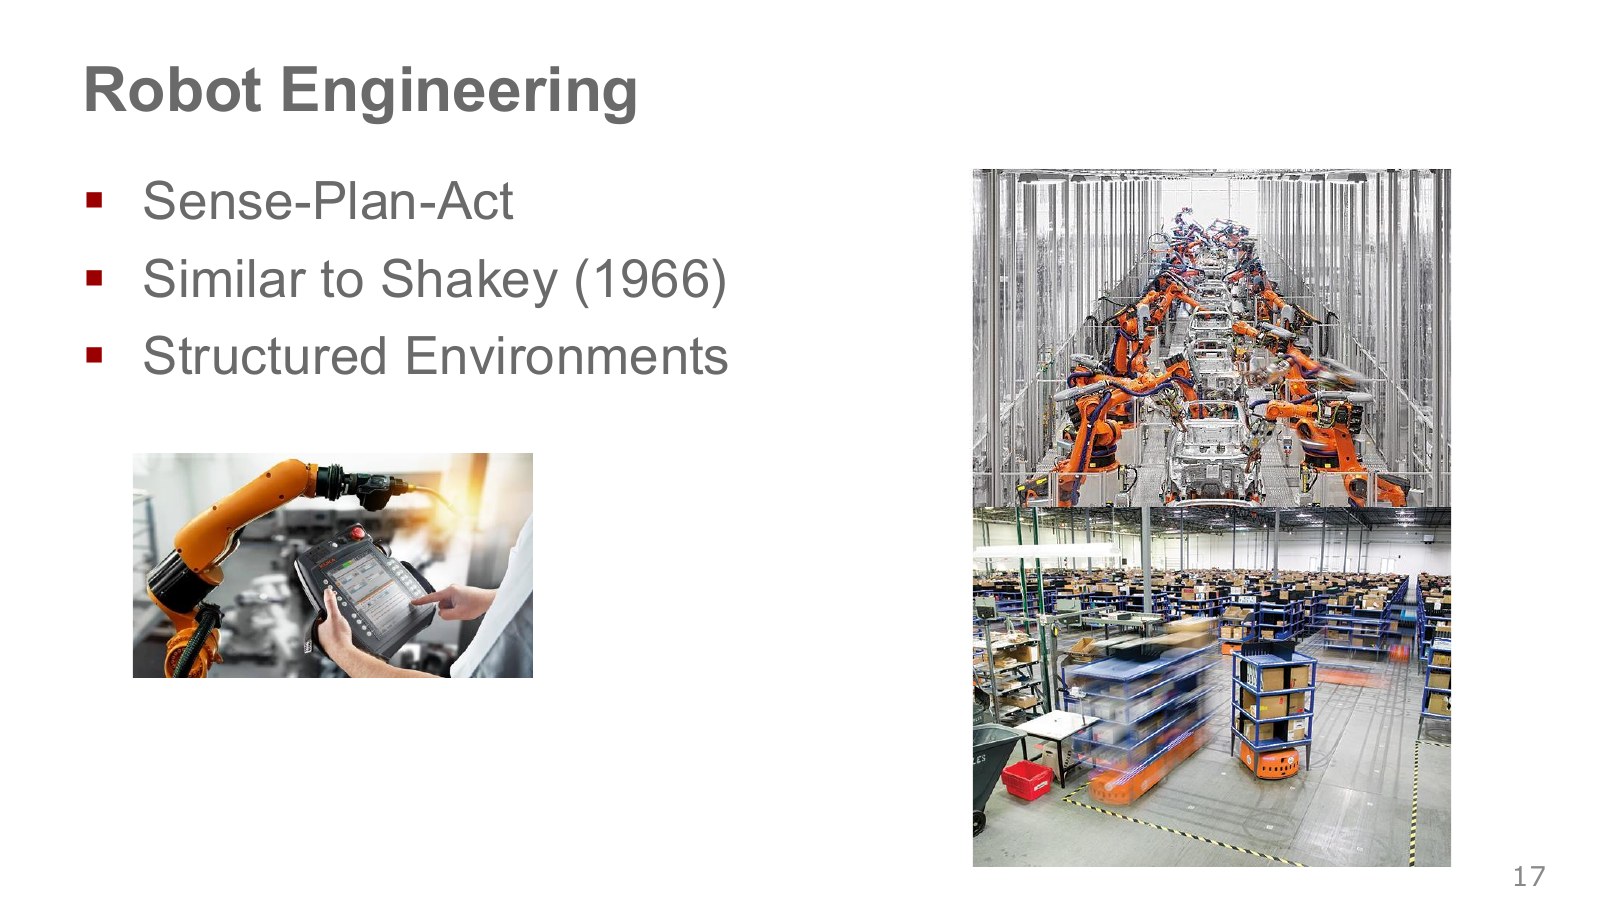
자동차 조립 라인과 정돈된 물류 환경에서는 물체의 위치와 작업 순서를 미리 정하기 쉽다. 로봇은 센서로 현재 상황을 파악하고, 알려진 환경 안에서 경로를 계획한 뒤, 높은 반복 정밀도로 작업한다. 이런 구조는 산업 자동화에서 큰 성과를 냈다.
어려움은 예상하지 못한 변화에서 나타난다. 부품의 위치가 달라지거나, 사람이 물체를 옮기거나, 집게가 미끄러지면 정해 둔 순서만으로는 복구하기 어렵다. 필요한 것은 현재 관측에 따라 다음 행동을 수정하는 능력이다.
작은 예로 현재 위치가 0.2 m, 목표가 1.0 m라고 하자. 고정된 피드백 규칙이 2 × (1.0 − 0.2) = 1.6 m/s를 요청하더라도, 환경이 속도를 0.5 m/s로 제한하면 0.1초 뒤 위치는 0.2 + 0.1 × 0.5 = 0.25 m가 된다. 다음 행동은 새 위치를 다시 보고 계산한다. 이 순환 자체는 피드백 제어이며, 그 규칙을 경험으로 개선하는 학습은 별도의 단계다.
직접 실행할 수 있는 Python 파일, 13개 테스트, CSV·결과 파일을 공개했다. 이 예제는 1차원 위치 전이 계산이며, 로봇 팔 물리 시뮬레이션은 뒤의 MuJoCo·Isaac Lab 예제로 연결한다.
이 루프를 시간순으로 펼치면 관측₀ → 행동₀ → 관측₁ → 행동₁이 된다. NTU 기초 강의 22:59–23:40도 같은 연결을 사용한다. 행동은 출력인 동시에 다음 입력이 생기는 원인이다. 따라서 저장된 영상에서 행동을 맞히는 성능과, 그 행동으로 바뀐 환경에서 계속 일하는 성능은 별도로 살펴야 한다. 위의 위치 예제에서도 한 번 정한 속도를 계속 내보내는 방식과 현재 위치를 다시 읽는 방식은 시간이 지날수록 다른 궤적을 만든다.
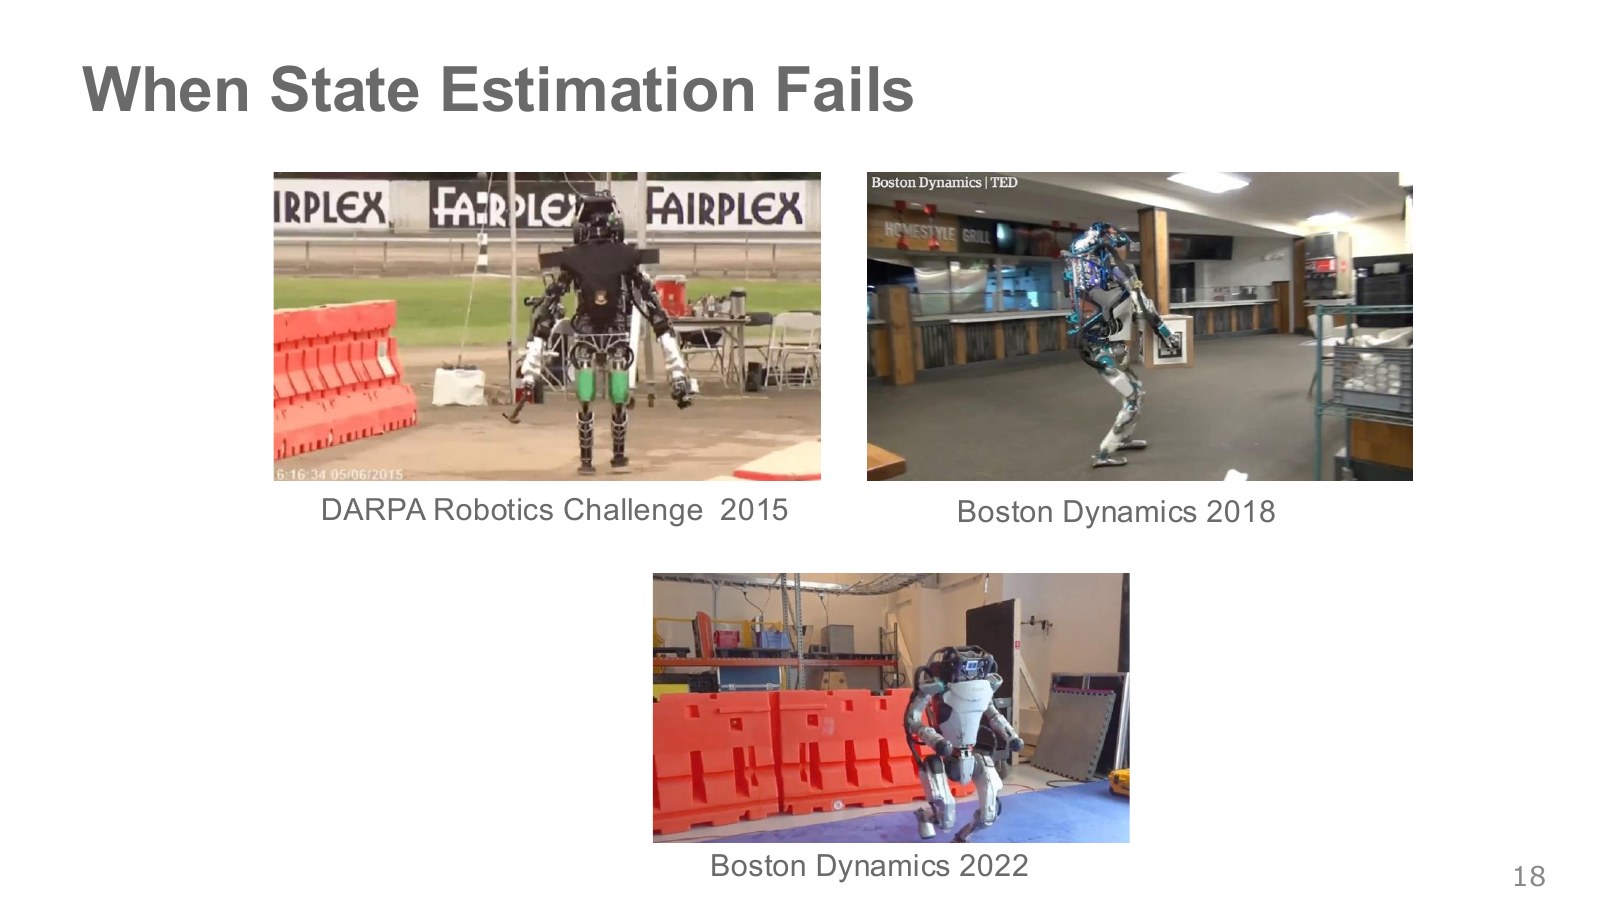
로봇이 행동하려면 자기 몸과 주변 물체가 어디 있는지 알아야 한다. 이 정보를 센서에서 계산하는 과정이 상태 추정(State Estimation)이다. 발을 딛을 바닥의 높이, 몸의 기울기, 문 손잡이의 위치를 잘못 알면 계획한 동작과 실제 접촉이 어긋난다.
강의는 2015년 DARPA Robotics Challenge와 이후 Boston Dynamics의 영상을 통해, 정교한 하드웨어도 인식·추정·계획의 작은 오차에 민감할 수 있음을 보여준다. 예를 들어 발이 예상보다 일찍 장애물에 닿으면 지지 상태가 바뀌고, 이후의 움직임도 연쇄적으로 달라진다.
로봇 학습은 이런 차이를 데이터에서 다룰 방법을 제공한다. 다만 학습 정책 역시 센서의 종류와 지연, 훈련에서 본 오차 범위에 영향을 받으므로, 인식과 제어를 이어서 평가해야 한다.
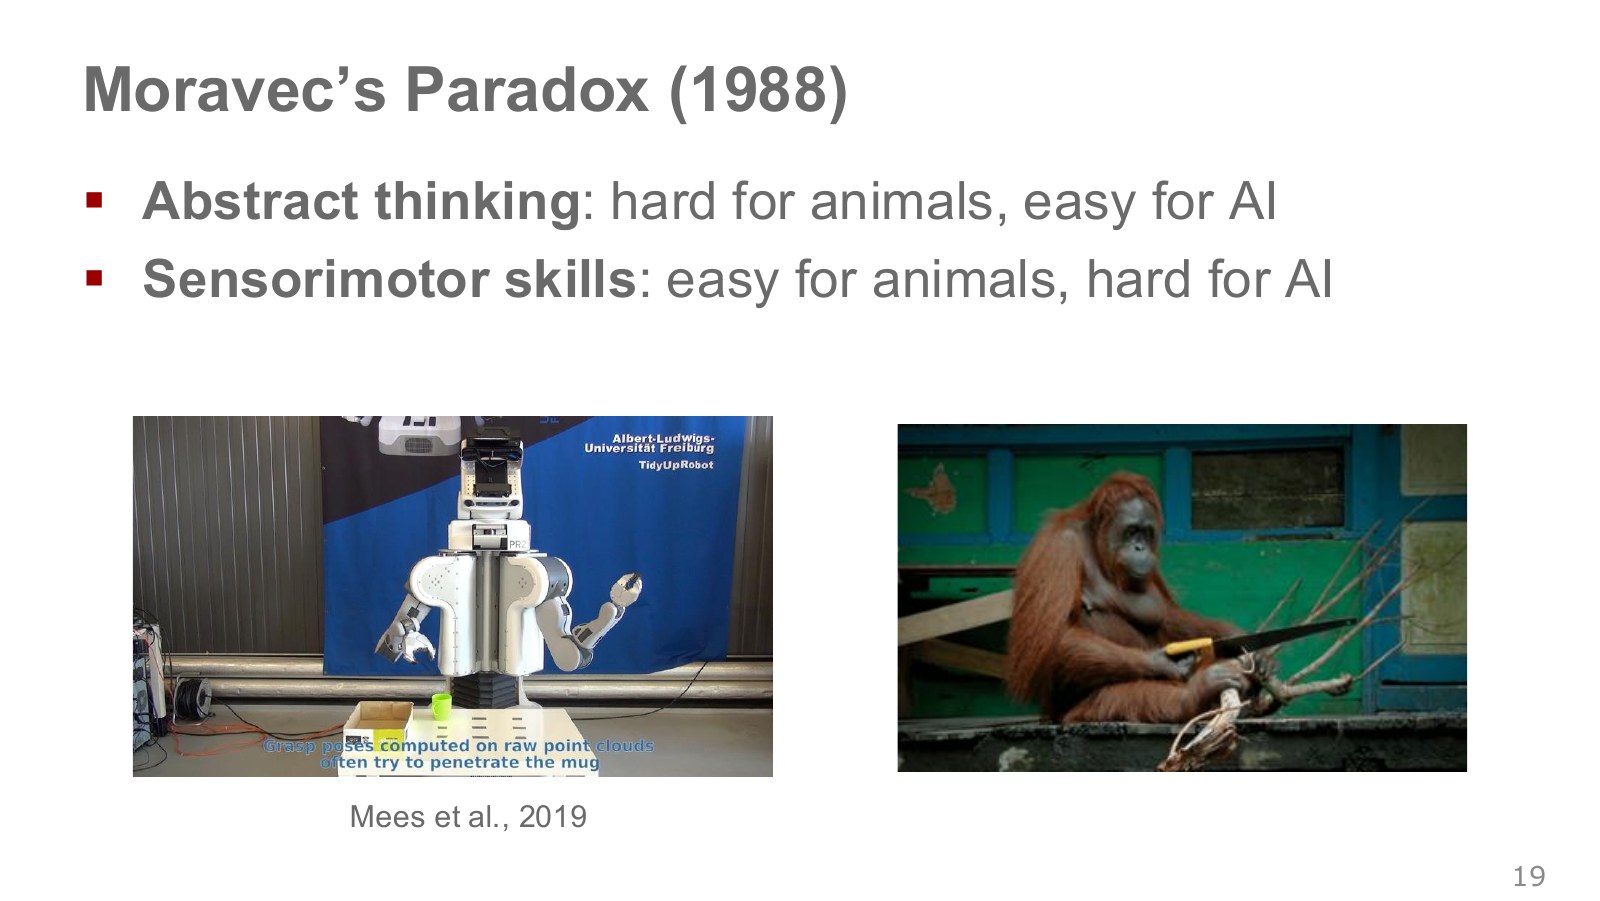
사람에게 어려운 추상적 문제를 컴퓨터가 잘 풀더라도, 사람이나 동물이 자연스럽게 하는 감각·운동 능력은 구현하기 어려울 수 있다. 이를 설명하는 관점이 모라벡의 역설(Moravec’s Paradox)이다.
컵을 집는 일에는 물체의 3차원 형태, 재질, 마찰, 접촉 위치와 힘 조절이 한꺼번에 들어간다. 슬라이드 왼쪽의 PR2 사례는 추정한 파지 위치가 컵과 맞지 않거나 힘이 부적절할 때 생기는 어려움을 보여준다. 오른쪽의 도구를 사용하는 동물과 대비하면, 일상적인 신체 기술에 얼마나 많은 경험이 축적되어 있는지 생각하게 된다.
로봇이 실패했을 때 ‘지능이 부족하다’고만 말하면 해결할 대상을 찾기 어렵다. 물체 표현이 틀렸는지, 접촉을 예측하지 못했는지, 힘을 잘못 적용했는지 나누어야 어떤 데이터를 더 모으고 어떤 모델을 바꿀지 정할 수 있다.
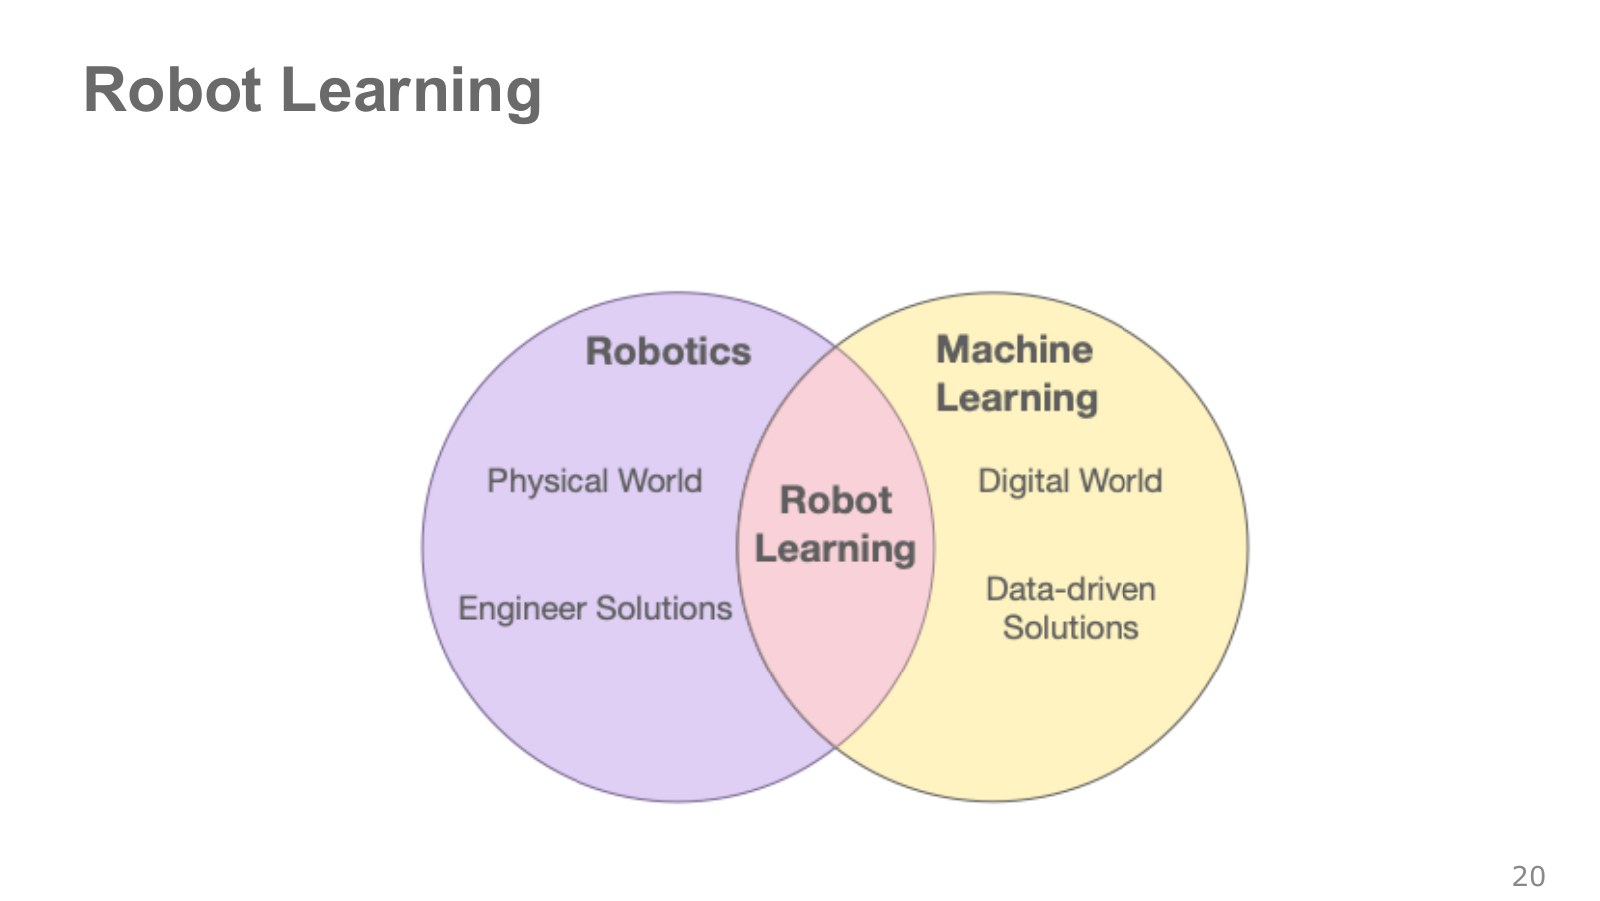
로봇 공학은 센서·기구·구동기·물리 법칙을 바탕으로 실제 세계의 문제를 푼다. 머신러닝은 데이터에서 반복되는 구조를 찾아 새로운 입력에도 적용할 수 있는 함수를 학습한다. 로봇 학습은 이 두 분야의 교차점에 있다.
컵의 위치를 매번 사람이 좌표로 적어 주는 대신 영상에서 찾게 하고, 모든 물체의 파지 규칙을 손으로 작성하는 대신 다양한 시연에서 행동을 배우게 하는 것이다. 그렇다고 기하학과 제어가 사라지는 것은 아니다. 학습한 인식 모델, 보정된 좌표 변환, 설계한 제어기를 함께 사용하는 시스템도 가능하다.
무엇을 데이터로 배우고 무엇을 구조와 물리 모델로 정할지는 문제의 특성에 따라 달라진다.
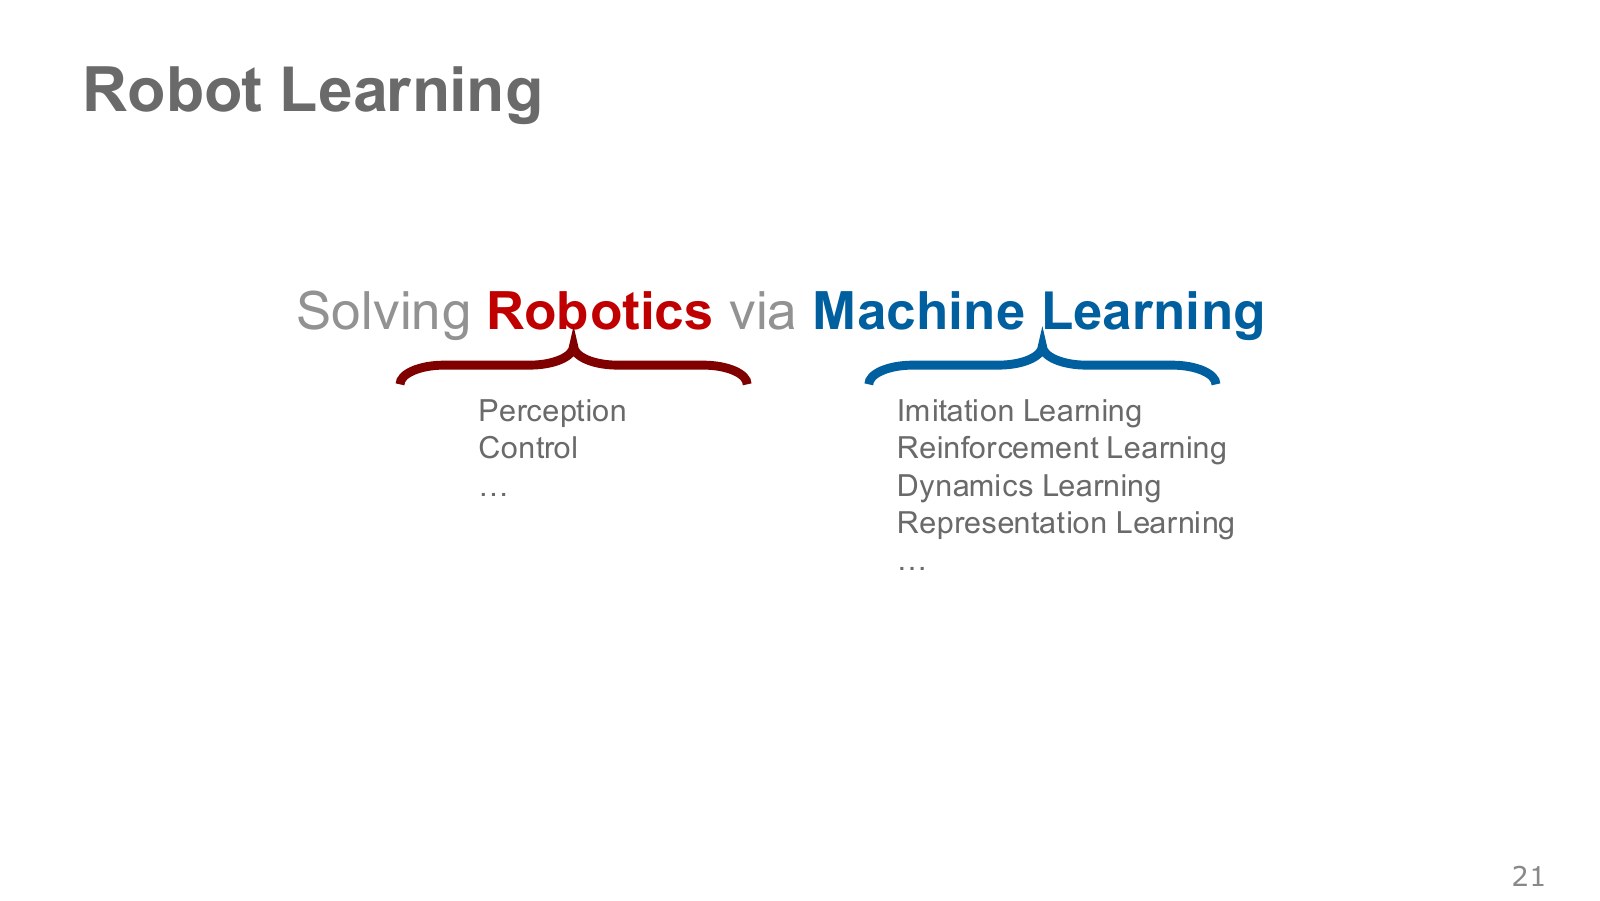
슬라이드 왼쪽은 해결할 로봇 문제이고, 오른쪽은 사용할 학습 도구다. 인식은 세상을 어떻게 읽는가에 관한 문제이며, 제어는 몸을 어떻게 움직이는가에 관한 문제다.
학습 도구에는 전문가 행동을 따라 배우는 모방학습, 보상을 이용해 행동을 개선하는 강화학습, 행동 이후의 상태를 예측하는 동역학 학습, 필요한 정보를 압축해 표현하는 표현학습 등이 있다.
예를 들어 같은 로봇 팔도 카메라 특징은 표현학습으로 얻고, 초기 정책은 시연으로 학습하며, 이후 작업 성공 보상으로 개선할 수 있다. ‘어떤 로봇인가’와 ‘어떤 학습 방법을 썼는가’는 서로 다른 질문이다.
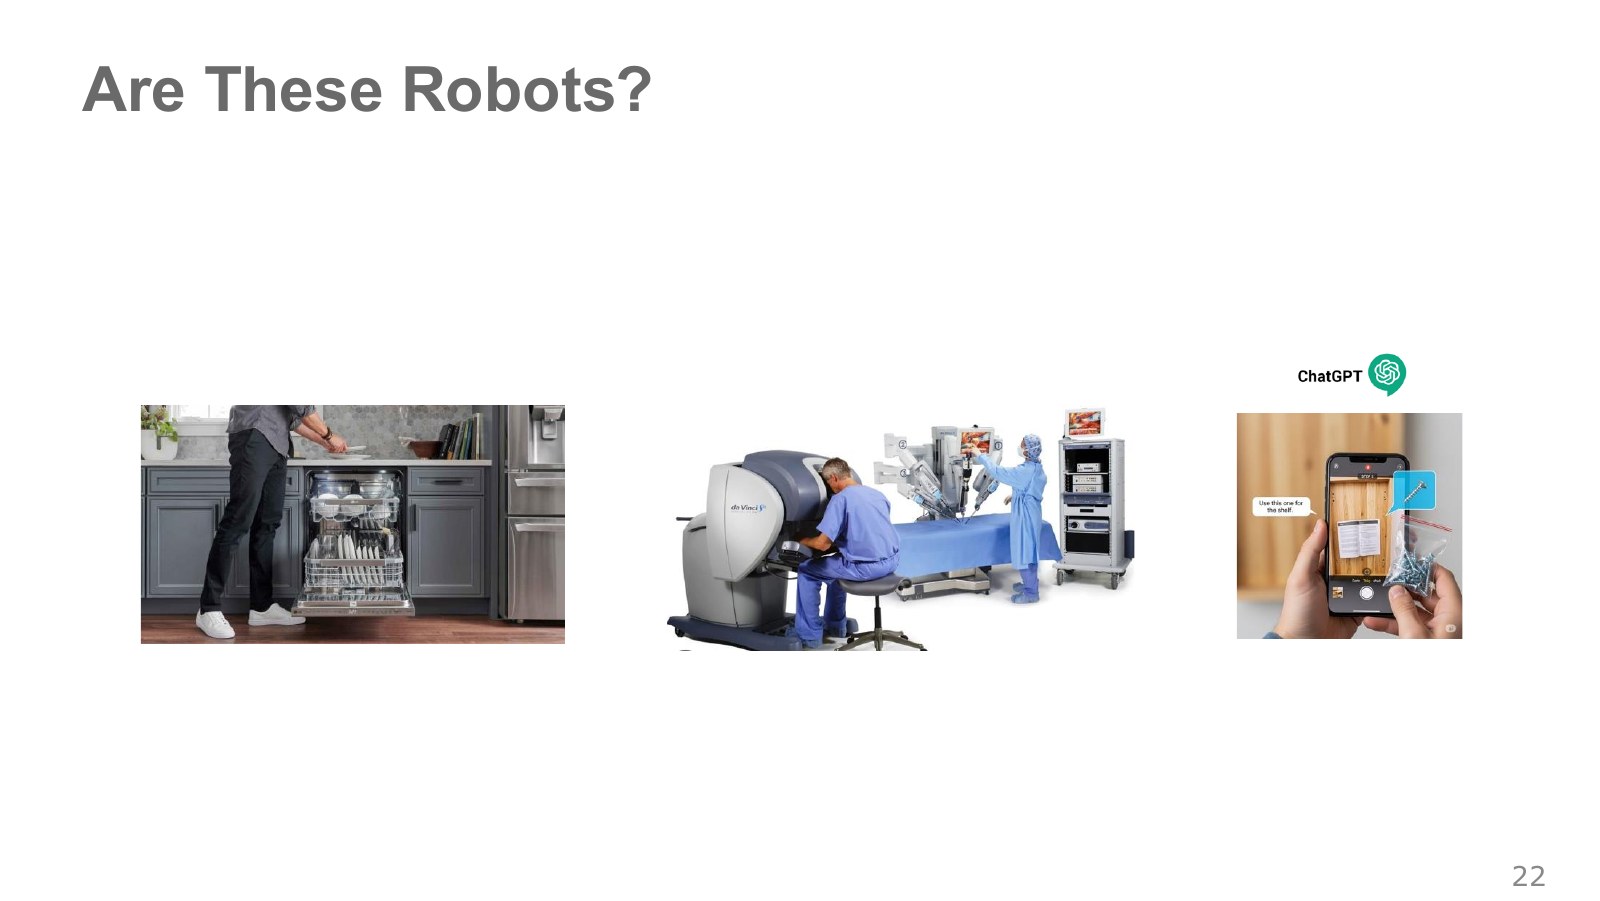
식기세척기는 물을 뿌리고 기구를 움직여 물리적 상태를 바꾼다. 수술 로봇은 사람의 입력을 정교한 기구 움직임으로 옮긴다. 스마트폰의 ChatGPT는 언어·영상 정보를 처리하지만, 그 자체가 주변 물체를 움직이는 몸은 아니다.
이 비교에서 물리적인 몸, 행동을 결정하는 주체, 자동으로 수행하는 범위를 나누어 보자. 원격 조작 로봇도 로봇이지만 자율 로봇과는 제어 구조가 다르다. 로봇이라는 말과 자율적이라는 말을 같은 뜻으로 쓰면 이 차이가 사라진다.
로봇 학습이 지향하는 것은 물리적 행동 능력과 상황에 따른 판단을 결합하는 일이다. 추론 결과가 실제 행동으로 이어지고, 행동 결과를 다시 관측하는 연결이 필요하다.
ETH 영상 38:05–40:35의 토론에서 중요한 것은 세 기계에 이름표를 붙이는 일보다 어떤 능력을 결합하려는지다. 강의는 가전제품의 신뢰성, 수술 팔의 정교한 물리적 조작, 파운데이션 모델의 폭넓은 의미 이해를 함께 지향한다. 예를 들어 ‘컵을 치워 줘’라는 요청을 이해하는 능력만으로는 컵을 깨뜨리지 않는 힘 조절이나 반복 가능한 동작이 따라오지 않는다. 성공적인 시스템에는 이 능력들의 연결이 필요하다.
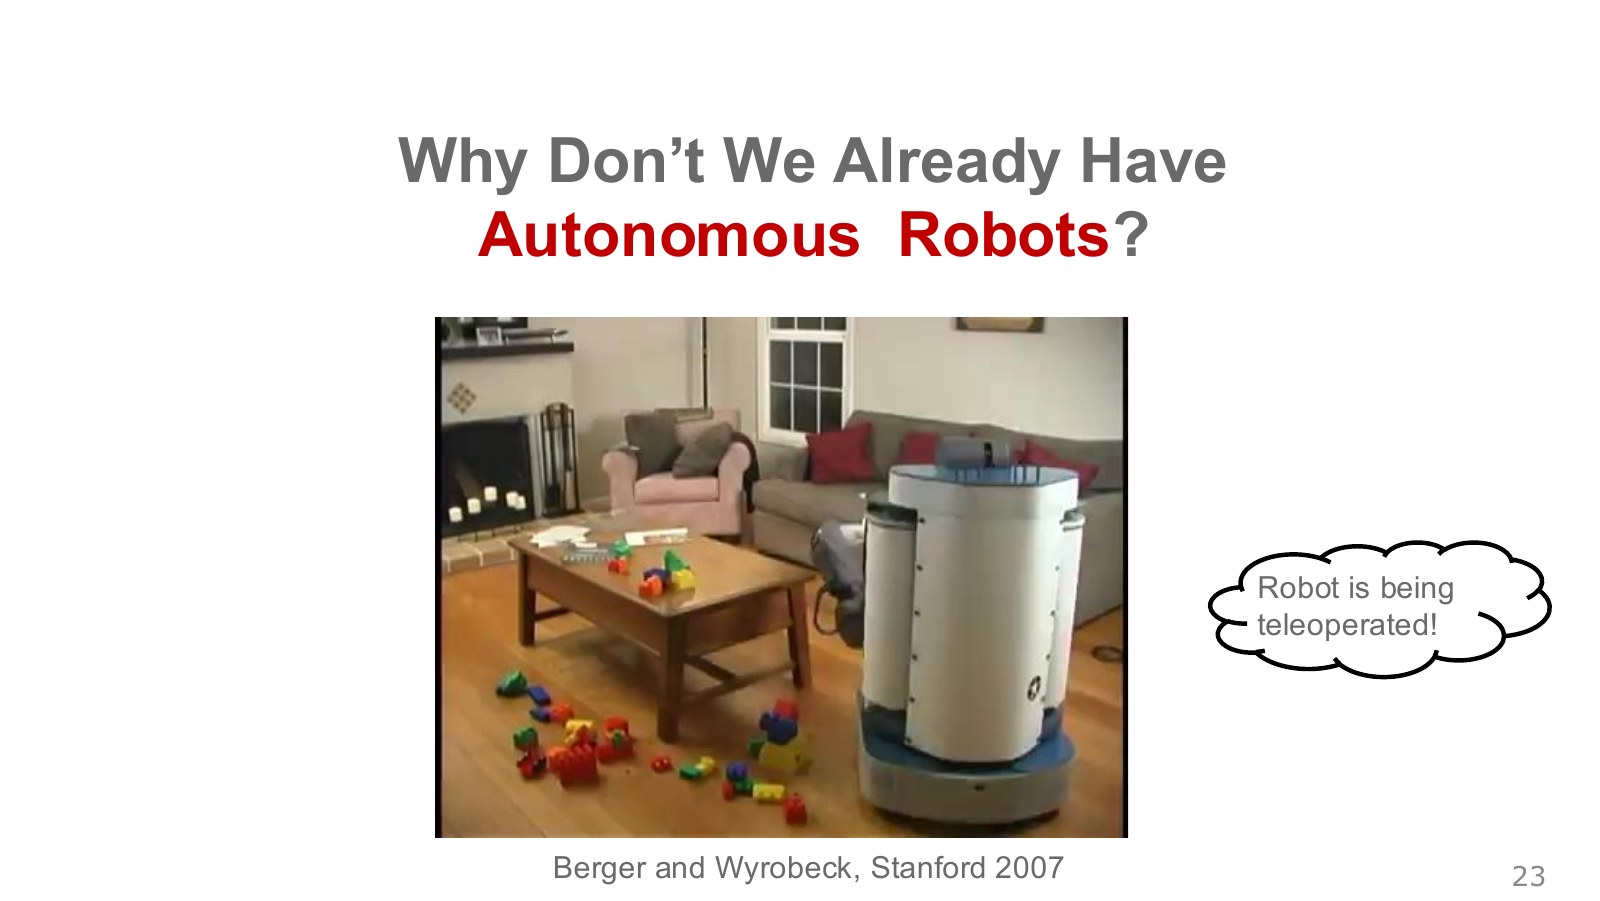
2007년 Stanford의 PR1 영상은 로봇이 방 안의 물건을 정리하는 모습을 보여준다. 슬라이드의 말풍선은 이 로봇을 사람이 원격 조작(Teleoperation)하고 있었다고 명시한다.
이 사례는 하드웨어가 할 수 있는 움직임과 로봇이 스스로 결정할 수 있는 행동의 차이를 드러낸다. 물건을 집어 옮길 팔과 집게가 있어도, 어떤 물건을 어디서 어떻게 잡고 다음에 무엇을 할지 결정하는 정책은 필요하다.
원격 조작은 학습 데이터 수집에도 쓰인다. 사람이 보여준 관측–행동의 연결을 기록하고, 이를 정책 학습에 이용하는 것이다. 다만 사람이 조작한 성공 장면과 학습한 정책의 자율 실행 결과는 구분해서 보아야 한다.
시연 데이터를 만들 때는 성공 영상만 저장하는 것으로 충분하지 않다. 학습하려는 정책이 실행 때 볼 카메라·관절 관측과, 그 순간 사람이 내린 행동을 시간에 맞춰 기록해야 한다. NTU 모방학습 강의 5:14–7:49는 전문가의 상호작용 기록을 관측–행동 학습 문제로 바꾸는 과정을 설명한다. 로봇 팔을 사람이 직접 이끌어 보여주거나 원격으로 조작하더라도, 최종적으로는 ‘이 정보를 보았을 때 어떤 명령을 냈는가’를 학습 가능한 짝으로 구성하는 것이다.
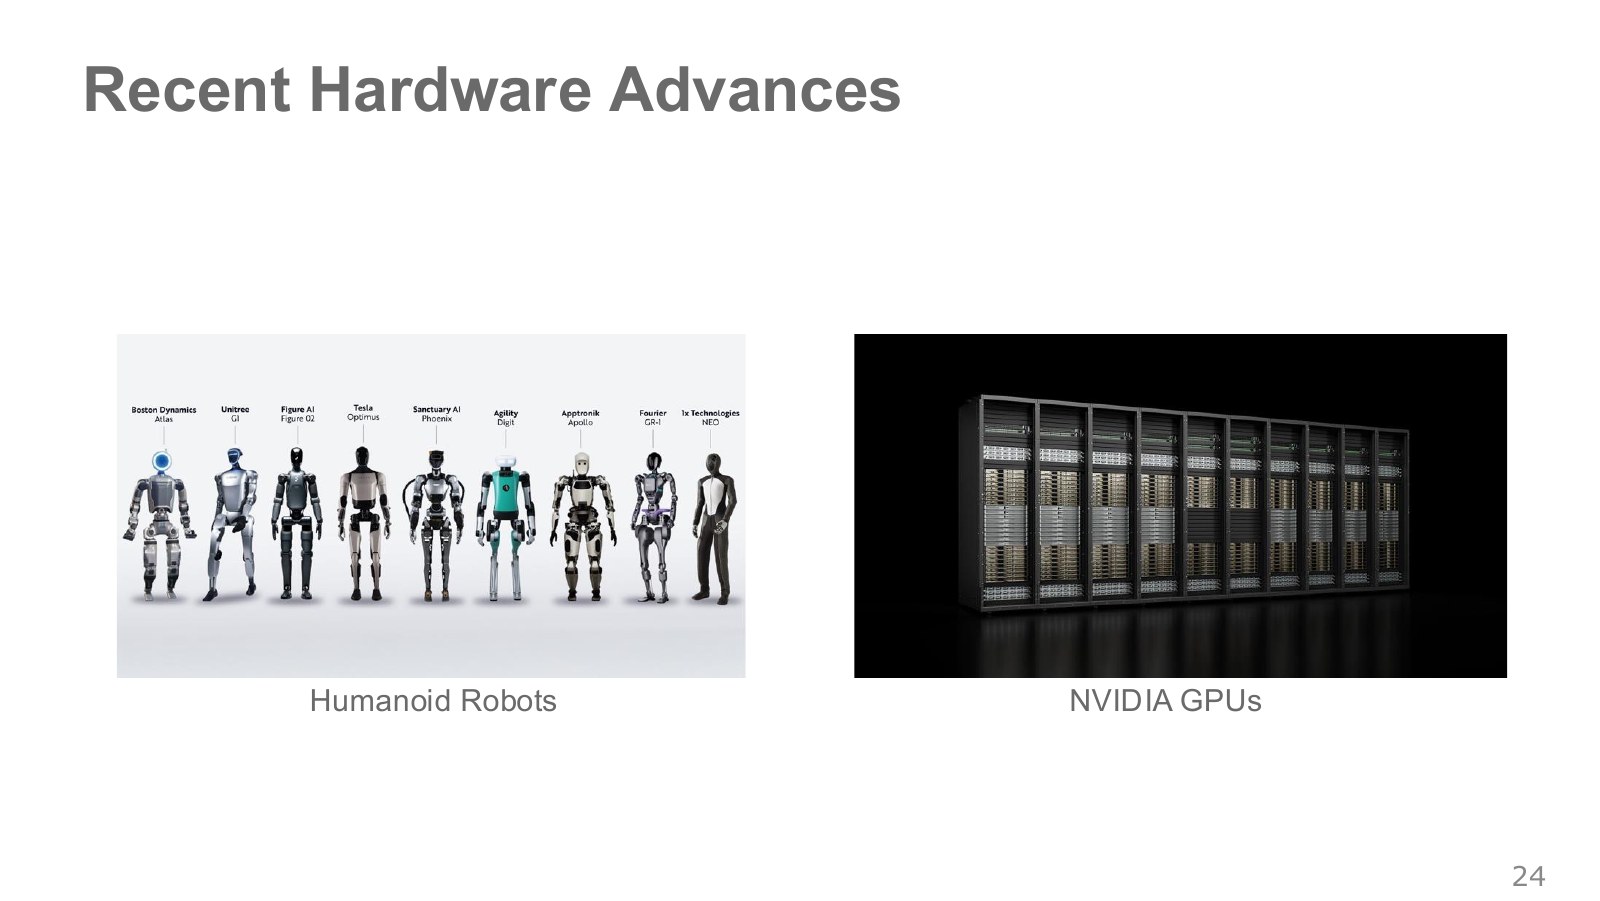
슬라이드 왼쪽은 다양한 휴머노이드 플랫폼이고, 오른쪽은 대규모 학습을 뒷받침하는 NVIDIA GPU 시스템이다. 로봇이 할 수 있는 움직임이 늘어난 동시에, 더 큰 모델과 더 많은 데이터를 다룰 계산 자원도 발전했다.
두 변화는 서로 다른 병목을 푼다. 손의 구조와 구동기는 가능한 접촉과 힘을 정하고, 계산 자원은 모델 학습과 추론의 규모에 영향을 준다. 좋은 몸체만으로 행동 지능이 생기지는 않으며, 큰 모델도 행동 인터페이스와 연결되어야 한다.
작은 실습에서는 먼저 관측·행동·보상의 의미를 확인하고, 실제 병목에 맞춰 병렬 시뮬레이션이나 GPU 학습을 활용하는 순서로 접근할 수 있다.
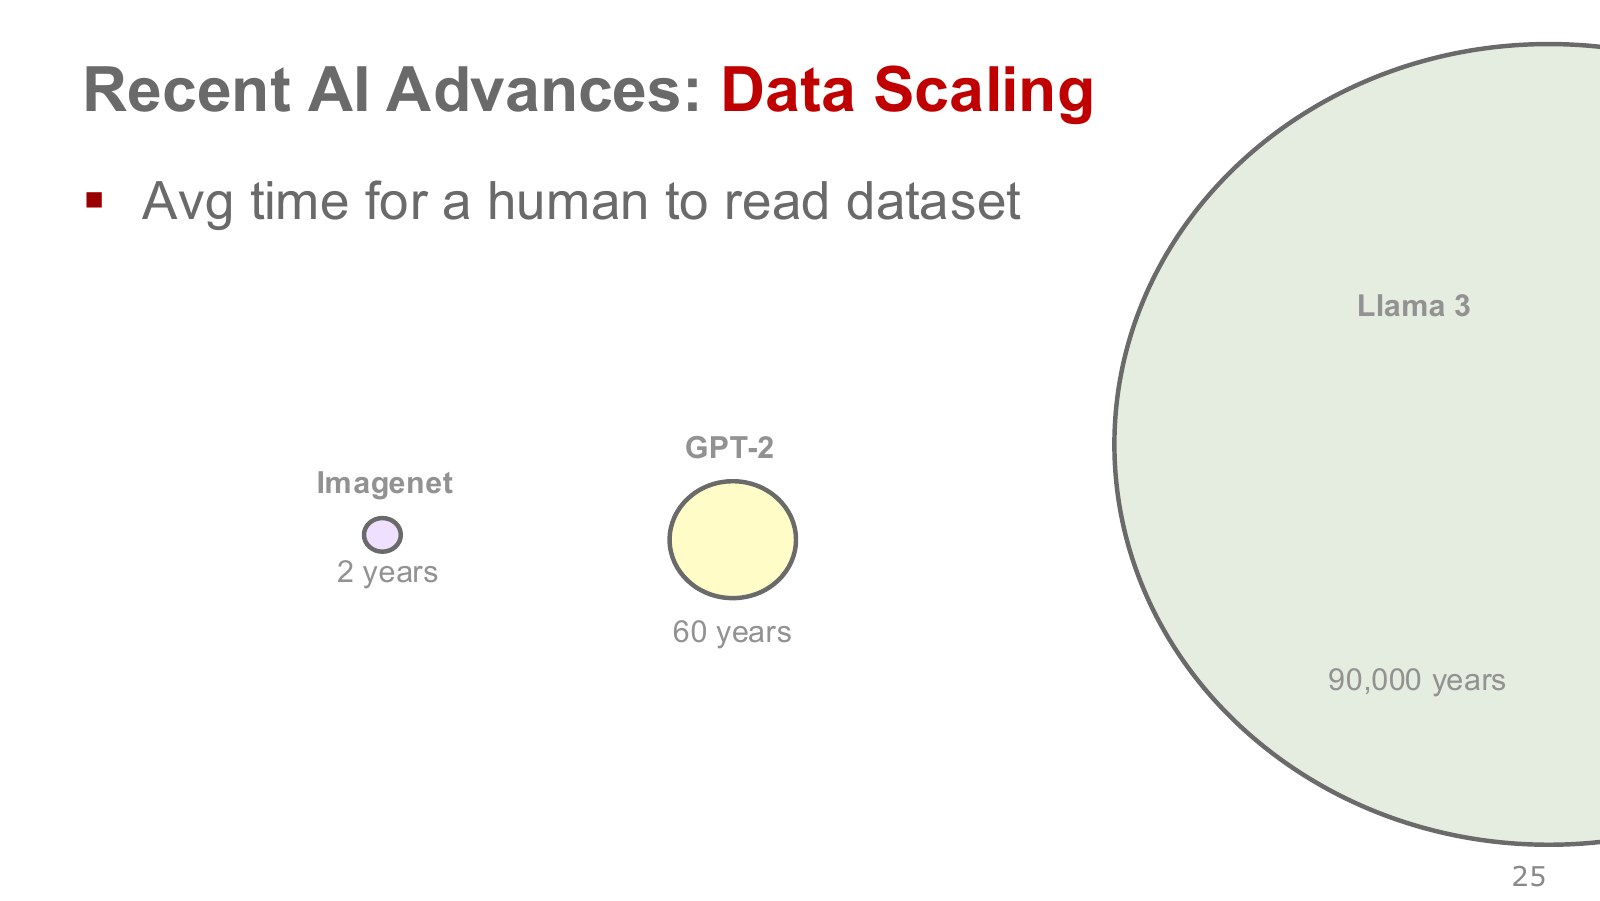
강의는 데이터 규모를 사람이 읽는 데 걸릴 시간에 빗대어 ImageNet, GPT-2, Llama 3를 비교한다. 이 비유의 요점은, 최근 모델이 한 사람이 직접 경험하거나 읽기 어려운 규모의 정보를 학습한다는 점이다.
이때 슬라이드의 연수는 강의에서 사용하는 설명용 환산이다. 원의 크기가 정확한 비율을 뜻하지도 않는다. 이미지 수, 텍스트 토큰 수, 로봇의 행동 궤적 수는 서로 다른 단위이므로 숫자만 나란히 놓아 학습의 난이도를 비교할 수는 없다.
로봇 데이터에서는 양과 함께 작업·물체·환경·로봇 형태의 다양성이 중요하다. 같은 장면을 연속으로 촬영한 많은 프레임과, 서로 다른 실패·복구 상황을 담은 궤적은 다른 정보를 제공한다.
연속된 프레임을 서로 다른 경험처럼 세면 데이터의 다양성을 과대평가하기 쉽다. DeepMind/UCL 1강 1:15:41–1:16:11은 한 방에서 움직이는 로봇의 입력이 시간적으로 강하게 연결된다고 설명한다. 같은 컵을 조금씩 다른 각도에서 본 수천 장과, 가려진 컵·미끄러운 컵·놓친 컵을 복구하는 수십 회의 시도는 채워 주는 경험의 종류가 다르다. 데이터 규모를 읽을 때 궤적 수와 함께 환경·물체·초기 조건이 얼마나 달라졌는지도 확인하자.
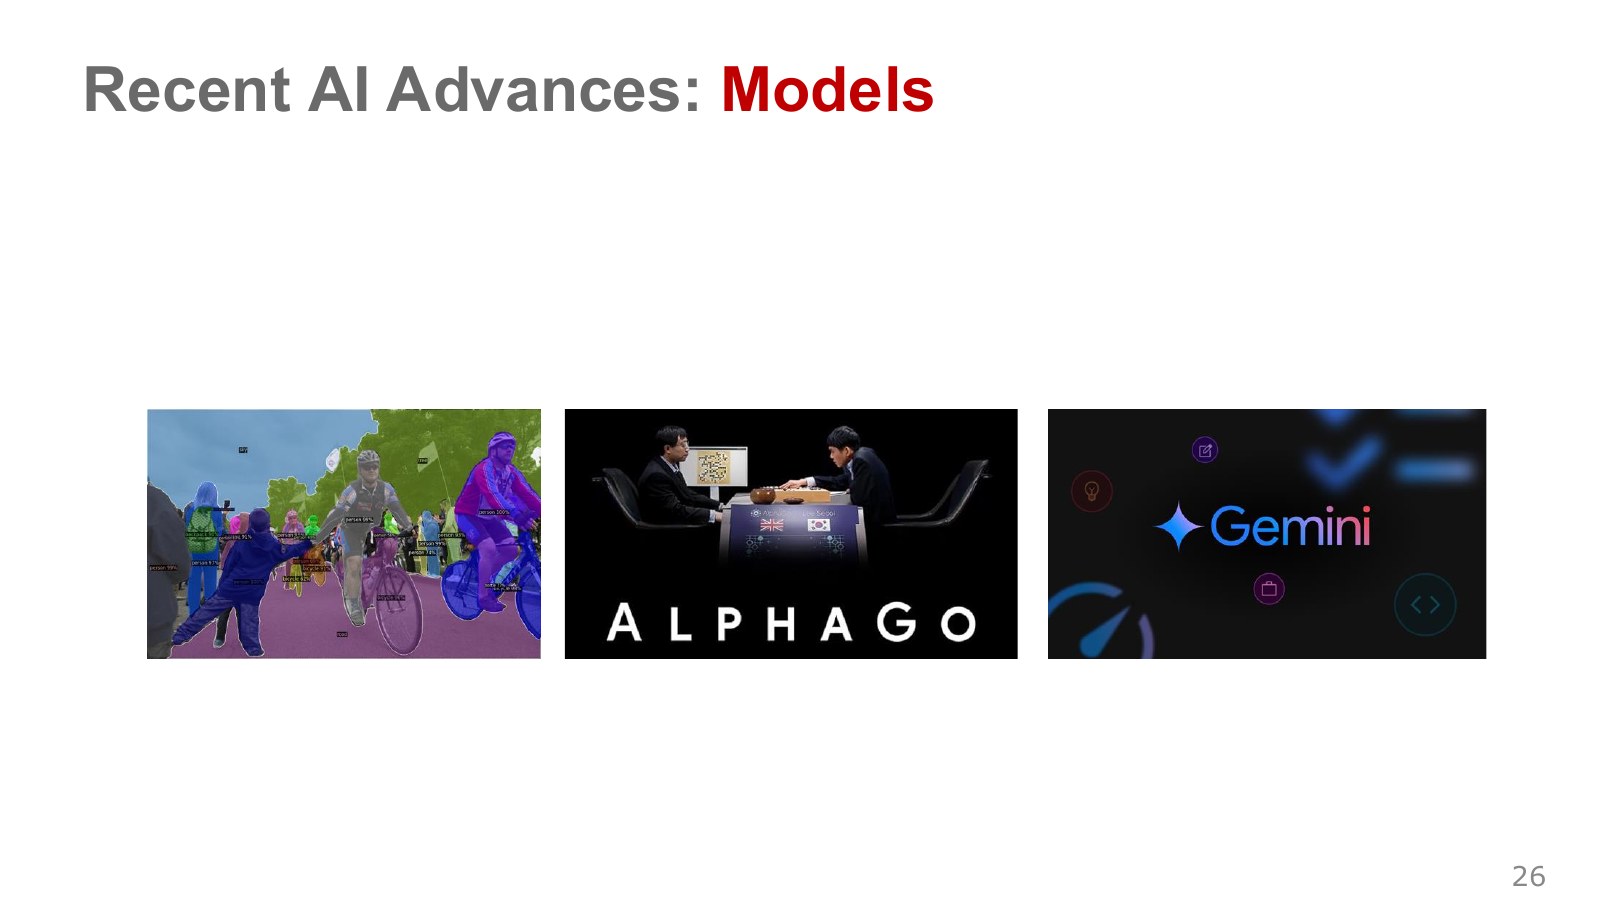
영상 속 물체를 픽셀 단위로 구분하는 모델, 바둑에서 장기적인 수를 선택하는 AlphaGo, 여러 입력 형식을 함께 처리하는 멀티모달 모델은 서로 다른 AI 능력을 보여준다.
로봇에서는 이 능력들이 연결된다. 컵을 찾는 인식, 어떤 순서로 일을 할지 정하는 판단, 말로 주어진 목표를 이해하는 능력이 모두 필요할 수 있다. 다만 이들이 같은 학습 신호로 만들어지는 것은 아니다.
영상 분할의 정답 마스크, 시연된 행동, 게임의 승패 보상은 각기 다른 학습 목표를 만든다. 어떤 성과를 로봇에 옮기려면 모델 구조와 함께 학습 데이터·목표·실행 조건을 살펴보아야 한다.
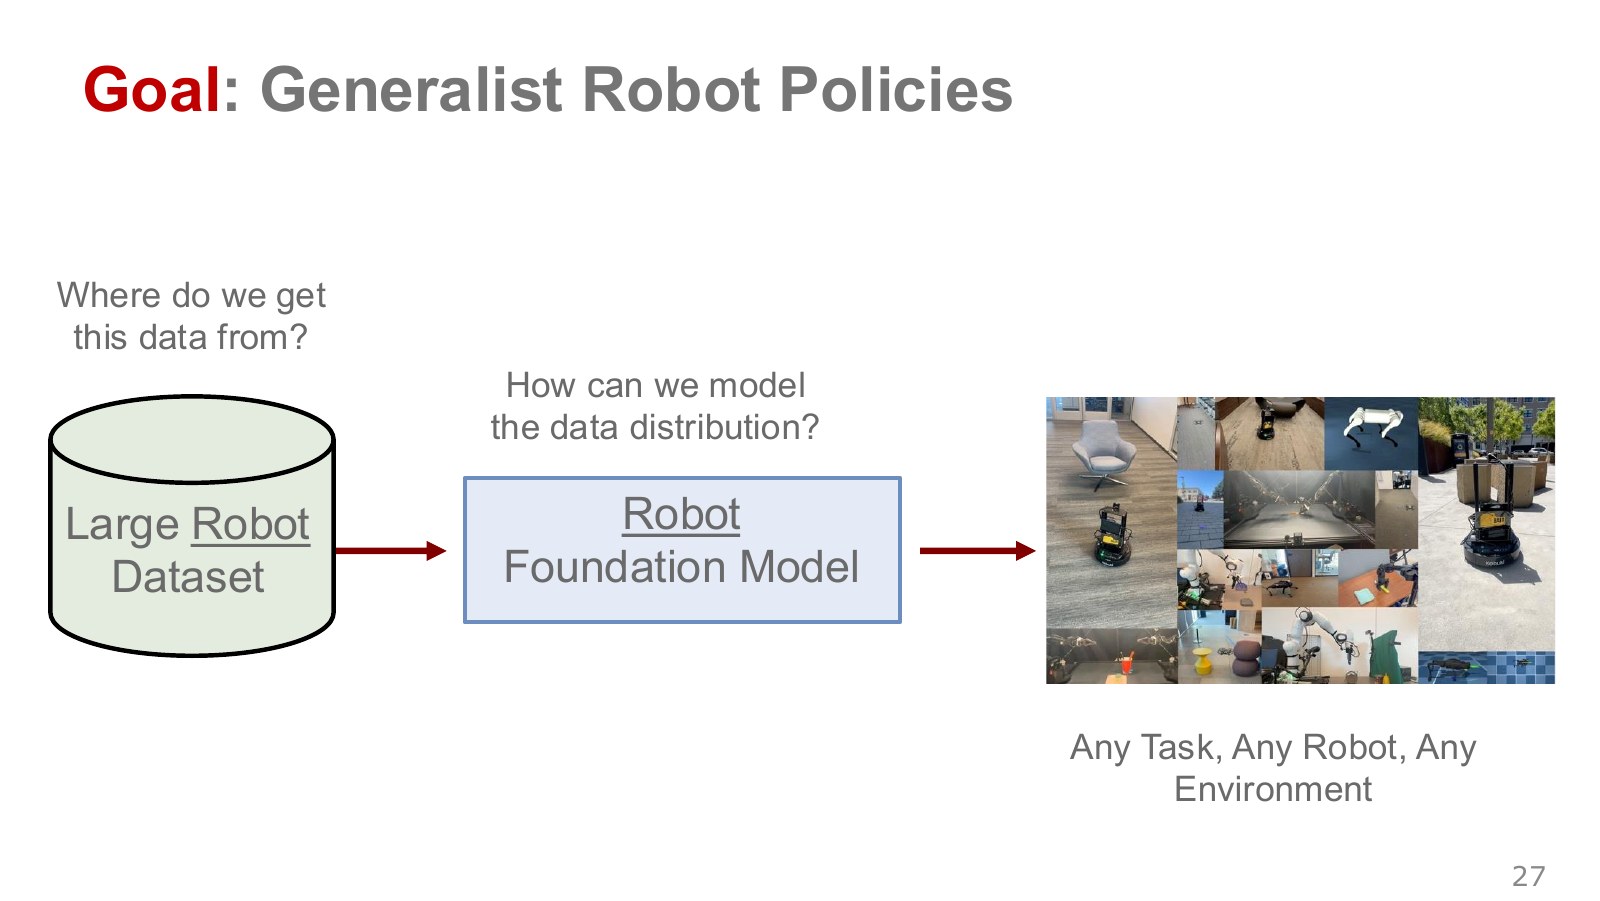
한 물체를 한 위치에서 집는 정책에서 출발해, 여러 물체·작업·로봇에서 사용할 수 있는 정책으로 확장하려는 목표가 범용 로봇 정책(Generalist Robot Policy)이다.
그림은 큰 로봇 데이터셋을 모델에 연결하고 다양한 로봇 행동을 출력하는 흐름을 보여준다. 이 목표에는 두 질문이 따라온다. 다양한 경험을 어디서 모을 것인가? 서로 다른 경험의 분포를 어떤 모델로 표현할 것인가?
‘범용’은 평가할 축을 나누어 이해하면 명확해진다. 새로운 컵에 적응하는 것, 새로운 방에서 움직이는 것, 처음 보는 명령을 따르는 것, 다른 관절 구조의 로봇으로 옮기는 것은 각각 다른 일반화 문제다.
ETH 1강 47:20–48:10의 범용 정책 구상은 데이터 수집과 이질적인 분포의 모델링을 함께 묻는다. 이를 평가 질문으로 바꾸면 ‘어떤 조합을 학습에서 보았고, 어떤 조합을 시험에서 처음 만났는가’가 된다. 빨간 컵과 파란 그릇으로 학습한 뒤 파란 컵을 시험하는 것과, 처음 보는 집게 구조로 옮기는 것은 다른 능력을 시험한다. 여러 작업에서 성공했다는 문장만으로 모든 로봇에 바로 적용된다고 결론 내릴 수 없는 이유다.
RT-2 논문 2쪽은 웹에서 배운 의미 이해를 기존 로봇 기술의 새로운 조합에 활용하는 것과, 새로운 물리 기술 자체를 습득하는 것을 구분한다. 물건을 집어 놓는 기술을 배웠다면 ‘그 숫자 옆에 놓아라’처럼 새로운 의미의 지시에 그 기술을 활용할 수 있다. 그렇다고 학습 데이터에 없던 모든 도구 사용이나 복잡한 접촉 기술까지 생겼다는 뜻은 아니다. 범용성을 읽을 때는 ‘무엇을 가리키는지 이해했는가’와 ‘필요한 동작을 실제로 할 수 있는가’를 따로 확인하자.
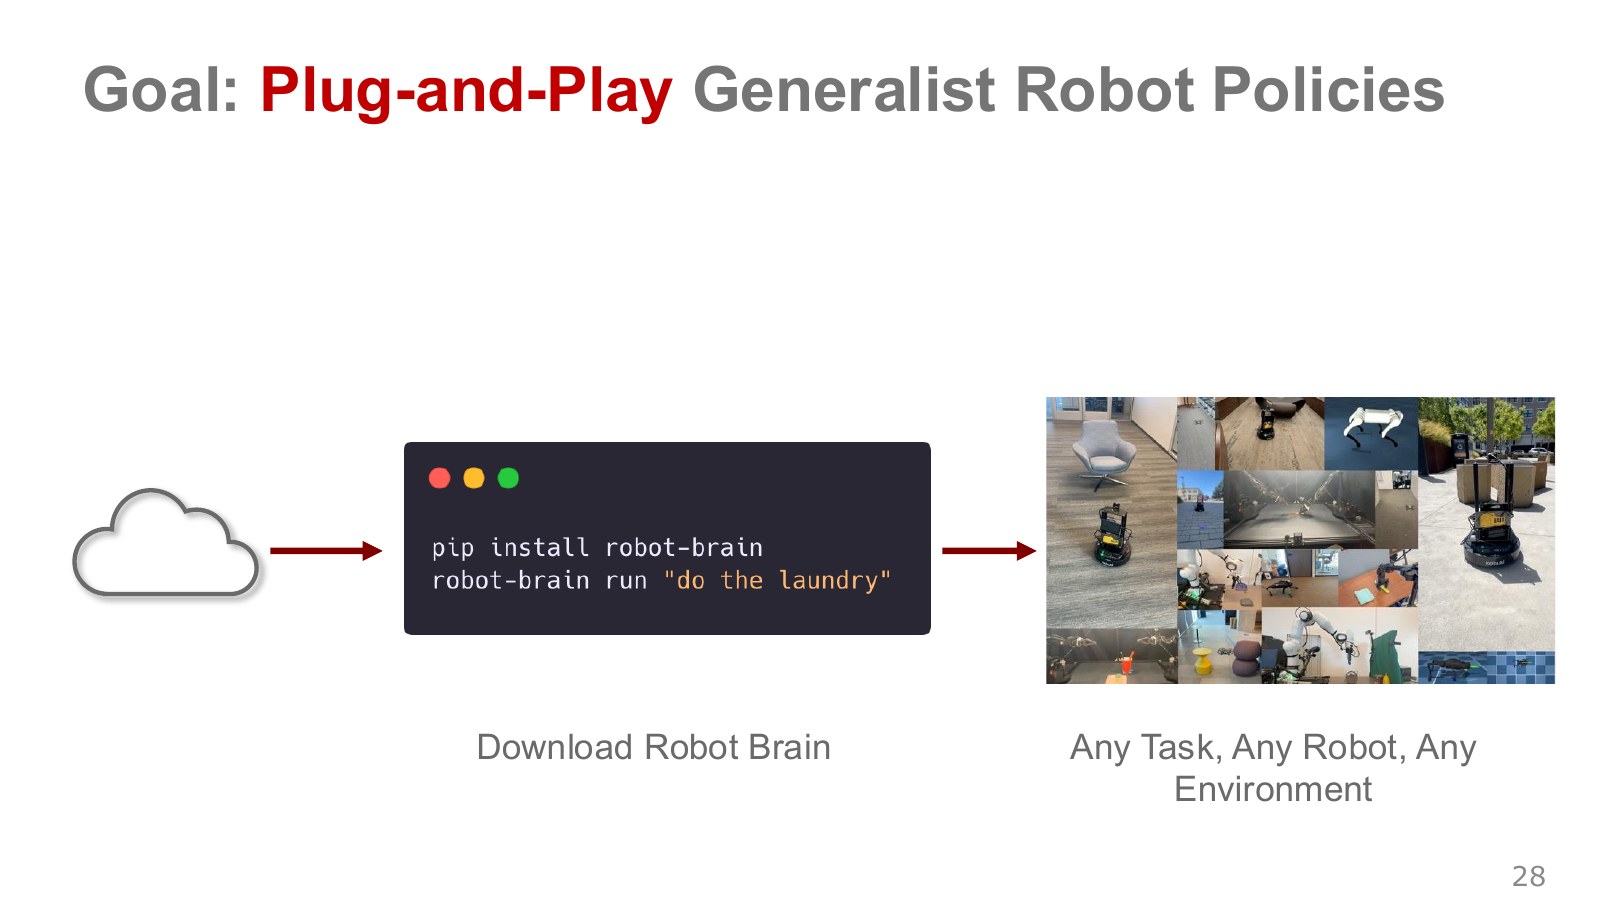
소프트웨어 패키지를 설치하듯 학습된 정책을 받아 로봇에 연결할 수 있다면 어떨까? 슬라이드의 robot-brain 명령은 그 미래를 표현하는 예시다. 그대로 설치해서 쓰는 실제 패키지 안내로 읽을 필요는 없다.
이 목표에 가까워지려면 모델 파일 이외의 약속도 맞아야 한다. 카메라 입력의 순서, 관절 상태의 의미, 행동의 단위, 좌표계, 정규화, 명령 주기가 호환되어야 한다.
출력값 0.1이 0.1 m 이동인지 0.1 m/s 속도인지, 정규화된 관절 목표인지에 따라 결과가 달라진다. 모델의 입력과 출력을 로봇의 실제 센서·구동기에 맞추는 과정이 배포의 핵심이다.
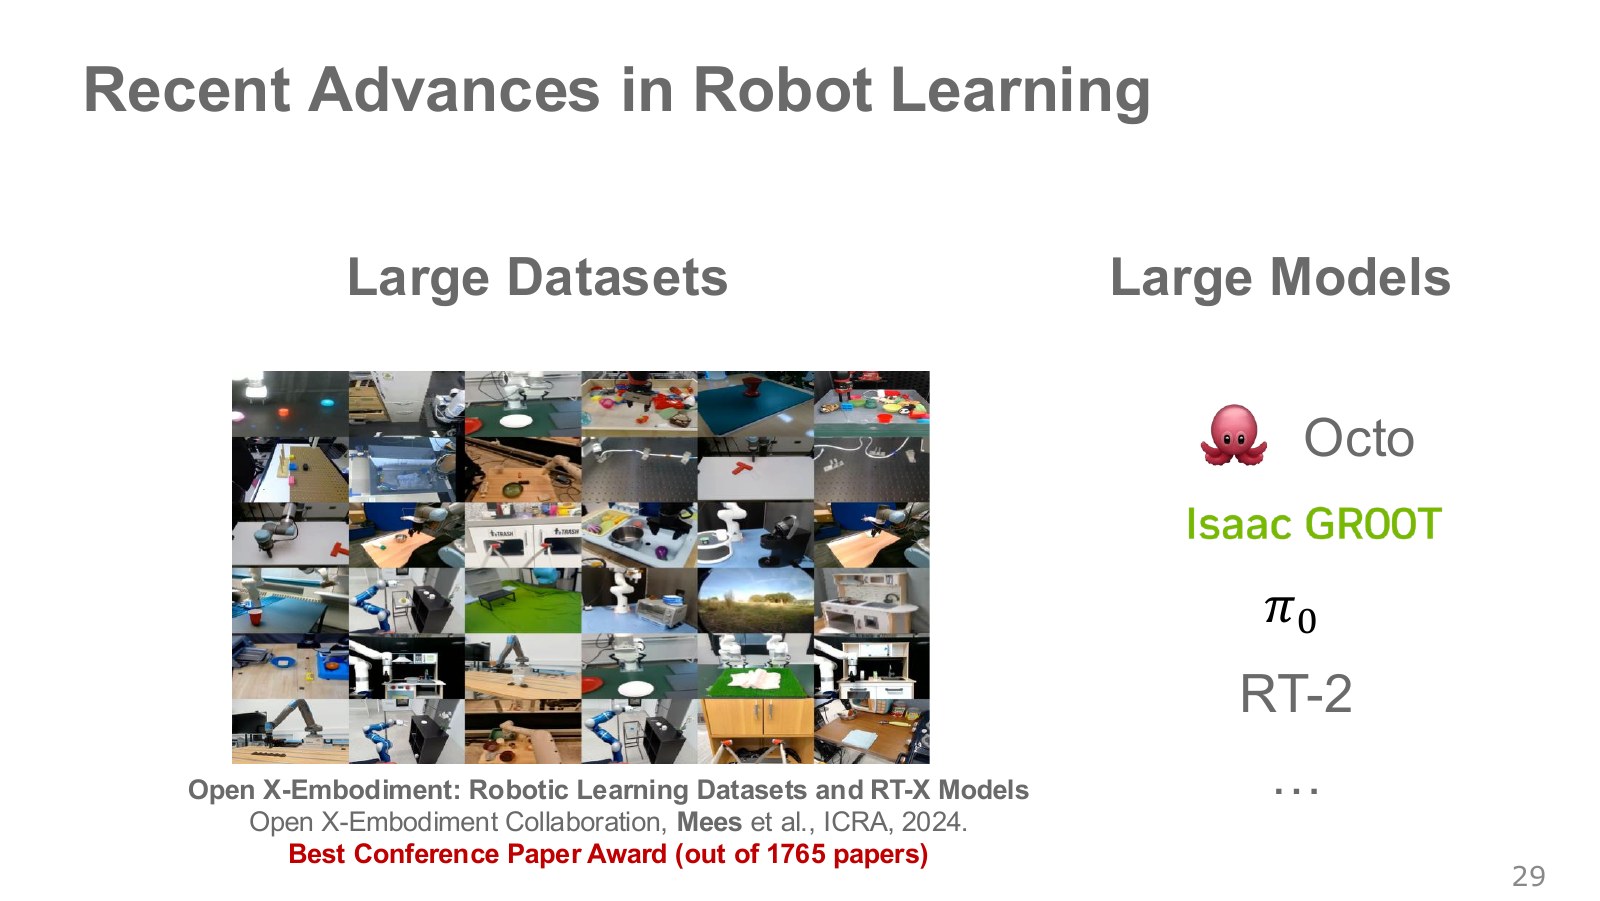
Open X-Embodiment는 여러 로봇에서 모은 데이터를 함께 이용하는 연구의 대표적인 사례다. 서로 다른 로봇의 관측과 행동을 공통 형식으로 연결하면, 한 플랫폼의 경험을 다른 작업과 로봇에도 활용할 기반이 생긴다.
슬라이드 오른쪽에는 Octo, Isaac GR00T, π₀, RT-2 등의 모델이 등장한다. 모두를 하나의 알고리즘으로 묶기보다, 어떤 데이터를 쓰며 어떤 행동을 출력하는지 비교하면 차이가 보인다.
공개 데이터·코드를 읽을 때는 행동 차원과 단위, 카메라 구성, 궤적의 시작·종료 기준부터 살펴보자. 여러 데이터셋을 모았다는 것과 그 의미까지 자동으로 같아졌다는 것은 다르다.
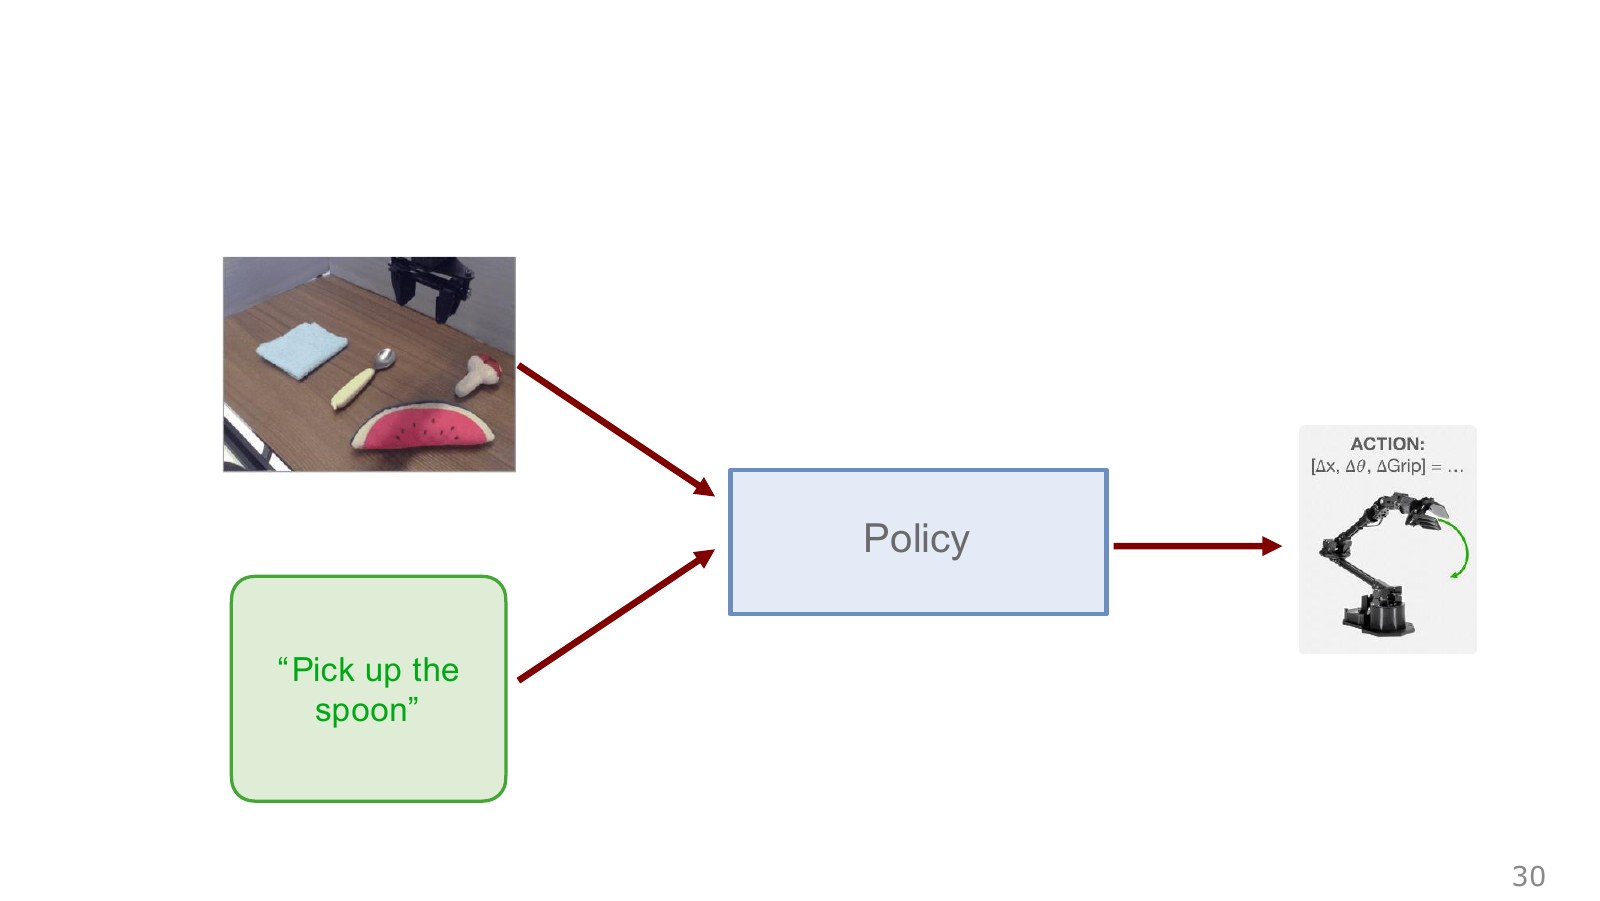
로봇 앞에 숟가락과 다른 물체들이 있고 ‘숟가락을 집어라’라는 지시가 주어졌다고 하자. 정책은 현재 영상과 지시를 함께 읽고, 손을 어느 방향으로 이동하고 회전하며 집게를 언제 닫을지 결정한다.
슬라이드의 행동 표기에는 위치 변화, 회전 변화, 집게 상태가 들어간다. 실제 모델에서는 여러 시점의 행동을 한 번에 예측하는 경우도 있지만, 기본적인 연결은 관측·목표 → 정책 → 행동이다.
관측은 로봇이 이용할 수 있는 정보다. 가려진 부분이나 센서 오차 때문에 실제 세계의 상태를 전부 포함하지 않을 수 있다. 그래서 과거 관측을 함께 사용하거나, 내부 상태를 추정하는 구조가 필요해진다.
DeepMind/UCL 1강 43:52–45:17은 벽을 바라보는 카메라 로봇을 예로 든다. 지금 영상에 벽만 보인다면 로봇 뒤에 무엇이 있는지, 어디서 돌아왔는지 알 수 없다. 같은 영상이라도 과거에 지나온 경로에 따라 다음에 할 행동이 달라질 수 있다. 이것이 부분 관측의 문제다. 현재 관측 하나가 행동 결과를 예측하는 데 필요한 정보를 충분히 담지 못할 수 있다.
우리의 숟가락 예제에서도 손이 숟가락을 가리면 현재 영상만으로 잡았는지 놓쳤는지 판단하기 어렵다. 직전 영상, 집게가 닫힌 정도, 힘 센서 등을 함께 쓰면 판단에 필요한 정보를 보완할 수 있다. 여기서 에이전트의 내부 상태는 이렇게 이용 가능한 정보를 다음 순간으로 이어가기 위한 표현이다. 물리 세계 전체의 상태와 카메라 한 장, 모델 내부의 기억을 같은 뜻의 ‘상태’로 섞어 쓰지 않는 것이 중요하다.
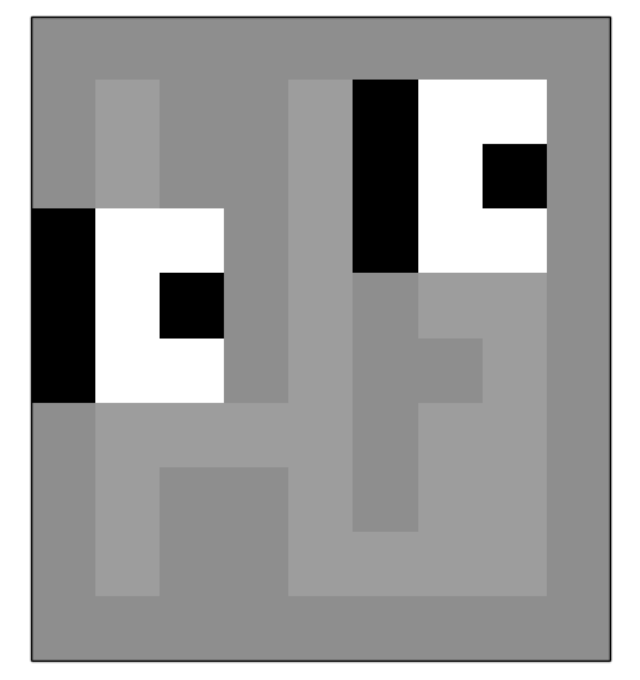
UCL 영상 47:31–51:08의 미로에서는 로봇이 자기 주변의 작은 칸들만 본다. 위 그림의 밝게 드러난 두 영역은 서로 다른 위치지만 같은 국소 모양을 보여준다. 오른쪽 위에서 왼쪽 위의 목표로 가려면 아래로 돌아가야 하는 반면, 왼쪽 통로에서는 위로 가야 한다. 현재 영상만 입력으로 쓰는 결정적 정책은 두 장면을 구별할 정보가 없으므로 같은 행동을 내게 되고, 두 상황 모두에서 최단 경로 행동을 선택할 수 없다.
이 때문에 ‘최근 영상 두 장을 넣으면 해결된다’고도 바로 결론 내릴 수 없다. 비슷한 통로를 연속해서 지나면 두 장을 함께 보아도 모양이 같을 수 있다. 이동 이력이나 위치 추정, 추가 센서처럼 상황을 구별하는 정보가 필요하다. 기억의 길이를 늘리는 것과 문제에 필요한 정보를 실제로 확보하는 것은 다르다.
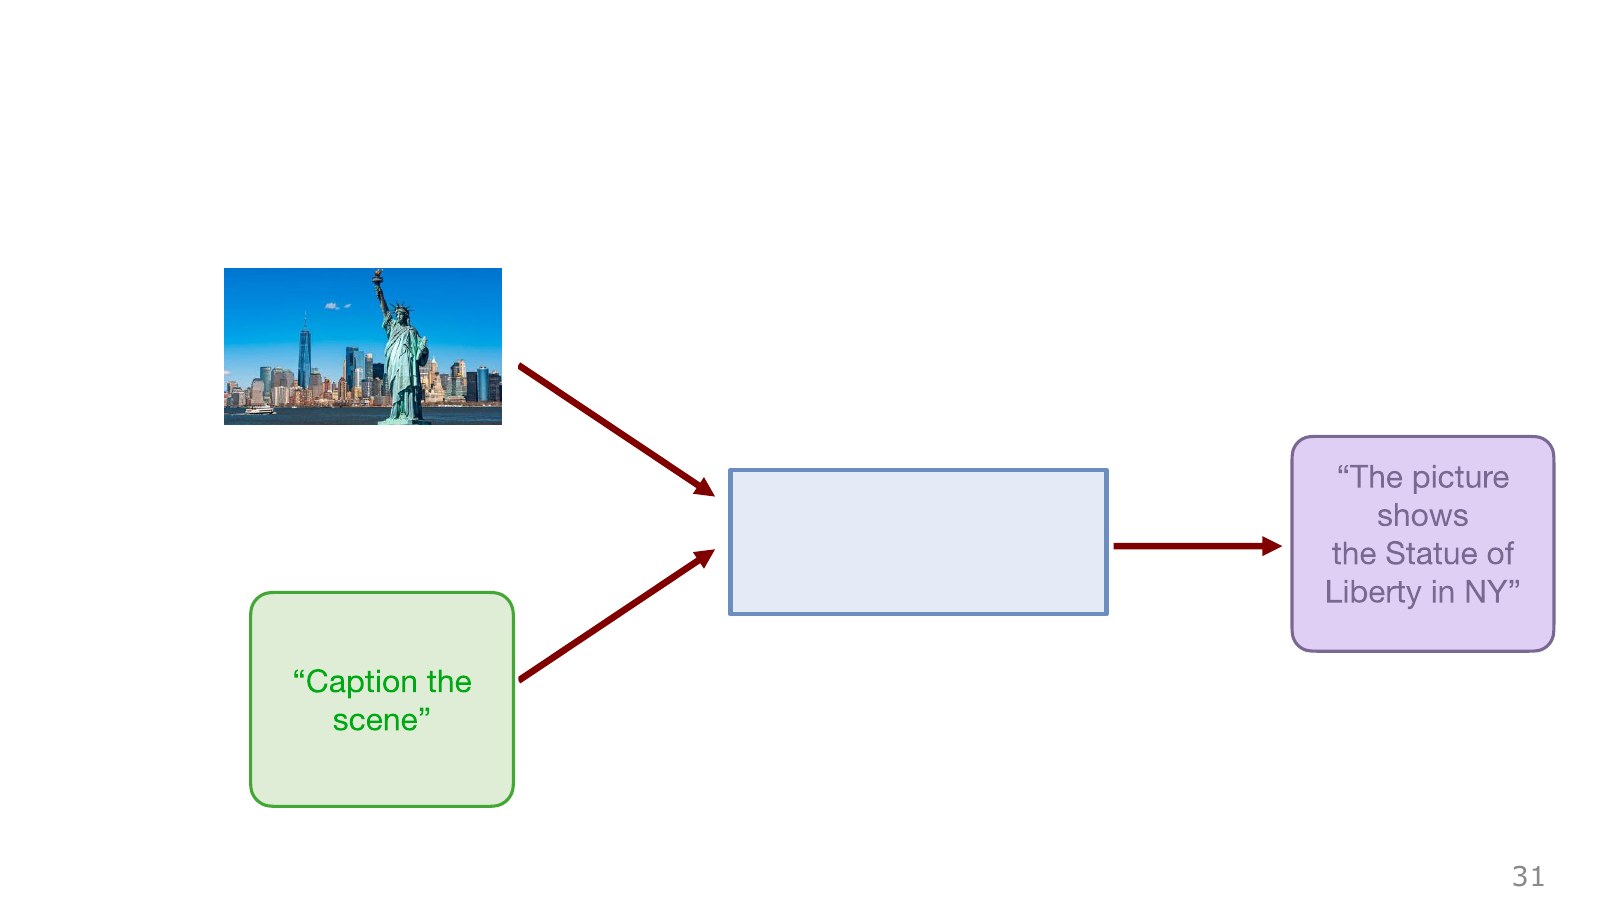
이번에는 로봇 앞의 영상 대신 자유의 여신상 사진을 주고 ‘이 장면을 설명해 달라’고 요청한다. 입력이 이미지와 언어 지시라는 점은 앞의 로봇 정책과 비슷하지만, 출력은 행동이 아니라 문장이다.
이 비교가 중요한 이유는 로봇 정책을 기존 시각·언어 모델과 연결할 수 있기 때문이다. 이미지에서 의미 있는 특징을 찾고 지시와 연결하는 능력을 활용하되, 최종 출력이 로봇 행동이 되도록 학습하는 접근을 생각할 수 있다.
‘숟가락이 탁자 위에 있다’는 설명을 잘하는 능력과, 숟가락을 실제로 집는 능력은 구분된다. 후자에는 접촉, 힘, 실행 시간과 같은 물리적 결과가 포함된다.
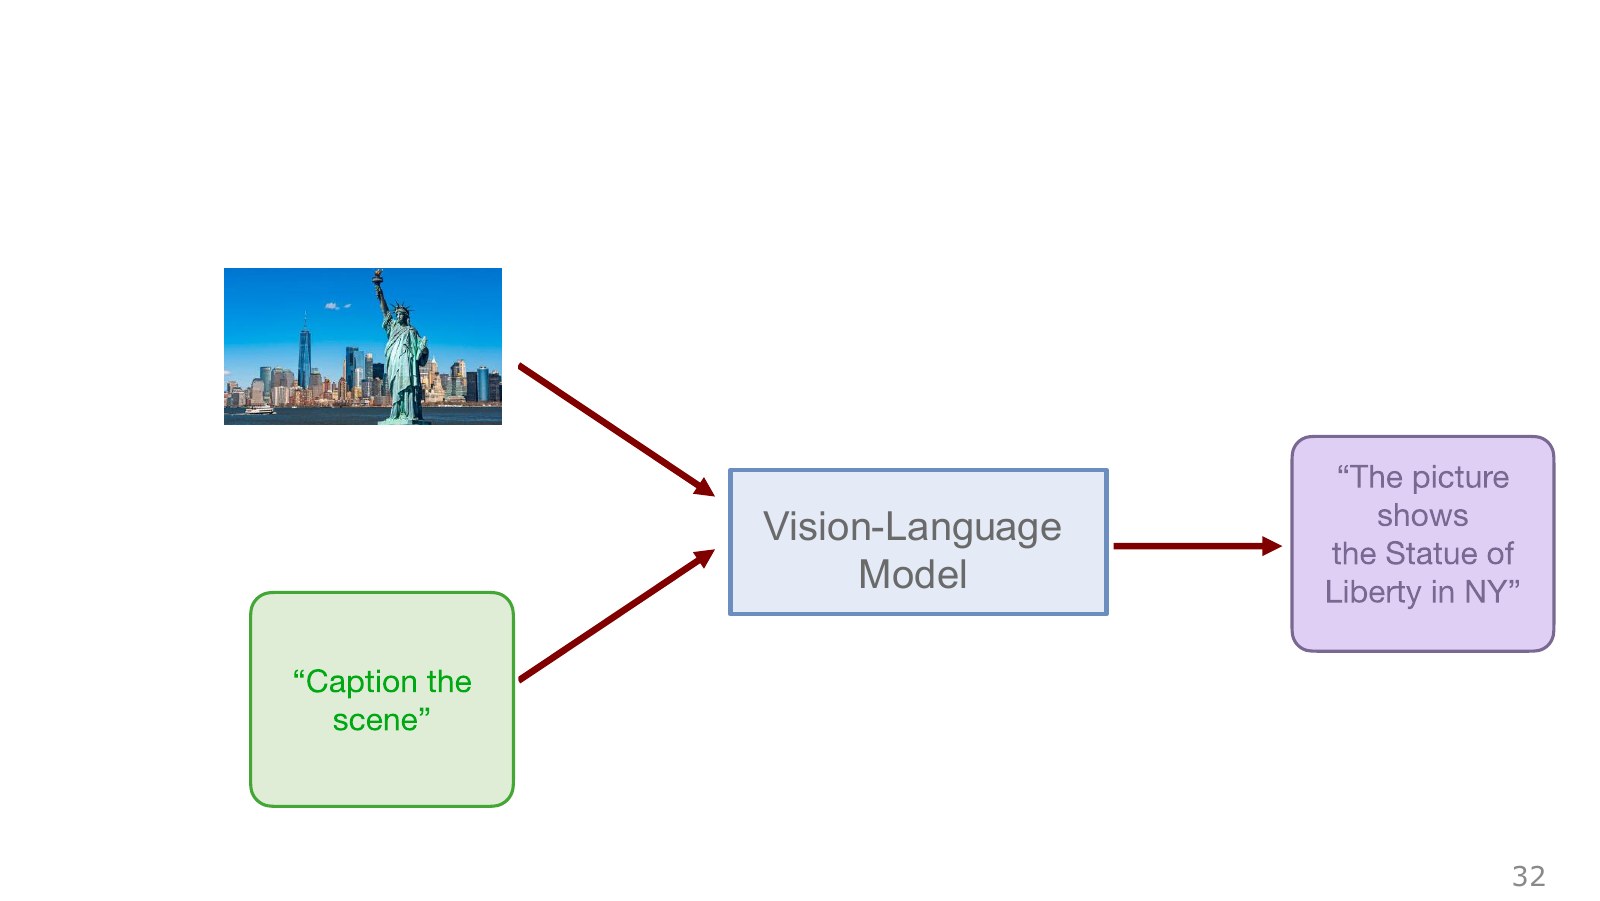
이미지와 언어를 함께 다루는 모델이 시각·언어 모델(Vision-Language Model, VLM)이다. 장면 설명이나 시각적 질의응답을 통해 얻은 표현은 물체의 의미와 작업 지시를 연결하는 데 도움이 될 수 있다.
로봇에 활용할 때는 모델이 만든 설명을 별도 계획기로 보낼 수도 있고, 모델이 직접 행동을 출력하도록 학습할 수도 있다. 행동까지 출력하는 모델을 VLA라고 부른다.
따라서 ‘VLM을 사용했다’는 설명만으로 전체 제어 구조가 정해지지는 않는다. 모델이 정보를 해석하는 지점, 행동을 선택하는 지점, 실제 명령으로 바꾸는 지점을 따라가야 시스템을 이해할 수 있다.
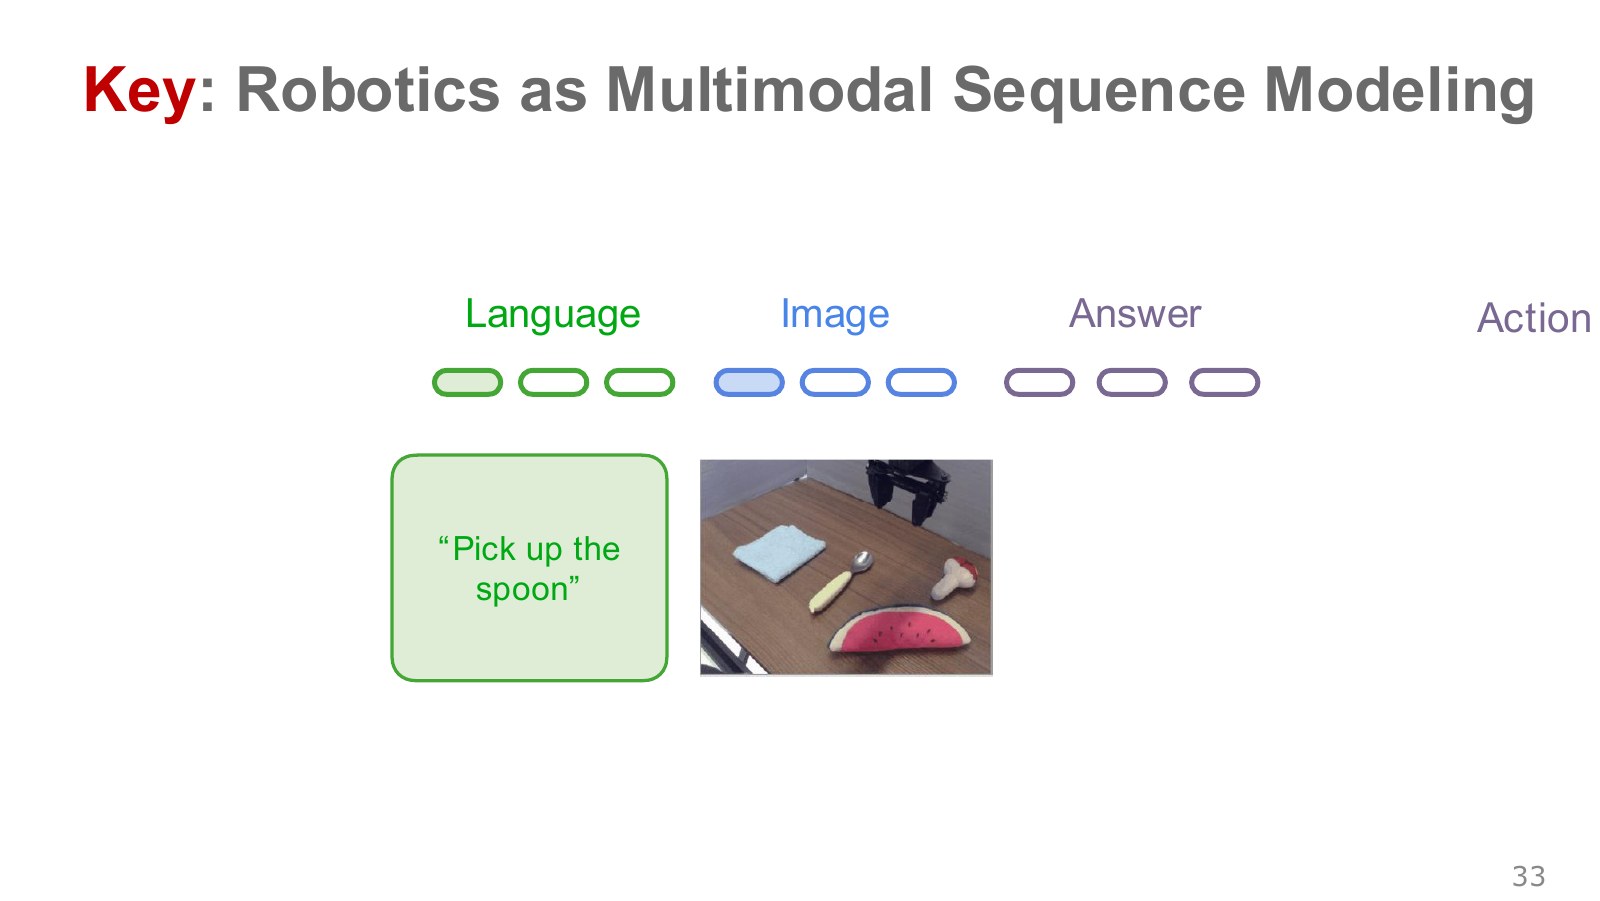
언어를 토큰의 열로 다루듯 이미지와 행동도 모델이 처리할 수 있는 표현의 열로 바꿀 수 있다. 이렇게 하면 이미지·지시·행동을 연결하는 문제를 멀티모달 시퀀스 모델링으로 정식화할 수 있다.
예를 들어 입력에는 ‘숟가락을 집어라’라는 언어 토큰과 현재 영상의 표현이 들어가고, 출력에는 로봇 행동을 나타내는 값이나 토큰이 이어진다. RT-2는 행동을 텍스트 토큰으로 표현하는 구체적인 사례다.
표현 형식을 맞춰도 행동의 물리적 의미는 남는다. 출력값을 위치·회전·집게 명령으로 해석하는 역변환과 제어 인터페이스가 있어야 실제 로봇이 움직인다.
ETH 1강 50:12–52:20의 전개는 로봇 정책의 이미지·지시·행동을 장면 설명 모델의 이미지·질문·문장과 대응시킨다. 입력과 출력을 시퀀스로 다룬다는 계산 틀을 공유하면 영상·언어 분야의 학습 기법을 가져올 수 있다. 다만 예측한 행동은 다시 세계를 바꾸고 다음 관측을 만든다. 예를 들어 ‘집게 닫기’를 맞혔더라도 닫는 시점이 늦어 숟가락을 놓쳤다면, 다음 단계에서는 성공 시연과 다른 입력을 처리해야 한다. 행동 토큰의 예측 정확도와 작업 전체의 성공률을 함께 보는 이유다.
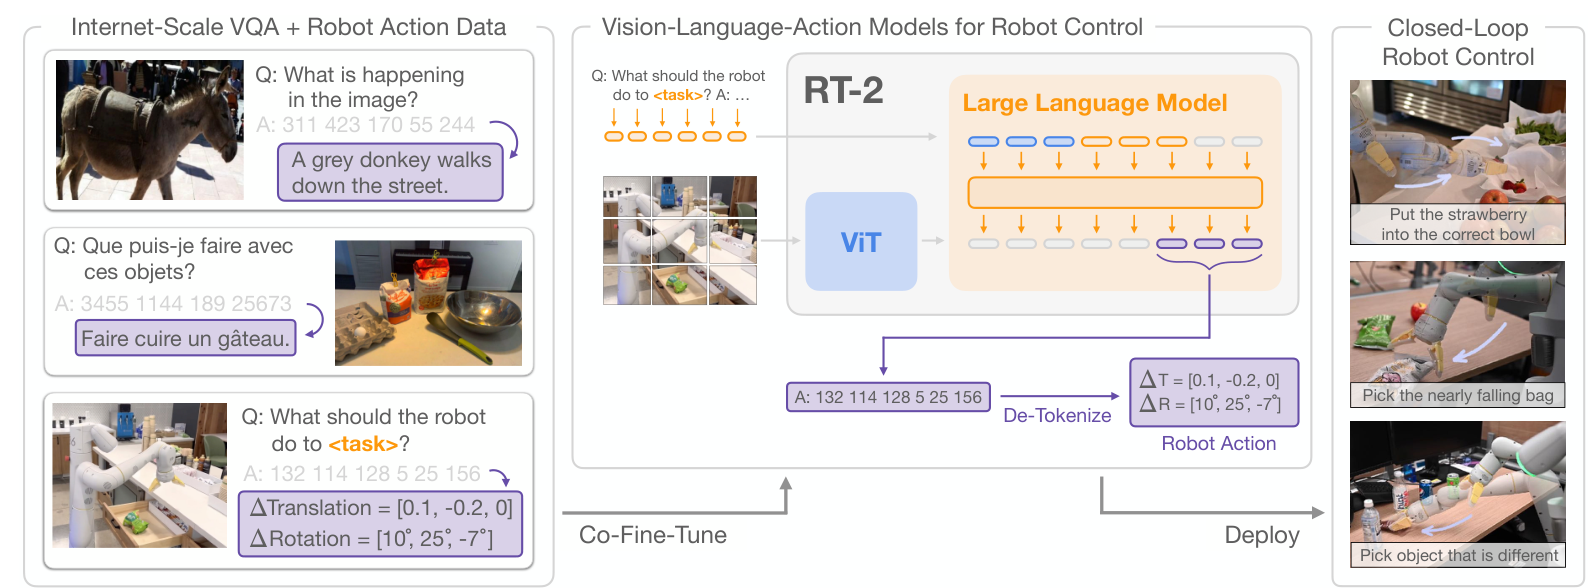
원본 그림에서 왼쪽은 학습 데이터의 두 종류다. 사진에 문장으로 답하는 시각·언어 데이터와, 로봇 카메라·지시에 행동으로 답하는 데이터가 함께 들어간다. 가운데는 이 데이터를 이용해 미세조정하는 모델이다. 여기서 ViT는 이미지를 모델이 처리할 표현으로 바꾸는 시각 인코더다. 보라색 출력 토큰은 다시 이동·회전 같은 로봇 명령으로 복원된다.
오른쪽의 폐루프 실행은 명령을 한 번 만든 뒤 작업이 끝날 때까지 눈을 감는 구조가 아니다. 행동 뒤의 새 관측을 다시 모델에 넣어 다음 명령을 계산한다. 다만 토큰을 행동으로 바꾸는 과정에는 학습 때 사용한 행동 형식과 로봇 인터페이스가 필요하다. 문자열로 ‘132’를 출력했다는 사실만으로 그 숫자의 단위나 물리적 의미가 정해지는 것은 아니다.
이미지·언어·행동을 한 모델에서 다룰 수 있다면, 남은 문제는 모델을 키우는 일뿐일까? 강의는 이 지점에서 로봇 공학의 차이를 짚는다.
로봇 데이터는 실제 행동을 수집해야 하고, 모델은 시간 안에 응답해야 하며, 평가는 다시 물리 세계에서 수행해야 한다. 문장이 조금 늦게 완성되는 것과, 균형을 잡는 로봇의 제어 명령이 늦는 것은 결과가 다르다.
모델의 규모뿐 아니라 어떤 데이터로 배웠는지, 필요한 주기로 행동을 낼 수 있는지, 환경이 바뀌었을 때 어떻게 평가할지를 함께 설계해야 한다.
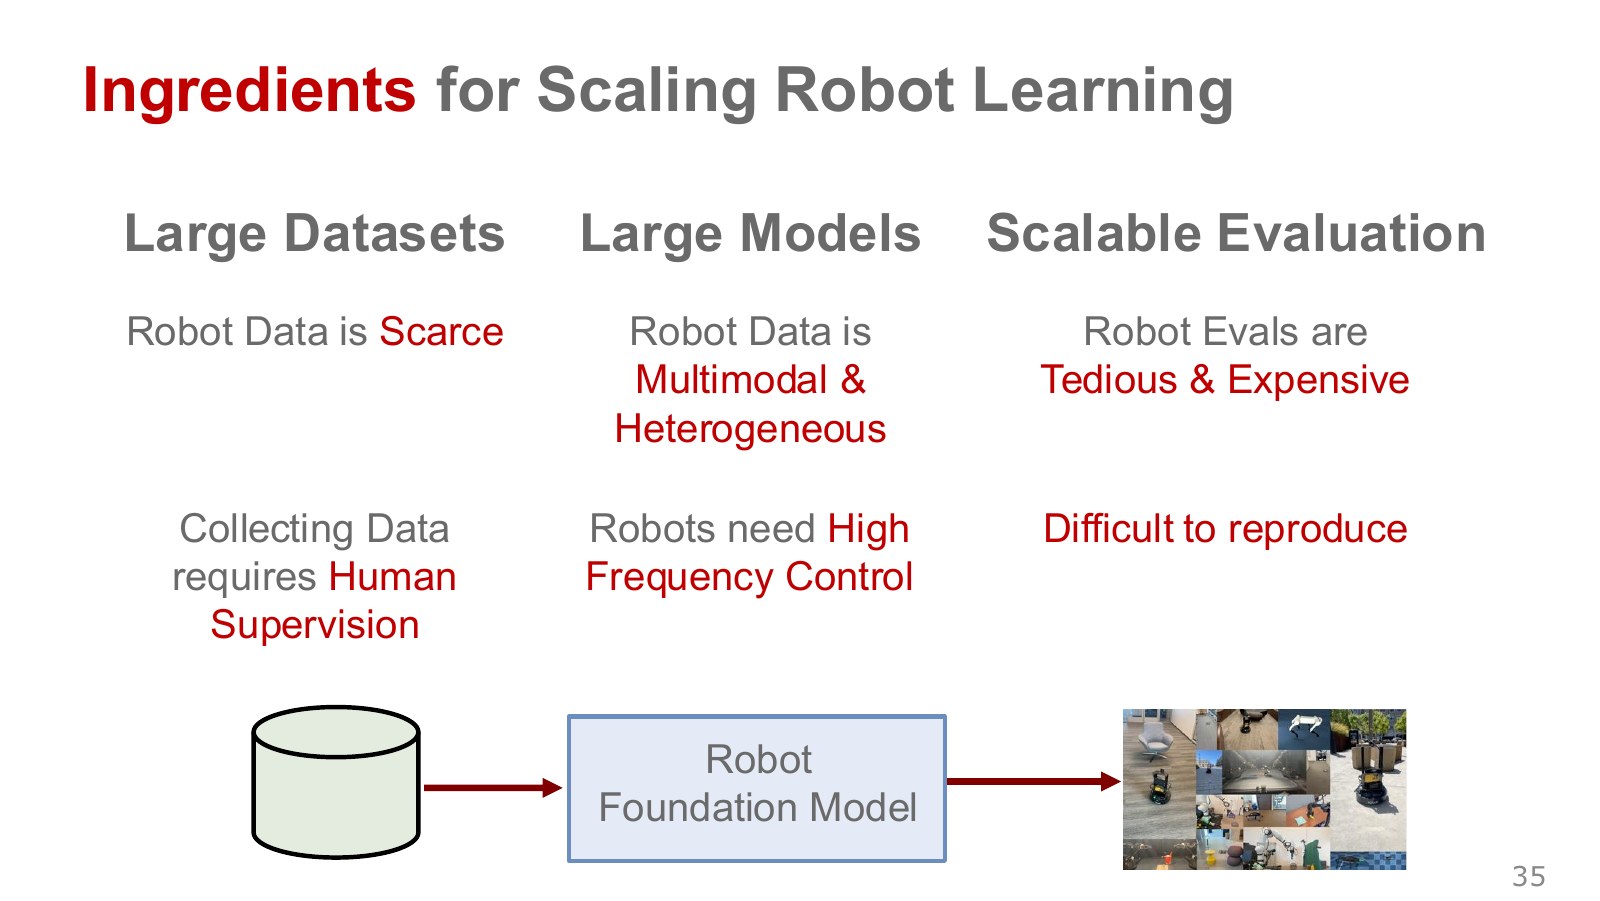
첫 번째 문제는 데이터 수집이다. 사람이 원격 조작하고 감독하는 궤적은 수집 비용이 크다. 영상·관절·힘처럼 여러 센서 신호를 같은 시간 기준으로 연결하는 일도 필요하다.
두 번째는 서로 다른 로봇과 실시간 실행이다. 로봇마다 센서와 구동기가 다르고, 행동의 차원과 단위도 다르다. 모델이 무겁다면 추론 지연과 제어 주기 사이의 관계도 살펴야 한다.
세 번째는 평가다. 실물 실험에서는 초기 상태를 똑같이 만들기 어렵고, 물체를 원위치로 돌리거나 실패를 복구하는 데도 비용이 든다. 그래서 시뮬레이션 평가, 반복 실험, 사람의 개입 기록을 함께 사용해 성능을 이해한다.
ETH 1강 52:57–54:36은 부족한 데이터, 서로 다른 감각·구동기, 실시간 실행, 실물 평가 비용을 연달아 다룬다. 이를 하나의 실험으로 연결하면 ‘관측을 얻은 시점 → 추론 완료 → 명령 적용 → 결과 측정’의 시간표가 필요하다. 예를 들어 10 Hz로 새 명령을 요구하는 환경은 행동 간격이 100 ms다. 추론에 150 ms가 든다면 동기식으로 매 단계 새 행동을 계산하는 구성은 그 주기를 유지할 수 없다. 이는 모델의 의미 이해 능력과 별도로 확인할 실행 조건이다. 행동 묶음을 예측하거나 느린 계획과 빠른 제어를 나누는 구조는 이런 조건을 다루는 방법이지만, 실제 지연과 동작 결과로 검증해야 한다.
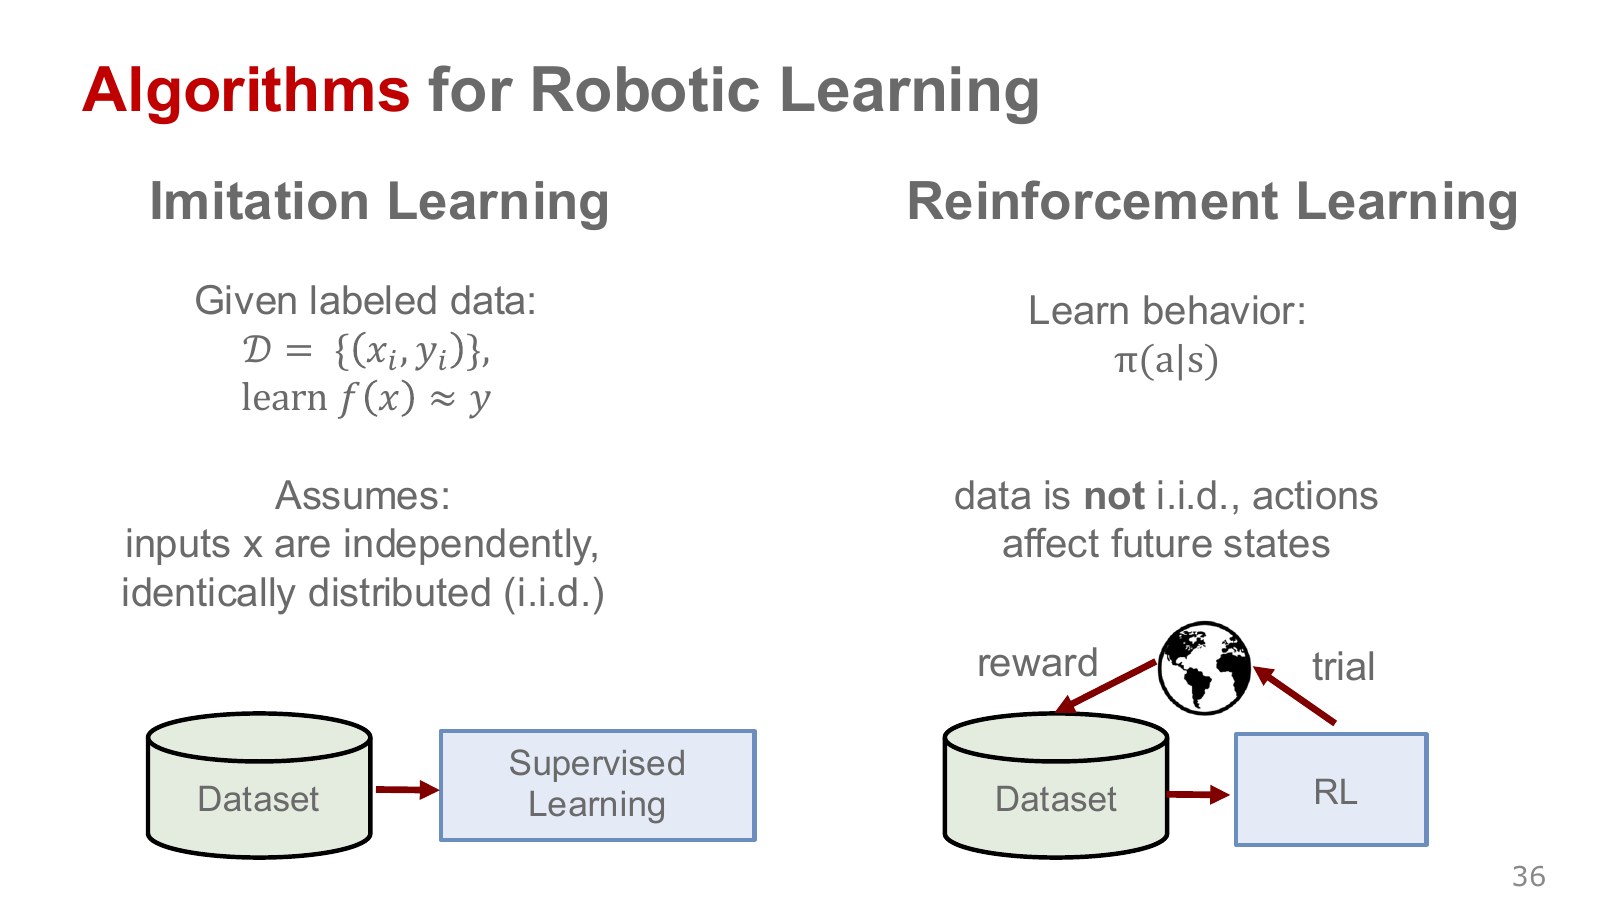
모방학습(Imitation Learning)은 전문가가 어떤 관측에서 어떤 행동을 했는지 배우는 방법이다. 관측을 입력으로, 시연 행동을 정답으로 두고 예측 함수를 학습하는 행동 복제(Behavior Cloning)가 대표적인 출발점이다.
강화학습(Reinforcement Learning)은 행동 결과에서 얻는 보상을 이용해 정책을 개선한다. 지금 한 행동이 다음 상태를 바꾸므로, 당장의 보상뿐 아니라 이후에 이어질 결과까지 고려한다.
슬라이드 왼쪽의 IID는 고전적인 지도학습 분석에서 사용하는 독립·동일 분포 가정이다. 실제 로봇 시연은 시간적으로 연결된 궤적이며, 모방 정책도 실행하면 다음 관측에 영향을 준다. 이를 ‘모방학습 데이터는 항상 독립’이라는 뜻으로 받아들이면 안 된다. DAgger 논문은 정책이 유도하는 관측 분포와 오차 누적 문제를 이해하는 연결 자료다.
컵 중앙에 정렬된 시연만 보고 학습했다면, 실행 중 조금 비껴난 상태에서 낯선 영상을 보게 될 수 있다. 작은 행동 오차가 다음 입력을 바꾸는 것이 순차적 의사결정의 특징이다.
보상은 각 순간의 정답 행동을 알려주는 레이블과 다르다. NTU 기초 강의 2:10–3:47은 무엇이 최선의 출력인지 바로 알려주기 어려워도 결과의 좋고 나쁨을 학습 신호로 쓸 수 있다는 점에서 출발한다. 로봇에게 ‘컵을 선반에 놓으면 +1’을 준다고 해도 어느 방향으로 손을 뻗을지, 언제 집게를 닫을지를 매 순간 정답으로 준 것은 아니다. 성공까지 이어지는 여러 선택을 경험 속에서 연결해야 한다.
이때 보상은 한 번의 전이에서 받는 신호이고, 리턴(Return)은 이후 여러 단계의 보상을 누적한 값이다. NTU의 게임 예제 8:29–10:19에서 옆으로 이동한 순간 점수가 없어도 그 이동이 다음 공격의 성공을 준비할 수 있다. 컵을 집는 로봇도 먼저 손을 물체 옆으로 빼는 행동이 당장은 목표에서 멀어 보여도, 충돌을 피하고 나중의 성공을 돕는다면 의미가 있다. 당장의 점수가 없는 행동을 모두 나쁜 행동으로 판단하면 이런 순서를 배울 수 없다.
목표를 숫자로 정하는 방식도 행동을 바꾼다. DeepMind/UCL 1강 16:31–17:13은 목표 도달 전 매 단계에 −1을 주는 경우를 설명한다. 정해진 조건에서 5단계 만에 도착하면 합이 −5, 20단계가 걸리면 −20이므로 빠른 도달을 선호하게 된다. ‘성공 여부’에 더해 ‘얼마나 빨리’까지 목적에 들어간 셈이다. 두 보상 설계가 항상 같은 최적 행동을 만든다는 뜻은 아니며, 종료 조건과 시간 제한도 함께 정해야 한다.
보상에 빠진 조건은 실제 성공과 학습 목표를 어긋나게 만들 수 있다. NTU 모방학습 강의 3:29–4:36은 접시를 목표 위치로 옮기되 깨뜨리는 사례로 이를 설명한다. 위치만 평가하면 다루는 과정의 손상이 목적에 반영되지 않는다. 컵 옮기기에서도 목표 위치, 파손, 흘림, 소요 시간 중 무엇을 성공 조건과 보상으로 다룰지 정해야 한다. 모방학습은 이런 행동의 예를 시연으로 제공하는 길을 열지만, 시연 밖 상황까지 자동으로 해결해 주는 것은 아니다.
NTU의 행동 복제 설명 7:54–9:01은 전문가가 늘 잘 운전했다면 벽에 가까워졌을 때의 복구 행동은 기록에 없을 수 있다고 지적한다. 로봇에서도 성공 시연을 더 많이 모으는 것과, 정책이 실제로 방문하는 어긋난 상태에서 어떻게 회복할지 알려주는 것은 서로 다른 데이터 수집 과제다. 어떤 상황이 부족한지 먼저 찾고, 그 상태에서의 시연이나 교정 데이터를 보완해야 한다.
NTU 원본 PPTX 13쪽의 수식을 PDF와 대조하면 리턴의 가장 단순한 형태를 확인할 수 있다.
T는 한 번의 시도가 끝나는 단계이고, r_t는 각 단계에서 받은 보상이다. Σ는 그 값들을 모두 더하라는 기호다. 원본의 R은 이 합을 가리키며, 다른 강의가 순간 보상에 쓰는 대문자 R_t와 표기가 다를 수 있다. 글자 모양보다 각 식에서 정의한 의미를 확인해야 한다. 예를 들어 보상이 [0, 0, 1]이면 합은 1이다. 이 기록만으로 세 행동 중 어느 것이 성공에 얼마나 기여했는지까지 알 수는 없다. 여러 실행 결과를 이용해 어떤 선택이 이후 성공 가능성을 높였는지 배우는 문제가 남는다.
UCL 원본 46쪽은 미래 보상에 할인율을 적용하고, 그 리턴의 기댓값을 가치로 정의한다. 다음 식은 종료되는 에피소드에 맞춰 합의 끝을 적은 표현이다.
γ는 0부터 1 사이의 할인율이다. γ=0.9이고 다음 보상들이 [0, 0, 1]이라면 지금 기준 리턴은 0 + 0.9×0 + 0.9²×1 = 0.81이다. 할인하지 않는 경우에는 1이다. E는 가능한 실행 결과를 평균적으로 고려한다는 뜻이다. 지금의 보상, 한 번 실행해 얻은 리턴, 같은 상태에서 정책을 반복 실행했을 때의 기대 리턴인 가치는 서로 다른 값이다. 보상은 과제에서 정하는 신호이며, 할인된 값은 그 신호를 어떤 시간적 기준으로 평가할지를 나타낸다.
행동 복제는 다른 목적함수에서 출발한다. 아래 식은 연속적인 로봇 명령을 설명하기 위한 제곱오차 예시이며, NTU 원본 수식을 그대로 옮긴 것은 아니다.
N은 시연에서 만든 관측–행동 쌍의 수, a_i*는 그 관측에서 전문가가 내린 행동이다. f_θ가 그 행동에 가까워지도록 파라미터를 바꾼다. 위치 이동량·회전량·집게 명령을 함께 예측한다면 단위와 범위가 다르므로, 실제 구현에서는 정규화나 항별 가중치를 정해야 한다. 이 손실이 작아지는 것과 로봇이 방문하는 모든 상태에서 성공하는 것은 동일하지 않다.
DAgger 원문 2쪽 식 (1)·(2)은 전문가가 방문한 상태에서의 손실과 학습 정책이 스스로 방문하는 상태에서의 손실을 나누어 쓴다. 실행 중 컵에서 비껴난 정책은 시연에 없던 관측을 만들 수 있다. 그래서 시험 데이터에서 행동을 잘 맞히는지에 더해, 정책을 끝까지 실행했을 때 어떤 상태를 방문하고 어디에서 복구에 실패하는지 확인해야 한다.
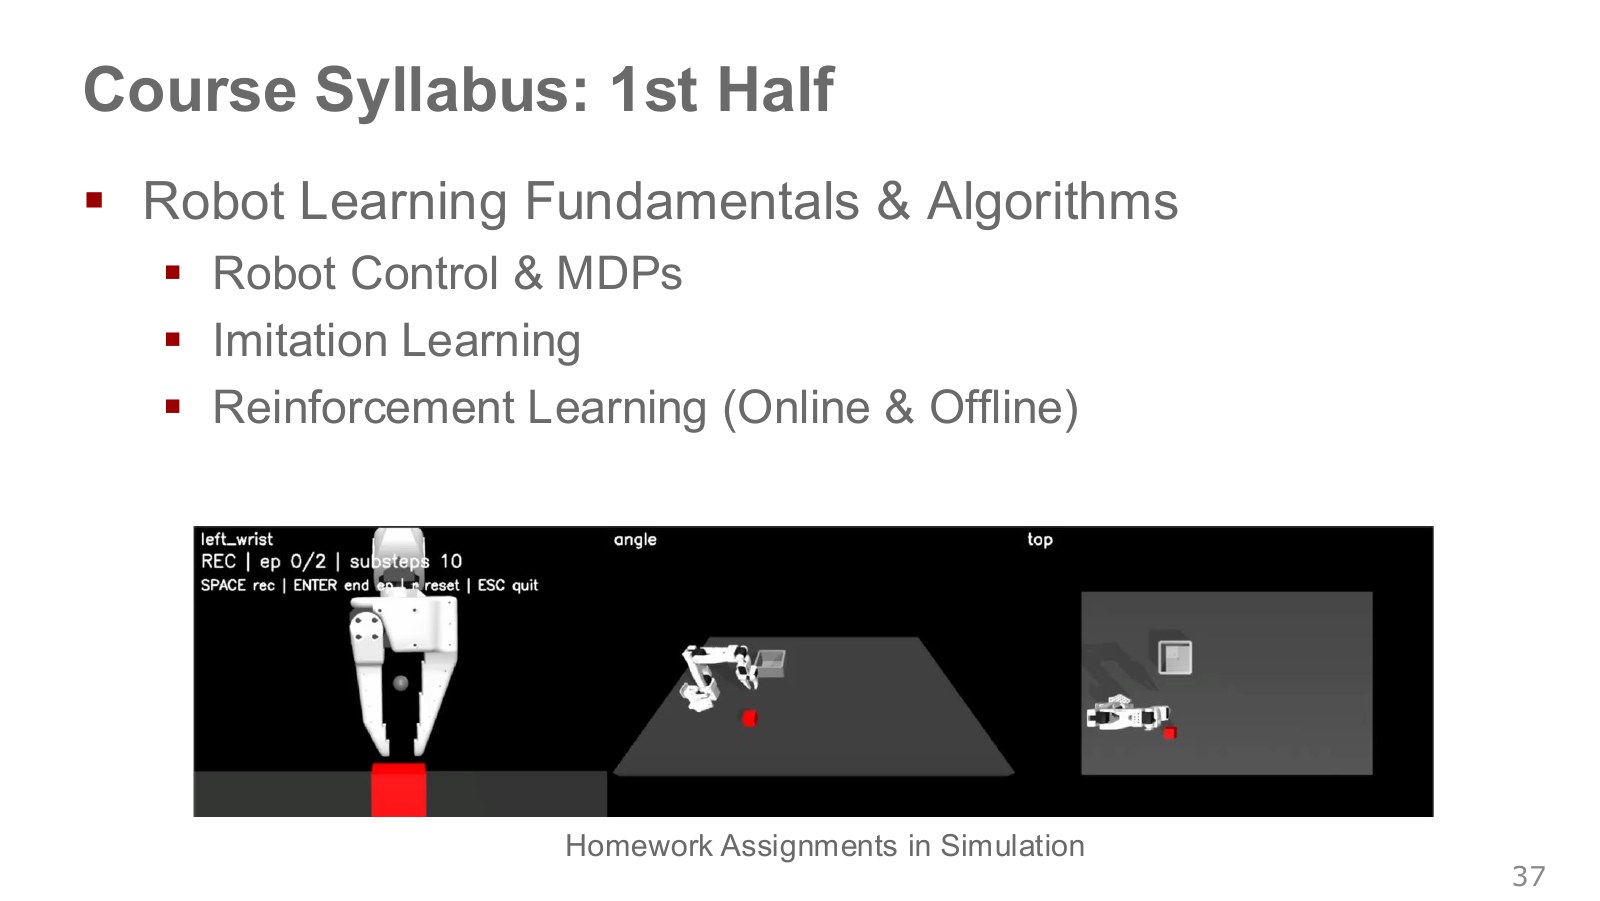
제어와 마르코프 결정 과정(Markov Decision Process, MDP)은 로봇–환경 상호작용을 표현하는 기본 언어다. 현재 상태에서 행동을 적용하면 다음 상태로 바뀌고 보상을 받는다는 구조를 명확히 한다.
강의에서는 SO-101 로봇 팔과 연결되는 MuJoCo 시뮬레이션 과제를 사용한다. 공식 HW2의 환경 코드에서는 관측 생성, 행동 처리, 물리 시뮬레이션 진행, 보상 계산이 어디에서 연결되는지 볼 수 있다. 학생이 채울 함수가 있는 과제 템플릿이다.
환경 코드에는 화면 표시 주기와 물리 계산·제어 주기가 따로 있다. 물리 시간 간격이 0.002초이고 행동 하나를 50번의 물리 계산 동안 유지한다면, 다음 행동을 계산하는 간격은 0.1초, 즉 10 Hz다. 화면의 FPS와 정책의 행동 갱신 빈도는 다른 개념이다.
확장 예제로는 NVIDIA의 Isaac Lab 공식 저장소가 있다. 로봇 학습 환경과 강화학습 실행 예제를 제공하므로, 로봇 모델·관측·행동·보상이 구성되는 방식을 살펴보기 좋다. 공식 문서의 설치·환경 예제로 연결하며, 이 글에서 Isaac Lab 학습을 실행한 결과로 소개하는 것은 아니다.
ETH 1강 56:55–58:26은 시뮬레이션 과제와 실제 프로젝트에서 같은 로봇 팔을 사용하는 이유를 코드 재사용과 연결해 설명한다. 옮겨 쓸 수 있는 것은 관측·행동 인터페이스와 제어 코드의 구조다. 시뮬레이터의 마찰·접촉·센서 지연까지 실제와 같아진다는 뜻은 아니다. 시뮬레이션에서 통과한 정책을 실물에서 평가할 때도 같은 명령이 같은 물리량을 뜻하는지부터 확인해야 한다.
기초 정책을 이해한 뒤에는 여러 작업과 데이터로 학습의 범위를 넓힌다. 생성 모델은 가능한 행동이나 궤적의 분포를 표현하는 데 쓰일 수 있고, Transformer는 시간에 걸친 관측과 행동의 관계를 다루는 계산 구조를 제공한다.
세계 모델(World Model)은 행동했을 때 환경이 어떻게 바뀔지 예측하는 모델이다. 미래를 예측할 수 있다면 후보 행동을 실제로 모두 실행하기 전에 비교하는 계획에도 연결할 수 있다.
이후의 질문은 여러 개념을 어떻게 하나의 로봇 시스템으로 묶을 것인가다. 명령을 이해하고, 장면을 읽고, 행동을 선택하고, 결과를 다시 관측하는 흐름 안에서 각 모델의 역할을 구분한다.
여기서는 학습과 계획도 나누어 보자. 새로운 실행 경험에서 예측 모델을 고치는 것이 학습이라면, 현재 가진 모델 안에서 여러 후보 행동의 결과를 계산해 비교하는 것은 계획이다. DeepMind/UCL 1강 1:13:26–1:14:28은 학습된 모델의 오류를 계획이 이용해 버릴 수 있다고 설명한다. 모델 안에는 통로가 있는데 실제 벽에는 없다면, 모델이 계산한 최단 경로는 현실에서 실행할 수 없다.
컵 예제로 바꾸면 접촉 모델이 집게의 미끄러짐을 과소평가할 때, 계획기는 아주 약한 힘으로 들어 올려도 된다고 계산할 수 있다. 예측 영상을 그럴듯하게 만드는 능력과 행동을 비교할 만큼 정확한 물리 예측 능력은 평가 질문이 다르다. 세계 모델을 쓰는 이유는 실제 시행착오를 줄이기 위해서이므로, 계획 결과가 실제 실행에서도 유지되는지 확인해야 한다.
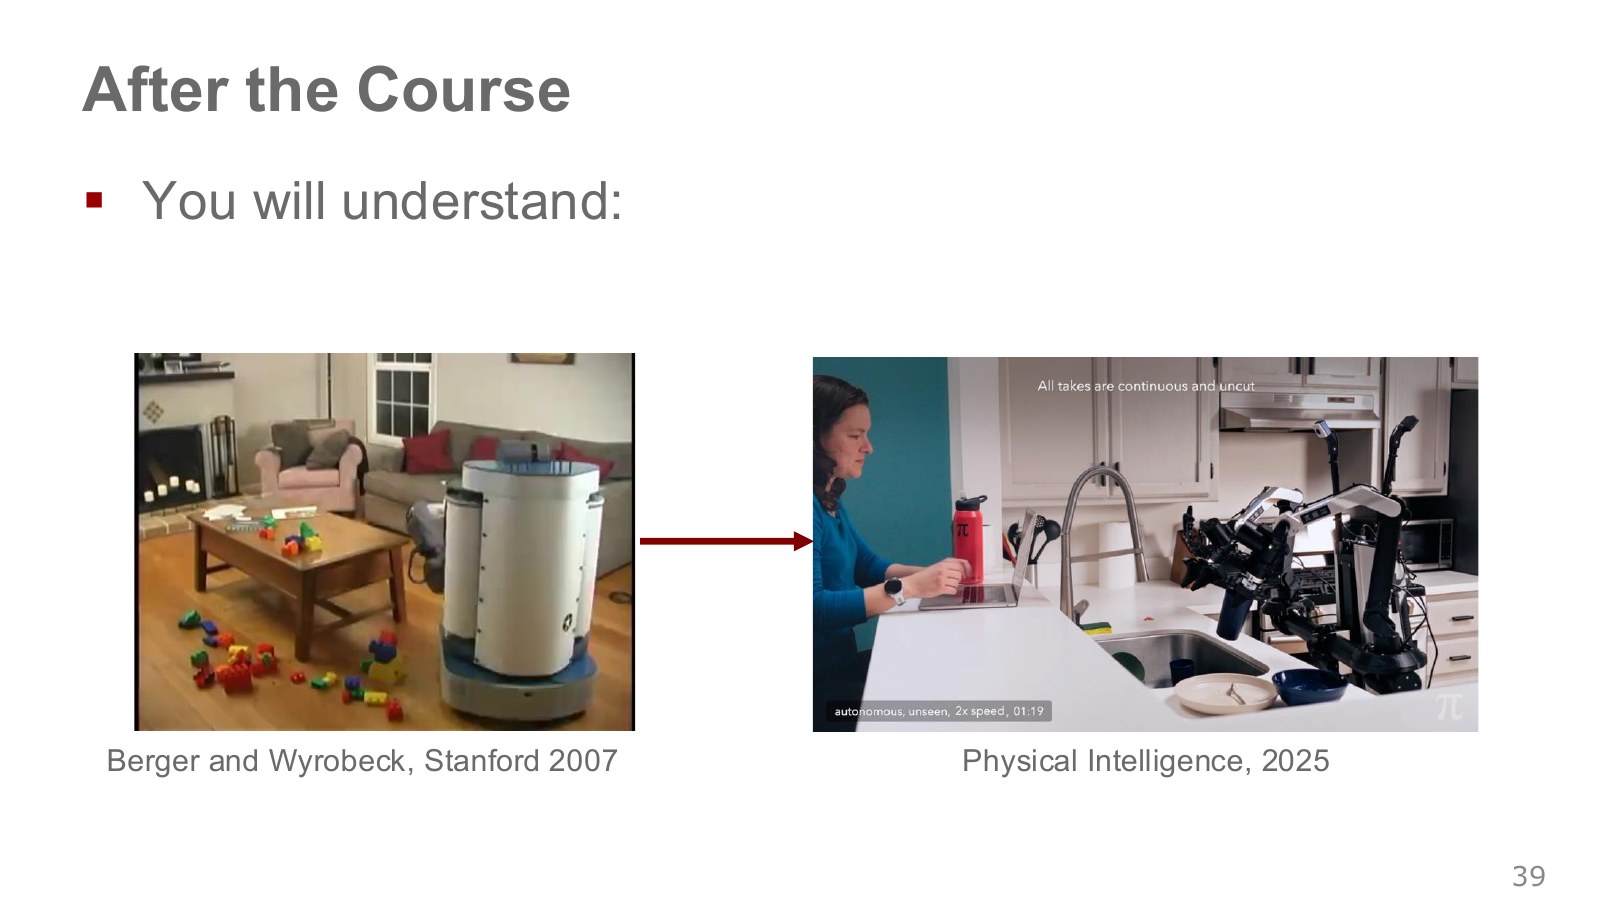
왼쪽의 2007년 PR1과 오른쪽의 2025년 Physical Intelligence 시연은 일상적인 물건 조작이라는 목표를 공유한다. 강의가 강조하는 변화는 사람이 실시간으로 행동을 고르는 원격 조작에서, 학습한 정책이 행동을 생성하는 방향으로 이동했다는 점이다.
같은 작업처럼 보여도 데이터, 로봇 구조, 센서, 초기 조건은 다르다. 따라서 이 비교는 발전 방향을 보여주는 사례로 읽고, 특정 모델의 개선 폭을 계산하는 통제 실험과는 구분하자.
실제 정책을 이해하려면 시연의 겉모습에서 한 단계 더 들어가 학습 데이터와 입력·출력, 실패 이후의 처리까지 살펴보면 된다.
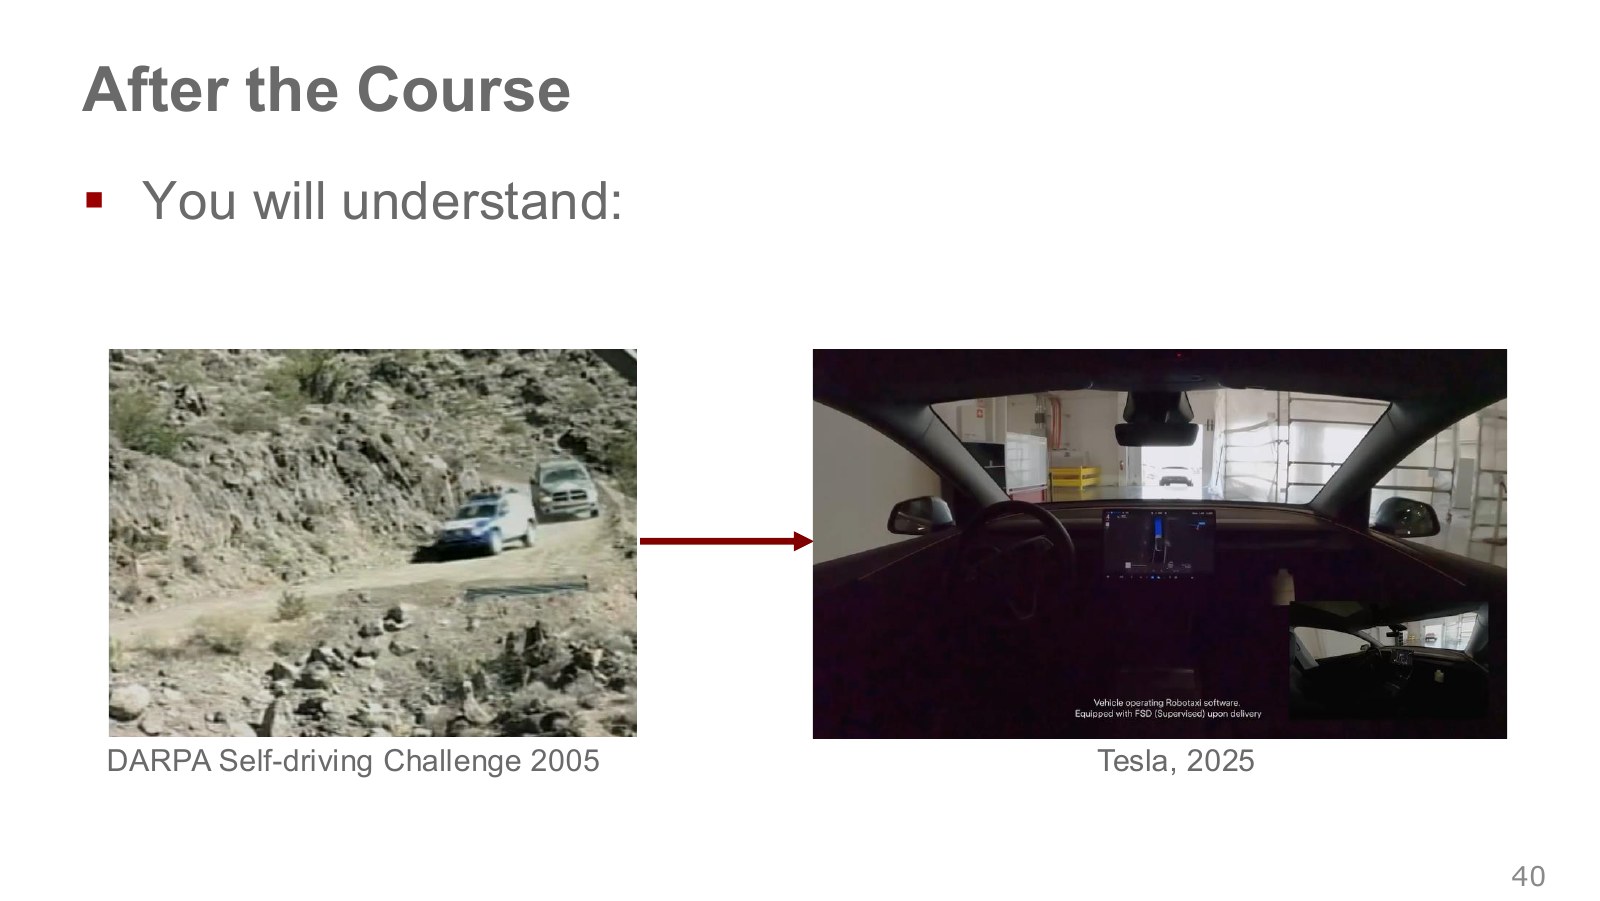
슬라이드는 2005년 DARPA 자율주행 챌린지와 2025년 Tesla 시연을 대비한다. 로봇 팔이 물체를 집는 문제와 자동차가 이동하는 문제는 다르지만, 센서로 주변을 파악하고 행동을 선택하며 결과를 다시 관측한다는 구조는 공유한다.
차선·장애물을 읽는 인식, 다른 차량의 움직임을 예상하는 예측, 앞으로의 경로를 정하는 계획, 조향·가속을 적용하는 제어가 연결된다. 어떤 부분을 학습하고 어떤 부분을 명시적인 모델로 다룰지는 시스템에 따라 다르다.
한 시연을 모든 도로와 조건의 자율성으로 일반화하지 않고, 작동 조건과 사람의 감독 범위를 함께 확인하는 것이 로봇 평가에도 유용한 관점이다.
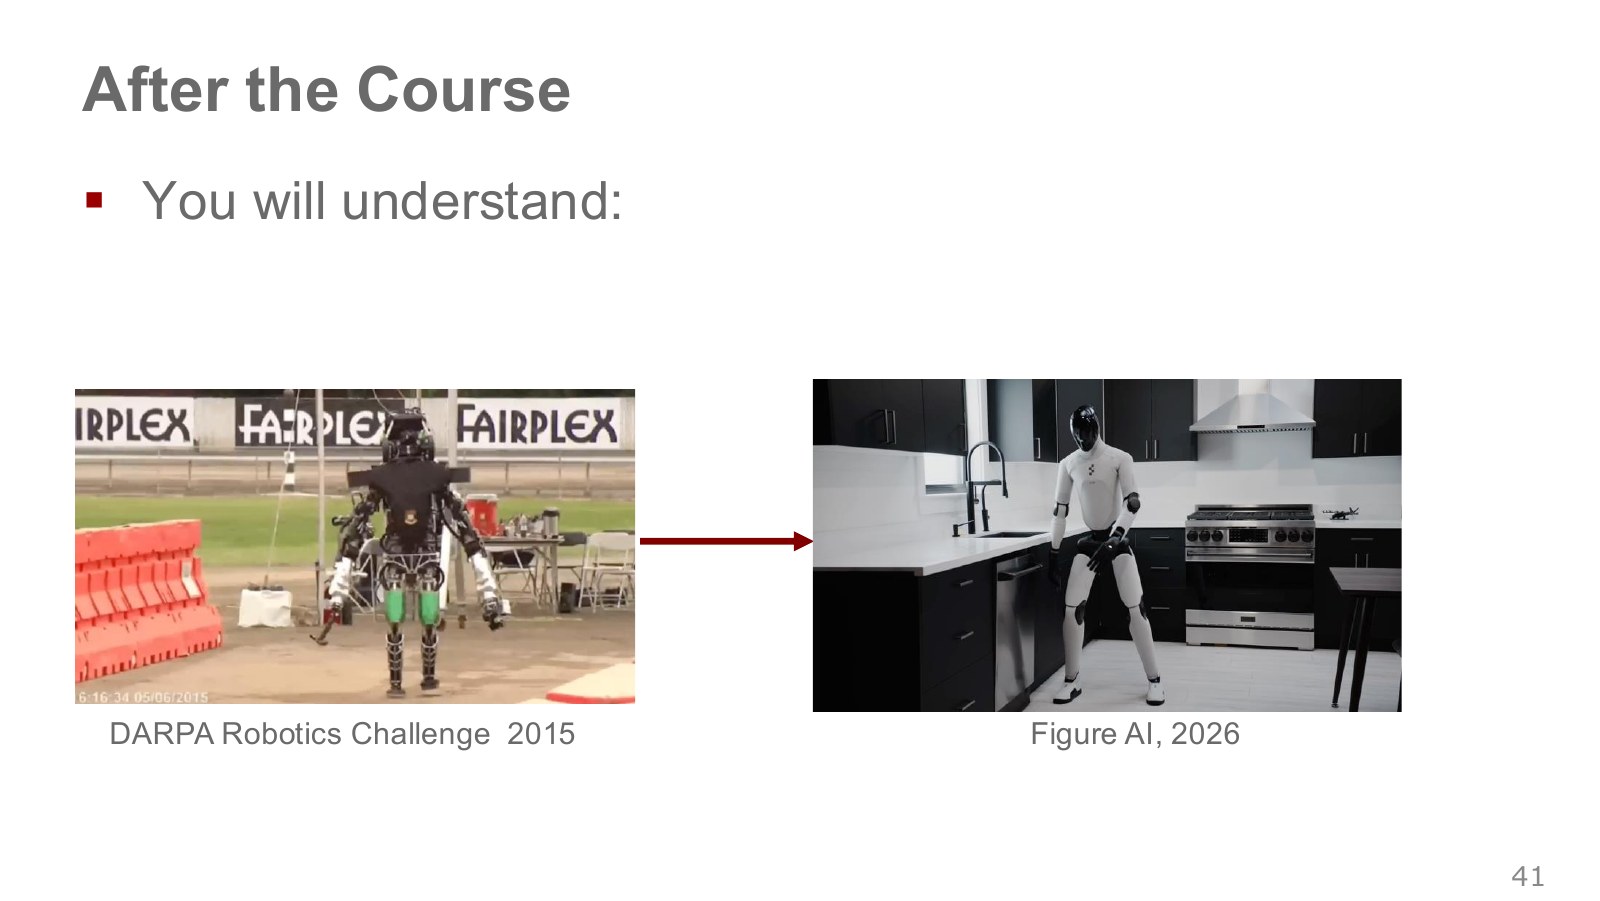
2015년 DARPA Robotics Challenge의 로봇과 이후 Figure 시연은 움직임과 물체 조작의 변화를 인상적으로 보여준다. 이때 사람처럼 생겼다는 사실과, 어떤 작업을 스스로 수행할 수 있는가는 나누어 생각해야 한다.
정책이 카메라와 몸의 상태를 어떻게 이용하는지, 사람의 시연을 어떤 형태로 학습하는지, 보지 못한 물체와 배치에서도 행동할 수 있는지를 보면 ‘부드러운 움직임’보다 구체적인 이해에 도달한다.
균형을 유지하는 저수준 제어, 물체와 접촉하는 조작, 여러 단계를 이어가는 작업 계획은 서로 연결되지만 같은 문제는 아니다. 범용 로봇 시스템을 읽을 때 이 층위를 구분하면 모델의 역할이 드러난다.
로봇 학습은 파운데이션 모델의 고수준 표현과 추론에서, 모터를 움직이는 저수준 제어까지 이어지는 분야다. 카메라·데이터·모델·제어·하드웨어를 함께 이해해야 한다는 점에서 여러 분야가 만나는 공부이기도 하다.
이 장에서 남길 질문은 단순하다. 무엇을 관측하는가, 어떤 행동을 내는가, 무엇을 신호로 배우는가, 어떤 환경에서 평가하는가? 이 네 질문은 로봇 팔, 이동 로봇, 자율주행, 휴머노이드의 논문과 코드를 읽을 때 공통으로 사용할 수 있다.
다음 장에서는 제어와 MDP를 통해 로봇과 환경의 상호작용을 더 구체적인 수학적 언어로 표현한다.
#코드로 이어서 보기
관측을 다시 사용하는 효과부터 확인하려면 직접 실행한 피드백 예제를 사용할 수 있다. Python 표준 라이브러리로 1차원 위치와 속도 제한을 계산한다.
cd docs/robot-learning/labs/01-feedback-loop
python3 -m unittest -v
python3 feedback_loop.py --out results
위치에 +0.4 m의 변화를 한 번 넣은 조건에서, 60회 계산 후 개방루프의 최종 오차는 0.4 m, 피드백의 최종 오차는 약 8.92×10⁻⁷ m였다. 이 값은 정해진 1차원 모델의 계산 결과다. 학습으로 정책을 갱신하는 예제가 아니라 실행 중 새 관측을 사용하는 효과를 보여준다. 정확한 결과와 실행·검사 방법을 함께 볼 수 있다.
로봇 팔 물리 시뮬레이션은 ETH MuJoCo 과제, 더 다양한 로봇 학습 환경은 NVIDIA Isaac Lab과 공식 문서로 이어서 살펴볼 수 있다.
#출처
- Oier Mees — Robot Learning: From Fundamentals to Foundation Models, ETH Zurich, Lecture 1 · 강의 영상
- 강의 슬라이드 이미지 제공 경로 · 출처 안내
- Hado van Hasselt — DeepMind × UCL, Introduction to Reinforcement Learning (2021) · 원본 슬라이드
- Hung-yi Lee — NTU ML 2021: RL Basics · Imitation Learning · 공식 강의 목차 · 원본 PPTX
- RT-2: Vision-Language-Action Models · Open X-Embodiment
- DAgger — A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning
- SRI — Shakey the Robot
강의·슬라이드 저작권: Oier Mees 및 해당 권리자에게 있습니다. 슬라이드에 포함된 사진·영상·논문 그림·상표의 권리는 각 원저작권자에게 있습니다. 이 글은 강의 자료를 출처와 함께 소개하며, 본문의 한국어 설명과 별도 코드 예제를 덧붙였습니다. P번호는 이미지 제공 경로의 파일 순서를 따릅니다.