강화학습 1강의 영상 속 물체를 픽셀 단위로 구분하는 모델에서 이어지는 글이다. 로봇이 컵을 집으려면 “컵이 있다”는 답과 “어느 픽셀들이 컵인가”라는 답을 구분해야 한다.
이 글은 Stanford CS231n 2026 Lecture 9의 semantic segmentation 단원, PDF 32–64쪽을 순서대로 한 장씩 읽는다. 각 원본 슬라이드 바로 아래에 그 장의 그림·연산·앞 장과 달라진 부분을 설명한다. 147쪽 강의 전체를 다루는 글은 아니다. 원본에 포함된 저자·그림 출처를 그대로 두고, 해설용 계산 예제는 별도로 표시한다.
공식 강의 일정 · 원본 PDF · 보충 영상: Stanford Online 2025 Lecture 9
영상은 2025년 영상, 본문의 슬라이드는 2026년 자료다. 2025 영상의 영어 수동 자막 트랙을 확인해 아래에 주제별 시간 링크를 추가했다. 자막의 발화 시각이지 2026 PDF 각 장의 전환 시각은 아니며, 한국어 설명은 원문 전사가 아닌 별도 해설이다. 구조·논문·수식은 현대 인공지능 VI에서 더 깊게 이어 읽을 수 있다.
먼저 구분할 것: segmentation은 인식 작업이고, 강화학습은 행동의 결과와 보상을 이용해 의사결정을 배우는 방법이다. 분할을 정책의 관측에 사용할 수 있지만 모든 강화학습 시스템에 필수인 것은 아니다.
#P032. 네 가지 출력 형식
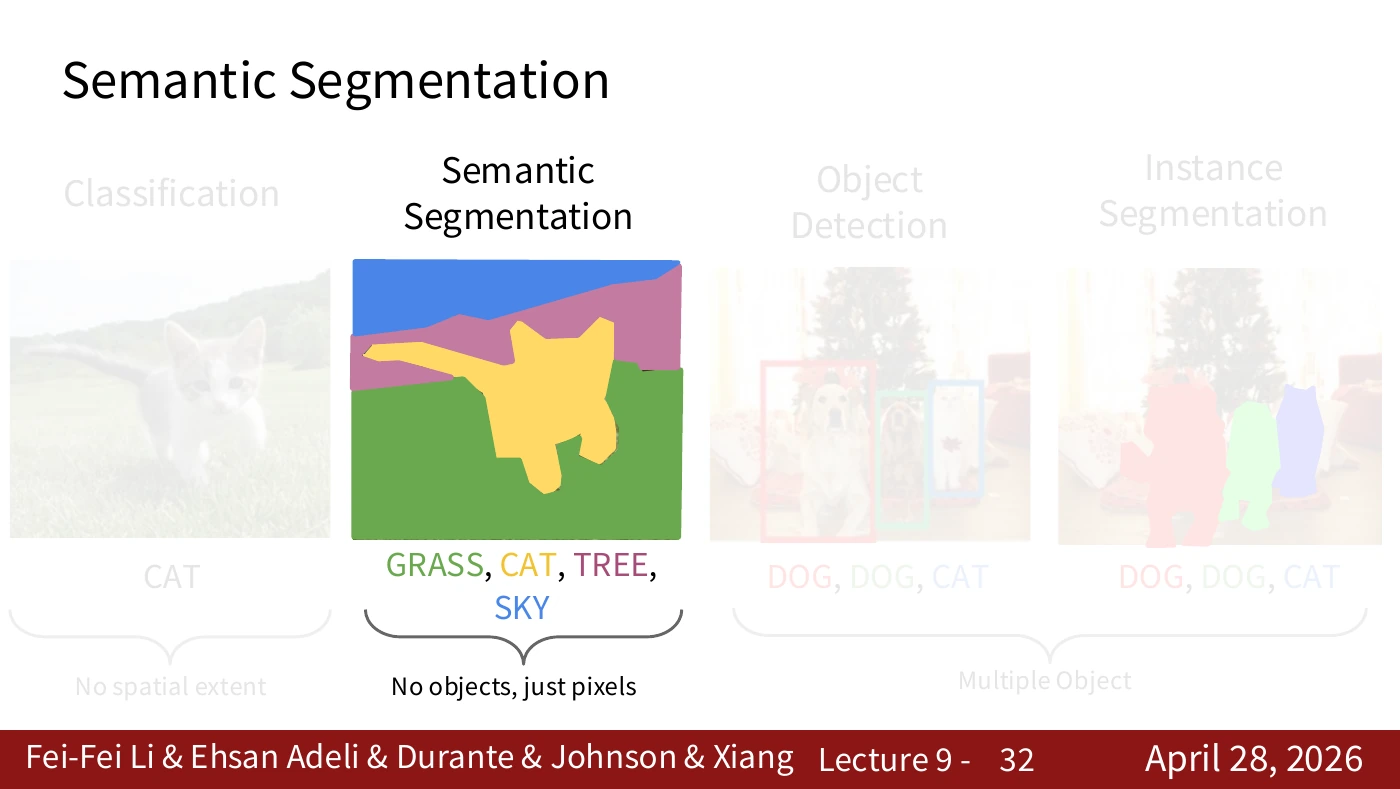
분류는 이미지 전체의 이름, 검출은 객체별 박스, 의미론적 분할은 픽셀별 범주, 인스턴스 분할은 객체별 마스크다. 같은 장면에서도 무엇을 출력하느냐가 다르다. 로봇이 두 컵 중 하나를 골라야 한다면 컵이라는 범주를 아는 것과 두 개체를 구분하는 것을 나누어 생각한다.
슬라이드에서는 semantic segmentation만 진하게 보이고 다른 작업은 흐리게 처리되어 있다. 이 강의 구간의 초점을 표시한 것이므로 흐린 작업이 중요하지 않다는 뜻은 아니다. 같은 범주의 두 물체가 같은 색을 갖는 이유를 말할 수 있으면 다음 장으로 넘어가자.
#P033. 픽셀마다 정답 범주가 있다
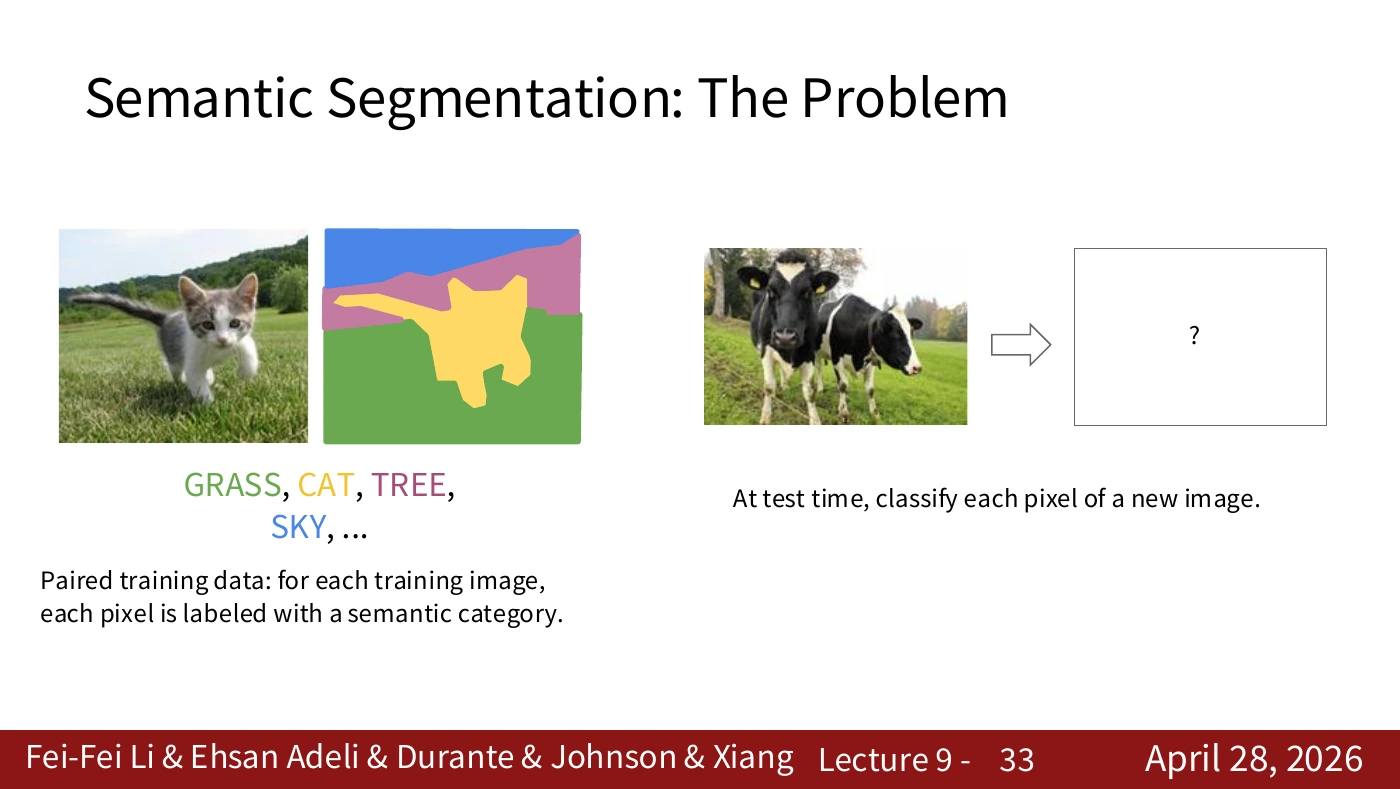
학습 데이터의 입력 영상과 label map은 공간적으로 짝을 이룬다. 새 영상에서도 각 픽셀의 범주를 예측한다. 여기서 픽셀별 예측은 그 픽셀의 RGB 값만 보라는 뜻이 아니다. 주변 문맥이 필요하며, 가림과 경계의 정답을 정하는 데이터 규칙도 중요하다.
왼쪽은 학습 때의 이미지-정답 쌍, 오른쪽 물음표는 새로운 이미지에서 채워야 할 예측이다. 학습용 정답을 입력에 함께 넣어 테스트하는 것으로 읽지 않는다. 이미지와 정답에 crop·resize를 적용할 때는 같은 좌표 변환을 적용해야 한다.
#P034. 어느 픽셀을 분류할 것인가
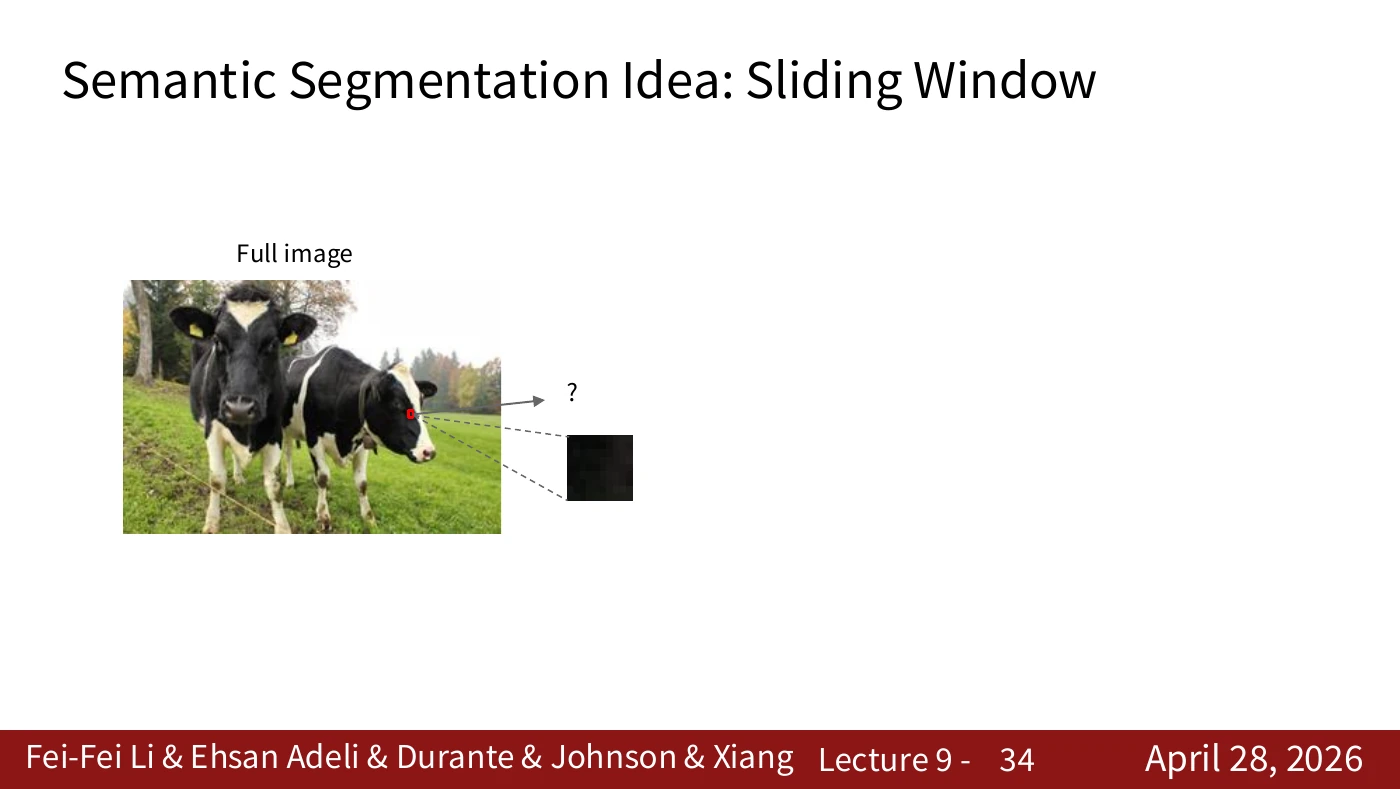
슬라이드의 물음표가 가리키는 위치를 먼저 본다. 영상 전체를 하나의 이름으로 압축하는 대신 특정 위치의 정답을 요구하는 출발점이다. 아직 효율적인 네트워크 설계를 제시한 장이 아니라 무엇을 예측할지를 정하는 장이다.
확대된 작은 검은 칸만 보면 물체의 일부인지 그림자인지 판단하기 어렵다. 원본 그림에서 위치를 먼저 찾은 다음 주변 정보를 가린 상태에서도 의미를 알 수 있는지 자문해 보자. 다음 장의 문맥 문제를 몸으로 이해하는 순서다.
#P035. 주변을 보아야 하는 이유
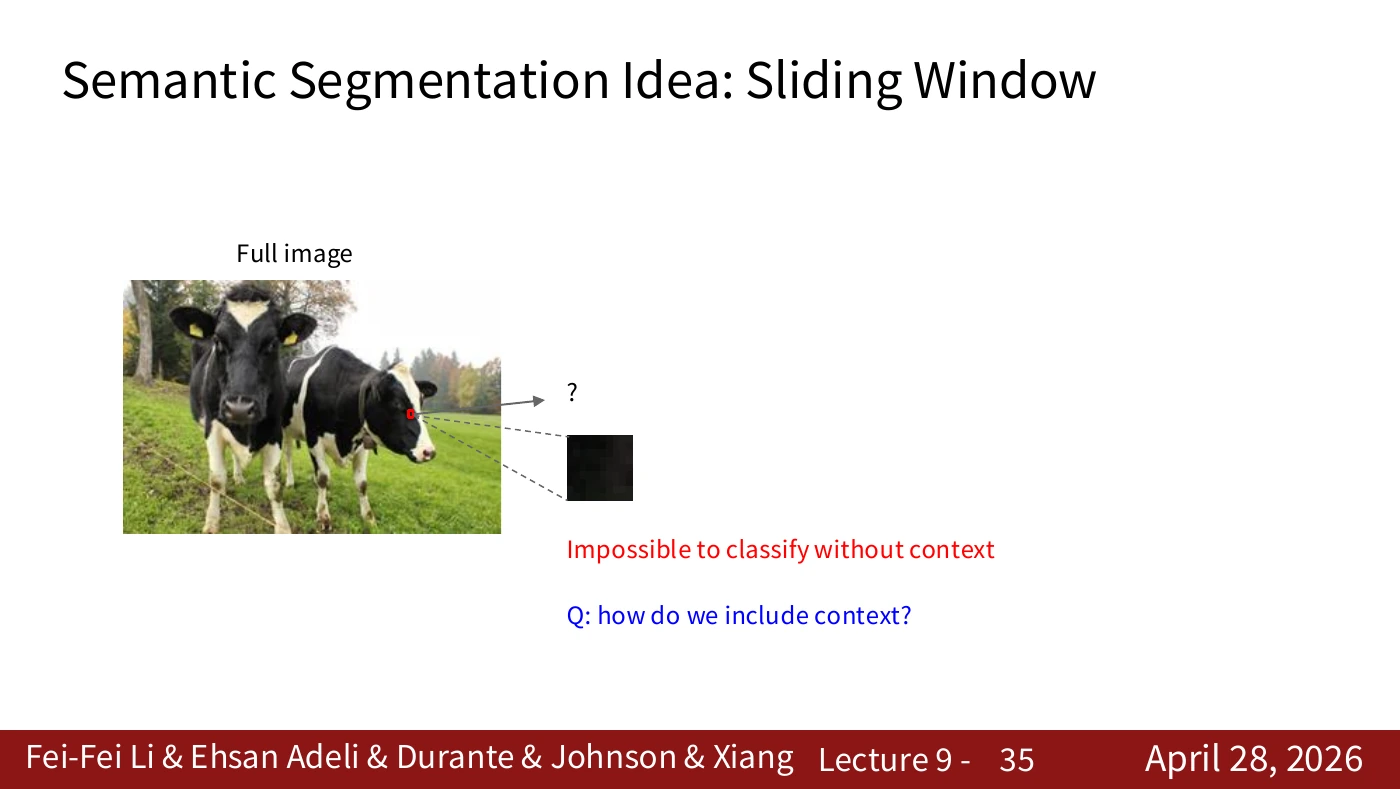
한 픽셀의 색만으로 소·풀 같은 의미를 안정적으로 판단하기 어렵다. 같은 색이 여러 물체에 나타나기 때문이다. 이 장의 질문은 문맥을 어떻게 포함하느냐이다. 창을 크게 하면 문맥은 늘지만 계산과 경계 처리도 함께 고려해야 한다.
빨간 문장은 문맥 없이 분류하기 어렵다는 한계, 파란 질문은 문맥을 넣는 방법을 묻는다. 모델의 이름부터 외우기보다 지금 부족한 정보가 무엇인지 붙잡는 장이다.
#P036. 문맥을 모델의 입력으로
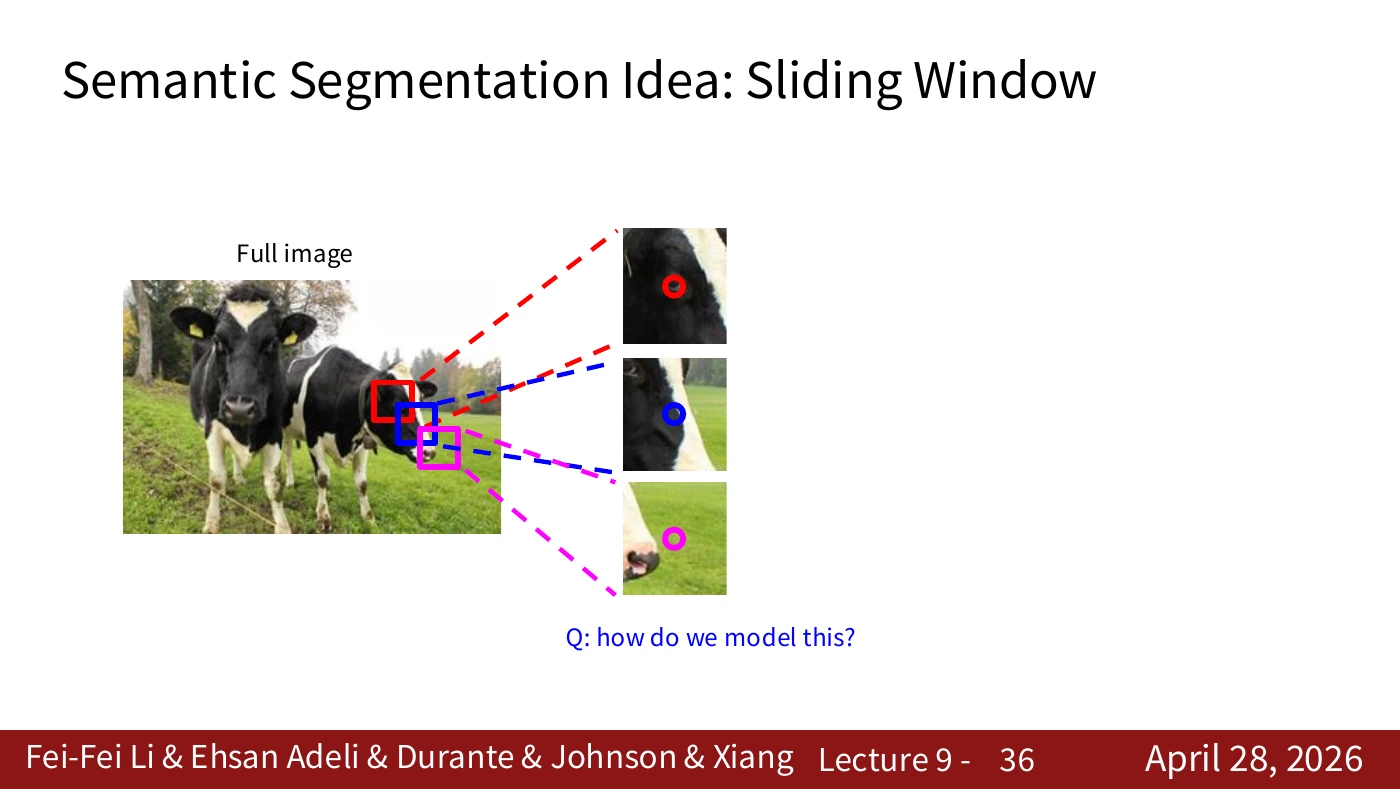
주변 영역을 보겠다는 직관을 실제 모델 입력으로 바꾸어야 한다. 다음 장의 patch 분류로 넘어가기 전 질문이다. 특정 중심 픽셀을 예측하더라도 그 주변의 여러 픽셀을 모델에 넣을 수 있다는 점을 연결한다.
빨강·파랑·분홍 창은 같은 이미지의 서로 다른 위치를 보여 준다. 창의 입력과 중앙 픽셀의 정답을 분리해서 보자. 모델은 창 전체의 대표 물체가 아니라 지정한 위치의 범주를 맞히도록 학습할 수 있다.
#P037. Patch를 CNN에 넣어 중심 픽셀 분류
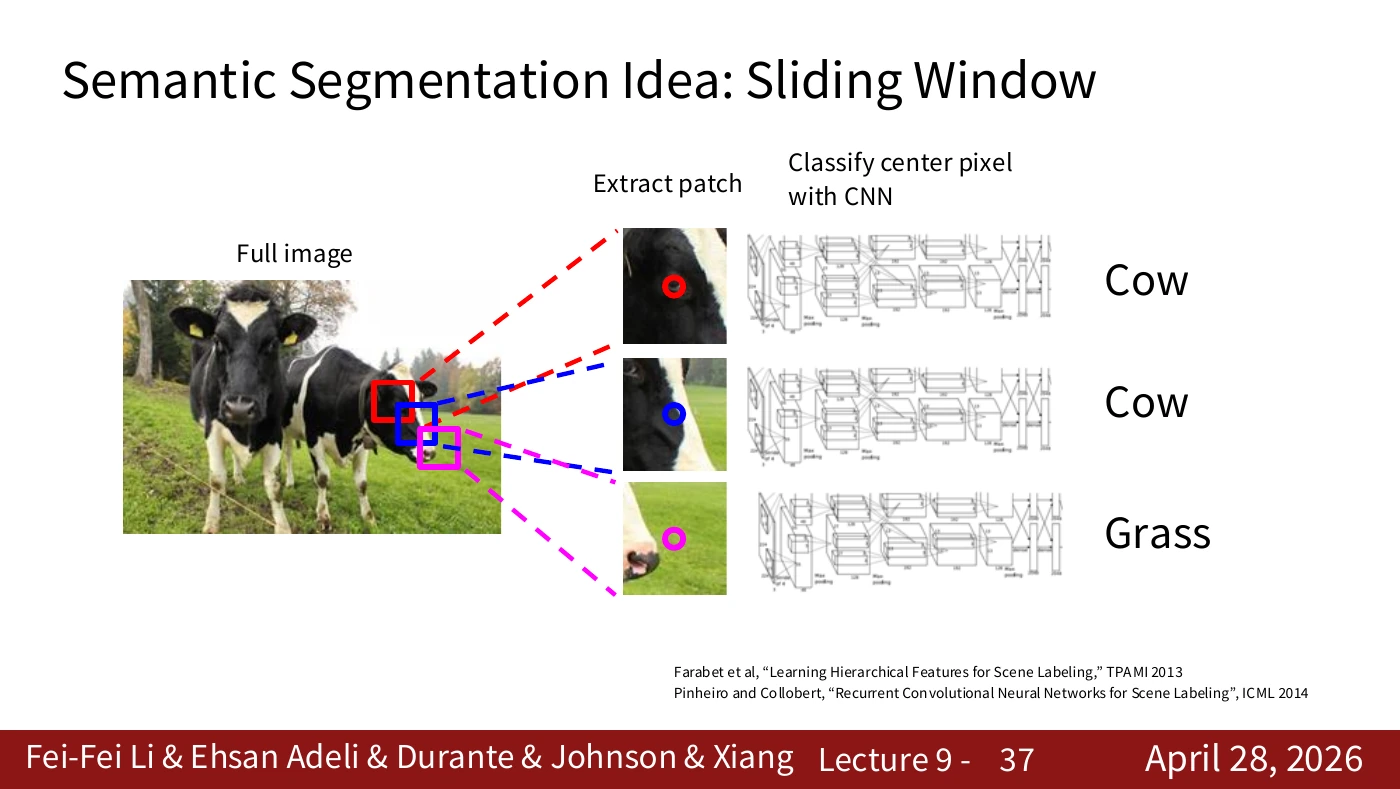
입력 전체에서 작은 창을 잘라 CNN에 넣고 중심 위치의 범주를 얻는다. 창의 예측 하나와 이미지 전체의 label map을 혼동하지 않는다. 여러 중심 위치에서 반복하면 공간적인 예측 지도가 생긴다.
위 두 창은 소에 해당하고 아래 창은 풀에 해당한다. 같은 CNN을 위치마다 재사용한다는 점이 중요하다. 물체 종류마다 완전히 다른 네트워크를 별도로 만드는 구조를 설명하는 그림이 아니다.
#P038. 겹치는 창의 중복 계산
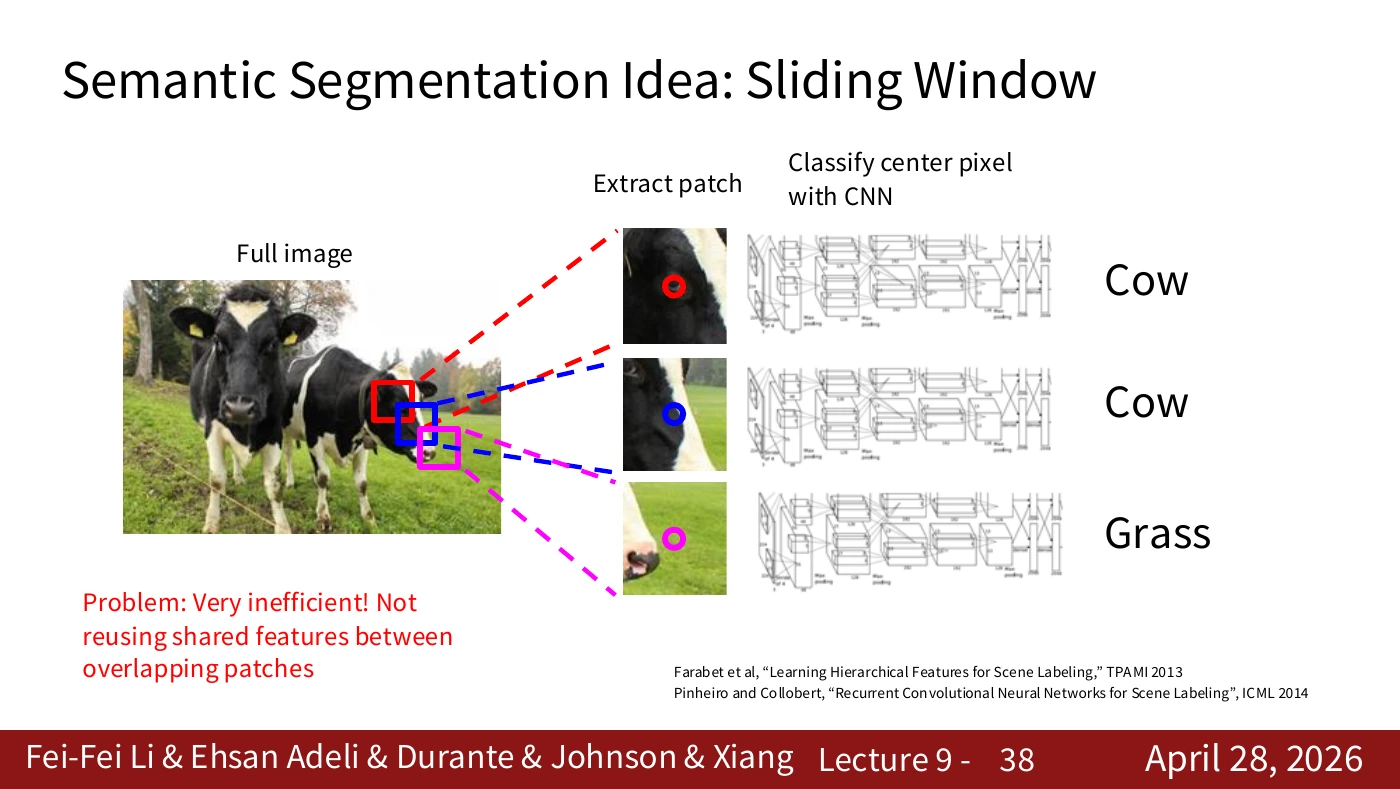
이웃한 창은 대부분의 입력을 공유한다. 각 창의 CNN을 독립적으로 계산하면 비슷한 저수준 특징을 반복 추출한다. 이 장의 한계는 목표의 오류가 아니라 공유하지 못한 계산의 비용이다. 이후 전체 영상에 대한 특징 재사용으로 이어진다.
예를 들어 31×31 창을 가로 한 칸 옮기면 30열이 겹친다. 창별로 모든 합성곱을 처음부터 실행하면 공유 영역도 다시 계산된다. 정확한 가속 배수는 구조와 구현에 달려 있지만 왜 공유할 여지가 있는지는 겹침만으로 확인할 수 있다.
#보충 영상 해설 · 주변을 본다는 말과 계산을 공유한다는 말
2025 강의 18:26–20:27은 두 문제를 순서대로 분리한다. 첫째, 초록색 픽셀 하나만 보고 잔디인지 초록색 옷인지 알기는 어렵다. 주변의 모양과 질감을 같이 봐야 한다. 이것이 P034–P037에서 창을 키우고 패치를 분류망에 넣는 이유다. 둘째, 창을 옆으로 한 칸 옮기면 대부분 같은 픽셀을 다시 읽는다. 문맥을 얻는 데 성공했어도 계산을 반복하는 문제는 남는다.
예를 들어 100×100 이미지의 모든 위치에서 망을 독립 실행하면 목표 위치는 10,000개다. 각 패치가 겹친다고 출력 정답이 같다는 뜻은 아니지만, 초반의 엣지·질감 계산에는 공유할 부분이 많다. 다음 장의 전환은 ‘주변을 보지 말자’가 아니라 주변을 보는 특징 계산을 이미지 전체에서 재사용하자는 것이다. 영상의 설명을 이 두 질문으로 나누면, sliding window에서 FCN으로 왜 넘어가는지 이해하기 쉽다.
#P039. 분류기의 공간 축소와 분할의 요구
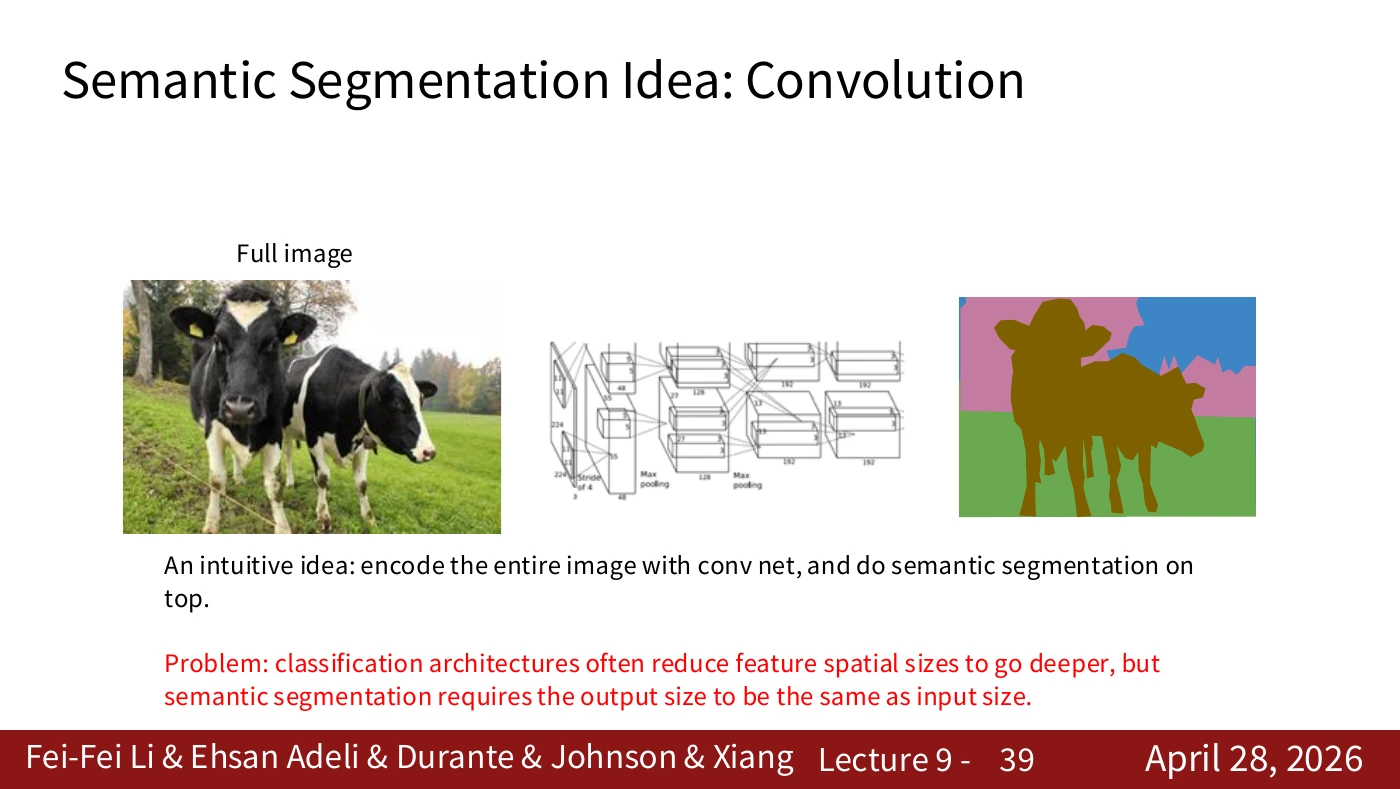
분류망은 깊어지며 feature map 크기를 줄이는 경우가 많다. 분할은 각 위치의 출력을 필요로 하므로 성긴 특징을 입력 좌표와 어떻게 다시 연결할지가 문제가 된다. 한 번의 전체 영상 인코딩을 쓰되 출력 위치를 유지하는 설계가 필요하다.
그림의 화살표는 영상 전체를 인코딩한 뒤 공간 예측 지도로 이어진다. 출력 해상도를 줄인 네트워크를 사용한다면 별도의 복원·정렬이 필요하다. 이미지 분류의 마지막 결과만 가져와서는 위치별 label map이 생기지 않는다.
#P040. 위치마다 C개 점수를 계산
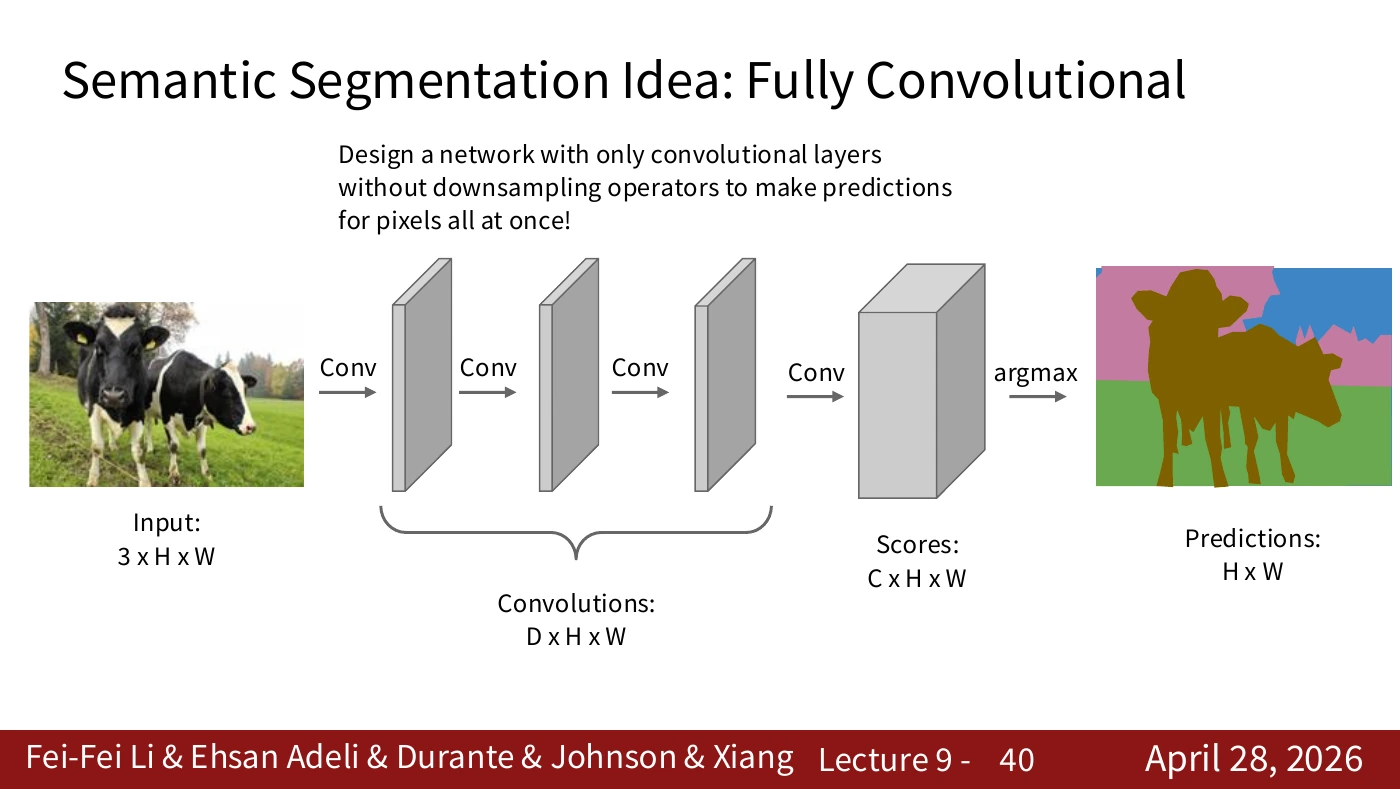
3×H×W 입력에서 C×H×W 점수 지도를 만들고, 범주 채널 방향 argmax로 H×W 예측을 얻는다. C는 범주 수이며 argmax 출력은 점수가 아니라 범주 ID다. 학습에서는 이산 ID 차이가 아니라 logits와 정답을 비교하는 손실을 사용한다.
그림의 D는 중간 특징 채널 수, C는 예측할 범주 수다. 두 수는 같을 필요가 없다. 최종 argmax는 공간 축을 없애는 것이 아니라 각 위치에서 C개 점수 중 범주 하나를 고른다. 아래 보충 계산에서 확률과 범주 ID를 다시 나눈다.
#보충 강의·논문 · 분류망을 FCN으로 바꾼다는 뜻
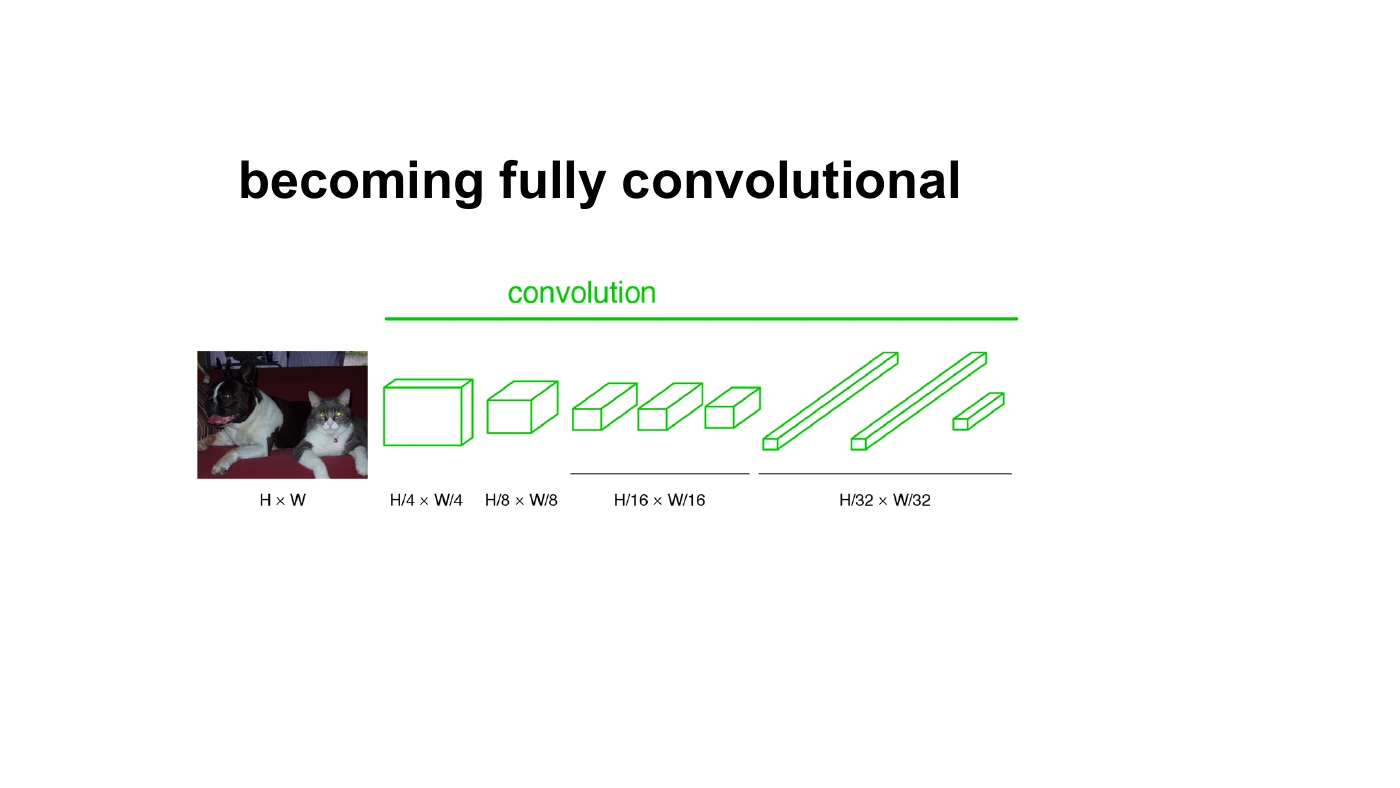
이 그림은 P040의 ‘convolution만으로 출력 지도를 만든다’를 공간 크기로 풀어 준다. 왼쪽 입력의 H와 W가 줄어들어도 오른쪽에는 한 개의 클래스 번호가 아니라 여러 위치가 남는다. 가령 입력이 320×320이고 누적 stride가 32인 설명용 망이라면, 경계 처리를 단순화했을 때 10×10 격자의 예측을 얻는다. 각 위치에서 K개 범주 점수를 내면 모양은 K×10×10이다. 이것을 입력 해상도로 정렬·확대해야 픽셀별 결과로 사용할 수 있다.
FCN 논문 3절과 4절은 기존 분류망의 학습된 특징을 버리고 처음부터 새 망을 만드는 대신, 공간 격자를 유지하는 계산으로 바꿔 dense prediction에 활용한다. 완전연결층의 가중치도 적절한 커널 모양으로 해석하면 convolution처럼 적용할 수 있다. 여기서 ‘fully convolutional’은 모든 층이 같은 크기의 특징 지도를 갖는다는 뜻이 아니다. pooling이나 stride 때문에 성긴 격자가 될 수 있다.
그러면 성긴 결과를 크게 늘리기만 하면 될까? 논문의 FCN-32s → FCN-16s → FCN-8s는 단순히 네트워크의 총 층 수를 표시한 이름이 아니다. 더 촘촘한 중간 단계의 예측을 결합하여 위치 정보를 보완하는 구조 차이다. 깊은 층의 ‘무엇인가’와 얕은 층의 ‘어디에 경계가 있는가’를 함께 쓰는 접근으로 읽자. 이 논문은 원리와 구조를 이해할 보충자료이며, 2015년 실험 성능을 현재 모든 데이터셋의 우열로 옮겨 말할 수는 없다.
2025 영상 20:57–22:13은 FCN의 이름과 down/up 흐름을 설명한다. 다음 P041–P043을 읽을 때는 위치별 점수 지도가 어디서 성겨지고, 어디서 다시 촘촘해지는가를 따라가면 된다.
#P041. 원본 해상도 계산의 비용
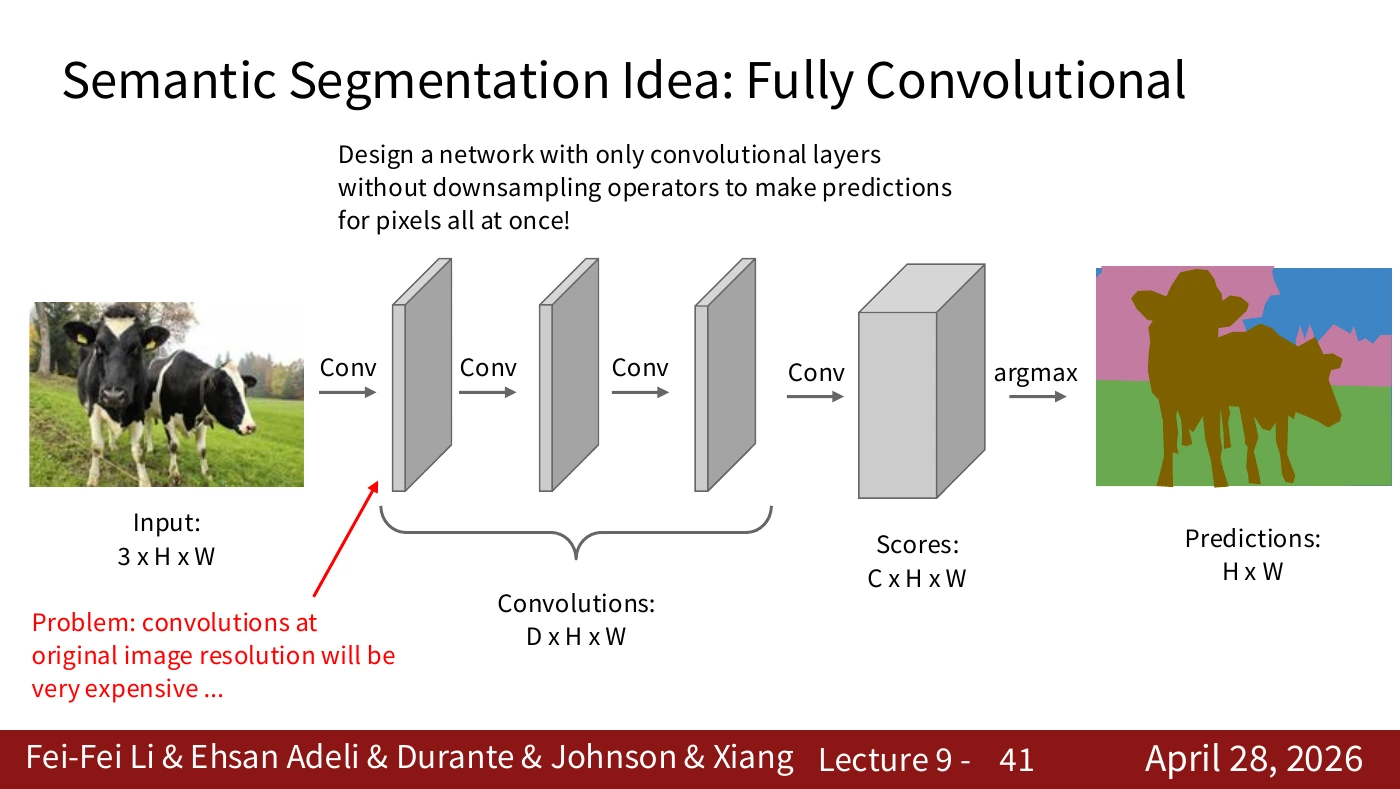
위치 정보를 끝까지 보존한다고 모든 문제가 해결되는 것은 아니다. 큰 H×W 격자에서 많은 합성곱을 실행하면 비용이 커진다. 위치를 조밀하게 유지하는 장점과 채널·커널·해상도에 따른 비용을 함께 읽는다.
각 변을 2배 키우면 위치 수는 4배가 된다. 같은 채널·커널 조건이라면 공간 연산도 그만큼 늘어나는 방향이다. 따라서 장면을 세밀하게 보는 일과 비용을 줄이는 일은 함께 설계해야 한다.
#P042. Downsampling과 upsampling의 결합
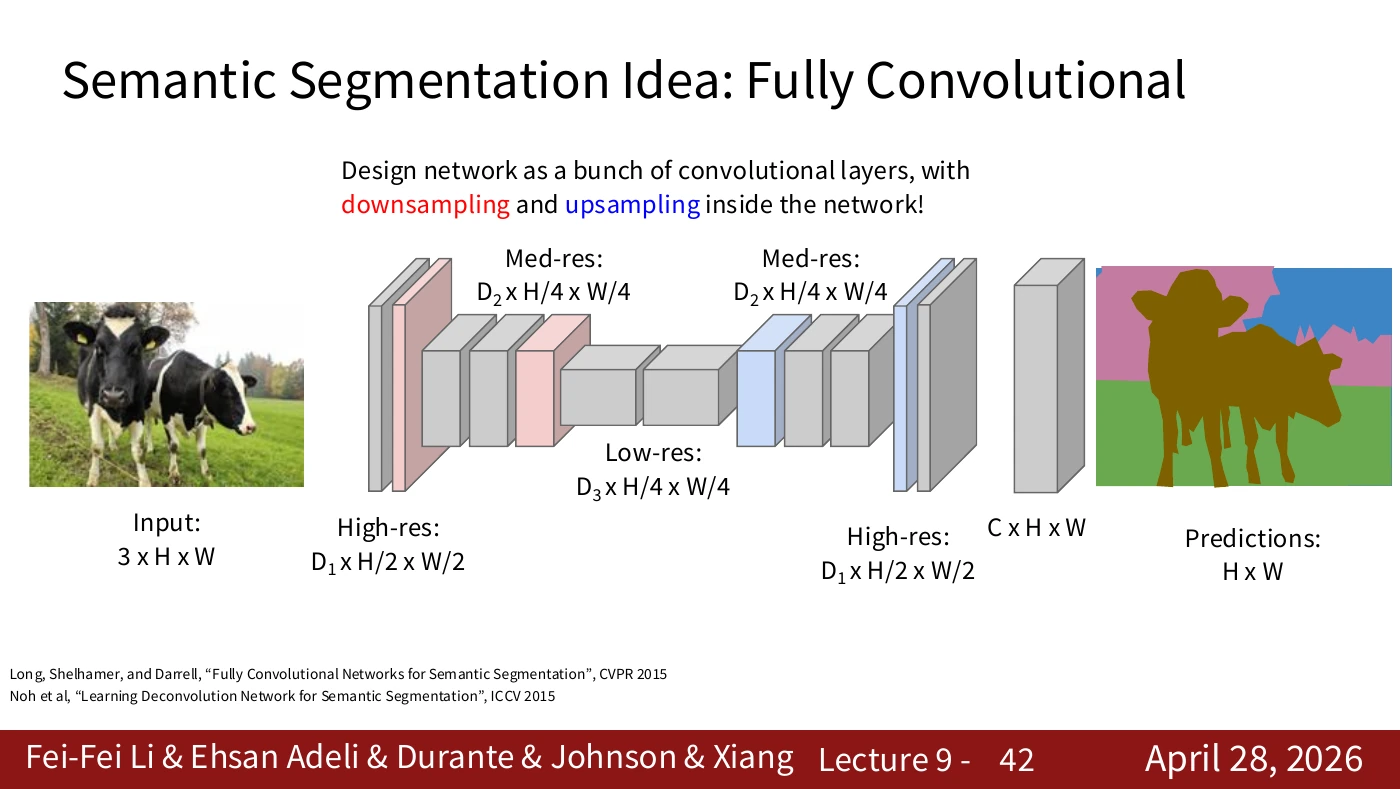
작은 격자에서 넓은 문맥을 처리하고 다시 조밀한 출력으로 옮기는 큰 흐름이다. 슬라이드의 각 중간 tensor 표기는 원본에 보이는 그대로 먼저 읽고, 공간 크기를 줄였다 키우는 의도를 설명한다. 확대가 잃어버린 세부를 자동 복구한다는 뜻은 아니다.
원본의 중간 해상도 표기에는 H/4×W/4가 여러 위치에 반복된다. 그림은 down/up 구조의 개념도이므로 이를 곧바로 특정 프레임워크의 정확한 layer shape 명세로 옮기지 않는다. 실제 구현에서는 각 층의 shape를 직접 확인한다.
#P043. 확대 연산을 무엇으로 채울까
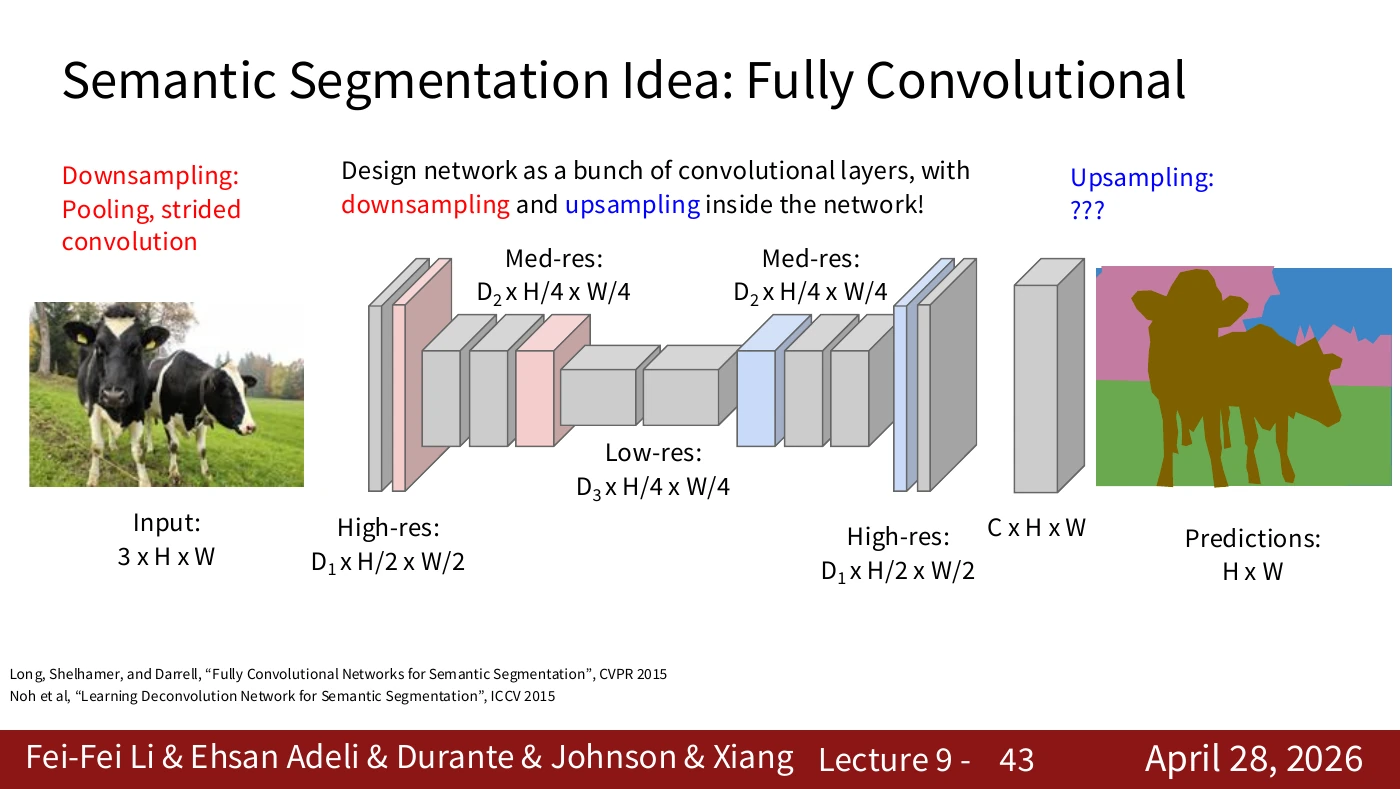
Downsampling 쪽은 pooling 또는 stride 합성곱을 적고, upsampling 쪽에는 물음표를 둔다. 앞 장 구조의 미완성 부분을 분명히 하는 장이다. 이후의 unpooling과 transposed convolution은 이 물음표에 대한 서로 다른 답이다.
왼쪽과 오른쪽은 대칭적으로 보이지만 실제로는 서로 역함수라고 가정할 수 없다. 평균·최댓값으로 버린 세부는 출력 크기를 늘려도 저절로 돌아오지 않는다. 확대 방식의 차이를 다음 두 장의 숫자 배열로 확인한다.
#P044. Nearest neighbor와 bed of nails
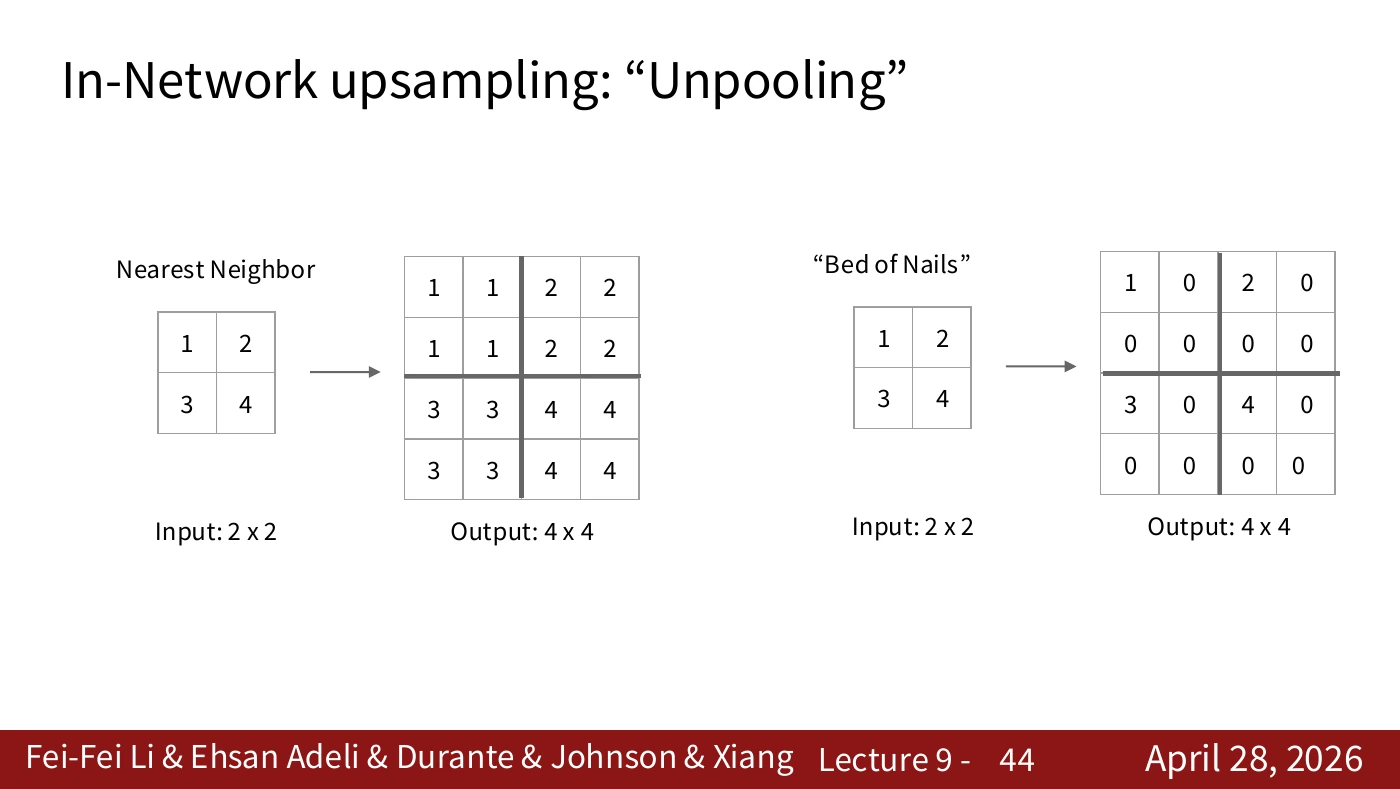
Nearest neighbor는 입력 값을 여러 출력 위치에 복사한다. Bed of nails 방식은 간격을 벌려 값을 놓고 나머지 위치를 0으로 채운다. 두 방식은 같은 출력 크기를 만들어도 값의 배열이 다르며, 어느 쪽도 새 경계를 관측해 만드는 연산은 아니다.
원본의 2×2 입력 [[1,2],[3,4]]에서 nearest neighbor는 각 값을 2×2 블록으로 복사한다. Bed of nails는 원래 값 사이를 0으로 채운다. 같은 4×4 shape인데 정보 배치가 다르므로 shape 확인만으로 구현 검증을 마칠 수 없다.
#보충 강의 · 최근접 복사와 bilinear 보간은 무엇이 다른가
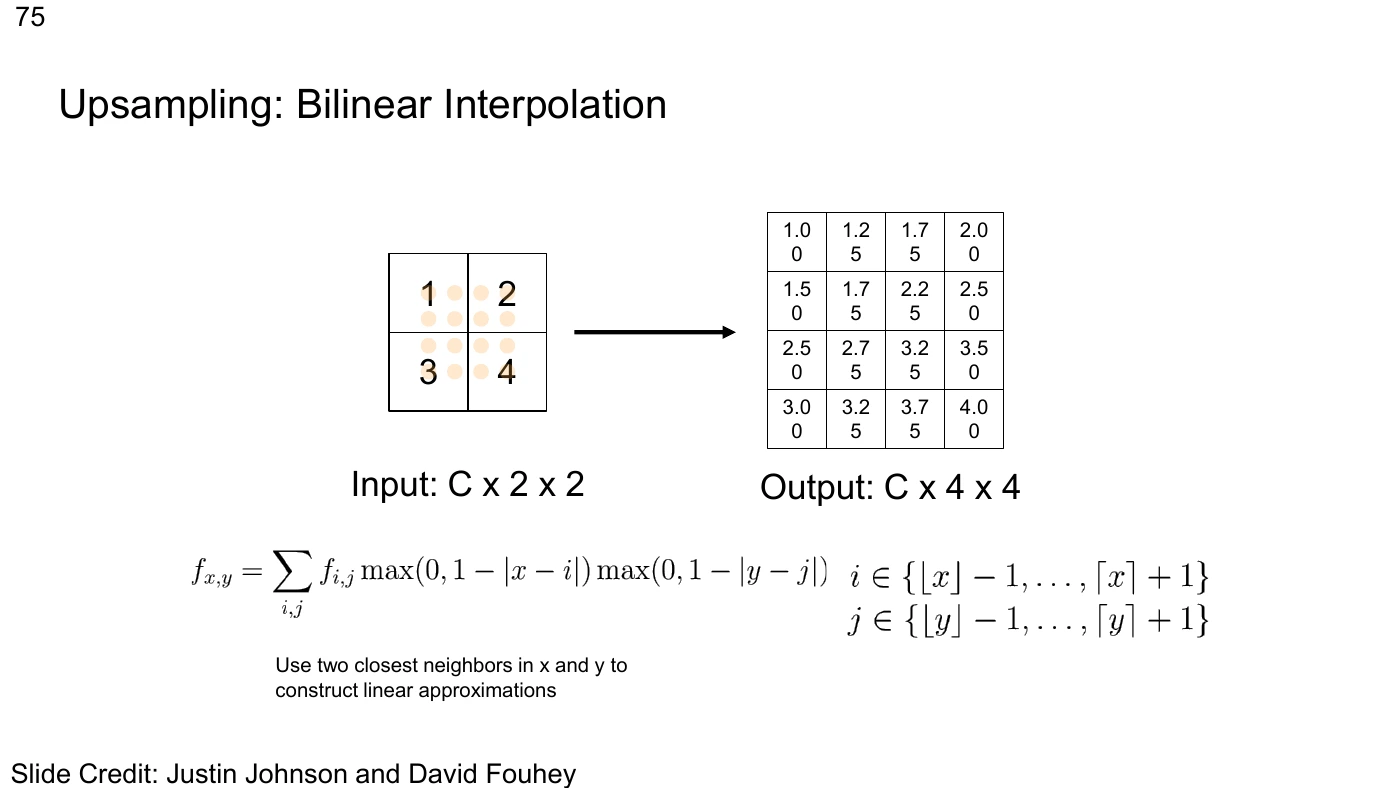
P044의 nearest neighbor는 가장 가까운 값 하나를 복사한다. bilinear 보간은 가로와 세로에서 가까운 값들을 거리로 가중하여 섞는다. 보충 그림의 1, 2, 3, 4를 네 모서리 값으로 생각하면, 정확히 중앙의 값은 네 값에 같은 가중치 1/4를 주어 2.5가 된다. 다른 위치에서는 가까운 모서리에 더 큰 비중을 준다. 이 2.5는 새 물체를 발견한 결과가 아니라 이미 있던 수치 사이를 메운 값이다.
원본의 4×4 숫자를 구현 결과와 비교할 때는 출력 픽셀의 중심을 입력의 어느 좌표에 놓았는지도 확인해야 한다. align_corners 같은 정렬 설정이나 경계 처리에 따라 중간 값이 달라질 수 있다. 따라서 ‘bilinear니까 모든 라이브러리에서 동일한 숫자’라고 외우기보다 좌표 대응과 가중치를 확인한다.
여기서 섞어도 되는 것은 연속적인 특징값이나 클래스별 점수다. 잔디=0, 소=1, 하늘=2처럼 범주를 임의의 정수로 붙인 label map에 bilinear를 적용해 0.5를 만들면 새로운 의미의 클래스가 되지 않는다. 정답 마스크 크기를 바꿀 때 최근접 보간을 흔히 쓰는 이유다. 모델 출력은 클래스별 점수 지도를 먼저 확대하고 마지막에 argmax할 수 있지만, 학습용 범주 ID를 평균 내는 일과는 다르다.
2025 영상 25:13–26:46은 nearest neighbor, bed of nails, max 위치를 저장하는 방식을 설명한다. 위 bilinear 그림은 그 영상의 해당 시점에 같은 그림이 나온다는 뜻이 아니라, 고정 규칙 upsampling을 비교하려고 덧붙인 다른 강의 자료다. 다음 P045에서는 ‘어디로 값을 보낼지 기억하는가’, P046 이후에서는 ‘보낼 값을 결정하는 가중치까지 학습하는가’를 구별하자.
#P045. Max pooling의 위치를 기억한 unpooling
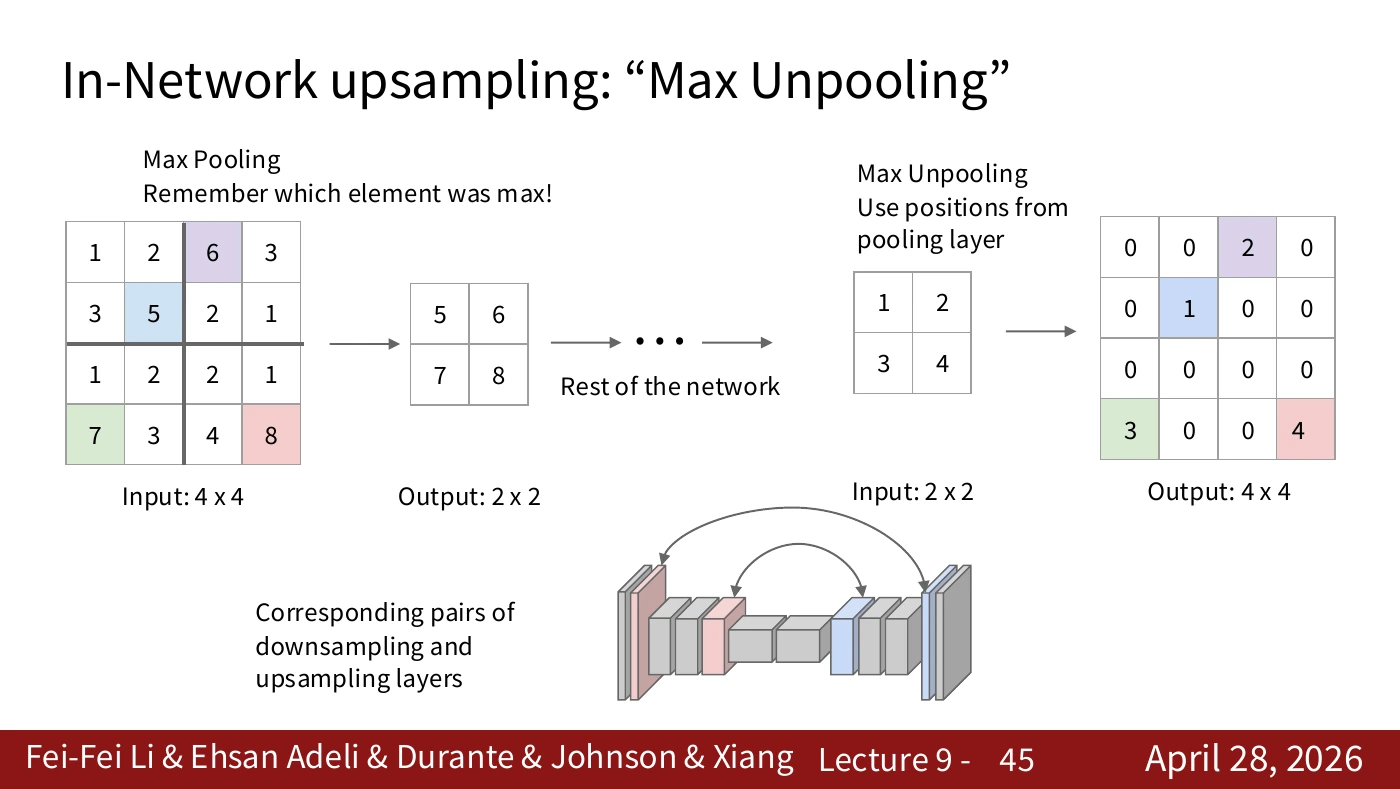
Max pooling 때 선택된 위치를 기억해 두었다가 그 위치에 값을 다시 놓는다. 나머지는 0이므로 pooling 이전의 모든 값이 되살아나는 역함수는 아니다. 위치 정보가 어디서 오는지를 확인해야 하며 encoder와 decoder의 대응도 필요하다.
원본은 pooling에서 얻은 최댓값 위치와 나중의 unpooling 입력 값을 구분해서 보여 준다. 복원 위치가 맞아도 사라진 나머지 값은 알 수 없다. 그림 아래의 연결은 대응되는 down/up 단계 사이에 위치 정보를 전달한다는 뜻이다.
#P046. 일반 합성곱의 공간 크기부터
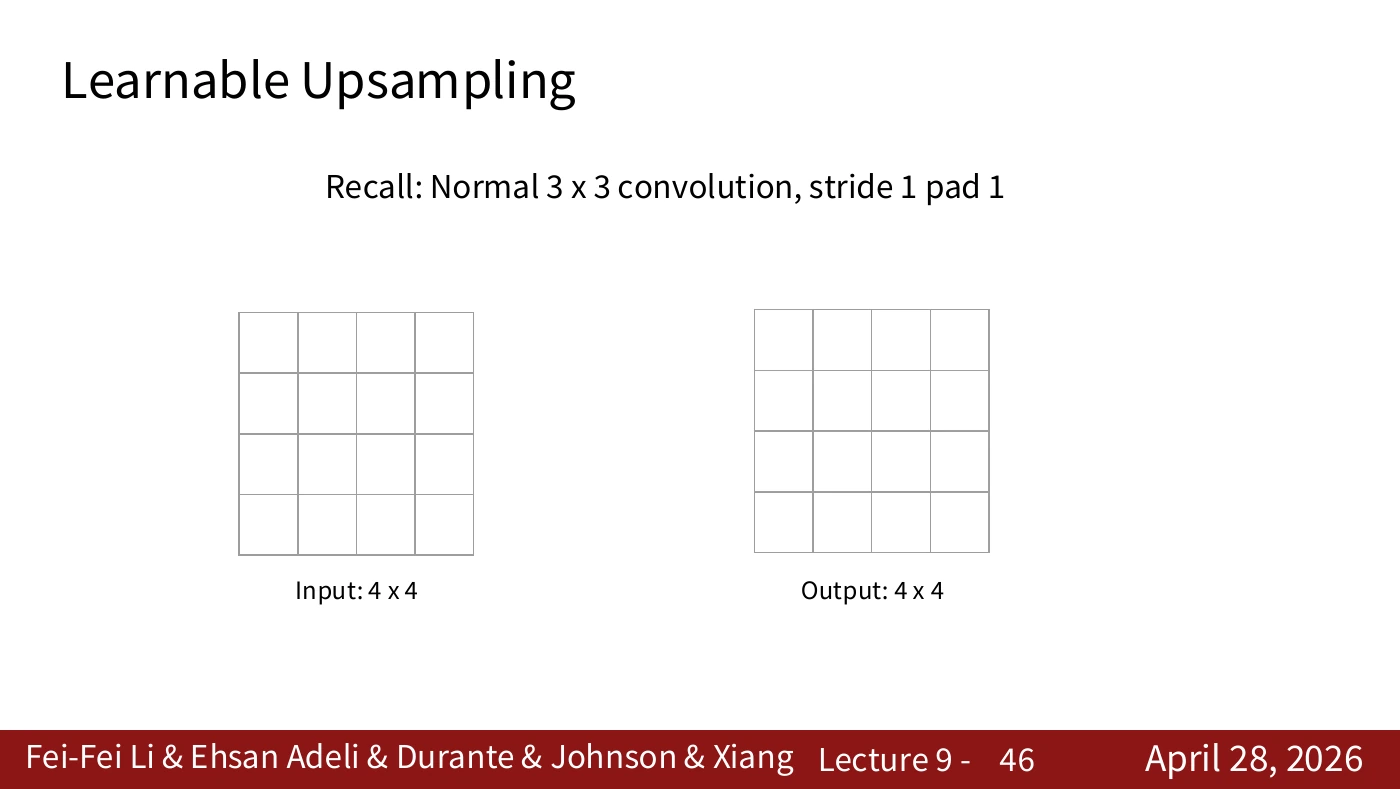
4×4 입력에 3×3 필터, stride 1, padding 1을 적용하는 예다. 출력도 4×4가 되는 설정을 먼저 확인한다. 이후 확대 연산과 비교하기 위해 이미 아는 합성곱의 입출력 관계를 다시 고정하는 장이다.
출력 크기를 정할 때는 필터 크기만 보지 않는다. stride와 padding까지 함께 적어야 같은 결과를 재현할 수 있다. 그림의 4×4를 암기하기보다 설정을 바꾸면 어디가 달라지는지 비교할 준비를 하자.
#P047. 출력 하나는 필터와 입력 창의 내적
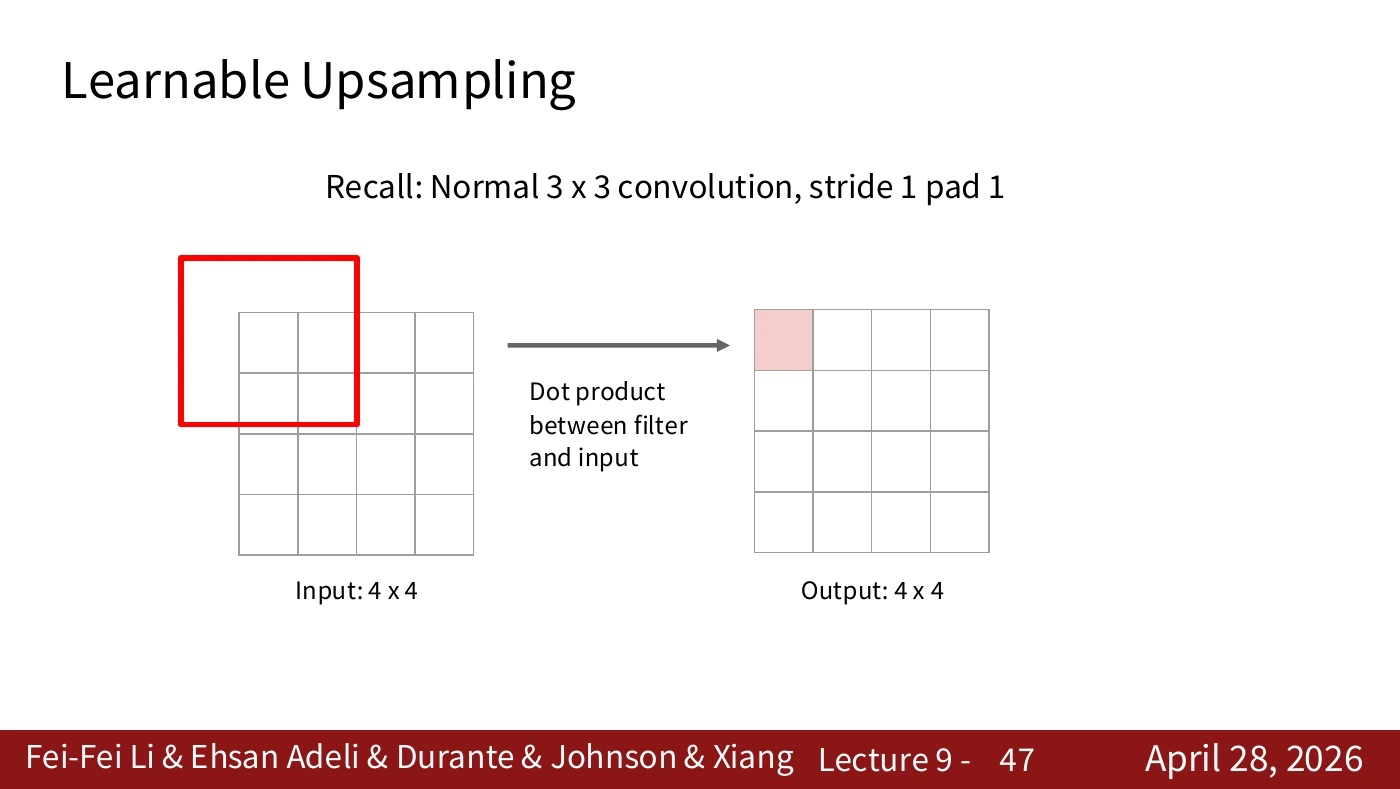
필터와 대응 입력 값을 곱해 더한 것이 출력 위치 하나다. 필터가 무엇을 곱하는지와 그 결과가 출력 어디에 기록되는지를 나누어 본다. 다음 장은 필터 위치를 옮겨 동일한 연산을 반복한다.
빨간 창은 가장자리에서 입력 바깥까지 걸쳐 있다. 이 예에서는 padding 1로 그 경계를 처리한다. 필터가 밖으로 나간다고 입력을 마음대로 잘라내는 것이 아니라 명시된 padding 규칙을 적용한다.
#P048. 필터를 이동하며 같은 가중치 재사용
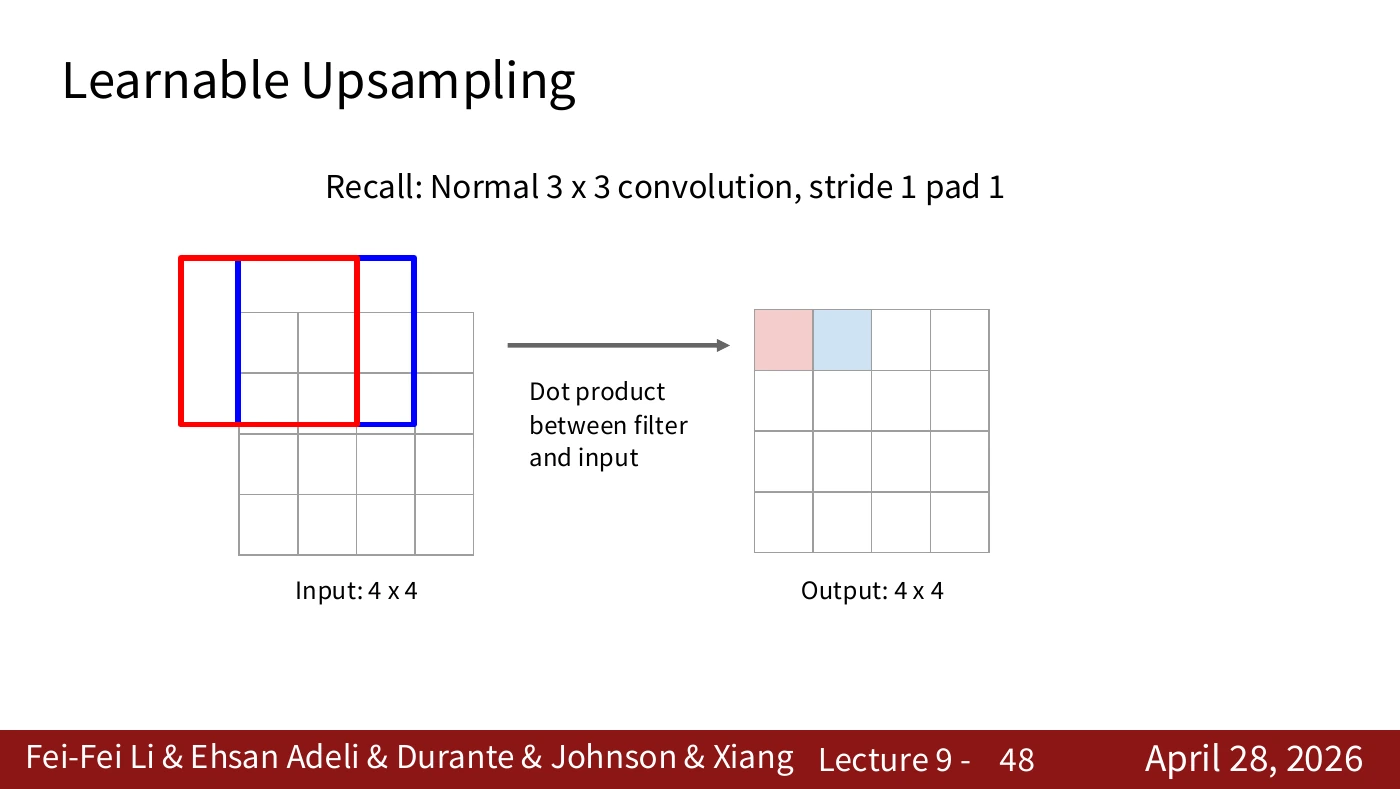
이전 장과 새 필터 위치를 비교한다. 새로운 위치에서도 가중치는 공유되지만 입력 창은 달라진다. 출력 지도의 여러 값이 같은 필터의 여러 공간 적용이라는 사실이 중요하다.
빨간 창과 파란 창의 이동, 출력의 빨간 칸과 파란 칸의 이동을 짝지어 본다. stride 1에서는 입력 쪽 한 칸 이동이 출력 쪽 한 칸 이동에 대응한다. 가중치 공유와 위치 이동을 시각적으로 연결하는 장이다.
#P049. Stride 2로 위치를 줄이기
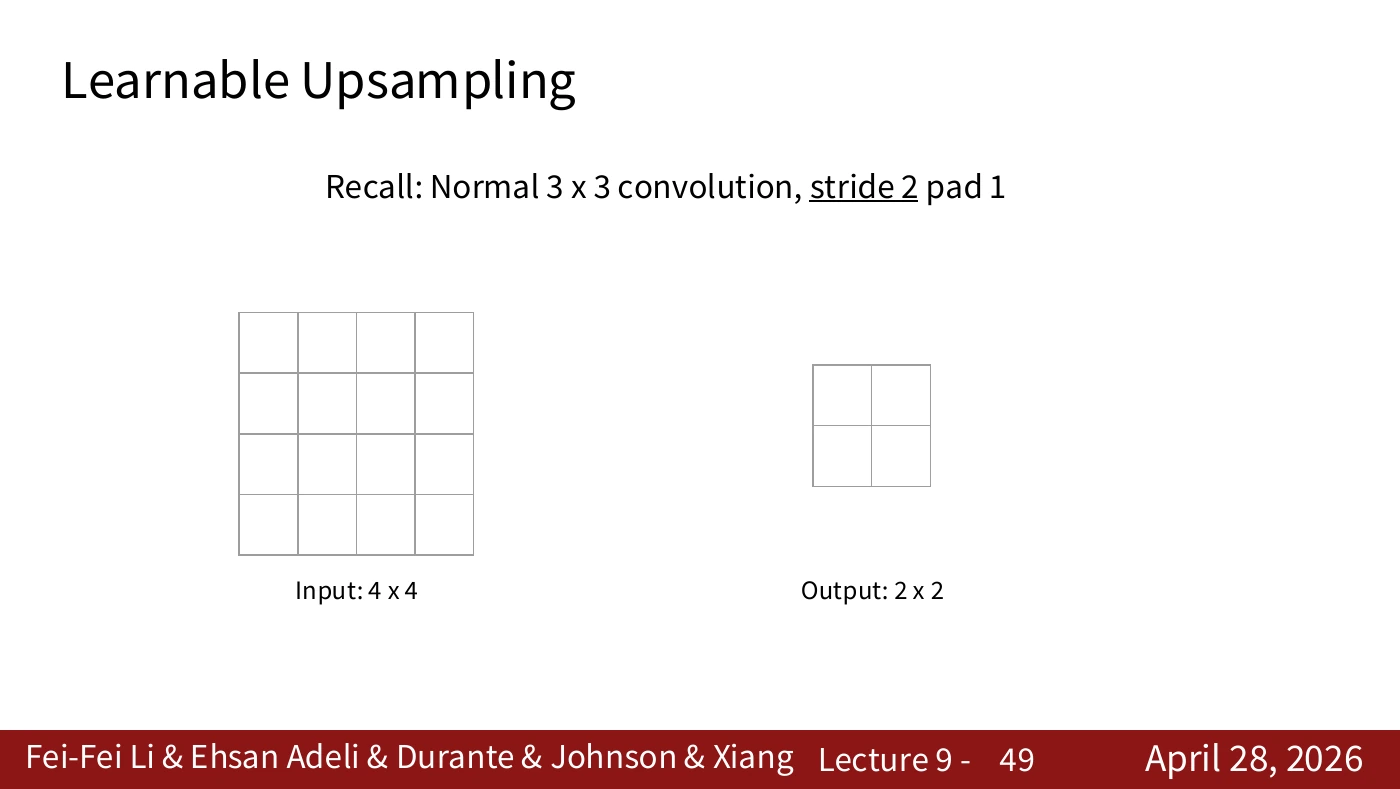
같은 3×3 필터와 padding 1에서 stride를 2로 바꾸면 이 예의 출력은 2×2가 된다. 공간을 건너뛰며 계산한 결과다. 채널이나 범주 수를 줄이는 것과 공간 해상도를 줄이는 것을 혼동하지 않는다.
4×4 입력이 2×2 출력이 된다는 것은 네 위치의 출력만 계산한다는 뜻이다. 입력의 나머지 픽셀을 전부 읽지 않는다는 단순한 설명과는 다르다. 필터 창은 여러 입력 픽셀을 함께 읽는다.
#P050. 성긴 출력에서도 내적 규칙은 같다
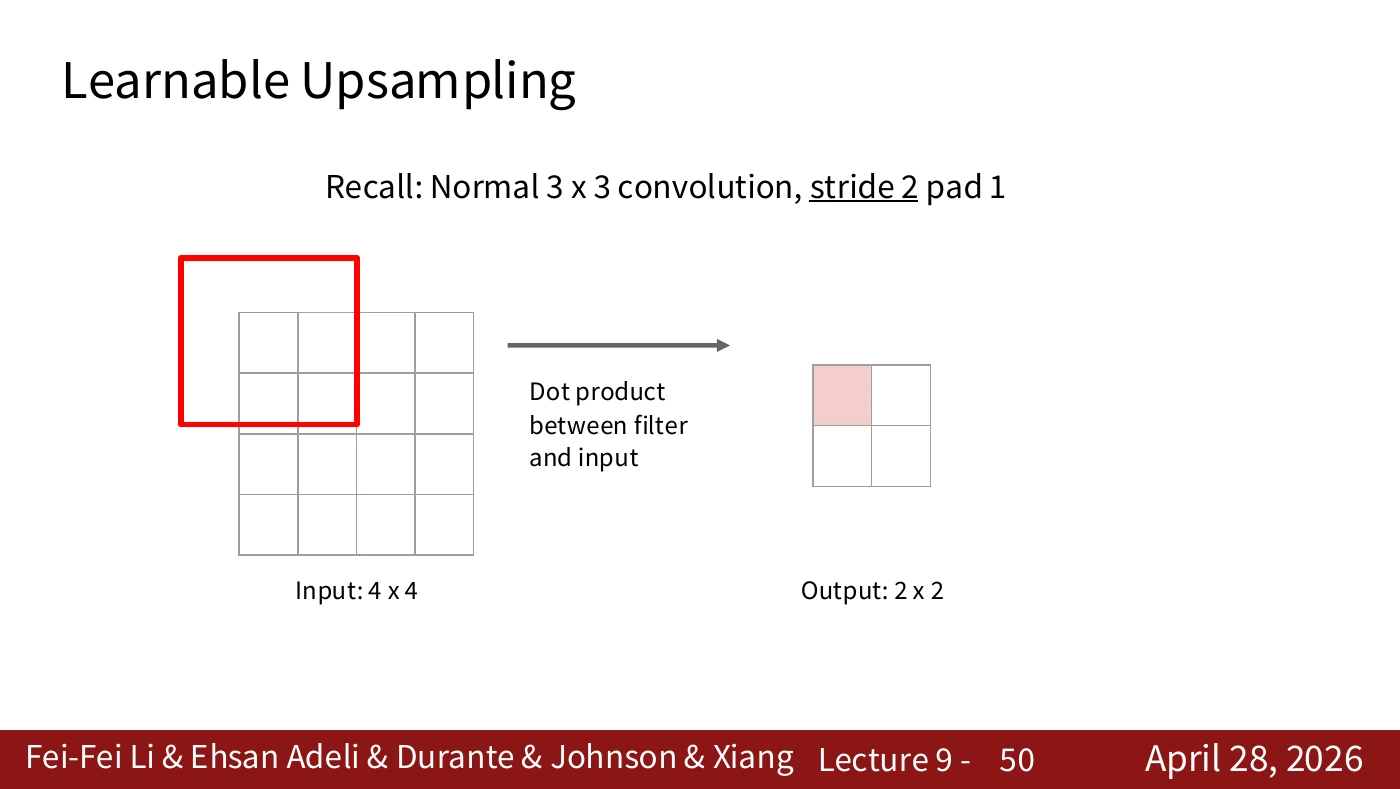
필터와 입력의 내적이라는 연산은 유지되고 필터 위치를 움직이는 간격만 달라진다. 출력 한 칸의 이동이 입력에서 어느 간격의 이동에 대응하는지 표시하며 읽는다.
한 출력 위치를 계산하는 규칙은 이전 stride 1 예제와 같다. 차이는 다음 창의 시작점이다. 연산 자체와 연산을 배치하는 격자를 나누어 생각하면 다음 transpose 설명이 쉬워진다.
#P051. Stride는 두 격자의 이동 비율
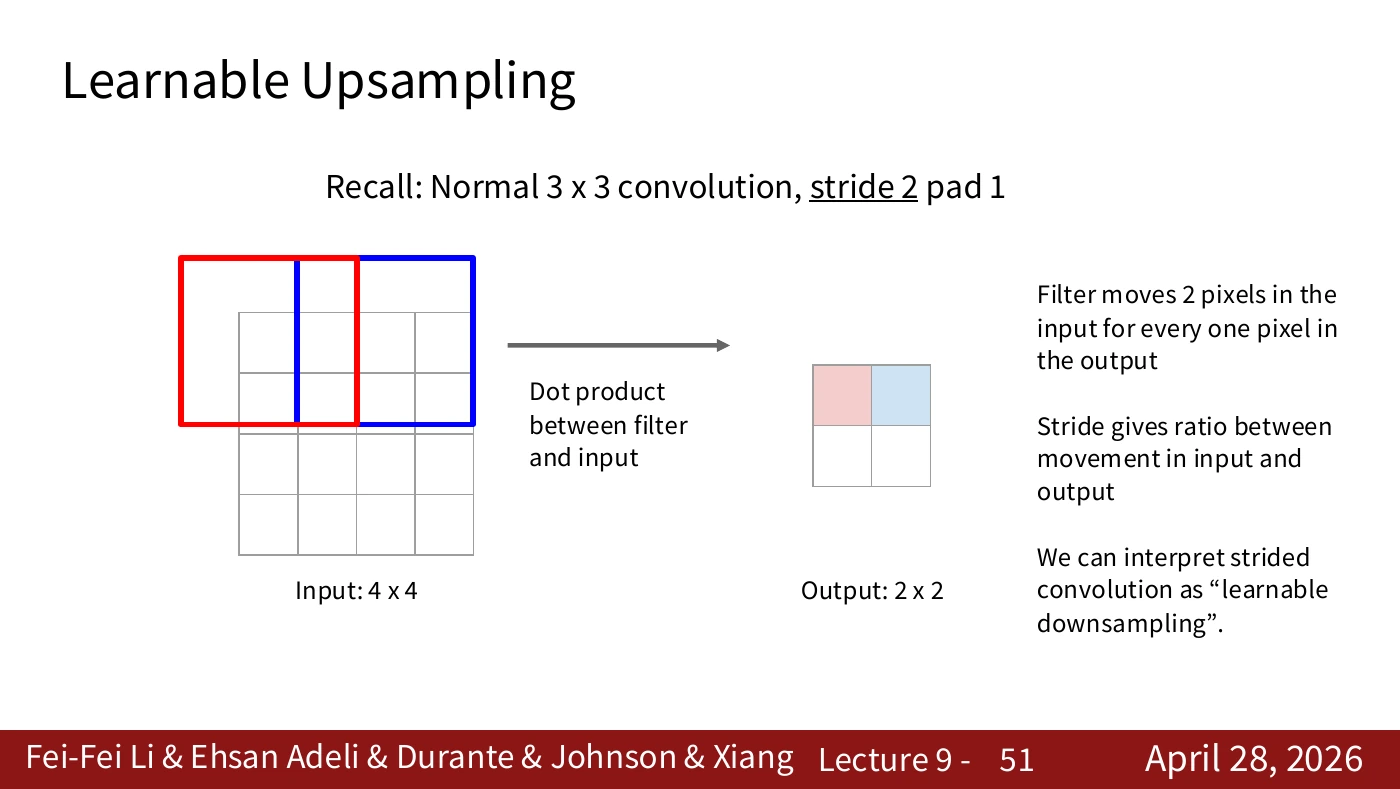
입력에서 필터를 두 칸 움직이면 출력에서는 한 칸 움직인다. 이 관점에서 stride 합성곱은 학습 가능한 downsampling으로 해석할 수 있다. pooling과 목적이 비슷해도 가중치가 학습되는 연산이라는 차이가 있다.
그림의 빨간 창과 파란 창 사이가 입력에서 두 칸이다. 출력의 두 색 칸은 이웃한다. 바로 이 비율을 다음 장에서는 출력 방향으로 뒤집어 읽는다. 역행렬로 원본을 복원하는 문제와는 다르다.
#P052. Transposed convolution의 크기 방향
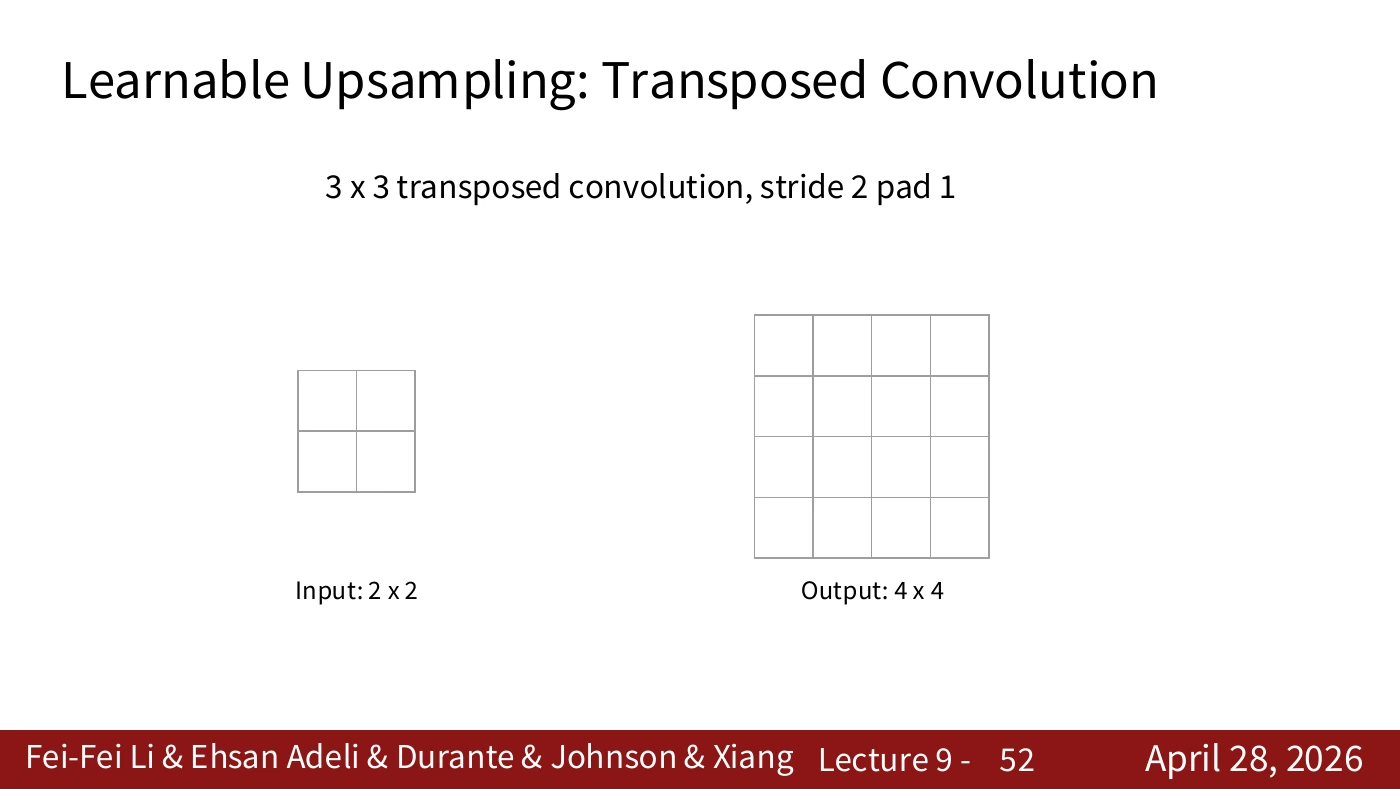
2×2 입력에서 더 큰 출력을 만드는 예로 전환한다. 이름의 transpose는 역복원 보장을 뜻하지 않는다. 실제 프레임워크의 출력 크기는 stride·padding·kernel·output padding의 정의에 따라 확인해야 하며 그림의 크기만으로 모든 기본값을 단정하지 않는다.
일반적인 1차원 출력 크기 관계는 (입력크기−1)×stride−2×padding+kernel+output_padding이다(dilation 1). 이 장의 2→4 표기는 경계·output padding 선택을 포함한 설명 예다. 예컨대 PyTorch에서 kernel 3, stride 2, padding 1의 기본 output_padding 0이면 크기 3이므로, 그림과 맞추려면 설정을 확인해야 한다.
#P053. 입력 값이 필터 패턴을 가중한다
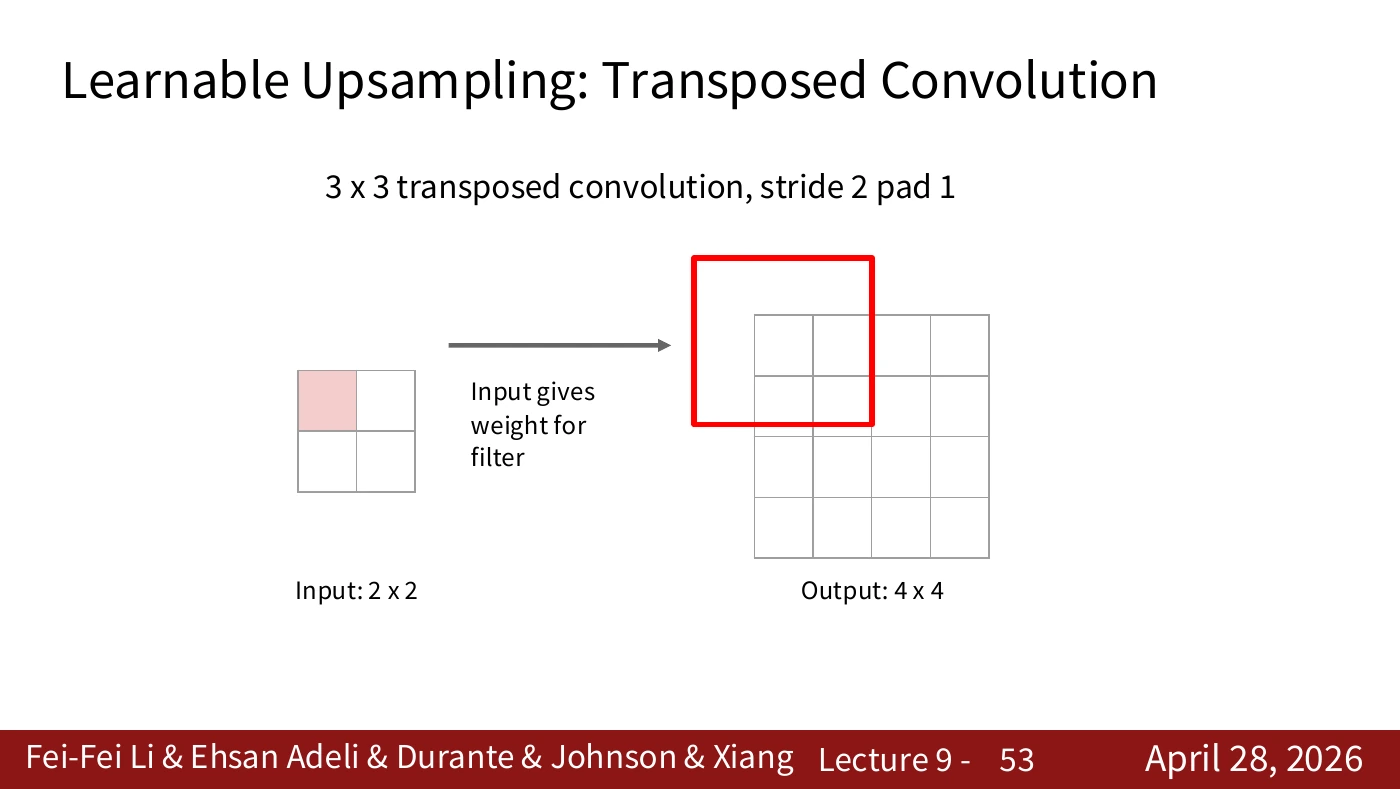
작은 입력의 한 값이 필터 패턴 전체에 곱해져 출력 영역에 기여하는 방식으로 읽는다. 일반 합성곱이 한 출력으로 여러 입력을 모았다면 여기서는 한 입력의 기여가 여러 출력 위치로 퍼지는 관점이 유용하다.
빨간 입력 하나의 값이 출력의 빨간 3×3 영역에 어떤 가중치로 기여하는지 본다. 한 입력이 여러 출력으로 퍼져도 필터 가중치를 공유한다는 원리는 유지된다. 확대된 출력 자체를 새로운 정답으로 취급하는 연산이 아니다.
#P054. 입력 한 칸과 출력 두 칸
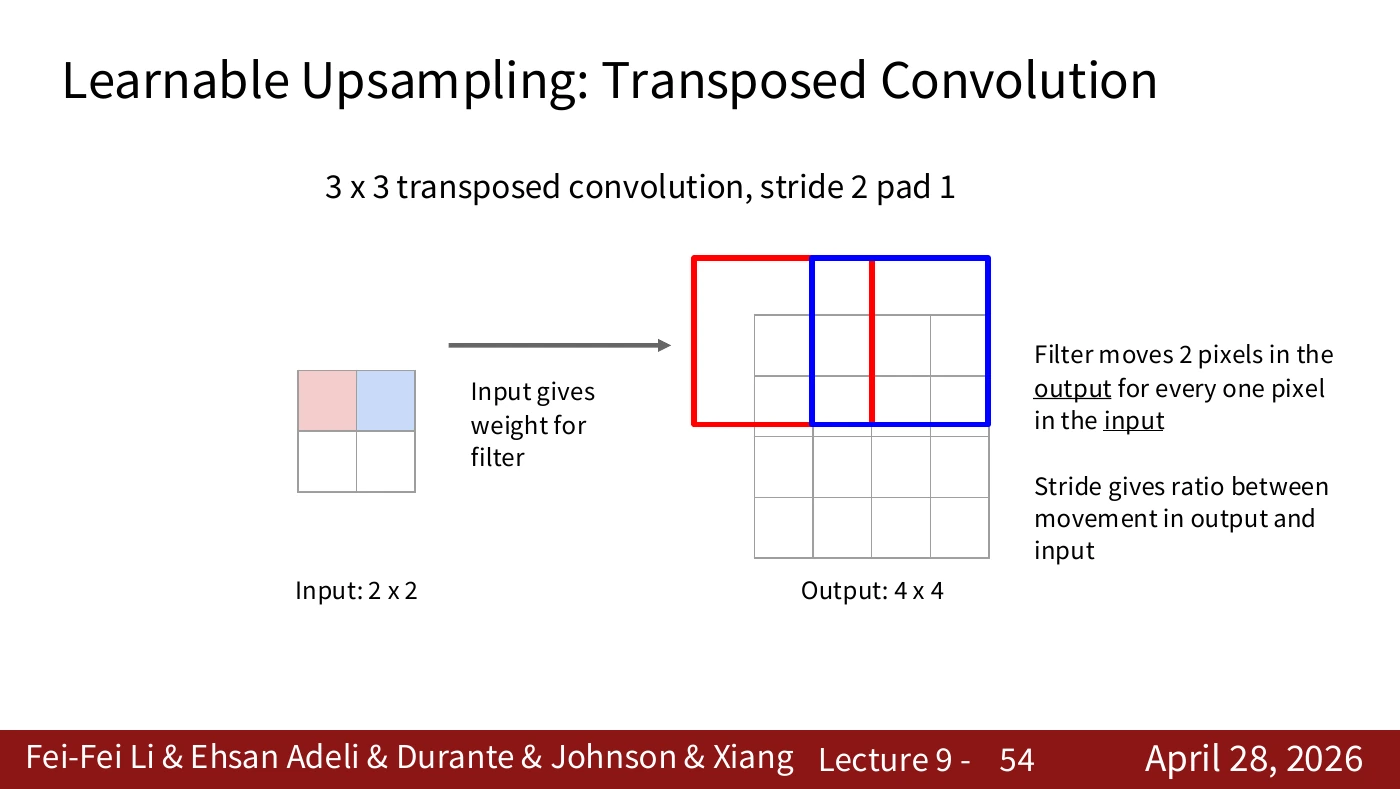
이 예에서는 입력 위치를 한 칸 옮길 때 출력에 놓이는 필터 패턴이 두 칸 옮겨진다. stride를 어느 격자에서 읽고 있는지 확인한다. 입력 값마다 서로 다른 필터를 새로 학습한다는 뜻은 아니다.
출력 쪽 빨간 창과 파란 창 사이가 두 칸으로 벌어진다. 입력에서 인접한 두 값이 출력에 놓는 패턴이 겹칠 수도 있다는 점을 다음 장에서 확인한다. stride가 커지면 무조건 매끈하게 커지는 것은 아니다.
#P055. 겹치는 기여는 더한다
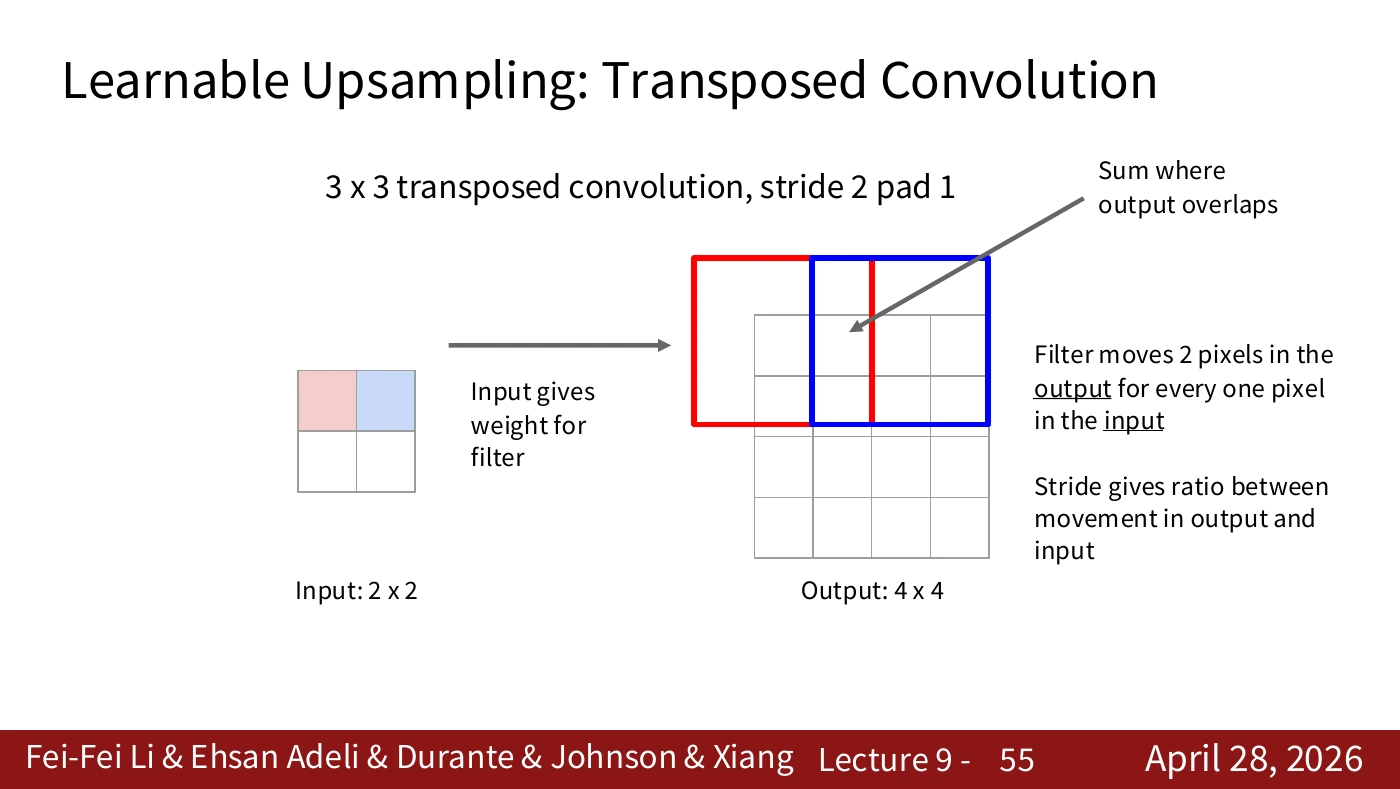
여러 입력이 출력의 같은 위치에 기여하면 그 값을 합산한다. 뒤에서 온 값으로 덮어쓰는 연산이 아니다. 겹침의 위치와 개수를 직접 따라가면 transposed convolution이 보간과 어떻게 다른지 보인다.
화살표가 가리킨 겹침 부분에는 두 입력의 가중된 필터 값이 모두 참여한다. 코드로 확인할 때는 이 위치의 값을 손으로 더해 본다. 단순 복사나 덮어쓰기 구현이면 값이 달라진다.
#P056. 전체 출력은 모든 입력 기여의 합
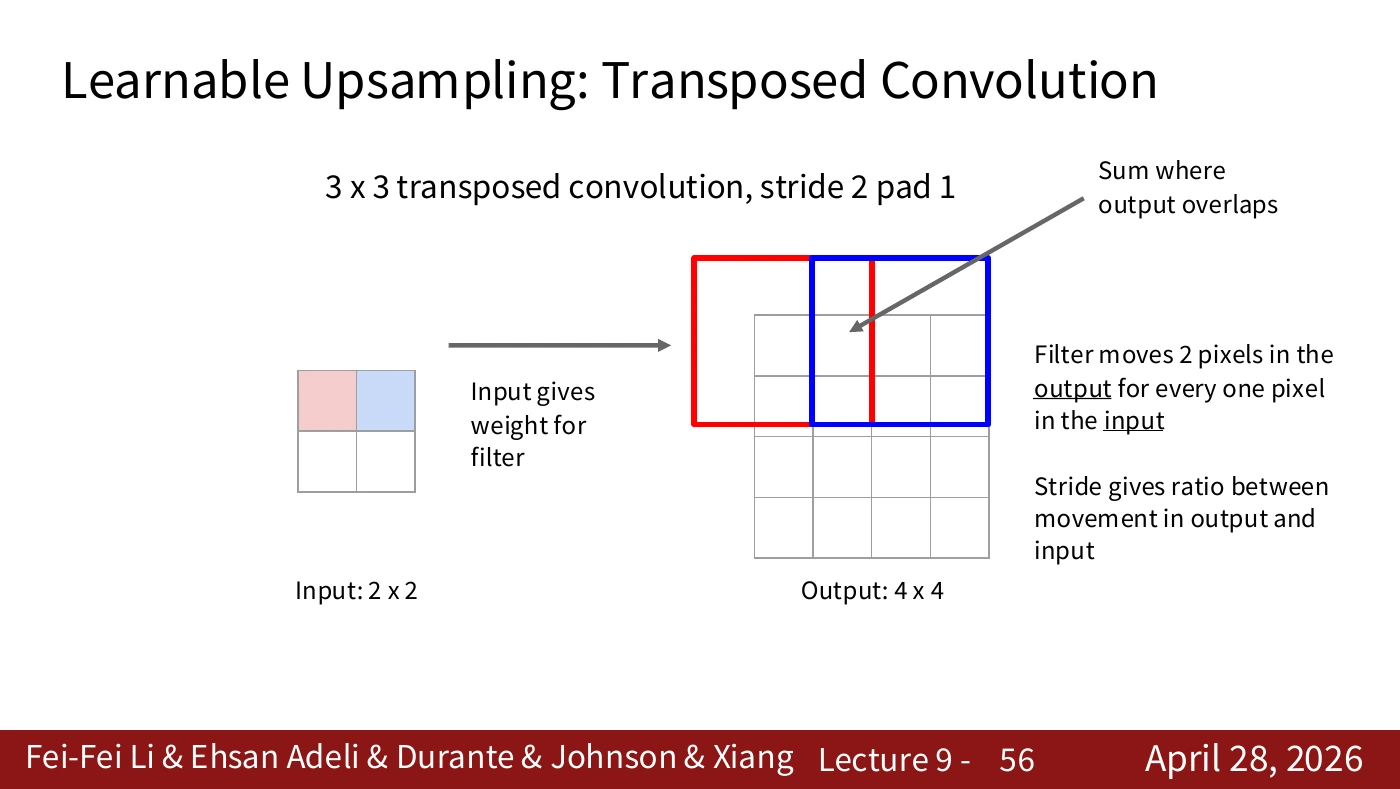
앞 장의 겹침 규칙을 남은 위치에도 적용한다. 화면에서 늘어난 격자 크기뿐 아니라 각 출력에 어떤 입력 값과 필터 계수가 참여했는지 확인한다. 이 계산만으로 실제 영상의 고해상도 정답을 안다는 뜻은 아니다.
다른 위치로 진행해도 겹침은 같은 합산 규칙을 따른다. 두 색 영역을 그림에서 분리해서 읽은 뒤 겹친 위치를 확인하자. 반복 슬라이드의 목적은 새 정의 추가가 아니라 같은 연산이 이동하며 어떻게 누적되는지 보여 주는 데 있다.
#P057. 1차원 예제로 겹침을 계산
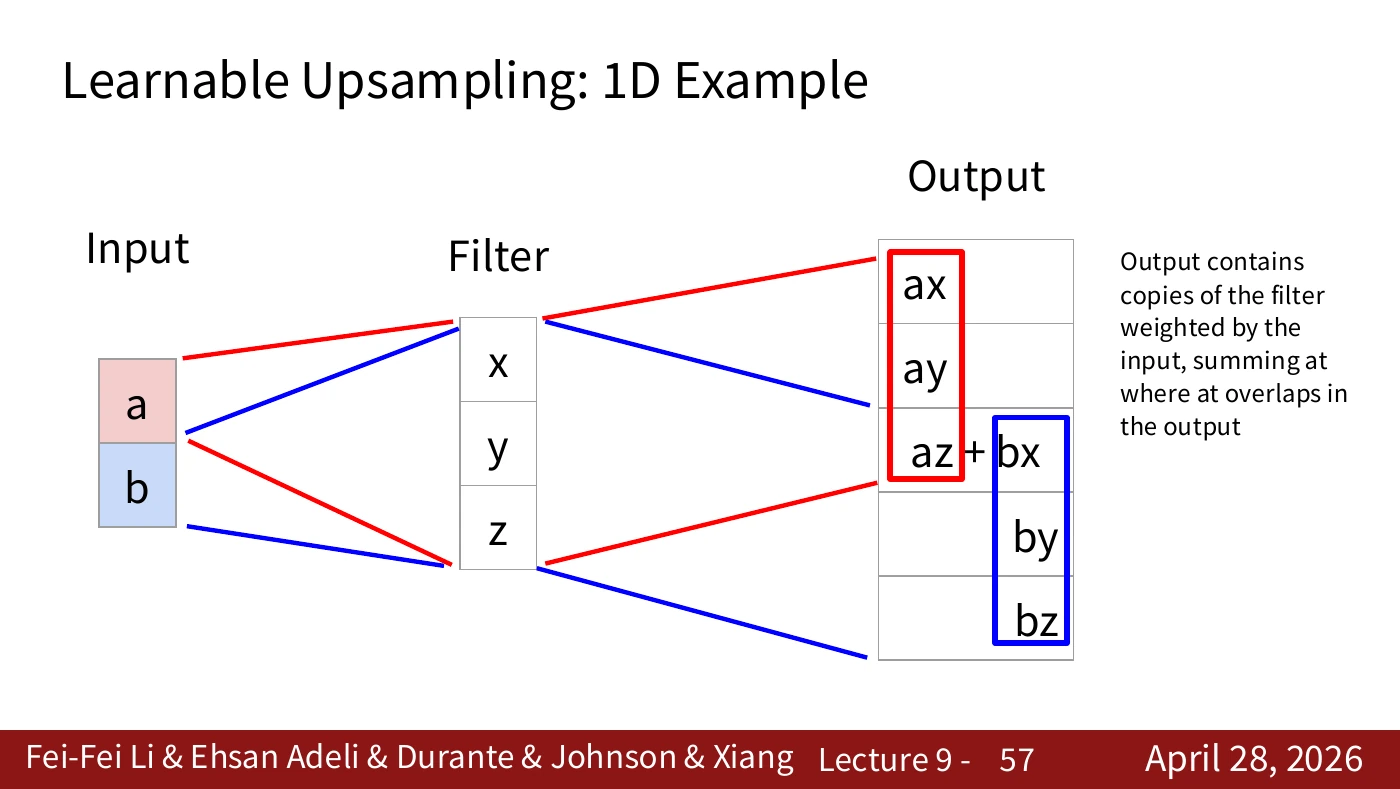
원본의 입력은 a,b이고 필터는 x,y,z다. a는 필터 전체에 곱해져 ax, ay, az를 만들고, b는 두 칸 이동한 위치에서 bx, by, bz를 만든다. 두 기여가 만나는 가운데 칸은 az+bx다. 따라서 출력은 [ax, ay, az+bx, by, bz]가 된다. 입력과 필터 기호를 바꾸어 읽으면 계산이 뒤집히므로 그림의 Input과 Filter부터 확인한다.
직접 계산해 보자. a=2, b=3, 필터 [x,y,z]=[1,4,5]라면 a의 기여는 [2,8,10,0,0], b의 기여는 [0,0,3,12,15]다. 합하면 [2,8,13,12,15]가 된다. 이 숫자는 강의 실험 결과가 아니라 그림의 합산 규칙을 확인하는 자체 예제다.
#보충 영상 해설 · 겹치는 값은 왜 더할까
2025 강의 28:09–28:46은 입력 a, b를 필터로 펼치고 겹치는 출력에 기여를 더하는 1차원 예제를 설명한다. 이 장은 큰 그림의 색깔보다 출력 한 칸에 어떤 입력이 도달했는가를 적어 보면 이해하기 쉽다.
입력 a의 기여는 [ax, ay, az, 0, 0], 두 칸 뒤에서 시작하는 b의 기여는 [0, 0, bx, by, bz]로 따로 쓸 수 있다. 둘을 더하면 본문의 [ax, ay, az+bx, by, bz]가 된다. 중앙 칸은 두 입력을 동시에 받지만 맨 왼쪽 칸은 a만 받는다. 이를 ‘큰 격자의 모든 칸을 같은 방식으로 복사한다’고 읽으면 겹침을 놓친다.
필터 x, y, z는 학습할 수 있으나, 확대된 격자가 원래 입력에서 사라진 정보를 유일하게 복구한다는 보장은 없다. 여러 입력이 같은 다운샘플 결과를 만들 수 있기 때문이다. 그래서 deconvolution이라는 별칭을 보더라도 이 글에서는 transposed convolution을 일반적인 역함수와 구별한다. P058로 돌아가면 이 국소 연산이 출력 지도를 만드는 경로의 한 부품임을 볼 수 있다.
#P058. 전체 구조의 물음표를 채우기
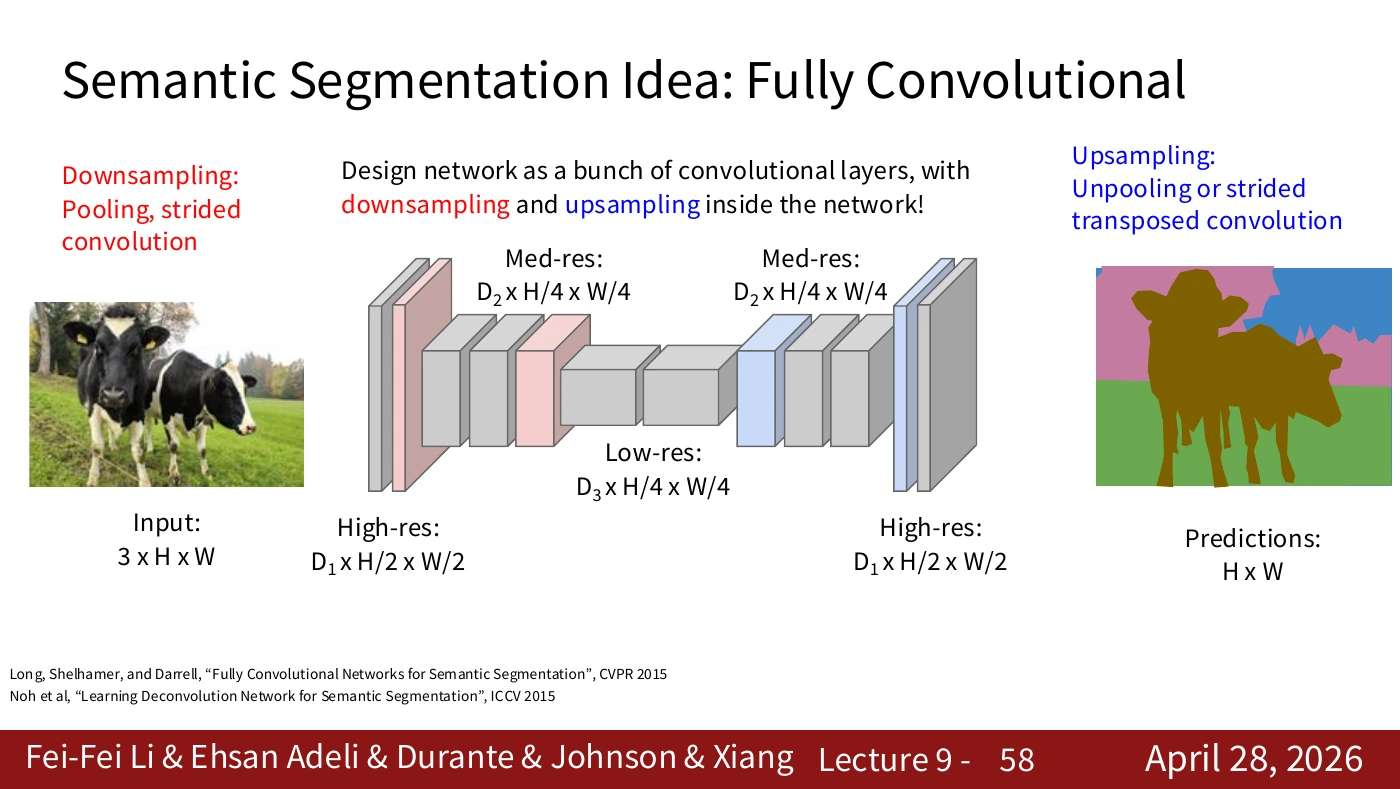
이제 upsampling 쪽에 unpooling 또는 stride transposed convolution을 넣을 수 있다. 앞의 작은 연산 예제를 전체 네트워크로 다시 합치는 장이다. 어느 선택이 최선인지 결론내리는 장은 아니며 경계 품질과 계산 비용을 실제로 비교해야 한다.
다운샘플링과 업샘플링의 종류, 중간 feature 채널, 마지막 범주 점수 지도를 따로 표시해 보자. 네트워크가 깊다고 최종 범주 수가 늘어나는 것이 아니며, 출력 범주 수는 데이터의 라벨 체계와 연결된다.
#P059. U-Net의 전체 모양
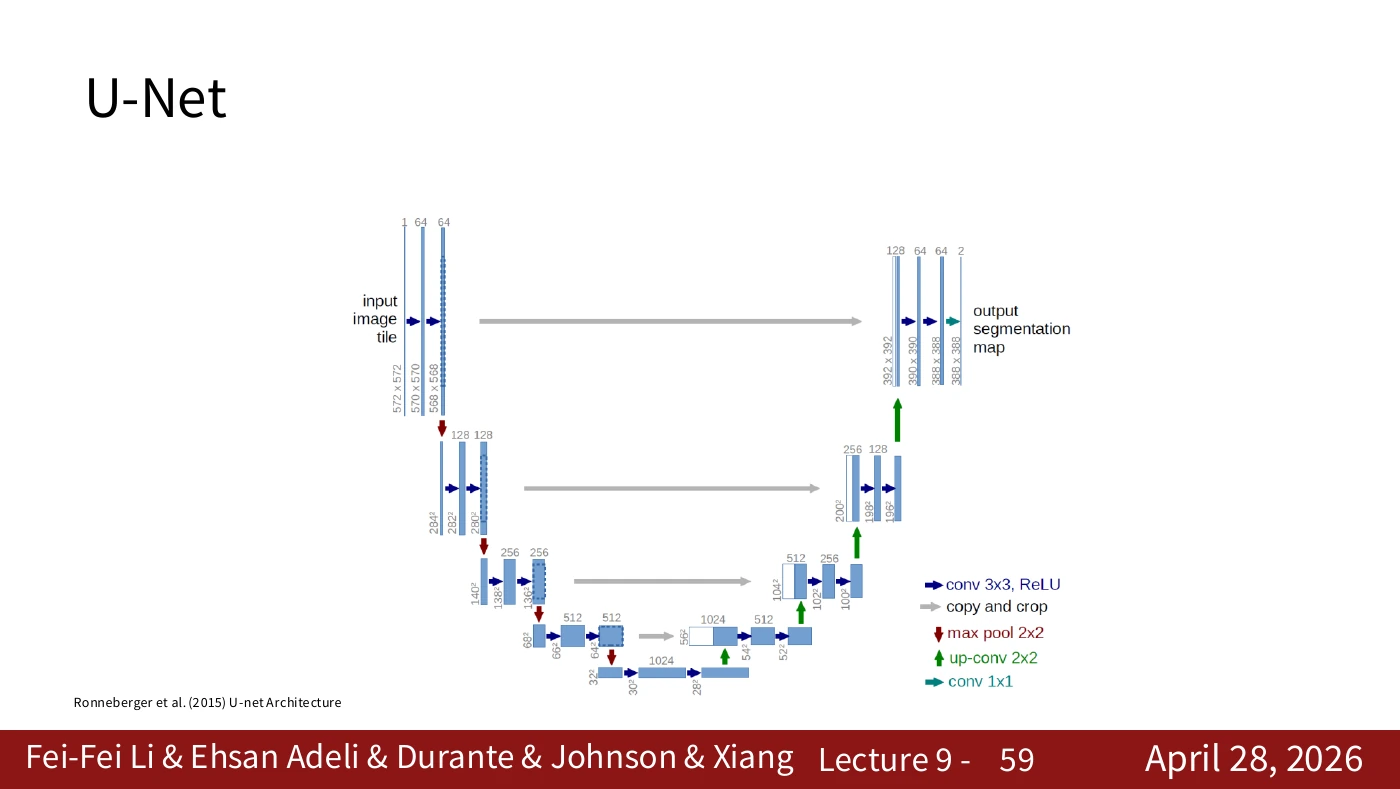
아래로 내려가는 경로, 위로 올라가는 경로, 중간의 연결을 먼저 구분한다. 원본 U-Net 구조는 Ronneberger 등의 2015년 연구다. 그림의 해상도 변화와 연결 경로를 읽되 이를 모든 현대 U-Net 구현의 크기 규칙으로 일반화하지 않는다.
파란 상자와 가로 연결, 아래로 내려가는 화살표, 위로 올라가는 화살표를 구분한다. 원래 U-Net은 valid convolution과 crop 때문에 입력과 출력 크기가 같지 않다. 현대 구현의 same padding 설정과 원본 구조를 섞지 않는 것이 중요하다.
#P060. 내려가는 경로는 문맥을 넓힌다
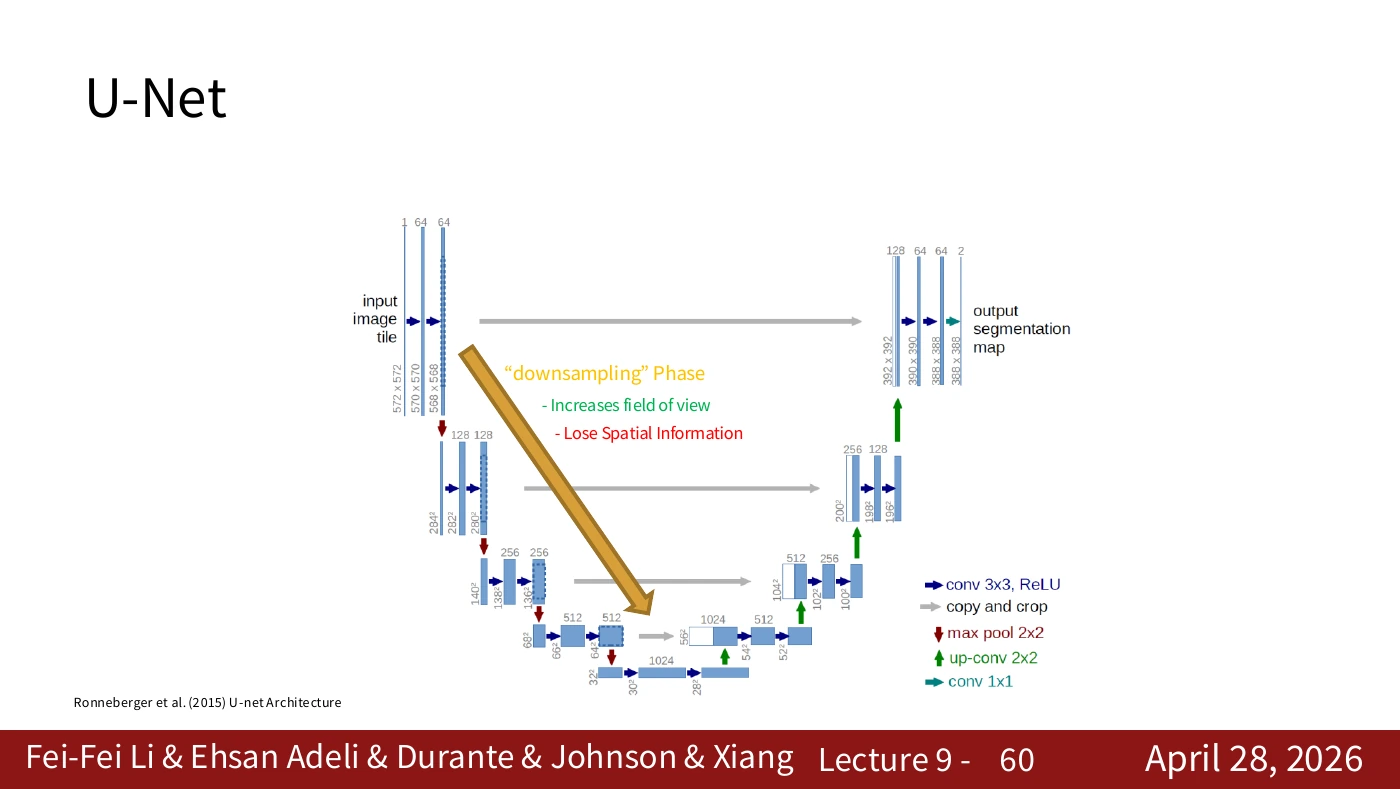
Downsampling 경로에서 넓은 영역의 정보를 결합하는 대신 세밀한 위치 정보가 줄어든다. 무엇이 손실되는지 이해해야 다음 경로가 필요한 이유를 설명할 수 있다. 깊은 특징만으로 얇은 경계를 잘 보존할 수 있다고 가정하지 않는다.
아래쪽으로 갈수록 더 넓은 입력 범위를 보는 특징을 만들 수 있다. 반면 작은 경계의 정확한 위치는 덜 직접적으로 남을 수 있다. 의미를 알아보는 능력과 위치를 정밀하게 보존하는 능력은 같은 질문이 아니다.
#P061. 올라가는 경로는 조밀한 지도를 만든다
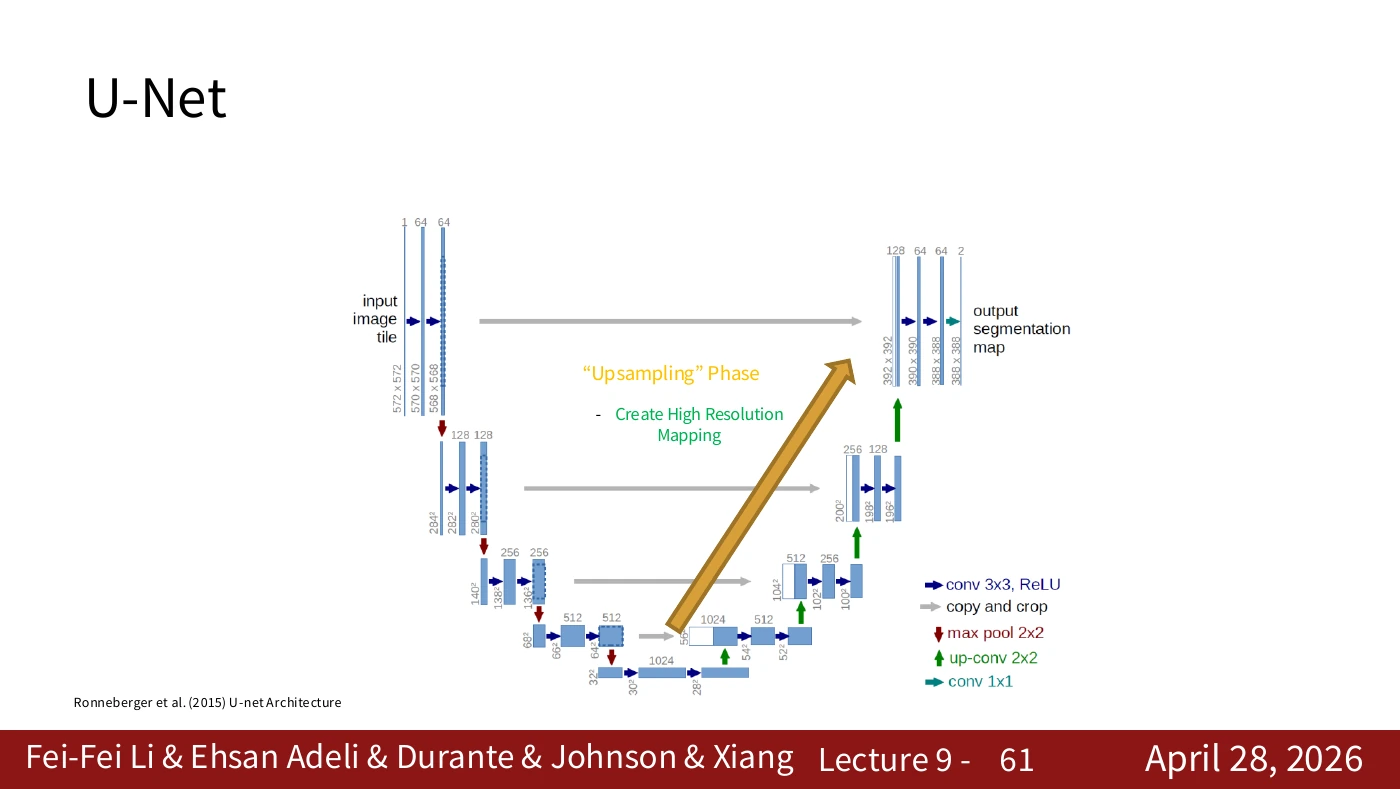
Upsampling 경로는 더 조밀한 출력을 만드는 역할을 한다. 크기를 늘리는 것과 정확한 경계를 아는 것은 별개다. 다음 장의 고해상도 특징 연결을 아직 보지 않고 확대 하나만으로 세부가 모두 복원된다고 설명하면 안 된다.
올라가는 경로는 조밀한 지도를 만드는 역할을 맡는다. 위쪽의 세밀한 경계를 얻으려면 이전 경로의 정보와 결합하는 설계가 필요하다. 이 장만 보고 U-Net을 단순한 이미지 확대기라고 요약하지 않는다.
#P062. 고해상도 특징을 이어 붙이기
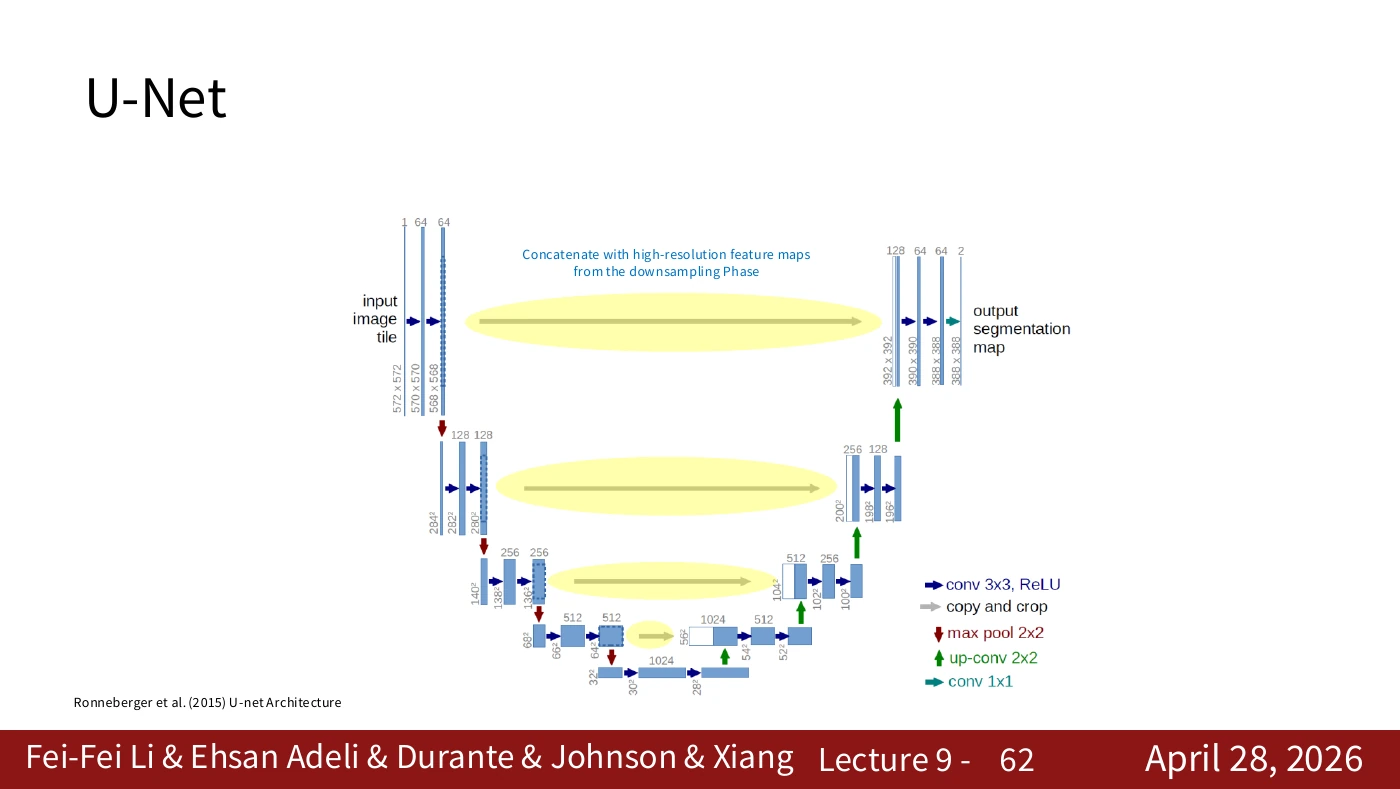
내려가는 경로의 특징과 올라가는 경로를 channel 방향으로 concatenate한다. FCN의 class score를 더하는 방식과 같은 연산이 아니다. 위치 격자의 정렬이 필요하며, 자세한 원논문 크기·crop 설명은 현대 인공지능 VI로 이어진다.
가로 연결은 서로 다른 단계의 특징을 이어 붙이는 경로다. 원본은 copy-and-crop을 표시한다. 덧셈이라면 채널 수를 같게 맞춰 더하지만 concatenation은 채널을 쌓으므로 이후 합성곱이 합쳐진 특징을 처리한다.
#보충 논문 · U-Net의 화살표를 복사·결합 연산으로 읽기
U-Net 원논문 2절과 그림 1을 P059–P062 옆에 놓으면, U자 모양보다 중요한 것이 양쪽 사이의 가로 화살표임을 알 수 있다. 왼쪽 경로는 공간 크기를 줄이며 더 넓은 문맥을 모으고, 오른쪽 경로는 위치별 예측을 위해 해상도를 올린다. 그런데 해상도만 키워서는 세포의 얇은 경계나 작은 구조가 저절로 되살아나지 않는다. 그래서 왼쪽의 더 촘촘한 특징을 오른쪽의 같은 해상도 단계로 전달한다.
원논문의 결합은 단순히 두 텐서의 값을 더하는 것이 아니라 채널 방향 concatenation이다. 설명용으로 두 특징이 각각 64×64×32, 64×64×32라면 결합 후 공간 크기는 그대로이고 채널은 64가 된다(H×W×C 표기). 그 뒤 convolution이 어떤 정보 조합을 사용할지 학습한다. 이것은 그림의 실제 채널 수를 베낀 수치가 아니라 결합 연산을 보여 주기 위한 예다. 앞의 FCN skip fusion과 U-Net의 특징 결합을 모두 ‘skip’이라고 부를 수 있어도 연산이 자동으로 같은 것은 아니다.
원래 U-Net 그림의 copy and crop에서 crop도 장식이 아니다. 논문은 padding 없는 convolution을 사용하여 경계 픽셀이 줄어들고, 합칠 특징 지도의 크기를 맞추기 위해 잘라낸다. 오늘날 same padding을 쓰는 구현은 입출력 크기와 crop 방식이 달라질 수 있다. 따라서 논문의 화살표와 내가 실행하는 코드의 텐서 모양을 함께 확인해야 한다.
2025 영상 29:11–31:17에서도 인코더의 공간 정보를 디코더에 전달하는 이유를 설명한다. 논문은 적은 주석 데이터 조건에서의 증강과 학습 방법까지 함께 다룬다. U자 구조를 선택했다는 이유만으로 적은 데이터에서 항상 잘된다는 보장은 없다. 이 자료를 읽고 확인할 것은 ‘왜 유명한가’보다 어느 해상도의 어떤 특징을, 어느 연산으로 합치는가다.
#P063. 계산 흐름을 한 번 더 연결
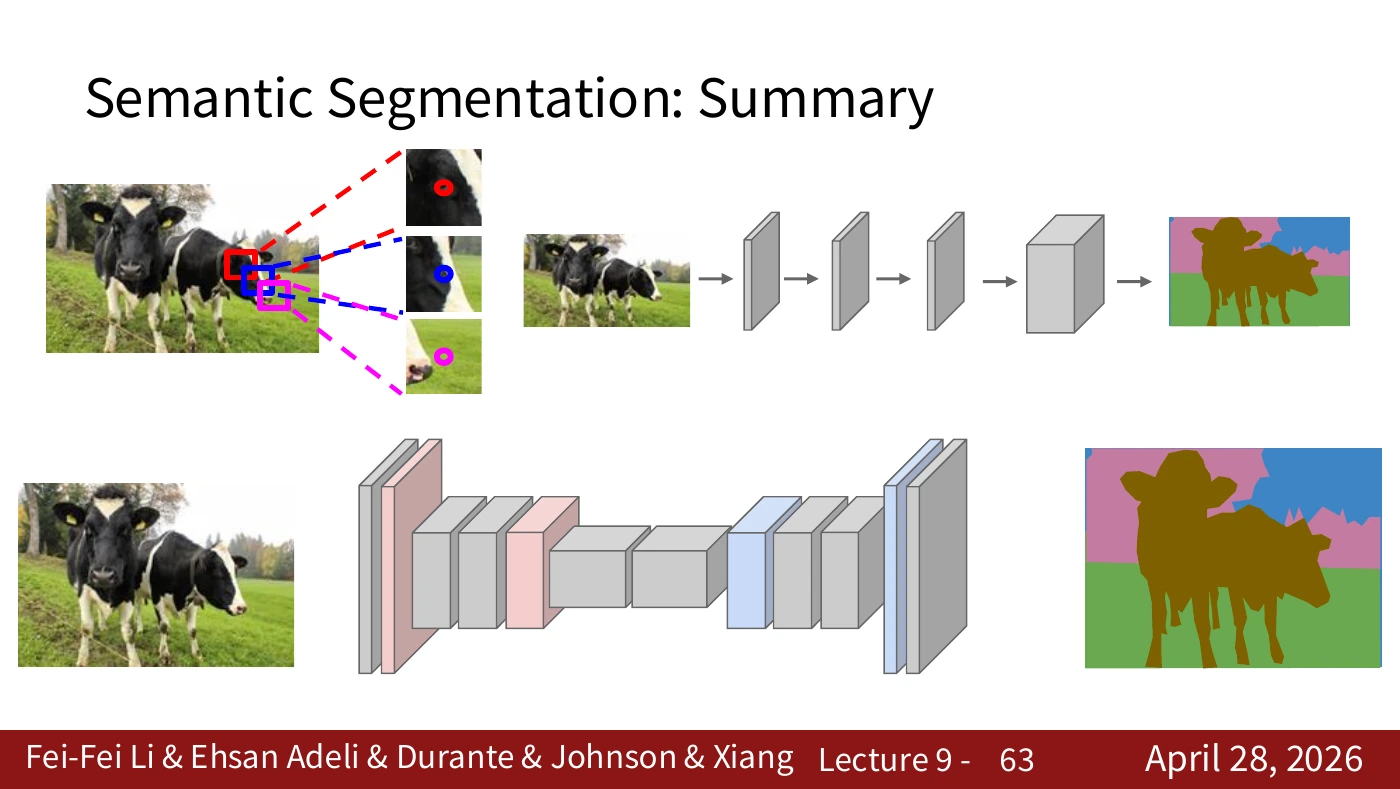
맨 위는 겹치는 patch마다 CNN을 반복하는 방식이고, 가운데는 전체 해상도에서 특징을 공유하는 방식이며, 아래는 내부에서 해상도를 줄였다 높이는 방식이다. 같은 픽셀별 분류 목표를 세 가지 계산 경로로 비교한 그림이다. 문맥을 보겠다는 요구에서 출발해 중복 계산을 줄이고, 이어서 조밀한 격자의 비용을 줄여 온 흐름을 되짚는다.
세 그림에서 공통점은 픽셀별 범주 출력이고 차이는 중간 계산이다. 가장 아래 그림이 항상 모든 데이터에서 최고라는 성능 표가 아니다. 정확도·경계·속도·메모리는 같은 조건에서 실험해야 한다.
#P064. 의미론적 분할은 개체 ID가 아니다
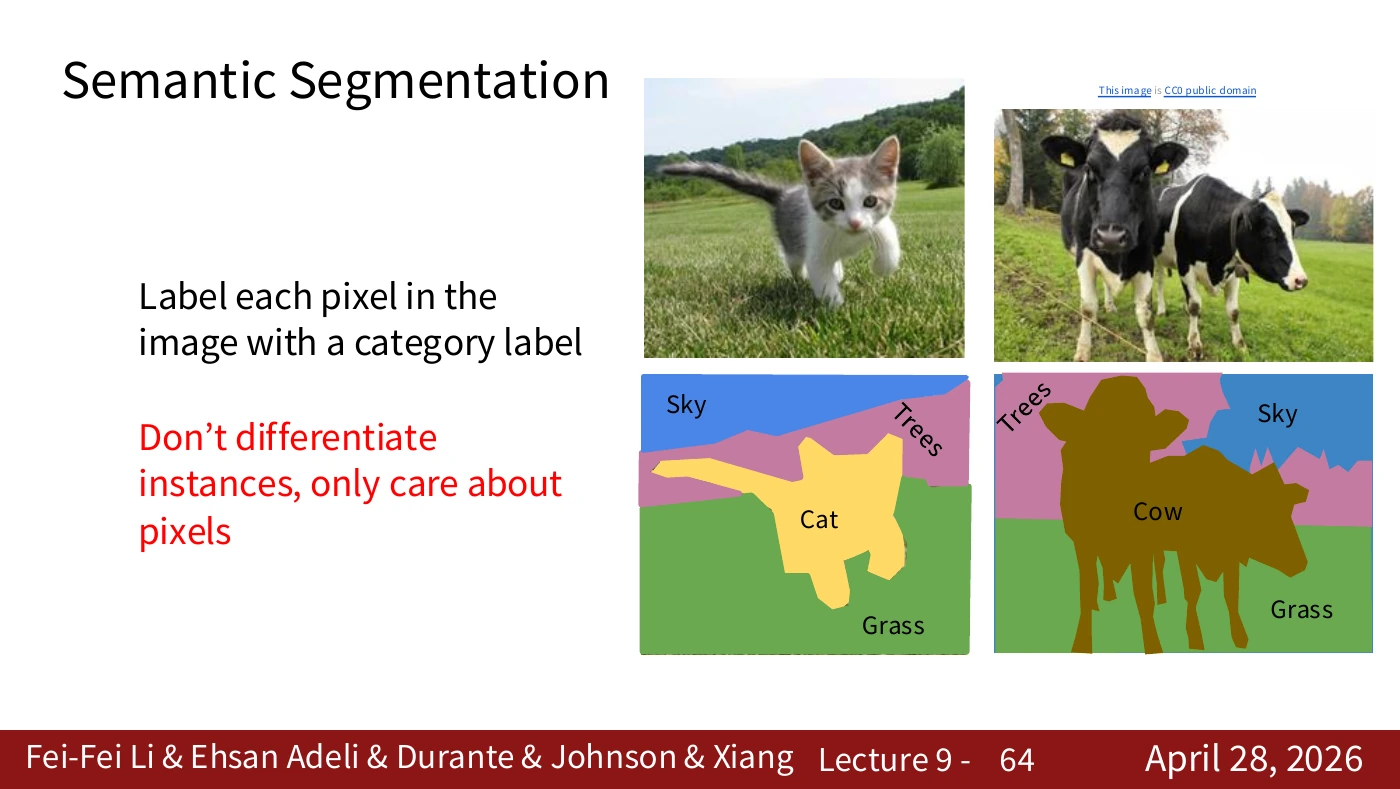
이 장은 픽셀마다 범주를 붙이지만 같은 범주의 개체를 따로 구분하지 않는다는 점을 다시 강조한다. 하늘·풀·동물 같은 범주와 개별 동물의 정체성을 분리해서 읽는다. 그림 일부에 CC0 표시가 있어도 전체 슬라이드의 재게시 라이선스가 자동으로 정해지는 것은 아니다.
같은 소가 두 마리 있어도 범주 지도에서는 소라는 같은 라벨을 받는다. 하나의 로봇 조작 대상을 고르는 문제에는 추가 구분이 필요할 수 있다. 이 지점에서 semantic과 instance의 차이를 다시 설명하고 강화학습의 관측으로 돌아간다.
#보충 계산: 점수, 범주 ID와 학습 손실
다음 식은 슬라이드의 연산을 설명하기 위한 표기다. z는 모델의 실수 점수, c는 범주, (h,w)는 출력 위치다. 물리 단위는 없다.
학습할 때는 정답 ID와 예측 ID의 숫자 차이를 줄이지 않는다. 컵 ID를 1에서 7로 바꿨다고 컵이 더 멀어진 것이 아니기 때문이다. 보통 점수에 softmax를 적용한 범주 확률과 정답을 교차엔트로피로 비교한다. 아래는 모든 유효 위치를 평균내는 표준적인 해설용 목적함수이며 원문 식 번호를 옮긴 것이 아니다.
Ω는 라벨이 있는 유효 픽셀 집합이고 비어 있지 않아야 한다. y는 정답 범주, p는 그 범주의 확률이다. 정답 확률이 0.8이면 해당 손실은 약 0.223, 0.2이면 약 1.609다. 틀린 답에 높은 확신을 주면 손실이 커진다. 실제 구현에서는 수치적으로 안정적인 logits 기반 함수를 쓰며, ignore label·클래스 가중치·평균 방식은 별도로 정한다.
#보충 실습: 마스크의 IoU를 손으로 확인하기
아래 코드는 학습된 분할 모델이 아니라 마스크 평가만 확인하는 작은 Python 예제다. 의존성 없이 실행된다. 컵 마스크의 교집합이 6픽셀이고 합집합이 12픽셀이 되도록 직접 정했다.
prediction = {0, 1, 2, 3, 4, 5, 6, 7, 8}
ground_truth = {3, 4, 5, 6, 7, 8, 9, 10, 11}
intersection = len(prediction & ground_truth)
union = len(prediction | ground_truth)
iou = intersection / union if union else None
print(intersection, union, iou)  # 6 12 0.5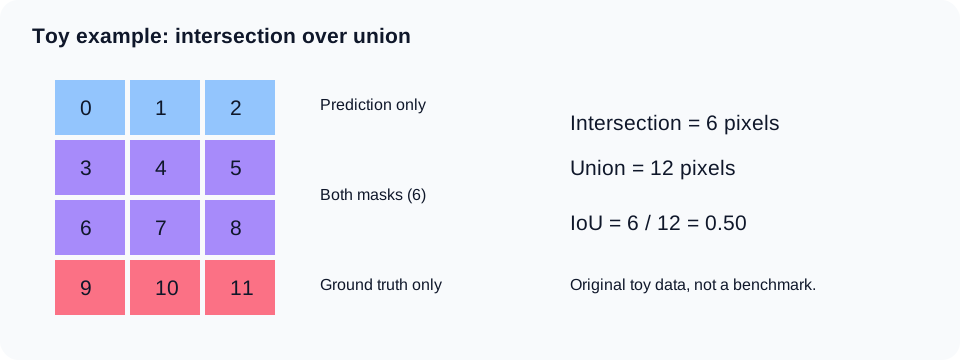
직접 제작한 12픽셀 격자. 파랑은 예측에만 속한 02, 보라는 두 집합에 속한 38, 분홍은 정답에만 속한 9~11이다.
P는 예측 영역, G는 정답 영역이며 단위는 픽셀 수다. 비율은 무차원이다. 둘 다 빈 영역이면 분모가 0이므로 평가 규칙을 정해야 한다. 코드의 None은 그 경우를 숨기지 않기 위한 선택일 뿐 모든 벤치마크의 규칙은 아니다. 여러 범주의 IoU를 평균낼 때도 포함 범주·빈 범주 처리·데이터셋 집계 방식을 먼저 확인한다.
픽셀 정확도만 보면 대부분을 차지하는 배경을 맞힌 모델이 좋아 보일 수 있다. 컵이 작다면 컵 전체를 놓쳐도 전체 픽셀 정확도는 높을 수 있다. 반대로 IoU가 높아도 집게가 닿는 작은 경계가 틀리면 조작은 실패할 수 있다. 인식 지표와 작업 성공률을 따로 측정해야 한다.
#보충 강의 · IoU가 좋아도 다른 카메라에서 실패할 수 있다
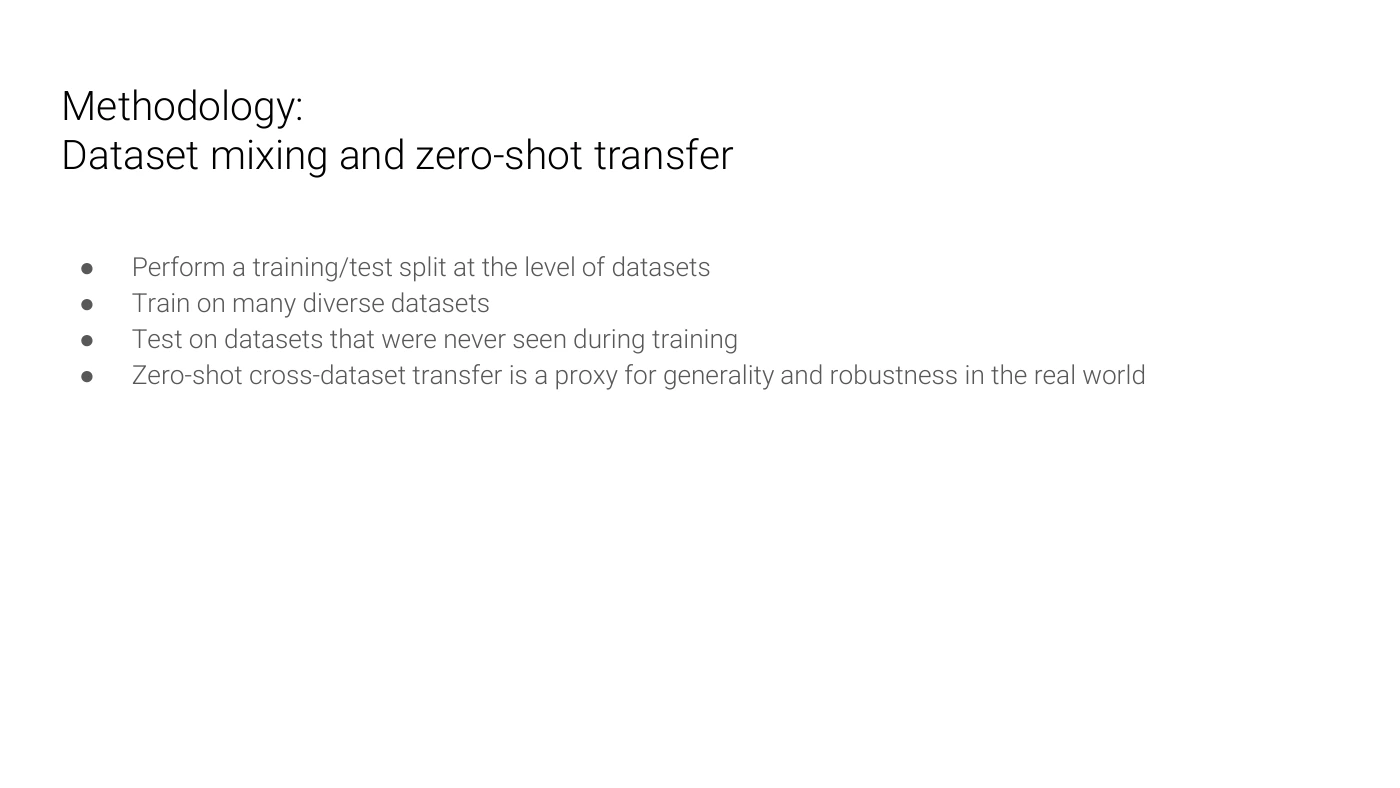
앞의 IoU 계산은 같은 픽셀 격자의 예측과 정답을 비교하는 방법이다. 하지만 어떤 데이터에서 계산했는지는 별도의 질문이다. 이 보충자료는 여러 데이터셋으로 학습하고 학습에 들어가지 않은 데이터셋에서 평가하는 방법을 제시한다. 한 영상의 인접 프레임을 무작위로 학습·평가에 섞는 것과는 다르다. 거의 같은 장면이 양쪽에 있으면 새로운 장소에 대한 일반화보다 익숙한 장면을 다시 맞히는 능력을 측정할 수 있다.
예를 들어 실내의 밝은 책상에서 컵을 잘 나누던 모델을 복도의 어두운 카메라에 연결한다고 하자. 조명, 배경, 카메라 높이, 가림 정도가 바뀌면 같은 ‘컵’이라도 입력 분포가 달라진다. 여러 데이터셋을 섞는 것은 이런 다양성을 학습에 넣으려는 접근이지만, 섞기만 하면 해결되는 것은 아니다. 데이터셋마다 물체 범주의 이름과 경계 주석 규칙도 맞춰야 한다.
그림에서 말하는 zero-shot cross-dataset transfer는 이 평가 맥락에서 학습에 쓰지 않은 데이터셋으로의 전이를 뜻한다. 텍스트 프롬프트로 임의의 새로운 클래스를 지정할 수 있다는 뜻과 동일하지 않다. 또한 강의는 이런 평가를 실제 세계의 일반성·강건성을 살피는 대리 지표로 설명할 뿐, 모든 실제 환경에서의 성공을 보장하지 않는다.
이것이 P064의 범주 마스크를 로봇 관측으로 가져오기 전에 필요한 점검이다. 테스트 장면이 학습 장면과 독립적인가, 카메라와 전처리가 달라졌는가, 작은 대상의 오류가 전체 평균에 묻히는가를 함께 기록하자. 평균 IoU 하나와 실제 작업 성공률은 서로 다른 평가 결과다.
#로봇으로 돌아가기: 마스크 다음에 남는 일
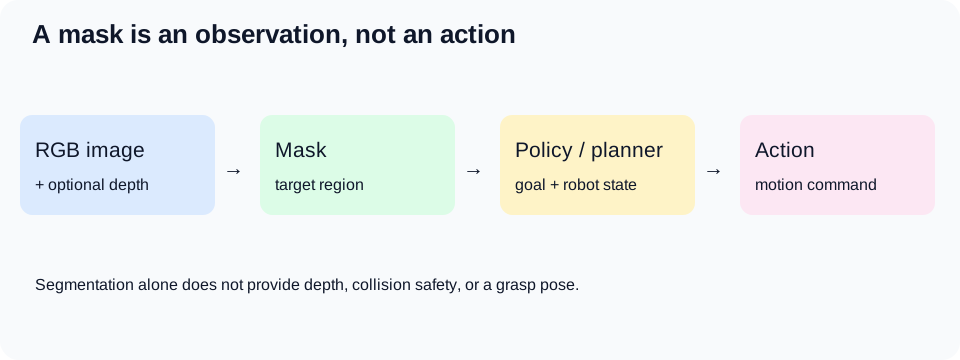
직접 제작한 시스템 예시. 특정 로봇 논문의 구조도나 필수 표준 구성이 아니다.
컵 마스크가 있으면 배경을 제외한 픽셀을 모으거나 깊이 영상에서 컵에 해당하는 점을 선택할 수 있다. 하지만 마스크만으로 3차원 위치, 가려진 면, 물체의 질량, 집게가 미끄러질 가능성이 모두 주어지는 것은 아니다. 깊이가 있다면 카메라 보정과 좌표 변환도 맞춰야 한다.
로봇 실험에서는 최소한 다음을 분리해 기록하자.
- 인식: 작은 물체·가림·반사에서 마스크가 안정적인가?
- 시간: 카메라 입력부터 제어가 쓰는 출력까지 지연이 얼마인가?
- 기하: 깊이와 마스크가 같은 시점·좌표계로 정렬되는가?
- 행동: 마스크가 맞아도 집기 실패가 생기는가? 충돌 검사는 별도로 있는가?
정책은 원시 영상으로 직접 학습할 수도 있고, 마스크나 특징을 입력받을 수도 있다. 따라서 “좋은 분할 모델 → 좋은 강화학습 정책”이라는 자동적인 결론은 성립하지 않는다. 인식 출력을 바꾸면 정책이 받는 관측의 분포도 달라진다. 학습 시와 실행 시의 전처리·해상도·지연이 다르면 정책의 입력 조건이 달라진다는 점까지 확인해야 한다.
#영상과 스크립트는 이렇게 함께 보기
공식 Stanford Online 강의 영상의 영어 수동 자막(en-US, manual), 총 1,173구간을 조회하고, 아래 주제에 해당하는 발화 구간을 읽어 확인했다(확인일: 2026-11-12). 수동 자막으로 표시되더라도 전문용어의 표기가 항상 정확한 것은 아니다. 아래는 자막을 길게 재게시한 것이 아니라 내용을 한국어로 정리한 듣기 안내다. 원문 대본은 영상의 자막·스크립트 기능에서 함께 읽자.
연도 차이: 시간은 2025 영상의 자막 시작 시각을 초 단위로 내린 값이다. 오른쪽 쪽수는 같은 개념을 설명하는 2026 자료의 함께 읽을 범위일 뿐, 영상 속 슬라이드 번호나 한 장씩의 정확한 전환 시각을 대조했다는 뜻은 아니다. 특히 31:42 부근에는 강사가 일부 슬라이드를 뒤쪽에 두었다고 설명하므로, 모든 장을 같은 순서로 강의했다고 가정하지 않는다.
| 영상에서 시작하기 | 자막을 바탕으로 확인한 내용 | 2026 자료와 함께 읽기 |
|---|---|---|
| 17:45 | 의미론적 분할은 이미지의 각 픽셀에 범주를 붙이는 문제로 소개된다. | P032–P033 |
| 18:26 | 픽셀 하나만으로는 문맥이 부족하다. 주변 패치를 보고 분류하지만, 위치마다 전체 망을 반복하면 비효율적이다. | P034–P038 |
| 20:57 | 이미지 전체에서 위치별 출력 지도를 만드는 fully convolutional network라는 이름을 설명한다. | P039–P041 |
| 21:40 | 공간 해상도를 낮춰 처리한 뒤 출력 해상도로 올리는 흐름을 설명한다. | P042–P043 |
| 24:04 | 픽셀별 분류 손실을 모으는 학습 목표를 설명한다. 이어 지도학습에는 정답 label map이 필요하다고 확인한다. | 본문의 보충 계산: softmax와 손실 |
| 25:13 | 최근접 복사, bed of nails, max 위치를 기억하는 unpooling을 구분한다. | P044–P045 |
| 26:46 | 고정 규칙과 달리 학습할 가중치를 가진 upsampling으로 넘어간다. 겹치는 기여는 더한다. | P046–P056 |
| 28:09 | 입력 a, b의 1차원 예제로 필터가 만든 출력과 중첩 합을 설명한다. | P057 |
| 29:11 | U-Net의 U자 구조, 다운·업샘플링, 인코더 특징을 디코더로 전달하는 이유로 이어진다. | P059–P062 |
| 32:40 | 픽셀 범주만으로는 같은 범주의 두 개체를 구분할 수 없다는 한계를 정리한다. | P063–P064 |
| 33:07 | 인스턴스 분할로 주제를 전환한다. 이 글의 의미론적 분할 단원 뒤에 이어 볼 구간이다. | 이 글의 장별 해설 범위 밖 |
영상에서 정답 지도를 설명하는 부분은 지도학습 분할의 조건으로 읽는다. 도구가 라벨 작성을 돕는다는 말과 정답·감독 신호 자체가 필요 없다는 말은 다르다. 또한 transposed convolution은 학습된 확장 연산이지 일반적인 정보 손실을 되돌리는 역함수는 아니라는 본문의 구분을 유지한다.
아래는 본문을 설명할 때 쓸 수 있도록 새로 작성한 짧은 발표용 스크립트다. 강사의 발언을 번역하거나 인용한 문장이 아니다.
컵이 있다는 사실과 컵의 픽셀을 아는 것은 다릅니다. 의미론적 분할은 각 위치에 범주를 붙이고, 인스턴스 분할은 같은 범주의 물체도 각각 구분합니다. 모델 안에서는 위치마다 여러 범주의 점수를 계산한 뒤 가장 큰 점수를 선택합니다. 계산을 줄이려고 해상도를 낮추지만, 다시 크게 만든다고 잃어버린 경계가 저절로 돌아오지는 않습니다. 그래서 문맥과 위치를 어떻게 함께 보존하는지 구조를 읽어야 합니다. 로봇에서는 이 마스크가 관측을 돕지만, 깊이와 좌표계, 충돌 검사와 행동 정책까지 대신해 주지는 않습니다.
#보충자료를 읽는 순서
- FCN 논문: P039–P043을 읽은 뒤 3절의 convolutionalization·upsampling, 4.2절의 skip fusion을 확인한다. 분류망을 픽셀 예측망으로 바꾸는 이유와 경계가 성긴 이유를 설명하는 자료다.
- U-Net 논문: P059–P062의 가로 화살표가 무엇을 전달하는지 확인하려면 그림 1과 2절부터 읽는다. crop·concatenation·출력 해상도를 코드와 대조한다.
- Georgia Tech Lecture 14: 전체 파일은 VGG·Inception·ResNet 등 배경부터 시작한다. 이 글에서는 PDF 57쪽의 FCN, 70쪽의 bilinear 보간, 90쪽의 데이터셋 전이 그림을 골라 관련 장 아래에서 설명했다. PPTX는 편집 가능한 파일 형식이고, 파일이 공개됐다는 사실 자체가 모든 포함 이미지의 자유로운 재사용 허가를 뜻하지는 않는다.
- 2025 Stanford 영상: 위 시간표로 개념을 다시 듣되 2026 슬라이드 번호와 일대일 대응시키지 않는다. 텍스트·그림에서 막힌 연산을 영상으로 확인하는 보충 경로다.
- 현대 인공지능 VI: 이번 1강의 픽셀별 분류·FCN·U-Net을 발판으로 기존 심화 글의 구조와 논문 설명으로 넘어간다. 이 글의 슬라이드를 대체하는 별도 강의 자료는 아니다.
#출처와 이어 읽기
- Stanford CS231n, 2026 Lecture 9, 2026-04-28. 이 글에서 다룬 원본 범위는 PDF 32–64쪽이며 각 이미지 아래에 해당 페이지 링크를 붙였다. 원본 확인일: 2026-11-12.
- Stanford Online CS231n Spring 2025 Lecture 9: 다른 연도의 보충 영상. 영어 수동 자막 트랙과 의미론적 분할 구간의 발화 시각을 확인했다. 시간표는 개념별 안내이며 2026 슬라이드 전환 시각이 아니다.
- Long, Shelhamer, Darrell, FCN, CVPR 2015 · Ronneberger et al., U-Net, 2015.
- 편집 가능한 강의 자료 참고: Georgia Tech CS6476 Fall 2025 14강 PPTX / PDF. 본문의 페이지 기준은 Stanford PDF다.
- 심화: 현대 인공지능 VI · 시작점: 강화학습 01.
원본 슬라이드는 해당 내용을 설명·비평하는 학습 자료로 인용했다. 저자 및 원본 이미지의 권리는 각 권리자에게 있으며, 이 글은 원본 자료에 대한 재사용 라이선스를 부여하지 않는다. 원본의 저자 표기와 페이지를 보존했고 전체 강의 PDF를 별도 재배포하지 않는다. 한국어 해설·별도 숫자 예제·발표용 스크립트와 보충 도식은 AI의 도움으로 작성했다.