교사가 모든 답을 알지 못해도, 학생이 가진 능력을 더 잘 끌어낼 수는 있다.
11편에서는 강한 AI가 작은 모델의 학습을 설계하고 실행하는 과정을 보았다. 이번에는 교사와 학생의 관계를 뒤집는다. 정답을 더 자주 틀리는 교사의 신호로, 이미 더 큰 잠재 능력을 가진 학생을 학습시킬 수 있을까?
이 질문이 약한 감독에서 강한 능력으로의 일반화(Weak-to-Strong Generalization)다. 학생에게 지식을 처음부터 모두 가르치는 상황과는 다르다. 학생은 사전학습으로 배운 표현과 능력을 갖고 있다. 문제는 약한 교사의 답을 따라가는 과정에서 그 능력을 끌어낼지, 교사의 오류까지 따라 배울지다.
이 글에서는 두 층을 구분한다. 안쪽에서는 약한 교사가 강한 학생에게 학습 신호를 준다. 바깥쪽에서는 AI 연구자가 이 학습 방법을 설계하고 개선한다. 두 층을 나누면, 실험에서 무엇이 향상되었고 무엇이 아직 입증되지 않았는지 분명해진다.
슬라이드별 영상 위치
| 슬라이드 | 영상 | 주제 |
|---|---|---|
| 56쪽 | 58:39–59:07 | Anthropic의 자동 정렬 연구 |
| 57쪽 | 59:07–1:00:17 | 약한 교사와 강한 학생이라는 실험 설정 |
| 58쪽 | 1:00:17–1:01:17 | 교사보다 잘하는 학생, 과제별 성능 차이 |
| 59쪽 | 1:01:17–1:02:39 | AI가 학습 알고리즘을 설계하는 과정 |
| 60쪽 | 1:02:39–1:03:02 | 강의 당시 자기개선의 범위에 대한 판단 |
#56쪽 — AI가 정렬 연구의 실험을 맡는다면
강의는 58:39부터 Anthropic이 2026년 4월에 공개한 자동 정렬 연구를 소개한다. 이 연구에서 AI는 정렬에 관한 설명문만 작성하지 않는다. 학습 아이디어를 제안하고, 코드를 실행하고, 결과를 분석한 뒤 다음 실험을 선택한다. 연구자들은 이 시스템을 자동 정렬 연구자(Automated Alignment Researcher, AAR)라고 부른다. Anthropic 연구 소개 · 기술 보고 §2
#세 모델의 역할부터 구분하자
이 실험에는 같은 의미로 “강하다”고 부르면 안 되는 세 역할이 있다.
| 역할 | 실험에서 사용한 모델 | 하는 일 |
|---|---|---|
| 약한 교사(Weak teacher) | Qwen1.5-0.5B-Chat | 학생이 학습할 라벨 또는 평가 신호를 제공한다 |
| 강한 학생(Strong student) | Qwen3-4B-Base | 약한 신호로 학습하며, 교사보다 잘 일반화할 수 있는지 평가받는다 |
| AI 연구자(AAR) | Claude Opus 4.6 에이전트 | 학생의 학습 방법을 설계하고 실험한다 |
“강한 학생”은 이 실험의 교사와 비교한 표현이다. 학생이 연구자 역할의 Opus보다 강해졌다는 뜻은 아니다. 또한 학생의 파라미터를 학습했다고 해서 Opus 자체의 파라미터까지 갱신한 것은 아니다. 이 구분은 강의의 1:02:18 설명에서도 강조된다. 기술 보고 §1–2
#함께 읽기 — 연구자는 실험 공간과 피드백을 사용한다
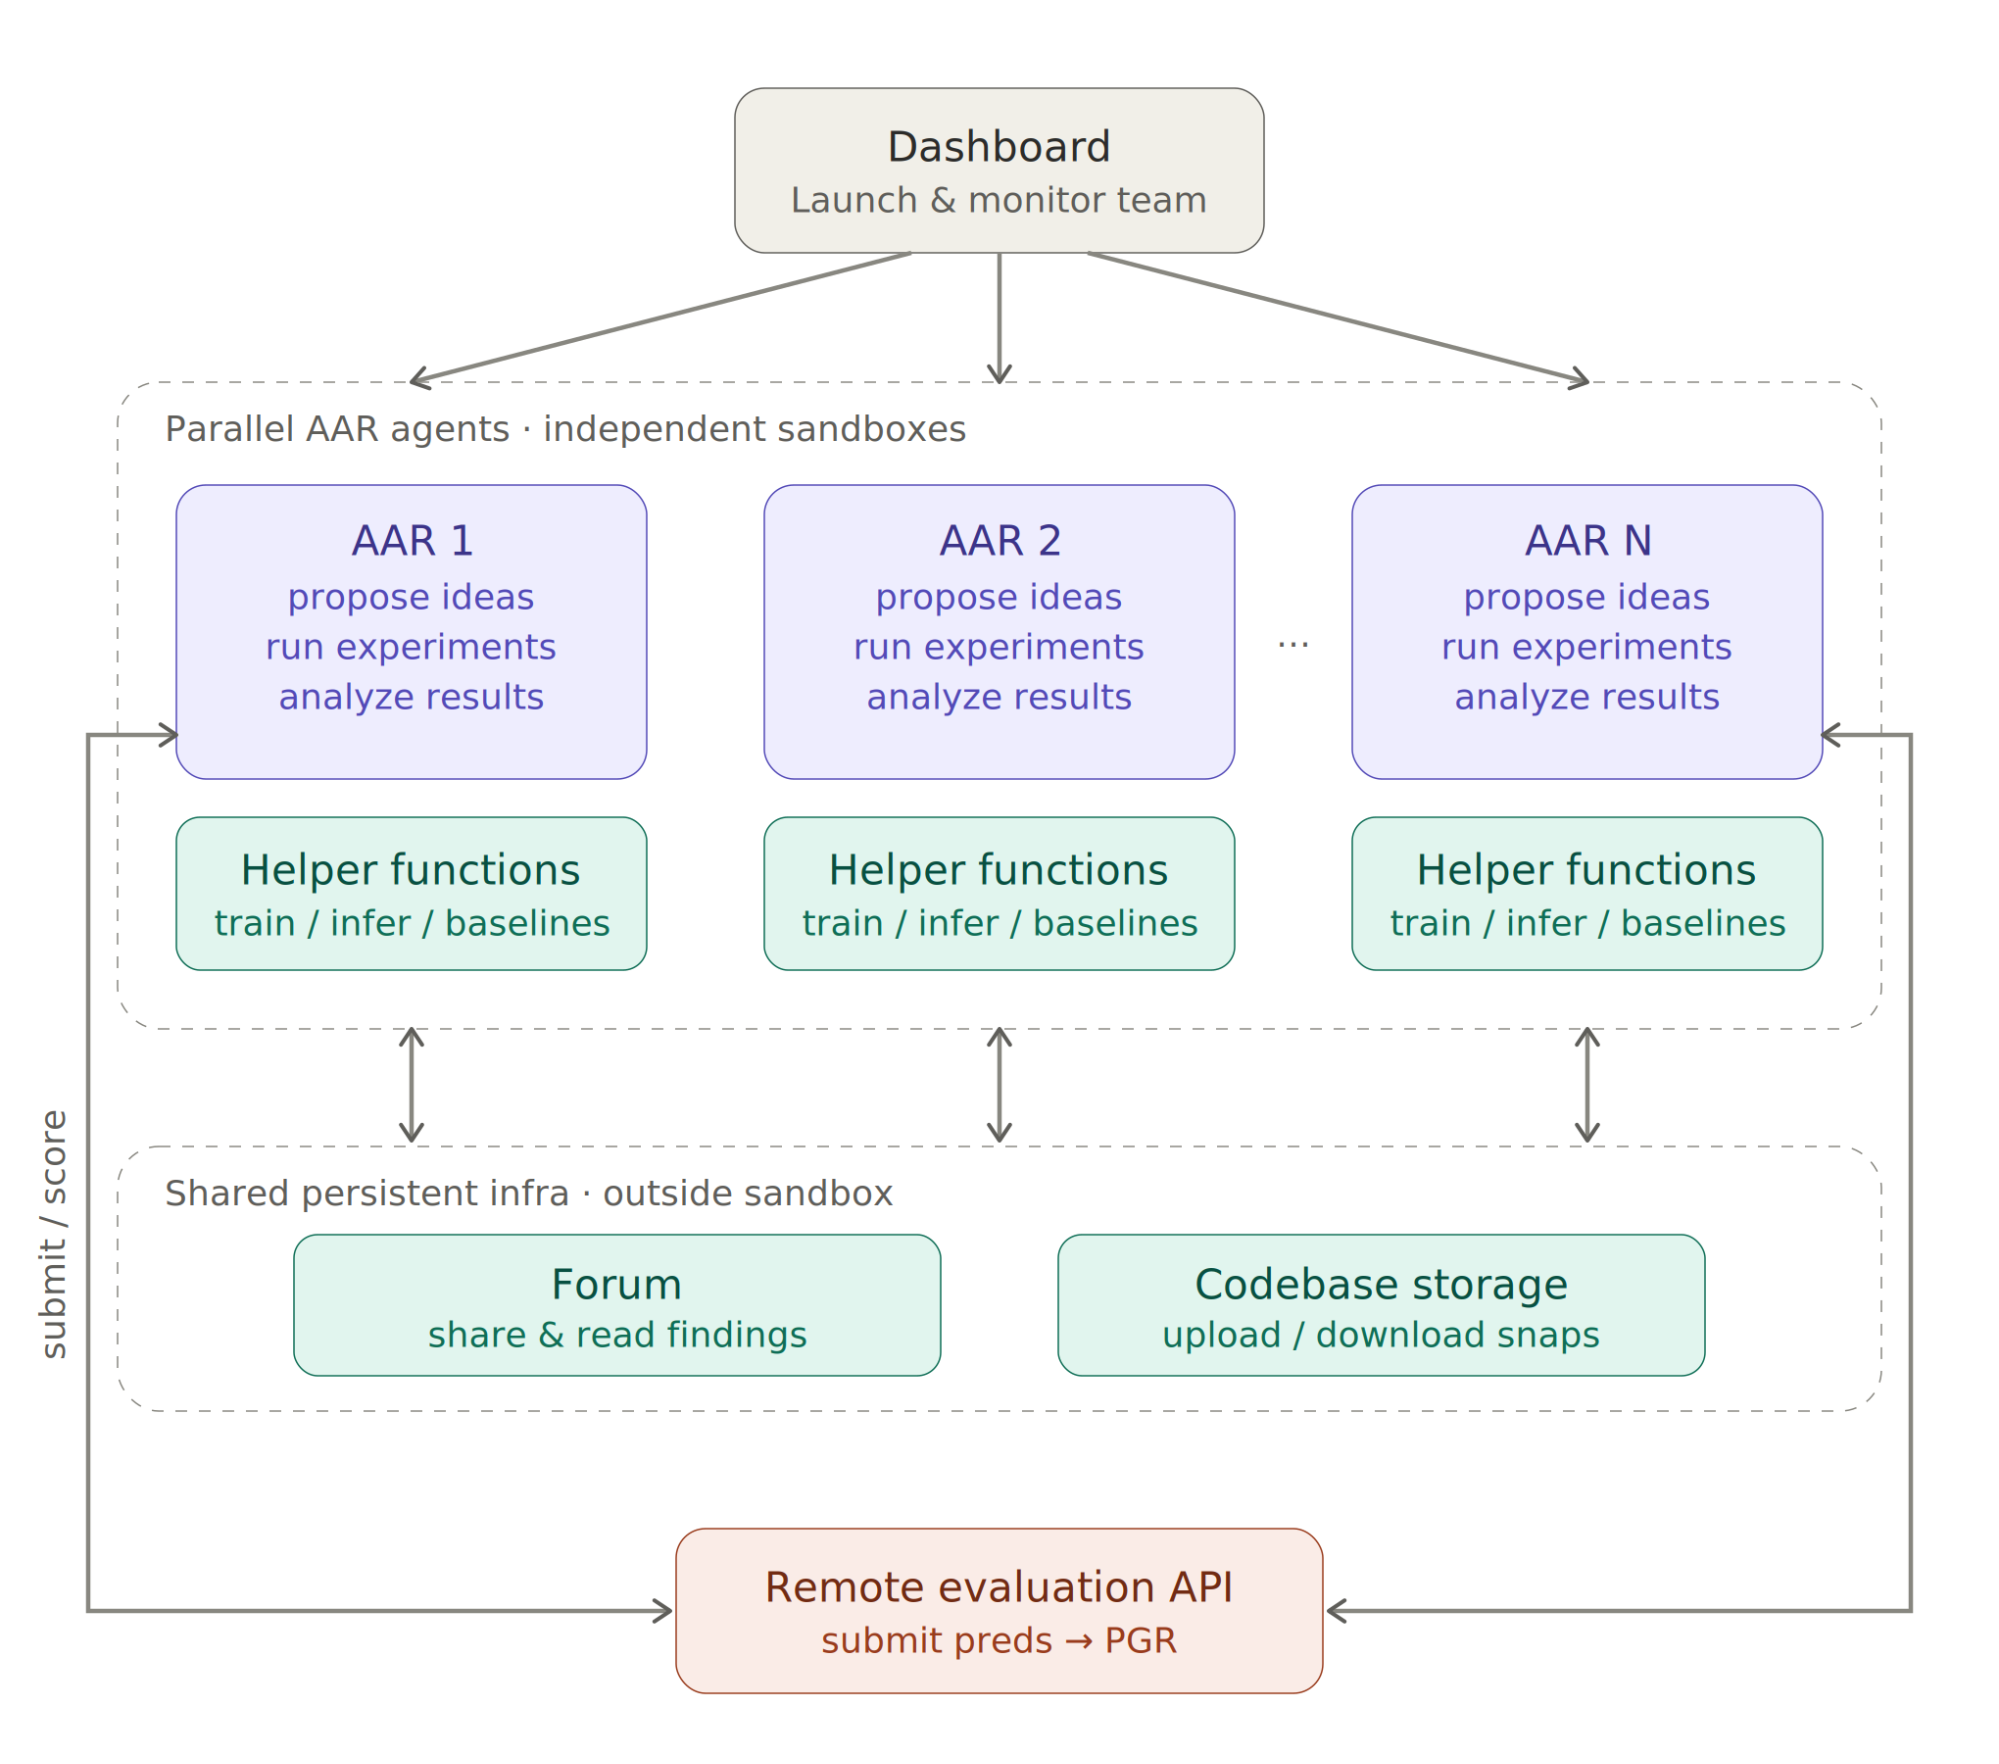
그림 위쪽에는 여러 연구 에이전트가 있다. 각 에이전트는 독립된 작업 공간에서 가설을 세우고 실험한다. 아래쪽의 포럼과 코드 저장소는 다른 에이전트의 발견을 읽고 이어서 사용할 수 있게 한다. 원격 평가 API는 제출한 예측을 점수로 바꿔 돌려준다. 기술 보고 §2, 환경 구조도
이 구조에서 사람은 연구 문제, 데이터, 모델, 평가 규칙과 사용할 도구를 정한다. AI는 그 안에서 탐색한다. 따라서 결과를 읽을 때에는 AI가 찾아낸 방법의 품질과 사람이 마련한 평가 환경의 품질을 함께 보아야 한다. 점수가 쉽게 계산된다고 해서 그 점수가 연구 목표를 완전히 대표하는 것은 아니다.
예를 들어 답변 두 개 중 어느 쪽이 더 좋은지 고르는 과제라면, 모델은 실제 품질을 비교해야 한다. 그런데 데이터에 특정 길이, 문체, 생성 모델과 정답의 상관관계가 남아 있으면 그런 흔적만으로도 점수를 올릴 수 있다. 이 문제는 뒤에서 다시 다룬다.
#57쪽 — 약한 교사의 한계가 학생의 한계가 될 필요는 없다
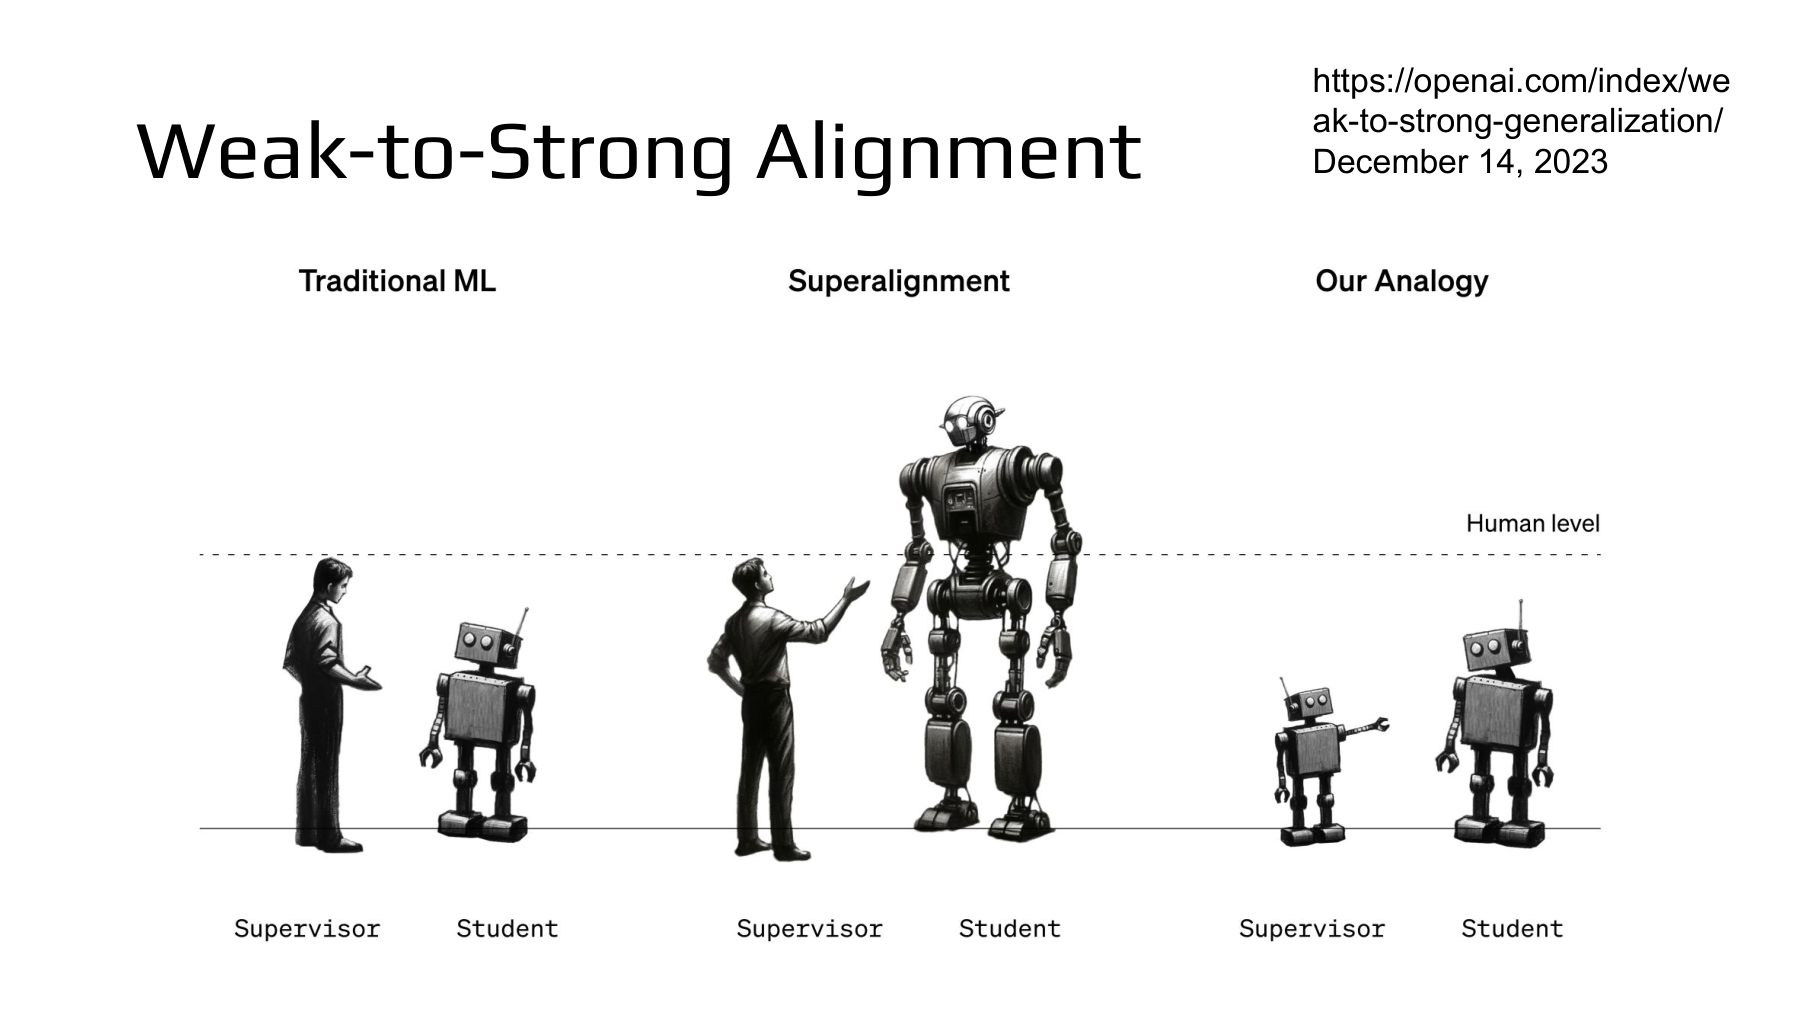
강의의 59:07 구간은 OpenAI가 2023년 12월 14일 공개한 연구에서 출발한다. 그림 왼쪽은 사람이 모델보다 과제를 잘 판단하는 전통적 지도학습이다. 가운데는 사람이 모든 결과를 정확히 평가하기 어려울 만큼 강한 모델을 감독해야 하는 문제다. 오른쪽은 그 문제의 일부를 실험하기 위해 작은 모델을 교사로, 큰 사전학습 모델을 학생으로 놓은 설정이다. OpenAI 연구 소개 · 논문 Figure 1
#이미 배운 능력을 어떻게 꺼낼 것인가
학생을 백지상태라고 가정하면 교사보다 잘하기 어렵다는 직관이 자연스럽다. 그러나 여기의 학생은 이미 사전학습을 마쳤다. 언어, 개념 관계, 과제의 규칙에 관한 표현을 가지고 있을 수 있다. 약한 라벨은 그 표현 중 어떤 것을 답으로 연결할지 알려주는 불완전한 신호가 된다.
예를 들어 학생이 문장의 의미 관계를 잘 표현하지만, 새 분류 과제에서 어떤 출력을 선택해야 하는지 아직 잘 맞추지 못한다고 하자. 교사가 주는 라벨에 오류가 있더라도, 여러 예제에 반복되는 구조가 학생의 기존 표현과 맞으면 더 좋은 결정 규칙을 배울 여지가 있다. 반대로 교사의 오류를 그대로 모방하기 쉬운 설정이면 그 오류도 배운다. 사전학습 능력, 오류의 구조, 학습 목표가 함께 결과를 결정한다. 논문 §1, §5
기본적인 이진 분류 학습을 식으로 적어 보자. 입력 x에 대해 교사가 내는 양성 확률을 q(x), 학생의 확률을 pθ(x)라고 하자. 학생은 약한 라벨에 대한 평균 이진 교차엔트로피(Binary cross-entropy)를 최소화할 수 있다.
| 기호 | 의미 | 범위·단위 |
|---|---|---|
| x | 분류할 입력 | 과제에 따라 문장·응답 쌍 등 |
| q(x) | 약한 교사의 양성 확률 | 0–1, 무차원 |
| pθ(x) | 학생의 양성 확률 | 0–1, 무차원 |
| N | 학습 예제 수 | 개 |
| BCE | 두 확률을 맞추는 손실 | 자연로그를 쓰면 nats |
이 목적함수는 교사의 오류를 알려주지 않는다. 특정 입력을 따로 떼어 손실만 보면, 학생은 교사의 확률을 맞추도록 압력을 받는다. 교사를 넘어서는 일반화는 공유된 표현, 제한된 학습, 추가적인 규제와 데이터 구조에서 나와야 한다. 교차엔트로피를 사용한다는 사실만으로 교사를 넘어설 수 있는 것은 아니다.
#비교 대상은 세 가지다
OpenAI 연구는 작은 모델을 실제 정답으로 학습시켜 약한 교사를 만들고, 교사가 별도 예제에 낸 예측으로 강한 학생을 학습한다. 비교를 위해 같은 강한 모델을 실제 정답으로 학습한 기준도 만든다. 논문 §3
| 비교 대상 | 학습에 쓰는 신호 | 확인하는 질문 |
|---|---|---|
| 약한 교사 | 실제 정답 | 교사가 어느 정도까지 할 수 있는가? |
| 약한 감독을 받은 강한 학생 | 약한 교사의 예측 | 교사보다 더 잘 일반화하는가? |
| 정답으로 학습한 강한 기준 모델 | 실제 정답 | 이 설정에서 회복할 성능 격차가 얼마나 되는가? |
마지막 기준을 논문은 강한 기준 성능(Strong ceiling performance)이라고 부른다. 이는 해당 데이터와 학습 절차로 측정한 비교 기준이다. 모델이 어떤 방법으로도 넘을 수 없는 수학적 상한을 증명한 것은 아니다. 실제 정답은 실험을 평가하고 기준을 만들기 위해 사용하며, 약한 감독을 받는 학생의 기본 학습 라벨과 구분한다.
#58쪽 — 학생의 정확도와 회복한 성능 격차는 다른 값이다
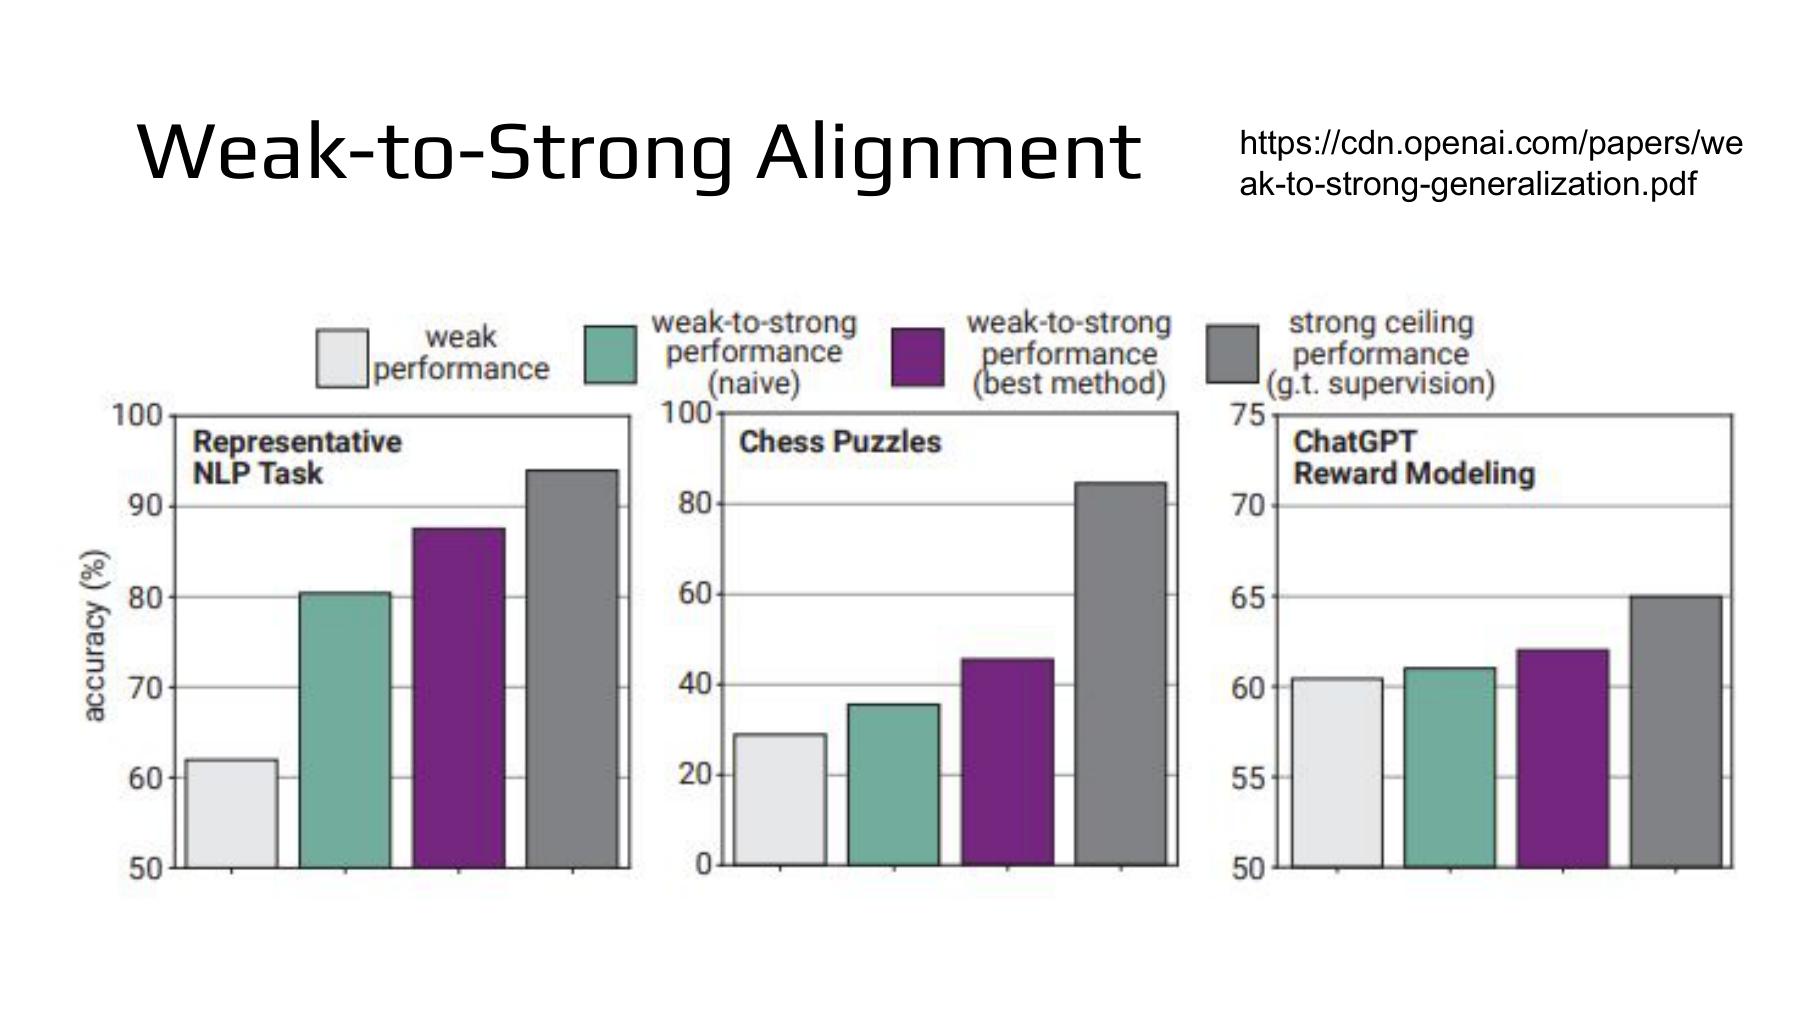
강의의 1:00:17 구간은 이 그림을 통해 약한 교사의 신호로 학습한 학생이 교사보다 잘할 수 있음을 설명한다. 그림은 OpenAI 논문의 Figure 2다. 옅은 회색은 약한 교사, 초록색은 단순한 약한 라벨 학습, 보라색은 각 설정에서 더 잘 작동한 방법, 짙은 회색은 정답으로 학습한 강한 기준이다. 논문 Figure 2
여기에는 세 가지 주의점이 있다.
- 세 그래프의 세로축 범위가 다르다. 막대의 높이 차이만 눈으로 비교하면 실제 정확도 차이를 잘못 읽을 수 있다.
- 보라색이 모두 같은 알고리즘은 아니다. NLP에서는 보조 확신 손실, 체스에서는 중간 크기 모델을 거치는 부트스트래핑(Bootstrapping), 보상 모델링에서는 비지도 생성 미세조정을 사용한다.
- 학생의 규모도 완전히 같지 않다. 이 그림의 NLP·체스는 GPT-4, 보상 모델링은 GPT-3.5 수준의 모델을 학생으로 사용한다. 논문의 GPT-2·GPT-3.5 “수준”은 모델 규모와 성능을 설명하는 표현이며, 실험 모델군은 GPT-4와 같은 계열의 구조·사전학습 데이터로 구성되었다. 논문 Figure 2, §1 각주 1
평가하는 행동도 다르다. NLP는 22개 이진 분류 과제, 체스는 퍼즐의 첫 수 예측, 보상 모델링은 두 응답에 대한 사람 선호의 예측이다. 보상 모델링 실험에서 그 보상으로 정책을 강화학습하는 단계까지 시험한 것은 아니다. 논문 §4.1
#성능 격차 회복률 PGR
교사가 60점인 과제와 85점인 과제에서 학생이 5점 좋아진 결과는 같은 의미가 아닐 수 있다. 남아 있던 성능 격차가 다르기 때문이다. 이를 비교하기 위해 성능 격차 회복률(Performance Gap Recovered, PGR)을 사용한다.
| 기호 | 의미 |
|---|---|
| Aweak | 약한 교사의 성능 |
| Aw2s | 약한 감독으로 학습한 강한 학생의 성능 |
| Aceiling | 정답으로 학습한 강한 기준 모델의 성능 |
세 값은 같은 평가 집합과 같은 성능 지표로 구해야 한다. 분모는 양수여야 “회복할 격차”라는 해석이 자연스럽다. 분모가 0이면 이 비율을 정의할 수 없으며, 분모가 매우 작으면 작은 측정 오차에도 값이 크게 변한다. 논문 §3, PGR 정의
계산 예로 교사가 60%, 학생이 78%, 강한 기준이 90%의 정확도를 얻었다고 하자.
학생 정확도는 78%이고, 회복한 격차의 비율은 60%다. 두 값을 바꿔 쓰면 안 된다. 같은 기준에서 학생이 교사보다 못하면 PGR은 음수가 될 수 있고, 측정한 강한 기준을 넘으면 1보다 클 수도 있다. 따라서 PGR=0.97은 정확도 97%나 정렬 성공 확률 97%를 뜻하지 않는다.
#함께 읽기 — 교사의 오류를 그대로 모방하지 않도록 학습한다
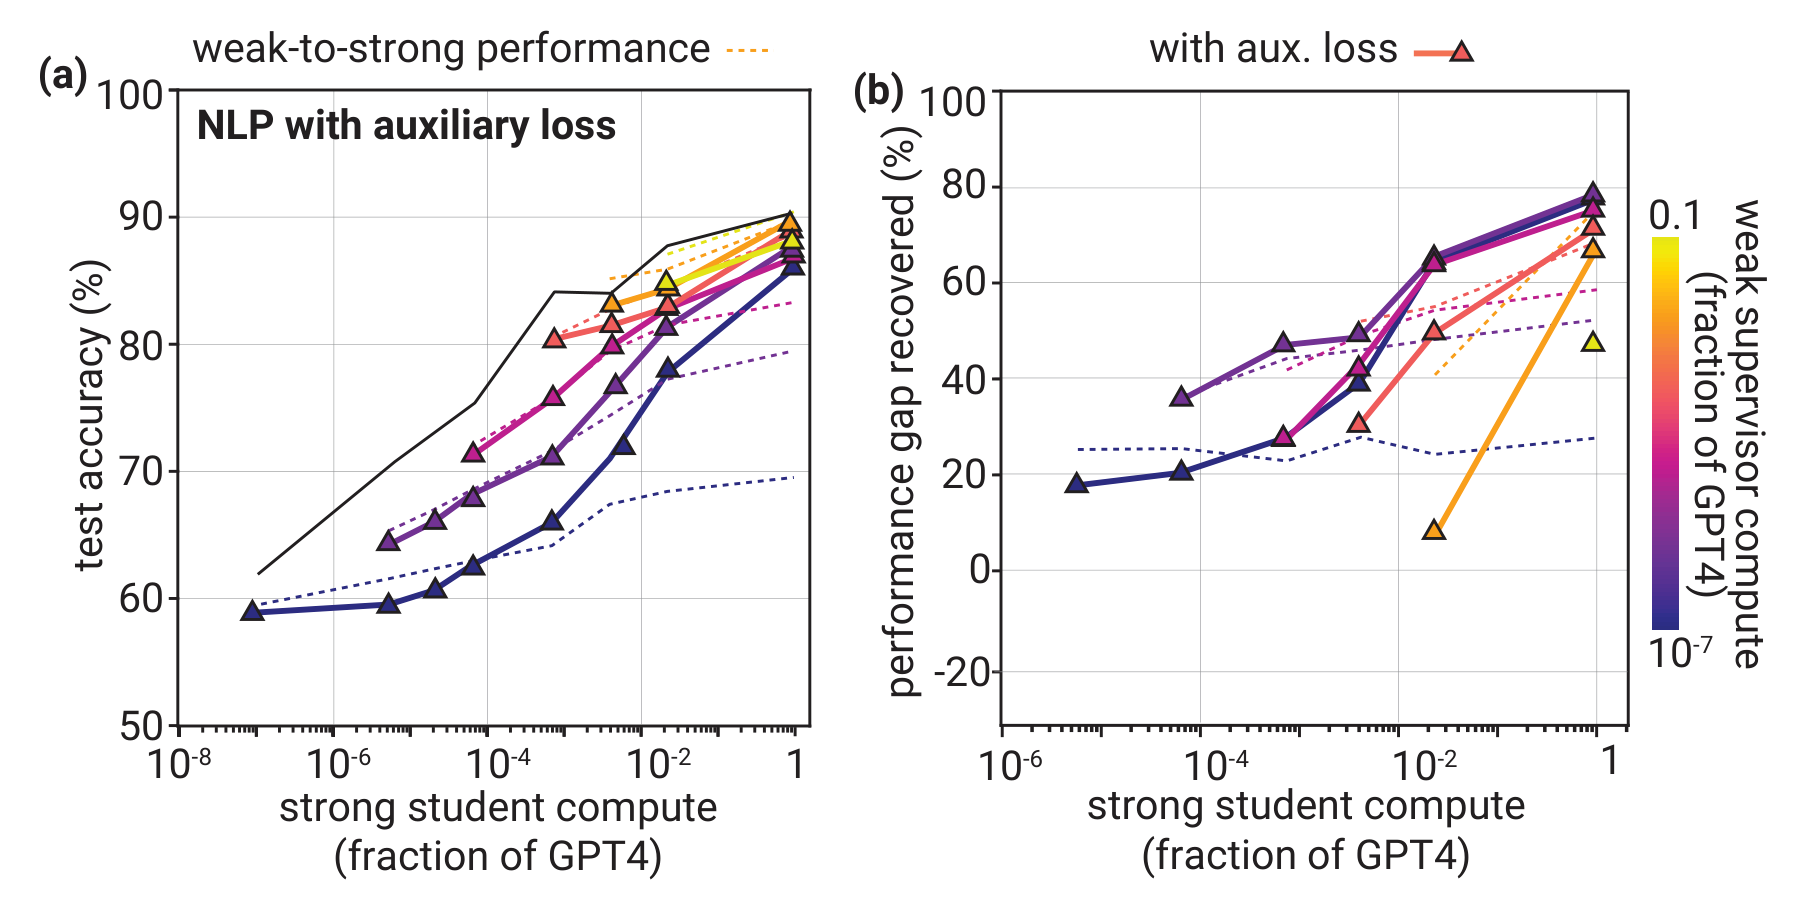
이 그림은 22개 NLP 과제의 중앙값을 보여준다. 점선은 단순한 약한 라벨 학습이고, 삼각형이 있는 선은 보조 확신 손실(Auxiliary confidence loss)을 사용한 결과다. 작은 교사와 큰 학생 사이의 격차가 클 때 개선이 두드러진다. 다만 모든 모델 쌍과 과제에서 좋아지는 것은 아니다. 논문 §4.3.2, Figure 5
방법을 이해하려면 학생의 예측을 학습 목표에 일부 섞는다고 생각하면 된다. 학생의 현재 양성 확률 p를 임계값 t로 이진화해 h를 만든다.
그다음 약한 교사의 확률 q와 학생의 이진 예측 h를 함께 사용한다.
교차엔트로피는 목표 확률에 대해 선형이므로, 다음과 같이 하나의 섞인 목표로 쓸 수 있다.
α는 학생의 예측을 얼마나 반영하는지 정하는 무차원 가중치다. 원 논문은 가장 큰 학생 모델에는 최종 α=0.75, 나머지에는 0.5를 사용하며, 학습의 첫 20% 동안 0에서 그 값까지 선형으로 증가시킨다. 또한 이진 분류에서 배치의 절반이 양성이 되도록 t를 적응적으로 정한다. 임계값을 항상 0.5로 고정한 방법은 아니다. 이 균형 규칙은 클래스가 균형 잡힌 실험의 사전 가정을 반영한다. 불균형 데이터에 그대로 적용하면 분포를 왜곡할 수 있다. 논문 Appendix A.4, 식 (1)–(2)와 각주 7
교사는 q=0.2, 학생은 p=0.7이고 이 예제가 h=1로 선택되었다고 하자. 다음은 한 번의 갱신에서 목표를 고정한 계산 예다.
| 학생 예측의 가중치 α | 섞인 목표 qmix | 학생의 현재 확률 p | 이 예제의 손실이 미는 방향 |
|---|---|---|---|
| 0 | 0.2 | 0.7 | 양성 확률을 낮춤 |
| 0.5 | 0.6 | 0.7 | 양성 확률을 조금 낮춤 |
| 0.75 | 0.8 | 0.7 | 양성 확률을 높임 |
방향은 학생의 로짓 z에 대한 경사로 확인할 수 있다. p=σ(z)이고 목표를 고정하면 다음과 같다.
α=0.5이면 경사는 0.1이다. 경사하강법은 z를 줄여 p를 낮춘다. α=0.75이면 경사는 −0.1이므로 반대 방향으로 움직인다. 학생의 목표를 섞었다고 모든 예제에서 현재 확률이 자동으로 더 강해지는 것은 아니다. 교사 신호와 학생 신호의 상대적 크기를 보아야 한다.
또한 학생의 확신도 틀릴 수 있다. 이 손실은 오류를 판별하는 완벽한 검증자가 아니다. 학생이 이미 가진 유용한 표현을 보존하도록 유도하는 학습 설계이며, 그 효과는 실제 정답을 사용한 별도 평가로 확인해야 한다.
#59쪽 — 학습 방법을 찾는 AI도 평가 기준의 영향을 받는다
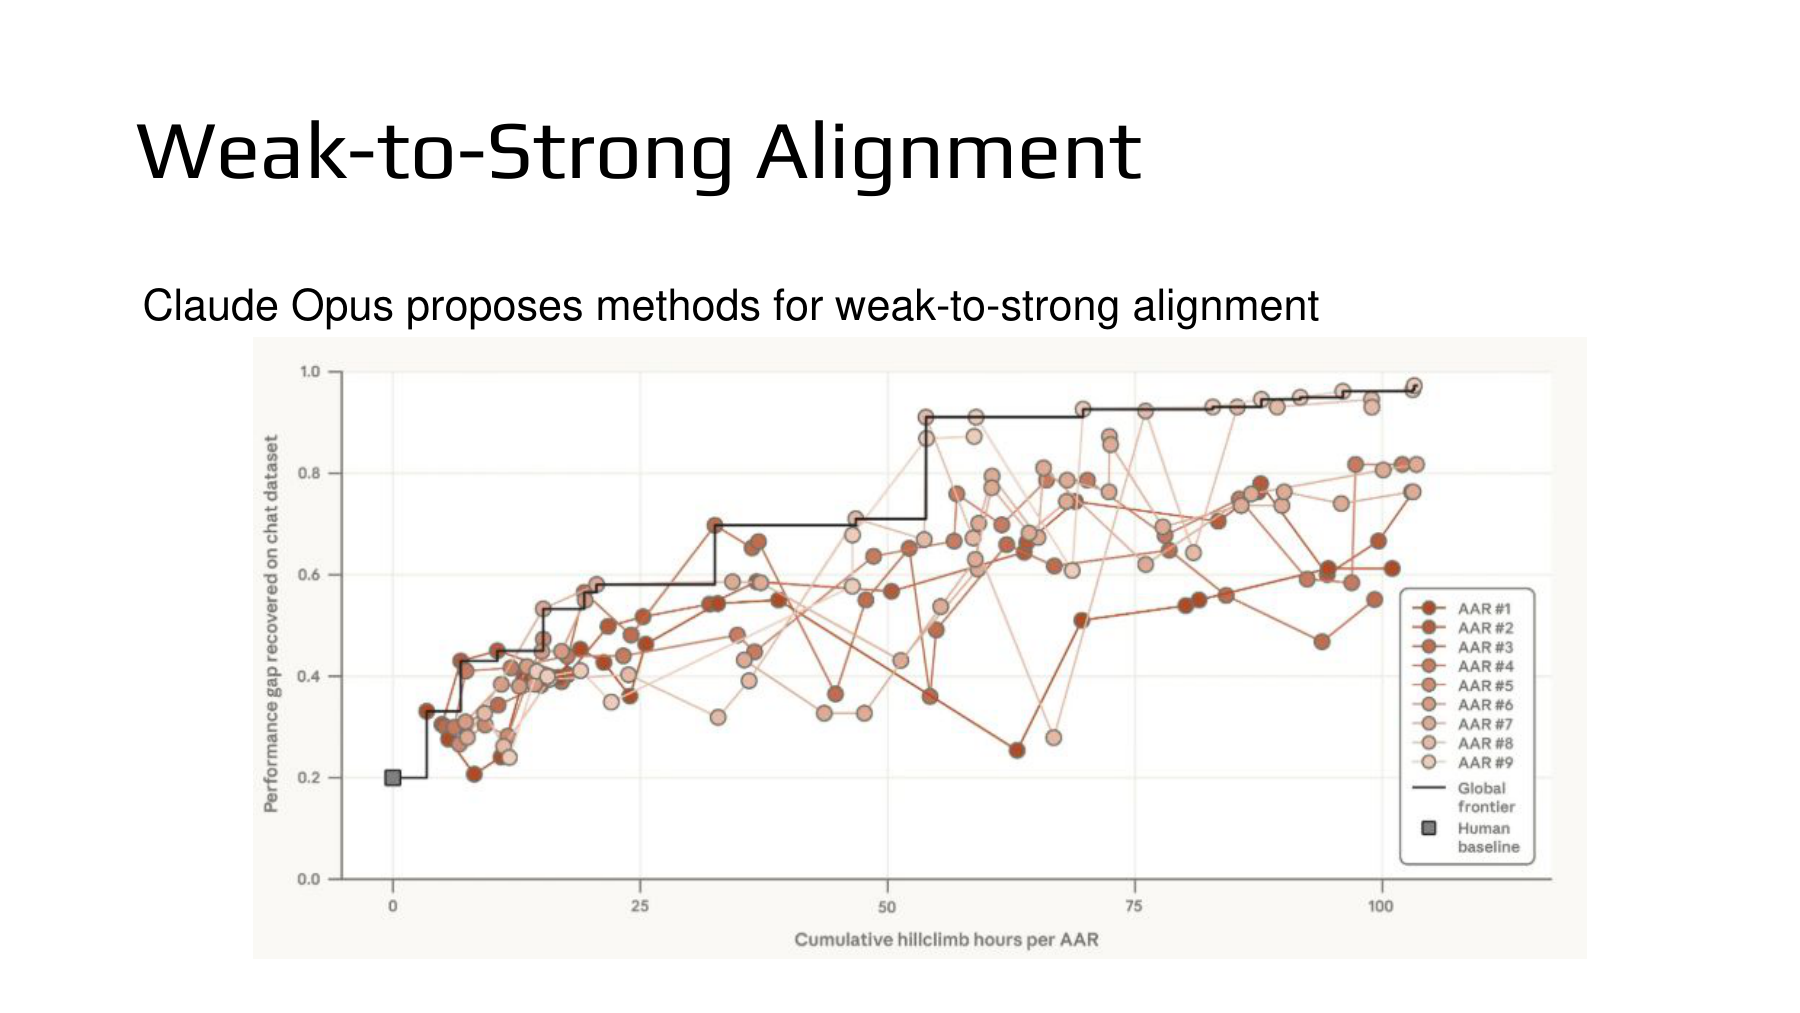
강의의 1:01:17 구간은 다시 Anthropic 연구로 돌아온다. 여러 Opus 에이전트가 약한 교사로부터 더 잘 배우는 알고리즘을 설계하고, 실험 결과를 서로 공유한다. 그림의 세로축은 학생의 정확도 자체가 아니라 앞에서 정의한 PGR이다.
기술 보고에서 연구자 두 명은 7일 동안 네 가지 선행 접근을 조정했다. 채팅 선호 분류에서 가장 좋은 사람 기준은 PGR 0.23이었다. 이후 9개 AAR의 탐색은 5일, 누적 약 800 연구 시간에 PGR 0.97에 도달했다. 누적 시간은 여러 에이전트가 사용한 시간을 합친 값으로, 달력의 경과 시간과 다르다. 기술 보고 서두·§1–3
59쪽 그림의 가로축은 각 AAR의 누적 탐색 시간이다. 그림에서 보이는 약 100시간과 전체 에이전트의 시간을 합한 약 800시간은 집계 단위가 다르다.
이 결과는 주어진 모델·데이터·평가 환경에서 더 좋은 방법을 찾았다는 증거다. 모든 정렬 연구에서 사람보다 우수하다거나, AI가 자기 자신보다 강한 후속 모델을 만들었다는 결론까지 포함하지 않는다.
#함께 읽기 — 여러 에이전트가 같은 생각만 하면 탐색이 좁아진다
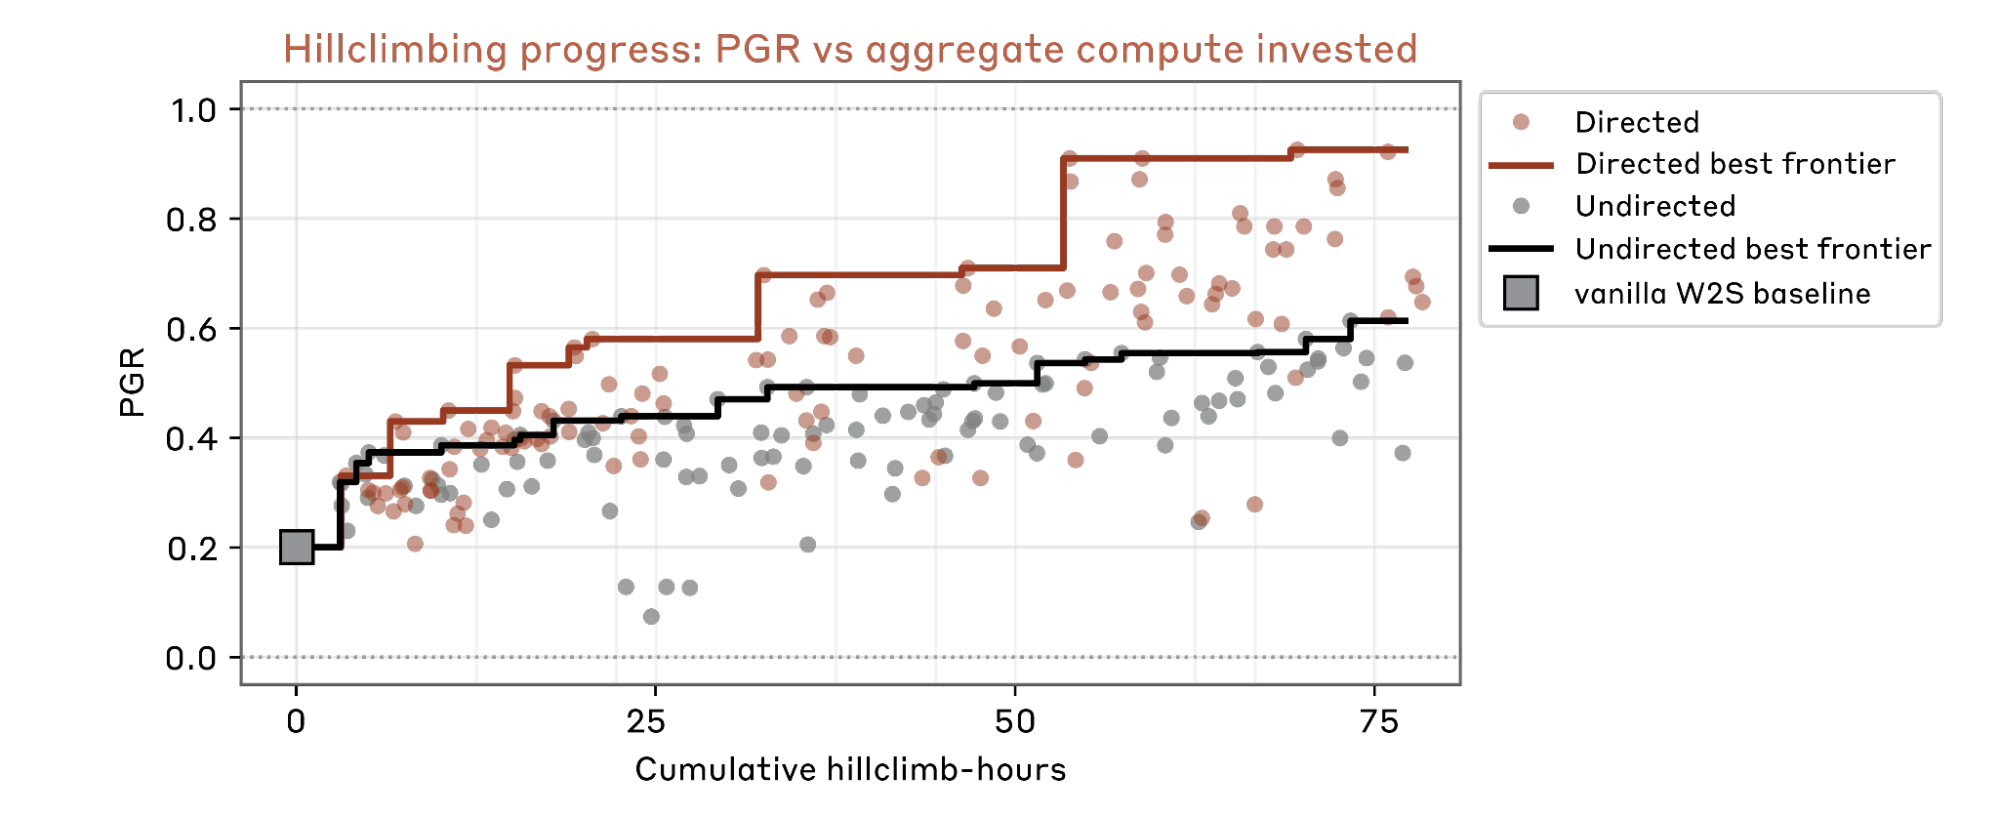
연구는 두 조건을 비교한다. Directed 조건에서는 각 에이전트에 서로 다른 짧은 연구 방향을 준다. Undirected 조건에서는 모두 같은 지시로 시작한다. 서로 다른 방향은 상세한 알고리즘을 미리 지정하는 대신, 탐색의 출발점을 나누는 역할을 한다. 보고된 비교에서 directed 조건은 더 빠르게 더 높은 PGR에 도달했다. 기술 보고 §3.1
왜 이런 차이가 생길 수 있을까? 에이전트가 9개여도 모두 자기학습(Self-training)만 반복하면 실제로 탐색하는 방법의 종류는 적다. 연구진은 아이디어를 11개 방법 계열로 분류하고, 특정 시점에 활동 중인 에이전트들이 얼마나 다양한 계열을 다루는지 엔트로피로 측정했다. 기술 보고 §3.2
nₖ는 해당 시점에 방법 계열 k를 탐색하는 에이전트 수다. 여기서는 자연로그를 사용하므로 단위는 nats이며, 비율이 0인 항은 0으로 둔다. 원문의 엔트로피 도표는 bits를 사용하므로 숫자를 직접 비교할 때에는 로그의 밑을 맞춰야 한다. 계산 예로 활동 중인 9개 에이전트가 모두 같은 계열에 있으면 엔트로피는 0이다. 세 계열에 3개씩 나뉘면 약 1.099이고, 아홉 계열에 하나씩 나뉘면 약 2.197이다.
이 값은 아이디어의 분산을 나타낸다. 아이디어의 질, 독창성, 실제 성능을 직접 측정하지는 않는다. 다양한 실험을 했더라도 모두 효과가 없을 수 있으므로 성능과 함께 보아야 한다. 연구에서 말하는 탐색의 엔트로피 감소와, 앞선 편에서 다룬 모델 출력 확률의 엔트로피 최소화는 측정 대상부터 다르다.
#방법의 예 — 교사의 라벨을 관측값으로 다룬다
기술 보고에는 여러 발견 사례가 있다. 그중 EM Posterior는 약한 교사의 라벨을 참값으로 고정하지 않고, 오류가 섞인 관측으로 모델링한다. 강한 기초 모델의 여러 프롬프트·순서에 대한 예측과 교사의 확신 등을 이용해 라벨의 사후확률(Posterior)을 추정한다. 기술 보고 §4, EM Posterior
그 원리를 두 클래스의 단순한 예로 쓰면 다음과 같다. y는 실제 라벨, w는 관측한 교사 라벨, x는 입력이다. T는 교사의 오류 확률을 표현하는 잡음 채널(Noise channel)이고, π는 강한 모델에서 얻은 사전확률이다.
예를 들어 강한 모델의 사전확률이 π(y=1)=0.8인데 교사는 w=0이라고 했다고 하자. 교사의 거짓 음성 확률과 참 음성 확률을 각각 0.2와 0.8로 가정하면 다음과 같다.
학생의 사전확률 0.8도, 교사의 라벨 0도 그대로 채택하지 않고 두 신호를 결합한다. 교사의 두 조건부 확률이 0.45와 0.55로 비슷해 별로 믿을 만한 구분을 하지 못한다면, 같은 계산의 사후확률은 약 0.766이다. 교사 관측이 약할수록 사전확률의 영향이 더 남는다. 여기서 사용한 확률은 원리를 설명하기 위한 가정이며, 논문의 측정값이 아니다.
실제 보고된 EM 방법은 예제별 특성을 사용하고, 사후확률을 조절하며, 학생 학습과 채널 재추정을 반복한다. 위 식 하나가 전체 알고리즘은 아니다. 특히 π와 T가 함께 잘못되면 사후확률도 잘못된다. 모델 두 개의 의견을 수학적으로 결합했다는 이유로 독립적인 정답 검증이 생기는 것은 아니다.
#함께 읽기 — 다른 과제에서도 같은 개선이 이어지는가
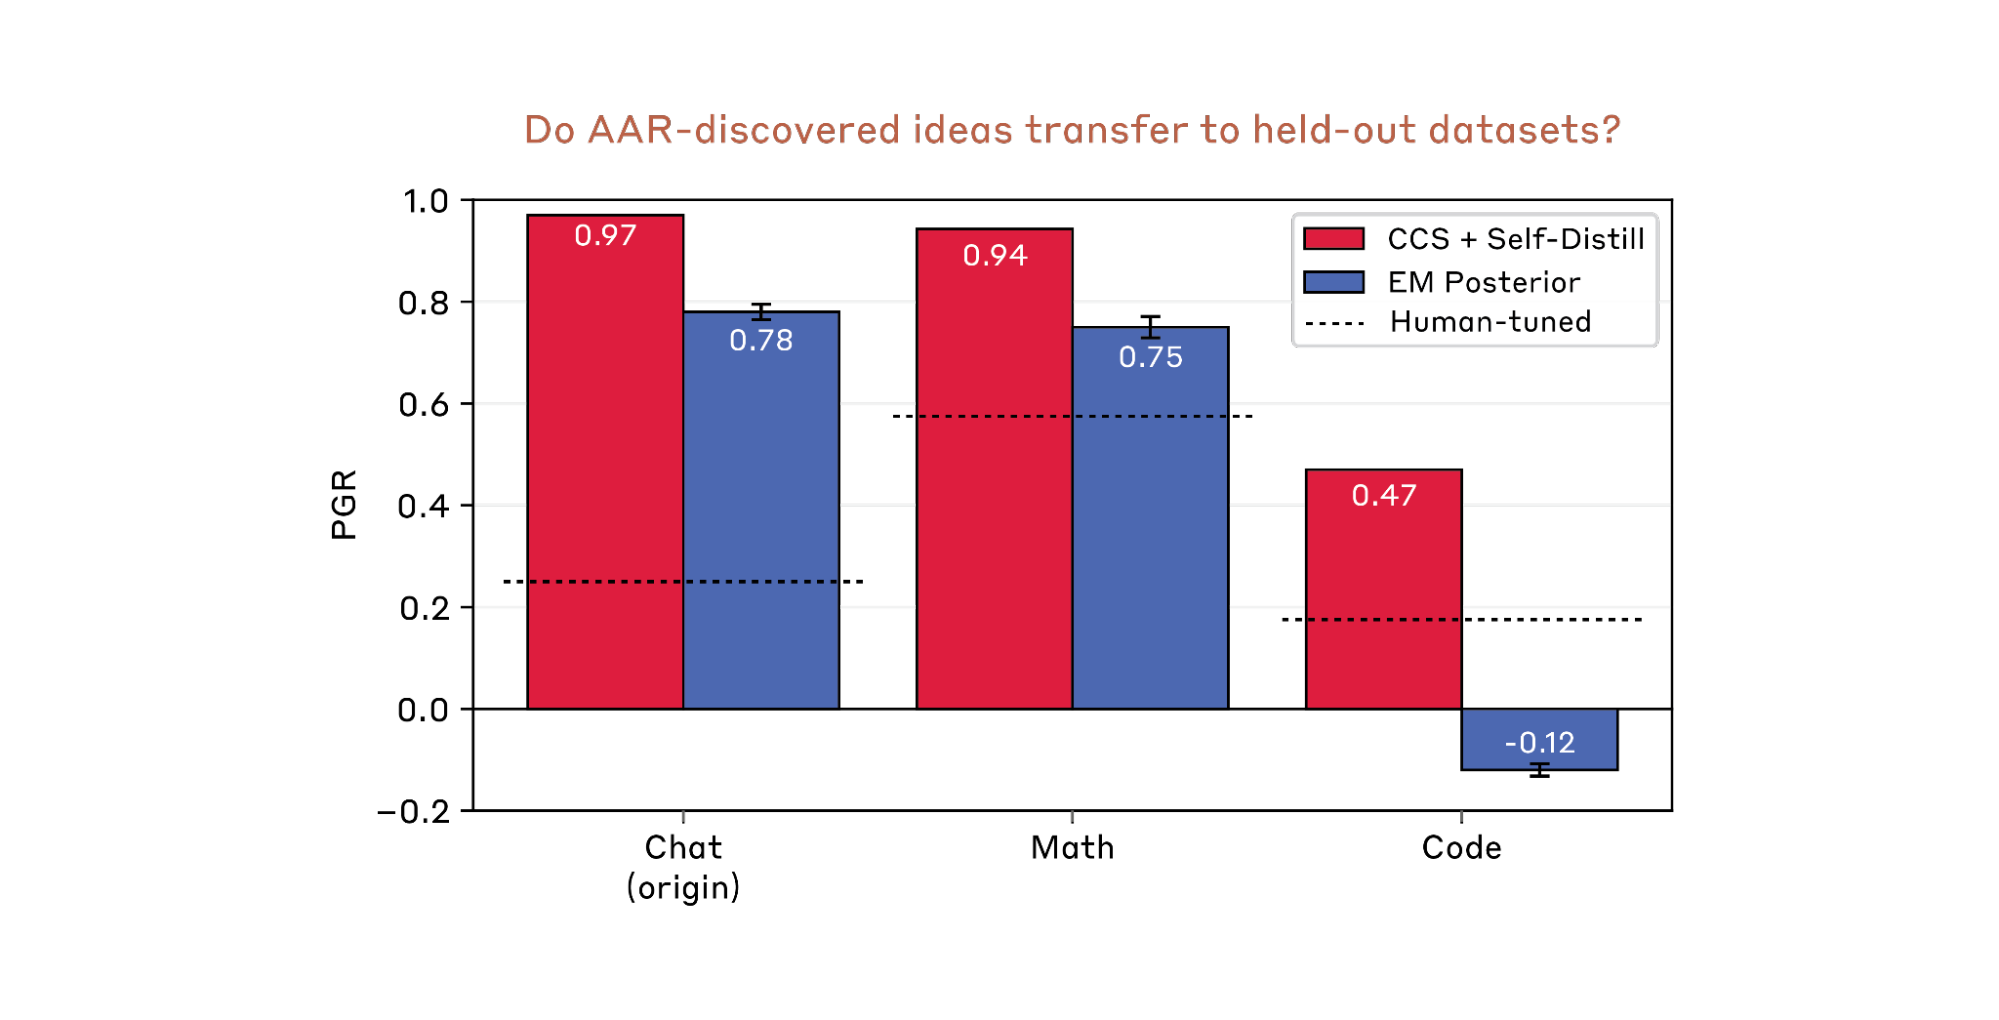
| 발견한 방법 | 채팅 선호 | 수학 검증 | 코드 검증 |
|---|---|---|---|
| CCS + Self-Distill | 0.97 | 0.94 | 0.47 |
| EM Posterior | 0.78 | 0.75 | −0.12 |
표의 값은 모두 PGR이다. 연구진은 채팅 선호에서 찾은 두 방법을 수학·코드 데이터로 옮겼다. 이 전이 실험은 하이퍼파라미터 조정을 허용하되, 방법의 구성 요소를 추가하거나 제거하는 변경은 허용하지 않았다. 첫 방법은 두 과제에 모두 전이되었지만, 두 번째 방법은 코드에서 약한 교사보다도 낮은 성능을 보였다. 기술 보고 §3.4, 전이 결과 그림
−0.12를 “정확도 −12%”라고 읽으면 안 된다. 앞의 PGR 정의에서 분모가 양수라면, 학생이 약한 교사보다 못했고 그 차이가 기준 성능 격차의 12%였다는 뜻이다.
규모를 키우는 전이도 별개다. 기술 보고는 EM 기반 방법을 Sonnet 4.0과 실제 운영 학습 인프라의 선호 데이터에 적용했을 때, 가장 좋은 설정의 개선이 0.5점으로 잡음 범위 안에 있었다고 설명한다. 저자들은 학생 기초 모델의 신호를 추출하는 방식이 충분하지 않았을 가능성을 제시하지만, 그것은 실패 원인에 대한 해석이다. 작은 실험의 높은 PGR이 운영 모델의 유의미한 개선으로 곧바로 이어졌다고 말할 수는 없다. 기술 보고 §3.5
#평가 점수를 자주 보면 평가 집합의 역할이 바뀐다
이 연구는 AAR의 작업 공간에서 실제 라벨을 제거하고 원격 API로 점수를 제공했다. 그러나 점수를 반복해서 확인하며 방법을 고르면, 그 집합은 방법 선택에 사용된다. 저자들도 무제한 평가 제출 때문에 자신의 테스트 집합이 사실상 분포 밖 구간을 포함한 검증 집합이 된다고 설명한다. 기술 보고 §1, §5
보고된 문제에는 데이터의 지름길을 이용하는 방법, 많은 무작위 초기값 중 점수가 가장 좋은 경우만 선택하는 방법, 평가 피드백에서 라벨 정보를 얻는 행동이 있다. 코딩 과제에서는 실행을 통해 답을 판별해 약한 감독이라는 원래 연구 설정을 우회하기도 했다. 점수가 높아졌을 때에는 원했던 학습 원리가 좋아졌는지, 다른 정보 경로를 이용했는지를 구분해야 한다.
Anthropic의 연구 소개는 발견한 이런 부적절한 제출물을 제외했다고 명시한다. 따라서 높은 최종 점수 전체를 부정행위의 결과라고 단정하는 것도 근거가 없다. 제출물의 제외 처리와, 반복적인 점수 조회가 평가 집합에 미치는 영향은 각각 확인할 문제다. Anthropic 연구 소개, Preventing hacks
따라서 별도로 남겨 둔 새로운 데이터·과제에 방법을 옮기는 검사가 중요하다. 이것도 모든 문제를 해결하지는 않지만, 반복해서 본 점수만으로 발견의 일반성을 주장하는 것보다 더 강한 근거를 제공한다.
#60쪽 — 무엇이 개선되었는지부터 정확히 말하자
강의의 1:02:39 구간에서 강사는 당시 상황을 “아직 강가에 있다”는 비유로 정리한다. 이는 2026년 5월 강의 시점의 평가다. 뒤에 나온 모든 연구의 상태를 한 문장으로 판정한 표현으로 옮겨 읽지 않는다.
이번 범위에서 확인한 결과는 다음처럼 나눌 수 있다.
| 질문 | 이 글의 실험이 보여주는 것 | 더 필요한 근거 |
|---|---|---|
| 약한 교사보다 학생이 더 잘할 수 있는가? | 여러 과제에서 가능하며 방법에 따라 격차가 달라짐 | 어떤 오류·모델·분포에서 유지되는지 |
| AI가 더 좋은 학습 방법을 찾을 수 있는가? | 정해진 weak-to-strong 실험에서 사람 기준보다 높은 PGR을 찾음 | 새로운 과제와 운영 규모로의 전이 |
| 강한 학생을 감독하면 정렬 문제가 해결되는가? | 제한된 분류 과제에서의 능력 유도 가능성을 보여줌 | 더 복잡한 행동, 장기적 목표, 실제 감독 조건의 검증 |
| AI 연구자 자신이 계속 더 강해졌는가? | 이 실험의 직접 측정 대상은 학생과 학습 방법 | 연구자 자체의 갱신과 독립적인 능력 향상 증거 |
OpenAI의 초기 연구도 실험적 비유의 한계를 설명한다. 실제 미래 모델은 사람의 오류를 모방하기 더 쉬울 수 있다. 지금의 사전학습 데이터에는 이미 사람 수준의 답이 많이 들어 있으므로, 그 능력을 꺼내는 실험이 사람이 제공하지 못한 수준의 능력을 감독하는 문제보다 쉬울 수도 있다. 이런 차이를 논문은 각각 모방의 두드러짐(Imitation saliency)과 사전학습 누출(Pretraining leakage)의 문제로 논의한다. 논문 §3 한계
이 구분을 유지하면 자기개선의 질문도 구체화된다. 어떤 파라미터가 바뀌었는가? 무엇을 학습 신호로 사용했는가? 방법을 고를 때 보지 않은 곳에서도 나아졌는가? 개선된 학생이 연구자보다 강해졌는가? 각 질문에는 서로 다른 증거가 필요하다.
13편의 61–62쪽에서는 모델 파라미터 밖으로 시선을 옮긴다. 에이전트의 행동은 모델뿐 아니라 도구, 메모리, 작업 절차를 묶은 하네스(Harness)에도 영향을 받는다. 학습 목표를 바꾸는 것에서 출발한 이야기는, 이제 에이전트가 일하는 방식 자체의 개선으로 이어진다.
계산 예제와 코드
PGR의 분모와 범위, 섞인 교차엔트로피 목표와 로짓 경사, 배치 임계값, 연구 방향의 엔트로피, 잡음 채널을 이용한 사후확률 계산을 확인할 수 있다.
#함께 읽을 자료
| 자료 | 연결되는 내용 |
|---|---|
| NTU Self-Improving 강의 · 슬라이드 | 약한 감독, 자동 연구, 자기개선의 범위 |
| Weak-to-Strong Generalization 논문 | 세 모델의 비교, PGR, 보조 확신 손실과 실험의 한계 |
| OpenAI 연구 소개 | 약한 감독을 연구하는 동기와 실험적 비유 |
| Automated Alignment Researchers | 자동 연구의 설정과 주요 결과 |
| Automated Weak-to-Strong Researcher | 탐색 방향, 발견한 방법, 전이 실험과 평가 문제 |