같은 모델도 무엇을 읽고, 어떤 도구를 쓰며, 실패를 어떻게 다음 행동에 반영하는지에 따라 다른 에이전트가 된다.
12편에서는 AI가 학생 모델의 학습 방법을 설계하는 과정과, 연구자 자신이 개선되었다는 주장을 구분했다. 이번에는 질문을 모델 밖으로 넓힌다. 모델의 가중치를 그대로 두고도 에이전트가 일을 더 잘하게 만들 수 있을까?
검색한 문서를 어떤 길이로 보여줄지, 도구가 실패했을 때 무엇을 다시 시도할지, 이전 작업의 어떤 기록을 불러올지는 모델의 다음 입력을 바꾼다. 이 실행 구조를 설계하는 것도 에이전트 개선의 대상이다.
강의의 마지막 두 장은 이 관점을 제시하고 다음 강의로 넘어간다. 아래의 ReAct, Generative Agents, Reflexion, SWE-agent는 그 짧은 문제 제기를 구체화하기 위한 보충 논문이다. 네 논문의 구조를 통해 가중치의 학습, 메모리의 갱신, 하네스의 수정을 나누어 읽는다.
#61쪽 — 에이전트에는 모델 밖의 구성 요소가 있다
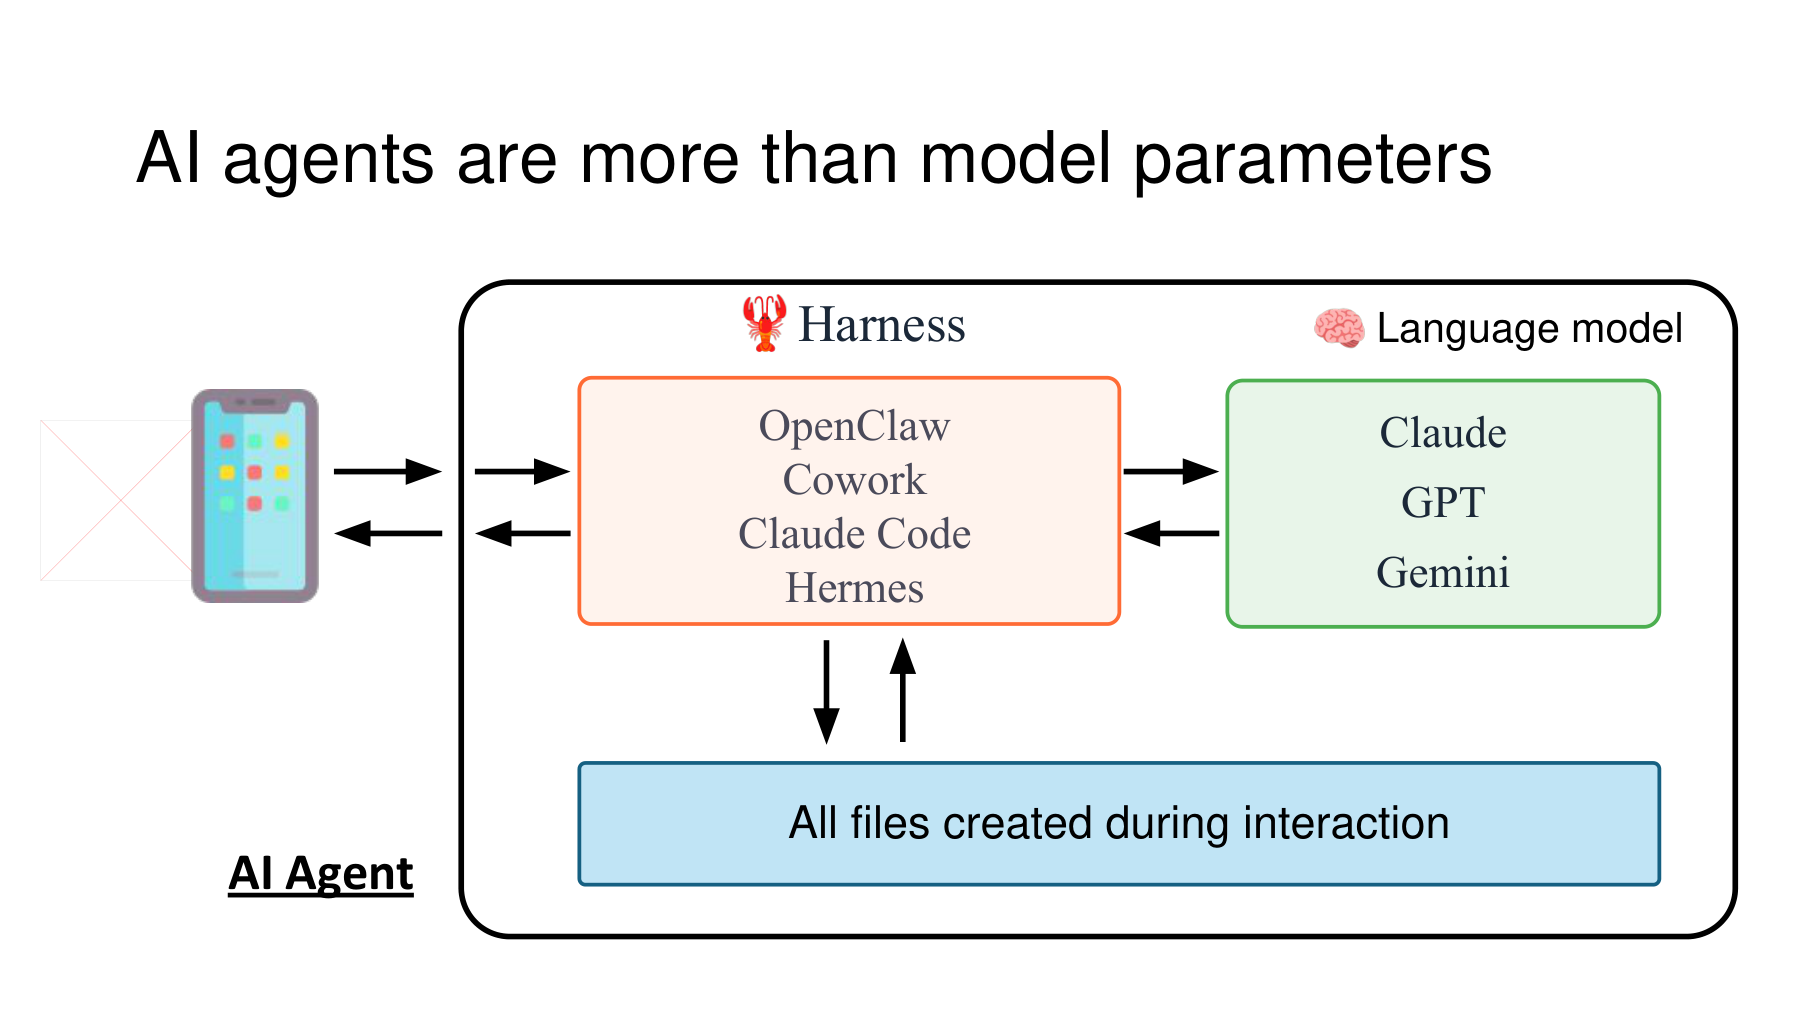
강의는 1:03:14 구간에서 에이전트가 언어모델의 파라미터만으로 이루어지지 않는다고 설명한다. 슬라이드의 하네스(Harness) 영역에는 OpenClaw, Cowork, Claude Code, Hermes가, 언어모델 영역에는 Claude, GPT, Gemini가 예시로 놓여 있다. 여기서는 강의가 사용한 구성 구분을 읽으면 된다.
하네스는 모델을 호출하고, 도구 요청을 실행하며, 결과를 다시 입력으로 묶는 실행 구조다. 어떤 정보와 행동을 모델에 제공할지, 작업 기록을 어떻게 유지할지, 언제 멈출지 같은 규칙을 포함할 수 있다. 구체적인 범위는 시스템마다 다르다. 강사가 모델만 조정하면 에이전트의 일부만 강화한 것이라고 말하는 이유도 여기에 있다. 강의 1:03:20
이 구분을 정확히 하려면 모델, 하네스, 실행 중 쌓이는 상태를 따로 보아야 한다.
| 구분 | 무엇을 담는가 | 변화의 예 |
|---|---|---|
| 모델 파라미터 θ | 사전학습·미세조정으로 얻은 가중치 | 학습으로 다음 토큰의 조건부 분포가 바뀜 |
| 하네스 H | 입력 구성, 도구 인터페이스, 기록·재시도·종료 규칙 | 검색 결과 형식이나 오류 처리 절차를 수정함 |
| 실행 상태 s | 현재 대화, 계획, 관측, 저장된 메모리와 파일 | 새 검색 결과를 읽고 작업 기록을 추가함 |
파일이라는 형식만으로 역할이 정해지지는 않는다. 관측 로그는 실행 상태이고, 다음 실행부터 읽히는 규칙 파일은 하네스 설정의 일부가 될 수 있다. 생성한 코드가 아직 실행되지 않았다면 그것은 산출물이다. 어떤 내용이 실제 다음 행동에 사용되었는지를 확인해야 개선의 경로를 설명할 수 있다.
#모델의 입력이 바뀌는 경로를 따라가자
다음은 구조를 이해하기 위한 간단한 표기다. 특정 논문의 알고리즘을 그대로 옮긴 식은 아니다. 작업 x와 실행 상태 sₜ를 받아 하네스의 입력 구성 함수 C가 모델에 보낼 문맥 cₜ를 만든다고 하자.
aₜ는 모델이 제안한 다음 행동이다. 도구 호출일 수도 있고 최종 답변일 수도 있다. 같은 θ를 사용해도 cₜ에 검색 결과, 실패 메시지, 관련 메모리 중 무엇을 넣었는지에 따라 행동의 분포가 달라질 수 있다.
도구 행동을 실행하면 외부 환경의 상태 eₜ에서 새로운 상태와 관측 oₜ₊₁이 나온다. 하네스는 이 관측을 실행 상태에 반영한다.
P는 도구 인터페이스를 통해 환경과 상호작용하는 과정을, U는 기록을 추가하거나 요약하는 갱신 규칙을 나타낸다. 여기서는 환경이 항상 같은 결과를 준다고 가정하지 않는다. 다만 이 실행 루프 동안 모델의 가중치 θ는 고정한다.
이때 새로운 관측을 받아 답이 나아지는 것은 가능하다. 그러나 그것만으로 θ가 학습되었다거나 H의 규칙이 자동으로 다시 설계되었다고 말할 수는 없다. 상태가 바뀌는 것과 상태를 처리하는 규칙이 바뀌는 것을 구분해야 한다.
#보충 A — ReAct: 관측을 다음 행동에 연결한다
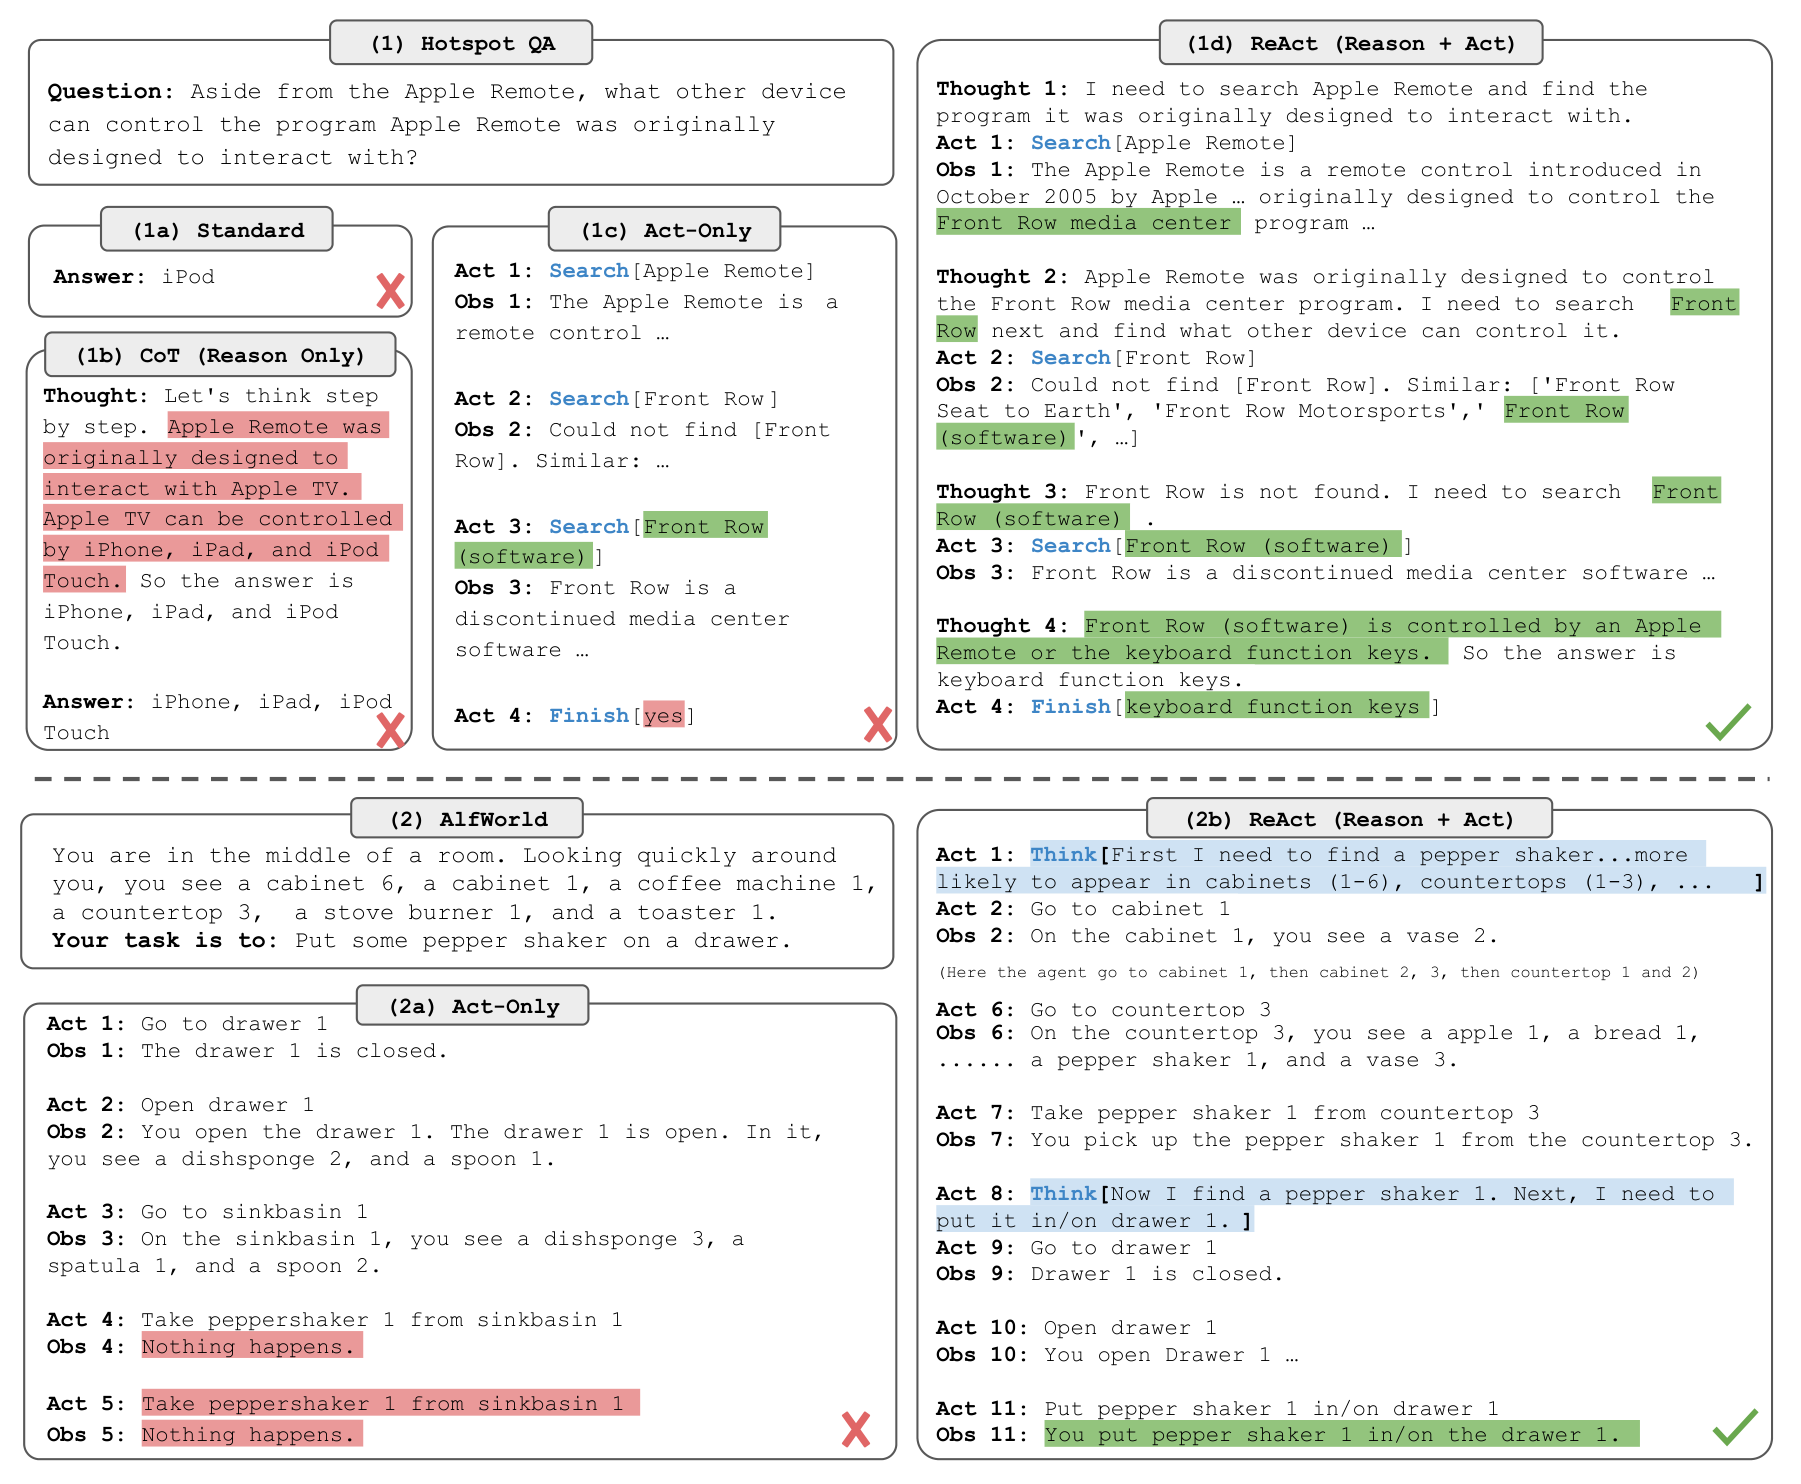
ReAct는 추론(Reasoning)과 행동(Acting)을 함께 구성한다. 그림 위쪽의 질의응답 예에서는 검색어를 정하고, 도구가 돌려준 내용을 읽고, 그 관측에 맞추어 다시 검색하거나 답한다. 아래쪽의 환경 과제에서는 물건을 실제로 찾았는지 확인하면서 행동 계획을 이어 간다. ReAct §2, Figure 1
핵심은 추론 문장을 길게 만드는 데 있지 않다. 처음 생각한 전제가 관측과 맞지 않으면 다음 행동을 바꿀 수 있도록 모델의 출력과 외부 피드백 사이에 연결을 만든다. 모든 행동 앞에 반드시 추론 문장 하나를 넣는 규칙도 아니다. 논문은 과제에 따라 추론을 드문드문 배치하는 경우를 포함한다. ReAct §2–3
예를 들어 저장소에서 함수를 찾는 에이전트를 생각해 보자. 검색 결과가 없으면 “함수가 없다”고 곧바로 결론 내릴 수도 있고, 검색 범위와 이름을 확인해 다시 찾을 수도 있다. 후자는 관측을 입력에 보존하고, 검색 전략을 바꿀 행동을 제공해야 가능하다. 이는 이 글의 설명용 상황이다.
여기서 다루는 것은 논문의 예시를 프롬프트에 넣는 ReAct 설정이다. 모델 가중치를 고정한 채 상호작용 순서를 설계할 수 있다는 점에 주목한다. 원 논문에는 별도의 미세조정 실험도 있으므로 ReAct 전체를 가중치 학습이 없는 연구라고 묶지 않는다. ReAct §3.2–3.3
#보충 B — Generative Agents: 저장과 검색은 다른 문제다
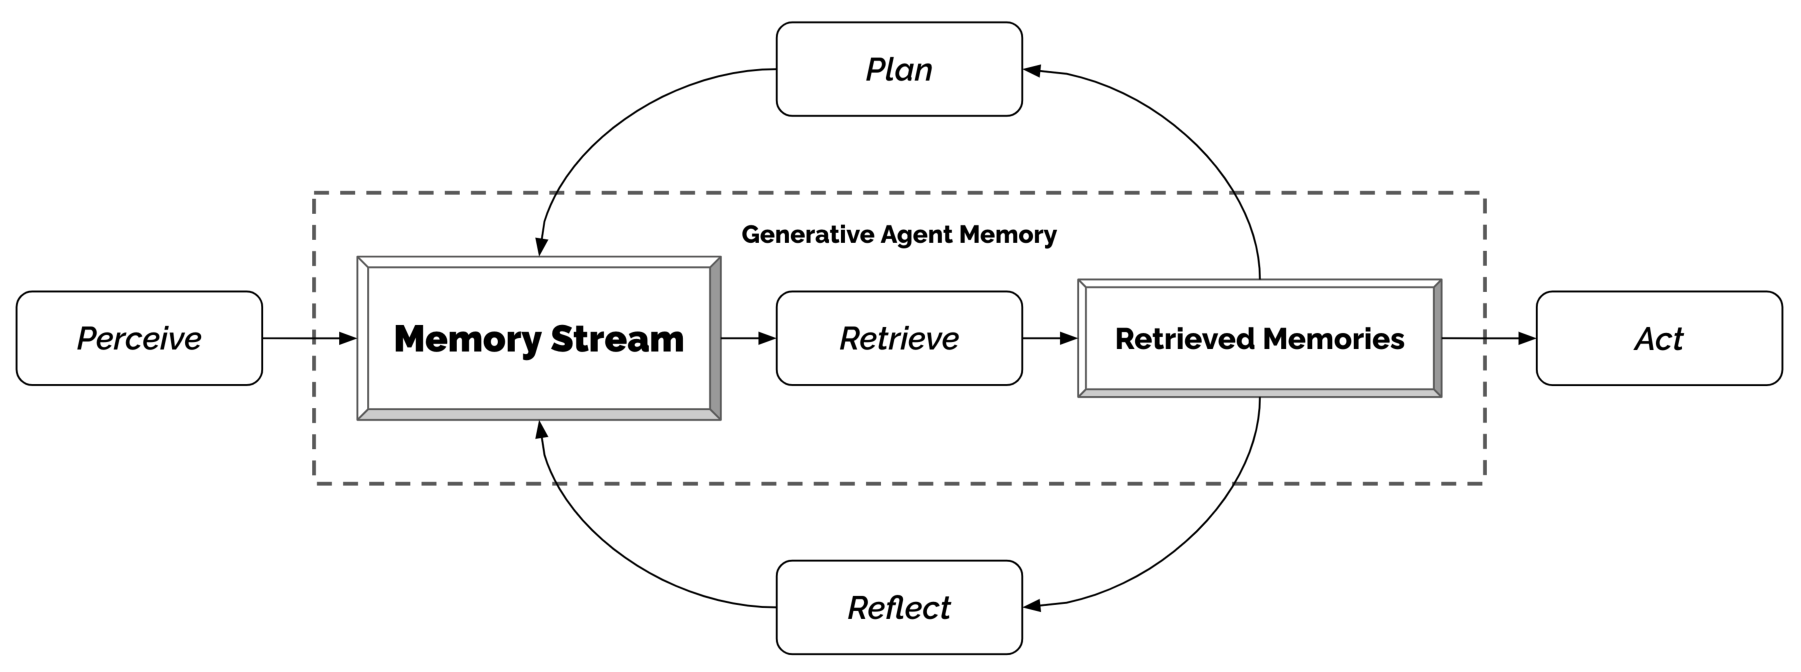
Generative Agents는 경험을 자연어로 기록하는 메모리 스트림(Memory stream)을 중심에 둔다. 현재 상황과 관련된 기억을 꺼내 행동을 정하고, 여러 기억에서 얻은 성찰(Reflection)과 계획(Planning)도 다시 저장한다. 연구의 대상은 가상 환경에서 그럴듯한 인간 행동을 구성하는 에이전트다. 이 구조를 모든 업무의 성능 향상으로 일반화하지 않는다. Generative Agents §4, Figure 5
기록을 많이 남기는 것만으로는 충분하지 않다. 저장소에는 있어도 현재 모델의 문맥에 들어오지 않은 기록은 그 호출에서 직접 읽히지 않는다. 반대로 오래된 추측을 관련성이 높다는 이유로 반복해서 꺼내면, 잘못된 전제가 다음 행동에도 남을 수 있다.
논문의 검색은 최근성(Recency), 중요도(Importance), 관련성(Relevance)을 결합한다. 최근성은 마지막으로 검색한 이후의 게임 시간, 중요도는 모델이 부여한 점수, 관련성은 질의와 기억의 임베딩 코사인 유사도를 사용한다. 세 점수는 각각 0–1 범위로 최소–최대 정규화(Min-max normalization)한 뒤 합친다. Generative Agents §4.1
#계산 예 1 — 같은 기억도 검색 규칙에 따라 순위가 바뀐다
아래는 “저장소의 배포 절차를 확인한다”는 상황을 위한 가상 점수다. 원 논문의 측정값이 아니며, 세 기록만을 후보 집합으로 삼는다. R은 이미 계산된 최근성 값, I는 중요도, Q는 현재 질문과의 관련성이다.
| 기억 | R | I | Q |
|---|---|---|---|
| A: 방금 남긴 일반 작업 메모 | 0.98 | 2 | 0.1 |
| B: 이전에 확인한 배포 규칙 | 0.80 | 9 | 0.9 |
| C: 최근의 배포 체크리스트 | 0.89 | 5 | 0.7 |
서로 범위가 다른 원점수를 바로 합치지 않고, 각 열을 후보 집합 안에서 정규화한다. 요소 j의 최대와 최소가 다르다는 조건에서 다음과 같다.
예를 들어 C의 중요도는 (5−2)/(9−2)=3/7이고, 관련성은 (0.7−0.1)/(0.9−0.1)=0.75가 된다. 후보의 해당 열 값이 모두 같으면 분모가 0이다. 아래 검산 코드에서는 순위를 구분하지 못하는 그 열의 기여를 0으로 두며, 이것은 이 예제에서 정한 처리 규칙이다.
정규화한 점수에 가중치를 적용한다. 원 논문의 구현은 세 가중치를 모두 1로 둔다.
| 기억 | 정규화한 (R, I, Q) | 가중치 (1, 1, 1)의 점수 | 최근성을 강조한 (0.8, 0.1, 0.1)의 점수 |
|---|---|---|---|
| A | (1, 0, 0) | 1.0000 | 0.8000 |
| B | (0, 1, 1) | 2.0000 | 0.2000 |
| C | (0.5, 3/7, 0.75) | 1.6786 | 0.5179 |
동일 가중치에서는 B가 먼저이고, 이 글에서 임의로 최근성 가중치를 높인 설정에서는 A가 먼저다. 기억의 내용도 모델의 가중치도 그대로인데 검색 규칙이 모델에 보여줄 정보를 바꾼다. 점수는 확률이 아니므로 합이 1을 넘는 것은 문제가 없다.
물론 B를 선택했다고 작업의 정답이 보장되지는 않는다. “중요해 보인다”, “질문과 비슷하다”, “사실이다”는 각각 다른 판단이다. 이 예는 검색 순위의 계산을 보여주며, 어떤 가중치가 실제 과제에서 좋은지는 별도 평가가 필요하다.
#보충 C — Reflexion: 실패에서 얻은 설명을 다음 시도에 남긴다
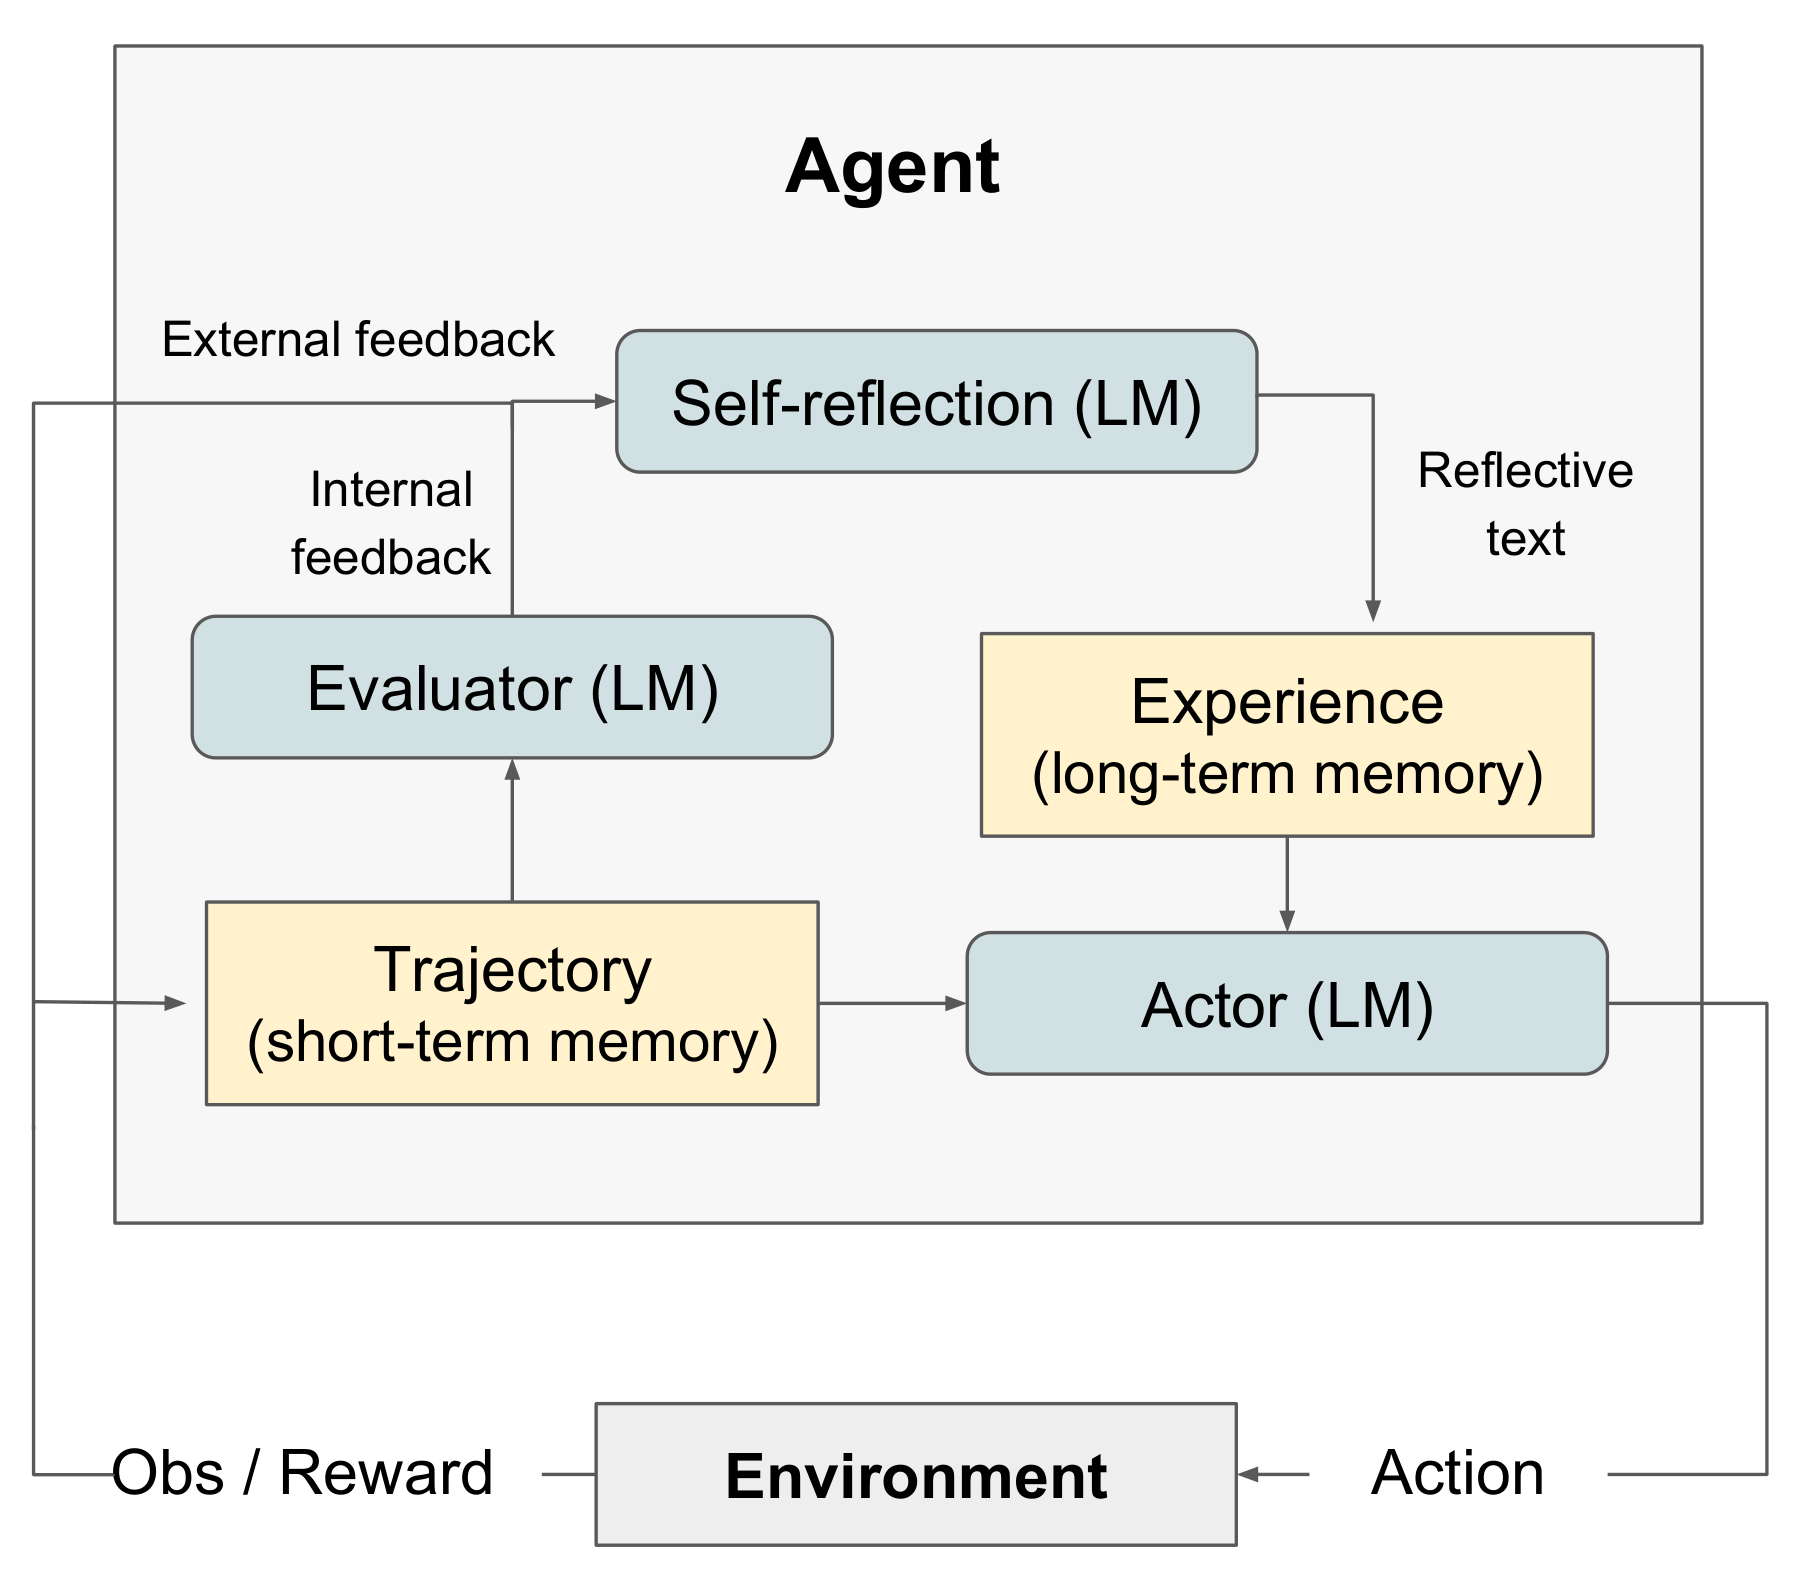
Reflexion은 행동자(Actor)가 시도한 과정, 평가자(Evaluator)의 피드백, 자기성찰(Self-reflection)이 만든 설명을 연결한다. 현재 시도의 궤적은 단기 기록이고, 실패에서 얻은 설명은 다음 시도가 참고할 경험 메모리에 저장된다. 피드백은 외부 결과, 규칙, 모델의 평가 등 여러 형태일 수 있다. Reflexion §3, Figure 2(a)
이 구조를 다음처럼 단순화할 수 있다. j는 시도 번호, τ는 그 시도의 행동·관측 기록, r은 피드백, m은 시도 사이에 남기는 메모리다. 앞에서와 같이 θ는 언어모델의 가중치만을 뜻한다.
여기서 ∥는 텍스트 기록의 연결이고, Keep은 다음 시도에 남길 기록을 정하는 규칙이다. 이 식은 역할을 설명하기 위한 표기이며 원 논문의 전체 알고리즘은 아니다. 중요한 점은 반성문을 추가하는 동안 가중치를 경사하강법으로 갱신하지 않는다는 것이다. 논문이 말하는 언어적 강화(Verbal reinforcement)는 이 피드백 경로를 가리킨다. Reflexion 서론·§3
가령 테스트 실패 뒤에 “경계 조건을 확인하지 않았다. 다음에는 빈 입력부터 실행한다”라는 메모리를 남길 수 있다. 다음 시도가 이 문장을 읽고 행동을 바꾸면 경험이 재사용된 것이다. 하지만 반성문이 원인을 잘못 짚었다면 같은 오류를 다른 말로 반복할 수 있다.
따라서 반성문의 유창함을 개선의 증거로 삼을 수는 없다. 수정한 행동이 검증을 통과했는지, 같은 실패가 줄었는지 확인해야 한다. 모델이 직접 만든 테스트도 오류를 포함할 수 있으므로, 그 테스트의 통과와 독립적인 최종 평가를 구분한다.
또한 메모리를 추가하는 규칙 H가 그대로라면, 바뀐 것은 m이다. 에이전트가 메모리 형식이나 보존 규칙을 수정하고 실제 다음 실행에 적용했다면 그때 H의 변화도 논의할 수 있다. 두 변화 모두 유용할 수 있지만 같은 종류의 개선은 아니다.
#보충 D — SWE-agent: 도구의 인터페이스도 성능에 관여한다
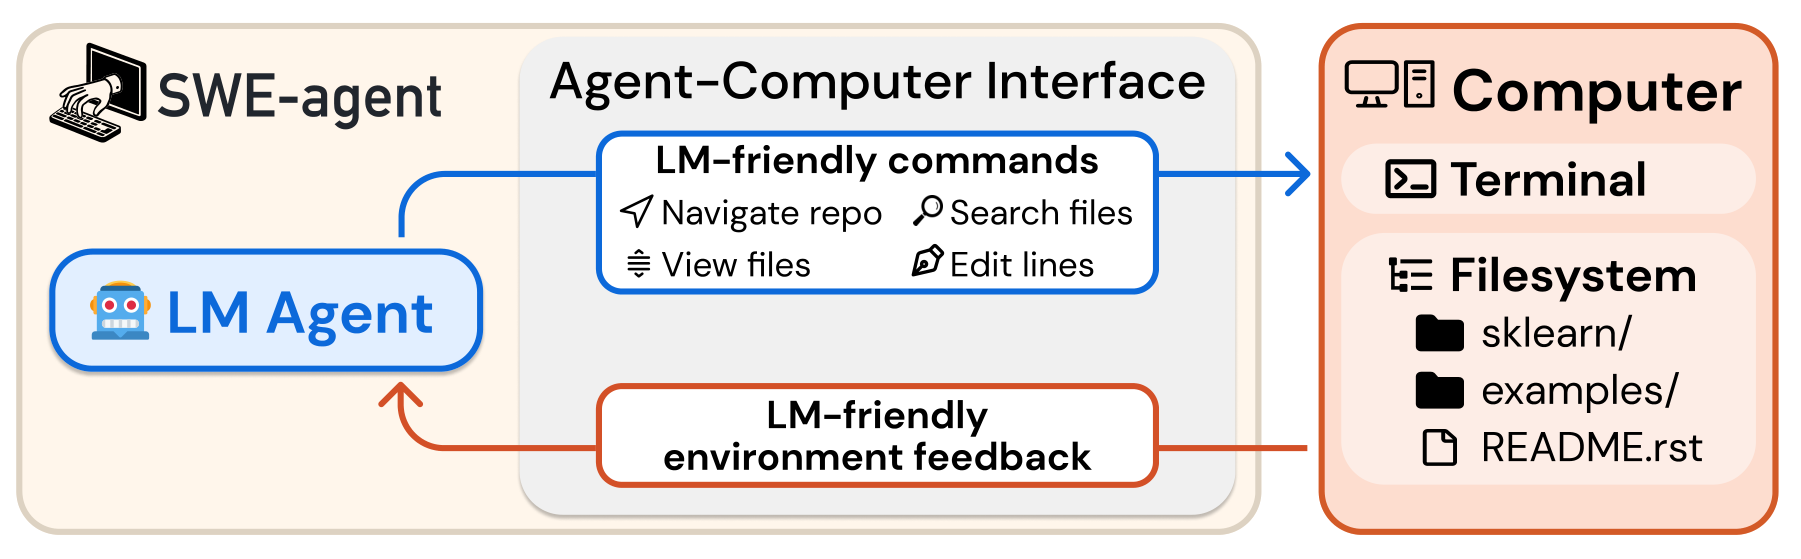
SWE-agent는 모델과 컴퓨터 사이의 에이전트–컴퓨터 인터페이스(Agent–Computer Interface, ACI)에 집중한다. 저장소를 탐색하고 파일을 읽고 수정하는 명령뿐 아니라, 명령의 결과를 어떤 형식으로 보여줄지도 설계 대상이다. 논문은 고정된 언어모델을 두고 이 인터페이스를 개선하는 설정을 명시한다. SWE-agent §2
같은 파일을 읽더라도 전체 내용을 매번 출력하는 방식과, 현재 위치·줄 번호·필요한 구간을 보여주는 방식은 다른 문맥을 만든다. 편집 결과가 문법 검사를 통과했는지 즉시 알려주면, 에이전트가 오류를 알아차리고 다음 행동을 정할 기회도 달라진다. 논문은 이런 탐색·편집·피드백 설계를 ACI의 구성 요소로 다룬다. SWE-agent §2–3
이 관점에서 “도구를 쓸 수 있다”는 설명은 출발점이다. 어떤 단위의 행동을 제공하는지, 실패를 얼마나 구체적으로 돌려주는지, 오래된 출력이 다음 문맥에 얼마나 남는지가 실행을 좌우한다. 하네스의 수정이 모델의 잠재 능력을 실제 작업으로 연결하는 방식이다.
그러나 반복 호출을 늘려 얻은 성과와 인터페이스 자체의 효과는 나누어 보아야 한다. 다음 계산은 왜 성공률과 예산을 함께 기록해야 하는지 보여준다.
#계산 예 2 — 재시도는 성공 가능성과 비용을 함께 바꾼다
일시적 오류가 있는 한 도구 요청을 생각하자. 매번 성공 확률 p가 같고, 시도들은 서로 독립이며, 성공을 정확히 감지해 즉시 멈춘다고 가정한다. 최대 K번 호출할 때 한 번 이상 성공할 확률은 다음과 같다.
실패가 K번 연속 발생할 확률을 1에서 뺀 것이다. K는 처음 호출을 포함한 최대 시도 수다. 이 예는 도구 요청 하나의 성공을 다루며, 에이전트 전체 과제의 성공률이나 실제 모델의 pass@k 측정값이 아니다.
실제로 사용한 호출 수를 N이라 하면, j+1번째 호출에 도달하려면 앞의 j번이 모두 실패해야 한다. 따라서 평균 호출 수는 다음과 같다.
성공 확률을 설명용으로 p=0.6이라고 정하면 결과는 다음과 같다. 모든 호출의 비용이 같다는 가정도 둔다.
| 최대 호출 K | 한 번 이상 성공할 확률 | 평균 호출 수 E[N] | 남는 실패 확률 |
|---|---|---|---|
| 1 | 60.0% | 1.00회 | 40.0% |
| 2 | 84.0% | 1.40회 | 16.0% |
| 3 | 93.6% | 1.56회 | 6.4% |
세 번의 상한을 두었다고 매 요청마다 세 번을 모두 호출하지는 않는다. 먼저 성공하면 멈추기 때문에 평균은 1.56회다. 다만 단일 호출의 성공 확률 p는 0.6으로 그대로다. 여기서 늘어난 성공 확률은 추가 시도 기회를 허용한 결과다.
p=0이면 어떤 유한한 K에서도 성공 확률은 0이고 호출 수는 K다. 잘못된 주소나 변하지 않는 권한 오류처럼 원인이 지속되면, 반복 호출이 독립적이라는 가정도 맞지 않는다. 관측에 따라 요청을 고치는 실제 에이전트는 시도별 성공 확률이 달라질 수 있으므로 위 식을 그대로 성능 예측에 사용하지 않는다.
#개선을 비교하려면 무엇을 같게 두어야 할까
새 하네스 H₁과 기존 하네스 H₀를 비교할 때에는 같은 모델과 과제를 사용하고, 허용한 자원과 정보도 맞추어야 한다. 평가 점수를 반복해서 보며 H₁을 고르면 그 평가 집합은 설계 과정에 사용된 것이다. 앞 편의 자동 연구와 마찬가지로, 최종 비교에는 별도로 남겨 둔 과제가 필요하다.
| 비교에서 고정하거나 기록할 것 | 구체적인 의미 |
|---|---|
| 모델과 생성 설정 | 동일한 가중치·버전과 샘플링 설정 사용 |
| 과제와 초기 상태 | 같은 문제, 저장소 상태, 초기 메모리, 도구 접근 범위 사용 |
| 반복 실행 조건 | 미리 정한 같은 seed 집합 사용, 외부 도구의 변동도 기록 |
| 예산 B | 모델·도구 호출, 토큰, 실행 시간 등의 상한을 사전에 정함 |
| 성공 판정 | 같은 독립 검사 사용, 시간 초과와 실행 실패도 전체 분모에 포함 |
같은 seed를 지정해도 원격 서비스나 도구의 동작까지 완전히 재현된다는 뜻은 아니다. 실행을 여러 번 반복하고 변동을 함께 보여주어야 한다. 메모리를 시험하는 비교라면 초기 메모리를 맞춘 뒤 각 조건의 갱신 규칙을 적용해야 이전 평가의 답이 한쪽에만 남는 상황을 피할 수 있다.
대응되는 과제와 실행 조건을 i로 묶으면, 예산 B 안에서 두 하네스의 성공 여부 차이를 다음처럼 요약할 수 있다. 아래는 비교 설계의 표기이며 논문에서 가져온 측정값은 없다.
Δ는 전체 n개 실행에서의 평균 성공 비율 차이다. 상한 B를 같게 주어도 실제 사용량은 다를 수 있으므로 전체 실행의 비용·시간도 함께 기록한다. 여러 B에서 비교하면 적은 자원에서 유리한지, 많은 시도를 허용해야 유리한지 볼 수 있다.
성공한 사례의 비용만 평균 내면 실패에 사용한 자원이 빠진다. 또한 같은 예산에서 나아졌다는 결과가 모든 과제와 모델에 대한 우위를 뜻하지는 않는다. 어떤 환경에서 어떤 구성 요소가 효과를 냈는지까지 확인해야 재사용할 수 있는 개선이 된다.
이 글의 ReAct, Generative Agents, SWE-agent는 사람이 설계한 하네스의 구성 요소를 이해하기 위한 사례다. Reflexion에서 직접 살펴본 변화는 다음 시도에 쓰는 텍스트 메모리의 갱신이다. 이 구조들만으로 AI가 스스로 하네스를 설계·교체하며 계속 강해졌다고 결론 내릴 수는 없다.
AI가 하네스를 개선했다는 주장을 확인하려면, AI가 어떤 수정 후보를 제안했는지부터 살펴야 한다. 이어서 후보를 어떤 과제로 검증하고, 어떤 기준으로 채택하며, 채택한 규칙이 다음 실행에 실제로 적용되었는지 추적해야 한다. 후보 제안 → 검증 → 채택 → 새 실행의 연결과 독립적인 성능 비교가 갖추어져야 개선의 주체와 효과를 설명할 수 있다.
#62쪽 — 자기개선의 대상이 시스템 전체로 넓어진다
강사는 1:03:28 구간에서 하네스를 어떻게 조정할지는 다음 강의에서 다루겠다고 말하고, 1:03:40에 이야기를 마친다. 이 두 슬라이드 자체가 하네스 자동 개선 알고리즘이나 실험 결과를 제시한 것은 아니다.
이번 글의 보충 자료는 그 다음 질문을 구체적으로 만든다. ReAct는 관측을 행동에 연결하고, Generative Agents는 경험을 검색 가능한 기억으로 다루며, Reflexion은 피드백을 다음 시도에 남긴다. SWE-agent는 행동과 관측의 인터페이스를 설계한다. 이들은 모두 모델 밖에서 바꿀 수 있는 구성 요소를 보여준다.
어떤 시스템이 스스로 더 나아졌다고 할 때에는 이제 세 가지를 물을 수 있다. 모델의 가중치가 바뀌었는가, 실행 상태와 메모리가 바뀌었는가, 하네스의 규칙이 바뀌었는가? 그리고 그 변화가 실제 다음 실행에 적용되었으며, 같은 조건의 새로운 과제에서도 도움이 되었는가?
이 구분은 무엇을 바꿔서 어떤 능력이 나아졌는지 설명할 수 있게 한다. 에이전트가 더 나은 행동을 하도록 만드는 학습 신호뿐 아니라, 그 신호를 기억하고 검증하고 다시 사용하는 구조까지가 다음 탐구의 대상이다.
상편에서 세운 구분은 하편의 첫 글인 14편으로 이어진다. 먼저 출제자·풀이자·검증자가 만드는 자기학습 루프를 살펴보고, 학습 손실이 줄어드는 것과 새로운 과제에서 능력이 나아지는 것을 나누어 본다.
계산 예제와 코드
두 교육용 예제의 메모리 점수 정규화와 순위, 가중치 변경, 값이 같은 열의 처리, 제한된 독립 재시도의 성공 확률과 평균 호출 수를 확인한다. 실제 에이전트를 실행하거나 논문의 벤치마크를 재현하는 코드는 아니다.
#함께 읽을 자료
| 자료 | 연결되는 내용 |
|---|---|
| NTU Self-Improving 강의 · 61–62쪽 | 모델 파라미터 밖으로 확장되는 에이전트 개선 |
| ReAct: Synergizing Reasoning and Acting in Language Models | 추론·행동·관측을 연결하는 프롬프트와 실행 구조 |
| Generative Agents: Interactive Simulacra of Human Behavior | 메모리 스트림, 검색, 성찰과 계획 |
| Reflexion: Language Agents with Verbal Reinforcement Learning | 가중치 갱신 없이 경험을 다음 시도에 반영하는 구조 |
| SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering | 모델이 사용하는 명령과 환경 피드백의 설계 |