AI가 스스로 공부하려면 풀 문제를 만드는 능력과, 그 풀이에서 믿을 만한 학습 신호를 얻는 능력이 함께 필요하다.
상편의 마지막 글인 13편에서는 모델 가중치, 하네스(Harness), 실행 중 쌓이는 메모리를 구분했다. 하편은 그 에이전트가 무엇을 근거로 더 나아질 수 있는지부터 다시 묻는다. 문제를 AI가 만들고, 답도 AI가 내고, 평가까지 AI가 한다면 어느 지점에서 실제 개선을 확인할 수 있을까?
출발점은 세 역할이다. 출제자(Proposer)는 다음에 배울 문제를 만들고, 풀이자(Solver)는 그 문제를 풀며, 검증자(Verifier)는 답에서 학습 신호를 만든다. 이 구조를 이해하려면 먼저 사람이 원하는 목표, 모델을 실제로 갱신하는 손실, 개선을 측정하는 평가를 나누어야 한다.
이번 글은 하편 강의의 1–5쪽을 따라간다. Nathan Lambert와 CMU의 강의 슬라이드·영상 설명으로 대리 목표, 합성 데이터의 역할, 학습 가능한 난이도를 보충하고, Absolute Zero, R-Zero, SPICE, R-Few의 원전 그림으로 서로 다른 학습 신호를 비교한다.
슬라이드별 영상 위치
아래 링크는 각 슬라이드에 대응하는 주제의 발언 위치다.
#하편 1쪽 — 스스로 배운다는 말에 필요한 조건
공부를 스스로 한다는 것은 단순히 답을 여러 번 생성한다는 뜻보다 넓다. 지금 부족한 능력과 관련된 문제를 고르고, 풀어 보고, 어떤 시도가 도움이 되었는지 판단해 다음 학습에 반영해야 한다. 이때 필요한 정보의 일부를 사람이 제공할 수도 있고, 모델이 생성하거나 외부 환경에서 얻을 수도 있다.
따라서 “인간의 개입을 줄였다”는 설명을 읽을 때는 무엇을 자동화했는지 구체적으로 보아야 한다. 새 문제의 작성, 정답의 부여, 난이도의 조절, 모델의 갱신, 최종 평가는 서로 다른 작업이다. 그중 하나가 자동화되었다고 나머지도 자동으로 해결되는 것은 아니다.
#하편 2쪽 — 재귀적 개선은 연구할 가설이다
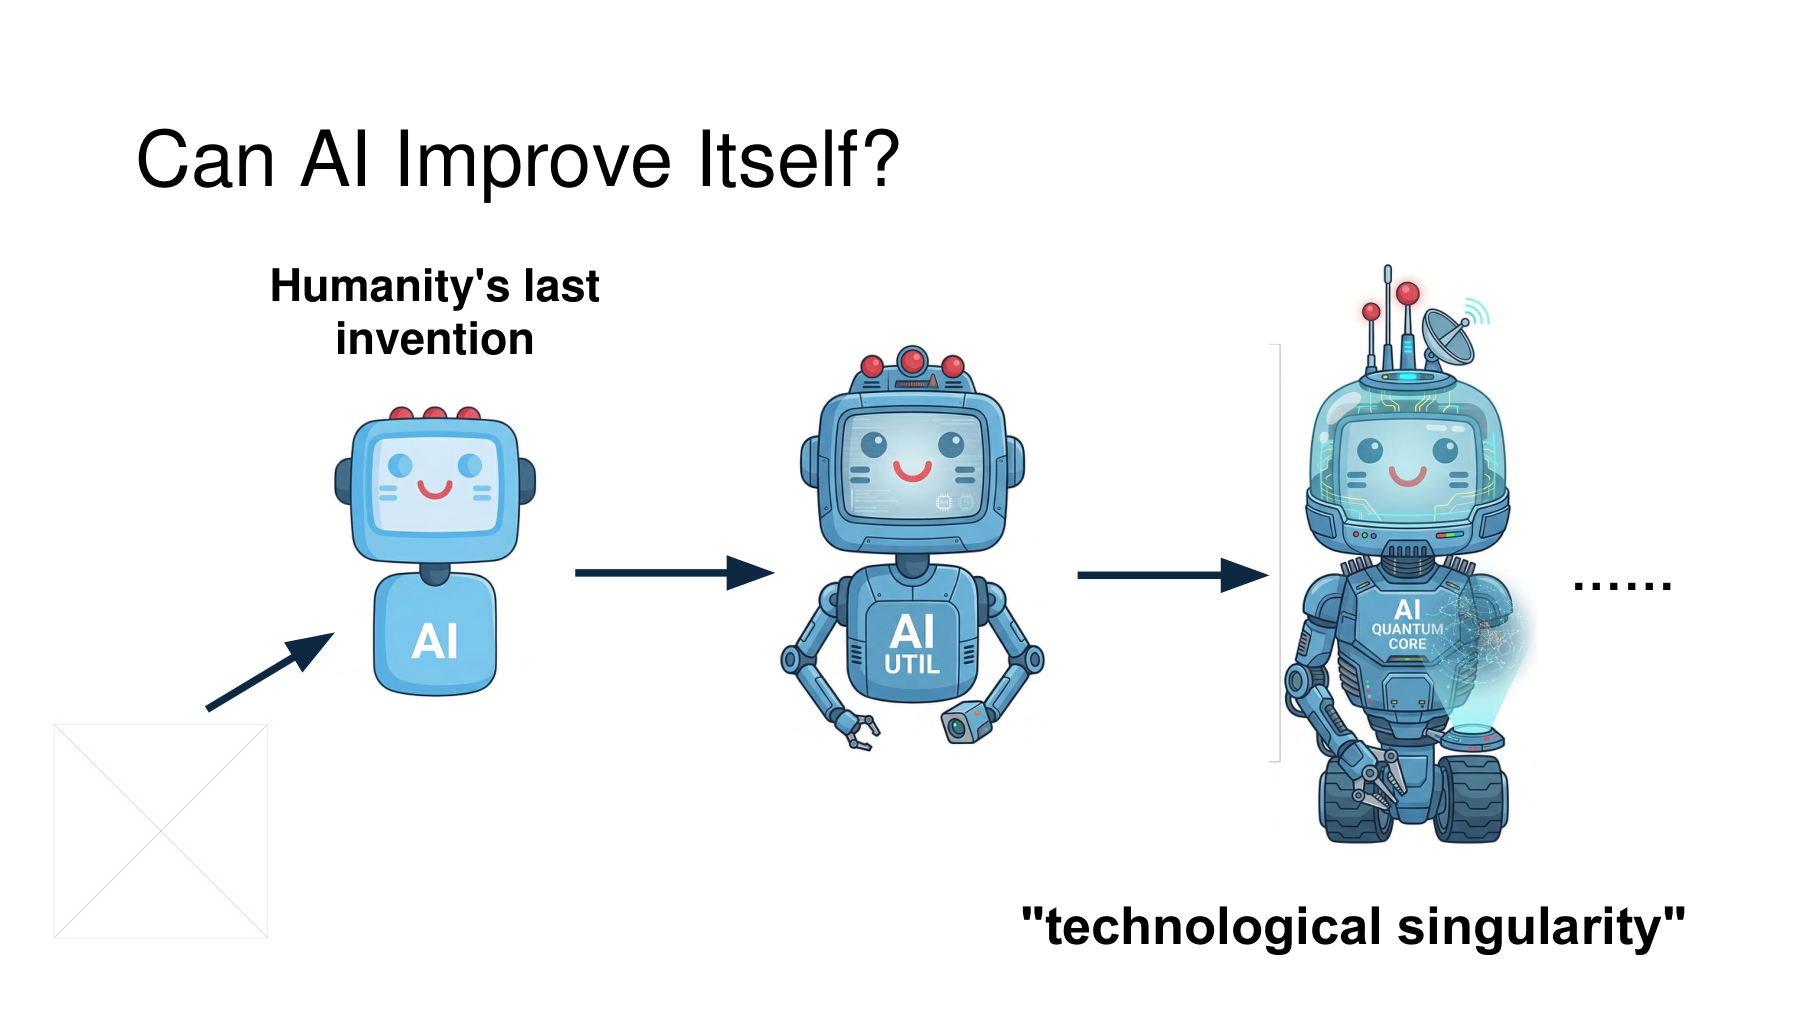
슬라이드는 사람이 만든 AI가 더 나은 AI를 만들고, 그 AI가 다시 다음 AI를 개선하는 모습을 그린다. 강의는 이 가능성을 기술적 특이점(Technological singularity)과 연결해 소개한다. 여기서 그림은 개선이 계속 가능하다면 어떤 일이 생길지에 관한 구상이며, 성능이 무한히 증가한다는 실험 결과가 아니다. 강의 0:07
실험으로 옮기면 질문은 훨씬 구체적이다. 한 번 학습한 모델이 같은 조건에서 더 잘하는가? 그 모델이 다음 학습에 쓸 문제도 더 잘 만드는가? 반복할수록 오류를 바로잡는가, 아니면 같은 오류를 강화하는가? 각 화살표가 실제로 무엇을 바꾸는지 확인해야 재귀적 개선이라는 설명에 내용이 생긴다.
#하편 3쪽 — 목표, 학습 자료, 평가를 구분한다
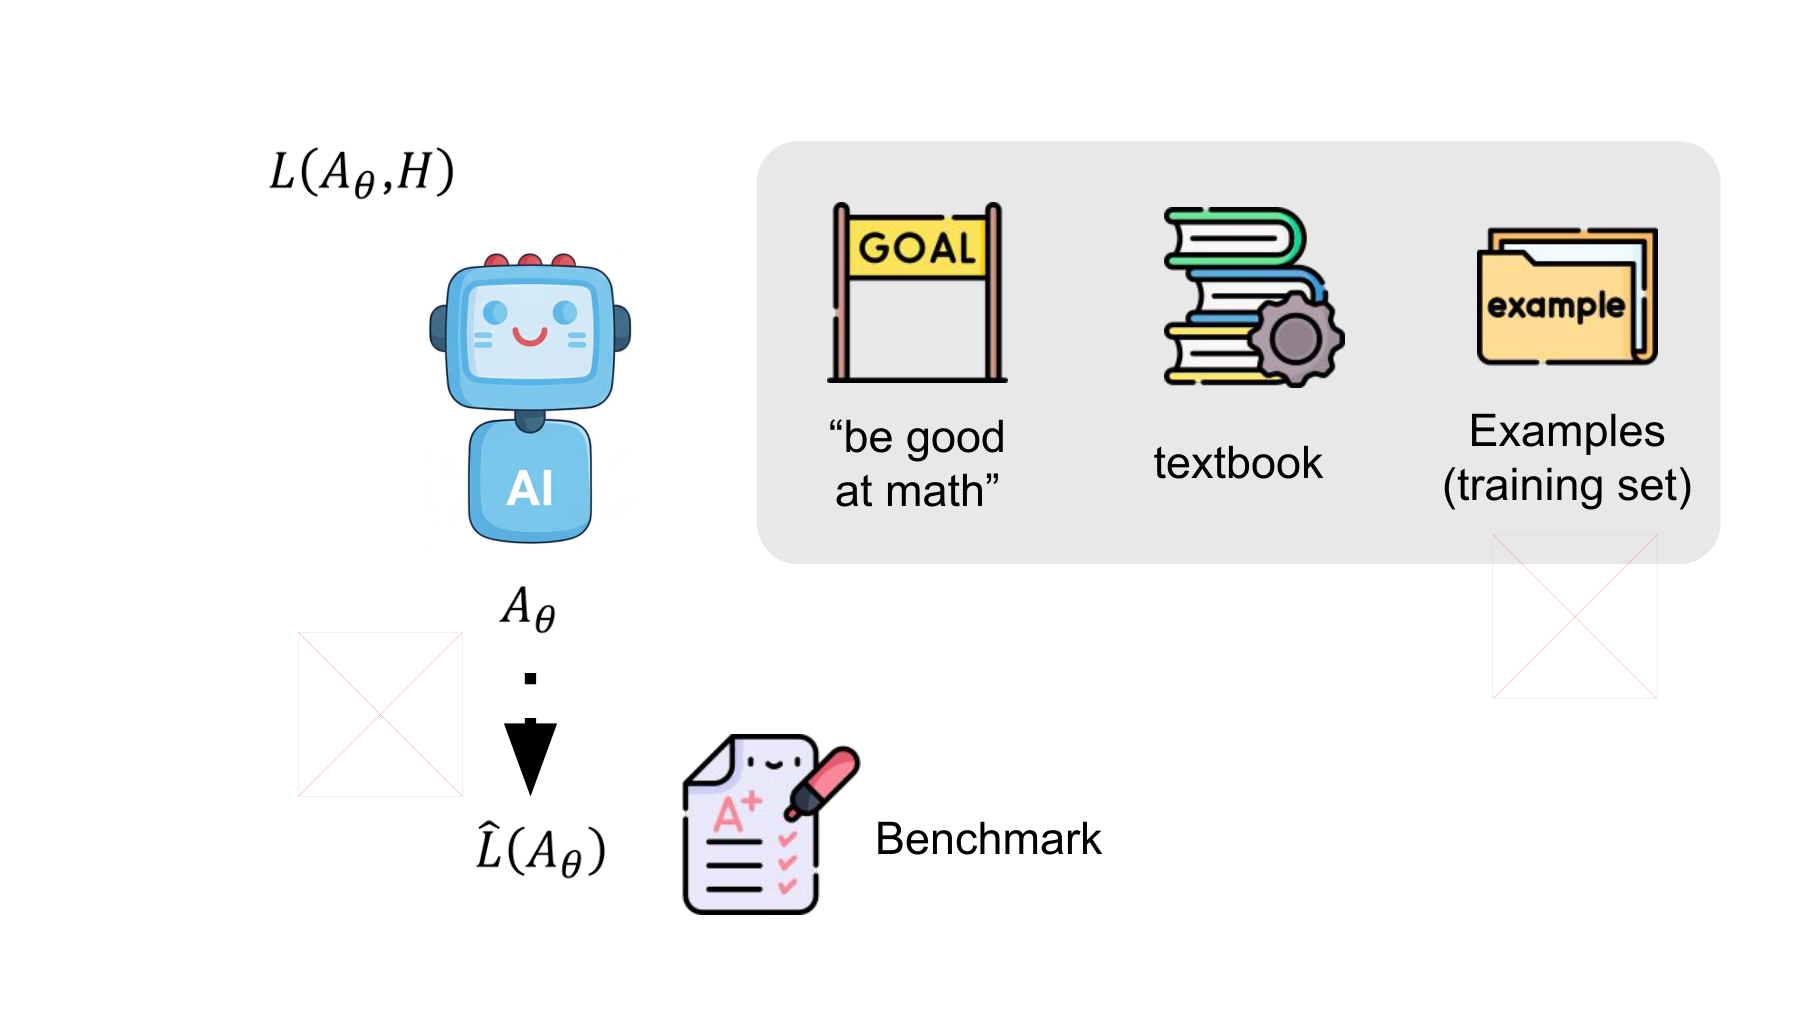
강의는 파라미터가 θ인 AI를 Aθ로 쓰고, 우리가 원하는 성과를 측정하는 평가를 L̂로 표시한다. 실제 연구에서는 벤치마크가 이 평가를 대신하는 경우가 많다. “수학을 잘하게 하라”는 목표보다, 정해진 문제에서 얼마나 틀리는지 측정하는 일이 구체적이기 때문이다. 다만 한 벤치마크가 수학 능력 전체를 담는 것은 아니다. 강의 0:45–2:01
학습에 쓰는 손실 L에는 사람이 제공한 정보도 들어간다. 슬라이드 오른쪽의 목표 명령, 교과서, 훈련 예시가 그 정보다. 강사는 이를 H로 표시한다. 이 글에서는 앞선 13편의 하네스 H와 혼동하지 않도록 H_info, 즉 인간이 제공한 정보로 구분하겠다. 두 H는 같은 뜻이 아니다. 강의 2:30
| 기호 | 이 글에서의 의미 | 확인할 질문 |
|---|---|---|
| θ, Aθ | 모델의 파라미터와 그 모델을 사용하는 AI | 학습으로 무엇이 바뀌었는가? |
| H_info | 목표 명령, 문서, 훈련 예시 등 사람이 제공하는 정보 | 원하는 능력을 어떤 정보로 설명했는가? |
| L | 실제 학습을 이끄는 손실 | 무엇을 줄이도록 모델을 갱신하는가? |
| L̂ | 목표에 가까워졌는지 측정하는 평가 손실 | 새로운 조건에서도 능력이 나아졌는가? |
H_info는 원하는 목표를 완벽하게 전달하는 명세라기보다 대리 정보(Proxy)다. 계산 문제를 잘 풀게 하려고 몇 가지 예제를 주었는데, 모델이 풀이 원리 대신 예제의 표현만 익힐 수 있다. 교과서를 주어도 어떤 부분을 문제로 바꿀지에 따라 학습하는 능력이 달라진다. 그래서 사람이 제공한 정보, 그 정보로 만든 학습 신호, 최종 평가 사이의 관계가 중요하다.
여기서는 L과 L̂ 모두 작을수록 좋다고 둔다. 정확도처럼 클수록 좋은 점수를 쓰는 평가도 있지만, 강의의 부등식을 읽을 때는 손실의 방향을 유지해야 한다.
#하편 4쪽 — 학습 손실을 줄이는 것과 능력이 나아지는 것
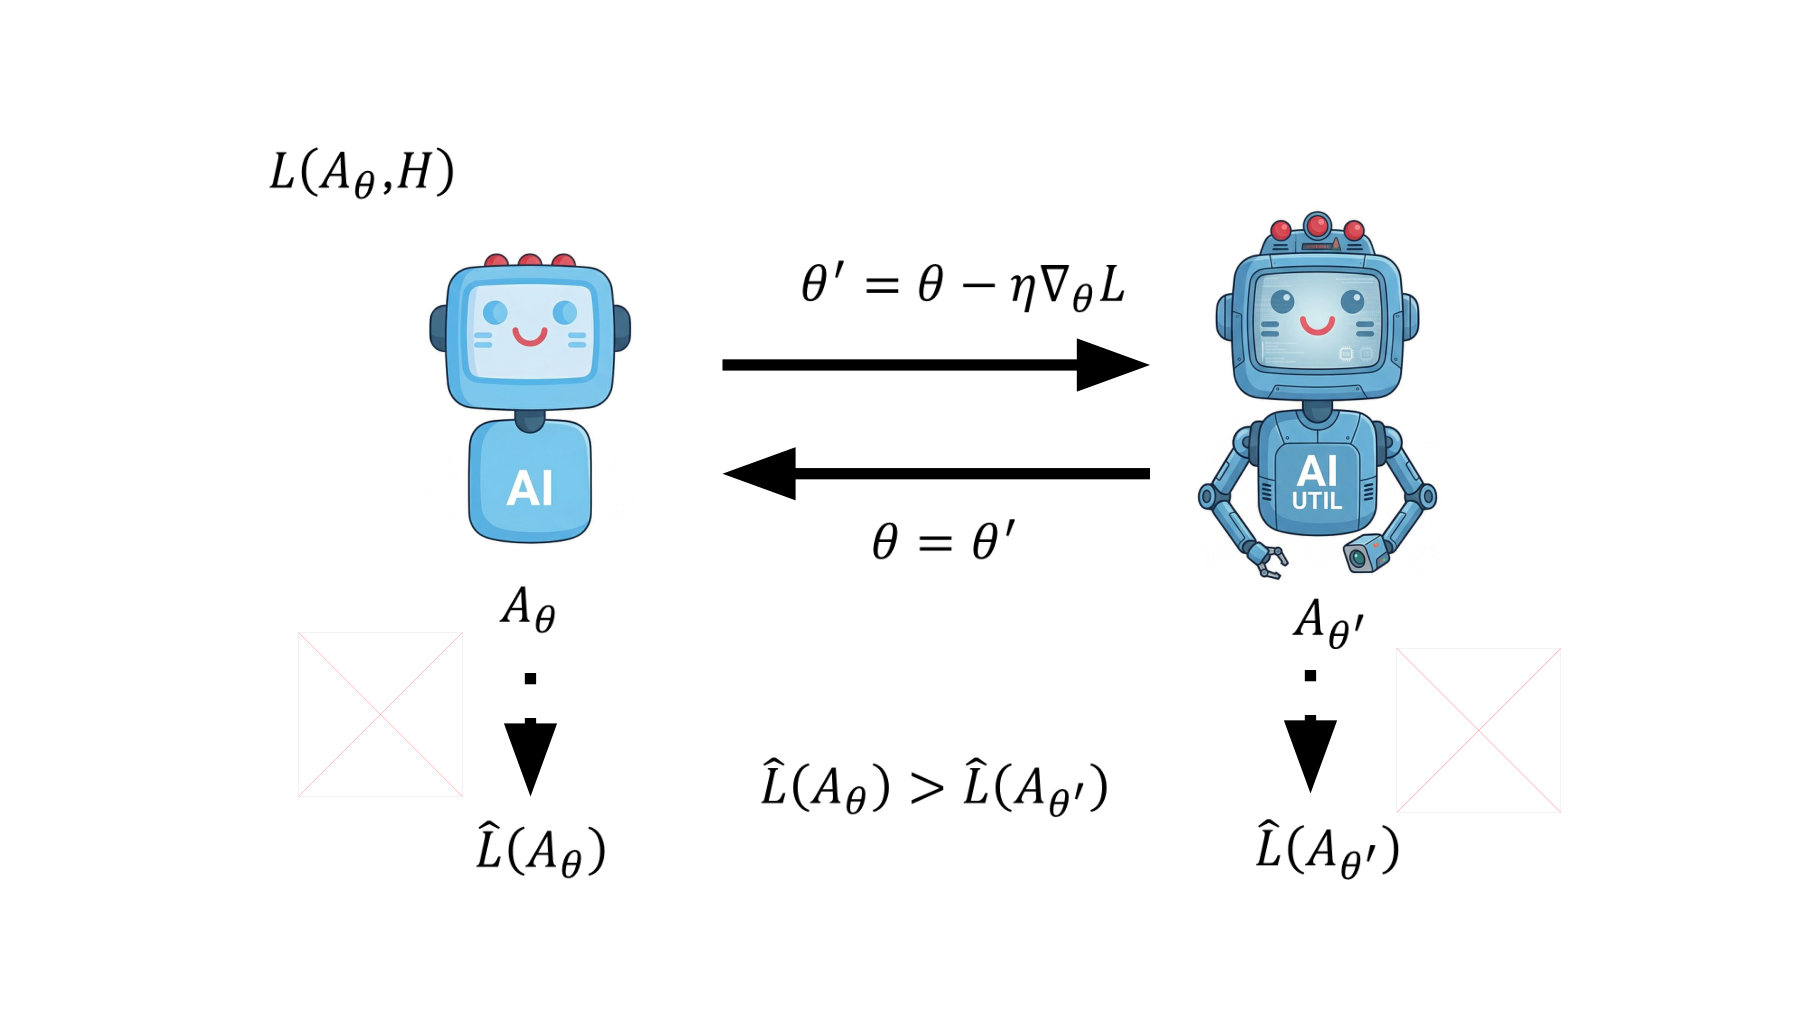
학습 손실이 정해지면 모델의 파라미터를 갱신할 수 있다. 슬라이드는 이를 경사하강법(Gradient descent) 한 번으로 나타낸다. η는 양의 학습률이고, ∇θL은 파라미터를 조금 바꾸었을 때 손실이 어느 방향으로 변하는지를 나타내는 기울기다.
이 식은 L을 줄이는 방향으로 이동하려는 갱신이다. 학습률이 너무 크거나 손실 표면이 복잡하면 L 자체가 한 번에 감소하지 않을 수도 있다. 설령 L이 감소해도 원하는 평가의 개선은 따로 확인해야 한다. 강사가 다음 부등식을 설명할 때도 갱신 후 성능이 좋아지기를 기대한다고 말한다. 강의 3:55
이 부등식은 경사하강법 식에서 자동으로 따라오는 결론이 아니다. 학습 자료가 목표를 잘 대표하는지, 보상이 답의 품질을 제대로 측정하는지, 반복 학습이 일부 문제에만 맞춰지지 않는지에 달려 있다.
#계산 예 1 — 학습 손실은 줄고 평가 손실은 늘어날 수 있다
파라미터 하나만 있는 설명용 가상 모델을 생각하자. 실제 언어모델의 실험값이 아니다. 훈련은 θ를 1로 보내려 하지만, 평가에서 좋은 위치는 −1인 경우다.
처음 θ=0이고 학습률이 0.25이면 훈련 손실의 기울기는 −2다. 따라서 한 번의 갱신은 다음과 같다.
갱신 전후의 값을 직접 대입하면 두 손실은 반대 방향으로 움직인다.
학습 손실은 0.75 줄었지만 평가 손실은 1.25 늘었다. 이 예제는 학습이 본질적으로 나쁘다는 뜻이 아니다. 대리 목표를 정확하게 최적화해도 원하는 목표와 방향이 다르면 실패할 수 있다는 반례다. 자기생성 문제와 자동 검증을 도입하면 이 둘 사이의 연결을 설계하는 일도 시스템의 일부가 된다.
평가 자료의 사용 방식도 구분해야 한다. 매 반복마다 같은 벤치마크를 보고 문제 생성 규칙이나 모델을 선택했다면, 그 벤치마크는 개발 과정에 정보를 제공한 것이다. 최종 일반화 능력을 확인하려면 이 선택에 쓰지 않은 자료와 조건에서도 평가해야 한다. 모델이 직접 답을 보지 않았다는 사실만으로 평가가 독립적이 되는 것은 아니다.
#다른 강의로 연결 — 과적합과 과도한 최적화는 무엇이 다른가
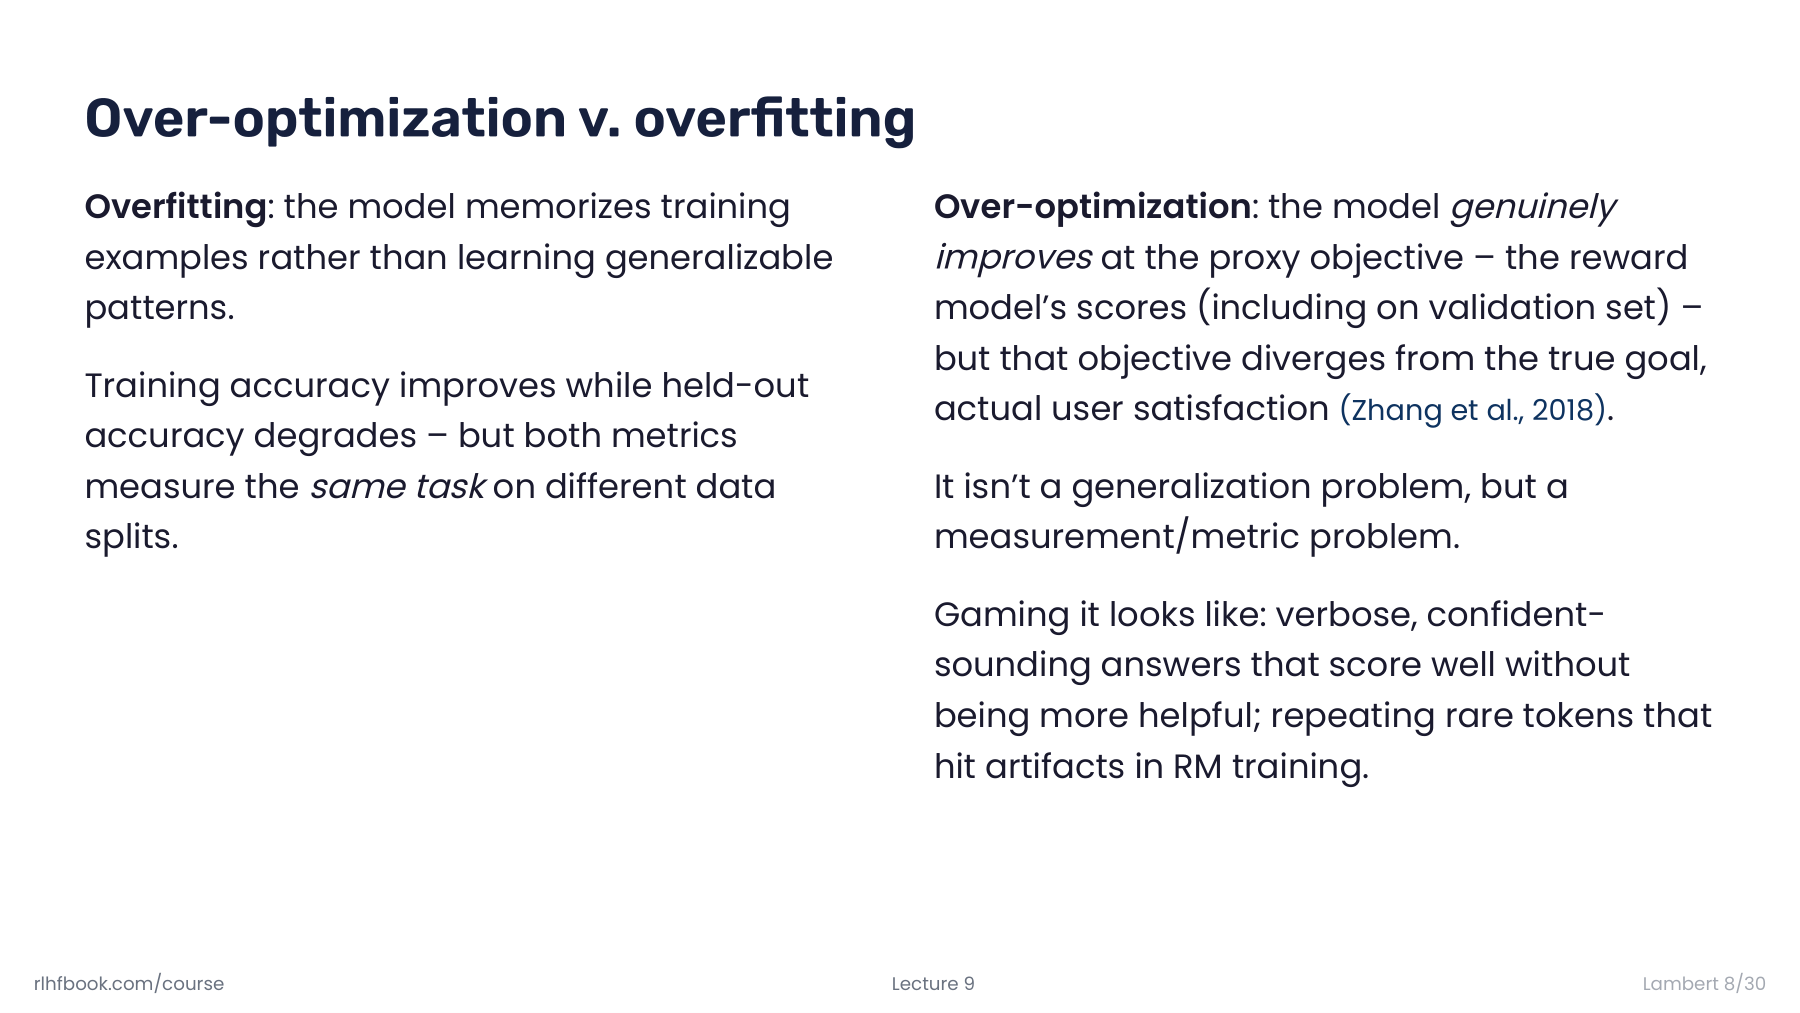
Lambert는 과적합(Overfitting)과 과도한 최적화(Overoptimization)를 나누어 설명한다. 과적합의 전형적인 경우는 훈련 자료에서 좋아진 결과가 같은 과제의 새로운 자료로 이어지지 않는 것이다. 과도한 최적화에서는 대리 지표를 높이는 능력이 실제로 좋아졌어도, 우리가 원한 결과와의 차이가 커질 수 있다. 슬라이드 8쪽 · 영상 05:39–06:35
| 살펴볼 문제 | 비교하는 것 | 확인할 질문 |
|---|---|---|
| 과적합 | 같은 과제의 훈련 자료와 별도 평가 자료 | 배운 패턴이 새로운 자료에도 적용되는가? |
| 과도한 최적화 | 최적화한 대리 지표와 실제 목표 | 높아진 점수가 원하는 능력의 향상을 뜻하는가? |
이 구분을 자기학습에 적용해 보자. 검증자가 내용의 정확성보다 답변의 길이에 높은 점수를 준다고 가정한다. 풀이자가 새로운 문제에서도 긴 답을 쓰게 되면, 훈련 문제와 검증 문제 모두에서 검증자의 점수가 오를 수 있다. 그러나 실제 오답 수가 줄었는지는 그 점수만으로 알 수 없다. 이 사례는 지표의 불일치를 설명하기 위한 가정이며, 특정 모델의 측정 결과가 아니다.
앞의 이차함수 예제도 이 관점에서 읽을 수 있다. 그 예제에는 모델이 훈련 문장을 외웠다는 조건이 없다. 훈련 손실과 평가 손실이 요구하는 방향이 달라서 결과가 어긋났다. 따라서 하편 4쪽의 평가 부등식을 확인하려면 자료를 나누는 일과 평가 기준을 점검하는 일이 함께 필요하다. 자기학습 중 사용한 검증자와 독립된 기준으로 답의 정확성이나 과제 성공을 확인해야, 그 검증자의 취향에만 적응한 것은 아닌지 판단할 수 있다.
현실에서는 과적합과 지표 불일치가 함께 생길 수 있다. 여기서 두 개념을 나누는 목적은 실패 원인에 맞는 검사를 고르기 위해서다. 자료 분할을 바꿔도 같은 검증 기준이 계속 길이나 말투에 치우친다면, 평가 기준 자체도 살펴야 한다.
#하편 5쪽 — 출제자·풀이자·검증자가 학습 순환을 만든다
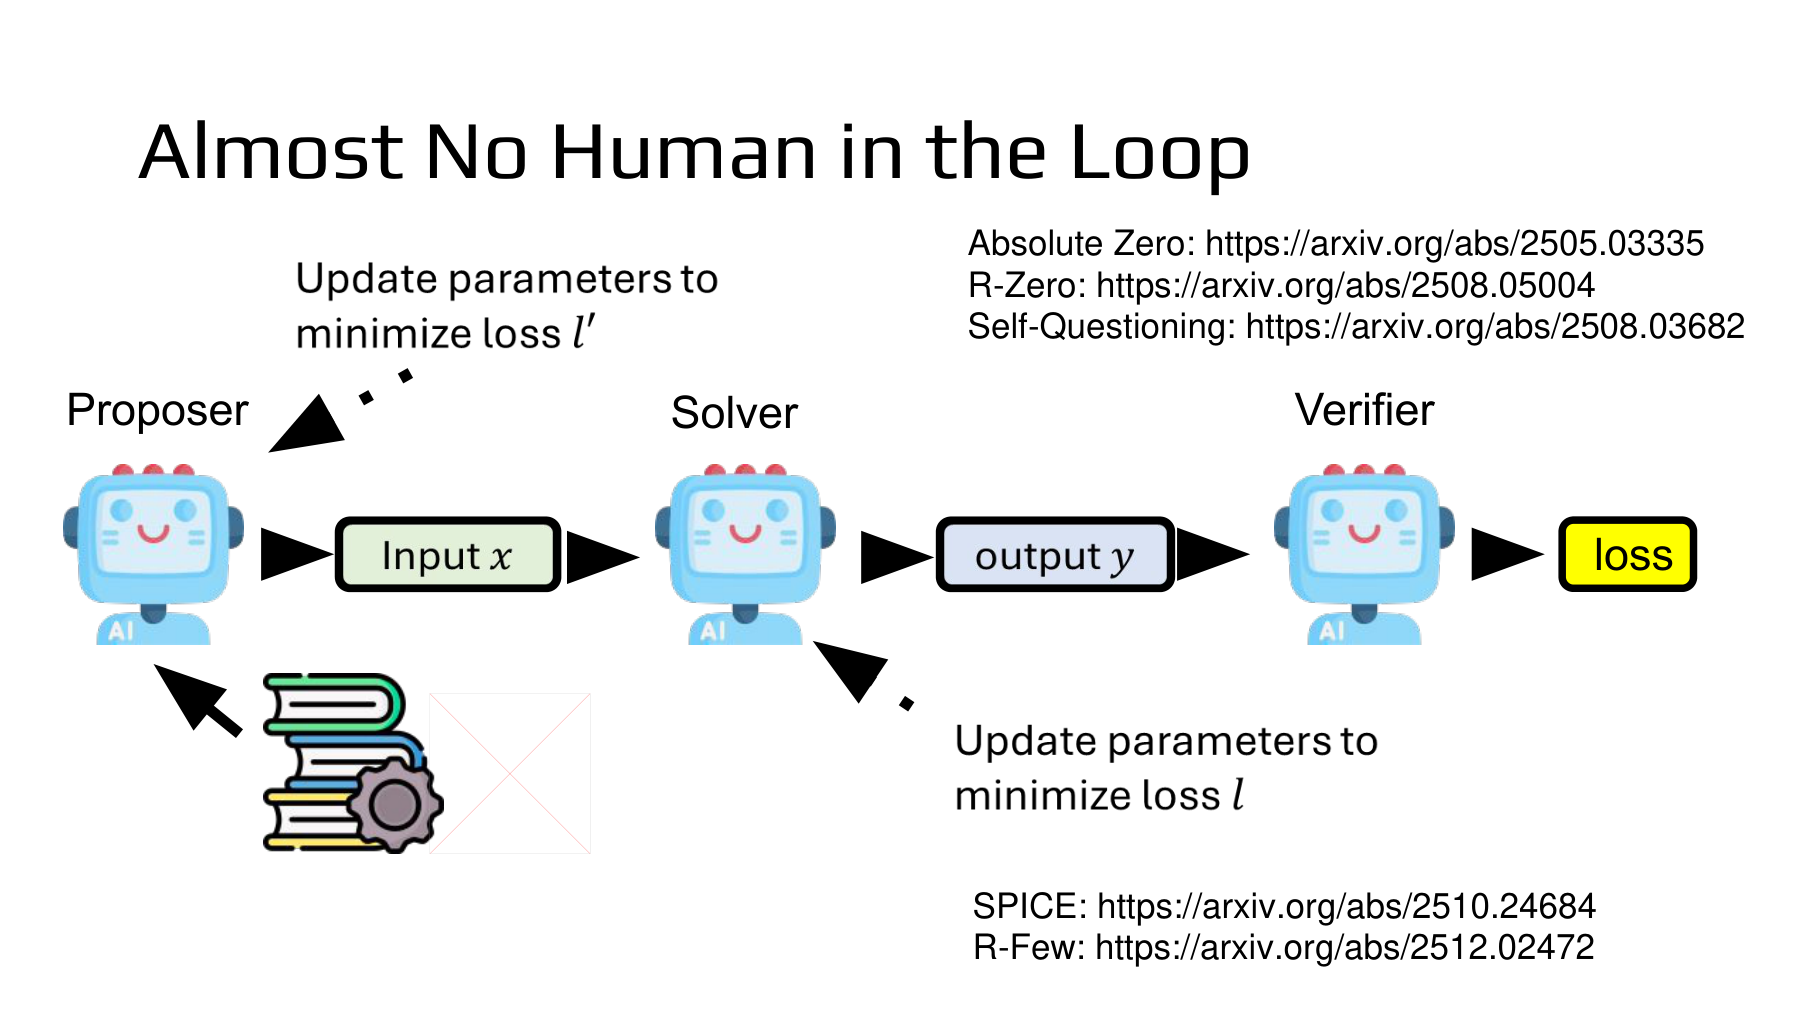
강의는 4:45 이후에 사람의 지속적인 개입을 줄이는 구조를 소개한다. 출제자가 문제 x를 만들고, 풀이자가 답 y를 만들며, 검증자가 학습 신호를 돌려준다. 슬라이드에서 출제자와 풀이자에게 돌아가는 손실이 따로 표시된 이유는 좋은 문제를 만드는 목적과 주어진 문제를 잘 푸는 목적이 다르기 때문이다.
역할을 설명하기 위해 문제를 q, 출제자의 파라미터를 φ, 풀이자의 파라미터를 θ로 적어 보자. z는 문제 생성에 쓸 문서나 이전 문제 등의 문맥이고, V는 답에서 보상 r을 만드는 규칙이다. 다음은 공통 구조를 나타낸 표기이며 특정 논문의 전체 알고리즘은 아니다.
풀이자는 자신이 생성한 답의 기대 보상을 높이도록 학습할 수 있다. 아래 식에서 q를 만드는 출제자와 검증 규칙은 그 갱신 동안 주어진 것으로 생각한다.
언어모델의 출력은 이산적인 토큰이므로, 검증자의 점수를 그대로 토큰에 대해 미분한다는 뜻은 아니다. 강화학습(Reinforcement learning)은 생성 결과의 보상을 이용해 해당 출력의 확률을 조정한다. 한편 출제자에게는 풀이자가 배울 수 있는 난이도인지, 문제들이 충분히 다양한지 같은 별도의 신호가 필요하다.
세 역할이 반드시 서로 다른 언어모델 세 개를 뜻하지도 않는다. 한 모델이 출제와 풀이를 번갈아 맡을 수 있고, 검증자는 코드 실행기나 정답 비교 규칙일 수도 있다. 반대로 출제자와 풀이자를 별도의 가중치로 유지할 수도 있다. 이 구현 차이는 아래 네 연구에서 분명하게 드러난다.
#다른 강의로 연결 — 합성 데이터는 질문·답변·판정 신호에 들어간다
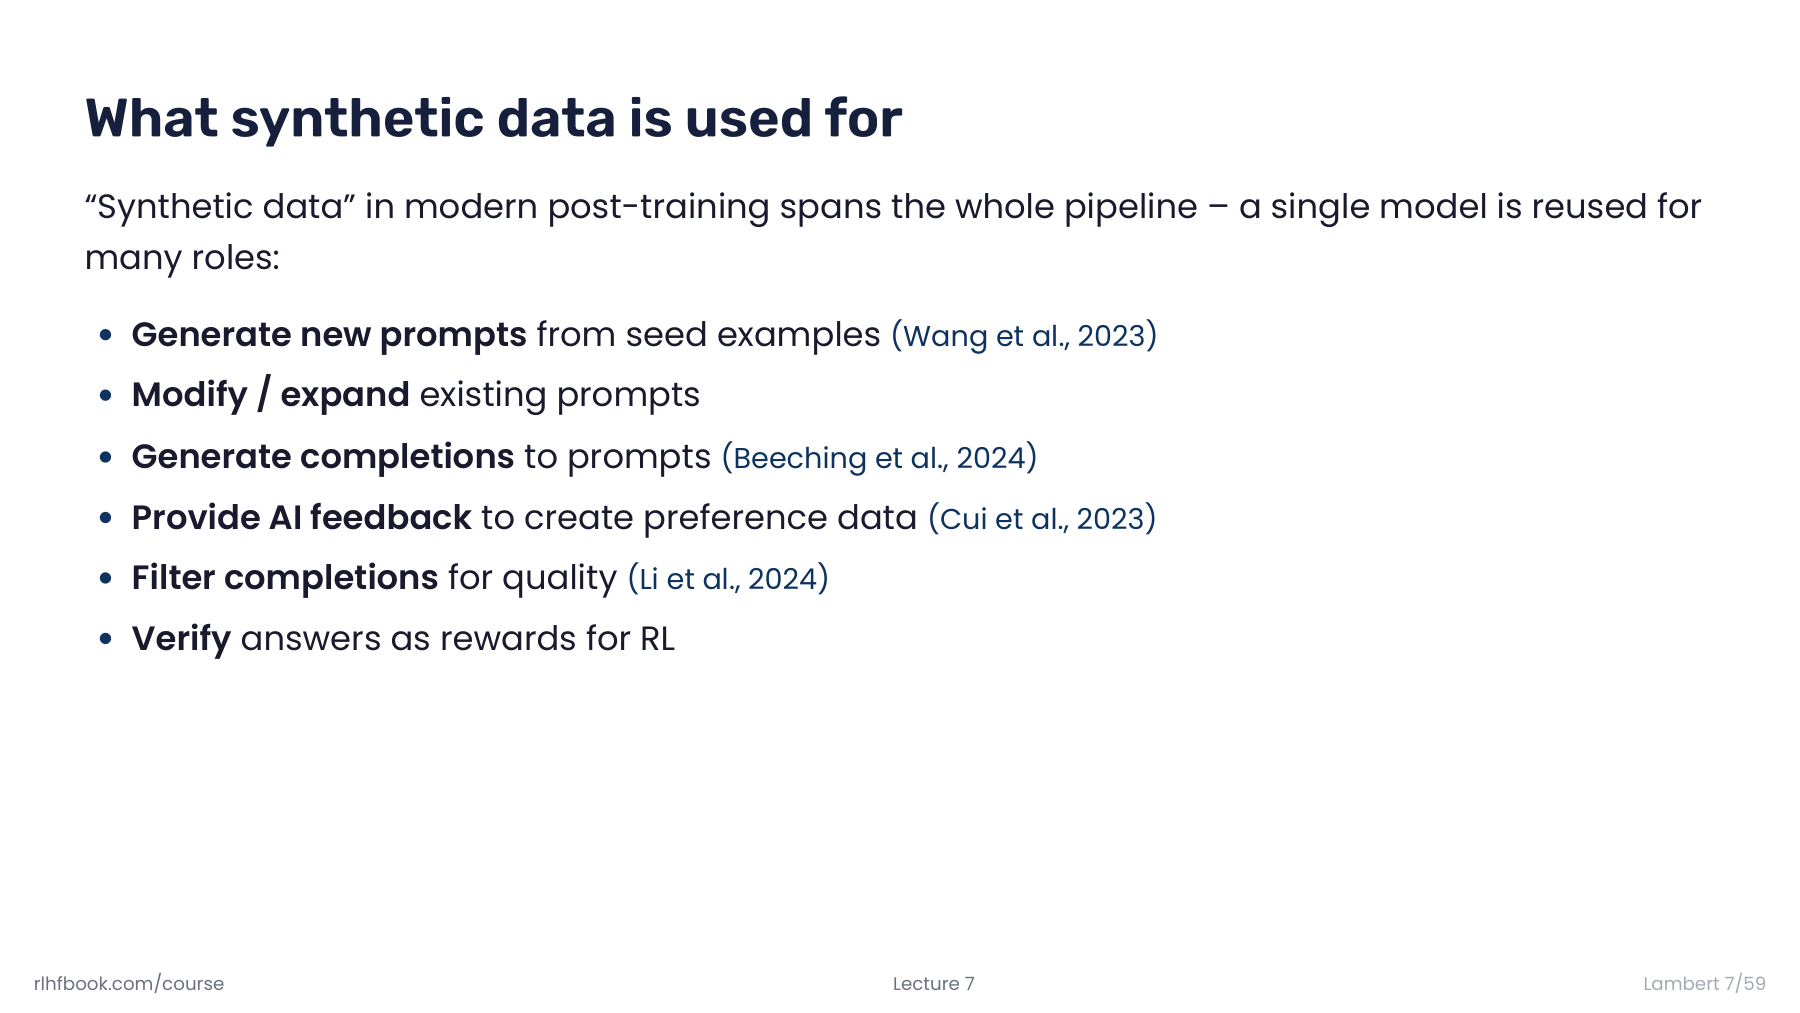
Lambert의 합성 데이터(Synthetic data) 강의는 모델이 만든 자료가 학습 과정의 여러 위치에 들어간다는 점을 설명한다. 출발 예제로 새 질문을 만들고, 질문에 대한 답을 생성하고, 답의 선호나 품질을 판정하는 신호도 생성할 수 있다. 한 모델을 이 여러 작업에 재사용할 수도 있다. 슬라이드 7쪽 · 영상 03:29–05:35
이를 NTU의 세 역할과 연결하면 다음과 같다. 이 표는 두 강의의 개념을 대응시킨 해설이다.
| Lambert 강의에서 만드는 자료 | NTU 구조에서 연결되는 역할 | 확인할 품질 |
|---|---|---|
| 새 질문과 수정한 질문 | 출제자가 학습할 문제를 공급한다 | 문제가 명확하고, 키우려는 능력과 관련되는가? |
| 질문에 대한 응답 | 풀이자가 학습 후보 답변을 만든다 | 실제로 맞는가? 서로 다른 풀이를 포함하는가? |
| 선호·품질·검증 신호 | 검증자가 답변의 선택과 보상에 정보를 준다 | 높은 점수가 올바른 답과 연결되는가? |
예를 들어 모델이 문서에서 질문을 만들고, 같은 모델이 그 질문에 답하고, 또 같은 모델이 답을 채점한다고 하자. 이때 “AI가 자료를 만들었다”라는 설명만으로는 학습 과정이 충분히 드러나지 않는다. 질문의 근거, 답변의 내용, 채점 기준을 각각 확인해야 한다. 세 단계가 같은 오해를 공유하면 그럴듯한 문제와 답, 높은 점수가 함께 만들어질 수 있다. 역할을 세 개로 나누는 것과 오류가 독립적인 검증 근거를 확보하는 것은 별개의 설계 문제다.
또한 자료를 생성한 다음에는 어떤 항목을 남기고 어떻게 파라미터 갱신에 사용할지 정해야 한다. Lambert는 반복적으로 나오는 생성물을 선별하는 과정도 설명한다. 영상 07:22–07:35 선별 규칙은 학습할 문제와 답의 분포를 바꾼다. 같은 답만 남기면 다양성이 줄 수 있고, 통과 기준이 잘못되면 잘못된 답을 더 많이 학습할 수 있다.
그래서 이 글의 네 연구를 읽을 때는 문제를 어디서 얻고, 답을 무엇으로 검증하며, 어떤 자료를 다음 갱신에 사용하는지를 함께 보면 된다. 뒤에서 볼 SPICE의 외부 문서와 R-Few의 앵커 예제는 이 연결에 기준 정보를 더하는 서로 다른 방법이다.
#보충 A — Absolute Zero: 실행 가능한 환경에서 답의 근거를 얻는다
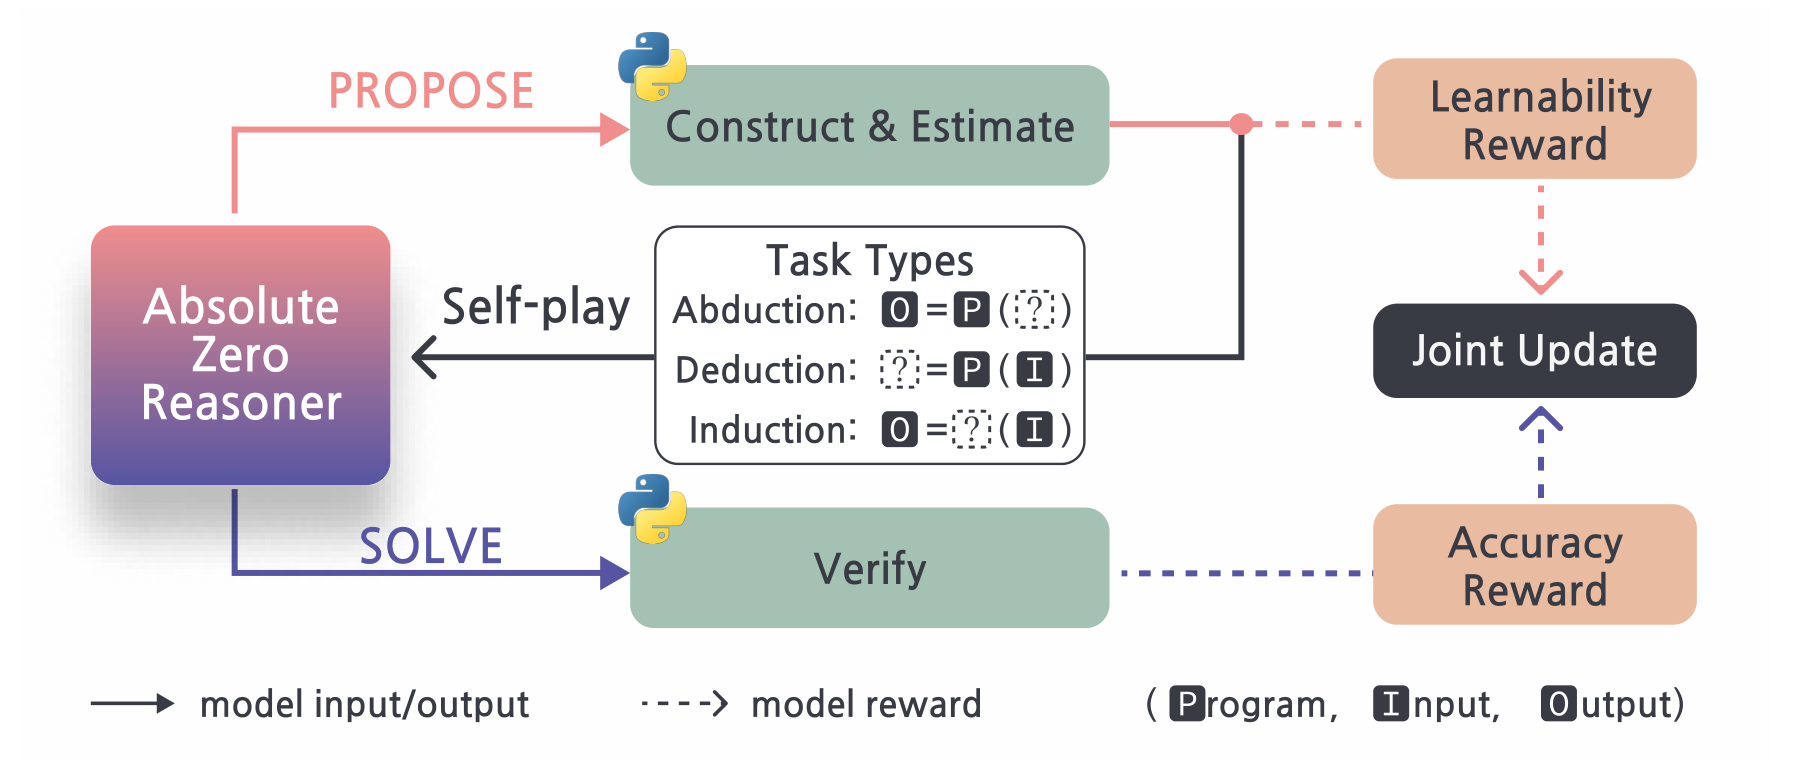
Absolute Zero Reasoner(AZR)는 하나의 모델이 문제 제안과 풀이를 함께 맡는다. 과제는 프로그램, 입력, 출력의 관계로 구성되며, 코드 실행기가 제안된 과제의 유효성을 확인하고 답을 검증한다. 출력 예측인 연역(Deduction), 주어진 출력을 만드는 입력 탐색인 가추(Abduction), 입출력 예시로 프로그램을 구성하는 귀납(Induction)을 학습 과제로 삼는다. Absolute Zero §3, Figure 4
예를 들어 프로그램이 입력에 2를 곱한 뒤 3을 더한다면, 입력 4에 대한 출력 11은 실행으로 확인할 수 있다. 그러나 몇 개의 입출력 예시만으로 프로그램을 복원하는 문제에서는 여러 프로그램이 같은 예시를 통과할 수 있다. 실행기가 있다는 것과 모든 의도에 대해 정답을 증명했다는 것은 다르다. 어떤 입력과 조건을 검사했는지까지가 검증의 범위다.
논문의 풀이자 기본 보상은 검증된 답과 값이 같은지를 사용한다. 아래의 지시 함수는 조건이 참이면 1, 거짓이면 0이다. y*는 환경에서 얻은 기준 답이며, 해당 보상식의 동등성은 Python 값의 동등성으로 판정한다. Absolute Zero §3.1, 식 5
출제자는 풀이자를 자주 실패시키기만 해서는 안 된다. 전혀 풀리지 않는 문제에서는 성공한 풀이의 신호를 얻기 어렵다. AZR는 여러 번 풀어 본 평균 성공 비율 p̄를 이용해 다음 기본 보상을 정의한다.
가령 유효한 한 과제를 10번 풀었다고 하자. 성공 횟수가 0, 1, 5, 9, 10이면 출제자의 기본 보상은 각각 0, 0.9, 0.5, 0.1, 0이다. 이 식은 성공이 적어도 한 번 관측된 어려운 문제를 높게 평가한다. 성공률 50%에서 최대가 되는 식은 아니다. 또한 10번 모두 실패했다는 관측이 그 문제가 원리적으로 불가능하다는 뜻도 아니다. Absolute Zero 식 4
위 두 식은 역할별 기본 보상이다. 실제 논문은 출력 형식이나 오답에 대한 추가 페널티를 결합한다. 또 “Zero Data”는 이 학습 단계에서 외부의 정답 주석 과제에 의존하지 않는다는 설정을 가리킨다. 사전학습 모델, 설계된 과제 유형, 코드 실행 환경은 남아 있고, 초기화에는 입력을 그대로 반환하는 identity function의 시작 삼중항도 사용한다. Absolute Zero 식 6·§3.3.1
#다른 강의로 연결 — 너무 어렵거나 쉬운 문제에서는 무엇을 배우는가
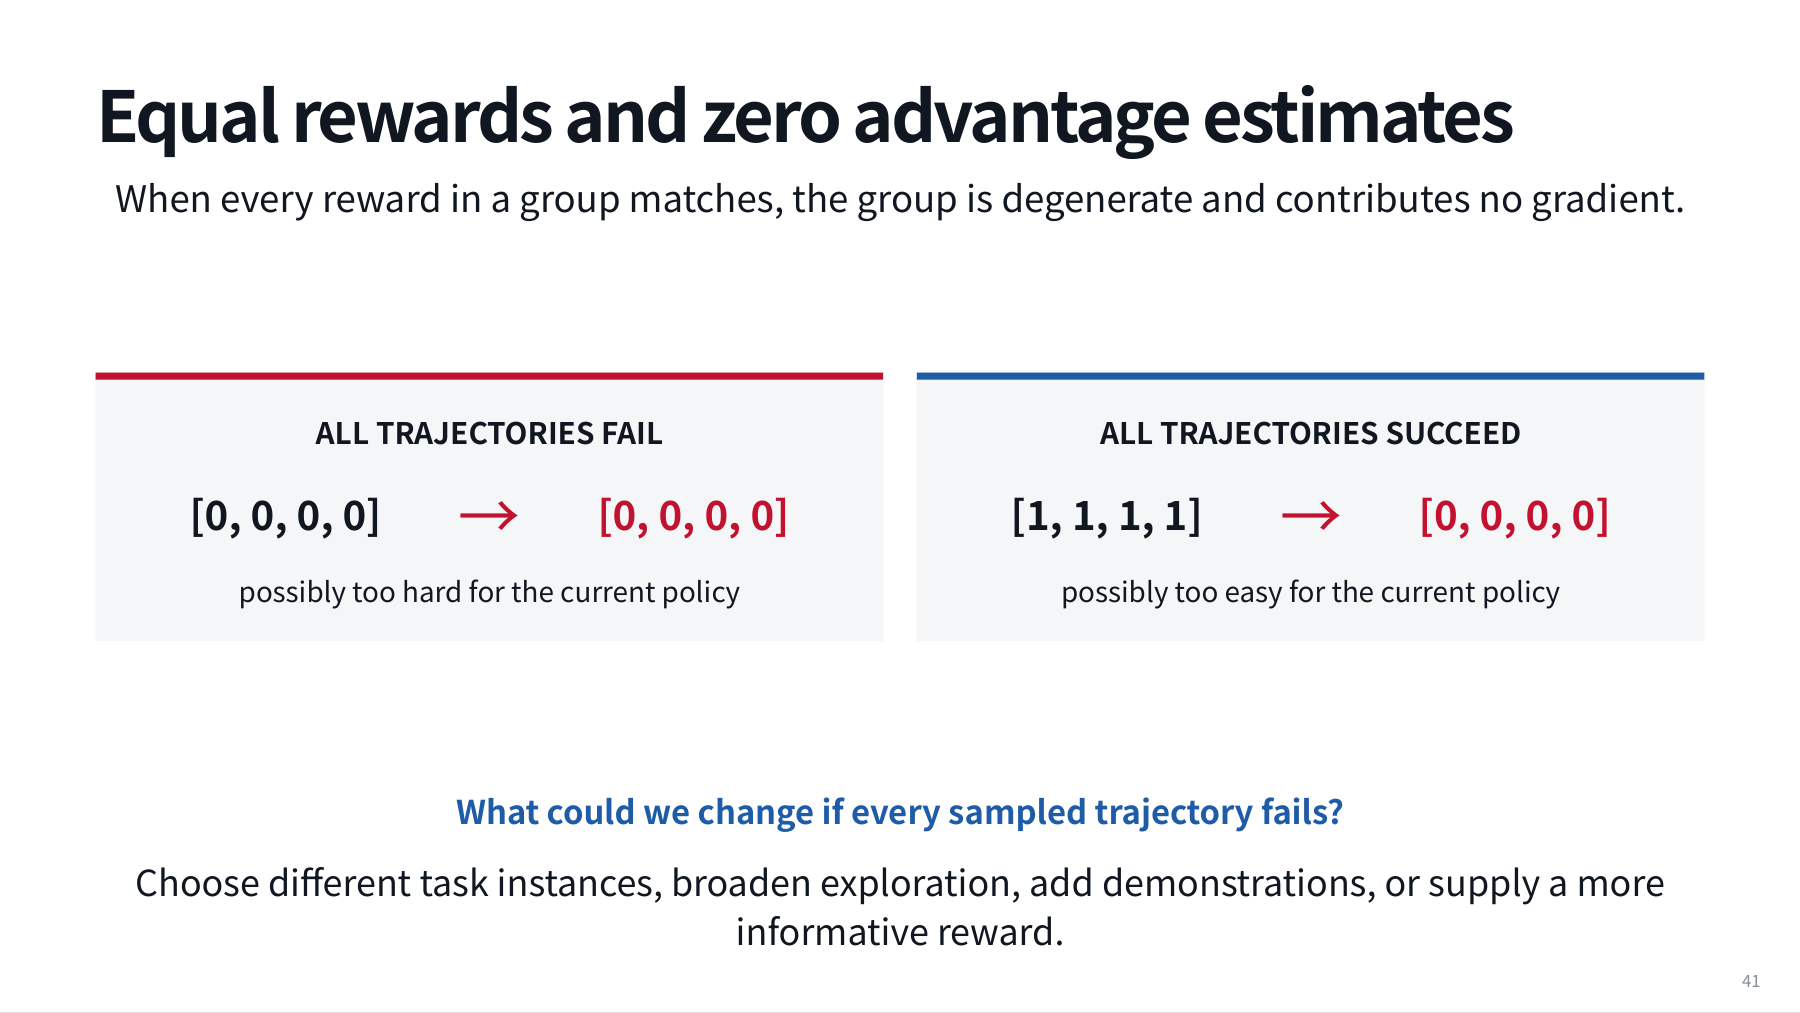
CMU의 강화학습 기초 강의는 현재 풀이자가 배울 수 있는 문제가 왜 필요한지 다른 각도에서 보여준다. 같은 문제를 여러 번 풀고, 각 보상에서 그 그룹의 평균 보상을 빼면 다른 풀이에 비해 얼마나 나았는지 알 수 있다. 이를 상대적 이점(Advantage)을 추정하는 데 사용한다. 37–41쪽
아래 표는 보상에서 그룹 평균을 뺀 값만 보여준다. GRPO 전체 목적함수에는 정규화, 정책 확률의 비율, 클리핑 등 추가 구성이 들어갈 수 있다.
| 같은 문제에서 얻은 보상 | 그룹 평균 | 각 보상에서 평균을 뺀 값 |
|---|---|---|
| 0, 0, 0, 0 | 0 | 0, 0, 0, 0 |
| 1, 1, 1, 1 | 1 | 0, 0, 0, 0 |
| 1, 1, 0, 0 | 0.5 | 0.5, 0.5, −0.5, −0.5 |
모든 시도가 실패하면 현재 모델에 너무 어려운 문제일 수 있다. 모든 시도가 성공하면 이미 익숙한 문제일 수 있다. 두 경우 모두 그룹 안의 보상 차이가 없어, 이 결과 보상을 이용한 상대적 정책 갱신 항에서는 풀이를 구분하는 신호가 사라진다. KL 규제나 별도의 보조 손실이 있다면 그 항의 경사까지 사라진다는 뜻은 아니다. 표준편차로 정규화하는 구현에서는 표준편차가 0인 그룹도 처리해야 한다. 41쪽 · 영상 1:13:46–1:14:29
이제 AZR의 출제 보상과 연결할 수 있다. CMU의 설명은 풀이자를 갱신할 신호를 다루고, AZR의 식은 출제자가 어떤 문제를 만들도록 유도할지를 정한다. 성공 가능성이 전혀 관측되지 않은 문제를 계속 공급하면, 생성 횟수가 늘어도 배울 수 있는 성공 사례가 생기지 않을 수 있다. 출제자에게는 현재 풀이자가 시도해 볼 만한 문제를 공급하는 역할이 있다.
다만 이 설명으로 모든 학습법에서 정답률 50%가 최적이라는 결론을 내릴 수는 없다. 위에서 확인한 AZR의 기본 보상식도 50%에서 최대가 아니다. CMU 강의는 모든 시도가 실패할 때 다른 과제를 고르거나, 안내·시연을 더하거나, 학습의 출발점을 바꾸거나, 더 많은 정보를 주는 보상을 사용하는 방법을 제시한다. 영상 1:14:33–1:15:07 문제의 난이도와 함께 탐색 방식, 시작 모델, 검증 신호를 조절해야 한다는 뜻이다.
#보충 B — R-Zero: 풀이자의 불확실성을 문제 생성에 돌려준다
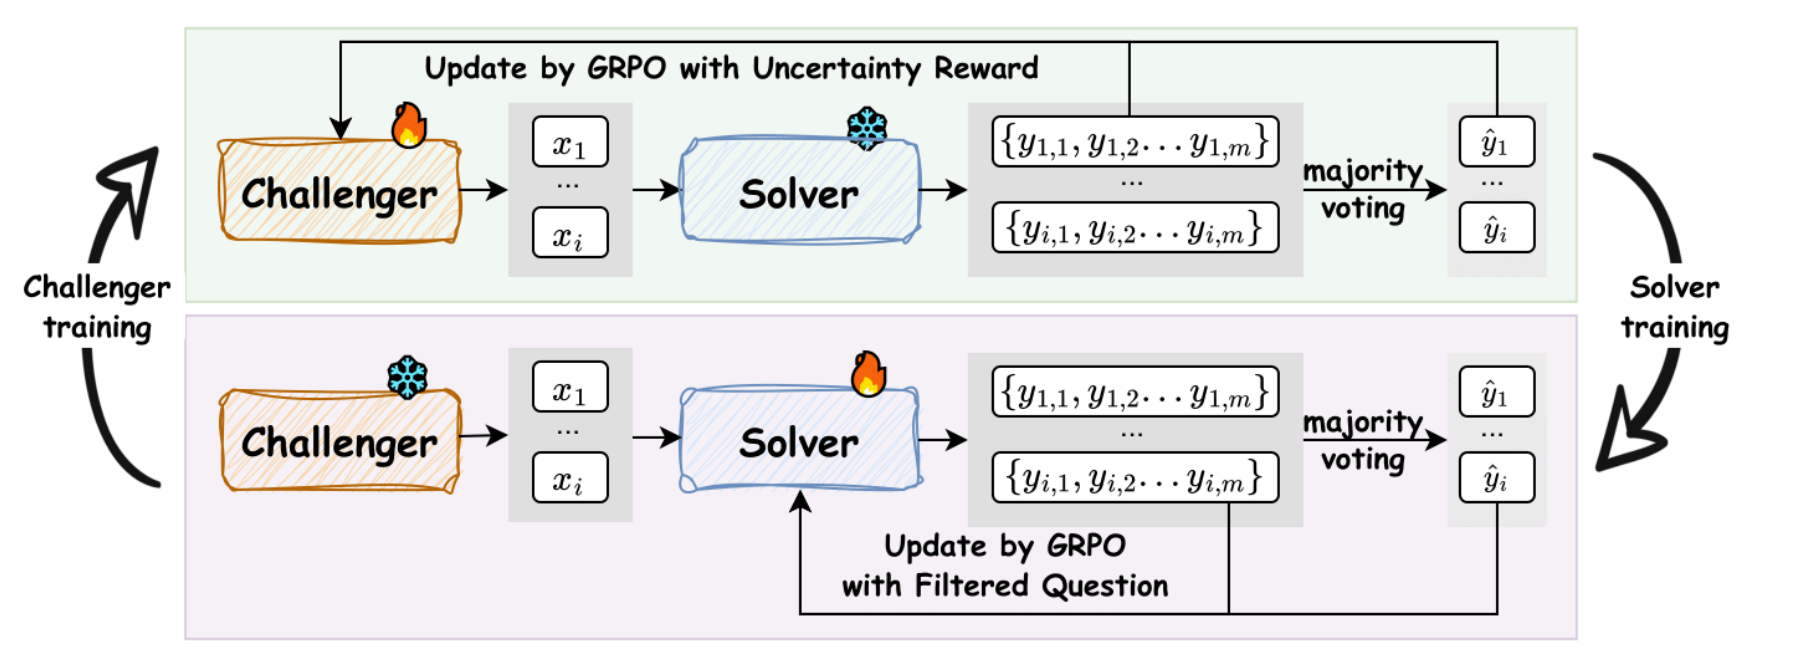
R-Zero는 같은 기반 모델에서 출제자에 해당하는 Challenger와 Solver를 초기화하되, 두 모델을 별도로 최적화한다. 먼저 Solver를 고정한 채 Challenger가 적절한 문제를 만들도록 학습하고, 다음에는 Challenger가 만든 문제를 걸러 Solver를 학습한다. R-Zero §2.1–2.4
여기서는 코드 실행기로 정답을 얻는 대신, 한 문제에 대해 Solver가 낸 여러 답에서 최빈값을 의사 정답(Pseudo-label)으로 삼는다. 이를 ỹ로 쓰면 p̂는 다음과 같다. m은 한 문제에 대해 생성한 답의 개수다.
여기서 p̂는 외부 정답을 기준으로 잰 정답률이 아니라 자신이 가장 자주 낸 답과의 일치율이다. 논문은 이 값으로 불확실성 보상을 만든다. 중간 정도의 일치율에 높은 보상을 주어, 현재 풀이자가 너무 확신하는 문제만 생성하지 않도록 한다. R-Zero §2.2
#계산 예 2 — 난이도 보상은 정답 보증서가 아니다
한 문제마다 답을 10개 생성한 가상 응답 묶음을 비교해 보자. 문제 형식 검사는 모두 통과했다고 가정한다. 같은 배치 안의 비슷한 문제들을 묶은 군집 C에 질문이 속하고, 배치 크기가 B일 때 R-Zero는 군집 비중에 비례한 반복 페널티도 적용한다.
아래에서는 B=20, 해당 군집의 문제 수가 4, λ=1이어서 모든 행의 반복 페널티를 0.2로 두었다. 배치와 군집 수는 이 예제를 위해 정한 값이다. R-Zero 반복 페널티 · 합성 보상
| 가상 문제 | 가장 자주 나온 답의 횟수 | p̂ | 불확실성 보상 u | 반복 페널티 후 보상 |
|---|---|---|---|---|
| A | 3 / 10 | 0.3 | 0.6 | 0.4 |
| B | 5 / 10 | 0.5 | 1.0 | 0.8 |
| C | 7 / 10 | 0.7 | 0.6 | 0.4 |
| D | 10 / 10 | 1.0 | 0.0 | 0.0 |
답 후보가 둘보다 많으면 A처럼 최빈 답이 30%일 수도 있다. 예를 들어 다섯 답의 횟수가 3, 2, 2, 2, 1이면 첫 답이 최빈값이다. 논문이 다수결(Majority voting)이라고 부르는 절차를 반드시 과반수 확보로 해석하지 않아야 한다.
이제 C가 “17×23은 얼마인가?”라는 문제라고 하자. 가상으로 381이 7번, 정답 391이 2번, 401이 1번 나왔다면 p̂는 0.7이지만 실제 정답률은 0.2다. 의사 정답 381과 일치하도록 학습하는 보상은 잘못된 합의를 강화할 수 있다. 보상 0.4는 여기서 정한 난이도·중복 기준의 계산값이며, 답이 참이라는 증거가 아니다.
R-Zero는 생성 문제를 일치율에 따라 추가로 선별한 뒤 Solver를 학습한다. 이런 필터는 문제 품질을 개선하기 위한 장치지만 외부 정답 검증을 대신하는 보장은 아니다. 논문도 자기진화 반복 이후 성능이 저하되는 구간을 보고한다. 루프를 더 오래 돌리는 것과 개선을 유지하는 것은 별개의 문제다. R-Zero §2.3 · §4.2
#보충 C — SPICE: 외부 문서를 문제와 기준 답의 근거로 쓴다
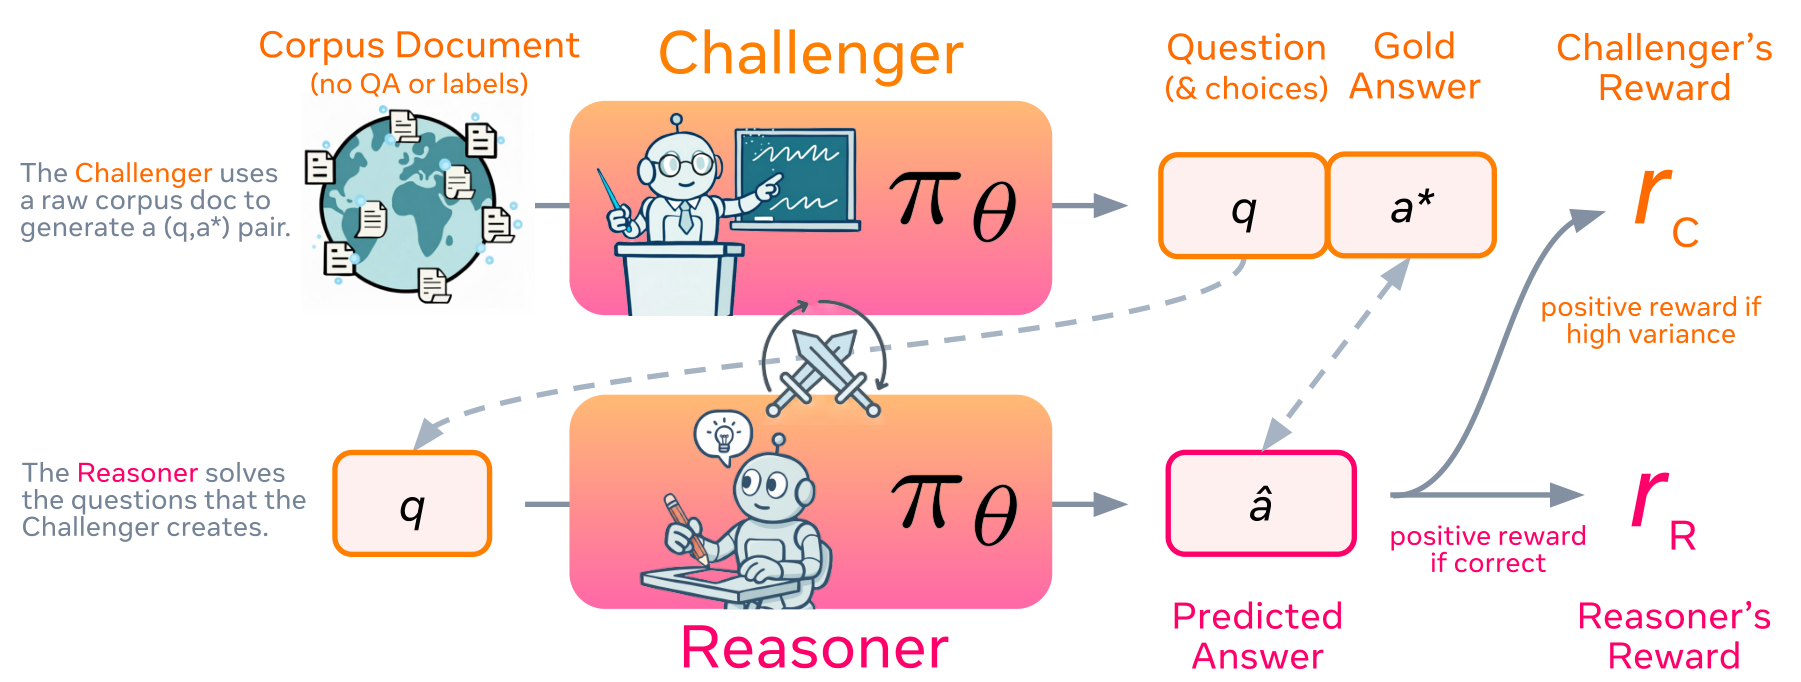
SPICE(Self-Play In Corpus Environments)는 한 모델이 Challenger와 Reasoner 두 역할을 맡되, 출제자가 외부 문서 코퍼스(Corpus)를 읽도록 한다. 출제자는 문서를 근거로 문제와 기준 답을 만들고, 풀이자는 그 문서를 직접 받지 않은 채 질문만 풀도록 한다. 같은 가중치를 쓰지만 두 역할이 보는 정보는 다르다. SPICE §2.1–2.3
이는 풀이할 때 검색 문서를 그대로 제공하는 RAG의 전형적인 사용 방식과도 구분된다. 이 구조에서 문서는 문제와 학습 신호를 만드는 쪽에 들어가고, 풀이자는 자신의 현재 능력으로 질문에 답한다. 외부 문서가 모델 내부의 지식만 반복하는 순환에 새로운 재료를 공급하는 셈이다.
논문은 객관식과 여러 형식의 단답형 문제를 생성하고, 문서에서 추출한 기준 답과 풀이의 동등성을 규칙 기반 검증자로 판단한다. 출제자에게는 풀이 결과의 정답 여부가 적절히 갈리는 문제에 높은 보상을 주고, 풀이자에게는 기준 답과 맞는 응답에 보상을 준다. 두 역할은 가중치를 공유하지만 각 역할의 보상으로 계산한 학습 신호를 사용한다. SPICE §2.2–2.4
따라서 SPICE의 사람 개입 감소를 “외부 데이터가 없다”로 읽으면 안 된다. 외부 문서가 핵심 재료다. 또한 문서가 있다고 문제가 자동으로 올바른 것은 아니다. 출제자가 문맥을 잘못 해석하거나, 질문을 모호하게 만들거나, 기준 답을 잘못 추출할 가능성은 남는다. 문서 기반이라는 사실은 검증의 근거를 제공하지만, 생성 과정의 모든 오류를 제거하지는 않는다.
#보충 D — R-Few: 소량의 기준 예제로 자기생성의 방향을 잡는다
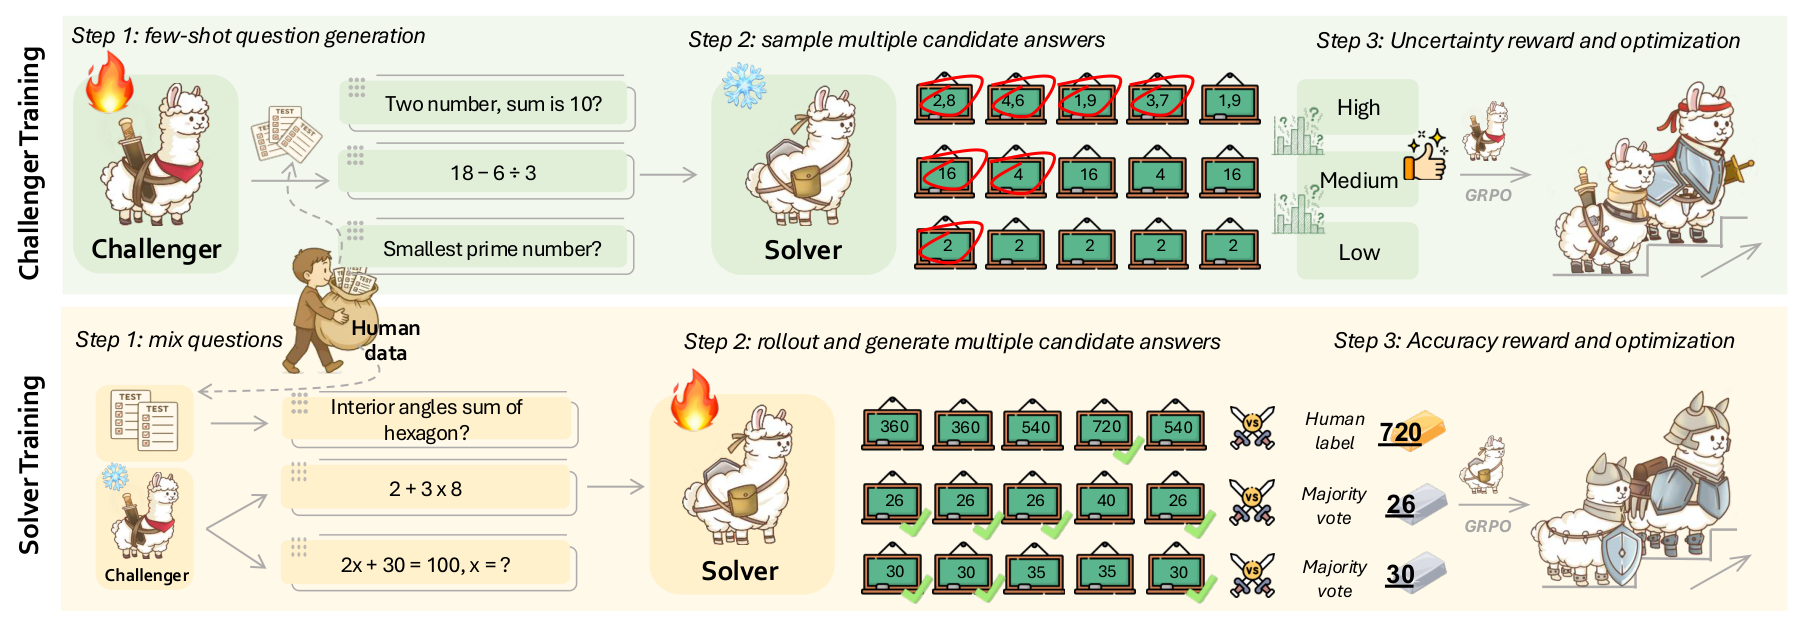
R-Few는 소량의 정답이 있는 앵커 예제(Anchor examples)를 자기생성 과정에 넣는다. Challenger는 예제 풀에서 일부를 뽑아 문맥 내 예시로 보고 새 문제를 만든다. Solver는 합성 문제와 앵커 문제를 함께 사용하면서, 현재 난이도에 맞는 항목을 고르는 온라인 커리큘럼(Online curriculum)으로 학습한다. R-Few §3.2–3.3
논문에서 0–5개를 샘플링한다는 말은 한 번의 문제 생성 문맥에 넣는 예제 수다. 전체 학습에 쓰는 인간 자료가 총 다섯 개뿐이라는 뜻은 아니다. 문맥에 예제를 넣는 것과 Solver가 정답이 있는 자료로 학습하는 것은 별도의 경로다. R-Few 식 4·Algorithm 1
이 선택은 인간의 정보를 완전히 제거하기보다, 적은 정보로 자기생성의 방향을 유지하려는 접근이다. 모델이 익숙한 유형만 반복하거나 인간이 원하는 문제 분포에서 멀어지는 현상을 줄이기 위해 외부 기준을 남긴다. 논문은 형식을 따르도록 돕는 짧은 지도 미세조정(SFT) 단계도 설명한다. “거의 사람 개입 없이”라는 강의 제목 안에서도 학습에 남아 있는 감독의 종류는 방법마다 다르다. R-Few 서론·§3.2
그림을 읽을 때도 기준 답과 다수결 답을 구별해야 한다. 원전은 그림 속 문제가 실제 데이터가 아닌 설명용 예시라고 명시한다. 맨 아래 “2x+30=100”의 실제 해는 35지만, 그림에서는 30이 세 번, 35가 두 번 나와 다수결 라벨이 30으로 표시된다. 식의 정답이 30이라는 뜻이 아니다. 외부 정답이 있는 예제와 합성 문제의 의사 정답을 섞을 때, 어떤 신호로 각 항목을 채점하는지 따로 보아야 한다. R-Few Figure 2
#검증자가 만드는 신호는 어디까지 믿을 수 있는가
강의 5쪽의 또 다른 연구인 Self-Questioning Language Models도 이 문제를 정면으로 다룬다. 수학 과제에서는 여러 답의 다수결을 정답의 대리 신호로 쓰고, 코딩에서는 출제자가 만든 단위 테스트를 이용한다. 논문은 출제자가 풀이자보다 더 정확하다고 자동으로 믿을 근거가 없다고 설명한다. Self-Questioning §4.2
이제 다섯 방법을 “누가 문제를 만드는가”와 함께 “어디에서 기준이 오는가”로 비교할 수 있다.
| 방법 | 문제 생성에 들어오는 재료 | 풀이를 채점하는 핵심 기준 | 남아 있는 확인 과제 |
|---|---|---|---|
| Absolute Zero | 모델이 만든 코드 과제와 이전 과제 | 코드 실행으로 얻은 결과 | 실행 조건과 검사 범위가 의도를 충분히 담는가? |
| R-Zero | 현재 모델이 만든 질문 | 여러 응답에서 얻은 의사 정답 | 자주 나온 답이 틀렸을 때 알아낼 수 있는가? |
| Self-Questioning | 주어진 주제와 모델이 만든 문제 | 수학의 다수결, 코딩의 생성 테스트 | 합의와 테스트가 같은 오류를 공유하지 않는가? |
| SPICE | 외부 문서 코퍼스 | 문서에서 추출한 기준 답과 동등성 검사 | 질문과 기준 답이 원문을 정확하게 반영하는가? |
| R-Few | 합성 문제와 소량의 앵커 예제 | 앵커의 정답과 합성 문제의 의사 정답 | 감독의 출처가 다른 자료를 어떻게 선택·혼합하는가? |
사전학습 모델과 사람이 설계한 학습 절차는 이 비교의 공통 배경이다. “Zero”나 “Few”라는 이름만으로 전체 시스템의 인간 지식 의존도를 판단할 수는 없다. 줄어든 것이 새 문제의 수작업 작성인지, 정답 주석인지, 반복 중의 개입인지 범위를 명시해야 한다.
#계산 예 3 — 같은 검증자도 입력의 품질에 따라 다른 학습 자료를 만든다
검증자가 정답을 90% 통과시키고 오답을 10% 잘못 통과시킨다고 하자. 이는 실제 논문의 측정값이 아닌 가상 검증자다. 정답을 통과시키는 조건부 확률을 t, 오답을 통과시키는 확률을 f, 검증 전 답의 실제 정답 비율을 p라고 쓰면, 통과한 답 중 정답 비율은 다음과 같다.
분자는 전체 중에서 “정답이면서 통과한” 비율이고, 분모는 정답 통과와 오답 통과를 더한 전체 통과 비율이다. 두 종류의 입력에서 검증자의 조건부 성능 t=0.9, f=0.1이 그대로 유지된다고 가정한다. 아래 표는 이 비율을 정확히 만족하도록 구성한 가상 집단이다.
| 생성한 답 1,000개의 구성 | 통과한 정답 | 통과한 오답 | 전체 통과 | 통과한 답의 실제 정답 비율 |
|---|---|---|---|---|
| 정답 600개, 오답 400개 | 540 | 40 | 580 | 540/580 ≈ 93.1% |
| 정답 200개, 오답 800개 | 180 | 80 | 260 | 180/260 ≈ 69.2% |
검증자의 두 조건부 확률은 같지만, 만들어진 답의 품질이 낮아지면 통과한 학습 자료에도 오답이 더 많이 섞인다. 첫 경우도 통과한 답 전체가 정답인 것은 아니다. 그래서 “검증을 통과한 자료만 학습했다”는 설명에는 검증자의 성능뿐 아니라 검증 전후의 자료 분포가 함께 필요하다.
현실에서는 문제 유형이 달라지면 t와 f도 달라질 수 있다. 특히 문제 생성기와 검증기가 같은 기반 모델의 오류를 공유하면, 반복되는 실수가 안정적으로 통과할 수 있다. 이 예제는 그런 변화까지 예측하는 모델이 아니라, 조건부 확률을 고정해도 통과율과 정확성이 다른 양이라는 점을 보여준다.
#자기학습에서 확인해야 할 세 가지 연결
첫째, 목표와 문제의 연결이다. 출제자가 만든 문제가 우리가 키우려는 능력과 관련되어야 한다. 풀이자의 불확실성이 높다는 이유만으로 그 문제가 유용하거나 명확하다고 결론 낼 수 없다.
둘째, 풀이와 검증의 연결이다. 실행 결과, 다수결, 문서의 기준 답, 인간의 앵커는 서로 다른 신뢰 근거다. 어느 쪽도 이름만으로 충분하지 않다. 무엇을 확인했고 어떤 오류가 여전히 통과할 수 있는지에 따라 학습 신호의 의미가 달라진다.
셋째, 학습과 최종 평가의 연결이다. 내부 보상이 높아지거나 생성 문제를 더 잘 풀게 되었다면 그 변화 자체는 관측할 수 있다. 그것이 새로운 과제에서의 능력 향상으로 이어지는지는, 선택에 사용하지 않은 자료와 비교 가능한 계산 예산에서 확인해야 한다.
출제자·풀이자·검증자의 순환은 학습 자료를 사람이 매번 작성하는 부담을 줄일 수 있다. 그 순환이 어디에서 새로운 정보를 얻고, 어떤 기준으로 잘못된 답을 걸러내며, 실제 목표와 얼마나 맞닿아 있는지가 자기개선의 성격을 결정한다. 하편을 읽는 동안에도 모델이 무엇을 바꾸었는지와, 그 변화가 무엇을 개선했는지를 함께 따라가면 된다.
15편에서는 하네스 자체의 개선으로 이어간다. 문제를 만드는 프롬프트에도 사람의 설계가 들어 있음을 확인한 뒤, 모델의 가중치를 고정하고 프롬프트·도구·작업 절차를 바꾸는 방법과 그 결과를 비교하는 기준을 살펴본다.
계산 예제와 코드
가상 손실 함수의 경사 갱신, AZR의 역할별 기본 보상, R-Zero의 일치율·난이도·반복 페널티, 잘못된 최빈 답의 예시, 검증 전후 정답 비율을 계산한다. 이차함수는 중앙 차분, 삼각형 보상은 구간별 식, 검증자의 조건부 확률은 개별 항목으로 구성한 혼동 행렬과 대조한다. 논문의 모델을 학습하거나 벤치마크 성능을 재현하는 코드는 아니다.
#함께 읽을 자료
| 자료 | 연결되는 내용 |
|---|---|
| NTU 하편 강의 · 1–5쪽 | 목표, 학습 손실, 평가와 출제자·풀이자·검증자 |
| Lambert L9 — Over-Optimization · 슬라이드 8쪽 | 과적합과 대리 목표의 과도한 최적화, 검증 자료에서도 남는 지표 불일치 |
| Lambert L7 — Synthetic Data · 슬라이드 7쪽 | 합성 질문·응답·평가 신호와 출제자·풀이자·검증자의 연결 |
| CMU L9 — RL Foundations for Agents · 슬라이드 41쪽 | 같은 보상에서 사라지는 그룹 상대 학습 신호와 문제 난이도 |
| Absolute Zero: Reinforced Self-play Reasoning with Zero Data | 실행 가능한 과제와 환경 기반 보상 |
| R-Zero: Self-Evolving Reasoning LLM from Zero Data | 출제자·풀이자의 교대 학습과 의사 정답 |
| Self-Questioning Language Models | 문제 생성, 다수결, 생성된 단위 테스트 |
| SPICE: Self-Play In Corpus Environments Improves Reasoning | 문서에 근거한 문제 생성과 역할 간 정보 차이 |
| Guided Self-Evolving LLMs with Minimal Human Supervision | R-Few의 소량 예제 감독과 혼합 커리큘럼 |