같은 언어모델도 어떤 정보를 받고, 어떤 도구를 쓰고, 실패 뒤에 무엇을 하느냐에 따라 다른 에이전트가 된다.
14편에서는 출제자·풀이자·검증자가 학습 문제와 보상을 만드는 순환을 살펴봤다. 그 순환에도 출제 지시, 실행기, 정답 판정처럼 누군가 설계한 부분이 남아 있었다. 이번에는 모델의 가중치를 학습하는 데서 한 걸음 옮겨, 모델을 사용하는 방법 자체를 개선할 수 있는가를 묻는다.
하네스(Harness)는 모델 주위에서 입력을 구성하고, 도구를 연결하고, 실행 순서를 정하는 시스템이다. AI가 그 코드를 고치거나 지시문을 다시 작성하면 에이전트의 행동도 달라질 수 있다. 다만 수정안을 만들었다는 사실과 더 좋은 시스템을 얻었다는 판단은 구분해야 한다. 이 글은 하편 6–10쪽의 흐름을 따라, 하네스를 바꿀 대상과 그 변화를 선택할 근거를 함께 살펴본다.
슬라이드별 영상 위치
아래 링크는 해당 주제를 설명하는 발언 위치다. 6쪽의 프롬프트 예시는 앞편의 출제자·풀이자 설명과 연결되는 문맥으로 표시했다. 그 문구를 직접 읽는 발언이나 정확한 화면 전환 시점을 뜻하지 않는다.
#하편 6쪽 — 자기학습에도 설계된 출발점이 있다
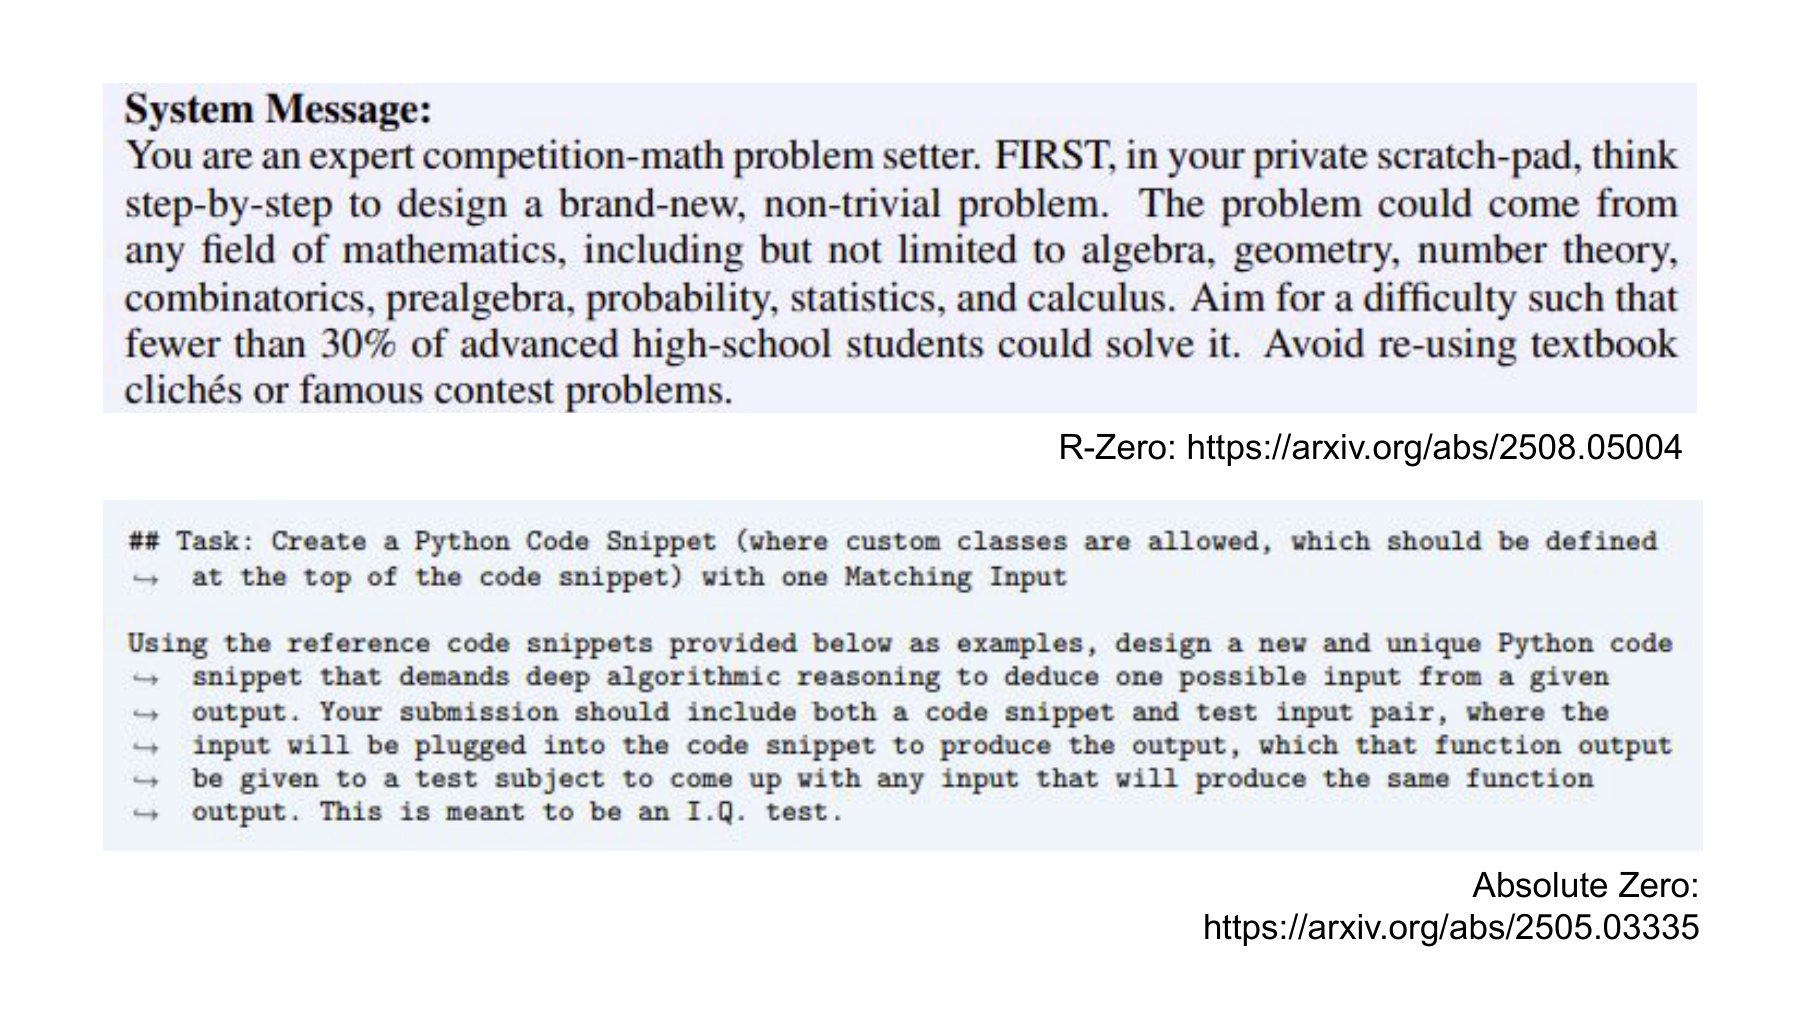
슬라이드의 두 예시는 앞편에서 다룬 자기학습이 어떤 출발점을 갖는지 보여준다. R-Zero의 지시는 수학 문제를 만드는 역할과 문제의 성격을 정한다. Absolute Zero의 지시는 코드와 입력을 어떤 관계로 구성해야 하는지 알려준다. 모델이 새로운 문제를 생성하더라도 무엇을 생성할지, 어떤 형식이어야 하는지, 어떤 환경에서 검증할지는 이미 구조화되어 있다.
여기서 지시문에 적힌 목표와 측정된 결과를 혼동하면 안 된다. 예컨대 어려운 문제를 만들라는 요구나 특정 정답률을 겨냥한 표현은 출제 방향을 제시한다. 그것만으로 생성된 문제가 실제 사람에게 그 난도를 갖는다고 확인된 것은 아니다. 출력 형식을 요구하는 문장도 모델의 응답이 매번 그 형식을 지킨다는 보장이 되지 않는다.
이 구분은 하네스 개선으로 이어진다. 출제 지시를 바꿨더니 문제의 종류가 달라질 수 있고, 잘못된 형식을 걸러내는 코드를 추가했더니 다음 단계에 들어가는 자료가 달라질 수 있다. 모두 시스템의 행동을 바꾸지만, 그 순간 모델 내부의 가중치를 갱신한 것은 아니다. 앞편의 자기학습 순환과 이번 편의 하네스 개선은 이렇게 서로 연결된다.
#하편 7쪽 — 에이전트는 모델과 하네스의 조합이다
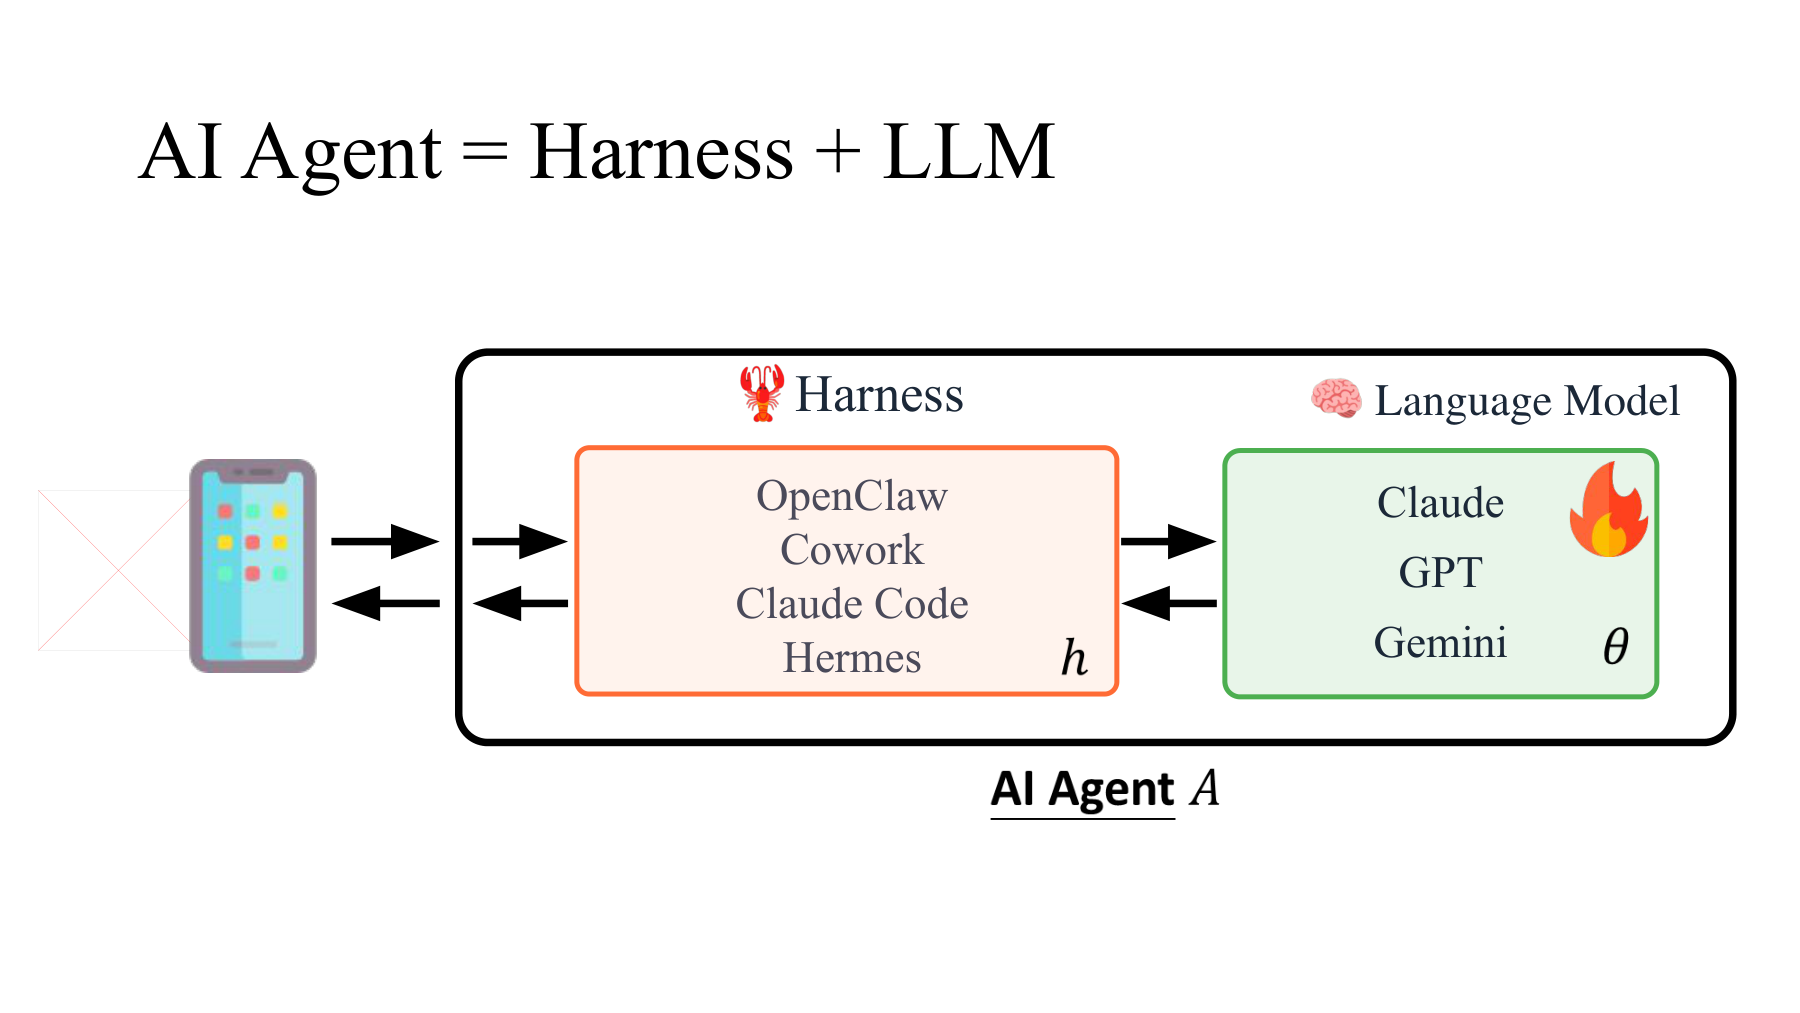
슬라이드의 “Harness + LLM”은 두 수를 더하는 식이 아니라 구성 관계다. 언어모델은 주어진 문맥에서 응답이나 도구 호출을 생성한다. 하네스는 모델에게 어떤 문맥을 보여 줄지, 생성한 호출을 어떻게 실행할지, 그 결과를 다음 입력에 어떻게 넣을지 정한다. 강의 5:15
원본 표기를 따라 모델 파라미터를 θ, 하네스를 소문자 h로 쓰면 에이전트를 다음처럼 나타낼 수 있다.
| 기호 | 의미 | 바뀌는 예 |
|---|---|---|
| θ | 언어모델의 학습된 가중치 | 미세조정이나 강화학습으로 내부 파라미터 갱신 |
| h | 모델을 호출하고 환경과 연결하는 구성 | 지시문, 도구 명세, 출력 파서, 실행 순서, 재시도·메모리 규칙 |
| H_info | 사람이 제공한 목표·자료·평가 정보 | 요구사항, 기준 예제, 채점 규칙 |
14편의 대문자 H는 사람이 제공하는 정보였다. 이번 슬라이드의 소문자 h는 하네스다. 본문에서도 대문자는 H_info로 구분한다. 두 범주가 현실에서 완전히 분리된 파일 묶음이라는 뜻은 아니다. 사람이 작성한 목표 문구를 하네스의 시스템 지시에 넣을 수 있다. 여기서 중요한 것은 최적화로 바꿀 구성과 그 구성을 평가하는 근거를 구별하는 일이다.
예를 들어 검색 도구가 긴 문서를 그대로 반환하는 경우와, 문서 위치·관련 문단·출처를 함께 반환하는 경우를 생각해 보자. 모델의 가중치는 같아도 다음 판단에 쓰는 정보는 다르다. 도구 호출 실패 뒤에 같은 요청을 반복하게 할지, 오류 종류를 알려 주고 인자를 수정하게 할지도 하네스의 선택이다.
#CMU 강의로 연결 — 기억을 남기는 방식도 하네스다
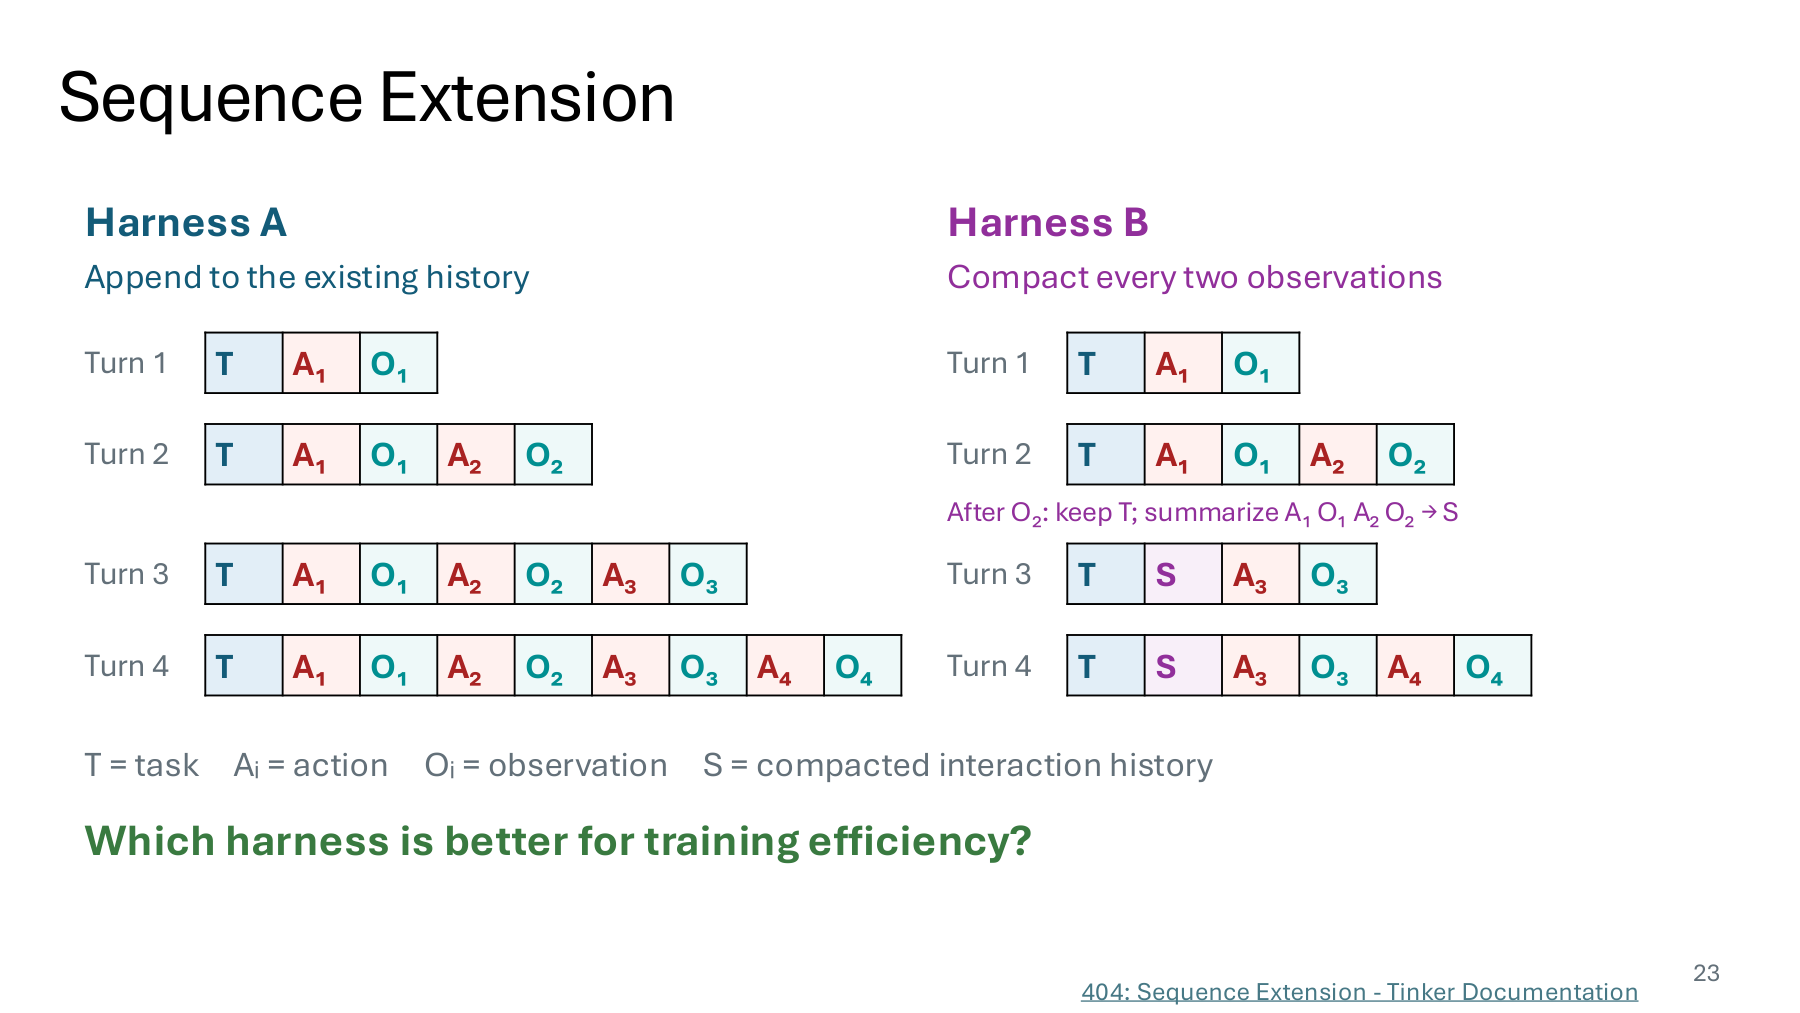
CMU의 「Reinforcement Learning Systems」는 하네스를 두 가지로 비교한다. 왼쪽 A는 과제 T 뒤에 행동 A와 관측 O를 계속 붙인다. 오른쪽 B는 두 번의 관측 뒤에 이전 상호작용을 요약 S로 바꾼다. 둘의 차이는 모델 이름이 아니라 다음 호출에 무엇을 보여 주는가다. CMU PDF 19–20쪽
코드 수정 에이전트가 첫 단계에서 파일을 읽고, 두 번째 단계에서 테스트를 실행했다고 생각해 보자. A는 읽은 코드와 오류 로그를 모두 다시 제공한다. B는 이를 “빈 입력에서 예외가 발생했고, 관련 함수는 parse_input이다”처럼 요약해 제공할 수 있다. 이 예시는 그림의 구조를 설명하기 위한 것이다. B의 입력이 짧아져도 오류를 재현하는 조건이나 정확한 줄 번호가 빠지면 다음 수정은 더 어려워질 수 있다. 반대로 긴 기록이 불필요한 정보로 가득하면 중요한 오류를 찾기 어려울 수 있다.
원 슬라이드의 마지막 질문은 학습 효율에 관한 것이다. 바로 다음 20쪽에서는 A의 경로를 하나의 이어진 학습 자료로 표현하고, B는 요약 전후를 별도 자료로 나누어 과제 T를 다시 넣는다. 따라서 “입력을 요약했으니 전체 계산도 항상 줄어든다”라고 판단할 수 없다. 추론 때 문맥이 얼마나 짧아지는지와, 그 실행 기록을 나중에 학습할 때 어떤 계산을 다시 해야 하는지는 따로 살펴야 한다. CMU PDF 20쪽
이 그림을 하네스 개선 실험으로 옮기면 변경 대상이 구체적으로 보인다. 요약을 시작하는 시점, 반드시 보존할 오류 정보, 도구 응답을 넣는 형식이 모두 h의 일부다. 두 하네스를 비교할 때는 성공률과 토큰 수뿐 아니라 요약에서 빠진 정보 때문에 생긴 실패도 확인해야 한다. θ가 같아도 관측을 구성하는 규칙이 바뀌면 행동은 달라질 수 있다.
#하편 8쪽 — 불꽃의 위치가 θ에서 h로 옮겨 간다
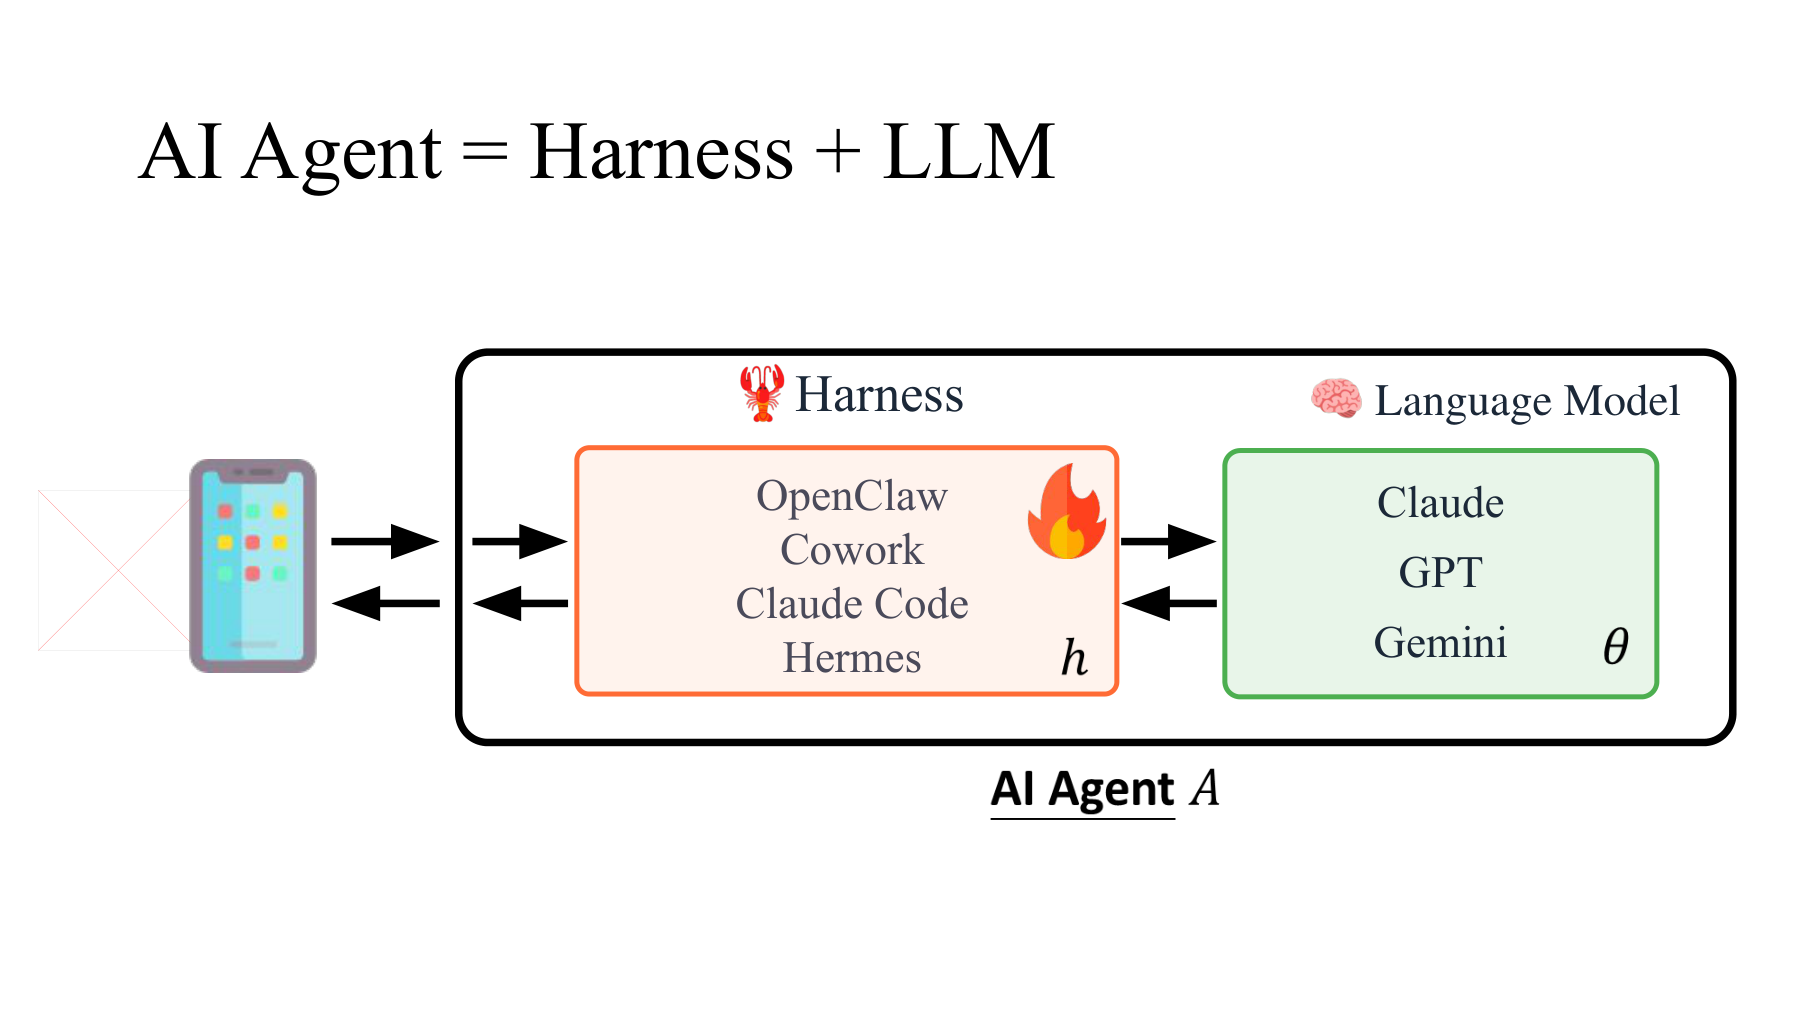
7쪽과 8쪽의 가장 중요한 차이는 불꽃의 위치다. 모델 쪽에 있던 개선 표시가 하네스 쪽으로 이동한다. 두 변화를 나란히 쓰면 다음과 같다.
두 번째 경우에는 모델을 새로 학습하지 않아도 시스템이 달라진다. 다만 더 긴 답을 한 번 생성했다는 것과 여러 과제에 다시 적용할 하네스를 수정했다는 것은 다른 변화다. 수정한 지시문, 코드, 메모리 사용 규칙 등을 다음 실행에서도 사용할 수 있는 형태로 남겨야 어떤 구성이 개선되었는지 비교할 수 있다.
θ를 고정했다는 설명만으로 비교가 완성되지는 않는다. 모델의 버전, 사용할 수 있는 도구, 시작 데이터, 실행 예산, 성공 판정이 함께 달라지면 그 결과에는 여러 효과가 섞인다. 예를 들어 h′가 h보다 두 배 많은 모델 호출을 사용한다면, 관측한 차이는 그 추가 호출까지 포함한 시스템의 차이다. 더 많은 자원을 쓰는 설계가 필요할 수도 있지만, 같은 예산에서 더 효율적이라고 말하려면 별도로 비교해야 한다.
#NAIRR 강의로 연결 — 반성 메모와 하네스 갱신을 구분한다
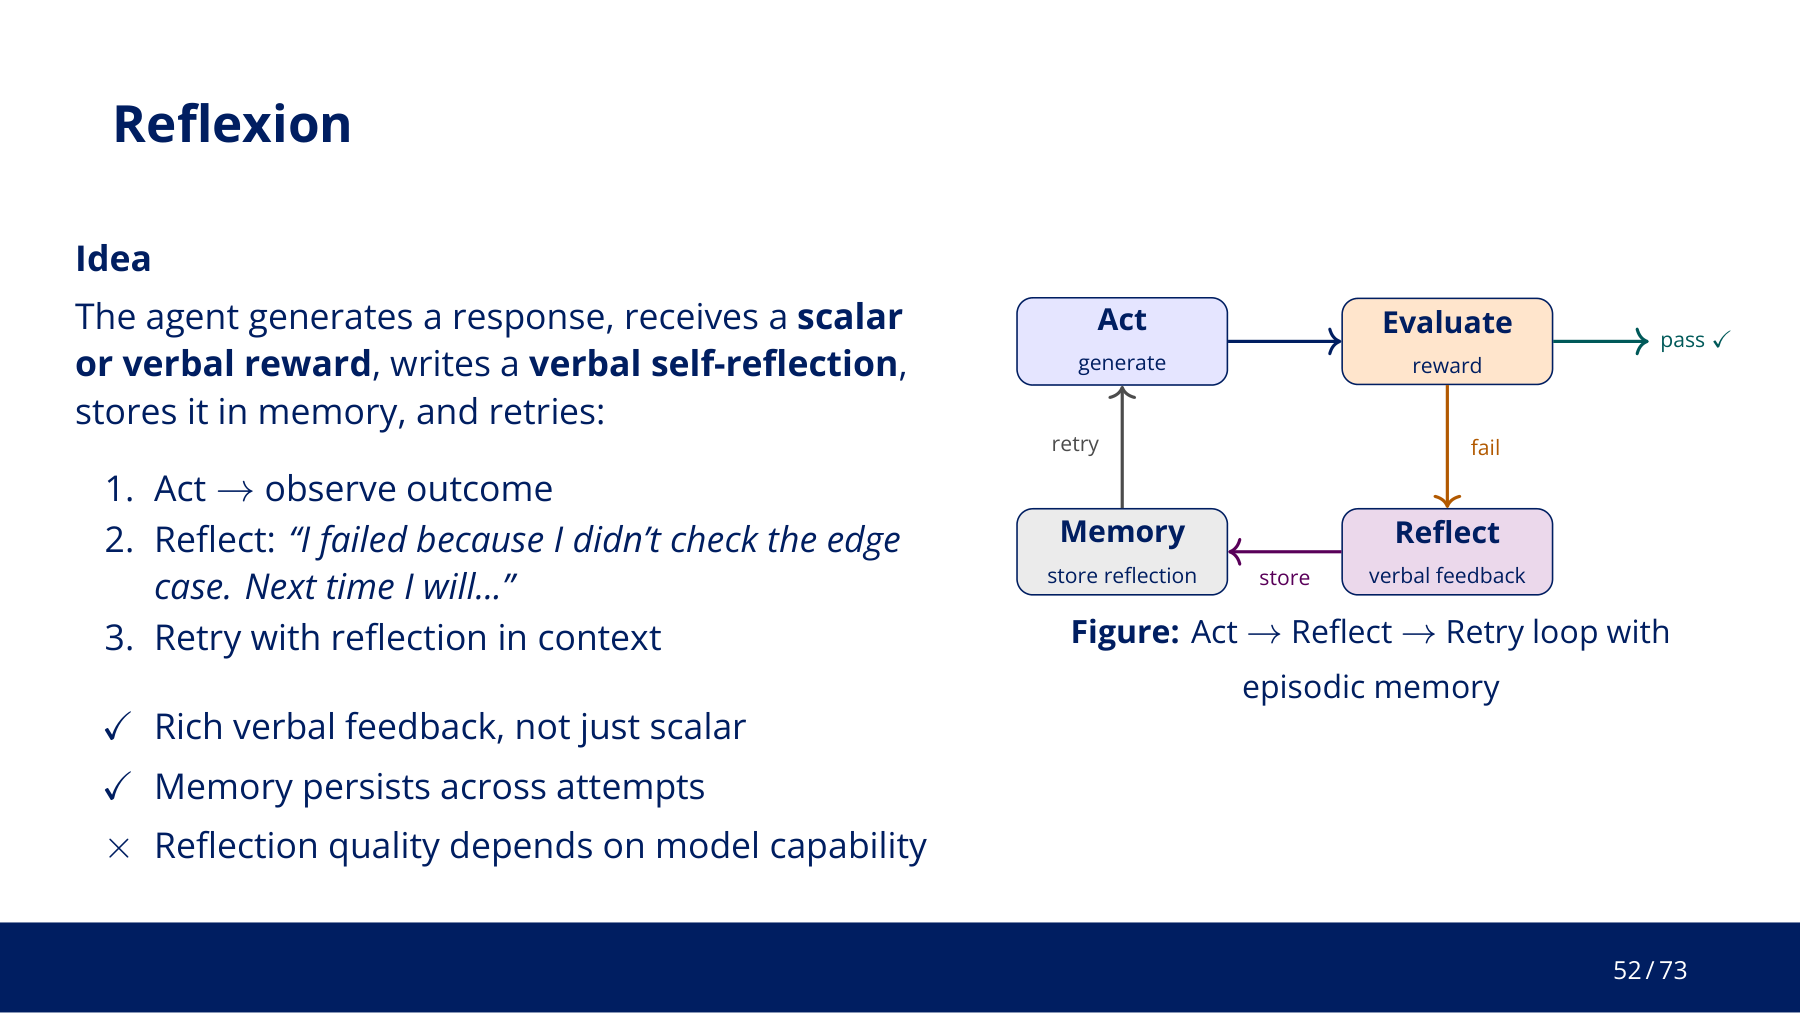
NAIRR의 「Training-Free Alignment of LLMs」는 개입 시점을 세 가지로 나눈다. 생성 전에는 프롬프트를 바꾸고, 생성 중에는 토큰 선택을 조절하며, 생성 후에는 완성된 응답을 검사·선별·수정한다. 마지막 방법이 응답 처리(Response Engineering)다. PDF 38–40쪽 · 강의 2:07:29–2:09:28
위 52쪽은 그중 Reflexion을 보여 준다. 에이전트가 행동한 뒤 평가를 받고, 실패 원인을 문장으로 정리하며, 그 문장을 다음 시도의 문맥에 넣는다. 강의에서도 행동 → 평가 → 반성 → 기억 → 재시도를 순서대로 설명한다. 이때 반성의 품질은 모델의 능력에 의존한다. “잘못한 이유를 썼다”는 사실만으로 그 진단이 맞는지는 확인되지 않는다. 강의 2:21:42–2:22:53
이 사례를 앞의 θ와 h에 연결할 때 한 단계를 더 구분해야 한다. 정해진 규칙에 따라 반성 메모가 하나 추가된 실행과 그 메모를 만들고 사용하는 규칙 자체를 수정한 실험은 서로 다른 변화다.
| 변화 | 직접 달라진 것 | 이 글에서의 해석 |
|---|---|---|
| 실패 뒤 “빈 입력을 확인하자”라는 메모를 다음 시도에 추가 | 실행 중 기억의 내용 | 고정된 하네스가 자신의 규칙에 따라 상태를 갱신한 실행 |
| 반성 메모를 언제 만들고, 무엇을 기록하고, 언제 불러올지 수정 | 기억 생성·사용 규칙 | 여러 실행에 적용할 하네스 후보 h′ |
| 성공·실패 기록으로 모델을 미세조정 | 모델 파라미터 | θ의 갱신 |
첫째 행의 시스템도 이전 경험을 이용해 다음 시도를 개선할 수 있다. 다만 여기서 우리가 최적화 대상으로 삼은 h를 “기억 생성·사용 규칙”으로 정의했다면, 기록의 내용이 달라졌다는 사실을 곧바로 하네스 코드가 개선됐다는 증거로 쓰지는 않는다. 무엇을 고정하고 무엇을 바꿀지 먼저 정의해야 비교가 가능하다.
예를 들어 한 하네스는 실패할 때마다 반성 문장을 모두 저장하고, 다른 하네스는 테스트로 확인된 원인만 기록하며 오래된 메모를 정리한다고 하자. 이것은 두 기억 관리 규칙의 비교다. 어느 쪽이 좋은지는 새로운 과제에서의 성공률과 비용으로 확인해야 한다. NAIRR 강의도 반복 처리가 지연·비용을 늘리고, 종료하지 못하는 반복이나 디버깅의 어려움을 만들 수 있다고 설명한다. PDF 50–52쪽 · 강의 2:19:42–2:21:39
#하편 9쪽 — 하네스에 경사하강법을 그대로 적용할 수 있을까
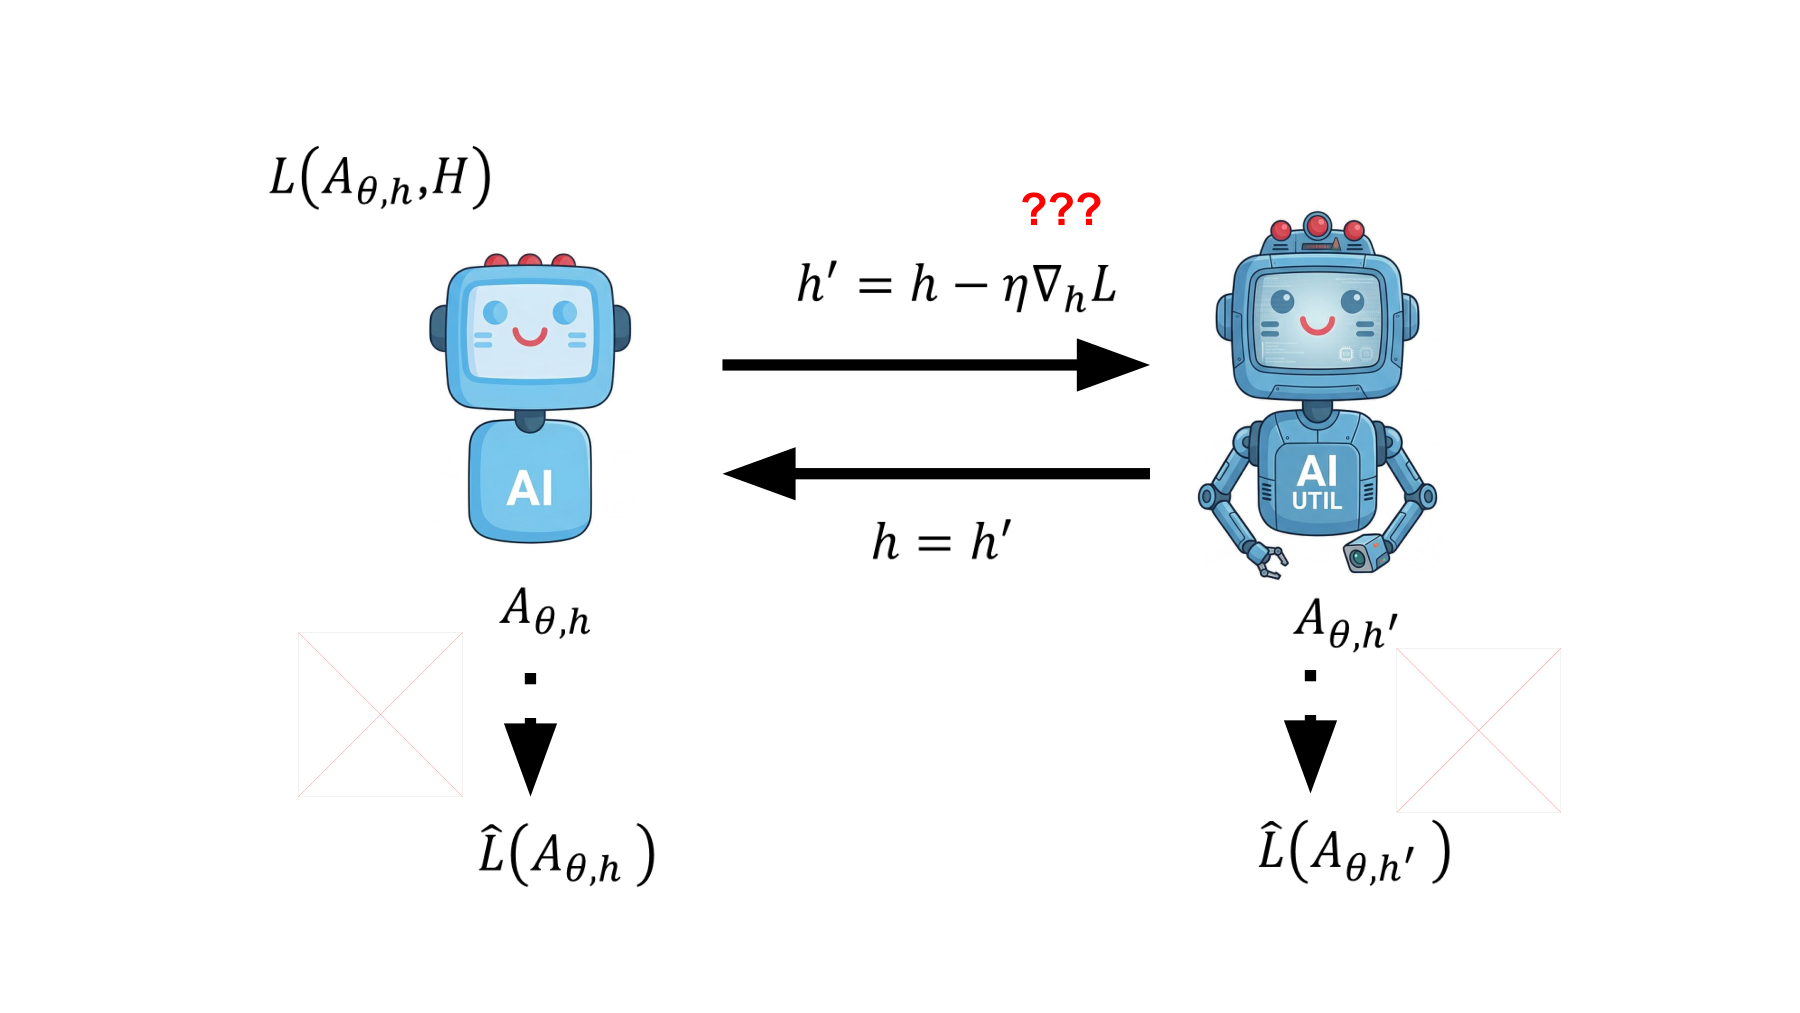
강의는 앞편의 학습 그림에 하네스 h를 넣는다. 시스템이 참고하는 목표·피드백을 L로, 결과가 좋아졌는지 확인하는 평가를 L̂로 쓰면 다음과 같다. 여기서도 두 손실은 작을수록 좋다고 읽는다.
그다음 슬라이드에는 익숙한 경사하강법 모양의 식이 등장한다. 그러나 식 옆에 빨간 물음표 세 개가 붙어 있다. 다음 표기는 바로 그 질문의 대상이며, 일반적인 하네스에 바로 실행할 수 있는 갱신 규칙이 아니다.
경사하강법은 미분할 변수와 그 변수의 연속적인 변화가 정해져 있어야 한다. 그런데 “검색 뒤에 확인 단계를 하나 추가한다”, “실패했을 때만 다시 호출한다”, “도구 설명을 더 명확하게 쓴다”는 수정에는 그대로 빼거나 미분할 실수 좌표가 주어져 있지 않다. 하네스의 코드와 문자열을 모델 가중치처럼 다룰 수는 없는 것이다. 강의 5:48–7:07
하네스 안의 일부 수치 변수를 연속적으로 최적화하거나 별도의 미분 가능한 표현을 설계할 수는 있다. 그렇다고 임의의 프롬프트·분기문·도구 연결 전체에 위 식이 자동으로 성립하지는 않는다. 필요한 것은 어떤 수정 후보를 만들고, 어떤 결과를 근거로 남길 것인지에 관한 구체적인 절차다.
#계산 예 1 — 같은 과제에서 무엇이 좋아졌는지 짝지어 본다
고정된 모델로 두 하네스를 비교하는 가상 실험을 만들자. 같은 100개 과제를 같은 시작 상태와 실행 예산에서 각각 한 번 수행했고, 성공 기준도 같다고 가정한다. 두 결과를 과제별로 짝지으면 다음 표를 얻었다고 하자.
| 같은 과제의 결과 | 과제 수 |
|---|---|
| h와 h′ 모두 성공 | 60 |
| h만 성공 | 10 |
| h′만 성공 | 20 |
| 둘 다 실패 | 10 |
과제 i의 성공 여부를 s_i(h)∈1로 쓰면, 평균 성공률과 두 구성의 차이는 다음처럼 계산한다. 이 절부터는 손실 대신 클수록 좋은 성공률 S를 사용한다.
새 하네스는 이 실행 기록에서 10%p 높다. 그러나 새로 성공한 20개 과제와 새로 실패한 10개 과제가 함께 있다. 평균 두 개만 보면 놓치기 쉬운 변화다. 실패 기록을 살펴보면 수정안이 어떤 종류의 문제를 돕고, 어떤 종류에는 방해가 되었는지 다음 가설을 세울 수 있다.
이는 주어진 100개 과제의 관측을 요약한 결과다. 새로운 과제에서도 반드시 10%p 좋아진다는 결론이나 통계적 유의성을 뜻하지 않는다. 생성과 환경에 확률성이 있다면 과제별 반복 실행도 필요하다. 각 실행 전에 상태를 초기화해야 이전 시도의 수정 파일이나 대화 기록이 다음 조건에 섞이지 않는다.
#하편 10쪽 — AI가 수정안을 만들고, 실행 결과로 선택한다
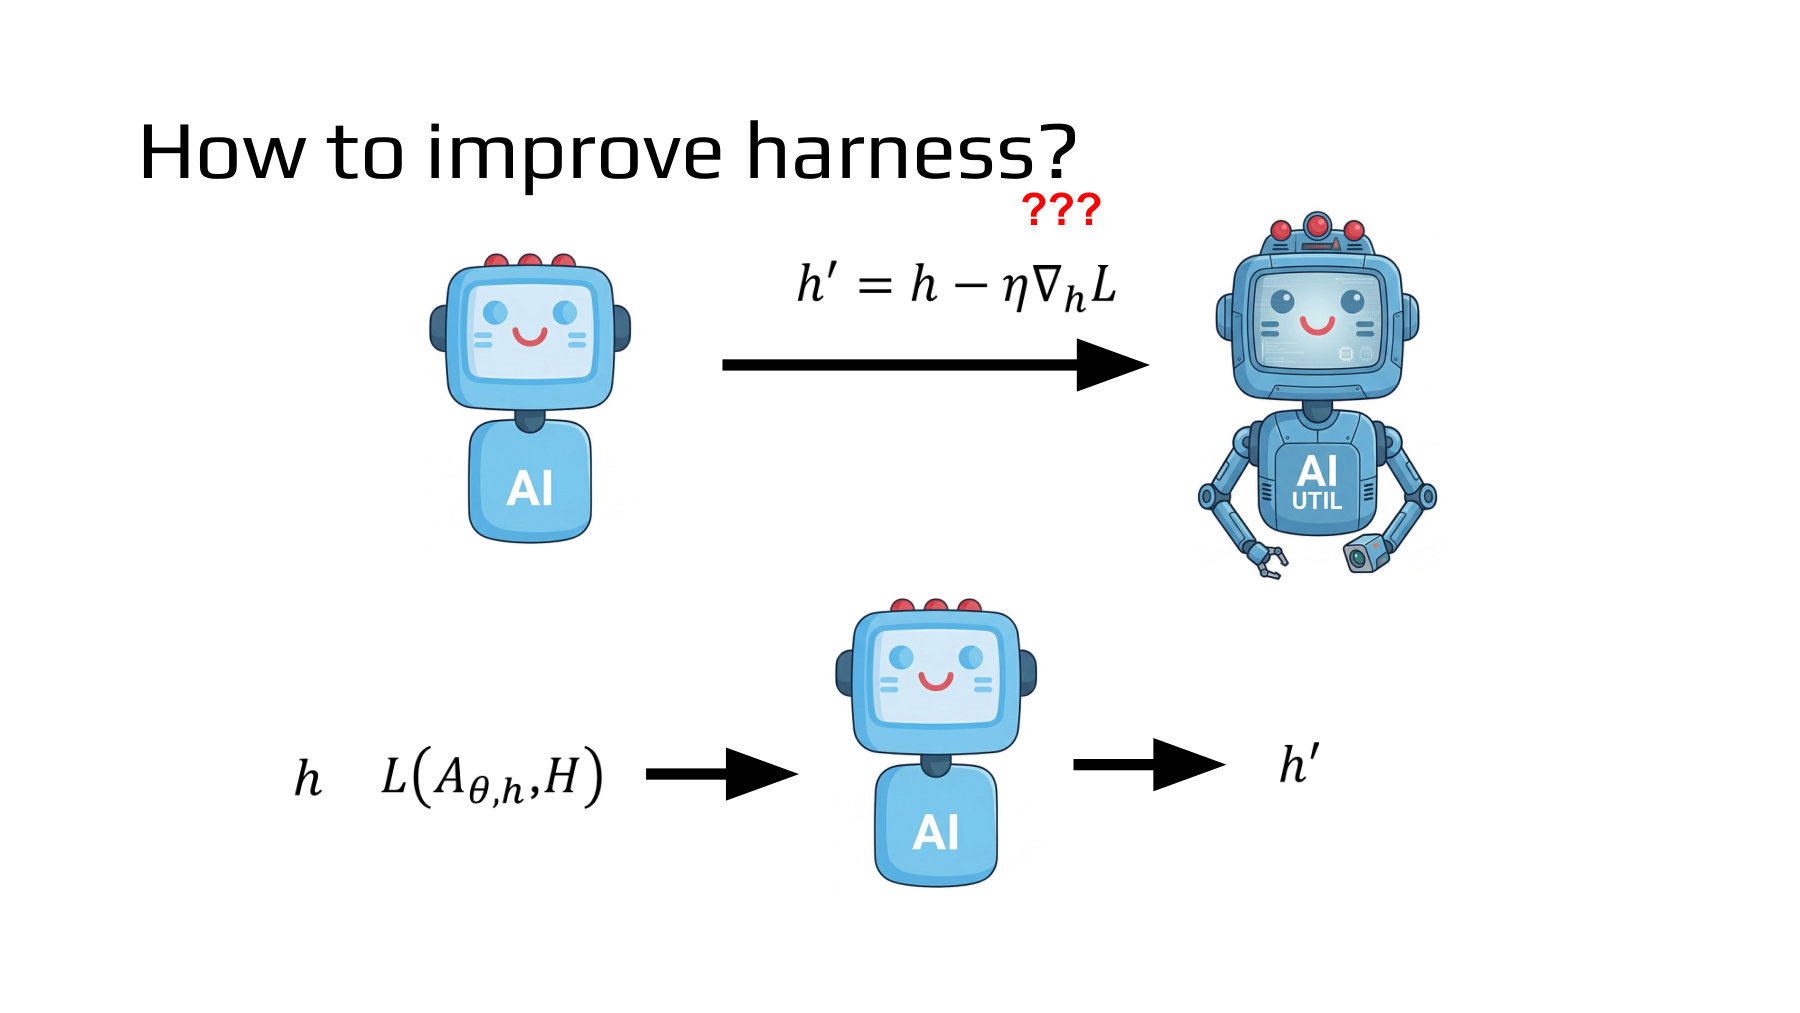
10쪽은 물음표를 다른 작업으로 바꾼다. AI에게 현재 하네스와 그 실행에서 얻은 신호를 주고, 새 하네스를 제안하게 하는 것이다. 자연어와 코드를 다룰 수 있는 모델이라면 지시문 수정, 예제 선택, 단계 추가, 조건 분기 변경 같은 후보를 만들 수 있다. 이것은 문자열에 수치 기울기를 직접 흘리는 연산과 다르다. 강의 7:07
실제 설계를 설명하기 위해 피드백 F_dev에 개발 과제의 점수, 실패 유형, 도구 응답, 기대 결과와의 차이를 담았다고 하자. 후보 생성기를 q_φ로 쓰면 다음과 같이 표현할 수 있다. 수정안을 만드는 모델은 개선 대상과 같은 모델일 수도, 별도의 고정 모델일 수도 있다. φ는 수정안을 만드는 모델의 파라미터를 나타낼 뿐, 이 과정에서 그 가중치를 학습한다는 뜻은 아니다.
만들어진 후보가 실행 가능한지 확인하고, 개발 과제에서 비교한 뒤 다음 구성을 고른다. 예를 들어 유효한 후보들의 집합을 C_t라 하고 기존 구성도 비교에 남겨 두면, 다음은 가능한 선택 규칙 하나다. 이 식은 설명을 위한 설계이며 모든 연구가 같은 규칙을 쓴다는 뜻은 아니다.
기존 구성을 포함하면 같은 개발 점수에서 더 낮은 후보를 굳이 선택하지 않을 수 있다. 하지만 이 장치는 관측한 개발 점수에 관한 것이며, 실제 기대 성능의 단조 증가를 보장하지 않는다. 확률적 실행의 우연과 개발 과제에 대한 과적합이 남아 있기 때문이다. 반복해서 선택에 사용한 과제는 최종 독립 평가 자료로 다시 취급하면 안 된다.
또한 강의는 AI가 내부에서 좋다고 여기는 기준과 사람이 최종적으로 원하는 평가가 다를 수 있음을 짚는다. AI가 자기 수정안을 설득력 있게 설명하더라도, 그 설명만으로 L̂의 개선을 확인한 것은 아니다. 강의 7:40
#MIT 강의로 연결 — 후보를 만드는 능력과 선택하는 근거
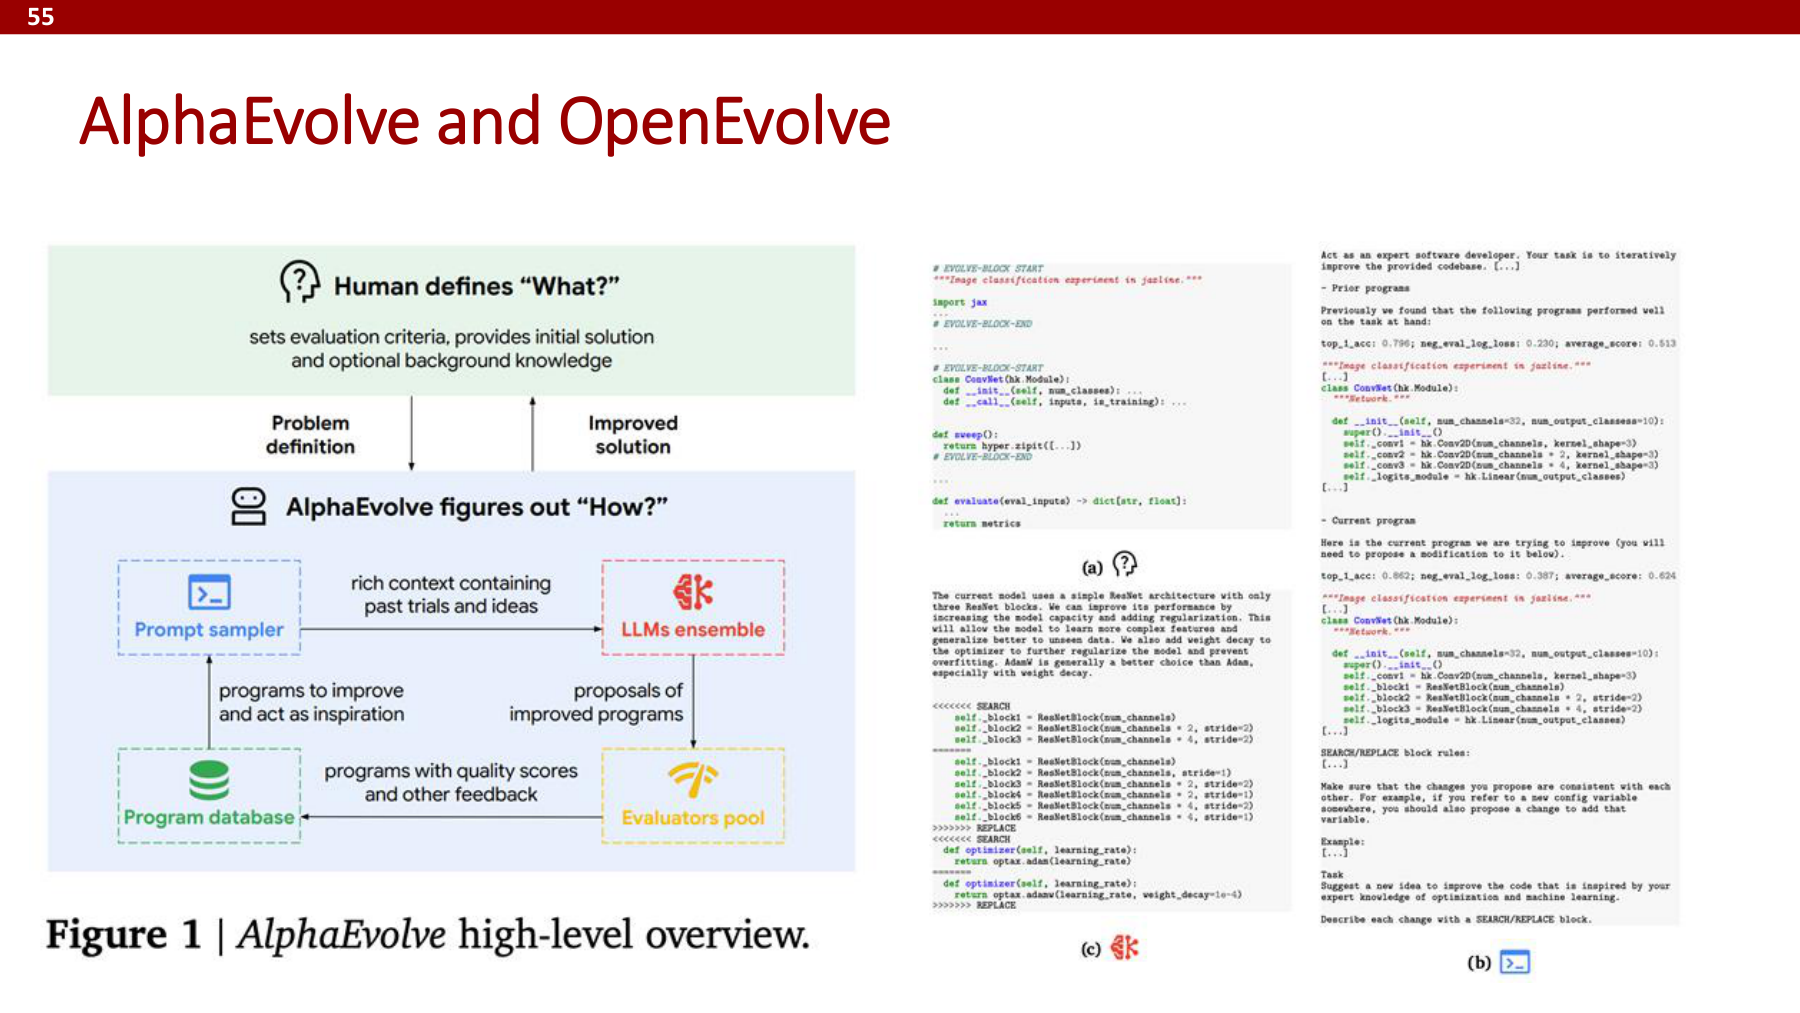
MIT의 「Self-evolving AI」 강의 55쪽은 AlphaEvolve와 OpenEvolve를 설명한다. 왼쪽 그림의 위에는 사람이 정의하는 평가 기준, 초기 해법, 배경지식이 있다. 아래에서는 저장된 프로그램을 골라 프롬프트를 구성하고, 언어모델이 수정 프로그램을 제안하며, 평가기가 실행 결과를 점수로 돌려준다. 프로그램과 평가 기록은 다시 다음 제안의 재료가 된다. MIT PDF 53–55쪽 · 공식 강의 영상
이 그림을 NTU 10쪽 옆에 놓으면 “AI가 새 코드를 쓴다” 뒤에 필요한 단계가 보인다. 코드 후보를 만드는 모델, 그 코드를 실행하는 환경, 결과를 판정하는 평가기, 이전 시도를 보관하는 기록이 각각 역할을 맡는다. 실패한 후보의 실행 오류와 점수도 다음 수정에 쓸 정보가 될 수 있다. 반대로 그 기록을 읽는 것만으로 올바른 수정이 보장되지는 않는다.
여기서 AlphaEvolve가 바꾸는 대상은 주어진 문제를 푸는 프로그램이다. 이 그림 전체를 그대로 “자신의 하네스 전체를 다시 작성한다”는 증거로 읽으면 범위가 넓어진다. 이번 글과의 연결은 후보 프로그램을 만들고 실행 결과로 선택하는 절차다. 그 탐색 대상을 하네스의 프롬프트·도구 호출 코드·실행 순서로 정했을 때, 앞에서 설명한 h의 후보 탐색과 같은 구조로 설계할 수 있다. 뒤의 AFlow는 실제 워크플로를 대상으로 이 연결을 더 구체적으로 보여 준다.
평가기의 역할도 중요하다. 예를 들어 파일을 처리하는 프로그램을 찾을 때 실행 시간만 보상하면, 일부 입력을 건너뛰는 코드가 빠르다는 점수를 얻을 수 있다. 이것은 강의의 실험 결과가 아니라 평가 기준을 설명하기 위한 예다. 올바른 출력과 처리 범위를 먼저 확인한 뒤 실행 시간을 비교해야 목적에 맞는 개선을 고를 수 있다. 하네스를 수정할 때도 실패를 숨기는 출력이나 더 많은 호출을 사용한 결과를 어떻게 평가할지 먼저 정해야 한다.
이 때문에 후보의 점수와 함께 평가기의 버전, 실행 환경, 사용한 입력, 비용을 남겨야 한다. 아래 계산 예에서는 그중 비용 제약 하나만 바꿔도 선택되는 하네스가 달라지는 모습을 살펴본다.
#계산 예 2 — 성공률이 높은 후보와 예산에 맞는 후보
아래는 같은 모델과 같은 100개 개발 과제를 사용한 별도의 가상 비교다. 실행 중 사용한 입력·출력 토큰 수를 합산해 과제당 평균을 구했다고 하자. 토큰 수는 이 예제의 자원 척도이며, 실제 요금이나 지연 시간과 같다는 가정은 하지 않는다.
| 하네스 | 성공한 과제 | 성공률 | 과제당 평균 토큰 | 100개 과제의 총 토큰 |
|---|---|---|---|---|
| A | 70 | 70% | 1,000 | 100,000 |
| B | 80 | 80% | 2,000 | 200,000 |
| C | 78 | 78% | 1,500 | 150,000 |
목표가 성공률 최대화라면 이 표에서는 B가 가장 높다. 그러나 과제당 평균 1,500토큰 이하라는 제약을 먼저 정했다면 B는 후보에서 빠지고 C가 선택된다. 평균 토큰을 T̄(h), 예산을 B_tok라 쓰면 이 선택은 다음과 같다.
C는 A보다 성공률이 8%p 높고 토큰은 50% 더 사용한다. B는 C보다 2개 과제를 더 성공시키는 데 총 50,000토큰을 더 사용했다. 따라서 이 기록에서 B와 C 사이의 추가 성공 1개당 추가 토큰은 25,000이다. 이 비율은 관측한 두 구성의 차이이며, 다음 한 과제를 성공시키는 데 항상 그만큼 든다는 뜻은 아니다.
평균 제약은 개별 과제의 상한과도 다르다. 어떤 요청이 매우 오래 걸리는 것이 문제라면 최대 토큰이나 지연 시간의 상위 분위수도 별도로 봐야 한다. 최종 하네스의 실행 비용과, 그 하네스를 찾기 위해 쓴 탐색 비용도 나눠야 한다. 탐색 토큰을 T_search, 배포 후 처리할 과제 수를 Q, 평균 실행 토큰을 T_run이라 하면 총량은 다음처럼 계산할 수 있다.
예를 들어 C를 찾는 데 300,000토큰을 썼다면 이후 100개 과제 처리까지 합친 총량은 450,000토큰이다. 실행 단계만 센 150,000토큰과 답하는 질문이 다르다. 평가를 보고할 때 어느 비용을 포함했는지 명확히 해야 하네스 최적화의 효율을 해석할 수 있다.
#보충 A — SWE-agent: 행동과 관측의 형식을 바꾼다
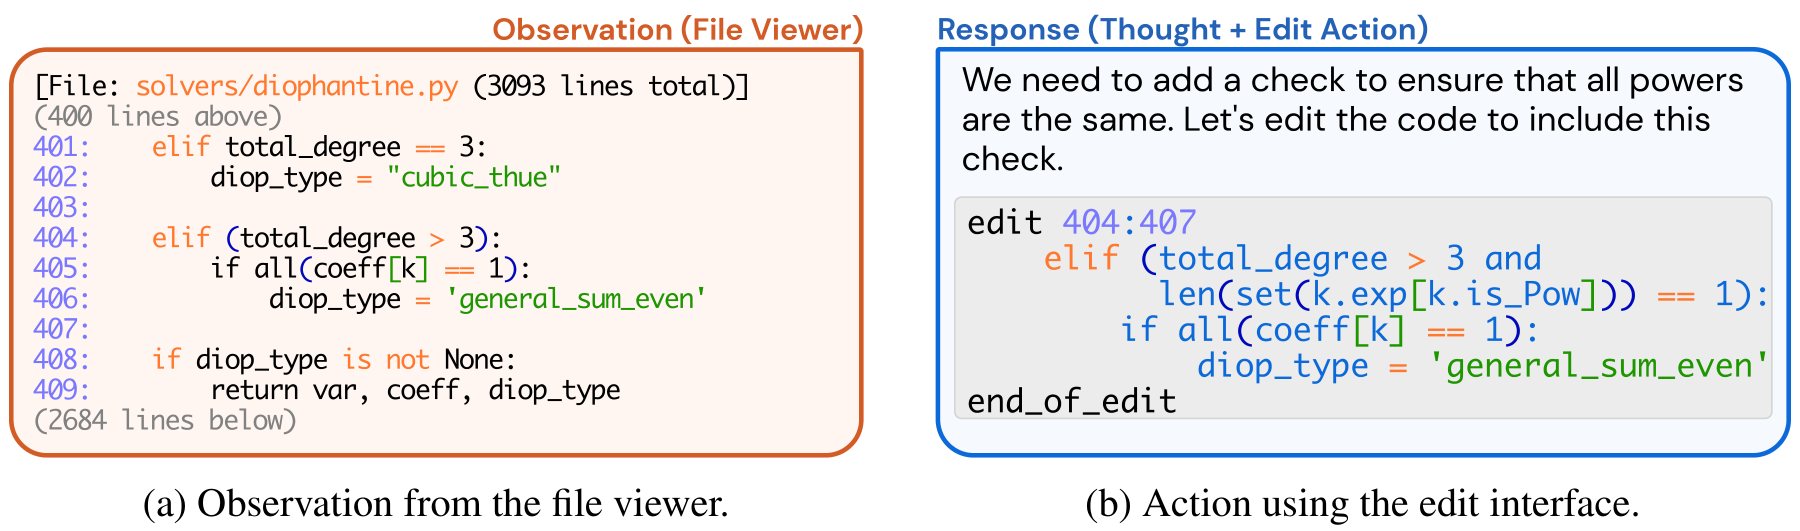
SWE-agent는 에이전트-컴퓨터 인터페이스(Agent-Computer Interface, ACI)를 모델이 사용하는 명령과 환경이 돌려주는 피드백을 함께 설계하는 문제로 다룬다. 그림에서는 파일의 위치와 줄 번호를 보여 주고, 편집 명령이 그 줄 범위를 지정한다. 논문은 기반 모델을 고정한 채 이러한 인터페이스를 비교한다. 원전 §2–3 개발 과정에서는 행동 기록을 사람이 분석하고 구성에 대한 그리드 탐색도 사용한다. 원전 §4, Configuration search
이 사례에서 바뀐 것은 모델이 코드를 표현하는 내부 가중치가 아니라, 무엇을 보고 어떤 단위로 행동하는가다. 사람이 편리하게 쓰는 명령이 모델에게도 가장 다루기 쉬운 명령인지는 따로 확인해야 한다. 수정 뒤 관련 코드와 오류를 바로 관측할 수 있다면 다음 행동을 선택하는 조건도 달라진다.
SWE-agent의 이 설계 연구 자체를 AI가 하네스를 자동으로 발명한 사례로 부르면 범위를 넓히게 된다. 여기서는 하네스가 성능에 영향을 줄 수 있는 구체적인 대상을 보여 준다. 그 대상을 자동으로 수정하고 선택하는 과정은 다음 두 사례에서 더 분명해진다.
#보충 B — DSPy: 프로그램과 그 프로그램의 최적화를 구분한다
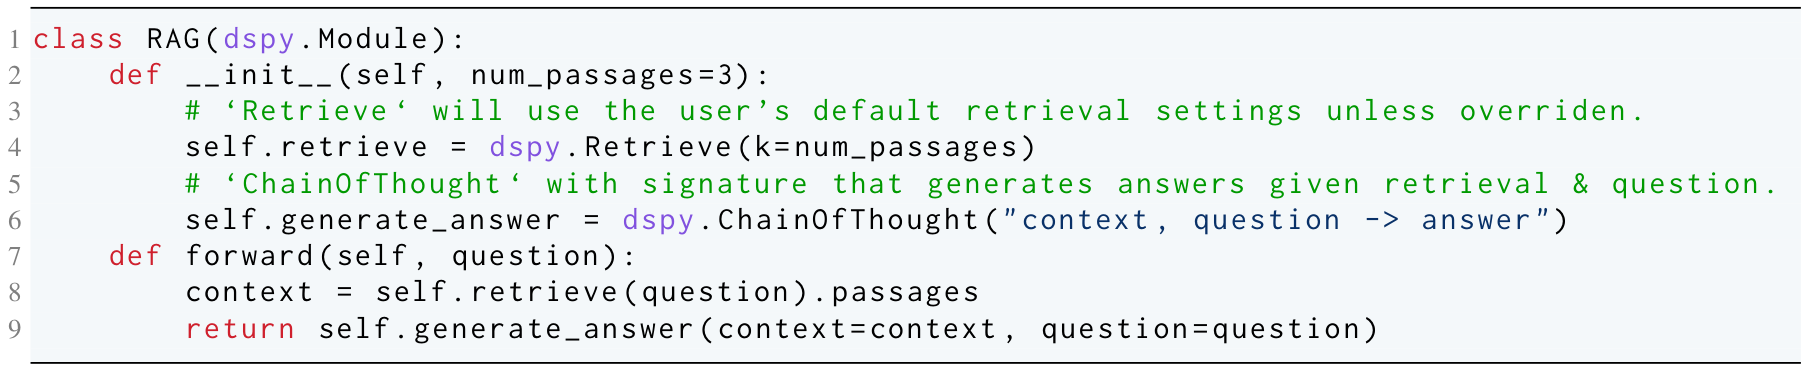
이 프로그램은 질문을 받아 문서를 검색하고, 검색한 문맥과 질문을 답변 모듈에 전달한다. DSPy는 이렇게 구성한 프로그램과, 자료·평가 기준을 이용해 그 프로그램을 최적화하는 절차를 구분한다. 원 논문의 컴파일러는 실행 기록에서 유용한 예제를 모으고, 후보를 선택해 모듈이 사용하는 프롬프트 등을 구성한다. 원전 §3.3–4
가중치를 고정한 모델에 넣을 예제를 선택한다면 이번 글의 h 개선으로 볼 수 있다. 다만 DSPy에는 모은 예제로 미세조정하는 경로도 있다. 프레임워크 전체가 항상 θ를 고정한다고 설명해서는 안 된다. 여기서는 동일한 모델을 호출하는 프로그램의 구성과 입력 예제를 최적화하는 경우에 초점을 둔다.
실험의 단위도 모델 이름 하나보다 구체적이어야 한다. 어떤 프로그램을 어떤 자료와 지표로 최적화했는지에 따라 같은 기반 모델의 결과가 달라질 수 있다. 프로그램, 선택된 예제, 최적화 설정을 함께 남기면 “좋은 프롬프트를 찾았다”는 설명을 다시 실행하고 비교할 수 있는 대상으로 바꿀 수 있다.
#보충 C — AFlow: 코드로 표현한 실행 흐름을 탐색한다
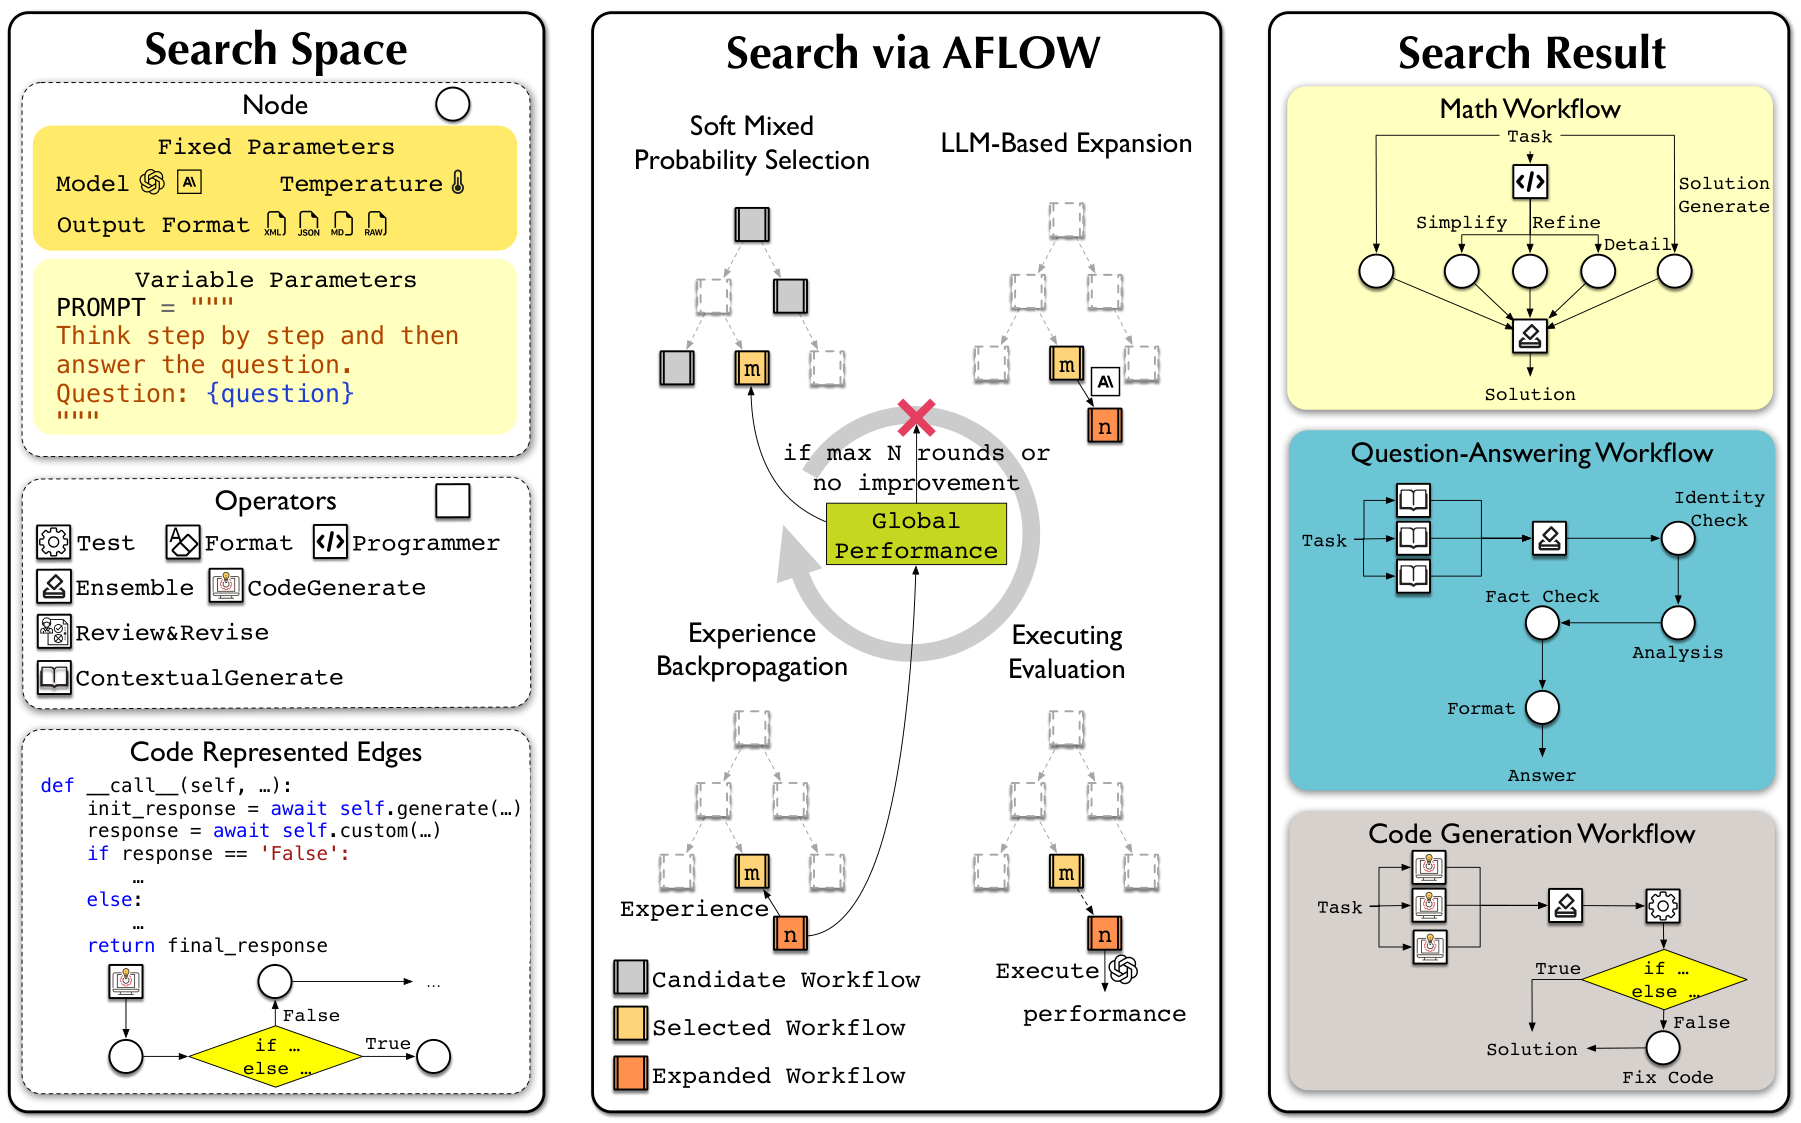
AFlow는 언어모델 호출과 그 연결을 코드로 나타내고, 몬테카를로 트리 탐색(Monte Carlo Tree Search, MCTS)의 변형으로 워크플로 후보를 탐색한다. 논문이 사용하는 실용적인 탐색 공간에서는 모델·온도·출력 형식을 고정하고 프롬프트와 코드로 표현한 연결을 중심으로 수정한다. 탐색 트리의 한 노드는 개별 모델 호출 하나가 아니라 완전한 워크플로 하나다. 원전 §3.2–4
수정안을 만드는 LLM은 이전 변경과 결과를 참고하고, 새 워크플로를 실행해 개발 점수를 얻는다. 그림의 경험 역전파(Experience Backpropagation)는 이 탐색 기록과 점수를 상위 후보에 반영하는 과정이다. 신경망의 θ에 미분값을 전파하는 역전파와 같은 연산이 아니다.
이 구조는 10쪽의 화살표를 구체화한다. AI가 코드를 생성하는 능력은 후보를 넓히고, 실행과 평가는 다음 후보를 고르는 근거가 된다. 반면 사용할 연산자, 실행 환경, 점수 함수, 탐색 예산은 여전히 정해져 있다. “자동으로 찾았다”는 말에는 그 검색 범위와 평가 조건이 함께 있어야 한다.
#보충 D — τ-bench: 한 번 성공하는가, 반복해서 성공하는가
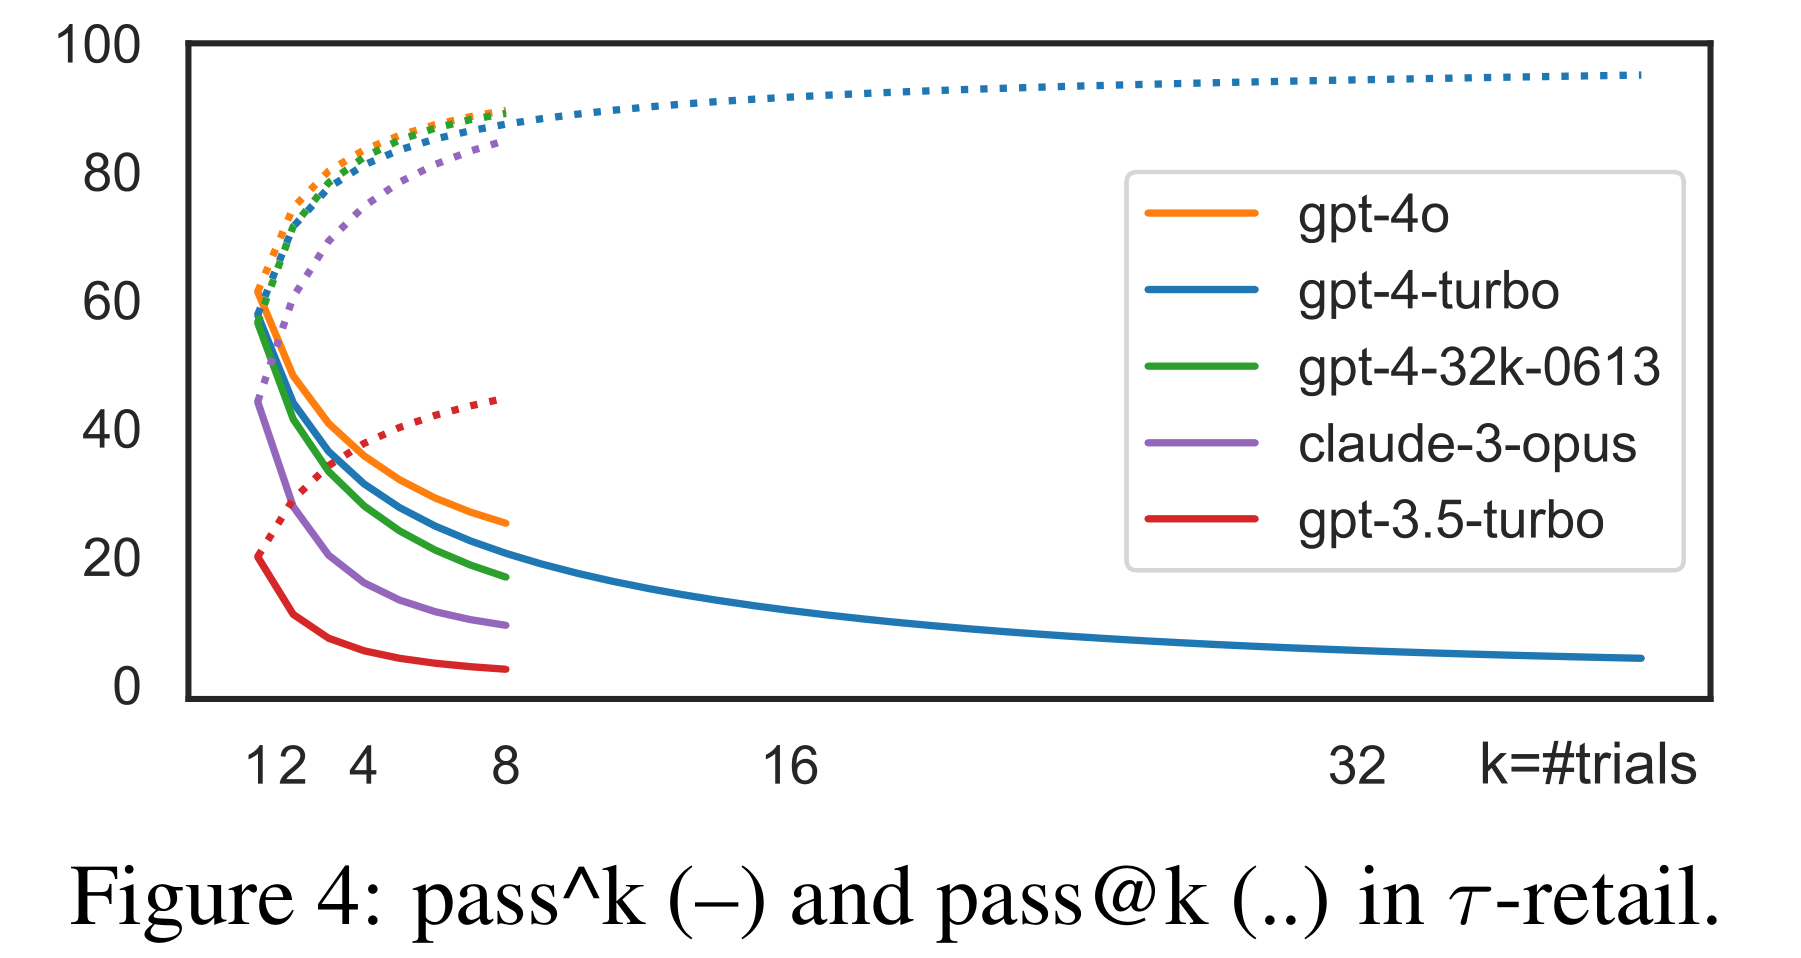
τ-bench는 에이전트가 도구와 모의 사용자에게 상호작용하며 과제를 수행하는 환경이다. 그림은 2024년 τ-retail 실험에서 두 지표를 비교한다. pass@k는 k번 중 적어도 한 번 성공하고, pass^k는 k번 모두 성공하는 경우를 본다. 현재 모델들의 순위를 나타내는 그림으로 읽어서는 안 된다. 원전 §3, §5
과제 i에서 한 번 성공할 확률을 p_i라고 하자. 같은 과제를 초기화해서 반복하며, 과제가 주어진 조건에서 각 시도가 독립이고 같은 분포를 따른다고 가정하면 두 확률은 다음과 같다. 첫 식은 성공 확률을 k번 곱하고, 둘째 식은 모두 실패할 확률을 1에서 뺀다.
여러 과제를 평가할 때는 이 값을 과제별로 계산한 다음 평균한다.
전체 평균 성공률을 먼저 구해 k제곱하면 일반적으로 다른 값이 된다. 쉬운 과제와 어려운 과제가 섞여 있기 때문이다. k=2일 때는 차이를 정확히 나타낼 수 있다. 아래 분산은 과제 사이의 성공 확률 차이다.
같은 평균 성공률이라도 어떤 과제를 안정적으로 풀고 어떤 과제에서 계속 실패하는지에 따라 반복 지표가 달라진다. 따라서 pass^k가 높다는 한 숫자만으로 모든 과제에서 고르게 믿을 만하다고 결론 내릴 수도 없다.
#계산 예 3 — 관측한 성공 횟수에서 두 지표를 계산한다
실제 평가에서는 p_i를 모르고, 과제 i를 n_i회 실행해 c_i번 성공한 기록을 얻는다. τ-bench는 n_i≥k일 때 다음 조합식으로 지표를 추정한다. 각 과제에서 k개의 시도를 고를 수 있는 전체 경우와, 그중 조건을 만족하는 경우를 세는 방식이다. 원전 추정식
위의 독립·동일분포 가정에서 두 식은 각 목표 확률의 불편추정량이다. 윗수가 k보다 작은 조합은 0으로 둔다. 관측 비율 c_i/n_i를 그대로 k제곱한 값과 이 조합식은 다르다.
이제 가상의 두 과제를 각각 초기화해 5회 실행했다고 하자. 첫 과제는 4회, 둘째는 2회 성공했고 k=2로 평가한다. 각 과제의 실행 5개에서 두 개를 고르는 조합은 10개다.
| 과제 | 성공 횟수 | 두 시도 모두 성공하는 조합 | 적어도 한 번 성공하는 조합 |
|---|---|---|---|
| 첫 과제 | 4/5 | 6/10 | 10/10 |
| 둘째 과제 | 2/5 | 1/10 | 7/10 |
같은 기록이지만 한 번 평균 성공률은 60%, 두 시도 모두 성공하는 추정치는 35%, 적어도 한 번 성공하는 추정치는 85%다. 재시도 후 좋은 결과를 식별해 선택할 수 있는 문제와, 매 요청이 안정적으로 끝나야 하는 문제는 요구하는 지표가 다르다. pass@k만으로는 시스템이 실제로 성공한 응답을 알아보고 선택할 수 있는지도 보장하지 않는다.
또한 반복 신뢰성은 무엇을 성공으로 채점했는가에 상대적이다. τ-bench 원문도 최종 데이터베이스와 필요한 응답이 맞아도 사용자 동의를 생략하는 등 일부 정책 위반이 남을 수 있다고 밝힌다. 따라서 pass^k는 정해진 채점 기준의 반복 성공을 측정하며, 모든 정책 준수의 완전한 인증은 아니다. 원전 보상 정의의 한계
#하네스의 자기개선을 읽는 기준
이번 다섯 장은 연결된 질문을 만든다. 6쪽은 자기학습에도 문제 생성의 방향과 형식이 주어진다는 점을 보여 준다. 7–8쪽은 개선 대상을 모델 가중치에서 모델을 사용하는 하네스로 옮긴다. 9쪽은 그 하네스를 무엇으로 최적화할 수 있는지 묻고, 10쪽은 AI가 수정 후보를 만드는 구조를 제시한다.
실험에서 이 흐름을 확인하려면 수정 대상, 비교 조건, 선택 기준을 함께 기록해야 한다. 하네스의 코드와 지시문, 기반 모델의 정확한 버전, 도구·환경의 초기 상태, 개발·최종 평가 자료, 반복 횟수와 실행 예산이 있어야 결과가 어떤 시스템에 관한 것인지 알 수 있다. 선택에 쓴 점수와 독립 평가의 점수를 구분하고, 평균 성능·비용·실패 유형을 함께 보면 개선의 범위도 더 분명해진다.
AI가 만드는 수정안은 이 과정의 중요한 한 부분이다. 수정안을 실행하고, 실패에서 정보를 얻고, 비교 가능한 조건에서 다음 구성을 선택하는 순환까지 갖추어야 하네스 개선을 구체적인 연구 대상으로 다룰 수 있다. 다음 16편은 하편 11쪽부터, 그중 프롬프트 최적화(Prompt Optimization)를 중심으로 이어간다.
계산 예제와 코드
같은 과제에 대한 두 하네스의 성공 차이, 예산 제약 아래 후보 선택, 탐색·실행 토큰의 합계, pass^k와 pass@k의 조합식을 계산한다. 과제별 기록과 집계 표를 대조하고, 조합식은 가능한 시도 묶음의 완전 열거로 확인한다. 불편성은 작은 베르누이 실험의 모든 결과에 정확한 확률을 부여해 별도로 계산한다. 모든 수치 예제는 설명용이며, 논문의 벤치마크를 다시 실행하는 코드는 아니다.
#함께 읽을 자료
| 자료 | 연결되는 내용 |
|---|---|
| NTU 하편 강의 · 6–10쪽 | 인간이 제공한 정보, 하네스와 모델, AI를 이용한 하네스 수정 |
| SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering | 모델을 고정한 ACI 설계와 행동·관측 형식 |
| DSPy: Compiling Declarative Language Model Calls into Self-Improving Pipelines | 모듈로 구성한 프로그램과 자료·지표에 따른 최적화 |
| AFlow: Automating Agentic Workflow Generation | 코드로 표현한 워크플로와 실행 피드백을 이용한 탐색 |
| τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains | 사용자·도구 상호작용, 성공 정의, pass^k와 pass@k |
| CMU RL Systems PDF 19–20쪽 · 공식 강의 영상 | 기록을 이어 붙이는 하네스와 문맥을 요약하는 하네스, 실행 기록의 학습 표현 |
| NAIRR PDF 38–40·50–52쪽 · 영상 2:07:29 · 2:19:42 · 2:21:42 | 응답 처리, 평가·수정 반복, Reflexion의 반성 기억과 비용 |
| MIT Self-evolving AI PDF 53–55쪽 · 공식 강의 영상 | AlphaEvolve의 후보 프로그램 생성·평가·기록, 사람이 정하는 목표와 평가 기준 |