자가개선을 이해하려면 무엇을 바꿨는지부터 확인해야 한다. 이번에는 그 대상이 지시문에서 메모리 설계와 에이전트 코드까지 넓어진다.
15편에서는 모델의 가중치 θ와 모델을 사용하는 하네스 h를 구분했다. 같은 모델도 지시문, 도구, 실행 순서가 달라지면 다른 시스템으로 작동한다. 이어지는 질문은 구체적이다. AI에게 하네스의 어느 부분을 맡기고, 어떤 정보를 주어 수정하게 할 것인가?
하편 11–15쪽은 네 가지 답을 보여 준다. OPRO는 이전 지시문과 점수로 새 지시문을 만든다. GEPA는 실패한 실행의 기록을 읽고, 서로 다른 문제에 강한 후보를 함께 유지한다. ALMA는 경험을 저장하고 꺼내는 메모리 설계를 코드로 바꾼다. Darwin Gödel Machine(DGM)은 코딩 에이전트 자신의 도구와 작업 절차까지 수정한다. 각 방법의 차이를 수정 대상 → 피드백 → 선택 기준의 순서로 읽어 보자.
슬라이드별 영상 위치
| 슬라이드 | 영상 | 주제 |
|---|---|---|
| 하편 11쪽 | 8:20부터 | OPRO와 프롬프트 최적화 |
| 하편 12쪽 | 9:44부터 | 이전 지시문과 점수를 넣는 메타 프롬프트 |
| 하편 13쪽 | 12:59부터 | GEPA의 후보 수정과 결합 |
| 하편 14쪽 | 13:53부터 | ALMA의 메모리 설계 탐색 |
| 하편 15쪽 | 15:31부터 | DGM의 작업 절차 개선과 성능 곡선 |
링크는 해당 주제를 설명하는 발언 위치다. 12쪽과 13쪽 사이의 10:27–12:59에는 여러 후보를 보관하고 수정하는 탐색의 일반 원리가 나온다.
#하편 11쪽 — 프롬프트를 탐색 대상으로 만든다
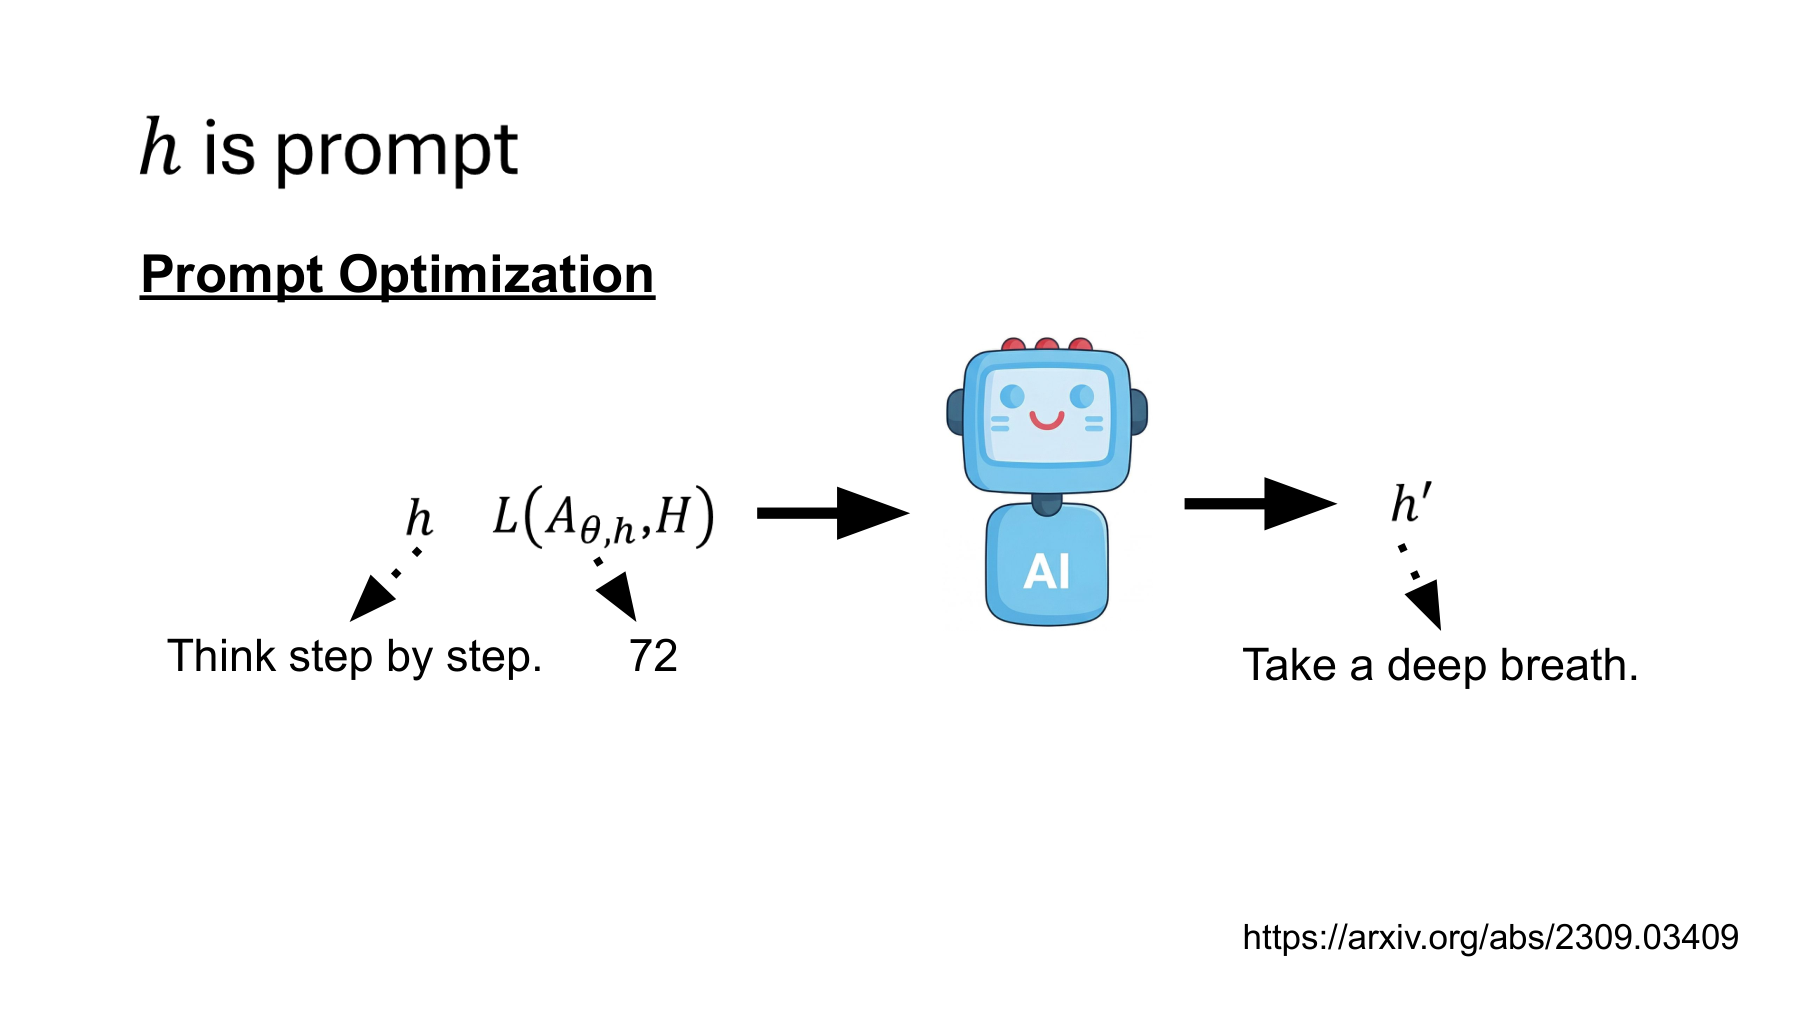
이 장에서는 하네스의 범위를 프롬프트(Prompt)로 좁힌다. 문제를 푸는 모델의 가중치는 그대로 두고, 그 모델에게 전달하는 지시문을 바꾸어 본다. 강의는 초기 지시문을 수학 문제에 적용해 점수를 얻고, 그 지시문과 점수를 다른 호출의 입력으로 넣어 더 좋은 후보를 요청하는 과정을 설명한다. 강의 8:20–9:44
슬라이드에서 왼쪽의 h는 현재 지시문이고, 오른쪽의 h′는 새 후보다. 가운데 모델이 하는 일은 후보 제안이다. 새 문장이 나왔다면 그 문장으로 대상 모델을 다시 실행해야 한다. 제안한 모델의 자신감만으로 평가값이 결정되지는 않는다.
#답을 만드는 모델과 후보를 만드는 모델
OPRO(Optimization by PROmpting) 원문은 두 역할을 구분한다. Optimizer LLM은 지시문을 제안한다. Scorer LLM은 그 지시문을 받아 실제 문제에 답한다. 수학 문제 실험에서는 그 답을 정답과 비교해 정확도를 계산한다. 따라서 여기서 scorer라는 이름을 보고 모델이 지시문의 문체에 주관적 점수를 준다고 이해하면 평가 과정이 달라진다. 두 역할에 같은 기반 모델을 사용할 수 있어도 호출의 목적은 다르다. OPRO §4.1–4.2
이 구조를 읽기 위한 표기를 만들자. 평가 문항 집합을 D, 문항 수를 N이라 하고, 정답 판정을 0 또는 1로 기록한다. 실행 설정을 고정한 한 번의 평가에서 지시문 h의 관측 정확도는 다음과 같다.
| 기호 | 의미 |
|---|---|
| x_i, y_i | i번째 문제와 기준 정답 |
| Aθ,h | 고정한 모델 θ를 지시문 h로 실행하는 시스템 |
| judge | 출력에서 답을 읽고 정답 여부를 판단하는 규칙 |
| S(h;D) | 해당 문항과 실행 조건에서 관측한 정확도 |
이 식에서 바꾸려는 것은 h다. 정답 판정 규칙이나 평가 문항도 함께 바꾸면 새로운 점수가 같은 대상을 측정하는지 다시 확인해야 한다. 답을 여러 번 생성하는 설정이라면 문항별 반복 수와 집계 방식도 정해야 한다. 위 식은 반복 실행 전체의 기대 정확도를 자동으로 주는 식이 아니다.
#그림의 72는 손실인가, 점수인가
원본 그림에는 평가 위치에 L이라는 표기와 숫자 72가 함께 있다. 강의에서는 이 숫자를 벤치마크에서 얻은 점수의 예로 설명한다. OPRO의 정확도는 클수록 좋다. 앞 편에서 사용한 손실(loss)은 작을수록 좋았으므로, 두 방향을 구분해서 읽어야 한다.
예를 들어 정답률이 72%라는 가정 아래 0–1 오류율을 손실로 정하면 다음 관계가 된다.
이는 정확도와 오류율 사이의 변환이다. 모든 손실이 1에서 점수를 뺀 값이라는 뜻은 아니다. 또 그림의 72를 논문의 정확한 실험 결과로 사용해서도 안 된다.
#‘깊게 숨쉬기’ 문장의 의미
그림에 나온 “Take a deep breath.”는 모델이 사람처럼 호흡해서 사고력을 높인다는 설명이 아니다. 모델 입력의 문자열을 바꾸었을 때 출력 분포와 정답률이 어떻게 달라지는지 탐색한 결과로 읽어야 한다.
OPRO의 유명한 비교에서는 PaLM 2-L, GSM8K, 답변 시작 위치에 지시문을 넣는 설정에서 기준 지시문의 71.8%와 탐색한 지시문의 80.2%를 보고한다. 차이는 8.4%p이며, 기준값 대비 상대 증가는 약 11.7%다. 특정 실험 조건의 결과이므로 현재의 모든 모델에 같은 문장이 최선이라고 옮길 수는 없다. OPRO Table 1·Table 4
독자가 가져갈 원리는 한 문장을 외우는 데 있지 않다. 자신이 풀려는 문제에서 후보를 실행하고, 같은 규칙으로 비교하고, 선택한 지시문을 새로운 문항에 적용하는 절차다.
#하편 12쪽 — 메타 프롬프트에는 탐색 이력이 들어간다
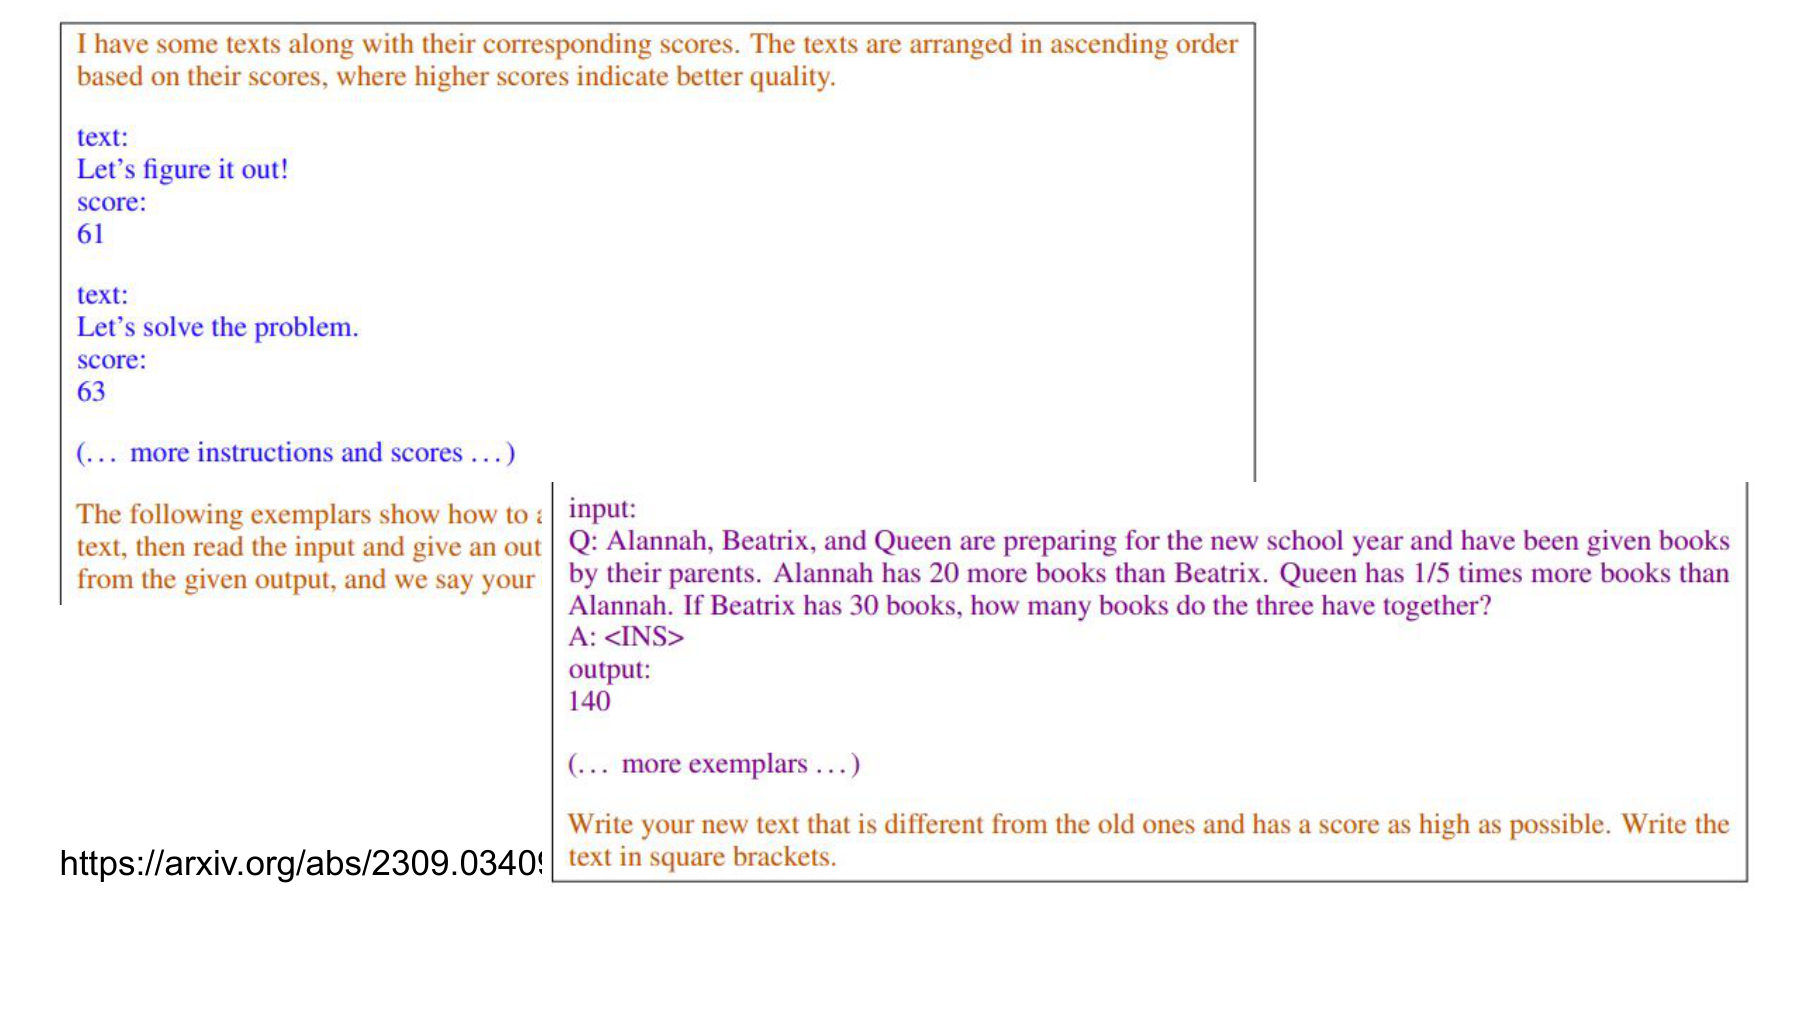
앞 장의 화살표를 실제 입력으로 펼친 그림이다. 모델에게 다른 모델이 사용할 지시문을 작성하도록 하는 입력을 메타 프롬프트(Meta-prompt)라고 부른다. 여기에는 이미 시도한 지시문, 그 지시문으로 얻은 점수, 해결할 문제의 예, 새 후보를 출력하는 요구가 함께 들어간다. 강의 9:44–10:27
각 요소가 맡는 역할은 다르다. 문제 예제는 어떤 일을 해야 하는지 보여 준다. 지시문을 삽입할 위치는 새 문장이 어느 문맥에서 읽힐지 알려 준다. 후보와 점수의 이력은 이미 시도한 방향을 제공한다. 출력 형식은 새 후보를 다음 평가에 연결하기 쉽게 만든다. 이 입력을 구성하는 것 자체도 하네스의 설계다.
여기서 사람이 “좋은 프롬프트”의 완성본을 직접 쓰는 부담은 줄어든다. 그러나 문제 집합, 점수 함수, 후보 수, 탐색 예산을 정하는 작업은 남는다. 새로운 후보가 같은 문구를 반복하거나, 일부 예제의 답을 지시문에 끼워 넣는다면 그 내용도 확인해야 한다.
#CMU 강의로 연결 — 평가 결과를 다음 제안에 되돌린다
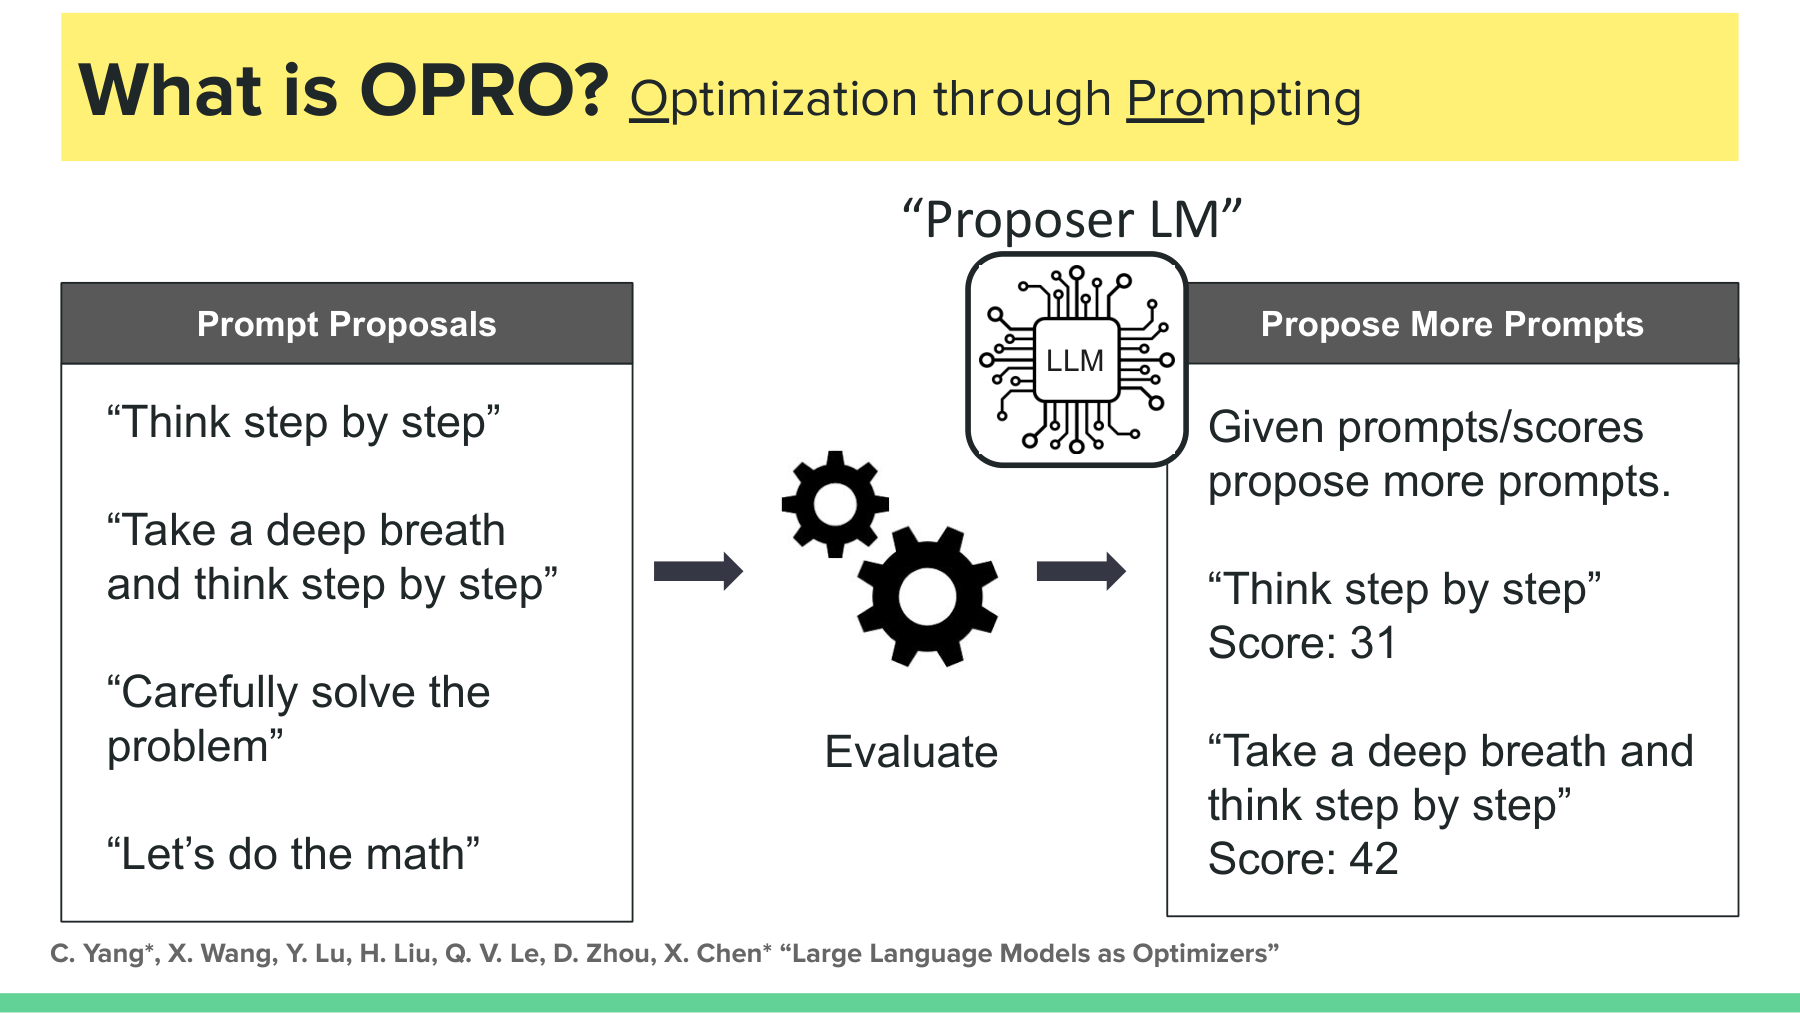
CMU 그림을 왼쪽에서 오른쪽으로 읽으면 후보가 먼저 평가기를 통과한다. 이후 후보 문장과 측정값이 제안 모델(Proposer LM)에 들어간다. 생성과 평가의 연결이 한눈에 보인다. 그림의 31·42는 이 연결을 보여 주는 표시이며, 앞 절에서 읽은 GSM8K 결과표와는 다른 값이다. CMU PDF 58쪽
예를 들어 자료 추출 에이전트의 지시문을 최적화한다고 하자. 평가가 JSON 형식만 검사하면, 올바른 JSON을 더 자주 출력하는 후보가 선택될 수 있다. 그 JSON 안의 날짜와 이름이 정확한지는 별도 조건이다. 피드백을 반복해서 돌려주는 과정은 평가기가 알려 주는 목표에 맞추어 탐색을 진행한다. 이 가상 예에서는 형식 통과율과 내용 정확도를 함께 정의해야 원하는 개선을 판단할 수 있다.
강의의 다음 구간은 한 줄로 후보를 계속 바꾸는 방식과 여러 후보를 보관하는 방식을 대비한다. 다만 OPRO 원논문도 과거의 상위 지시문과 점수를 보관하고 단계마다 여러 후보를 생성한다. 따라서 OPRO 전체를 “직전 지시문 하나만 남기는 방법”으로 설명하면 맞지 않는다. 다음 GEPA의 특징은 단순히 후보가 여러 개라는 사실보다 실행 피드백을 어떻게 사용하고, 어떤 후보를 다음 부모로 선택하는가에 있다. OPRO §4.2·§5.1
#계산 예 1 — 탐색 점수와 선택 점수를 구분한다
다음은 데이터 역할을 설명하기 위한 가상 실험이다. 후보를 만드는 데 쓰는 fit 문항과 후보 선택용 validation 문항을 각각 50개 준비했다. OPRO 원문 실험을 그대로 재현한 설정은 아니다.
| 후보 | fit 정답 수 | fit 정확도 | validation 정답 수 | validation 정확도 |
|---|---|---|---|---|
| A | 34/50 | 68% | 35/50 | 70% |
| B | 39/50 | 78% | 40/50 | 80% |
| C | 41/50 | 82% | 33/50 | 66% |
fit만 보면 C가 가장 높다. 그러나 미리 정한 선택 규칙이 validation 정확도 최대화라면 B를 고른다.
이 표는 C의 평가 간 차이를 보여 준다. 다만 50문항의 단일 결과만으로 그 차이의 원인이 과적합이라고 확정할 수는 없다. 문항 구성과 실행 변동도 영향을 줄 수 있다. 선택한 B를 고정한 뒤, 선택에 사용하지 않은 test 50문항에서 기준 A는 34개, B는 38개를 맞혔다고 하자.
이 8%p는 해당 test 평가에서 관측한 차이다. 통계적 유의성이나 다른 배포 환경의 개선까지 이 숫자만으로 주장하지 않는다. B를 고른 다음 test 결과를 보고 다시 지시문을 바꾸면, 그 test 자료도 탐색에 영향을 준 자료가 된다.
OPRO 역시 프롬프트 탐색의 과적합 문제를 논의하며, 기본 설정에는 별도 검증 세트를 두지 않고 검증 세트를 이용한 추가 분석을 제시한다. 위 표의 데이터 분리는 이 글에서 제안한 비교 설계다. OPRO §5.4
#탐색 비용은 어디에서 발생하는가
후보 8개를 각 25문항에서 실행하고, 최종 후보 2개를 각 100문항에서 다시 실행하는 별도의 가상 예를 생각해 보자. 문항당 대상 모델을 한 번만 호출한다면 대상 모델 실행 수는 다음과 같다.
여기에 후보를 만드는 호출, 실패를 분석하는 호출, 재시도와 도구 실행은 포함되지 않았다. 같은 400회라도 입력과 출력 길이가 다르면 토큰 비용도 다르다. 프롬프트를 찾는 비용과 찾은 프롬프트를 서비스에 사용하는 비용을 나눠야, 가중치를 학습하지 않는 방법의 실제 자원 요구를 이해할 수 있다.
#하편 13쪽 — GEPA는 실패 기록과 서로 다른 강점을 이용한다
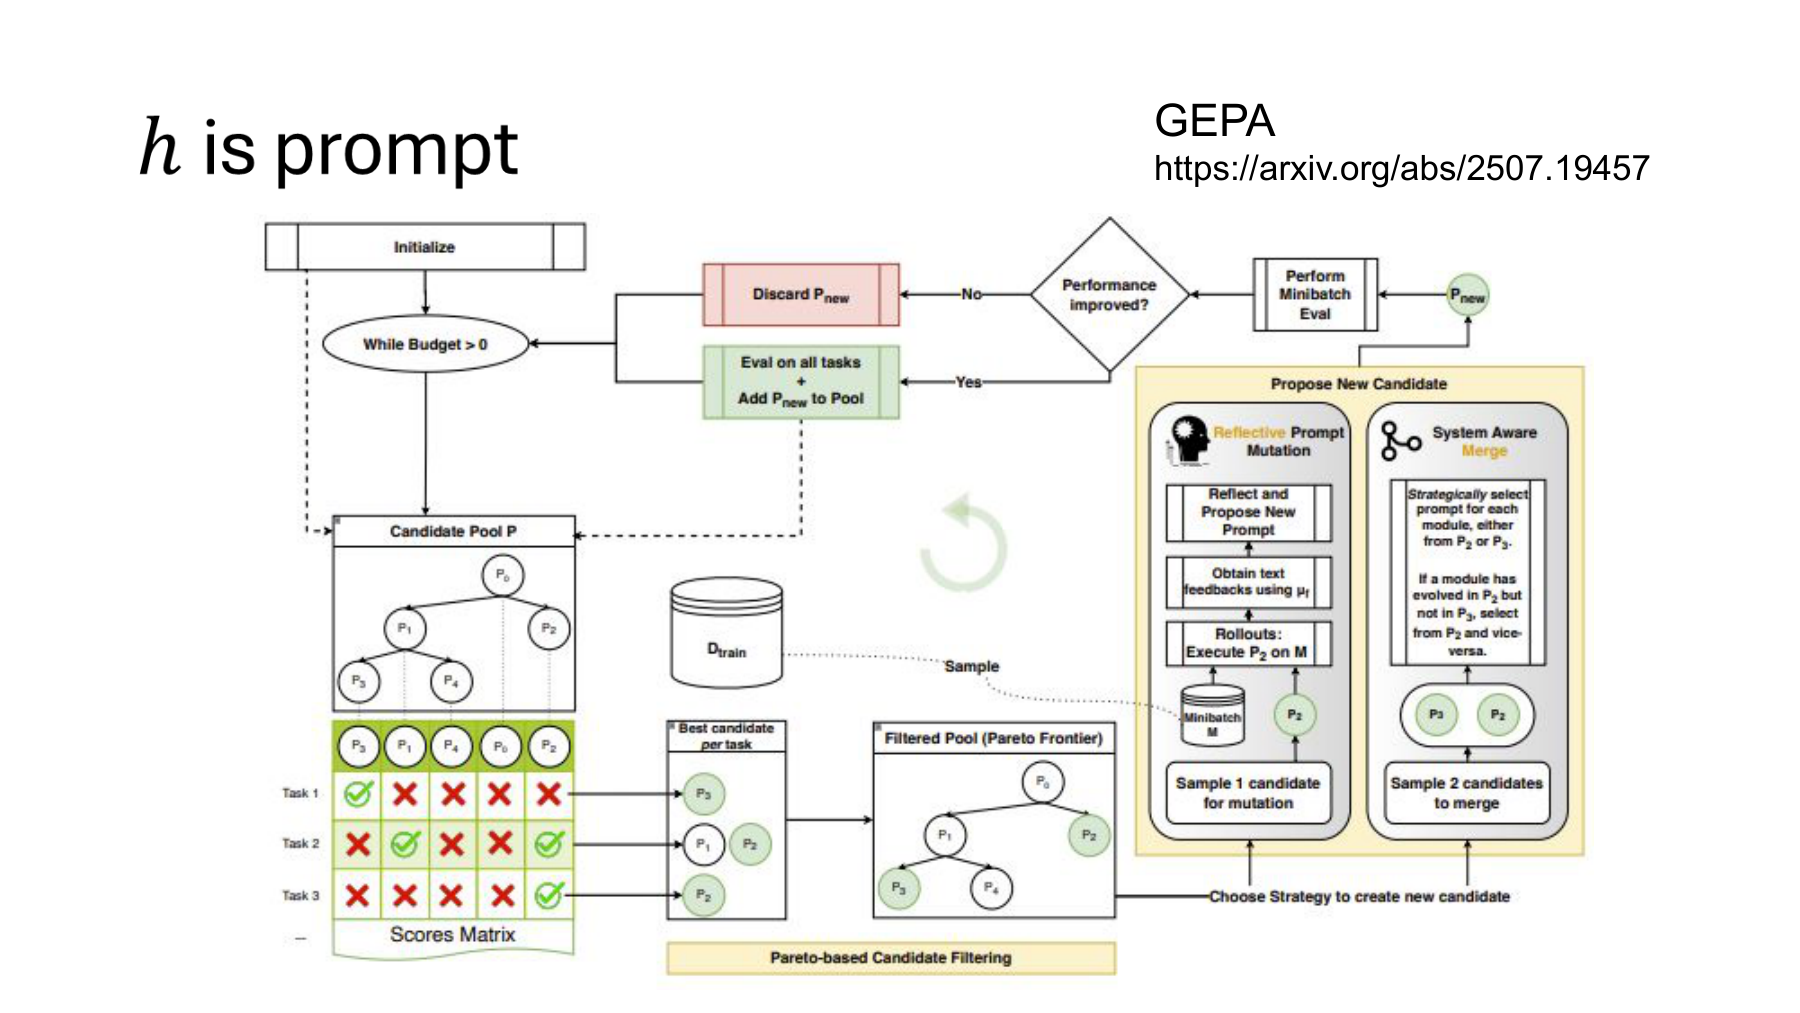
복잡한 그림을 한 번에 외울 필요는 없다. 왼쪽은 무엇을 다음 후보의 출발점으로 고를지, 오른쪽은 그 후보를 어떻게 수정할지, 위쪽은 수정 결과를 어떻게 평가할지를 보여 준다. NTU 강의도 후보 하나를 수정하는 경우와 두 후보를 결합하는 경우를 나누어 설명한다. 강의 12:59–13:53
GEPA(Genetic-Pareto)는 프롬프트를 사용하는 프로그램을 실행하고, 입력·출력·도구 응답·오류 등의 기록에서 수정 단서를 찾는다. 여기서 프로그램은 여러 LLM 모듈로 구성될 수 있다. 개선 대상으로 선택된 모듈의 지시문을 바꾸어도 다른 모듈과 연결해 다시 실행해야 전체 시스템의 점수를 알 수 있다. 원문의 프롬프트 최적화에서는 기반 모델 가중치를 고정한다. GEPA §2–3
#Stanford 저자 강연으로 연결 — 같은 0점에도 다른 정보가 있다
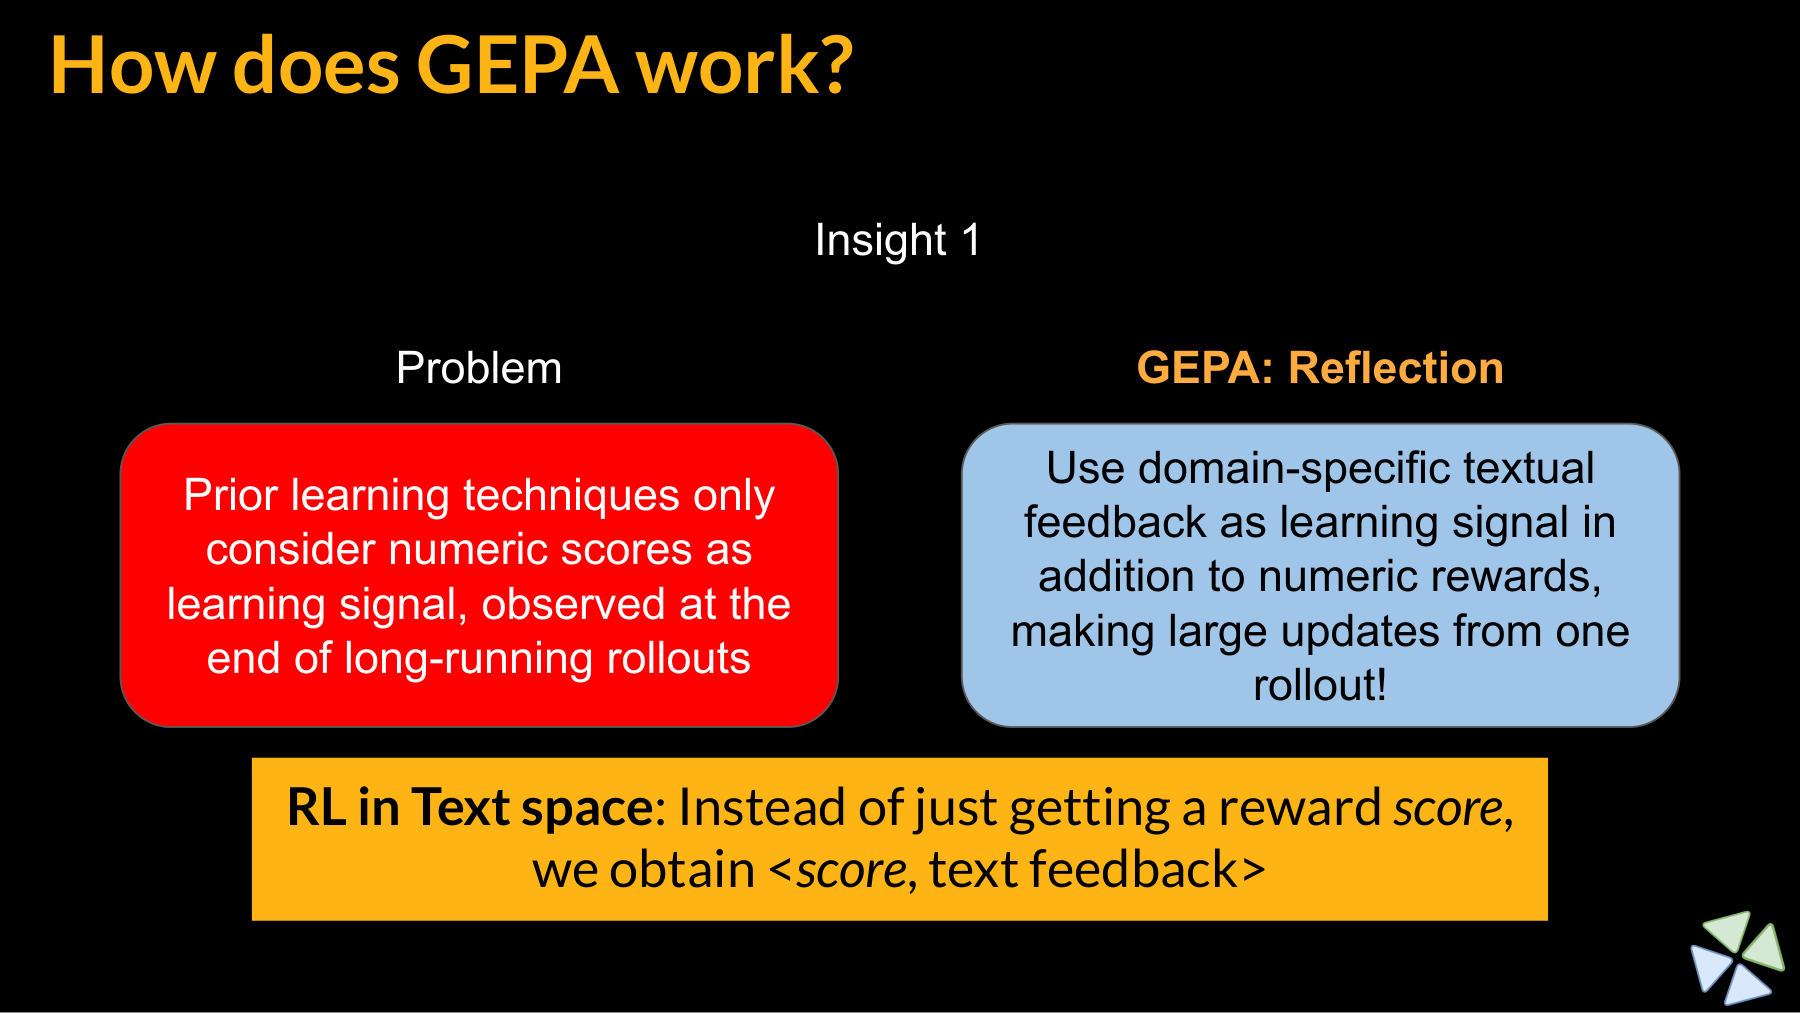
위 슬라이드는 피드백의 정보량에 주목한다. 실행이 실패해서 점수 0을 받았다는 사실은 중요하다. 여기에 어떤 도구 호출이 실패했는지, 어떤 입력 형식이 잘못됐는지까지 있으면 다음 수정의 방향을 더 구체적으로 정할 수 있다. 같은 저자의 후속 ICLR 발표는 컴파일러가 어떤 API를 사용할 수 없다고 알려 주는 경우를 예로 든다. 반성 모델은 이 기록에서 대체 API를 쓰는 수정안을 제안할 수 있다. ICLR 발표 2:25–2:58
예를 들어 실패한 코드 실행 세 개를 다음처럼 기록했다고 하자. 아래 표는 이 차이를 설명하기 위해 만든 예다.
| 최종 점수 | 함께 남은 기록 | 다음 후보에서 검토할 부분 |
|---|---|---|
| 0 | 함수 이름을 찾을 수 없다는 오류 | 사용할 수 있는 API와 버전 확인 |
| 0 | 결과는 맞지만 출력 파서가 실패 | 출력 형식과 불필요한 설명 문장 |
| 0 | 필요한 파일을 읽기 전에 수정 시작 | 파일 확인과 수정의 실행 순서 |
이런 기록이 있으면 단순히 “더 정확히 답하라”는 지시보다 구체적인 후보를 만들 수 있다. 다만 오류 기록의 원인 분석도 모델이 하는 추론이다. 정확한 수정인지 확인하는 단계는 여전히 필요하다. 수정한 후보를 실행해 같은 실패가 줄었는지, 다른 성공 사례를 망가뜨리지 않았는지 살펴야 한다.
슬라이드는 이를 텍스트 공간의 강화학습이라는 직관으로 표현한다. 여기서는 피드백을 읽고 자연어 지시를 탐색하는 과정을 가리킨다. 모든 강화학습이 숫자 하나만 활용한다는 명제나, GEPA가 GRPO의 경사 갱신을 그대로 수행한다는 뜻으로 확대하면 안 된다.
#후보를 만들고 확인하는 순서
GEPA의 핵심 절차는 다음처럼 읽을 수 있다. 원전 Algorithm 1–2와 저자 발표 5:24–6:17이 이 과정을 설명한다.
- 기존 후보 중 다음에 수정할 부모 후보와 모듈을 고른다.
- 피드백용 자료의 작은 묶음에서 실행 기록과 점수를 모은다.
- 반성 모델이 그 정보를 읽고 새 지시문을 제안한다.
- 같은 작은 묶음에서 부모와 새 후보를 비교한다.
- 개선된 후보를 선택용 문항 집합에서도 평가하고 점수행렬에 기록한다.
후보를 결합하는 경로에서는 모듈별로 어떤 변경을 가져올지도 고려한다. 문자열 두 개를 이어 붙이는 것만으로 두 기능이 자연스럽게 결합된다고 가정하지 않는다. 또한 선택용 문항 집합은 반복해서 부모 선택에 영향을 준다. 최종 일반화 성능을 보고할 자료는 그 탐색 과정과 구분해야 한다.
#Stanford 저자 강연으로 연결 — 평균이 낮아도 다음 탐색에 가치가 있다
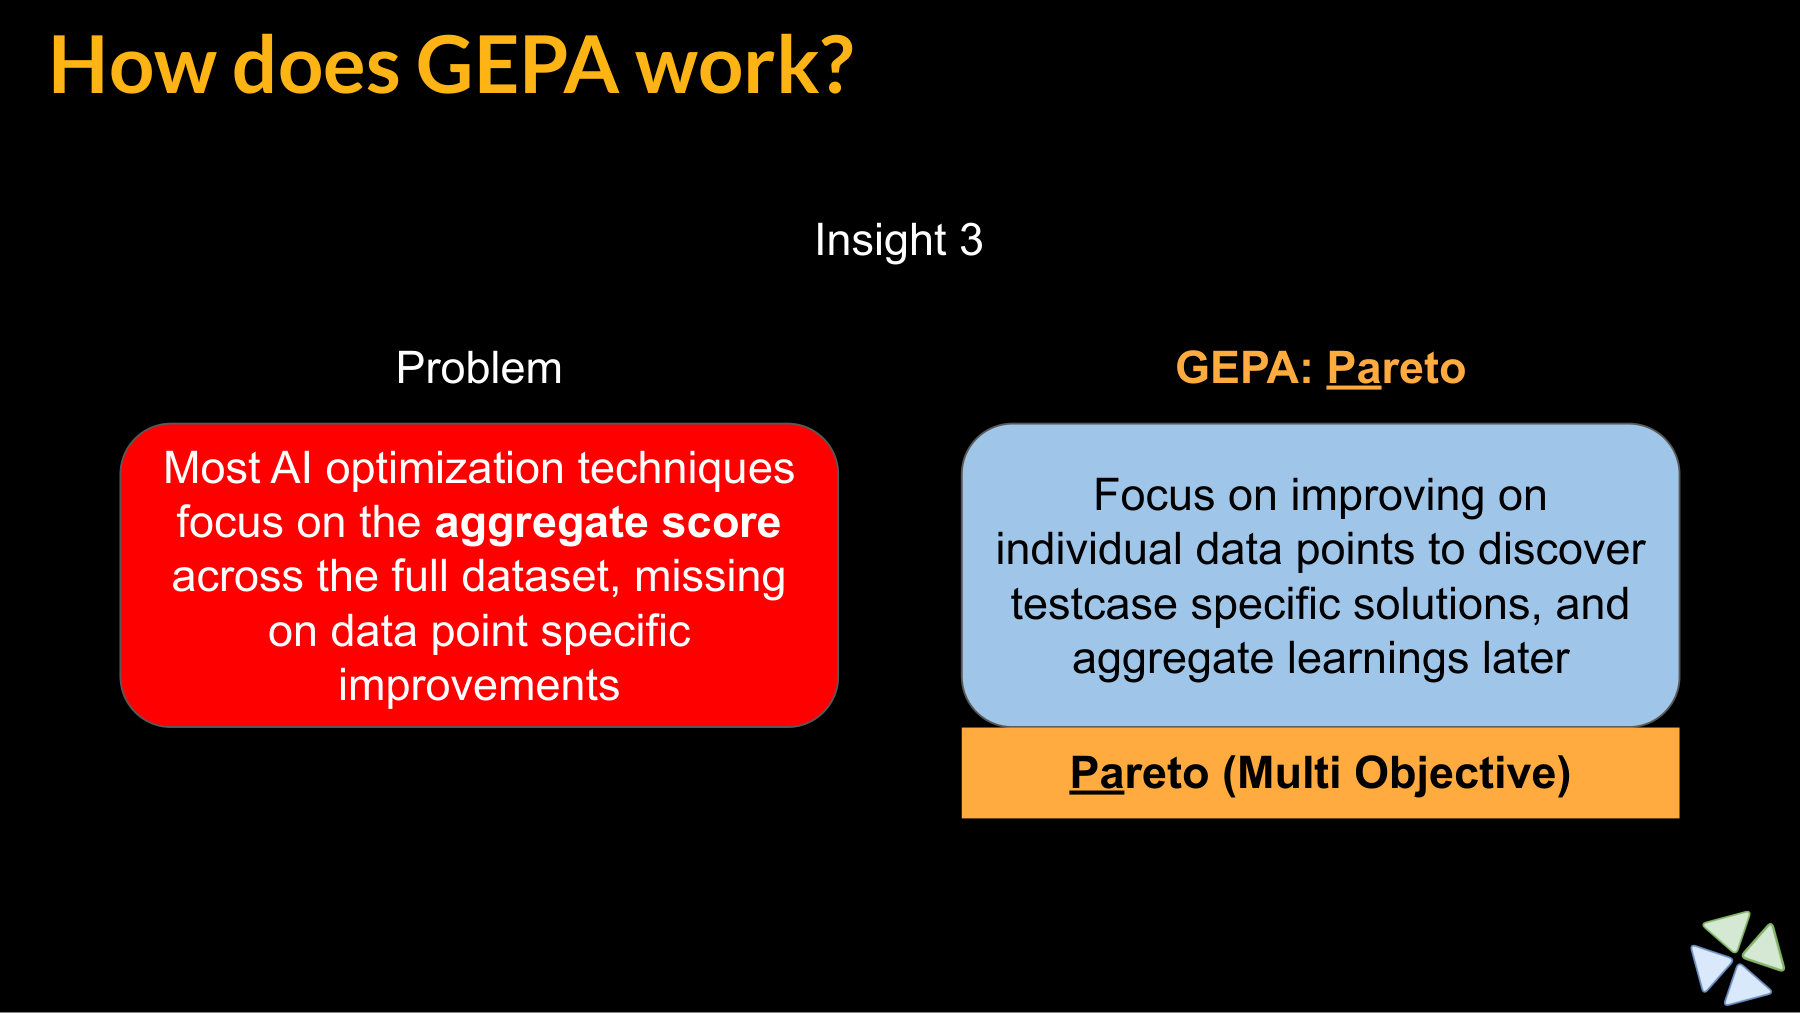
후보 하나의 평균만 보면 어떤 문제를 잘 풀었는지 사라진다. 평균 1위의 후보가 약한 문제를 다른 후보가 해결한다면, 그 후보에도 다음 수정에 쓸 단서가 있다. 저자는 후속 발표에서 문항별 강점을 보존하면 드문 해결 방법을 이후 후보로 전달할 수 있다고 설명한다. ICLR 발표 6:54–7:24
GEPA에서 이 생각은 문항별 점수행렬과 부모 선택 절차로 구체화된다. 비용과 정확도 두 축을 비교하는 파레토 그림으로 바로 치환하기보다, 각 문항을 하나의 성능 축으로 놓는 방식부터 확인하는 것이 정확하다.
#계산 예 2 — 문항별 후보 선택을 직접 계산한다
아래는 세 문항과 네 후보의 가상 점수행렬이다. 점수는 0–1 범위의 평가값이며, 한 번의 정답 여부만 주는 이진 정확도라고 가정하지 않는다. 세 문항의 가중치는 같다.
| 후보 | 문항 1 | 문항 2 | 문항 3 | 평균 점수 |
|---|---|---|---|---|
| A | 0.90 | 0.80 | 0.20 | 0.6333 |
| B | 0.40 | 0.30 | 0.95 | 0.5500 |
| C | 0.60 | 0.60 | 0.60 | 0.6000 |
| D | 0.70 | 0.50 | 0.10 | 0.4333 |
평균만 보면 A가 가장 높다. 그러나 문항 3의 최고 후보는 B다. k번째 후보의 i번째 문항 점수를 s_k[i]로 쓰면 문항별 최고 후보 집합은 다음과 같다.
이 예에서는 문항 1과 2의 집합이 각각 A만 포함하고, 문항 3은 B만 포함한다. 따라서 합집합은 A와 B다. 원문의 Algorithm 2는 이 후보들 안에서 지배되는 후보를 제거한 뒤, 각 후보가 문항별 최고 집합에 등장한 횟수에 비례해 다음 부모를 뽑는다. 이 표에서는 A와 B가 서로를 지배하지 않는다.
이렇게 하면 평균이 A보다 낮은 B도 다음 수정의 출발점이 될 수 있다. 여기서 확률은 이 예의 후보 선택 확률이다. B가 선택되면 더 좋은 자손이 나올 확률이 1/3이라는 뜻은 아니다.
한 가지를 더 구분하자. 일반적인 파레토 비지배(Pareto nondominance)는 다른 후보가 모든 문항에서 같거나 더 좋고 적어도 하나에서 더 좋을 때 지배된다고 정의한다. 이 정의에서는 C도 비지배 후보다. A는 문항 3에서 C보다 낮고, B는 문항 1·2에서 C보다 낮기 때문이다. 그러나 C는 어느 문항에서도 최고가 아니므로 위의 문항별 최고 합집합에는 들어가지 않는다.
따라서 이 표에서 일반 비지배 집합은 A·B·C이고, GEPA의 해당 부모 선택에 쓰는 집합은 A·B다. D는 A에게 모든 문항에서 지배된다. 이 예는 원문의 구체적인 선택 절차가 “모든 비지배 후보를 똑같이 뽑는다”와 다름을 보여 준다. 부모 선택에서 빠졌다는 사실을 전체 후보 기록에서 영구 삭제됐다는 뜻으로 읽을 필요도 없다. GEPA Algorithm 2
#GEPA의 실험 결과를 어디까지 읽을 수 있는가
GEPA 원문의 Qwen3-8B 비교에서는 여섯 과제의 평균 점수가 GEPA 54.85, GRPO 48.91이다. 그러나 같은 표의 AIME-2025에서는 GRPO 38.00이 GEPA 32.00보다 높다. 제목의 “Can Outperform Reinforcement Learning”은 실험 조건에 따라 우수한 결과를 낼 수 있다는 주장이다. 모든 과제와 모든 RL 방법에 대한 순위로 읽으면 안 된다. GEPA Table 1, §4
사용한 실행 횟수(rollout)가 적어도 총비용이 같은 비율로 줄었다는 뜻은 아니다. 반성 모델의 호출, 기록의 길이, 후보 평가 범위를 함께 세어야 한다. 자신의 시스템에서 비교하려면 같은 기반 모델과 문항, 판정 규칙, 비용 범위를 고정하고 결과를 확인해야 한다.
#하편 14쪽 — ALMA는 기억을 관리하는 설계를 바꾼다
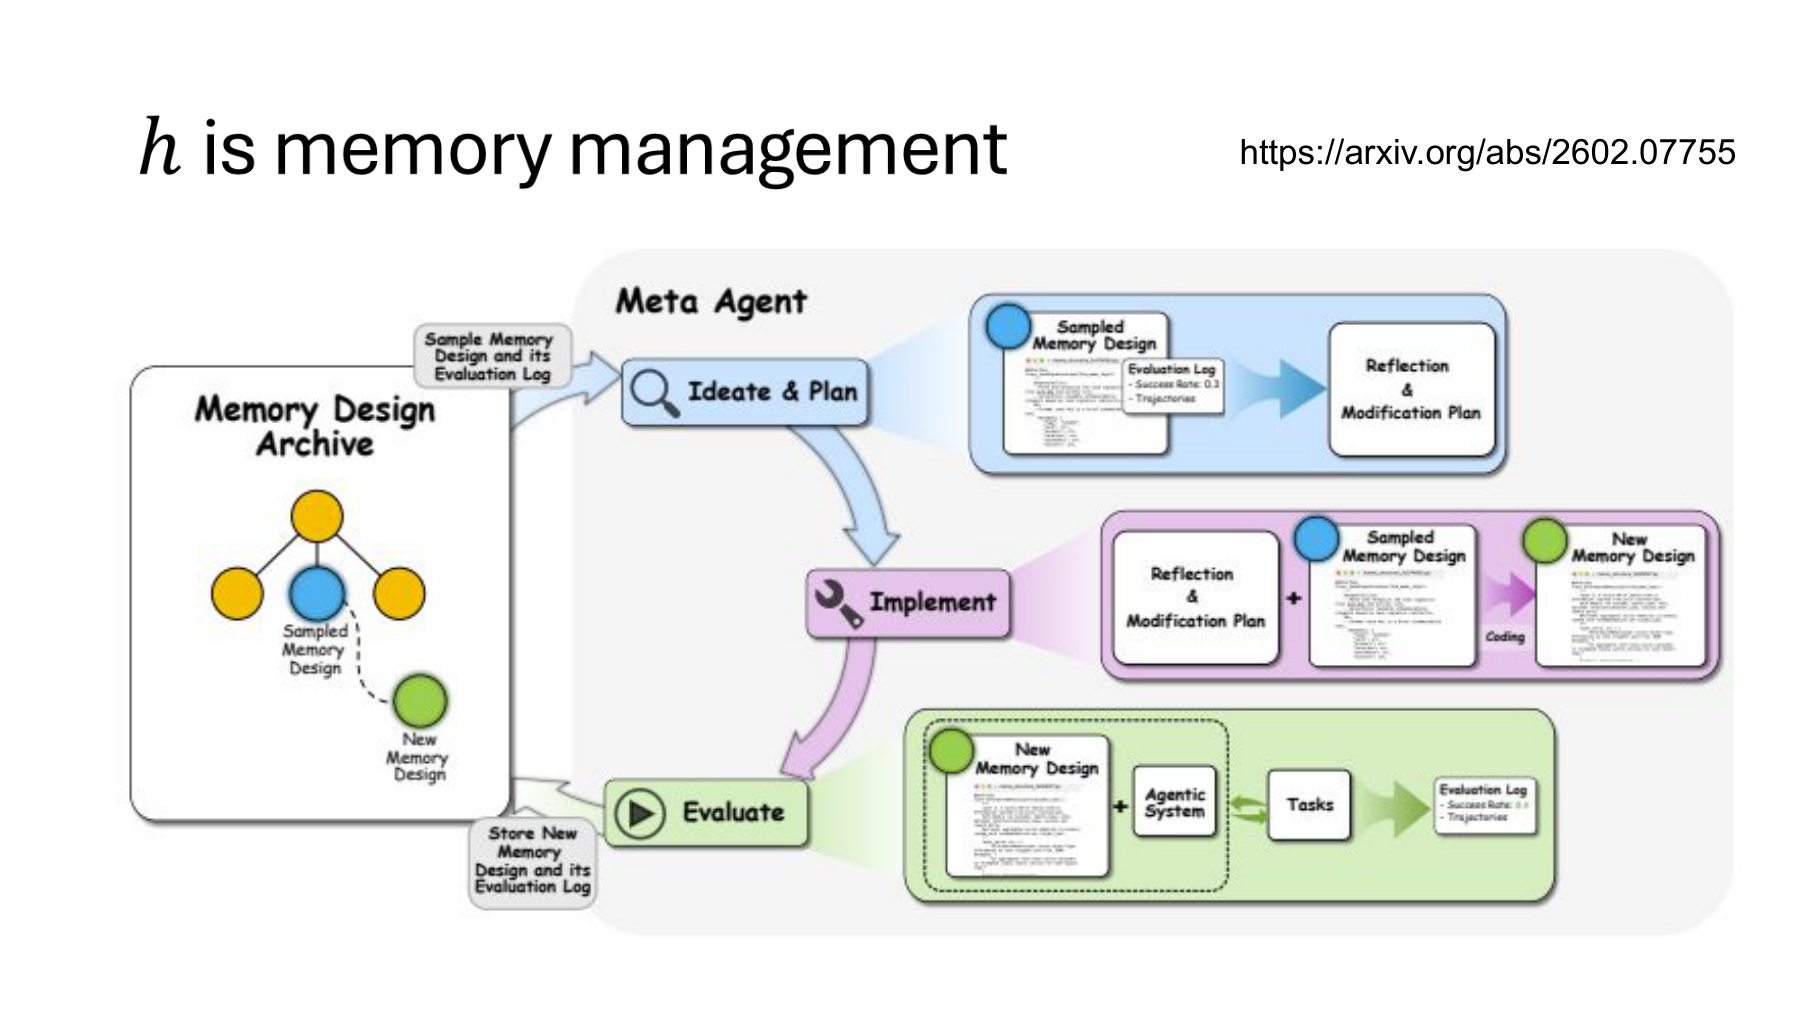
앞에서는 지시문을 바꿨다. 이제 수정 대상이 메모리 관리(Memory management)로 옮겨 간다. 에이전트가 과거의 경험을 활용하려면 무엇을 저장할지, 어떤 구조로 묶을지, 현재 문제에 무엇을 꺼내 줄지 정해야 한다. NTU 강의는 이 설계를 후보로 만들고 평가하는 방법을 소개한다. 강의 13:53–15:31
ALMA는 Automated meta-Learning of Memory designs for Agentic systems의 약자다. 그림의 Meta Agent는 기존 메모리 설계 코드와 평가 로그를 읽고 새로운 설계를 구현한다. 평가할 때는 그 설계를 고정된 과제 수행 에이전트에 연결한다. 원문의 주된 인터페이스는 general_update()와 general_retrieve()이며, 그 안의 저장 구조와 갱신·검색 절차를 코드로 표현한다. ALMA §3.1–3.3
#기억 내용과 기억 설계는 서로 다른 상태다
두 수준을 나누어 생각하면 그림이 쉬워진다. 기억 내용은 지금까지 쌓인 경험이다. 기억 설계는 그 경험을 어떤 기준으로 저장하고 검색할지 정한 코드다.
설명을 위해 기억 내용을 M, 설계를 φ로 쓰자. φ는 이 절에서 메모리 코드를 가리키는 식별자다. 신경망의 연속 가중치 벡터라는 가정은 하지 않는다. 에이전트가 만든 실행 기록을 τ_t, 현재 문제를 q_t라고 하면 갱신과 검색을 다음처럼 표현할 수 있다.
U_φ는 어떤 경험을 어떻게 저장할지 정한다. R_φ는 현재 문제에 사용할 자료 z_t를 꺼낸다. φ를 고정하고 새 기록을 넣으면 같은 설계에서 내용이 변한 것이다. 반대로 검색 규칙이나 저장 코드를 고쳐 φ′를 만들면 설계 자체가 변한 것이다. 두 변화는 동시에 일어날 수 있으므로 어떤 수준을 평가하는지 명시해야 한다.
| 변화 | 달라진 것 | 예 |
|---|---|---|
| 경험 축적 | M | 실패한 API 호출과 해결 조건을 추가 저장 |
| 검색 결과 변화 | z_t | 새 질문에 맞는 과거 오류 사례를 검색 |
| 메모리 설계 개선 | φ | 버전·환경 조건을 저장하고 검색에 반영하도록 코드 수정 |
이 표의 API 사례는 설명용이다. 과거에 성공한 명령도 현재 버전에서는 실패할 수 있다. 단순히 성공 문장을 저장하는 설계보다 적용 조건을 함께 저장하는 설계가 도움이 될 수 있지만, 더 긴 기록이 매번 유리한 것은 아니다. 필요한 기록을 놓치거나 오래된 조건을 무시하는 경우도 평가해야 한다.
#안쪽의 경험 활용과 바깥쪽의 설계 탐색
그림의 안쪽에서 에이전트는 메모리를 사용해 과제를 수행한다. 바깥쪽에서 Meta Agent는 그 성능과 로그를 보고 메모리 코드를 바꾼다. 그래서 ALMA를 읽을 때는 “무엇을 기억했는가”와 “어떻게 기억하도록 설계했는가”를 함께 봐야 한다.
실험 설계에서도 이 두 수준을 분리한다. ALMA는 먼저 경험을 수집해 메모리를 만들고, 이후의 과제에서 그 기억이 얼마나 도움이 되는지 평가한다. 설계를 찾는 단계에서는 배포 구간의 메모리를 고정하는 static mode를 사용한다. 선택한 설계의 시험에서는 내용을 계속 갱신하는 dynamic mode도 평가한다. static이라고 해서 메모리 설계의 update 함수가 불필요한 것은 아니다. 앞선 수집 단계에서 그 함수가 기억 내용을 만들기 때문이다. ALMA §3.2
이 구분을 일반적인 실험에 적용해 보자. 두 메모리 설계에 서로 다른 경험을 미리 넣어 주면 설계와 경험량의 효과가 섞인다. 후보 B가 먼저 푼 시험 문제의 정답을 기억하고 후보 A는 빈 상태로 시작한다면 공정한 비교도 어렵다. 설계를 비교할 때는 경험 수집에 사용한 자료, 시작 상태, 문제 순서, 배포 중 갱신 여부를 함께 정해야 한다. 이 문단은 위 구조에서 도출한 비교 원칙이다.
#원전 결과표로 확인 — 평균 개선과 개별 조건의 차이
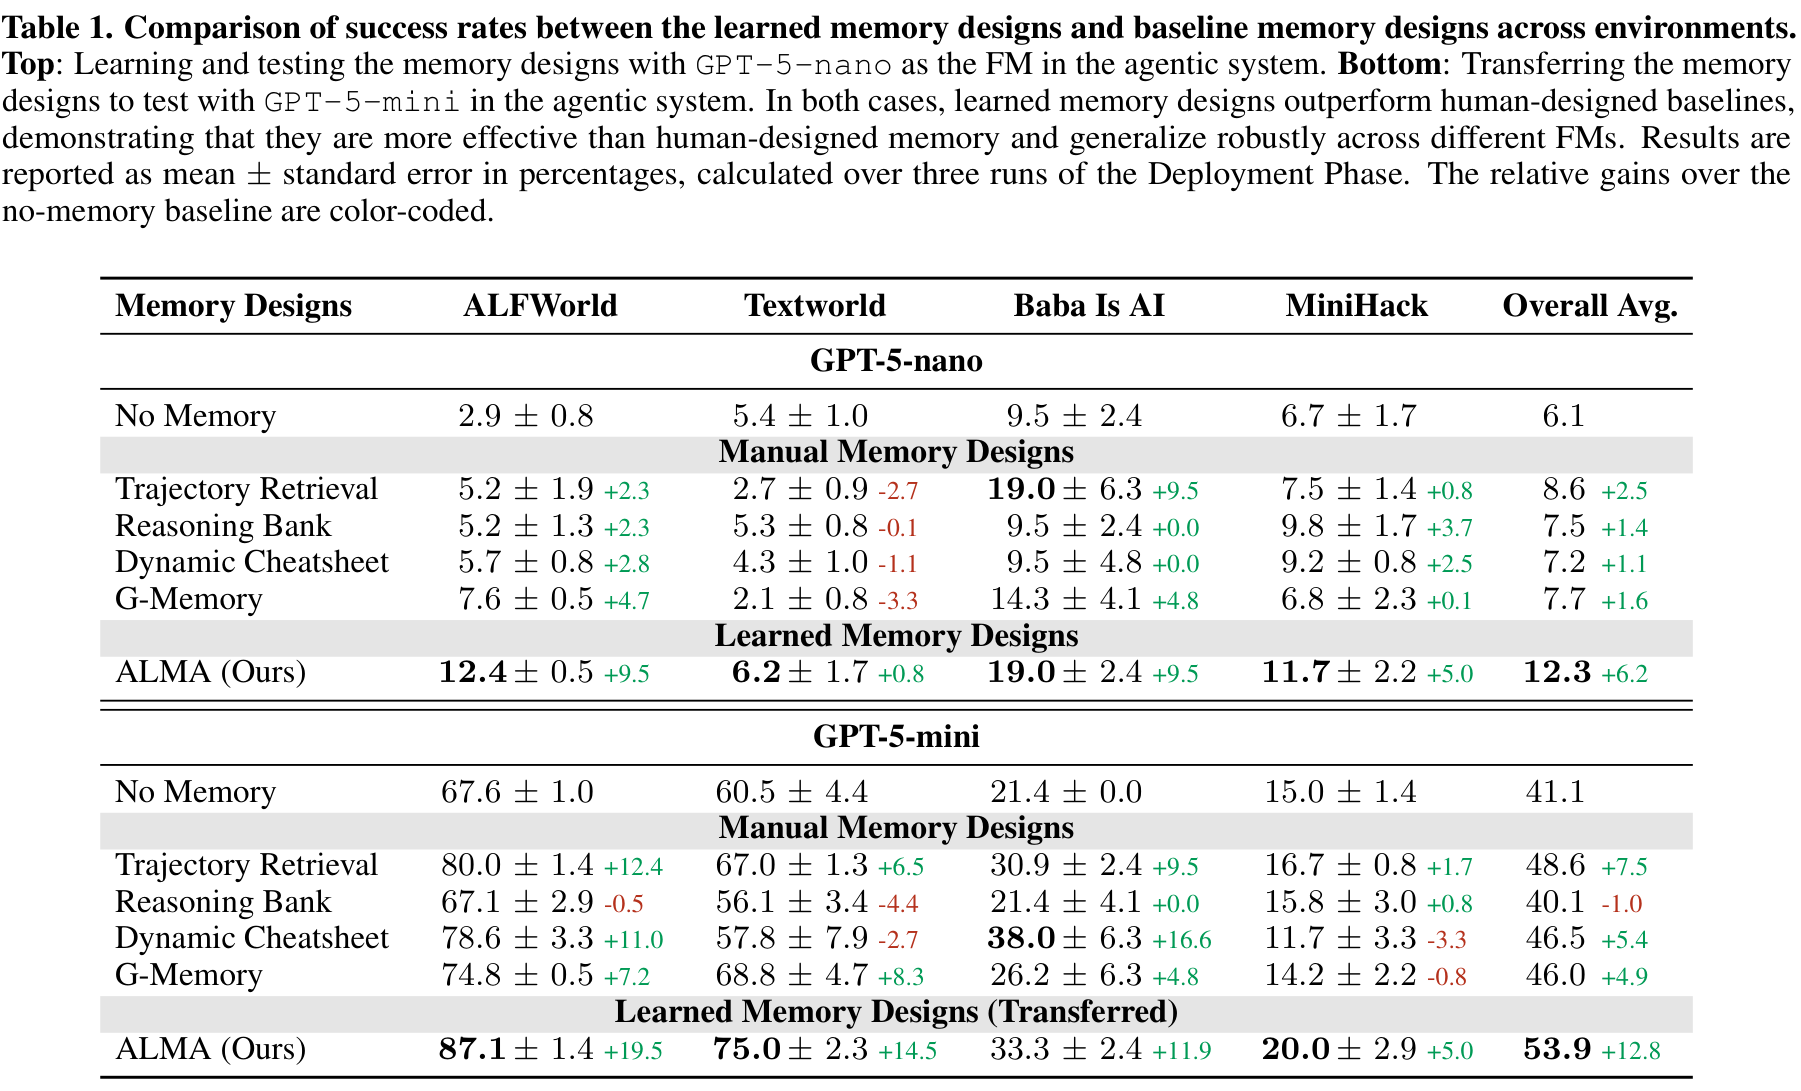
표는 ALFWorld, TextWorld, Baba Is AI, MiniHack의 성공률을 비교한다. 표시된 전체 평균에서 GPT-5-nano는 메모리 없음 6.1%에서 ALMA 12.3%로, GPT-5-mini는 41.1%에서 53.9%로 높아진다. 표의 표시값을 빼면 각각 6.2%p와 12.8%p 차이다. 환경별 오차 표시는 배포 단계 3회 실행의 표준오차다. ALMA §4.1, Table 1
그러나 GPT-5-mini의 Baba Is AI에서는 Dynamic Cheatsheet 38.0%가 ALMA 33.3%보다 높다. 평균 결과를 모든 환경에서 모든 기준선을 이겼다는 주장으로 바꾸면 안 된다. 또한 표시값들은 이미 반올림되어 있으므로, 개별 셀을 다시 평균한 값의 마지막 자릿수까지 원자료와 같다고 가정하지 않는다.
이 표가 보여 주는 연구 질문은 메모리 용량을 무조건 늘릴 수 있는가보다 구체적이다. 같은 에이전트가 경험을 더 잘 활용하도록 저장·갱신·검색의 방법을 찾을 수 있는가? 자신의 시스템에 적용하려면 성공률과 함께 검색된 자료의 길이, 저장·검색 호출 비용, 오래된 경험 때문에 생긴 실패도 살펴볼 수 있다.
#하편 15쪽 — DGM은 에이전트 자신의 코드를 수정한다
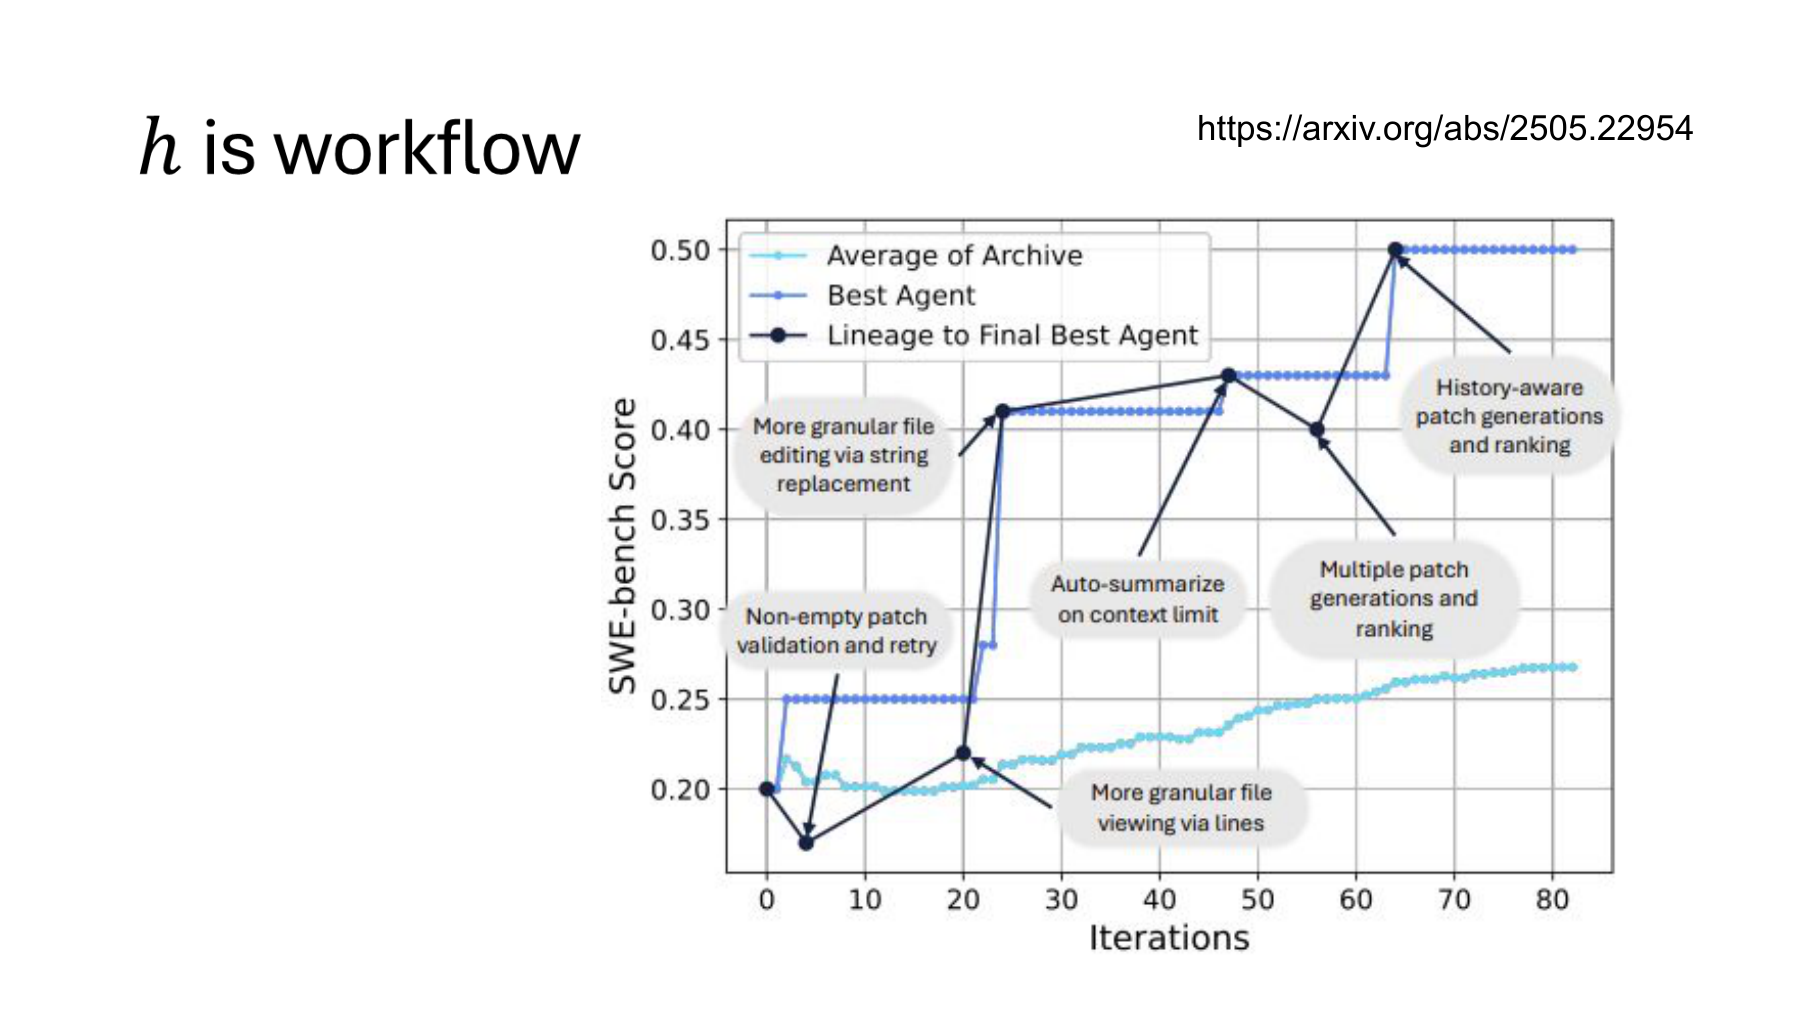
이 장에서는 하네스 h가 작업 절차(Workflow)까지 포함한다. 그래프에는 파일의 지정한 줄을 읽는 도구, 문자열 치환으로 편집하는 도구, 문맥이 길어질 때 요약하는 절차 등이 표시된다. NTU 강의는 이 변화를 에이전트가 자기 작업 방법을 개선한 사례로 설명한다. 강의 15:31–17:12
DGM(Darwin Gödel Machine)의 수정 대상은 코딩 에이전트 자신의 코드다. 이 에이전트가 외부 과제의 저장소를 고치는 능력과, 자기 도구·지시·실행 절차를 고치는 능력이 연결된다. 기반 모델의 가중치는 고정하며, 자기 코드를 바꾼 후보를 코딩 벤치마크로 평가한다. DGM §3
예를 들어 외부 프로젝트의 함수 하나를 고쳤다면 그 프로젝트가 달라진다. 반면 다음 과제에서도 사용할 파일 편집 도구를 자신의 코드에 추가했다면 에이전트의 하네스가 달라진다. 두 작업 모두 코드를 쓰지만 변화가 남는 위치가 다르다. 이 위치를 확인하면 단순한 과제 해결과 시스템 개선을 구분할 수 있다.
#그래프의 세 선을 따로 읽는다
이 그림에는 서로 다른 세 가지 집계가 있다. DGM Figure 3 및 설명
| 선 | 읽는 방법 |
|---|---|
| 밝은 파란색 | 보관한 후보들의 평균 점수 |
| 파란색 | 그때까지 발견한 최고 후보의 점수 |
| 어두운 선과 점 | 최종 최고 후보로 이어지는 조상 후보의 경로 |
최고 점수의 상승이 모든 수정의 성공을 뜻하지는 않는다. 새 후보가 기존 최고보다 못해도 기존 최고를 보관했다면 최고 기록은 남는다. 조상 경로가 중간에 내려가는 부분은 낮은 점수의 후보가 이후 탐색의 출발점이 될 수 있다는 점을 보여 준다.
이를 확인하기 위해 평가 규칙과 각 후보의 기록 점수가 고정된 가상 archive를 생각하자. 시점 t의 후보 집합을 ℋ_t라고 하면 최고 점수와 평균은 다음처럼 다르다.
기존 후보를 유지하면서 새 후보를 추가하는 경우에는 최고 기록이 내려가지 않는다.
이것은 집합의 최댓값 성질이다. 새 후보가 항상 더 좋다는 증명은 아니다. 예를 들어 점수 0.4와 0.3인 두 후보에 0.2인 새 후보를 추가하면 최고는 0.4로 유지되지만 평균은 내려간다.
따라서 최고 기록, 전체 후보의 분포, 다음 탐색에 사용한 경로는 서로 다른 질문에 답한다. 위 수식은 고정 점수를 가정한 예다. 실제 실험에서 평가 자료나 반복 수를 바꾸어 점수를 다시 측정하면 측정 변동도 함께 고려해야 한다.
#성능 수치와 자기수정의 범위
DGM 원문은 SWE-bench 실험에서 20.0%에서 50.0%로의 개선을 보고한다. 이 비교는 SWE-bench Verified의 200문항 부분집합에 관한 것으로, 전체 500문항의 점수라고 적으면 안 된다. 또한 탐색 중 모든 후보를 같은 문항 수로 평가한 것은 아니다. 원문은 작은 묶음에서 시작해 유망한 후보를 더 큰 묶음으로 평가하는 절차를 사용한다. DGM §4.2–4.4
표시된 시작점과 끝점의 차이는 30%p이며, 최종 성능 수준은 시작의 2.5배다. 이 숫자가 모델 가중치의 지능이 같은 비율로 늘었다는 뜻은 아니다. 해당 코딩 시스템과 평가 조건의 변화다. Polyglot도 탐색 부분집합의 14.0%→38.0%와 전체 벤치마크의 14.2%→30.7%를 구분해서 보고한다. 같은 절
이름에 Gödel이 들어가지만, 개선이 수학적으로 반드시 유익하다는 증명을 수행한 것은 아니다. DGM은 변경을 벤치마크에서 경험적으로 확인한다. 자기수정의 범위도 구체적이다. 논문의 구현에서는 archive 유지와 부모 선택을 포함하는 바깥 탐색 과정은 고정되어 있다. 에이전트가 모든 평가 규칙과 탐색 규칙을 자유롭게 바꾼다고 설명하면 범위가 넓어진다. DGM §3
또한 DGM은 단순히 부모보다 점수가 높은 후보만 남기는 방식이 아니다. 기본 코드 편집 기능을 유지하는 후보를 보관하며, 당장의 점수가 낮은 후보도 나중에 좋은 변경으로 이어질 수 있다. 이런 후보 보존과 실제 계보는 다음 편에서 더 자세히 살펴본다.
#네 방법을 하나의 질문으로 읽기
다섯 장을 따라가며 하네스의 범위가 넓어졌다. 이를 비교할 때는 “스스로 좋아졌다”는 표현을 다음 표의 구체적인 동작으로 풀어 쓰면 된다.
| 방법 | 바꾸는 대상 | 수정에 사용하는 근거 | 확인할 평가 경계 |
|---|---|---|---|
| OPRO | 지시문 | 이전 후보와 과제 점수 | 후보를 만든 자료와 최종 시험 자료 |
| GEPA | 모듈별 프롬프트 | 실행 기록·텍스트 피드백·문항별 점수 | 부모 선택과 최종 성능 평가 |
| ALMA | 메모리의 저장·갱신·검색 코드 | 경험 활용 성능과 실행 로그 | 경험 내용의 변화와 설계의 변화 |
| DGM | 에이전트 자신의 코드와 작업 절차 | 코딩 과제 평가와 후보의 기록 | 수정 가능한 코드와 고정된 바깥 탐색 |
네 방법을 자신의 연구로 옮긴다면, 먼저 변경할 파일이나 지시문을 하나의 버전으로 고정할 수 있어야 한다. 그다음 평가에 사용할 문제, 실행 조건, 비용 범위를 정한다. 수정안을 만드는 AI에게는 다음 개선에 필요한 정보가 제공되어야 하고, 선택한 수정안에는 새로운 문제에서도 유효한지 확인할 기회가 필요하다. 이 순서가 있어야 결과가 어떤 시스템의 어느 변화에 관한 것인지 설명할 수 있다.
한편 프롬프트가 길어졌거나 메모리에 더 많은 내용이 쌓였다는 사실만으로 성능이 좋아졌다고 판단할 수 없다. 정확도, 비용, 실패의 종류를 함께 보아야 한다. 이번 편의 계산 예처럼 평균과 문항별 결과, 현재 최고 후보와 탐색 중간 후보도 서로 다른 정보를 준다.
다음 17편은 하편 16쪽부터 이어진다. DGM이 어떤 후보를 보관하고 어떤 경로를 거쳐 다음 후보를 만들었는지 살펴본 뒤, 프로그램 수준의 최적화와 모델 학습이 연결되는 흐름으로 나아간다.
계산 예제와 코드
정확도와 오류율, 후보 선택, 실행 예산, 문항별 최고 후보와 일반 비지배 집합, 부모 선택 확률, archive의 최고·평균을 계산한다. 동률과 지배 후보 제거는 별도 작은 사례로 확인한다. 출판된 결과의 산술 확인과 본문의 가상 예제를 구분하며, 실제 모델이나 논문 벤치마크를 다시 실행하는 코드는 아니다. ALMA 표의 표시 평균과 이미 반올림된 셀을 다시 평균한 값의 차이도 기록한다.
#함께 읽을 자료
| 자료 | 이 글과 연결되는 내용 |
|---|---|
| NTU 하편 PDF 11–15쪽 · 강의 영상 | 프롬프트에서 메모리·워크플로로 확장되는 하네스 개선 |
| OPRO, arXiv v3 | 후보 이력과 점수로 지시문을 제안하는 메타 프롬프트, 과적합 분석 |
| CMU LLMs 강의 PDF 58쪽 | 후보 생성 모델과 평가 순환의 역할 구분 |
| GEPA, arXiv v2 | 실행 피드백, 모듈별 수정, 문항별 부모 선택의 실제 알고리즘 |
| Stanford GEPA 발표 PDF 27쪽 · 31쪽 | 텍스트 피드백과 개별 문항의 강점을 보존하는 이유 |
| GEPA 저자 ICLR 2026 발표 · 2:25 · 5:24 · 6:54 | API 오류 활용, 자료 분리, 문항별 후보 선택과 결합 |
| ALMA, arXiv v1 | 기억 내용을 활용하는 과정과 메모리 설계 코드를 탐색하는 과정 |
| Darwin Gödel Machine, arXiv v3 | 에이전트 자체 코드 수정, 후보 보관, 평가 범위와 자기수정의 경계 |
OPRO는 2023년 처음 공개된 연구의 2024년 v3를, GEPA·ALMA·DGM은 각각 2026년 2월·2월·3월에 공개된 위 판본을 기준으로 읽었다. Stanford 슬라이드는 2025년 강연 자료이며 ICLR 영상은 그와 별도의 후속 발표다. 성능 수치는 해당 판본의 실험 결과다.