자가개선(Self-improvement)은 매번 현재의 최고 후보만 바꾸는 과정이 아니다. 좋은 수정안을 찾으려면 후보의 다양성, 프로그램의 구조, 경험을 저장하고 활용하는 방법까지 함께 설계해야 한다.
16편에서는 프롬프트(OPRO·GEPA), 메모리 설계(ALMA), 에이전트 코드(DGM)를 바꾸는 방법을 비교했다. 이번에는 DGM의 실제 후보 계보를 읽고, 에이전트 프로그램을 선언적으로 구성하는 DSPy와 경험 검색을 결합한 학습으로 넘어간다. 순서는 탐색 계보 → 프로그램 최적화 → 하네스와 파라미터 → 검색과 학습의 결합이다.
슬라이드별 영상 위치
| 원본 | 영상·원전 | 살펴볼 내용 |
|---|---|---|
| 하편 16쪽 | 17:12부터 | DGM 후보 계보와 단계적 평가로 이어지는 발언 |
| 하편 17쪽 | 동일 영상 | Archive Tree, 성능 색상, 평가 규모 |
| 하편 18쪽 | 동일 영상 | DSPy의 선언형 언어모델 프로그램 |
| 하편 19쪽 | 동일 영상 | 하네스와 모델 파라미터의 차이 |
| 하편 20쪽 | 동일 영상 | 경험 검색과 fine-tuning의 연결 |
앞편의 제공 자막 검증 기록은 16쪽 DGM 계보 이야기의 주제 시작점을 17:12로 기록한다. 정확한 화면 전환 프레임은 아니며, 17–20쪽의 독립 주제 발화 시각은 검증되지 않아 임의의 타임코드를 만들지 않았다. 이 글의 논문 해설과 예제는 강사의 직접 발언을 인용한 것으로 표시하지 않는다.
#하편 16쪽 — 한 번의 승리보다 후보 아카이브가 중요한 이유
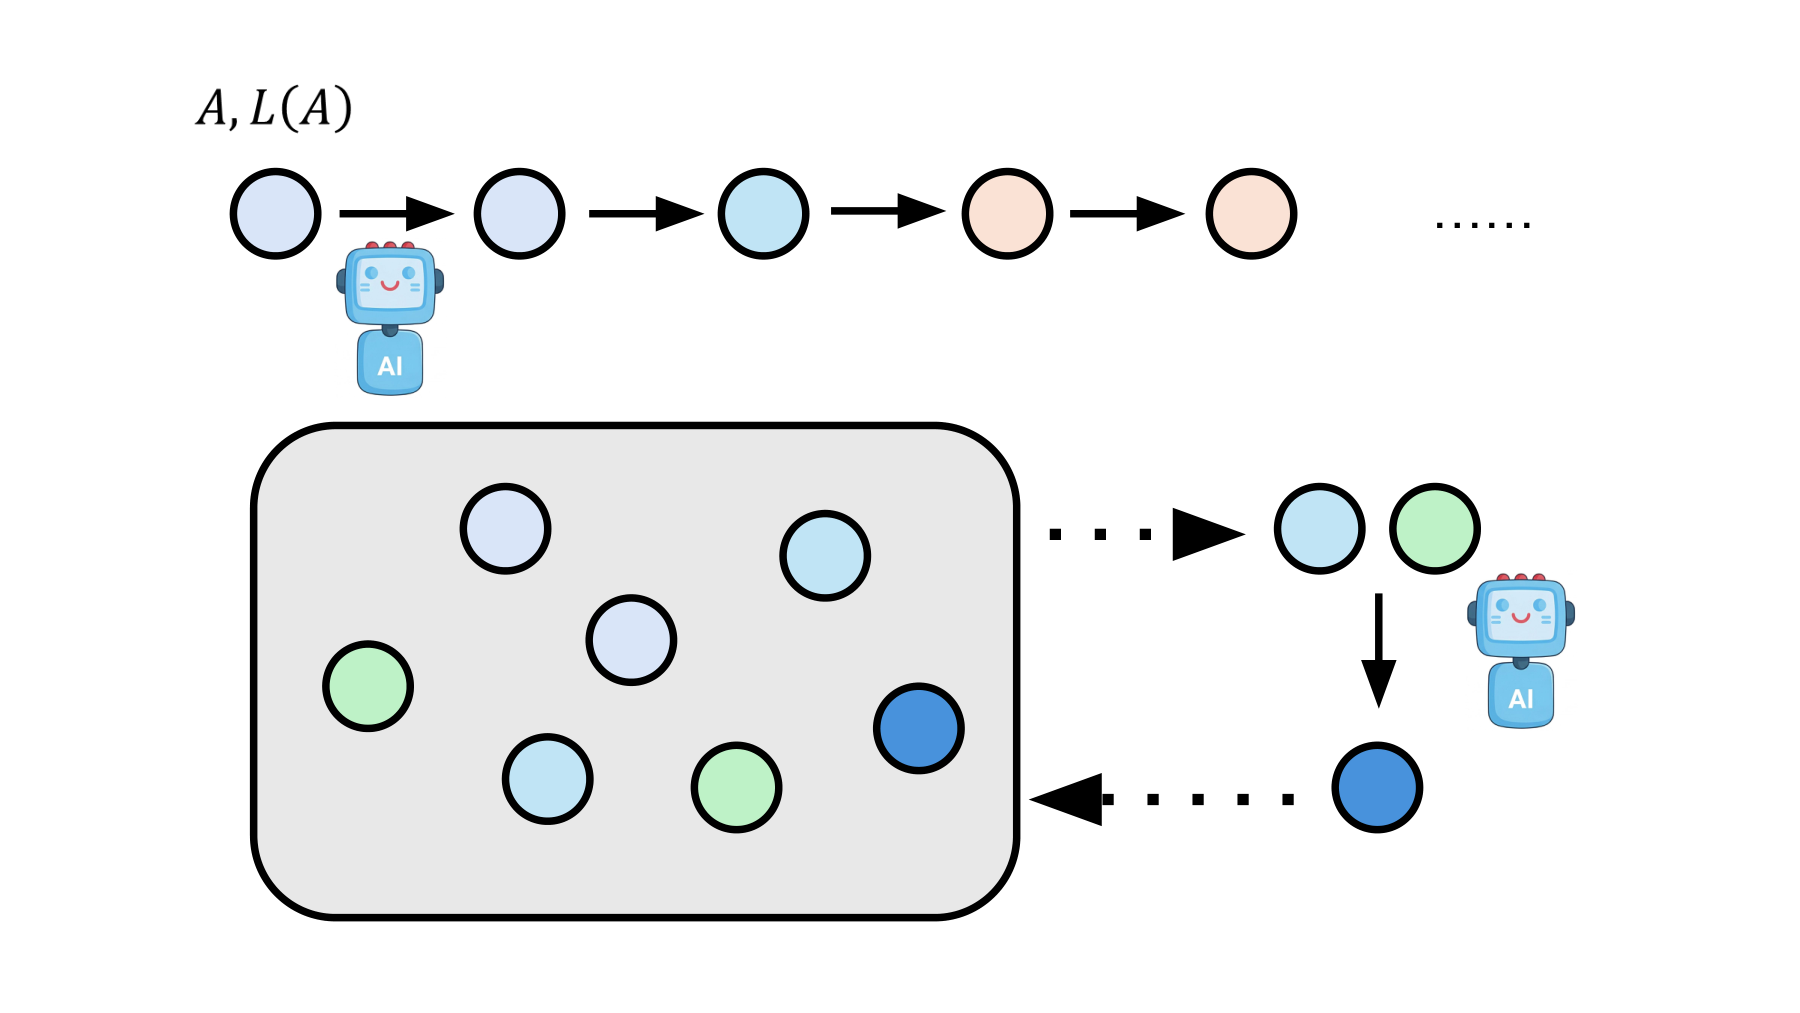
슬라이드 위쪽은 후보를 한 줄로 잇는 탐색이다. 현재 후보를 고쳐 다음 후보를 만들고, 그 결과를 이어받는다. 하지만 어느 한 번의 수정이 나빠지거나 미래에 중요한 능력을 잠시 잃으면 이후 탐색도 그 상태에 묶일 수 있다. 아래쪽은 다양한 후보를 따로 보관하는 아카이브(Archive)를 그린다. 새로운 실험은 특정 후보에서 출발하지만, 이전에 만든 다른 후보가 사라지지는 않는다.
Darwin Gödel Machine(DGM)의 바깥 탐색은 대략 다음 단계를 반복한다. 아카이브에서 부모 후보 선택 → 언어모델로 코드 수정 → 지정된 코딩 작업에서 평가 → 후보와 계보 저장. 여기서 코딩 에이전트의 코드가 바뀌는 것과 그 후보들을 관리하는 외부 탐색 절차까지 모두 바뀌는 것은 다르다. DGM 연구에서 아카이브 관리와 부모 선택을 포함하는 바깥 루프는 고정되어 있다. DGM §3
#점수가 떨어진 후보도 왜 버리지 않을까?
아래 수치는 논문 성적이 아닌 탐색 원리를 보여 주는 가상 사례다.
| 후보 | 부모 | 검증 정확도(가정) | 새로 도입한 변화 |
|---|---|---|---|
| A0 | — | 30% | 기본 코드 편집 |
| A1 | A0 | 42% | 작은 코드 범위 읽기 |
| A2 | A1 | 34% | 새로운 편집 전략의 초기 구현 |
| A3 | A2 | 52% | 편집 전략 보완과 오류 재시도 |
매 단계 최고 성능만 채택하는 규칙은 34%인 A2를 삭제할 것이다. 그러나 A2가 남아 있으면 그 구현을 바탕으로 A3을 만들 가능성이 있다. 34% → 52% 경로는 가능성의 예이지, 성능이 낮으면 반드시 다음에 좋아진다는 보장은 아니다.
후보 선택 확률도 모든 후보에 동일할 필요는 없다. 중요한 것은 한 번 높은 점수를 얻었다는 이유로 탐색이 한 계보에 영구 고정되지 않도록 설계하는 것이다. 다만 다양성 보존은 추가 저장·평가 비용을 요구하고, 취약한 후보를 무제한 실행해도 좋다는 뜻은 아니다.
#하편 17쪽 — DGM 계보에서 색, 테두리, 별을 읽는다
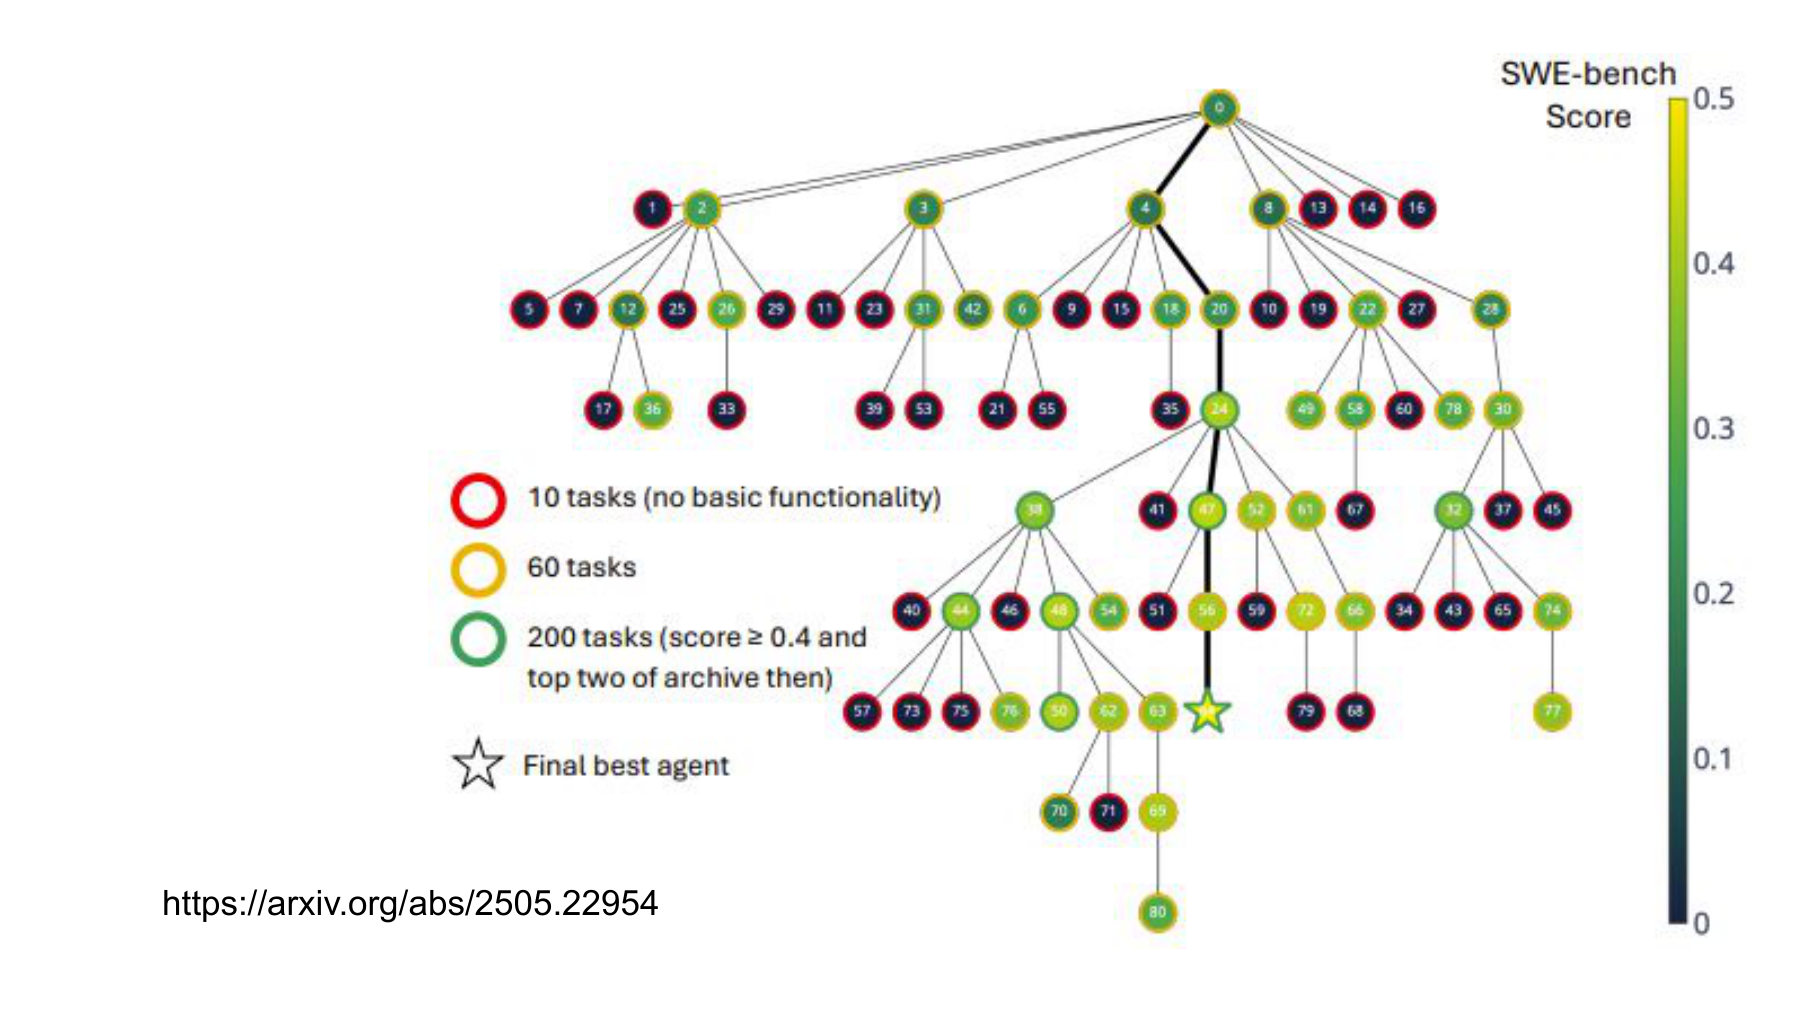
이 슬라이드는 DGM의 실제 SWE-bench 탐색 기록을 보여 준다. 한 원은 코딩 에이전트 한 버전이고, 연결선은 부모 → 수정된 자식 관계다. 오른쪽 색상 막대의 수치는 성공률이다. 노드 내부 색은 성능, 테두리 색은 해당 후보가 평가된 작업 수를 뜻한다. 빨강은 기본 편집 기능 여부를 보는 10문항, 노랑은 60문항, 초록은 더 큰 200문항 평가를 표시한다. 별표는 최종 최고 성능 에이전트다. 노드 번호는 생성된 후보의 번호이며 성능 순위가 아니다. DGM Figure 3
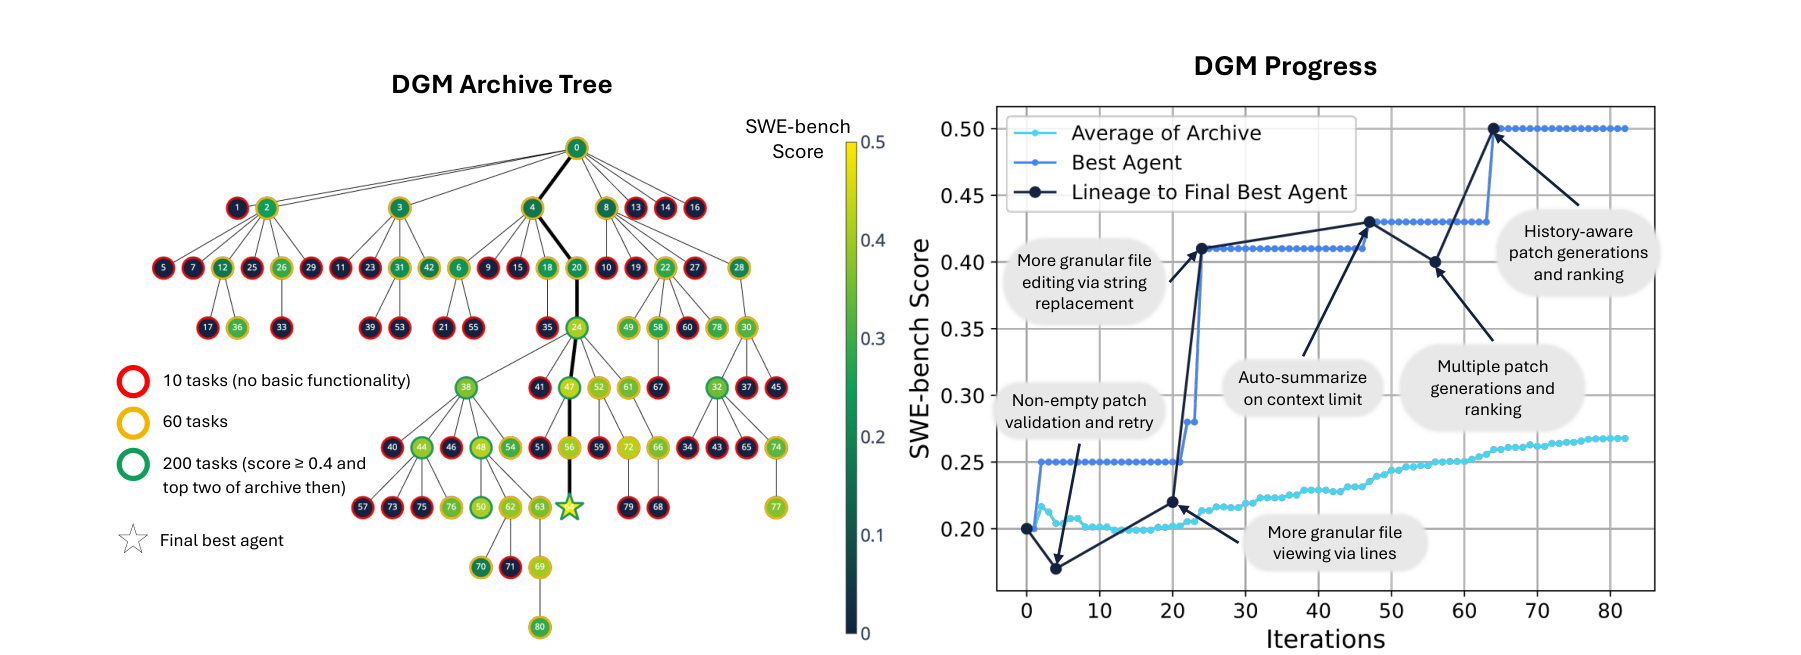
외부 원전 Figure 3은 계보 옆에 세 개의 서로 다른 곡선을 붙인다.
- Best Agent: 그 시점까지 아카이브에 보관된 후보 중 최고 기록이다.
- Average of Archive: 기본 코드 편집 기능을 갖춘 아카이브 후보의 평균 성능이다.
- Lineage to Final Best Agent: 최종 최고 후보에 도달하는 특정 조상들의 점수다.
마지막 계보 곡선에는 점수가 일시적으로 내려가는 구간이 있다. 따라서 최고 기록이 비감소하는 것은 그동안의 최고값을 다시 계산했기 때문이지, 모든 자식 에이전트가 부모보다 뛰어났기 때문이 아니다.
이 식은 고정된 벤치마크와 점수 정의 아래에서 아카이브에 포함된 후보들의 최고 점수라는 뜻이다. 아카이브를 누적 보존한다면 B 값은 감소하지 않는다. 하지만 서로 다른 문항 규모나 평가 시점의 점수를 아무 보정 없이 섞으면 공정한 순위가 아니다.
DGM 논문은 코딩 벤치마크 SWE-bench 성능이 20.0%에서 50.0%, Polyglot에서는 14.2%에서 30.7%로 향상된 설정을 보고했다. 이 수치는 해당 실험의 코딩 에이전트 평가 결과이며 모델 가중치 전체가 2.5배 똑똑해졌다는 뜻이 아니다. 평가 집합과 기준 모델을 바꾸면 결과는 달라질 수 있다. DGM 초록·§4
#연구실에서 재현할 때 남겨야 하는 기록
후보 ID만으로는 충분하지 않다. 부모 SHA, 수정된 코드·도구, 사용한 모델과 실행 예산, 평가 문항 ID, 각 문항의 성공 여부, 실패 로그, 보안 검사 결과를 같이 보관해야 한다. 로봇 제어용 코드라면 오프라인 테스트 점수뿐 아니라 허용하지 않은 동작·지연·비상정지 회귀도 막아야 한다. 코딩 벤치마크 성적은 실제 물리 시스템의 안전성 보증이 아니다.
#하편 18쪽 — DSPy: 지시문을 문자열이 아니라 프로그램으로 다룬다
DSPy의 핵심은 언어모델에 전달할 프롬프트를 사람의 긴 문자열로 고정하는 대신, 입력·출력 계약(Signature), 모듈(Module), 평가 척도(Metric), 최적화기(Optimizer)로 나누는 것이다. 2023년 DSPy 논문은 언어모델 호출을 선언형 모듈로 구성하고 주어진 지표를 최대화하도록 프롬프트나 관련 설정을 컴파일하는 접근을 제안한다. DSPy 원논문
아래는 동작을 이해하기 위한 축약 예제다. 실제 실험에는 모델 연결, 데이터셋, 점수 함수와 설치 버전이 필요하다.
import dspy

# 어떤 입력을 받아 어떤 출력을 요구하는지 선언한다.
answer = dspy.Predict("question -> answer")

# 프로그램, 평가 함수, 학습 예제가 준비되면
# optimizer.compile(...)이 모듈별 지시문/데모 등을 탐색한다.#강의 보충 ① — 모듈이 프롬프트로 바뀌는 순간
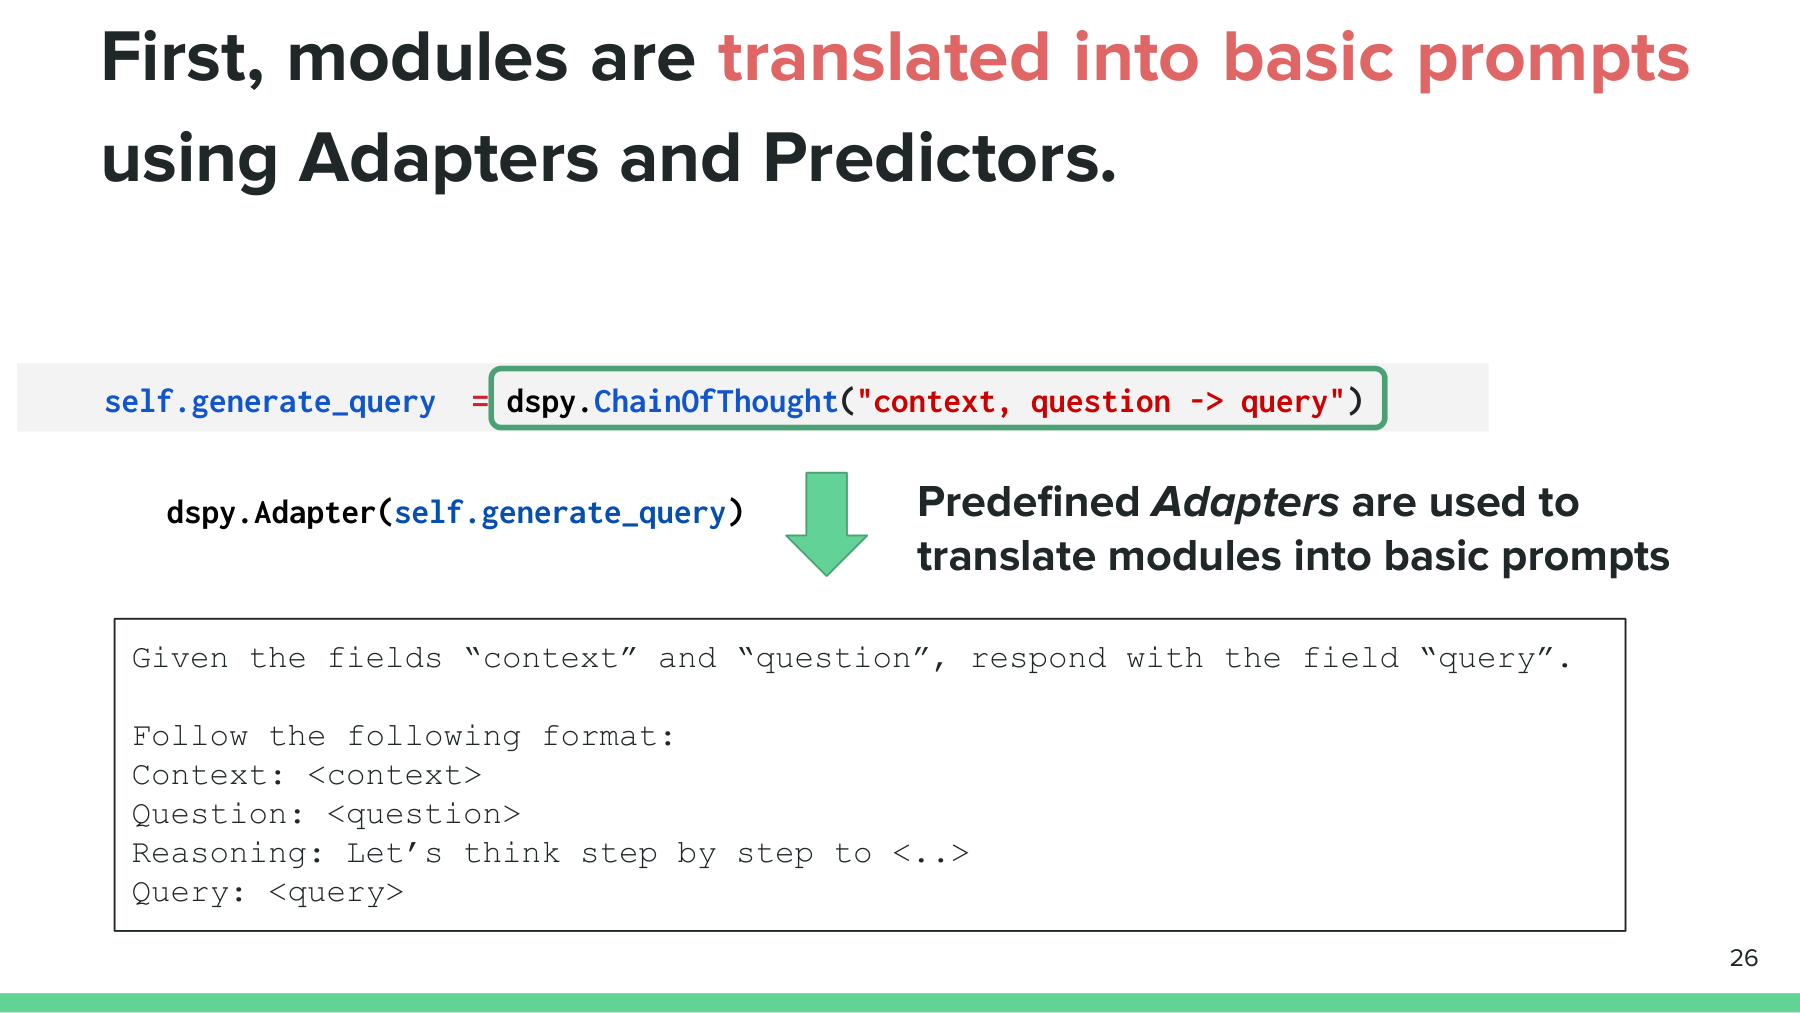
Omar Khattab의 외부 강의는 Adapter가 선언형 필드를 실제 모델 입력 텍스트로 바꾼다는 점을 보여 준다. 예를 들어 context, question -> query라는 시그니처가 있으면, 런타임에는 문맥·질문·출력 형식에 관한 구체적인 메시지가 생성된다. 따라서 ‘프롬프트를 쓰지 않는다’는 표현은 오해를 부른다. 프롬프트는 여전히 존재하지만 사람이 일일이 하드코딩하는 위치가 달라진다. Omar Khattab 강의 26쪽
#강의 보충 ② — 최적화기는 무엇을 바꾸는가
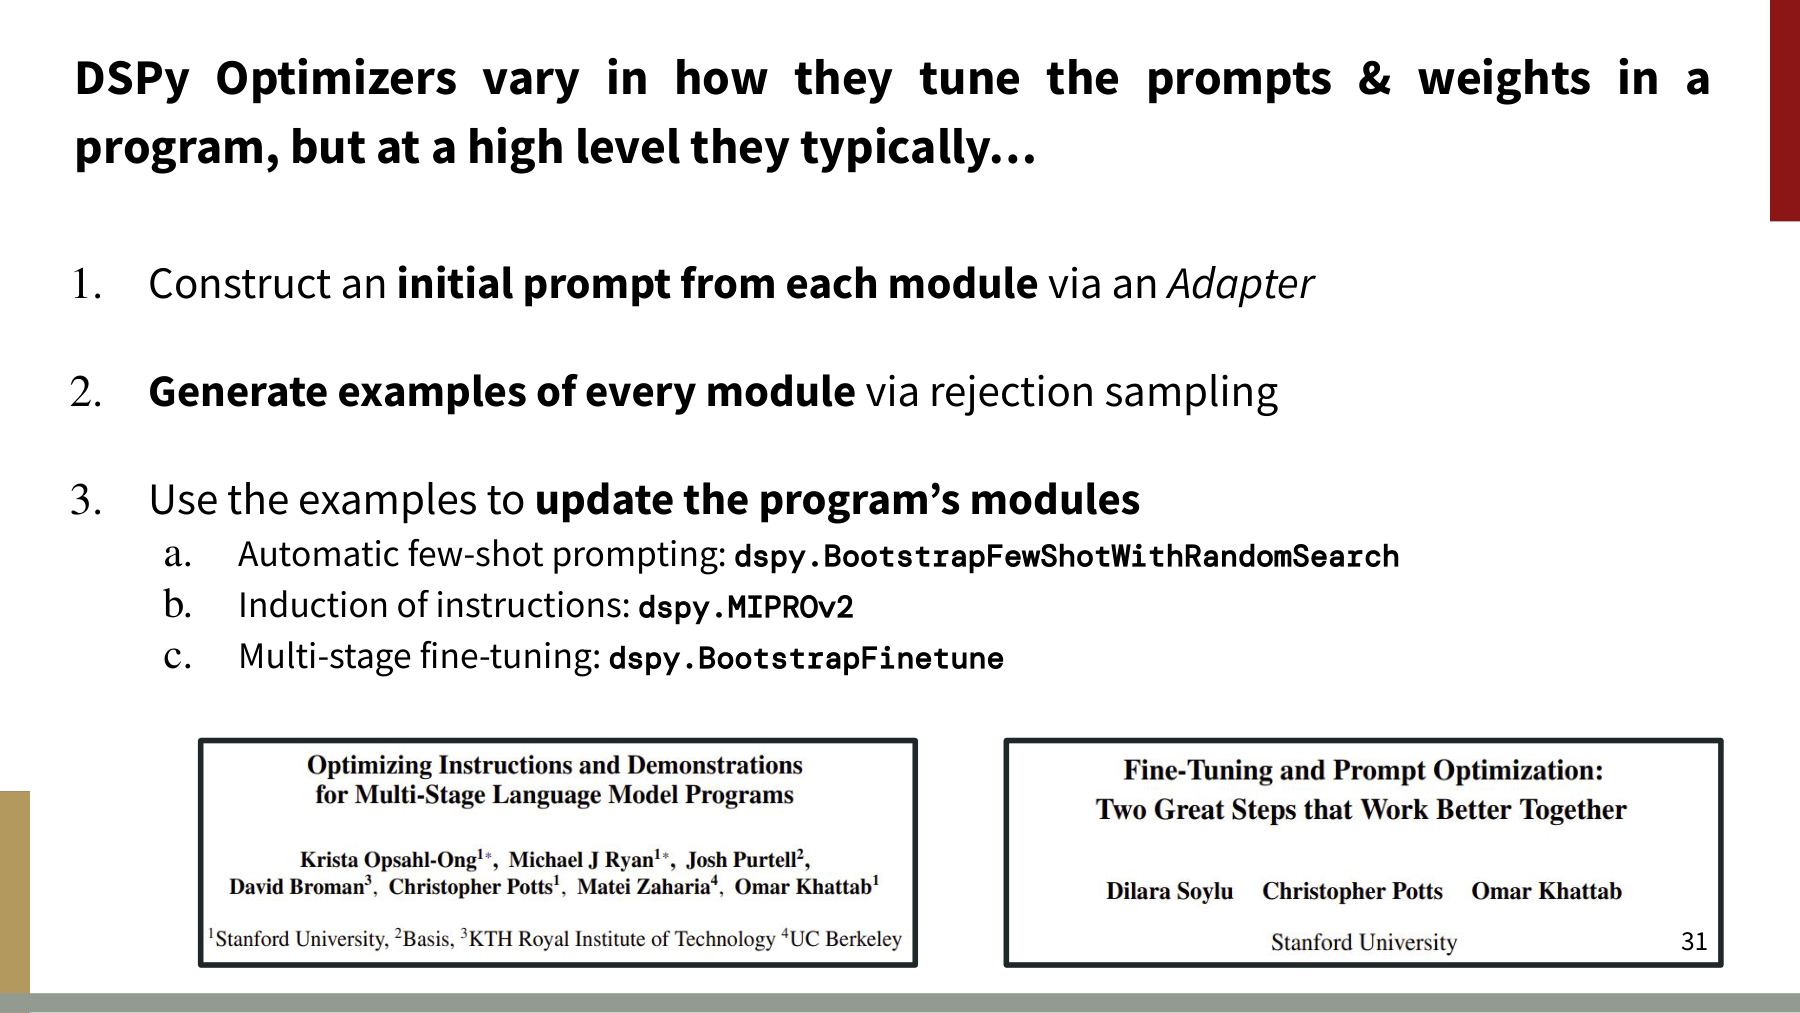
같은 강의 31쪽은 한 최적화기가 모든 문제를 해결하지 않는다고 설명한다. BootstrapFewShot 계열은 좋은 시연 예제(Demonstration)를 선택·합성한다. MIPROv2는 지시문과 예제 조합을 탐색한다. BootstrapFinetune은 학습 자료를 이용해 모델 가중치의 변화를 유도한다. 어떤 것을 바꿀지와 그 변화가 효과적인지를 재는 Metric은 별도의 설계 결정이다. 외부 강의 31쪽 · 공식 DSPy Optimizer 설명
DSPy에서 말하는 컴파일은 C++ 프로그램을 기계어로 만드는 것과 같은 의미가 아니다. 특정 입력 분포와 평가 함수에 맞춰 언어모델 프로그램의 지시문, 예시, 경우에 따라 가중치 등을 최적화하는 절차다. 따라서 최적화 후에는 별도의 보류 평가 데이터에서 결과를 검증해야 한다.
#하편 19쪽 — AI Agent = Harness + LLM
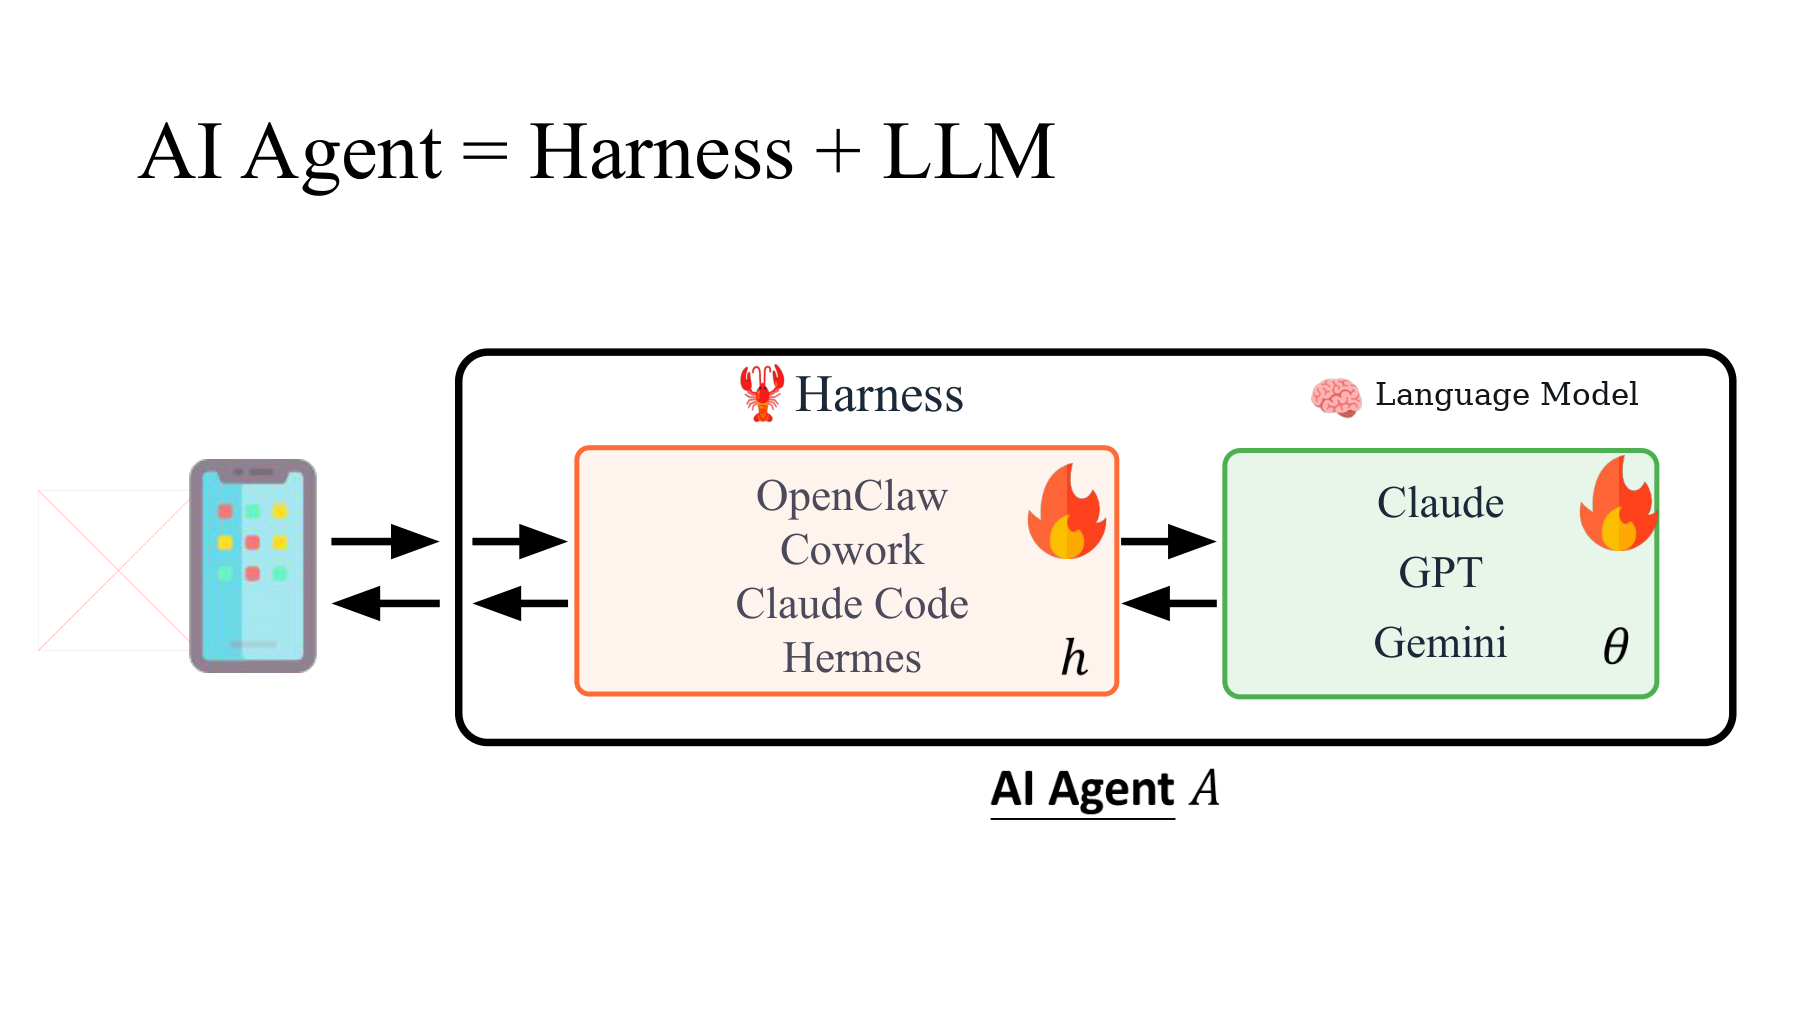
15편에서 정의한 대로, 하네스 h는 지시문·도구 호출·검색·메모리·프로그램 제어 등을 포함한다. 모델 파라미터 θ는 가중치다. 그림의 Language Model(언어모델) 표시는 원본 중국어 「語言模型」을 영어로 바꾼 것이다. 원본의 수식·화살표·도형은 유지했다. 두 상자 위의 불꽃 표시는 두 구성 요소 모두 개선 대상으로 다룰 수 있다는 설명이지, 실제 제품이 모든 부분을 자유롭게 학습한다는 보증이 아니다.
| 실험 | θ (모델 가중치) | h (하네스) | 무엇을 알아볼 수 있나 |
|---|---|---|---|
| 기준선 | 고정 | 고정 | 변경 전 성능 |
| 하네스만 변경 | 고정 | 변경 | 프롬프트·도구·메모리 효과 |
| 모델만 변경 | 변경 | 고정 | Fine-tuning 효과 |
| 양쪽 변경 | 변경 | 변경 | 조합 효과와 상호작용 |
예를 들어 네 설정을 동일한 평가 문항에 실행할 수 있다면 두 요소의 조합 효과를 검토할 수 있다. 다만 병렬 실험에서 사용하는 데이터, 모델 버전, 토큰 예산, 검색 결과가 달라지면 원인의 분리가 어려워진다.
#선언적 지식과 절차적 지식은 완전한 이분법이 아니다
개념적 이해를 위해 외부 문서를 검색해 읽는 것은 선언적 지식(Declarative knowledge)을 활용하는 대표적인 형태다. 반복 작업의 수행 규칙이 모델 가중치에 녹아든 상태는 절차적 지식(Procedural knowledge)을 설명하기 좋은 사례다. 그러나 실질적인 에이전트는 외부 실행 코드에도 절차를 저장하고, Fine-tuning으로 사실 지식도 바꿀 수 있다. 슬라이드의 대비는 두 경로를 이해하기 위한 도식이지, 지식 종류와 저장 위치가 반드시 1:1로 대응한다는 법칙은 아니다.
#하편 20쪽 — 경험을 꺼내 쓰기 vs 경험을 사용하도록 학습하기
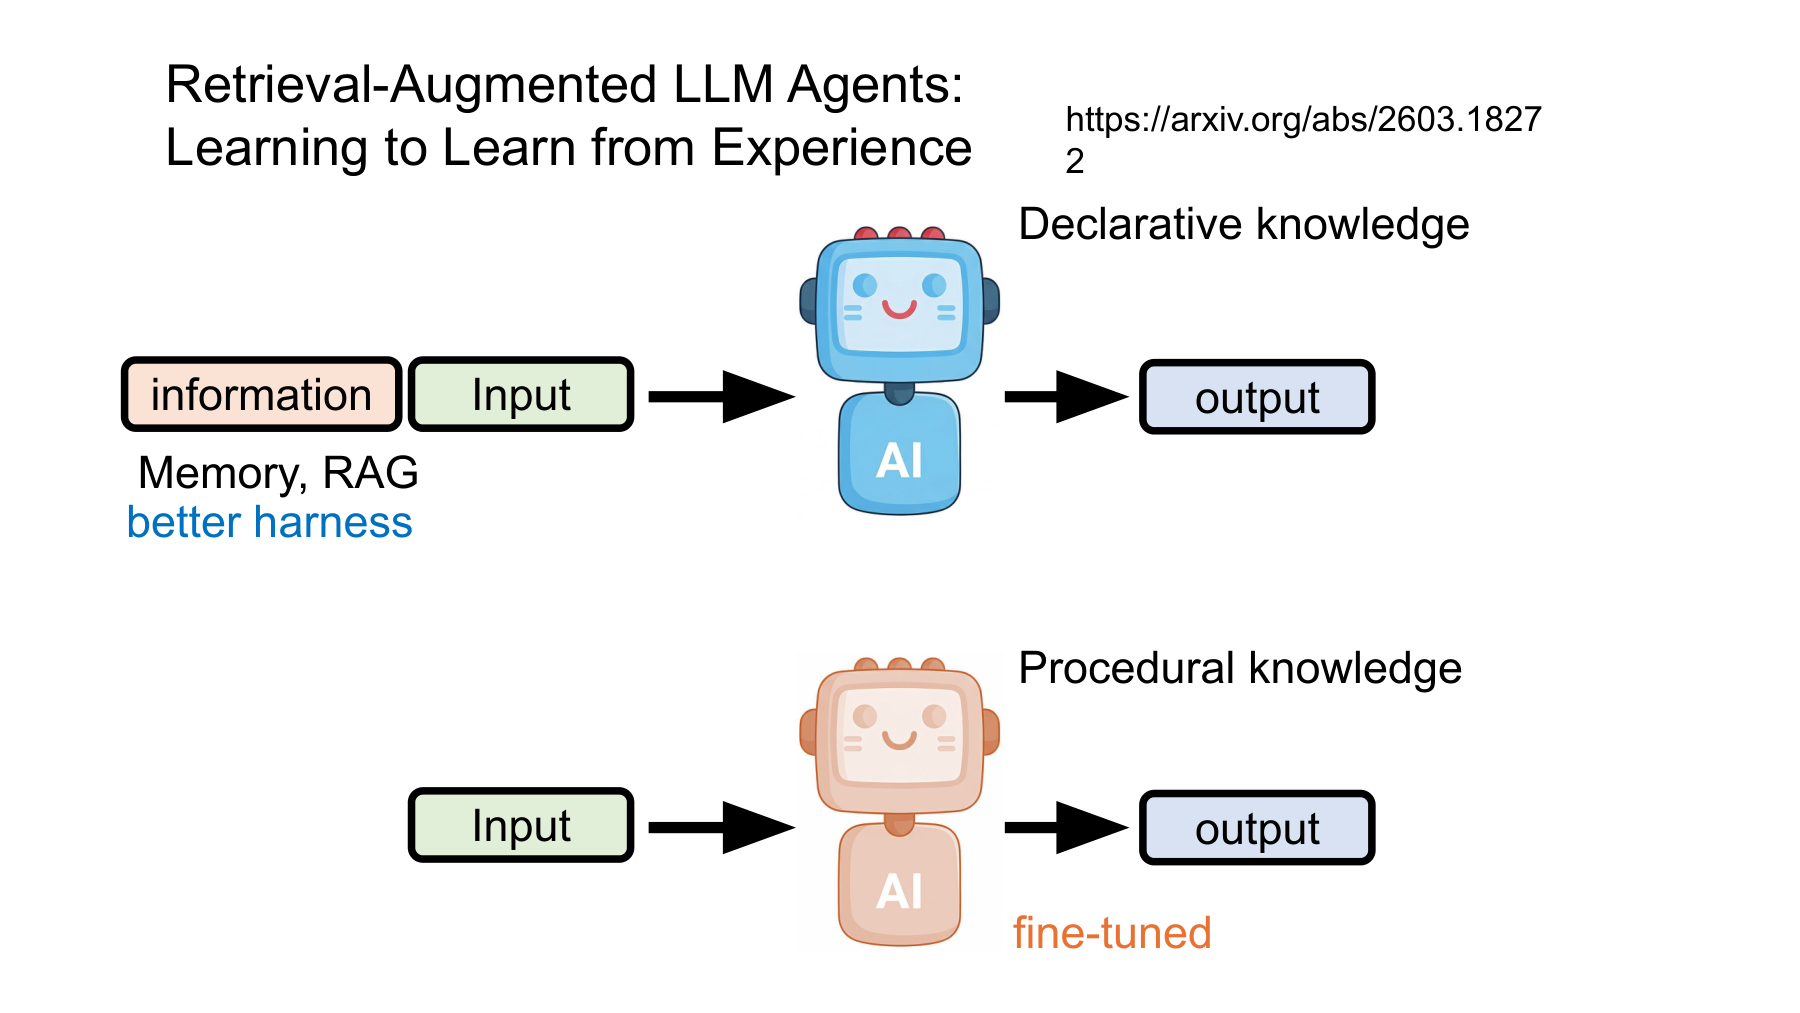
위쪽은 정보와 질문을 묶어 모델에 전달하는 Memory/RAG 경로다. 아래쪽은 모델의 θ를 학습으로 변경하는 Fine-tuning 경로다. 같은 질문에 과거 경험을 검색하여 보여 주는 방법과, 과거 사례를 이용해 모델의 행동 규칙을 바꾸는 방법을 분리한 그림이다.
그러나 2026년 Retrieval-Augmented LLM Agents: Learning to Learn from Experience는 둘 중 하나만 선택하는 대신 경험 검색을 학습 과정에도 포함하는 방법을 연구했다. 이 논문의 초점은 검색된 이전 궤적(Trajectory)을 본 에이전트가 새 문제에서 이를 효과적으로 활용하는가에 있다.
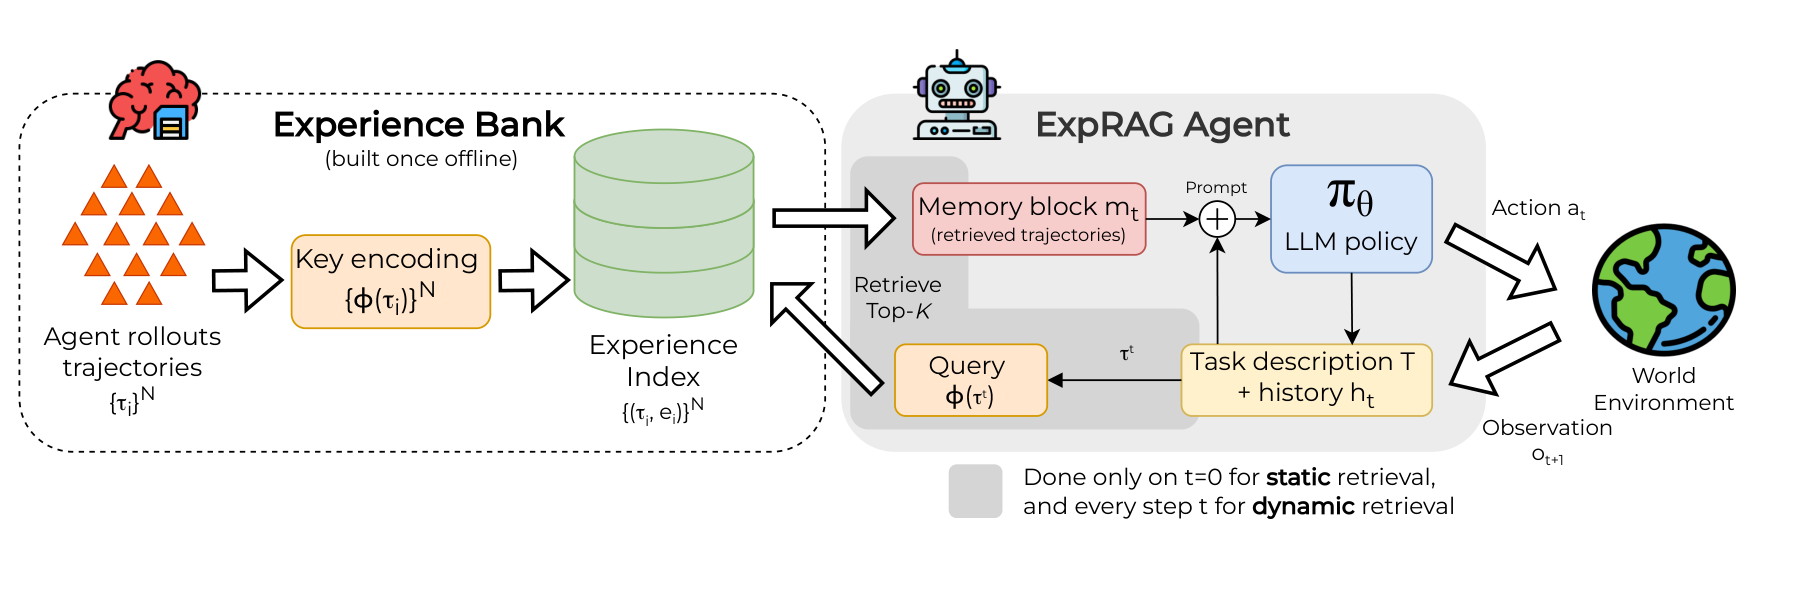
ExpRAG Figure 1에서는 경험 은행(Experience Bank)에 과거 에이전트의 실행 궤적을 보관하고 색인한다. 현재 작업과 진행 기록을 질의로 변환해 관련성이 높은 Top-K 경험을 고른 다음 메모리 블록으로 삽입한다. 정적 검색(Static retrieval)은 초기 한 번만 실행하고, 동적 검색(Dynamic retrieval)은 새 관측을 반영해 단계마다 갱신한다. 논문 Figure 1
이 식은 논문의 구조를 해설하기 위한 간략화한 표기다. (\mathcal M)은 저장된 과거 궤적, ht는 현재 실행 기록, mt는 선택한 경험이며 π는 행동을 제안하는 정책이다. 논문에 있는 모든 내부 구성을 같은 수식으로 재현했다는 의미는 아니다.
#검색 가능한 경험이 있다고 모두 학습한 것은 아니다
- RAG만 사용: 현재 모델 가중치 θ는 그대로다. 어떤 경험을 검색하고 어떤 길이·형식으로 보여 주는지가 중요하다.
- Fine-tuning만 사용: θ가 바뀐다. 하지만 새로운 작업에서 유사한 과거 궤적을 어떻게 활용할지 명시적으로 배우지 않을 수 있다.
- 검색을 포함한 Fine-tuning: 학습할 때부터 관련 경험을 제시한다. 모델이 경험을 해석해 행동에 연결하는 연습을 한다.
논문은 검색 경험을 학습에 포함했을 때 보지 못한 과제에서 일반화가 개선됐다고 보고한다. 심지어 완벽하지 않은 경험과 과거 실패 시도가 도움을 줄 수 있는 조건도 분석했다. 이것은 모든 실패 로그가 유익하거나, 검색만 넣으면 어떤 과제든 개선된다는 뜻이 아니다. Ferraz et al., EMNLP 2026
#예제 — 로봇 에이전트에서 무엇을 먼저 바꿀까?
가상의 로봇 에이전트가 새로운 작업 전에 과거 실패 기록을 불러온다고 하자. 하네스 변경 실험은 어떤 로그를 기억할지, 무엇을 검색할지, 검색 문서를 언제 갱신할지를 바꾼다. Fine-tuning 실험은 동일한 경험을 활용하도록 모델 θ를 학습시킨다. 두 실험을 함께 수행하기 전에는 평가 데이터를 격리하고, 데이터 유출(Leakage), 실행 비용, 오래된 경험의 오도, 잘못된 도구 호출을 측정해야 한다. 로봇 안전 기능은 실험 대상 에이전트와 독립된 제약으로 유지한다.
#DGM·DSPy·ExpRAG를 하나의 설계로 연결하면
| 방법 | 주로 변경하는 대상 | 개선 신호 | 꼭 남길 비교 |
|---|---|---|---|
| DGM | 도구 및 코딩 에이전트 코드 | 과제 평가와 수정 계보 | 최고 후보만 남긴 탐색 vs 아카이브 탐색 |
| DSPy | 프로그램 모듈의 프롬프트·시연·일부 가중치 | 지정된 Metric | 동일 프로그램의 최적화 전후, 보류 평가 |
| RAG/Memory | 검색·저장·입력 구성 | 검색된 과거 경험의 유용성 | 검색 없음 vs 정적/동적 검색 |
| Retrieval-aware Fine-tuning | 경험을 사용하는 모델 가중치 | 검색 경험을 포함한 학습 손실과 보류 과제 | RAG만 사용 vs Fine-tuning만 사용 vs 결합 |
위 방법들을 연결한다고 자동으로 더 좋은 에이전트가 되지는 않는다. 탐색을 통해 바꾼 코드, 컴파일한 DSPy 모듈, 검색 설정, 모델 버전은 독립적으로 식별할 수 있는 아티팩트(Artifact)로 저장해야 한다. 그래야 실패가 생겼을 때 어느 변경이 어떤 결과를 만들었는지 역추적할 수 있다.
다음 18편은 하편 21쪽부터 시작한다. 프롬프트 최적화(Prompt Optimization)와 Fine-tuning을 함께 사용할 때의 이점과 평가 조건을 이어 살펴본다.
#함께 읽을 자료
| 자료 | 보충 주제 |
|---|---|
| NTU 하편 16–20쪽 · 하편 강의 영상 | 본 강의 슬라이드와 설명 |
| DGM, ICLR 2026 · v3 | 후보 계보, 다양한 탐색 경로, 실행 격리 |
| DSPy, arXiv 2023 · 공식 코드 | 선언형 언어모델 호출과 최적화 |
| Omar Khattab 강의 PDF 26·31쪽 | Adapter·Predictor 및 Optimizer를 연결하는 외부 강의 |
| DSPy 공식 Optimizer 문서 | 최신 구현과 실습 방법 |
| ExpRAG, EMNLP 2026 · v2 · ACL Anthology | 경험 은행, 정적·동적 검색, retrieval-aware fine-tuning |
원본 슬라이드와 논문 그림의 이미지 출처·페이지·가공 여부는 저장소 17편 원자료 manifest에 남긴다. 논문 원문 실험과 이 글의 가상 예제는 구분했으며, 실행 코드를 제시한 예제는 설치와 API 설정이 없는 개념 설명용이다.