같은 에이전트에서 프롬프트와 모델 가중치를 모두 바꿀 수 있다. 그러나 둘을 동시에 바꾼다는 사실만으로 개선이 보장되지는 않는다. 무엇을 먼저 최적화하는지, 어떤 점수를 기준으로 평가하는지, 나중에 목표가 달라져도 유효한지가 중요하다.
17편에서는 에이전트 코드와 후보 아카이브, DSPy 프로그램, 과거 경험을 검색해 활용하는 모델을 살펴봤다. 이번 하편 21–25쪽에서는 그 다음 질문으로 넘어간다. 메모리와 지시문 같은 외부 구성 요소를 잘 만드는 것과, 가중치 θ를 직접 학습시키는 것 사이에는 어떤 상호작용이 있을까?
슬라이드별 영상 위치
| 원본 | 강의 영상·대응 논점 | 핵심 질문 |
|---|---|---|
| 하편 21쪽 | NTU 하편 전체 영상 · ExpRAG 논문 | 경험을 검색해서 읽는 모델을 다시 학습시키면 무엇이 달라지나? |
| 하편 22쪽 | 같은 강의 영상 · BetterTogether 논문 | 프롬프트와 가중치 업데이트의 순서는 중요한가? |
| 하편 23쪽 | 같은 강의 영상 · DSPy 강의 PDF | 하네스를 경사하강으로 바로 갱신할 수 있나? |
| 하편 24쪽 | 같은 강의 영상 · E-SPL 논문 | 진화와 강화학습은 각각 어떤 역할을 하나? |
| 하편 25쪽 | 같은 강의 영상 · 원본 PDF | 목표가 바뀌면 과거의 최고 후보를 계속 써야 하나? |
위 링크는 원 강의의 참고 위치다. 21–25쪽에 대응하는 검증된 발화 시각을 확보하지 못했으므로 초 단위로 추정하지 않았다. 아래의 추가 논문 해설과 예제는 확인되지 않은 강사의 영상 발화로 인용하지 않는다.
#하편 21쪽 — 검색으로 기억을 보여 주고, 그 기억을 사용하도록 학습한다
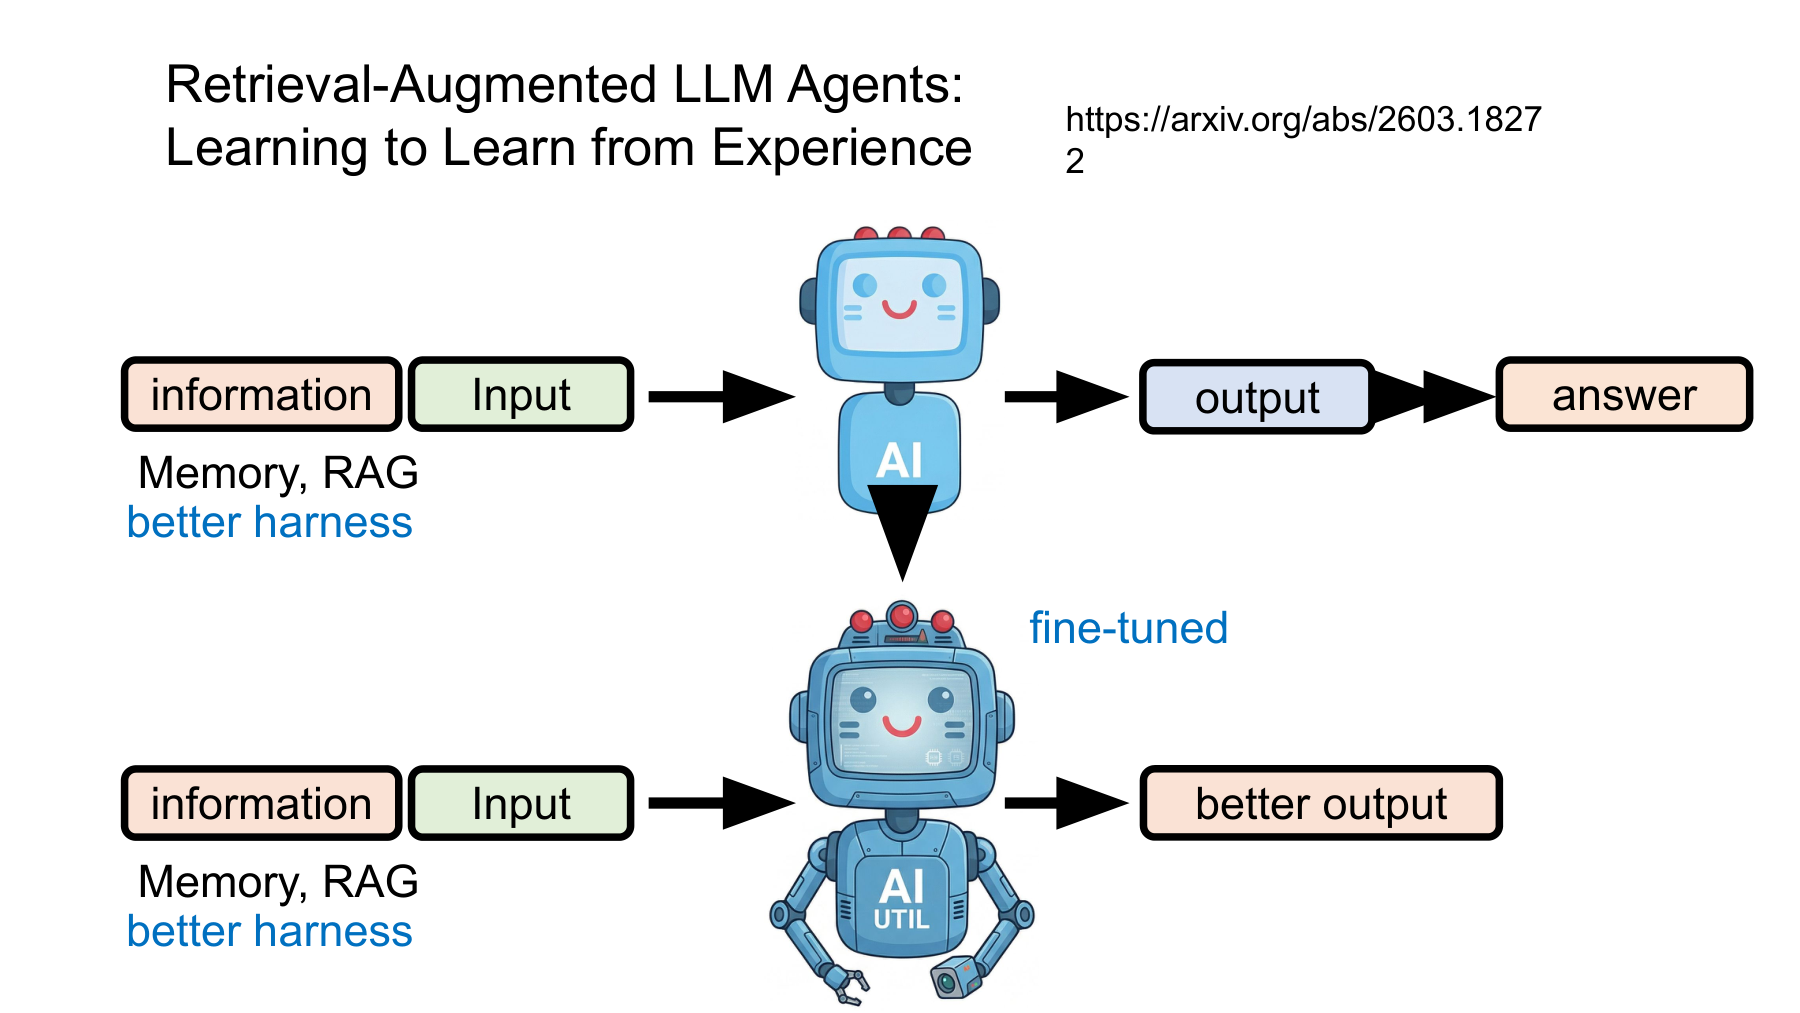
이 슬라이드는 앞 20쪽의 정적 대비에서 한 걸음 더 나간다. 위쪽의 정보·입력 → AI → 출력 → 답 경로는 검색 기반 경험 활용(Retrieval-Augmented Generation, RAG)이다. 여기서 과거 문서는 외부 입력으로 전달된다. 아래쪽의 화살표는 이 상태에서 모델을 미세조정(Fine-tuning)하여 같은 정보·입력을 더 잘 활용하게 만든다는 방향을 가리킨다.
#검색과 학습은 서로 다른 업데이트다
| 기제 | 변하는 대상 | 학습이 없어도 가능한가? | 발생할 수 있는 실패 |
|---|---|---|---|
| RAG·메모리 검색 | 검색 색인, Top-K, 조립한 문맥 등 h | 가능 | 잘못된 경험 검색, 긴 문맥·오래된 정보 |
| Fine-tuning | 가중치 θ 또는 LoRA 어댑터 | 아니요 | 과적합, 학습 데이터 누출, 기존 능력 회귀 |
| 검색 경험을 사용하도록 학습 | 학습된 θ와 검색 문맥 h의 결합 | 학습 필요 | 훈련에만 등장한 경험 패턴을 외움 |
ExpRAG는 실제 실행 궤적(Trajectory)을 Experience Bank에 보관한 다음 새 문제에서 관련 경험을 Top-K 검색해 LLM 정책에 넣는 구조다. 연구의 중요한 질문은 찾아 온 경험을 모델이 제대로 해석해서 행동에 반영하느냐다. 검색 품질과 활용 능력은 같은 측정치가 아니다. ExpRAG, EMNLP 2026
이를 읽기 위한 단순화 표기는 다음과 같다. 이는 원논문의 모든 구현을 복제한 식은 아니다.
첫 번째는 추론할 때 정보를 붙여서 실행하는 식이고, 두 번째는 그런 입력을 활용하도록 학습한 새 모델을 만드는 과정이다. 학습을 하면 항상 개선된다는 뜻은 아니다. 실제 연구에 적용할 때는 동일 검색 색인, 고정된 평가셋, Token 비용, 검색 여부를 함께 기록해야 한다.
#외부 DSPy 강의 보충 — RAG 프로그램도 하나의 파라미터가 아니다
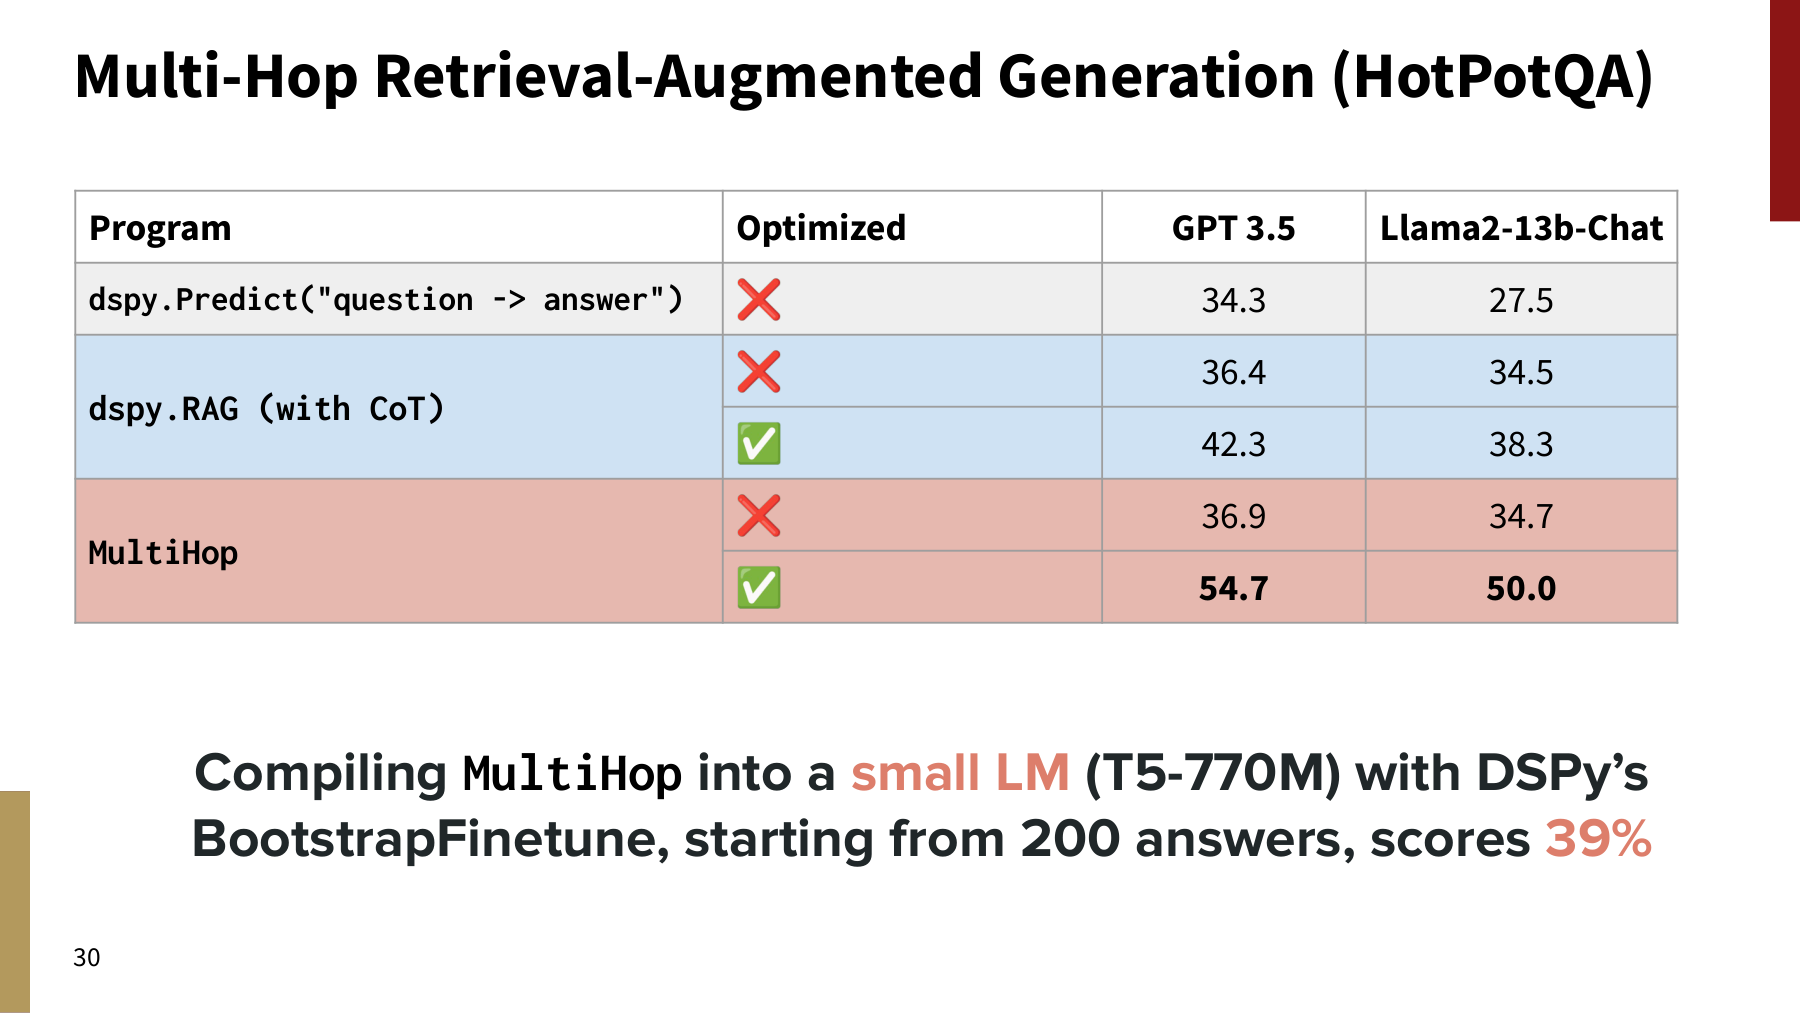
Omar Khattab의 공식 DSPy 강의는 같은 MultiHop 프로그램을 최적화 전후로 비교한다. 강의 표에서 GPT-3.5를 사용한 MultiHop은 최적화 전 36.9, 최적화 후 54.7로 표시된다. 이는 해당 강의의 HotPotQA 비교이며, 현재 어떤 LLM과 데이터셋에도 그대로 일반화할 수 없다. 작은 T5-770M의 BootstrapFinetune 결과와도 모델·학습 조건이 다르므로 단일 순위표처럼 섞으면 안 된다. 강의 30쪽
#하편 22쪽 — BetterTogether: Prompt Optimization과 Fine-tuning을 함께 한다
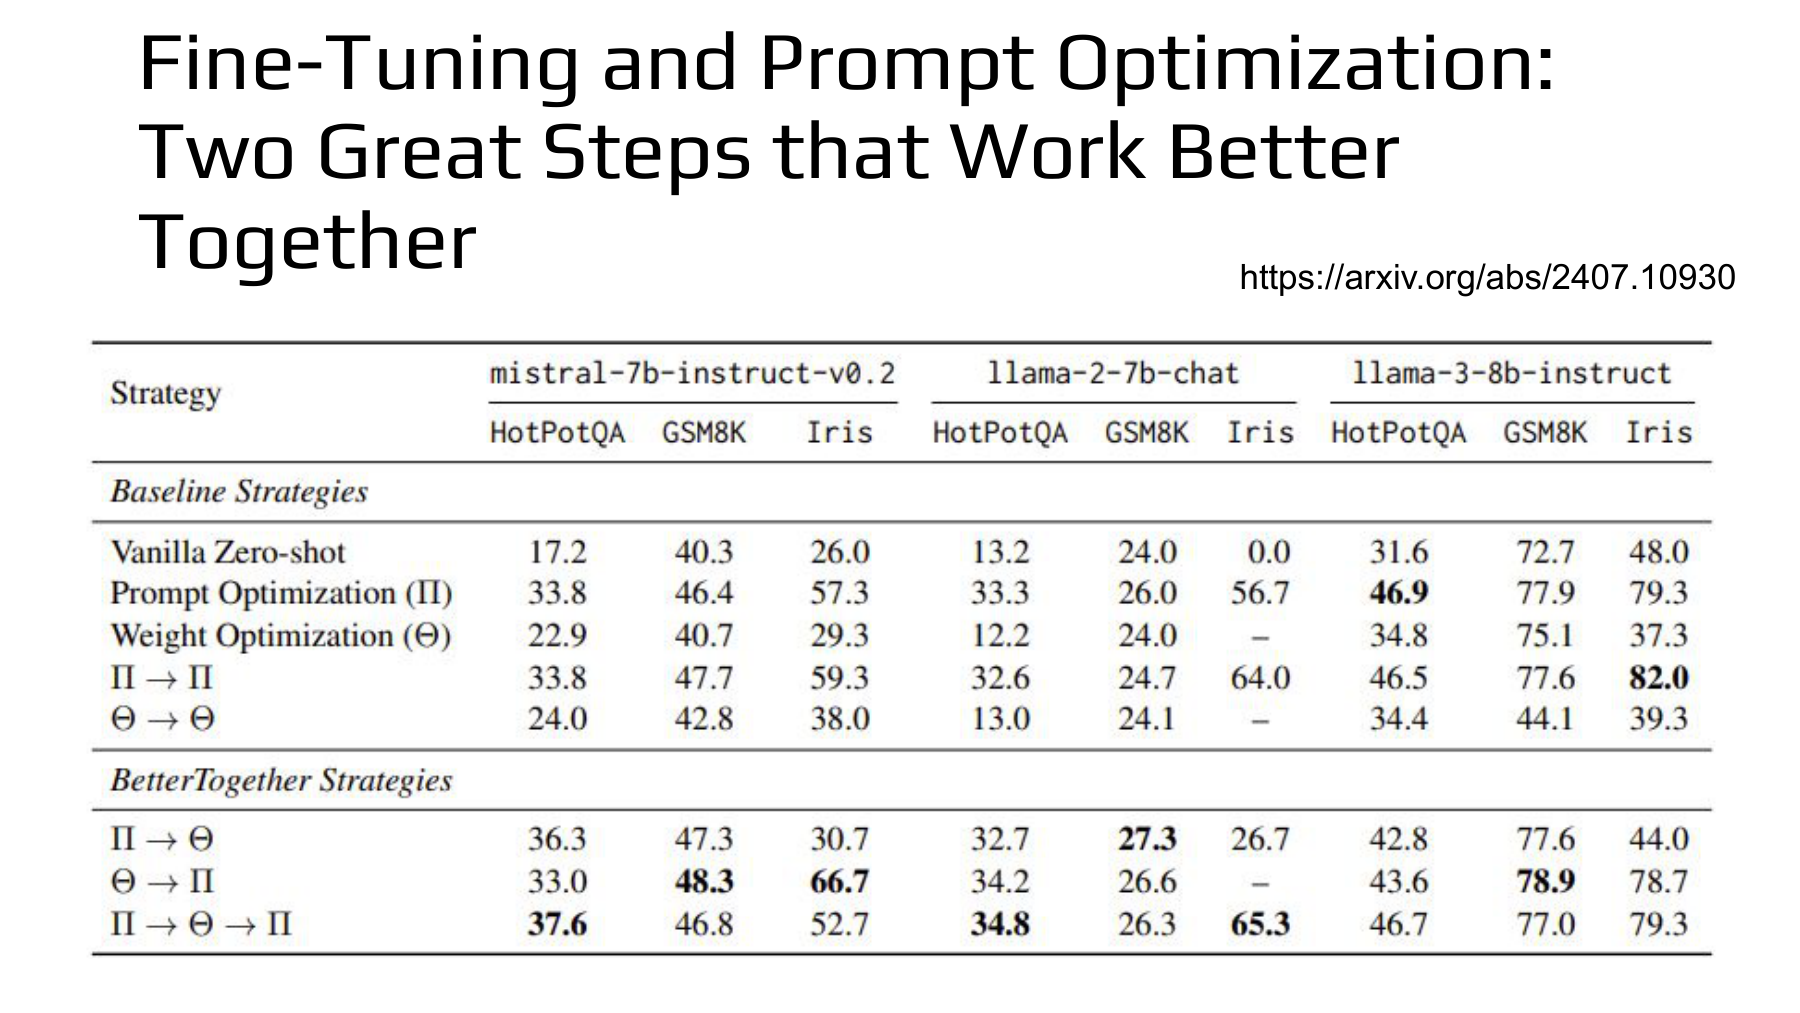
이 장은 Fine-Tuning and Prompt Optimization: Two Great Steps that Work Better Together 연구(Soylu, Potts, Khattab; EMNLP 2024)의 Table 1을 가져온다. 원문은 모듈형 언어모델 파이프라인에서 중간 단계의 정답이나 각 모듈의 경사정보가 없어도 전체 문제 점수로 조합을 최적화할 수 있는가를 실험했다. 원문
슬라이드의 기호 Π는 Prompt Optimization, Θ는 Weight Optimization이다. 화살표는 최적화 순서를 나타낸다. 그러므로 Π → Θ → Π는 ‘추론할 때 세 개 프롬프트를 순서대로 실행한다’는 뜻이 아니라, 프롬프트 개선 → Fine-tuning → 새 가중치에서 다시 프롬프트 개선 순서로 시스템을 준비했다는 의미다.
| 원전 표기 | 업데이트 순서 | 변화하는 대상 |
|---|---|---|
| Π | 프롬프트만 최적화 | h의 지시문·예제 |
| Θ | Fine-tuning만 수행 | θ의 가중치 |
| Π → Θ | 프롬프트 → 가중치 | 먼저 h, 나중 θ |
| Θ → Π | 가중치 → 프롬프트 | 먼저 θ, 나중 h |
| Π → Θ → Π | 프롬프트 → 가중치 → 프롬프트 | 새 θ에 맞춰 h를 다시 탐색 |
#원문 표를 정확하게 읽어 보자
Mistral-7B-Instruct-v0.2의 HotPotQA에서 Π만 최적화한 결과는 33.8, Π→Θ→Π는 37.6이다. 차이는 +3.8%p다. 다만 원전에서는 모든 조합이 언제나 가장 높은 것은 아니다. Llama-3-8B-Instruct의 Iris에서는 Π→Π가 82.0이고 Π→Θ→Π는 79.3으로 오히려 2.7%p 낮다.
또한 표의 ’–‘는 실패율 0%가 아니라 학습할 사례가 충분하지 않아 해당 실험 조건에서 결과를 보고하지 않은 셀이다. 데이터셋과 초기 프롬프트가 바뀌면 어떤 경로가 이기는지도 달라진다. Soylu et al., Table 1
#논문 알고리즘은 무엇을 실행했을까?
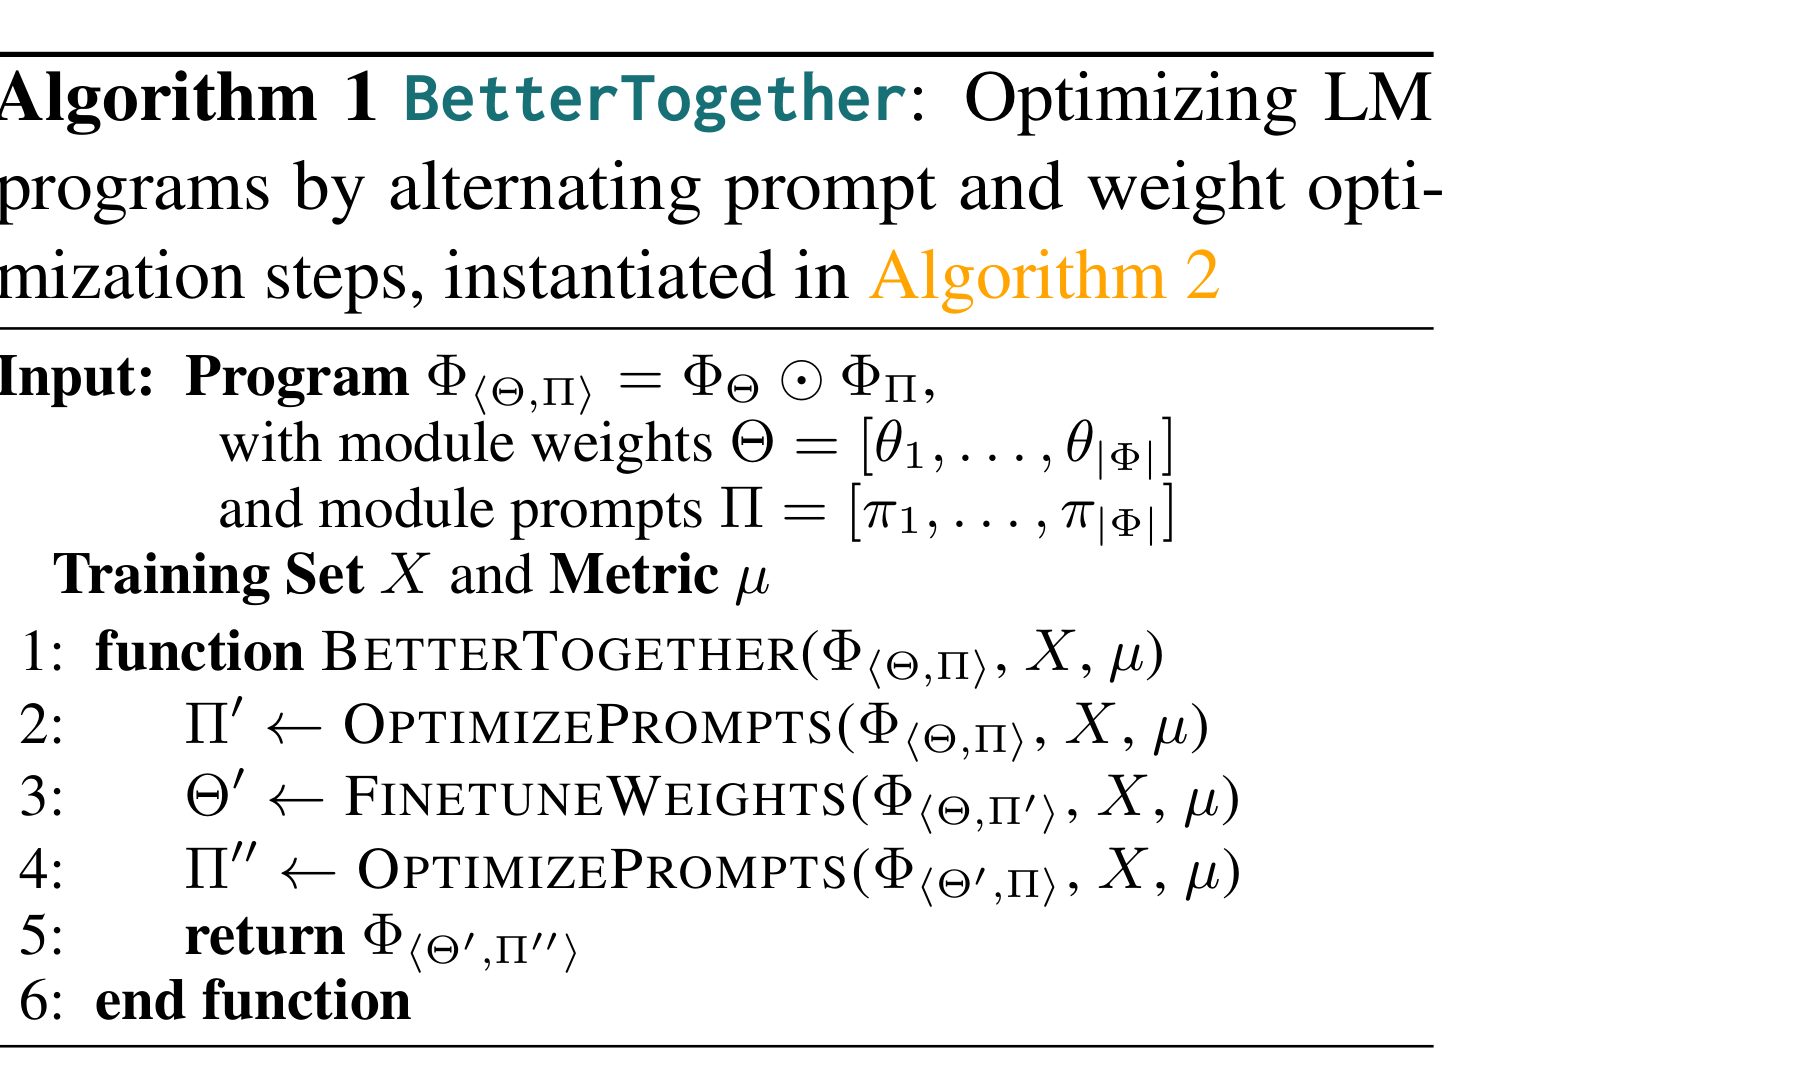
이 메타 최적화기는 좋은 few-shot 시연 사례를 모으는 프롬프트 단계와, 프로그램의 중간 궤적에서 합성한 자료로 모듈 가중치를 학습하는 단계를 번갈아 적용한다. 각 단계는 측정 가능한 최종 품질 지표를 필요로 한다. 세 단계를 더 많이 실행할수록 무조건 좋아지는 것은 아니며, 새 평가셋에서의 성능과 호출·학습 비용을 별도로 측정해야 한다. BetterTogether §3
#외부 강의 보충 — 최종 지표만 있어도 모듈을 개선할 수 있다
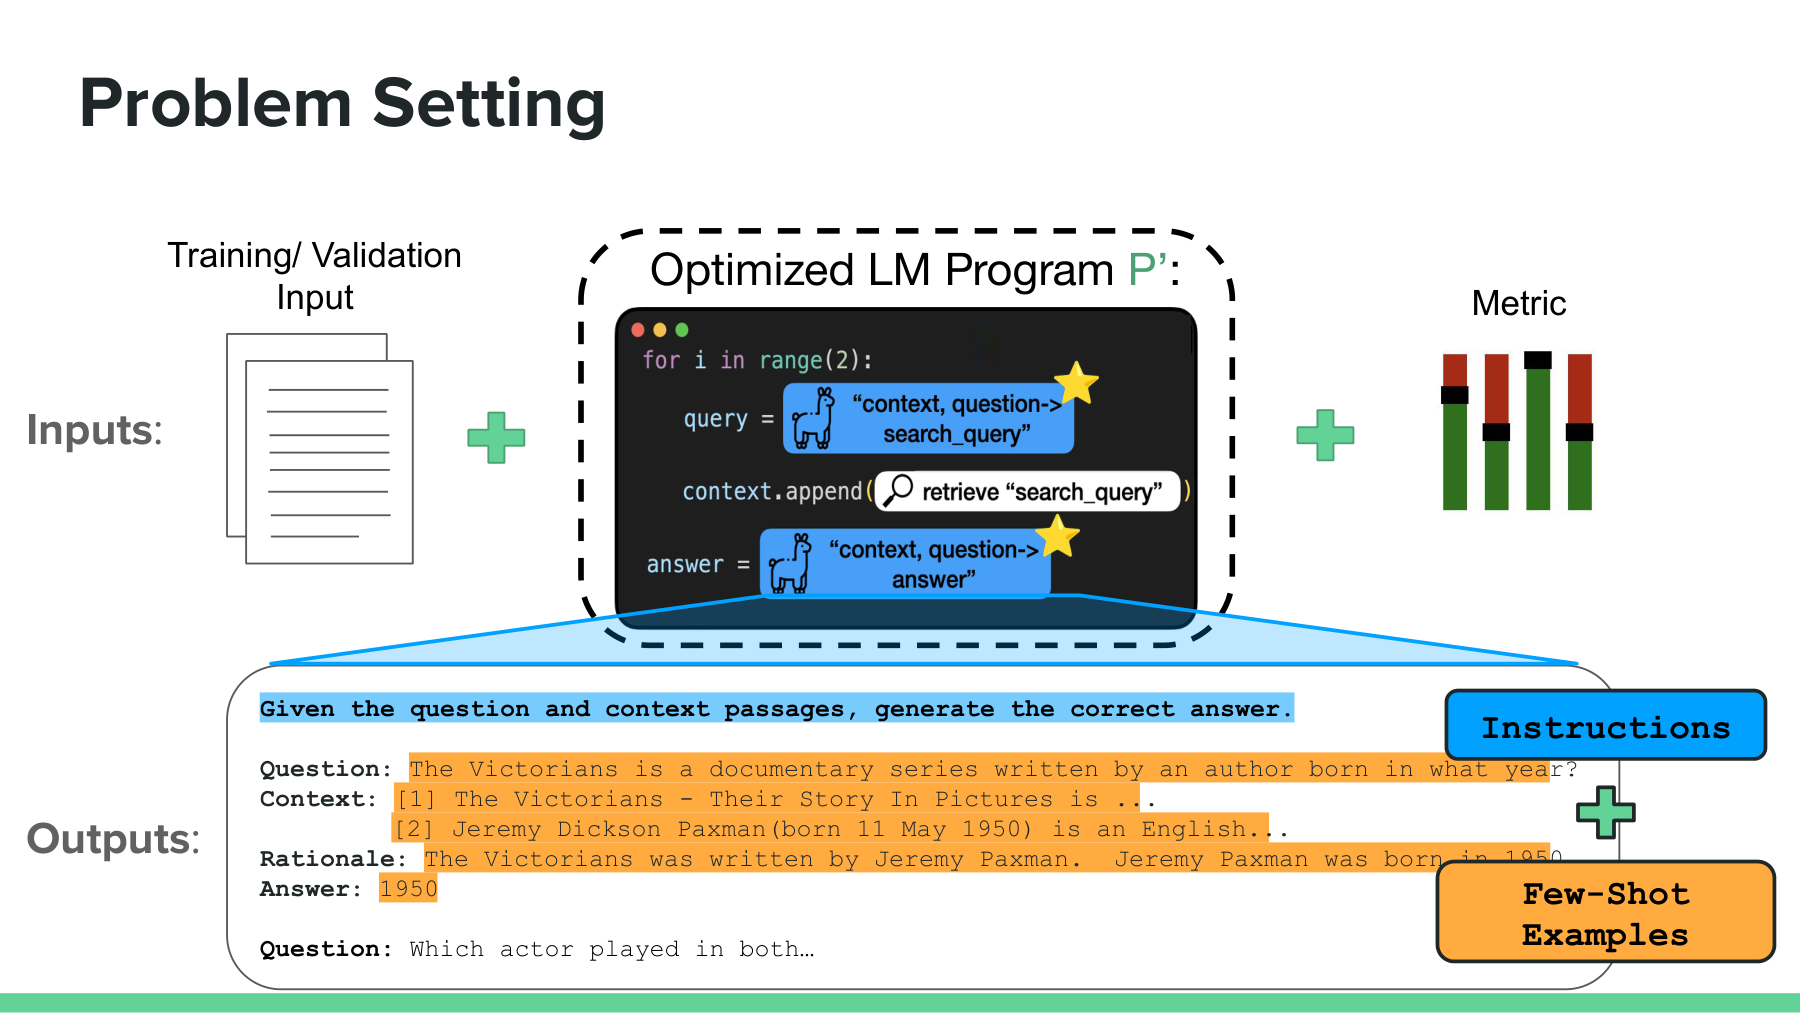
Khattab 강의 35쪽의 그림에서 입력과 LM Program P′ 사이에 ‘Instructions’와 ‘Few-Shot Examples’가 보인다. 실제 평가자가 관측하는 것은 최종 결과에 대한 Metric이다. 검색 질의를 만드는 모듈과 답을 만드는 모듈에는 각각 사람 손으로 붙인 정답 라벨이 없을 수 있다. 이 때문에 실제 프로그램의 실행 궤적에서 학습 후보를 추출하고, 후보 프로그램을 다시 전체 태스크에서 평가하는 과정이 필요하다. 강의 35쪽
#하편 23쪽 — 모델 가중치 θ와 하네스 h의 업데이트는 왜 다른가
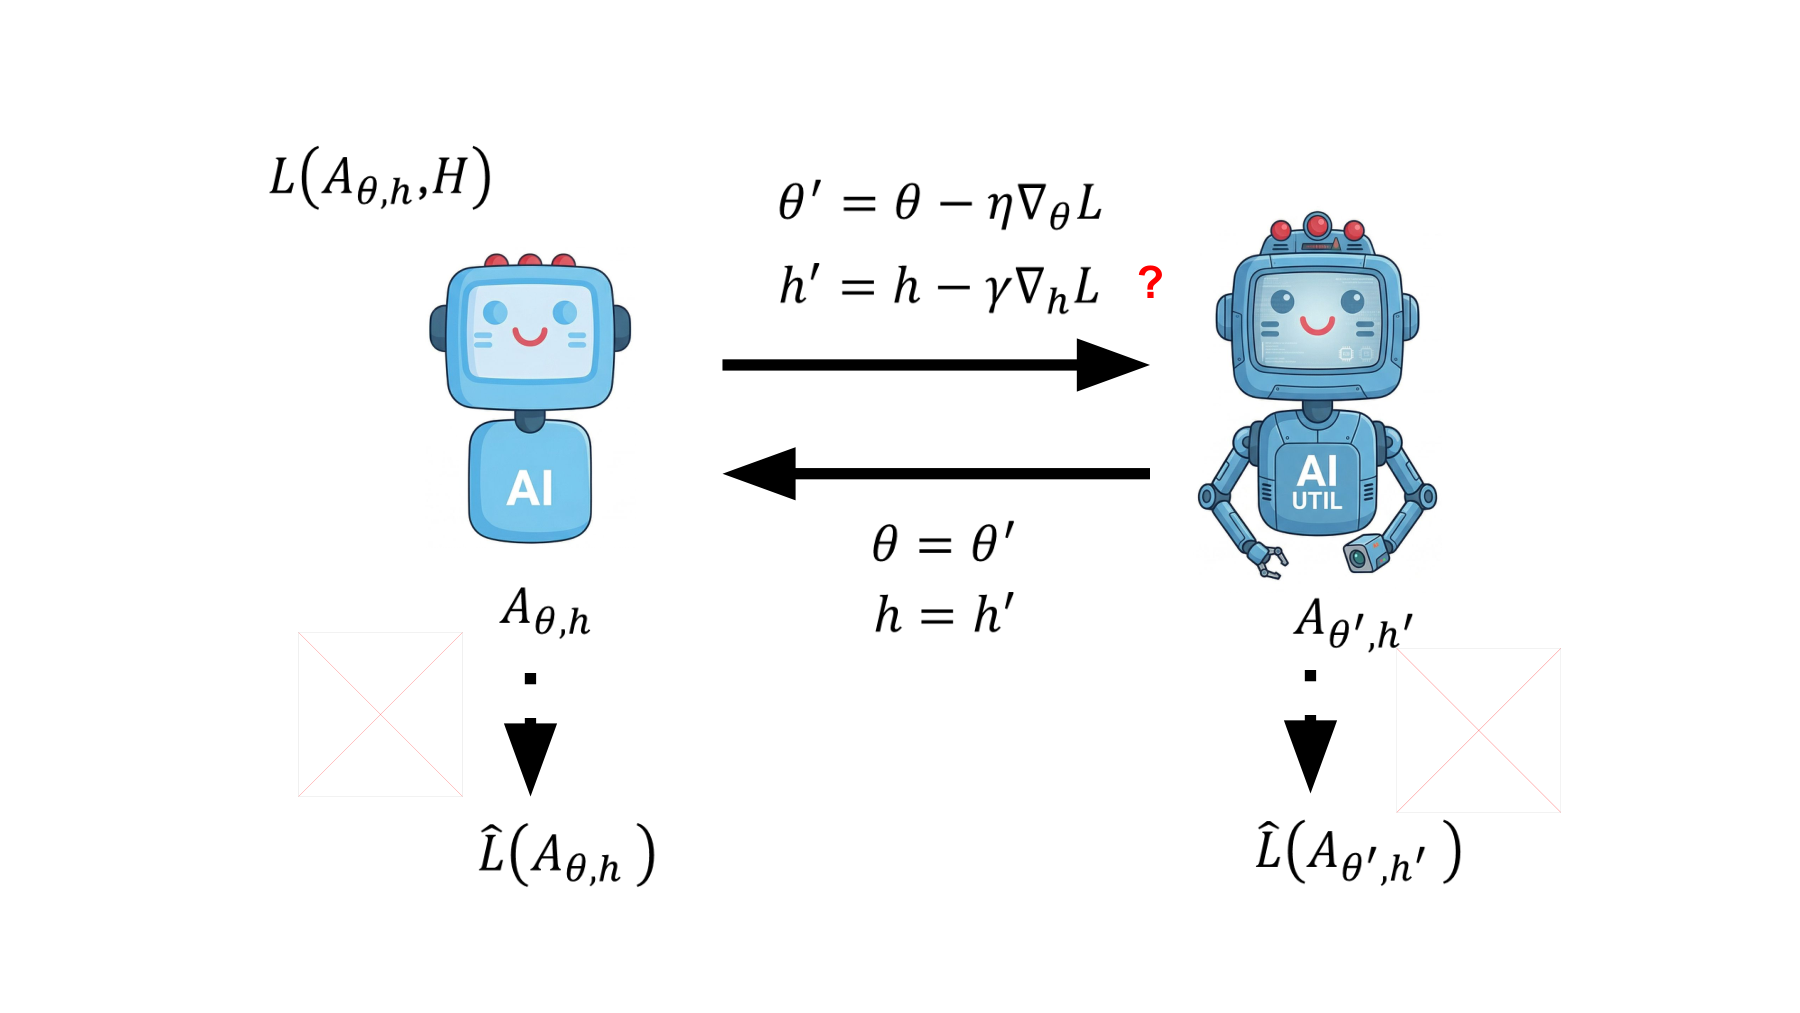
원본의 첫 번째 식은 전형적인 경사하강법을 보여 준다. 연속적인 모델 파라미터 θ에 대해 미분 가능한 훈련 손실 L을 정의하면 다음과 같이 표현할 수 있다.
그 아래의 식에는 질문표가 붙어 있다.
여기서 h가 문자열·JSON 도구 설명·메모리 인덱스·프로그램 분기·코드라면, 이를 하나의 연속 벡터처럼 두고 경사하강식을 그대로 적용할 수 없다. 단어 하나를 바꿔도 실행 경로가 불연속적으로 달라질 수 있고, 일부 요소는 미분 자체가 정의되지 않는다.
더 적절한 일반형은 후보를 만들고 평가해 선택한다는 것이다.
하네스 수정과 가중치 학습을 결합할 수는 있지만, 둘이 동일한 업데이트 규칙으로 계산된다는 뜻은 아니다. 예를 들어 OPRO와 GEPA는 프롬프트 후보 제안·선택을 이용하고, DSPy와 BetterTogether는 모듈별 최적화기를 조합한다.
#강의 보충 — 최적화 환경에 실제로 주어진 것은 무엇인가?
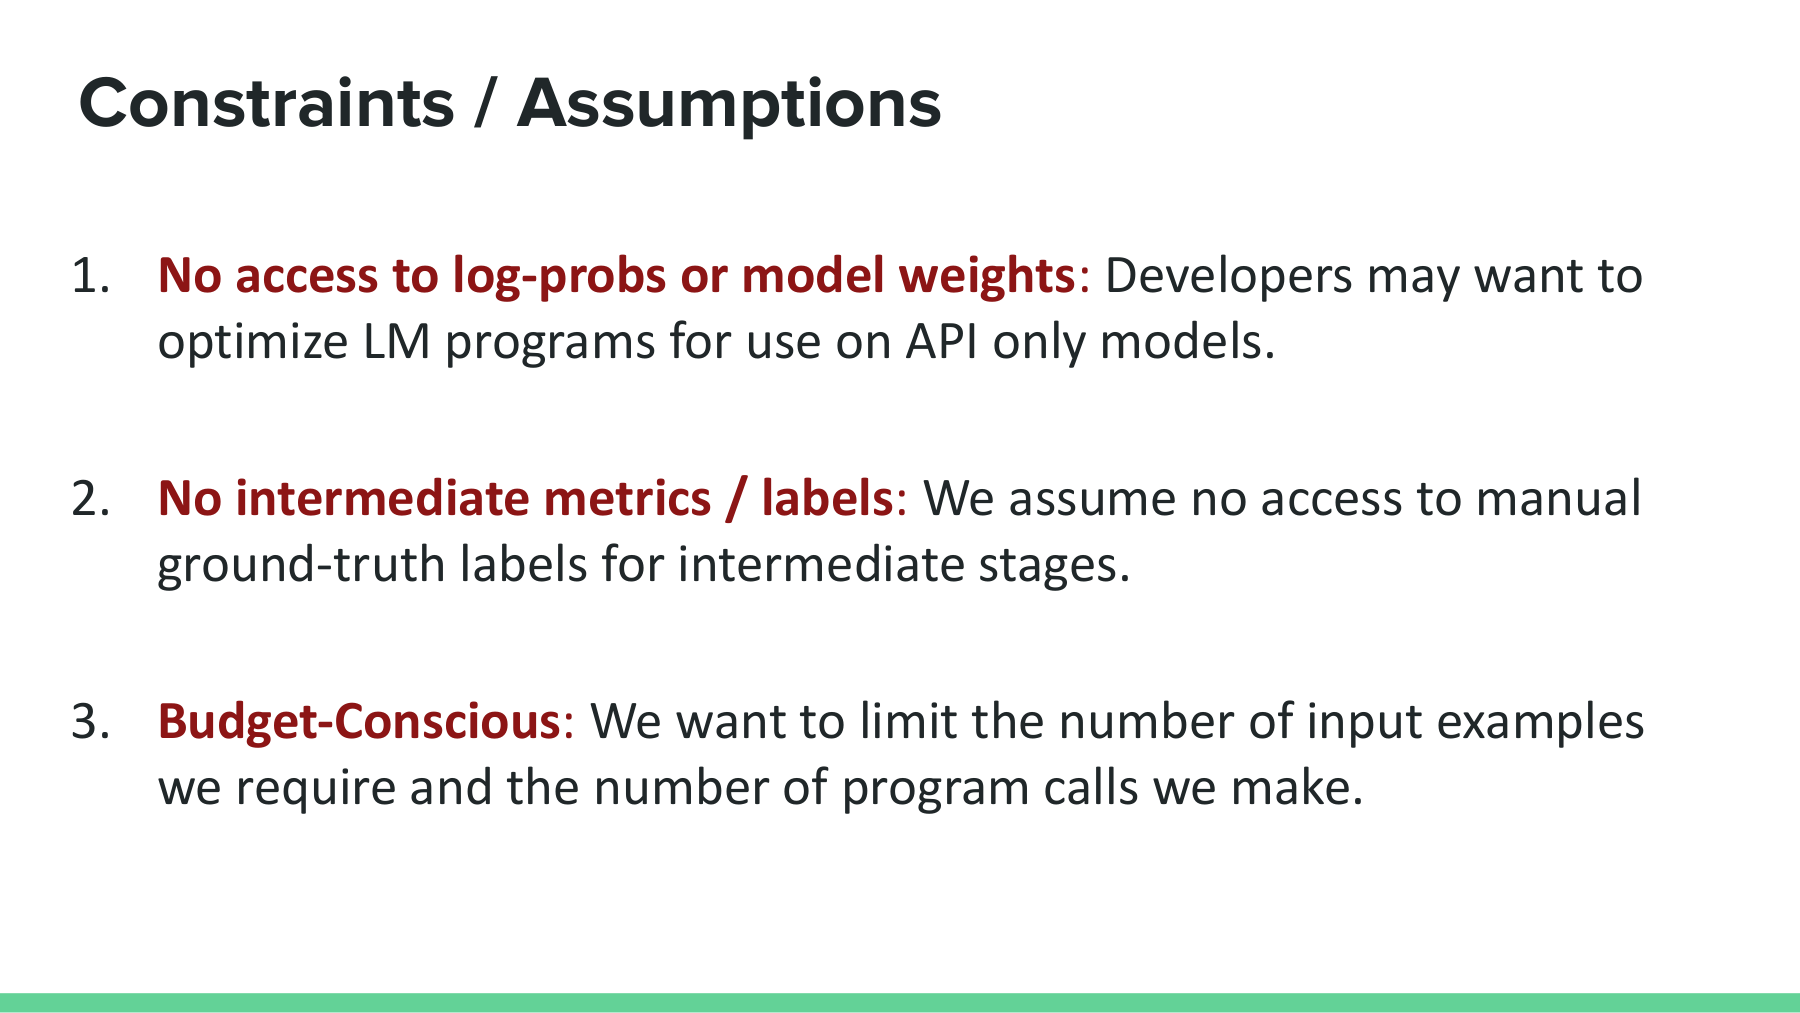
Khattab 강의 36쪽은 세 가지 제약을 구체적으로 나열한다. (1) API 전용 모델은 로그 확률(Log probabilities)이나 가중치 접근이 없을 수 있다. (2) 중간 모듈의 사람 라벨이 없을 수 있다. (3) 실험 가능한 모델 호출과 학습 데이터에는 예산이 있다. 이 제약에서는 ‘모든 구성 요소를 한꺼번에 역전파하면 된다’는 설명이 맞지 않는다. 강의 36쪽
반면 Fine-tuning 인터페이스가 있는 모델이나 LoRA를 사용할 수 있다면 θ의 일부를 학습할 수 있다. 이때도 대상 θ, 고정된 h, 데이터 분할, 하이퍼파라미터, 모델 버전을 명시해야 개선 원인을 비교할 수 있다.
#하편 24쪽 — E-SPL: 시스템 프롬프트 진화와 RL을 동시에 실행한다
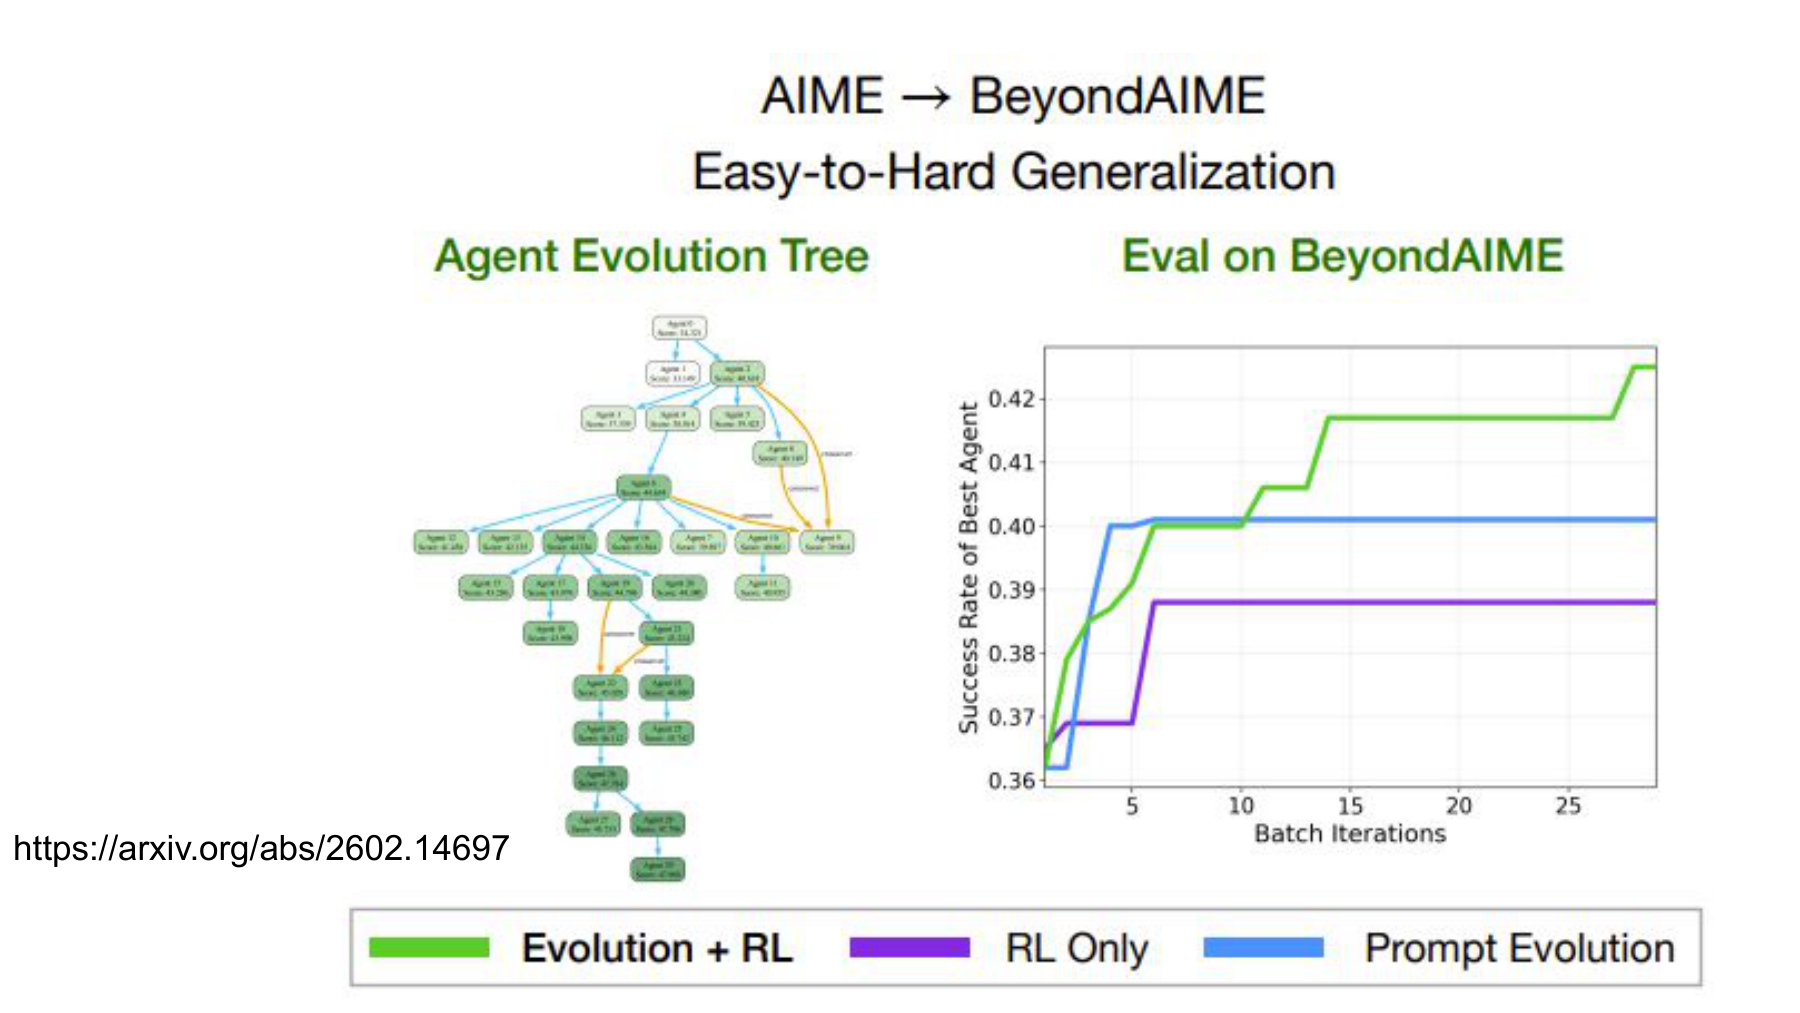
NTU 슬라이드의 왼쪽은 Agent Evolution Tree, 오른쪽은 AIME에서 BeyondAIME로 일반화(Easy-to-Hard Generalization)한 결과다. 사용한 원전은 Evolutionary System Prompt Learning for Reinforcement Learning in LLMs의 2026년 논문이다. 공식 arXiv
E-SPL(Evolutionary System Prompt Learning)은 기존 DGM의 단순 복제와 다르다. 하나의 RL 학습 루프에서 서로 다른 시스템 프롬프트 후보로 답변 궤적을 생성하고, 그 결과를 두 경로로 재사용한다.
- 가중치 업데이트: 문제별 보상으로 RL이 모델 파라미터 θ를 갱신한다.
- 문맥 업데이트: 후보 프롬프트의 상대적 점수·실패 기록을 읽어 Mutation(변이)과 Crossover(교차)로 다음 지시문을 만든다.
프롬프트 개체군과 모델 가중치가 모두 변하기 때문에, 과거 라운드의 점수와 현재 라운드의 점수를 직접 비교하면 평가 기준이 흔들린다. E-SPL은 같은 라운드에서 동일한 문제와 모델을 공유한 후보들의 상대 순위를 활용하고, 이를 TrueSkill 계열의 누적 평가로 연결한다. E-SPL §3
여기서 μ는 후보의 추정 평균 역량, σ는 불확실성, λ와 T는 탐색·활용 강도를 조절한다. 높은 평균 성능뿐 아니라 불확실성이 큰 후보도 탐색될 수 있다. 이것은 논문의 탐색 모형을 읽는 간단한 핵심식이며 특정 설정에서 값이 어떻게 선택됐는지는 원문을 따로 보아야 한다.
#세 곡선은 무엇을 비교하나?
연구가 보고한 AIME→BeyondAIME 성공률을 아래와 같이 구분할 수 있다.
| 방식 | 성공률 | 의미 |
|---|---|---|
| RL Only | 38.8% | 고정된 프롬프트 아래 가중치 갱신 |
| Prompt Evolution | 40.0% | 모델 가중치 고정, 프롬프트 진화 |
| Evolution + RL (E-SPL) | 45.1% | 프롬프트 진화와 가중치 학습 결합 |
E-SPL은 RL Only 대비 +6.3%p, Prompt Evolution 대비 +5.1%p다. 같은 데이터셋의 논문 보고값이며, 여러 종류의 모델·작업·예산에서 항상 같은 개선폭이 발생한다는 보장은 없다. 특히 테스트 성능이 좋은 결과를 발견했다고 해서 추후 다른 평가 문제에서도 우위를 자동으로 인정할 수 없다. 원문 Figure 1·§4
#왜 두 업데이트를 결합하는가?
프롬프트는 사람이 읽을 수 있는 해결 전략·주의사항 같은 선언적 지식을 담기 좋다. 가중치 업데이트는 반복 경험을 통해 그 전략을 실행하는 행동 패턴을 변화시킬 수 있다. E-SPL은 이러한 역할 분담이 일반화에 도움을 준다는 가설과 실험을 제시한다. 그러나 모든 절차적 지식이 가중치에만 들어가고 모든 선언적 지식이 프롬프트에만 들어간다는 엄격한 법칙은 아니다.
#하편 25쪽 — 개선의 목표 자체가 달라질 수 있다
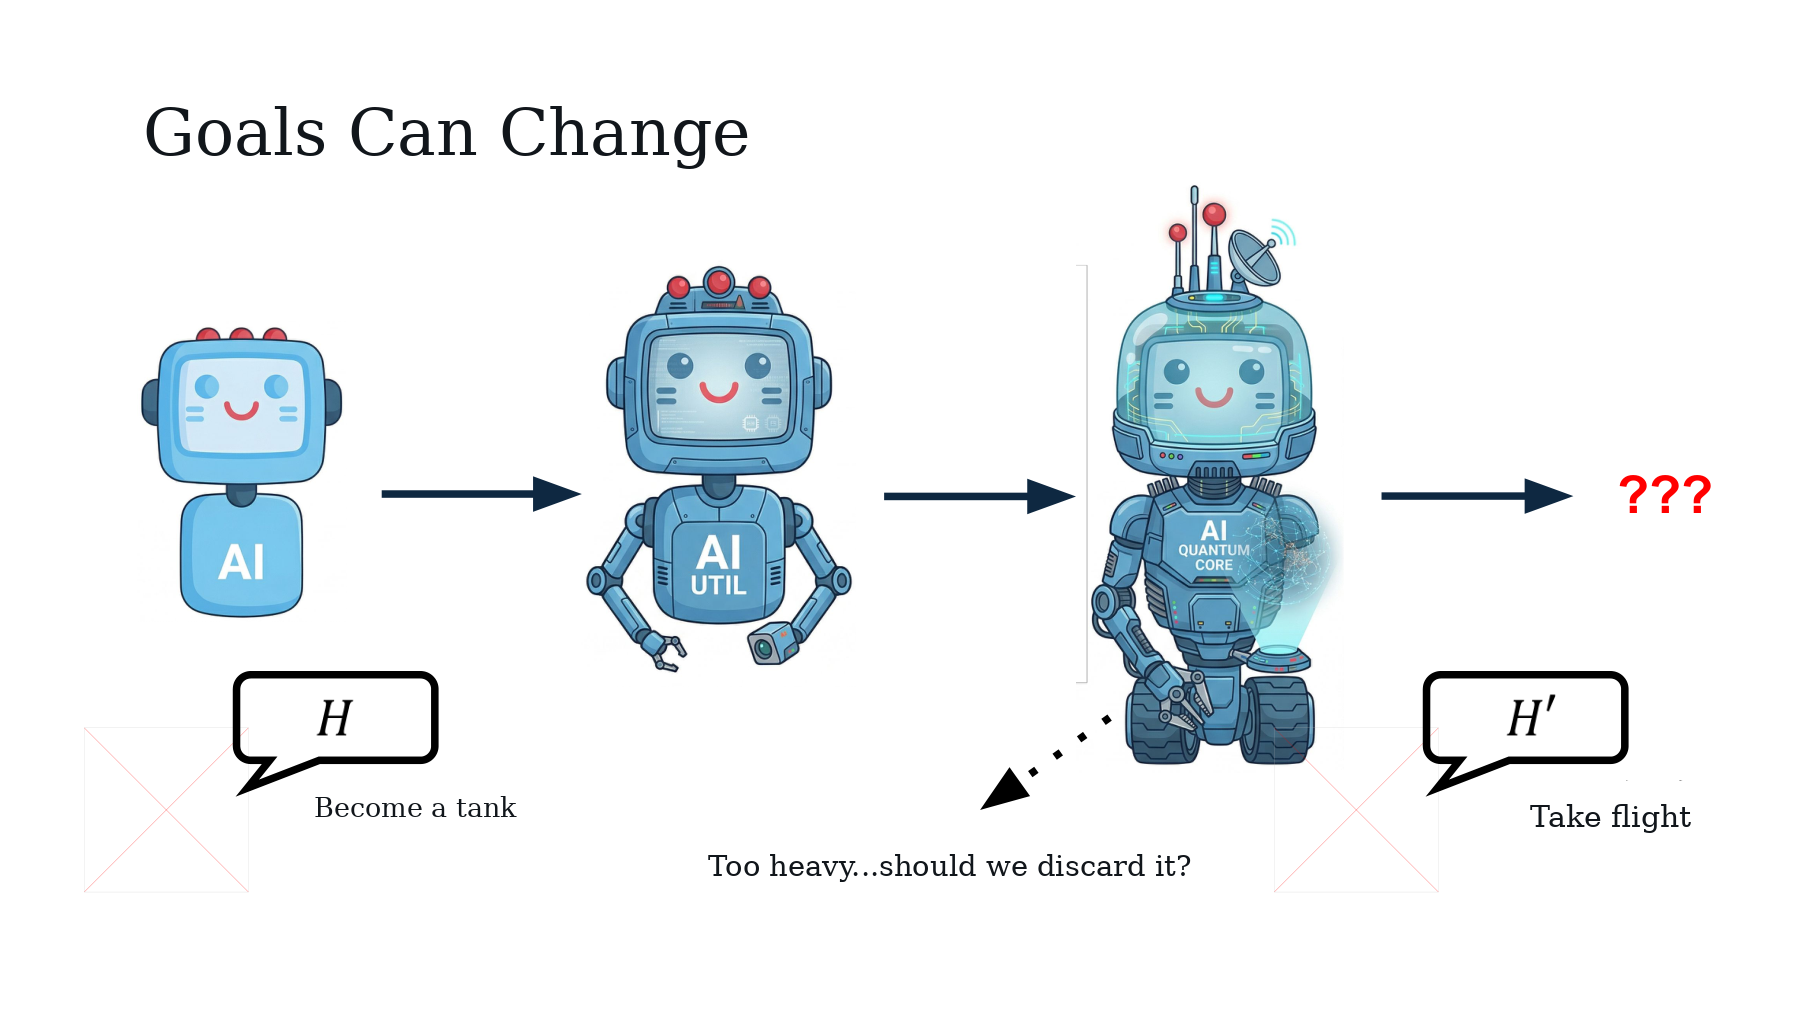
마지막 그림의 제목은 목표는 바뀔 수 있다(Goals Can Change)다. 그림은 AI 로봇이 더 강해지기 위해 탱크처럼 무거운 구조로 바뀌었지만, 새로운 목표가 ‘날기’로 전환되자 과거에 추가한 부품이 부담이 되는 상황을 표현한다. 이전 목표에서 성능을 높인 변화가 새 목표에서도 유용한지는 다시 검증해야 한다는 은유다.
목표 H가 시간에 따라 달라진다면, 개선 판정은 하나의 고정된 점수만으로 결정되지 않는다.
이 식은 상황별 목표를 표현한 해설용 표기다. 실제 최적화가 각 시점에 전역 최적해를 찾는다는 뜻이 아니다.
로봇의 예를 생각해 보자. 처음 목표가 ‘빠르게 물체를 이동’이라면 공격적인 경로 계획과 큰 가속이 유리할 수 있다. 다음 목표가 ‘사람 가까이에서 안전하게 협업’이라면 충돌 위험, 접근 속도, 안전 정지, 센서 지연이 우선 제약이 된다. 새 목표에서 높은 성공률을 보고하더라도 안전 제약을 위반하면 채택하지 않아야 한다. 목표 변화는 한 문장을 고치는 일이 아니라 평가 함수·제약 조건·운용 환경이 함께 달라지는 문제다.
#최선 후보를 유지하면서도 현재 목표를 바꾸는 방법
가중치 θ와 하네스 h를 모두 바꾸는 시스템이라면 각 버전과 평가 조건을 별도로 보존한다. 새 목표에 맞지 않는 기존 메모리나 도구 호출이 있다면 제거할 수 있어야 하지만, 이전 목표의 동작과 안전 회귀 테스트를 다시 재현할 수 있도록 남겨야 한다. 시스템이 과거에 무엇을 최적화했는지 기록하지 않으면 ‘스스로 개선됐다’는 주장을 다시 검증하기 어렵다.
#다섯 장의 연결: 무엇을 바꾸는가, 무엇을 평가하는가
| 접근법 | 최적화 대상 | 개선에 사용하는 신호 | 놓치면 안 되는 경계 |
|---|---|---|---|
| ExpRAG + Fine-tuning | 검색 경험과 모델 가중치 | 과거 궤적, 정답·보상·학습 손실 | 검색 유무와 가중치 변화의 효과 분리 |
| BetterTogether | 모듈 프롬프트 Π와 가중치 Θ | 최종 성능 지표와 중간 생성 궤적 | 조합 순서·데이터셋·실험 예산 |
| E-SPL | 시스템 프롬프트 개체군과 RL 정책 | 동일 라운드의 상대 성능·보상 | 서로 다른 모델 시점의 절대 점수 혼합 금지 |
| Goal Change | 목표 H 및 선택 기준 | 새로운 평가 지표·제약 | 과거 최적화의 성능을 현재 목표에 그대로 대입 금지 |
이번 다섯 장의 핵심은 개선이란 하나의 숫자가 아니라, 어떤 구성 요소를 어떤 목표로 수정했는지 설명할 수 있는 실험 과정이라는 점이다. 19편은 하편 26쪽부터 시험 시점 학습(Test-Time Training, TTT)과 망각 문제로 이어진다.
계산 예제와 코드
원전 Table 1과 E-SPL의 공개 수치에서 퍼센트포인트 차이를 계산하며, 결측 기호와 실제 결과를 구별한다. 17편부터 이어진 그림 이미지·출처·비공식 영어 편집 내역은 원자료 manifest에 기록한다. 해당 논문의 학습·벤치마크 자체를 재현한 결과라고 주장하지 않는다.
#함께 읽을 자료
| 자료 | 이 글에서 활용한 내용 |
|---|---|
| NTU 하편 PDF 21–25쪽 · 하편 강의 영상 | 기준 강의 슬라이드 5장 |
| ExpRAG, EMNLP 2026 | 경험 검색과 사용 방식의 차이 |
| BetterTogether, EMNLP 2024 · arXiv v2 | 프롬프트·가중치 최적화의 교대 순서, Table 1, Algorithm 1 |
| Omar Khattab, Compound AI Systems & DSPy 강의 | 원전 외부 강의 슬라이드 30·35·36쪽 |
| DSPy BetterTogether 공식 설명 | 현재 최적화기 개념과 호출 조건 |
| E-SPL, 2026 · 공식 구현 | 프롬프트 진화와 RL 공동 업데이트, 쉬운 문제에서 어려운 문제로의 일반화 |
위에서 논문 표의 수치는 해당 논문의 실험 설정에 한정된다. 하편 25쪽은 비공식 영어 레이블 편집본이며 원문 의미를 대체하지 않는다.