먼저 쉬운 답부터. 모든 학생에게 거의 같은 점수를 주는 시험지로는 실력 차이를 판단하기 어렵다. 유전자 교란을 예측하는 AI도 비슷한 문제가 있을 수 있다. 이번 연구는 모델부터 바꾸기 전에 평가 지표가 의미 있는 반응과 무정보 예측을 구별할 수 있는가를 확인했다. 14개 데이터셋과 18개 지표를 분석한 결과, 교정된 지표에서는 여러 딥러닝 모델이 단순 기준선을 넘어섰다. 그렇다고 모든 모델이 모든 생물학 문제를 해결했다는 결론은 아니다.[1]
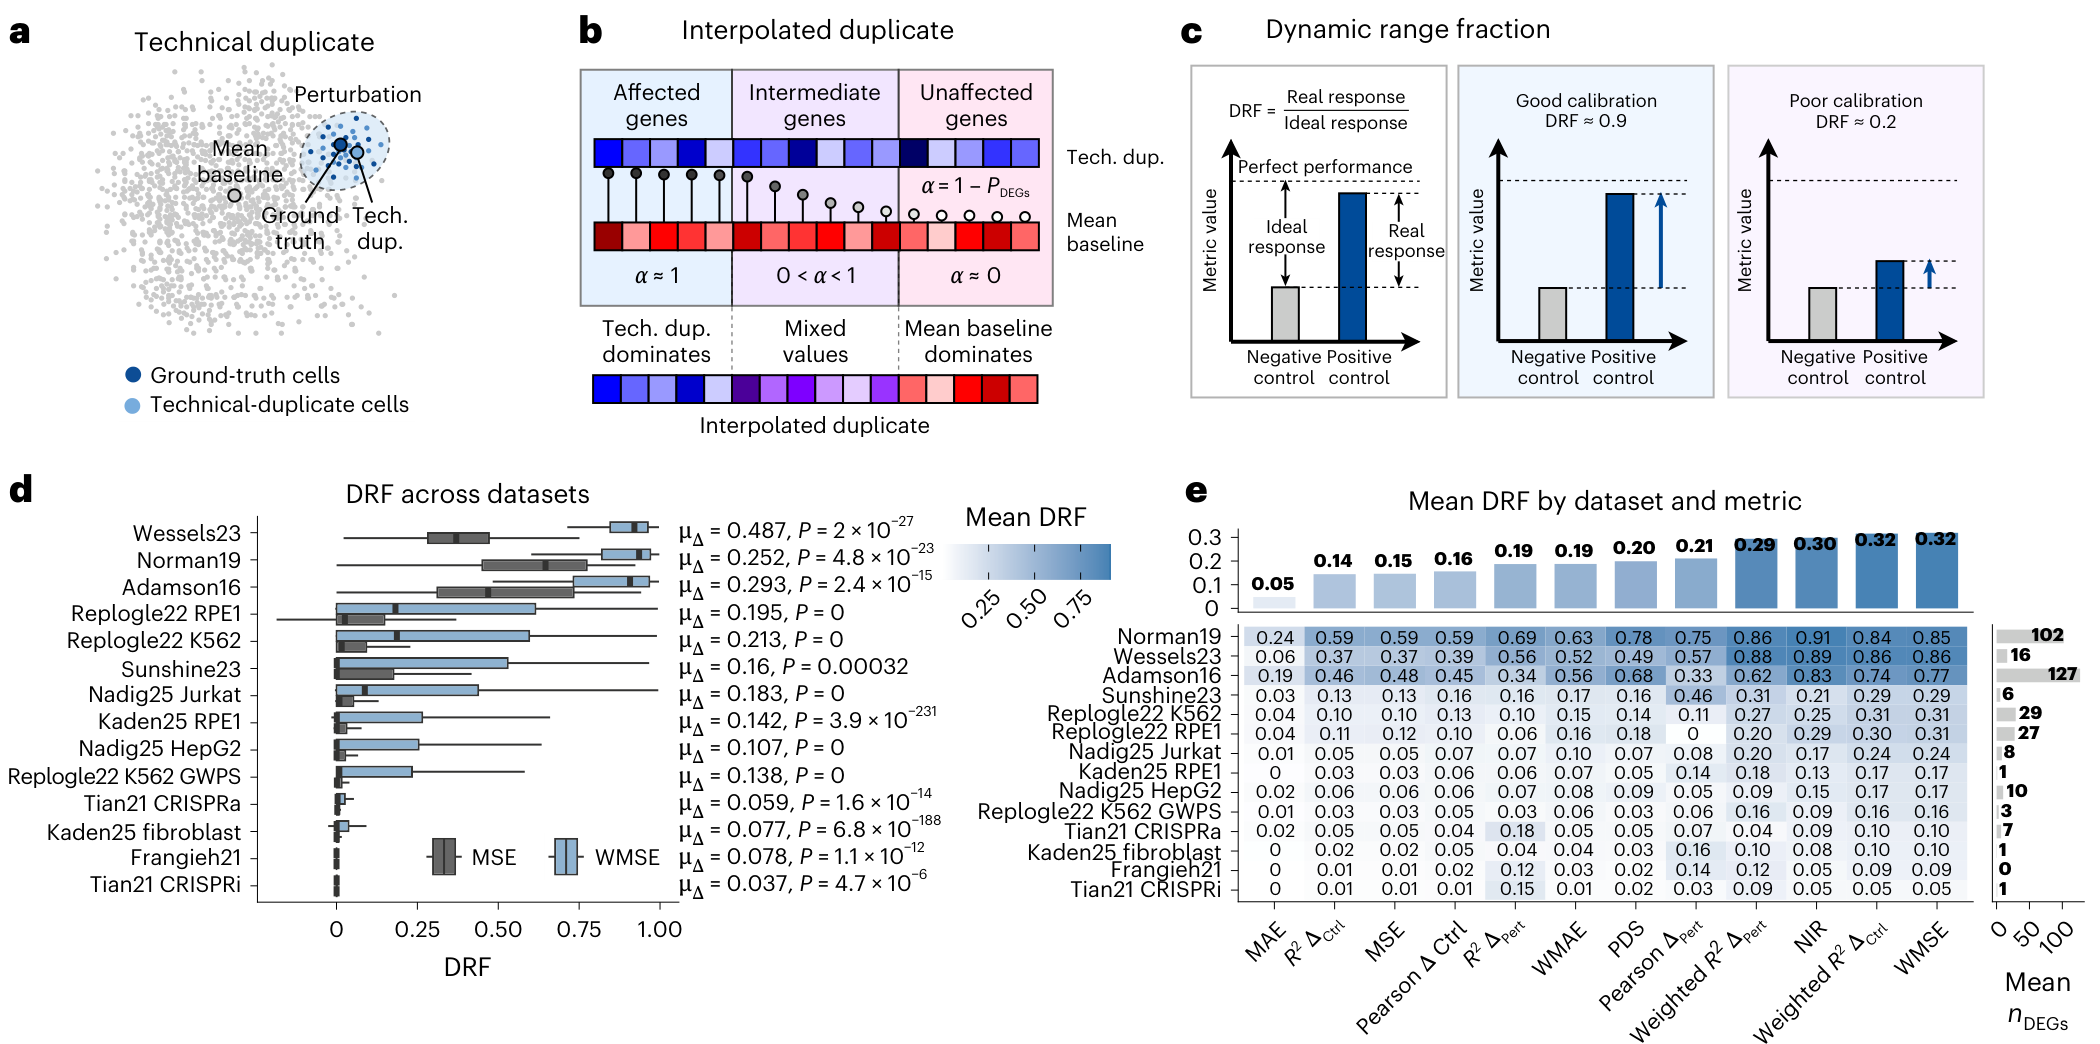
#원본 Figure 1 읽기: 모델 점수보다 대조군의 간격을 먼저 본다
a는 같은 교란의 세포를 두 집단으로 나눠 한쪽으로 다른 쪽을 예측하는 양성 대조다. b는 그 예측과 평균 기준선을 유전자별로 섞는 보간 대조를 보여준다. c는 양성·음성 대조 사이의 실제 간격을 이상적인 간격과 비교하는 DRF다. d·e는 여러 데이터셋과 지표에서 그 간격이 얼마나 살아 있는지 비교한다. 여기에 나온 교정 값은 특정 신약의 효과나 세포의 생존율이 아니다.[1]
처음 읽는 분 교란·전사체·기준선·양성 대조를 처음 읽는다면 그림으로 보기
유전자 교란(genetic perturbation)은 특정 유전자의 작동을 억제하거나 활성화해 세포가 어떻게 변하는지 관찰하는 실험이다. 전사체(transcriptome)는 세포에서 어떤 RNA가 얼마나 나타나는지에 관한 정보다. 여기서 예측하는 것은 이런 발현 반응이지 DNA 서열 전체나 세포의 모든 기능이 아니다.
기준선(baseline)은 복잡한 모델이 넘어야 할 단순한 비교 방법이다. 훈련 집합의 교란 후 평균 발현을 언제나 내놓는 방법은 쉽지만 개별 교란의 고유한 반응을 이해하지 않는다. 양성 대조(positive control)는 반대로 의미 있는 정보를 가진 예측이라면 평가 지표가 이를 알아보는지 검사하는 기준이다. 시험 당시의 정답에 접근할 수 있는 대조군을 실제 배포 가능한 예측기로 소개하면 안 된다.
#1. 평균을 내놓는 방법이 똑똑해 보이는 두 이유
유전자 하나를 바꿨을 때 수많은 유전자가 같은 크기로 변하는 것은 아니다. 일부 유전자에 중요한 반응이 집중되면 전체 유전자에 균일한 가중치를 주는 오차는 그 신호를 희석할 수 있다. 대부분의 변하지 않은 유전자를 잘 맞힌 평균 예측이, 소수의 핵심 반응을 놓쳤는데도 좋은 점수를 받을 수 있다. 논문은 이런 문제를 신호 희석(signal dilution)으로 설명한다.[1]
또 대조 세포와 교란된 세포 사이에 여러 교란에 공통된 변화가 있으면, 대조 세포를 기준으로 계산한 상관관계가 높아질 수 있다. 이 공통 변화를 맞히는 것과 특정 유전자 교란의 고유한 효과를 맞히는 것은 다르다. 논문이 설명하는 control bias는 이 기준점 선택의 문제다. 높은 상관값을 곧 특정 교란 메커니즘의 이해로 읽으면 안 되는 이유다.[1][2]
많은 유전자 가운데 소수만 변하면 MSE는 어떻게 보일까? 기호·연산·계산 과정 펼치기
G는 평가할 유전자 수다. 설명용으로 10,000개 유전자 가운데 열 개만 반응 크기 1이고 나머지는 0이라고 하자. 모든 변화를 0으로 예측하면 중요한 열 개를 전부 놓쳐도 MSE는 10/10,000=0.001이다. 이 가상 수치는 실제 데이터셋을 재계산한 결과가 아니다. 오차가 작아 보인다는 사실과 필요한 생물학적 신호를 포착했다는 사실이 다를 수 있음을 보여준다. 실제 발현값의 정규화·단위·변화 유전자 수에 따라 값은 달라진다.
이 설명은 MSE를 쓰면 무조건 틀린다는 주장이 아니다. 전체 발현을 비현실적으로 예측하는 모델을 거르는 데 직접 오차 지표는 여전히 유용하다. 이번 논문도 단일 지표만 정답으로 삼지 말고 평가 목적이 다른 지표를 함께 보라고 강조한다. 모델에 유리한 점수만 골라내는 것과 지표의 감도를 사전에 검증하는 것은 다른 행동이다.[1]
#2. 왜 정답을 일부 아는 대조군이 필요한가
연구진은 같은 교란에 속한 세포를 두 부분으로 나누고, 한쪽의 평균 발현으로 다른 쪽을 예측하는 technical-duplicate 대조를 사용했다. 두 집단은 동일한 교란 신호를 공유하므로, 무관한 평균만 예측하는 기준선보다 더 많은 관련 정보를 갖는다. 그런데 이런 대조조차 지표에서 크게 좋아 보이지 않는다면 실제 모델의 낮은 점수를 능력 부족만으로 설명하기 어렵다.[1]
세포 표본에는 잡음이 있기 때문에 단순한 반쪽 평균이 완벽한 정답은 아니다. 논문은 유전자별 교란의 유의성에 따라 technical duplicate와 평균 기준선을 혼합한 interpolated duplicate를 제시한다. 교란 효과가 뚜렷한 유전자에는 교란별 정보의 비중을 높이고, 효과가 약한 곳에는 평균의 비중을 높인다. 이 절차를 이해해야 양성 대조를 이상적인 무잡음 측정으로 오해하지 않는다.[1][2]
중요한 구분은 평가 장치를 점검하는 대조군과 보지 못한 교란을 예측해야 하는 모델이다. 양성 대조는 평가할 교란의 자료를 사용할 수 있다. 따라서 이를 실제 모델보다 높은 점수를 얻었다며 배포 가능한 최강 모델로 소개하면 비교 목적이 바뀐다. 이 연구에서는 해당 대조로 지표의 식별 가능성을 점검한 뒤, 별도로 훈련에서 제외한 교란이나 조합을 예측하는 모델을 비교한다.
#3. DRF는 정확도 점수가 아니라 지표의 구별 능력을 묻는다
동적 범위 비율(Dynamic Range Fraction, DRF)은 음성 대조에서 완벽한 예측까지의 이상적인 점수 차이 가운데, 양성 대조가 얼마만큼의 차이를 보여주는지 계산한다. 아래는 점수가 높을수록 좋은 방향으로 읽는 형태다. 손실 지표에서는 증가·감소 방향과 구현의 정의를 일관되게 맞춰야 한다.[1]
양성 대조의 개선이 전체 가능한 간격의 얼마인가? 기호·연산·계산 과정 펼치기
m은 평가 지표, y는 정답, ŷp와 ŷn은 양성·음성 대조의 예측이다. ε는 수치 안정화를 위한 작은 값이다. 높은 값이 좋은 점수라고 할 때 음성 0.90·양성 0.91·완벽 1이면 DRF는 대략 0.1이다. 음성 0.20·양성 0.80·완벽 1이면 약 0.75다. 두 예는 원논문의 실측값이 아니라 개념 계산이다. 후자는 해당 대조가 보여주는 차이를 더 넓게 드러낸다. 음성 대조가 이미 완벽에 가까우면 분모가 작아 해석이 민감해질 수 있다는 점도 함께 확인해야 한다.
DRF를 모델의 합격선이나 생물학적 안전 점수로 쓰는 것도 잘못이다. 값은 데이터의 잡음, 교란 강도와 선택한 대조군에 의존한다. 연구진은 대조군 변경, 세포 수, 시퀀싱 깊이, 변동성이 큰 유전자 선택 수 등을 바꾸며 교정이 어떻게 달라지는지 살폈다. 이는 한 데이터셋의 높은 DRF를 모든 환경으로 복사하지 말아야 한다는 이유이기도 하다.[1][2]
#4. 14개 데이터셋 교정과 모델 비교의 범위를 구분한다
14개 데이터셋·18개 지표는 교정 분석의 범위다. 모든 모델이 14개 데이터셋의 모든 가능한 일반화 조건에서 검증됐다는 뜻은 아니다. 본문은 보지 못한 단일 교란과 보지 못한 조합 예측을 구분하고, Replogle22 K562·Nadig25 HepG2 및 Norman19·Wessels23의 모델 비교를 설명한다. 새 세포 유형이나 새 공여자 맥락으로의 일반화는 다루지 않았다.[1]
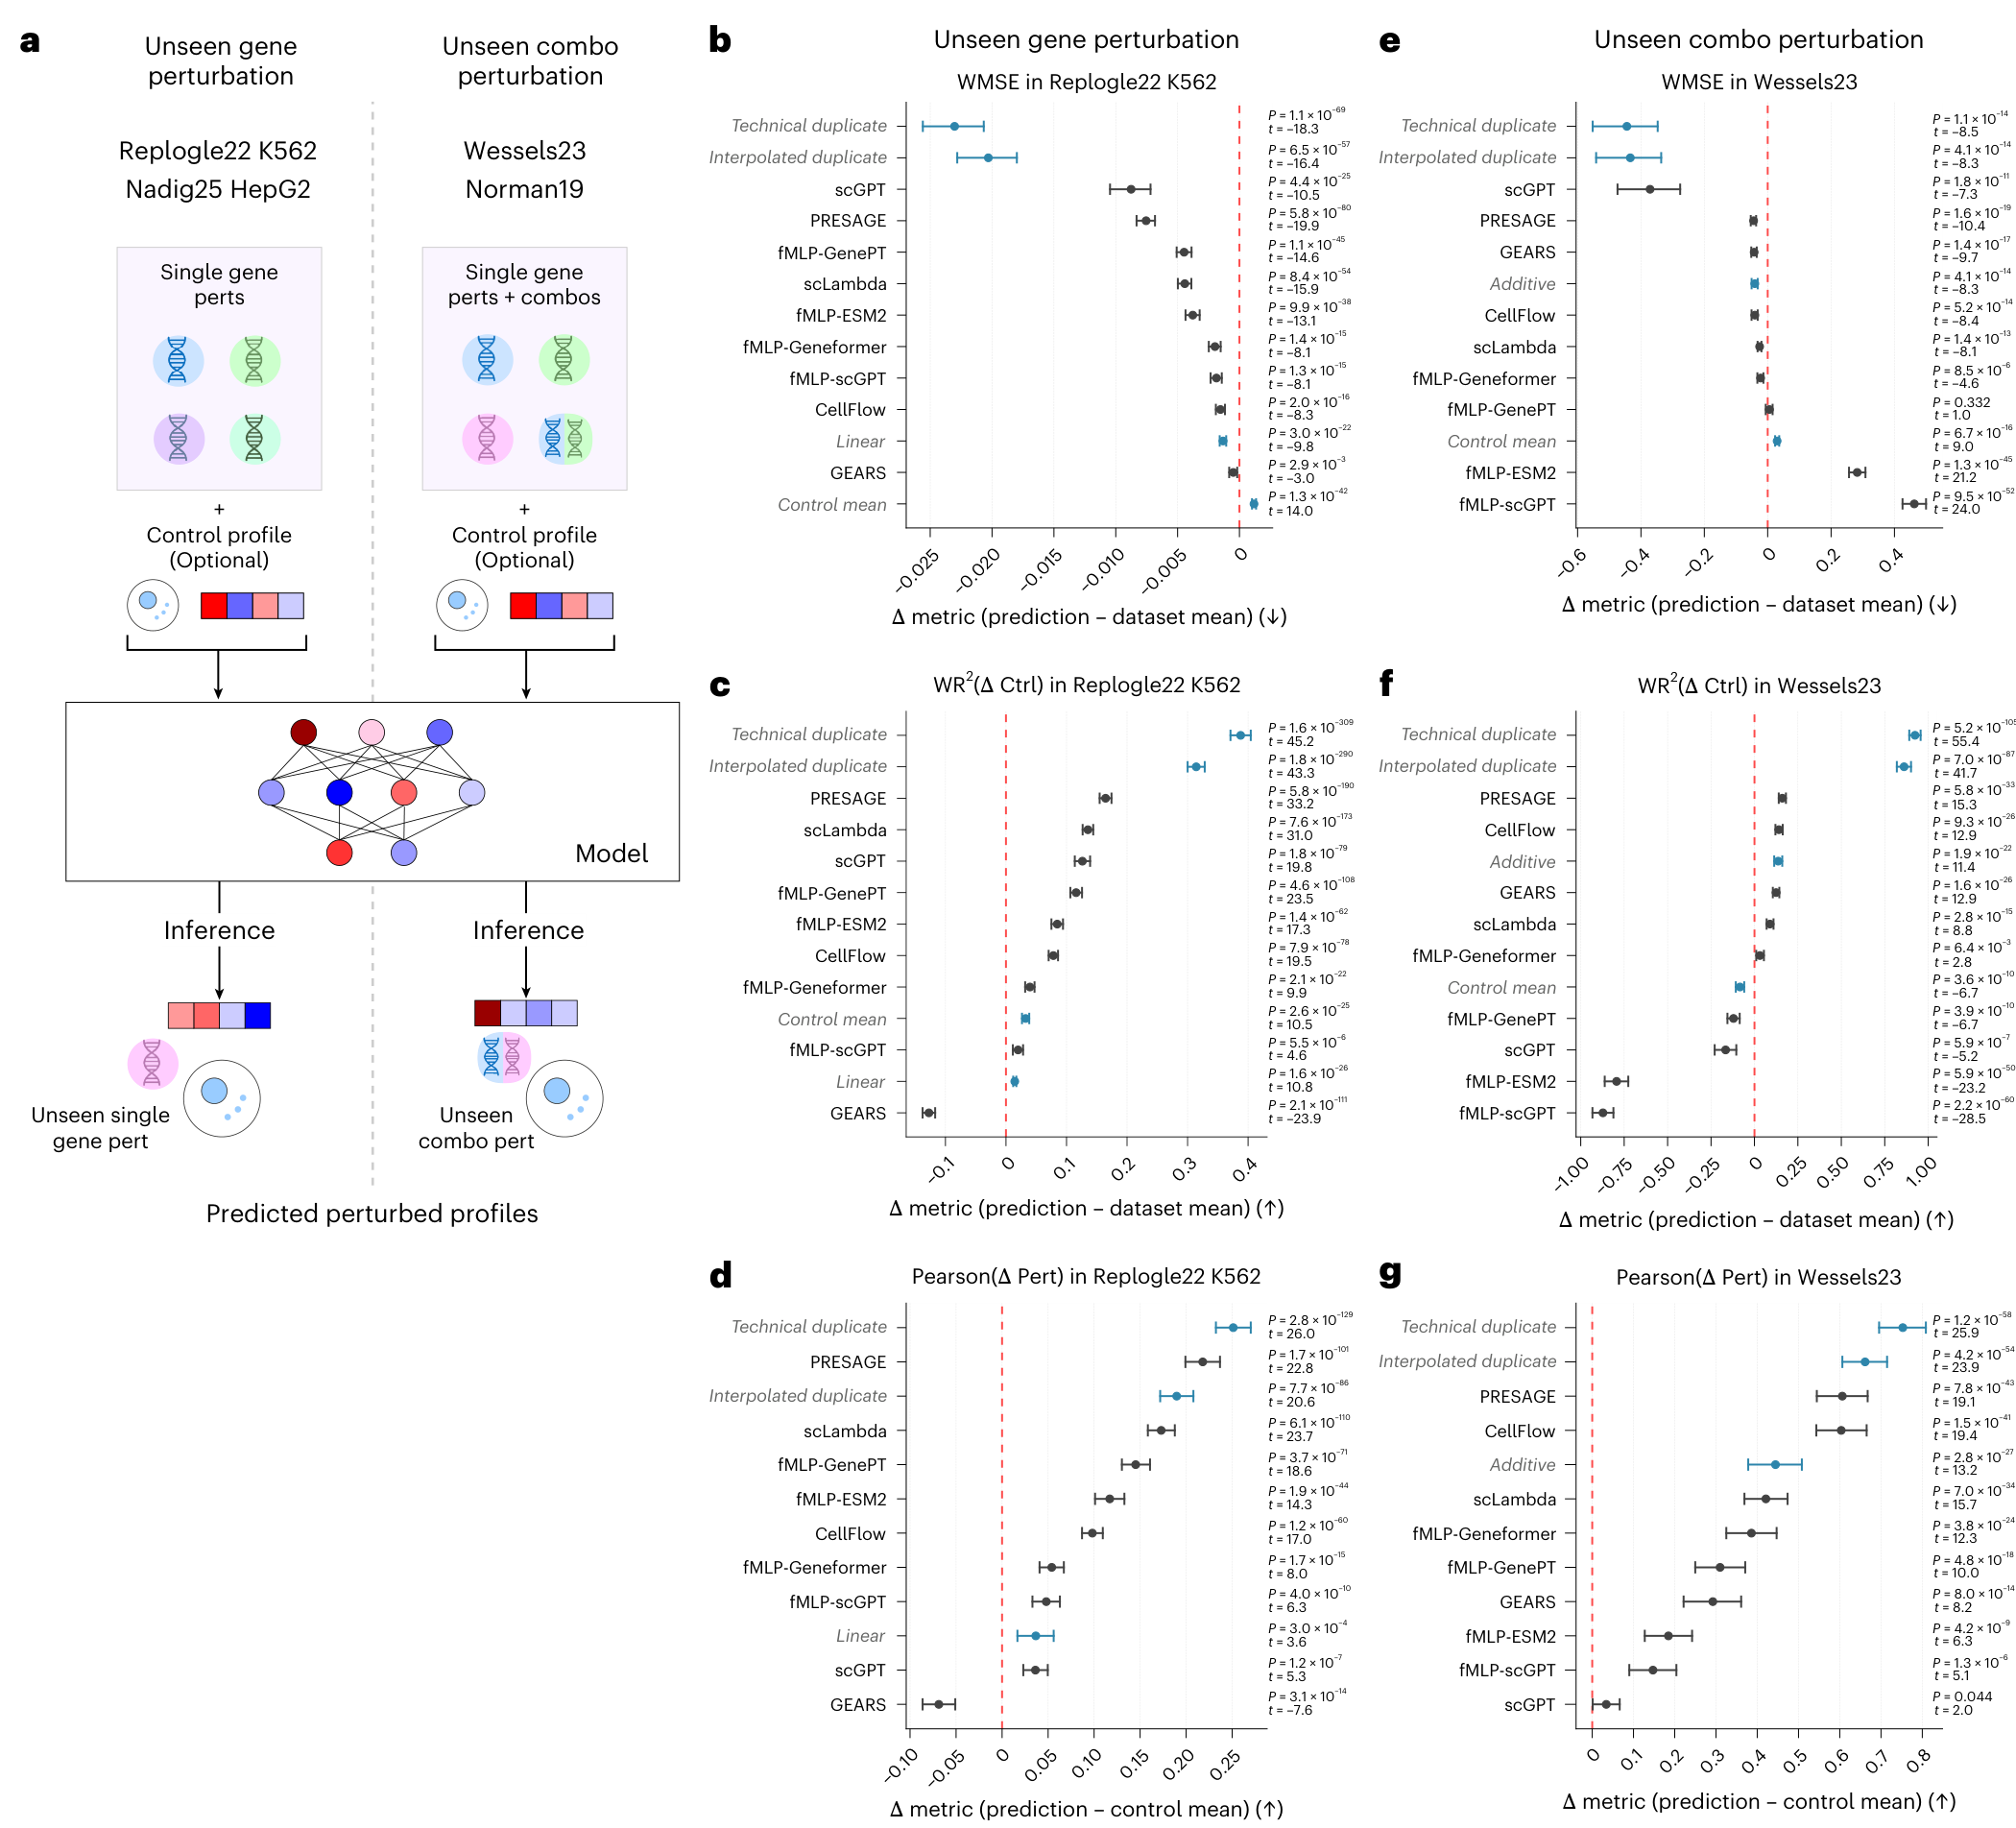
#원본 Figure 2 읽기: 오른쪽으로 갔다고 모든 목적에서 승자는 아니다
a는 단일 유전자 교란과 조합 교란의 학습·시험 구분이다. b–d는 단일 교란, e–g는 조합 예측에서 서로 다른 평가 지표를 보여준다. 일부 가로축은 기준선과의 점수 차이이고, 직접 오차는 낮을수록 좋은 값이므로 방향을 먼저 읽어야 한다. 에러 바와 비교 집단도 함께 봐야 하며 어느 패널에서 오른쪽에 있다는 사실만으로 모든 지표에서 최고라고 부를 수 없다.[1]
본문의 모델에는 scGPT·GEARS와 더 최근의 PRESAGE·scLambda·CellFlow, 그리고 여러 기반 모델의 임베딩을 입력으로 쓰는 MLP 비교가 포함된다. 임베딩을 사용하는 작은 예측기를 평가한 결과를 기반 모델 자체가 모든 교란을 직접 예측한 결과로 바꾸면 안 된다. 모델 계열·버전·재학습 설정과 지표가 모두 비교의 조건이다.[1]
| 질문 | 자료·관측 | 넘어서면 안 되는 해석 |
|---|---|---|
| 지표가 대조군 차이를 구별하는가 | 14개 데이터셋·18개 지표 교정 | 모든 세포·모델 조합의 성능 보증 |
| 기존 모델의 신호가 있었나 | 잘 교정된 지표에서 여러 모델이 무정보 기준선을 상회 | 모든 모델·지표에서 우월 |
| 조합 학습 자료가 충분한가 | Norman19 훈련 조합 범위 0.63% | 모든 생물학적 조합의 대표성 |
| 더 넓은 조합 자료에서는 어떤가 | Wessels23의 PRESAGE가 18개 중 15개 지표에서 additive를 초과 | 어떤 조합·세포 맥락에도 일반화 |
| 현실적 효용을 입증했나 | 일부 경로·근접 구조 회복 분석과 연관 | 치료 효과나 임상 성과 입증 |
#5. 단순 덧셈이 이미 잘 맞는 데이터셋의 한계
두 유전자를 각각 교란한 변화량을 더해 조합 효과를 예측하는 additive baseline은 단순하지만 강한 기준이다. Norman19에서는 상당수 효과가 가산적이고, 이 연구의 훈련 집합에 포함된 조합은 가능한 4,950쌍 가운데 31쌍, 약 0.63%였다. 그 조건에서 비가산적 상호작용을 학습할 기회가 제한되고 덧셈 기준선이 이미 이상적 간격의 많은 부분을 차지할 수 있다.[1]
비교한 Wessels23은 가능한 조합 가운데 훈련에 포함된 비율이 10.3%였다. 이 조건에서 여러 모델이 일부 교정 지표로 additive baseline을 넘었고, PRESAGE는 18개 지표 중 15개에서 이를 초과했다. 15/18을 83.3%의 세포 예측 성공률로 바꾸면 안 된다. 지표의 개수와 성공한 표본의 비율은 다른 분모다.[1]
두 데이터셋이 조합 범위만 다른 통제 실험이라는 해석도 피해야 한다. 유전자 수와 교란 강도, 실험 조건 등이 다르다. 더 넓은 조합 노출이 학습에 유리하다는 설명을 지지하지만, 차이의 모든 원인이 coverage 하나라고 확정한 것은 아니다. 논문 역시 추가 조합 데이터셋 평가가 필요하다고 명시한다.
#6. 결과를 AI 낙관론으로만 바꾸면 놓치는 것
이 연구는 이전 벤치마크의 모든 부정적 결과가 틀렸다는 선언이 아니다. 일부 지표가 신호를 잘 구별하지 못해 존재하던 예측력을 가릴 수 있다는 증거다. 교정된 지표에서도 모델 사이의 순위는 평가 목적에 따라 달라진다. 전체 발현을 맞히는 문제, 변화량의 상대 순서를 맞히는 문제, 올바른 교란을 검색하는 문제는 동일하지 않다.[1]
따라서 평가자는 모델을 본 뒤 이기는 지표만 선택하는 일을 피해야 한다. 먼저 사용 목적을 정하고, 양성·음성 대조와 여러 지표군을 함께 설계하는 것이 더 설득력 있다. 직접 오차 지표에서 기준선보다 현저히 나쁘다면 교정이 낮다는 이유만으로 무시할 수 없다. 생물학적으로 비현실적인 값을 내놓는지 살피는 방어선으로도 필요하다.
추가로 이 논문이 다루지 않은 것은 보지 못한 세포 유형·공여자·조건에서의 반응이다. 같은 세포계에서 새로운 유전자 교란을 예측하는 것과, 새 환자 조직에서 같은 반응을 예측하는 것은 다른 일반화 문제다. 실험 자료의 전사체 반응을 잘 맞힌 모델이 약물의 안전성이나 사람의 치료 효과를 입증한 것으로 연결되지도 않는다.[1]
#7. 이해관계와 다음 벤치마크의 설계
논문은 여러 저자가 Shift Bioscience 직원이며 Bo Wang이 Xaira Therapeutics의 Chief Artificial Intelligence Scientist라고 이해관계란에 공개한다. 이는 논문 공개 시점의 고지이며 현재 모든 직함을 별도로 조사했다는 뜻은 아니다. 이런 이해관계가 결과를 자동으로 무효화하지는 않지만, 평가 코드·처리 조건·모델 버전 공개와 독립 반복의 필요성을 판단하는 맥락이다.[1]
재현 코드는 공식 저장소에 제공된다. 그러나 이 글에서는 모든 모델을 다시 훈련하거나 14개 데이터셋을 내려받아 전부 재계산하지 않았다. PRESAGE 등 개별 모델의 사용 조건이 저장소 전체의 편의성 때문에 사라지는 것도 아니다. 공개된 코드와 실제 재현 실행, 그리고 임상 검증은 서로 다른 완료 상태로 기록해야 한다.[3]
다음 연구에서는 더 다양한 조합 자료와 새로운 세포 맥락, 잡음과 데이터 크기 변화에서 같은 교정 원리가 유지되는지 확인할 필요가 있다. 서로 다른 평가 목적의 결과를 한 점수로 무리하게 합치지 않고, 양성 대조가 어디까지 구별되는지부터 보고하면 모델의 실패와 시험지의 둔감함을 더 잘 나눌 수 있다. 이번 후보의 의미는 AI가 무엇이든 예측한다는 것이 아니라, AI의 능력을 판단하는 측정 도구도 검증해야 한다는 것이다.
#출처와 열람 범위
[1] Miller 외, Deep learning perturbation models can outperform baselines on calibrated metrics. Nature Biotechnology, 2026-10-01, DOI 10.1038/s41587-026-03307-w [2] 동일 논문 Supplementary Notes 1·2. 대조군과 지표 교정, 데이터 품질·선택 조건에 관한 추가 분석 [3] Shift Bioscience 공식 재현 코드: Perturbation-Models-Outperform-Baselines편집일은 2026년 10월 2일, 본문·원도판·권리 재확인일은 10월 5일이다. 출판사의 최종 공개 본문과 PDF, 보충자료의 관련 대목을 확인했다. 원논문 Figure 1·2는 전체 패널·축·주석을 유지하며 CC BY 4.0과 출처를 표시한다. 첨부의 97점과 이전 후보 검색 범위는 편집 기록이며 이 작업에서 새로 계산한 과학적 확률이나 전수 검색 결과가 아니다. 개별 임상 진단·치료 권고 또는 독립 모델 재훈련은 수행하지 않았다.