컵으로 손을 옮기는 명령은 어떻게 모터의 움직임이 될까? 좌표계부터 제어까지 따라간 다음, 로봇의 행동을 평가하고 학습하는 수학적 틀로 연결해 보자.
Oier Mees · ETH Zurich 2026 2강 영상 · 공식 강의 · 원본 PDF
“컵 쪽으로 손을 1cm 움직여라.” 짧은 명령이지만 로봇에는 여러 문제가 숨어 있다. 어느 좌표계에서 1cm인가? 관절을 얼마나 돌려야 하는가? 몇 초 동안 움직이며, 목표를 지나치면 어떻게 고칠 것인가? 컵을 놓쳤다면 다음 행동은 무엇인가?
01장에서 정책은 정보를 받아 행동을 고르는 규칙이었다. 이번 장에서는 정책이 고른 행동이 물리적 움직임이 되는 과정을 먼저 살펴보고, 여러 행동의 결과를 평가하는 마르코프 결정 과정(Markov Decision Process, MDP)으로 이어 간다. 앞부분의 제어와 뒷부분의 학습은 하나의 로봇 시스템 안에서 만난다.
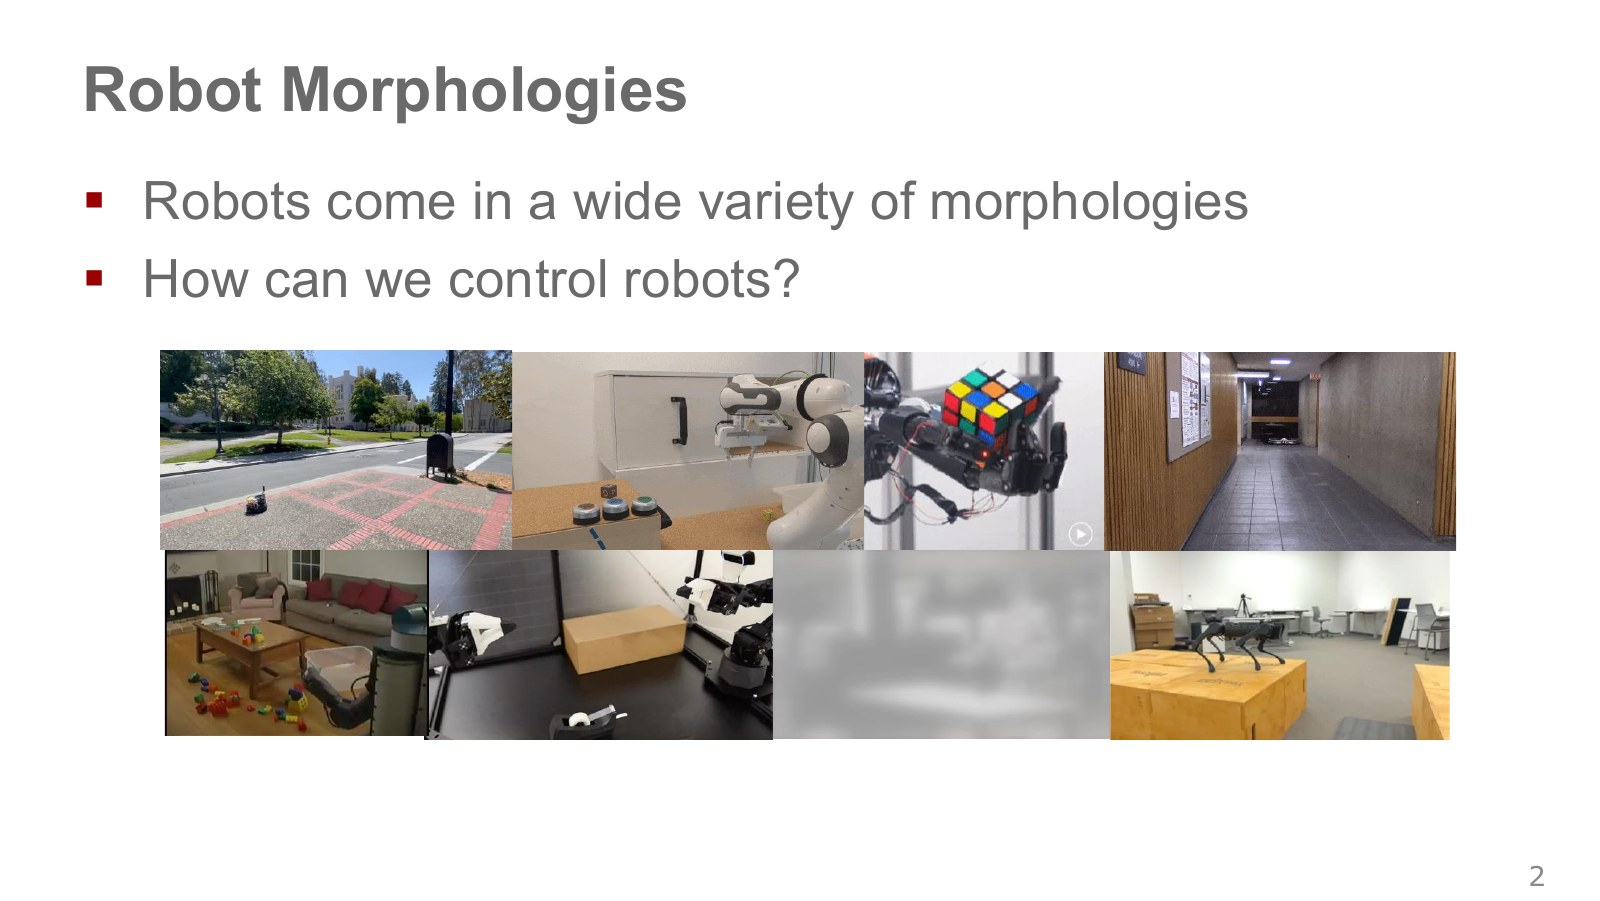
드론은 프로펠러를, 로봇 팔은 관절을, 이동 로봇은 바퀴를 움직인다. 여기서 형태 또는 신체 구성(morphology)은 단순한 외관이 아니다. 관절의 연결 방식과 움직일 수 있는 방향, 센서와 구동기의 배치까지 행동의 가능성을 결정한다.
강의 1:00–2:14는 서로 다른 하드웨어의 공통 문제를 높은 수준의 목표에서 실제 구동 명령으로 내려오는 과정으로 설명한다. “앞으로”라는 말도 바퀴 속도인지, 몸체 속도인지, 발의 목표 위치인지에 따라 다르다. 이후 수식에서 행동 a를 만나면 먼저 어느 장치에 어떤 물리량을 명령하는가를 확인하자.
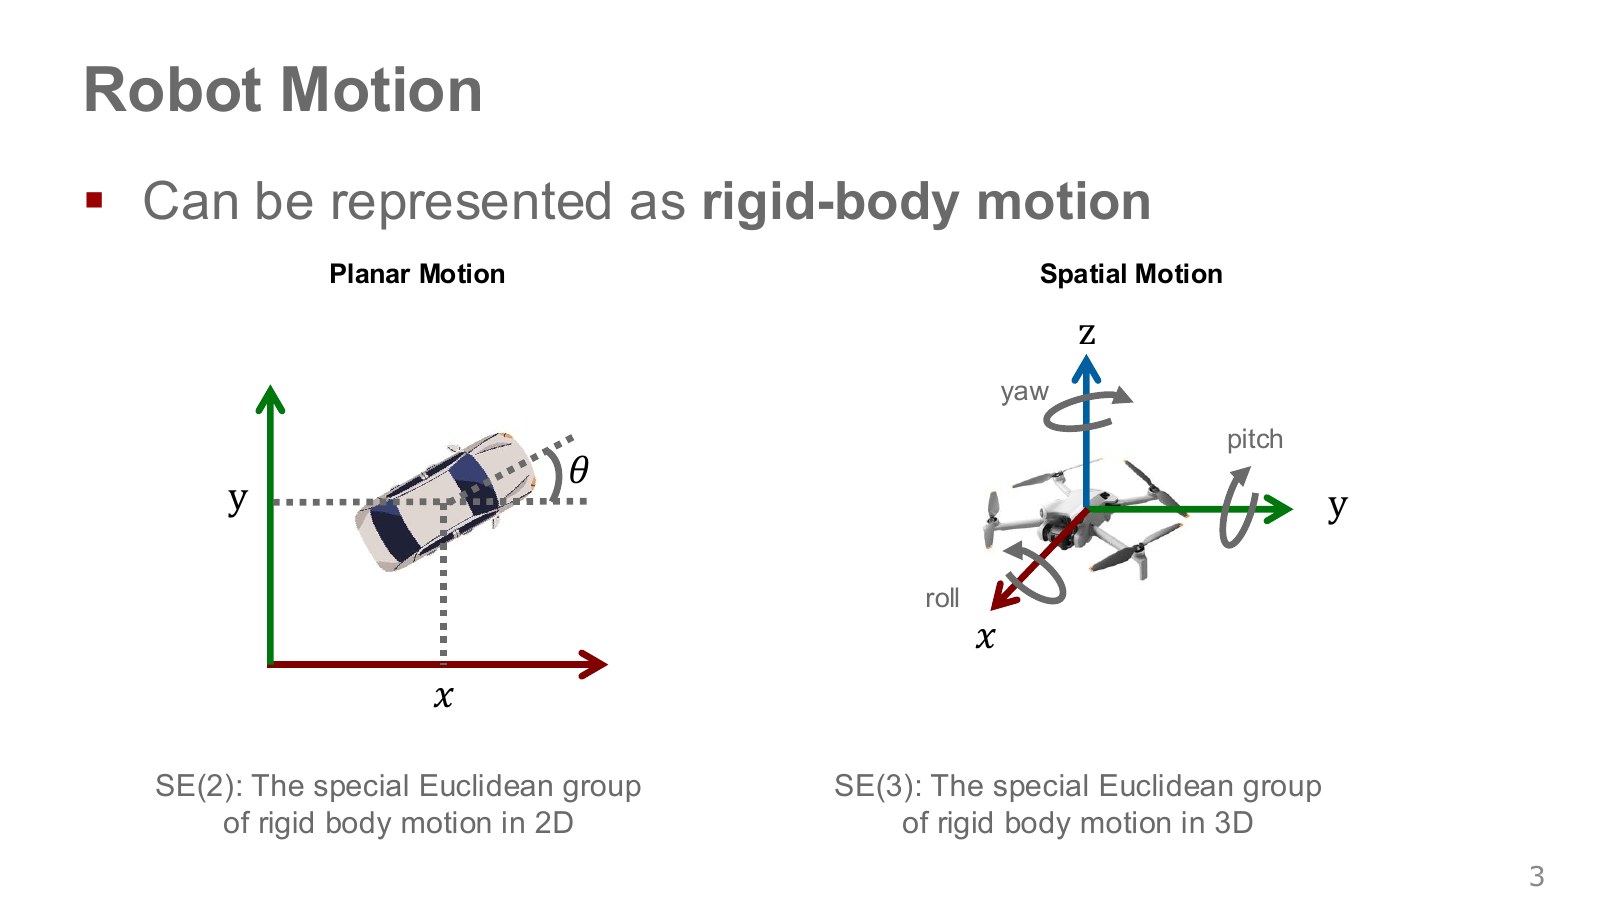
강체(rigid body)는 몸체 안 두 점 사이의 거리가 움직이는 동안 변하지 않는다는 모델이다. 쇠로 만든 링크 하나를 이렇게 근사하면, 표면의 모든 점을 따로 추적하지 않고 몸체에 붙인 좌표계의 위치와 방향으로 운동을 표현할 수 있다. 관절이 있는 로봇 전체가 하나의 강체라는 뜻은 아니다.
평면 이동은 보통 위치 두 개 (x, y)와 방향 하나 θ로 표현한다. 이 자세들의 공간이 SE(2)다. 공간에서 움직이면 위치 (x, y, z)와 방향의 세 자유도가 필요하며 SE(3)를 사용한다. 여기서 자세(pose)는 위치(position)와 방향(orientation)을 함께 뜻한다. 드론의 높이만 알아서는 기울어진 방향까지 알 수 없다.
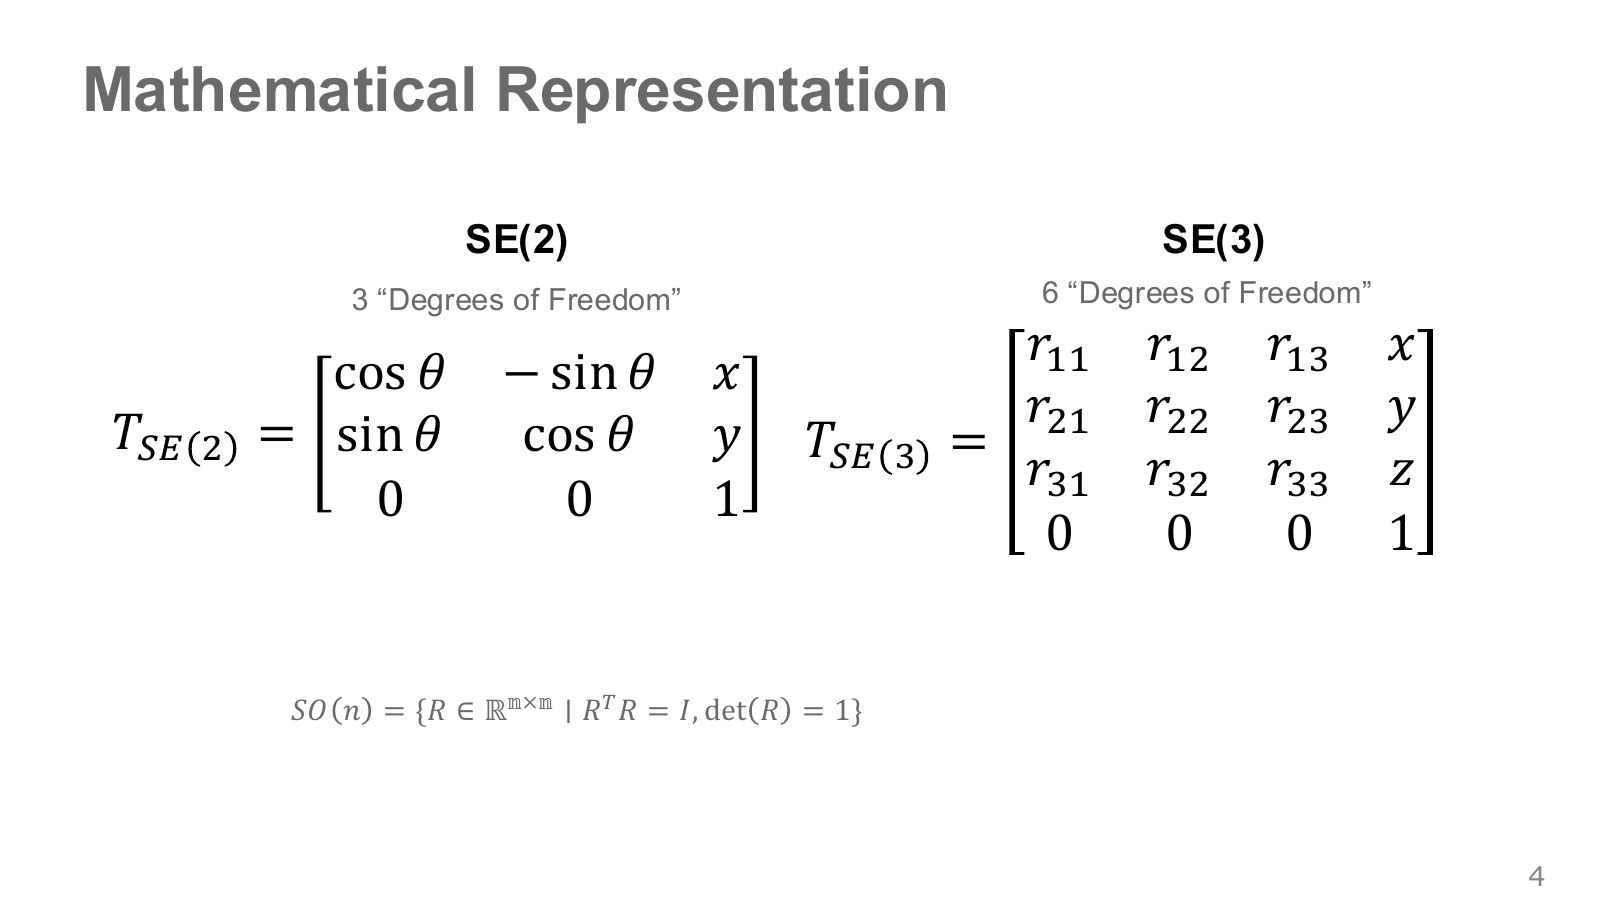
평면의 회전과 이동을 한 번에 계산하는 동차 변환 행렬은 다음과 같다. 슬라이드의 평면 식을 다시 적었다.
왼쪽 위 2×2 부분은 회전, 오른쪽 열의 (x, y)는 이동이다. 점을 (pₓ, pᵧ, 1)로 늘려 쓰면 행렬 곱 하나에 두 계산이 들어간다. 물결표는 마지막에 1을 붙인 동차 좌표를 뜻한다. 3차원에서는 회전 부분이 3×3, 전체가 4×4가 된다.
예를 들어 B 좌표계를 A에서 반시계 방향 90° 돌리고 원점을 (1m, 2m)로 옮겼다고 하자. B의 점 (1m, 0m)는 A에서 (1m, 3m)가 된다. 좌표계가 다르면 같은 두 숫자가 같은 장소를 뜻하지 않는다.
회전 행렬 R은 RᵀR = I, det(R) = 1을 만족한다. 첫 조건은 길이와 각도를 보존하고, 두 번째는 거울 반사를 제외한다. 행렬에 원소 9개가 있다고 방향의 자유도가 9개인 것은 아니다. 제약을 만족하는 3차원 회전은 자유도 3개다.
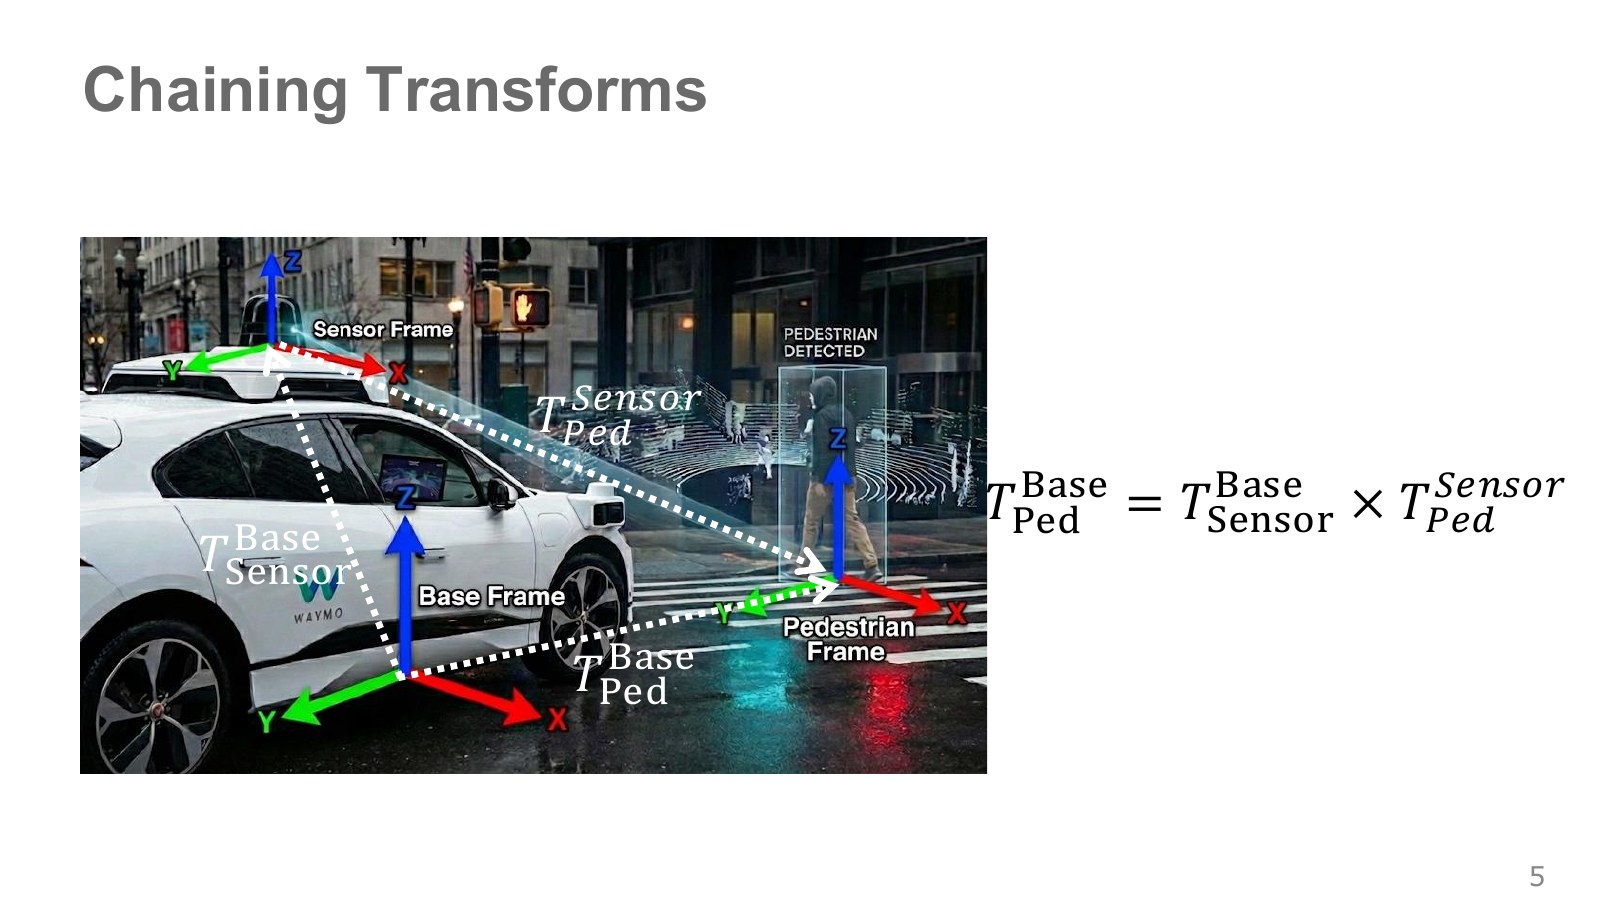
자동차 위 카메라가 보행자를 찾으면 위치는 먼저 카메라 기준으로 나온다. 제어기가 자동차 기준 위치를 사용한다면 두 좌표계 사이의 변환을 적용해야 한다. 강의 5:37–7:09의 차량 그림은 이 연결을 보여 준다.
여기서는 위 첨자가 도착 좌표계, 아래 첨자가 출발 좌표계다. 오른쪽 변환부터 적용하면 중간의 sensor가 맞물린다. 순서를 뒤집으면 일반적으로 다른 결과가 나온다. 로봇 팔에서도 베이스→어깨→팔꿈치→손목의 변환을 연결하는 같은 원리를 쓴다.
센서와 베이스 사이의 관계를 알아내는 것이 외부 파라미터 보정의 한 역할이다. Modern Robotics의 동차 변환 영상·스크립트 (영상 1:51–2:49)도 좌표 표현과 변환의 합성을 설명한다. 행렬을 곱할 때는 단위와 어느 방향의 변환인지부터 적어 두자.
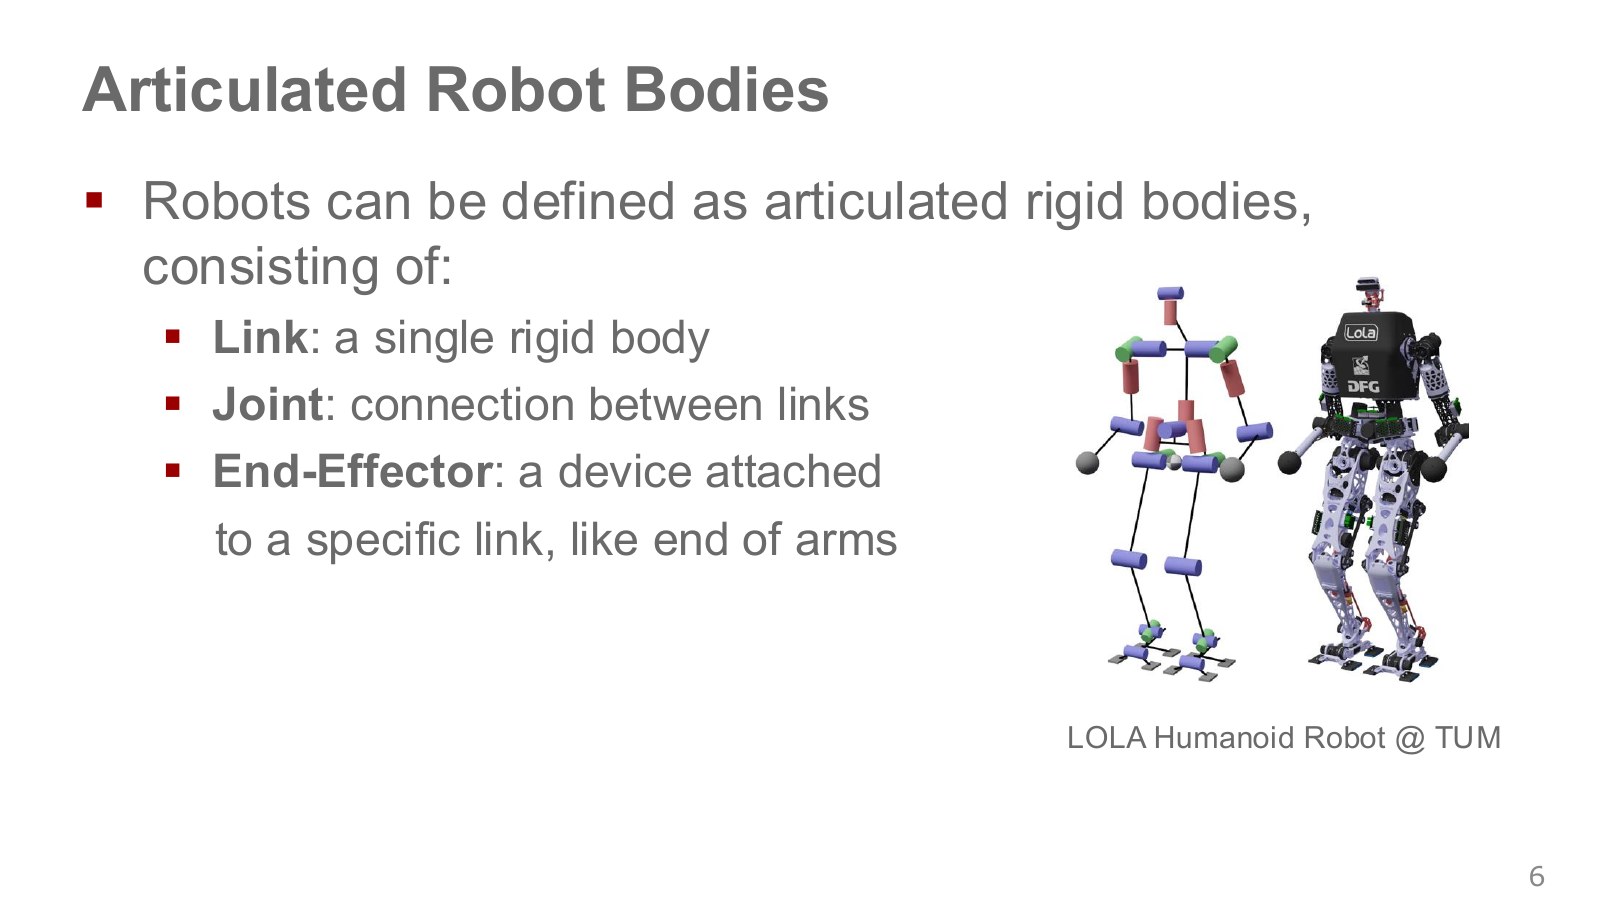
링크(link)는 개별 강체, 관절(joint)은 링크 사이의 상대 운동을 제한하는 연결, 말단 장치(end-effector)는 작업을 수행하는 도구다. 사람 팔에 비유하면 위팔과 아래팔이 링크, 팔꿈치가 관절, 물체를 다루는 손이 말단 장치에 대응한다.
관절 각도가 변하면 링크 사이 좌표 변환이 달라지고, 연결된 변환들을 곱하면 손의 위치가 나온다. “관절이 몇 개 있는가”에서 끝내지 말고, 어느 링크와 어느 축으로 연결되는지 보아야 한다. 링크 길이나 관절 축이 다르면 같은 각도 벡터를 넣어도 손이 가는 곳이 달라진다.
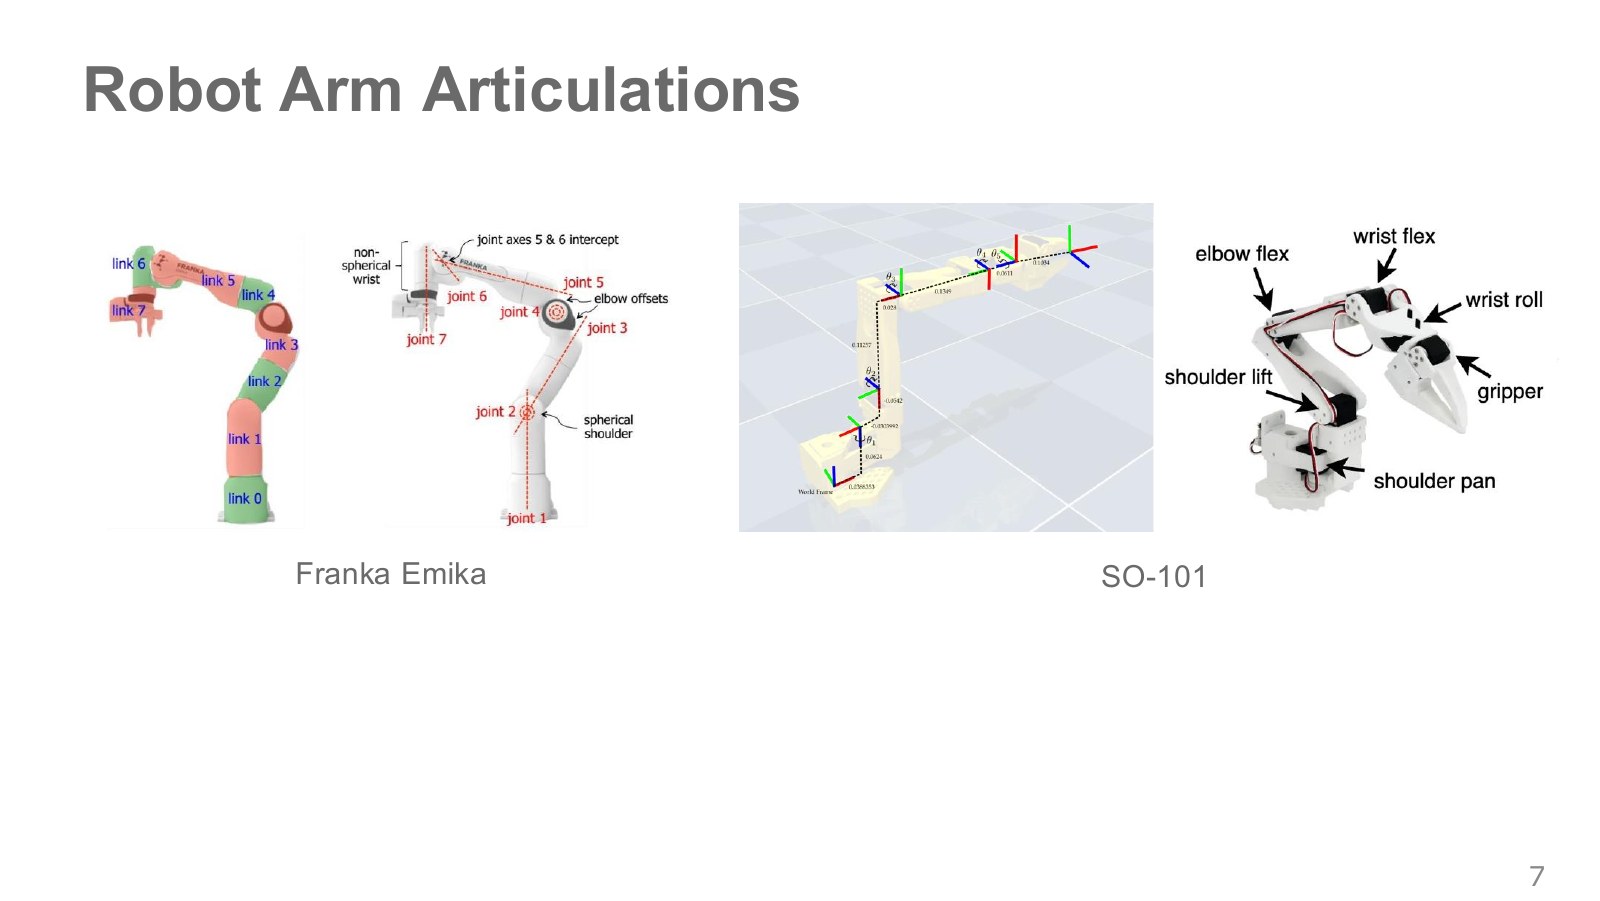
슬라이드는 Franka와 SO-101의 축과 관절 이름을 비교한다. 더 비싸거나 관절이 많은 로봇도, 간단한 로봇도 링크 사이 변환을 연결한다는 수학적 구조는 공유한다. 그러나 관절 수, 가동 범위, 도달 가능한 자세와 명령 형식은 하드웨어마다 다르다.
팔의 자유도와 그리퍼의 열림·닫힘을 구분해서 세어야 한다. 손끝의 3차원 위치를 정하는 변수, 손의 방향을 정하는 변수, 집게 폭을 정하는 변수는 같은 역할이 아니다. 예제에서 관절 벡터의 길이가 6이라고 해서 모두 6자유도 공간 자세 제어에 쓰인다고 가정하지 말자.
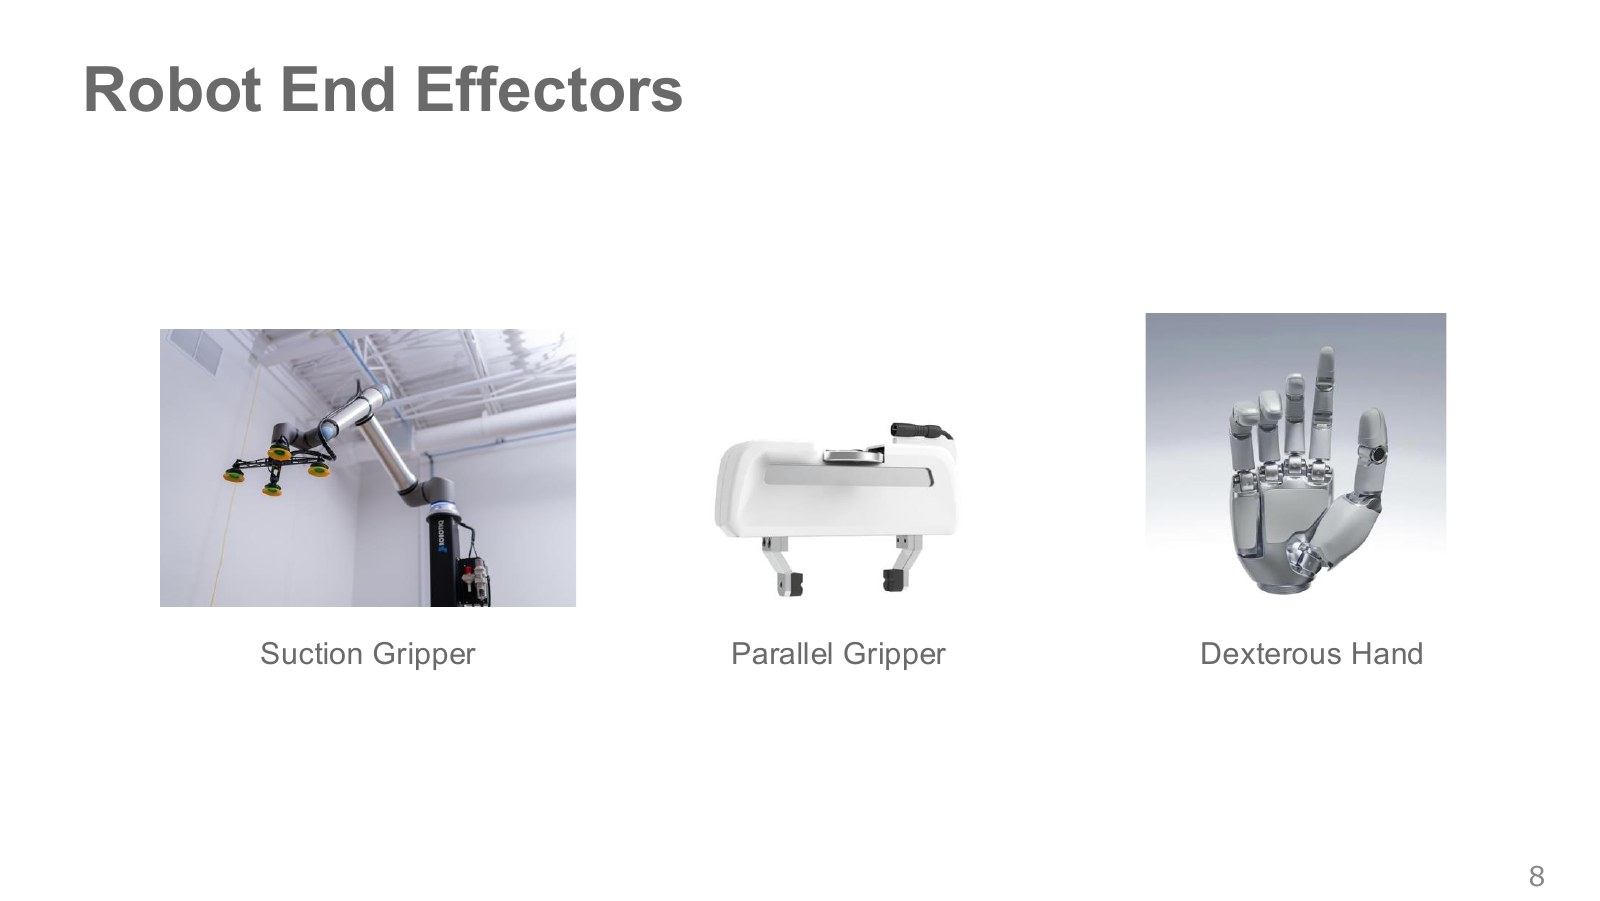
흡착 그리퍼는 진공을 켜고 끄는 명령을 가질 수 있고, 평행 그리퍼는 집게 폭이나 힘을 조절한다. 다관절 손에서는 여러 손가락의 관절을 함께 다뤄야 한다. 물체와 접촉하는 구조가 바뀌면 필요한 정밀도와 학습할 행동의 차원도 달라진다.
강의 9:09–10:35에서 흡착을 이진 행동으로 설명하는 것은 흡착 기능의 켜짐·꺼짐에 대한 단순화다. 흡착기 전체를 물체 위로 가져가는 팔의 위치·방향까지 이진이 되는 것은 아니다. 한 정책의 행동에 연속적인 팔 명령과 이산적인 집기 명령이 함께 들어갈 수도 있다.
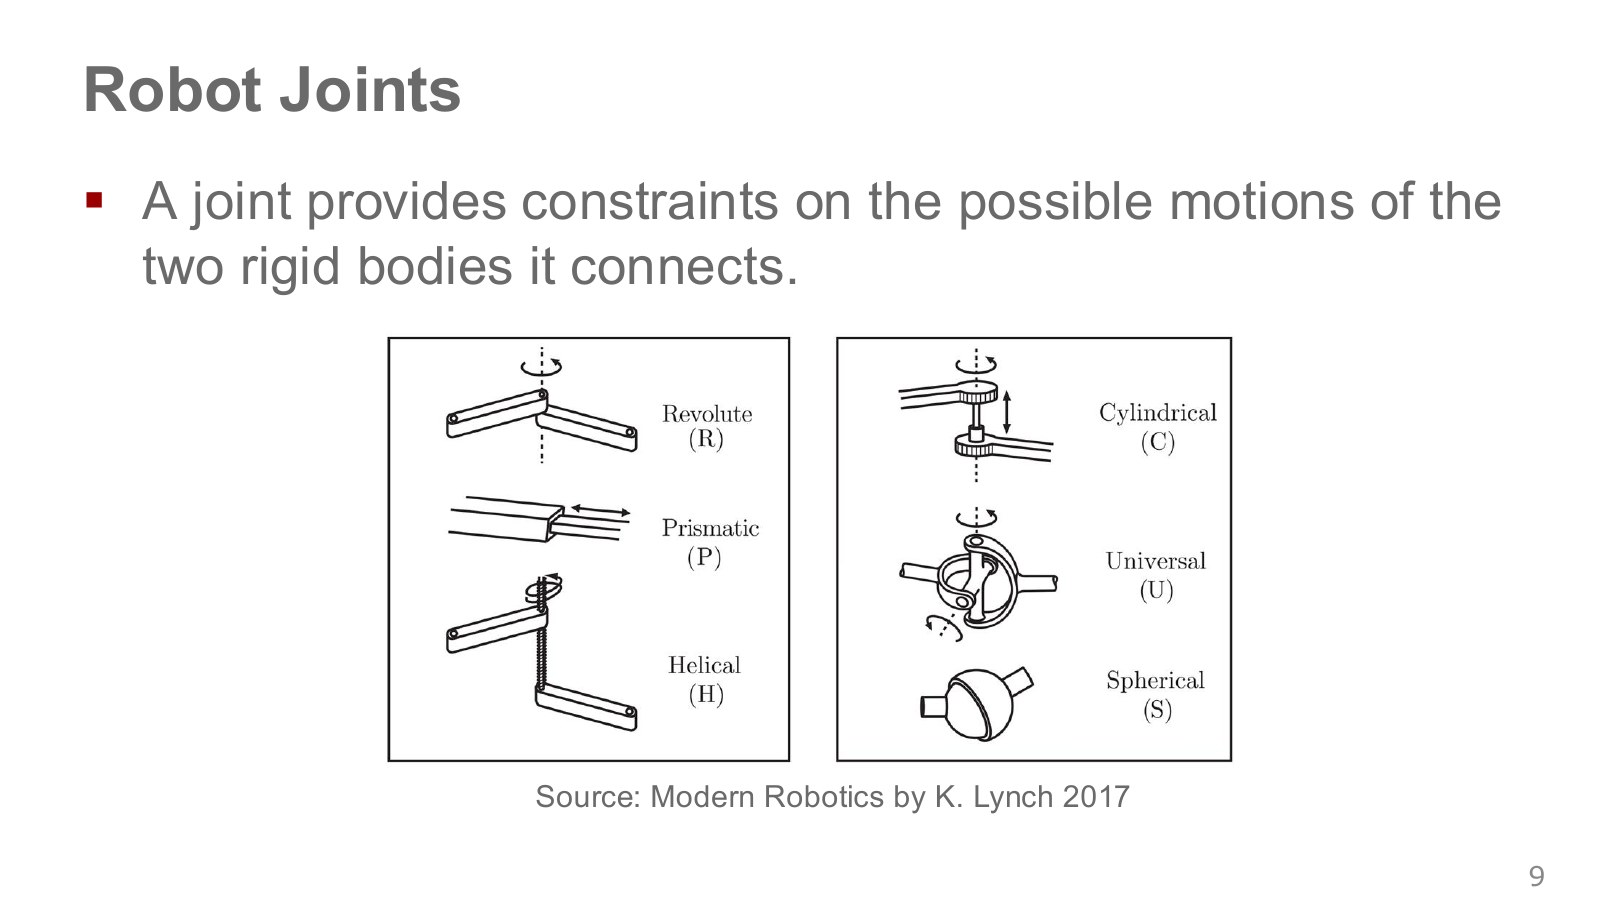
두 강체가 아무 제약 없이 상대적으로 움직이면 공간에서 위치 3개와 방향 3개가 필요하다. 회전 관절(revolute joint)은 이 가운데 한 축 회전만 허용하고 나머지 상대 운동을 막는다. 직동 관절(prismatic joint)은 한 축의 직선 이동을 허용한다.
그림의 구면 관절, 원통 관절 등은 허용하는 회전과 이동의 조합이 다르다. 로봇을 모델링할 때 관절 이름은 도형을 외우기 위한 말이 아니라, 어떤 좌표가 독립적으로 변할 수 있는가를 정하는 정보다. 모터 개수와 기구학적 자유도도 항상 일치하는 것은 아니다.
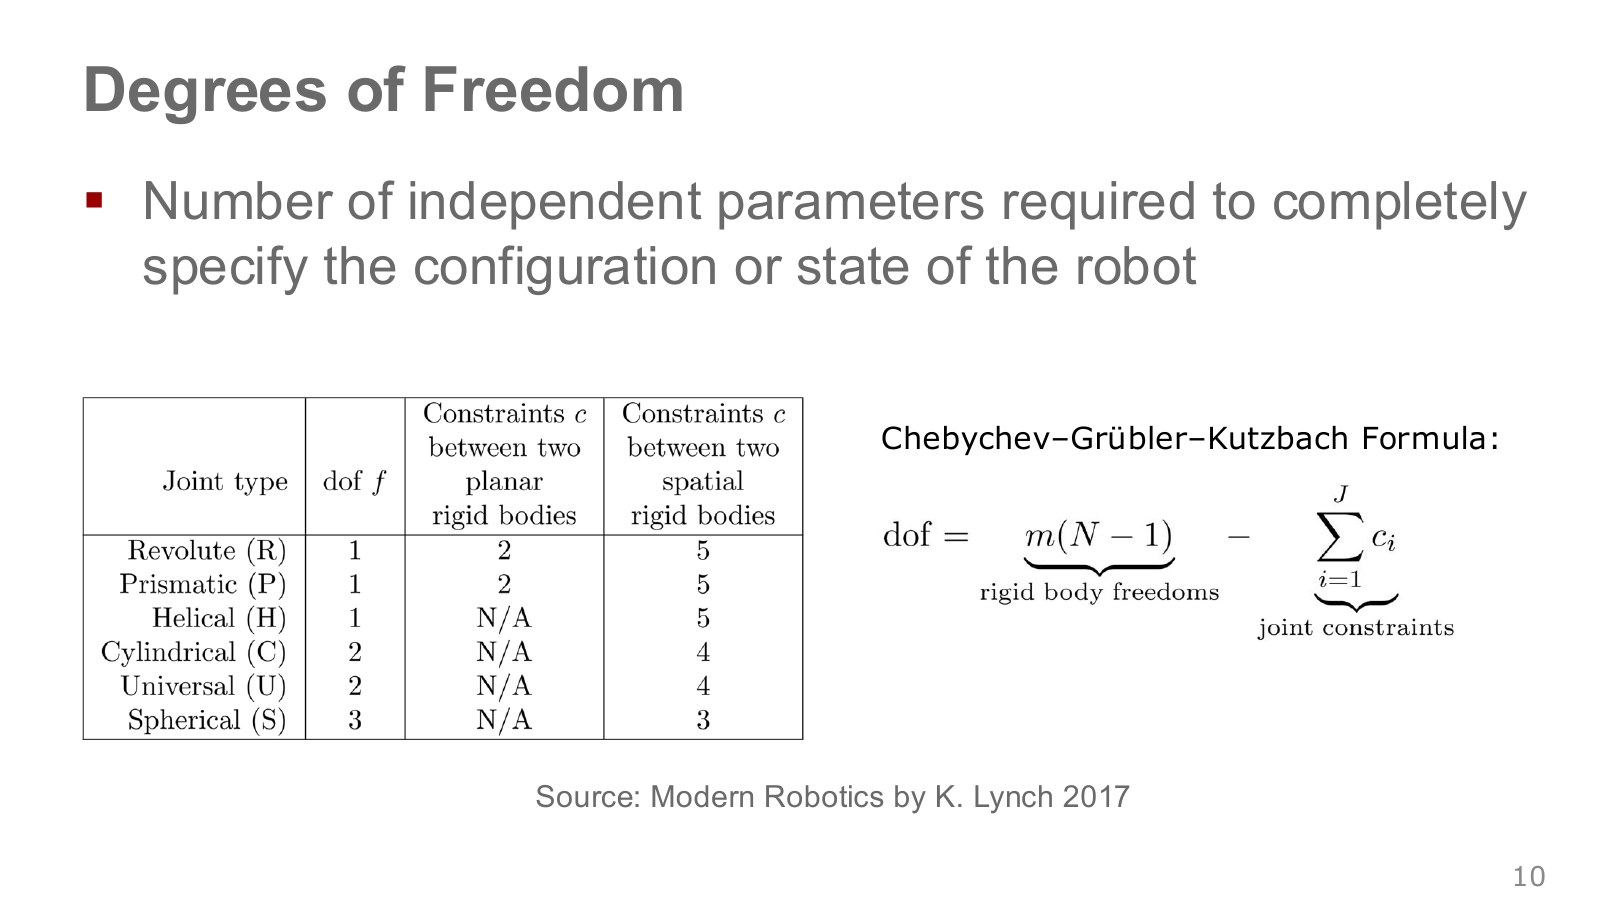
자유도(DoF)는 로봇의 기하학적 구성(configuration)을 정하는 데 필요한 독립적인 변수의 수다. 슬라이드는 강체가 원래 가진 자유도에서 관절 제약을 빼는 계산을 소개한다.
m은 평면 강체라면 3, 공간 강체라면 6이다. N은 고정 베이스를 포함한 링크 수, J는 관절 수, cᵢ는 각 관절이 없애는 상대 자유도다. 제약들이 독립적이라는 조건에서 쓰는 계산이며, 특수한 기구에서는 단순 대입만으로 맞지 않을 수 있다. 평면 2R 직렬 팔은 링크 3개와 회전 관절 2개이므로 3×(3−1)−2−2 = 2다.
여기서 구성과 동역학적 상태는 다르다. 2자유도 팔의 구성이 두 관절 각도라면, 미래 움직임을 예측하는 상태에는 두 관절 속도도 필요할 수 있다. 같은 각도에서도 이미 빠르게 움직이는 팔과 정지한 팔은 다음 순간이 다르다. 뒤에서 MDP의 상태를 만들 때 이 차이가 중요해진다.
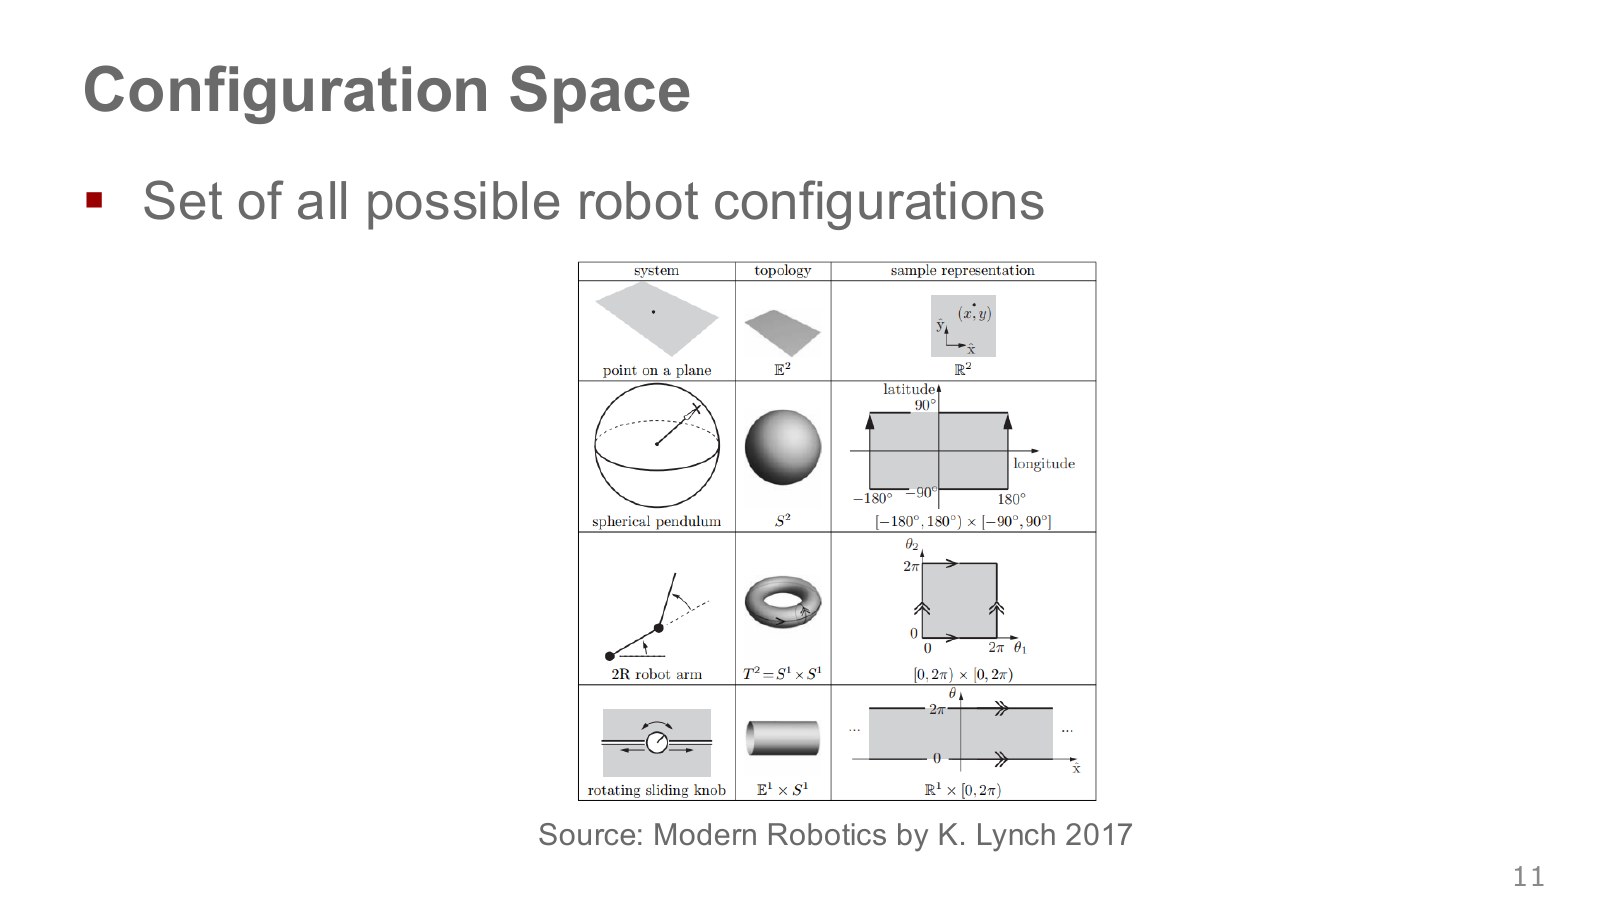
구성 공간(configuration space, C-space)은 가능한 모든 관절 구성의 집합이다. 2R 팔의 구성 하나는 두 각도의 짝 (q₁, q₂)이고, 이 공간 안 한 점이 로봇 팔의 한 자세를 뜻한다. 책상 위의 손끝 위치를 그리는 공간과는 다르다.
제한 없이 회전하는 관절의 각도는 한 바퀴 뒤에 같은 상태로 돌아온다. 이런 관절 두 개의 이상적인 구성 공간은 원 두 개를 곱한 토러스 구조다. 실제 관절에 회전 제한이 있으면 가능한 부분만 남는다.
강의 12:38–13:57의 핵심은 각도 경계에서 단순 뺄셈을 조심하라는 것이다. 설명용으로 359°에서 1°로 간다면 짧은 차이는 +2°다. 숫자를 그대로 빼 얻는 −358°와 다르다. 다만 기계적 한계나 케이블 때문에 경계를 넘을 수 없는 관절이라면 이 짧은 경로도 허용되지 않을 수 있다. 신경망 입력에 sin(q), cos(q)를 쓰는 이유 중 하나도 이런 주기성을 표현하기 위해서다.
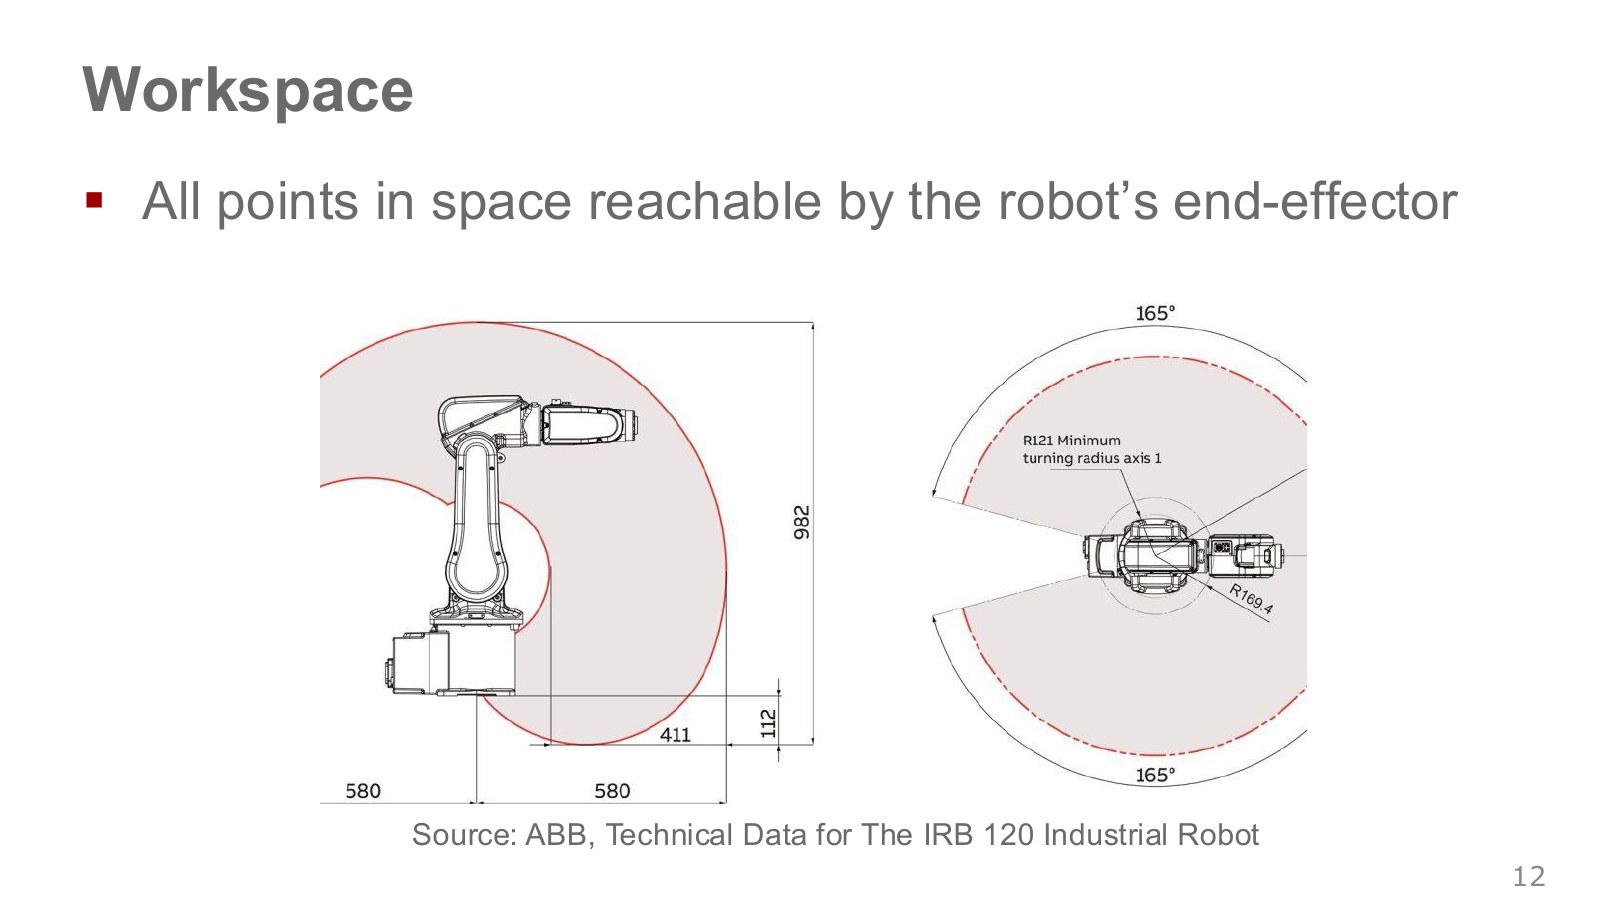
작업 영역(workspace)은 여기서 말단 장치가 물리적으로 도달할 수 있는 위치들의 집합이다. 그림의 ABB 로봇 도달 영역처럼 베이스 주변에서 손을 뻗을 수 있는 범위를 생각하면 된다. 관절 각도로 이루어진 C-space와는 좌표의 의미가 다르다.
어떤 점이 이 영역 안에 있어도 원하는 방향으로 잡을 수 있는지, 장애물 없이 접근할 수 있는지는 별도 문제다. “컵이 팔 길이 안에 있다”는 조건만으로 집기가 가능한 것은 아니다. 손목 방향, 관절 한계, 팔꿈치와 테이블의 충돌도 확인해야 한다.
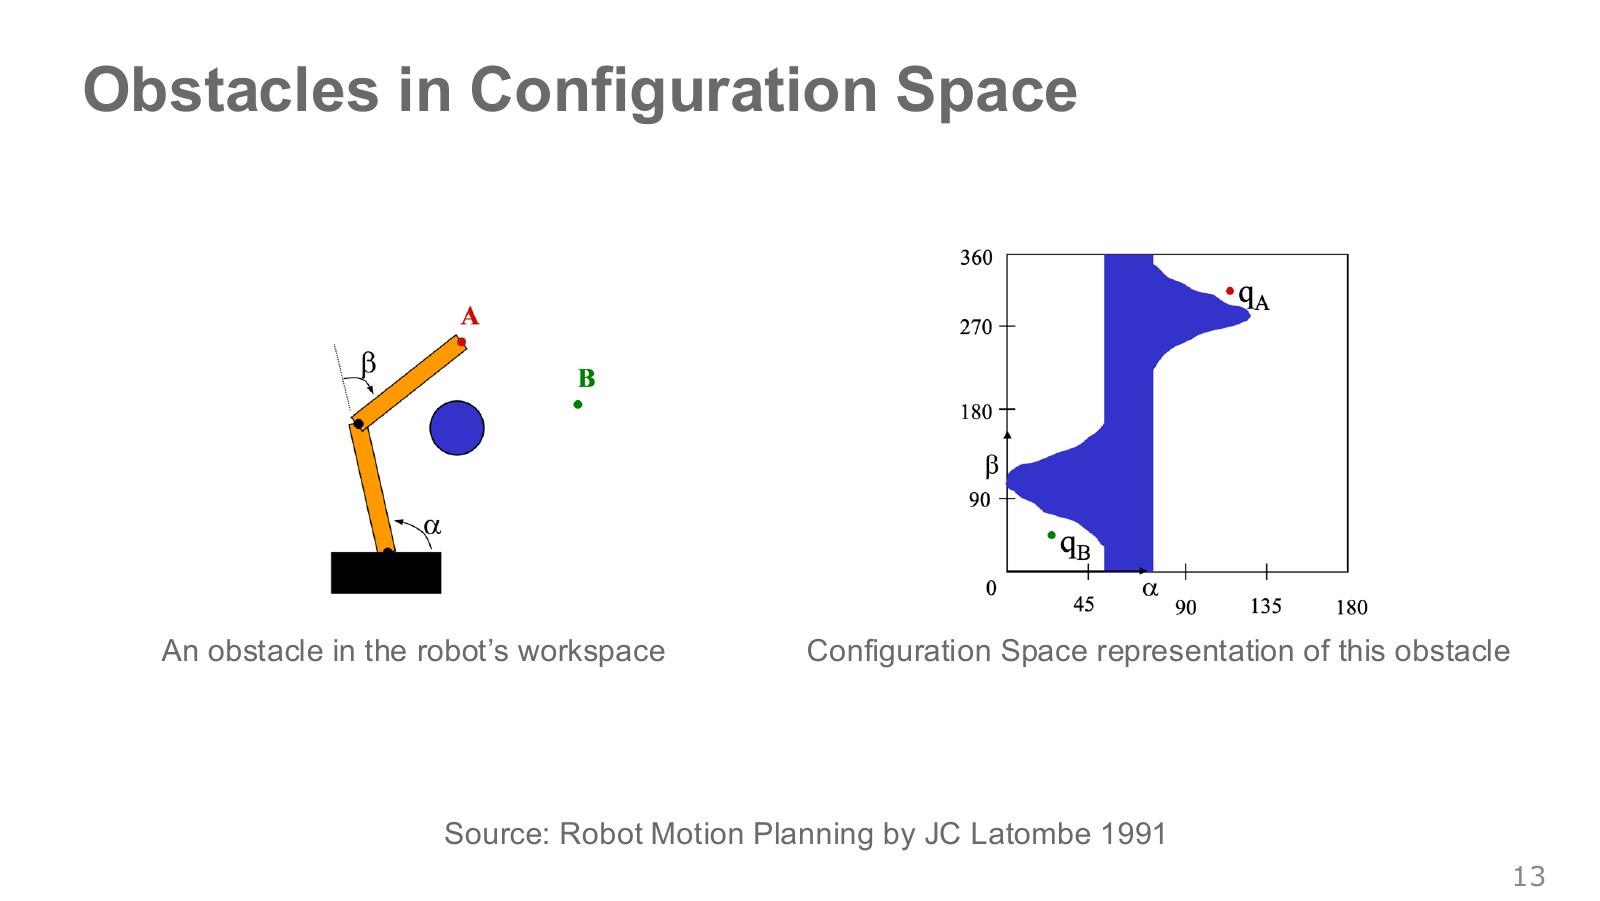
왼쪽 파란 원은 실제 공간의 장애물이다. 오른쪽은 두 관절 각도의 조합 중 팔이 장애물과 부딪히는 영역을 칠한 것이다. 장애물 모양을 그대로 옮긴 그림이 아니라, 팔 전체의 형상과 충돌 여부를 각도별로 계산한 결과다.
손끝이 장애물 밖에 있어도 팔 중간 링크가 닿을 수 있다. 반대로 같은 손끝 위치를 만들더라도 팔꿈치를 다른 쪽으로 굽히면 충돌을 피할 수 있다. 따라서 손끝만 잇는 직선을 그리는 것과 로봇 전체가 안전하게 지나가는 경로를 찾는 것은 다르다.
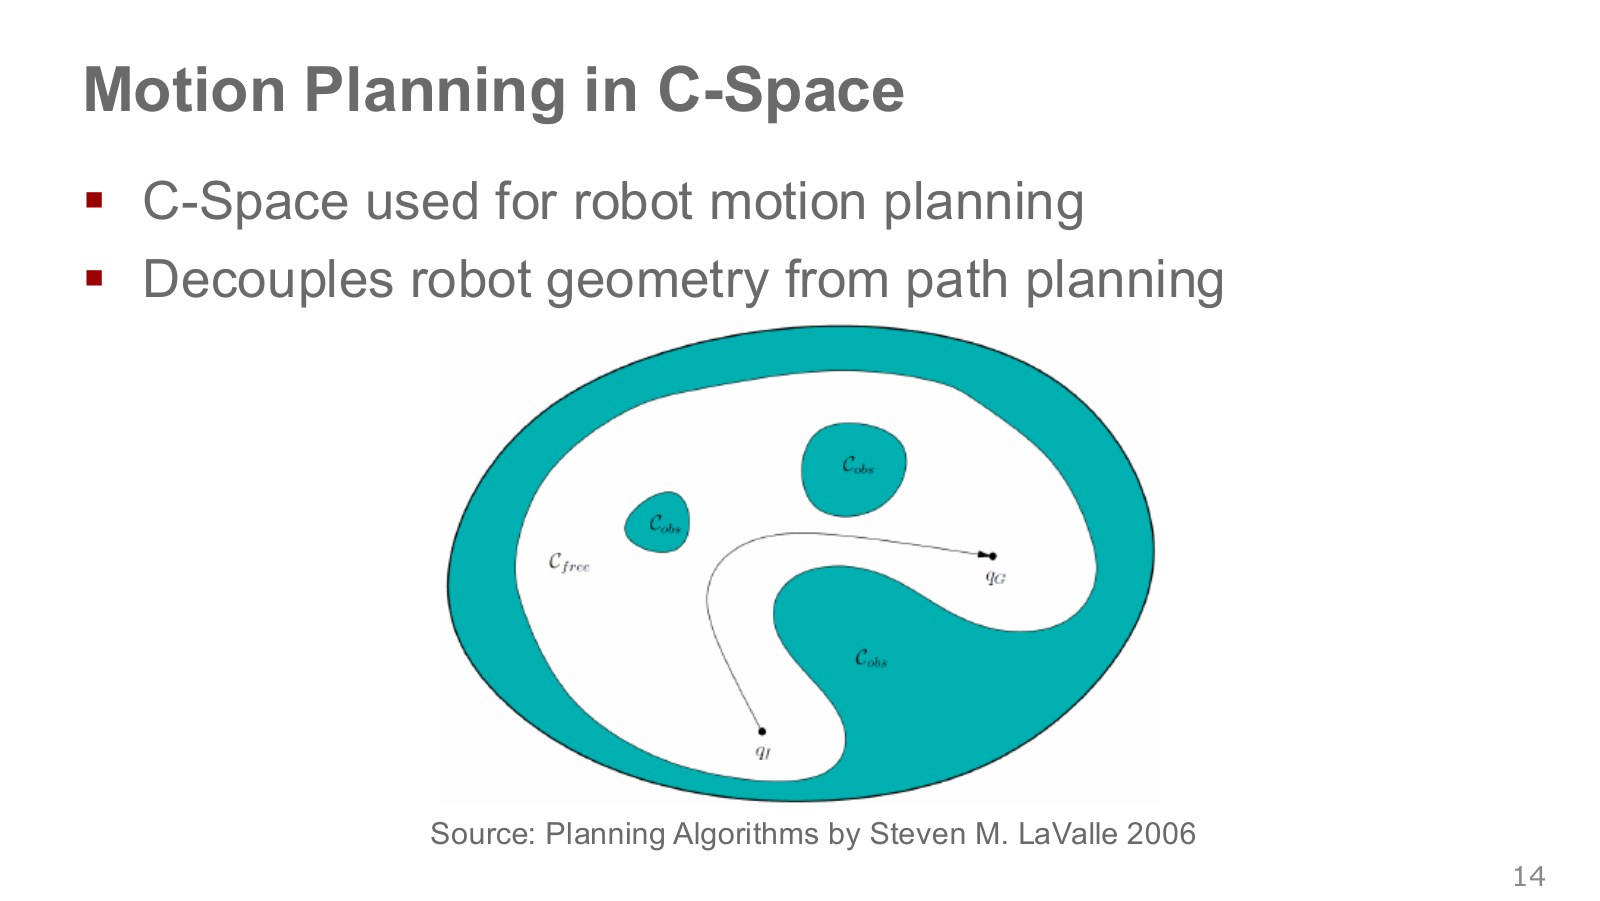
C-space에서 로봇의 시작 구성과 목표 구성을 두 점으로 놓으면, 경로 계획은 충돌 없는 영역 안에서 두 점을 연결하는 문제로 바뀐다. 로봇의 두꺼운 형상과 장애물의 관계는 충돌 판정에 들어가고, 경로 자체는 구성들의 연속으로 표현된다.
강의 14:44–16:42는 차원이 높아질수록 금지 영역 전체를 미리 계산하기 어렵다는 문제를 학습으로 연결한다. 이것이 기하학적 계획을 모두 버린다는 뜻은 아니다. 샘플링 기반 계획은 필요한 구성들에서 충돌을 검사할 수 있고, 학습한 정책도 실행 중 제약과 충돌 검사가 필요하다. 이번 장에서는 경로(path)는 어디로, 궤적(trajectory)은 언제 어떻게 움직이는지를 구분해 두자.
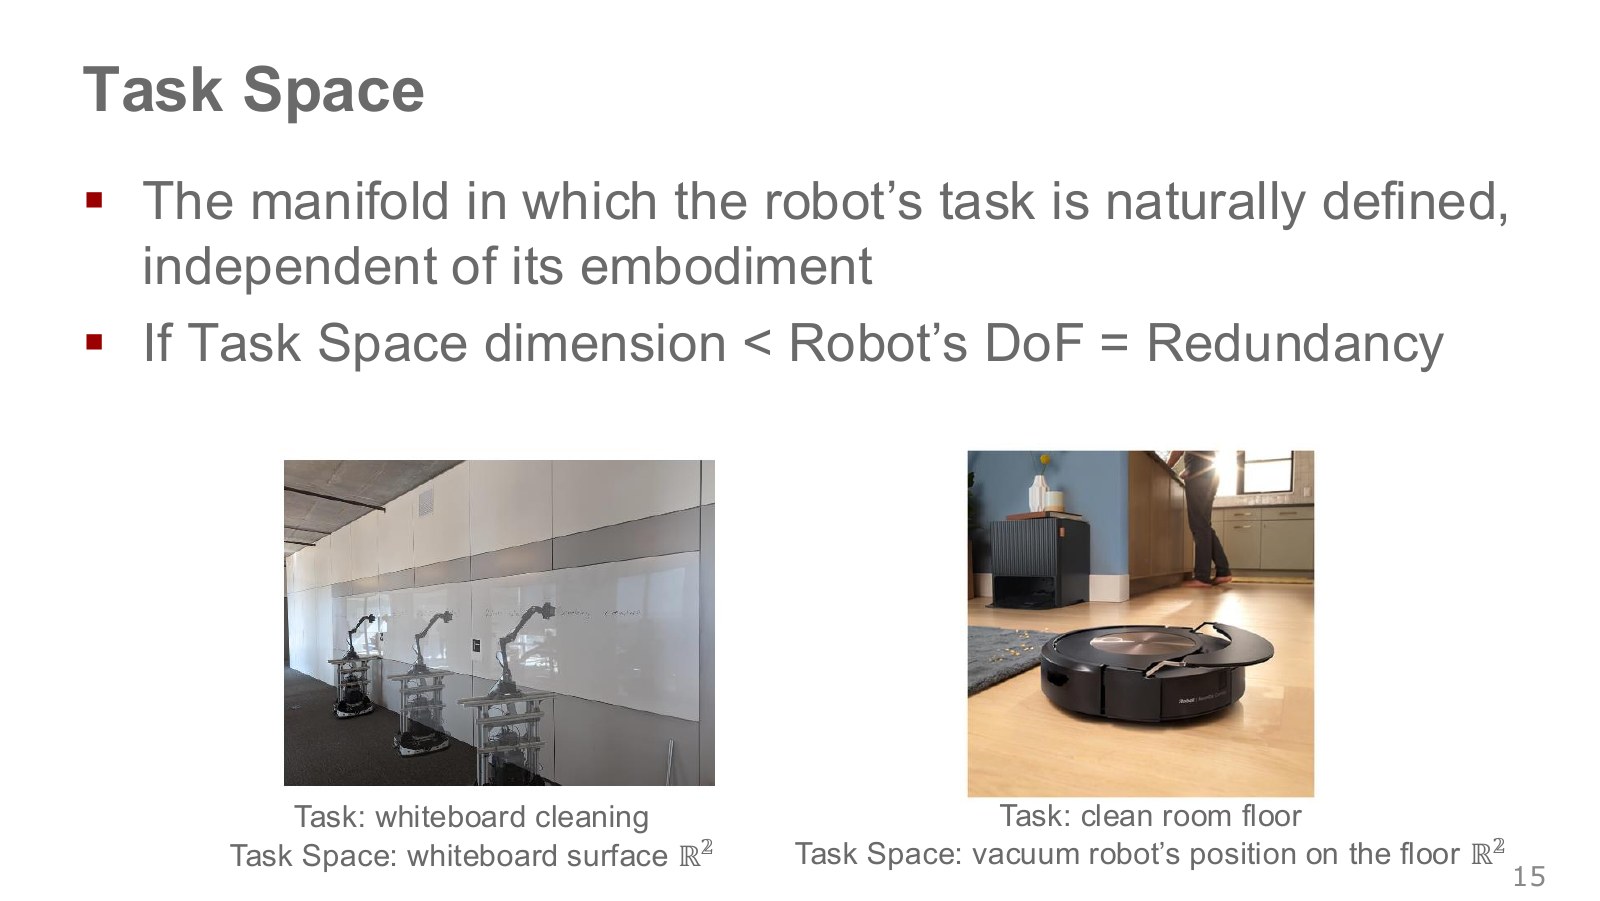
과업 공간(task space)은 수행할 일을 표현하기에 자연스러운 변수들의 공간이다. 화이트보드를 닦는 위치는 보드 표면의 두 좌표로, 바닥 청소 위치는 바닥 위 두 좌표로 표현할 수 있다. 로봇이 어떤 관절 구조를 가졌는지와 별개로 목표를 설명하는 출발점이다.
그렇다고 실제 제어에 두 숫자만 있으면 된다는 뜻은 아니다. 지우개가 보드에 닿는 방향과 힘을 유지해야 한다면 그것들도 제약으로 추가된다. 과업을 몇 차원으로 표현할지는 무엇을 고정하고 무엇을 자유롭게 둘지에 달려 있다.
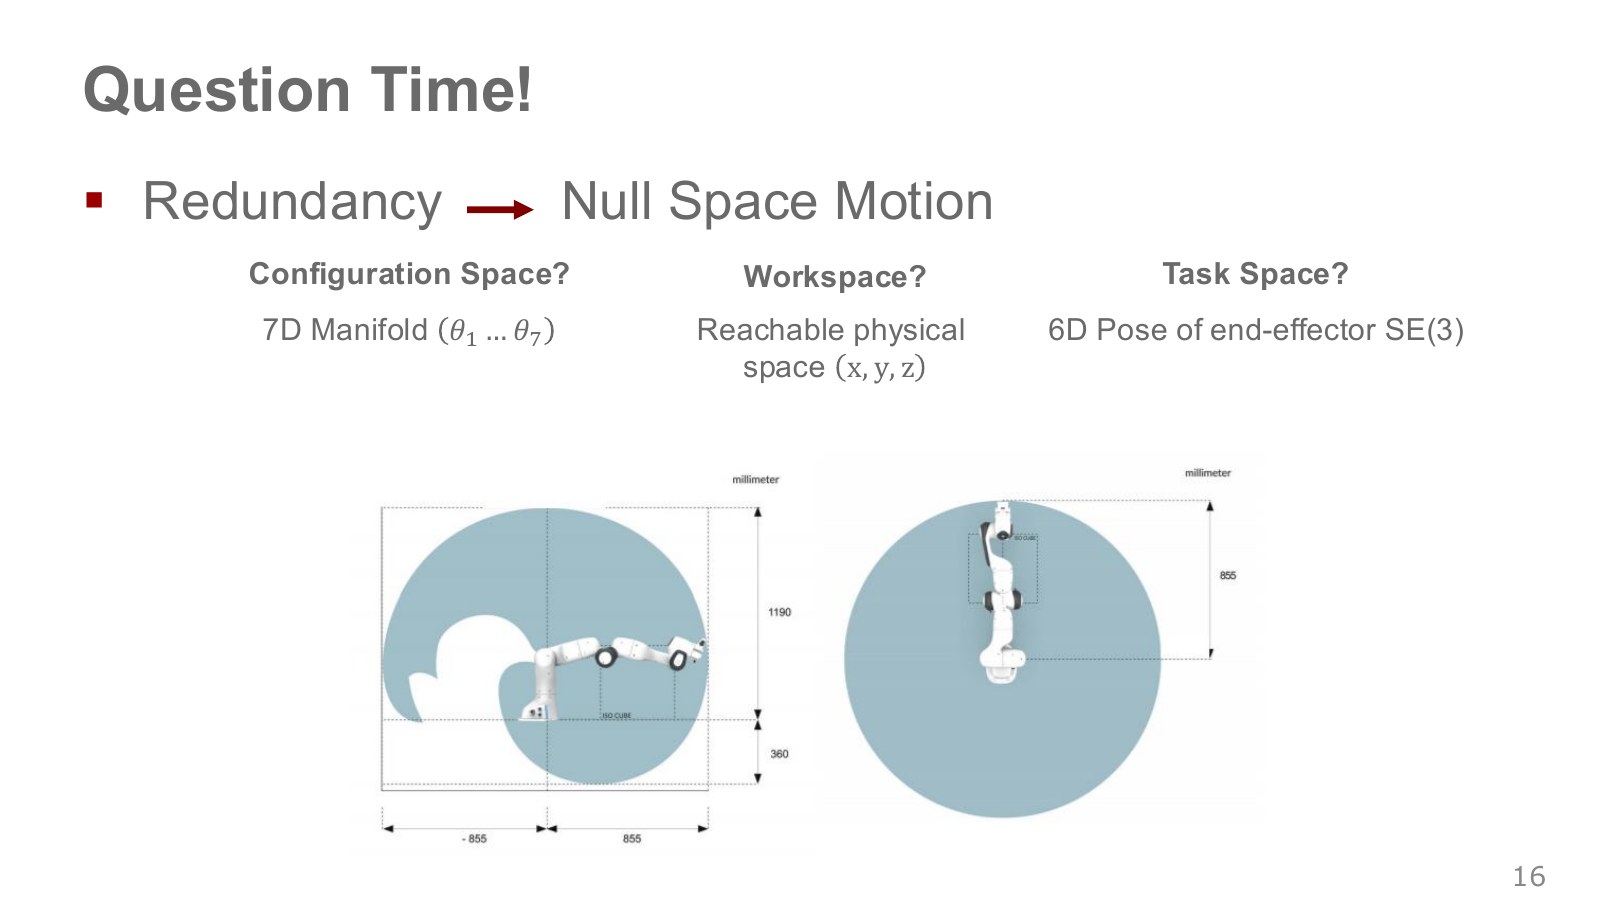
Franka의 팔 관절 구성은 7차원이고, 손의 위치·방향을 모두 정하는 공간 자세는 국소적으로 6차원이다. 일반적인 자세에서는 같은 손의 자세를 만드는 관절 구성이 여러 개 있을 수 있다. 이를 여유 자유도 또는 중복성(redundancy)이라고 한다.
강의 18:20–19:17의 커피잔 예처럼 손을 고정하고도 팔꿈치를 움직일 여지가 있다. 널 공간(null space) 운동은 미소 운동의 관점에서 현재 과업 출력을 바꾸지 않는 관절 운동이다. 이 여유를 관절 한계 회피나 장애물과 거리 확보에 사용할 수 있다. 단순한 차원 차이 계산은 특이 자세나 추가 접촉 제약에서는 달라질 수 있다.
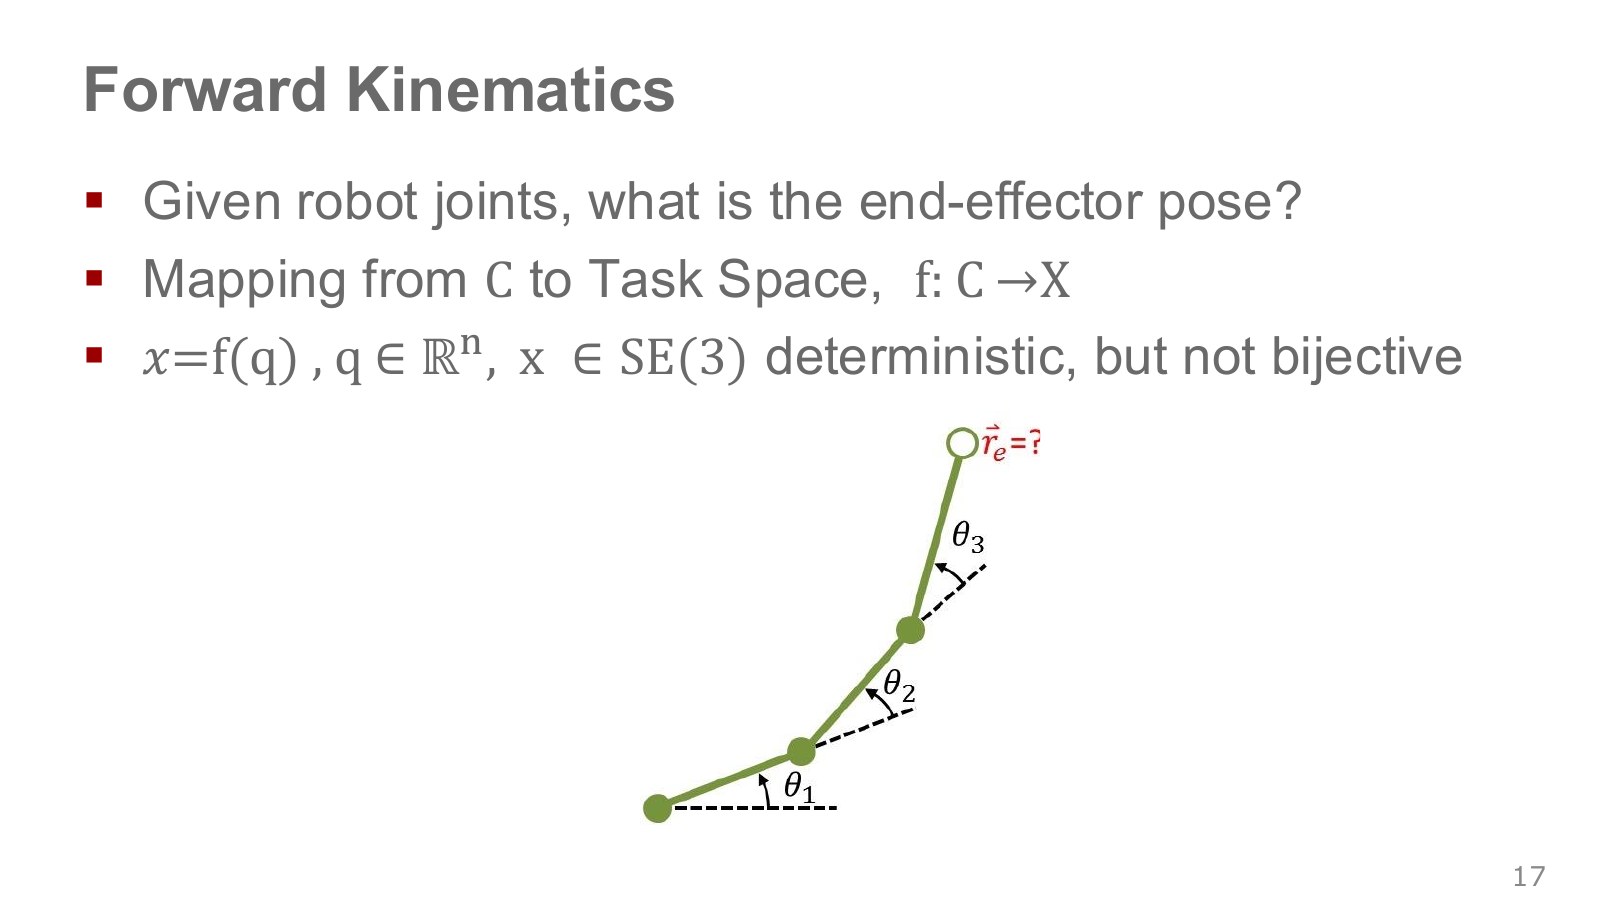
순기구학(forward kinematics, FK)은 관절 구성 q를 알고 있을 때 말단 장치의 위치·방향을 계산한다. 링크 길이와 관절 축이 정해진 모델에서는 각 구성이 하나의 손 자세를 만든다. 기호로는 x = f(q)다.
두 링크의 길이를 각각 l₁, l₂, 두 회전각을 q₁, q₂라 한 평면 2R 팔의 손끝 위치는 다음과 같다. 이 식은 원리를 보여 주기 위한 별도 예제다.
두 번째 링크의 방향이 q₂가 아니라 q₁+q₂인 이유는 두 번째 각도를 첫 번째 링크에 대해 재기 때문이다. 각 링크가 1m이고 (q₁, q₂)=(0°, 90°)이면 손끝은 (1m, 1m)다. FK는 힘이나 가속도를 계산하는 동역학과 구별한다.
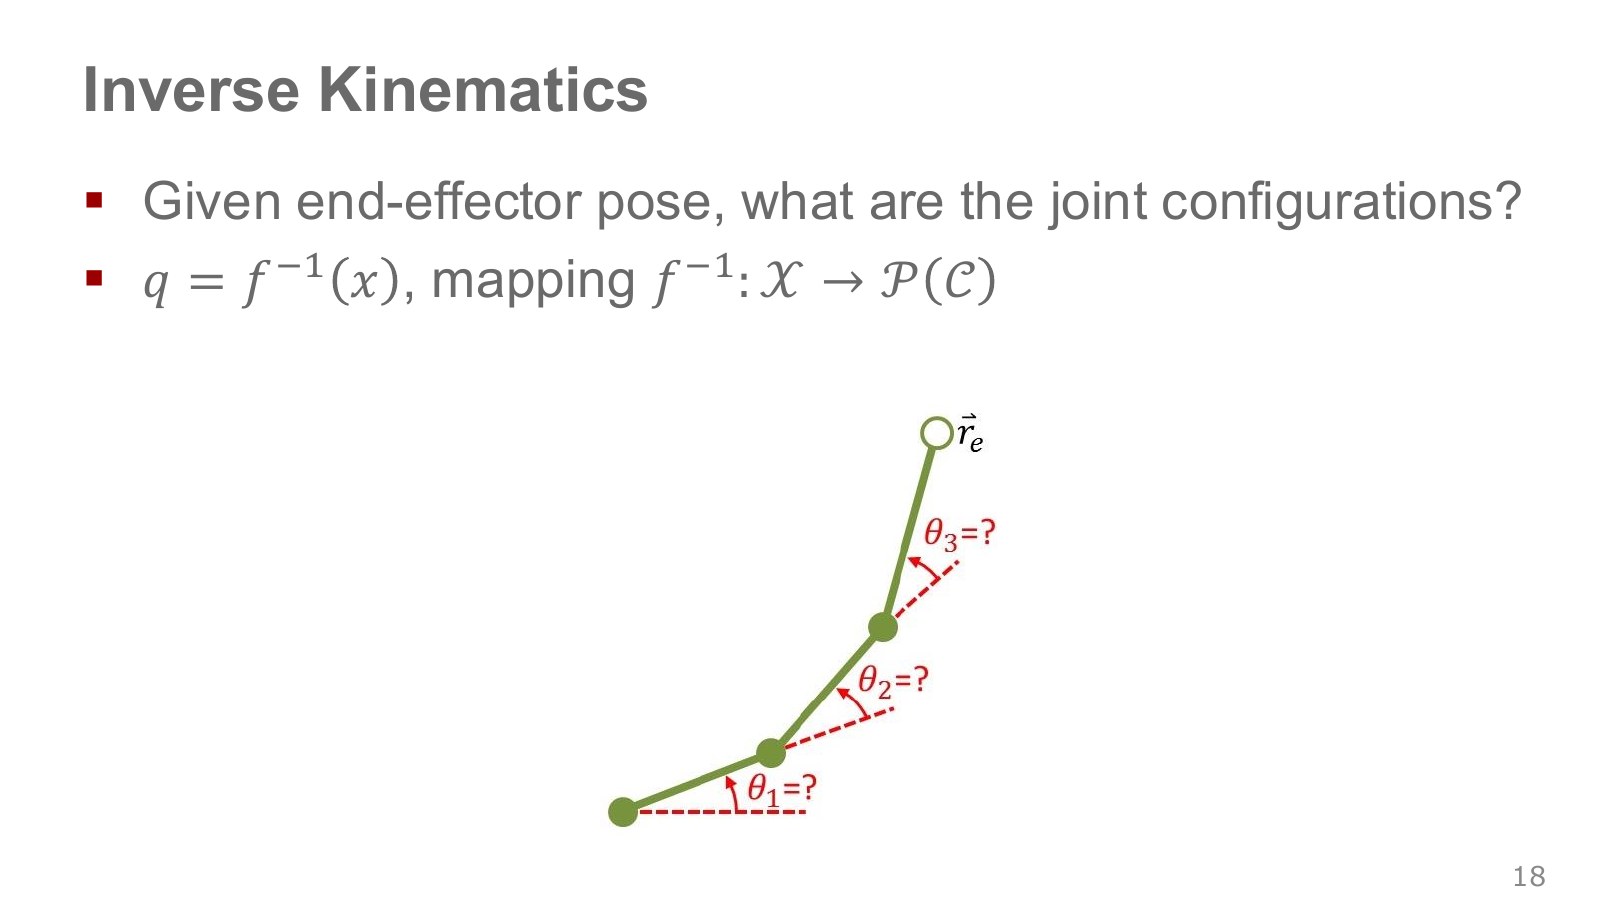
역기구학(inverse kinematics, IK)은 원하는 손의 위치·방향을 만드는 관절 구성을 찾는다. 정책이 손끝 목표를 출력하는 시스템에서는 이 목표를 관절 명령으로 바꾸는 연결 고리가 된다.
위 2R 팔에서 (90°, −90°)를 넣어도 손끝 위치는 (1m, 1m)다. 같은 위치를 서로 다른 팔꿈치 자세로 만들 수 있다. 여기서는 위치만 목표로 했으므로 두 해의 손끝 방향이 같다는 뜻은 아니다. 목표에 방향까지 포함하면 해의 집합이 달라진다. 따라서 f⁻¹이라는 기호를 보더라도 한 개의 답을 돌려주는 단순 역함수로 읽지 말자.
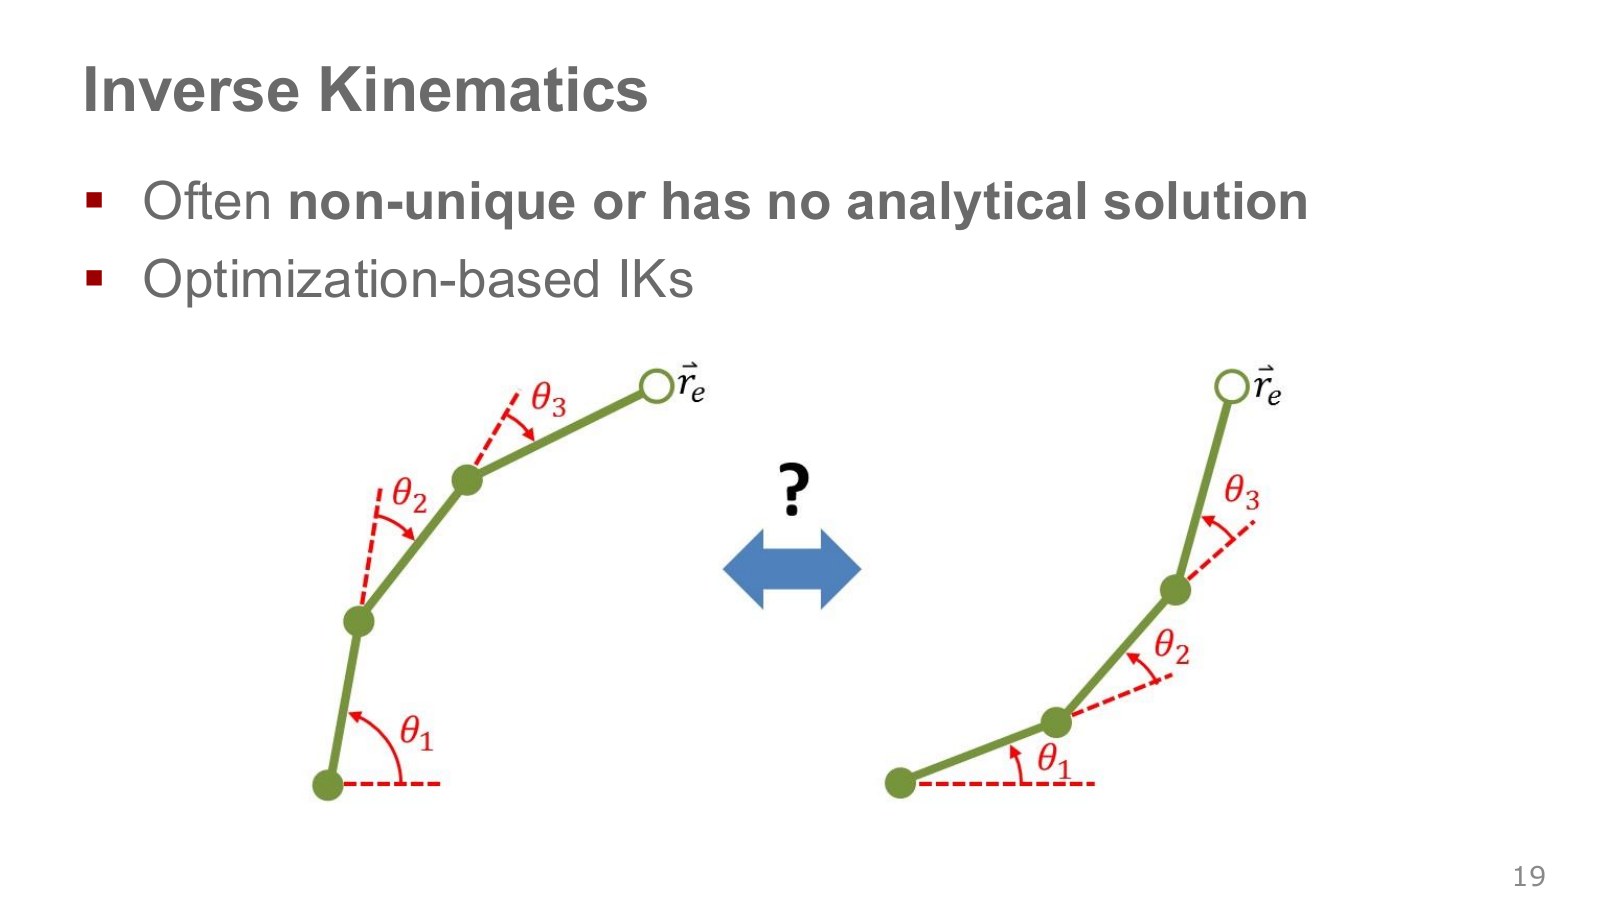
목표가 도달 영역 밖이면 정확한 해가 없고, 도달 가능하더라도 관절 한계나 충돌 조건을 넣으면 가능한 해가 사라질 수 있다. 해가 여러 개라면 현재 자세와 가까운 것, 장애물에서 먼 것처럼 선택 기준이 필요하다.
강의 20:42–21:30는 이를 오차를 줄이는 최적화 문제로 설명한다. 수치 해법은 초기 자세와 보폭에 따라 다른 결과를 낼 수 있다. 작은 손끝 오차를 얻었다고 해서 이동 경로의 충돌까지 해결된 것은 아니다.
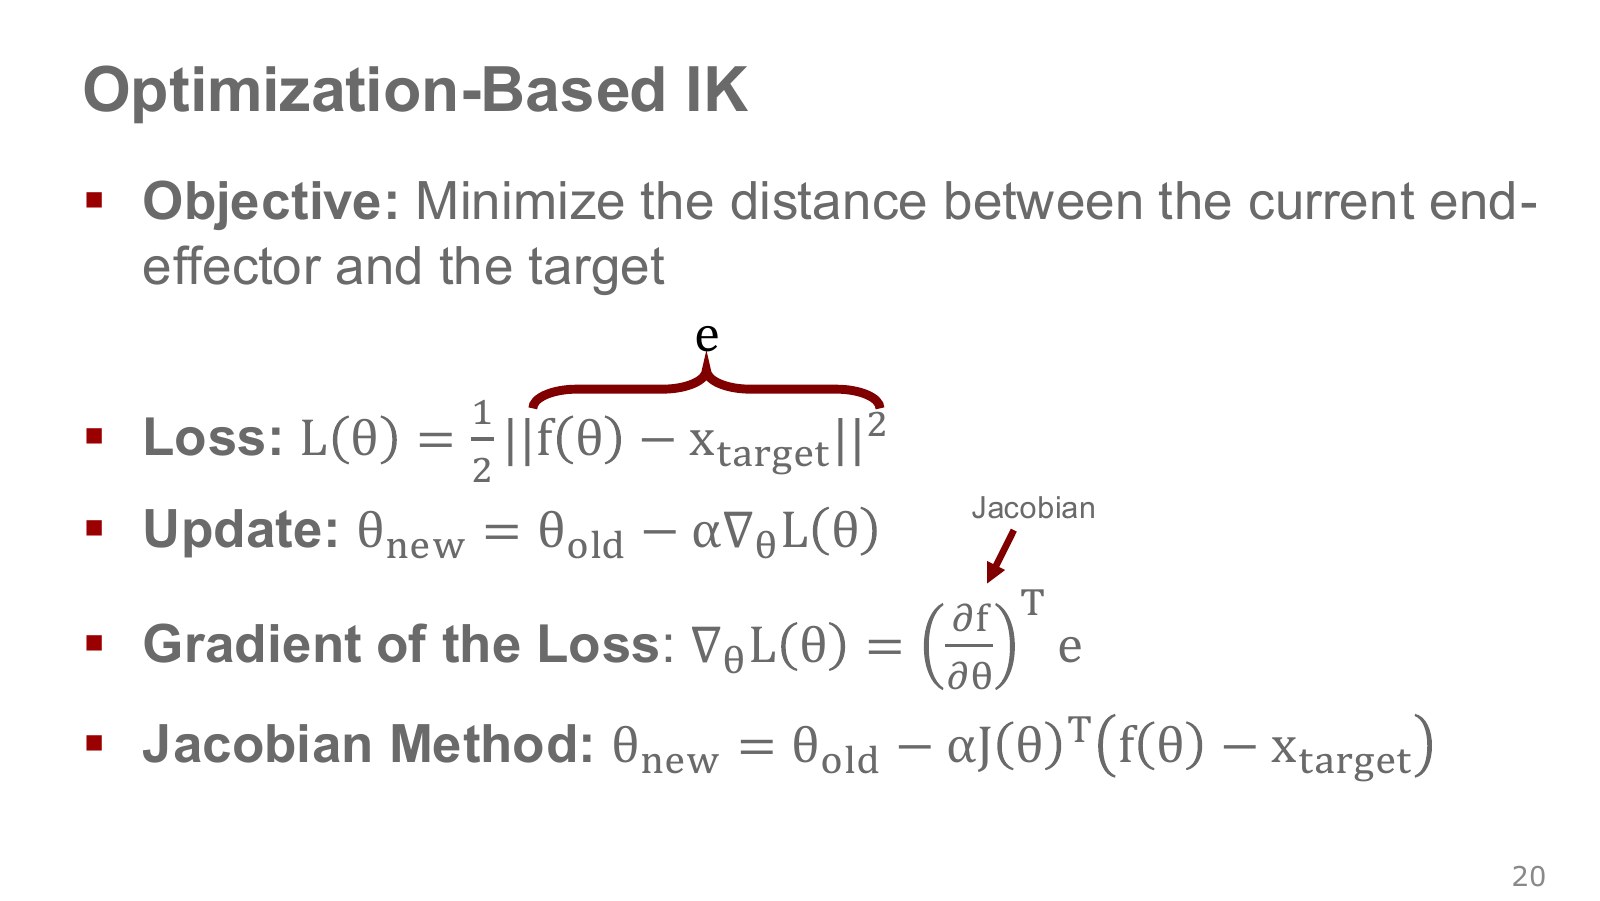
먼저 위치 목표만 다루어 f(q)와 목표 x*를 같은 유클리드 좌표의 벡터로 두자. 슬라이드의 θ를 관절 변수 q로 통일해 쓰면 다음과 같다.
J는 야코비안(Jacobian)이다. 관절을 아주 조금 바꾸었을 때 손끝 위치가 어느 방향으로 얼마나 바뀌는지 나타낸다. 과업 좌표가 m개, 관절 변수가 n개라면 J는 m×n이고, Jᵀe는 관절 변수와 같은 n차원이다. α는 한 번에 얼마나 움직일지 정하는 보폭, k는 최적화 반복 번호다.
오차가 f(q)−x*이므로 빼는 방향으로 갱신한다. 이는 야코비안 전치를 쓰는 경사 하강이며, 역행렬이나 의사역행렬을 바로 쓰는 방법과 다르다. 손의 회전까지 포함하려면 SE(3) 행렬을 무작정 빼기보다 회전 오차의 표현과 위치·회전의 상대 가중치를 정해야 한다.
강의 21:31–22:19와 아래 실행 예제의 수치 미분 대조를 함께 보면, 이 식이 단지 기호 조작이 아니라 관절을 어느 쪽으로 바꿀지 계산하는 규칙임을 확인할 수 있다.
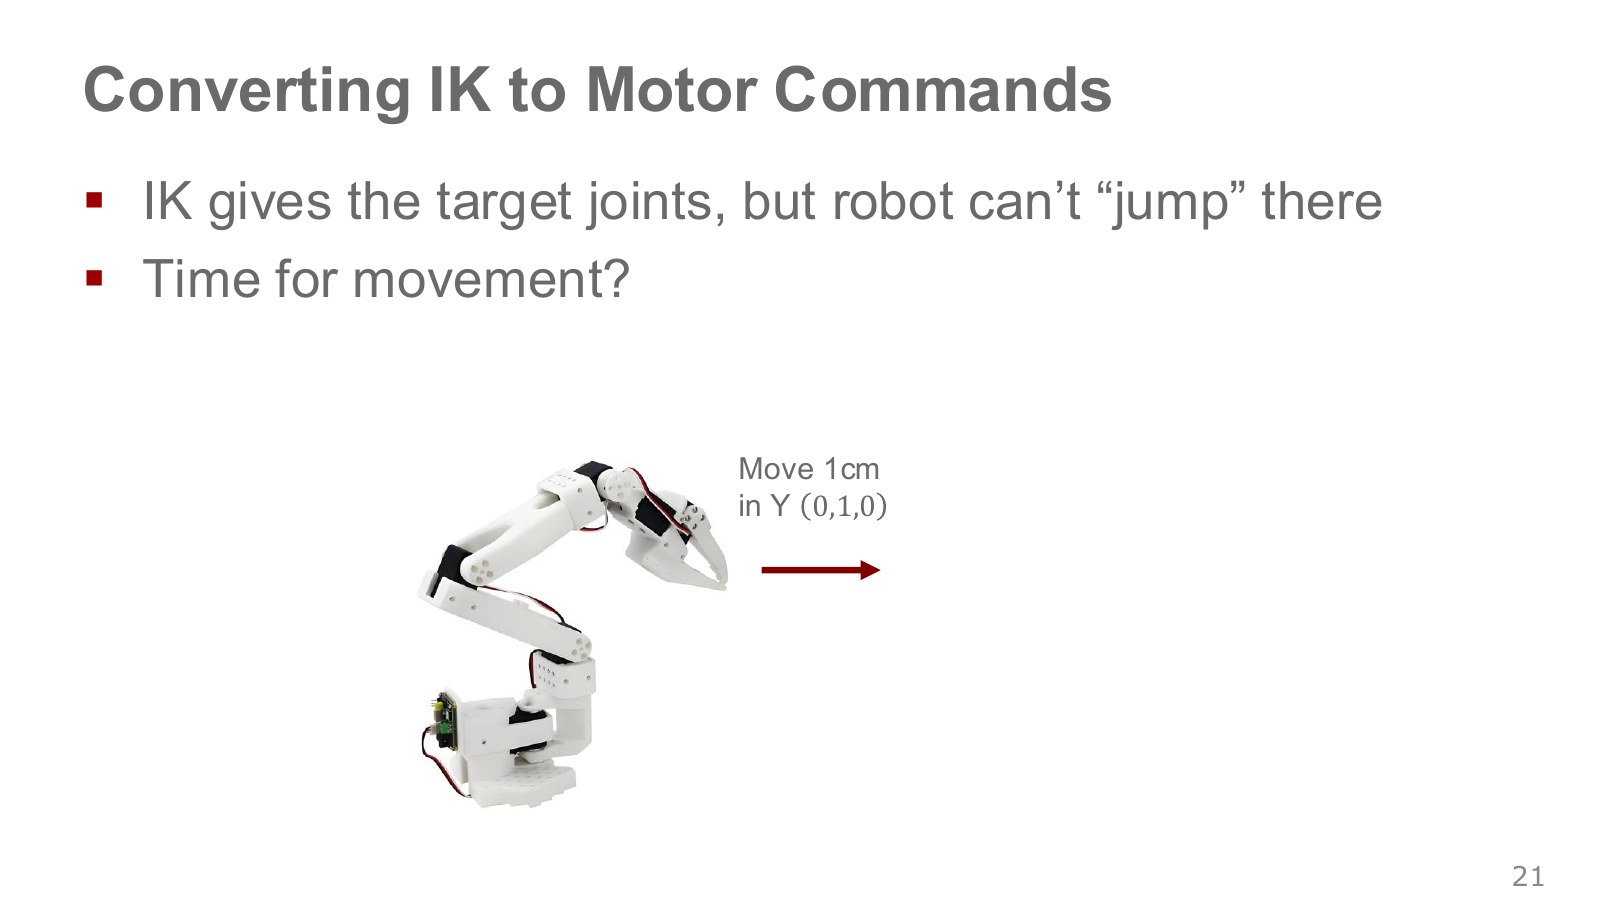
IK가 목표 각도를 주어도 로봇은 현재 자세에서 순간 이동할 수 없다. 시작과 끝 사이에 관절이 지나갈 순서와 시간을 정하고, 실제 측정값을 보며 구동해야 한다. 목표 자세만 정한 문제에서 움직임을 실행하는 문제로 넘어가는 지점이다.
슬라이드의 “Y 방향 1cm”도 좌표계가 정해져야 의미가 있다. 손 기준 Y와 베이스 기준 Y는 다를 수 있다. 손의 직선 이동을 원한다면 과업 공간 경로를 먼저 정해 IK를 반복할 수 있다. 시작·끝의 관절 각도만 직선으로 보간하면 손끝 경로는 일반적으로 직선이 아니다.
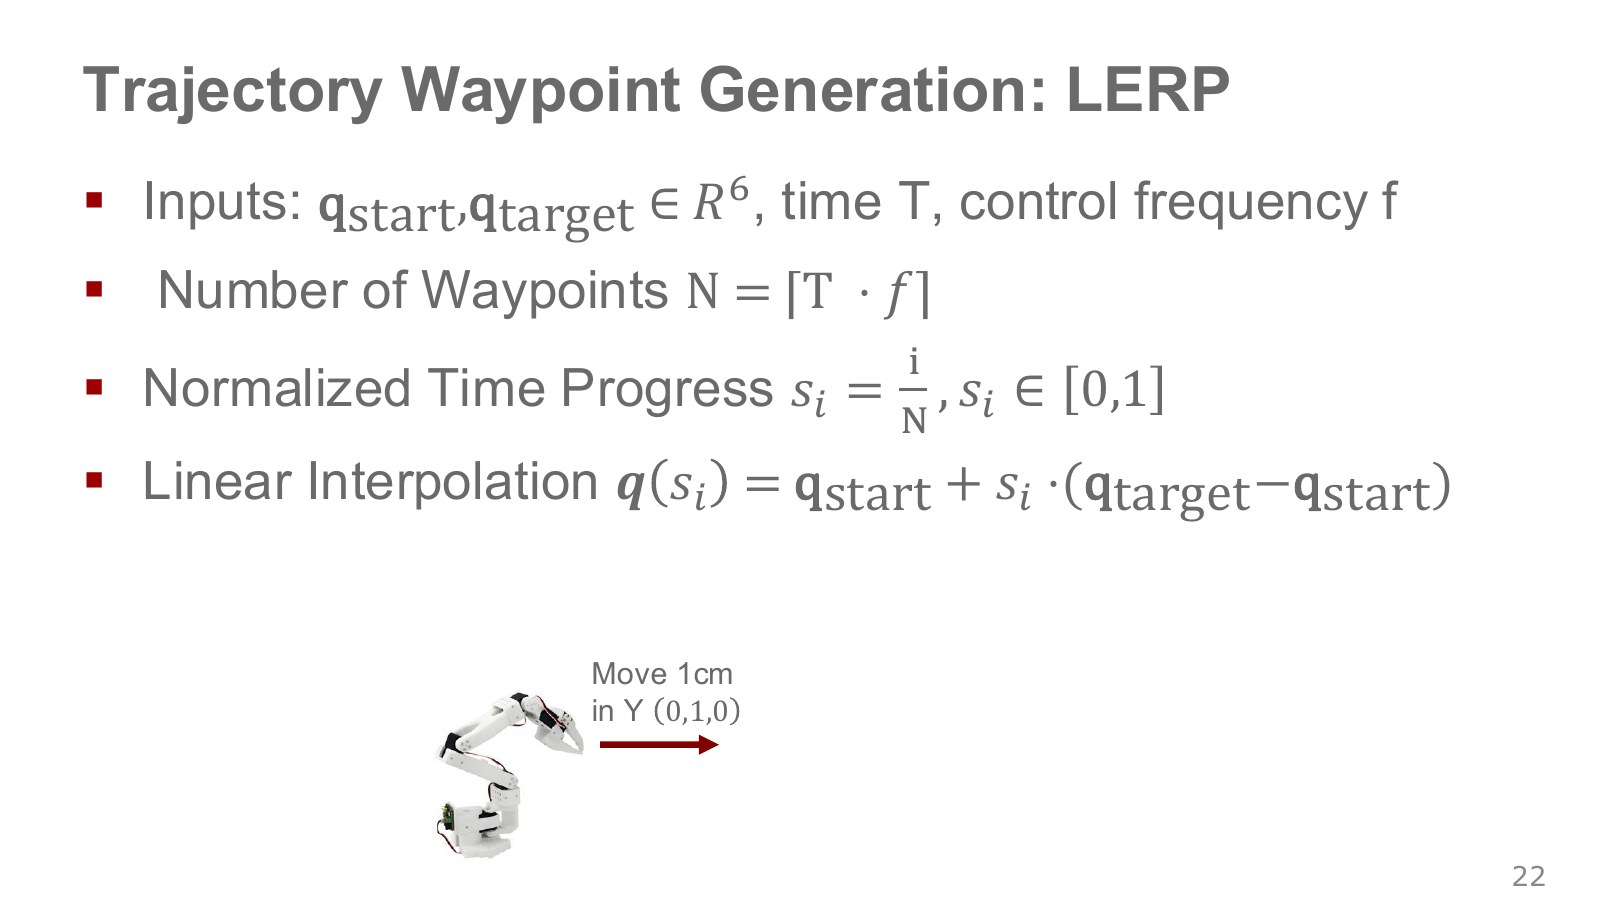
이동 시간 T초, 제어 빈도 fHz라면 시간 간격은 약 1/f초다. 설명용으로 N = ceil(Tf)를 구간 수라 정의하고 양 끝을 포함해 N+1개 지점을 만든다고 하자. 슬라이드의 보간식을 이 규칙으로 쓰면 다음과 같다.
sᵢ는 0에서 1까지의 진행률이다. 한 관절을 0rad에서 1rad로 1초 동안 움직이고 f=100Hz라면 N=100, 양 끝을 포함한 지점은 101개다. 첫 목표는 0, 중간 목표는 0.5, 마지막 목표는 1rad다. 반올림 때문에 시간이 조정되는 구현에서는 실제 Δt도 함께 정해야 한다.
모든 로봇의 q가 슬라이드 예처럼 6차원인 것은 아니다. 관절 수에 맞는 벡터를 사용하며, 회전 제한이나 각도 경계도 고려해야 한다. 이 단계는 목표 궤적을 만드는 것이지 실제 모터가 그 궤적을 따라갔다는 측정이 아니다.
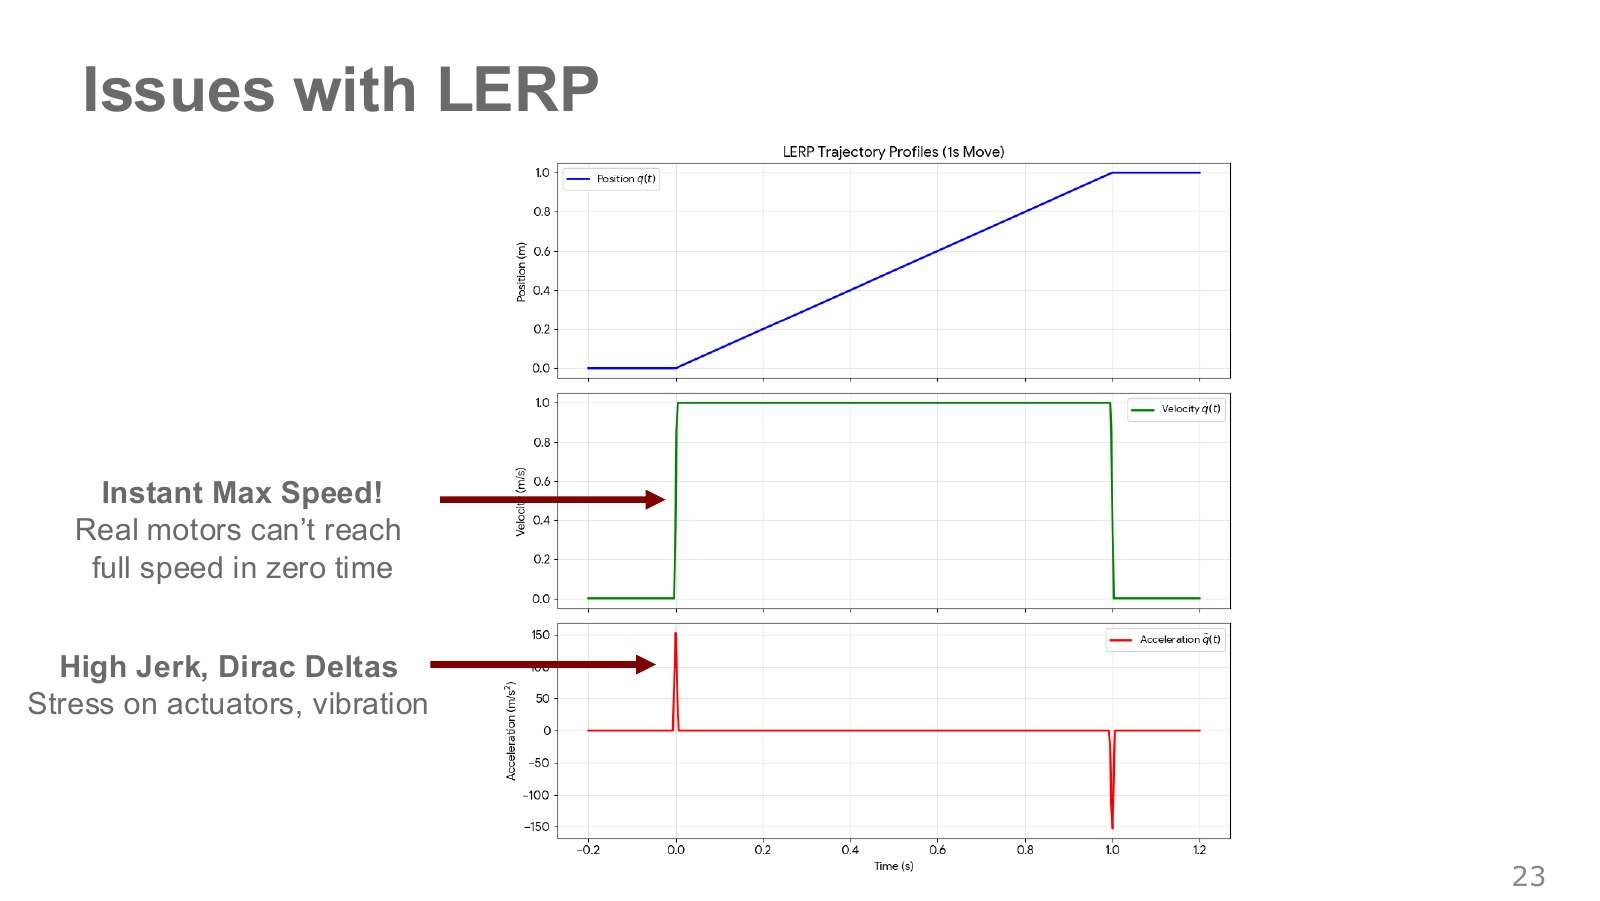
위치를 직선으로 보간하면 이동 중 속도는 일정하다. 그러나 이동 전에는 정지했다가 시작 순간 일정 속도로 바뀌고, 끝에서는 다시 정지한다. 이상화된 연속 시간에서는 이런 속도 점프에 충격적인 가속도가 필요하다. 실제 모터는 그대로 따라갈 수 없어 추종 오차나 진동이 생길 수 있다.
강의 23:58–24:48의 그래프는 이 시작·끝 문제를 보여 준다. 위치의 연속성만 확인해서는 충분하지 않다. 속도는 위치의 시간 미분, 가속도는 속도의 시간 미분, 저크(jerk)는 가속도의 시간 미분이다. 어느 차수까지 부드럽게 만들 것인지가 하드웨어 부담과 연결된다.
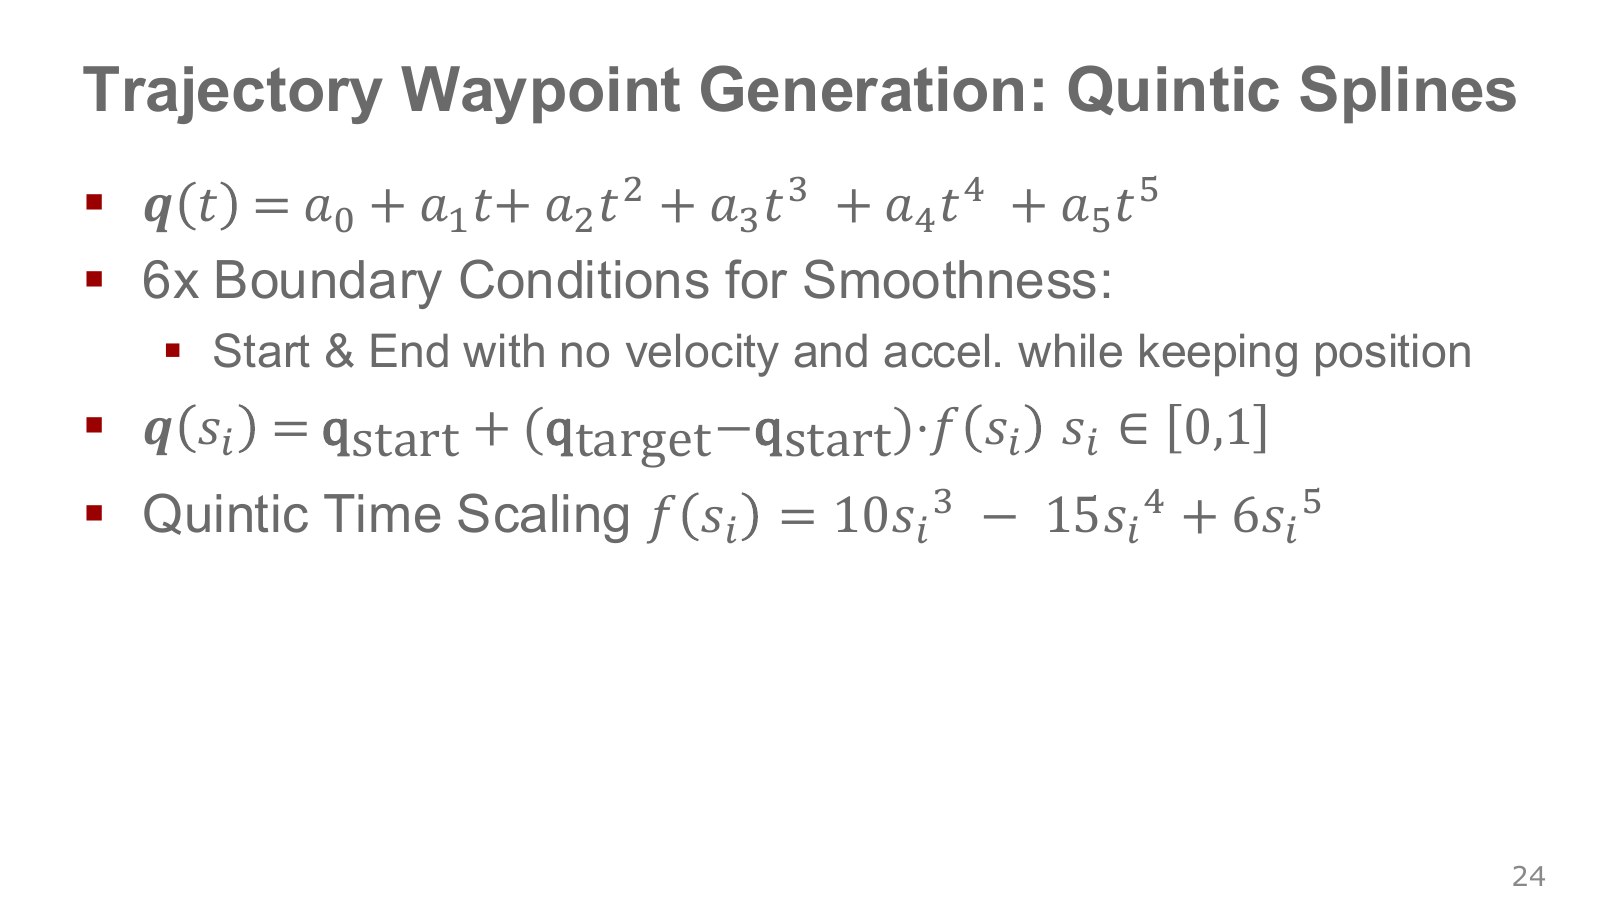
시작·끝의 위치 두 조건에 속도 0 두 조건, 가속도 0 두 조건을 더하면 경계 조건은 여섯 개다. 계수가 여섯 개인 5차 다항식으로 이 조건들을 맞출 수 있다. 정규화된 시간 s=t/T에 대한 슬라이드 식을 h라고 적어 다른 함수 이름과 구분하자.
q₀, q₁은 시작과 끝 관절 벡터다. h(0)=0, h(1)=1이고 양 끝에서 h′, h″가 0이다. 같은 관절 공간 경로를 이동하되 시간에 따른 진행 속도를 바꾼다. 작은 속도로 출발하고 가운데에서 빨라졌다가 천천히 멈춘다.
Modern Robotics의 궤적 영상·스크립트 (영상 1:19–2:49)는 3차·5차·사다리꼴·S자 시간 스케일링의 차이도 비교한다. 5차식은 이 경계 조건을 만족하지만, 모든 구동기의 속도·가속도 한계를 자동으로 만족시키는 것은 아니다.
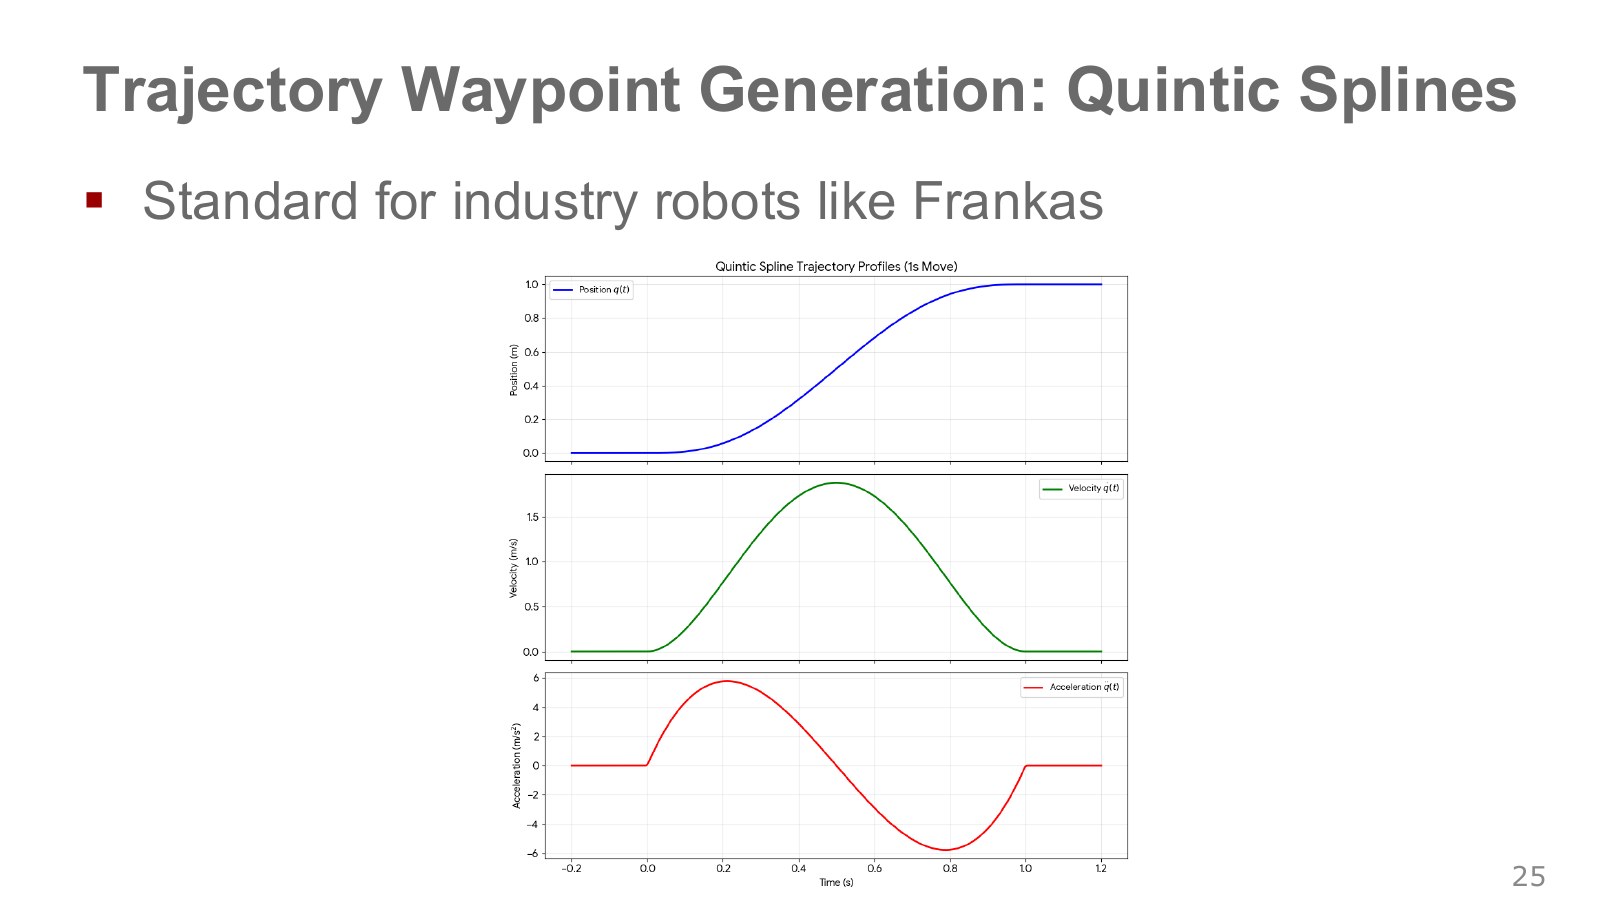
위 식을 시간으로 미분하면 속도는 1/T, 가속도는 1/T²에 비례한다. 같은 이동을 절반 시간에 하면 최고 속도는 두 배, 최고 가속도는 네 배가 된다. “부드러운 식을 썼다”와 “모터가 감당할 수 있다”는 서로 다른 조건이다.
한 관절이 0rad에서 1rad로 1초 동안 이동할 때 이 5차식의 최고 속도는 1.875rad/s다. 같은 구간의 선형 보간 속도 1rad/s보다 크다. 출발과 도착을 완만하게 만든 만큼 가운데에서 더 빨리 가기 때문이다. 아래 그림은 이 식을 직접 계산한 결과다.
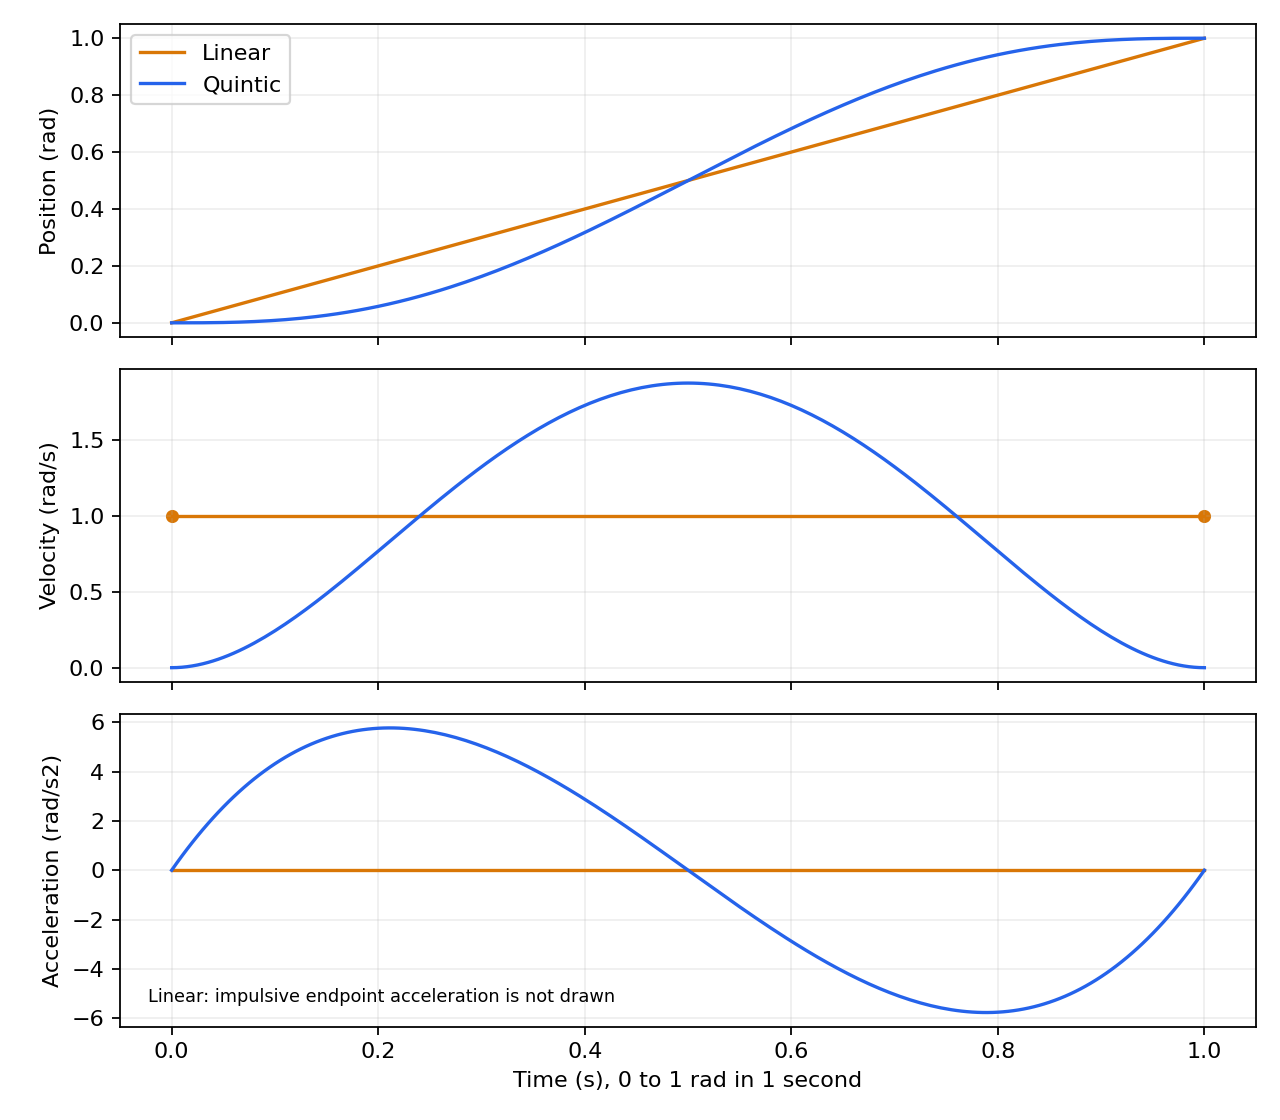
관절별 최대 속도와 가속도를 보고 T를 늘리거나 다른 시간 스케일링을 선택한다. 위치·속도·가속도가 연속이어도 저크까지 연속인 것은 아니므로 요구하는 운동 품질에 맞게 판단해야 한다.
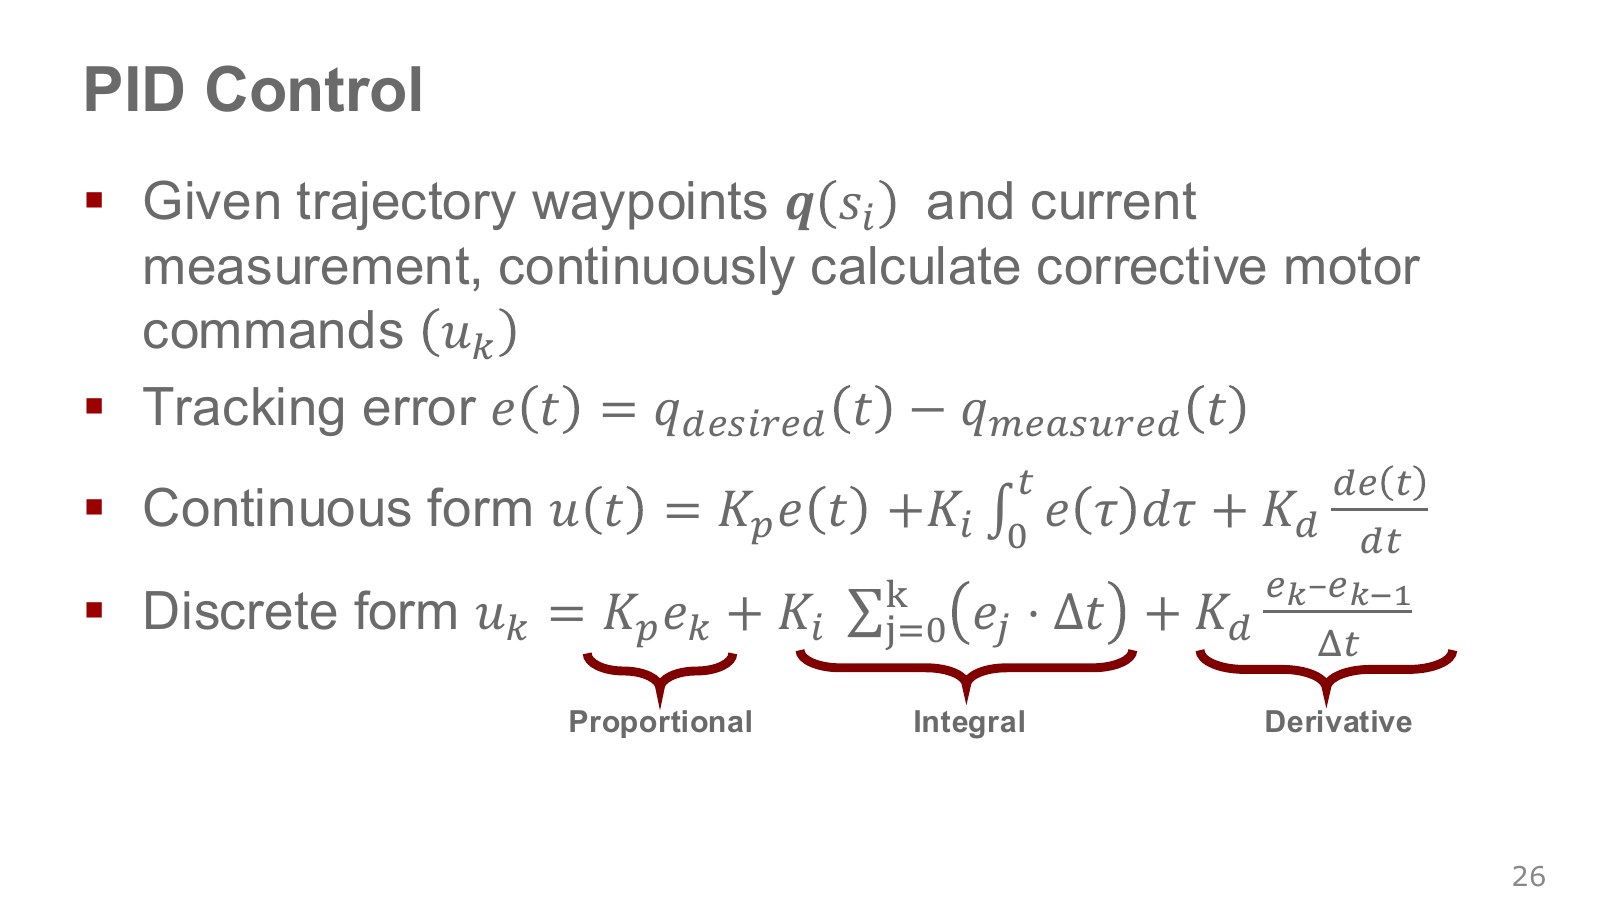
중력, 마찰, 하중 때문에 실제 관절은 목표 궤적에서 벗어난다. PID 제어는 목표와 측정의 차이를 반복해서 읽고 보정 명령을 계산한다. 여기서 오차는 목표에서 측정값을 뺀 값이다.
Kp, Ki, Kd는 세 항의 이득이고 Δt는 측정·명령 간격이다. 비례(P)는 지금의 오차, 적분(I)은 지속해서 쌓인 오차, 미분(D)은 오차가 변하는 빠르기에 반응한다. 이득의 단위는 입력 오차와 출력 명령이 각도·속도·토크 중 무엇인지에 따라 달라진다.
수치 예를 들면 현재 오차 0.1, 직전 오차 0.12, Δt=0.02, 누적 적분값 0.2에서 Kp=10, Ki=0.5, Kd=2라면 세 항은 1, 0.1, −2로 명령은 −0.9다. 현재 목표에 못 미쳐도 이미 빠르게 가까워지는 중이면 미분항이 제동 방향으로 작용할 수 있다. 이 숫자는 계산 이해를 위한 예제이며 실제 로봇의 이득 추천값은 아니다.
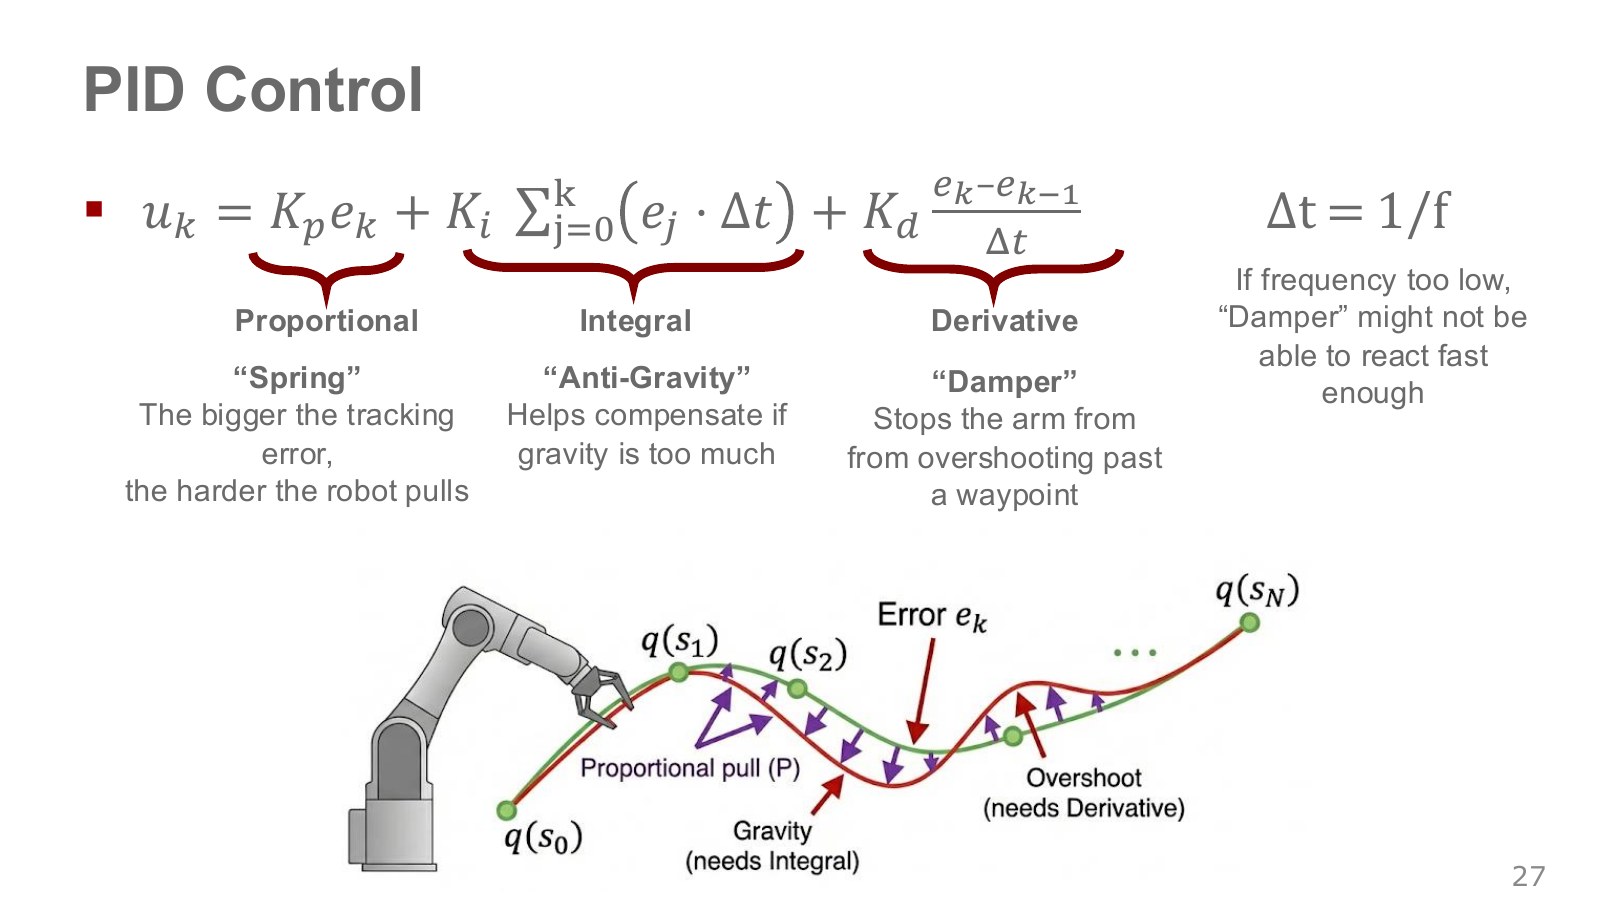
강의 25:55–27:51는 비례항을 잡아당기는 스프링, 적분항을 중력처럼 지속되는 방해를 보정하는 역할, 미분항을 과도한 운동을 줄이는 댐퍼에 비유한다. 적분항이 중력을 직접 알아내는 것은 아니다. 지속되는 오차를 누적해 보정하는 것이므로, 동역학 모델을 쓰는 중력 보상과는 원리가 다르다.
이득을 무작정 크게 하면 진동하거나 구동 한계에 닿을 수 있다. 적분은 명령이 포화된 동안 계속 쌓이는 와인드업을 다뤄야 하고, 미분은 센서 잡음을 증폭할 수 있다. 제어 빈도를 바꾸면 Δt가 달라지므로 같은 이득 숫자의 결과도 다시 확인해야 한다.
정책이 목표 관절 위치를 비교적 느리게 정하고, 하위 제어기가 더 빠르게 이를 추종하는 구성이 흔하다. 아래 공식 ETH 과제에서도 정책 호출과 물리 시뮬레이션 주기가 분리된다.
여기까지는 “주어진 목표로 어떻게 움직일 것인가”를 다뤘다. 이제는 “어떤 목표를 다음으로 정할 것인가”가 남는다. 컵을 집기 전에 장애물을 치울지, 물체를 놓쳤을 때 다시 접근할지 같은 순서의 문제가 여기에 해당한다.
학습한 정책이 손끝 목표를 출력하고, IK·궤적 생성·하위 제어기가 이를 실행하는 시스템을 만들 수 있다. 다른 시스템은 관절 위치나 토크를 직접 출력한다. 어느 층까지 정책이 맡는지에 따라 행동의 뜻과 학습 난이도가 달라진다.
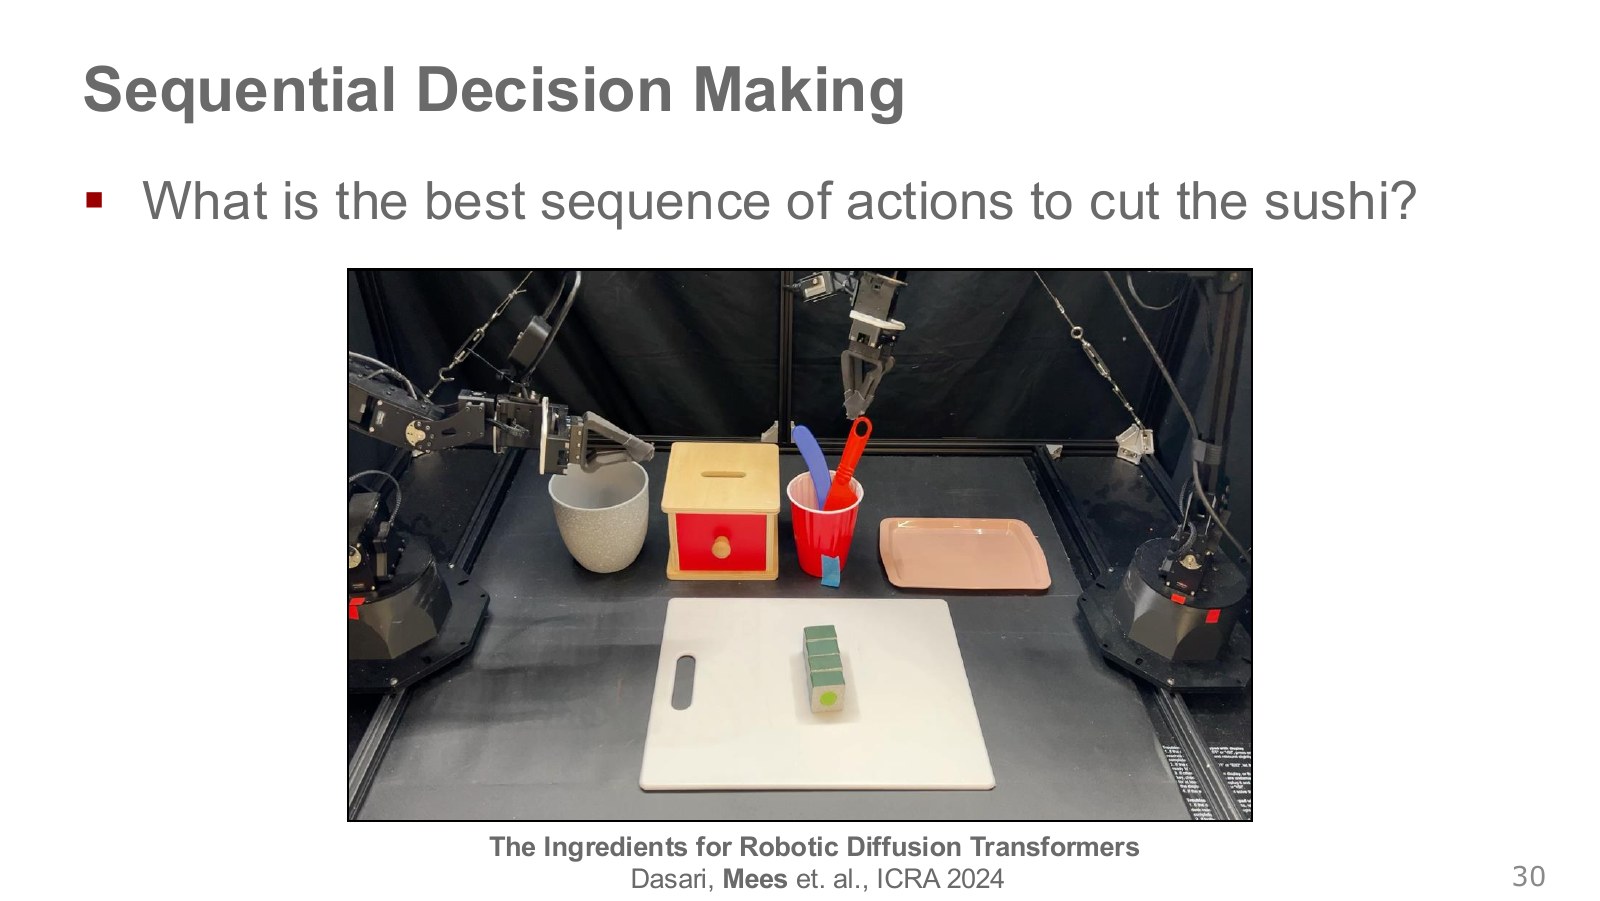
슬라이드의 양팔 시연은 도구를 잡고, 다른 손으로 옮겨 잡고, 목표에 맞추어 작업하는 순서를 보여 준다. 강의 29:02–30:38에서는 실제 음식이 아니라 모형 초밥을 쓰는 예라고 설명한다. 한 장면의 멋진 자세보다, 다음 단계가 가능하도록 현재 행동을 고르는 것이 핵심이다.
칼을 쥔 손의 위치 오차가 작아도 잘못된 순서로 집으면 나중 동작을 할 수 없다. 행동 하나는 다음 관측과 다음 행동의 가능성을 바꾼다. 이를 순차적 의사결정(sequential decision making) 문제로 표현한다.
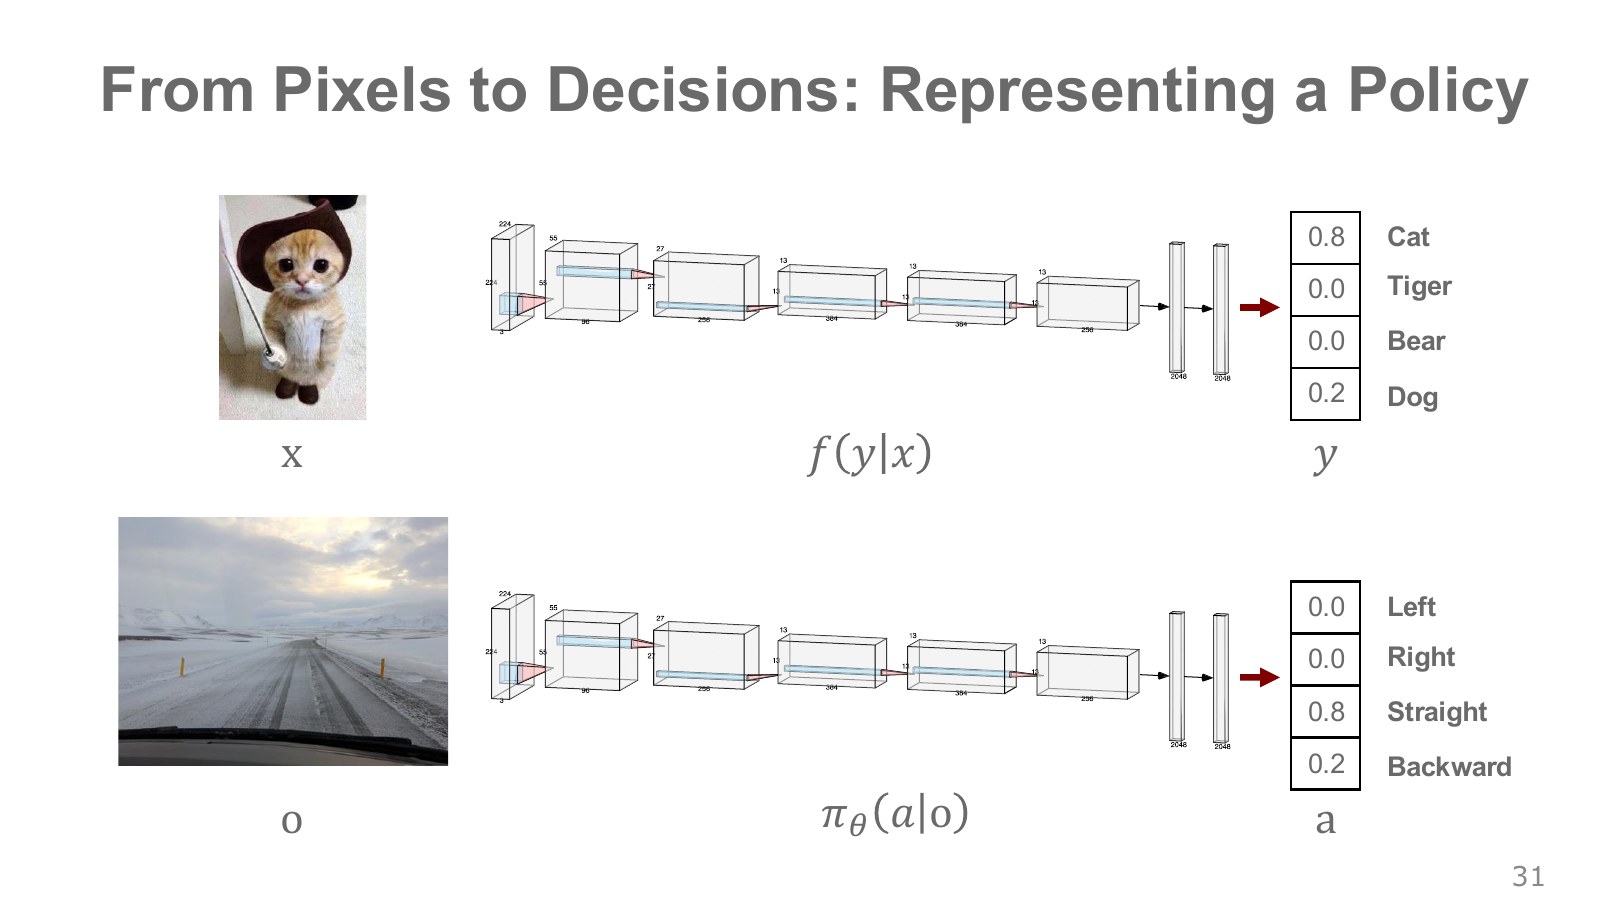
고양이 사진 분류기는 이미지에서 클래스 점수나 확률을 계산한다. 정책 신경망도 카메라 영상에서 왼쪽·오른쪽 같은 행동 확률을 계산할 수 있다. 그림의 0.8은 현재 입력에서 해당 출력을 선택할 확률로 읽으며, 성공률이나 보상 점수와 같지 않다.
강의 30:45–33:23의 차이는 실행 뒤에 드러난다. 사진을 잘못 분류해도 사진 속 고양이는 바뀌지 않지만, 자동차가 잘못 꺾으면 다음 카메라 영상부터 달라진다. 그래서 정답 데이터에서 출력 하나를 맞히는 평가와, 실제 폐루프에서 계속 행동하는 평가는 다르다.
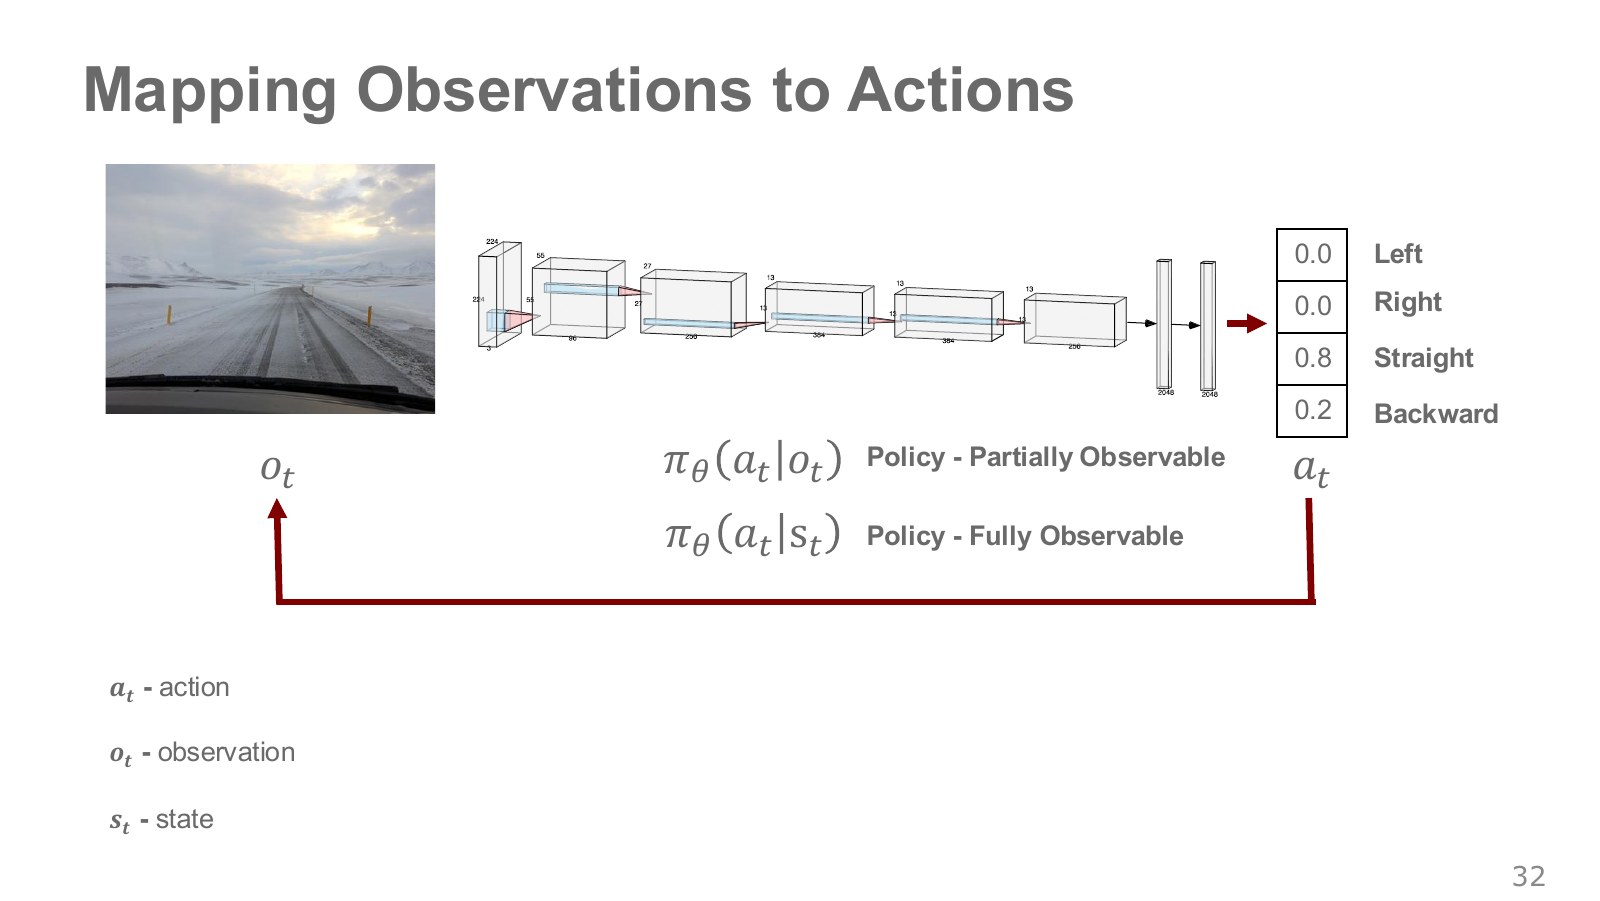
시점 t의 상태를 sₜ, 관측을 oₜ, 행동을 aₜ라고 쓰자. 신경망 가중치 θ로 정의한 확률적 정책은 다음처럼 적을 수 있다.
세로줄 |은 “이 정보가 주어졌을 때”, ∼는 “분포에서 뽑는다”는 뜻이다. 연속 행동에서는 버튼별 확률 목록 대신 토크나 위치 변화량의 분포를 출력할 수 있다. 결정적 정책은 주어진 입력에서 하나의 행동을 낸다.
관측 하나만 쓰는 정책은 부분 관측 문제를 표현하는 가장 단순한 선택이다. 과거 영상과 행동을 모은 이력이나 내부 메모리를 이용하는 정책도 있다. 현재 관측을 s라고 이름만 바꿔 붙여도 필요한 정보가 저절로 생기지는 않는다.
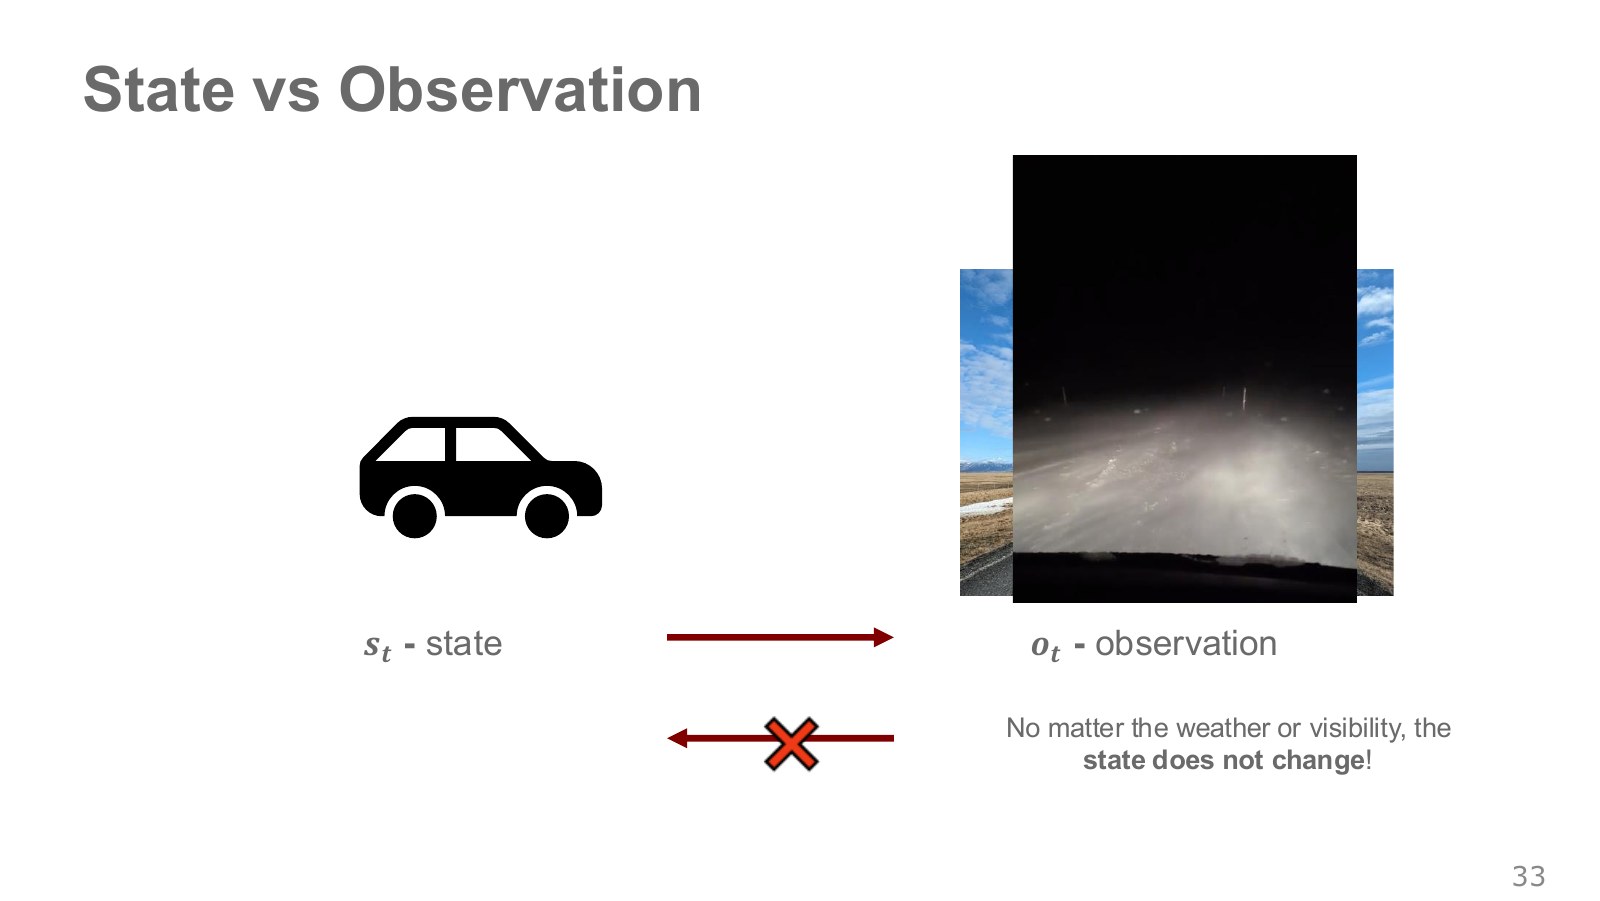
자동차의 위치·속도·방향을 상태에, 카메라 영상을 관측에 넣어 보자. 같은 위치와 속도라도 조명이나 안개에 따라 영상은 크게 달라질 수 있다. 반대로 비슷한 영상이 서로 다른 속도나 가려진 장애물 상황에서 나올 수 있다. 관측에서 상태를 정확히 되찾을 수 있다고 일반적으로 보장할 수 없다.
슬라이드의 “날씨와 무관하게 상태는 같다”는 문장은 선택한 자동차 운동 상태를 고정하고 시야 조건을 바꾸는 예로 읽어야 한다. 날씨가 마찰이나 움직임에 영향을 준다면 그 영향은 상태·외란·전이 모델에 반영해야 한다. 현실의 날씨 변화가 모든 물리적 상태를 그대로 둔다는 뜻은 아니다.
DeepMind/UCL 1강 43:52–45:17의 벽을 바라보는 카메라 로봇도 같은 문제다. 뒤쪽을 조금 전에 봤다는 이력이 다음 행동에 중요할 수 있다. 이때 다루는 확장은 부분 관측 MDP(POMDP)다.
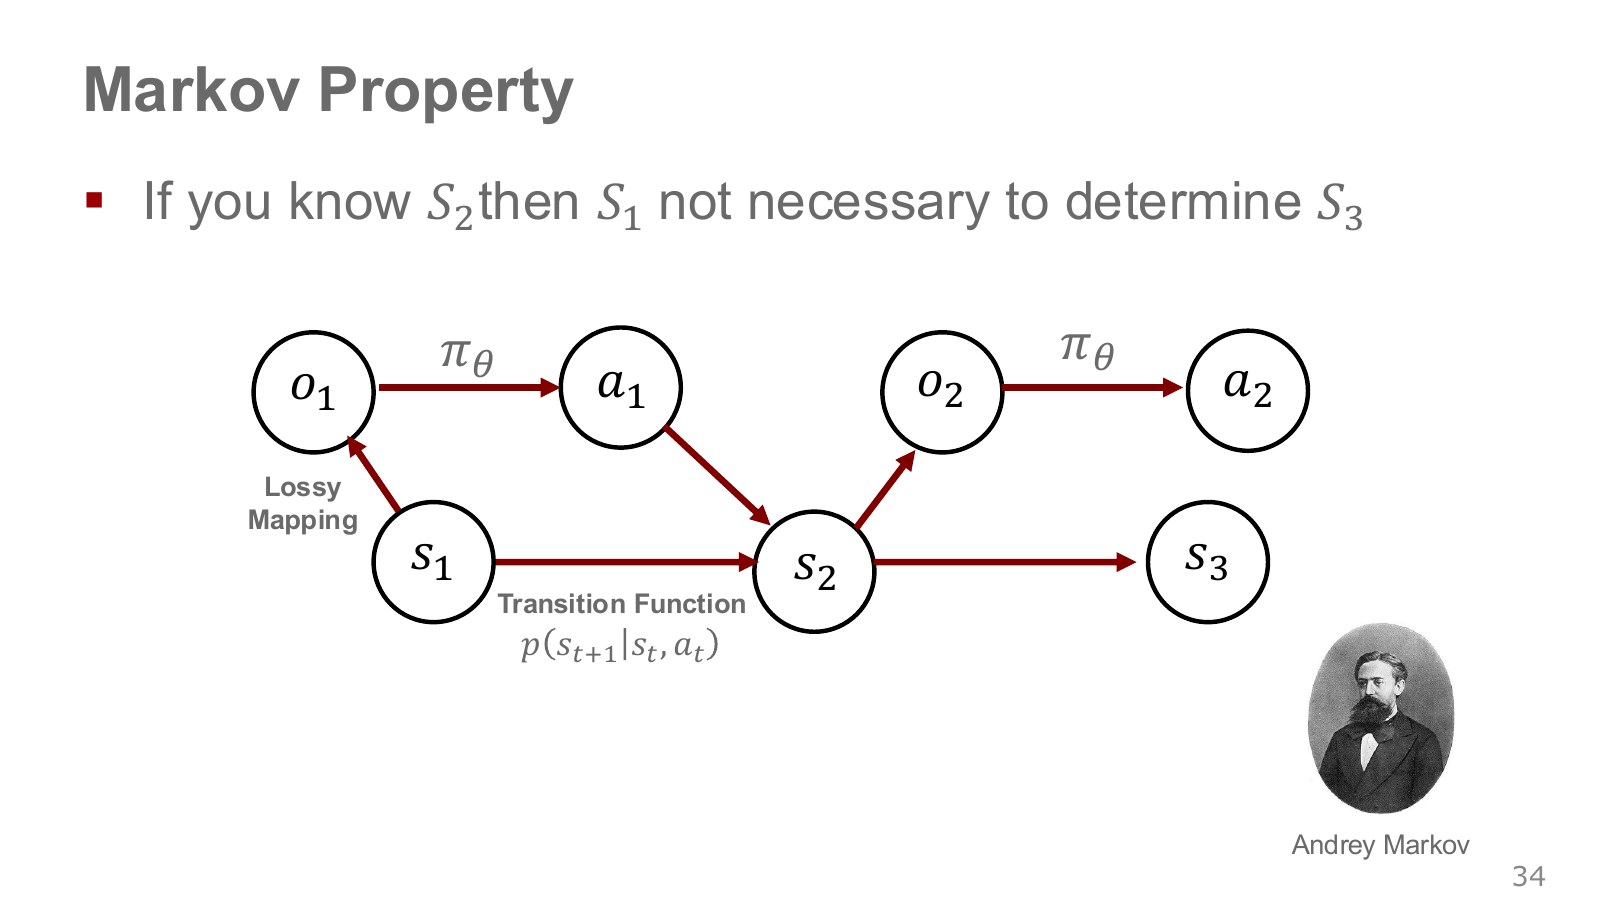
현재 상태와 행동을 알고 있을 때, 더 오래된 이력을 추가해도 다음 상태의 조건부 분포가 달라지지 않으면 마르코프 성질을 만족한다. 제어된 과정의 형태로 쓰면 다음과 같다.
예를 들어 관절 각도만 같아도 관절 속도가 다르면 다음 위치가 달라진다. 이 모델에서 각도만 상태로 두는 것은 정보가 부족할 수 있다. 각도와 속도, 관련 물체 상태 등을 함께 넣어야 하는 이유다. 필요 정보가 현재 상태에 압축돼 있다는 조건이며, 과거 관측을 버리는 것이 언제나 옳다는 명령이 아니다.
강의 34:52–36:00와 UCL 40:49–43:17은 이 조건을 설명한다. 마르코프성이 성립해도 전이가 확률적일 수 있다. 현재 정보가 충분하다와 미래 결과가 하나로 결정된다는 다른 주장이다.
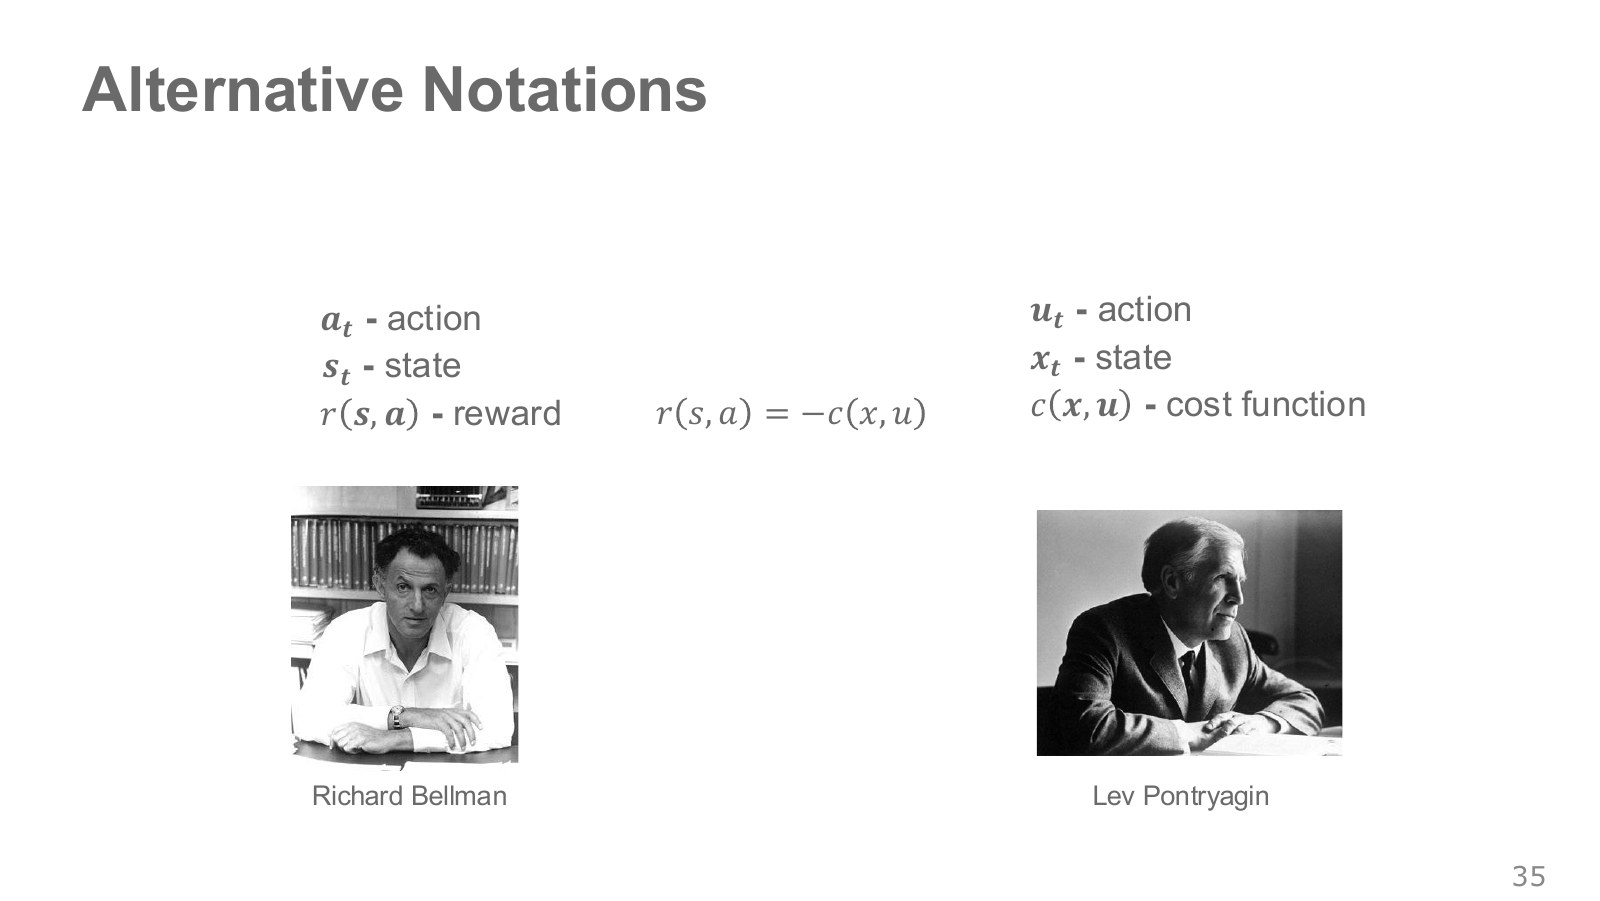
로봇 제어 문헌은 상태를 x, 입력을 u, 비용을 c(x,u)로 쓰는 경우가 많다. 강화학습 문헌은 상태를 s, 행동을 a, 보상을 r(s,a)로 쓰곤 한다. 기호 이름보다 어떤 물리량과 시간 단계를 나타내는지 대응시키면 된다.
같은 조건에서 r = −c로 두면 누적 비용 최소화와 누적 보상 최대화는 같은 선호를 표현한다. 단, 시간 구간·할인·종료 조건까지 맞아야 한다. 역기구학에서 쓴 손 위치 x와 여기서의 전체 상태 x도 같은 글자지만 역할은 다를 수 있다.
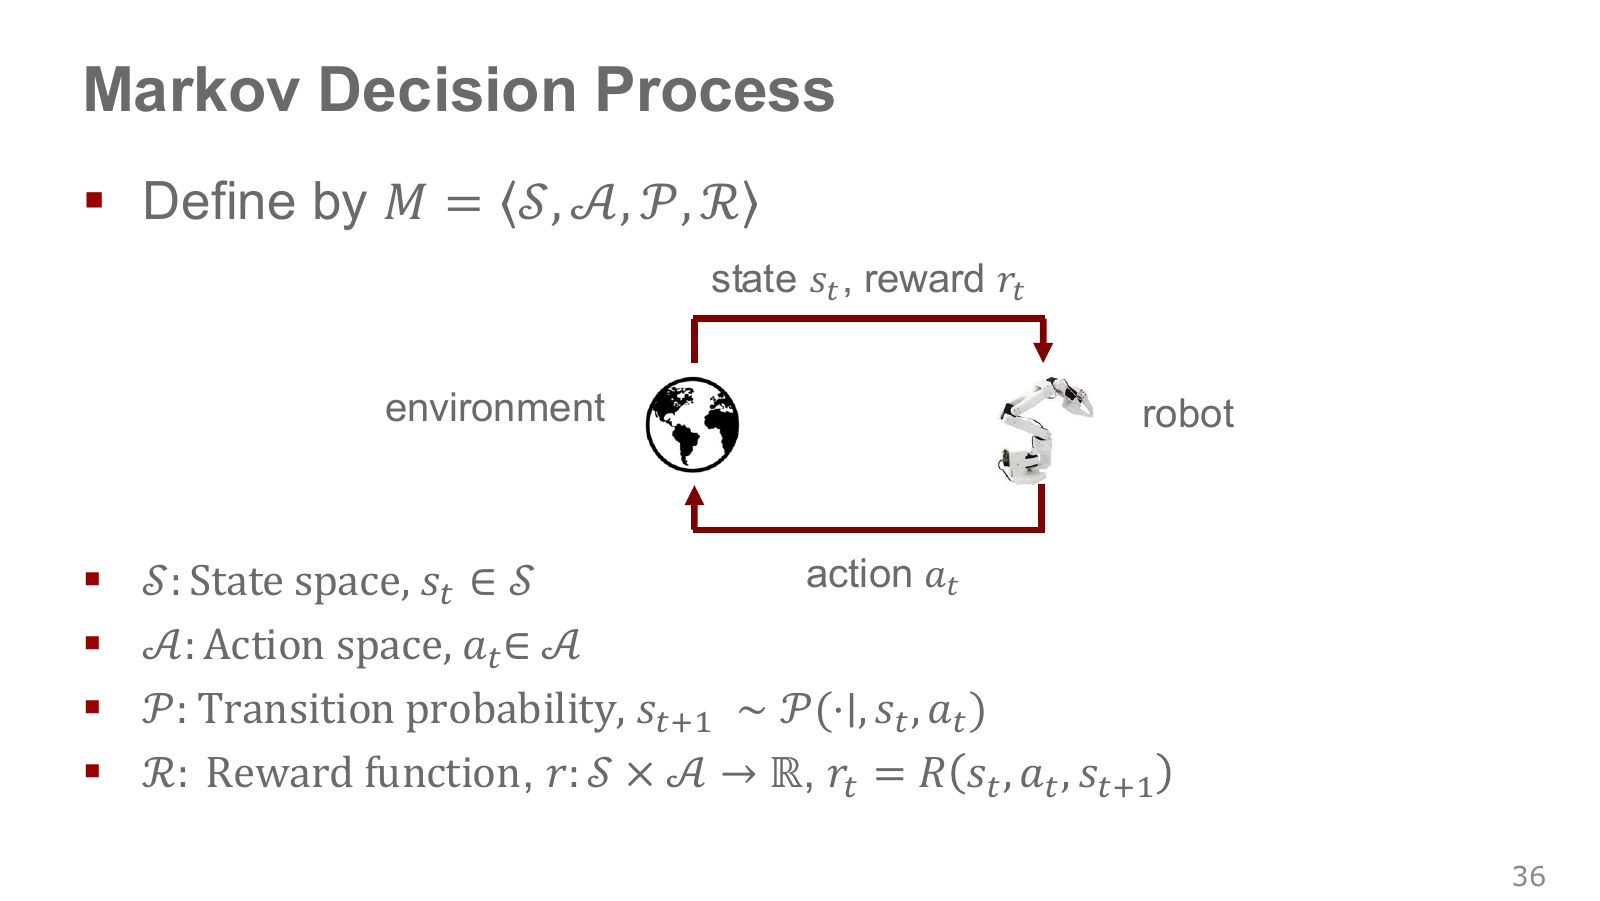
MDP는 의사결정 문제의 재료를 수학적으로 명시하는 틀이다. 슬라이드는 네 요소로 제시하고, 실제 학습 문제에서는 시작 상태 분포와 시간 구간 또는 할인 조건도 함께 정한다.
| 요소 | 뜻 | 컵 집기에서 확인할 내용 |
|---|---|---|
| 상태 공간 S | 가능한 상태들의 집합 | 관절 각도·속도, 컵 위치, 접촉 등 무엇을 넣는가? |
| 행동 공간 A | 가능한 명령들의 집합 | 손끝 목표인가, 관절 목표인가, 토크인가? |
| 전이 P | 상태와 행동에서 다음 상태가 생기는 규칙 | 중력·마찰·접촉과 하위 제어가 어떻게 작용하는가? |
| 보상 R | 행동 결과를 평가하는 수치 규칙 | 집기 성공·이동 시간·충돌을 어떻게 반영하는가? |
슬라이드에는 보상을 r(s,a)와 R(s,a,s′)로 적은 표기가 함께 나온다. 이 글에서는 행동 aₜ로 sₜ에서 sₜ₊₁로 이동하며 얻는 보상을 rₜ라고 정하고, 다음처럼 쓴다.
다른 책에서 같은 전이의 보상을 rₜ₊₁이라고 부를 수 있다. 계산 전에 첨자의 약속을 맞추면 된다. 보상이 확률적으로 발생하는 더 일반적인 모델도 가능하다. MDP를 정의했다고 좋은 정책을 이미 구한 것은 아니다. 이 틀 안에서 어떤 경험을 모으고 정책을 어떻게 개선할지가 학습 알고리즘의 몫이다.
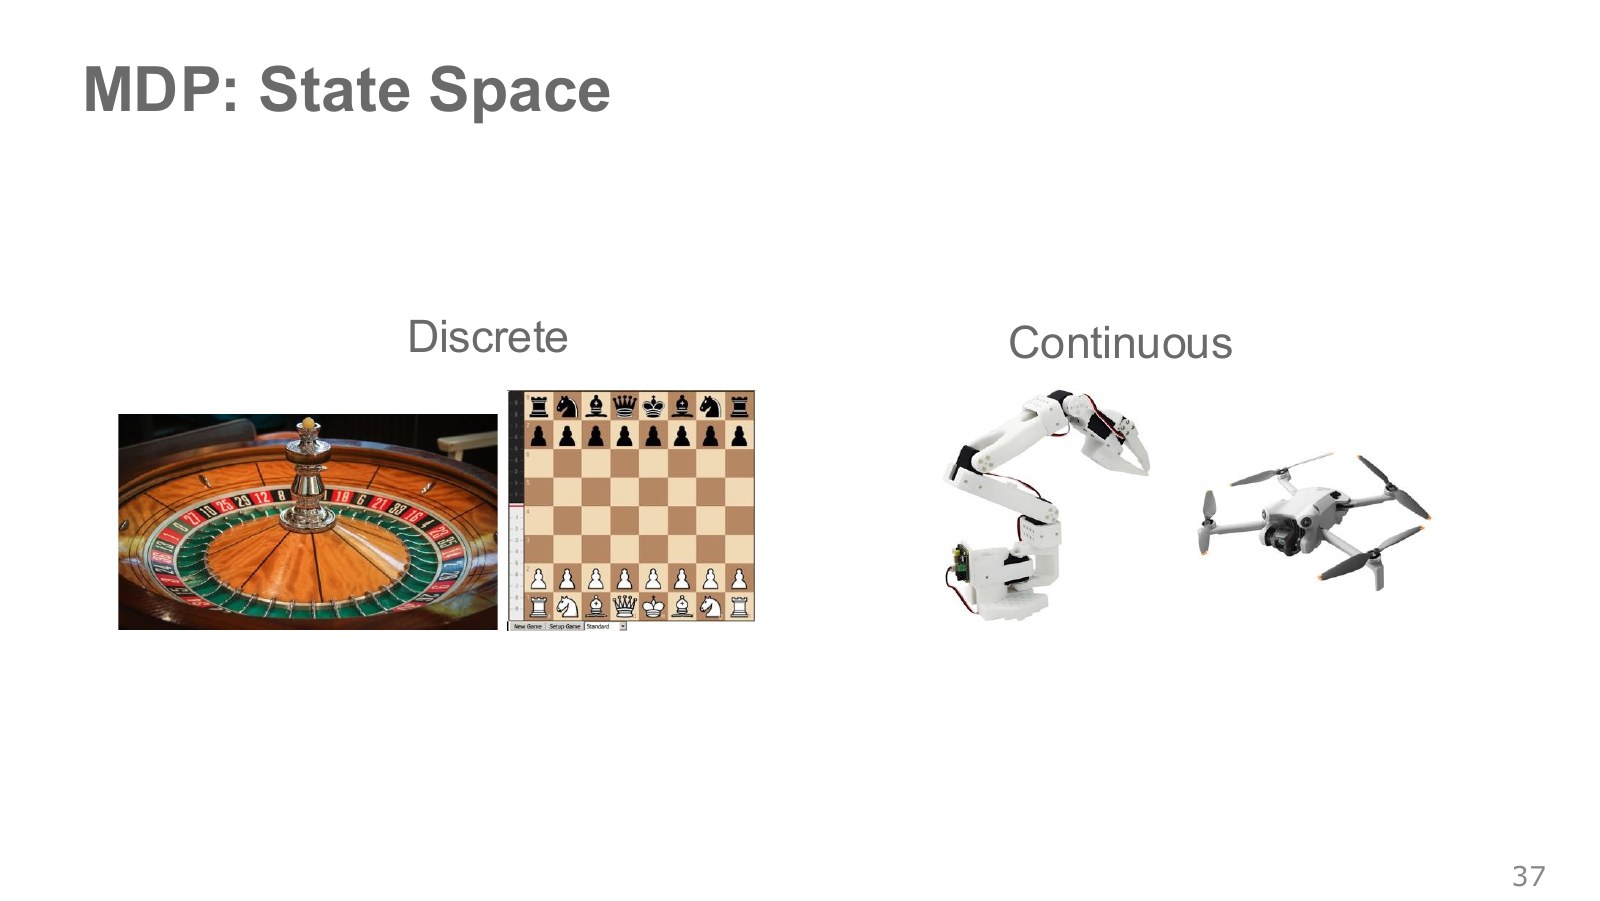
격자 칸이나 보드 게임의 경우 상태를 이산적인 경우들로 나타낼 수 있다. 반면 관절 각도·속도와 물체 위치는 연속적인 값으로 모델링하는 경우가 많다. 센서 숫자가 유한 정밀도로 저장된다는 사실과, 문제를 연속 공간으로 다룬다는 선택은 양립한다.
관절 각도 하나를 100개 구간으로 나눠도 7개 관절 조합은 100⁷개다. 여기에 속도와 물체 상태를 더하면 표는 급격히 커진다. 신경망 같은 함수 근사기를 쓰는 이유는 여러 입력에서 표현과 계산을 공유하기 위해서다. 연속 공간에 적용했다고 자동으로 미방문 상태에서 잘 작동하는 것은 아니다.
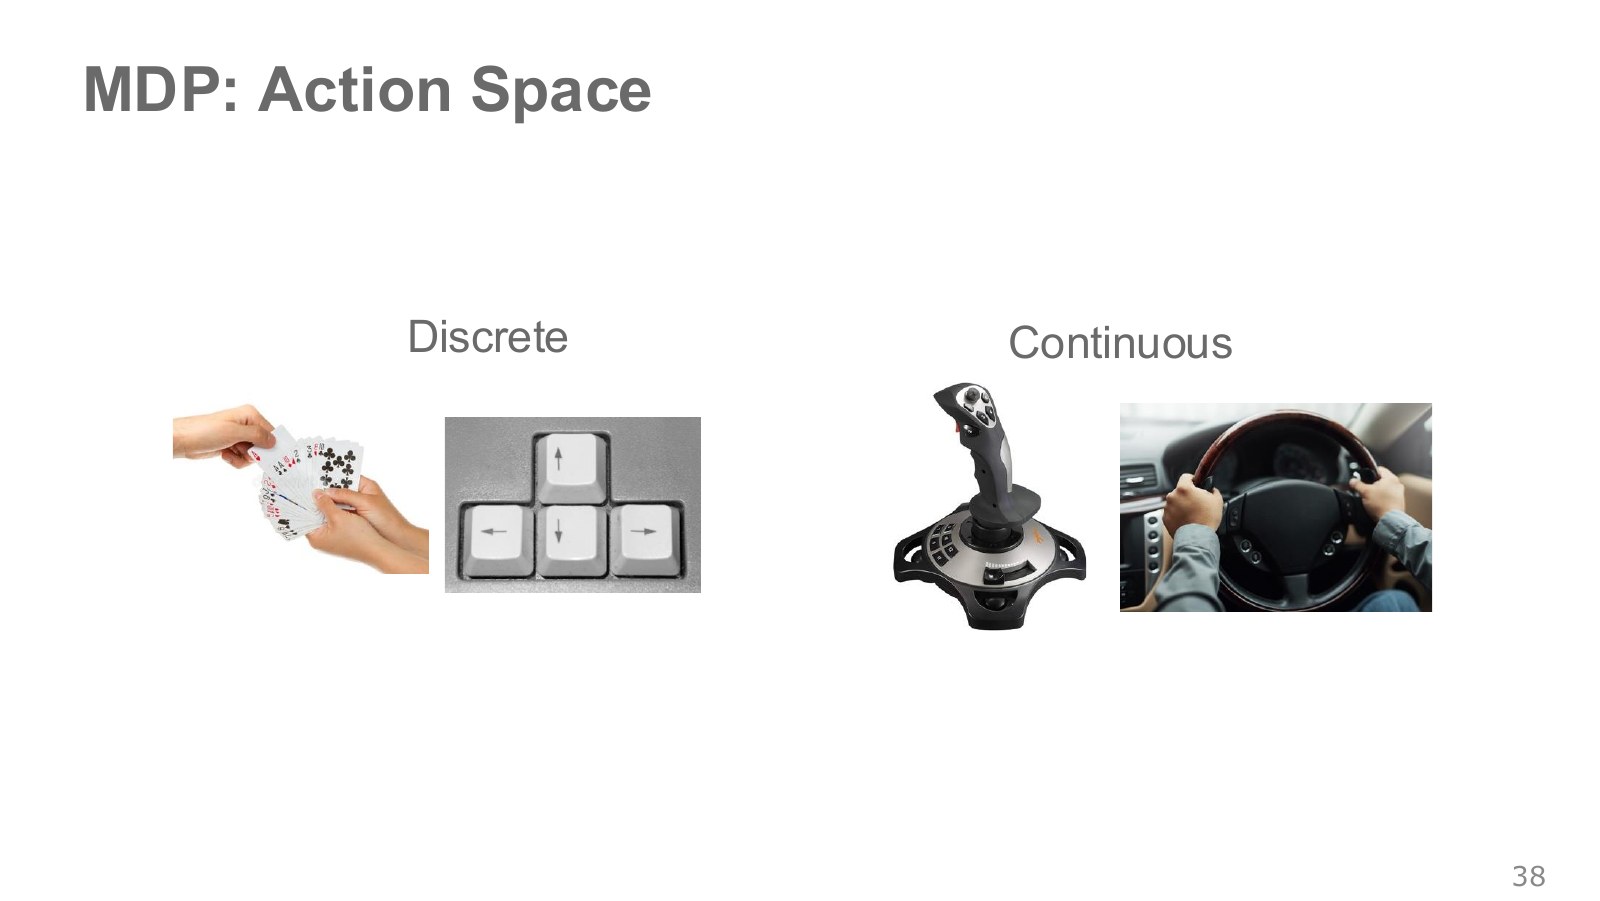
왼쪽·오른쪽 중 하나를 고르는 것은 이산 행동이다. 관절 토크를 실수로 고르는 것은 연속 행동이다. 같은 로봇도 인터페이스에 따라 어느 쪽을 쓸 수 있다. 환경이 행동을 어떻게 해석하는지 알아야 정책 출력을 읽을 수 있다.
0.5가 0.5rad의 목표인지, 정규화된 범위의 중간값인지, 0.5N·m의 토크인지 구분하자. 같은 위치 변화량을 매 0.01초 적용하는 것과 매 0.1초 적용하는 것도 다르다. 정책 주기, 하위 제어 주기, 물리 계산 간격을 함께 기록해야 움직임을 재현할 수 있다.
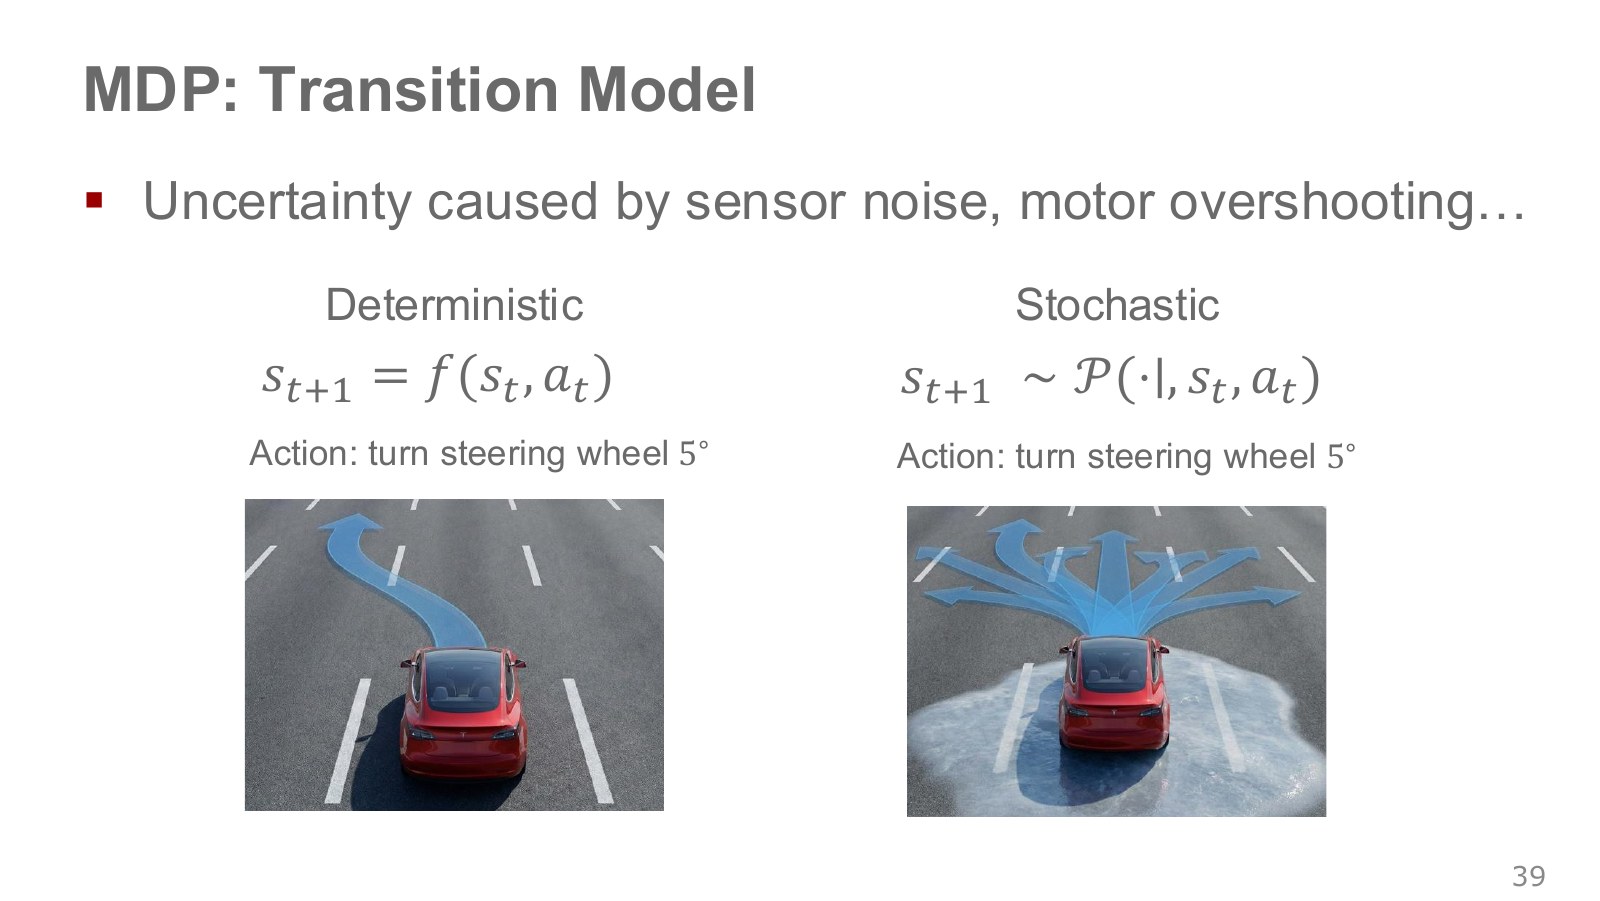
결정적 모델은 상태와 행동이 정해지면 다음 상태도 하나로 정한다. 확률적 모델은 가능한 다음 상태들에 분포를 둔다. 강의 39:30–40:26의 조향 예처럼 같은 핸들 명령도 노면과 구동 오차에 따라 다르게 나타날 수 있다.
여기서 구분이 하나 더 필요하다. 센서 잡음은 무엇을 보았는지의 불확실성, 동역학 외란은 실제로 어디로 움직였는지의 불확실성이다. 완전한 물리 상태와 측정값을 나누는 모델에서는 전자는 관측 모델, 후자는 전이 모델에 넣는다. 일부 요인을 상태에서 생략하면 그 영향이 확률적 전이처럼 나타날 수도 있다. 두 종류를 구별하면 모델이 틀렸는지, 측정이 흔들렸는지 진단하기 쉽다.
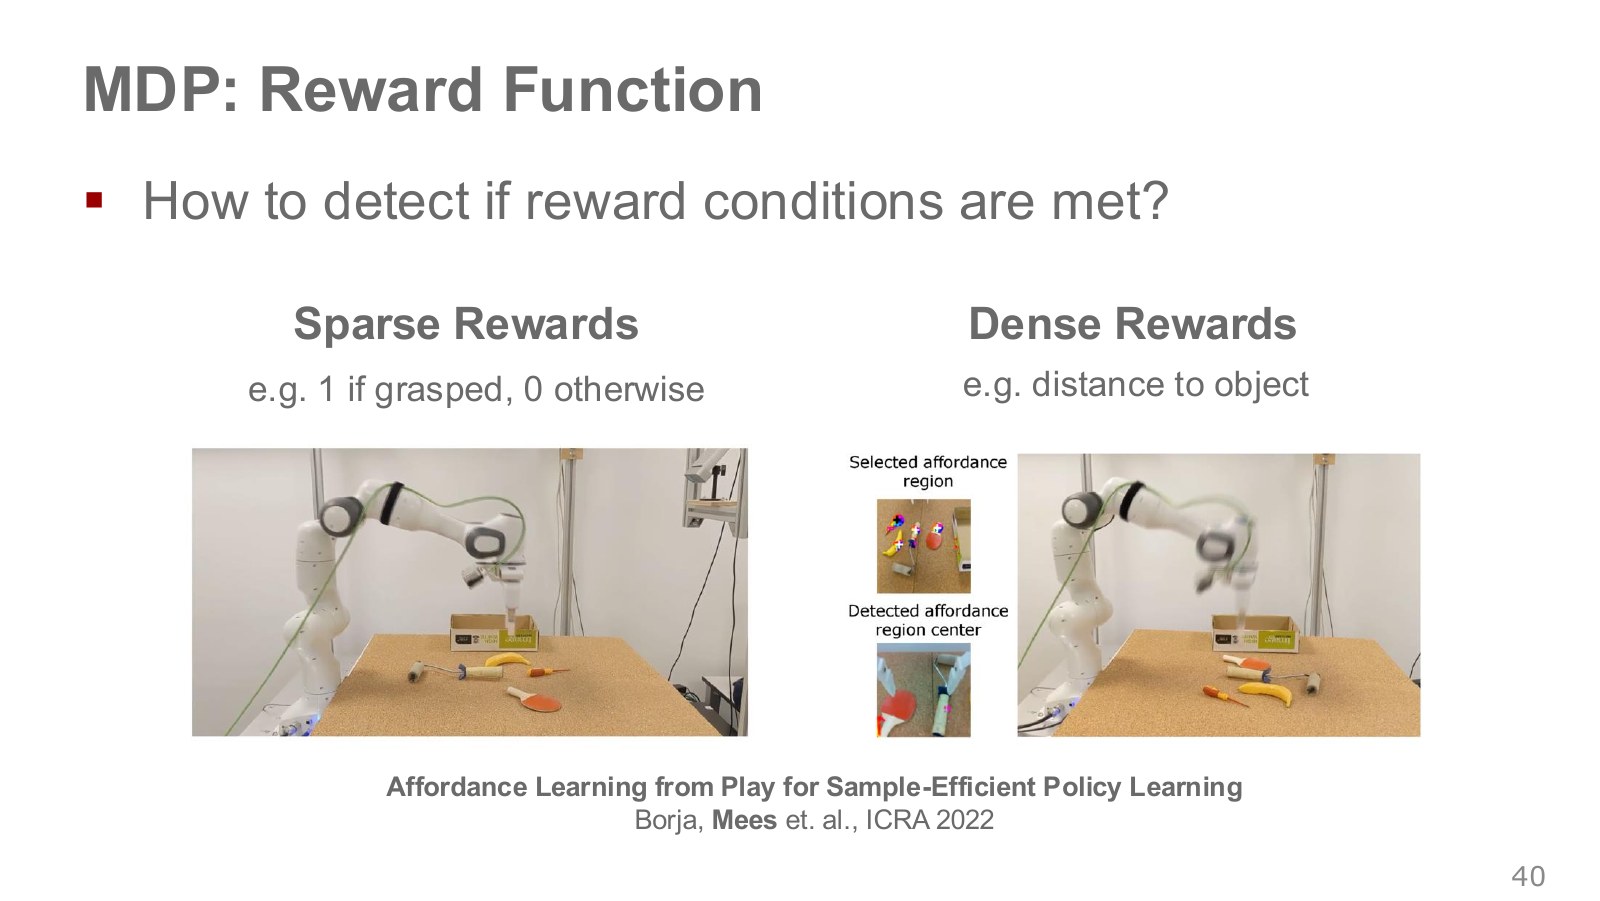
희소 보상(sparse reward)은 집기에 성공했을 때 1, 그 외에는 0처럼 드물게 주어진다. 성공의 의미는 분명하지만 우연히 성공을 만나기 전까지는 어떤 행동이 나았는지 신호가 적을 수 있다. 밀집 보상(dense reward)은 손과 물체 사이 거리처럼 중간 진행에도 수치를 준다.
가까이 가기를 보상하려면 거리를 최대화하지 않도록 부호나 변환을 정해야 한다. 다음은 설명을 위한 별도 예다.
거리가 0.2m일 때 −0.2, 0.05m일 때 −0.05이므로 더 가까운 쪽의 보상이 크다. 그러나 가까이 있기만 하고 집지 않는 행동도 높은 점수를 얻을 수 있다. 성공 조건, 접촉·충돌, 물체 이동 등을 목적에 맞게 설계해야 한다.
강의 40:29–41:48의 두 시연은 해당 실험에서 보상 신호가 학습에 영향을 준다는 예다. 밀집 보상이 모든 문제에서 더 좋은 최종 정책을 보장한다거나 희소 보상이 학습 불가능하다는 결론은 아니다. 보상을 측정할 성공 판정기와 센서가 있는지도 실제 시스템에서는 중요한 조건이다.
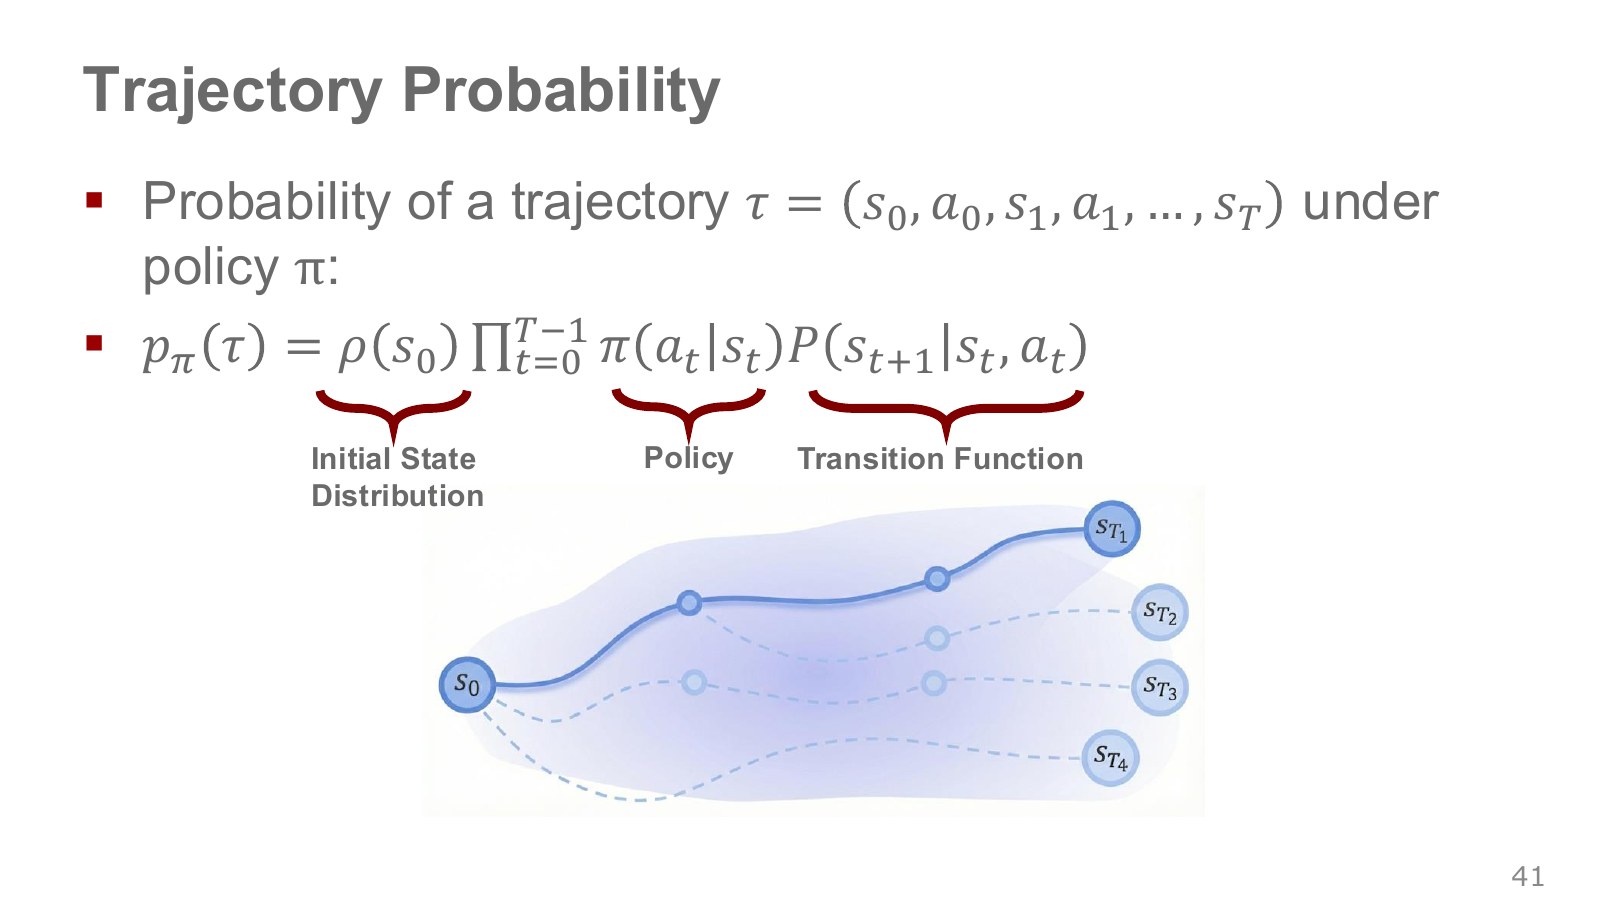
하나의 궤적은 시작 상태에서 행동하고 다음 상태로 이동한 기록의 연속이다. H번 행동한 기록을 τ=(s₀,a₀,s₁,…,aₕ₋₁,sₕ)라고 쓰자. 슬라이드의 곱을 같은 의미로 적으면 다음과 같다.
ρ₀는 시작 상태 분포이고, ∏는 각 단계 값을 곱한다는 기호다. 이산적인 설명 예에서 시작 상태 확률이 0.5, 첫 행동 확률 0.8, 다음 상태 확률 0.9, 둘째 행동 확률 0.6, 마지막 상태 확률 0.7이라면 이 특정 궤적의 확률은 0.1512다. 시간 단계들이 서로 독립이라는 가정으로 곱한 것이 아니라, 앞선 상태·행동에 조건부인 값들을 순서대로 곱한 것이다.
강의 41:51–43:02처럼 정책만 바꿔도 궤적의 분포가 달라진다. 연속 변수에서는 위 기호를 확률 밀도로 해석해야 하며, 정확한 실수 좌표 한 점의 확률과 혼동하면 안 된다. 현재 식은 상태를 조건으로 행동하는 정책에 대한 식이다. 관측을 사용하는 POMDP에서는 관측 생성 과정과 정책의 이력 의존성도 포함해야 한다.
유한 구간 문제에서는 H단계 안에 작업을 끝내야 한다. 같은 위치라도 100단계가 남았을 때와 1단계가 남았을 때 최선의 행동은 다를 수 있다. 남은 시간을 상태에 넣거나 시간에 따라 달라지는 정책을 사용해야 이 차이를 표현할 수 있다.
종료 시간을 미리 정하지 않은 문제에는 할인율 γ를 사용할 수 있다. 0≤γ<1이면 먼 미래의 보상을 점점 작게 가중한다. 보상이 유계이면 무한 합을 유한하게 만드는 역할도 한다. γ=0은 즉시 보상만 보고, 1에 가까울수록 먼 미래를 더 크게 반영한다. 종료가 보장되는 에피소드에서는 γ=1인 비할인 합을 쓰기도 한다.
강의 43:06–44:47의 5초 제한 예는 시간 자체가 전략을 바꾼다는 설명이다. 실습 API에서도 과업의 종료(terminated)와 외부 시간 제한으로 중단(truncated)을 구분한다. “200번 실행했으니 성공했다”처럼 해석해서는 안 된다.
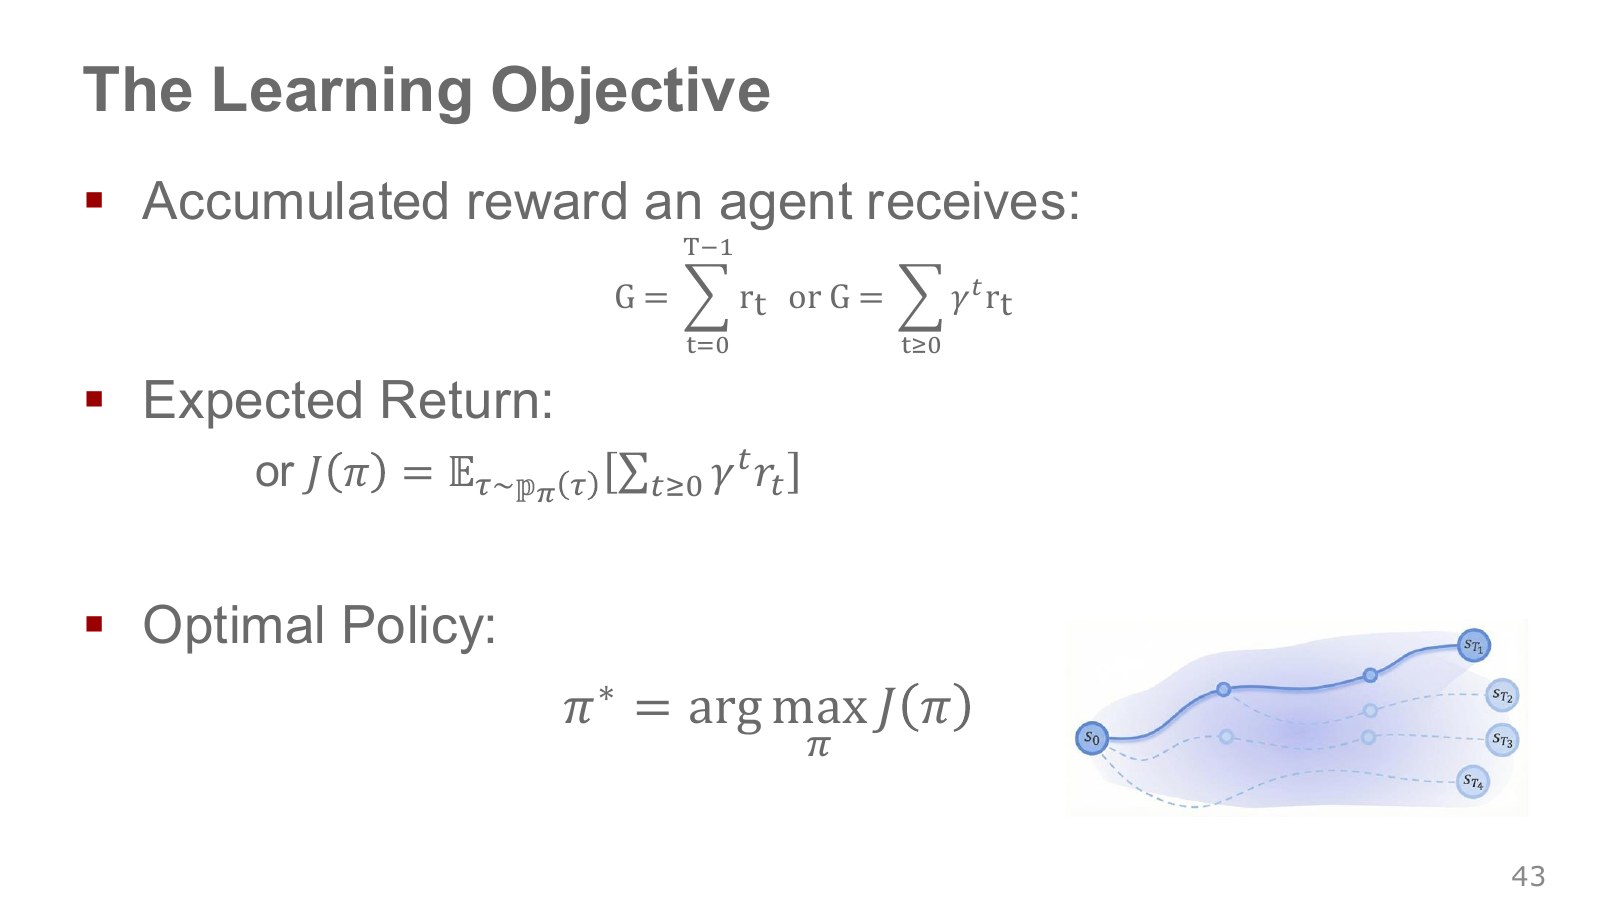
이 글의 보상 첨자 규칙에서 유한 구간의 할인 리턴과 정책 목적은 다음과 같다. 슬라이드의 누적 보상·기대값·최적화 관계를 하나의 표기로 연결했다.
G는 한 번 실행한 궤적의 점수다. J는 시작 상태·정책·전이에서 발생하는 가능한 여러 궤적에 대한 기대 리턴이다. arg max는 최대 점수 자체가 아니라 그 값을 이루는 정책을 찾는다는 뜻이다. 여러 최적 정책이 있을 수 있어 ∈로 적었다.
세 단계의 보상이 [0, 0, 1]이고 γ=0.9이면 리턴은 0.81이다. 당장 0점을 받은 첫 행동도 마지막 성공을 준비했을 수 있다. 무작위성이 있는 문제에서는 운 좋게 한 번 성공한 실행과 평균적으로 잘하는 정책을 구분해야 한다. 강의 44:51–45:57는 이 기대값을 학습 목표로 연결한다.
보상을 어떻게 정했는지가 여기까지 그대로 이어진다. 빠르기만 보상하면 충돌이 목적에서 빠질 수 있고, 손의 거리만 보상하면 실제 집기가 목적에서 빠질 수 있다. 좋은 정책은 우리가 적어 둔 문제의 목적에 대해 좋은 정책이므로, 수식을 최적화하기 전에 목적이 원하는 행동을 표현하는지 확인해야 한다.
#실제 시뮬레이션에서 관측·행동·보상 확인하기
작은 예제로 Gymnasium의 Pendulum-v1을 사용했다. 회전 관절 하나를 가진 역진자를 위로 세워 두는 환경이다. 아래 결과는 위쪽 근처에서 시작하는 고정 PD 제어기를 실행한 것이다. 시연 데이터나 보상으로 파라미터를 훈련하는 단계는 포함하지 않는다.
관측은 [cos(θ), sin(θ), θ̇], 행동은 −2에서 +2N·m 사이의 토크 하나다. 원래 모델의 상태 (θ, θ̇)를 이 관측으로 표현하면 각도 경계의 주기성을 다룰 수 있다. 보상은 각도의 제곱, 각속도의 제곱, 토크의 제곱을 가중해 더한 비용의 음수다. 세워져 있고 움직이지 않으며 토크가 0이면 보상이 가장 높다.
실행에서는 seed=7, 초기 각도 범위 ±0.2rad, 초기 각속도 0으로 같은 초기 조건을 만들고, 토크 0과 u = clip(−15θ−3θ̇, −2, 2)를 각각 200단계 비교했다. 이 제어기는 위쪽 근처의 유지 예제다. 아래쪽에서 시작해 진자를 들어 올리는 스윙업 능력은 이 결과로 입증하지 않는다.
| 고정 제어 방식 | 200단계 보상 합 | 마지막 각도(rad) |
|---|---|---|
| 토크 0 | -502.751685 | 0.159858 |
| PD | -0.019170 | 0.000000 |
200단계에서 두 실행 모두 terminated=False, truncated=True였다. 과업 성공 판정으로 끝난 것이 아니라 기본 시간 제한에 도달한 것이다. 보상 합은 이 한 초기 조건에서의 할인하지 않은 실행 리턴이며, 모든 시작 상태에 대한 기대 성능이나 RL 알고리즘 간 비교가 아니다.
핵심 실행 순서는 다음과 같다. 관측으로 명령을 만들고 step에 전달한 뒤, 새 관측과 보상을 받는다. reset에서 시드를 고정하는 것은 재현할 초기 조건을 정하는 일이다.
import gymnasium as gym
import numpy as np

env = gym.make("Pendulum-v1")
obs, info = env.reset(seed=7, options={"x_init": 0.2, "y_init": 0.0})
for _ in range(200):
    theta = np.arctan2(obs[1], obs[0])
    torque = np.clip(-15.0 * theta - 3.0 * obs[2], -2.0, 2.0)
    action = np.array([torque], dtype=np.float32)
    obs, reward, terminated, truncated, info = env.step(action)
    if terminated or truncated:
        break
env.close()
실행 파일·환경 버전·CSV·수치 검증 결과를 함께 공개했다. 좌표 변환 예제, 2R 팔의 두 IK 해, 야코비안 기울기의 수치 미분, 5차식의 경계 조건, PID 계산, 궤적 확률과 리턴을 검사한 결과도 들어 있다.
#로봇 팔 실습으로 이어가기
ETH의 공식 HW2는 이 장의 내용을 세 단계로 연결한다. 먼저 공간의 목표점을 IK로 관절 구성으로 바꾸고, 다음으로 궤적 생성과 제어를 추가하며, 마지막으로 MuJoCo 환경에서 정책을 훈련한다.
| 공식 예제 | 확인할 연결 | 실행 전 읽을 내용 |
|---|---|---|
| Exercise 1 | 목표점 → IK → 관절 구성 | 자세를 직접 바꾸는 시각화는 물리적 추종 제어와 다르다. |
| Exercise 2 | 5차 궤적 → IK → PID → 물리 시뮬레이션 | 목표와 실제 관절 오차, 이득, 출력 명령의 의미를 확인한다. |
| Exercise 3 | 관측 → 정책 행동 → 구동기 → 다음 관측·보상 | 정규화된 행동을 물리적 목표로 바꾸는 처리를 확인한다. |
공식 설명에서 Exercise 3의 정책은 10Hz, 물리 계산은 500Hz이며 한 정책 행동 사이에 물리 계산을 50번 한다. Exercise 2의 data.ctrl은 토크 입력이고 Exercise 3에서는 관절 목표로 해석된다. 같은 변수 이름이라도 로드된 구동기 모델에 따라 뜻이 달라진다. 위 표는 공개 과제와 코드를 읽는 안내이며, 이 글에서 공식 SO-101 과제를 훈련하거나 실물 로봇을 구동한 결과는 아니다.
더 큰 병렬 시뮬레이션 환경은 NVIDIA Isaac Lab 공식 튜토리얼에서 이어갈 수 있다. 먼저 관측·행동·물리 계산·보상의 경계를 읽을 수 있게 된 뒤 규모를 늘리면, 설정이 바뀌어도 문제의 구조를 따라가기 쉽다.
다음 03장에서는 보상으로 시행착오를 시작하기 전에 전문가의 행동을 보고 정책을 배우는 모방학습을 살펴본다. 현재 관측에서 시연 행동을 맞히는 학습이 실제 실행에서 왜 어려워지는지가 이번 장의 순차적 의사결정과 연결된다.
#출처와 함께 읽을 자료
- Oier Mees — ETH Robot Learning, 2강 Robot Control & MDPs · 2026-02-23 강의 영상 · 슬라이드
- 강의 슬라이드 이미지 사본. P번호는 이 사본의 파일 순서다. 운영 안내와 전환·마무리 전용 장은 생략했다.
- Lynch·Park — Modern Robotics, 동차 변환 · 시간 스케일링. 영상과 공식 스크립트를 함께 제공한다.
- Hado van Hasselt — DeepMind × UCL 2021, Introduction to RL · 강의 PDF
- Farama Foundation — Gymnasium Pendulum 문서 · ETH HW2 원본 코드
강의 슬라이드의 저작권은 Oier Mees 및 각 자료의 해당 권리자에게 있다. 슬라이드에 포함된 Modern Robotics, ABB, Latombe, LaValle 등의 도표·사진은 각 원저작자의 자료다. 이 글의 설명용 2R 팔, 보상·확률 계산과 직접 생성한 그래프는 개념을 풀어 쓴 별도 예제다.