공장 검사 카메라의 조명이 어두워졌다. 첫 영상에서 모델을 조금 조정하자 부품이 다시 잘 보인다. 두 번째 영상은 어느 모델로 읽어야 할까? 같은 조명이 이어진다면 방금 배운 것이 도움이 된다. 두 번째 영상이 옆 라인의 밝은 카메라에서 왔다면 출발점부터 어긋날 수 있다.
18편은 목표가 바뀌는 순간에 끝났다. 하편 26–30쪽에서는 그 순간에 무엇을 남길지 살펴본다. 상편 7편에서 다룬 테스트 시점 학습(Test-Time Training, TTT)을 출발점으로 삼는다. 이번에는 한 입력의 변화가 다음 입력까지 전달되는 경로, 그리고 그 결과를 실제로 측정한 음성인식 실험에 초점을 둔다.
식 풀이 바로가기 경사 충돌 · 회전 손실 미분 · 밝기 보정 · 음성 환경 변화 · 망각 측정
슬라이드별 영상 위치
| 원본 | NTU 2026년 5월 22일 강의 | 영상을 보며 따라갈 부분 |
|---|---|---|
| 26쪽 | 26:56 | 전차에서 비행기로 목표가 바뀔 때 레이더를 남길 이유 |
| 27쪽 | 27:55 | 입력을 보고 모델을 갱신한 다음 출력하는 순서 |
| 28쪽 | 28:46 | 방금 바뀐 파라미터를 다음 입력의 출발점으로 쓰는 선택 |
| 29쪽 | 29:07 | 두 방식 사이의 해법을 다룬 이전 강의와 연구 |
| 30쪽 | 29:37 | 가중치나 하네스를 바꾸면 오래된 기술은 어떻게 될까? |
시각은 각 논점에 대한 설명이 시작되는 위치다.
#하편 26쪽 — 전차의 레이더는 비행기에도 쓸 수 있을까?
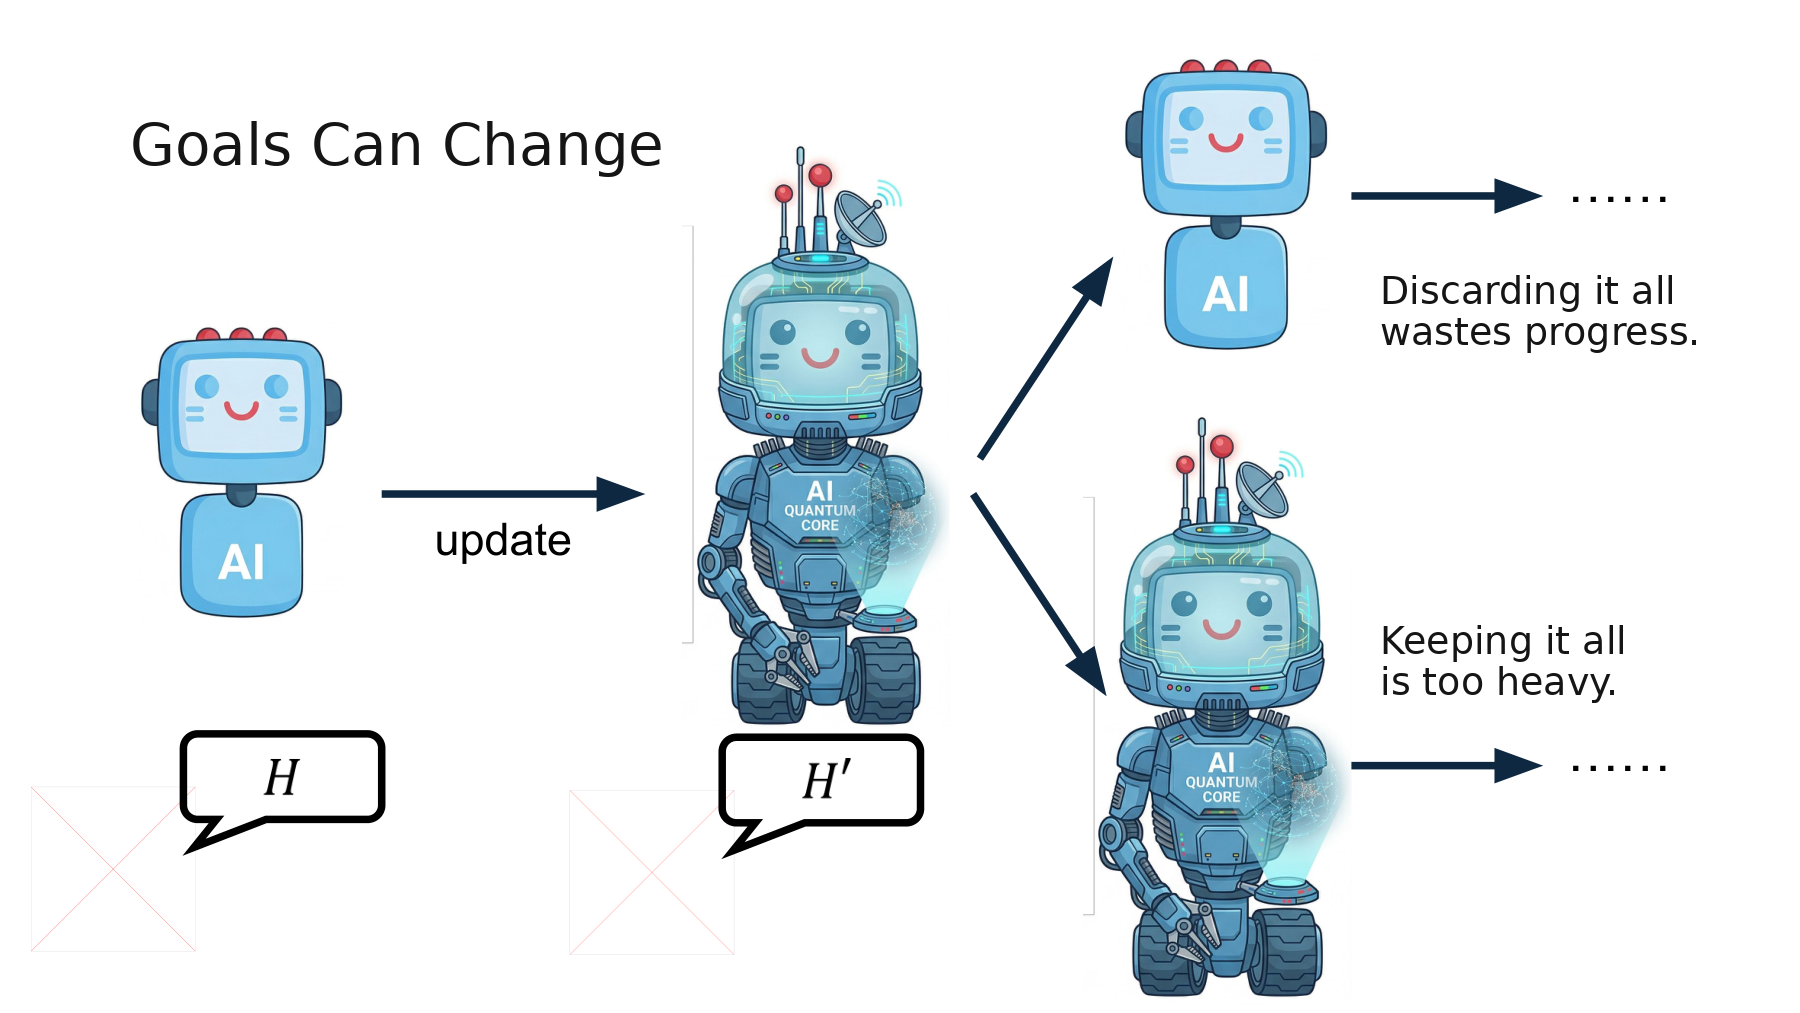
그림 왼쪽에서 목표 H에 맞춰 로봇을 갱신한다. 가운데에서 다음 목표 H′를 만나면 경로가 갈린다. 위쪽 로봇은 원래 몸으로 돌아가고, 아래쪽 로봇은 무거운 장비를 단 채 출발한다. 강사는 전차의 레이더를 예로 든다. 비행기에도 레이더는 쓸모가 있다. 그렇다고 궤도까지 싣고 날 필요는 없다. 레이더를 예로 드는 부분 27:29
하편은 이 비유에서 출발해 음성인식으로 넘어간다. 두 사례에서 무엇이 바뀌었는지를 짚어 두면 좋다. 로봇 사례에서는 성공 조건이 지상 주행에서 비행으로 바뀐다. 음성인식 실험에서는 성공 조건이 계속 정확한 받아쓰기다. 달라지는 것은 마이크로 들어오는 배경 소음, 곧 입력 분포(input distribution)다. 후자에서는 같은 지표로 적응 전후를 비교할 수 있다.
#식 풀이 · 새 과제를 배울 때 예전 과제의 손실이 커지는 방향
레이더의 비유를 가중치 두 개로 옮겨 보자. 기존 과제 A의 예시 몇 개를 저장해 두었다고 하자. 그 예시의 평균 손실을 미분한 벡터가 g_A다. 새 과제 B에서 구한 경사는 g_B다. 경사는 손실이 증가하는 방향이므로, 학습률 η로 선택한 방향 d를 빼야 한다. 한 걸음이 작을 때 A의 손실 변화는 다음 내적으로 근사된다.
예시에서 g_A = (1, 0), g_B = (−1, 2), η = 0.1로 둔다. B의 경사를 그대로 따라가면 첫 번째 가중치가 0.1 증가한다. A는 바로 그 가중치가 커질 때 손실이 증가하는 과제다.
예전 과제의 손실을 1차 근사에서 늘리지 않으려면 d의 첫 성분이 0 이상이어야 한다. 이 조건을 만족하면서 (−1, 2)에 가장 가까운 벡터는 (0, 2)다. 충돌하는 첫 성분만 0으로 만들고 두 번째 성분은 남긴다.
A의 손실 변화 근사는 0이고 B의 손실은 약 0.4 줄어든다. 이것이 GEM(Gradient Episodic Memory) 논문의 경사 투영(gradient projection)을 두 숫자로 줄인 예다. 실제 GEM은 저장한 과제별 예시로 조건을 검사한다. 메모리에 든 예시의 손실과 전체 과제 정확도는 다른 측정량이므로, 예전 기술의 보존 여부는 평가 자료에서 다시 확인해야 한다. Lopez-Paz·Ranzato, NeurIPS 2017, 식 7–8
#하편 27쪽 — 세 줄 모두 같은 파란 로봇에서 출발한다
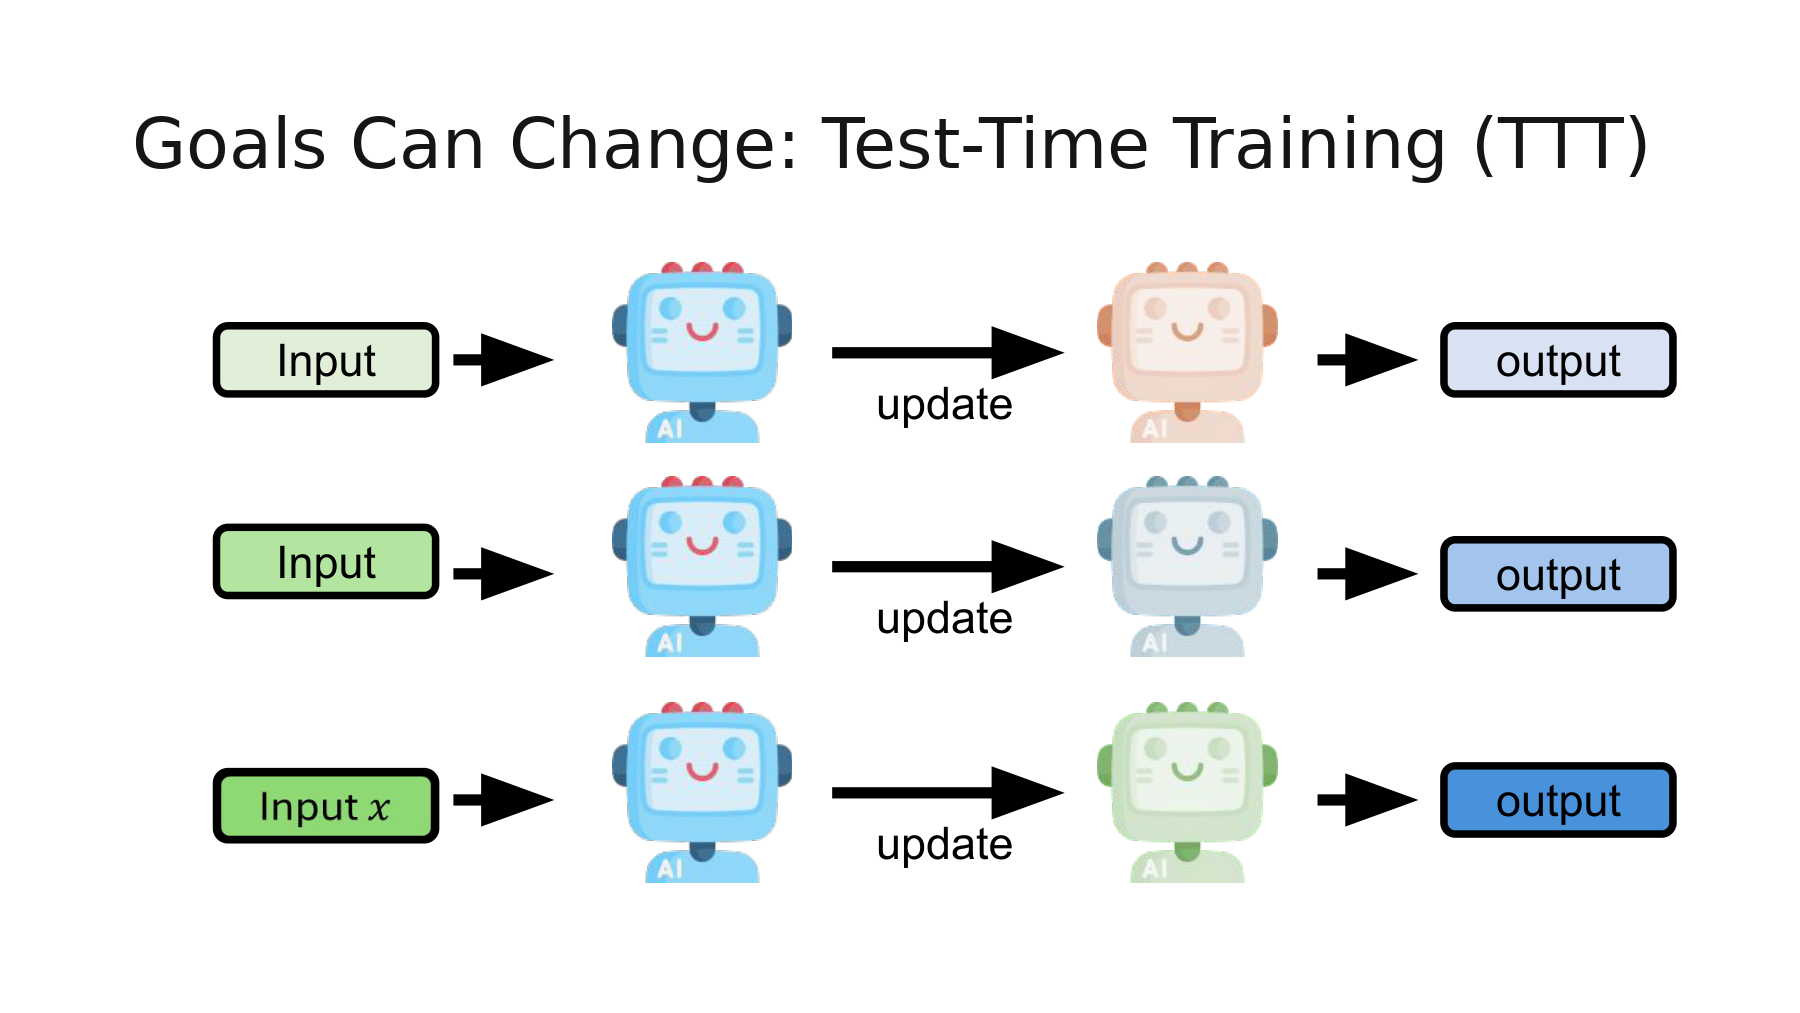
위에서 아래로 왼쪽 로봇의 색부터 보자. 세 입력이 달라도 출발점은 매번 파란색이다. 각 줄을 가로로 읽으면 입력 → 기준 모델 → 갱신 → 적응한 모델 → 출력 순서다. 첫 번째 입력을 풀기 위해 바꾼 가중치는 두 번째 줄로 넘어가지 않는다. 기준 가중치를 θ₀, 현재 입력을 xₜ, 적응 연산을 A라고 쓰면 다음 한 줄로 읽을 수 있다.
정답을 모르는데 무엇을 학습할까? Sun 등의 머신비전 실험에서는 사진을 0°, 90°, 180°, 270° 중 하나로 회전한다. 사진 속 물체 이름은 몰라도 프로그램이 돌린 각도는 안다. 물체 분류와 회전 예측이 특징 추출기를 공유하도록 미리 학습하고, 테스트 때는 회전 예측 손실로 공유 특징을 조정한다. 이어 물체 분류기가 그 특징으로 원래 사진을 읽는다. 원형 와셔를 찍은 사진처럼 회전해도 모양이 거의 같다면 각도 과제에서 배울 정보가 적다. 보조 과제와 관심 과제가 어떤 특징을 공유하는지가 중요하다. Sun 외, ICML 2020, §2
#식 풀이 · 물체 이름 없이도 회전 손실의 경사를 구하는 법
이미지를 프로그램으로 90° 돌렸다. 모델이 네 각도에 점수를 하나씩 준다. 계산을 손으로 따라가기 위해 정답 각도의 점수(logit)만 z로 두고 다른 세 점수는 0으로 고정하자. 소프트맥스(softmax) 분모에서 3이 나오는 까닭은 다른 각도가 각각 exp(0) = 1을 보태기 때문이다. 정답 각도의 확률을 p, 그 확률에 음의 자연로그를 취한 손실을 L이라 하자. Stanford CS231n, Softmax classifier
처음에는 z = 0이므로 네 각도가 모두 같은 확률을 받는다. p = 1/4, L = ln 4 ≈ 1.3863이다. 로그의 미분과 마지막 항 −z의 미분을 각각 적용하면 기울기가 나온다.
현재 기울기는 0.25 − 1 = −0.75다. 학습률을 0.4로 두고 음의 기울기를 빼면 정답 점수가 올라간다.
새 손실은 −ln p(z₁) ≈ 1.1701이다. 여기까지 확인한 것은 알고 있는 회전 각도에 대한 손실 감소다. 실제 TTT는 공유 특징 추출기의 가중치까지 연쇄법칙(chain rule)으로 경사를 전달한다. 이 한 좌표 계산에는 물체의 정답이 한 번도 들어가지 않았다. 불량 부품 분류 성능도 좋아졌는지는 별도로 측정해야 한다. Sun 외, ICML 2020, 식 2–3
#보충 강의 · 답을 더 오래 계산하면 무엇이 바뀔까?
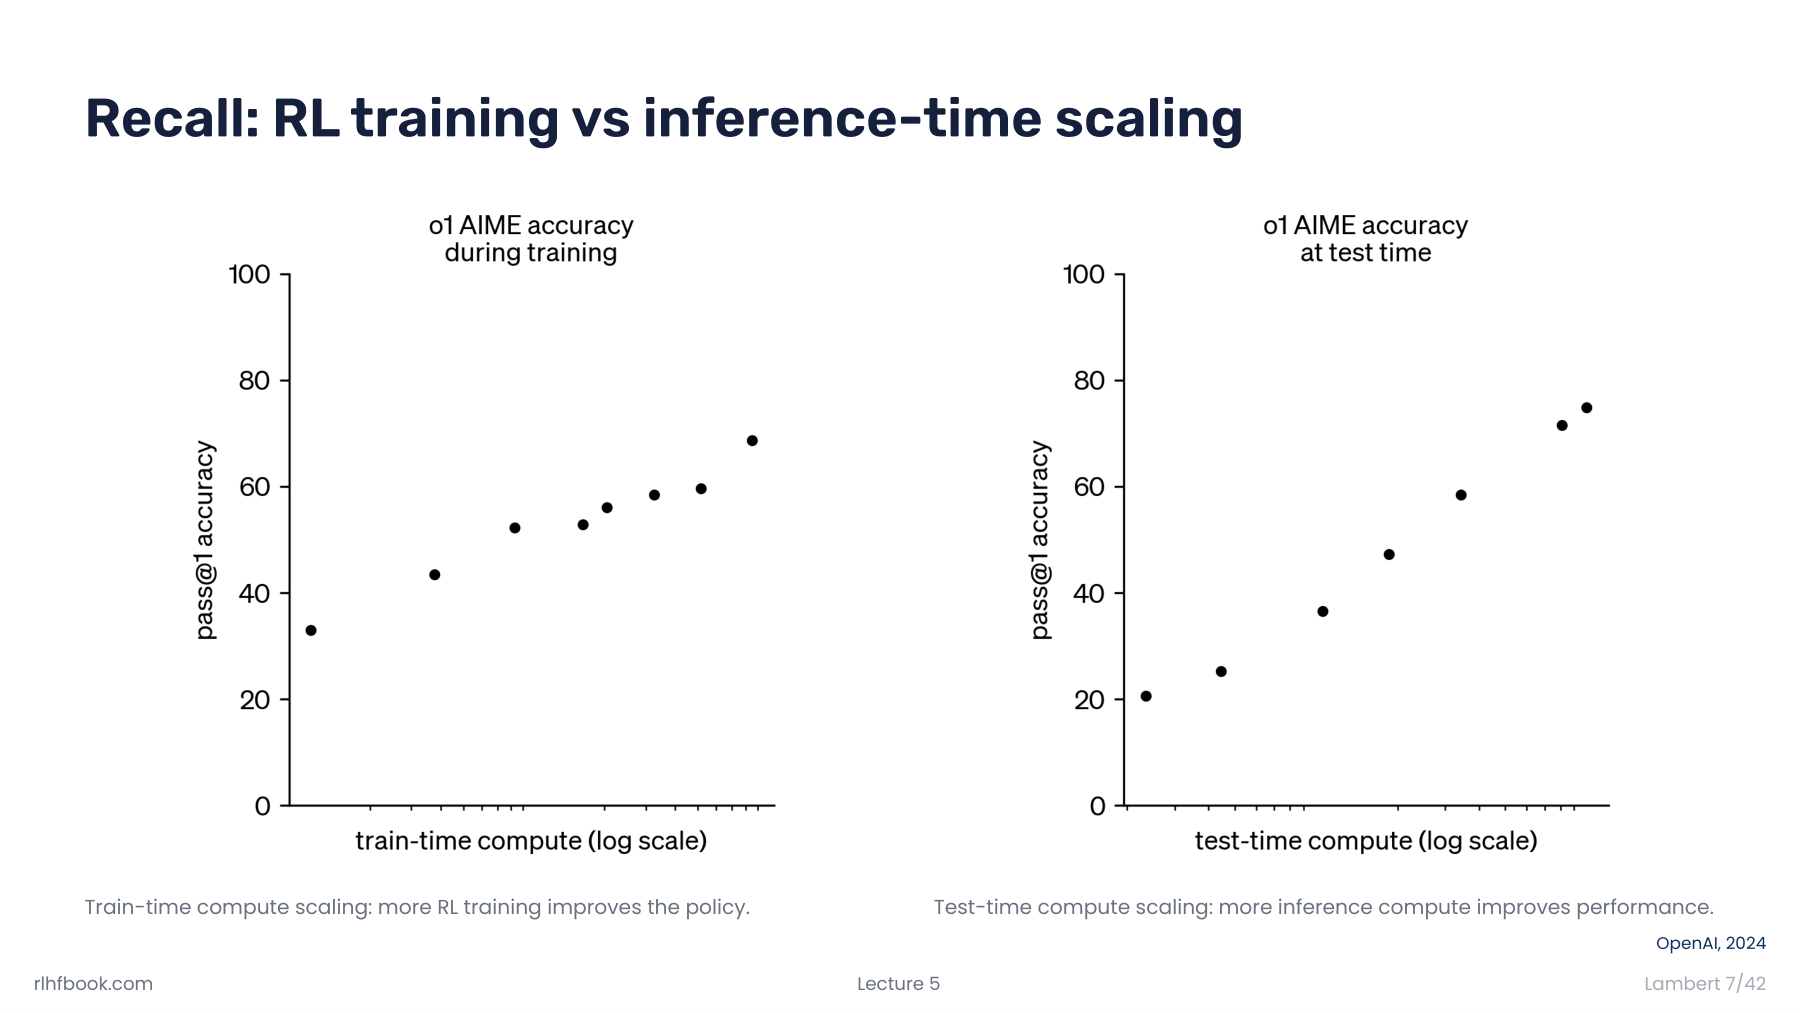
Nathan Lambert의 두 그래프는 가로축부터 다르다. 왼쪽에서는 정책이 학습에 쓴 계산량을 바꾼다. 오른쪽에서는 이미 학습한 추론 모델에 한 문제를 풀 시간을 더 준다. 다음 장의 소수 합 예제에서 모델은 후보 수를 검토하고 덧셈을 확인하는 토큰을 생성한다. 그 문제를 푼 뒤에도 같은 가중치로 다음 요청을 받을 수 있다. 반면 NTU 27쪽의 update 화살표를 구현하려면 현재 입력에서 얻은 신호로 파라미터가 실제로 움직여야 한다. 영상 5:51–6:33에서 Lambert는 오른쪽의 더 긴 추론을 먼저 설명하고 왼쪽의 RL 학습 시간으로 돌아온다. 두 실험을 비교할 때는 생성 토큰 수와 가중치 갱신 횟수를 따로 기록하면 된다. Lambert 5강 슬라이드 7–8쪽 · Lambert의 그래프 해설 5:51
#하편 28쪽 — 다음 줄의 왼쪽 로봇을 보자
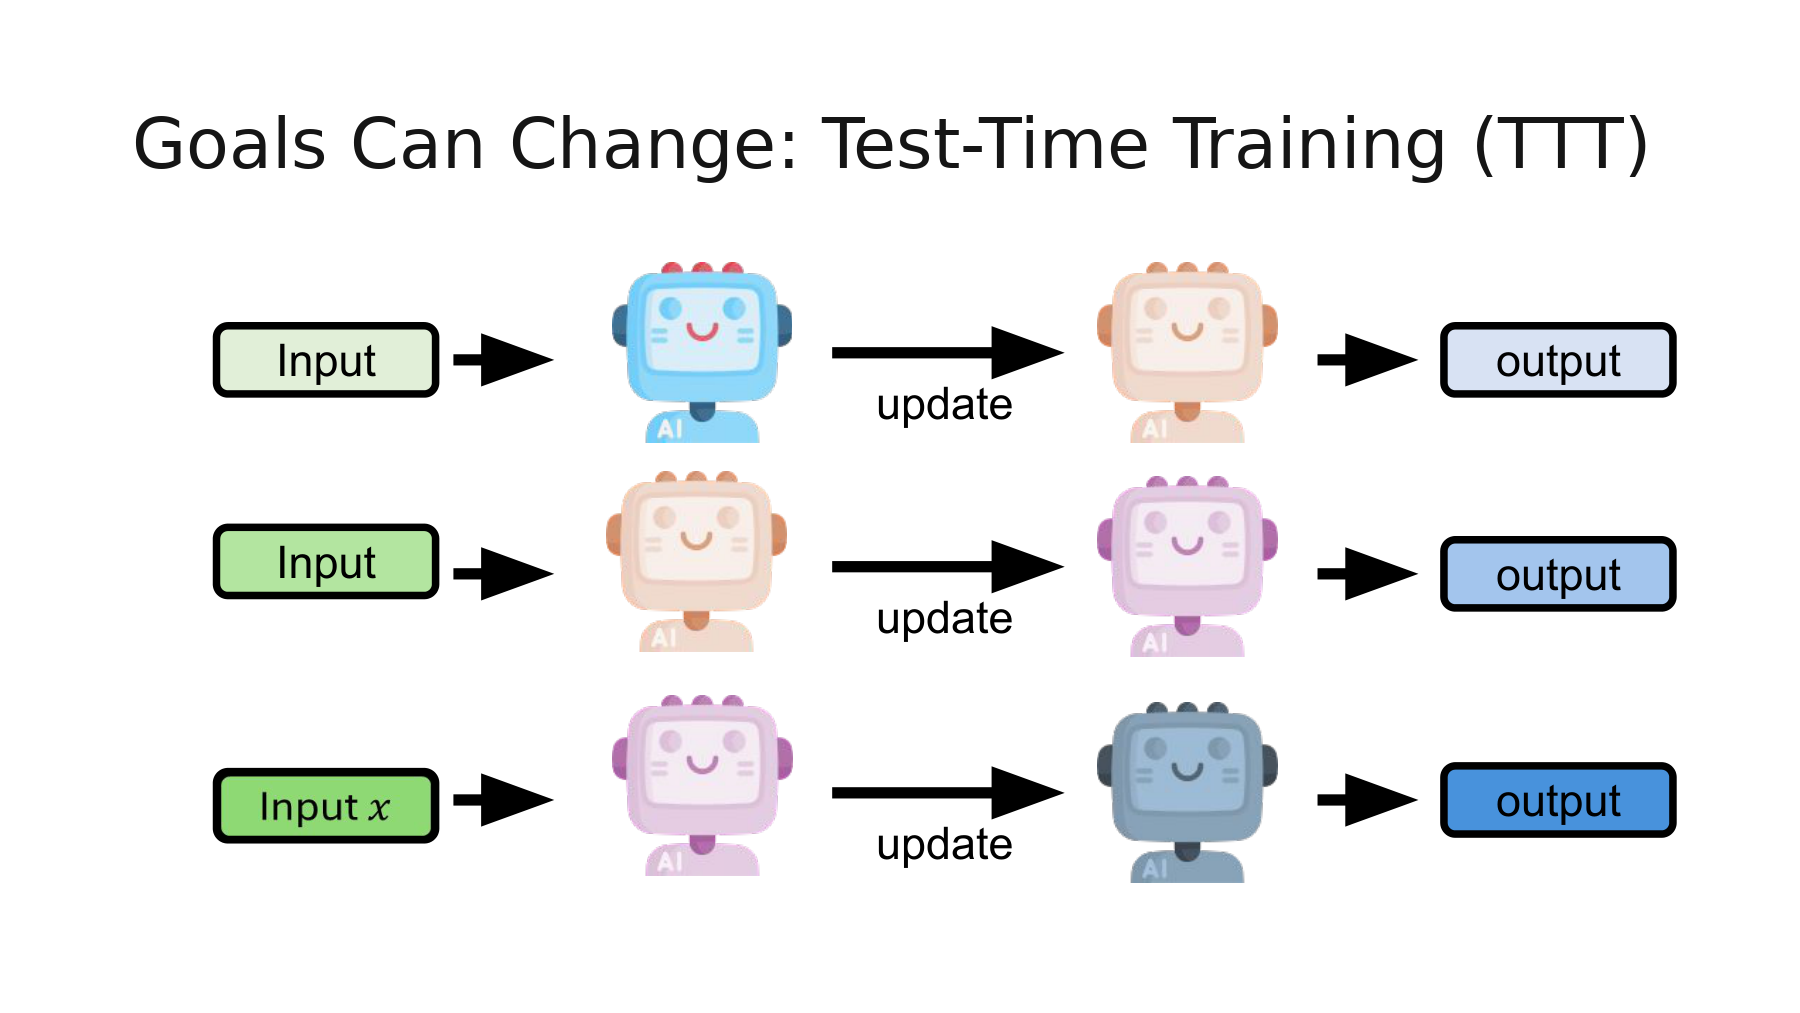
27쪽과 나란히 보면 차이는 한 곳에 있다. 첫 줄 오른쪽의 주황색이 둘째 줄 왼쪽에 다시 나타난다. 다음에는 보라색이 이어진다. 수식에서도 적응 연산 A는 같다. 첫 번째 인자가 직전 가중치로 바뀐다.
카메라 예제로 크기를 계산해 보자. 화면에 밝기 기준표가 있고, 그 표에서 읽은 보정 목표를 zₜ라고 하자. 기준 보정값은 0이다. 한 프레임마다 현재 보정값 b를 목표까지 절반만 움직인다. 아래 숫자는 상태 전달을 설명하기 위해 만든 예제다.
| 프레임 | 보정 목표 | 매회 0에서 시작한 뒤의 값 | 직전 값에서 이어간 뒤의 값 |
|---|---|---|---|
| 어두운 카메라 1 | 4 | 2 | 2 |
| 같은 카메라 2 | 4 | 2 | 3 |
| 밝은 카메라로 전환 | 0 | 0 | 1.5 |
둘째 프레임에서 목표까지 남은 오차는 2와 1이다. 앞선 프레임의 경험이 도움이 됐다. 셋째 프레임에서는 0과 1.5로 순서가 뒤집힌다. 이 계산에서는 프레임마다 한 번씩 똑같이 갱신했다. 결과를 가른 것은 계산 횟수보다 무엇을 물려받았는가다.
#식 풀이 · 보정 오차가 언제 절반으로 줄어드는가?
표의 변화량 1/2을 일반적인 학습률 η로 쓰자. 시작값을 이어받는 줄에서는 bₜ = bₜ₋₁ + η(z − bₜ₋₁)이다. 양쪽에서 같은 목표 z를 빼고 공통 인수를 묶으면 첫 식이 나온다. 같은 조명이 t번 유지되면 이 식을 t번 대입할 수 있다.
목표 4, 초기값 0, η = 0.5를 넣으면 두 프레임 뒤의 값은 3이다. 셋째 프레임에서는 조명이 바뀌므로 목표 4로 유도한 닫힌식을 멈추고, 새 목표 0을 한 단계 갱신식에 넣는다.
매번 초기화하는 방식은 첫 식의 반복 횟수가 항상 1이다. 밝은 카메라로 바뀌는 순간에는 기준값이 우연히 새 목표와 같아 오차가 0이다. 반대로 같은 어두운 영상이 오래 들어오면 연속 적응의 오차가 매번 절반으로 줄어든다. 표에서 두 방식의 순위가 바뀌는 이유를 계산으로 확인할 수 있다.
#보충 논문 · 이미지 손상이 계속될 때는 어느 막대를 비교할까?
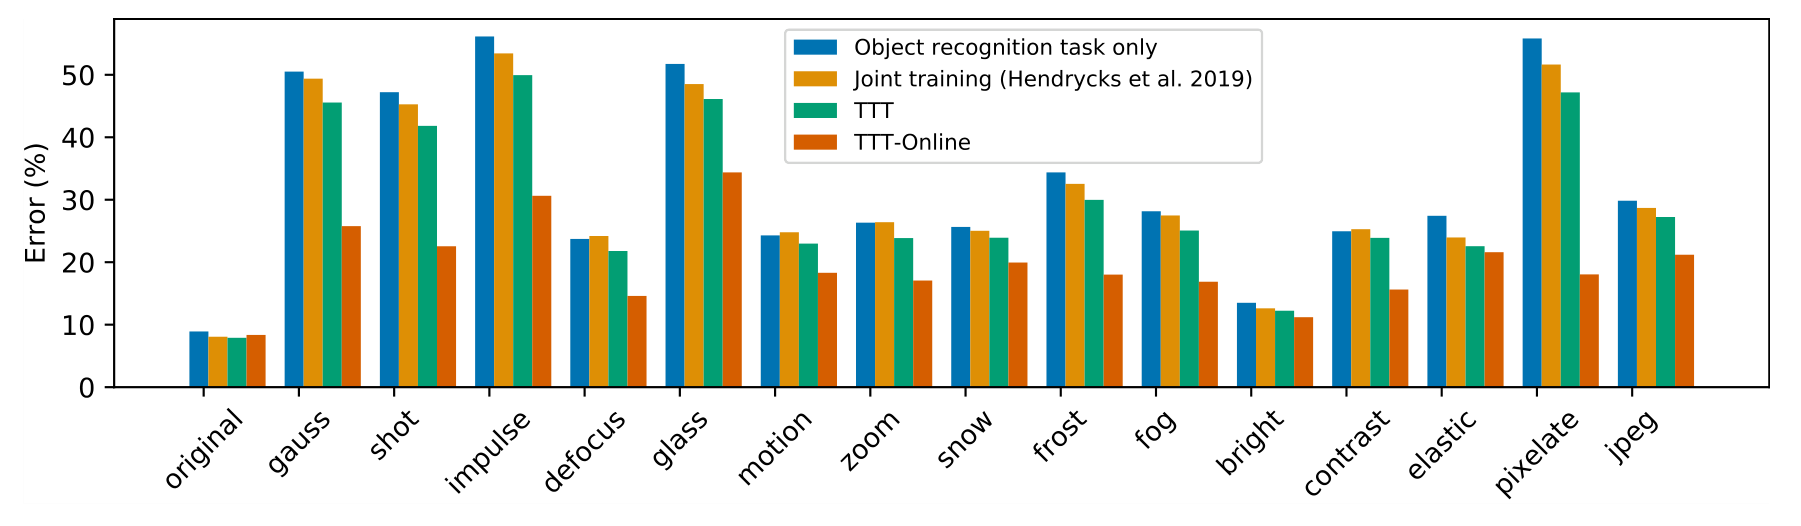
가로축에서 손상 한 종류를 고르고 그 안의 네 막대를 읽자. 세로축은 분류 오류율이라 낮을수록 좋다. 첫 두 막대는 물체 분류만 학습한 모델과 회전 예측까지 공동 학습한 모델이다. 뒤 두 막대는 테스트 입력으로 특징을 조정한다. 뒤의 두 막대는 같은 손상 유형에서 개별 적응과 온라인 적응이 기록한 오류율이다. 저자들은 가장 강한 손상 단계인 5에서 표준 TTT는 이미지마다 10회, 온라인 TTT는 새 이미지마다 1회 갱신했다. 따라서 두 막대의 차이에는 상태 이월과 갱신 횟수가 함께 들어간다. 이 그림만으로 카메라가 바뀌는 순간의 잔류 오차를 알 수는 없다. 그 질문에는 손상의 순서와 전환 직후 성능까지 기록한 실험이 필요하다. Sun 외, 그림 1 및 §3.1
#하편 29쪽 — 한 발화에 맞춘 모델과 다음 발화를 준비하는 모델
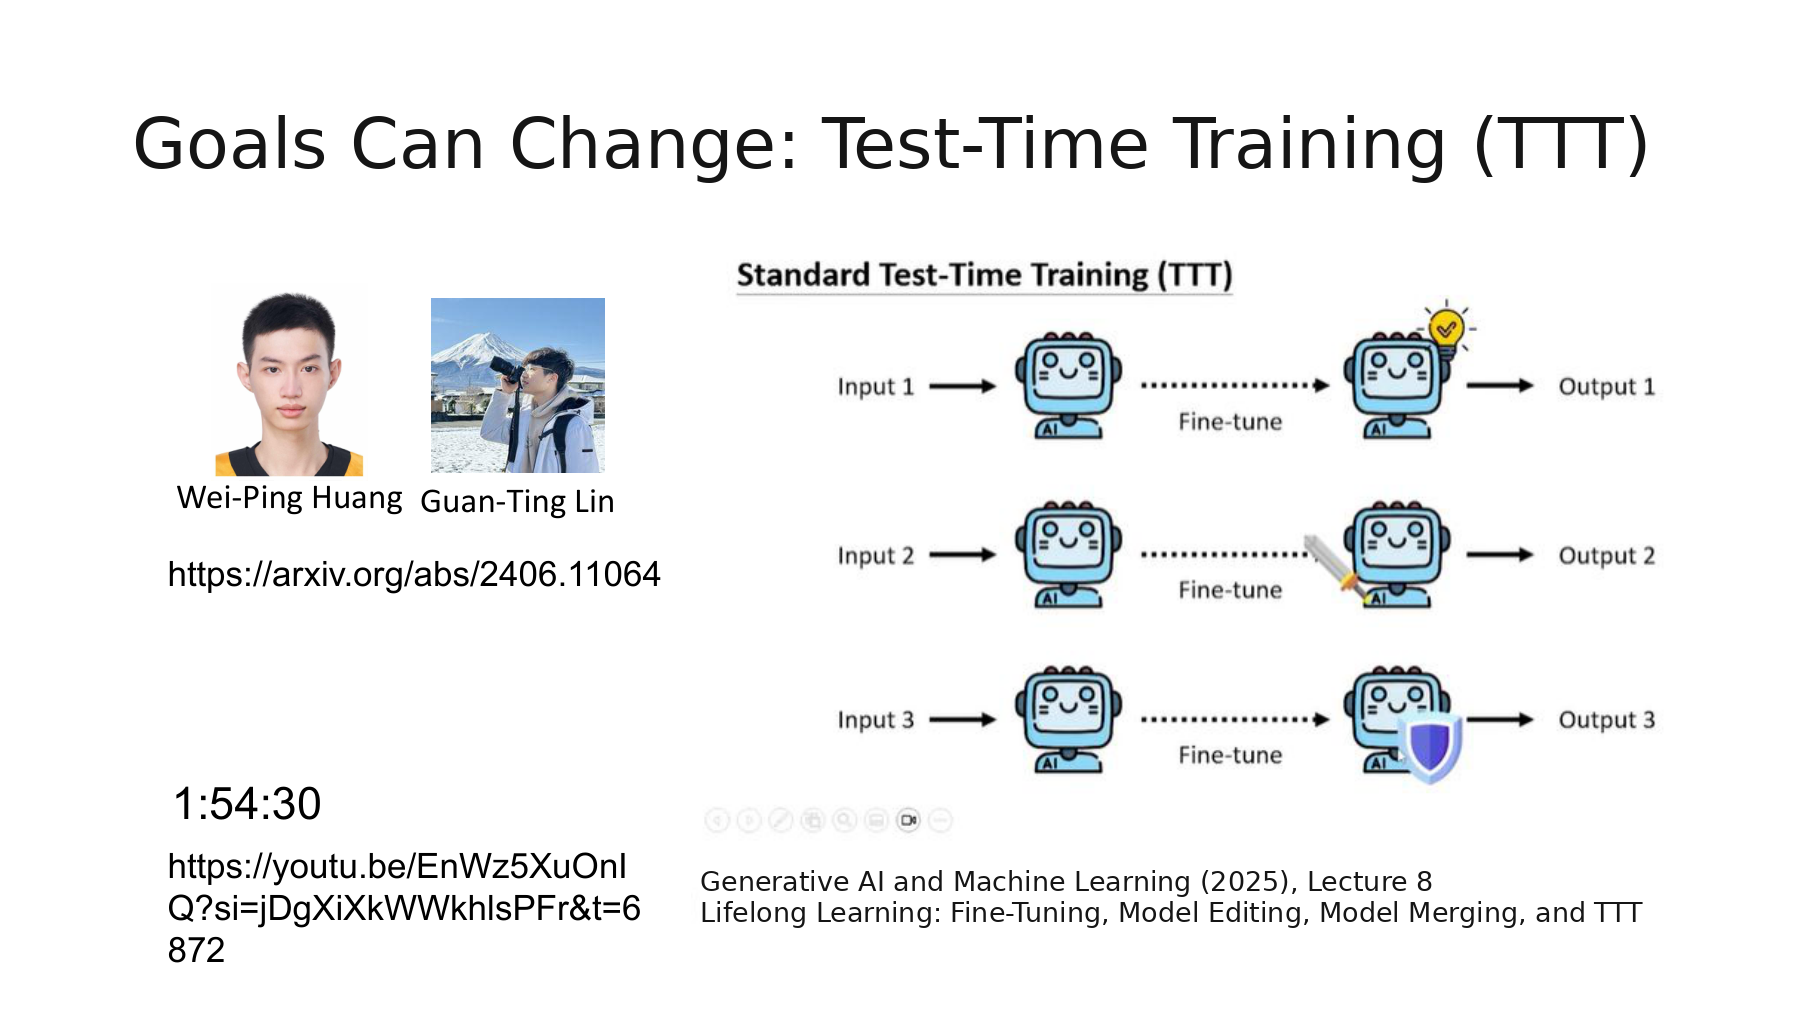
슬라이드 오른쪽은 매번 같은 모델에서 시작하는 그림이다. 왼쪽 논문에서 Lin, Huang, Lee는 한 가지 질문을 더한다. 한 문장을 잘 듣기 위해 급히 바꾼 값 중 무엇을 다음 문장에도 남길까? 2025년 8강에서 강사는 한 발화에 빠르게 적응하는 과정과 여러 발화에서 천천히 배우는 과정을 나눠 설명한다. 슬라이드의 1시간 54분대 링크는 이 이전 강의를 가리킨다. 2025년 8강 1:54:32 · 빠른 갱신과 느린 갱신 1:56:16
#보충 논문 · DSUTA의 두 가지 갱신 속도
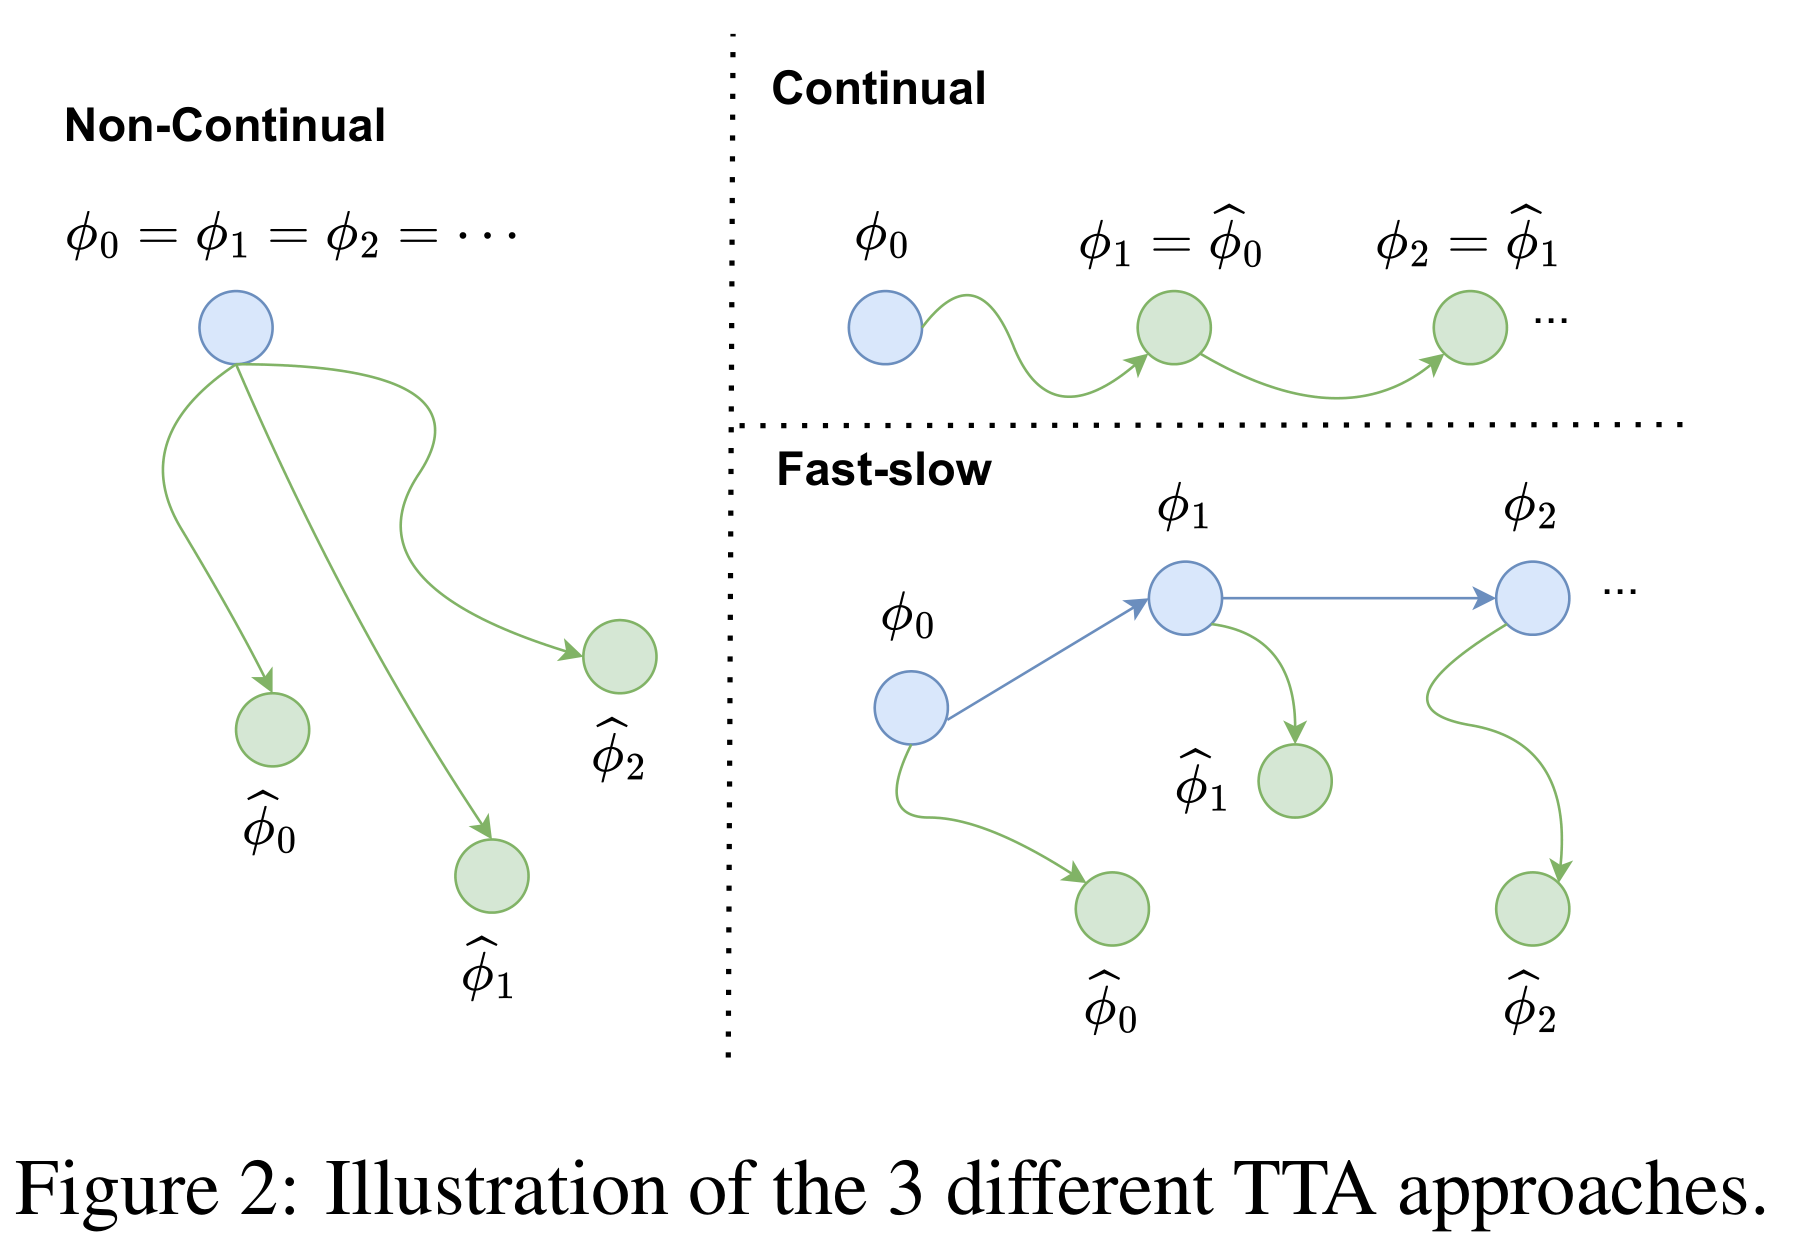
Dynamic SUTA(DSUTA)는 발화가 도착하면 현재 기준 가중치를 복사한다. 빠른 적응은 그 복사본을 현재 음성으로 여러 번 조정해 전사를 출력한다. 느린 갱신은 최근 발화를 버퍼에 모아 평균 적응 손실로 기준 가중치를 조정한다. 다음 발화는 이 기준 가중치에서 출발한다. 따라서 한 문장의 특이한 발음이 낳은 마지막 갱신을 매번 통째로 이어받을 필요가 없다. 정답 전사는 평가에 쓰고, 적응에는 라벨 없는 음성과 모델 출력에서 계산한 손실을 사용한다. 논문 §3.1–3.2 및 알고리즘 1
소음이 바뀌었다는 것을 모델이 어떻게 아는가? 동적 초기화(dynamic reset)를 추가한 방식은 최근 음성이 이전 소음 환경에서 적응한 모델에 얼마나 잘 맞는지, 사전학습 모델과의 손실 차이로 추적한다. 여러 발화에서 그 지표가 기존 범위를 벗어나는지 확인한 뒤 기준 가중치를 초기화한다. 이때 모델은 실제 소음 전환 시각이나 정답 전사를 받지 않는다. 논문 §3.3
#식 풀이 · 정답 전사 없이 환경 변화의 신호를 계산한다
DSUTA 논문에서 L은 라벨 없이 계산하는 음성 적응 손실이다. 같은 발화 xᵢ를 이전 환경의 기준 모델 φ_D와 사전학습 모델 φ_pre에 각각 넣고 손실을 뺀다. 논문은 이 차이를 손실 개선 지수(Loss Improvement Index, LII)라고 부른다. 빼는 순서에 주의하자. 아래 예시에서 −0.06은 이전 환경에 맞춘 모델의 손실이 0.06 더 낮았다는 뜻이다.
설명용으로 최근 발화 네 개에서 얻은 지수가 −0.06, −0.02, 0.00, +0.04였다고 하자. 평균은 아직 음수다. 그래도 평소보다 나빠졌는지는 이전 환경에서 기록한 평균과 비교해야 알 수 있다.
이전 환경의 평균 μ가 −0.10, 표준편차 σ가 0.08이었다면 최근 M = 4개 평균의 표준오차를 0.08/√4로 계산한다. 논문에 나온 버퍼 평균 판정식을 적용하면 다음과 같다.
2.25는 논문의 판정 경계 2를 넘는다. 이전 환경의 기준 모델이 최근 네 발화에서 사전학습 모델보다 평균 손실이 0.01 낮아도, 과거 환경에서 얻던 이점은 크게 줄었다. 이 계산에서 확인한 것은 한 번의 경계 초과다. 실제 알고리즘은 일시적인 변동에 대응해 인내 횟수(patience) 조건도 적용한다. 인접 발화들의 오차가 강하게 연관되면 평균의 표준오차가 예상보다 클 수 있다. 이 값을 소음이 바뀌었을 확률로 해석할 수는 없다. Lin 외, §3.3과 부록 알고리즘 2
단어 오류율(Word Error Rate, WER)은 기준 전사와 비교해 필요한 치환 S, 삭제 D, 삽입 I의 합을 기준 단어 수 N으로 나눈다. 가령 기준 단어 20개에서 두 단어를 바꾸고 하나를 빠뜨리고 하나를 더 썼다면 WER은 20%다.
기준 전사의 20개 단어가 분모다. 모델이 덧붙인 단어는 분자에만 들어간다.
| 논문 표 2의 방식 | 다음 발화에 남기는 것 | MD-Hard WER ↓ |
|---|---|---|
| Source model | 사전학습 가중치 고정 | 74.6% |
| SUTA | 발화마다 사전학습 가중치로 복귀 | 60.4% |
| CSUTA | 직전 발화에서 적응한 가중치 | 83.6% |
| DSUTA | 최근 발화 묶음으로 갱신한 기준 가중치 | 45.6% |
| DSUTA + Fixed reset | 정해진 주기마다 기준 가중치 초기화 | 49.4% |
| DSUTA + Dynamic reset | 손실 지표가 환경 변화를 가리킬 때 초기화 | 39.8% |
이 표는 소음 조건이 차례로 바뀌는 MD-Hard 스트림의 3회 평균이다. DSUTA에서 동적 초기화를 추가하자 WER이 45.6%에서 39.8%로 5.8%p 하락했다. 같은 DSUTA에 50개 발화마다 고정 초기화를 적용하면 49.4%로 오히려 3.8%p 높아졌다. 단순 누적(CSUTA)은 고정 모델보다 9.0%p 높았다. 여기서 확인한 것은 이 소음 순서에서의 받아쓰기 성능이다. 예전 환경의 능력이 얼마나 남았는지는 그 환경의 별도 평가 세트로 검사해야 한다. Lin 외, EMNLP 2024, 표 2
45.6%에서 39.8%로 바뀐 결과를 상대 오류 감소율로 표현할 수도 있다. 기준은 동적 초기화를 추가하기 전 DSUTA의 오류율 45.6%다.
따라서 표에 표시된 반올림 수치를 기준으로 WER의 절대 차이는 5.8%p, 상대 감소율은 약 12.7%다. 같은 두 칸에서 나온 숫자라도 분모가 다르다.
#하편 30쪽 — 새 일을 배운 뒤, 예전 일도 다시 시켜 보자
강사는 가중치를 계속 바꾸다가 예전 능력을 잃는 문제를 떠올린 뒤, 시스템 지시문이나 외부 메모리 같은 하네스(harness)만 바꿔도 예전 일을 못할 수 있는지 묻는다. 두 경우는 점검할 곳이 다르다. 예를 들어 지시문 개정 후 기존 출력에서 단위가 빠졌다면, 같은 가중치·같은 입력에 이전 지시문을 다시 붙여 보자. 단위가 돌아온다면 해당 사례의 행동 변화는 지시문 교체로 설명할 수 있다. NTU 하편 30:18
#보충 강의 · 예전 데이터를 다시 보여 주고, 별도 문제로 확인한다
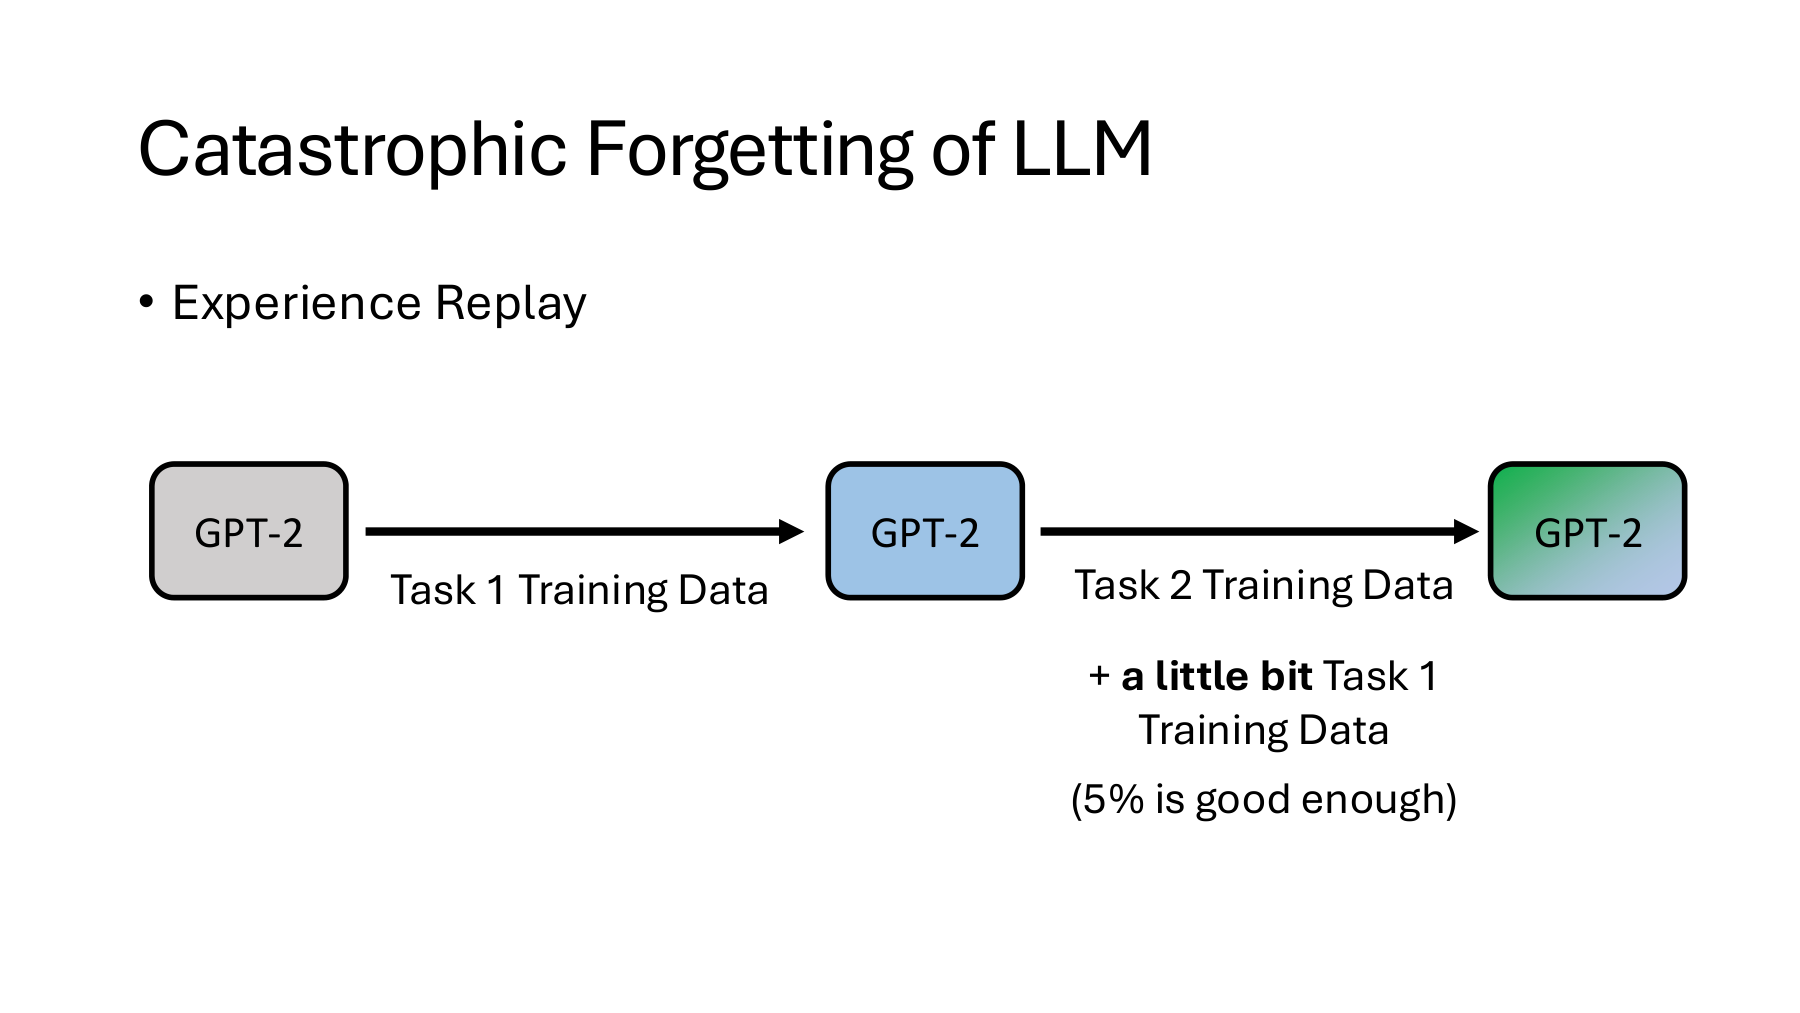
2025년 후학습 강의 28–30쪽은 순차 미세조정, 중요한 가중치의 변화를 억제하는 정규화 방식(MAS), 그리고 경험 재생(experience replay)을 비교한다. 가운데 장의 더하기 기호를 보자. 새 과제의 학습 자료에 예전 과제의 학습 예시 일부를 더한다. 예전 입력과 그때 요구했던 출력을 다시 보므로, 새 과제만 풀다가 기존 대응 관계를 잃는 일을 줄일 수 있다. 강사가 말한 약 5%의 분모는 새 과제의 학습 예시 수다. 새 예시가 1,000개라면 예전 예시 약 50개를 섞는 셈이다. 실제로 쓸 비율은 저장할 수 있는 데이터와 과제의 유사성에 따라 검증해야 한다. 2025년 6강 42:56 · 강의 28–30쪽
머신비전이라면 망각을 어떻게 확인할까? 두 카메라 A와 B에 각각 학습용과 평가용 사진을 마련해 보자. 아래는 같은 평가 사진을 B 적응 전후에 다시 판독한 가상 결과다. 재생에는 A의 학습 사진만 사용하고 A의 평가 사진은 끝까지 따로 둔다.
| 동일한 평가 세트 | B에 적응하기 전 | B에 적응한 뒤 | 정확도 변화 |
|---|---|---|---|
| 기존 카메라 A | 90% | 82% | −8%p |
| 새 카메라 B | 60% | 78% | +18%p |
새 카메라에서 얻은 18%p와 기존 카메라에서 잃은 8%p를 따로 읽어야 한다. 여기서 경험 재생의 효과를 조사하려면, 같은 초기 모델에서 B만으로 적응한 경우와 A의 학습 사진 일부를 섞은 경우를 같은 갱신 예산으로 비교한다. 두 경우 모두 같은 A·B 평가 세트로 측정하면, 예전 능력을 얼마만큼 지키면서 새 환경에 얼마나 적응했는지 볼 수 있다.
#식 풀이 · 최종 평균 정확도 80.3%에 가려진 망각은 얼마일까?
위 표를 두 과제의 연속학습 기록으로 읽자. GEM 논문의 역방향 전이(Backward Transfer, BWT)는 각 과제를 배운 직후와 마지막 과제를 배운 후의 정확도를 같은 평가 세트에서 비교한다. 기존 과제가 A 하나인 이 예에서는 BWT가 82 − 90 = −8%p다. B에서 얻은 +18%p는 새 과제의 적응 이득이다. GEM, 식 2–4
이제 세 번째 카메라 C가 생겼다고 하자. 각 행은 그 카메라까지 학습을 마친 시점이다. 각 열은 같은 카메라의 고정 평가 세트다. 대각선은 해당 카메라를 배운 직후 정확도다. C 행의 수치는 설명을 위해 추가했다.
| 학습을 마친 시점 | A 정확도 | B 정확도 | C 정확도 |
|---|---|---|---|
| A 직후 | 90% | — | — |
| B 직후 | 82% | 78% | — |
| C 직후 | 86% | 71% | 84% |
C까지 배운 시점에서 최종 성능은 마지막 행을 가로로 읽는다. 각 카메라를 같은 비중으로 세면 평균 정확도(ACC)는 다음과 같다.
망각을 알고 싶을 때는 열을 세로로 읽는다. A는 처음 배웠을 때의 90%에서 86%로, B는 78%에서 71%로 변했다. 기존 과제 두 개의 차이를 평균한다. 방금 배운 C는 이후 과제의 영향을 아직 받지 않았으므로 분모에 넣지 않는다.
A만 보면 직전 시점보다 4%p 회복했다. 그래도 A를 처음 배운 직후와 비교하면 4%p 낮다. “회복했다”와 “망각이 남았다”가 동시에 맞을 수 있는 이유는 비교하는 시점이 다르기 때문이다. 평균 정확도 80.3%만 보면 이 차이는 보이지 않는다.
27쪽의 파란 로봇, 28쪽에서 이어지는 색, 29쪽의 느리게 갱신하는 기준 모델은 모두 같은 질문에 대한 다른 답이다. 이번 입력을 위해 바꾼 것 중 무엇을 다음 입력에 남길 것인가? 20편은 하편 31쪽에서 이어진다.