검사 카메라가 품번의 숫자 0을 알파벳 O로 잘못 읽었다. 누군가 판독 지시문에 ‘숫자 자리에서는 0을 먼저 확인하라’고 덧붙이자 오답이 줄었다. 여기까지는 검사 지시문이 좋아진 것이다. 다음에 다른 오류가 생겼을 때 어떤 실패 사례부터 읽고 어떤 지시문을 제안할지까지 달라졌다면, 이번에는 수정을 만드는 방법이 바뀌었다. 둘 중 무엇이 좋아졌는지 어떻게 확인할까?
20편에서는 에이전트 주위의 코드와 지시문인 하네스(harness)를 수정한 뒤 예전 능력이 남았는지 측정했다. 하편 36–40쪽에서는 개선기(improver)가 다음 수정의 대상이 된다. Hyperagents는 에이전트와 후보 선택 규칙을, Learning to Self-Evolve는 문맥을 편집하는 모델의 학습을 살펴보는 두 사례다. 카메라와 품번은 손으로 셀 수 있게 만든 예제이고, 논문의 실험값은 각 그림과 표에서 따로 읽는다.
식 풀이 바로가기 두 편집자 비교 · 수학 정답률 · 50회 개선량 · 부모 후보 선택 · 세 막대의 차이 · 수정 전후 보상 · 편집 확률 갱신
슬라이드별 영상 위치
| 하편 원본 | 강의 영상 | 따라갈 질문 |
|---|---|---|
| 36쪽 | 35:08 | 고정된 편집기에서 자기 자신을 편집하는 경우로 어떻게 넘어갈까? |
| 37쪽 | 35:16 | 한 번 바뀐 하네스가 다음 수정의 편집자가 된다는 뜻은 무엇일까? |
| 38쪽 | 35:48 | 여러 후보 중 다음 수정의 출발점을 누가 고를까? |
| 39쪽 | 36:33 | 선택 규칙 세 가지는 훈련과 테스트에서 어떤 결과를 냈을까? |
| 40쪽 | 37:29 | 편집 모델을 학습시키려면 무엇을 보상해야 할까? |
링크는 강사가 해당 논점을 설명하는 구간으로 이동한다. NTU 2026년 5월 22일 강의
#하편 36쪽 — 그림 속 h는 무엇을 고치고, 누가 고치는가?
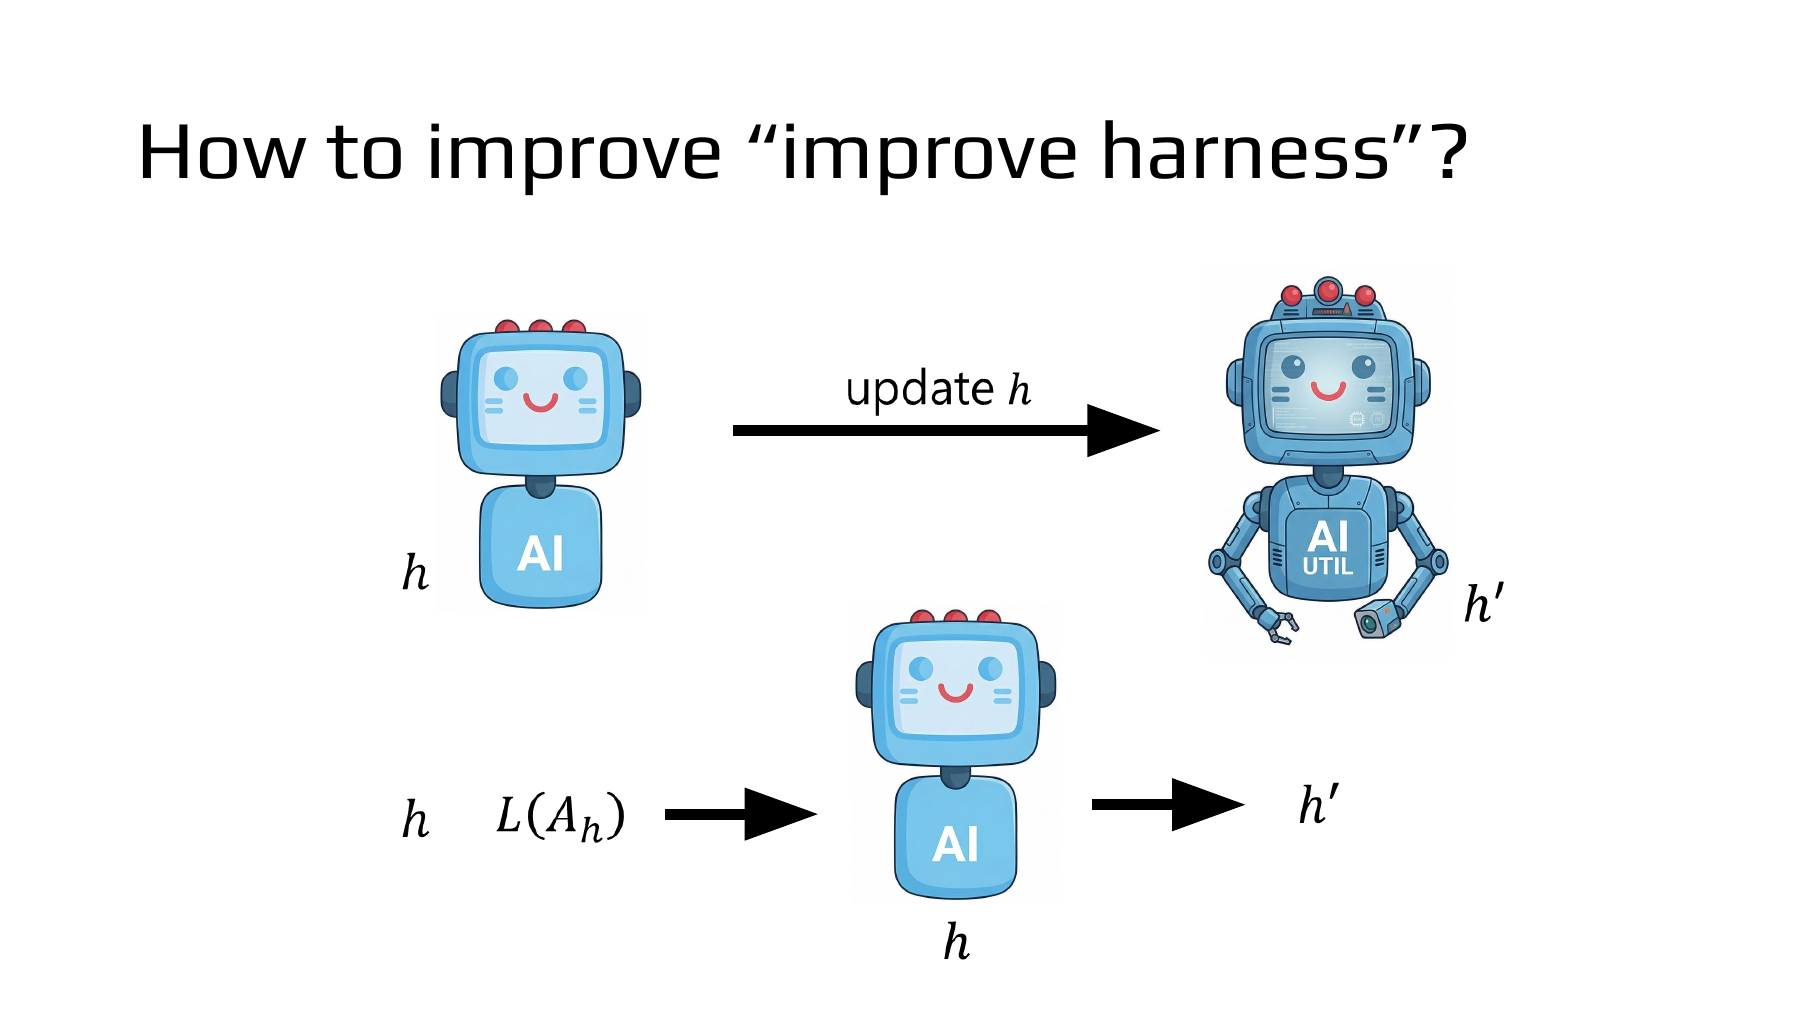
윗줄의 h → h′는 검사 에이전트의 하네스(harness)가 새 버전으로 바뀐다는 뜻이다. 아랫줄에서는 같은 h가 두 번 등장한다. 화살표 왼쪽의 h는 편집할 대상이다. 옆에 붙은 L(Aₕ)는 그 하네스로 움직인 에이전트가 과제를 풀었을 때의 손실이다. 가운데 로봇 밑의 h는 그 정보를 읽고 수정안을 내는 에이전트의 하네스다. 그러므로 현재 버전으로 구성된 에이전트가 자신의 하네스를 편집할 수 있다. 다음 세대의 수정 방식까지 바뀌려면 그 편집이 다음 수정안을 만드는 부분에도 영향을 주어야 한다. NTU 강의 35:08
#식 풀이 1. 개선 규칙 하나를 바꾸면 서로 다른 두 검사기도 함께 나아질까?
탁상 카메라로 부품을 검사한다고 하자. 가상 실험에서 검사기 A는 금속 반사광 때문에, 검사기 B는 부품의 가려진 모서리 때문에 종종 틀린다. 원래 편집 규칙 U₀와 바꾼 규칙 U₁에 같은 부모 검사기와 같은 실패 기록을 준다. 각 규칙은 같은 호출·토큰 예산으로 한 번만 수정한다. 부모마다 편집기에 공개하지 않은 라벨 이미지 20장을 따로 준비하고, 그 부모와 두 자식의 정답 수를 같은 20장에서 센다.
| 부모 검사기 | 수정 전 정답 수 | U₀로 수정 후 | U₁로 수정 후 |
|---|---|---|---|
| A · 금속 반사광 | 14/20 | 15/20 | 17/20 |
| B · 모서리 가림 | 16/20 | 18/20 | 17/20 |
부모 i에서 규칙 U가 높인 정확도를 Δᵢ(U)라고 하자. nᵢ는 표의 정답 수다. 예를 들어 U₁으로 A를 고치면 3장을 더 맞혀 15%p 오르지만, B를 고치면 1장을 더 맞혀 5%p 오른다.
기존 규칙 U₀의 개선 폭은 A에서 5%p, B에서 10%p다. 이제 같은 부모끼리 두 규칙의 개선 폭을 빼고, 두 부모에 같은 비중을 주어 평균을 낸다.
규칙을 바꿨을 때 평균 개선 폭은 2.5%p 더 컸다. 그러나 반사광을 처리하는 A에서는 이전 규칙보다 10%p 더 얻었고, 모서리를 검사하는 B에서는 이전 규칙보다 5%p 덜 얻었다. U₁이 낸 두 자식의 최종 점수가 똑같이 17/20이라는 사실만으로는 이 차이가 보이지 않는다. 새 검사 환경에서도 편집 규칙이 나아졌다고 주장하려면 다른 부모 검사기와 여러 번의 독립적인 수정에서도 개선 폭을 비교해야 한다.
#보충 강의 · 새 과제에 적응하는 능력을 어떻게 검사할까?
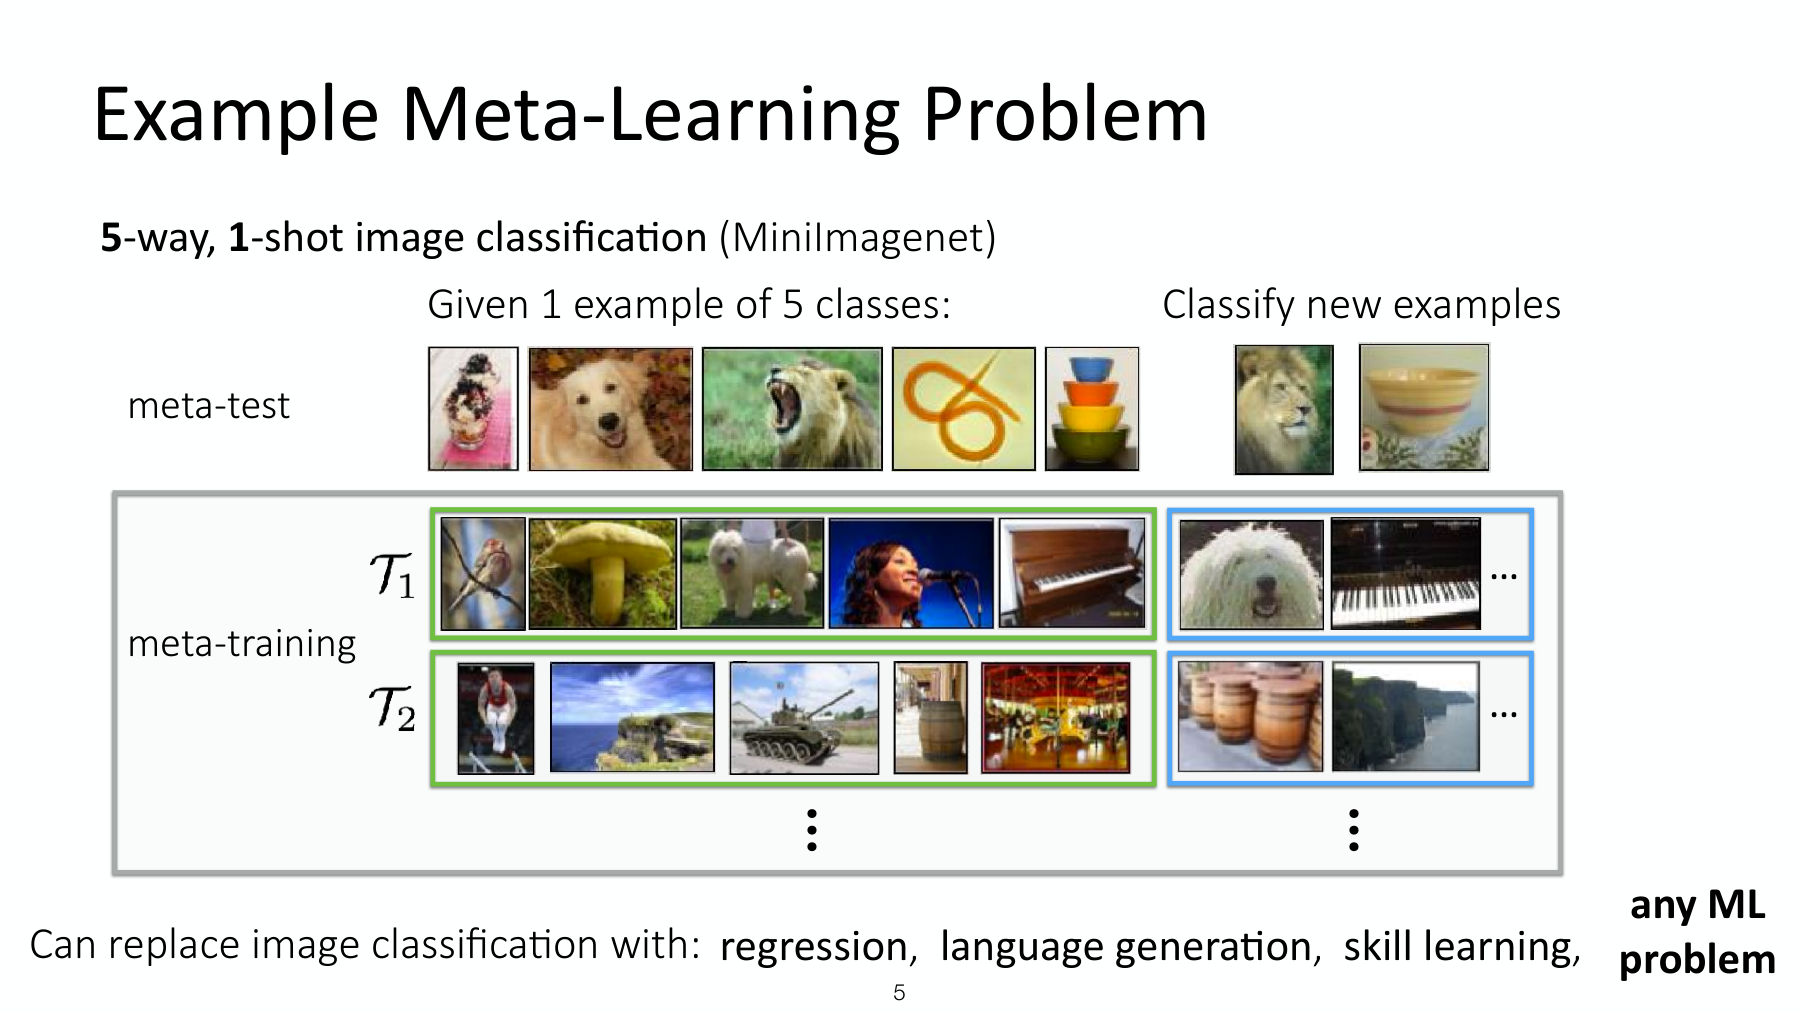
Stanford CS330의 미니이미지넷(MiniImageNet) 그림에서 한 과제는 다섯 종류의 이미지 분류다. 5-way는 한 과제 안에서 구분할 범주가 다섯이라는 뜻이고, 1-shot은 범주마다 정답을 알려 준 이미지가 한 장씩이라는 뜻이다. 다섯 장을 보고 같은 범주의 다른 이미지를 분류한다. 메타 테스트(meta-test)에서는 메타 훈련 때 보지 않은 범주로 새 과제를 구성해, 이 적응 방식이 옮겨 가는지 확인한다. NTU의 두 검사기에 연결되는 점은 적응에 쓰는 자료와 적응 후 성능을 재는 자료를 나누고, 출발 과제도 바꾸어 본다는 평가 방식이다. Stanford의 그림 자체는 하네스가 자신을 편집하는 실험을 다루지 않는다. Stanford CS330, Optimization-Based Meta-Learning 5쪽
#하편 37쪽 — 수정된 에이전트가 다음 수정의 편집자가 된다
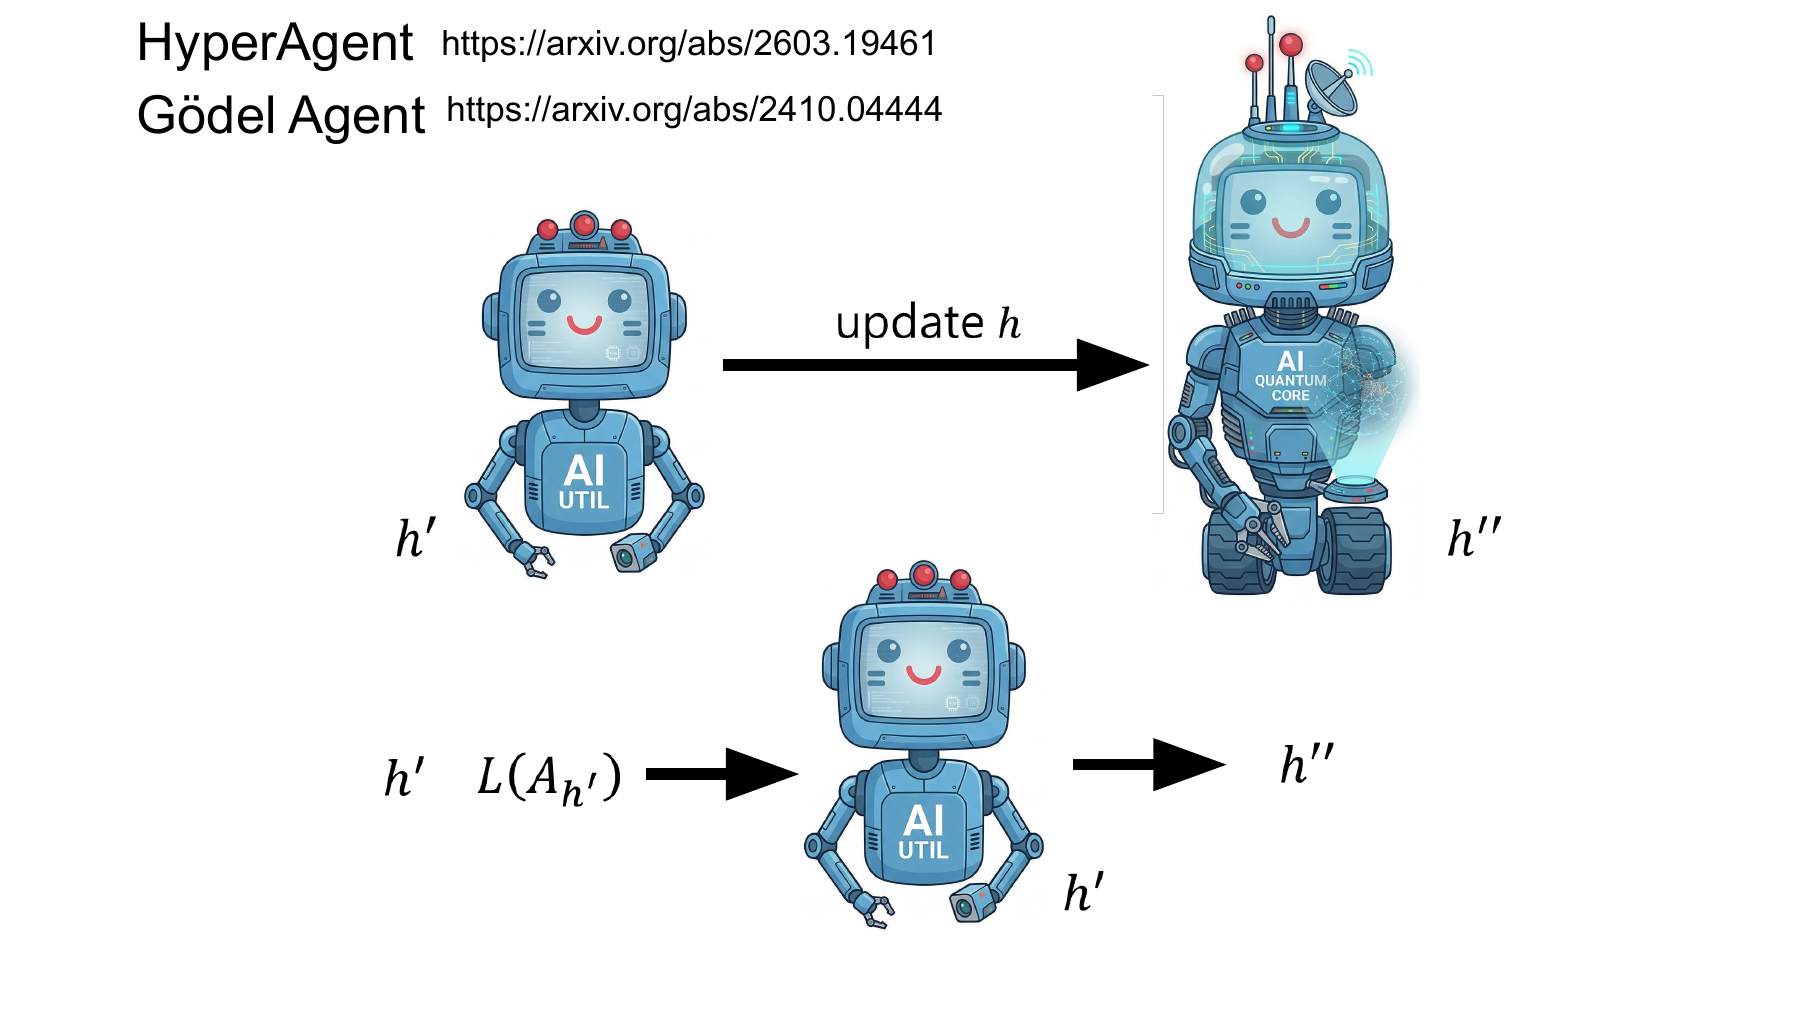
윗줄에서 h′는 이미 한 번 고친 하네스다. 화살표 끝에는 다음 버전 h″가 있다. 아랫줄에도 h′라는 표기가 두 번 나온다. 왼쪽의 h′는 이번에 고칠 대상이고, 가운데 로봇의 h′는 누가 고치는지를 나타낸다. 가운데 로봇은 현재 버전과 그 버전의 실행 결과 L(A_h′)를 받아 다음 버전을 제안한다. 예를 들어 수학 답안 채점기가 채점 규칙만 바꾸면 당장의 판정이 달라진다. 다음 개정 때 검토할 오류 사례를 고르는 방식까지 바꾸면 후속 버전을 만드는 과정도 달라진다. 둘은 서로 다른 실험으로 확인할 수 있다. NTU 원본 37쪽
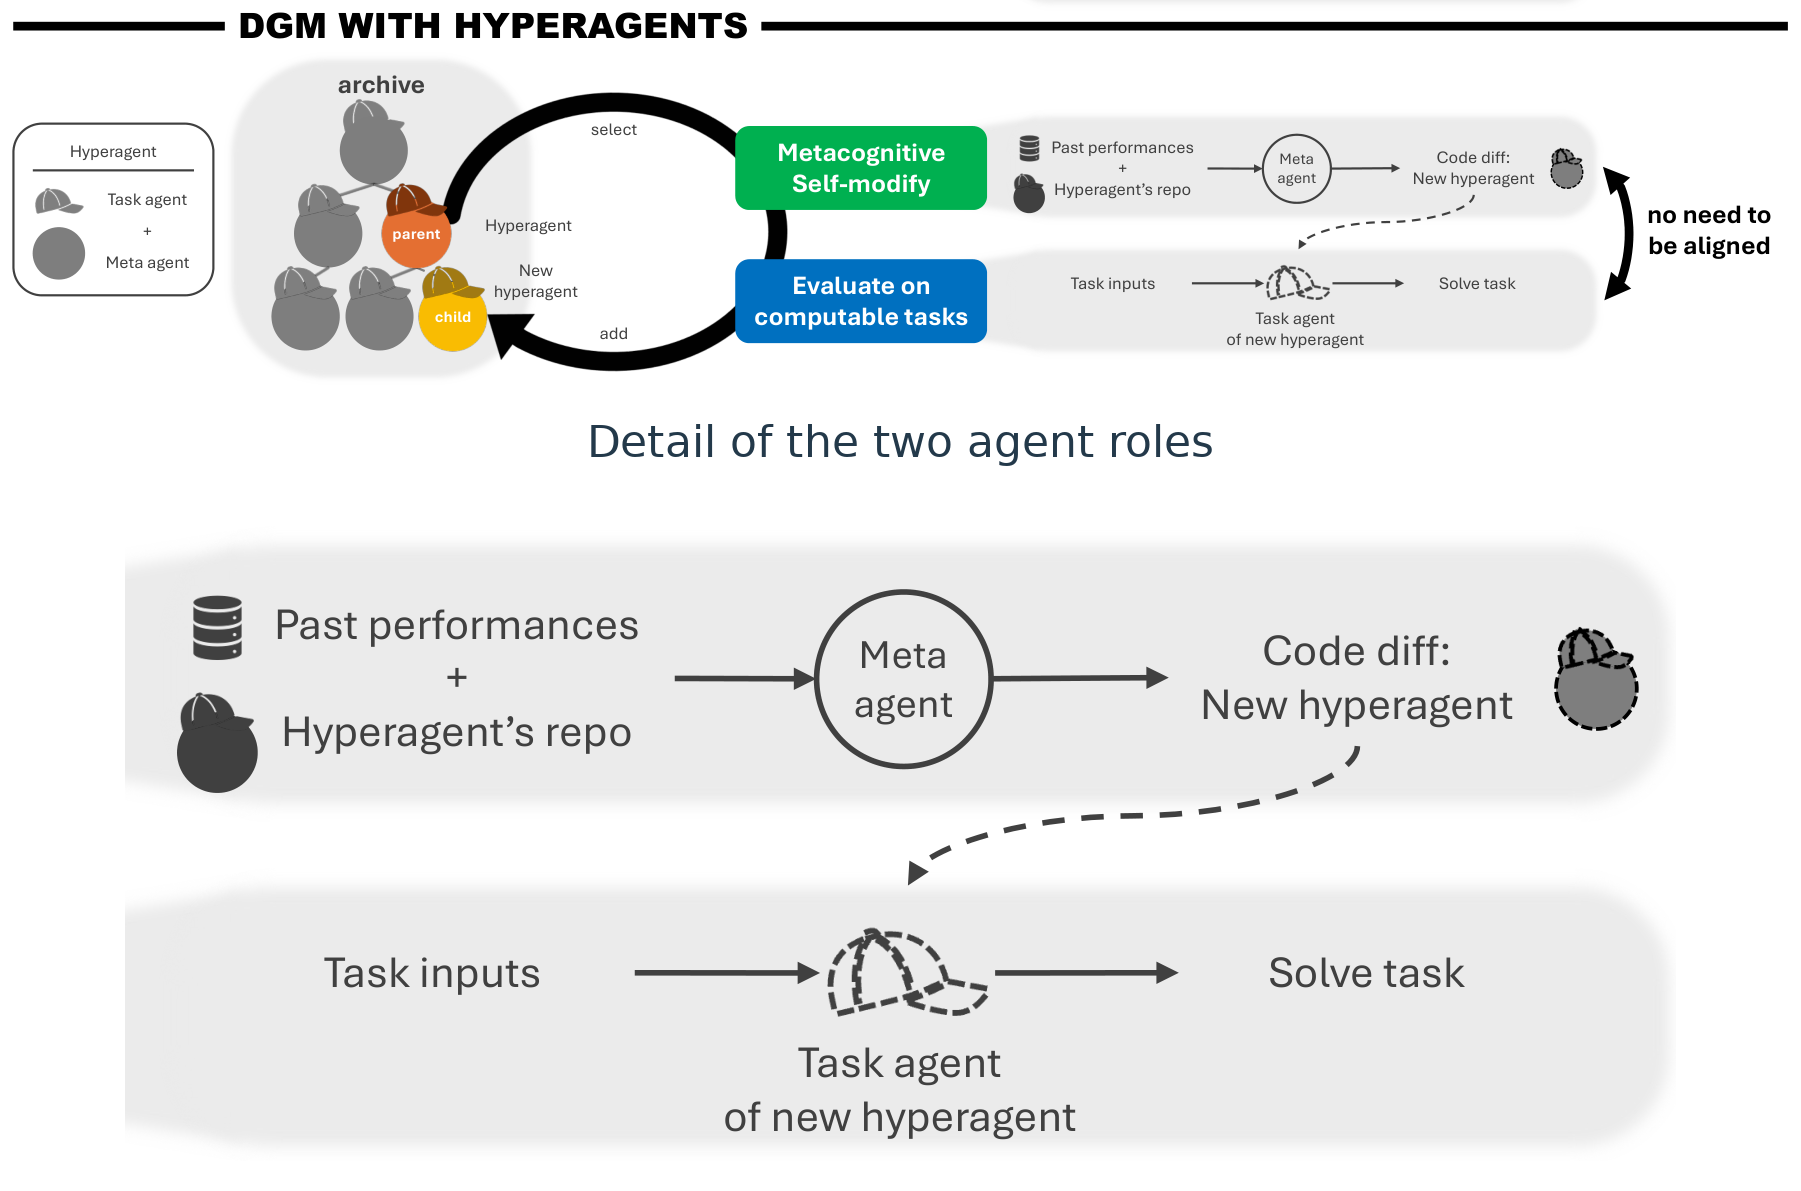
Zhang 등의 Hyperagents 그림 1에서 과제 에이전트(task agent)는 입력을 받아 문제를 풀고, 메타 에이전트(meta agent)는 다음 버전을 제안한다. 둘이 한 프로그램 안에 들어 있어, 자식은 과제 풀이 방법과 후속 버전을 만드는 방법을 함께 이어받을 수 있다. 가령 올림피아드 답안을 잘 채점하는 능력과 그 채점기를 잘 개선하는 능력은 평가 대상이 다르다. 연구진은 이를 확인하려고 채점 결과 자체를 재는 실험과, 제한된 횟수 안에 더 나은 채점기를 만들어 내는 실험을 구분했다. 이 절의 수치는 2026년 5월 NTU 강의에 앞서 나온 3월 논문판에서 가져왔다. Hyperagents, 그림 1 및 §3
ACL 저자 발표 3분 지점에서는 고정 설계, 고정된 편집자를 쓰는 자동 설계, 편집자도 바꾸는 설계를 한 화면에서 비교한다. 오른쪽 설계에서 개선 절차가 어디로 되돌아가는지 눈으로 따라간 뒤, 6분 2초의 결과표에서 그 구조로 얻은 최종 에이전트를 무엇으로 평가했는지 확인해 보자. ACL 발표 3:00 · 세 가지 설계 · 6:02 · 과제별 결과
#식 풀이 2. 수학 정답률의 10.8%p 차이가 말해 주는 것
슬라이드가 함께 인용한 Yin 등의 Gödel Agent는 과제를 수행하는 전략과 그 전략을 개선하는 절차를 모두 바꿀 수 있게 했다. 논문 표 1은 이렇게 얻은 최종 풀이 전략을 다국어 초등 수학 문장제(MGSM)에서 평가한다. 저자들이 비교 조건을 맞춘 Gödel-base는 외부 자료를 보지 않는 폐쇄형(closed-book)이며, 최종 풀이에는 GPT-3.5를 쓴다. MGSM에서는 검증 128문항, 시험 800문항을 썼다. 표의 시험 정확도는 Meta Agent Search가 53.4%, Gödel-base가 64.2%다. Gödel Agent, 표 1 · 부록 B, 평가 조건
10.8%p는 두 정확도의 차이고, 20.2%는 53.4%를 기준으로 한 상대 증가율이다. 같은 표에서 제약을 푼 Gödel-free의 90.6%는 실행 조건이 달라 위 식에 섞지 않았다. 이 비교로 어느 풀이 전략이 MGSM에서 더 정확했는지는 알 수 있다. 편집자 자체가 얼마나 나아졌는지 보려면 다른 과제에서 그 편집자가 어떤 후속 후보를 만들어 내는지 재야 한다.
#식 풀이 3. 편집자를 고정하고 50번의 개선 효과를 잰다
Hyperagents 연구진은 논문 심사와 로봇 보상 설계에서 경험을 쌓은 하이퍼에이전트를 올림피아드 수학 답안 채점으로 옮겼다. 채점기는 문제·제출 답안·참고 풀이·채점 기준을 받고 전문가가 준 점수 0, 1, 6, 7 중 하나를 예측한다. 정확도는 전문가와 점수가 일치한 답안의 비율이다. 훈련·검증·시험에 각각 100건을 사용했다. 옮긴 버전의 메타 에이전트를 고정하고도 새 과제에 맞는 더 좋은 과제 에이전트를 만들어 낼 수 있는지가 질문이다. Hyperagents, §5.2 · 부록 C.4, 채점 데이터
최대 k번 새 후보를 만든 뒤 검증 정확도로 후보 한 개를 고른다. 그 후보의 시험 정확도에서 시작 버전의 시험 정확도를 빼는 값이 개선량(improvement@k)이다. 아래에서 A₀는 시작 채점기, Aᵢ는 i번째 후보를 뜻한다.
연구진이 보고한 5회 반복의 중앙값이다. 이식한 버전은 새 과제에서 처음에 0점을 기록했지만, 그 메타 에이전트가 만든 후보는 검증으로 선택한 뒤 시험에서 0.630에 도달했다(개선량의 95% 부트스트랩 신뢰구간 0.540–0.630). 같은 50회 예산에 경험을 쌓기 전의 초기 메타 에이전트를 고정한 조건의 개선량 중앙값은 0.000이었다. 50은 수정 횟수 예산이고 100은 시험 답안 수다. 0.630은 전문가의 채점과 일치한 비율이므로 수학 문제 63개를 직접 풀었다는 뜻도 아니다. Hyperagents, 그림 3 및 본문 · 이식 후 수치
#하편 38쪽 — 어느 부모를 다시 고를지도 달라질 수 있다
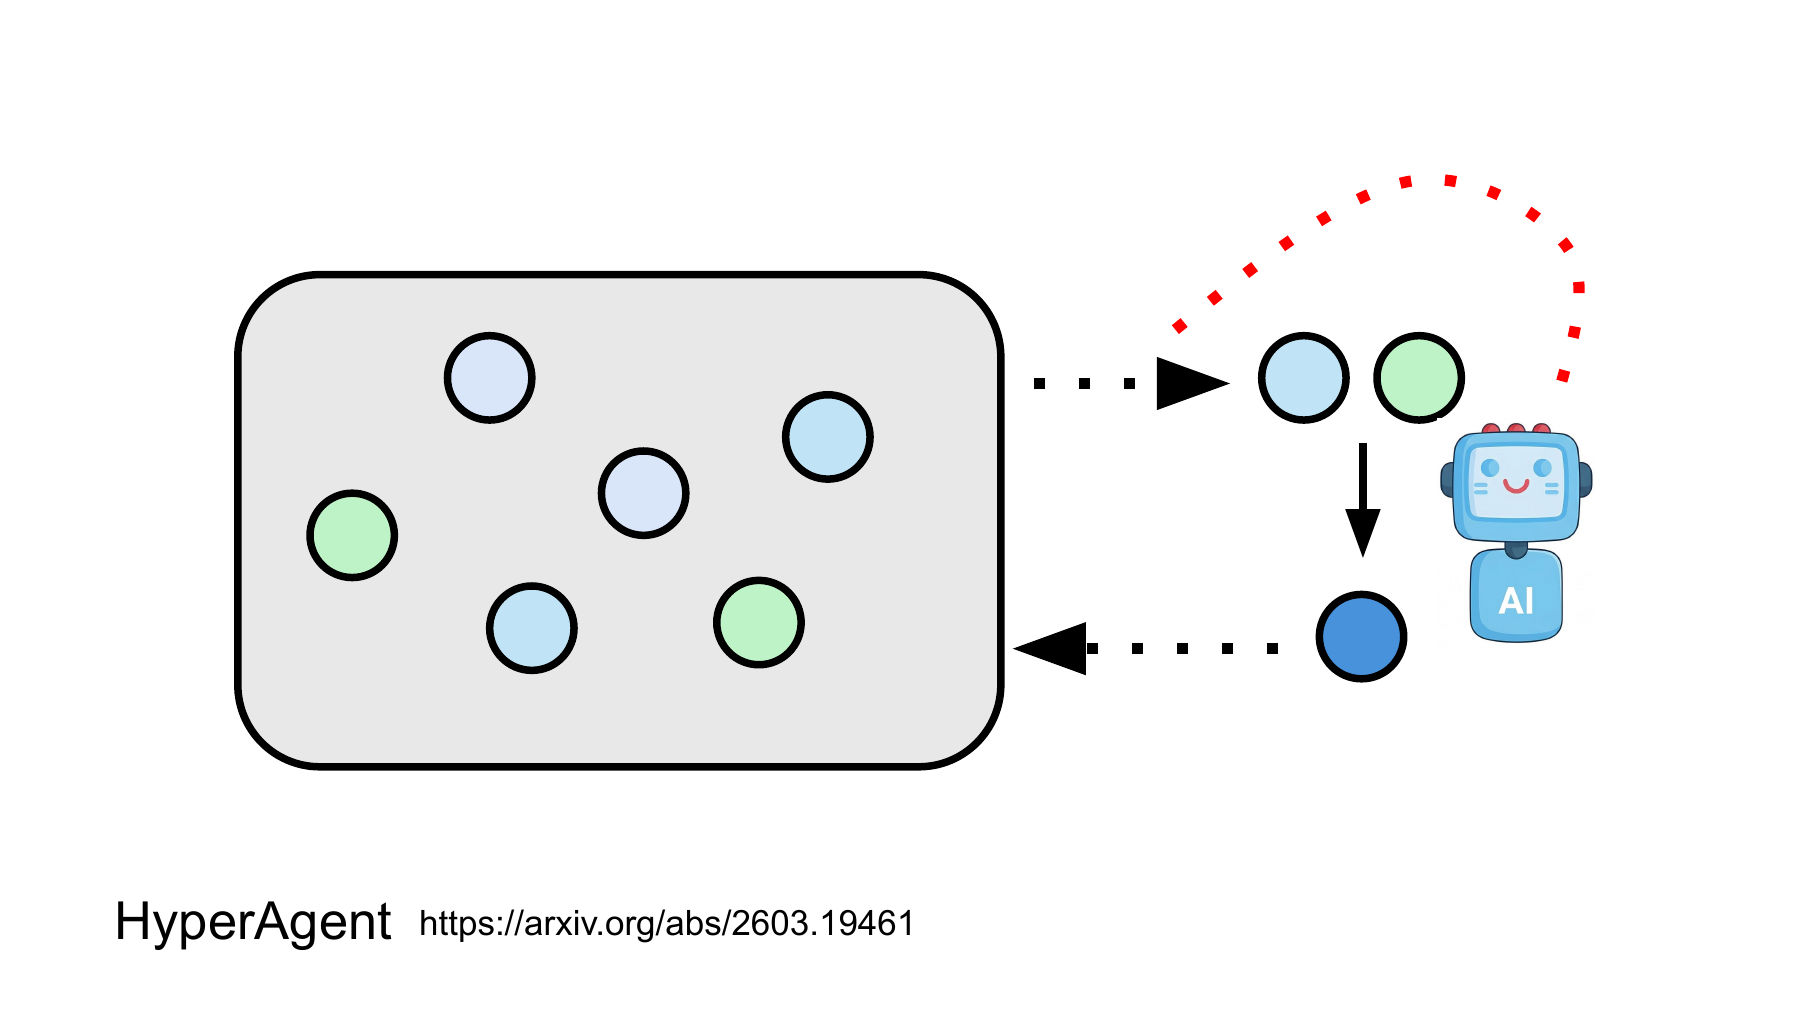
회색 상자는 지금까지 만든 후보를 모은 아카이브다. 위 점선 화살표를 따라 후보를 꺼내고, 오른쪽에서 새 후보를 만든다. 아래 점선 화살표는 새 후보가 다시 아카이브로 들어가는 길이다. 빨간 점선이 가리키는 위쪽에는 별도의 결정이 있다. 다음 개정의 출발점으로 어떤 과거 버전을 고를까? 37쪽에서 편집하는 방법이 바뀔 수 있음을 보았다면, 여기서는 편집할 부모를 고르는 규칙까지 바꾸는 경우를 살핀다. 그림 속 원은 버전을 구별하기 위한 표시다. 색마다 특정 점수나 데이터셋이 배정되어 있지는 않다. NTU 원본 38쪽
이 구분은 논문의 실험 설계에도 있다. 본문의 주요 실험은 성능과 이미 낳은 자식 수를 반영하는 사람이 정한 부모 선택 규칙을 고정했다. 그래야 편집자 변경의 효과를 따로 읽을 수 있다. 부록 E.5의 별도 실험은 무작위 선택에서 출발해 선택 규칙 자체도 바꾸도록 했다. 여러 실행에서 이미 얻은 점수에 덜 시도한 후보를 위한 탐색 가산점을 더하는 UCB(Upper Confidence Bound) 계열의 방식이 나타났다. Hyperagents, §3 · 부록 E.5, 부모 선택 실험
#식 풀이 4. 점수가 낮은 부모를 한 번 더 고를 이유
채점기를 개선한다고 하자. 부모 A는 정규화한 평가 점수가 0.82이고 이 버전에서 자식이 15개 나왔다. 부모 B는 점수가 0.70이고 자식이 3개다. 부록에서 관찰된 가산점 형태에 설명용 가상 수치를 넣어 보자. 전체 자식 수를 N, 부모 i의 자식 수를 nᵢ, 점수를 sᵢ, 탐색 가중치를 c로 둔다. 이 예제에서는 선택 점수 U가 큰 부모를 한 번 고른다.
점수만 비교하면 A가 0.12 앞선다. 그러나 B의 탐색 가산점은 약 0.343, A는 약 0.172다. 이 차이가 0.12보다 커서 c=0.4이면 B를 고른다. c=0.2로 낮추면 A의 선택 점수는 약 0.906, B는 0.872가 되어 이번에는 A를 고른다. B의 1.043은 선택 순위를 정하는 값이라서 1을 넘어도 된다. B가 낳을 자식의 정답률이나 성공 확률을 예측한 값은 아니다. 39쪽의 세 조건은 이처럼 후보의 우선순위를 정하는 방식이 달라졌을 때 마지막 시험 성능도 달라졌는지를 비교한다. Hyperagents, 부록 E.5
#하편 39쪽 — 부모를 고르는 규칙까지 맡기면 더 좋은 에이전트가 나올까?
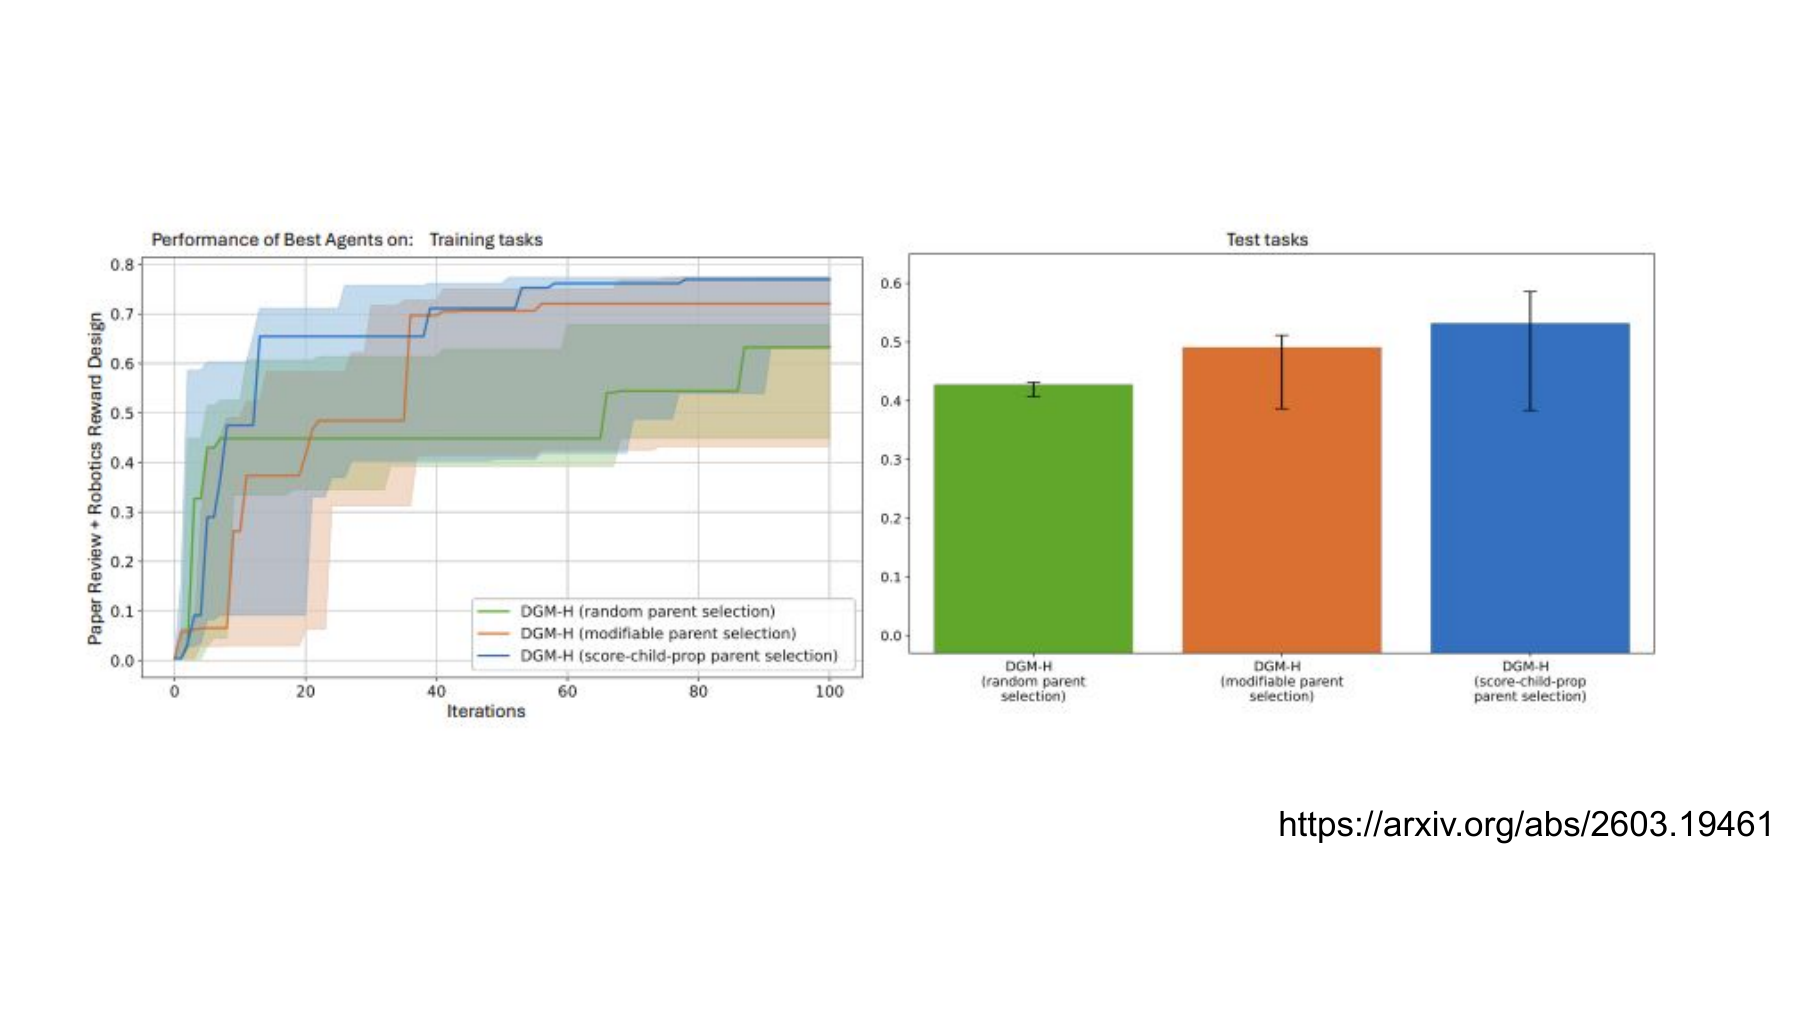
38쪽의 빨간 점선을 실험으로 바꾸면 이렇게 물을 수 있다. 다음 수정의 출발점을 고르는 권한을 주었을 때, 마지막에 어떤 에이전트가 남는가? 세 조건 모두 후보를 만들고 평가한다. 달라지는 것은 다음 부모를 고르는 방식이다. 초록은 끝까지 무작위로 고른다. 주황은 무작위로 출발하되 선택 규칙을 고칠 수 있다. 파랑은 후보의 점수와 자식 중 컴파일에 성공한 수를 반영하는 연구팀의 규칙을 고정한다. 각 조건을 다섯 번씩 실행했다. NTU 설명 36:33 · Hyperagents, 강의 당시 판본, 부록 E.5
왼쪽부터 읽자. 가로축은 반복 횟수다. 세로축은 논문 심사와 시뮬레이션 로봇 보상 설계 두 과제의 점수를 평균한 값이다. 선은 해당 시점까지 찾은 훈련 과제 최고 후보를 추적한다. 낮은 점수의 새 후보가 들어와도 기존 최고 기록은 남는다. 오른쪽은 각 방식이 찾아낸 최고 후보를 따로 떼어 테스트 과제에서 평가한 결과다. 왼쪽 마지막 점과 오른쪽 막대는 사용하는 문제가 다르다.
#식 풀이 5. 주황색 막대의 이득과 불확실성은 어떻게 읽을까?
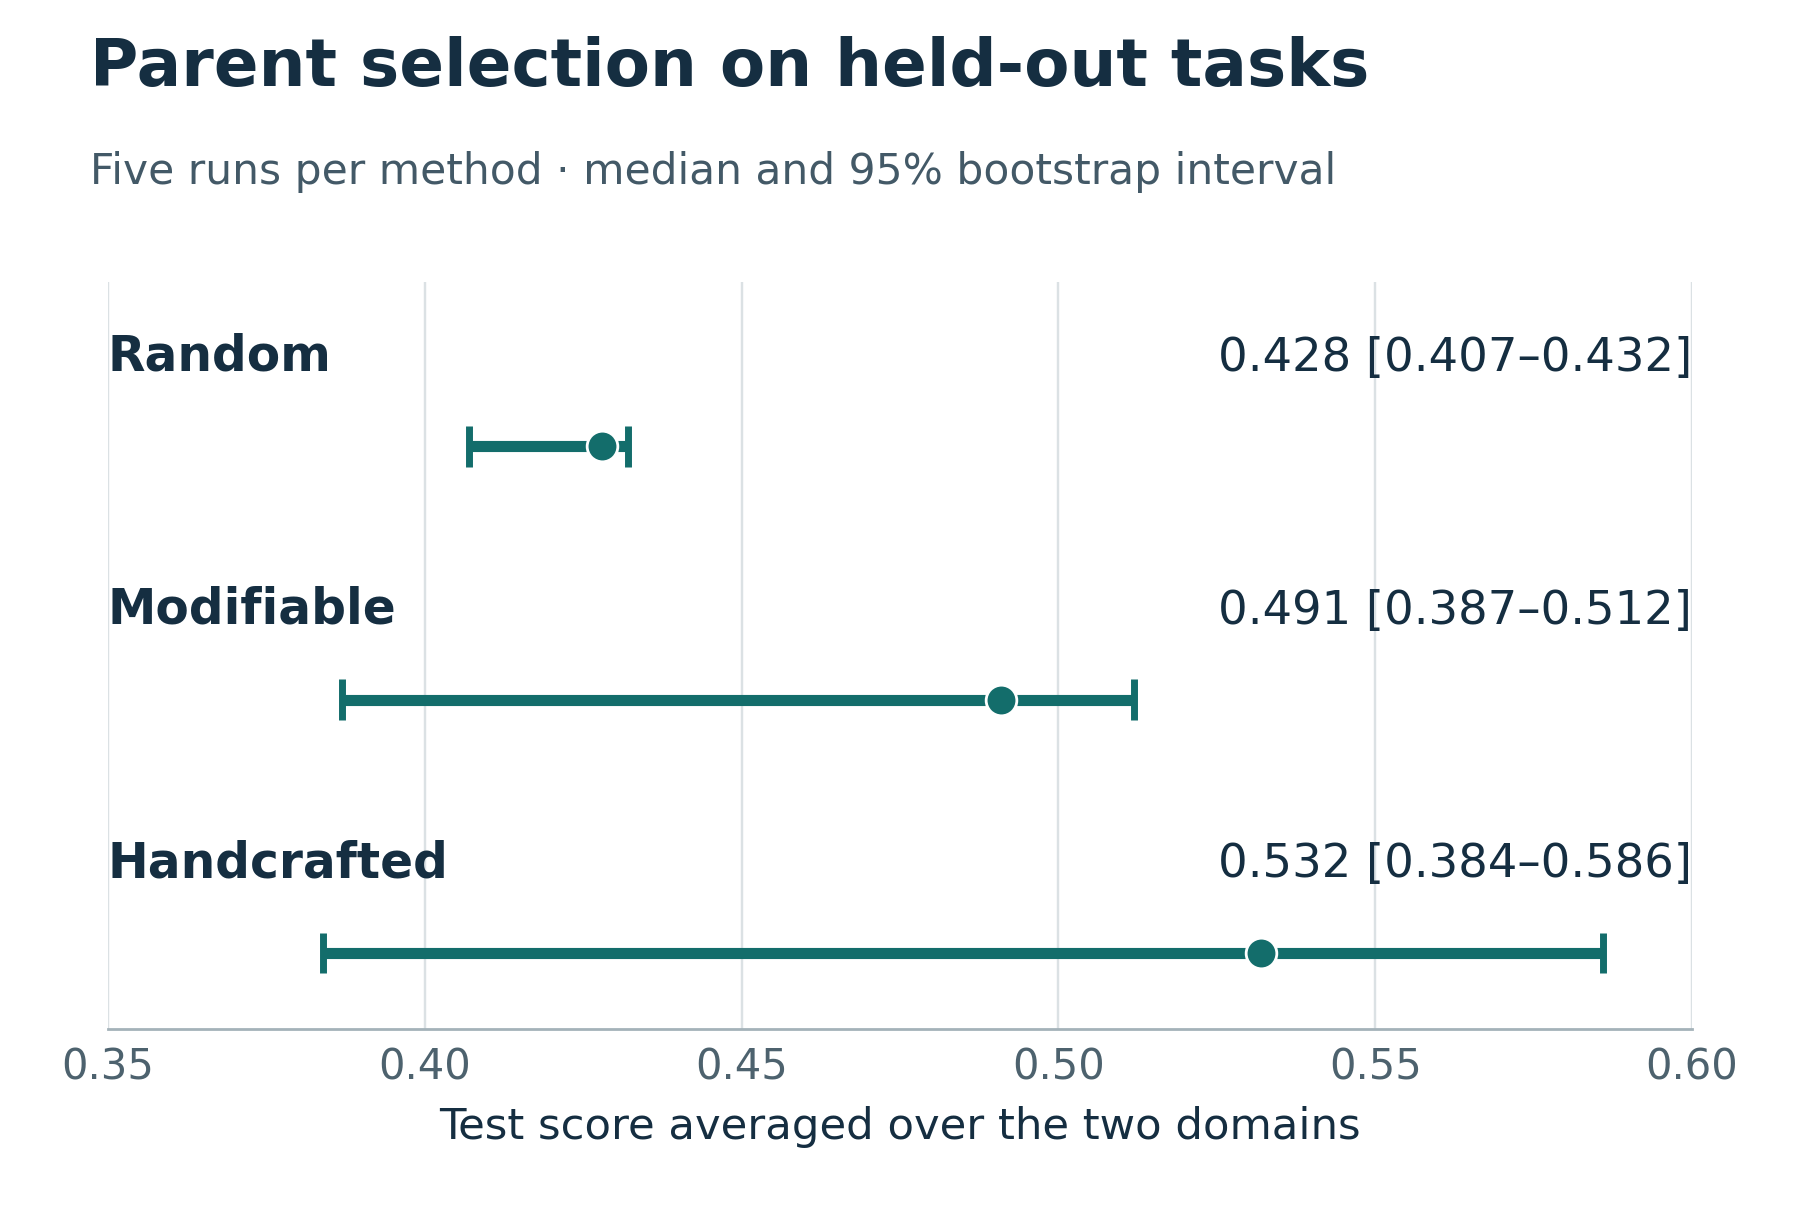
| 부모 선택 방식 | 테스트 대표 점수 | 보고된 신뢰구간 |
|---|---|---|
| 무작위 고정 | 0.428 | 0.407–0.432 |
| 무작위로 시작해 선택 규칙도 수정 | 0.491 | 0.387–0.512 |
| 연구팀이 설계한 규칙 고정 | 0.532 | 0.384–0.586 |
두 가지 집계가 들어간다. 한 실행의 점수는 두 과제 점수의 평균이고, 방법을 대표하는 값은 반복 실행의 중앙값이다. 저자들은 다섯 실행을 1,000회 재표집한 부트스트랩(bootstrap)으로 95% 신뢰구간을 구했다. 아래 뺄셈은 표에 실린 대표값끼리의 차이다. 실험 통계의 정의 · 그림 11과 수치
출발 에이전트의 점수 0.030도 함께 보자. 같은 출발점에서 주황 조건의 대표값까지 오른 폭은 0.461이다. 그중 얼마가 선택 규칙을 고칠 권한과 관련이 있는지 물으려면, 후보 자체는 계속 개선하되 선택만 무작위로 고정한 조건과 비교해야 한다.
따라서 관측된 비교값은 0.063점이다. 이 수치는 두 과제를 합친 점수이므로 ‘로봇 동작 성공률이 6.3%p 올랐다’고 읽을 수 없다. 또 다섯 번의 실행에서 저자들이 보고한 조건 간 차이는 통계적으로 유의하지 않았다(p > 0.05). 이번 실행에서 파란 막대가 가장 높았다는 것과 다음 실행에서도 그 순서가 유지될지는 별개의 질문이다.
#하편 40쪽 — 좋은 수정안을 낸 편집자에게 어떤 보상을 줄까?
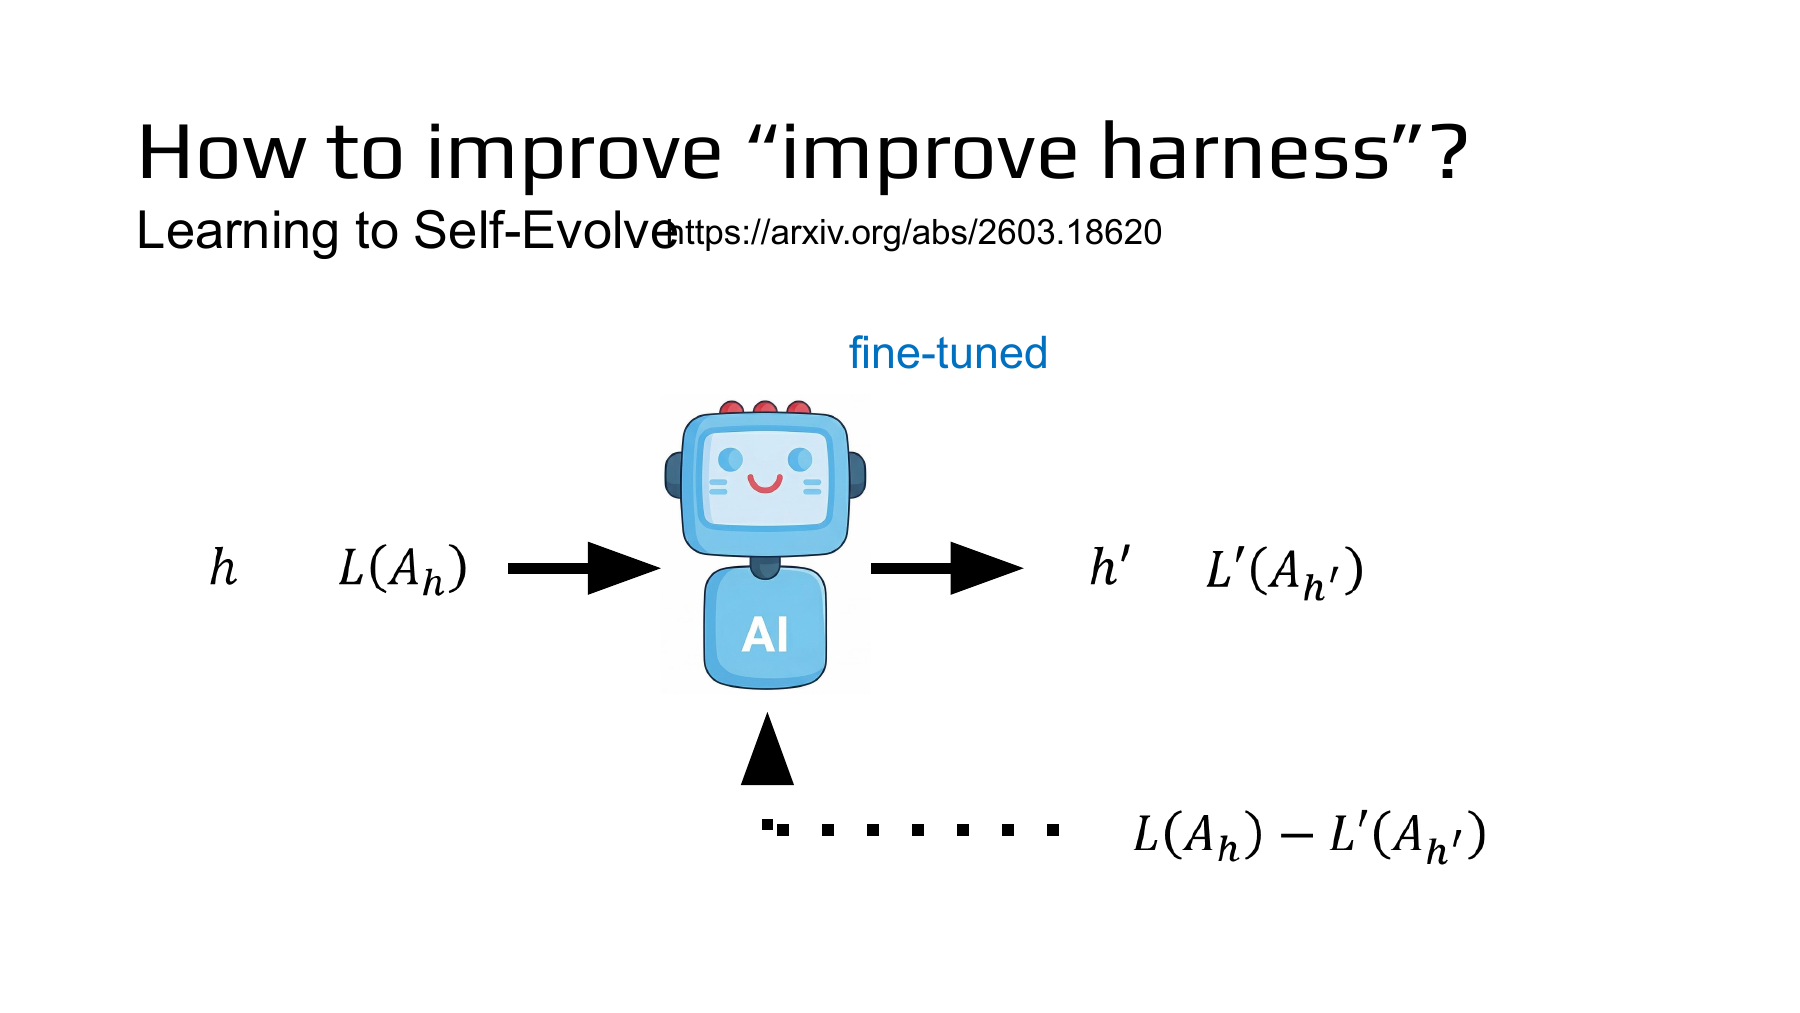
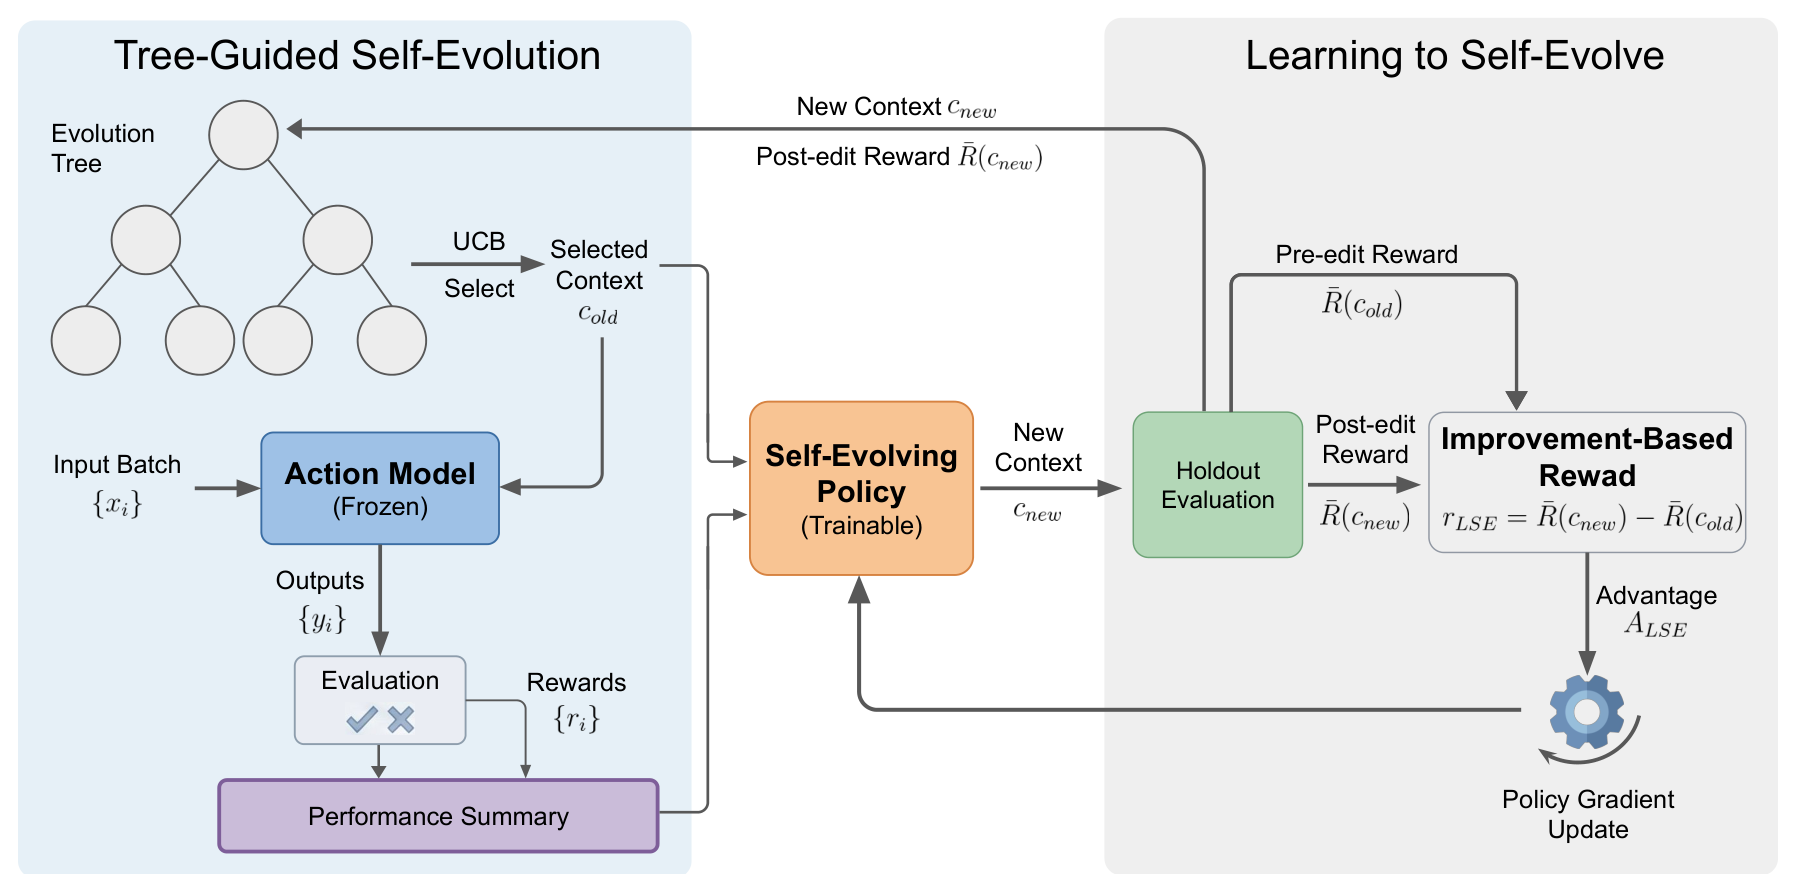
그림 중앙의 파란 로봇으로 들어가는 선을 두 개 따라가자. 왼쪽에서는 현재 하네스 h와 실행 결과가 들어간다. 로봇이 수정안 h′를 내면, 아래의 점선이 수정 전 손실에서 수정 후 손실을 뺀 값을 편집자에게 돌려준다. 38쪽에서 살핀 것은 선택 규칙의 변경이다. 여기서 ‘fine-tuned’라고 적힌 대상은 수정 지시문을 만드는 편집 모델이다. NTU 설명 37:29 · 두 점수의 차이를 설명하는 38:20
Chen 등의 Learning to Self-Evolve(LSE)에서 행동 모델(action policy)은 주어진 문맥으로 문제를 푼다. 편집 정책(edit policy)은 문맥과 이전 시도의 피드백을 읽고 지시문 필드를 고친다. 학습 때는 편집 정책의 가중치를 갱신한다. 테스트 때는 학습한 편집 정책이 여러 문맥을 제안하며, 문제를 푸는 행동 모델의 가중치는 고정된다. 아래 그림에서는 왼쪽의 여러 회차 탐색과 오른쪽의 한 번짜리 학습 신호를 구별해 읽자. LSE, 그림 1 · §3.1–3.2
#식 풀이 6. 최종 점수가 높은데도 왜 편집 보상은 음수일까?
검사 결과에서 품번을 읽는 지시문을 고치는 가상 예제다. 각 행에서 수정 전후를 같은 평가 이미지 20장으로 채점한다고 하자. 정답 한 건에 1점을 준다. 시작 지시문 A에서는 16건에서 15건으로, 시작 지시문 B에서는 9건에서 13건으로 바뀌었다.
| 시작 지시문 | 수정 전 성공률 | 수정 후 성공률 | 이번 수정의 이득 |
|---|---|---|---|
| A | 16/20 = 0.80 | 15/20 = 0.75 | −0.05 |
| B | 9/20 = 0.45 | 13/20 = 0.65 | +0.20 |
A로 얻은 최종 점수는 더 높다. 그러나 편집 행위의 결과를 묻자 순서가 바뀐다. 정답 수의 순변화는 A에서 한 건 감소, B에서 네 건 증가다. 논문의 식 7에서는 문맥 c에 대한 평균 보상을 R̄(c)로 쓰고, 수정 후 값에서 수정 전 값을 뺀다. 슬라이드는 손실이 낮을수록 좋다는 기준이라 빼는 순서가 반대다. 이 예제에서 손실을 오답률로 놓으면 두 식은 정확히 같다.
서로 다른 난도의 이미지로 수정 전후를 채점하면 쉬운 이미지가 늘어난 효과도 차이에 들어온다. 논문은 각 회차의 피드백용 문제 묶음과 별도로 고정된 홀드아웃(holdout)에서 문맥을 비교한다. 같은 홀드아웃을 후보 선택에 반복 사용했으므로, 그 점수와 새 데이터에서 한 번만 측정한 성능도 구별해야 한다. LSE, 식 4 · 식 7과 평가 방법
#식 풀이 7. 그 보상은 다음에 같은 편집을 제안할 확률을 어떻게 바꿀까?
이제 같은 출발 문맥에서 두 후보 편집 A와 B를 고른다고 하자. 앞 표와 별개인 작은 계산이다. A는 평가 성공률을 0.15 올리고 B는 0.05 내린다. A를 제안할 확률을 p, B를 제안할 확률을 1−p라고 쓰면 편집 한 번의 기대 이득 J는 다음과 같다.
편집 정책이 두 후보에 부여한 로짓(logit)의 차이, 즉 정규화 전 선호 점수의 차이를 z라고 하고, p를 시그모이드로 계산해 보자. z가 0이면 둘의 확률이 같다. 이 점에서 기울기는 0.05다. 학습률 0.4로 기대 이득을 높이는 방향으로 한 번 움직인다.
A를 제안할 확률이 50%에서 약 50.5%로 올랐다. 50.5%는 특정 편집을 고를 확률이다. 품번 판독 정확도와는 측정 대상이 다르다. 논문 식 9–10은 실제 문장 편집을 표본으로 뽑고 그 편집의 로그 확률에 대한 기울기에 개선량을 곱한다. 위 계산에서는 후보가 둘뿐이어서 기댓값을 직접 미분할 수 있었다. LSE, 식 9–10
#보충 논문 · 67.3%는 어느 모델이 무엇을 한 결과일까?
BIRD에서는 자연어 질문을 SQL로 바꾸고, 질의를 실행한 결과로 정확도를 잰다. 논문 표 1의 모든 행에서 SQL을 작성하는 행동 모델은 Qwen3-4B-Instruct다. 바꾼 것은 지시문을 만드는 방법이다. 다섯 데이터베이스 영역에서 LSE의 점수는 72.0, 68.5, 72.0, 59.8, 64.0%다. 똑같은 비중으로 평균하면 67.26%, 표처럼 반올림하면 67.3%다. 초기 지시문은 57.2%, 별도 편집 학습을 하지 않은 Qwen 편집자는 62.2%, GPT-5 편집자는 65.2%였다. 같은 행동 모델에 대해 학습한 편집자가 얻은 차이는 각각 10.1, 5.1, 2.1%p다. 각 영역의 고정 홀드아웃 50문제에서 생성 8회에 걸쳐 성능을 평균하고, 진화 25회 동안 얻은 최고 홀드아웃 성능을 보고했다. LSE, 표 1 · §4.2 평가 결과 · 부록 A 평가 절차
20편에서는 수정 전후에 같은 일을 다시 시켜 능력이 남았는지 확인했다. 이번에는 한 가지를 더 기록해야 한다. 어떤 편집자가, 어느 출발점에서, 어떤 평가 문제를 기준으로 개선량을 만들었는가? 이 세 가지가 있으면 하네스가 좋은 것과 하네스를 고치는 법이 나아진 것을 각각 시험할 수 있다. 다음 슬라이드 41쪽은 갱신 대상을 모델 파라미터로 옮긴다. NTU 하편 41쪽
Hyperagents와 Learning to Self-Evolve 논문 그림의 출처와 편집 범위는 각 그림 아래에 표시했다. 논문 그림 이용 조건