검사 카메라가 품번의 0을 O로 읽는다. 21편에서는 실패 사례를 보고 판독 지시문을 바꾸는 편집자를 살펴봤다. 이번에는 그 사진으로 판독 모델을 다시 학습시킨다. 누군가는 어떤 사진과 손실을 쓸지 정하고, 학습 코드는 그 선택에 따라 가중치를 바꾼다. 어느 쪽이 좋아졌는지 어떻게 알 수 있을까?
하편 41–45쪽을 읽을 때는 화살표 끝에 남는 것을 보자. 41쪽에는 새 가중치, 44쪽에는 채택한 훈련 실험의 검증 기록, 45쪽에는 다시 실행할 알고리즘이 남는다. 아래 풀이에서는 카메라 계산 예제와 실제 논문·실험 기록을 구분했다.
식 풀이 바로가기 경사하강 한 걸음 · 같은 사진으로 비교 · 후학습 점수 격차 · 바이트당 비트 · 채택한 실험 수 · 학습률 두 개 비교 · 전문가 쏠림 점수
슬라이드별 영상 위치
| 하편 원본 | 강의 영상 | 따라갈 질문 |
|---|---|---|
| 41쪽 | 38:44 | 손실 함수가 정해지면 어떤 값이 갱신될까? |
| 42쪽 | 39:09 | 강사가 상편 52:17로 돌아간 이유는 무엇일까? |
| 43쪽 | 39:17 | 한 모델이 다른 모델을 훈련시키면 어느 모델을 채점할까? |
| 44쪽 | 39:48 | 훈련 실험을 반복한 그래프의 점과 계단은 무엇일까? |
| 45쪽 | 40:06 | 알고리즘과 그 점수를 입력하면 무엇을 새로 제안할까? |
41–44쪽 링크는 해당 주제가 시작되는 지점이다. 45쪽 링크는 강사가 갱신 규칙을 만드는 능력도 학습할 수 있는지 묻는 대목이다. 40:10에는 다음 쪽의 SEAL 도표가 보인다. 45쪽에 적힌 두 프로젝트의 실험은 아래에서 원 논문으로 보충한다. NTU 2026년 5월 22일 강의
#하편 41쪽 — 같은 오차를 보고도 가중치를 얼마나 바꿀지는 누가 정할까?
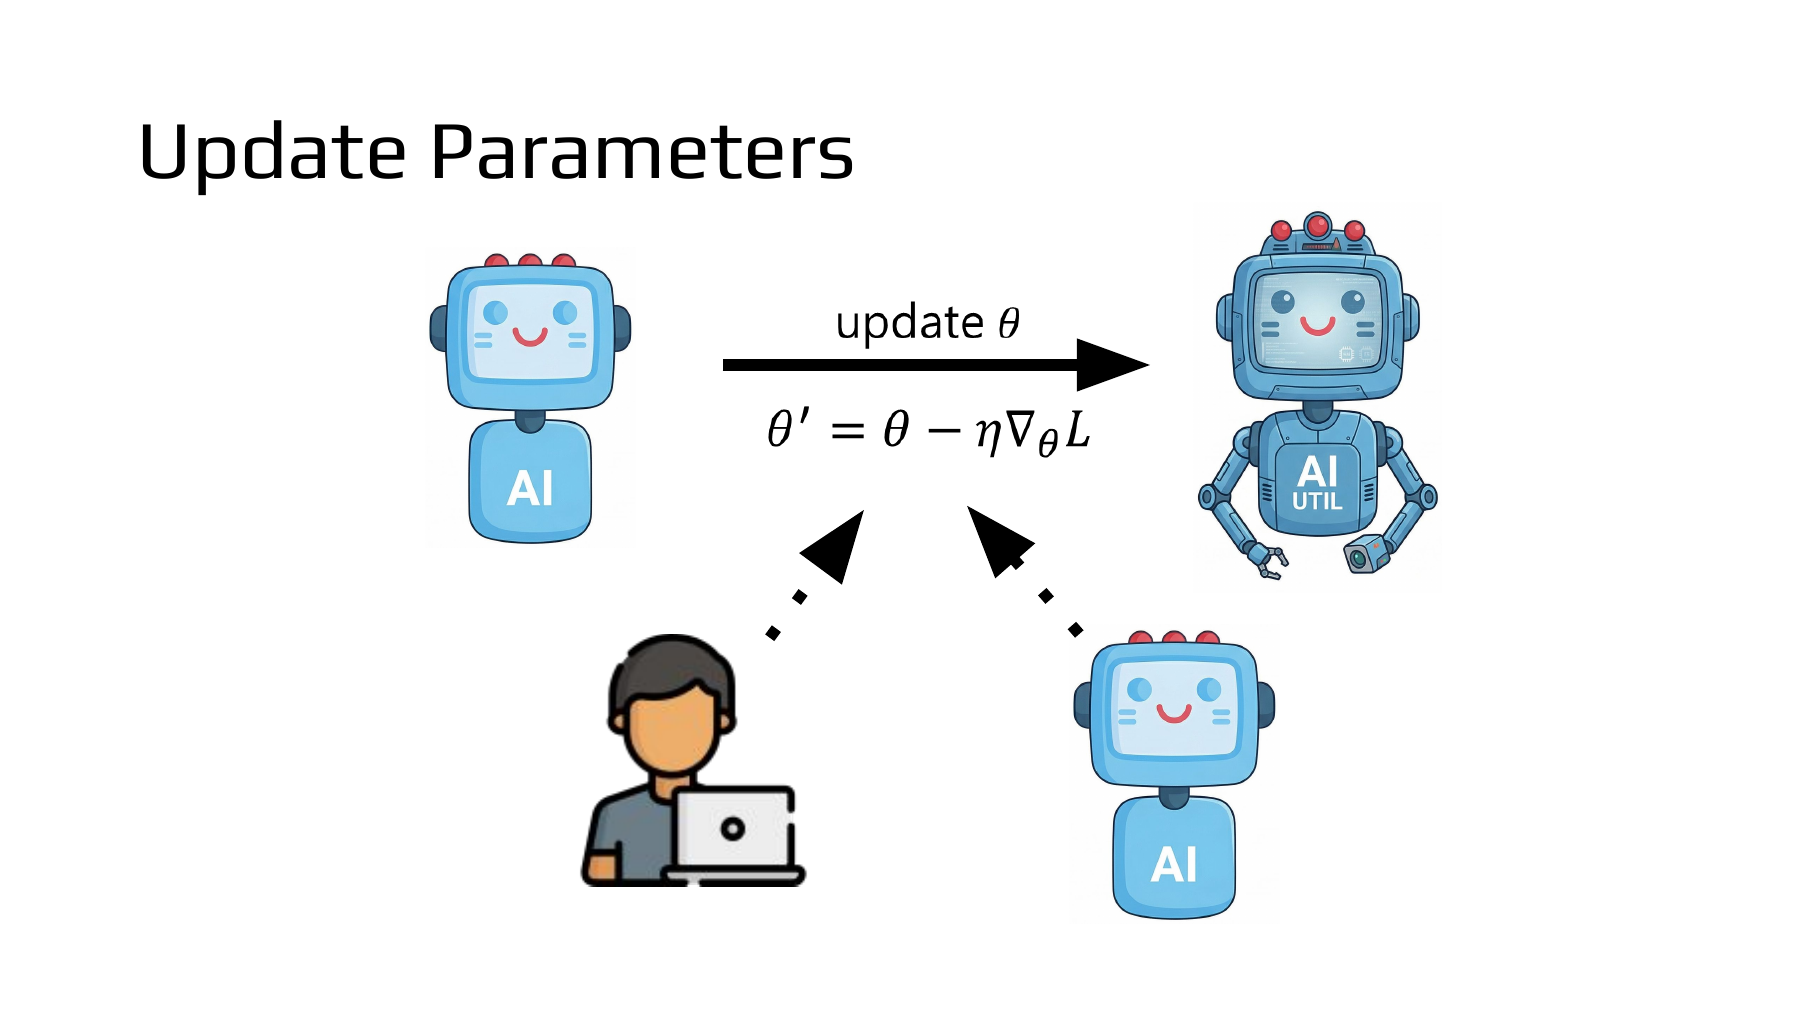
그림 가운데 실선 화살표를 먼저 읽자. 왼쪽 모델이 쓰던 숫자 묶음이 파라미터(parameter) θ이고, 한 번 학습한 뒤 오른쪽 모델이 쓰는 값이 θ′다. 손실(loss) L은 지금 예측이 얼마나 빗나갔는지 나타내는 수다. 그 아래에서 사람과 AI가 업데이트 식으로 점선을 보낸다. 두 점선은 한 번의 학습에 사람이 한 번, AI가 한 번 순서대로 개입한다는 뜻일까? 강사는 경사하강법과 Adam, AdamW를 사람이 설계한 예로 든 뒤, 기계도 파라미터를 바꾸는 알고리즘을 설계할 수 있는지 묻는다. 위쪽은 학습되는 모델, 아래쪽은 학습 규칙을 정할 수 있는 주체다. NTU 강의 38:44
#식 풀이 1. 밝기 보정값을 1만큼 올리면 손실은 얼마나 줄까?
카메라가 기준 패치의 밝기를 100으로 읽었다. 독립된 기준기는 같은 패치를 104로 측정했다. 카메라 출력에 보정값 θ를 더해 기준값을 예측한다고 하자. 손으로 계산할 수 있도록 가상의 측정 한 건, 보정값 하나로 줄였다. θ가 0이면 예측은 100, 오차는 예측에서 기준값을 뺀 −4다. 손실을 오차 제곱의 절반으로 두면 8이다. 앞에 ½을 붙여 두면 미분할 때 제곱에서 나오는 2와 약분된다.
현재 지점에서 기울기는 −4다. θ를 조금 올리면 손실이 내려간다는 뜻이다. 학습률(learning rate) η를 0.25로 정하고 기울기에 곱한 뒤 기존 θ에서 뺀다. 음수를 빼므로 θ가 1로 올라간다. 슬라이드의 ∇는 파라미터가 여러 개일 때 각 방향의 미분값을 모은 것으로, 이 예제에서는 미분값 하나다.
오차의 크기는 4에서 3으로 줄고 손실은 8에서 4.5로 줄었다. 같은 데이터와 기울기에 학습률만 2.5로 바꾸면 어떻게 될까? 새 θ는 10, 예측은 110이다. 기준 104를 지나쳐 오차의 크기가 6으로 커지고 손실은 18이 된다. 현재 오차가 가리키는 방향을 알아도, 좋은 한 걸음의 크기는 별도로 정해야 한다. 이 예가 보여 주는 현상은 하나의 이차 손실에서 직접 계산한 결과다.
#보충 강의 · 타원 그림에서 한 번의 업데이트를 읽는 법
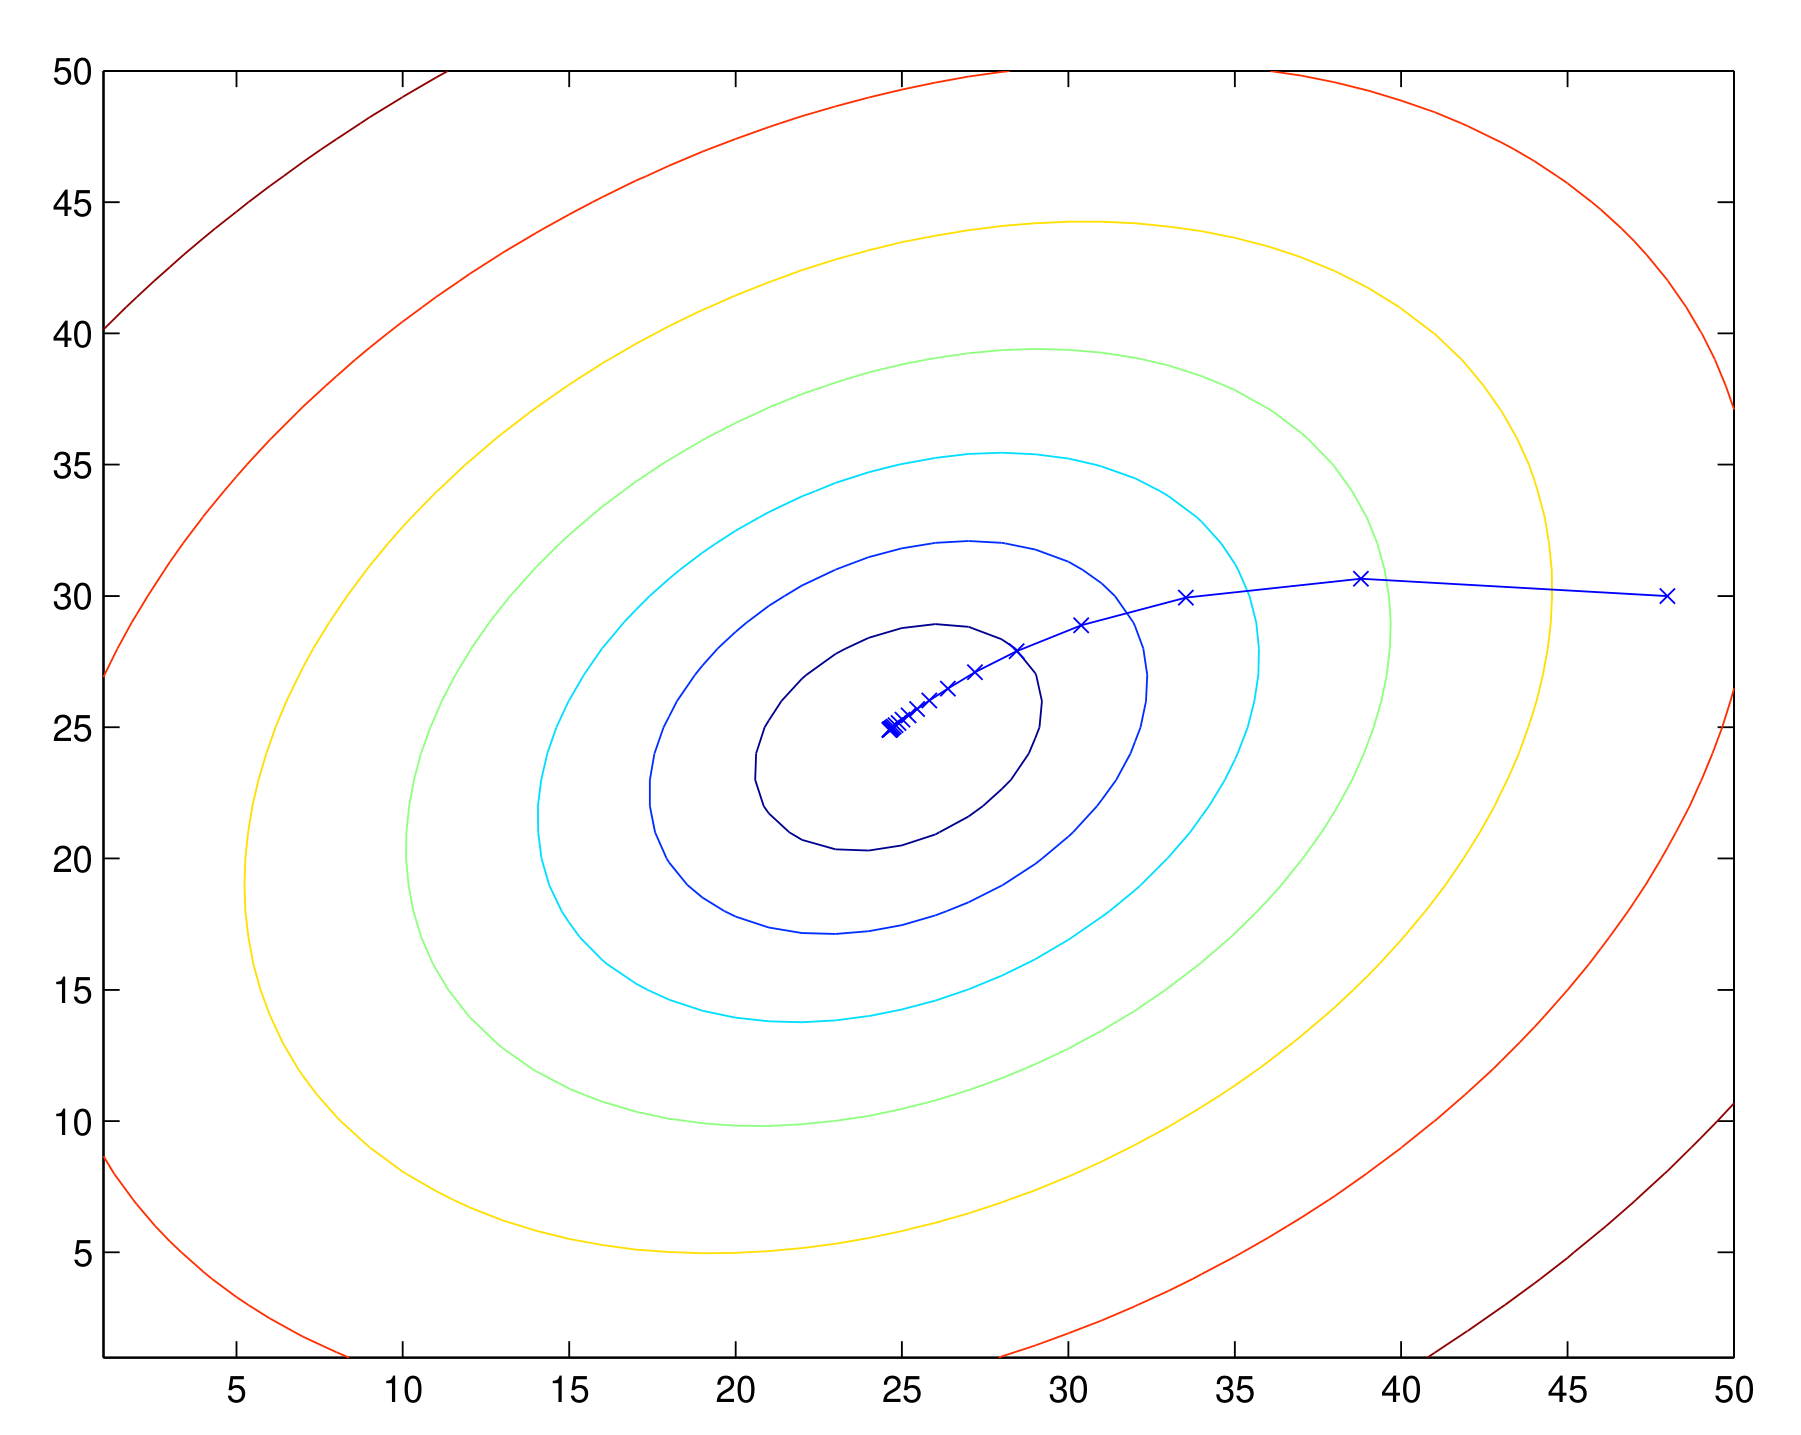
Stanford CS229 강의 노트의 그림에는 파라미터가 두 개 있다. 평면 위 한 점이 두 숫자의 한 조합이다. 한 타원 위에서는 손실이 같고, 안쪽 타원일수록 손실이 작다. 시작점 부근의 × 표시에서 다음 × 표시로 옮겨 가는 선분 하나가 앞에서 계산한 한 번의 업데이트에 해당한다. 가로축과 세로축은 모두 파라미터이므로, 세로축의 높이를 손실로 읽으면 경로를 잘못 해석한다. 두 점의 실제 손실 감소량을 알려면 손실 함수나 해당 등고선의 값이 필요하다. Stanford CS229 강의 노트 6쪽
Andrew Ng의 강의에서는 경사하강법을 언덕 위에서 걷는 과정으로 설명한다. 한 걸음을 내디디면 다음 방향은 새 위치에서 다시 구한다. 앞의 카메라에서도 첫걸음 뒤 기울기는 1−4=−3이므로, 학습률을 0.25로 유지하면 보정값은 1에서 1.75로 이동한다. Stanford 강의의 경사하강 단원 26:17 · 공식 강의 대본
#하편 42쪽 — 상편 52분 17초에 등장한 두 모델의 역할
42쪽은 상편의 한 장면으로 돌아가는 링크다. 52분 17초부터 들으면 강사가 강한 모델에 학습 절차를 맡겨 더 작은 모델을 키우는 경우를 설명한다. 52분 53초부터는 PostTrainBench의 사례를 구체적으로 다룬다. 목표와 기본 모델을 받은 에이전트가 훈련 코드를 준비하고 실행하면, 그 코드가 기본 모델의 가중치를 바꾼다. 최종 과제를 푸는 쪽도 이렇게 학습한 모델이다. 이 역할 구분은 하편 43쪽의 그림을 읽을 때 그대로 쓰인다. 상편 영상 52:17 · 상편 영상 52:53 · 상편 원본 51쪽
#식 풀이 2. 학습한 검사기가 일곱 장을 더 맞혔다면 누구의 점수가 오른 걸까?
가상 검사 실험에서 훈련 에이전트가 부품 사진으로 검사기를 학습시킨다. 측정자는 학습에 쓰지 않은 같은 사진 50장을 꺼내 학습 전후의 검사기에 각각 보여 준다. 각 사진에서 정답 여부를 짝지어 세자. 처음에 32장을 맞혔다. 원래 틀렸던 사진 중 10장은 학습 후에 맞혔지만, 원래 맞았던 사진 중 3장은 학습 후에 틀렸다. 전체 정답 수에는 두 변화가 모두 들어간다.
14%p는 학습된 검사기가 이 50장에 대해 얻은 순개선이다. 틀렸던 10장이 모두 개선된 사실과, 맞았던 3장이 새로 틀렸다는 사실도 함께 읽을 수 있다. 이 실험에서 훈련 에이전트는 사진에 답하지 않았으므로 에이전트 자신의 정답률은 측정하지 않았다. 훈련 방법 두 개를 비교하려면 같은 기본 모델 사본에서 시작해 같은 계산 예산을 주고, 두 사본을 같은 미공개 평가 사진으로 채점하면 된다. 다음 슬라이드의 PostTrainBench를 읽을 때도 누가 훈련을 설계하고 누구의 출력을 채점했는지 먼저 확인하자. 11편에서는 같은 벤치마크의 과제와 시간 예산을 살펴봤다.
#하편 43쪽 — 학습을 설계하는 모델과 실제로 학습하는 모델은 누구인가?
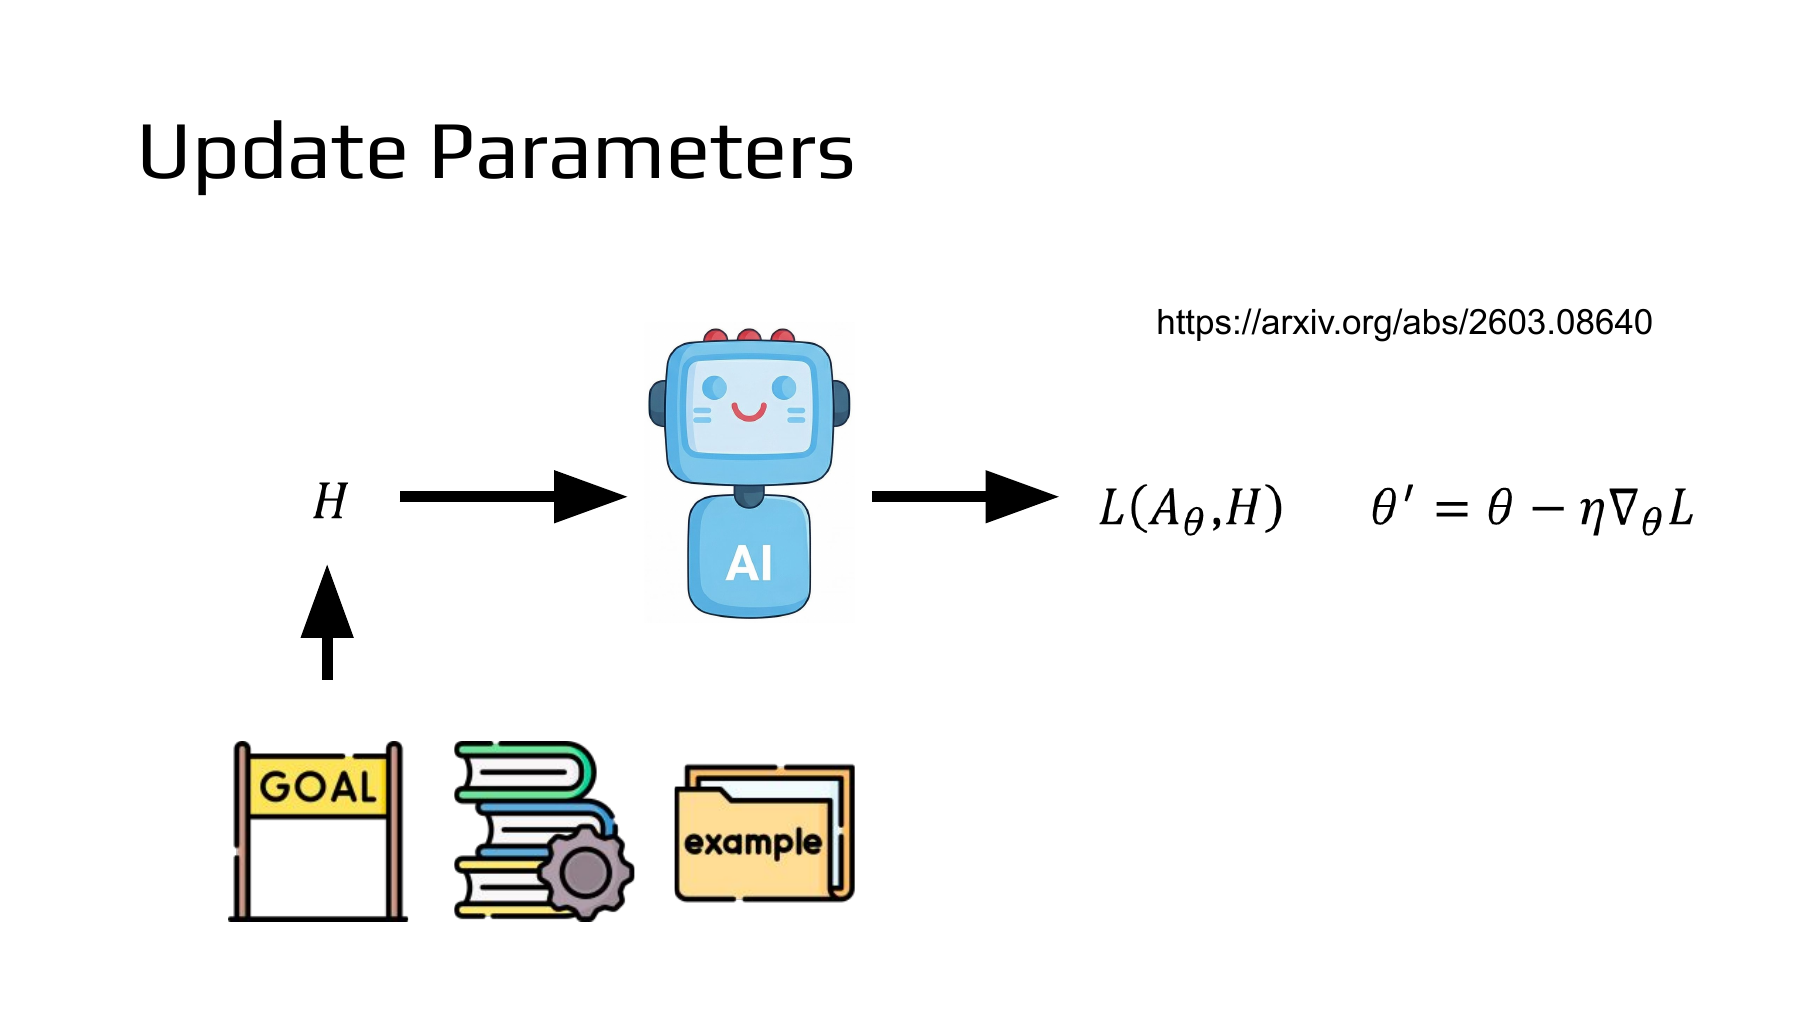
왼쪽 아래의 깃발은 목표, 책은 참고 자료, 폴더는 예시다. 강사는 이렇게 사람이 제공한 정보를 H라고 쓴다. 가운데의 로봇은 H를 읽고 어떤 데이터로 무엇을 학습시킬지 정한다. 오른쪽의 L(Aθ, H)는 현재 가중치 θ를 가진 모델 A에 적용할 학습 손실이다. 손실이 정해지면 학습 알고리즘이 기울기를 계산해 θ를 θ′로 갱신한다. 이 그림을 실제 실험에 대입하려면 먼저 θ가 누구의 가중치인지 짚어야 한다. NTU 하편 43쪽 · 강의 39:17
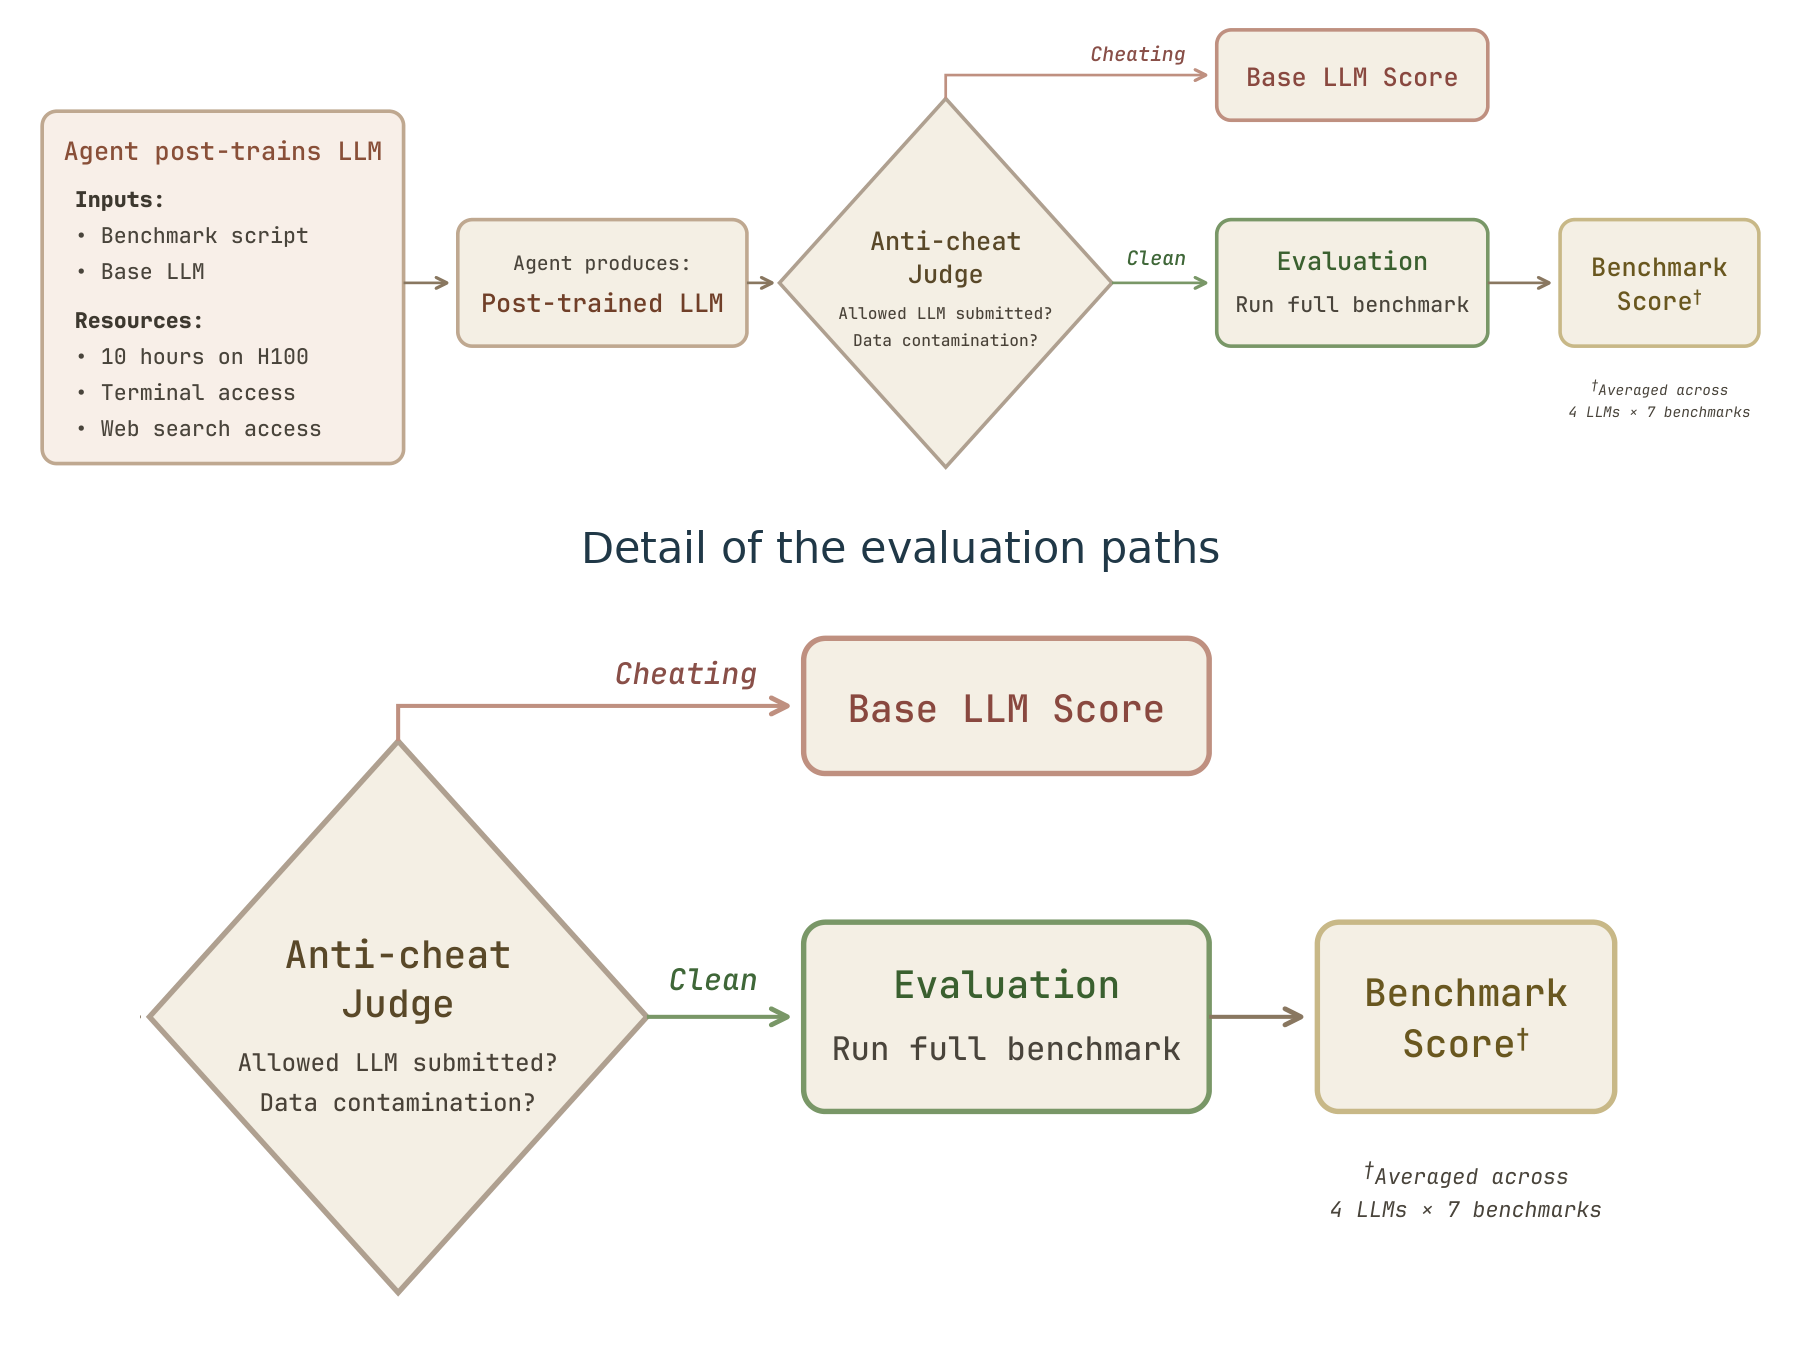
PostTrainBench 그림 2에서 연구진은 에이전트에 기반 언어 모델 하나, 목표 벤치마크 하나, H100 GPU 한 대와 10시간을 준다. 에이전트는 학습 데이터를 고르고 후학습(post-training) 코드를 작성한다. 기울기로 바뀌는 θ는 제출할 기반 모델의 가중치다. 예를 들어 Claude Code에서 동작하는 Opus가 학습을 지휘하고 Qwen이 대상이면, 마지막에 채점하는 파일은 학습을 마친 Qwen의 체크포인트다. 그림을 오른쪽까지 따라가면 평가가 둘로 갈린다. 규칙을 지킨 제출물은 목표 벤치마크에서 평가한다. 시험 데이터 혼입이나 모델 바꿔치기로 판정한 실행에는 원래 기반 모델의 점수를 부여한다. PostTrainBench, §2와 그림 2
#식 풀이 3. 기반 모델과 공식 모델 사이의 점수 차이를 얼마나 줄였을까?
논문 표 1에서 기반 모델의 가중 점수는 7.5%, Claude Code·Opus 4.6이 후학습시켜 제출한 모델들의 점수는 23.2%, 제작사가 공개한 지시 학습(instruction-tuned) 모델들의 점수는 51.1%다. 네 기반 모델과 일곱 벤치마크를 종합한 수치다. 표의 세 값을 같은 척도 위에 놓고, 먼저 두 거리를 구하자. PostTrainBench, 표 1
분모는 기반 모델에서 공식 지시 학습 모델까지의 간격 43.6%p다. 그중 약 36.0%를 이번 후학습이 메웠고, 27.9%p가 남았다. 36.0%는 표의 반올림된 값으로 여기서 계산한 격차의 비율이다. 23.2%는 가중 평가 점수여서 임의의 문제 하나를 맞힐 확률로 읽을 수 없다. 10시간·GPU 한 대는 후학습 에이전트에 준 예산이고 공식 모델은 외부 비교 대상이다. 이 표만으로 같은 비용을 썼을 때 누가 더 효율적인지는 결정할 수 없다. PostTrainBench, 평가 방법 · 표 5의 벤치마크 가중치
#하편 44쪽 — 작은 언어 모델을 5분씩 학습시키면 어떤 변경을 남길까?
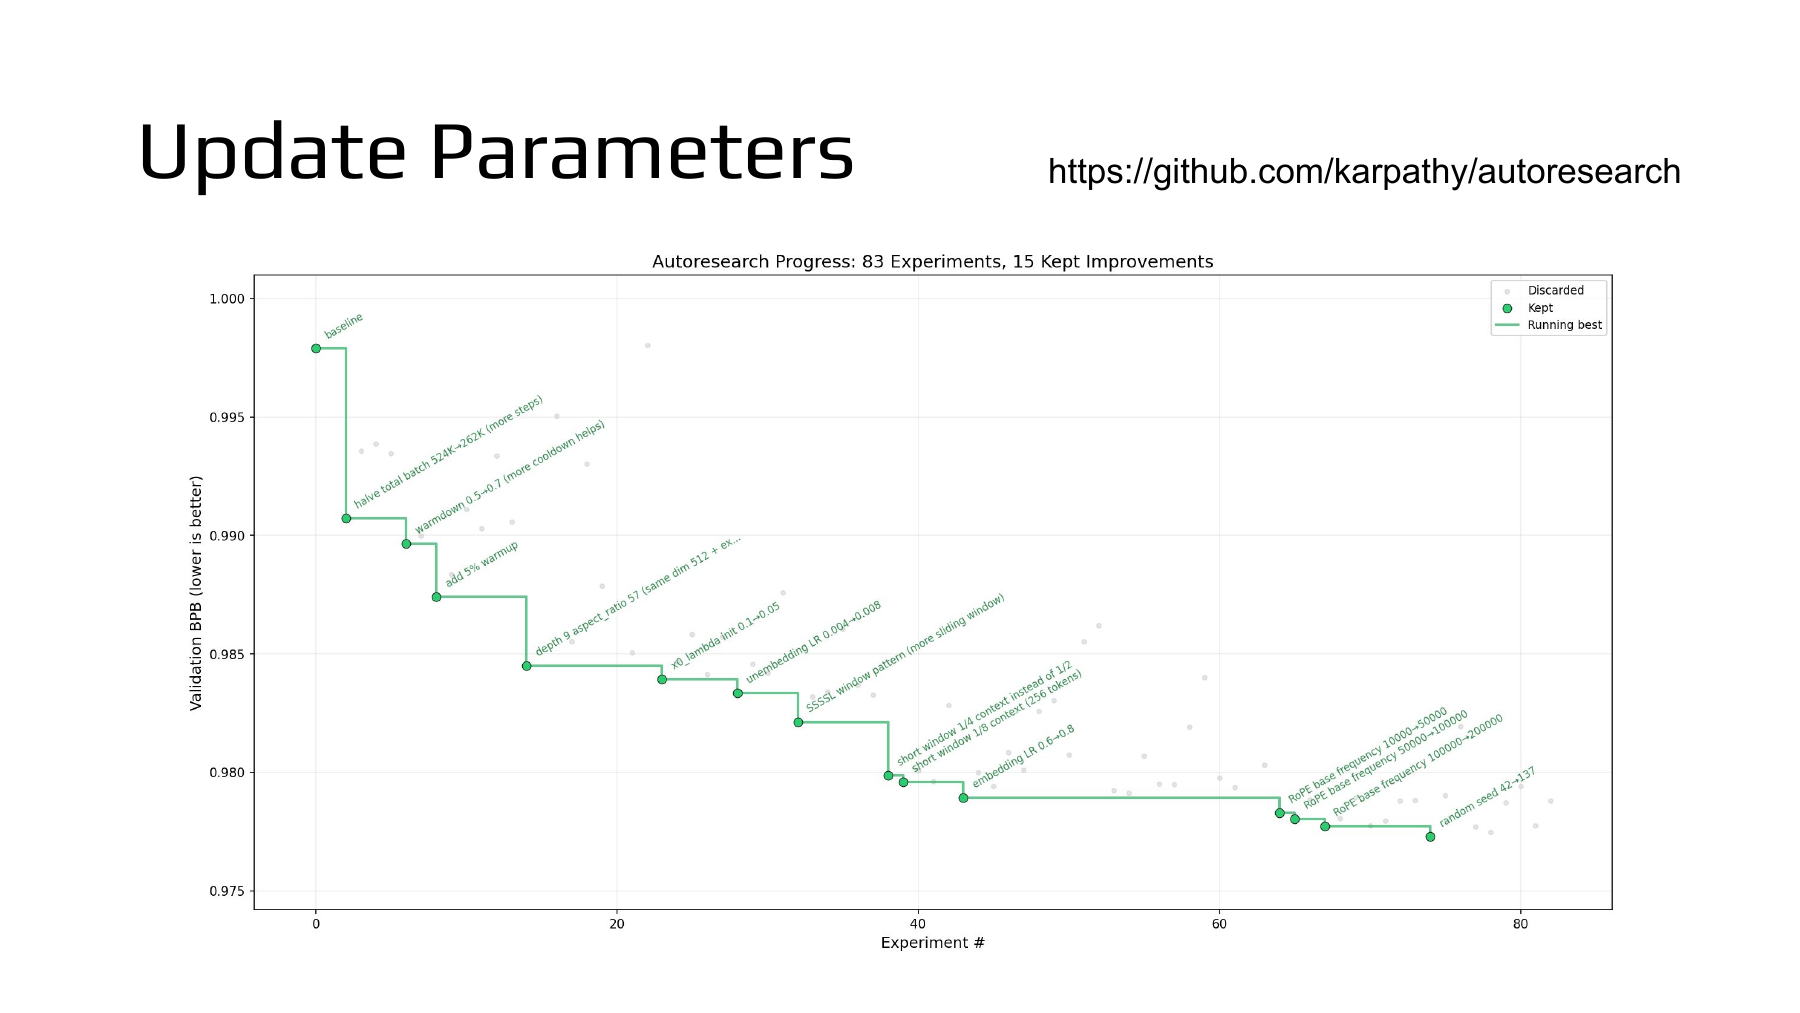
Andrej Karpathy의 autoresearch에서는 사람이 program.md에 실험 지침을 적는다. 에이전트는 train.py에서 모델 구조, 옵티마이저, 배치 크기 같은 선택을 바꾼다. prepare.py는 데이터 준비와 검증 점수 계산 방식을 고정한다. 한 번의 실험에서 실제 가중치는 새 학습 코드로 훈련한 작은 언어 모델 안에서 바뀐다. 다음 실험으로 이어지는 것은 채택한 학습 코드의 버전이다. 아래에서는 2026년 5월 강의 전에 공개된 3월 26일 코드판을 사용한다. autoresearch, 당시 README · 강의 39:48
#식 풀이 4. 똑같은 네 바이트에 모델이 얼마의 확률을 주었을까?
세로축 BPB(bits per byte)는 검증 텍스트 한 바이트를 예측하는 데 든 평균 비트 수다. 실제로 나타난 다음 토큰의 조건부 확률을 p라고 할 때 예측 비용은 −log₂ p다. 절반의 확률을 주면 1비트, 4분의 1이면 2비트, 8분의 1이면 3비트다. 코드에서는 토큰별 음의 로그 확률을 자연로그 단위(nat)로 더한 뒤 바이트 수와 ln 2로 나눈다. 바이트 길이가 0인 특수 토큰은 제외한다. 공식 평가 함수
가상 예제로 두 토큰이 합쳐서 B=4바이트인 짧은 검증 텍스트를 생각하자. 모델 A가 실제 두 토큰에 차례로 1/2, 1/8의 확률을 주면 총비용은 4비트다. 모델 B가 같은 토큰에 1/2, 1/4을 주면 총비용은 3비트다.
두 모델은 같은 텍스트를 보았다. B는 두 번째 토큰에 더 높은 확률을 줘서 한 바이트당 0.25비트를 줄였다. 실제 그래프에서도 세로축이 낮을수록 좋다. 기본 실험은 한 GPU에서 학습 시간 5분을 맞춘다. 시작 준비와 컴파일은 이 예산에서 빠진다. 빠른 코드가 같은 시간에 더 많은 학습 단계를 진행할 수 있으므로, 이 점수는 주어진 장비와 시간에서 얻은 결과다. 실험 예산과 비교 조건
#식 풀이 5. 83개 기록 중 채택 15건이면 새 변경은 몇 건 남았을까?
먼저 맨 왼쪽의 초록 점을 보자. baseline은 원래 코드로 실행한 첫 실험이며, 이 점도 채택(KEEP)에 포함된다. 슬라이드 제목의 83은 전체 기록 수, 15는 상태가 KEEP인 행 수다. 모든 기록 중 채택된 비중과 첫 기준점을 뺀 후속 기록 중 채택된 비중을 구분해 계산할 수 있다. NTU 하편 44쪽 · 기준 실험과 기록 형식
둘째 값의 뜻은 이후 82개 기록 가운데 14개를 남겼다는 것이다. 공식 분석 노트북이 별도로 출력하는 채택률의 분모는 KEEP + DISCARD이며 실행 실패(CRASH)는 제외한다. 그래프를 그릴 때도 실패 행을 뺀 뒤 가로축 번호를 다시 매기고, 기준보다 BPB가 0.0005 넘게 높은 점은 숨긴다. 그래서 화면에 보이는 점만 세면 전체 실험 수를 복원할 수 없다. 제목·점·채택률을 계산한 노트북
초록 계단은 그때까지 채택한 실험 중 가장 낮은 BPB다. 다음 제안이 나빠져도 이전 기록은 남아 선이 올라가지 않는다. 그림 맨 오른쪽의 마지막 초록 점 옆에는 난수 시드 변경도 적혀 있다. 시드 하나가 낸 개선량까지 그대로 새로운 학습 원리의 효과라고 할 수 있을까? 두 코드 버전을 같은 여러 시드로 짝지어 다시 학습하고 새로운 평가 텍스트에서도 차이가 유지되는지 보면, 45쪽의 ‘더 좋은 학습 알고리즘’이라는 질문에 더 직접적으로 답할 수 있다. 당시 실험 그래프
#하편 45쪽 — 이번에는 가중치를 바꾸는 규칙을 누가 고를까?
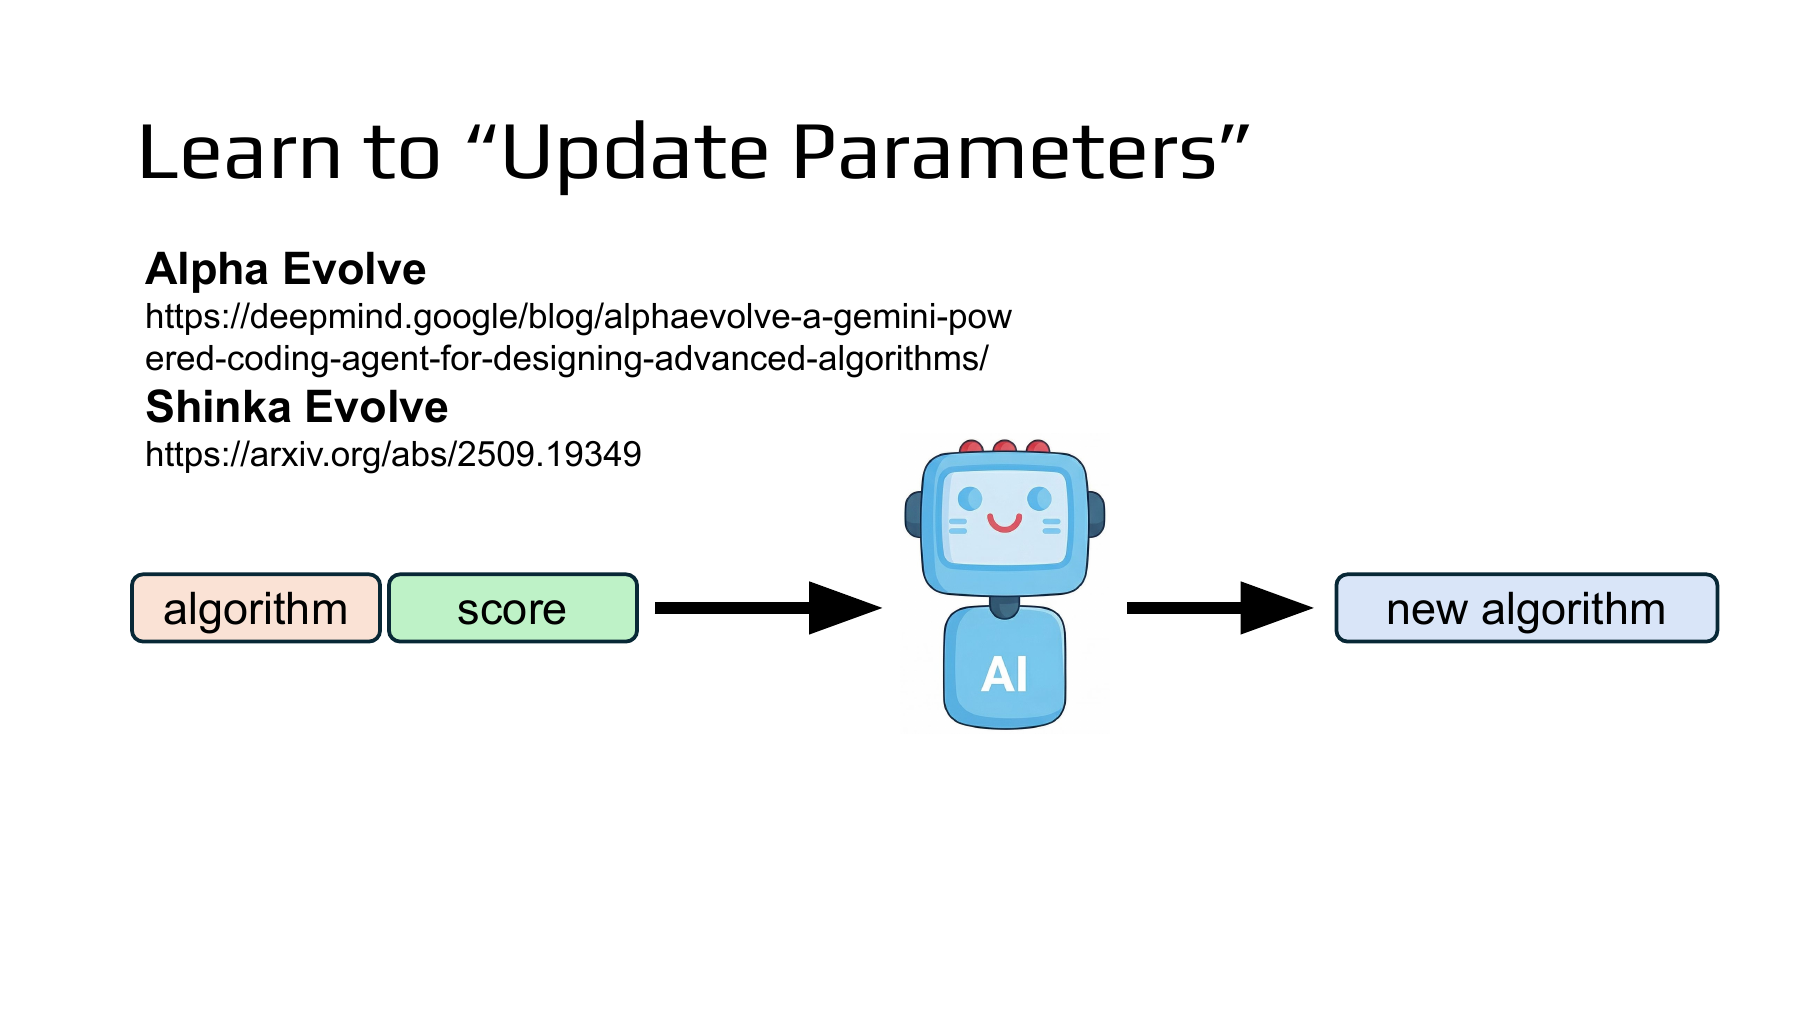
그림 왼쪽에는 숫자 하나와 프로그램 하나가 나란히 있다. 숫자(score)는 그 프로그램을 실행해 얻은 성적이고, 프로그램(algorithm)은 같은 절차를 다시 실행할 수 있는 코드다. 가운데 에이전트가 둘을 읽고 오른쪽의 새 프로그램을 제안한다. 새 코드의 성적은 실제로 실행한 뒤에 생긴다. 그 코드가 학습 규칙이라면 안쪽에서는 규칙대로 모델 가중치를 바꾸고, 바깥쪽에서는 어느 규칙으로 학습했을 때 결과가 좋았는지 비교한다. NTU 하편 45쪽
강사는 여기서 한 발 더 들어가 학습 알고리즘을 제안하는 언어 모델 자체를 훈련할 수 있을까라고 묻는다. 슬라이드에 적힌 AlphaEvolve와 ShinkaEvolve에서는 프로그램 후보가 평가를 거치며 바뀐다. 그런 탐색은 제안자의 가중치를 고정하고도 가능하다. 이 차이를 염두에 두고 두 연구가 무엇을 바꿨는지 읽어 보자. 강의 40:06
#식 풀이 6. 한 과제에서 잘된 학습률이 두 과제에서도 최선일까?
검사 카메라 두 대의 판독 오차를 각각 보정한다고 하자. 가상 예제에서 보정값 θ의 정답은 두 카메라 모두 0이다. 다만 같은 보정 오차가 생겼을 때 B의 손실은 A보다 세 배 가파르게 증가한다. 이를 곡률 a로 나타내면 A는 a=1, B는 a=3이다. 후보 규칙 둘은 학습률 η만 다르다. 두 카메라 모두 θ₀=2에서 시작해 한 번만 갱신한다.
| 규칙 후보 | A의 새 보정값 → 손실 | B의 새 보정값 → 손실 | 두 손실의 평균 |
|---|---|---|---|
| η=0.25 | 1.5 → 1.125 | 0.5 → 0.375 | 0.750 |
| η=0.75 | 0.5 → 0.125 | −2.5 → 9.375 | 4.750 |
B의 큰 보폭부터 대입해 보자. 시작 기울기는 3×2=6이므로 2에서 4.5만큼 움직인다. 최솟값 0을 지나 −2.5에서 멈추어 시작 손실 6보다 더 큰 손실을 낸다.
안쪽 갱신의 출력은 새 보정값 θ₁이다. 바깥 비교의 출력은 선택한 규칙이다. A 하나만 기준으로 삼으면 0.75가 이기고, 두 카메라를 같은 비중으로 평가하면 0.25가 이긴다. 비교할 과제와 예산이 정해져야 ‘더 좋은 학습법’이라는 말에 측정 가능한 뜻이 생긴다.
#보충 논문 · AlphaEvolve는 새 프로그램을 어떻게 채점할까?
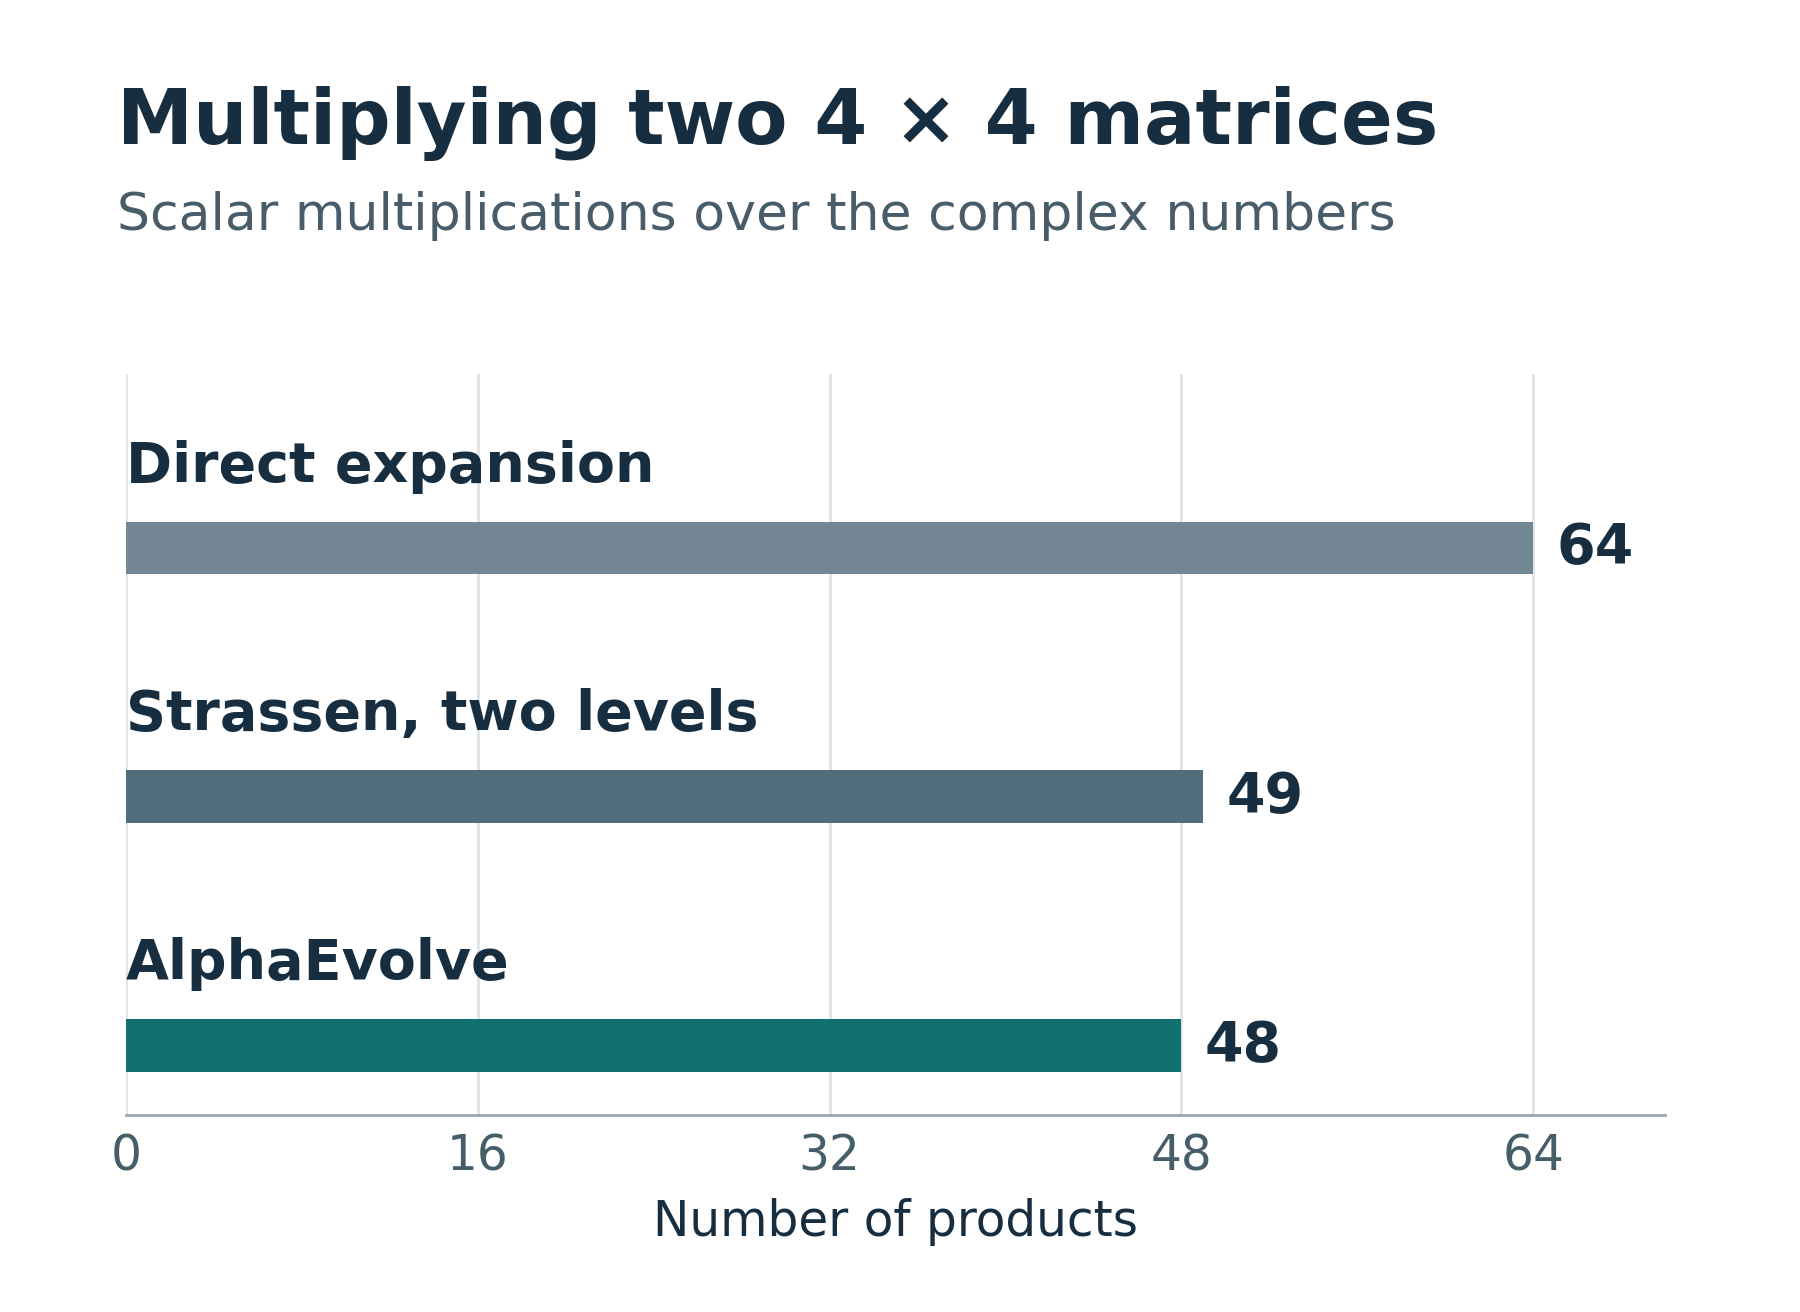
행렬 두 개를 곱하는 방법은 여러 가지다. DeepMind의 2025년 연구에서 에이전트가 편집한 것은 행렬곱 알고리즘을 찾아내는 프로그램이었다. 이전 프로그램들이 프롬프트에 들어가고, 언어 모델이 초기화·손실·최적화기 등을 수정한다. 평가자는 후보가 올바른 행렬곱을 표현하는지와 그 계산에 필요한 곱셈 수를 확인한다. 원 논문 그림 2에서 초기 프로그램과 평가 함수가 들어가는 곳, 평가 결과가 다음 선택으로 이어지는 경로를 볼 수 있다. AlphaEvolve, 그림 2와 §2.1 · DeepMind 연구팀 설명
위 보충 그림을 첫 항목부터 계산해 보자. 4×4 행렬곱의 결과에는 원소가 16개 있다. 각 원소를 길이 4인 두 벡터의 내적으로 직접 계산하면 스칼라 곱셈은 16×4=64회다. 슈트라센(Strassen) 방식은 2×2 블록 곱을 7번으로 줄인다. 이를 두 단계 적용하면 7×7=49회다. 연구진이 찾은 절차는 같은 4×4 복소 행렬곱을 48회로 계산한다. 49에서 48로 줄어든 단위는 곱셈 한 번이다. 덧셈과 메모리 이동, 장비에서의 실제 실행 시간을 비교하려면 별도의 측정이 필요하다. AlphaEvolve, 표 2 · 복소수 조건과 결과 해설
#식 풀이 7. ShinkaEvolve는 예측 오차와 전문가 쏠림을 어떻게 한 점수로 만들까?
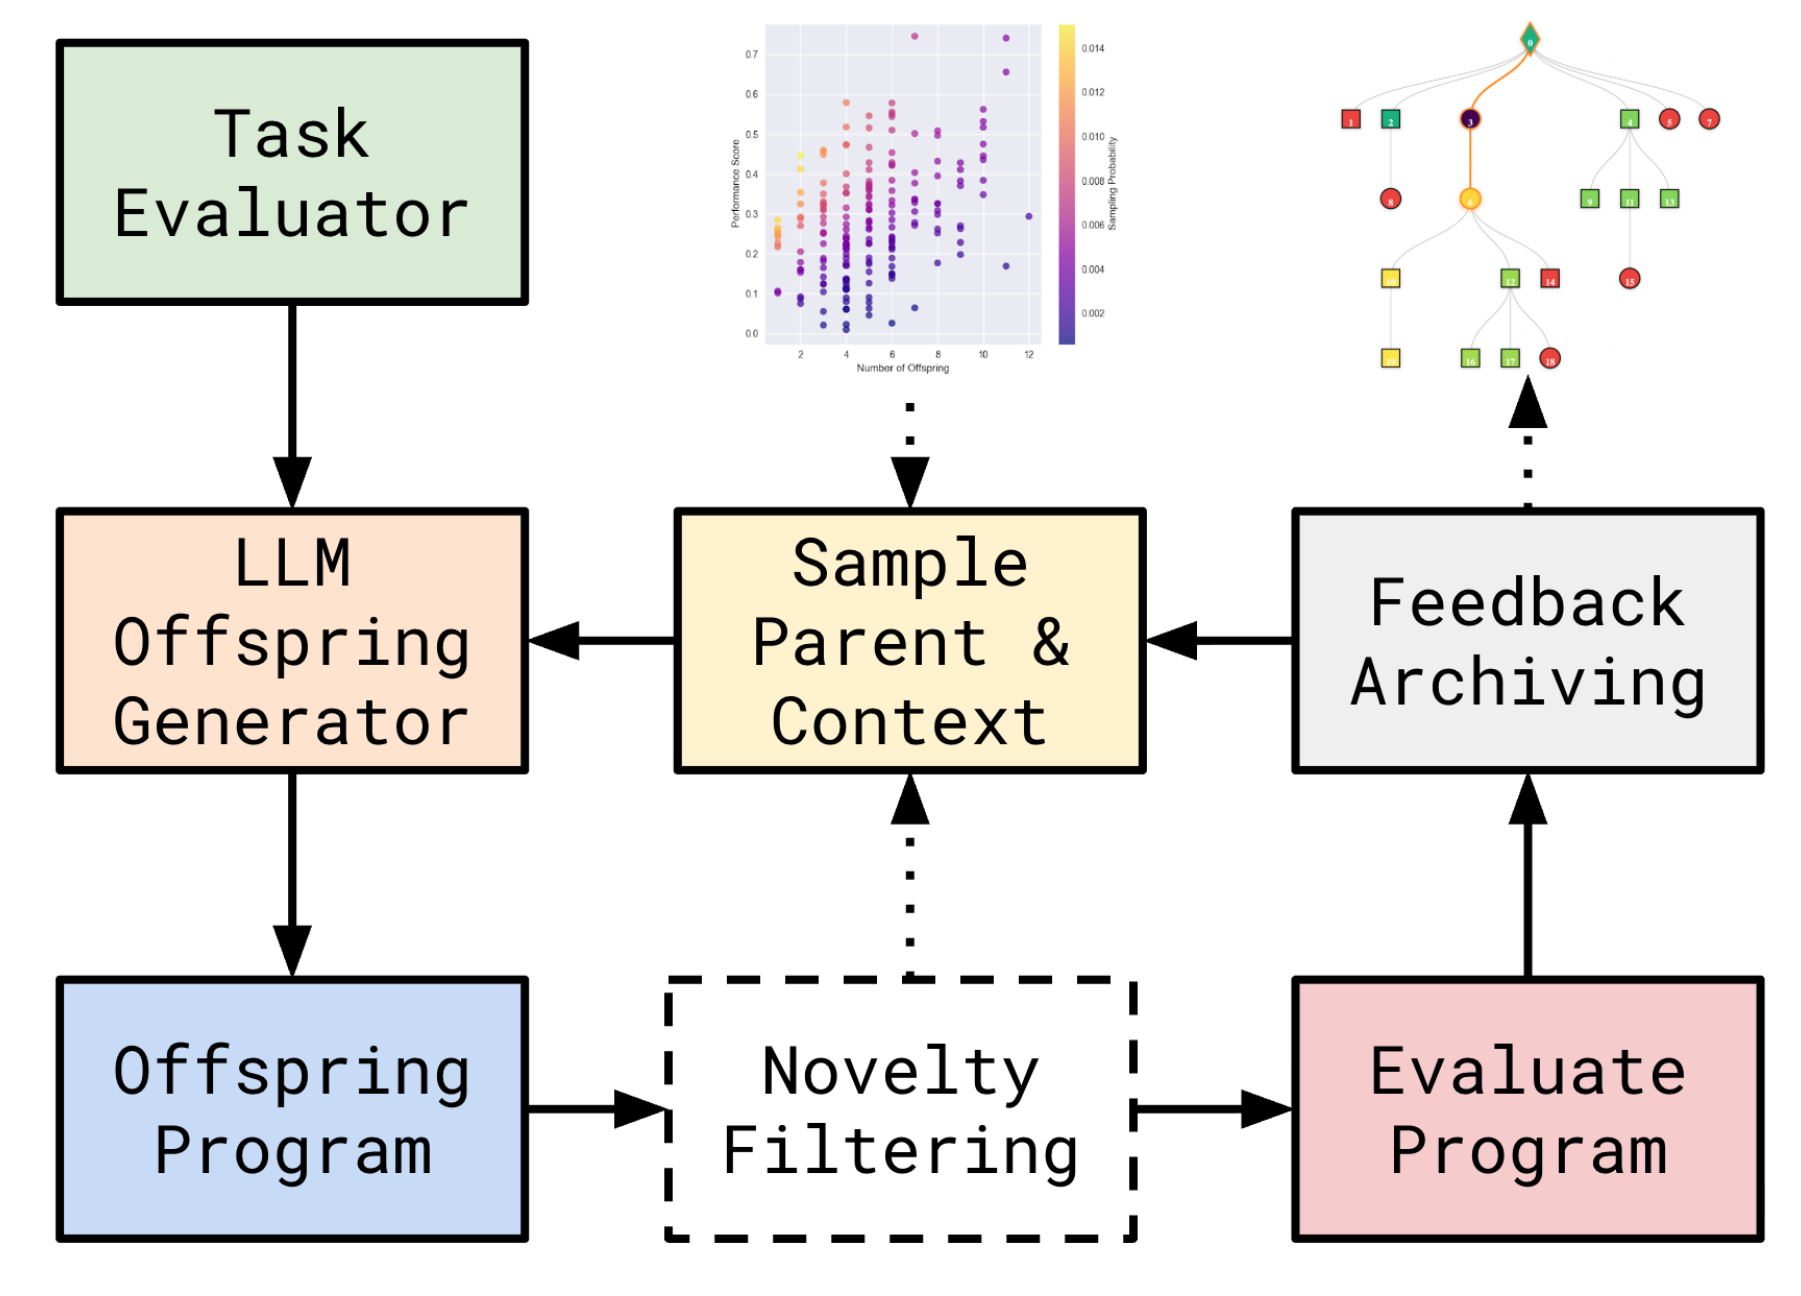
혼합 전문가 모델(Mixture of Experts, MoE)에서는 라우터가 각 토큰을 처리할 전문가를 고른다. 2025년 9월 ShinkaEvolve 논문에서 진화시킨 코드는 훈련 중 전문가 쏠림을 줄이는 보조 손실 함수였다. 연구진은 전문가 64개 중 토큰당 8개를 활성화하는 5억 5,600만 파라미터 모델로 후보를 평가했다. 안쪽 훈련에서는 다음 토큰의 교차엔트로피(CE)에 후보 보조 손실의 0.01배를 더했다. 바깥쪽에서는 학습 결과의 CE와 실제 쏠림을 함께 채점했다. 보충 그림에서 새 후보의 평가 결과가 다시 저장소로 돌아가는 화살표가 이 바깥 비교에 해당한다. ShinkaEvolve, §4.4
부록 식 4–5를 손으로 계산해 보자. 설명용으로 전문가를 두 개로 줄이고 토큰마다 한 곳만 선택한다. 후보 A로 학습하면 토큰 100개 중 60개와 40개가 두 전문가로 가고 최종 CE는 2.00이다. B에서는 52개와 48개, CE는 2.05다. 균등 사용의 기준은 양쪽 모두 0.5다. 각 전문가의 점유율 fᵢ가 이 기준에서 벗어난 양의 절댓값을 더한 뒤 2로 나눈다. ShinkaEvolve, 부록 B.4 식 4–5
큰 점수가 이기므로 B가 0.03 앞선다. B는 CE에서 0.05 손해를 보았지만 쏠림을 0.08 줄였다. 앞의 0.01은 모델을 훈련할 때 후보 보조 손실에 곱하는 계수다. 바깥 채점식의 D에 다시 곱하면 다른 기준으로 후보를 선택하게 된다. 논문의 실제 탐색은 사전학습 비용을 고려해 30회 진행했고, 최종 CE는 마지막 1,000만 토큰 구간에서 평균했다. 평가 절차와 적합도 식
41쪽의 θ′, 44쪽의 계단, 45쪽의 새 알고리즘은 각각 다른 결과를 기록한다. 첫째는 한 모델의 가중치, 둘째는 여러 훈련 실험에서 유지한 검증 기록, 셋째는 다음에 실행할 수 있는 학습 절차다. 다음 46쪽의 SEAL은 한 걸음 더 들어간다. 모델이 스스로 학습에 쓸 내용을 제안한다면, 그 제안은 어떤 결과를 보고 채점할까? NTU 하편 46쪽
논문 그림 이용 조건. PostTrainBench와 ShinkaEvolve