검사 카메라가 노란 부품을 보고 ‘왼쪽’이라고 답했다. 작업 지시서 한 줄을 읽혀 주자 같은 사진에 ‘오른쪽’이라고 답한다. 이때 달라진 것은 어디에 있을까? 저장된 모델 파일을 열어 보면 가중치는 같을 수 있다. 반면 방금 읽은 지시서를 지우고 처음부터 실행하면 답이 되돌아올 수 있다. 두 관찰은 함께 성립한다.
23편에서는 여러 과제를 거치며 어떤 학습 규칙을 익힐지 살펴봤다. 하편 51–55쪽에서는 그 규칙이 한 입력 시퀀스를 읽는 동안 어디에 무엇을 쓰는지 따라간다. TTT 층의 안쪽 가중치, Titans의 신경망 메모리, Transformer가 문맥에서 읽는 값을 차례로 비교한다. 손계산에 쓰는 토큰, 카메라, 분류 지시서는 설명을 위해 정한 예시다.
식 풀이 바로가기 토큰 쓰기와 읽기 · 토큰 순서와 손실 · KV 캐시 크기 · 놀람과 망각 · 메모리 갱신 주기 · 초기화 뒤 남는 개선 · 새 규칙 읽기
슬라이드별 영상 위치
| 하편 원본 | 강의 영상 | 그 장면에서 볼 것 |
|---|---|---|
| 51쪽 | 45:47 | 은닉 상태를 작은 모델의 가중치로 읽는 방법 |
| 52쪽 | 47:34 | RNN·Transformer·Mamba를 비교한 이전 강의 |
| 53쪽 | 47:54 | Titans와 Nested Learning에서 입력을 처리하는 동안 달라지는 것 |
| 54쪽 | 48:42 | 모델의 행동이 바뀌었다는 관찰로 무엇을 알 수 있는가 |
| 55쪽 | 50:25 | 강사가 은닉 상태와 느리게 바뀌는 가중치를 뇌와 유전자에 대응시키는 이유 |
각 링크는 강사가 해당 주제를 말하는 시각이다. 51쪽의 도식에서는 시간이 왼쪽에서 오른쪽으로 흐른다. 본문에 소개하는 2025년 보충 강의는 52쪽 슬라이드에 실린 별도 영상이다. NTU 2026년 5월 22일 수업
#하편 51쪽 — 토큰 하나를 읽으면 모델의 어느 숫자가 바뀔까?
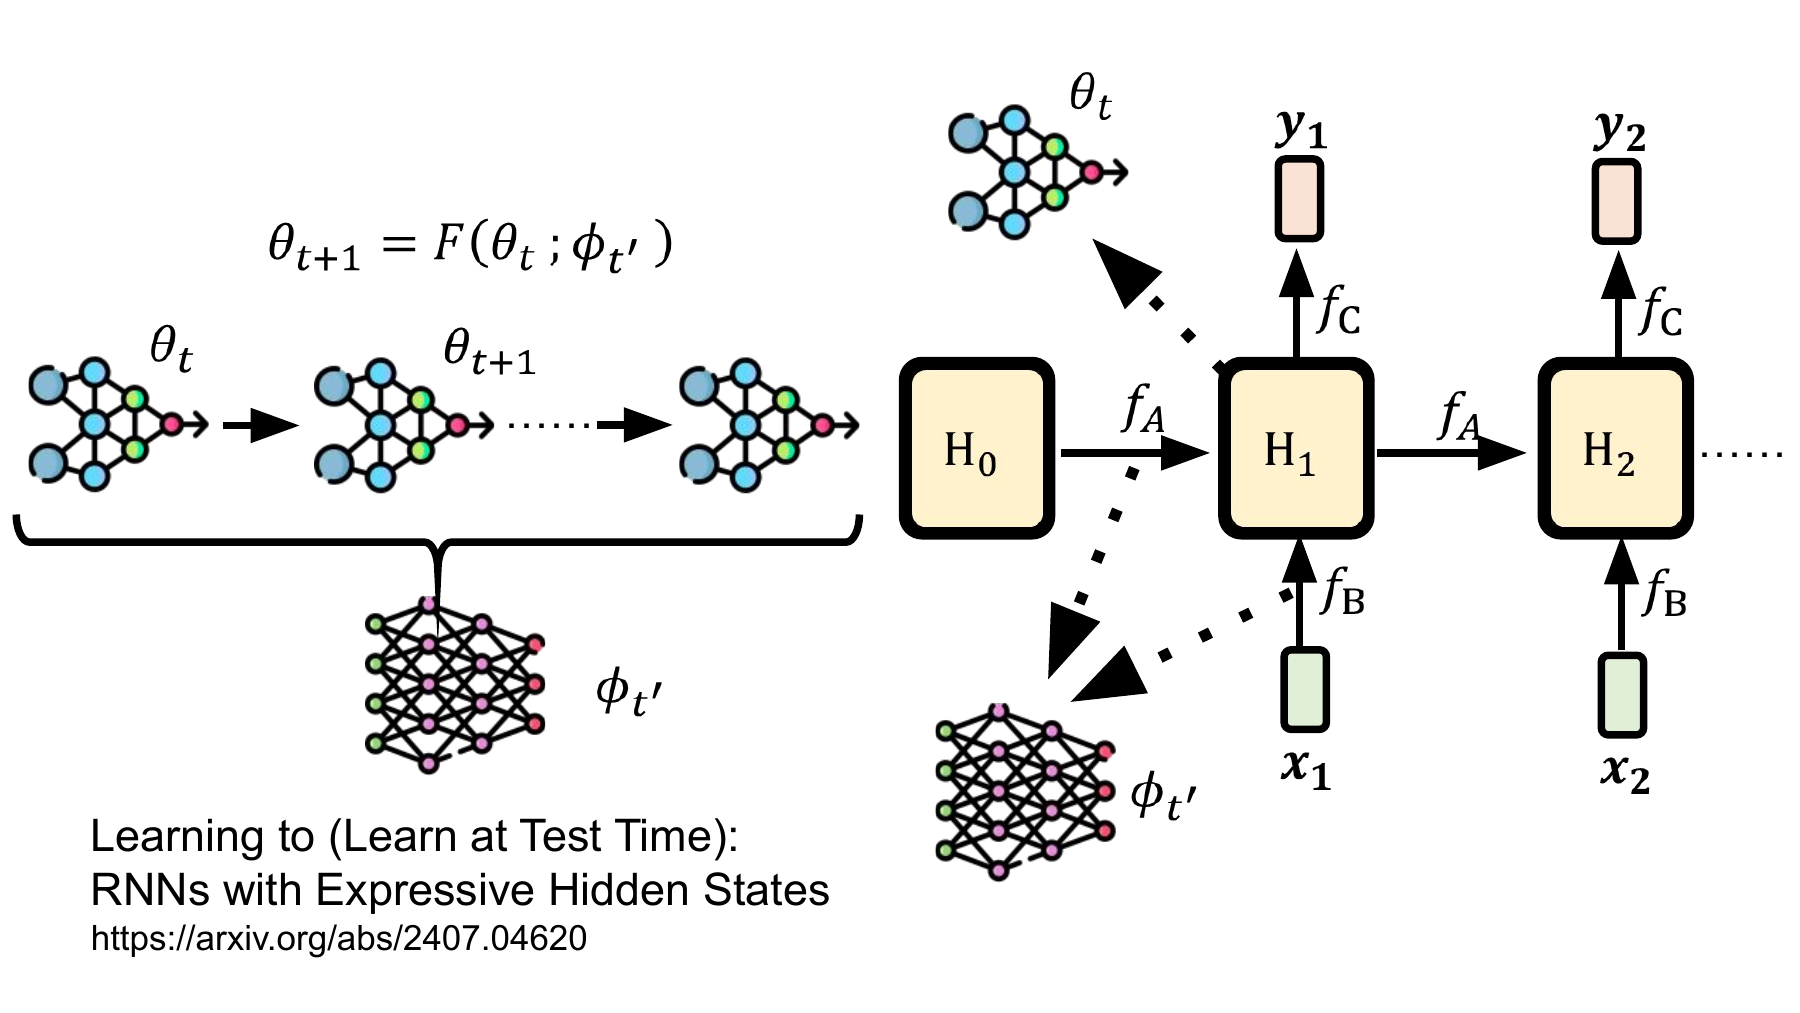
오른쪽 그림에서 아래의 입력 x₁과 왼쪽의 은닉 상태(hidden state) H₀를 따라가 보자. f_A는 이전 상태에서 가져올 정보를, f_B는 새 입력에서 가져올 정보를 정한다. 두 경로가 만나는 상자가 H₁이다. 위쪽의 f_C는 그 상태를 읽어 출력 y₁을 만든다. x₂가 들어오면 같은 함수들이 H₁에서 H₂를 만든다. 강사는 앞쪽 슬라이드의 빠른 파라미터 θ를 이 상자에, 학습 방법을 정하는 느린 파라미터 φ를 이 함수들에 대응시킨다. 같은 계산을 한 문장을 읽으며 달라지는 값과 다른 문장에서도 재사용하는 규칙으로 나눠 보는 것이다. 강의 45:47, 논문 소개 · 46:46, H를 파라미터로 읽는 대목
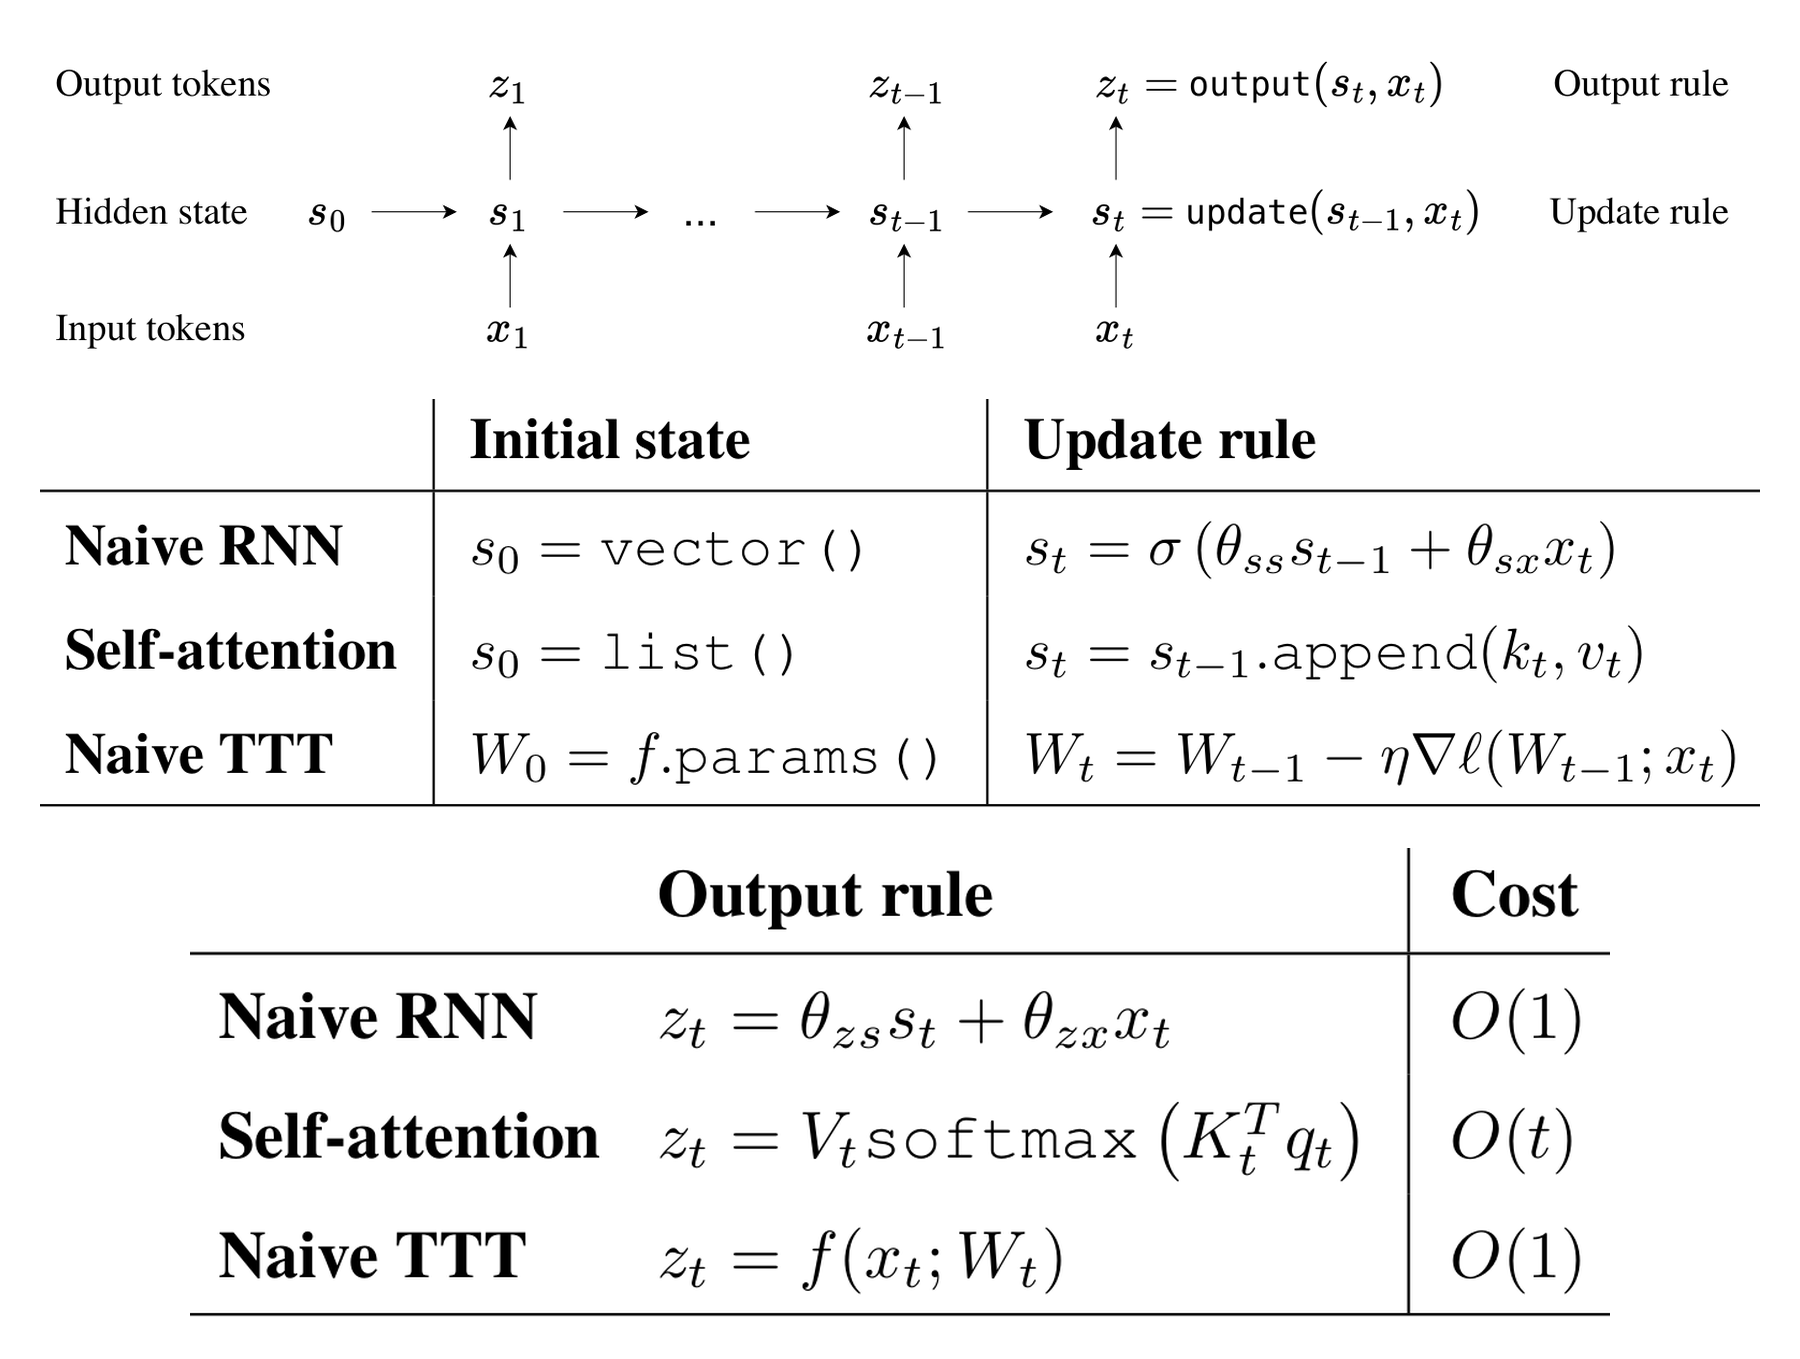
Sun 등의 보충 그림은 은닉 상태를 실제로 작은 예측기의 가중치 W로 쓰는 한 가지 구현을 보여 준다. 가운데 표의 갱신식을 위에서 아래로 읽으면 단순 순환신경망(RNN)은 상태 벡터를 바꾸고, 자기어텐션(self-attention)은 키와 값 한 쌍을 목록에 붙이고, TTT 층은 W에서 학습률을 곱한 손실 기울기를 뺀다. 아래 표의 출력식은 그렇게 바뀐 상태에서 무엇을 꺼내는지 보여 준다. 강의가 제시한 메타학습 관점은 세 경우에 적용할 수 있다. 이 중 테스트 시점 학습층(TTT layer)은 순전파 안에 자기지도 손실과 경사 갱신을 명시한다. ICML 2025 논문, 그림 2
#식 풀이 1. 한 토큰이 가중치에 무엇을 쓰고 무엇을 읽을까?
논문의 식 3과 4에서 현재 토큰의 벡터 xₜ를 세 방향으로 투영한다. 키 kₜ는 작은 모델에 입력할 특징, 값 vₜ는 복원할 목표 특징, 질의 qₜ는 갱신 직후 읽어 낼 때 쓰는 특징이다. 셋 다 현재 입력에서 얻으므로, 토큰 하나를 처리하는 순간에 다음 단어의 정답을 기다릴 필요가 없다. 세 투영 행렬은 바깥 학습에서 정한다. 논문 식 3–4
손으로 계산하려고 작은 예측기를 곱셈 하나 f(k; w)=wk로 줄이고 손실에 ½을 붙이자. 이때 미분하면 제곱의 2가 사라진다. 이전 가중치가 0, 학습률 η가 ½인 상태에서 토큰 A가 (k,v,q)=(1,2,2)를 준다고 하자. 갱신 전 예측은 0이고 목표는 2다.
마지막 줄에서 복원 손실은 키 1을 넣어 재고, 층의 출력 z₁은 질의 2를 넣어 읽는다. z₁은 다음 층으로 넘어가는 특징이다. 언어 모델은 이 특징을 더 처리해 다음 토큰의 확률을 낸다. 이 손계산은 편향·정규화를 생략하고 한 토큰마다 기울기를 새로 구한 예다. 논문은 실제 장치에서 여러 기울기를 병렬로 계산할 수 있도록 토큰 미니배치도 도입한다. 논문 §2.4, 그림 3
#식 풀이 2. 같은 두 토큰도 읽는 순서가 바뀌면 다음 단어의 확률이 달라질까?
이번에는 B의 목표 특징만 −2로 바꾸자. A와 B 모두 키는 1, 질의는 2다. 같은 초기값 w₀=0에서 시작해 매번 위 식으로 갱신하면 새 가중치는 이전 가중치와 새 목표의 중간값이다.
| 읽은 순서 | 첫 토큰을 쓴 뒤 | 둘째 토큰을 쓴 뒤 | 마지막 출력 z₂=2w₂ |
|---|---|---|---|
| A → B | 1 | (1−2)/2 = −0.5 | −1 |
| B → A | −1 | (−1+2)/2 = 0.5 | 1 |
이제 단어가 두 종류뿐인 가상 언어 모델에서, 출력 z₂를 단어 C의 로짓(logit)으로 두고 다른 단어의 로짓은 0으로 고정하자. 두 문장 모두 실제 다음 단어는 C라고 가정한다. 소프트맥스를 적용하면 C에 준 확률과 다음 토큰 손실은 아래와 같다. ln은 자연로그다.
같은 토큰 두 개라도 뒤에 온 값이 마지막 w에 더 크게 남는다. 안쪽 손실 ℓ은 현재 토큰에서 만든 v를 얼마나 잘 복원하는지 측정한다. 바깥 손실 L은 그 방식으로 기억한 뒤 실제 다음 단어에 얼마의 확률을 줬는지 측정한다. 훈련 때는 바깥 손실로 투영과 나머지 언어 모델을 학습한다. 배포 후에는 새로운 문장의 토큰만으로도 그 문장을 위한 W를 갱신할 수 있다. 논문 §2.2, 두 학습 루프
#하편 52쪽 — 긴 문장을 읽을 때 어떤 기억이 계속 커질까?
이 표지는 강사가 연결한 2025년 NTU 기계학습 제4강이다. 그 강의는 순환신경망, 자기어텐션, Mamba가 앞부분의 정보를 어떻게 다음 위치로 전달하는지 비교한다. 51쪽에서는 H를 무엇으로 볼지 물었다. 52쪽의 보충 강의를 볼 때는 다음 토큰을 처리하려고 지난 토큰에서 어떤 숫자를 들고 왔는지를 따라가 보자. 본 강의 47:34 · 2025년 제4강 영상 · 강의 슬라이드 10–11쪽
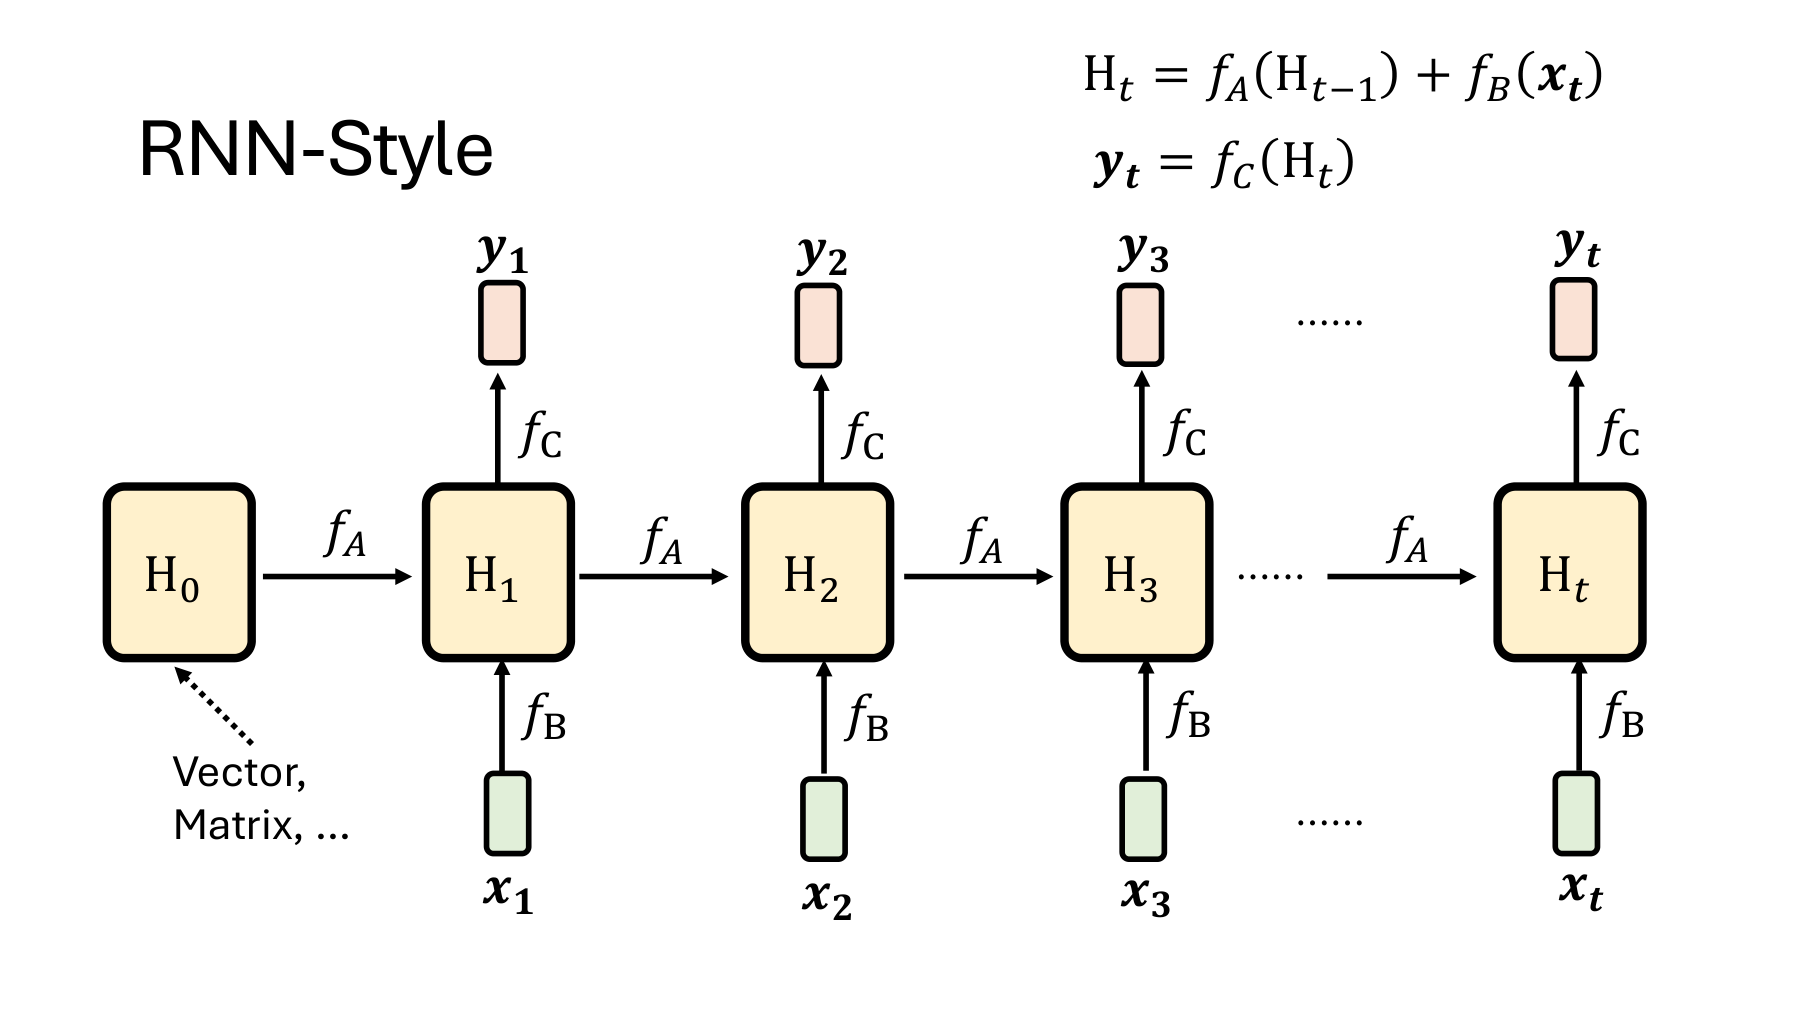
보충 슬라이드 11쪽에서 H₁은 H₀와 x₁로 만든다. H₂를 계산할 때 x₁에서 직접 건너오는 선은 없다. H₁이 전달한 정보로 H₂를 계산한다. 같은 강의의 17쪽에서는 경로가 달라진다. 새 질의가 지금까지의 키들과 각각 내적을 구하고, 그 점수를 소프트맥스로 바꿔 각 값에 곱한다. 앞선 키와 값을 저장해 두는 것이 키·값 캐시(KV cache)다. 2025년 강의 12:30, 상태가 바뀌는 경로 · 상태 갱신 11쪽 · 자기어텐션 17쪽
같은 영상의 46:00에서는 키와 값을 하나의 행렬에 누적하는 선형 어텐션(linear attention)을 유도한다. 선택한 선형식은 학습 때 위치들을 묶어 계산하고, 추론 때는 행렬 상태 하나를 순서대로 갱신해 계산할 수 있다. 바로 앞의 17쪽은 점수에 소프트맥스를 적용한다. 아래 저장량 비교는 이 17쪽의 전체 자기어텐션을 기준으로 한다. 2025년 강의 46:00 · 보충 강의 40쪽
#식 풀이 3. 4번째와 8번째 토큰에서 저장량과 읽기 횟수는 얼마나 다를까?
어텐션 헤드 하나에서 키와 값이 각각 숫자 2개짜리 벡터라고 하자. 각 위치가 모든 이전 위치와 자기 자신을 볼 수 있다. t번째 출력 직전 캐시에는 t쌍이 있고, 현재 질의는 키마다 한 번씩 점수를 계산한다. 비교할 TTT는 2차원 키를 2차원 값으로 보내는 편향 없는 선형 모델 W 하나를 상태로 쓴다고 하자.
| 현재 위치 | KV 캐시의 숫자 | 현재 질의와 키의 내적 | 선형 TTT의 W에 든 숫자 |
|---|---|---|---|
| 4번째 토큰 | 16개 | 4회 | 4개 |
| 8번째 토큰 | 32개 | 8회 | 4개 |
TTT도 토큰마다 W를 갱신하고 Wq를 계산하는 비용을 낸다. 표가 센 것은 문맥을 들고 가는 상태와 한 위치에서 비교하는 키 수다. 실행 시간과 전체 GPU 메모리에는 층의 폭, 모델 가중치, 임시 배열, 병렬화 방식도 영향을 준다. 고정 크기 상태의 대가는 압축이다. 앞에서 쓴 식에 목표값 (2,−2)를 넣으면 마지막 w는 −0.5다. 다른 목표값 (0,−1)을 넣어도 −0.5다. 마지막 가중치만 읽으면 어느 쌍이 들어왔는지 구분할 수 없다. 논문의 장문 실험은 이 압축이 다음 단어 예측에 쓸 정보를 얼마나 남겼는지 퍼플렉서티(perplexity)로 평가한다. 값이 작을수록 실제 다음 단어에 더 높은 확률을 줬다는 뜻이다. 그림 1 오른쪽에서 훈련 연산량을 맞춘 모델들을 비교하면, 앞서 읽은 토큰 수가 16k를 넘어갈 때도 TTT-Linear와 TTT-MLP의 퍼플렉서티는 계속 낮아졌고 이 실험의 Mamba 곡선은 더 낮아지지 않았다. TTT 논문, 긴 문맥 실험 그림 1 · 상태와 계산량 비교, 그림 2
#하편 53쪽 — Titans는 무엇을 기억하고, Nested Learning은 언제 다시 쓸까?
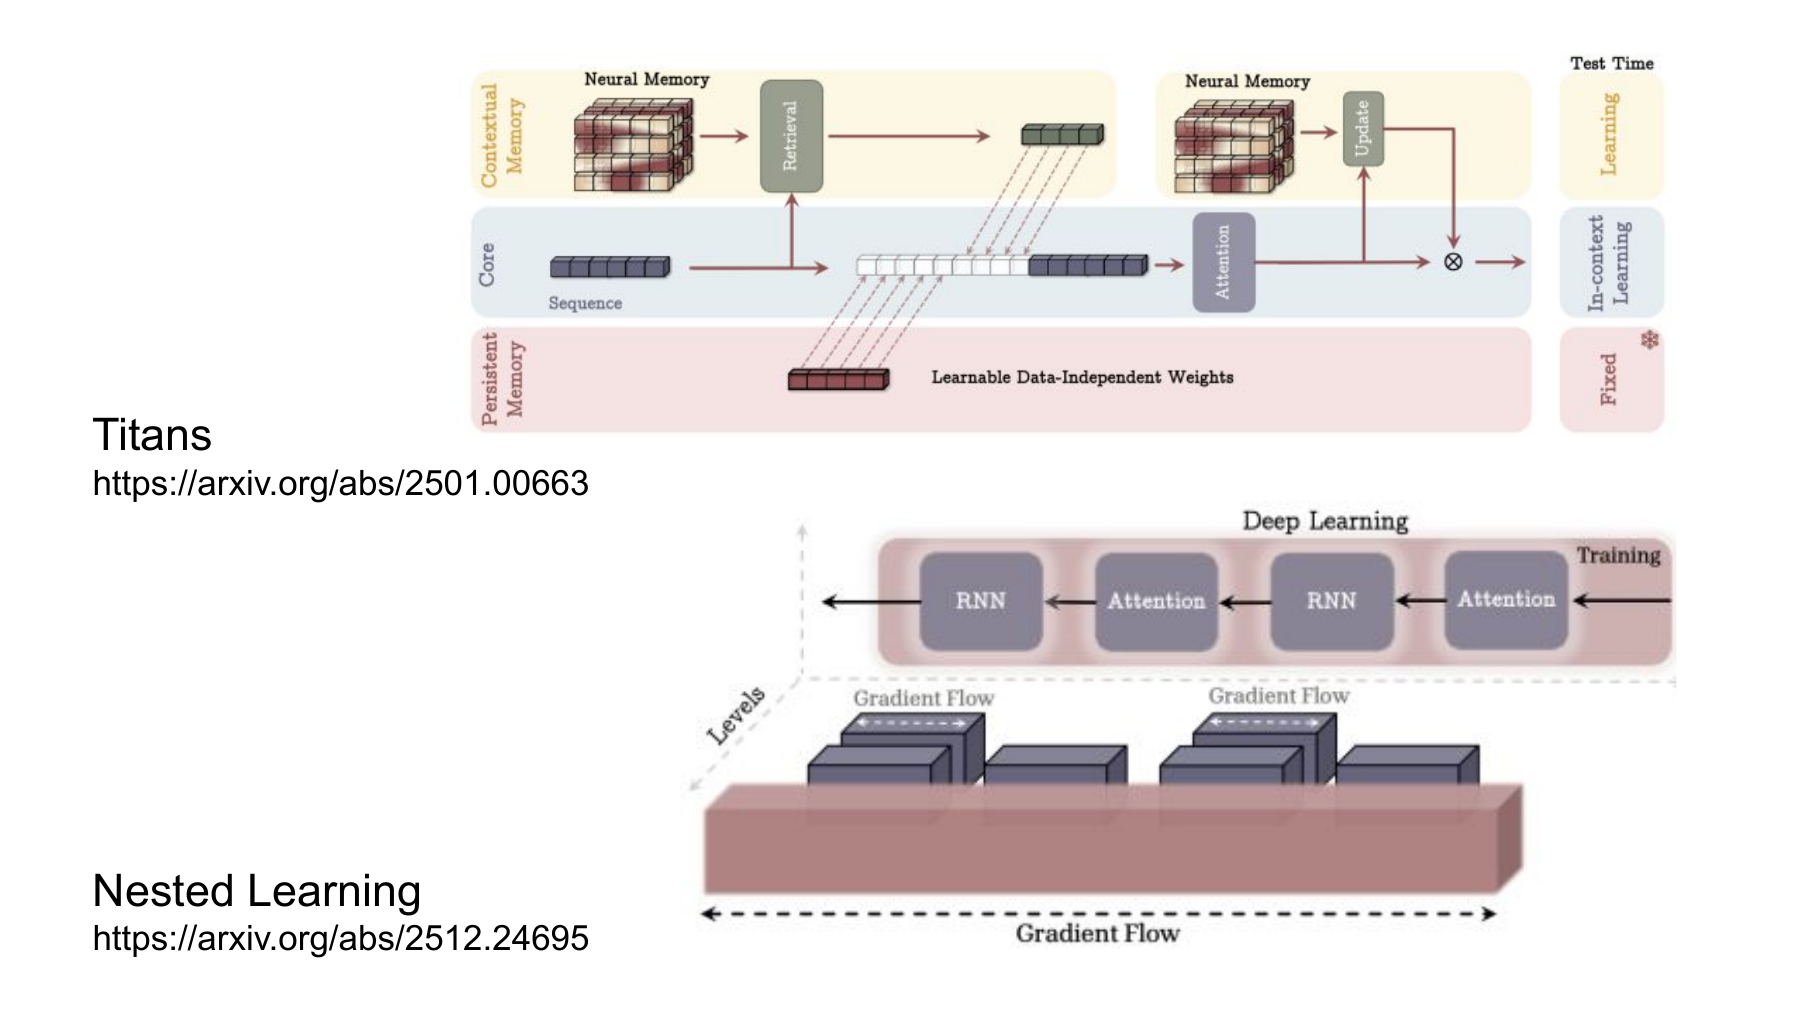
위 그림은 Titans의 세 설계 중 메모리를 문맥으로 쓰는 방식(memory as a context, MAC)이다. 새 토큰 묶음이 들어오면 먼저 위쪽 신경 메모리에서 관련 정보를 꺼낸다. 가운데의 주의집중(attention)은 이 정보, 현재 토큰 묶음, 아래쪽의 학습된 고정 벡터를 함께 읽는다. 그 결과로 위쪽 메모리를 갱신한다. 그림에서 ‘학습’과 ‘고정’이 동시에 보이는 이유다. 아래의 영구 메모리(persistent memory)는 훈련 때 배운 입력 독립적인 벡터이고, 위의 문맥 메모리(contextual memory)는 지금 읽은 내용에 따라 바뀐다. 강사는 두 논문을 소개하며, 무엇을 상태라고 부르고 무엇을 학습되는 가중치라고 부르는지 다시 묻는다. NTU 하편 53쪽 · 강의 47:54 · Titans, 그림 2
#식 풀이 4. 같은 토큰을 읽어도 왜 직전 갱신이 영향을 줄까?
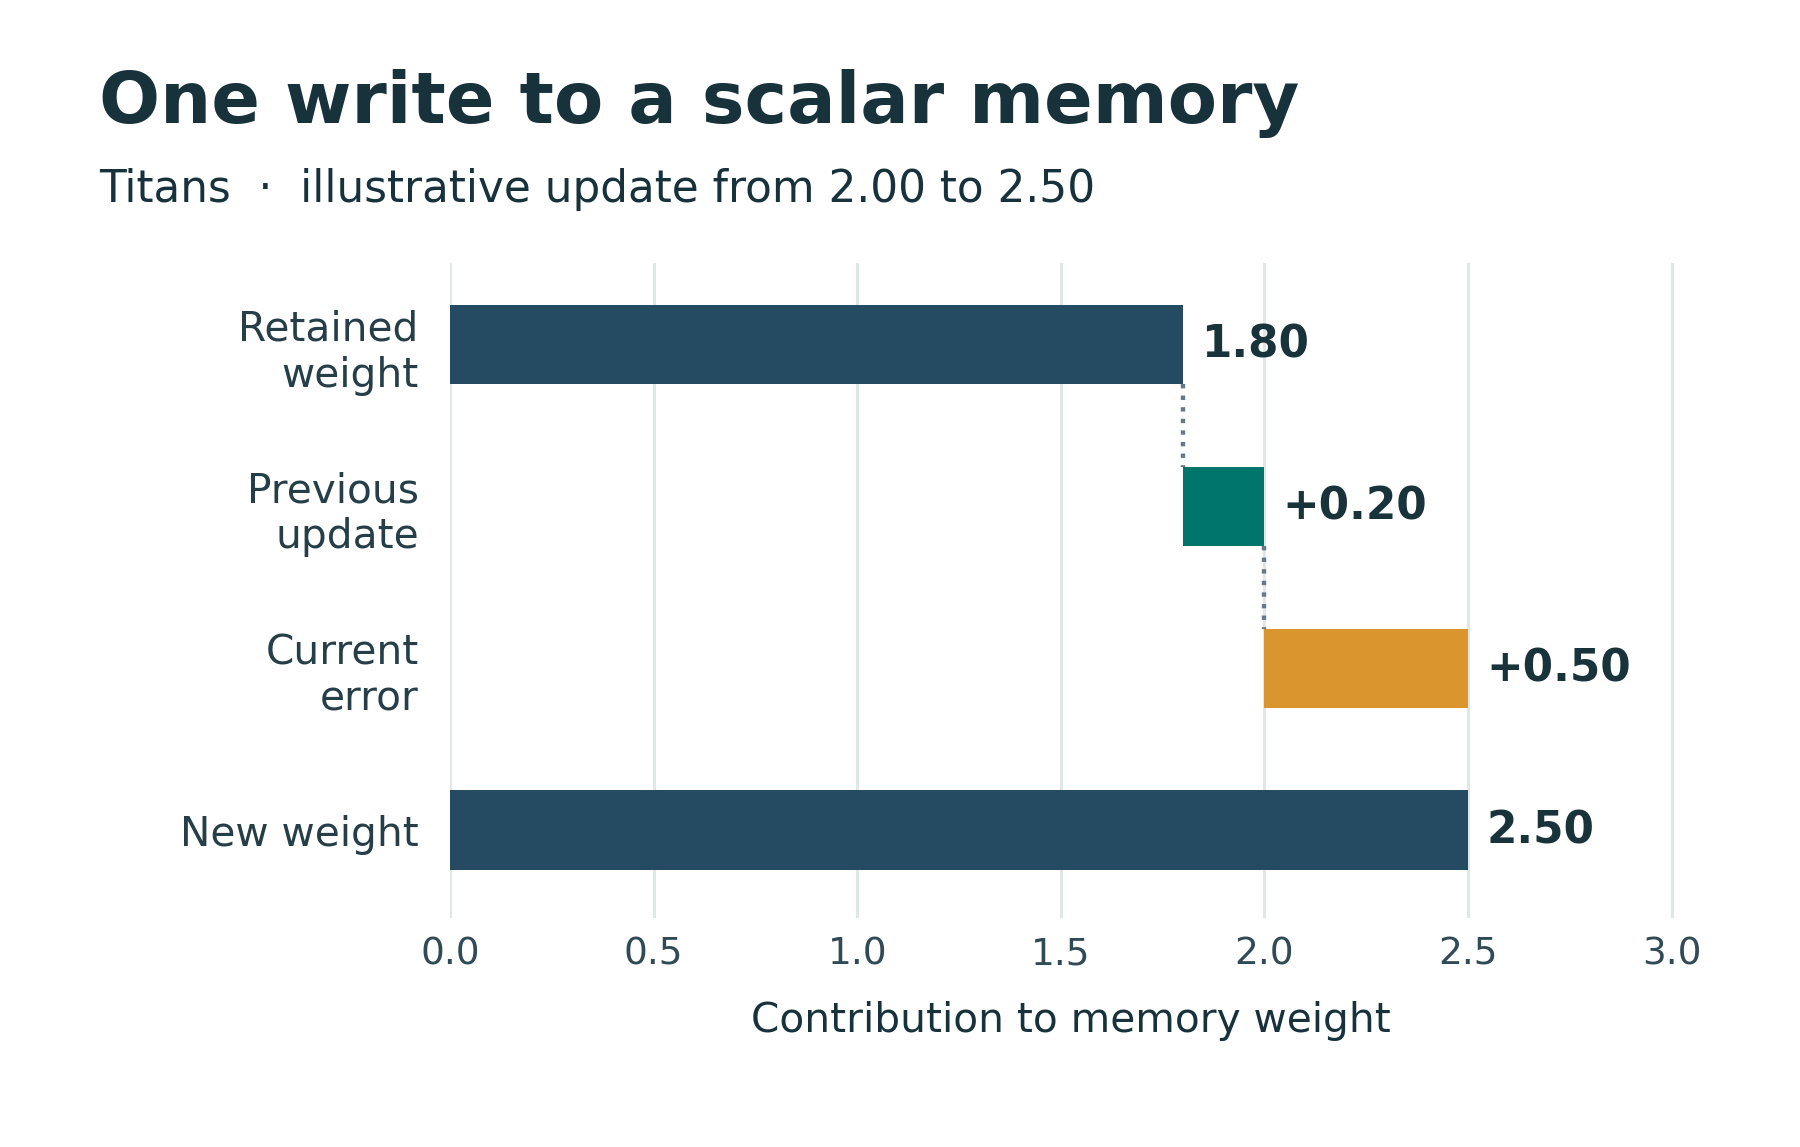
Titans에서 놀라움(surprise)을 계산하려면 메모리가 틀린 방향과 크기를 알아야 한다. 토큰에서 키 k와 값 v를 만들고, 메모리가 키로 복원한 값이 v에서 얼마나 벗어났는지 잰다. 논문 식 (12)의 제곱오차를 1차원으로 줄여 보자. 가상 예제에서 메모리는 키에 숫자 m을 곱한다. 직전 값은 m=2, 새 키는 k=1, 목표는 v=3이다. 출력 2를 목표 3에 가깝게 하려면 m을 키워야 한다. Titans, 식 (11)–(14)
직전 갱신량을 S, 이번에 쓸 갱신량을 S′라 하자. η는 직전 갱신을 얼마나 이어받을지, θ는 지금의 기울기를 얼마나 반영할지, α는 기존 메모리에서 얼마나 덜어낼지를 정한다. 원 논문에서는 입력에 따라 달라질 수 있는 계수들이다. 한 번의 계산을 위해 S=0.4, η=0.5, θ=0.25, α=0.1로 둔다.
그림의 막대는 이전 메모리에서 남은 1.80, 직전 갱신에서 이어진 0.20, 이번 오차가 보탠 0.50을 표시한다. 같은 키를 다시 읽으면 출력은 2.5, 제곱오차는 1에서 0.25로 줄어든다. 직전 갱신만 버려 η=0으로 두면 새 메모리는 2.30이다. 망각만 끄고 α=0으로 두면 2.70이다. 두 계수는 서로 다른 항에 작용한다. 실제 논문의 구성요소 제거 실험에서도 이를 따로 측정했다. 표 5의 장문맥 정확도는 신경 메모리 기준 모델(LMM) 92.68%, 모멘텀 제거 87.12%, 가중치 감쇠 제거 85.60%였다. 각 차이는 그 표의 실험 조건에 해당한다. Titans, §5.9 및 표 5
#식 풀이 5. 여덟 토큰 동안 세 메모리에 몇 번씩 쓸까?
아래 그림의 RNN과 attention을 옆으로 읽으면 순서대로 연결한 층이 보인다. 연구진은 여기에 어떤 양을 어떤 신호로 얼마나 자주 갱신하는가라는 축을 더했다. 이것이 중첩 학습(Nested Learning)의 관점이다. 한 구현인 연속체 메모리 시스템(continuum memory system, CMS)에서는 여러 다층 퍼셉트론(MLP)을 거쳐 출력을 계산한다. 각 블록은 자신의 토큰 묶음이 끝날 때 가중치를 갱신한다. 블록이 토큰을 처리하는 시점과 그 블록의 가중치를 다시 쓰는 시점을 나눠 보자. Nested Learning, 그림 2 · §7.1, 식 (70)–(71)
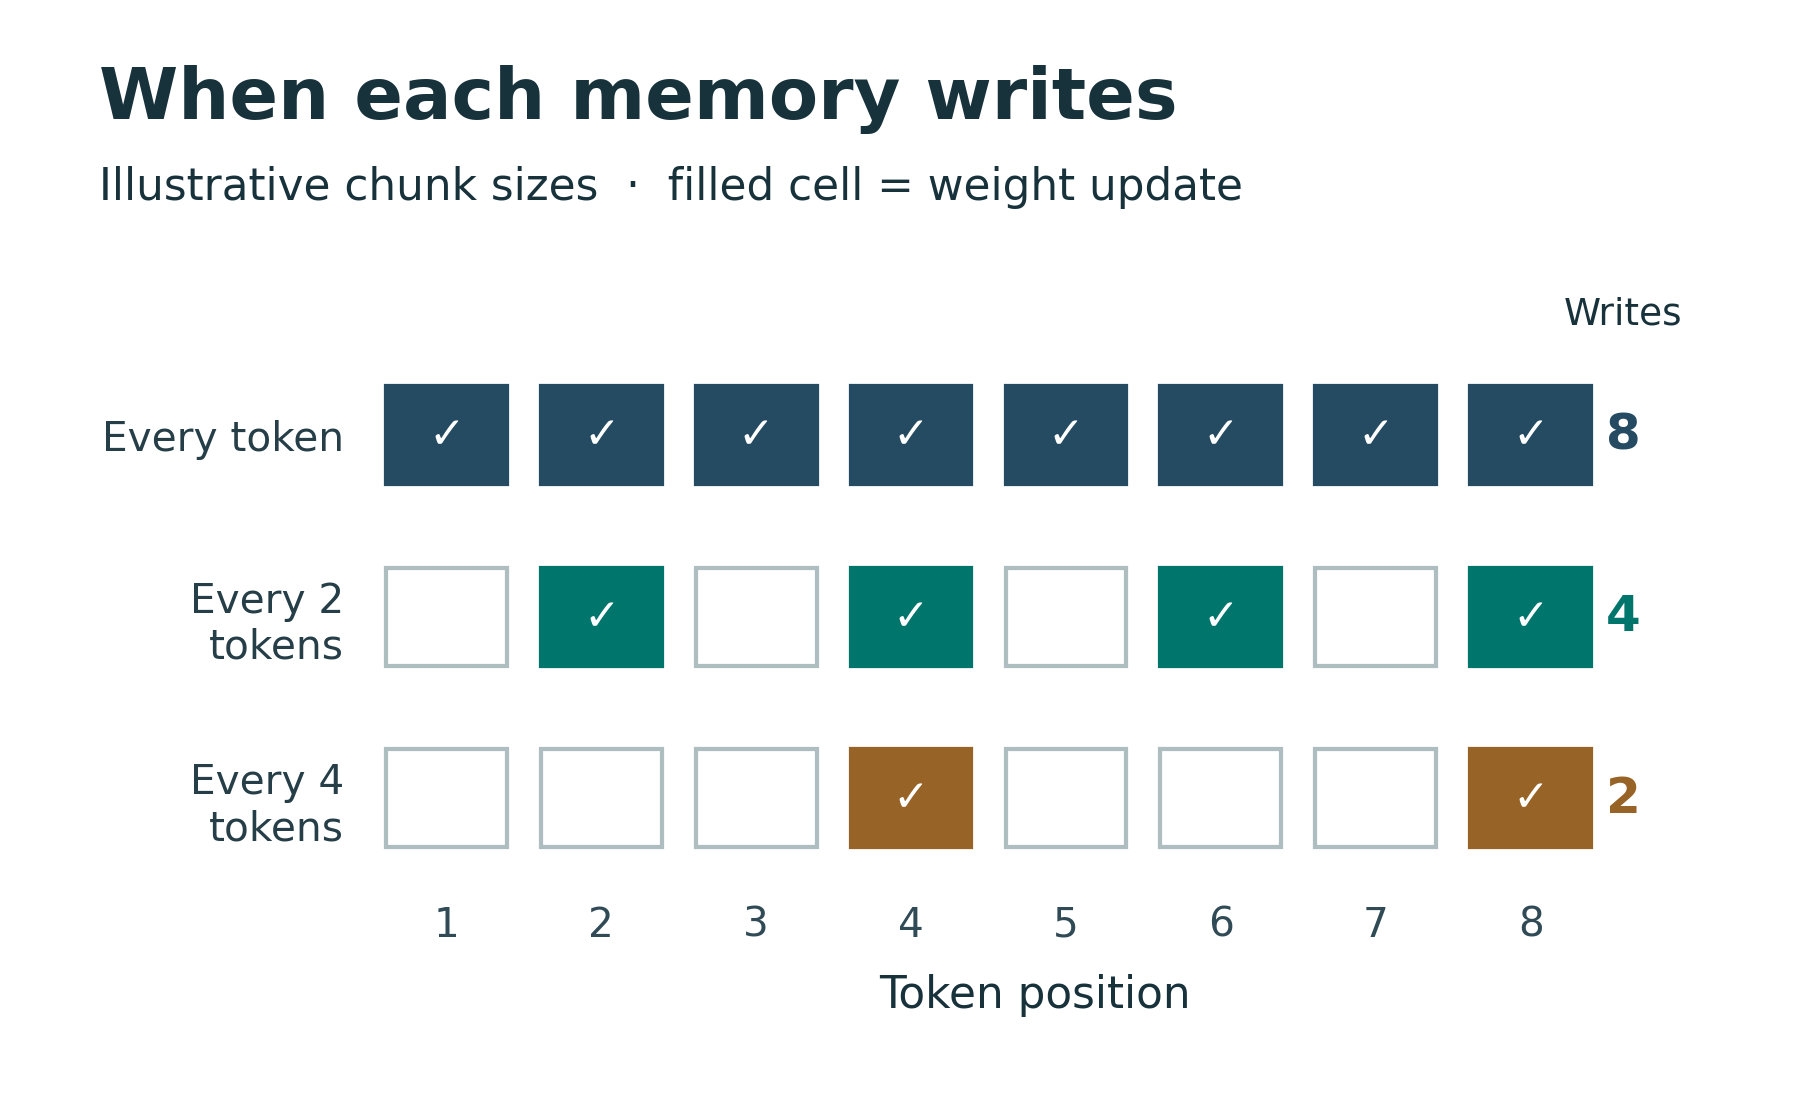
가상 일정에서 세 블록의 갱신 간격 C를 1, 2, 4토큰으로 둔다. 첫 토큰을 1번으로 세고 완성된 묶음의 끝에서만 쓴다. 그러면 길이 T인 구간 안에서 한 블록이 쓴 횟수 N은 완성된 묶음의 수다.
4번과 8번에서는 세 블록이 모두 쓴다. 7번에서는 가장 빠른 블록만 쓴다. 느린 블록도 7번의 입력을 처리하며 다른 출력을 낼 수 있다. 이때 쓰는 가중치는 4번이 끝날 때 갱신한 값이다. 따라서 ‘4토큰마다 쓴다’는 말은 ‘4토큰마다 한 번만 대답한다’는 뜻으로 읽으면 안 된다. 또 이 일정만 세어서는 각 기억이 정확히 몇 토큰 동안 남는지 알 수 없다. 그 값은 무엇을 썼는지, 이후의 쓰기가 어떻게 간섭하는지에도 달려 있다. Nested Learning, 식 (70)–(71)
#하편 54쪽 — 답이 바뀌면 모델의 무엇이 달라졌다고 말할 수 있을까?
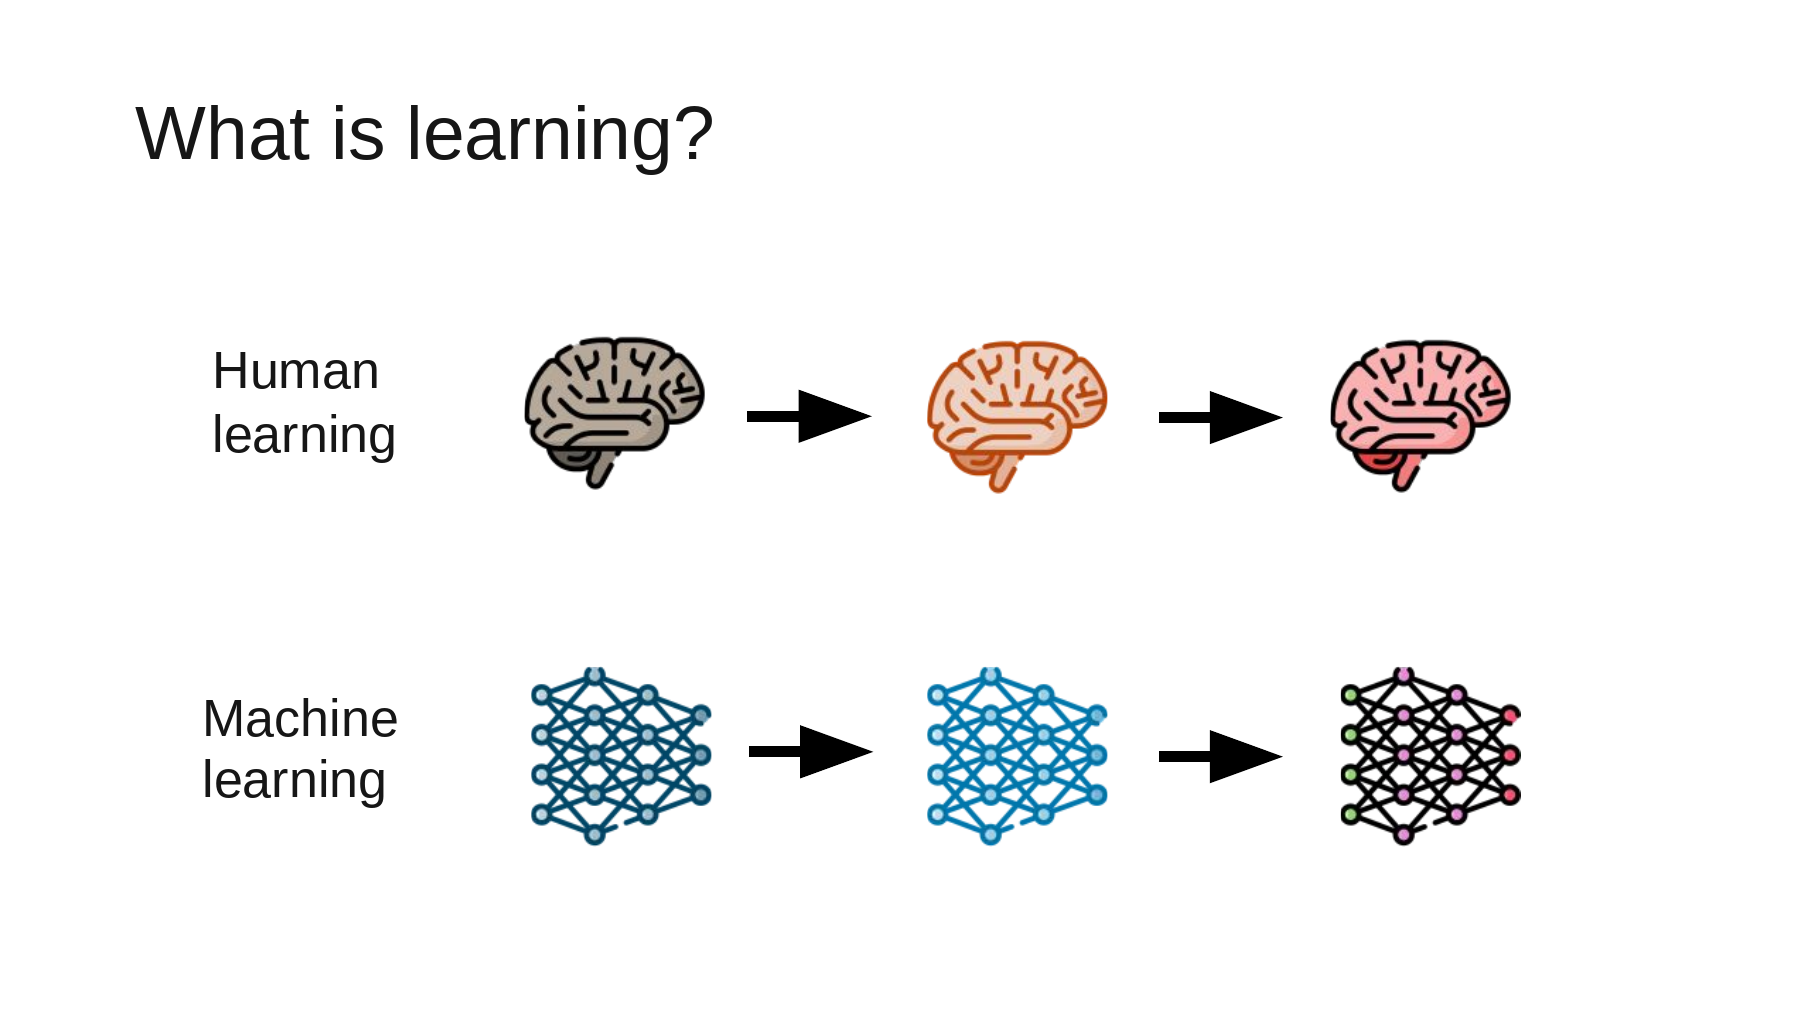
슬라이드에는 두 줄의 그림이 있다. 위에서는 경험을 거치며 사람의 뇌 색이 바뀌고, 아래에서는 훈련을 거치며 신경망 색이 바뀐다. 강사는 이 그림에서 출발해 ‘행동이 달라졌다’는 관찰과 ‘가중치를 업데이트했다’는 설명을 나눌 실마리를 준다. 모델이 어제와 다른 답을 냈다면, 답을 낼 때 어떤 정보를 볼 수 있었는지도 확인해야 한다. 강의 48:42 · 가중치와 뇌 연결의 비유, 49:17
가령 한 공장에서는 작업 교대 때마다 부품을 넣을 통의 위치가 달라진다. 오늘의 지시서는 ‘파란 부품은 왼쪽, 노란 부품은 오른쪽’이다. 검사기는 색을 이미 구분할 수 있다. 새로 알아야 할 것은 오늘 어떤 색이 어느 통으로 가는지다. 이전 교대에서 익힌 색 인식 능력과 오늘 지시서에서 얻은 정보를 이 예제에서는 따로 확인할 수 있다.
#식 풀이 6. 지시서를 지운 뒤에도 남은 개선은 얼마일까?
파란 부품 두 장과 노란 부품 두 장으로 작은 확인 문제를 만든다. 네 사진은 매번 같고, 각 사진을 독립적으로 검사한다. 모델의 저장 가중치, 판독 방식, 오늘의 정답도 고정한다. 지시서를 주지 않은 조건에서는 모든 부품을 왼쪽으로 보내고, 지시서를 주면 네 장을 모두 올바른 통에 보낸다고 가정하자. 마지막 조건에서는 같은 체크포인트를 다시 열고 대화 기록과 실행 상태를 비운다. 세 결과는 설명을 위한 가정값이다.
| 같은 사진 네 장에 대한 결과 | 파란색 2장 | 노란색 2장 | 오늘 지시서 기준 정답 |
|---|---|---|---|
| 지시서를 주기 전 | 왼쪽 2회 | 왼쪽 2회 | 2/4 |
| 지시서가 문맥에 있을 때 | 왼쪽 2회 | 오른쪽 2회 | 4/4 |
| 원래 체크포인트에서 새로 실행 | 왼쪽 2회 | 왼쪽 2회 | 2/4 |
지시서가 보이는 동안 얻은 개선과, 초기화한 뒤에도 남은 개선을 각각 첫 조건과 비교한다. 정확도의 차이이므로 단위는 퍼센트포인트(%p)다.
이 네 장에서 지시서의 효과는 50%p, 새 실행에서 관측한 잔여 효과는 0%p다. 첫 두 행만 보면 지시서가 행동에 미친 영향을 확인할 수 있다. 세 번째 행을 더해야 그 효과가 초기화 뒤에도 재현되는지 답할 수 있다. 배포 시스템에 대화 이력이나 외부 메모리가 연결돼 있다면 새 실행이 해당 정보를 다시 읽는지도 기록해야 한다. Brown 등의 2020년 GPT-3 실험은 문맥 속 예시만으로 과제를 지정하고, 평가 중 모델 가중치는 고정한 실제 사례다. GPT-3 논문 §2, 과제 제시 방법
#하편 55쪽 — 가중치를 고정한 채 새 규칙을 따르는 방법은?
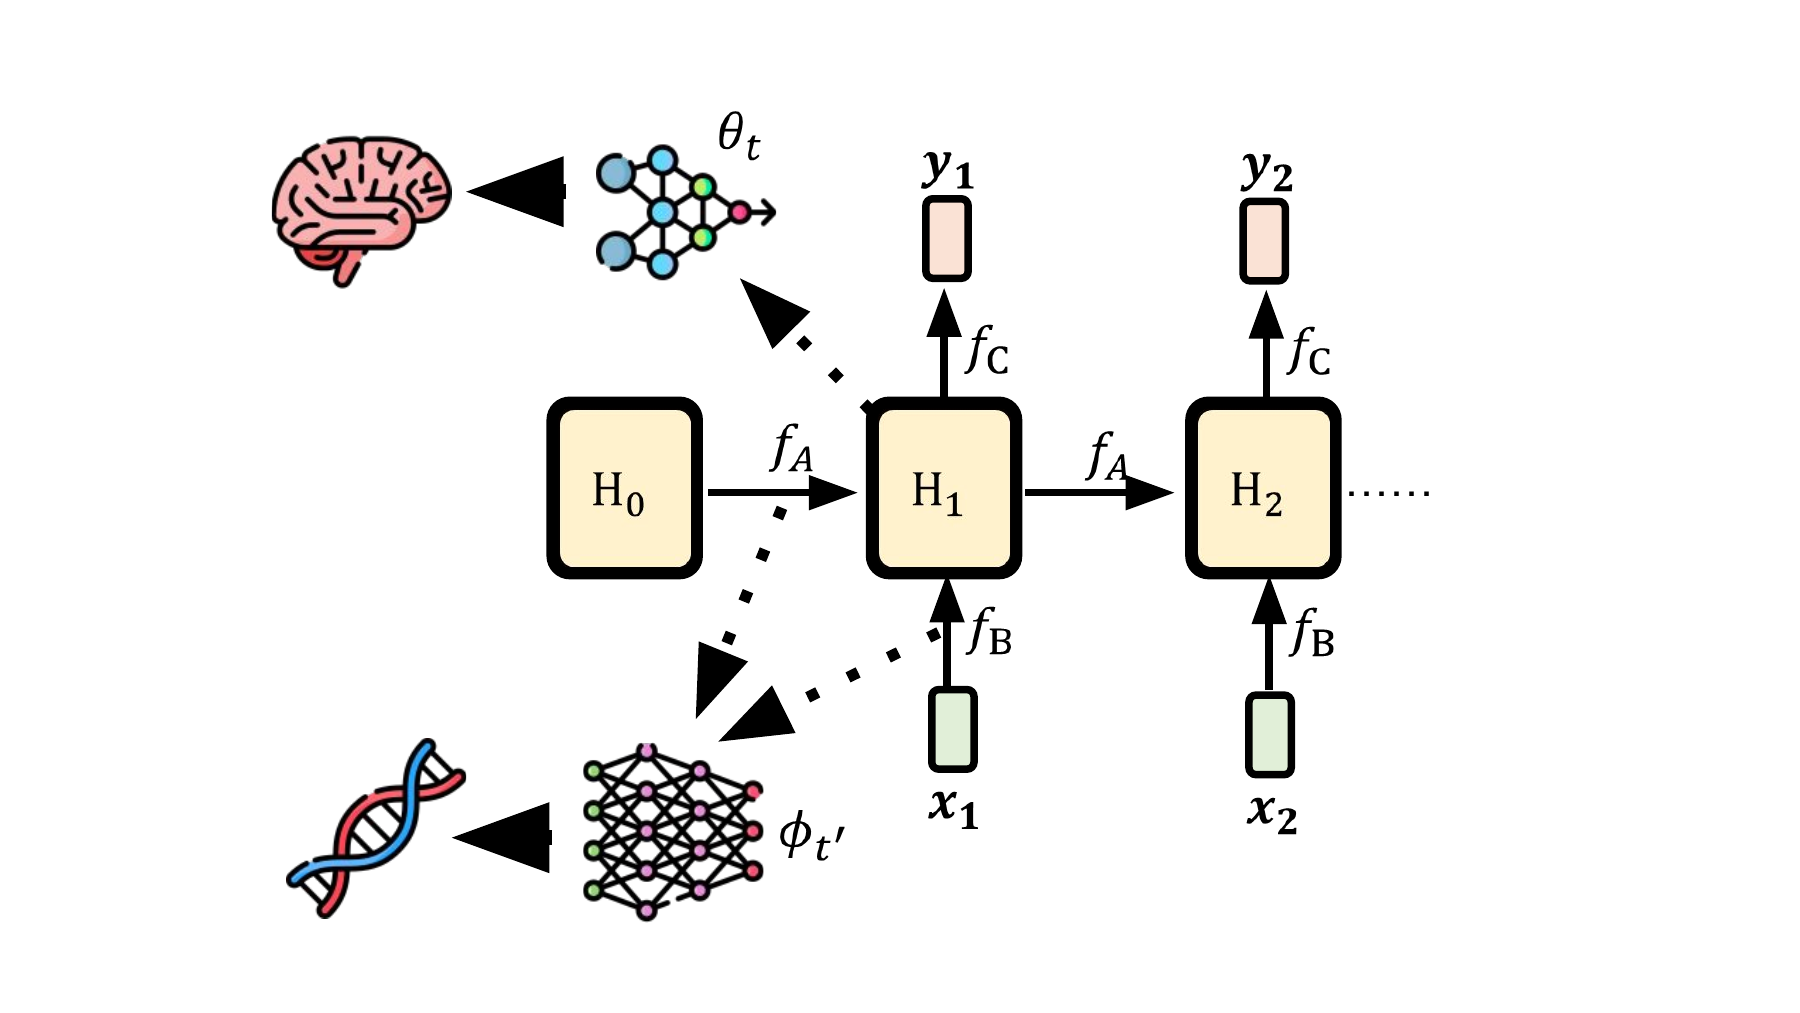
이번에는 그림의 대응이 달라진다. 오른쪽의 H₀, H₁, H₂는 입력을 차례로 읽으며 달라지는 상태다. 위쪽 화살표는 빠르게 바뀌는 상태를 사람의 뇌에, 아래쪽은 상태를 바꾸는 규칙을 정하는 바깥 가중치를 유전자에 연결한다. 강사가 비교하는 축은 한 번의 경험으로 무엇이 바뀌는가다. 뇌와 유전자는 여기서 변화가 일어나는 시간 척도를 설명하기 위한 비유다. 강의 50:25 · 문맥에 새 규칙을 넣는 장면 51:54
#식 풀이 7. 같은 사진에서 어텐션 출력의 부호가 왜 뒤집힐까?
파란 부품 한 장만 보자. 예제에서는 지시서를 두 줄로 표현한다. 첫째 줄은 파란 부품, 둘째 줄은 노란 부품에 관한 줄이다. 카메라의 질의(query)가 각 줄의 키(key)와 얼마나 잘 맞는지 계산한 점수를 각각 ln 3과 0으로 둔다. 점수에는 키 차원에 따른 스케일링을 이미 적용했다. 소프트맥스(softmax)는 두 점수를 양수로 만든 다음 합이 1이 되게 나눈다. Vaswani 등, 2017, 식 1
여기서 3/4는 파란 부품에 관한 줄에서 읽는 비중이다. ‘왼쪽’과 ‘오른쪽’을 각각 +1과 −1로 적고, 두 줄의 값(value)을 그 비중으로 더한다. 예제에서는 색으로 키를 만들고 방향으로 값을 만든다. 다음 교대에 방향만 서로 바꾸면 질의와 키는 그대로이고 값 두 개의 부호만 바뀐다.
양수면 왼쪽, 음수면 오른쪽이라고 읽는 같은 판독기로 같은 사진을 다른 통으로 보냈다. 0.75는 지시서의 줄에 붙인 어텐션 가중치다. 최종 방향의 정답 확률과 구별된다. 이 손계산에서는 행렬을 학습하는 단계를 추가할 필요가 없었다. 51쪽의 TTT 층은 같은 ‘이전 입력이 다음 출력에 영향을 준다’는 현상을 전혀 다른 연산, 즉 작은 모델의 가중치에 대한 경사 갱신으로 구현한다. 어텐션 원 논문 §3.2.1 · TTT 원 논문 §2.3
어떤 실험을 해야 둘을 가릴 수 있을까? 같은 사진과 지시서를 두 모델에 주고 최종 답만 모으면 둘 다 정답을 낼 수 있다. 구현을 볼 수 있다면 한 토큰을 처리하기 전후로 TTT의 안쪽 가중치 W가 변했는지, 어텐션이 어느 키와 값을 읽었는지, 저장된 바깥 가중치는 같았는지를 각각 확인할 수 있다. ‘학습했다’는 말에 이렇게 바뀐 값과 지속 시간을 붙이면 실험으로 확인할 수 있는 주장이 된다. 다음 56쪽은 그 지속 시간을 대화 안의 은닉 상태, 세션 사이에 남는 파일 메모리, 네트워크 가중치로 나눠 본다. NTU 하편 56쪽