의미론적 영상 분할은 이미지를 보고 “고양이”라고 답하는 데서 멈추지 않는다. 어느 픽셀이 고양이이고, 어느 픽셀이 배경인지를 공간적인 label map으로 돌려준다. 출력의 유효 영역은 입력 전체일 수도, 문맥을 제외한 중앙 영역일 수도 있다. 원래 U-Net의 572 → 388이 후자의 예다. 넓은 문맥을 보는 능력과 정확한 위치를 복원하는 능력을 동시에 설계해야 한다.
이 글의 FCN 해설은 2015년 3월 8일의 1411.4038v2, U-Net 해설은 2015년 5월 18일의 1505.04597v1을 기준으로 한다. 원논문 그림은 해당 설명 바로 옆에 두었다. “계산 예제”와 “해설용 재표현”은 이해를 돕기 위해 별도로 만든 것이며 논문의 실험 결과나 원문 식 번호와 구분한다. PSPNet·DeepLabv3·v3+는 원본 구조도와 비교 실험으로 확장했고, MRF·ICM은 별도로 정의한 작은 모델의 전수검사 예제로 다룬다.
#6.1 분류에서 dense prediction으로
분류는 입력 전체를 하나의 feature vector로 압축한다. 반면 semantic segmentation은 각 위치마다 K개 class score를 내야 한다. 출력 tensor가 H × W × K가 되고, 같은 class에 속한 서로 떨어진 물체는 같은 label을 받는다. 물체마다 별도의 ID를 붙이는 instance segmentation과 구분되는 지점이다.
한 장의 이미지에 하나의 class를 붙이는 대신, 모든 위치에서 class score를 계산해 원래 해상도의 label map을 만든다.
#FCN의 질문: 분류기의 공간 출력을 버리지 않으면 어떻게 될까
FCN을 “fully connected layer를 convolution으로 바꾼 모델”이라고만 외우면 가장 중요한 연결이 빠진다. 어떤 가중치를 어떤 모양으로 바꾸는지, 그렇게 얻은 성긴 점수 지도를 어떻게 픽셀에 다시 연결하는지, 이 과정을 어떻게 한 번에 학습하는지가 하나의 설계다. 원논문은 기존 분류망의 사전학습 표현을 가져와, 이미지 전체의 픽셀별 손실로 미세조정하는 방법과 서로 다른 해상도의 예측을 결합하는 구조를 설명한다. FCN v2, §3–4
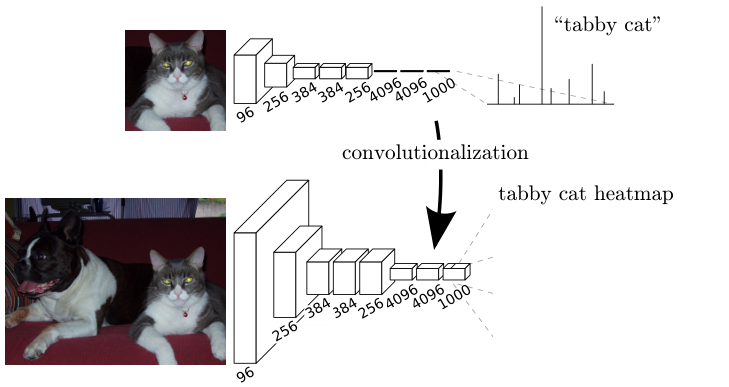
그림의 위쪽은 한 입력에 대한 분류이고 아래쪽은 더 큰 입력에 대한 공간 점수 지도다. 여기의 분류기 출력과, 이후 PASCAL용 21채널 분할 head를 붙인 출력을 혼동하지 않아야 한다. 이 그림은 가중치를 바꾸지 않고 연산의 공간적 적용 범위를 넓힐 수 있다는 점을 먼저 보여 준다.
Jonathan Long, Evan Shelhamer, Trevor Darrell · 2015-03-08 · 1411.4038v2 원문 · 논문 속 그림 위치 · 크게 보기 원논문 도판 발췌. 그림 부분만 잘라 무손실 WebP로 변환했으며 내용·색상은 다시 그리지 않았다. 한국어 설명은 별도 작성했다. 도판의 권리는 원권리자에게 있으며 블로그 코드의 MIT 라이선스나 CC 재배포 허락이 적용된다는 뜻은 아니다.그림은 입력에서 출력 방향으로 읽는다. 앞쪽 합성곱 층은 작은 창에서 특징을 추출한다. 마지막 층을 지나더라도 출력 위치를 유지하면, 그 위치가 입력의 어느 영역을 보았는지 추적할 수 있다. 이때 출력 하나가 보는 입력 영역이 수용영역(receptive field)이다. 큰 입력에 같은 필터를 적용하는 것은 큰 이미지를 통째로 하나의 새로운 완전연결층에 넣는 것과 다르다. 같은 크기의 지역 연산을 여러 위치에서 공유하는 것이다.
#완전연결층을 합성곱으로 바꾼다는 말의 실제 계산
모든 완전연결층을 무조건 1×1 convolution으로 바꾸는 것은 아니다. 완전연결층이 원래 보던 공간 범위를 커널이 덮어야 한다. 예를 들어 7 × 7 × 512 특징을 flatten해 4,096개 출력으로 보내는 층을 생각하자. 그 가중치 행 하나는 25,088개 값을 읽는다. 이를 7 × 7 × 512 커널 하나로 다시 배열하면 같은 내적을 계산한다. 4,096개 행은 4,096개 출력 필터가 된다. 그 뒤 1 × 1 × 4096에서 채널을 섞는 층은 1×1 합성곱으로 표현할 수 있다. 7×7이라는 예는 변환 원리를 보여 주는 크기 예시이며, 실제 FCN 전체의 padding과 crop 설정을 생략한 채 모든 중간 tensor의 크기를 확정하는 표는 아니다. FCN v2, §3.1
다음은 이를 인덱스로 풀어 쓴 해설용 재표현이다. stride 1, padding 없음, 입력 채널 C, 커널 크기 k를 가정한다. 딥러닝 라이브러리에서 보통 convolution이라고 부르는 cross-correlation 표기를 사용한다.
o는 출력 채널, (i,j)는 출력의 공간 위치, (u,v)는 커널 안의 위치다. 처음 한 창에서 계산하면 완전연결층과 같은 내적이고, 창을 옮기면 같은 가중치로 다음 위치의 내적을 계산한다. 공간 위치마다 새로운 가중치를 만드는 것이 아니므로 입력이 커져도 같은 필터를 사용할 수 있다. 입력은 네트워크의 최소 크기·stride·경계 처리 조건을 여전히 만족해야 한다.
작은 숫자로 확인하기: flatten과 convolution은 어디서 같아지는가
단일 채널 입력을 [[1, 2, 4], [3, 5, 8], [6, 9, 13]], 커널을 [[1, 0], [0, -1]], bias를 0으로 두자. 왼쪽 위 2×2 창을 flatten하면 [1, 2, 3, 5]다. 가중치 [1, 0, 0, -1]와의 내적은 1 − 5 = −4다. 같은 계산을 오른쪽 창에 적용하면 2 − 8 = −6, 아래 왼쪽은 3 − 9 = −6, 아래 오른쪽은 5 − 13 = −8이다.
출력 지도는 [[-4, -6], [-6, -8]]이다. 첫 값만 보면 완전연결층의 출력이고 네 값을 모으면 합성곱 출력이다. 이미지의 내용이 달라진 것이 아니라 같은 가중치를 평가하는 위치가 늘어났다. 이 예제는 논문의 정확도 실험이 아니라 가중치 재배열을 확인하기 위한 계산이다.
독립적인 sliding-window 분류는 이웃한 두 창이 공유하는 영역도 반복 계산하기 쉽다. FCN은 공통된 앞단 feature map을 한 번 계산하고 이후 층에서도 공간 연산을 공유한다. 따라서 “픽셀마다 신경망을 새로 실행한다”와 “한 신경망이 모든 출력 위치를 함께 계산한다”는 의미상 비슷한 목표를 가져도 계산량은 다르다. 원논문의 whole-image 학습 설명은 이 중복을 순전파와 역전파 양쪽에서 줄이는 데 초점을 둔다. FCN v2, §3–3.4
#왜 분류기를 바꾸기만 하면 경계가 거친가
공간 정보가 남았다는 것과 원래 픽셀 간격으로 남았다는 것은 다르다. pooling과 stride가 누적되면 마지막 위치 사이의 간격이 입력 기준으로 벌어진다. FCN-32s의 32는 층 수나 출력 영상의 한 변 길이가 아니라, 성긴 예측의 output stride다. 마지막 score map을 32배 늘려도, 이미 사라진 경계를 보간만으로 새로 관측할 수는 없다. FCN v2, §4.1–4.2
이 문제를 이해하려면 두 질문을 분리하면 된다. “차량이 이 근처에 있는가?”는 넓은 수용영역이 돕는다. “차량과 배경의 경계가 정확히 어느 픽셀인가?”는 세밀한 위치 정보가 돕는다. 깊은 feature는 넓은 문맥을 담지만 해상도가 낮고, 얕은 feature는 더 조밀하지만 그 자체만으로는 대상의 의미를 구별하기 어렵다. 단순히 깊은 feature를 버리고 얕은 feature만 쓰는 것은 해결이 아니다.
#Figure 3을 연산 그래프로 읽기: 32s → 16s → 8s
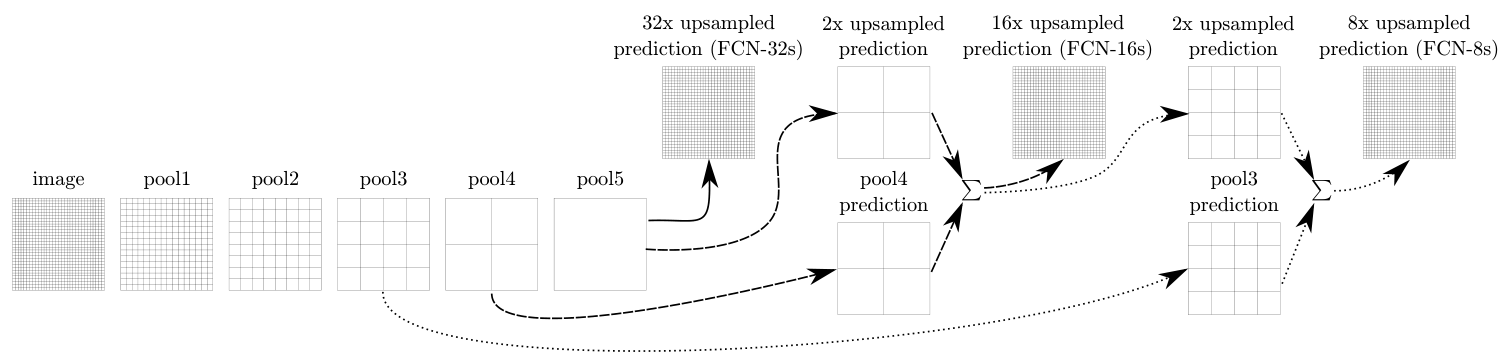
위쪽의 단일 경로가 FCN-32s다. 중간 경로에서는 pool4에서 나온 점수를 결합하고, 아래 경로에서는 pool3 점수를 한 번 더 결합한다. 그림에서 생략된 중간 합성곱 층이 실제 모델에 없는 것은 아니다. 서로 다른 격자가 어느 입력 위치에 대응하는지도 맞춰야 한다.
Jonathan Long, Evan Shelhamer, Trevor Darrell · 2015-03-08 · 1411.4038v2 원문 · 논문 속 그림 위치 · 크게 보기 원논문 도판 발췌. 그림 부분만 잘라 무손실 WebP로 변환했으며 내용·색상은 다시 그리지 않았다. 한국어 설명은 별도 작성했다. 도판의 권리는 원권리자에게 있으며 블로그 코드의 MIT 라이선스나 CC 재배포 허락이 적용된다는 뜻은 아니다.원논문에서 pool4의 feature를 그대로 최종 class score와 더하는 것은 아니다. 먼저 1×1 합성곱으로 class score를 만든다. 깊은 층의 예측도 같은 class 채널을 갖는다. 두 출력을 동일한 공간 격자에 맞춘 뒤 원소별 합(elementwise sum)으로 결합한다. FCN-8s에서는 pool3에서 만든 class score를 같은 방식으로 추가한다. 이 sum은 뒤의 U-Net에서 사용하는 channel concatenation과 다른 연산이다. FCN v2, §4.2
아래 식은 논문에 붙은 식 번호가 아니라 Figure 3의 흐름을 정리한 해설용 기호다. S4, S3는 각각 pool4·pool3를 class score로 투영한 결과, U2·U8은 공간 크기를 키우는 연산이다. Align은 목표 격자와의 crop·좌표 정렬을 나타낸다.
이 표는 padding 오프셋이 이미 정렬됐다고 가정한 설명용 크기 예제다. 실제 Caffe 모델의 중간 크기를 그대로 전사한 표는 아니다. batch 차원은 생략했다.
| 지점 | tensor 크기 예시 | 무엇을 하는가 |
|---|---|---|
| 깊은 class score | 16×16×21 | stride 32의 성긴 의미 정보 |
| 2배 확대 + pool4 score | 32×32×21 + 32×32×21 | 같은 class 채널끼리 더함 |
| 2배 확대 + pool3 score | 64×64×21 + 64×64×21 | 더 세밀한 격자의 점수 추가 |
| 마지막 8배 확대·정렬 | 512×512×21 | 각 출력 픽셀의 class score |
여기서 21은 PASCAL의 배경을 포함한 출력 채널 수다. 32×32×21 두 개를 더한 결과는 여전히 32×32×21이다. U-Net처럼 이어 붙였다면 채널 수가 42가 됐을 것이다. 덧셈 전에 argmax로 class ID를 뽑아서는 안 된다. 예를 들어 class 3과 class 5를 더해 class 8을 만드는 것은 의미가 없다. 연속적인 score를 합친 뒤 마지막에 class를 선택해야 한다.
#손실이 전체 영상의 학습으로 이어지는 이유
모든 유효 출력 위치의 손실을 더하면, 각 위치에서 생긴 gradient도 더해진다. 아래는 원논문 §3의 설명을 교차엔트로피 형태로 풀어 쓴 것이다. Ωvalid는 학습에서 포함하는 위치 집합이며, 모호한 정답을 제외하는 규칙과 손실의 합·평균 정규화는 구현에서 명시해야 한다.
이 식이 “독립적인 patch SGD를 어떤 순서로 실행해도 같은 학습이 된다”는 뜻은 아니다. 같은 parameter에서 같은 표본의 gradient를 모아 같은 정규화와 업데이트를 적용할 때의 관계다. patch마다 parameter를 먼저 바꾸거나 표본 분포를 바꾸면 업데이트 경로도 달라질 수 있다. FCN의 장점은 많은 겹치는 위치를 계산할 때 앞단 연산을 재사용한다는 데 있다. FCN v2, §3.4
#원논문 결과는 무엇을 지지하는가
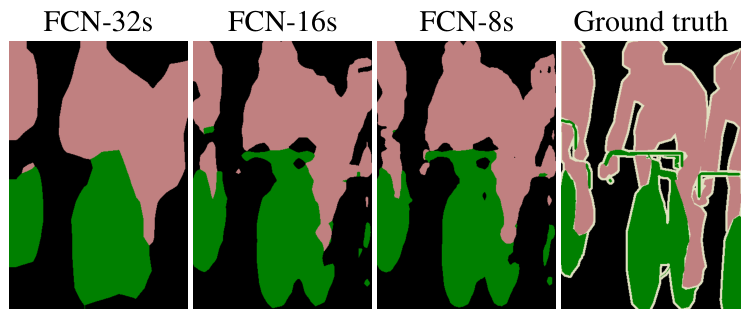
왼쪽부터 32s·16s·8s·정답이다. 단순히 사진을 크게 만든 결과가 아니라, 다른 stride의 예측을 결합한 모델들의 분할 결과다. 이 한 장은 정성적 예시이므로 전체 데이터 성능이나 모든 경계의 개선을 보장하지 않는다.
Jonathan Long, Evan Shelhamer, Trevor Darrell · 2015-03-08 · 1411.4038v2 원문 · 논문 속 그림 위치 · 크게 보기 원논문 도판 발췌. 그림 부분만 잘라 무손실 WebP로 변환했으며 내용·색상은 다시 그리지 않았다. 한국어 설명은 별도 작성했다. 도판의 권리는 원권리자에게 있으며 블로그 코드의 MIT 라이선스나 CC 재배포 허락이 적용된다는 뜻은 아니다.같은 비교 조건의 수치를 함께 읽어야 한다. 다음은 v2 Table 2의 VOC2011 검증 부분집합에 대한 mean IU다. 추가 학습 자료와 겹치지 않는 검증 부분집합이라는 조건이 붙으며, VOC2012 test 결과와 섞지 않는다. FCN v2, Table 2 및 §4.3
| 모델 | mean IU (%) | 이 비교에서 확인할 질문 |
|---|---|---|
| FCN-32s-fixed | 45.4 | 마지막 층만 미세조정하는 것으로 충분한가 |
| FCN-32s | 59.4 | 사전학습된 표현 전체를 분할에 맞추면 어떻게 되는가 |
| FCN-16s | 62.4 | pool4의 더 세밀한 score를 결합한 효과는 어떤가 |
| FCN-8s | 62.7 | pool3까지 추가했을 때 남는 이득은 얼마나 되는가 |
59.4에서 62.4는 3.0 percentage points이고, 62.4에서 62.7은 0.3 points다. 이 비교만으로 “skip을 많이 넣을수록 언제나 크게 좋아진다”고 결론낼 수 없다. 또한 final-layer-only와 전체 미세조정의 차이를 skip의 효과로 잘못 설명하면 안 된다. 데이터 분할과 학습 조건이 다르면 숫자만 이어 붙인 순위표도 의미가 바뀐다.
v2의 §4.3은 마지막 업샘플링 필터는 bilinear로 고정하고, 중간 업샘플링 필터는 bilinear로 초기화한 뒤 학습했다고 설명한다. “FCN의 모든 upsampling은 학습된다” 또는 “모두 고정 보간이다”라는 한 문장으로 줄이면 이 버전의 실제 설정을 놓친다. 후속 논문이나 공개 코드의 다른 시점 설정을 가져올 때도 해당 버전을 따로 확인해야 한다. FCN v2, §4.3
FCN에서 가져갈 핵심은 세 가지 연결이다. 완전연결 가중치를 공간 연산으로 재해석하고, 성긴 의미와 세밀한 위치의 score를 결합하며, 픽셀별 손실을 통해 전체 망을 조정한다. “1×1 합성곱을 쓴다”는 설명만으로는 이 연결이 드러나지 않는다.
#6.2 encoder–decoder가 잃고 되찾는 것
encoder는 stride와 pooling으로 해상도를 줄이며 receptive field를 넓힌다. 덕분에 “이 픽셀이 자동차의 일부인가”를 넓은 문맥에서 판단하지만, 정확한 경계는 흐려진다. decoder는 interpolation, unpooling, transposed convolution 등으로 score map을 키운다.
encoder는 넓은 문맥을 얻는 대신 위치 정보를 압축하고, decoder는 interpolation 또는 transposed convolution으로 공간 해상도를 복원한다.
Transposed convolution은 convolution을 선형 연산으로 표현했을 때 전치 행렬에 대응한다. 입력 하나가 여러 출력 위치에 기여하도록 계산할 수 있지만, 잃어버린 입력을 유일하게 복구하는 역함수는 아니다. 출력 크기는 다음 관계로 확인한다. 여기서 s는 stride, p는 padding, d는 dilation, k는 kernel 크기, o는 output padding이다.
계산 예제: 전치 합성곱은 왜 역행렬이 아닌가
다음 1차원 valid 연산을 생각하자. 커널 [1, 2]가 길이 3의 입력을 읽으면 길이 2의 출력이 나온다.
C는 2×3이고 Cᵀ는 3×2다. 길이가 다시 커져도 값이 원래대로 돌아오지 않는다. 이 예는 전치 연산의 의미를 보여 줄 뿐, FCN이 사용하는 특정 업샘플링 커널의 수치가 아니다. 출력 크기가 맞는지와 정보가 복구됐는지는 서로 다른 질문이다.
kernel overlap이 위치마다 균일하지 않으면 checkerboard artifact가 생길 수 있다. 이는 여기의 원논문 수치와 별개인 구현 검토 항목이다. 출력 크기뿐 아니라 격자 정렬, 보간 방식, 경계 패턴을 확인해야 한다.
#6.3 U-Net과 skip connection
U-Net은 contracting path와 expanding path를 연결한다. 하지만 U자 모양만 보고 이해했다고 생각하면 원래 설계의 절반을 놓친다. 유효 합성곱으로 생기는 크기 감소, crop 뒤 feature concatenation, 경계에 가중치를 주는 학습 목표, 적은 주석 영상을 늘리는 augmentation까지 함께 읽어야 한다. 아래는 2015년 원형에 대한 설명이며, same padding·BatchNorm·Dice loss를 넣은 후속 구현을 원형으로 소개하지 않는다. U-Net v1, §2–3
깊은 층의 의미 정보와 얕은 층의 위치 정보를 concatenate해 작은 물체와 경계를 되살린다.
#원본 Figure 1: 각 화살표가 바꾸는 것은 무엇인가
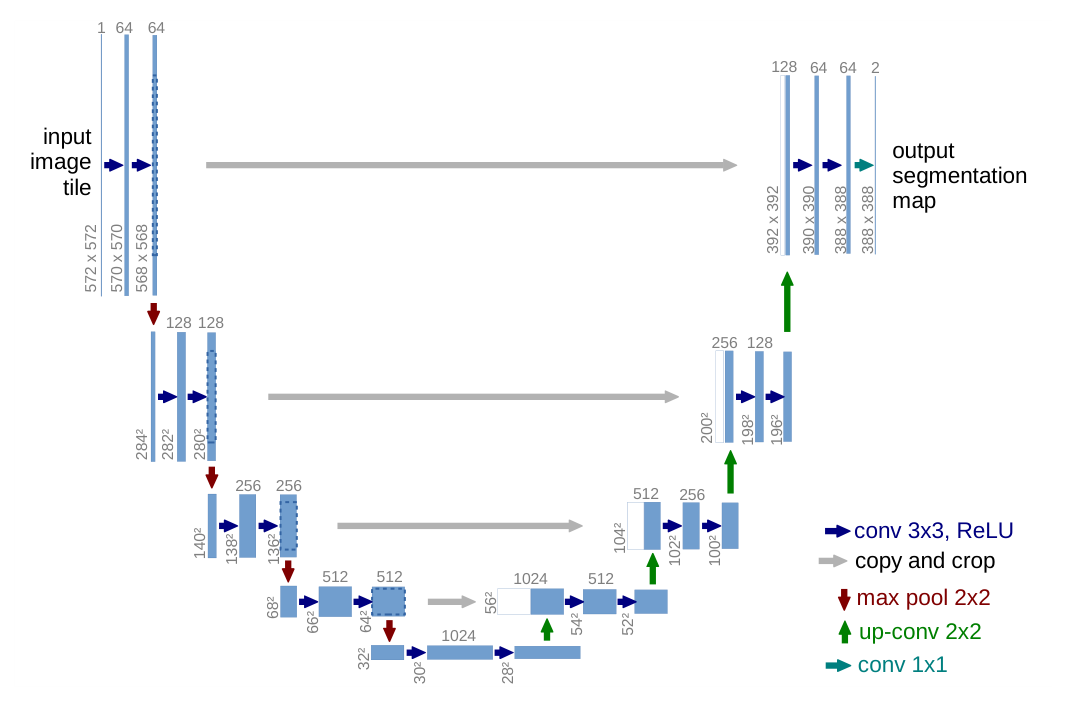
파란 상자는 다채널 feature map이다. 위 숫자는 채널 수, 옆 숫자는 공간 크기다. 아래로 가는 빨간 화살표는 2×2 max pooling, 위로 가는 초록 화살표는 2×2 up-convolution, 회색 화살표는 encoder feature의 copy-and-crop이다. 오른쪽의 흰 부분은 이어 붙일 encoder feature를 나타낸다.
Olaf Ronneberger, Philipp Fischer, Thomas Brox · 2015-05-18 · 1505.04597v1 원문 · 논문 속 그림 위치 · 크게 보기 원논문 도판 발췌. 그림 부분만 잘라 무손실 WebP로 변환했으며 내용·색상은 다시 그리지 않았다. 한국어 설명은 별도 작성했다. 도판의 권리는 원권리자에게 있으며 블로그 코드의 MIT 라이선스나 CC 재배포 허락이 적용된다는 뜻은 아니다.왼쪽 경로에서 두 번의 3×3 convolution과 ReLU를 적용하고, 2×2 max pooling으로 공간 크기를 줄인다. 단계가 내려갈수록 feature 채널은 64, 128, 256, 512, 1024로 늘어난다. 오른쪽에서는 2×2 up-convolution으로 공간 크기를 키우고 채널 수를 줄인 뒤, 왼쪽의 대응 feature를 crop하여 채널 방향으로 이어 붙인다. 이후 두 번의 3×3 convolution이 결합된 정보를 처리하고, 마지막 1×1 convolution이 출력 class score를 만든다. U-Net v1, §2
원본 그림은 일반적인 블록 그림과 달리 연산 후 크기를 적어 놓았다. 따라서 “대칭 encoder–decoder”라는 문장으로 끝내지 말고, 572 → 570 → 568에서 출발해 실제 숫자를 따라가야 한다. 한 단계에서 격자가 얼마나 줄어드는지 확인하면 crop이 장식적인 구현 세부가 아니라 필수 연산임을 알 수 있다.
#572×572는 왜 388×388이 되는가
padding 없는 3×3 convolution은 각 축에서 2픽셀을 줄인다. 두 번 적용하면 4픽셀이 줄어든다. pooling과 up-convolution은 또 다른 크기 변화를 만든다. 다음 표는 Figure 1의 연산을 산술적으로 전개한 표다. 한 변 길이만 적었으며 영상은 정사각형, batch 차원은 생략했다.
| 위치 | 공간 크기의 변화 | 두 합성곱 뒤 채널 수 |
|---|---|---|
| encoder 1 | 572 → 570 → 568 → pooling 284 | 64 |
| encoder 2 | 284 → 282 → 280 → pooling 140 | 128 |
| encoder 3 | 140 → 138 → 136 → pooling 68 | 256 |
| encoder 4 | 68 → 66 → 64 → pooling 32 | 512 |
| bottleneck | 32 → 30 → 28 | 1024 |
| decoder 1 | up 56 → 54 → 52 | 512 |
| decoder 2 | up 104 → 102 → 100 | 256 |
| decoder 3 | up 200 → 198 → 196 | 128 |
| decoder 4 | up 392 → 390 → 388 | 64 |
| output head | 388 → 388, 1×1 convolution | 예측 class 수 |
따라서 원형의 출력은 입력과 같은 크기가 아니다. 입력의 넓은 문맥을 사용해 중앙 영역을 예측한다. 원본 그림 아래 설명의 “가장 낮은 해상도 32×32”는 마지막 pooling 직후의 격자와 연결해서 읽어야 한다. 그 다음 두 번의 valid convolution을 지나면 그림의 bottleneck feature는 28×28이다. U-Net v1, Figure 1
계산 예제: crop 크기와 concat 뒤 채널 수 직접 구하기
첫 decoder 단계의 feature는 28×28×1024다. up-convolution 뒤 56×56×512가 된다. 대응하는 encoder feature는 64×64×512이므로 그대로는 이어 붙일 수 없다. 중앙 56×56을 남기려면 각 변에서 (64−56)/2 = 4픽셀을 잘라야 한다.
두 56×56×512를 channel 방향으로 concatenate하면 56×56×1024가 된다. 이어지는 두 번의 3×3 valid convolution이 공간 크기를 56→54→52로 줄이고, 최종적으로 해당 단계의 출력 채널을 512로 만든다.
나머지 skip에서도 계산은 같다. 136→104는 각 변 16픽셀, 280→200은 40픽셀, 568→392는 88픽셀을 crop한다. skip crop의 4·16·40·88과 입력·출력 차이의 92픽셀은 서로 다른 값이다. 하나는 특정 feature map끼리 맞추는 계산이고, 다른 하나는 전체 네트워크 입출력 유효 영역의 차이다.
그림의 긴 회색 화살표는 decoder가 직접 복원해야 할 위치 단서를 전달한다. 그렇다고 encoder의 모든 activation이 이미 정확한 경계를 의미하는 것은 아니다. 다음 합성곱이 깊은 문맥과 얕은 특징을 함께 사용하도록 학습해야 한다. skip이 있다는 사실만으로 경계 정확도를 보장할 수는 없다.
#FCN의 skip과 U-Net의 skip을 구분하기
두 모델 모두 얕은 층과 깊은 층을 연결하지만 무엇을 결합하는지와 결합 연산이 다르다.
| 비교 항목 | FCN-16s·8s | 원래 U-Net |
|---|---|---|
| 얕은 층에서 전달하는 것 | class score로 투영한 출력 | 다채널 encoder feature |
| 결합 | 같은 위치·class의 score를 sum | crop한 feature를 channel concat |
| 결합 직후 채널 수 | class 수 유지 | 두 입력 채널 수의 합 |
| 결합 뒤 역할 | 더 세밀한 격자의 예측 형성 | 합성곱으로 결합 feature를 다시 가공 |
이 표는 두 원논문의 구조를 나란히 읽은 비교이지 동일 조건의 성능 순위가 아니다. FCN v2, §4.2, U-Net v1, §2
해설용으로 encoder feature를 E, decoder feature를 D라고 쓰면 U-Net 결합은 다음과 같다. ConvBlock은 단순 합을 뜻하지 않으며 학습되는 두 합성곱 등을 묶은 기호다.
“같은 크기끼리 붙인다”는 말도 주의해야 한다. 원형에서는 encoder feature가 더 크므로 crop을 마친 뒤 크기가 같아진다. padding을 추가해 크기를 유지하는 구현은 유용한 변형일 수 있지만, 그것을 원논문의 tensor trace와 섞어 설명하면 572→388을 재현할 수 없다.
#U-Net의 원래 손실: Dice가 아니라 공간 가중 교차엔트로피
원논문은 각 픽셀의 class score에 softmax를 적용하고 공간적인 weight map을 결합한다. 먼저 픽셀 x에서 class k의 logit을 a_k(x)라고 쓰면 다음 확률을 얻는다. softmax의 합은 다른 픽셀 방향이 아니라 같은 픽셀의 class 방향이다. U-Net v1, §3
ℓ(x)는 정답 class, Ω는 평가하는 출력 픽셀 영역, w(x)는 학습 손실에 곱할 공간 가중치다. v1 원문 식 (1)은 아래처럼 음수 부호 없이 표기되어 있다. 원문 표기를 보존한다.
이를 코드에서 최소화할 음의 로그우도 손실로 쓰려면, 별도로 다음과 같이 정의해야 한다. 아래의 마이너스는 원문 식을 그대로 전사한 것이 아니라 최소화 목적을 명확히 하기 위한 정의다.
정답 확률이 0.1에서 0.9로 오르면 log p는 약 −2.303에서 −0.105로 커진다. 반대로 −log p는 2.303에서 0.105로 작아진다. 따라서 원문의 E를 그대로 “최소화하는 cross entropy”라고 부르면 부호와 설명이 어긋난다. 이 숫자 확인만으로도 수식을 옮기는 과정에서 흔히 생기는 오류를 막을 수 있다.
뒤의 6.5에서 소개하는 Dice 계열 목표는 분할 손실을 비교하기 위한 추가 설명이다. 2015년 U-Net이 Dice loss로 학습했다고 해석하면 안 된다. 원형의 특징적인 학습 장치는 다음의 경계 weight map이다.
#원문 식 (2): 붙어 있는 두 세포 사이를 왜 더 벌점 주는가
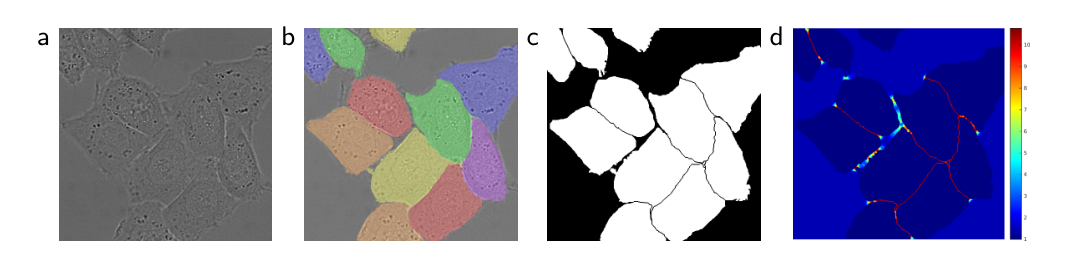
(a)는 원영상, (b)는 개체를 구분해 표시한 정답, (c)는 학습에 사용할 분할 마스크, (d)는 손실 가중치 지도다. 특히 붙은 세포 사이의 좁은 틈을 보자. (d)는 모델의 예측 확률이나 attention map이 아니라 정답으로부터 준비하는 학습용 가중치다.
Olaf Ronneberger, Philipp Fischer, Thomas Brox · 2015-05-18 · 1505.04597v1 원문 · 논문 속 그림 위치 · 크게 보기 원논문 도판 발췌. 그림 부분만 잘라 무손실 WebP로 변환했으며 내용·색상은 다시 그리지 않았다. 한국어 설명은 별도 작성했다. 도판의 권리는 원권리자에게 있으며 블로그 코드의 MIT 라이선스나 CC 재배포 허락이 적용된다는 뜻은 아니다.세포가 대부분 foreground라면 내부 픽셀을 맞히는 것만으로 평균 손실을 많이 줄일 수 있다. 그런데 두 세포 사이의 가느다란 배경 틈을 잘못 채워 버리면 분리된 두 세포가 한 덩어리처럼 보인다. 이 오류는 작은 면적에서 발생하지만 결과를 해석할 때는 중요하다. U-Net 논문은 class 빈도 보정에 더해, 이러한 세포 사이 분리 경계를 강조하는 항을 둔다. U-Net v1, Figure 3 및 식 (2)
w_c(x)는 class 빈도의 불균형을 보정하는 항이다. d1(x)는 가장 가까운 세포의 경계까지의 거리, d2(x)는 두 번째로 가까운 세포의 경계까지의 거리다. 예측한 마스크와 정답 사이의 오차 거리가 아니며, 단지 이미지 바깥 테두리까지의 거리도 아니다. w0는 추가 가중치 크기, σ는 거리 변화에 따른 감소 범위를 조절한다. 논문 실험에서는 w0=10, σ≈5 pixels를 사용했다.
식을 왼쪽에서 오른쪽으로만 외우지 말고 지수 안을 읽어 보자. 두 세포 경계에 모두 가까우면 d1+d2가 작아지고, 음의 지수의 크기가 작아져 추가 항이 커진다. 하나의 세포 경계에는 가까워도 다른 세포가 멀면 합이 커져 추가 항이 작아진다. 따라서 모든 외곽 경계에 똑같이 큰 값을 주는 항이 아니다. 또한 분자는 (d1+d2)²이지 d1²+d2²가 아니다.
계산 예제: 경계 weight가 확률의 gradient를 얼마나 바꾸는가
설명을 위해 wc=1, w0=10, σ=5로 고정하자. 첫 픽셀의 거리가 d1=1, d2=1이면 가중치는 약 10.2312다. 두 번째 픽셀의 거리가 d1=1, d2=9이면 약 2.3534다. 둘 다 가장 가까운 경계까지 1픽셀이지만, 두 번째 경계의 위치 때문에 벌점이 달라진다. wc=1은 이 계산 예제에서 정한 값이지 논문 전체 데이터의 class weight라고 주장하는 값이 아니다.
두 픽셀의 정답 확률이 모두 0.5라면 손실은 각각 wA×log 2와 wB×log 2다. 동일한 확률 오류라도 첫 픽셀은 약 4.35배 크게 반영된다. 다음 gradient 식은 weighted softmax cross entropy를 미분한 해설용 유도이며 원논문 식 번호가 아니다. 정답 indicator를 y_k(x)로 썼다.
정답 채널에서 p=0.5, y=1이면 gradient는 −0.5w다. 경계 픽셀의 weight가 크면 같은 오류에도 parameter 업데이트에 더 강한 신호가 전달된다. 이때 weight map은 정답에서 준비한 것이며, 이 식의 w 자체를 attention parameter처럼 학습시키는 설명은 아니다. 구현에서 손실을 평균 내면 선택한 정규화 상수가 gradient 전체에도 추가로 곱해진다.
실제 구현을 점검할 때는 거리의 단위도 pixel이라는 점을 기억해야 한다. 이미지를 절반 크기로 바꿨는데 같은 물리 폭의 경계를 강조하려면 거리와 σ의 관계를 다시 따져야 한다. 이 문장은 논문의 새로운 실험 결과가 아니라 거리식을 이미지 resize에 적용할 때 생기는 산술적 고려다. weight map은 추론 시 입력으로 넣는 정답 채널이 아니므로 데이터 누출과도 구분해야 한다.
#큰 영상은 어떻게 처리하는가: overlap-tile과 mirror context
원형이 중앙 영역만 출력한다고 해서 매번 388×388짜리 영상만 처리한다는 뜻은 아니다. 더 큰 영상을 입력 tile로 나누고, 각 tile의 유효 출력 영역을 이어 붙일 수 있다. 원논문은 영상 가장자리의 문맥을 mirroring으로 확보하는 overlap-tile 방식을 설명한다. U-Net v1, Figure 2
572 입력에서 388 출력을 얻는 도식의 대칭적인 여백은 (572−388)/2=92다. 출력 tile의 간격을 388로 두면 입력 tile끼리는 572−388=184만큼 겹친다. 이 숫자는 Figure 1 크기에 대한 계산 예제다. “입력 tile은 겹치지만 사용할 중앙 출력은 맞닿도록 놓는다”는 구조를 이해하면, 왜 큰 문맥을 읽으면서도 경계 부근의 불완전한 출력을 피하려는지 알 수 있다.
입력 영상 가장자리의 mirror context와, 각 convolution에 same padding을 넣는 것은 같은 조작이 아니다. 전자는 어떤 문맥을 tile 밖에서 제공할지의 문제이고 후자는 네트워크 층마다 feature 크기를 유지할지의 문제다. encoder feature를 decoder 크기에 맞추는 crop도 또 다른 단계다. 세 가지를 모두 “padding 처리”라는 말로 덮으면 출력 정렬을 검증하기 어렵다.
#적은 주석 데이터에서 학습시키는 나머지 장치
원논문은 강한 data augmentation, 특히 elastic deformation을 강조한다. 작은 격자에 무작위 변위를 만들고 보간해 매끄러운 변형장을 얻는 방식이다. 3×3의 거친 격자, Gaussian 변위의 표준편차 10픽셀, bicubic interpolation이라는 구체적인 설정이 제시되어 있다. 큰 입력 tile과 batch size 1, 높은 momentum 0.99도 원문의 학습 설정이다. U-Net v1, §3–3.1
이 설정을 이해하는 요령은 “사진 수가 적으니 복사본을 많이 만든다”에서 한 걸음 더 가는 것이다. 세포의 모양이 조금 늘어나거나 휘어져도 같은 의미의 정답을 유지하게 만들어, 학습에 필요한 변형 불변성을 제공하려는 것이다. 다만 augmentation은 새로운 독립 실험 대상이나 병원 데이터를 수집한 것과 같지는 않다. 같은 원영상에서 만든 변형들이므로 평가 분할과 독립성은 별도로 유지해야 한다.
구현 메모: 원형 설명과 현대적인 선택을 섞지 않기
아래는 재현 코드를 작성할 때의 검토 항목이며 원논문의 문장을 그대로 옮긴 설정 목록이 아니다. 기하 변형은 이미지와 정답에 같은 좌표장을 적용해야 한다. class ID mask를 연속값으로 보간하면 존재하지 않는 label이 생길 수 있으므로 label 보간 정책을 따로 지정한다. loss에는 probability가 아니라 logits를 받는 라이브러리 API도 있으므로 softmax 중복 적용 여부를 확인한다. ignore label이 있다면 weight와 reduction 양쪽에서 동일하게 제외한다.
same padding, BatchNorm, pretrained encoder, Dice와 cross entropy의 결합, 3차원 convolution은 각각 별도의 설계 선택이다. 그런 구현을 사용해도 되지만 2015년 원형의 동일 재현이라고 표시하려면 달라진 항목을 밝혀야 한다. 특히 원형의 572→388 구조에 572×572 정답을 그대로 붙이면 loss의 공간 대응부터 틀어진다.
#무엇을 실험했고, 어디까지 주장할 수 있는가
논문이 평가한 세포·전자현미경 과제는 자연영상 PASCAL 분할과 같은 시험이 아니다. 예를 들어 PhC-U373와 DIC-HeLa의 segmentation 결과는 각각 IoU 0.9203, 0.7756으로 보고된다. 이를 FCN의 21-class mean IU와 같은 표에 넣어 “U-Net이 무조건 더 높다”고 읽을 수 없다. 데이터, label, 점수 정의와 평가 절차가 다르기 때문이다. U-Net v1, §4
전자현미경 과제의 주석 영상 30장도 “서로 독립적인 환자 30명”을 뜻하지 않는다. 원문은 Drosophila 신경계의 serial-section 전자현미경 영상을 설명한다. 적은 주석 영상으로 얻은 결과는 중요하지만, 그것을 모든 의료영상이나 임상 배포에서의 보장으로 확대하지 않는다. 세 과제에서 같은 구조를 사용했다는 설명도 하나의 checkpoint가 모든 과제를 동시에 해결했다는 뜻으로 바꾸지 않는다.
Figure 3의 정답은 개별 세포를 구별하지만 모델의 마지막 출력을 설명할 때는 의미론적 class와 개체 ID를 분리해야 한다. 세포 사이의 배경 틈을 학습하면 이후 개체를 분리하는 데 도움이 되지만, 그 사실만으로 U-Net의 출력 head가 자동으로 고유 instance ID를 예측하는 것은 아니다. 손실 가중치가 어떤 실패를 줄이려는지와 최종 과제 정의를 함께 읽어야 한다.
U-Net의 핵심은 “skip이 있는 encoder–decoder” 한 문장보다 크다. 원형의 해상도 변화를 따라가고, concat의 채널 계산을 확인하고, 정답 기반 경계 가중치가 어떤 gradient를 키우는지 계산하고, augmentation과 평가의 범위를 구분해야 구조와 학습을 함께 이해한 것이다.
#6.4 dilation으로 해상도를 지키며 문맥 넓히기
FCN과 U-Net이 던진 질문은 “성긴 의미 정보와 세밀한 위치 정보를 어떻게 결합하는가”였다. 이제 질문을 하나 더하자. 해상도를 계속 줄이지 않으면서 서로 다른 범위의 문맥을 어떻게 모을까? PSPNet의 pooling grid와 DeepLab의 dilation rate는 모두 다중 스케일을 다루지만 같은 연산은 아니다. 이 절은 PSPNet 1612.01105v2, DeepLabv3 1706.05587v3, DeepLabv3+ 1802.02611v3의 구조와 비교 실험을 기준으로 읽는다.
feature map 해상도를 더 줄이지 않고 간격을 벌린 kernel을 병렬 적용한다. DeepLab의 ASPP는 이 응답들을 합쳐 multi-scale context를 만든다.
#PSPNet: 전체 장면 하나와 여러 부분 장면을 함께 읽기
작은 patch의 모양만으로 범주를 결정하기 어려울 때 주변 장면이 단서가 된다. 그렇다고 모든 위치를 global average pooling으로 하나의 벡터에 섞으면, 어느 부분에서 관측한 문맥인지 구분하기 어렵다. PSPNet은 원래 feature를 남겨 두면서 전체·큰 부분·더 작은 부분의 요약을 함께 붙인다. 핵심은 pyramid pooling module, 줄여서 PPM이다. PSPNet, §3.2–3.3, Figure 3
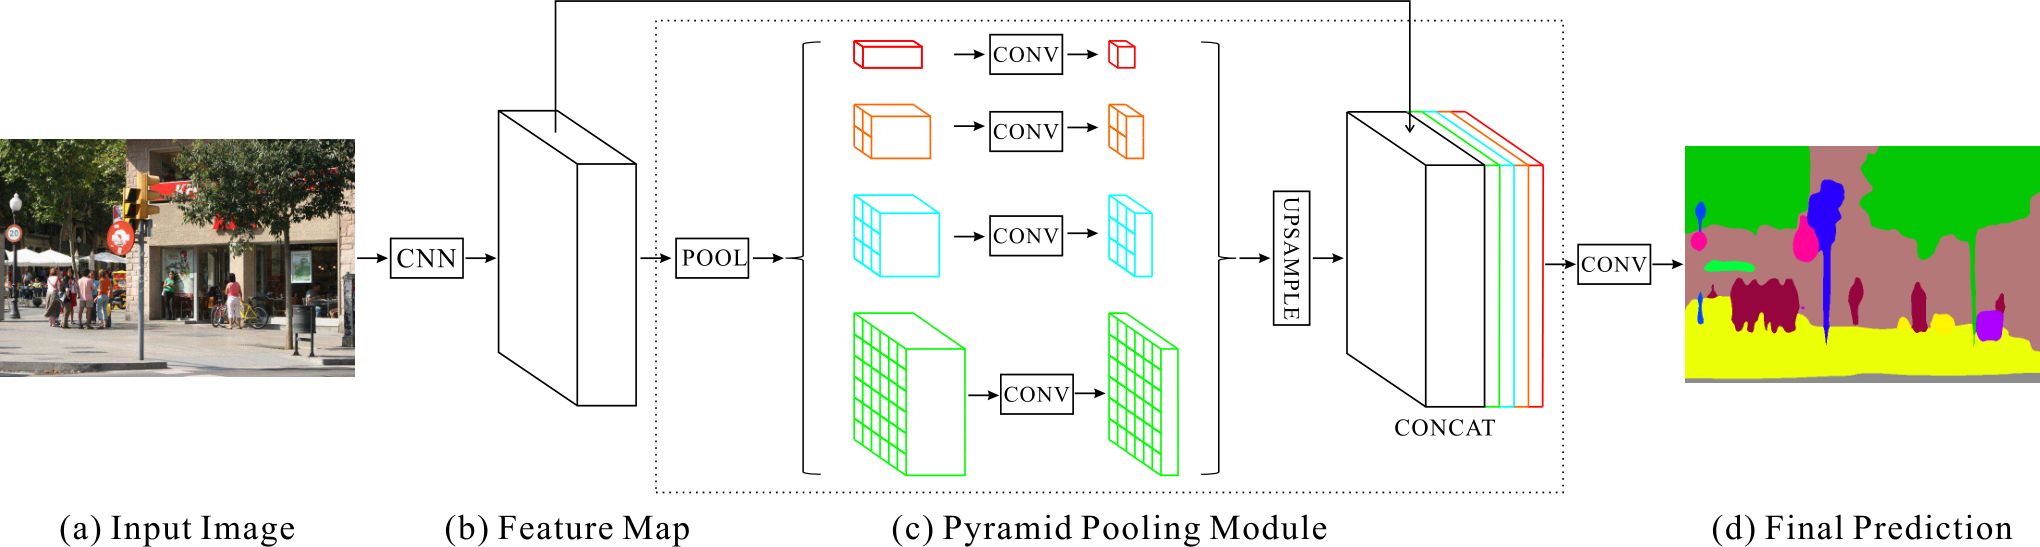
왼쪽 CNN 출력을 기준으로 점선 상자 안의 네 경로를 읽는다. 각 색은 다른 pooling grid다. 작은 grid의 feature를 CONV로 처리하고 원래 공간 크기로 올린 뒤, 처음 feature와 CONCAT한다. 오른쪽의 분할 결과는 이 결합을 학습한 결과이지 pooling 값을 그대로 색으로 바꾼 것이 아니다.
Hengshuang Zhao et al. · 1612.01105v2 · 원논문 · 원문 속 그림 · 크게 보기 원논문 도판 발췌. 원문 PNG 파일을 그대로 사용했다. 한국어 해설은 별도 작성. 원권리자의 권리가 유지되며 블로그 코드의 MIT 라이선스가 도판의 재배포 허락을 뜻하지 않는다.여기서 1, 2, 3, 6은 pooling 뒤 출력 격자의 한 변에 놓일 bin 수다. “각각 1×1·2×2·3×3·6×6 convolution을 적용한다”거나 “dilation rate가 1·2·3·6이다”라는 뜻이 아니다. 1×1 grid는 영상 전체의 문맥이고, 2×2 grid는 네 개의 큰 부분을 구분한 문맥이다. grid가 촘촘해질수록 더 작은 영역에서 요약한다.
다음은 Figure 3을 재표현한 식이다. 원문 식 번호가 아닌 해설용 연산 표기다. F는 encoder feature, A_b는 출력이 b×b인 평균 풀링, φ_b는 1×1 채널 변환 등을 묶은 학습 연산, U는 bilinear resize다.
계산 예제 — feature가 60×60×2048이라면. 크기 반올림을 피하려고 60을 선택했다. 이것은 설명용 입력이며 논문의 모든 이미지에서 중간 특징이 60×60이라는 뜻은 아니다. 네 분기를 각각 512채널로 줄이는 구성에서 다음이 성립한다.
| 경로 | pooling 직후 H×W×C | 채널 축소 뒤 | resize 뒤 |
|---|---|---|---|
| global | 1×1×2048 | 1×1×512 | 60×60×512 |
| 2-grid | 2×2×2048 | 2×2×512 | 60×60×512 |
| 3-grid | 3×3×2048 | 3×3×512 | 60×60×512 |
| 6-grid | 6×6×2048 | 6×6×512 | 60×60×512 |
원래 2048채널을 포함하면 출력은 60×60×4096이다. 2048+4×512=4096이므로, 네 pooling 출력을 서로 더한다고 생각하면 이 채널 계산을 재현할 수 없다. 6-grid에서 한 bin은 이 예제에 한해 10×10 영역의 평균이다. feature 크기가 grid로 나누어떨어지지 않으면 adaptive pooling의 구간 배정과 구현을 확인해야 한다.
global 분기의 1×1 값을 60×60으로 키우면 각 위치에 같은 전역 정보를 전달한다. 2×2 이상의 분기는 위치에 따라 다른 문맥을 전달할 수 있다. resize는 요약 과정에서 사라진 미세 경계를 새로 관측하지 않는다. 그래서 원래 feature가 연결에 남는다. 문맥 요약과 위치 정보는 역할이 다르다.
학습에는 중간 층의 보조 분류 손실도 사용한다. 다음은 목적함수를 요약한 식이며, 논문에서 검토한 보조 손실 가중치 중 0.4를 선택한 설정을 나타낸다. 보조 head는 추론 시 두 번째 최종 예측기로 반드시 실행하는 구조가 아니다. PSPNet, §4, Table 2
실험은 무엇을 입증했는가. 아래는 Table 1의 ADE20K validation, ResNet-50, single-scale 비교다. 표의 baseline에는 해당 절의 학습 구성이 적용되어 있으므로 다른 절의 더 약한 baseline을 섞지 않는다. 수치는 논문 표의 mean IoU이며 실험을 독립 재현한 값은 아니다.
| 같은 Table 1 안의 설정 | mIoU (%) |
|---|---|
| baseline | 37.23 |
| global average pooling만 추가 | 40.07 |
| 네 grid의 average pooling | 41.07 |
| 네 grid + average pooling + dimension reduction | 41.68 |
37.23→41.68은 4.45 percentage points, global-only 대비는 1.61 points다. 이 비교는 다중 지역 문맥의 효용을 지지하지만, “pooling 하나 때문에 모든 데이터에서 같은 폭으로 개선된다”는 법칙은 아니다. 보조 손실·증강·backbone·multi-scale testing이 다른 최고 점수와 이 표를 직접 빼서 PPM의 단독 기여라고 부르면 안 된다. PSPNet Table 1, 저자 공개 구현의 ss/ms 결과 구분
#DeepLabv3: pooling 범위 대신 합성곱의 표본 간격을 바꾸기
Atrous convolution은 filter의 계수를 늘리지 않고 읽는 위치의 간격을 바꾼다. 1차원으로 쓰면 아래와 같다. r은 dilation rate이고 w[k]가 학습되는 계수다. 실제 2차원에서도 같은 원리가 두 축에 적용된다. DeepLabv3, §3, 식 (1)
계산 예제. 3×3 kernel에 r=6을 쓰면 각 축의 전체 폭은 13이다. 그러나 학습할 공간 계수는 여전히 9개이며, 13×13의 169개 위치를 모두 읽는 dense kernel이 아니다. 커널의 사이에 학습되지 않는 “새 계수”를 삽입한 것도 아니다. 표본 위치는 넓게 퍼지지만 그 사이의 정보를 해당 층 하나에서 모두 관측하는 것은 아니다.
Dilation만 설정하면 해상도가 자동 보존된다는 설명도 불완전하다. 다음은 1차원 출력 크기를 구하는 일반 연산식이다.
k=3, r=6, s=1에서 입력 크기를 유지하려면 이 대칭 padding 예에서는 p=6이 필요하다. p=0이면 H−12로 줄어든다. 따라서 receptive field, stride, dilation, padding을 각각 명시해야 한다. 입력 경계에서는 일부 표본이 실제 영상이 아닌 padding을 읽는다는 사실도 남는다.
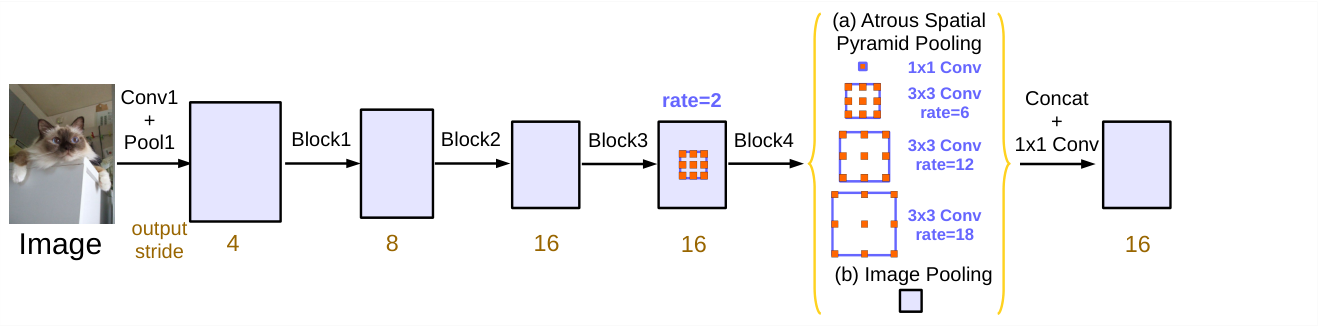
오른쪽 ASPP는 다섯 분기를 가진다. 1×1 경로, rate 6·12·18의 세 경로, Image Pooling 경로를 구분해서 읽는다. 그림 앞쪽의 backbone stride와 block 내부 multi-grid는 이 병렬 분기 자체와 다른 설정이다.
Liang-Chieh Chen et al. · 1706.05587v3 · 원논문 · 원문 속 그림 · 크게 보기 원논문 도판 발췌. 원문 PNG 파일을 그대로 사용했다. 한국어 해설은 별도 작성. 원권리자의 권리가 유지되며 블로그 코드의 MIT 라이선스가 도판의 재배포 허락을 뜻하지 않는다.DeepLabv3의 개선된 ASPP는 output stride 16 설정에서 1×1 분기 하나, 3×3 atrous 분기 세 개, image-level pooling 분기를 함께 사용한다. 각 분기는 256채널이며 연결 뒤 1×1 변환으로 다시 256채널을 만든다. DeepLabv3, §3.2, Figure 5
계산 예제 — encoder feature 32×32일 때. 네 convolution 분기는 각각 32×32×256이다. global pooling 분기는 1×1에서 채널 변환을 거쳐 32×32×256으로 resize한다. 연결 직후는 32×32×1280, 투영 뒤는 32×32×256이다. PSPNet의 four-grid pooling과 달리 ASPP의 atrous 분기들은 같은 공간 격자에서 서로 다른 간격의 표본을 읽는다.
Output stride를 16에서 8로 낮춰 같은 크기의 입력을 처리하면, 이상적으로 각 축의 특징 크기가 두 배이고 공간 위치 수는 네 배다. 입력 좌표계에서 대략 같은 간격을 유지하려면 r도 두 배로 조정하는 구성을 쓴다. 원문의 OS=8 추론에서는 12·24·36으로 바꾼다. 홀수 입력 크기의 실제 출력은 padding과 rounding에 달려 있으므로 513/16 같은 비정수만으로 정확한 feature shape를 선언하지 않는다.
큰 rate가 항상 유리한 것은 아니다. feature map보다 지나치게 넓게 벌어진 표본은 대부분 경계 밖으로 나간다. 극단적으로 중앙 표본만 유효해지면 넓은 문맥을 본다는 의도와 달라진다. image pooling은 이 문제를 단순히 “더 큰 rate 하나”로 해결하지 않고, 별도의 전역 요약 경로를 제공한다.
같은 조건에서 모듈을 바꾼 실험. Table 5에서 ResNet-101, VOC validation, output stride 16의 Multi-grid (1,2,4) + ASPP(6,12,18)은 76.58%다. rate 24를 추가하면 76.46%, image pooling을 더한 구성은 77.21%다. 추가 경로가 많다고 단조롭게 좋아지지 않으며, image-level 경로의 개선은 이 비교에서 0.63 points다. DeepLabv3, Table 5
Table 6의 77.21→78.51→79.45→79.77→82.70은 각각 평가 output stride, multi-scale, flip, COCO 사전학습의 조건이 순서대로 바뀌는 비교다. 마지막 수치를 처음 수치에서 뺀 뒤 모두 ASPP 덕분이라고 설명하지 않는다. 학습된 모듈의 효과와 더 비싼 추론·추가 학습 데이터의 효과는 별개다.
#DeepLabv3+: 문맥을 모은 뒤 경계를 복원할 decoder를 붙이기
DeepLabv3+의 질문은 “ASPP에서 문맥을 모았으니 끝인가?”이다. 성긴 high-level feature를 단번에 키우기보다, 더 조밀한 low-level feature와 결합한 뒤 공간적으로 정제한다. U-Net과 닮은 encoder–decoder 목적이 있지만 모든 해상도 단계에서 반복 연결하는 원형 U-Net과 동일한 구조는 아니다. DeepLabv3+, §3, Figure 2
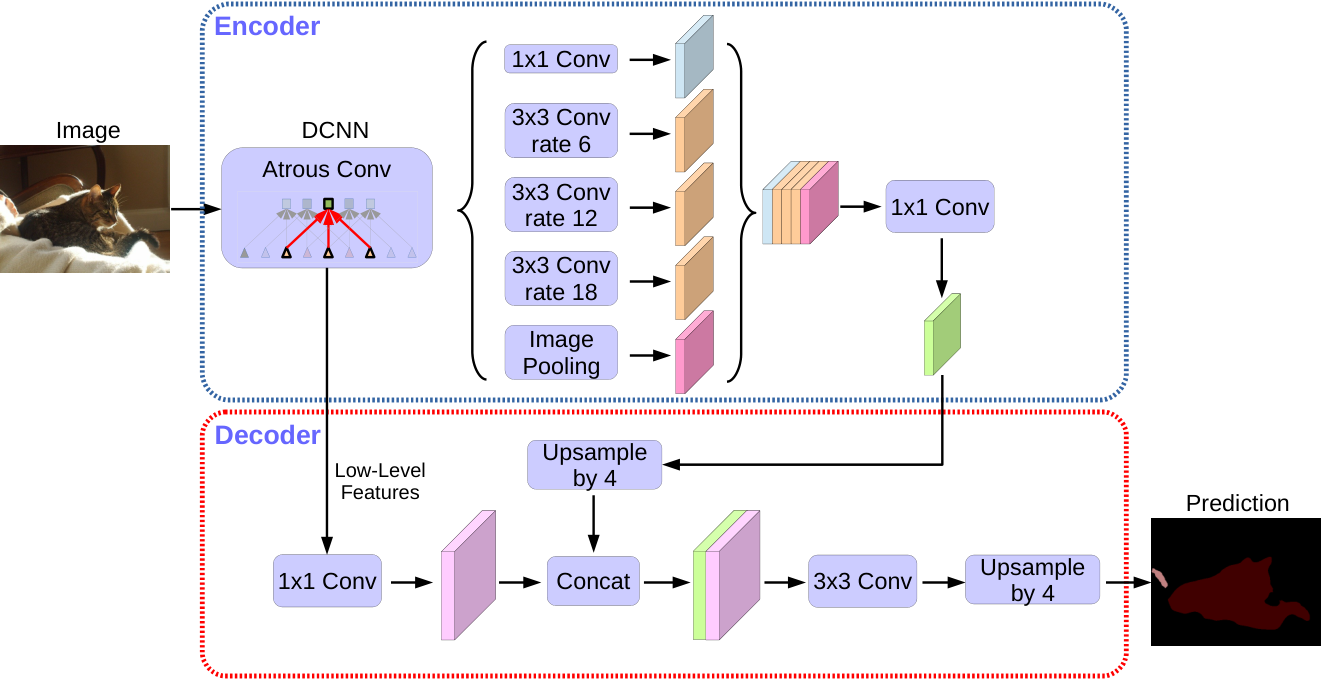
상단은 encoder, 하단은 decoder다. decoder로 들어오는 것은 class ID가 아니라 특징이다. 왼쪽 low-level feature의 1×1 변환과 위쪽 feature의 4배 확대가 CONCAT보다 먼저 일어난다는 순서를 따라간다.
Liang-Chieh Chen et al. · 1802.02611v3 · 원논문 · 원문 속 그림 · 크게 보기 원논문 도판 발췌. 원문 PNG 파일을 그대로 사용했다. 한국어 해설은 별도 작성. 원권리자의 권리가 유지되며 블로그 코드의 MIT 라이선스가 도판의 재배포 허락을 뜻하지 않는다.계산 예제 — 512×512 입력, encoder OS=16을 가정한 정렬된 격자. 이는 연산 이해용 예이며 논문의 홀수 crop 크기나 모든 backbone의 실제 shape 표를 대신하지 않는다.
| 위치 | 텐서 H×W×C | 처리 목적 |
|---|---|---|
| encoder 출력 | 32×32×256 | ASPP로 문맥을 반영한 feature |
| 4배 bilinear 확대 | 128×128×256 | low-level 격자와 공간 정렬 |
| low-level feature의 1×1 투영 | 128×128×48 | 얕은 특징의 채널 수 축소 |
| channel concat | 128×128×304 | 256+48, score sum 아님 |
| 두 번의 3×3 정제 | 128×128×256 | 결합된 문맥·위치 정보를 처리 |
| class head와 최종 resize | 512×512×K | 픽셀별 logits |
48채널은 “원래 low-level feature가 48채널”이라는 뜻이 아니다. 채널 투영의 출력이다. 실험에서 확인한 설계 선택이지 임의의 데이터와 backbone에서도 유일한 최적값이라는 상수가 아니다. 마찬가지로 두 번의 3×3 합성곱을 세 번으로 늘렸을 때 자동 개선되지 않았다. DeepLabv3+, Tables 1–2
#Atrous separable convolution의 비용은 어디서 줄어드는가
공간 연산을 채널마다 수행하는 depthwise convolution과, 채널을 섞는 pointwise 1×1 convolution을 분리한다. dilation은 이 중 공간 표본을 읽는 단계에 적용된다. 다음은 multiplier=1, bias·정규화 parameter 제외의 계산식이다.
k=3, 입력·출력 채널이 256이면 일반 합성곱은 589824개, 분리 합성곱은 67840개 parameter다. 약 8.69배 차이지만 이것을 실장치에서 8.69배 빠르다는 측정으로 바꾸면 안 된다. 메모리 이동, 중간 tensor, kernel launch와 하드웨어 지원도 영향을 준다. 또한 임의의 dense convolution을 아무 손실 없이 항상 같은 depthwise-pointwise 필터로 분해할 수 있다는 주장도 아니다. 표현 구조 자체가 달라진다.
정확도와 연산량을 같이 읽는 실험. 아래는 Table 3의 VOC2012 validation, ResNet-101, 학습·평가 OS=16, single-scale, flip 없음이라는 같은 조건이다. B는 10억 단위이며 원문 열 이름은 Multiply-Adds다.
| 구성 | mIoU (%) | Multiply-Adds |
|---|---|---|
| decoder 없음 | 77.21 | 81.02B |
| decoder 있음 | 78.85 | 101.28B |
Decoder 추가는 이 조건에서 1.64 points 향상과 20.26B의 연산 증가를 함께 보인다. “가벼운 decoder”라는 표현을 “비용이 전혀 없다”로 읽지 않는다. 이 ResNet 비교에 Xception·추가 데이터·다중 스케일을 사용한 최고 성능을 섞어 decoder 단독 효과라고 계산하지 않는다. DeepLabv3+, Table 3, PDF 9쪽
#세 구조를 구별하는 점검 질문
PSPNet은 어떤 지역으로 나누어 요약했는가, DeepLabv3는 어떤 간격으로 공간 표본을 읽고 전역 요약을 더했는가, DeepLabv3+는 문맥 feature에 어떤 저수준 특징을 연결해 경계를 정제했는가를 물으면 된다. 표면적인 피라미드 모양보다 pooling grid·dilation rate·decoder의 역할이 더 중요하다. 구현에서는 채널 축, bilinear resize의 좌표 설정, training/evaluation output stride, BN의 학습 조건, 원래 label의 해상도를 함께 기록한다.
#6.5 pixelwise loss와 class imbalance
가장 직접적인 학습 목표는 모든 픽셀에 cross entropy를 더하는 것이다.
하지만 도로 영상의 하늘·도로처럼 큰 class가 작은 표지판·보행자보다 훨씬 많은 픽셀을 차지하면, 평균 loss는 큰 class에 끌린다. class weight를 주면 희소 class의 오류를 더 크게 반영할 수 있다.
앞서 본 U-Net의 원문 식 (2)는 이 class 빈도 보정 외에 두 세포 경계 사이의 거리를 이용하는 공간 가중치를 추가한다. class마다 상수 하나를 주는 것과 픽셀 위치마다 다른 weight를 주는 것은 구분해야 한다.
Dice 계열 목표는 예측 영역과 정답 영역의 겹침을 직접 본다. 아래는 손실함수를 비교하기 위한 일반적인 추가 설명이며 원래 U-Net의 학습 손실이 아니다. 작은 foreground에 대한 목적을 설계할 때 검토할 수 있지만, batch 구성과 smoothing ε의 선택도 함께 명시해야 한다.
cross entropy의 픽셀별 확률 오류와 Dice의 영역 겹침은 같은 양이 아니다. cross entropy를 썼다는 사실만으로 모델 확률의 calibration이 보장되는 것도 아니다. 어떤 목표를 최적화했는지와 실제 per-class IoU·boundary 품질·확률 신뢰도를 각각 평가했는지를 분리한다.
#6.6 MRF: 예측 뒤에 공간 구조를 넣는 방법
먼저 이름을 구분한다. 마르코프 확률장(Markov random field, MRF)은 공간적 의존성을 표현하는 모델이고, ICM은 정해진 모델에서 label을 찾는 최적화 방법이다. MRF가 CNN의 한 종류인 것도, ICM이 반드시 신경망을 학습시키는 알고리즘인 것도 아니다. 이 절에서는 Besag의 1986년 논문을 역사적 출발점으로 삼고, 계산은 별도로 정의한 작은 Potts 모델에서 직접 검증한다. Besag, On the Statistical Analysis of Dirty Pictures, JRSS B 48(3), 1986
이 기존 Gibbs 식에서 x는 상태 변수다. 아래 예제에서는 혼동을 피하려고 label 상태를 y, 관측을 x로 쓰고 temperature T=1로 둔다. 원자료의 기호와 예제의 기호를 구분한다.
각 픽셀의 관측 적합도와 이웃 label의 매끄러움 비용을 더하고, ICM은 한 위치씩 가장 낮은 local energy의 label로 갱신한다.
#그림의 노드와 선은 무엇을 나타내는가
위 개념도는 원논문 그림을 복제한 것이 아니라, 이웃 label을 하나씩 갱신하는 생각을 보여 주는 기존 해설 그림이다. 원논문의 특정 도판을 확인한 것처럼 번호를 붙이지 않는다. 아래에서는 아예 세 노드가 한 줄로 연결된 그래프 1—2—3을 사용한다. 노드는 픽셀 또는 작은 영역의 label이고, 선은 두 label의 조합에 비용을 주겠다는 모델링 선택이다. 선이 있다고 두 픽셀의 RGB 값이 같다는 뜻은 아니다.
4-neighborhood 영상에서는 보통 위·아래·왼쪽·오른쪽을 이웃으로 선택한다. 대각선을 포함한 8-neighborhood도 가능하지만 다른 그래프다. 그래프를 바꾸면 에너지와 최적해도 달라지므로 “MRF를 적용했다”는 설명만으로는 재현할 수 없다. 모든 MRF가 pairwise potential만 가져야 하는 것도 아니다. 더 큰 clique를 사용하는 모델도 있다.
Hammersley–Clifford 정리를 연결할 때에는 적절한 유한 그래프 설정에서 확률의 엄격한 양성성(positivity) 같은 전제를 확인해야 한다. “이웃만 보면 된다”는 설명만으로 임의의 분포와 임의의 에너지 표현이 항상 동치가 되는 것은 아니다. 이 절의 예는 모든 상태의 에너지가 유한하므로 아래 Gibbs 분포가 양의 확률을 갖는다.
#Unary와 pairwise를 숫자로 분리하기
관측을 x, label들을 y라고 쓰면 조건부 에너지 모델을 다음처럼 정의할 수 있다. 아래는 원논문 식의 전사가 아니라 이 절의 해설용 모델이다. Z는 가능한 label 배치 전체에 대해 확률의 합이 1이 되도록 만드는 정규화상수다.
구체적인 예로 Potts형 pairwise 비용을 선택하자.
D_i(k;x)는 위치 i에 label k를 줄 때의 unary 비용, λ는 이웃과 다른 label을 줄 때의 벌점이다. 무방향 edge는 한 번씩만 합산한다. i→j와 j→i를 둘 다 세면 pairwise 가중치를 의도치 않게 두 배로 만든다. λ=0이면 위치별 unary 최소화로 분리된다. 큰 λ는 같은 label을 선호하지만 얇은 실제 구조도 지울 수 있다.
Gaussian 관측 모델을 선택했다면 unary를 (x_i−μ_k)²/(2σ²) 등으로 만들 수 있다. 또는 CNN 확률에서 −log p_θ(k|X)를 unary로 선택할 수 있다. 후자는 관측 전체 X에 의존하는 조건부 에너지의 선택이며, 그것을 별도의 가정 없이 순수한 생성형 p(x_i|y_i)와 같다고 부르면 안 된다. MRF의 local Markov 성질은 label 사이의 조건부 독립성에 관한 것이지 unary가 반드시 작은 RGB patch만 읽어야 한다는 제약이 아니다.
#ICM에서 전체 label 배치를 매번 탐색하지 않아도 되는 이유
나머지 label을 고정하고 i만 바꾸면, i와 관계없는 에너지 항은 모두 상수다. 그 항들을 뺀 다음, i를 포함하는 unary와 edge만 비교한다. pairwise 예에서의 순차 갱신은 다음과 같다.
이웃 y_j는 현재까지 갱신된 상태를 사용한다. 조건부 확률을 최대화하는 것과 음의 로그에 해당하는 local energy를 최소화하는 것은 같은 선택을 준다. Z와 멀리 떨어진 node의 비용을 계산하지 않아도 되는 이유다. 독립적으로 모든 node의 unary argmin을 동시에 한 번 적용하는 것과 다르다.
다음 알고리즘은 label 수와 이웃 수가 작은 경우의 직접 구현이다. 한 sweep은 각 node를 한 번 방문하는 것이다. 같은 비용이면 기존 label을 유지하도록 정해, 동률 이동에 의한 무의미한 순환을 막는다.
초기 label y를 선택한다.
정해진 순서로 각 node i를 방문한다.
    모든 후보 label의 local energy를 계산한다.
    현재 label보다 비용이 엄격히 작을 때에만 바꾼다.
한 sweep에서 바뀐 label이 없으면 종료한다.
변경마다 전체 에너지가 엄격히 감소하고 가능한 상태가 유한하다면 종료한다. 다만 도달점은 한 node 변경으로 더 낮아지지 않는 좌표별 최소점이며, 전역 최적해나 posterior mean이라는 보장은 없다. 구현에서 float 비교 허용오차, node 순서, 초기화, 최대 sweep 수와 실제 수렴 여부를 함께 기록해야 한다.
#계산 예제 1: 작은 잡음은 왜 정리되는가
그래프는 1—2—3, label은 0/1, λ=0.6이다. unary 비용을 아래처럼 정한다. 데이터에서 추정한 값이 아니라 연산을 보이기 위해 만든 숫자다.
| node | D(0) | D(1) | unary만 보면 |
|---|---|---|---|
| 1 | 2.0 | 0.0 | 1 |
| 2 | 0.0 | 0.4 | 0 |
| 3 | 2.0 | 0.0 | 1 |
초기 101의 unary 합은 0, 다른 label을 잇는 edge가 둘이므로 전체 비용은 1.2다. 중앙을 0으로 유지하면 local cost=1.2, 1로 바꾸면 0.4+0=0.4다. 따라서 중앙을 1로 바꾼 111은 전체 비용 0.4가 된다. 이것이 공간 일관성 항이 고립된 예측을 정리하는 한 가지 경우다.
그렇다고 중앙이 실제로 작은 물체인 경우까지 바꾸는 것이 정답은 아니다. 모델은 이 예제에서 “이웃과 다르면 비용이 든다”는 사전 선택을 따랐을 뿐이다. 에너지가 줄었다는 사실과 실제 분할 정확도가 올랐다는 사실은 별개의 검증 항목이다.
#계산 예제 2: 전역 최적해가 있어도 ICM이 못 움직이는 반례
노드 두 개 1—2에 각각 D(0)=1, D(1)=0, λ=2를 주자. 가능한 상태를 전부 계산할 수 있다.
| 상태 | unary 합 | pairwise | 총 에너지 |
|---|---|---|---|
| 00 | 2 | 0 | 2 |
| 01 | 1 | 2 | 3 |
| 10 | 1 | 2 | 3 |
| 11 | 0 | 0 | 0 |
00에서 한 node만 바꾸면 비용이 2→3으로 나빠져 ICM은 멈춘다. 하지만 11의 비용은 0이다. 둘을 함께 바꾸면 좋아지지만 하나씩 바꾸면 먼저 손해를 봐야 하는 구조다. “충분히 반복하면 반드시 전역 최적해”라는 설명을 이 네 줄만으로 반박할 수 있다. 무작위 재시작은 다른 시작점을 시도하는 방법일 뿐, 제한된 횟수의 재시작이 일반적으로 전역 최적성을 보장하지는 않는다.
#계산 예제 3: 병렬 갱신으로 바꾸면 왜 단조 감소가 깨질 수 있는가
같은 두 노드에서 unary를 모두 0, λ=1로 두고 01로 시작한다. 두 노드가 이전 sweep의 이웃만 보고 동시에 갱신하면 첫 노드는 1을, 둘째는 0을 선택해 10이 된다. 다음에는 다시 01이다. 각자가 옛 이웃에 맞추었지만 계속 엇갈린다. 반면 한 node씩 즉시 반영하면 11 또는 00으로 간다.
이 반례는 “GPU에서 모든 픽셀을 병렬로 바꾸면 원래 ICM과 동일하다”는 가정을 경계하게 한다. 독립 집합을 나눈 checkerboard 갱신처럼 같은 묶음 안에 edge가 없게 만드는 방식은 별도로 분석할 수 있다. 단순한 동시 갱신과 순차 갱신을 이름만 같게 붙이지 않는다.
#원논문과 이 예제가 각각 뒷받침하는 것
Besag의 논문은 noisy image 복원을 확률 모델과 반복적인 local optimization으로 다루는 연구다. 여기서는 공개된 논문 서지·요약으로 방법의 맥락을 확인했지만, 원문 전체 도판과 모든 복원 실험의 수치를 직접 검수했다고 주장하지 않는다. 위 세 예제는 논문의 표가 아니라 독립적으로 정의하고 전수검사한 작은 모델이다. 따라서 논문의 실제 복원율로 인용하면 안 된다.
오늘날 신경망 뒤에 공간 비용을 넣더라도 먼저 unary 정의, graph, λ, 초기화와 update rule을 결정해야 한다. MRF와 CRF를 모델 이름만으로 혼용하거나, DeepLabv3/v3+가 이전 DeepLab의 DenseCRF 후처리를 그대로 필수로 사용한다고 설명하지 않는다. 학습되는 decoder와 에너지 최적화 후처리는 서로 다른 방식으로 공간 구조를 반영한다.
#6.7 무엇을 측정해야 하는가
pixel accuracy만 보면 배경을 잘 맞힌 모델이 과대평가될 수 있다. class별 Intersection over Union(IoU)은 예측과 정답의 합집합 가운데 교집합이 차지하는 비율이다.
보고서에서는 class별 IoU와 그 평균 mIoU, 작은 class의 recall, boundary metric을 구분해 본다. resize와 padding을 원복한 뒤 평가했는지도 중요하다. 한 픽셀의 정렬 오류가 얇은 구조물에서는 큰 점수 차이가 될 수 있기 때문이다. U-Net 원형처럼 중앙 유효 영역을 출력한다면, 예측과 비교할 정답이 정확히 같은 위치여야 한다.
검증 문제: 배경이 95%, foreground가 5%인 영상에서 모두 배경이라고 예측했다고 하자. pixel accuracy는 95%지만 foreground IoU는 0이다. 관측된 높은 accuracy가 경계를 잘 복원한다는 증거가 되지 않는다는 점을 숫자로 확인할 수 있다. 이는 설명용 예제이며 위 논문들의 데이터 비율이나 실험 결과가 아니다.
#6.8 한 번에 연결하기
encoder는 넓은 문맥을 만들고, decoder는 공간 출력을 복원한다. FCN의 skip은 class score를 더하고 U-Net의 skip은 feature를 이어 붙인다. 원형 U-Net의 valid convolution은 feature 크기를 줄이므로 crop과 유효 출력 영역을 계산해야 한다. 손실에서는 픽셀별 확률 오류, class 빈도, 경계 위치의 중요도를 구분한다. 평가에서는 분할 점수의 이름뿐 아니라 데이터와 label·split·정렬 조건까지 확인한다.
글을 읽은 뒤 다음을 직접 설명할 수 있는지 확인해 보자. FC층이 언제 7×7이고 언제 1×1로 바뀌는가? FCN의 score 두 개를 더해도 채널 수가 늘지 않는 이유는 무엇인가? U-Net의 572→388과 crop 4·16·40·88은 어떻게 계산하는가? 원문 E의 부호와 최소화할 손실은 어떻게 구분하는가? 가장 가까운 경계까지의 거리가 같아도 두 번째 경계 때문에 weight가 달라지는 이유는 무엇인가?
FCN은 dense prediction을 위한 공간적 계산과 전이학습을 연결했고, U-Net은 생의학 영상에서의 localization을 위해 feature 결합·유효 출력 영역·경계 가중 학습을 함께 설계했다. DeepLab 계열의 dilation과 spatial pyramid는 문맥을 확장하는 또 다른 축이다. 새 architecture를 읽을 때도 “무엇을 어느 해상도에서 계산하고, 무엇을 결합하고, 어떤 오류에 벌점을 주는가”로 분해하면 이름보다 연산이 먼저 보인다.
#원문과 그림 다시 보기
Long·Shelhamer·Darrell, FCN 1411.4038v2, 2015-03-08 — Figure 2의 분류망 변환, Figure 3의 skip 연산 그래프, Figure 4와 Table 2의 비교를 함께 읽는다.
Ronneberger·Fischer·Brox, U-Net 1505.04597v1, 2015-05-18 — Figure 1의 크기·채널, Figure 2의 overlap-tile, Figure 3과 식 (1)·(2)의 학습 목표를 함께 읽는다.
U-Net 저자 연구실의 프로젝트 페이지 — 논문과 저자 제공 소프트웨어를 연결하는 출발점이다. 코드나 후속 모델을 사용할 때에는 버전과 원형에서 달라진 설정을 별도로 확인한다.