영상 잡음제거와 생성모델은 모두 관측과 잠재적인 깨끗한 신호의 관계를 다루지만, 같은 과제는 아니다. 이 글은 어떤 값을 추정하는지, 어떤 분포를 학습하는지, 학습 때 알고 있는 값이 추론 때도 주어지는지를 구분하며 읽는다. 기존 강의 수식은 유지하고, 원논문 근거와 별도의 계산 예제를 덧붙였다. 예제의 작은 숫자·텐서 크기는 논문 실험을 재현한 결과가 아니다.
#7.1 잡음제거를 추정 문제로 보기
깨끗한 값 x에 잡음이 더해져 y를 관측했다고 하자. 복원기를 평가하는 MSE는 정답과 예측의 제곱 오차다. 제곱 오차를 최소화하는 결정과 원래 분포에서 표본을 생성하는 결정은 다를 수 있다.
선형 MMSE는 주변 patch의 가중합을, median filter는 window 안 절대편차를 최소화하는 값을 사용한다.
선형 계수 식 Rzz⁻¹rzx에서는 역행렬의 존재와 변수의 중심화 여부를 확인해야 한다. 비영 평균을 갖는 데이터에서 bias 없는 선형식과 affine 추정기를 같은 것으로 취급하지 않는다. 수치 구현에서는 역행렬을 직접 만드는 것보다 선형시스템을 풀고, 특이하거나 조건이 나쁜 경우의 처리도 명시한다. 이것은 원자료의 짧은 식을 적용하기 위한 수학적 조건 설명이다.
계산 예제. y를 관측한 뒤 x가 −1 또는 +1일 확률이 각각 1/2라고 하자. 상수 예측 a의 조건부 제곱오차는 다음과 같다.
최소점은 a=0이다. 그런데 이 예에서 실제 깨끗한 x는 0이 아니다. 조건부 평균이 제곱오차에 최적이라는 사실이 “한 번 생성한 표본도 항상 평균값이어야 한다”는 뜻은 아니라는 점을 확인한다. 영상의 여러 가능한 세부를 평균내면 흐려질 수 있다는 직관도 이와 연결되지만, 모든 복원기의 흐림을 이 예제 하나로 설명할 수는 없다.
#7.2 impulse noise에는 왜 median이 강한가
계산 예제. 창 안 값이 [10, 11, 12, 13, 255]이면 평균은 60.2, 중앙값은 12다. 255 하나가 평균을 끌어올리는 정도와 달리 중앙값은 순서에 의존한다. 중앙값은 절대편차 합의 최소화점이다. 다만 절대편차 최소점이 항상 하나뿐인 것은 아니다. 짝수 표본 [0, 2]에서는 0과 2 사이의 모든 값이 같은 절대편차 합을 갖는다.
복원의 지표는 어떤 오차를 허용하는지를 정한다. PSNR의 L은 해당 비교에서 사용하는 peak dynamic range다. 다음 식은 MSE>0일 때 해석한다.
L=1이고 MSE=0.01이면 20 dB, MSE=0.0025이면 약 26.0206 dB다. 제곱오차가 4분의 1이면 약 6.0206 dB가 오른다. 0–255 영상과 0–1 영상을 비교하면서 L 또는 MSE의 단위를 한쪽만 바꾸면 틀린 점수가 나온다. MSE=0의 이상적 경우는 무한대이며 임의의 작은 상수를 넣었다면 그 규칙을 기록한다. PSNR 하나로 생성된 질감의 사실성이나 후속 검출 성능을 모두 판정하지 않는다.
#7.3 discriminative model과 generative model
분류기의 p(y|x)와 생성기의 p(x)는 목적이 다르다. 잠재변수 모델에서는 prior에서 z를 뽑고 pθ(x|z)로 x를 만든다. 반대로 관측 x가 주어졌을 때 z를 추론하는 것은 posterior pθ(z|x)의 문제다. 아래부터 encoder는 근사 posterior를 만드는 qφ, decoder는 likelihood를 만드는 pθ(x|z)를 뜻한다.
확률적 decoder의 출력은 “정답 이미지 그 자체”일 수도 있는 결정값과 구분한다. Bernoulli likelihood라면 픽셀별 확률을, Gaussian likelihood라면 평균과 선택한 분산 구조를 출력한다. 재구성 손실을 BCE 또는 MSE로 쓰는 이유도 이 관측 모델과 연결해 설명해야 한다. Kingma·Welling, Auto-Encoding Variational Bayes, §2–3
#7.4 VAE: 계산하기 어려운 posterior를 학습 가능한 근사로
VAE의 핵심 문제는 “latent에 noise를 넣자”보다 구체적이다. 복잡한 decoder를 쓰면 pθ(x)=∫pθ(x,z)dz를 계산하기 어렵고, 그 값이 posterior의 분모에도 등장한다. 각 x마다 비싼 추론을 반복하는 대신 qφ(z|x)를 신경망으로 만들어 학습한다. 처음 논문은 2013년에 공개되었으며, 여기서 링크한 본문은 2022-12-10 수정의 v11이다. 최초 공개 시점과 참고 버전을 구분한다.
encoder가 qφ(z|x)의 평균과 분산을 만들고, 재매개변수화로 z를 뽑아 decoder가 pθ(x|z)를 복원한다.
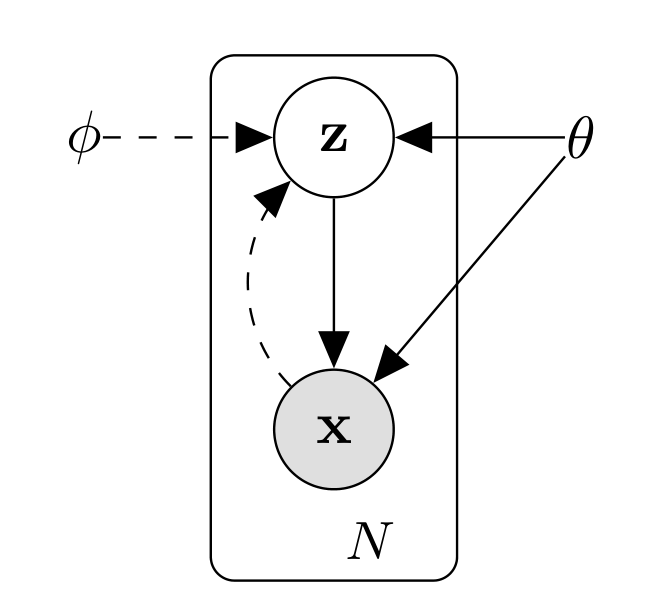
실선의 생성 방향과 점선의 추론 방향을 반대로 읽지 않는다. θ와 φ는 같은 변수의 두 이름이 아니라 서로 다른 parameter 묶음이다. N 표시는 관측별 잠재변수가 반복되는 plate다. 그림 자체는 convolution encoder나 U-Net 블록의 층별 구조도가 아니다.
Diederik P. Kingma; Max Welling · 1312.6114v11 · 원논문 · 원문 속 그림 · 크게 보기 원논문 도판 발췌. 원문 PDF에서 도판 영역만 잘라 고해상도로 렌더링했다. 한국어 해설은 별도 작성. 원권리자의 권리가 유지되며 블로그 코드의 MIT 라이선스가 도판의 재배포 허락을 뜻하지 않는다.#ELBO에 등장하는 두 KL을 구분하기
다음 두 줄은 원문 식 (1)–(3)의 관계를 학습용으로 다시 정리한 것이다. 첫 줄의 KL은 근사 posterior와 실제 posterior의 차이, 둘째 줄의 KL은 근사 posterior와 prior의 차이다.
두 KL의 오른쪽 분포가 다르다. 첫 번째 KL을 직접 계산할 수 있어서 ELBO를 쓰는 것이 아니다. 실제 posterior가 어려우므로 계산 가능한 둘째 줄의 lower bound를 최적화한다. 고정된 θ에서 ELBO를 높이면 posterior 근사 gap을 줄이지만, θ도 함께 학습할 때 모든 minibatch마다 실제 likelihood가 단조 증가한다고 보장하는 설명은 아니다.
유도 순서. log pθ(x,z)=log pθ(z|x)+log pθ(x)를 Eq[log pθ(x,z)−log q]에 대입한다. x에 관한 log pθ(x)는 z 평균 밖으로 나올 수 있고, 남는 Eq[log q−log posterior]가 KL이다. 이 관계에서 KL≥0을 적용하면 lower bound가 된다. 최대화 문제를 optimizer가 최소화하는 loss로 바꿀 때에는 −ELBO = reconstruction NLL + KL로 부호가 바뀐다.
#Gaussian KL을 숫자로 계산하기
표준정규 prior와 대각 Gaussian posterior를 선택하면 다음 닫힌식을 얻는다. μ와 σ는 각각 latent 차원의 평균과 표준편차이며, σ²가 분산이다. AEVB, Appendix B
계산 예제. latent가 1차원, μ=1, σ=0.5이면 KL은 0.818147… nats다. σ²=0.25를 식에 넣어야 한다. 반대로 μ=0, σ=1이면 posterior와 prior가 같아 KL=0이다. logvar를 출력하는 구현이라면 σ=exp(logvar/2)이지 exp(logvar)가 아니다.
해설용 작은 모델의 tensor를 추적해 보자. 원논문의 모든 실험 설정을 주장하는 표가 아니라, MNIST형 입력과 latent 20을 선택한 예다.
| 값 | shape | 역할 |
|---|---|---|
| 입력 x | B×784 | 관측 28×28을 펼친 값 |
| μ, logvar | 각각 B×20 | posterior parameter, 표본 자체 아님 |
| ε와 z | 각각 B×20 | 외부 noise와 재매개변수화 표본 |
| decoder logits | B×784 | Bernoulli 선택 시 픽셀별 logit |
| reconstruction NLL, KL | 각각 B | feature/latent 축을 합한 표본별 항 |
| 최종 loss | scalar | 선택한 batch reduction |
픽셀 784개를 평균내고 KL 20개는 합산한 loss와, 둘 다 표본별로 합한 뒤 batch 평균을 낸 loss는 상대 가중치가 다르다. loss 숫자가 작아졌다고 모델이 좋아졌는지, 단지 reduction을 바꿨는지 확인한다.
#재매개변수화는 sampling을 삭제하지 않는다
ε는 θ·φ와 무관한 표준정규에서 뽑는다. 같은 ε를 고정한 채 z를 μ와 σ의 미분 가능한 함수로 표현한다. 그러면 decoder의 손실을 z에서 encoder parameter까지 chain rule로 전달할 수 있다. 이것은 categorical sample 등 모든 확률변수에 같은 Gaussian 식을 그대로 적용할 수 있다는 뜻은 아니다.
계산 예제. μ=1, logvar=log(0.25), ε=2이면 z=2다. ∂z/∂μ=1, ∂z/∂logvar=0.5σε=0.5가 된다. ε=0으로 항상 고정하면 stochastic estimator의 목적을 바꾸는 것이고, z를 detach하면 encoder로 갈 reconstruction gradient가 끊긴다. 패키지의 검증 코드에서는 logvar에 대한 위 도함수를 유한차분으로 대조한다.
논문의 실험을 읽는 기준. Figure 2의 학습 비교에서는 처리한 데이터 수에 따른 variational lower bound를 본다. 이를 FID 그래프나 모든 모델의 정확한 marginal likelihood 그래프라고 부르지 않는다. 원문은 MNIST와 Frey Face 등에 대한 생성·추론 학습을 검토한다. “KL을 크게 주면 무조건 collapse, 작게 주면 무조건 좋은 generation”은 원문이 입증한 일반 법칙이 아니다. posterior collapse는 decoder·objective·optimization 등을 함께 검토할 문제다. AEVB, §5, Figures 2–3
#7.5 diffusion: 쉬운 파괴 과정과 학습된 복원 과정
DDPM은 데이터에 noise를 더하는 규칙을 알고 있는 과정으로 정한다. 모델은 그 역방향의 조건부 분포를 근사한다. 잡음을 더했던 정확한 표본을 언제나 역산하는 알고리즘이 아니라, noise에서 데이터 분포의 새 표본을 만들어 가는 모델이다. 참고 논문은 Ho·Jain·Abbeel, 2006.11239v2다.
forward process는 작은 Gaussian noise를 누적하고, reverse process는 시간 t가 주어진 denoiser로 noise를 단계적으로 제거한다.
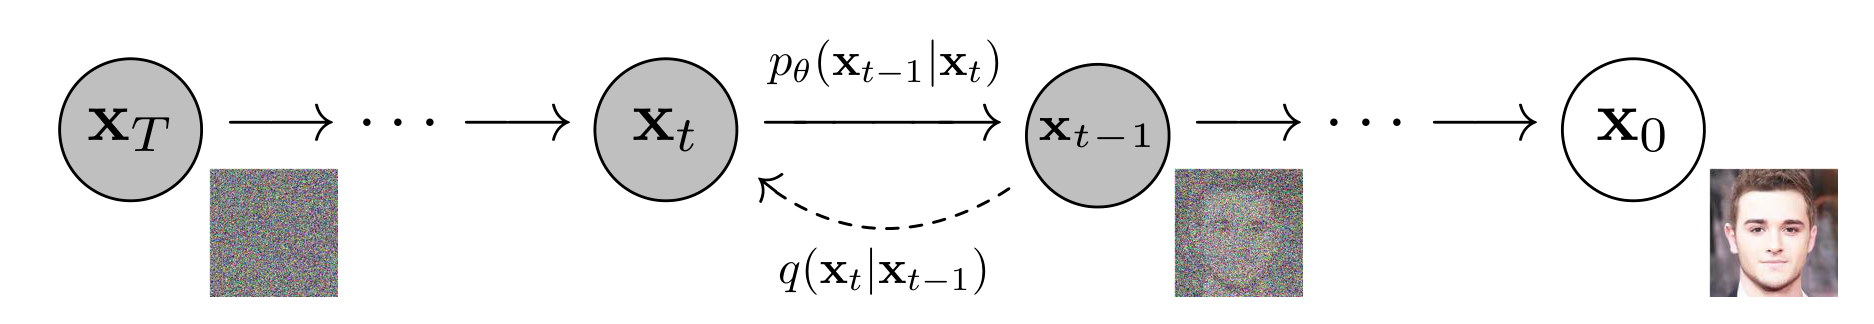
그림의 배치를 왼쪽에서 오른쪽으로 무조건 시간 증가라고 읽으면 안 된다. x0가 오른쪽이고 xT가 왼쪽이다. 어떤 화살표가 q이며 어떤 화살표가 학습할 pθ인지 먼저 확인한다. 얼굴 이미지는 한 예시이며 모델이 얼굴만 생성한다는 뜻은 아니다.
Jonathan Ho; Ajay Jain; Pieter Abbeel · 2006.11239v2 · 원논문 · 원문 속 그림 · 크게 보기 원논문 도판 발췌. 원문 PDF에서 도판 영역만 잘라 고해상도로 렌더링했다. 한국어 해설은 별도 작성. 원권리자의 권리가 유지되며 블로그 코드의 MIT 라이선스가 도판의 재배포 허락을 뜻하지 않는다.#T번의 noise 추가를 학습 때 매번 실행하지 않아도 되는 이유
αt=1−βt, barαt=∏αs다. 독립 Gaussian noise의 선형 결합이 Gaussian이므로 임의의 t에 대한 조건부 평균과 분산을 한 번에 쓸 수 있다. αt와 누적곱 barαt를 같은 변수처럼 사용하면 안 된다.
계산 예제. barαt=0.64, x0=0.5, ε=−1이면 xt=0.8×0.5+0.6×(−1)=−0.2다. 모델이 ε를 −0.8로 예측했다면 추정 x0는 (-0.2+0.6×0.8)/0.8=0.35다. 실제 ε=−1을 알 때만 이 식에서 x0=0.5를 정확히 되찾는다. 네트워크가 noisy input을 봤다는 것만으로 실제 주입한 ε를 유일하게 아는 것은 아니다.
이미지에서는 x0·xt·ε·예측 ε가 모두 같은 B×C×H×W shape를 갖는다. t는 보통 표본별로 선택하며 timestep embedding을 네트워크에 전달한다. 서로 다른 t를 batch에 섞으면 해당 표본의 계수를 [B,1,1,1]처럼 broadcast해야 한다. batch 전체에 첫 표본의 계수만 사용하는 버그를 조심한다.
#“역방향 posterior를 모른다”를 정확히 쓰기
학습 데이터 x0까지 주어지면 q(x_{t−1}|xt,x0)는 닫힌 Gaussian이다. 어려운 것은 x0를 모르는 역방향 분포를 모델링하는 것이다. 둘을 같은 posterior라고 묶으면 DDPM의 학습 유도를 이해할 수 없다. DDPM, §2–3, 식 (6)–(7)
이 평균에 위의 ε 기반 x0 재표현을 대입하면, 모델 평균을 noise predictor로 parameterize할 수 있다.
계산 예제. 두 step에서 β1=0.1, β2=0.2라면 α1=0.9, α2=0.8, barα2=0.72다. t=2의 posterior variance는 (0.1/0.28)×0.2=1/14≈0.0714286이다. β2=0.2와 같지 않다. 이 숫자는 설명용 schedule이며 원논문의 실제 1000-step schedule이 아니다.
#Lsimple은 ELBO에서 가중치를 바꾼 objective다
Noise MSE와 variational bound의 관계는 있지만, t별 계수를 버린 Lsimple이 원래 bound와 수치적으로 완전히 같은 식은 아니다. 원논문 §3.4는 이 단순화가 reconstruction의 다른 측면에 가중치를 주는 변경임을 설명한다. “수식 정리만 했으니 언제나 최적해·학습 경로가 같다”로 요약하지 않는다. DDPM, 식 (12)–(14)
학습은 x0, t, ε를 뽑아 xt를 만들고 그 t에서 한 번 network를 평가하는 것이 기본이다. 생성은 xT에서 t를 내려가며 여러 번 평가한다. 원논문 설정은 T=1000이고 β를 0.0001에서 0.02까지 선형 증가시켰다. 현재의 다른 sampler·step 수·variance parameterization은 별도의 선택이며 원형 DDPM과 구분한다.
학습: x0, t, ε 표본 → xt 생성 → εθ(xt,t) → noise MSE → parameter 갱신
생성: xT ~ Normal(0,I)
      t = T, ..., 1:
          μθ(xt,t)를 계산
          t > 1이면 선택한 σt로 Gaussian noise를 추가
          t = 1에서는 최종 step noise를 0으로 둠
위 생성 설명에서 σt를 어떤 규칙으로 선택했는지도 코드에 명시해야 한다. βt와 posterior variance를 혼동하거나, 마지막 step에서 불필요한 noise를 더하거나, t를 0-based 배열에 잘못 대응시키면 다른 생성 과정을 구현하게 된다.
실험은 무엇을 보여 주었는가. 원논문 Table 2의 unconditional CIFAR-10에서 ε prediction과 고정 isotropic variance를 사용한 bound 학습은 FID 13.51, Lsimple은 3.17이다. 이는 목적함수 선택이 sample quality에 중요했음을 보여 주며, 더 좋은 FID가 더 좋은 NLL과 같다는 뜻은 아니다. Table 1에서도 두 지표를 따로 보고한다. DDPM Tables 1–2, PDF 5쪽
FID의 reference 집합도 중요하다. 원문은 위 3.17을 training-set reference로 계산했고, test-set reference로 계산한 값은 5.24라고 설명한다. 둘을 다른 모델의 개선폭처럼 비교하지 않는다. DDPM의 U-Net backbone에는 timestep 조건과 attention 등이 있으며, VI의 2015년 분할 U-Net 도식과 모든 층·loss가 같은 모델은 아니다.
#7.6 조건을 주고 생성 방향을 조절하기
Class label이나 text 조건 c를 denoiser에 전달해 conditional model을 만들 수 있다. Classifier-free guidance(CFG)는 별도 classifier gradient 대신, 조건이 있을 때와 없을 때의 예측 차이를 활용한다. 참고 버전은 Ho·Salimans 2207.12598v1이다. Figure 1은 생성 예시이며, 아래에 발췌한 Figure 4가 ImageNet 64×64의 IS–FID 실험 곡선이다. 생성 예시와 정량 평가를 구분해 읽는다. CFG 원문
조건부 noise 예측과 무조건 예측의 차이를 키워 prompt 일치도를 높인다. guidance가 커질수록 충실도와 다양성의 균형이 달라진다.
기존 강의 식의 w는 아래 s와 같은 코드에서 자주 쓰는 convention이다. 원논문의 가중치와 이름이 같아도 기준점이 다를 수 있다.
s=0이면 unconditional, s=1이면 conditional prediction이다. s>1이면 둘 사이의 단순 보간이 아니라 조건 방향으로 외삽한다. 원논문 convention에서는 w_paper=0이 conditional이다. 동일 숫자 “guidance 3”이라도 서로 다른 convention을 비교하면 안 된다.
계산 예제. εu=0.2, εc=−0.1, s=3이면 결과는 −0.7이다. 두 값 사이인 −0.1~0.2 안에 있지 않다. s=3을 원논문 가중치 3과 같다고 넣으면 −1.0으로 바뀌므로 분명히 다른 설정이다. 이 계산은 guidance가 확률적인 정답을 보장한다는 증거가 아니라 표기의 기준점을 확인하는 예다.
학습에서 일정 확률로 조건을 제거해 unconditional 모드도 학습한다. 추론에서는 같은 xt와 t에 대해 조건부·무조건 예측을 얻는다. 두 요청을 batch에 붙여 한 호출로 처리해도 두 branch의 계산량이 사라지는 것은 아니다. 강한 guidance에서 조건 일치·다양성·왜곡 사이의 trade-off를 평가하고, 단순히 “scale이 높을수록 정확”이라고 쓰지 않는다.
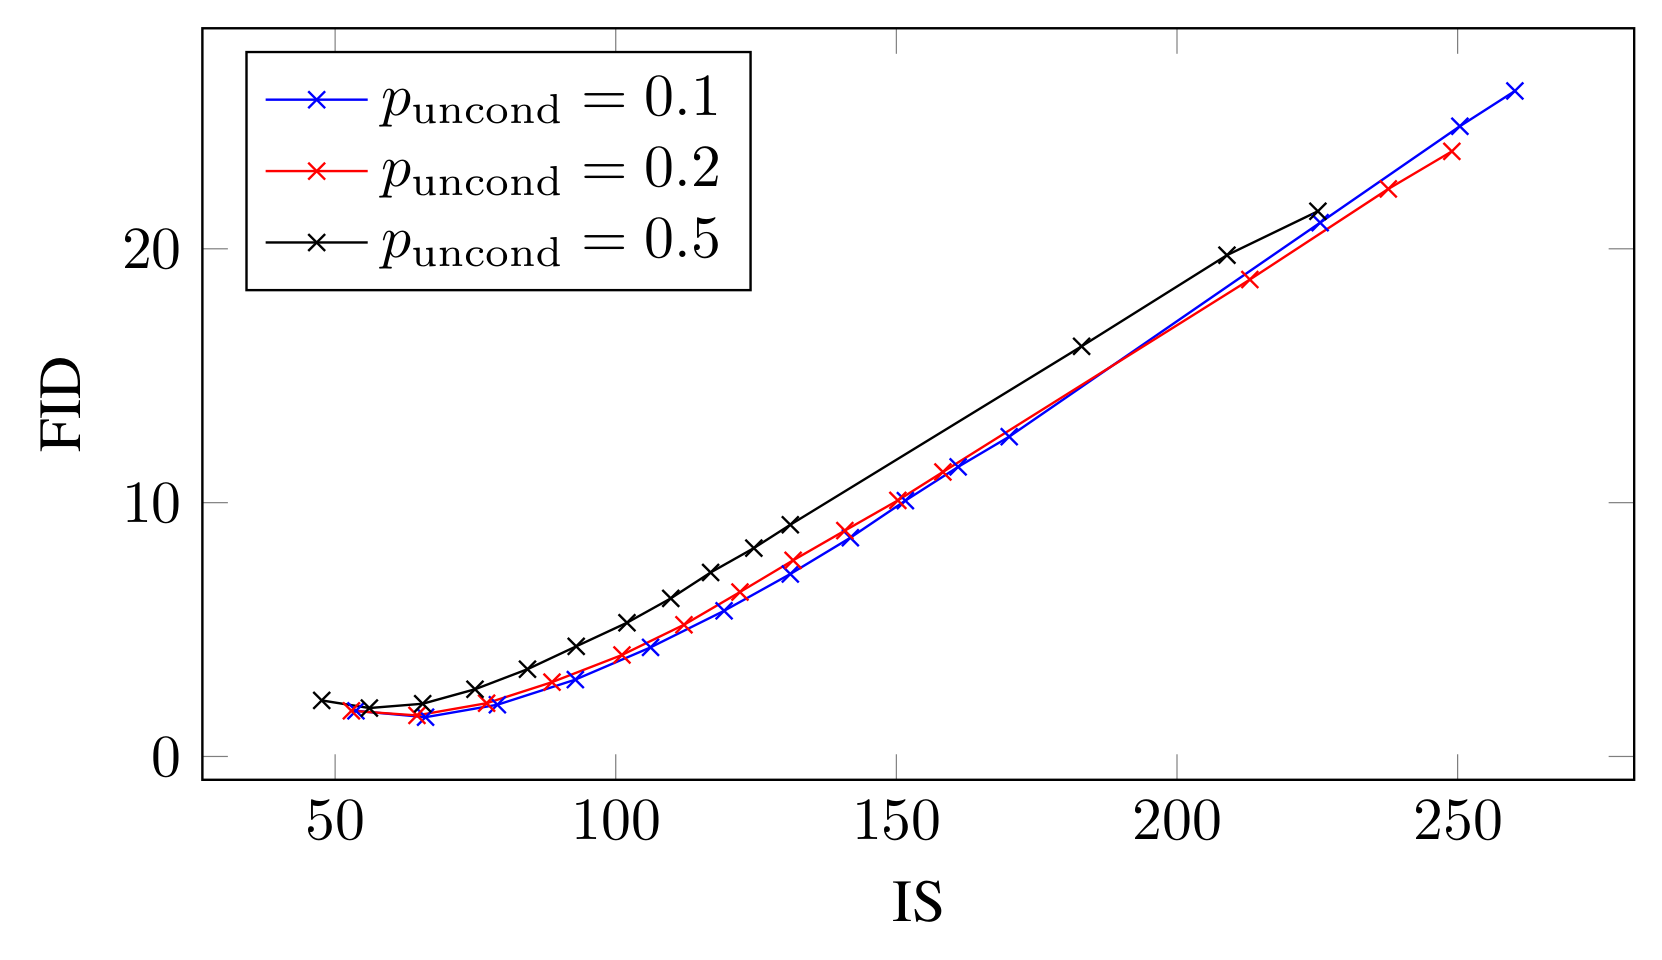
가로축은 guidance weight가 아니라 IS이며 클수록 좋고, 세로축은 FID이며 작을수록 좋다. 범례의 세 값은 학습 시 조건을 제거하는 확률 p_uncond이고, 각 곡선 안의 점들이 추론 guidance strength의 sweep이다. 높은 IS만 보고 선택하면 FID가 나빠지는 구간을 놓칠 수 있다. 구조도가 아니라 같은 평가 설정의 trade-off 도판이다.
Jonathan Ho, Tim Salimans · 2207.12598v1 · 원논문 · 원문 속 그림 · 크게 보기 원논문 도판 발췌. 지정한 PDF 버전에서 그림 영역만 잘라 고해상도 PNG로 렌더링했으며 내용을 다시 그리지 않았다. 한국어 해설은 별도 작성. 원권리자의 권리가 유지되며 블로그 코드의 MIT 라이선스가 도판 재배포 허락을 뜻하지 않는다.같은 페이지의 Table 1에서 p_uncond=0.1인 모델의 FID는 w_paper=0일 때 1.80, 0.1일 때 1.55, 0.2일 때 2.04다. 작은 guidance에서 개선된 뒤 다시 나빠지는 예이므로 “w를 늘리면 FID도 계속 좋아진다”는 설명은 맞지 않는다. 이 값들은 위의 s=w_paper+1 관계로 읽어야 하며, 모든 데이터셋의 최적값을 0.1로 정하는 규칙은 아니다. CFG v1, Figure 4·Table 1, PDF 7쪽
#7.7 pixel space를 벗어나기: latent diffusion
Latent diffusion은 먼저 autoencoder로 영상의 공간 정보를 압축한 뒤, 그 표현 공간에서 denoising을 학습한다. 생성 과정 전체가 한 번의 network 평가로 끝나는 것은 아니다. 확산의 반복은 latent에서 수행하고, 최종 latent를 영상으로 decode하는 단계는 별도로 수행한다. Rombach 등, 2112.10752v2, §3, Figure 3
고해상도 pixel 전체가 아니라 autoencoder의 latent에서 denoising하고, 마지막에 decoder로 복원해 계산량을 줄인다.
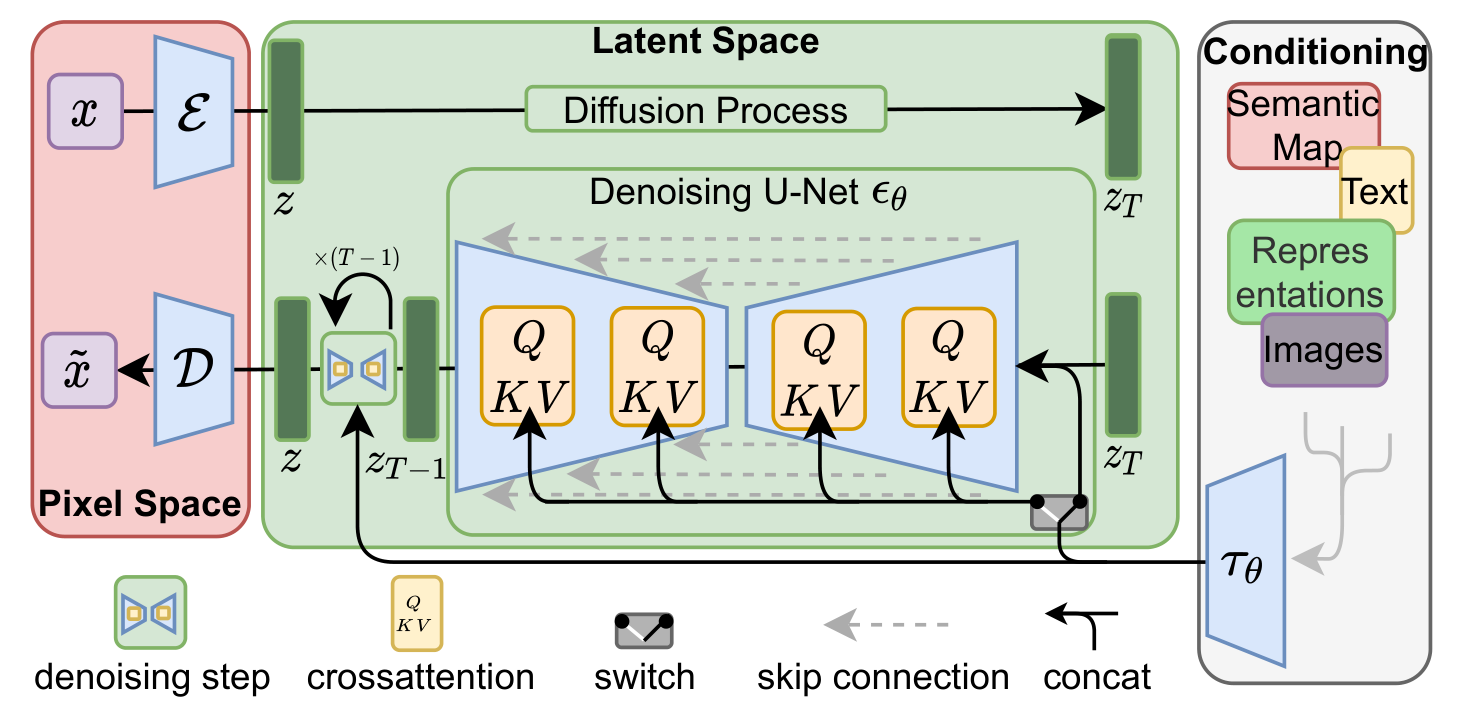
왼쪽의 붉은 영역은 영상과 latent 사이를 연결하는 E·D이고, 가운데 초록 영역이 반복적인 확산·잡음제거 계산이다. 오른쪽 조건은 과제에 따라 concatenation 또는 cross-attention으로 전달된다. attention에서는 영상 feature가 Q, 조건 표현이 K·V를 제공한다. 상단 확산 화살표와 U-Net의 denoising 경로를 구분하고, 모든 조건이 항상 동일한 방식으로 주입된다고 읽지 않는다.
Robin Rombach, Andreas Blattmann, Dominik Lorenz, Patrick Esser, Björn Ommer · 2112.10752v2 · 원논문 · 원문 속 그림 · 크게 보기 원논문 도판 발췌. 지정한 PDF 버전에서 그림 영역만 잘라 고해상도 PNG로 렌더링했으며 내용을 다시 그리지 않았다. 한국어 해설은 별도 작성. 원권리자의 권리가 유지되며 블로그 코드의 MIT 라이선스가 도판 재배포 허락을 뜻하지 않는다.Figure 3의 공간 구분을 아래 압축률 예제와 연결한다. 그림은 특정한 512×512 입력·4채널 latent를 모든 LDM에 고정하는 사양표가 아니다. 또한 encoder·decoder 경로가 있다고 해서 inference의 매 denoising step마다 두 모듈을 모두 실행하는 것은 아니다. LDM v2, §3.2–3.3 및 Figure 3, PDF 4쪽
계산 예제 — f=8인 한 구성. 512×512×3 입력을 64×64×4 latent로 압축한다고 가정하자. 공간 위치 수는 262144→4096으로 64분의 1, scalar 수는 786432→16384로 48분의 1이다. “차원이 64배 줄어든다”는 표현은 공간과 채널을 함께 세는지에 따라 달라진다. 모든 LDM이 f=8 또는 4채널을 쓰는 것은 아니며, 이 표는 선택한 구성의 산술 예다.
조건을 붙이는 cross-attention도 텐서로 계산할 수 있다. 아래는 한 attention head의 설명용 표기다. 영상 feature의 위치 수 L, text token 수 M, head 차원 d를 사용한다.
L=4096, M=77, d=64이면 attention score는 4096×77이다. softmax는 각 영상 위치에서 text token 축을 따라 정규화한다. text token을 영상의 channel 축에 단순 연결해 4096×4096 self-attention을 만든다고 설명하면 틀린 연산이 된다. 출력은 다시 영상 위치마다 하나의 feature를 만든다.
압축률에 관한 실험은 재구성 품질, 생성 품질, 학습·샘플링 비용을 구분해서 읽는다. 원논문의 autoencoder 비교와 f별 생성 실험은 압축이 지나치게 크면 세부 보존이 나빠질 수 있다는 trade-off를 검토한다. Reconstruction FID와 최종 generation FID는 같은 실험이 아니다. 논문에 없는 하드웨어에서의 배속을 위 scalar 수의 비율로 추정해 확정하지 않는다.
#7.8 score matching과 SDE로 통합해 보기
Score는 log-density의 입력에 대한 gradient다. 모델 parameter에 대한 학습 gradient와 다르다. 밀도가 높은 방향에 관한 국소 벡터장이며, 그 값 자체가 확률이나 class confidence는 아니다. Song 등, 2011.13456v2, §3–4
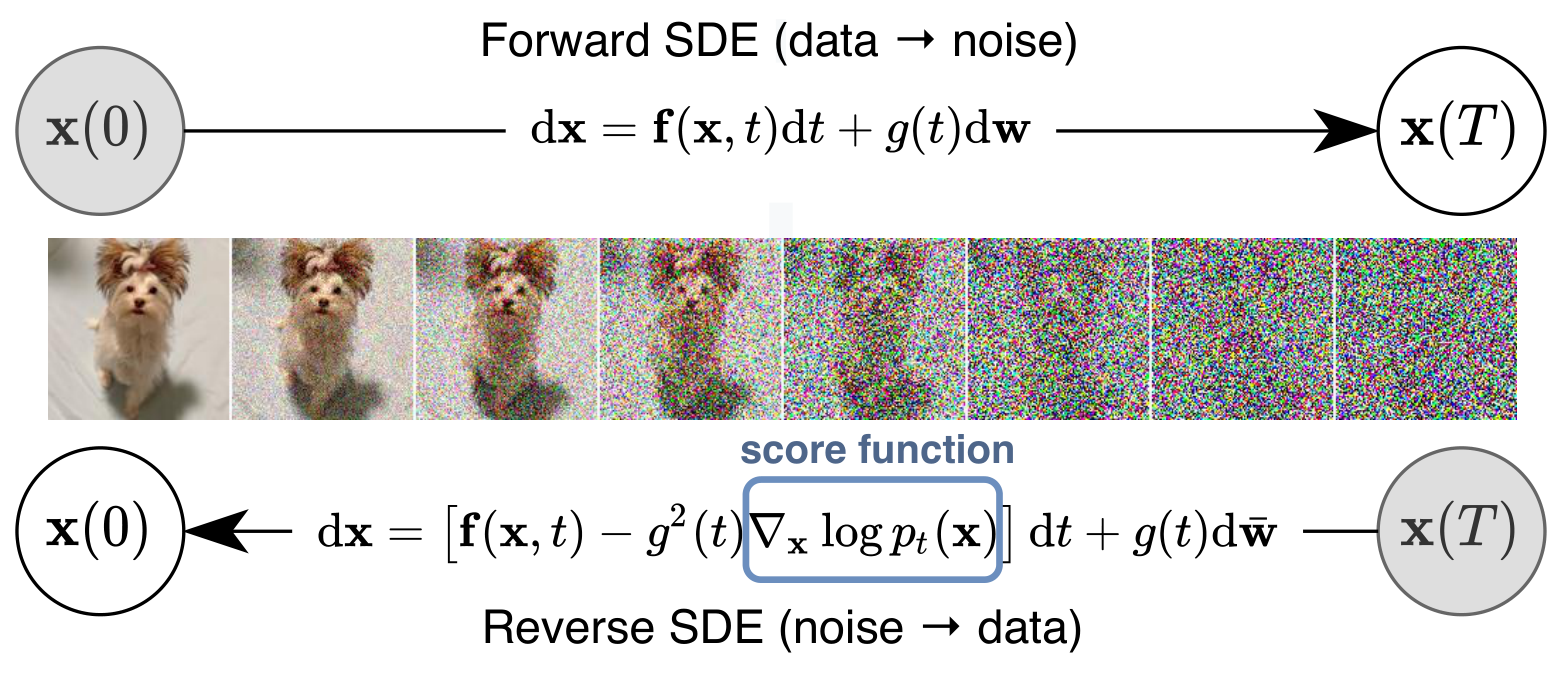
위 화살표는 x(0)에서 x(T)로 잡음을 더하는 과정, 아래 화살표는 x(T)에서 x(0)으로 생성하는 과정이다. 강조한 score는 역방향 drift의 항이며 시간마다 달라지는 분포에서 추정한다. 가운데 그림은 변화의 예시이지 특정 사진을 반드시 동일하게 복구한다는 보장이 아니다. 이 Figure 1 자체에는 probability-flow ODE의 경로 비교가 들어 있지 않다.
Yang Song, Jascha Sohl-Dickstein, Diederik P. Kingma, Abhishek Kumar, Stefano Ermon, Ben Poole · 2011.13456v2 · 원논문 · 원문 속 그림 · 크게 보기 원논문 도판 발췌. 지정한 PDF 버전에서 그림 영역만 잘라 고해상도 PNG로 렌더링했으며 내용을 다시 그리지 않았다. 한국어 해설은 별도 작성. 원권리자의 권리가 유지되며 블로그 코드의 MIT 라이선스가 도판 재배포 허락을 뜻하지 않는다.Gaussian forward perturbation에서 x0까지 주어진 conditional score는 아래처럼 실제 주입 noise와 직접 연결된다. x0를 모르는 noisy marginal의 score는 그 noise target의 조건부 평균과 연결되므로 두 score를 동일한 표본값으로 바꾸지 않는다.
앞의 예제에서 barα=0.64, xt=−0.2, x0=0.5이면 conditional score는 5/3≈1.666667이다. 반면 x0~N(0,1)이고 같은 VP perturbation을 적용한 marginal은 N(0,1)이므로 xt=−0.2의 marginal score는 0.2다. 서로 다른 conditioning의 값이 왜 다를 수 있는지 숫자로 확인한다.
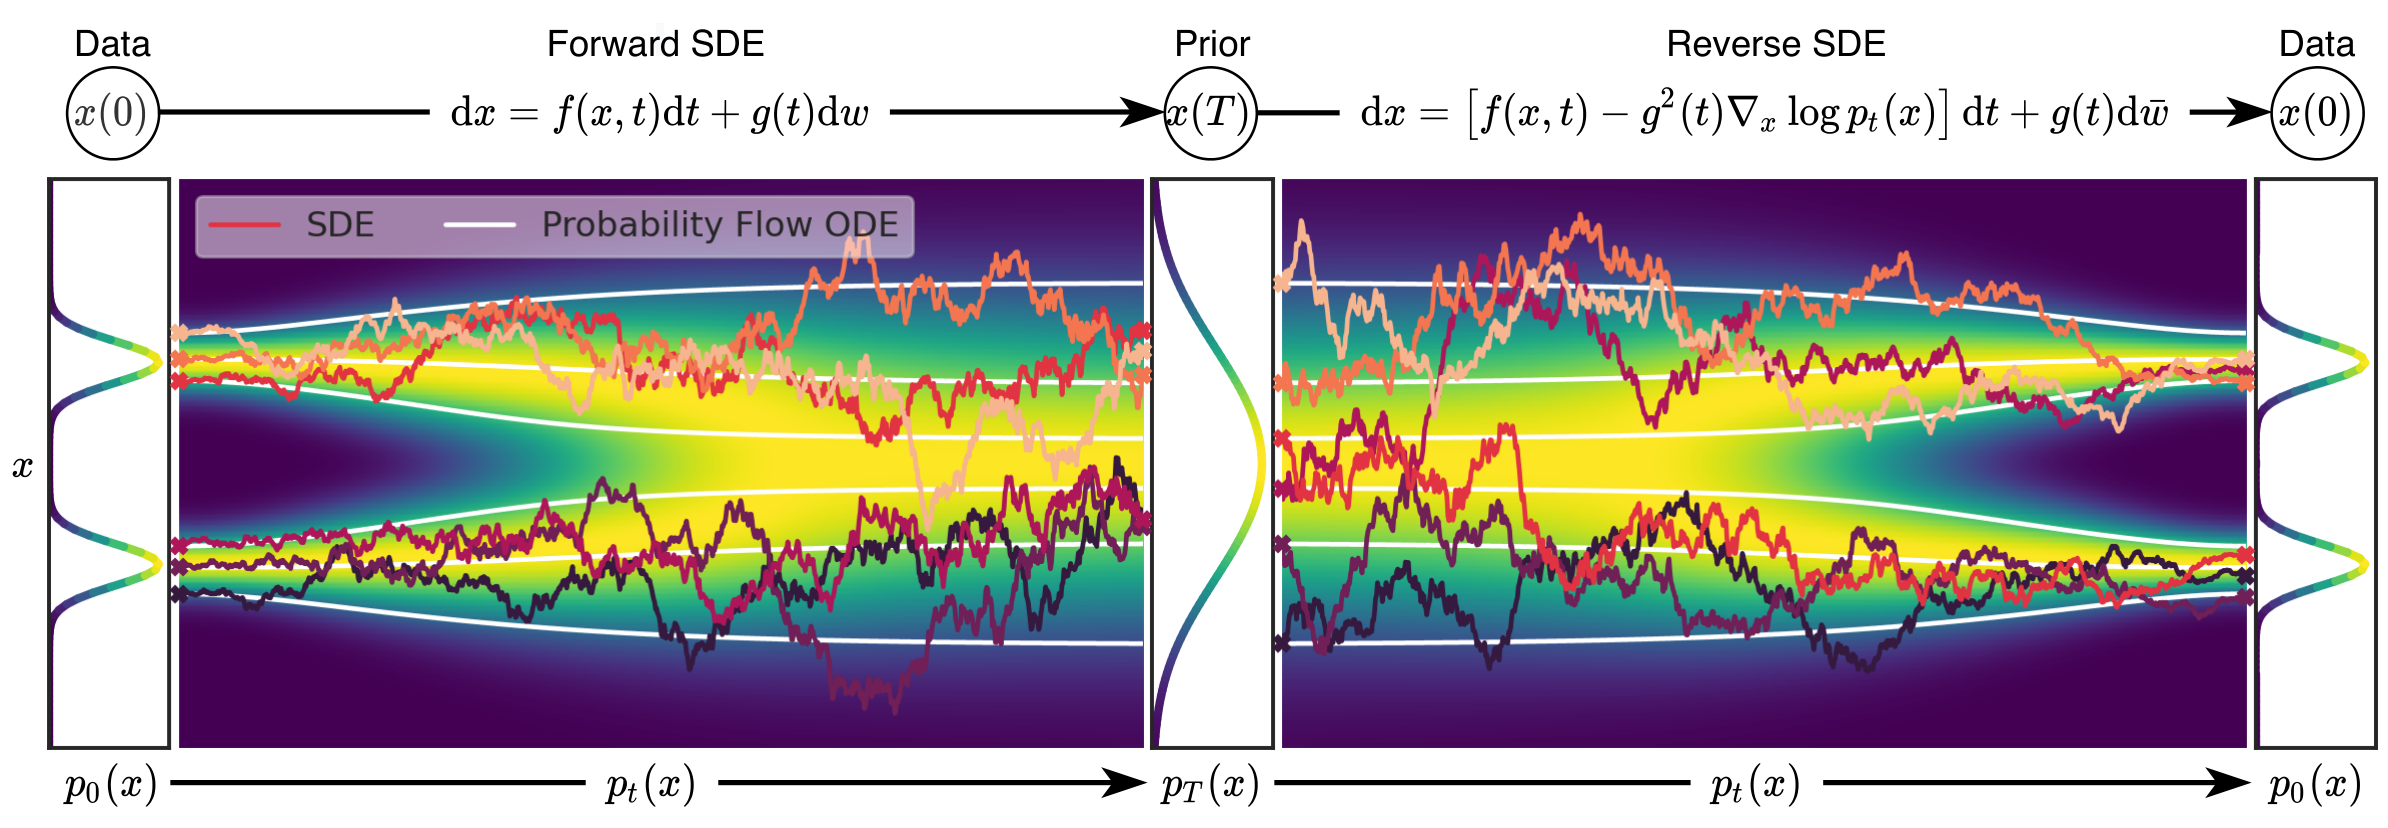
양 끝은 데이터 분포, 가운데는 prior다. 배경의 분포와 개별 sample의 경로를 구분해 보자. 거친 SDE 경로와 매끄러운 ODE 경로는 표본별로 일치할 필요가 없다. 원문에서 연결하는 것은 연속시간의 시간별 marginal 분포이며, ODE를 얻을 때 score 계수의 1/2가 필요하다는 아래 식과 함께 읽는다.
Yang Song, Jascha Sohl-Dickstein, Diederik P. Kingma, Abhishek Kumar, Stefano Ermon, Ben Poole · 2011.13456v2 · 원논문 · 원문 속 그림 · 크게 보기 원논문 도판 발췌. 지정한 PDF 버전에서 그림 영역만 잘라 고해상도 PNG로 렌더링했으며 내용을 다시 그리지 않았다. 한국어 해설은 별도 작성. 원권리자의 권리가 유지되며 블로그 코드의 MIT 라이선스가 도판 재배포 허락을 뜻하지 않는다.Scalar diffusion coefficient g(t)를 쓰는 원문의 설정에서 reverse-time SDE는 다음과 같다. 이 표기에서는 t를 T에서 0으로 적분하여 dt가 음수다. 양의 역시간 변수로 바꾸면 drift의 부호를 다시 변환해야 한다.
Probability-flow ODE는 diffusion noise를 빼기만 한 reverse SDE가 아니다. score 계수가 1/2로 다르다. 정확한 score와 연속시간 조건에서 같은 시간별 marginal 분포를 따를 수 있다는 관계이지, 두 경로가 표본마다 똑같다는 뜻은 아니다. 학습 오차와 수치 적분 오차도 별도로 남는다.
계산 예제. 표준정규의 score=−x이고 VP에서 β=1이면 f=−x/2, g²=1이다. reverse SDE drift는 x/2이고 probability-flow ODE drift는 0이다. reverse dt<0이므로 양의 x에서 drift에 의한 이동은 평균 쪽을 향한다. ODE가 0인 이 예는 이미 시간별 marginal이 표준정규로 유지되는 특수한 경우이며 일반 영상의 생성 경로가 정지한다는 뜻이 아니다.
원문 Figure 1은 forward·reverse SDE를, Figure 2는 SDE와 probability-flow ODE의 관계를 보여 준다. §4에서는 predictor–corrector 등 수치 solver를 설명한다. 실험의 좋은 sample quality는 score model·architecture·solver 설정을 함께 사용한 결과다. SDE 표기 하나만 바꿔 모든 기존 모델보다 좋아졌다는 인과 설명은 아니다. 두 원본 개념 도판은 본문에 발췌했지만, 이 그림들만으로 solver별 성능 순위를 정하지 않는다. 모든 solver ablation의 수치 전사나 학습 재현을 수행한 것은 아니다.
#7.9 한 번에 연결하기
MMSE는 특정 loss 아래의 최적 추정을, VAE는 계산 어려운 posterior를 근사하는 학습을, DDPM은 정해진 perturbation을 뒤집는 확률 모델을 다룬다. CFG는 조건부·무조건 예측을 결합하고, LDM은 반복 계산의 공간을 바꾸며, Score-SDE는 noisy distribution과 solver의 관계를 연속시간에서 설명한다.
정리할 때에는 prior와 posterior, α와 누적곱, analytic conditional posterior와 학습할 reverse distribution, 원래 bound와 reweighted loss, 코드 guidance scale과 논문 scale, 공간 압축률과 전체 tensor 원소 수를 각각 구분한다. 하나의 식을 외우기보다 실제 숫자를 넣었을 때 shape·부호·단위가 맞는지 확인하는 것이 구현의 출발점이다.