NTU Hung-yi Lee, Machine Learning 2026 Spring · Self-Improving 상편 · 슬라이드 1–5쪽 해설
- 기준 강의일: 2026년 5월 8일.
- 원고·자료 확인일: 2026년 11월 12일. 영어 편집 이미지 구성: 2026년 11월 16일.
- 기준 자료: 전체 62쪽 PDF. 표지를 1쪽으로 센다.
- 공식 강의 페이지 · PPTX · PDF · YouTube
이번 글은 자가개선(Self-improvement)을 읽는 기준을 세운다. 강의 슬라이드를 한 장씩 보고, 그 아래에서 한국어 해설과 추가 수식·예시로 의미를 풀어간다.
슬라이드의 중국어 문구를 영어로 옮긴 비공식 영어 편집본을 사용한다. 원본 페이지와 비교할 수 있도록 각 이미지에 공식 PDF 링크를 붙였다. 본문의 한국어 해설과 교육용 예시는 원 강의에 추가한 설명이다. 관련 개념에는 DeepMind × UCL과 GEPA 저자 강연의 원본 영어 슬라이드, DGM 논문의 원본 도식을 함께 배치했다.
영상 시간은 zh-TW 제공 자막에서 해당 주제 설명이 시작되는 시각을 기준으로 잡았다. 화면의 정확한 슬라이드 전환 프레임을 측정한 값은 아니다.
| 슬라이드 | 이번 글의 해설 주제 | 영상 설명 구간 |
|---|---|---|
| 1쪽 | AI가 스스로 성장한다는 질문을 어떻게 구체화할까? | 약 00:01–00:10 |
| 2쪽 | Good의 재귀적 자기개선 구상은 무엇을 전제할까? | 약 00:10–00:51 |
| 3쪽 | 2028년 전망과 현재의 실험 결과를 어떻게 읽을까? | 약 00:51–01:40 |
| 4쪽 | 피드백이 반복되면 실제로 개선되는가? | 약 01:40–02:39 |
| 5쪽 | 무엇이 바뀌고, 사람은 어디에 관여하며, 어떻게 평가할까? | 약 02:39–03:37 |
#1쪽 — AI가 스스로 성장할 수 있는가?
첫 페이지는 강의 전체의 질문을 제시한다. 여기서 먼저 할 일은 ‘스스로’와 ‘성장’이 가리키는 대상을 구체화하는 것이다.
#같은 “좋아졌다”에도 서로 다른 변화가 있다
AI가 수학 문제를 풀다가 계산 실수를 고쳤다고 하자. 현재 문제의 답은 더 좋아졌다. 그런데 다음 대화를 시작할 때 그 경험이 사라진다면, 관찰한 것은 현재 답변을 개선한 효과다. 이것만으로 모델 가중치가 학습되었다고 판단할 수는 없다.
반면 이전 풀이를 학습 자료로 삼아 모델을 미세조정했다면 가중치가 바뀐다. 실패 경험을 “분모가 0인지 먼저 검사하라”는 규칙으로 저장해 다음 문제에도 사용한다면, 모델 가중치를 그대로 둔 채 지속되는 기억이 바뀐다. 코드를 실행하는 순서나 테스트 도구를 개선했다면 에이전트의 작업 방식이 바뀐다.
따라서 다음 두 질문을 함께 해야 한다.
- 이번 문제의 결과가 달라졌는가?
- 그 경험 때문에 이후 문제를 처리하는 시스템도 달라졌는가?
둘 다 연구할 가치가 있지만, 입증하려는 주장이 다르다. 현재 문제의 해결률을 높였다는 실험과, 경험을 누적해 이후의 새로운 문제를 더 잘 푼다는 실험은 각각 설계해야 한다.
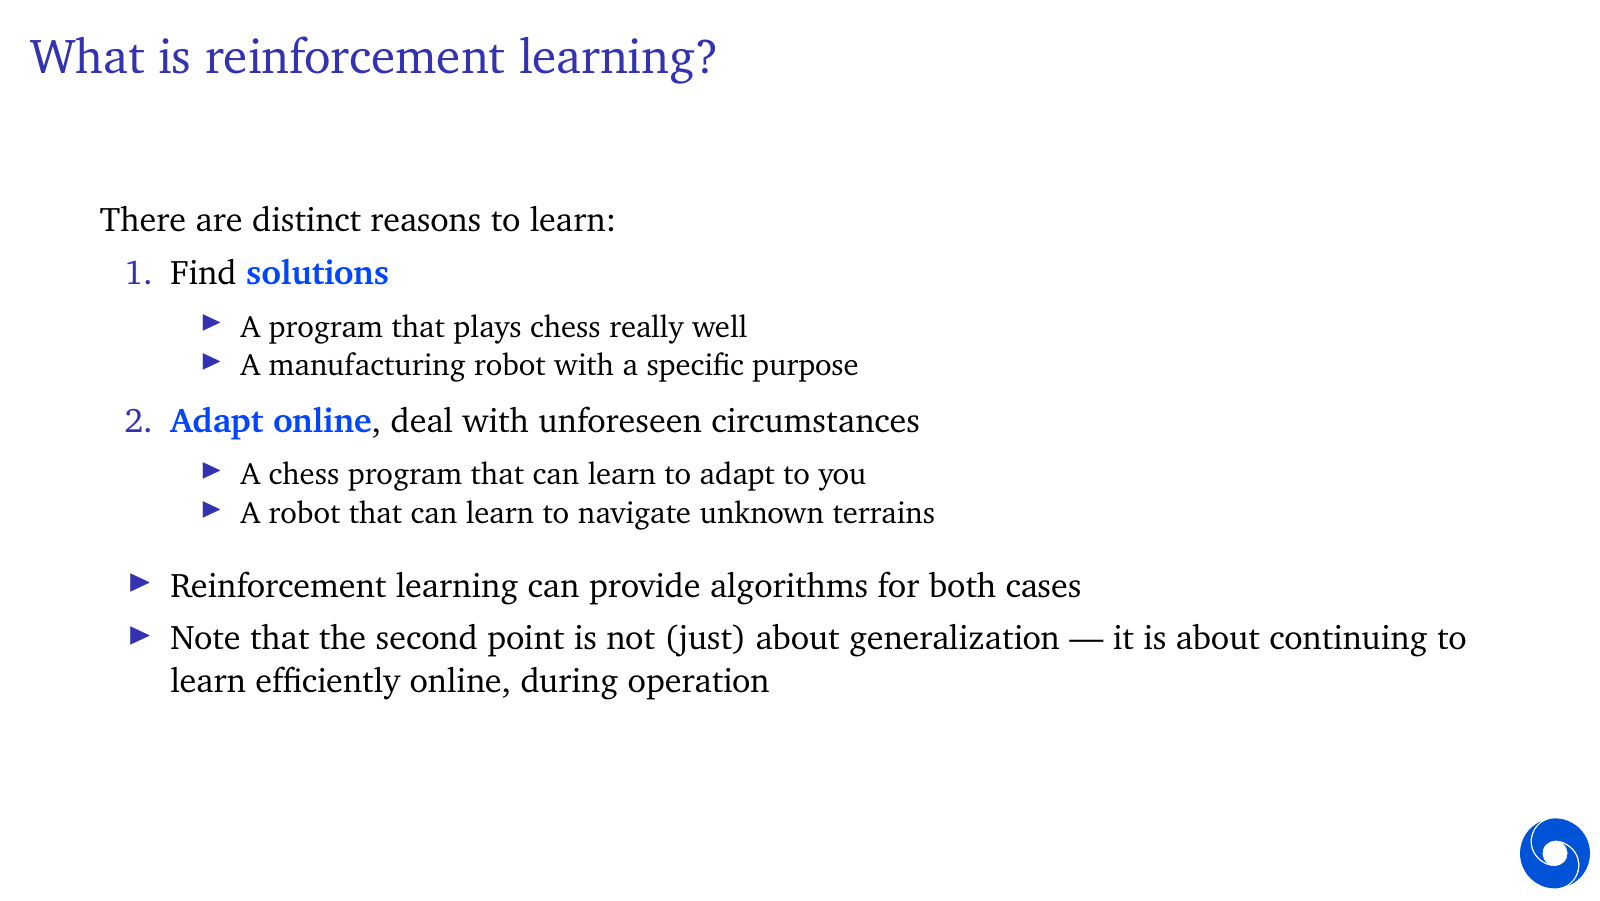
Hado van Hasselt의 강의는 학습의 목적을 나누어 설명한다. 하나는 체스를 잘 두거나 특정 제조 작업을 수행하는 해법을 얻는 것이다. 다른 하나는 운용 중에 처음 만난 상대나 지형에 맞춰 계속 배우는 것이다. 첫 경우에도 학습은 필요하다. 다만 학습을 마친 뒤 정책을 고정해 사용할 수 있다. 둘째 경우에는 새로운 경험이 이후 행동에 어떻게 반영되는지까지 확인해야 한다. 원본 강의 17쪽
이 구분을 자가개선 AI에 적용하면, 새 문제를 잘 푸는 일반화(Generalization)와 사용 중 경험을 누적하는 적응(Online adaptation)을 따로 평가할 수 있다. 예를 들어 처음 보는 질문에 잘 답했다면 일반화의 근거가 된다. 이전 실패를 기억하거나 파라미터를 갱신한 덕분에 다음 질문을 더 잘 풀었다고 주장하려면, 그 업데이트의 유무를 비교해야 한다. 이 예시는 강의의 구분을 LLM에 적용한 설명이다.
#Self-improvement와 강화학습의 관계
이 연재에서는 Self-improvement를 넓은 주제로 삼고, 구체적인 방법에 따라 자기수정(Self-correction), 자기학습(Self-training), 강화학습(Reinforcement Learning), 프롬프트·에이전트 구조 개선을 구분한다.
가령 DeepSeek-R1-Zero는 보상을 이용해 모델을 학습시키는 사례이고, GEPA는 기반 모델의 가중치를 고정하고 프롬프트를 최적화하는 사례다. 두 방법 모두 개선을 추구하지만 바꾸는 대상과 업데이트 방식이 다르다. “Self-reinforcement”라는 표현을 사용할 때도 실제 절차가 보상 기반 가중치 학습인지 먼저 밝히는 편이 정확하다. R1, GEPA
첫 장에서 가져갈 질문은 다음과 같다.
AI가 경험을 되돌려 활용할 때 무엇이 바뀌며, 그 변화가 어떤 문제에서 도움이 되는가?
이 질문을 정해 두면 이후에 “자가개선에 성공했다”는 논문을 읽을 때 확인할 대상이 선명해진다.
#2쪽 — “인류의 마지막 발명”이라는 말의 전제
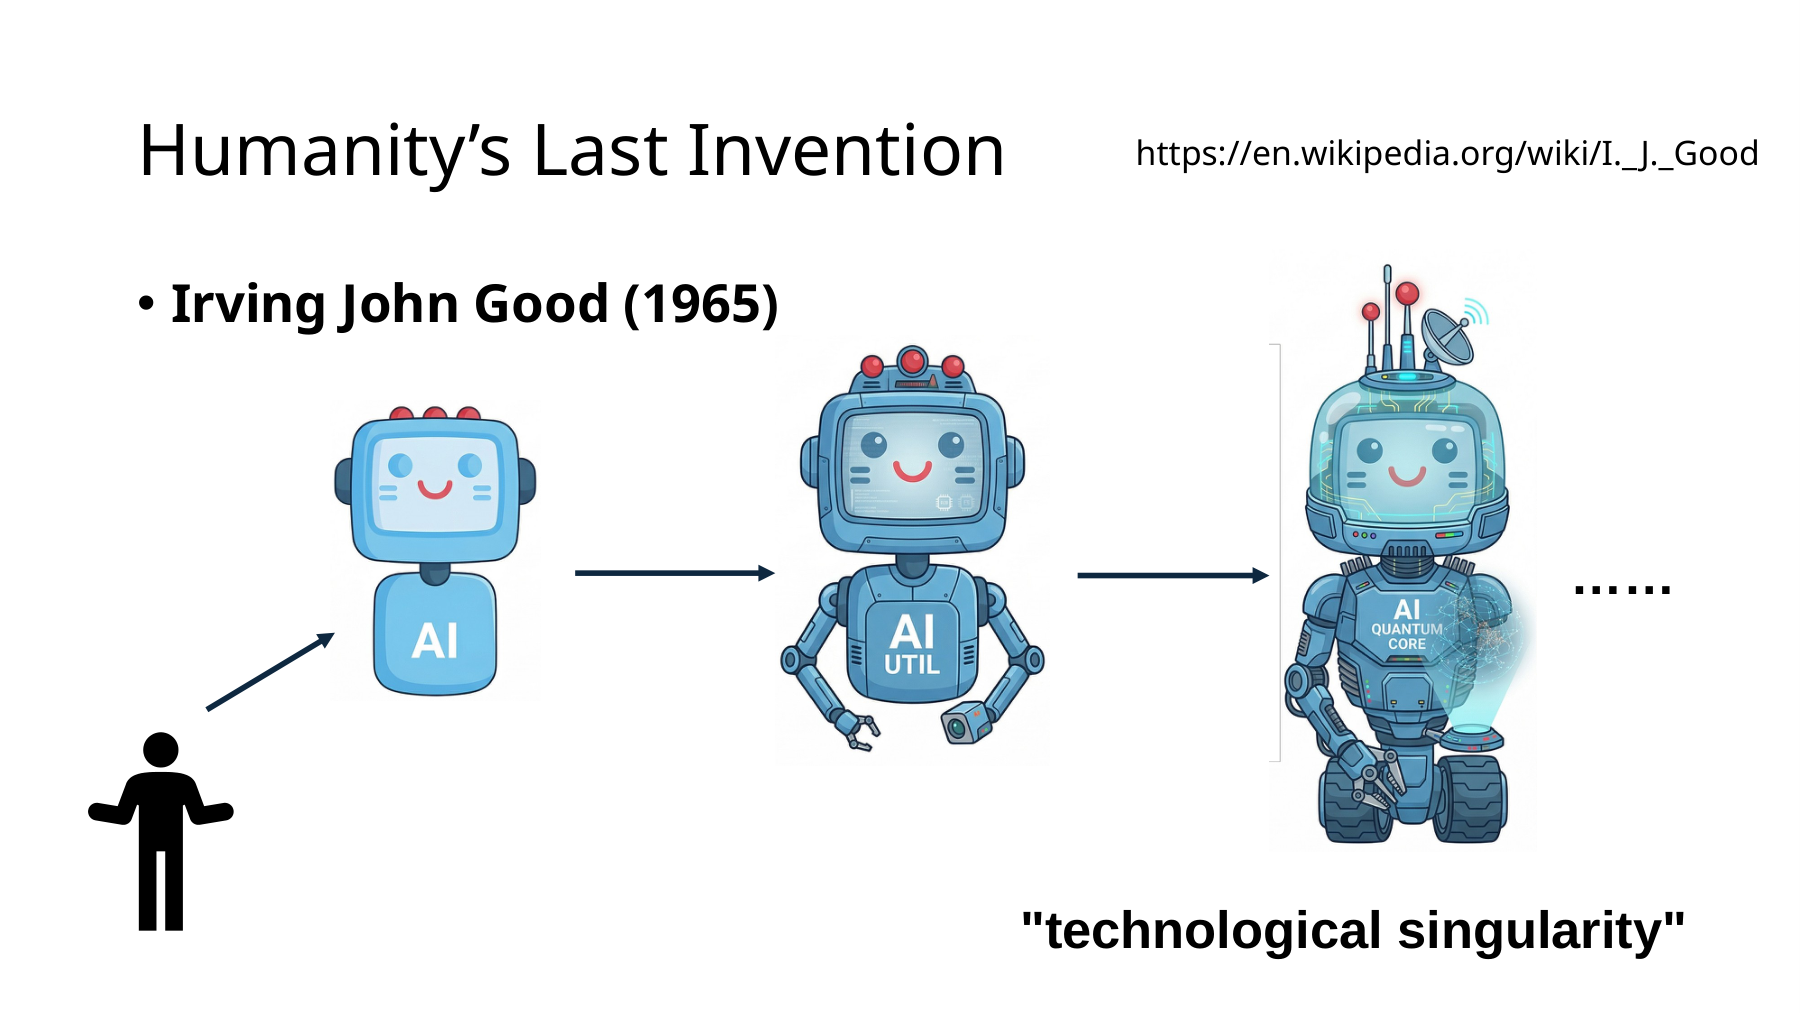
이 페이지는 I. J. Good의 1965년 논의를 소개한다.
Good의 유명한 논변은 아무리 뛰어난 인간이라도 그의 모든 지적 활동을 크게 능가하는 기계를 가정한다. 기계 설계도 지적 활동이므로, 그러한 기계는 더 좋은 기계를 설계할 수 있으며 그 과정에서 지능 폭발(Intelligence explosion)이 일어날 수 있다는 주장이다. 해당 대목은 원문 인쇄 33쪽에 있다. 역사적 조건부 논변이며, 현대 LLM의 실험 결과를 보고한 문장은 아니다. Good, 1965, §2
#문제 해결 능력과 개선 능력을 분리해서 보자
어떤 모델이 수학 문제를 잘 푼다고 하자. 이것은 문제 해결 능력에 관한 관찰이다. 더 나은 학습 알고리즘을 제안하고, 실험을 실행하고, 결과를 분석하고, 실제 후속 모델을 만들어내는 능력은 추가로 확인해야 한다.
교육용으로 다음 네 단계를 구분해 볼 수 있다.
| 단계 | 확인하려는 능력 | 필요한 증거의 예 |
|---|---|---|
| 과제 수행 | 주어진 문제를 해결한다 | 새로운 문제에서의 정확도·성공률 |
| 개선 작업 수행 | 더 좋은 프롬프트·데이터·코드를 만든다 | 변경 전후 시스템의 비교 |
| 개선 과정 반복 | 이전 변경의 결과를 다음 변경에 활용한다 | 여러 회차의 성능·비용·실패 기록 |
| 개선 절차 자체 개선 | 더 좋은 개선 방법을 찾아낸다 | 같은 자원으로 더 나은 후보를 찾거나 개선 속도가 높아지는 결과 |
이 표는 설명을 위한 구분이다. 분야 전체의 공식 단계 체계를 뜻하지 않는다. 연구가 어느 단계의 증거를 제시했는지 구체적으로 읽기 위한 도구다.
#반복적인 개선도 속도가 줄어들 수 있다
“개선이 반복된다”는 조건만으로 성장 속도가 계속 빨라진다는 결론은 나오지 않는다. 이를 간단한 가상 모형으로 보자.
어떤 고정 과제에서의 성능을 0과 1 사이의 값 로 나타내고, 매 회차 남은 격차의 일정 비율만 줄인다고 가정하자.
, 라면 성능은 다음처럼 변한다.
계속 개선되지만 증가량은 로 줄어든다. 이 모형은 지능의 실제 성장 법칙을 주장하지 않는다. 반복적인 개선과 지속적인 가속이 논리적으로 다른 주장임을 보여 주는 계산 예시다.
실제 연구에서도 한 번의 성능 향상, 여러 회차의 누적 향상, 개선 효율 자체의 향상을 구분해서 보고해야 한다. 여기에 필요한 데이터와 계산 자원, 결과를 판별하는 평가 기준이 각 회차에서 어떻게 공급되는지도 중요하다.
Good의 논변은 가능성을 생각하게 하는 출발점이다. 현재 시스템을 평가할 때는 그 가능성에 이르는 각 연결 고리의 증거를 살펴봐야 한다.
#3쪽 — 2028년 전망을 읽는 방법
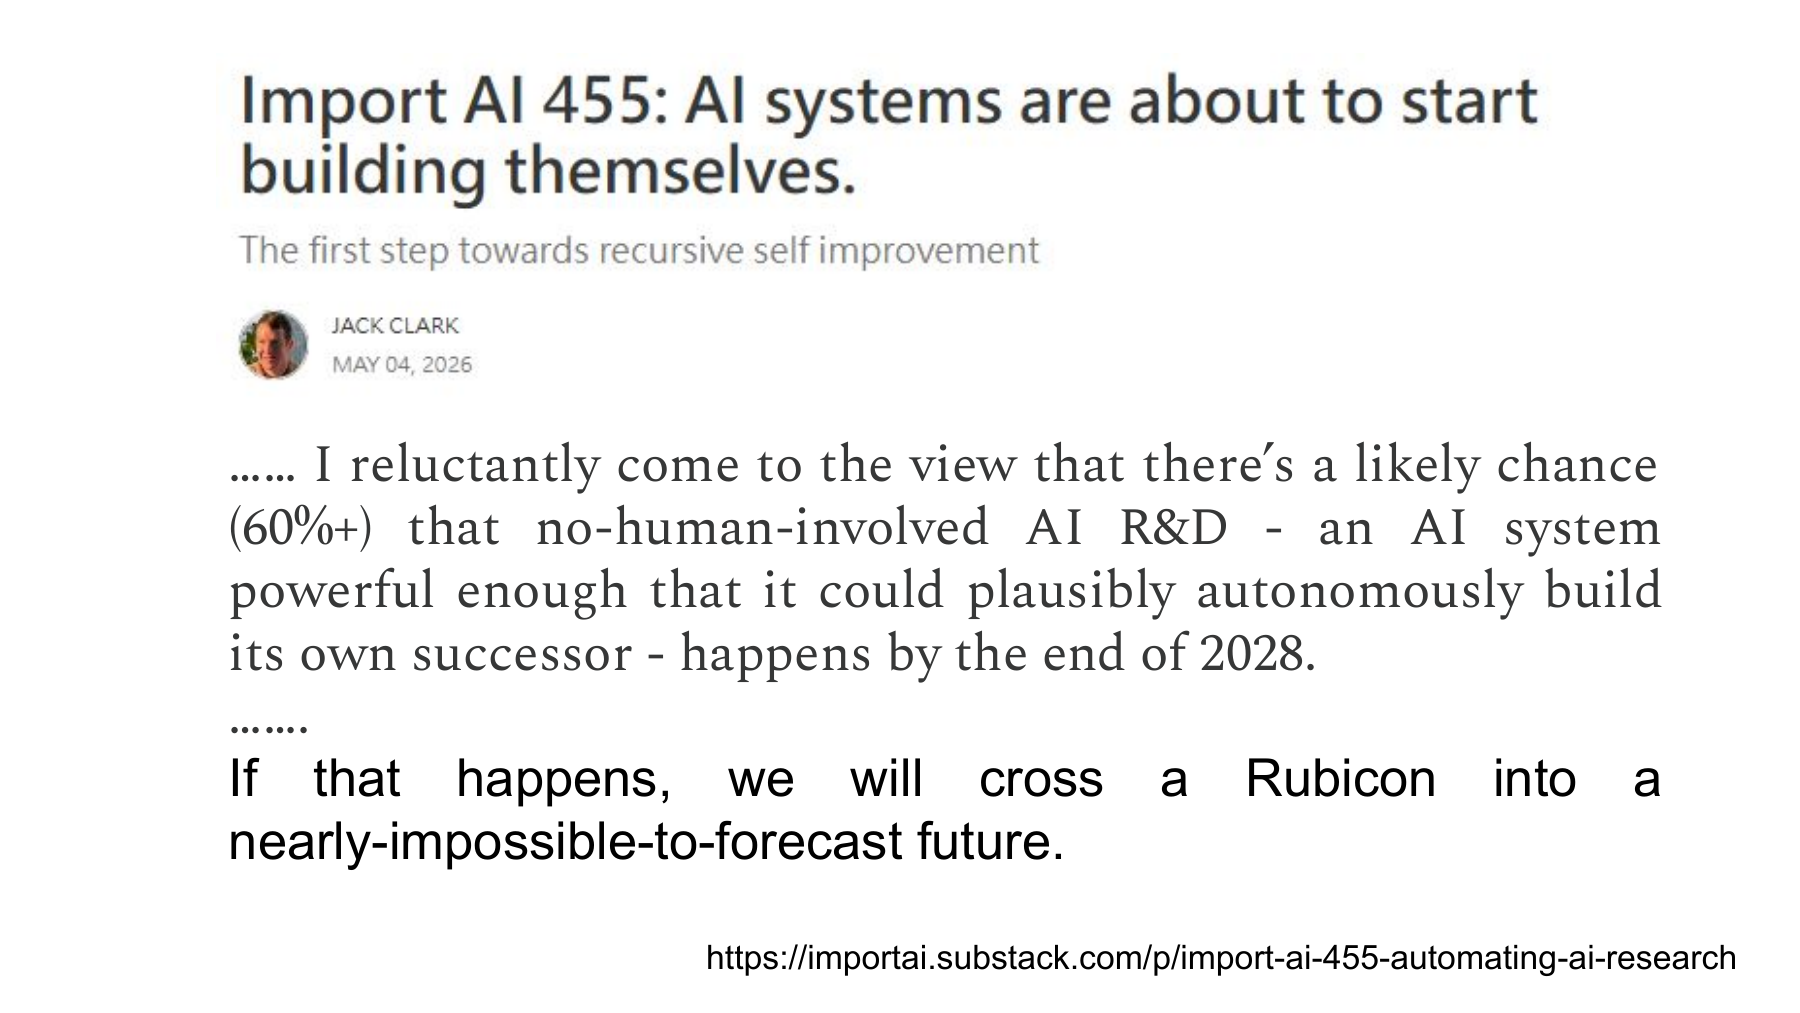
이 페이지는 Jack Clark의 Import AI 455를 인용한다. 원문은 2026년 5월 4일에 게시되었다. Clark은 2028년 말까지 인간 개입 없는 AI 연구개발, 곧 자신의 후속 시스템을 자율적으로 개발할 수 있는 수준이 등장할 가능성을 60% 이상으로 본다는 개인 전망을 제시한다. 원문
| 항목 | 정확하게 읽을 내용 |
|---|---|
| 발언 시점 | 2026년 5월 4일 |
| 전망 대상 시점 | 2028년 말 |
| 전망의 대상 | 인간 개입 없이 후속 AI 시스템을 개발할 수 있는 수준의 AI 연구개발 |
| 60% 이상의 의미 | 글쓴이의 주관적 확률 판단 |
| 이 숫자로 해석할 수 없는 것 | 자가개선 실험의 성공률, 벤치마크 정확도, 연구자 전체의 합의 |
날짜와 수치의 종류를 함께 기록해야 독자가 현재 확인된 능력과 미래 전망을 구분할 수 있다.
#최신 논문은 “어느 부분이 자동화되었는가”를 보여 준다
자가개선의 실제 범위를 이해하는 데 도움이 되는 최근 사례가 있다.
GEPA — ICLR 2026. 실행 기록과 피드백을 활용해 프롬프트 후보를 만들고 평가한다. 공식 논문 §3은 최적화 과정에서 기반 LLM 가중치를 고정한다고 명시한다. 이 연구는 프롬프트를 통한 시스템 개선의 사례로 읽어야 한다. 공식 논문, 인쇄 4쪽
#보충 강의 · GEPA의 프롬프트 개선 절차
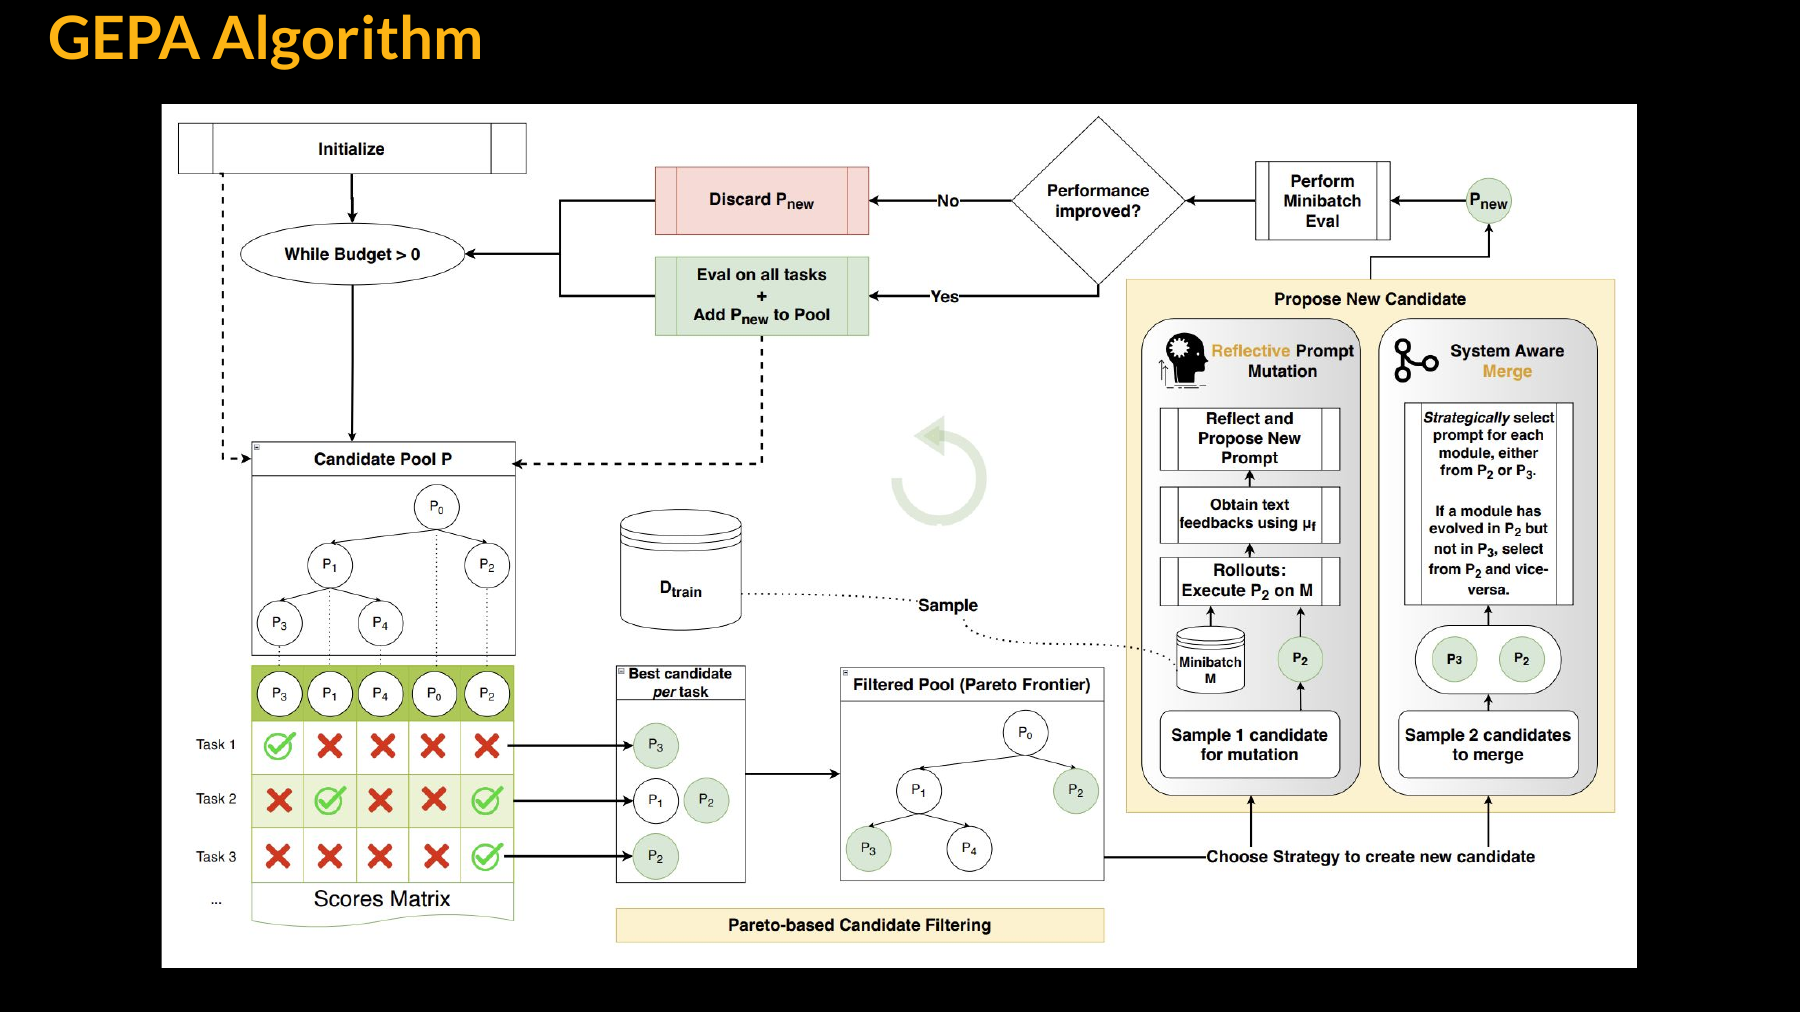
그림 왼쪽의 후보 풀(Candidate pool)은 여러 프롬프트 후보를 보관한다. 문제별 점수표에서는 후보마다 잘 푸는 문제가 다를 수 있다. 오른쪽 경로는 한 후보의 실행 기록과 텍스트 피드백을 읽어 새로운 프롬프트를 제안한다. 다른 경로는 두 후보의 구성 요소를 결합한다. 새 후보는 소규모 평가에서 개선이 확인되면 전체 평가를 거쳐 풀에 들어간다. 개선이 확인되지 않은 후보는 버린다. 따라서 여기서 반복되는 것은 단순한 답변 재생성이 아니라 다음 실행에 사용할 프롬프트의 탐색이다. 저자 강연 34쪽
#보충 논문 · DGM의 코드 수정과 과제 평가
Darwin Gödel Machine — 최초 공개 2025년 5월, 확인 판본 v3는 2026년 3월 12일. 코딩 에이전트가 자신의 코드를 수정하고 후보를 평가한다. 이 실험의 기반 모델은 동결되어 있으며, 바뀌는 대상은 도구와 작업 방식 등 에이전트 구현이다. 탐색 절차의 일부도 고정되어 있다. 논문 §1·§3·§4.1
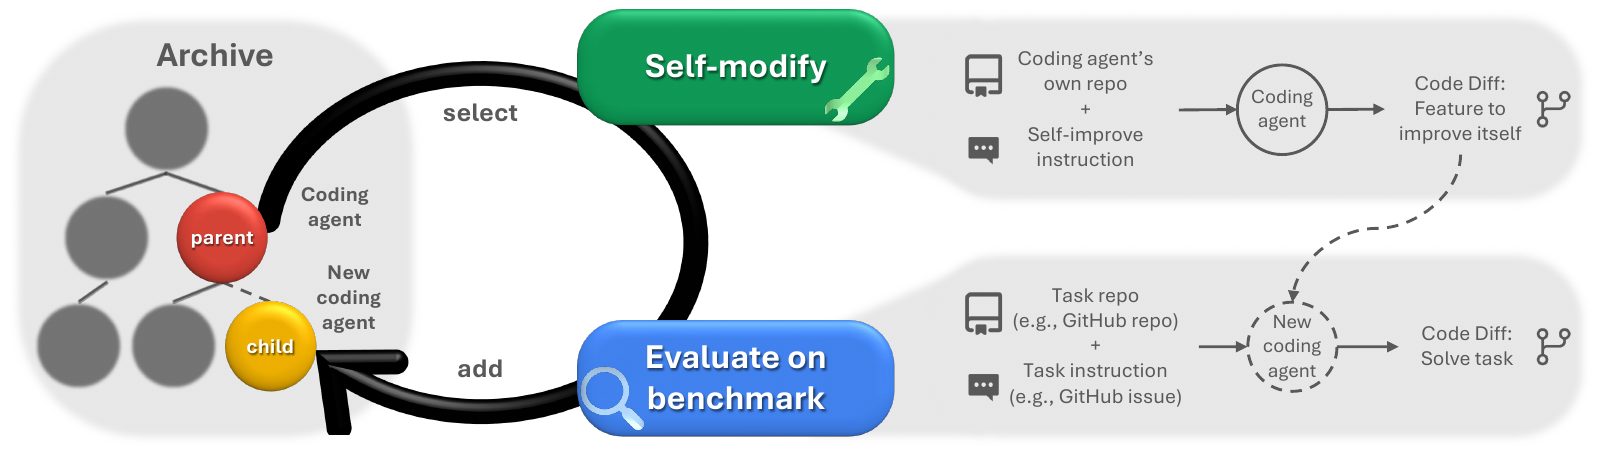
오른쪽 위에서는 에이전트가 자기 자신의 코드 저장소를 수정한다. 오른쪽 아래에서는 그렇게 바뀐 에이전트가 별도의 과제 저장소에서 문제를 푼다. 두 곳 모두 코드 변경을 출력하지만 목적이 다르다. 위쪽 변경은 도구·작업 흐름 등 에이전트의 구현을 바꾸고, 아래쪽 변경은 주어진 코딩 문제를 해결한다. 왼쪽 아카이브(Archive)는 여러 버전의 에이전트를 보관하여 다음 수정의 출발점으로 활용한다. 원문 Fig.1·§3
이 구조에서 바뀌는 것은 에이전트 코드다. 논문의 실험에서는 사전학습된 기반 모델을 고정했고, 아카이브 관리와 부모 선택을 담당하는 탐색 절차도 수정 대상에서 제외했다. 따라서 “자신을 고친다”는 표현을 읽을 때는, 수정 가능한 코드와 고정된 바깥 절차를 함께 표시해야 한다. 코딩 성능의 개선이 자기수정 능력의 개선을 나타낸다는 연구의 가정도 모든 과제에 자동으로 확장되는 결론은 아니다. 원문 §1·§3
이들 결과를 이해할 때는 “무엇이 달라졌는가”를 정확히 적으면 된다. 프롬프트 개선, 에이전트 코드 개선, 기반 모델 재학습, 후속 모델 연구개발 전체의 자동화는 각각 범위가 다르다.
#전망을 실험 결과와 연결해서 읽기
이런 연구들을 연결할 때는 다음과 같이 근거의 범위를 구체적으로 밝힐 수 있다.
프롬프트와 에이전트 코드를 자동으로 개선하는 연구가 구체화되고 있다. 후속 AI의 연구개발 전체를 자율적으로 수행하는 수준에 대해서는, 자동화된 단계와 사람이 맡은 단계를 함께 확인해야 한다.
독자는 미래 전망을 연구 동기로 받아들이고, 개별 실험에서는 검증된 범위를 읽을 수 있다. 이 페이지의 역할도 앞으로 살펴볼 기술들이 왜 관심을 받는지 이해하는 데 있다.
#4쪽 — 피드백이 돌아온다고 개선되는 것은 아니다
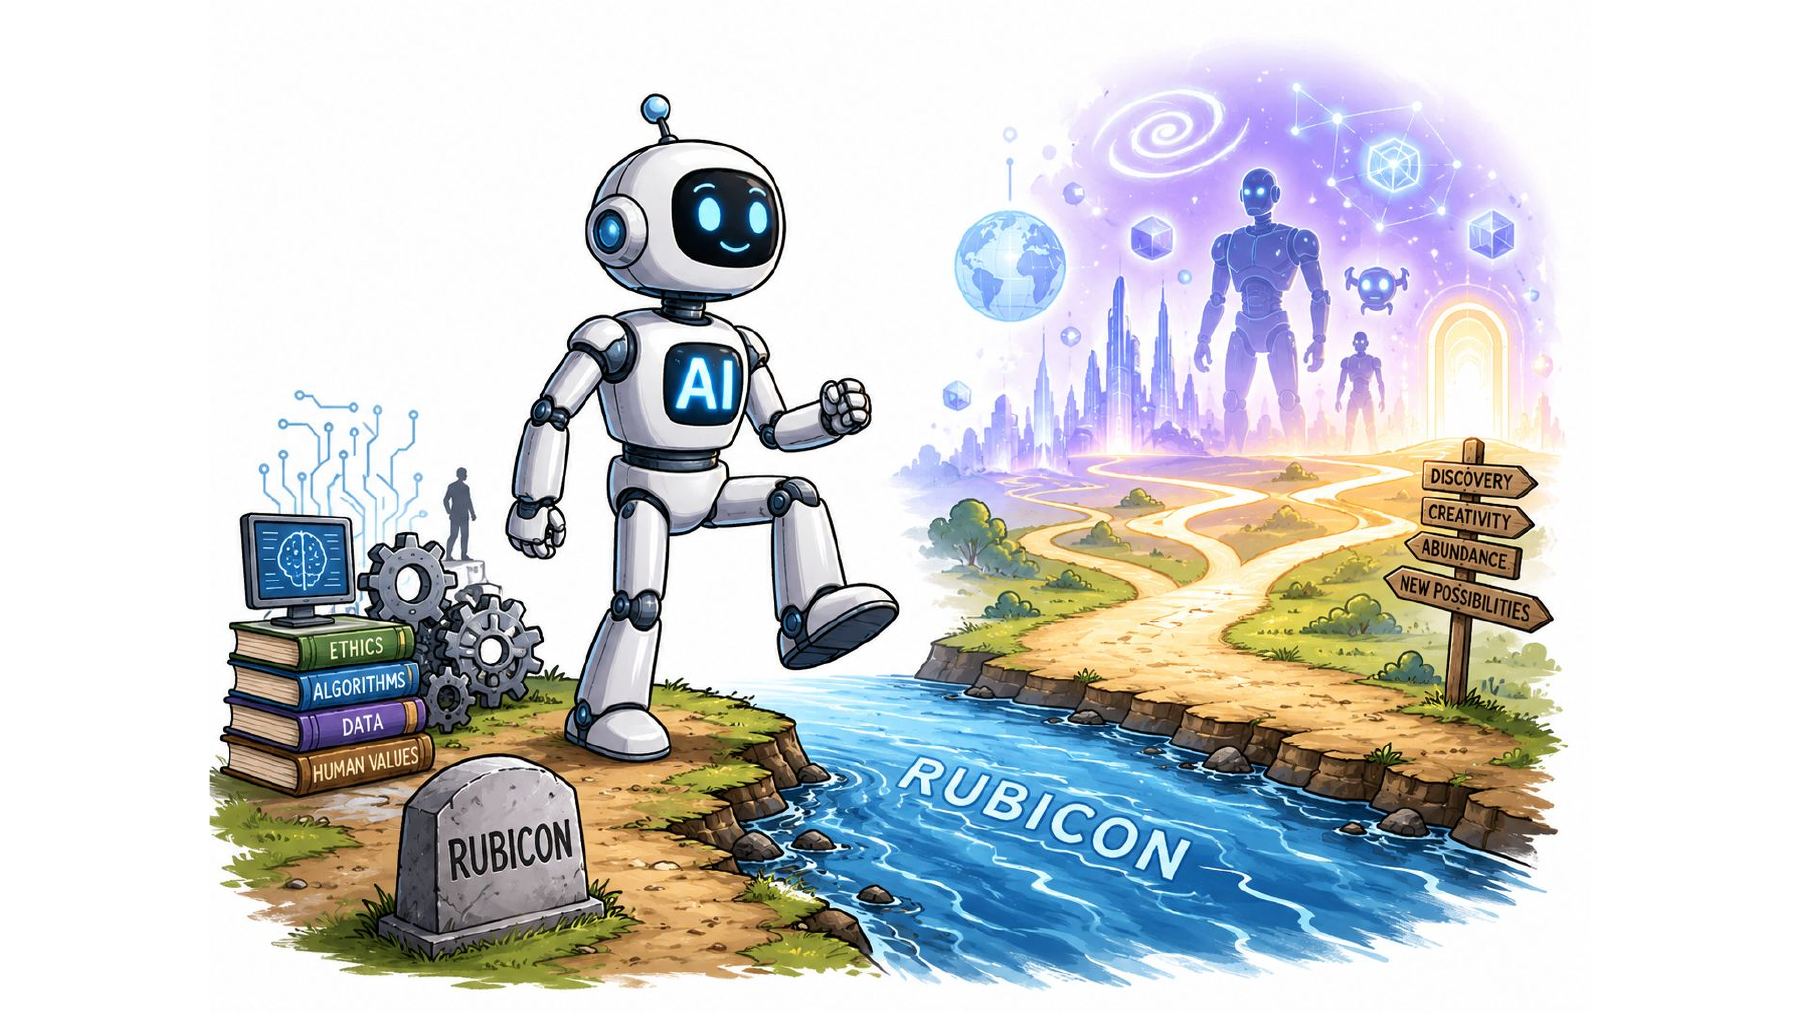
원본은 루비콘(Rubicon)을 건너는 그림으로 큰 전환점의 이미지를 제시한다. 여기서는 그 비유를 계기로, 실제 자가개선 시스템에 필요한 피드백 구조를 살펴보자. 아래 절차는 이해를 돕기 위해 별도로 정리했다.
- 현재 시스템에서 변경 후보를 만든다.
- 개발 문제로 후보를 평가한다.
- 채택 기준을 통과한 후보를 다음 버전에 반영한다. 통과하지 못했다면 새 후보를 만든다.
- 다음 버전을 출발점으로 개선을 반복한다. 반복을 마친 뒤에는 후보 선택에 쓰지 않은 분리된 최종 평가로 성능을 확인한다.
이 절차는 특정 논문의 알고리즘을 그대로 옮긴 것이 아니다. 후보를 만들고 평가하는 반복과, 최종 성능을 확인하는 절차를 구분한 교육용 모형이다. 실제 방법은 여러 후보를 보관하거나, 당장 점수가 낮아도 다양성을 위해 남겨 두는 등 더 복잡할 수 있다.
#“다시 검토했다”와 “더 잘 풀었다”는 별도로 측정한다
다음은 설명용 가상 사례다. 논문의 측정값이나 계산 예산을 맞춘 방법 비교 결과가 아니다.
100문제에서 처음에는 80문제를 맞혔다고 하자. 모델에게 다시 검토하게 했더니 다음 변화가 생겼다.
| 수정 전 → 수정 후 | 문제 수 |
|---|---|
| 정답 → 정답 | 72 |
| 정답 → 오답 | 8 |
| 오답 → 정답 | 6 |
| 오답 → 오답 | 14 |
| 합계 | 100 |
모델은 6개의 오답을 고쳤지만, 동시에 8개의 정답을 잘못 바꿨다.
정답률은 80%에서 78%로 내려간다. “수정에 성공한 사례가 있다”는 관찰만으로 전체 성능의 향상을 주장하기 어려운 이유다.
이를 일반화해 보자.
- : 처음 정답일 확률.
- : 오답을 고칠 확률.
- : 정답을 망가뜨릴 확률.
수정 후 정답률 는 다음과 같다.
첫 항은 원래 정답이었던 문제를 유지한 비율, 둘째 항은 원래 오답이었던 문제를 고친 비율이다. 따라서 성능 향상 조건은 다음과 같다.
오답을 고치는 이득이 정답을 망가뜨리는 손실보다 커야 한다. 이 식은 정답·오답의 이진 평가를 가정한다. 부분 점수가 있는 과제라면 점수 변화로 일반화해야 한다.
#실제 연구도 평가 조건을 따져 읽어야 한다
ICLR 2024의 「Large Language Models Cannot Self-Correct Reasoning Yet」는 외부 피드백 없이 자신의 답을 수정하는 내재적 자기수정(Intrinsic self-correction)을 분석했다. 연구가 시험한 추론 설정에서는 개선이 어렵거나 수정 후 성능이 하락하는 경우가 보고되었다. 이 결과의 적용 범위는 당시의 모델·과제·방법이다. 이후의 모든 모델이나 검증기를 추가한 시스템에 대한 불가능성 정리로 읽으면 안 된다. 공식 논문 소개
여기서 실험 설계의 질문이 나온다. 수정에 추가 계산을 사용했다면, 같은 총예산으로 처음부터 여러 답을 생성해 선택하는 방법과 비교했을 때도 이득이 있을까? 이 질문은 위의 가상 표만으로 답할 수 없으며, 별도의 비교 실험이 필요하다.
#외부 피드백과 독립적인 최종 평가는 다르다
코드를 실행한 결과나 정답과의 비교는 생성 과정 바깥에서 들어오는 피드백이다. 하지만 그 문제들을 후보 선택에 계속 사용했다면, 해당 점수는 개발 과정에 관여한 점수다.
최종 평가의 독립성은 별개의 조건이다. 개선 과정에서 후보를 만들거나 고르는 데 사용하지 않은 문제를 남겨 두고, 확정한 시스템을 평가해야 새로운 문제로의 일반화를 확인하기 쉽다. 외부 검증기를 쓴다는 사실만으로 이 조건까지 충족되지는 않는다.
#보충 강의 · GEPA의 후보 선택과 최종 평가
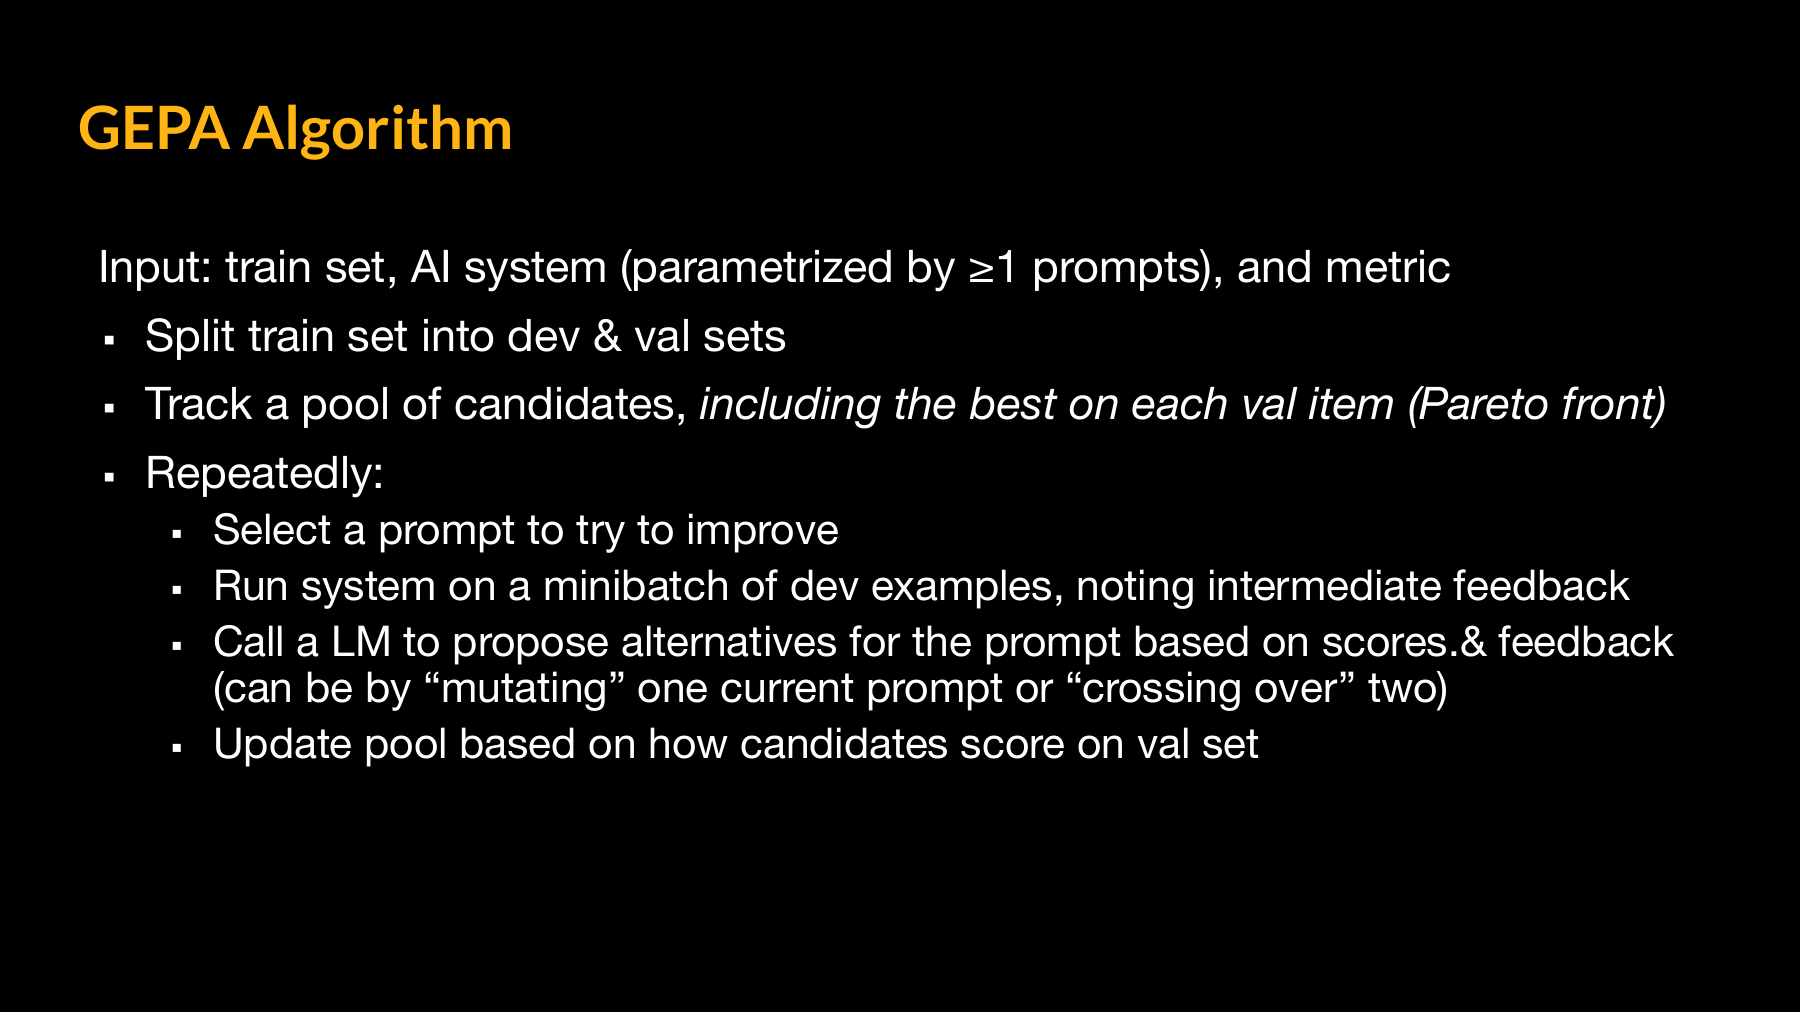
이 슬라이드에서 dev는 실행 기록과 피드백을 얻어 프롬프트를 바꾸는 데 쓰인다. val은 어떤 후보를 보관할지 판단하는 데 쓰인다. 두 집합을 나누었더라도 둘 다 최적화 과정에 관여한다. 특히 후보 선택에 반복해서 사용한 검증 점수는, 선택 과정에서 분리된 최종 시험 점수와 역할이 다르다. GEPA 공식 논문의 첫 그림도 검증 성능 곡선과 별도의 시험 집합 성능을 구분해 표시한다. 저자 강연 33쪽 · 공식 논문 Fig.1
또한 검증기가 측정하는 범위도 확인해야 한다. 코드가 제공된 테스트를 모두 통과했다는 사실은 그 테스트의 조건을 만족했다는 근거다. 아직 시험하지 않은 모든 입력에서도 올바르게 동작한다는 보장은 추가로 필요하다.
#5쪽 — 자가개선을 정의하는 세 가지 축
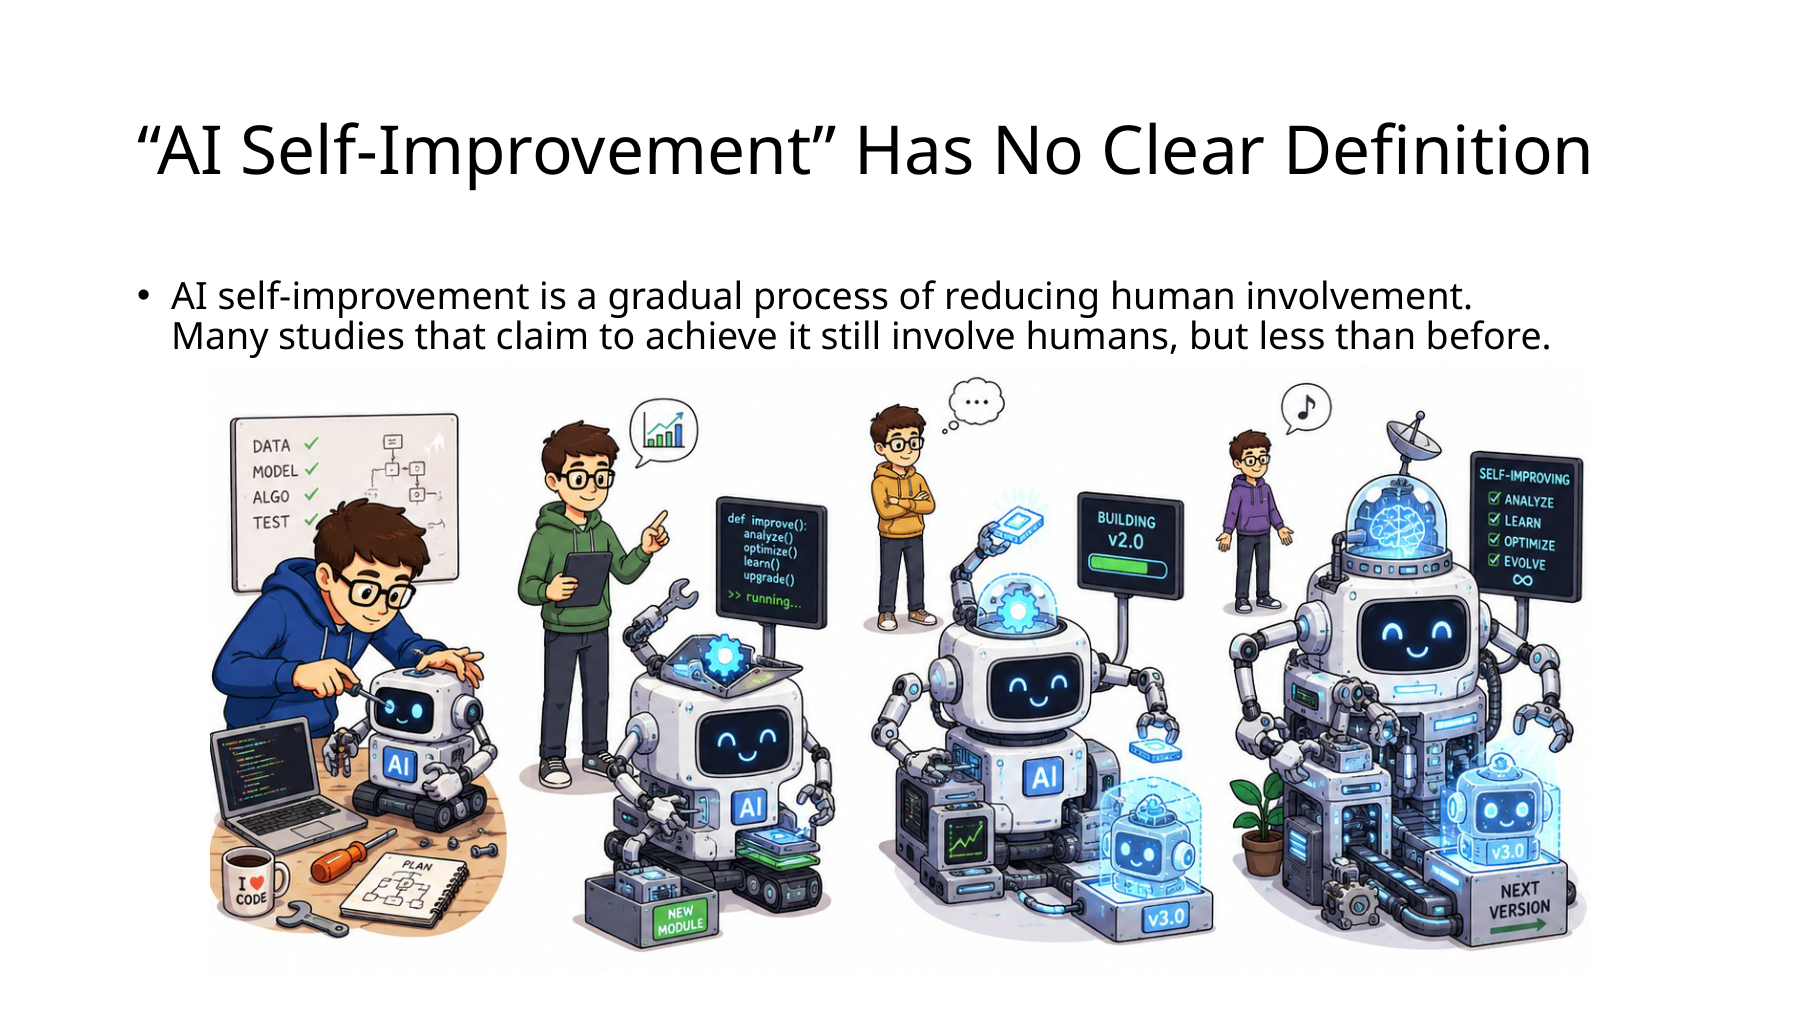
이 페이지는 AI 자가개선에 단일하고 명확한 정의가 없으며, 많은 연구에서 인간의 개입이 점차 줄어드는 양상으로 나타난다고 설명한다.
이 연재에서는 논문을 세 축으로 읽겠다.
- 변경 대상: 무엇을 바꾸는가?
- 자동화 범위: 그 과정의 어느 부분을 AI가 수행하는가?
- 평가 근거: 변화가 도움이 되었다는 것을 무엇으로 확인하는가?
#첫 번째 축: 무엇을 바꾸는가?
설명을 위해 지속적으로 유지되는 시스템 상태를 다음처럼 나누자.
| 기호 | 의미 | 구체적인 예 |
|---|---|---|
| 모델의 가중치 | 미세조정 또는 강화학습으로 갱신한 파라미터 | |
| 프롬프트·도구·실행 규칙 | 모델 호출 순서, 검색 도구, 테스트 실행 코드 | |
| 다음 과제에도 재사용하는 기억 | 실패 사례에서 추출한 규칙, 저장한 해결 경험 |
하네스(Harness)는 모델을 호출하고 도구를 연결하며 작업 순서를 정하는 실행 코드와 규칙을 뜻한다. 현재 한 문제를 푸는 동안의 임시 답변이나 대화 맥락은 위의 지속되는 기억과 따로 구분한다.
이 구분으로 여러 방법을 읽어 보자.
| 방법 | 직접 바뀌는 대상 | 결과를 볼 때 확인할 사항 |
|---|---|---|
| 일반적인 추론 중 자기수정 | 현재 답변·풀이·맥락 | 수정 후 정확도, 잘못된 수정, 추가 계산량 |
| 자기 생성 자료를 이용한 미세조정 | 자료를 선별한 기준, 새로운 문제에서의 성능 | |
| 검증 가능한 보상을 이용한 강화학습(Reinforcement Learning with Verifiable Rewards, RLVR) | 보상 설계, 검증 범위, 보상과 평가의 관계 | |
| 프롬프트·에이전트 구조 개선 | 실제 변경 내용, 평가 중 사용한 모델과 도구 | |
| 기억 기반 적응 | 경험의 보존·검색 방식, 다른 과제로의 전이 |
“언제 바뀌는가”도 별도의 질문이다. 추론 중 가중치를 고정하고 답만 수정할 수 있고, 테스트 시점 학습(Test-time training)처럼 문제 처리 중 가중치를 갱신할 수도 있다. 시점만으로 변경 대상을 판단하지 말고, 실제 업데이트 절차를 확인해야 한다. Test-Time Training, ICML 2020
#자기 생성 데이터에는 어떤 외부 정보가 들어갈까?
STaR는 2022년에 발표된 대표적인 연결 사례다. 소수의 풀이 예시를 바탕으로 풀이를 생성하고, 틀린 경우 정답을 조건으로 다시 풀이를 생성하며, 정답을 얻은 풀이로 미세조정을 반복한다. 문제와 정답 정보, 초기 예시가 들어간다는 점을 함께 보아야 한다. 스스로 만든 출력이 학습 자료의 일부가 되는 것과 외부 기준이 전혀 없는 것은 다른 조건이다. 또한 최종 답이 맞았다는 사실만으로 풀이의 모든 단계가 타당하다고 보증되지는 않는다. STaR 원문
DeepSeek-R1-Zero는 2025년 보고서에서 사전학습된 DeepSeek-V3-Base에 선행 지도 미세조정(SFT) 없이 강화학습을 적용했다. 정답 정확도와 출력 형식에 관한 규칙 기반 보상을 사용한다. 따라서 “선행 SFT 없이”라는 조건을 “사전학습이나 사람이 설계한 채점 기준 없이”로 확대해서 읽으면 안 된다. R1 자체에는 cold-start 자료와 SFT를 포함하는 여러 단계가 있으므로 R1-Zero와 구분해야 한다. 2025년 보고서 §2.2–2.3
이 두 예시는 자가개선에서 다음 질문이 왜 필요한지 보여 준다.
경험은 누가 만들었고, 어떤 경험이 좋은지는 무엇으로 판단했으며, 그 결과가 어디에 저장되었는가?
#두 번째 축: 인간의 개입은 어디에 있는가?
“사람이 전혀 개입하지 않았다”는 한 문장보다, 작업을 나누어 기록하면 구조가 잘 보인다. 아래 표는 특정 논문의 구현이 아닌, 연구를 읽을 때 사용할 점검표다.
| 개선 과정의 요소 | 확인할 질문 |
|---|---|
| 목표 | 풀 문제와 성공 기준을 누가 정했는가? |
| 시작 모델 | 어떤 사전학습 모델에서 출발하는가? |
| 데이터 | 문제·정답·경험을 누가 만들고 제공하는가? |
| 검증기·보상 | 무엇을 검사하며, 검사 기준은 누가 설계했는가? |
| 변경 후보 | 프롬프트·자료·코드·가중치 중 무엇을 누가 바꾸는가? |
| 선택과 중단 | 다음 버전과 반복 종료를 누가 결정하는가? |
사람이 목표와 검증 환경을 만들고 AI가 후보 생성과 선택을 수행하는 시스템도 충분히 연구할 가치가 있다. 자율성은 각 단계에 걸쳐 다르게 나타날 수 있으므로, “자가개선”이라는 이름과 함께 자동화된 범위를 구체적으로 적으면 된다.
#세 번째 축: 변화와 개선을 어떻게 구분할까?
상태가 달라졌다는 사실은
로 표현할 수 있다. 그러나 성능의 향상은 별도로 측정해야 한다.
가중치, 하네스, 기억 중 무엇이 바뀌든, 최종적으로 관심 있는 것은 정해 둔 평가 문제에서의 결과다. 이를 설명하기 위한 평가 함수를 다음처럼 쓰자.
- : 평가할 시스템 상태.
- : 상태 를 이용해 문제를 푸는 전체 시스템.
- : 평가 문제.
- : 평가 대상으로 정한 문제 분포.
- : 샘플링 등 실행의 무작위성.
- : 명시한 추론 자원 제약.
- : 정답·채점 기준으로 계산하는 평가 점수.
변경 전후 차이는 다음과 같다.
같은 조건에서 이면 해당 평가 기준에서의 향상이다. 실제 실험에서는 유한한 문제와 실행 횟수로 이 값을 추정하므로, 작은 차이는 변동성과 함께 해석해야 한다.
이 수식에는 두 가지 주의가 필요하다.
첫째, 는 우리가 선택한 평가 기준이다. 수식으로 적었다고 현실의 유용성을 모두 측정하는 완벽한 기준이 되지는 않는다. 학습 때 사용한 보상 가 높아졌는지와, 최종적으로 관심 있는 평가 가 좋아졌는지를 구분해야 한다.
둘째, 의 의미를 명시해야 한다. 생성 토큰 수, 도구 호출 수, 실행 시간은 서로 다른 자원이다. 같은 토큰 수가 항상 같은 비용이나 연산량을 뜻하지 않는다. 개선 후보를 탐색하거나 모델을 학습하는 데 쓴 비용은 최종 시스템의 추론 비용과 별도로 기록한다.
이 기준에서 두 가지 비교가 모두 유효하다.
| 비교 | 답하려는 질문 |
|---|---|
| 비슷한 추론 예산에서의 성능 비교 | 같은 자원으로 더 잘 푸는가? |
| 예산을 늘려 가며 성능 곡선 비교 | 계산을 더 허용할 때 어디까지 개선되는가? |
예산이 다른 시스템의 성능을 비교할 때도 비교 목적과 비용을 함께 제시하면 의미가 있다. 다만 계산을 더 사용한 효과와 학습·설계 변경의 효과를 분리해서 이해할 수 있도록 해야 한다.
#머신비전 연구로 옮겨 생각해 보기
다음은 위 기준을 적용한 가상의 실험 설계다.
불량 검출 모델이 라벨 없는 이미지에 의사 라벨(Pseudo-label)을 붙이고, 신뢰도가 높은 예측을 선별해 다시 학습한다고 하자. 여기서는 생성 결과가 학습 자료가 되고 가 바뀐다.
그런데 자기가 붙인 라벨을 자기가 더 잘 맞힌다는 사실만 측정하면, 잘못된 예측에 더 확신을 갖게 된 경우까지 좋아졌다고 판단할 수 있다. 따라서 사람의 정답을 가진 별도 시험 자료에서 비교하고, 촬영 조건이나 장비가 달라졌을 때도 효과가 유지되는지 확인하도록 설계할 수 있다.
동일 촬영 세션이나 매우 비슷한 이미지가 개발 자료와 시험 자료 양쪽에 섞이면 일반화 주장이 약해질 수 있으므로, 무엇을 새로운 상황으로 볼 것인지에 맞춰 분할 단위를 정한다. 같은 장비의 새로운 이미지에 대한 개선인지, 새로운 장비로의 전이에 대한 개선인지도 명시한다.
이 예시는 자가개선이 머신비전 연구의 실제 문제와 어떻게 연결되는지 보여 준다. 핵심은 생성 자료의 출처, 선별 기준, 업데이트 대상, 평가 조건을 한 실험 안에서 추적하는 것이다.
#이번 5장을 읽고 논문에서 확인할 네 문장
자가개선 연구를 읽을 때 다음 네 문장을 채워 보자.
- 이 시스템은 자신의 ______을 바꾼다.
- 좋은 변경인지는 ______으로 판단한다.
- 사람은 ______을 설계하거나 제공한다.
- 변경의 효과는 ______ 조건의 새로운 문제에서 확인했다.
이 네 문장이 구체적이면, “스스로 발전한다”는 큰 표현을 실제 구현과 실험에 연결할 수 있다.
다음 글 자가개선 AI 02 — 학습 목표는 누가 만드는가는 6–10쪽을 따라간다. 학습의 기본 구조에서 출발해 손실 함수(Loss function), 지식 증류(Knowledge distillation), 자기 생성 의사 정답(Pseudo-answer)을 구분한다. 특히 “같은 모델이 만든 답으로 같은 모델을 학습하면 왜 도움이 될 수 있는가?”를 조건과 실패 사례까지 연결해 다룬다.
#참고 자료와 판본
-
Hung-yi Lee. Machine Learning 2026 Spring, Self-Improving. 공식 일정 2026-05-08. 강의 페이지, PDF, 영상.
-
I. J. Good. Speculations Concerning the First Ultraintelligent Machine. Advances in Computers 6, 31–88, 1965. 본문에서 사용한 대목은 §2, 인쇄 p33. 원문 스캔.
-
Jack Clark. Import AI 455. 2026-05-04. 미래 전망을 확인하기 위한 출처. 원문.
-
Agrawal et al. GEPA: Reflective Prompt Evolution Can Outperform Reinforcement Learning. ICLR 2026. 공식 PDF.
-
Zhang et al. Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents. 최초 2025-05-29, 사용 판본 v3 2026-03-12. v3 본문.
-
DeepSeek-AI. DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. 학습 구성 설명은 v1 2025-01-22 기준. v1 본문. 현재 arXiv에는 2026-01-04의 v2도 존재하므로 판본을 구분한다.
-
Zelikman et al. STaR: Bootstrapping Reasoning With Reasoning. 최초 2022-03-28, NeurIPS 2022. 논문.
-
Huang et al. Large Language Models Cannot Self-Correct Reasoning Yet. 최초 2023-10-03, ICLR 2024. 공식 논문 소개.
-
Sun et al. Test-Time Training with Self-Supervision for Generalization under Distribution Shifts. ICML 2020. 논문.
-
Hado van Hasselt. Reinforcement Learning, Lecture 1: Introduction. DeepMind × UCL, 2021. 본문 사용: PDF 17쪽. 공식 PDF.
-
Lakshya A Agrawal et al. GEPA: Reflective Evolution of Compound AI Systems. Stanford CS329T 초청강연, 2025-10-28. 본문 사용: PDF 33·34쪽. 공식 강의 일정 · 원본 슬라이드. 강연 제목과 ICLR 2026 논문 제목을 구분한다.