보상 코드를 작성하는 AI와 답의 품질을 판단하는 AI는 역할이 다르다. 두 경우 모두 무엇을 좋은 결과로 볼지는 별도로 정하고 검증해야 한다.
4편 — 정답은 드문데, 무엇을 보상해야 할까에서는 학습용 대리 보상(Proxy reward)과 실제 과제의 평가 기준을 구분했다. 이번에는 보상 설계의 탐색 방법을 비교하고, 코드로 적기 어려운 평가 기준을 모델이 학습하는 문제로 넘어간다.
기준 자료는 Hung-yi Lee의 NTU Machine Learning 2026 Spring, Self-Improving 상편 21–25쪽이다. 강의일은 2026년 5월 8일이다. 표지를 1쪽으로 센다. 공식 PDF · 원본 PPTX
21·22쪽의 영어 원본은 그대로 사용한다. 23–25쪽의 중국어 제목과 설명은 영어로 옮긴 비공식 편집본이다. 23쪽은 공개 PDF에서 제목 아래가 가려져 있으므로, 보이지 않는 내용을 복원했다고 주장하지 않는다. 발표자 노트의 비유와 추가 연구 해설을 본문에서 구별한다. 수식 재표현과 숫자 예시는 이 글의 설명용 계산이며 논문의 실험 결과가 아니다.
| 원본 | 읽을 때 구별할 것 |
|---|---|
| 21쪽 | 보상 후보 하나를 고치는 탐색과 후보 집단·트리를 유지하는 탐색 |
| 22쪽 | 보상 코드를 설계하는 바깥 반복과 정책을 학습하는 안쪽 반복 |
| 23쪽 | 보상 형성의 비유와 도파민 보상 예측 오차 연구 |
| 24쪽 | 사람이 직접 점수를 주는 일과 사람의 선호를 학습한 보상 모델 |
| 25쪽 | AI가 점수를 출력한다는 사실과 AI 피드백으로 학습한다는 사실 |
#21쪽 — 좋은 보상을 찾는 과정도 탐색 문제다
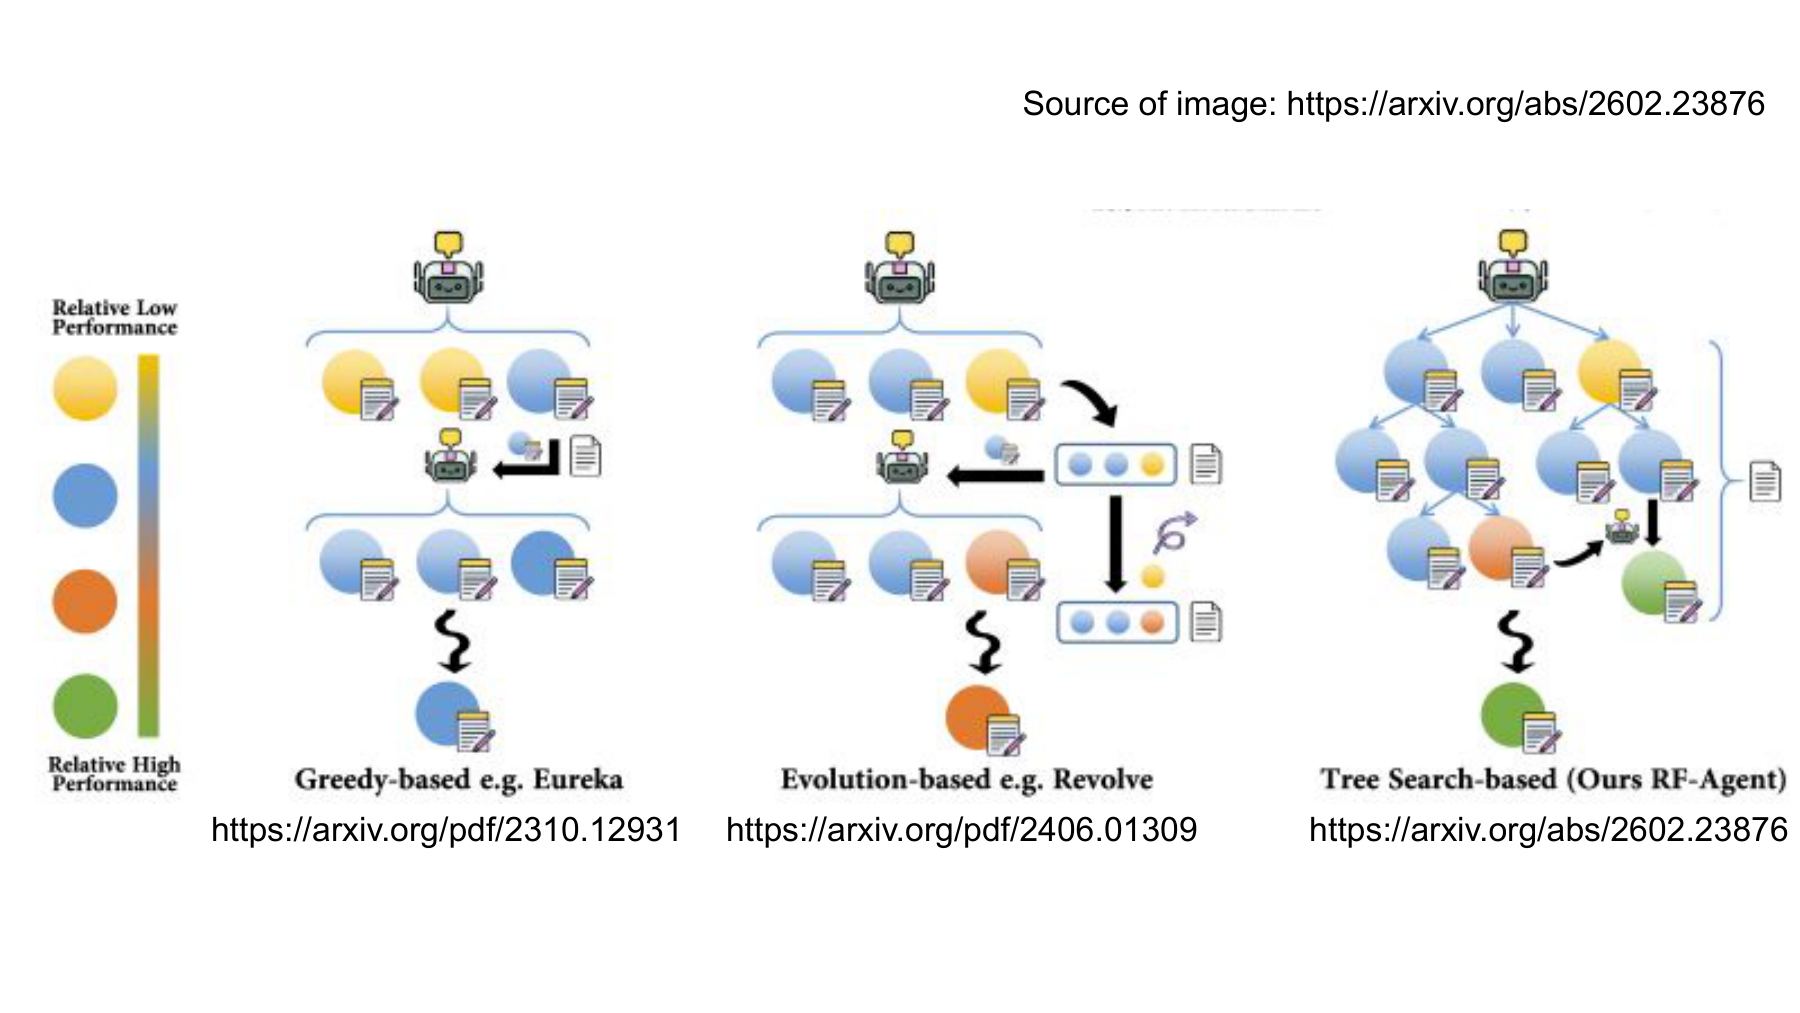
원본은 Eureka, REvolve, RF-Agent를 나란히 놓는다. 그림의 출처는 RF-Agent 논문이다. 따라서 이 그림은 여러 연구를 중립적인 공통 실험으로 새로 측정한 결과가 아니라, RF-Agent 저자들이 선행 방법과 자신의 방법을 비교하기 위해 만든 추상화로 읽는다. RF-Agent Figure 1과 §1
#같은 보상 생성이라도 무엇을 보존하느냐가 다르다
Eureka는 환경 코드와 과제 설명을 바탕으로 보상 코드를 만들고, 정책 학습 결과를 피드백으로 사용한다. 그다음 반복에서 유망한 후보와 실패 기록을 활용한다. 원 논문은 이를 진화적 최적화(Evolutionary optimization)로 설명한다. 한편 REvolve와 RF-Agent의 비교에서는 최상위 후보 중심의 반복을 강조하여 탐욕적 탐색(Greedy search)으로 단순화한다. 두 설명이 사용하는 추상화 수준이 다르다는 점을 기억하자. Eureka §3 · REvolve §1
REvolve는 보상 함수의 집단(Population)을 유지하고, 돌연변이·교차·이주 같은 유전 프로그래밍(Genetic programming) 연산을 사용한다. 사람은 정책이 움직인 결과를 비교하고 자연어 피드백을 제공한다. LLM이 Python 보상 코드를 작성한다고 해서 사람이 목표 판단에서 사라진 것은 아니다. REvolve §2–3
RF-Agent는 보상을 수정한 경로를 트리(Tree)로 관리하고, 몬테카를로 트리 탐색(Monte Carlo Tree Search, MCTS)으로 다음에 확장할 경로를 선택한다. 여기서 트리의 가지는 로봇의 관절 행동 하나하나가 아니라, 보상 함수 설계를 발전시키는 선택과 그 이력에 대응한다. RF-Agent §4
| 비교 축 | Eureka의 대표 반복 | REvolve | RF-Agent |
|---|---|---|---|
| 다음 개선의 출발점 | 선택한 유망 후보와 학습 피드백 | 보상 후보 집단과 유전 연산 | 선택한 트리 경로와 누적 이력 |
| 보상 형태 | 실행 가능한 코드 | 실행 가능한 코드 | 실행 가능한 코드 |
| 중요한 평가 근거 | 해당 보상으로 학습한 정책의 결과 | 사람의 정책 비교·자연어 피드백 | 정책 학습 결과와 평가 지표 |
| 혼동하지 말 것 | LLM 문맥 개선과 LLM 가중치 학습 | 사람의 피드백을 제거한 자동화 | 로봇 행동 탐색과 보상 설계 탐색 |
이 표는 방법의 구조를 비교한 것이며, 모든 구현·태스크에서의 성능 순위를 뜻하지 않는다. 서로 다른 실험의 최고 점수만 모아 같은 조건의 순위표로 만들 수는 없다.
#함께 읽기 A — REvolve 원본 Figure 1
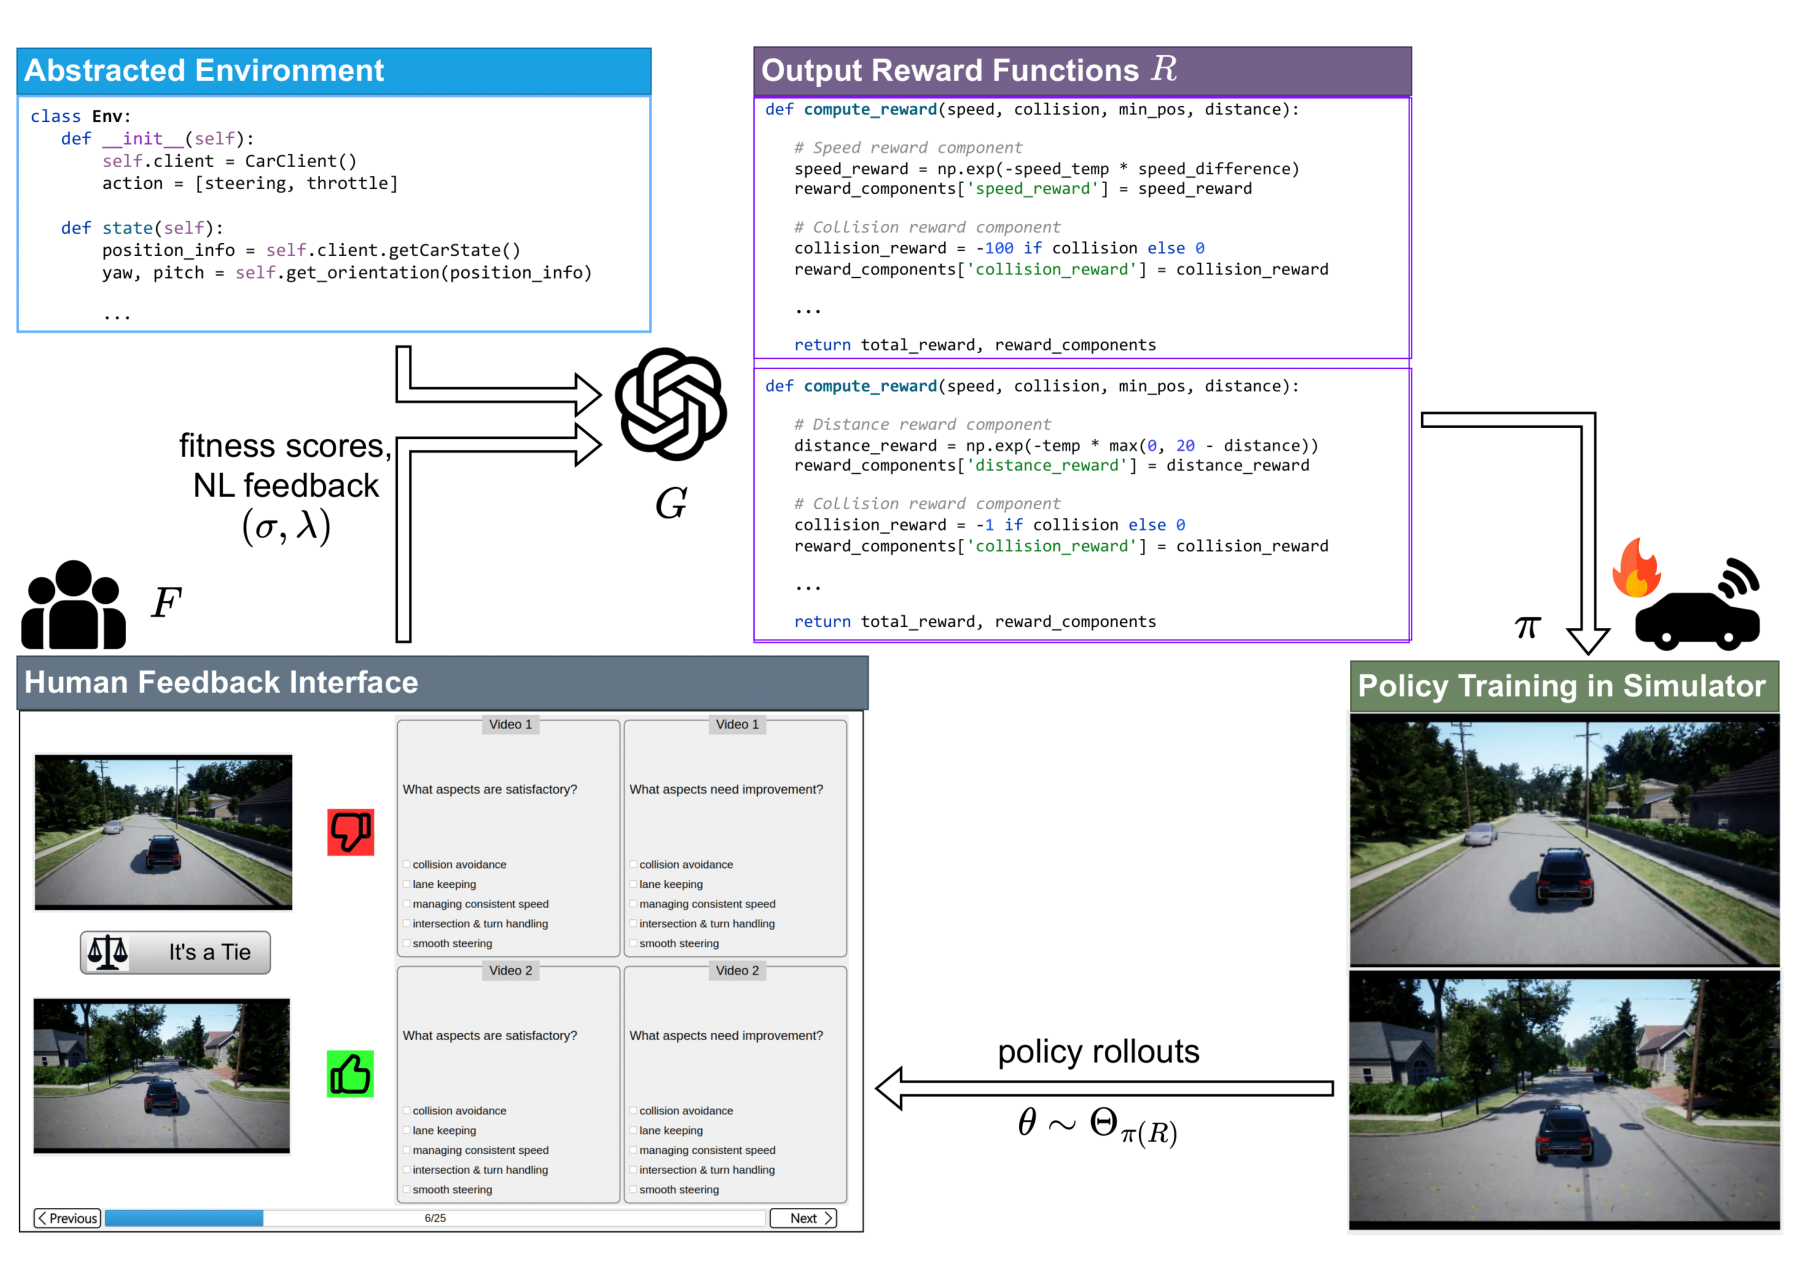
그림을 왼쪽에서 시작해 보자. 과제와 환경 변수가 보상 설계자에게 들어간다. 설계자가 만든 여러 보상은 각각 정책 학습에 사용된다. 그 뒤 사람이 비교하는 것은 보상 코드의 문장 표현이 아니라 학습된 정책의 실행 결과(Rollout)다. 선호와 자연어 피드백이 다음 보상 집단을 만드는 재료가 된다. REvolve v4, PDF 3쪽 Figure 1
예를 들어 두 주행 정책이 모두 목적지에 도착해도 하나는 급격하게 차선을 바꾸고 다른 하나는 부드럽게 움직일 수 있다. 사람이 후자를 선호한다는 정보는 단순 도착 여부보다 넓은 기준을 전달한다. 이 주행 예시는 그림의 의미를 설명하는 가상 상황이다. 실제 차량 도로 주행을 검증했다는 뜻이 아니다.
이 방식에는 새로운 질문도 남는다. 피드백을 준 사람들의 기준이 서로 다르면 어떻게 합칠까? 같은 사람이 반복 비교하면서 판단을 바꾸면 어떻게 기록할까? 사람을 피드백 과정에 둔다는 사실과 평가가 완전하고 일관된다는 사실은 같지 않다. 연구를 재현할 때는 평가 지침, 비교 대상의 제시 순서, 평가자 수, 불일치 처리도 확인해야 한다.
#22쪽 — 보상 설계의 트리와 정책 학습의 루프를 분리한다
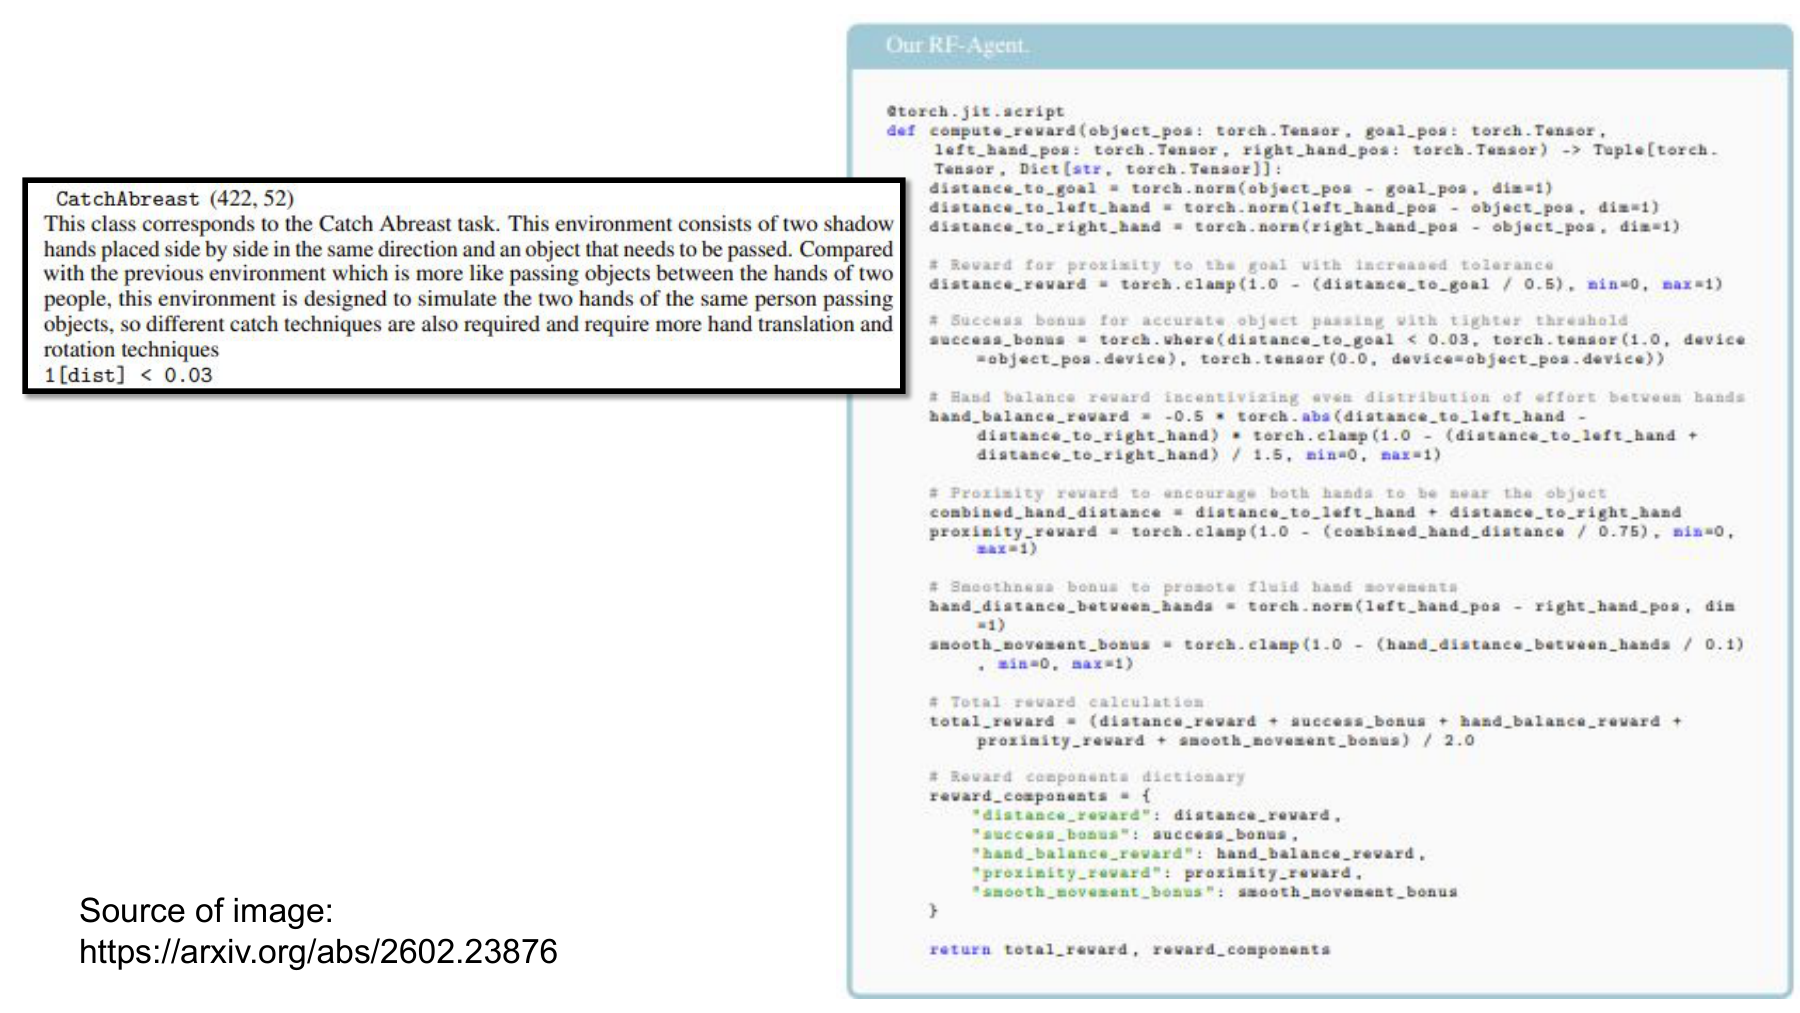
원본은 RF-Agent의 구성과 탐색 경로를 더 구체적으로 보여준다. 한 번의 보상 설계 선택 뒤에는 해당 보상으로 정책을 학습하고 평가하는 작업이 들어간다. 따라서 LLM 호출 횟수만 세면 전체 비용을 놓칠 수 있다. RF-Agent Figure 2, §3–4
#두 종류의 행동과 두 종류의 피드백
바깥 반복의 행동은 보상 코드를 새로 만들거나 수정하는 것이다. 안쪽 반복의 행동은 로봇 정책이 환경에서 수행하는 제어다. 바깥 반복은 학습된 정책의 성능과 실패 기록을 보고, 안쪽 반복은 보상 값을 이용해 정책 파라미터를 갱신한다.
다음 수식은 4편의 두 반복을 다시 적은 설명용 표기다. 논문의 모든 구현 세부 사항을 재현한 식은 아니다.
여기서 는 보상 후보의 코드·설정, 는 그 보상으로 학습한 정책, 는 학습 예산, 는 공통 기준으로 얻은 평가 값이다. LLM에 전달할 기록에는 후보 코드, 수정 의도, 실행 오류, 각 보상 항의 변화, 정책 평가를 함께 저장할 수 있다.
RF-Agent는 이력을 활용하는 문맥 추론과 MCTS를 결합하고, 설계 생각과 코드가 맞는지 정렬하는 절차 및 자체 검증 절차를 설명한다. 자체 검증은 정책 실행 평가를 대신하는 무오류 판정기가 아니다. 논문이 사용하는 안쪽 학습과 환경 피드백이 여전히 필요하다. RF-Agent §4.2–4.3 및 부록 B
#검색 트리가 필요한 이유와 필요한 대가
설명용으로 후보 A는 손잡이 접근을, 후보 B는 접촉 유지 비용을, 후보 C는 문짝 각도를 강조한다고 하자. 현재 A가 가장 좋아도 A만 계속 고치면 B에서 출발했을 때 발견할 수 있는 개선을 놓칠 수 있다. 트리는 어떤 수정에서 무엇이 나왔는지 남기고, 이미 유망한 경로를 더 활용할지 덜 조사한 경로를 탐색할지 선택하게 한다.
그러나 후보를 보존한다고 계산 비용이 사라지지는 않는다. 가상 예로 보상 후보 8개를 각각 독립 시드 3개로 처음부터 학습하면 정책 학습은 24회다. 각 학습 예산이 라면 총 안쪽 학습 예산은 이며, 여기에 LLM 생성과 평가 비용이 추가된다. 이 계산은 RF-Agent의 보고 비용이 아니라, 실험 예산을 설명하기 위한 예제다.
비교 실험에서는 다음 질문이 중요하다. 같은 완전 학습 횟수에서 성공률을 비교했는가? LLM 토큰·시간과 정책 학습 시간을 함께 보고했는가? 좋은 후보를 선택하는 평가 조건이 최종 테스트와 분리되어 있는가? 여러 방법에 서로 다른 탐색 예산을 주면, 차이를 알고리즘 자체의 효과로만 해석하기 어렵다.
또한 이 글이 읽는 RF-Agent 판본은 arXiv v1, 2026년 2월 27일이다. 이 판본의 실험은 17개 저수준 제어 태스크의 시뮬레이션 평가를 다룬다. 이를 곧바로 모든 실제 로봇, 센서 오차, 사람과의 협업 환경에서의 성능 보장으로 넓히지 않는다. 판본 정보 · 실험 §5.1
#23쪽 — 도파민 비유는 어디까지 유효할까?
원본 제목은 ‘도파민과 Reward Shaping의 관계’다. 공개 PDF의 23쪽은 제목 아래가 가려진 상태이며, 원본 PPTX에는 그림 위에 덮개 도형이 있다. 이 글은 해당 정적 화면을 유지한다. 아래 설명은 공개 PPTX의 발표자 노트에 있는 중간 목표와 보상에 관한 비유를 출발점으로 삼은 추가 해설이다.
비유의 교육적 역할은 분명하다. 최종 결과를 기다려야만 학습하는 대신, 그 결과를 예측하는 단서가 행동 조절에 도움이 될 수 있다는 것이다. 그러나 여기서 ‘도파민은 쾌락 점수이고 뇌는 우리가 작성한 보상 함수 그대로 작동한다’는 결론으로 가면 설명이 과해진다.
#함께 읽기 B — 보상 자체와 보상 예측 오차는 다르다
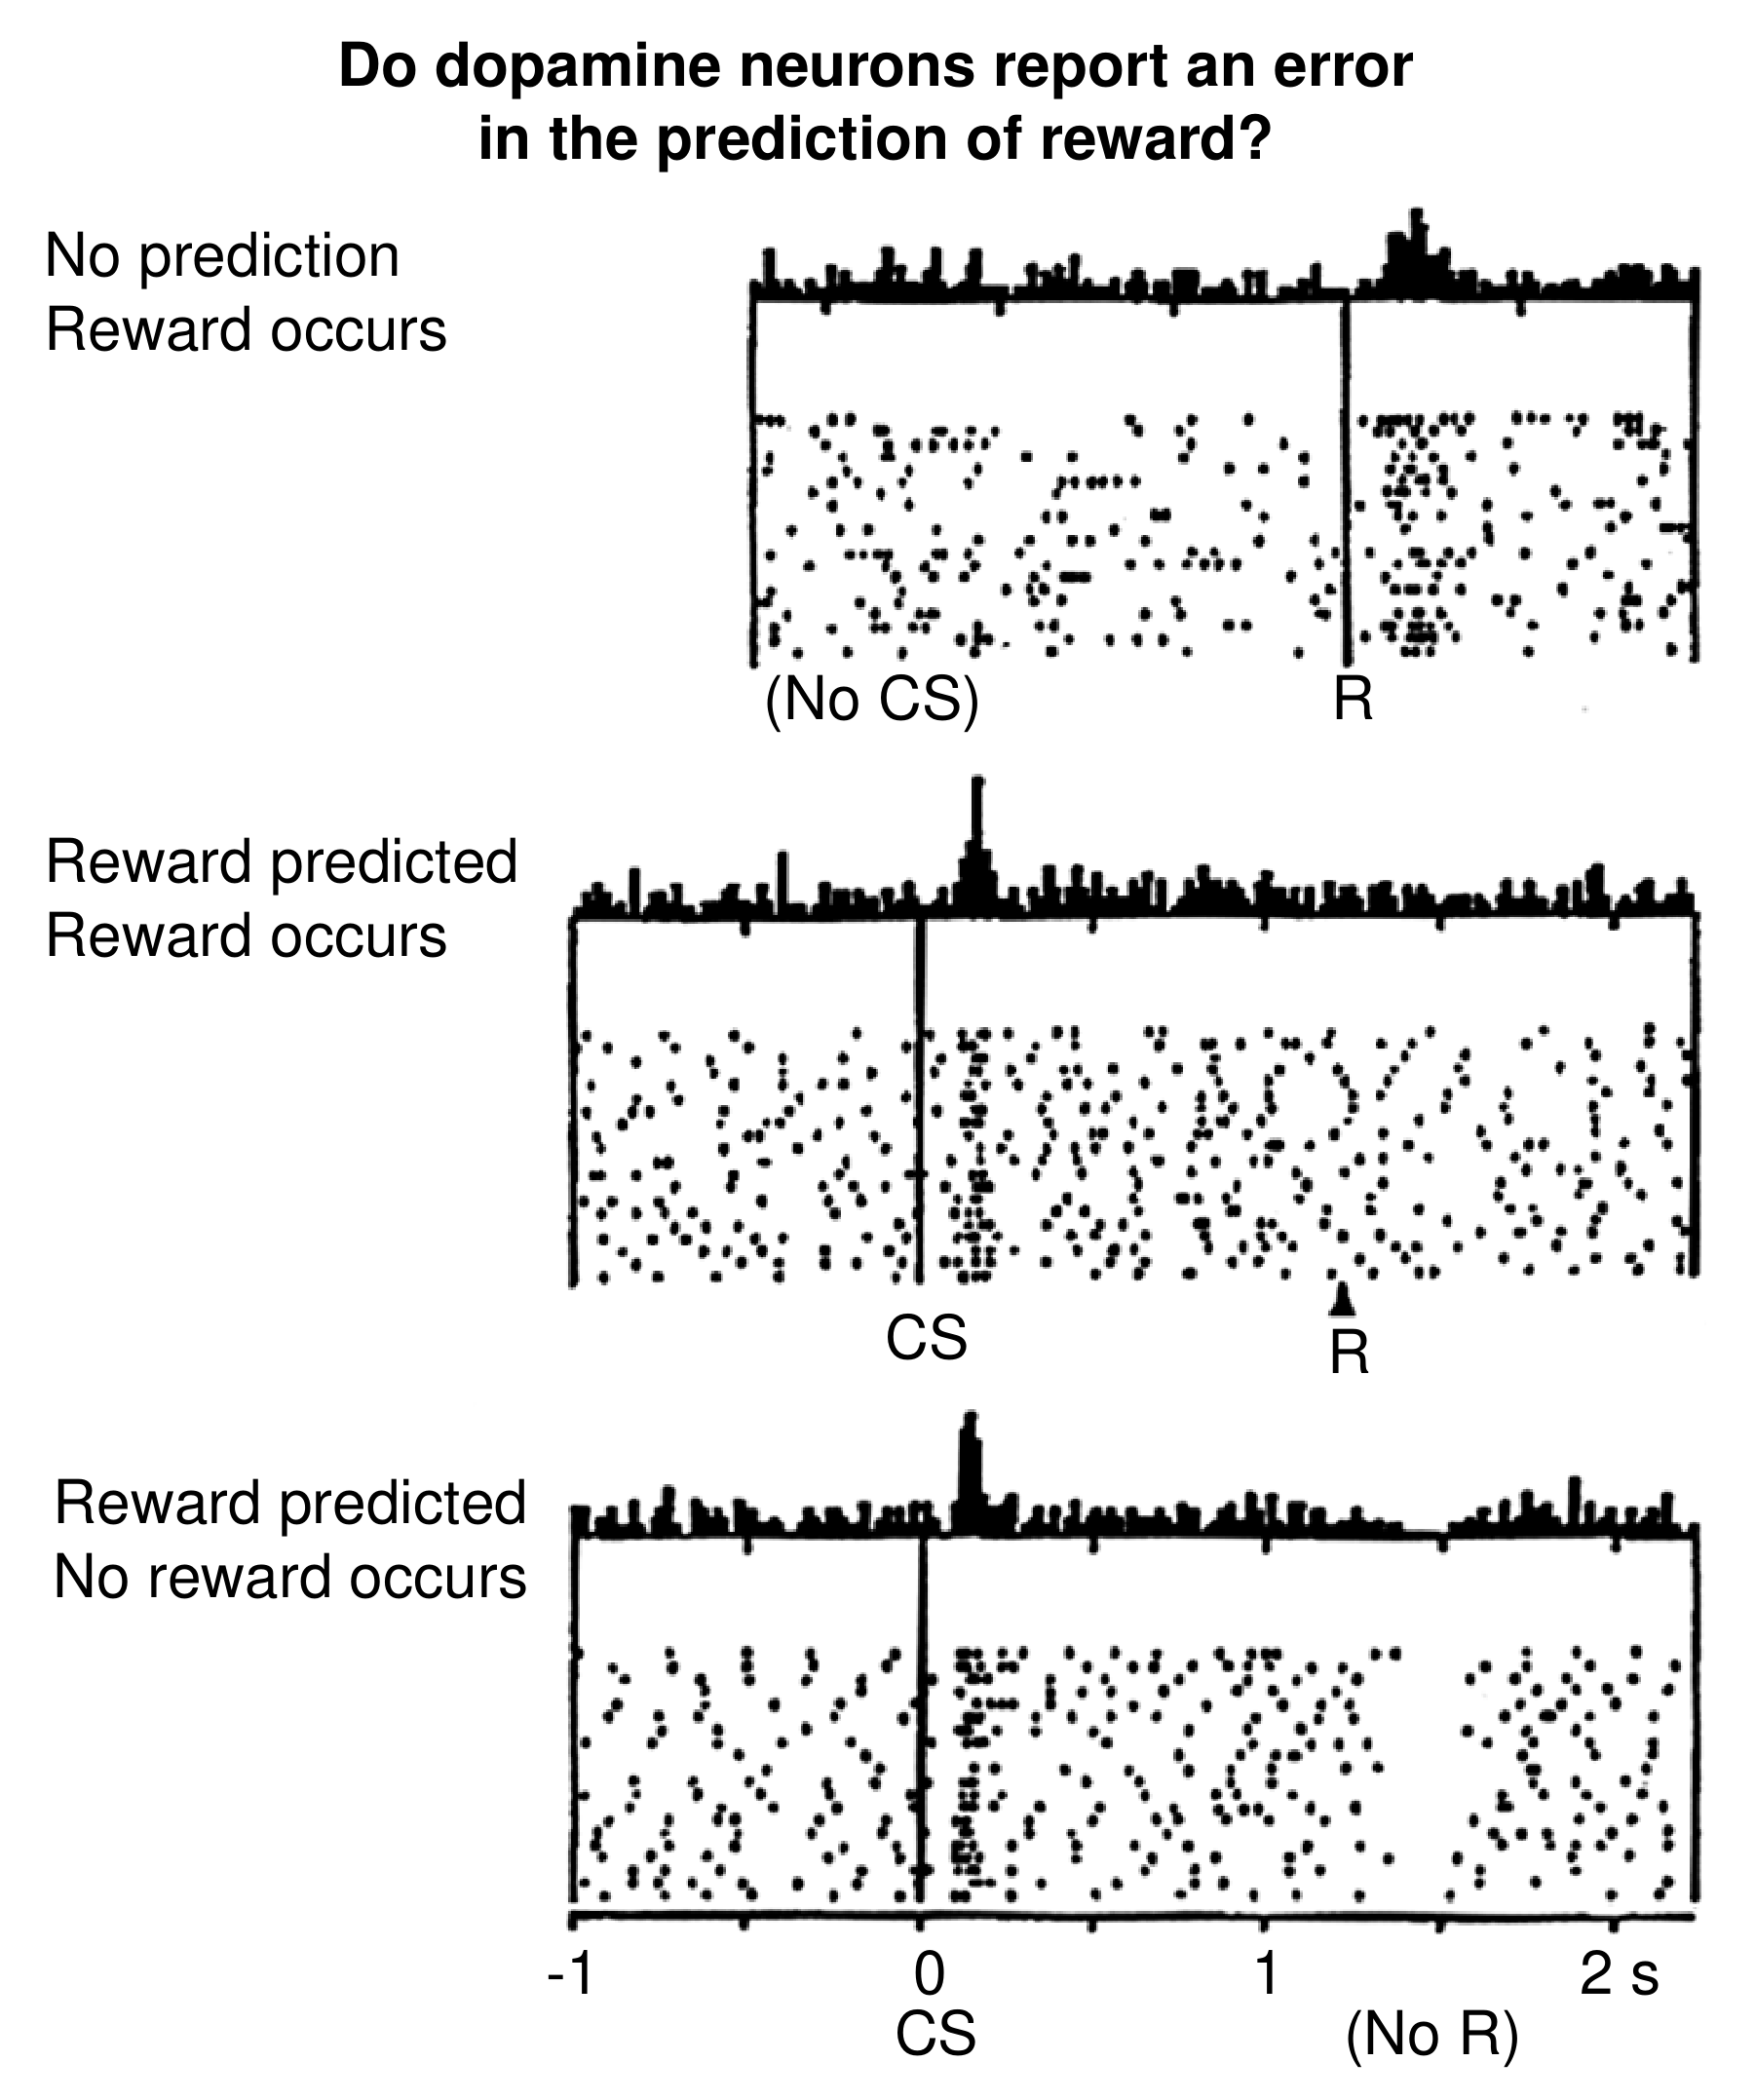
Schultz·Dayan·Montague의 1997년 논문 Figure 1은 특정 실험 조건에서 기록한 도파민 뉴런의 반응을 비교한다. 위쪽은 예측하지 못한 보상, 가운데는 단서로 예측한 보상, 아래쪽은 예측했지만 실제로 오지 않은 보상이다. 그림의 CS는 조건 자극, R은 보상 시점이다. 원문 PDF 2쪽, 인쇄 1594쪽
논문의 핵심 해석은 보상에 대한 반응을 예측과 실제 결과의 차이와 연결하는 것이다. 예측을 학습하면 반응 시점이 보상 자체에서 앞선 단서 쪽으로 바뀔 수 있고, 기대한 보상이 누락되면 그 예상 시점에 반응 감소가 나타난다. 이는 이 논문이 다루는 실험과 계산 모형의 연결이지, 모든 도파민 활동에 대한 하나의 완전한 정의가 아니다.
강화학습의 시간차 오차(Temporal-difference error)를 단순한 상태 가치 모형으로 쓰면 다음과 같다. 아래는 표기를 정리한 설명식이다.
는 실제 받은 보상이고, 는 현재 상태에서 예상하는 미래 보상의 가치다. 는 두 값을 비교하는 갱신 신호다. 보상과 예측 오차는 같은 변수가 아니다.
마지막 한 스텝 뒤 종료하며 인 가상 예를 보자. 보상 1을 예상하지 못해 이었다면 오차는 1이다. 이미 1을 예상했다면 같은 보상을 받아도 오차는 0이다. 1을 예상했는데 아무 보상도 오지 않으면 오차는 −1이다. 이 숫자는 뉴런 발화량을 측정한 값이 아니다.
4편의 잠재 함수 보조 항 와 모양이 비슷하다는 점은 흥미롭다. 하지만 보상 함수를 바꾸는 PBRS와 가치 예측을 갱신하는 TD 오차는 역할이 다르다. 수식 일부가 비슷하다는 사실을 생물학적 동일성이나 학습 보장으로 바꾸면 안 된다.
발표자 노트가 사용하는 진화·음식·중간 목표의 비유도 이 경계를 지켜 읽는다. 그것만으로 현대인의 식습관이나 중독의 원인을 설명하거나 의학적 판단을 내릴 수는 없다. 이 장에서 가져갈 것은 학습 신호와 궁극적 목표를 구분하는 관점이다.
#24쪽 — 손으로 적기 어려운 평가 기준을 모델이 배운다
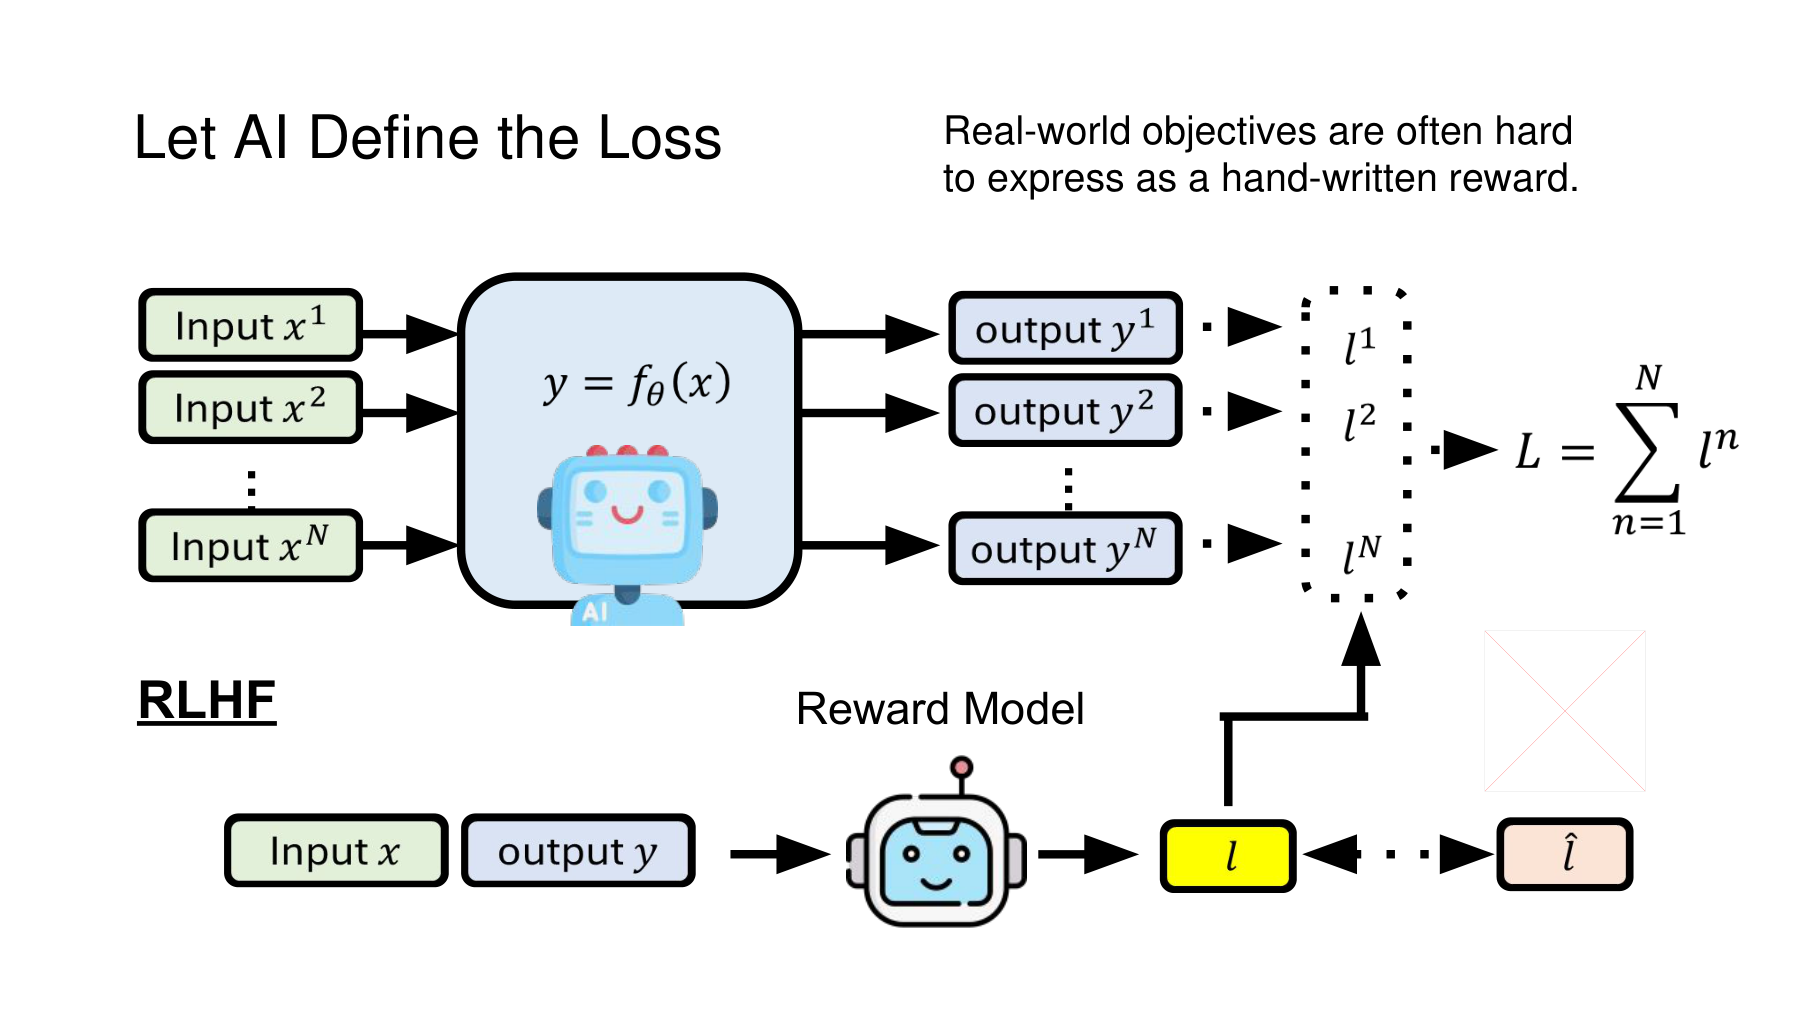
문 열기 성공은 각도나 상태로 정의할 수 있다. 그러나 긴 요약이 유익한지, 답이 질문에 충실한지, 불필요하게 위험한 내용을 포함하는지는 간단한 조건문 몇 개로 충분히 표현하기 어렵다. 원본의 RLHF 그림은 이런 판단을 학습한 보상 모델(Reward model)을 도입하는 방향을 보여준다.
일반적인 선호 기반 RLHF 흐름에서는 사람이 답 후보들을 비교하고, 그 비교 자료로 보상 모델을 학습한다. 그 뒤 정책이 생성한 답에 대해 보상 모델이 점수를 제공한다. 사람이 매 토큰이나 매 학습 스텝을 실시간으로 직접 채점해야 한다는 뜻은 아니다. Stanford CS224N Lecture 10, PDF 58–62쪽
#함께 읽기 C — 선호 비교에서 보상 모델의 손실까지
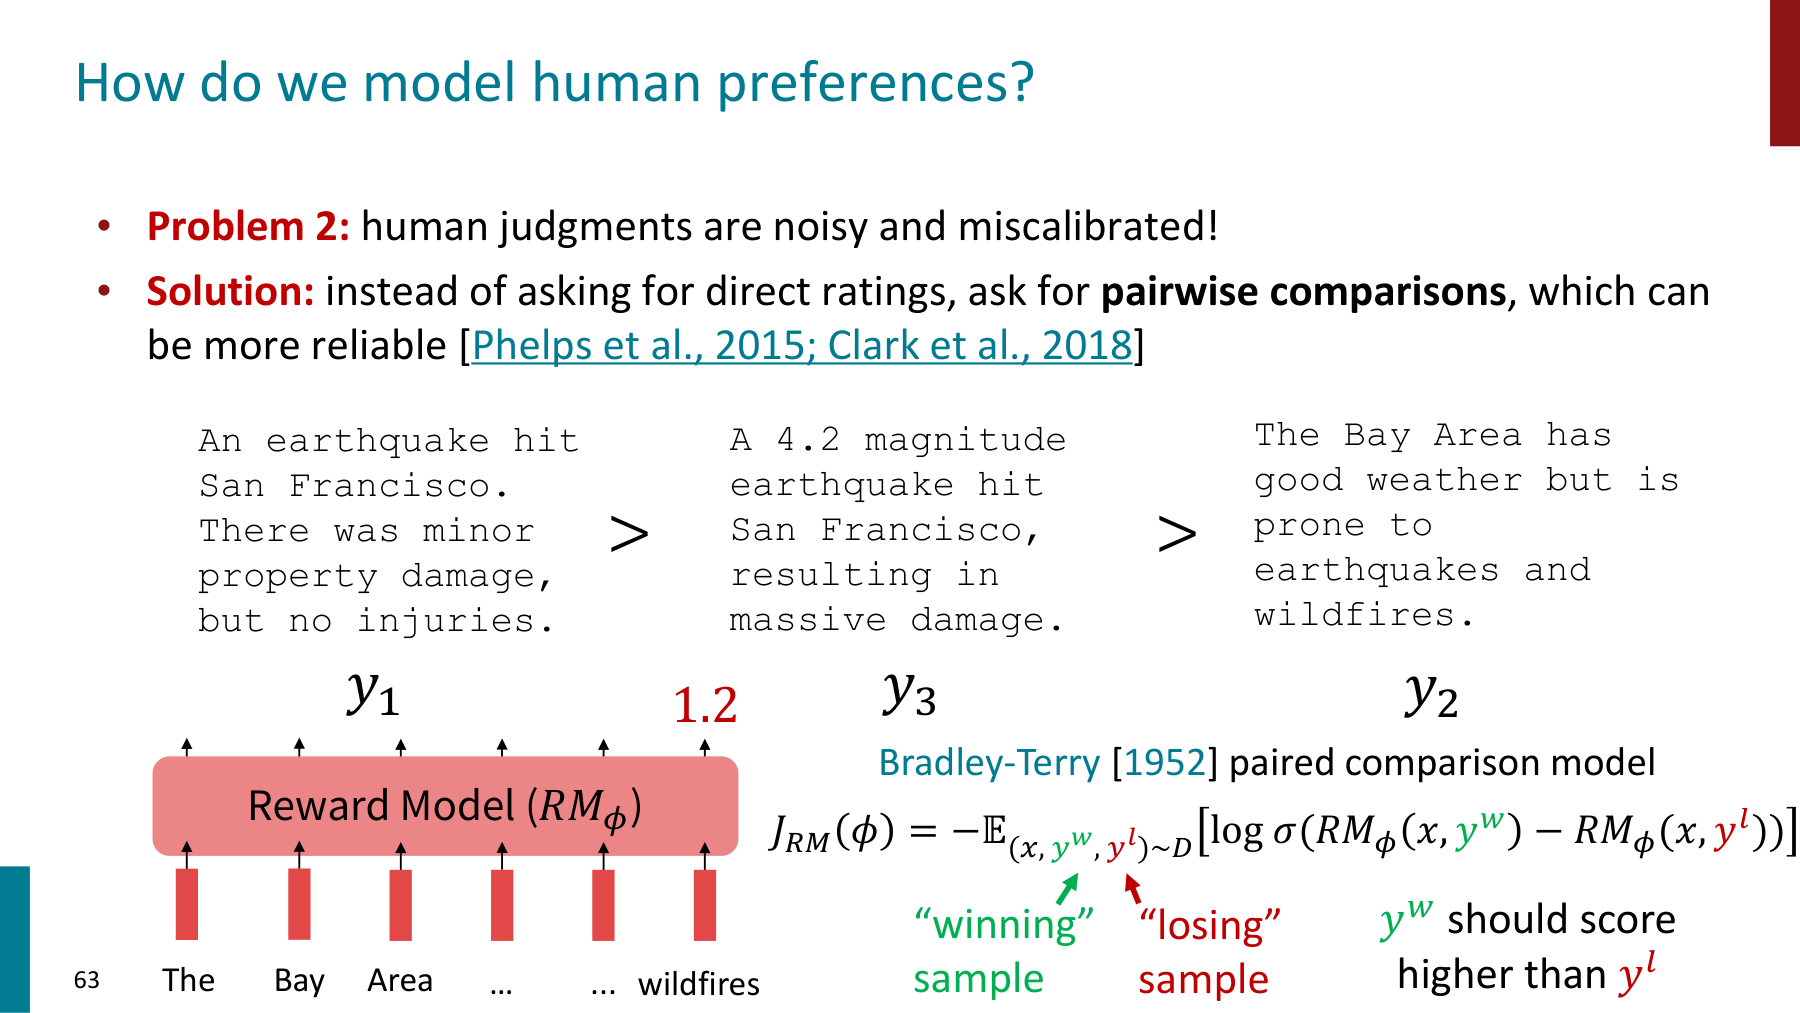
Stanford의 이 슬라이드는 같은 질문에 대한 답들을 비교하고, 선택된 답의 점수가 더 높아지도록 보상 모델을 학습하는 식을 보여준다. 인쇄 번호는 63이며, PDF의 실제 페이지 번호는 60이다.
질문을 , 선호된 답을 , 덜 선호된 답을 , 보상 모델의 점수를 로 쓰자. Bradley–Terry 형태의 쌍별 비교 모형에서는 다음처럼 선호 확률을 표현할 수 있다.
관측된 선호를 잘 설명하도록 보상 모델을 학습하는 대표적인 손실은 다음과 같다.
이 식에서 학습하는 파라미터는 보상 모델의 다. 생성 정책의 파라미터 와 구별해야 한다. 비교 자료가 어떤 기준으로 만들어졌는지에 따라 학습되는 선호도 달라진다.
#숫자로 읽기: 점수 차이가 1.5라면
설명용으로 선호 답의 점수를 1.2, 다른 답의 점수를 −0.3으로 두자. 점수 차이는 1.5이고, 모형의 선호 확률은 다음과 같다.
이는 그 답이 사실일 확률이 81.76%라는 뜻이 아니다. 지정한 비교 모형이 해당 선호를 설명하는 확률이다. 두 점수에 같은 상수 100을 더해도 차이는 1.5로 같으므로 선호 확률은 바뀌지 않는다. 이처럼 쌍별 선호는 점수의 절대 영점을 정해주지 않는다.
또한 사람의 비교 자체에 의견 차이와 잡음이 있으면, 그 자료로 학습한 모델도 이를 반영한다. 선호 학습은 진실 판별과 같은 문제가 아니며, 사실성·도움·안전 같은 기준을 어떤 방식으로 통합했는지 확인해야 한다.
#보상 모델을 잘 맞추는 학습과 생성 정책을 바꾸는 학습
보상 모델이 준비되면, 생성 정책은 높은 점수를 받는 답을 더 자주 만들도록 학습할 수 있다. 다음은 완성된 답 하나를 하나의 선택으로 단순화한 대표적인 목적식이다.
는 기준 정책이며, 는 기준 정책에서 너무 멀어지는 것을 억제하는 항의 강도다. 기대값 아래의 로그 비율은 KL 발산으로 연결된다. 이 식은 PPO의 전체 구현식이 아니며, 토큰별 보상 처리·가치 추정·최적화 세부 사항은 생략했다. Stanford PDF 62쪽, 인쇄 66쪽
KL 제약을 넣었다고 보상 모델의 오류가 사라지는 것은 아니다. 정책이 점수 모델의 취약점을 찾을 수 있으므로, 최종 답은 다시 독립적인 기준으로 평가해야 한다. 4편의 대리 보상 문제는 여기에서도 남는다.
#25쪽 — RLHF에도 이미 AI가 있다. RLAIF는 무엇이 달라질까?
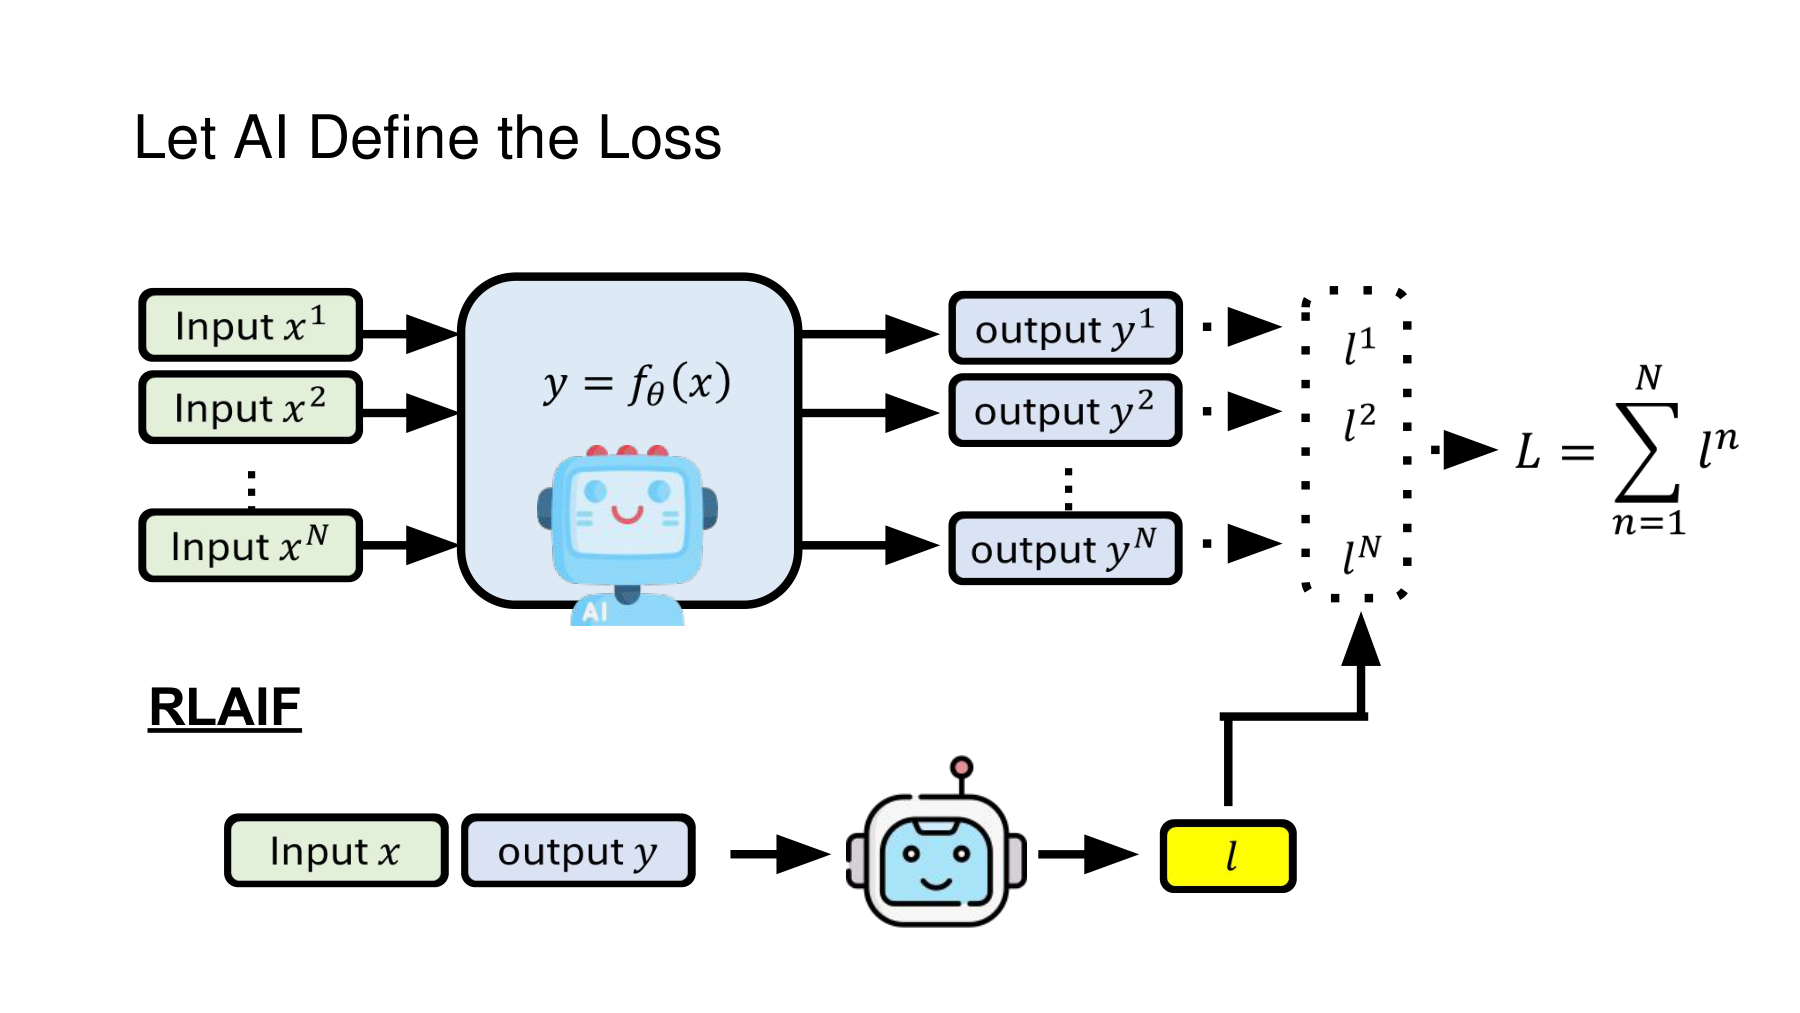
원본은 RLHF에서 RLAIF로 넘어간다. 여기서 혼동하기 쉬운 문장은 “사람 대신 AI가 점수를 준다”이다. 앞서 본 RLHF에서도 실제 정책 학습 중에는 보상 모델이라는 AI가 점수를 줄 수 있다. 따라서 최종 점수의 출력 주체만으로 RLHF와 RLAIF를 나누면 구분이 흐려진다.
선호 기반 구성에서 중요한 구분은 보상 모델을 학습할 비교·평가 신호가 어디서 왔는가이다. RLHF는 인간의 피드백을, RLAIF는 AI가 생성한 피드백을 주요 감독 신호로 사용한다. 구체적인 방법은 학습된 선호 모델을 둘 수도 있고 AI 평가를 직접 활용할 수도 있으므로, 모든 RLAIF가 같은 구조라고 단정하지 않는다.
#함께 읽기 D — Constitutional AI의 두 학습 단계
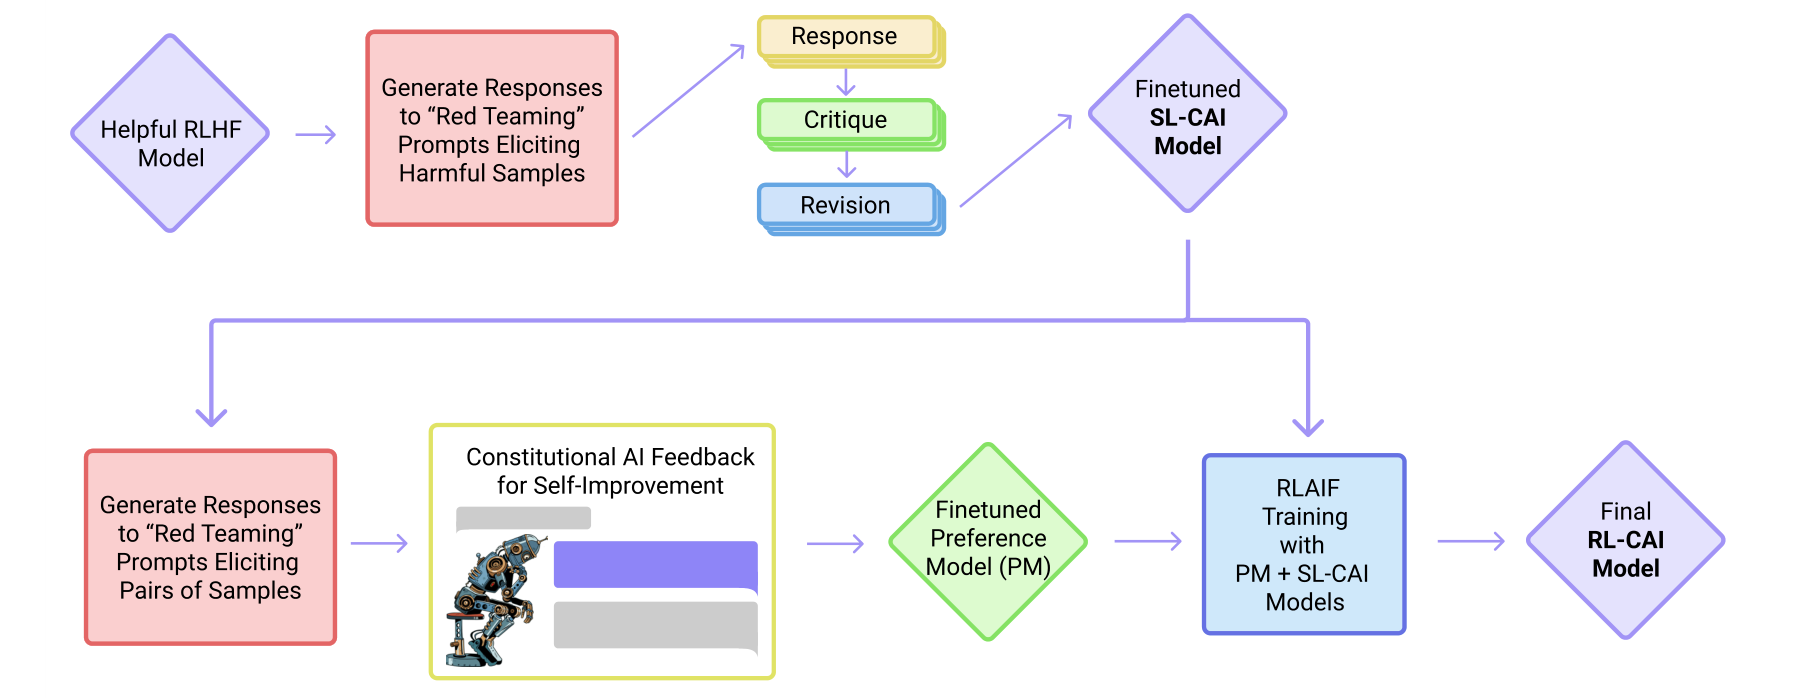
Constitutional AI의 원본 Figure 1은 위쪽에 비평·수정 결과를 이용하는 지도학습(Supervised learning) 단계를, 아래쪽에 AI가 답 쌍을 평가해 선호 모델을 학습하고 그 모델로 강화학습하는 단계를 배치한다. Bai et al., arXiv v1, PDF 2쪽 Figure 1
위쪽은 3편에서 본 수정 답을 학습 목표로 사용하는 과정과 연결된다. 아래쪽에서는 AI의 선호 판단으로 자료를 만들고, 선호 모델(Preference model)을 학습한 뒤, 그 점수를 이용해 생성 정책을 훈련한다. 비평 텍스트 생성, 선호 자료 생성, 보상 모델 학습, 생성 정책 학습은 서로 다른 단계다.
이 연구에서 인간의 개입은 사라지지 않는다. 원칙인 헌법(Constitution)을 사람이 정하고, 기본 모델과 초기 학습 자료도 이미 존재한다. 논문은 유해성 피드백의 자동화를 다루면서 도움성에 관한 인간 피드백과 결합하는 구성을 설명한다. 따라서 ‘어떤 인간 감독도 없이 처음부터 AI가 자기 목표를 발명했다’고 요약하면 원문과 어긋난다. Constitutional AI §4 및 인간·AI 피드백 결합 설명
#평가자를 AI로 바꾸어도 남는 세 질문
어떤 기준을 따르는가? 같은 답도 사실성, 정중함, 간결함, 위험 회피 중 무엇을 강조하느냐에 따라 선호가 달라질 수 있다. 기준을 프롬프트·원칙·라벨 지침으로 명시해야 결과를 해석할 수 있다.
무엇을 근거로 판단하는가? AI가 표현의 매끄러움만 보고 답을 고르는지, 계산 실행·출처 대조·검사 도구의 결과도 사용하는지 구별한다. 같은 모델이 답을 만들고 평가하면 같은 오류를 반복할 가능성도 점검해야 한다. 평가자 모델을 바꾸는 것은 도움이 될 수 있지만, 모델 이름이 다르다는 사실만으로 오류가 독립이라고 보장되지는 않는다. 이 문단은 검증 설계에 관한 추가 제안이다.
최종 검증은 누가 무엇으로 하는가? AI 평가 점수 상승을 곧바로 사용자 효용이나 실제 정확도 상승으로 읽지 않는다. 사람이 별도로 평가한 자료, 실행 가능한 테스트, 보지 않은 질문, 실제 환경의 성공 기준 등 과제에 맞는 독립 근거가 필요하다.
예를 들어 가상의 요약 평가에서 AI 평가자가 긴 답에 높은 점수를 주는 경향이 있다고 하자. 생성 정책은 내용을 더 정확하게 만드는 대신 장황하게 써서 점수를 올릴 수 있다. 이때 필요한 것은 평가 프롬프트를 더 강하게 쓰는 일만이 아니다. 길이를 통제한 비교, 사실 대조, 새로운 평가 질문을 통해 무엇이 개선되었는지 확인해야 한다.
#두 종류의 자가개선을 한 표로 정리하기
| 질문 | 보상 코드 설계 자동화 | 선호·평가 피드백 자동화 |
|---|---|---|
| AI가 주로 만드는 것 | 환경 상태를 받아 점수를 계산하는 코드 | 답의 선호·비평·평가 자료 |
| 대표 연결 사례 | Eureka, REvolve, RF-Agent | Constitutional AI의 RLAIF 단계 |
| 이후 실제 학습 대상 | 환경에서 행동하는 정책 | 선호 모델 및 답을 생성하는 정책 |
| 놓치기 쉬운 사람의 역할 | 과제·환경·성공 기준·피드백 설계 | 원칙·평가 지침·자료·최종 평가 |
| 공통된 위험 | 대리 보상을 잘 높이지만 실제 목표를 놓칠 수 있다 | 평가 모델의 선호를 잘 맞추지만 실제 목표를 놓칠 수 있다 |
이 표의 핵심은 자동화의 이름보다 어떤 산출물이 바뀌었는지, 어느 파라미터가 학습됐는지, 품질 판단에 어떤 정보가 추가됐는지를 확인하는 것이다. LLM이 코드를 수정하는 것만으로 LLM 파라미터가 학습된 것은 아니다. AI가 더 높은 점수를 주는 것만으로 정책의 실제 능력이 좋아진 것도 아니다.
#이해를 확인하는 세 질문
질문 1. REvolve는 사람 없이 좋은 보상을 찾는 방법인가? 아니다. 이 글이 읽은 방법은 사람의 정책 선호와 자연어 피드백을 보상 진화에 사용한다.
질문 2. 보상 모델의 점수 차이를 시그모이드에 넣은 값은 답의 사실 확률인가? 아니다. 지정한 쌍별 비교 모형에서의 선호 확률이다. 사실성의 확률로 사용하려면 별도 정의와 검증이 필요하다.
질문 3. RLHF에서 신경망이 점수를 주면 이미 RLAIF인가? 아니다. 인간의 비교 자료를 학습한 보상 모델이 점수를 주는 일반적인 RLHF 구성이 있다. 피드백 자료의 출처와 학습 단계를 확인해야 한다.
다음 범위는 원본 26–30쪽이다. AI 자신의 평가를 어떤 신호로 만들 수 있는지, 언어로 매기는 점수와 여러 응답의 일치, 확신·엔트로피를 이용한 접근으로 이어진다. 아직 공개하지 않은 다음 편의 링크는 만들지 않는다.
#함께 읽을 원문
| 자료 | 사용한 판본·위치 | 연결 내용 |
|---|---|---|
| NTU Self-Improving | 2026-05-08 강의, PDF 21–25쪽; 23쪽은 공개 PPTX의 노트와 구별 | 기준 강의 |
| Eureka | 저자 프로젝트 PDF, §3 | 보상 코드 생성·학습 피드백 |
| REvolve | v4, 2025-05-23, Figure 1은 PDF 3쪽 | 집단 탐색과 인간 피드백 |
| RF-Agent | v1, 2026-02-27, Figure 1–2·§4–5 | 이력과 MCTS 기반 보상 설계 |
| Schultz·Dayan·Montague | Science, 1997-03-14, Figure 1은 PDF 2쪽 | 보상 예측 오차와 도파민 연구의 연결 |
| Stanford CS224N Lecture 10 | 2024년 강의, PDF 60쪽(인쇄 63), PDF 62쪽(인쇄 66) | 선호 모형과 KL 제약 목적 |
| Constitutional AI | v1, 2022-12-15, Figure 1·§4 | 원칙에 따른 AI 피드백과 RLAIF |
원본 슬라이드·논문 도해와 이 글의 추가 해설은 구분해서 읽는다. 원저작자와 자료 위치는 각 그림에 표시하며, 출처 표시는 원저작물 전체에 대한 재사용 허가를 뜻하지 않는다.