학습하기 쉬운 보상과 실제로 이루려는 목표는 같지 않을 수 있다. AI가 보상을 설계하더라도, 그 보상으로 학습한 정책은 별도의 성공 기준으로 평가해야 한다.
3편에서는 답을 고치는 자기수정(Self-correction)과 모델 파라미터를 바꾸는 학습을 구분했다. 또한 정답을 모방하는 지도학습과 보상을 사용하는 강화학습을 비교했다.
이번에는 그다음 질문을 다룬다. 정답 대신 점수를 주면 된다고 했는데, 그 점수는 누가 어떻게 만들어야 할까?
기준 자료는 Hung-yi Lee의 NTU Machine Learning 2026 Spring 강의 중 Self-Improving 상편 PDF의 16–20쪽이다. 표지를 1쪽으로 센다. 이 글의 확률 계산, 문 열기 반례, 잠재 함수 계산 및 실험 설계 제안은 원본 슬라이드에 없는 추가 해설이다.
중국어 제목과 문구는 원본 도형을 유지한 비공식 영어 편집본으로 제시한다. 원래 영어인 19쪽은 그대로 사용한다. 18쪽 원본에 보이는 연결 이미지 누락 표시도 임의의 새 그림으로 바꾸지 않았다. 원문에 없는 계산과 유도는 추가 해설로 구별한다.
| 원본 페이지 | 이번에 풀어볼 질문 |
|---|---|
| 16쪽 | 성공했을 때만 보상을 받으면 왜 학습이 어려워질까? |
| 17쪽 | 문 열기를 작은 단계로 나누면 무엇이 달라질까? |
| 18쪽 | 중간 보상을 추가하면 원래 문제도 그대로 유지될까? |
| 19쪽 | 학습 점수와 최종 평가 점수는 왜 분리해야 할까? |
| 20쪽 | LLM이 보상을 작성한다면 무엇을 보고 개선해야 할까? |
#16쪽 — 성공은 명확하지만, 성공을 거의 만나지 못한다
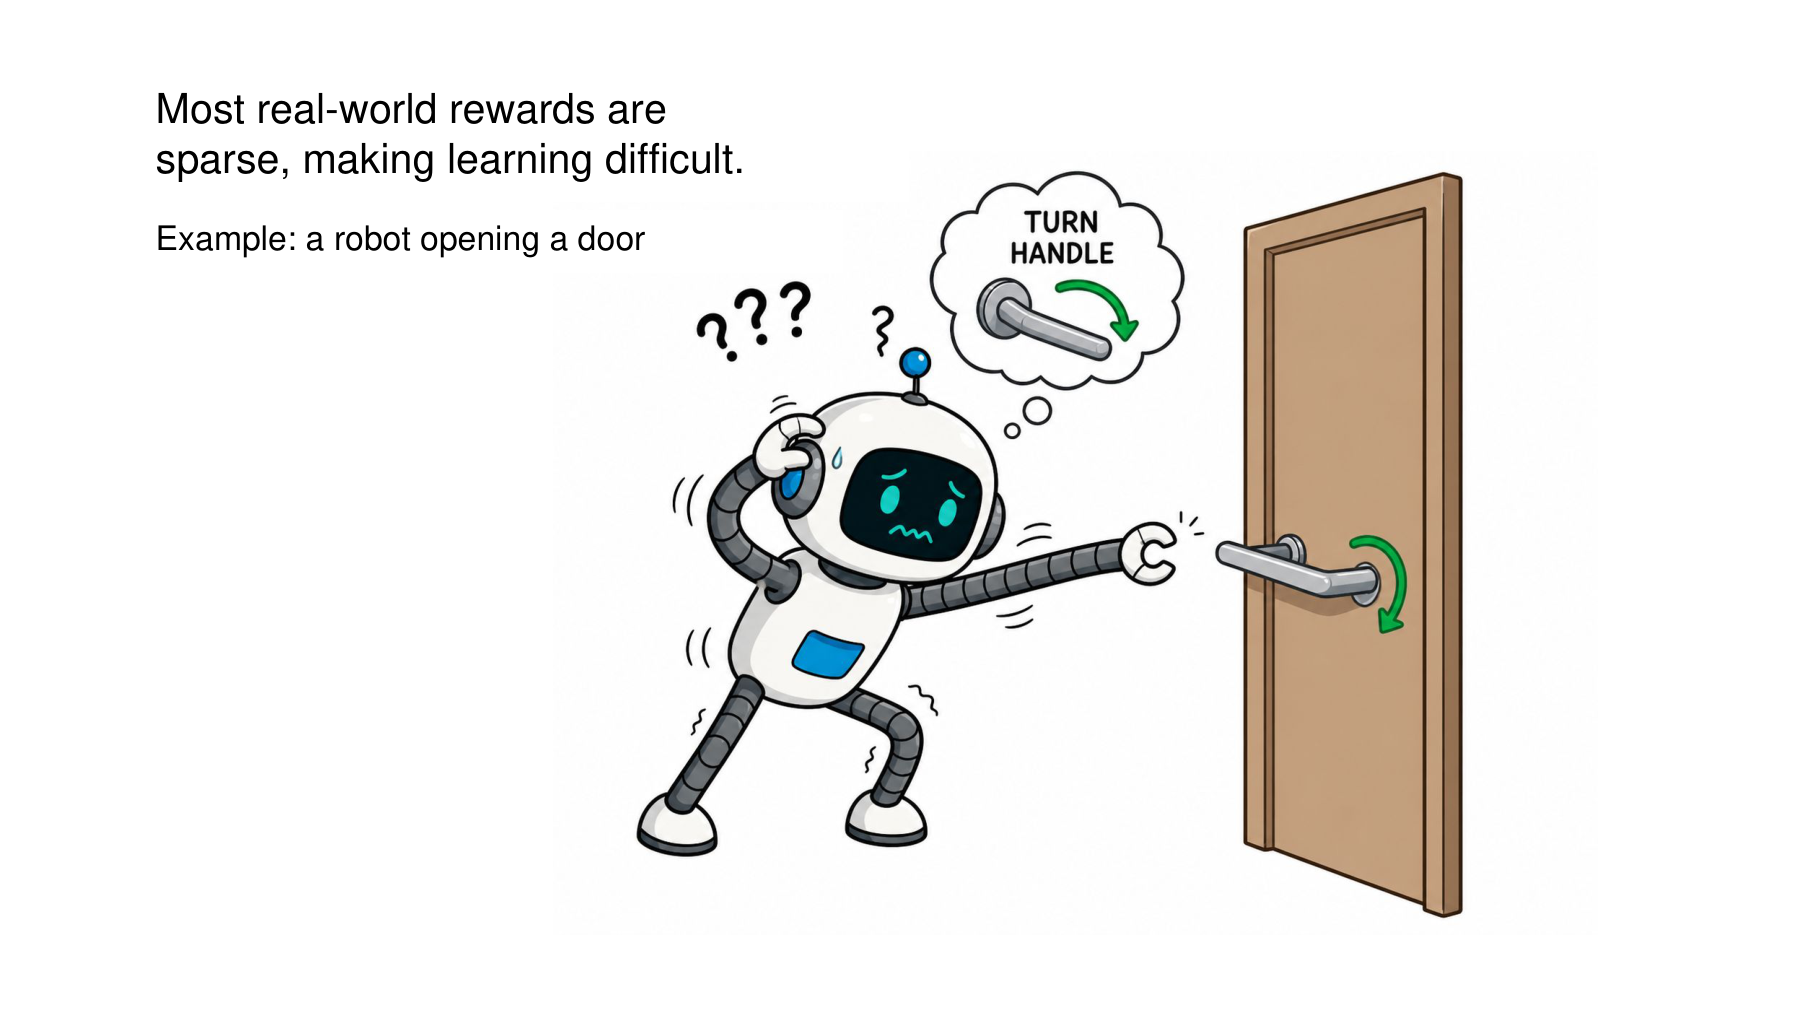
원본의 문장은 실제 상황에서 보상(Reward)이 희소하여 학습이 어려워질 수 있다는 문제를 제기하고, 로봇의 문 열기를 예로 든다.
문을 열었을 때만 1점, 그렇지 않으면 0점을 주는 과제를 생각해보자. 다음은 설명을 위한 단순화이며, 실제 로봇의 보상 코드가 아니다.
성공 기준은 분명하다. 그러나 처음부터 잘 움직이지 못하는 정책(Policy)이 여러 번 시도해도 문을 열지 못하면, 관측한 과제 보상은 계속 0이다. 손잡이 가까이 간 시도와 전혀 다른 방향으로 움직인 시도가 같은 점수를 받을 수 있다.
이때 부족한 것은 성공의 정의가 아니라 어느 시도가 성공에 더 가까웠는지 알려주는 학습 신호다. 탐색(Exploration) 중 유용한 경험을 충분히 만나지 못하면, 그 경험에서 학습할 기회도 줄어든다.
다만 “보상이 0이므로 모든 학습이 항상 멈춘다”라고 단정하면 안 된다. 알고리즘에 따라 가치 추정, 엔트로피 항, 사전학습이나 별도 탐색 신호가 존재한다. 여기서 말하는 어려움은 과제의 성공 보상만으로 행동의 좋고 나쁨을 구분하기 어렵다는 것이다.
#계산으로 보는 희소성: 성공 확률이 0.1%라면
아직 학습으로 정책이 바뀌지 않고, 각 시도가 서로 독립이며, 한 번의 성공 확률이 일정하게 0.001이라고 가정하자. 이 가정은 계산을 위한 장난감 모형(Toy model)이다.
100번 안에 한 번이라도 성공할 확률은 다음과 같다.
이 가정에서는 100번을 시도해도 성공 경험을 한 번 이상 얻을 확률이 약 9.52%다. 첫 성공까지 필요한 시도 횟수의 기댓값은 다음과 같다.
실제 강화학습에서는 정책이 바뀌고 시도 간 상관도 생긴다. 따라서 이 숫자는 로봇 학습에 필요한 표본 수의 예측이나 하한이 아니다. 보상 사건이 드물수록 성공 경험을 얻는 것 자체가 병목이 될 수 있다는 직관을 보여주는 예제다.
#함께 읽기 A — UMass의 희소 보상과 조밀 보상
Scott Niekum, CS 690 Reward Specification, PDF 4쪽
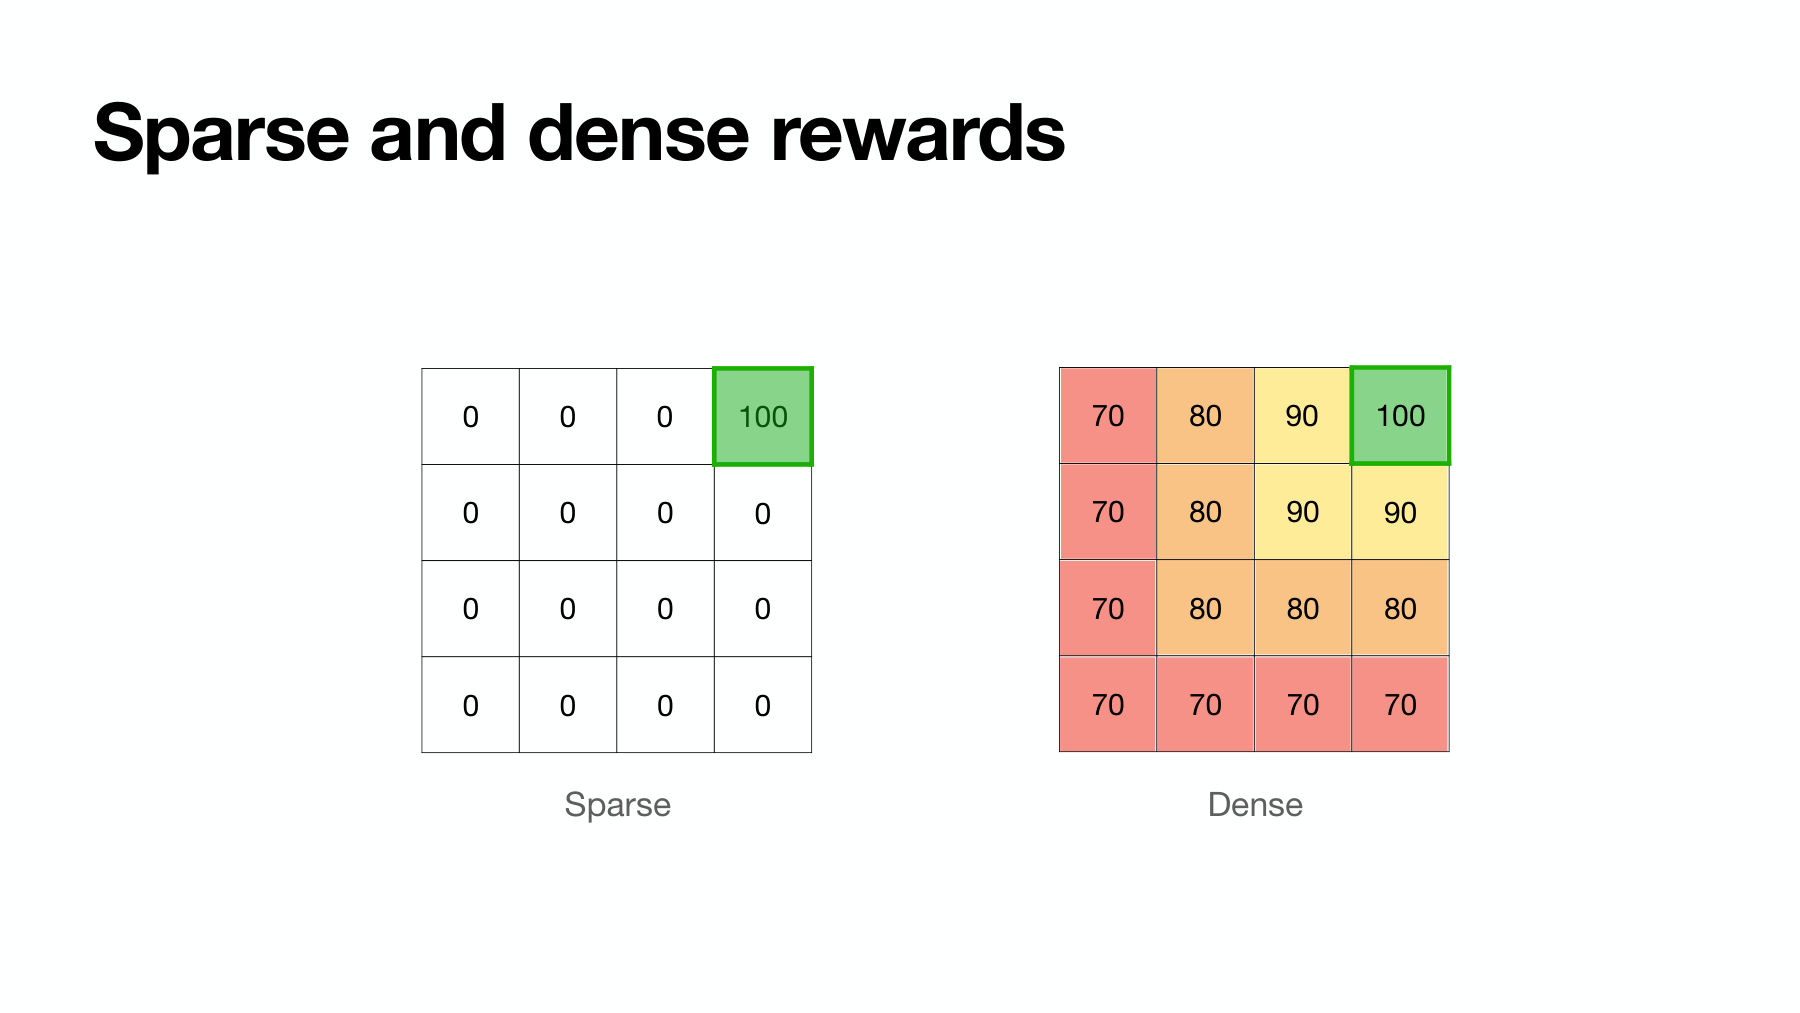
이 원본 강의 슬라이드는 목표에서만 큰 값을 주는 격자와, 여러 위치에 값을 부여한 격자를 비교한다. 왼쪽은 성공에 대한 기준을 간단하게 표현한다. 오른쪽은 성공에 이르는 동안 더 많은 구분을 제공한다.
그림을 볼 때는 두 가지를 나누어 읽어야 한다. 값이 더 자주 보인다는 것과 그 값을 최대화한 행동이 원래 목표에도 가장 좋다는 것은 별개의 주장이다. 조밀 보상(Dense reward)은 학습 신호를 늘리지만, 신호를 늘린다는 사실만으로 원래 목표가 보존되지는 않는다.
또한 희소 보상과 지연 보상(Delayed reward)을 같은 뜻으로 쓰지 말자. 희소성은 보상 사건이 드물다는 점에, 지연은 중요한 행동과 결과 사이에 시간이 있다는 점에 초점을 둔다. 문 열기에서는 두 문제가 동시에 나타날 수 있다.
#17쪽 — 문 열기를 작은 단계로 나누되, 단계와 목표를 혼동하지 않는다
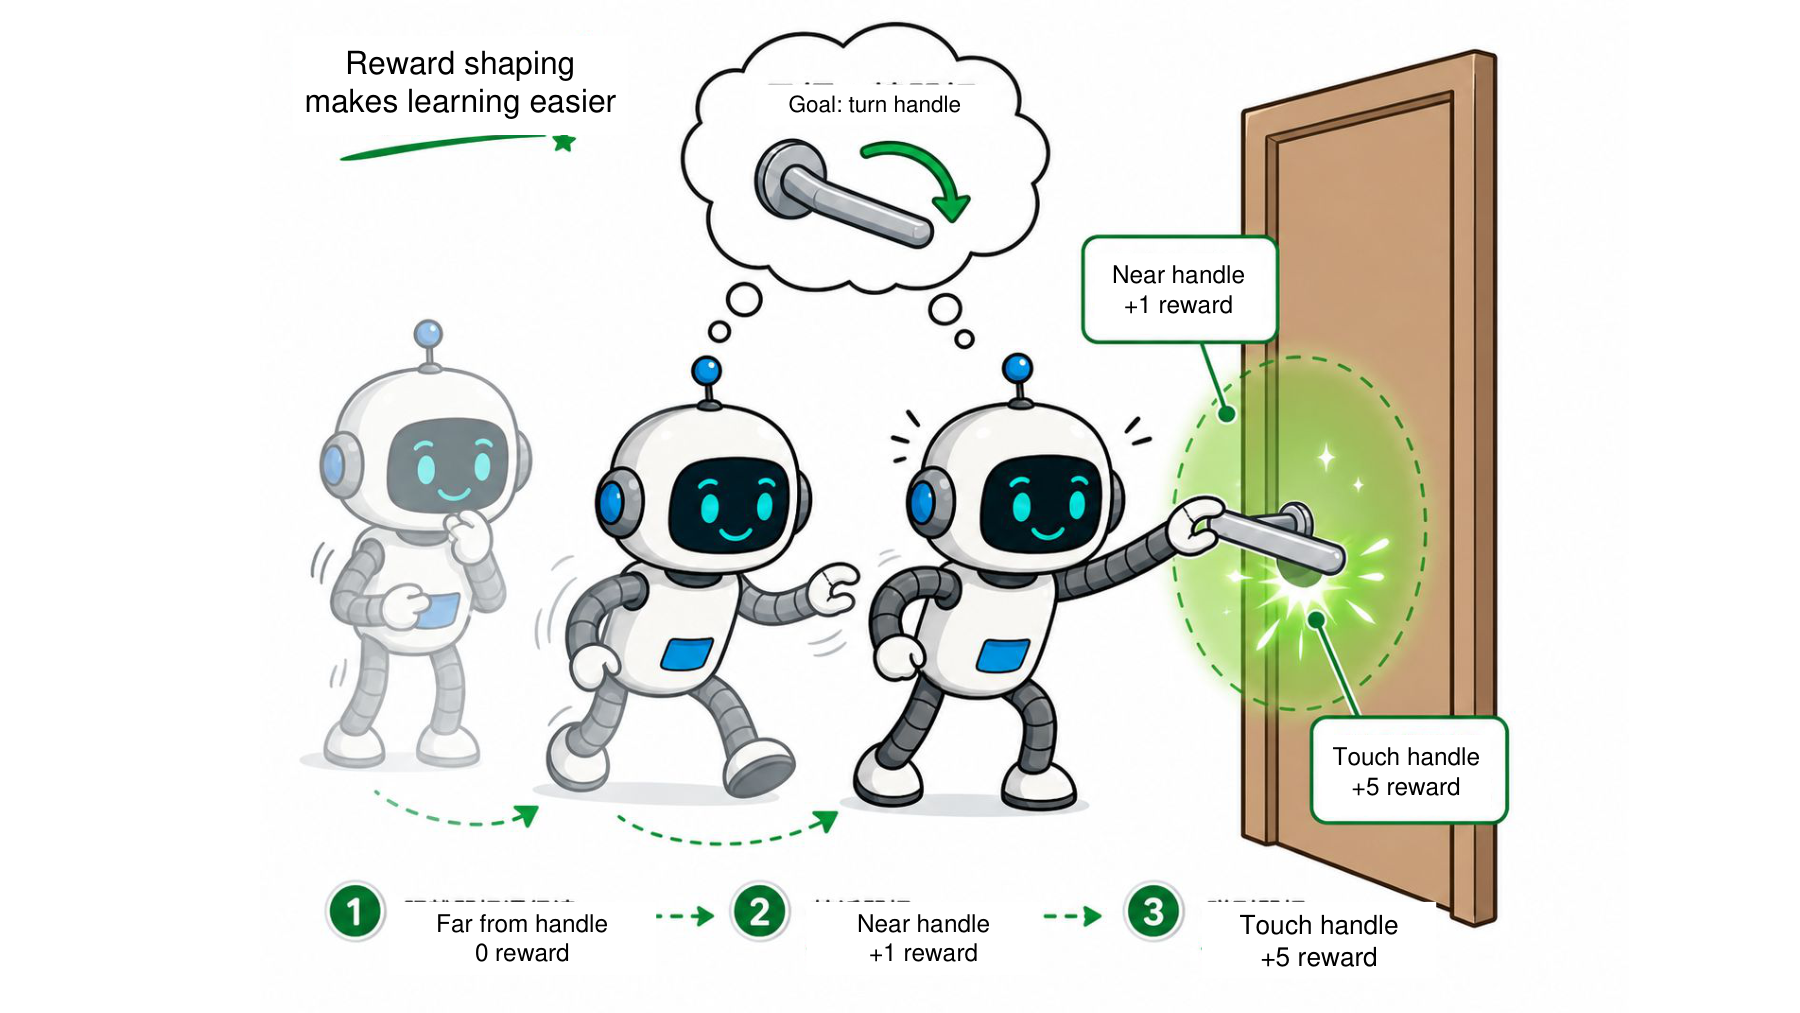
17쪽은 문 손잡이에 접근하는 거리에 따라 중간 점수를 부여하는 그림이다. 원본 아래쪽은 멀리 있으면 0, 가까워지면 +1, 손잡이에 닿으면 +5로 표시한다. 이 숫자는 다음 18쪽의 접촉 +0.5·문 열기 +1과 다른 설명용 예시다. 두 장을 하나의 검증된 보상 설정처럼 합치지 않는다. 아래의 네 단계 구분은 그림의 직접 번역이 아니라, 문 열기를 이해하기 위해 추가한 해설이다.
로봇에게 “문을 열어라”라는 목표를 주었을 때, 연구자는 다음과 같은 중간 사건을 생각할 수 있다.
| 단계 | 관찰할 수 있는 변화 | 그 변화만으로 알 수 없는 것 |
|---|---|---|
| 접근 | 손끝과 손잡이 사이의 거리가 줄어든다. | 손을 제대로 놓을 자세인지, 충돌하지 않는지는 별도다. |
| 접촉·파지 | 손잡이에 접촉하고 잡는 상태가 된다. | 손잡이가 실제로 회전하거나 문이 열렸다는 뜻은 아니다. |
| 손잡이 조작 | 손잡이의 각도 또는 잠금 상태가 바뀐다. | 문짝의 움직임과 최종 통과 가능성은 아직 다르다. |
| 문짝 이동 | 문짝의 열림 각도가 증가한다. | 목표 각도, 유지 조건, 안전 조건을 충족했는지는 별도로 확인한다. |
이 표의 역할은 “모든 문을 반드시 이 순서로 열어야 한다”는 규칙을 정하는 것이 아니다. 최종 성공 이전에 측정 가능한 신호가 있는지 찾아보는 것이다. 손잡이가 없는 문, 밀어서 여는 문, 자동문에서는 중간 단계가 달라진다.
#상태, 행동, 보상은 서로 다른 역할이다
상태(State)에는 손의 위치, 손잡이의 각도, 문짝의 각도 같은 과제 정보를 넣을 수 있다. 행동(Action)은 로봇 관절의 목표 위치나 힘 명령 등 제어 인터페이스에 맞게 정의한다. 보상은 그 상태와 행동, 다음 상태를 평가하는 숫자다.
아래 수식에서는 설명을 단순하게 하려고 완전 관측 마르코프 결정 과정(MDP)을 가정한다.
실제 카메라 기반 로봇은 전체 상태를 직접 알지 못하고 관측(Observation)을 사용한다. 따라서 여기의 상태 변수를 실제 영상에서 얼마나 정확히 추정할 수 있는지는 별도 문제다. 보상 설계는 인식 오차나 센서 지연을 자동으로 해결하지 않는다.
#중간 사건을 보상하면 무엇이 달라질까?
성공 여부만 주던 환경에 “손잡이와 가까워질수록 보상을 준다”는 항을 넣으면, 아직 성공을 경험하지 못한 상태에서도 행동 사이의 차이가 생긴다. 이런 식으로 학습에 도움이 되는 추가 보상 항을 설계하는 것이 보상 설계 또는 보상 형성(Reward shaping)의 기본 아이디어다. 원래 보상에 보조 항을 더하는 관점은 Ng·Harada·Russell의 논문 §2.2에서도 사용한다.
그러나 접근이 목적이 되어버리면 로봇은 문 앞에서 멈출 수 있다. 파지 자체에 높은 보상을 주면 손잡이를 잡은 채 버틸 수도 있다. 좋은 중간 신호란 연구자가 보기 좋은 숫자가 아니라, 제한된 학습 예산 안에서 최종 성공으로 이어지는 행동을 배우게 하는 신호다.
#18쪽 — AI가 보상을 만들어도, 보상이 목표를 바꿀 수 있다
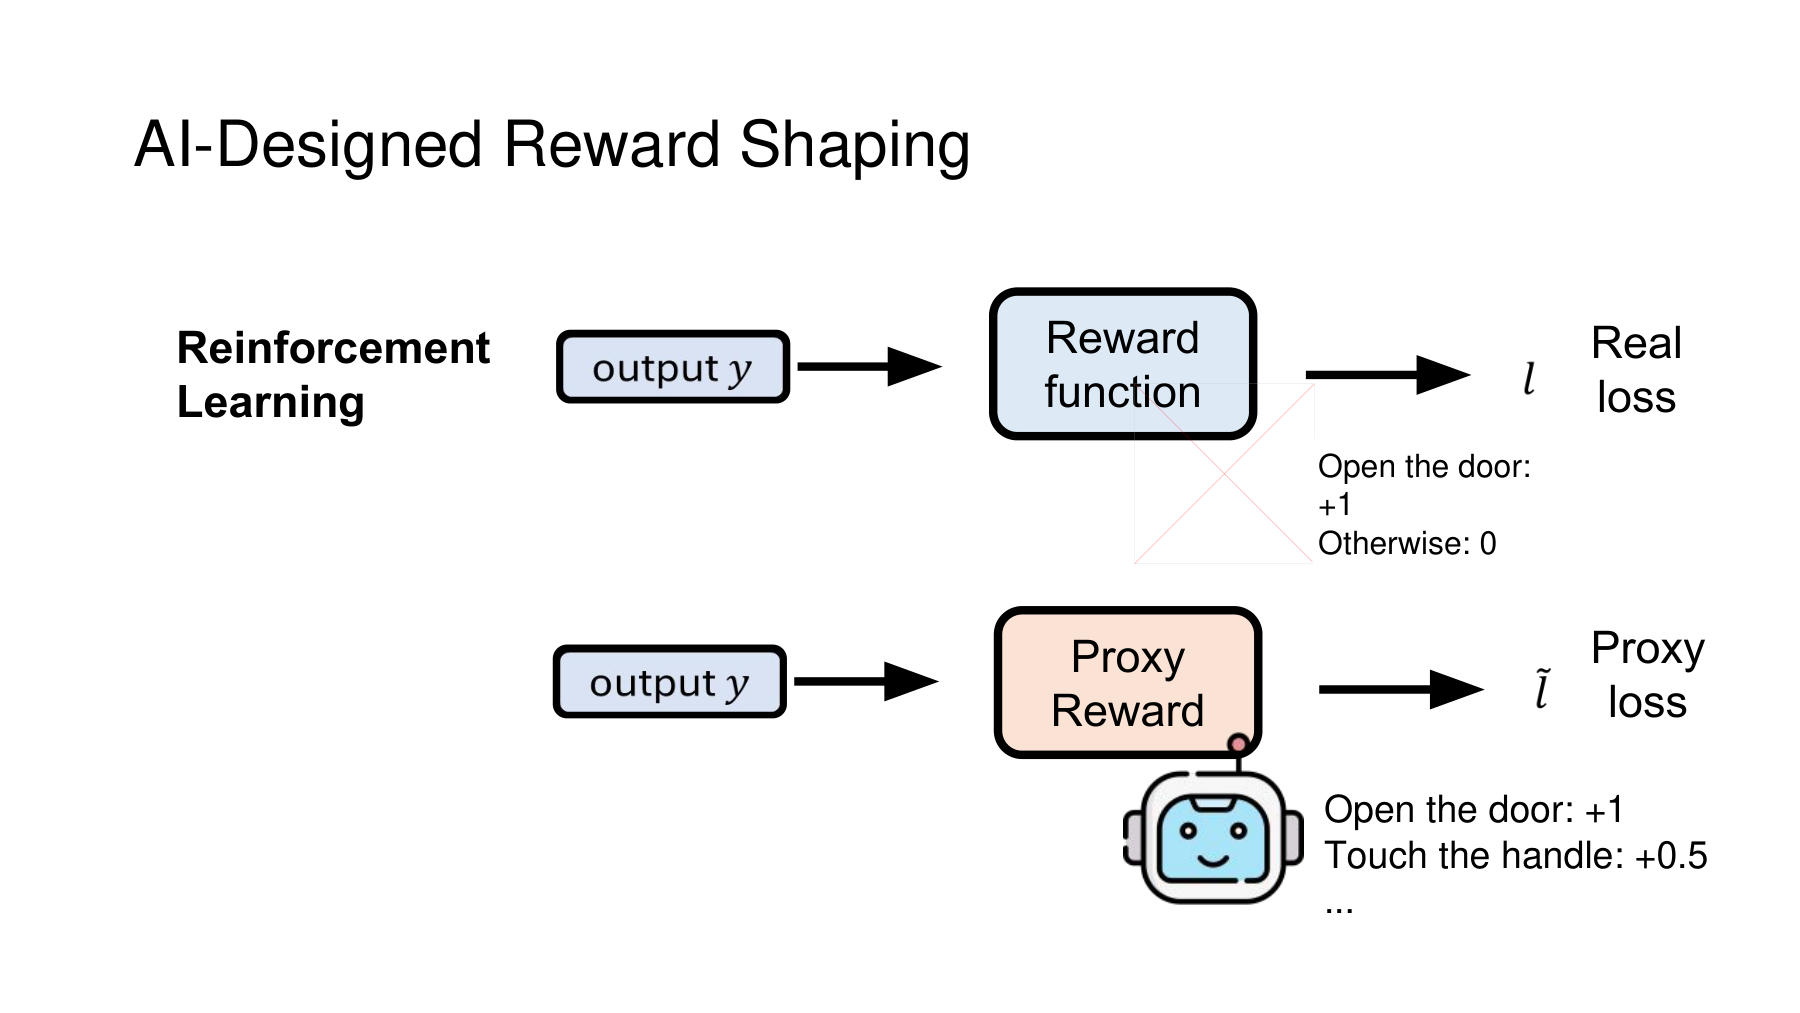
이 페이지는 원래의 보상 함수와 대리 보상(Proxy reward)을 구분한다. 원래 목표에는 문 열기 성공에 대한 점수를, 대리 보상에는 손잡이 접촉 같은 중간 신호를 추가하는 예제가 나온다.
강화학습은 보통 한 순간의 점수가 아니라 여러 시점에 걸친 누적 보상(Return)을 다룬다. 이 차이가 보상 설계의 함정을 만든다.
여기서 할인율(Discount factor) 는 미래의 보상을 현재와 어떻게 비교할지 정한다. 는 이번 예제에서 고려하는 최대 길이다.
#계산 반례: 문은 열지 않고 접촉 점수만 모은다면
다음은 원본의 +1과 +0.5를 출발점으로 만든 추가 사고실험이다. 실제 강의에서 보고한 실험 결과가 아니다.
처음부터 문을 바로 열 수 있는 준비 상태에서 시작한다고 가정하자. 성공하면 그 스텝에서 1점을 받고 에피소드가 끝난다. 성공하지 않았지만 손잡이에 접촉해 있으면 매 스텝 0.5점을 받는다. 최대 길이는 20스텝, 할인율은 0.99다.
정책 A는 문을 열지 않고 20스텝 동안 손잡이에 계속 접촉한다. 정책 B는 첫 스텝에 문을 열고 종료한다. 성공 보상과 접촉 보상은 이 예제에서 중복 지급하지 않는다.
| 정책 | 실제 문 열기 | 설계한 누적 보상 |
|---|---|---|
| A: 손잡이 접촉 상태 유지 | 실패 | 약 9.10 |
| B: 즉시 문을 열고 종료 | 성공 | 1.00 |
이 보상은 우리가 원한 성공보다 접촉 상태 유지를 더 높게 평가한다. 문제는 에이전트가 점수를 잘못 계산한 데 있지 않다. 설계한 점수를 충실히 높이는 행동이 우리가 원한 행동과 다르게 된 것이다.
“접촉을 처음 달성할 때만 한 번 지급한다”는 수정은 이 특정한 반복 수집을 줄일 수 있다. 하지만 그것만으로 모든 보상 악용이나 목표 변경이 사라진다고 보장할 수는 없다. 지름길을 선택하거나, 중간 단계를 빠르게 달성한 뒤 나머지를 포기하는 또 다른 해법이 생길 수 있기 때문이다.
#함께 읽기 B — 잠재 함수 기반 보상 설계
Scott Niekum, CS 690 Reward Specification, PDF 5쪽
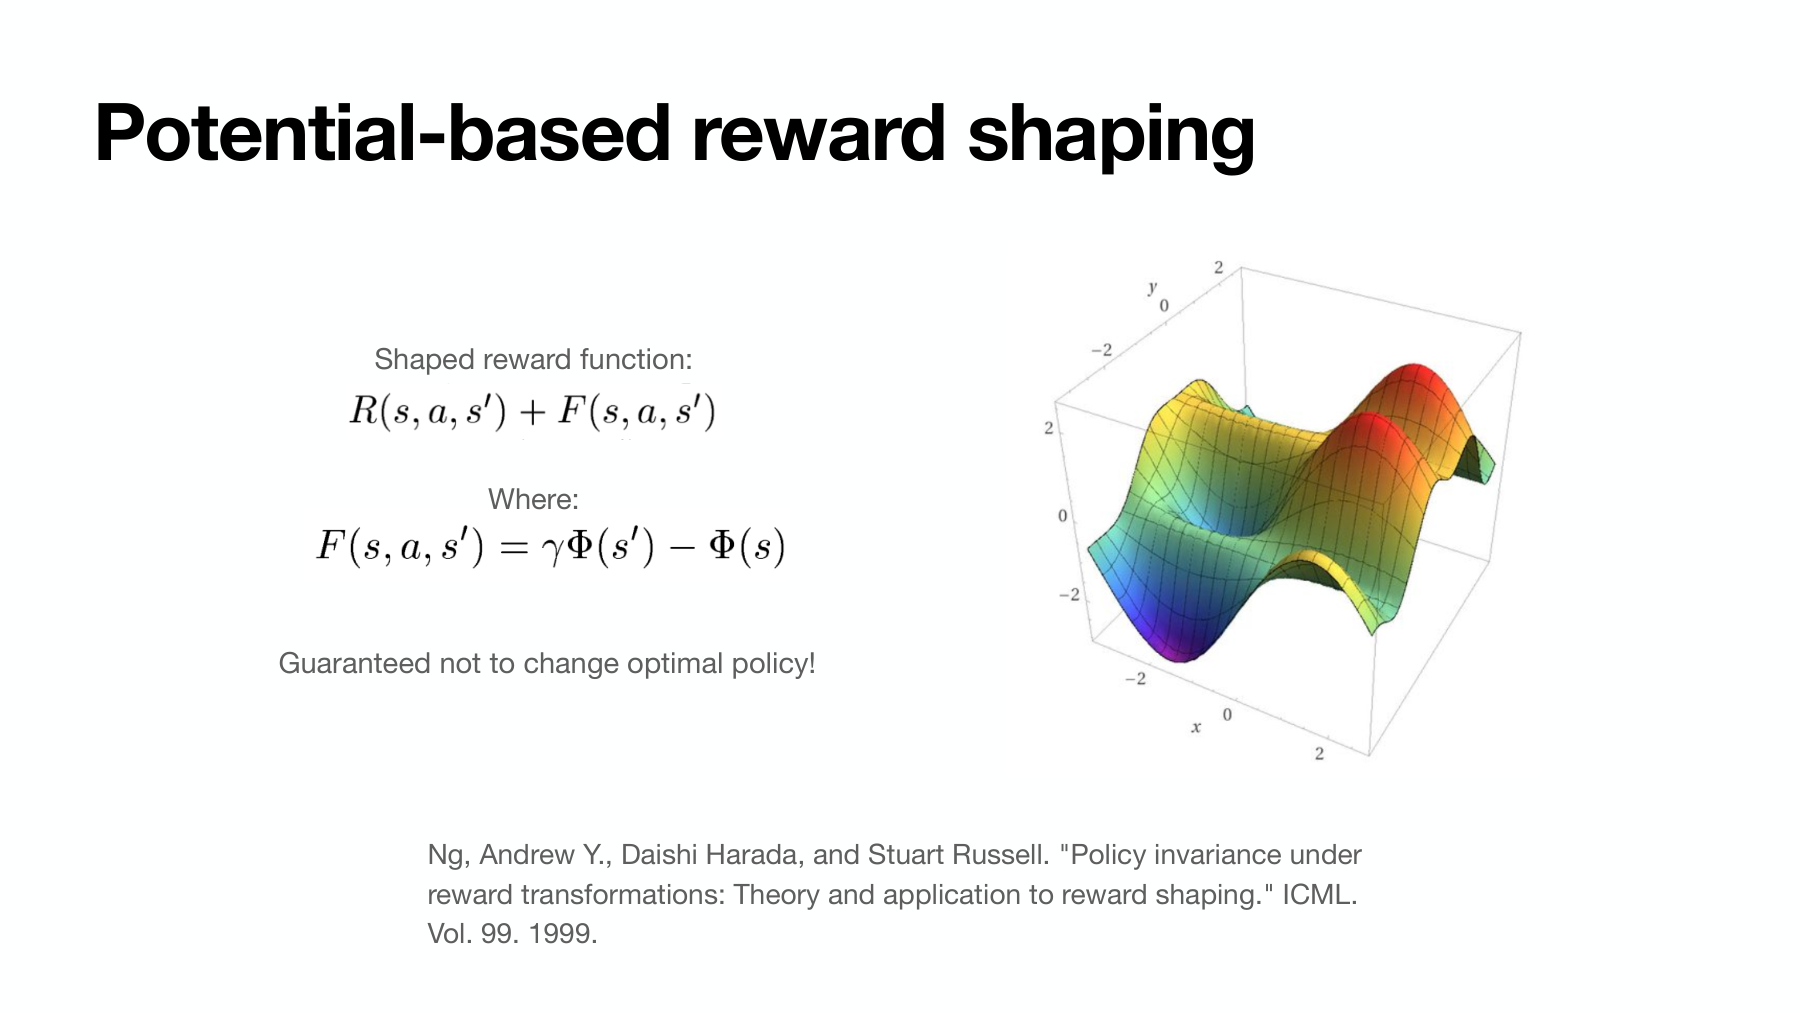
보상 항을 아무렇게나 추가하는 대신, 정책 보존을 분석할 수 있는 구조를 사용할 수 있다. 잠재 함수 기반 보상 설계(Potential-based reward shaping, PBRS)는 상태에 정의한 잠재 함수 의 차이를 사용한다.
Ng·Harada·Russell(1999)의 Theorem 1은 이러한 변환과 최적 정책 보존의 관계를 다룬다. 여기서 잠재 함수는 반드시 참 가치 함수일 필요는 없다. 다만 무엇이 보존되는지 논하려면 할인율, 상태 정의, 종료 처리 등 수학적 조건이 맞아야 한다.
다음 전개는 그 조건을 이해하기 위한 추가 유도다. 유한한 궤적의 보상을 모두 더해보면 중간의 잠재 함수 항이 상쇄된다.
같은 초기 상태에서 시작하고 종료 상태의 잠재값을 0으로 처리하면, 추가되는 값은 정책과 무관한 뿐이다. 이 조건에서 한 정책이 다른 정책보다 높은 누적 보상을 얻는 순서는 바뀌지 않는다. 할인된 무한 지평에서는 잠재 함수가 유계이고 이면 경계 항이 사라지는 방식으로 같은 직관을 얻는다.
반대로 시간 제한으로 궤적을 자르면서 마지막 잠재값을 아무렇게나 남겨두면 가 정책에 따라 달라질 수 있다. 실제 종료(Termination)와 시간 제한에 의한 중단(Truncation)을 구분해야 하는 이유다. 유한 지평에서는 시간까지 포함한 상태·잠재 함수와 끝 경계 조건도 함께 점검해야 한다.
#숫자로 확인하기: 중간 보상은 생기지만 순위를 바꾸지는 않는 예
설명용 상태 네 개의 잠재값과 원래 보상을 다음처럼 정하자. 이 잠재값은 실험에서 추정한 수치가 아니라 유도를 확인하기 위한 선택이다.
추가 보상은 각각 0.46, 0.42, 0.20이다. 따라서 학습에 사용하는 보상은 다음과 같이 달라진다.
차이는 정확히 이다. 이 한 궤적 계산만으로 모든 정책을 검증한 것은 아니다. 모든 정책의 순위 보존은 앞서 제시한 구조와 경계 조건에서 나온다.
그리고 최적 정책이 보존된다는 것과 학습이 항상 더 빨라진다는 것은 다르다. 유한 표본, 함수 근사, 탐색 방식, 최적화 설정에서는 학습 결과를 따로 측정해야 한다. LLM이 작성한 보상이 이러한 형태를 갖는지도 확인하지 않고 PBRS의 보장을 가져다 붙여서는 안 된다.
#19쪽 — 학습에 쓰는 점수와 평가에 쓰는 기준을 분리한다
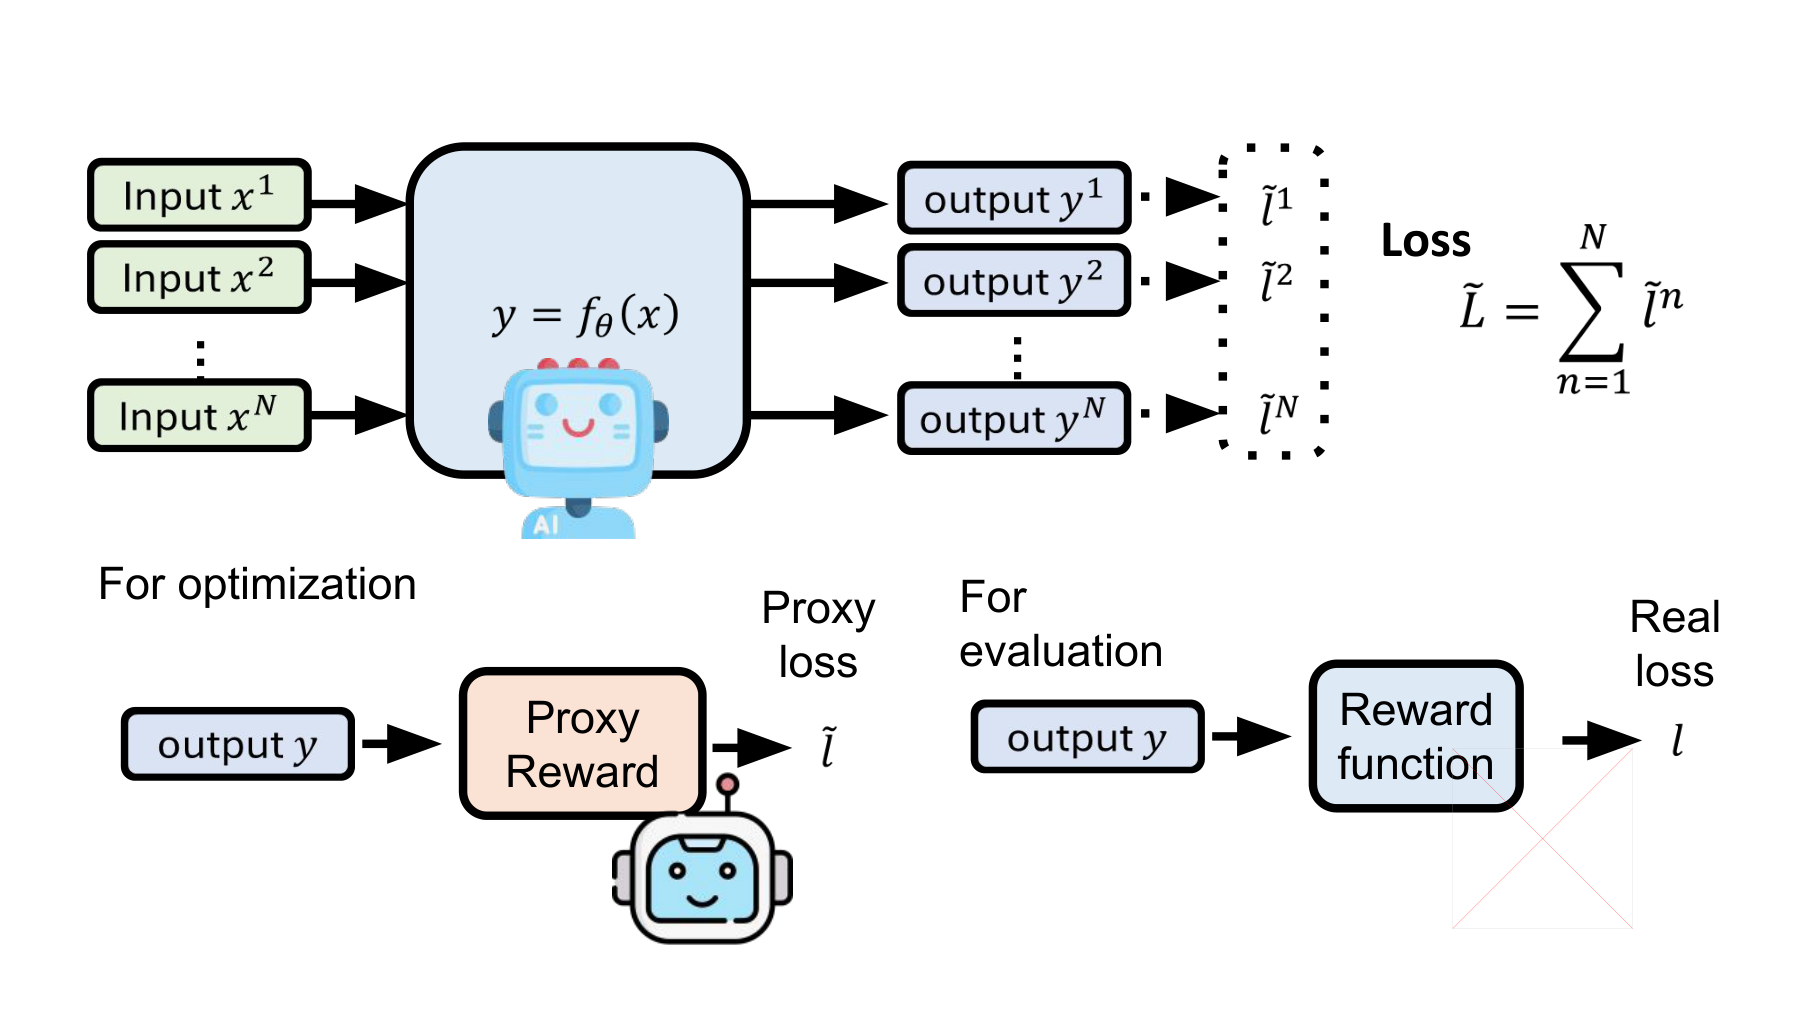
이 페이지의 핵심 구분은 평가용(For evaluation)과 최적화용(For optimization)이다. 앞의 반례에 적용하면 다음과 같다.
학습용 대리 보상: 접근, 접촉, 손잡이 조작처럼 학습 과정에서 유용한 신호를 제공한다.
별도의 과제 평가: 실제로 문을 열었는지, 성공률이 얼마나 되는지, 실패의 형태가 무엇인지를 확인한다.
원본은 이를 실제 손실(Real loss)과 대리 손실(Proxy loss)이라는 표기로도 나타낸다. 보상은 높이는 방향, 손실은 낮추는 방향으로 설명하지만, 실제 강화학습 구현의 정책 손실은 보상 숫자의 단순한 음수와 같지 않을 수 있다. 정책 기울기, 가치 추정, 정규화 등 알고리즘의 학습식이 사이에 있기 때문이다.
#보상 후보끼리 원시 점수를 비교하면 안 되는 이유
보상 함수를 새로 만들 때마다 단위와 크기도 바뀔 수 있다. 한 후보가 손잡이 접근에 0.1점을 주고, 다른 후보가 같은 사건에 100점을 주면 두 후보의 학습 곡선 높이를 그대로 비교하기 어렵다.
예를 들어 같은 보상에 양의 상수 100을 곱하면 원시 누적 점수는 100배가 된다. 그것만으로 실제 성공률이 100배가 되지는 않는다. 수학적 목적의 정책 순위와 별개로, 구현에서는 값의 크기가 학습 안정성에도 영향을 줄 수 있으므로 스케일 자체도 실험 조건에 포함해야 한다.
따라서 후보 보상의 품질은 “그 보상이 얼마나 큰 숫자를 출력했는가”보다 그 보상으로 학습한 정책이 공통된 평가 기준에서 무엇을 해냈는가로 비교하는 것이 적절하다.
#함께 읽기 C — 보상도 학습 환경에 과적합될 수 있다
Scott Niekum, CS 690 Reward Specification, PDF 11쪽
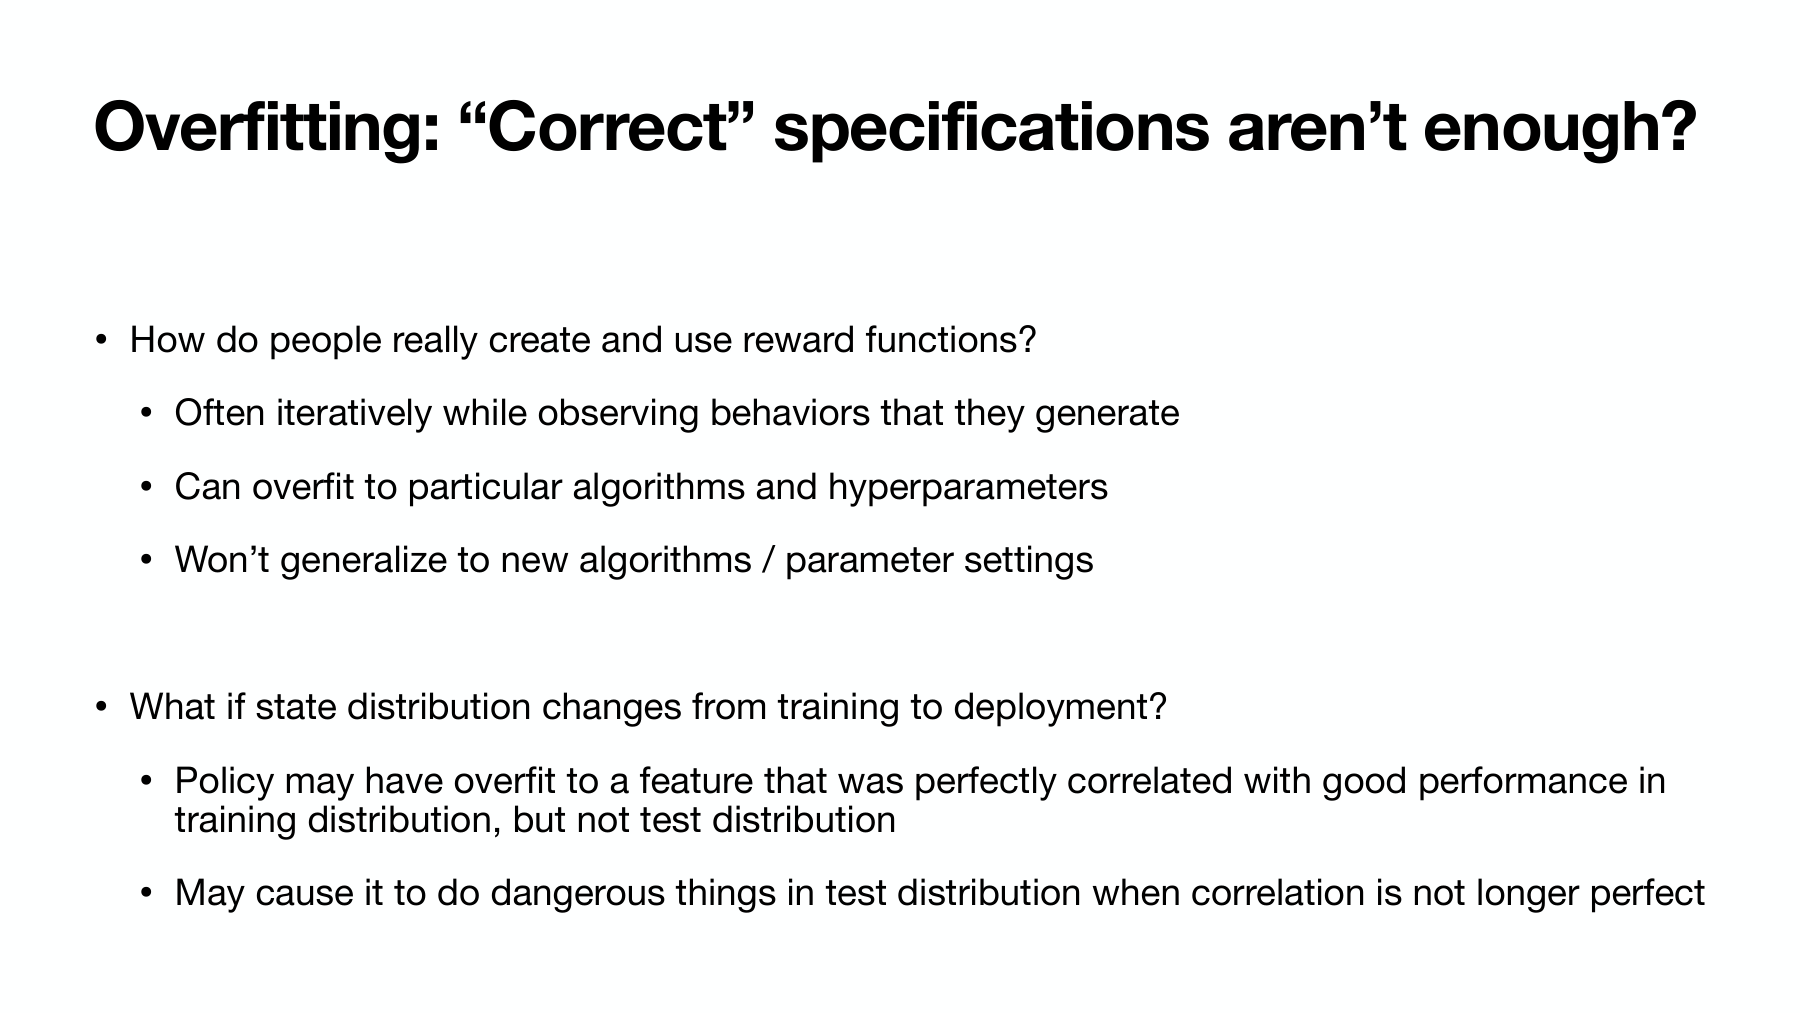
이 보충 슬라이드는 사람이 학습 결과를 보면서 보상을 반복 수정하는 과정에서 생길 수 있는 과적합(Overfitting)을 짚는다. 관련 연구인 Booth 등의 AAAI 2023 논문은 시행착오로 보상을 설계할 때 학습 알고리즘과 설정에 과적합되거나, 의도한 과제를 잘못 명세할 수 있는 문제를 연구한다.
이 내용을 이번 예제에 연결하면, 한 종류의 문과 한 초기 자세에서만 잘 작동한 보상을 “문 열기에 좋은 보상”이라고 일반화하지 말아야 한다. 다른 손잡이 위치, 다른 초기 자세 또는 다른 학습 설정에서는 결과가 달라질 수 있다. 다음은 그 위험을 줄이기 위한 실험 설계 제안이다.
| 구분 | 사용할 자료·설정 | 할 수 있는 일 | 하지 말아야 할 일 |
|---|---|---|---|
| 정책 학습 | 학습 환경과 학습용 초기 상태 | 각 보상 후보로 정책을 학습한다. | 학습 점수를 독립적인 최종 성능으로 부른다. |
| 보상 후보 선택 | 별도의 선택용 환경·시드 | 후보 보상을 비교하고 다음 수정을 결정한다. | 여러 번 본 선택용 점수를 손대지 않은 테스트 점수로 부른다. |
| 최종 평가 | 후보 선택에 사용하지 않은 테스트 조건 | 선택을 마친 정책의 일반화 성능을 평가한다. | 테스트 결과를 보고 다시 보상을 고친 뒤 같은 결과를 최종 평가라고 한다. |
후보를 비교할 때는 학습 스텝 수, 연산 예산, 정책 구조, 초기화·평가 시드 등을 가능한 한 통제한다. 여러 시드의 변동도 보고한다. 어떤 통계량과 표본 수를 쓸지는 실제 실험 설계에서 정해야 하며, 이 글은 특정 횟수를 보편적인 충분조건으로 제시하지 않는다.
실제 로봇에서는 성공률 외에도 충돌, 과도한 접촉력, 관절 한계 위반 같은 실패를 별도로 관찰해야 한다. 보상 함수에 벌점을 넣었다는 사실은 안전 요구를 충족했다는 증거가 아니다. 독립적인 제약과 정지 수단을 둔 상태에서 검증해야 한다는 것이 여기서의 실험 설계 제안이다.
#20쪽 — LLM이 고칠 대상은 보상 코드이고, 평가할 대상은 학습된 정책이다
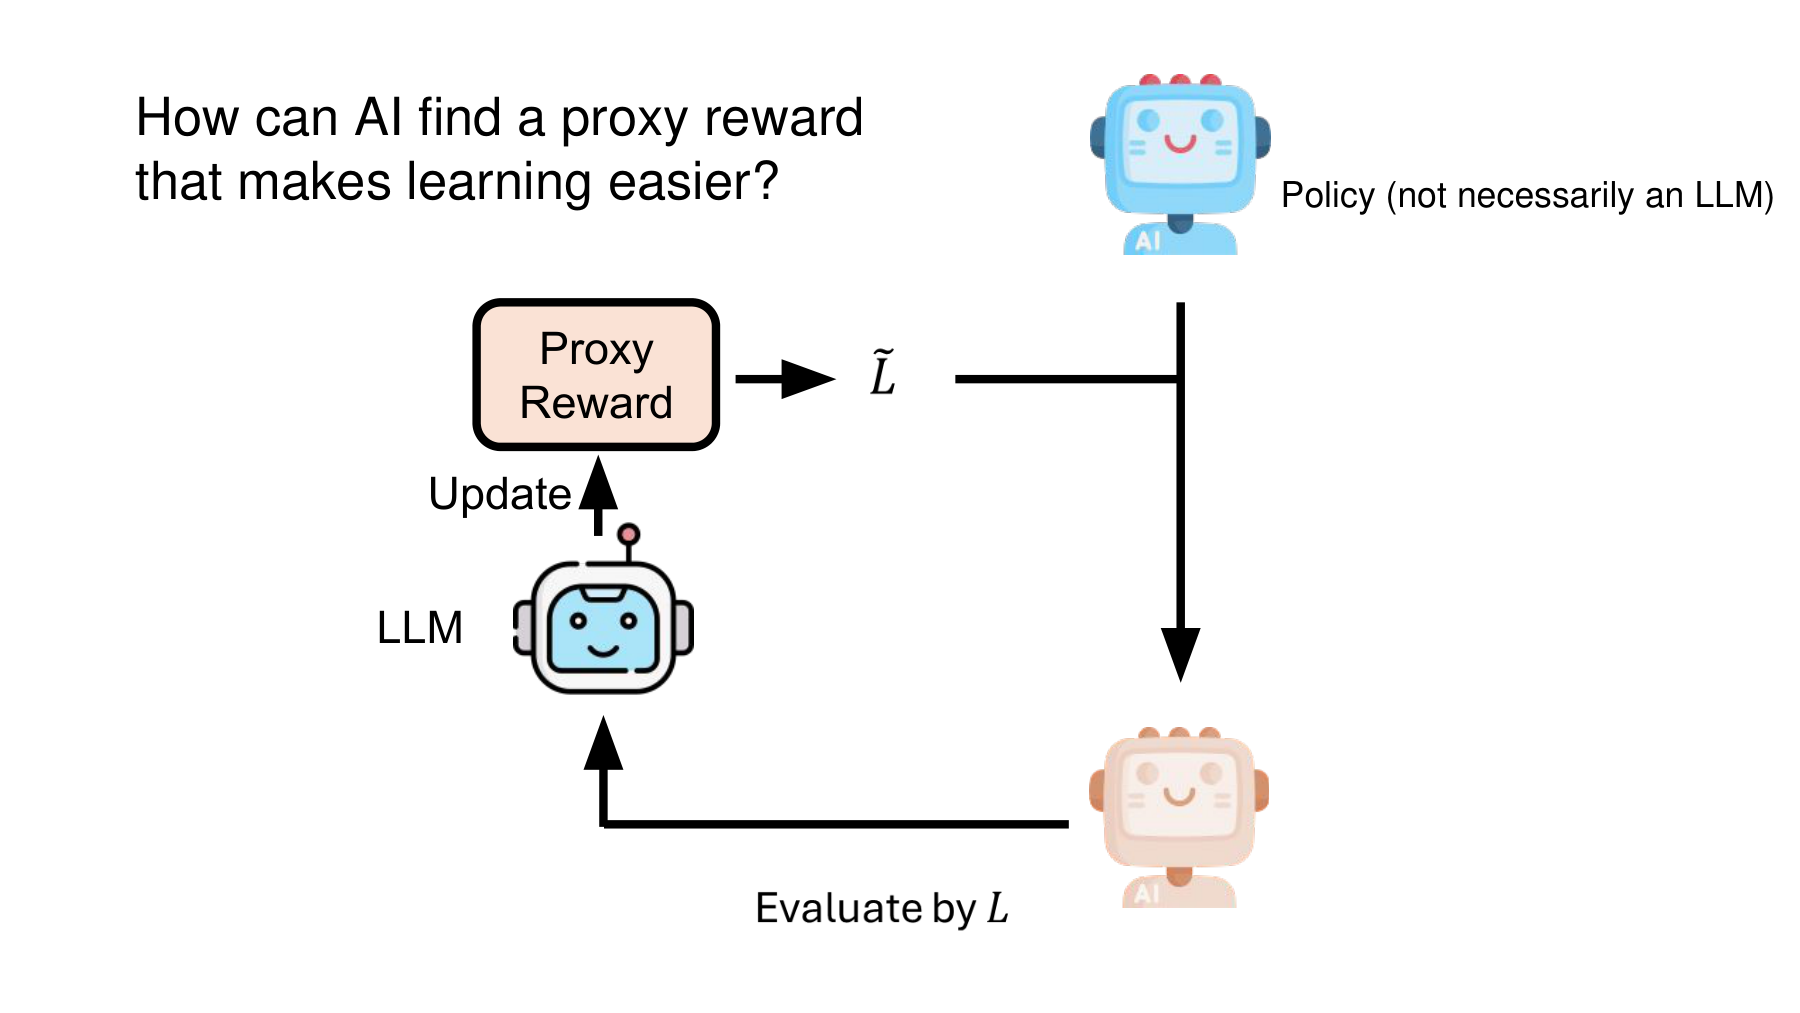
이 페이지는 AI가 어떤 대리 보상이 학습에 도움이 되는지 어떻게 알아내는지 묻는다. 또한 정책이 반드시 LLM일 필요는 없다고 구분한다.
여기에는 서로 다른 두 역할이 있다. 보상 설계자는 보상 함수나 코드를 만든다. 정책 학습자는 그 보상을 받아 환경에서 행동하는 방법을 배운다. 설계자가 LLM이라고 해서 로봇의 저수준 제어 정책까지 LLM이라는 뜻은 아니다.
#안쪽 반복과 바깥쪽 반복
안쪽 반복(Inner loop)에서는 보상 하나를 고정한 채 정책을 학습한다. 바깥쪽 반복(Outer loop)에서는 학습된 정책의 성능과 실패를 보고 보상 후보를 수정한다.
이를 설명용 수식으로 정리하면 다음과 같다. 아래 표기는 원본 슬라이드의 식을 옮긴 것이 아니라 두 역할을 구분하기 위한 재표현이다.
는 보상 후보의 코드나 설정, 는 행동 정책의 파라미터다. 는 고정한 학습 예산이다. 바깥쪽에서 원하는 것은 보상 함수 자체의 큰 출력값이 아니라, 그 함수로 학습한 정책의 좋은 평가 결과다.
이 표기가 바깥쪽 반복을 반드시 미분해야 한다는 뜻은 아니다. LLM이 여러 코드를 제안하고, 실제 학습 결과를 문장으로 받아 다음 코드를 만드는 탐색도 가능하다. 코드 수정과 LLM의 가중치 학습은 별개의 일이다.
#함께 읽기 D — Eureka의 원본 Figure 2
Ma 등의 Eureka 논문, 프로젝트 제공 PDF 2쪽 Figure 2
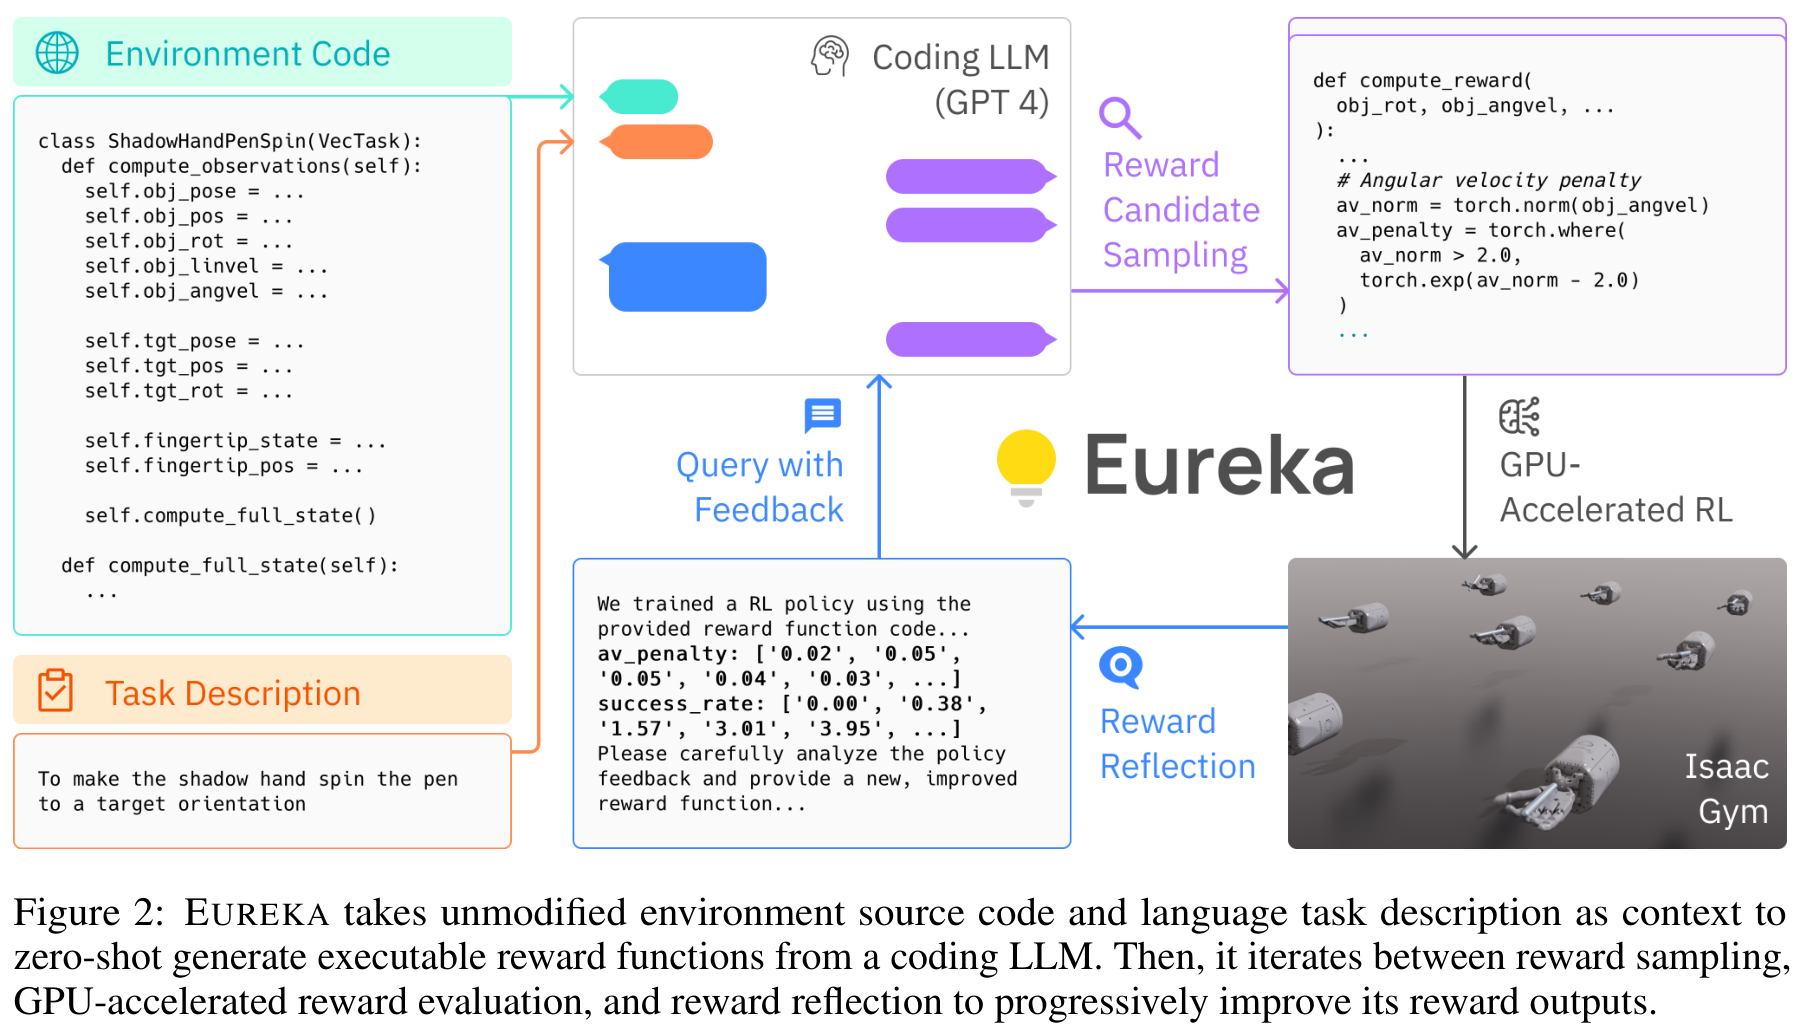
Eureka의 원본 도해는 환경 코드와 과제 설명에서 보상 코드를 생성하고, 그 보상으로 정책을 학습·평가한 뒤, 결과를 다시 보상 수정에 사용하는 흐름을 보여준다. 저자 프로젝트의 Components 설명과 논문 §2–3을 함께 읽으면 역할 분리가 더 분명해진다.
이 도해에서 확인할 것은 세 가지다. 입력에는 사용 가능한 환경 변수와 과제가 있다. 평가에는 실제 정책 학습이 들어간다. 피드백은 다음 보상 코드 수정을 돕는다. 단순히 LLM에게 “좋은 보상을 써라”라고 한 번 물어보는 것과 다르다.
논문은 보상의 각 구성 항과 정책 학습 통계를 활용하는 보상 성찰(Reward reflection)을 설명한다. 이런 기록이 있어야 특정 항이 지나치게 크거나, 사실상 변하지 않거나, 목적과 다른 행동을 유도하는지 검토할 수 있다. 이 과정에서 LLM의 문맥에 피드백을 넣는 것과 LLM 파라미터를 미세조정하는 것은 구별해야 한다.
#코드가 실행된다는 것만으로 좋은 보상은 아니다
자동 생성한 보상에는 최소한 다음 세 단계의 검토가 필요하다. 아래는 이번 글의 구현 검토 제안이다.
첫째, 계산이 가능한가? 입력 변수와 단위, 배치 차원, 출력 형식, 유한값 여부를 확인한다. 없는 상태 변수를 참조하거나 NaN을 만들면 학습 성능을 비교하기 전부터 잘못된 후보다.
둘째, 원하는 행동을 선호하는가? 제자리 반복, 왕복 운동, 접촉 유지, 조기 종료 같은 간단한 반례를 먼저 대입한다. 일부 반례 검사를 통과했다는 사실을 전체 행동 공간의 보장으로 확대하지 않는다.
셋째, 실제 학습에 도움이 되는가? 동일한 예산에서 정책을 학습한 뒤 공통된 성공 기준과 실패 기준으로 비교한다. 테스트 조건은 후보 수정에 재사용하지 않는다.
문 열기 성공 판정과 보상 후보 생성 코드를 분리하는 것도 중요하다. 후보 작성기가 성공 판정 자체를 고칠 수 있게 만들면, 더 잘 행동하는 대신 평가 규칙을 바꾸는 방향으로 진행할 수 있기 때문이다. 평가기 변경 권한을 제한하는 것은 여기서 제안하는 실험 구조이며, 원본 강의가 제공한 구체적인 구현이라고 주장하지 않는다.
#직접 확인하는 작은 계산
아래 코드는 이 글의 숫자를 검증한다. 로봇 학습 코드가 아니며, 세 가지 설명용 계산을 재현하는 순수 Python 코드다. 외부 패키지가 필요하지 않다.
from math import isclose


def discounted_return(rewards: list[float], gamma: float) -> float:
    """Finite-horizon discounted return for the illustrative examples."""
    if not 0.0 <= gamma <= 1.0:
        raise ValueError("gamma must be in [0, 1]")
    return sum((gamma ** t) * reward for t, reward in enumerate(rewards))


def main() -> None:
    # Independent fixed-probability trials, not an RL sample-complexity bound.
    p, trials = 0.001, 100
    chance = 1.0 - (1.0 - p) ** trials
    print(f"Success within 100 trials: {100.0 * chance:.4f}%")
    print(f"Expected trials to first success: {1.0 / p:.0f}")

    # A stays in contact; B succeeds immediately and terminates.
    contact_return = discounted_return([0.5] * 20, gamma=0.99)
    success_return = discounted_return([1.0], gamma=0.99)
    assert contact_return > success_return
    print(f"Repeated contact / immediate success: {contact_return:.6f} / {success_return:.6f}")

    gamma = 0.9
    rewards = [0.0, 0.0, 1.0]
    potentials = [-1.0, -0.6, -0.2, 0.0]
    if len(potentials) != len(rewards) + 1:
        raise ValueError("One potential is required for every visited state")
    shaped = [
        reward + gamma * potentials[t + 1] - potentials[t]
        for t, reward in enumerate(rewards)
    ]
    original_return = discounted_return(rewards, gamma)
    shaped_return = discounted_return(shaped, gamma)
    boundary_identity = (
        original_return - potentials[0]
        + gamma ** len(rewards) * potentials[-1]
    )
    assert isclose(shaped_return, boundary_identity, rel_tol=0.0, abs_tol=1e-12)
    assert isclose(shaped_return, 1.81, rel_tol=0.0, abs_tol=1e-12)
    print("Shaped rewards:", [round(value, 2) for value in shaped])
    print(f"Original / shaped return: {original_return:.2f} / {shaped_return:.2f}")


if __name__ == "__main__":
    main()
첫 계산은 독립 시행이라는 가정 아래 희소한 성공을 만날 확률을 보여준다. 두 번째는 중간 보상을 반복 수집하는 행동이 최종 성공보다 높은 점수를 받을 수 있음을 확인한다. 세 번째는 잠재 함수의 경계 항이 상쇄되는 관계를 검증한다. isclose를 사용하는 이유는 부동소수점 계산값을 문자열처럼 정확히 같은 숫자로 비교하지 않기 위해서다.
이 코드를 실제 실험에 연결할 때는 과제 종료 규칙, 시간 제한, 평가 환경을 먼저 정의해야 한다. 계산 예제에서 확인한 항등식을 실제 신경망 학습의 수렴 보장으로 취급해서는 안 된다.
#이해를 확인하는 세 질문
질문 1. “손잡이 접촉에 0.5점”은 항상 좋은 보상일까?아니다. 언제, 몇 번, 어떤 조건에서 지급하는지에 따라 누적 보상이 달라진다. 한 번의 중간 성취 보상과 매 스텝 반복 지급하는 보상은 서로 다른 목적을 만들 수 있다.
질문 2. 잠재 함수 기반 보상 설계는 모든 실패를 해결할까?아니다. 가정이 맞을 때의 최적 정책 보존과, 유한한 학습에서의 효율·안정성·안전은 별개의 문제다. 종료 경계 처리가 잘못되면 순위 보존의 전제부터 깨질 수 있다.
질문 3. LLM이 좋은 보상 코드를 쓰게 되면, 로봇도 학습을 마친 것일까?아니다. 코드 제안, 정책 학습, 독립 평가는 다른 단계다. 좋은 코드처럼 보인다는 판단을 실제 정책의 성능 검증으로 대체할 수 없다.
#이번 다섯 장의 연결
16쪽은 성공 보상이 드문 문제를 제기한다. 17쪽의 문 열기 문맥에서는 중간 신호를 어떻게 생각할지 살펴본다. 18쪽은 실제 목표와 대리 보상을 구분하게 하고, 19쪽은 최적화와 평가의 역할을 나눈다. 20쪽에서는 보상 작성과 정책 학습을 서로 다른 반복 과정으로 연결한다.
핵심은 “AI가 보상을 만들었는가”보다 “그 보상으로 학습한 정책이 원래 목표를 더 잘 이루는가”다. 사람이 설계하든 AI가 설계하든, 이 질문은 남는다.
다음 자가개선 AI 05 — 보상을 만드는 AI와 답을 평가하는 AI는 원본 21–25쪽을 다룬다. 보상 설계 관련 연구를 비교하고, RLHF와 RLAIF의 학습 신호를 구별한다.
#출처와 함께 읽을 자료
| 자료 | 읽을 위치 | 이 글에서 연결한 내용 |
|---|---|---|
| Hung-yi Lee, NTU Self-Improving | PDF 16–20쪽 | 기준 강의의 흐름과 표기 |
| Scott Niekum, UMass CS 690 Reward Specification | PDF 4·5·11쪽 | 희소·조밀 보상, 잠재 함수 기반 보상, 과적합 |
| Ng, Harada, Russell, ICML 1999 | §2.2, §3 Theorem 1; PDF 3–4쪽 | 보상 변환과 정책 보존의 조건 |
| Booth et al., AAAI 2023 | 논문과 저자 연구 자료 | 시행착오 보상 설계의 과적합과 잘못된 과제 명세 |
| Ma et al., Eureka 프로젝트 제공 논문 | PDF 2쪽 Figure 2, §2–3 | 보상 코드 생성, 정책 학습·평가, 보상 성찰 |
| Eureka 저자 프로젝트 | Components와 공개 태스크 예제 | 보상 생성기와 정책 학습자의 역할 구분 |
원본 자료의 공개 접근이나 출처 표시를 재사용 허가와 동일하게 취급하지 않는다. 원문 슬라이드, 논문 그림, 이 글의 추가 설명과 가상 계산을 구분한다.