NTU Hung-yi Lee, Machine Learning 2026 Spring · Self-Improving 상편 6–10쪽
강의일은 2026년 5월 8일, 원문·자막 대조일은 2026년 11월 12일이다. 표지를 1쪽으로 센다. 슬라이드의 중국어 문구를 영어로 옮긴 비공식 영어 편집본을 사용하며, 각 이미지 아래에 한국어 해설을 붙인다. 영어 편집 이미지의 구성일은 2026년 11월 16일이다. 공식 원문은 각 이미지의 PDF 링크에서 확인할 수 있다.
앞선 자가개선 AI 01 — AI는 무엇을 바꿀 때 더 좋아지는가에서 변경 대상·자동화 범위·평가 기준을 나눴다. 이번에는 그중 모델의 파라미터를 학습하는 구조를 따라간다.
영상 구간은 제공 자막의 주제 설명 시각이다. 정확한 화면 전환 프레임을 측정한 값은 아니다. 본문의 추가 수식과 계산 예시는 학습을 돕기 위해 별도로 작성했다. 보충 자료는 관련 설명 옆에 원본 영어 강의 슬라이드와 논문 도해로 넣었다. 보충 자료 확인일은 2026년 11월 16일이다.
#6쪽 — AI는 어떻게 학습하는가?
이 장은 자가개선에 앞서 기계학습의 기본 구조를 복습하는 연결 페이지다. 가운데 썸네일은 강사의 2025년 입문 과정 제5강을 가리킨다.
자가개선을 이해하려면 먼저 일반적인 학습에서 무엇이 바뀌는지 알아야 한다. 교육용으로 모델을 다음처럼 나타내자.
- : 입력.
- : 파라미터 로 정해지는 모델.
- : 그 모델의 출력.
- : 학습으로 바꿀 수 있는 가중치와 편향 등의 값.
예를 들어 이미지에서 사람의 관절 위치를 추정한다면, 는 이미지이고 는 관절 좌표다. 언어모델에서는 입력 문맥을 받아 다음 토큰의 확률분포를 계산하고, 그 분포에 따라 토큰을 선택하며 문장을 만들어 간다.
추론(Inference)은 주어진 모델로 출력을 계산하는 일이다. 파라미터 학습(Parameter learning)은 정해 둔 기준에 따라 를 바꾸는 일이다. 이 장부터는 후자의 구조에 집중한다.
그래서 자가개선의 질문도 구체적으로 바뀐다.
모델을 바꾸는 학습 자료나 목표를 AI가 만들어낼 수 있을까? 그렇다면 그 목표가 좋은지는 어떻게 판단할까?
다음 7쪽은 이 질문을 세 부분으로 나누어 준다.
#7쪽 — 목표, 후보 집합, 최적화를 구분하자
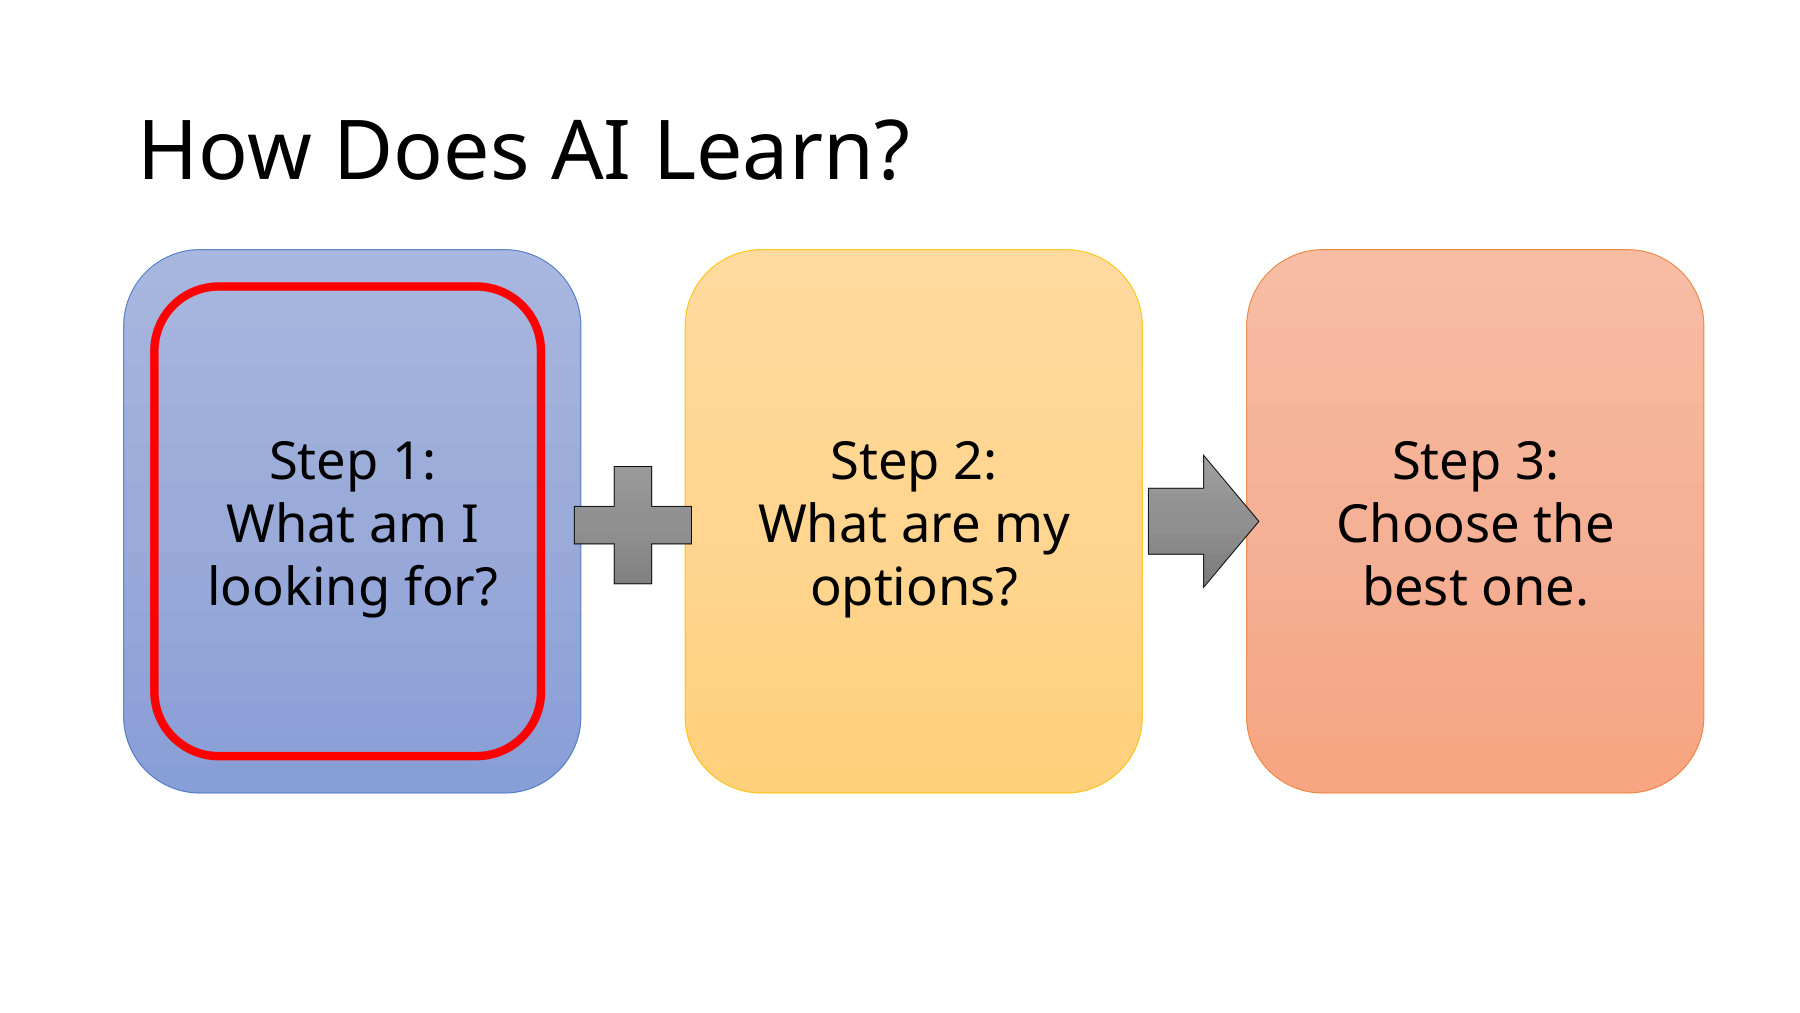
그림은 찾으려는 것, 가능한 선택지, 좋은 것을 선택하는 절차를 나눈다. 첫 번째 파란 상자에 빨간 테두리가 있다. 이번 강의에서 특히 관심을 두는 부분이다.
이 구분을 기계학습의 용어로 풀어보자.
| 원본의 질문 | 기계학습에서 대응하는 개념 | 관절 위치 추정의 예 |
|---|---|---|
| 무엇을 찾는가? | 문제 정의와 좋은 출력의 기준 | 이미지에서 정답 관절 좌표와 가까운 좌표를 출력한다 |
| 어떤 선택지가 있는가? | 가설 공간(Hypothesis space), 모델이 표현할 수 있는 함수 집합 | 선택한 신경망 구조와 가능한 파라미터 값 |
| 좋은 것을 어떻게 선택하는가? | 최적화(Optimization) | 손실을 계산하고 경사하강법 등으로 파라미터를 갱신한다 |
#모델 구조와 학습 목표는 역할이 다르다
같은 신경망 구조에서도 값에 따라 서로 다른 함수가 나온다. 이러한 후보 집합을 설명용으로 다음처럼 쓰자.
여기서 는 허용하는 파라미터 값의 집합이고, 는 그 값들로 표현할 수 있는 함수들의 집합이다.
한편 손실 함수(Loss function) 는 후보 모델이 얼마나 잘하고 있는지 평가한다. 이 기준에서 가장 좋은 파라미터라는 이상적인 목표는 다음과 같다.
실제 학습 알고리즘은 이 목표를 향해 후보를 탐색한다. 경사하강법(Gradient descent)의 기본 형태는 다음과 같다.
- : 한 번에 얼마나 움직일지 정하는 학습률(Learning rate).
- : 현재 위치에서 손실이 증가하는 방향을 나타내는 기울기.
- 음의 부호: 그 반대 방향으로 이동하여 손실을 낮추려는 갱신.
이 식이 모든 신경망에서 항상 전역 최솟값을 찾는다는 뜻은 아니다. 실제로 도달하는 해는 초기값, 자료, 모델 구조, 최적화 설정 등에 영향을 받는다. 또한 학습 자료에서 좋은 후보가 새로운 자료에서도 좋으려면 일반화(Generalization)를 별도로 확인해야 한다. 보충: Stanford CS229 강의 노트, 지도학습·경사하강법
#보충 강의 · Stanford CS229 — 최적화는 어떤 값을 바꾸는가
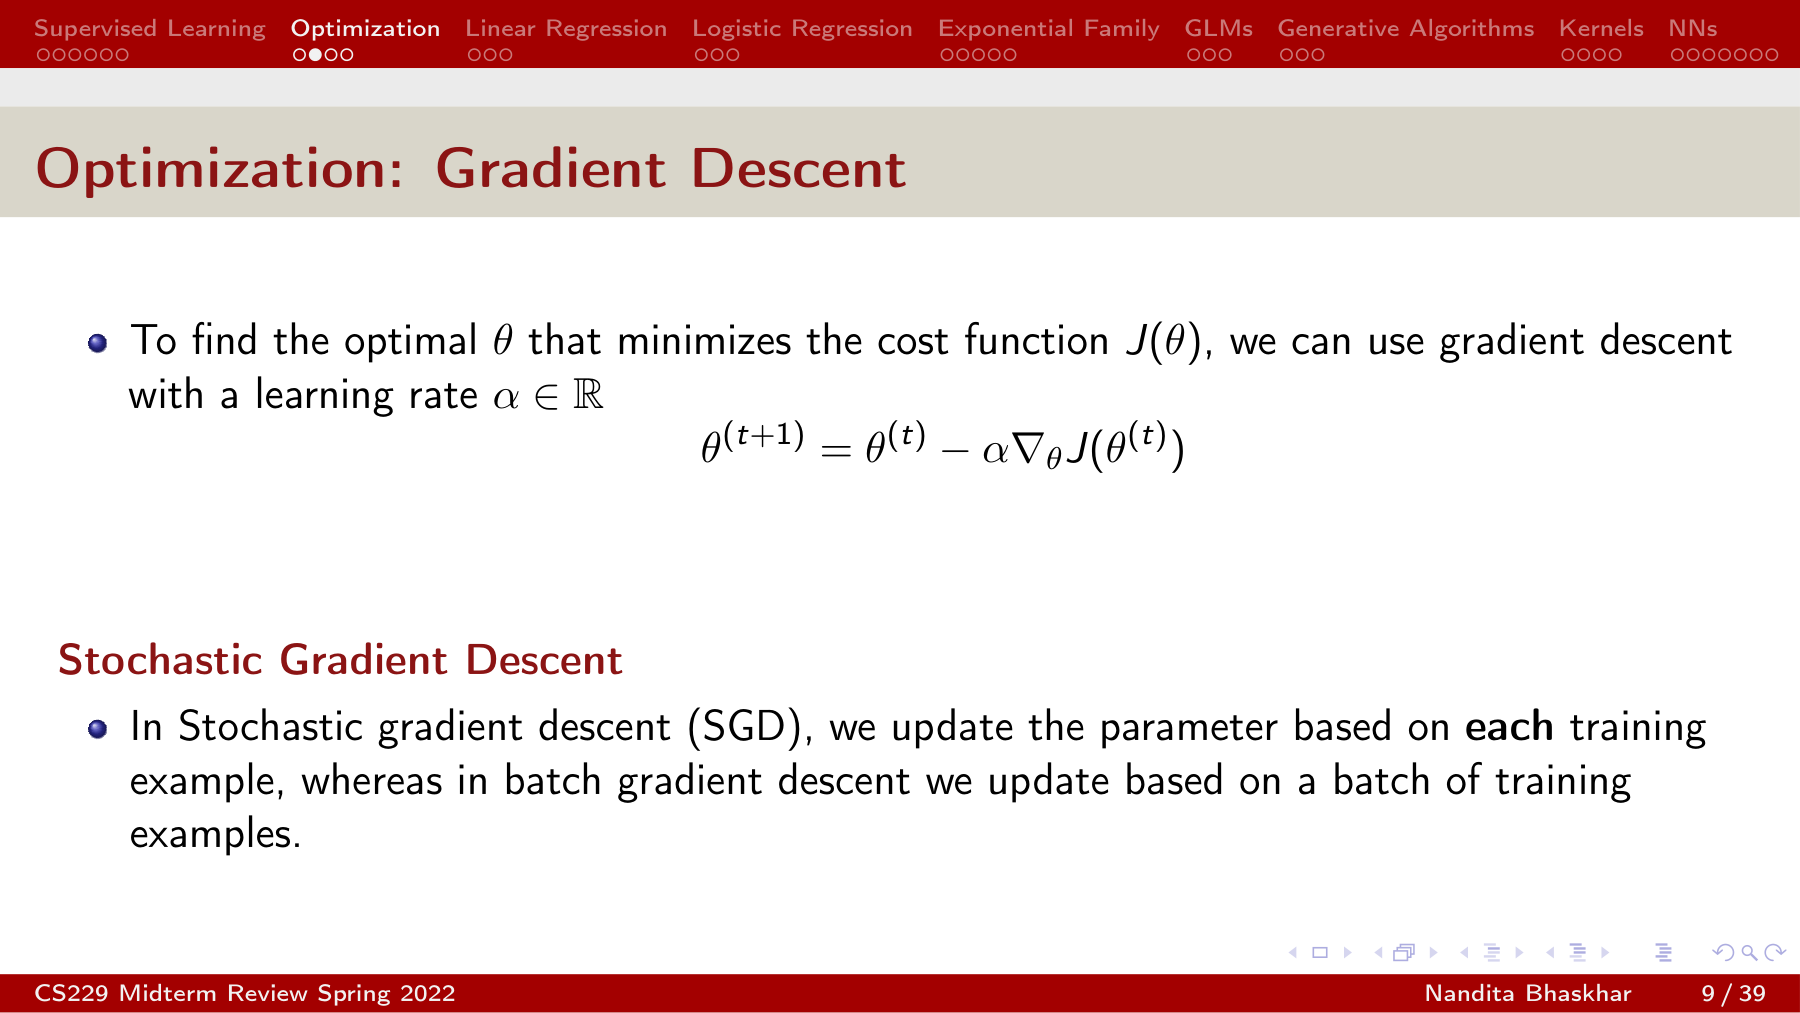
Stanford 슬라이드의 는 앞에서 쓴 전체 손실 에, 학습률 는 에 대응한다. 갱신식에서 실제로 바뀌는 값은 파라미터 다. 아래의 확률적 경사하강법(Stochastic Gradient Descent, SGD) 설명은 한 번의 갱신에 어떤 학습 예제를 사용하는지 구분한다.
이 식을 이번 강의의 첫 상자와 연결하면 차이가 보인다. 교사가 바뀌어 목표 라벨이 달라지면, 같은 경사하강법을 사용해도 손실과 기울기가 달라질 수 있다. 따라서 최적화 알고리즘을 확인하는 일과, 그 알고리즘에 제공할 목표를 검토하는 일은 각각 필요하다.
#왜 첫 상자가 강조되었을까?
자가개선에서 바뀔 수 있는 것은 학습 대상의 구조만이 아니다. 좋은 답을 정의하는 자료, 정답, 보상, 손실도 AI가 생성하거나 제안할 수 있다.
예를 들어 같은 모델과 같은 최적화 알고리즘을 사용하더라도 다음 두 학습은 다르다.
- 사람이 검토한 관절 좌표를 목표로 사용한다.
- 기존 모델이 예측한 관절 좌표를 목표로 사용한다.
후보를 탐색하는 방식은 같아도, 무엇에 가까워지도록 학습하는지가 달라진다. 이 차이가 8–10쪽을 관통한다.
#8쪽 — 출력과 정답의 차이가 학습 신호가 된다
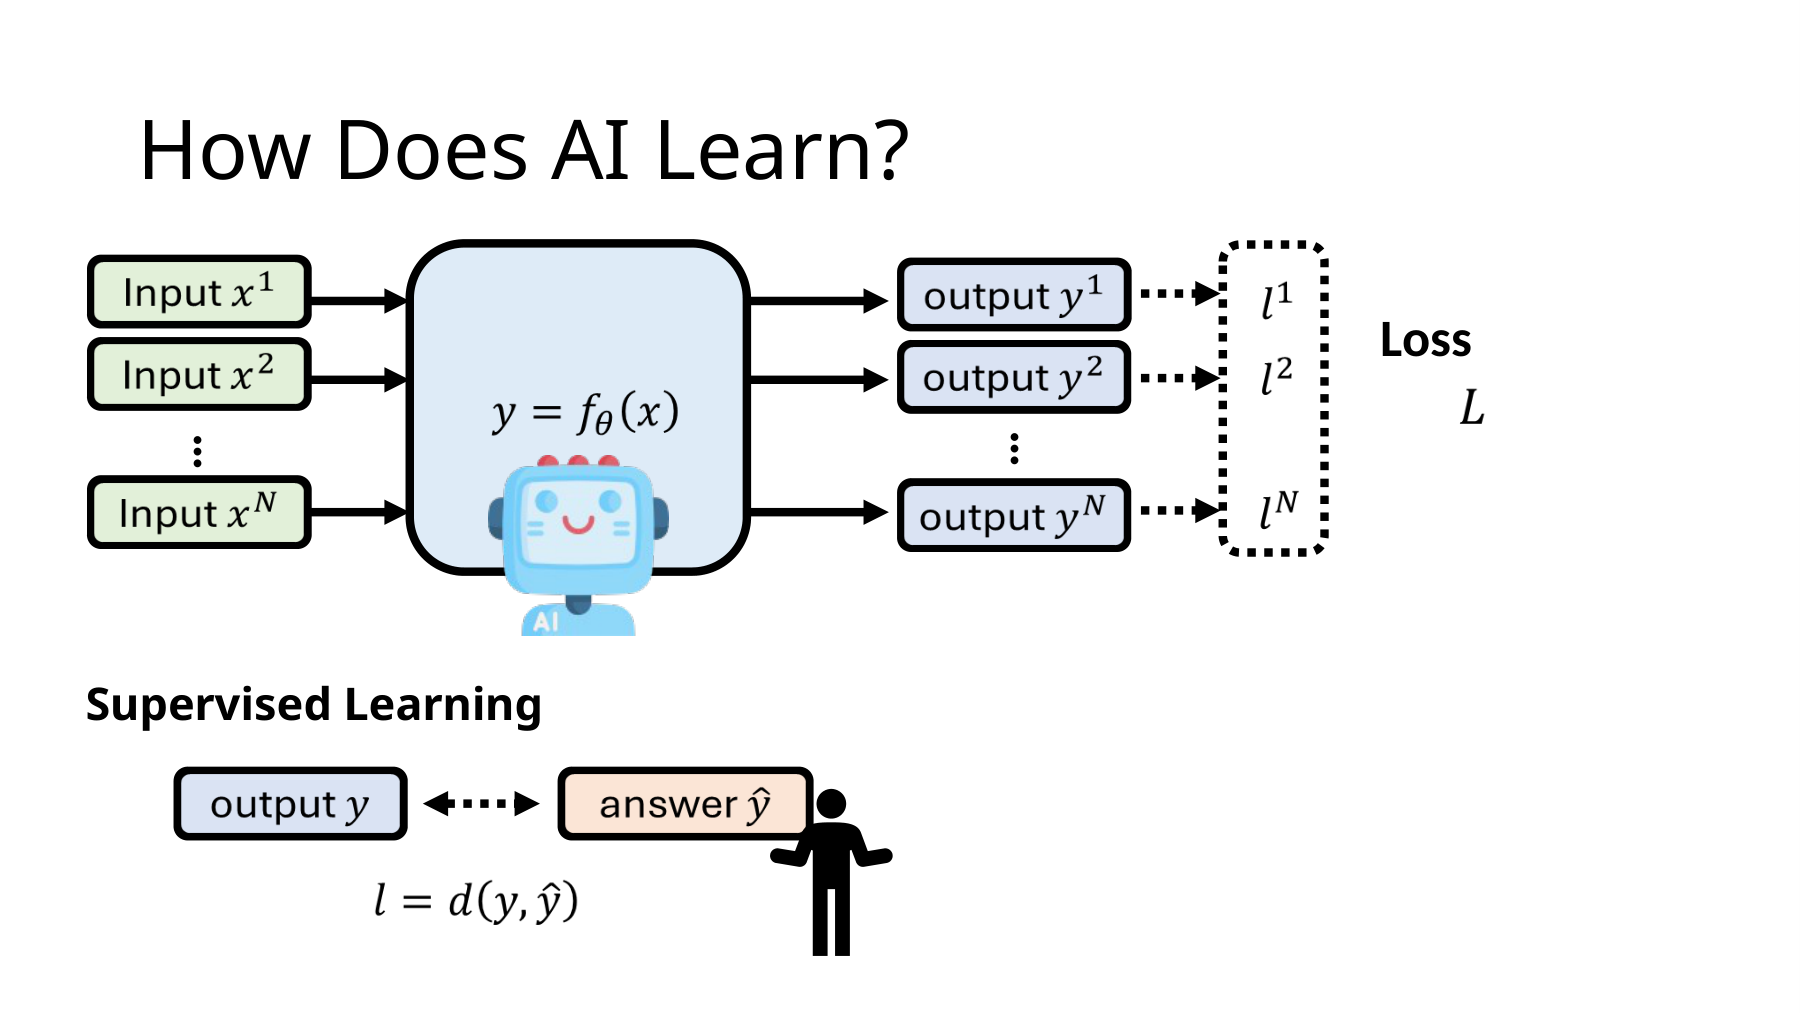
이 그림에서는 가 모델 출력이고 가 정답 또는 학습 목표다. 다른 교재에서는 를 예측값으로 쓰기도 하므로, 이번 글에서는 원본 표기를 유지한다.
#그림을 왼쪽에서 오른쪽으로 읽기
입력 이 같은 모델을 통과하여 출력 을 만든다. 위첨자 은 거듭제곱이 아니라 예제 번호다.
출력과 대응하는 목표의 차이를 개별 손실로 계산한다.
여기서 는 차이를 평가하는 함수다. 모든 경우에 대칭성이나 삼각부등식을 만족하는 수학적 거리(Metric)라는 뜻은 아니다.
원본 8쪽은 개별 손실을 모은 전체 손실을 로 표시한다. 자막의 설명을 수식으로 풀어 쓰면 다음과 같고, 합 기호는 다음 9쪽에 직접 표시되어 있다.
한 예제에서 좋은 출력이 무엇인지 정한 뒤, 자료 전체에서 그 기준을 만족하도록 파라미터를 바꾸는 구조다.
#숫자로 보는 회귀 손실
다음은 거리 예측을 이용한 가상 계산 예시다. 단위는 미터이고, 개별 손실을 제곱오차로 정한다.
| 예제 | 정답 | 모델 A 출력 | A의 제곱오차 | 모델 B 출력 | B의 제곱오차 |
|---|---|---|---|---|---|
| 1 | 1.0 | 1.2 | 0.04 | 1.1 | 0.01 |
| 2 | 2.0 | 1.9 | 0.01 | 2.5 | 0.25 |
| 합계 | 0.05 | 0.26 |
첫 번째 예제에서는 B가 더 정확하지만, 두 예제를 합친 이 기준에서는 A가 더 좋다.
평균제곱오차(Mean Squared Error, MSE)를 사용한다면 합을 으로 나눈다. 이 예에서 A는 0.025, B는 0.13이다. 고정된 같은 자료에서 합과 평균은 후보의 순서를 같게 만들지만 기울기의 크기는 달라지므로, 실제 구현에서는 학습률과 손실의 정의를 함께 봐야 한다.
#분류에서는 교차엔트로피를 사용할 수 있다
정답 클래스에 모델이 부여한 확률을 라고 하면, 대표적인 손실은 다음과 같다.
자연로그 기준의 가상 예시에서 정답 클래스 확률이 0.8이면 손실은 약 0.223이고, 0.2이면 약 1.609다. 단순히 최종 선택이 맞았는지만 세는 정확도와 달리, 정답 클래스에 부여한 확률 변화에도 반응한다. 보충: CS229의 분류·로지스틱 회귀
여기까지는 학습 목표가 주어졌다고 가정했다. 다음 장부터는 그림 아래의 정답 상자를 누가 채우는가를 바꿔 본다.
#9쪽 — 강한 AI의 답으로 배우는 지식 증류
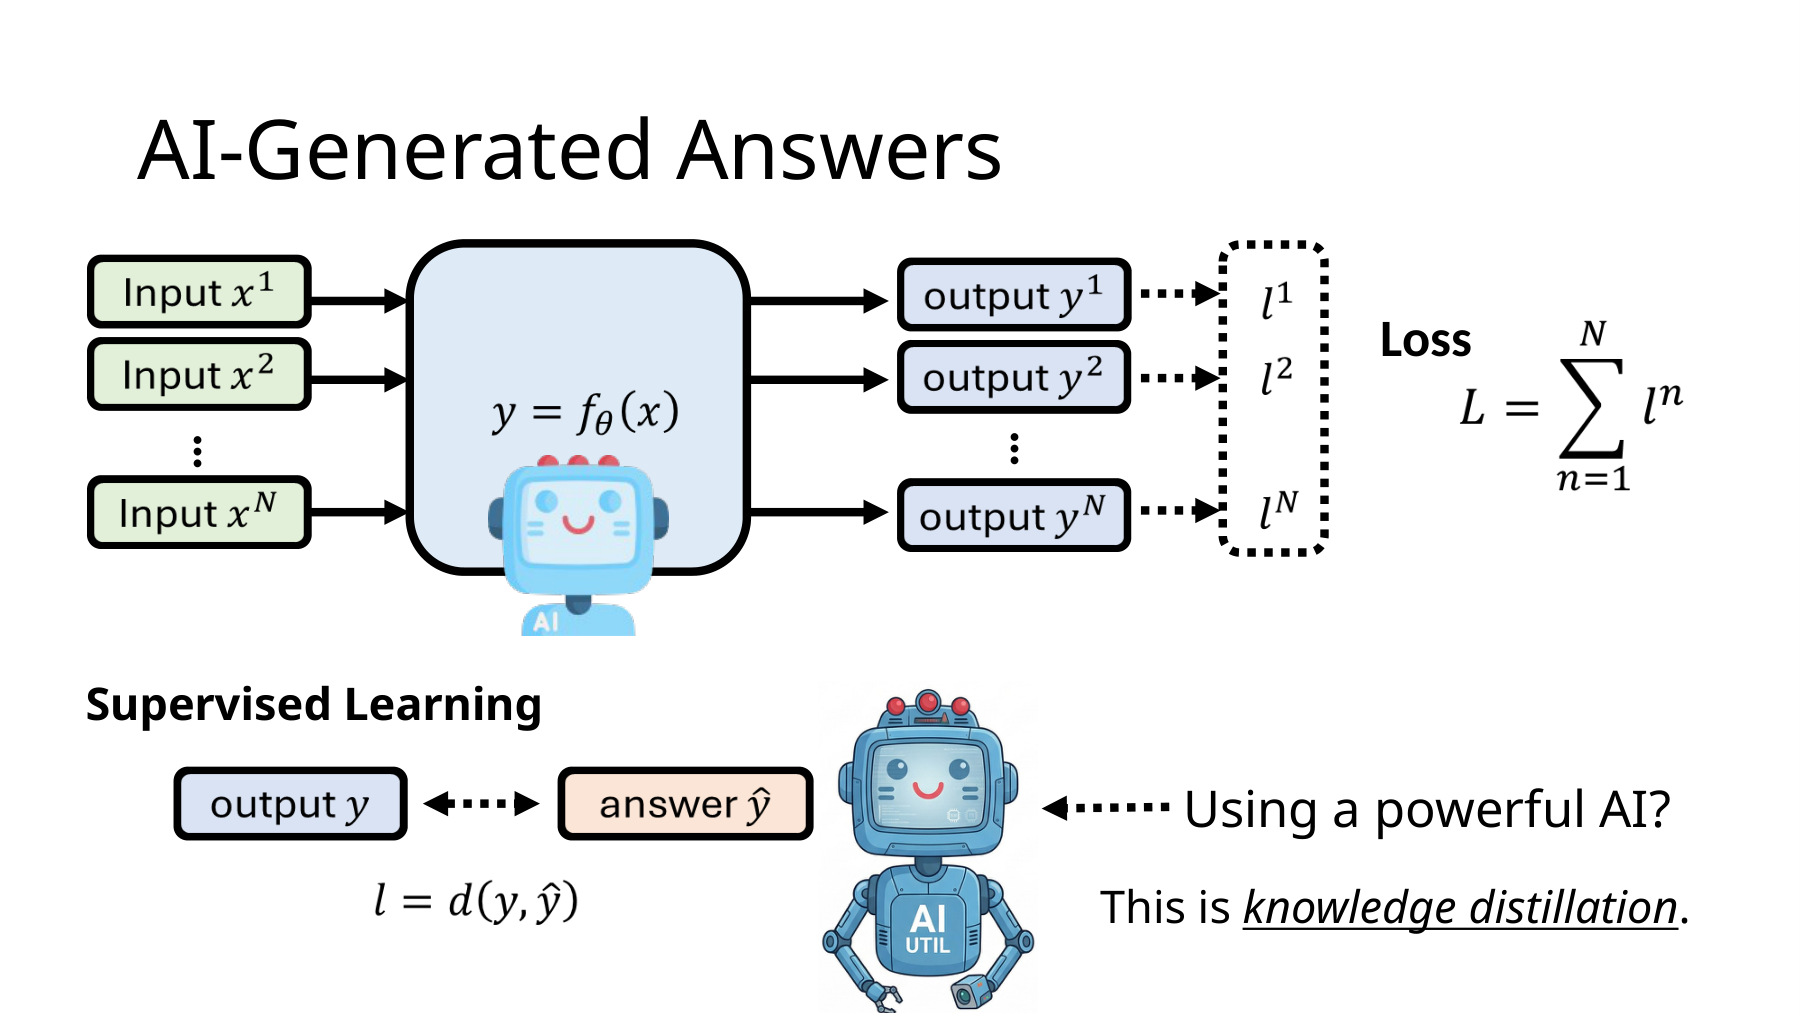
이전 장과 비교하면 아래 정답 상자 옆에 다른 모양의 강한 AI가 생겼다. 그 AI가 학습 목표를 제공한다. 원본은 이를 지식 증류(Knowledge distillation)로 소개한다.
가르치는 모델을 교사(Teacher), 배우는 모델을 학생(Student)이라고 부른다. 학생의 출력이 교사가 제공한 목표에 가까워지도록 학습한다.
#답변을 전달하는 방식과 확률분포를 전달하는 방식
우선 원본의 답 상자에 맞춰 생각해 보자. 교사 모델이 질문 에 대해 답변 를 만든다. 는 AI가 만든 목표를 구분하기 위해 추가한 기호다. 원본에서 가 놓인 자리에 들어간다고 보면 된다.
언어모델이 그 답변을 학습하는 손실의 한 형태는 다음과 같다.
문장 전체의 확률은 토큰별 조건부 확률의 곱이므로, 음의 로그를 취하면 토큰별 손실의 합으로 계산할 수 있다.
다른 방식은 교사의 출력 확률분포 자체를 목표로 사용하는 것이다. 클래스 에 대한 교사 분포를 , 학생 분포를 라고 하자.
여기서는 교사 분포를 학생 업데이트 동안 고정한 목표로 취급한다. 두 방식은 모두 교사의 출력을 이용하지만, 전달하는 정보의 형태가 다르다. Hinton 등의 2015년 논문은 출력 분포와 온도(Temperature)를 이용한 증류를 설명한다. 원문 §2
#보충 강의 · Lambert — 교사 분포는 고정하고 학생을 갱신한다
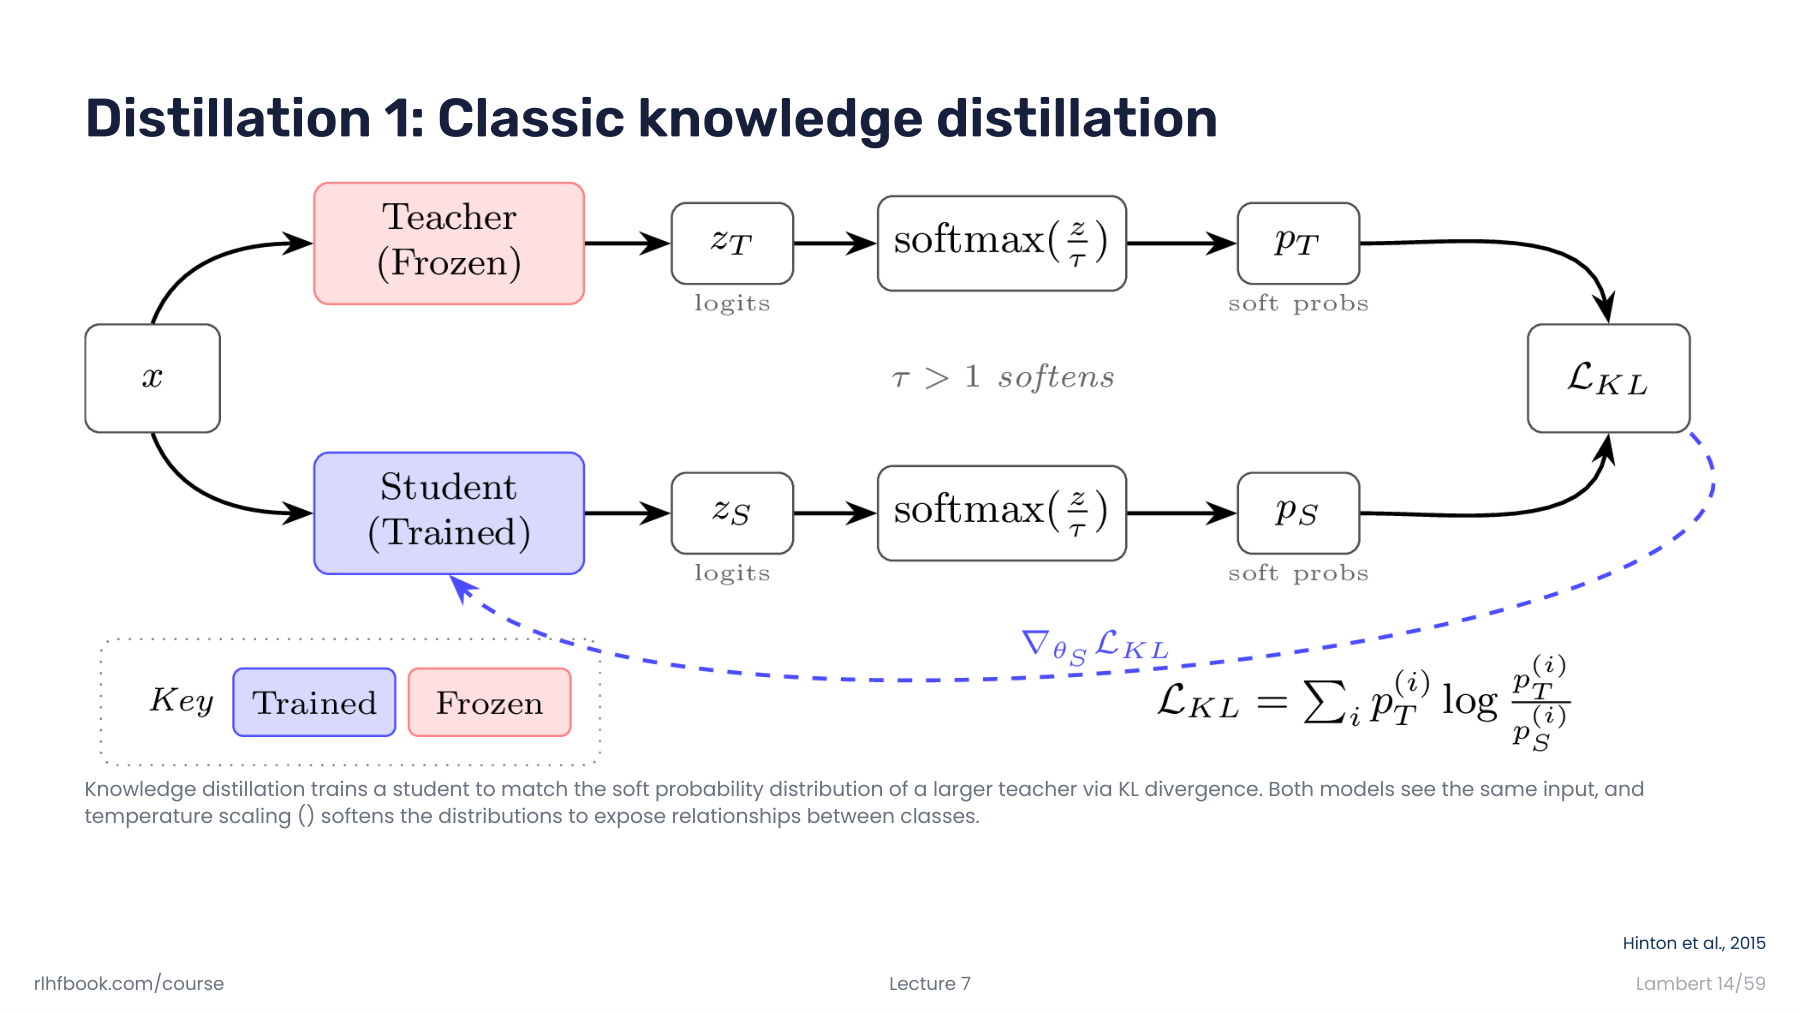
위쪽 교사는 Frozen, 아래쪽 학생은 Trained로 표시되어 있다. 같은 입력을 두 모델에 넣지만, 점선 화살표가 돌려보내는 기울기는 학생만 바꾼다. 교사가 만든 목표까지 함께 움직이면 무엇을 따라가야 하는지 바뀌므로, 이 그림에서는 교사 분포를 고정한다.
가운데 온도(Temperature) 는 로짓을 확률로 바꿀 때 분포의 뾰족함을 조절한다. 그림의 설정은 가장 큰 확률 이외의 정보도 드러낸다. 이 구조가 앞에서 소개한 “완성된 답변을 목표로 주기”와 구별되는 지점이다. 학생은 선택된 답 하나뿐 아니라 교사의 확률분포를 맞춘다.
#확률분포는 무엇을 더 남겨 주는가?
다음은 세 클래스에 대한 가상 예시다.
| 목표 표현 | 클래스 A | 클래스 B | 클래스 C |
|---|---|---|---|
| 최빈 클래스만 남긴 목표 | 1.0 | 0.0 | 0.0 |
| 교사의 부드러운 목표(Soft target) | 0.7 | 0.2 | 0.1 |
두 표현 모두 가장 유력한 클래스가 A라고 말한다. 부드러운 목표는 교사가 B를 C보다 더 가능성 있는 대안으로 보았다는 정보도 남긴다. 학생은 이러한 상대적 관계까지 학습할 수 있다.
다만 교사 분포에도 오류가 있을 수 있다. 자세한 분포를 받았다는 사실만으로 그것이 올바른 목표가 되지는 않는다.
#“강한 교사”는 반드시 더 큰 모델일까?
지식 증류를 항상 “큰 모델을 작은 모델로 압축하는 것”으로만 한정할 필요는 없다. 무엇이 더 나은 학습 신호를 제공하는지가 핵심이다. Noisy Student는 동일하거나 더 큰 학생과 학습 중 노이즈를 사용하는 구성을 연구한다. 따라서 모델 크기와 교사의 신호 품질을 구분해야 한다. Noisy Student, CVPR 2020
이 장의 학습 목표는 다른 교사가 제공한다. 다음 10쪽은 그 교사 자리에 학습 대상 자신을 놓는다.
#10쪽 — 자기 답으로 자기 자신을 가르칠 수 있을까?
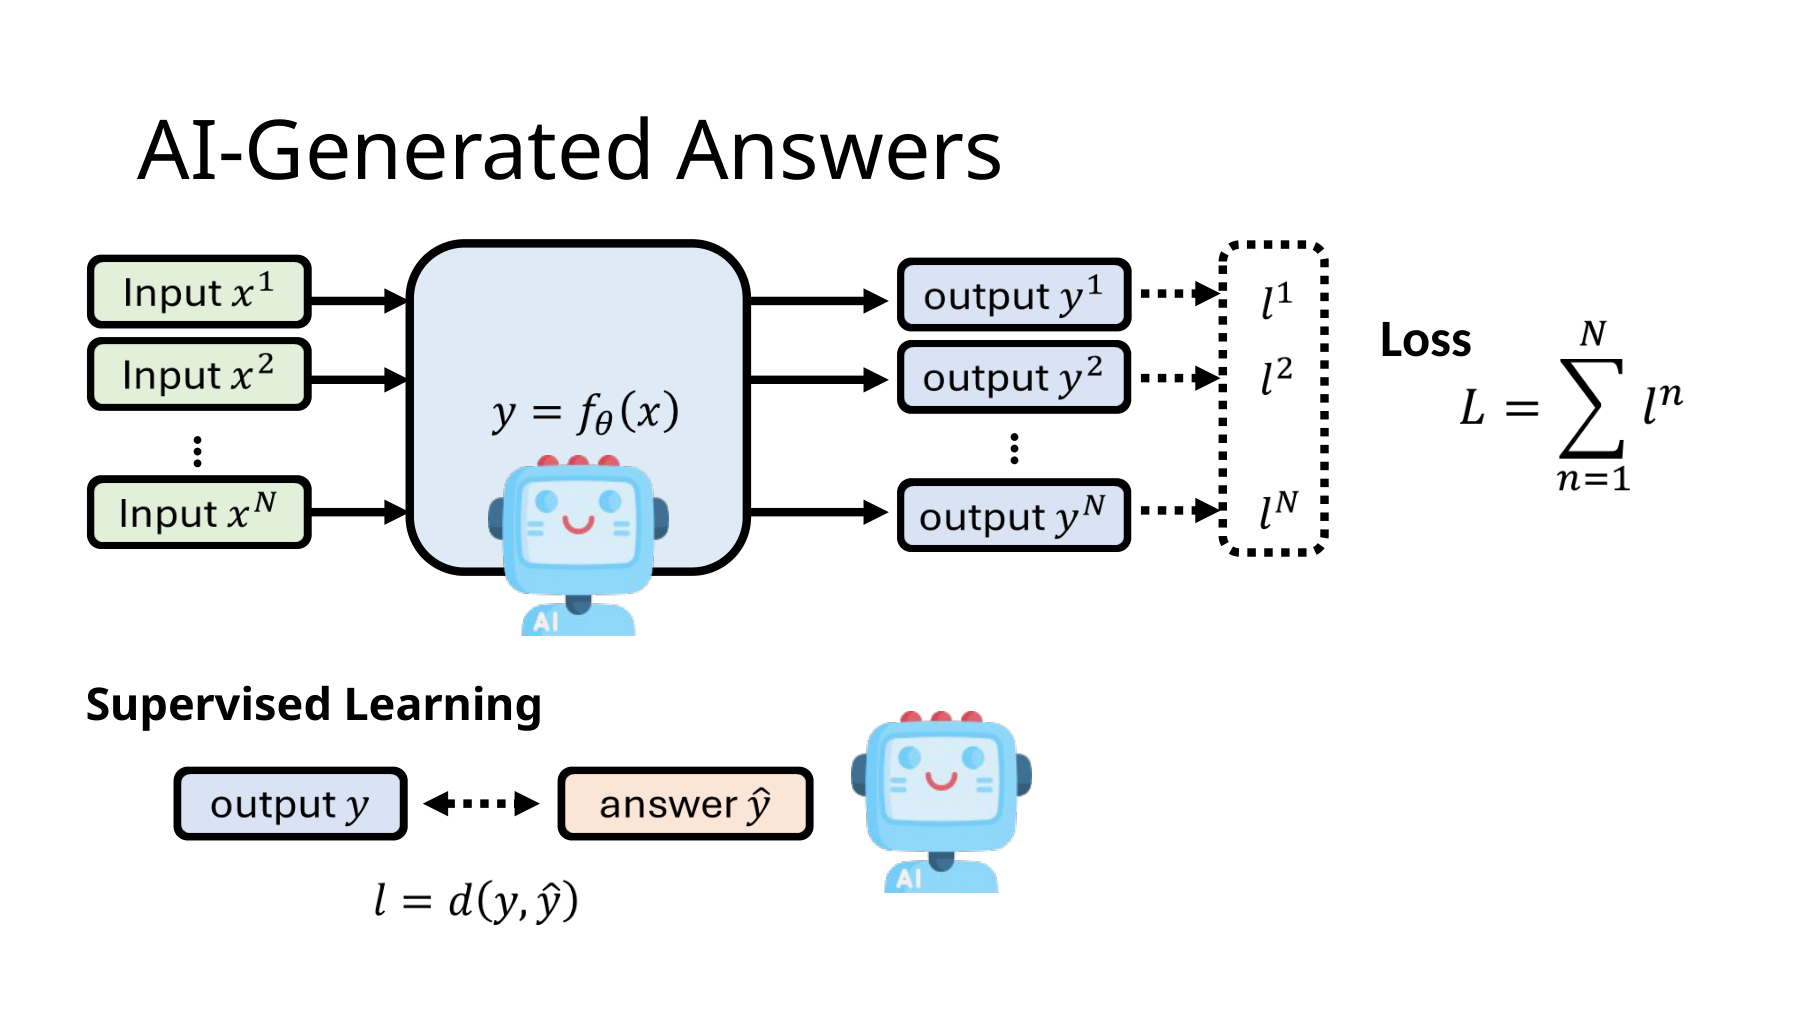
가장 큰 시각적 변화는 아래쪽의 교사 로봇이 위쪽 학습 모델과 같은 모습이 되었다는 점이다.
이 장은 자기 생성 의사 정답(Pseudo-answer)을 학습 목표로 사용할 수 있는지 질문한다. 의사 정답은 학습에 사용하려고 붙인 목표이며, 실제로 옳다고 확인된 답을 뜻하지 않는다.
같은 모델의 출력을 학습한다고 할 때에는 어떤 형태의 출력을 목표로 삼는가부터 구분해야 한다.
#경우 A. 자신의 확률분포를 그대로 맞추는 경우
모델의 현재 가중치를 라고 하자. 같은 입력에서 얻은 분포를 고정된 목표로 사용한다.
stop-gradient는 목표를 만드는 쪽으로는 미분을 전달하지 않는다는 뜻이다. 학생도 에서 시작하고, 입력·온도·실행 조건이 같아서 출력 분포가 정확히 같다고 가정한다.
온도 1에서 교차엔트로피의 학생 로짓(Logit) 에 대한 기울기는 다음과 같다.
두 분포가 같으면
이 증류 손실 자체에서는 학습 방향이 나오지 않는다. 위 결과는 증류의 로짓 기울기를 동일 분포에 적용한 추가 유도다. Hinton et al., 2015, §2
조건을 빠뜨리지 말아야 한다. 드롭아웃이나 입력 증강으로 두 분포가 달라지거나, 별도의 정답 손실과 정규화 항을 더하면 이야기가 달라진다. 기존 옵티마이저의 모멘텀이나 가중치 감쇠 때문에 파라미터가 움직일 수도 있으므로, 여기서는 해당 증류 손실의 기울기에 관해서만 말한다.
또한 기울기가 0인 것과 손실값이 0인 것은 다르다.
두 분포가 같아도 교차엔트로피는 분포의 엔트로피만큼 남는다. 예를 들어 이면 교차엔트로피는 약 0.5004다. 이 값 자체가 남아 있다고 해서 학생에게 더 움직일 방향이 생기는 것은 아니다.
#보충 강의 · Lambert — 교차엔트로피에서 무엇이 줄어드는가
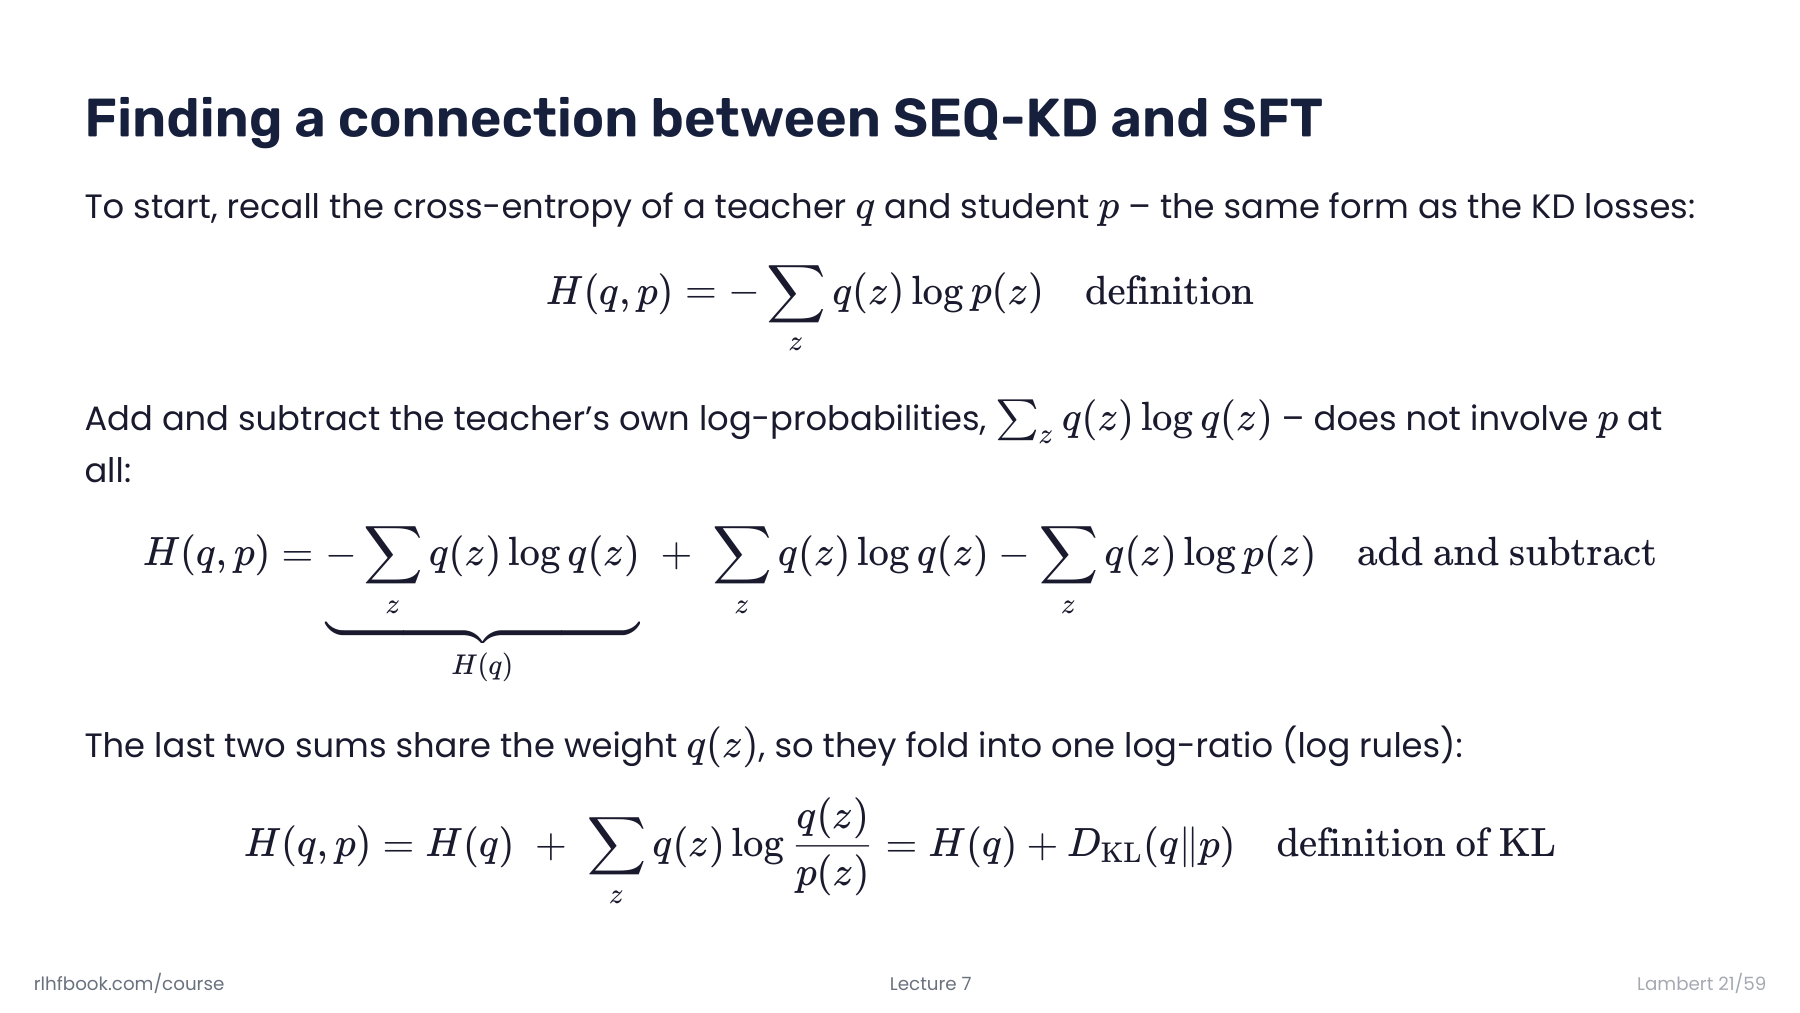
슬라이드의 는 위에서 쓴 다. 마지막 줄은 이를 교사 자체의 불확실성 와 두 분포의 차이를 나타내는 KL 발산으로 나눈다. 교사를 고정하면 학생이 바꿀 수 있는 항은 KL 쪽이다.
따라서 교사와 학생의 분포가 같아진 뒤에도 남아 있는 를 학생의 미해결 오차로 해석하면 안 된다. 학생이 줄일 수 있는 항이 KL뿐이라는 해석에는 “교사 고정”이 필요하다. 같은 파라미터로 교사도 다시 계산하며 그쪽까지 미분하면, 앞의 고정 목표 문제와 다른 목적 함수를 최적화하게 된다.
#경우 B. 자신의 예측을 하나의 확정 라벨로 바꾸는 경우
이번에는 불량 여부를 분류하는 가상의 모델을 보자. 모델이 불량일 확률을 0.8로 출력했다고 하자. 이 예측을 보고 의사 라벨을 “불량”, 즉 로 정한다.
이진 교차엔트로피에서 불량 로짓 의 기울기는 다음과 같다.
경사하강법은 로짓을 높이는 방향으로 움직인다. 하나의 로짓을 직접 갱신하는 계산 예시에서 , 학습률 이라면
같은 모델의 예측에서 출발했어도 학습 신호가 생겼다. 목표를 이라는 확률에서 이라는 확정 라벨로 바꾸었기 때문이다.
그러나 실제 정답이 정상이라면, 모델은 잘못된 판단에 더 확신을 갖게 된 것이다. 출력 확률이 높아진 것과 실제 정확도가 높아진 것은 각각 확인해야 한다. 모델이 낸 0.8이라는 값이 실제로 80%의 정답률을 보장하는 것도 아니다.
이 계산은 한 로짓의 움직임을 보여 주는 예시다. 실제 신경망은 여러 입력이 가중치를 공유하므로 모든 예제의 출력이 같은 방식으로 변한다고 일반화할 수 없다.
#심화. 무작위로 생성한 답을 모두 그대로 학습하면?
최빈 답을 확정 라벨로 만드는 것과, 모델 분포에서 무작위로 답을 뽑는 것은 다르다. 답을 선별하지 않고 그대로 최대우도로 학습한다고 가정하면,
일 때 시작점에서의 기대 기울기는
이다. 이는 출력 공간이 고정되고 미분과 합의 교환이 가능한 통상적인 조건에서, 확률의 합이 1이라는 사실로 얻는 추가 유도다.
유한한 표본에서는 기울기가 0이 아닐 수 있다. 다만 표본 때문에 값이 움직였다는 것만으로 정답 방향의 학습 신호가 생겼다고 보기는 어렵다. 이 역시 여러 회차의 실제 학습이 절대로 아무 효과도 낼 수 없다는 주장으로 확대하면 안 된다.
#실제 자기학습은 무엇을 달리하는가?
자기 생성 자료를 이용하는 연구는 목표를 만드는 과정, 자료, 학생의 학습 조건에 변화를 준다.
| 달라지는 요소 | 학습 신호가 달라지는 이유 |
|---|---|
| 정답·테스트·보상으로 생성 결과 선별 | 학습에 남기는 출력의 분포가 달라진다 |
| 학생 입력에 증강 적용 | 같은 내용을 달리 관측해도 교사의 목표를 재현하도록 학습한다 |
| 학생 모델에 노이즈 적용 | 목표를 만든 교사와 학생의 실행 조건이 달라진다 |
| 새 라벨 없는 입력 추가 | 이전 학습에서 다루지 않은 입력 영역에 제약을 준다 |
| 학생의 초기화·용량·학습 과정 변경 | 동일한 신호도 다른 함수와 최적화 경로로 표현할 수 있다 |
세 가지 원문 사례를 연결해 볼 수 있다.
Noisy Student, CVPR 2020. 교사가 라벨 없는 이미지에 의사 라벨을 만들고, 정답 자료와 의사 라벨 자료를 함께 사용해 학생을 학습한다. 학생에는 데이터 증강과 모델 노이즈를 적용한다. 학생은 교사와 동일하거나 더 큰 모델일 수 있다. 원문
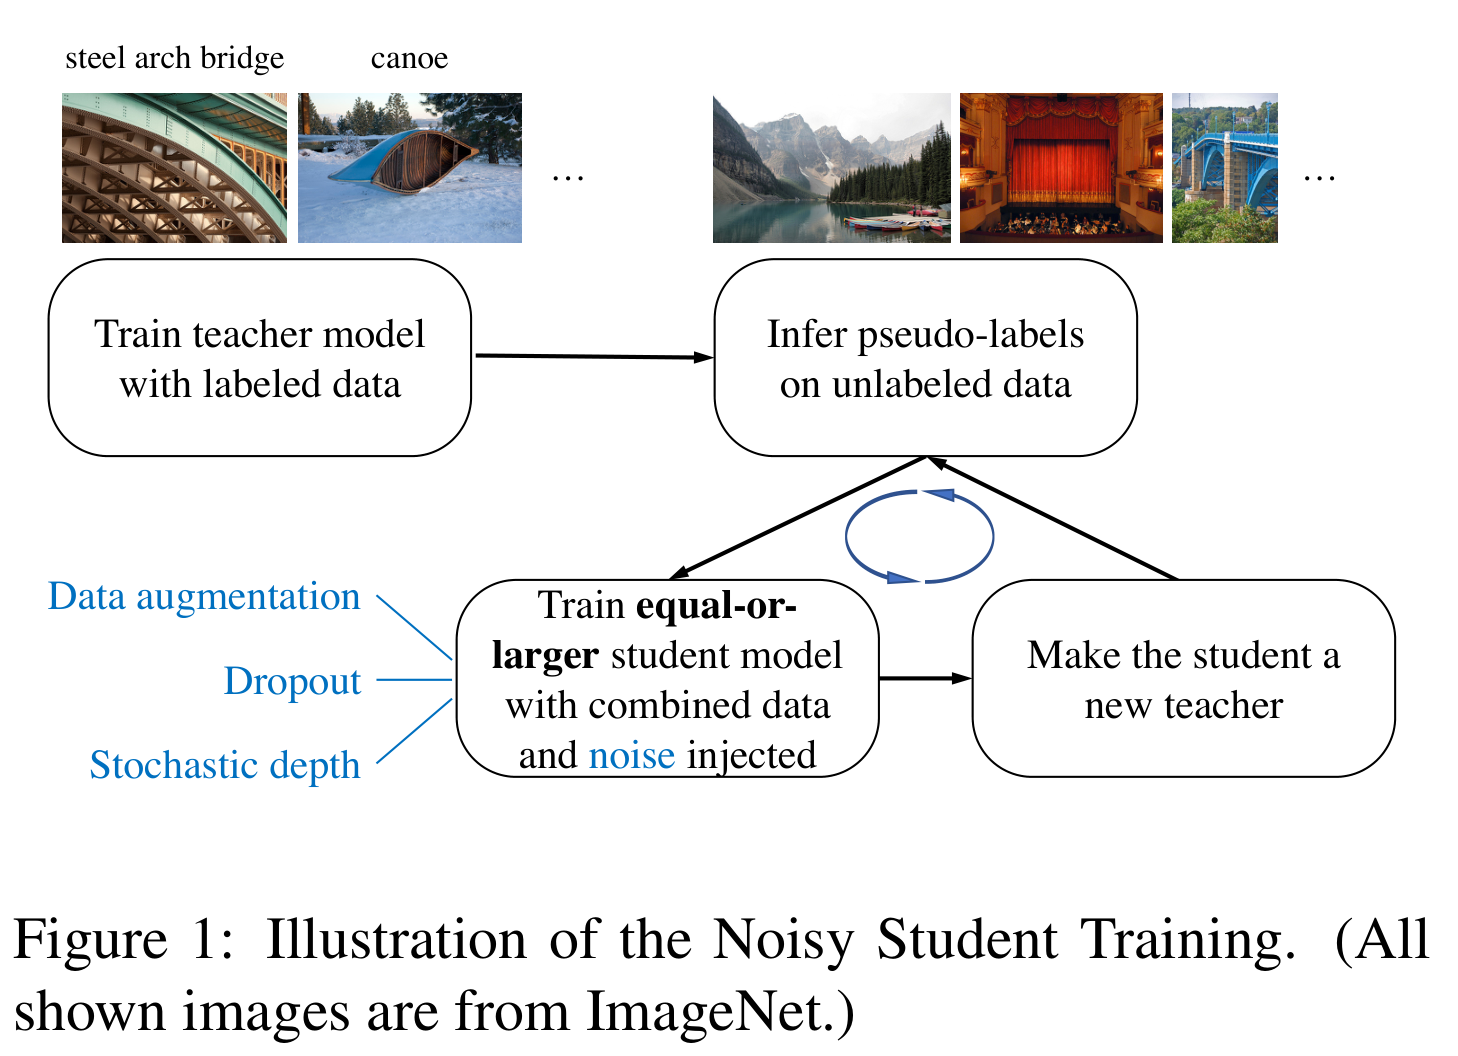
왼쪽 위의 교사는 정답이 있는 자료로 출발한다. 그다음 라벨 없는 입력에 의사 라벨을 붙이고, 아래의 학생은 두 종류의 자료를 함께 사용한다. 파란 글씨의 자료 증강(Data augmentation), 드롭아웃(Dropout), 확률적 깊이(Stochastic depth)는 학생을 학습할 때 적용하는 변화를 표시한다. 의사 라벨을 만들 때의 교사는 이러한 노이즈를 끈다.
이 그림은 앞의 “같은 입력·같은 실행 조건에서 같은 분포를 그대로 맞추는 경우”와 왜 다른지 보여 준다. 새 입력을 추가하고 학생의 학습 조건을 바꾸기 때문이다. 마지막 화살표는 학습된 학생을 다음 교사로 사용하는 반복이다. 이 화살표만으로 개선이 보장되지는 않으며, 별도의 평가에서 실제 효과를 확인해야 한다.
STaR, NeurIPS 2022. 생성한 풀이 중 정답을 얻은 것을 학습하며, 틀린 경우 정답을 조건으로 다시 풀이를 생성한다. 문제·정답 정보와 초기 풀이 예시가 들어간다. 원문
ReST, 2023년 8월. 자료를 생성하는 Grow와 보상 점수로 선별한 자료를 학습하는 Improve를 구분한다. 원문은 음의 로그우도와 여러 오프라인 강화학습 손실을 다루므로, 하나의 손실만 사용하는 방법으로 한정하면 안 된다. 원문 §3
위 요소가 있다는 사실만으로 개선이 보장되지는 않는다. 의사 라벨이 틀리거나, 좋은 결과를 고르는 기준이 부정확하거나, 증강이 정답 의미를 바꾸면 문제가 생길 수 있다. 변화의 방향과 새로운 자료에서의 효과를 함께 확인해야 한다.
이번 10쪽이 제기하는 질문은 다음처럼 구체화된다.
자기 출력으로 배우는 과정에서 어떤 학습 신호를 새로 구성했고, 그 신호가 원하는 능력을 높이는지는 어떻게 확인했는가?
다음 자가개선 AI 03 — 자기수정은 언제 학습이 되는가에서는 11쪽부터 이어지는 자기수정(Self-correction)을 다룬다. 답을 수정하는 과정과, 수정된 답을 학습 자료로 삼아 파라미터를 바꾸는 과정을 나누어 살펴본다.
#함께 읽을 자료
- Hung-yi Lee, NTU ML 2026 공식 강의. 이번 범위는 Self-Improving 상편 PDF 6–10쪽.
- Stanford CS229 강의 노트. 지도학습, 경사하강법, 분류 손실의 기초.
- Nandita Bhaskhar, Stanford CS229 Midterm Review. 문서 표지 날짜 2022-05-06. PDF 9쪽의 경사하강법 슬라이드를 7쪽 해설에 넣었다.
- Hinton, Vinyals, Dean, Distilling the Knowledge in a Neural Network. 2015-03-09. 확률분포를 이용한 지식 증류.
- Xie et al., Self-training with Noisy Student improves ImageNet classification. CVPR 2020, 사용 판본 arXiv v4(2020-06-19). PDF 2쪽 Figure 1을 10쪽 해설에 넣었다.
- Zelikman et al., STaR: Bootstrapping Reasoning With Reasoning. NeurIPS 2022. 생성 풀이의 선별과 학습.
- Gulcehre et al., Reinforced Self-Training (ReST) for Language Modeling. 사용 판본 2023-08-21. 생성과 선별·학습의 반복.
- Nathan Lambert, Post-training Course, Lecture 7 · 공식 PDF. PDF 14쪽의 증류 도식과 21쪽의 교차엔트로피 전개를 각각 9쪽·10쪽 해설에 넣었다.