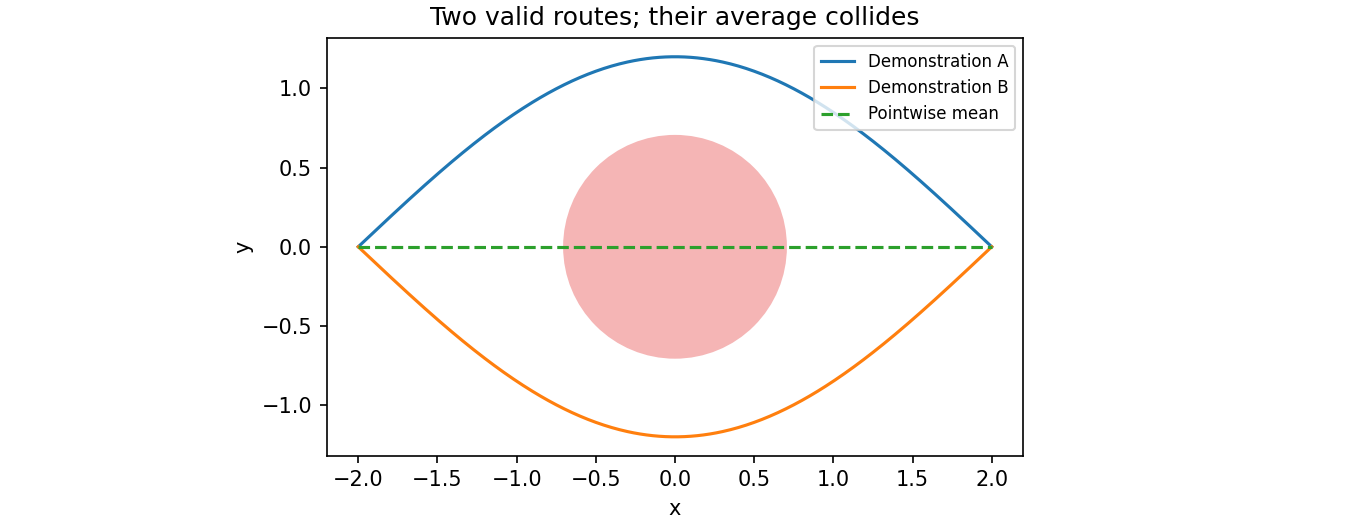
장애물을 왼쪽으로 돌아도, 오른쪽으로 돌아도 성공할 수 있다. 그런데 두 시범을 평균내면 장애물 한가운데로 향한다. 이번 장은 여러 정답을 하나로 뭉개지 않고, 그중 실행 가능한 행동을 만들어 내는 방법을 다룬다.
Oier Mees · ETH Zurich 2026 6강 · 공식 강의 · 원본 PDF
05장에서는 좋은 행동의 확률을 높이는 정책 경사를 배웠다. 이번에는 그 정책이 표현할 수 있는 분포의 모양에 초점을 맞춘다. 정책을 개선하는 알고리즘과 행동 분포를 표현하는 모델은 다른 설계 축이다. 확산 모델로 행동을 만든다는 사실만으로 강화학습을 했다고 말할 수는 없다.
생성 모델(generative model)은 자료가 나타나는 분포를 배우고 새로운 표본을 만드는 모델이다. 사진을 생성할 수도 있고, 관측 영상과 지시를 보고 앞으로 실행할 관절 목표의 묶음을 생성할 수도 있다. 여기서는 잠재변수 모델, 확산 모델, flow matching의 순서로 살펴본다. 원강의의 과목명은 Robot Learning이며, 이 장의 주요 로봇 사례는 시연 자료를 배우는 모방 학습이다.
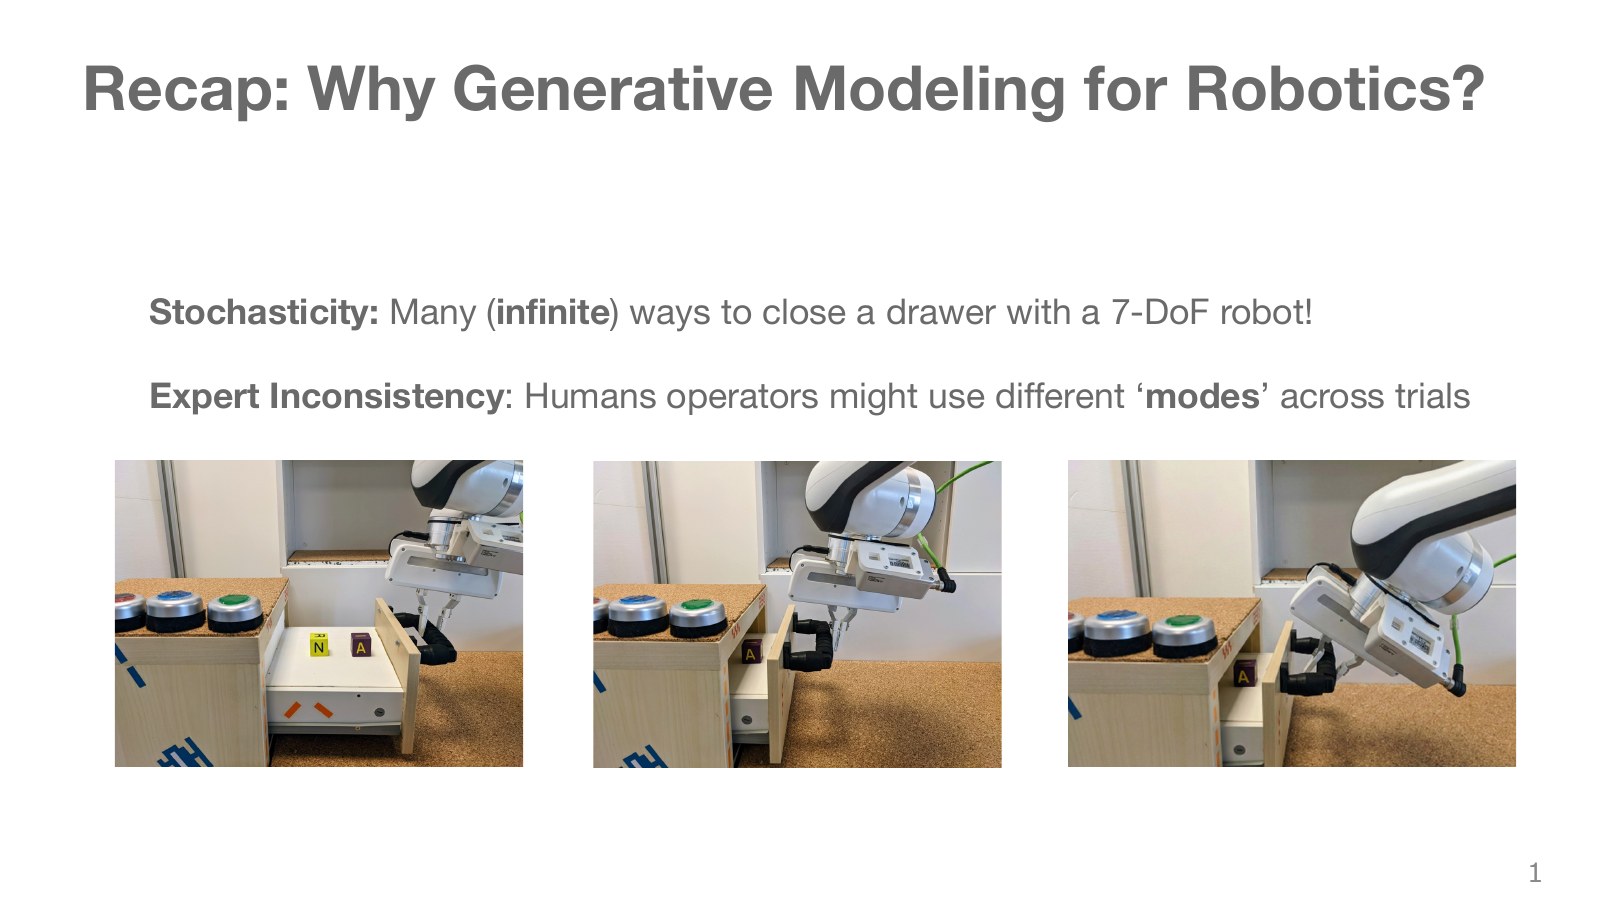
세 사진의 로봇 팔은 같은 서랍 열기 목표를 두고 서로 다른 자세를 취한다. 손잡이를 잡을 위치, 팔꿈치 방향, 접근 경로가 달라도 성공할 수 있다. 7자유도 팔은 손의 위치와 방향을 유지하면서도 팔꿈치 쪽을 움직일 여지가 있다. 이 기구학적 중복성은 같은 목표를 달성할 구성이 여럿 있다는 뜻이다.
시연자의 습관까지 더해지면 자료에는 여러 행동 방식이 섞인다. 관측 하나에 정답 행동 하나만 대응한다고 가정하는 회귀 모델은 이를 놓치기 쉽다. 다만 중복성이 곧 무작위성이라는 뜻은 아니다. 결정론적 정책도 여러 해 중 하나를 일관되게 고를 수 있다. 생성 정책의 장점은 여러 유효한 방식의 분포를 함께 표현할 수 있다는 데 있다.
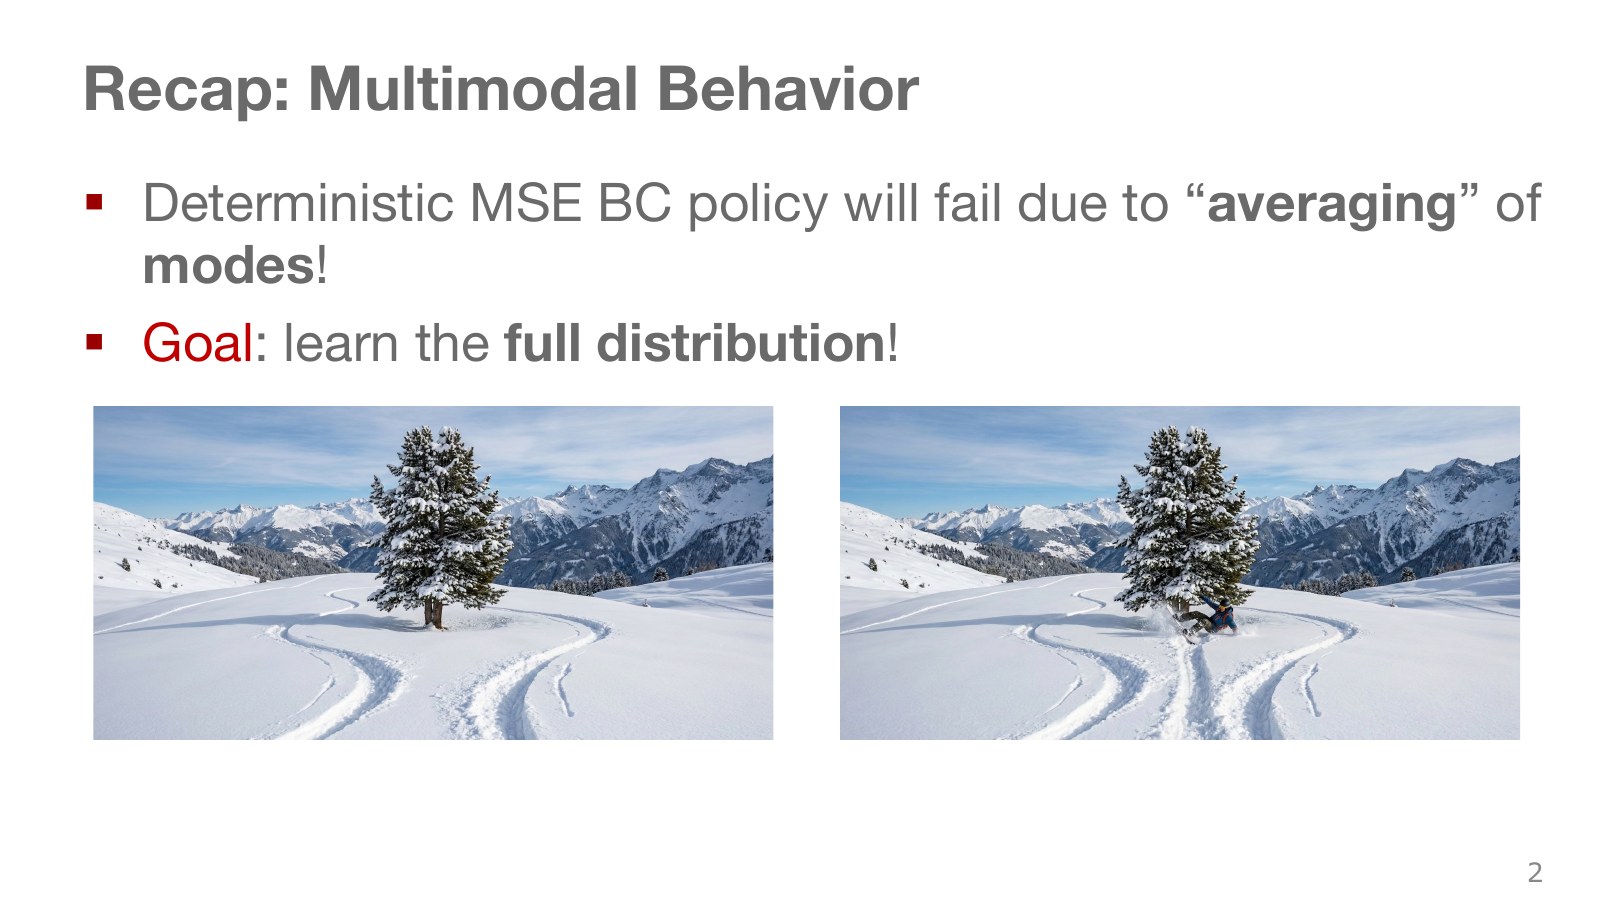
가운데 나무를 피해 가는 두 경로를 보자. 왼쪽 경로와 오른쪽 경로는 각각 성공하지만, 같은 진행 단계의 위치를 평균내면 나무 쪽으로 향한다. 여기서 다봉성(multimodality)은 확률밀도가 높은 봉우리가 여러 개 있다는 뜻이다. 카메라·언어처럼 입력의 종류가 여러 개라는 멀티모달과는 문맥이 다르다.
제곱 오차를 최소화해 행동 하나를 예측하면, 충분한 표현력과 적절한 학습 조건에서 관측에 대한 행동의 조건부 평균을 지향한다. 두 방식 사이가 성공 영역이면 평균도 괜찮지만, 그 사이가 장애물이면 문제가 된다. “평균이 항상 나쁘다”보다 “떨어진 여러 정답 사이의 평균이 유효한 정답이라는 보장이 없다”가 정확하다.
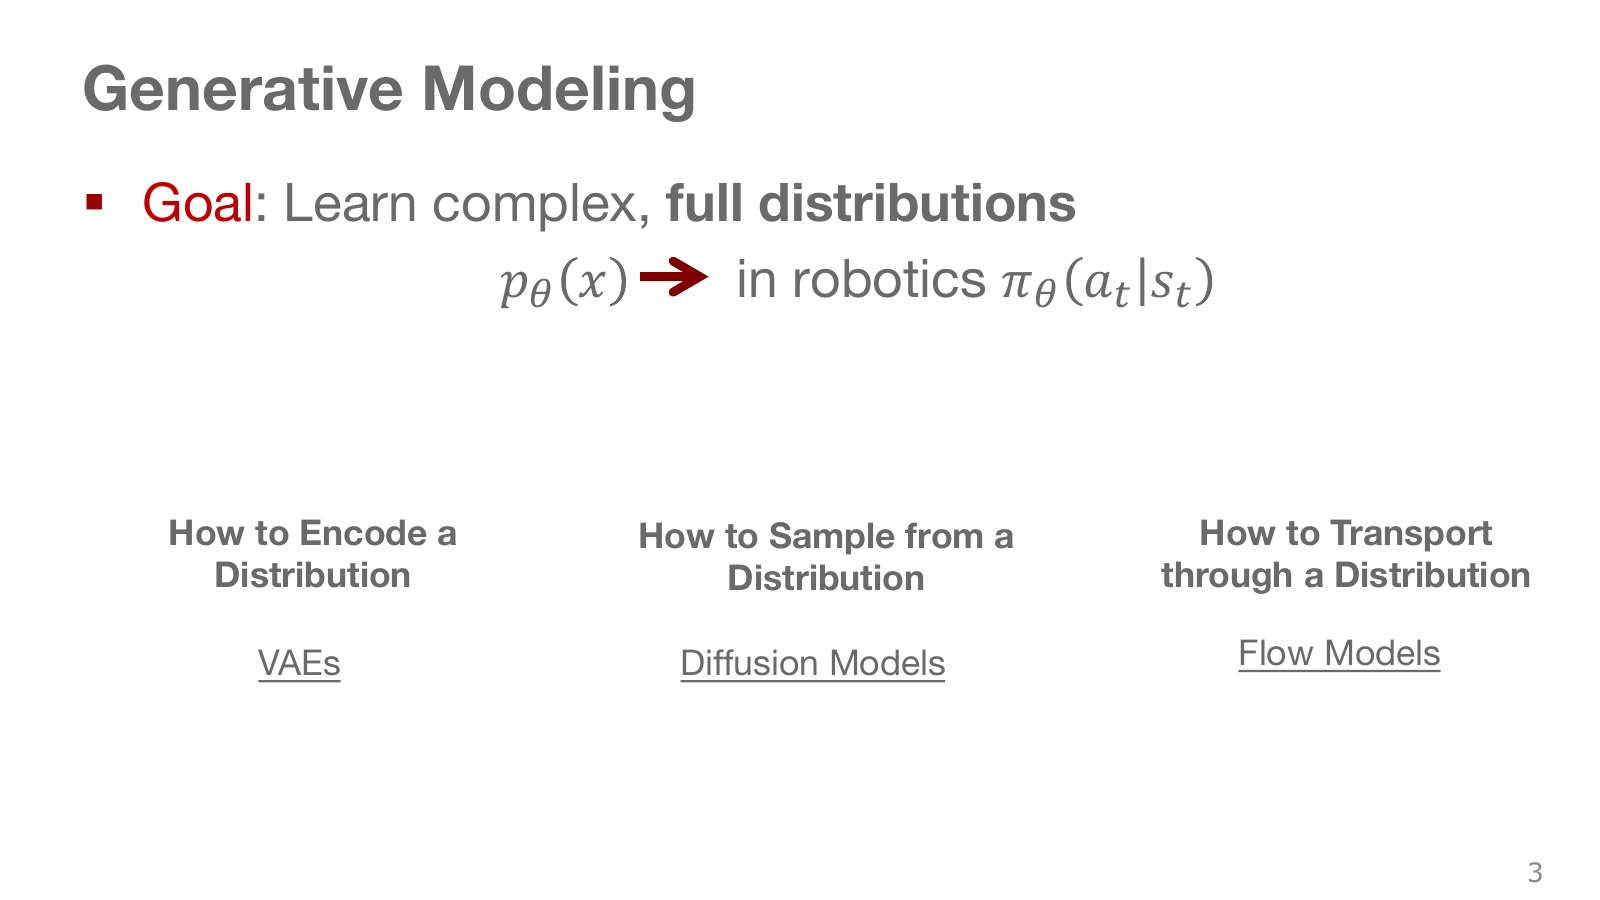
왼쪽의 잠재변수 모델은 간단한 숨은 변수에서 복잡한 결과를 만든다. 가운데 확산 모델은 자료에 잡음을 섞는 과정을 뒤집도록 배운다. 오른쪽 flow matching은 잡음 표본을 자료 분포로 옮기는 방향장을 배운다. 세 방법 모두 간단하게 뽑을 수 있는 무작위 입력에서 출발해 복잡한 분포를 표현한다.
이를 로봇에 적용할 때는 현재 영상, 관절 상태, 작업 지시를 조건으로 넣어야 한다. “아무 행동”을 생성하는 대신 “지금 이 장면에서 서랍을 여는 행동”의 분포를 만드는 것이다. 이 세 계열이 생성 모델 전체의 목록은 아니다. 자기회귀 모델이나 GAN 등도 있지만, 이 강의는 로봇 행동 생성으로 이어지는 세 계열에 집중한다.
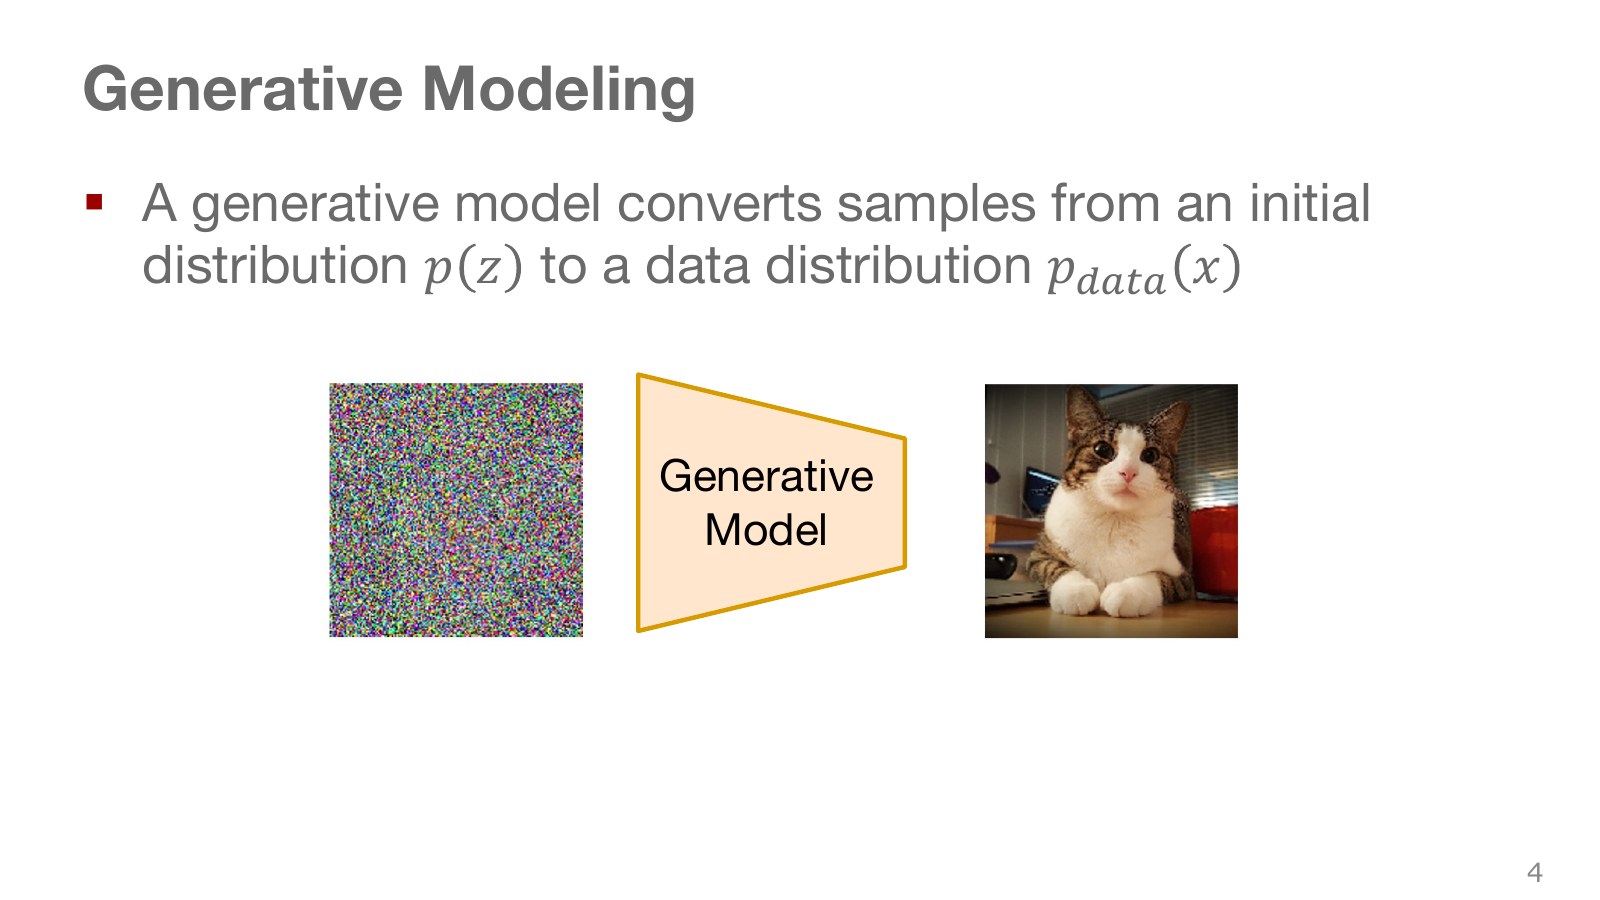
그림의 시작은 정규분포에서 뽑은 숫자 벡터이고, 끝은 고양이 이미지다. 정규분포는 평균 주변에 종 모양으로 값이 모이는 분포이며, 표준정규분포는 평균 0, 각 축의 분산 1을 사용한다. 신경망은 무작위 숫자들을 자료처럼 생긴 결과로 바꾸는 변환을 학습한다.
매 잡음 벡터에 특정 고양이 사진을 미리 정답으로 붙여 외우는 방식으로만 이해하면 안 된다. 중요한 것은 변환된 표본 전체가 자료 분포를 닮도록 만드는 학습 원리다. 로봇에서는 출력의 각 숫자가 픽셀 밝기 대신 관절 목표나 손의 이동량을 나타낼 수 있다. 같은 무작위 입력을 쓰더라도 관측 조건이 다르면 다른 행동이 나와야 한다.
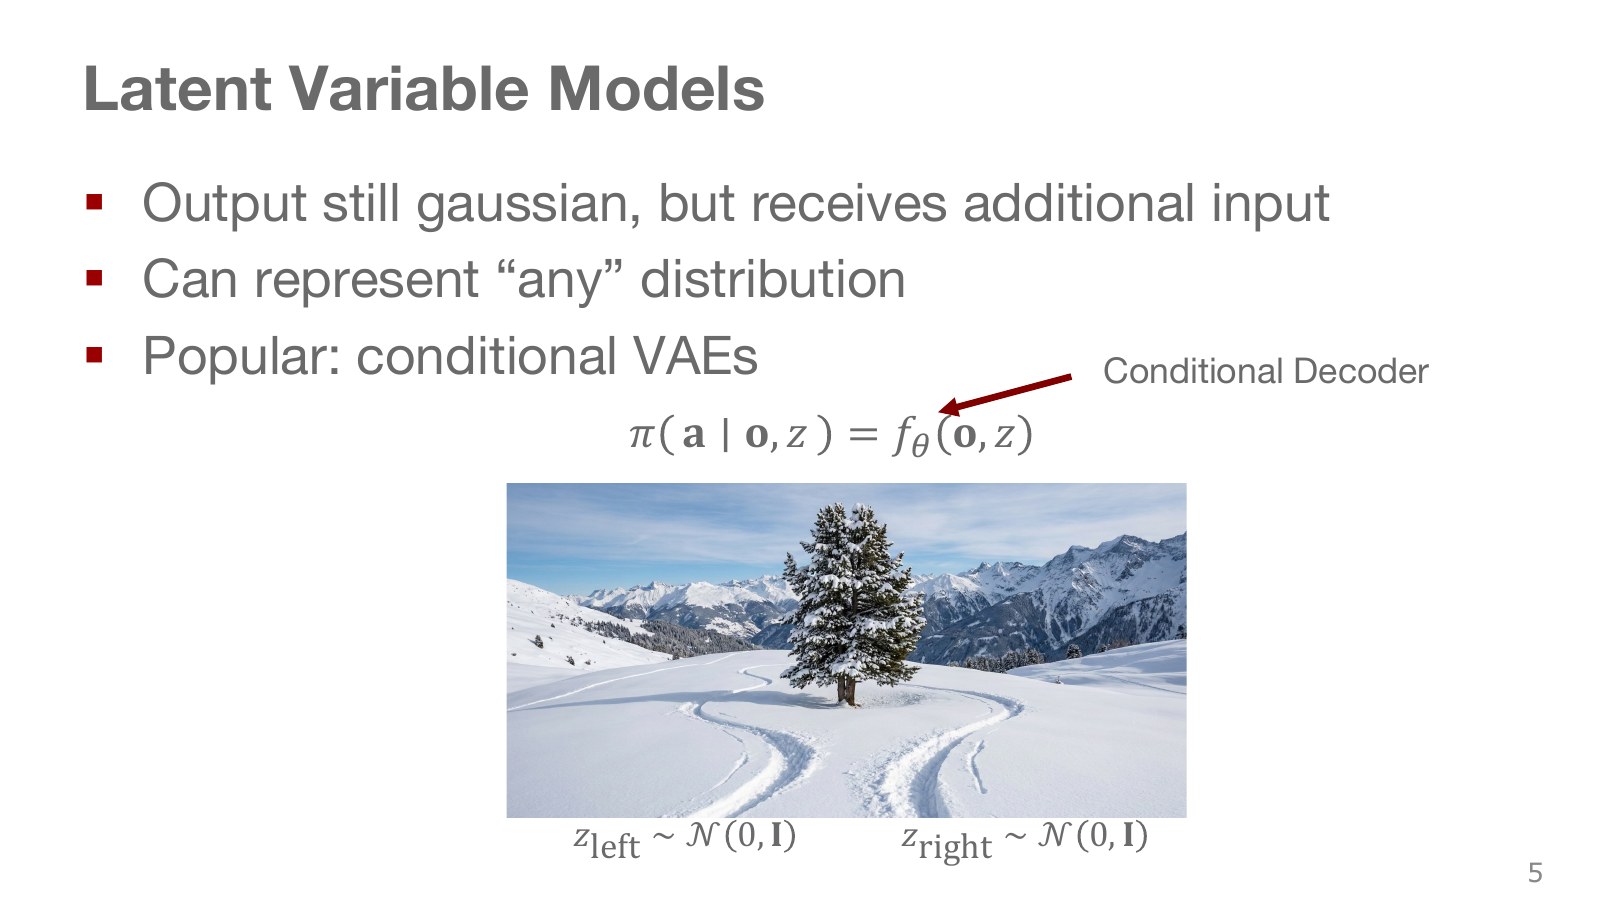
잠재변수(latent variable)는 자료에서 직접 주어지지 않지만 결과의 차이를 설명하는 변수다. 컵을 왼쪽에서 잡는 방식과 오른쪽에서 잡는 방식을 숨은 선택으로 생각해 보자. 먼저 잠재변수를 뽑고, 관측과 그 변수를 함께 보고 행동을 만든다.
적분은 가능한 잠재변수마다 만들어지는 분포를 그 빈도에 맞춰 합한다는 뜻이다. 각 조건부 분포가 단순해도 이들을 합한 전체 분포는 여러 봉우리를 가질 수 있다. 신경망과 잠재공간이 충분히 유연할 때 얻는 표현력과, 제한된 자료로 실제 학습한 성능은 구별해야 한다.
한 행동 묶음 안에서는 선택한 방식을 유지하는 것이 중요하다. 제어 순간마다 독립적으로 왼쪽·오른쪽 방식을 바꾸면 손이 흔들릴 수 있다. 분포를 잘 맞추는 문제와 시간에 걸쳐 일관된 행동을 만드는 문제는 함께 고려해야 한다.
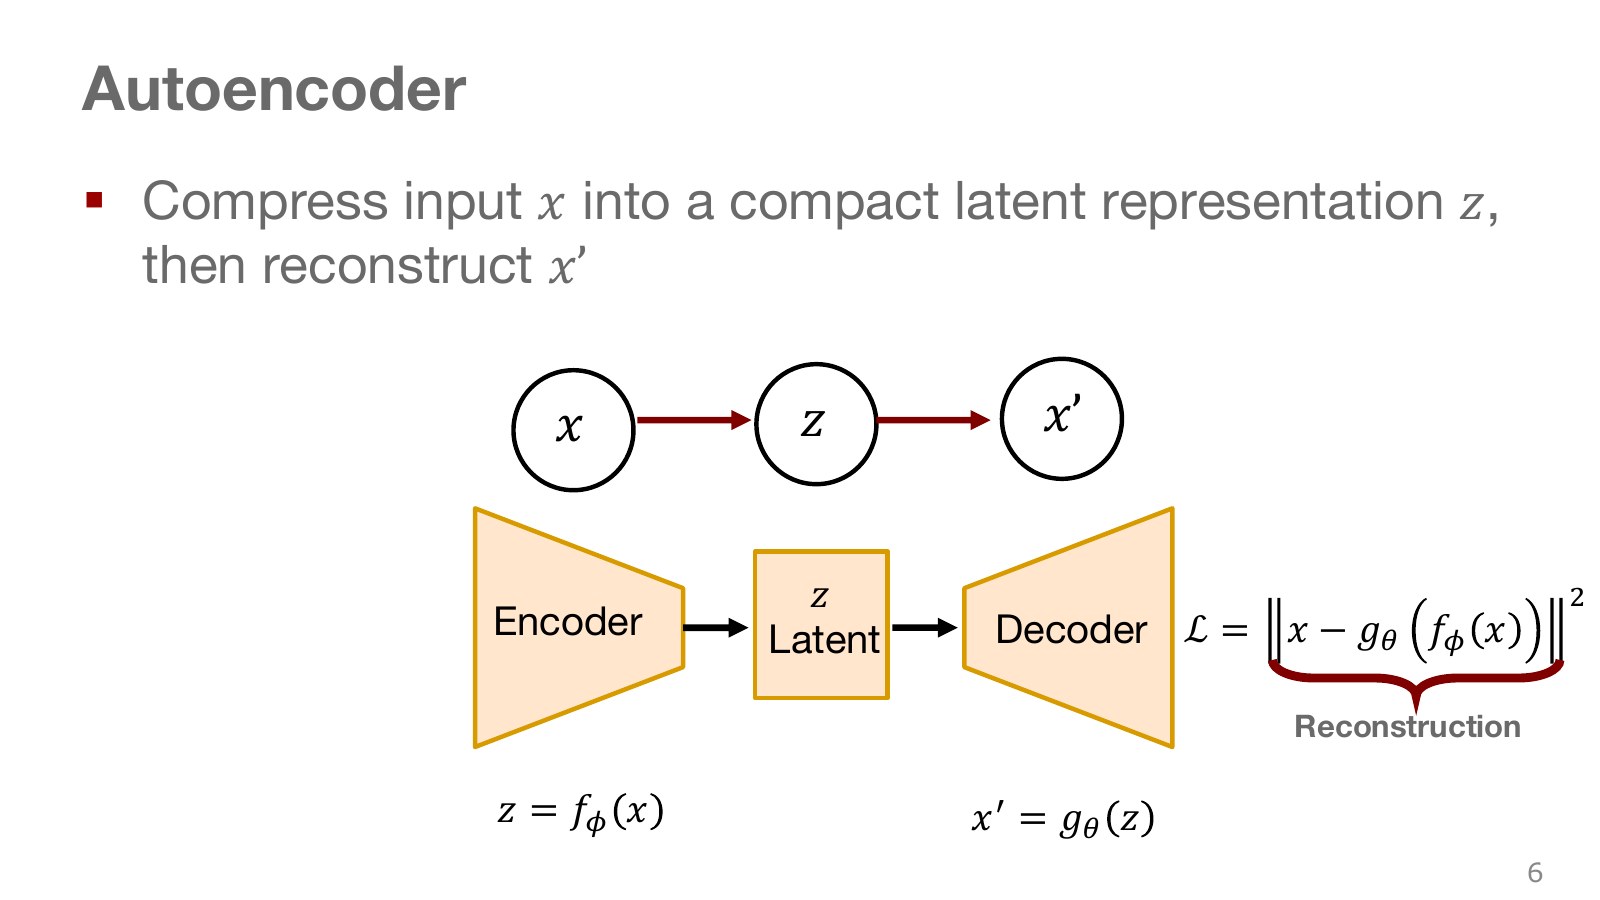
왼쪽 인코더는 큰 입력을 작은 벡터로 압축하고, 오른쪽 디코더는 그 벡터에서 입력을 복원한다. 사진이라면 픽셀 수보다 작은 표현을 통과시켜 물체의 형태나 배치 같은 정보를 담게 한다. 복원(reconstruction)은 입력과 비슷한 결과를 다시 만드는 작업이다.
인코더의 가중치는 φ, 디코더의 가중치는 θ로 구별한다. 병목(bottleneck)은 중간 표현의 용량을 제한하는 부분이다. 너무 작으면 필요한 정보도 잃고, 너무 넓으면 입력을 단순히 외울 수 있다. 복원을 잘한다고 반드시 로봇 제어에 중요한 접촉이나 안전 정보를 보존했다고 볼 수는 없다. 무엇을 입력으로 쓰고 어떤 복원 목표를 주었는지가 중요하다.
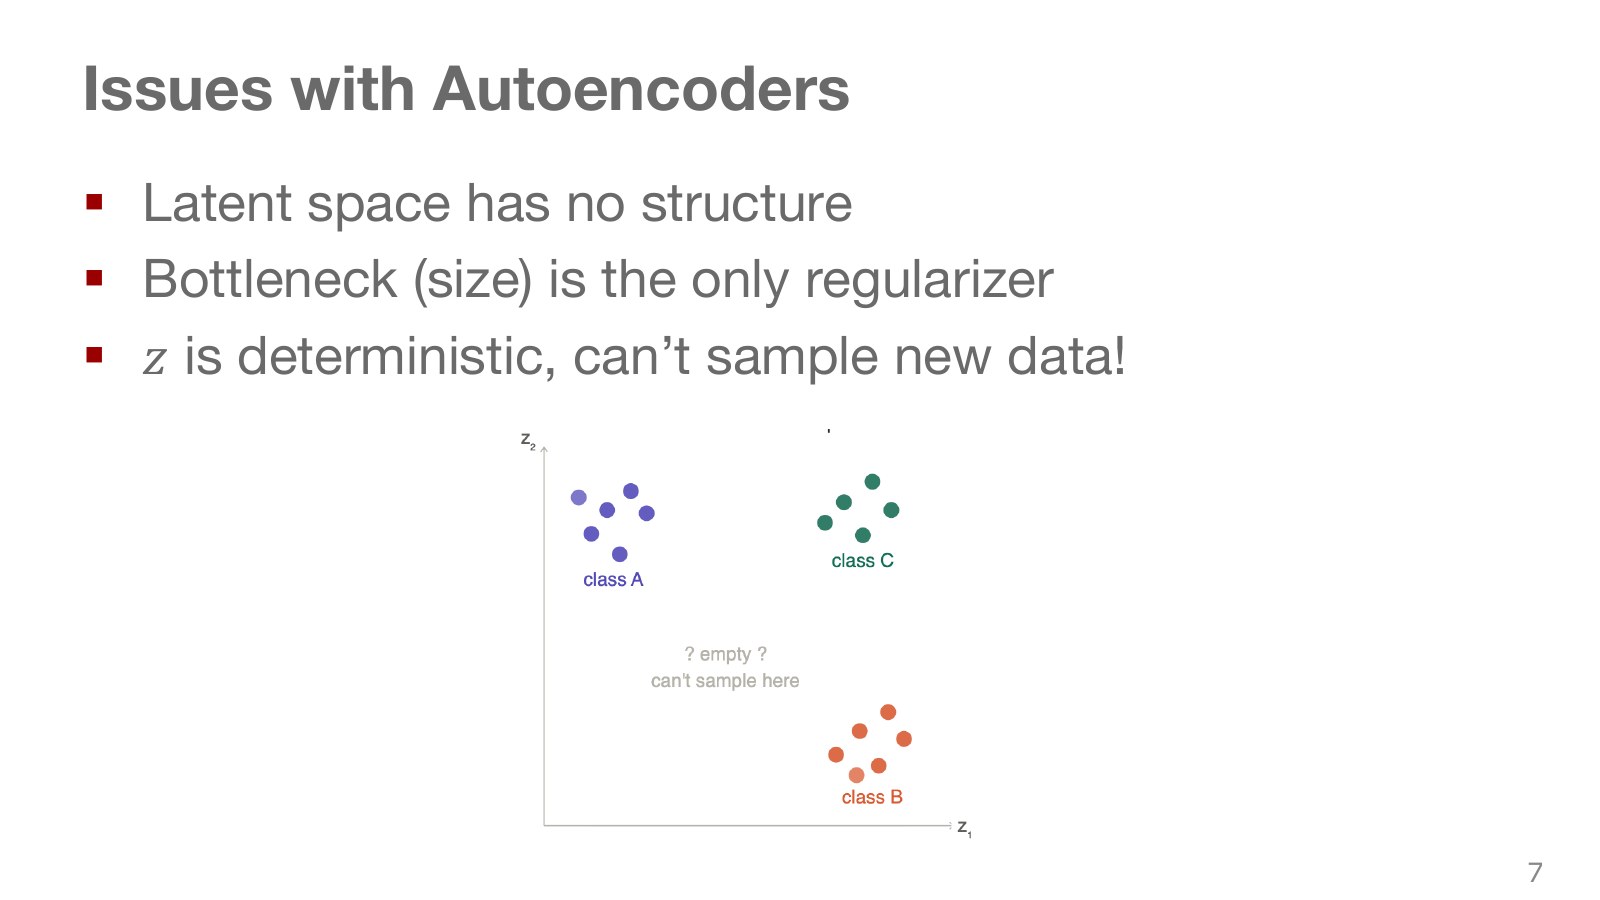
색이 모인 잠재공간을 보자. 오토인코더는 학습 입력이 지나간 자리에서는 잘 복원할 수 있지만, 그 사이의 드물게 쓰인 자리에서 어떤 결과를 낼지는 충분히 배우지 않았을 수 있다. 따라서 표준정규분포에서 아무 점이나 뽑아 디코더에 넣는 일이 곧 좋은 생성으로 이어지지는 않는다.
문제는 디코더가 결정론적이라는 사실 자체가 아니다. 무작위 입력을 결정론적 함수로 변환해도 확률분포를 생성할 수 있다. 일반 오토인코더에는 “나중에 어느 분포에서 코드를 뽑을 것인가”와 “학습 중 그 공간을 어떻게 채울 것인가”를 맞추는 장치가 부족하다는 점이 핵심이다.
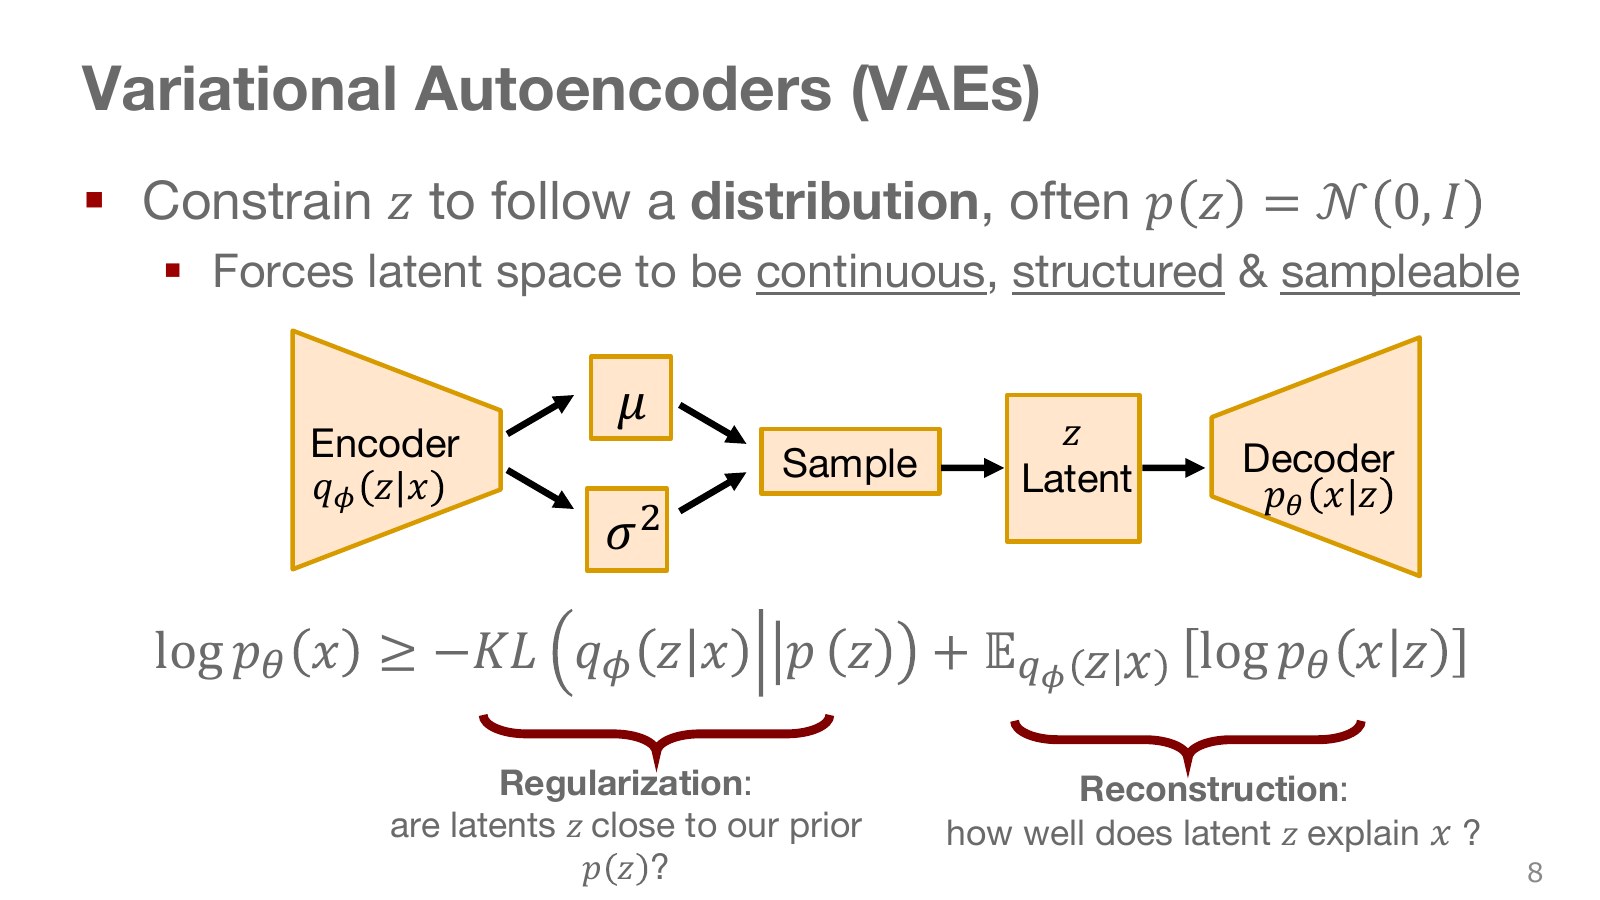
VAE(변분 오토인코더)의 인코더는 코드 하나 대신 평균과 분산을 출력한다. 그 분포에서 코드를 뽑아 디코더에 전달한다. 사전분포(prior)는 자료를 보기 전에 코드를 뽑는 규칙이고, 근사 사후분포는 입력을 보고 어떤 코드가 어울리는지 추정하는 규칙이다.
첫 식의 기대값은 “뽑은 코드로 입력을 얼마나 잘 설명하는가”를 평가한다. KL 발산은 두 분포의 어긋남을 재는 비음수량이다. 두 번째 식의 KL이 0 이상이므로 ELBO는 로그 가능도보다 클 수 없다. 이름 그대로 evidence lower bound, 즉 관측 자료의 로그 가능도에 대한 하한이다. 사전분포와 비교하는 KL과 실제 사후분포와 비교해 하한의 간격을 나타내는 KL을 혼동하지 말자.
Berkeley VAE 강의 53:50–56:53는 이 간격이 어디서 생기는지 설명한다. 하한을 높이는 것과 실제 가능도를 높이는 관계가 이 식에서 드러난다. 조건부 행동 모델에서는 관측과 시연 행동을 함께 보는 인코더, 관측과 잠재변수로 행동을 복원하는 디코더를 구성할 수 있다. 실행 때는 미래 시연 행동을 모르므로 학습용 인코더에 그 정답을 넣을 수 없다.
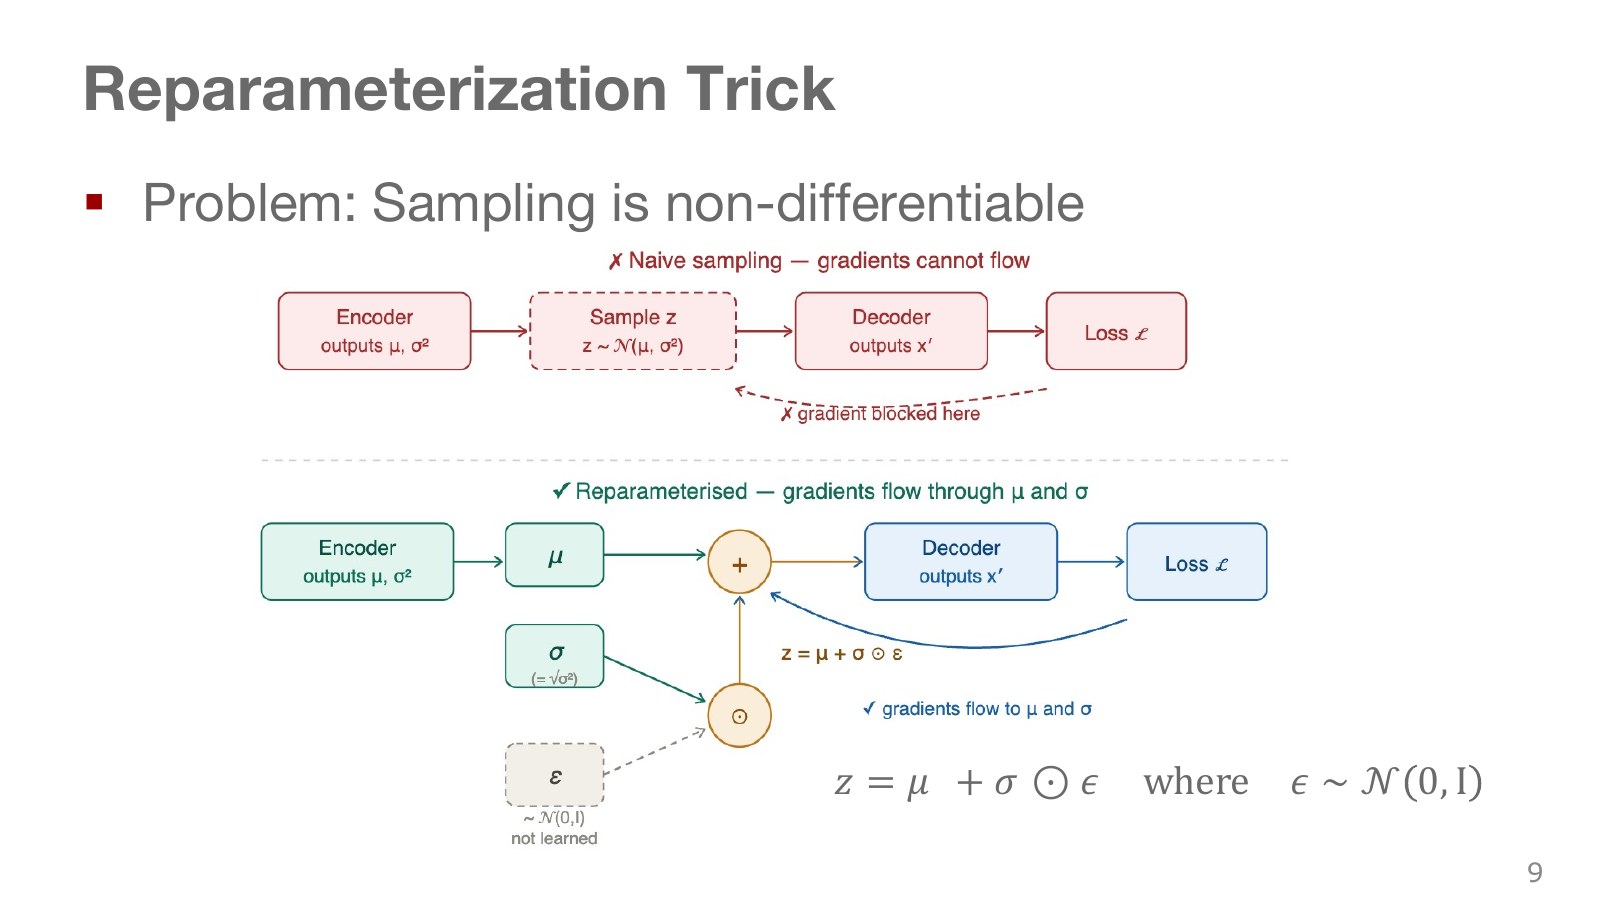
분포에서 표본을 뽑는 단계를 그대로 두면 인코더 가중치로 이어지는 미분을 다루기 불편하다. 대신 표준정규 잡음을 따로 뽑고 평균과 표준편차로 변환한다.
가운데 곱 기호는 같은 위치 원소끼리 곱한다는 뜻이다. 역전파 한 번에서는 뽑아 놓은 잡음 값을 고정하고, 평균과 표준편차를 바꿀 때 복원 결과가 어떻게 달라지는지 미분한다. 무작위성을 없애는 것이 아니라 무작위 수의 출처를 가중치 밖으로 옮긴 것이다.
분산과 표준편차도 구별해야 한다. 그림의 σ²가 분산이라면 위 식에는 그 제곱근인 σ가 들어간다. 구현에서 로그 분산을 출력했다면 절반으로 나눈 뒤 지수 함수를 적용해 표준편차를 얻는다. 05장의 SAC에서도 같은 경로 미분 아이디어를 행동 표본에 적용했다.
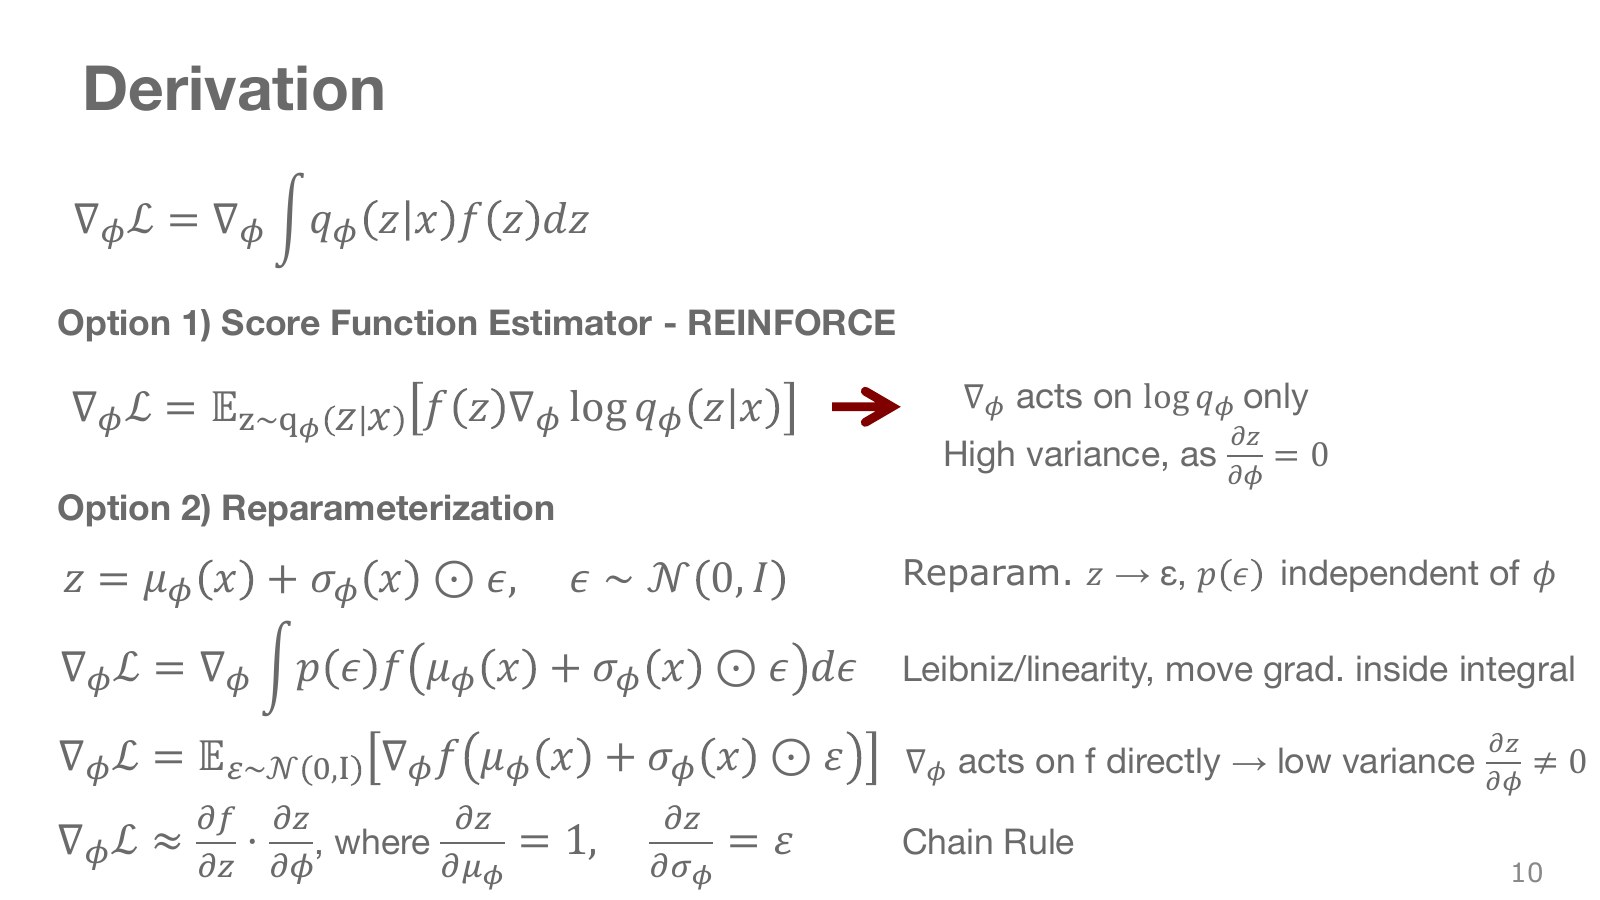
왼쪽은 분포가 바뀔 때 각 결과의 가중치가 어떻게 바뀌는지 계산하는 score-function 방식이다. REINFORCE에서 사용한 로그 확률 미분이 여기에 속한다. 오른쪽은 고정 잡음에서 결과를 만드는 함수를 통과해 직접 미분하는 pathwise 방식이다.
이 식은 잡음 분포가 가중치와 무관하고 기대값과 미분을 교환할 수 있는 조건에서 쓴다. 단순히 기대값의 선형성만으로 모든 무작위 계산을 미분할 수 있는 것은 아니다. 경로 방식은 많은 연속 잠재모델에서 유용하지만, 항상 더 낮은 분산을 보장하거나 이산 표본에도 곧바로 적용되는 만능 해법은 아니다. 출력까지 이어지는 미분 가능한 경로가 필요하다.
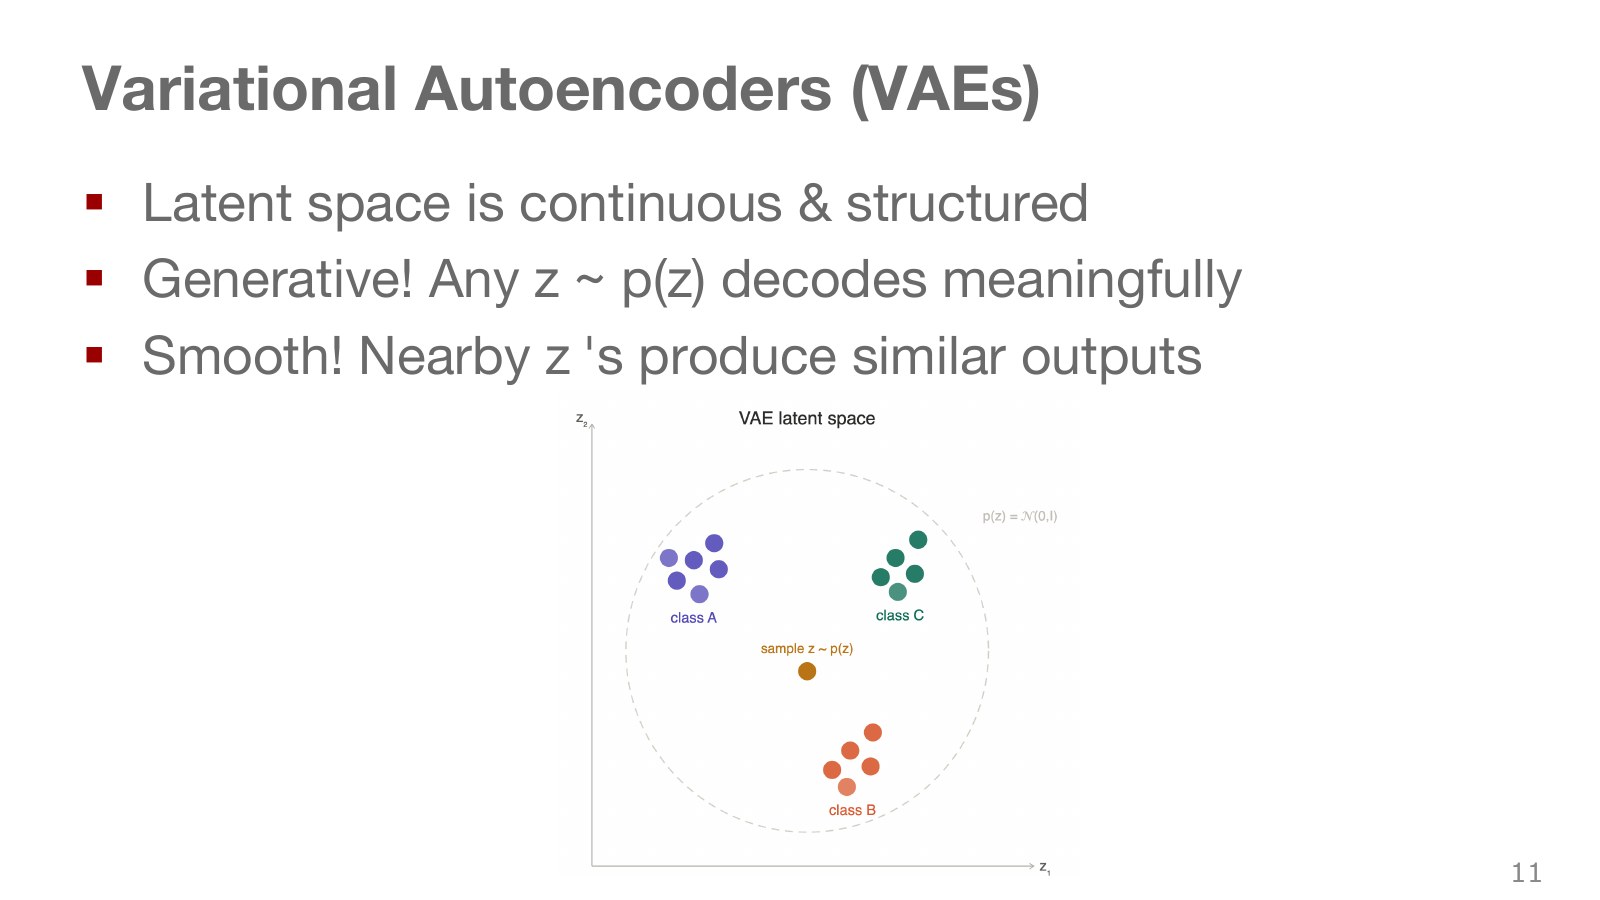
그림 위쪽은 입력을 인코더에 통과시키는 학습 과정, 아래쪽은 사전분포에서 코드를 뽑아 디코더로 보내는 생성 과정이다. VAE는 두 과정이 만나는 잠재공간을 만들려고 한다. 비슷한 코드가 비슷한 결과를 만드는 성질은 보간이나 표본 생성에 도움이 된다.
하지만 KL 정규화를 넣었다고 모든 코드가 의미 있고 모든 중간 결과가 자연스럽다는 보장이 생기지는 않는다. 특히 행동 코드 둘 사이를 보간한 결과가 충돌 없는 움직임인지 여부는 물리 환경과 제약을 따로 확인해야 한다. 잠재공간의 부드러움과 실제 로봇 궤적의 안전성은 다른 속성이다.
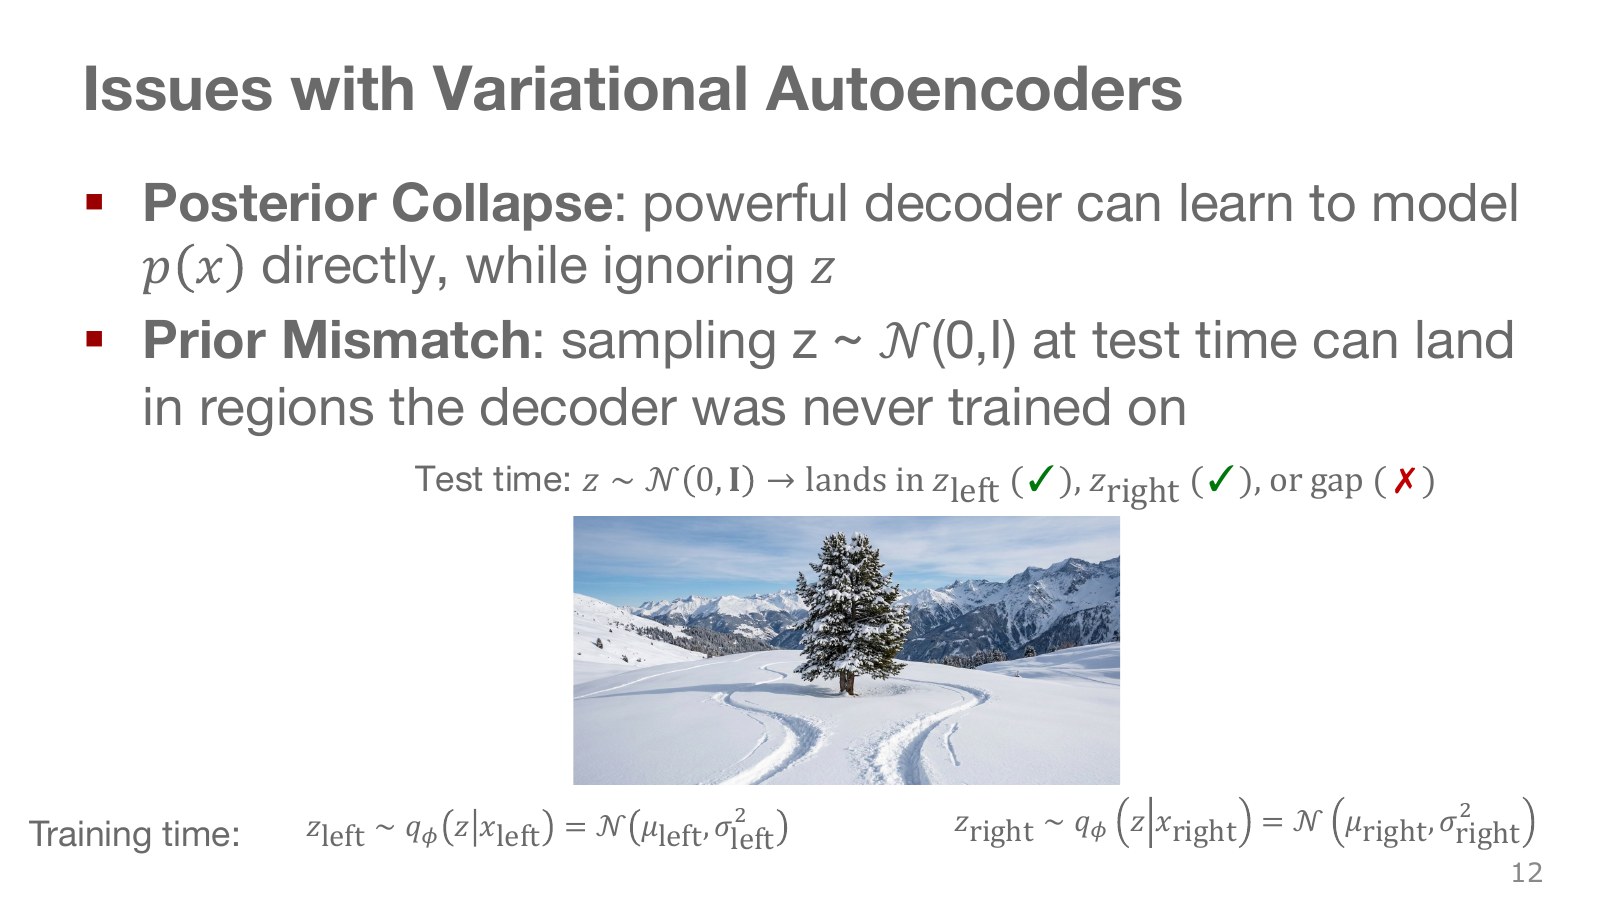
Posterior collapse는 디코더가 잠재변수를 거의 쓰지 않는 현상이다. 다른 조건만으로도 복원을 잘하거나 정규화 압력이 강하면, 서로 다른 코드를 넣어도 결과의 차이가 작아질 수 있다. 그렇다고 디코더가 반드시 결정론적이 되는 것은 아니다. 잠재변수 이외의 확률성을 가질 수 있다.
Prior mismatch는 학습 입력들이 실제로 사용하는 잠재분포와 생성 때 뽑는 사전분포가 어긋나는 문제다. 입력별 근사 사후분포를 모두 모은 분포를 생각하면 이해하기 쉽다. 표준정규분포에서 뽑은 점이 학습 중 거의 쓰이지 않은 영역에 놓이면 복원이 나빠질 수 있다. 가우시안의 밀도가 작다는 것과 수학적으로 지지집합 밖이라는 말은 구별해야 한다. 복원과 정규화의 균형은 VAE의 중요한 설계 문제다.
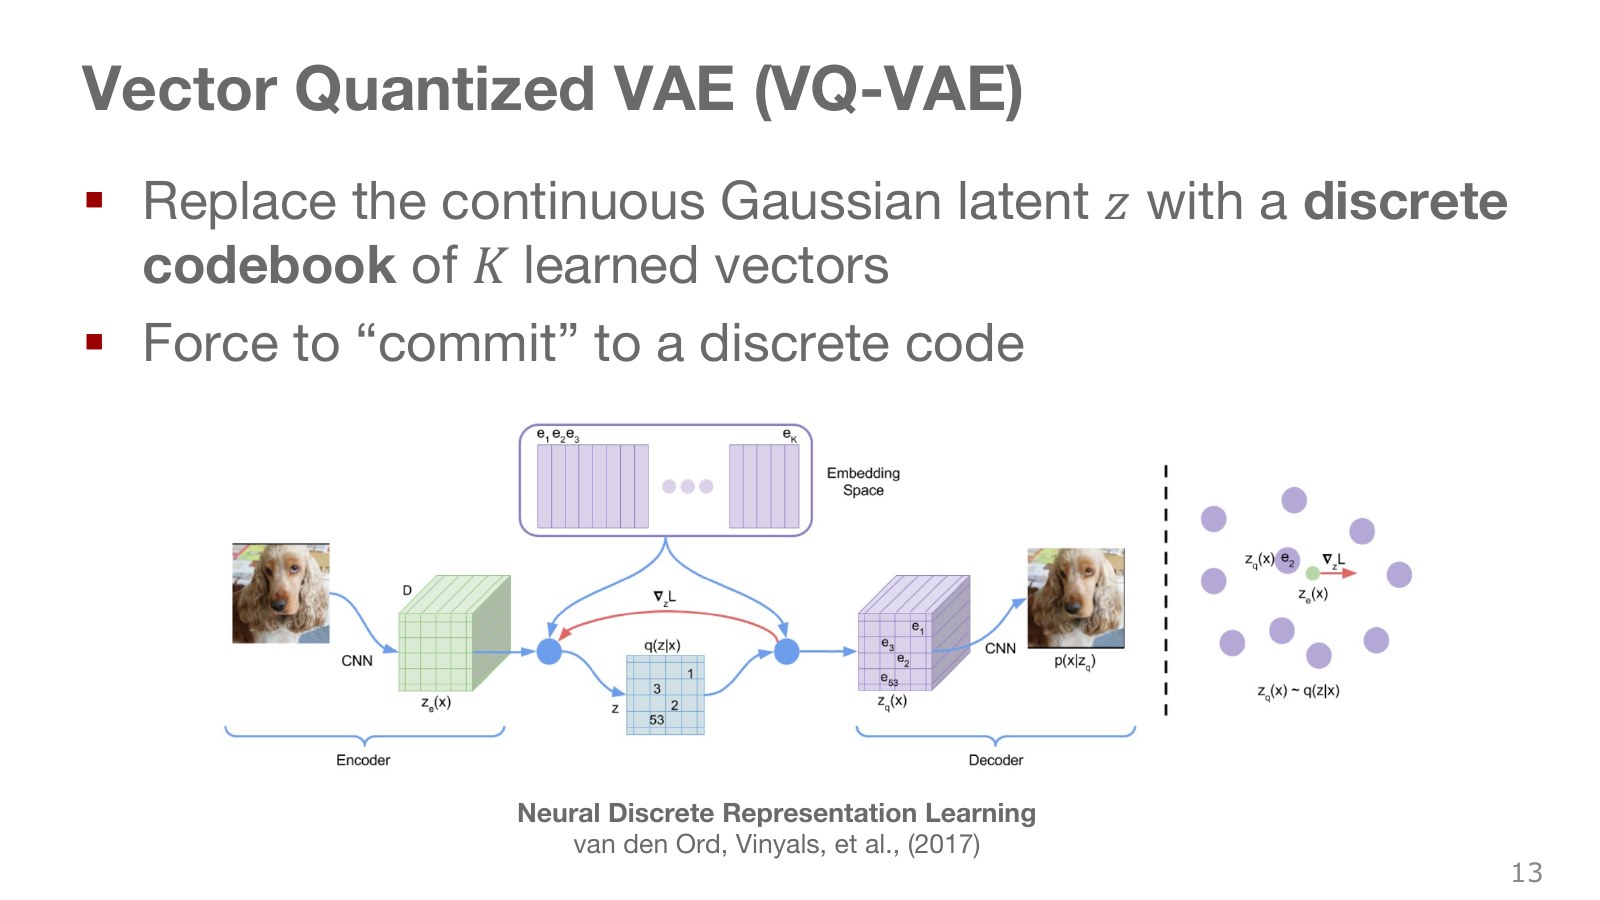
VQ는 vector quantization, 벡터 양자화다. 인코더가 연속 벡터를 만들면 미리 정한 개수의 대표 벡터 가운데 가장 가까운 것을 고른다. 코드북(codebook)은 이 대표 벡터들의 목록이다. 그림의 색 점들은 목록에 들어 있는 벡터, 각 영역은 같은 대표를 선택하게 되는 입력 범위로 읽을 수 있다.
번호는 이산적이지만 선택된 벡터의 원소는 실수다. “코드 7”과 “7차원 벡터”는 전혀 다른 말이다. 코드북 항목 수와 각 항목의 차원도 별개다. 영상은 위치별로 코드를 골라 여러 토큰으로 표현할 수 있다. VQ-VAE의 기본 학습은 VAE처럼 매 입력에 가우시안 평균과 분산을 내고 KL을 계산하는 구조와 다르다.
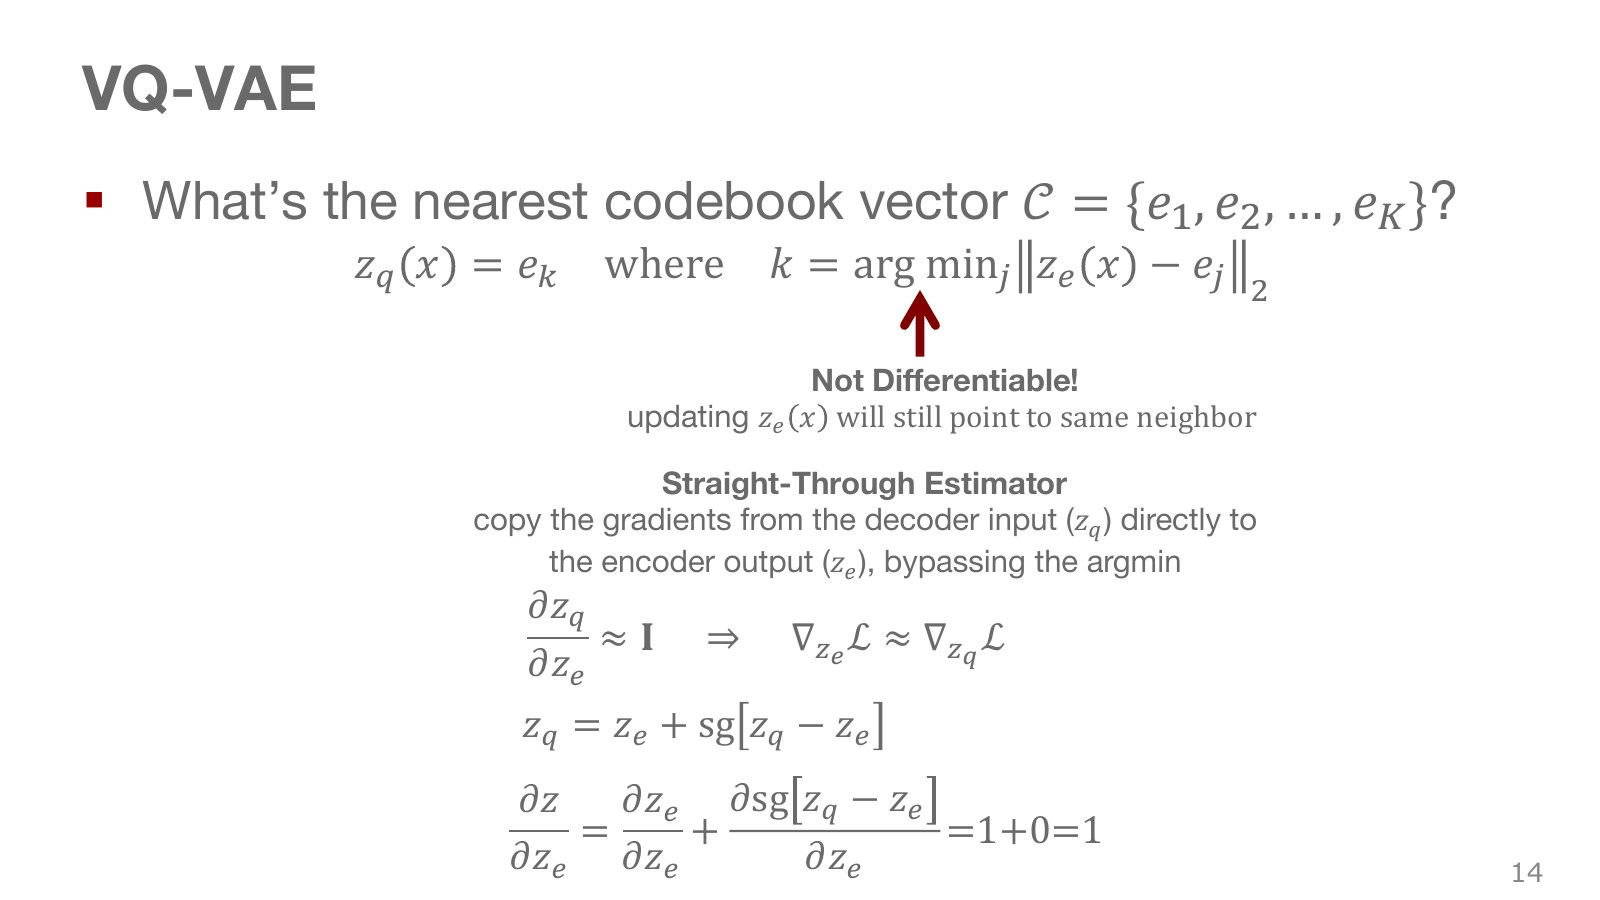
인코더 출력이 조금 움직여도 같은 대표 벡터가 선택되는 동안 양자화 결과는 변하지 않는다. 따라서 그 영역에서 실제 미분은 0이고 경계에서는 미분이 정의되지 않을 수 있다. 이 상태로 복원 오차를 그대로 역전파하면 인코더가 충분한 학습 신호를 받기 어렵다.
Stop-gradient 연산은 앞으로 계산할 때 값을 그대로 전달하고, 뒤로 미분할 때 그 경로의 기울기를 0으로 취급한다. 위 식의 순전파 결과는 양자화된 코드이고, 인코더 출력에 대한 역전파는 항등함수처럼 전달된다. STE는 실제 양자화 함수의 미분을 정확히 구한 결과가 아니라 학습을 위한 대체 기울기다. 그래서 이산 선택을 지나 학습할 수 있지만 편향이 없는 추정이라고 주장해서는 안 된다.
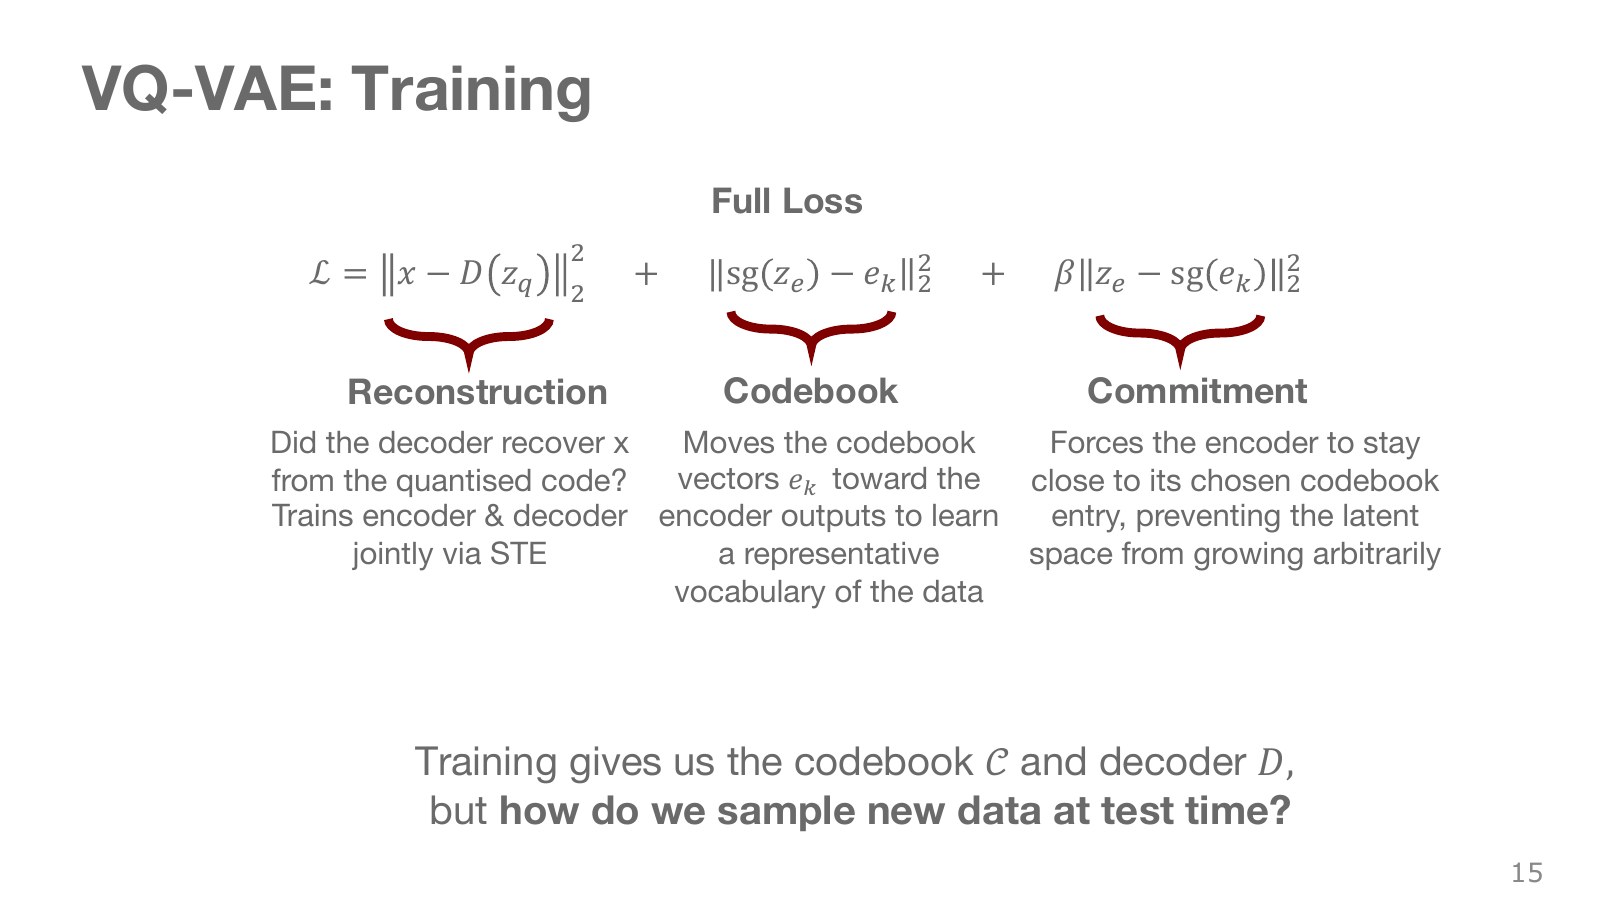
세 손실을 나누면 무엇을 학습하는지 보인다. 복원 항은 코드로부터 원래 입력을 되찾게 한다. 코드북 항은 선택된 대표를 인코더 출력 쪽으로 당긴다. 커밋먼트 항은 인코더가 고른 대표에서 멀어지지 않게 붙잡는다.
가운데 항에서는 인코더 쪽을 고정하고 코드북을 바꾼다. 마지막 항에서는 코드북 쪽을 고정하고 인코더를 바꾼다. 복원 오차는 디코더를 직접 학습하고, STE를 통해 인코더에도 전달된다. β는 커밋먼트의 가중치이며 뒤에서 확산에 쓰는 잡음 분산 기호와 역할이 다르다.
학습된 코드북만으로 “어떤 번호 조합을 얼마나 자주 뽑아야 할까?”까지 해결되지는 않는다. 이 질문이 다음 생성 단계로 이어진다. 코드북을 손실의 직접 기울기 대신 이동평균으로 갱신하는 변형도 있다.
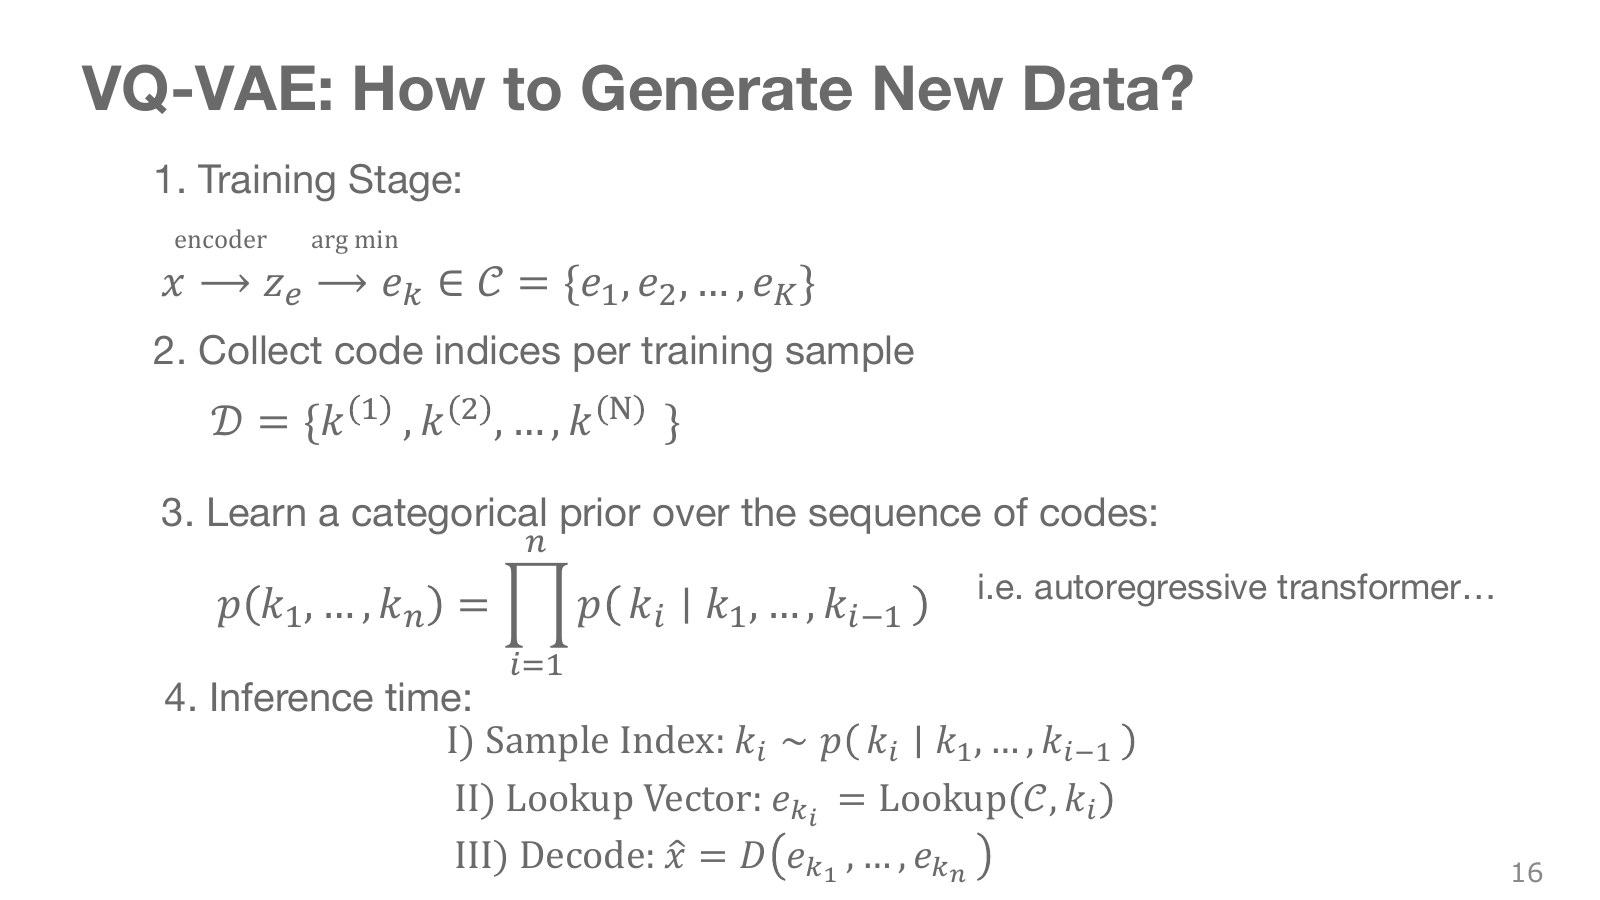
첫 단계에서 인코더·코드북·디코더를 학습한 뒤, 자료를 코드 번호의 배열로 바꾼다. 두 번째 단계에서는 그 번호 배열의 분포를 별도 모델로 학습할 수 있다. 생성 때는 번호를 뽑고 해당 벡터를 찾아 디코더에 전달한다.
앞 번호들을 보고 다음 번호를 고르는 방식은 토큰 사이의 관계를 보존한다. 서로 다른 위치에 쓰이는 코드를 독립 균등하게 뽑으면 학습 자료에 없던 조합이 생길 수 있다. 예를 들어 두 토큰이 언제나 같은 접근 방향을 나타냈는데 하나는 왼쪽, 하나는 오른쪽으로 뽑으면 일관되지 않은 행동 묶음이 된다. 양자화는 표현을 이산화하는 도구이며, 그 표현의 올바른 공동분포를 배우는 단계는 따로 필요하다.
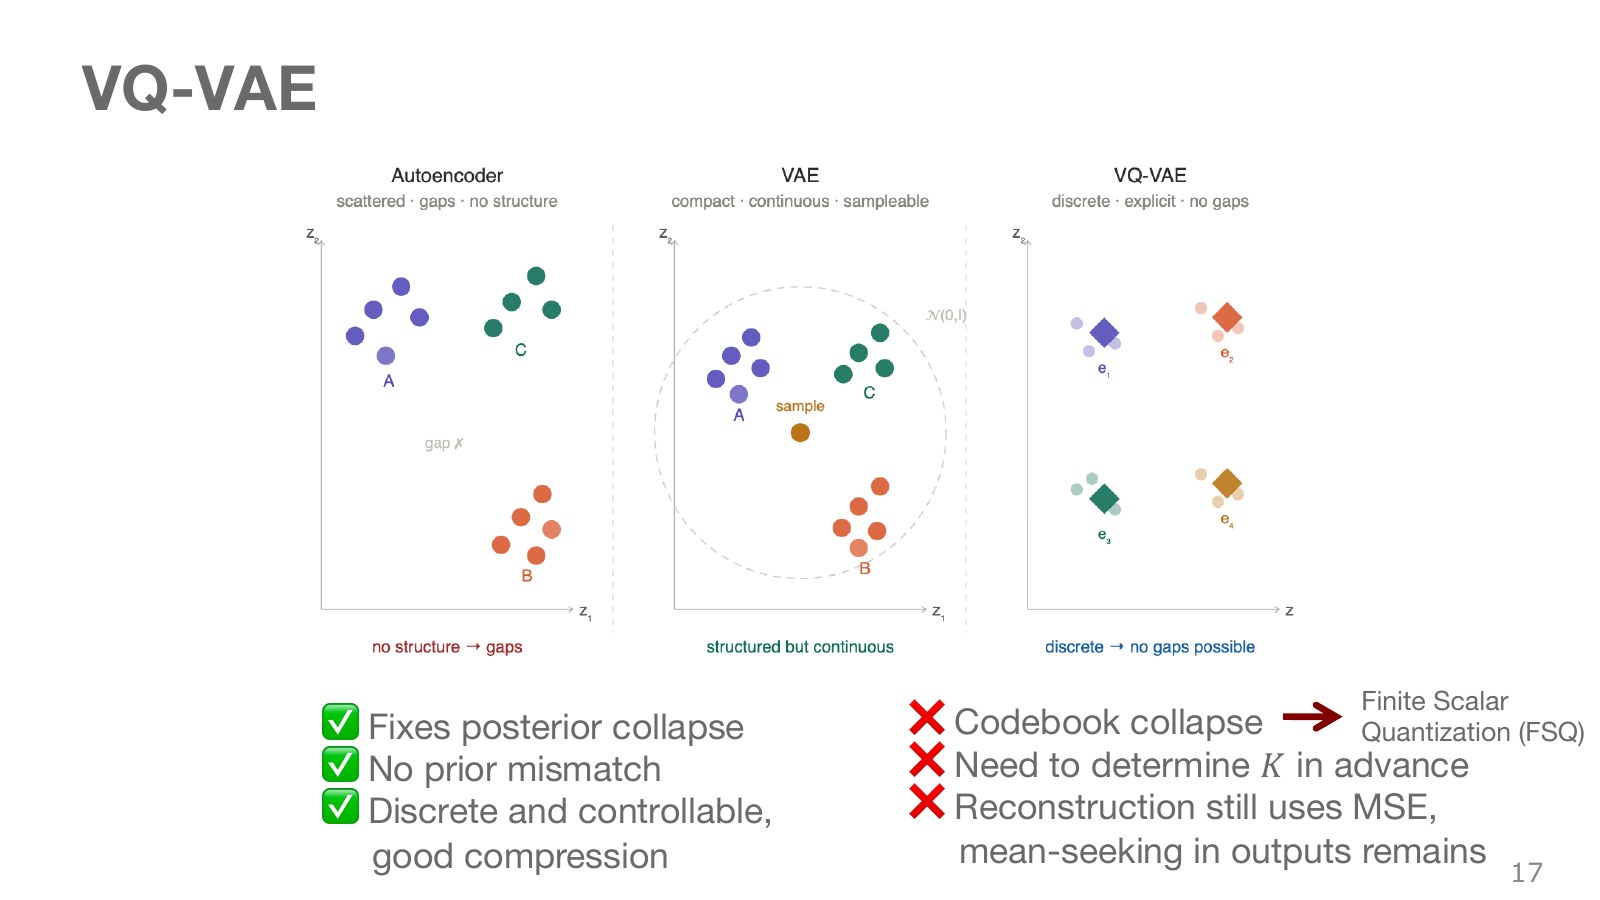
표의 AE는 복원 중심, VAE는 연속 확률 잠재공간, VQ-VAE는 이산 코드 목록을 사용한다. VQ-VAE는 사전분포를 연속 공간의 모든 지점에 맞추는 대신 코드 번호의 분포로 배울 수 있다는 장점이 있다. 그러나 코드북을 잘 쓰지 못해 일부 코드만 선택되는 codebook collapse나, 잘못 배운 코드 분포 문제는 남는다. “틈이 전혀 없다”는 표현을 모든 코드 조합의 품질 보장으로 읽으면 안 된다.
FSQ 논문은 각 축의 연속 값을 제한된 스칼라 수준으로 반올림해 암묵적인 격자 코드북을 만든다. 별도의 학습된 대표 벡터 목록과 최근접 탐색을 줄이는 접근이다. 그렇다고 이산화 전후 신경망이나 코드 사용 분포까지 학습이 필요 없어지는 것은 아니다. 표현의 해상도, 압축 정도, 분포 학습의 어려움은 여전히 함께 판단해야 한다.
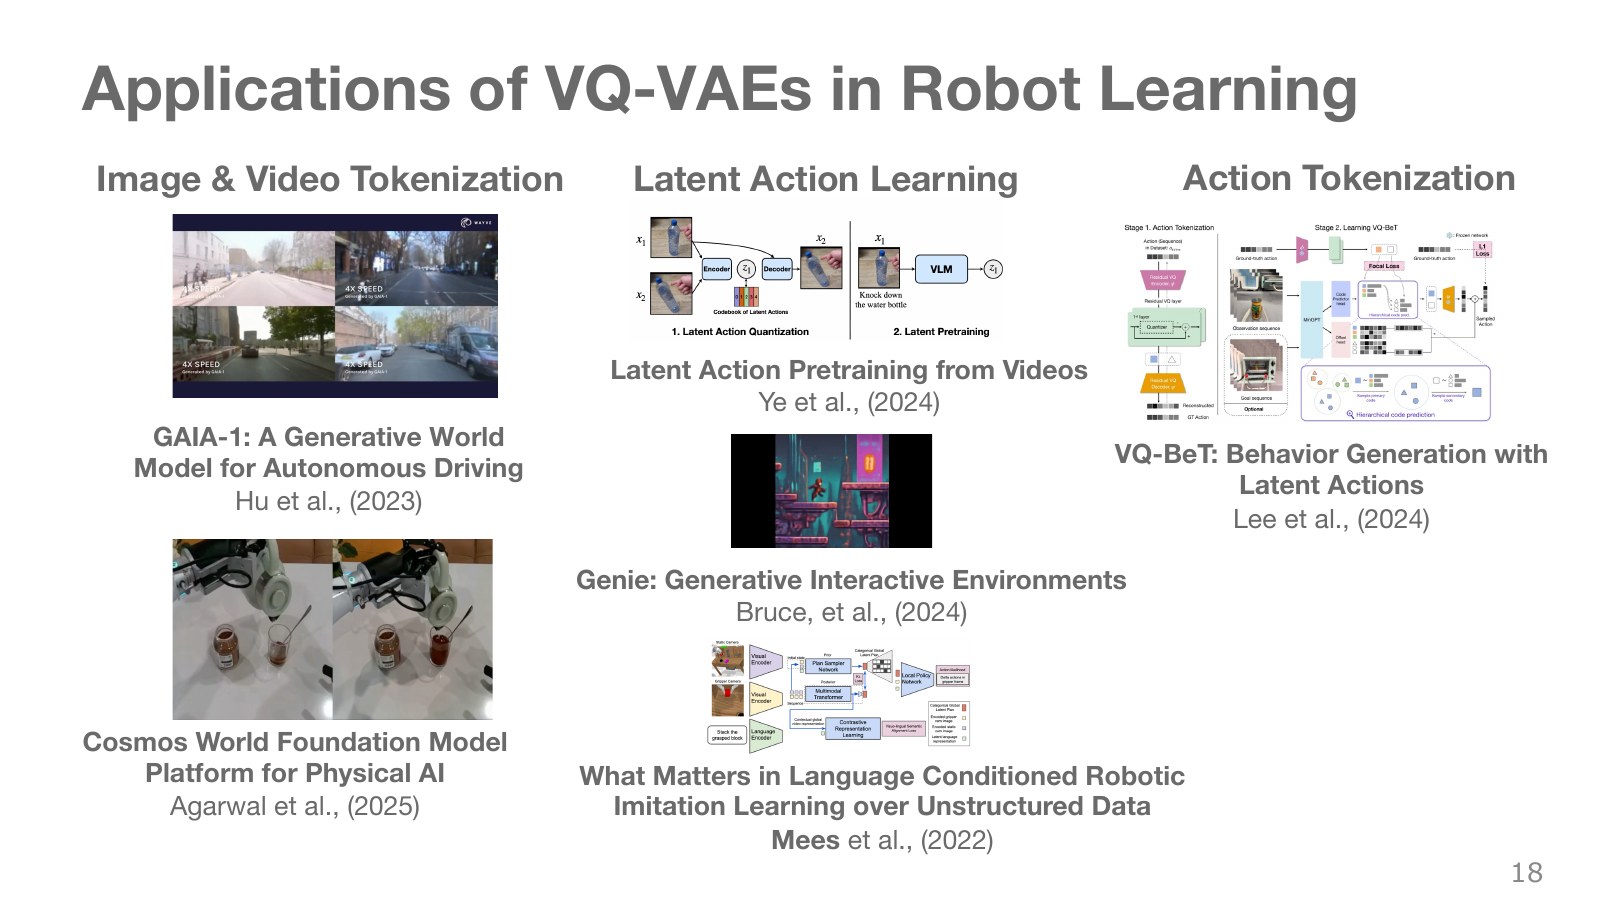
세 열은 이산 표현이 쓰이는 서로 다른 위치를 보여 준다. 첫째, 이미지나 영상을 토큰으로 바꾸면 미래 장면을 생성하는 월드 모델에 사용할 수 있다. 둘째, 연속된 두 영상 사이의 변화를 잠재 행동으로 압축하면 행동 라벨이 없는 영상에서도 변화의 규칙을 배울 수 있다. 셋째, 실제 관절 명령이나 행동 묶음을 토큰화하면 로봇 제어 출력을 이산 시퀀스로 표현할 수 있다.
가운데 잠재 행동은 영상 변화의 코드이므로 곧바로 어느 모터에 몇 볼트를 줄지 알려 주는 물리 명령은 아니다. 실제 로봇 행동과 연결하는 학습이나 디코더가 필요하다. 왼쪽과 오른쪽도 각각 “보이는 세계를 생성하는 것”과 “실행할 행동을 생성하는 것”으로 목적이 다르다. 그림에 함께 나온 GAIA-1, Cosmos, Genie, VQ-BeT 등의 이름을 모두 같은 VQ-VAE 구조의 복제품으로 이해해서는 안 된다.
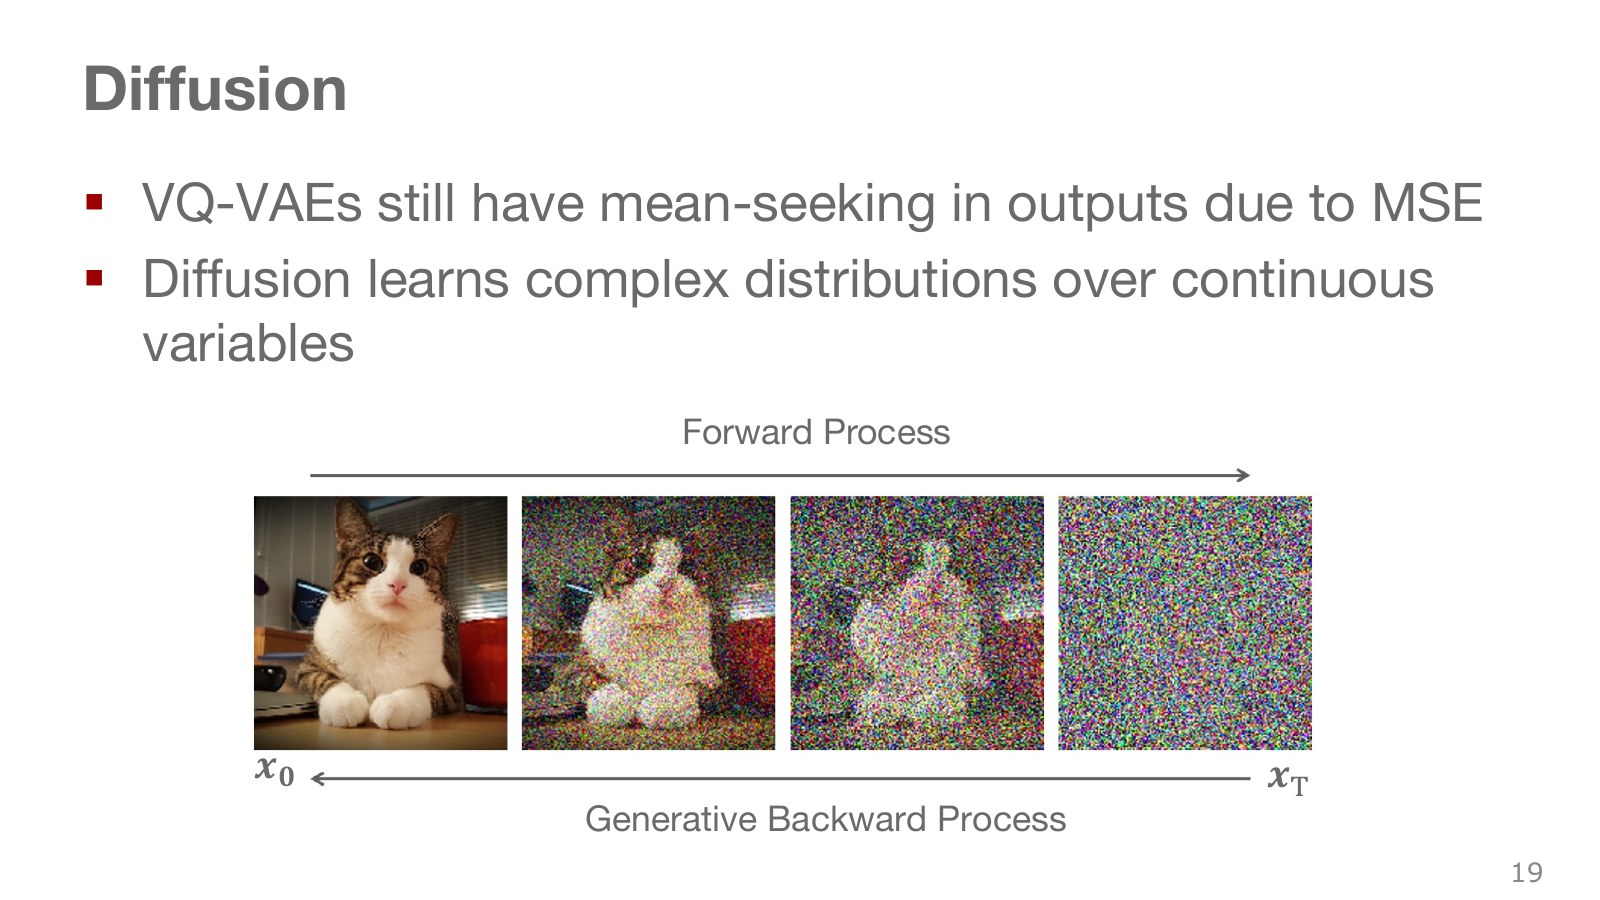
고양이가 점차 잡음으로 바뀌는 윗줄은 학습 자료를 만드는 방향이다. 아랫줄은 잡음에서 출발해 자료를 생성하는 방향이다. 학습 중에는 원본을 알고 있으므로 원하는 잡음 수준의 입력과 그에 대한 목표를 만들 수 있다. 생성 때는 원본을 모르므로 학습한 예측을 반복해서 사용한다.
잠재변수 모델이 작은 코드에서 결과를 만드는 데 초점을 두었다면, 여기서는 여러 잡음 수준을 거치는 복원 문제를 만든다. 그렇다고 모든 확산이 원본 픽셀에서만 작동하거나 잠재공간을 쓰지 않는 것은 아니다. 압축한 잠재표현에서 확산을 수행하는 방식도 있다. 로봇 정책에서는 그 대상이 영상 대신 행동 묶음이 될 수 있다.
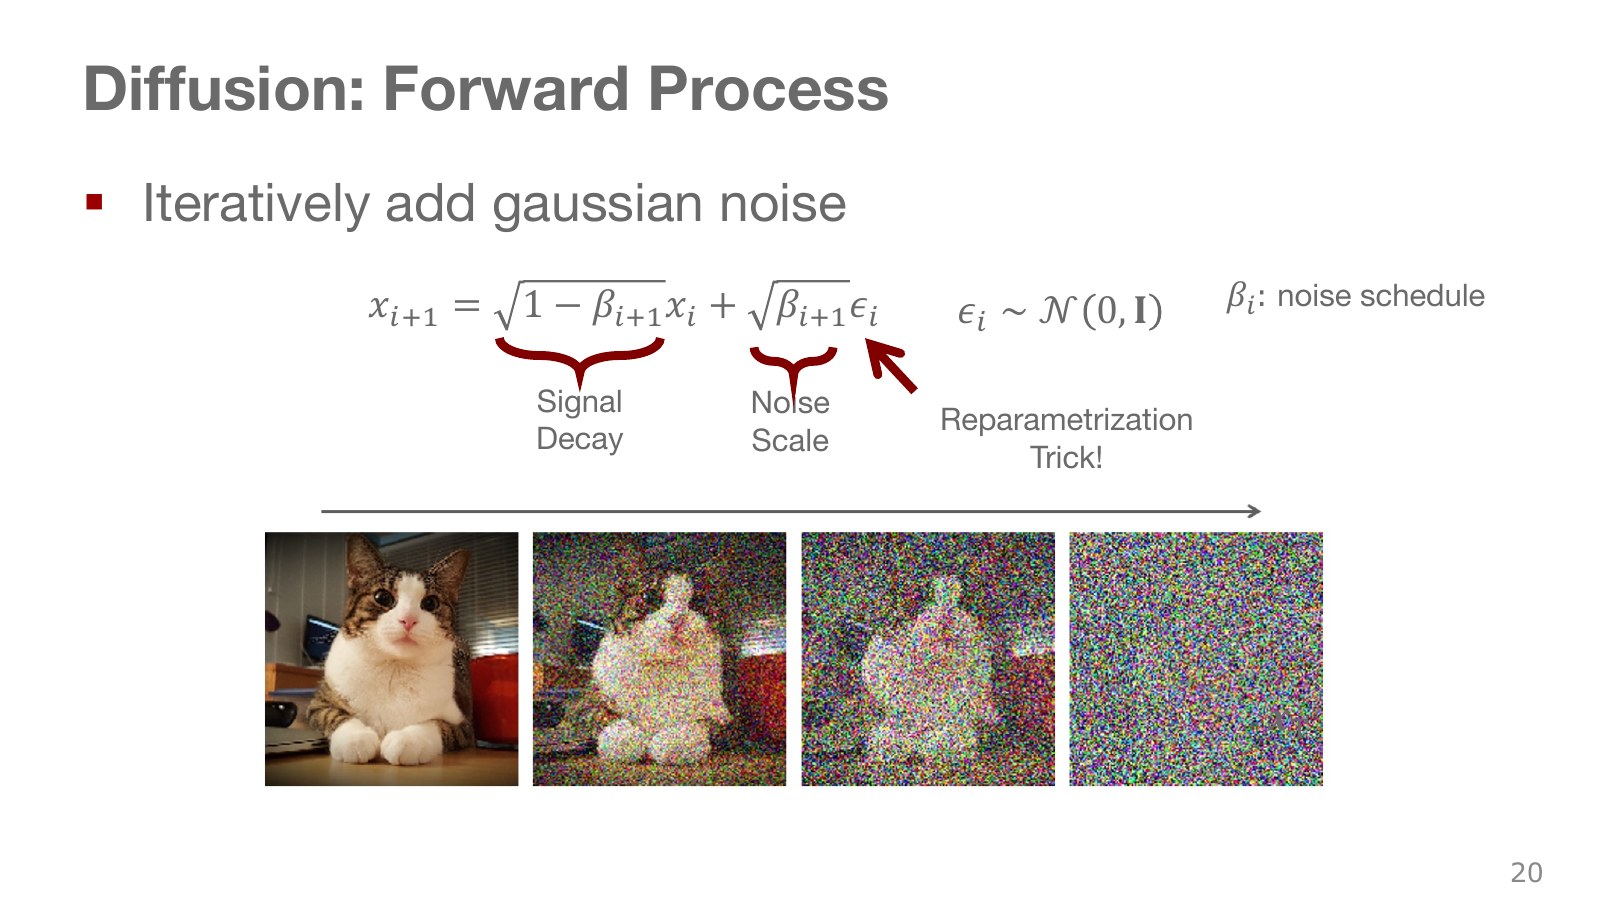
각 단계에서 현재 값을 조금 줄이고 독립 가우시안 잡음을 더한다. 기존 값을 그대로 두고 잡음만 누적하는 것과 달리, 신호의 크기를 함께 조절한다.
β는 추가하는 잡음의 분산이고, 실제 잡음 표본 앞에는 그 제곱근이 곱해진다. 작은 β를 여러 번 적용하면 원본의 특징이 점차 약해진다. 어느 단계에 얼마나 잡음을 섞을지 정한 목록이 noise schedule이다.
여기서 단계 번호는 실제 로봇이 움직이는 시간과 다르다. 제어 시점 하나에서 행동 묶음을 만들기 위해 내부 잡음 제거 계산을 수십 번 수행할 수 있다. 로봇의 미래 행동 길이와 신경망을 호출하는 잡음 제거 횟수를 같은 숫자로 혼동하지 말자.
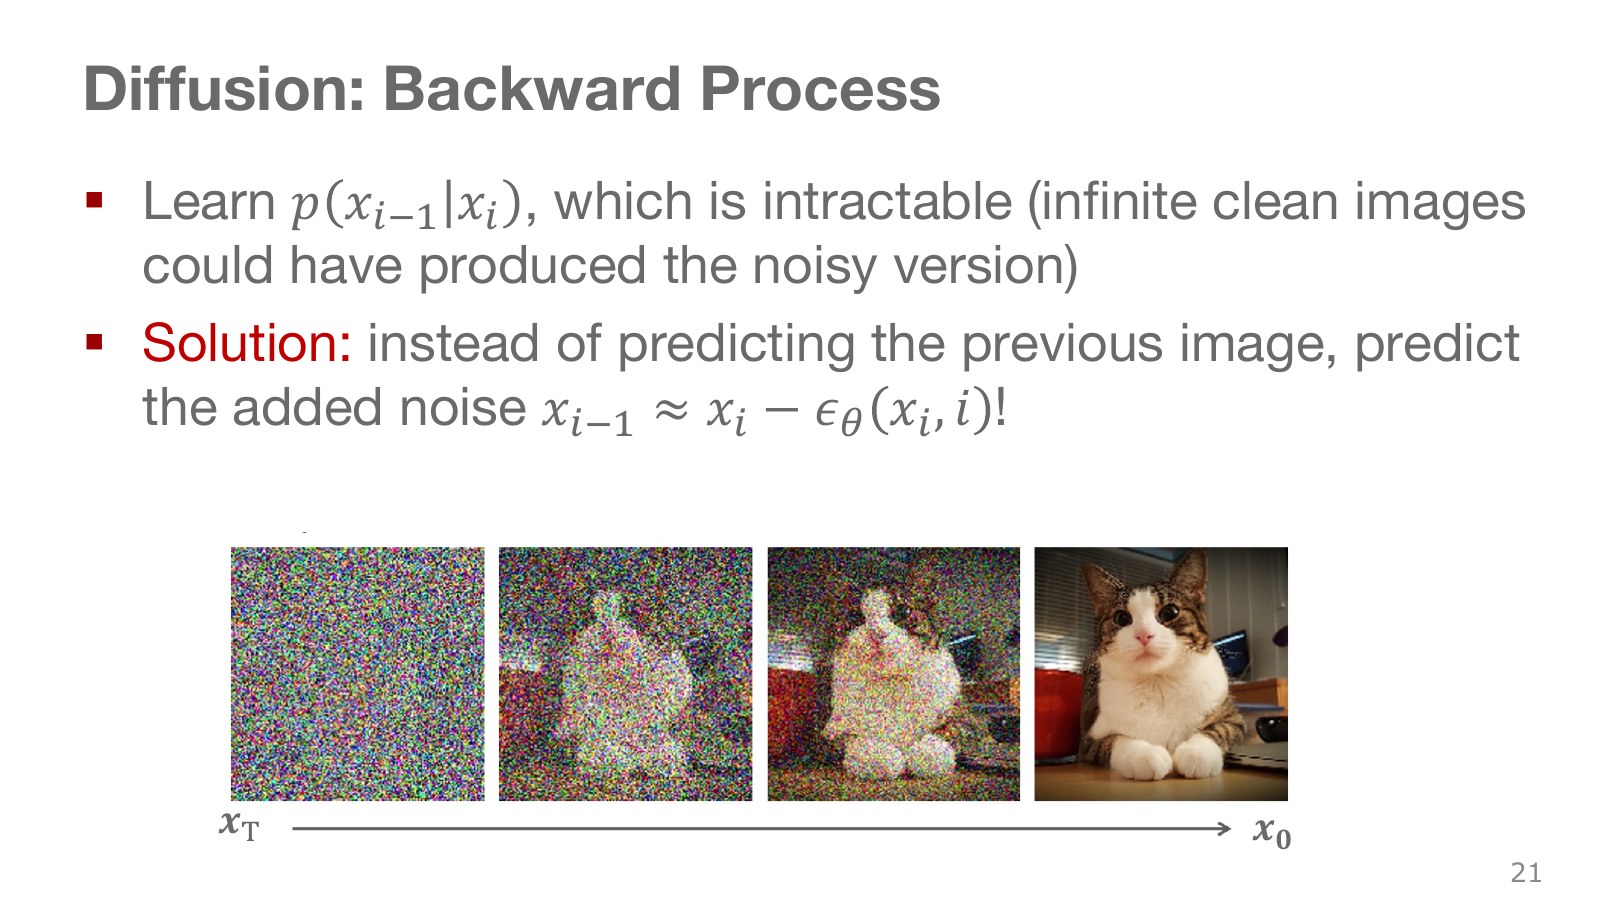
학습 자료에는 원본과 추가한 잡음을 알고 있지만, 실행 때 주어지는 것은 잡음 섞인 입력뿐이다. 따라서 모델은 현재 입력과 잡음 단계로부터 어떤 성분을 제거해야 할지 추정한다. 일반적으로 한 입력에 대응할 수 있는 원본은 여러 개이므로, 잡음 제거도 불확실성을 가진 문제다.
학습에서 자주 쓰는 잡음 예측 방식은 원본에서 현재 단계까지 누적된 잡음을 예측한다. 마지막 한 단계에서 더한 잡음만 맞히는 문제가 아니다. 또한 예측값을 현재 입력에서 그대로 한 번 빼는 것으로 모든 확산 샘플러가 완성되는 것도 아니다. 신호와 잡음의 계수, 다음 단계의 분산이 실제 갱신식에 들어간다.
원본까지 알고 조건을 붙인 역방향 사후분포는 계산 가능한 가우시안으로 정리할 수 있다. 반면 실행 때는 원본을 모르므로 신경망의 역과정이 이를 근사하도록 학습한다. 이것이 정방향에 잡음을 넣는 규칙을 아는 것만으로 생성이 해결되지 않는 이유다.
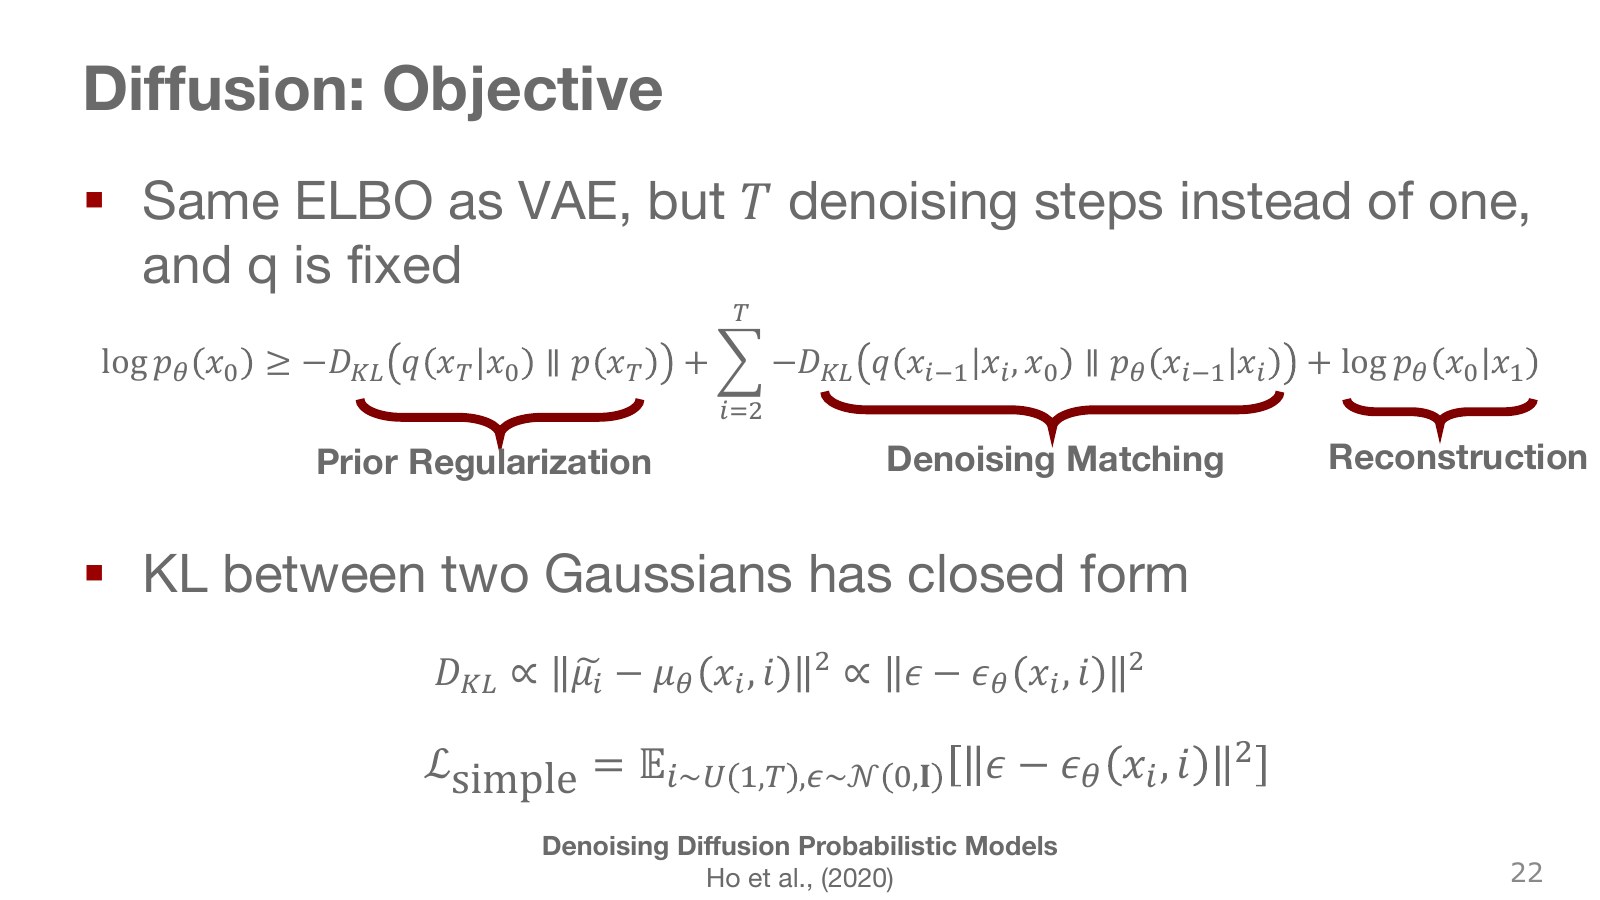
위쪽 식은 VAE처럼 로그 가능도의 하한을 사용하되, 중간 잡음 상태가 여러 개 있는 경우다. 처음의 KL은 마지막 잡음 분포와 시작 사전분포를 맞춘다. 가운데 항들은 한 단계씩 되돌리는 분포를 맞추고, 마지막 복원 항은 깨끗한 자료를 설명한다. 엄밀한 하한에는 해당 중간 상태에 대한 기대값이 포함된다.
실무에서 널리 쓰는 단순화된 학습 목표는 임의의 잡음 단계를 고른 뒤 예측 잡음과 실제 잡음 사이의 제곱 오차를 줄이는 것이다.
원래 변분 목표를 유도하면 단계별 가중치가 생길 수 있다. 가중치를 단순화한 위 손실이 원래 가능도 목적과 항별로 완전히 같다고 말해서는 안 된다. 그리고 이 모델도 MSE를 쓴다. 앞의 평균 행동 문제는 MSE라는 연산 자체의 금지가 아니라, 행동 전체를 한 번에 평균으로 예측하는 구조의 문제였다. 잡음 수준별 예측을 생성 과정에 반복 적용하면 다봉 분포를 만들 수 있다. DDPM 원논문.
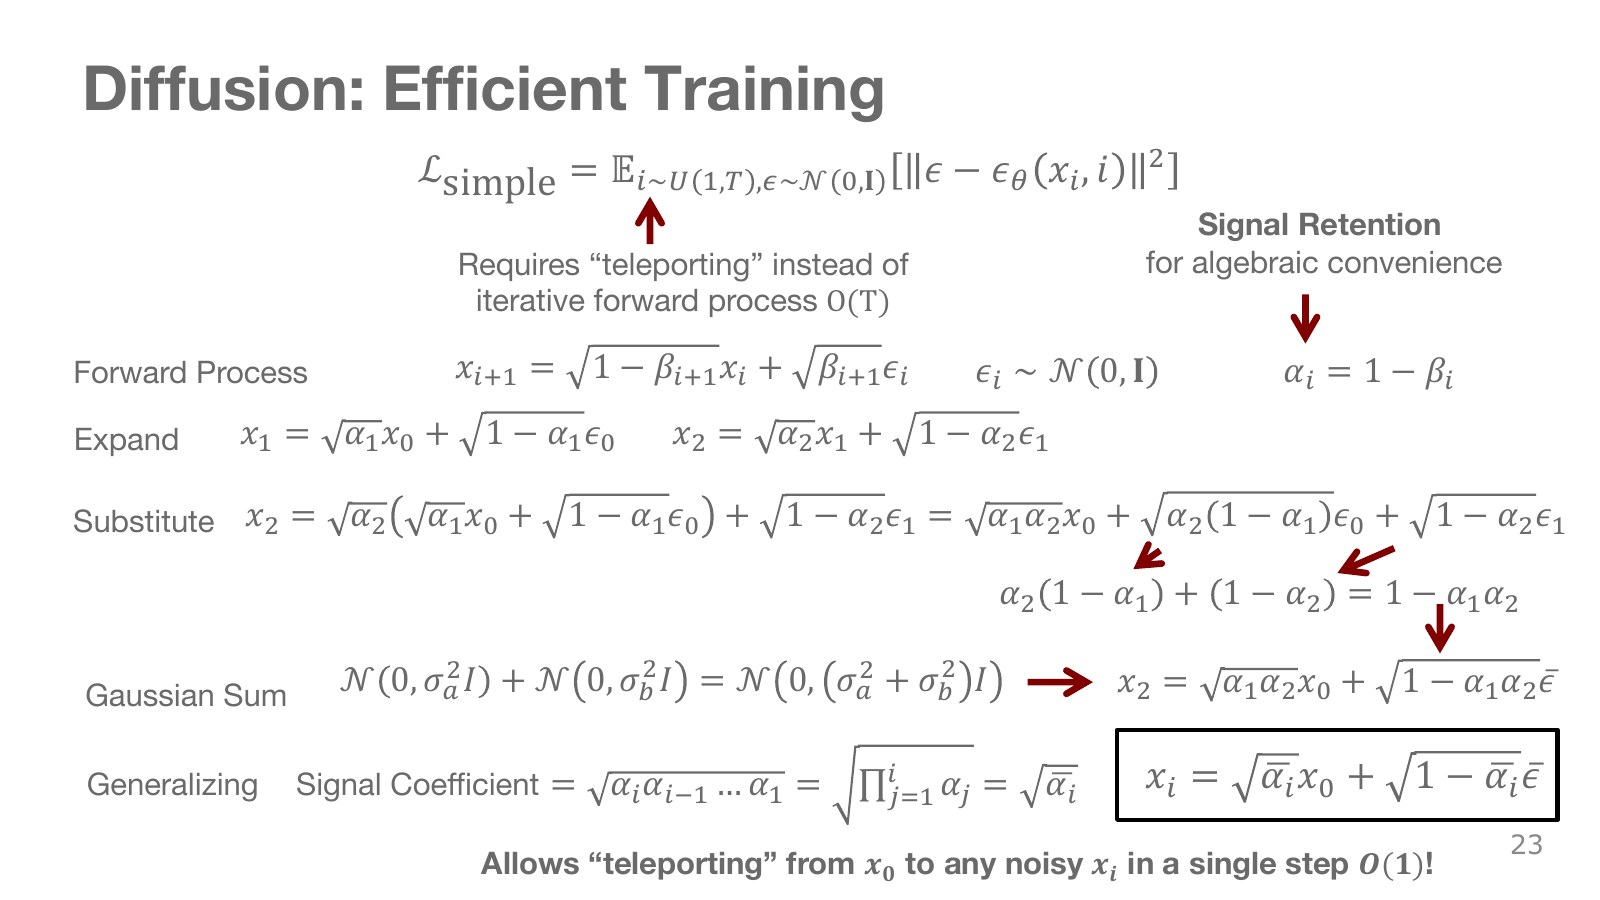
한 단계씩 잡음을 넣는 식을 여러 번 대입하면, 원본의 계수는 단계별 신호 계수의 곱으로 정리된다. 독립 가우시안 잡음의 합은 분산을 합해 하나의 가우시안으로 나타낼 수 있다.
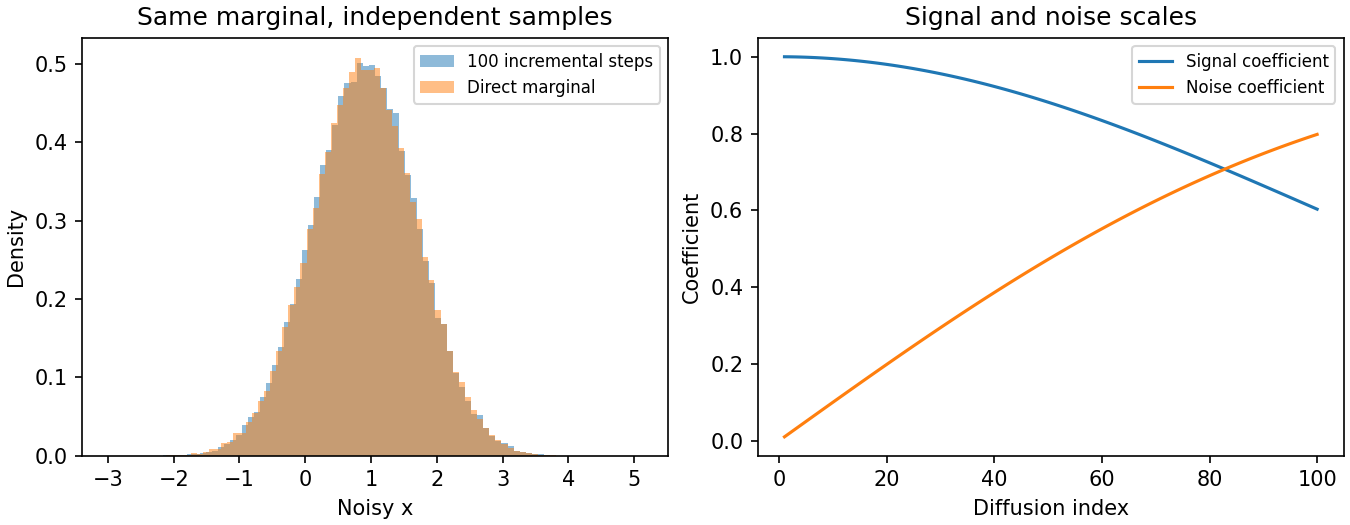
이 식 덕분에 학습 때 800단계 표본 하나를 만들려고 앞의 799개를 모두 계산할 필요가 없다. 누적 계수를 준비해 두면 선택한 단계로 직접 갈 수 있다. “한 번에 간다”는 말은 잡음 단계 수에 대한 계산의 이점이며, 자료 차원이나 신경망 계산까지 없어지는 뜻은 아니다.
직접 만든 표본과 단계별로 만든 표본은 각 단계의 주변분포가 같다는 관계다. 서로 독립적으로 뽑았다면 표본 값이 같지는 않다. 여러 시점의 잡음을 제각각 뽑는 것만으로 원래 마르코프 연쇄의 공동 경로가 재현되는 것도 아니다.
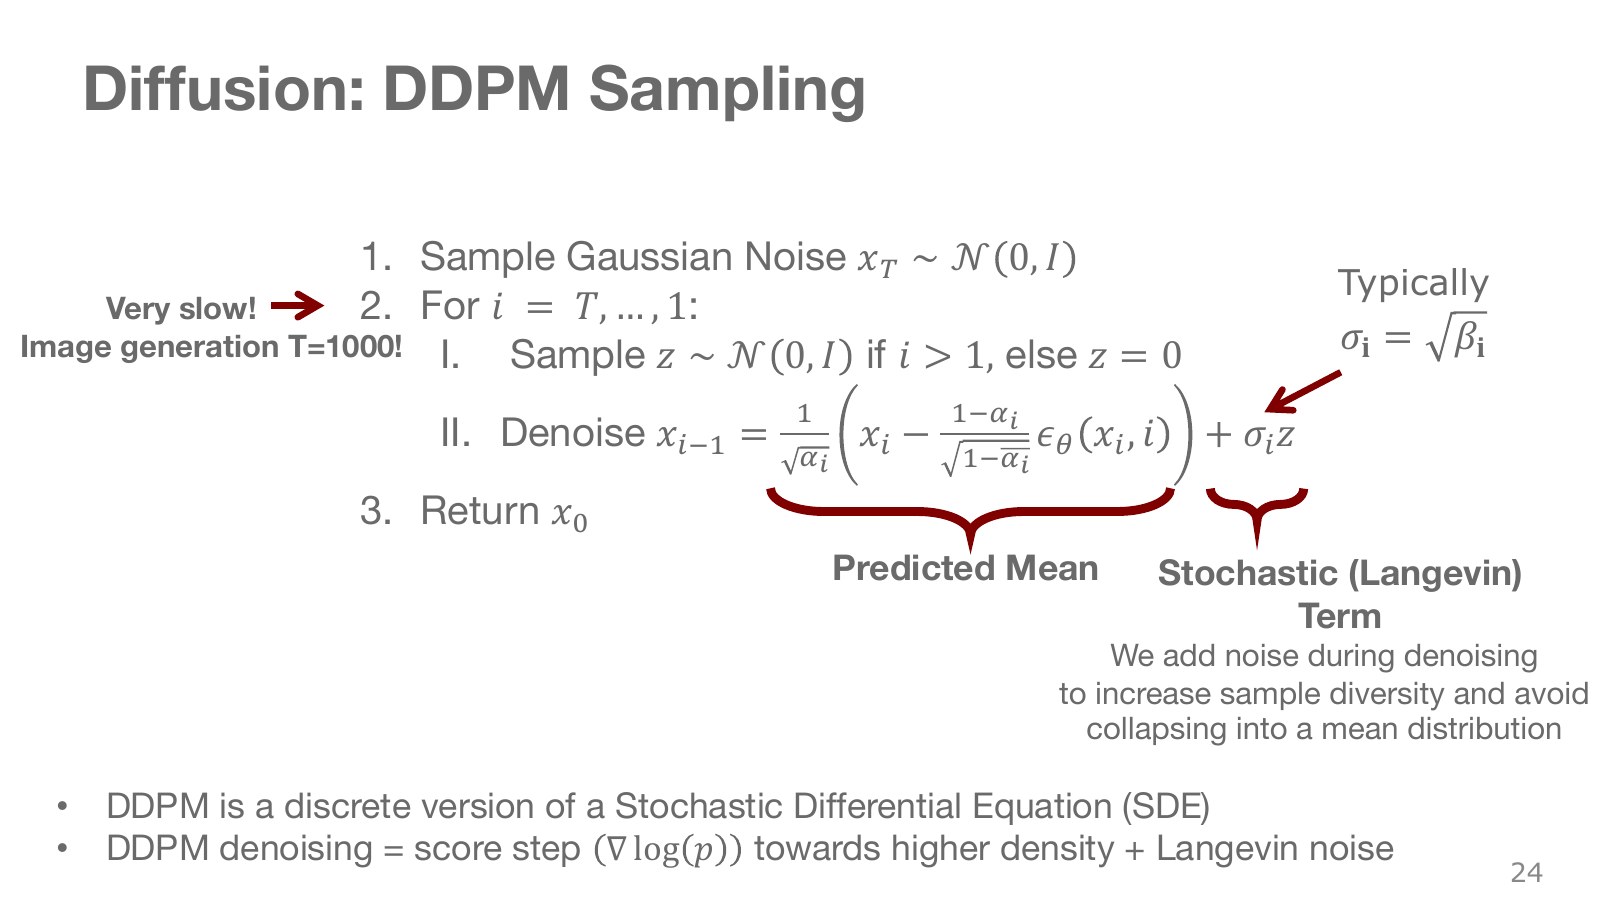
생성은 가우시안 잡음에서 출발해 큰 잡음 단계부터 거꾸로 진행한다. 예측 평균 쪽으로 움직이고, 선택한 역과정의 분산에 맞는 잡음을 더한다.
여기서 새 잡음은 표준정규분포에서 뽑고 마지막 단계에서는 0으로 둔다. σ는 역과정의 표준편차이며, β의 제곱근을 쓰거나 원논문의 다른 분산 선택을 사용할 수 있다. 예측된 평균만 보는 것과 그 평균 주변에서 표본을 뽑는 것은 다르다.
다만 매 단계 새 잡음을 넣어야만 다양한 결과가 나온다고 일반화하면 안 된다. 초기 잡음이 달라지는 것만으로도 결정론적 변환은 여러 결과를 낼 수 있다. 다음 DDIM이 그 사례다. 또한 이 DDPM 식에서 잡음 항만 지운 것을 모든 결정론적 샘플러와 같다고 볼 수는 없다. 각 샘플러는 자신이 근사하려는 역과정에 맞는 갱신식을 가진다. 여기서 score는 자료 로그 밀도의 공간 기울기이며, 강화학습의 보상 점수가 아니다.
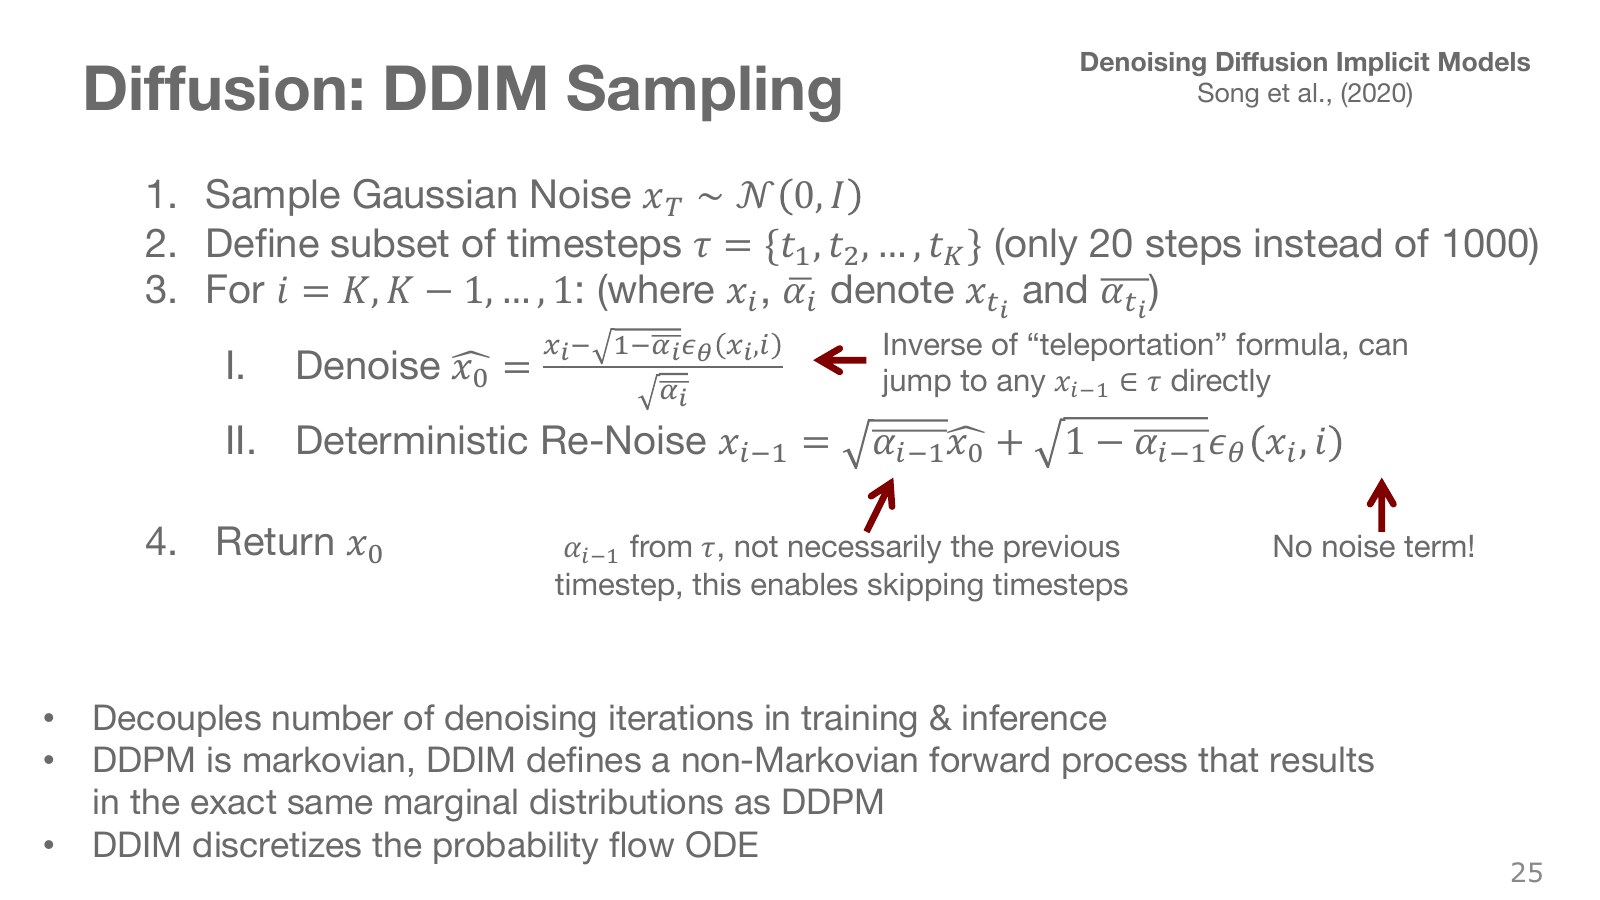
먼저 현재 입력에서 깨끗한 원본을 추정한다. 다음에는 그 추정 원본과 예측한 잡음 방향을 조합해 더 낮은 잡음 수준의 입력을 만든다. 중간 단계를 건너뛸 수 있으므로 학습 때의 단계 수와 실행 때의 예측 횟수를 분리할 수 있다.
위 식은 η를 0으로 둔 결정론적 DDIM이다. 같은 조건과 같은 초기 잡음이면 같은 결과가 나온다. 초기 잡음을 바꾸면 다른 결과가 나올 수 있으므로 분포의 다봉성이 사라지는 것은 아니다. 단계 수를 줄이면 빠르지만 예측과 이산화 오차의 영향이 달라진다. 1,000단계를 20단계로 줄이는 예시는 모든 작업에서 품질이 그대로라는 보장이 아니다.
Berkeley 확산 강의 52:11부터는 학습 목적과 실행 샘플러의 선택을 분리해 설명한다. DDPM과 같은 정방향 주변분포를 사용한다는 성질을, 유한 횟수로 생성한 분포·표본 경로까지 항상 동일하다는 뜻으로 확대하지 말자. DDIM 원논문.
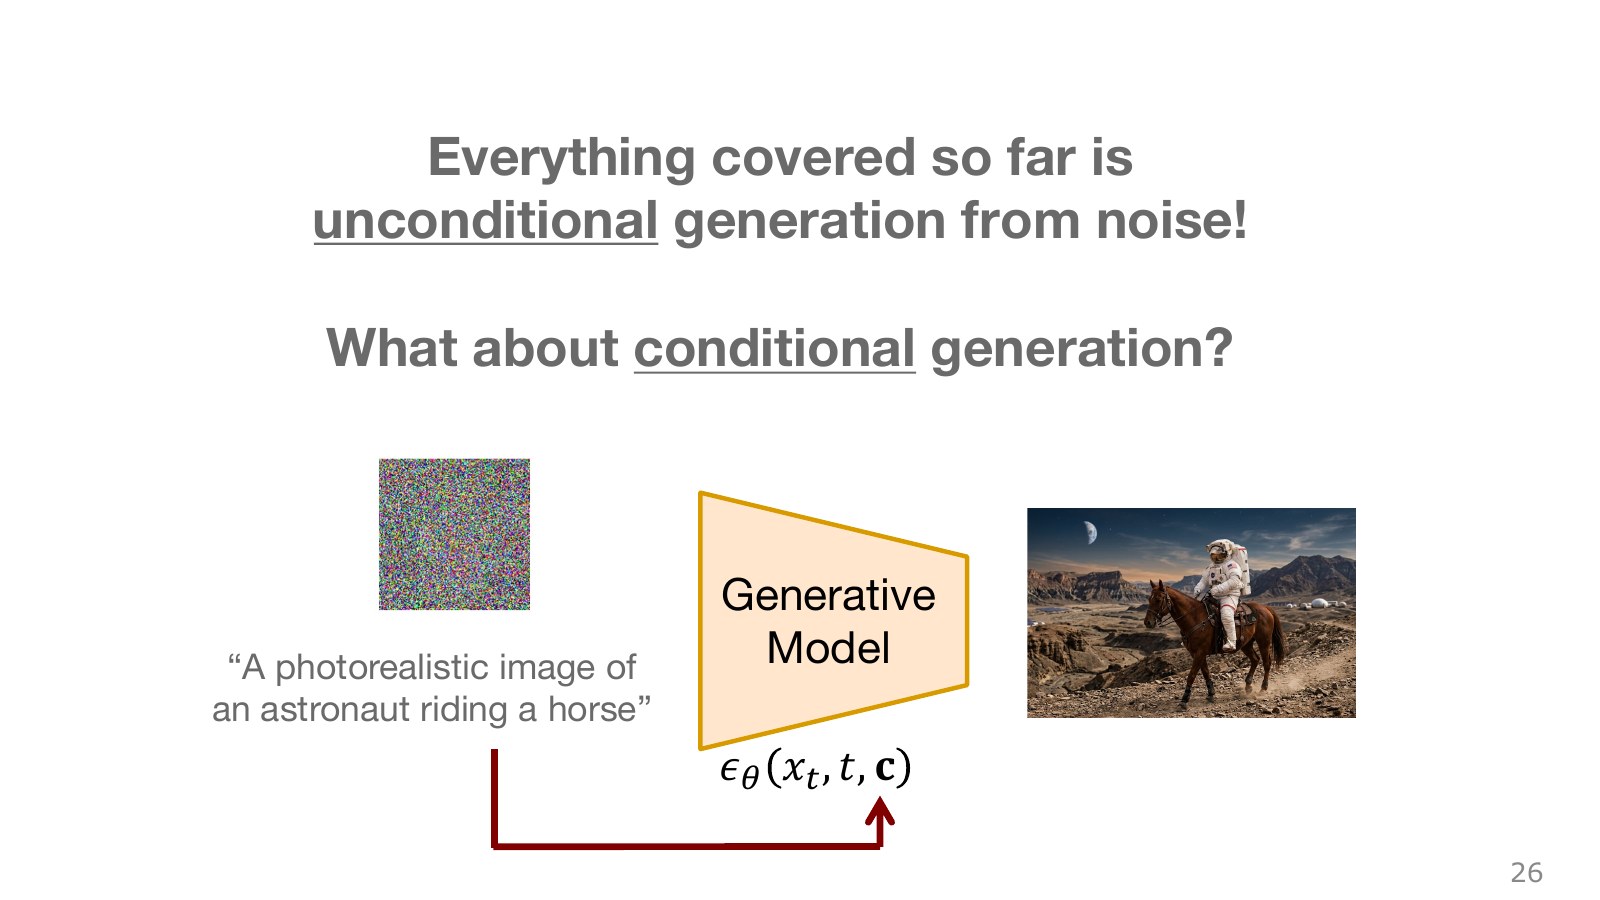
우주비행사 그림에서 글 지시는 어떤 이미지를 만들지 제한한다. 로봇에서는 카메라 영상, 자기 관절의 감각인 고유수용감각(proprioception), 언어 지시를 조건으로 사용한다. 같은 컵이라도 “집어라”와 “옆으로 밀어라”가 요구하는 행동 분포는 다르다.
잡음 예측 신경망에 조건을 추가하면 관측에 맞춘 복원을 배울 수 있다. 조건은 정답 행동 자체가 아니며, 생성 후에 받는 강화학습 보상과도 역할이 다르다. 앞의 확산 식에서 조건을 생략한 것은 잡음 과정을 먼저 설명하기 위한 단순화다. 앞서 소개한 잠재변수 정책도 이미 관측에 조건화할 수 있었다.
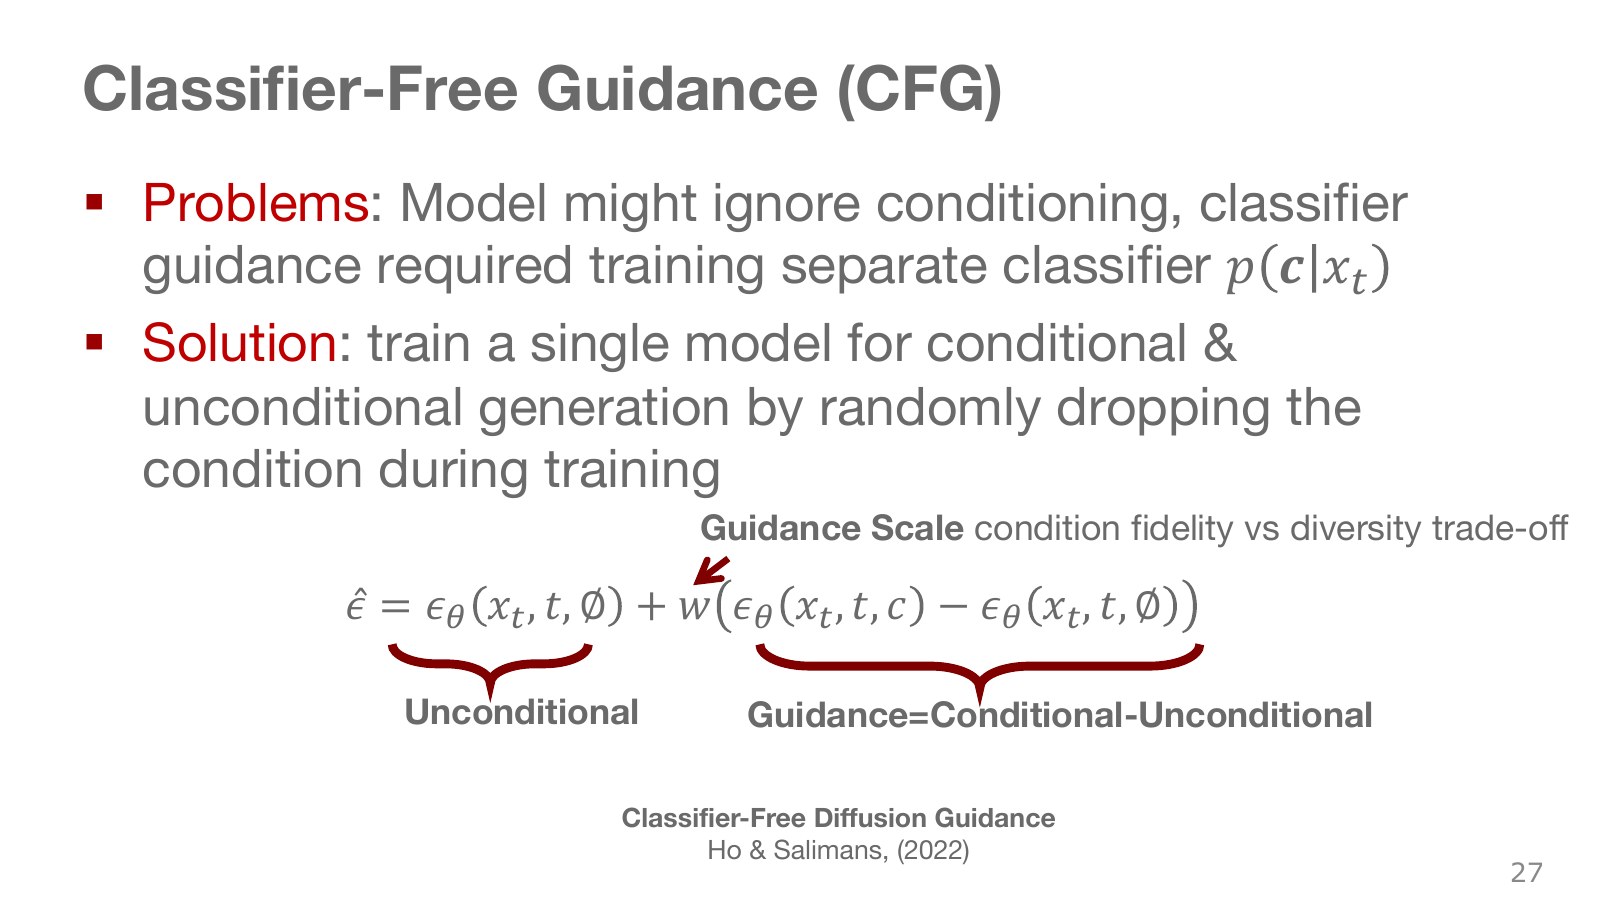
학습 때 일부 자료의 조건을 빈 토큰으로 바꿔, 같은 모델이 조건부 예측과 무조건 예측을 모두 배우게 한다. 실행 때는 두 예측의 차이를 원하는 강도로 반영한다.
여기서 u는 조건을 비운 예측, c는 조건을 준 예측이다. 이 표기에서 w가 0이면 무조건 예측, 1이면 원래 조건부 예측, 1보다 크면 그 차이를 더 밀어 주는 외삽이 된다. 조건이 원하는 방향을 강조할 수 있지만 결과의 다양성이 줄거나 왜곡될 수 있다.
별도 분류기를 학습하는 classifier guidance와 달리, CFG는 조건을 지운 학습을 통해 같은 예측 모델 안에서 두 경우를 다룬다. “분류기 없이”라는 이름이 조건 없이 생성한다는 뜻은 아니다. 모든 Diffusion Policy가 반드시 CFG를 쓴다는 뜻도 아니다. 로봇에서 어떤 조건을 지울지는 설계해야 하며, 필요한 상태 정보까지 무작정 없앤다고 안전한 행동이 되는 것은 아니다. CFG 논문.
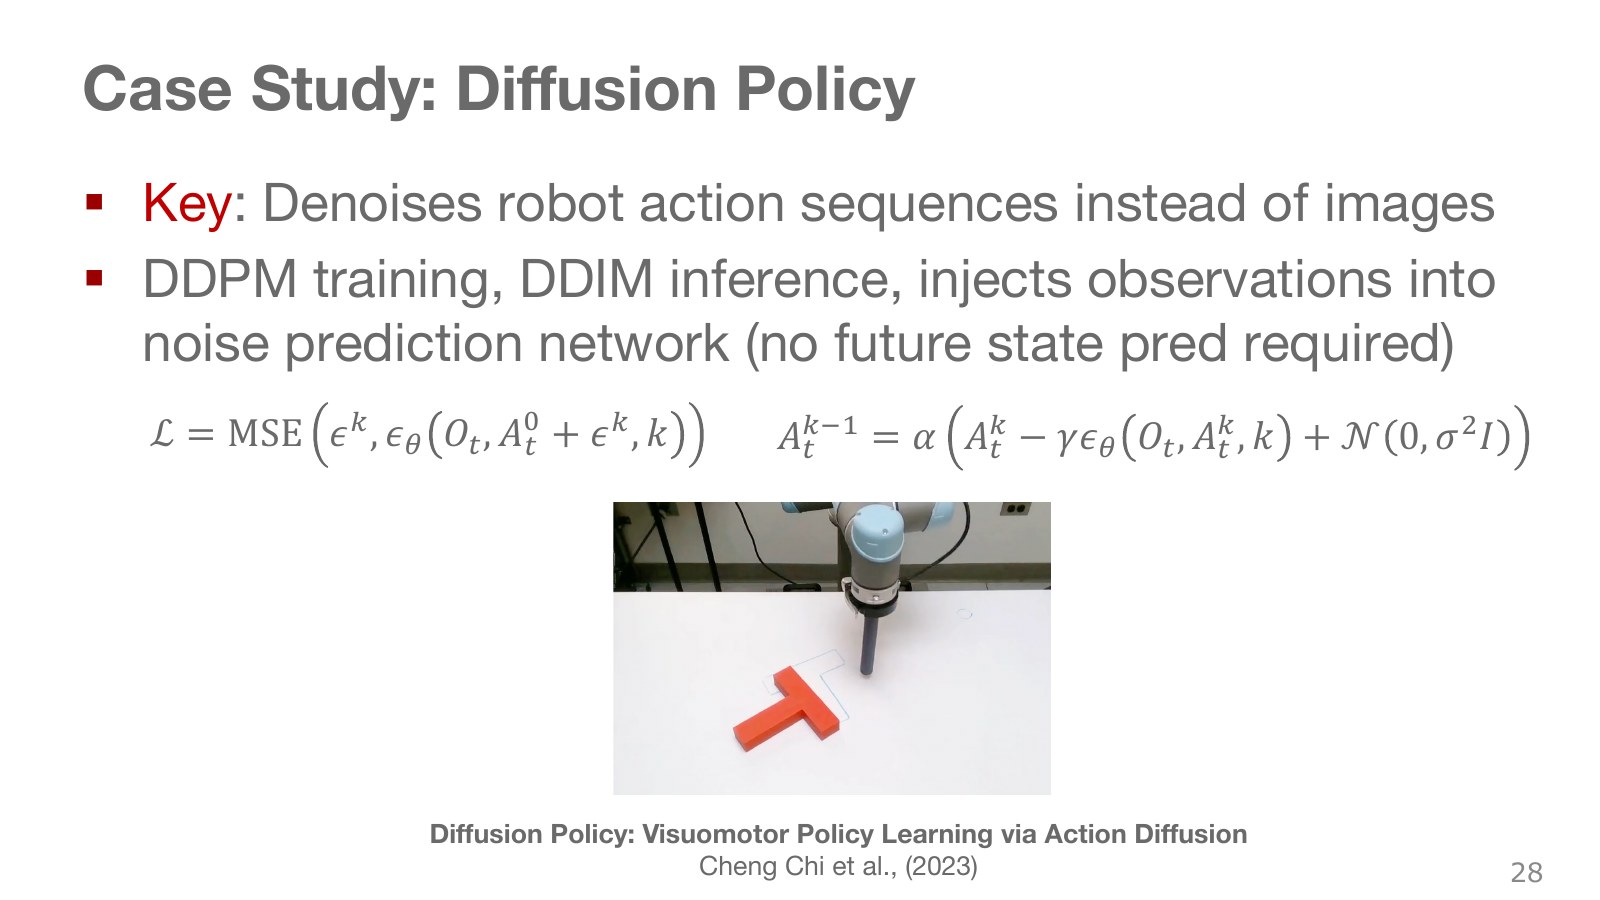
탁자 위 T자 물체를 목표 윤곽에 맞춰 미는 작업을 보자. 물체 중심만 가까워서는 충분하지 않고 방향과 접촉 위치도 맞아야 한다. 같은 목표를 향해 여러 접촉 순서를 선택할 수 있어, 시연의 다봉성을 표현하는 일이 유용하다.
Diffusion Policy는 시연에서 얻은 행동 묶음에 잡음을 넣고, 현재 관측을 조건으로 그 잡음을 예측하도록 학습한다. 행동 묶음은 앞으로 여러 제어 시점에 보낼 명령을 이어 붙인 배열이다. 이 기본 학습은 시연을 배우는 모방 학습이며, 보상을 최대화하는 강화학습을 자동으로 수행하는 것은 아니다.
슬라이드의 “행동에 잡음 추가”는 위처럼 계수를 포함한 과정을 간추린 표현으로 읽으면 된다. 출력은 미래 행동이지 반드시 미래 영상이나 세계 상태 예측은 아니다. 긴 행동 묶음을 예측하더라도 일부만 실행하고 새 관측으로 다시 계획하는 receding horizon 방식을 사용할 수 있다. Diffusion Policy 논문·영상·코드.
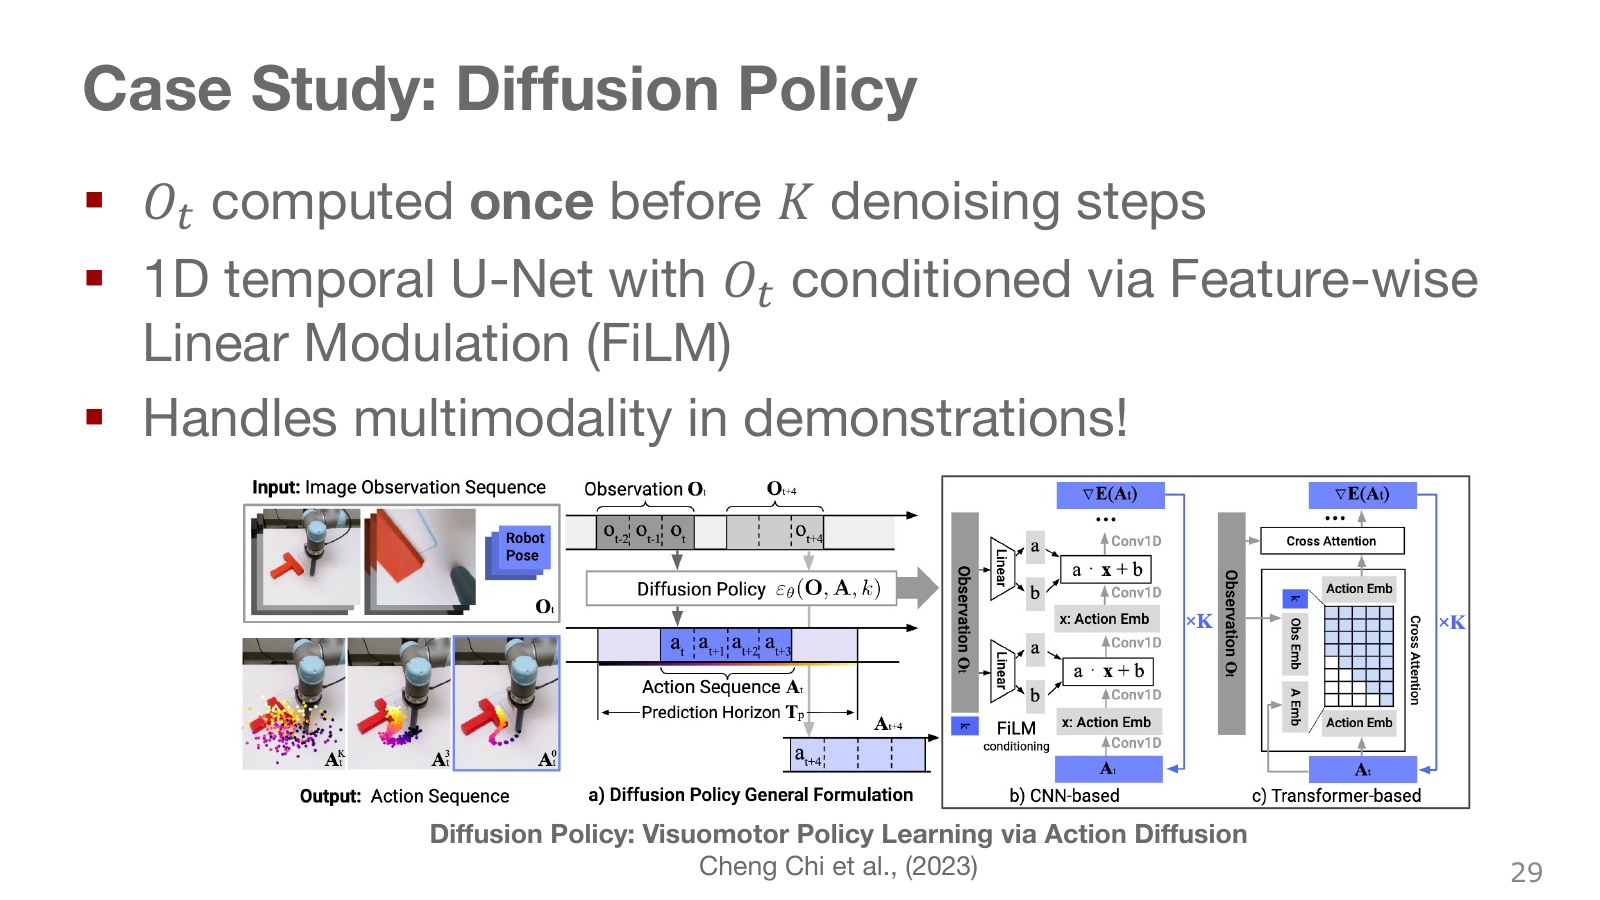
왼쪽 사진들은 관측 영상과 관절 상태가 조건으로 들어가고, 잡음 덩어리가 일관된 행동 묶음으로 정리되는 모습을 보여 준다. 가운데 시간선에서는 예측 구간과 실제 실행 구간이 나뉜다. 실행한 뒤에는 다시 관측하므로 환경의 변화에 대응할 수 있다.
오른쪽 U-Net의 1D 축은 행동 묶음의 시간축이다. 시간을 줄여 넓은 문맥을 보고 다시 늘려 각 시점의 행동을 복원하는 구조이며, 앞쪽 특징을 뒤쪽에 연결하는 경로가 세부 정보를 보완한다. FiLM은 조건으로부터 특징별 배율과 이동량을 만들어 중간 활성값을 조절한다. Transformer 변형에서는 행동 토큰이 관측 토큰을 참조하는 attention 구조를 사용할 수 있다.
관측 특징을 한 번 계산한다는 말은 한 번의 행동 묶음 생성 안에서 여러 잡음 제거 단계가 그 특징을 재사용한다는 뜻이다. 로봇 실행 전체에서 카메라를 한 번만 읽는다는 뜻은 아니다. 행동의 단위와 범위를 정규화하는 일도 중요하다. 미터 단위 이동과 라디안 단위 회전을 무작정 같은 숫자 규모로 다루면 학습 균형이 달라진다.
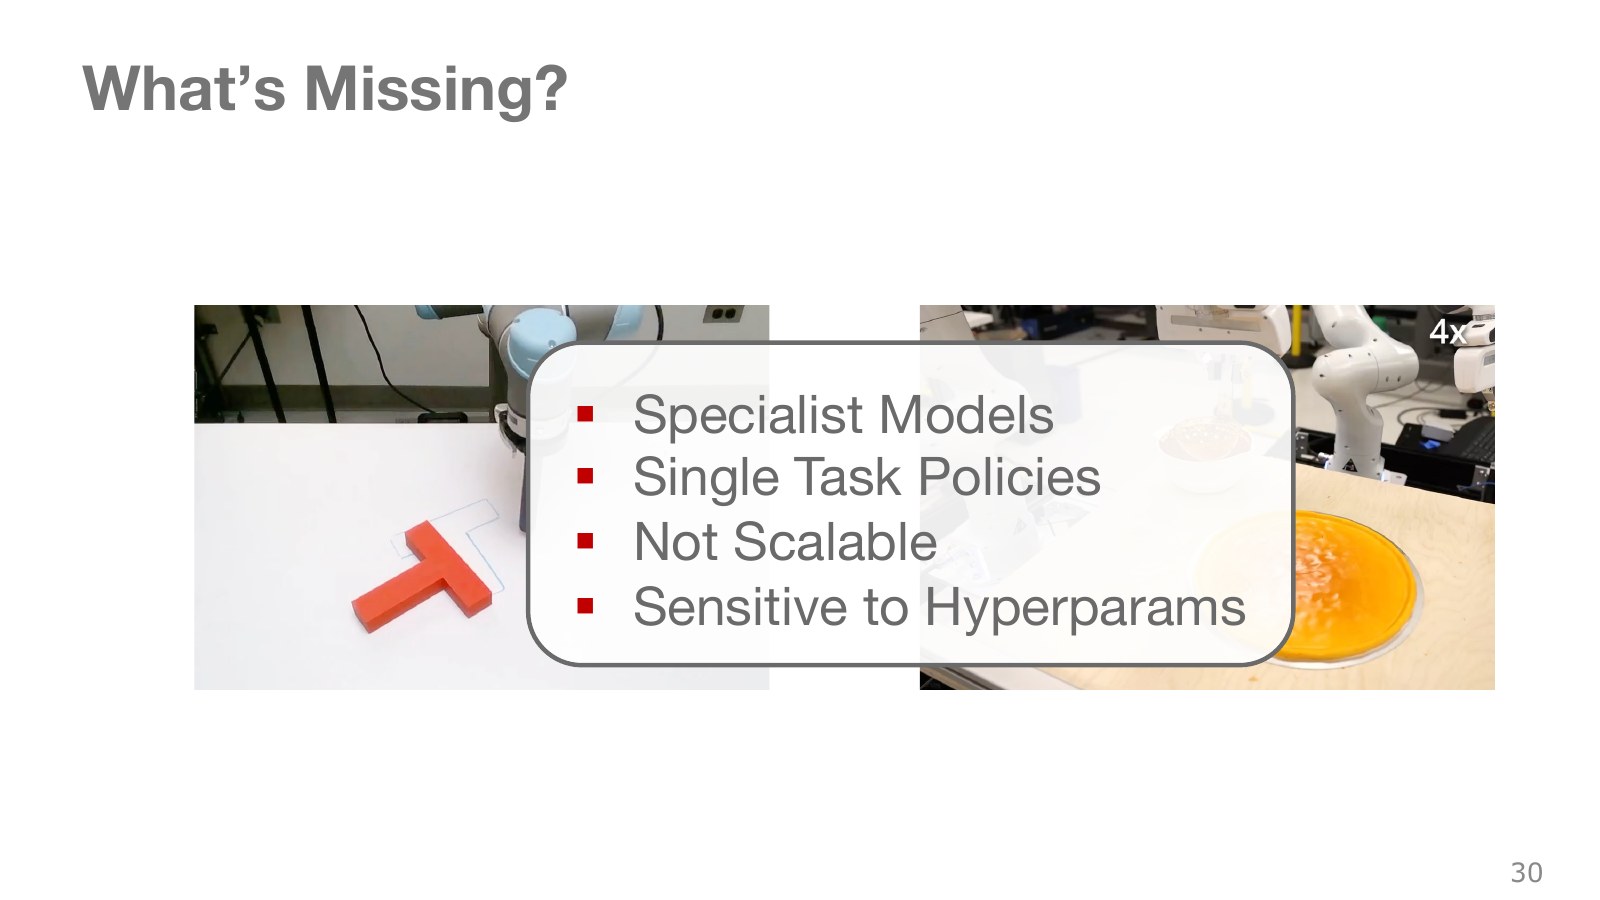
사진의 물체·도구·접촉 방식이 달라지면 필요한 행동 분포도 달라진다. 한 작업에 맞춰 학습한 전문 정책을 그대로 다른 작업이나 다른 로봇에 적용하기는 어렵다. 자료 규모뿐 아니라 관측 형식, 작업 조건, 행동 차원과 단위를 함께 다뤄야 한다.
원강의는 초기 Transformer형 Diffusion Policy의 학습 민감성과 확장의 어려움을 짚는다. 이는 확산 정책이 원리적으로 여러 작업을 배울 수 없다는 뜻은 아니다. 실제로 다음 Octo와 DiT Policy는 자료와 구조를 바꾸어 그 방향으로 확장한다. 성공한 단일 작업 시연과 다양한 조건에서의 일반화 검증은 따로 읽어야 한다.
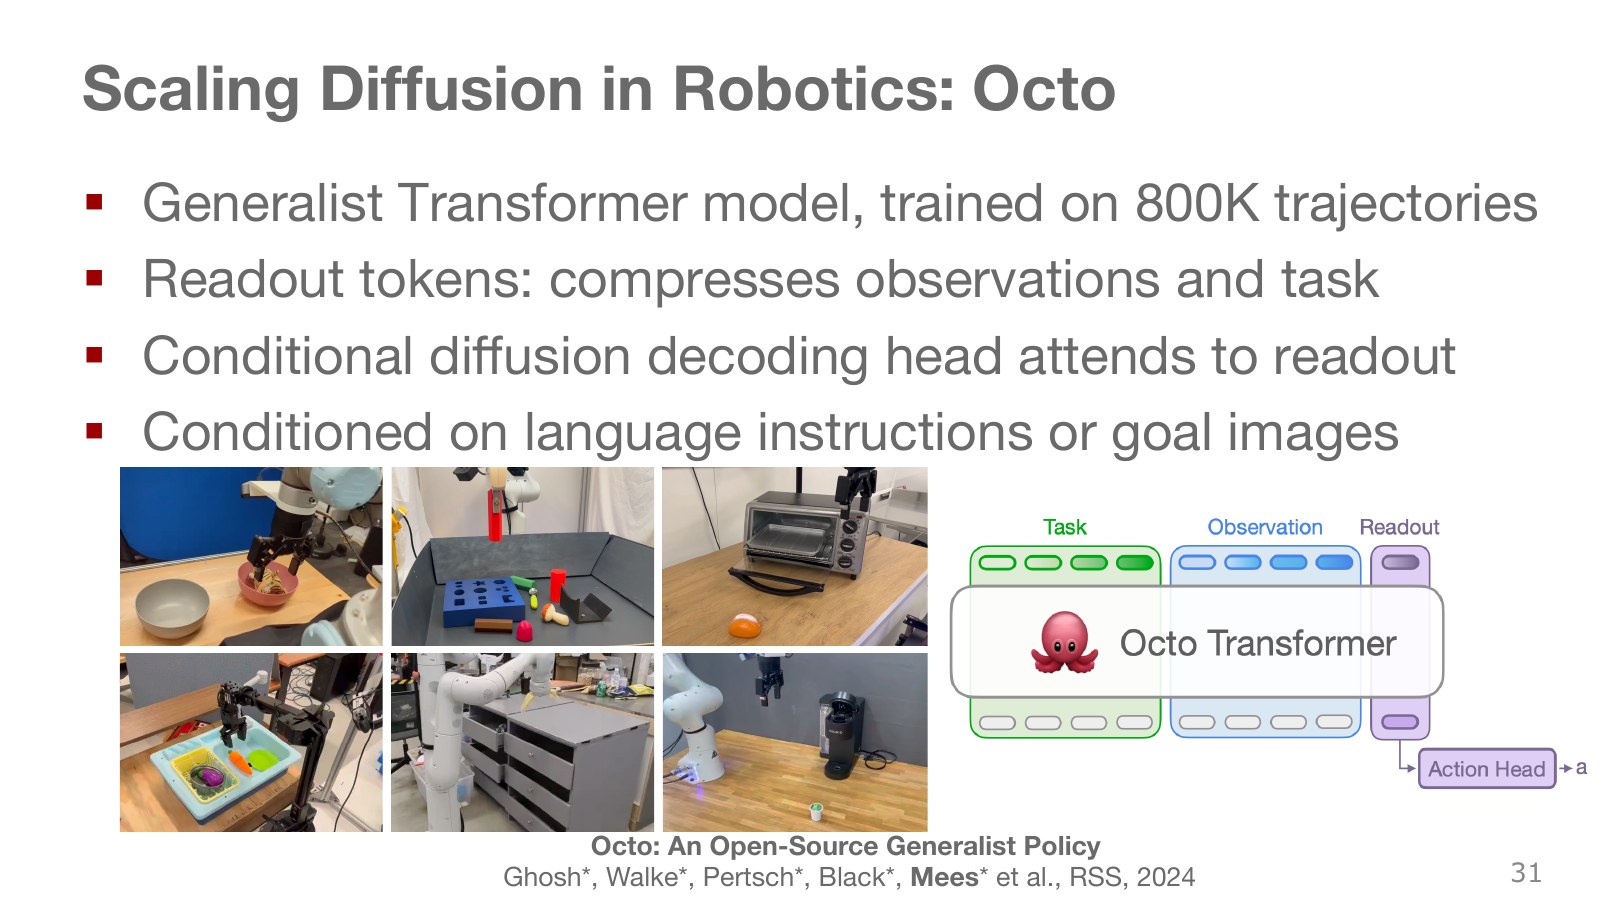
아래 구조는 언어 또는 목표 이미지, 관측 토큰, readout 토큰과 행동 헤드로 나뉜다. 토큰은 모델이 처리하는 정보의 한 슬롯이다. Readout 토큰은 앞의 작업·관측 정보를 모아 행동 출력을 위한 표현을 만든다. 그 표현을 조건으로 작은 확산 헤드가 행동 묶음을 생성한다.
Octo 논문은 Open X-Embodiment의 약 80만 궤적으로 학습한 일반 로봇 정책을 다룬다. 궤적 하나에는 여러 제어 단계가 있으므로 80만 단일 행동과 같은 수치가 아니다. 논문의 확산 행동 헤드는 작은 MLP로 구현된다. 따라서 readout이 attention으로 정보를 모으는 부분과, 그 결과를 받는 행동 헤드가 모두 같은 cross-attention 블록이라고 섞어 설명해서는 안 된다.
사전학습 표현을 새 로봇에 맞춰 조정할 수 있다는 것이 핵심이며, 다운로드만 하면 어떤 로봇의 관절 순서와 단위에도 즉시 맞는다는 뜻은 아니다. 입력·출력 어댑터와 추가 학습 조건이 필요하다.
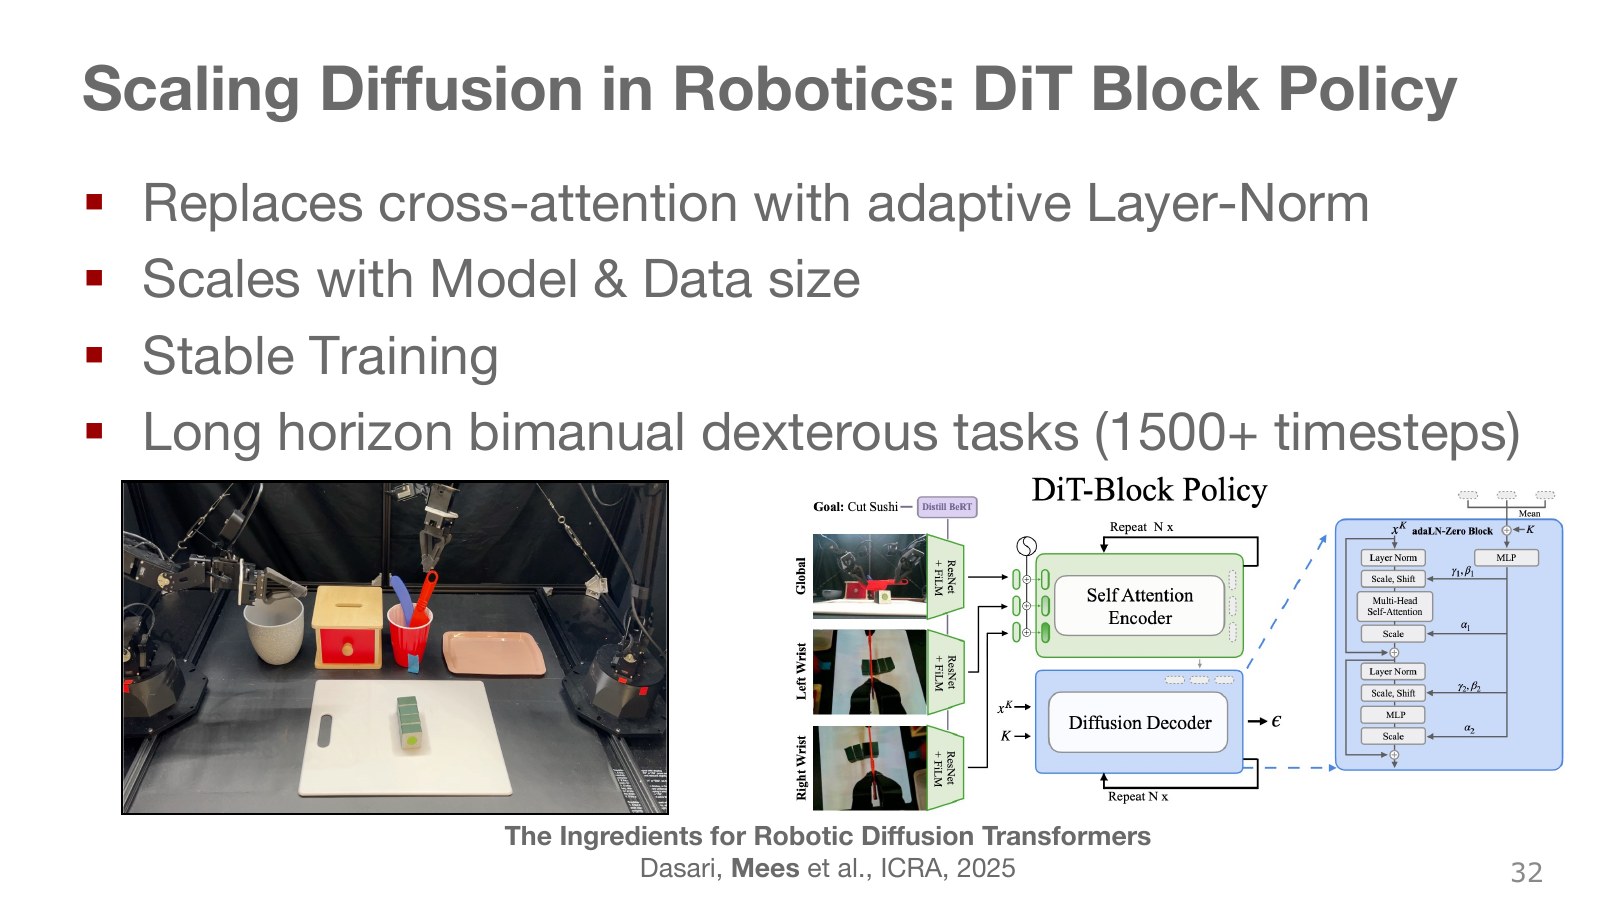
그림의 관측 인코더는 영상과 로봇 상태를 모으고, 행동 생성기는 잡음 섞인 행동 토큰을 갱신한다. AdaLN은 adaptive layer normalization이다. 정규화한 특징을 조건에 따라 얼마나 확대하고 옮길지 조절해 관측과 잡음 단계 정보를 전달한다. FiLM에서 보았던 “조건으로 내부 특징을 조절한다”는 아이디어와 연결된다.
DiT Policy 논문은 특정 구조 변경과 학습 설계 아래의 안정성과 복잡한 조작 성능을 보고한다. 이를 모든 Transformer에서 cross-attention이 불필요하다는 증명으로 받아들이면 안 된다. 초밥 자르기 같은 긴 작업의 1,500단계라는 길이와, 한 행동 묶음을 생성할 때 수행하는 확산 단계 수도 다르다. 하나는 환경 안의 제어 시간, 다른 하나는 모델 내부의 생성 계산이다.
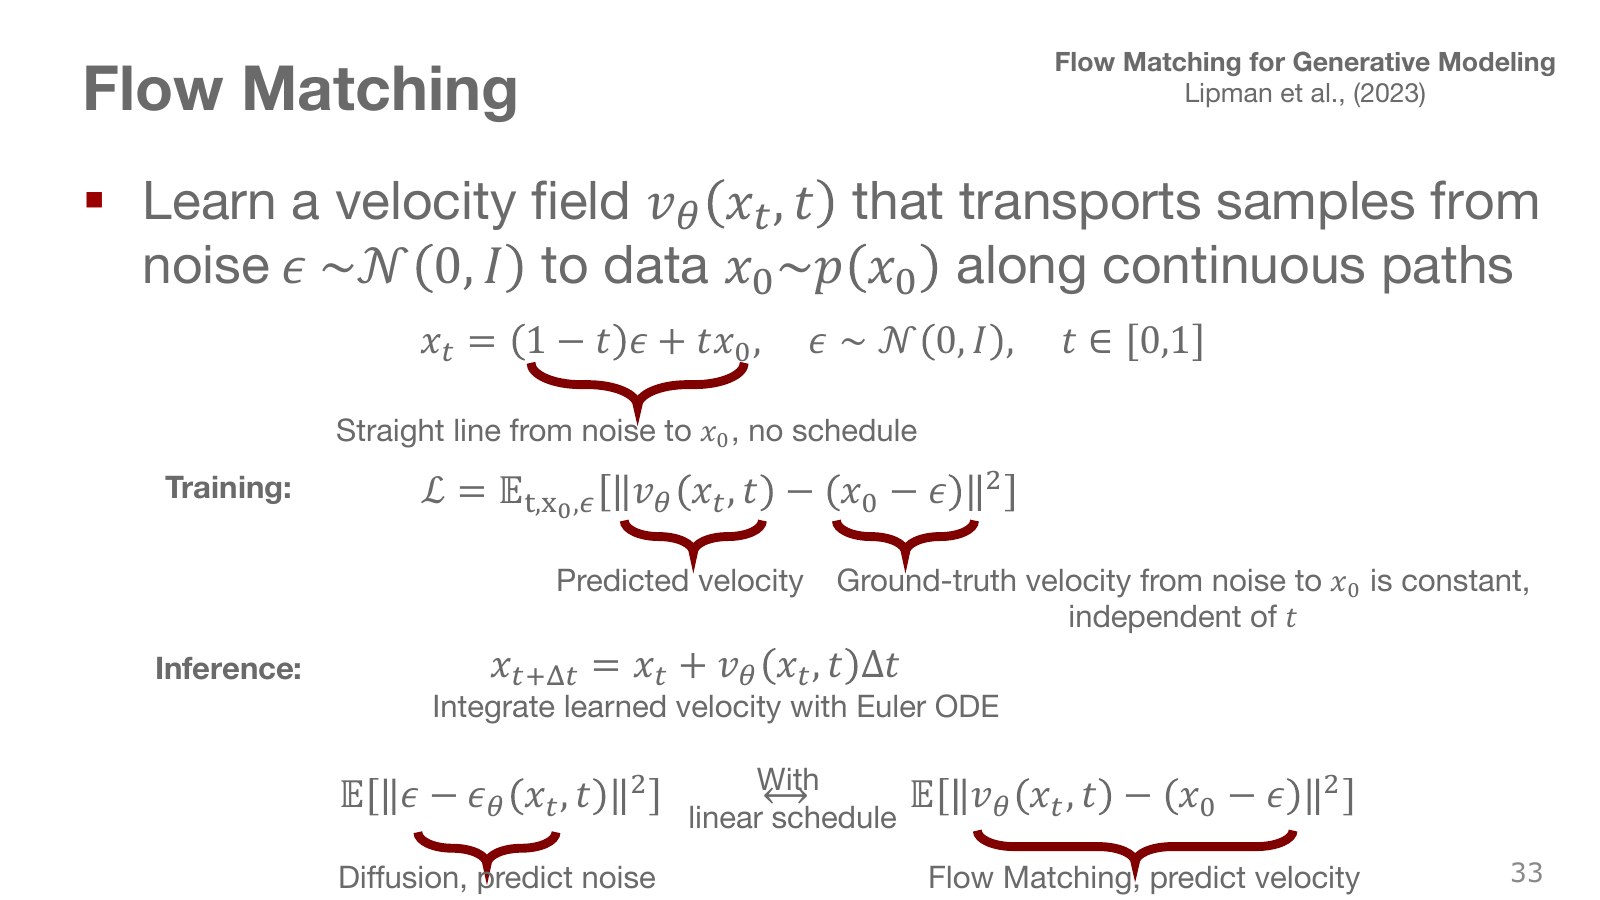
잡음 하나와 자료 하나를 뽑아 직선으로 연결해 보자. 0에서는 잡음, 1에서는 자료가 되도록 두 값을 섞으면 그 사이 어느 지점에서든 학습 예제를 만들 수 있다.
속도장(vector field)은 현재 위치와 생성 시간을 보고 어느 방향으로 얼마나 움직일지 알려 주는 함수다. 생성 때는 새 잡음에서 시작해 그 함수를 따라 적분한다. 가장 간단한 Euler 방식은 현재 속도에 작은 시간 간격을 곱해 위치에 더한다.
한 잡음–자료 쌍의 목표 속도는 일정하지만, 학습된 전체 속도장이 어디서나 일정한 것은 아니다. 여러 쌍이 같은 중간 위치 부근을 지나면 모델은 그 조건에서의 평균 속도를 배우고, 그 장을 적분한 실제 경로는 휠 수 있다. 이 역시 MSE를 쓰지만 한 번에 평균 행동을 출력하는 것과 다른 생성 구조다. 여기의 생성 시간은 실제 로봇의 이동 시간이 아니다. 생성 경로의 중간 행동 배열을 모두 로봇에 실행하지는 않는다.
직선 보간은 이 강의에서 택한 경로이며 flow matching 전체가 반드시 이 경로만 쓰는 것은 아니다. Flow Matching 원논문.
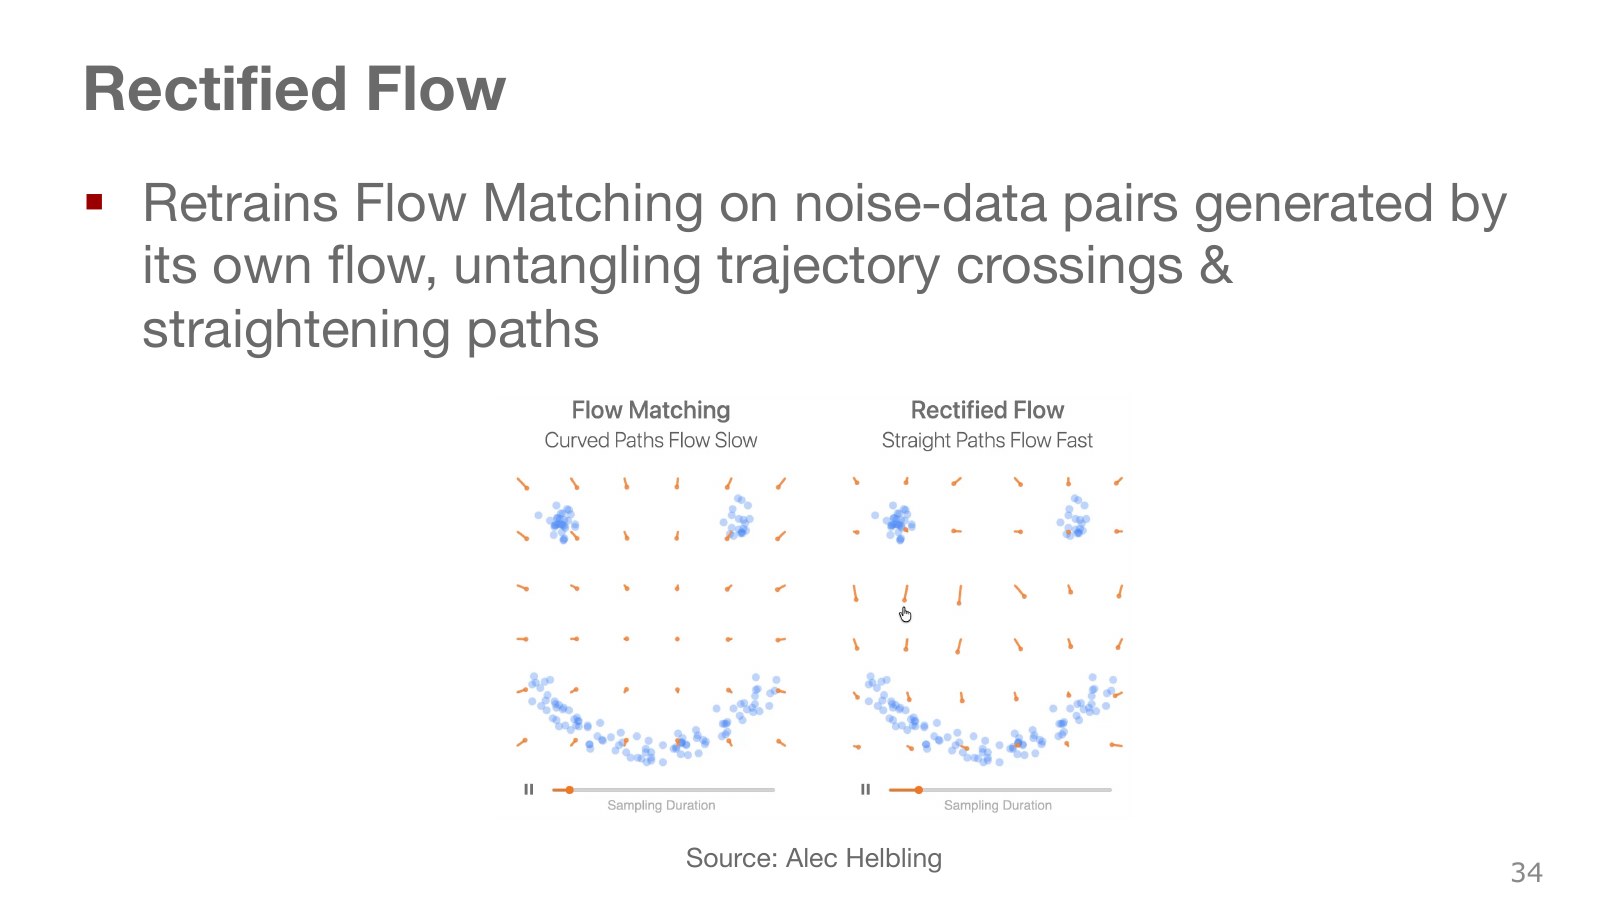
아무 잡음과 아무 자료를 무작위로 짝지으면 직선들이 서로 가로지를 수 있다. 같은 중간 위치에서 서로 다른 목표 방향이 겹치면, 이를 하나의 매끄러운 속도장으로 표현하는 과정에서 굽은 흐름이 생긴다. 그림의 왼쪽과 오른쪽 곡선 차이는 이 이동을 단순하게 만들려는 시도다.
먼저 흐름을 학습하고, 새 잡음에서 그 흐름을 끝까지 따라가 도착점을 얻는다. 이제 출발 잡음과 그 도착점을 한 쌍으로 묶어 다시 학습한다. 이 재결합·재학습을 reflow라고 부른다. 원래 독립적으로 고른 짝 대신 현재 모델이 연결한 짝을 사용하는 것이다.
경로를 더 곧게 만들면 적은 적분 단계로 근사하기 쉬워질 수 있다. 그렇다고 모든 흐름이 정확히 직선이 되거나, 언제나 한 단계로 같은 품질을 내는 것은 아니다. 학습 오차와 적분 오차, 분포 표현의 한계가 남는다. 학습용 직선 쌍의 교차와, 유일해 조건을 만족하는 매끄러운 ODE의 실제 해 경로가 같은 시공간 점에서 교차하는 문제도 구별해야 한다. Rectified Flow 논문.
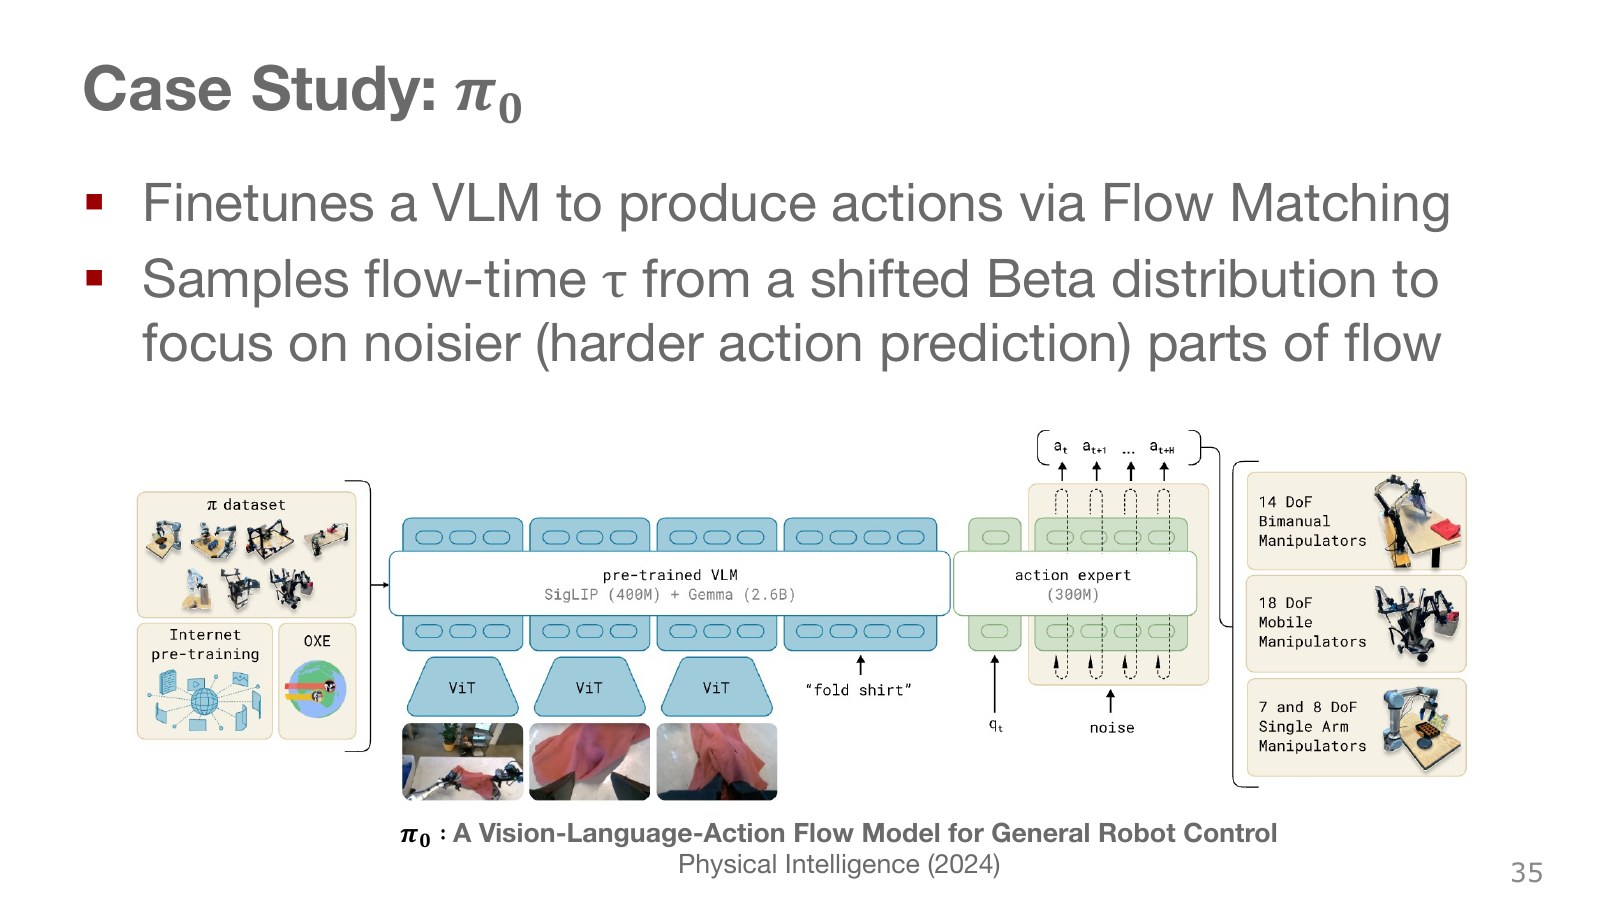
왼쪽에는 로봇 자료와 인터넷 사전학습 자료, 가운데에는 영상·언어 모델, 오른쪽에는 행동을 만드는 action expert가 있다. 카메라 영상과 “셔츠를 접어라” 같은 언어를 해석하는 표현을 활용하면서, 관절 상태와 잡음 섞인 행동을 로봇 전용 가중치로 처리한다. 사진의 양팔·이동형·단일 팔 로봇은 서로 다른 신체 구조를 함께 다루려는 범위를 보여 준다.
π₀ 원논문의 4절과 부록 B에서 생성 시간은 0이 잡음, 1이 깨끗한 행동이다. 이 장의 직선 flow 식과 같은 방향이다. 확산에서 0을 깨끗한 자료로 쓰던 표기와 섞으면 적분 방향을 거꾸로 구현하기 쉽다. 관측을 고정한 채 잡음 행동에서 시작해 0에서 1로 적분하고, 얻은 행동 묶음의 일부를 실행한 뒤 다시 관측한다.
학습 시간을 균등하게 뽑는 대신 잡음이 큰 작은 시간 쪽을 강조하는 shifted Beta 분포를 사용한다. 부록의 설정은 상한 0.999와 변환된 Beta(1.5,1)를 사용한다. 이 선택은 관측에서 행동을 예측하기 어려운 구간에 학습 비중을 주려는 설계이지, 모든 flow 모델이 따라야 하는 필수 규칙은 아니다.
그림의 모델 크기와 모듈 이름은 이 강의에 인용된 원래 π₀ 구성의 설명이다. 언어·영상 사전학습이 있다고 해서 인터넷 이미지에 실제 모터 명령 라벨이 붙어 있는 것은 아니다. 로봇 행동 자료와 flow 학습이 그 연결을 담당한다. 여러 로봇을 함께 학습하려면 행동 차원·정규화·입출력 대응도 맞춰야 한다.
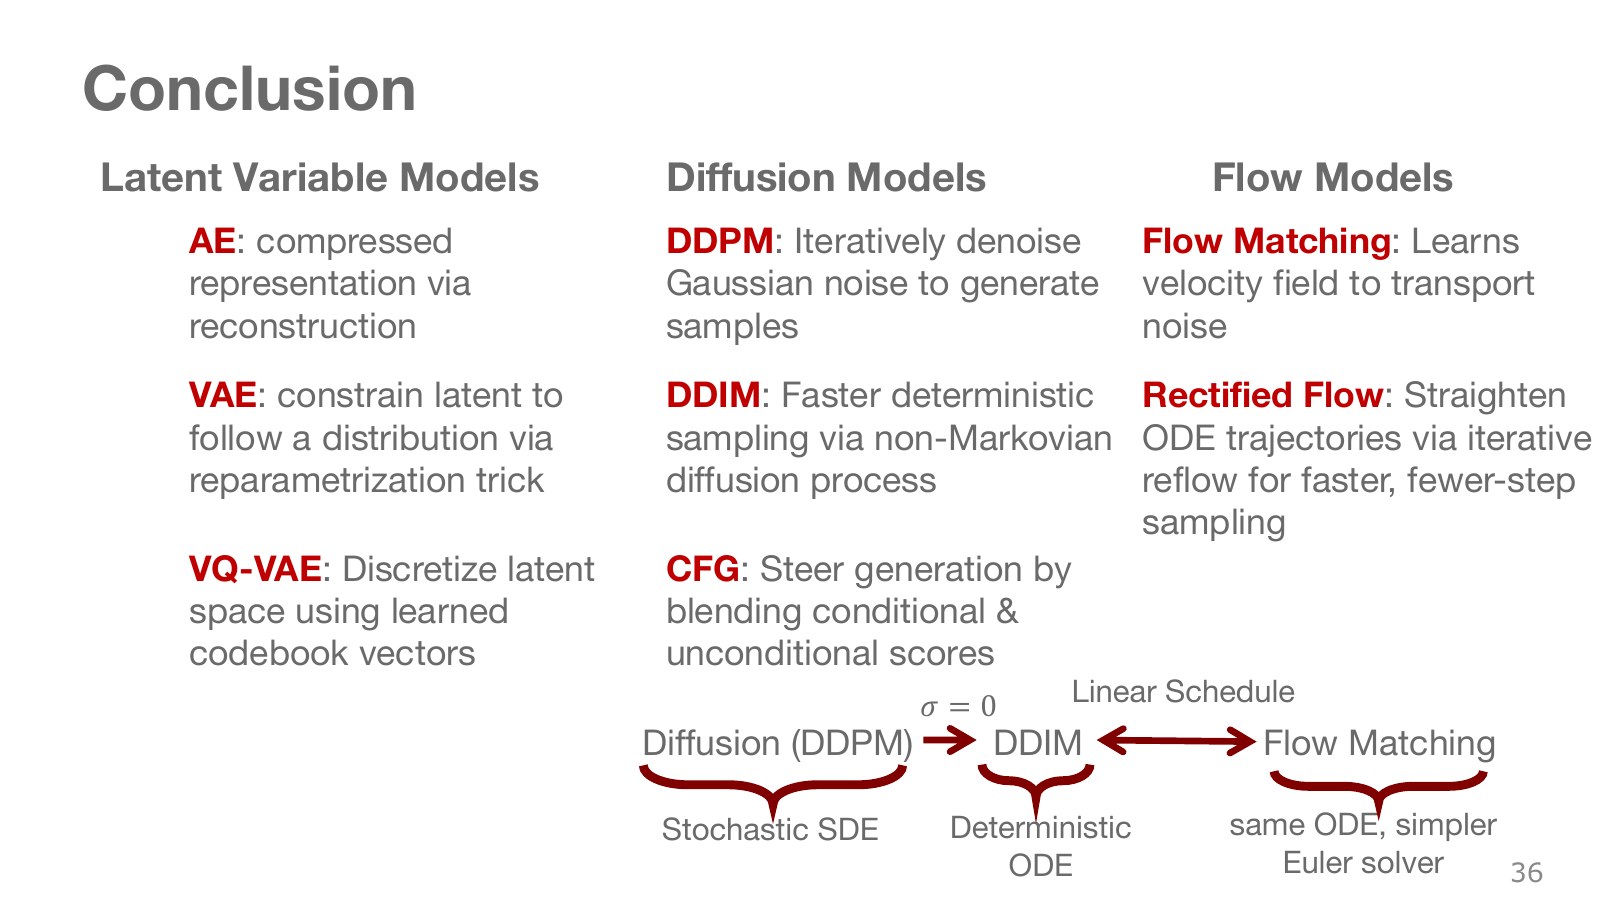
세 계열을 비교할 때 “어느 것이 가장 최신인가”보다 무엇을 예측하고 어떻게 표본을 만드는지 먼저 보자.
| 계열 | 학습하는 핵심 | 생성할 때 하는 일 | 로봇에서 살필 점 |
|---|---|---|---|
| VAE | 입력을 설명하는 확률 잠재표현과 디코더 | 사전분포에서 코드 표집 후 복원 | 실행 때 정답 행동 없이 코드를 뽑을 수 있는가 |
| VQ-VAE | 이산 코드북과 복원, 별도의 코드 분포 | 코드 번호 표집·벡터 조회·복원 | 코드 조합과 실제 행동 사이의 대응이 있는가 |
| DDPM·DDIM | 여러 잡음 수준의 예측 | 잡음에서 단계적으로 자료 복원 | 생성 횟수·지연·행동 묶음 길이를 구별하는가 |
| Flow matching | 위치와 생성 시간에 따른 속도장 | 잡음에서 속도장을 적분 | 시간 방향과 적분 간격이 일관되는가 |
확산의 잡음 예측과 flow의 속도 예측은 선택한 확률 경로와 시간 매개화 아래에서 서로 변환해 연결할 수 있다. 그렇다고 유한 단계 DDPM, DDIM, 모든 flow 샘플러가 같은 알고리즘이나 같은 품질을 낸다는 뜻은 아니다. 이산화와 학습 목표의 가중치, 조건 처리, 계산량을 함께 봐야 한다.
다양한 행동을 만들 수 있다는 것만으로 좋은 행동이 보장되지는 않는다. 자료에 실패가 많으면 그 분포도 배울 수 있고, 제약을 모르면 위험한 행동을 생성할 수 있다. 생성 모델은 정책의 표현 도구이며, 무엇을 배우게 할지와 어떻게 평가할지는 모방 학습·강화학습·제어 시스템의 설계 문제로 남는다.
#직접 실행해 확인한 계산
로봇 없이도 식의 의미를 확인할 수 있도록 실행 코드와 결과를 공개했다. 두 우회 경로의 평균 충돌, 가우시안 잠재모델의 ELBO와 KL 간격, 재매개변수화 미분, 양자화의 실제 미분과 STE의 차이, 확산 주변분포, DDIM의 원본 복원 대수, CFG 가중치, flow 적분 오차를 계산했다.
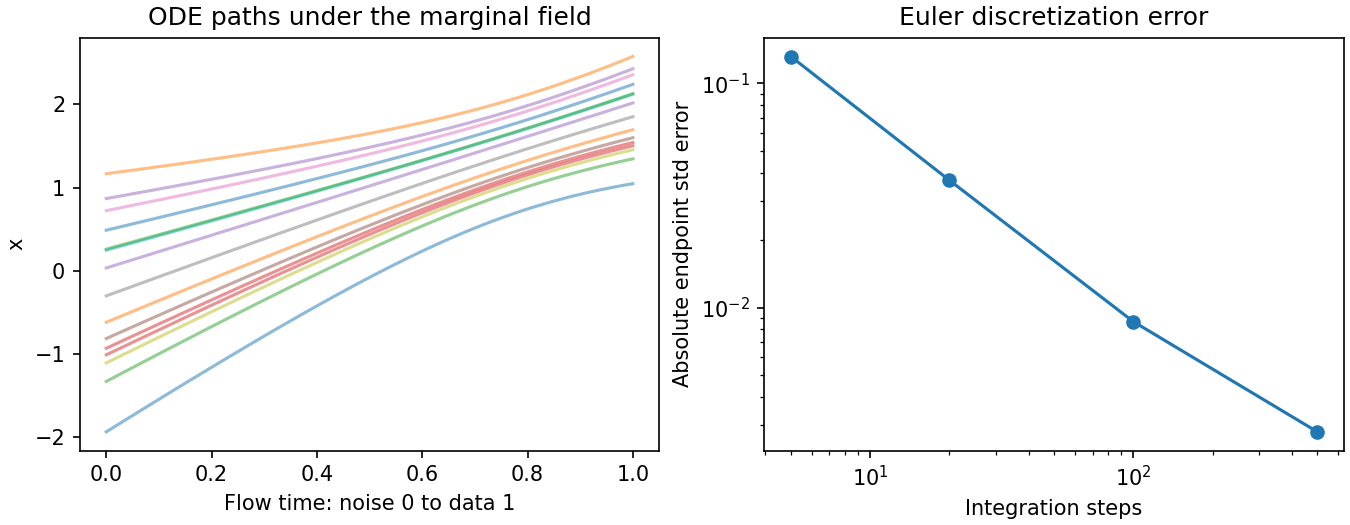
이 예제는 알려진 확률분포를 이용한 수치 계산이다. DDIM 확인에는 정답 잡음을 사용했으므로 학습된 잡음 예측기의 성능 검증이 아니다. VAE·Diffusion Policy 신경망 학습, 공식 과제, 로봇 물리 시뮬레이션이나 실제 하드웨어 실행을 했다는 뜻도 아니다. 실행 가능한 로봇 사례는 Diffusion Policy 공식 코드와 논문 프로젝트의 시뮬레이션·실험 설정을 참고할 수 있다.
#함께 읽을 강의와 원자료
- Berkeley CS294-158, Deep Unsupervised Learning 2024: 4강 잠재변수·VAE와 6강 확산. 본문에서는 ELBO 간격과 학습·샘플러 분리를 보완했다.
- VAE 원논문 · VQ-VAE: 확률 잠재표현, 재매개변수화, 코드북 학습의 출발점이다.
- DDPM · DDIM · CFG: 잡음 예측 목표와 생성 절차를 구별해 읽는다.
- Diffusion Policy · Octo · DiT Policy: 행동 묶음과 조건 전달, 다중 작업 확장을 비교한다.
- Flow Matching · Rectified Flow · π₀: 속도장을 배우는 원리와 실제 행동 생성 연결을 다룬다.
- Cheng Chi 초청 강연: 4:30–7:31에서 알고리즘뿐 아니라 하드웨어·자료·구성품과 조달이 실제 시스템의 중요한 조건이라고 설명한다. 이 녹화를 Diffusion Policy 수식의 추가 강의라고 가정하지 않고, 모델 밖의 구현 조건을 보완하는 자료로 읽었다.
슬라이드·강의의 저작권은 Oier Mees와 각 인용 자료의 권리자에게 있다. 본문은 원자료에 대한 한국어 설명이며, 자체 수치 그림은 JJo가 생성했다. 사진에 인용된 논문·모델의 그림과 영상에도 각 원저작자의 권리가 적용된다. Oier Mees · ETH Computer Vision and Geometry Group.