운전자가 도로를 보고 핸들을 돌린 기록을 모으면, 로봇도 그 기록에서 운전을 배울 수 있을까? 출발점은 입력과 정답이 있는 지도학습이다. 하지만 로봇이 내놓은 답은 다음에 보게 될 장면을 바꾼다. 시연에서 행동을 배우는 방법과 실제 실행에서 생기는 세 가지 어려움을 차례로 살펴보자.
Oier Mees · ETH Zurich 2026 3강 · 공식 강의 · 원본 PDF
02장에서는 원하는 손끝 위치를 관절 목표와 제어 명령으로 바꾸고, 상태·행동·전이·보상으로 의사결정 문제를 적었다. 이제는 그 안의 정책을 어떻게 얻을지 다룬다.
모방학습(imitation learning)은 전문가가 보여 준 행동을 학습 신호로 사용하는 방법들의 묶음이다. 사람의 원격조작 기록이나 기존 제어기의 실행 기록이 시연이 될 수 있다. 이번 장의 주된 방법은 보상만으로 시행착오를 시작하는 대신, 같은 상황에서 전문가가 무엇을 했는지를 맞히며 출발한다. 시연자의 행동이 언제나 최적이라는 뜻은 아니므로 데이터의 품질과 범위도 함께 보아야 한다.
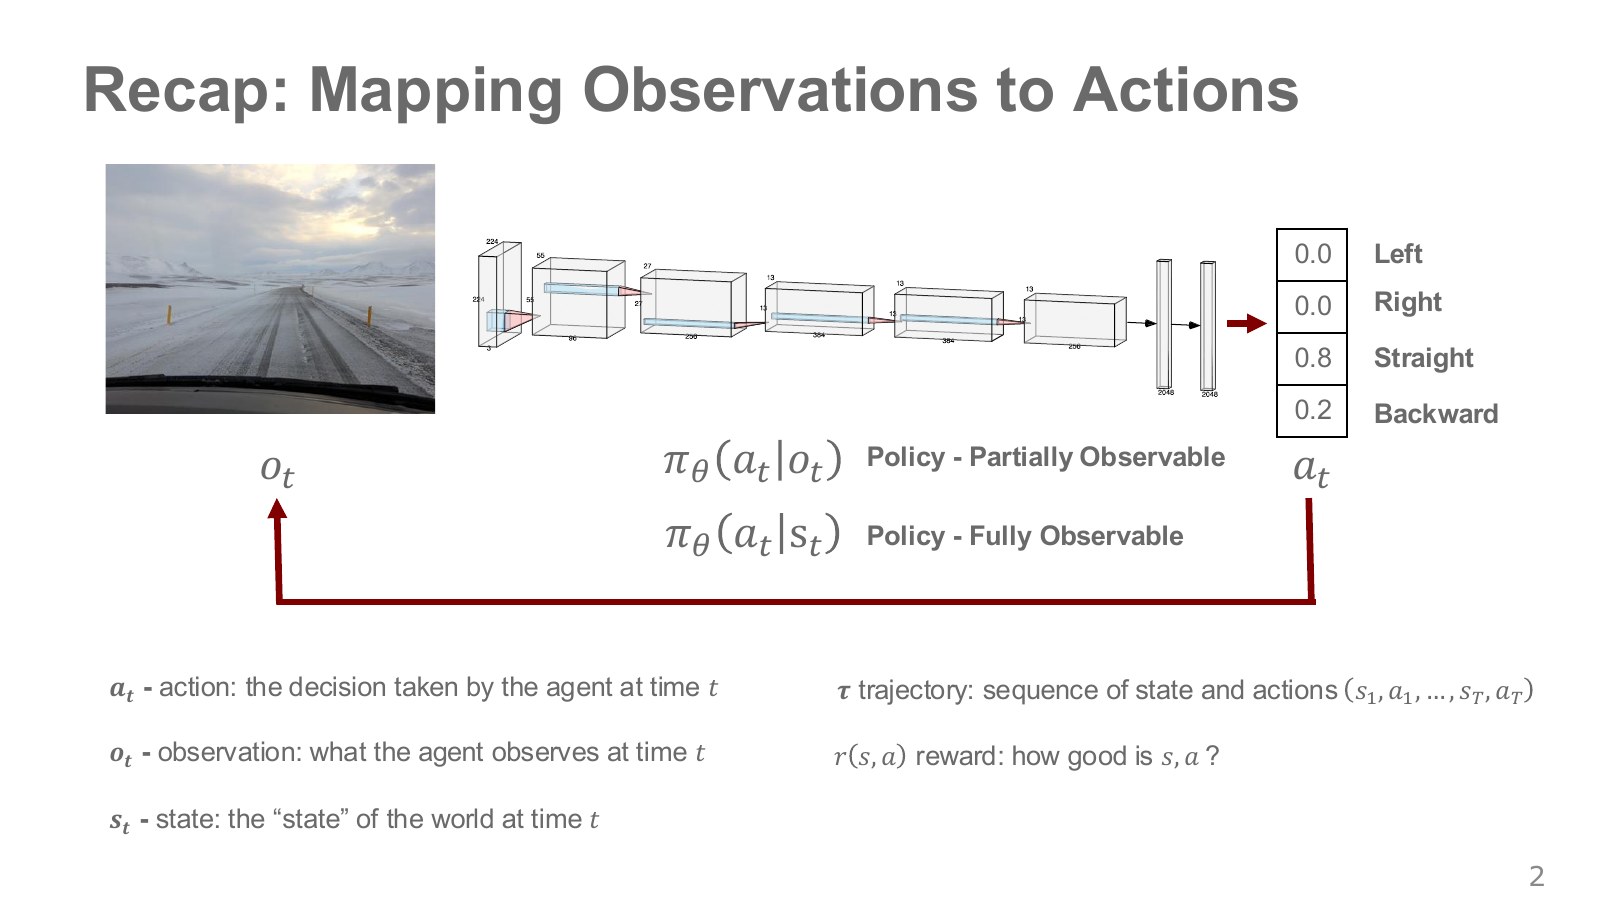
도로 영상은 관측, 핸들을 돌리는 명령은 행동이다. 차의 실제 위치·속도·방향을 포함해 다음 결과를 예측하는 데 필요한 정보는 상태로 모델링한다. 카메라 영상 한 장이 그 정보를 모두 보여 준다는 보장은 없다.
신경망 가중치 가 행동을 고르는 규칙을 정한다. 는 시점 의 관측 가 주어졌을 때 행동 에 두는 확률 또는 밀도다. 세로줄은 “주어졌을 때”라는 조건을 나타낸다. 완전한 상태를 사용할 수 있으면 관측 대신 를 조건으로 적는다.
그림의 빨간 아래쪽 화살표는 행동이 환경을 바꾸어 다음 영상으로 돌아오는 경로다. 위쪽의 0.8은 직진 선택 확률이지 성공률이 아니다. 자동차가 잘못 꺾으면 다음 카메라 화면도 달라진다. 따라서 저장된 사진에서 답을 잘 맞히는지와, 계속 행동하며 과업을 끝내는지는 따로 확인해야 한다. 원강의 2:09–2:49.
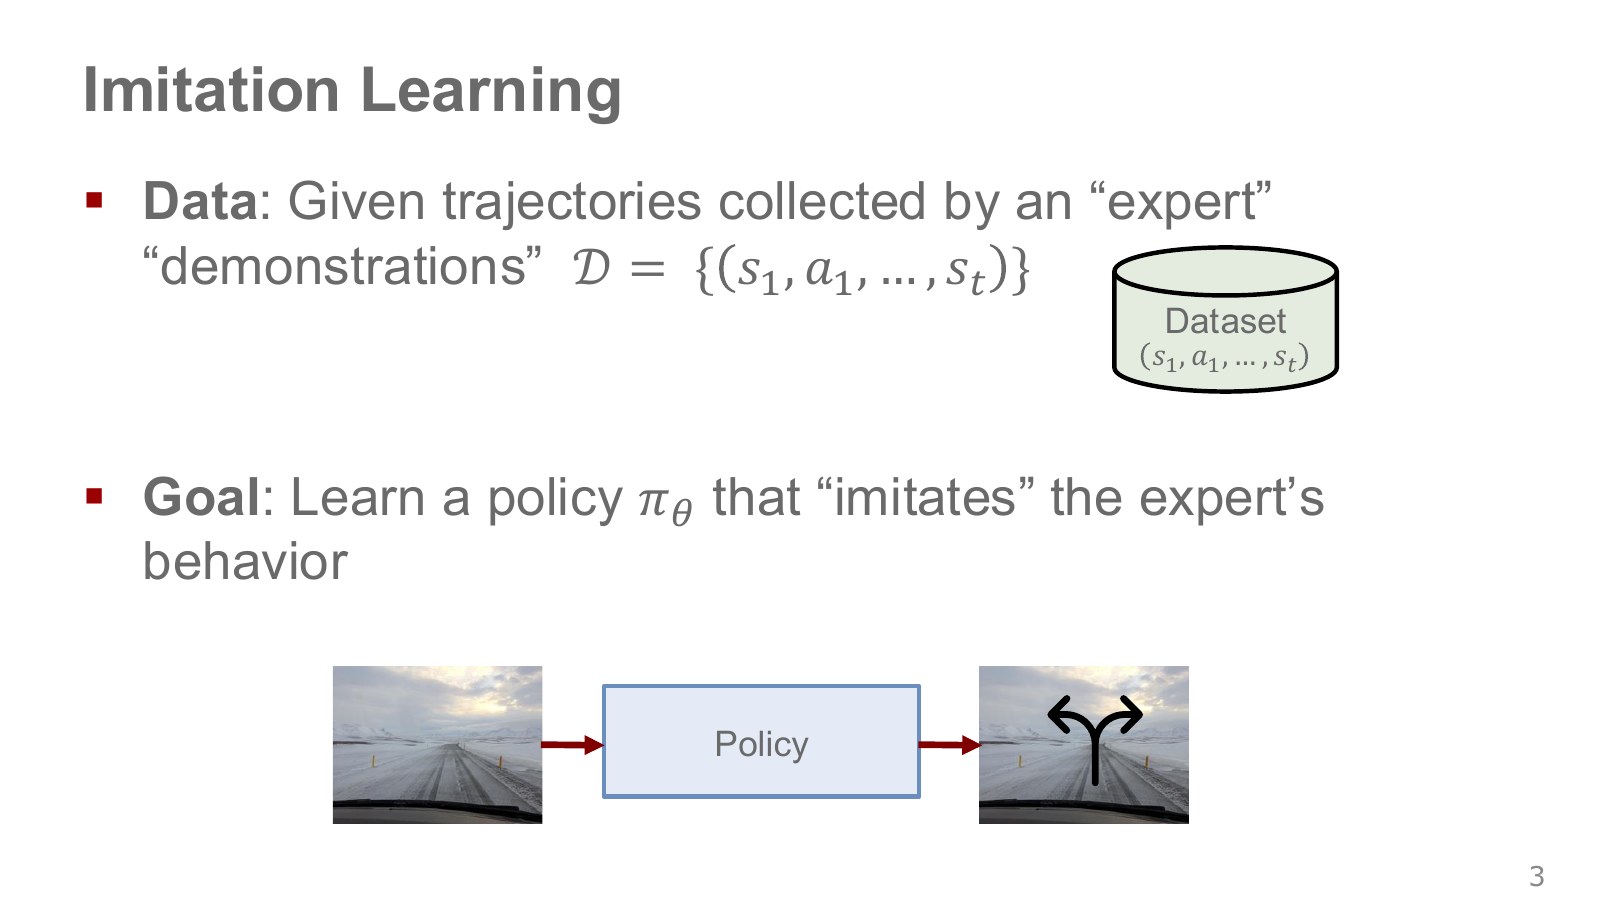
시연(demonstration)은 전문가가 과업을 수행하는 동안 관측하고 행동한 기록이다. 궤적(trajectory) 는 이런 상태·행동 또는 관측·행동을 시간 순서로 이어 놓은 한 번의 실행이다. 여러 실행을 모은 집합이 데이터셋 다.
컵 집기 시연이라면 각 시점의 카메라 영상, 관절 측정값, 집게 명령과 팔 명령을 같은 시간 기준으로 기록할 수 있다. 영상만 있고 로봇이 실행할 행동의 대응이 없다면, 여기서 다룰 기본 행동 복제의 정답 쌍이 바로 생기는 것은 아니다. 사람이 손으로 집는 영상과 로봇의 관절 토크 사이에는 별도의 대응 문제가 남는다.
학습용으로 궤적을 잘라 관측과 전문가 행동의 쌍 를 만든다. 별표는 여기서 전문가가 제공한 정답이라는 표시이며 수학적으로 증명된 최적값이라는 뜻은 아니다. 예를 들어 영상이 찍힌 뒤 0.1초 후의 행동을 잘못 붙이면, 정책이 배워야 할 반응 시점도 어긋난다. 원강의 2:41–3:54.
NTU 모방학습 5:26–7:51도 운전 기록과 로봇 팔 시연을 같은 관측–행동 학습 문제로 연결한다. 보상을 설계하기 어려운 과업에서 행동의 예시를 얻는 출발점이다. 다만 “옮긴다”는 목표만으로 명령의 단위가 정해지지는 않으므로, 위치 목표·위치 변화량·속도·토크 중 무엇을 기록했는지 먼저 정해야 한다.
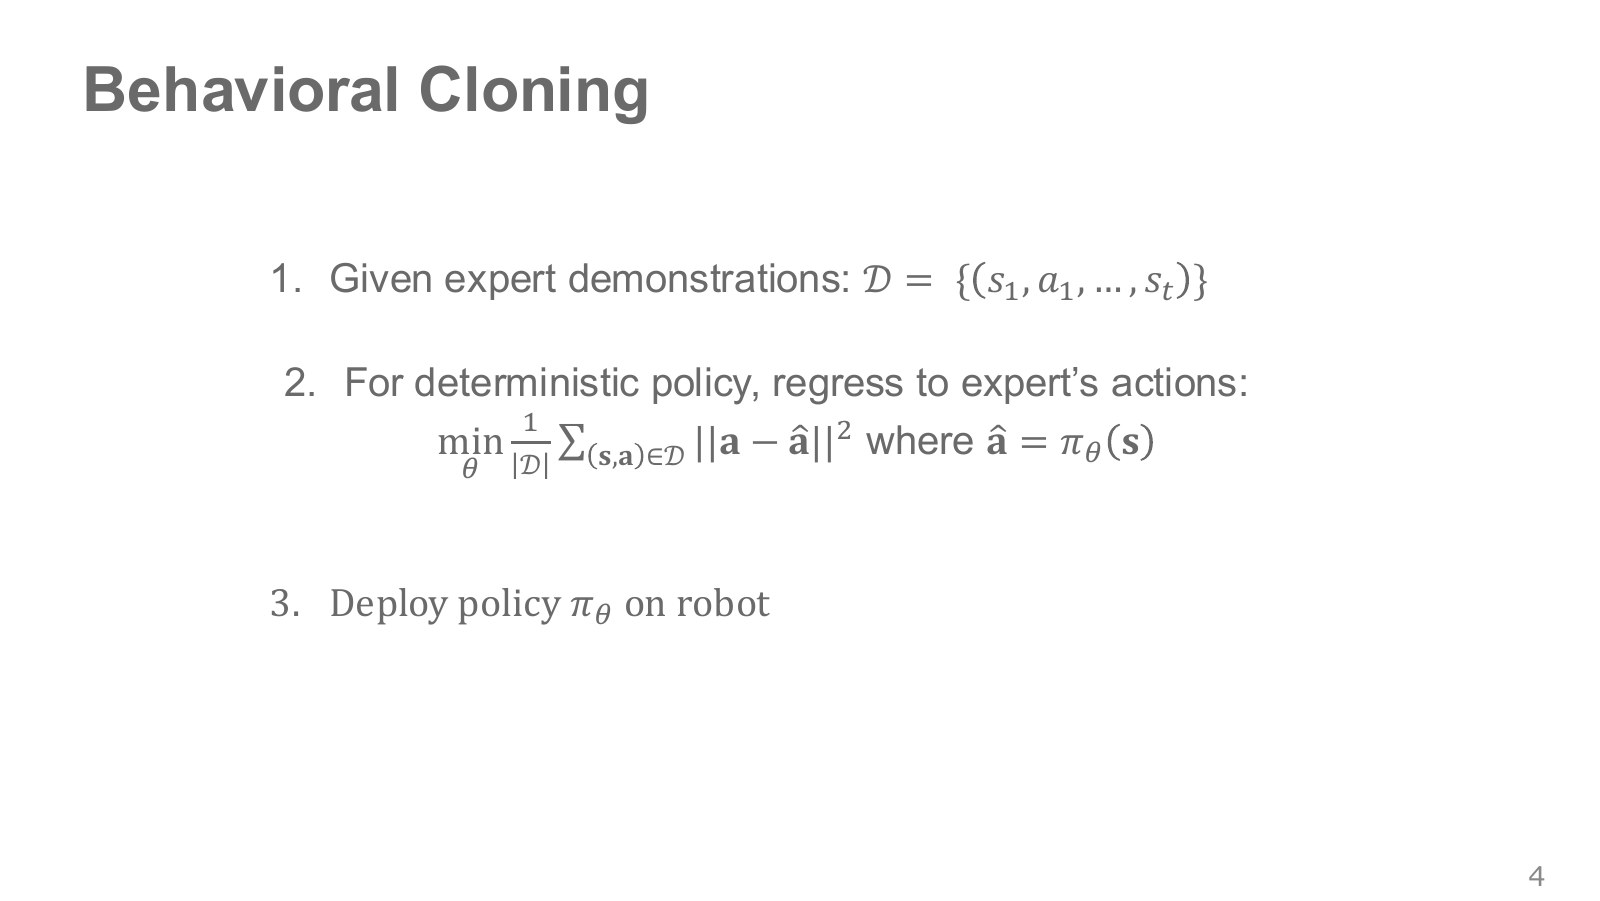
행동 복제(behavioral cloning, BC)는 시연을 지도학습 데이터로 바꾸어 정책을 학습한다. 지도학습은 입력과 정답의 쌍을 이용해 예측 규칙을 찾는 방법이다. 연속적인 행동 하나를 예측하는 결정적 정책에서는 회귀, 즉 숫자 값을 맞히는 문제로 만들 수 있다.
은 관측–행동 쌍의 수다. 모자 표시가 붙은 는 정책이 예측한 행동이고 는 시연 행동이다. 벡터의 노름을 제곱한다는 것은 각 행동 성분의 차이를 제곱해 더한다는 뜻이다. 이를 평균낸 평균제곱오차(MSE)가 작아지도록 가중치를 바꾼다.
실제 학습은 여러 쌍을 작은 묶음인 미니배치로 뽑고, 신경망으로 행동을 예측하고, 오차가 각 가중치에 얼마나 민감한지 미분해 가중치를 갱신하는 과정을 반복한다. 이 미분을 네트워크의 뒤에서 앞으로 계산하는 절차가 역전파다. 원강의 3:56–5:01.
행동을 하나의 값 대신 분포로 예측한다면, 전문가 행동에 높은 확률 또는 밀도를 주도록 다음 음의 로그 가능도(NLL)를 줄일 수 있다.
가능도는 “이 모델이 관측된 행동에 얼마나 큰 가능성을 주는가”를 평가한다. 로그는 단계별 곱을 합으로 다루기 쉽게 만들고, 앞의 음수는 최대화 문제를 최소화 문제로 바꾼다. 연속 행동에서는 특정 실수 한 점의 확률과 확률 밀도를 구별해야 한다. 또한 토크와 거리처럼 단위가 다른 성분을 무작정 더하면 손실의 비중이 달라지므로 정규화와 가중치를 확인해야 한다.
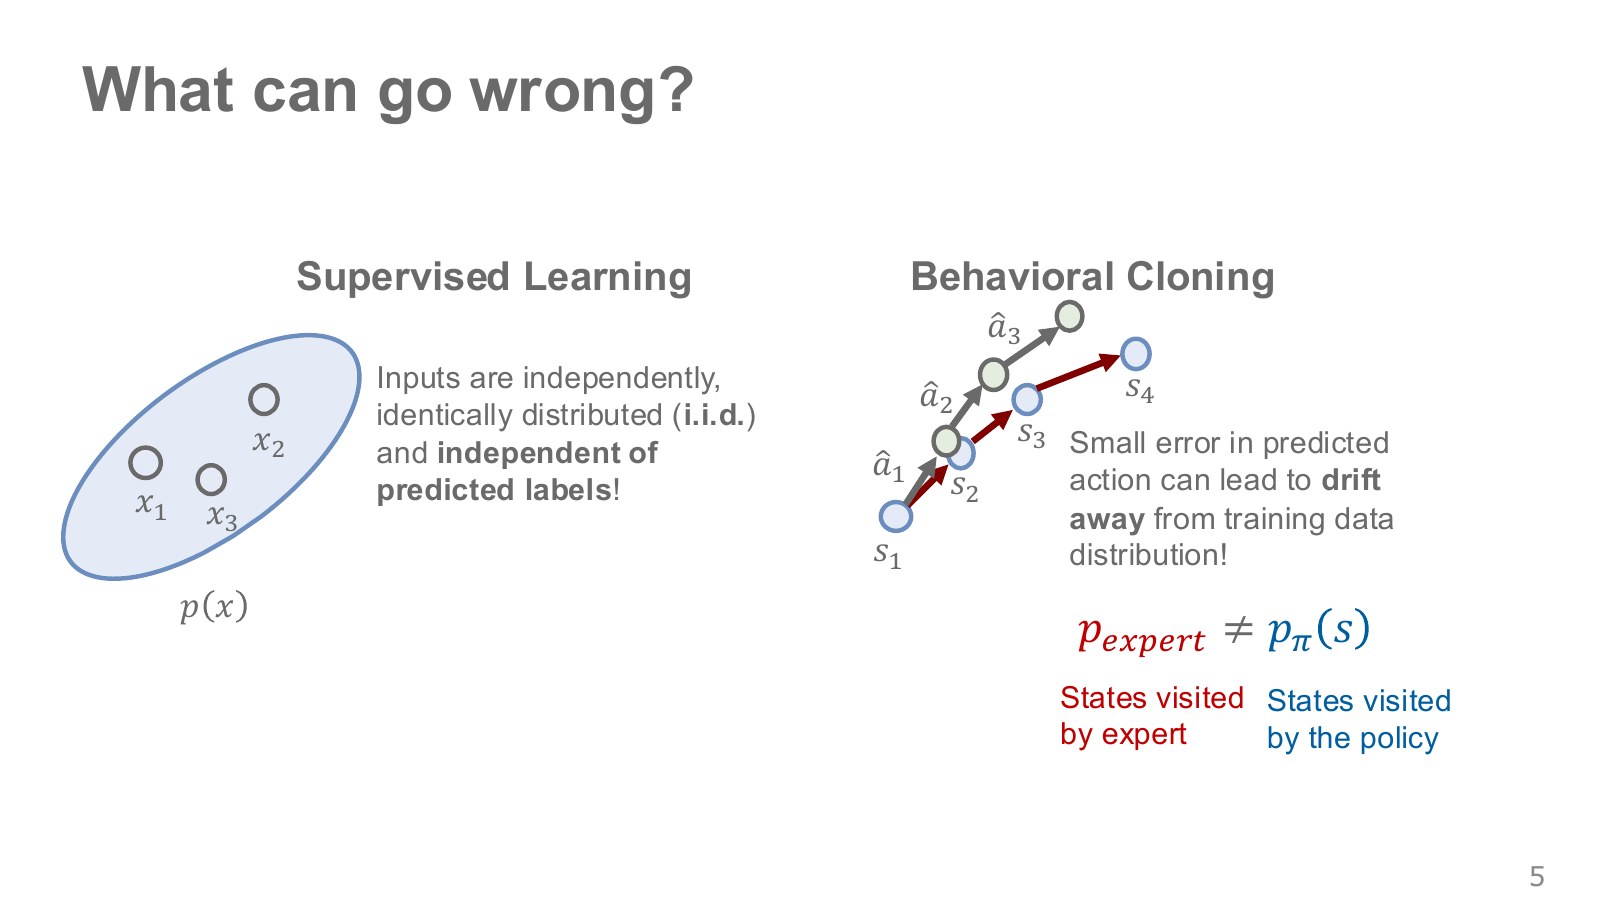
왼쪽 타원 속 점들은 고정된 입력 데이터다. 사진을 고양이로 분류하든 개로 분류하든 다음 사진의 픽셀은 바뀌지 않는다. 오른쪽에서는 회색 전문가 경로와 실제 정책 경로가 작은 행동 오차 뒤에 갈라진다. 정책이 조금 다른 곳으로 이동하면 그다음 입력도 전문가가 보았던 것과 달라진다.
분포 이동(distribution shift)은 학습 때 자주 보던 입력과 실행 때 만나는 입력의 분포가 달라지는 현상이다. 여기서는 날씨 변화처럼 외부에서 입력이 바뀌는 경우에 더해, 정책 자신의 행동이 입력 분포를 바꾼다. 차선을 조금 벗어난 정책이 더 낯선 영상을 보고 다시 잘못 꺾는 것이 누적 오차(compounding error)다.
전문가와 학습자가 방문하는 상태 분포를 각각 , 로 적자. 같은 도로에서 출발해도 두 분포는 달라질 수 있다. 이 분포는 상태마다 어느 정도 자주 방문하는지를 나타내며, 행동의 선택 확률과는 다른 개념이다. 원강의 5:38–8:44.
i.i.d.는 표본들이 서로 독립이고 같은 분포에서 나온다는 가정이다. 입력과 정답이 서로 무관하다는 뜻은 아니다. 지도학습은 오히려 입력과 정답의 관계를 배우려 한다. 핵심 차이는 예측이 미래 입력을 바꾸는 폐루프다. 연속된 시연 프레임도 서로 상관돼 있으므로, 프레임을 무작위로 섞는 것만으로 학습과 실제 실행의 분포 차이가 해결되지는 않는다.
2016년 NVIDIA의 DAVE-2 연구는 전방 카메라 영상을 신경망에 넣어 조향 명령을 예측했다. 도로 경계와 차량 상태의 모든 중간 규칙을 사람이 각각 작성하는 대신, 사람이 운전하며 남긴 영상–조향 대응을 학습한 것이다. 사진 속 차량은 이 접근을 보여 주는 실차 시연이다. 원강의 8:50–9:53.
종단 간(end-to-end)이라는 말은 이 예에서 영상 입력부터 조향 출력까지 연결된 학습을 가리킨다. 가속·제동·목적지 선택·모든 안전 판단까지 하나의 네트워크가 해결했다는 뜻으로 넓혀 읽으면 안 된다. 논문은 학습 데이터와 평가 조건을 구체적으로 정한 조향 시스템이다. NVIDIA 원 논문.
그렇다면 낯선 상태에서의 누적 오차 문제를 어떻게 줄였을까? 데이터에 잘 운전하는 모습만 넣는 대신, 중앙에서 벗어났을 때 어떻게 복귀할지도 가르친 것이 중요한 연결점이다.
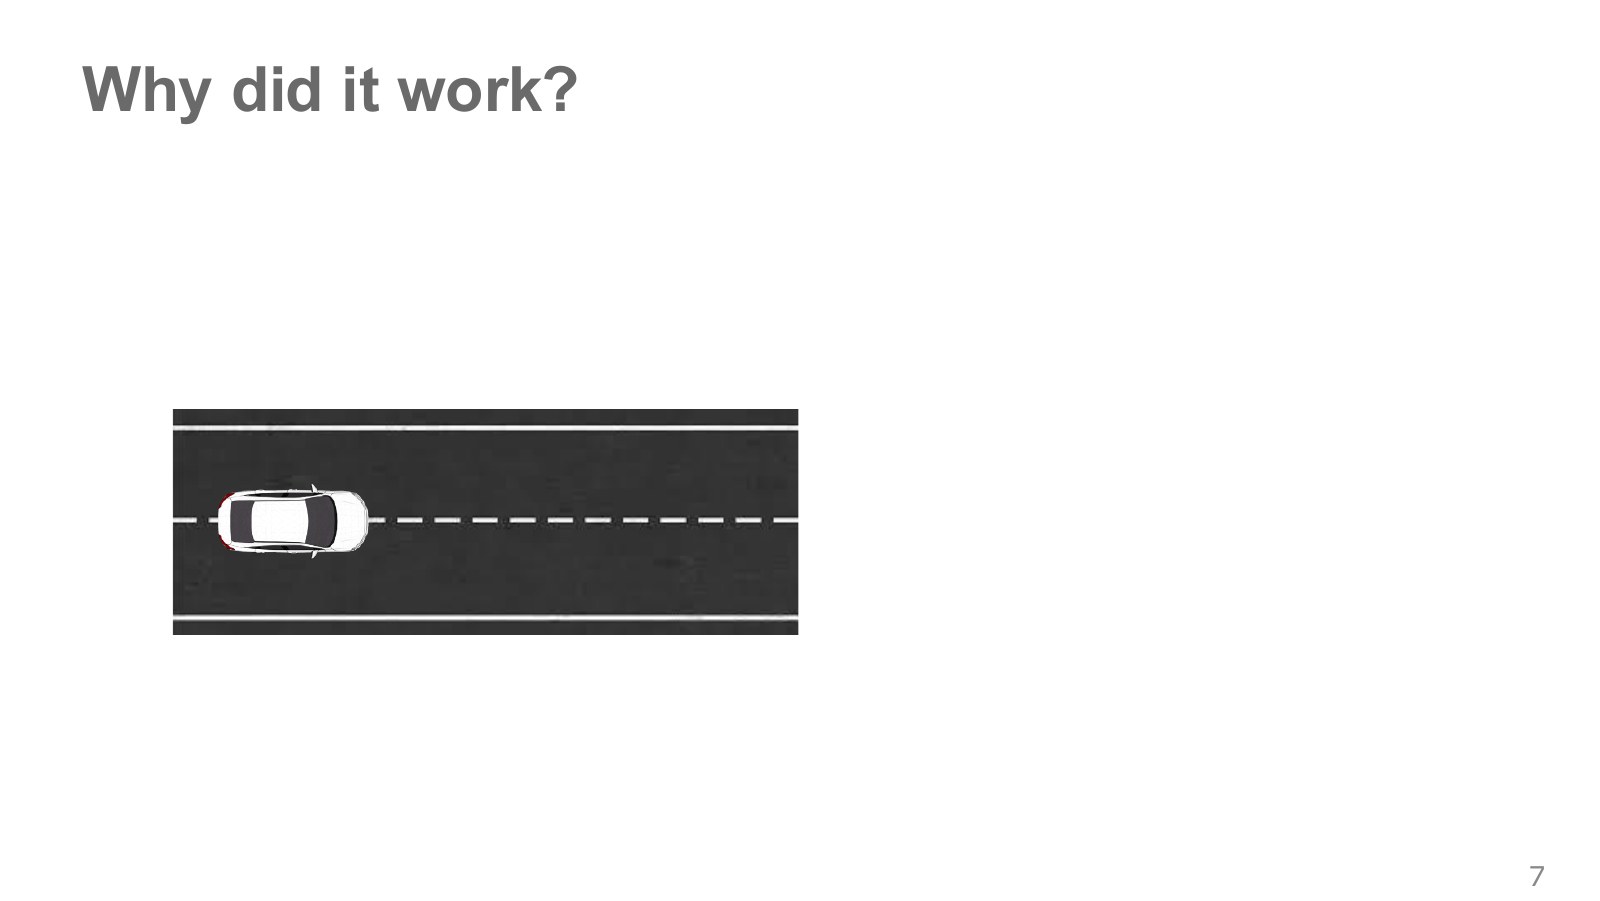
위에서 본 자동차가 차선 중앙을 따라 곧게 간다고 하자. 그 장면에 대한 전문가 행동은 거의 직진일 수 있다. 비슷한 영상과 비슷한 행동을 수천 번 모으면 중앙에서 직진하는 대응은 많이 배울 수 있다.
하지만 기록의 양과 기록이 다루는 상황의 범위는 다르다. 중앙을 정확하게 달린 데이터만 늘리면, 왼쪽 가장자리에서 오른쪽으로 복귀하는 예는 여전히 없을 수 있다. 정책이 잘해야 하는 것은 시연 경로를 재생하는 일만이 아니라 조금 빗나간 현재 상태에서 올바른 다음 행동을 고르는 일이다. 원강의 10:03–10:53.
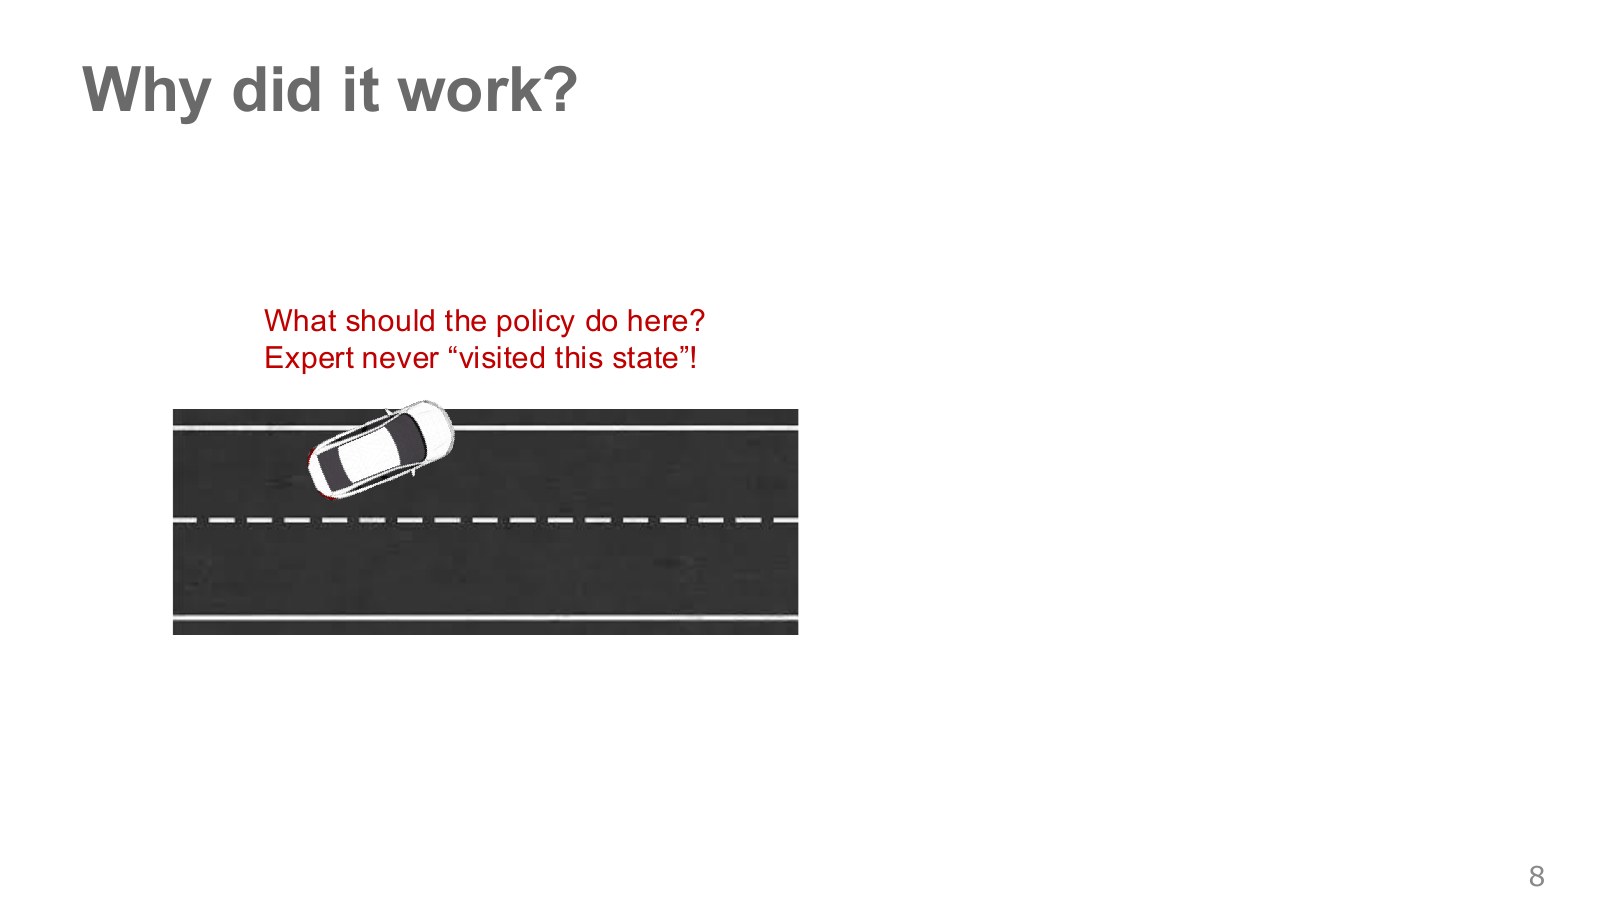
이제 차량이 차선에서 어긋나고 방향도 비스듬해졌다. 중앙에서 보던 도로 영상과 다르게 보이며, 필요한 조향도 직진과 다르다. 정책이 익숙한 중앙 영상과 잘 맞는다는 사실만으로 이런 복귀 행동까지 알아냈다고 할 수 없다.
이 상태를 학습 데이터에 추가하려면 그 장면의 영상뿐 아니라 어느 방향으로 얼마나 돌려야 돌아오는지라는 행동 정답이 필요하다. 무작정 잘못된 장면을 늘리는 것과, 그 장면에서의 좋은 복구 행동을 함께 기록하는 것은 다른 일이다. 원강의 10:55–11:59 · NTU의 시연 밖 상황 설명 8:00–9:01.
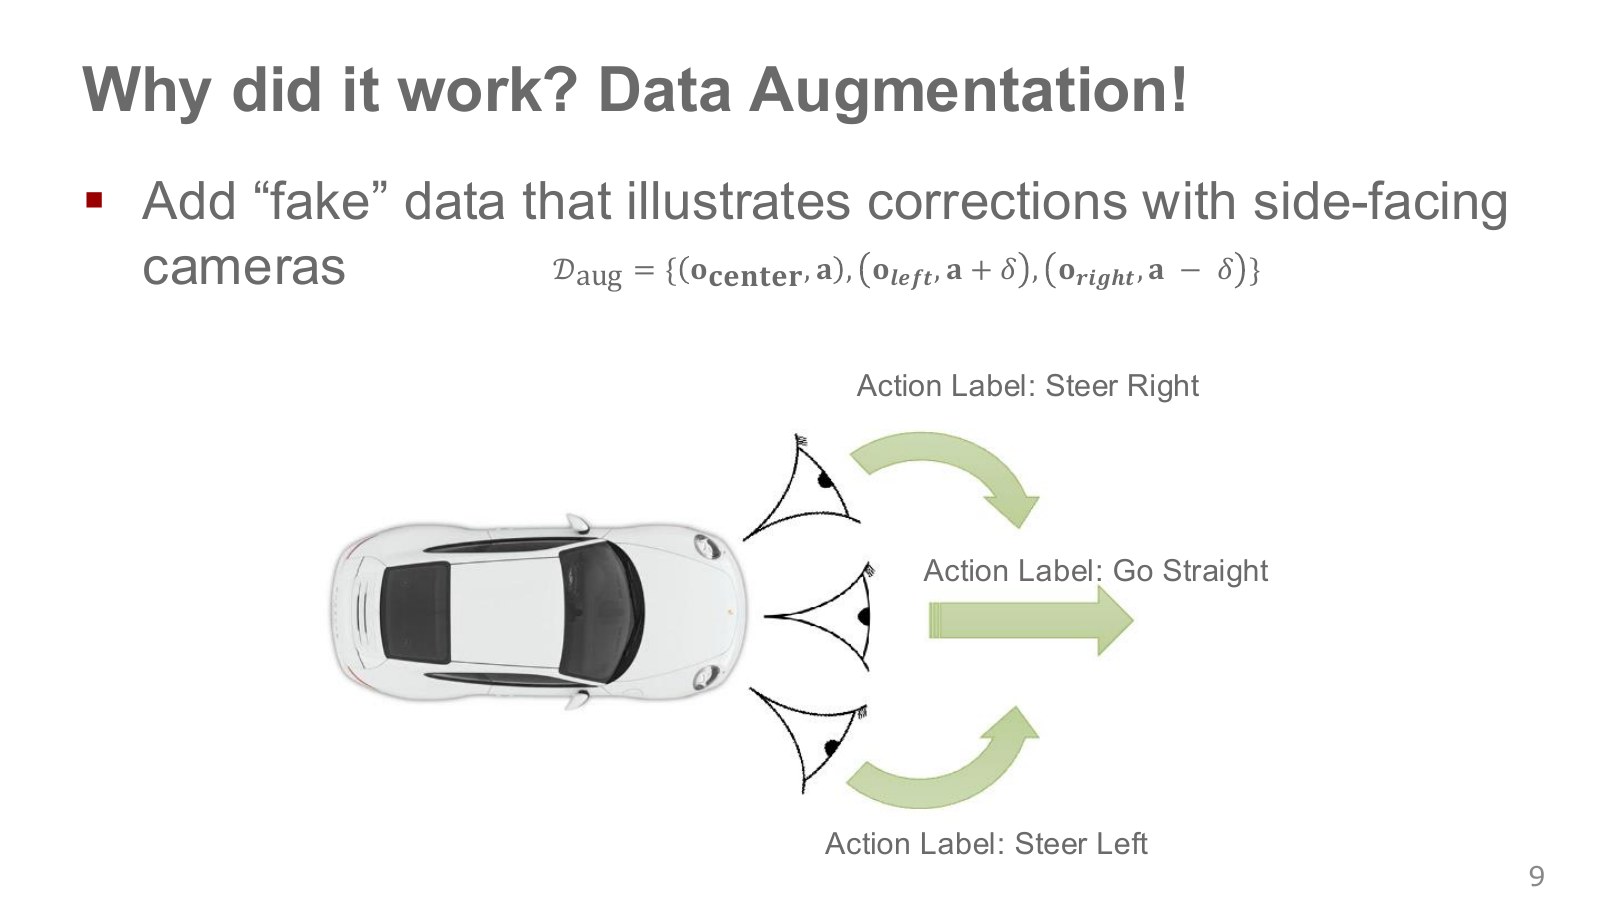
데이터 증강(data augmentation)은 기존 데이터에 타당한 변환을 적용해 학습할 경우를 늘리는 방법이다. 자동차에서는 중앙 카메라 외에 양옆 카메라의 영상을 이용해, 차가 중심에서 벗어나 보이는 장면을 만들 수 있다. 그때 행동 정답도 중심으로 돌아오도록 보정해야 한다.
아래 식에서는 오른쪽 조향을 양수로 두고, 설명용 보정 크기를 로 적었다. 왼쪽으로 치우친 시야에는 오른쪽 복귀 행동, 오른쪽으로 치우친 시야에는 왼쪽 복귀 행동을 대응시킨다.
는 중앙·왼쪽·오른쪽 카메라 관측이다. 부호는 조향 좌표의 약속에 따라 달라진다. 모든 차량에서 같은 상수 보정이 정확하다는 식은 아니며, 카메라의 위치·방향과 원하는 복귀 경로를 고려해야 한다.
NVIDIA 원 논문의 학습 구조를 보면, 영상에 적용하는 이동·회전 변환과 정답 조향의 보정이 별도 상자로 그려져 있다. 영상만 옮기고 원래 조향 정답을 그대로 붙이면 잘못된 대응을 학습시킬 수 있다.
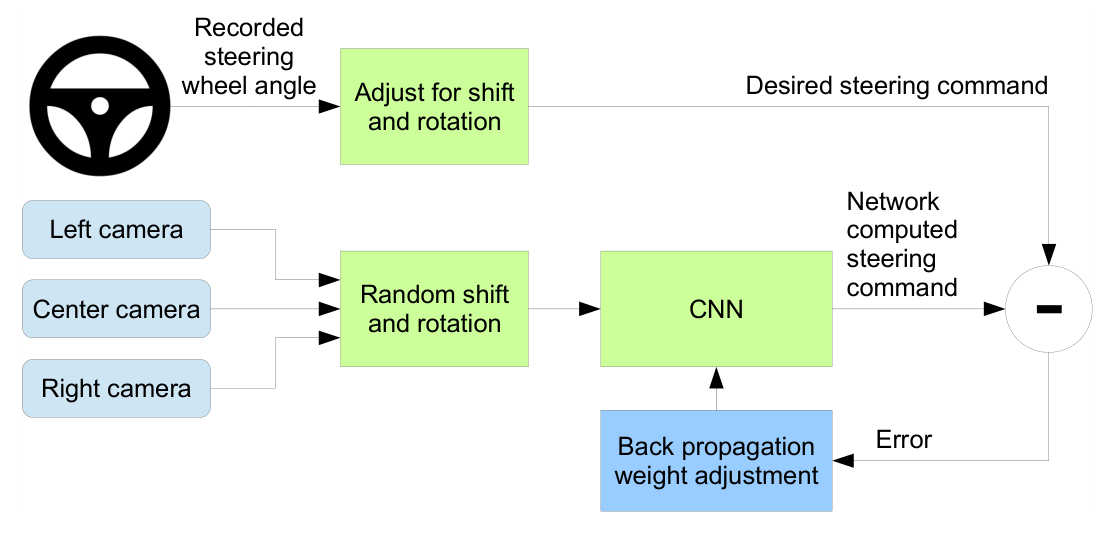
CNN은 영상의 공간적인 특징을 계산하는 합성곱 신경망이다. 그림의 역전파 화살표는 정답과 예측의 차이로 가중치를 갱신하는 학습 경로다. 학습 시에는 여러 카메라와 보정된 영상으로 데이터를 만들고, 실제 실행에서는 중앙 전방 카메라를 사용하는 구성을 구별하자. 원강의 12:01–13:03.
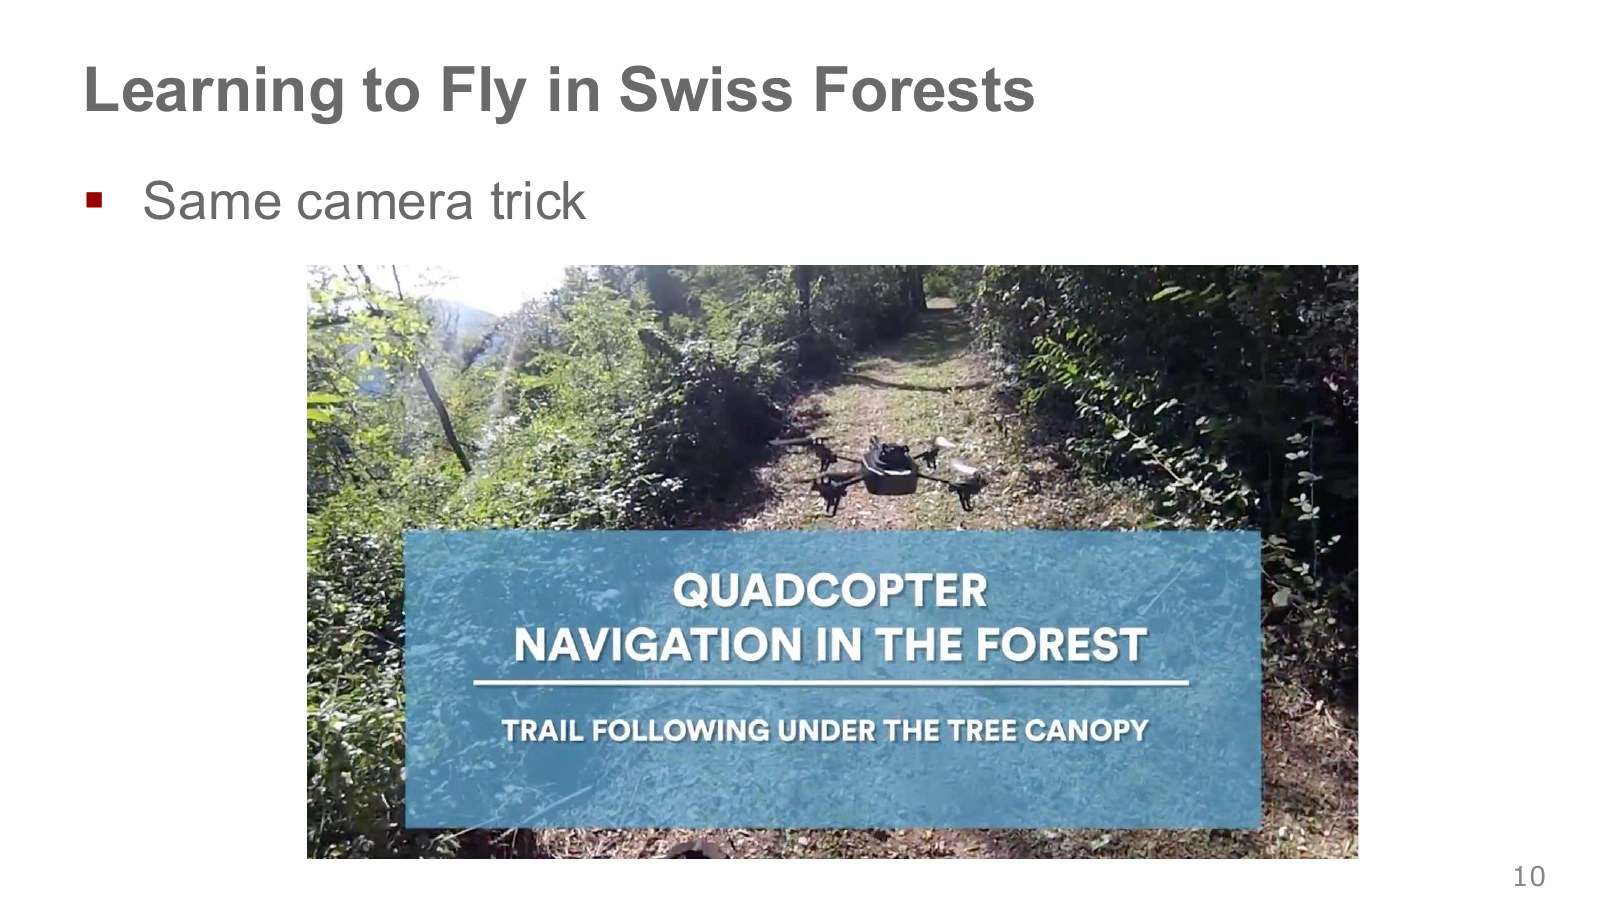
숲길 예에서는 사람이 머리에 중앙·왼쪽·오른쪽 방향 카메라를 달고 길을 걷는다. 중앙 카메라는 길을 따라 진행하는 장면을, 양옆 카메라는 방향이 어긋난 듯한 장면을 제공한다. 그 영상에 직진·좌회전·우회전 정답을 붙여 길을 따라갈 방향을 분류한다.
사람이 숲속에서 드론의 모든 모터 명령을 직접 시연한 것은 아니다. 카메라의 방향과 사람이 길을 따라 걷는다는 가정을 이용해 방향 선택의 정답을 만드는 방식이다. 영상에서 방향을 고르는 네트워크와, 기체를 안정적으로 날리는 하위 제어는 구별해야 한다.
Giusti 등의 원 논문은 세 카메라를 이용한 데이터 수집, 좌우 반전 시 정답 방향도 바꾸는 증강, 숲길 분류와 주행·비행 평가를 설명한다. 길이 없는 모든 숲이나 모든 장애물 회피로 결과를 일반화할 수는 없다. 원 논문 · 원강의 13:12–15:06 · Berkeley의 같은 수집 원리 설명 2:44–5:06.
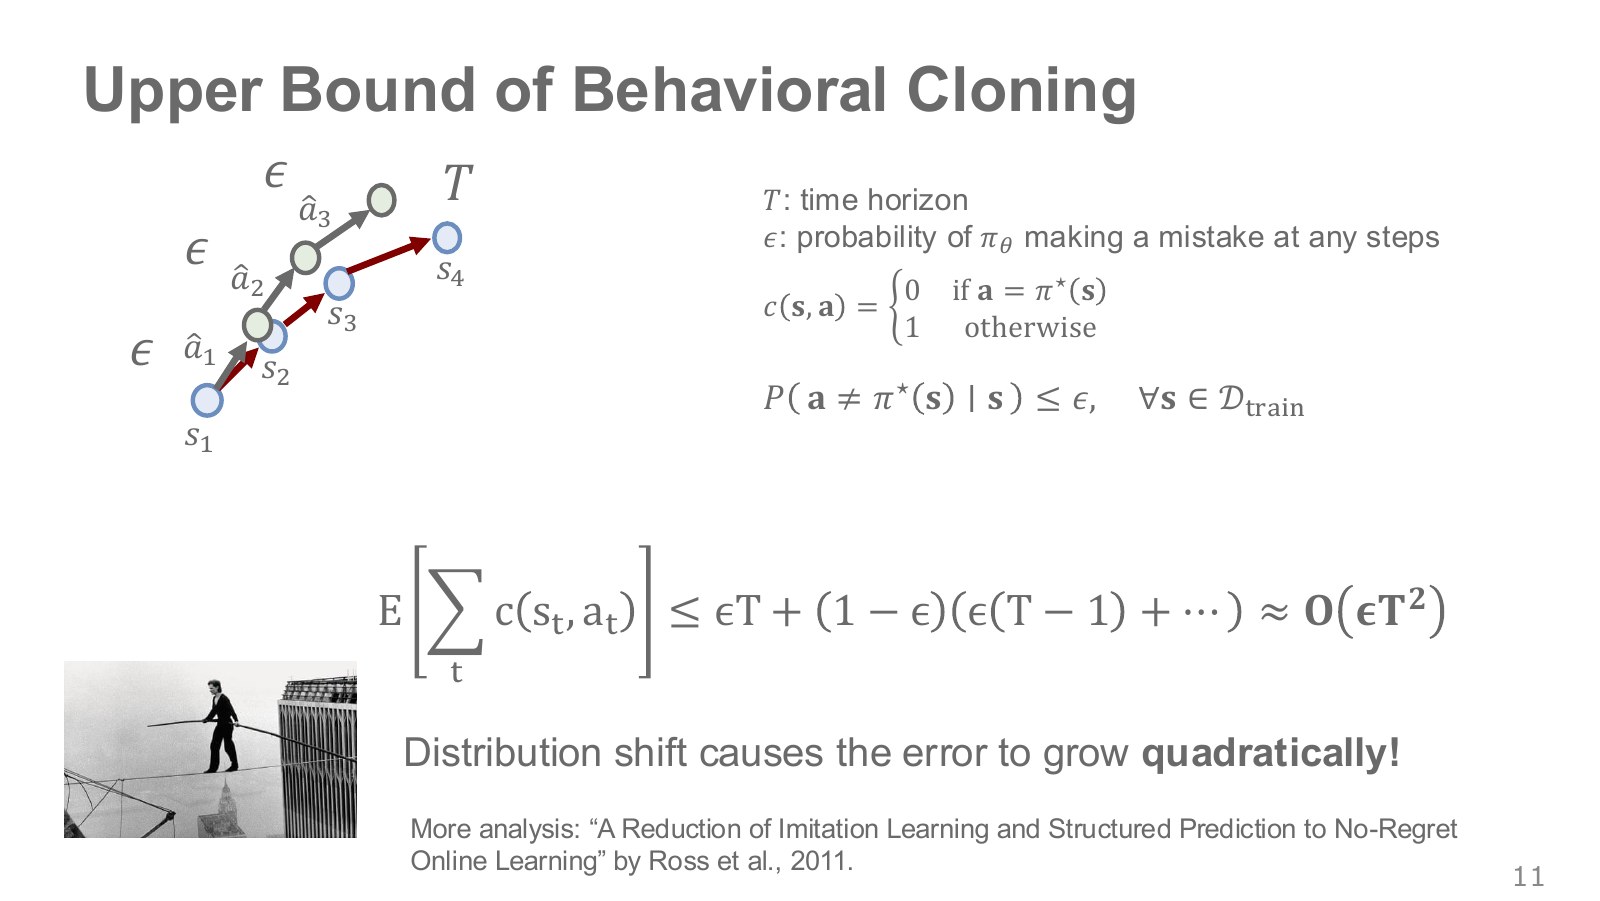
한 번의 행동을 틀릴 가능성이 작아도, 한 번 벗어난 뒤 계속 낯선 상태에 머물면 과업 전체의 손실은 커질 수 있다. 줄타기 그림은 한 번의 실패가 남은 단계 전부에 영향을 주는 경우를 비유한다.
는 실행 단계 수, 은 전문가가 방문하는 상황에서의 작은 행동 오류율이라고 하자. 비용을 한 단계당 0 또는 1로 두고, 이탈 후에는 남은 단계마다 비용 1이 생기는 단순 모형을 생각해 보자. 첫 단계에서 이탈하면 번, 둘째 단계에서 처음 이탈하면 번의 비용이 생긴다.
위 합은 이런 영향을 보수적으로 더한 직관이다. 는 큰 에 따른 증가 차수를 말하며 “BC는 항상 제곱만큼 나빠진다”는 실험 예측이 아니다. 한 단계 비용이 1 이하이면 실제 총비용은 를 넘지 않으므로 큰 상한은 정보가 약해질 수도 있다.
이탈 전 각 단계의 오류 확률이 일정하게 0.01이고, 한 번 이탈하면 회복하지 않는 별도 계산에서 일 때 기대 비용은 약 1.9728이다. 위의 단순 합은 2.1로 이를 덮는다. 오류가 한 번씩 독립적인 단발 손실로만 끝난다고 보면 0.2였을 것이므로, “남은 시간에 미치는 영향”이 무엇인지 비교할 수 있다.
Ross 등의 원 논문 2쪽은 전문가 분포의 모방 오차와 유계 과업 비용 등 조건 아래에서 일반적인 상한을 다룬다. 여기서 연속 토크가 전문가와 정확히 같을 확률을 그대로 0–1 오차로 세는 식을 무작정 적용하면 안 된다. 행동 오차와 과업 비용을 어떻게 연결할지 가정이 필요하다. 원강의 15:11–18:00 · Berkeley의 줄타기 계산 6:45–10:40.
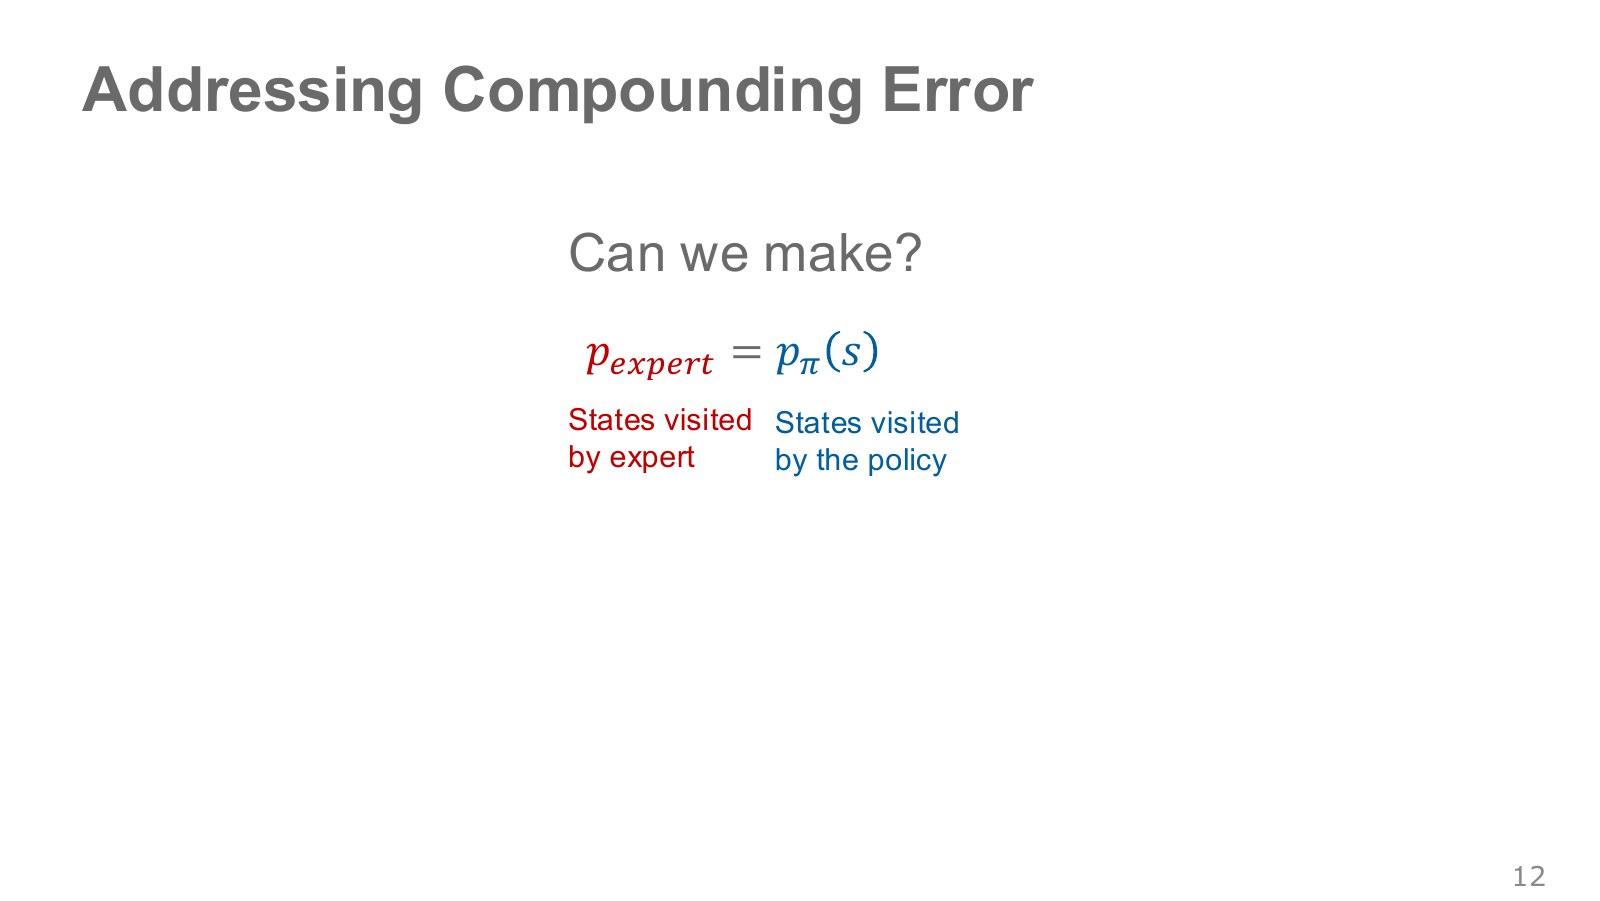
데이터에 없던 상태에서 자꾸 실패한다면, 그 상태를 학습에서 다루도록 만들 수 있다. 핵심 질문을 “전문가가 갔던 곳을 정확히 따라갔는가?”에서 “현재 정책이 도착한 이곳에서 전문가라면 무엇을 할까?”로 바꾸는 것이다.
그림의 두 분포를 같게 하자는 표시는 이 간극을 줄이려는 목표다. 현실에서 모든 상태의 방문 비율이 완벽하게 일치해야만 학습이 가능하다는 뜻은 아니다. 학습자가 자주 겪는 상태에 유용한 정답이 없다는 문제를 직접 다룬다고 이해하면 다음 알고리즘의 자료 수집 순서가 분명해진다. 원강의 18:03–18:40.
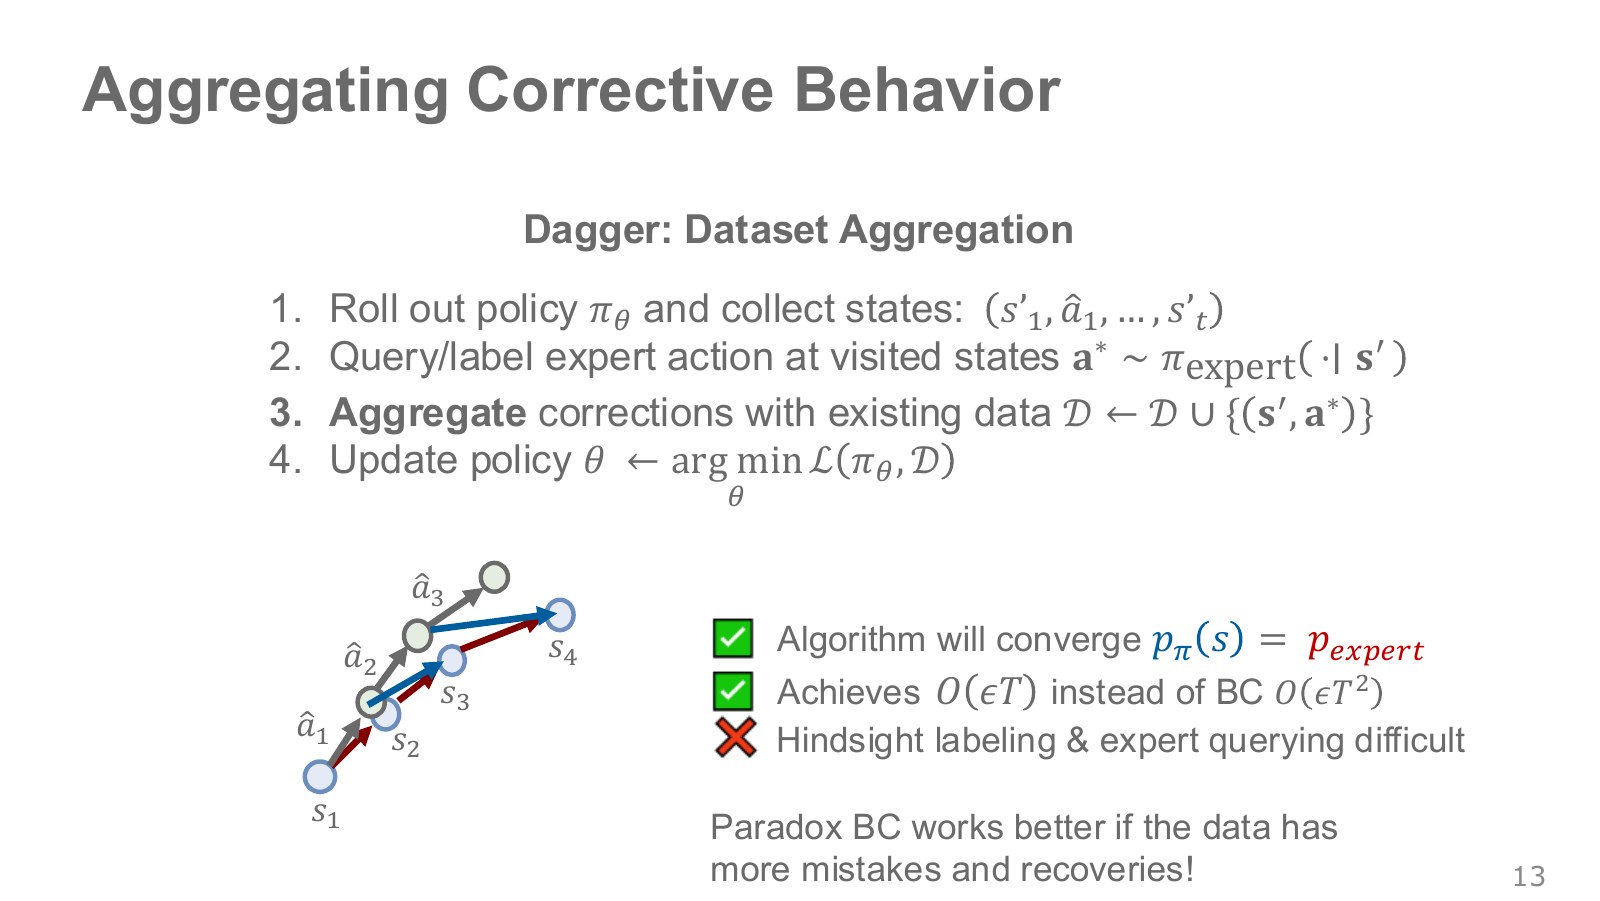
DAgger는 Dataset Aggregation, 즉 데이터셋을 누적한다는 이름이다. 처음에는 전문가 시연으로 정책을 만들지만, 이후에는 학습된 정책이 방문한 상태를 모아 전문가에게 그 상태에서의 정답 행동을 묻는다.
- 현재 정책으로 한 번 실행해 방문 상태를 기록한다. 이렇게 정책을 환경에서 실행해 기록을 얻는 것을 롤아웃(rollout)이라 한다.
- 방문한 각 상태에서 전문가가 택할 행동을 구한다.
- 새 상태–전문가 행동 쌍을 기존 데이터에 더한다.
- 누적된 데이터로 정책을 다시 학습하고 반복한다.
여기서 는 데이터 수집·학습 반복 번호다. 정책이 잘못한 행동을 그대로 정답으로 복제하는 것이 아니라, 그 행동 때문에 도착한 상태에 전문가의 좋은 행동을 붙인다. 과거 데이터를 버리지 않는 이유는 원래 잘하던 상태와 새 복구 상태를 함께 다루기 위해서다. 그림의 파란 교정 화살표가 이 추가 학습을 나타낸다.
원 알고리즘에는 수집 중 전문가와 학습자 정책을 섞는 설정과 학습·정책 선택에 대한 조건도 있다. 이론의 요점은 정책이 유도한 상태 분포에서의 모방 손실을 다루는 것이다. 그림의 분포 등호를 모든 실제 신경망이 전문가의 방문 분포와 정확히 같아진다는 무조건적 보장으로 읽으면 안 된다. 선형 차수의 성능 보장도 어떤 모방 손실과 비용·회복 조건을 쓰는지에 달려 있다. 원 논문 3–4쪽.
“실수가 있는 데이터가 도움이 된다”는 말에서 중요한 것은 실수 뒤의 올바른 복구 예다. 잘못된 행동만 더 많이 섞으면 목적이 바뀔 수도 있다. 또한 정지 화면을 보고 로봇 관절 토크를 일일이 지정하는 일은 사람에게 어렵다. 이 비용이 다음 개입 방식으로 이어진다. 원강의 18:44–20:27.
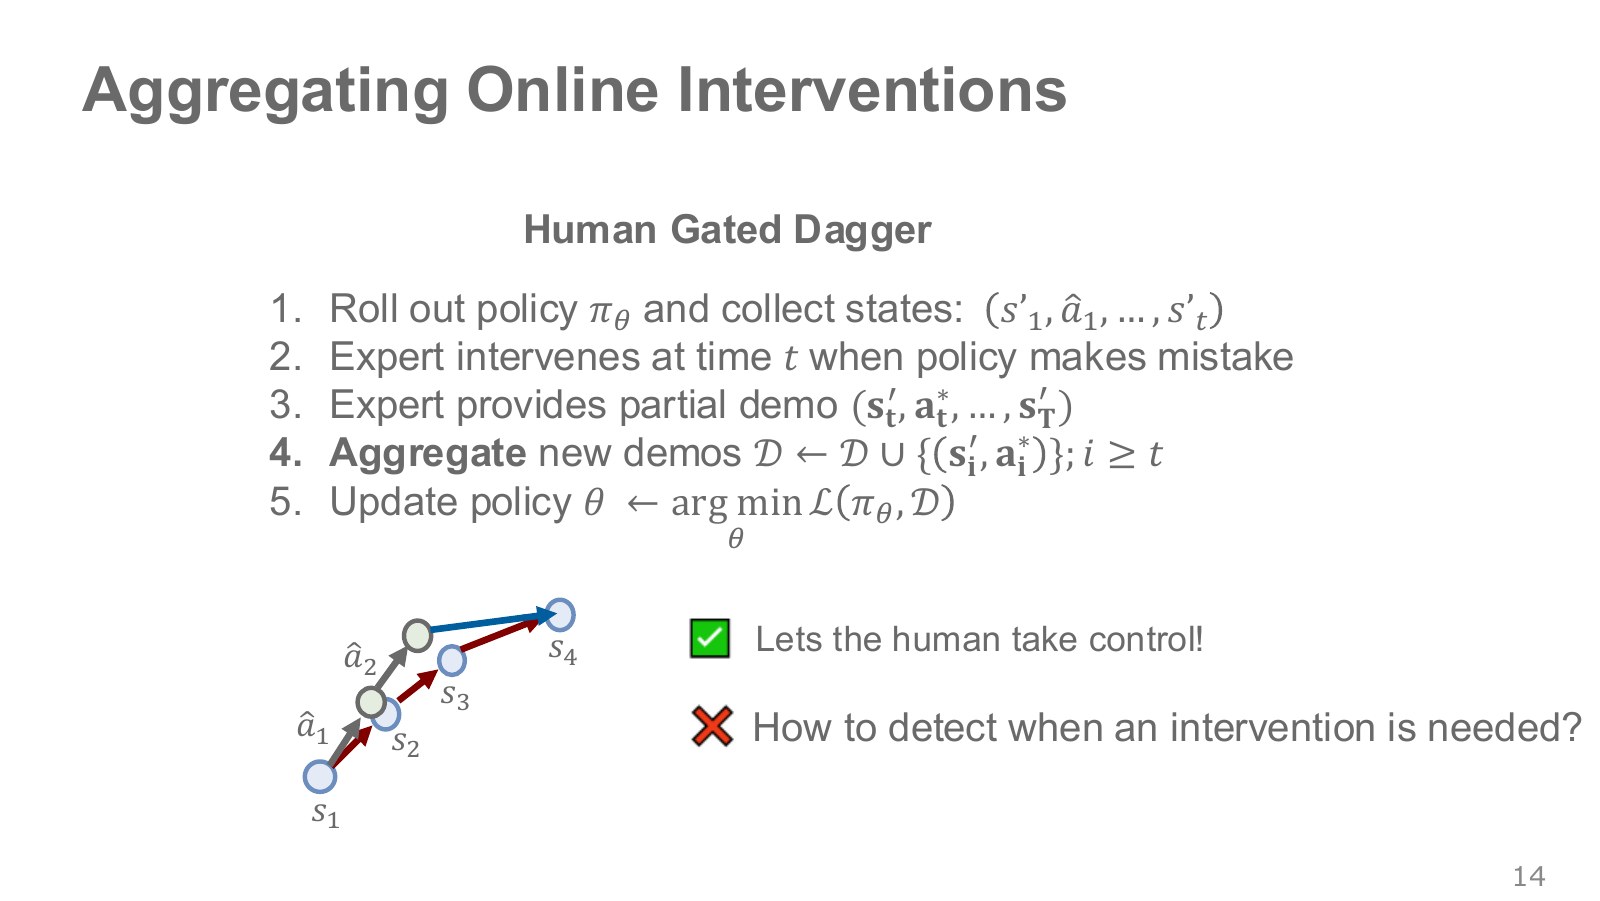
개입(intervention)은 정책 실행을 사람이 이어받아 일부 구간을 시연하는 것이다. 운전 교습에서 강사가 처음부터 끝까지 대신 운전하기보다, 필요한 순간에 핸들을 이어받는 모습을 생각하면 된다.
Human-Gated DAgger에서는 사람이 실행을 지켜보다가 문제가 생길 때 조종권을 가져오고, 복구 구간의 관측–행동 기록을 새 시연으로 추가한다. 지나간 화면마다 별도로 정답을 붙이는 부담을 줄일 수 있다. 하지만 모든 상태에 정답을 묻는 기본 DAgger와 수집되는 데이터의 분포가 같지는 않다.
어느 순간에 개입할지, 개입 전후의 명령을 어떻게 연결할지, 사람이 감독하지 않는 구간의 오차를 어떻게 발견할지가 남는다. 정책의 확률이 높다고 실제로 확신할 만한 상황이라는 보장은 없다. 어려운 순간을 알아보는 문제와 그때 해야 할 행동을 배우는 문제를 나누어 생각해야 한다. 원강의 20:32–22:25.
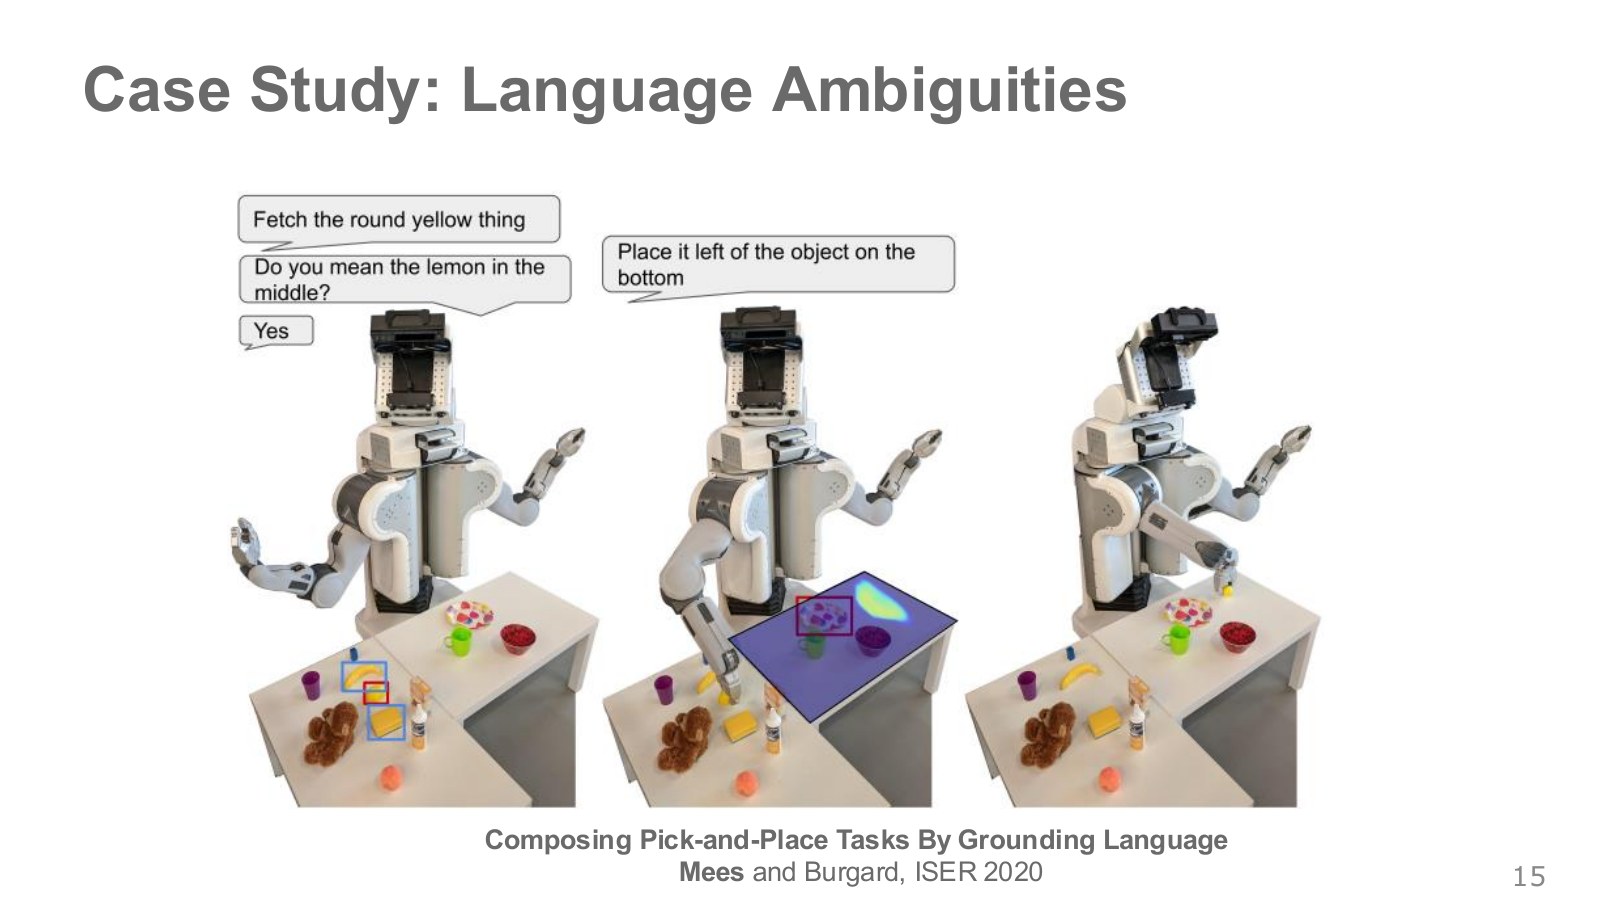
“둥글고 노란 물건을 가져와.” 테이블에 노란 물건이 여러 개 있다면, 집게를 어느 방향으로 움직일지보다 먼저 어떤 물체를 가리키는지가 불확실하다. 사진의 상자들은 지시의 후보가 되는 물체 영역을 나타낸다.
로봇은 “아래쪽 가운데 레몬을 말하나요?”처럼 후보를 구별하는 질문을 만들고 사용자의 답을 받은 뒤 행동할 수 있다. “아래쪽 물체의 왼쪽” 같은 상대 위치 표현도 어떤 물체를 기준으로 하는지 먼저 정해야 한다. 지시를 시각적 대상과 연결하는 일을 언어 그라운딩(language grounding)이라고 한다.
이 예는 전문가에게 모든 모터 명령을 다시 묻는 대신, 과업을 정하는 데 부족한 정보를 질문하는 경우다. 앞의 개입 필요성 탐지와 연결되지만, 이 사례 자체가 모든 로봇 실패를 감지하는 만능 장치인 것은 아니다. 원강의 22:30–23:15.
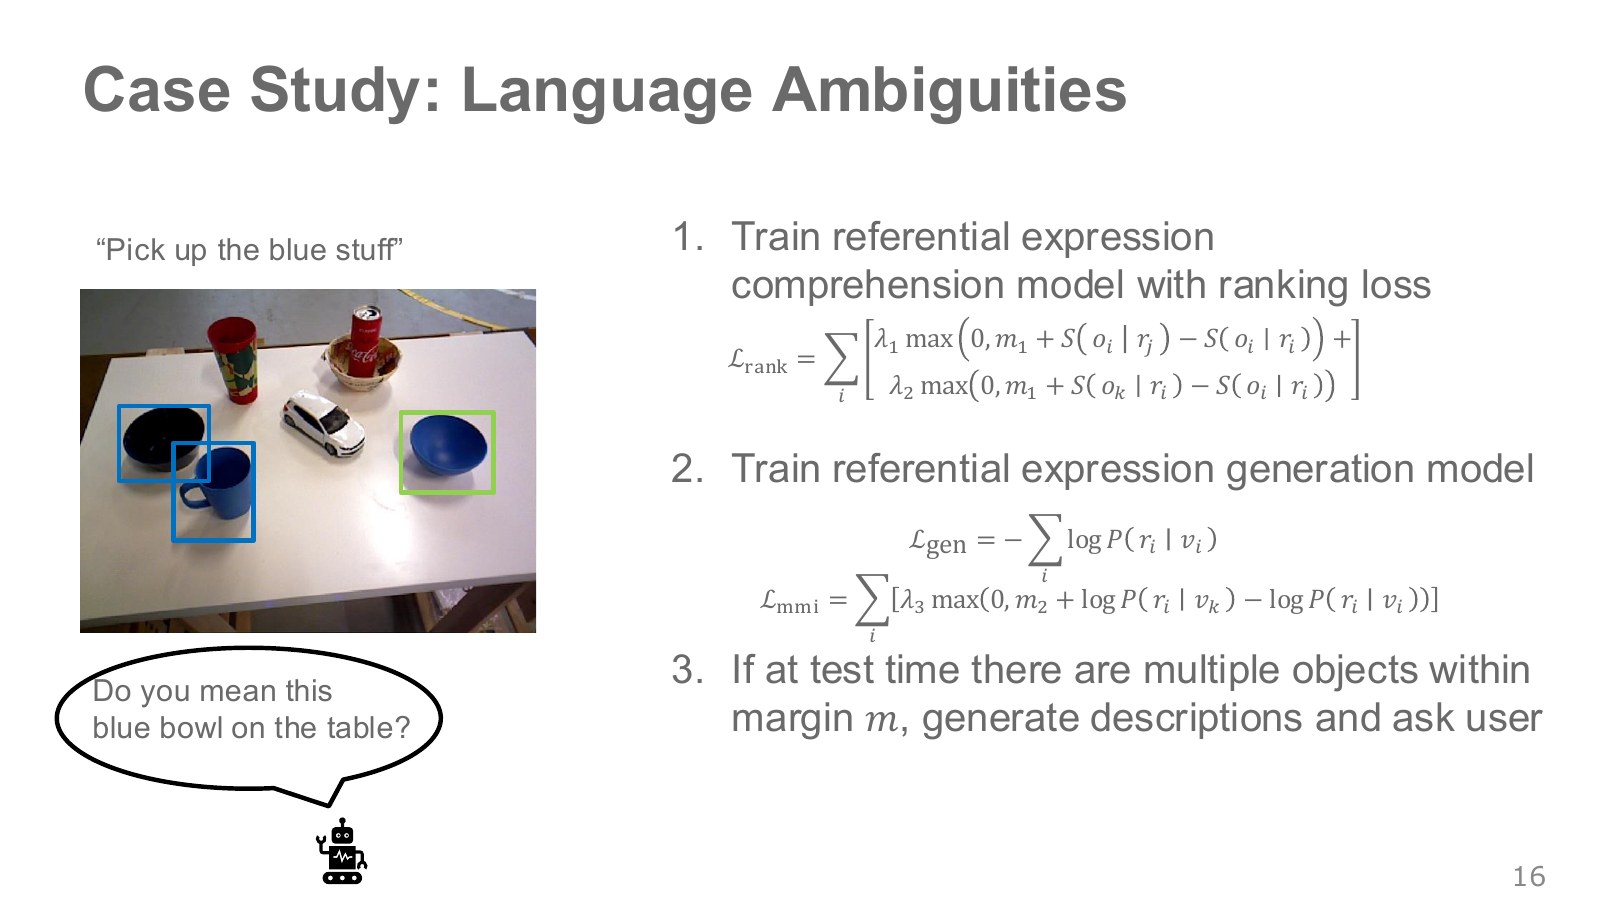
“파란 것을 집어라”라는 지시에 파란 그릇과 컵이 함께 후보가 될 수 있다. 지시 표현 이해 모델은 문장과 물체가 얼마나 잘 맞는지 점수로 비교한다. 여기서 는 정답 물체, 는 그 물체를 가리키는 문장, 는 문장과 물체의 적합도 점수다. 이 절의 은 보상 기호가 아니라 문장이라는 별도 표기다.
정답 쌍의 점수가 오답 쌍보다 적어도 만큼 높도록 만들자. 이 최소 점수 차이를 마진(margin)이라 한다. 원본의 순위 손실을 한 정답 쌍에 대한 두 항으로 나누면 다음과 같다.
첫 줄은 같은 물체에 틀린 문장 를 붙인 경우, 둘째 줄은 같은 문장에 다른 물체 를 붙인 경우다. 는 두 벌점의 비중이다. 는 차이가 이미 충분하면 벌점을 0으로 만들고, 부족한 만큼만 벌점을 준다. 예를 들어 정답 점수 0.8, 오답 점수 0.4, 마진 0.2이면 벌점은 0이다. 오답이 0.7이면 마진이 0.1 부족하다. 이 수치는 구조를 설명하는 별도 예다.
질문하려면 후보 물체를 구별하는 문장도 만들어야 한다. 를 물체와 주변의 시각적 특징이라고 하면, 실제 설명 문장에 높은 가능도를 주는 생성 손실과 다른 물체를 헷갈리지 않게 하는 구별 항을 쓸 수 있다.
여기서 는 구별 항의 가중치, 는 정답과 다른 물체 사이에 요구하는 로그 가능도의 차이다. 첫 항은 해당 물체의 설명을 잘 생성하도록 하고, 둘째 항은 그 설명이 다른 후보에도 똑같이 잘 맞는 것을 줄인다. 예를 들어 “파란 것”보다 “테이블 오른쪽의 파란 그릇”이 후보를 더 잘 구별할 수 있다.
실행 때 여러 후보의 점수가 가깝다면 그 차이를 질문 기준으로 이용할 수 있다. 다만 점수 차이가 작다는 것과 실제 실패 확률이 정확히 얼마라는 것은 다르다. 점수는 모델의 비교 신호이며 검증 없이 확률로 읽어서는 안 된다. 원본 순위 식은 정답 점수가 높아지는 방향이므로 말로 설명된 부호보다 식의 두 점수 차이를 기준으로 읽었다. 원강의 23:15–24:40.
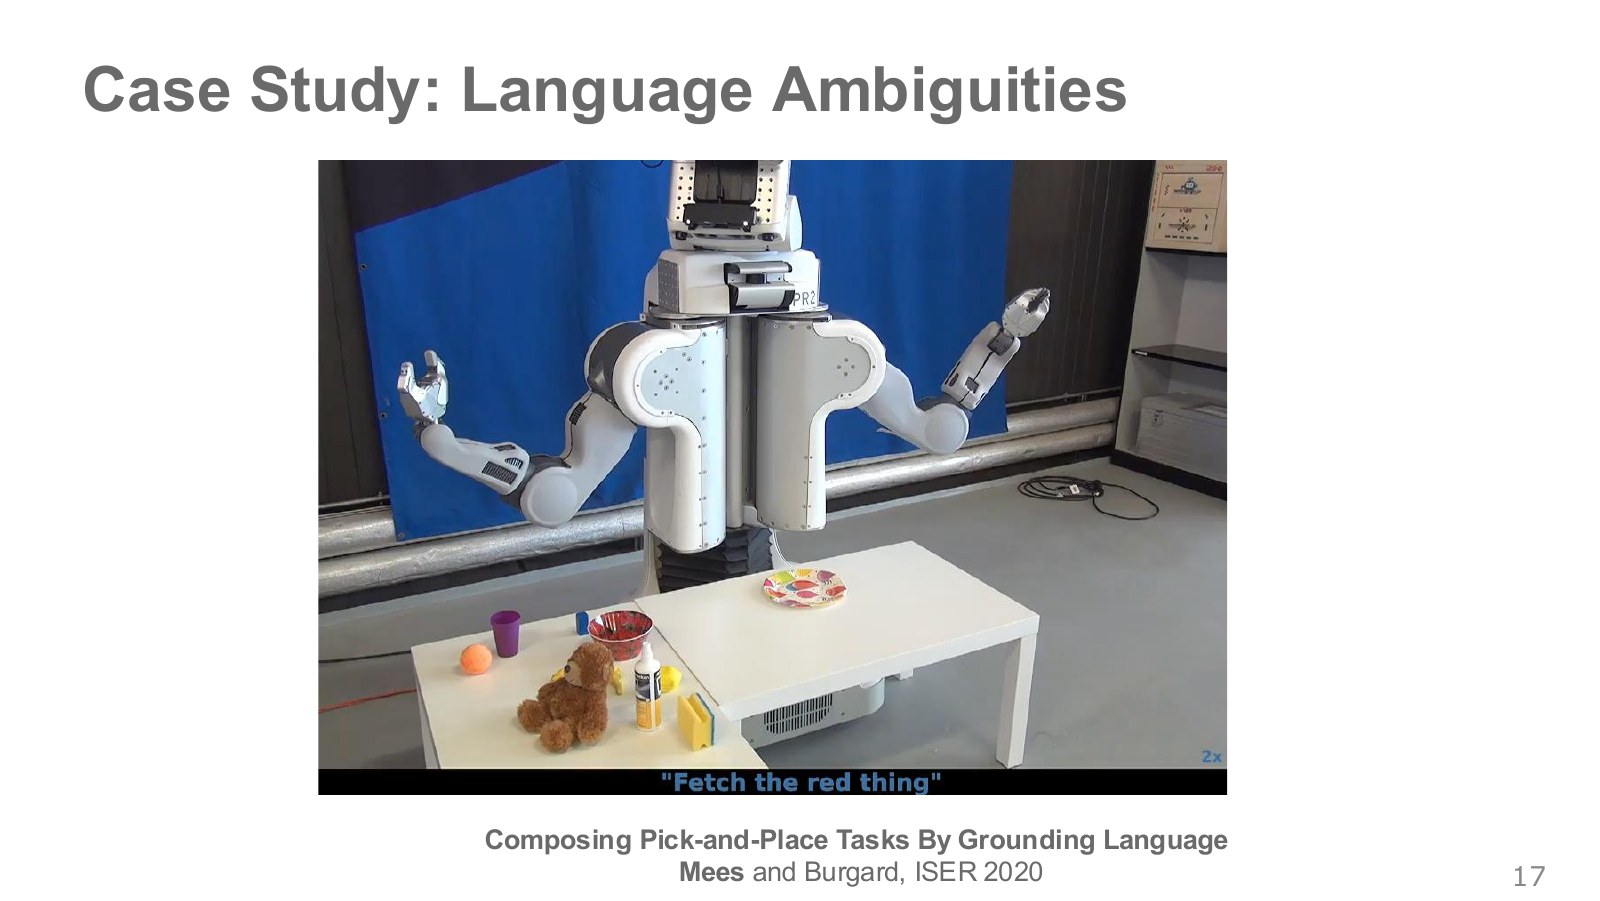
실제 로봇 화면에서는 음성 지시를 받은 뒤 후보를 고르고, 필요하면 “가운데 바나나를 말하나요?”처럼 확인한 후 집어 옮긴다. 사람의 답변은 모호한 목표를 좁혀 주는 새로운 정보다. 목표가 정해진 다음에야 그 목표를 실행할 팔의 행동을 결정할 수 있다.
이 순서를 보면 불확실성의 원인을 구분할 수 있다. 대상을 모르는데 관절 제어 이득만 바꾸어도 지시가 명확해지지는 않는다. 반대로 대상을 제대로 골랐어도 손이 미끄러지면 저수준 접촉·제어 문제를 다뤄야 한다. 무엇을 할지, 어디에 할지, 어떻게 움직일지를 나누어 진단하는 것이 중요하다. 원강의 시연 24:40–25:25.
자전거가 도로에 같은 위치로 찍혔어도, 직전 몇 초 동안 차도로 다가왔는지 멀어졌는지에 따라 운전자의 판단은 다를 수 있다. 현재 사진만 받는 정책은 그 움직임을 알 수 없다.
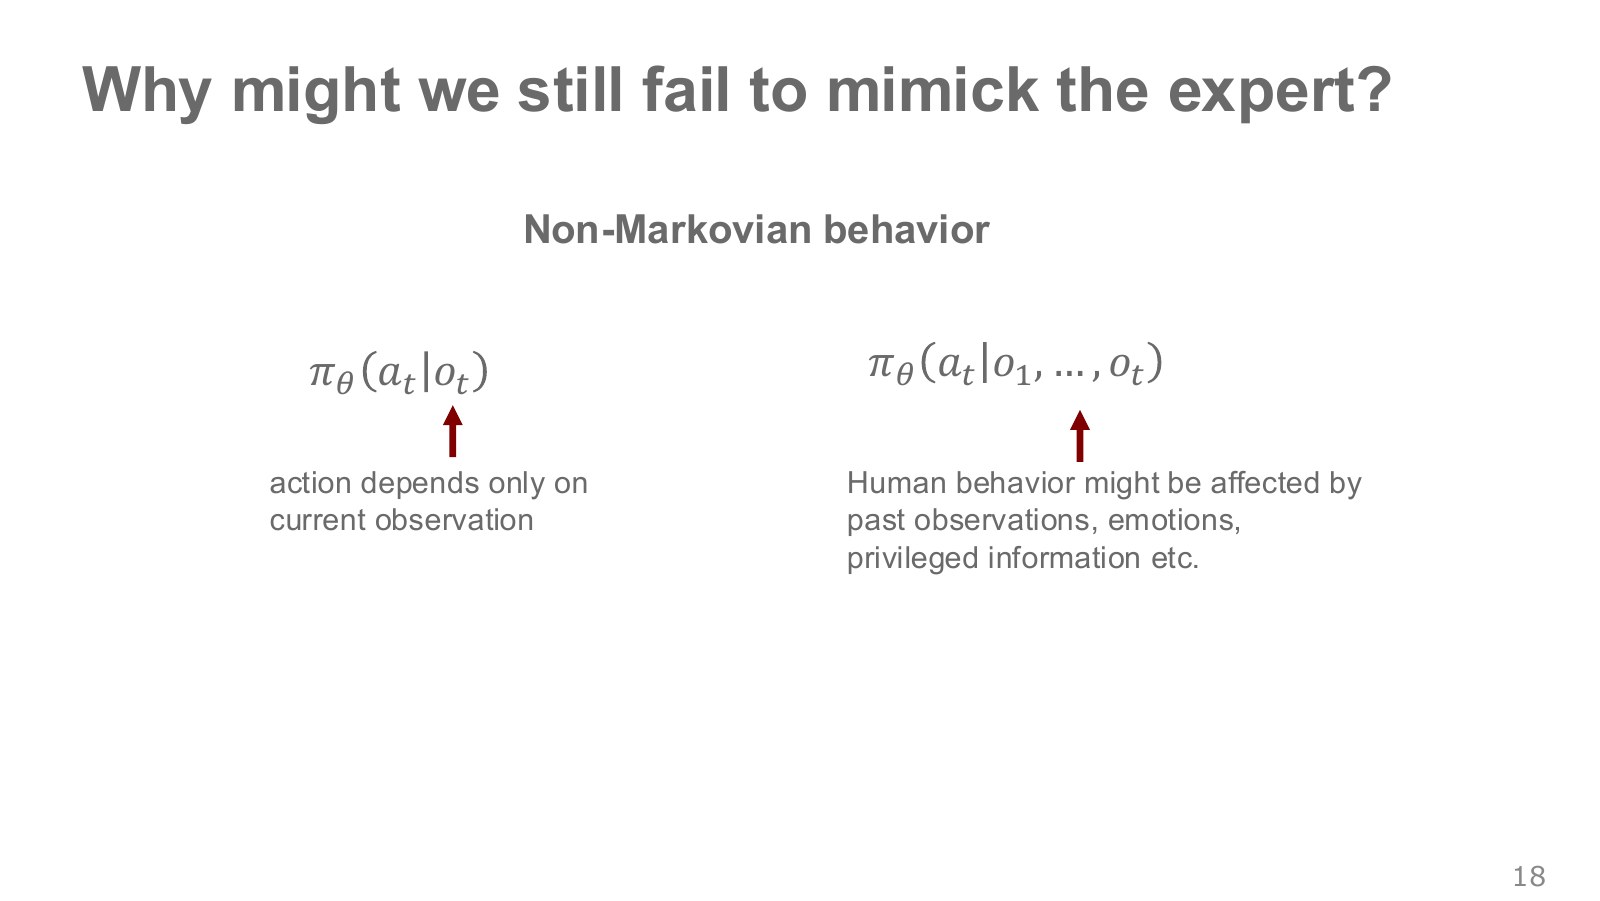
이때 시연자의 행동은 현재 관측만의 함수로 충분히 설명되지 않는다. 과거 관측, 의도, 직전에 본 사각지대 등 정책에 제공되지 않은 정보가 영향을 준다. 이를 현재 입력에 대한 비마르코프적 행동 문제로 설명한다.
는 처음부터 현재까지의 관측 이력이다. 같은 관측에서 두 행동이 나온다고 즉시 “사람이 일관성이 없다”고 결론 내릴 수 없다. 사람이 이용한 정보가 정책 입력에서 빠졌을 수 있다. 반대로 이력을 추가해도 설명되지 않는 의도 차이나 여러 유효한 방식은 뒤의 다봉 분포 문제로 남을 수 있다. 원강의 25:28–27:31.
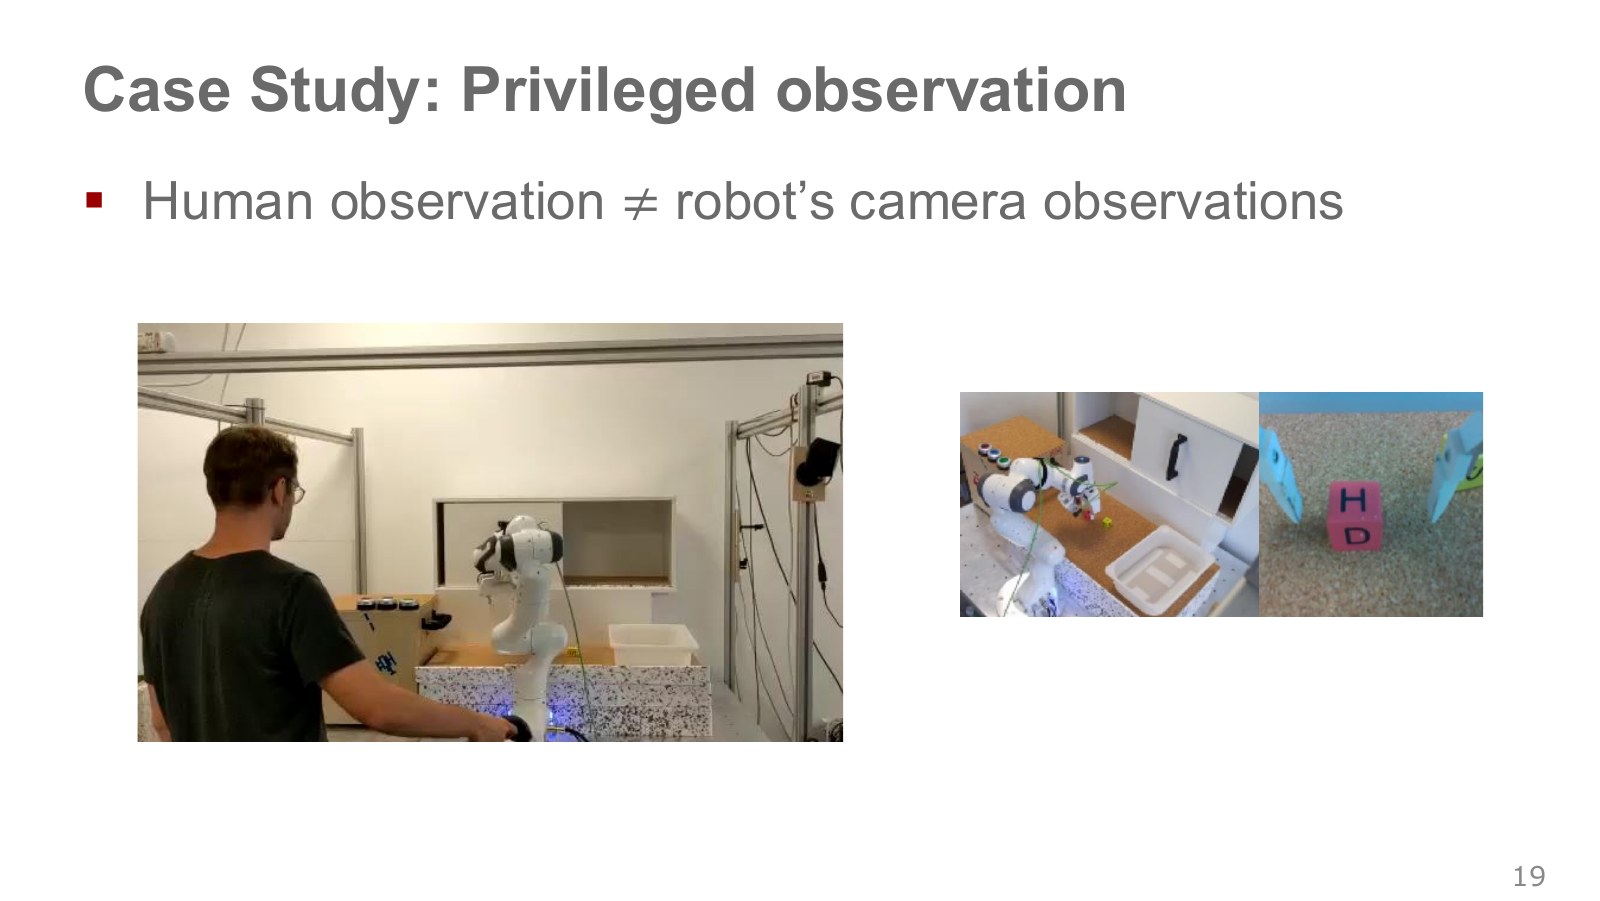
왼쪽 사람은 로봇과 테이블을 직접 둘러볼 수 있다. 오른쪽의 로봇 카메라 영상에는 물체가 작게 보이거나 손에 가려질 수 있다. 사람은 다른 시야에서 손잡이를 확인했지만 정책은 가려진 손잡이를 보지 못한 채 같은 행동을 맞혀야 할 수 있다.
이렇게 시연자에게만 있는 정보를 특권 정보 또는 특권 관측(privileged observation)이라 한다. 이 단어는 특별한 학습 알고리즘 이름보다 정보를 누가 사용할 수 있는가를 말한다. 시뮬레이터가 제공하는 정확한 물체 위치를 사람이 보면서 시연하지만 실제 정책은 카메라만 받는 경우도 해당할 수 있다.
데이터를 만들 때 사람이 정책과 같은 카메라 화면을 보도록 하거나, 정책에 필요한 센서를 제공하는 방법을 검토할 수 있다. 학습 때만 볼 수 있는 정보를 이용한다면 실행 때 그 정보가 없어도 작동하는 별도 학습 설계가 필요하다. 모든 문제를 시연 횟수만 늘려 해결할 수 없는 이유다. 원강의 27:36–28:43.
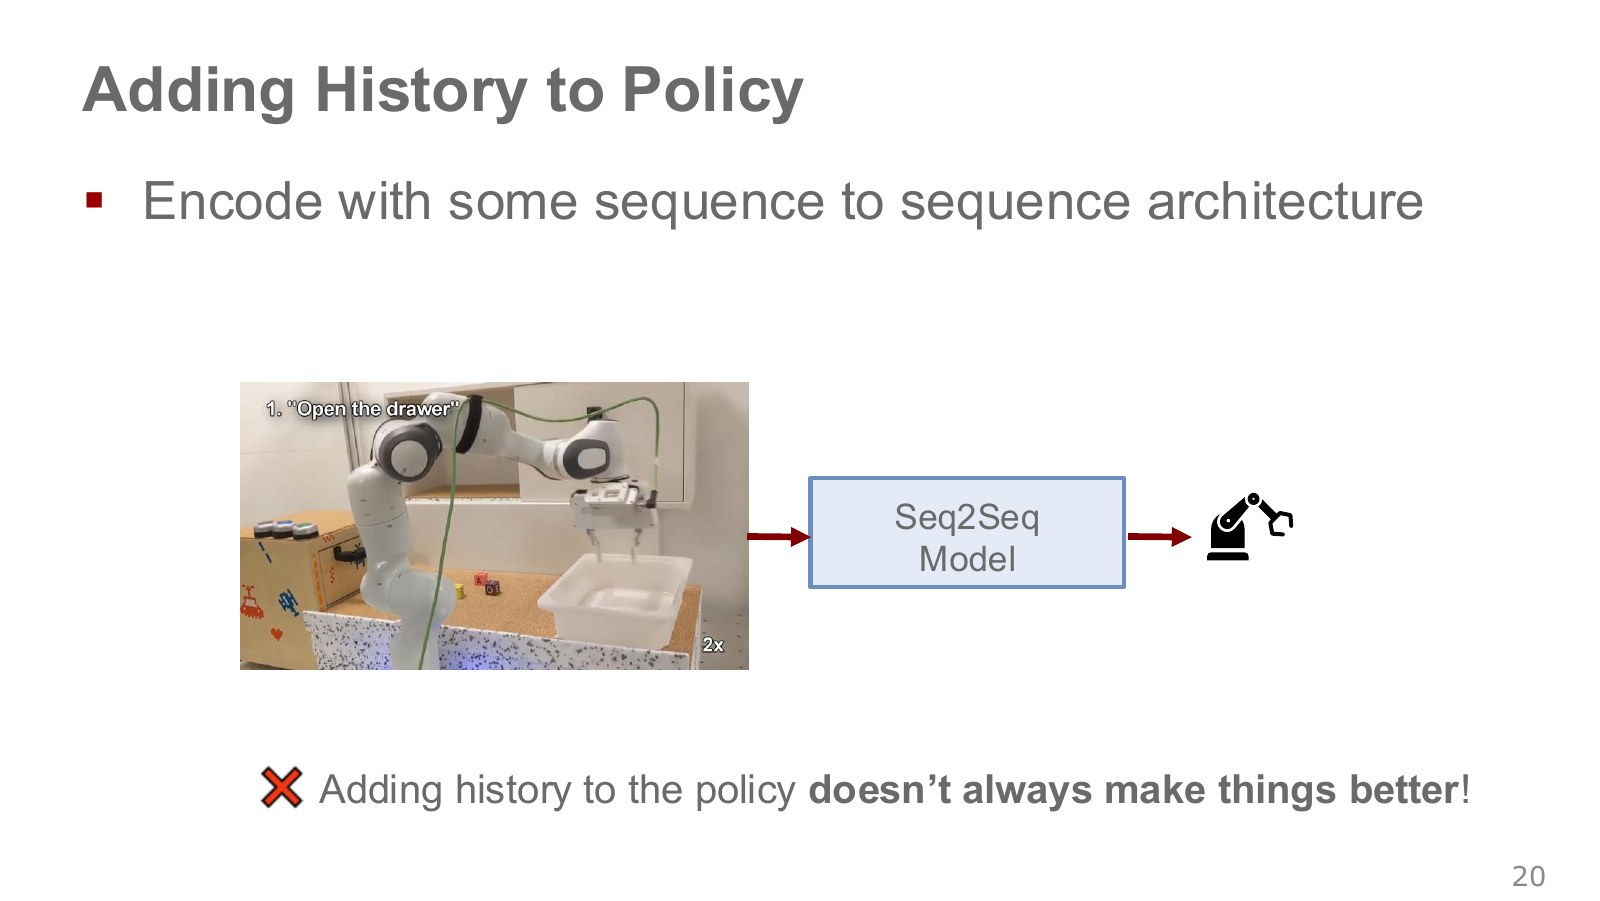
시퀀스 모델(sequence model)은 순서가 있는 여러 입력 사이의 관계를 계산한다. 과거 몇 장의 영상을 각각 특징으로 바꾸고 그 순서를 읽으면, 한 장에서는 보이지 않던 이동 방향이나 직전 행동의 맥락을 얻을 수 있다.
그림의 Seq2Seq는 시퀀스를 입력으로 받아 출력 시퀀스나 행동을 계산하는 구조를 뜻한다. RNN·LSTM은 이전 정보를 내부 상태에 이어 담는 방식이고, Transformer는 입력들 사이의 관계에 주의를 배분하는 방식이다. 이름만 바꾸면 자동으로 필요한 기억을 얻는 것은 아니며, 입력 구간·시간 간격·지연과 계산 비용도 정해야 한다.
과거 행동을 입력한다면 실행 시 그 자리에 무엇이 들어가는지도 중요하다. 학습에서는 전문가의 이전 행동을 보았는데 실제 실행에서는 정책 자신의 이전 행동을 보게 되면, 이 입력 역시 달라질 수 있다. 기억을 추가하는 것과 올바른 단서를 배우는 것은 별도 문제다. 원강의 28:45–29:54 · Berkeley의 이력 모델 설명 8:59–9:46.
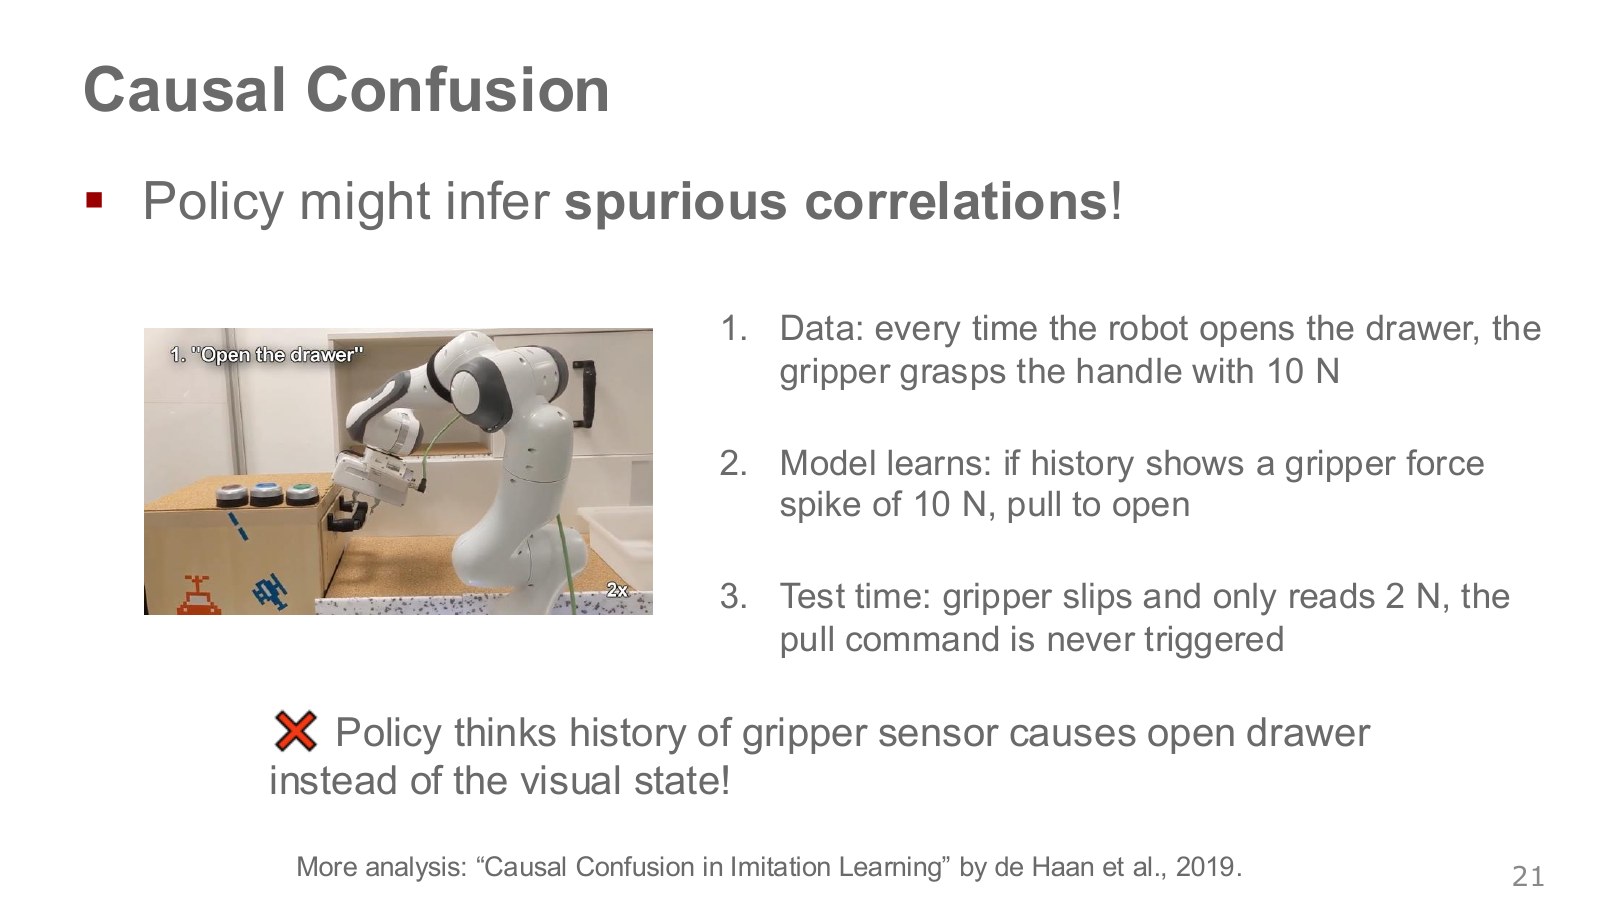
시연에서 서랍을 열 때마다 집게 힘 센서가 먼저 10N을 읽었다고 하자. 모델은 손잡이가 제대로 잡혔는지 보는 대신 “10N 신호가 나오면 당긴다”는 쉬운 규칙을 배울 수 있다. 실행에서 센서값이 2N으로 달라지면 당기기 명령이 나오지 않을 수 있다.
상관관계는 두 현상이 데이터에서 함께 나타난다는 뜻이다. 인과관계는 한 요인이 다른 결과를 만들어 내는 과정과 관련된다. 시연에서 늘 함께 있던 단서가 환경을 바꾸어도 행동을 정하는 올바른 근거라는 보장은 없다. 이를 정책 학습의 인과 혼동(causal confusion) 문제로 다룬다.
힘 센서 자체가 쓸모없다는 결론은 아니다. 실제 파지 상태와 힘은 물리적으로 중요할 수 있다. 문제는 특정 숫자와 행동의 우연한 대응에만 의존하고, 바뀐 조건에서 필요한 접촉·시각 정보를 놓치는 경우다. 이 서랍 예는 개념 설명이며 모든 힘 기반 제어가 잘못됐다는 증거가 아니다.
Berkeley 강의의 다른 예는 브레이크 표시등이다. 사람이 보행자를 보고 브레이크를 밟은 결과 표시등이 켜졌는데, 모델이 그 표시등만 보고 브레이크 행동을 예측하면 최초로 멈춰야 하는 순간을 놓칠 수 있다. 이력을 늘리면 이런 쉬운 단서도 더 많이 제공될 수 있다. Berkeley 9:58–12:38.
단서를 가려 보거나 환경 조건을 바꾸는 개입으로 무엇에 의존하는지 확인할 수 있다. 단순히 모델을 크게 하거나 이력을 길게 주는 것만으로 인과적 해석이 보장되지는 않는다. 원강의 29:56–31:51 · de Haan 등의 원 논문과 프로젝트.
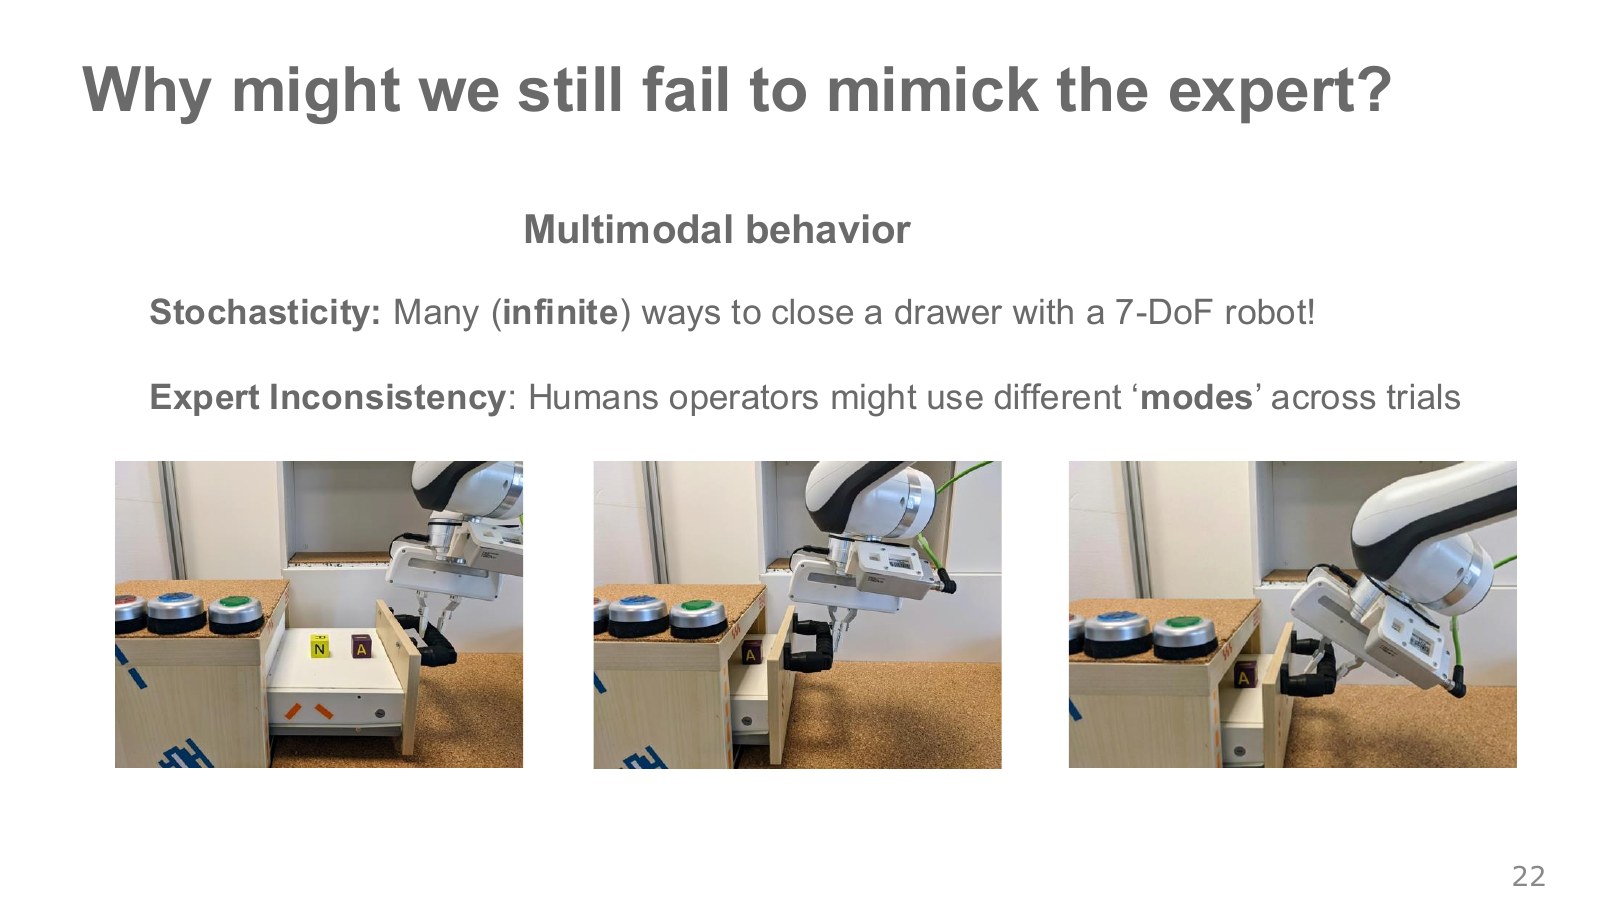
서랍을 닫을 때 손잡이를 잡아 밀 수도 있고, 앞면을 손으로 밀 수도 있다. 사진 속 팔도 위쪽·옆쪽 등 서로 다른 접근 자세로 같은 목표를 달성할 수 있다. 02장에서 본 여유 자유도는 같은 손끝 자세를 여러 관절 구성으로 만드는 여지를 준다.
이처럼 비슷한 입력에서 서로 떨어진 여러 행동이 자주 나타나면 행동 분포에 여러 봉우리가 생긴다. 이를 다봉성 또는 여러 모드(multimodality)라고 한다. 여기서 모드는 행동 방식의 갈래다. 영상·언어·힘 같은 여러 감각 종류를 뜻하는 멀티모달과는 다른 의미다.
사람들이 서로 다른 방식을 사용해도 모두 성공했다면 단순히 정답 하나가 틀렸다고 볼 수 없다. 정책이 하나의 평균값만 내도록 만들었을 때 이 다양성을 어떻게 처리하는지가 문제다. 원강의 31:54–33:30.
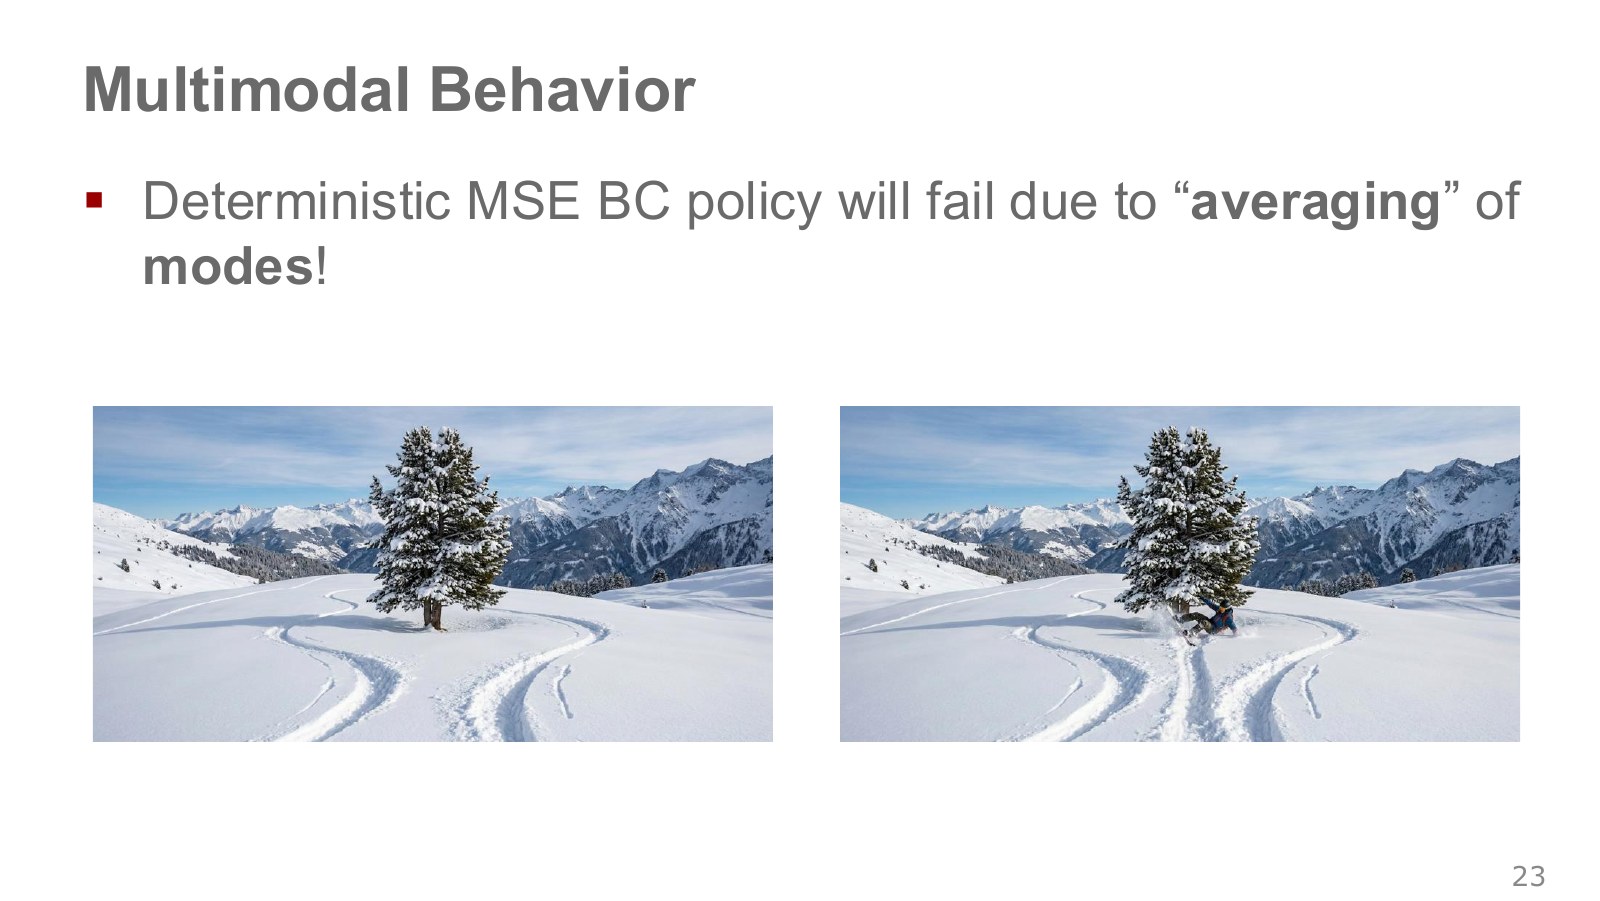
눈길의 나무를 왼쪽으로 돌아간 자국과 오른쪽으로 돌아간 자국이 모두 있다. 두 경로를 점별로 평균낸 선은 둘 사이, 즉 나무 쪽을 향할 수 있다. 개별 정답들의 평균이 좋은 실행은 아닐 수 있다.
같은 입력에서 행동 정답이 절반은 −1, 절반은 +1이라고 하자. 하나의 상수 행동 로 제곱 오차를 최소화하면 다음처럼 된다.
오차 계산만 보면 0은 최선이다. 하지만 −1과 +1이 각각 장애물을 도는 선택이라면 0은 필요한 회피 동작을 하지 않을 수 있다. MSE가 계산을 틀린 것이 아니라 한 점을 잘 맞히는 목적과 여러 가능한 행동을 표현하는 목적이 다르다.
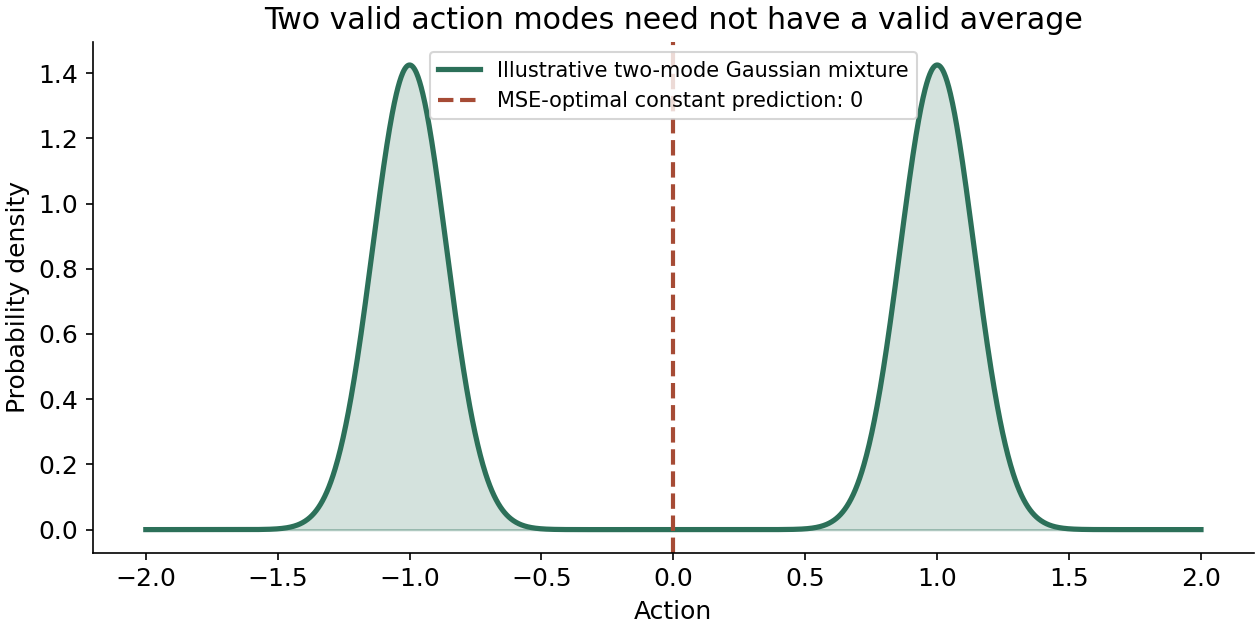
세로축은 확률 밀도다. 곡선의 높이는 특정 행동 하나의 확률이 아니라, 주변 구간에 얼마나 가능성이 모였는지를 읽는 값이다. 일반적인 제곱 손실의 최적 단일 예측도 조건부 평균과 연결된다. 다만 이 나무 비유가 모든 행동 좌표에서 평균이 반드시 충돌한다는 뜻은 아니다. 입력과 행동 표현, 여러 유효한 해의 배치를 함께 보아야 한다. 원강의 33:33–34:16.
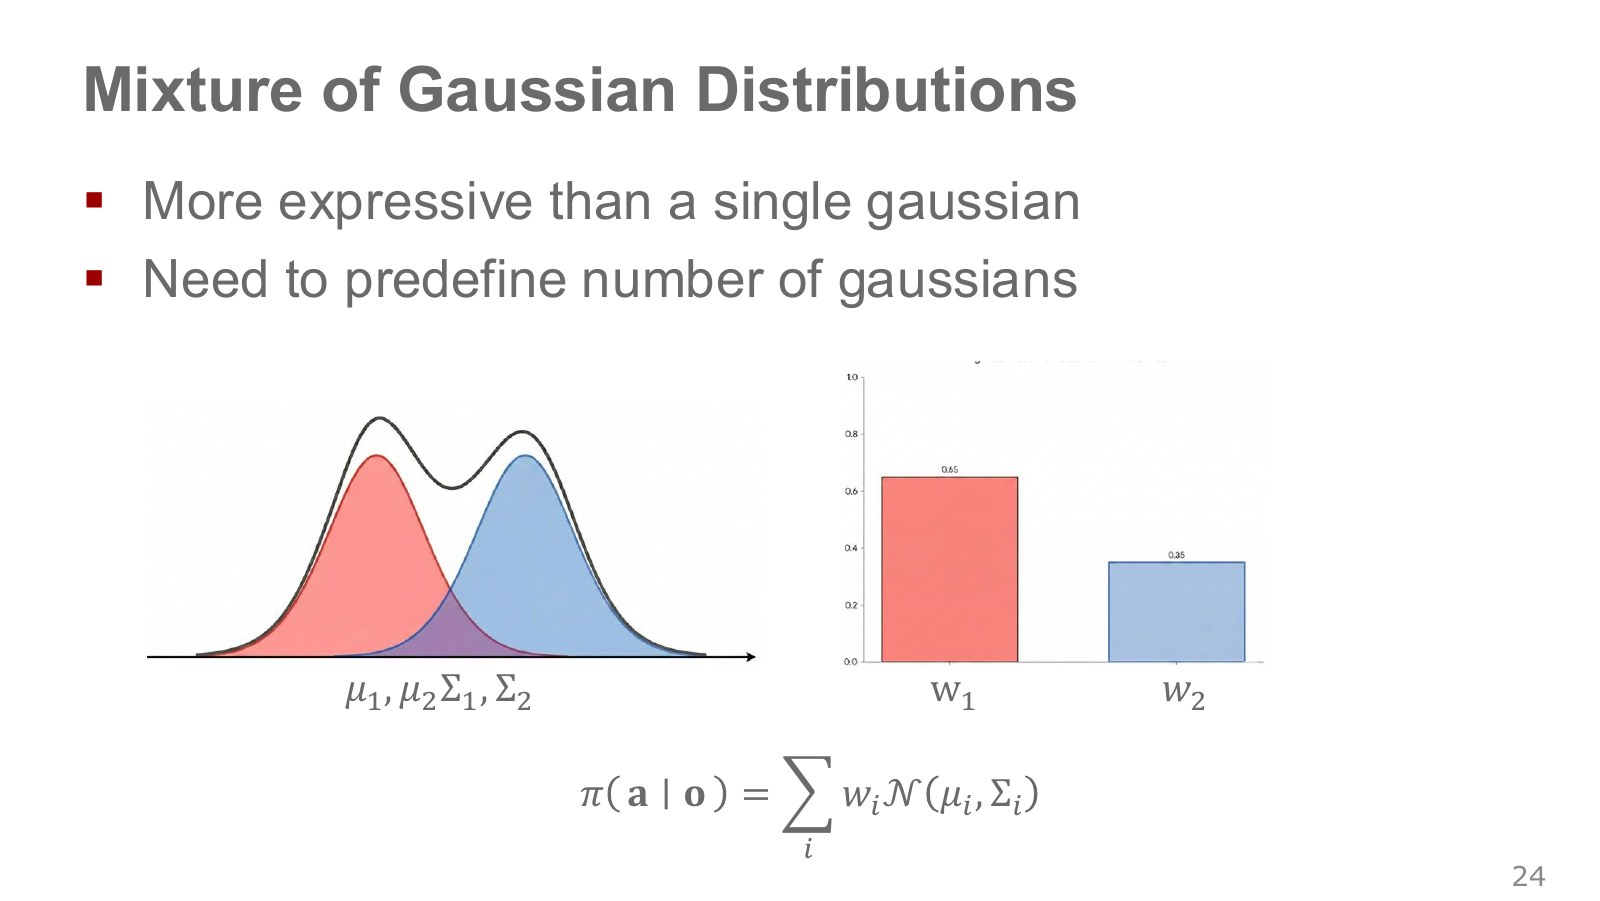
가우시안 분포는 평균 주변에 가능성이 모이는 종 모양 분포다. 행동이 여러 갈래라면 가우시안 여러 개를 가중해서 합칠 수 있다. 빨간 곡선과 파란 곡선이 각 성분, 검은 곡선이 합쳐진 분포다.
는 각 성분의 중심인 평균, 는 행동 성분들이 얼마나 퍼지고 함께 변하는지 나타내는 공분산, 는 성분을 선택할 가중치다. 가중치는 음수가 아니고 합이 1이다. 그림의 막대 0.65와 0.35는 두 성분의 비중이며, 곡선의 최고 높이가 각각 65%·35%라는 뜻은 아니다.
실제 정책에서는 관측이 바뀔 때 이 값들도 신경망 출력으로 바뀐다. 행동을 뽑으려면 먼저 가중치에 따라 성분을 선택하고 그 성분에서 표본을 뽑을 수 있다. 마지막에 두 평균을 다시 가중 평균해 하나의 행동으로 만들면 앞의 평균 문제를 되살릴 수 있다.
보통 성분 수 를 미리 정해야 하고, 높은 행동 차원에서 많은 성분의 평균·공분산을 출력하는 부담이 있다. 성분들이 겹치면 눈에 보이는 봉우리 수가 성분 수와 꼭 같지도 않다. 분포 표현을 바꾸면 학습도 그 분포의 시연 행동 가능도를 높이는 방식으로 맞춰야 한다. 원강의 34:19–35:14 · Berkeley의 혼합 분포 설명.
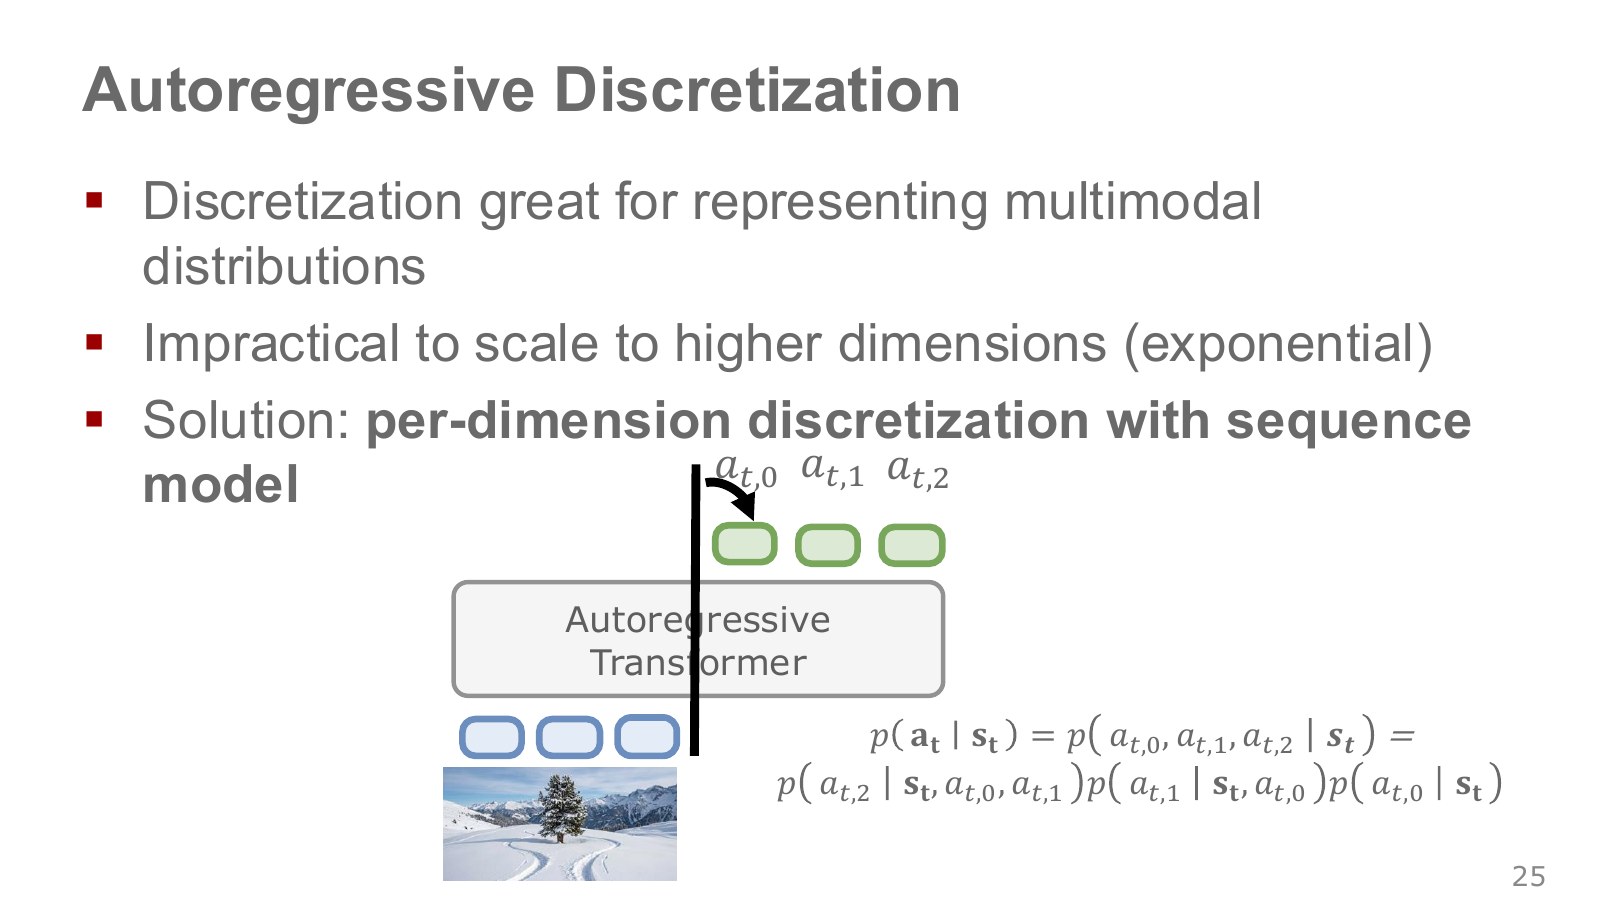
연속적인 조향 값을 여러 구간인 빈(bin)으로 나누면, 각 구간의 선택 확률을 분류기로 출력할 수 있다. 왼쪽·오른쪽 구간에 높은 확률을 주고 가운데는 낮게 주는 식으로 여러 모드를 나타낼 수 있다.
문제는 행동이 여러 차원일 때다. 각 좌표를 개 빈으로 나누고 개 좌표 조합을 하나의 거대한 분류로 만들면 개 선택지가 된다. 예를 들어 7차원 행동을 각 100개 빈으로 나누면 개 조합이다.
자기회귀(autoregressive) 방식은 앞에서 고른 행동 성분을 조건으로 다음 성분을 고른다. 세 성분 행동의 확률은 확률의 연쇄 법칙으로 다음처럼 쓸 수 있다.
는 시간 세 단계가 아니라 같은 시점의 행동 벡터 안 세 좌표다. 앞에서 뽑은 x방향과 맞는 y방향을 뒤에서 선택하면, 좌표들을 서로 독립적으로 뽑는 것보다 조합의 일관성을 표현하기 쉽다.
그림의 되돌아가는 화살표는 먼저 생성한 토큰을 다음 예측에 다시 넣는 경로다. 각 성분의 출력 목록은 개로 줄일 수 있지만 생성은 순차적이며, 모델 내부 계산량이 단순히 라고 보장되는 것은 아니다. 좌표 순서와 양자화 정밀도, 실행 지연도 고려해야 한다. Transformer는 사용할 수 있는 시퀀스 모델의 한 종류이며 반드시 거대한 언어 모델을 사용해야 하는 것은 아니다. 원강의 35:16–37:24.
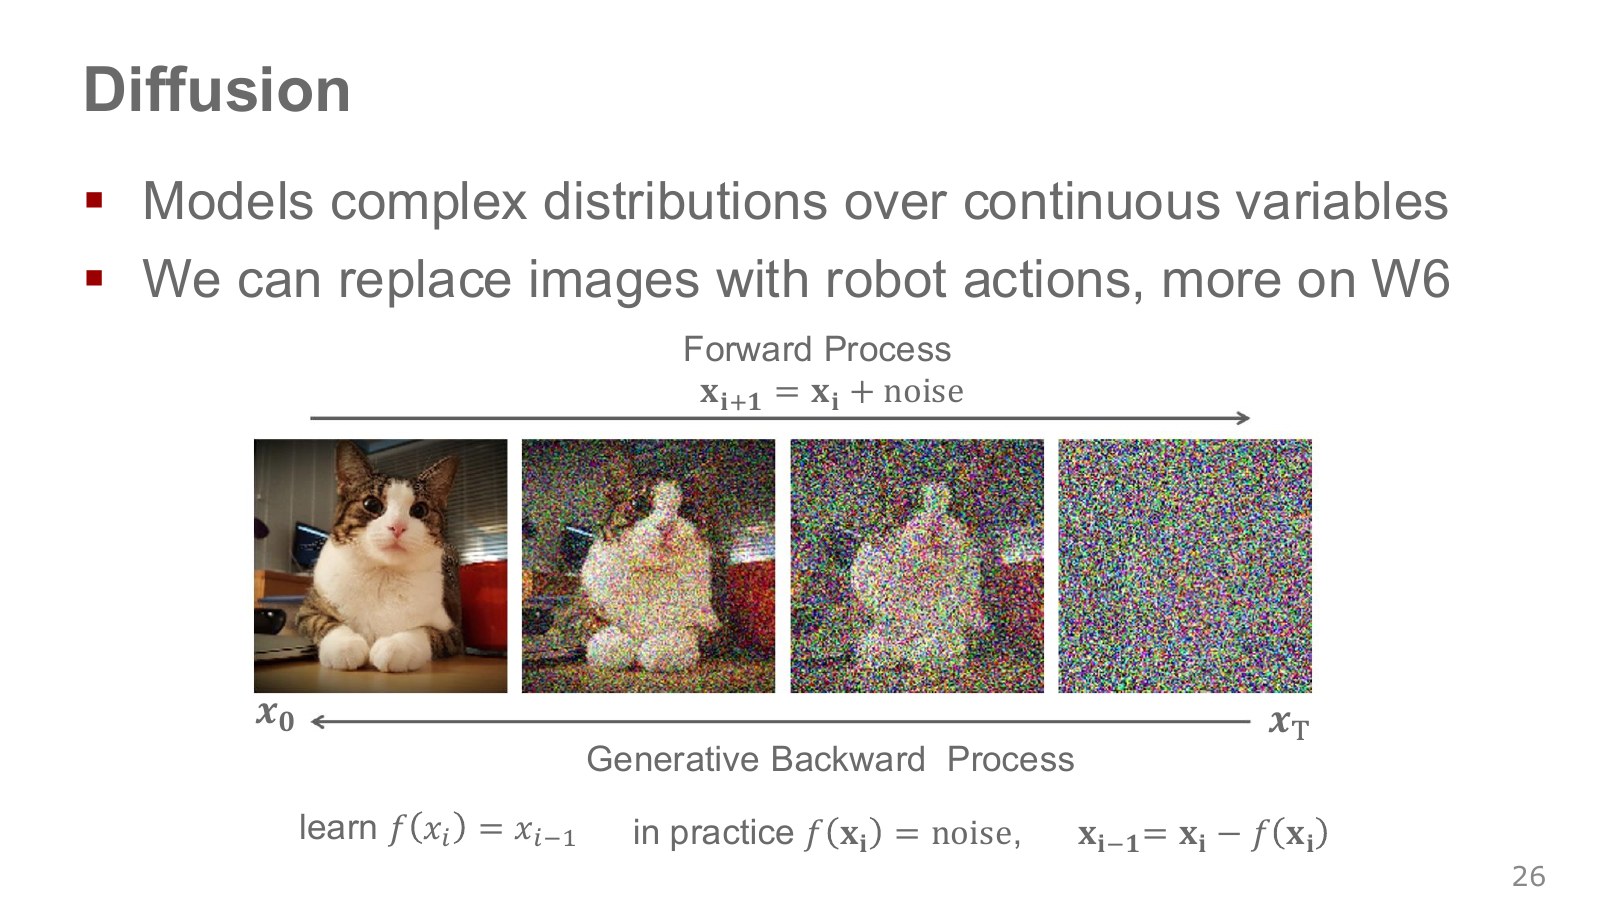
고양이 사진은 오른쪽으로 갈수록 잡음이 많아진다. 정방향 과정은 깨끗한 데이터에 잡음을 더해 학습할 입력을 만드는 과정이고, 역방향 생성은 잡음에서 출발해 조금씩 구조를 만들어 가는 과정이다.
이때 아래첨자는 로봇이 실제 움직인 시간과 구별해야 한다. 여기서는 실제 제어 시점을 , 잡음 단계 번호를 로 적자. 학습용 잡음 표본을 만드는 흔한 표현은 다음과 같다.
는 깨끗한 데이터, 은 뽑은 잡음, 는 해당 단계에 남길 신호 비율을 정하는 값이다. 모델은 잡음 단계와 현재 관측을 받아 섞인 잡음 등을 예측하도록 배울 수 있다. 실제 역방향 갱신에는 잡음 스케줄과 계수 등이 들어가므로 원본의 “잡음을 빼기”는 원리를 설명하는 축약이다.
로봇에서는 사진 대신 행동 벡터나 짧은 행동 시퀀스를 생성 대상으로 두고, 현재 카메라 관측과 목표를 조건으로 줄 수 있다. 한 행동을 만들기 위해 여러 잡음 제거 계산을 하더라도, 계산 중인 매 단계마다 로봇이 움직인다는 뜻은 아니다.
Diffusion Policy의 원 프로젝트는 관측에 조건을 둔 행동 시퀀스 생성과 짧은 구간 실행 후 재계획을 실제 로봇 문제로 연결한다. 여러 모드를 표현하는 것과 한번 선택한 방식으로 일관되게 실행하는 것도 함께 고려한다. 이 글에서 그 모델을 학습한 결과는 아니며, 자세한 확산 학습은 이후 생성 모델 장에서 이어진다. 원강의 37:28–39:06.
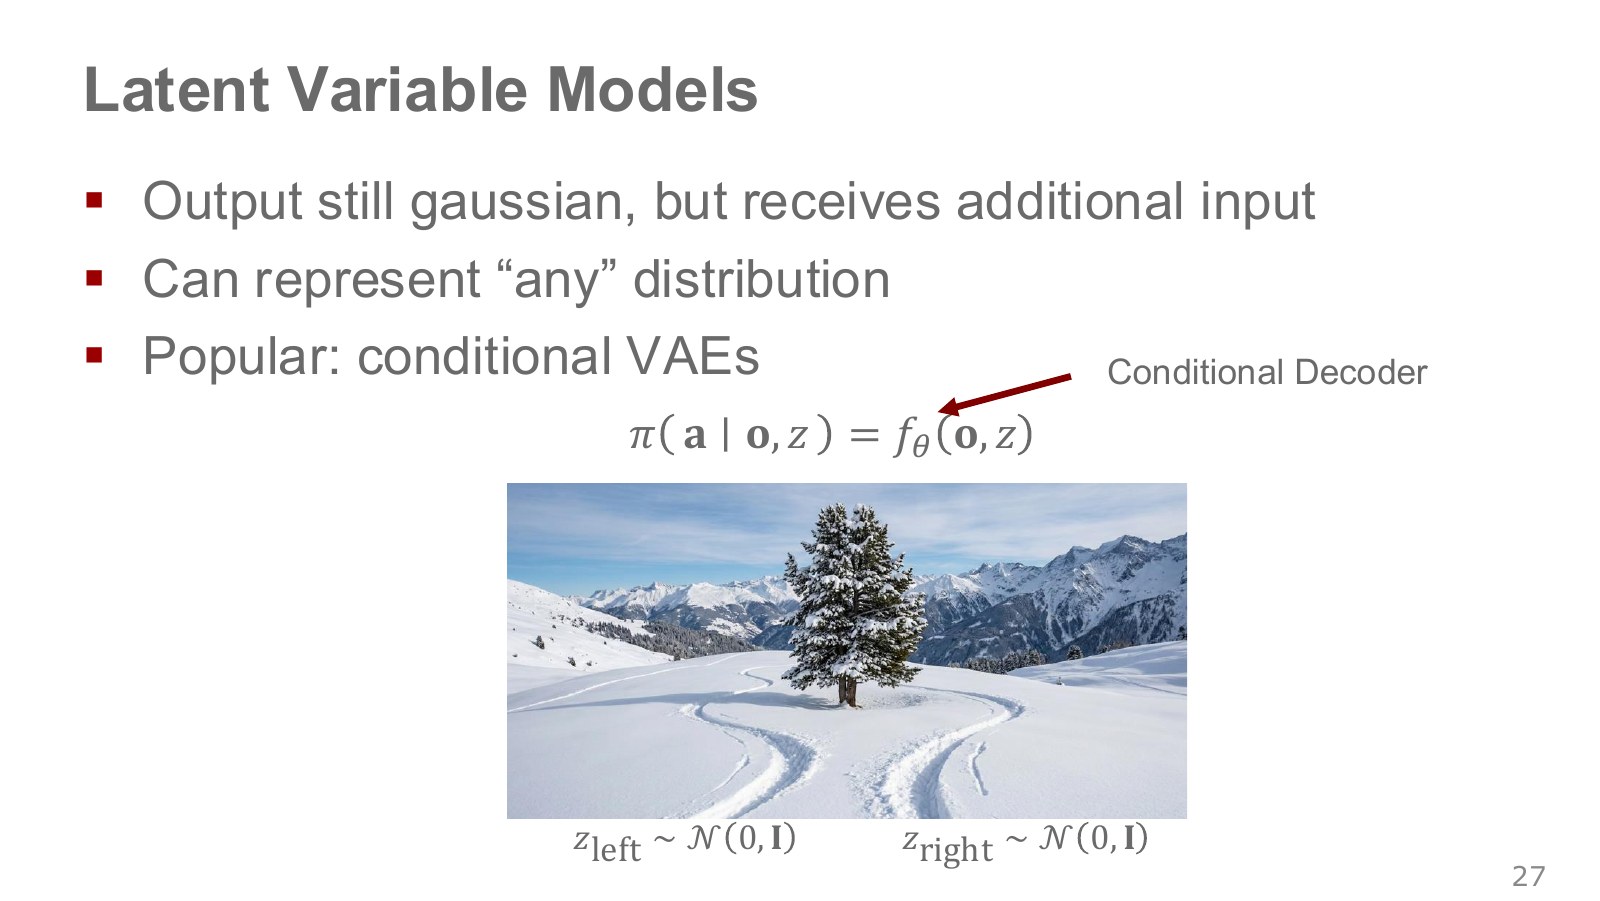
잠재 변수(latent variable) 는 데이터에 직접 정답 이름으로 적혀 있지 않지만 행동의 차이를 설명하도록 학습하는 내부 변수다. 같은 나무 앞 장면에서도 어떤 에서는 왼쪽 경로, 다른 에서는 오른쪽 경로를 만드는 식이다.
디코더(decoder)는 관측과 잠재 변수를 받아 행동 분포를 만드는 네트워크다. 입력 조건을 추가해 출력하는 구조를 조건부 디코더라고 부른다.
예를 들어 처럼 단순한 사전 분포를 쓸 수 있다. 를 고정했을 때 출력이 단순한 분포여도 여러 를 거쳐 나온 결과 전체는 복잡한 분포를 표현할 수 있다. 충분한 표현력을 가진 모형에 대한 가능성과 실제 학습이 잘됐다는 사실은 구별해야 한다.
아무 난수나 신경망에 추가한다고 왼쪽·오른쪽 모드가 저절로 생기지는 않는다. 난수가 정답 행동과 무관하면 네트워크가 그 입력을 무시할 수도 있다. 뒤에서 볼 조건부 변분 오토인코더(CVAE)는 학습 때 시연을 보고 유용한 를 추정하는 경로를 함께 만든다. 원강의 39:11–40:17.
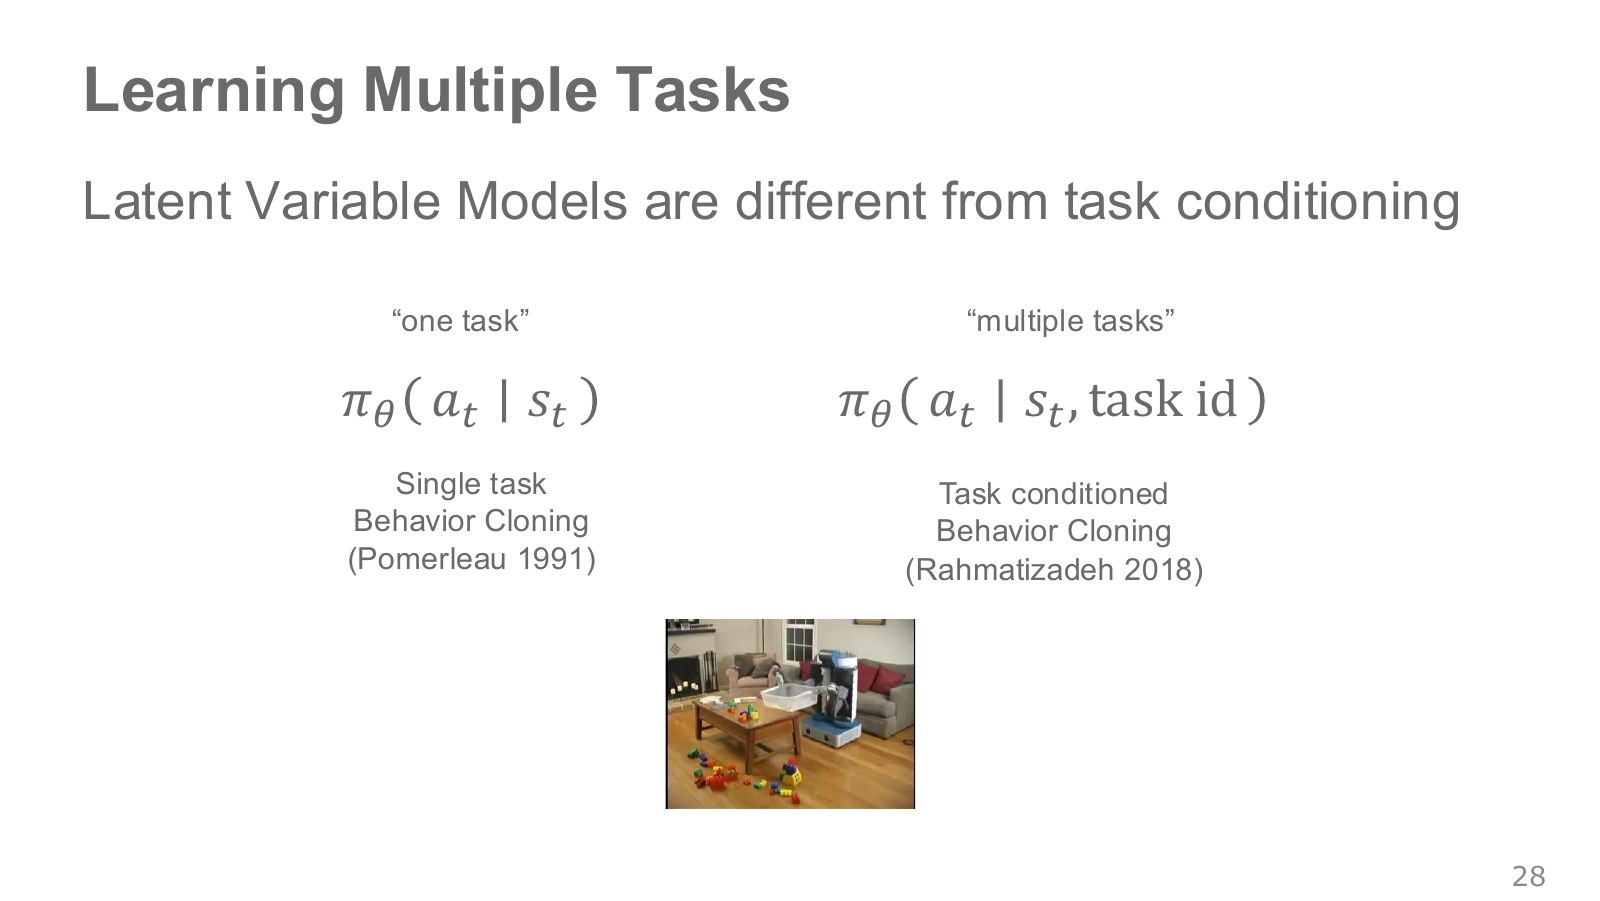
“서랍을 열어라”와 “서랍을 닫아라”는 어떤 목표를 수행할지의 차이다. 서랍을 열되 위에서 잡을지 옆에서 잡을지는 같은 목표를 어떻게 수행할지의 차이다. 과업 조건과 잠재 행동 모드를 이렇게 나누어 보면 혼동이 줄어든다.
과업 ID를 쓰는 정책은 처럼 적을 수 있다. 예를 들어 세 과업을 [1,0,0], [0,1,0], [0,0,1]처럼 서로 다른 벡터로 표시하는 것이 원핫(one-hot) 인코딩이다. 언어 문장이나 목표 영상도 과업을 지정하는 입력이 될 수 있다.
과업 조건을 추가해도 그 목표를 달성하는 방식이 하나로 줄어드는 것은 아니다. 그러므로 처럼 목표 와 수행 방식 를 함께 조건으로 사용할 수 있다. 목표를 바꾸는 문제와 목표 안의 다양한 실행을 표현하는 문제를 구분하자. 원강의 40:22–41:01.
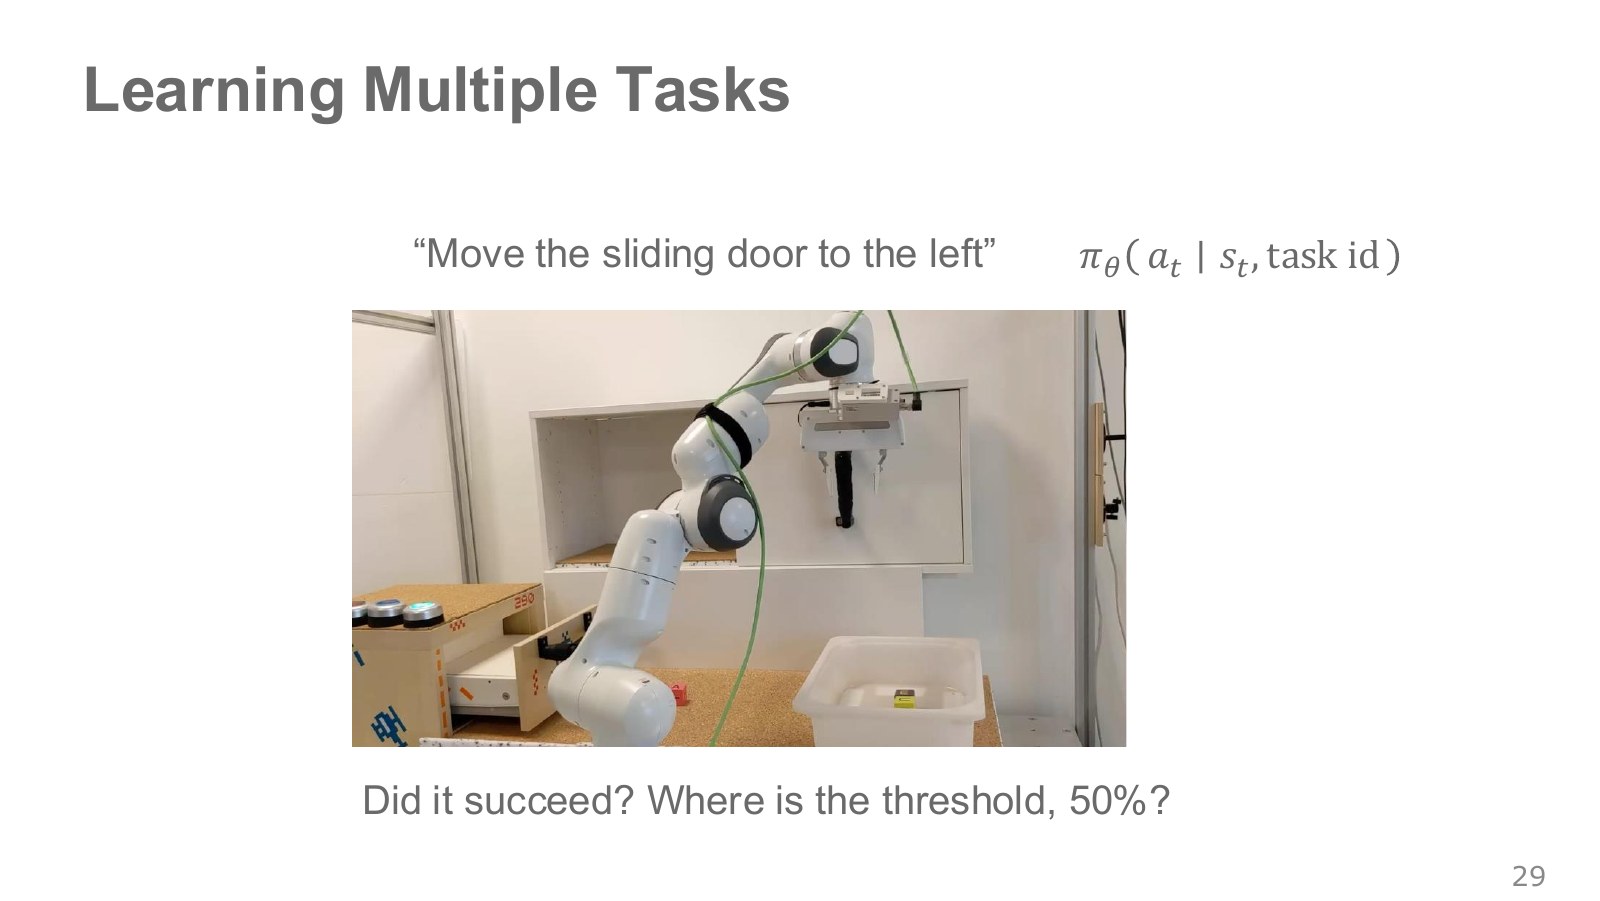
슬라이딩 문을 “왼쪽으로 옮겨라”라고만 지시했다고 하자. 문이 절반만 이동한 모습에 어떤 사람은 충분하다고 하고 다른 사람은 끝까지 가야 한다고 할 수 있다. 사진의 50%는 정책의 신뢰도 수치가 아니라 문이 얼마나 이동했을 때 성공으로 볼지에 대한 질문이다.
연속적으로 움직이는 물체를 “열기”라는 과업 이름 하나로만 묶으면, 실제로 원하는 이동량과 끝 상태를 놓칠 수 있다. 평가하려면 목표 위치와 허용 오차, 다른 물체의 상태 등 무엇을 성공으로 볼지 구체화해야 한다. 목표를 영상이나 상태로 주는 방법은 이런 연속적인 목표를 표현하는 한 출발점이다. 원강의 41:03–42:47.
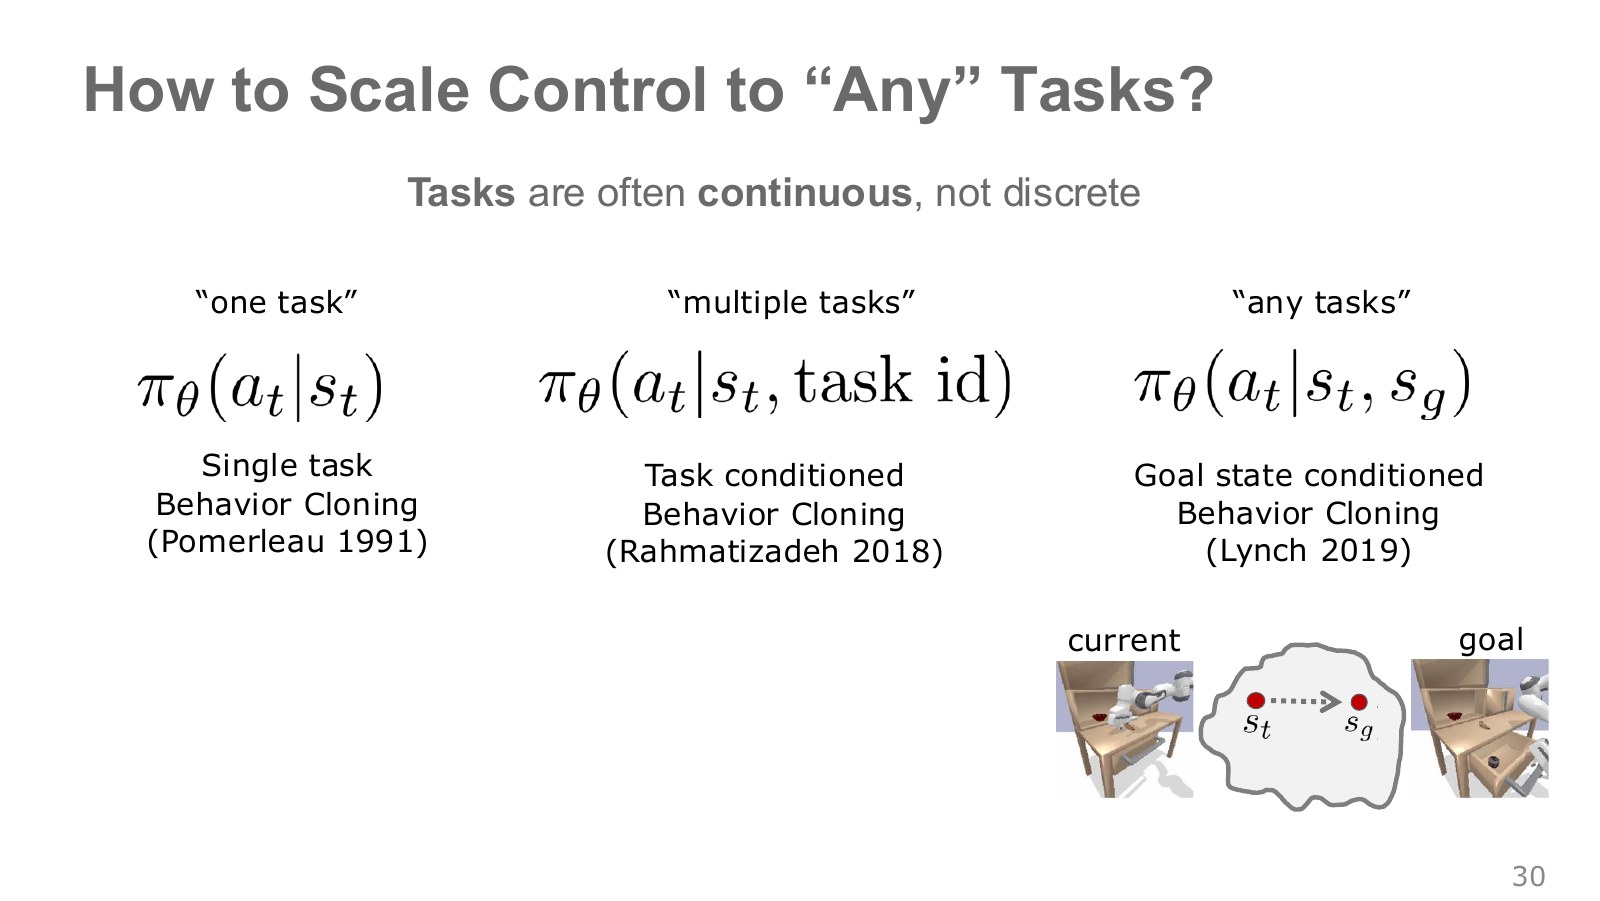
문을 몇 cm만 열거나 다른 위치로 옮기는 일을 각각 새 과업 번호로 만드는 대신, 원하는 끝 상태 를 입력할 수 있다. 현재 상태 에서 그 목표를 향해 행동하는 목표 조건부 정책(goal-conditioned policy)이다.
오른쪽 그림의 현재 장면과 목표 장면 사이를 연결하는 행동을 배우는 셈이다. 같은 현재 장면에서도 목표 문 위치가 달라지면 행동이 달라져야 한다. 학습과 실행에서 목표의 의미와 센서 표현도 맞아야 한다.
Berkeley 강의는 여러 목적지로 이동한 기록의 마지막 상태를 목표로 붙여 학습하는 방식을 설명한다. 특정 목적지 하나로 가는 기록보다 다양한 상태를 경험할 수 있다는 장점이 있다. 다만 데이터 밖의 새 시작·목표 조합이나 물리적으로 불가능한 목표까지 해결한다는 보장은 없다. Berkeley 목표 재표기 설명 0:24–3:10 · 원강의 42:50–43:15.
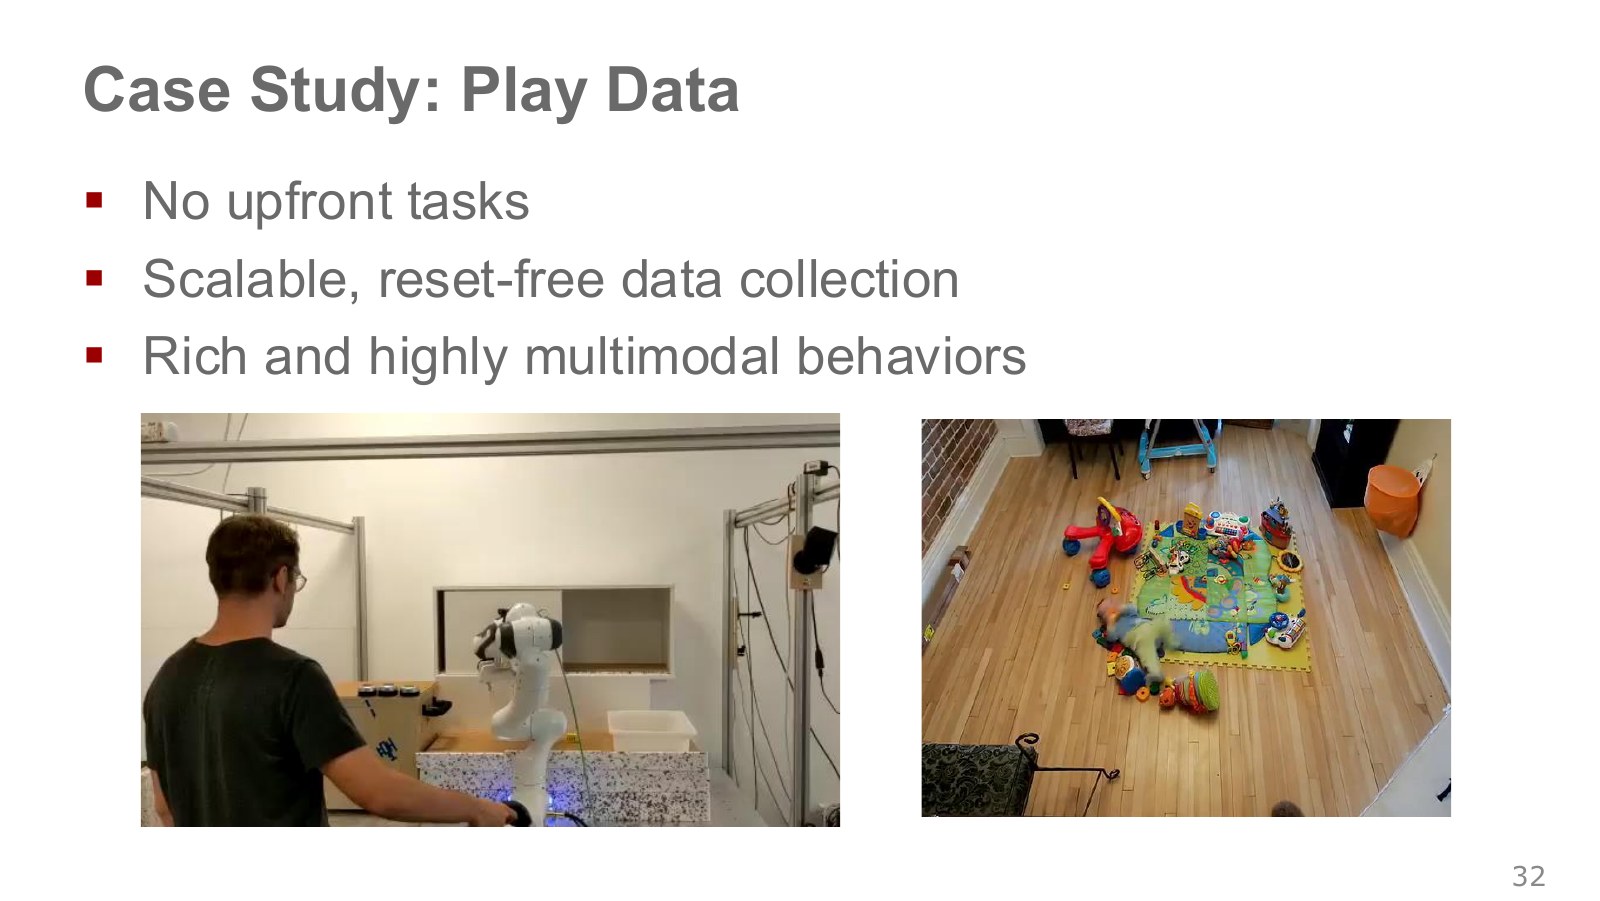
놀이 데이터(play data)는 사람이 로봇을 원격조작하며 물체를 열고 닫고 옮기는 등 다양한 상호작용을 연속해서 남긴 기록이다. 매번 “이 에피소드는 서랍 열기”라고 과업을 미리 나누거나 같은 초기 장면으로 되돌리지 않고 이어서 수집할 수 있다.
사진의 장난감 놀이와 닮은 점은 정해진 정답 순서를 반복하기보다 여러 가능성을 탐색한다는 것이다. 하지만 여기서 실제 수집자는 사람이며, 로봇이 혼자 호기심을 학습해 움직였다는 뜻은 아니다. 또한 무작위 토크보다 사람이 물체의 쓰임을 알고 만드는 구조적인 움직임이라는 점이 중요하다.
문을 열었다가 닫고, 물체를 잘못 잡아 다시 잡는 기록에는 과업 사이 전환과 복구도 담길 수 있다. 기록이 다양해진다고 모든 상황이 포함되지는 않으므로, 어떤 물체·접촉·시야가 실제로 수집됐는지도 확인해야 한다. 원강의 43:17–44:19 · Learning Latent Plans from Play 원 논문.
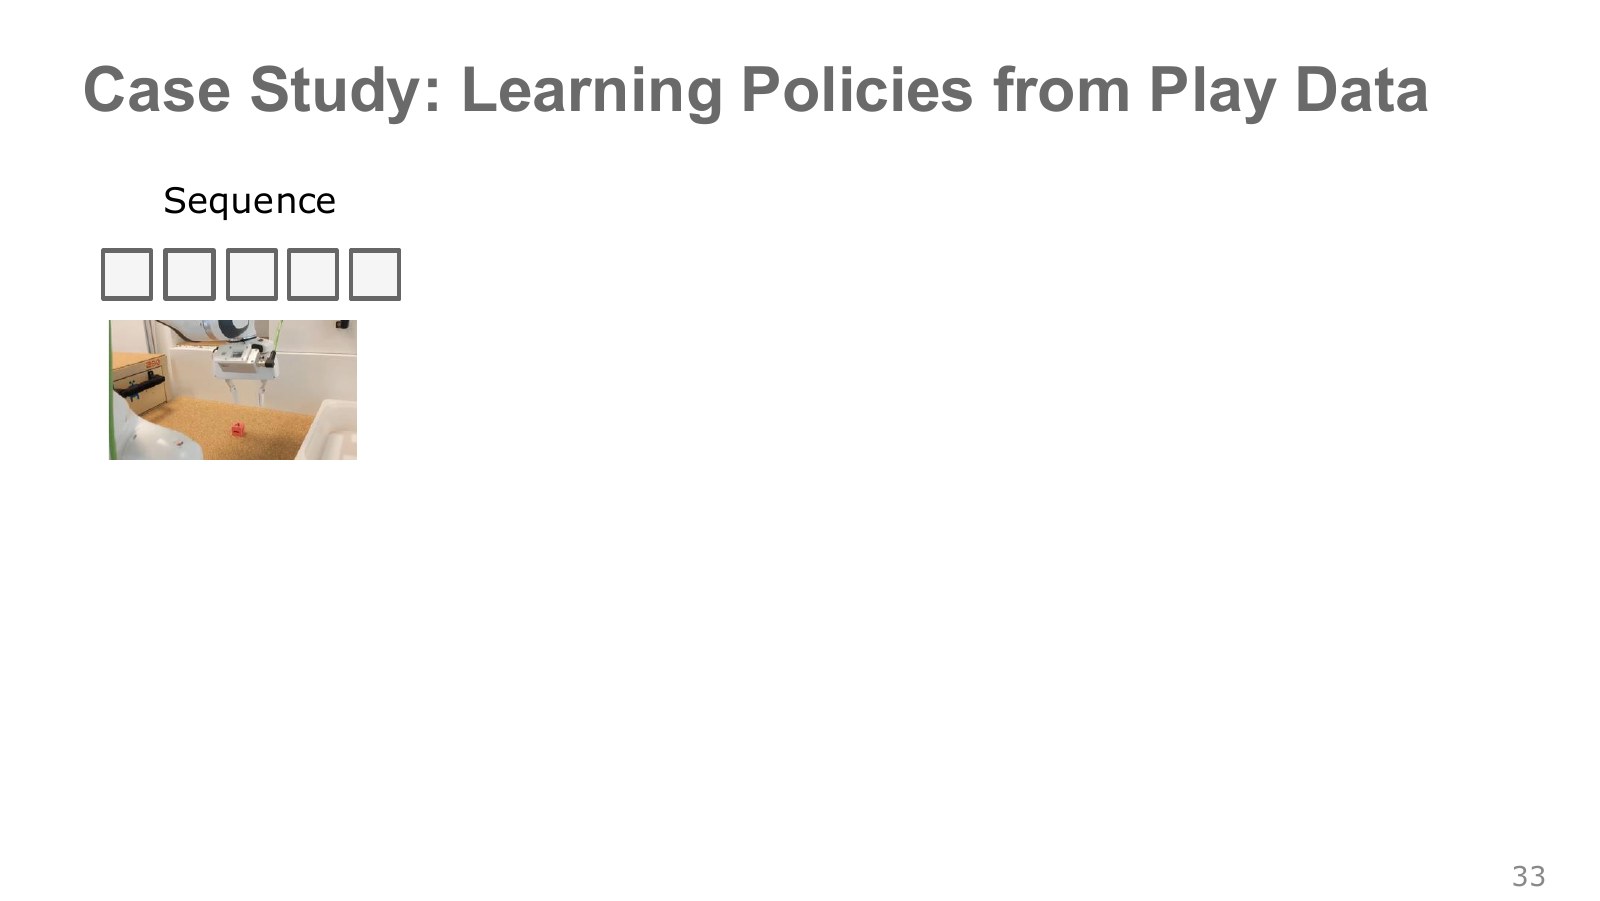
위의 네모들은 연속된 관측들을 나타낸다. 긴 기록에서 임의의 짧은 시간 창을 뽑으면, 그 사이 실제 수행한 행동도 함께 얻는다. 창을 뽑는다는 것은 순서를 무작위로 섞는 것이 아니라 연속된 구간의 시작과 끝을 선택하는 것이다.
예를 들어 관측 와 그 사이 행동 를 한 구간으로 정할 수 있다. 마지막 관측은 실제로 그 행동들을 거쳐 도달한 장면이다. 학습할 때 “이 끝 장면으로 가는 행동의 예”로 사용할 재료가 생긴다.
한 프레임씩 독립적으로만 뽑으면 전체 구간에 걸친 수행 방식의 일관성을 읽기 어렵다. 뒤의 계획 인식기는 구간 전체를 보고 “어떤 방식으로 이 끝점에 왔는가”를 추정한다. 원강의 44:22–44:56.
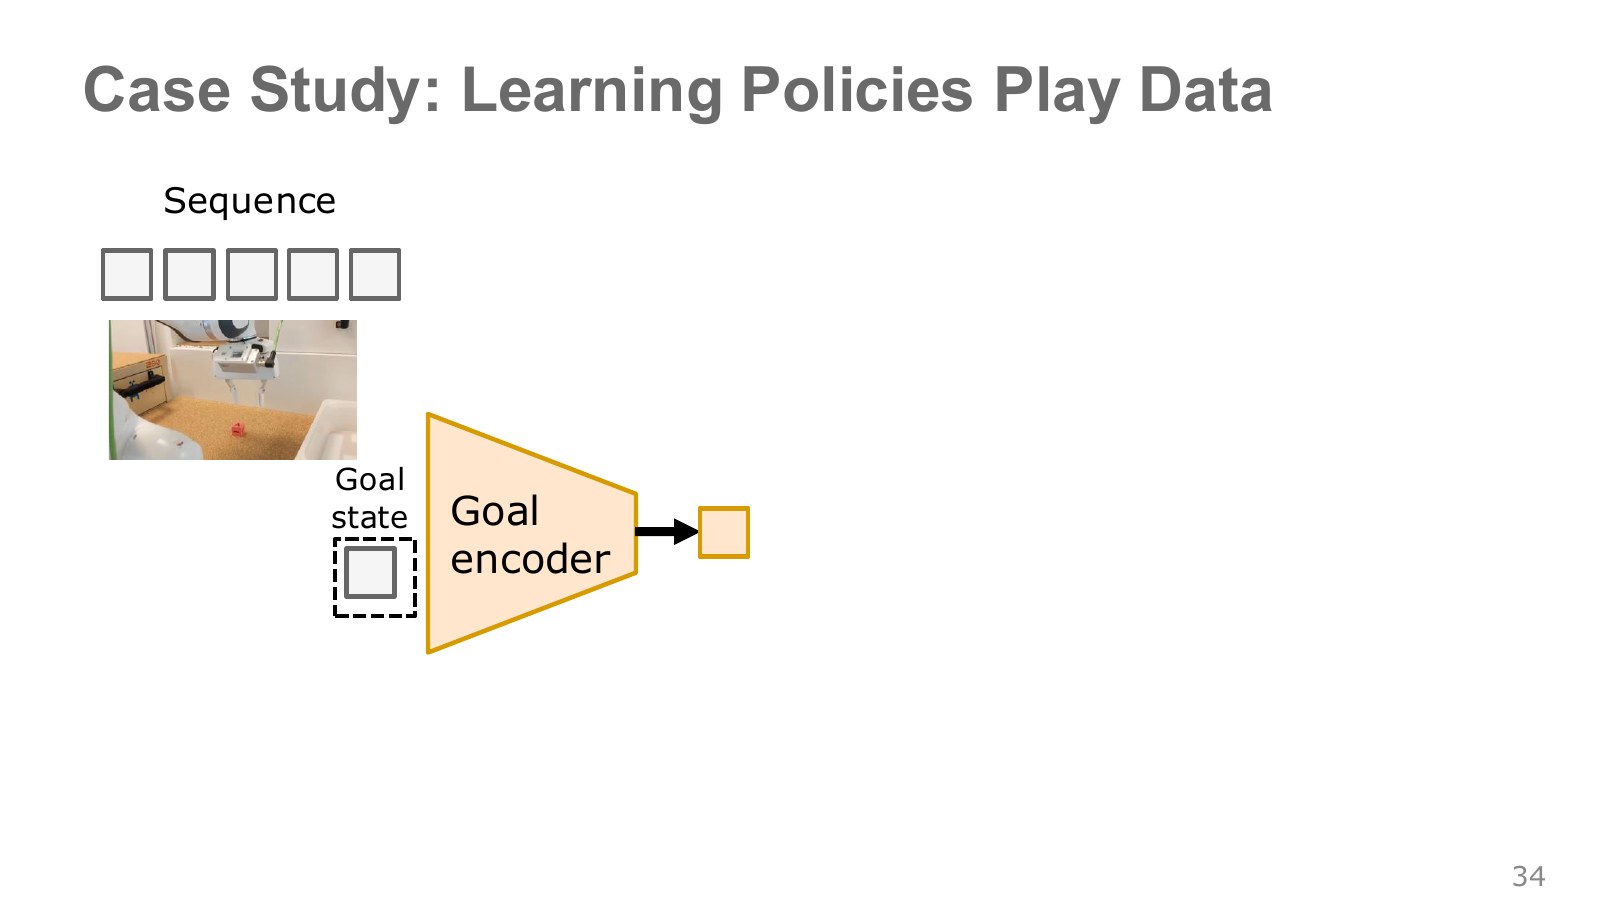
노란 삼각형 목표 인코더(goal encoder)는 마지막 장면을 신경망이 다루기 쉬운 특징 벡터로 바꾼다. 인코더는 입력의 유용한 정보를 다른 표현으로 옮기는 네트워크다. 사진의 모든 픽셀을 과업 이름 하나로 분류하는 것과는 다르다.
이제 같은 구간의 앞 장면들은 현재 입력, 마지막 장면은 목표, 실제 행동들은 정답이 된다. 사람이 과업 이름을 따로 달지 않아도 기록 자체에서 목표 정답을 만드는 목표 재표기(goal relabeling)다. 데이터를 이용해 학습 신호를 스스로 구성한다는 점에서 자기지도(self-supervised) 학습이라고 부른다.
여기서 “스스로”는 목표 라벨을 만드는 과정을 말한다. 관측–행동 데이터의 수집까지 사람이 필요 없었다는 뜻은 아니다. 또한 원 논문에서 라고 쓰는 입력은 인코딩된 영상·고유감각 특징일 수 있다. 02장의 완전한 물리 상태와 자동으로 같은 것으로 가정하면 안 된다.
같은 시작과 끝을 잇는 경로가 여러 개일 수 있으므로, 이 목표만 추가해도 다봉성 문제가 모두 사라지는 것은 아니다. 다음 블록은 그 사이의 실행 방식을 따로 나타낸다. 원 논문 4–5쪽.
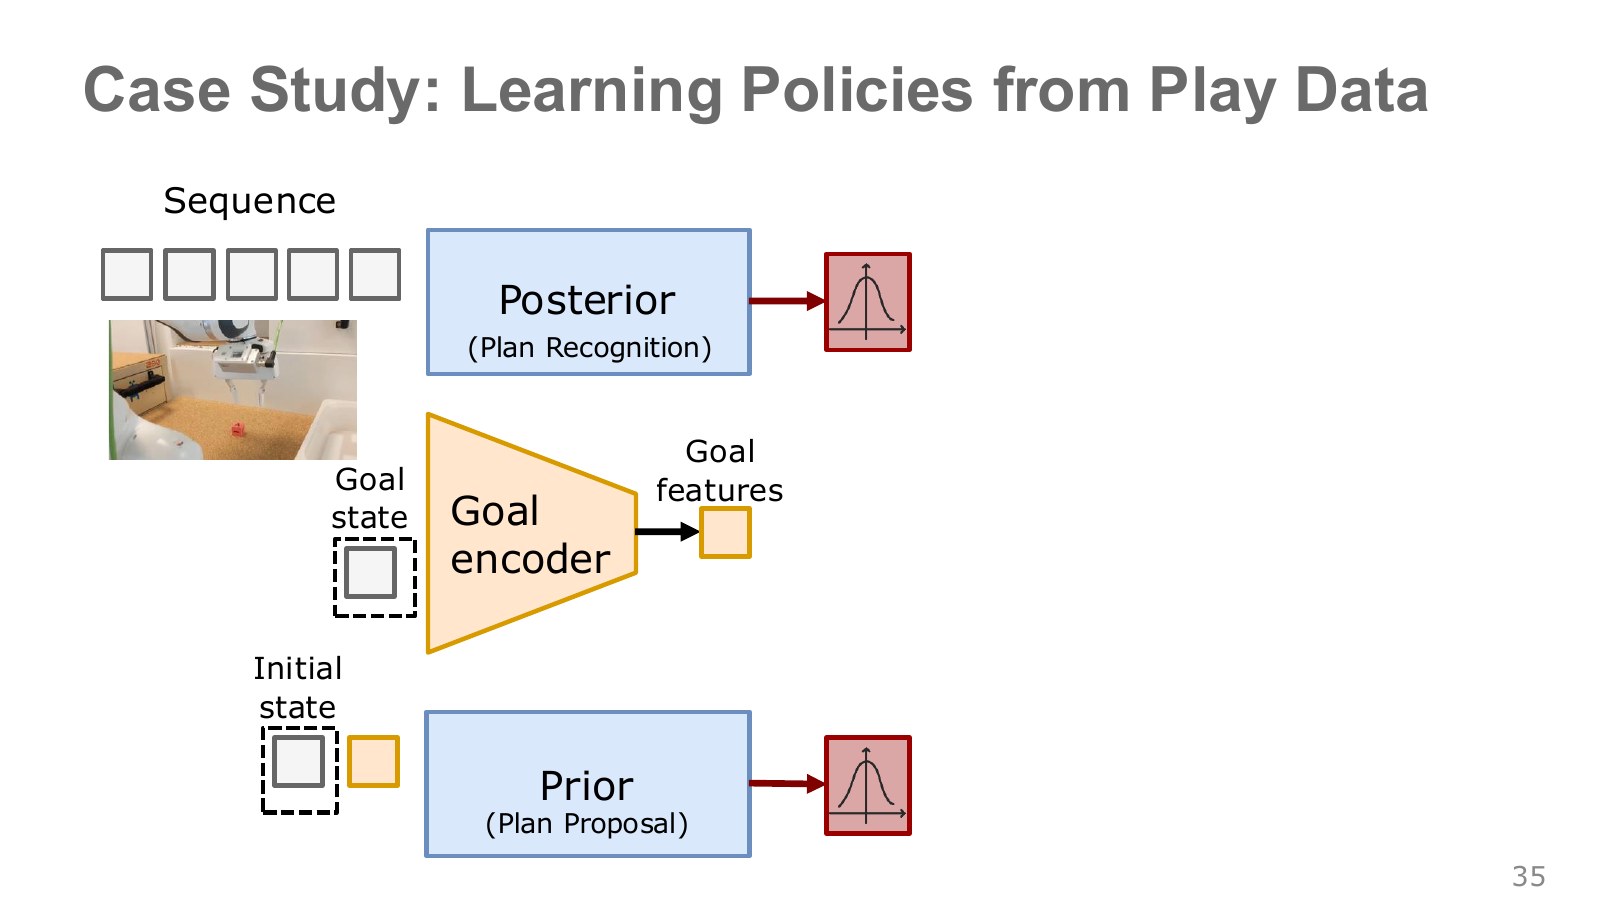
위쪽 계획 인식(plan recognition)은 학습 중 구간 전체를 본다. 물체를 어느 쪽으로 잡았고 어떻게 옮겼는지까지 보고, 그 행동을 설명하는 잠재 계획 의 분포를 만든다. 원본에서는 이 경로를 posterior라고 표시한다.
아래쪽 계획 제안(plan proposal)은 시작 상태와 목표 상태만 본다. 아직 실제로 수행한 중간 경로를 모르므로, 그 둘을 연결할 수 있는 계획들의 분포를 제안해야 한다. 원본의 prior가 이 경로다.
사전 분포(prior)는 구체적인 시연 구간의 중간 행동을 보기 전에 계획에 두는 분포, 사후 분포(posterior)는 관측한 시연 구간을 이용해 계획을 추정하는 분포라고 이해하자. 실제 학습의 계획 인식 네트워크는 계산하기 어려운 참 사후 분포를 근사한다.
실행 때는 미래의 정답 시연 구간을 볼 수 없다. 그래서 두 경로가 필요한 것이다. 학습에서만 볼 수 있는 전체 구간의 정보를 활용하되, 실제 실행에서는 시작·목표로 계획을 제안할 수 있게 연결한다. 원강의 45:00–45:46.
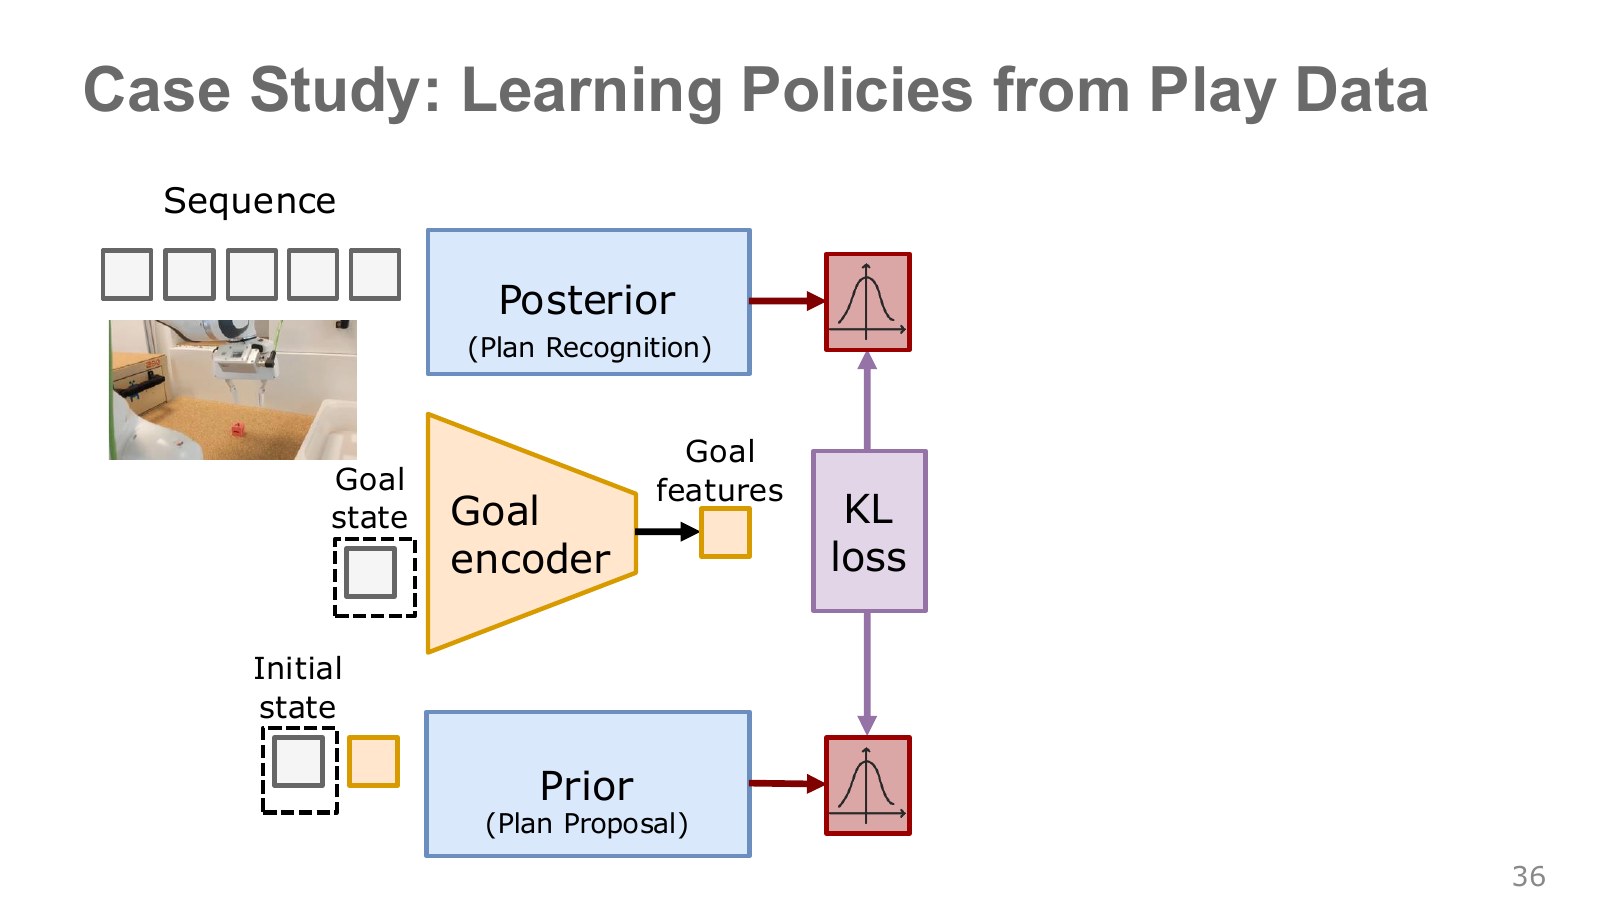
보라색 KL loss 상자는 두 계획 분포를 비교한다. KL 발산(Kullback–Leibler divergence)은 한 분포가 자주 내는 값을 다른 분포가 얼마나 다르게 설명하는지 비교하는 양이다. 같은 분포이면 0이며, 일반적으로 순서를 바꾸면 값도 달라지므로 보통의 대칭적인 거리와는 다르다.
계획 인식기가 시연에서 찾아낸 계획에 실행용 계획 제안기도 가능성을 두도록 학습한다. 전체 시연을 본 경로에서만 가능한 코드를 쓰고 실행용 경로에서는 그 코드를 거의 뽑지 못한다면, 학습 때 잘 되던 디코더가 실제 실행에서 쓸모없을 수 있다.
이 조건만 맞추면 충분한 것은 아니다. 두 경로가 모두 아무 정보 없는 같은 분포를 내면 KL만 작을 수도 있다. 그래서 다음 페이지의 행동 재구성 목적과 함께 최적화한다. 가 실제 행동 차이를 설명하는 데 쓰이는지도 확인해야 한다. 원강의 45:48–46:03.
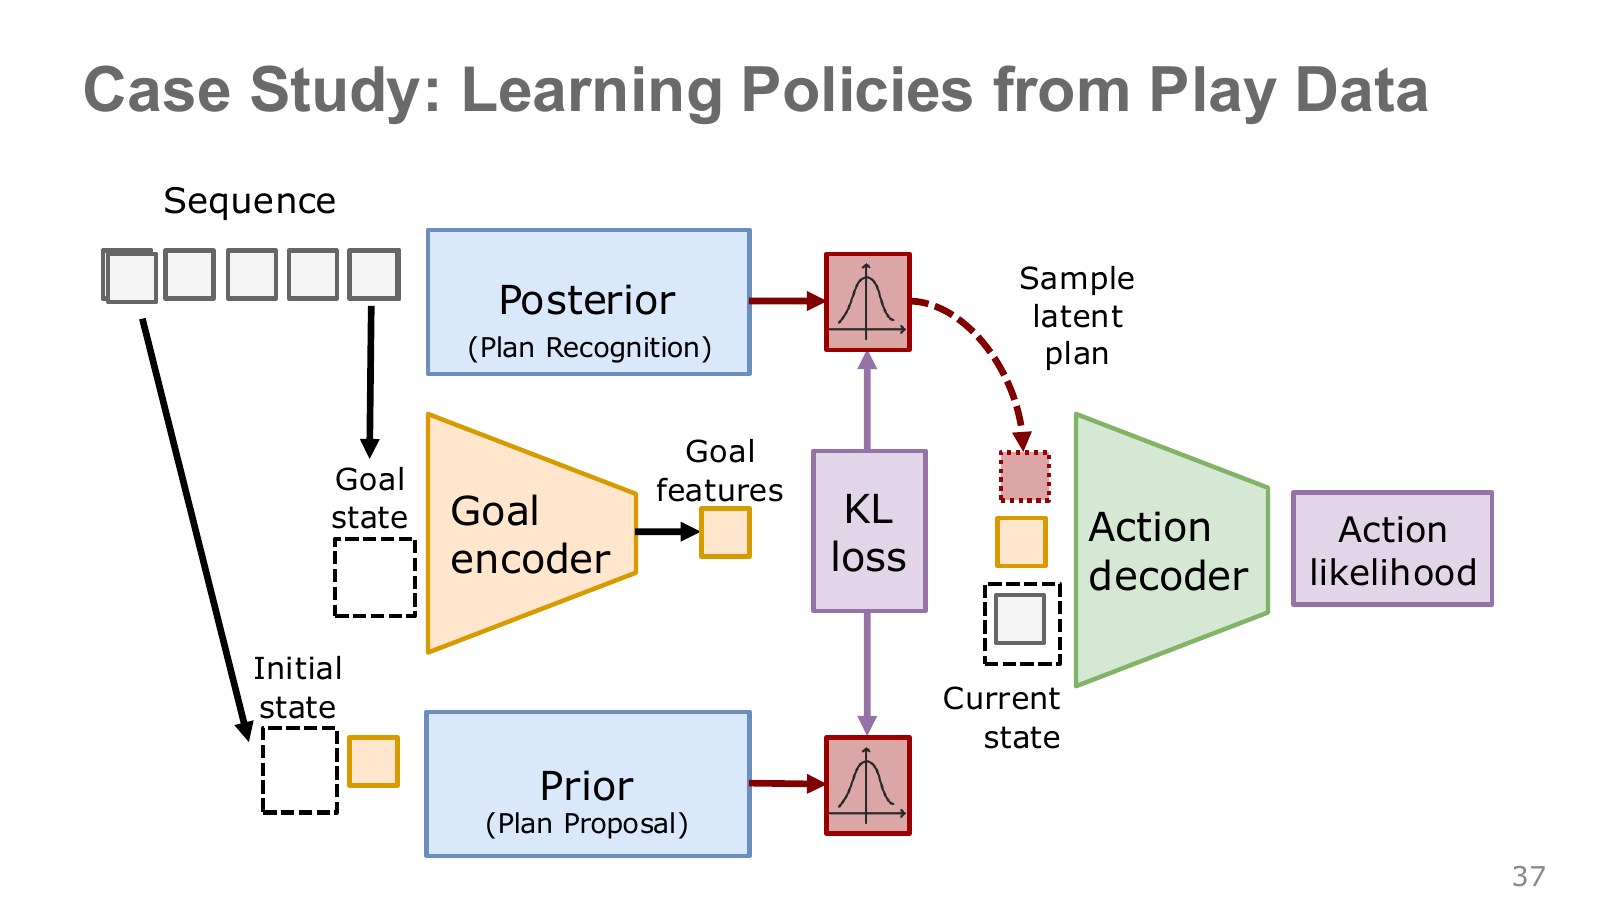
초록색 행동 디코더(action decoder)는 현재 상태 특징, 목표 특징, 표본으로 뽑은 잠재 계획을 받아 시연 행동을 설명한다. “표본을 뽑는다”는 것은 분포가 허용하는 값 중 하나를 해당 가능성에 따라 선택하는 것이다.
학습 때는 계획 인식기가 시연 전체에서 추정한 를 사용해 그 시연의 행동을 높은 가능도로 재구성한다. 행동 가능도 상자는 예측 분포가 실제 시연 행동을 얼마나 잘 설명하는지 계산하는 부분이다. 픽셀 그림을 다시 그리는 목적이 아니라, 이 정책에서는 시연 행동을 복원하는 목적이 중심이다.
실행 때는 계획 인식기를 떼고 계획 제안기가 시작·목표에서 뽑은 를 사용한다. 계획을 정해도 매번 새로 관측한 상태를 받아 행동하므로, 잠재 계획을 고정하는 것과 고정된 모터 명령열을 무조건 재생하는 것은 다르다.
원 논문 도식에서 왼쪽은 학습, 오른쪽은 실행이다. 왼쪽의 entire sequence 입력이 오른쪽에서는 사라진다는 점을 먼저 보자.
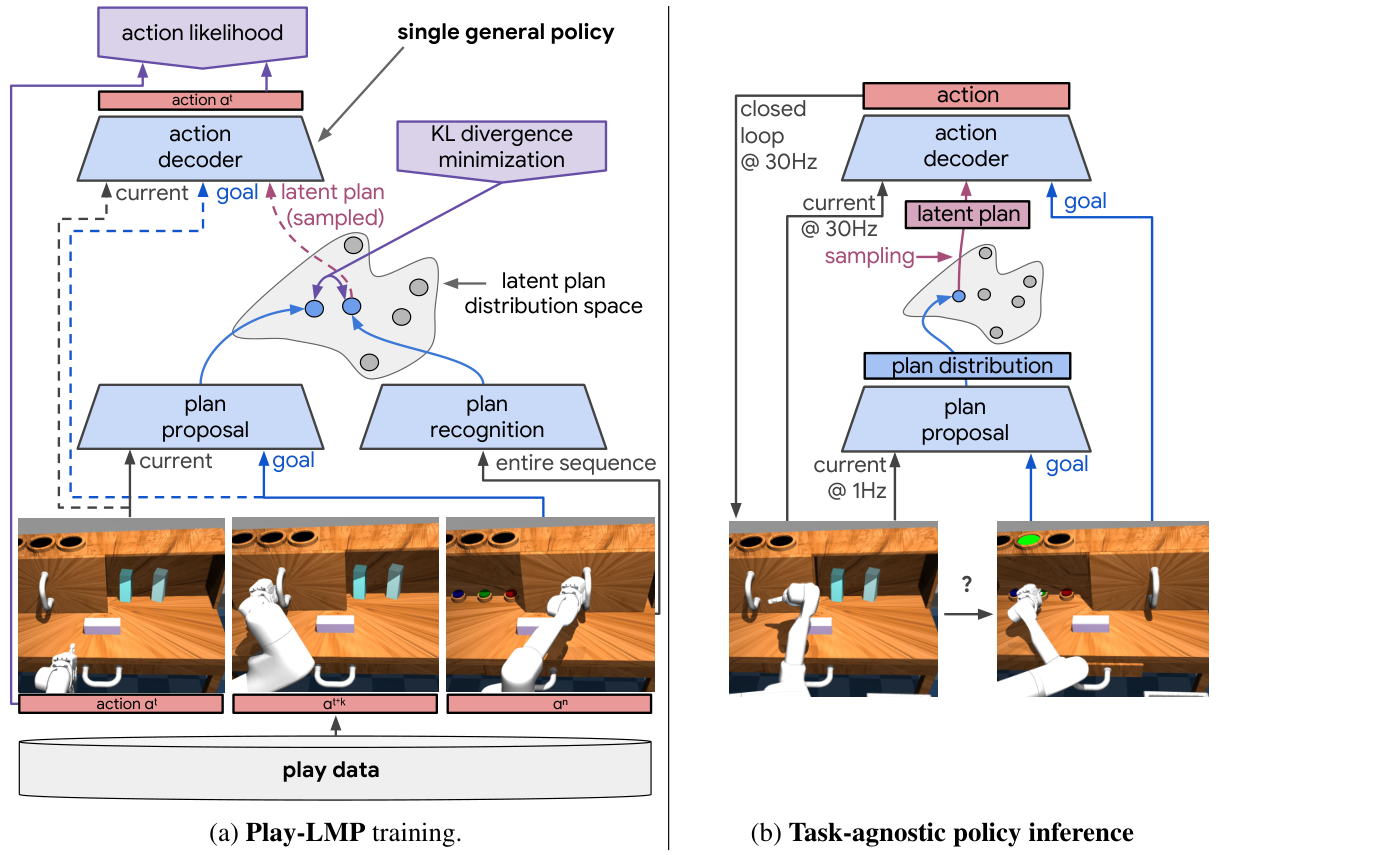
그림의 1Hz 계획 제안과 30Hz 행동 계산은 해당 연구의 시간 구조다. 계획은 상대적으로 느리게, 현재 상태에 반응하는 행동은 더 빠르게 갱신하는 계층을 보여 준다. 모든 잠재 계획 모델이 반드시 같은 주기를 사용하는 것은 아니다. 원 논문 2·5–6쪽 · 원강의 46:05–46:39.
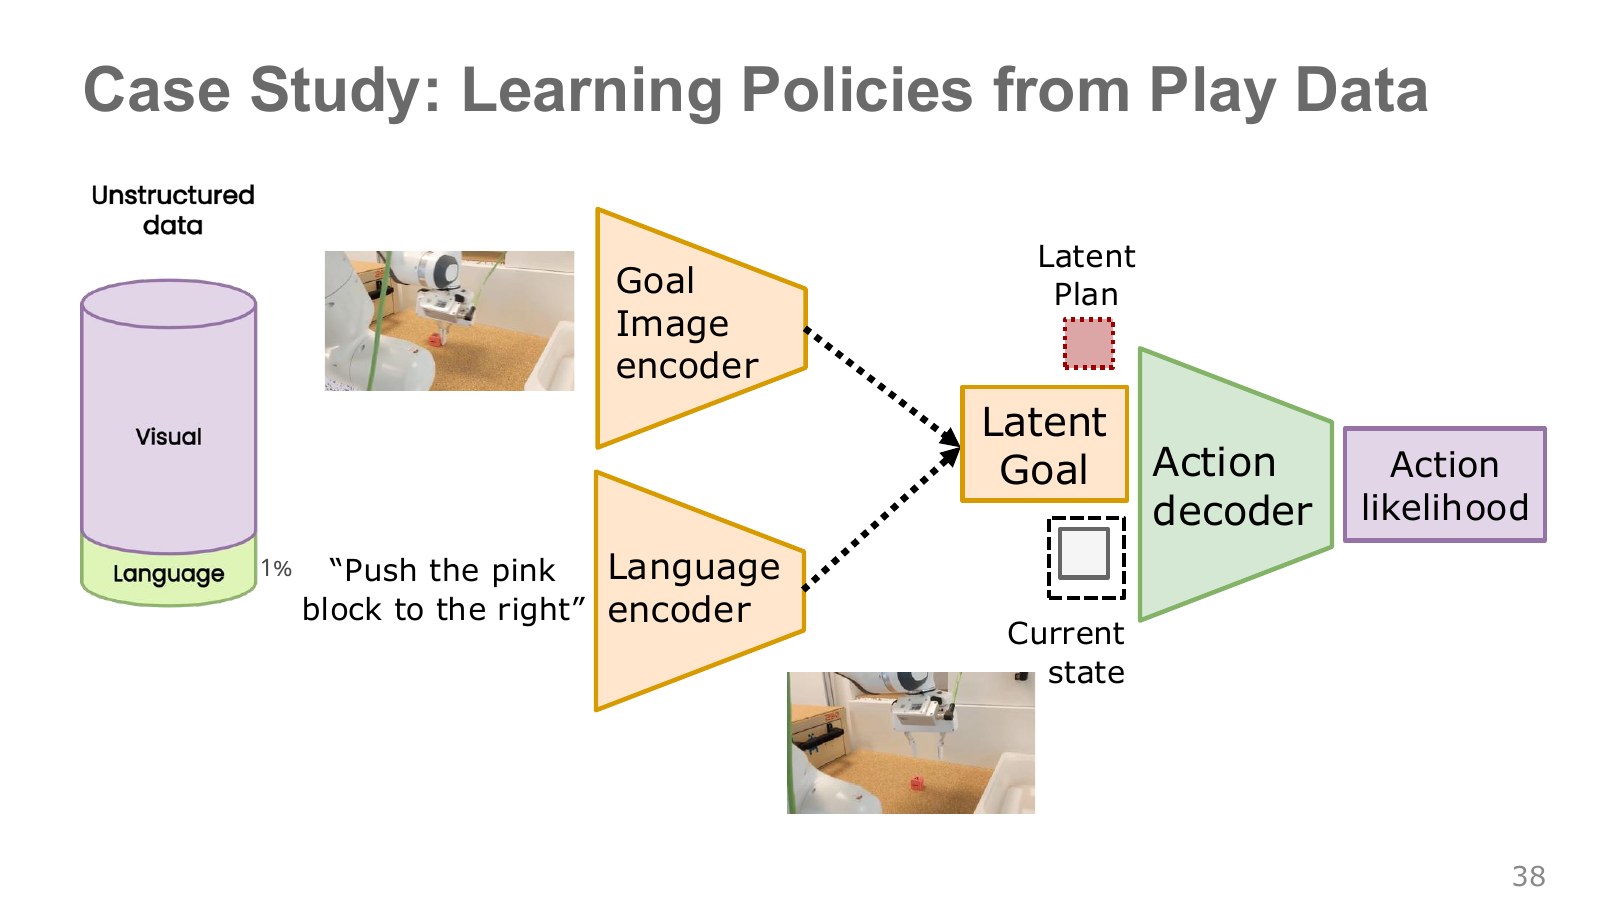
앞에서는 원하는 끝 장면의 영상을 목표로 주었다. 하지만 사람은 “분홍 블록을 오른쪽으로 밀어”처럼 문장으로 요청하고 싶을 수 있다. 노란 두 인코더는 목표 영상과 언어 문장을 각각 정책이 사용할 목표 특징으로 바꾸는 경로다.
두 종류의 표현이 맞물리도록 학습하면, 영상 목표가 있는 많은 놀이 구간과 언어가 붙은 일부 구간을 함께 이용할 수 있다. 이 그림의 작은 언어 비중은 해당 연구 설정의 부분적인 언어 라벨을 나타내며, 모든 과업에서 같은 라벨 비율이면 충분하다는 법칙은 아니다.
공통 표현을 쓴다고 모든 문장이 원하는 장면으로 자동 변환되는 것도 아니다. 언어가 지정한 대상·방향과 실제 시야를 연결하는 근거가 필요하다. 앞의 모호한 “파란 것” 사례처럼 목표 자체가 불분명하면 확인도 필요할 수 있다.
여기서 목표를 나타내는 latent goal과 수행 방식을 나타내는 latent plan도 구분하자. 목표 특징은 무엇을 이룰지, 계획 특징은 그 목표를 어떤 방식으로 이을지를 맡도록 설계한 표현이다. 원강의 46:41–47:18 · 언어 조건부 놀이 학습의 후속 연구.
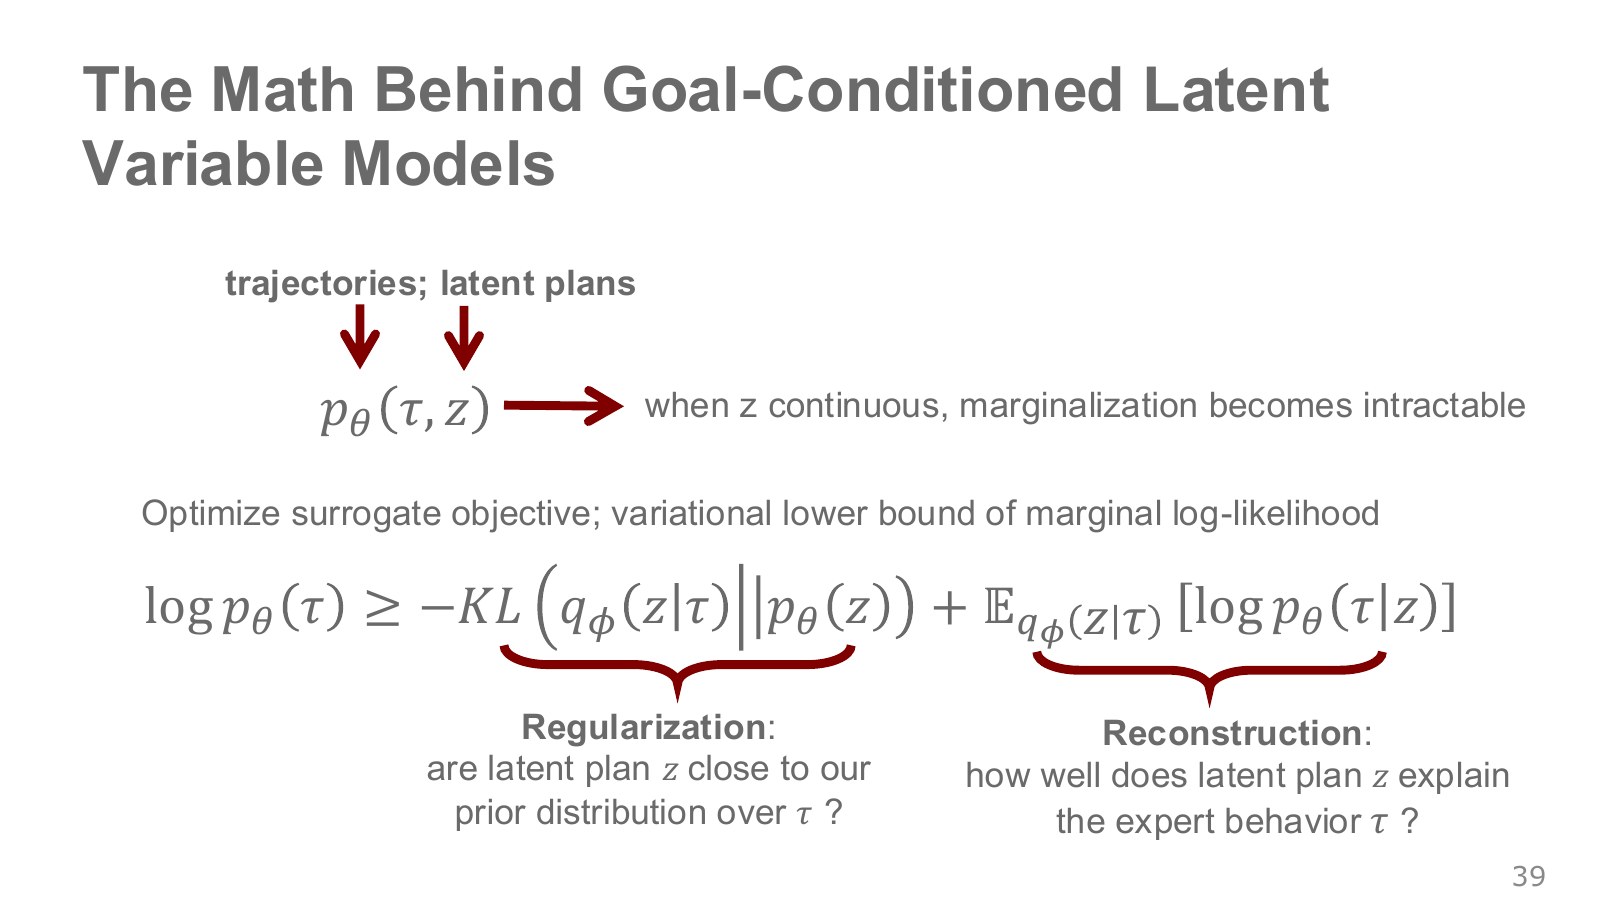
같은 시연을 설명할 수 있는 잠재 계획은 여러 개다. 를 모르는 상태에서 시연의 가능도를 구하려면, 가능한 계획마다 “그 계획의 가능성 × 그 계획으로 시연을 설명할 가능성”을 합쳐야 한다. 잠재 변수가 연속적이면 합 대신 적분으로 쓴다.
이렇게 숨은 변수를 합쳐 없애는 연산이 주변화(marginalization)다. 연속 변수라는 이유만으로 항상 계산 불가능한 것은 아니다. 여기서는 복잡한 신경망 디코더가 들어간 적분을 정확하고 효율적으로 계산하기 어렵다는 점이 문제다.
이 절의 는 학습할 시연 구간을 나타내는 약식 표기다. 실제 행동 디코더에서는 구간 안 각 시점의 관측을 조건으로 행동 가능도를 계산한다. 이 수식을 로봇의 물리적 상태 전이까지 모두 생성하는 세계 모델이라고 읽어서는 안 된다.
시연을 보고 유용한 계획을 추정하는 분포 를 도입하면, 로그 가능도의 변분 하한(ELBO)을 최적화할 수 있다.
는 생성 쪽 모형의 가중치, 는 시연에서 계획을 추정하는 모형의 가중치다. 는 한 번 뽑은 하나의 값이 아니라 그 분포 아래의 평균을 뜻한다. 실제 계산에서는 표본을 뽑아 이 평균과 기울기를 추정할 수 있다.
첫 항은 재구성이다. 시연에서 뽑은 계획이 실제 행동을 잘 설명하면 커진다. 둘째 항은 정규화다. 그 계획 분포가 실행에서 쓸 사전 분포와 너무 어긋나는 것을 벌점으로 다룬다. 학습에서는 이 전체 값을 높이거나 음수를 손실로 두어 줄인다.
가장 중요한 기호는 다. 정확한 로그 가능도와 같은 값이라고 무조건 등호로 쓰지 않는다. 하한과 실제 값 사이의 차이는 근사 추정 분포가 참 사후 분포와 얼마나 다른지에 연결된다. 원강의 47:22–48:41 · Berkeley 변분 추론 강의 PDF 11–16쪽 · Kingma·Welling의 VAE 원문.
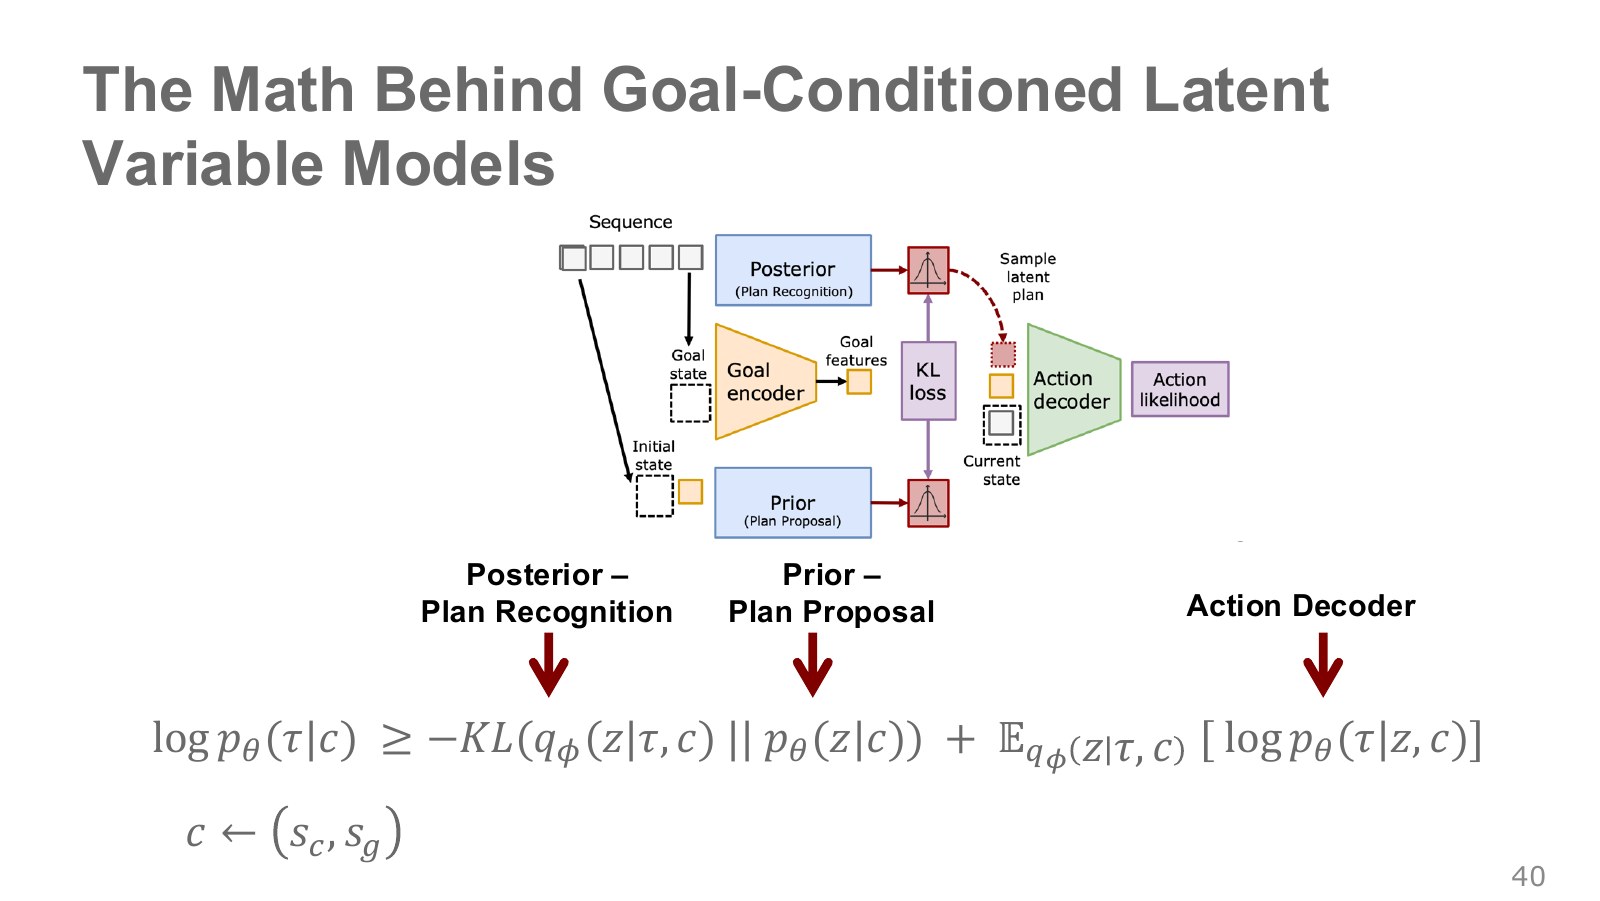
목표를 조건으로 추가하면 를 시작·목표 정보로 둘 수 있다. 같은 모양의 식에 조건 가 붙는다. 원본의 posterior, prior, action decoder가 각각 어느 항에 들어가는지 나누어 보자.
| 수식의 부분 | 그림의 블록 | 사용할 수 있는 정보 |
|---|---|---|
| 계획 인식, 근사 사후 | 학습 중 전체 시연 구간과 시작·목표 | |
| 계획 제안, 조건부 사전 | 시작·목표. 실행에서도 사용한다. | |
| 행동 디코더의 시연 가능도 | 계획과 목표, 각 시점의 관측으로 시연 행동을 설명한다. |
참 사후 분포 를 정확히 계산하기 어려워 신경망 로 근사한다. 같은 잠재 변수를 두고도, 전체 시연을 보기 전 분포와 시연을 본 뒤의 추정 분포는 역할이 다르다.
왜 하한인지 확인하는 관계는 다음과 같다.
오른쪽은 앞의 정규화 항과 다르다. 정규화 항은 와 사전을 비교하고, 여기서는 와 참 사후를 비교한다. 표기가 비슷해도 비교 대상이 다르다는 점을 먼저 확인하자.
이 관계를 작은 두 계획짜리 계산으로 확인했다. 사전 확률을 0.6·0.4, 각 계획에서 데이터가 나올 가능도를 0.8·0.2로 두면 주변 가능도는 0.56이다. 임의의 근사 사후 0.7·0.3을 쓰면 로그 주변 가능도는 약 −0.5798, ELBO는 −0.6606이며 차이는 0.0808로 음수가 아니다. 근사 분포를 참 사후로 맞추면 차이가 0이 된다. 이 계산은 원리를 위한 이산 잠재 변수 예이며 실제 CVAE를 학습한 결과는 아니다.
학습 때는 전체 시연에서 얻은 계획을 잘 복원하고, 실행 때는 시작·목표만으로 그에 맞는 계획을 제안하도록 두 목적을 연결한다. 이 연결이 잘됐는지는 식의 값뿐 아니라 실제 목표 도달과 복구 행동에서도 평가해야 한다. 원강의 48:45–49:21 · Play-LMP의 세 구성요소, 원 논문 5–6쪽.
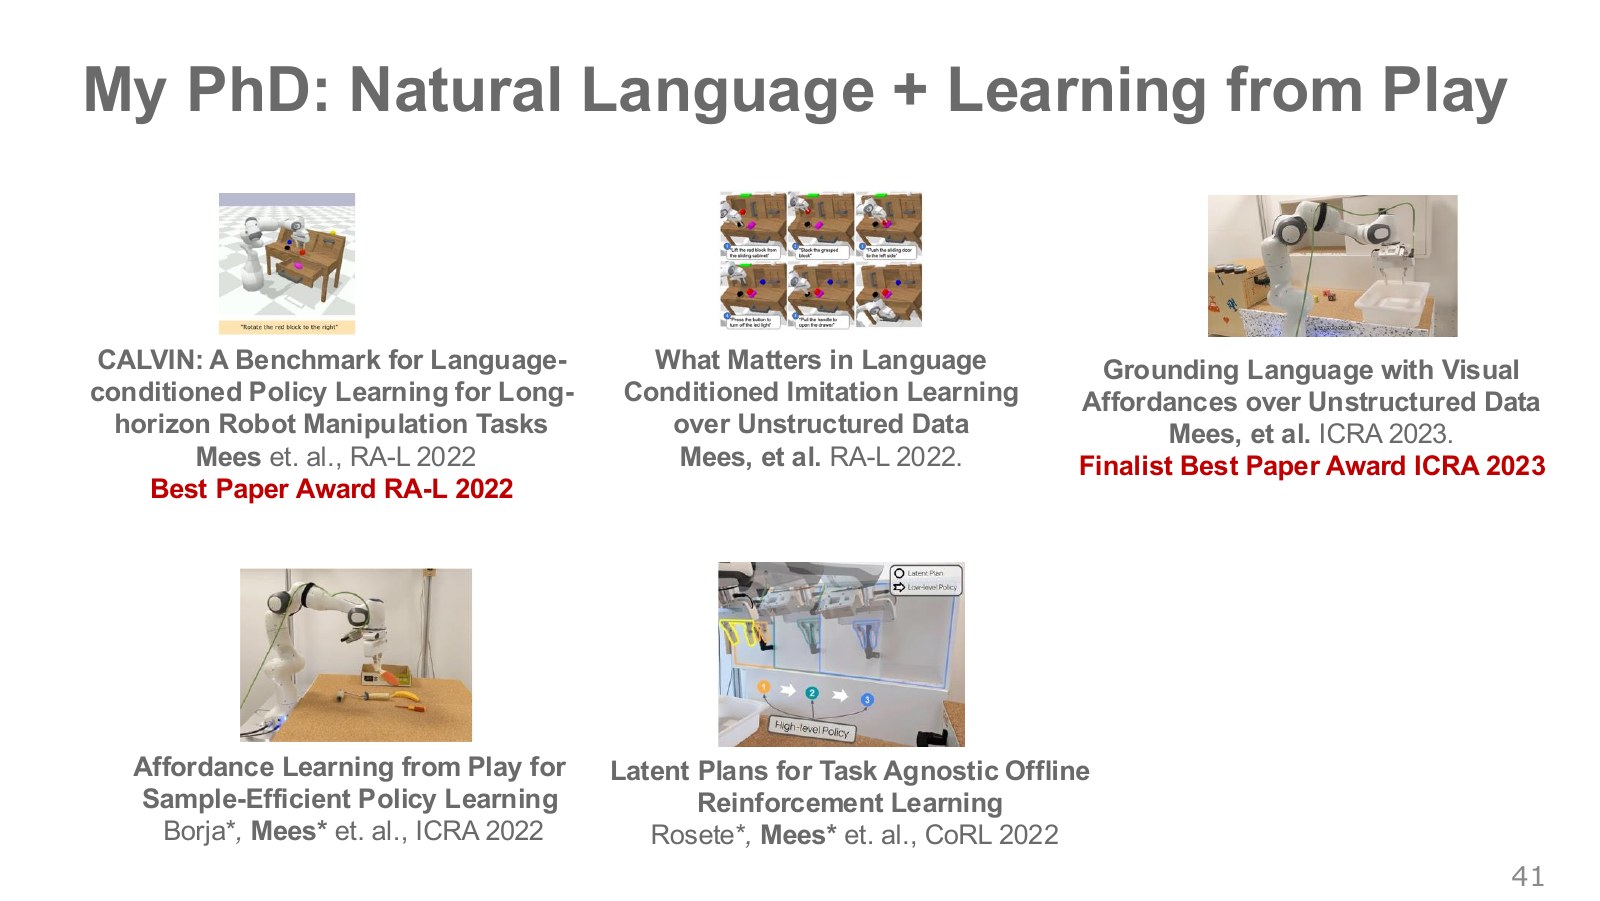
위의 연구들은 모두 같은 역할을 하는 새 정책 이름이 아니다. 무엇을 평가하고 무엇을 추가로 학습하는지 나누면 이번 장과 이어 읽기 쉽다.
| 연구 | 이 장에서 이어지는 질문 |
|---|---|
| CALVIN | 언어로 주어진 여러 조작 지시를 순서대로 수행하는 능력을 어떻게 평가할까? 데이터와 평가 환경을 제공하는 벤치마크다. |
| What Matters in Language Conditioned Robotic Imitation Learning | 놀이 데이터에서 언어 조건부 정책을 학습할 때 표현·계층 구조 등 설계 선택은 어떤 차이를 만들까? |
| Grounding Language with Visual Affordances | 문장의 대상과 실제로 상호작용할 물체 영역을 어떻게 연결할까? |
| Affordance Learning from Play | 놀이 기록에서 사람이 만지는 영역을 배워 후속 정책 학습을 도울 수 있을까? |
| Latent Plans for Task-Agnostic Offline RL | 모방으로 배운 짧은 잠재 기술들을 더 긴 목표를 위해 어떻게 이어 붙일까? |
어포던스(affordance)는 물체와 에이전트의 관계에서 가능한 행동이나 상호작용 기회를 가리킨다. 손잡이는 잡아당기기, 버튼은 누르기와 연결해 생각할 수 있다. 픽셀에서 “무엇인지”를 알아보는 일과 “어디를 어떻게 만질 수 있는지”를 추정하는 일은 다르다.
벤치마크는 비교할 과제·데이터·평가 규칙이고, 학습 알고리즘은 주어진 데이터에서 정책을 얻는 방법이다. 후속 연구의 성능 수치를 다른 환경의 결과와 그대로 섞기보다 성공 판정·관측·행동·데이터 조건부터 맞추어 읽자. 원강의 49:25–49:37.
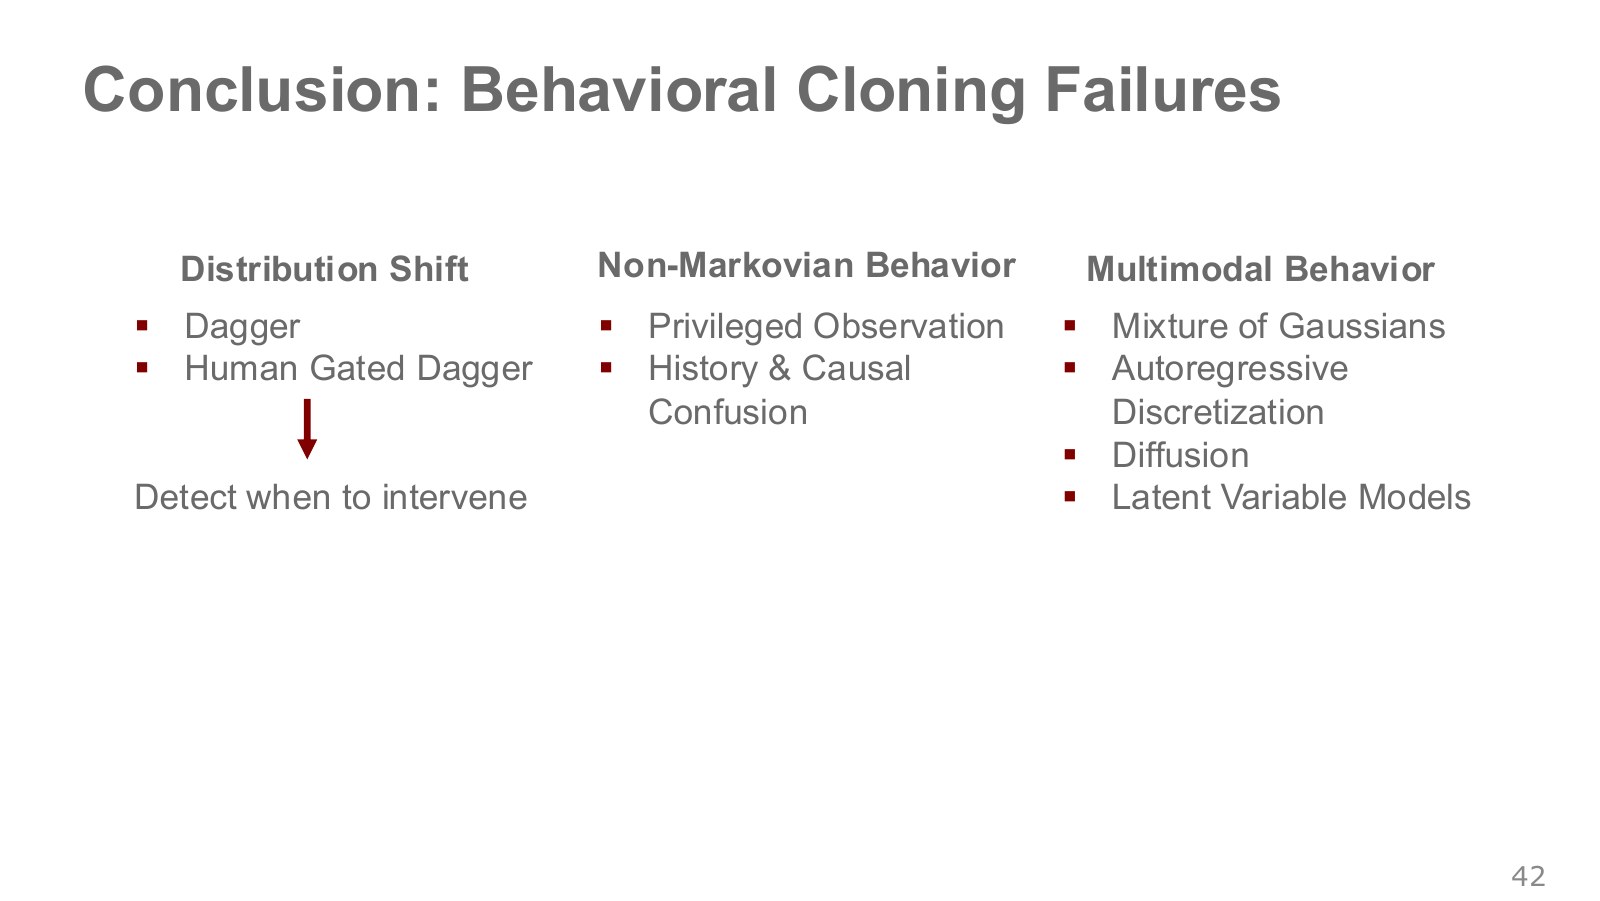
마지막 그림은 세 가지 다른 원인을 나눈다. 어느 모델이 최신인지 고르기 전에 현재 실패가 어느 쪽에 가까운지 살펴보자.
| 관찰한 문제 | 먼저 확인할 것 | 연결되는 방법 |
|---|---|---|
| 조금 벗어난 뒤 계속 더 틀린다. | 실행 중 방문한 상태에 좋은 정답이 있는가? | 복구 데이터, 타당한 증강, DAgger·사람 개입 |
| 같은 사진에서 시연 행동이 설명되지 않는다. | 시연자만 가진 시야·기억·목표가 있는가? | 입력 정보 정렬, 이력 모델. 쉬운 가짜 단서에 의존하는지도 확인 |
| 두 유효한 행동 사이의 평균으로 간다. | 행동 분포가 여러 갈래인가? | 혼합 분포, 자기회귀 이산화, 확산·잠재 변수 모델 |
여러 원인이 동시에 있을 수 있다. 생성 모델이 여러 행동 모드를 표현해도 필요한 목표 정보가 빠져 있으면 어떤 모드를 골라야 할지 알기 어렵다. DAgger로 입력 범위를 넓혀도 모형이 모든 행동을 하나의 평균으로 눌러 버리면 표현 문제가 남는다.
이번 장의 기준은 좋은 행동 데이터, 실행 때 실제로 주어지는 정보, 행동의 여러 가능성을 담는 표현이다. 이 셋을 구분하면 학습 손실은 작은데 실제 로봇이 실패하는 이유를 더 구체적으로 찾을 수 있다. 원강의 49:39–50:27.
#작은 실행 예제로 데이터 범위와 수식을 확인하기
직접 실행할 수 있도록 NumPy로 만든 1차원 합성 환경을 공개했다. 실제 로봇이나 ETH 과제 환경을 재현한 것이 아니라, 정책이 방문한 상태에 정답을 붙이는 과정을 분리해서 보는 예다.
상태 는 목표 0에서의 옆방향 편차다. 한 단계 뒤 상태는 현재 편차에 정책 행동과 작은 외란을 더해 정한다. 정책은 꼴의 선형 함수이며 출력은 −1에서 +1로 제한한다. 전문가 정답은 같은 제한 아래 로 둔다.
처음 데이터는 중앙 상태와 직진 정답 스무 쌍뿐이다. 이 데이터만으로는 중앙 밖에서 어떤 기울기 를 써야 하는지 결정할 수 없다. 최소 노름 최소제곱 해는 이다. 다음으로 정책을 실행하고 방문한 상태에 전문가 정답을 추가해 다시 맞추는 과정을 세 번 반복했다. 이 예에서는 첫 번째 추가 뒤 기울기 −0.8을 식별했다.
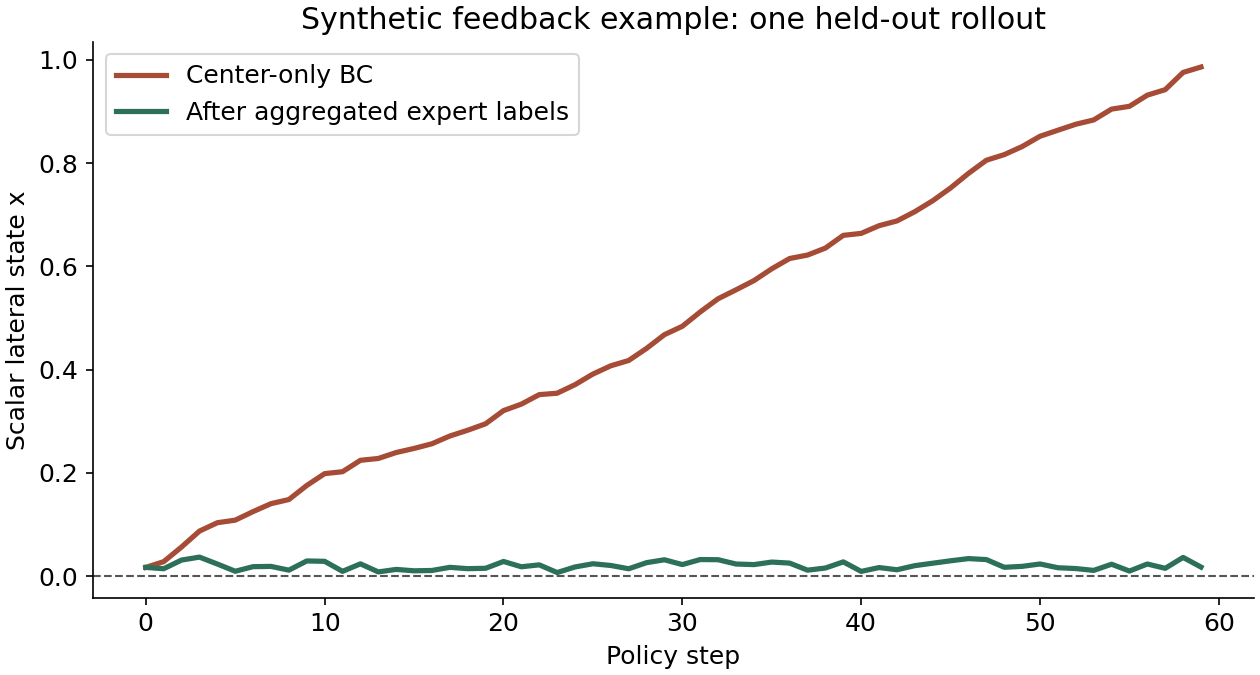
| 이 합성 환경에서 학습한 정책 | 학습된 기울기 | 별도 평가20회에서 상태 RMS의 평균 |
|---|---|---|
| 중앙 데이터만 사용 | 0 | 0.415916 |
| 방문 상태의 전문가 정답 누적 | −0.8 | 0.035215 |
RMS는 매 실행에서 상태 편차를 제곱해 평균낸 뒤 제곱근을 취한 값이다. 표는 그 값을 평가20회에서 다시 평균냈다. 각 실행은60단계이고 두 정책에 같은 평가 시드1000–1019를 사용했다. 상태의 단위는 설명용이며, 로봇 팔의 위치 오차나 성공률로 읽지 않는다.
이 차이는 중앙만 있는 의도적으로 좁은 데이터와, 정답 구조가 선형인 전문가라는 설정에서 얻었다. DAgger가 모든 환경에서 이 비율만큼 좋아진다는 비교도, 신경망 기반 BC의 일반적인 성능 측정도 아니다. 학습된 정책으로 생긴 입력을 다시 학습 자료에 넣는 흐름을 직접 확인하는 목적이다.
같은 실행 파일에는 MSE 평균 행동, 혼합 밀도의 정규화, 자기회귀 확률의 합, 누적 오차 상한, ELBO와 사후 KL 관계를 포함한15개 검사를 넣었다. 실행 파일·설정·결과 JSON·CSV를 함께 확인할 수 있다.
#실제 로봇 팔 학습으로 이어가기
ETH의 공식 HW3는 SO-101 시뮬레이션에서 시연 수집 → 행동 복제 → 개입 데이터 추가 → 목표 조건부 학습을 연결한다.
| 공식 예제 | 연결해서 읽을 개념 |
|---|---|
| Exercise1, MSE policy | 원격조작 기록을 모으고 상태 차이에서 행동 라벨을 계산해 정책을 학습한다. 관측·행동 좌표와 스케일을 확인한다. |
| Exercise2, DAgger | 장애물 분포를 바꾼 실행에서 실패를 관찰하고, 사람이 이어받은 교정 기록을 추가해 재학습한다. |
| Exercise3, 여러 큐브 | 목표 큐브의 색과 목표 통 위치를 조건으로 받는다. 목표 정보가 관측 입력에 실제 들어가는지 확인한다. |
이 과제의 교정 수집은 사람의 온라인 개입을 사용하므로, 모든 방문 상태에 정답을 질의하는 기본 DAgger의 설명과 구분해서 읽으면 좋다. 성공 판정도 집게가 목표 위치에 왔는지와 물체를 실제 통 안에 놓았는지를 구별한다.
공식 과제와 관련 코드는 참고용으로 읽었으며 이 글에서 그 정책을 훈련하거나 실물 로봇을 구동한 결과는 아니다. 직접 실행한 것은 위의 합성 환경과 수치 검사다. 더 큰 로봇 시연 학습을 확인하려면 Diffusion Policy의 공개 코드·노트북을 이어 볼 수 있다.
다음 04장에서는 시연 행동을 정답으로 받는 대신, 환경에서 행동한 결과의 보상을 이용해 정책을 개선하는 강화학습의 첫 알고리즘으로 이어 간다.
#출처와 함께 읽을 자료
- Oier Mees — ETH Robot Learning 3강 · 영상 · PDF · 이미지 사본
- Sergey Levine — Berkeley CS285, Supervised Learning of Behaviors · 누적 오차 영상 · 실전 BC 영상 · 목표 조건부 학습 영상
- Hung-yi Lee — NTU 모방학습
- Ross·Gordon·Bagnell — DAgger, AISTATS2011
- Bojarski et al. — NVIDIA End to End Learning for Self-Driving Cars
- Giusti et al. — Forest Trails
- Mees·Burgard — Composing Pick-and-Place Tasks By Grounding Language
- de Haan·Jayaraman·Levine — Causal Confusion
- Lynch et al. — Learning Latent Plans from Play · 프로젝트
- Berkeley CS285 — Variational Inference and Generative Models · Kingma·Welling — Auto-Encoding Variational Bayes
- Chi et al. — Diffusion Policy · ETH 공식 HW3
P번호는 이미지 사본의 파일 순서다. 운영 안내·전환 문구·감사·참고문헌 전용 장은 생략했다. 강의 슬라이드의 저작권은 Oier Mees 및 포함 자료별 권리자에게 있다. NVIDIA와 Play-LMP의 보충 도식은 각 원저작자의 자료이며, 직접 계산한 그래프와 합성 예제는 별도의 설명용 자료다.