컵 앞에 멈춘 손만 보면 집으러 가는 중인지, 이미 집기를 실패하고 물러나는 중인지 알기 어렵다. 로봇에게는 지금 보이는 장면뿐 아니라 그 장면까지 이어진 과정이 필요하다. 이번 장은 그 과정을 시퀀스로 표현하고, 필요한 정보를 attention으로 연결하는 방법을 다룬다.
Oier Mees · ETH Zurich 2026 7강 · 공식 강의 · 원본 PDF
06장에서는 여러 가능한 행동의 분포를 VAE·확산·flow matching으로 표현했다. 이번에는 자료를 어떤 단위로 나누고, 과거와 미래 행동 사이의 관계를 어떤 구조로 배울지 살펴본다. 생성 방식과 시퀀스 모델 구조는 결합할 수 있는 설계 요소다. Transformer가 반드시 자기회귀 방식으로만 작동하는 것은 아니며, 확산이나 flow 모델의 내부에서도 사용할 수 있다.
시퀀스(sequence)는 순서가 있는 자료의 나열이다. 문장의 단어, 영상의 프레임, 시간순 관절 명령이 모두 예다. 토큰(token)은 모델이 처리하는 단위이고, 임베딩(embedding)은 그 단위를 숫자 벡터로 표현한 것이다. 언어 토큰은 보통 사전의 정수 번호를 거쳐 벡터로 바뀐다. 이미지 패치나 연속 행동을 나타내는 토큰은 처음부터 연속 벡터일 수도 있다. “모든 것을 토큰으로 다룬다”는 말이 모든 입력을 똑같은 정수로 바꾼다는 뜻은 아니다.
강의는 언어 모델의 원리에서 출발해 시각·언어 모델(VLM), 그리고 시각·언어·행동 모델(VLA)로 이어진다. 토큰의 번호를 맞히는 일과 로봇이 현실에서 목표를 달성하는 일 사이에 어떤 연결이 필요한지 보자.
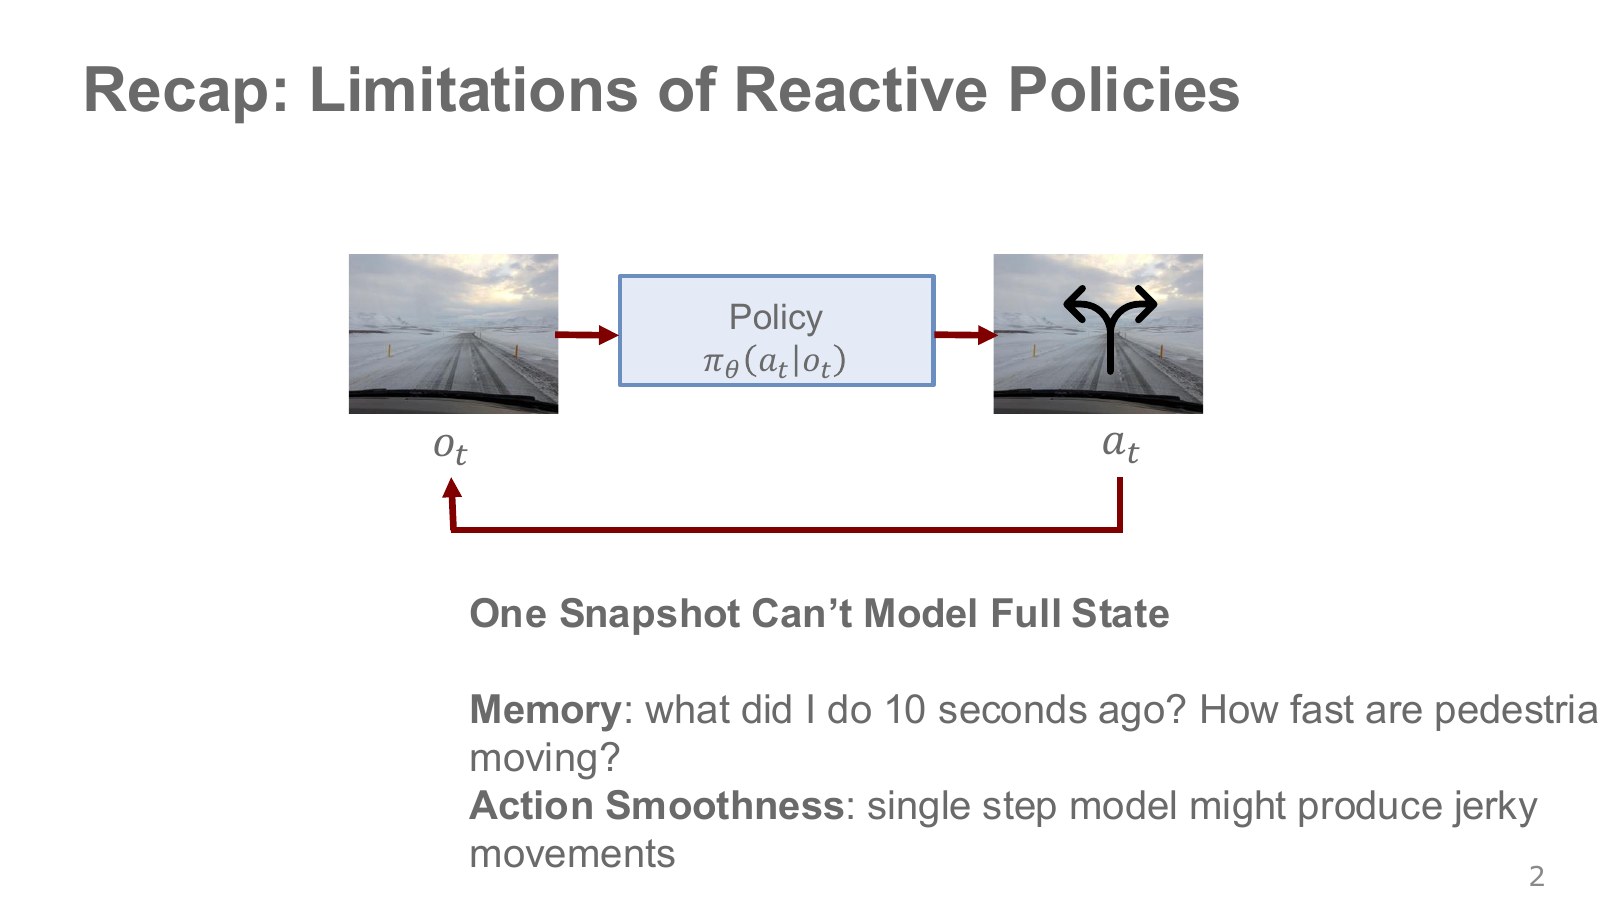
빙판길 사진과 세 갈래 화살표 사이에 정책이 놓여 있다. 현재 관측만 넣어 다음 행동을 정하는 반응형 정책이다. 하지만 정지 사진에서 같은 위치에 있는 보행자라도 차 쪽으로 다가오는 중인지 멀어지는 중인지에 따라 적절한 행동이 달라진다. 이전 위치와 시간 간격을 보면 속도를 추정할 수 있다.
또 다른 문제는 행동의 연결이다. 매 순간 독립적으로 접근 방향을 새로 정하면, 손이 왼쪽과 오른쪽 사이를 오가며 흔들릴 수 있다. 과거 정보를 사용하는 문제와 앞으로 여러 명령을 일관되게 만드는 문제는 서로 연결되지만 같지는 않다. 앞쪽은 관측의 기억, 뒤쪽은 출력 행동 묶음의 설계다.
한 관측에 충분한 상태 정보가 이미 들어 있거나 작업이 단순하면 반응형 정책도 적절할 수 있다. 이 그림의 요점은 모든 단일 시점 정책이 실패한다는 것이 아니라, 센서 한 장면이 의사결정에 필요한 정보를 충분히 담는지 확인하라는 데 있다.
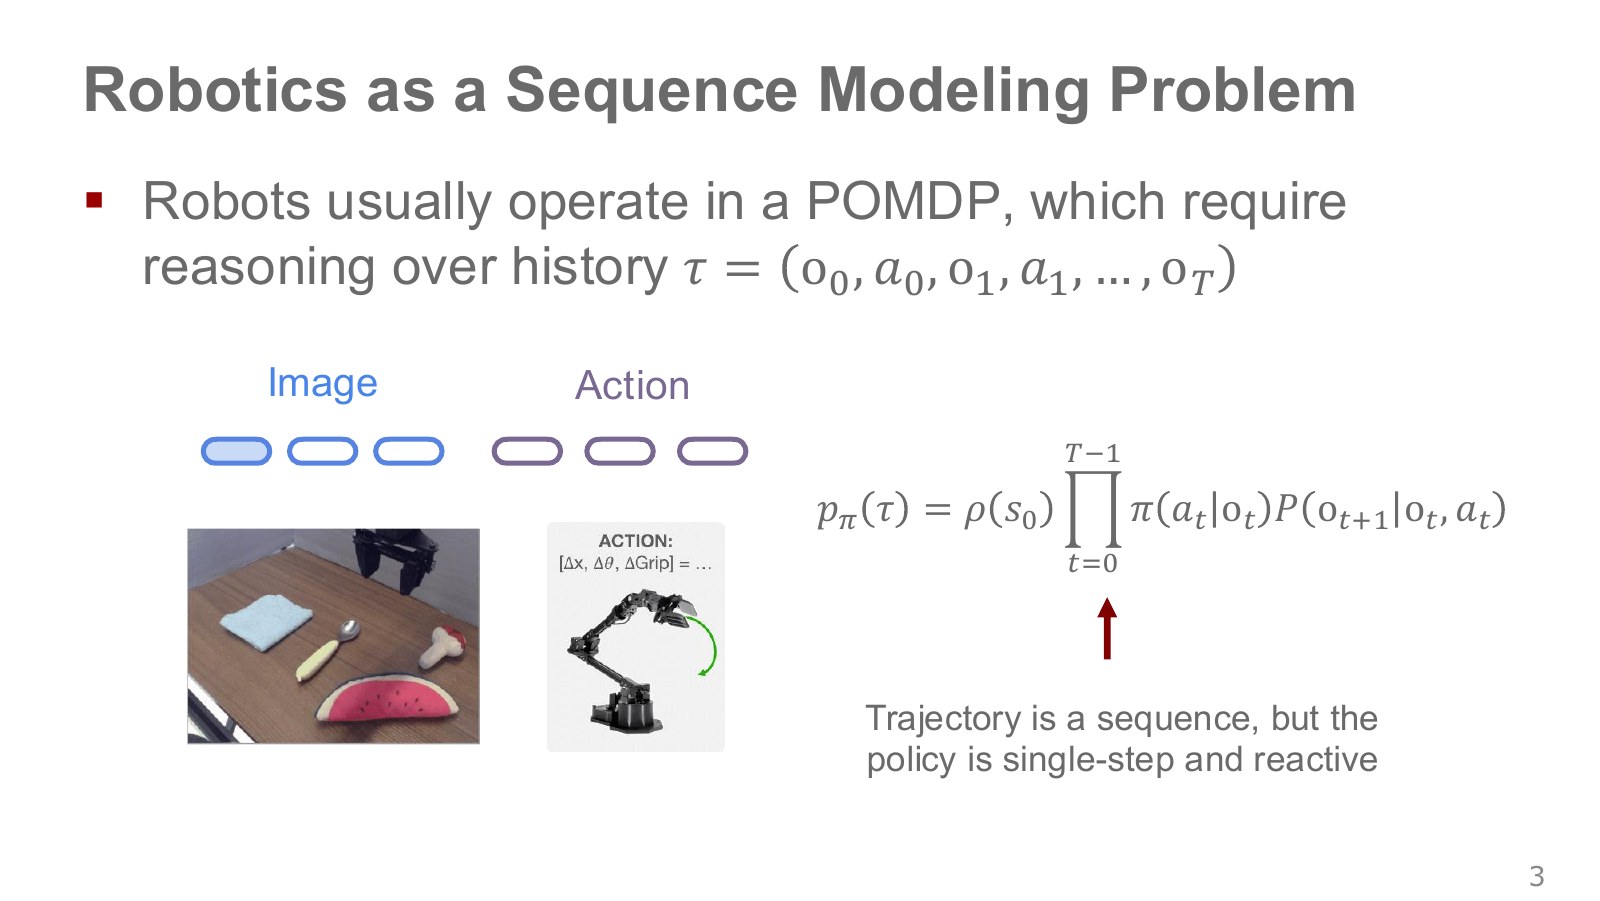
탁자 사진은 현재 보이는 장면이고, 로봇 그림은 그 장면에 작용하는 행동을 뜻한다. 실제 세계의 상태에는 가려진 물체, 접촉 상태, 속도처럼 사진에서 완전히 알 수 없는 정보가 있다. 이를 부분 관측 마르코프 결정 과정(POMDP)으로 모델링할 수 있다. 세계의 상태는 마르코프 성질을 가져도 관측 영상만의 연쇄는 그렇지 않을 수 있다.
여기서 o는 관측, a는 행동, h는 현재까지의 이력이다. 예를 들어 손을 닫았다는 과거 명령을 알아야 현재 손가락 모양과 물체 위치를 해석하기 쉬울 수 있다. 신경망이 이력을 입력받는다고 곧바로 숨은 상태를 정확히 복원하는 것은 아니며, 보지 못한 정보는 여전히 불확실하다.
슬라이드의 짧은 궤적 확률식은 반응형 정책을 되짚는 요약이다. 일반적인 부분 관측 문제에서 다음 관측을 현재 관측과 행동만으로 충분히 예측할 수 있다고 놓으면 추가 가정이 된다. 관측 이력으로 적으면 다음과 같이 표현할 수 있다.
이력 전체 대신 숨은 상태의 확률분포인 belief를 갱신하거나, 학습된 요약 벡터를 사용할 수도 있다. 이 장의 시퀀스 모델은 그 요약과 참조를 데이터로 배우는 접근이다.
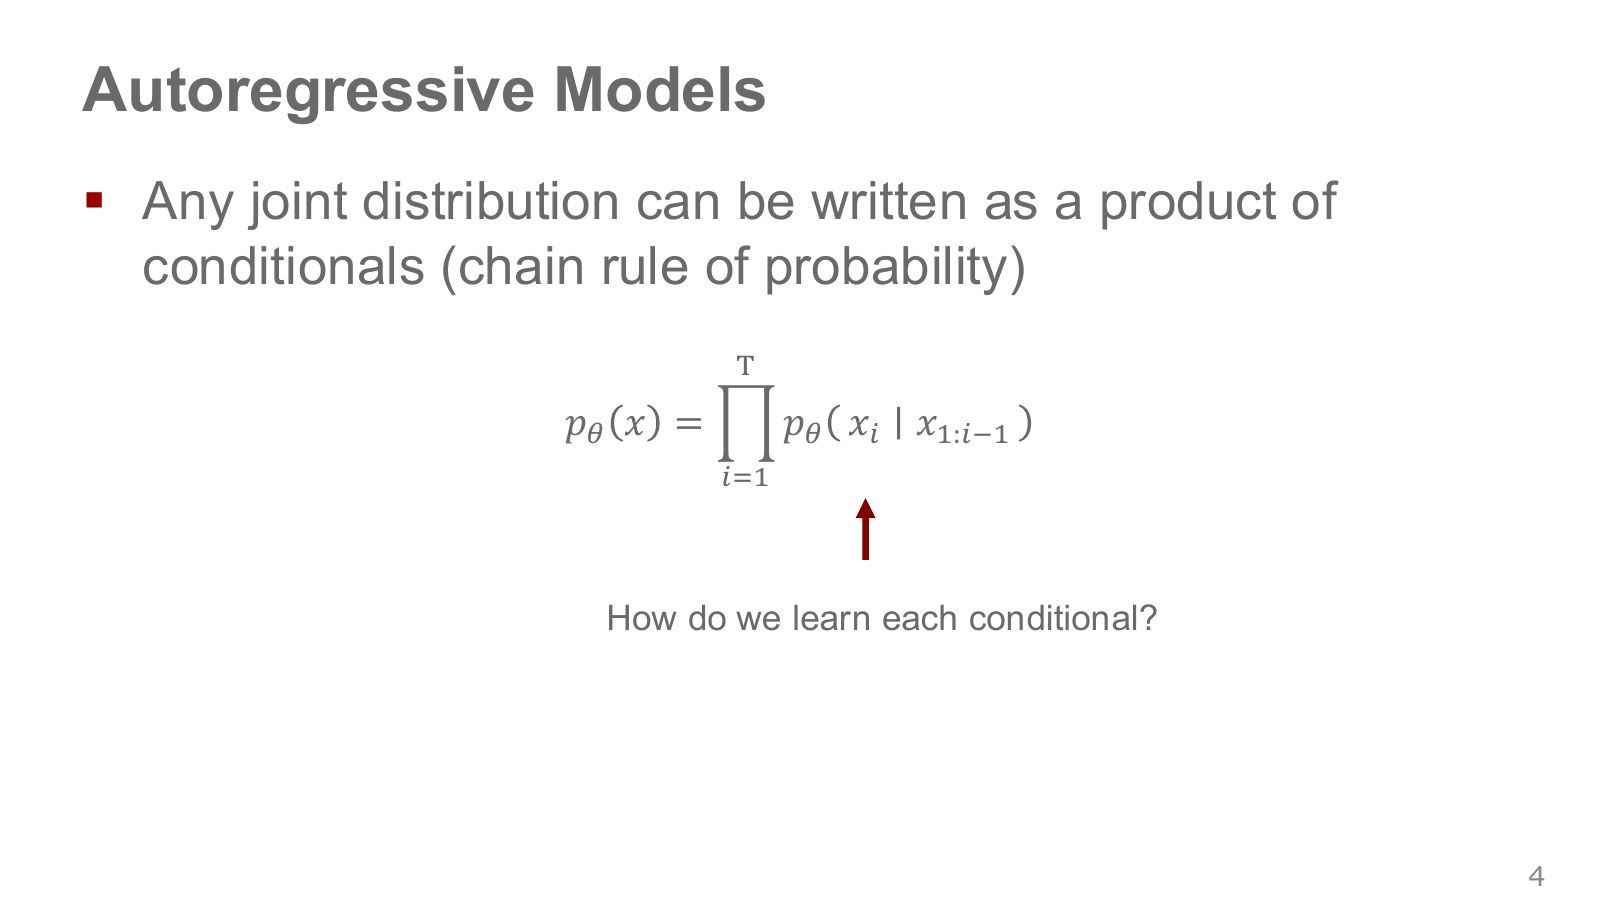
문장을 한 단어씩 이어 쓰는 과정을 떠올려 보자. 먼저 첫 토큰을 고르고, 그 결과를 보고 둘째를 고른다. 이후에도 지금까지의 토큰을 조건으로 다음 것을 고른다. 이렇게 앞의 결과를 다음 입력에 사용하는 생성 방식이 자기회귀(autoregressive)다.
이 분해 자체는 확률의 연쇄 법칙이며, 마르코프 가정을 요구하지 않는다. 무엇을 얼마나 오래 기억할지는 각 조건부 분포의 모델링 문제다. 표기가 앞 한 토큰만을 보는 것처럼 줄어들어 있더라도, 본문에서는 x의 전체 앞부분을 조건으로 둔다.
로봇에서는 관측·행동·언어 등을 시퀀스로 구성할 수 있다. 다만 환경의 다음 관측까지 모델이 생성할지, 주어진 관측에서 행동만 생성할지는 다르다. 시퀀스 모델을 사용한다고 반드시 미래 영상을 예측하는 월드 모델이 되는 것은 아니다.
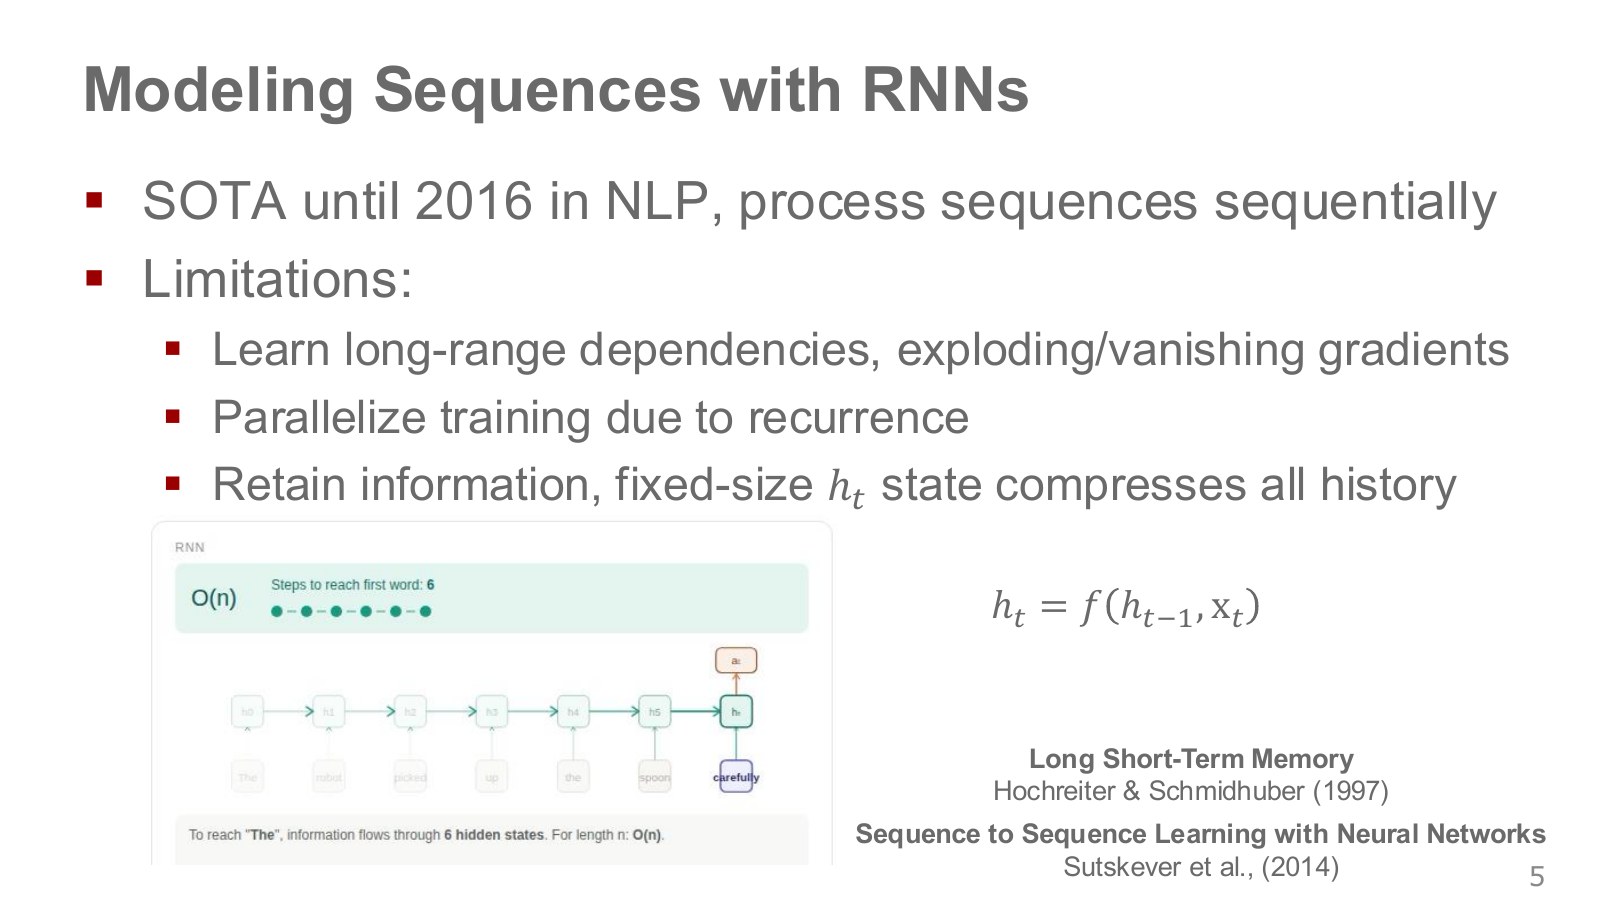
아래 가로줄의 작은 상자들은 같은 신경망을 시간순으로 펼친 모습이다. RNN, 즉 순환 신경망은 이전 기억과 새 입력으로 다음 기억을 만든다. 각 시점마다 서로 다른 모델을 새로 만드는 것이 아니라 가중치를 공유한다.
여기서 u는 신경망 내부의 요약 벡터다. 앞의 관측·행동 이력 h와 구별하려고 다른 기호를 썼다. 고정 크기 벡터를 갱신하므로 가변 길이 입력을 받을 수 있고, 실행 때 기억의 크기를 작게 유지할 수 있다.
반면 먼 과거의 정보가 현재 학습 오차에 영향을 주려면 여러 갱신을 통과해야 한다. 미분이 연속으로 곱해지면서 너무 작아지거나 커지는 기울기 소실·폭주가 생길 수 있다. LSTM은 정보의 유지와 삭제를 조절하는 게이트로 이 문제를 줄였다. 또한 다음 기억을 계산하려면 이전 기억이 먼저 필요하므로 시간축 학습의 병렬화에 제약이 있다. 이는 단순히 자기회귀라는 말과 같은 문제가 아니다. Transformer도 자기회귀 생성에 사용할 수 있기 때문이다.
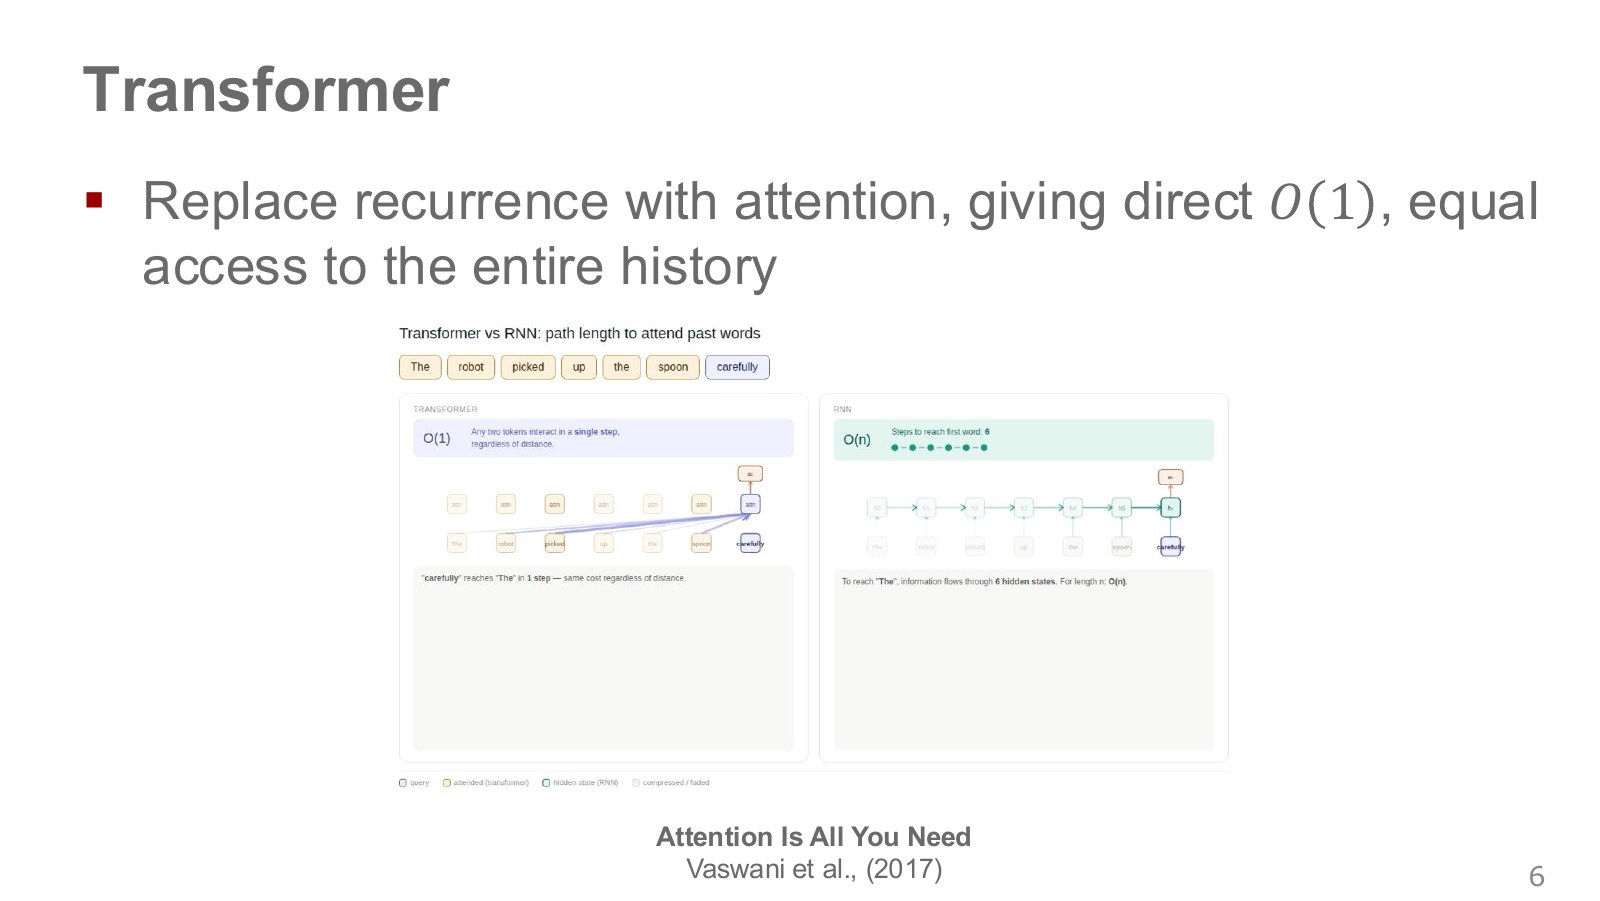
두 그림은 마지막 단어가 앞의 단어를 참조하는 경로를 비교한다. RNN에서는 중간 기억들을 순서대로 거치지만, self-attention은 현재 층에 들어온 토큰 표현들을 직접 비교할 수 있다. 멀리 떨어진 두 위치 사이의 연결 경로가 짧아진다는 것이 장점이다.
슬라이드의 O(1)은 두 위치 사이를 연결하는 경로 길이를 뜻한다. 문장 길이가 늘어나도 전체 attention 계산량이 일정하다는 뜻은 아니다. 표준 dense attention은 모든 위치 쌍을 비교하므로 토큰 수의 제곱에 비례하는 계산이 필요하다.
또한 직접 연결이 있다고 긴 문맥을 항상 정확히 이해하거나 모든 과거를 무한히 기억하는 것은 아니다. 문맥 창, 모델 용량, 위치 정보, 학습 자료가 제한한다. Transformer는 모든 장거리 의존 문제를 자동으로 해결한 마법 상자라기보다, 그 관계를 학습하기 좋은 연결 구조다.
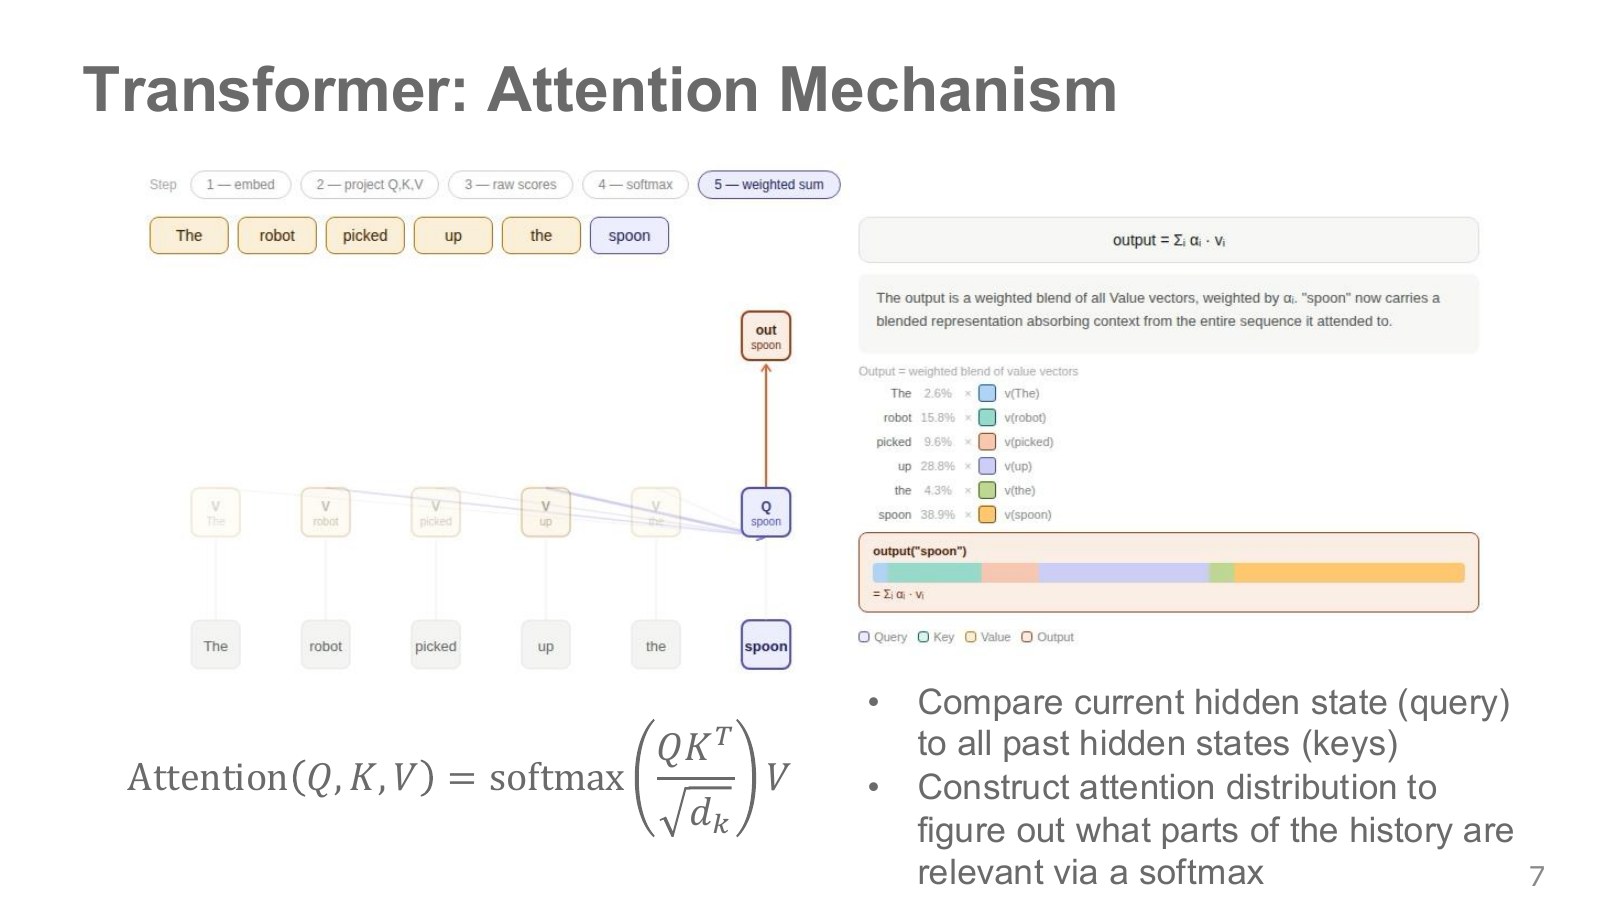
문장의 마지막 spoon 토큰이 나머지 단어를 참고해 새 표현을 만드는 그림이다. 각 토큰은 세 가지 벡터를 만든다. Query는 지금 찾는 정보, Key는 자신이 어떤 정보를 갖고 있는지 나타내는 비교용 표현, Value는 실제로 전달할 내용이다. 검색어와 검색 대상의 표지를 비교한 뒤 내용물을 모으는 과정으로 생각할 수 있다.
X의 행 하나가 토큰 하나다. 학습되는 세 가중치 행렬이 같은 입력에서 서로 다른 역할의 벡터를 만든다. Q와 K의 내적은 비교 점수이고, 차원에 따른 점수 크기를 완화하기 위해 Key 차원의 제곱근으로 나눈다. Softmax는 각 Query 행에서 점수를 0 이상이며 합이 1인 가중치로 바꾼다. 마지막 곱은 Value의 가중합이다. 그림 오른쪽의 색 띠는 각 Value가 얼마나 섞였는지 나타낸다.
M은 허용하지 않는 연결을 막는 마스크이며, 제한이 없으면 0이다. 예를 들어 두 Key에 대한 점수가 0과 1이면 softmax 가중치는 약 0.269와 0.731이다. 그렇다고 두 번째 단어가 현실에서 중요할 확률이 73.1%라는 의미는 아니다. 모델 내부의 정보 혼합 가중치이며, 그대로 인과적 설명이나 물체 검출 확률이 되지는 않는다.
Stanford CS25 23:38–28:12는 이 과정을 노드 사이의 정보 전달로 설명한다. NTU self-attention 24:57–30:03에서는 비교 점수 계산과 Value 가중합을 분리해 따라갈 수 있다. 여러 head는 서로 다른 가중치로 이 참조를 병렬 수행하고, 층을 쌓는 것은 그 결과를 다시 처리하는 순차적 깊이다.
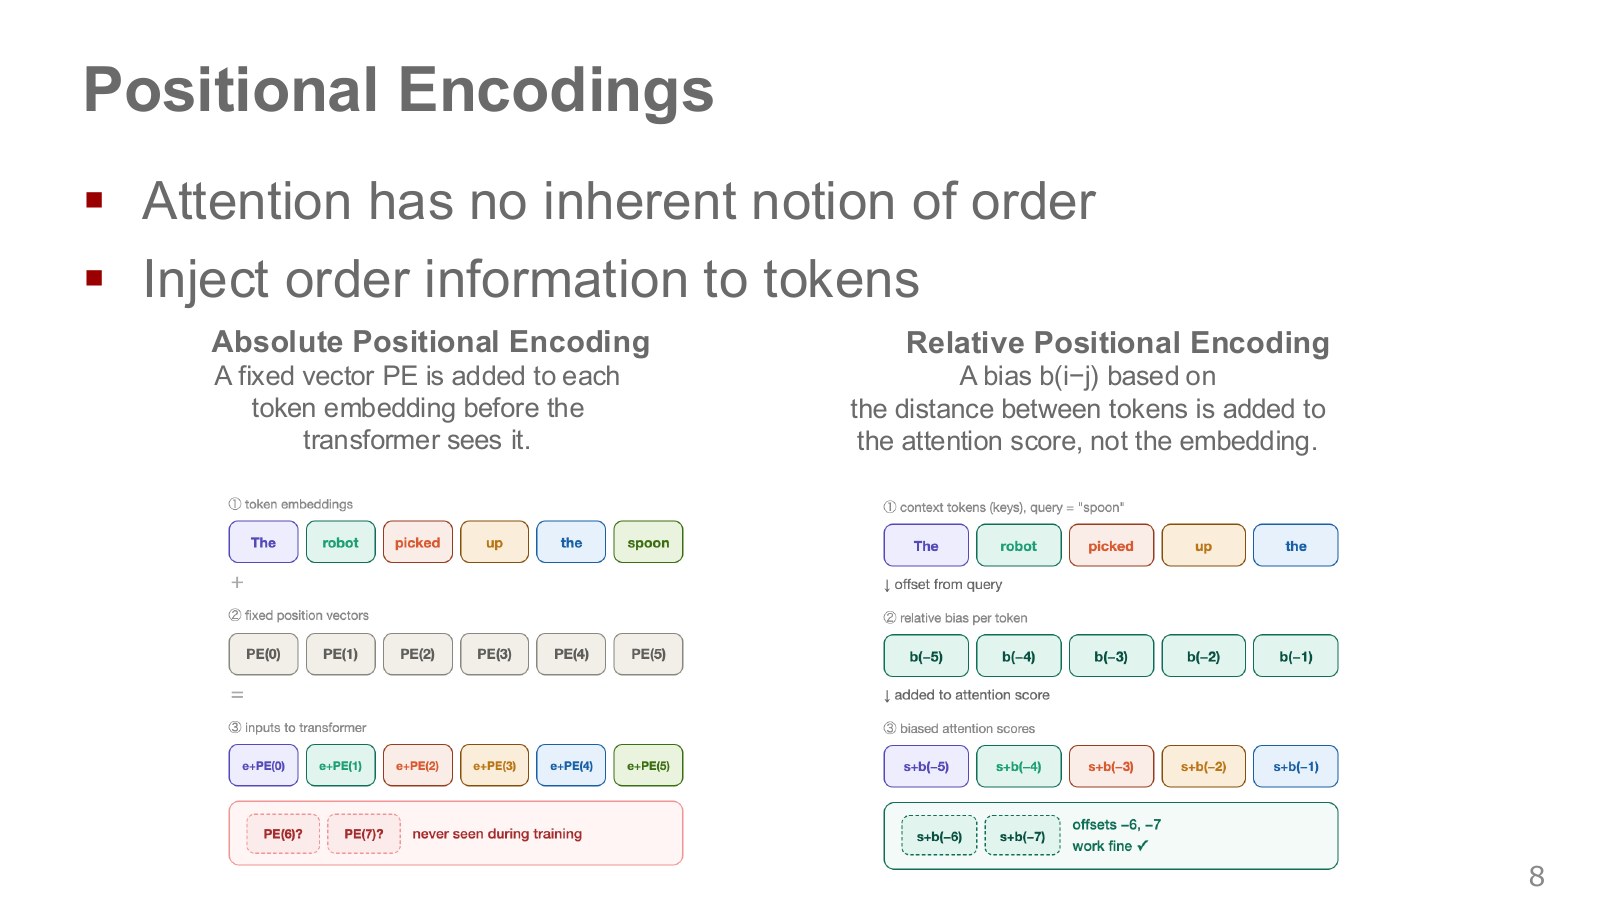
같은 단어들을 넣더라도 “로봇이 숟가락을 집었다”와 “숟가락이 로봇을 집었다”는 다른 문장이다. 위치 신호와 순서에 따른 마스크가 없는 기본 self-attention은 입력을 재배열하면 출력도 같은 방식으로 재배열되는 성질이 있다. 내용만 비교해서는 누가 먼저이고 뒤인지 충분히 구분하지 못한다.
왼쪽 절대 위치 표현은 각 위치의 벡터를 토큰 임베딩에 더한다. 오른쪽 상대 위치 표현은 Query와 Key가 몇 칸 떨어졌는지를 비교 점수에 반영한다. 거리가 네 칸이라는 관계는 문장 전체가 뒤로 이동해도 유지된다.
절대 위치에도 고정 사인·코사인과 학습된 표 등 여러 방식이 있다. 상대 위치 역시 한 가지 식만 있는 것은 아니다. 학습 때보다 긴 입력을 처리하는 데 도움이 될 수 있지만, 상대 위치를 썼다고 임의의 길이로 완벽하게 일반화하는 것은 아니다. 보지 못한 거리, 학습 길이, attention 분포 변화의 영향이 남는다. 그림 아래의 긴 길이 체크는 이 설계의 의도를 보여 주는 것으로 읽자.
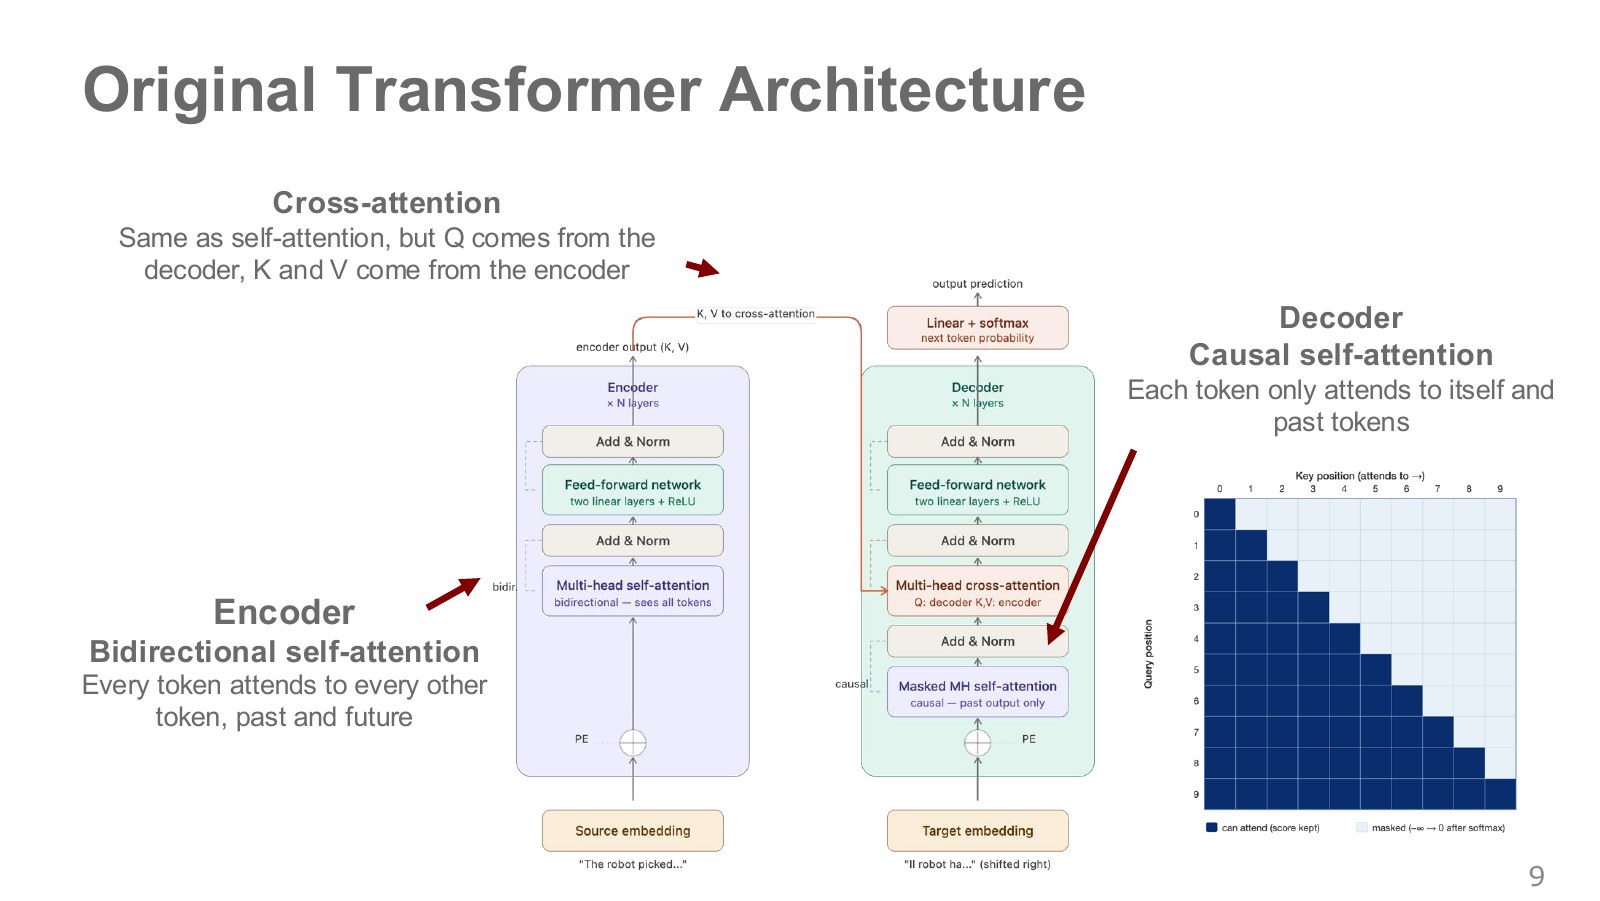
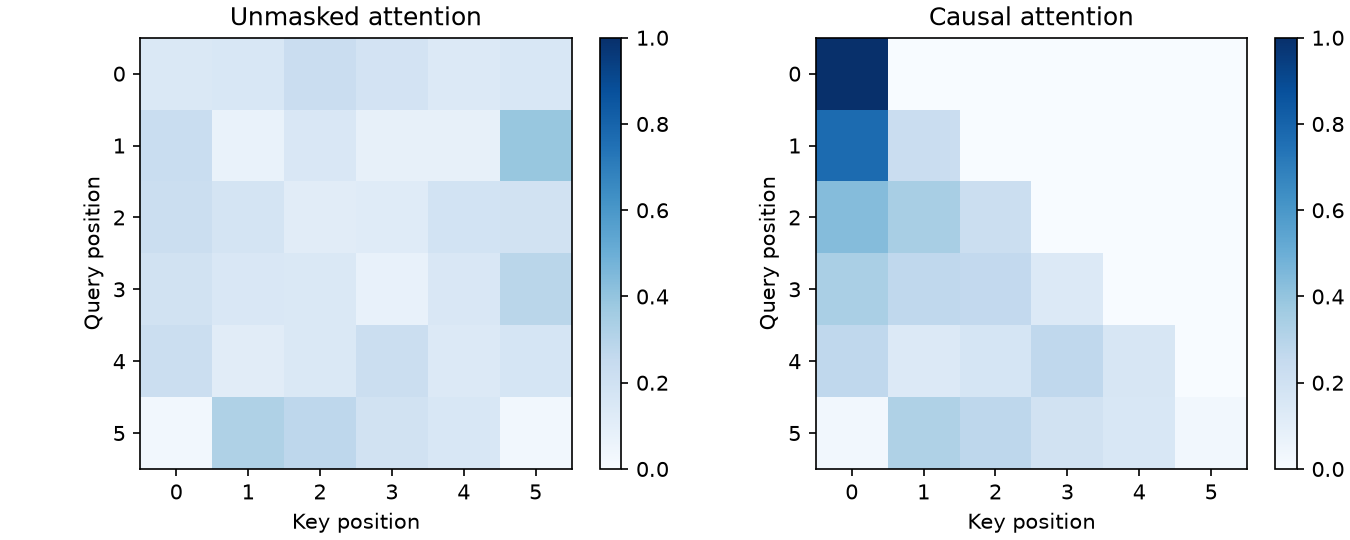
가운데 두 기둥은 번역을 위한 원래 Transformer의 인코더와 디코더다. 인코더는 이미 주어진 원문 전체를 읽으므로 각 토큰이 앞뒤 원문을 모두 참조해도 된다. 디코더는 번역문을 생성하므로 아직 만들지 않은 뒷부분을 미리 볼 수 없다. 오른쪽 아래 삼각형은 그 허용 범위를 나타낸다. 행은 질문하는 위치, 열은 참조할 위치이며 대각선과 왼쪽 아래만 열려 있다.
Causal mask는 미래 위치의 점수에 음의 무한대를 더해 softmax 후 가중치를 0으로 만든다. 이 causal은 생성 순서를 지킨다는 의미이며, 신경망이 자동으로 원인과 결과를 구별한다는 의미는 아니다. 자료 길이를 맞추기 위해 넣은 빈 토큰을 가리는 padding mask와도 목적이 다르다.
Cross-attention에서는 Query가 디코더에서, Key와 Value가 인코더 출력에서 온다. “지금까지 만든 번역에 다음 말을 잇기 위해 원문의 어디를 참고할까?”를 계산한다. Self-attention은 세 벡터가 같은 시퀀스에서 나온다는 점이 다르다.
블록 안의 feed-forward network는 각 위치의 특징을 비선형으로 바꾸고, Add는 이전 표현을 더해 정보와 미분의 경로를 유지한다. Norm은 특징의 크기를 조절하는 정규화다. 여러 head가 모은 정보를 이 처리와 함께 반복한다. Transformer 전체가 Value를 한 번 평균내는 연산 하나로 끝나는 것은 아니다.
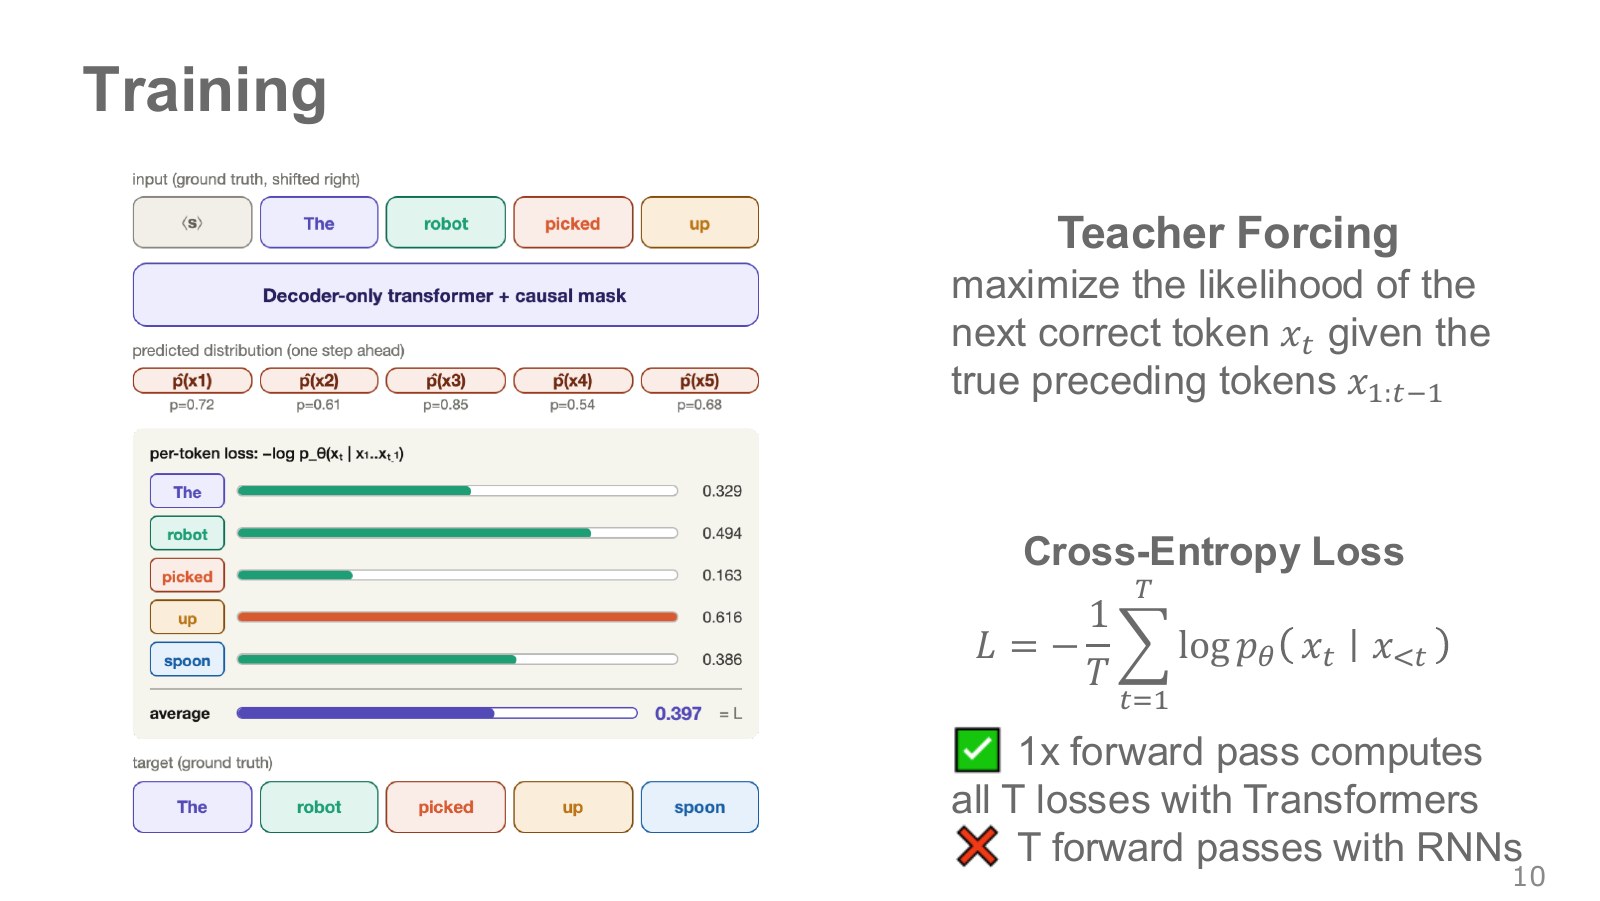
윗줄 입력은 정답 문장을 한 칸 오른쪽으로 민 것이다. 시작 토큰 다음에 The를 넣고 robot을 예측하는 식으로, 각 위치는 자기 앞에 있는 정답 토큰을 받는다. 이를 teacher forcing이라고 한다. 모델이 틀린 단어를 냈다고 그 단어를 즉시 다음 학습 입력으로 쓰는 방식과 구별된다.
각 위치에서 정답에 준 확률이 클수록 손실이 작다. 가령 정답 확률이 0.8이면 손실은 약 0.223, 0.01이면 약 4.605다. 이산 정답 하나에 대한 cross-entropy와 같은 계산이다. 로봇 행동 토큰만 학습 목표로 쓰는 모델에서는 관측·지시 부분의 손실을 제외하는 마스크를 둘 수 있다.
정답 문장이 이미 있으므로 causal mask를 적용한 Transformer는 한 번의 batched forward 계산에서 여러 위치의 손실을 구한다. 그러나 실제 생성에서는 다음 토큰이 이전 생성 결과에 의존해 순차적으로 진행한다. “학습이 병렬”과 “생성이 한 번에 끝남”을 혼동하지 말자. 실행에서는 모델 자신의 실수가 뒤쪽 입력으로 들어가므로 학습 조건과 달라지는 문제도 남는다.
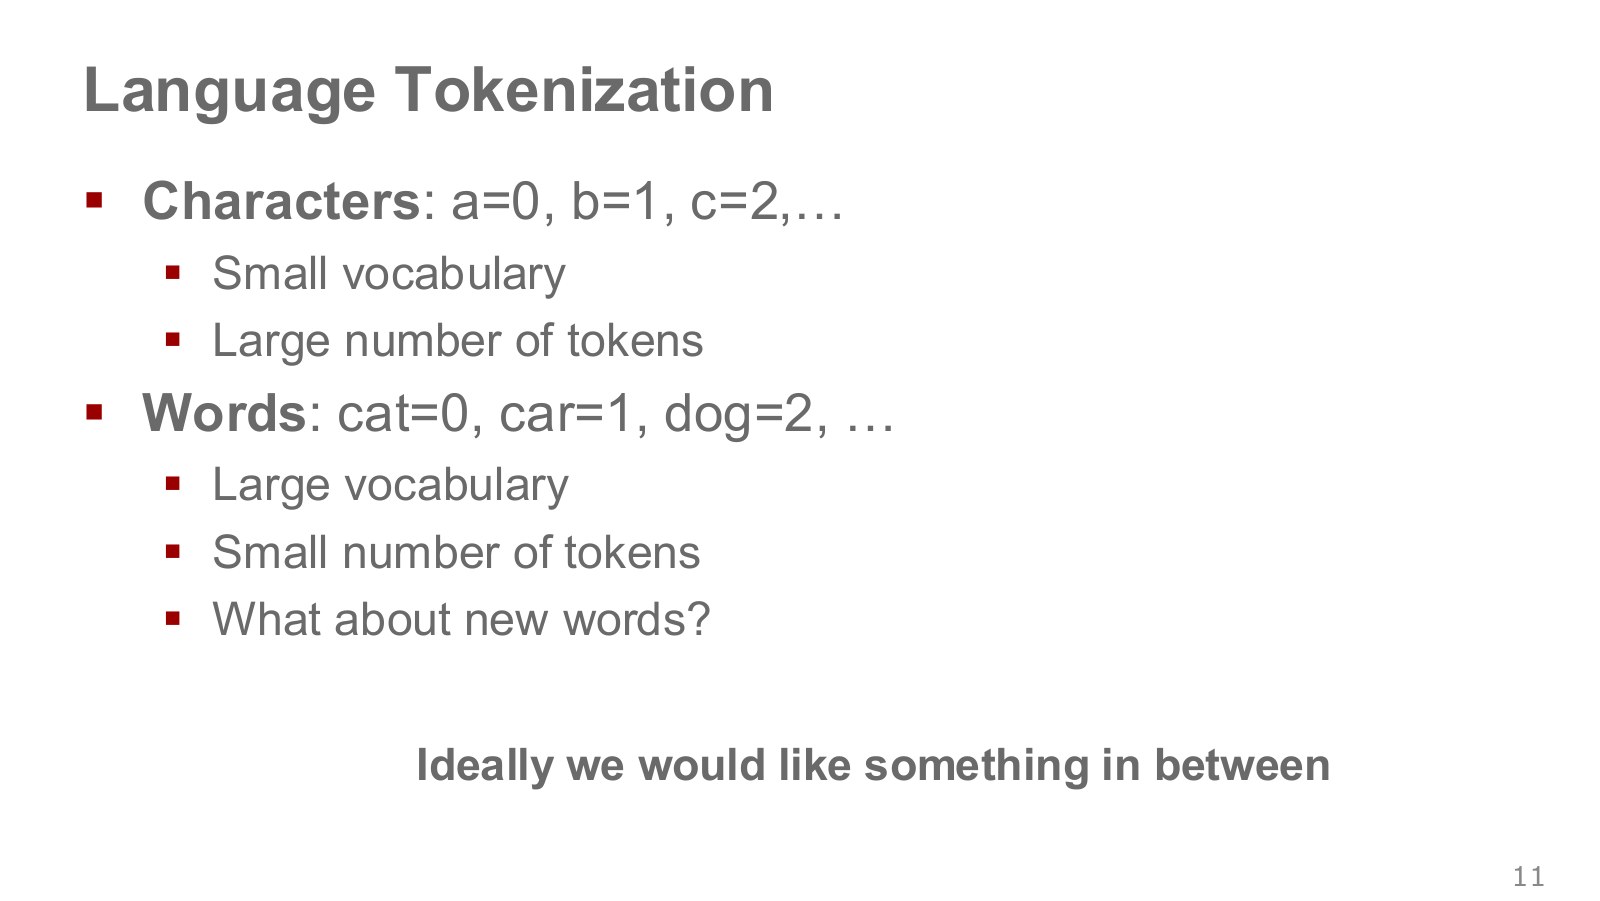
문자마다 번호를 주면 사전은 작지만 긴 문장이 매우 많은 토큰이 된다. 단어마다 번호를 주면 시퀀스는 짧아지지만 사전이 커지고 새 단어를 처리하기 어렵다. 예를 들어 robot, robots, robotic을 모두 별개 단어로 등록할 수도 있고, 공통 부분 robot과 끝부분을 나눌 수도 있다.
사전(vocabulary)은 사용할 수 있는 토큰 목록이다. 토큰 번호 자체의 숫자 크기에는 보통 단어 의미의 순서가 없다. 번호로 임베딩 표의 행을 찾아 벡터를 얻고, 학습 과정에서 그 벡터가 유용한 표현으로 조정된다.
토큰화를 고르는 일은 의미만의 문제가 아니다. 시퀀스가 길어지면 attention의 비교 수와 생성해야 할 횟수가 늘어난다. 같은 정보를 얼마나 짧고 안정적으로 표현할지라는 문제는 뒤에서 로봇 행동 압축으로 다시 등장한다.
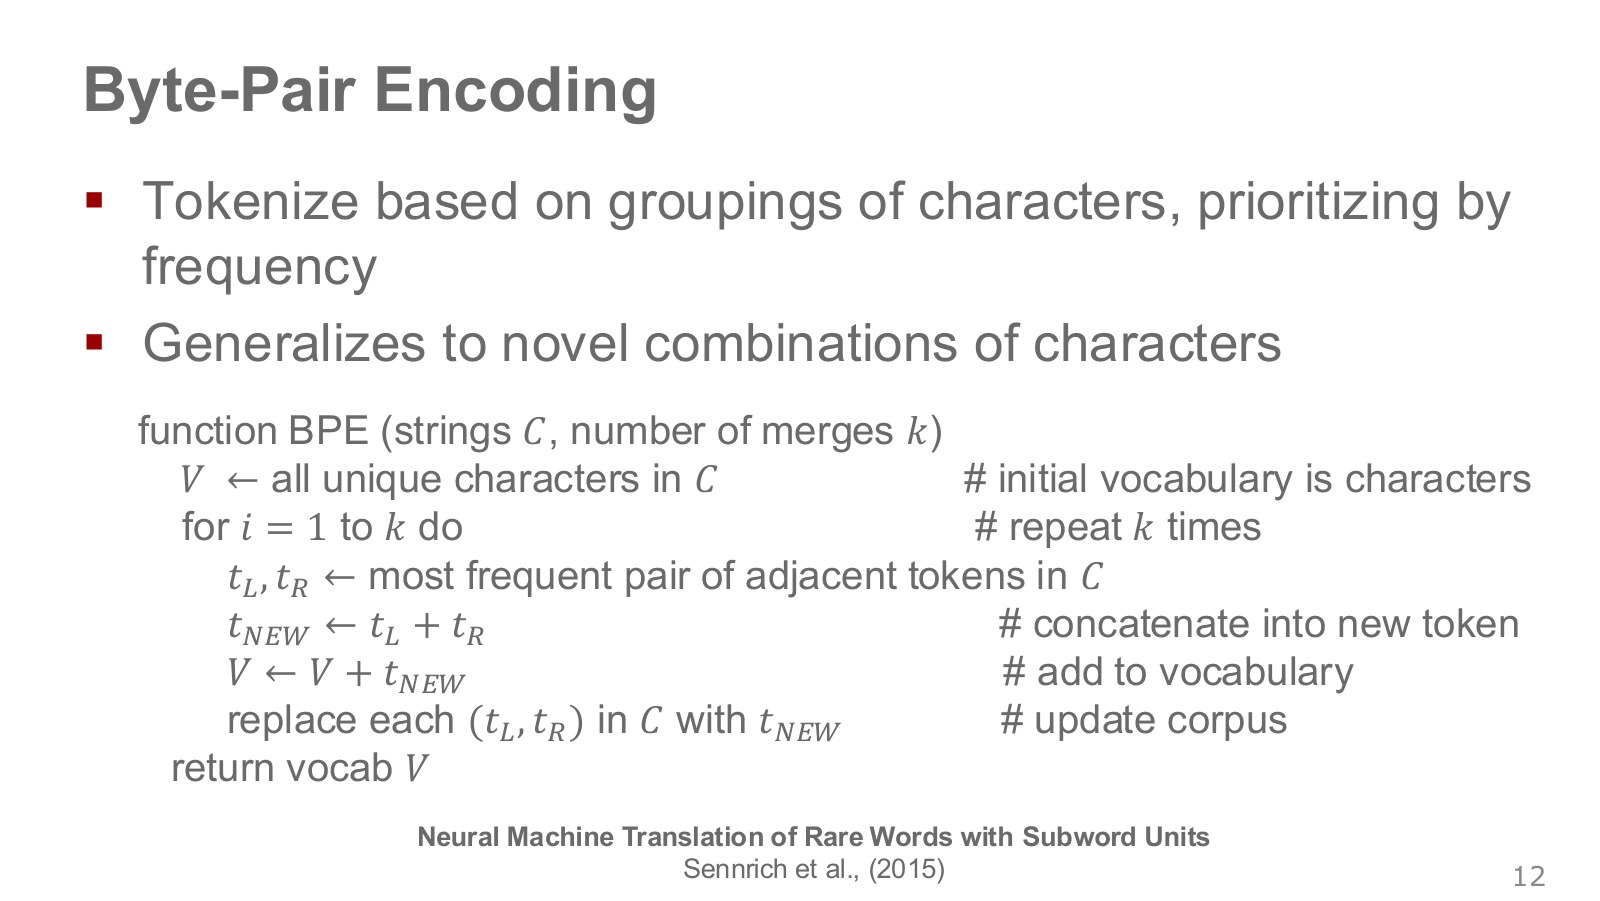
처음에는 문자 같은 작은 기호로 자료를 나눈다. 전체 학습 말뭉치에서 가장 자주 연속으로 나타나는 두 토큰을 찾고, 그 쌍을 새 토큰 하나로 합친다. 이 과정을 반복해 목표 사전 크기를 만든다. 합치는 규칙은 학습 때 만들고, 새 문장을 인코딩할 때 같은 규칙을 적용한다.
예를 들어 r과 o가 자주 붙으면 ro를, 그다음 ro와 b가 자주 붙으면 rob을 새 토큰으로 만들 수 있다. 중요한 것은 각각의 합침이 기호의 조합을 보존한다는 점이다. 원래 기호로 다시 풀 수 있으므로 토큰 수가 줄어드는 것이 곧 문장 정보의 손실을 뜻하지는 않는다.
원래 subword BPE 논문은 드문 단어를 알려진 하위 단위로 표현하는 접근을 설명한다. 기본 문자 집합에 없는 기호까지 항상 처리한다는 주장은 별개다. 뒤의 byte-level 표현은 그 바닥 기호 집합을 더 촘촘히 마련하는 방법이다.
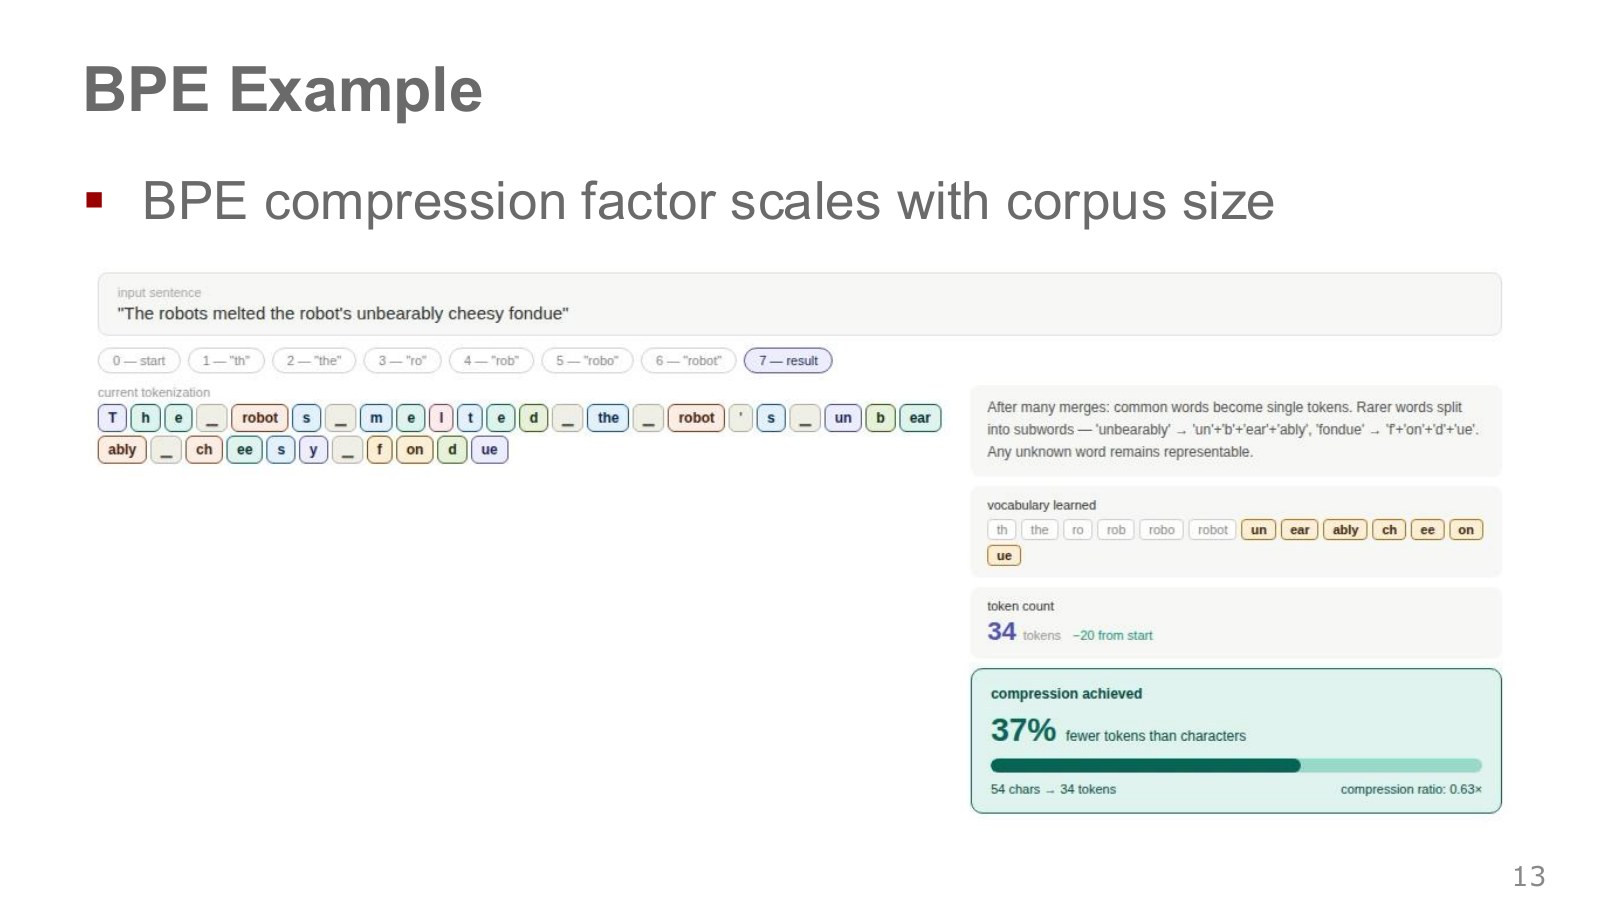
예시 문장은 합침이 진행되며 자주 나오는 부분이 큰 단위로 묶인다. 그림의 54개 문자에서 34개 토큰으로 줄었다는 숫자는 이 예시의 토큰 개수 비교다. 실제 디스크 파일이 정확히 37% 작아진다는 뜻은 아니다. 토큰 번호를 저장하는 비트 수와 사전의 크기도 있기 때문이다.
더 큰 말뭉치는 빈번한 패턴을 더 잘 추정하는 데 도움이 된다. 그러나 말뭉치를 늘리면 어떤 입력에서든 압축률이 반드시 좋아진다고 보장되지는 않는다. 언어, 띄어쓰기, 기호, 사전 크기, 학습 분포가 영향을 준다. 한국어 문장과 영어 코드의 토큰 수가 다른 이유도 이 선택과 관련된다.
우리가 직접 실행한 작은 문자 BPE도 반복 문자열을 더 적은 토큰으로 바꾸고 원문으로 복원한다. 상용 언어 모델의 실제 토크나이저를 재현한 것은 아니다. 이번 예제에서는 원리를 확인하는 데 필요한 합침 규칙만 구현했다.
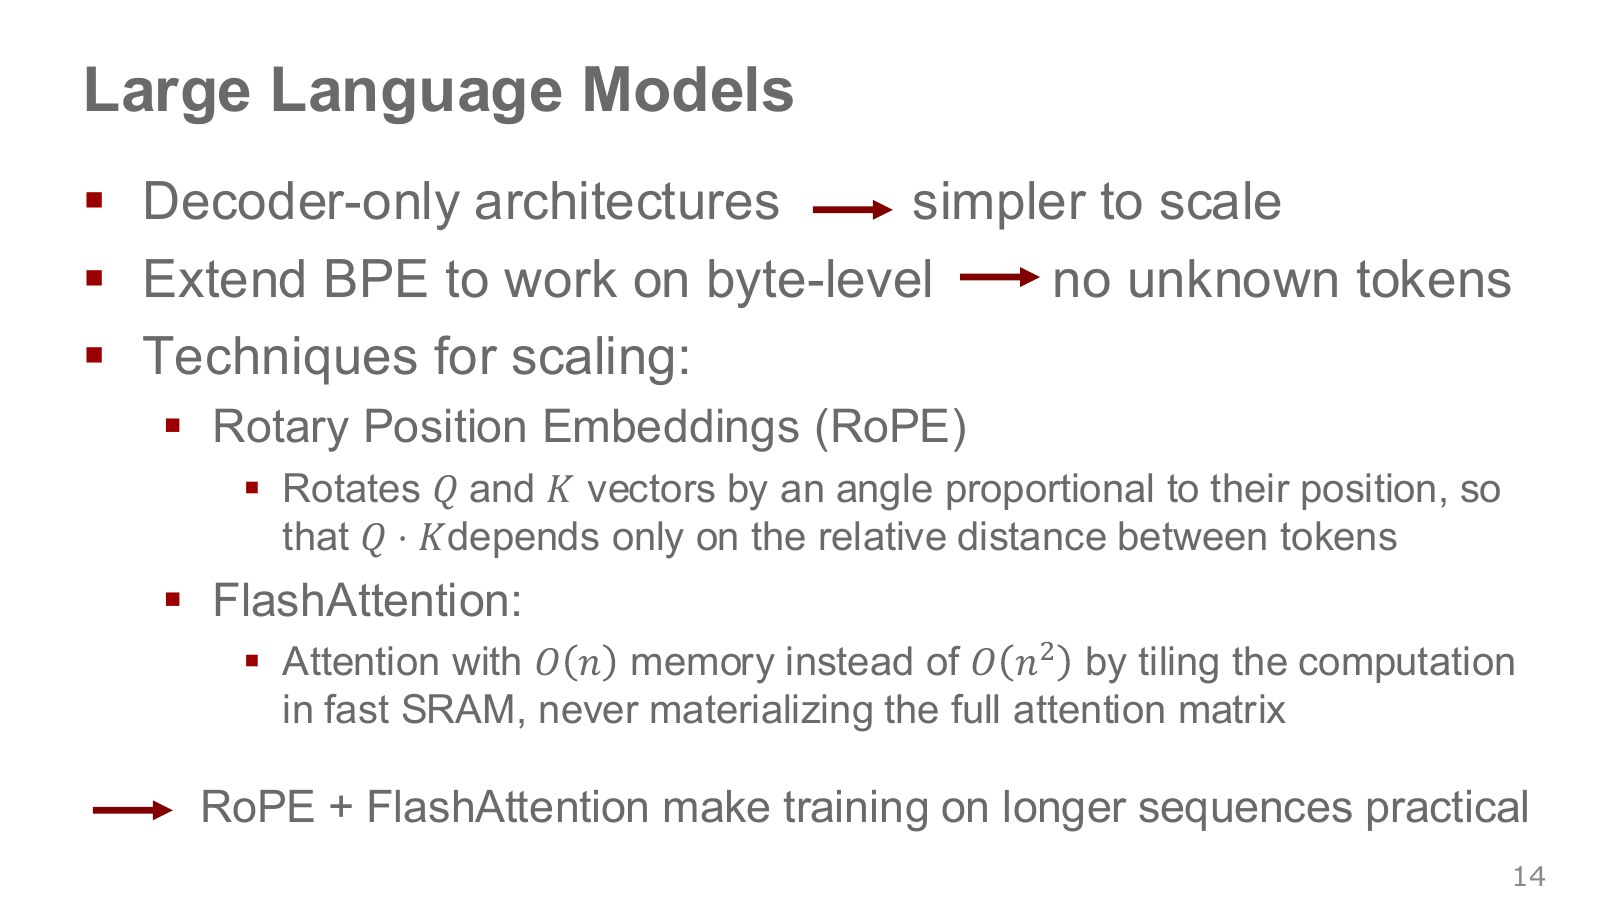
첫째, decoder-only 모델은 원래 번역 구조의 독립 인코더를 두지 않고 입력 문맥과 출력 시퀀스를 하나의 생성 모델로 다룬다. GPT 계열의 중요한 설계지만 모든 언어 모델이 이 구조를 쓰는 것은 아니다. 둘째, byte-level 토큰화는 원시 바이트를 기본 기호로 사용해 새로운 문자도 그 바이트열로 표현할 수 있게 한다. 표현할 수 있다는 것과 의미를 이해한다는 것은 다르다.
셋째, RoPE는 Query와 Key 벡터의 일부 좌표쌍을 위치에 따른 각도로 회전시킨다. 두 벡터의 내적에 들어가는 위치 효과가 상대적 위치 차이로 표현되도록 한다. 내용 벡터 자체도 여전히 내적에 영향을 주므로, 점수 전체가 거리 하나로만 정해진다는 뜻은 아니다. 긴 길이 일반화에도 별도 문제가 남는다. RoPE 논문.
넷째, FlashAttention은 전체 토큰 쌍의 가중치 행렬을 큰 메모리에 한꺼번에 저장하지 않도록 계산을 작은 블록으로 나누고 메모리 이동을 줄인다. 필요한 attention을 정확하게 계산하는 방식이며, 비교 대상을 임의로 생략하는 sparse attention과 다르다. 고정된 head 차원에서 attention 계산의 저장 메모리를 선형 수준으로 줄여도 dense attention의 전체 연산량이 선형으로 바뀌는 것은 아니다. FlashAttention 논문.
긴 문맥을 지원한다는 말은 이런 설계와 학습 조건이 함께 만든 결과다. RoPE와 FlashAttention을 넣는 것만으로 모델의 기억 정확도나 실시간 제어 지연이 자동으로 보장되지는 않는다.
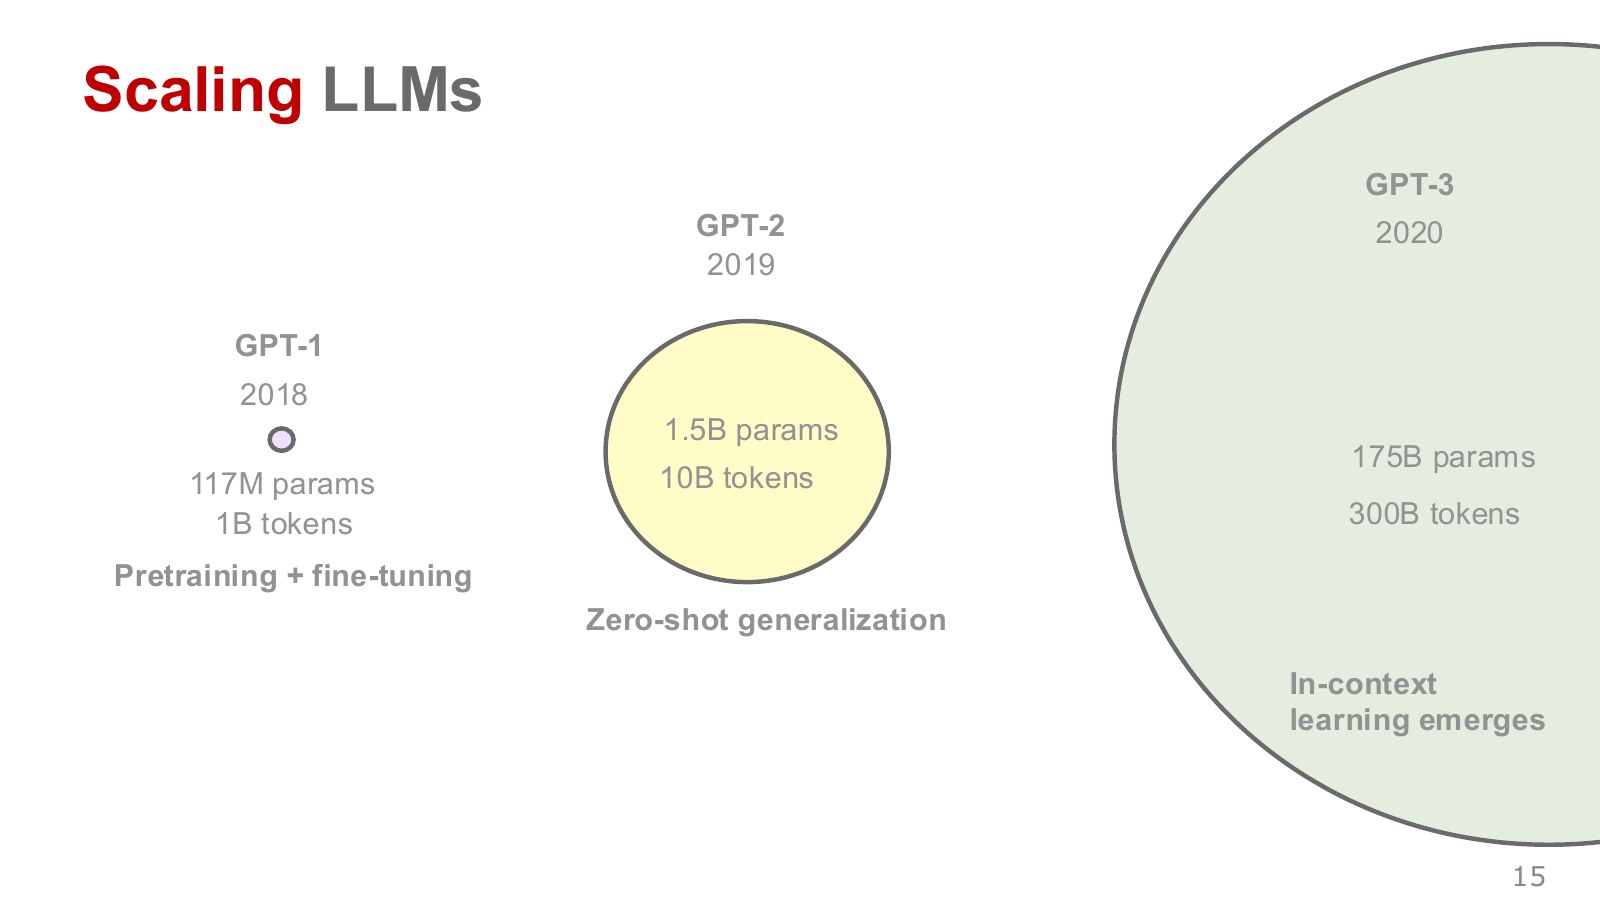
작은 원에서 큰 원으로 이어지는 그림은 GPT 계열의 역사적 규모 비교다. 파라미터는 신경망이 학습으로 조절하는 가중치이고, 학습 토큰 수는 모델이 훈련 중 본 자료의 양이다. 파라미터가 많다고 학습 자료도 자동으로 많아지는 것은 아니다.
사전학습은 넓은 자료로 일반적인 표현과 예측 능력을 배우는 단계다. 미세조정은 이후 특정 자료나 목적에 맞춰 가중치를 갱신하는 단계다. 문맥 내 학습(in-context learning)은 프롬프트에 예시를 넣어 그 패턴에 맞게 답하게 하는 것으로, 그 실행 중에 일반적인 의미의 가중치 업데이트를 하지 않는다.
Zero-shot은 요청에 별도 시범 예시를 넣지 않는 설정, few-shot은 몇 개 예시를 넣는 설정이다. 둘 다 사전학습 자료가 전혀 없다는 뜻은 아니다. 큰 모델이 예시를 잘 활용한다는 실험과, 모든 작업에서 규모만 늘리면 충분하다는 주장은 구별해야 한다.
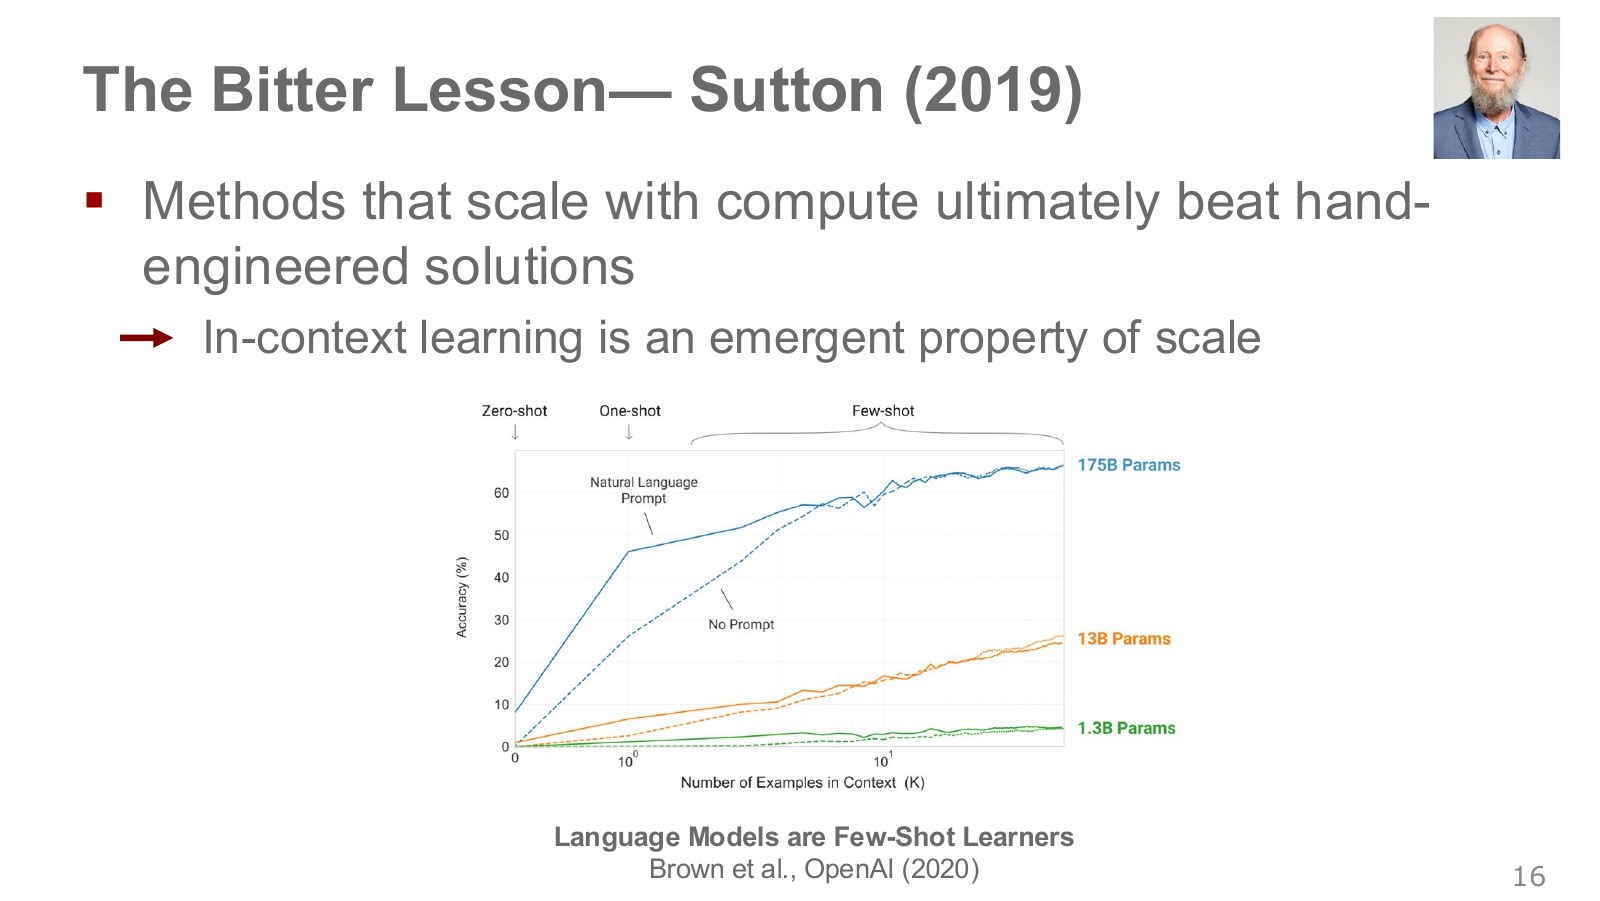
왼쪽 인물은 강화학습 연구자 Richard Sutton이다. The Bitter Lesson은 여러 분야의 역사에서 계산량을 활용하는 일반적 방법이 장기적으로 강한 성과를 보였다는 논지다. 사람이 구조를 전혀 설계하지 말아야 한다는 명령이라기보다, 현재의 수작업 지식만으로 확장 가능성을 제한하지 말자는 주장으로 읽을 수 있다.
그래프의 가로축은 문맥에 넣은 예시 수, 세로축은 해당 실험의 정확도다. 곡선의 색은 모델 크기를 구별하고, 큰 모델이 이 설정에서 예시를 더 잘 활용하는 모습을 보여 준다. 인용된 언어 실험의 정확도 축을 로봇의 실제 성공률로 읽어서는 안 된다.
로봇으로 옮기면 질문은 구체적이다. 어떤 센서와 행동 자료를 얼마나 모을 것인가, 여러 로봇의 단위를 어떻게 맞출 것인가, 늘어난 계산이 실제 제어 주기 안에 들어오는가? 규모는 이런 설계를 대체하는 단어가 아니라 그 설계가 확장될 수 있는지 묻는 기준이다.
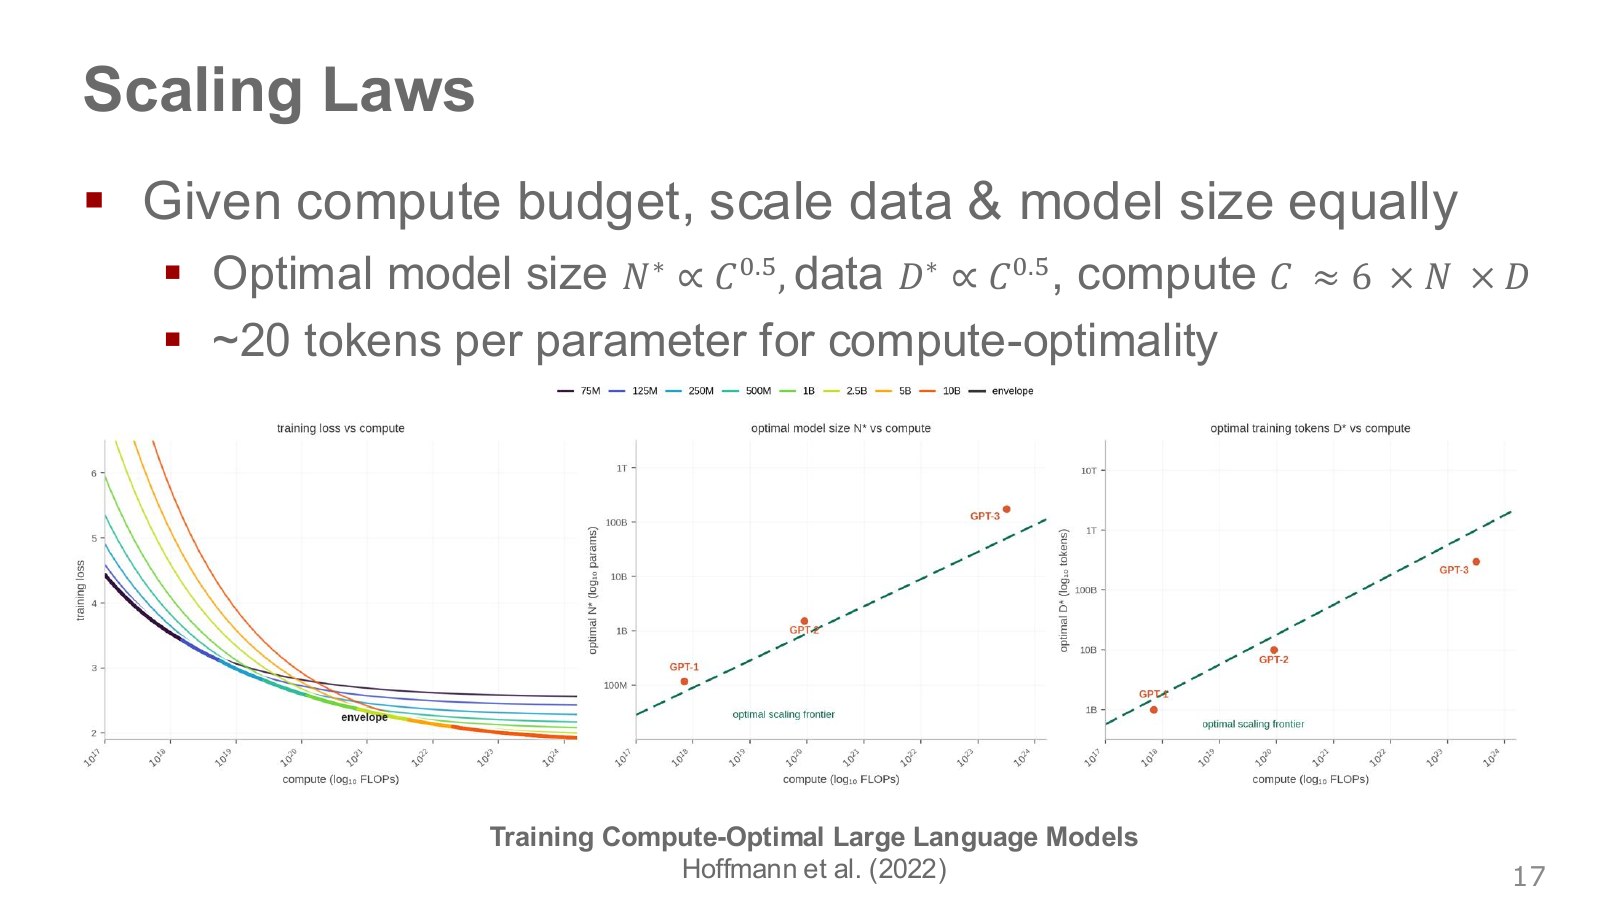
왼쪽 여러 곡선은 모델 크기마다 계산량을 더 쓸 때 손실이 어떻게 내려가는지 보여 준다. 같은 계산 예산에서 가장 큰 모델이 항상 가장 낮은 손실을 주는 것은 아니다. 너무 큰 모델은 충분히 학습하지 못할 수 있고, 너무 작은 모델은 자료를 더 보아도 표현력의 한계에 먼저 도달할 수 있다. 곡선들의 아래쪽 경계가 예산마다 유리한 선택을 연결한 선이다.
N은 파라미터 수, D는 학습 토큰 수, C는 학습 계산량이다. 오른쪽 두 그래프는 예산이 커질 때 유리한 모델 크기와 자료 양도 함께 늘어남을 보여 준다. 대략 이 관계를 따르면 계산량을 4배로 늘릴 때 모델과 자료를 각각 2배로 늘리는 식이다.
파라미터당 약 20토큰이라는 수치는 Chinchilla 논문의 설정에서 나온 학습 계산 효율의 경험적 지침이다. 모든 언어·모델·목표에 적용되는 법칙이나 로봇 시연 개수의 공식은 아니다. Dense 모델의 이 근사에는 attention 부가 비용, 실행 비용, 자료 품질 등의 조건도 함께 고려해야 한다.
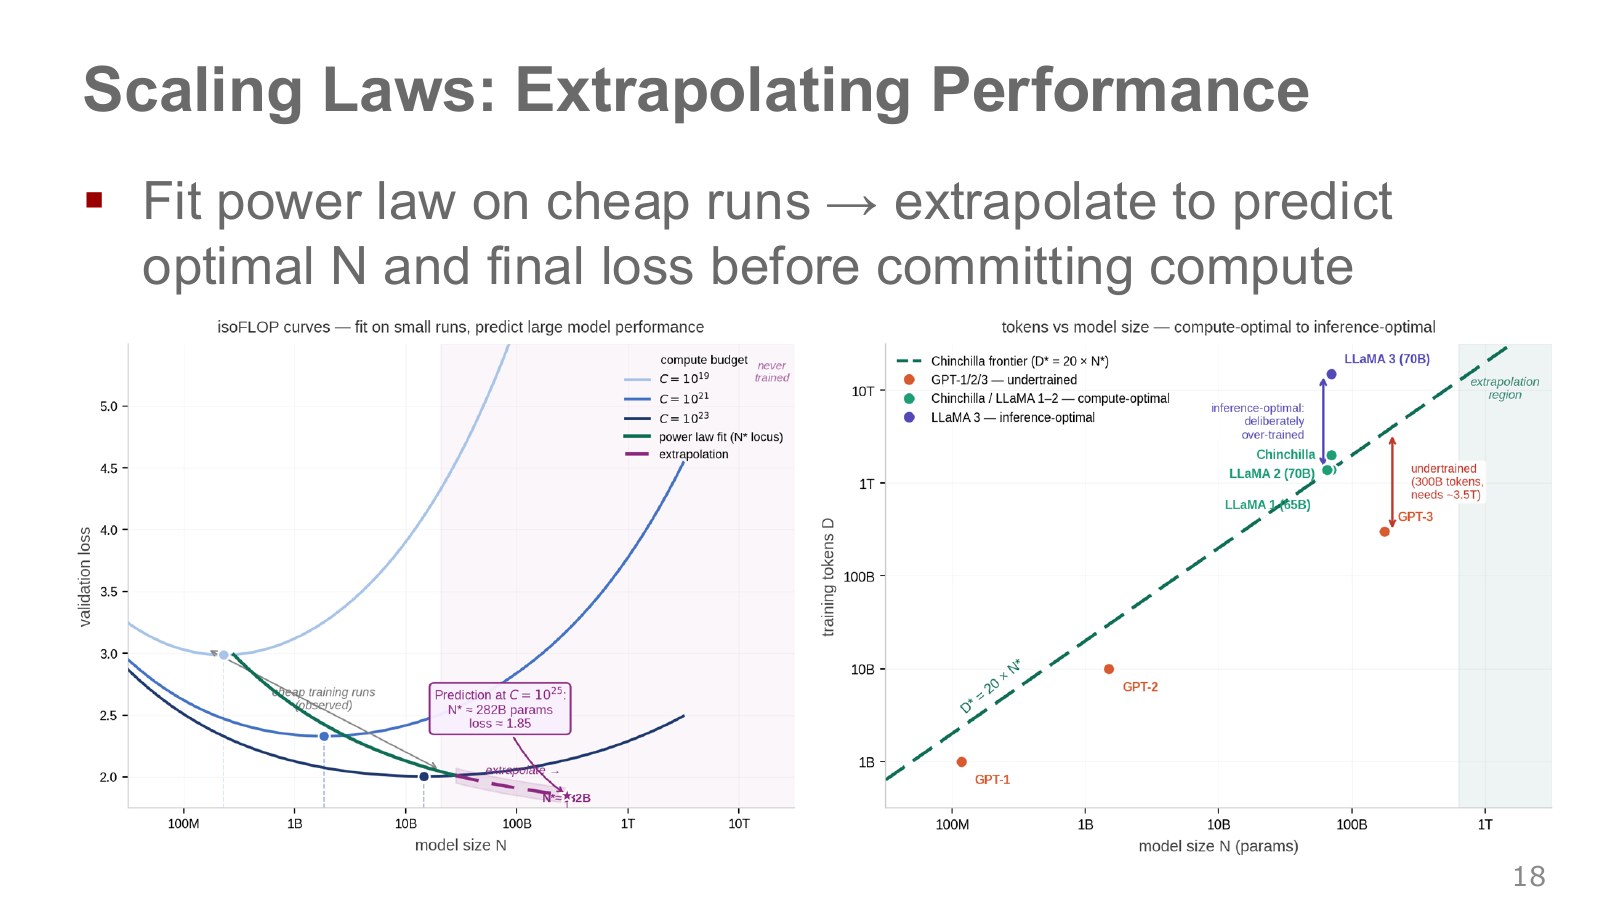
왼쪽 isoflop 곡선은 같은 계산 예산에서 모델 크기를 바꿔 본 결과다. 가장 낮은 손실의 위치를 여러 예산에서 추정하면 더 큰 학습의 유리한 크기를 예상할 수 있다. 외삽(extrapolation)은 관측한 범위 밖을 예측하는 것이므로, 관계가 그대로 이어진다는 가정과 오차가 함께 따른다.
오른쪽은 모델 크기와 학습 토큰 수를 비교한다. 학습 계산만 최소화하는 선택과, 배포 뒤 수많은 질의에 응답하는 전체 비용을 줄이는 선택은 다를 수 있다. 작은 모델을 자료로 더 오래 학습하면 초기 학습 비용은 늘어도 반복 실행이 저렴해질 수 있다.
이 때문에 “20토큰보다 더 학습했으니 잘못된 선택”이라고 단정할 수 없다. 특히 로봇에서는 지연, 전력, 장치 메모리와 실패 비용까지 중요하다. 언어 예측 손실을 잘 외삽했다고 물리 작업의 성공률과 안전 제약까지 같은 정확도로 예측한 것도 아니다.
로봇은 지시를 읽는 것뿐 아니라 컵과 손의 위치를 보아야 한다. 지금까지의 임베딩은 단어를 숫자 벡터로 바꾸었다. 다음 단계는 이미지에서도 여러 위치의 정보를 벡터 단위로 만드는 것이다.
입출력 인터페이스를 공통된 벡터 시퀀스로 맞추면 같은 attention 연산을 쓸 수 있다. 그러나 인터페이스가 같다는 것만으로 언어와 이미지가 같은 의미 공간에 놓이는 것은 아니다. 먼저 이미지를 토큰으로 만드는 방법을 보고, 이어서 두 종류 자료의 의미를 연결하는 학습을 살펴본다.
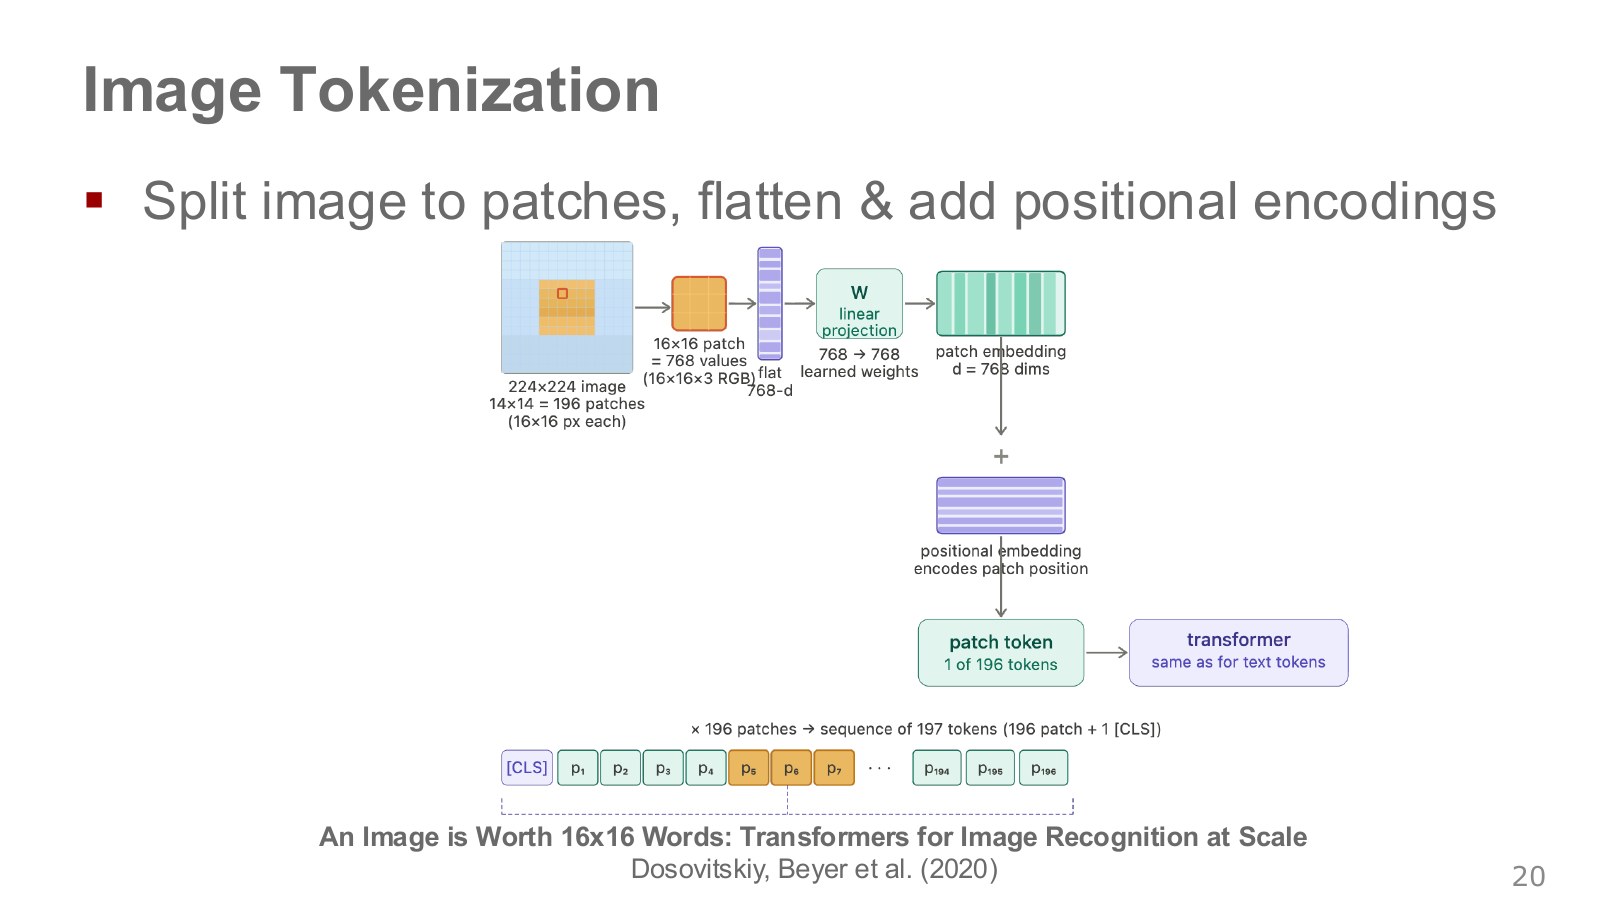
224×224 이미지를 한 변 16픽셀인 패치로 나누면 가로 14개, 세로 14개로 총 196개가 된다. 여기서 16×16은 패치의 픽셀 크기이며, 이미지를 가로세로 16조각씩 나눈다는 뜻은 아니다. RGB 패치 하나는 16×16×3=768개의 숫자로 펼칠 수 있다.
펼친 벡터를 학습 가능한 선형 변환으로 모델 차원에 맞추고 위치 정보를 더한다. 그림의 768→768은 해당 예시의 차원 선택이며, 다른 모델에서도 반드시 같아야 하는 수치는 아니다. 위치 정보는 어느 패치가 이미지의 위쪽·아래쪽에서 왔는지 구별하게 해 준다.
앞의 분류용 특수 토큰 CLS까지 포함하면 이 예시의 시퀀스 길이는 197이 된다. 모든 시각 모델이 CLS를 쓰거나 그 하나의 벡터만 다른 모델에 전달하는 것은 아니다. 뒤의 VLM은 여러 패치 특징을 언어 모델에 넘길 수 있다. Vision Transformer 논문.
사과 이미지 패치와 apple이라는 단어를 같은 차원의 벡터로 만들었다고 하자. 길이가 같아졌다는 사실만으로 둘이 서로 비슷한 의미를 가진다고 모델이 알 수는 없다. 같이 등장하는 자료와 학습 목표가 필요하다.
정렬(alignment)은 여기서 서로 다른 종류 자료의 표현이 대응하도록 학습하는 것을 뜻한다. 이미지 전체와 설명 문장의 의미를 가깝게 만드는 정렬, 질문에 맞춰 이미지 정보를 읽어 답하도록 만드는 정렬, 특정 단어와 이미지의 위치를 연결하는 정렬은 서로 다른 수준이다. 다음 CLIP이 첫 번째에 강한 도구라고 해서 마지막의 정확한 물체 위치까지 자동으로 얻는 것은 아니다.
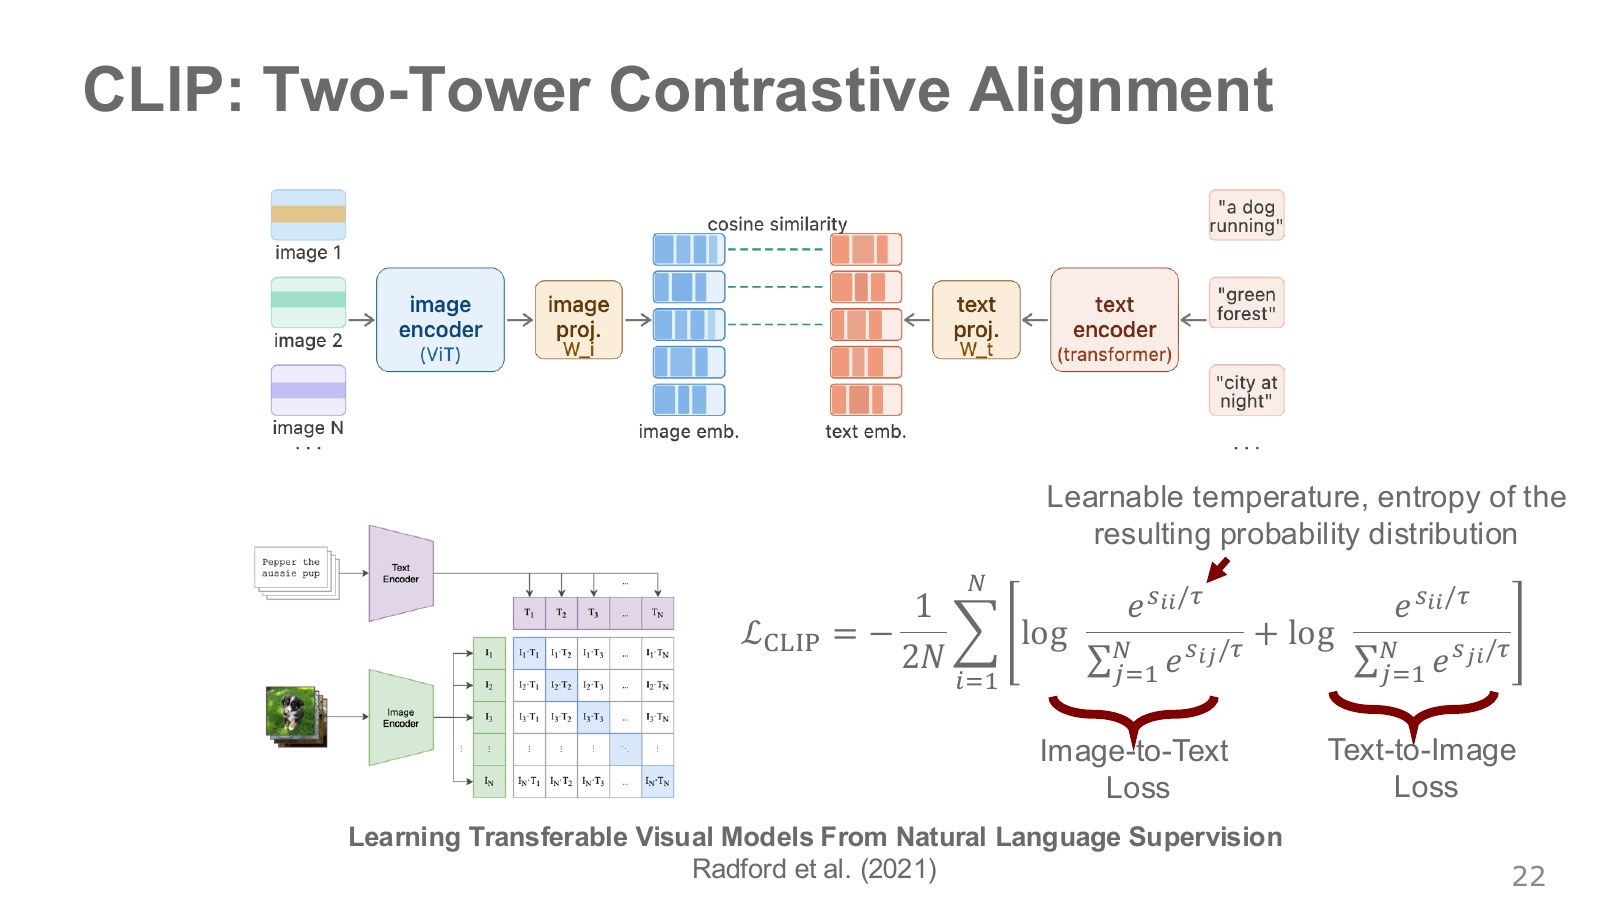
위쪽 두 탑은 이미지 인코더와 텍스트 인코더다. 같은 배치에 N개의 이미지·문장 쌍을 넣고 각각 벡터로 만든다. 길이를 정규화한 벡터의 내적으로 코사인 유사도를 계산하면 N×N 표가 생긴다. 행과 열의 번호가 같은 칸이 원래 짝이며, 각 이미지가 자신의 문장을 다른 문장보다 높은 점수로 찾도록 학습한다. 반대 방향도 함께 계산한다.
s는 유사도, τ는 양수 온도다. 온도가 작으면 비슷한 점수 차이가 더 날카로운 선택 확률로 변한다. 두 번째 방향에서는 이미지에 대해 정규화하므로 첫 번째 확률 표를 그대로 옮기는 것과는 다르다.
CLIP은 이 구조만으로 문장을 한 토큰씩 생성하는 언어 모델은 아니다. 또 한 장의 이미지에 여러 올바른 문장이 있을 수 있어, 배치의 다른 쌍을 모두 의미상 완전한 오답이라고 보기는 어렵다. CLIP 원논문은 이러한 대조 학습으로 얻은 전이 가능한 시각 표현을 다룬다. 그림은 ViT 인코더 예시이며 원논문에는 다른 이미지 인코더 계열도 있다.
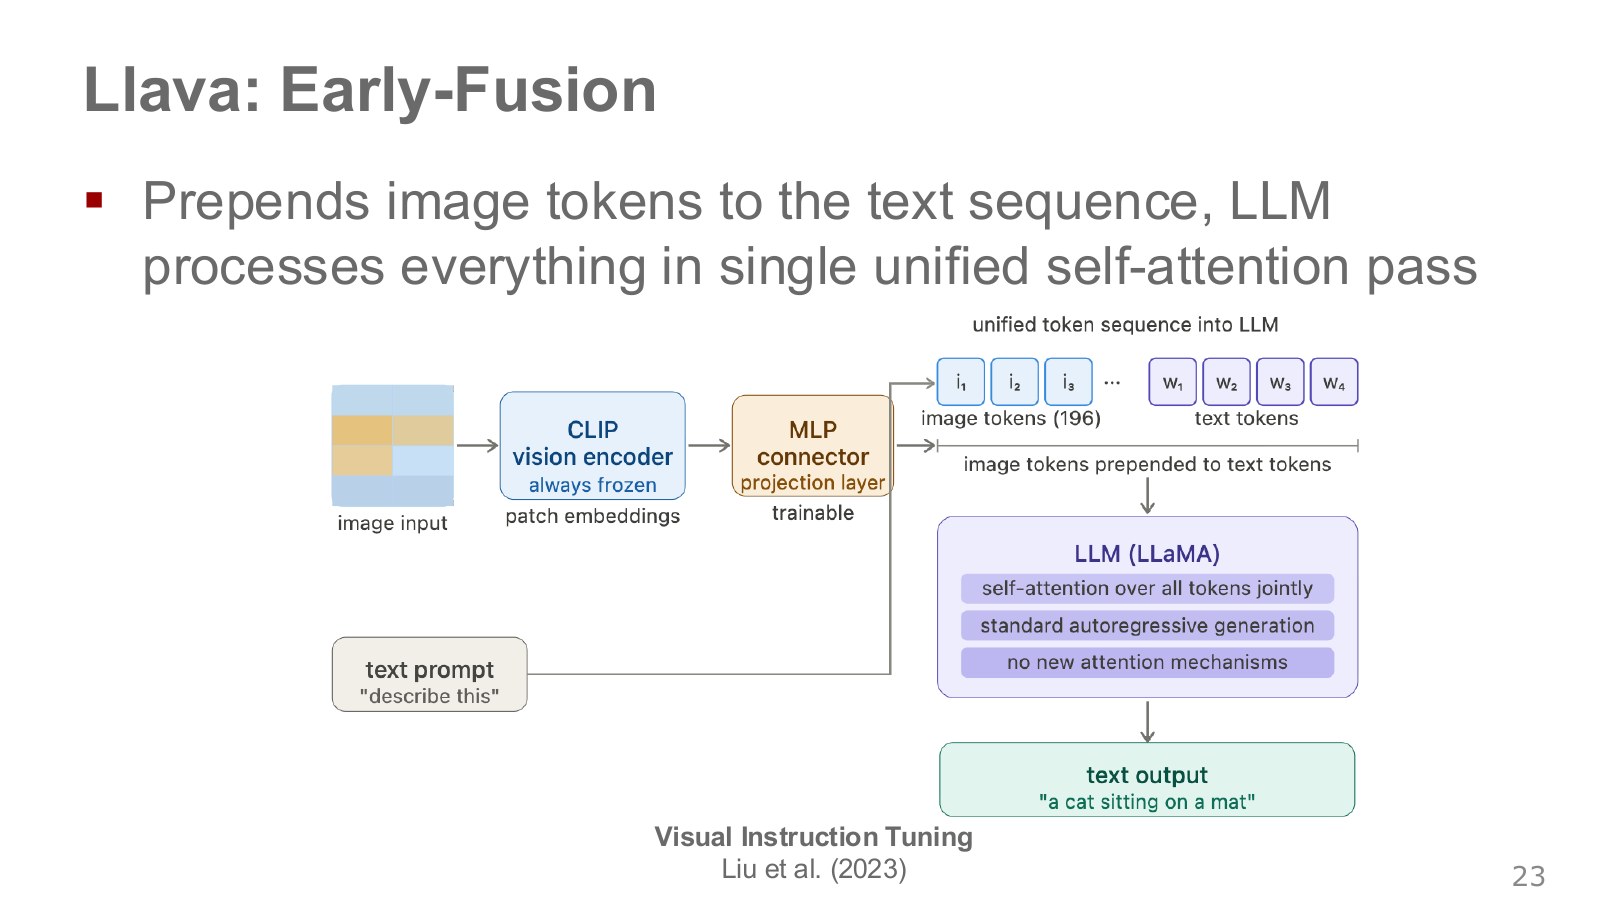
왼쪽 이미지를 시각 인코더에 넣고 여러 패치 특징을 얻는다. 가운데 connector는 그 특징의 차원을 언어 모델의 입력 공간에 맞춘다. 그런 다음 이미지 특징을 텍스트 임베딩과 함께 넣어, 언어 모델의 attention이 두 종류 정보를 참조하도록 한다. 출력은 “무엇이 보이는가?” 같은 질문에 대한 문장이다.
Early fusion이라는 이름은 이 설명에서 이미지와 글이 언어 모델의 공통 시퀀스 처리에 함께 들어간다는 뜻이다. 원시 픽셀과 글자를 같은 방식으로 처리한다는 뜻은 아니다. 앞에 시각 인코더가 있고, 이미지 특징의 형태와 수는 모델 버전에 따라 다르다.
원래 LLaVA 논문의 선형 투영과 후속 구성의 MLP connector는 구분해야 한다. 이 슬라이드의 MLP 그림을 모든 LLaVA 버전의 동일한 구조로 외우지 말자. 얼리는 가중치와 학습하는 가중치 역시 학습 단계·변형마다 확인해야 한다. 특징 정렬과 시각 지시 학습을 통해, 단순한 이미지·글 유사도 비교에서 이미지에 관한 답변 생성으로 목적이 바뀐다.
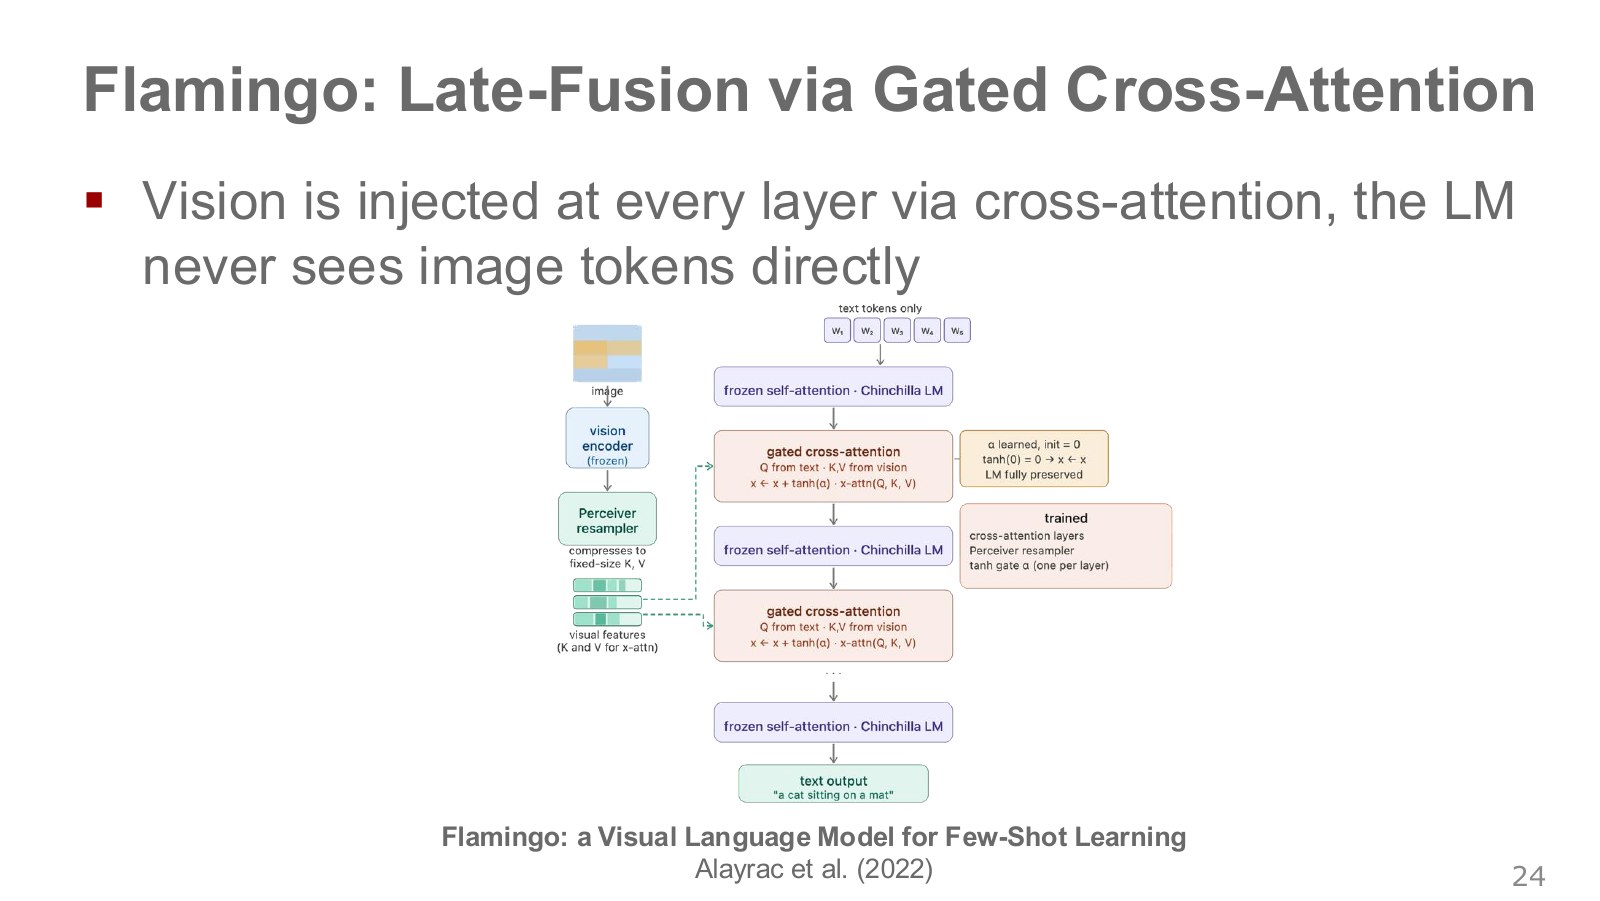
위쪽 시각 인코더가 만든 특징은 Perceiver Resampler를 거쳐 정해진 수의 시각 표현으로 모인다. 언어 모델 쪽에 추가한 gated cross-attention은 텍스트의 Query로 시각 Key·Value를 참조한다. 이미지 토큰을 텍스트 토큰과 같은 self-attention 시퀀스에 바로 이어 붙이는 방식과 정보가 만나는 위치가 다르다.
게이트 가중치 g를 0에서 시작하면 처음에는 추가 경로의 기여가 0이다. 이후 학습을 통해 시각 정보를 반영하는 정도를 조절한다. 새 통로를 여는 동안 사전학습 언어 모델의 가중치를 고정할 수 있다는 것이 중요한 설계다.
다만 게이트가 점점 열린다는 것은 가능한 학습 동작을 설명하는 것이며 단조 증가가 보장되는 것은 아니다. 새 블록을 어느 간격으로 넣는지도 구성에 따라 달라 “모든 모델의 매 층에 반드시 하나”라고 외우지 않는다. “언어 모델이 이미지 토큰을 직접 보지 않는다”는 말은 같은 입력 토큰열에 붙이지 않는다는 뜻이지, 결과가 시각 정보에 영향을 받지 않는다는 뜻이 아니다. Flamingo 원논문.
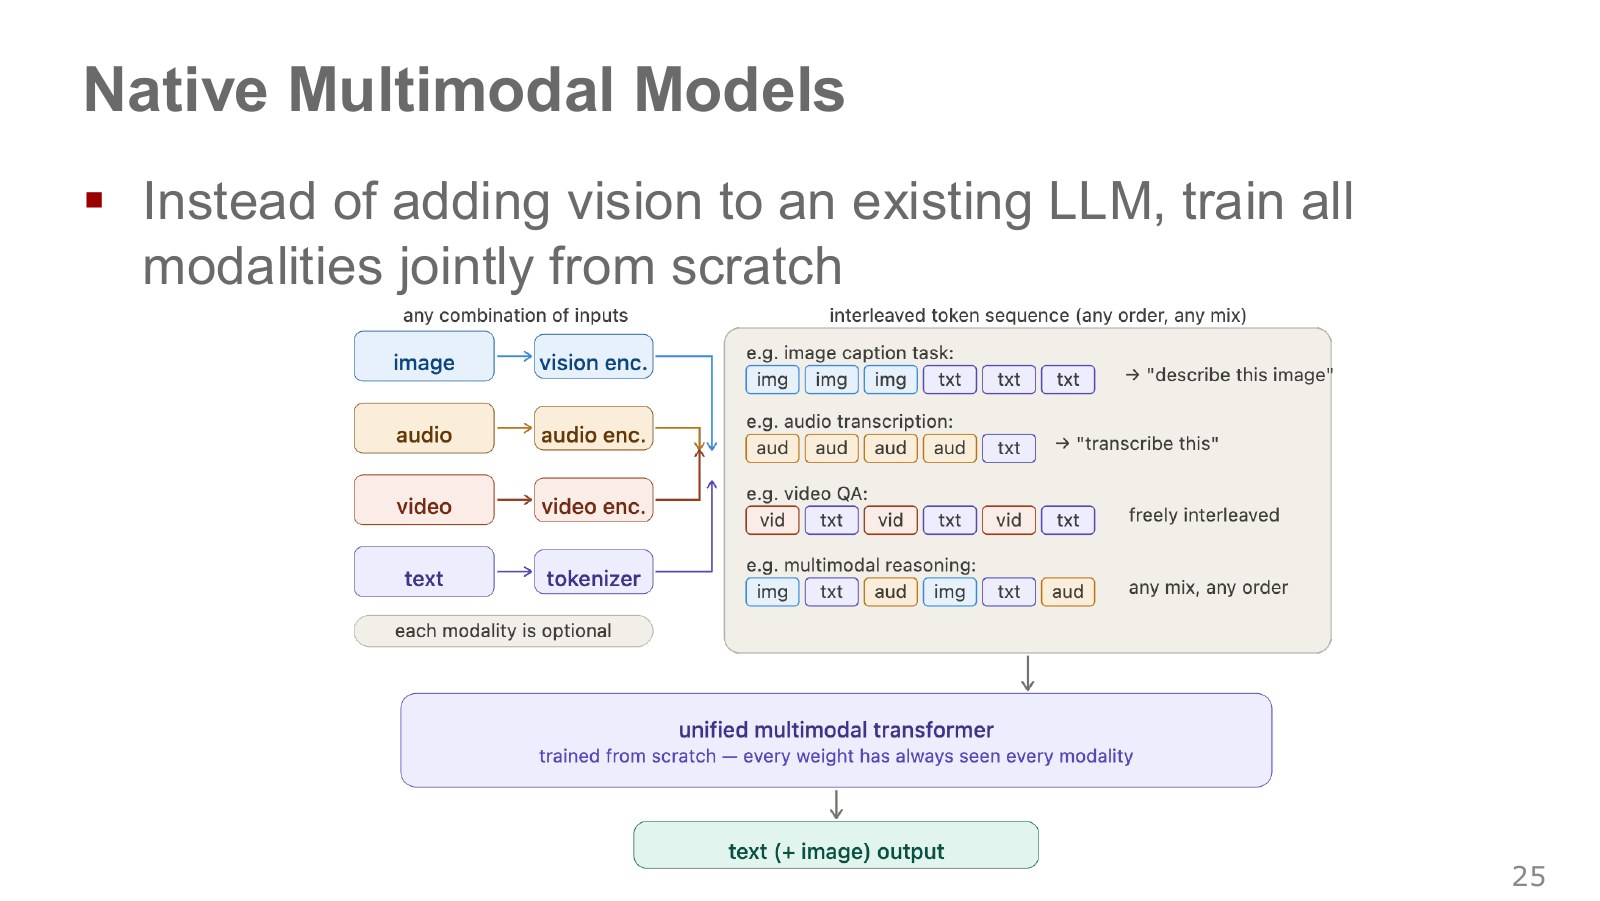
위쪽에는 이미지·음성·영상·텍스트가 각각의 인코더 또는 토크나이저를 통과한다. 오른쪽의 예시에서는 이미지 뒤 설명, 음성 뒤 글, 영상 뒤 질문처럼 여러 단위가 섞여 나온다. 공통 시퀀스 모델이 서로 다른 자료 사이의 관계를 학습하는 구성이다.
Native multimodal은 보통 여러 종류 자료를 처음부터 긴밀하게 함께 다루도록 훈련한 모델을 가리킨다. 용어만으로 모든 구성요소를 무작위 초기값에서 학습했다거나 모든 가중치가 모든 종류 자료를 똑같이 본다고 단정할 수는 없다. 실제 모델에는 별도 인코더, 여러 학습 단계, 다른 손실과 마스크가 있을 수 있다.
음성·영상처럼 시간축이 다른 자료를 합치려면 타임스탬프와 정렬도 중요하다. 함께 넣을 수 있는 벡터 차원만 맞춘다고 동시 발생한 소리와 움직임을 저절로 구분하지는 않는다. 이 그림은 세부 제품 사양보다 공동 학습의 설계 방향을 보여 준다.
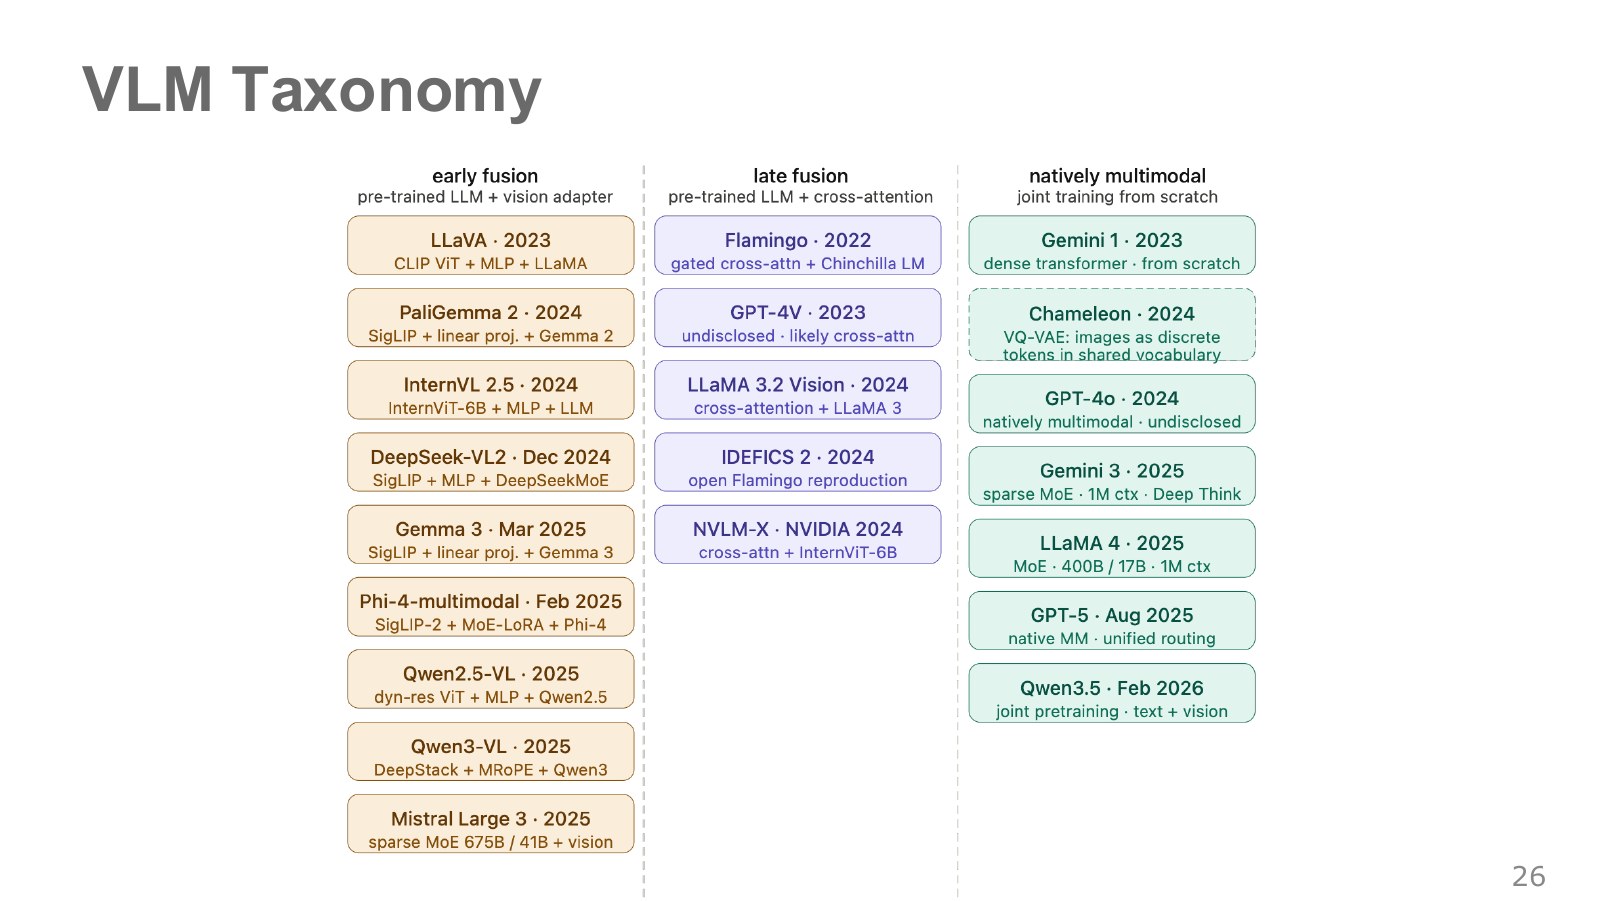
세 열의 큰 구분은 시각 특징을 언어 토큰열에 합치는 방법, 별도 cross-attention 통로로 넣는 방법, 여러 종류 자료를 함께 학습하는 방법이다. 왼쪽의 연결기, 가운데의 추가 attention, 오른쪽의 공동 학습이라는 차이를 먼저 읽으면 모델 이름이 바뀌어도 비교 기준을 유지할 수 있다.
표에는 공개 논문으로 구조를 확인할 수 있는 모델과 내부 구조가 충분히 공개되지 않은 모델이 섞여 있다. 그림 안의 “likely”나 “undisclosed”는 추정 또는 미공개라는 뜻이다. 그런 항목을 특정 구조가 확인된 사례로 다시 서술하지 않는다. 또한 개별 모델은 한 열의 특징만 가지지 않을 수 있다.
이 구분은 품질 순위표가 아니다. 바꾸는 가중치 수, 시각 토큰 수, 학습 자료, 언어 능력 보존, 영상 길이와 계산 비용을 함께 비교해야 한다. 특정 이름이 어느 열에 있다는 것만으로 그 모델이 로봇의 관절 명령까지 낼 수 있다는 뜻도 아니다.
질문은 이제 “숟가락이 어디 있나?”에서 “숟가락을 집으려면 어떤 명령을 내야 하나?”로 바뀐다. 이미지 설명은 글을 출력하면 끝나지만, 행동 출력은 실제 로봇의 기구학·제어기·환경과 연결되어야 한다.
언어와 이미지를 토큰으로 연결한 것처럼 행동도 모델이 다룰 단위로 만들 수 있다. 그러나 연속 값의 해상도, 관절마다 다른 단위, 생성 지연, 시간적 일관성이 새 문제로 들어온다. 이 단계에서는 Transformer 구조만이 아니라 행동 표현과 실행 인터페이스가 핵심이다.
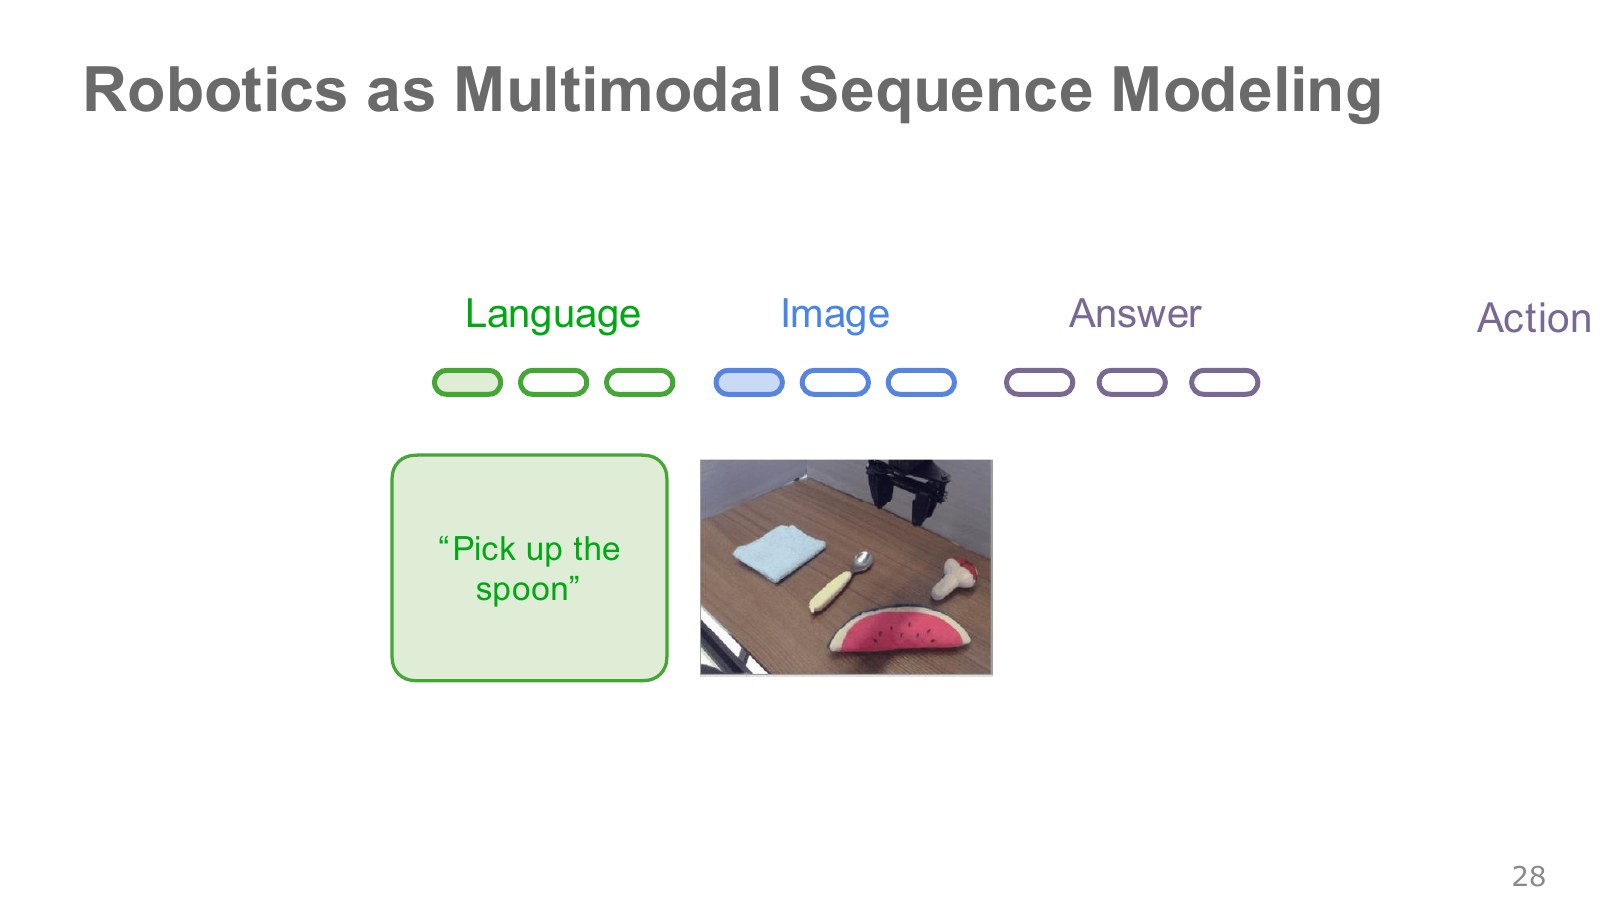
왼쪽의 “숟가락을 집어라”는 언어 조건이고, 가운데 사진은 현재 상황이다. 오른쪽 출력이 설명 문장 대신 행동을 나타내면 VLA, 즉 vision-language-action 모델의 형태가 된다. 행동 표현은 손의 이동량, 회전 변화, 그리퍼 열림 정도 등으로 구성할 수 있다.
출력 토큰은 약속된 디코더를 거쳐 숫자 명령으로 바뀐다. 그 숫자가 관절 목표인지, 말단 장치의 상대 위치인지, 속도인지에 따라 뒤의 제어 과정이 다르다. 토큰 번호를 모터에 그대로 전송하는 것은 아니다. 기존 제어기가 목표를 따라가게 하는 저수준 역할도 남는다.
과거 영상과 행동을 입력 시퀀스에 실제로 넣으면 그 이력에 조건화할 수 있다. 하지만 Transformer를 썼다고 모든 VLA가 긴 과거를 입력받는 것은 아니다. 어떤 모델은 현재 영상 몇 장만 사용한다. 구조가 제공하는 가능성과 실제 입력 설계를 구별하자.
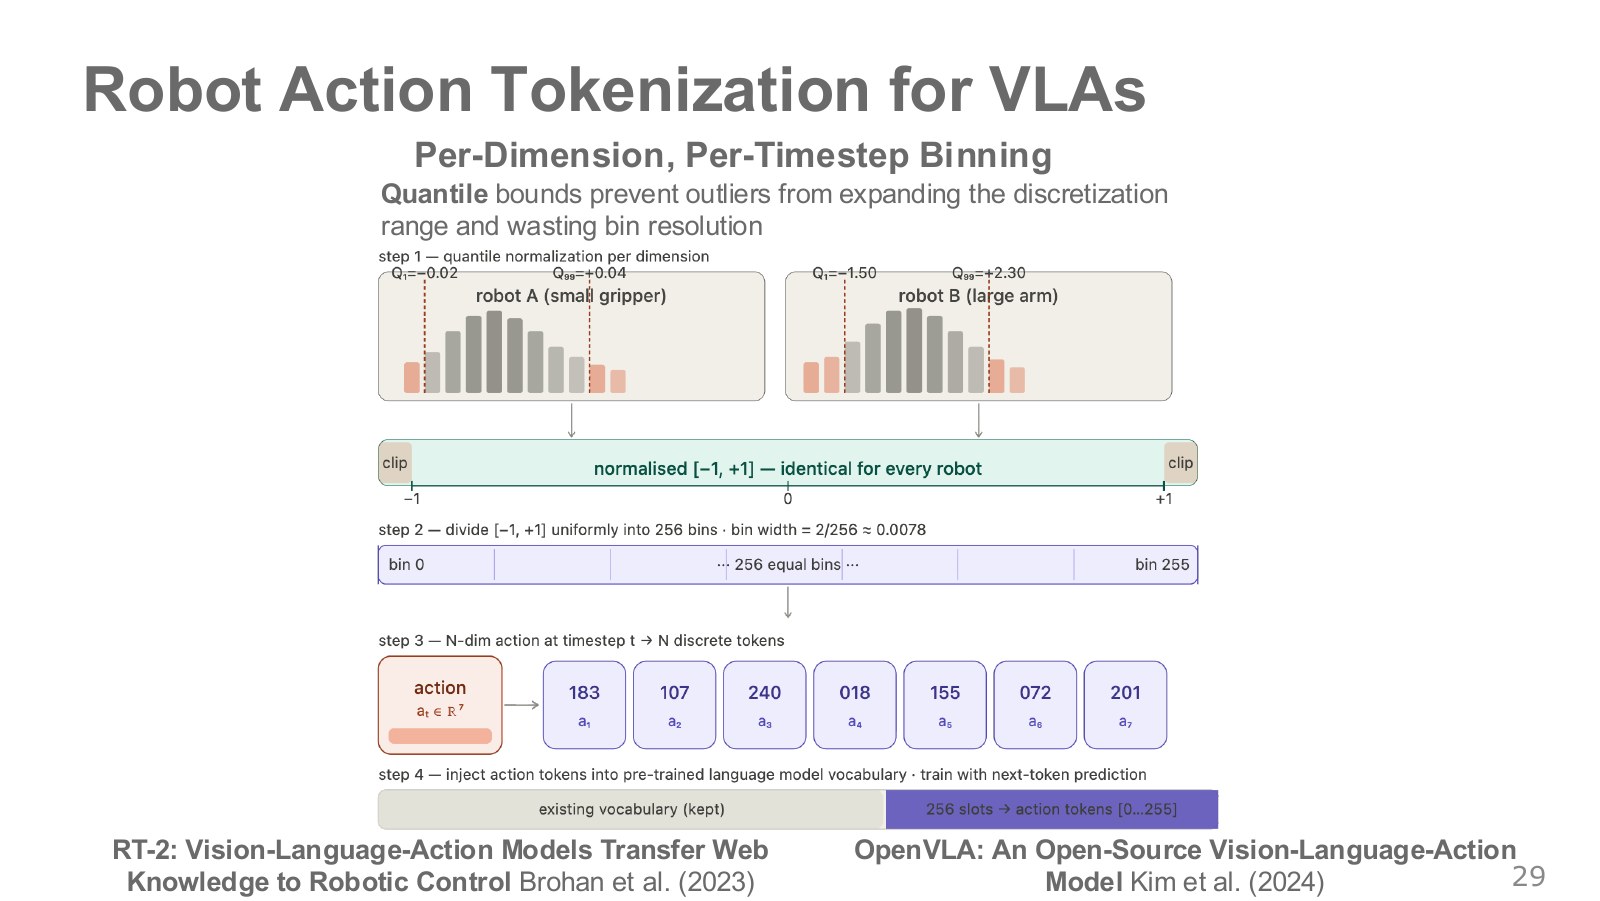
위 히스토그램의 두 로봇은 행동 값의 실제 범위가 다르다. 왼쪽은 작은 이동량, 오른쪽은 큰 범위를 사용한다. 각 행동 차원의 학습 자료에서 아래·위 분위수를 정해 그 범위를 정규화하면, 드문 큰 이상값 하나 때문에 나머지 값들이 좁은 몇 구간에 몰리는 문제를 줄일 수 있다.
l과 h는 선택한 아래·위 분위수이고 서로 달라야 한다. u가 정확히 1이면 계산 중 256이 나오므로 마지막 번호 255로 제한한다. 복원할 때 구간의 중앙값을 쓰면 범위 안에서는 원래 단위로 구간 폭 절반 이하의 오차가 생긴다. 범위 밖 값을 잘라낸 오차에는 같은 보장이 없다.
OpenVLA 논문은 각 차원의 1·99번째 백분위수 사이를 256구간으로 나눈다. 원래 RT-2의 min–max 방식과 이 세부 선택을 구별해야 한다. 행동 토큰을 언어 모델 어휘에 연결할 수 있고, OpenVLA에서는 기존 어휘의 일부 슬롯을 재사용한다.
정규화한 번호 체계가 같아져도 각 로봇에서 같은 번호가 같은 물리 동작을 뜻하는 것은 아니다. 관절 순서, 좌표계, 절대값·변화량, 이동 단위와 그리퍼 의미를 맞춰야 한다. 7차원 행동을 차원마다 번호 하나로 쓰면 한 제어 시점에 토큰 7개가 필요하다.
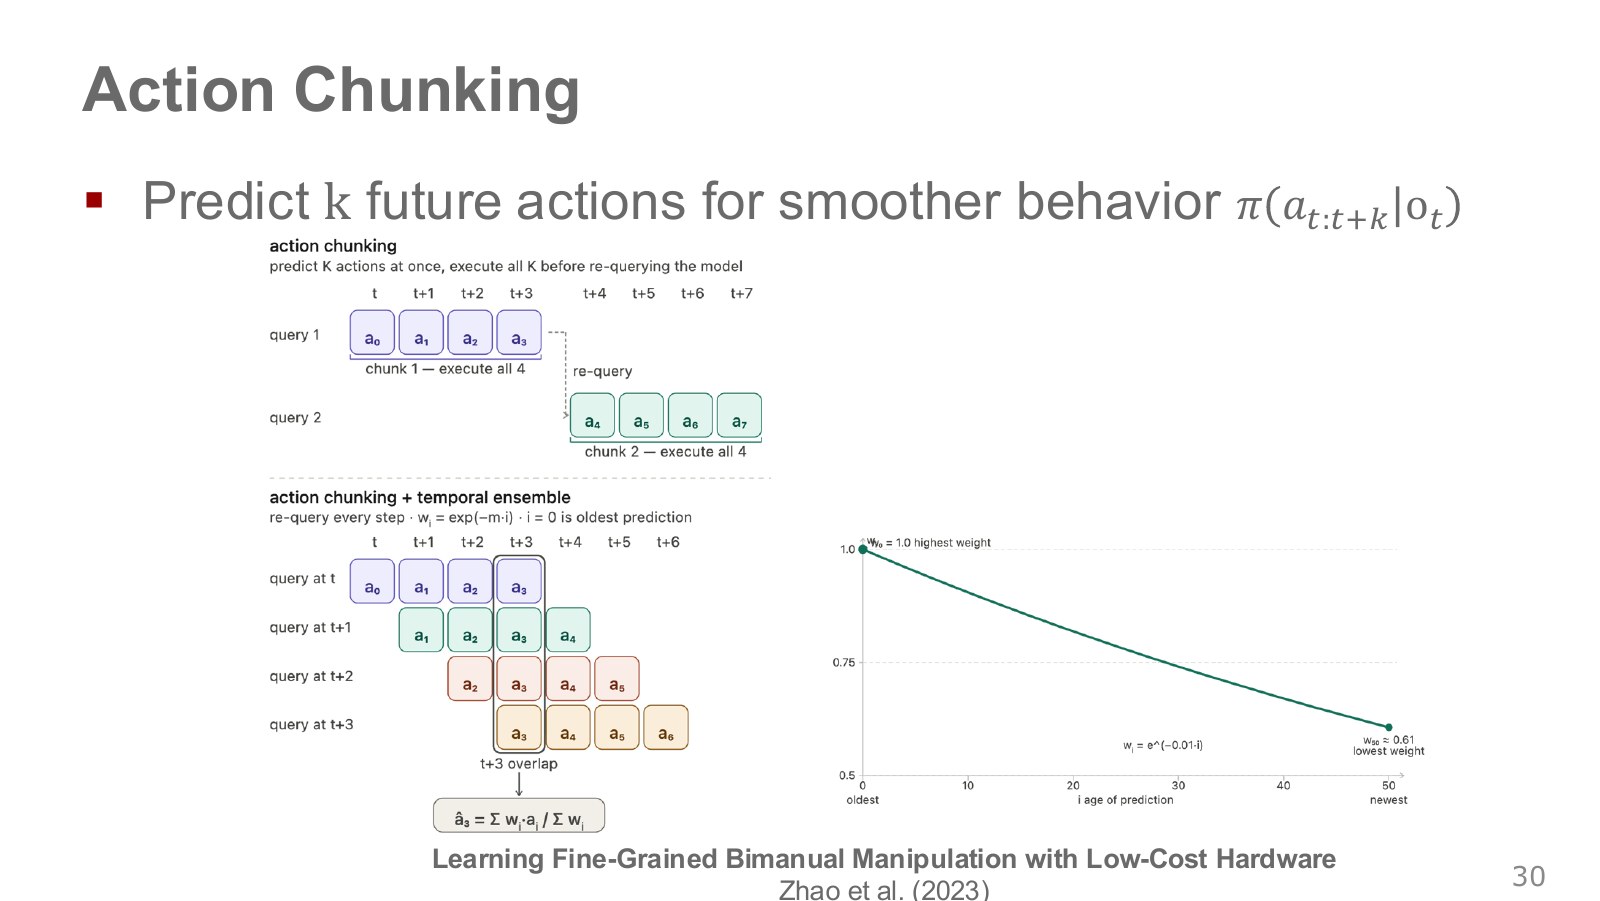
위쪽은 한 번 예측한 네 행동을 모두 실행하고 다시 관측하는 방식이다. 묶음 안의 동작을 함께 계획할 수 있지만, 새 관측을 반영하는 시점이 드물어진다. 아래쪽은 매 순간 새 묶음을 예측하고, 같은 실제 실행 시점을 가리키는 여러 예측을 합친다. 과거에 예측한 “지금 행동”과 방금 예측한 “지금 행동”을 모으는 것이다.
원래 ACT 논문은 가장 오래된 예측을 i=0으로 놓고 지수 감소 가중치를 쓴다. 따라서 이 표기에서 양의 감소 계수는 오래된 예측에 더 큰 무게를 준다. 흔히 생각하는 “가장 최신 예측의 가중치가 제일 크다”와 반대이므로 인덱스를 확인해야 한다. 본문의 계산 예제도 오래된 순서로 1·2·3이라는 예측을 주어 이 차이를 확인한다.
이는 서로 다른 시점의 실제 행동을 단순히 평균내는 필터와 다르다. 겹친 여러 계획이 같은 시점에 무엇을 하라고 말하는지 결합한다. 부드러움과 새 관측 반영 사이의 절충이며, 각 계획이 전혀 다른 유효한 경로를 택했다면 평균이 안전하다는 보장은 없다. 매 순간 정책을 다시 호출하는 계산 비용도 생긴다.
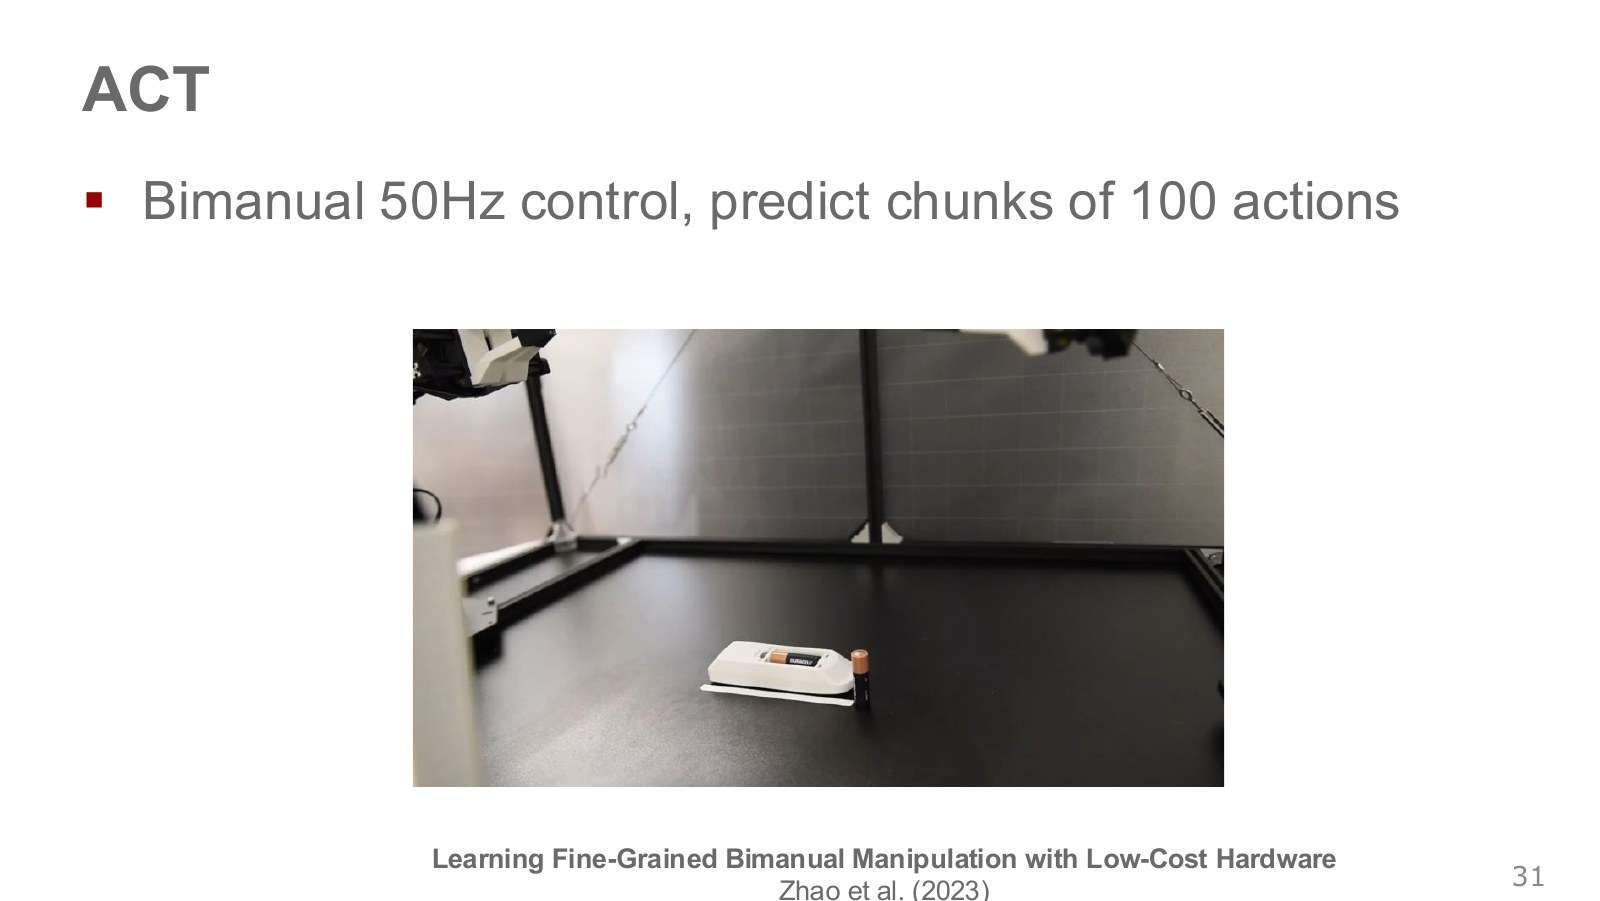
영상의 배터리 끼우기는 두 손의 위치와 접촉 순서를 정밀하게 맞춰야 하는 작업이다. ACT의 ALOHA 설정은 두 팔을 합한 14차원 행동을 50Hz로 제어하고, 길이 100의 행동 묶음을 예측한다. 묶음 하나는 약 2초에 대응하며, 차원별 수치로 세면 1,400개다. 하지만 이 1,400개 수치를 언어 토큰처럼 하나씩 순서대로 생성하는 구조는 아니다.
원논문은 조건부 VAE와 Transformer를 결합한다. 학습용 인코더는 시연 행동 묶음과 관절 상태로 잠재 스타일 분포를 만들고, 정책 디코더는 영상·관절 상태·스타일을 보고 행동 묶음을 예측한다. 이 연결은 06장의 잠재변수 모델과 이어진다.
실행 때는 미래 시연 행동을 알 수 없으므로 학습용 인코더를 버리고, 원논문 설정에서는 사전분포의 평균인 0으로 스타일을 고정해 결정론적으로 디코딩한다. 따라서 ACT를 매번 잠재 코드를 무작위로 뽑는 자기회귀 VLA라고 설명하면 부정확하다. 영상의 유연한 동작은 모델·자료·하드웨어·제어 설정이 합쳐진 결과이며, 행동 묶음만 넣으면 같은 정밀도가 보장되는 것은 아니다. 공식 프로젝트와 코드.
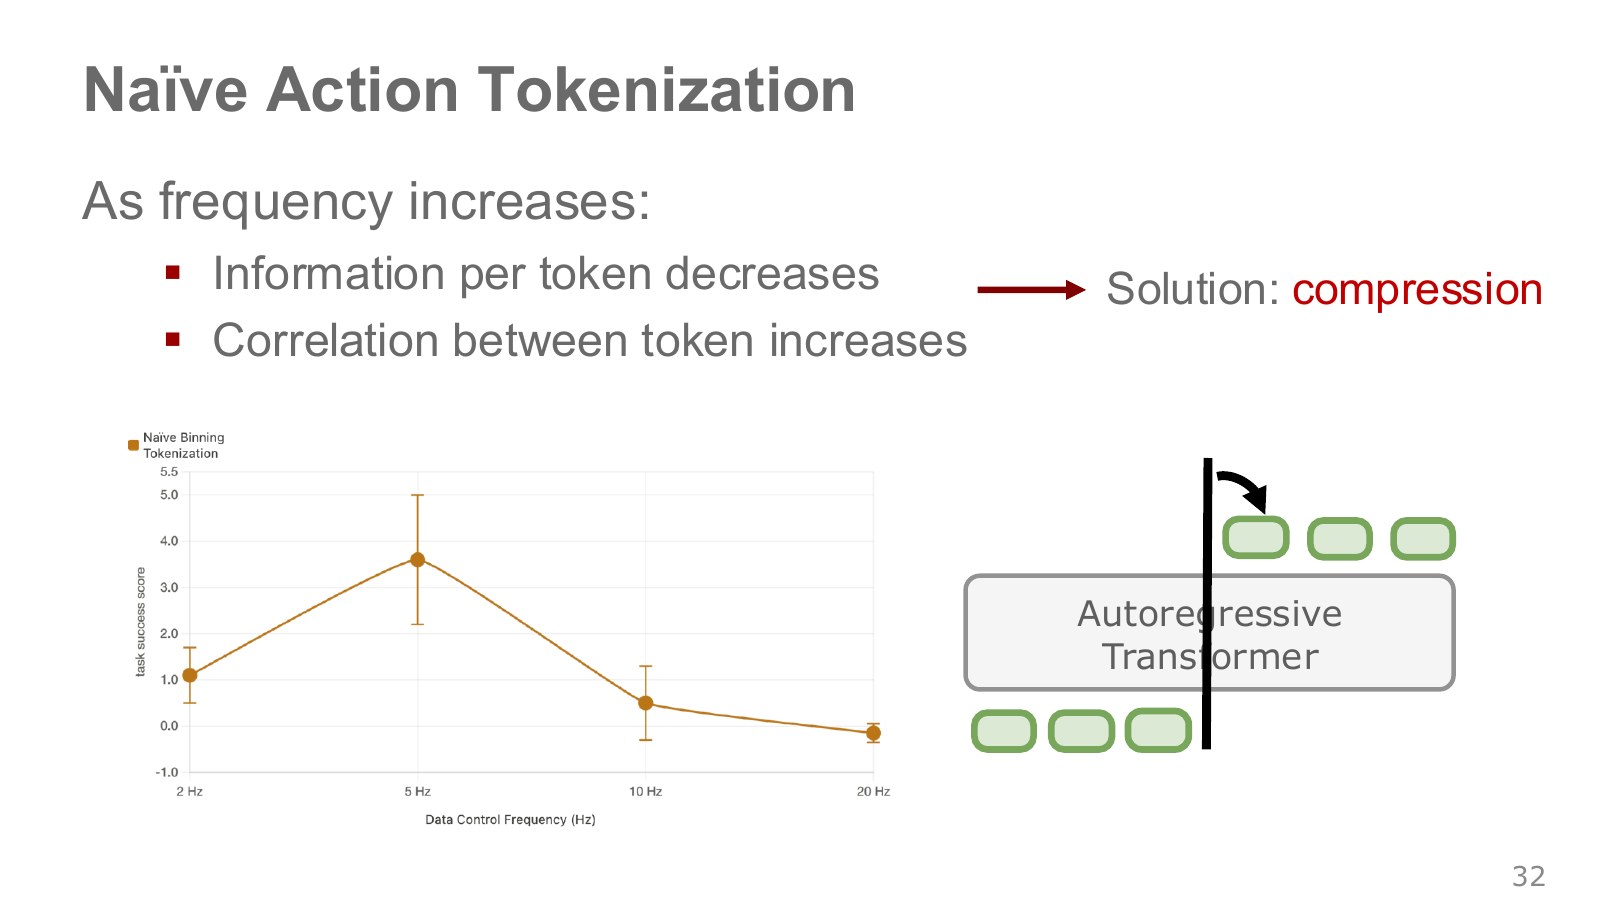
왼쪽 그래프는 해당 실험에서 단순 구간화 토큰을 쓰는 정책의 성능이 높은 자료 제어 주파수에서 나빠지는 모습을 보여 준다. 오른쪽은 이웃 행동이 매우 비슷할 때 앞 토큰을 복사하기 쉬운 자기회귀 구조를 강조한다. 짧은 시간 간격으로 움직임을 기록하면 물리적으로 연속한 값들이 거의 같아지기 때문이다.
Teacher forcing에서는 실제 앞 행동을 정답으로 받으므로, 다음 값도 거의 같다고 예측하는 것만으로 높은 토큰 정확도를 얻을 수 있다. 그러나 실제 실행에서 자기 예측을 계속 이어 쓰면 필요한 변화가 나타나지 않거나 오차가 쌓일 수 있다. 토큰 예측 정확도와 긴 작업의 성공률을 별도로 확인해야 하는 이유다.
제어 주파수가 높다는 것은 초당 명령 수가 많다는 뜻이다. 행동 신호 자체가 급격하게 진동한다는 뜻은 아니다. 같은 부드러운 곡선도 더 자주 기록하면 샘플 수와 중복이 늘어난다. 이 실험의 결과를 모든 고주파 제어와 모든 Transformer의 한계로 일반화하지 않는다.
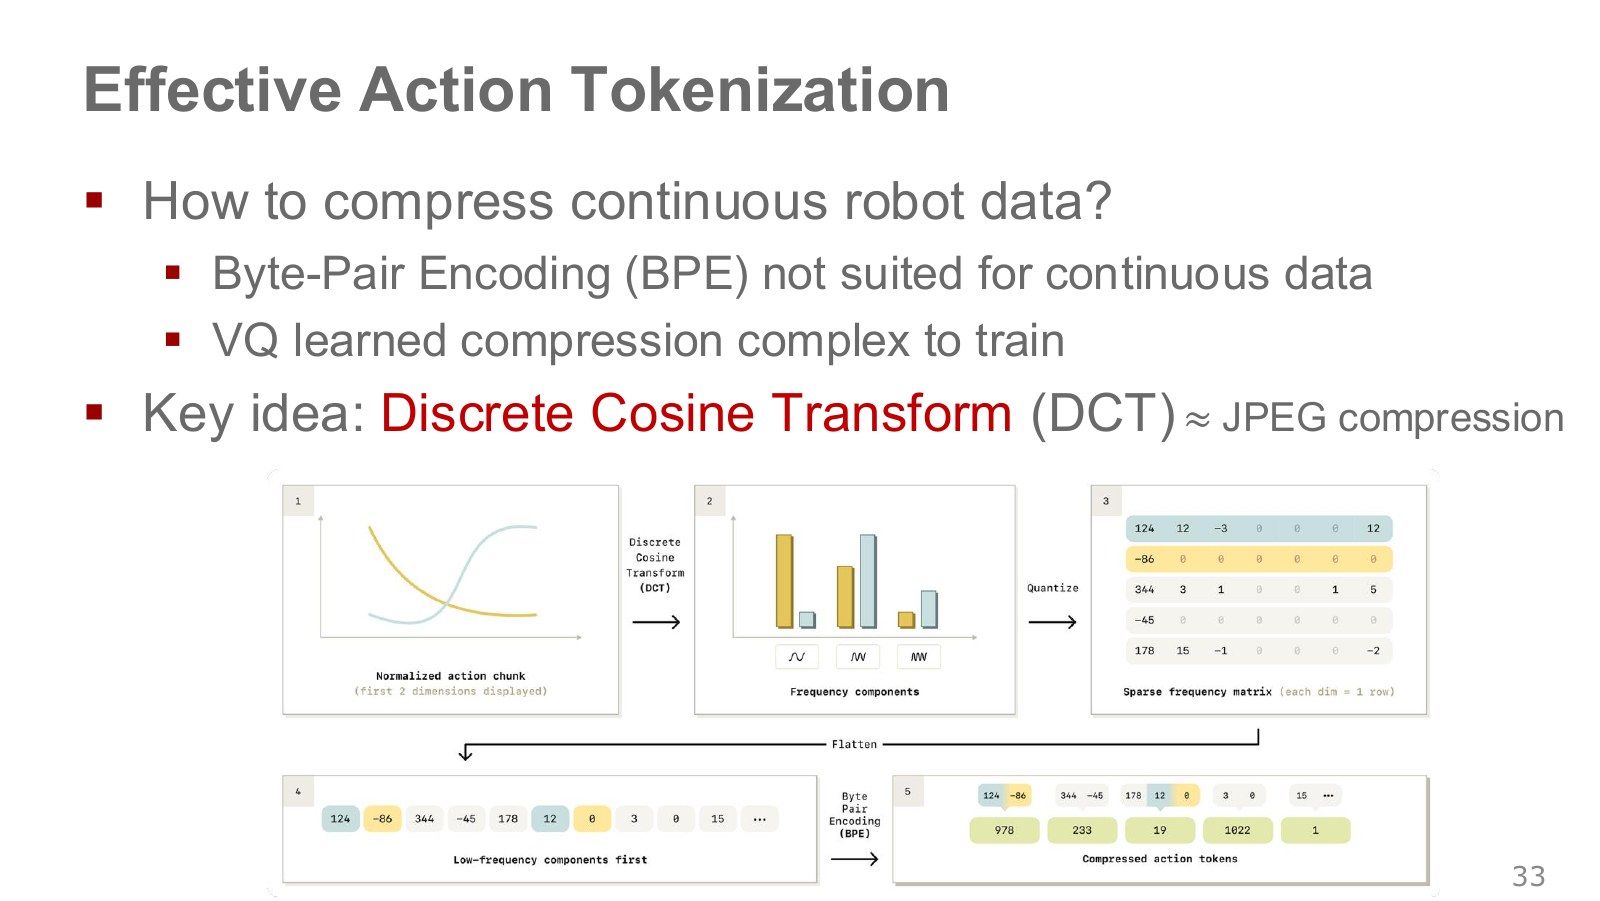
다섯 상자를 차례로 읽자. 첫째, 여러 시점의 행동을 차원별로 정규화한다. 둘째, 각 차원의 시간 신호에 DCT, 즉 이산 코사인 변환을 적용한다. 전체적인 곡선과 빠른 변화를 서로 다른 코사인 성분의 계수로 표현한다. 셋째, 계수를 확대하고 반올림해 정수로 만든다. 넷째, 여러 차원을 낮은 주파수부터 펼친다. 다섯째, 반복되는 정수 패턴을 BPE로 묶어 최종 토큰을 만든다.
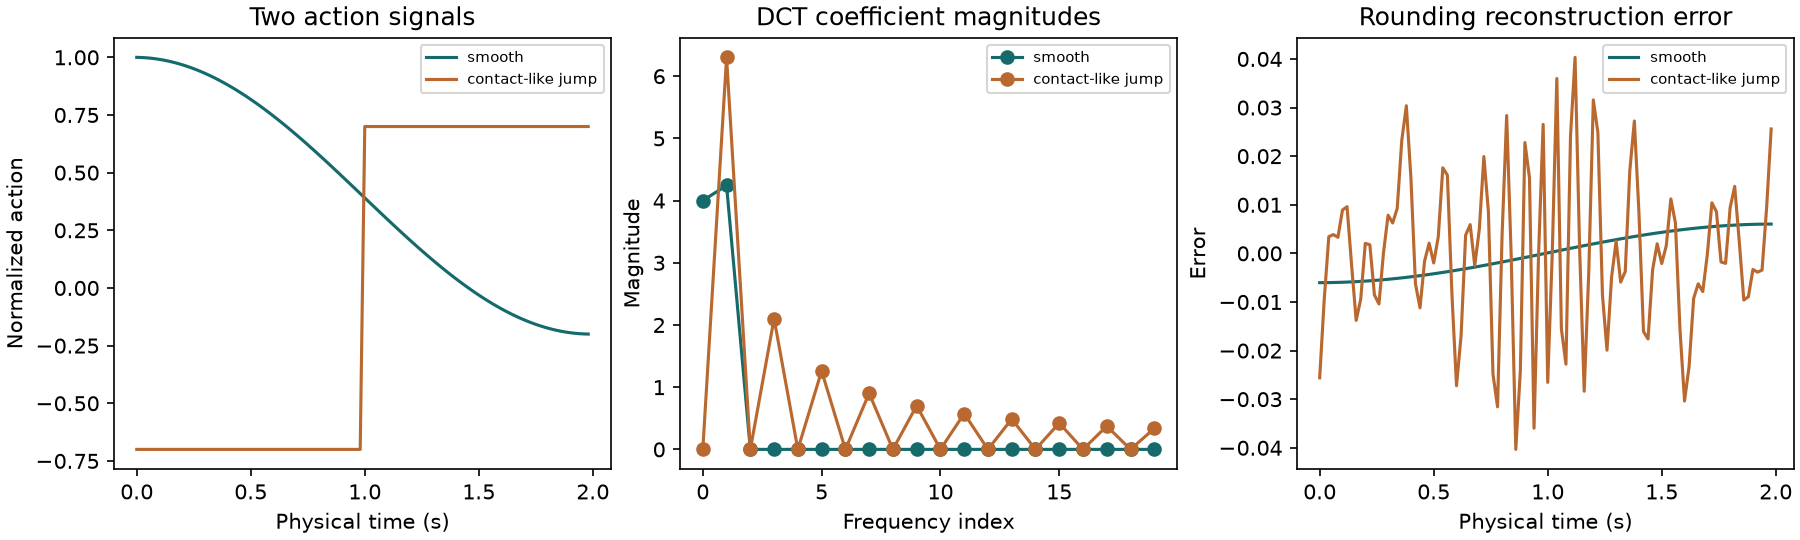
H는 행동 묶음의 길이, k는 주파수 성분 번호, γ는 반올림의 해상도를 정하는 배율이다. DCT 자체는 전체 계수를 보존하면 원래 신호로 되돌릴 수 있다. 손실은 주로 계수 반올림과 범위 제한 같은 단계에서 생긴다. 작은 계수가 0이 되면 긴 0 패턴이 만들어지고, BPE가 이를 짧게 표현할 수 있다. BPE 자체는 정수 기호열을 복원할 수 있게 묶는 단계다.
부드러운 움직임은 에너지가 낮은 주파수에 집중되는 경향이 있다. 하지만 접촉이나 급한 전환의 높은 주파수 성분이 언제나 불필요한 잡음인 것은 아니다. γ를 낮춰 더 강하게 압축하면 중요한 세부 동작도 잃을 수 있다. “언어 BPE는 연속 값에 바로 쓰기 어렵다”에서 출발해, DCT와 정수화 뒤에는 다시 BPE를 활용한다는 연결이 핵심이다. FAST 원논문.
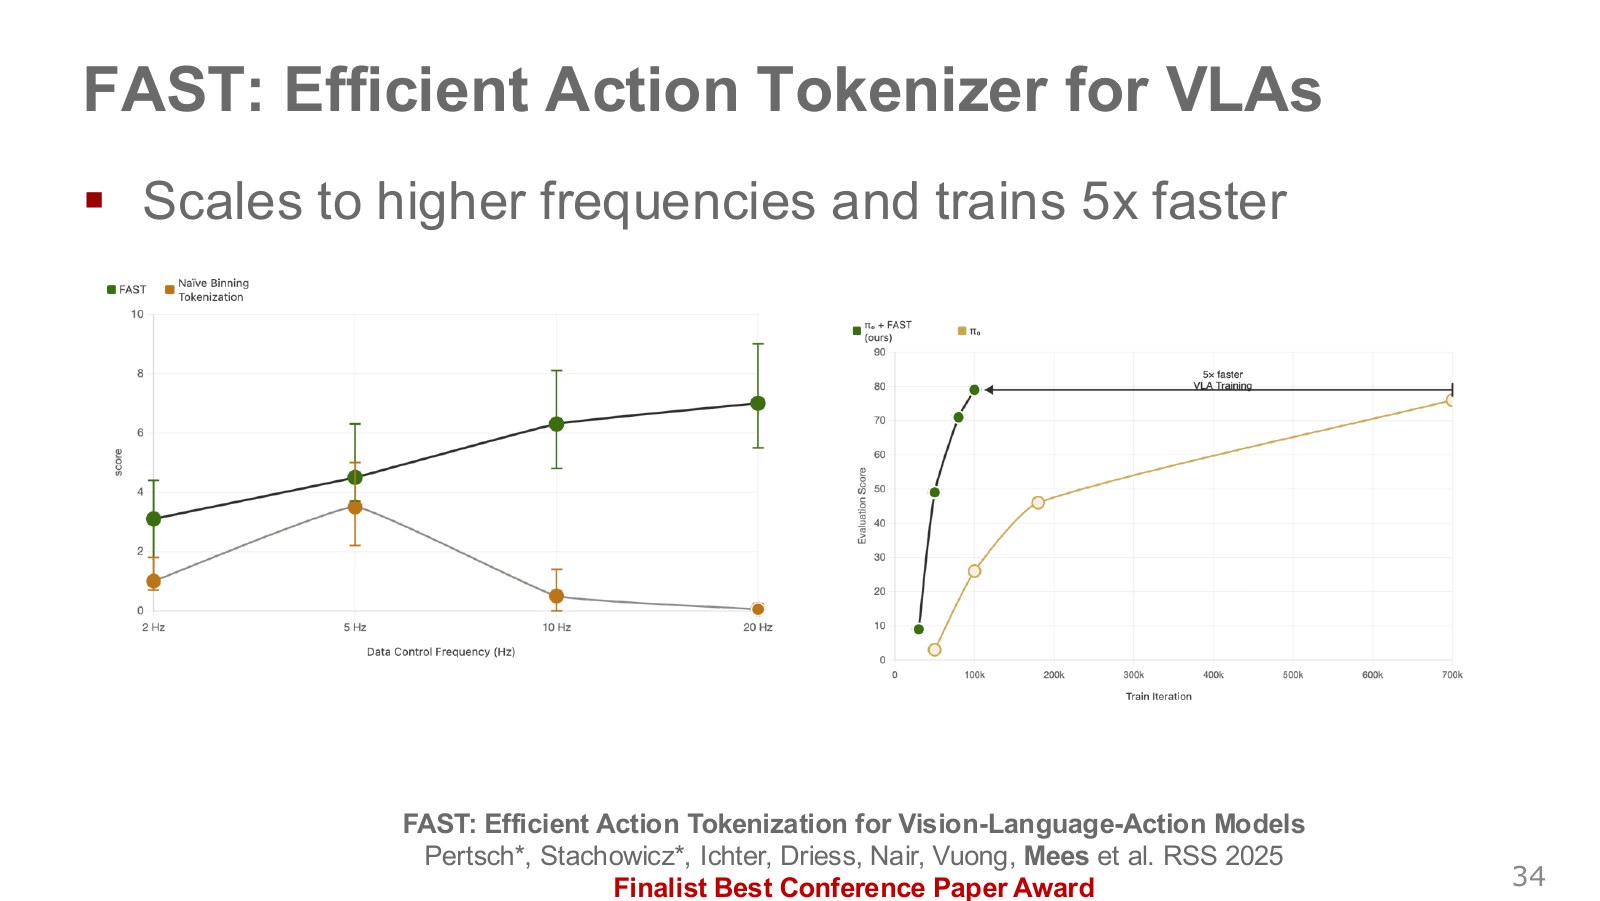
왼쪽 그래프의 가로축은 자료의 제어 주파수이고 세로축은 실험의 평가 점수다. 이 설정에서는 단순 구간화와 달리 FAST가 높은 주파수 자료에서도 성능을 유지·개선하는 경향을 보인다. 오차 막대는 반복 실행이나 평가의 변동을 표현하므로 평균 점만 보고 차이를 절대적인 규칙으로 받아들이지 않는다.
오른쪽 가로축은 학습 반복 횟수, 세로축은 평가 점수다. 원강의의 말 중 test time이라는 표현이 나오지만, 이 그림의 5배 주장은 생성 지연이 5배 짧다는 뜻으로 읽으면 안 된다. 원논문은 비교한 설정에서 확산 계열 정책과 유사한 성능에 도달하는 학습 속도 개선을 보고한다. 모든 작업·장치·모델의 실행 속도가 똑같이 좋아진다는 보장은 아니다.
또 FAST를 붙인 자기회귀 정책과 06장의 flow matching 정책은 행동을 만드는 절차가 다르다. 같은 기반 시각·언어 표현을 활용하더라도 어떤 출력 표현과 학습 목표를 선택했는지 따로 비교해야 한다. FAST 공식 연구 페이지.
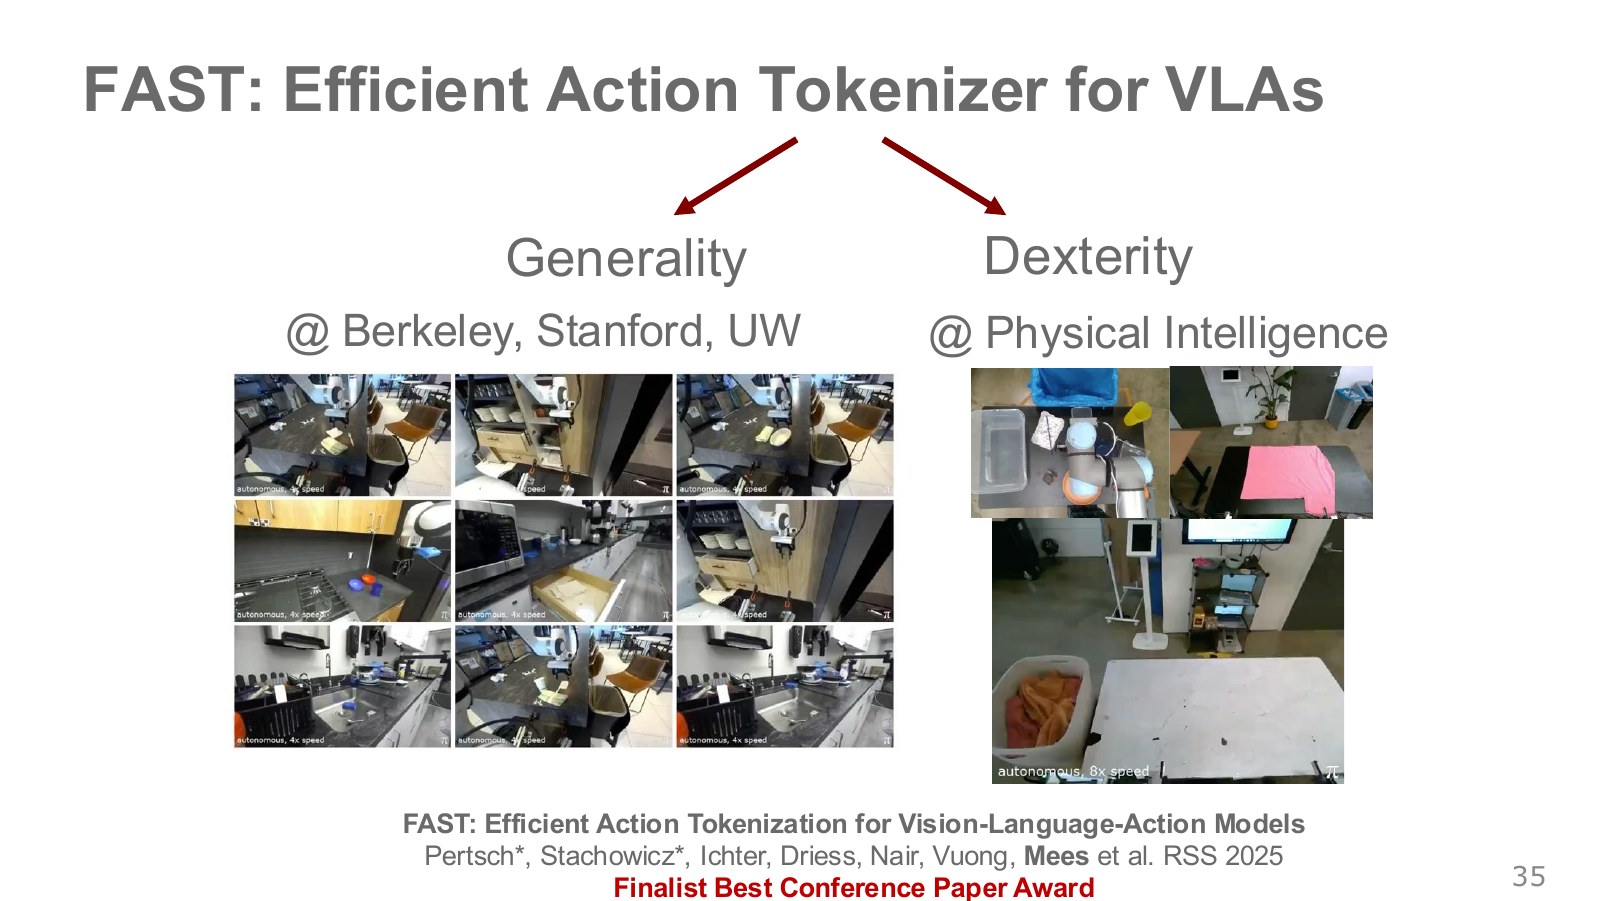
왼쪽 사진 묶음은 여러 주방과 환경에서 작업하는 범위를, 오른쪽 사진은 빨래 접기 등 정교하고 긴 양팔 작업을 보여 준다. 일반성은 새로운 물체·장면·지시에서 얼마나 잘 작동하는지, 정교함은 작은 오차를 허용하지 않는 제어와 접촉을 얼마나 안정적으로 수행하는지로 나누어 볼 수 있다.
FAST 계열 실험은 이 두 방향의 확장을 함께 살핀다. 다만 보지 못한 주방에서 평가했다는 말과 어떤 로봇·어떤 물체에서도 무조건 작동한다는 말은 다르다. 학습 자료와 하드웨어, 지시 범위, 성공 기준을 함께 확인해야 한다.
공개된 범용 행동 토크나이저 FAST+는 다른 자료에 적용할 출발점을 제공한다. 그래도 입력의 행동 차원·단위·정규화·길이를 맞춰야 하며, 토크나이저를 내려받는 것만으로 로봇 정책이 학습되는 것은 아니다. 이번 글에서 직접 실행한 예제는 그 원리의 작은 수치 계산이고, 이 사진의 실물 작업을 재현한 실험은 아니다.
지금까지의 흐름을 세 질문으로 정리해 보자. 첫째, 현재 관측만으로 충분한가, 아니면 이전 행동과 관측을 함께 봐야 하는가? 둘째, 그 자료를 문자·패치·연속 벡터·행동 토큰 중 어떤 단위로 표현할 것인가? 셋째, 출력이 자기회귀 토큰인지, 한 번에 만드는 행동 묶음인지, 반복적으로 갱신하는 확산·flow 행동인지?
| 방법·개념 | 해결하려는 부분 | 그 자체로 보장하지 않는 것 |
|---|---|---|
| 이력 조건화 | 지금 장면에 없는 과거 정보 활용 | 숨은 상태의 완전한 복원 |
| Attention·위치 정보 | 문맥의 관계와 순서 학습 | 무한한 기억과 일정한 전체 계산량 |
| CLIP·VLM | 시각과 언어의 표현·출력 연결 | 정확한 위치 제어와 행동 성공 |
| ACT·행동 묶음 | 여러 시점의 행동을 함께 예측 | 모든 환경 변화에 대한 즉각 대응 |
| FAST | 연속 행동을 효율적인 시퀀스로 표현 | 압축 손실 제거와 안전한 실행 |
Transformer는 기억과 행동 사이의 관계를 배울 구조를 제공한다. 실제 로봇의 결과는 자료·표현·학습 목표·생성 지연·제어기와 평가가 함께 결정한다. 토큰 정확도나 언어 모델 손실만 보지 말고, 실시간 조건에서 작업이 끝까지 수행되는지를 확인해야 한다.
#보충 연결: Decision Transformer는 어떤 결과를 원하는지도 입력한다
공식 7주차 논문 토론 자료인 Decision Transformer는 시퀀스 모델링을 강화학습 문제와 연결하는 사례다. 위의 원강의 슬라이드에 별도 알고리즘 페이지가 있는 것으로 취급하지 않고, 여기서 보충해 살펴본다.
자료에 저장된 궤적에서 각 시점 이후의 보상 합인 return-to-go를 계산하고, 그 값·상태·행동을 번갈아 시퀀스로 넣는다.
학습 때는 관측된 궤적의 결과로 계산한 수익을 사용한다. 실행 때는 원하는 수익과 현재 상태, 과거 이력을 주어 행동을 예측한다. 보상을 받으면 남은 목표 수익도 그만큼 조정한다. 가치 함수를 Bellman 식으로 반복 갱신하거나 정책 경사를 직접 계산하는 것과 다른 offline RL 접근이다.
원하는 수익을 크게 적는 것만으로 그 결과를 만들 수 있는 것은 아니다. 학습 자료가 뒷받침하지 않는 행동과 결과를 조건으로 요구하면 외삽 문제가 생긴다. 문맥 속 예시를 준다는 사실만으로 이 알고리즘을 단순한 무학습 프롬프트 사용과 같다고 보아서도 안 된다. 먼저 궤적 자료로 모델 가중치를 학습해야 한다. 행동이 연속이면 원논문처럼 연속 행동 예측 손실을 사용할 수 있어 모든 출력이 반드시 언어 어휘의 정수 토큰인 것도 아니다.
#직접 실행한 예제와 함께 읽을 자료
예제 코드와 수치 결과에는 attention 가중치·미래 마스크·입력 재배열, teacher forcing 손실, 작은 문자 BPE의 복원, 분위수 구간화의 경계와 오차, ACT의 시간 앙상블, DCT 양자화와 복원 계산을 담았다. 정답 미래 토큰을 바꾸어도 앞부분 출력이 바뀌지 않는지도 확인했다. 신경망 정책 학습이나 실제 로봇·물리 시뮬레이션을 실행했다는 뜻은 아니다.
- Stanford CS25 공식 녹화: Andrej Karpathy 강의의 23:38–28:12를 Q·K·V와 다중 head 설명에 연결했다.
- Stanford CS224n 2024 Transformer 슬라이드: attention, 위치 정보, 원래 인코더·디코더 구성을 보충한다.
- NTU 2021 self-attention: 공개 영어 자막 24:57–30:03의 점수 계산과 Value 가중합 설명을 참고했다. 원본 PPTX와 PDF도 자료 보관본에 함께 저장했다.
- Attention Is All You Need: scaled dot-product attention과 학습·병렬화의 기본 구조다.
- ACT·ALOHA 프로젝트: 원논문·코드·실물 조작 영상을 확인할 수 있다. 자체 예제와 구분해 읽는다.
- FAST 공식 프로젝트: 행동 토큰 압축과 공개 토크나이저 자료다. 본문의 DCT 예제는 이 공개 모델의 실행을 대신하지 않는다.
- Humanoid Locomotion as Next Token Prediction: 공식 토론 목록의 추가 사례다. 본문에서 실험 전체를 재현한 것으로 취급하지 않는다.
슬라이드와 강의의 저작권은 Oier Mees와 각 인용 자료의 권리자에게 있다. 자체 설명과 수치 그림은 JJo가 작성했다. 사진·논문 그림·시연 영상은 각각 원저작자의 자료다. Oier Mees · ETH Computer Vision and Geometry Group.