컵을 집기 직전에 팔을 어느 쪽으로 움직여야 할까? 지금 손끝이 컵에 가까워지는지만 보면, 잠시 돌아가더라도 충돌을 피하는 행동의 이점을 놓친다. 강화학습에서는 행동 뒤에 이어질 결과까지 한 숫자로 평가하고, 그 평가를 이용해 행동을 바꾼다. 이번 장은 그 숫자인 가치를 어떻게 계산하고 배울지 다룬다.
Oier Mees · ETH Zurich 2026 4강 · 공식 강의 · 원본 PDF
03장의 행동 복제는 “이 상황에서 전문가가 한 행동”을 정답으로 삼았다. 이번에는 로봇이 행동하고 받은 보상(reward)을 이용해, 앞으로 더 좋은 결과를 얻는 행동 규칙을 찾는다. 보상은 평가 신호이며 특정 모터 명령을 직접 알려 주는 답안은 아니다.
앞부분에서는 작은 표에 모든 상태를 적어 가치를 정확히 계산한다. 중간에는 실제로 관찰한 전이에서 값을 배우고, 뒷부분에는 표를 신경망으로 바꾸어 영상과 연속 행동을 다룬다. 이 세 단계에서 무엇을 이미 알고 있고 무엇을 데이터로 배워야 하는지 구별하면 알고리즘들이 한 흐름으로 이어진다.
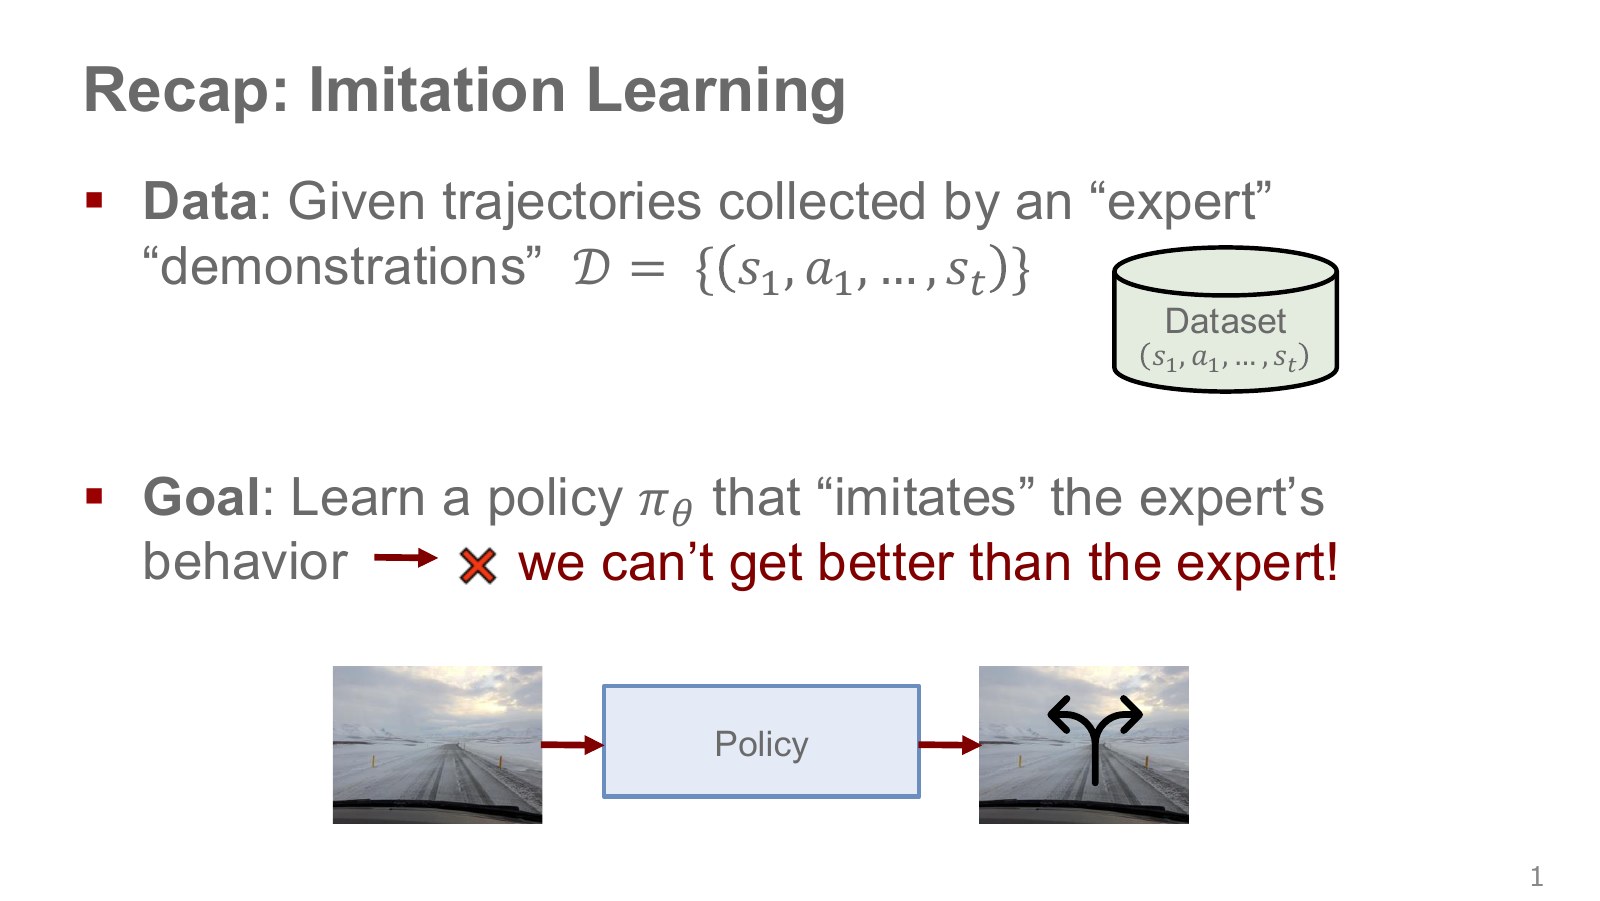
원통 모양의 데이터셋은 전문가가 남긴 상태–행동 궤적을 담는다. 도로 사진이 정책 상자를 지나 조향으로 이어지는 그림은, 관측을 입력받아 시연과 비슷한 행동을 내도록 학습한다는 뜻이다.
행동 복제의 기본 손실에는 전문가보다 더 높은 누적 보상을 찾으라는 요구가 없다. 시연이 잘못됐거나 느린 경우에도 그 행동을 맞히는 것이 학습 목표일 수 있다. 강화학습은 평가 기준을 누적 보상으로 바꾸어 그 한계를 넘을 수 있는 경로를 만든다.
그림의 “전문가보다 잘할 수 없다”는 문장은 이 목적의 차이를 강조한다. 모든 모방학습기가 어떤 평가에서도 시연자 성능을 절대로 넘지 못한다는 수학적 불가능성으로 읽지는 말자. 일반화나 여러 시연의 결합으로 평가 결과가 달라질 수 있지만, 행동 복제만으로 보상 개선이 보장되는 것은 아니다.
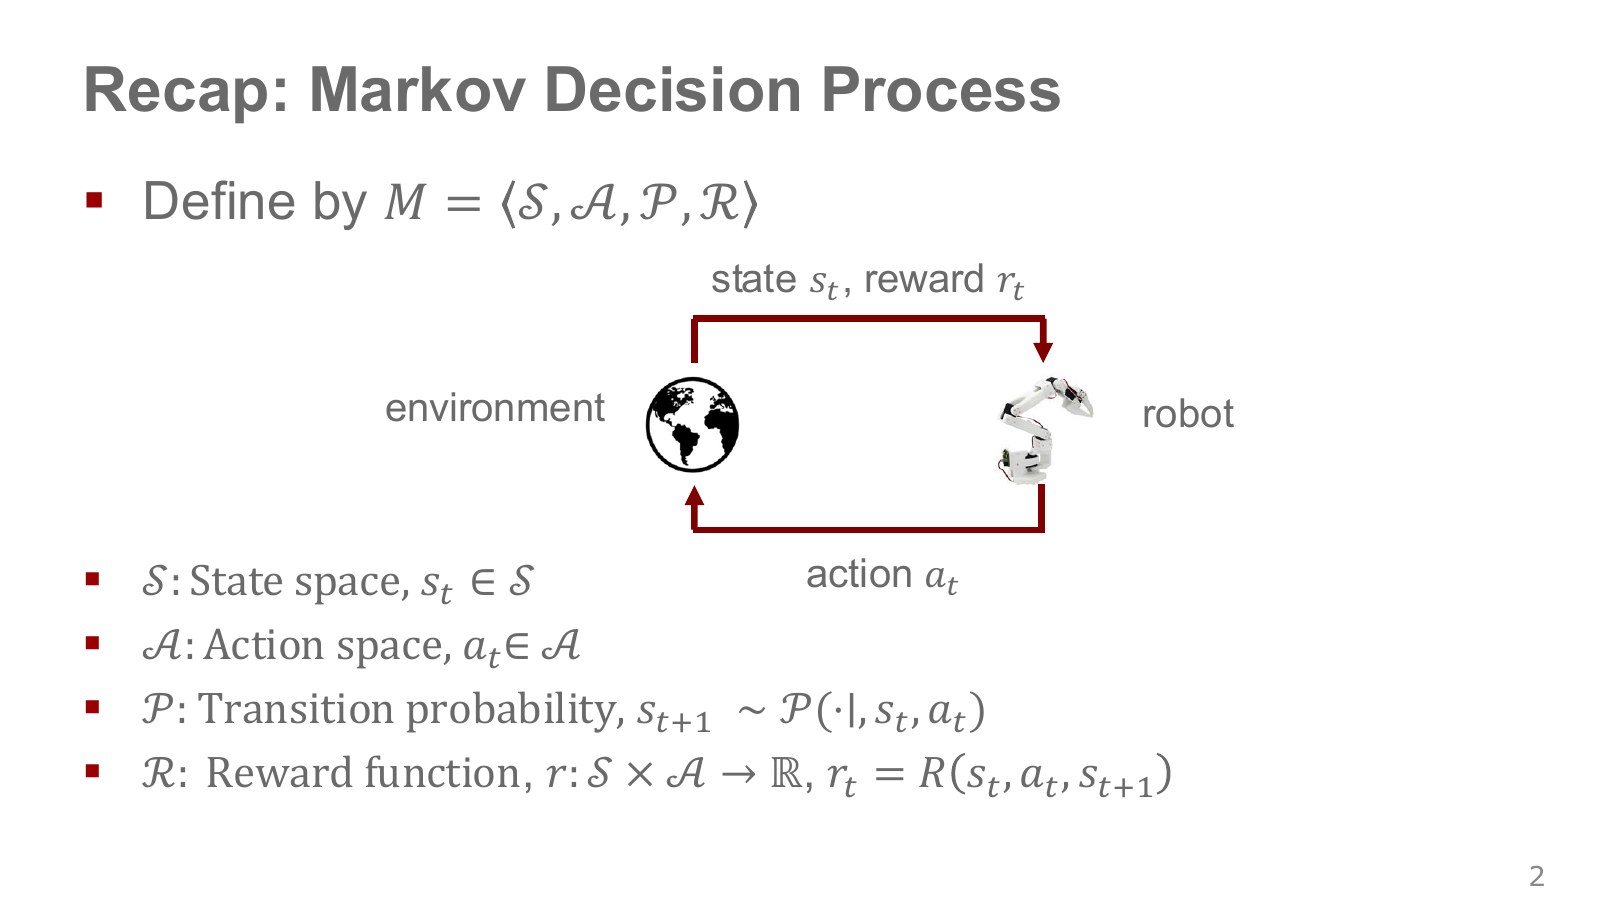
마르코프 결정 과정(MDP)은 환경과 에이전트의 반복 상호작용을 나타낸다. 상태 공간 는 가능한 상태들의 집합, 행동 공간 는 가능한 명령들의 집합이다. 전이 는 현재 상태 에서 행동 를 했을 때 다음 상태 가 나올 가능성이다.
위쪽 화살표는 환경이 상태와 보상을 돌려주는 경로, 아래쪽 화살표는 로봇의 행동이 환경으로 들어가는 경로다. 한 번 실행하면 다음 묶음을 얻는다.
는 물리적인 실행 순서다. 이후 식의 는 계산을 반복한 횟수이므로 서로 구별한다. 보상은 다음 상태에 따라 달라질 수도 있어 로 쓴다. 간단히 라고 쓰는 식에서는 그 전이에 대한 기대 즉시 보상으로 이해한다. 원본의 보상 함수 표기도 이 두 관례가 섞여 있다.
컵 집기라면 상태에 관절 위치·속도와 물체 배치 등이 들어갈 수 있고, 행동은 손끝 변화량이나 토크가 될 수 있다. 영상 관측만 쓰는 경우에는 그것이 완전한 마르코프 상태인지 별도로 따져야 한다. 상태·관측 구별은 02장을 따른다.
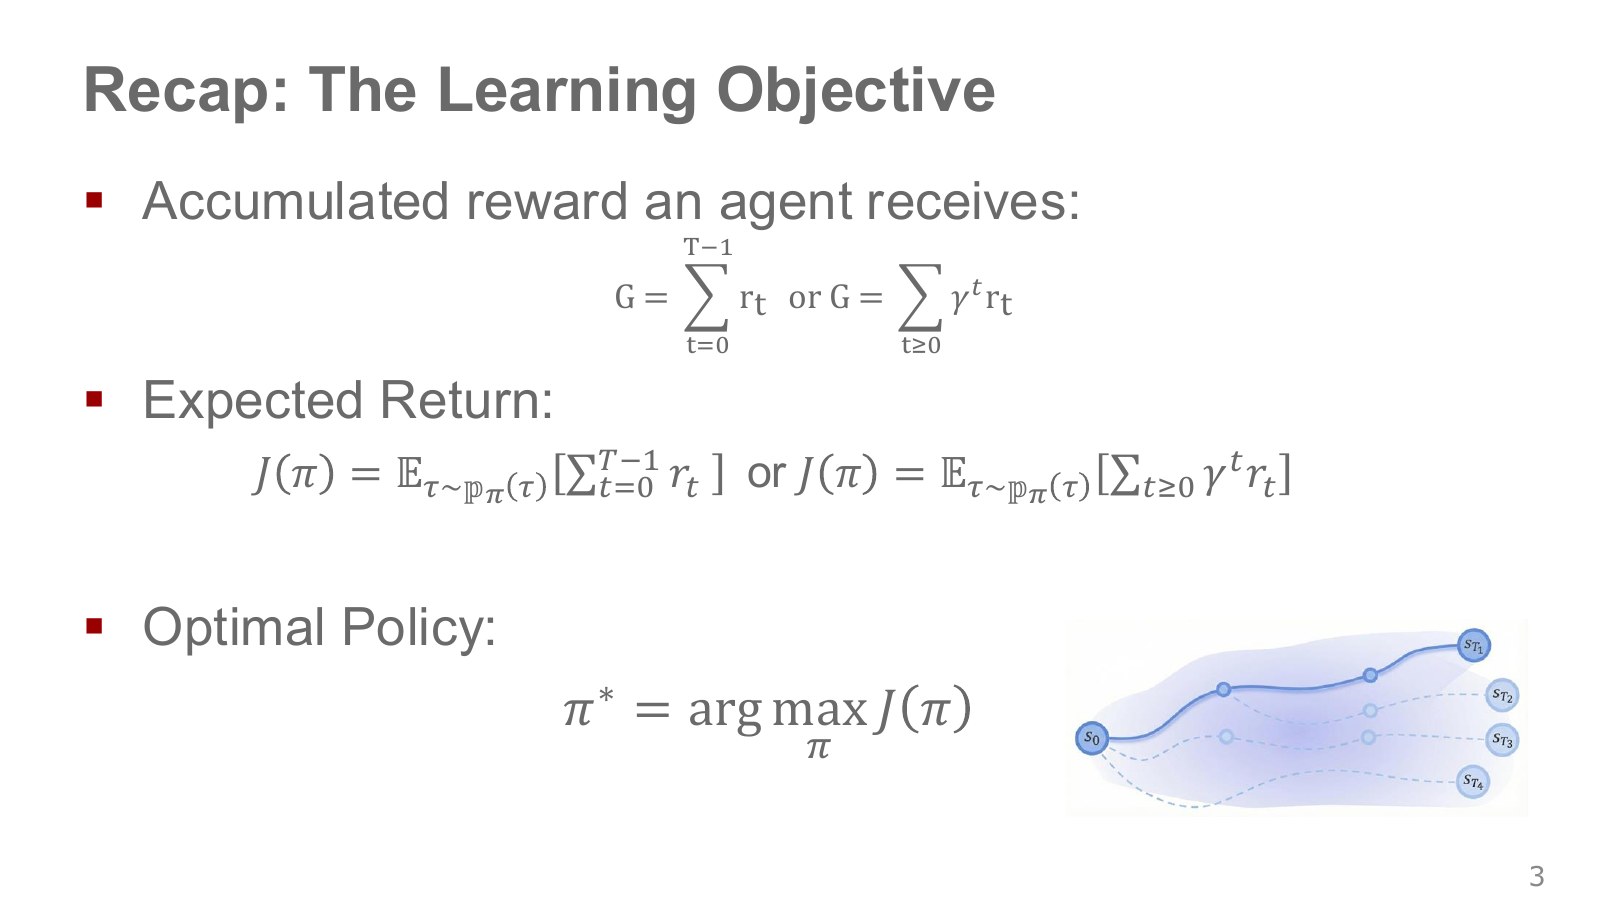
리턴(return)은 한 번 실행하면서 받는 보상의 합이다. 할인율 를 두면 먼 시점의 보상에 더 작은 가중치를 준다. 다음 식에서 는 유한 실행의 단계 수다.
는 시간 순서의 상태와 행동인 궤적, 는 정책이다. 는 가능한 결과들의 확률을 고려한 평균이다. 오른쪽의 갈라지는 경로처럼 같은 정책도 환경 외란이나 확률적인 행동 때문에 여러 실행을 만들 수 있다. 한 번 성공한 영상만으로 기대 성능을 알 수는 없다.
최적 정책 는 이 기대 리턴을 가장 크게 하는 정책이다. 가 가장 큰 값을 뜻한다면 는 그 값을 만드는 선택을 뜻한다. 여러 정책이 같은 성능을 낼 수도 있다. 무한 합에서는 보상이 유계이고 인 설정을 주로 사용한다.
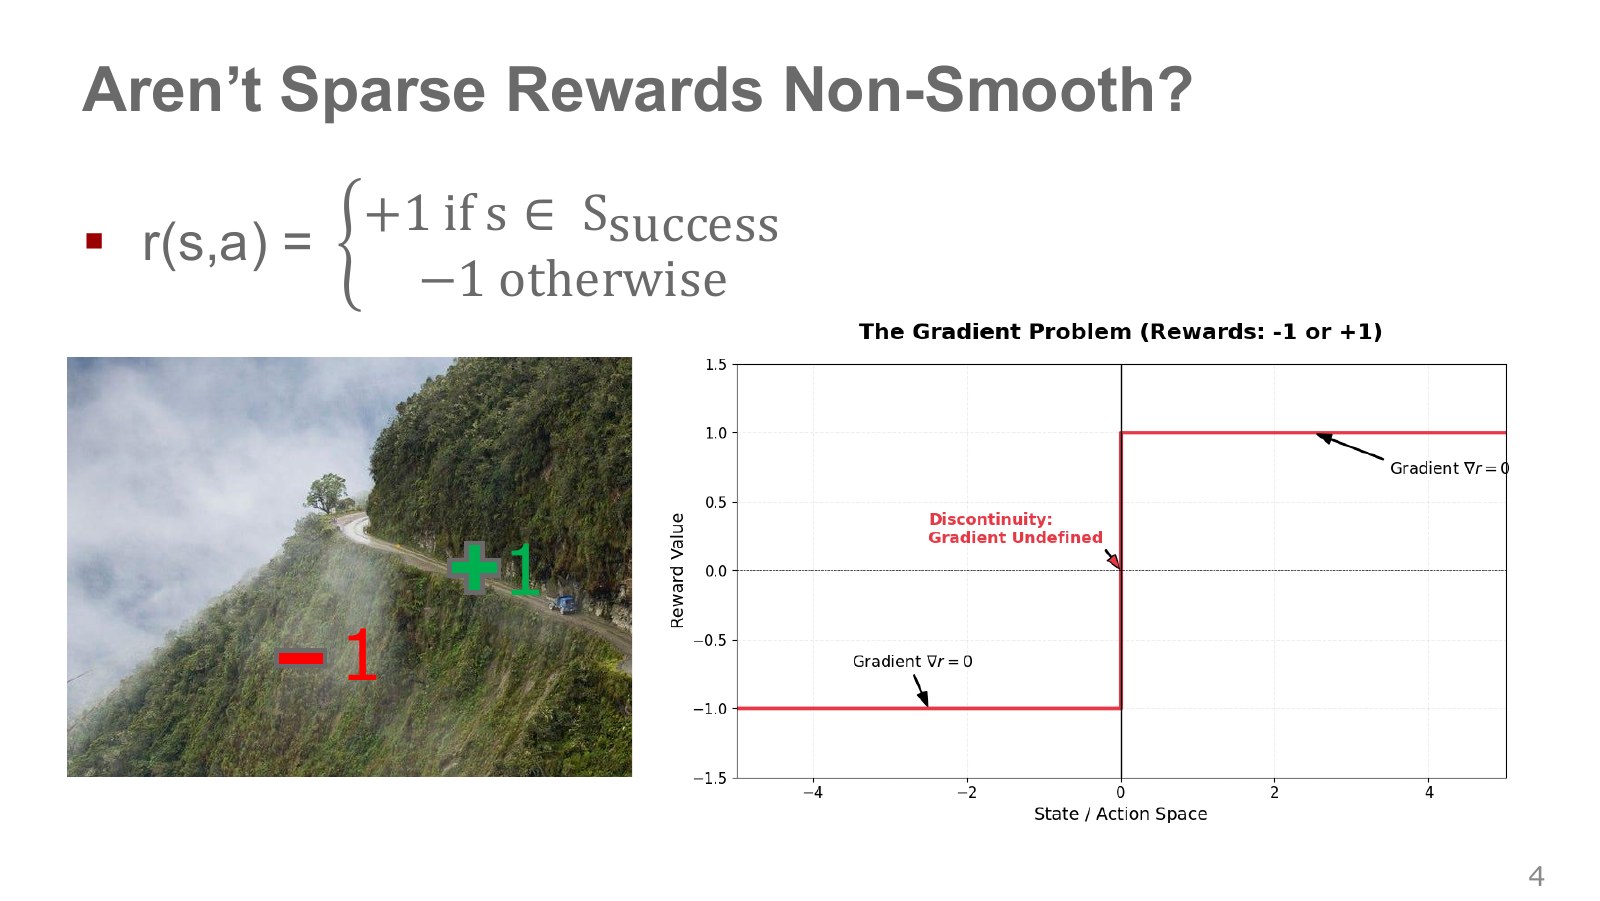
길 위에 있으면 +1, 절벽 밖이면 −1인 단순 보상을 생각하자. 오른쪽 빨간 선은 두 결과 사이에서 값이 갑자기 바뀌는 계단 함수다. 평평한 부분에서는 위치를 조금 바꾸어도 보상이 같아서 미분값이 0이고, 경계에서는 보통의 미분이 정의되지 않는다.
따라서 로봇의 위치나 행동을 미세하게 바꾸며 이 보상 자체의 기울기를 그대로 따라가는 방법은 어디로 개선해야 할지 유용한 정보를 얻기 어렵다. 경계에서 기울기가 “엄청 크니 그냥 따라가면 된다”는 뜻도 아니다.
희소 보상과 불연속 보상은 구별하자. 희소하다는 것은 유의미한 보상을 드물게 받는다는 뜻이고, 불연속이라는 것은 입력 변화에 따라 값이 점프한다는 뜻이다. 이 예는 단순한 이진 결과를 쓰지만, 모든 희소 보상이 똑같은 모양의 계단 함수인 것은 아니다.
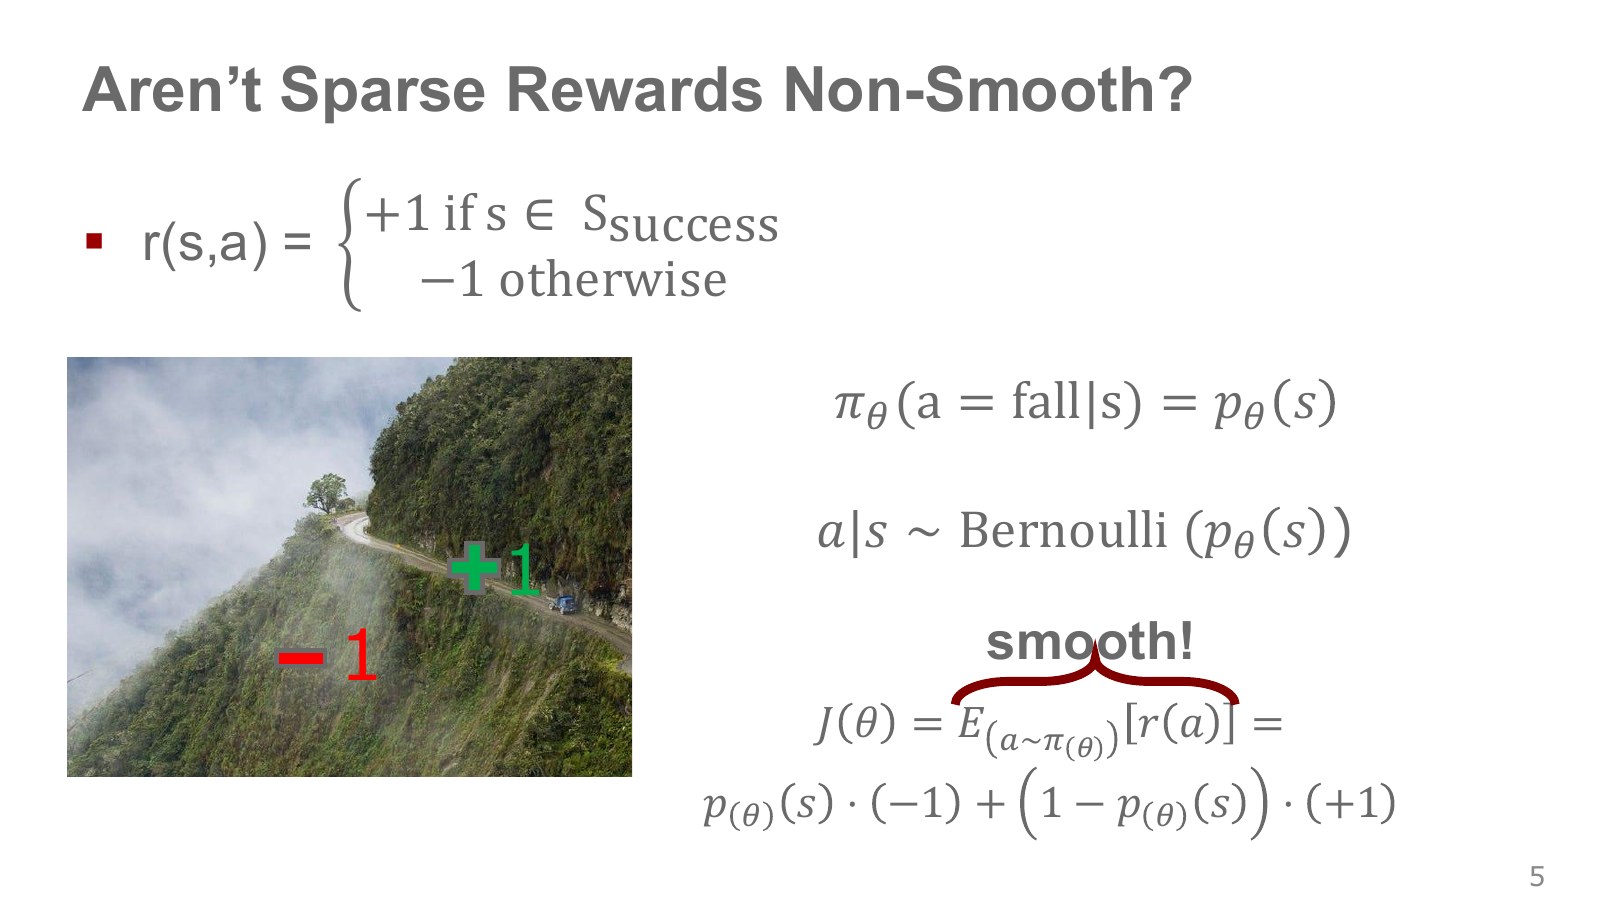
를 현재 상태에서 실패할 확률로 두자. 는 정책을 정하는 매개변수다. 실패 여부를 0 또는 1인 베르누이 변수로 모델링하면, 실패 확률과 성공 확률을 곱해 기대 보상을 계산할 수 있다.
실패 확률이 0.1이면 기대 보상은 0.8이다. 실제 한 번 실행에서 0.8점을 받는다는 뜻은 아니다. 실행 결과는 여전히 +1 또는 −1이지만, 많은 실행을 평균한 값이 0.8이라는 뜻이다.
실패 확률이 매개변수에 대해 미분 가능하면, 기대 보상도 그 확률을 통해 미분할 수 있다. 즉 결과의 보상을 직접 미분하는 것과, 좋은 결과가 나올 확률을 바꾸는 것은 다르다. 모든 확률적 정책이 자동으로 매끄러운 목적을 만드는 것은 아니며 분포의 매끄러움과 기대값·미분을 교환할 조건 등이 필요하다.
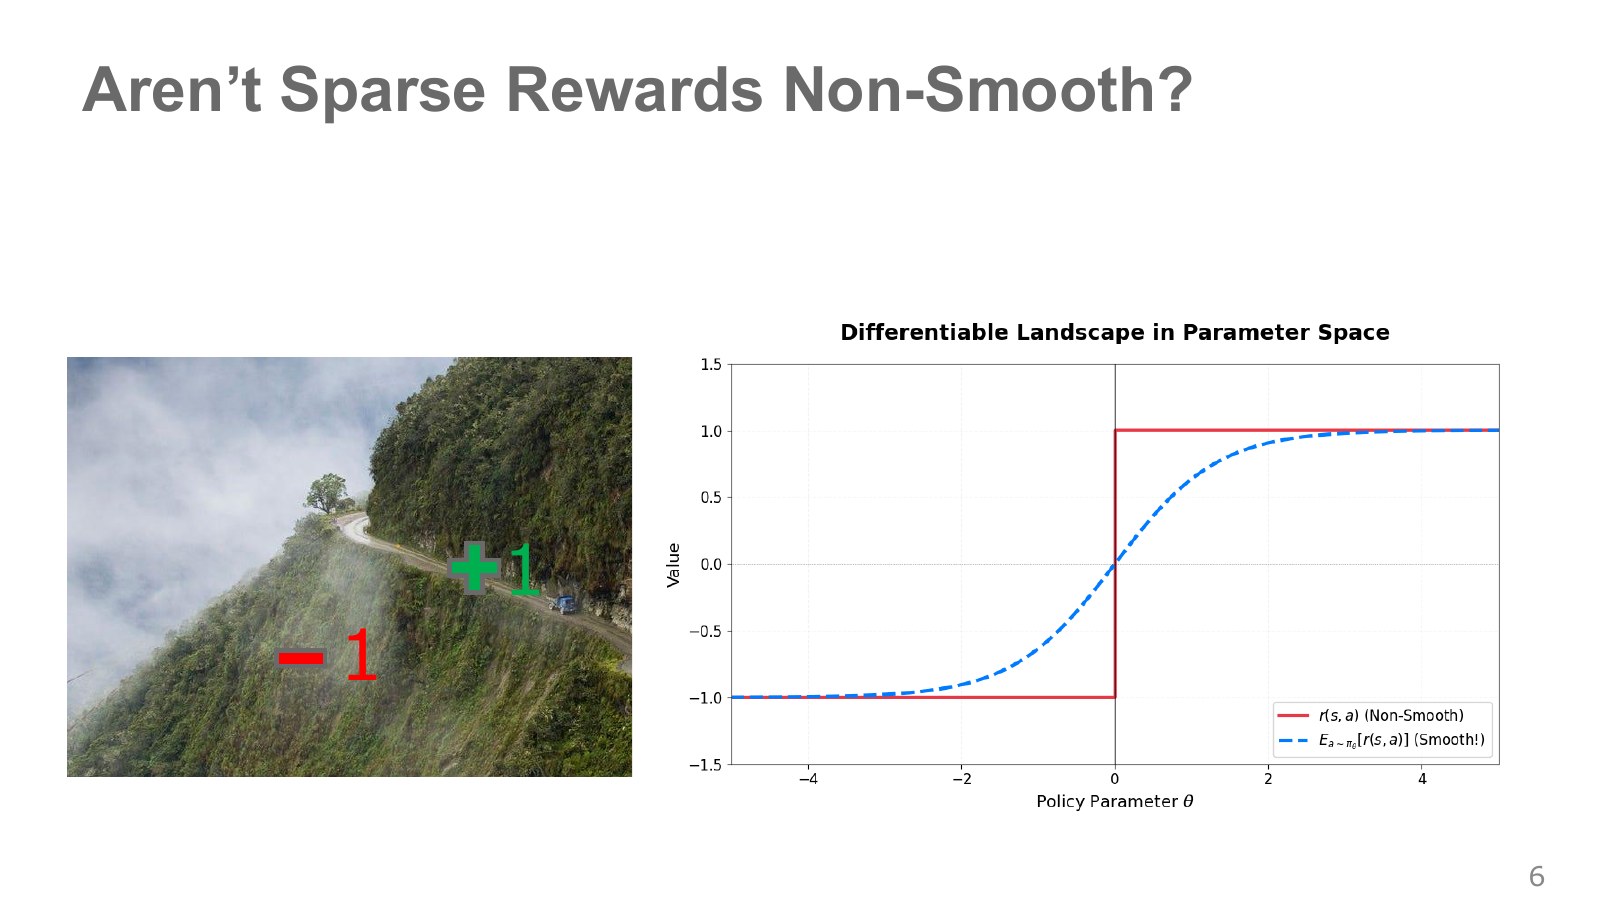
빨간 계단은 특정 결과의 좋고 나쁨을, 파란 점선은 정책을 바꿀 때 달라지는 평균 결과를 보여 준다. 가로축은 정책 매개변수다. 파란 곡선이 위로 올라간다는 것은 그 방향으로 매개변수를 조절할수록 성공 쪽에 더 큰 확률을 준다는 예시다.
앞 장에서는 를 실패 확률로 정의했으므로 그 값이 커지면 기대 보상은 내려간다. 그래프의 올라가는 방향과 비교할 때는 “현재 기호가 성공 확률인가, 실패 확률인가”부터 확인해야 한다. 원본 그림의 두 선을 아무 조건 없이 같은 입력 함수로 빼고 더하지는 말자.
이 설명은 정책 기울기 방법이 이진 보상에서도 학습 신호를 얻을 수 있는 직관이다. 이번 장의 가치 반복과 Q-learning은 보상을 직접 미분하지 않고 값의 재귀 관계와 표본 갱신을 사용한다. 강화학습의 모든 알고리즘이 이 파란 곡선을 경사 하강하는 것은 아니다.
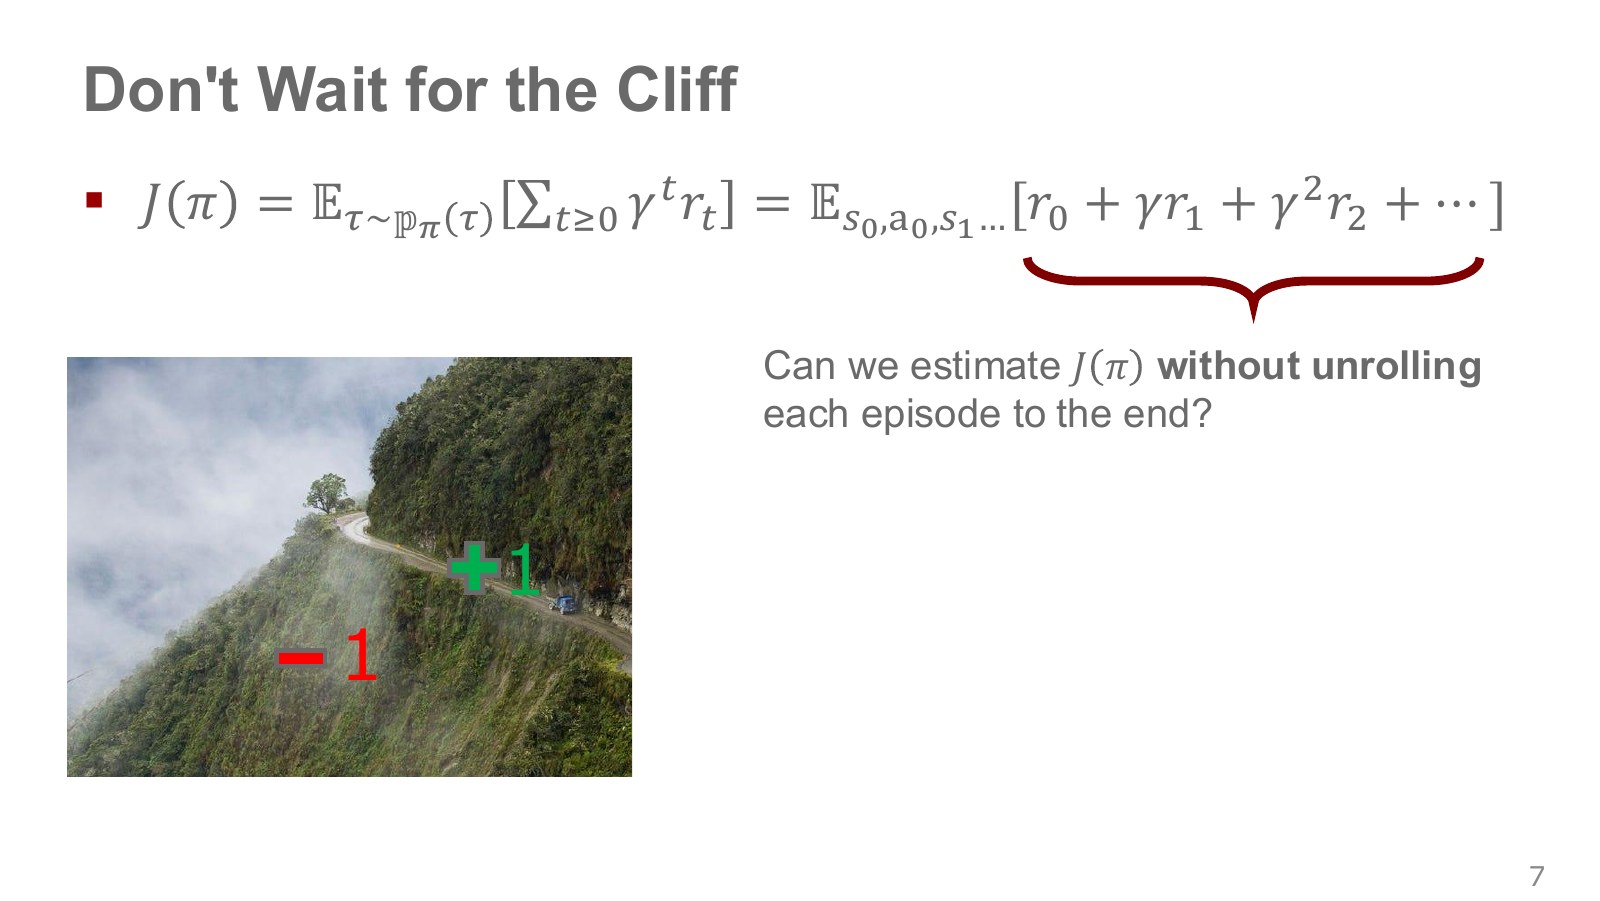
를 실제로 전부 더하려면 긴 실행을 기다려야 한다. 이를 끝난 궤적에서 측정하는 방식은 직관적이지만, 한참 뒤의 결과가 필요한 과업에서는 갱신이 늦어진다.
대신 “지금까지 받은 보상”과 “다음 상태에서 앞으로 받을 보상의 예상치”를 이어 붙일 수 있다. 이때 예상치를 제공하는 것이 가치 함수(value function)다. 아직 끝나지 않은 실행에서도 값을 갱신할 수 있다는 점이 핵심이다.
그렇다고 아무 경험 없이 절벽의 위험을 저절로 알아내는 것은 아니다. 모델이나 이전 데이터로부터 추정한 미래 값이 있어야 하며, 그 추정도 틀릴 수 있다. 끝까지 실행하지 않고 배우는 계산 방법과 실제 장비에서 위험한 탐색을 막는 운영 방법은 별개다.
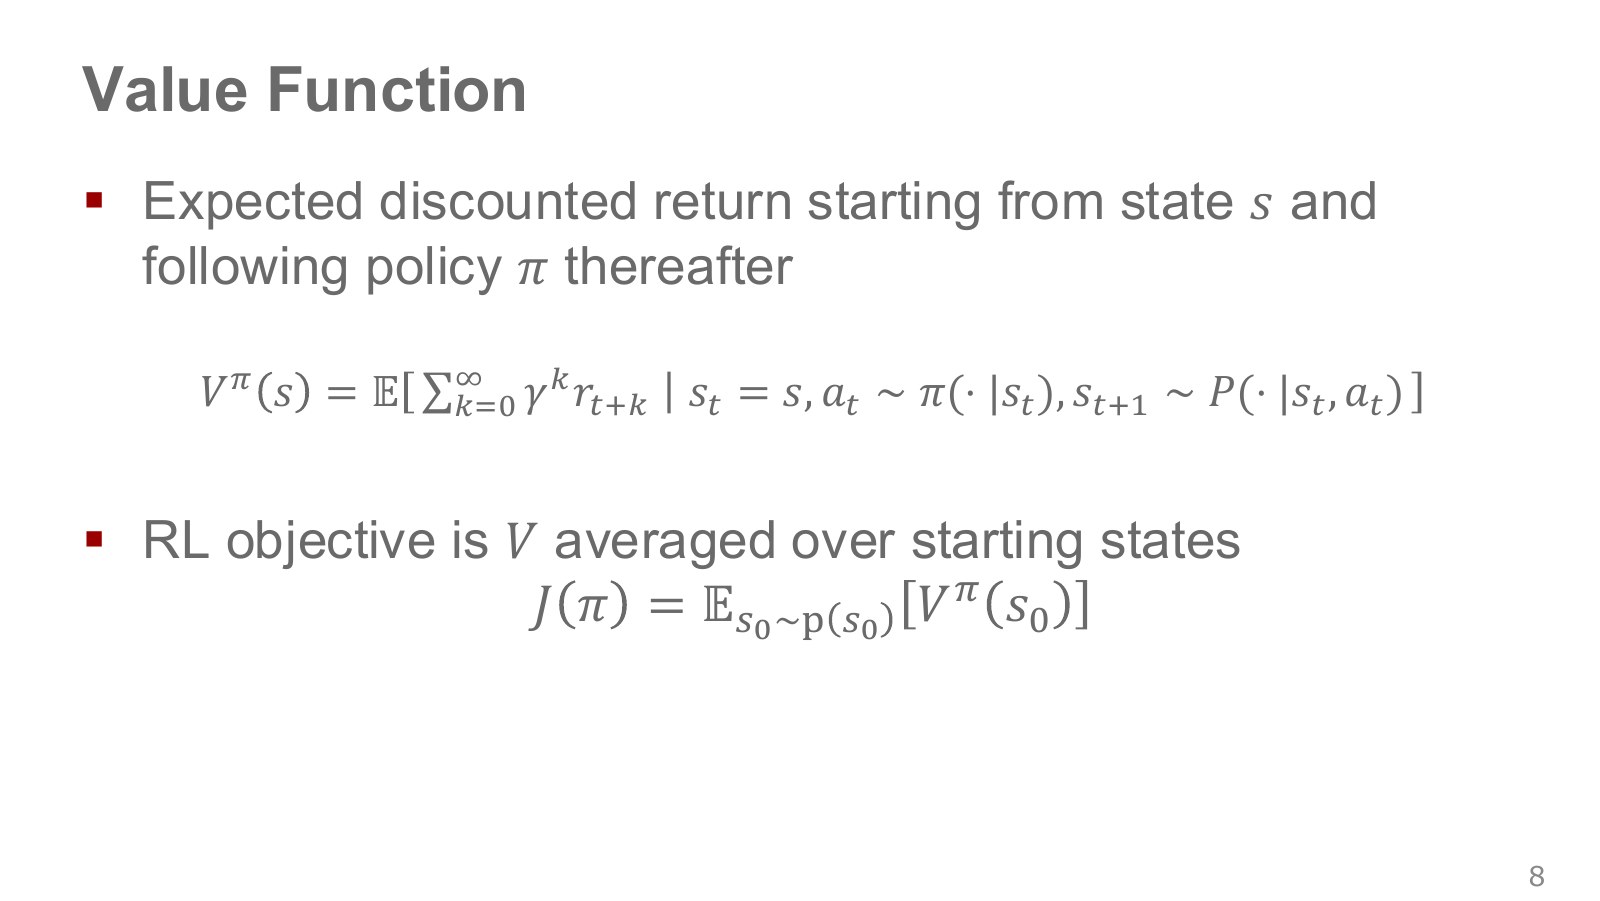
는 상태 에서 출발해 이후 정책 를 따를 때의 기대 리턴이다. 위첨자 는 거듭제곱이 아니라 “어느 정책을 평가하는가”를 표시한다.
컵에 가까운 상태라도 집게가 엉뚱하게 움직이는 정책을 쓰면 가치가 낮을 수 있다. 따라서 가치는 위치만의 고유한 점수가 아니라 환경·보상·할인율·정책이 함께 정하는 숫자다. 성공 확률과도 일반적으로 다르며 음수가 되거나 1을 넘을 수 있다.
처음 상태를 여러 곳에서 뽑는다면 전체 목표는 그 시작 분포 에 대해 가치를 평균한 다. 한 상태의 예상 성능과 실험 전체의 평균 성능을 연결하는 관계다.
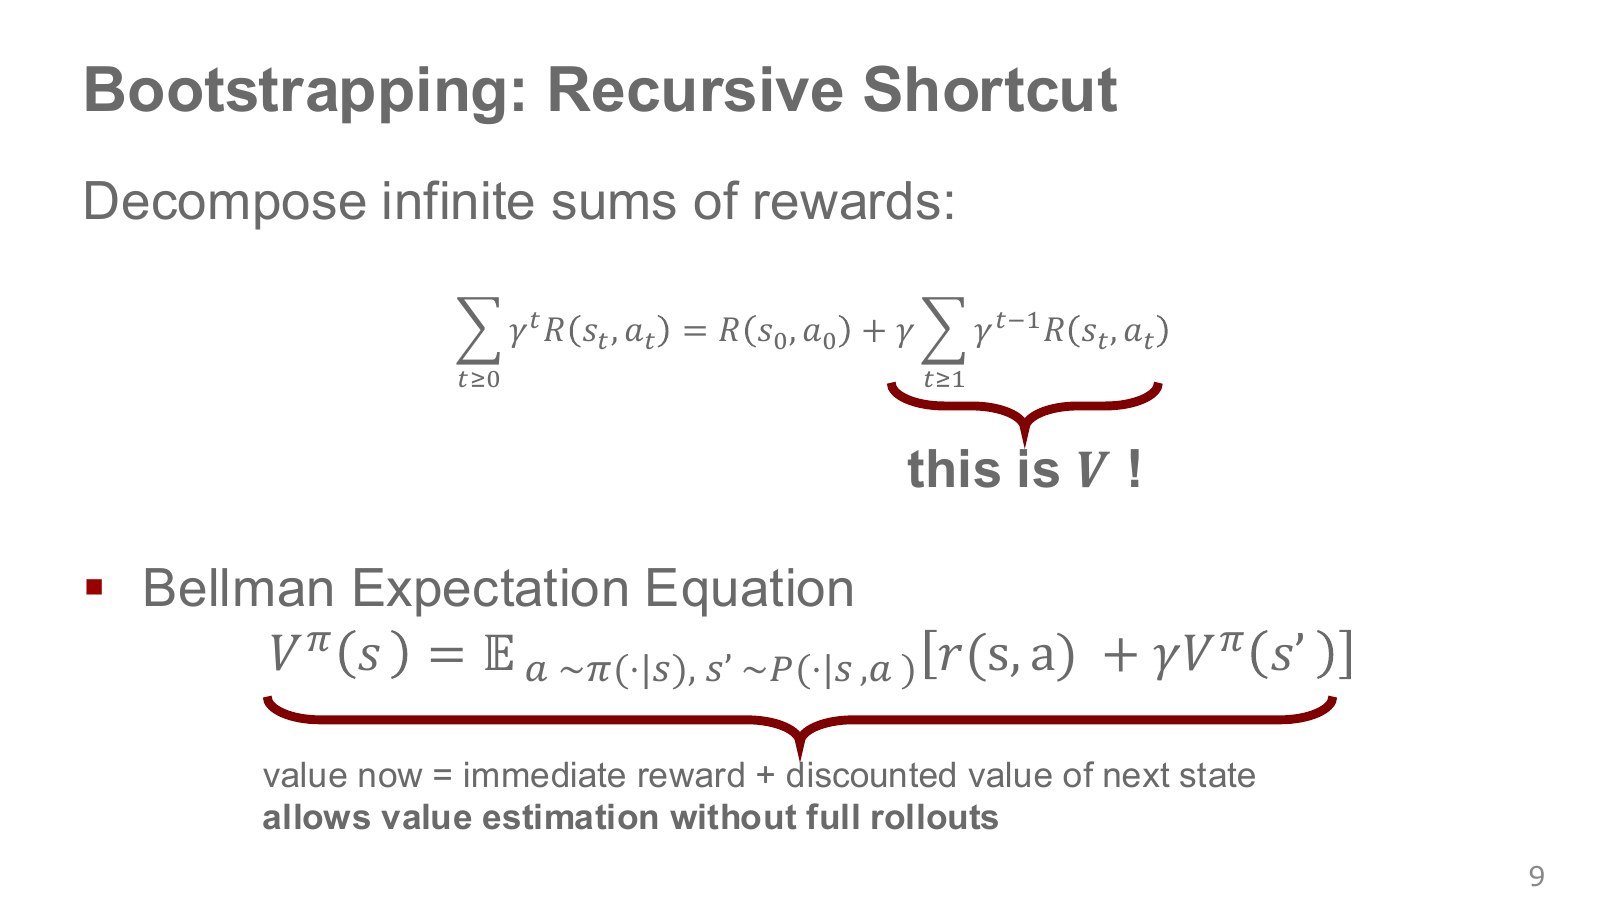
미래 보상의 합에서 첫 항을 떼면 나머지에는 할인율 하나가 공통으로 붙는다. 이 단순한 분해가 긴 시간의 문제를 한 단계의 재귀 관계로 바꾼다.
바깥 합은 정책이 고를 수 있는 행동들의 평균, 안쪽 합은 그 행동 뒤 환경이 만들 수 있는 다음 상태들의 평균이다. “다음 상태 가치가 이미 현재 보상까지 포함한다”고 읽으면 보상을 두 번 세게 된다. 여기서 는 다음 상태에 도착한 뒤의 보상을 요약한다.
현재의 추정치를 다음 추정의 재료로 사용하는 것을 부트스트래핑(bootstrapping)이라 한다. 다음 가치가 0.8, 지금 보상이 0.2, 할인율이 0.9라면 한 단계 목표는 0.92다. 실제 과업 종료 뒤에는 더 받을 보상이 없으므로 미래 항을 0으로 둔다.
Silver의 동적 계획법 강의 13:00부터도 벨만 관계를 반복 계산으로 바꾸어 설명한다. 방정식의 참값 관계와, 그 참값을 얻기 위해 임시 값을 반복 갱신하는 알고리즘을 구별하자.
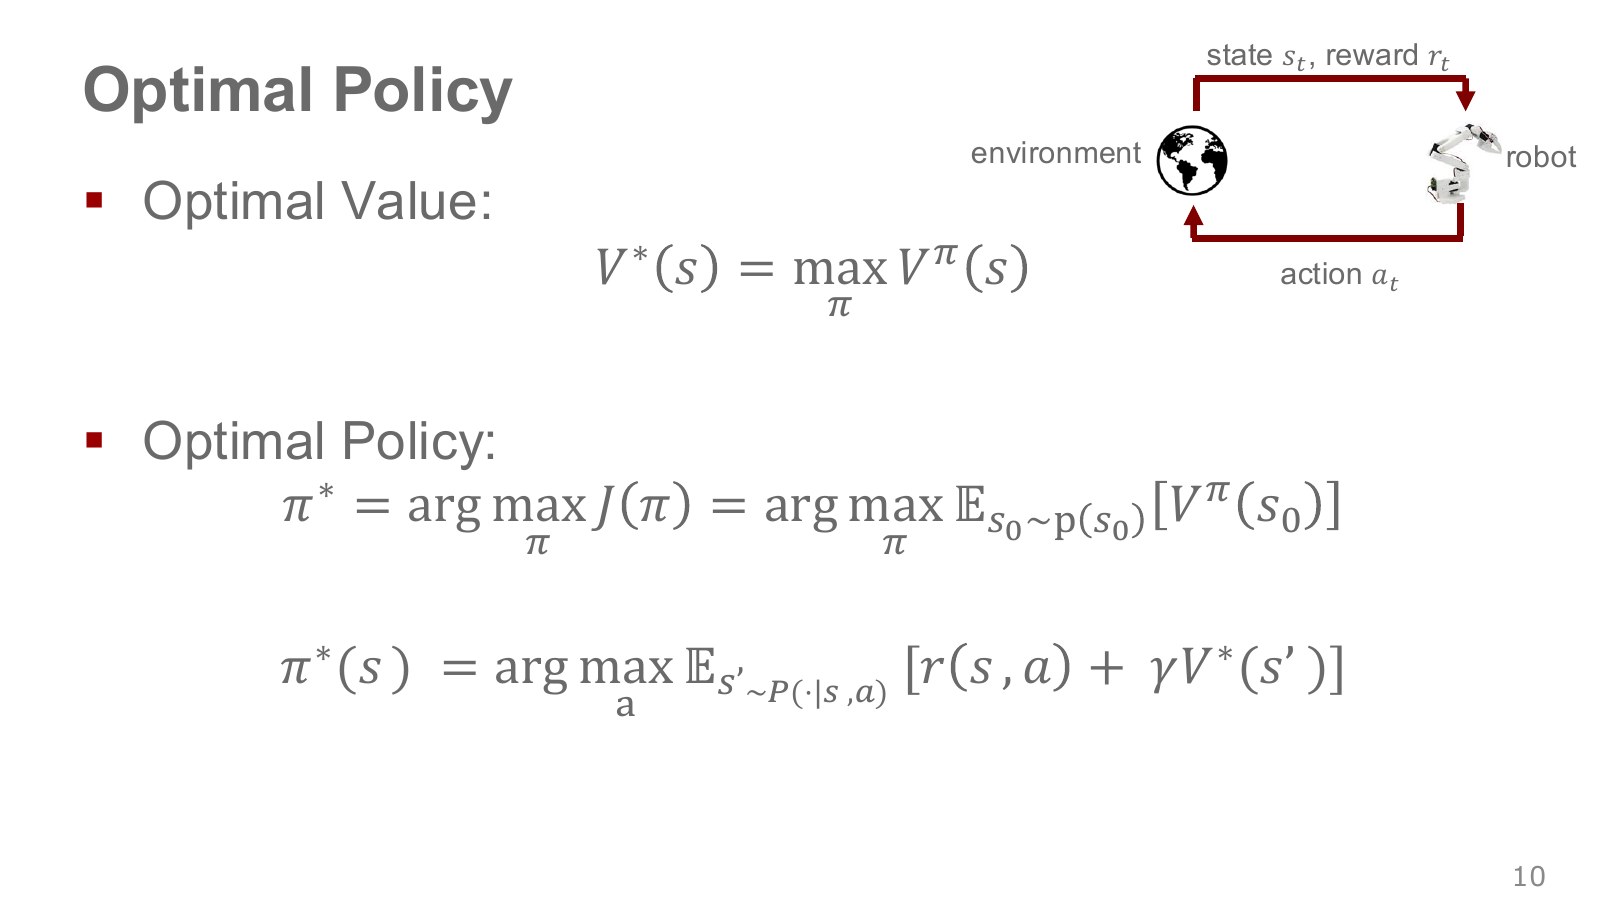
정책을 고정한 와 달리 는 가능한 정책 중 가장 좋은 가치다. 그 값을 이미 알고 있다면, 현재 보상과 다음 최적 가치의 합이 가장 큰 행동을 고르면 된다.
첫 줄은 최대 가치, 둘째 줄은 그 가치를 만드는 행동이다. 동점 행동이 여럿일 수 있어 원소라는 기호 를 썼다. 위 식은 여기서 다루는 유한 상태·행동, 할인 MDP의 조건에서 읽는다.
이것은 지금 당장 보상이 큰 행동만 고르는 근시안적 규칙이 아니다. 다음 상태의 가치 안에 긴 미래가 들어 있기 때문이다. 당장은 보상이 없는 밀기 행동도 나중의 집기를 쉽게 만든다면 큰 값을 가질 수 있다.
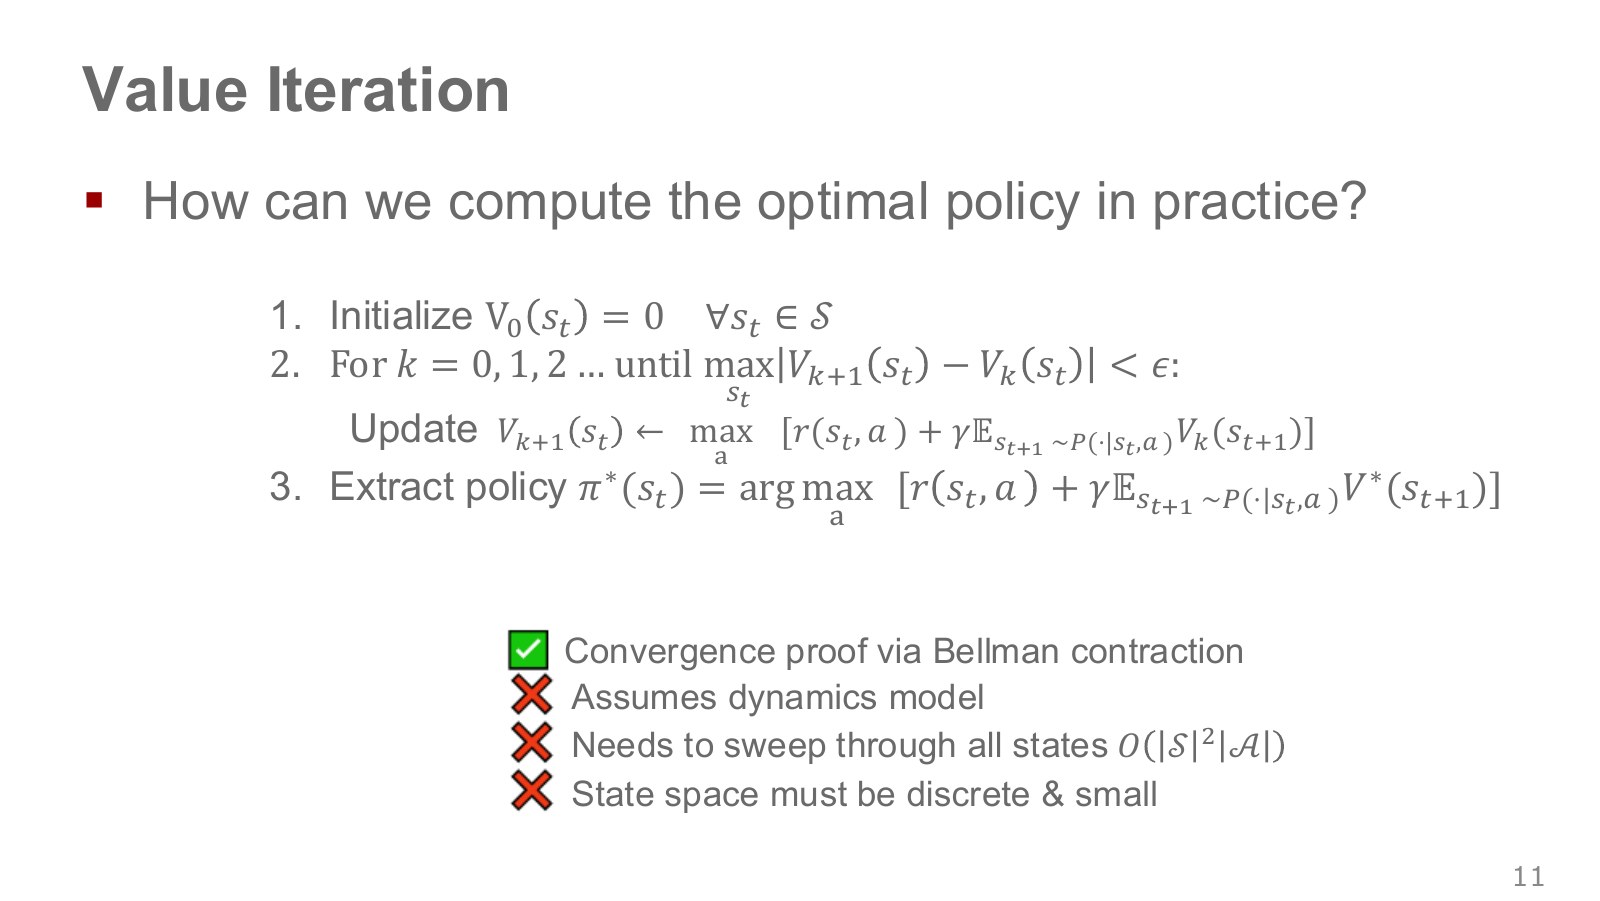
가치 반복(value iteration)은 모든 상태의 값을 처음에는 0처럼 간단한 수로 두고, 최적 벨만 관계의 오른쪽을 반복 계산한다.
한 번의 스윕(sweep)은 표에 있는 모든 상태를 한 차례 갱신하는 것이다. 동기식 계산에서는 스윕을 마칠 때까지 이전 표를 그대로 읽고 새 표에 쓴다. 가 증가해도 실제 로봇이 한 발 움직인 것은 아니다. 모델 위에서 계산을 반복한 횟수다.
유한 할인 MDP에서 이 연산은 두 가치 표의 최대 차이를 최대 배로 줄이는 수축(contraction) 성질을 가진다. 반복하면 같은 고정점인 최적 가치에 가까워진다. 할인율 1인 모든 문제에 같은 보장을 그대로 적용할 수는 없다.
표의 최대 변화량이 충분히 작아지면 멈추고, 그 표에 대해 최선 행동을 추출한다. 조밀한 전이 행렬로 모든 다음 상태를 합하면 한 스윕의 연산량은 대략 다. 실제로 가능한 다음 상태가 적은 희소 전이는 더 싸게 계산할 수 있다. 상태 수가 적고 모델을 아는 경우에 좋은 기준 해법이 된다.
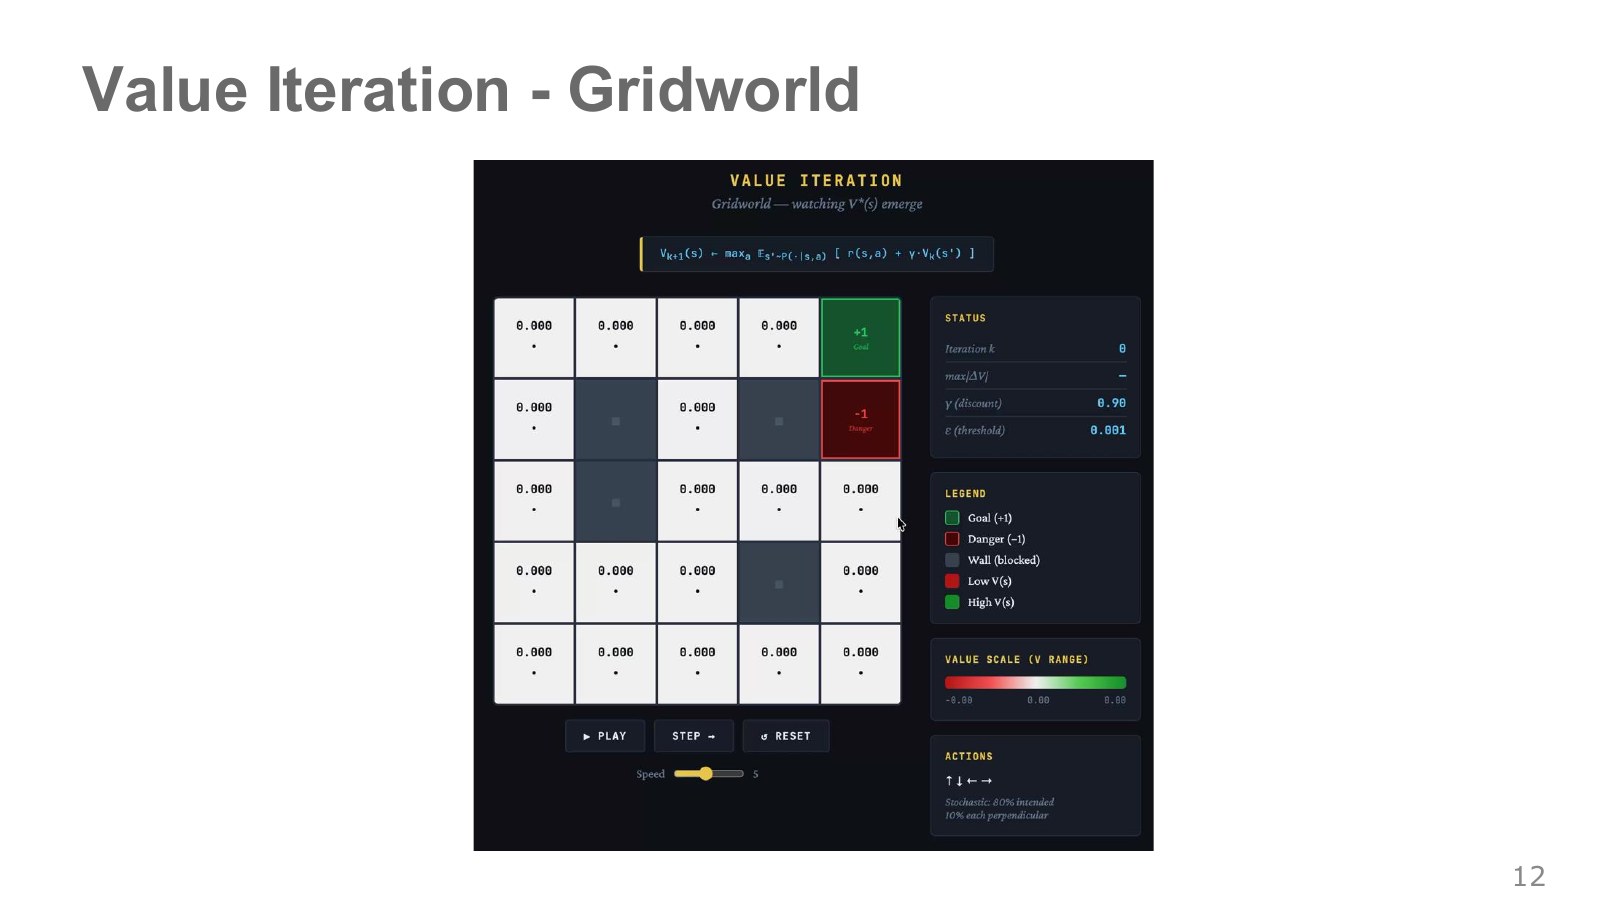
초록 칸은 목표, 빨강 칸은 위험, 회색 칸은 벽이다. 흰 칸의 숫자는 그 칸에서 앞으로 얻을 할인 보상의 추정치이며, 화살표는 그 추정치로 고른 행동이다. 색은 숫자의 높낮이를 보기 쉽게 표시한 것으로, 방문 횟수나 성공 확률 자체는 아니다.
원본 데모는 의도한 방향으로 80%, 양옆 방향으로 각각 10% 움직이는 예다. 벽이나 경계를 만나면 어떻게 처리하는지도 전이 모델의 일부다. 초기에 값이 모두 0이었다가 목표 근처부터 값이 생기는 이유는, 한 스윕에서 미래 보상 정보가 한 단계씩 앞쪽 상태에 전달되기 때문이다.
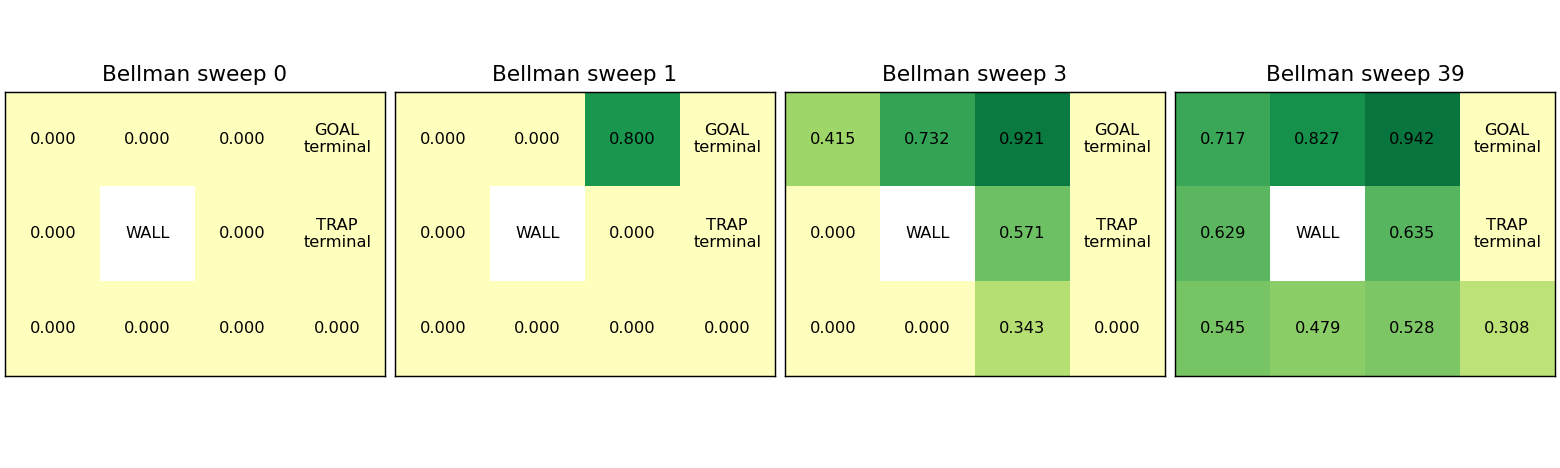
다음 그림은 같은 원리를 확인하려고 직접 만든 별도 3×4 환경이다. 목표에 들어갈 때 +1, 위험에 들어갈 때 −1을 받고 종료한다. 따라서 종료 칸의 이후 가치 자체는 0이다. 목표 칸의 +1 표지와 그 칸의 미래 가치를 혼동하지 않기 위해 이렇게 정했다.
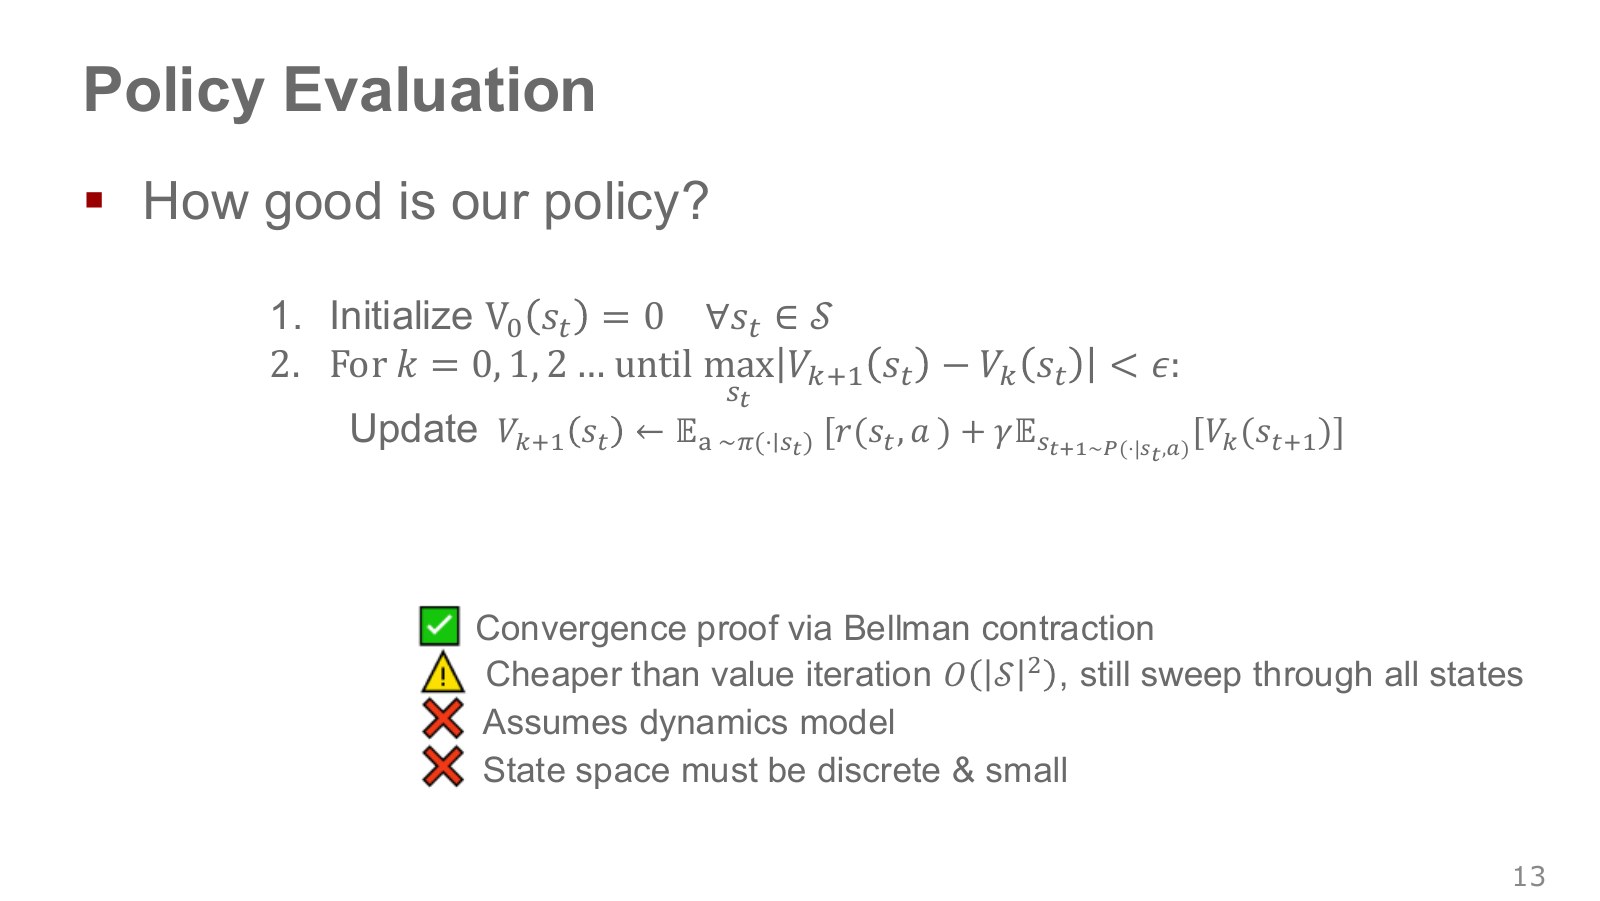
이번에는 행동을 바꾸지 않고 특정 정책 가 얼마나 좋은지 묻는다. 정책 평가(policy evaluation)는 최선 행동을 고르는 대신, 그 정책이 실제로 택할 행동들에 대해 평균을 낸다.
가령 어떤 상태에서 두 행동의 한 단계 예상 결과가 각각 0과 1이고 정책이 반반 선택하면, 평가값은 0.5다. 최선 행동만 고르는 연산이라면 1이겠지만, 그것은 현재 정책을 평가하는 질문과 다르다.
그림의 “더 싸다”는 표현도 구현 조건을 본다. 결정적 정책이거나 정책을 평균낸 전이 행렬과 보상을 미리 구했다면 한 스윕을 로 셀 수 있다. 확률 정책의 모든 행동을 매번 명시적으로 합하면 행동 수의 비용도 남는다. 최댓값을 평균으로 바꿨다고 모든 구현에서 행동 관련 계산이 사라지는 것은 아니다.
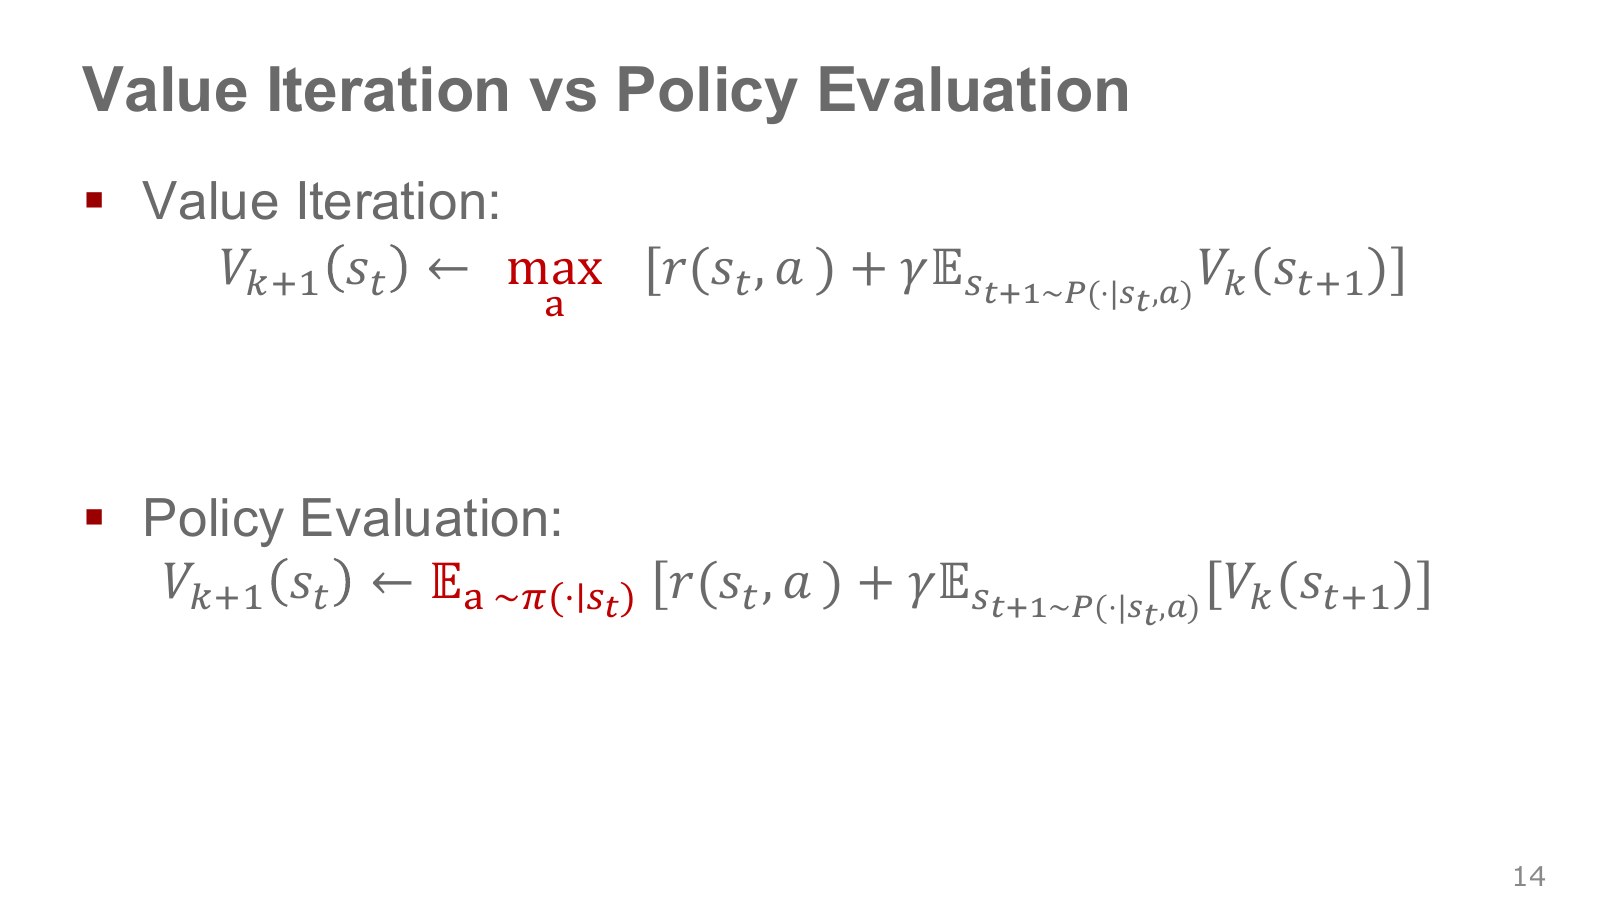
빨간 는 “지금부터 가장 잘할 행동을 고른다면?”이라는 질문이다. 빨간 는 “이미 정한 정책이 실제로 하는 대로 행동한다면?”이라는 질문이다. 둘 다 다음 상태의 가치를 사용하지만, 현재 행동을 정하는 규칙이 다르다.
예를 들어 컵을 향해 곧장 가는 행동의 예상 결과가 0.8이고 돌아가는 행동이 0.6이라고 하자. 현재 정책이 둘을 반반 선택하면 평가에는 0.7이 들어가고, 최댓값 연산에는 0.8이 들어간다. 이 숫자는 차이를 보여 주기 위한 자체 예다.
정책 평가와 가치 반복을 식의 모양만 보고 같은 알고리즘으로 외우면 안 되는 이유다. 무엇을 고정하고 무엇을 개선하는지를 먼저 정해야 다음 단계인 정책 반복이 이해된다.
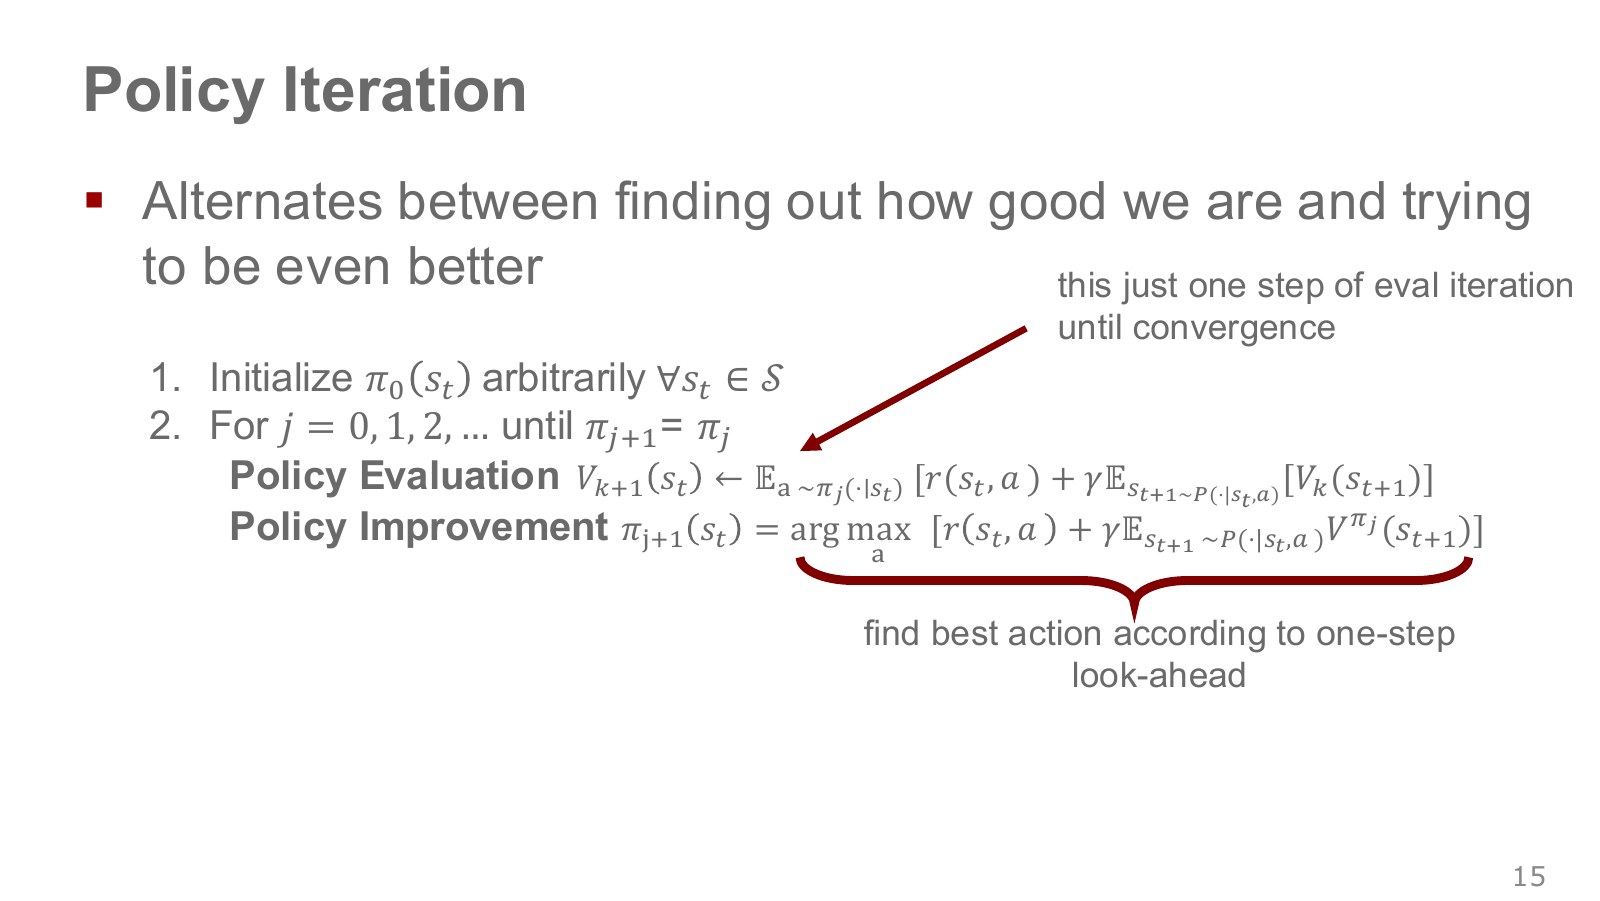
정책 반복(policy iteration)은 두 작업을 번갈아 수행한다. 먼저 현재 정책을 충분히 평가해 를 구한다. 그다음 이 값을 기준으로 더 좋은 한 단계 행동을 고른다.
는 정책을 바꾼 횟수다. 그 안에서 가치 평가를 반복하는 와 다르다. 원본의 평가 줄 하나는 보통 수렴할 때까지 반복하는 안쪽 계산을 줄여 적은 것이다. 평가를 한 번만 하고 바로 개선하는 변형은 일반화된 정책 반복과 관련되지만, 여기서의 정확한 평가 절차와 구별한다.
유한 할인 MDP에서 정확한 평가와 탐욕적 개선을 하면 가치는 나빠지지 않는다. 매번 모든 상태의 값이나 특정 시작점의 리턴이 엄격하게 올라가야 한다는 뜻은 아니다. 동점 행동만 바뀌거나 이미 최적일 수 있다. 동점에서는 기존 행동을 유지하는 등 일관된 규칙을 쓰면 쓸데없는 정책 교체도 줄일 수 있다.
Silver의 평가–개선 연결 설명 35:40부터도 같은 두 질문을 구분한다. 손실 함수를 한 번 미분하는 것과 달리, 여기서는 모델의 확률들을 합하여 표를 계산하고 정책을 바꾼다.
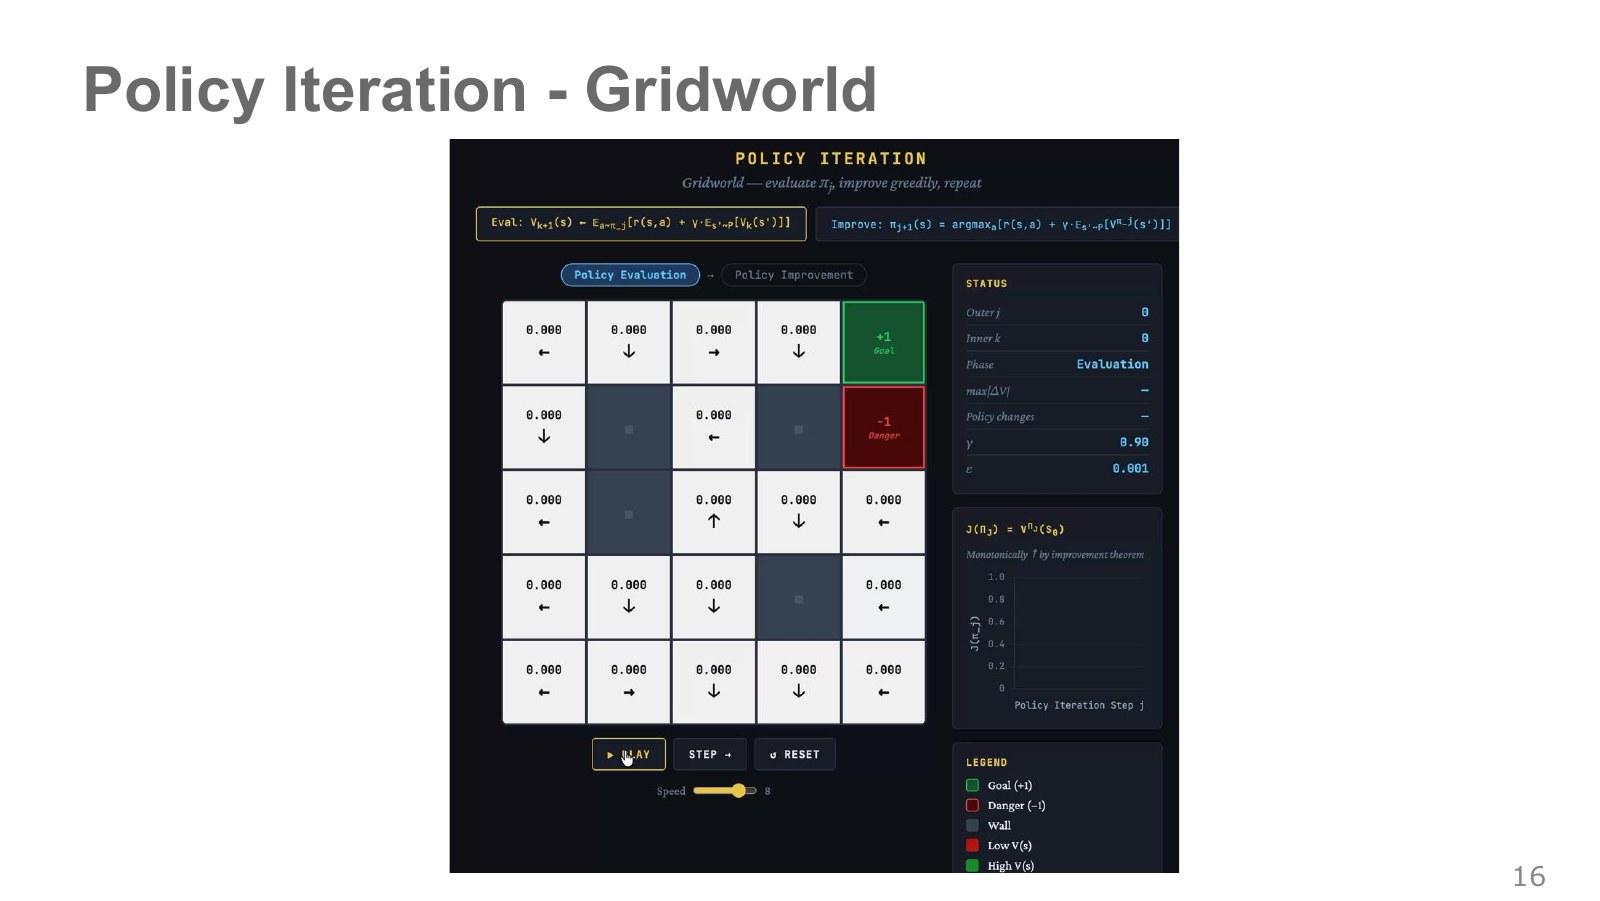
화면 위의 두 단계는 현재 화살표를 유지한 채 숫자를 계산하는 평가와, 계산된 숫자를 보고 화살표를 바꾸는 개선이다. 평가 중 숫자가 바뀐다고 바로 새 정책을 실행한 것은 아니다.
오른쪽의 리턴 그래프는 여러 스윕의 가치 표와 또 다른 층위의 요약이다. 어떤 시작 분포에서 성능을 평균했는지 알아야 의미를 해석할 수 있다. 현재 숫자를 전부 0으로 초기화한 직후의 그래프와 수렴한 정책의 실제 성능을 같은 것으로 보지는 말자.
자체 예제에서는 정책 평가를 작은 선형 방정식으로 정확히 풀고, 개선 전후의 모든 비종료 상태 가치를 비교했다. 가치가 나빠지지 않는지와 최종 결과가 가치 반복의 해와 일치하는지를 따로 확인했다. “그래프가 올라가 보인다”보다 무엇을 비교했는지 명확히 하는 방법이다.
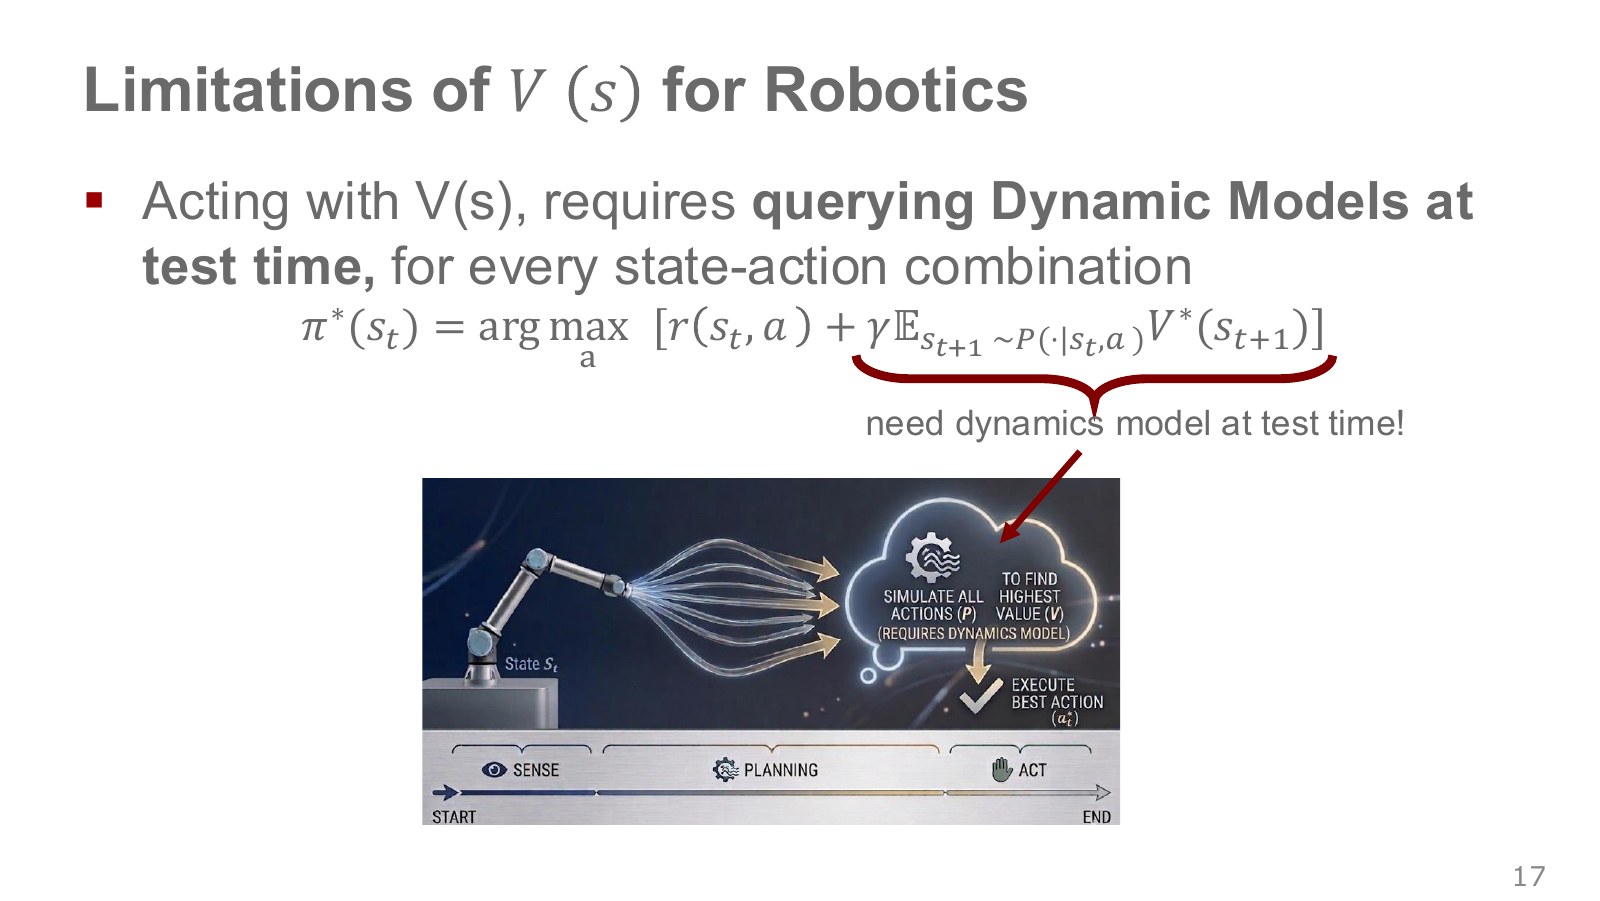
는 상태의 점수다. 현재 어떤 행동을 해야 하는지 알려면, 행동별로 도착할 수 있는 다음 상태와 그 가치를 비교해야 한다. 로봇 팔 그림에서 여러 가상의 궤적이 계획 상자로 모이는 것은 이 계산 부담을 나타낸다.
이런 한 단계 탐색 방식은 보상과 전이 모델 를 질의해야 한다. 접촉·마찰이 복잡한 환경에서는 모델이 틀리기 쉽고, 계산이 느리면 다음 제어 명령을 제시간에 내기 어렵다. 상태 가치를 학습했다는 사실만으로 행동 선택까지 공짜가 되지는 않는다.
다만 “가치 반복으로 얻은 정책은 배포 때 반드시 모델을 다시 돌려야 한다”는 절대적 제한은 아니다. 작은 표 문제에서는 미리 최선 행동까지 저장할 수 있다. 여기서 다루는 한계는 상태 가치로부터 그때그때 행동을 계산하는 방식에 관한 것이다.
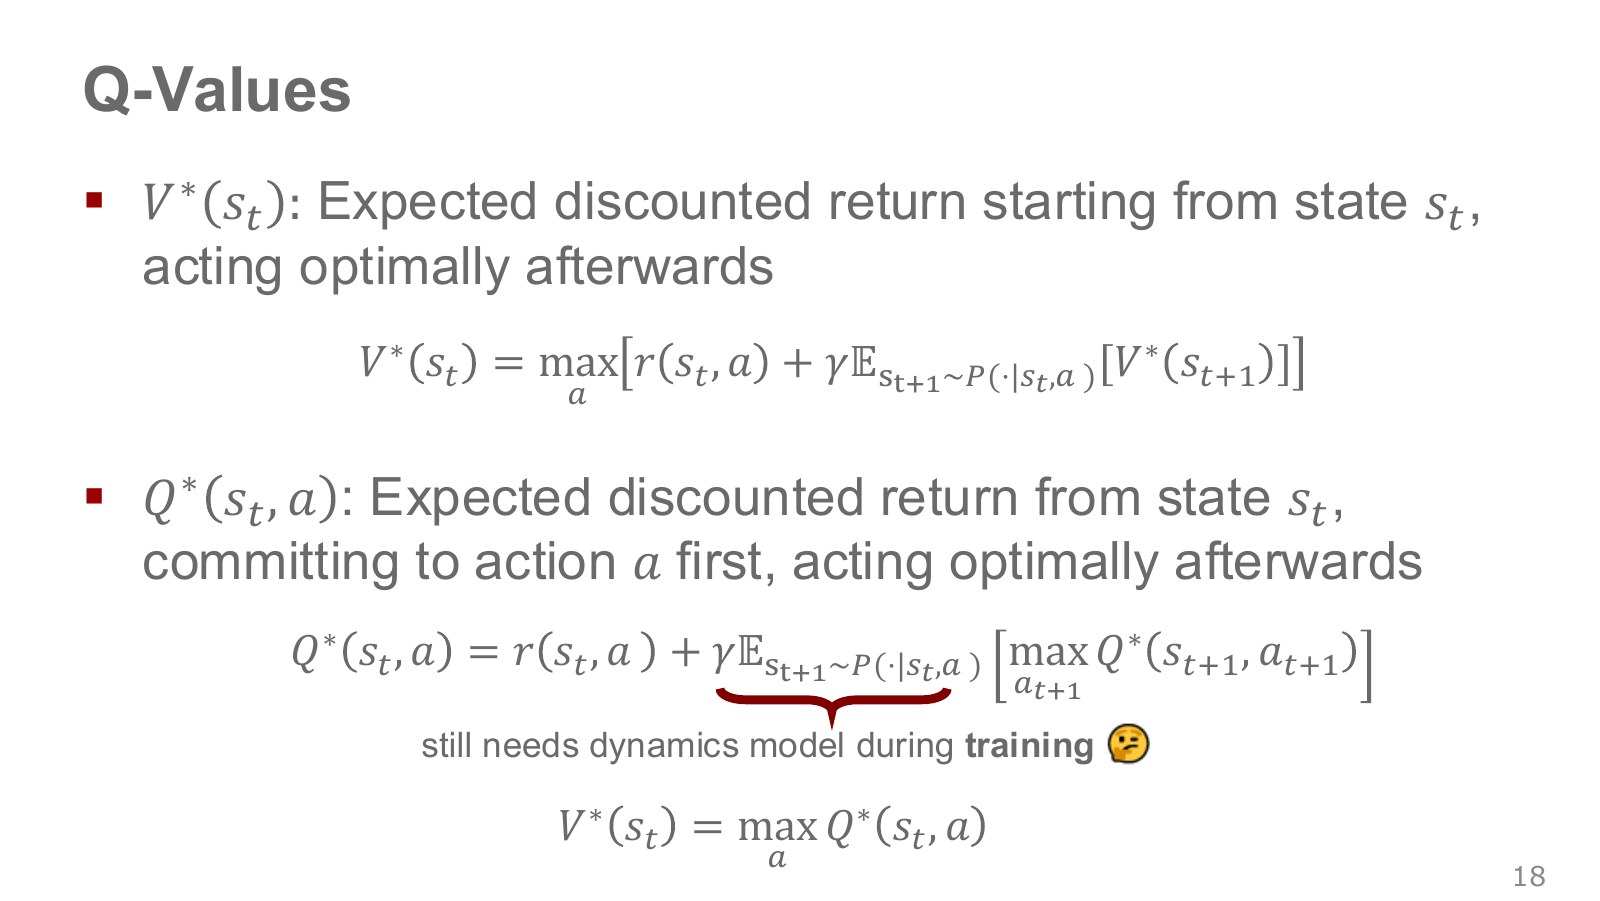
는 현재 상태에서 첫 행동만 로 고정하고, 그 뒤 정책 를 따를 때의 기대 리턴이다. 보다 입력에 행동 하나가 더 들어간다. 별표가 붙은 는 그 이후를 최적으로 행동하는 경우다.
는 다음 상태에서 고려하는 행동이므로 지금 실행한 와 다르다. “컵 앞에서 왼쪽으로 1cm 움직인다”와 “오른쪽으로 1cm 움직인다”에 서로 다른 Q 값을 둘 수 있다. 좋은 Q 함수는 어느 명령이 장기적으로 유리한지를 압축해 저장한다.
위 식을 전이 모델로 직접 반복 계산하는 Q 값 반복은 학습·계산 중 모델을 쓴다. Q 함수라는 표현 자체가 모델을 필요로 한다는 뜻은 아니다. 다음 장면의 Q-learning은 같은 관계를 실제 표본으로 학습한다.
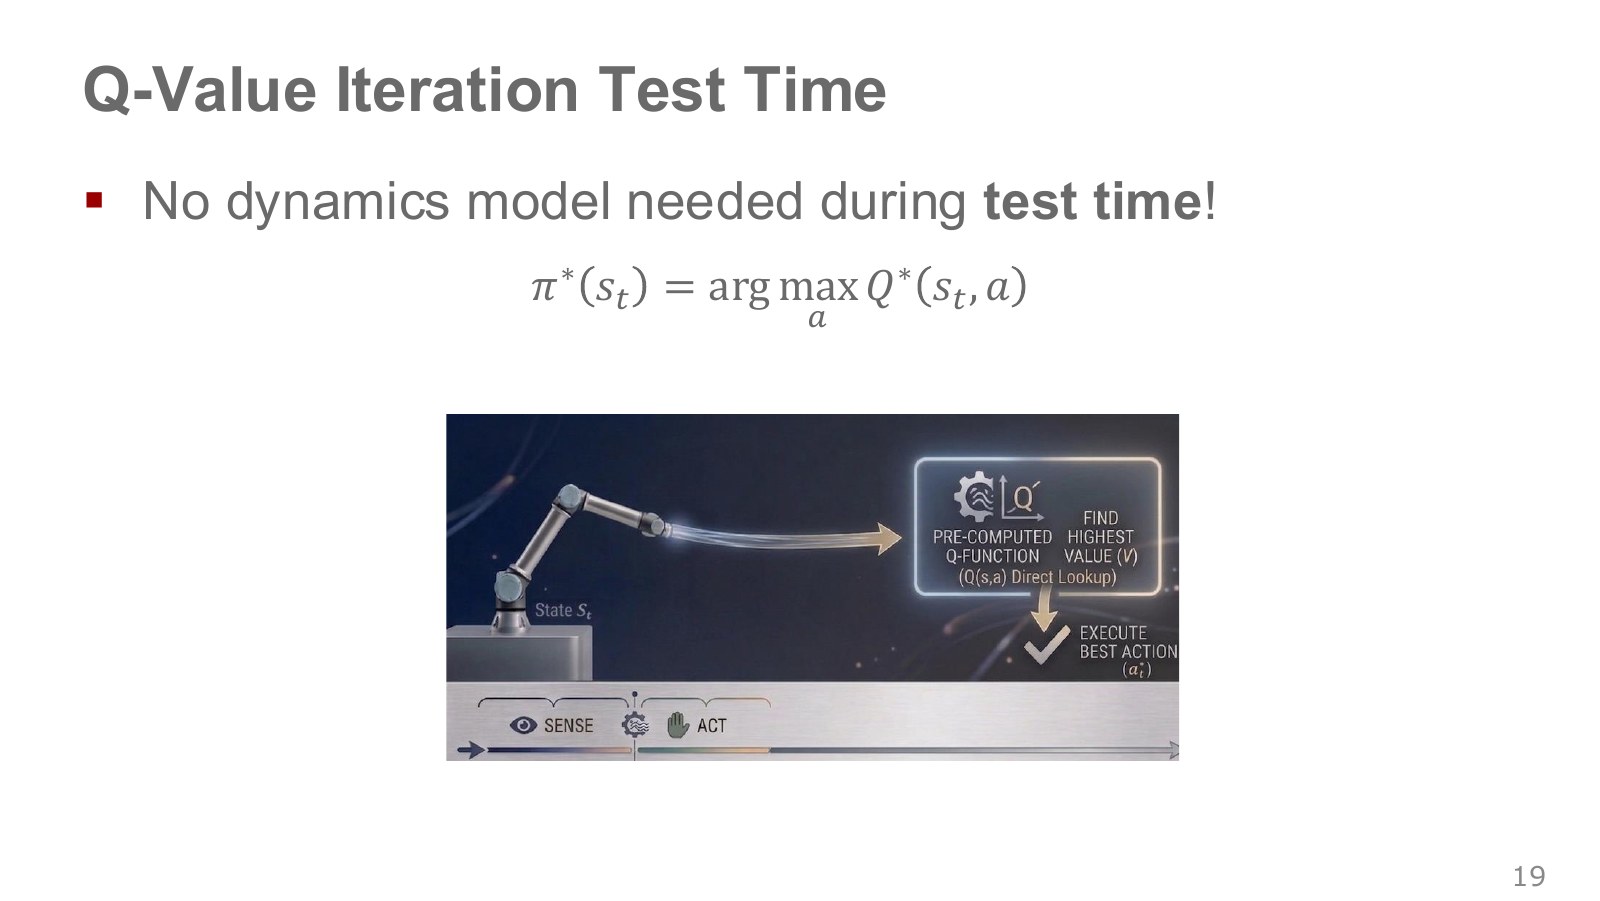
행동이 유한 개라면 그 행동들의 Q 값을 읽고 가장 큰 값을 주는 행동을 고른다.
아래 그림의 짧아진 경로는 배포 때 전이 모델을 시뮬레이션하는 대신, 이미 학습한 Q 함수를 평가한다는 뜻이다. 이때 탐욕적(greedy)이라는 말은 Q 추정치에 대한 최댓값 선택을 말한다. Q가 긴 미래를 반영하므로 즉시 보상만 탐낸다는 의미는 아니다.
Q 추정치가 틀리면 이 선택도 틀릴 수 있다. 또한 연속 행동에서는 후보를 전부 나열할 수 없어 자체가 어려워진다. 식 한 줄로 적었다고 실제 계산 비용까지 사라지는 것은 아니며, 이 문제는 뒤의 CEM과 DDPG로 이어진다.
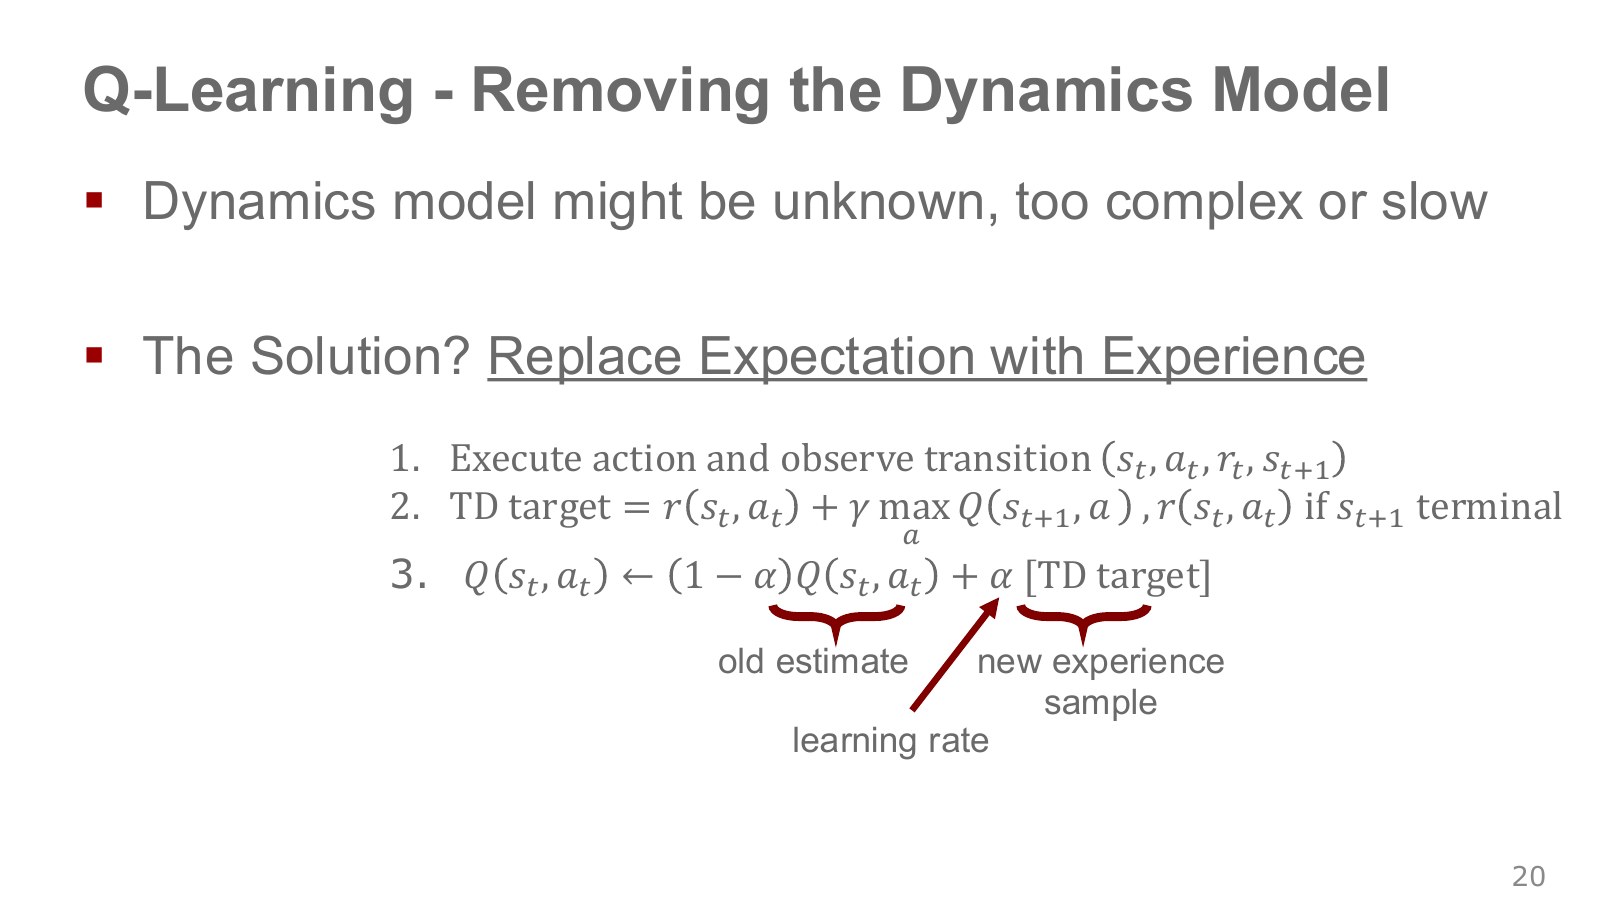
Q-learning은 환경에서 얻은 를 이용한다. 가능한 다음 상태를 모두 합하는 대신, 실제로 나온 다음 상태 하나를 사용해 갱신할 목표를 만든다. TD(temporal difference)는 현재 추정과 한 단계 뒤의 보상·추정치를 연결하는 시간 차분이다.
이면 과업이 실제로 끝났다는 뜻이고 미래 항은 사라진다. 는 TD 오차, 는 얼마나 많이 갱신할지 정하는 학습률이다. 나머지 상태–행동 표는 이 한 번의 표형 갱신에서 그대로 둔다.
현재 값 0.4, 보상 0.2, 다음 최댓값 0.8, 할인율 0.9, 학습률 0.25라면 목표는 0.92, 새 값은 0.53이다. 과업이 끝났다면 목표는 0.2만 남아 새 값은 0.35가 된다. 보상과 목표, 목표와 갱신 뒤 값을 서로 구별하자.
한 전이가 현재 Q에 대한 벨만 목표의 표본이라는 것과, 그것이 이미 참 최적 가치 의 정확한 정답이라는 것은 다르다. 다음 상태 추정의 오차도 목표에 들어간다. 시간이 길어 강제로 잘린 실행은 실제 과업 종료와 다를 수 있으므로, 구현에서는 종료와 시간 제한을 구별해 미래 항을 정해야 한다.
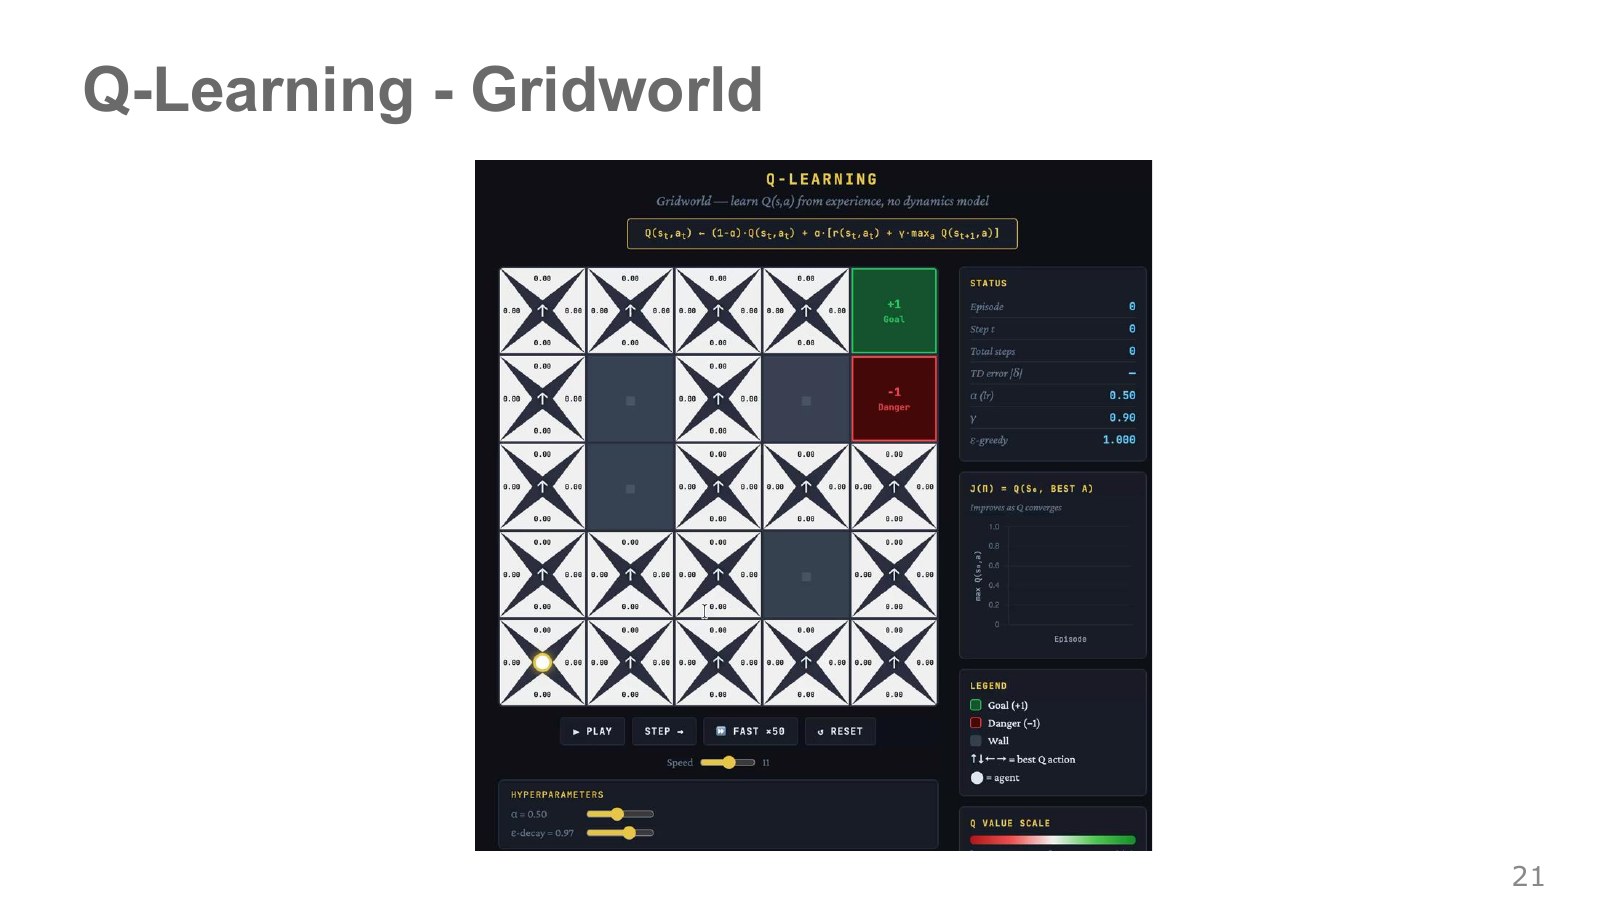
각 칸의 네 삼각형은 네 방향 행동의 Q 추정치를 나타낸다. 가치 반복에서는 상태마다 최선 값 하나를 표시했지만, Q-learning은 같은 칸에서도 행동마다 다른 숫자를 유지한다. 탐색한 경로 주변의 값이 먼저 바뀌는 이유다.
현재 정보로 가장 좋아 보이는 행동만 반복하면 다른 행동의 장점을 발견하지 못할 수 있다. 탐색(exploration)은 새로운 정보를 얻기 위해 덜 확실한 행동도 시도하는 것이고, 활용(exploitation)은 이미 좋다고 추정한 행동을 고르는 것이다. -greedy는 일정 확률로 무작위 행동을 고르는 단순한 절충이다.
학습률 0.1을 썼다거나 오랫동안 실행했다는 이유만으로 모든 값의 수렴이 보장되지는 않는다. 표형 유한 할인 문제의 전형적인 보장에는 상태–행동 방문 범위와 횟수, 적절히 감소하는 학습률 등의 조건이 필요하다. 낯선 상태를 한 번도 만나지 못한 데이터로 그 상태의 좋은 행동까지 알아낼 수는 없다.
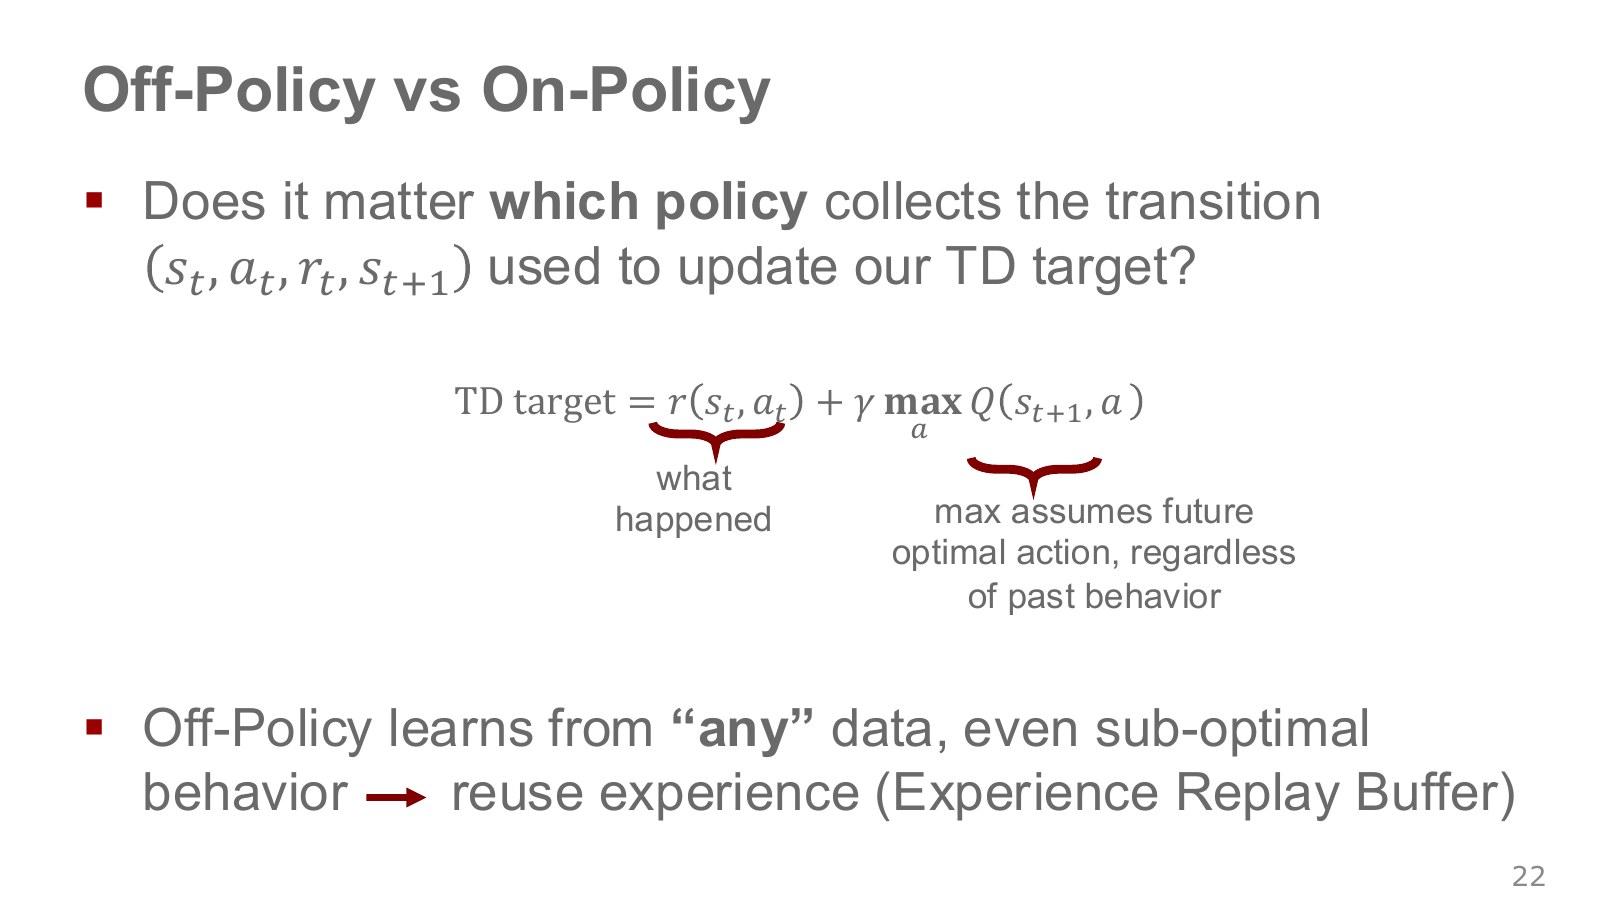
행동 정책(behavior policy)은 실제 전이를 수집할 때 행동을 고르는 규칙이다. 목표 정책(target policy)은 지금 그 성능을 평가하거나 개선하려는 규칙이다. 둘이 다를 수 있는 학습을 오프폴리시(off-policy)라고 한다.
Q-learning은 실제 실행한 와 받은 를 사용하면서도, 다음 단계에서는 현재 Q 기준의 최선 행동을 가정한다. 그래서 오래된 정책이나 탐색 정책이 모은 기록도 재사용할 수 있다. 다음 장의 목표 네트워크에서 쓰는 “목표”와는 다른 구분이다.
“어떤 데이터든 쓸 수 있다”는 말은 데이터 품질과 범위를 무시해도 된다는 뜻이 아니다. 같은 환경·보상 정의의 유효한 전이가 필요하고, 필요한 행동을 관찰하지 못했다면 그 영역의 가치도 알기 어렵다. 신경망으로 미관찰 행동의 큰 값을 만들어 버리는 문제는 오프라인 강화학습에서 특히 중요해진다.
Silver의 온폴리시·오프폴리시 설명 4:10부터도 “따르는 행동과 배우려는 행동이 같은가”를 기준으로 나눈다. 남의 기록을 사용한다는 표면적 모습만으로 모방학습과 같은 목적이라고 생각하면 안 된다. 여기서는 기록의 보상과 미래 가치를 이용한다.
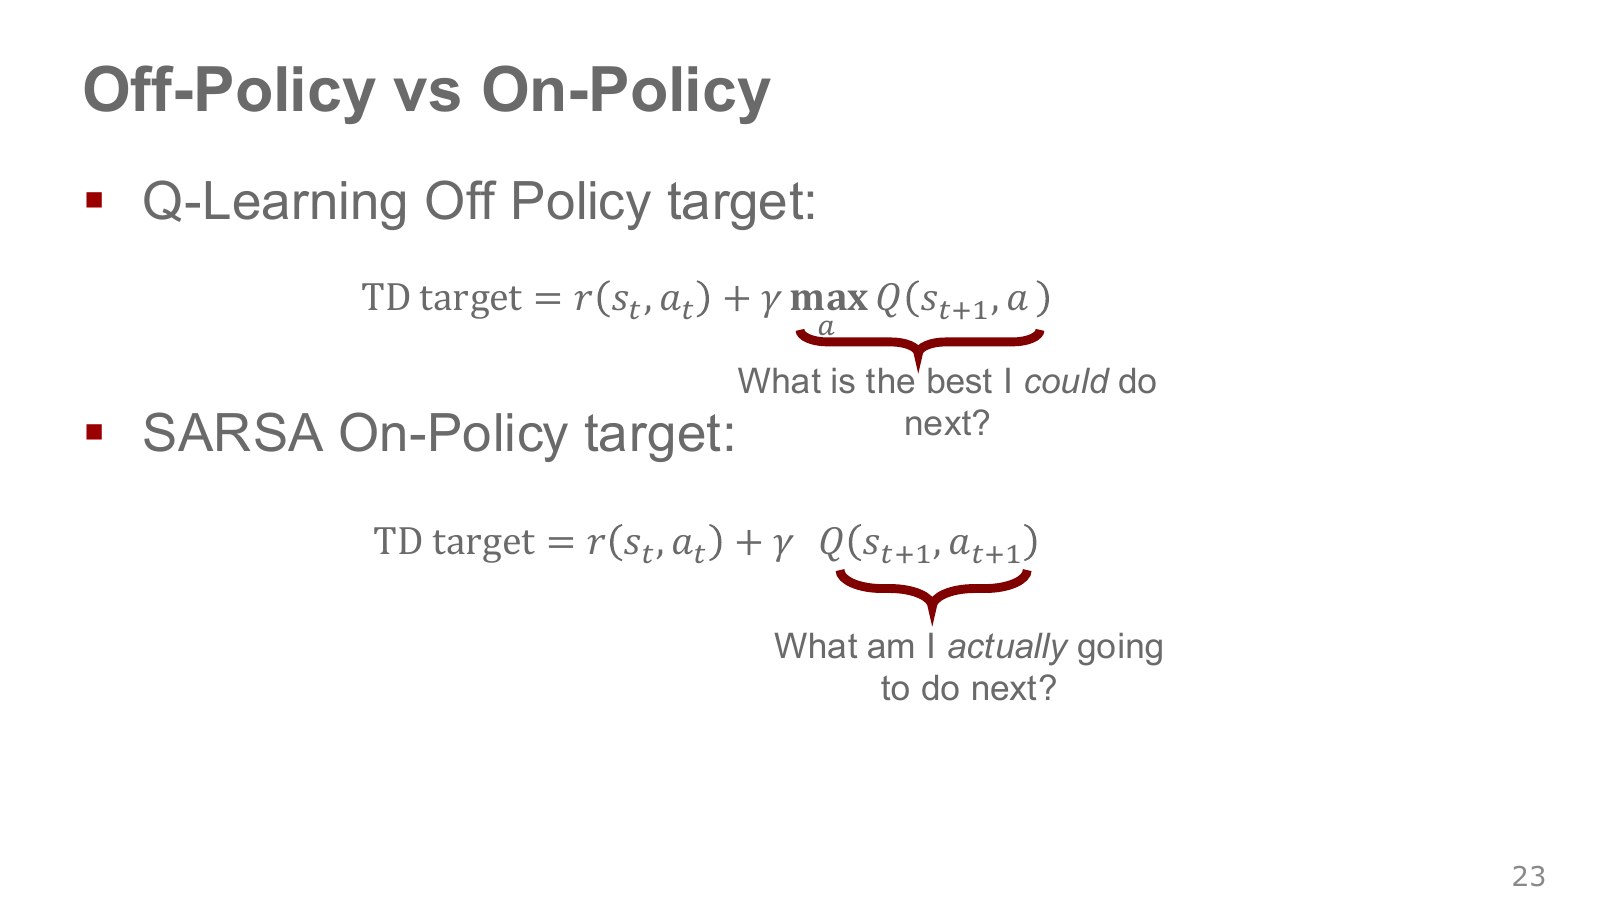
SARSA는 State–Action–Reward–State–Action의 순서에서 나온 이름이다. 다음 상태에 도착한 뒤 현재 행동 정책으로 고른 다음 행동 까지 사용한다.
다음 상태의 두 행동 가치가 0.8과 −0.4인데 탐색 때문에 둘째 행동을 택했다고 하자. Q-learning 목표에는 0.8이 들어가지만 SARSA 목표에는 −0.4가 들어간다. SARSA는 탐색 행동까지 포함한 현재 정책의 결과를 배운다.
원본의 “무엇을 가장 잘할 수 있는가”와 “실제로 다음에 무엇을 할 것인가”라는 두 질문이 바로 이 차이다. Q-learning도 실제 환경에 명령을 보내 경험을 얻는다. 실제 실행 여부가 아니라 미래 가치를 계산할 때 어느 정책의 행동을 쓰는가가 구분 기준이다.
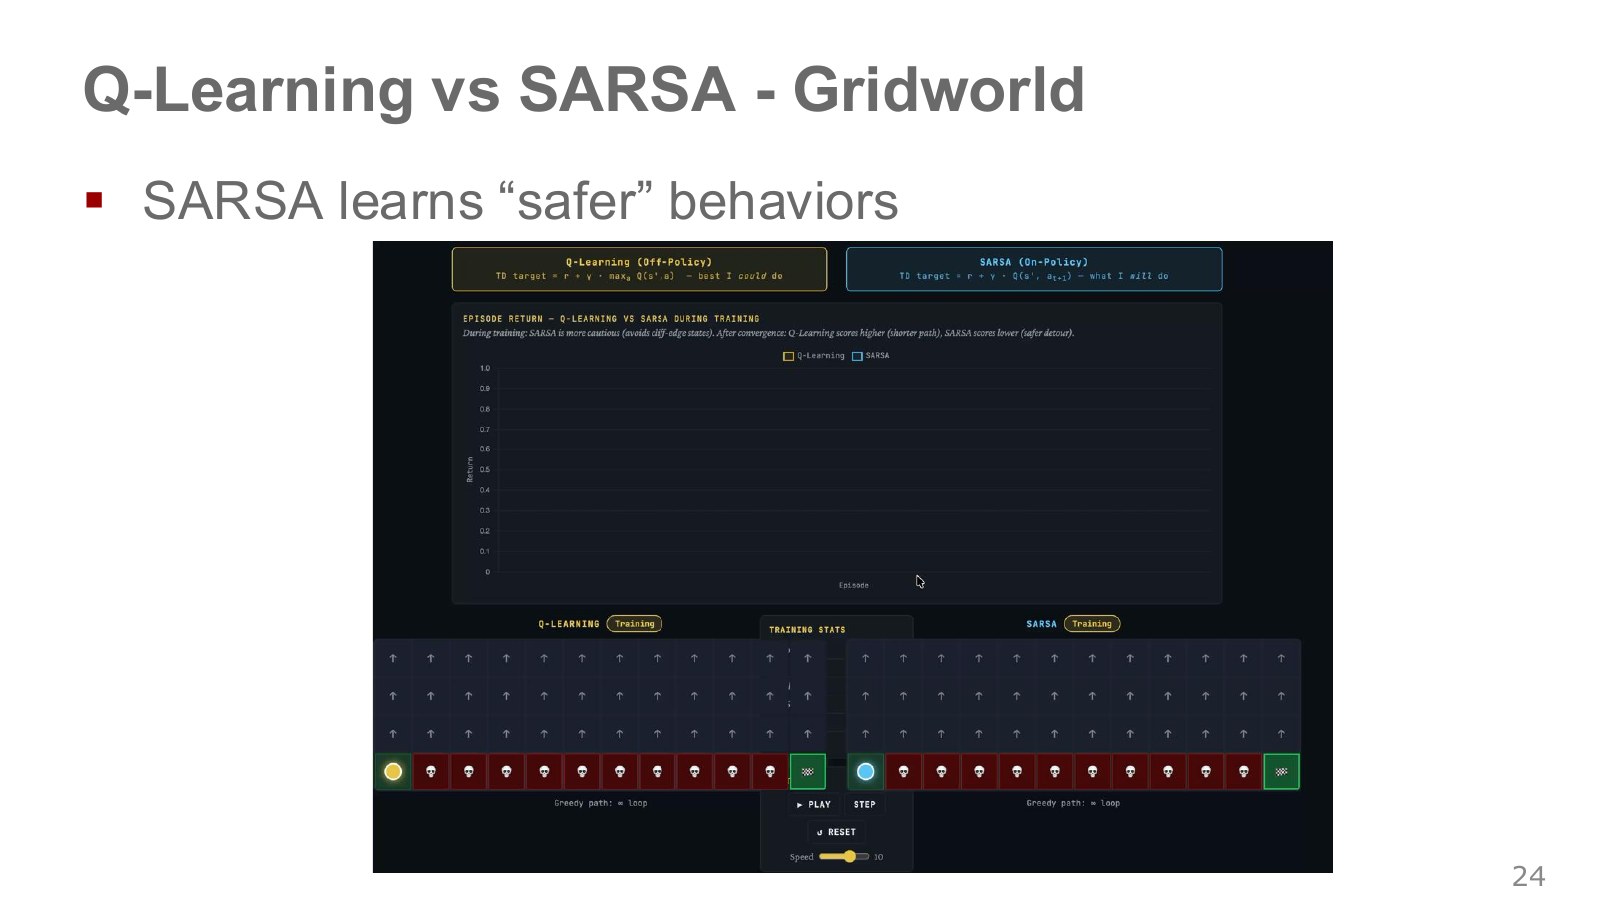
두 격자 모두 왼쪽 아래에서 시작해 오른쪽 아래 목표로 간다. 빨간 줄은 떨어질 수 있는 절벽이고, 그 위의 길은 짧지만 한 번 아래로 잘못 움직이면 큰 손실을 받는다. 안전하게 돌아가면 이동 단계는 늘지만 탐색 실수에 덜 민감하다.
탐색을 계속하는 SARSA는 그 탐색 실수도 현재 정책의 일부로 평가한다. 그래서 이 설정에서는 가장자리에서 떨어진 길에 더 높은 값을 줄 수 있다. Q-learning의 목표는 다음에도 최선 행동을 택한다고 계산하므로, 탐욕적으로 실행할 때 짧은 길을 선호하는 값이 될 수 있다.
이것은 “SARSA는 항상 안전하고 Q-learning은 항상 위험하다”는 보장이 아니다. 탐색률을 줄였는지, 전이 자체에 미끄러짐이 있는지, 절벽에 빠지면 종료하는지 원점으로 돌아오는지에 따라 결과가 달라진다. 표본 정책의 실제 학습 중 성능과 탐욕적으로 고정한 평가 정책의 성능도 따로 보아야 한다.
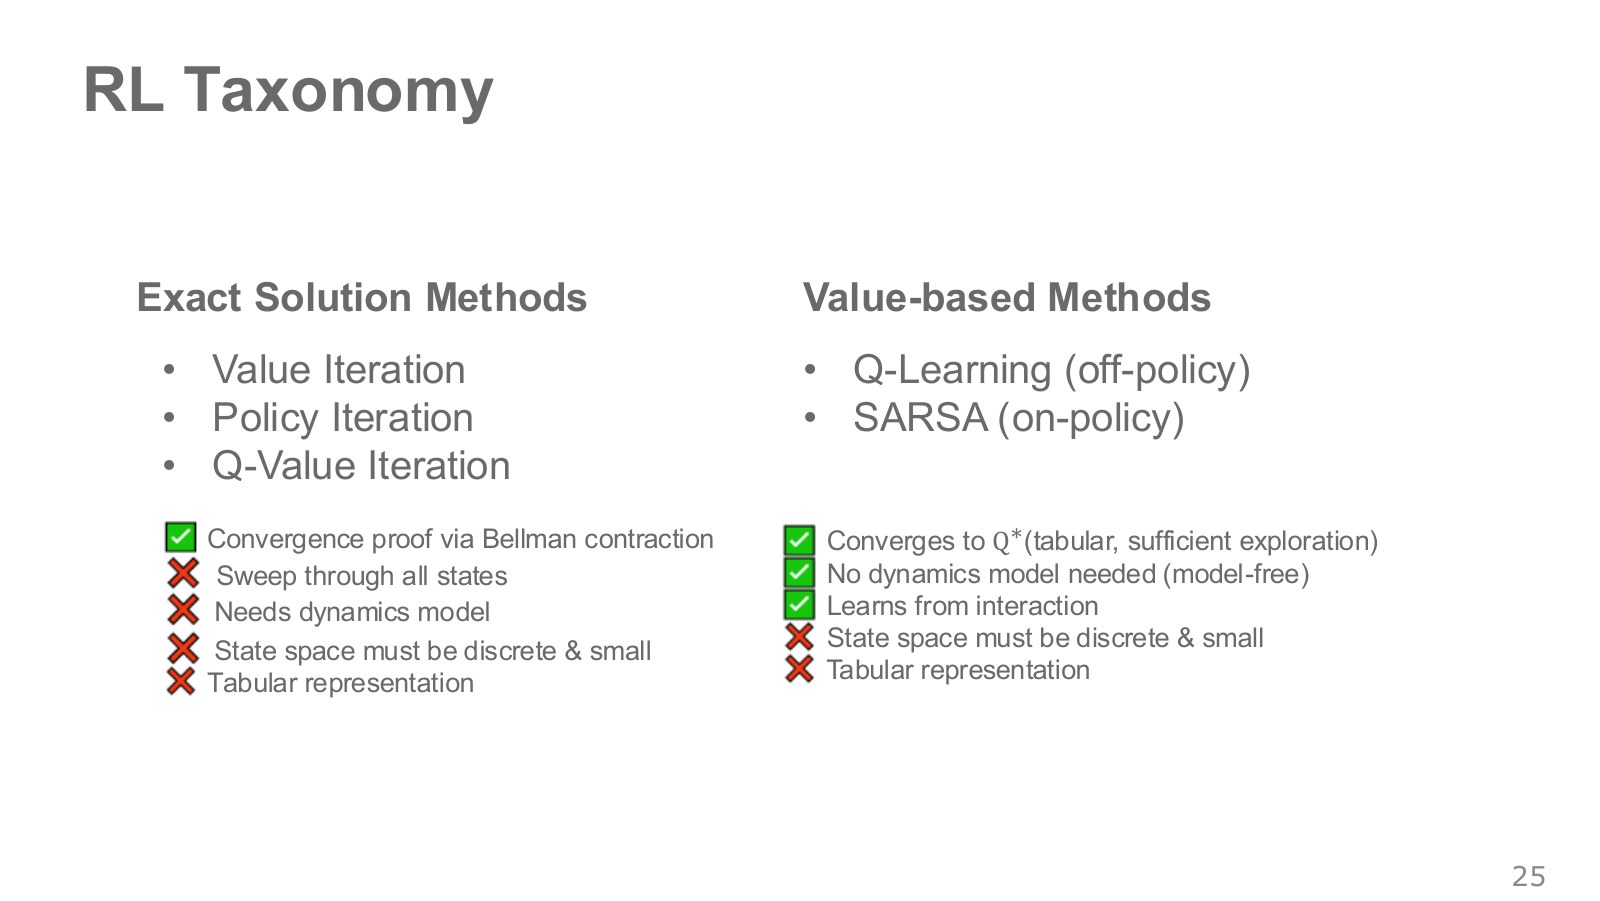
왼쪽은 모델을 알고 가능한 다음 상태를 계산하는 동적 계획법(dynamic programming)이다. 큰 문제를 중복되는 작은 문제로 나누고 그 계산 결과를 재사용한다. 여기서는 상태별 가치를 표에 저장하는 방식으로 배웠다.
오른쪽은 전이 표본에서 가치를 갱신하는 모델 프리(model-free) 방법이다. 환경의 다음 상태를 예측하는 모델을 명시적으로 학습하거나 질의하지 않아도 된다. “물리 법칙이 없다”거나 시뮬레이터도 쓸 수 없다는 뜻은 아니다. 시뮬레이터에서 얻은 경험으로 모델 프리 학습을 할 수도 있다.
또한 가치 반복도 가치를 사용하는 방법이므로, 그림의 두 열은 서로 완전히 배타적인 큰 철학의 분류라기보다 이번에 다룬 알고리즘 묶음이다. Q-learning의 표형 수렴 조건과 SARSA의 정책 변화 조건을 생략하고 “오래 탐색하면 언제나 최적”으로 외우지는 말자.
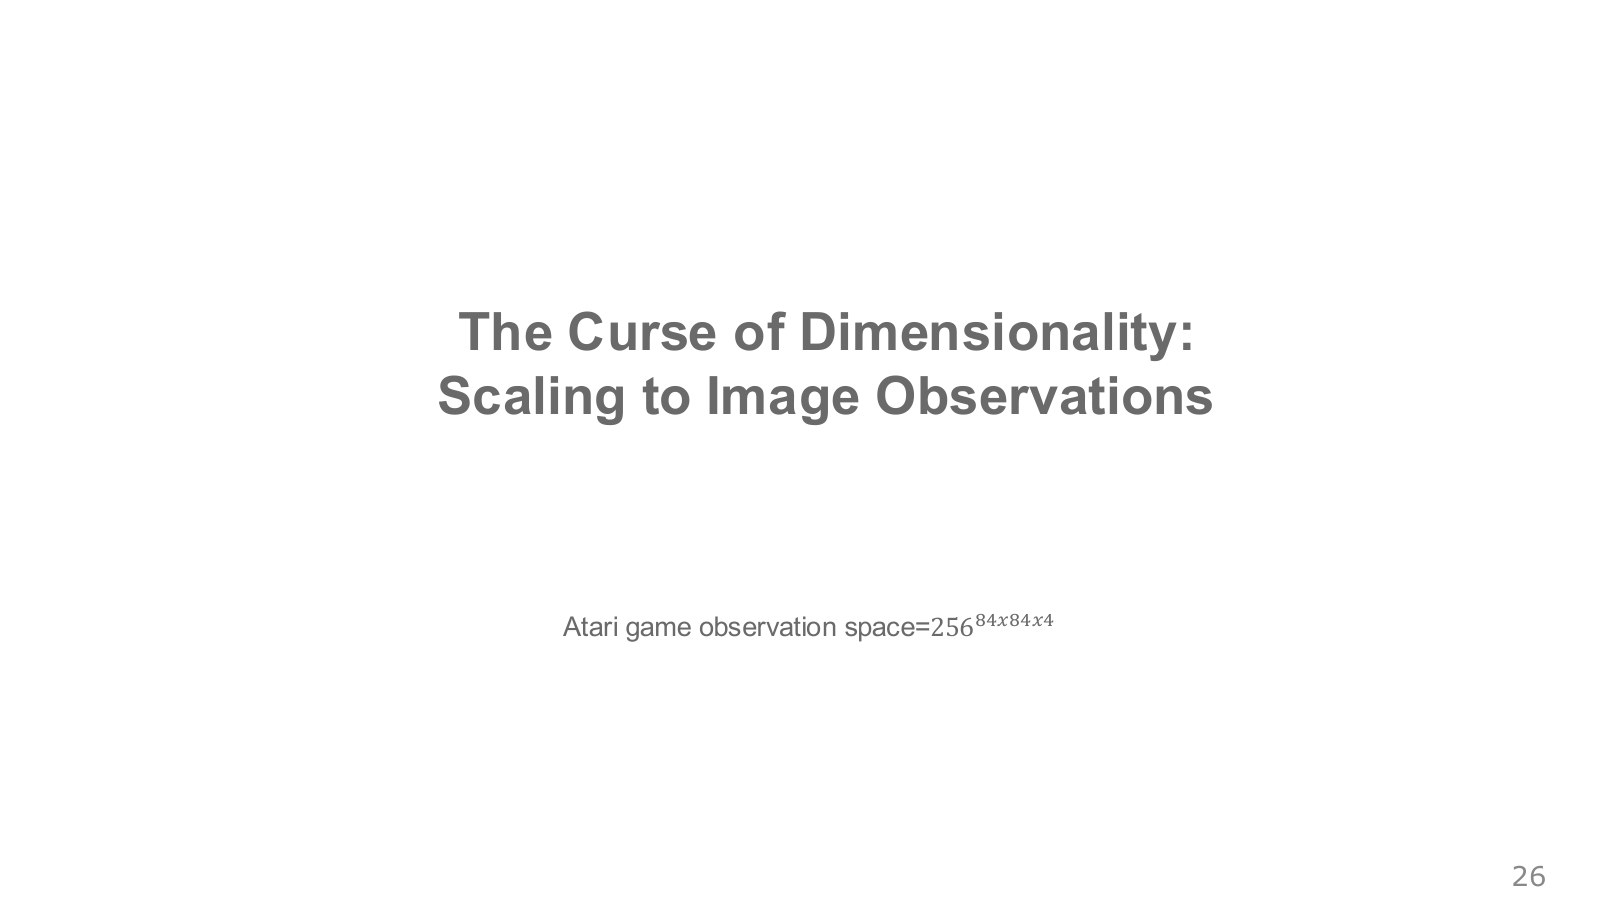
회색 영상의 한 픽셀은 0부터 255까지 256가지 값을 가질 수 있다. 84×84 크기 영상 4장을 입력으로 쌓으면 픽셀 값 조합의 단순 상한은 다음처럼 커진다.
모든 조합이 실제 게임에서 나오는 유효한 장면이라는 뜻은 아니다. 그렇더라도 관찰한 영상마다 독립적인 표 항목을 두고 충분히 방문하겠다는 전략은 비현실적이다. 비슷한 장면에서 배운 것을 새 장면에도 활용하는 일반화가 필요하다.
프레임 네 장을 쌓는 이유도 있다. 공의 위치가 같은 단일 사진만으로는 왼쪽으로 가는지 오른쪽으로 가는지 구별하기 어렵다. 짧은 시간의 변화를 보여 주려는 것이다. 정해진 프레임 수가 모든 환경의 숨은 상태를 완전히 복원한다는 뜻은 아니다.
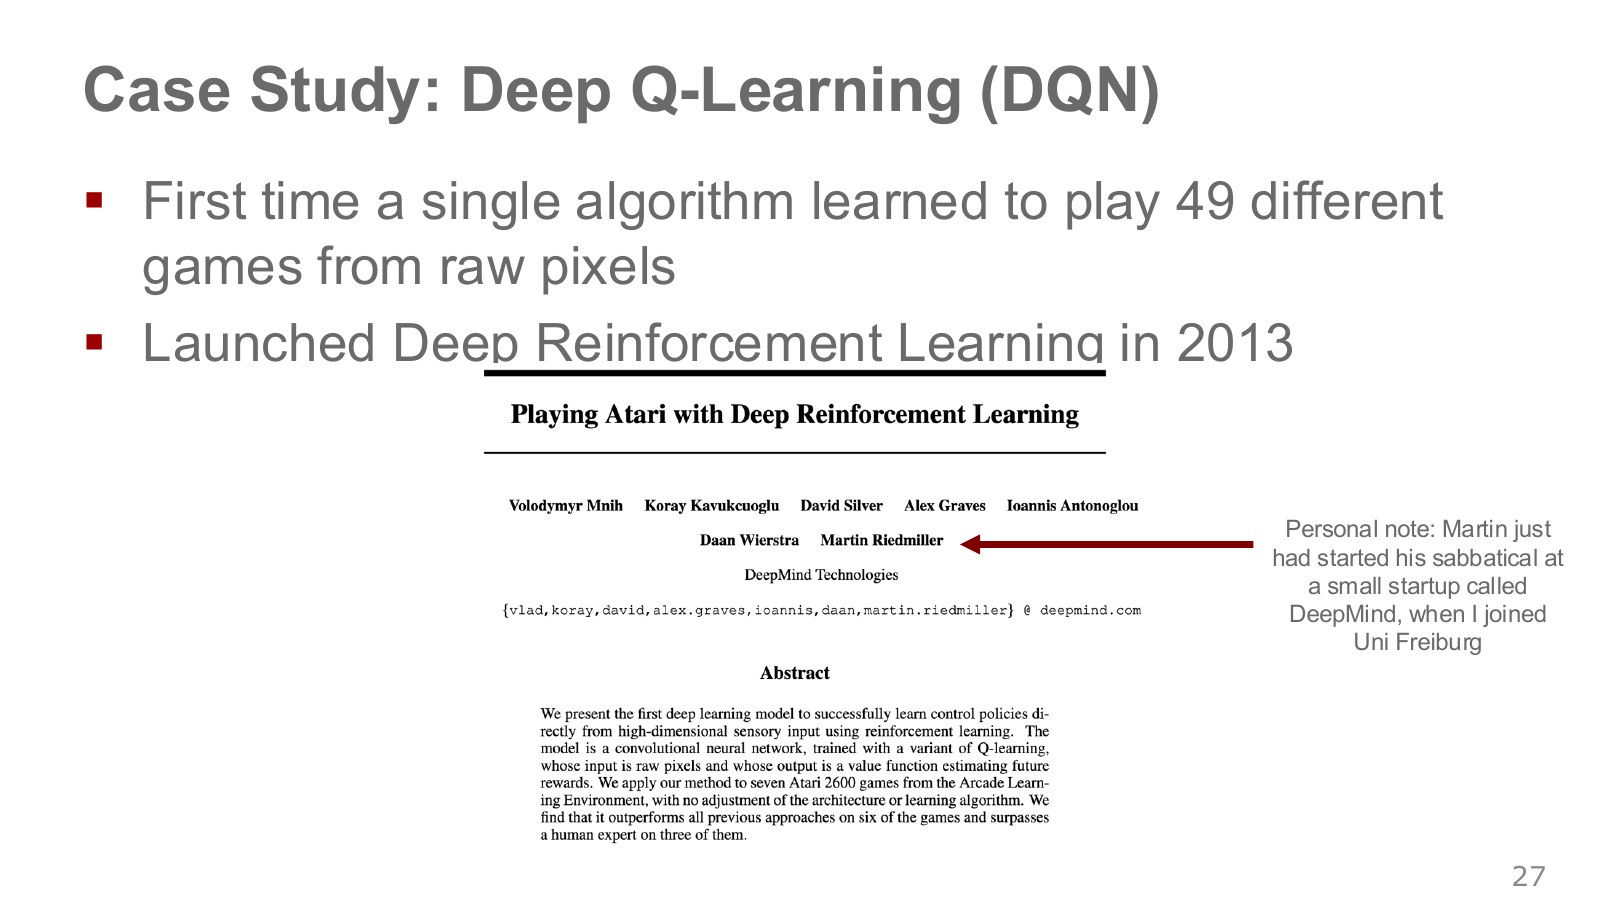
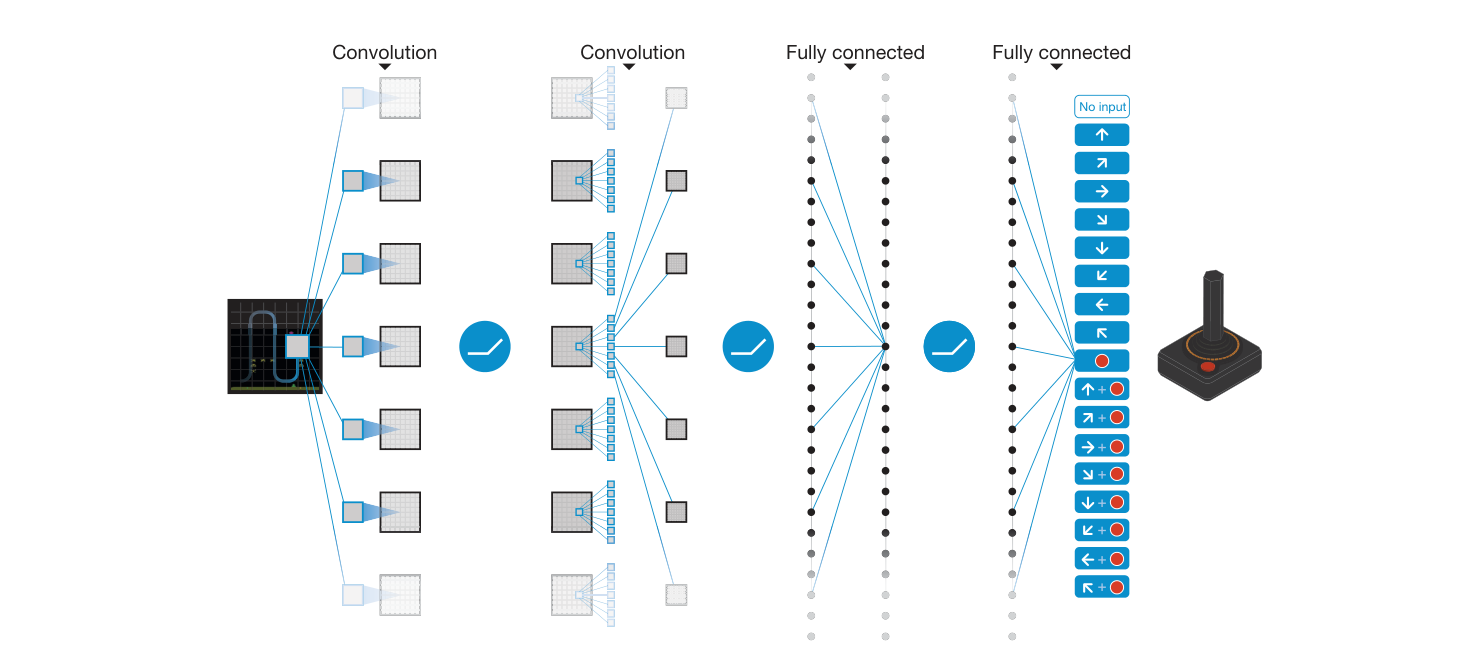
DQN(Deep Q-Network)은 Q 표를 신경망으로 바꾼다. 영상 속 지역 패턴을 읽는 합성곱(CNN) 층과 특징을 모으는 층을 거쳐, 왼쪽 이동·오른쪽 이동·발사 같은 이산 행동마다 Q 값을 출력한다. 이 출력은 행동의 성공 확률이나 분류 확률이 아니다.
같은 구조와 학습 규칙을 여러 게임에 적용했다는 것이 핵심이다. 하나의 동일한 가중치 정책이 49개 게임을 동시에 마스터했다는 뜻은 아니며, 게임별로 각각 학습한 결과다. 원본은 2013년 논문 이미지와 49개 게임 설명을 함께 놓았지만, 2013년 논문은 7개 게임, 2015년 Nature 논문은 49개 게임 결과를 보고한다. 두 시점의 범위를 나누어 읽어야 한다.
아래는 2015년 원 논문의 구조 그림이다. 여러 합성곱 층은 입력의 패턴을 특징으로 옮기고, 오른쪽의 출력들은 각 버튼 조합의 가치를 나타낸다. 영상 전체를 모든 행동마다 처음부터 별도 표로 외우는 방식과의 차이다.
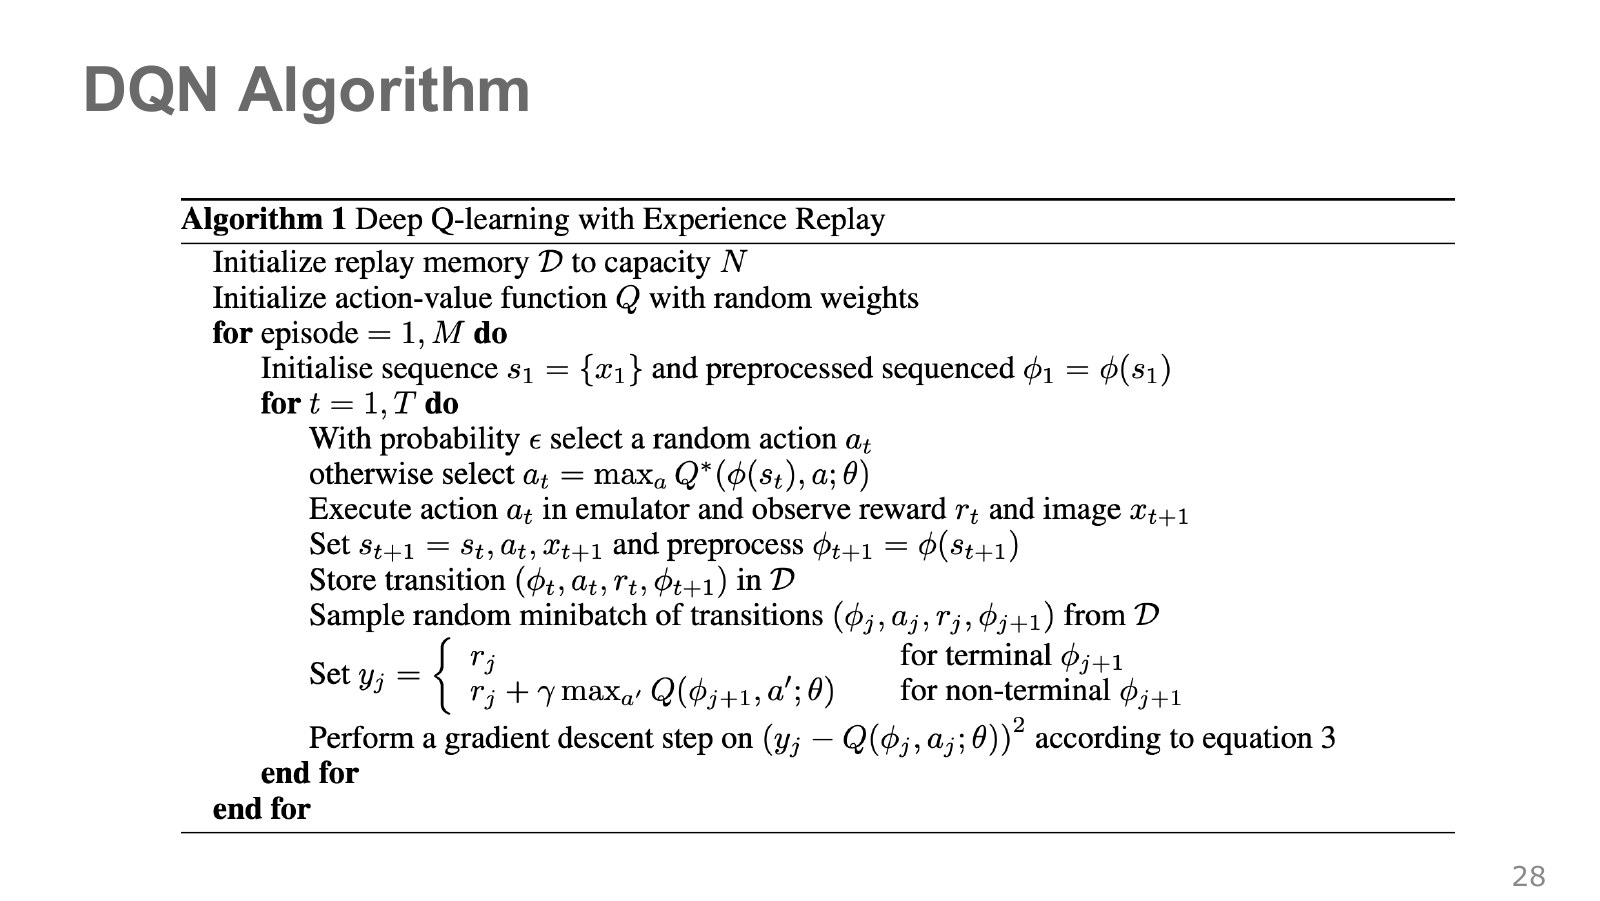
작은 글씨의 알고리즘은 크게 수집 → 저장 → 표본 추출 → 목표 계산 → 신경망 갱신 순서다. 는 프레임 축소·회색화·쌓기처럼 입력을 만드는 전처리이며, 이 페이지에서의 는 Q 네트워크의 가중치다.
- 경험 메모리와 Q 네트워크를 초기화한다.
- 현재 Q로부터 탐색 행동 또는 최선 행동을 선택한다. 행동을 반환하는 연산은 이며 최대 Q 숫자 자체를 모터 명령으로 쓰는 것이 아니다.
- 게임에서 전이를 얻어 메모리에 넣는다.
- 메모리의 여러 과거 전이에서 작은 묶음인 미니배치를 뽑는다.
- 각 전이에 TD 목표를 만들고, 현재 예측과 목표의 제곱 차이를 줄이도록 가중치를 바꾼다.
지금 새로 얻은 전이가 그 즉시 다음 미니배치에 반드시 포함되는 것은 아니다. 또한 표형 Q-learning에서는 항목 하나를 바꾸지만, 신경망 가중치를 바꾸면 비슷한 다른 입력의 출력도 함께 달라질 수 있다. 이 공유가 일반화의 장점이면서 불안정성의 원인이기도 하다.
이 페이지는 2013년 의사코드이고 다음 페이지들에서는 별도 목표 네트워크까지 포함한 안정화 구성을 설명한다. 원본에서 시간 때문에 빠르게 넘어간 알고리즘도 이 순서로 풀어 읽으면 각 저장소와 기호가 연결된다.
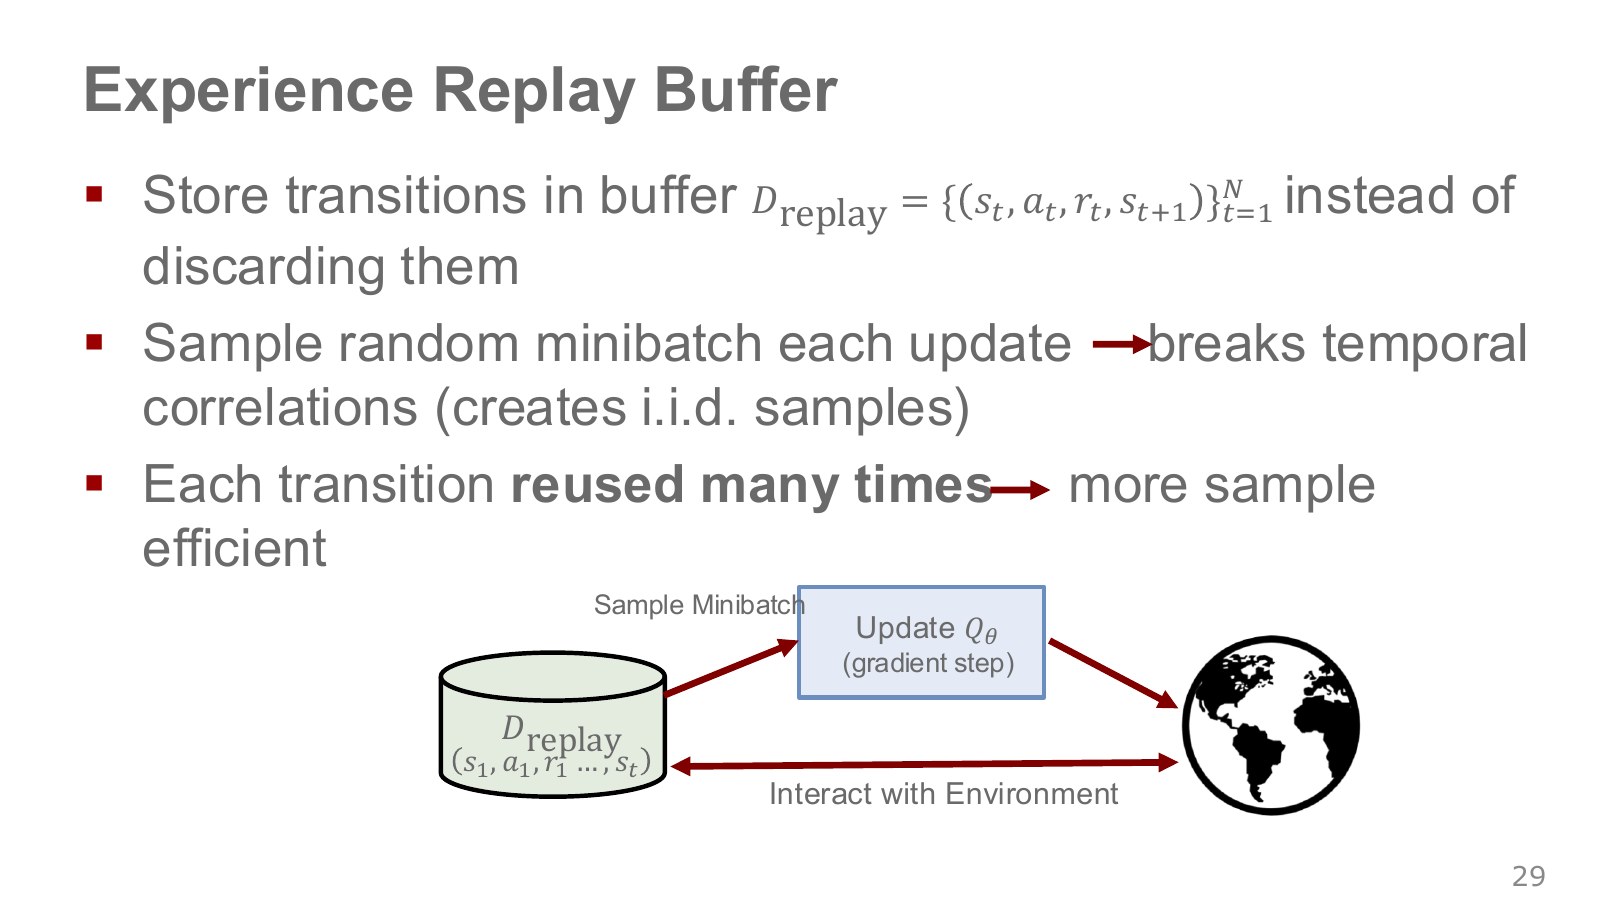
원통 는 과거 전이를 보관하는 리플레이 버퍼(replay buffer)다. 환경에서 들어온 전이를 저장하고, 갱신할 때 여러 시점의 기록을 무작위로 뽑는다. 같은 비싼 실물 상호작용을 여러 학습 갱신에 활용할 수 있다.
연속 프레임만 차례대로 학습하면 입력들이 강하게 비슷하고 정책이 지나간 좁은 구간에 몰리기 쉽다. 무작위 추출은 이런 시간 상관을 줄이고 갱신 입력을 섞어 준다. 하지만 저장된 데이터의 분포와 환경 방문 기록이 자동으로 완전히 독립·동일 분포가 되는 것은 아니다. 중복 표본, 바뀌는 버퍼, 달라지는 정책도 남는다.
버퍼가 과거 데이터를 재사용한다는 장점과, 그 데이터가 목표 행동을 충분히 다루는지는 별개의 문제다. 목표 보상을 한 번도 경험하지 못한 버퍼에서는 그 성공 정보를 아무리 다시 뽑아도 새로 만들 수 없다. 오프폴리시와 탐색의 범위가 여기서 다시 연결된다.
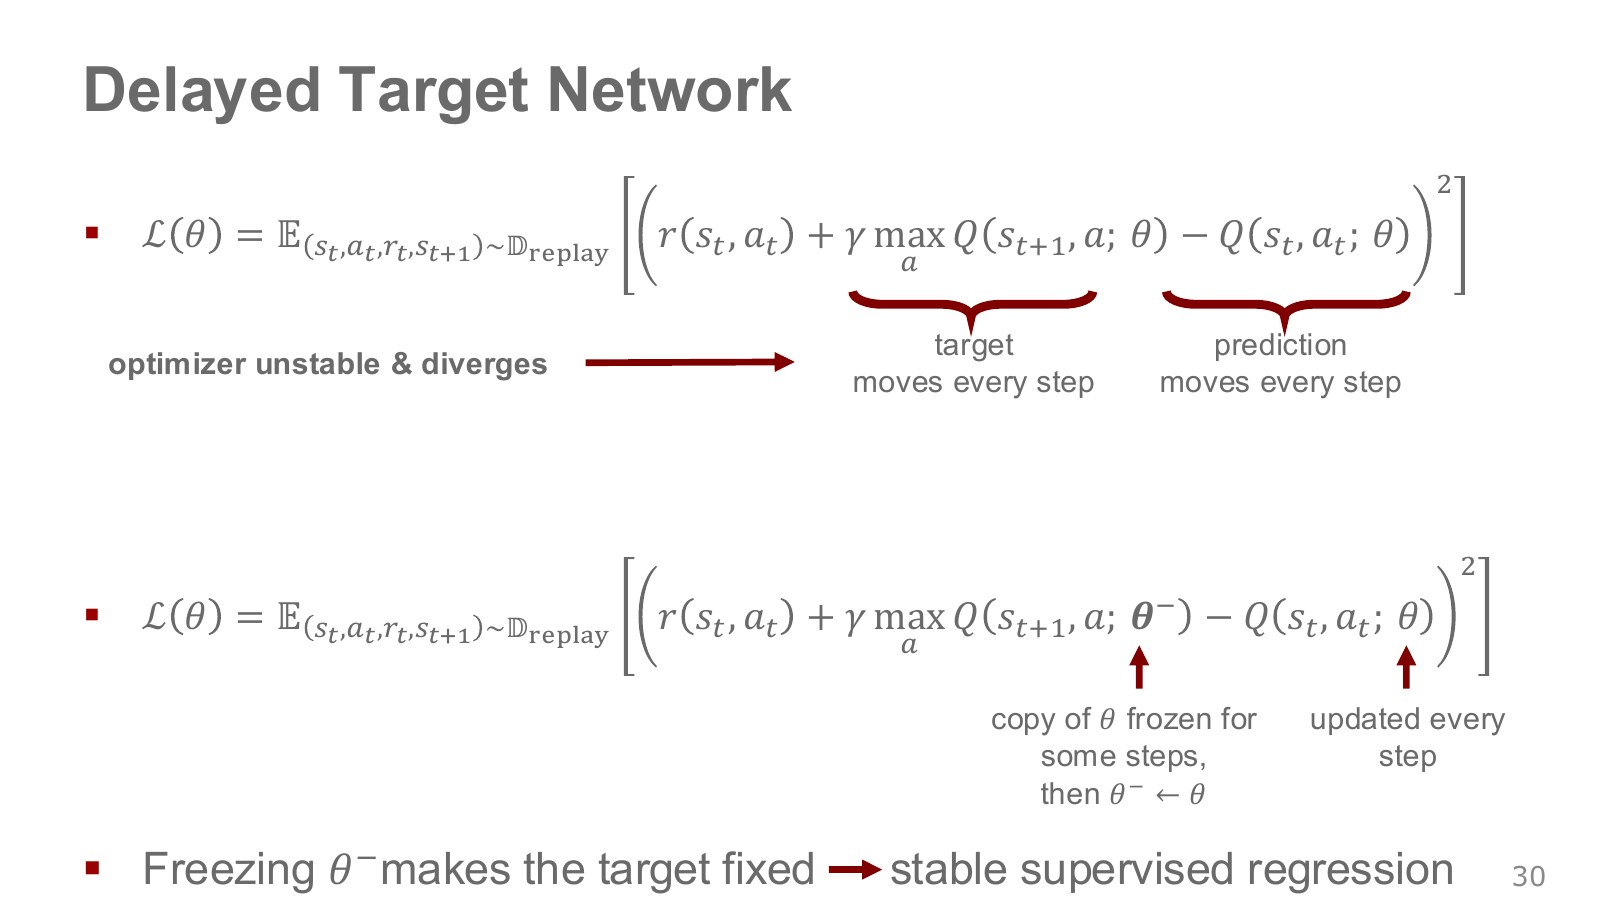
위 식은 하나의 가중치로 현재 예측과 다음 상태 목표를 모두 만든다. 현재 값을 고치려고 가중치를 바꾸면 다음 상태 출력도 같이 바뀌어, 방금 맞추려던 정답이 다시 움직인다.
아래 식의 는 목표 네트워크(target network)의 가중치다. 현재 학습 네트워크 를 복사한 뒤 일정 기간 고정해, 목표 숫자를 만드는 경로를 분리한다.
는 미니배치 크기다. 는 목표를 상수처럼 취급해 그 경로로 기울기를 보내지 않는다는 표시다. 이 때문에 “벨만 오차의 양쪽을 전부 미분하는 것”과 구현이 다르다. 목표 네트워크를 만든다고 신경망 Q-learning의 전역 수렴이 보장되는 것은 아니다.
정해진 주기마다 로 복사할 수 있다. 현재 배치의 같은 전이에 대한 목표는 고정되지만, 새 표본을 뽑으면 목표 숫자들이 달라질 수 있고 복사 주기에도 바뀐다. Berkeley CS285 8강 Part2, 2:13–6:57은 수집·미니배치·목표 복사의 시간 간격을 나누어 설명한다.
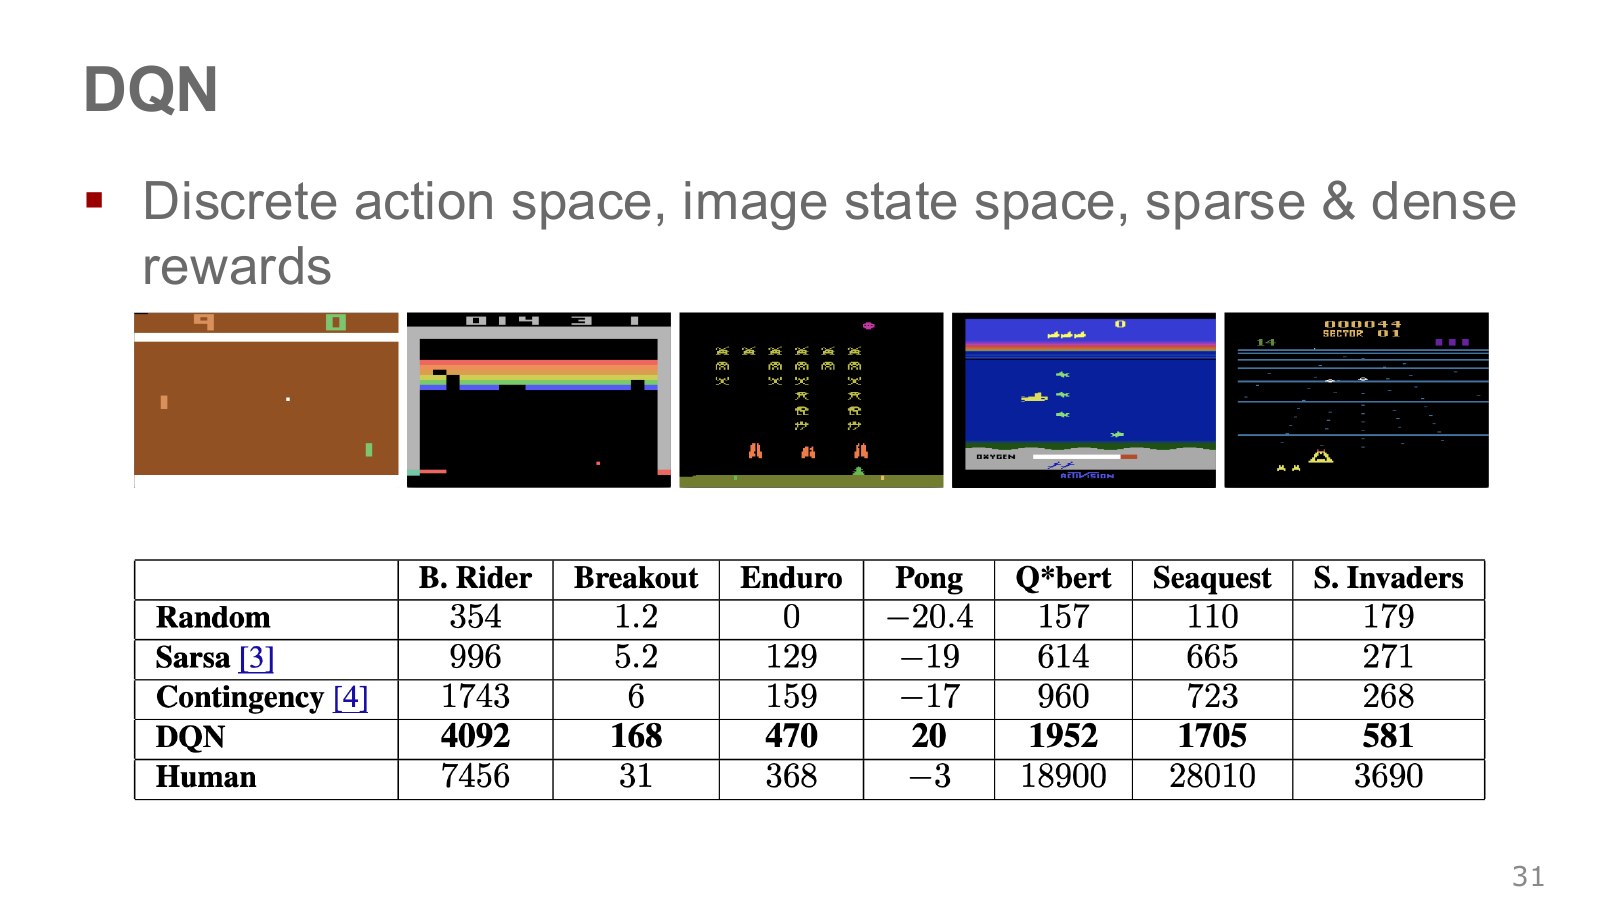
위의 게임 화면들은 관측 입력이 서로 다른 게임 장면이라는 뜻이다. 아래 표의 열은 게임, 행은 무작위 정책·기존 방법·DQN·사람의 성능이다. 각 칸은 그 게임의 점수이므로 서로 다른 열의 숫자를 그대로 더해 보편적인 지능 점수로 읽을 수 없다.
예를 들어 원본 표에서 Breakout의 DQN은168, 사람은31이고, Seaquest의 DQN은1705, 사람은28010이다. 한 게임에서 사람 점수를 넘었다고 모든 게임에서 같은 결과라는 뜻은 아니다. Pong처럼 음수 점수도 있으므로 비율을 단순히 나누는 해석도 조심해야 한다.
이 표는 7개 게임을 다룬 2013년 결과다. 원본 자막의 47 또는 다른 페이지의49라는 발화·표기를 이 표의 열 수로 읽으면 맞지 않는다. 일반성의 의미는 게임별 특수 해법을 일일이 설계하는 대신, 공통 구조와 학습 방법을 넓게 적용했다는 데 있다.
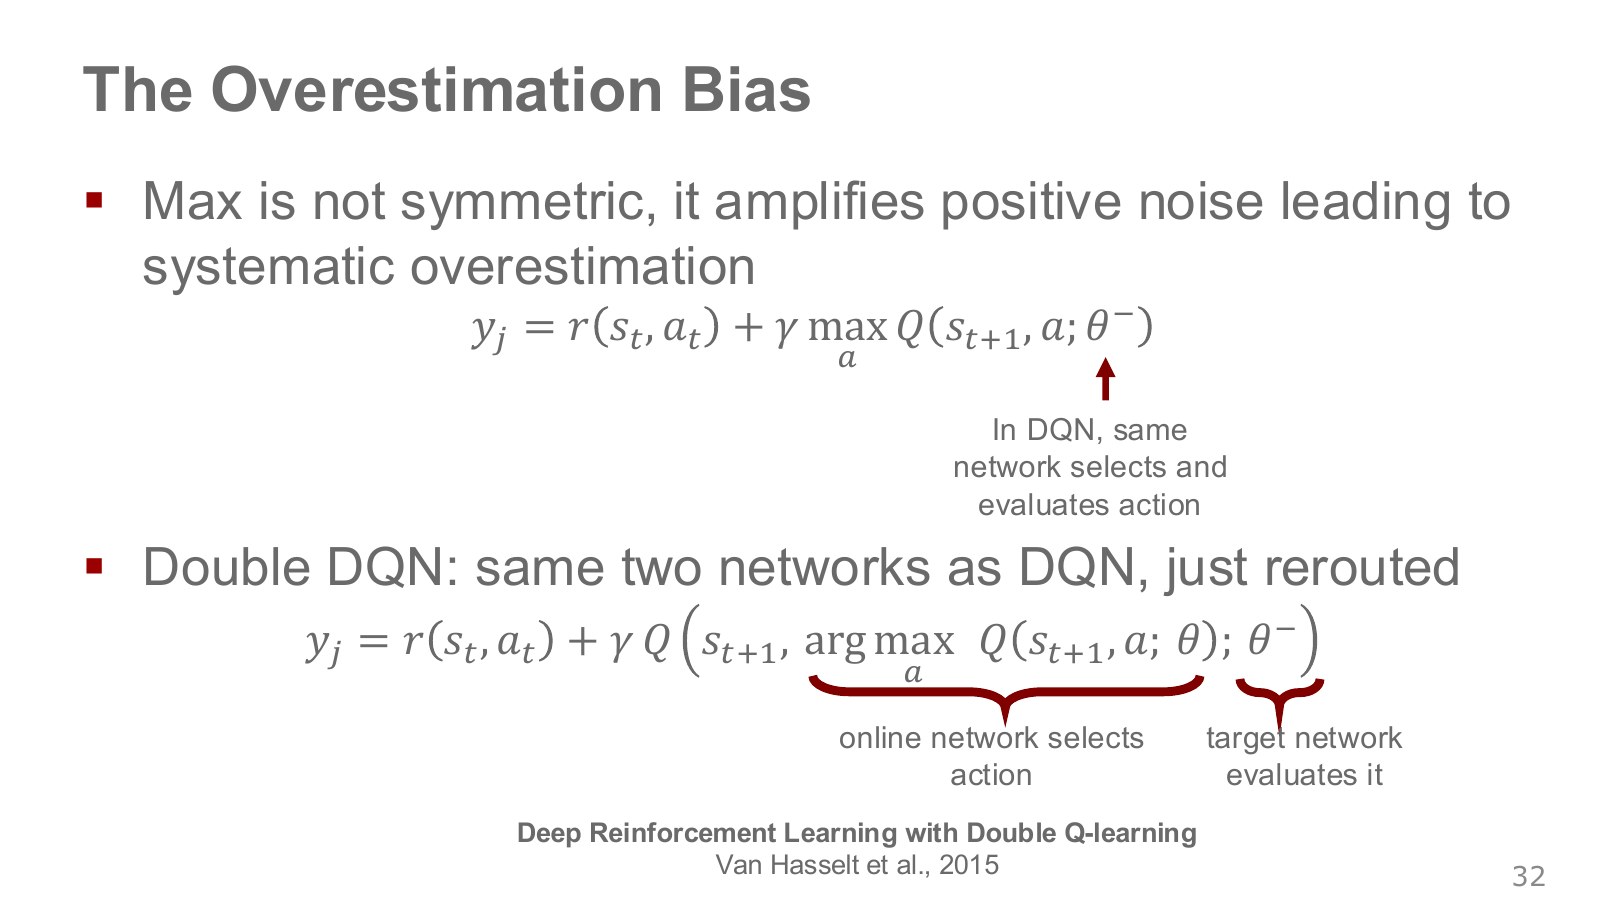
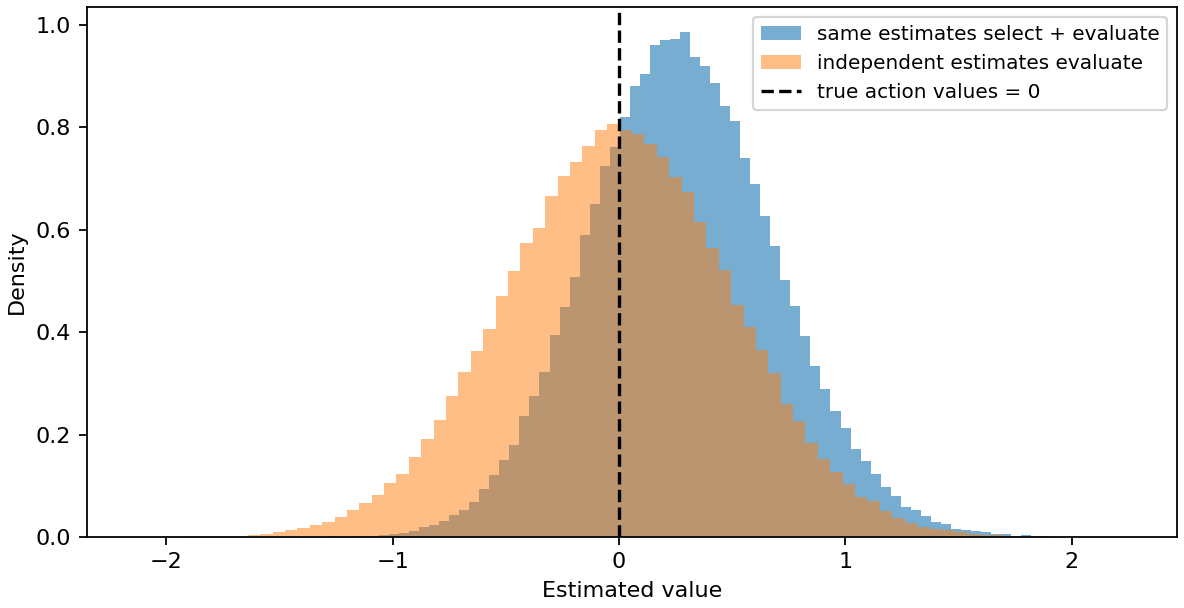
진짜 가치가 같은 두 행동도 추정에는 오차가 있을 수 있다. 그중 큰 추정치를 고르면, 우연히 위로 틀린 값을 선택하기 쉽다. 이것이 과대 추정 편향(overestimation bias)의 직관이다.
같은 행동들의 불편 추정치에 대해 기댓값으로 보면 최대 추정값이 참값의 최댓값보다 커지거나 같을 수 있다. 개별 실행에서 최대 추정치가 언제나 참값보다 높다는 뜻은 아니다. 모든 추정치가 아래로 틀린 표본도 나올 수 있다.
Double DQN은 현재 네트워크로 다음 행동을 고르고, 목표 네트워크로 그 행동의 가치를 평가한다. 기존 두 네트워크의 역할을 다시 연결하는 것이다.
현재 네트워크의 두 출력이 2·1이고 목표 네트워크가 0.5·1.5라고 하자. 일반 DQN은 목표에서 큰1.5를 쓰지만, Double DQN은 현재 네트워크가 고른 첫 행동을 목표 네트워크로 평가해0.5를 쓴다. 실제 두 네트워크는 서로 상관될 수 있으므로 이 분리만으로 모든 편향이 사라지거나 항상 더 나은 정책을 얻는 것은 아니다.
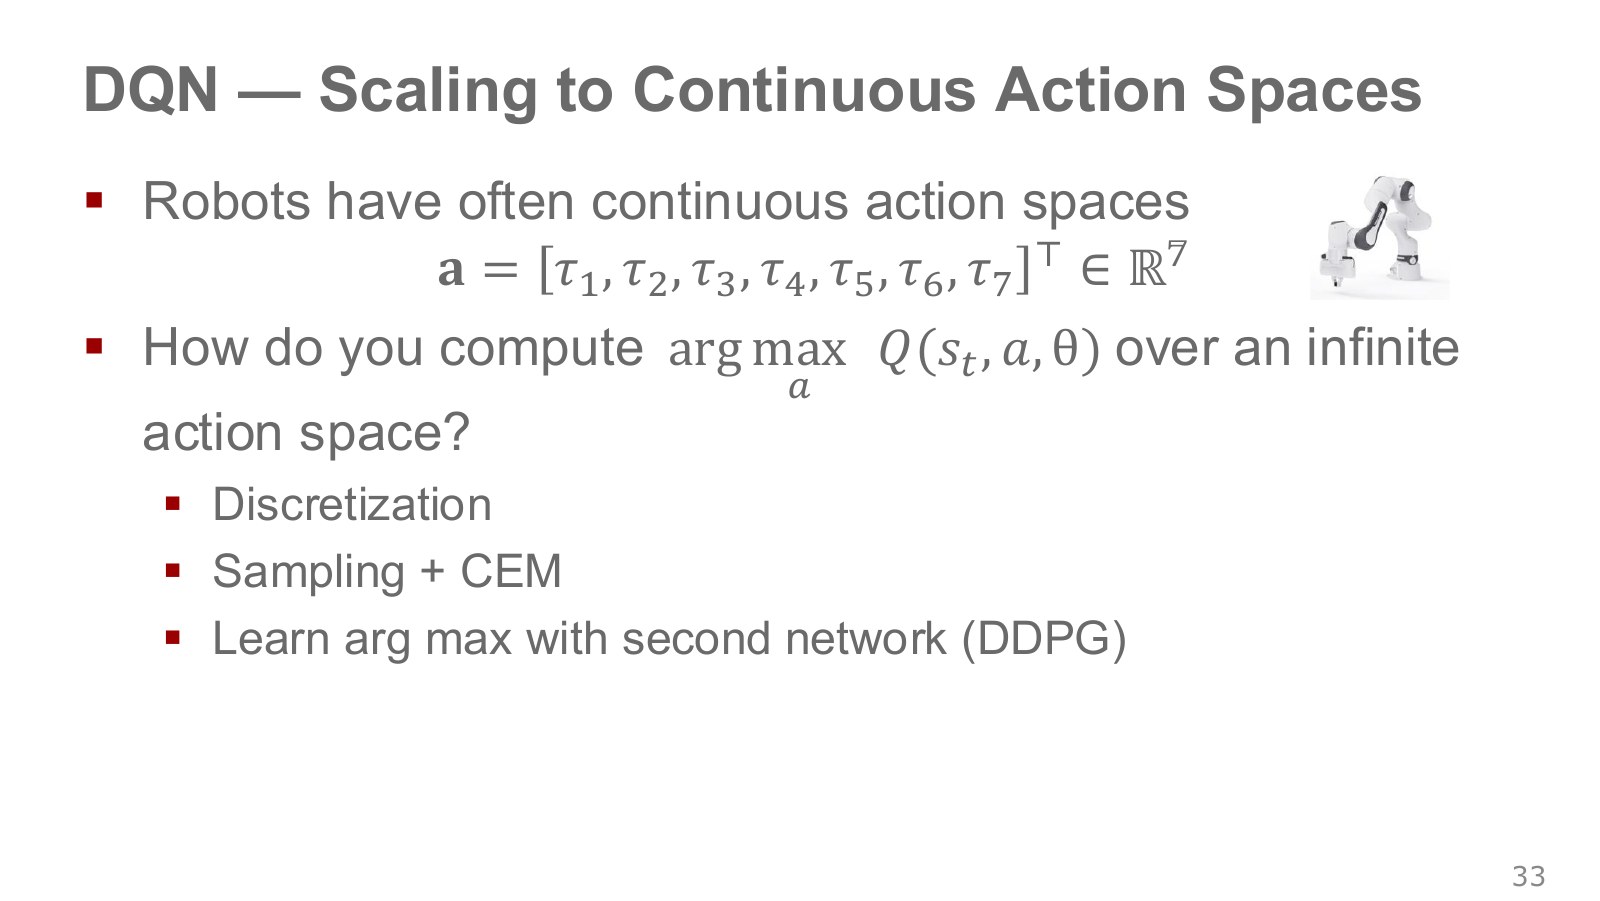
로봇 팔의 일곱 관절에 각기 토크를 명령한다면 행동은 실수 일곱 개의 벡터다. 처럼 적지만 실제 장비에는 허용 범위와 단위가 있다. 차원이7이라는 것과 가능한 행동 수가7이라는 것은 전혀 다르다.
각 관절을10개 값으로만 나누어도 조합은 개다. 모든 조합을 Q에 넣어 비교하는 방식은 차원이 늘 때 급격히 비싸진다. 신경망이 가치를 빠르게 계산해도, 좋은 행동을 찾는 계산이 남는다.
이번 장은 세 가지 접근을 비교한다. 문제의 기하를 이용해 행동을 이산화하거나, 후보를 뽑아 탐색하거나, 최선 행동을 내는 별도 정책을 학습한다. “연속 함수에는 최댓값을 구할 방법이 없다”는 뜻은 아니다. 일반적인 비선형 신경망의 최댓값을 빠르고 정확히 구하기가 어렵다는 뜻이다.
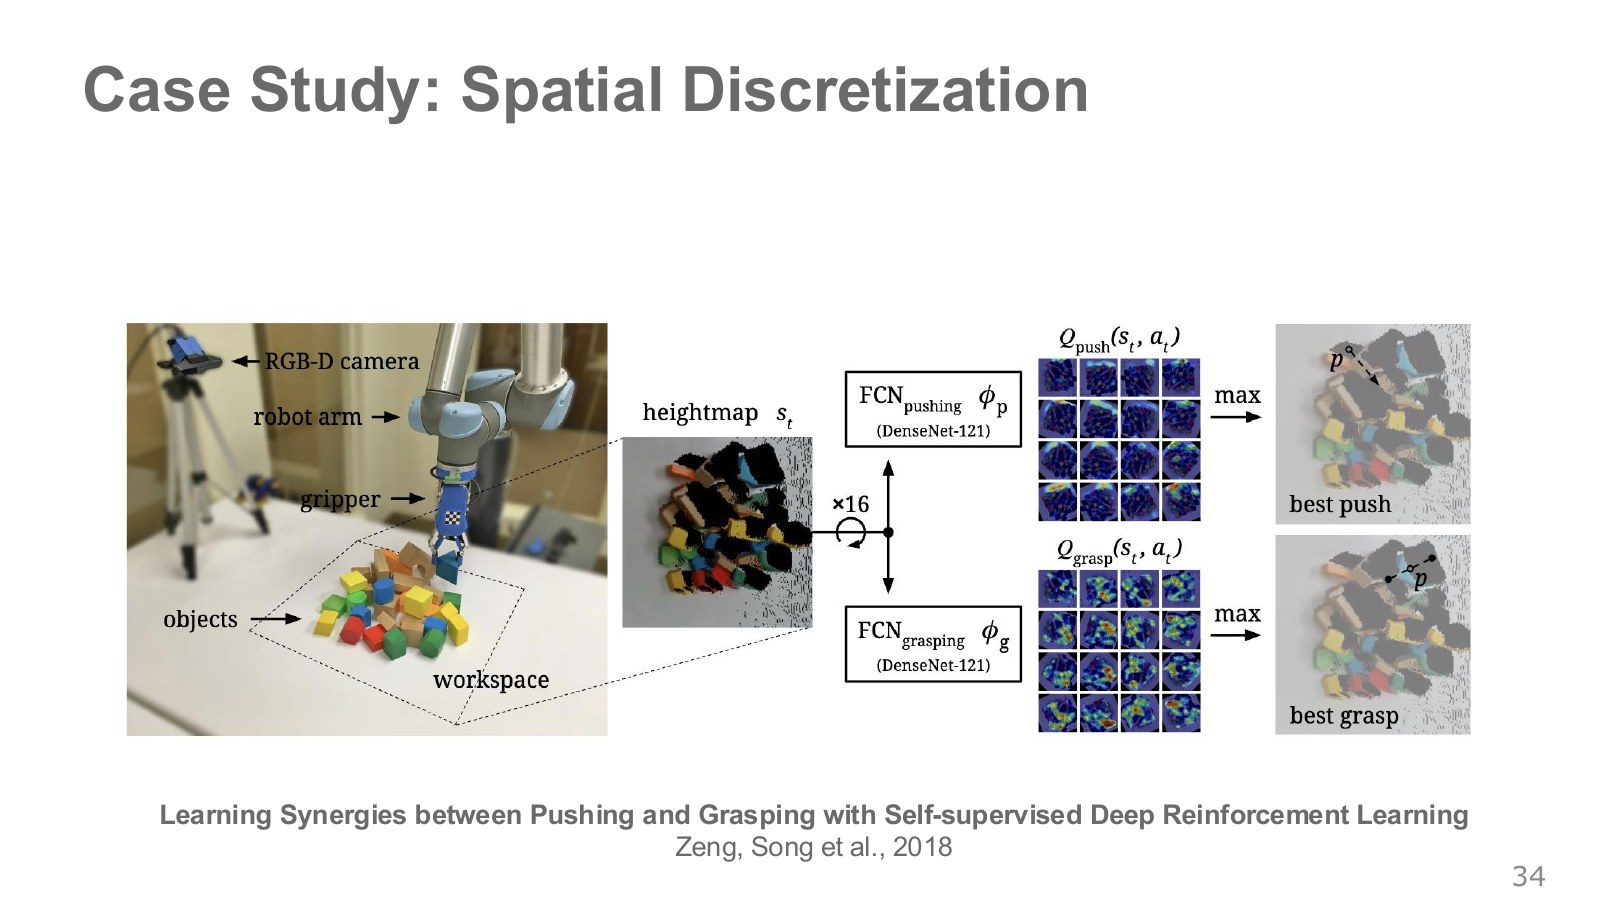
왼쪽의 RGB-D 카메라는 색과 깊이를 함께 측정한다. 이 데이터를 위에서 내려다본 높이 지도(heightmap)로 바꾸면, 각 픽셀이 작업대의 위치와 그곳의 높이에 대응한다. 사진의 원근 때문에 같은 픽셀 간격이 실제 거리와 달라지는 일반 영상과 구별된다.
가운데의 두 네트워크는 밀기와 집기를 각각 평가한다. 완전 합성곱 네트워크(FCN)는 출력 하나만 만드는 대신 위치별로 촘촘한 Q 지도를 만든다. 밝은 위치는 그 위치에서 해당 동작을 시작했을 때 더 좋은 결과를 예상한다는 뜻이다.
×16과 여러 작은 지도는16개 방향을 고려한다는 표시다. 원 논문은 입력 높이 지도를22.5도 간격으로 회전시켜 평가하고, 밀기16개·집기16개의 총32개 Q 지도를 비교한다. 최종 행동은 동작 종류·위치·방향의 조합이다. 오른쪽 점과 선은 선택된 동작의 위치와 방향을 나타낸다.
이 방법이 일곱 관절의 모든 토크 조합을 직접 출력하는 것은 아니다. 사람은 밀기·집기라는 동작 프리미티브와 작업 공간을 정해 주고, 아래 수준에서는 역기구학과 움직임 계획이 사용된다. 학습하는 것은 그 준비된 동작을 언제 어디서 선택해야 좋은가다. Zeng et al. 원 논문 3–4쪽.
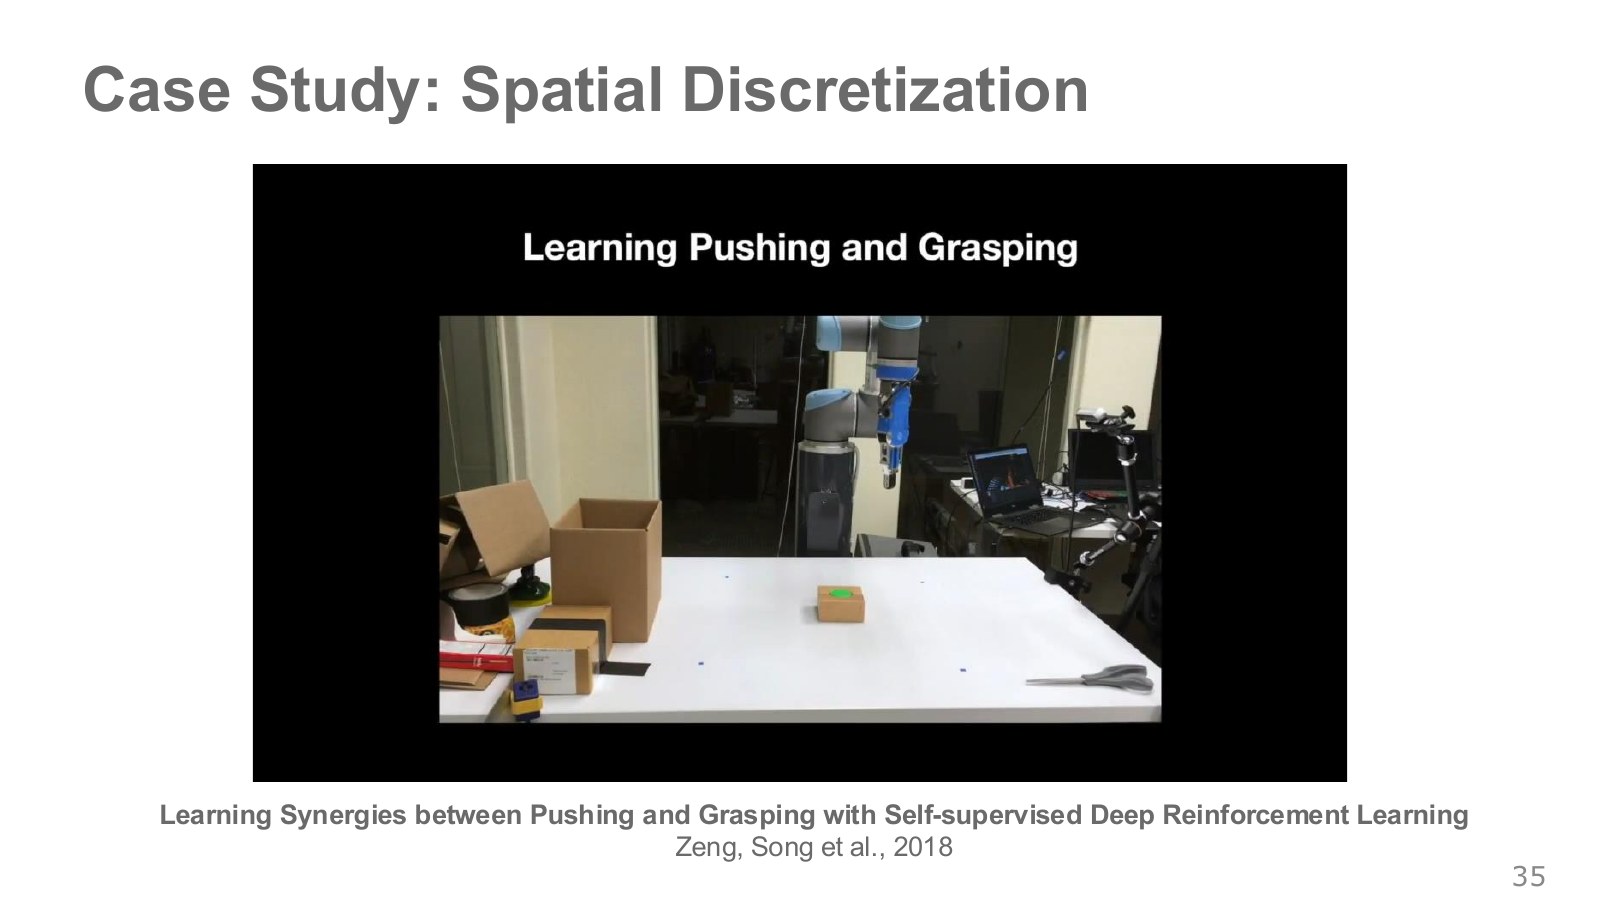
물체들이 붙어 있으면 곧장 집기 어려울 수 있다. 먼저 한 물체를 밀어 분리한 뒤 집으면 성공할 가능성이 커진다. 장기 가치를 쓰는 이유가 여기서 드러난다. 밀기 직후 물체를 들어 올리지 못했더라도 다음 상태의 집기 가치가 높아질 수 있다.
벨만 갱신은 그 다음 상태의 좋은 값을 앞선 밀기 행동으로 전달한다. 그래서 즉시 집기 성공만 보고 행동을 고르는 방법과 달리, 준비 동작의 이점을 반영할 수 있다.
이를 “모든 것이 아무 설계 없이 저절로 생겼다”고 읽지는 말자. 원 논문은 밀기·집기 동작, 높이 지도, 학습 신호와 성공 판정 등을 설계한다. 성공한 집기에1, 감지 가능한 장면 변화를 만든 밀기에0.5를 주는 보상 구성을 사용한다. 밀기에 즉시 보상이 전혀 없었던 실험이라고 설명하면 맞지 않는다. 사람이 정하지 않은 것은 모든 장면에서 “먼저 밀고 다음에 집어라”라는 구체적인 행동 순서다. 원 논문의 방법 · 연구 프로젝트와 코드.
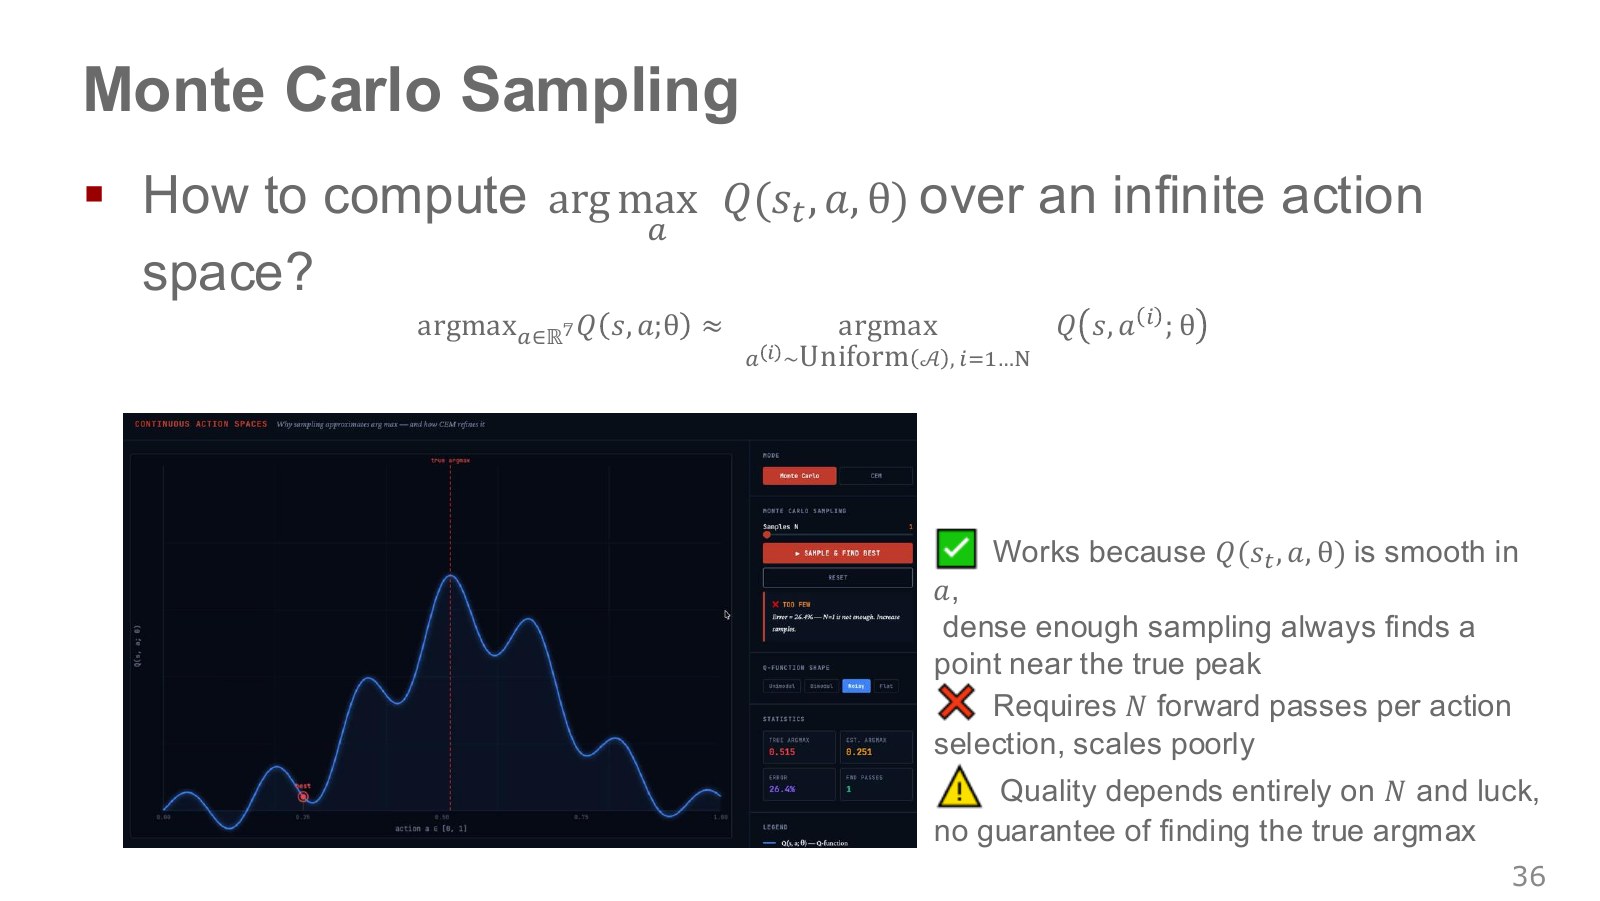
가장 단순한 연속 최적화는 유효한 범위에서 행동 후보 개를 뽑고 Q를 비교하는 것이다. 몬테카를로 표본 추출이라는 말은 여기서 무작위 표본을 이용한다는 뜻이다.
그래프의 높은 봉우리는 Q가 큰 행동 영역이다. 후보가 그 근처에 있어야 좋은 행동을 고를 수 있다. 단지 Q가 매끄럽다는 이유로 유한한 무작위 후보가 반드시 전역 최댓값 근처에 놓이는 것은 아니다. 좋은 영역이 좁거나 차원이 높으면 놓치기 쉽다.
좋은 영역에 들어갈 확률이 한 번에1%라면, 독립적으로100번 뽑아 적어도 한 번 들어갈 확률은 약63.4%다. 꽤 많이 뽑아도 실패할 수 있다는 자체 예다. 확률은 으로 계산한다.
후보 개에는 대략 개의 Q 평가가 필요하다. 다만 후보들을 한 미니배치로 병렬 처리할 수 있으므로 “신경망 호출을 반드시 번 직렬로 기다린다”와는 다르다. Berkeley의 연속 행동 설명 1:57부터도 정확도와 병렬 계산의 절충을 함께 설명한다.
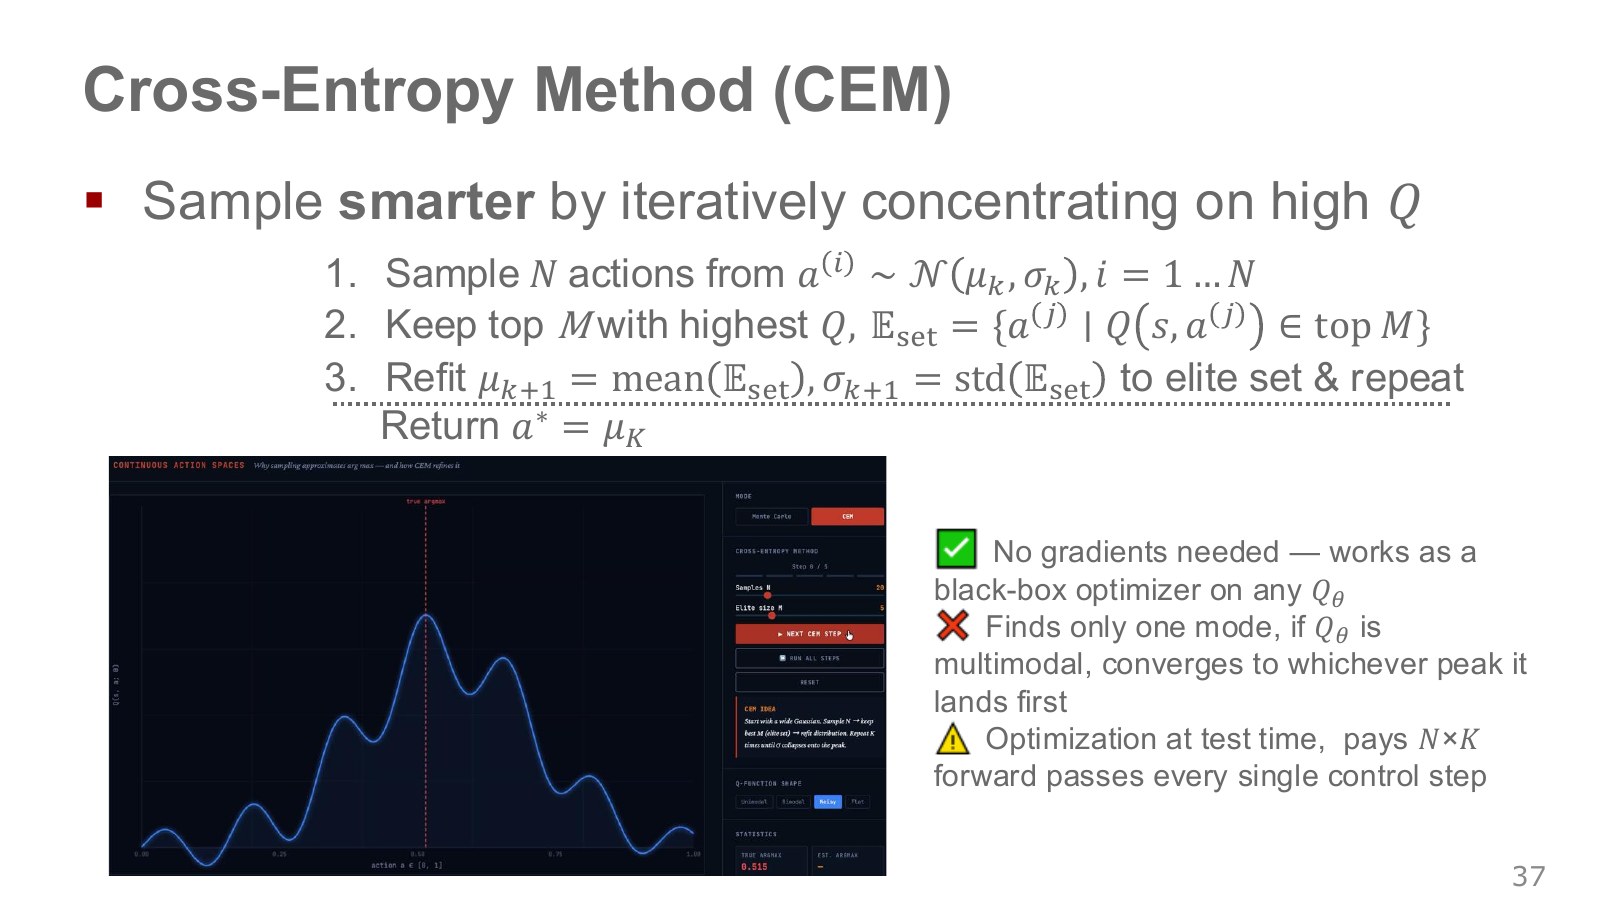
교차 엔트로피 방법(Cross-Entropy Method, CEM)은 후보 분포를 갱신하는 반복 최적화다. 이번에는 모든 범위에서 계속 똑같이 뽑는 대신, 점수가 높았던 후보 주변으로 다음 추출을 집중한다.
- 현재 평균과 분산을 가진 분포에서 행동 후보를 뽑는다.
- Q가 높은 상위 후보인 엘리트 집합을 고른다.
- 그 후보들의 평균·표준편차로 분포를 다시 맞춘다.
- 정해진 횟수만큼 반복하고 행동을 반환한다.
원본의 와 는 현재 후보 분포의 중심과 퍼짐이다. 이는 환경 상태의 불확실성이나 정책의 성공 확률이 아니다. 분산이 너무 빨리0에 가까워지면 탐색이 멈출 수 있어 하한 등을 둘 수 있고, 실제 행동 범위도 지켜야 한다.
단일 가우시안 분포를 쓰는 이 형태는 여러 봉우리 중 한쪽으로 몰리거나 중간으로 잘못 모일 수 있다. CEM 전체가 반드시 한 종류의 분포만 써야 하는 것은 아니지만, 이 단순한 형태에 전역 최적 보장은 없다. 후보 수 , 반복 수 이면 선택 때 대략 개 Q 평가를 지불한다.
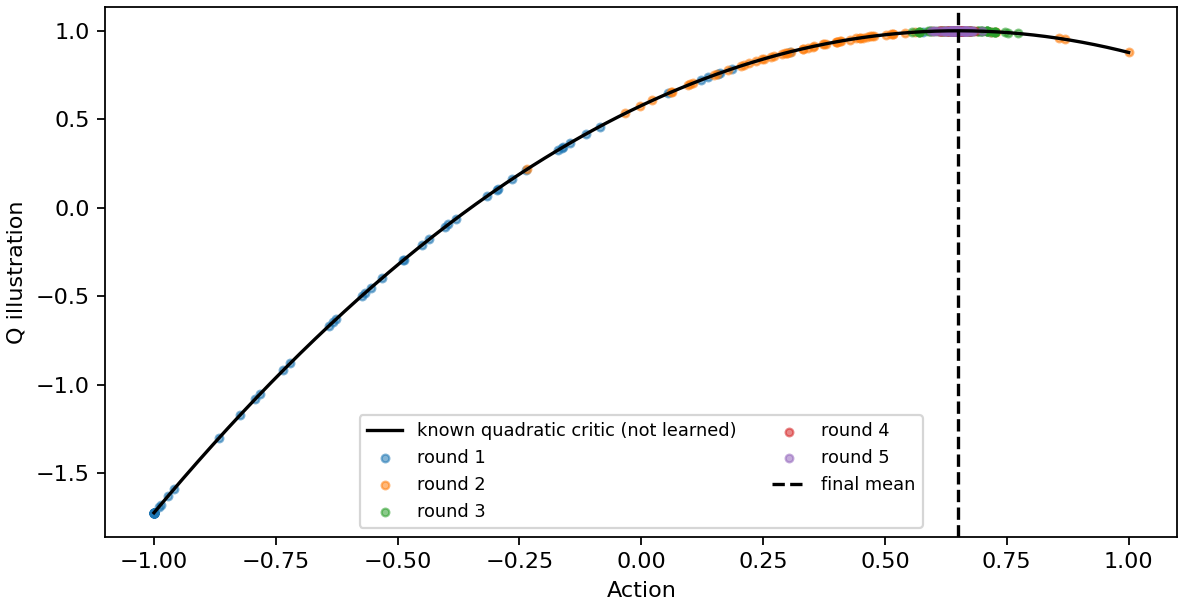
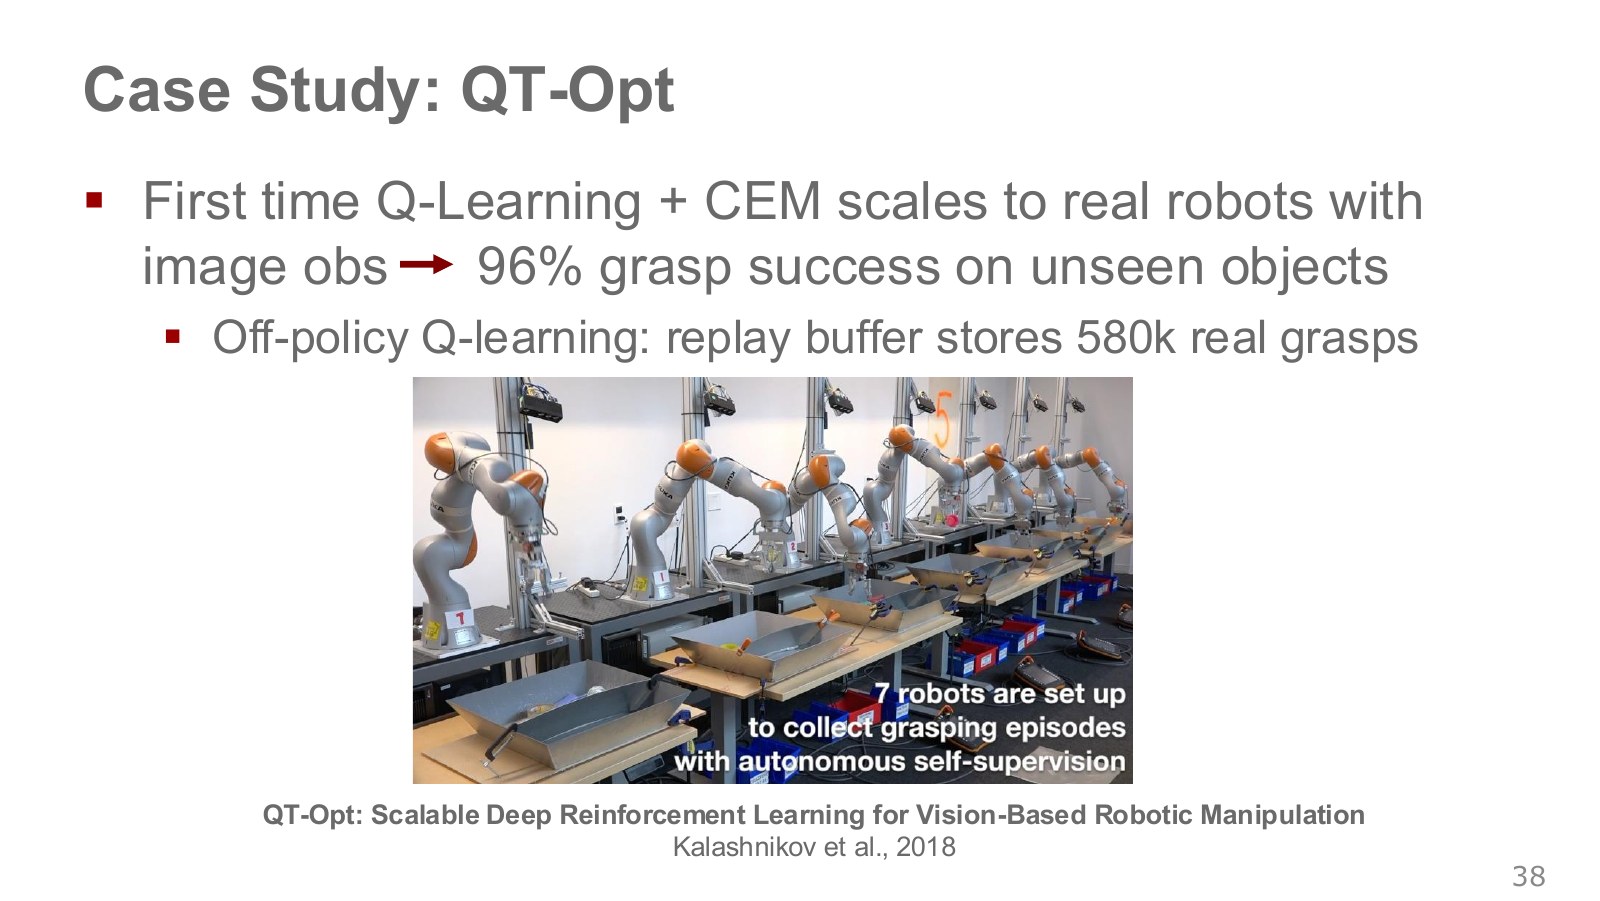
사진 속 여러 로봇은 서로 다른 집기 경험을 모으는 장치들이다. QT-Opt는 영상에 조건을 둔 Q 함수를 학습하고 CEM으로 연속 행동을 찾는 구성을 큰 실물 데이터에 적용했다. 비싼 로봇 전이를 리플레이 버퍼에서 여러 번 사용한다는 의미가 여기서 중요하다.
원 논문은58만 회가 넘는 실물 집기 시도와, 연구의 미관찰 물체 평가에서96% 집기 성공률을 보고한다. 이것은 학습 데이터 수가58만 장의 사진이라는 뜻도 아니고, 모든 로봇·모든 물체·모든 작업의 성공률이96%라는 뜻도 아니다. 물체·장비·평가 절차가 정해진 실험 결과다.
또한 처음 사진 한 장에서 파지점을 정하고 끝까지 그대로 실행하는 방식과 달리, 실행 중 관측을 보며 집기 전략을 바꾸는 폐루프 제어를 다룬다. 물체를 다시 잡거나 접촉으로 위치를 바꾸는 행동은 장기 집기 결과를 높이는 선택으로 이해할 수 있다. “최초의 모든 실물 Q-learning”처럼 넓은 역사적 우선권으로 일반화하지 않는다. Kalashnikov et al. 원 논문.
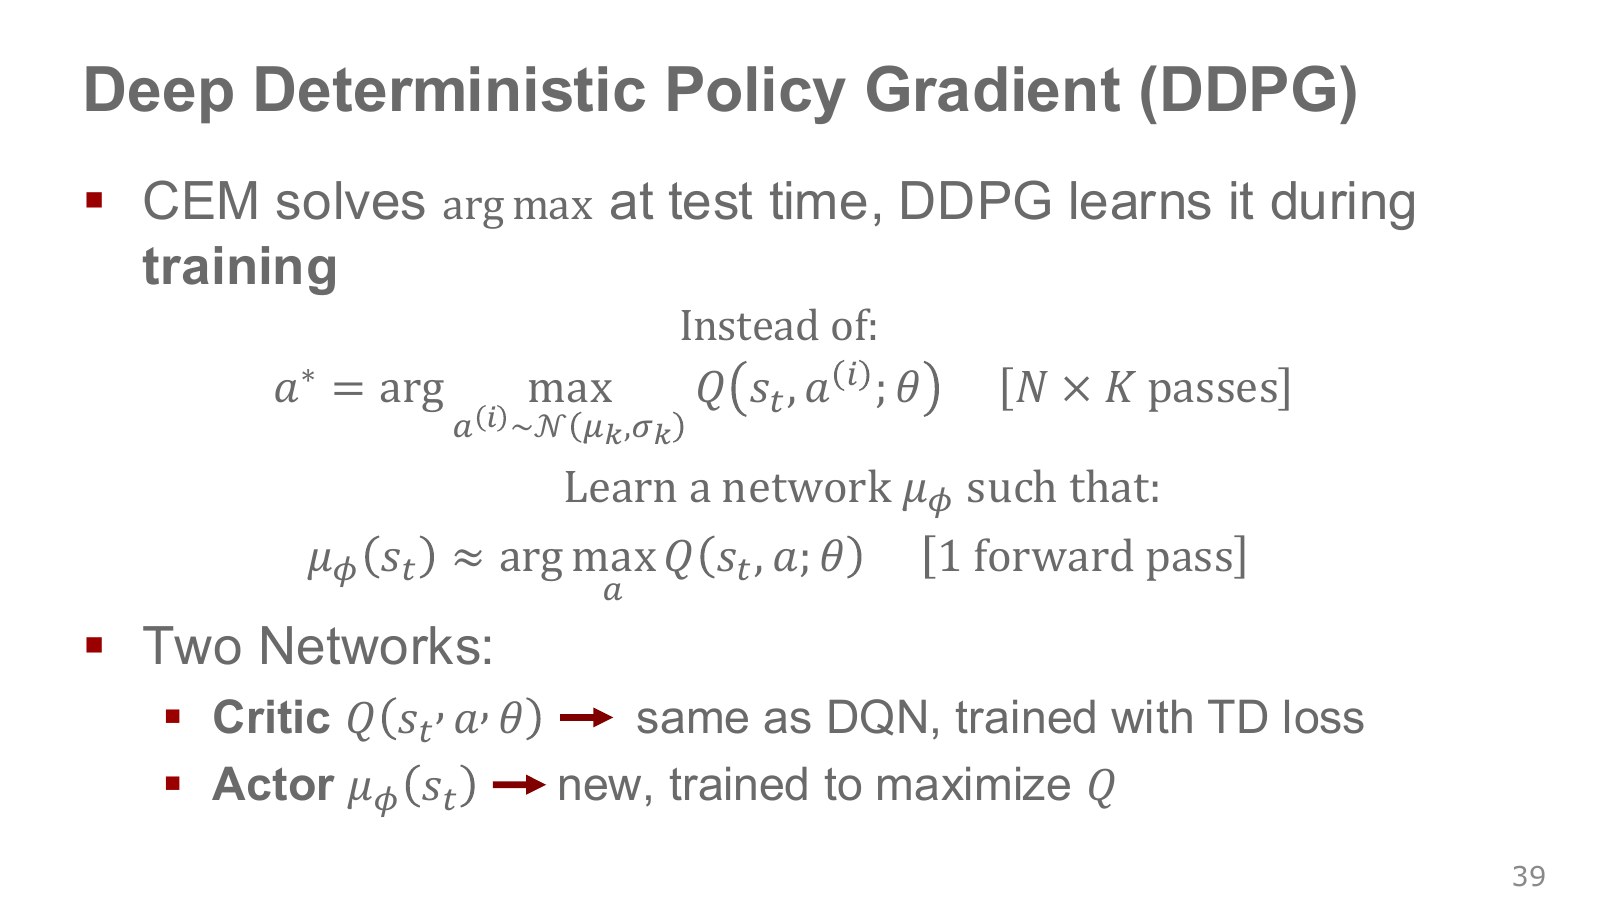
CEM은 로봇이 행동할 때마다 후보를 다시 비교한다. DDPG(Deep Deterministic Policy Gradient)는 그 대신 상태에서 좋은 연속 행동을 바로 출력하는 네트워크를 학습한다. 이 네트워크가 액터(actor)다. 행동을 평가하는 Q 네트워크는 크리틱(critic)이다.
는 액터 가중치, 는 크리틱 가중치다. 같은 상태에서 액터가 명령을 제안하면, 크리틱은 그 명령이 얼마나 좋은지를 추정한다. 액터는 크리틱이 높은 값을 주는 방향으로 바뀌고, 크리틱은 보상·다음 상태를 이용한 TD 목표로 바뀐다.
원본의 “두 네트워크”는 이 두 역할을 말한다. 실제 DDPG 구현에는 각각의 목표 복사본도 있어 네트워크 인스턴스가 둘만 있는 것은 아니다. 크리틱 목표의 대표 형태는 다음과 같다.
배포할 때 액터 순전파 한 번으로 행동을 제안할 수 있다는 장점이 있다. 는 근사라는 뜻이며, 액터가 매 상태에서 진짜 전역 최댓값을 찾아낸다는 증명은 아니다. Berkeley의 액터 도입과 목표 복사본 설명 6:15–9:42.
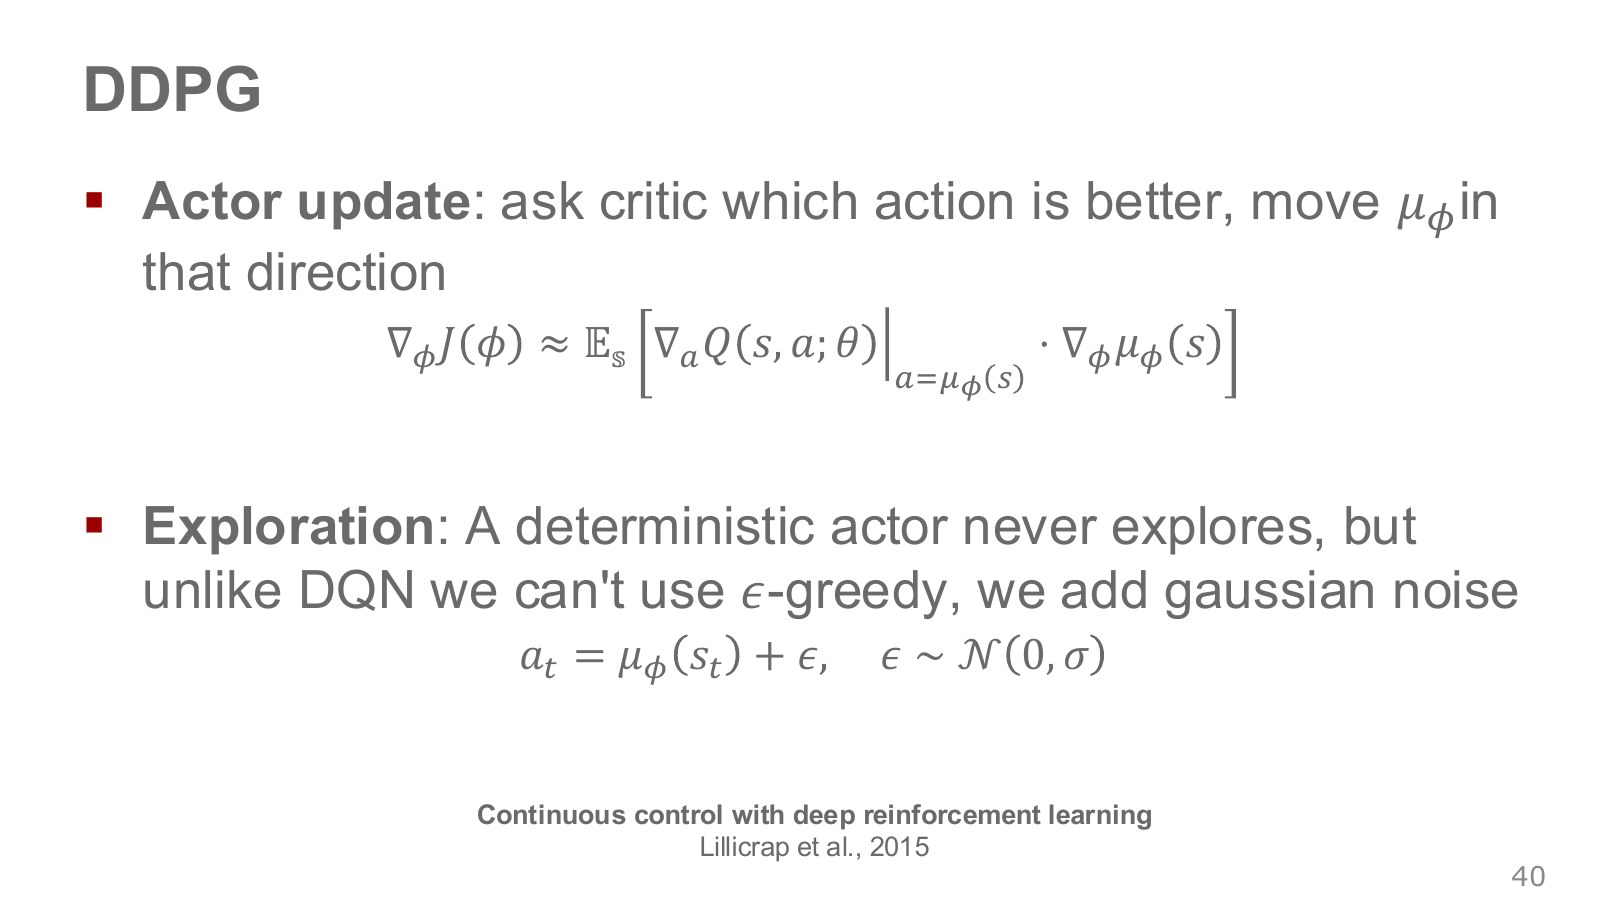
크리틱이 “행동을 조금 이쪽으로 바꾸면 Q가 커진다”는 방향을 알려 주면, 그 방향으로 액터의 가중치를 바꾼다. 연쇄 법칙(chain rule)은 이 두 변화의 민감도를 연결한다.
는 행동을 바꾸었을 때 점수가 얼마나 바뀌는지, 는 가중치를 바꾸었을 때 행동이 얼마나 바뀌는지를 나타낸다. 벡터에서는 알맞은 야코비안 곱으로 계산한다. 이때 액터 손실의 기울기를 계산하며 크리틱의 가중치 자체를 액터와 함께 갱신하는 것은 아니다.
자체1차원 예에서 , , , 이면 현재 행동은0.4다. 행동에 대한 미분은0.5, 가중치에 대한 행동 미분은2라서 곱은1이다. 작은 가중치 변화로 직접 차분한 값과도 일치하는지 실행 파일에서 확인했다.
결정적 액터는 같은 입력에서 같은 행동을 내므로, 수집 중에는 행동에 잡음을 더하는 방식 등을 사용한다. 연속 공간에서도 확률적으로 무작위 행동을 섞는 방식이 수학적으로 불가능한 것은 아니다. 국소 잡음은 그 대신 자주 쓰는 선택이다. 행동 한계와 잡음 크기를 정해야 하며, 독립 가우시안 잡음을 더한다고 시간적으로 매끄러운 명령이 자동으로 되는 것은 아니다.
DDPG 원 논문은 시간 상관이 있는 Ornstein–Uhlenbeck 잡음을 사용했다. 원본의 가우시안 잡음 도식은 탐색의 단순한 설명으로 구별한다.
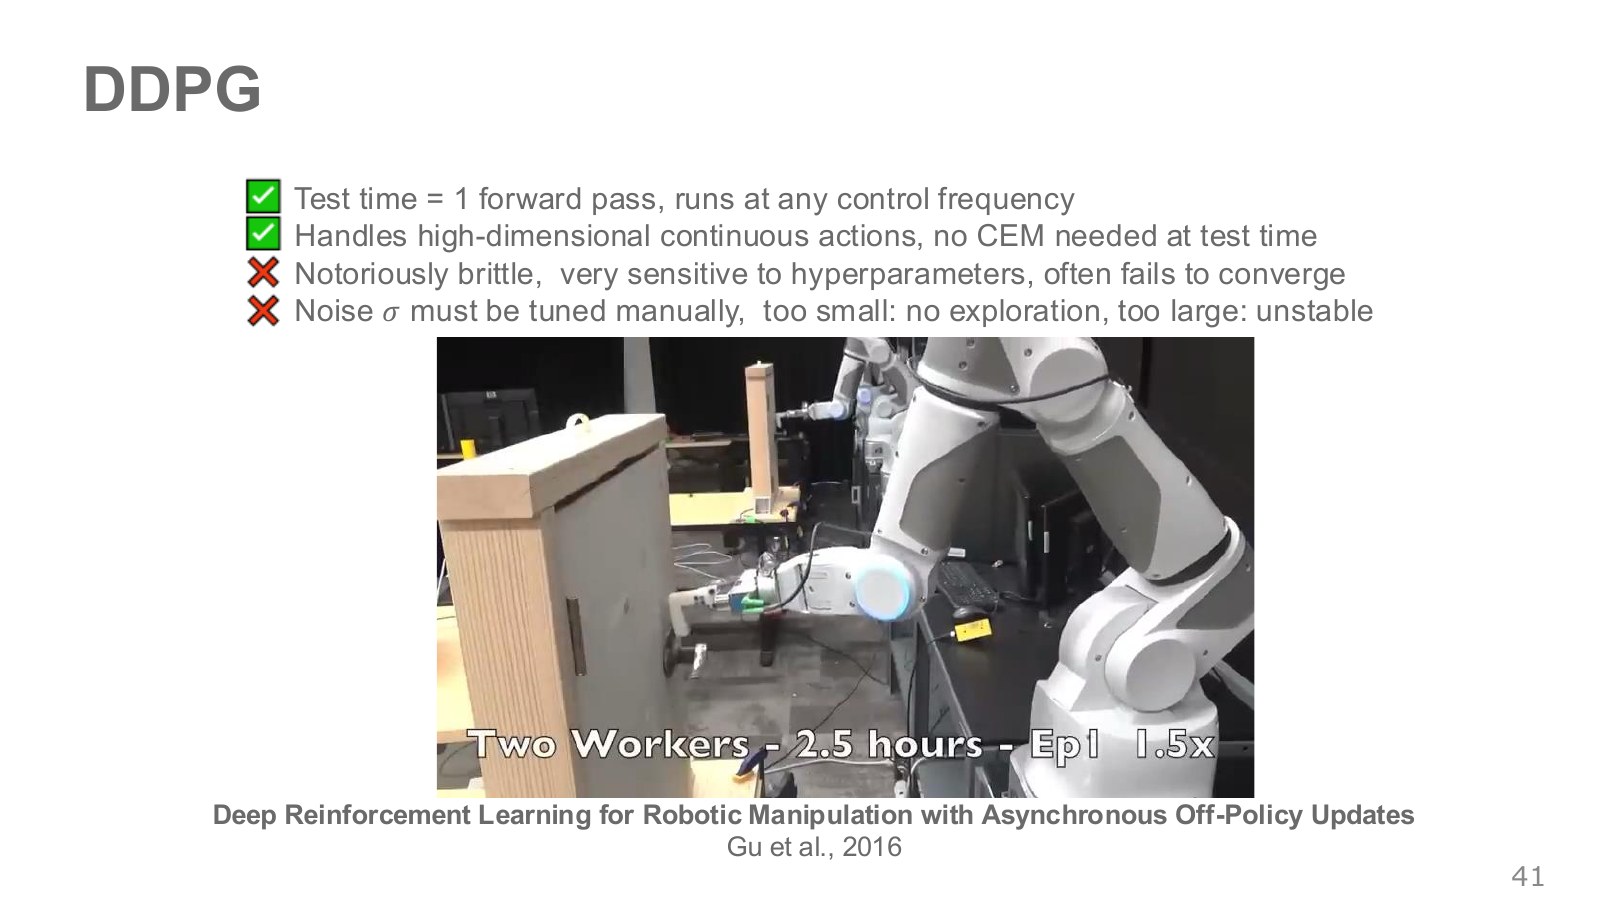
로봇이 문이나 손잡이를 조작하는 사진은 연속 제어 적용을 보여 준다. 액터가 있으므로 CEM 후보 검색을 매번 하지 않아도 된다. 그렇다고 어떤 제어 주파수에서도 항상 실행된다는 뜻은 아니다. 모델 크기, 영상 처리, 하드웨어, 통신 지연까지 전체 시간을 재야 한다.
DDPG는 크리틱 오차, 액터의 그 오차 활용, 탐색 범위, 학습률 같은 요소에 민감할 수 있다. 크리틱이 실제보다 높게 평가한 행동을 액터가 적극적으로 찾으면, 예측 Q는 높아지는데 실제 리턴은 떨어지는 상황도 생길 수 있다.
원본 영상의 “작업자2대·2.5시간” 같은 표시는 특정 연구 설정의 실험 문맥이다. 내 로봇에서도 같은 시간에 학습된다는 보편적 사양이 아니다. Gu et al.의 비동기 오프폴리시 로봇 학습을 실물 사례로 읽되, 이 글에서 그 훈련을 수행한 결과와는 구별한다.
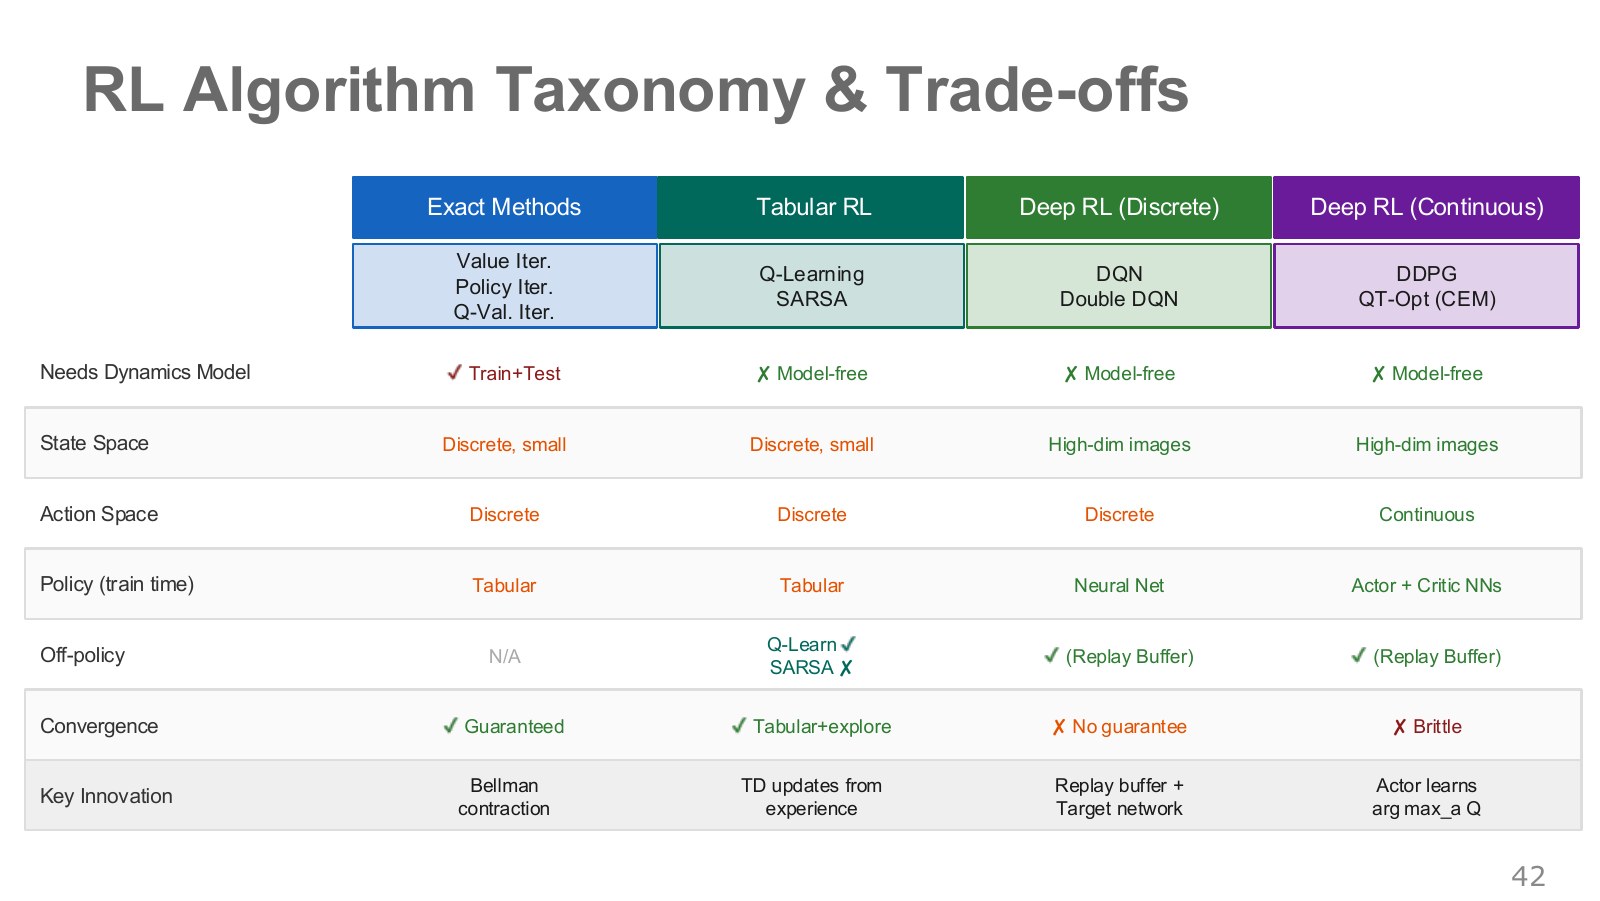
표의 열은 이번 장에서 거쳐 온 네 묶음이다. 알려진 모델 위에서 표를 계산하는 방법, 경험으로 표를 배우는 방법, 신경망으로 이산 행동 가치를 배우는 방법, 연속 행동까지 처리하는 방법이다.
| 질문 | 표형 동적 계획법 | 표형 Q-learning·SARSA | DQN·Double DQN | QT-Opt·DDPG |
|---|---|---|---|---|
| 전이 모델을 직접 계산하는가 | 그렇다 | 표본 경험 사용 | 표본 경험 사용 | 표본 경험 사용 |
| 상태를 어떻게 표현하는가 | 작은 상태 표 | 작은 상태–행동 표 | 신경망 특징, 영상 등 | 신경망 특징, 영상·벡터 등 |
| 행동을 어떻게 고르는가 | 모델로 개선하거나 정책 표 저장 | Q 표 비교 | 유한 행동 출력 비교 | 후보 검색 또는 액터 |
| 오래된 경험 재사용 | 모델 자체로 계산 | Q-learning 가능, SARSA는 정책 일치 고려 | 리플레이 활용 | 오프폴리시 리플레이 활용 |
| 보장의 핵심 조건 | 유한 할인 MDP·정확한 계산 등 | 방문·학습률·정책 변화 조건 | 일반적인 전역 수렴 보장 없음 | 일반적인 전역 수렴 보장 없음 |
원본 표를 엄밀한 배타적 분류로 외우지는 말자. Q 값 반복은 학습 때 모델을 사용해도 저장한 Q로 실행할 수 있다. 연속 행동 열에서도 QT-Opt는 액터로 행동을 바로 내는 DDPG와 달리 검색 비용을 지불한다. 영상만 가능한 것도 아니다. DQN은 연속 벡터 상태와 이산 행동에도 사용할 수 있다.
같은 “모델 프리”라도 필요한 데이터, 실행 시간, 행동 표현은 다르다. 로봇 문제를 고를 때는 모델을 아는가, 관측에 필요한 정보가 있는가, 행동을 나열할 수 있는가, 얼마나 비싼 경험을 얼마나 많이 모을 수 있는가를 함께 물어야 한다.
#직접 실행해 확인한 계산
작은3×4 확률 격자에서 가치 반복과 정책 반복을 계산하고, 전이 표본24만 개로 표형 Q-learning을 수행했다. 목표·위험에 들어갈 때만 +1·−1을 받고 종료하며, 할인율은0.9다. 다른 칸의 즉시 보상은0이다. 벽·경계·미끄러짐을 명시한 별도 환경으로, ETH 데모나 과제를 재현했다고 부르지 않는다.
Q-learning 쪽에는 미리 계산한 전이 행렬의 평균을 목표로 넣지 않고, 시뮬레이터가 뽑은 다음 상태와 보상 하나씩을 사용했다. 방문 범위를 통제하려고 유효한 상태와 행동을 균등하게 골라 질의했다. 따라서 에피소드 처음부터 탐색한 학습의 표본 효율과 비교하는 실험은 아니다.
검사한 내용은 전이 확률 합, 종료 보상 중복 방지, 벨만 고정점, 정확한 정책 평가, 가치 반복과 정책 반복의 일치, 개선의 비감소, 상태–행동 방문 범위, 학습 Q 오차, 학습 정책의 가치 차이, TD 수치, 종료 목표, Double DQN의 선택/평가 분리, 잡음 최대값 편향, CEM, 액터 연쇄 미분 등18개다. 이번 실행의 최대 Q 추정 오차는 약0.0269였고, 학습된 탐욕적 정책의 가치는 이 작은 환경에서 최적 정책과 수치 오차 범위 내에서 일치했다. 설정·seed·모든 수치는 실행 코드와 결과 JSON·CSV에 함께 남겼다.
DQN·DDPG 신경망이나 실제 로봇을 훈련한 결과는 아니다. CEM은 미리 정한 이차 함수를 검색한 예이고, 두 추정치의 잡음 실험도 실제 Double DQN 결과와 구별한다.
#공식 과제로 이어가기
ETH 공식 HW4는 이번 개념을 실제 실행 구조에 연결할 수 있는 자료다. 고정한 커밋의 안내와 관련 파일을 참고했으며, 공식 과제를 대신 구현·실행했다는 결과로 제시하지 않는다.
| 과제 부분 | 이 장에서 연결할 질문 |
|---|---|
| Ex1, GridWorld의 가치·정책 반복 | 같은 모델에서 두 방법의 정책이 일치하는가? 미끄러짐 확률이 커지면 경로가 어떻게 바뀌는가? |
| Ex2, CartPole DQN | 연속적인 상태4개와 이산 행동2개를 구분했는가? 버퍼와 목표 네트워크의 갱신 간격은 무엇인가? |
| Ex3·Ex4, SO100의 PPO·SAC | 연속 행동으로 넘어갈 때 정책·데이터 재사용 방식이 어떻게 달라지는가? 이 부분의 알고리즘은 후속 장과 연결한다. |
원본 과제의 CartPole 화면을 본다고 그 알고리즘이 곧바로 로봇 관절 토크를 출력하는 것은 아니다. SO100 과제도 정규화된 관절 위치 명령을 다루므로, 이번 장의 토크 벡터 예와 행동의 물리적 의미를 구별해야 한다.
다음 05장에서는 정책을 직접 개선하는 방법과 연속 제어를 더 이어 간다.
#출처와 함께 읽을 자료
- ETH Robot Learning 4강 · 영상 · PDF · 이미지 사본
- David Silver — 동적 계획법 · 강의 영상 · 모델 프리 제어 · 강의 영상
- Berkeley CS285 가치 함수 · Deep RL with Q-Functions · 목표 네트워크 영상 · 연속 행동 영상
- DQN 2013 · DQN 2015 · Double DQN
- 밀기와 집기 · QT-Opt · DDPG · 비동기 실물 로봇 학습
P번호는 이미지 사본의 파일 순서다. 감사·참고문헌 전용 장은 생략했다. 슬라이드의 저작권은 Oier Mees 및 포함 자료별 권리자에게 있다. DQN 원 논문 도식은 해당 원저작자의 자료이며, 자체 격자·잡음·CEM 그림은 별도의 교육용 계산이다.