AI의 자기평가, 여러 답의 일치, 높은 확신은 학습 신호가 될 수 있다. 그러나 그 신호가 좋아졌다는 사실만으로 답이 더 정확해졌다고 할 수는 없다.
5편 — 보상을 만드는 AI와 답을 평가하는 AI에서는 보상 코드를 설계하는 AI와 답의 품질을 평가하는 AI를 구분했다. 이번에는 평가용 정답이 없는 상황에서 모델의 출력으로 어떤 신호를 만들 수 있는지 살펴본다. “AI가 스스로 채점한다”는 말 안에도 서로 다른 세 가지 방법이 들어 있다.
하나는 말로 점수를 매기는 자기평가다. 다른 하나는 여러 번 답하고 일치하는 답을 찾는 집계다. 마지막은 출력 확률이 얼마나 한곳에 모이는지 측정하는 엔트로피다. 이 셋은 사용하는 정보와 계산 방법이 다르다. 선택된 답만 바꾸는지, 신경망의 파라미터까지 바꾸는지도 따로 확인해야 한다.
기준 자료는 Hung-yi Lee의 NTU Machine Learning 2026 Spring, Self-Improving 상편 26–30쪽이다. 강의일은 2026년 5월 8일이며, 표지를 1쪽으로 센다. 공식 PDF · 원본 PPTX
아래 다섯 장은 원본의 도해와 수식을 유지하고 중국어 제목·설명을 영어로 옮긴 비공식 편집본이다. 30쪽에 잘려 있는 SUTA 논문 주소의 마지막 숫자는 정식 논문과 대조해 수정했다. 보충 그림·표는 원 논문의 해당 영역을 발췌했다. 본문의 추가 수식과 가상 숫자 예제는 강의 해설이며, 논문의 실험 결과와 구분한다.
| 원본 | 이번에 확인할 질문 |
|---|---|
| 26쪽 | 답을 생성하는 모델과 손실을 만드는 평가자는 어떤 역할을 맡는가? |
| 27쪽 | “5점”이라는 평가와 “Yes” 토큰의 확률은 무엇이 다른가? |
| 28쪽 | 다수결로 고른 답은 언제 의사 정답이 되고, 언제 실제 학습에 쓰이는가? |
| 29쪽 | 엔트로피가 낮아진다는 것은 무엇을 뜻하며, 무엇을 보장하지 않는가? |
| 30쪽 | 이미지·음성·언어에서 엔트로피 최소화는 각각 무엇을 바꾸는가? |
#26쪽 — 평가 신호를 만드는 역할과 답을 만드는 역할
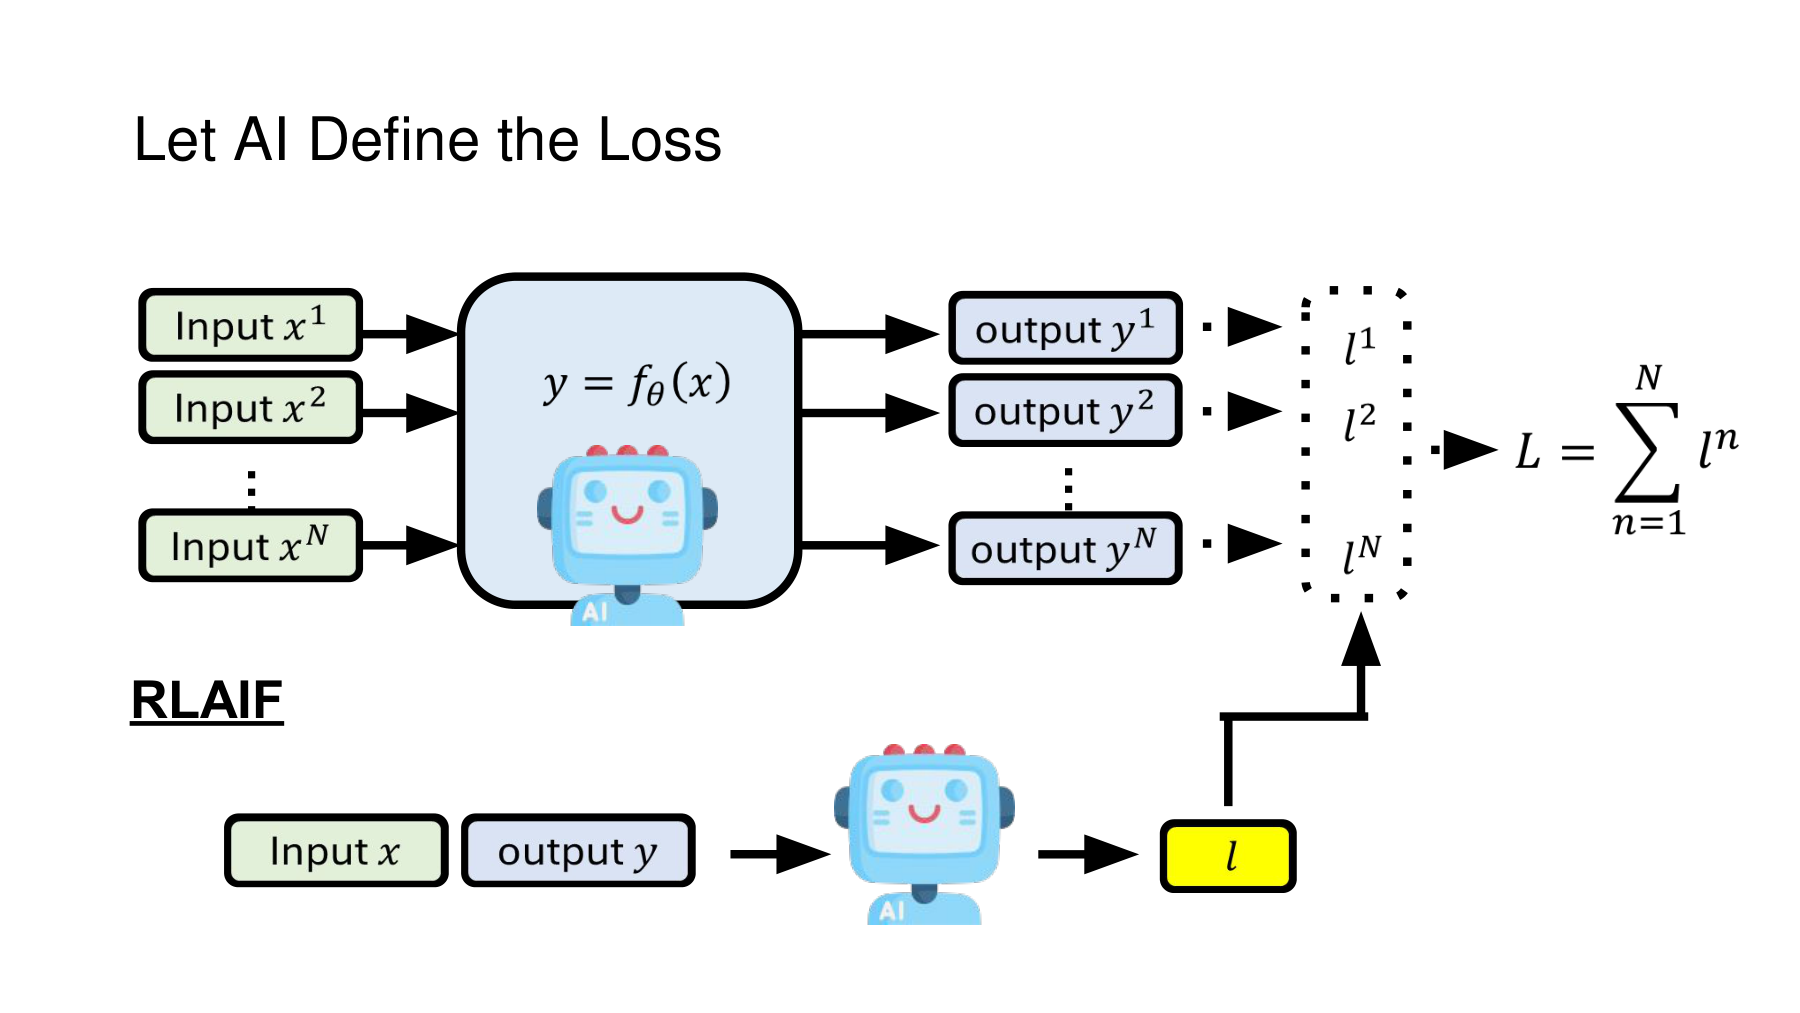
원본 위쪽에는 입력, 모델의 출력, 각 예제의 손실, 손실의 합이 놓여 있다. 아래쪽의 RLAIF 그림은 입력과 답을 평가자에게 주고, 그 평가로 손실을 만드는 경로를 보여준다. 이번 다섯 장은 정답 라벨이 항상 주어지지 않을 때 평가 신호를 무엇으로 만들 것인가라는 질문을 구체화한다.
#같은 AI 그림이 같은 파라미터를 뜻하지는 않는다
질문을 , 답을 , 생성 정책을 라고 쓰자. 생성 정책은 질문에 대한 답을 만들고, 평가자는 질문과 답을 받아 점수나 손실을 계산한다. 아래는 이 역할을 구분하기 위한 설명용 표기다.
평가자의 파라미터는 , 평가 기준이나 지침은 로 표시했다. 마지막 함수는 점수를 학습 목적에 맞는 손실로 바꾸는 규칙이다. 예를 들어 높은 점수가 좋은 평가라면, 최소화할 손실에서는 부호나 기준점을 바꾸어야 한다.
생성자와 평가자에 같은 종류의 모델을 쓸 수도 있고, 서로 다른 모델을 쓸 수도 있다. 동일한 가중치의 모델을 다른 프롬프트로 호출할 수도 있다. 슬라이드에 같은 로봇 아이콘이 있다는 사실만으로 두 역할이 동일한 파라미터를 공유한다고 읽으면 안 된다. 반대로 모델 이름이 다르다는 이유만으로 두 모델의 오류가 독립이라고 볼 수도 없다. 실제 설계에서는 모델·프롬프트·학습 자료·평가 근거를 확인해야 한다.
5편의 구분도 그대로 남는다. AI가 어떤 답을 높게 평가하는 일, 그 평가로 학습 자료를 만드는 일, 생성 정책의 파라미터를 업데이트하는 일은 각각 다른 단계다. 점수만 계산했다면 아직 생성 모델을 학습한 것이 아니다.
#정답 라벨이 없다는 말과 기준이 없다는 말은 다르다
형식을 지켰는지, 요청한 항목을 포함했는지처럼 평가 지침을 명확히 쓸 수 있는 과제에서는 AI 평가가 유용한 신호가 될 수 있다. 그러나 모델 자신이 어려워하는 계산이나 지식 문제에서 자기평가만 반복하면, 답을 만들 때의 오류가 평가에도 이어질 수 있다. 이 글에서는 이를 검증 설계의 위험으로 다룬다. 모든 AI 평가가 무효라는 결론도, 모든 자기평가가 정확하다는 결론도 내리지 않는다.
중요한 질문은 “외부 라벨을 썼는가?” 하나가 아니다. 어떤 사전 지식과 평가 기준이 이미 들어 있고, 새로 주어진 입력에서 무엇을 배우며, 개선 여부를 무엇으로 확인하는가?도 함께 물어야 한다. 사전학습 모델과 사람이 정한 평가 지침을 사용하면서 완전히 아무 정보 없이 목표를 만들었다고 설명하면 과정이 사라진다.
#27쪽 — 말로 표현한 점수와 토큰의 확률을 구별한다
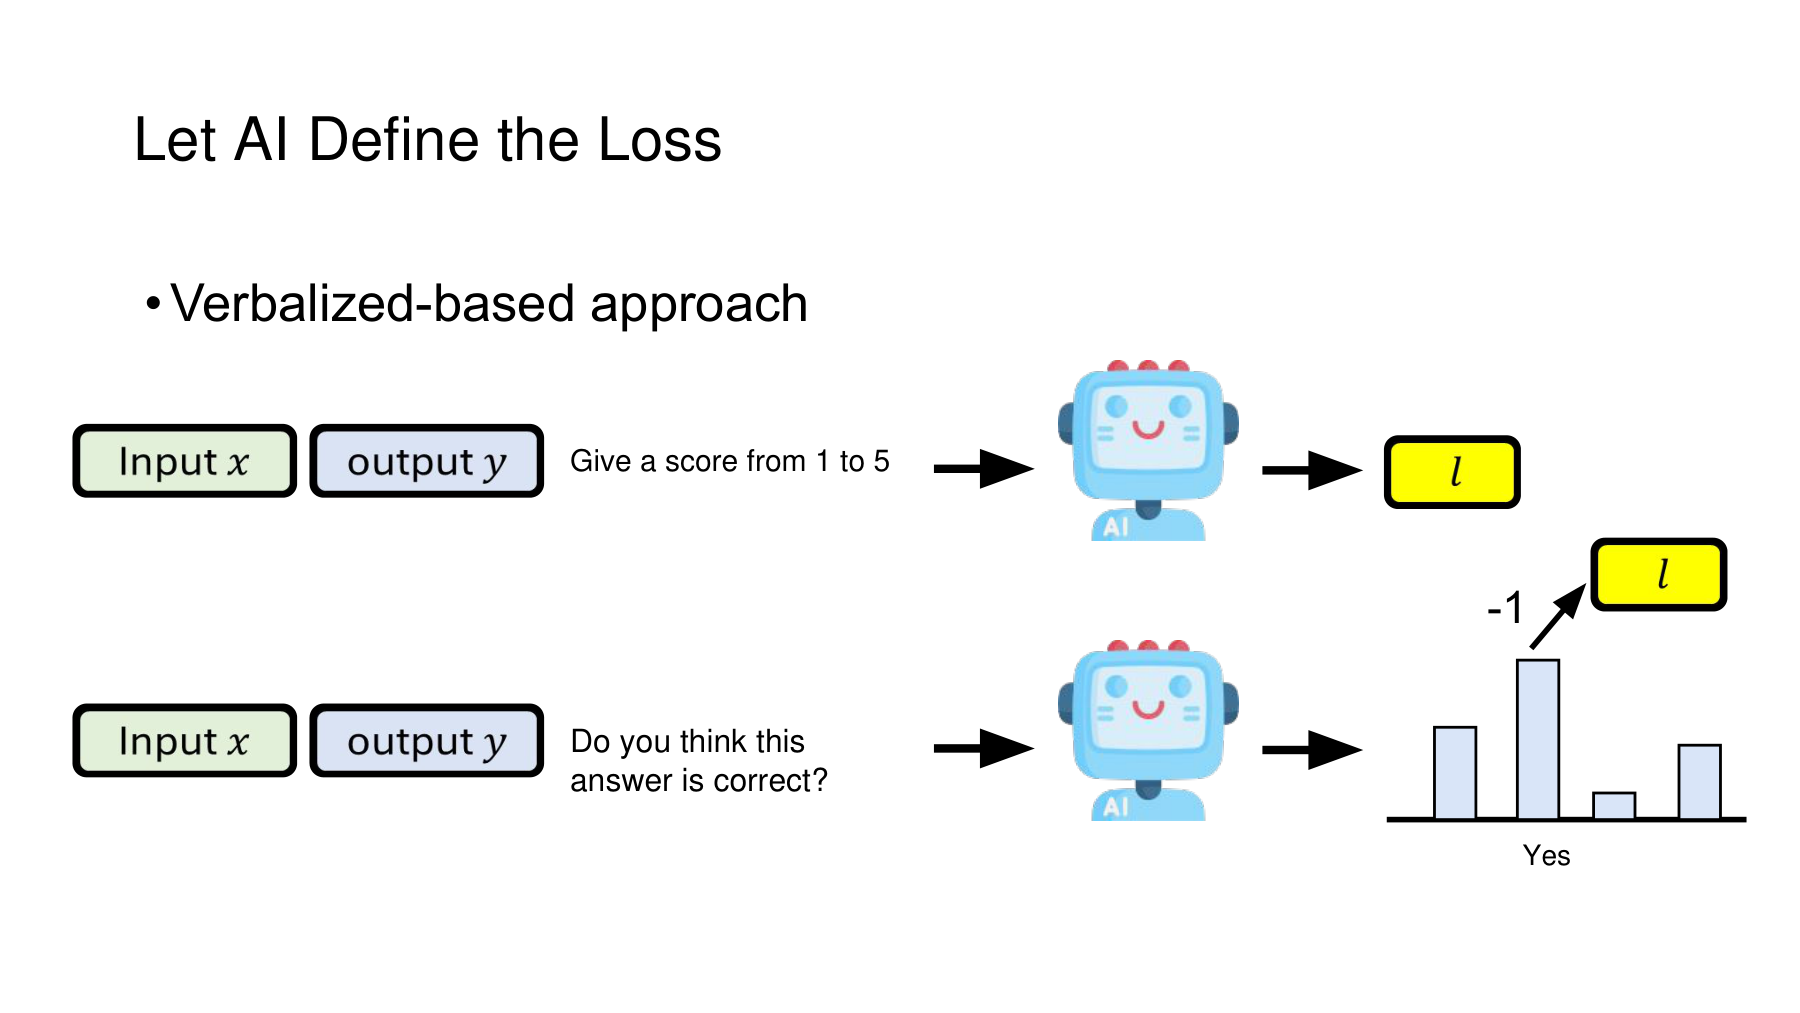
원본은 언어로 평가를 표현하는 방법(Verbalized-based approach)을 보여준다. 위쪽에서는 입력과 답을 보고 1–5점 사이의 점수를 요구한다. 아래쪽에서는 답이 맞는지 물은 뒤, 평가자가 “Yes”에 해당하는 응답을 낼 확률을 손실과 연결한다. 아래 그림의 −1은 높은 긍정 확률을 낮은 손실로 바꾸는 부호에 주목하게 한다.
#1–5점 평가: 숫자가 나와도 곧바로 확률은 아니다
평가자가 기준에 따라 점수 를 낸다고 하자. 높은 점수가 좋은 답을 뜻한다면 다음처럼 손실을 정의할 수 있다. 이는 원리를 보여주는 한 가지 선택이지, 모든 RLAIF가 사용하는 고정된 손실식은 아니다.
가상 예로 답 A가 4.5점, 답 B가 2점이면 손실은 각각 0.5와 3이다. 이 목적을 최소화하는 쪽은 A를 선호한다. 반대로 평가 점수 자체를 손실이라고 부르고 그대로 최소화하면 좋은 답의 점수를 낮추는 방향이 된다. 평가 점수, 보상, 손실은 이름만 바꾸어 같은 방향으로 최적화할 수 있는 변수가 아니다.
또한 4점은 “정답일 확률 80%”가 아니다. 1–5점 척도는 사실성·충실성·간결함 같은 기준을 어떻게 묶었는지에 따라 달라진다. 1점에서 2점으로 올라가는 변화와 4점에서 5점으로 올라가는 변화를 같은 크기로 취급할지도 설계 선택이다. 숫자를 출력한다는 사실만으로 척도의 의미나 보정(Calibration)이 정해지지는 않는다.
#“맞습니다”라는 문장과 그 문장을 생성할 확률
아래 그림을 단순화하면 평가 프롬프트를 받은 모델의 긍정 응답 확률을 사용한다. “Yes”가 하나의 토큰으로 표현되는 단순한 경우를 생각하자.
이 식은 슬라이드의 음수 부호를 설명하는 표기다. 평가자가 “Yes”를 생성할 가능성이 커지면 이 손실은 작아진다. 하지만 이는 주어진 프롬프트 아래에서 특정 응답을 생성할 확률이지, 별도 검증 없이 사용할 수 있는 정답 확률은 아니다.
실제로는 “Yes”, “ yes”, “Correct”처럼 답의 표현이 달라질 수 있다. 토크나이저에 따라 단어가 여러 토큰으로 나뉘기도 한다. Yes와 No의 확률만 다시 정규화하면 전체 어휘에서의 Yes 확률과 다른 수치가 된다. 평가 모델이 “확신도 90%”라는 문자열을 출력하는 경우에는, 그 문자열의 숫자와 그 문자열 자체의 생성 확률도 구분해야 한다.
예를 들어 수학 답에 대한 평가자가 매끄러운 설명에 이끌려 높은 긍정 확률을 준다고 하자. 같은 답을 다시 계산해 얻은 검증 결과와 그 확률은 서로 다른 근거다. 이 글의 제안은 두 수치를 같다고 놓지 말고, 실제 정답이 있는 별도 자료에서 평가 신호와 정확도의 관계를 확인하는 것이다.
#평가를 사용한 선택과 평가를 사용한 학습
답 후보를 여러 개 생성하고 점수가 가장 높은 것을 반환하면 재순위화(Reranking)를 수행한 것이다. 이 작업만으로 가중치가 바뀌지는 않는다. 높은 점수의 답을 학습 목표로 저장하거나, 점수를 보상으로 삼아 정책을 업데이트해야 학습 단계로 넘어간다.
따라서 “평가자가 더 좋은 답을 골랐다”와 “생성 모델이 다음 질문에도 더 좋은 답을 만들도록 바뀌었다”는 별도로 검증해야 한다. 선택 단계의 비용 증가를 모델 자체의 능력 향상으로만 설명하는 것도 피한다.
#28쪽 — 여러 답의 일치는 유용하지만 정답 인증서는 아니다
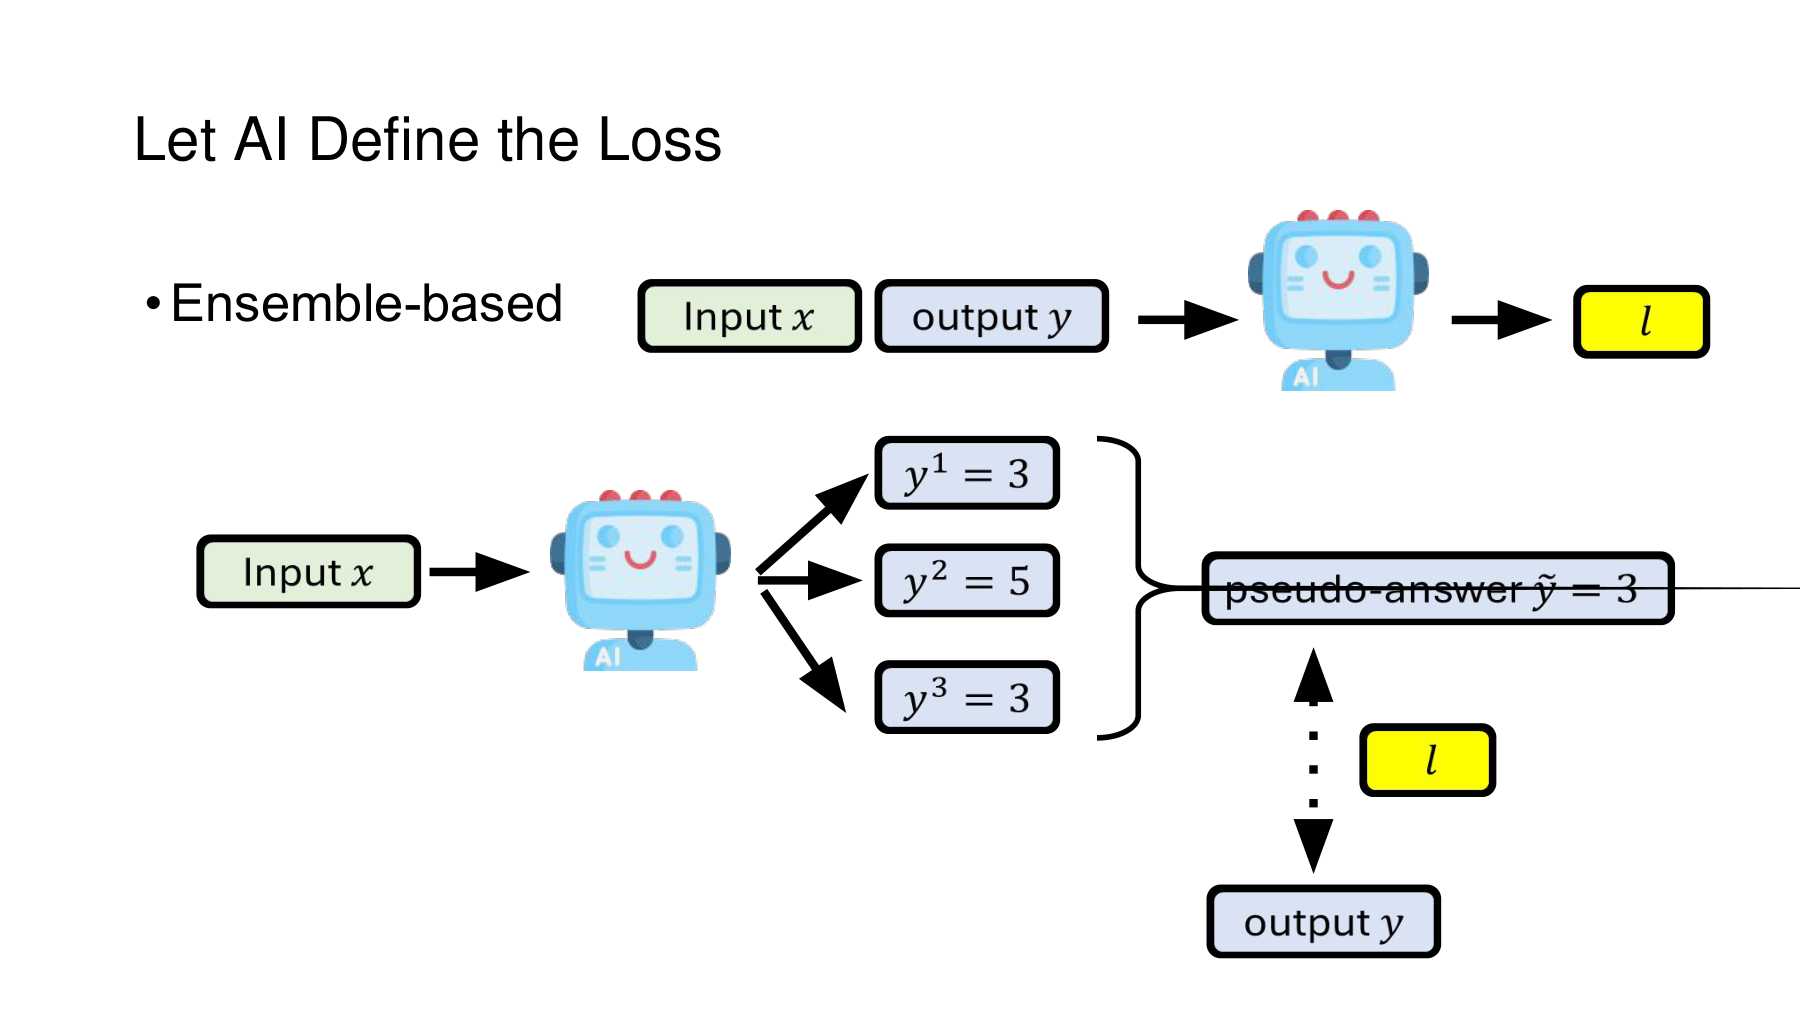
원본은 같은 질문에서 나온 답 3, 5, 3을 모아 3을 대표 답으로 선택한다. 외부 정답 대신 모델 출력들의 일치를 이용하는 집계 기반 방법(Ensemble-based approach)이다. 다만 그림의 “ensemble”을 반드시 서로 다른 세 모델의 결합으로만 읽을 필요는 없다. 한 모델을 여러 번 샘플링해도 여러 답을 만들 수 있다.
답 추출 함수를 통해 각 응답에서 최종 답을 얻었다고 하자. 개 표본에서 답 의 빈도와 다수 답은 다음처럼 쓸 수 있다.
3, 5, 3의 경우 답 3의 표본 비율은 2/3이다. 여기서 알 수 있는 것은 이 표본 세 개 중 두 개의 최종 답이 3이었다는 사실이다. “3이 실제 정답일 확률이 2/3이다”라고 해석하려면 별도의 확률 모형과 검증이 필요하다.
#함께 읽기 A — Self-Consistency는 무엇을 바꾸는가?
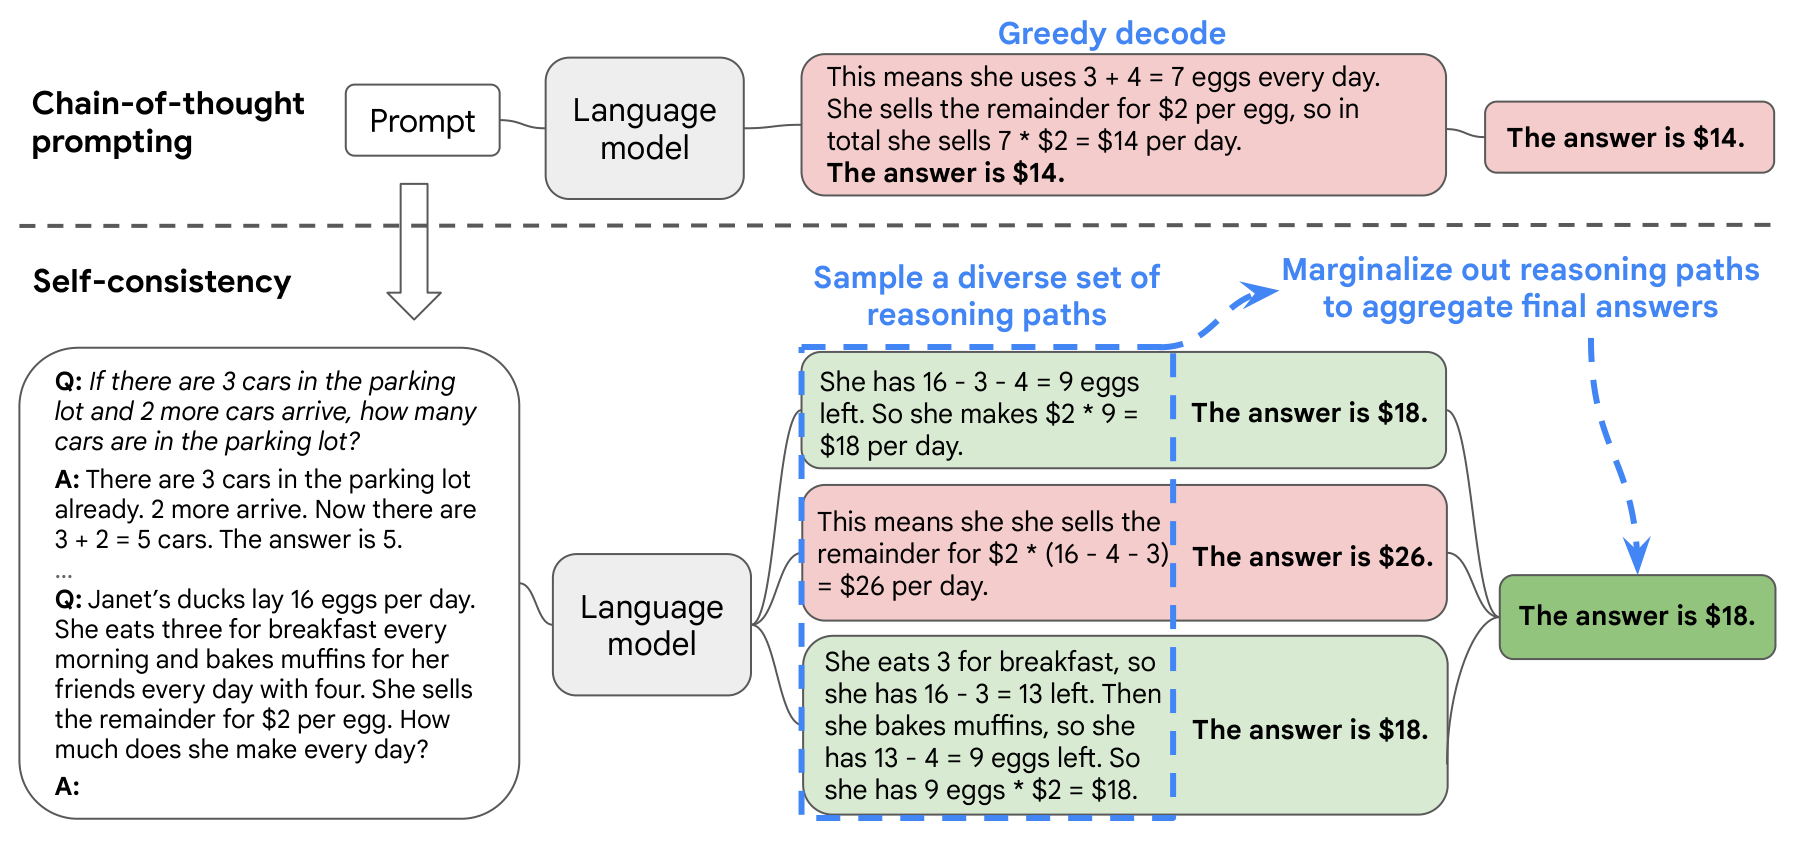
Wang 등의 Self-Consistency Improves Chain of Thought Reasoning in Language Models는 여러 추론 경로를 샘플링하고 최종 답을 집계하는 방식이다. 원본 Figure 1은 하나의 탐욕적 경로(Greedy path)만 택하는 경우와, 여러 경로가 도달한 답을 모으는 경우를 대비한다. 이 글은 arXiv v4의 ICLR 2023 판본을 읽는다. 원문 PDF 2쪽 Figure 1, §2
그림의 요점은 “설명을 세 번 길게 적으면 무조건 좋아진다”가 아니다. 서로 다른 추론 경로를 샘플링하고, 비교 가능한 형태로 최종 답을 추출한 뒤, 그 답의 일치를 이용한다는 것이다. 원 논문의 자기일관성(Self-consistency)은 추론 시점의 디코딩·집계 전략이다. 그 집계만으로 신경망의 가중치를 새로 학습하는 절차는 아니다. §2–3
원본 강의의 그림은 이를 더 넓은 학습 신호의 관점으로 연결한다. 집계한 답을 의사 정답(Pseudo-label)으로 삼아 모델을 학습할 수도 있다. 예를 들어 다음은 선택한 답을 학습 목표로 사용하는 지도학습 형태의 설명식이다. Self-Consistency 논문의 원래 학습 목적식이라고 주장하지 않는다.
추론에서 3을 골라 반환하는 것과, 이후 학습에서 3의 생성 가능성을 높이는 것은 다르다. 후자는 의사 정답이 틀렸을 때 그 오류를 강화할 수 있다. 따라서 집계의 품질과 학습 후 일반화를 따로 측정해야 한다.
#무엇이 “같은 답”인가?
숫자 답 “3”, “3.0”, “정답은 3입니다”를 서로 다른 문자열이라고 세면 의미상 같은 답이 분산된다. 반대로 단위를 무시하고 “3 m”와 “3 cm”를 같은 답으로 묶으면 실제로 다른 답을 합친다. 분수·반올림·선택지 표현·코드 실행 결과까지 고려하면, 답 추출과 정규화는 단순한 부수 작업이 아니다.
동률일 때의 처리도 필요하다. 한 답을 임의로 골라 의사 정답으로 저장할지, 추가 표본을 만들지, 해당 예제를 제외할지 정해야 한다. 이 선택은 추가 계산 비용과 학습 자료의 분포를 바꾼다.
#표본 수를 늘려도 공통된 오해는 남을 수 있다
가상 예로 모델이 문제의 조건 하나를 잘못 읽어, 열 번 중 아홉 번 같은 오답을 만든다고 하자. 표본을 더 뽑으면 그 오답이 다수라는 사실을 더 안정적으로 확인할 수도 있다. 집계는 표본 사이의 흔들림을 줄이는 데 도움이 될 수 있지만, 공통된 잘못된 가정을 자동으로 고치지는 않는다.
반복 호출이 독립적인 난수를 쓰더라도, 모든 호출은 같은 모델의 지식과 편향을 공유한다. “같은 분포에서 독립적으로 샘플링했다”와 “서로 독립적인 정답 근거를 얻었다”는 다른 말이다. 다양성 있는 경로, 계산 도구, 새로운 증거를 활용하는지에 따라 집계의 의미도 달라진다.
#29쪽 — 엔트로피는 불확실성의 모양을 재지, 정답을 읽지 않는다
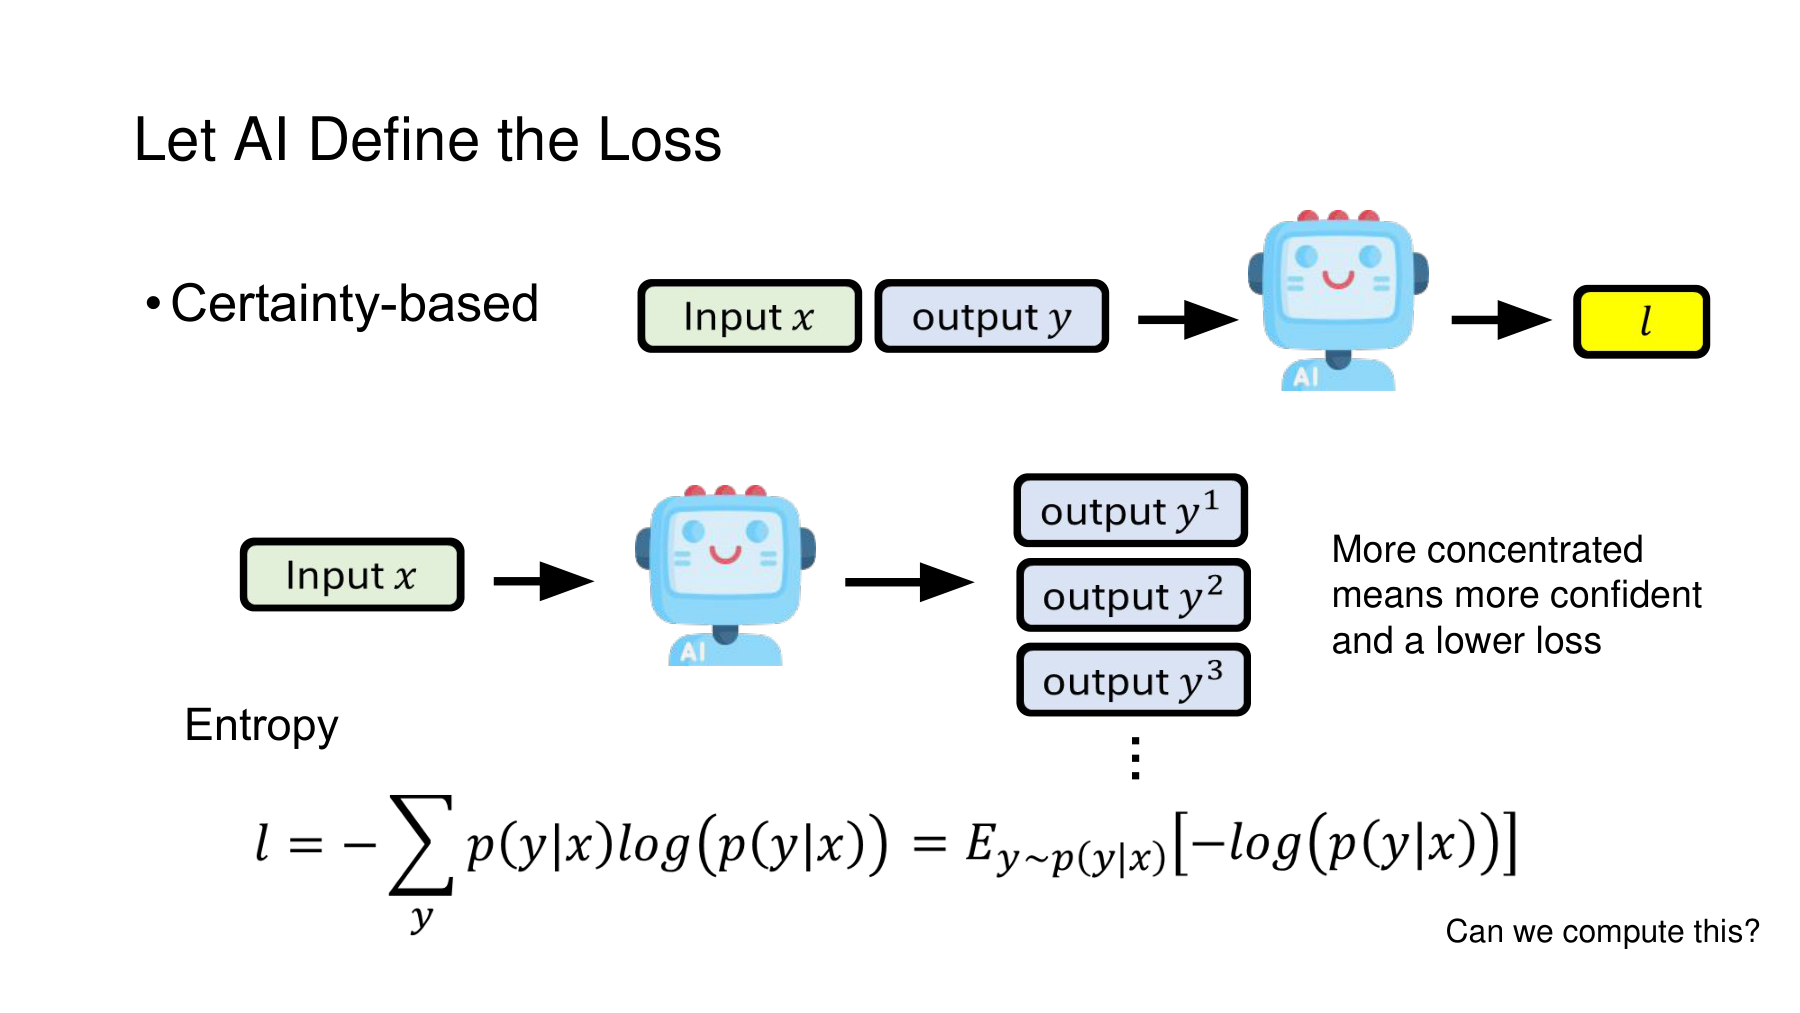
이번에는 모델에게 점수를 말하게 하거나 여러 답의 문자열을 세는 대신, 모델이 가진 출력 확률분포를 직접 본다. 원본은 확률이 한곳에 더 모일수록 모델이 더 확신한다고 해석하고, 그 집중도를 손실과 연결한다. 여기에 사용하는 양이 엔트로피(Entropy)다.
#같은 확률 질량이 어느 답에 붙어 있는지가 중요하다
먼저 가능한 출력이 유한한 분류 문제를 생각하자. 아래는 자연로그를 사용하는 섀넌 엔트로피(Shannon entropy)다. 단위는 나트(nat)이며, 확률이 0인 항은 극한값 0으로 취급한다.
세 답이 모두 같은 확률이면 모델은 어느 한 답에도 집중하지 않는다. 한 답에 큰 확률을 주면 분포가 더 뾰족해지고 엔트로피가 낮아진다.
그러나 두 번째 분포에서 0.8이 붙은 답이 실제 정답인지는 엔트로피 식에 들어 있지 않다. 답의 위치를 바꾸어도 확률 값들의 모양이 같으면 엔트로피는 같다.
첫 번째 분포가 A에, 두 번째 분포가 B에 가장 높은 확률을 준다면, 두 모델의 가장 유력한 답은 다르다. 실제 정답이 B일 때 두 번째는 맞고 첫 번째는 틀리지만, 엔트로피만으로는 그 차이가 드러나지 않는다.
#직접 계산: 더 확신하면서 더 틀리는 경우
다음은 정답이 B라고 가정한 설명용 예제다. 세 확률의 순서는 A, B, C다. 정답 B의 확률에 대한 음의 로그값도 함께 적었다. 이 값은 정답을 알고 있을 때 계산하는 교차엔트로피 손실이다.
| 분포 | 가장 유력한 답 | 엔트로피 | 정답 B의 확률 | 정답 기준 손실 |
|---|---|---|---|---|
| (0.8, 0.1, 0.1) | A: 오답 | 0.6390 | 0.10 | 2.3026 |
| (0.98, 0.01, 0.01) | A: 오답 | 0.1119 | 0.01 | 4.6052 |
| (0.1, 0.8, 0.1) | B: 정답 | 0.6390 | 0.80 | 0.2231 |
첫 행에서 둘째 행으로 바뀌면 엔트로피는 줄어든다. 하지만 정답 B의 확률도 0.1에서 0.01로 줄어, 정답 기준 손실은 커진다. 정확도는 두 경우 모두 틀린 상태이며, 오답에 대한 확신만 강해졌다.
이 예는 엔트로피 최소화가 항상 실패한다는 증명이 아니다. 엔트로피 감소만으로 정확도 증가를 보장할 수 없다는 반례다. 실제 성능 향상은 기본 모델의 능력, 데이터 분포, 적응시키는 파라미터, 학습 절차를 포함한 추가 조건과 실험 근거로 판단해야 한다. 이 차이는 30쪽의 연구들을 읽을 때 핵심이 된다. Tent §3 · LLM 엔트로피 최소화 §5
#“이것을 계산할 수 있는가?” — 어떤 출력 공간을 뜻하는가?
원본 아래쪽은 출력 분포의 엔트로피를 합과 기대값으로 연결한 뒤 계산 가능성을 묻는다. 유한한 분류에서 모든 클래스의 확률을 얻을 수 있다면 직접 합산할 수 있다. 하지만 언어 모델의 출력이 완성된 답 전체를 뜻한다면, 가능한 모든 문장을 나열하는 계산은 다른 문제가 된다.
짧은 문장도 여러 토큰의 조합으로 만들어진다. 가능한 전체 문장 수는 길이와 함께 매우 빠르게 증가한다. 반면 특정 접두 문맥(Prefix)이 주어졌을 때 다음 토큰의 어휘 분포는 모델의 로짓(Logits)으로 계산할 수 있다. 출력 문장 전체의 엔트로피와 다음 토큰 한 번의 엔트로피를 같은 양으로 적으면 안 된다.
길이를 고정한 단순한 경우, 엔트로피의 연쇄 법칙은 다음과 같다. 종료 토큰과 가변 길이를 다루는 실제 구현에는 그에 맞는 정의가 필요하다.
각 시점의 다음 토큰 엔트로피를 더하되, 그 시점에 도달할 수 있는 접두 문맥들에 대해서도 평균해야 한다. 실제로 샘플링한 한 경로에서 토큰 엔트로피를 계산하는 것은 이 전체 기대값을 다루는 한 방법이지만, 한 경로의 수치가 모든 가능한 경로를 정확히 합한 값은 아니다. 합을 쓸지 길이로 나눈 평균을 쓸지에 따라서도 학습 신호가 달라진다. LLM 엔트로피 최소화 논문은 이런 토큰·궤적 수준의 추정과 목적을 구별한다. 정식 논문 §2–3
세 번째 양도 구분하자. 28쪽의 답 3, 5, 3에서 얻는 경험적 답 빈도의 엔트로피는 다음과 같다.
이 값은 답 추출·정규화와 표본 수에 의존한다. 모델의 전체 어휘 분포나 모든 가능한 문장의 확률분포를 직접 계산한 값이 아니다. 세 수치를 모두 “모델의 엔트로피”라고만 부르면 서로 다른 방법을 비교하면서도 같은 양을 측정한다고 오해하기 쉽다.
| 측정 대상 | 실제로 이용하는 정보 | 주의할 점 |
|---|---|---|
| 완성된 답 전체의 분포 | 가능한 답들의 확률 | 전체 출력 공간을 그대로 합산하기 어렵다 |
| 주어진 문맥의 다음 토큰 분포 | 어휘별 로짓과 확률 | 문맥·길이·합산 방법을 명시해야 한다 |
| 표본에서 추출한 답의 빈도 | 여러 응답과 답 정규화 규칙 | 표본 수와 추출 방식에 따라 값이 달라진다 |
#30쪽 — 이미지, 음성, 언어에서 무엇이 실제로 바뀌는가?
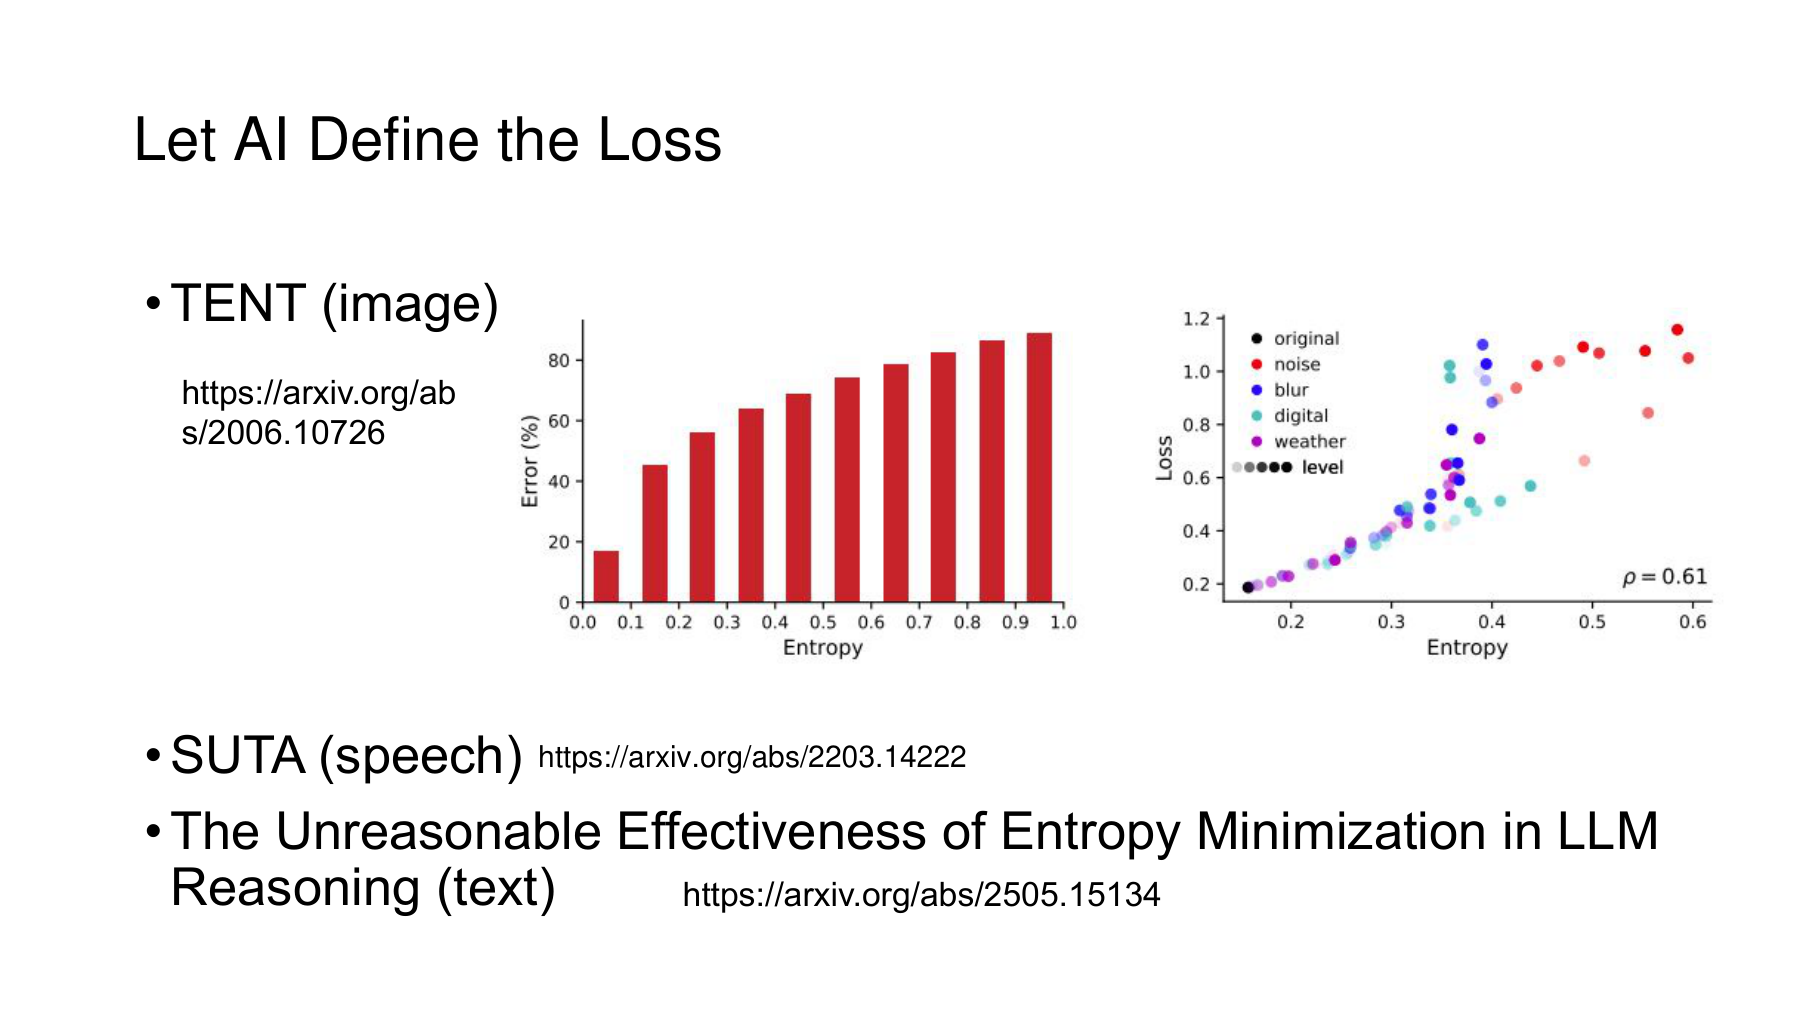
원본은 이미지의 Tent, 음성의 SUTA, 언어 모델의 엔트로피 최소화 연구를 연결한다. 같은 “엔트로피를 줄인다”는 표현을 쓰지만, 모델 구조와 업데이트 대상, 입력 조건은 다르다. 서로 다른 실험의 수치를 한 줄의 성능 순위로 비교하기보다, 어떤 분포의 엔트로피를 어떤 파라미터에 대해 줄이는가를 읽어야 한다.
원본 SUTA 주소에는 마지막 숫자가 빠져 있다. 영어 편집본에는 확인된 arXiv 2203.14222를 표기했다. 아래 해설과 보충 그림은 Interspeech 2022 정식 논문을 기준으로 한다.
#함께 읽기 B — Tent: 예측 엔트로피로 테스트 시점에 적응한다
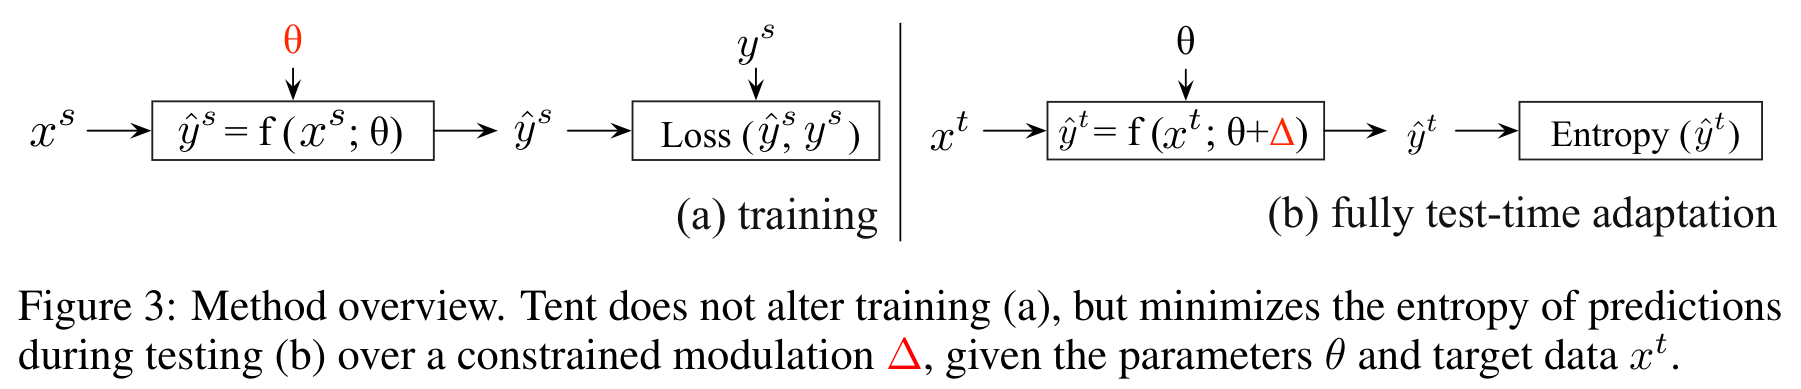
Tent는 학습 때와 달라진 입력 분포에 대해, 정답 라벨 없이 테스트 시점 적응(Test-time adaptation)을 수행하는 방법이다. 원본 Figure 3은 정답 라벨로 지도학습하는 경로와, 예측 엔트로피를 이용해 적응하는 경로를 나란히 보여준다. 이 글은 ICLR 2021, arXiv v3, 2021년 3월 18일 판본을 사용한다. 원문 PDF 3쪽 Figure 3
모델이 현재 입력을 잘 설명하도록 제한된 자유도를 조절한다는 점이 중요하다. 해당 방법은 정규화 통계(Normalization statistics)를 재추정하고, 정규화 계층의 채널별 아핀 변환 파라미터를 엔트로피 목적에 맞추어 업데이트한다. 전체 신경망의 모든 가중치를 무제한으로 학습하는 방식과 같지 않다. §3, Algorithm 1
예를 들어 학습 때보다 흐릿하거나 잡음이 있는 이미지가 들어왔을 때, 기본 모델의 분류 구조는 유지하면서 입력 변화에 적응하려는 것이다. 이 설명용 상황에서 새 정보는 “모델이 자기 생각을 다시 읽는 것”만이 아니다. 새로운 테스트 입력과 그 분포가 들어온다. 정답 라벨이 없다는 이유로 아무 외부 정보도 없다고 말할 수 없다.
원본 30쪽에 들어 있는 Tent의 그래프는 보고된 설정에서 엔트로피와 오류가 어떻게 연결되는지 보여준다. 이를 모든 입력·모델에서 엔트로피가 낮으면 반드시 맞는다는 수학적 보장으로 바꾸면 안 된다. 29쪽의 반례와 Tent의 실험 결과는 모순이 아니다. 반례는 보편적 보장이 없음을 보이고, 연구는 특정 방법과 조건에서 실제 이득이 있음을 평가한다.
#함께 읽기 C — SUTA: 한 발화의 음성 인식에도 같은 식만 붙이면 될까?
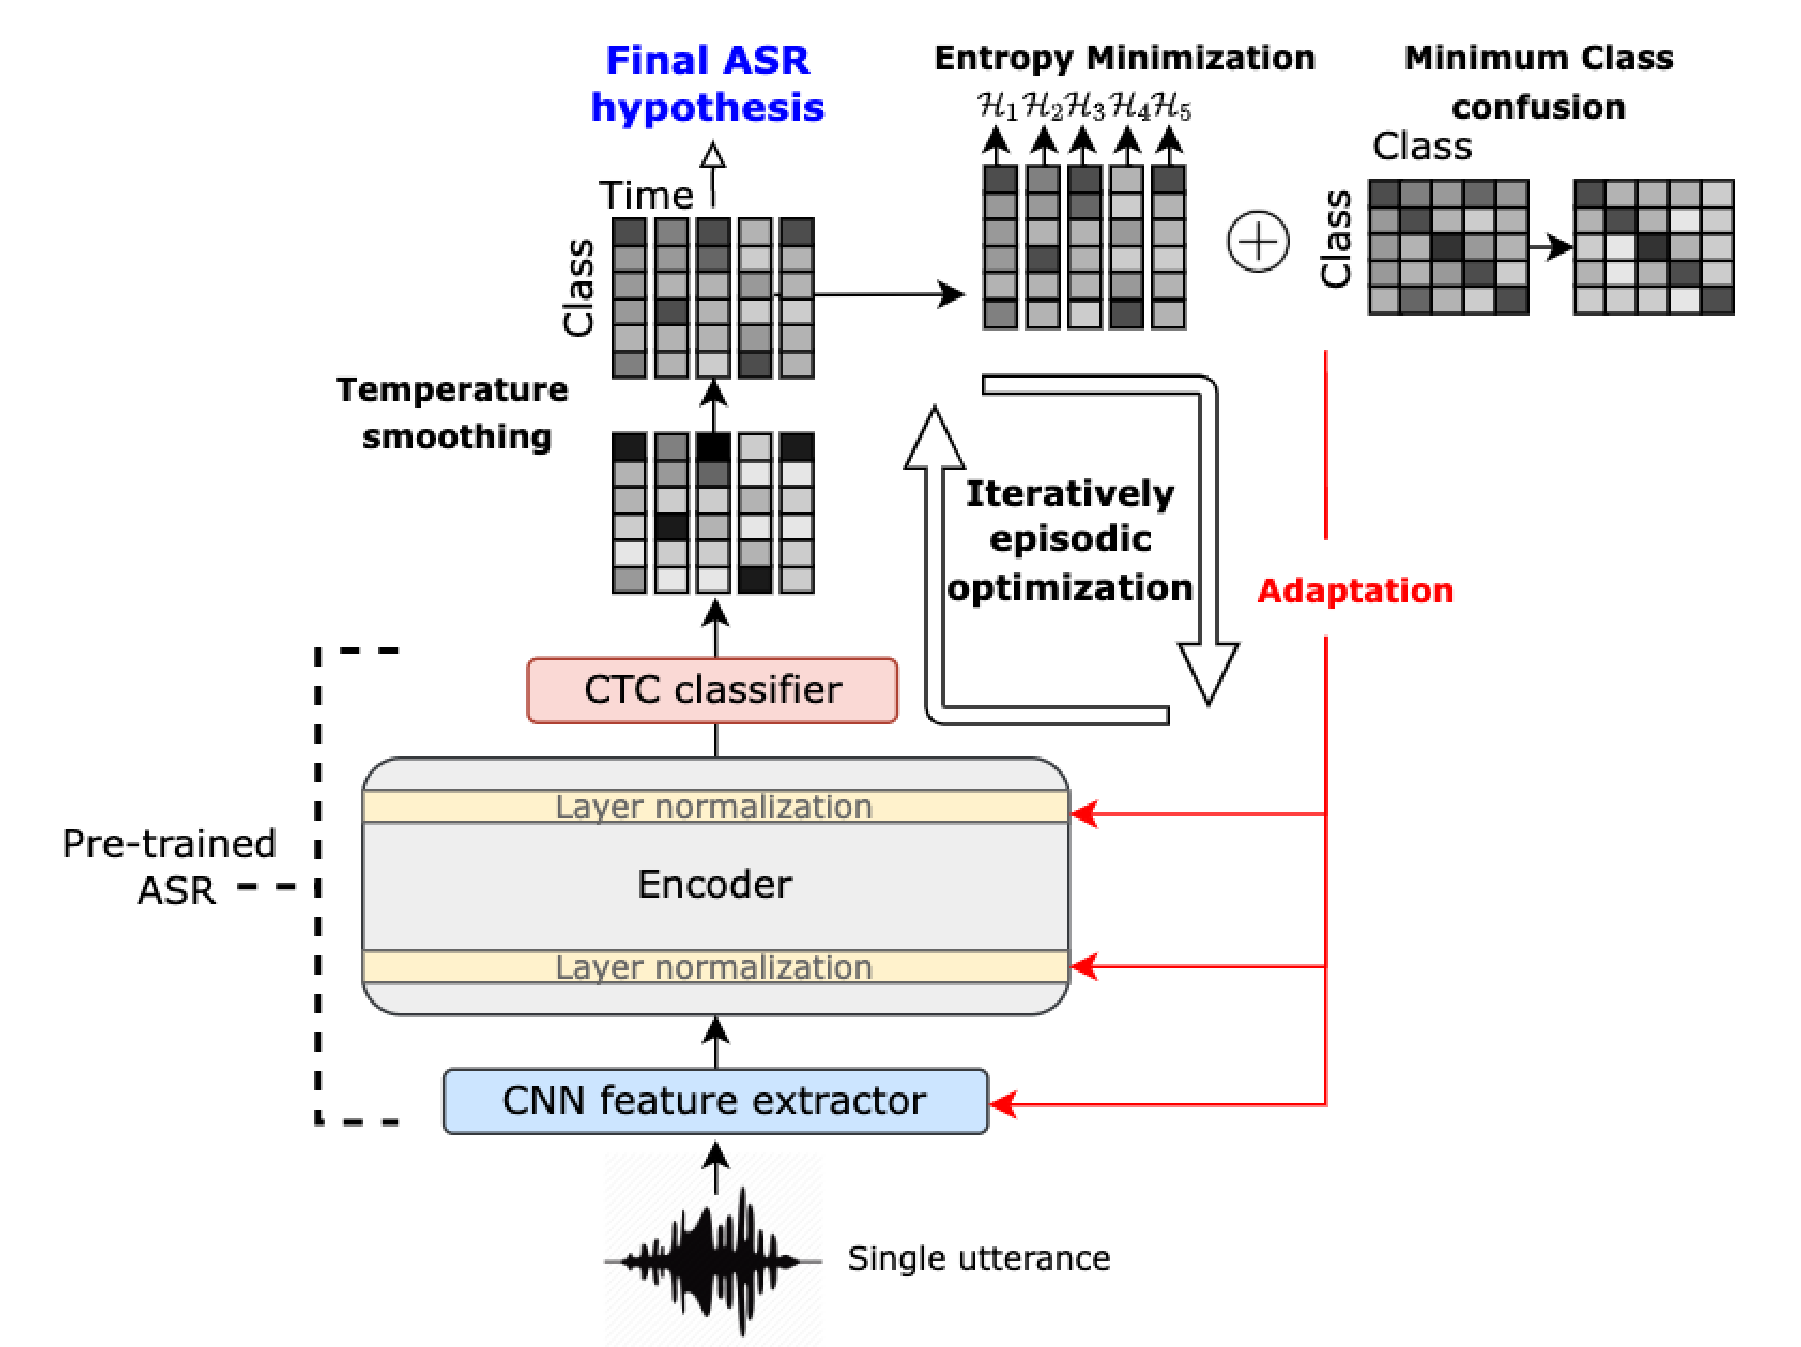
SUTA는 단일 발화(Single utterance)를 이용한 음성 인식의 테스트 시점 적응을 다룬다. 그림의 왼쪽은 대부분을 고정한 모델과 적응할 파라미터를 구분하고, 오른쪽은 온도 평활화(Temperature smoothing), 엔트로피 최소화, 최소 클래스 혼동(Minimum class confusion)을 연결한다. Lin·Li·Lee, Interspeech 2022, PDF 1쪽 Figure 1
음성 인식의 CTC 출력에서는 글자를 내지 않는 공백 토큰(Blank token)이 여러 프레임에서 큰 확률을 차지한다. 모든 프레임의 분포를 무조건 더 뾰족하게 만들면, 의미 있는 글자 구분보다 공백 예측만 강화할 위험이 있다. 논문은 공백이 가장 유력한 프레임을 엔트로피 계산에서 제외하고, 클래스 혼동을 줄이는 목적을 함께 사용한다. §2.2.1–2.2.4
온도 평활화도 보자. 이 단계는 확률을 먼저 덜 극단적으로 만들어 최적화 신호를 다루는 역할을 한다. “확신을 높이려고 학습한다”는 목표와 “계산에 사용하는 분포를 온도로 평활화한다”는 연산은 서로 다른 층위에 있다. 엔트로피 최소화라는 이름만 보고 모든 단계에서 분포를 날카롭게만 만든다고 생각하면 실제 방법을 놓친다.
또한 논문의 기본 실험 설정은 계층 정규화(Layer normalization)와 특징 추출기(Feature extractor)를 적응 대상으로 삼는다. 매 발화마다 원래 모델 가중치에서 시작해 정해진 횟수만큼 적응하고, 그 발화의 최종 인식 결과를 얻는다. 여러 발화를 지나며 업데이트를 무제한 누적하는 방식과 구분해야 한다. Algorithm 1, §3.4
따라서 “Tent에서 잘됐으니 음성 모델에도 같은 엔트로피 식 하나만 붙인다”는 구현은 SUTA의 재현이 아니다. 출력 구조, 공백 토큰, 적응 대상, 목적 함수의 조합, 초기화 규칙까지 함께 옮겨야 한다.
#언어 모델: EM-FT, EM-RL, EM-INF는 같은 학습이 아니다
Agarwal 등의 The Unreasonable Effectiveness of Entropy Minimization in LLM Reasoning는 엔트로피 최소화를 언어 모델의 사후학습과 추론에 적용한다. 여기서는 NeurIPS 2025 정식 논문을 기준으로 세 방식을 구분한다. 정식 논문 §2–4
| 방법 | 직접 바꾸는 대상 | 엔트로피를 쓰는 방식 | 모델 가중치 업데이트 |
|---|---|---|---|
| EM-FT | 모델 파라미터 | 자기 생성 출력의 토큰 수준 엔트로피를 미분해 최소화 | 있음 |
| EM-RL | 생성 정책의 파라미터 | 음의 엔트로피를 보상으로 두고 강화학습 | 있음 |
| EM-INF | 추론 중의 로짓 | 디코딩 과정에서 로짓을 최적화해 엔트로피를 낮춤 | 없음 |
EM-FT는 정답 문장을 따라가게 하는 일반적인 지도 미세조정과 겉모양이 비슷해도 목표가 다르다. 정답 토큰의 음의 로그확률을 최소화하는 대신, 모델이 만들어 낸 문맥에서 출력 분포의 엔트로피를 직접 다룬다. 외부 정답을 학습하지 않았는데도 기존 능력을 더 일관되게 활용할 수 있는지 묻는 실험이다. §3.1
EM-RL은 음의 엔트로피를 보상으로 사용한다. 논문은 전체 궤적의 로그확률을 이용한 형태와 토큰별 분포를 이용한 형태를 구분한다. 계산 방식이 다르므로, 단순히 “엔트로피 보상”이라는 이름만으로 모두 같은 업데이트라고 볼 수 없다. 또한 보상이 실제 정답 검사 결과인 것은 아니다. 보상 증가와 별도 정답 평가의 향상을 구분해서 읽어야 한다. §3.2, Table 1
EM-INF는 더 분명한 경계를 보여준다. 추론 중 로짓을 최적화하지만 모델 가중치는 바꾸지 않는다. 따라서 이 방법으로 어떤 답의 품질이 높아졌다고 해도, 그것만으로 모델이 새로운 지식을 가중치에 저장했다고 말할 수는 없다. 1편부터 구별해 온 “출력 과정의 개선”과 “파라미터 학습”의 차이가 여기에서도 중요하다. §4
#함께 읽기 D — 성능이 좋아진 표만 보면 놓치는 조건
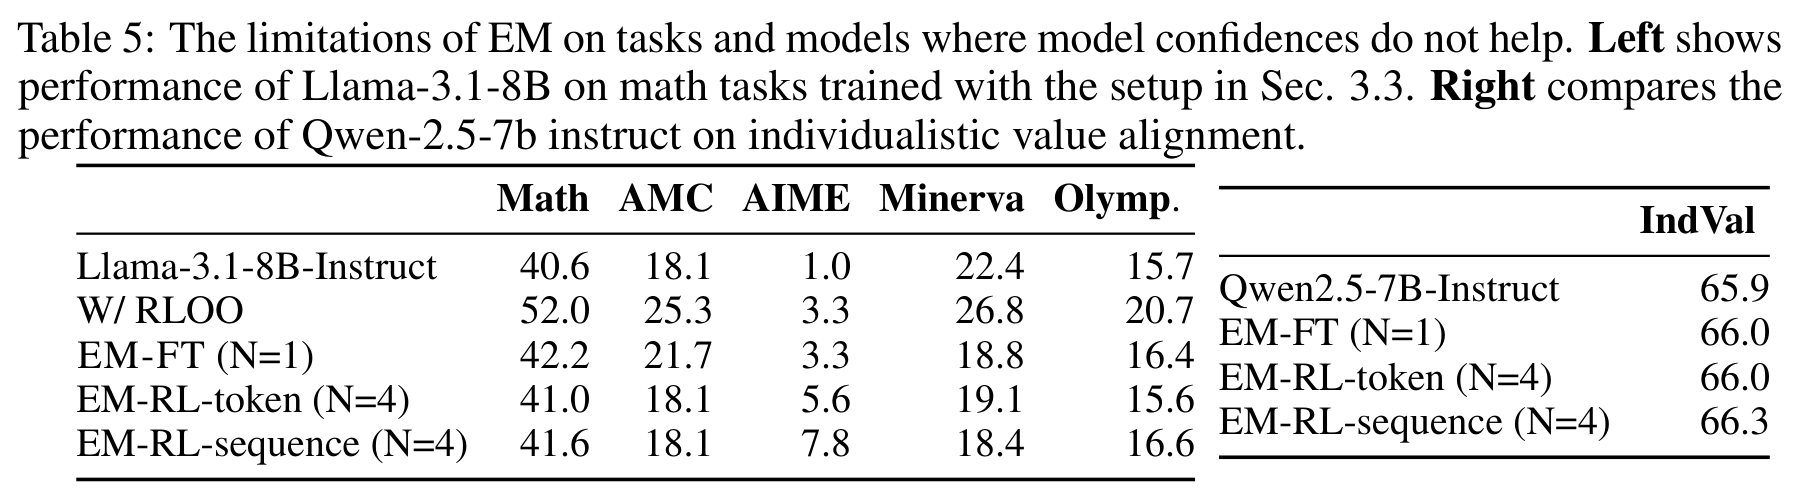
같은 논문의 Table 5는 엔트로피 최소화의 한계를 보여준다. 왼쪽은 Llama-3.1-8B-Instruct 기반의 수학 과제, 오른쪽은 Qwen-2.5-7B-Instruct의 개인별 가치 판단 과제를 다룬다. 이 표는 모든 모델에서 일관된 향상이 나온다는 주장을 뒷받침하는 표가 아니다. PDF 9쪽 Table 5, §5
구체적으로 같은 Minerva 열에서 기본 Llama-3.1-8B-Instruct의 보고값은 22.4, EM-FT는 18.8이다. 반면 다른 열에서는 향상이 나타나기도 한다. 오른쪽 IndVal에서는 기본값 65.9와 비교해 세 엔트로피 방법의 보고값이 66.0, 66.0, 66.3이다. 이 작은 차이만으로 확실한 개선을 선언할 수는 없다. 해당 표에는 신뢰구간이 제시되어 있지 않으며, 이 글도 통계적 유의성을 새로 주장하지 않는다.
저자들은 기본 모델의 초기 추론 능력과 과제에 맞는 확신이 중요하다고 해석한다. 모델이 이미 가진 능력을 더 일관되게 활용하는 데 도움이 될 수 있지만, 잘못된 지식이나 과제에 맞지 않는 사전 편향까지 확신 있게 만들 수 있다는 것이다. 이는 저자들의 실험에 근거한 해석이며, 특정 모델 이름만으로 모든 새 과제에서의 성공·실패를 예측하는 규칙은 아니다. §5–6
#강화학습에서는 엔트로피를 키우기도 하는데 모순일까?
탐색을 유지하려는 강화학습에서는 엔트로피 보너스를 더해 행동이 너무 일찍 하나로 굳는 것을 막기도 한다. 이번 연구처럼 엔트로피를 줄이는 방법과 방향이 반대다. 그러나 목적과 학습 단계가 다르면 필요한 신호도 달라질 수 있다.
새 환경에서 유용한 행동을 아직 찾지 못했다면 탐색이 필요하다. 반면 이미 사전학습된 모델이 가진 유용한 능력을 더 일관되게 끌어내려는 설정에서는, 일부 조건에서 확률을 집중시키는 방법이 도움이 될 수 있다. 이것은 엔트로피를 높이거나 낮추는 것 중 어느 하나가 보편적으로 정답이라는 뜻이 아니다. 어떤 분포를, 어떤 목적 아래에서, 어떤 기본 모델로 조절하는지가 먼저다. LLM 논문도 기존 엔트로피 정규화와 자신의 독립적인 최소화 목적을 구별한다. §2–3
#세 신호를 비교할 때 남겨야 하는 기록
| 신호 | 직접 측정하는 것 | 대표적인 착각 | 별도로 확인할 것 |
|---|---|---|---|
| 언어적 자기평가 | 평가 프롬프트에 대한 점수·긍정 응답 | 높은 점수나 Yes 확률이 곧 정답 확률이다 | 실제 정답과의 관계, 평가 기준·표현 변화에 대한 민감도 |
| 여러 응답의 일치 | 추출한 답의 표본 빈도 | 같은 오답을 반복해도 다수결이면 맞다 | 답 정규화, 공통 오류, 표본 수와 계산 예산 |
| 엔트로피 | 확률분포의 불확실성·집중도 | 분포가 뾰족해지면 더 정확하다 | 별도 정확도, 기본 모델의 능력, 업데이트 대상과 조건 |
이 표는 구현을 검증하기 위한 정리다. 세 방법을 실험한다면 결과를 한 개의 점수로 합치지 말고, 적어도 실제 과제 성능과 대리 신호의 변화를 나누어 남기는 편이 좋다. 정확도가 오르지 않았는데 자기평가 점수만 상승한 경우와, 토큰 예산을 더 써서 답 선택이 좋아진 경우를 같은 개선으로 기록하지 않는다.
테스트 시점 적응에서는 평가 절차도 분명해야 한다. 각 입력마다 원래 모델로 돌아가는지, 이전 입력의 업데이트를 누적하는지, 정답 라벨을 적응이나 설정 선택에 사용했는지 명시한다. 테스트 입력을 라벨 없이 활용하는 적응 자체와, 테스트 정답을 보고 방법을 고르는 누출(Leakage)은 구분해야 한다. 최종 비교에 사용하는 정답을 반복적으로 보면서 설정을 고르면 독립적인 성능 평가가 되기 어렵다.
이는 특정 논문의 절차를 모두 같은 것으로 묶으려는 요구가 아니다. 각 방법이 실제로 사용한 조건을 기록하고, 같은 비용·입력·초기 모델 아래의 비교와 조건이 다른 비교를 나누자는 제안이다. 가능하면 여러 시드의 변동과 실패 사례도 함께 보고한다.
#이해를 확인하는 세 질문
질문 1. 모델이 열 번 중 아홉 번 같은 답을 하면 그 답이 맞을 확률은 90%인가?그렇게 단정할 수 없다. 관측된 것은 같은 답의 표본 빈도다. 반복되는 체계적 오해가 있을 수 있으며, 이를 정답 확률로 쓰려면 별도의 정의와 검증이 필요하다.
질문 2. 엔트로피가 줄면 정답 기준 손실도 반드시 줄어드는가?아니다. 정답이 B인데 A에 확률을 더 집중시키면 엔트로피는 낮아지면서 B의 음의 로그확률은 커질 수 있다. 이 글의 세 클래스 예제가 그 반례다.
질문 3. Self-Consistency와 EM-INF도 모델 가중치를 학습하는가?여기서 읽은 Self-Consistency는 여러 경로를 샘플링해 답을 집계하는 추론 전략이고, EM-INF는 가중치 업데이트 없이 추론 로짓을 조절한다. 그 결과를 추가 학습에 사용하도록 별도 절차를 붙일 수는 있지만, 그 절차를 두 방법의 원래 동작과 구분해야 한다.
이번 다섯 장의 핵심은 정답이 없어도 신호는 만들 수 있지만, 그 신호의 의미와 실제 개선을 따로 검증해야 한다는 것이다. 다음 범위는 원본 31–35쪽이다. 자기평가 신호를 이용하는 학습과 테스트 시점의 변화로 이어진다. 다음 편: 자가개선 AI 07 — 자기학습은 언제 멈추고, 언제 적응해야 할까.
#함께 읽을 원문
| 자료 | 이 글이 사용한 판본·위치 | 연결 내용 |
|---|---|---|
| NTU Self-Improving | 2026-05-08 강의, PDF 26–30쪽 | 기준 강의와 세 평가 신호 |
| Self-Consistency | arXiv v4 / ICLR 2023, Figure 1은 PDF 2쪽 | 여러 추론 경로와 최종 답 집계 |
| Tent | arXiv v3, 2021-03-18 / ICLR 2021, Figure 3은 PDF 3쪽 | 예측 엔트로피와 정규화 파라미터 적응 |
| SUTA | Interspeech 2022, 인쇄 2198–2202쪽, Figure 1은 PDF 1쪽 | 단일 발화의 CTC 음성 인식 적응 |
| Entropy Minimization in LLM Reasoning | NeurIPS 2025 정식 논문, §2–5, Table 5는 PDF 9쪽 | EM-FT·EM-RL·EM-INF와 기본 모델 의존성 |
원본 그림·표와 추가 해설은 구분해서 읽는다. 각 이미지에 원저작자와 자료 위치를 표시했다. 출처 표시는 원저작물 전체에 대한 재사용 허가를 뜻하지 않는다.