학습 신호를 스스로 만들 수 있다는 사실과, 그 신호를 오래 따라가도 정확해진다는 사실은 다르다. 이번에는 자기학습의 적용 범위와 테스트 시점의 짧은 적응을 구분한다.
6편 — 스스로 확신하는 AI는 더 정확해질까에서는 자기평가·다수결·엔트로피를 살폈다. 이번 편은 NTU Machine Learning 2026 Spring, Self-Improving 상편의 31–35쪽을 이어간다. 기준 강의일은 2026년 5월 8일이며, 표지를 PDF 1쪽으로 센다. 공식 강의 자료 · 원본 PDF
#이번 편은 영상 설명을 어떻게 반영했는가
상편 영상의 중국어(대만), zh-TW 제공 자막을 실제로 열람했다. 조회 결과의 트랙 종류는 manual이며, 확인일은 2026년 11월 17일이다. 이는 조회 도구의 자막 분류이지, 모든 발언을 직접 청취해 오탈자까지 검증했다는 뜻은 아니다. 아래의 ‘영상 설명’은 자막을 대조한 한국어 요약이고, 원문 전체 번역이나 축어록이 아니다.
| 본문 연결 | 실제 자막에서 확인한 주제 구간 | 읽는 방법 |
|---|---|---|
| 31쪽에서 32쪽으로 | 31:13–31:57 | 자기 보상 학습의 유효성을 묻고 URLVR 논문을 소개한다. 31쪽의 입력 퍼플렉서티 세부 설명은 인용 논문을 읽어 보충한다. |
| 32쪽 | 31:58–32:52 | 다수결 보상과 정답 보상의 학습 곡선을 비교한다. |
| 33쪽 | 32:52–33:34 | 다섯 방법의 초기 개선과 이후 저하를 설명한다. |
| 34쪽 | 33:34–34:46 | 입력, 학습 신호, 파라미터 조정, 새 출력을 연결한다. |
| 34–35쪽 | 34:46–36:00 | 작은 범위의 적응과 2025년 8강을 연결한다. |
시간은 내용이 대응하는 발언 구간이다. 영상 프레임에서 슬라이드 전환 시각을 하나씩 확인한 표는 아니다. 특히 31쪽의 입력 퍼플렉서티 논문을 자세히 설명하는 발언은 이 구간의 자막에서 확인하지 못했다. 그 부분을 강사의 발언으로 만들어 넣지 않고 ‘논문 추가 해설’로 구분했다.
본 강의 이미지 다섯 장은 원본 도해·수식·그래프를 유지하고 중국어 제목·문구를 영어로 옮긴 비공식 편집본이다. 함께 읽는 보충 자료 네 개는 원본 그림 또는 원본 영어 슬라이드다. 아래의 계산과 실험 설계 제안은 별도 표시한 추가 해설이며, 논문의 실험을 재현한 결과가 아니다.
#31쪽 — 출력의 확신 말고, 입력 자체를 학습 신호로 삼을 수 있을까
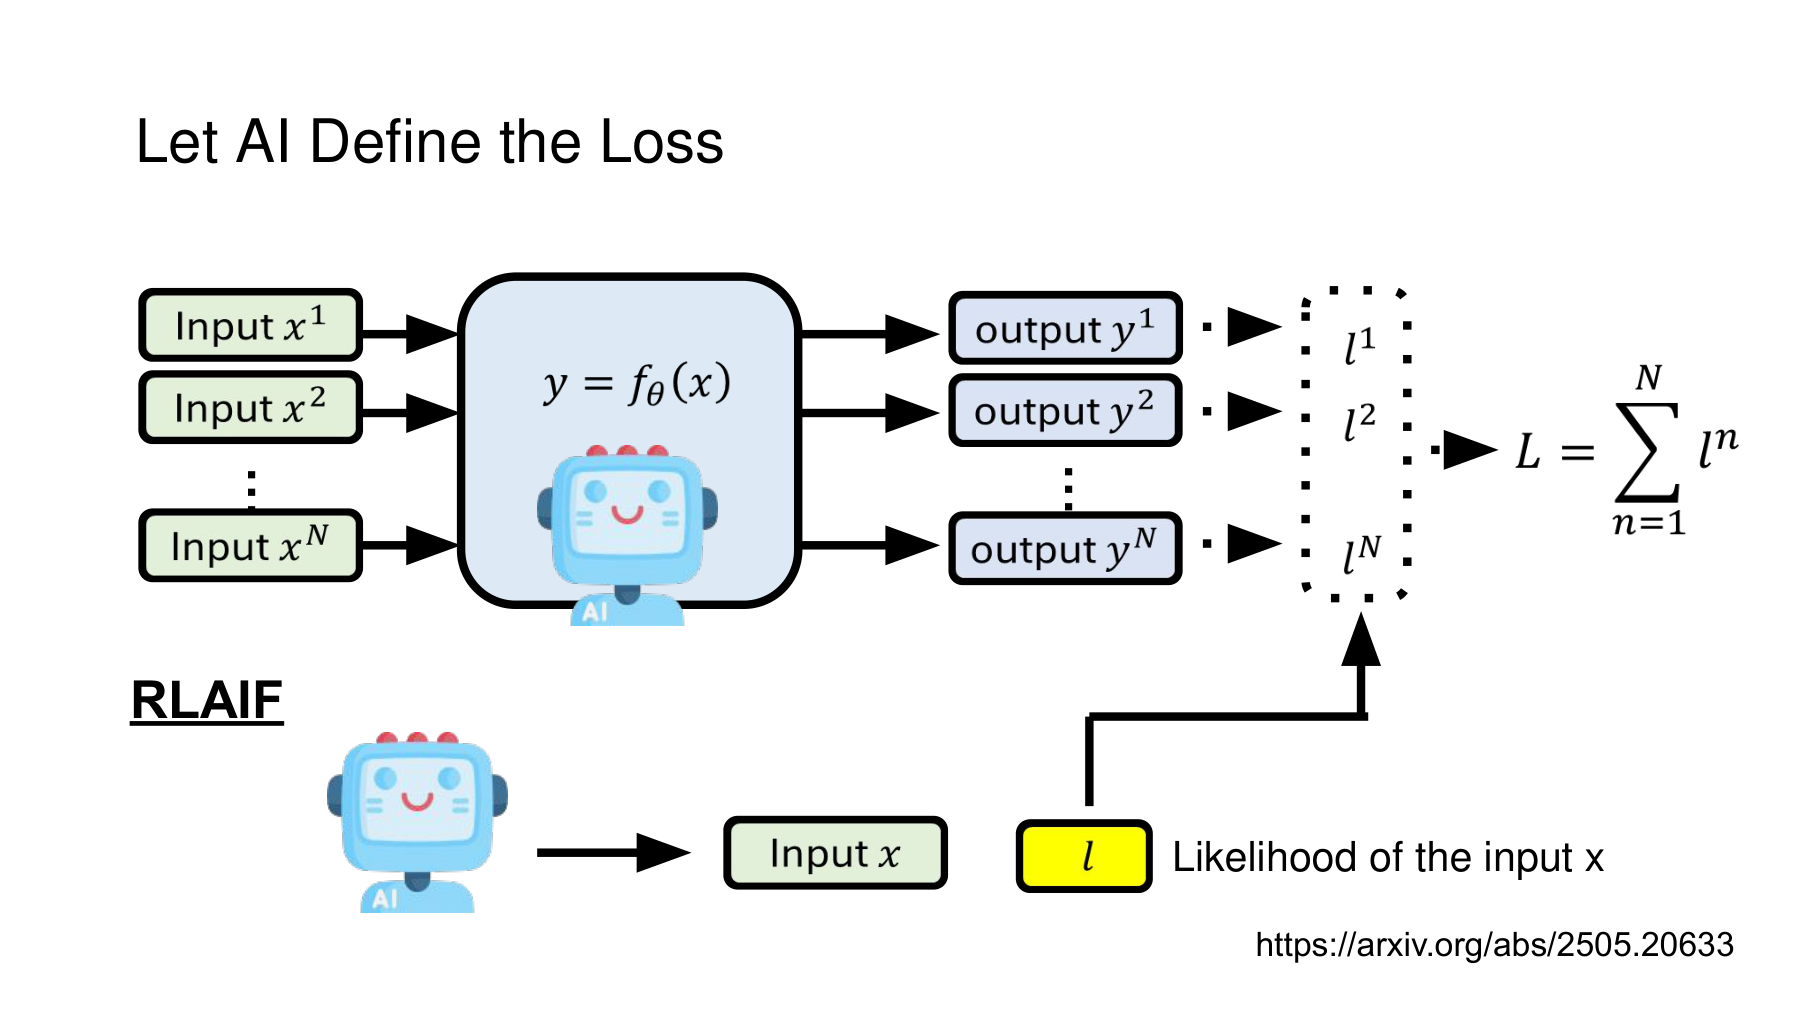
그림 위쪽은 입력에서 출력을 만들고 손실을 합산하는 익숙한 구조다. 아래쪽에는 입력 x를 생성할 가능도(Likelihood)를 이용하는 경로와 논문 주소가 있다. 중요한 전환은 ‘내 답을 얼마나 확신하는가’에서 ‘지금 들어온 문장을 얼마나 잘 예측하는가’로 학습 대상을 바꾸는 것이다. 원본 31쪽
#논문 추가 해설 — 입력 NLL과 퍼플렉서티
원본에 연결된 Hu 등의 Test-Time Learning for Large Language Models는 라벨 없는 테스트 입력의 퍼플렉서티(Perplexity)를 줄이는 TLM을 제안한다. 선택적 표본 학습과 LoRA를 결합한다. 여기서는 2025년 5월 27일의 arXiv v1을 읽는다. 논문 §4, PDF 4–5쪽 · ICML 2025 출판 정보
관측된 입력을 토큰들의 열로 쓰자. 각 토큰을 앞선 토큰들로 예측하는 평균 음의 로그 가능도(Negative log-likelihood, NLL)는 다음과 같다. 아래는 논문의 식을 이 글의 기호로 다시 적은 것이다.
첫 토큰의 문맥에는 시작 토큰을 둘 수 있다. 로그는 자연로그다. 지수 함수는 증가 함수이므로, 같은 입력과 같은 길이 정규화를 사용하면 NLL을 줄이는 것과 퍼플렉서티를 줄이는 것은 목적값의 순서상 일치한다. 그러나 두 목적 함수의 경사 크기까지 같지는 않다. 같은 학습률을 사용한 한 번의 업데이트가 동일하다는 뜻은 아니다.
원본 그림의 ‘likelihood’를 그대로 낮추면 방향이 반대가 된다. 잘 예측할수록 가능도는 높아지고, NLL과 퍼플렉서티는 낮아진다. 따라서 원본의 노란 손실 상자는 개념도이며, 실제 최적화의 부호·로그·정규화는 구현에서 확인해야 한다.
설명용 계산. 두 관측 토큰에 부여한 확률이 처음에는 0.5와 0.25, 이후에는 0.8과 0.5라고 가정하자.
이 계산이 알려주는 것은 관측된 두 입력 토큰에 더 높은 확률을 배정했다는 사실이다. 아직 생성하지 않은 답이 맞는지, 입력에 적힌 주장 자체가 사실인지까지 알려주지는 않는다. 거짓 문장도 높은 가능도로 예측할 수 있다.
#함께 읽기 A — 입력과 출력의 퍼플렉서티가 함께 움직인 실험
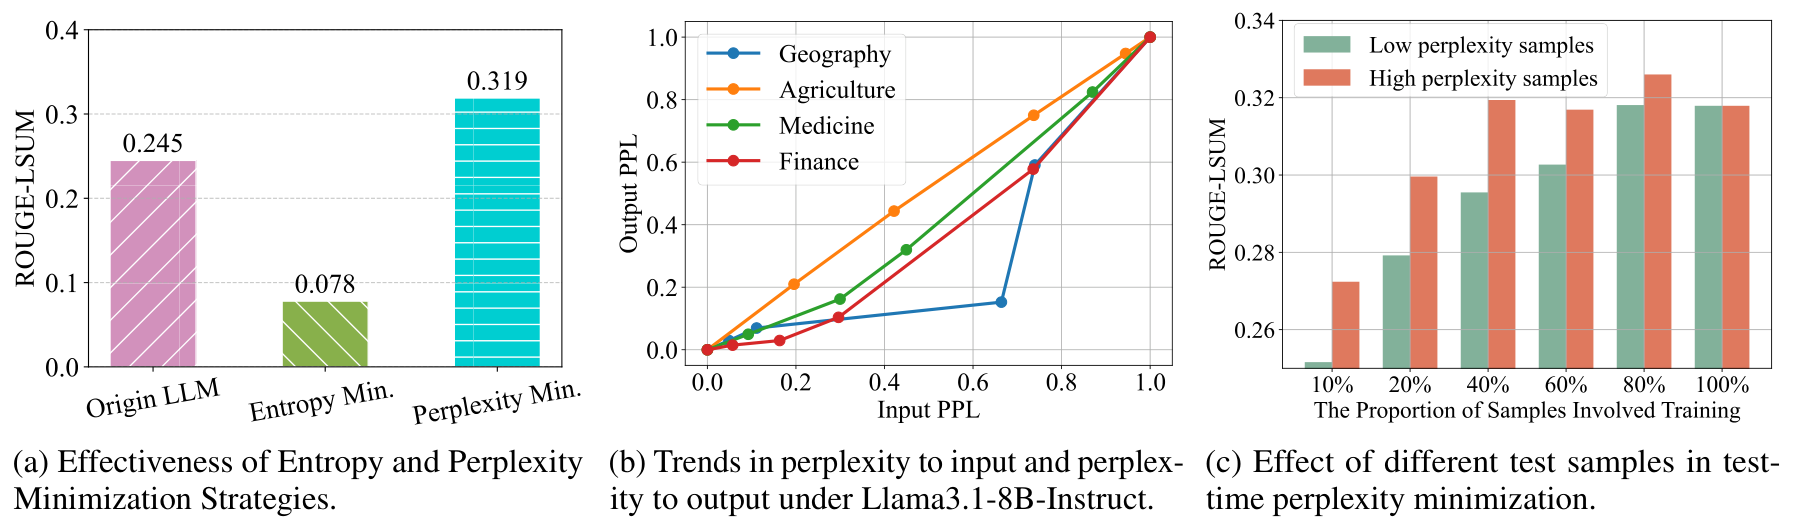
왼쪽은 목적 함수 선택에 따른 결과, 가운데는 입력·출력 퍼플렉서티의 정규화된 추세, 오른쪽은 학습에 쓰는 표본 선택을 비교한다. 가운데 축을 모든 모델에 적용되는 절대 퍼플렉서티 눈금으로 읽지 않는다. 이 그림은 논문에서 보고한 조건의 관측이며, 입력 적합도 향상이 언제나 정답 향상으로 이어진다는 보편 명제가 아니다. TLM Figure 1, PDF 4쪽
왜 조건이 필요할까? 입력 손실을 줄이는 방향이 정답을 잘 맞히는 방향과 같아야 하기 때문이다. 이를 추가 수학 해설로 확인하자. 정답을 알고 분석할 때만 계산할 수 있는 손실을 다음처럼 두자.
주변에서 두 번 연속 미분 가능한 손실과 충분히 작은 학습률을 가정하고 1차 테일러 전개를 하면 다음과 같다.
두 경사의 내적이 양수이면 1차 항은 정답 손실을 낮추는 쪽이다. 음수이면 반대다. 0이면 1차 항만으로 판정할 수 없다. 유한한 학습률에서는 나머지 항도 고려해야 한다. 논문도 경사 정렬 가정을 사용한다. 정답 손실의 경사는 여기서 설명을 위한 분석 도구이지, 라벨 없는 배포 환경에서 사용할 수 있다고 가정한 신호가 아니다. TLM 식 (4), PDF 5쪽
또 하나의 구분이 있다. 슬라이드의 넓은 RLAIF 표기만으로 TLM을 ‘AI 심판의 점수로 수행하는 강화학습’이라고 단정하지 않는다. 입력 NLL을 직접 줄이는 자기지도 업데이트와 정책 경사로 보상을 최대화하는 학습은 다른 절차다. 이 논문의 Algorithm 1은 배치 예측 후 업데이트하는 순서를 제시하므로, 뒤의 34쪽 개념도와 예측·업데이트 순서까지 같다고 가정해서도 안 된다. TLM Algorithm 1
#32쪽 — 초반에는 잘되는데, 계속 학습하면 왜 달라질까
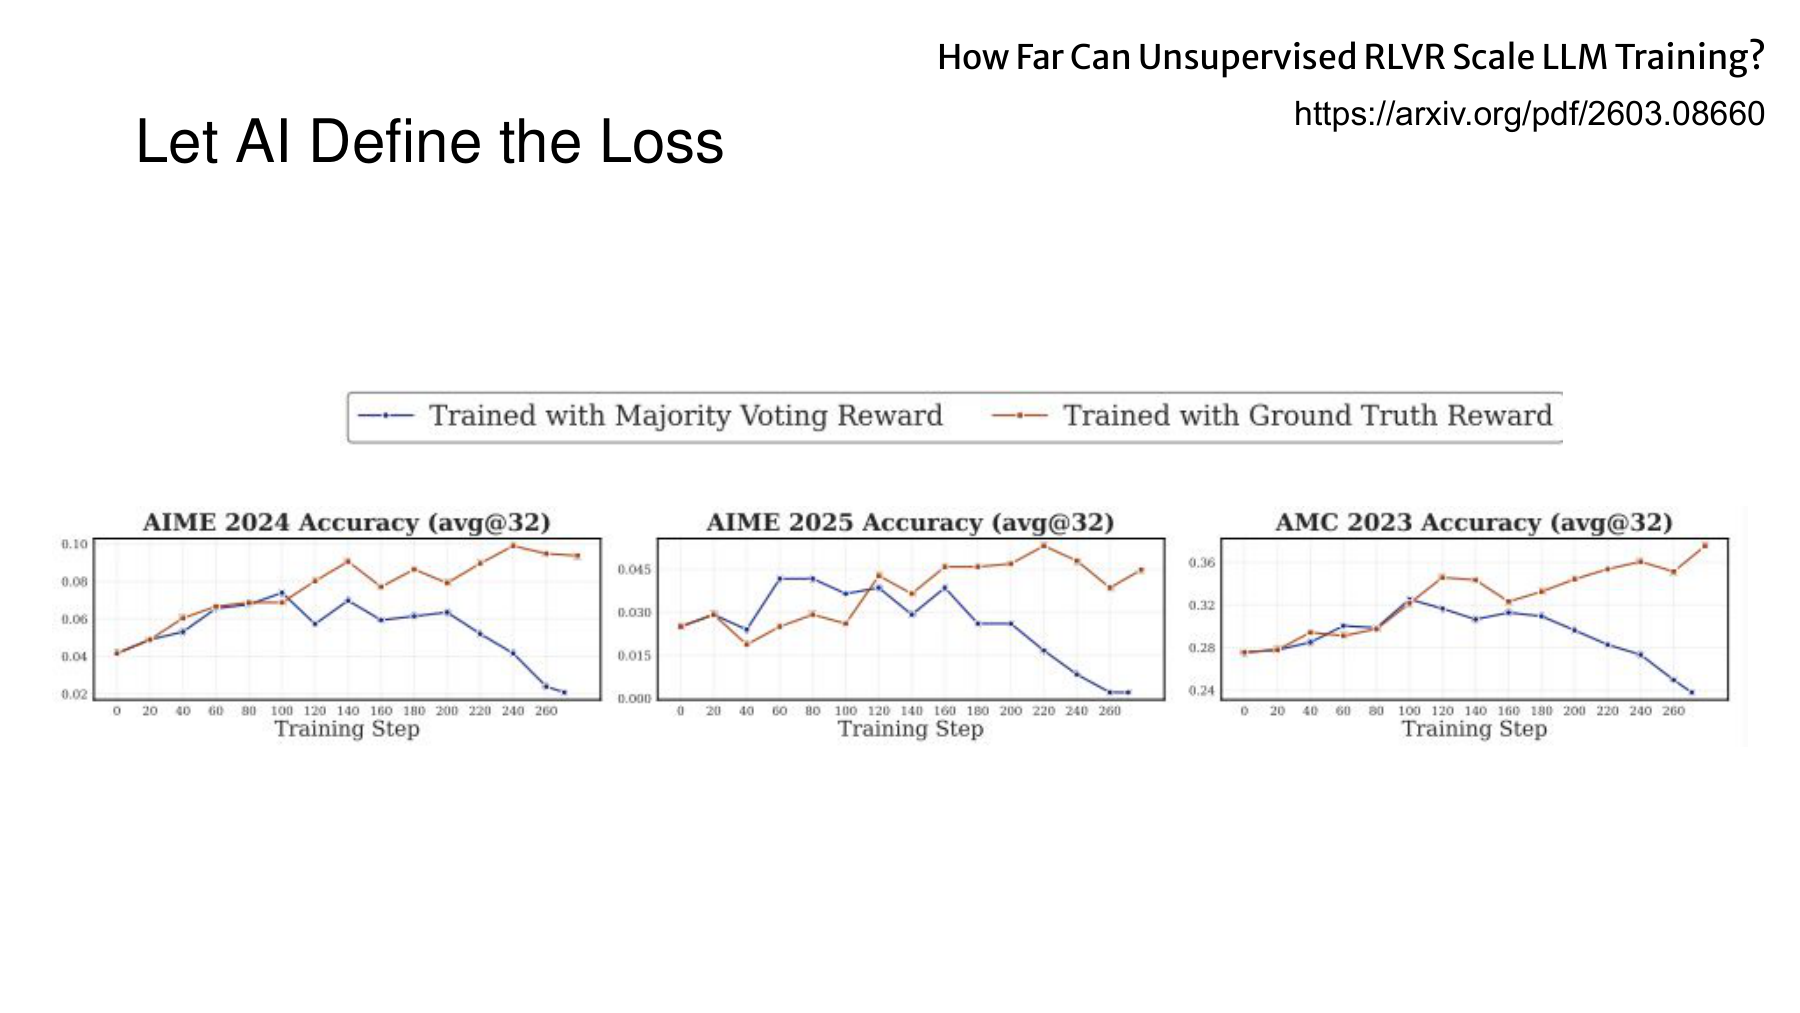
영상 설명 · 31:13–32:52. 강사는 자기 보상 학습이 얼마나 지속될 수 있는지 묻는다. 이어 다수결 보상과 정답에 근거한 보상의 곡선을 비교한다. 초반의 비슷한 성능이 끝까지 유지되지는 않는다는 설명이다. 여기서 ‘사람의 보상’은 매 학습 단계의 실시간 인간 채점으로 한정해 읽지 않는다.
원본은 He 등의 How Far Can Unsupervised RLVR Scale LLM Training? Figure 2에서 정확도 패널을 가져왔다. 논문의 해당 실험은 Qwen3-1.7B-Base를 DAPO-17k로 학습하고 AIME 2024·AIME 2025·AMC 2023을 평가한다. 이번 글은 2026년 3월 9일의 arXiv v1을 기준으로 읽는다. 논문 §4.1.1, PDF 12쪽
#먼저 축과 평가 단위를 읽는다
가로축은 학습 단계(Training step)다. 세 패널은 서로 다른 평가 데이터이며, 세로축 범위도 같지 않다. 따라서 선의 높이를 패널 사이에서 바로 비교하지 않는다. 지표의 avg@32는 문제당 32개 생성 결과의 평균 정확도다. 32개 중 하나만 맞으면 성공으로 세는 pass@32와 다르다. Figure 2의 평가 설정
또한 이 그림은 훈련 중 계산한 대리 보상 자체가 아니라, 정답을 이용해 별도로 잰 정확도를 보여준다. 훈련에 정답 라벨을 쓰지 않는 것과 평가에도 정답이 필요 없다는 것은 다르다. ‘Unsupervised’는 해당 학습 단계의 감독 신호에 관한 말이다. 사전학습 데이터, 사람이 정한 과제, 보상 규칙, 평가 설계까지 없어졌다는 뜻은 아니다.
#추가 해설 — 다수결은 정답을 검사하는 장치가 아니다
같은 질문에서 답 K개를 생성해 가장 자주 나온 답을 의사 정답으로 삼는 간단한 형태를 적어 보자. 다음은 원리를 설명하는 표기이며, 논문의 학습 코드 전체를 옮긴 식은 아니다.
의사 정답과 실제 정답이 같을 때는 두 보상이 같은 방향을 가리킬 수 있다. 둘이 다르면 의사 정답을 더 자주 생성하도록 학습할수록 틀린 답에 더 높은 점수를 줄 수 있다. 실제 구현에는 답 추출·동치 처리·동률 처리 규칙도 필요하다. 예를 들어 ‘0.5’와 ‘1/2’를 다른 답으로 세면, 표기 차이를 의견 차이로 잘못 계산한다.
설명용 계산: 독립적인 이진 답 세 개. 각 답이 맞을 확률을 p라고 두고, 답이 조건부 독립이며 오답은 하나의 동일한 선택지라고 가정하자. 세 개 중 다수결이 맞을 확률은 다음과 같다.
원래 잘 맞히는 쪽의 다수결은 유리하지만, 원래 틀리는 쪽의 다수결은 더 나빠질 수 있다. 이는 특정 가정 아래의 작은 계산이다. 실제 언어모델의 답 공간은 이진이 아니며, 공통된 오해나 유사한 추론 패턴도 있다. 여러 번 생성했다는 사실만으로 독립적 검증 근거가 여러 개 생기는 것은 아니다.
따라서 이 슬라이드의 실무적 질문은 ‘대리 보상이 올랐는가’ 하나가 아니다. 대리 보상, 정답 기반 성능, 출력 다양성을 따로 추적했는가가 중요하다. 실제 정답을 볼 수 없는 환경에서는 이 그래프처럼 성능 저하 시점을 즉시 알아낼 수 있다는 가정도 버려야 한다.
#33쪽 — 다섯 방법은 같은 방식으로 실패하지 않는다
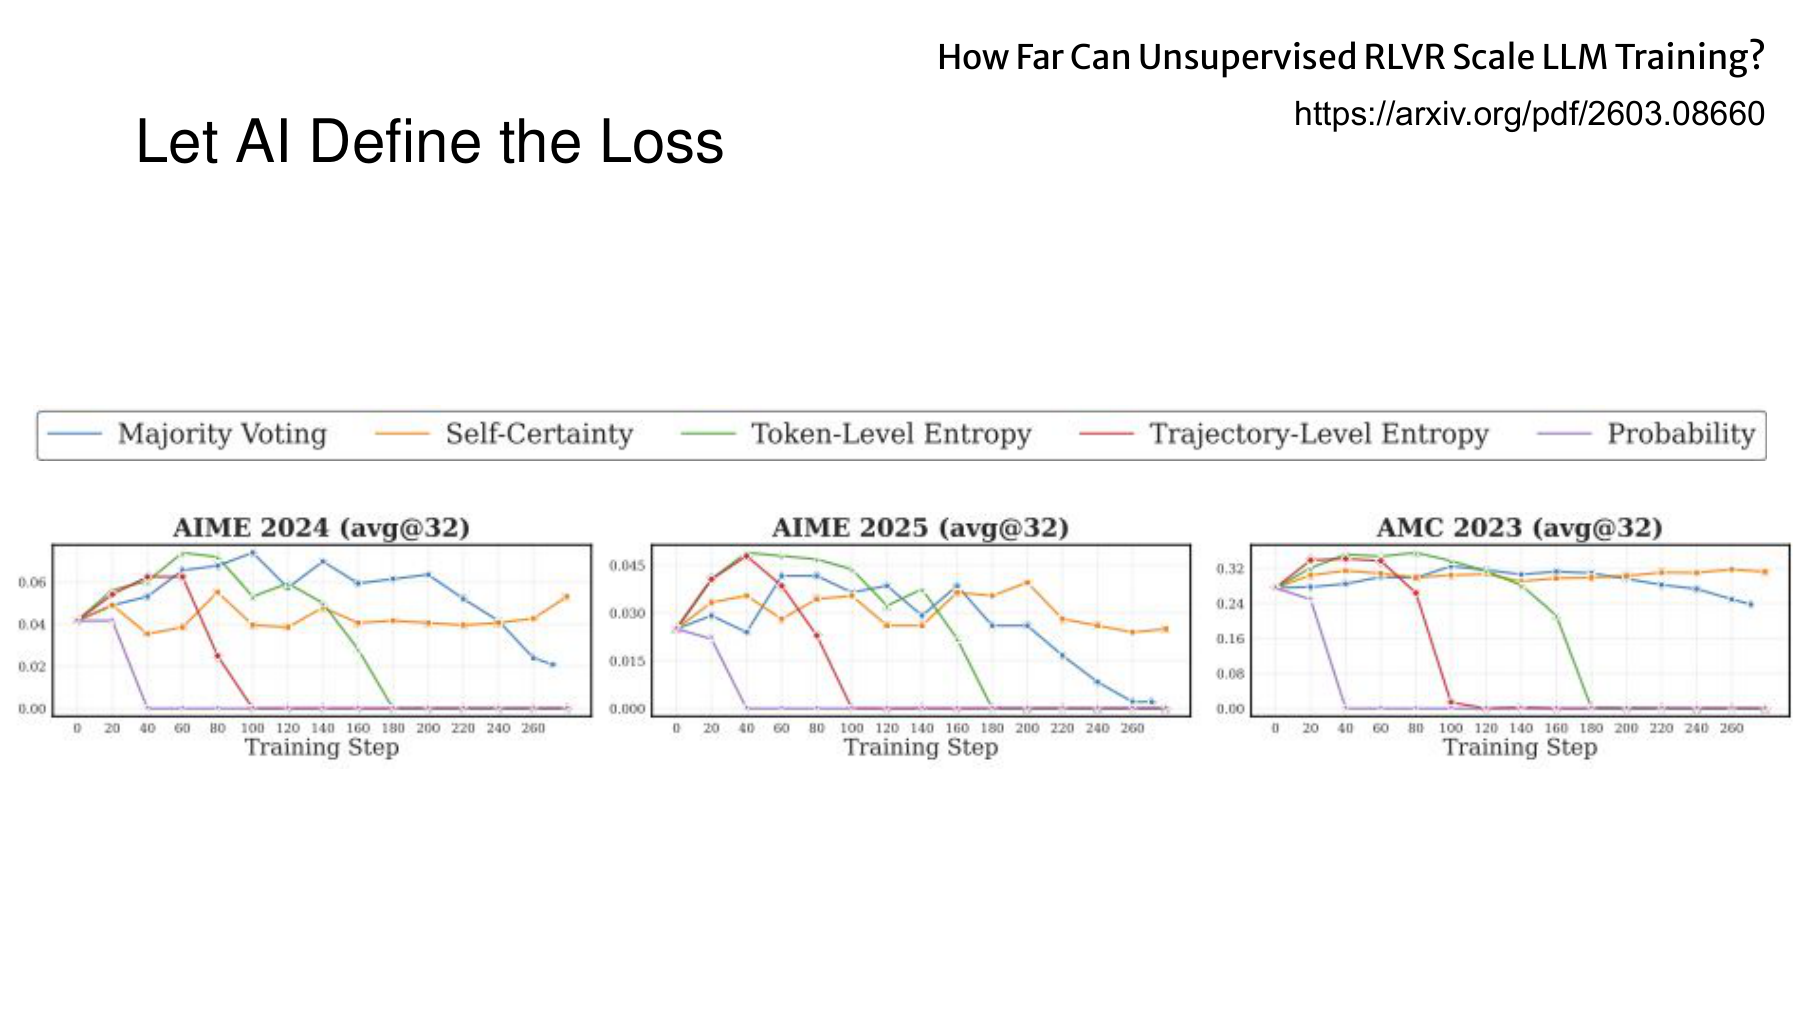
영상 설명 · 32:52–33:34. 강사는 다섯 방법의 비교에서 안정성이 서로 다름을 짚는다. 자기학습이 처음부터 무용한 것이 아니라, 초기 개선 뒤에도 같은 신호를 계속 따를 때 문제가 생길 수 있다는 설명이다.
그림에는 다수결, Self-Certainty, 토큰 수준 엔트로피, 궤적 수준 엔트로피, 확률 기반 보상이 있다. 표시된 학습 구간에서 모든 곡선이 0으로 내려간 것은 아니다. 이 그림만으로 모든 모델·모든 보상·모든 자기학습이 반드시 붕괴한다고 결론 내리지 않는다. 논문 Figure 3 및 §4.1.2, PDF 13쪽
논문은 이 설정에서 점진적 저하, 지나치게 짧아지는 답, 반복되는 답이라는 서로 다른 양상을 분석한다. 구현과 길이 처리도 중요하다. 특정 확률 보상의 문제를 모든 확률 기반 방법의 필연적 결함으로 확대하지 않는다. 실패 양상 분석
#추가 해설 — 점수 공식은 출력 형식에 어떤 유인을 줄까
완성된 답의 확률을 토큰 조건부 확률의 곱으로 사용한다고 하자. 생성 종료를 포함한 유한한 토큰 열의 확률은 다음처럼 분해된다.
오직 길이 효과를 보기 위해 모든 조건부 확률을 0.9로 둔 가상 계산을 하자.
이 점수는 내용의 완결성을 직접 나타내지 않는다. 필요한 설명을 생략해도 짧은 문자열이 유리할 수 있다. 평균 로그 확률로 길이 효과를 조정하는 방법이 있지만, 그것만으로 정답성이 보장되는 것도 아니다. 반대로 토큰 평균 엔트로피를 최소화하는 점수는 예측하기 쉬운 반복을 유리하게 만들 여지가 있다. 어떤 점수를 택하든 그 점수가 놓치는 반례를 먼저 만들어 보는 것이 도움이 된다.
보상 조작(Reward hacking)을 탐지할 때는 정답률 외에 답 길이, 반복 비율, 유효한 답의 비율, 중단·거절 양상을 함께 보는 편이 낫다. 이는 이 글의 점검 제안이다. 임의의 길이 제한을 걸었다고 보상의 목적 불일치가 해결됐다고 표시하지 않는다.
#함께 읽기 B — ‘작은 데이터’와 ‘작은 배치’는 다르다
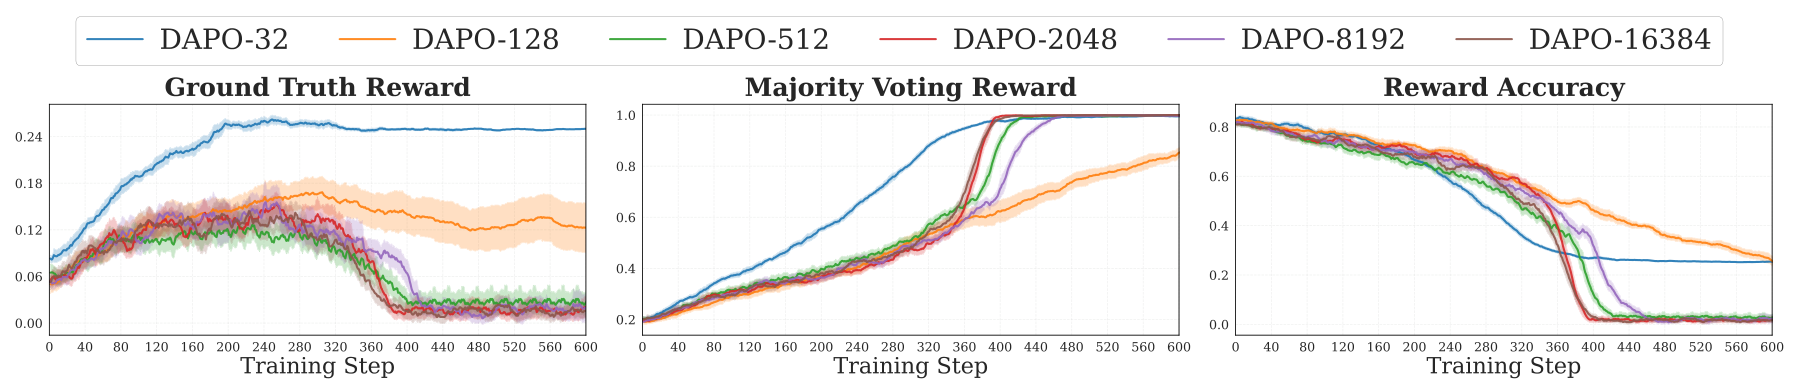
Figure 6은 전체 학습 데이터의 크기를 바꾸고, 배치 크기 32와 총 600개 최적화 단계를 고정한 비교다. 32·128개 표본 조건에서는 관측 구간의 성능이 안정적이었지만 더 큰 조건에서는 저하가 나타났다. 128이라는 수를 다른 모델의 안전 임계값으로 가져오면 안 된다. 논문 §5.1, PDF 16쪽
여기서 32와 128은 단지 미니배치 크기가 아니라 학습에 사용하는 서로 다른 문제의 총수다. 같은 단계 수에서도 각 문제의 반복 노출 정도가 달라진다. 두 설정을 ‘데이터 크기 하나만 다르고 모든 학습 경험은 동일하다’고 읽을 수 없다.
추가 계산. 배치마다 입력 32개를 사용하고 600번 갱신한다면, 생성 롤아웃 수를 제외한 입력 사용 횟수는 19,200회다. 이를 고르게 사용했다고 가정하면 문제 32개에서는 평균 600회, 128개에서는 150회, 512개에서는 37.5회 노출에 해당한다.
이것은 입력 사용량을 환산한 계산이지, 각 표본의 실제 방문 기록이나 논문의 롤아웃 비용을 재현한 값은 아니다. 핵심은 데이터 수, 배치, 단계, 생성 횟수, 실제 파라미터 이동량을 나누어 기록하자는 것이다. 작은 데이터에 제한한 결과와 대규모 일반 학습의 결과를 같은 말로 묶지 않아야 다음의 TTT를 이해할 수 있다.
#34쪽 — 추론하는 동안 파라미터를 잠깐 바꾼다
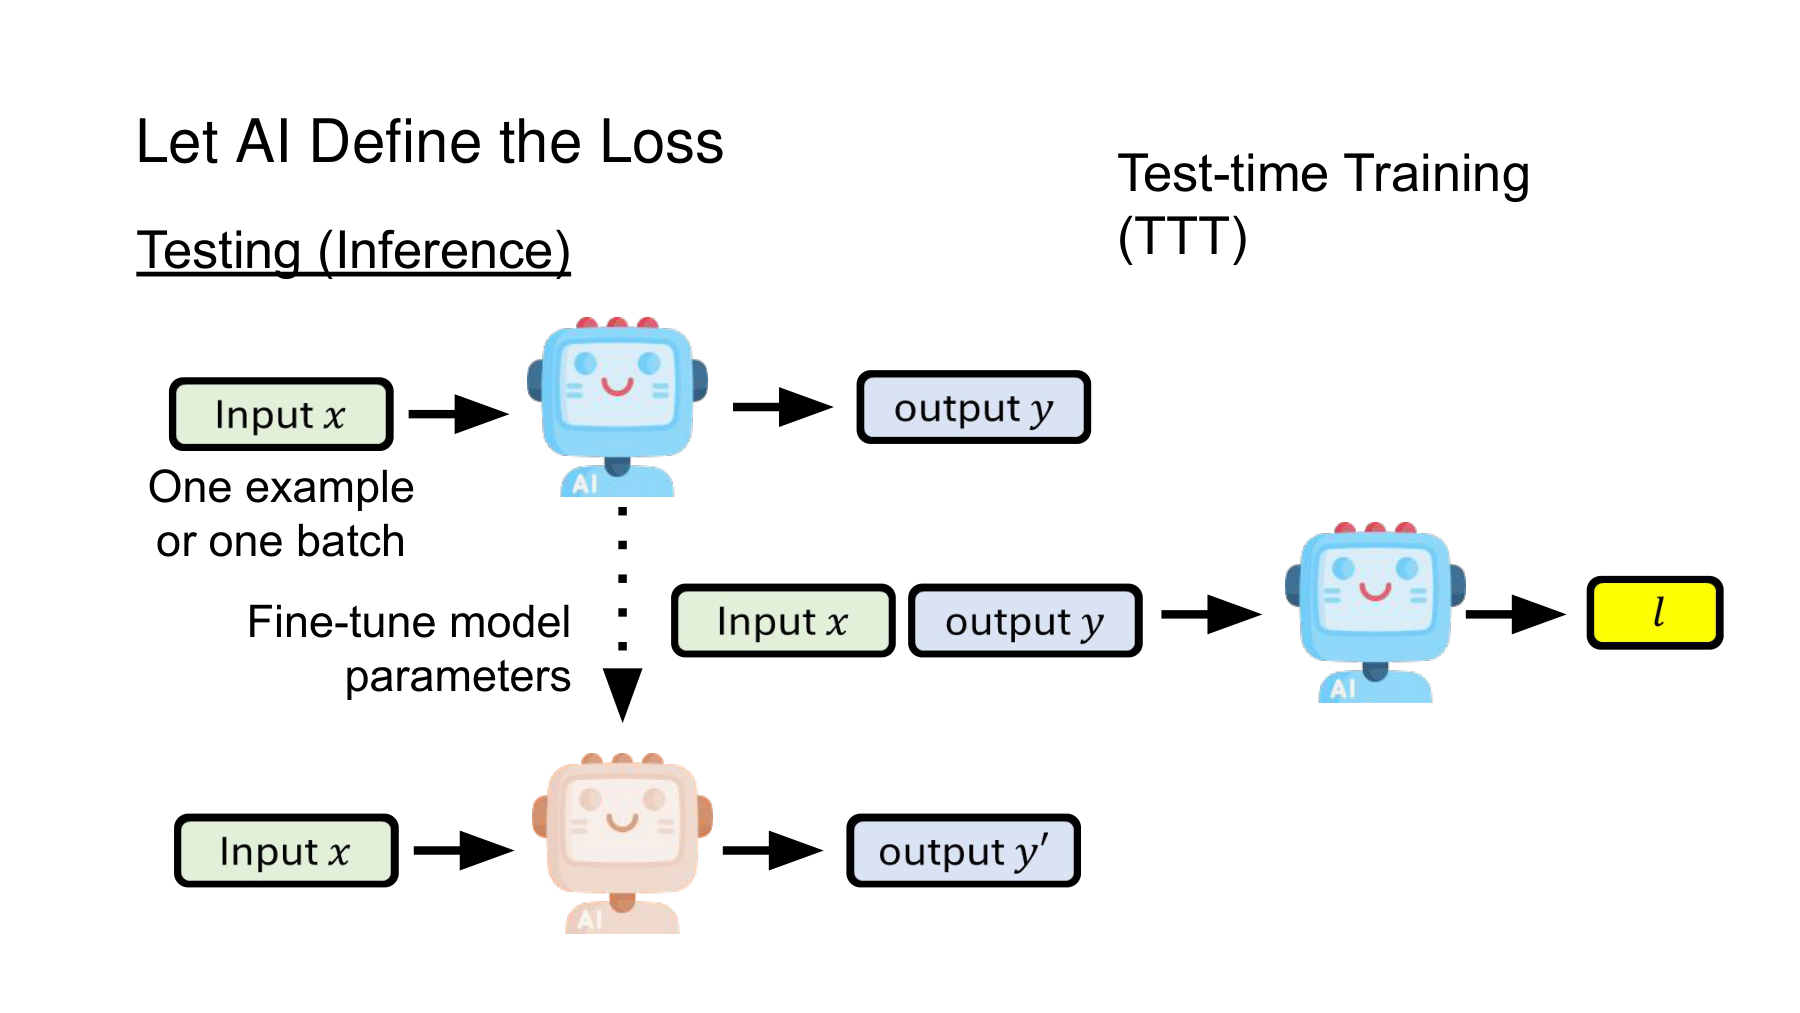
영상 설명 · 33:34–34:46. 강사는 테스트 입력으로 출력을 만들고, 자체 학습 신호로 파라미터를 조정한 뒤 같은 입력에 새 출력을 내는 흐름을 설명한다. 사용자는 최종 답을 받지만, 내부에는 학습 단계가 들어 있다.
#입력과 정답 라벨을 분리해서 보자
일반적인 고정 모델 추론에서는 입력을 받아 가중치를 바꾸지 않고 출력을 만든다. 여기서 설명하는 테스트 시점 학습(Test-Time Training, TTT)은 라벨 없는 테스트 입력으로 허용된 파라미터를 갱신한다. 정답 라벨은 업데이트에 주지 않는다. Sun 등의 2020년 TTT는 단일 테스트 입력을 자기지도 과제로 바꾸어 이 흐름을 구현한 사례다. TTT 원 논문 §2
다음은 경사 기반 적응의 설명용 일반식이다. 학습 가능한 파라미터 묶음을 , 테스트 입력 또는 입력 배치를 라고 쓰자. 다른 가중치는 고정할 수 있다.
무슨 파라미터를 갱신하는지, 어떤 손실을 계산하는지, 몇 번 갱신하는지에 따라 다른 방법이 된다. 모든 층을 바꿀 수도 있다는 식으로 확대하지 말고, 실제로 갱신하는 어댑터·정규화 계수·특징 추출기 등의 범위를 확인해야 한다.
또한 모든 TTT가 먼저 완성 답 y를 생성해야 하는 것은 아니다. 입력 토큰 NLL이나 회전 예측 같은 보조 과제는 완성된 답을 거치지 않고 학습 신호를 만든다. 반대로 샘플링한 답의 보상으로 학습한다면, 불연속 토큰을 곧바로 미분하는 것으로 끝나지 않는다. 정책 경사 등의 학습 절차가 따로 필요하다. 위 일반식은 적절한 목적 함수를 이미 구성했다는 전제의 개념식이다.
#함께 읽기 C — 더 오래 생각하기와 학습하기의 차이
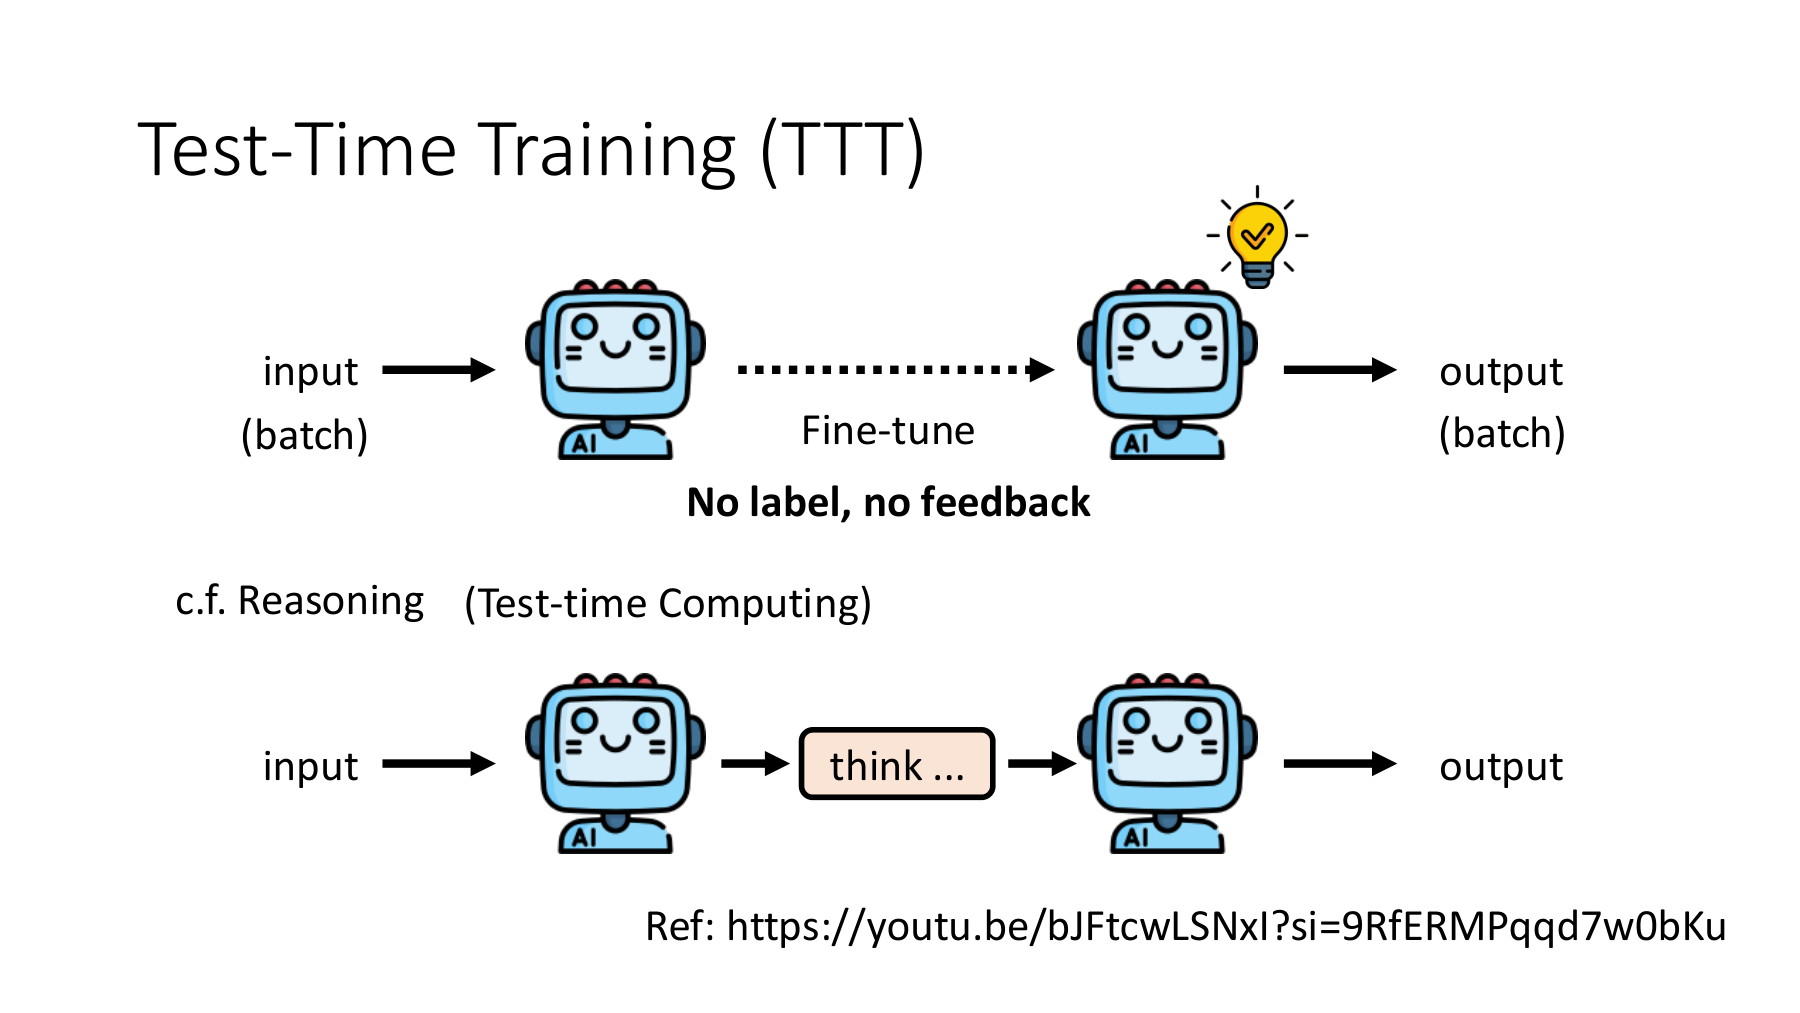
2025년 강의의 위쪽은 파라미터 미세조정, 아래쪽은 추론 계산을 늘리는 구성을 대비한다. 아래쪽처럼 더 긴 추론 경로를 생성하거나 후보를 더 많이 고르는 것과, 위쪽처럼 손실로 가중치를 갱신하는 것은 다르다. NTU GenAI-ML 2025, Post PDF 86쪽
| 구분 | 바뀌는 대상 | 이 글에서 확인하는 질문 |
|---|---|---|
| 긴 추론·후보 생성 | 생성된 토큰과 선택할 후보 | 같은 가중치로 계산량을 늘렸는가? |
| 문맥 예시·검색 자료 활용 | 모델이 읽는 입력 문맥 | 추가 정보를 읽었는가? |
| 경사 기반 TTT | 명시한 학습 가능 파라미터 | 손실·역전파·업데이트가 있었는가? |
이 표는 개념을 분리한 것이며, 실제 시스템에서는 함께 사용할 수 있다. 예를 들어 여러 후보를 생성해 의사 정답을 고른 뒤 그것으로 업데이트할 수 있다. 이 경우 후보 선택 단계와 파라미터 학습 단계를 각각 기록한다. 마찬가지로 KV 캐시에 계산 결과가 쌓이는 현상만으로 가중치 학습이 일어났다고 판단하지 않는다.
#추가 수학 해설 — 작게 움직여도 방향이 틀리면 손해다
‘조금만 학습하면 괜찮다’는 말은 보장이 아니다. 앞의 경사 정렬 논의를 한 변수로 줄여 보자. 다음은 설명용 손실이며 실제 언어모델 실험이 아니다.
대리 손실은 낮아졌지만 실제 목표 손실은 커졌다. 짧은 적응은 실패의 범위를 제한하는 설계 선택일 수 있어도, 잘못된 목적을 올바르게 바꾸지는 않는다. 이 때문에 업데이트 횟수뿐 아니라 목표와 연결된 독립 평가가 필요하다.
#35쪽 — 한 문제에 적응한 뒤, 무엇을 남길 것인가
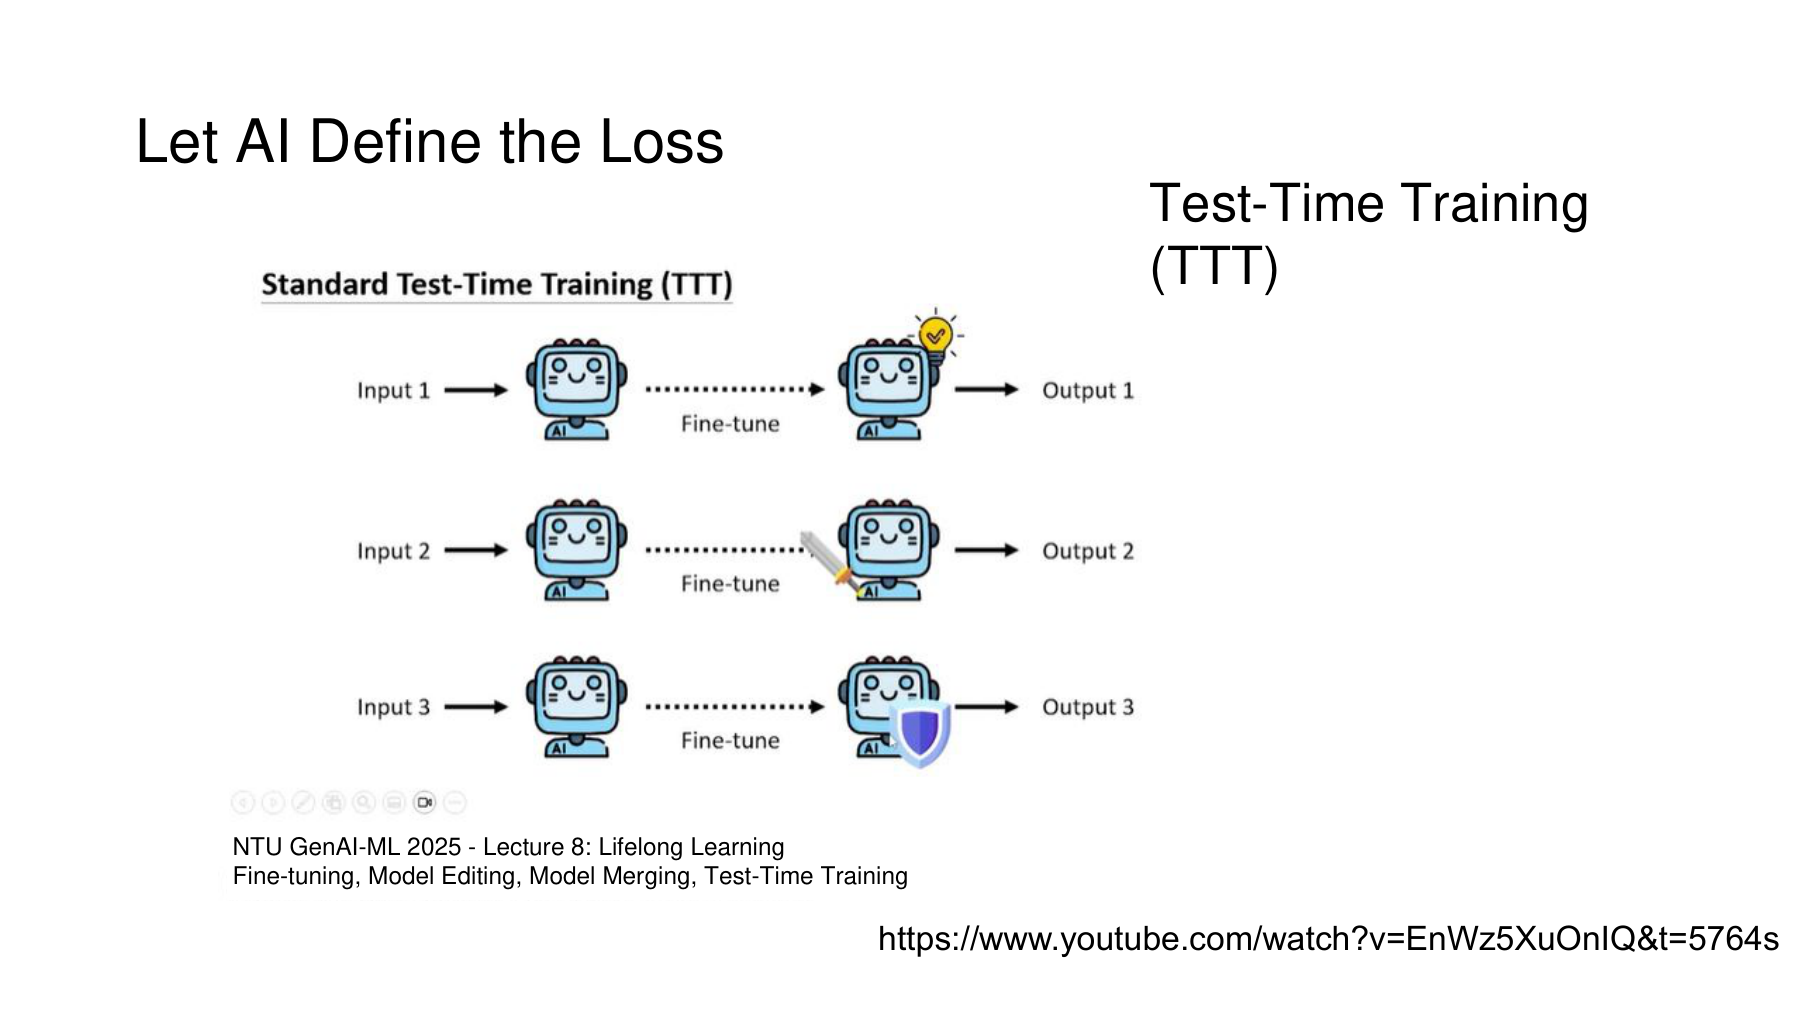
영상 설명 · 34:46–36:00. 강사는 작은 데이터와 제한된 조정이 TTT의 상황에 맞는다고 연결한다. 이어 더 자세한 설명은 2025년 8강을 참고하도록 안내한다. ‘작다’는 이유만으로 모든 배포 환경에서 안전하다는 보증은 아니다.
원본은 2025년 8강 1:36:04를 연결한다. 이 편에서는 해당 강의의 공식 PPT를 추가로 읽되, 그 영상의 자막까지 대조했다고 표시하지 않는다. 원본 35쪽의 세 줄 그림은 각 입력마다 기준 모델에서 다시 시작하는 표준 TTT를 보여준다. Post PDF 95쪽
#초기화하는 적응과 누적하는 적응
한 입력에 대한 업데이트 연산을 U로 쓰면 차이가 분명해진다. 아래는 초기화형과 누적형을 비교하기 위한 표기다.
초기화형(Episodic)은 앞 입력에서 바뀐 가중치를 다음 입력에 전달하지 않는다. 누적형(Continual/Online)은 이전 업데이트의 영향을 이어받는다. 뒤 방식은 지속적인 분포 변화에 적응할 여지가 있지만, 이전 입력의 잘못된 업데이트도 다음 입력에 전달될 수 있다. 2020년 TTT 논문도 표준형과 온라인형의 초기화 차이를 명시한다. Sun et al., §2, PDF 2쪽
설명용 계산. 각 입력의 보조 손실을 다음과 같이 단순화하자. 여기서 a는 보조 과제가 요구하는 가상의 목표다.
| 처리 방식 | 첫 입력의 업데이트 결과 | 둘째 입력의 시작값 | 둘째 입력의 업데이트 결과 |
|---|---|---|---|
| 입력마다 초기화 | 1 | 0 | −1 |
| 이전 값을 누적 | 1 | 1 | −0.5 |
같은 두 입력과 같은 학습률이어도 둘째 결과가 다르다. 누적형에서 순서를 뒤집으면 마지막 값은 +0.5가 된다. 결과를 비교할 때 입력 순서와 초기화 규칙을 기록해야 하는 이유다. 실제 구현에서는 모델 가중치뿐 아니라 옵티마이저의 운동량·통계·어댑터 상태를 어떻게 초기화하는지도 명시하는 것이 좋다. 이는 이 글의 구현 점검 제안이다.
#함께 읽기 D — 정답을 모르는데 어떻게 손실을 만드는가
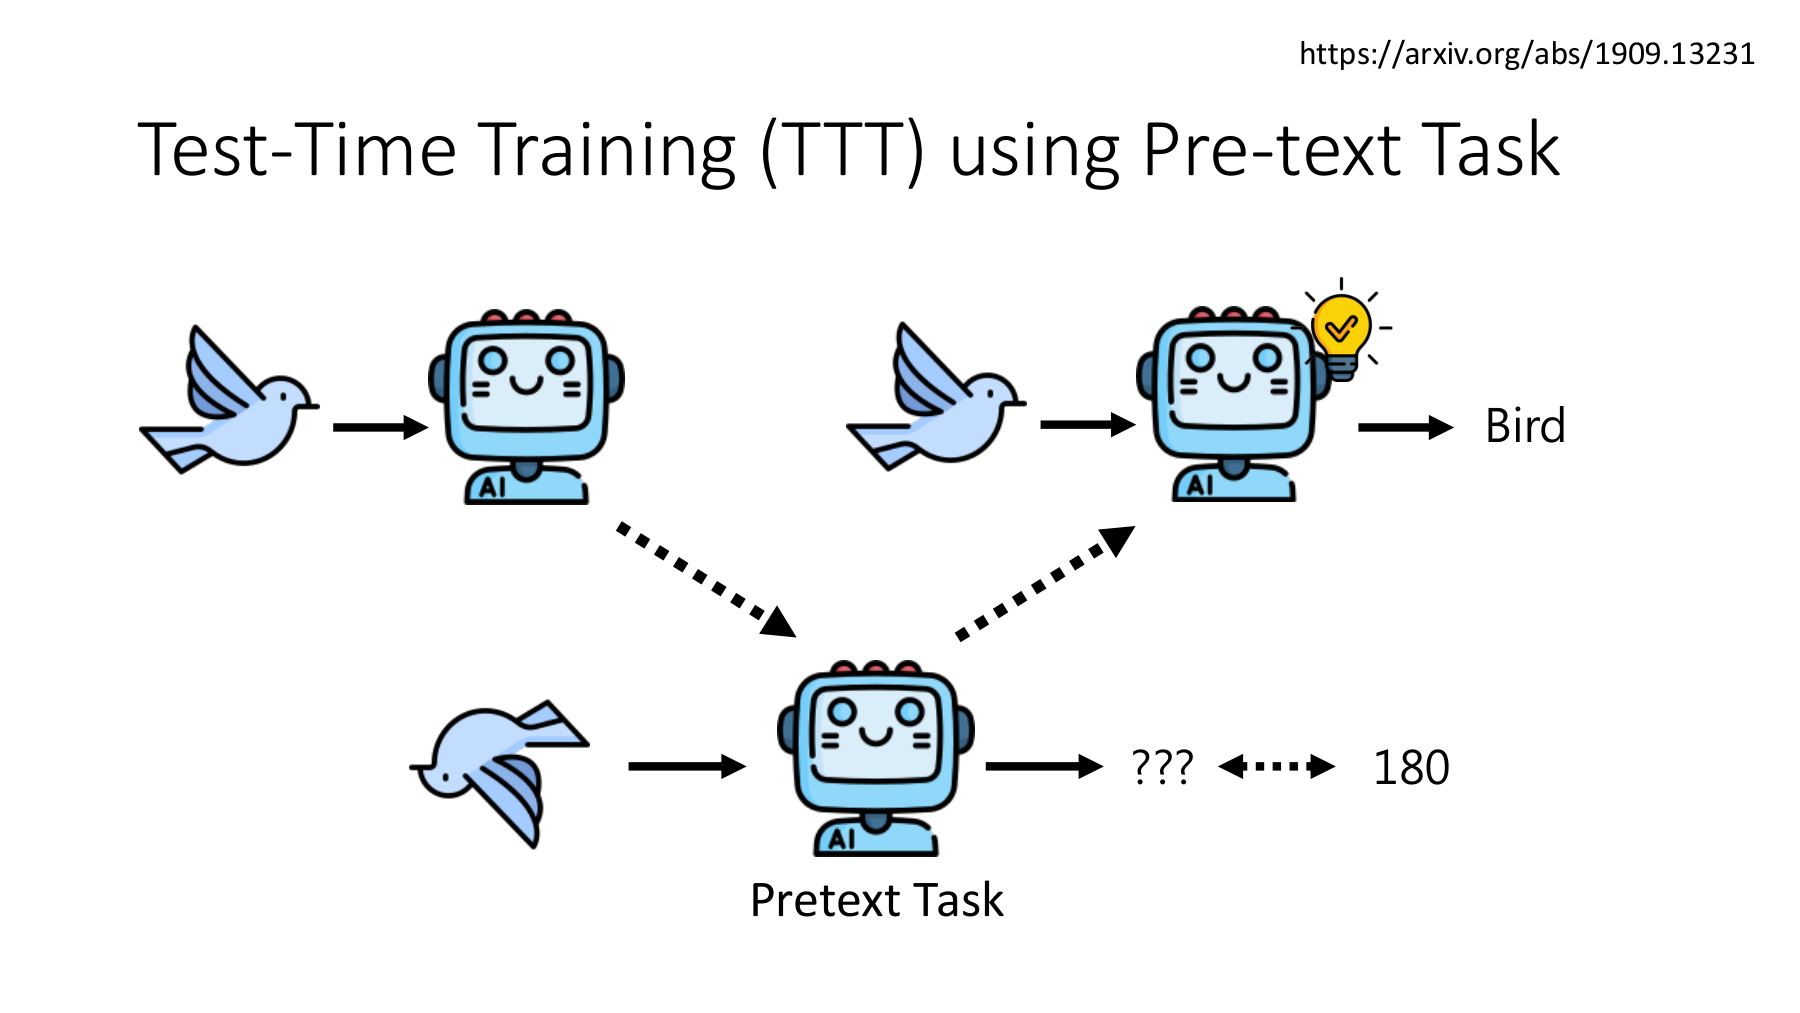
이 슬라이드에서는 새의 종류를 맞히는 본 과제와, 이미지를 얼마나 회전했는지 맞히는 보조 과제를 나눈다. 새의 정답 라벨은 없어도, 프로그램이 180도로 회전시켰다는 사실은 알고 있다. 보조 과제(Pretext task)의 라벨은 변환 과정에서 만들어진다. 자기지도 학습이 언제나 모델 자신의 답을 정답으로 복사하는 방식은 아니다. NTU Post PDF 94쪽
TTT 원 논문에서는 회전 예측과 본 과제가 특징 추출기를 공유한다. 테스트 때 보조 손실로 공유 부분을 조정하고 본 과제의 예측에 활용한다. 그 연결이 다른 과제에도 유효한지는 따로 검증해야 한다. Sun et al., §2의 식 (2)–(3)
예를 들어 물체의 방향이 핵심인 과제와 방향 변화에 둔감해야 하는 과제는 원하는 표현이 다를 수 있다. ‘라벨을 자동으로 만들 수 있다’만으로 좋은 보조 과제가 되는 것은 아니다. 어떤 불변성이나 정보를 학습시키는지, 그것이 최종 과제를 돕는지부터 확인해야 한다. 이 예시는 과제 설계에 관한 추가 설명이다.
#연구에 적용할 때 먼저 고정할 조건
아래 표는 이 글의 실험 설계 제안이다. 논문의 성능 수치를 가져온 표가 아니다.
| 항목 | 사전에 명시할 내용 |
|---|---|
| 접근 가능한 데이터 | 테스트 입력만 쓰는지, 별도의 자료·도구·사람 피드백도 쓰는지 |
| 업데이트 대상 | 어느 층·어댑터·정규화 계수를 바꾸고 무엇은 고정하는지 |
| 적응 예산 | 학습률, 최대 갱신 횟수, 배치, 생성 후보 수, 지연 시간 |
| 상태의 수명 | 매 입력 초기화인지, 누적인지, 언제 되돌리는지 |
| 평가 | 고정 모델 대비 성능, 실패·반복, 다른 과제의 저하, 계산 비용 |
테스트 입력으로 적응하는 것 자체는 TTT 평가 프로토콜의 일부일 수 있다. 그러나 그 사실을 숨기고 고정 모델과 같은 조건이라고 보고하면 비교가 어긋난다. 테스트 정답으로 손실을 만들거나, 테스트 점수를 반복해서 보며 최적의 학습률·중단 시점을 고르는 것도 구분해야 한다. 설정 선택용 검증 자료와 최종 평가 자료의 역할을 나누어 기록하자.
기계비전에 적용한다면 조명·노이즈 변화에 대한 적응을 실험할 수 있다. 다만 이 글의 LLM·분류 실험이 실시간 로봇 제어의 안전성을 검증한 것은 아니다. 입력 변화, 추정 성능, 시간 예산을 분리해 평가하고, 적응 실패 때 복구할 기준 모델을 보존하는 것이 합리적이다. 이는 적용 설계 제안이며 구현·실험 완료 보고가 아니다.
#이번 다섯 장을 관통하는 구분
31쪽은 입력 자체에서도 학습 신호를 만들 수 있음을 보여준다. 32–33쪽은 초기의 성능 향상과 장기적인 자기강화가 다른 문제임을 묻는다. 34–35쪽은 이 아이디어를 제한된 테스트 입력에 적용할 때 무엇을 갱신하고 무엇을 되돌릴지 구체화한다.
자기학습의 이름보다 중요한 것은 신호의 출처, 실제 목표와의 관계, 업데이트 범위, 독립 평가다. 대리 손실 하락, 정답률 향상, 지속적 일반화는 같은 지표가 아니다.
확인 질문 1. 입력 퍼플렉서티가 낮아지면 답이 맞다는 뜻인가? 아니다. 입력 토큰을 더 잘 예측했다는 뜻이며, 정답과의 연결에는 조건과 검증이 필요하다.
확인 질문 2. Figure 6의 128개 표본이 모든 모델의 안전 기준인가? 아니다. 특정 모델·데이터·보상·예산에서의 관측이다. 미니배치 크기와 전체 데이터 수를 혼동하지 않는다.
확인 질문 3. 추론 토큰을 더 많이 생성하면 TTT인가? 그것만으로는 아니다. 이 글의 경사 기반 TTT는 실제 파라미터 업데이트를 포함한다.
다음은 8편, 원본 36–40쪽이다. 원본의 ‘Math Warning’ 구간으로 들어가, 거대한 출력 공간의 엔트로피를 실제로 어떤 식으로 계산하고 최적화하는지 살핀다. 다음 편: 자가개선 AI 08 — 엔트로피를 제대로 줄이려면, 빠진 경사를 찾아라.
#영상·슬라이드·논문 출처
| 자료 | 사용한 범위 | 이 글에서의 역할 |
|---|---|---|
| NTU Self-Improving 상편 영상 | zh-TW 제공 자막, 주제 구간 31:13–36:00; 2026-11-17 열람 | 영상 설명 요약. 원본 슬라이드 전환 시각은 별도 검증하지 않음 |
| NTU Self-Improving PDF | 2026-05-08 강의, PDF 31–35쪽 | 본 강의 이미지 다섯 장 |
| Test-Time Learning for Large Language Models | arXiv v1, 2025-05-27, Figure 1·Algorithm 1·§4.1 | 입력 퍼플렉서티와 조건부 경사 정렬 |
| How Far Can Unsupervised RLVR Scale LLM Training? | arXiv v1, 2026-03-09, Figure 2·3·6, §4.1·5.1 | 초기 향상·이후 저하·데이터 규모 비교 |
| NTU GenAI-ML 2025 8강 Post | 2025년 가을 강의, PDF 86·94–96쪽 | TTT와 추론 계산, 회전 보조 과제, 초기화와 누적 |
| TTT 원 논문 | ICML 2020, §2·4 | 자기지도 TTT의 절차와 적용 조건 |
영상 요약, 논문에서 확인한 결과, 이 글의 계산·설계 제안은 서로 구분한다. 그림마다 원저작자·판본·페이지를 표시했다. 출처 표시는 원저작물 전체의 재사용 허가를 뜻하지 않는다.