로봇이 컵을 집으려면 팔을 움직이기 전에 그 행동의 결과를 예상할 수 있어야 한다. 7장이 여러 관측과 명령을 시간순으로 읽는 법이었다면, 이번 장은 아직 실행하지 않은 명령을 넣어 미래를 시험하는 법이다.
슬라이드의 저작권은 Oier Mees와 각 그림·영상의 원저작권자에게 있다. PDF 페이지 순서로 번호를 붙였으며, 강의 영상의 자동 자막을 대조해 운영 안내를 건너뛰고 기술 설명을 정리했다. 슬라이드 아래 영상 링크는 해당 설명이 나오는 구간으로 이동한다. ETH Zurich 공식 강의 · 공식 PDF · 8강 영상
#행동을 입력하면 무엇을 예측할까
컵을 밀어서 접시 위에 올린다고 해 보자. 손을 1cm 더 움직였을 때 컵이 접시에 안착할지, 테두리에 걸려 넘어질지는 명령만 봐서는 알 수 없다. 월드 모델은 지금까지 본 것과 앞으로 취할 행동을 바탕으로 그 다음에 일어날 일을 예측한다. 이 예측은 후보 행동을 고를 때도, 정책을 학습시킬 때도 쓸 수 있다.
본강에 앞서 소개된 SO-101 팀 프로젝트는 월드 모델을 어떻게 시험할지 보여 준다. 직선으로 물체를 미는 과제에서 시작해 장애물을 돌아 밀기, 처음 보는 물체를 밀기로 난도를 높인다. 모델이 물체의 움직임을 예측하더라도 목표 도달과 사용한 행동 단계 수는 실제 실행으로 평가한다. 프로젝트 소개 구간
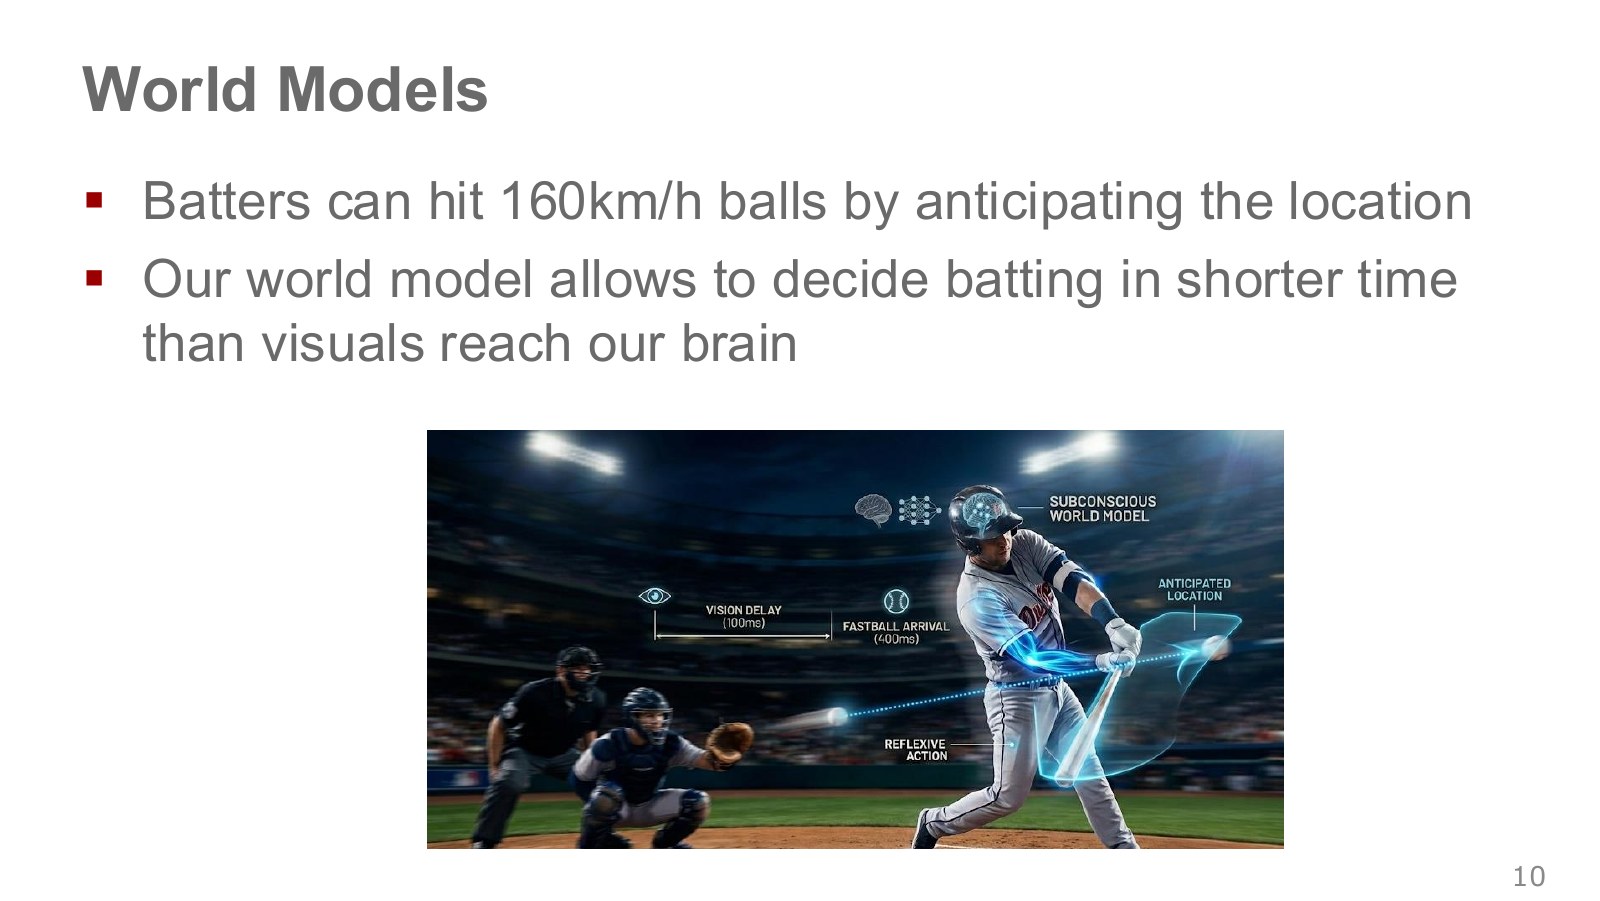
그림의 공 위치와 배트가 지나갈 위치 사이에는 시간 차가 있다. 타자는 몇 번 본 공의 위치로부터 방향과 속도를 가늠하고, 배트를 휘두르는 데 걸리는 시간까지 고려한다. 로봇도 한 프레임에서 같은 곳에 보이는 공이 왼쪽에서 들어오는지 오른쪽에서 들어오는지에 따라 다른 명령을 내려야 한다.
강의에서 제시한 예시 수치를 쓰면 공이 오는 데 약 400ms, 시각 신호 전달에 약 100ms가 걸려 판단과 스윙에 약 300ms가 남는다. 이는 강의의 근삿값이다. 공이 타석에 도달한 뒤 반응하는 방식보다, 공의 초기 궤적에서 어디로 올지 미리 가늠하는 이유를 보여 준다.
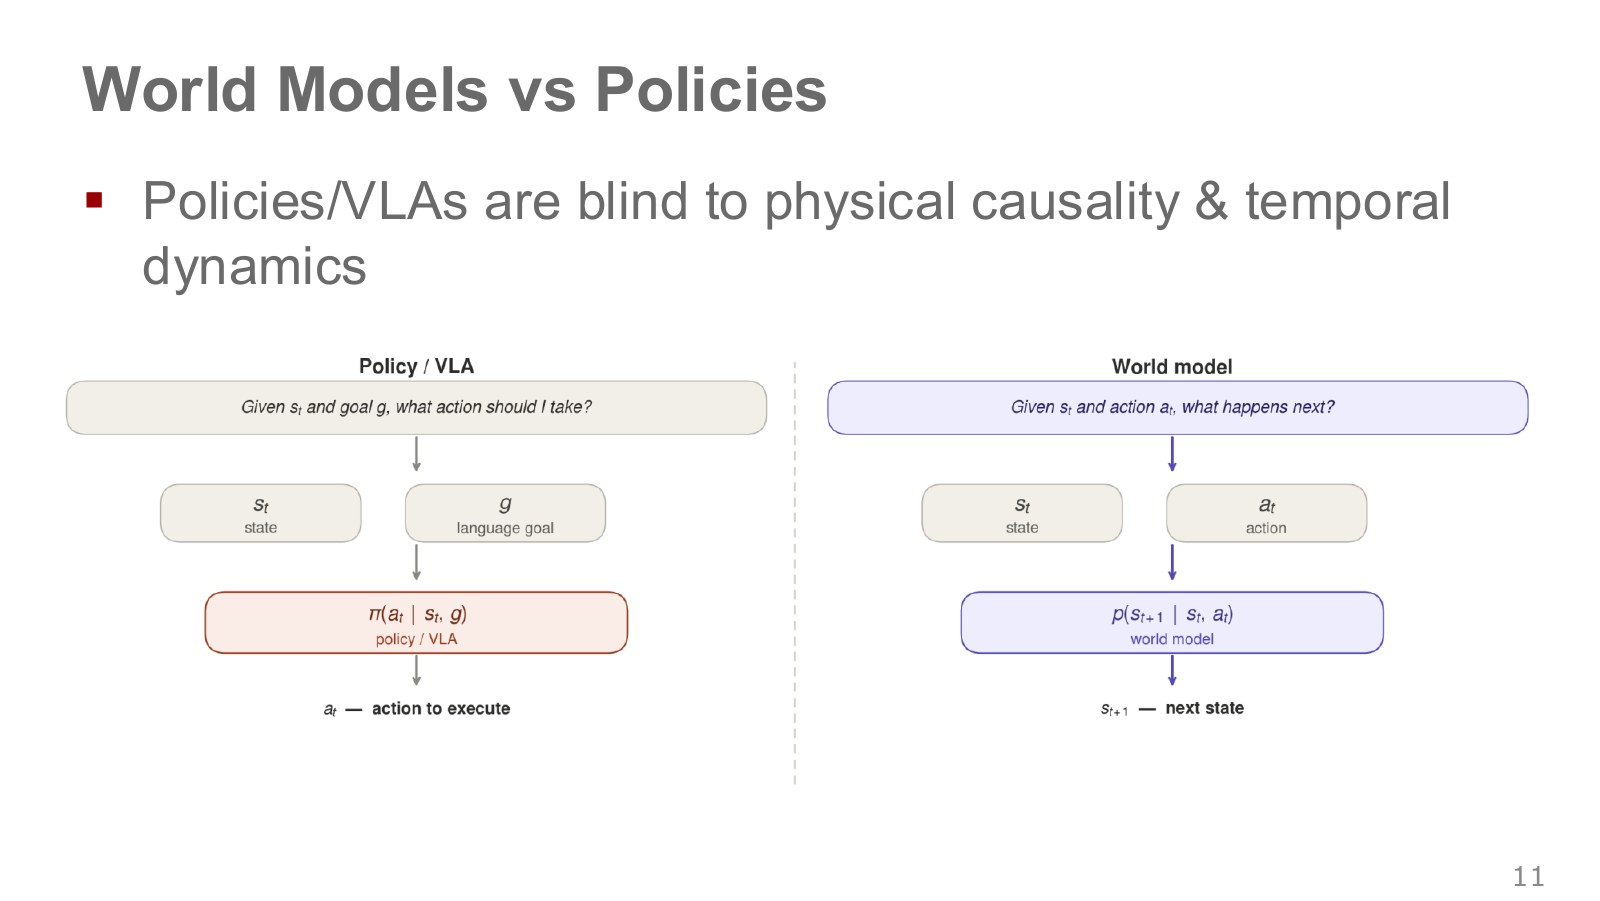
왼쪽 화살표는 현재 상태와 목표에서 행동으로 이어진다. “컵을 접시로 옮겨라”라는 지시에 대해 손을 어느 방향으로 움직일지 고르는 정책이다. 오른쪽은 현재 상태와 후보 행동에서 다음 상태로 이어진다. 같은 컵에 왼쪽과 오른쪽 밀기를 각각 넣어 결과를 비교할 수 있다. 영상 이력을 쓰는 VLA도 움직임의 규칙을 학습할 수 있다. 여기서 나누는 기준은 외부에 제공하는 입력과 출력이다.
기호 뜻과 계산 과정 자세히 보기 정책과 월드 모델이 받는 질문
이 식을 말로 읽으면
왼쪽은 목표를 보고 어떤 행동을 고를지, 오른쪽은 행동이 정해졌을 때 다음에 무슨 일이 일어날지 나타낸다.
기호 하나씩 이해하기
- 지금 상태
- 목표
- 지금 선택할 행동
- 행동 후 상태
계산을 따라가는 순서
- 컵이 접시 왼쪽에 있다고 가정한다. 정책에 접시로 옮기는 목표를 주면 오른쪽 밀기를 선택할 수 있다.
- 월드 모델에는 그 밀기를 넣고, 컵의 다음 위치나 넘어질 가능성을 예측한다.
작은 예시로 확인하기
정책이 오른쪽 밀기에 확률 0.8을 줬더라도 성공 확률은 0.8이라는 뜻이 아니다. 성공 여부는 예측된 결과를 따로 평가한다.
식을 이해하기 위한 설명용 예시입니다.
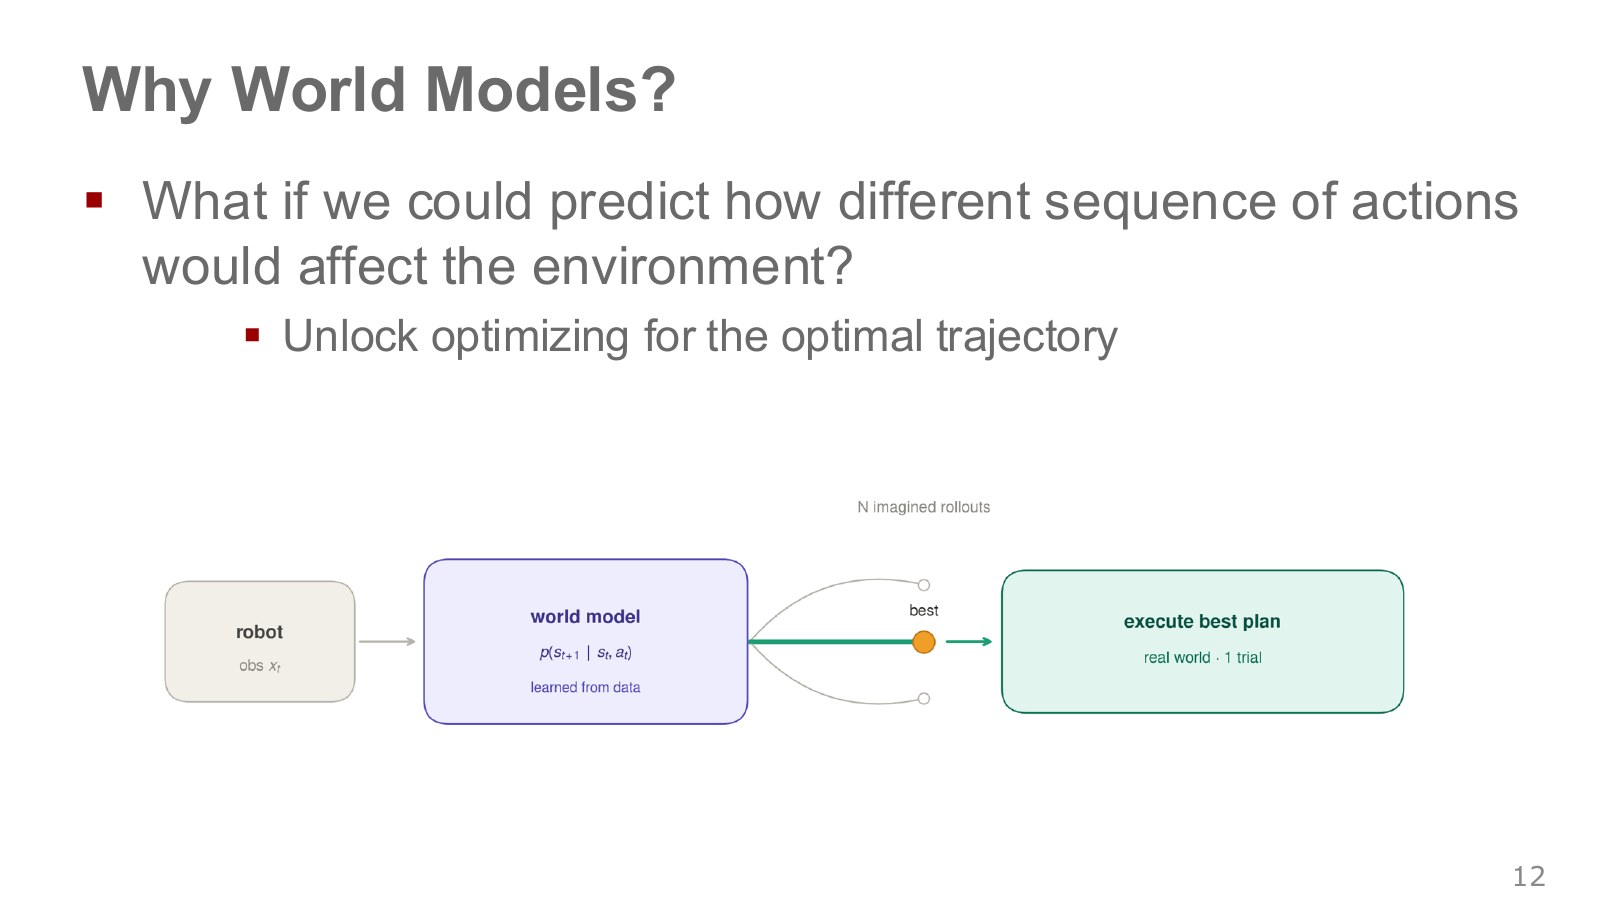
가운데 상자에서 나온 갈래 하나가 행동을 여러 번 연결해 본 예측 궤적, 즉 롤아웃이다. 첫 동작이 쉬워도 이후 컵이 벽에 막히면 계획 전체의 점수는 낮을 수 있다. 오른쪽으로 먼저 돌아가는 후보가 더 길어도 최종 목표까지 닿는다면 선택할 만하다. 실제 실행 후에는 새 관측으로 출발점을 갱신한다.
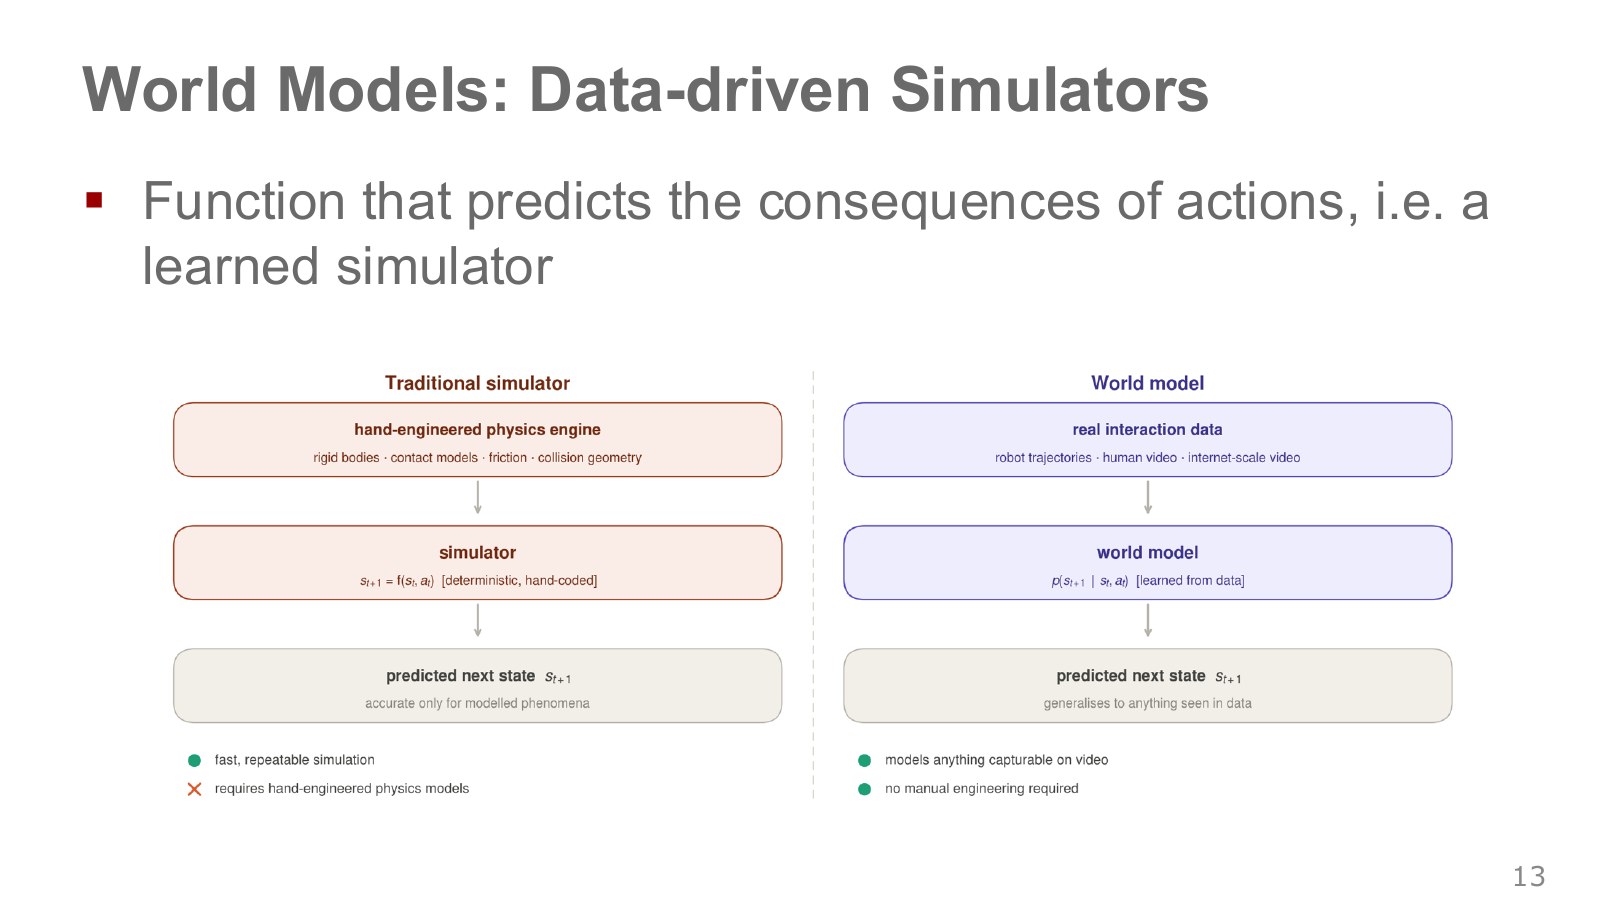
왼쪽 시뮬레이터는 질량·마찰·접촉 규칙을 지정해 다음 상태를 계산한다. 오른쪽 모델은 관측과 로봇 명령이 짝지어진 경험에서 변화 규칙을 추정한다. 천이 접히는 모양처럼 모델링하기 까다로운 장면을 배울 수 있지만, 훈련에서 거의 본 적 없는 재질이나 접촉은 잘못 예측하기 쉽다. 두 접근은 결합할 수 있다.
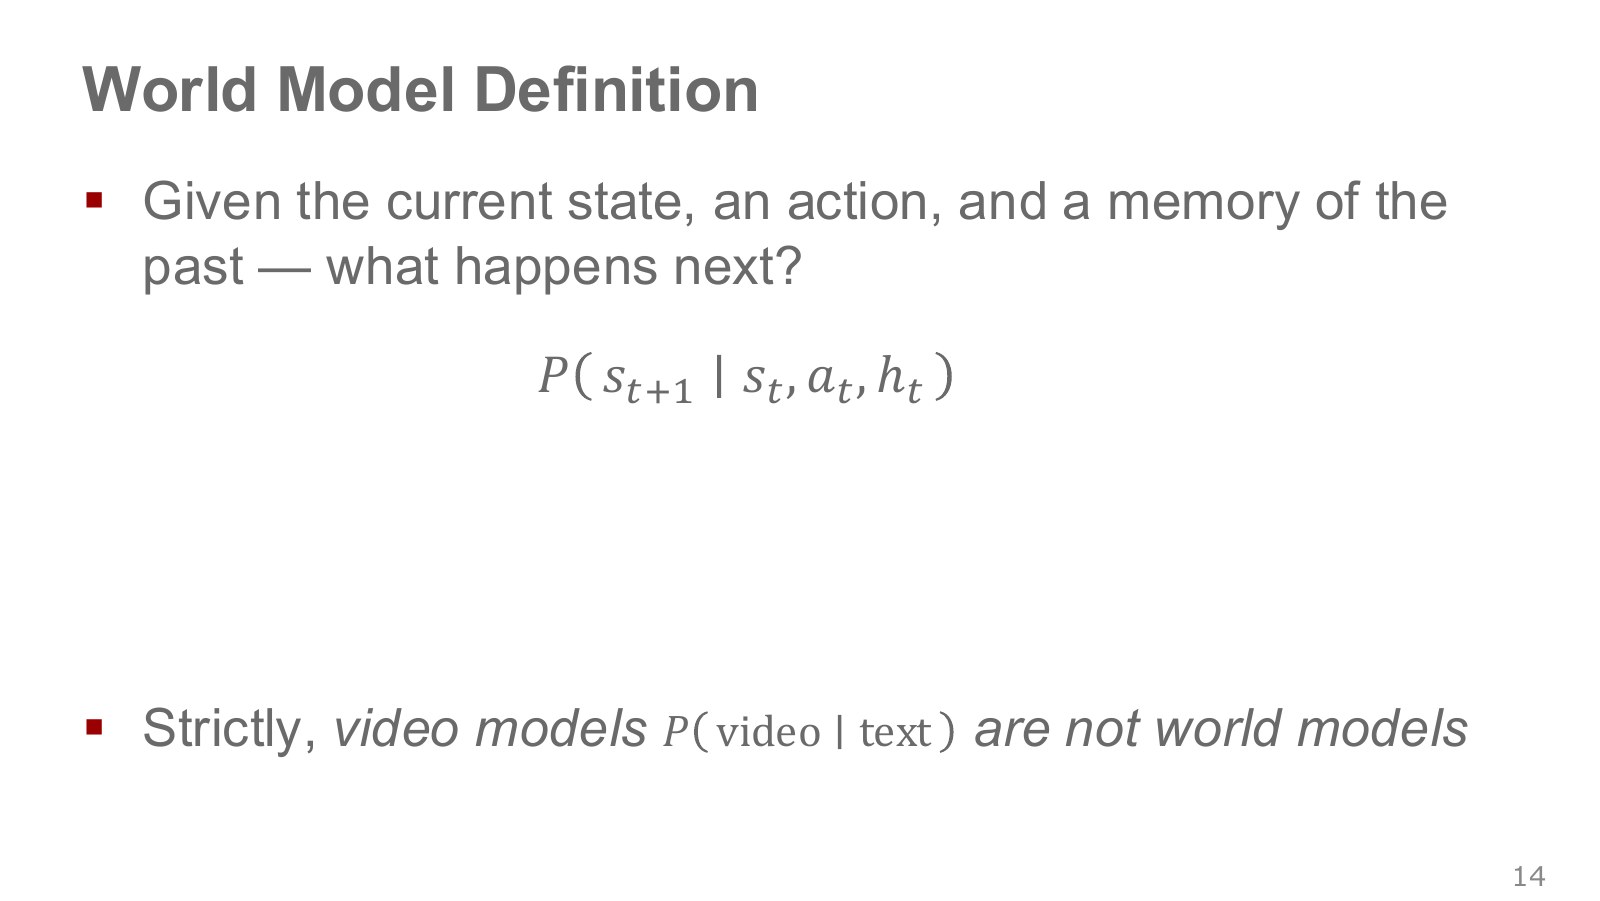
컵을 같은 속도로 밀어도 바닥에 물기가 있으면 더 멀리 미끄러질 수 있다. 이럴 때 조건부 분포는 지금 아는 정보를 기준으로 어느 결과가 얼마나 가능할지 나타낸다. 강의에서 쓰는 행동 조건부 월드 모델은 미래를 예측할 때 구체적인 후보 행동을 바꿔 넣을 수 있다. 텍스트로 장면을 생성하는 영상 모델은 그 자체로는 이 입력을 제공하지 않는다.
기호 뜻과 계산 과정 자세히 보기 현재 상태·행동·기억을 조건으로 한 전이
이 식을 말로 읽으면
세로선 오른쪽은 예측에 이미 주어진 정보이고, 왼쪽은 아직 알 수 없어 예측하려는 다음 상태다.
기호 하나씩 이해하기
- 과거에서 얻은 기억
- 현재 상태 또는 추정값
- 시험할 명령
- 데이터로 학습한 전이 분포
계산을 따라가는 순서
- 현재 컵 위치와 오른쪽으로 밀라는 명령을 고정한다.
- 이전에 바닥에서 미끄러짐이 관찰됐다는 기억을 추가하면 더 멀리 움직일 가능성을 높게 예측할 수 있다.
작은 예시로 확인하기
서로 겹치지 않는 두 위치만 가능하고 가까운 곳에 0.7을 주었다면 먼 곳의 확률은 0.3이다.
식을 이해하기 위한 설명용 예시입니다.
#영상으로 계획하기
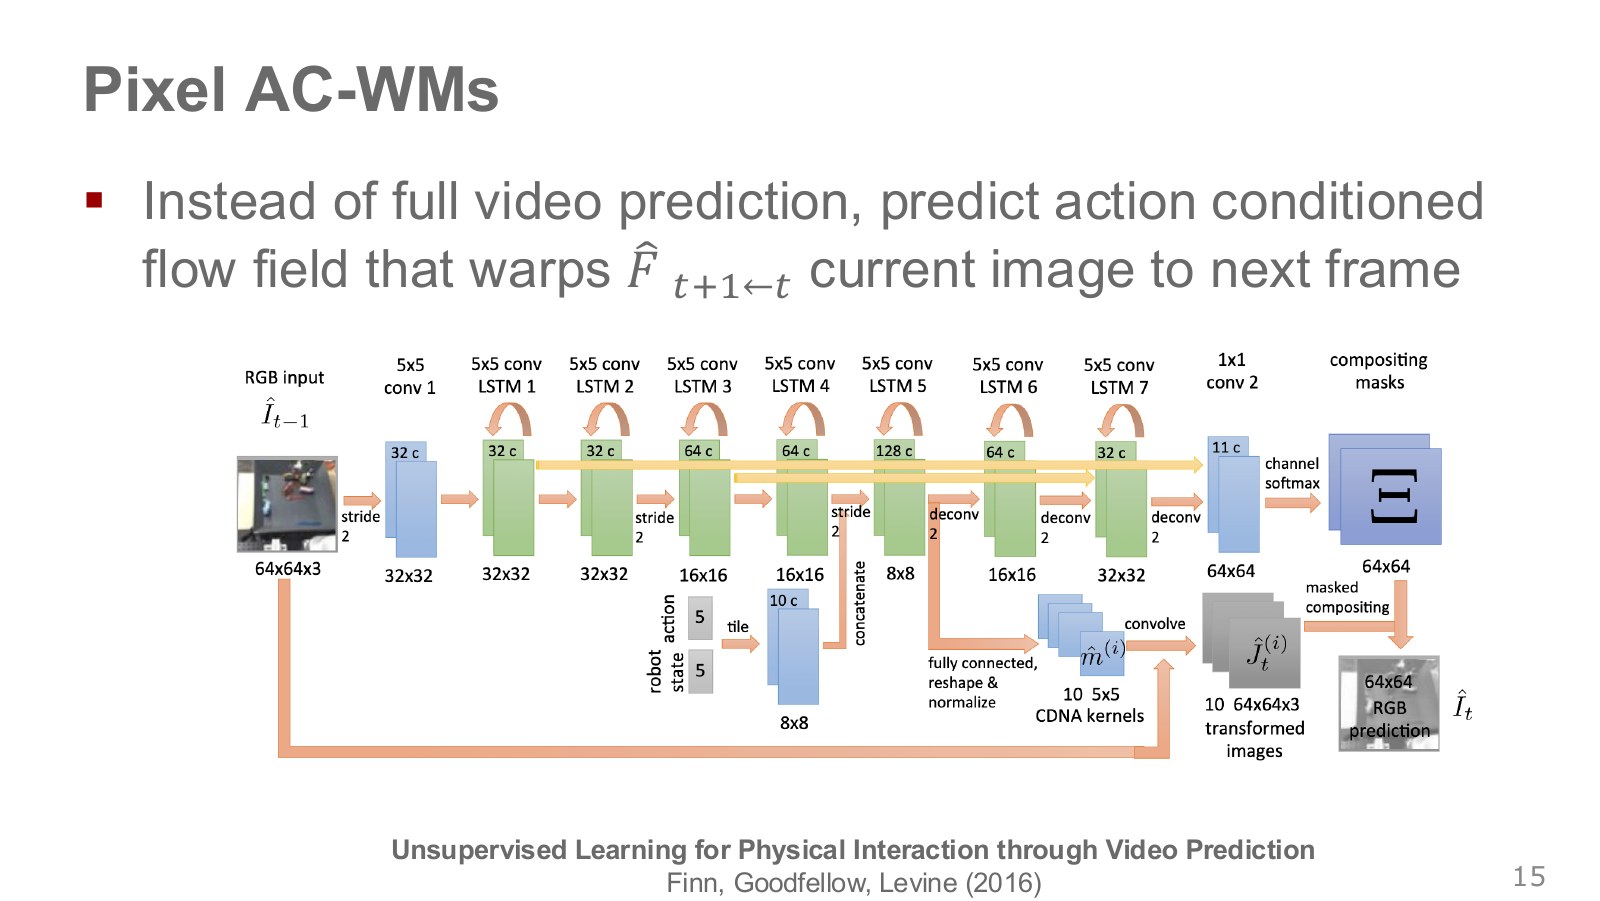
왼쪽 카메라 프레임이 주황색 경로를 통해 오른쪽까지 이어진다. Finn 등의 CDNA 모델은 이전 영상에 여러 이동 변환을 적용하고, 마스크로 어느 영역에 어떤 변환을 섞을지 정한다. 로봇 팔과 컵은 서로 다른 방향으로 움직이고 배경은 그대로일 수 있다. 이전 프레임에 없던 가려진 표면의 색과 모양은 이동만으로 알기 어렵다. Finn 외, Video Prediction
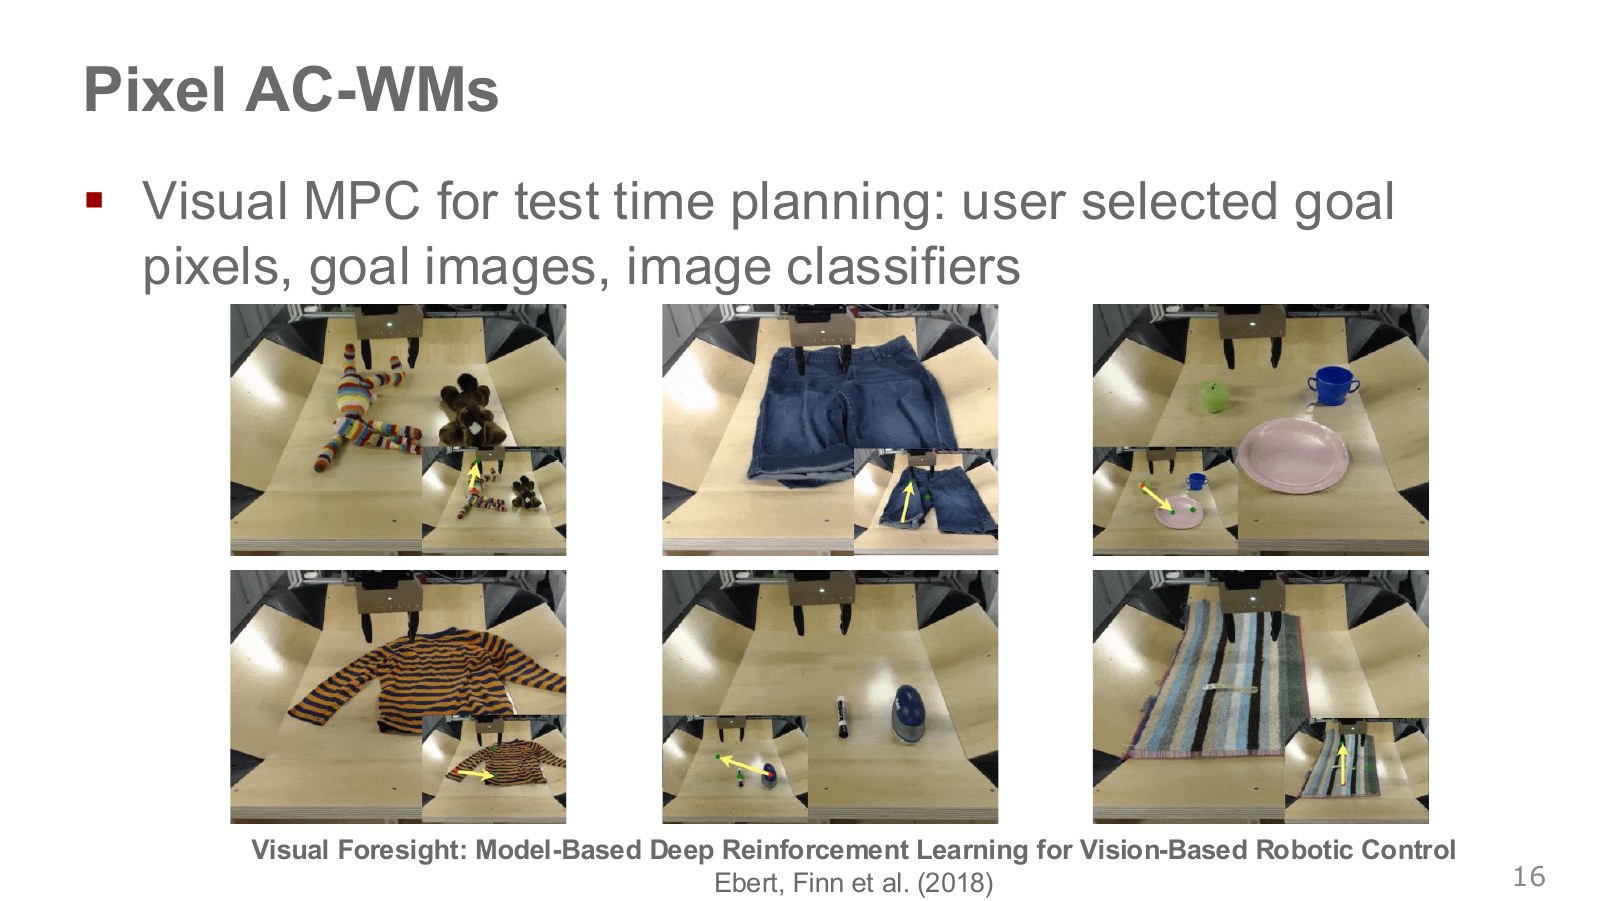
옷과 접시 예시처럼 사용자는 영상에서 옮길 점과 도착점을 고를 수 있다. 카메라 영상에서 해당 점이 도착점 쪽으로 움직인 후보에 낮은 비용을 준다. 원하는 완성 사진을 줄 수도 있고, 분류기가 “서랍이 닫혔다”고 판단하는 점수를 쓸 수도 있다. 성공을 어느 방식으로 정하느냐에 따라 같은 월드 모델로 다른 작업을 계획한다. Ebert 외, Visual Foresight
Visual Foresight의 모델에는 로봇이 스스로 모은 상호작용 영상과 실제 명령이 들어간다. 학습할 때 ‘이 물체를 저기로 옮겨라’는 사람이 붙인 과제 라벨이 없어도 다음 영상을 예측할 수 있다. 실행할 때는 사용자가 목표 픽셀을 골라 어느 후보 경로가 더 좋은지 정한다.
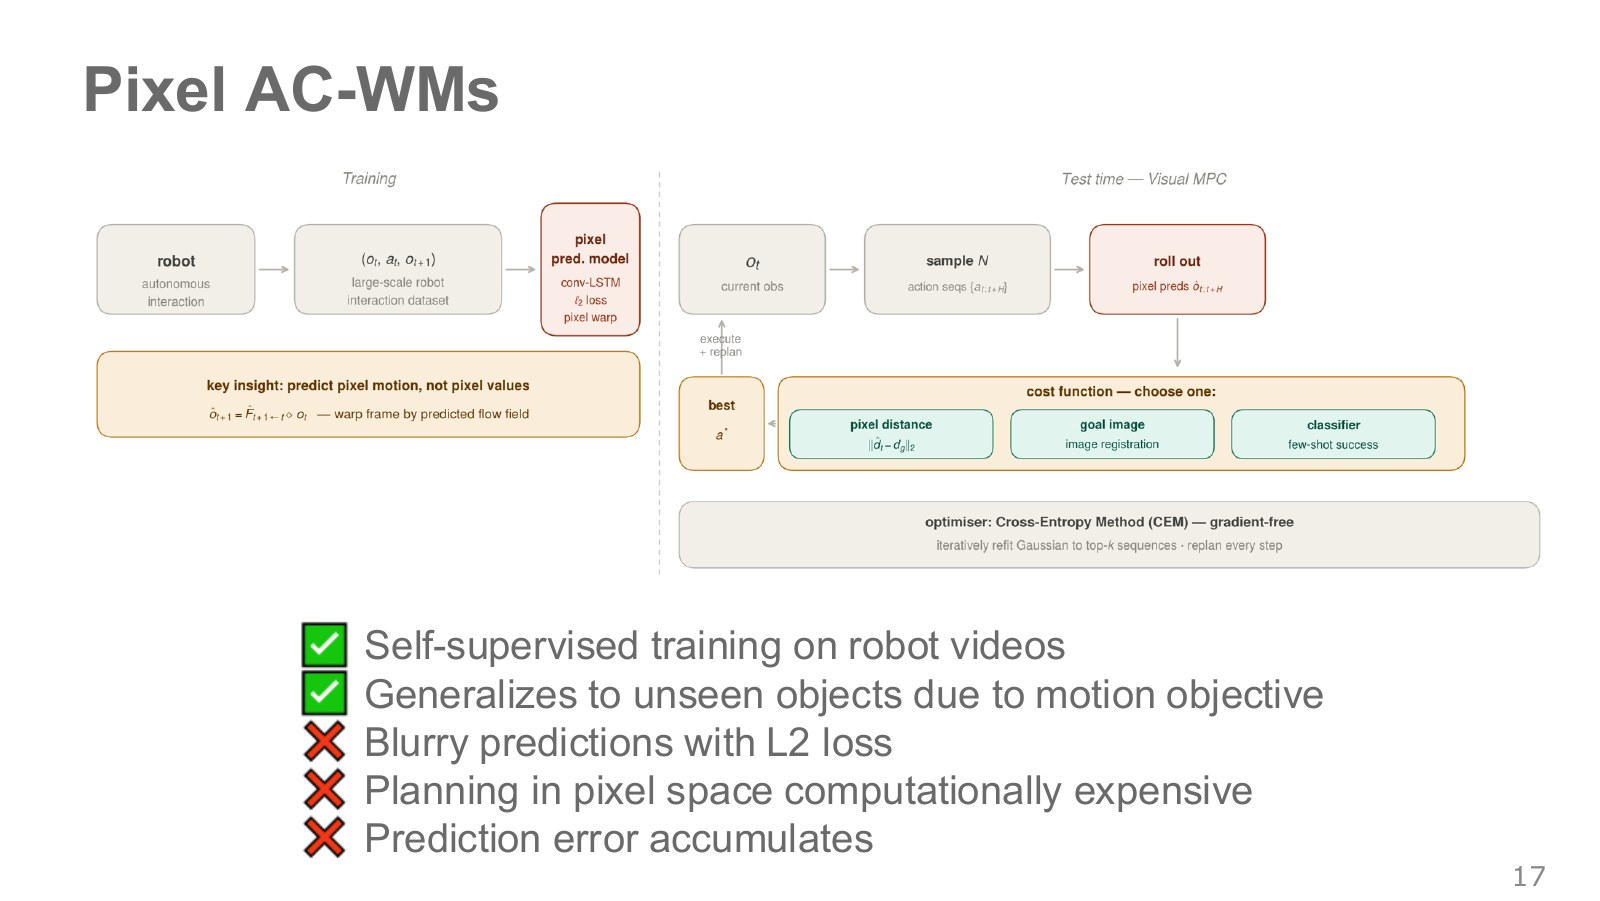
왼쪽은 모델 학습이다. 로봇이 실행한 명령과 그 전후 영상을 모으면 다음 프레임이 학습 표적이 된다. 오른쪽은 실행이다. 교차 엔트로피 방법(CEM)은 후보 행동열을 샘플링하고, 예상 비용이 낮은 상위 후보를 골라 다음 샘플링 분포를 업데이트한다. 모델 예측 제어(MPC)는 고른 행동열의 앞부분만 실행한 뒤 실제 장면을 보고 다시 계획한다. CEM은 후보를 찾는 절차이고 MPC는 관측으로 계획을 고치는 실행 방식이다.
픽셀 단위의 제곱오차로 두 가능한 위치를 평균내면 물체 윤곽이 흐려질 수 있다. 그 프레임을 다음 입력으로 계속 쓰면 어긋남이 누적된다. 후보마다 여러 프레임을 계산해야 하는 비용까지 더해져, 이후의 잠재 공간 접근은 제어에 필요한 정보를 압축해서 비교한다.
Berkeley CS285에서는 몇 스텝마다 계획을 다시 풀면 각 계획의 정확도에 덜 의존하고 더 짧은 구간만 내다볼 수 있다고 설명한다. 예를 들어 첫 동작 뒤 컵이 예상보다 적게 미끄러졌다면, 현재 위치에서 남은 명령을 다시 계산한다. Sergey Levine · CS285 모델 기반 강화학습 슬라이드
기호 뜻과 계산 과정 자세히 보기 예측 비용이 작은 행동열 선택
이 식을 말로 읽으면
각 행동 후보로 미래 상태를 차례대로 예측하고, 그 상태들의 비용을 더했을 때 가장 작은 행동열을 고른다.
기호 하나씩 이해하기
- 예측할 단계 수
- 시험할 행동열
- 상태가 목표에서 벗어난 정도 등을 매기는 비용
- 모델이 예측한 상태
계산을 따라가는 순서
- 첫 후보와 둘째 후보를 같은 실제 관측에서 시작해 각각 두 단계씩 예측한다.
- 각 후보의 비용을 더하고 더 작은 후보의 첫 행동을 실행한다. 새 센서 값이 들어오면 다시 계획한다.
작은 예시로 확인하기
두 후보의 단계별 비용이 각각 3과 1, 그리고 2와 1이면 합은 4와 3이다. 이 후보 집합에서는 둘째를 선택한다.
식을 이해하기 위한 설명용 예시입니다.
#잠재공간에서 상상하기
후보 수와 예측 길이가 커지면 매번 영상 전체를 생성하는 비용이 늘어난다. 대신 컵의 위치와 움직임처럼 행동 선택에 중요한 정보를 짧은 숫자 벡터에 담을 수 있다. 이 압축 표현을 잠재 표현이라고 한다. 압축 과정에서 컵이 손에 잡혔는지 같은 정보가 사라지면 계산이 빨라도 잘못된 계획을 고르게 된다.
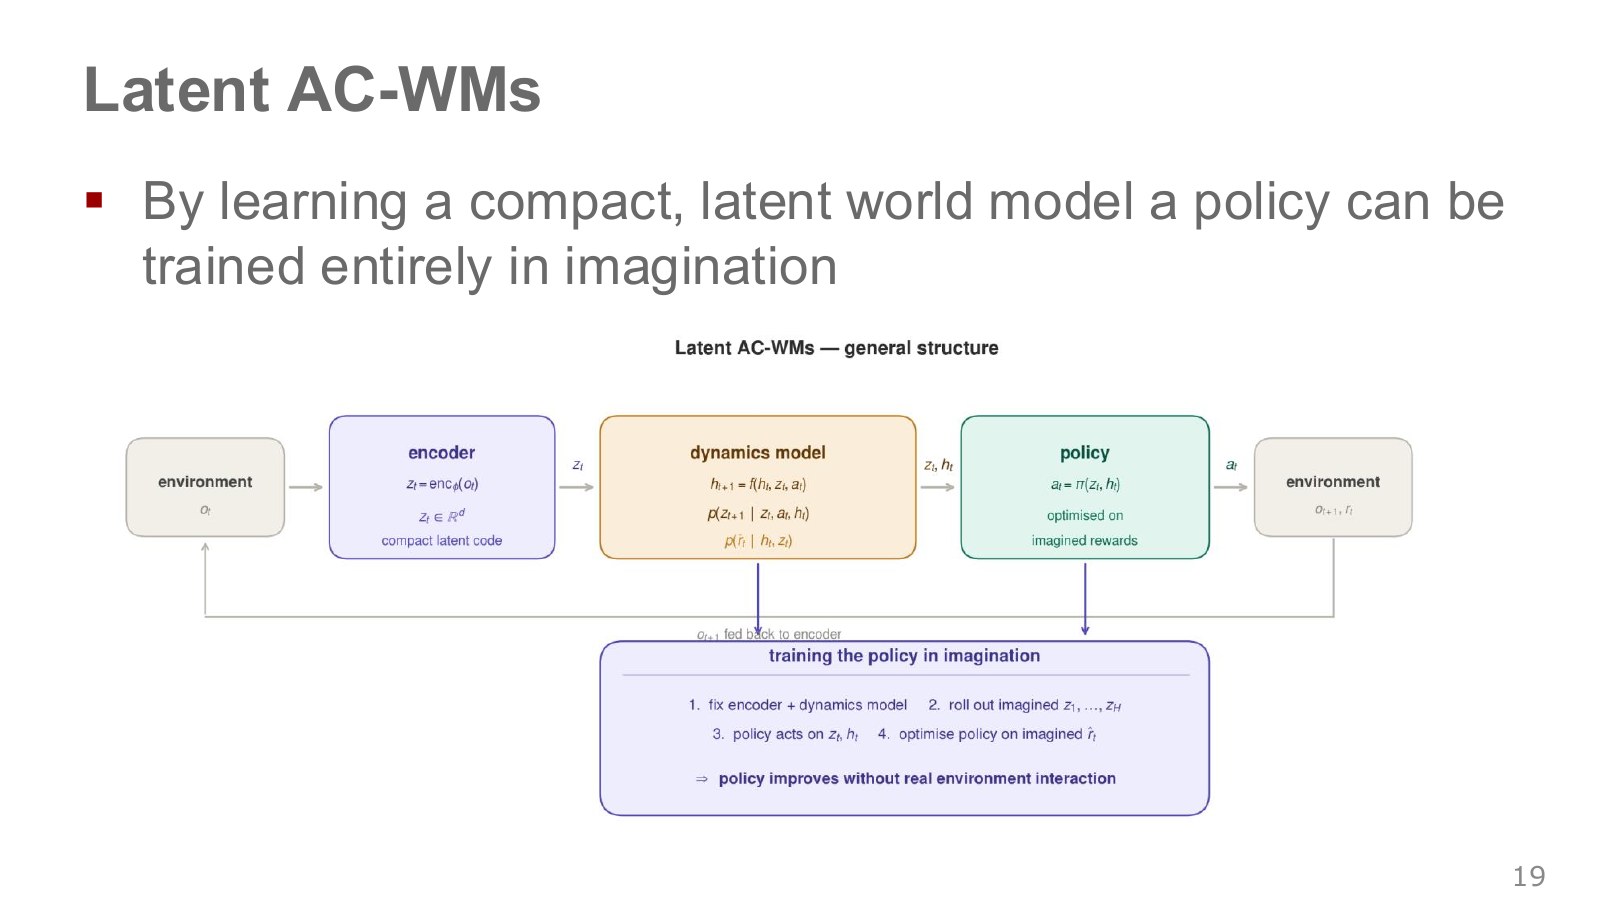
왼쪽 인코더는 관측을 숫자 벡터로 바꾼다. 가운데 동역학 모델은 행동을 받으면 벡터와 보상을 예측한다. 정책은 그 다음 행동을 고르고 다시 동역학 모델에 넣는다. 아래 루프는 이런 예측 경험으로 정책을 개선하는 과정이다. 모델 학습에 쓰이는 환경 데이터와 모델 안에서 만들어 낸 정책 학습 데이터를 구분하면 그림의 두 경로가 보인다.
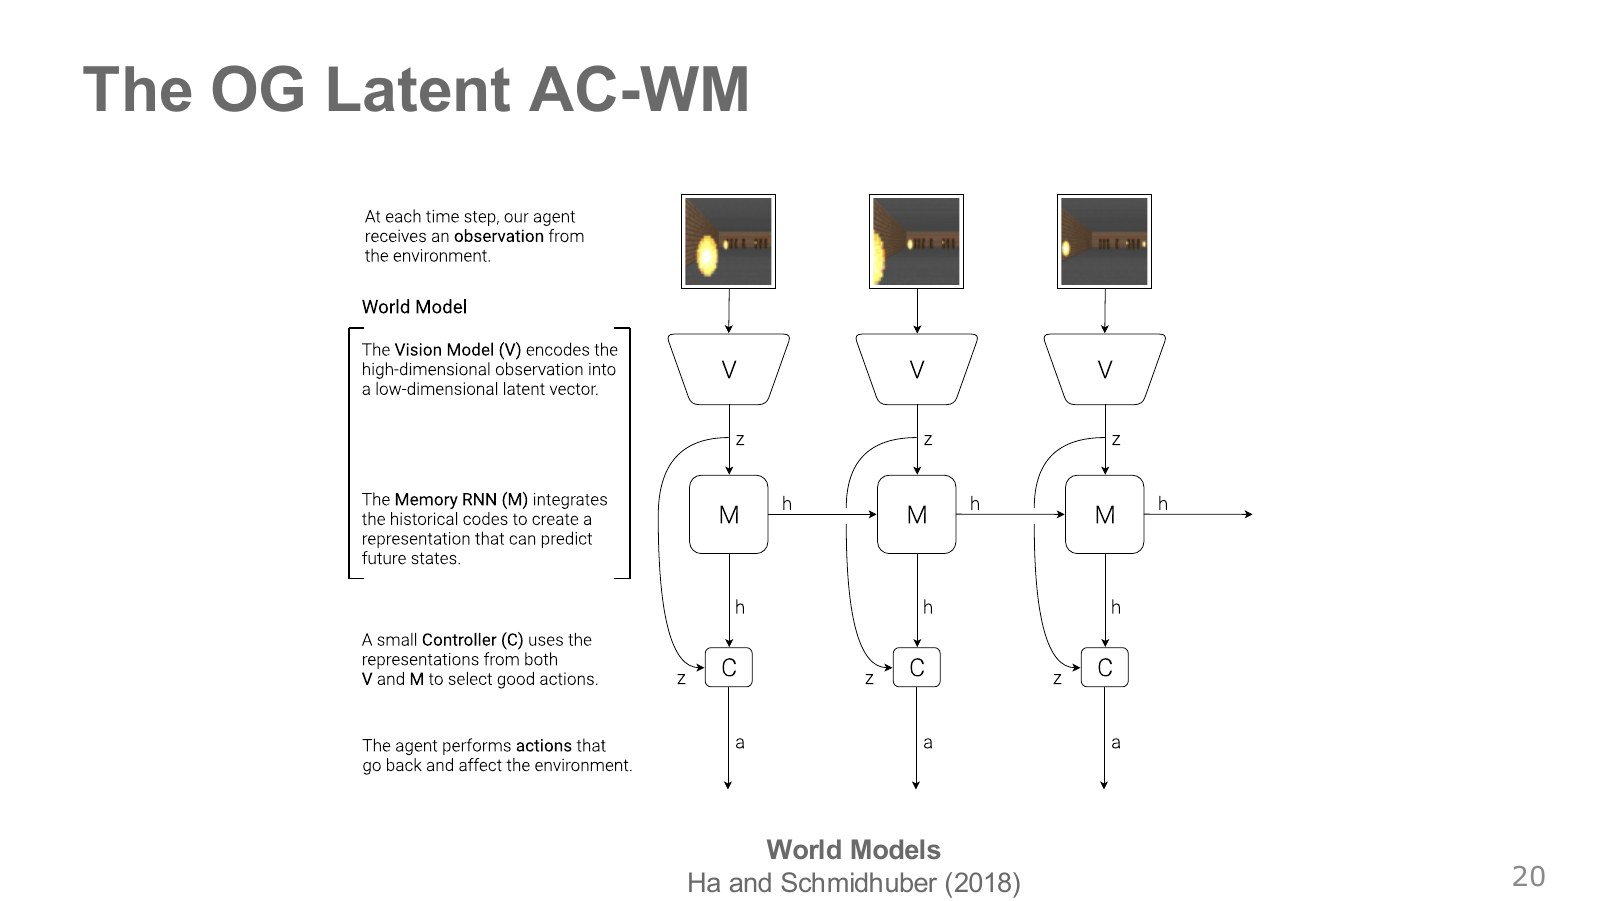
Ha와 Schmidhuber 그림에서 V는 현재 프레임을 압축하고 M은 이전 장면과 행동을 기억한다. C는 지금 본 것과 기억을 함께 읽어 행동을 선택한다. 도로 굽이가 화면에서 사라져도 직전에 어느 쪽으로 꺾였는지 기억하면 조향에 활용할 수 있다. Ha와 Schmidhuber, World Models
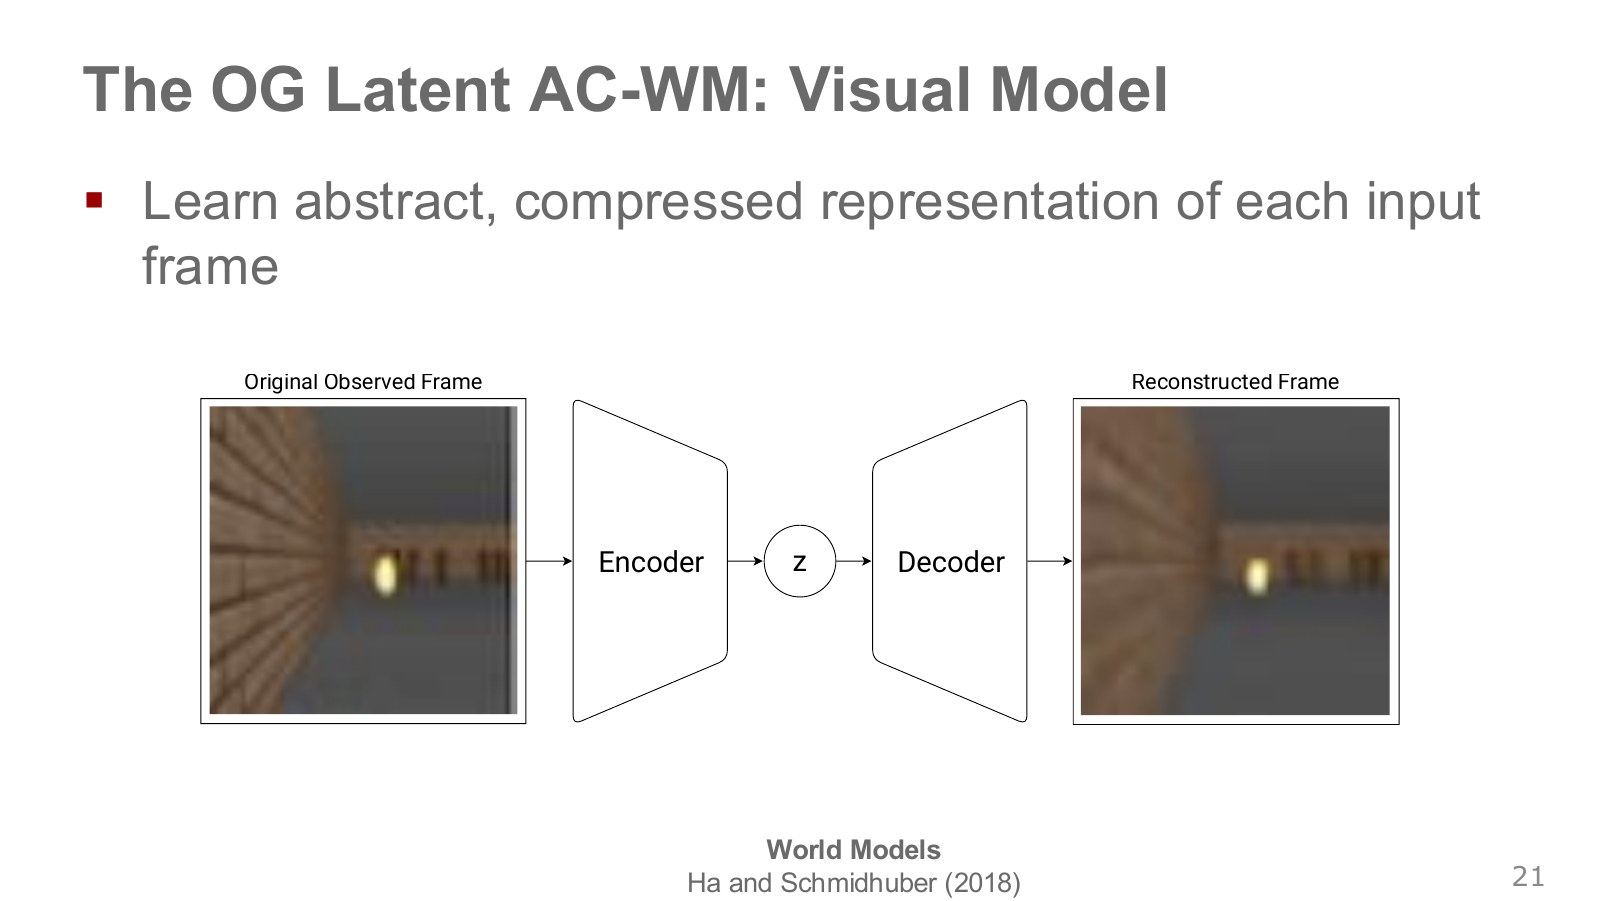
왼쪽 게임 화면을 VAE 인코더로 압축하고 디코더로 다시 그린 것이 오른쪽이다. 복도와 밝은 물체는 남지만 표면 무늬가 흐려진다. 벽을 피하는 과제에서는 충분할 수 있고, 벽의 작은 표지판이 목적지라면 문제가 된다. 재구성 품질과 행동에 필요한 정보의 보존을 따로 평가할 이유다.
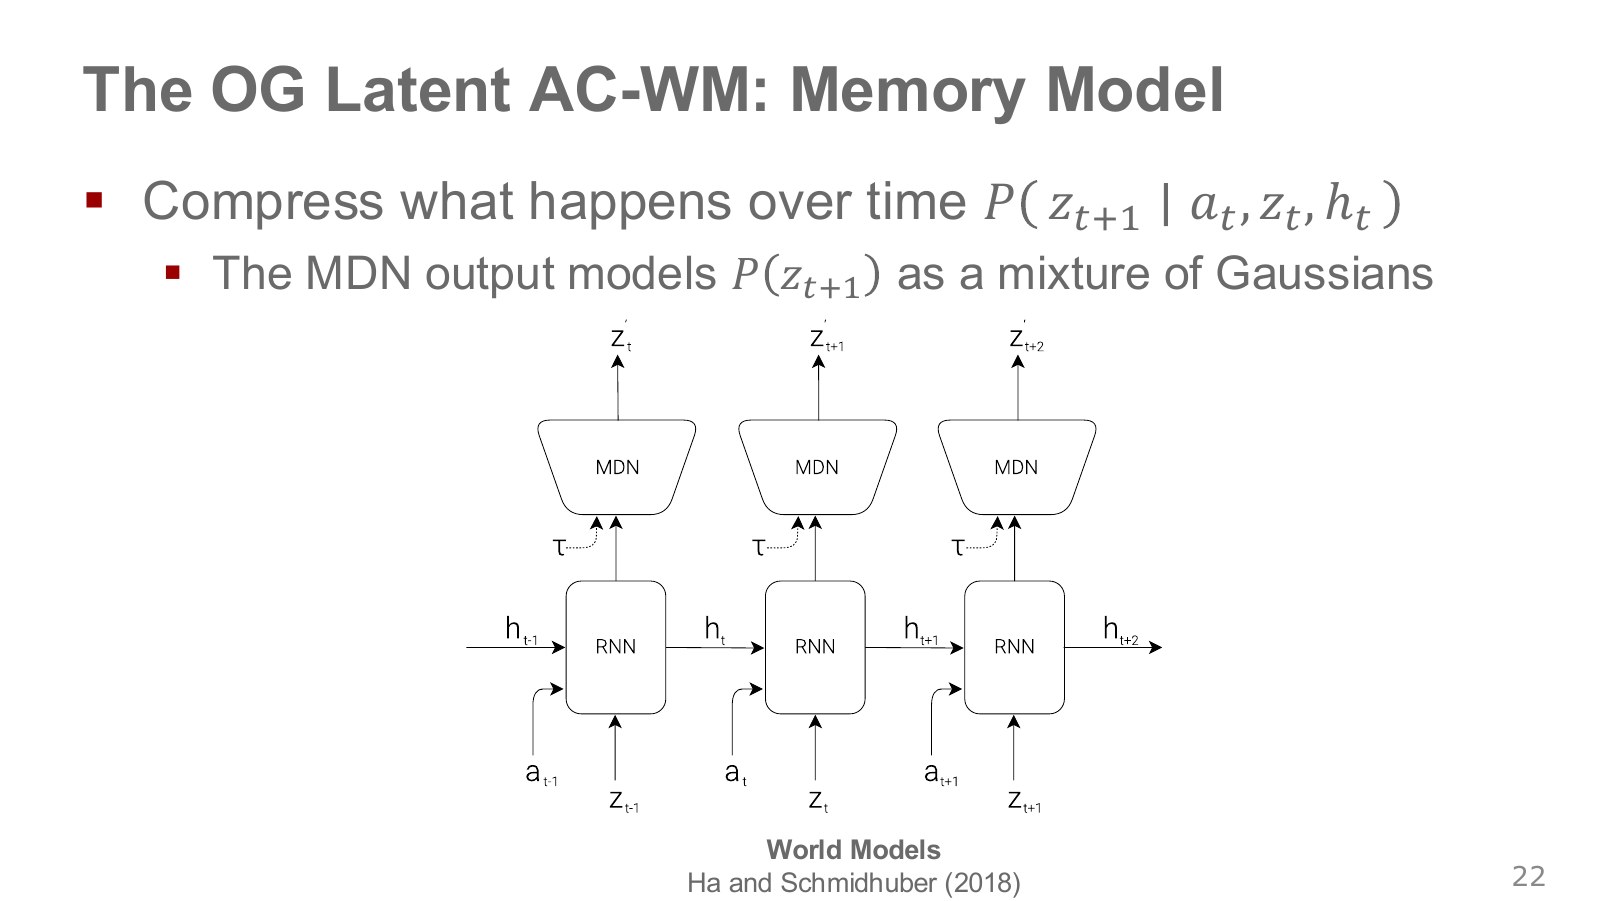
그림의 RNN은 기억을 다음 시점으로 넘긴다. 위쪽 혼합 밀도망(MDN)은 다음 잠재값의 분포를 여러 가우시안 성분으로 표현한다. 공이 장애물의 양쪽 중 하나로 튀는데 평균만 예측하면 장애물 한가운데로 들어가는 결과를 낼 수 있다. 두 위치 주변의 가능성을 각각 남기면 양쪽 미래를 따로 평가할 수 있다.
기호 뜻과 계산 과정 자세히 보기 여러 미래를 섞어 표현하는 혼합 분포
이 식을 말로 읽으면
가능한 미래 주변에 여러 종 모양의 분포를 놓고 각 성분에 다른 비중을 주어 전체 예측 분포를 만든다.
기호 하나씩 이해하기
- 다음 장면의 잠재 벡터
- 성분의 혼합 비중
- 성분의 중심
- 성분 내부의 퍼짐과 방향
계산을 따라가는 순서
- 현재 장면과 행동, 기억을 네트워크에 넣으면 성분별 중심과 퍼짐, 비중을 얻는다.
- 예측을 한 번 샘플링할 때 먼저 비중에 따라 성분을 고른 뒤 그 성분 안에서 값을 뽑는다.
작은 예시로 확인하기
왼쪽 튕김의 비중이 0.7, 오른쪽의 비중이 0.3이라면 성분 선택을 많이 반복할수록 약 70%가 왼쪽 성분에서 나온다.
식을 이해하기 위한 설명용 예시입니다.
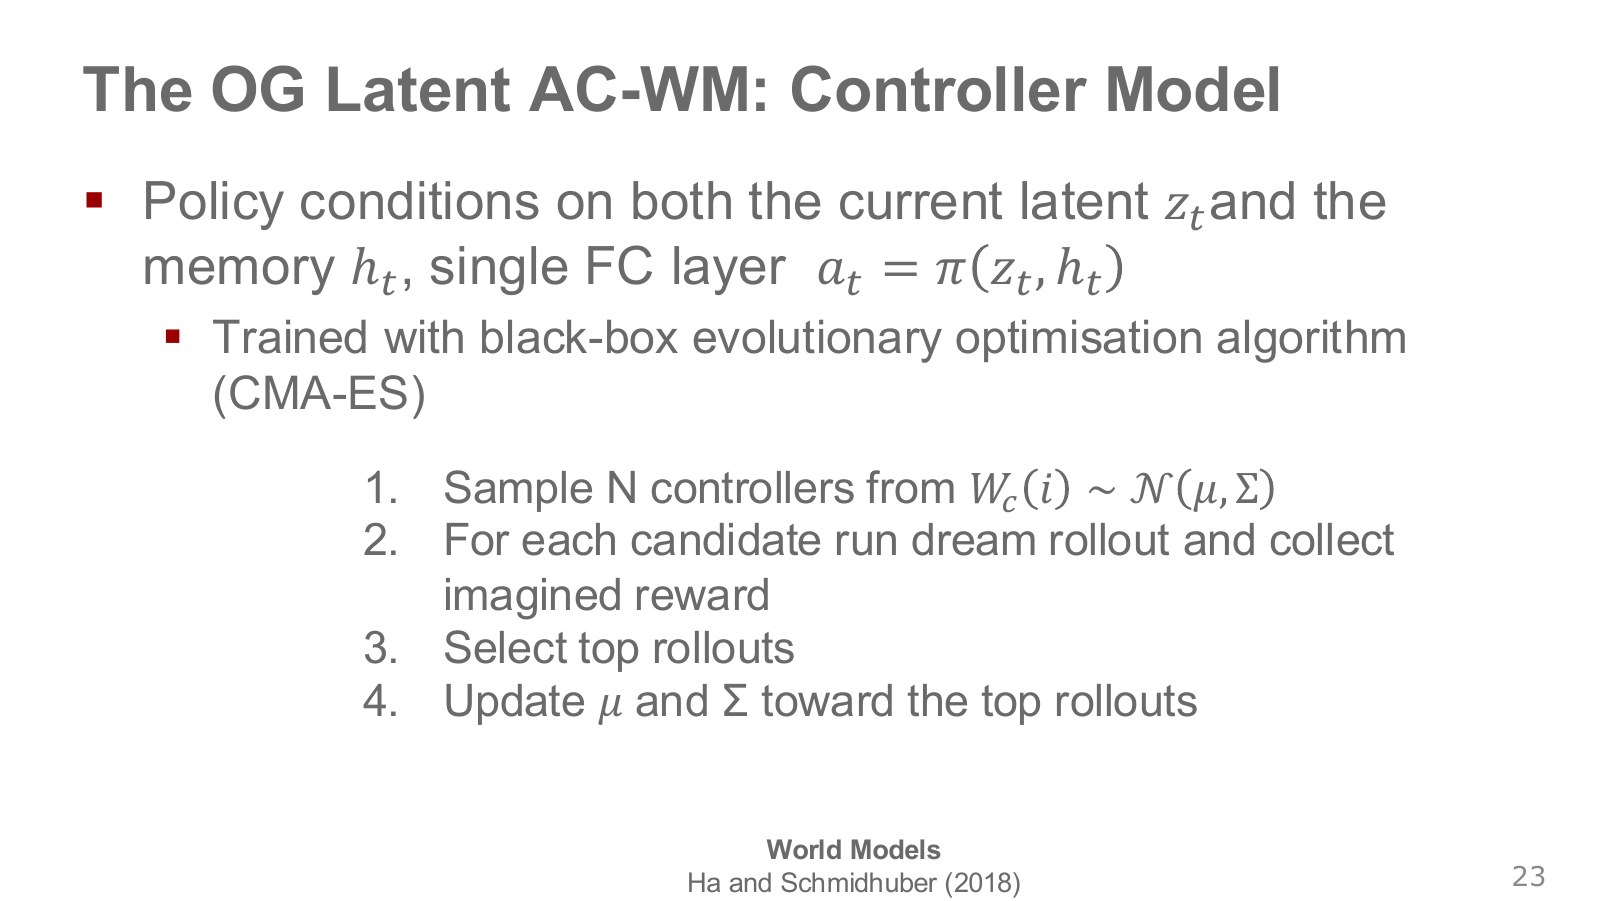
CMA-ES는 여러 제어기 가중치를 뽑아 각 제어기로 에피소드를 실행하고, 높은 보상을 얻은 후보가 다음 세대에 더 자주 나오도록 평균과 공분산을 고친다. P018의 CEM과 비슷하게 후보를 평가하지만, 여기서 최적화하는 것은 지금 당장 실행할 명령열이 아니라 여러 장면에서 계속 쓸 제어기 가중치다. 원 논문에서는 과제에 따라 원래 환경과 학습된 꿈의 환경을 달리 사용했다.
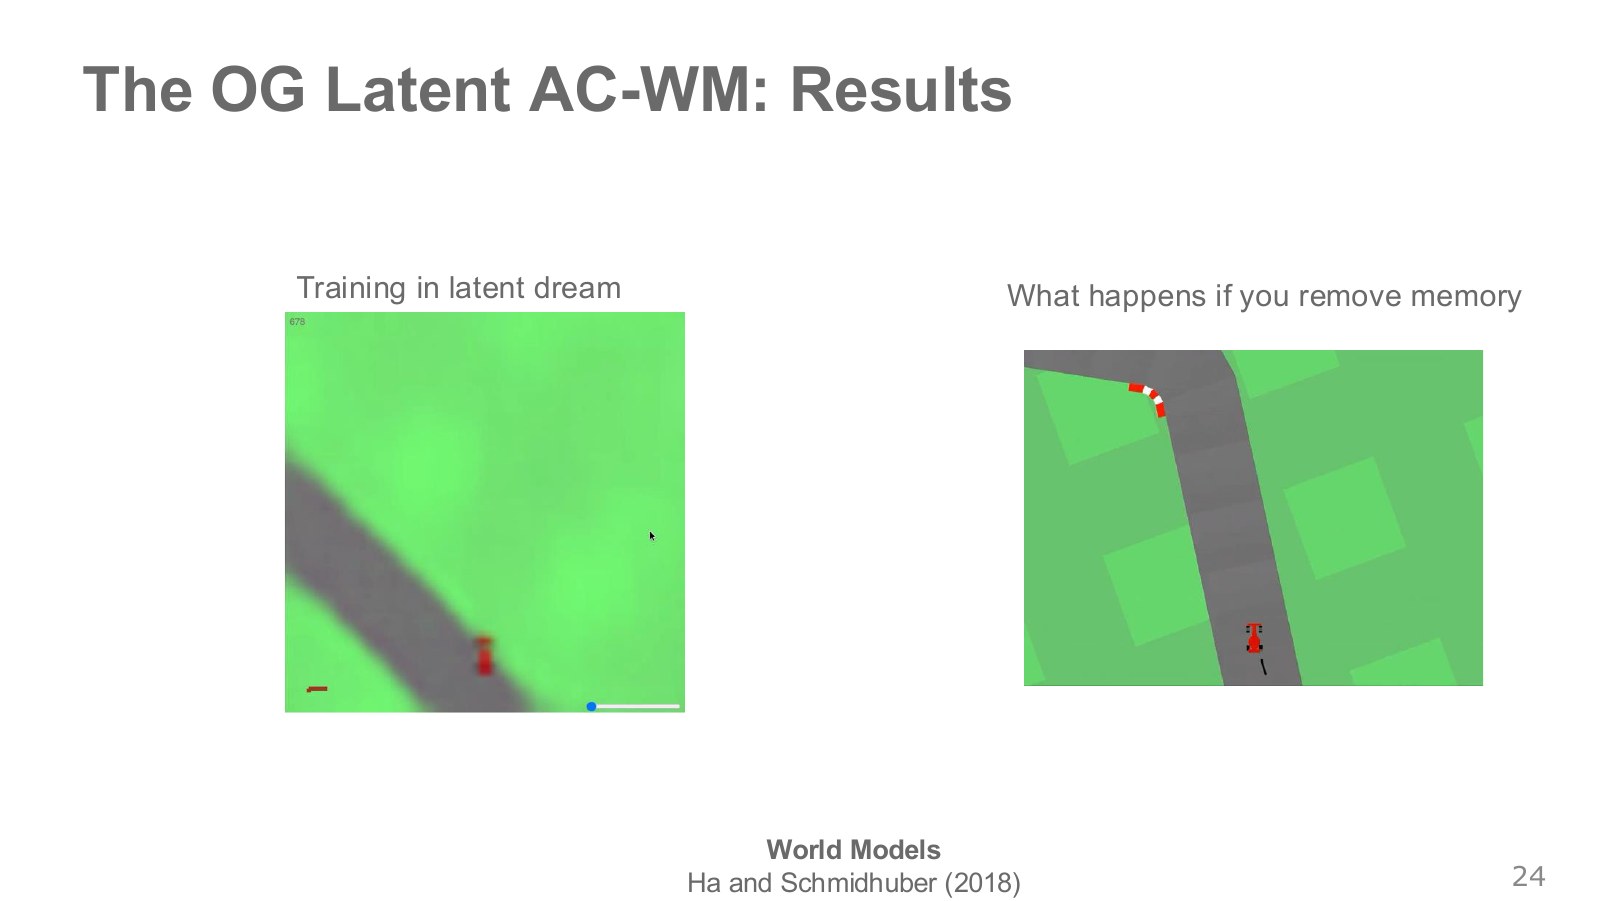
오른쪽 그림은 기억의 역할을 묻는다. 현재 화면에 도로가 일부만 보여도 이전 프레임에서 곡선이 어떻게 이어졌는지 알면 조향할 근거가 생긴다. 모듈 하나를 빼고 같은 과제에서 성능이 얼마나 바뀌는지 보는 절차가 제거 실험이다. 이 사례의 결과를 기억이 충분히 들어 있는 관측을 쓰는 다른 로봇까지 그대로 일반화할 필요는 없다.
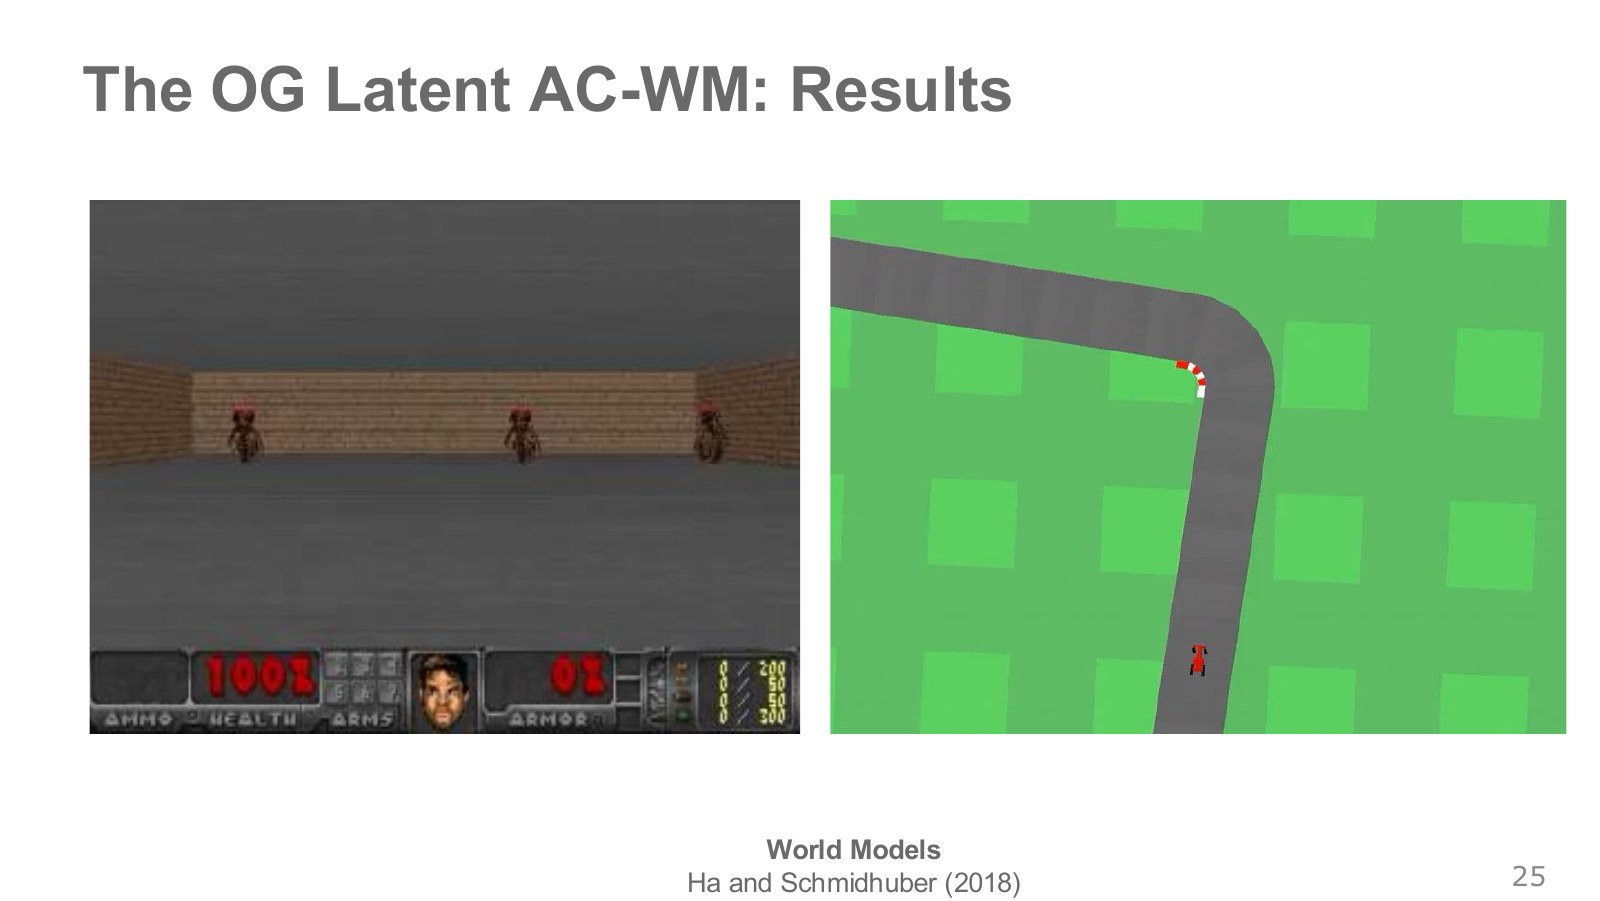
왼쪽은 Doom 계열 환경, 오른쪽은 CarRacing이다. 원 논문의 Doom 실험에서는 학습된 환경 안에서 제어기를 훈련한 뒤 원래 게임에서 검증했다. 꿈속 모델이 놓친 허점을 정책이 이용하면 원래 게임에서는 성능이 떨어질 수 있다. 저자들이 꿈 환경의 샘플링 온도를 바꾼 이유도 예측을 지나치게 확신하는 상황을 피하기 위해서였다.
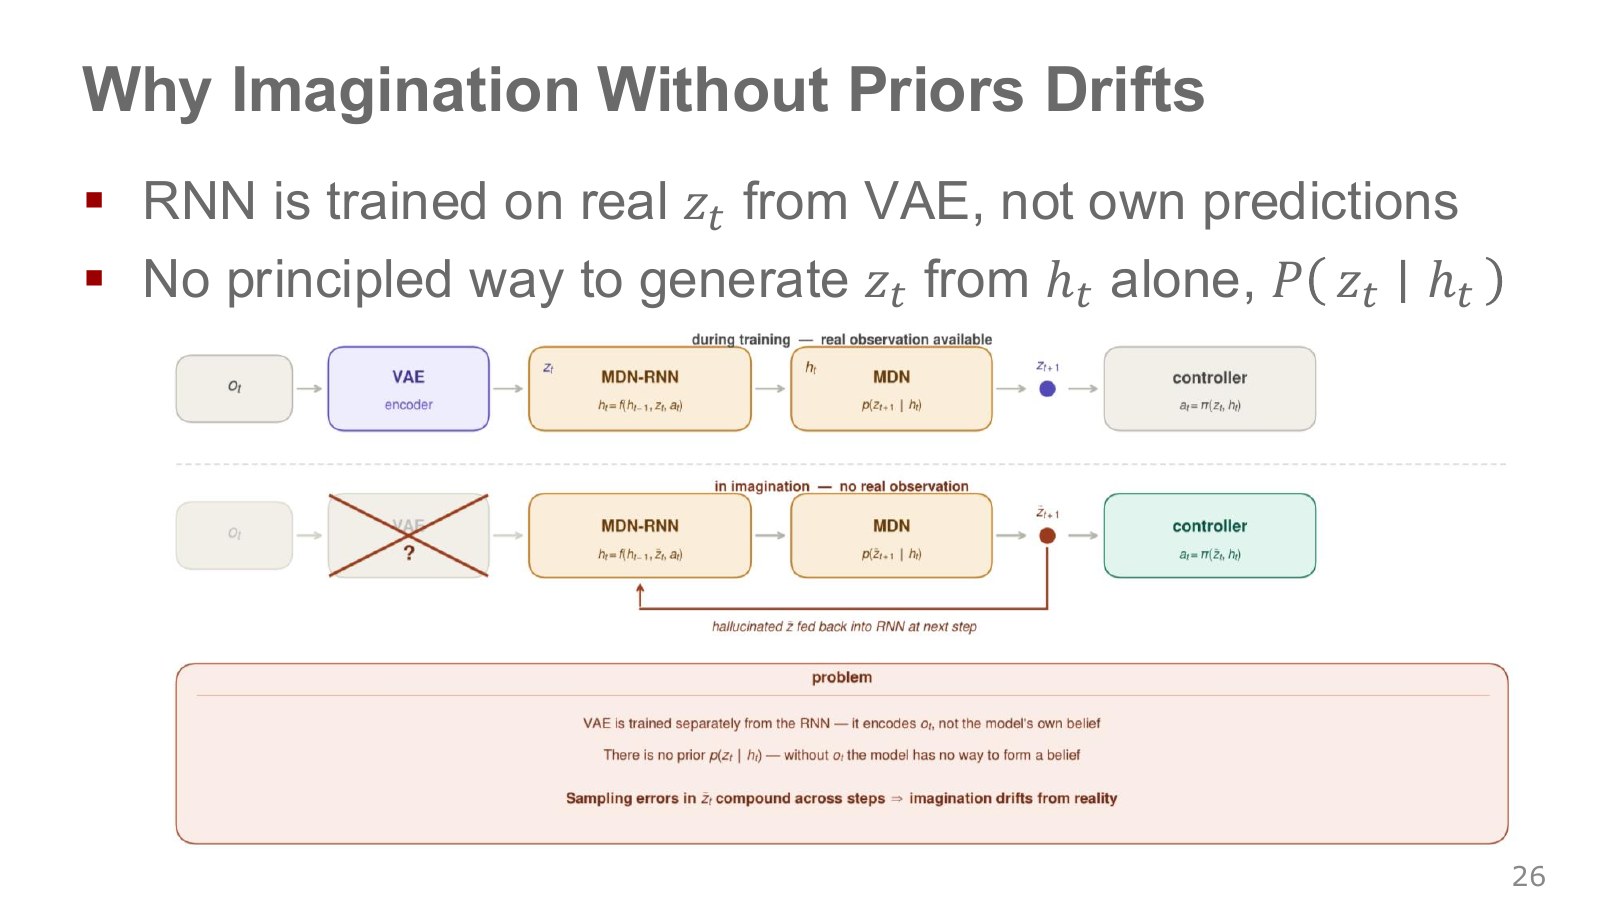
위쪽에는 실제 화면을 인코딩한 값이 들어가지만 아래쪽은 모델이 스스로 만든 잠재값을 다시 입력한다. 예측된 컵이 조금 옆으로 틀어졌다면 다음 예측은 그 틀어진 위치에서 시작한다. 기존 MDN-RNN에도 미래를 샘플링할 전이 분포는 있다. 다음 장의 RSSM은 같은 시점에 대해 관측 전의 추정과 관측을 반영한 추정을 별도로 두고 함께 학습한다.
#PlaNet과 Dreamer
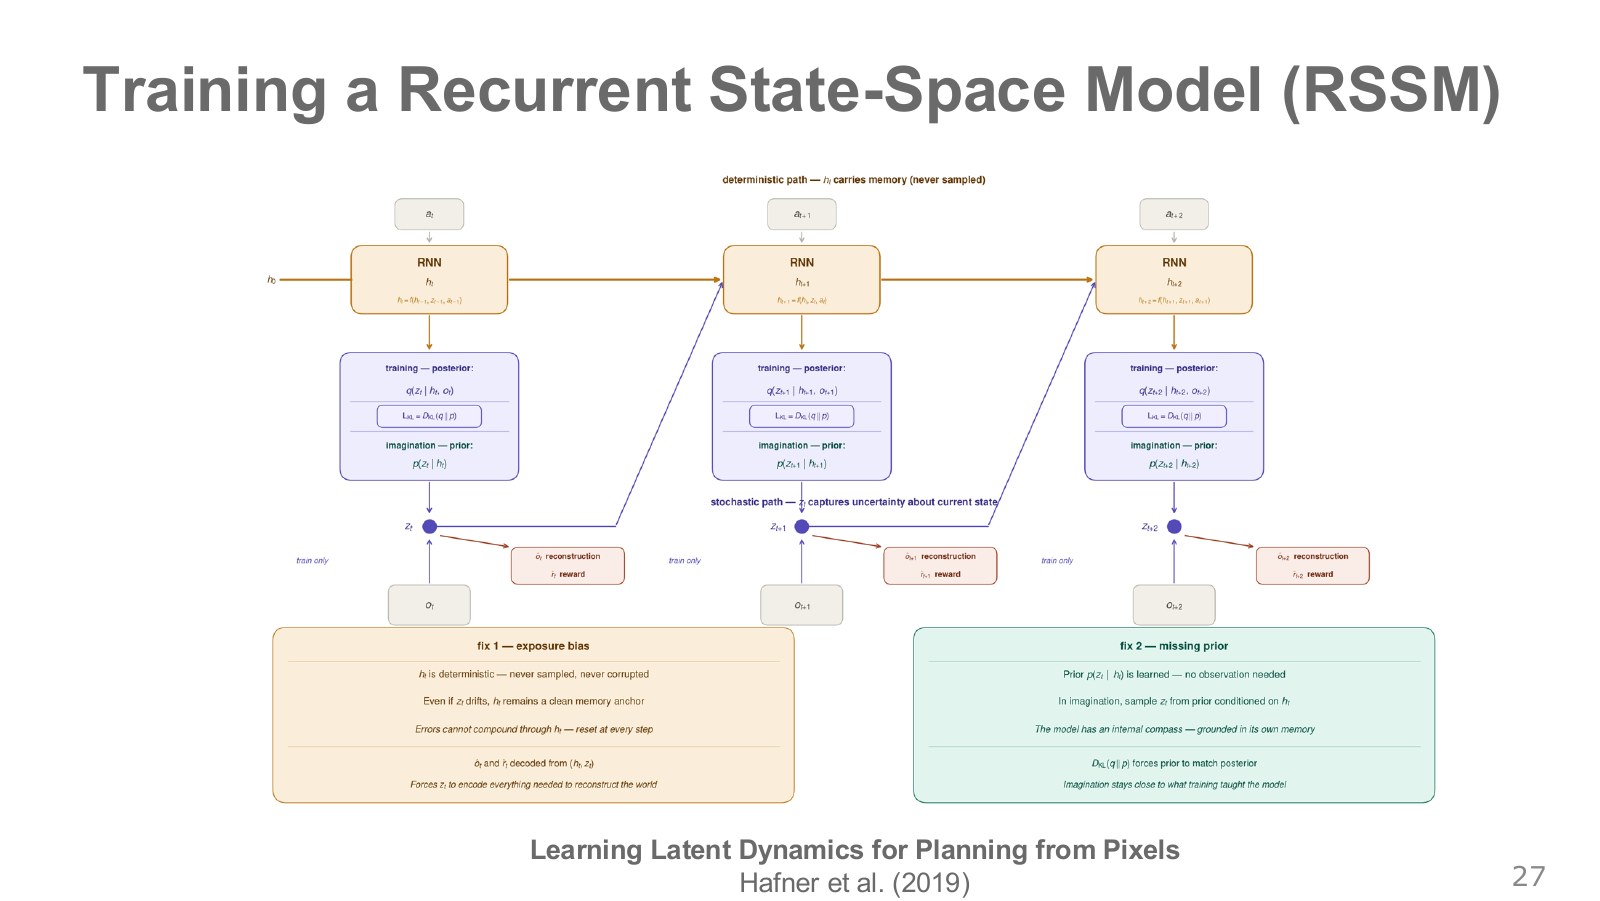
주황색 RNN 경로는 이전 잠재 상태와 행동에서 얻은 기억을 이어 간다. 녹색 사전분포는 새 사진을 보기 전의 추정이고, 보라색 사후분포는 새 사진을 본 뒤의 추정이다. 예를 들어 손을 내밀었다는 기억만으로는 집기가 성공했는지 모른다. 사진에서 컵이 들린 것을 확인하면 새 추정에 그 정보가 들어간다. 학습 중에는 두 분포를 가깝게 하고 관측과 보상도 설명하도록 훈련한다. Hafner 외, PlaNet
기호 뜻과 계산 과정 자세히 보기 RSSM의 예측과 관측 보정
이 식을 말로 읽으면
먼저 이전 상태와 행동으로 기억을 갱신한다. 그 기억으로 미래를 예상하고, 실제 관측이 들어오면 잠재 상태 추정을 보정한다.
기호 하나씩 이해하기
- 반복해서 전달되는 기억
- 확률적으로 표현하는 잠재 상태
- 새 센서 관측
- 각각 사전분포와 사후분포
계산을 따라가는 순서
- 직전 프레임과 닫기 명령을 바탕으로 컵을 잡았을 가능성을 예측한다.
- 새 프레임에서 컵이 그대로 탁자에 있으면 관측을 받은 쪽 추정이 그 정보를 반영한다.
작은 예시로 확인하기
예를 들어 예측이 잡기 성공에 0.7을 줬더라도 사진에 빈 손이 또렷하면 보정한 추정은 성공에 더 작은 값을 줄 수 있다.
식을 이해하기 위한 설명용 예시입니다.
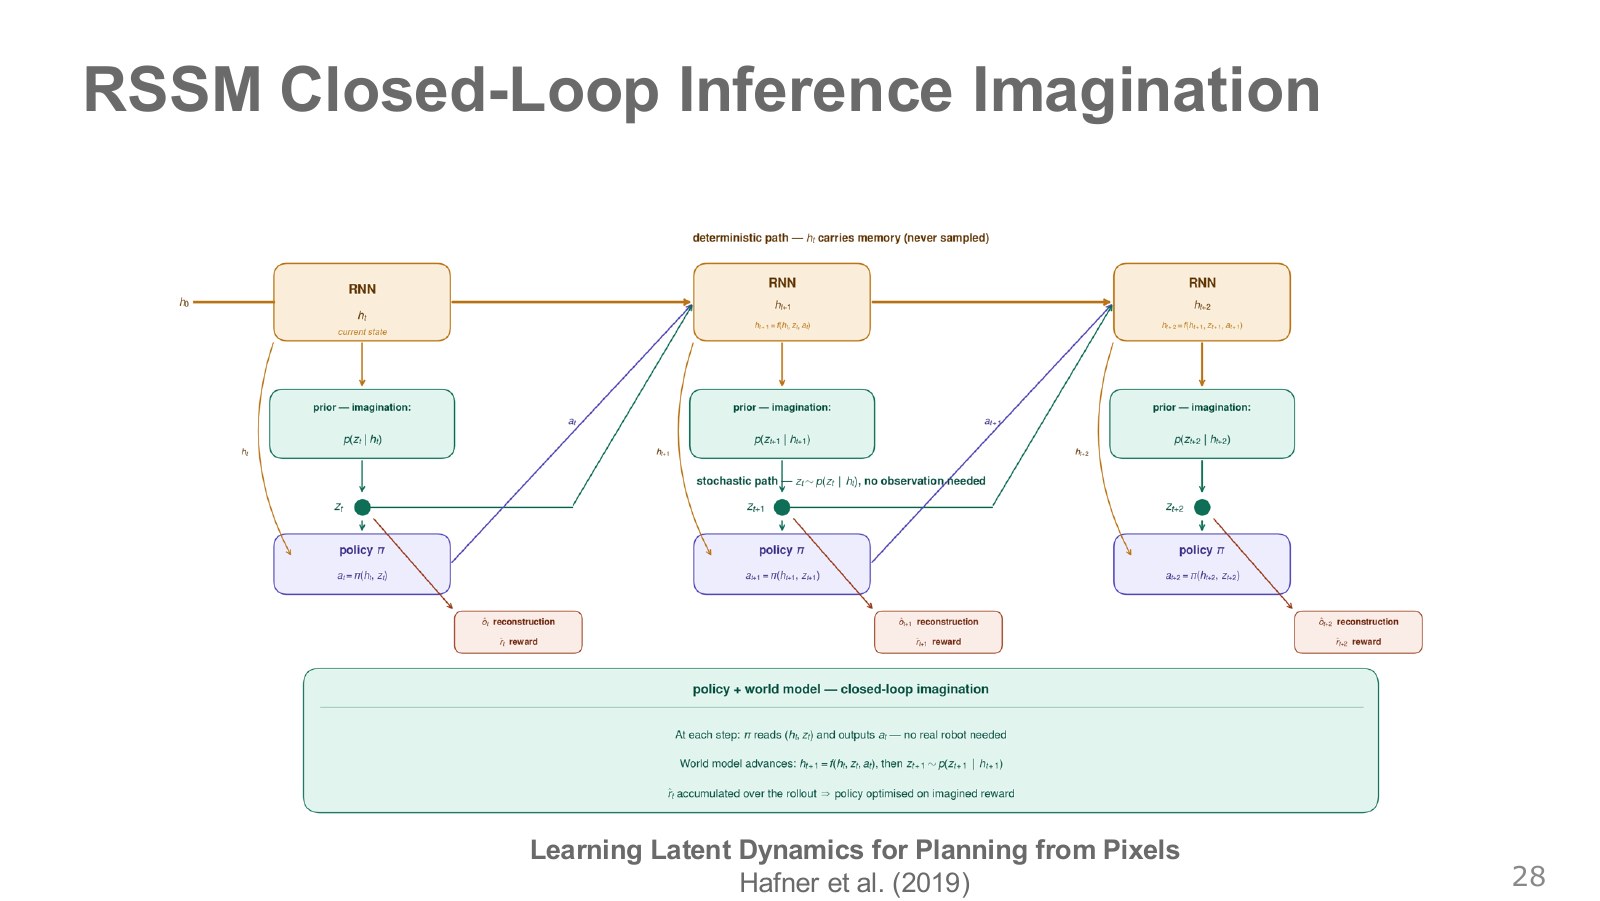
그림 아래에서 정책은 예측 상태를 읽어 다음 행동을 고르고, 모델은 그 행동으로 다시 상태를 예측한다. 이 고리는 상상 안에서 닫혀 있다. 새 실제 관측이 없으므로 미래 잠재값은 사전분포에서 뽑는다. 실제 로봇을 움직일 때는 센서 관측이 들어와 상태 추정을 고친다. 두 고리를 구분하면 RSSM을 써도 긴 상상에서 오차가 남는 이유를 이해할 수 있다.
RSSM의 은닉 상태는 정해진 함수로 갱신하지만, 입력으로 받은 이전 잠재값에는 이미 표집과 예측 오차가 들어 있다. 학습 때 실제 관측을 본 사후분포를 기준으로 사전분포를 맞추면 상상과 관측 사이의 차이를 줄일 수 있다. 긴 상상 경로는 여전히 실제 관측으로 재확인할 필요가 있다.
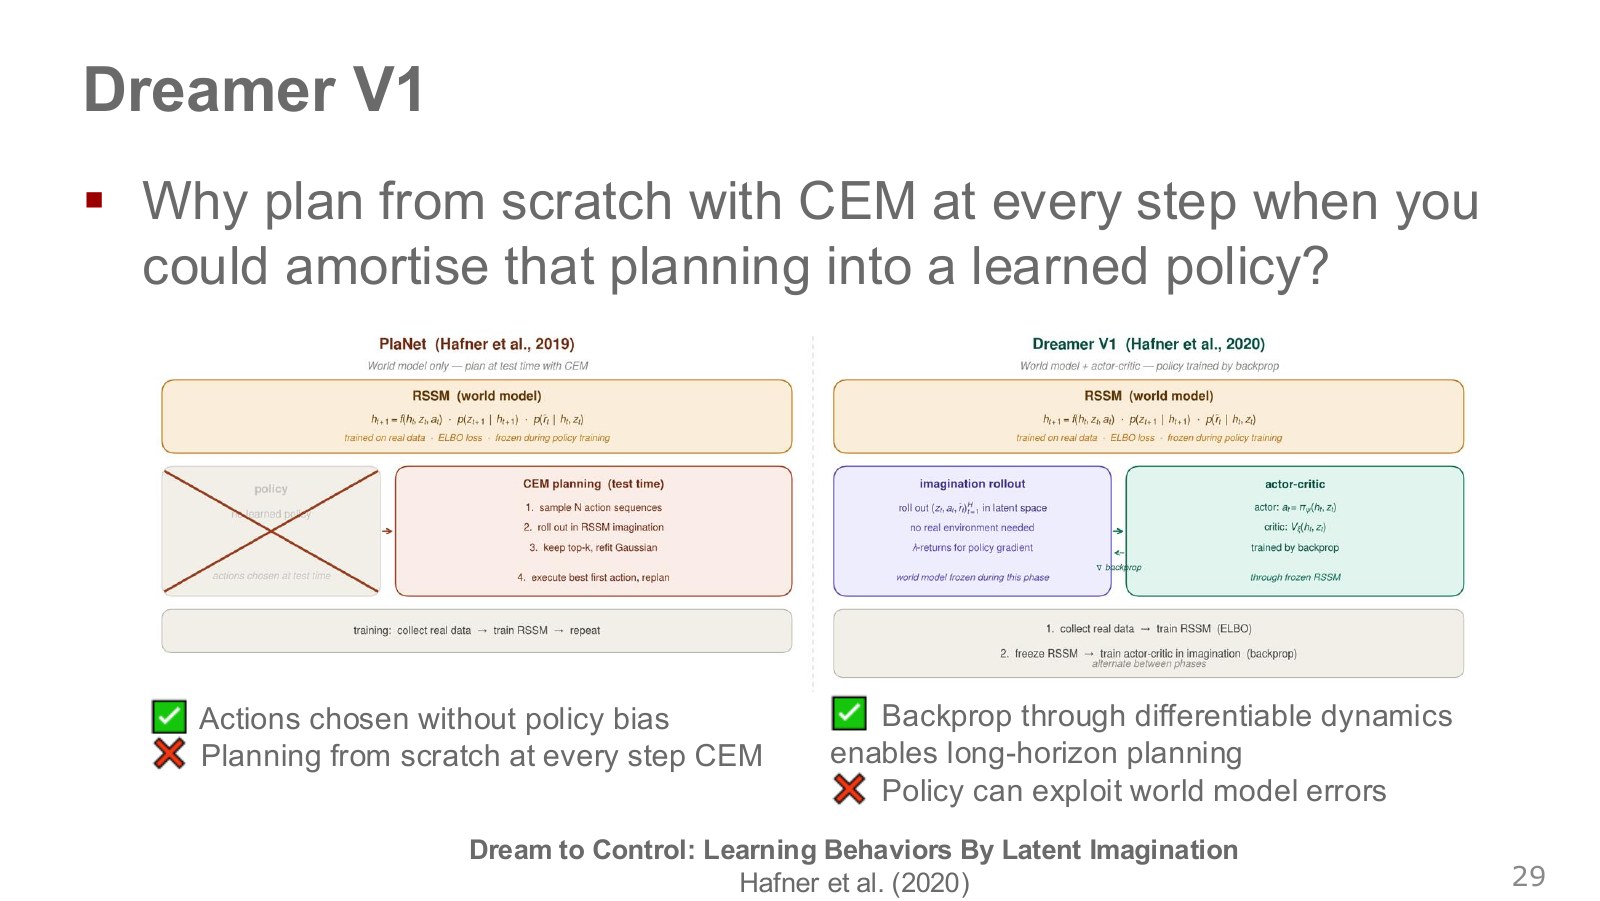
왼쪽 PlaNet은 새 관측마다 잠재공간에서 CEM으로 행동열을 찾는다. 오른쪽 Dreamer는 상상 궤적으로 행동을 내는 actor와 앞으로의 보상을 평가하는 critic을 학습한다. 실행 때 actor를 호출하면 매 순간 후보를 처음부터 많이 뽑는 비용을 줄일 수 있다. 대신 actor가 모델이 과대평가하는 행동을 배울 수 있으므로 실제 환경에서의 검증이 중요하다. Hafner 외, Dream to Control
기호 뜻과 계산 과정 자세히 보기 상상 궤적의 할인 보상
이 식을 말로 읽으면
모델이 예측한 보상에 미래일수록 작은 가중치를 곱하고 더한다. 이 식은 유한 상상 구간의 기본 계산을 보여 준다.
기호 하나씩 이해하기
- 모델이 예측한 보상
- 할인율
- 상상할 단계 수
- 예측 할인 보상의 합
계산을 따라가는 순서
- actor가 고른 행동으로 월드 모델을 여러 번 진행하고 단계별 보상을 얻는다.
- 이 합은 정책 후보를 비교하는 직관을 준다. 실제 Dreamer는 구간 밖의 가치 추정도 이용한다.
작은 예시로 확인하기
할인율이 0.9이고 지금 보상이 1, 다음 보상이 2면 합은 1+0.9×2로 2.8이다.
식을 이해하기 위한 설명용 예시입니다.
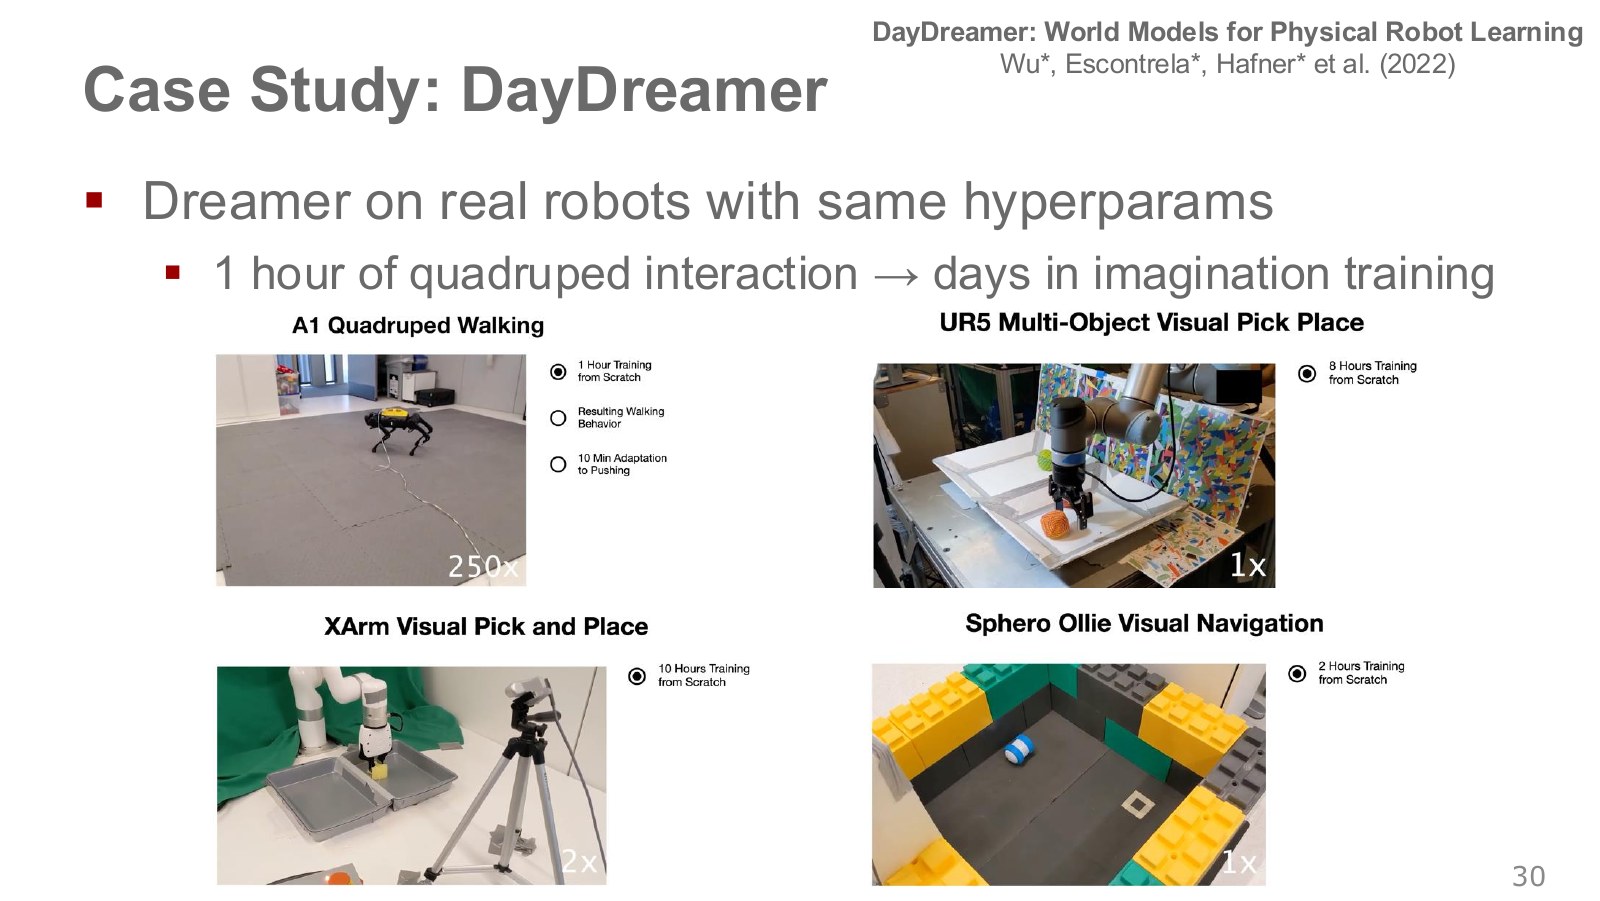
네 사진은 A1 사족 보행, UR5 물체 옮기기, XArm 집기, Sphero 주행이다. 사족 로봇이 약 한 시간의 실제 경험으로 일어서고 걷는 행동을 배운 사례와 팔의 조작 실험은 서로 다른 과제다. 물리 로봇에서는 모터 제어 주기와 학습 연산이 동시에 진행되어야 하므로 저자들은 데이터 수집과 학습을 비동기로 실행했다. Wu 외, DayDreamer
왼쪽 인물은 가상 도장에서 연습하고 오른쪽은 현실에 남아 있다. 월드 모델의 상상 훈련에서는 GPU가 과거 데이터로 배운 변화 규칙을 빠르게 되풀이한다. 가상 도장의 바닥이 현실보다 덜 미끄럽다면 그 안에서만 익힌 걸음걸이는 위험할 수 있다. 비유에서 중요한 점은 연습을 옮길 수 있다는 것과 연습 결과를 현실에서 확인해야 한다는 것이다.
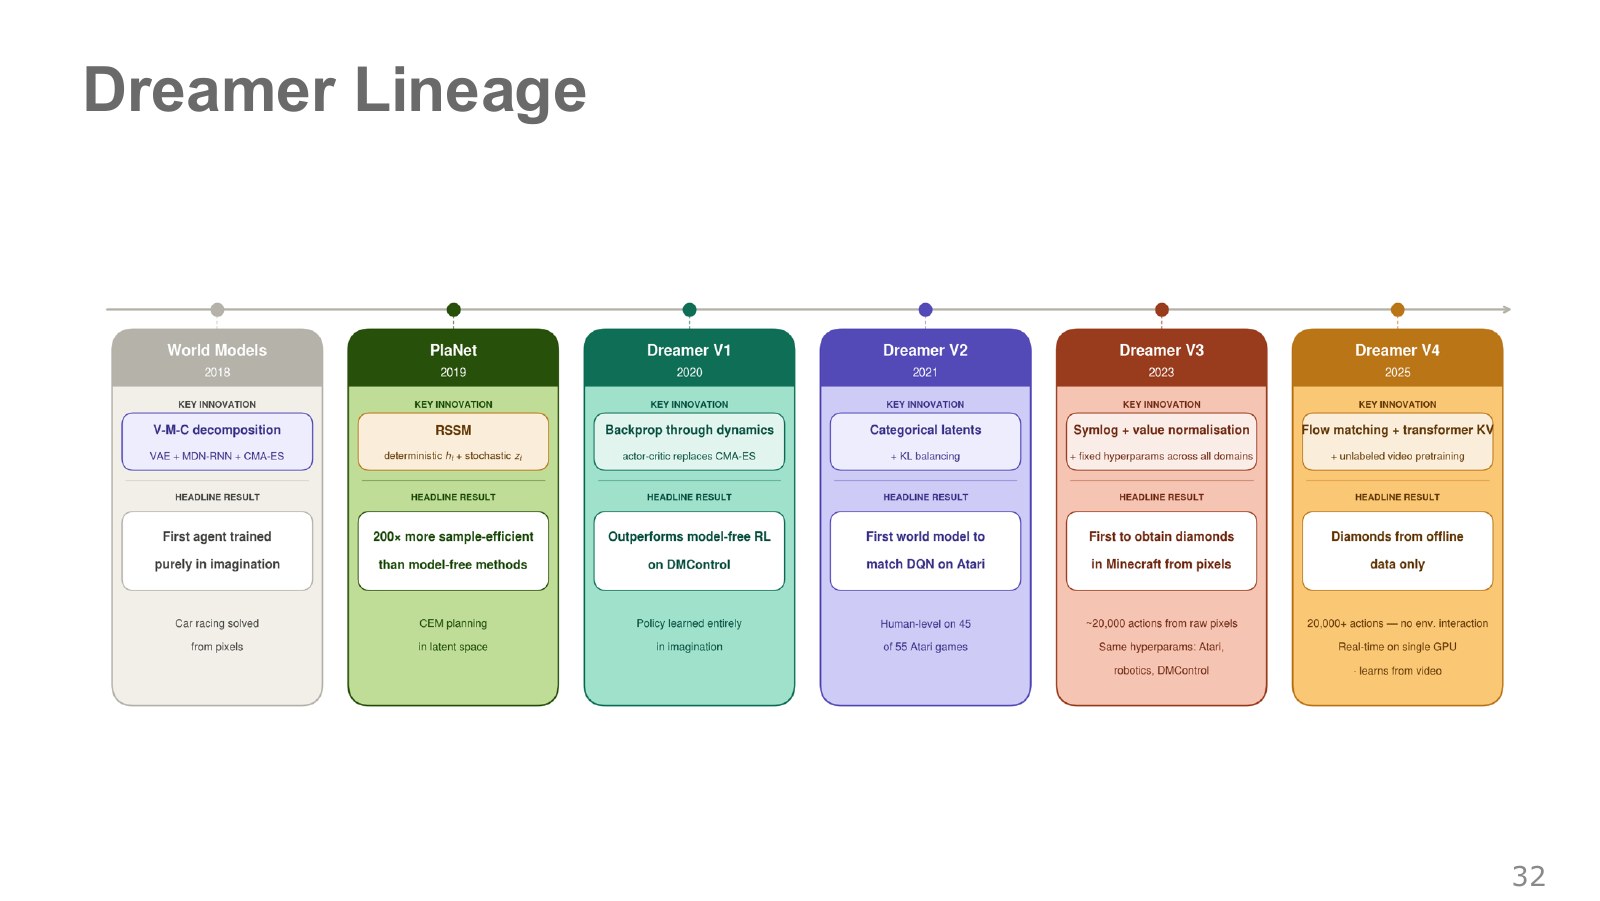
카드를 왼쪽부터 읽으면 압축과 기억을 분리한 V/M/C, RSSM에서 계획하는 PlaNet, 상상으로 정책을 학습하는 Dreamer V1, 범주형 잠재값을 쓰는 V2, 보상 규모가 다른 과제의 학습을 안정화하는 V3, 더 큰 영상 데이터로 확장한 V4가 이어진다. 뒤의 모델이 앞의 모델과 모든 벤치마크에서 같은 조건으로 겨룬 표는 아니므로, 카드의 성과는 각 논문의 과제와 함께 읽는다. Dreamer V2 · Dreamer V3
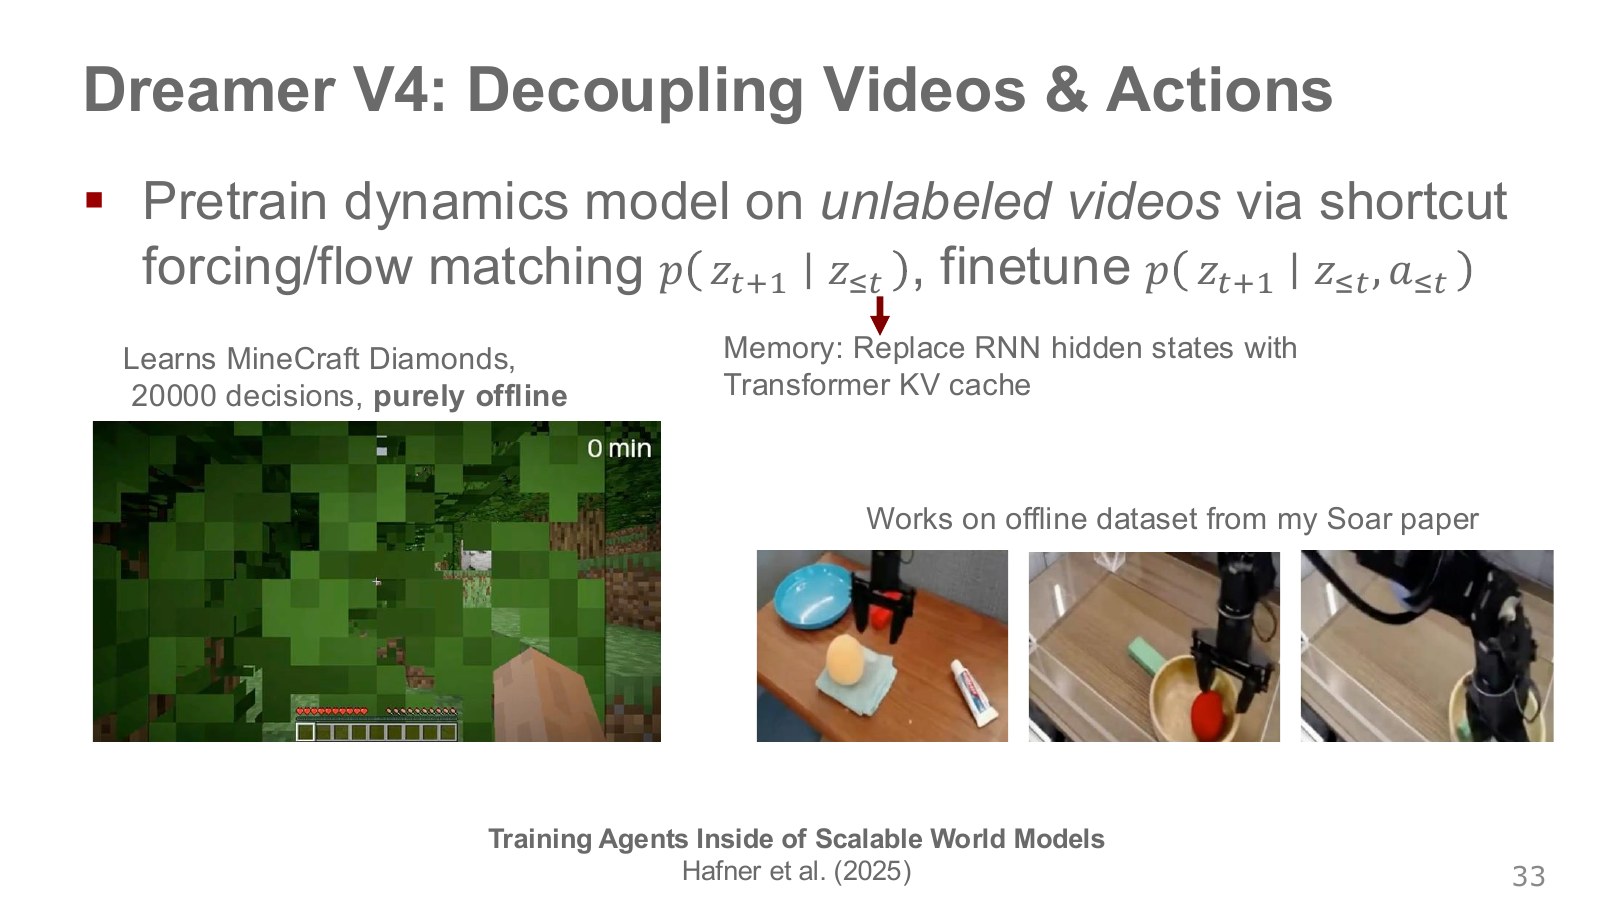
Minecraft 화면 왼쪽은 오프라인 데이터에서 배운 에이전트의 예다. 행동 기록이 없는 영상으로도 장면이 시간에 따라 어떻게 변하는지는 예습할 수 있다. 이후 행동이 기록된 데이터가 있어야 특정 명령이 어떤 변화를 만들었는지 구분할 수 있다. V4의 Minecraft 성과는 해당 데이터·행동 공간·평가 설정에 해당한다. 오른쪽 로봇 이미지는 강의에서 언급한 별도의 데이터 적용 사례다. Hafner 외, Dreamer V4
기호 뜻과 계산 과정 자세히 보기 행동 라벨 없이 예습하고 행동 조건을 추가한다
이 식을 말로 읽으면
처음에는 관찰한 영상의 이어질 모습을 예측하고, 다음 학습에서는 기록된 명령도 받아 그 명령에 따른 변화를 예측한다.
기호 하나씩 이해하기
- 현재까지의 영상 표현
- 현재까지의 행동 이력
- 두 학습 단계의 모델 파라미터
계산을 따라가는 순서
- 행동 라벨 없는 영상에서는 이미 나온 화면을 바탕으로 다음 화면을 맞힌다.
- 로봇 명령이 함께 기록된 자료로 적응시키면 같은 화면에서 서로 다른 명령을 주는 질문을 할 수 있다.
작은 예시로 확인하기
사람이 컵을 옮기는 영상은 이동의 단서를 준다. 로봇 손을 오른쪽 2cm 움직이는 명령의 의미는 명령이 기록된 로봇 데이터로 연결한다.
식을 이해하기 위한 설명용 예시입니다.
#대규모 영상과 로봇 행동
게임 안에서는 자주 만나는 물체와 카메라 움직임이 제한적이다. 인터넷 영상은 더 다양한 움직임과 물체를 보여 주지만 촬영 자세와 배경, 영상의 목적도 제각각이다. 큰 영상 모델을 활용하는 발상은 여기서 나온다. 로봇이 쓸 표현을 만들려면 인터넷 영상에서 익힌 패턴을 로봇 시점과 조작 데이터에 연결해야 한다.
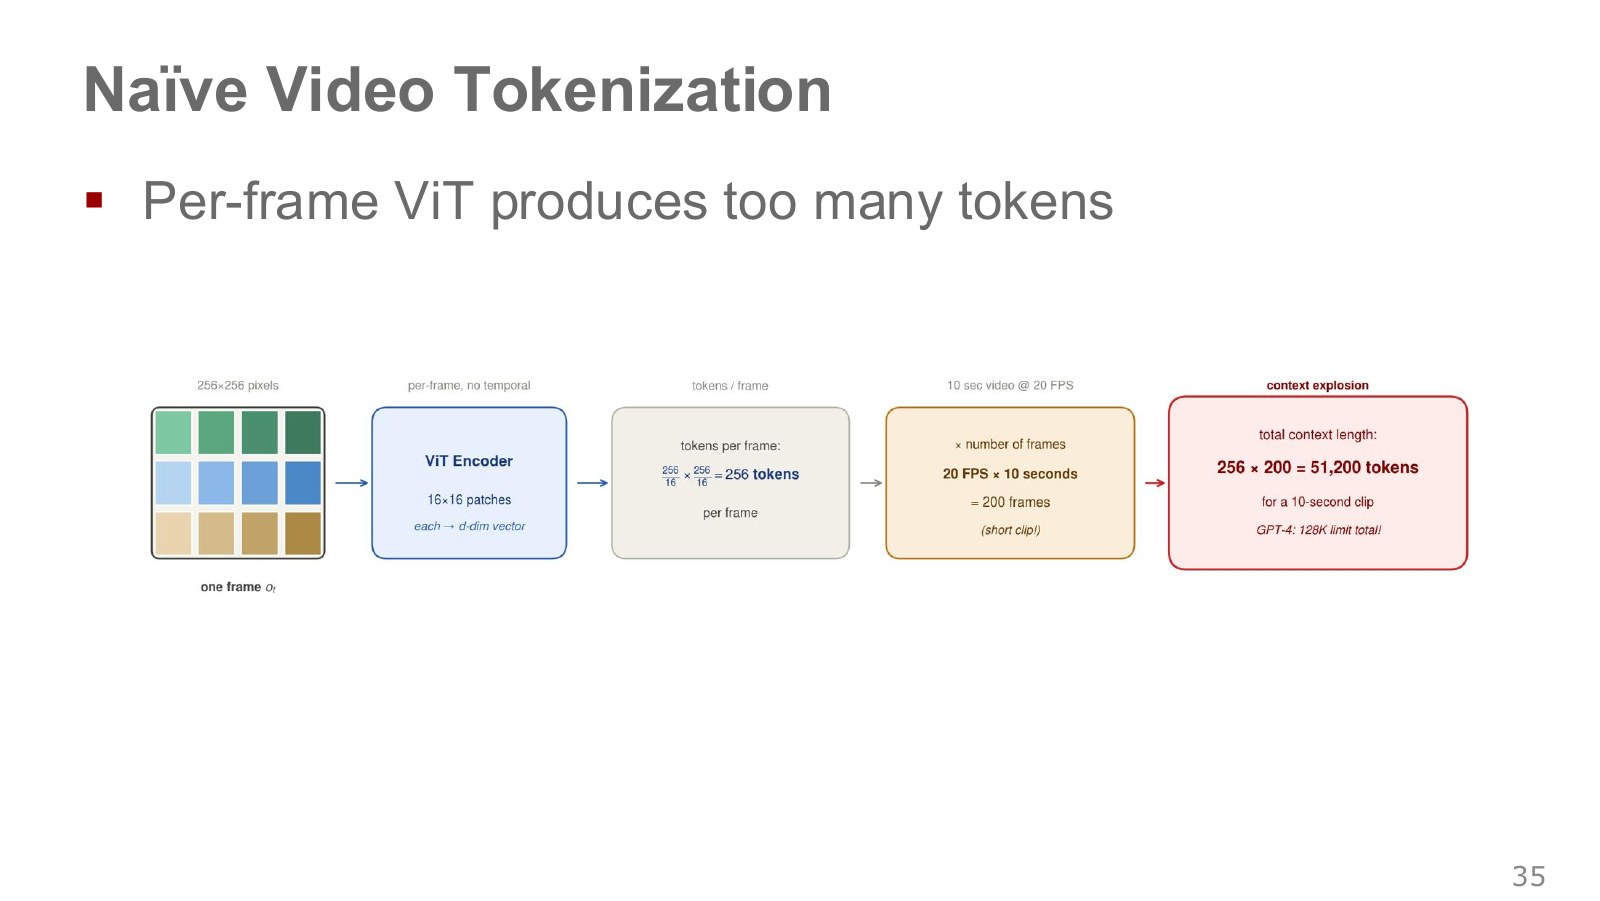
왼쪽 격자의 한 칸은 한 패치다. 256×256 픽셀을 16×16 픽셀 패치로 나누면 가로와 세로에 각각 16칸이 생긴다. 이를 초당 20장씩 10초 동안 각각 세면 256개 패치가 200번 반복된다. 모든 토큰 쌍을 비교하는 일반적인 밀집 attention에서는 토큰 수가 두 배일 때 비교할 쌍이 약 네 배로 늘어난다.
Stanford CS231n의 ViT 설명에서는 각 이미지 패치를 벡터 하나로 투영하고, 그 벡터들을 Transformer에 입력한다. 영상에서 같은 절차를 프레임마다 반복하면 아래 식처럼 이미지 한 장의 패치 수에 프레임 수가 곱해진다. Justin Johnson · CS231n 1:04:44 · 강의 슬라이드
기호 뜻과 계산 과정 자세히 보기 패치 수와 프레임 수를 곱한다
이 식을 말로 읽으면
가로와 세로에 놓이는 패치 수를 곱한 다음 프레임 수를 곱해 영상 전체의 토큰 수를 센다.
기호 하나씩 이해하기
- 전체 토큰 수
- 프레임 한 변의 픽셀 수
- 패치 한 변의 픽셀 수
- 초당 프레임 수와 영상 길이의 곱
계산을 따라가는 순서
- 한 프레임을 가로 16칸, 세로 16칸으로 나누면 256개 패치가 생긴다.
- 초당 20장의 영상 10초에는 200장이 있으므로 256을 200번 더한 값과 같다.
작은 예시로 확인하기
같은 해상도와 프레임 속도에서 5초면 25,600개다. 프레임 묶기나 추가 토큰을 쓰는 경우 실제 입력 길이는 달라진다.
식을 이해하기 위한 설명용 예시입니다.
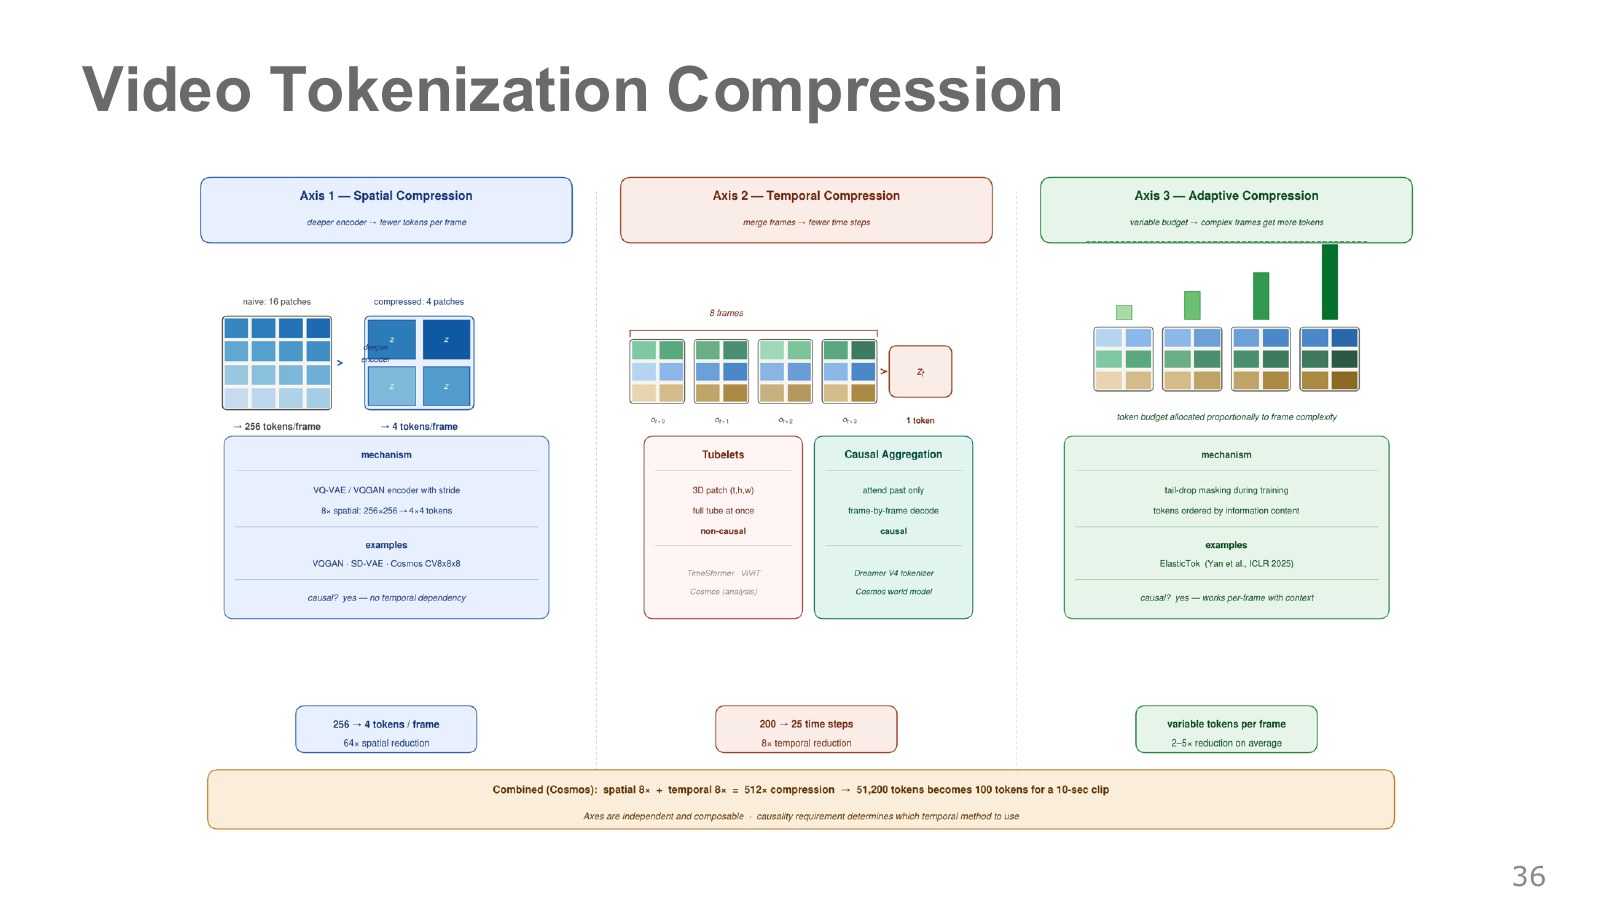
첫 열은 한 프레임의 인접 위치를 묶는 공간 압축이다. 둘째는 여러 프레임에 걸친 변화를 한 단위로 묶는 시간 압축이다. 셋째는 장면에 따라 토큰 수를 다르게 배정하는 적응 압축이다. 멈춰 있는 벽은 강하게 압축해도 되지만, 손가락이 컵 손잡이에 처음 닿는 장면을 너무 거칠게 줄이면 접촉 시점을 잃는다. 슬라이드의 압축 수치는 원리를 보여 주는 예다.
시간 압축에 미래 프레임을 쓰면 이미 녹화한 영상을 묶을 때는 편리하다. 실시간 제어에서 지금 명령을 내릴 때는 미래 프레임이 아직 없으므로, 현재까지의 프레임으로 토큰을 만들어야 한다. 정적인 배경과 빠른 접촉 장면에 같은 토큰 수를 배정할 필요도 없다.
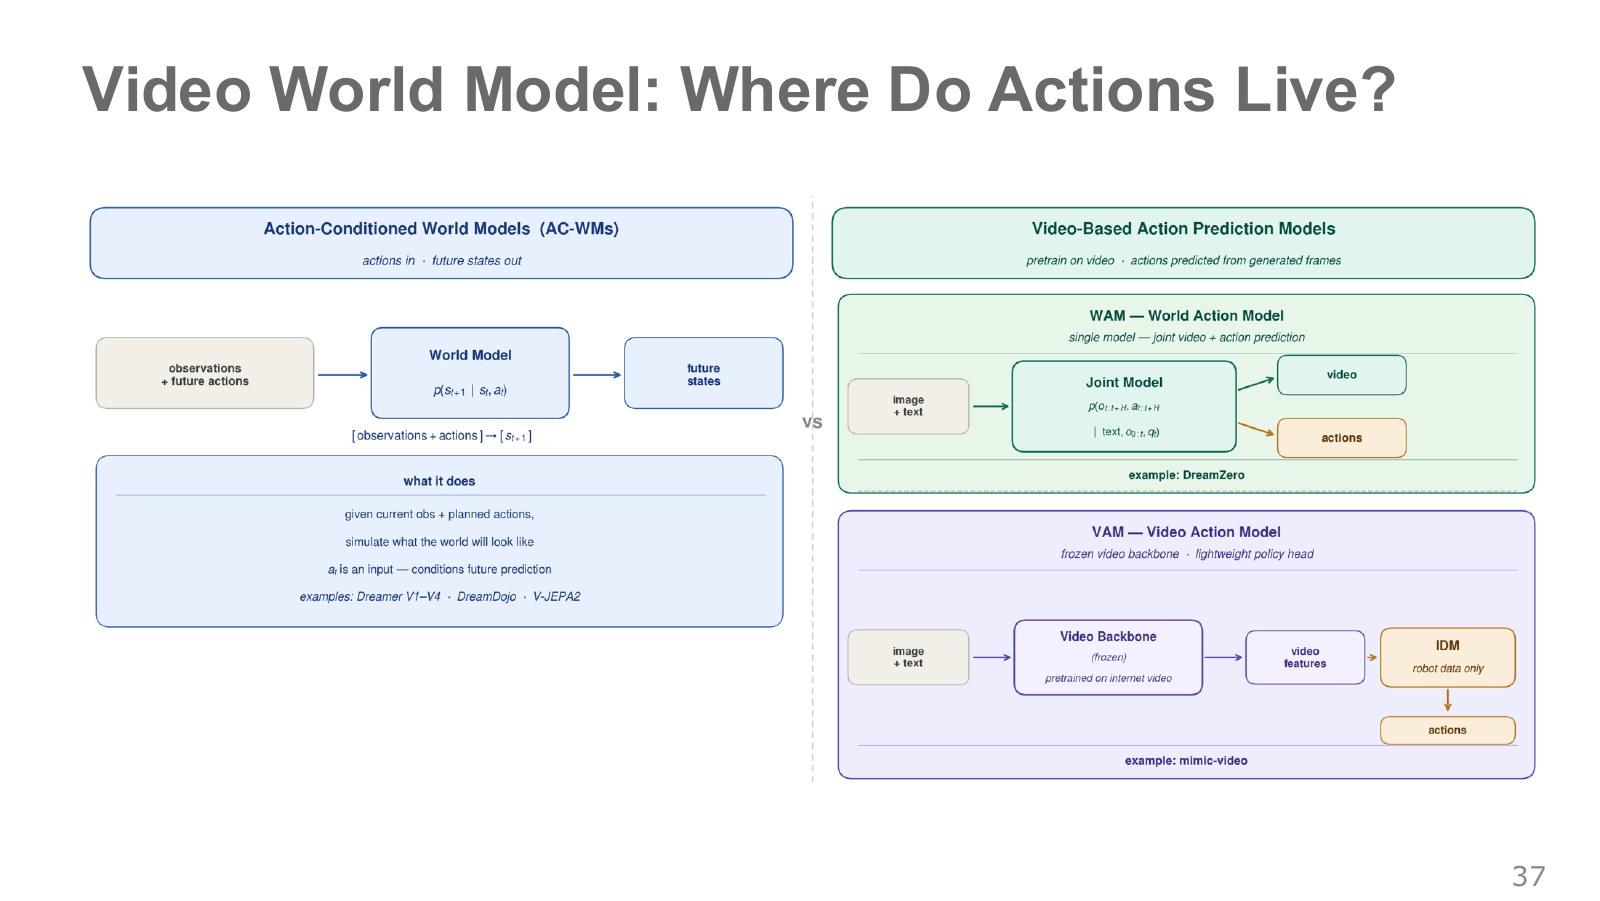
왼쪽 행동 조건부 모델은 “오른쪽으로 2cm 밀면?”이라는 질문에 미래 상태를 답한다. 오른쪽 위 DreamZero는 미래 영상과 행동을 함께 내고, 아래 mimic-video는 영상 모델의 중간 표현에서 행동 디코더가 명령을 읽는다. 모두 영상을 쓰지만, 후보 행동을 미리 주어야 하는지와 실행 명령이 어디서 나오는지가 다르다.
영상 모델은 사전학습 단계에서 물체가 구르거나 손을 따라 이동하는 장면을 많이 볼 수 있다. 실행 중에는 그 학습에서 얻은 특징만 꺼내 쓸 수도 있다. 그래서 영상 학습에 든 비용과 모터에 명령을 한 번 내리는 데 걸리는 시간을 분리해 비교해야 한다.
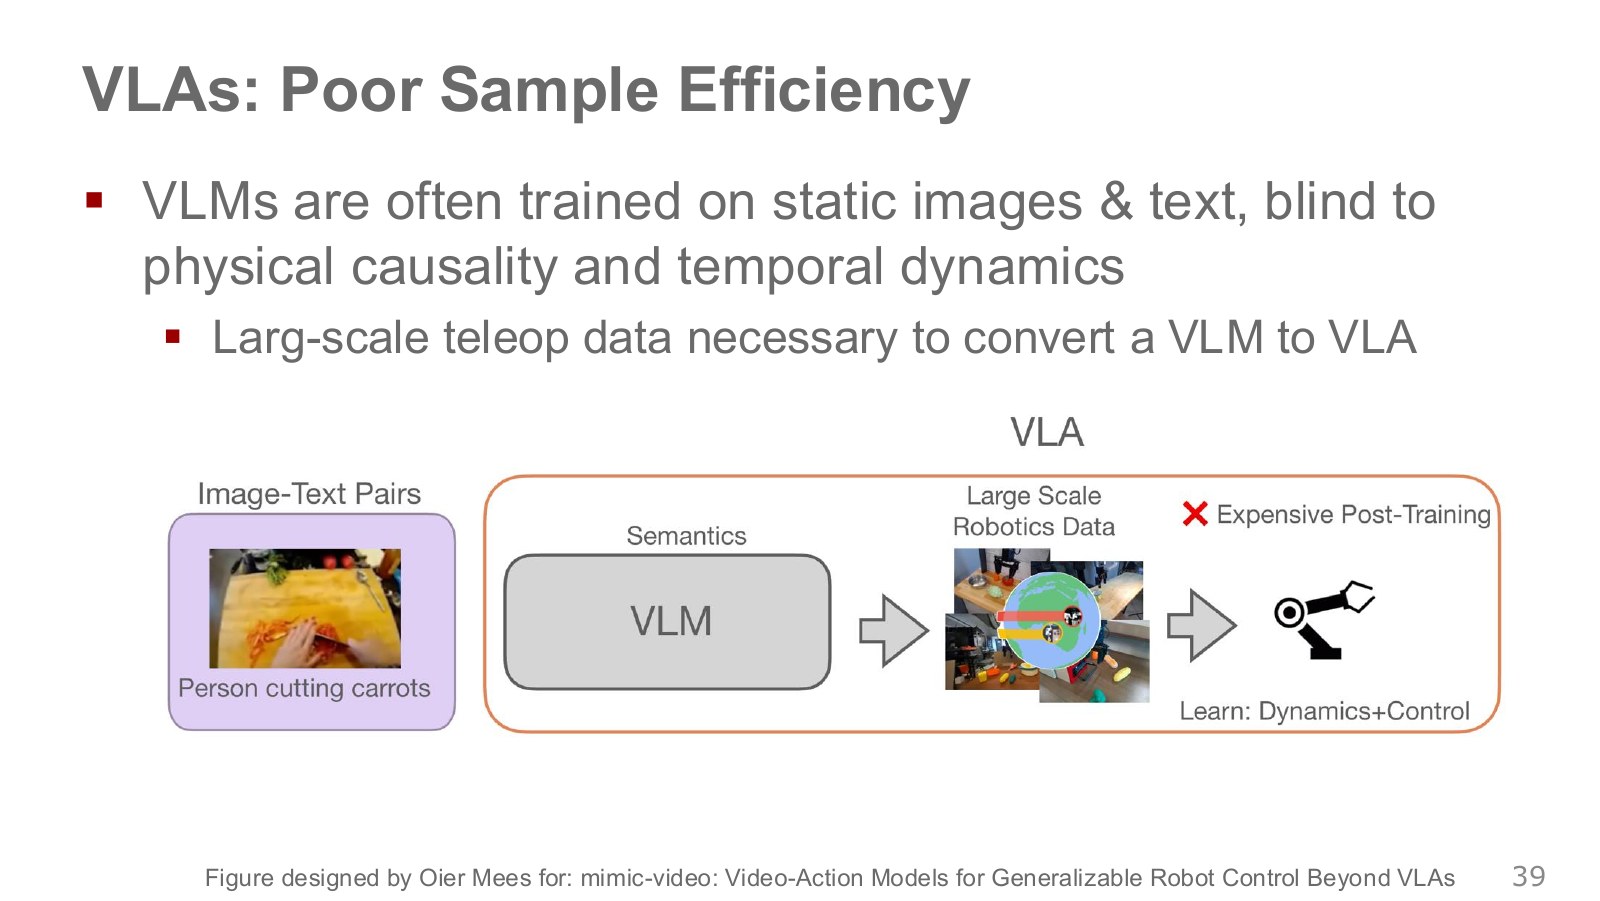
당근 그림과 설명으로 칼과 당근을 알아볼 수 있다. 칼을 누르는 순서와 방향, 잘린 조각이 어디로 움직일지는 연속 프레임이 더 직접적인 단서를 준다. 강의의 VLA 비교는 정지 이미지·텍스트 위주로 사전학습한 VLM을 로봇으로 옮기는 설정이다. 이미 영상이나 로봇 경험을 포함한 모델이라면 어떤 학습 자료를 썼는지부터 살펴봐야 한다.
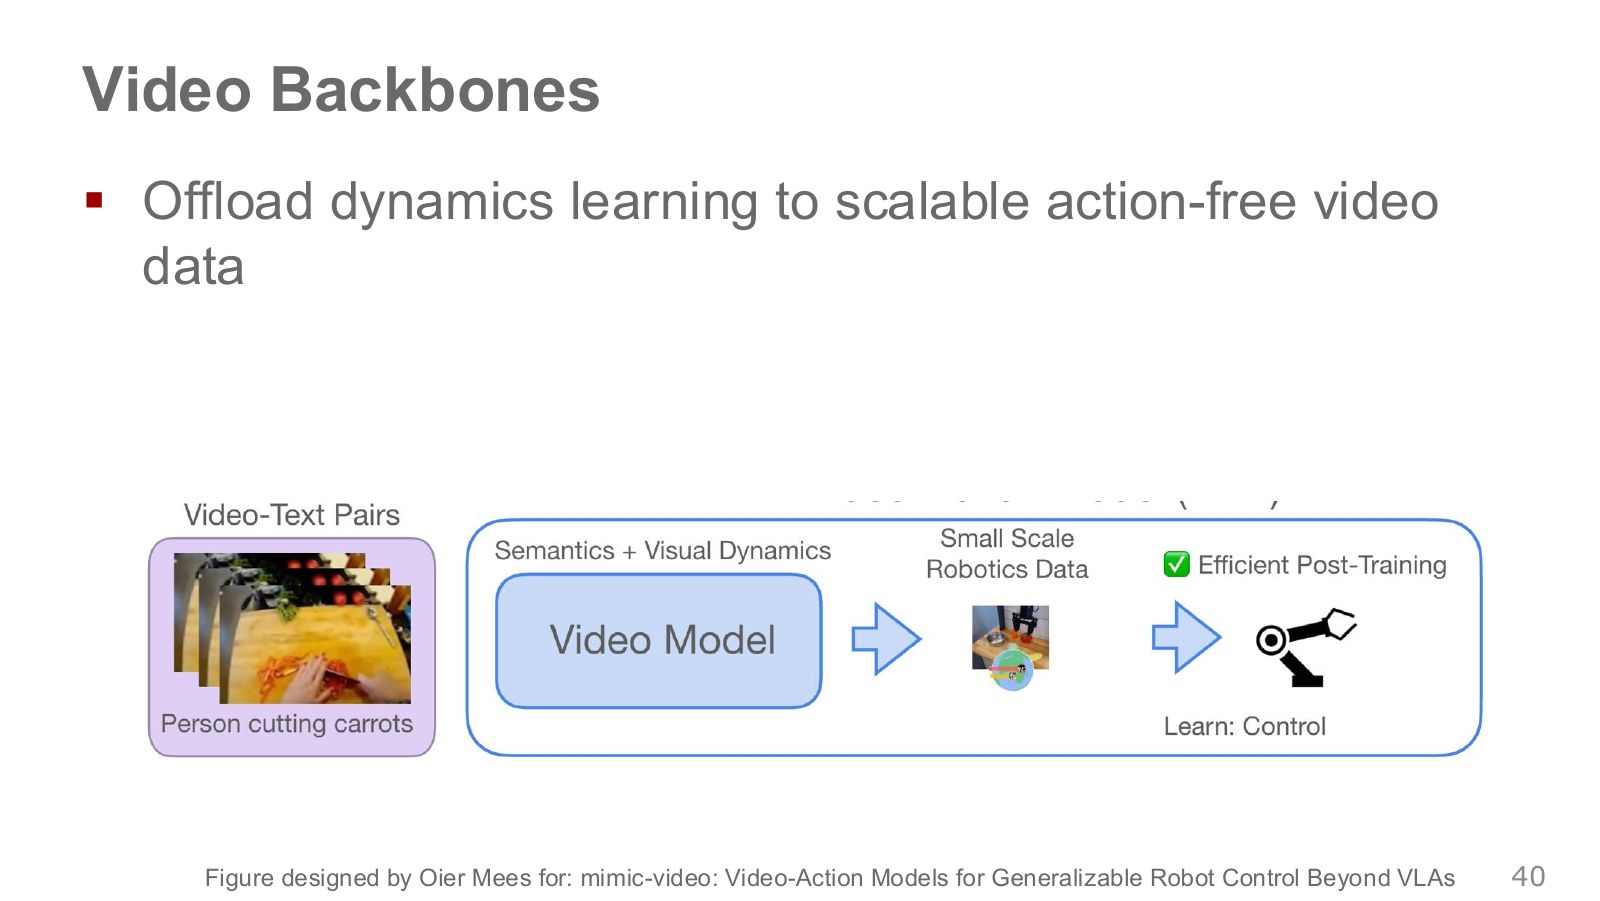
그림의 영상-텍스트 입력에는 보통 로봇의 관절 각도나 모터 토크가 붙어 있지 않다. 그래도 물체가 손을 따라 움직이는 장면에서 시간적 단서를 학습할 수 있다. 실제 로봇에 맞춘 행동은 카메라 영상과 명령이 함께 기록된 자료에서 배운다. 사람 손의 동작을 그대로 로봇의 모터 명령으로 복사할 수 없는 이유다.
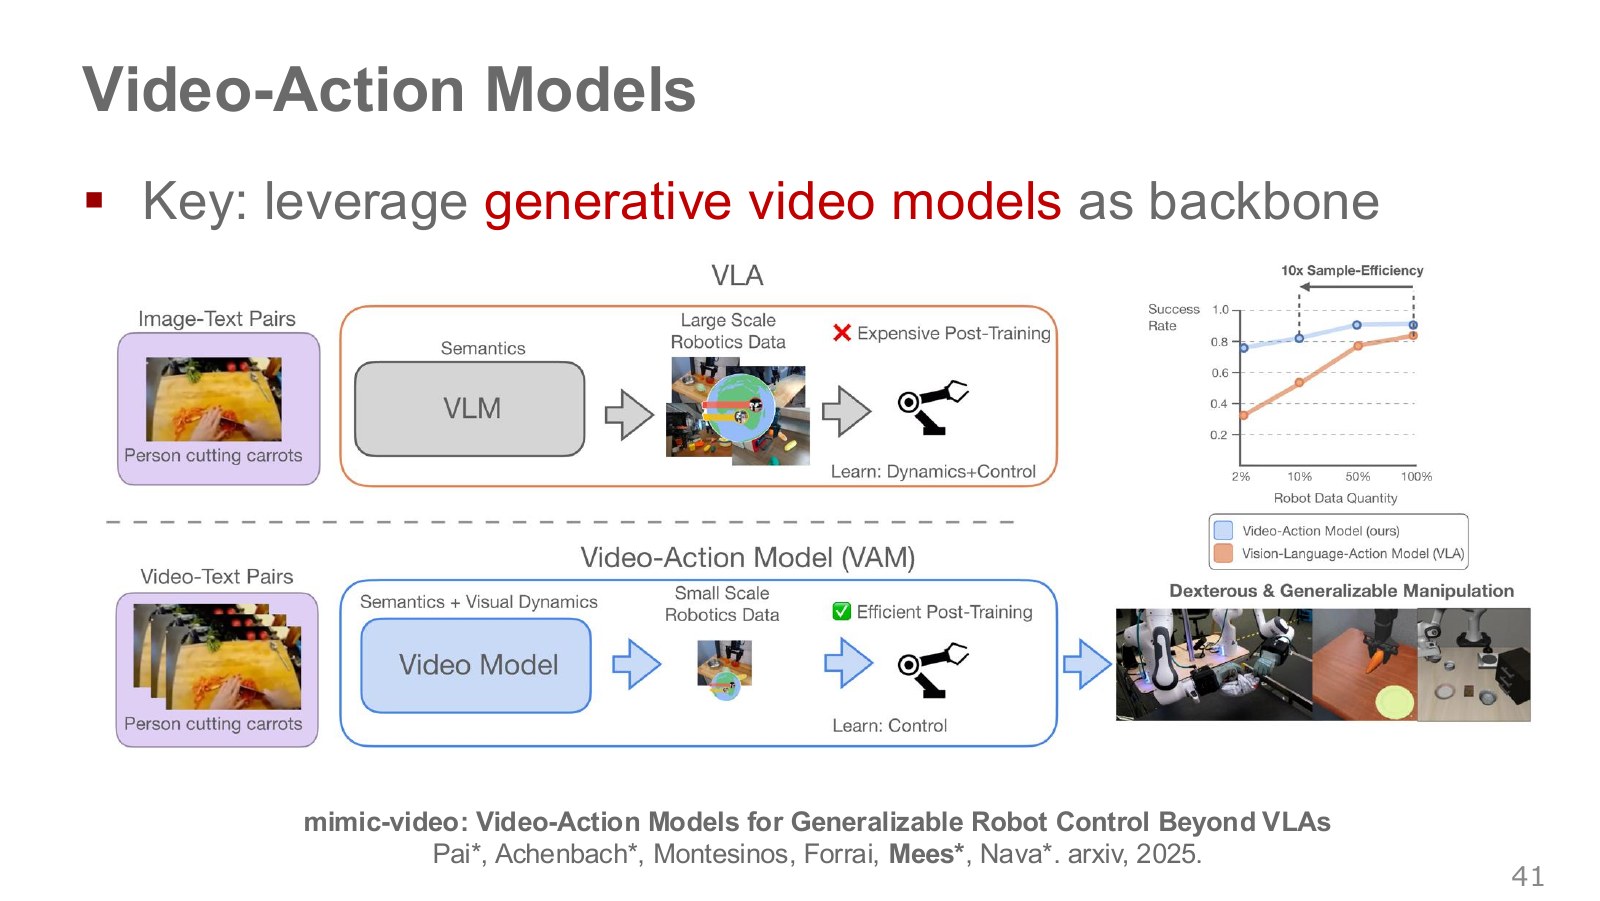
위쪽은 VLM을 로봇 행동으로 적응시키는 경로이고 아래는 생성 영상 모델을 뼈대로 쓰는 경로다. mimic-video에서 행동 디코더는 예상된 시각적 변화에 대응하는 로봇 명령을 낸다. 결과의 방향에서 행동을 추정하므로 역동역학 모델(IDM)이라고 부른다. 같은 장면 변화에 여러 관절 동작이 가능하며, 학습 데이터가 어느 명령을 고를지에 영향을 준다. Pai 외, mimic-video
그래프의 가로축은 디코더가 예측 영상을 받았는지 전문가 영상을 받았는지를 나눈다. 전문가 영상은 실행 때 미리 알 수 없는 결과를 주는 실험용 기준이다. 그 입력에서 성공률이 높아지면 영상 예측 오차를 줄일 여지가 있다는 뜻이다. 전문가 영상을 주어도 남는 실패는 행동 디코더와 로봇 실행까지 살펴봐야 한다. 사본에서 막대가 보이지 않아 실험의 비교 대상과 해석을 영상 설명과 논문으로 보완했다. mimic-video
논문에서 말하는 오라클은 실제 미래 프레임에서 추출한 잠재 표현을 제공하는 실험 조건이다. 이 조건에서 성공률이 거의 완벽했다는 결과는 해당 비교에서 예측 쪽을 개선할 여지가 컸음을 보여 준다. mimic-video 논문
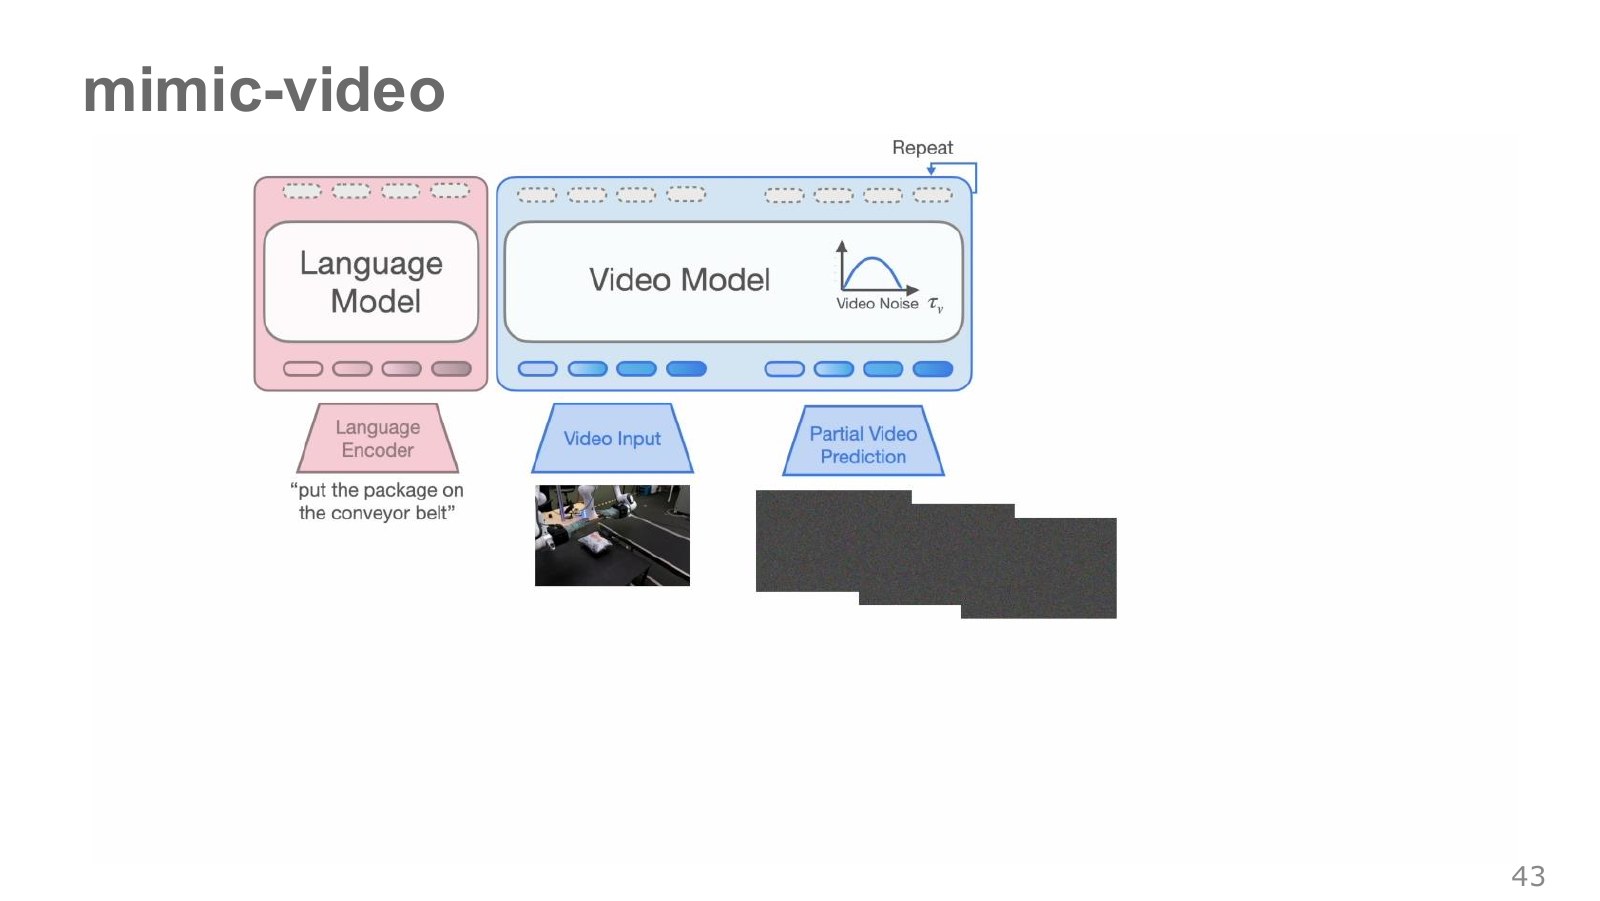
분홍색 언어 모델은 지시를, 파란색 영상 모델은 현재 화면과 부분적으로 정제된 미래 표현을 다룬다. 부분적으로 노이즈가 남아 있어도 특징에는 물체의 움직임과 작업의 방향을 결정할 정보가 들어 있을 수 있다. 디코더는 그 특징으로 행동 묶음을 만든다. 이렇게 하면 화면으로 보기 좋은 완성본까지 생성하는 작업을 평소 제어 경로에서 줄일 수 있다.
mimic-video가 사용하는 Cosmos-Predict2의 특징은 최종 RGB 프레임을 복원하기 전에 꺼낼 수 있다. 영상 쪽에서 어느 정도까지 잡음을 제거해 특징을 얻는지와, 행동 쪽에서 몇 단계에 걸쳐 제어값을 정제하는지는 따로 조절한다. mimic-video 논문
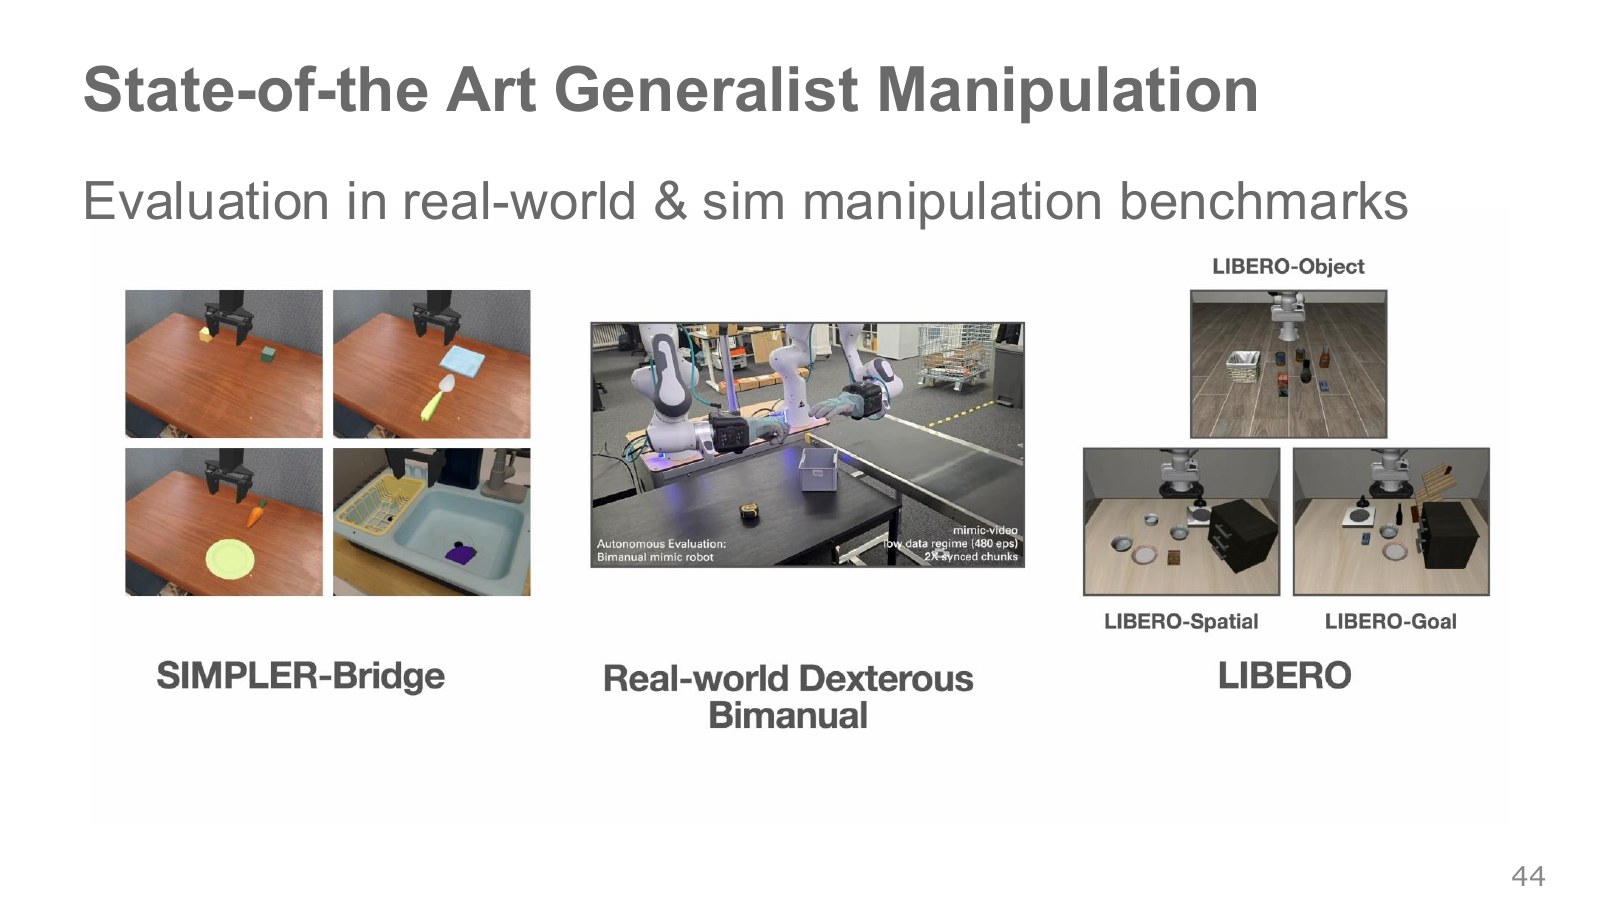
SIMPLER-Bridge는 시뮬레이션에서 조작을 비교한다. 가운데는 실제 양팔 조작이고, LIBERO의 Object·Spatial·Goal 분할은 물체·배치·목표를 바꿨을 때의 일반화를 나눠 본다. 같은 성공률이라도 무엇을 바꿨고 몇 번 시험했는지 알아야 비교할 수 있다.
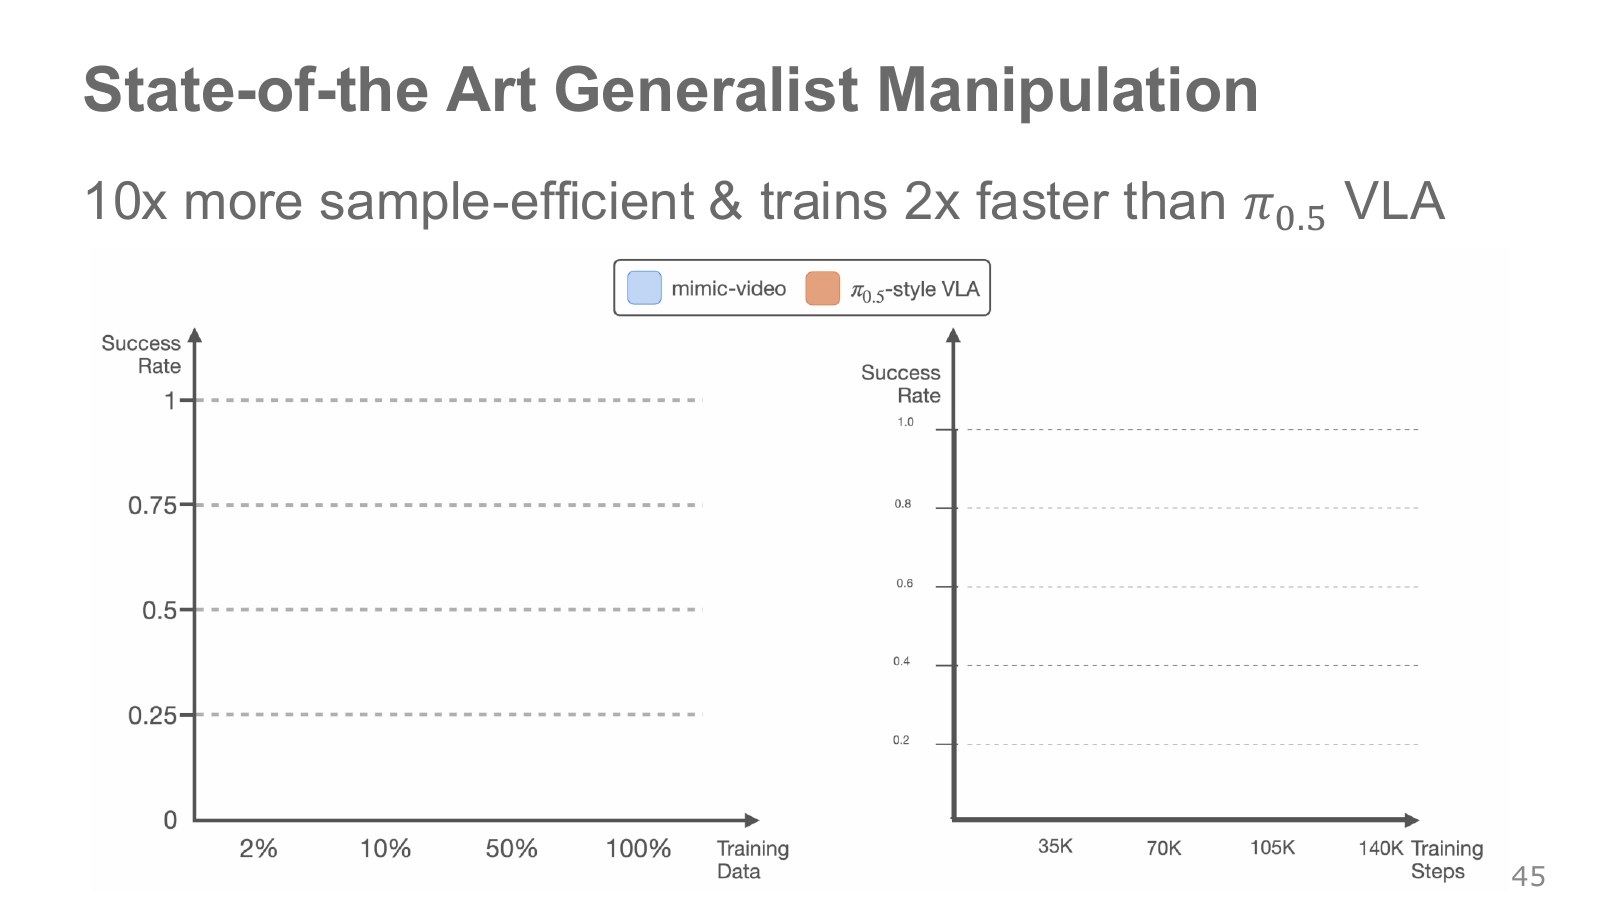
왼쪽 그래프는 로봇 데이터 비율, 오른쪽은 학습 스텝 수를 가로축으로 둔다. 강의의 약 10배 데이터 효율과 2배 빠른 학습은 저자들이 비교한 mimic-video와 계열 기준의 실험 결과다. 스텝을 줄였다는 보고를 장비와 배치 크기가 다른 실행의 실제 소요 시간까지 줄었다는 뜻으로 읽을 수는 없다. 사본의 축과 영상 설명을 논문과 함께 읽었다. mimic-video
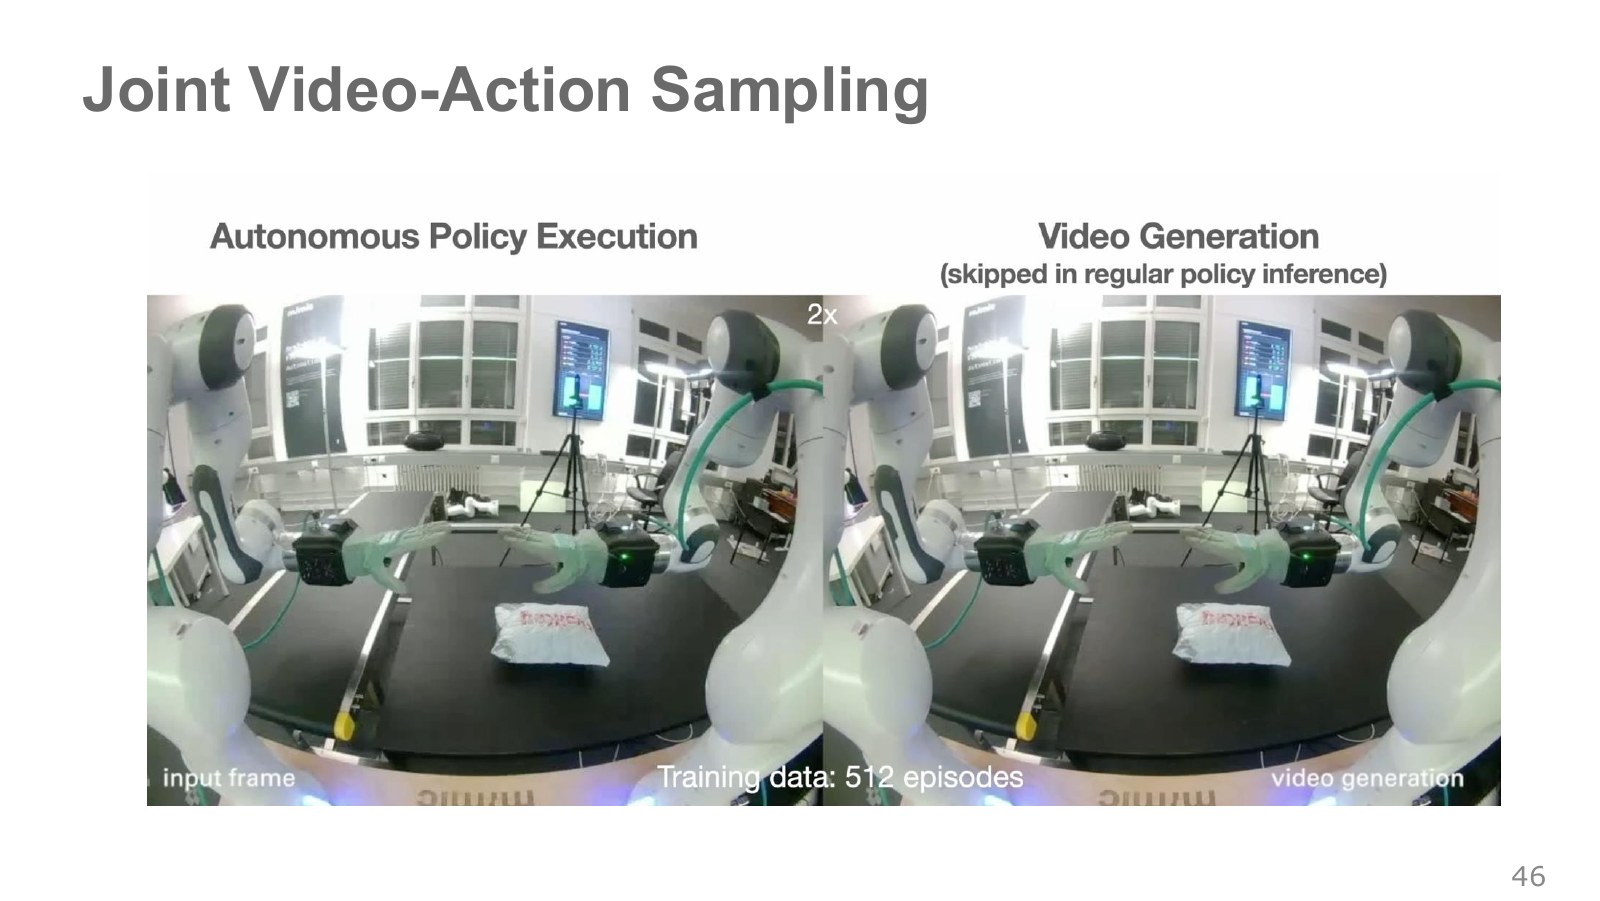
두 장면이 비슷해 보여도 왼쪽은 로봇 모터가 명령을 받은 결과이고 오른쪽은 영상 생성 결과다. 슬라이드는 이 영상 렌더링을 정규 정책 추론에서 생략한다고 표시한다. 512 에피소드 표기는 화면 속 시연의 조건이다. 로봇이 작업을 끝냈는지는 실제 실행 결과로 확인한다.
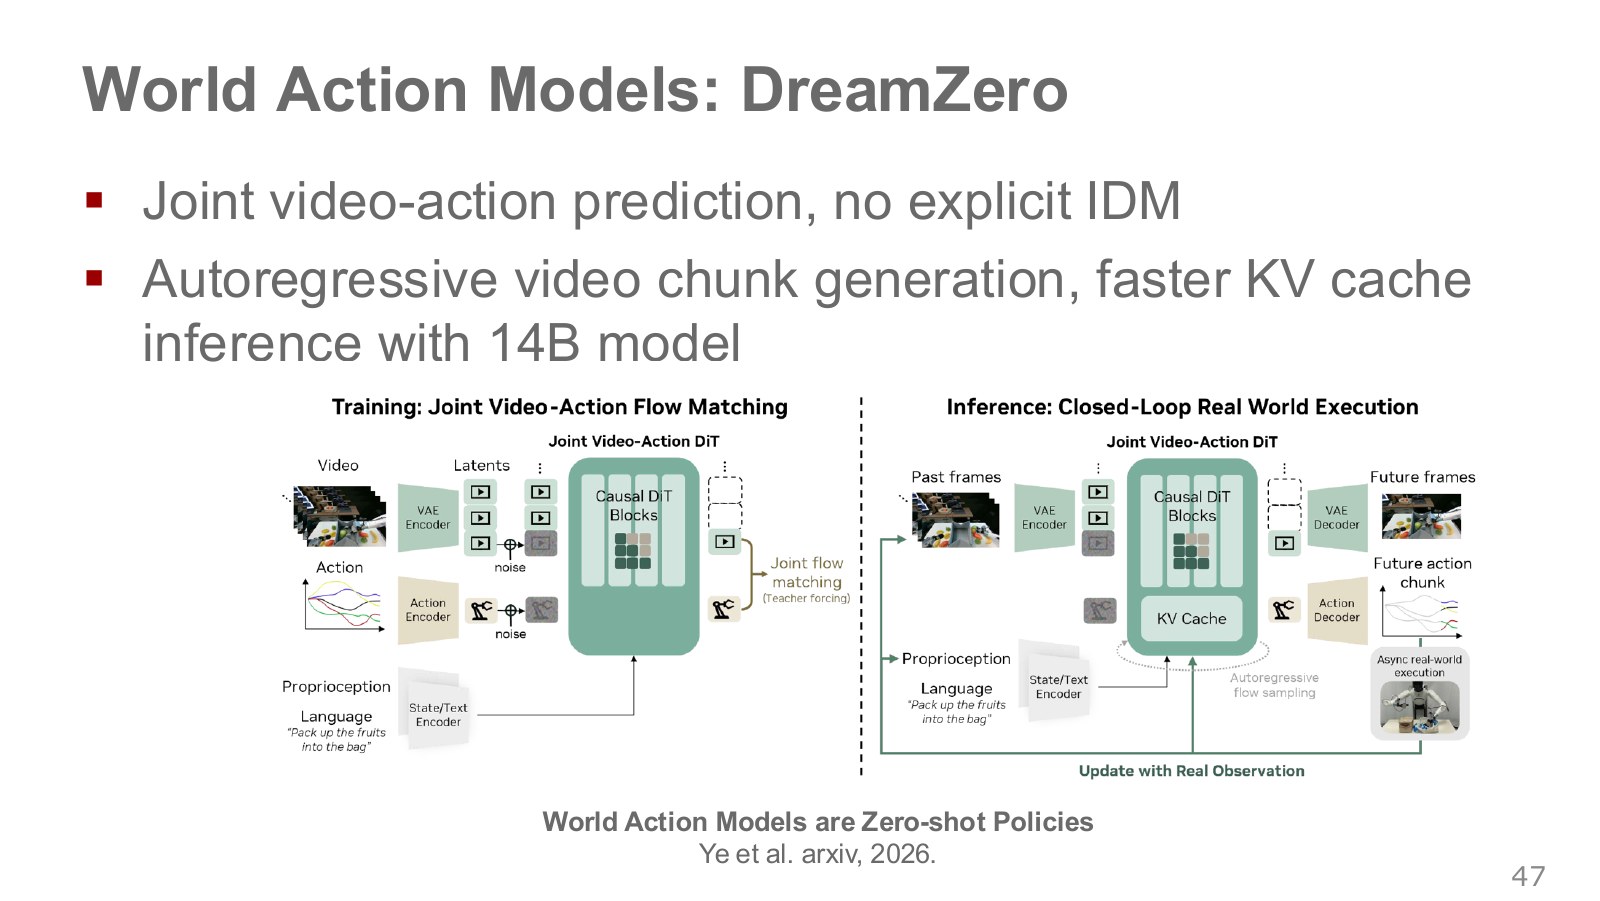
왼쪽 그림에서 영상과 행동에 노이즈를 넣고 같은 모델에서 두 출력을 학습한다. 오른쪽에서 로봇은 행동 묶음을 실행하고 실제 프레임을 다시 받아 다음 묶음을 만든다. 이전 프레임의 attention 정보를 KV 캐시에 저장해 매번 전부 다시 계산하는 부담을 줄인다. Ye 외, DreamZero
예컨대 예측 속 집게는 컵을 잡았지만 실제 카메라에는 컵이 탁자에 남아 있을 수 있다. 다음 묶음의 문맥을 실제 프레임으로 갱신하면 앞선 예측을 그대로 이어가는 대신 다시 접근할 기회가 생긴다.
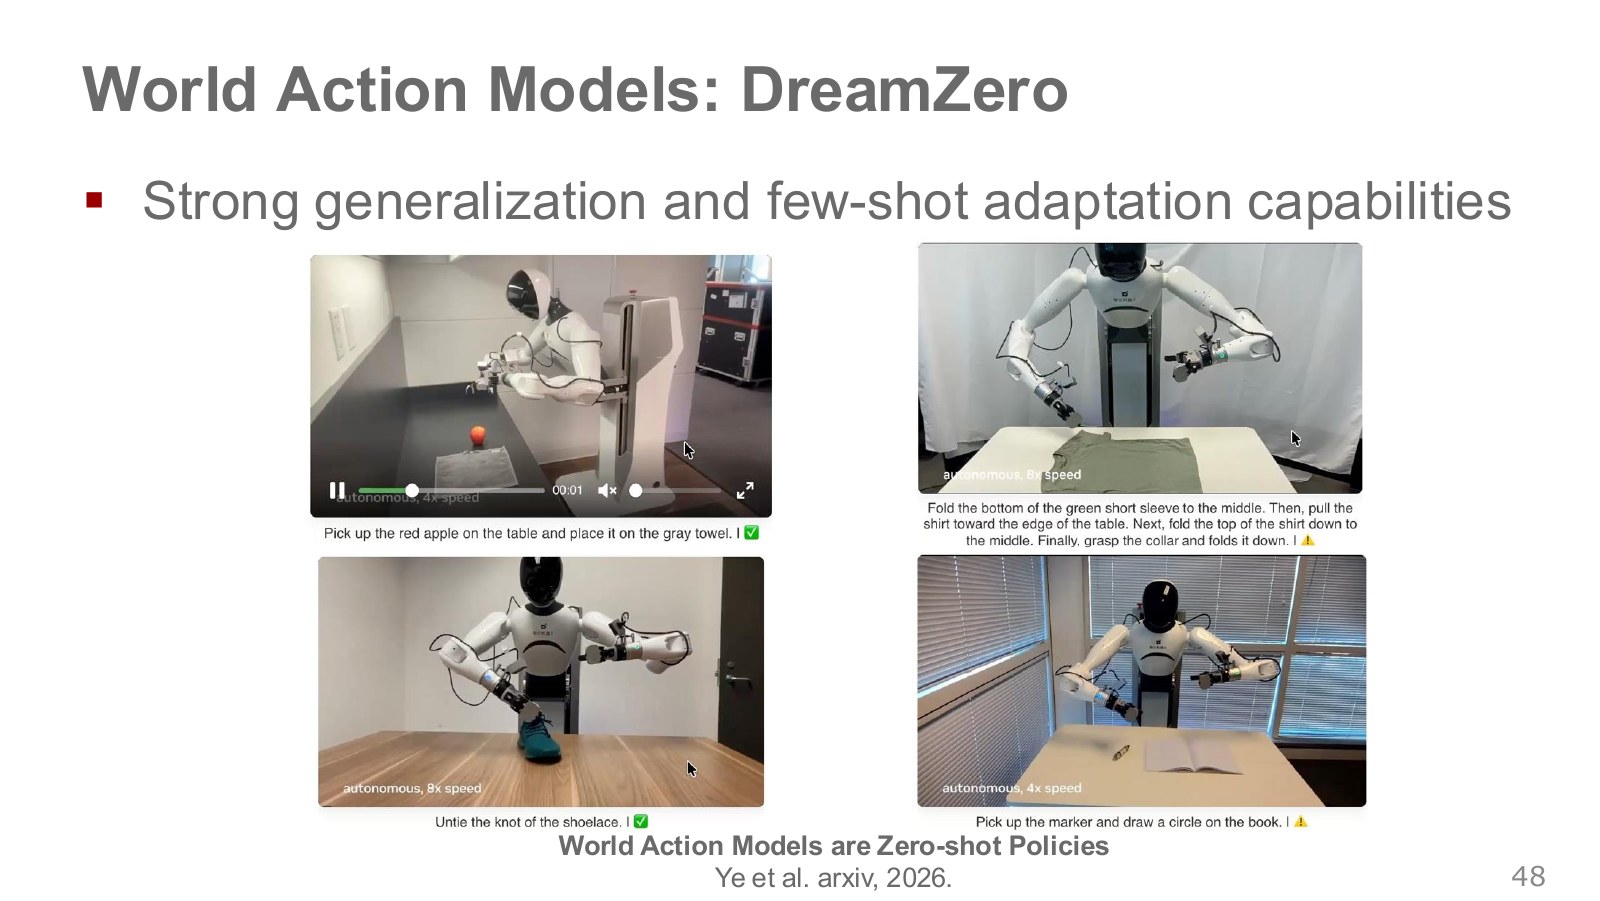
사진에는 사과 옮기기, 셔츠 접기, 끈 풀기, 원 그리기가 나온다. 장면이 익숙해 보여도 행동의 순서와 필요한 접촉은 과제마다 다르다. 제로샷은 해당 시험 과제로 추가 학습을 하지 않는 설정이고, 소량 적응은 적은 추가 데이터로 모델을 조정하는 설정이다. 데모 사진을 읽을 때도 어느 조건에 해당하는지 구분해야 한다.
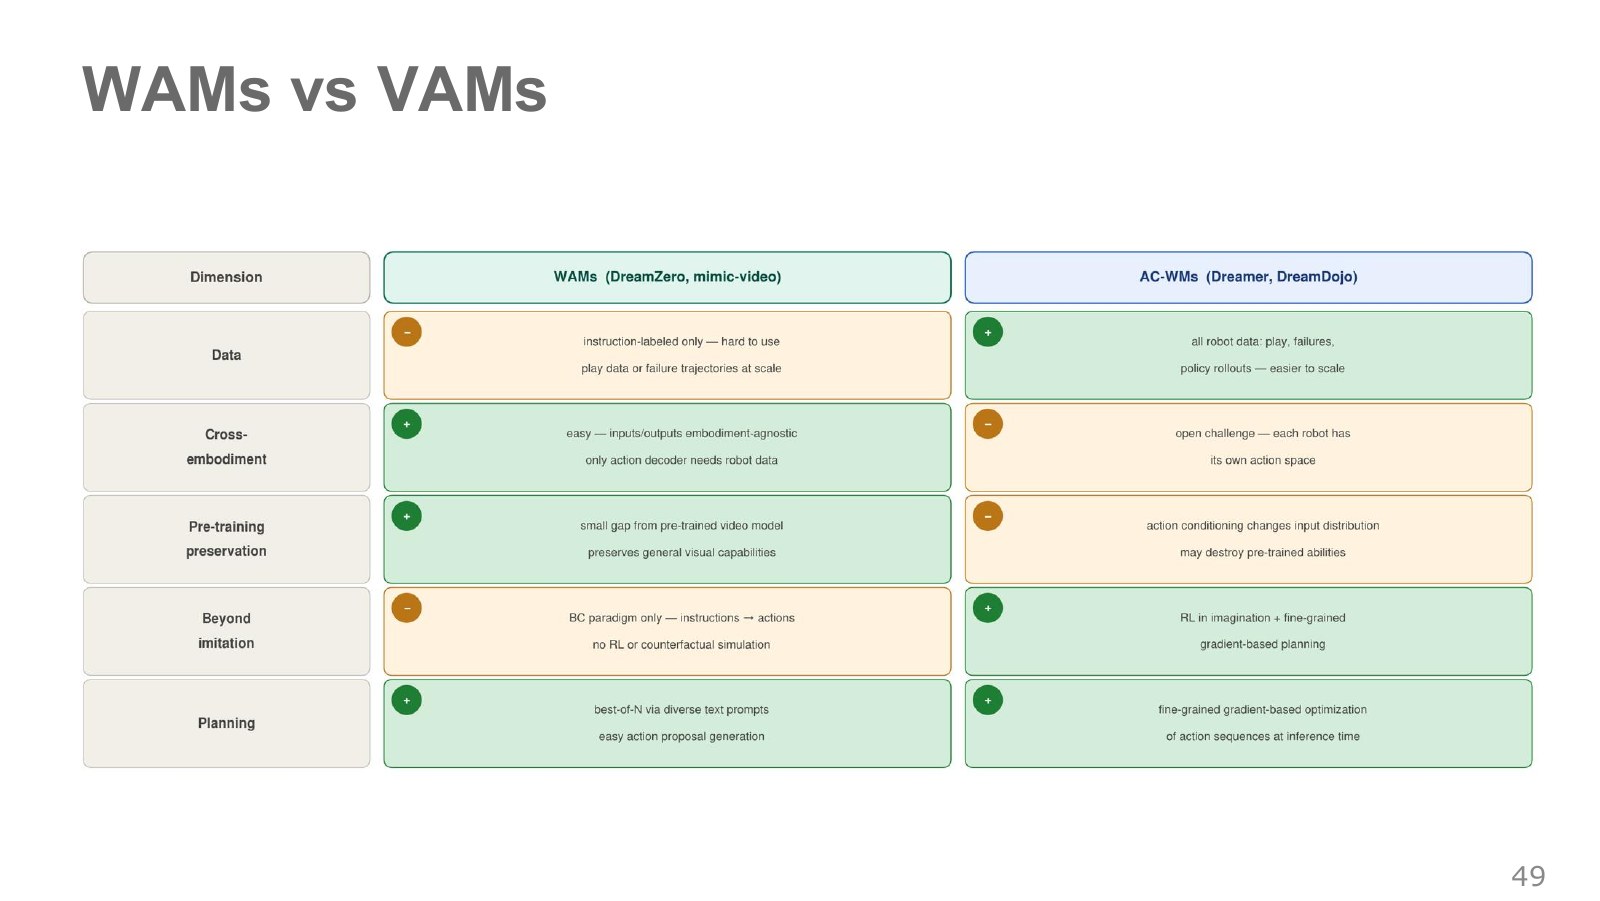
이 표는 DreamZero와 mimic-video를 같은 쪽에 묶고 Dreamer류를 반대편에 둔다. P038의 세분류에서는 DreamZero를 WAM, mimic-video를 VAM으로 나눴다. 여기서는 모델에 후보 명령을 바꿔 넣어 결과를 비교할 수 있는지, 목표를 주면 명령이 직접 나오는지, 어떤 단계에 로봇 데이터가 필요한지를 비교하면 분류가 달라져도 이해할 수 있다.
#픽셀을 그리지 않는 예측
컵이 이미 들렸는지 판단할 때 벽의 무늬까지 정확히 예측할 필요는 없다. 반면 손과 컵 사이의 틈을 압축에서 잃으면 잡기 계획이 틀어진다. 이 질문은 예측 목표를 픽셀에서 과제에 맞는 표현으로 옮기는 JEPA로 이어진다.
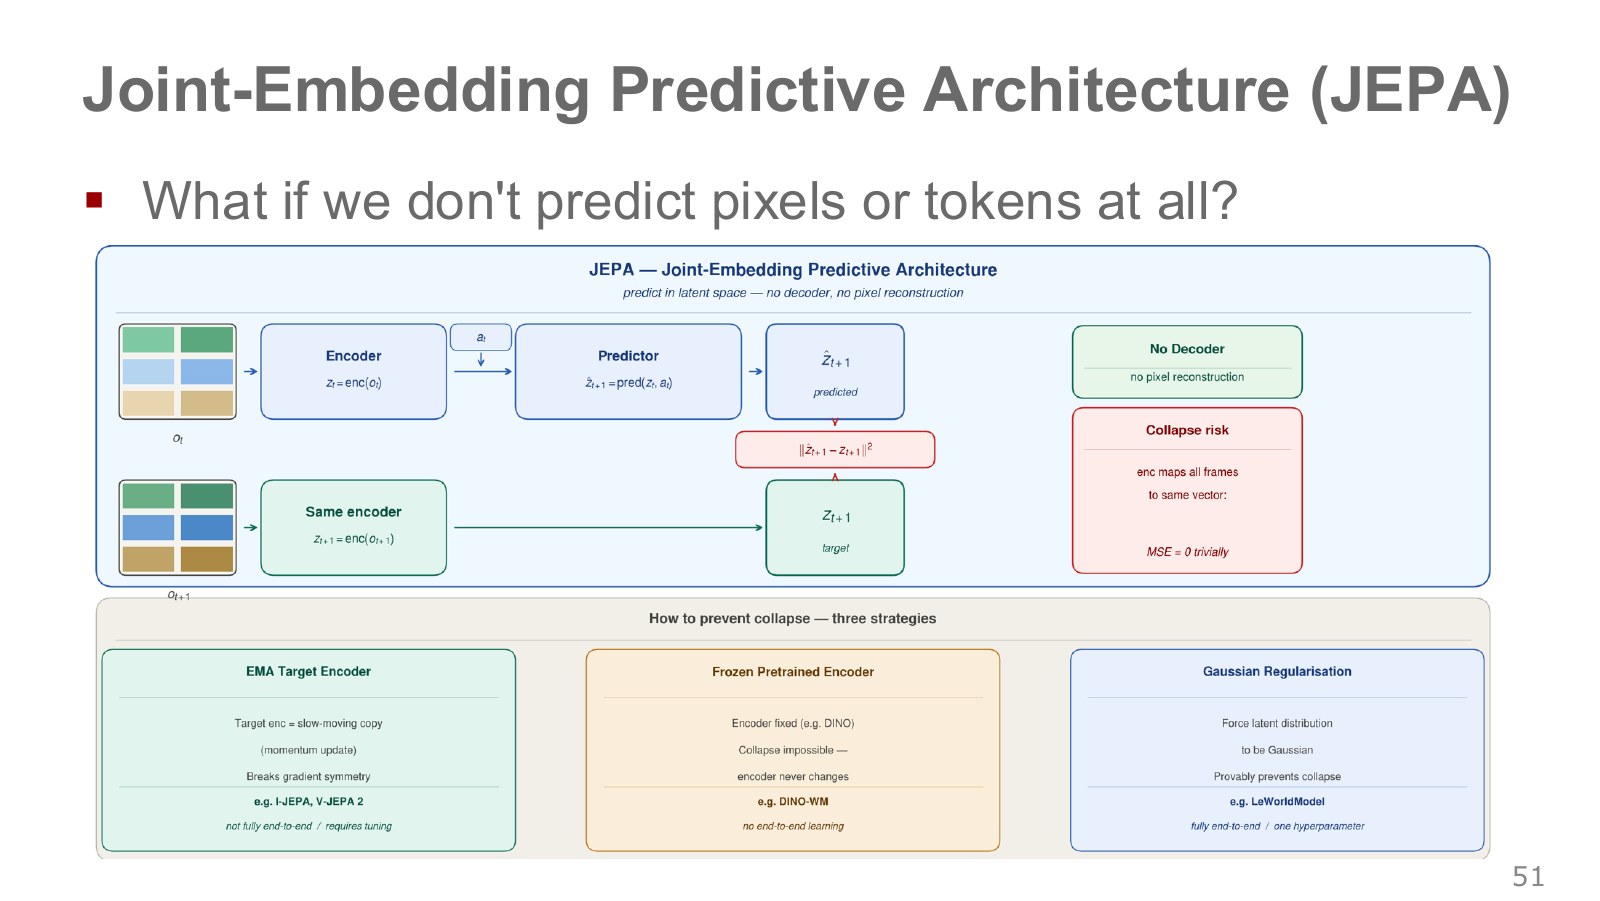
위쪽 예측기는 현재 표현과 행동에서 다음 표현을 예상하고, 아래쪽 인코더는 학습 중 실제 다음 프레임을 숫자 벡터로 만든다. 둘을 비교하면 매번 RGB를 복원할 필요가 없다. 두 경로가 모든 장면을 같은 벡터로 보내면 오차는 작아져도 계획에는 쓸 수 없다. 이를 표현 붕괴라고 한다. 아래 세 상자는 느리게 갱신하는 표적 인코더, 사전학습 후 고정한 인코더, 표현 분포를 퍼뜨리는 정규화라는 설계들을 보여 준다. 각 방식이 보존하는 정보와 보장 범위는 다르다. V-JEPA 2 · DINO-WM · LeWorldModel
기호 뜻과 계산 과정 자세히 보기 미래 장면의 임베딩에서 예측 오차 계산
이 식을 말로 읽으면
현재 임베딩과 행동으로 예측한 미래 벡터를 실제 다음 장면의 벡터와 비교하고, 좌표별 오차의 제곱을 더한다.
기호 하나씩 이해하기
- 현재 관측의 임베딩
- 예측에 넣은 명령
- 예측한 벡터
- 실제 다음 프레임을 인코딩한 표적
계산을 따라가는 순서
- 현재 프레임을 인코딩하고 예측기에 행동과 함께 넣는다.
- 학습에서는 실제 다음 프레임도 인코딩해 예측과 비교한다. 예측 오차만 줄이면 두 표현이 모두 같은 값으로 무너질 수 있다.
작은 예시로 확인하기
예측 벡터가 (1, 2), 표적이 (2, 2)라면 오차 제곱합은 1이다. 모든 장면을 (0, 0)으로 보내면 오차는 0이어도 물체를 구분할 수 없다.
식을 이해하기 위한 설명용 예시입니다.
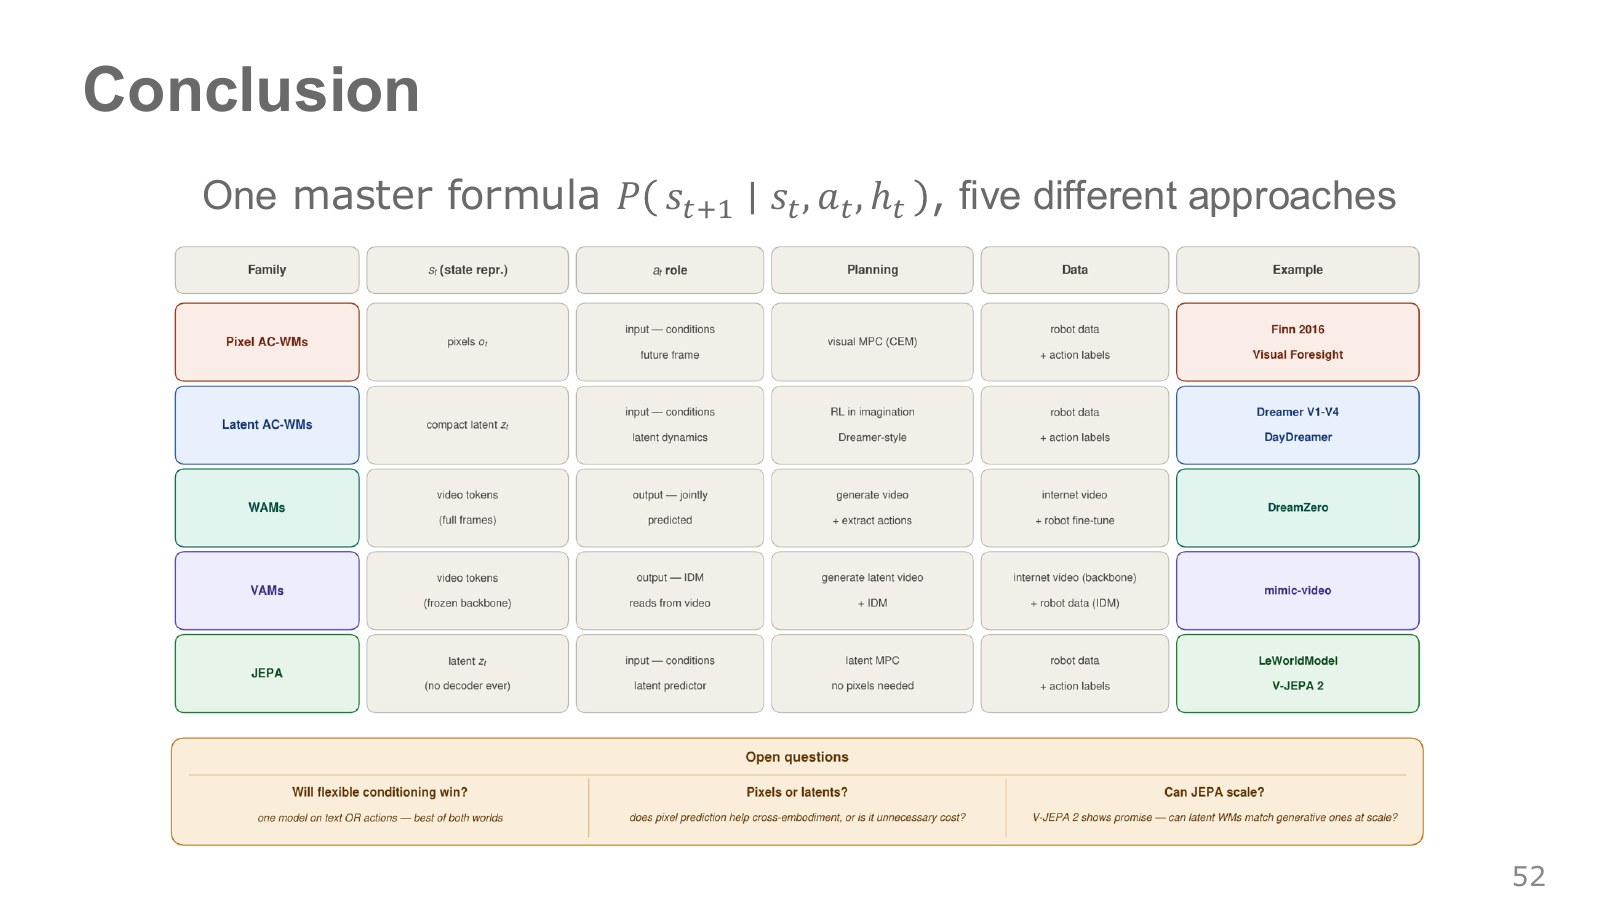
픽셀 모델에서는 컵 위치가 영상 어디로 옮겨 가는지 보고, Dreamer류는 압축 상태에서 여러 걸음의 보상이나 행동을 평가한다. DreamZero는 미래 영상과 명령을 함께 내고, mimic-video는 영상 특징으로 명령을 낸다. JEPA 계열의 계획에서는 예상 미래와 목표를 벡터로 비교할 수 있다. 어느 구조에서든 실제 로봇을 움직인 뒤 새 관측을 다시 읽는 과정이 예측과 현실을 이어 준다.
#직접 실행해 보기
가상 로봇의 위치가 0이고 목표가 1이라고 하자. 모델은 명령 1을 주면 1만큼 움직인다고 예측한다. 실제 예제에서는 같은 명령으로 0.8만큼만 움직이도록 설정했다. 처음 계획을 그대로 따르면 위치 0.8에 멈춘다. 새 위치를 읽어 남은 거리 0.2를 다시 명령하면 0.96까지 이동하고, 한 번 더 반복하면 0.992에 도달한다.
이 예제는 모델을 바꾸지 않고도 관측을 받아 다시 계획할 때 어떤 차이가 생기는지 보여 준다. 파이썬 표준 라이브러리만 사용했으며, 물리 로봇과 Dreamer 학습은 포함하지 않는다. 실행 파일과 결과