같은 컵을 집으라는 지시라도 로봇마다 보이는 장면과 받는 명령이 다르다. 한 대는 손목 카메라가 있고 다른 한 대는 작업대 카메라만 있다. 집게를 열라는 뜻도 어떤 기록에서는 1, 다른 기록에서는 0으로 저장된다. 이전 장 · 월드 모델
공식 강의 일정과 영상 자동 자막을 기준으로 설명을 정리했다. 그림은 공개 이미지 사본의 순서로 표시했다. 공식 PDF는 암호가 걸려 있어 PDF 내부와 이미지 사본의 일치 여부는 확인하지 못했다. ETH 공식 일정 · 공식 PDF · 슬라이드 이미지 사본
#한 로봇의 한 작업에서 출발하기
강의 사이트의 9주차 녹화다. 사본 표지에는 Lecture 10이라고 적혀 있다. 이 글의 장 번호는 공식 일정의 주차를 따른다.
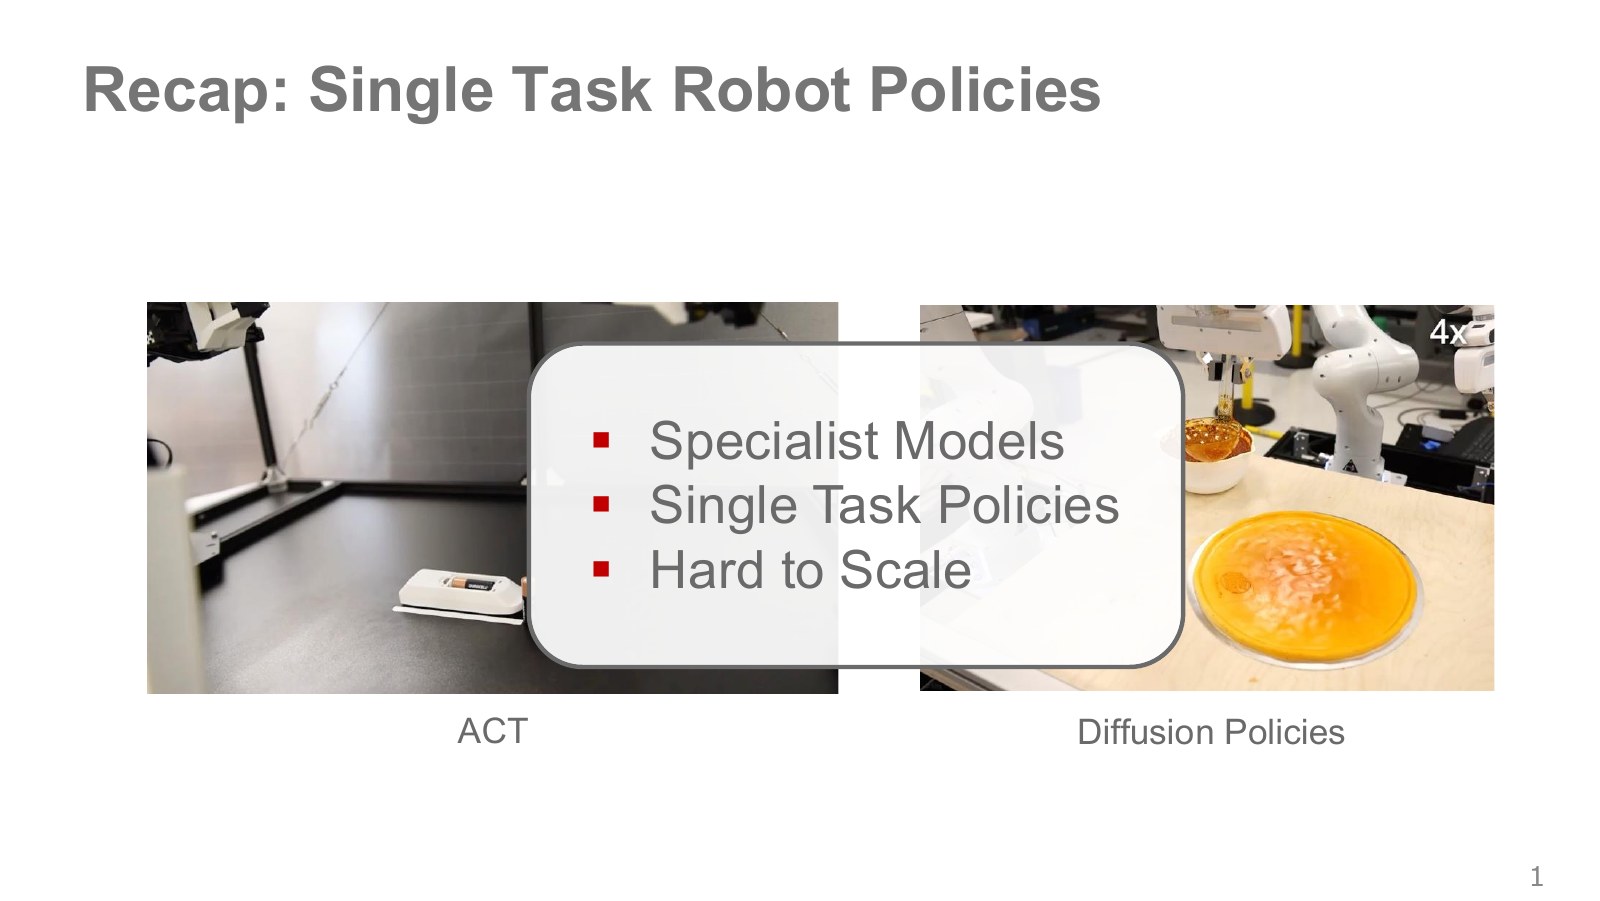
한 종류의 팔로 케이블을 끼울 때 ACT나 Diffusion Policy는 그 작업에 맞는 정밀한 움직임을 배울 수 있다. 새 카메라나 다른 팔을 추가할 때마다 학습을 반복하면 작업 수와 장비 수가 늘어나는 만큼 비용도 커진다.
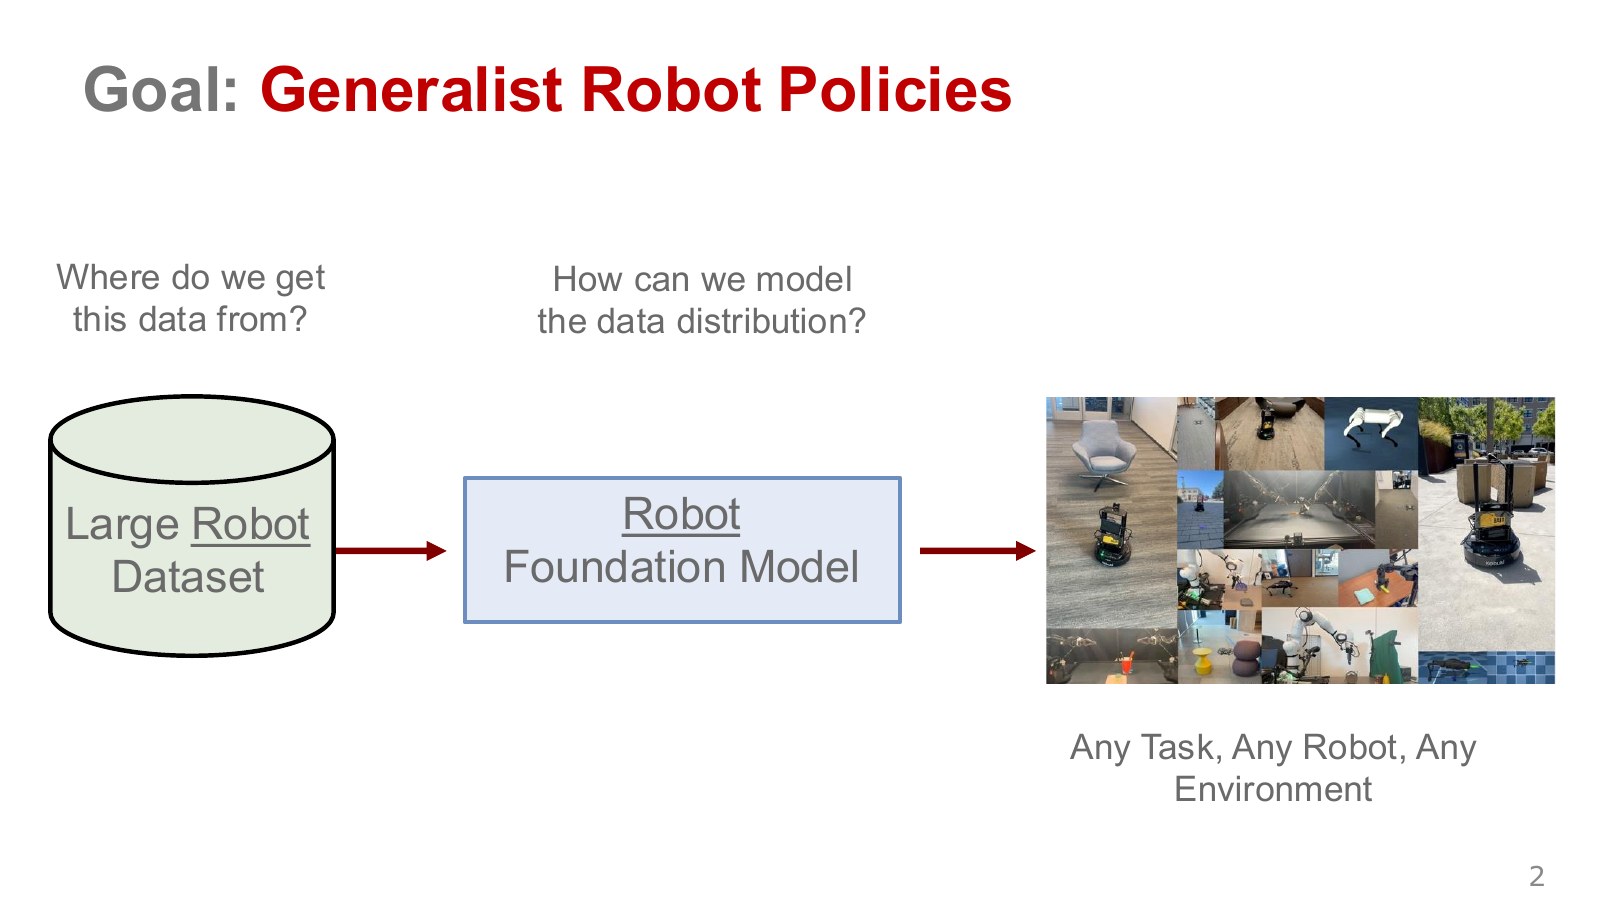
정책은 지금 본 장면과 지시를 다음 행동으로 바꾸는 규칙이다. 새 물체, 새 환경, 새 로봇에서의 성공은 서로 다른 시험이다. 예를 들어 같은 팔로 낯선 컵을 집는 것과 새 팔을 연결하는 것은 필요한 적응이 다르다.
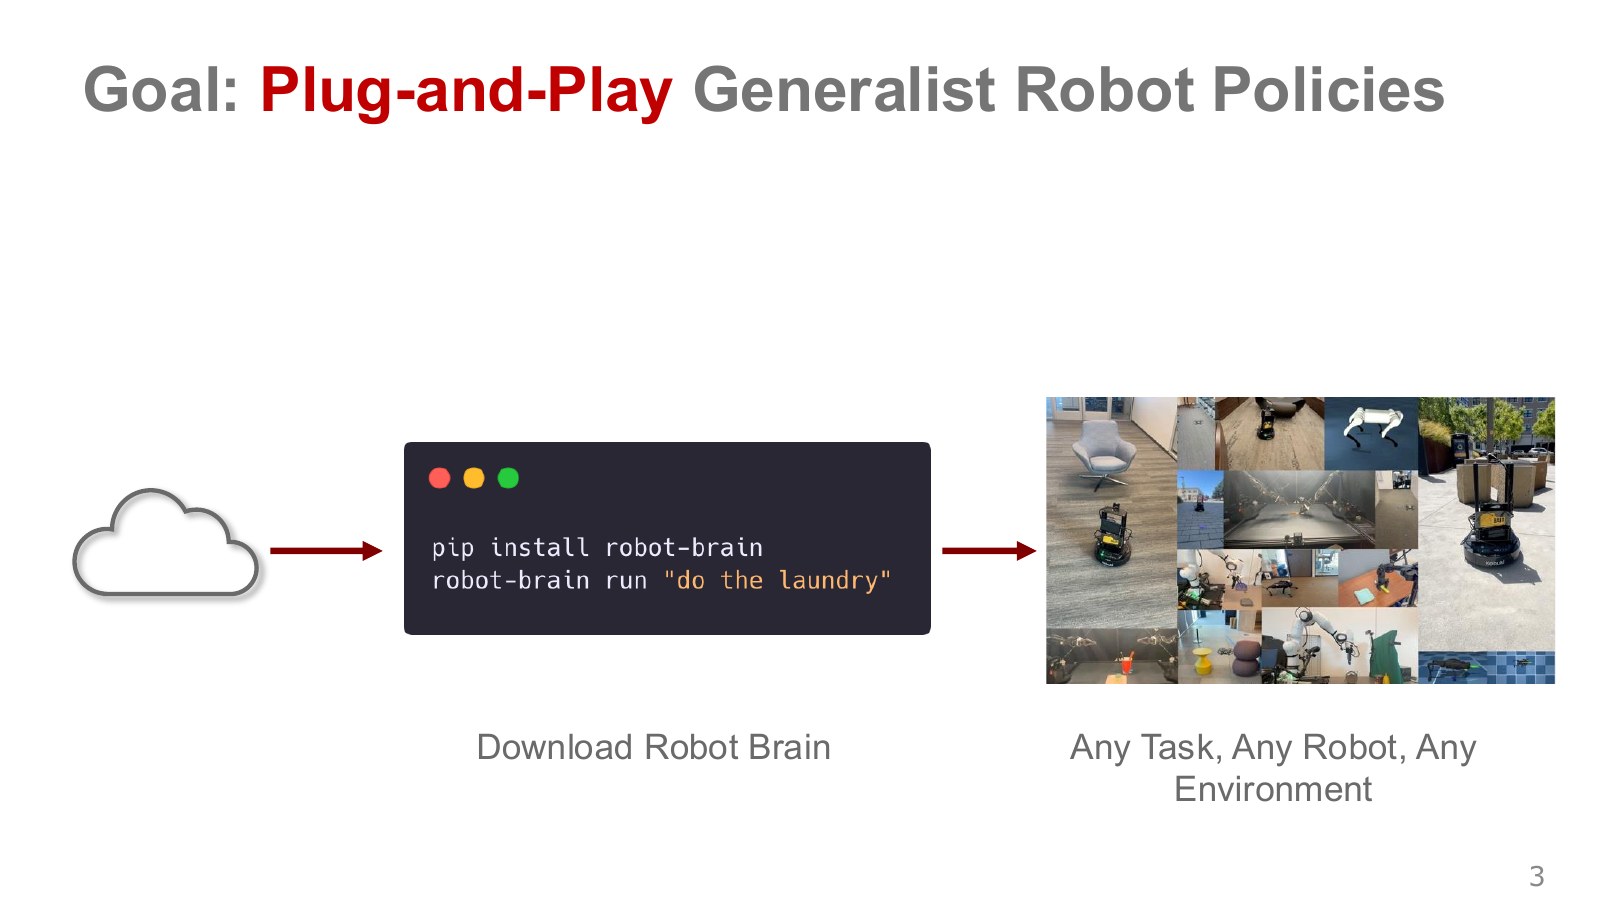
터미널 그림은 설치만으로 여러 장비를 제어하고 싶은 연구 목표를 보여 준다. 실제 연결에는 카메라 순서와 좌표계, 제어 주기, 명령 단위와 장비별 동작 범위를 맞추는 작업이 따른다.
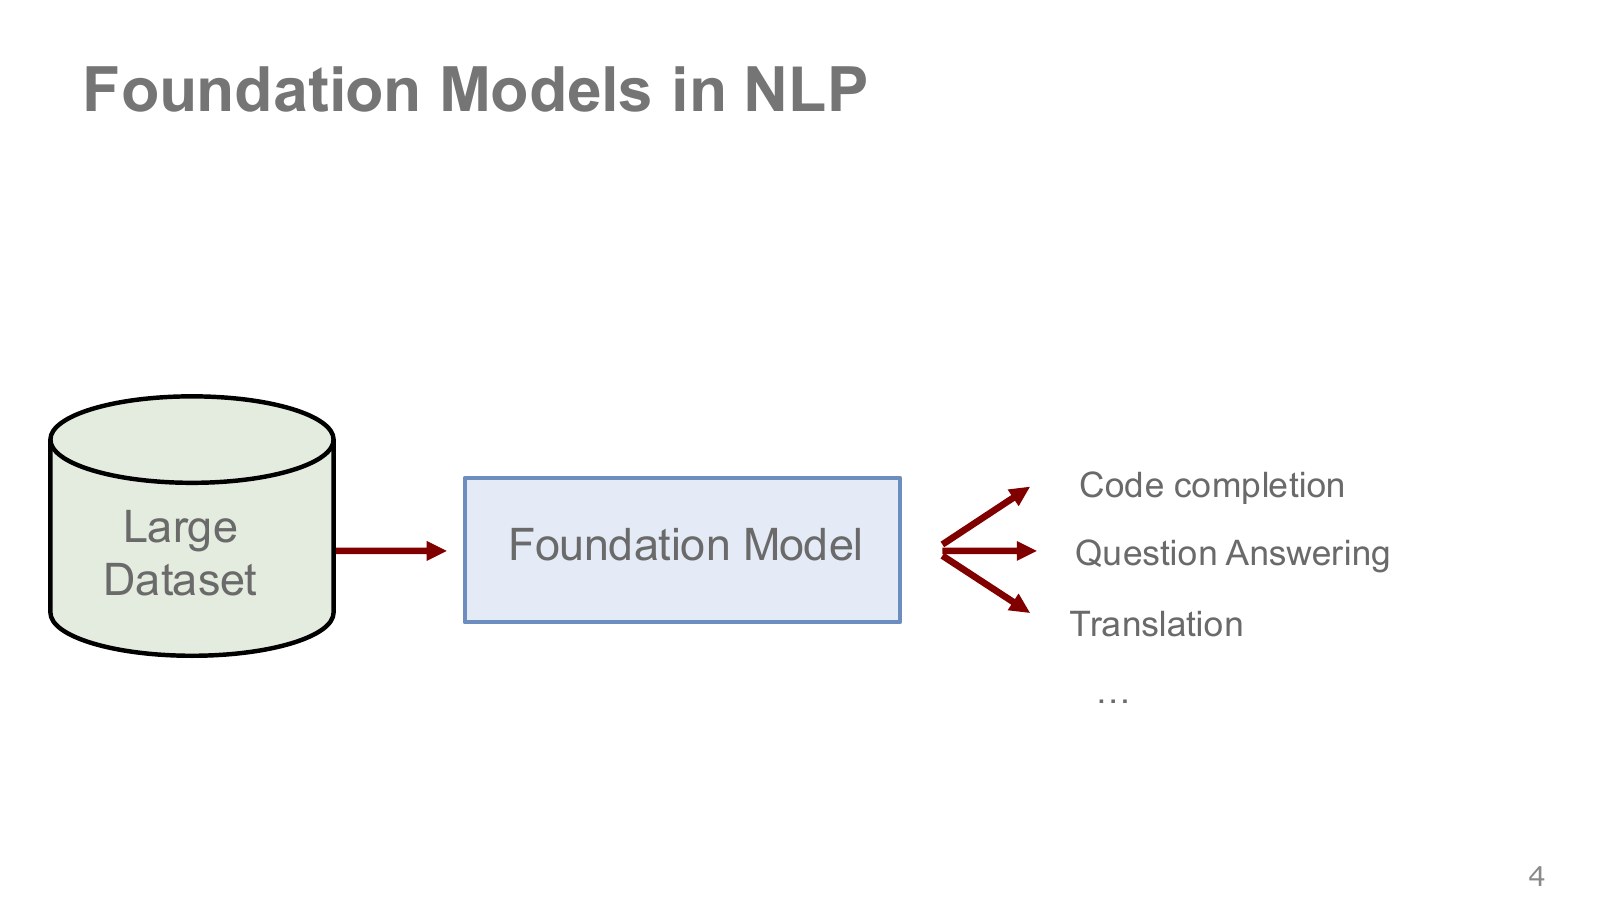
코드 완성과 번역처럼 입력과 출력이 다른 작업을 토큰 시퀀스로 다루면 한 모델에서 표현을 공유할 수 있다. 로봇에서는 사진, 지시, 움직임도 학습 단위로 바꿀 수 있지만 마지막 출력은 물리 장비가 실행할 수 있어야 한다.
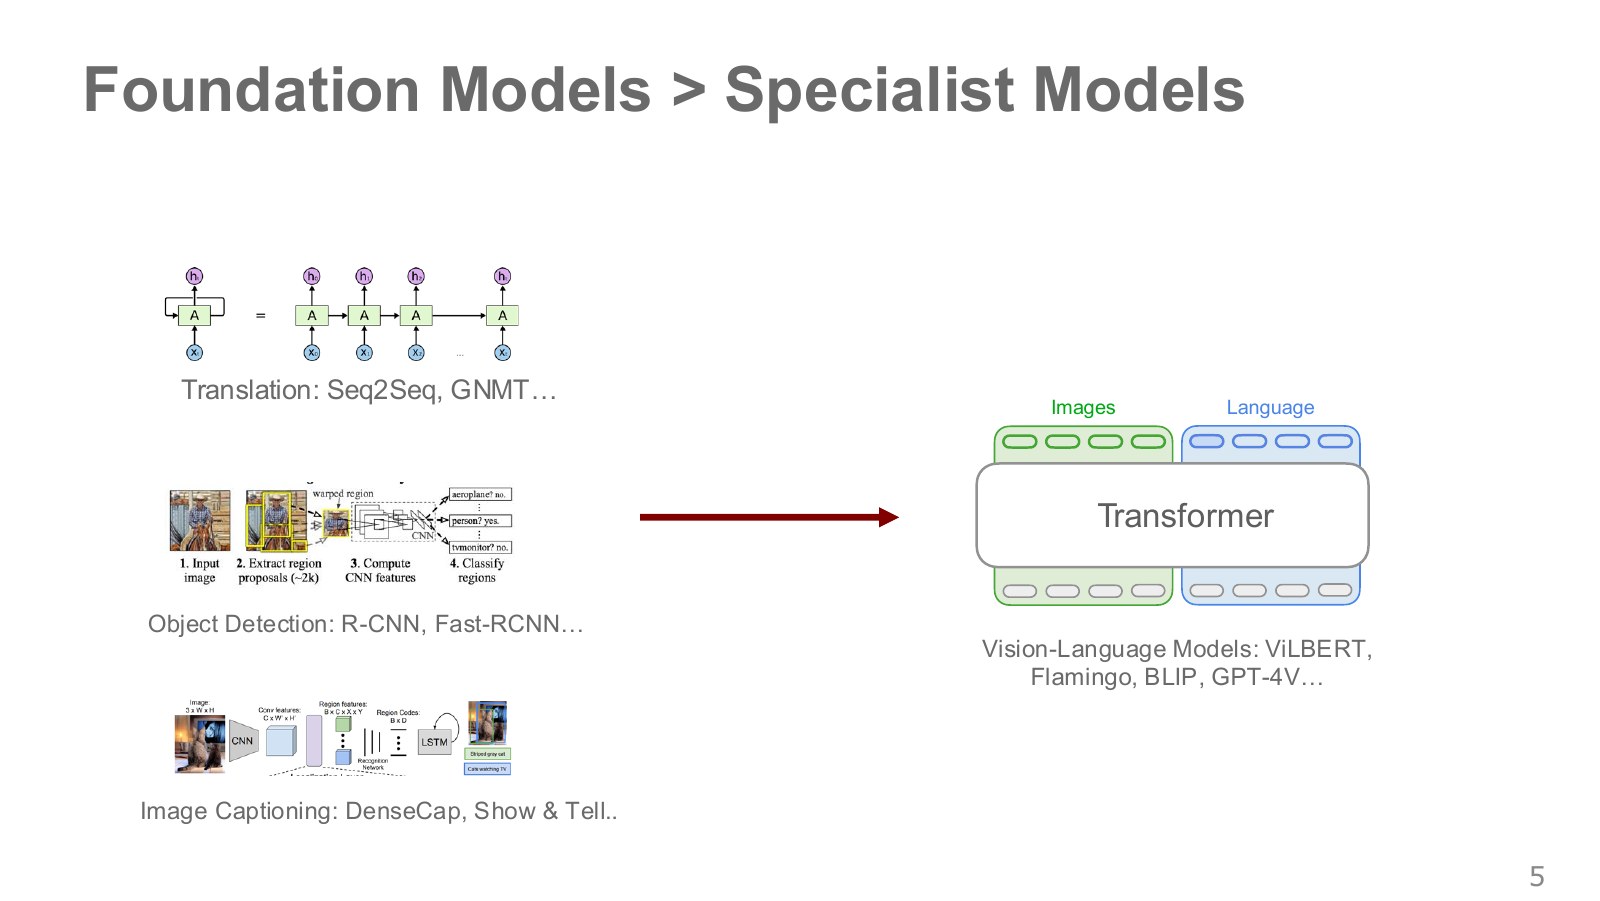
번역과 객체 검출 그림은 분야마다 전용 모델을 만들던 방식에서 공유 모델로 옮겨가는 흐름을 보여 준다. 로봇에서는 같은 과제의 성공률과 실행 속도를 전문 정책과 직접 비교해야 공유 모델의 이득을 판단할 수 있다.
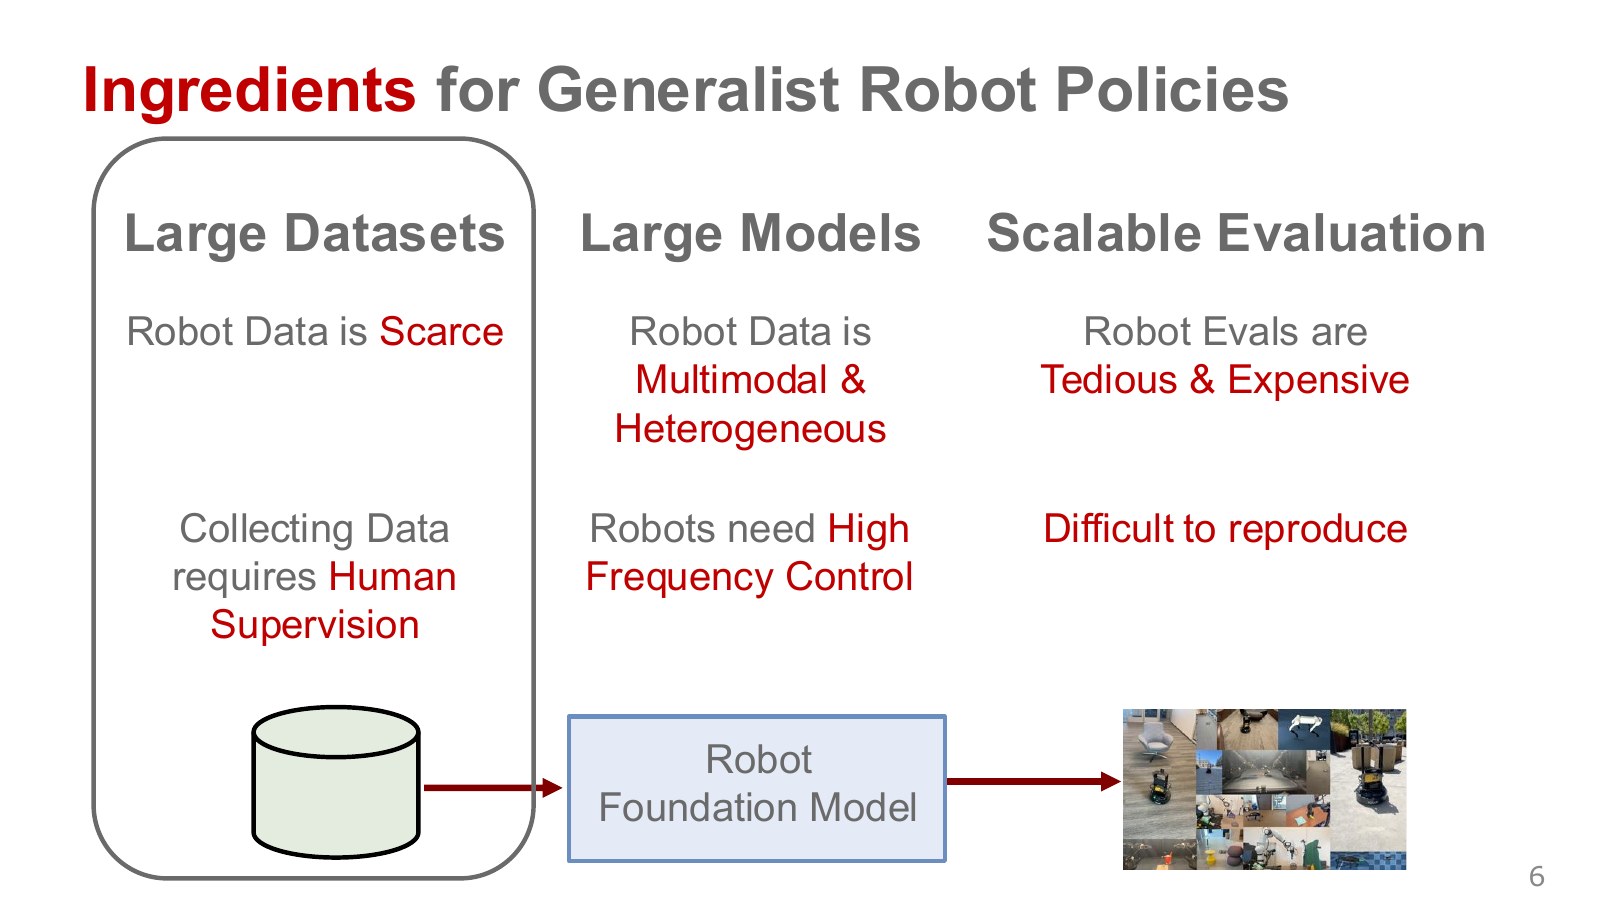
다양한 장비의 경험을 모으는 방법, 입력과 출력 차이를 받아들이는 구조, 그 차이를 반복 측정하는 평가가 함께 필요하다.
#서로 다른 시연을 모으기
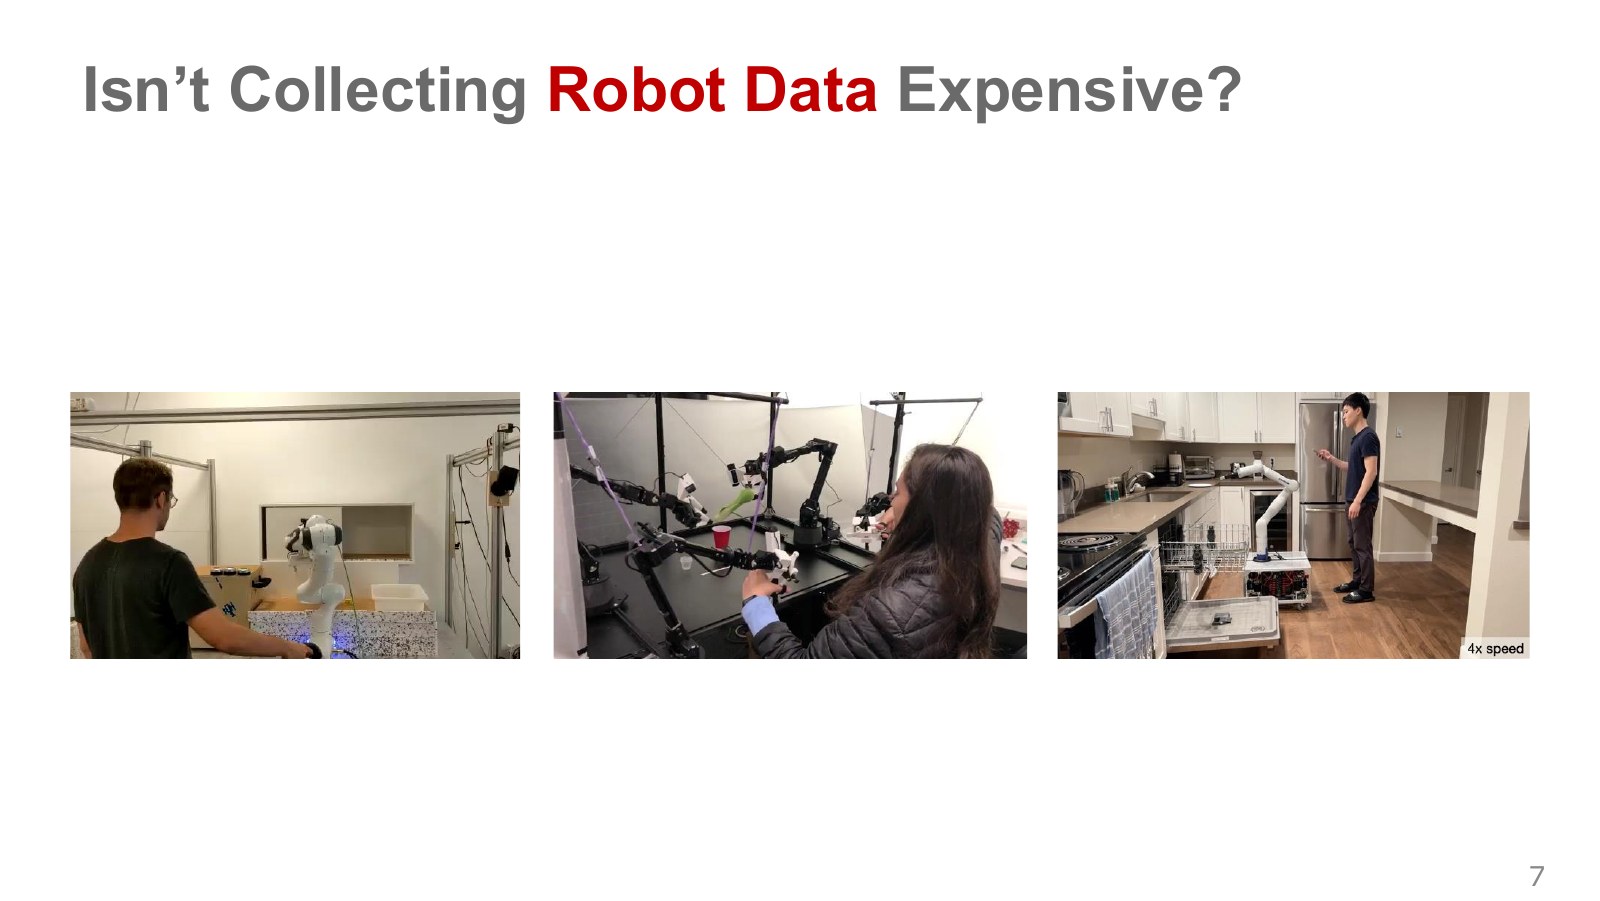
사람이 팔을 조종해 컵을 놓는 장면 하나를 찍으려면 초기 위치를 맞추고, 실패하면 다시 배치하며, 센서와 동작을 함께 기록해야 한다. 이런 물리적 반복이 웹 문서 수집과 다른 비용을 만든다.
실험실마다 기록 방법이 다르더라도 한 에피소드에서 시간순 관측과 행동을 읽게 만들 수 있다. 이때 공통 저장 형식은 데이터에 접근하는 방법을 맞추고, 좌표와 의미 변환은 별도로 적용한다.
강의의 촉각 연구실 예처럼, 개별 논문을 위해 모은 작은 자료도 다른 실험실 기록과 함께 쓸 수 있다. Mees는 박사과정에서 Franka를 직접 원격 조작하던 경험을 떠올리며, 새 과제마다 모든 시연을 다시 찍는 비용에서 이 아이디어가 출발했다고 설명한다.
여러 기관이 모은 조작 기록을 공동 학습에 쓴다. 어떤 부분이 공유되는지 보려면 에피소드 수와 함께 로봇 종류, 작업의 중복, 카메라 구성을 살펴야 한다. 프로젝트
Open X-Embodiment 논문은 22종 로봇의 실제 에피소드 100만 개 이상을 보고한다. 이 숫자는 모아 놓은 자료 전체의 규모다. 아래 Octo의 약 80만은 그중 해당 모델의 사전학습에 쓰인 에피소드 수다. Open X-Embodiment 논문
서로 다른 실험실에서 촬영한 조작 영상은 모델을 훈련한 장면과 시험 장면을 구분해 읽어야 한다. 기존 장비에서 새 물체를 다루는 경우와 새 장비에 적응하는 경우의 증거가 각각 필요하다.
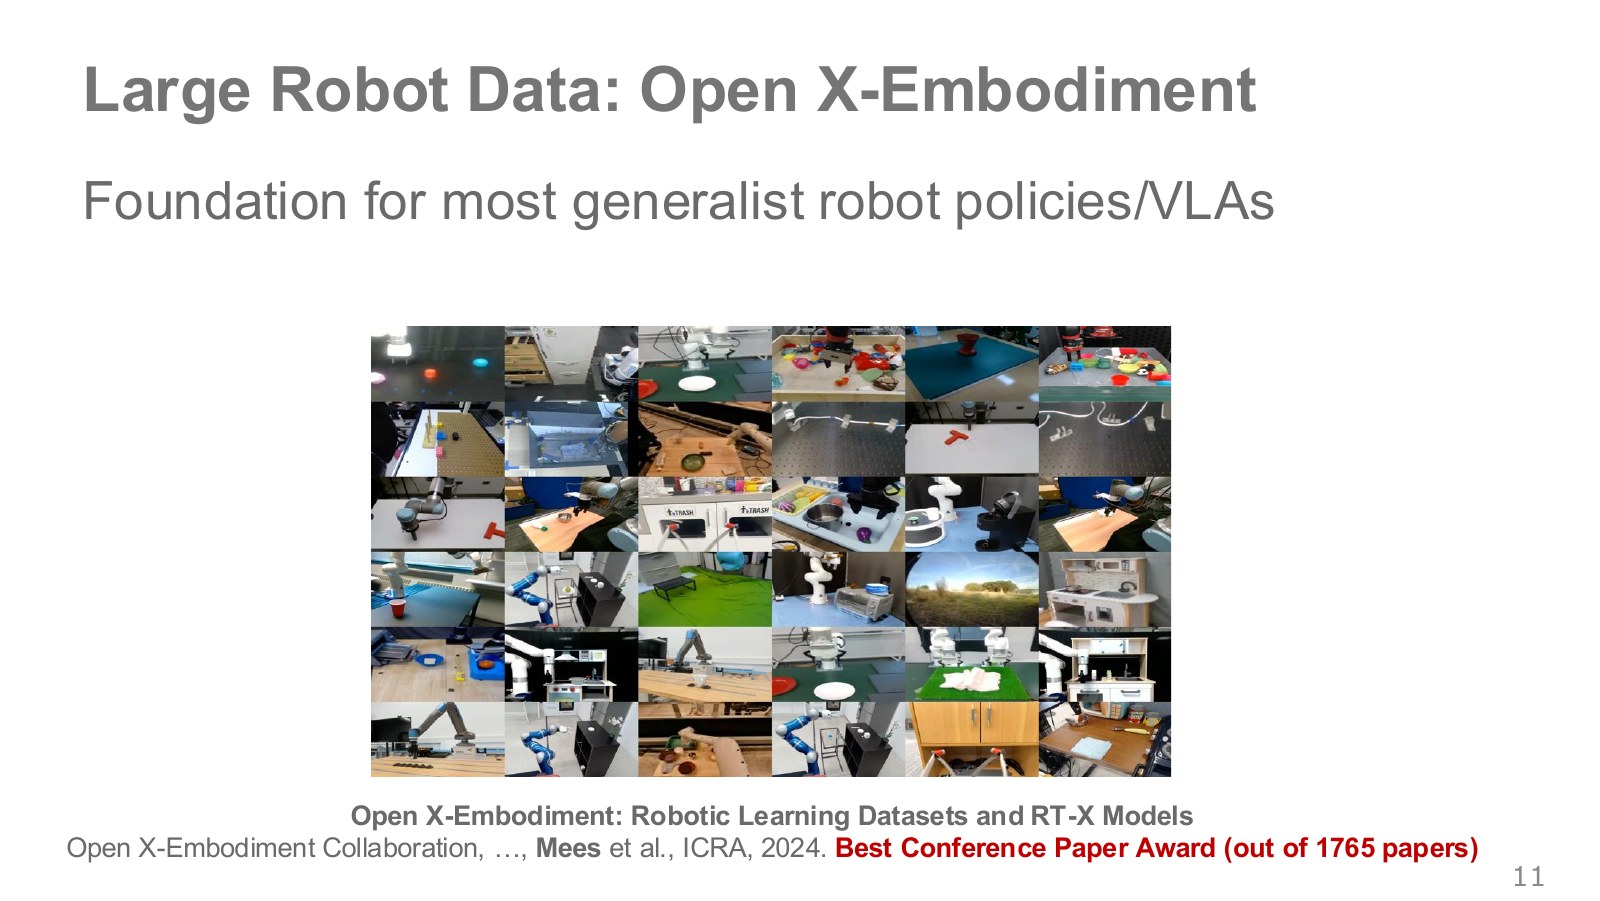
OXE는 여러 후속 정책이 일부 데이터를 다시 쓸 수 있게 했다. 공개된 전체 에피소드 수와 개별 정책의 훈련에 실제로 사용한 에피소드 수는 자료 선택과 필터에 따라 달라진다.
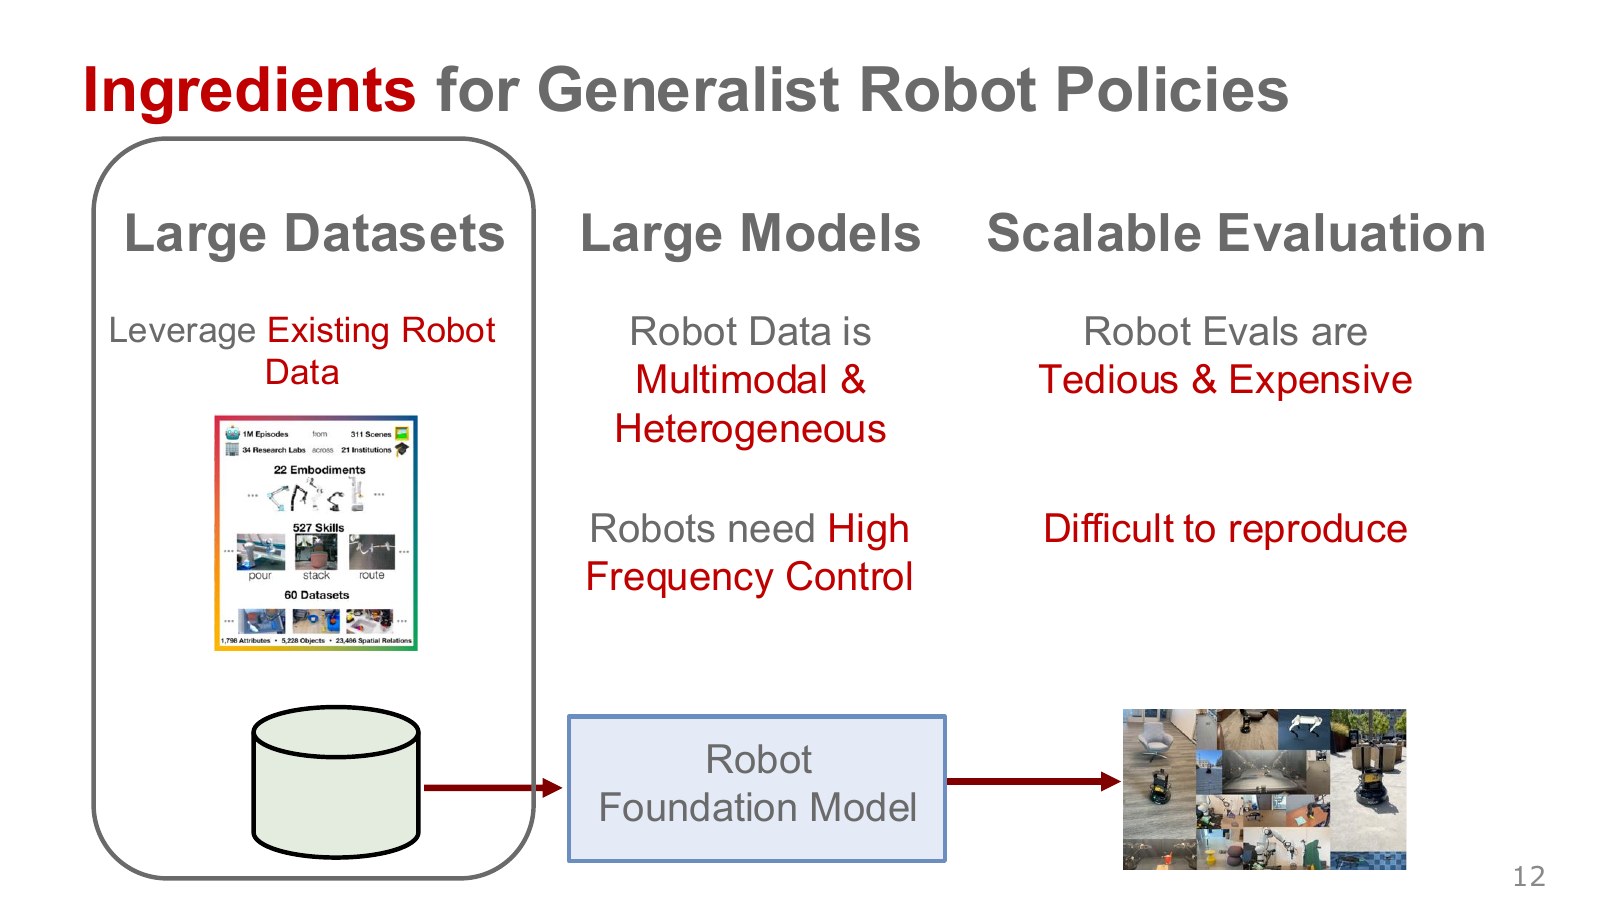
카메라가 하나인 팔과 손목 카메라가 있는 팔을 함께 학습시키려면 두 입력을 받아들이면서 빠진 관측이 무엇인지 알아야 한다.
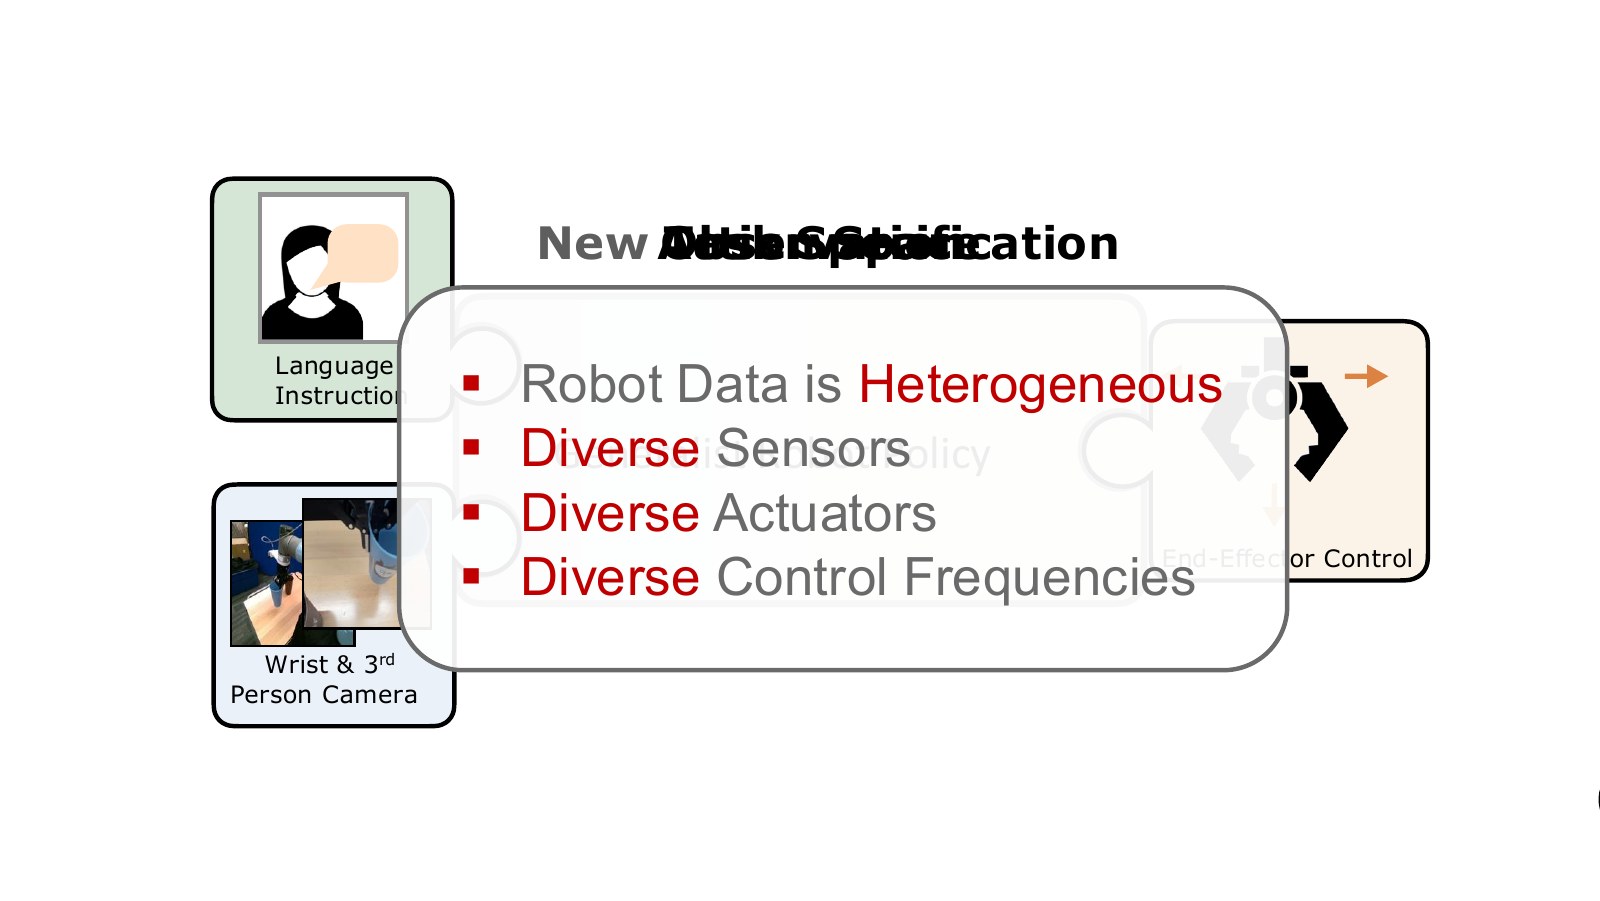
외부 카메라와 손목 카메라는 같은 컵을 다른 위치에서 본다. 같은 출력값이라도 한 로봇은 손끝 이동량, 다른 로봇은 관절 속도로 해석할 수 있다. 두 차이를 입력과 출력에서 각각 처리한다.
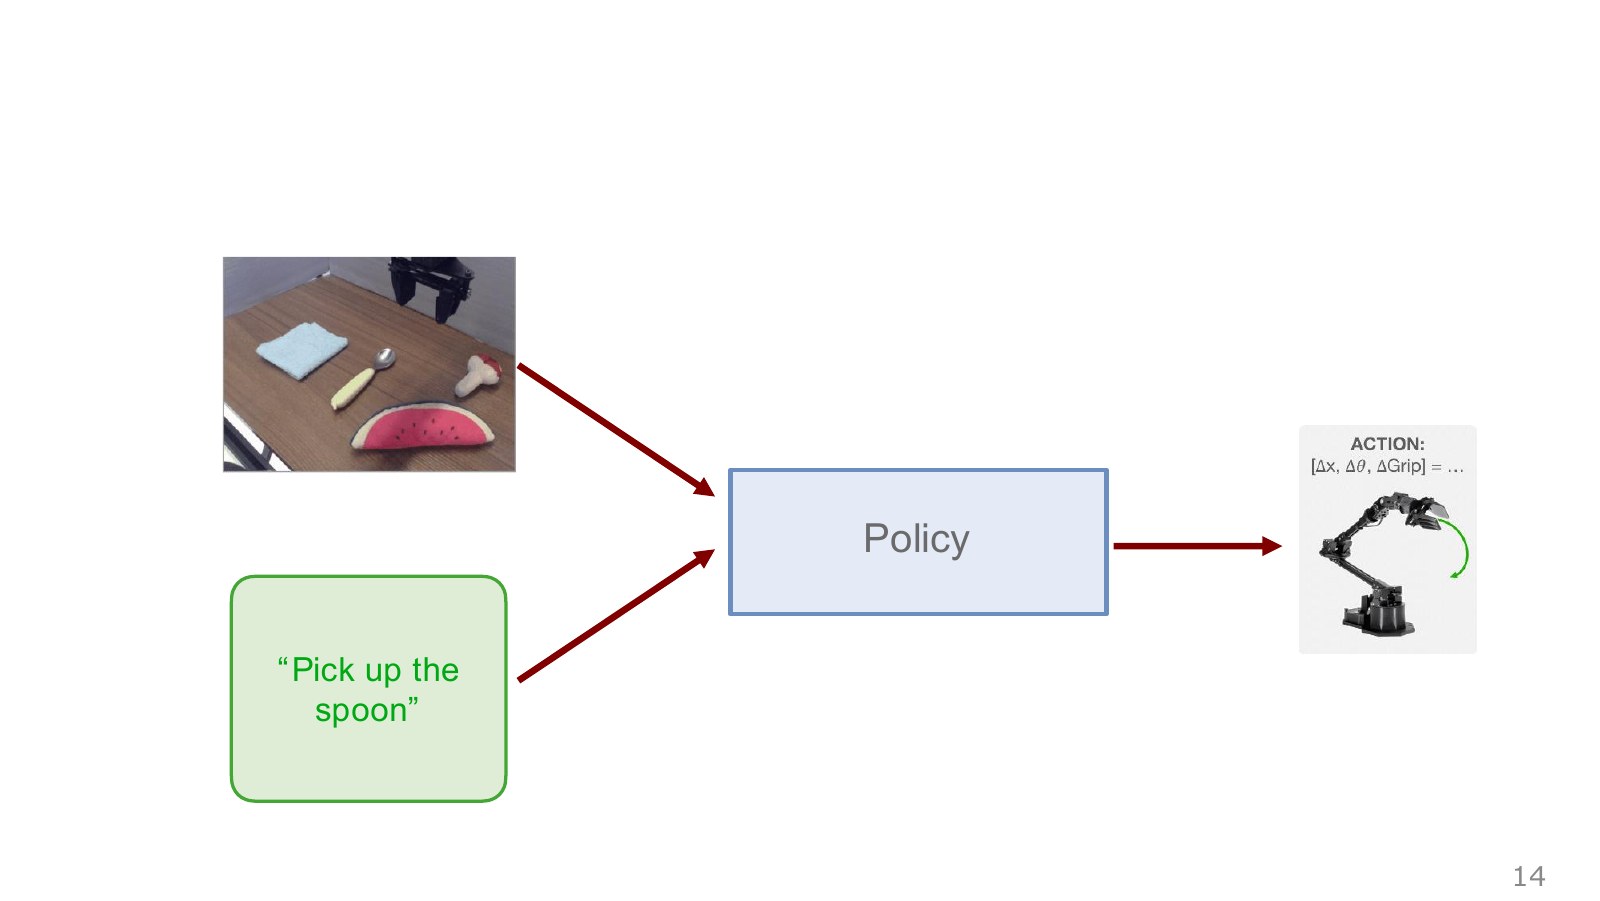
숟가락을 집으라는 말과 사진을 함께 받은 정책은 어떤 물체인지 구별하고, 손을 어디로 이동할지 정한다.
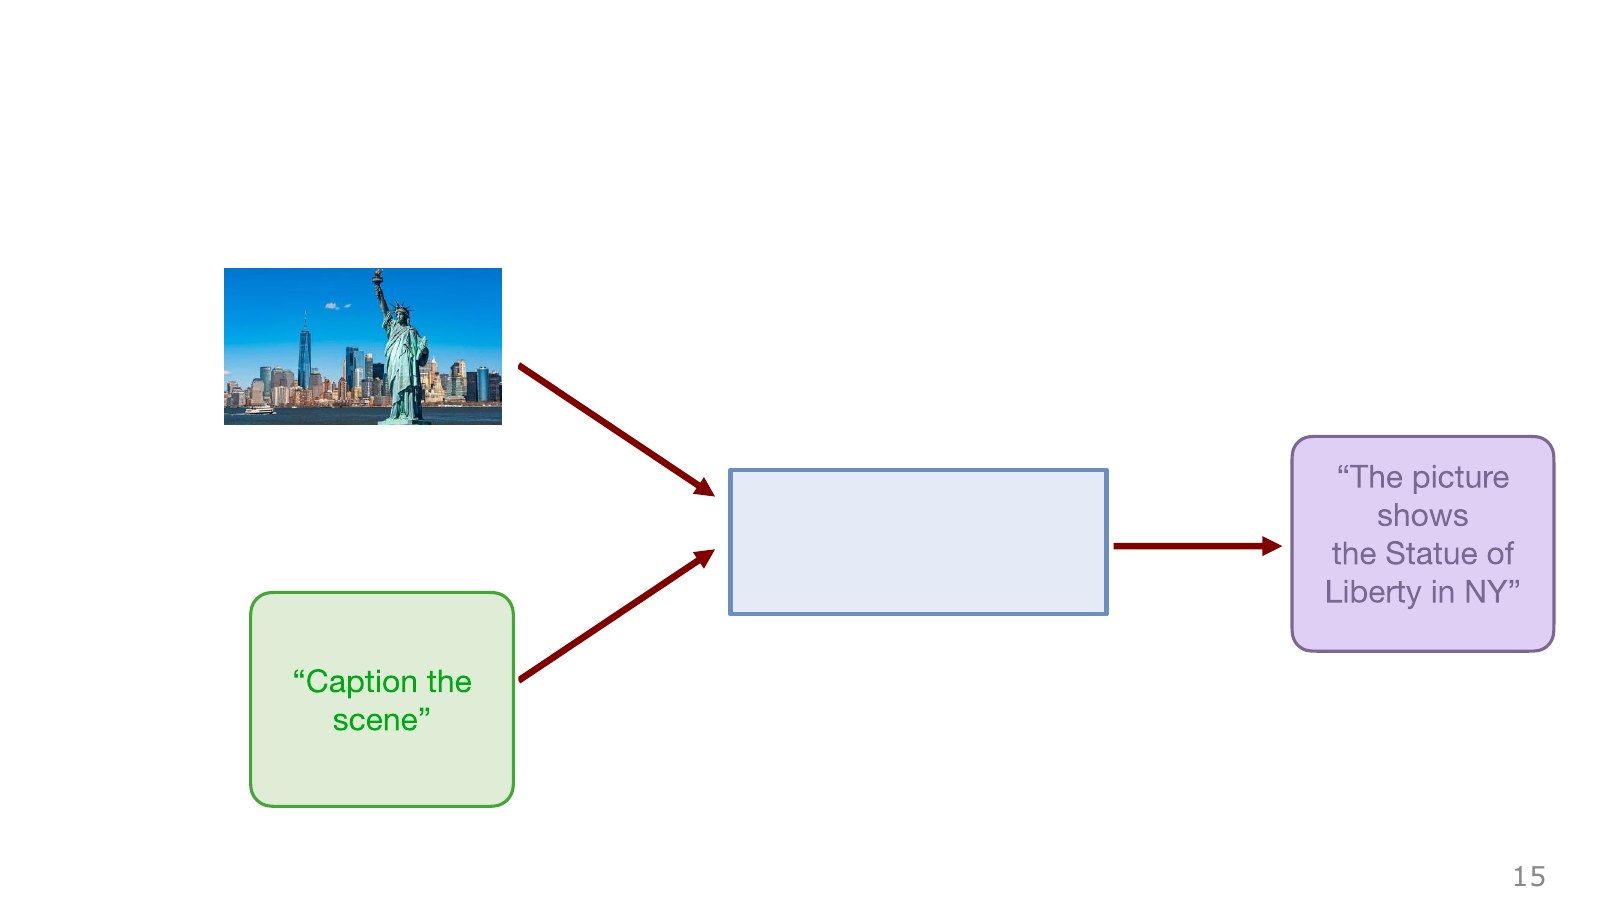
자유의 여신상 그림에 대해 설명을 요청하면 시각언어 모델은 이미지와 문장을 연결한다. 이 그림은 로봇 지시도 입력 형식이 비슷하다는 점을 보여 준다.
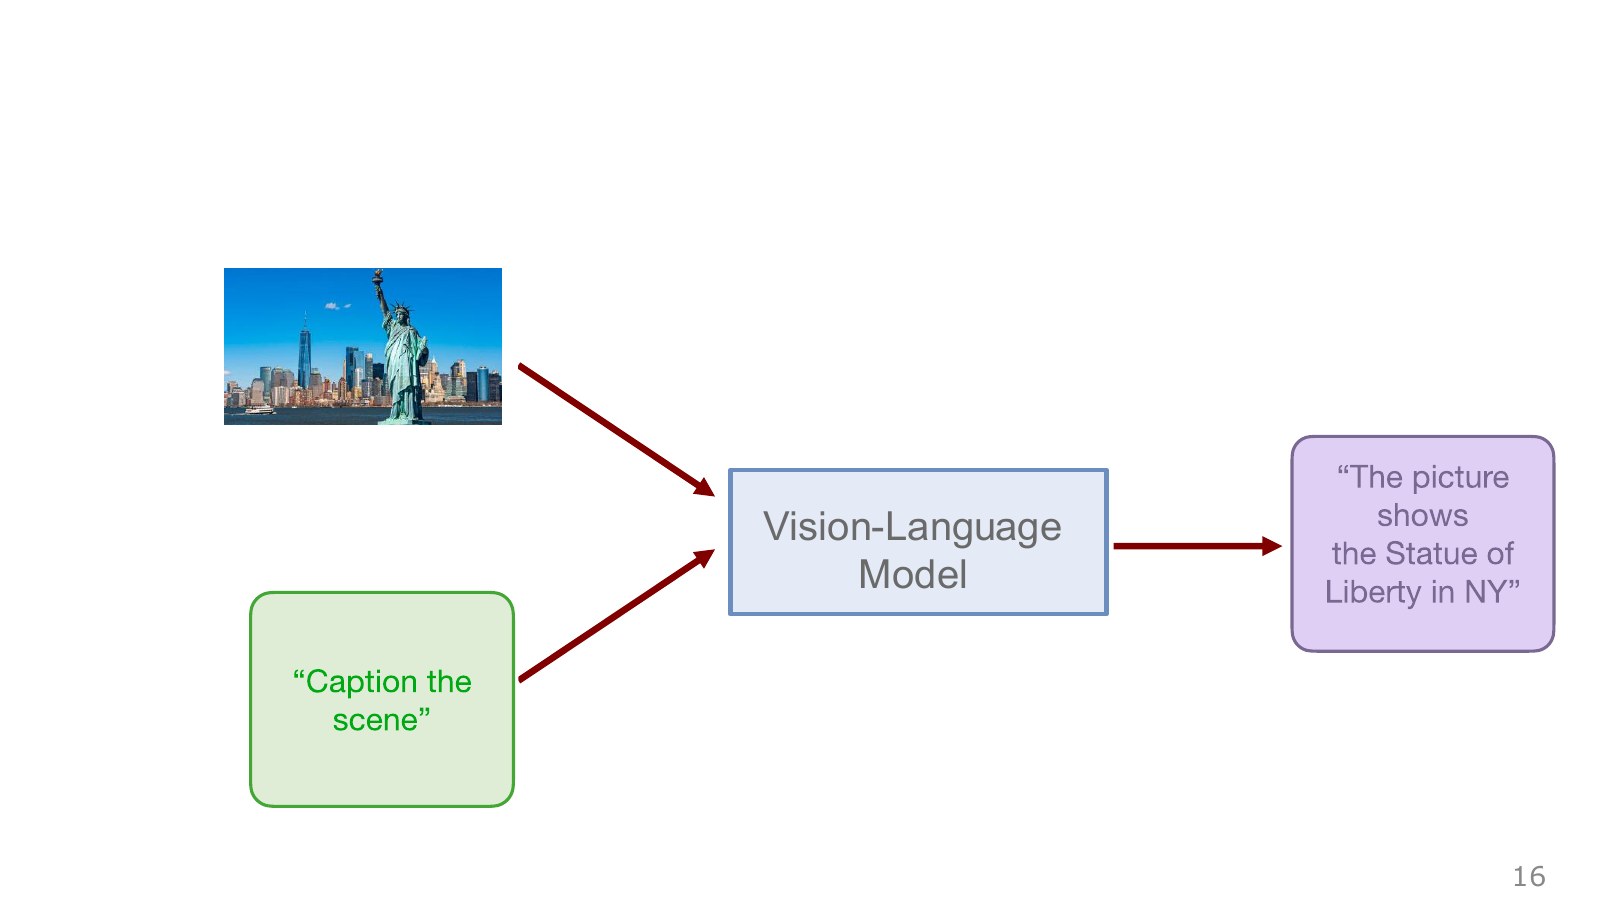
시각언어 모델의 출력은 설명 문장이다. 행동 정책을 만들 때는 그 표현을 이용해 손끝 이동이나 집게 열림 같은 제어값을 예측하도록 학습한다.
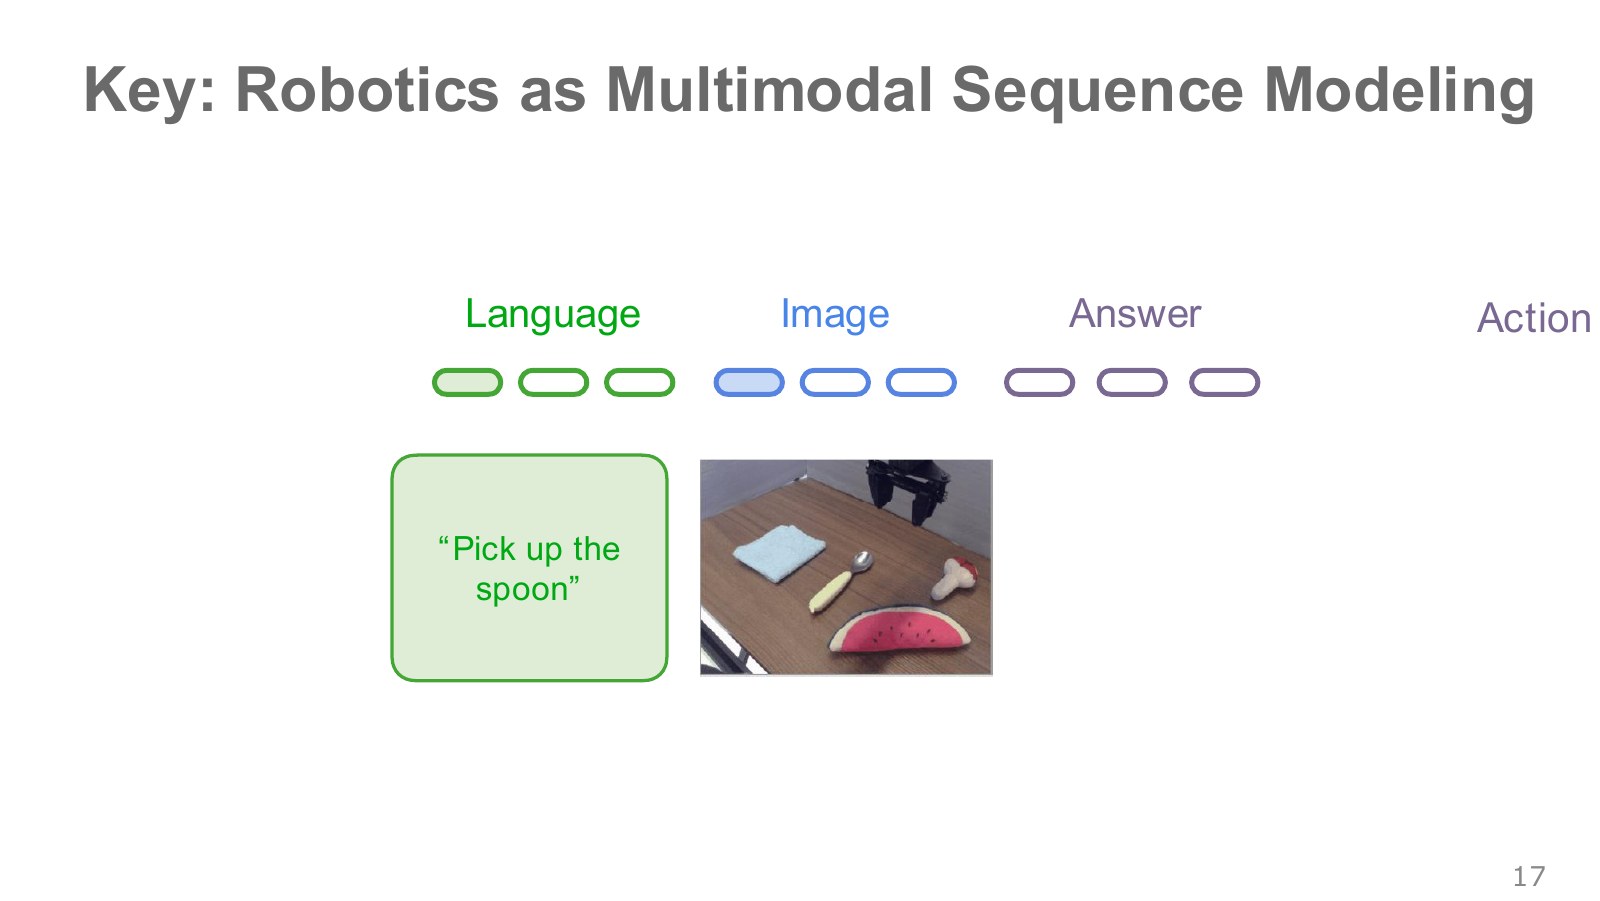
이미지 패치와 지시의 단어를 벡터로 바꾸고 Transformer에서 서로 참고하게 한다. 행동도 토큰으로 표현하거나, 연속값을 만드는 별도 모듈을 붙일 수 있다.
#Octo가 목표와 관측을 행동으로 바꾸는 법
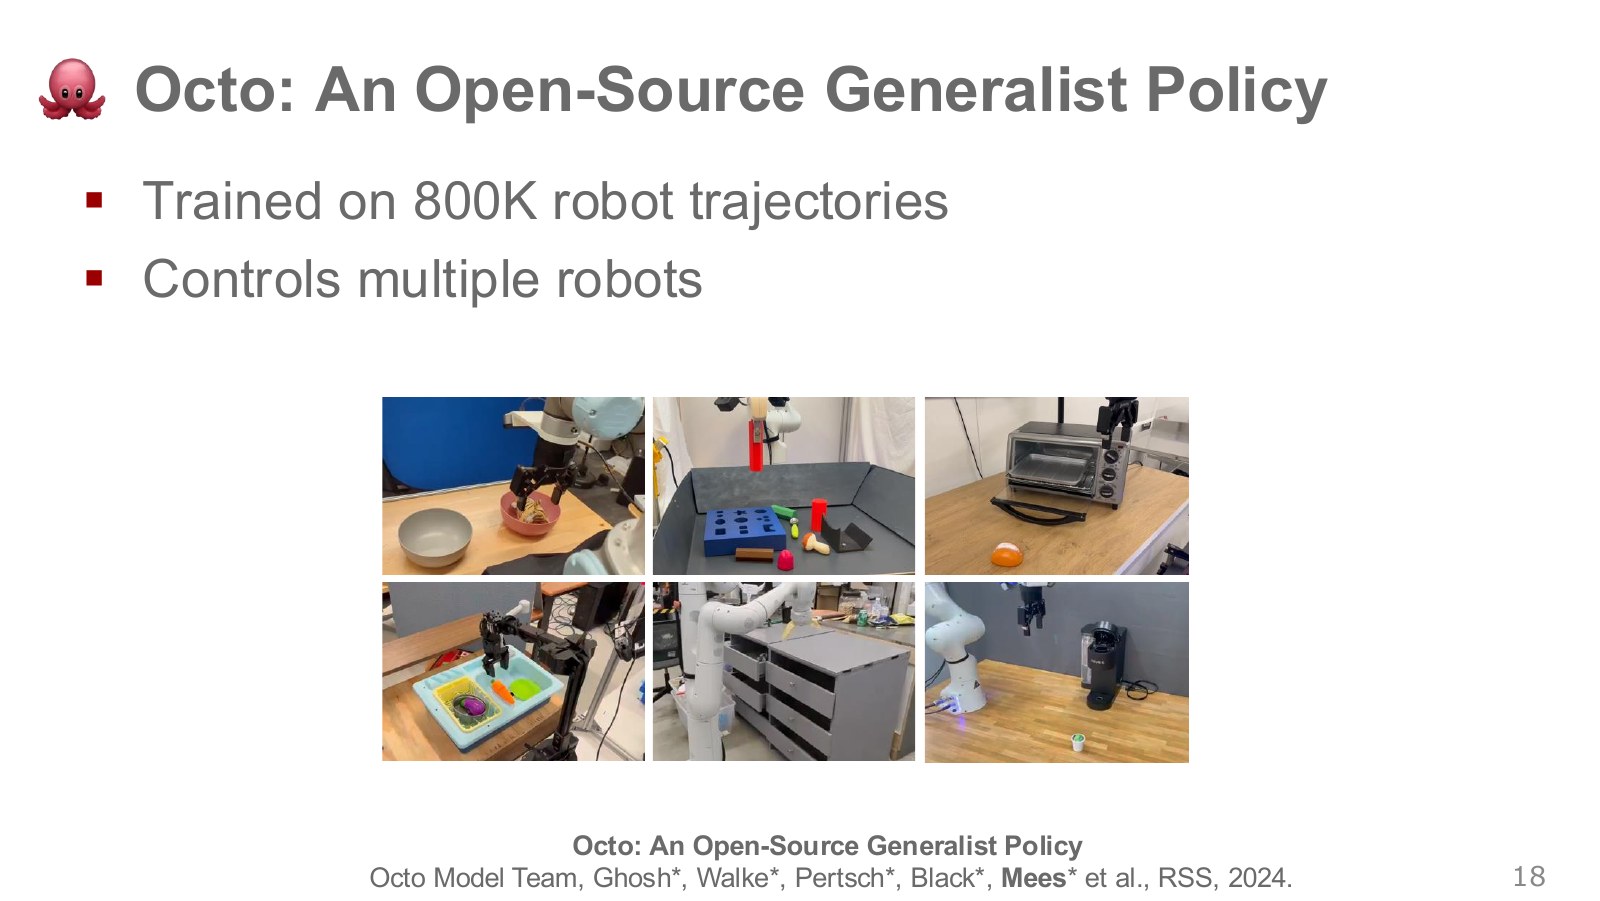
Octo는 OXE에서 선별한 약 80만 에피소드로 학습한 공개 정책이다. 언어 지시 또는 목표 이미지를 받을 수 있고, 데이터가 있는 장비에서 직접 평가하거나 새 장비의 자료로 미세조정한다. Octo 프로젝트
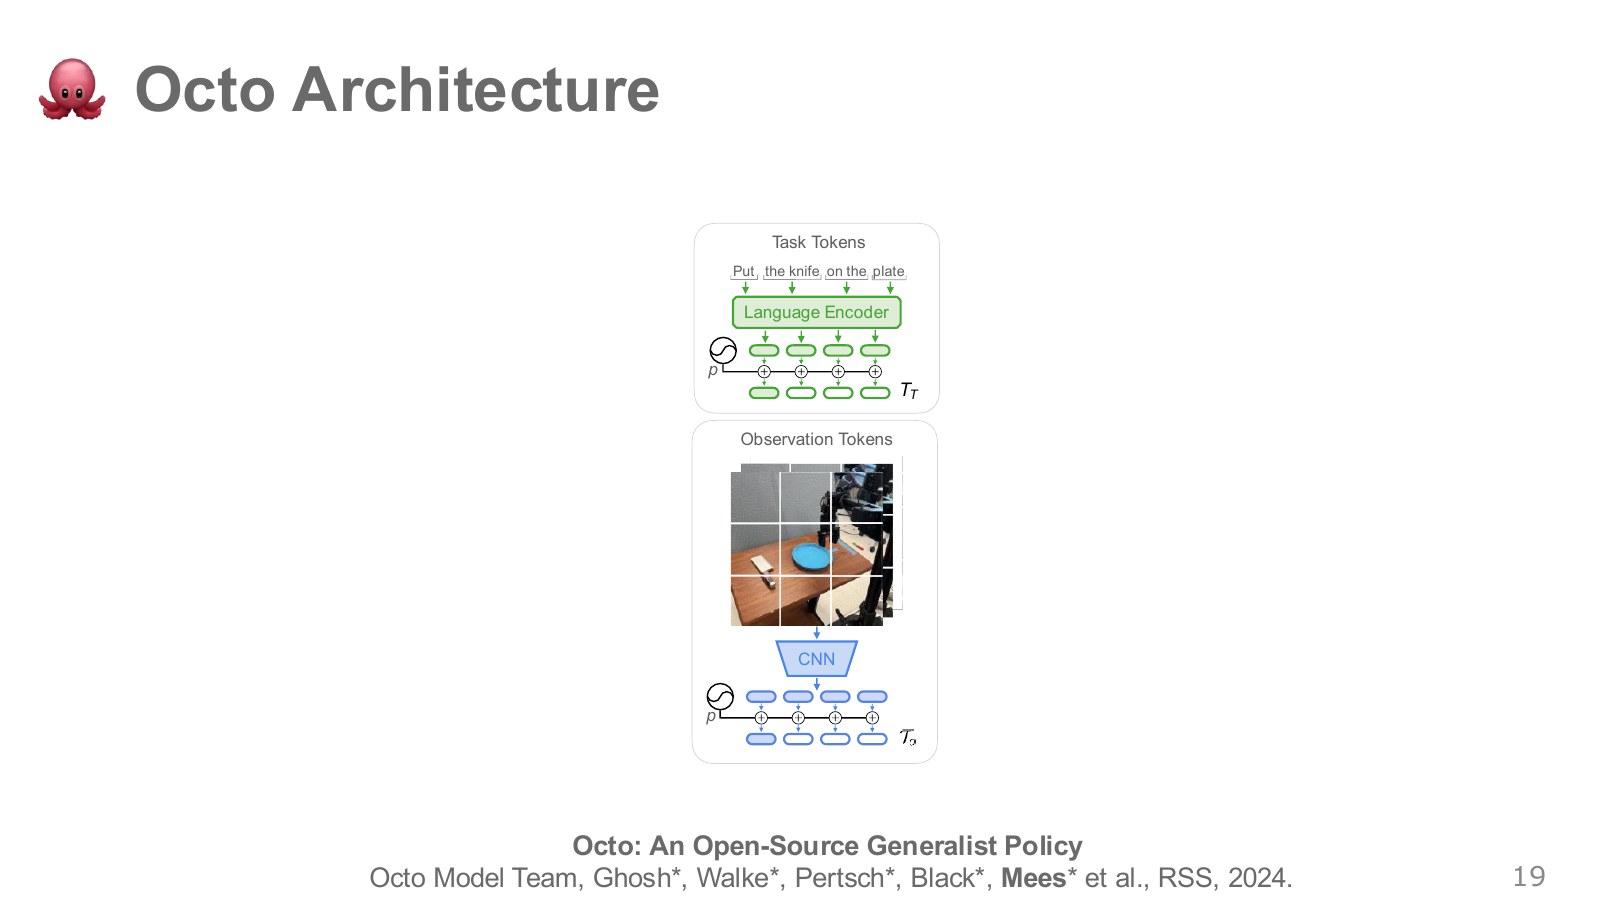
칼을 접시 위에 놓으라는 문장은 목표를, 외부·손목 영상은 현재 위치를 알려 준다. 그림의 두 줄을 따라가면 무엇을 할지와 지금 어디에 있는지가 따로 들어간다.
언어는 사전학습된 T5가 표현하고, 영상은 작은 합성곱 인코더에서 관측 토큰으로 바뀐다. Transformer는 둘을 함께 읽으며 보라색 리드아웃 토큰에 행동을 생성하는 데 필요한 정보를 모은다. 이 토큰 자체의 숫자를 모터에 보내는 대신 확산 헤드에 전달한다. Octo 논문
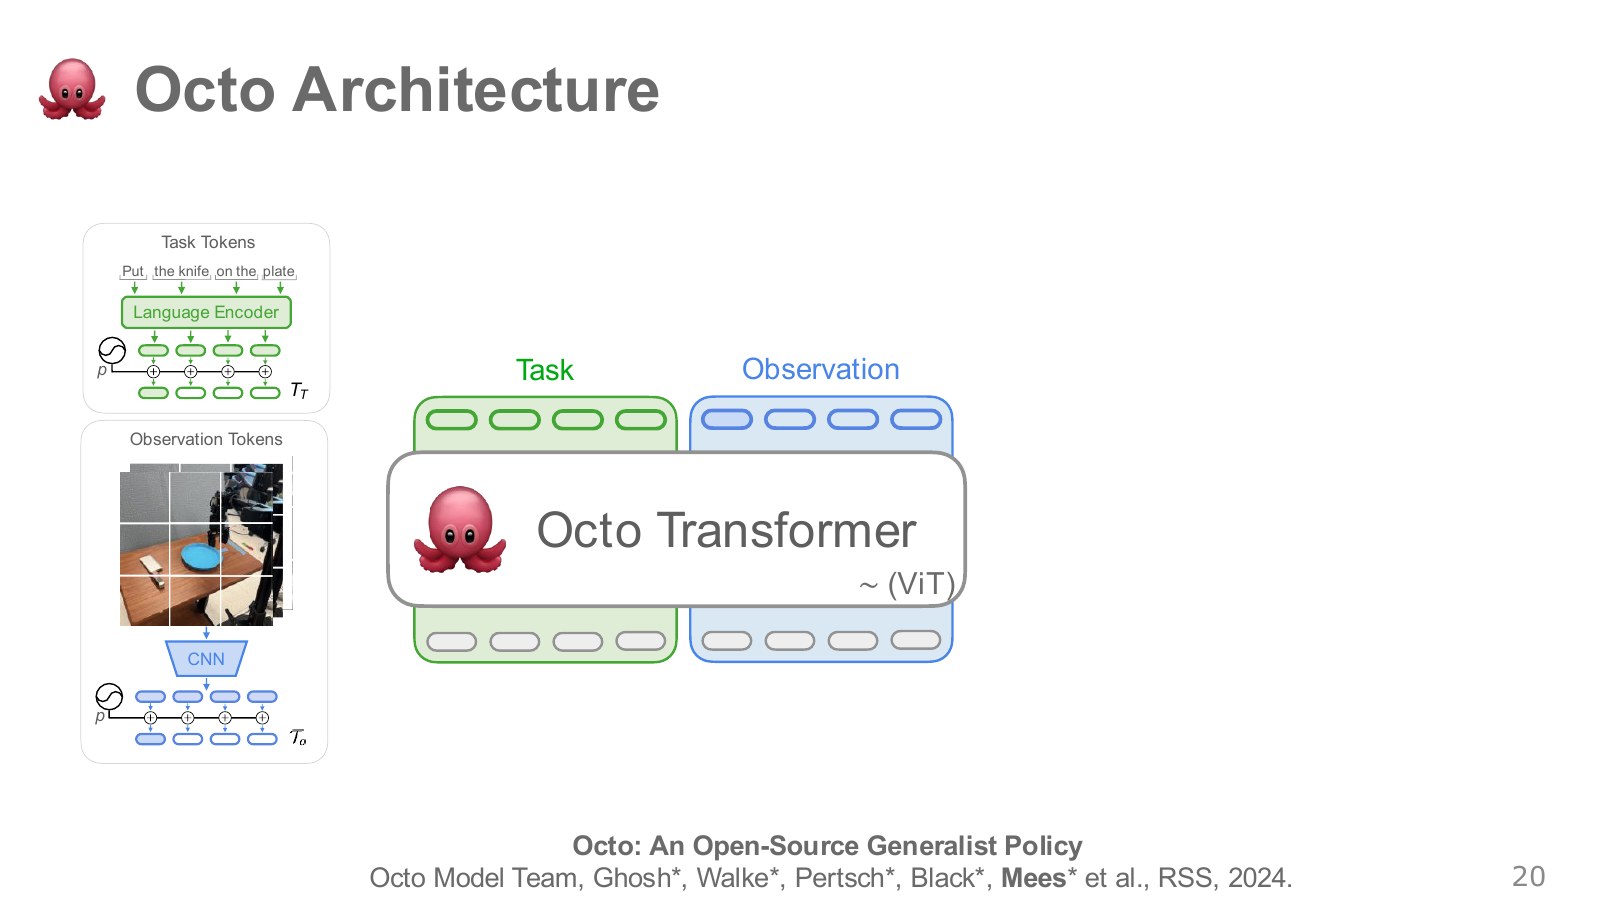
Octo는 블록 단위의 인과 어텐션을 사용한다. 현재 시점의 행동을 만드는 표현이 과거와 현재 관측을 읽게 해, 실행할 때 아직 찍히지 않은 미래 카메라를 참조하는 상황을 막는다.
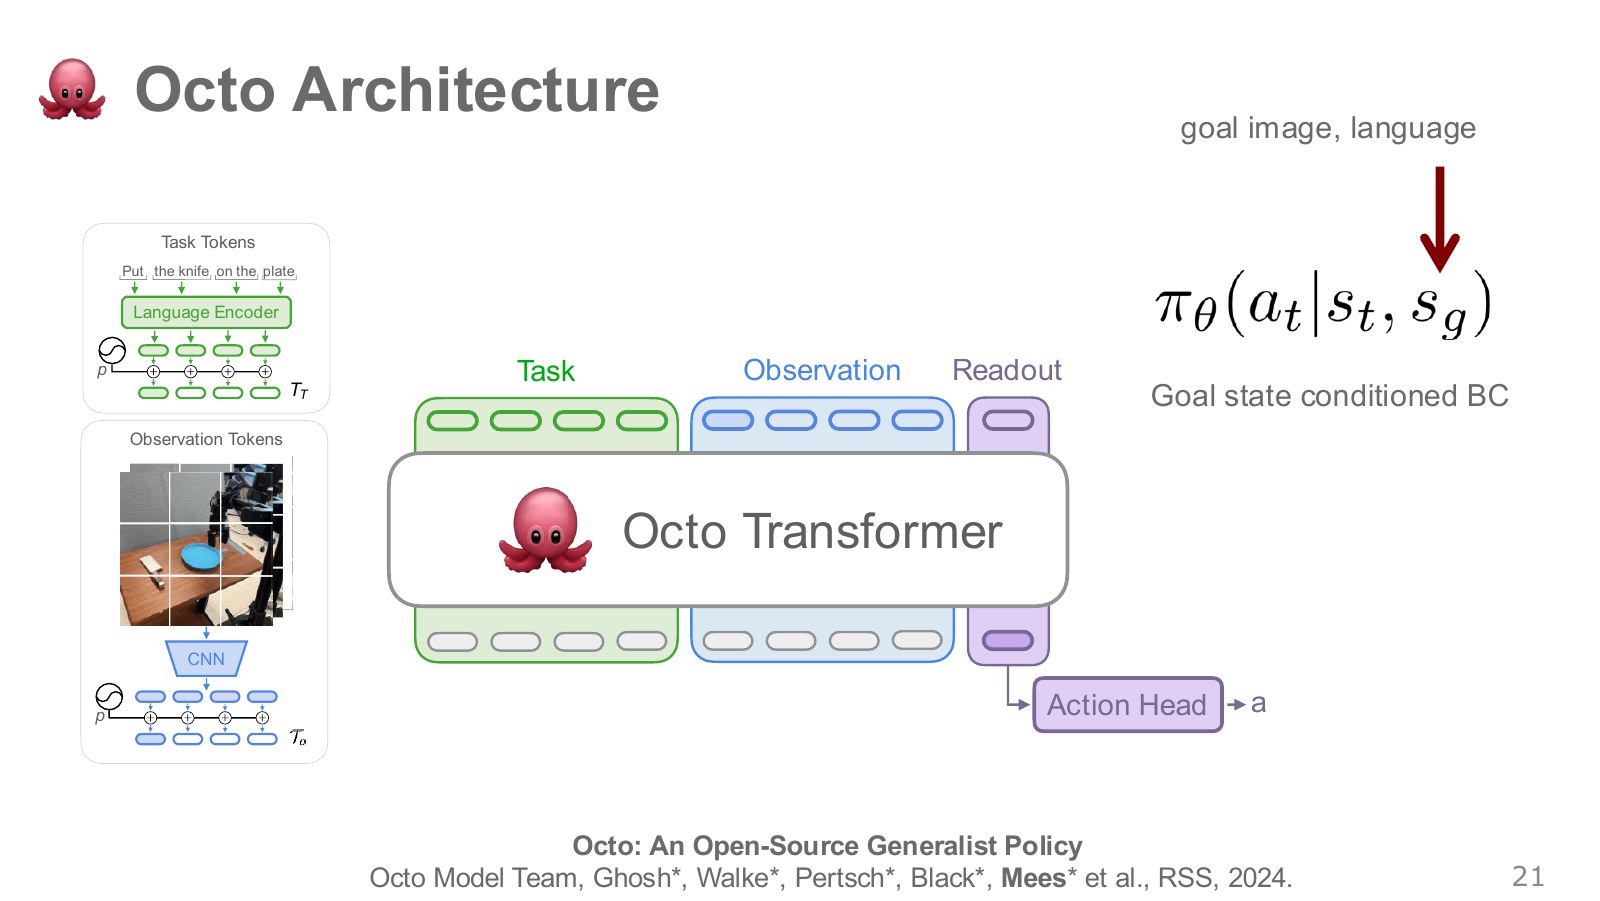
목표 상태 이미지를 준다면 접시에 칼이 놓인 완성 사진과 현재 사진의 차이가 행동 선택에 쓰인다. 언어로 목표를 표현할 때도 같은 방식으로 정책에 조건을 제공한다.
기호 뜻과 계산 과정 자세히 보기 목표를 조건으로 행동 선택
이 식을 말로 읽으면
현재까지의 관측과 목표를 입력하면 정책은 각 행동의 가능성을 정한다. 같은 장면에서 목표를 바꾸면 움직임도 달라질 수 있다.
기호 하나씩 이해하기
- 현재 행동
- 현재까지의 관측
- 목표
계산을 따라가는 순서
- 먼저 영상에서 칼과 접시의 위치를 읽는다.
- 목표를 조건으로 넣고 실행할 동작을 고른다.
작은 예시로 확인하기
칼을 접시에 놓으라는 지시에서는 접시 쪽으로, 서랍에 넣으라는 지시에서는 서랍 쪽으로 움직인다.
식을 이해하기 위한 설명용 예시입니다.
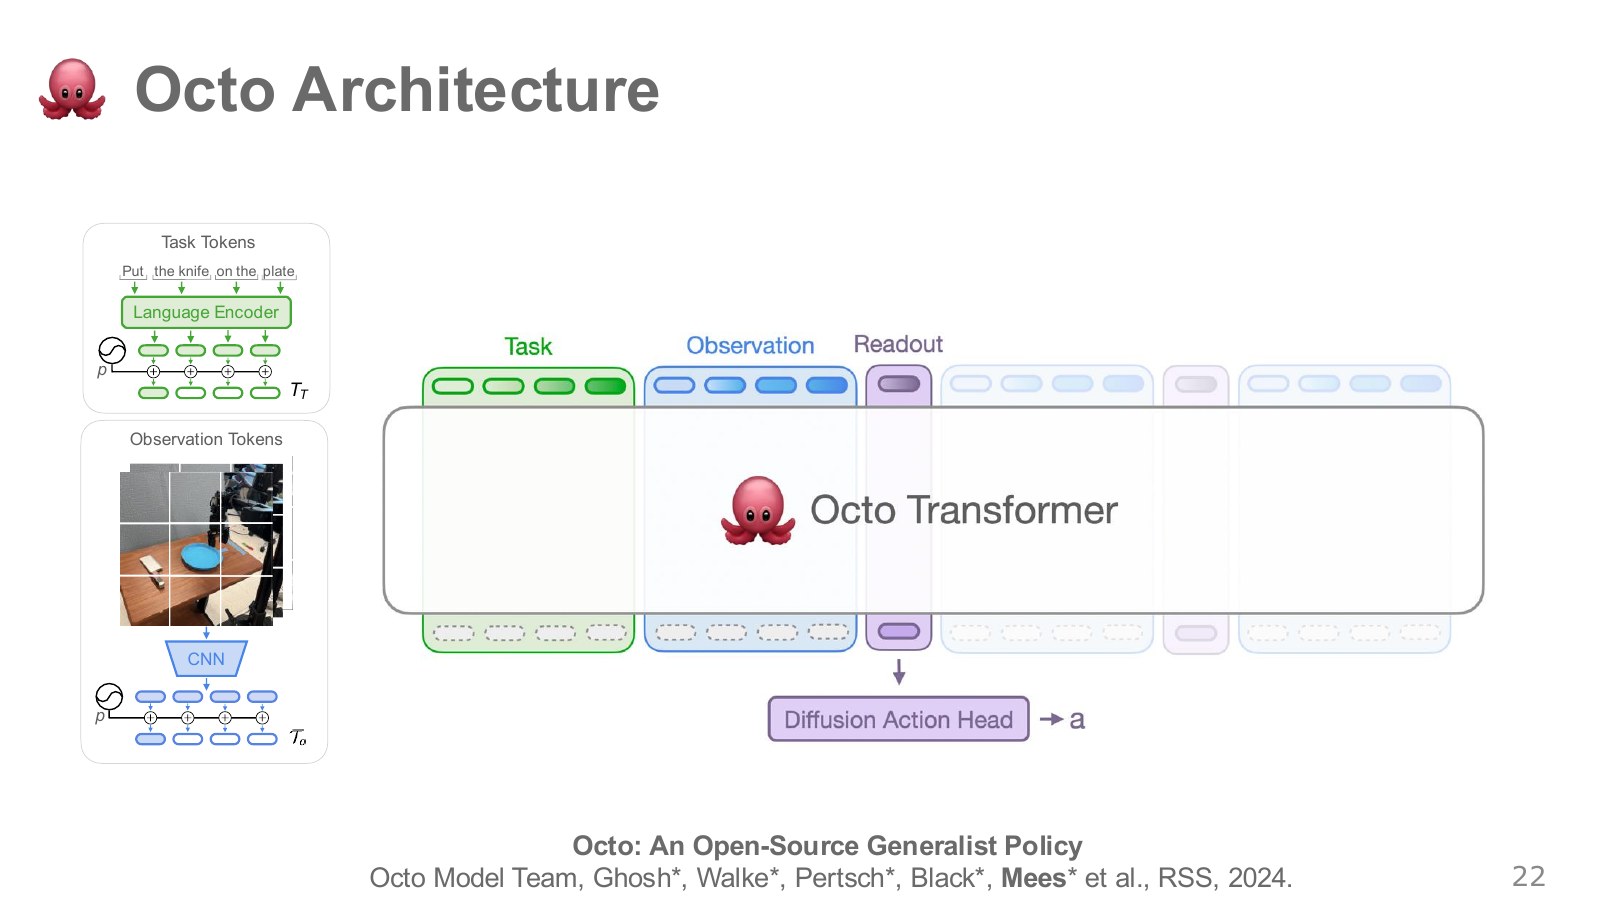
읽기용 토큰에 모인 정보를 행동 모듈에 보내면 노이즈에서 여러 시점의 연속 제어값을 만들어 낸다. 같은 컵을 왼쪽으로 돌아 집거나 오른쪽으로 접근하는 움직임을 학습하는 데 분포가 필요하다.
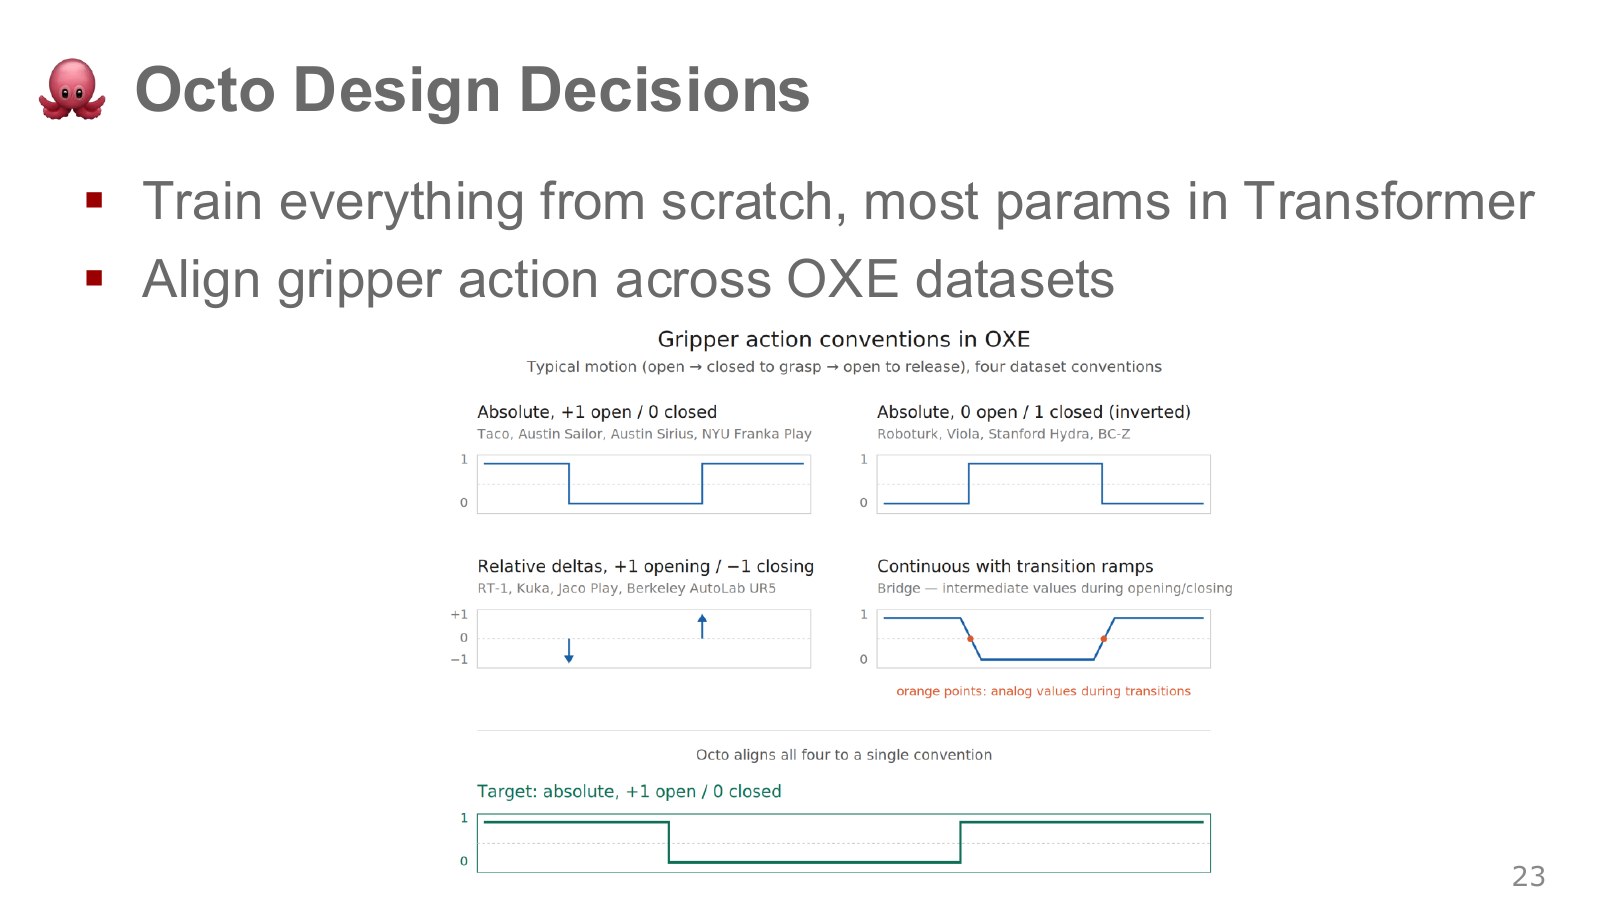
한 데이터의 1은 열림이고 다른 데이터의 1은 닫힘이다. 연속값이나 변화 방향만 기록한 데이터도 있다. 두 이진 절대값 규약은 반전으로 맞출 수 있고, 상대 명령은 열고 닫는 시점과 상태를 살펴 변환해야 한다.
기호 뜻과 계산 과정 자세히 보기 집게의 절대값 규약 변환
이 식을 말로 읽으면
같은 집게 상태를 반대로 기록한 두 이진 규약을 맞추려면 기존 값에서 열림과 닫힘의 번호를 서로 바꾼다.
기호 하나씩 이해하기
- 열림을 1로 기록한 값
- 닫힘을 1로 기록한 값
계산을 따라가는 순서
- 기록에서 0과 1이 실제 어느 상태인지 확인한다.
- 닫힘 기준의 값을 1에서 뺀다.
작은 예시로 확인하기
완전히 열린 시점의 닫힘 기준이 0이면 결과는 1이다. 닫힌 시점에 기존 값이 1이면 결과는 0이다.
식을 이해하기 위한 설명용 예시입니다.
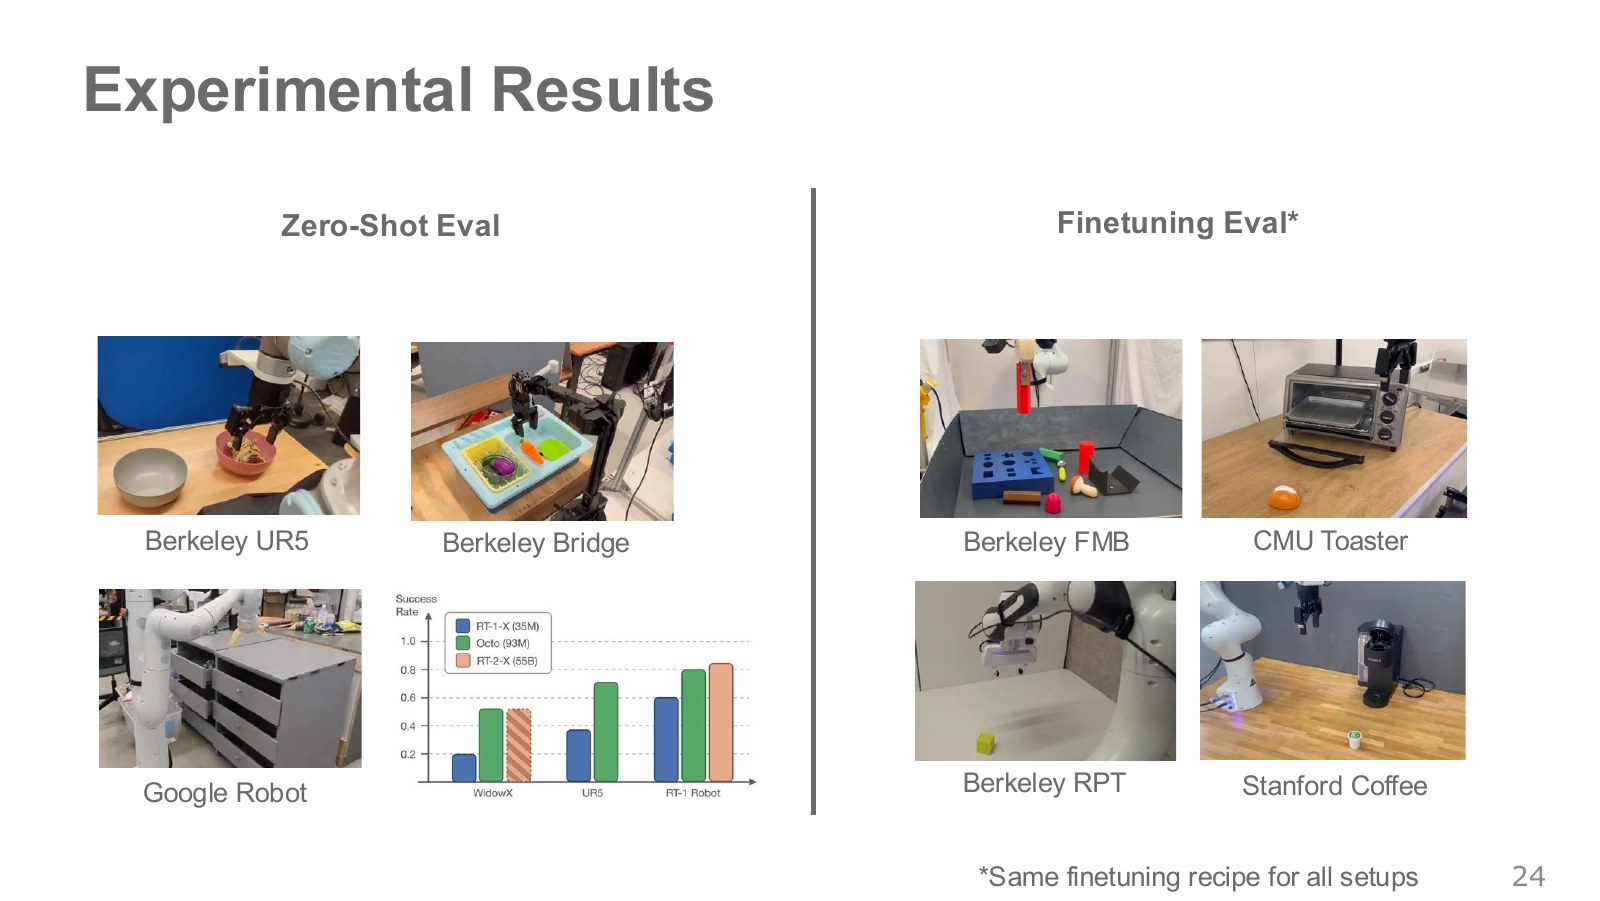
제로샷 결과는 해당 평가에서 새 시연으로 추가 학습하지 않은 모델의 결과다. 커피 만들기나 정밀 삽입 등 미세조정 결과는 해당 과제 자료를 쓴 뒤 측정한다. 그림의 두 묶음은 출발 조건이 다르다.
영상으로 집게가 닫히는 위치와 물체가 빠지는 시점을 살펴보면 성공률 숫자만으로 찾기 어려운 오류를 알 수 있다. 여러 장비를 평가할수록 조건별 반복과 실패 기록이 필요하다.
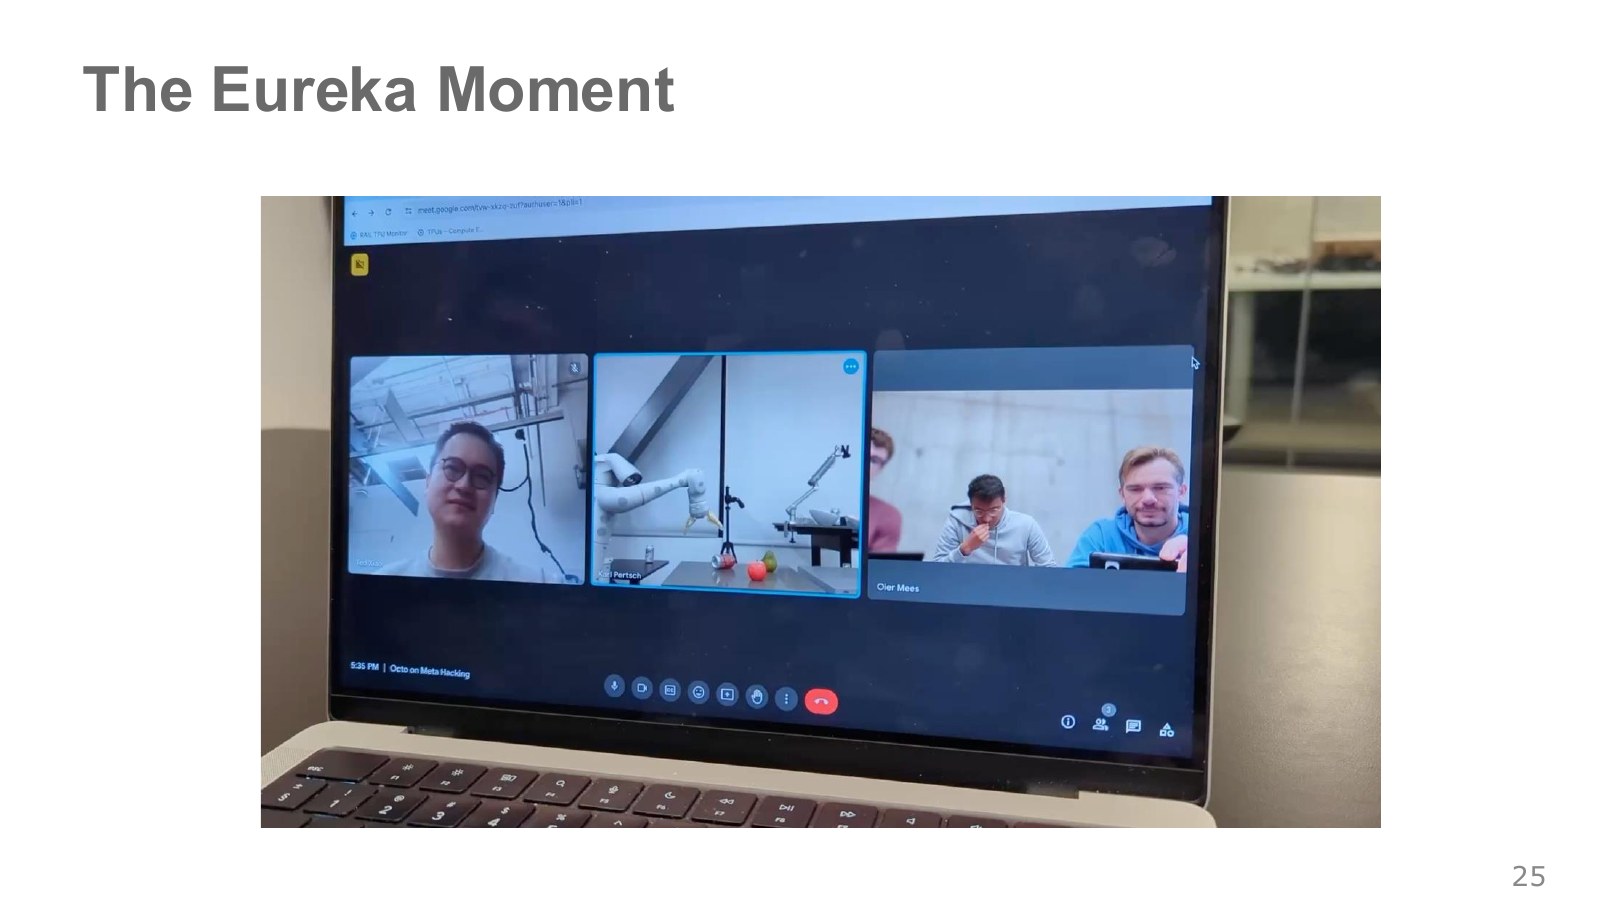
강연자가 보여 준 첫 Google 로봇 파지에서는 원격 서버에서 정책을 실행했고 Quan Vuong이 현장 평가를 도왔다. 학습에 Google 로봇 기록이 들어 있었지만, 테스트 장소는 수집 때와 다른 건물이었다. 한 번 성공한 영상은 낯선 장소에서도 작동한 사례이며 성공률은 반복 시험으로 따로 계산한다.
새 로봇의 손목 영상이나 힘 센서를 추가하면 입력 형식이 달라진다. 7개 관절 속도 대신 손끝 목표 자세를 내보내려면 출력 형식도 달라진다.
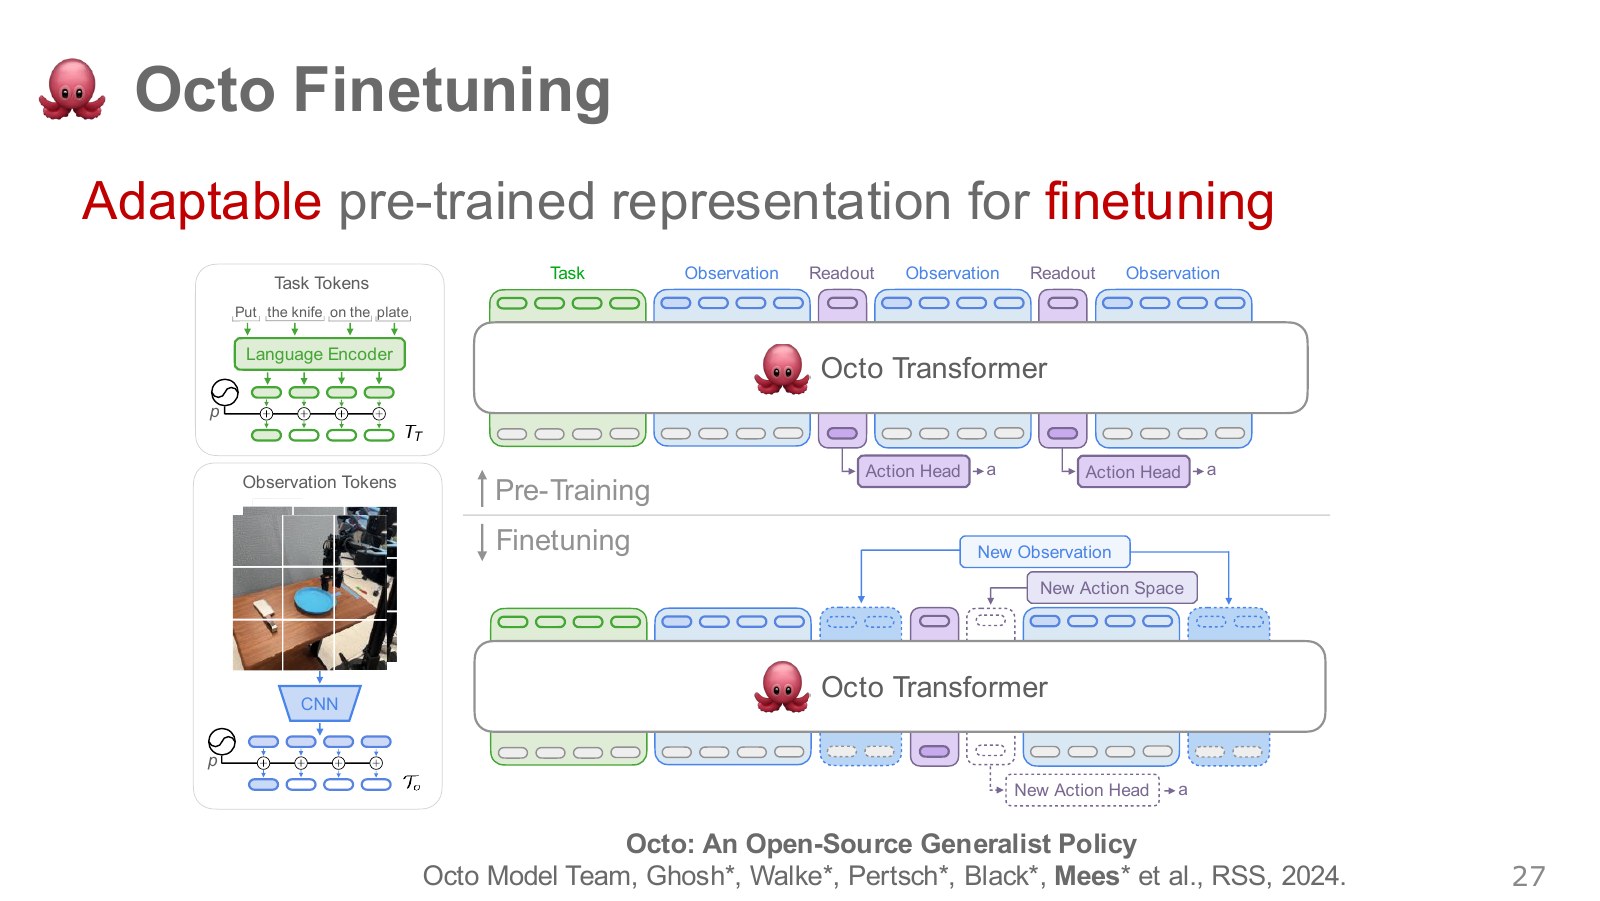
Octo 그림의 위쪽은 사전학습, 아래쪽은 미세조정이다. 새 센서를 토큰으로 바꾸는 모듈과 새 출력 헤드를 연결하고, 이미 배운 장면 표현을 초기값으로 쓴다.
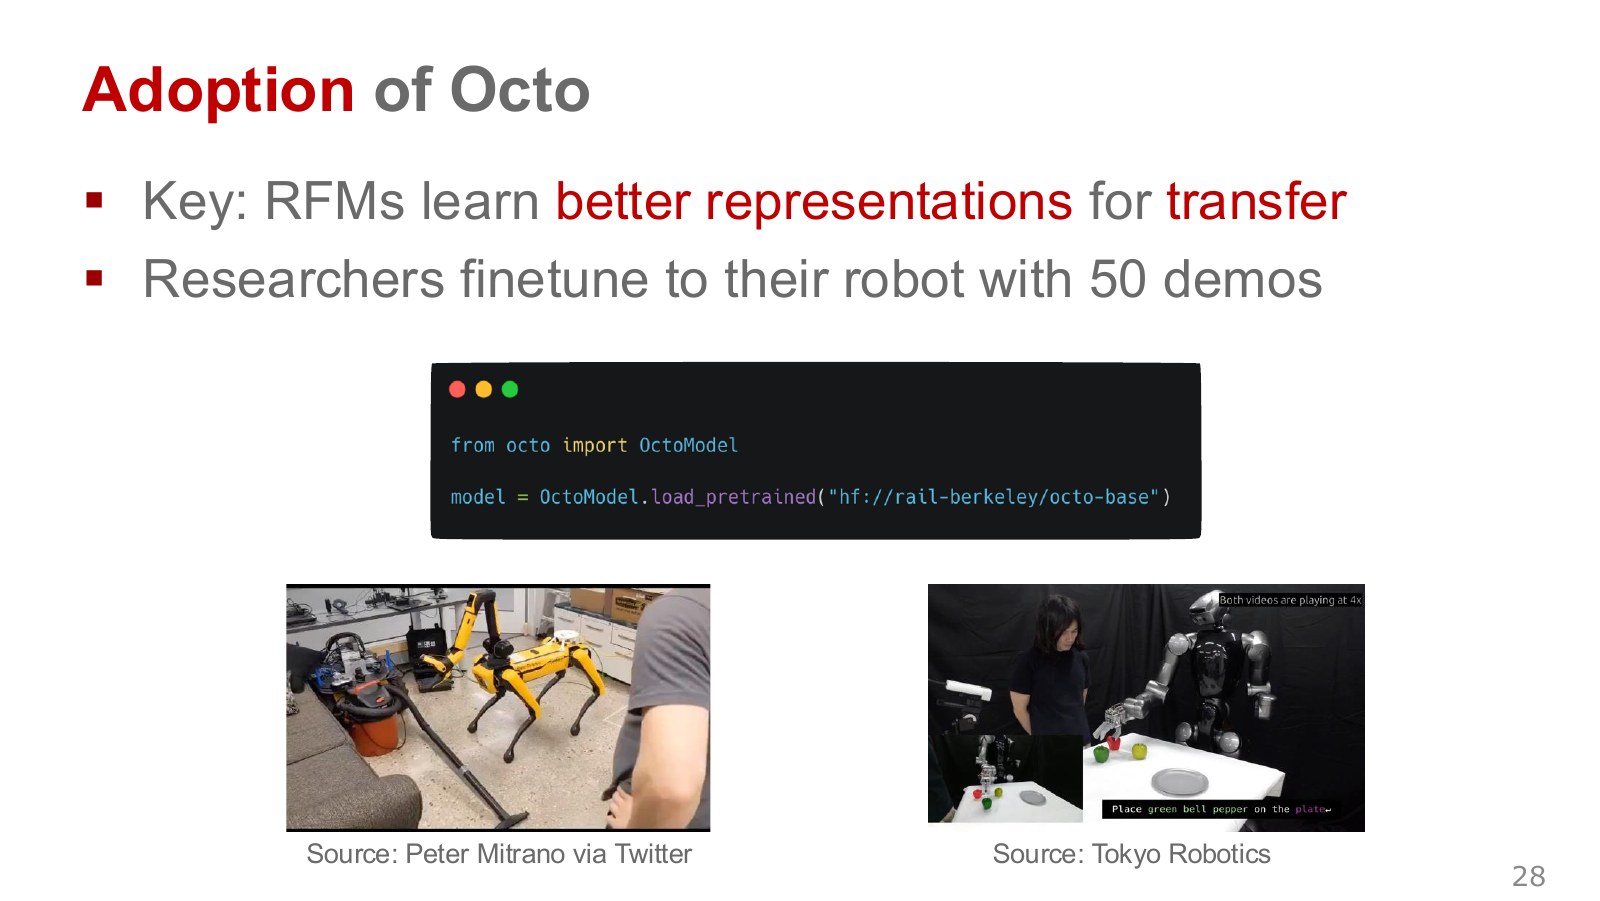
그림의 시연은 연구팀이 공개 모델을 출발점으로 쓴 사례다. 약 50개라는 수치는 소개된 활용 사례의 규모다. 필요한 시연 수는 작업의 정밀도와 사전학습 자료의 관련성에 따라 달라진다.
#장비가 달라도 공유할 수 있는 것
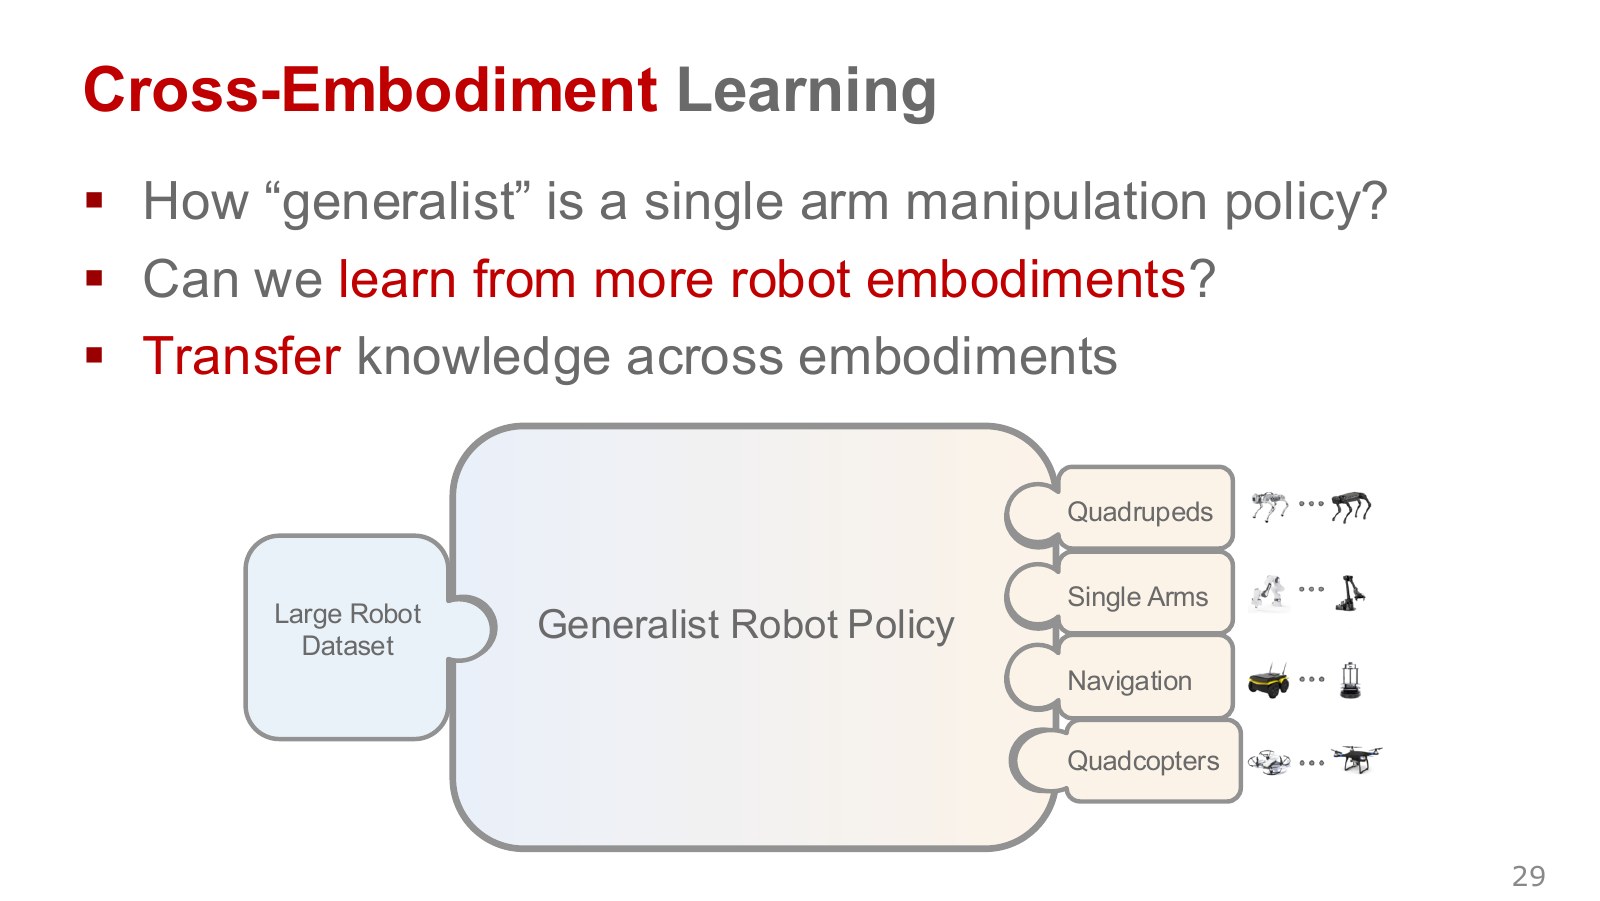
바퀴 로봇의 주행, 네 발 로봇의 보행, 드론의 비행은 관측과 제어가 크게 다르다. 장면을 읽는 표현을 얼마나 공유할 수 있는지 보려면 이런 차이를 가진 장비까지 시험할 수 있다.
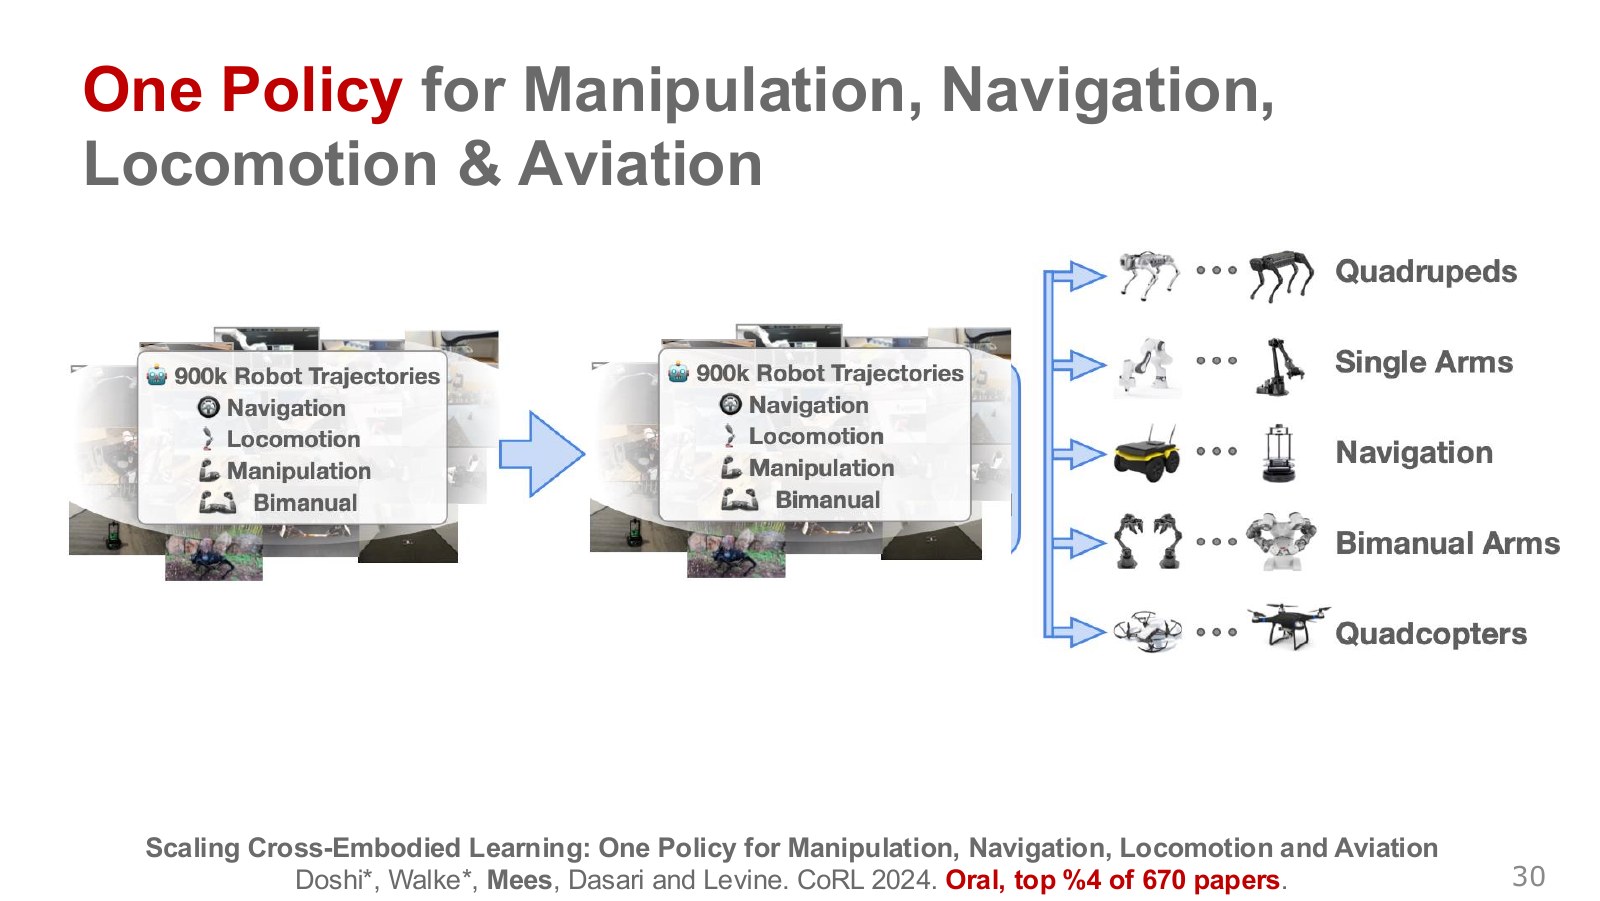
CrossFormer는 약 90만 궤적을 모아 여러 장비를 하나의 정책 구조로 다뤘다. 사진에서 같은 장애물을 찾아도 팔을 피해 움직이는 방법과 드론이 고도를 바꾸는 방법은 다르다.
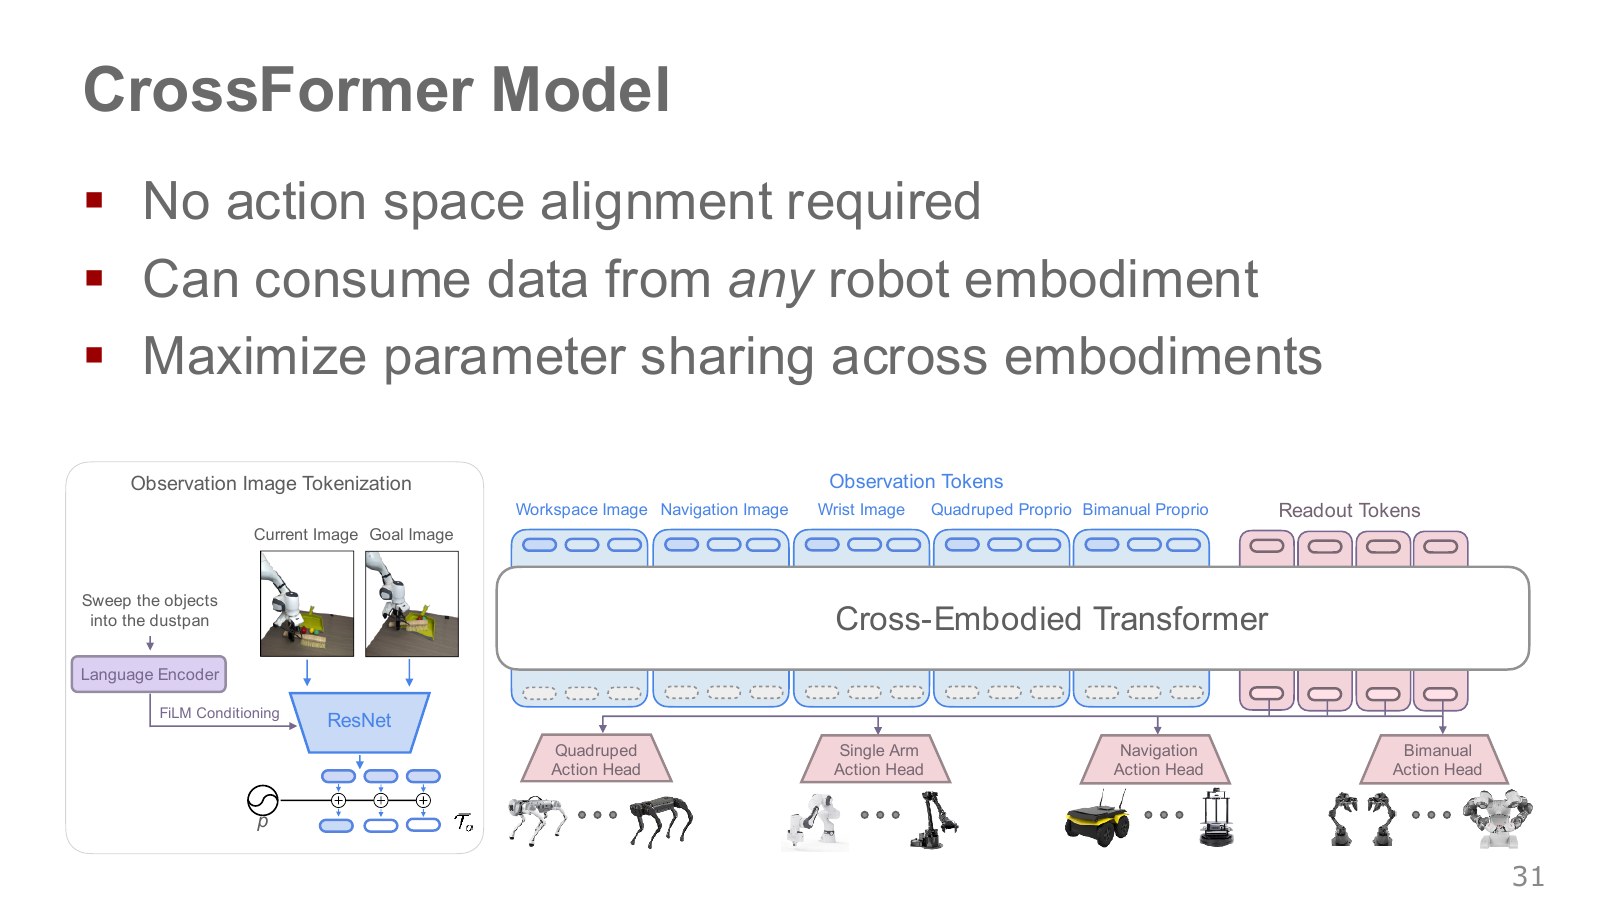
CrossFormer는 Transformer 본체를 공유하고 장비마다 출력 헤드를 둔다. 헤드는 공유 표현을 해당 장비의 제어 벡터로 바꾸는 마지막 모듈이다. 드론과 양팔의 행동 차원을 억지로 맞추지 않고도 본체를 공동 학습할 수 있다. CrossFormer 프로젝트
강의의 예에서 WidowX는 5Hz, 양팔 정교 조작 장비는 50Hz로 제어한다. 같은 1초를 예측하려 해도 각각 다섯 개와 쉰 개의 명령이 필요하다. 장비별 헤드는 행동 벡터의 차원뿐 아니라 이런 시간 해상도도 맞출 수 있다.
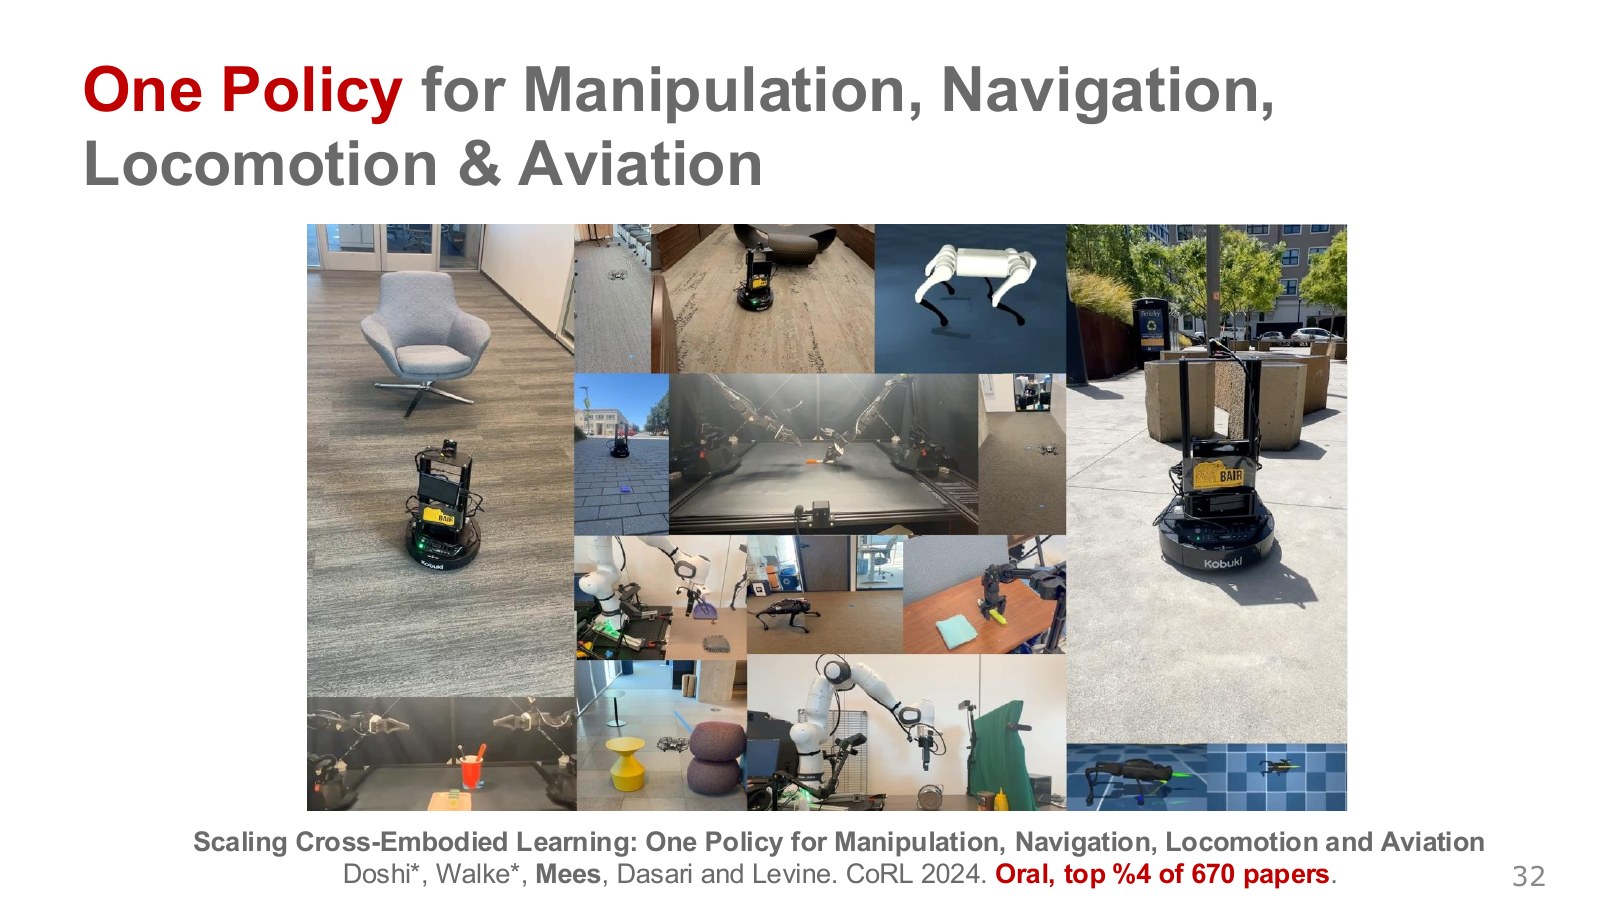
각 영상에서 같은 체크포인트의 공유 표현을 쓰지만 연결된 제어기는 다르다. 이미 지원하는 장비에서의 실행과 학습에 없던 장비의 즉시 제어를 구분해 읽는다.
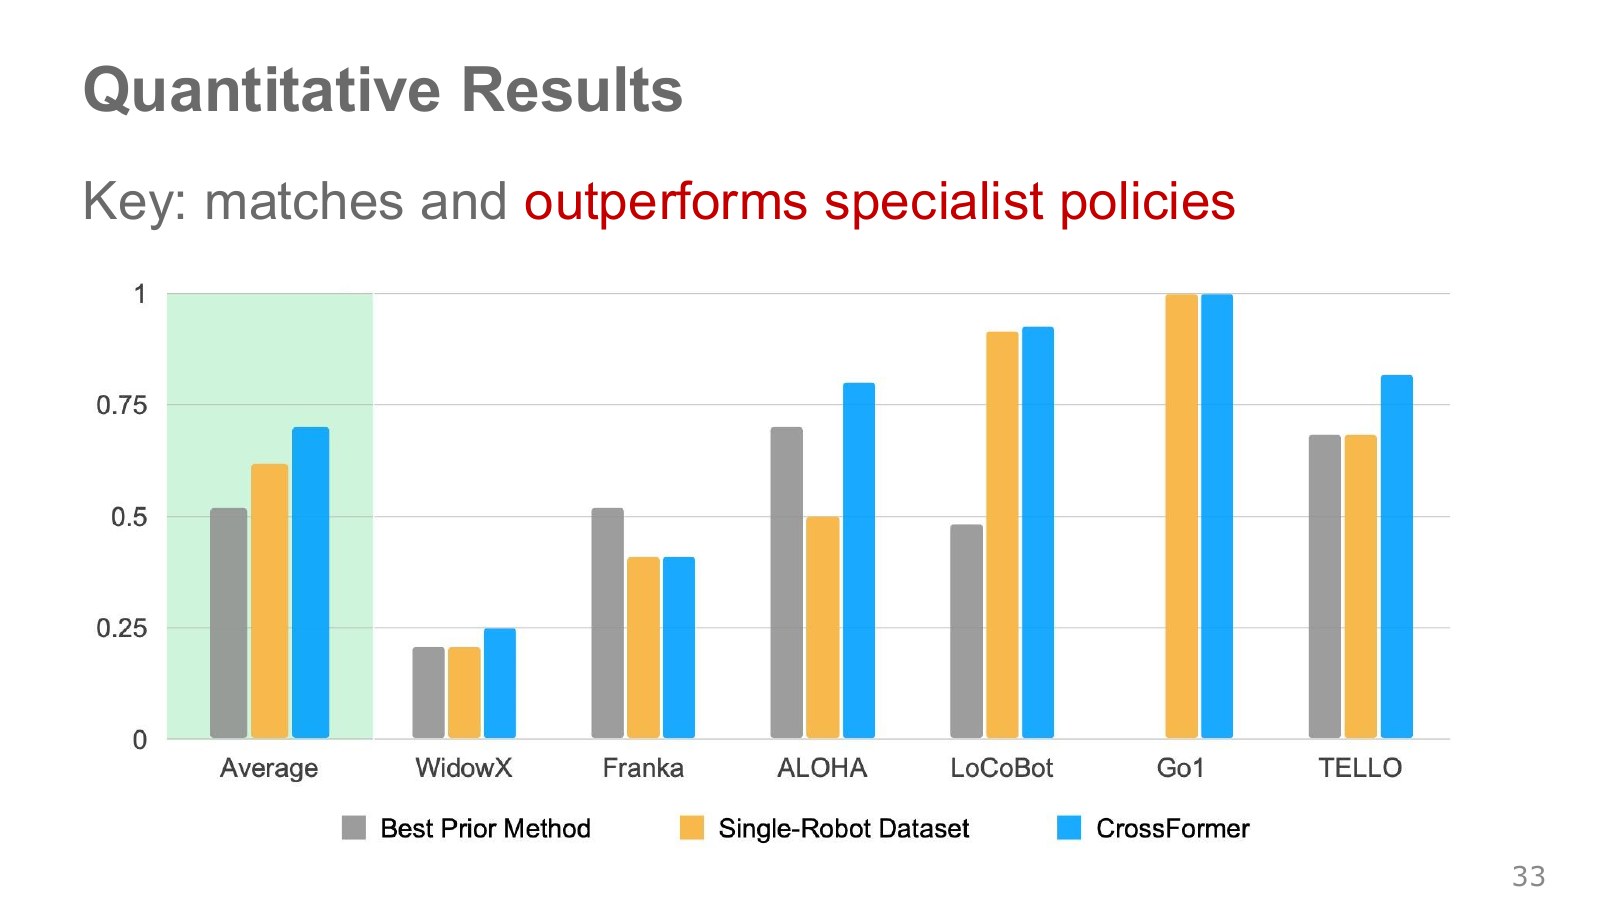
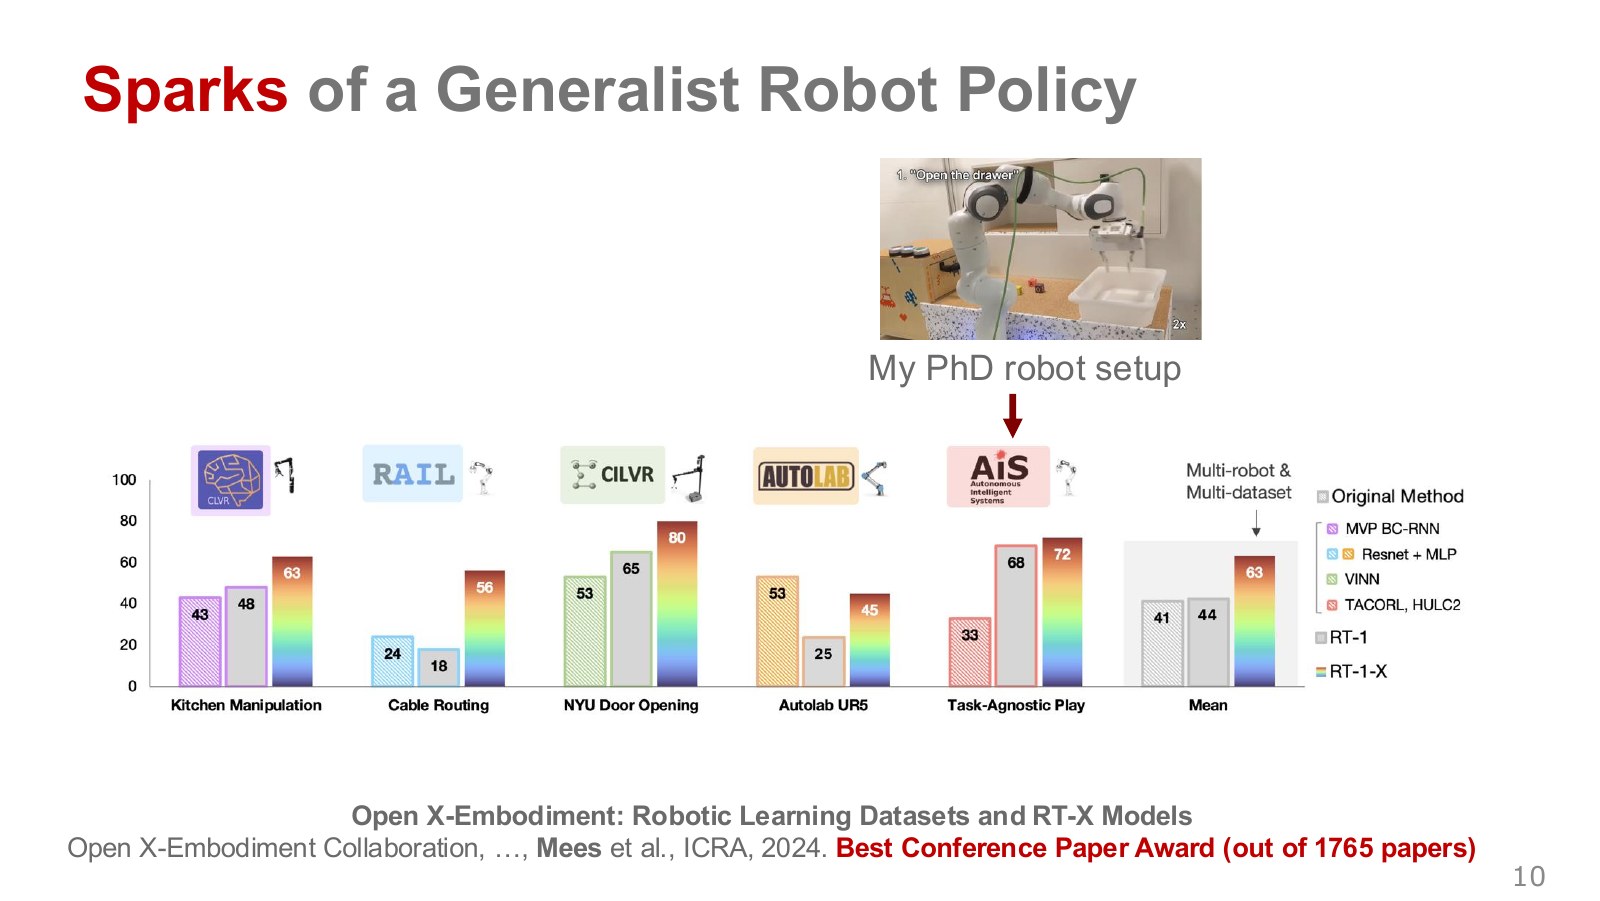
평균 막대 옆의 장비별 막대가 중요하다. 일부 장비에서 얻은 큰 개선이 다른 장비에서의 하락을 가릴 수 있다. 기준 정책과 데이터, 시험 횟수가 같아야 비교를 해석할 수 있다.
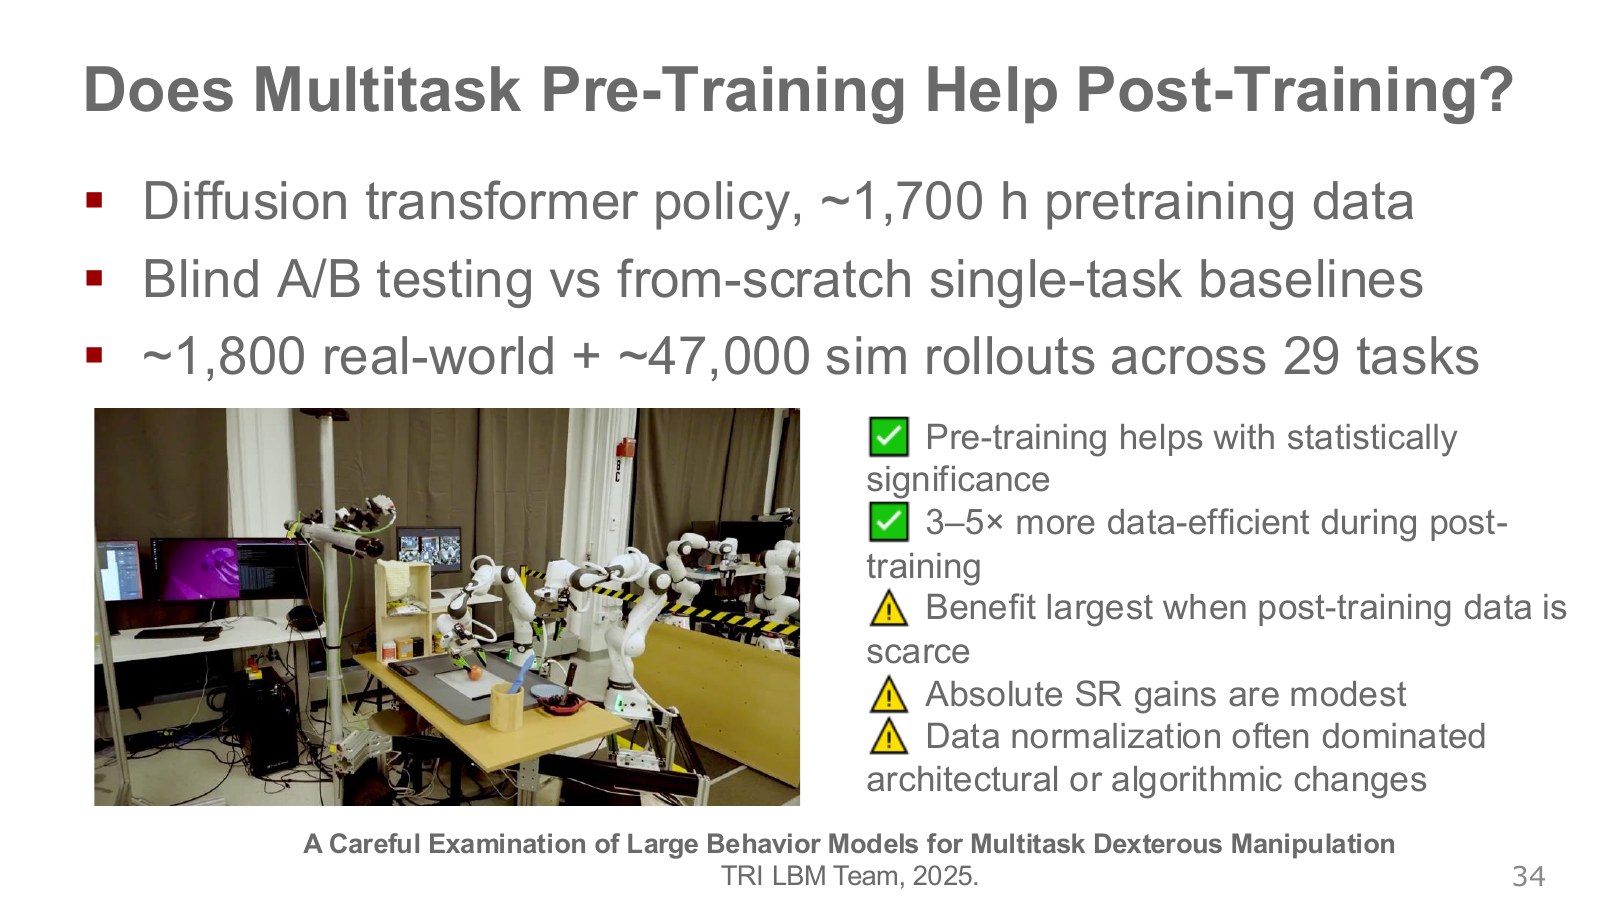
TRI는 29개 작업에서 사전학습 정책과 처음부터 학습한 정책을 비교했다. 환경 변화에 대응해야 하는 일부 설정에서는 새 작업에 필요한 데이터가 3~5배 적었다. 모든 작업의 성공률이 그 배수만큼 높아졌다는 수치는 아니다. TRI 원자료
블라인드 A/B 실험에서는 운영자가 어느 정책을 평가하는지 모른 채 결과를 판정했다. 사후학습 자료가 적을 때 사전학습의 이점이 컸고, 데이터 정규화 선택도 결과에 영향을 줬다. 서로 다른 정책의 차이를 해석할 때 데이터 전처리까지 실험 조건으로 남겨야 하는 이유다. TRI 연구
#웹에서 배운 표현을 로봇으로 옮기기
로봇 데이터만으로 배우면 새로운 물체 이름을 이해하는 데도 시연이 필요할 수 있다. 웹에서 배운 이미지와 단어의 연결을 재사용하면 물체를 찾는 단서를 얻고, 집는 동작은 로봇 기록으로 배운다.
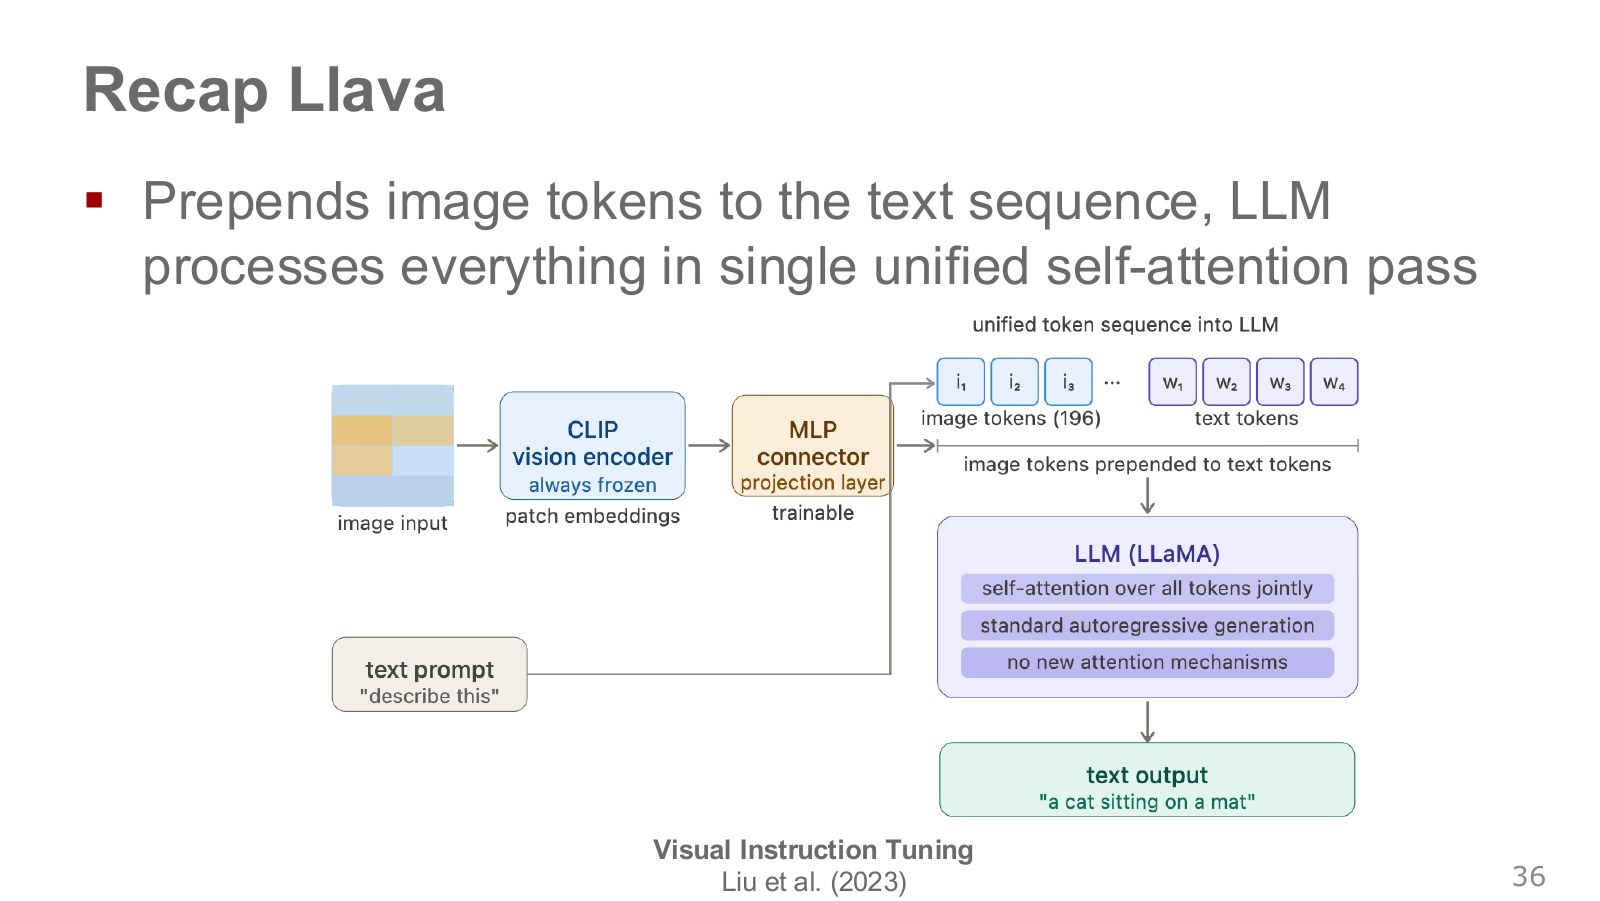
이미지 인코더가 사진을 벡터 묶음으로 바꾸고, 투영층이 언어 모델이 읽을 수 있는 크기로 맞춘다. 모델은 이 묶음과 텍스트를 같은 시퀀스에서 읽는다. LLaVA 프로젝트
문장의 다음 단어를 고르는 문제에 연결하려면 연속 움직임을 번호로 바꾸는 규칙이 필요하다. 번호를 다시 물리 단위로 되돌리는 규칙까지 정해야 실행할 수 있다.
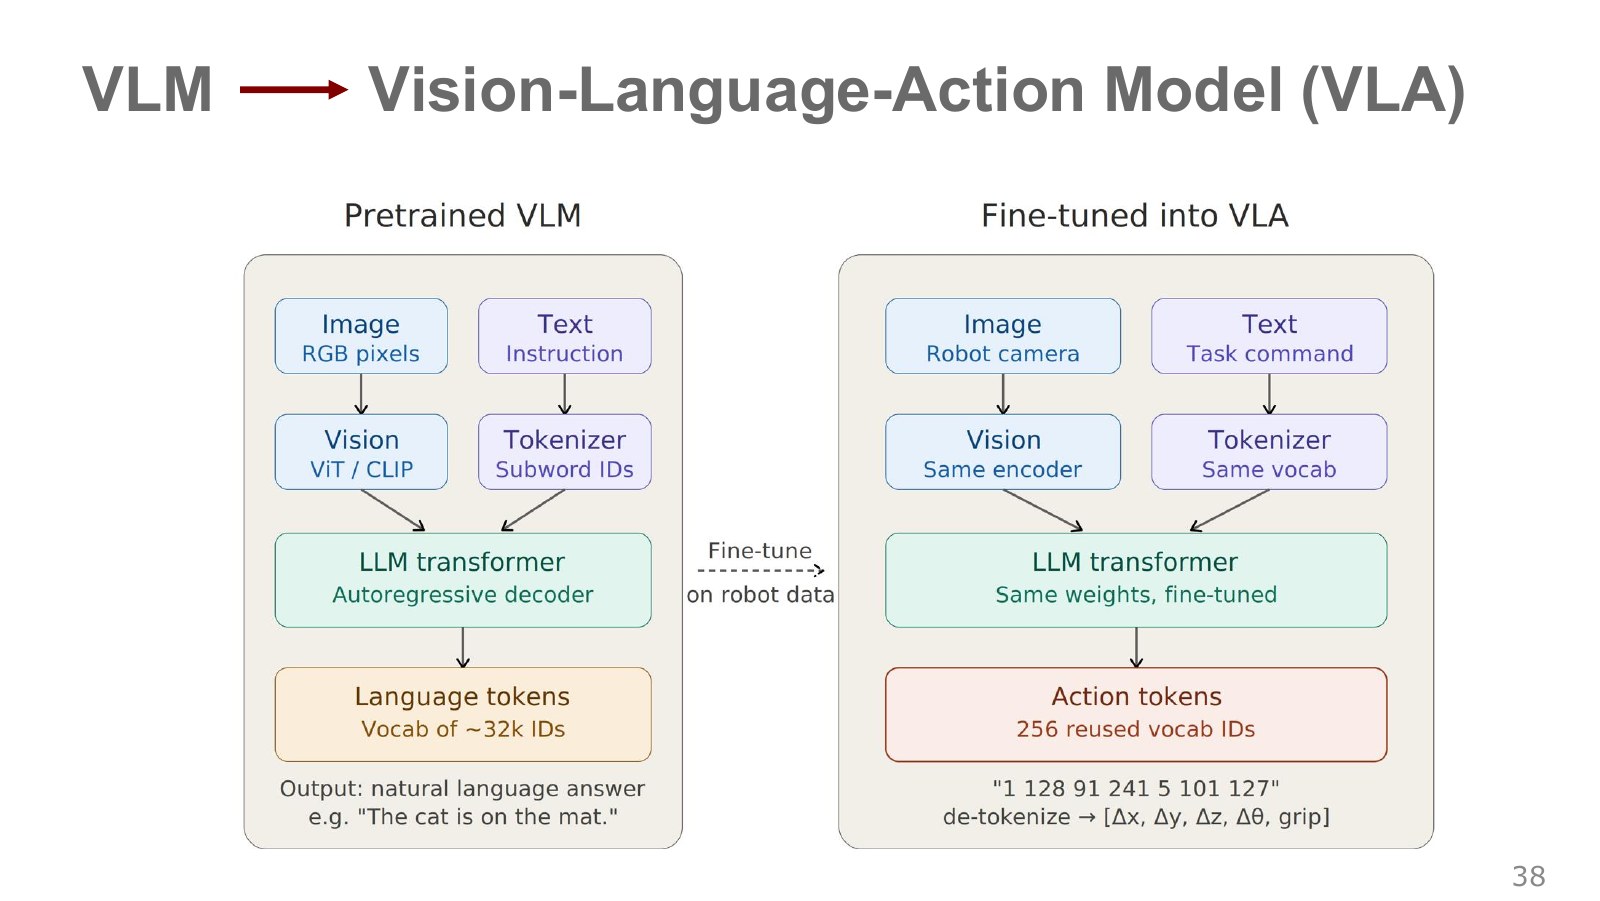
VLM에 행동 학습을 더하면 지시와 영상에서 행동을 예측하는 VLA가 된다. 입력이 같은 사진이어도 출력 목표가 설명 문장인지 실제 제어값인지에 따라 학습 자료가 달라진다.
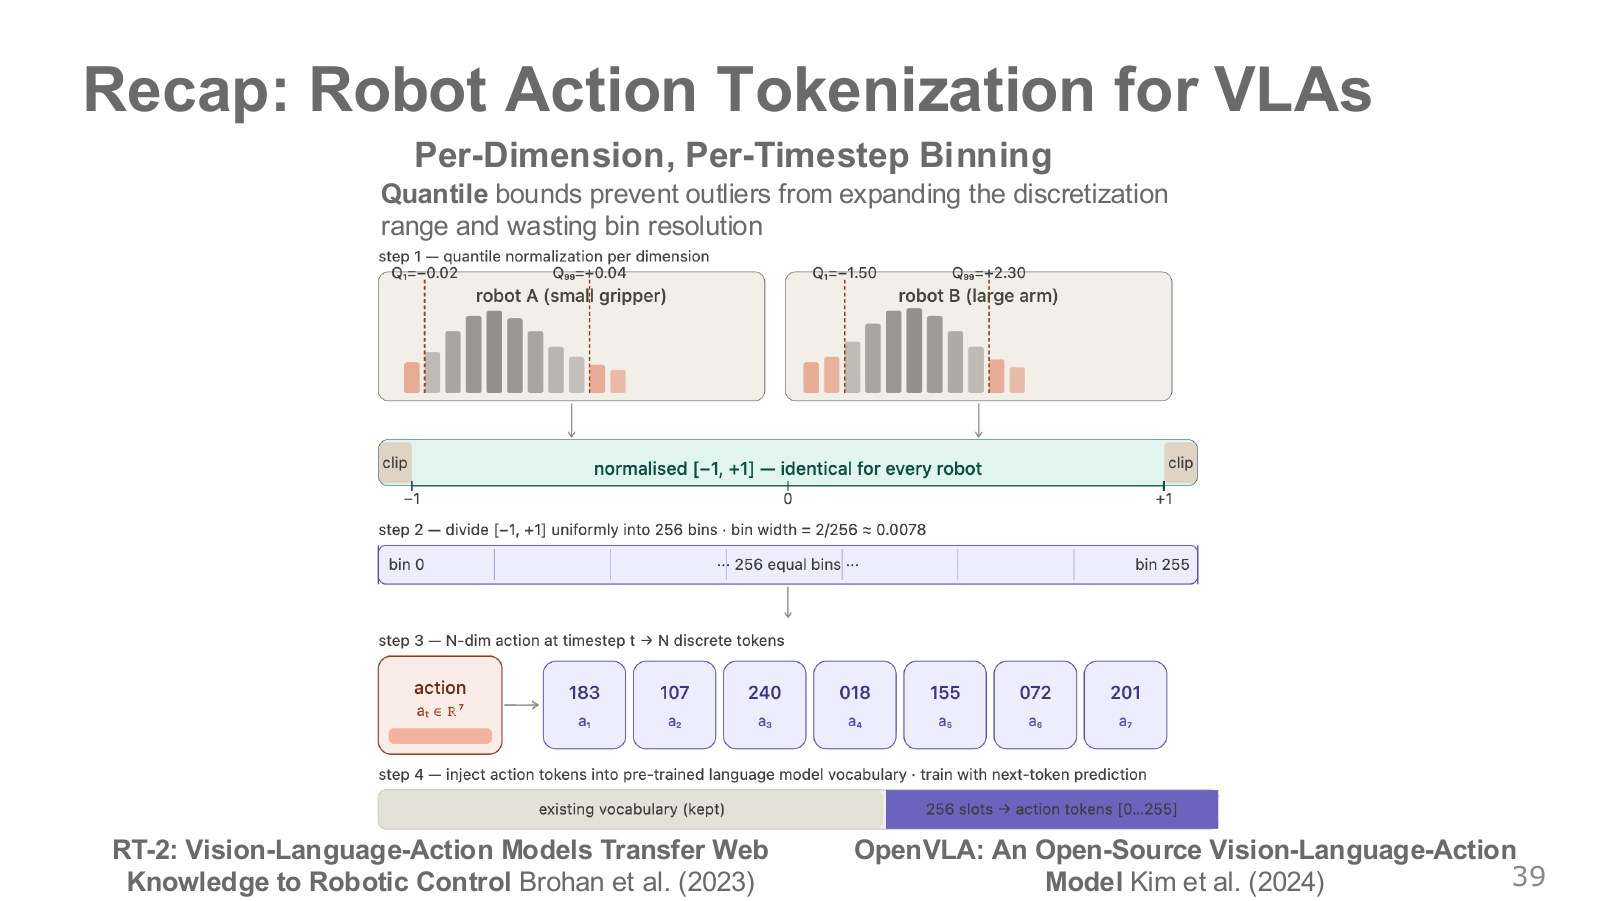
극단값 하나가 전체 구간을 넓히면 자주 쓰는 작은 이동을 촘촘히 표현하기 어렵다. 행동 차원별로 하한과 상한을 잡고, 범위를 자른 뒤 같은 폭의 칸으로 나눈다. 아래는 256칸을 쓰는 강의 예를 간단히 적은 식이다. OpenVLA
기호 뜻과 계산 과정 자세히 보기 연속 행동을 256칸으로 나누기
이 식을 말로 읽으면
하한과 상한 사이에서 명령이 어디쯤인지 계산하고 그 비율을 256개 구간 중 하나의 번호로 바꾼다.
기호 하나씩 이해하기
- 행동값
- 하한과 상한
- 칸 번호
계산을 따라가는 순서
- 하한을 뺀 후 구간 폭으로 나누고 비율을 0과 1 사이로 자른다.
- 256을 곱하고 내림한다. 상한에서 나오는 256은 255로 맞춘다.
작은 예시로 확인하기
하한이 0cm, 상한이 4cm라면 1cm는 비율 0.25에 해당하고 64번 칸에 들어간다.
식을 이해하기 위한 설명용 예시입니다.
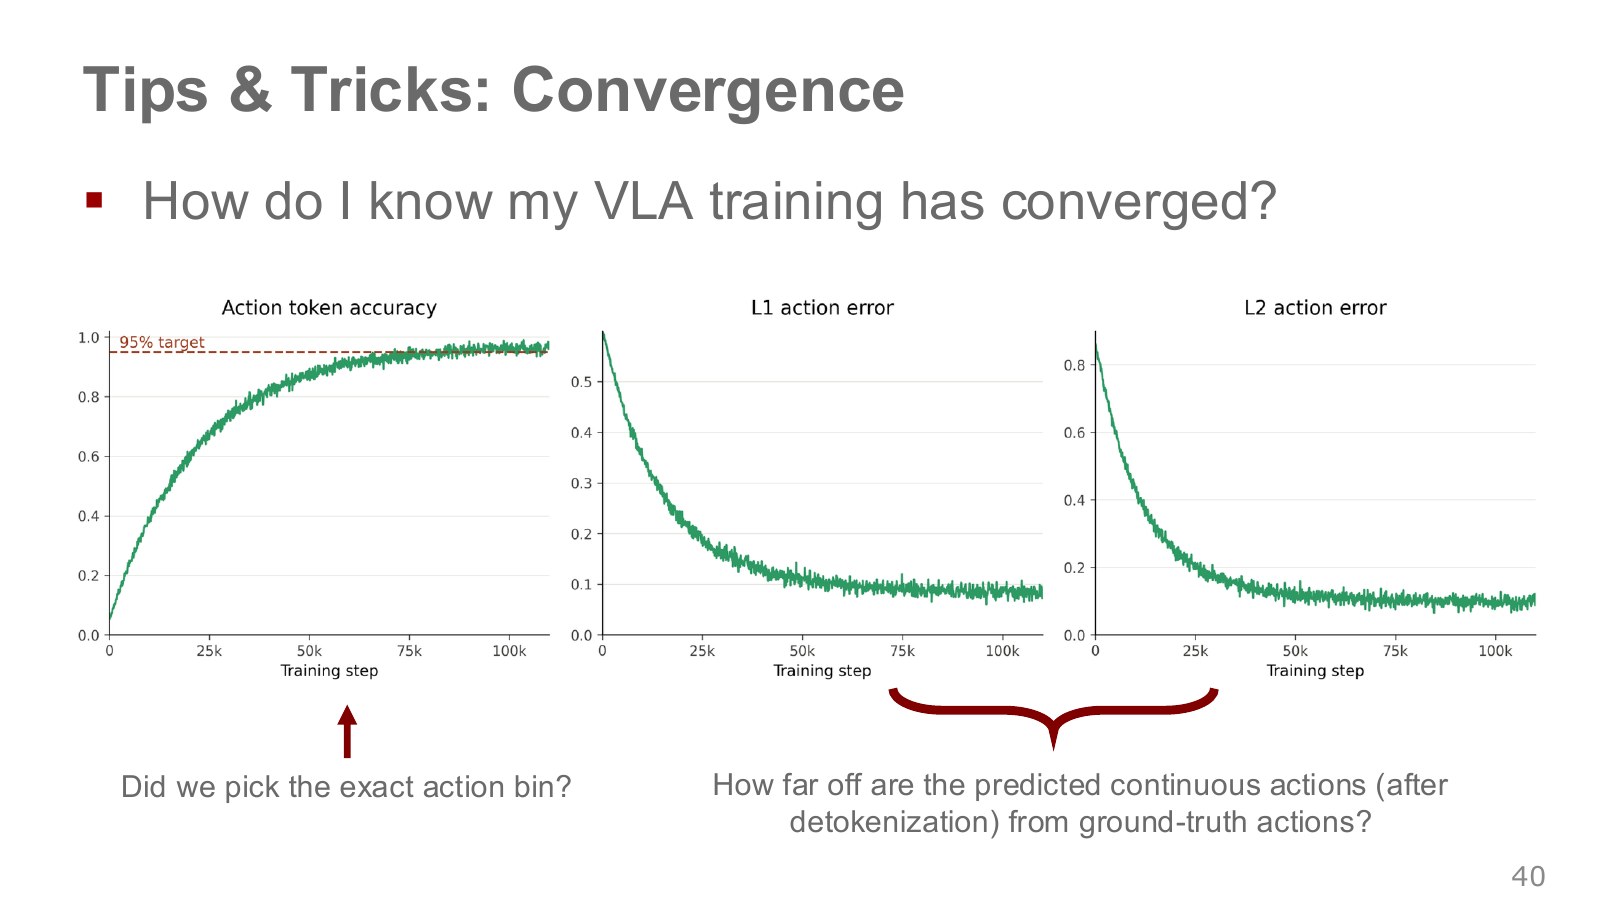
정답 칸과 바로 옆 칸을 고른 경우도 토큰 정확도에는 오답으로 들어간다. 실제 명령으로 되돌린 뒤 얼마나 벗어났는지도 함께 본다. 아래는 평균 절대 오차이며, 서로 다른 단위의 행동을 합칠 때는 차원별 값이나 정규화 기준을 함께 보고한다.
강연에서 제시한 약 95%는 자기회귀형 모델의 학습 진행을 볼 때 쓴 경험칙이다. 정답 토큰을 앞에 넣는 교사 강요로 계산하므로, 모델이 자기 예측과 실제 센서 입력으로 이어가는 롤아웃의 성공률과는 측정 조건이 다르다. 같은 체크포인트에서 역변환한 제어 오차도 함께 보는 이유다.
기호 뜻과 계산 과정 자세히 보기 명령의 평균 절대 오차
이 식을 말로 읽으면
예측을 연속값으로 복원한 뒤 실제 명령과의 차이를 절댓값으로 구한다. 차이의 평균이 전형적인 오차 크기를 보여 준다.
기호 하나씩 이해하기
- 정답 명령
- 복원한 예측 명령
- 비교한 값의 수
계산을 따라가는 순서
- 예측값과 정답의 차이에서 부호를 없앤다.
- 차이를 더한 뒤 비교한 값의 개수로 나눈다.
작은 예시로 확인하기
두 이동량의 차이가 각각 0.1cm와 0.3cm라면 평균은 0.2cm다. 같은 단위끼리 비교했다.
식을 이해하기 위한 설명용 예시입니다.
#서로 다른 기록을 한 번에 학습하기
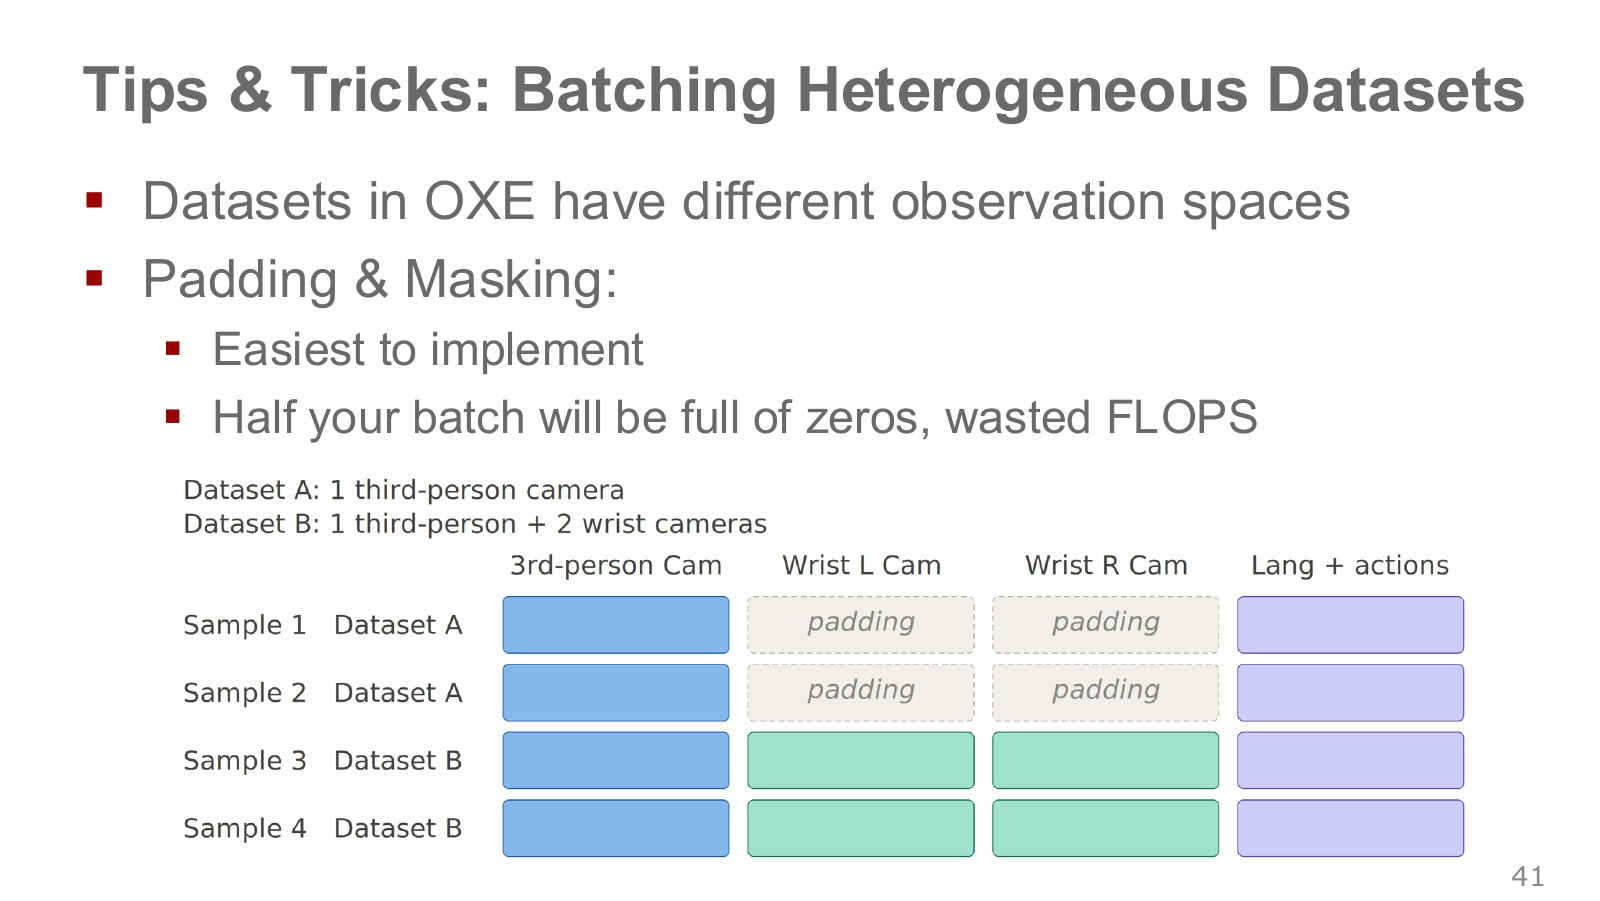
카메라 하나인 예시를 카메라 세 대인 예시와 같은 길이로 만들려면 빈 자리를 채울 수 있다. 마스크는 그 자리가 실측 관측이 아님을 알려 준다. 일반적인 밀집 계산에서는 빈 자리에도 일부 비용이 든다.
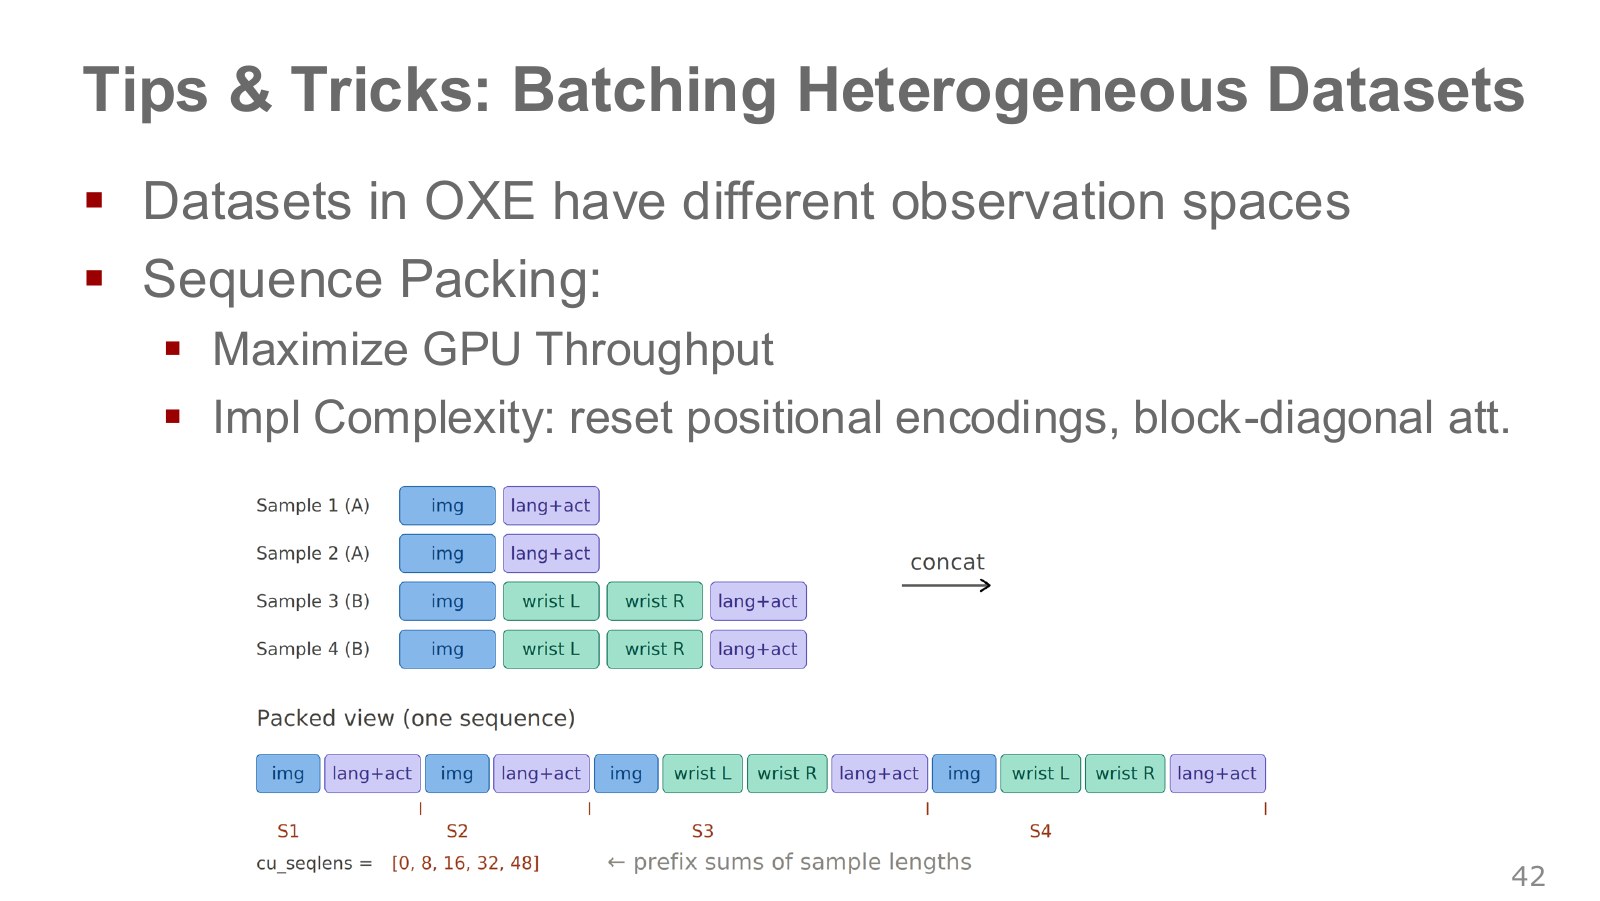
길이가 다른 샘플을 이어 붙여 같은 배치에 넣으면 패딩을 줄인다. 각 샘플의 시작과 끝을 기록해야 서로 무관한 영상과 지시가 섞이지 않는다.
기호 뜻과 계산 과정 자세히 보기 이어 붙인 시퀀스의 경계
이 식을 말로 읽으면
앞에서부터 토큰 개수를 누적하면 각 샘플이 하나로 이어진 배열 안에서 어디에서 끝나는지 알 수 있다.
기호 하나씩 이해하기
- 앞의 샘플 i개가 끝나는 경계
- 샘플 j의 길이
계산을 따라가는 순서
- 첫 경계를 0으로 두고 첫 샘플 길이를 더한다.
- 다음 샘플 길이를 차례로 더해 각 구간을 정한다.
작은 예시로 확인하기
길이가 8, 8, 16, 16이면 경계는 0, 8, 16, 32, 48이다. 세 번째 샘플의 위치는 16번부터 31번까지다.
식을 이해하기 위한 설명용 예시입니다.
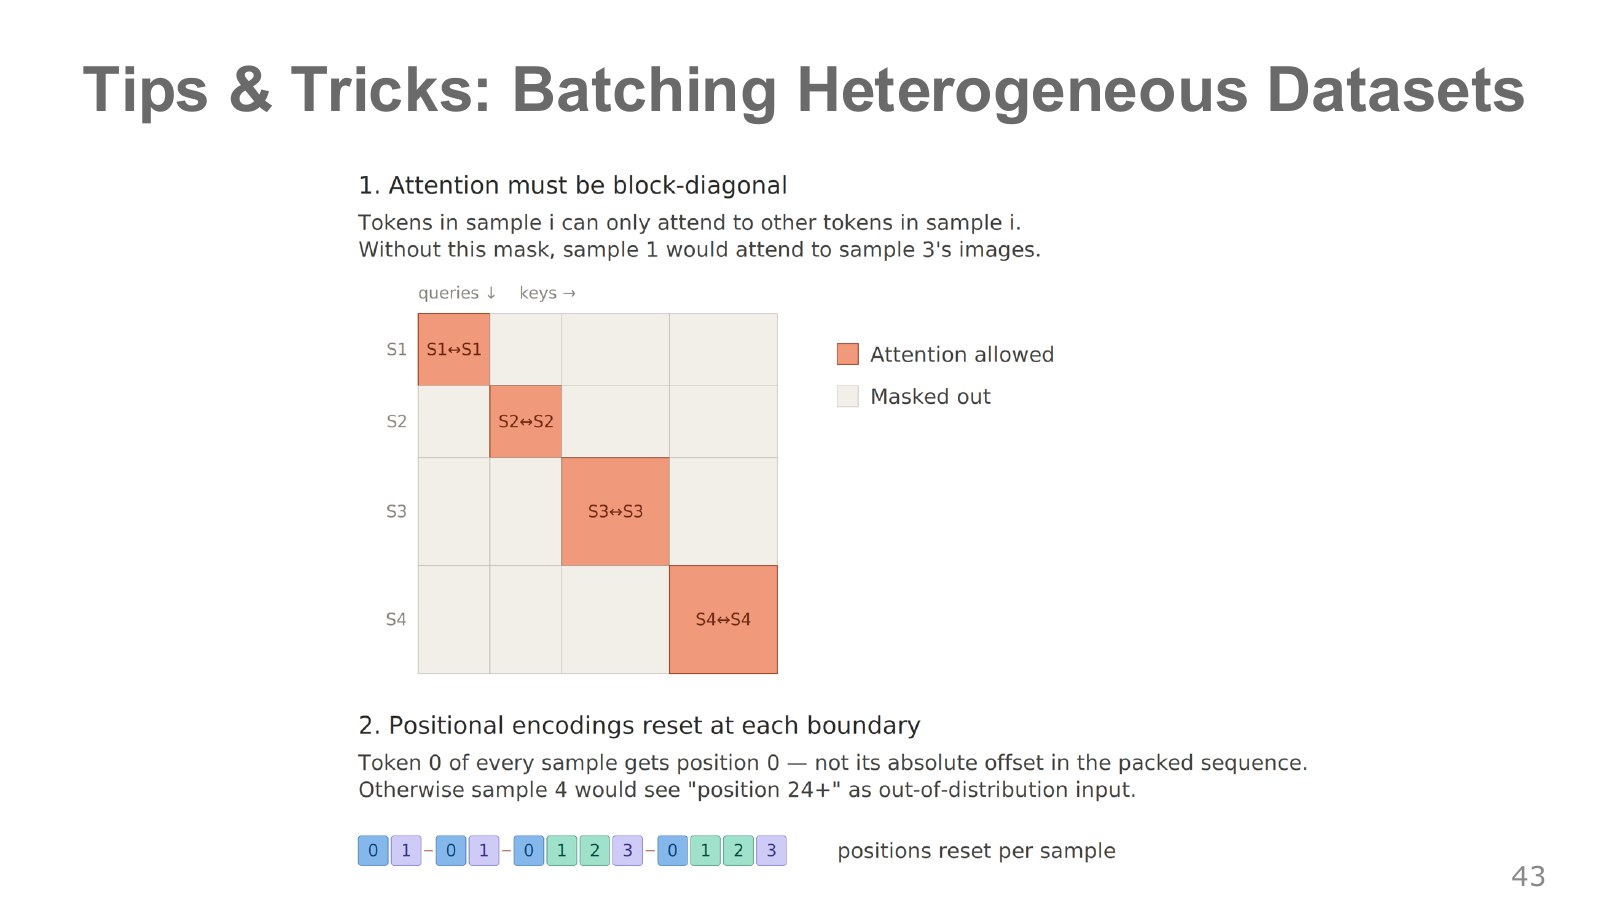
그림의 대각선 블록은 같은 샘플 안에서만 토큰이 서로를 읽을 수 있음을 뜻한다. 샘플마다 위치 번호도 처음부터 부여한다. 아래의 마스크에 시간 방향 제약이 필요하면 인과 마스크를 함께 적용한다.
기호 뜻과 계산 과정 자세히 보기 샘플 사이의 어텐션 차단
이 식을 말로 읽으면
같은 샘플의 점수는 유지하고 다른 샘플의 점수에는 음의 무한대를 더한다. 정규화 후 다른 샘플의 가중치는 0이다.
기호 하나씩 이해하기
- 어텐션 점수에 더하는 값
- 토큰 i의 샘플 번호
계산을 따라가는 순서
- 이어 붙인 각 토큰에 원래 샘플 번호를 붙인다.
- 두 번호를 비교해 샘플 경계를 넘는 참조를 막는다.
작은 예시로 확인하기
첫 시연의 영상은 둘째 시연의 지시를 읽을 수 없다. 자기 시연에서는 시간 방향 제약이 허용하는 토큰을 읽는다.
식을 이해하기 위한 설명용 예시입니다.
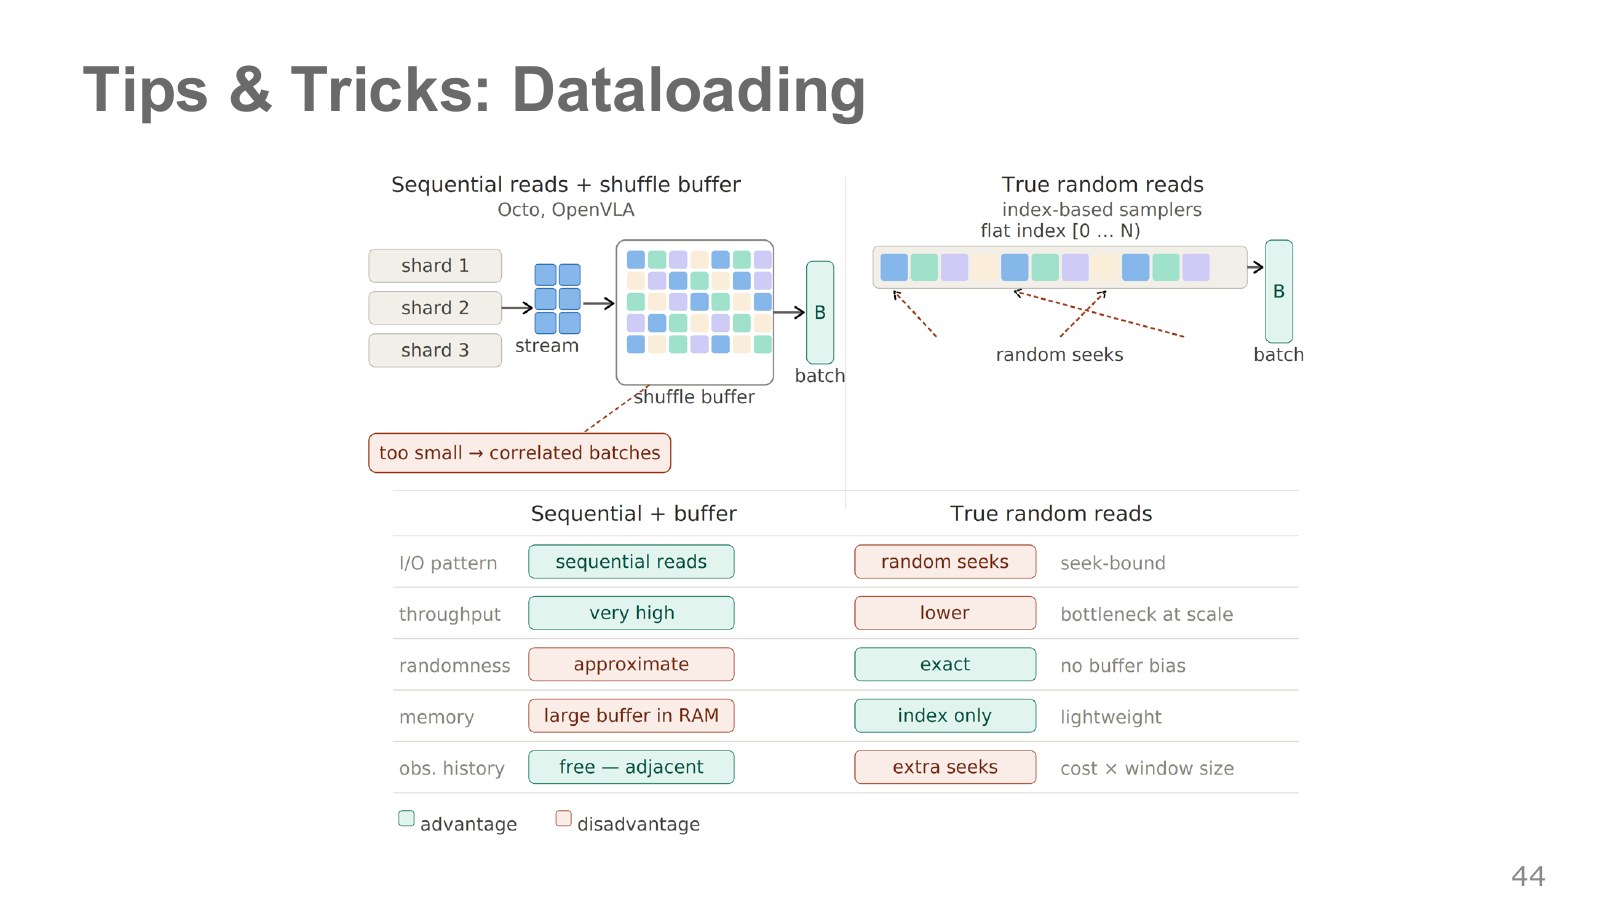
순차 읽기는 저장 장치에 유리하지만 버퍼가 작으면 같은 시연의 이웃 프레임이 배치에 몰린다. 무작위 읽기는 섞기 쉽지만 저장 장치 탐색이 늘어난다. 실제 선택은 처리량과 배치 내 장비·과제 비율을 함께 재어 정한다.
Mees는 초기 Octo 실험에서 약 2만 표본의 버퍼와 궤적 단위 섞기를 함께 사용했을 때 일반화가 나빴다고 회고한다. 이미지 디코딩 전에 여러 궤적의 프레임을 섞고 버퍼를 약 50만 표본으로 늘렸다. 두 변경을 함께 적용한 경험이므로 버퍼 크기 하나만의 효과로 볼 수는 없다.
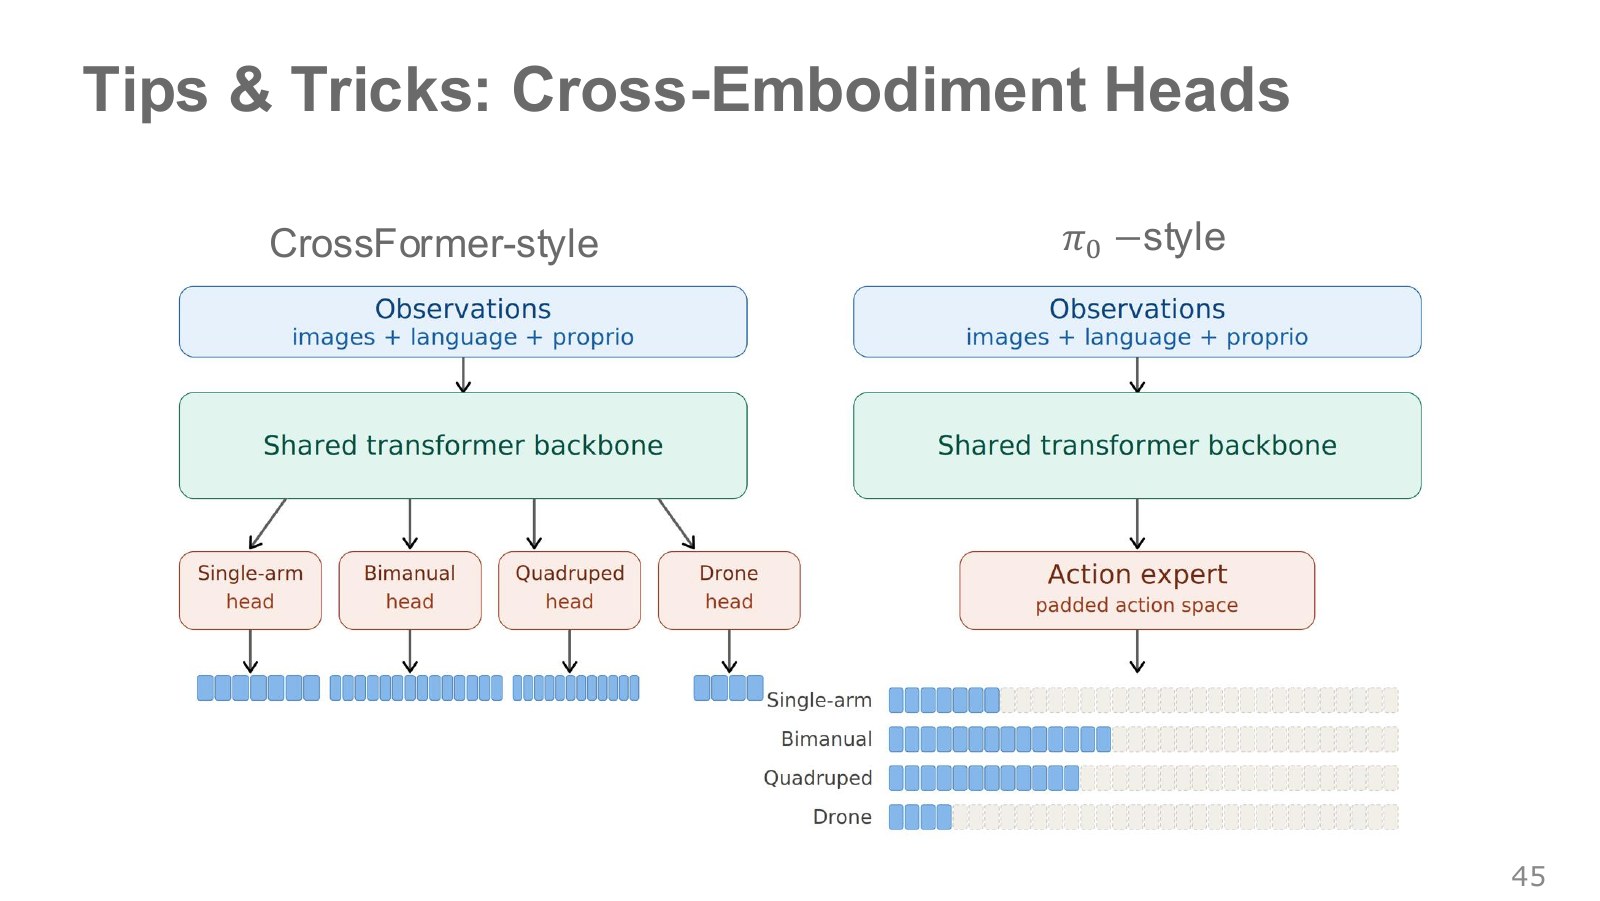
왼쪽은 장비에 맞는 헤드가 별도로 있다. 오른쪽은 길이를 맞춘 제어 벡터를 한 모듈에서 내고 장비마다 사용하는 부분을 정한다. 공통 길이를 맞춰도 각 차원이 뜻하는 물리 명령은 별도로 정의한다.
같은 사진과 같은 지시라도 연결된 팔이 다르면 실행할 명령이 달라질 수 있다. 명시적으로 장비 종류를 지정하거나 관절 상태와 영상에서 단서를 얻는 방식이 있다.
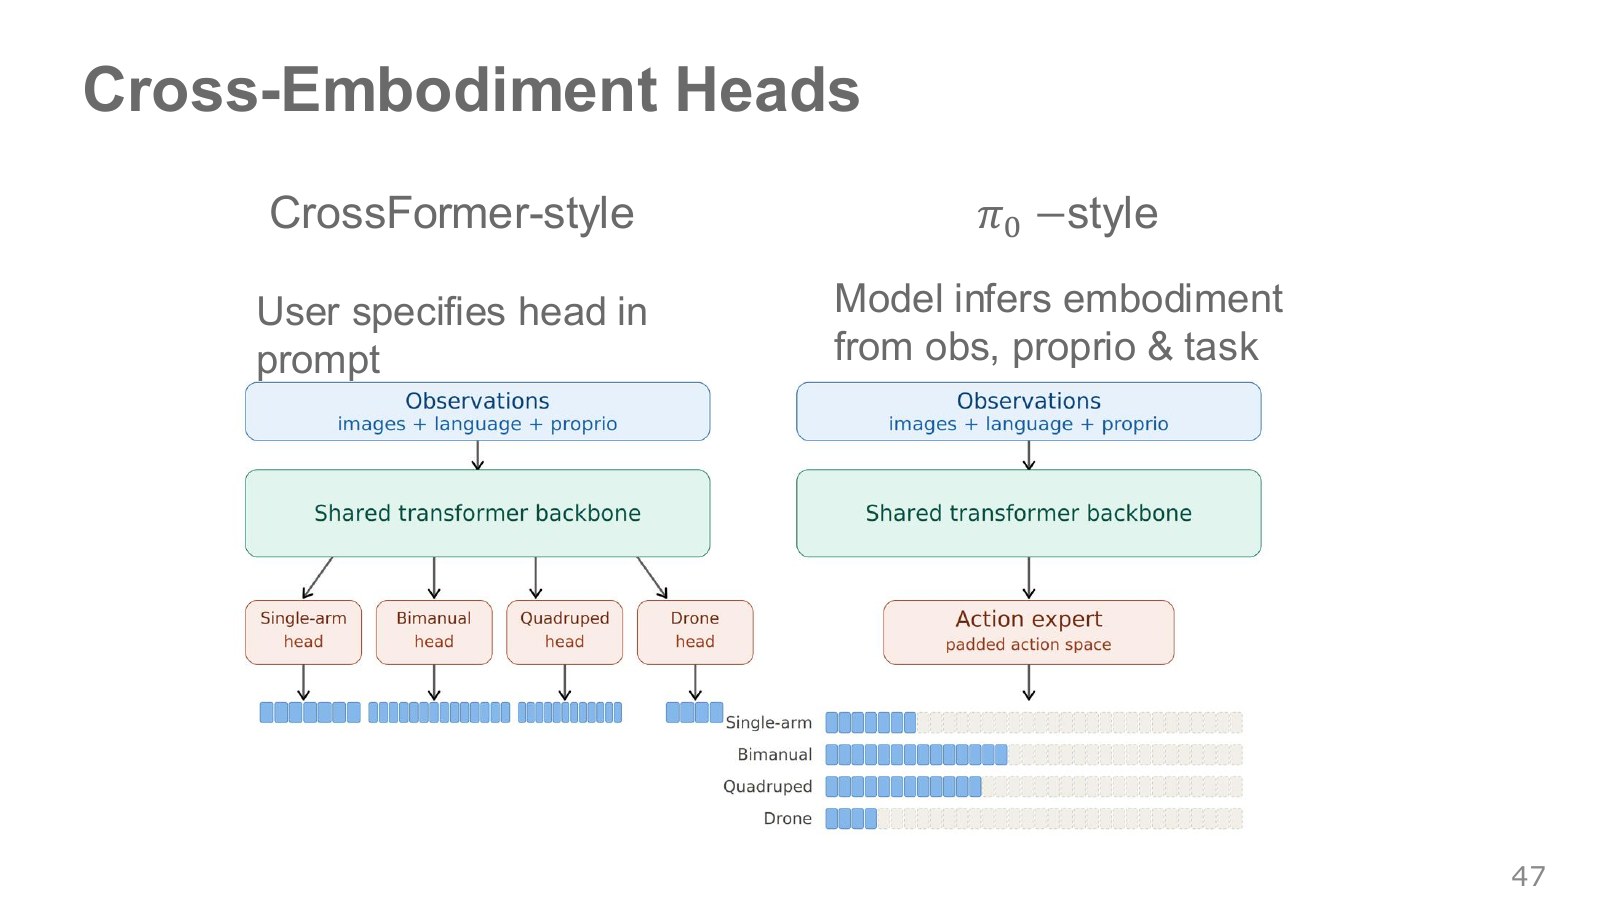
왼쪽에서는 지정된 장비의 헤드를 선택한다. 오른쪽의 단일 전문가 구조에서는 사진, 관절 등 자기 상태, 과제 지시가 장비의 단서가 된다. 낯선 장비에서도 이 단서로 올바른 출력을 얻는지는 별도 평가가 필요하다.
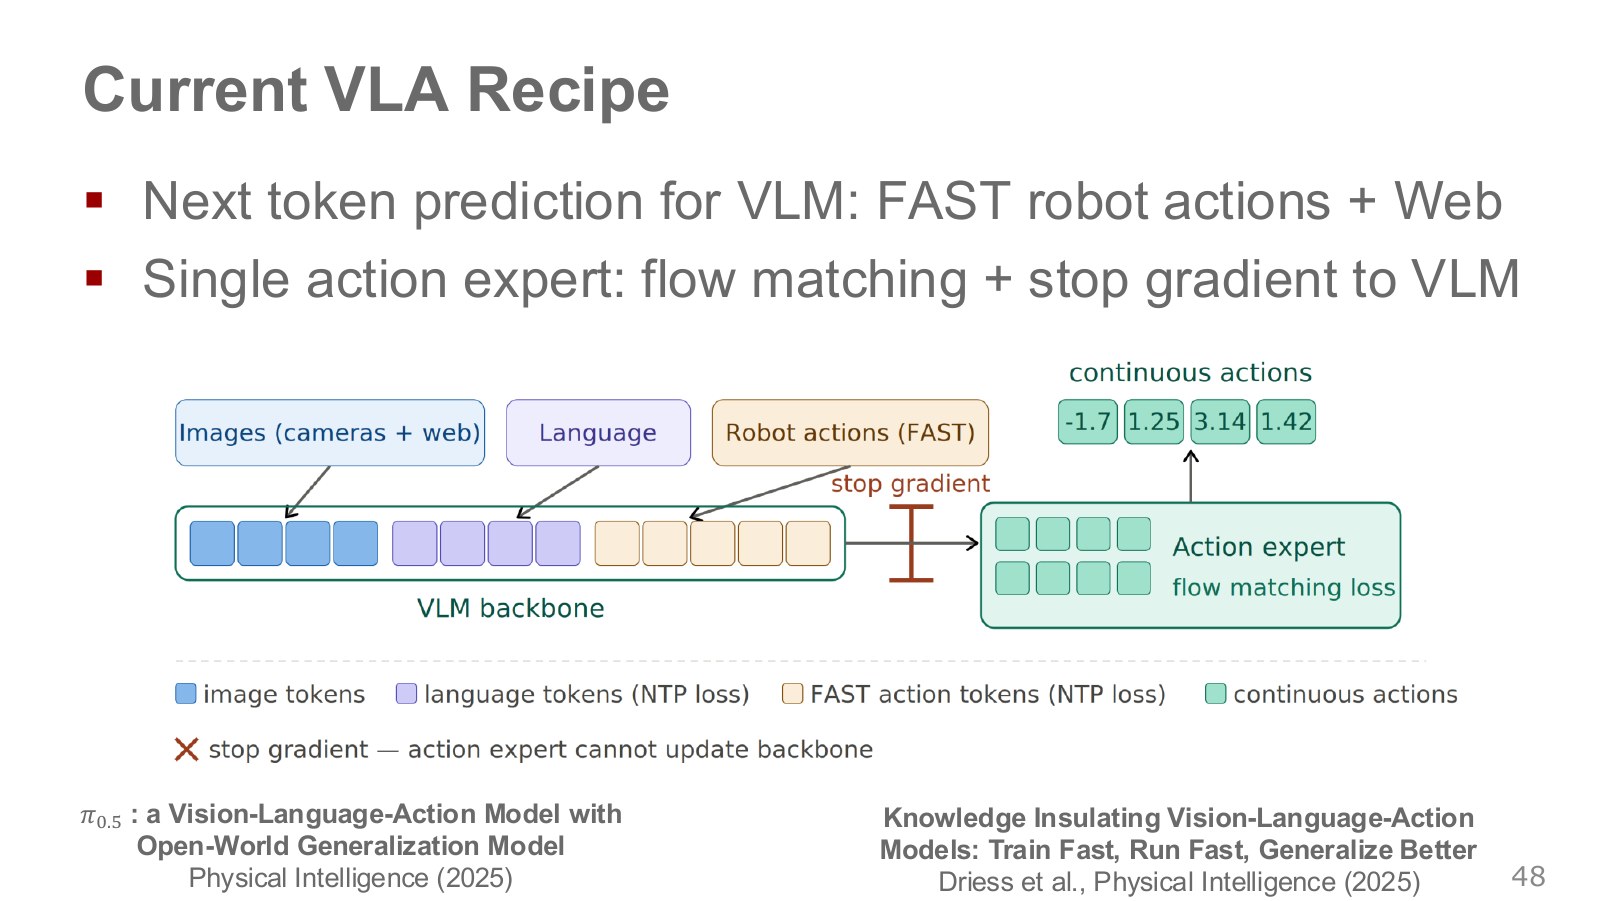
FAST는 여러 시점의 움직임을 압축한 토큰으로 학습 신호를 준다. 연속 행동 모듈은 flow matching으로 실행할 수치 묶음을 만들고, 정지된 기울기 경로는 연속 행동 손실이 본체를 직접 바꾸지 않게 한다. 본체는 토큰과 웹 데이터 손실을 통해 여전히 학습한다. Knowledge Insulation
논문의 행동 전문가는 VLM의 관측 표현을 읽고, 학습 표적으로 사용한 FAST 정답 행동 토큰은 직접 읽지 않는다. 이 참조 제한과 기울기 차단은 역할이 다르다. 전자는 행동을 예측할 때 읽을 정보를 정하고, 후자는 연속 행동 손실로 어느 파라미터를 갱신할지 정한다. 연구팀 설명
기호 뜻과 계산 과정 자세히 보기 연속 행동 손실의 기울기 차단
이 식을 말로 읽으면
연속 행동 모듈은 본체의 표현을 읽되 이 경로로 본체를 갱신하지 않는다. 본체는 토큰 예측에서 학습 신호를 받는다.
기호 하나씩 이해하기
- 시각언어 본체의 표현
- 연속 행동 모듈의 파라미터
- 값은 전달하고 기울기는 끊는 연산
- 행동 손실의 가중치
계산을 따라가는 순서
- 순방향에서는 본체의 특징을 행동 모듈로 보낸다.
- 역방향에서 연속 행동 손실의 기울기는 행동 모듈에만 전달한다.
작은 예시로 확인하기
연속 이동의 오차를 줄이면서 본체는 지시 문장과 FAST 행동 토큰을 예측하는 손실로 따로 갱신할 수 있다.
식을 이해하기 위한 설명용 예시입니다.
#시뮬레이션 점수를 실물과 비교하기
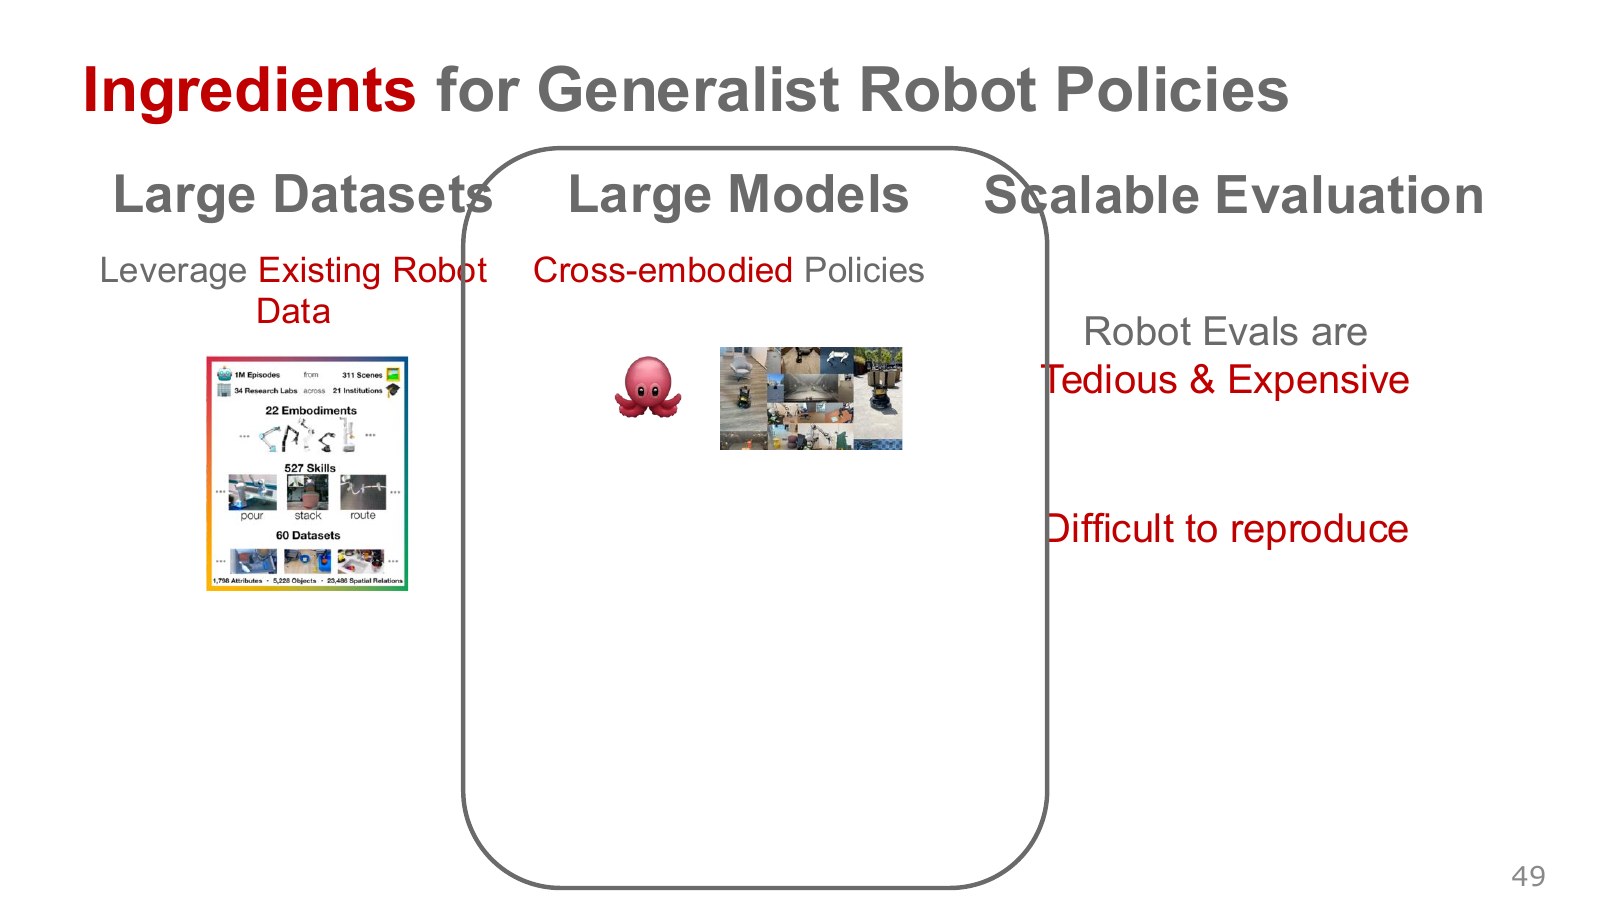
데이터와 모델을 키웠다면 시험 장비도 늘어난다. 대표 사례 몇 개의 영상에서 벗어나 물체 위치나 배경을 바꾸고 같은 조건을 여러 번 시험해야 비교할 수 있다.
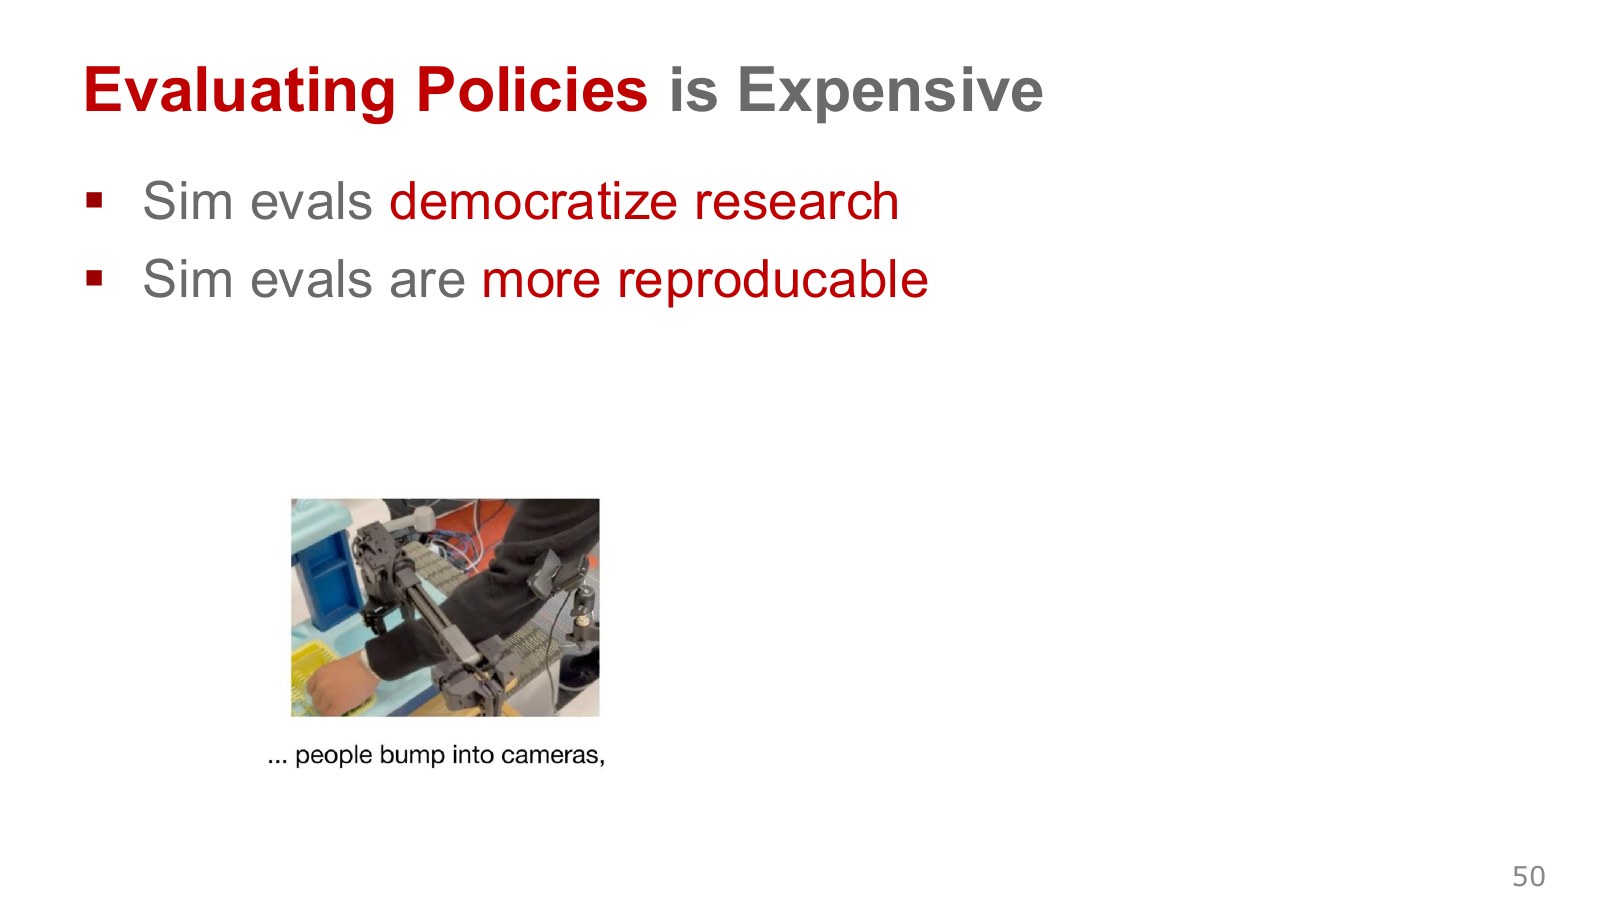
사람이 카메라에 부딪히거나 물체 위치가 달라지면 같은 체크포인트도 다른 결과를 낸다. 시뮬레이터는 초기 위치를 반복하기 쉽고, 실물 시험은 실제 접촉과 마찰을 반영한다.
강연의 다른 예는 고장 난 모터를 교체하는 상황이다. 같은 팔 자세에서도 관절 영점이나 센서값이 바뀌면 기존 정책이 다른 자세로 읽을 수 있다. 카메라 위치가 바뀌는 경우와 마찬가지로 체크포인트를 비교하기 전에 장비 설정과 보정을 기록해 둬야 결과를 해석할 수 있다.
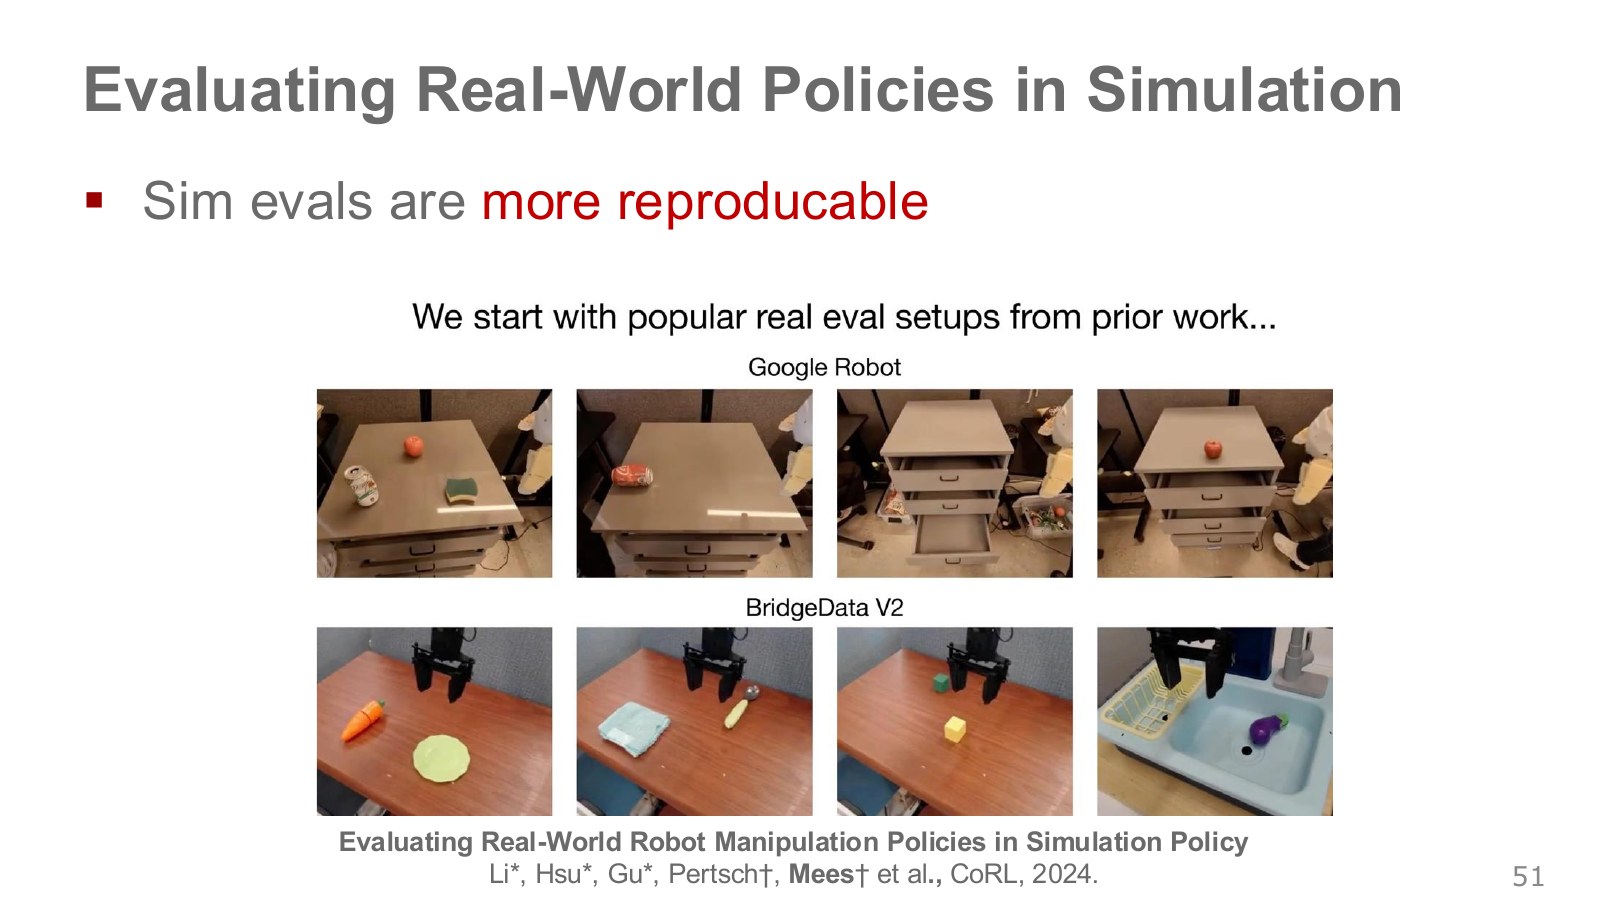
SIMPLER는 기존 Google Robot과 WidowX 평가 장면을 대응시킨다. 정책을 같은 종류의 지시로 실행하되 실제 카메라와 제어기의 차이가 결과를 좌우하는지 따져야 한다. SIMPLER 프로젝트
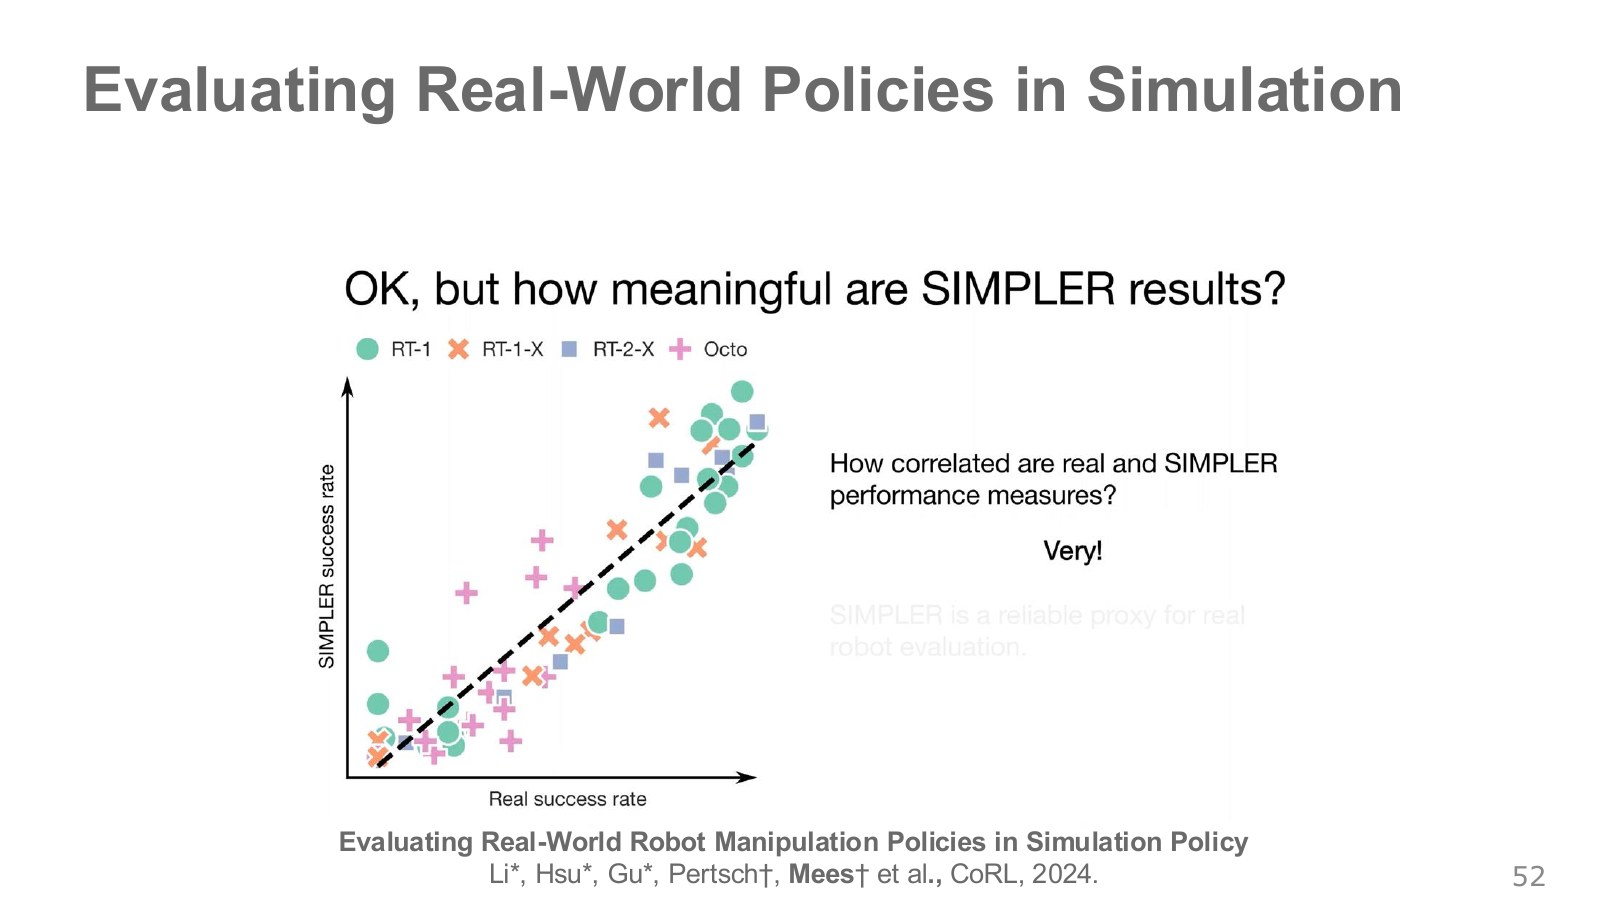
산점도의 한 점은 같은 정책과 과제의 실물·시뮬레이션 결과를 연결한다. 비슷한 순서를 보이는 범위에서 후보를 선별할 수 있지만, 새 과제에서 순서가 유지되는지와 실제 성공률은 실물에서 확인한다.
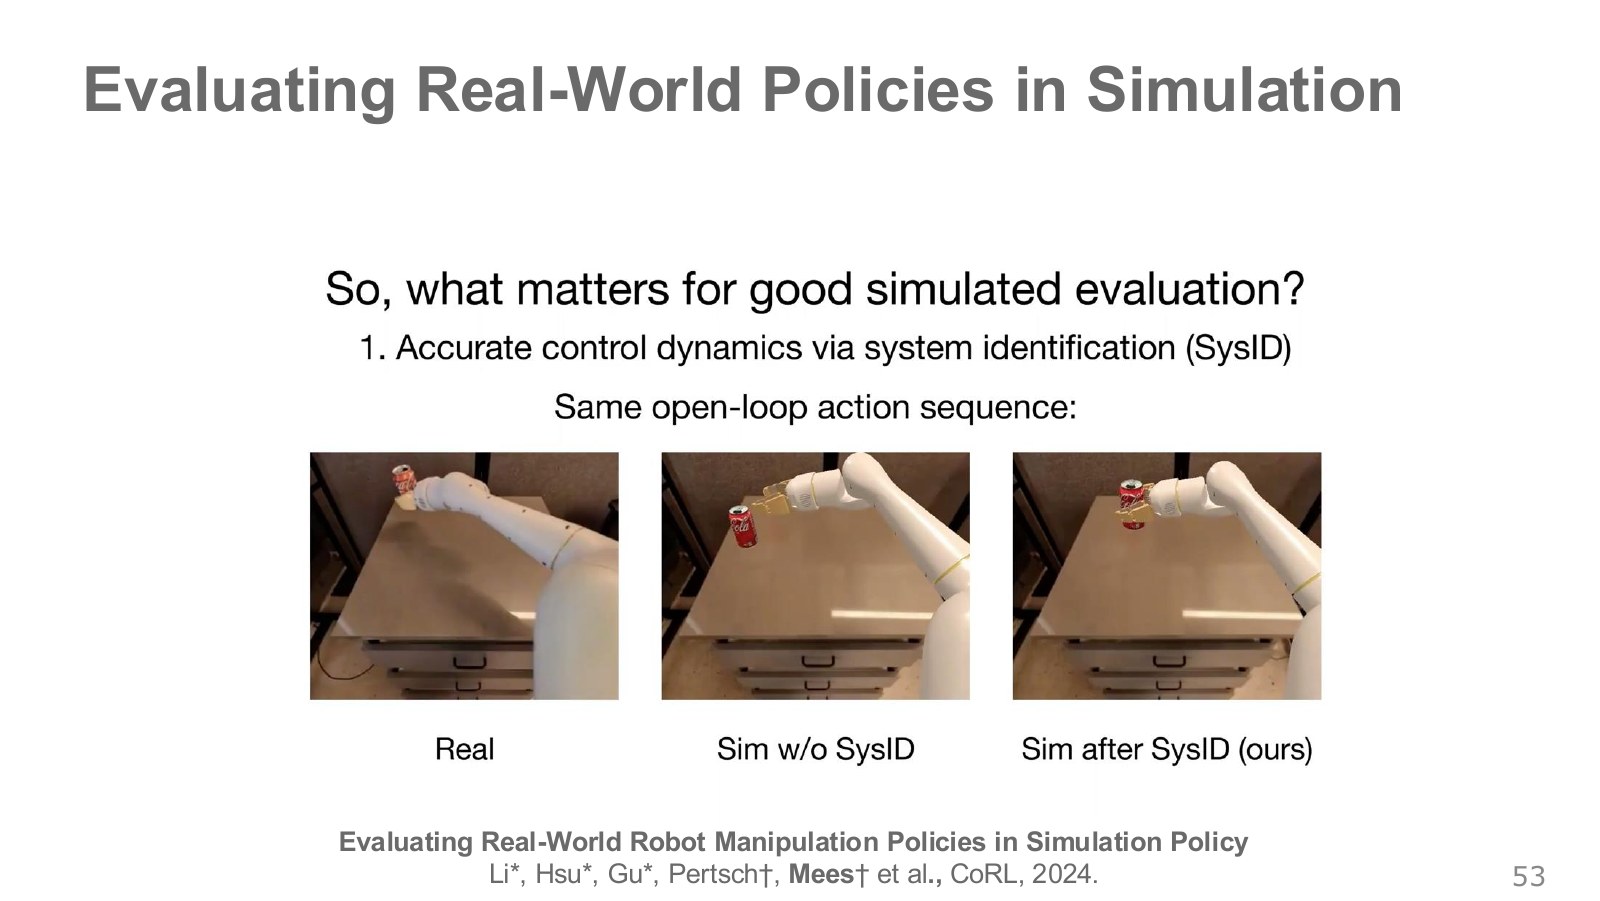
같은 명령열을 실물과 시뮬레이터에 넣고 손끝이 움직인 경로를 비교한다. 이 차이를 줄이도록 제어 반응을 조정하는 절차가 시스템 식별이다. 그림의 조정 전후 경로에서 명령과 실제 이동 사이의 어긋남을 읽는다.
기호 뜻과 계산 과정 자세히 보기 같은 명령에 대한 손끝 경로 맞추기
이 식을 말로 읽으면
같은 명령을 받았을 때 두 손끝 위치가 떨어진 거리를 여러 시점에서 재고, 그 제곱합이 작은 시뮬레이터 설정을 찾는다.
기호 하나씩 이해하기
- 조정할 설정
- 가상 손끝 위치
- 실물 손끝 위치
계산을 따라가는 순서
- 같은 명령열을 실행하고 경로의 시간과 좌표계를 맞춘다.
- 설정 후보마다 오차 제곱합을 계산하고 작은 쪽을 고른다.
작은 예시로 확인하기
두 시점의 거리가 1cm와 2cm면 제곱합은 5제곱센티미터다. 두 거리 모두 1cm가 되면 2제곱센티미터다.
식을 이해하기 위한 설명용 예시입니다.
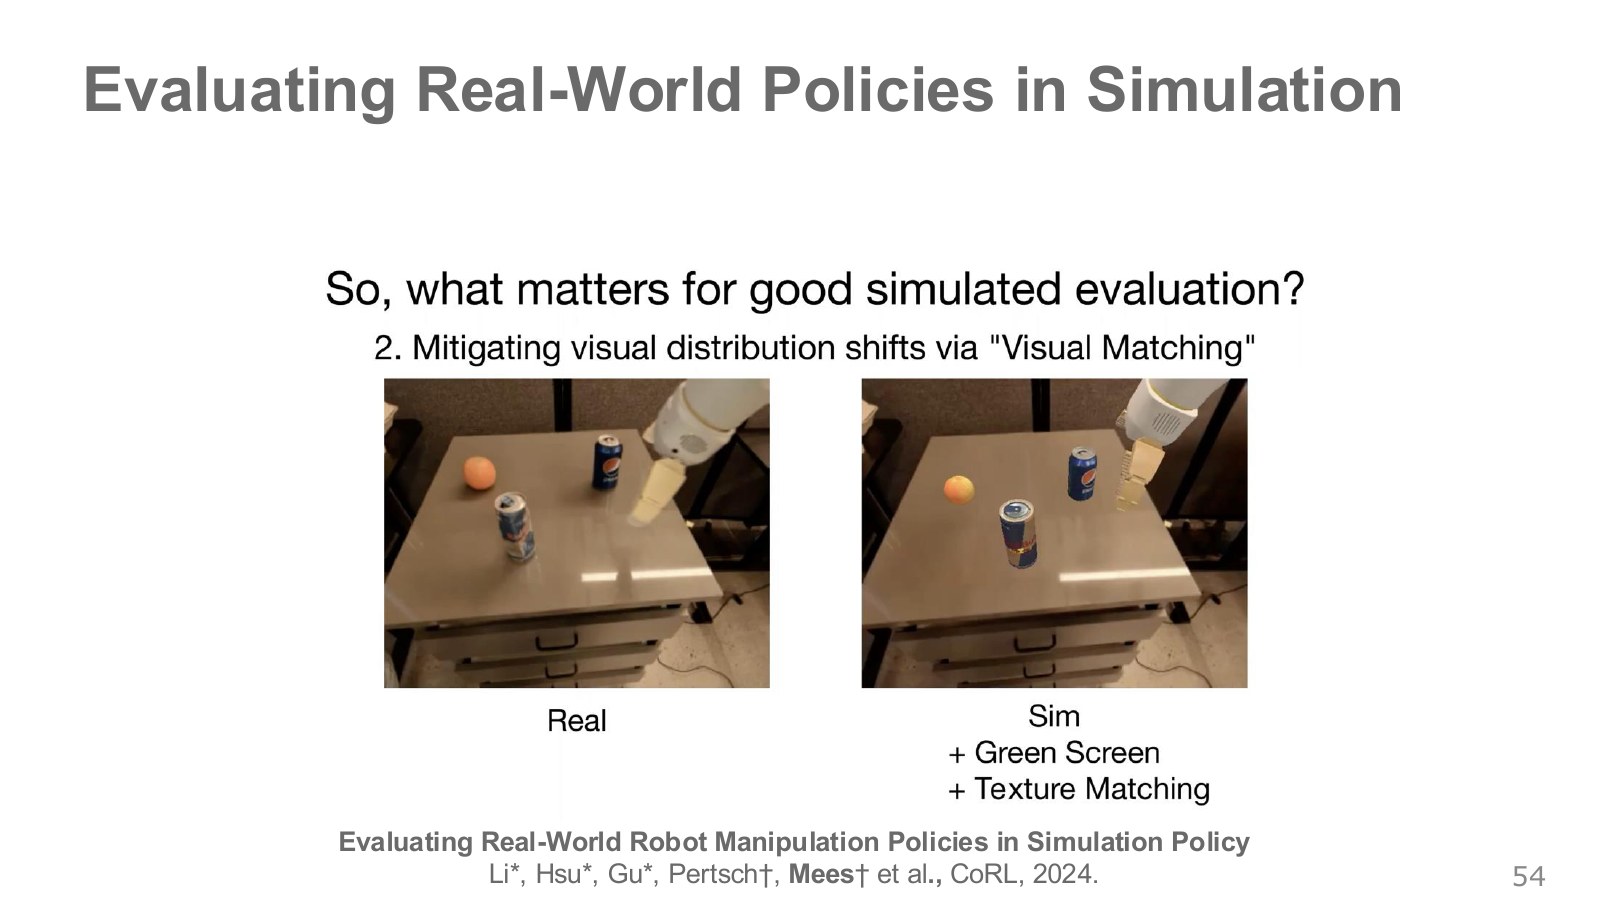
실물 작업대와 가상 작업대의 배경·질감 차이만으로도 정책의 입력이 달라진다. Visual Matching은 외형 차이를 줄여 제어 비교에 집중하도록 돕는다. 접촉이나 관절 지연은 앞 슬라이드의 동역학과 관련된 문제다.
그린 스크린 방식은 시뮬레이터에서 움직이는 로봇과 물체를 분리해 실제 작업대 배경 위에 합성한다. 텍스처 매칭은 실제 캔의 무늬를 가상 캔의 표면에 입힌다. 전자는 배경, 후자는 물체 외형에 주로 작용한다. SIMPLER 프로젝트
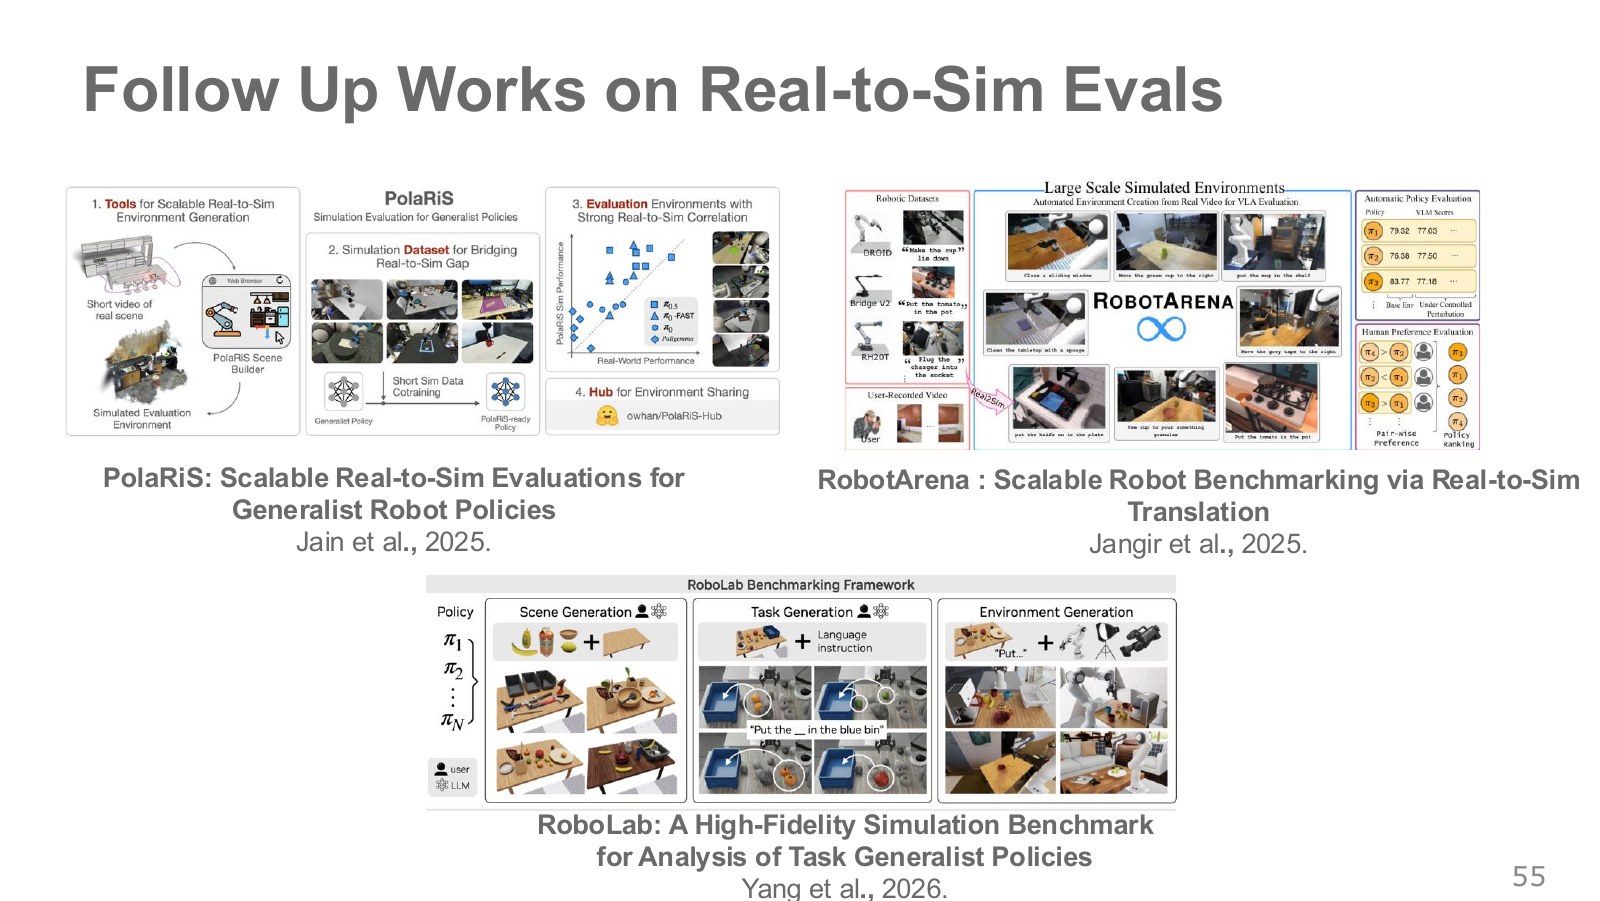
PolaRiS, RobotArena, RoboLab은 실물 장면을 다양한 가상 환경으로 옮기고 비교할 수 있는 과제를 넓힌다. 각 도구를 비교할 때는 장비·카메라·과제 범위와 실제 비교에 쓰인 대응 실험을 먼저 확인한다.
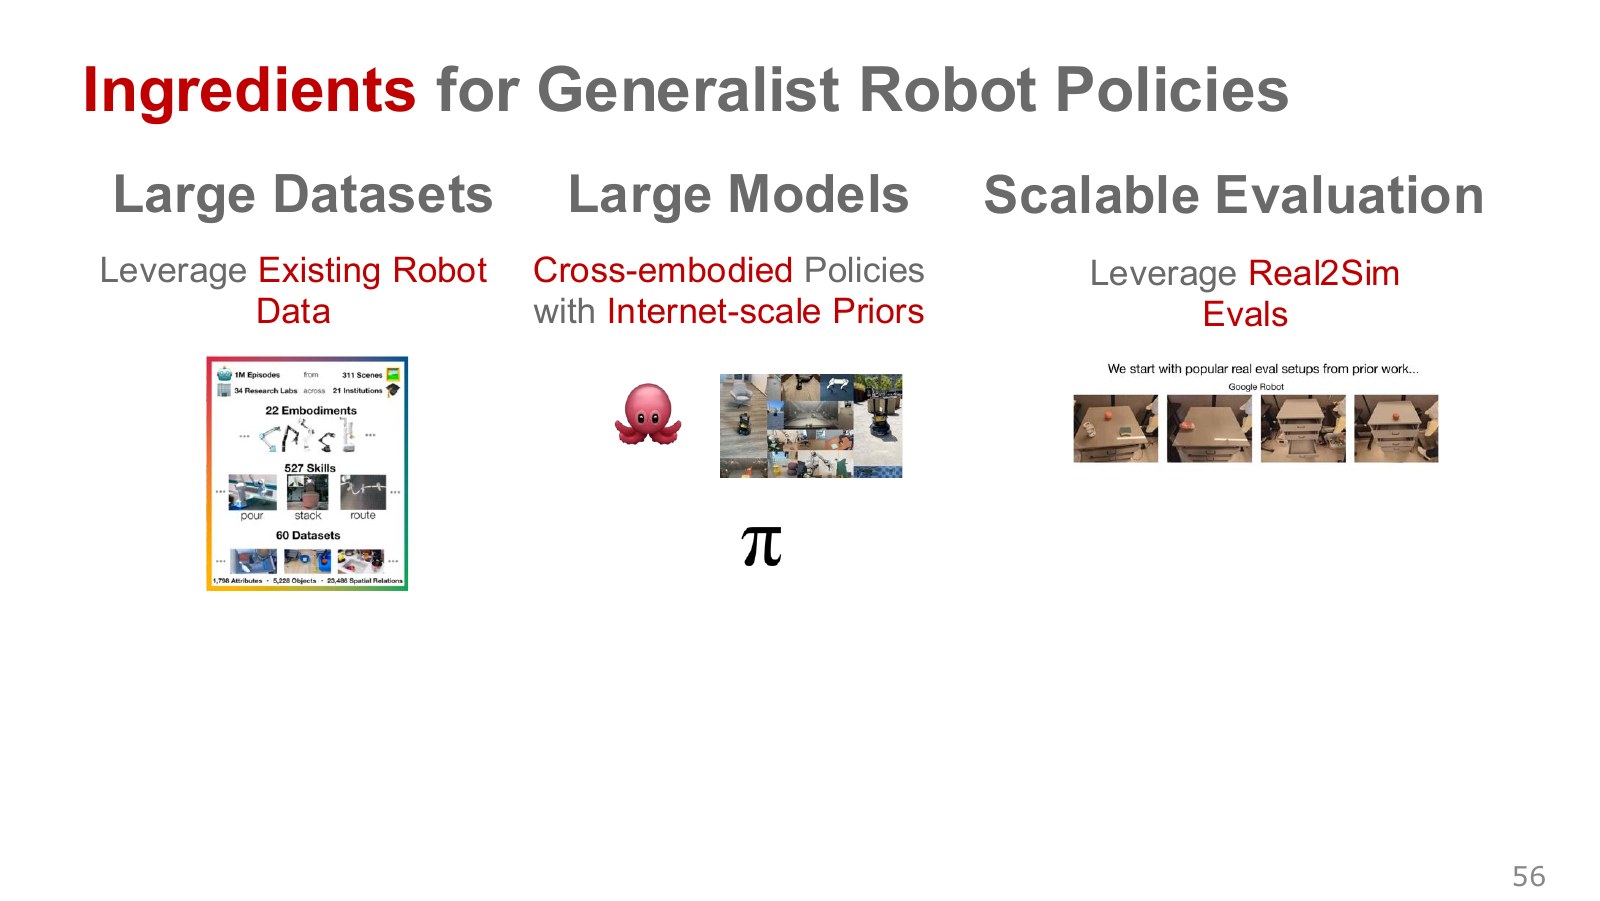
같은 집기 과제라도 데이터에서는 집게 명령의 뜻을 맞추고, 모델에서는 로봇별 출력으로 연결하며, 평가에서는 새 물체와 새 장비를 따로 시험한다. 세 단계의 선택을 기록해야 다음 실패가 어디에서 생겼는지 좁힐 수 있다.
#초청 강연에서 보는 성공률과 실행 시간
Quan Vuong은 같은 작업에서 성공률과 실행 시간을 함께 비교한다. 두 정책이 모두 10번 중 8번 성공해도, 한쪽이 30초 걸리고 다른 쪽이 15초에 끝난다면 처리량이 다르다. 강연 그래프에서 가로축은 실행 시간, 세로축은 성공률이다. 위 숫자는 그래프의 축을 읽기 위한 예다. Quan Vuong 초청 강연 3:43
공식 읽기 자료의 Gato는 여러 종류의 관측과 행동을 시퀀스로 묶는 사례다. π∗0.6 논문의 RECAP은 실제 실행과 사람의 교정에서 얻은 경험을 다시 정책 개선에 사용한다. 같은 사전학습 정책도 이후 어떤 경험을 모으고 활용하는지에 따라 달라질 수 있다. Gato · π∗0.6 및 RECAP